
L’évaluation de la variabilité constitue le socle méthodologique sur lequel repose l’ensemble de l’inférence statistique contemporaine, tout particulièrement au sein des sciences du comportement et de la psychologie quantitative. Lorsque les chercheurs s’attachent à comparer des groupes expérimentaux ou des populations cliniques distinctes, la simple comparaison des moyennes s’avère fondamentalement incomplète, voire trompeuse, si elle n’est pas contextualisée par une estimation rigoureuse de la dispersion sous-jacente des mesures. Dans ce cadre, la notion de variance combinée — traditionnellement désignée sous le vocable anglo-saxon de pooled variance — émerge comme un estimateur d’une importance capitale. Elle permet de synthétiser les fluctuations aléatoires internes à plusieurs sous-échantillons indépendants afin de fournir une approximation non biaisée et plus efficace de la variance commune de la population parente, renforçant ainsi la validité des tests d’hypothèses subséquents.
La modélisation statistique moderne, telle qu’elle s’articule dans les environnements de calcul de haute performance comme le langage de programmation statistique R, requiert une maîtrise approfondie des principes algébriques et computationnels gouvernant cette agrégation des variances. Loin de constituer une banale moyenne arithmétique des variances d’échantillons, la variance combinée fait intervenir une pondération rigoureuse par les degrés de liberté respectifs de chaque sous-groupe. Ce mécanisme préserve la représentativité mathématique des différentes strates d’observation, en accordant un poids proportionnel à la quantité d’information empirique apportée par chaque cohorte. Qu’il s’agisse de calibrer le dénominateur du classique test t de Student pour échantillons indépendants, de dériver le carré moyen résiduel au sein d’une analyse de variance unidirectionnelle, ou encore de standardiser l’estimation d’une taille d’effet à travers le calcul du d de Cohen ou du g de Hedges, la variance combinée s’impose comme un pivot incontournable.
Toutefois, l’usage de cet estimateur repose sur des postulats théoriques stricts, au premier rang desquels figurent l’homoscédasticité et la normalité de la distribution des résidus. En pratique, le chercheur ou l’analyste de données utilisant l’écosystème R se trouve régulièrement confronté à des dilemmes méthodologiques : comment vérifier formellement ces conditions d’application ? De quelle manière implémenter l’algorithme arithmétique de base ou concevoir des fonctions personnalisées modulaires et défensives capables de traiter des architectures de données complexes ? Ce traité exhaustif a pour ambition d’explorer de manière approfondie les dimensions théoriques, mathématiques et informatiques de la variance combinée dans R. En parcourant ses fondements épistémologiques, ses dérivations matricielles et scalaires, ses implémentations pas à pas en R de base ainsi que ses intégrations modernes dans l’écosystème Tidyverse, ce guide offre une référence technique et conceptuelle complète destinée aux chercheurs, psychomètres et praticiens de la science des données.
1. Fondements conceptuels de la variance combinée en psychologie quantitative
1.1 Définition théorique et principe d’agrégation
Au sein de la modélisation statistique paramétrique, la variance combinée représente un estimateur ponctuel synthétique de la variabilité intra-groupe, obtenu en regroupant de manière pondérée les variances calculées sur deux ou plusieurs échantillons indépendants. D’un point de vue théorique, cette approche repose sur le postulat fondamental selon lequel les différents groupes d’individus observés partagent une structure de variance populationnelle commune, notée couramment σ2, même si leurs tendances centrales respectives divergent sous l’effet d’un traitement expérimental ou d’une appartenance catégorielle distincte. L’agrégation ne consiste nullement en une juxtaposition aveugle des données brutes, mais plutôt en une intégration réfléchie des dispersions internes, permettant de filtrer les fluctuations d’échantillonnage propres à chaque sous-ensemble.
La justification épistémologique de ce regroupement dans les plans expérimentaux inter-sujets s’enracine dans la volonté d’optimiser l’efficacité statistique. En agrégeant les informations relatives à la dispersion au lieu d’estimer des variances séparées pour chaque condition, le statisticien réduit l’erreur quadratique moyenne de l’estimateur final. Cette stratégie s’avère particulièrement cruciale en psychologie quantitative, où la variabilité interindividuelle, tributaire de multiples sources de bruit de mesure et de spécificités psychométriques, tend à masquer les effets réels des interventions ou des facteurs environnementaux.
Il convient d’établir une différenciation fondamentale entre la variance combinée et la variance globale non partitionnée de l’ensemble des données agglomérées. Lorsque l’on regroupe l’intégralité des observations au sein d’un vecteur unique sans tenir compte de la variable de classification de groupe, la variance totale calculée intègre mécaniquement l’écart existant entre les moyennes des groupes. En d’autres termes, la variance globale regroupe à la fois la variabilité intra-groupe (erreur pure) et la variabilité inter-groupe (effet du facteur). À l’inverse, la variance combinée isole et quantifie exclusivement la dispersion intra-groupe, en faisant abstraction de l’écartement systématique induit par les différences de moyennes, garantissant ainsi une mesure pure de l’aléa résiduel.
1.2 Importance dans l’inférence statistique et les tests d’hypothèses
Le rôle de la variance combinée dans l’édifice de l’inférence statistique fréquentiste se manifeste avec une netteté remarquable lors de l’estimation de l’erreur type de la différence entre deux moyennes indépendantes. Dans le cadre canonique du test t de Student, la variance combinée intervient directement au dénominateur du ratio de test pour pondérer l’estimation de l’imprécision d’échantillonnage. En mutualisant l’estimation de la variance entre les deux conditions, le test gagne des degrés de liberté précieux, ce qui resserre la distribution de référence de la statistique t et affine la région critique associée au rejet de l’hypothèse nulle.
Ce procédé entretient un lien direct et indissociable avec le principe de parcimonie des paramètres, cher à la modélisation linéaire générale. En contraignant le modèle à estimer un unique paramètre de variance résiduelle pour l’ensemble des conditions expérimentales au lieu d’allouer un paramètre distinct par groupe, le chercheur préserve les degrés de liberté du système et stabilise l’inférence. Si le postulat d’une variance commune est vérifié, l’estimateur combiné possède une variance d’échantillonnage inférieure à celle de tout estimateur individuel isolé, ce qui constitue la définition même de la propriété d’efficacité statistique selon les critères établis par Ronald Fisher et Jerzy Neyman.
L’exactitude de cette estimation exerce un impact direct et déterminant sur la puissance statistique des protocoles expérimentaux. Une sous-estimation accidentelle de la variance combinée, résultant par exemple de l’élimination arbitraire de cas atypiques ou d’un biais d’échantillonnage, produit une inflation inacceptable du taux d’erreur de première espèce (α), conduisant à détecter des effets illusoires. Inversement, une surestimation due à une mauvaise gestion méthodologique de la variance dilate artificiellement l’erreur type, réduisant drastiquement la probabilité de rejeter une hypothèse nulle fausse et pénalisant de facto la puissance des études comportementales.
1.3 Applications typiques en sciences comportementales
Les protocoles de recherche en psychologie clinique et en sciences cognitives fournissent une illustration éclatante de la nécessité d’utiliser la variance combinée. Considérons par exemple la comparaison de scores d’anxiété standardisés, mesurés à l’aide de l’inventaire STAI (State-Trait Anxiety Inventory), entre un échantillon de patients admis en institution psychiatrique et un groupe contrôle apparié issu de la population générale. L’hypothèse de travail postule souvent que, bien que le niveau moyen d’anxiété soit nettement plus élevé dans la cohorte clinique, les processus générateurs de variabilité biologique et psychologique sous-jacents demeurent équivalents d’un groupe à l’autre, justifiant ainsi l’usage d’une estimation combinée de la dispersion.
Un autre cas emblématique réside dans l’évaluation de l’efficacité d’interventions psychothérapeutiques brèves à travers des plans parallèles pré-test/post-test. Lorsque les chercheurs quantifient le changement psychométrique suite à une thérapie cognitivo-comportementale versus une thérapie basée sur la pleine conscience, l’analyse porte fréquemment sur des scores de changement ou sur des contrastes en fin de protocole. Le recours à la variance combinée permet ici d’obtenir une métrique d’erreur de mesure commune indispensable pour évaluer si l’hétérogénéité des réponses individuelles au traitement excède ce que le simple hasard prédirait sous l’action d’une variabilité basale constante.
Enfin, dans les paradigmes d’attention sélective ou de psychologie cognitive expérimentale, la mesure des temps de réaction chronométriques standardisés requiert une manipulation rigoureuse de la dispersion. Face à des tâches de type Stroop ou Posner, les latences de réponse affichent régulièrement une dispersion intra-condition qui doit être agrégée méthodiquement entre les blocs de conditions congruentes et incongrues, assurant ainsi la robustesse des comparaisons inter-groupes et fournissant une base stable pour le calcul standardisé des indices de discrimination perceptive.
2. Formulation mathématique et dérivation analytique de sp2
2.1 Équation classique pour deux échantillons indépendants
La dérivation formelle de la variance combinée, universellement désignée par le symbole sp2 (où l’indice p renvoie au terme pooled), repose sur une formulation arithmétique rigoureuse pondérée par les degrés de liberté. Pour deux échantillons indépendants notés 1 et 2, comprenant respectivement des tailles d’échantillons n1 et n2, ainsi que des variances échantillonnales sans biais s12 et s22, l’expression canonique s’énonce comme suit :
sp2 = [ (n1 – 1) s12 + (n2 – 1) s22 ] / (n1 + n2 – 2)
Chacune des composantes de cette égalité possède une signification statistique précise. Les grandeurs n1 et n2 représentent les effectifs stricts des observations colligées dans chaque groupe respectif. Les termes s12 et s22 désignent les estimateurs quasi-sans biais des variances de chaque échantillon, calculés en divisant la somme des carrés des écarts à la moyenne respective par leur degré de liberté propre (c’est-à-dire n1 – 1 et n2 – 1). Par conséquent, le produit (n1 – 1) s12 reconstitue exactement la somme des carrés des écarts (Sum of Squares, SS) pour le premier groupe, et il en va rigoureusement de même pour le second groupe.
Le dénominateur de cette relation fondamentale, formalisé par n1 + n2 – 2, correspond à l’addition directe des degrés de liberté associés aux deux échantillons individuels : dftotal = (n1 – 1) + (n2 – 1). La soustraction de deux unités traduit mathématiquement la perte de deux degrés de liberté imposée par l’estimation préalable et indispensable de deux moyennes d’échantillons distinctes (&ymacr;1 et &ymacr;2). Ce dénominateur agit comme un facteur de normalisation exact, garantissant que l’espérance mathématique de la variance combinée converge rigoureusement vers le paramètre populationnel inconnu σ2.
2.2 Pondération par les degrés de liberté versus moyenne arithmétique simple
Il est fréquent d’observer chez les statisticiens néophytes la tentation erronée de procéder à un calcul fondé sur la moyenne arithmétique simple des variances, consistant à poser (s12 + s22) / 2. Cette formulation simpliste n’est valide que dans le cas particulier et idéal où les tailles d’échantillons sont rigoureusement identiques (n1 = n2). Dès lors que les cohortes sont déséquilibrées (n1 ≠ n2), la moyenne arithmétique simple introduit un biais substantiel dans l’estimation de la variance résiduelle globale, en attribuant à tort un poids démesuré au groupe comportant le plus petit nombre d’observations.
La démonstration de ce biais est immédiate dès lors que l’on examine la nature probabiliste de la précision d’un estimateur. Un groupe comptant un effectif massif de 200 participants apporte une stabilité stochastique infiniment supérieure à celle d’un groupe restreint de 15 sujets. Accorder à la variance de ces deux échantillons une pondération égale de 50 % revient à ignorer la réduction substantielle de la variance d’échantillonnage inhérente au grand groupe. L’équation de la variance combinée rectifie précisément cette distorsion en conférant à chaque somme de carrés un poids proportionnel à son propre degré de liberté, matérialisant ainsi le théorème de Gauss-Markov relatif aux estimateurs linéaires sans biais de variance minimale (BLUE).
D’un point de vue asymptotique, la convergence de l’estimateur combiné s’appuie directement sur la loi des grands nombres. Lorsque la somme cumulée des effectifs tend vers l’infini, la variance combinée sp2 converge presque sûrement vers la variance théorique σ2 commune aux populations sous-jacentes. Les fluctuations d’échantillonnage de chaque variance locale s’annulent mutuellement, offrant une précision d’estimation inaccessible à partir de l’analyse isolée d’un échantillon individuel de taille modeste.
2.3 Relation formelle avec la variance résiduelle de l’ANOVA
L’analyse algébrique approfondie de la variance combinée met en lumière son identité mathématique absolue avec le carré moyen résiduel (couramment noté MSE pour Mean Squared Error ou CME pour Carré Moyen de l’Erreur) obtenu dans le cadre d’une analyse de variance (ANOVA) à un facteur inter-sujets. Dans un modèle linéaire où une variable dépendante continue est expliquée par un facteur catégoriel dichotomique, l’ANOVA partitionne la somme totale des carrés en une somme des carrés inter-groupes (SSB ou Sum of Squares Between) et une somme des carrés intra-groupes (SSW ou Sum of Squares Within).
Or, la somme des carrés intra-groupes s’écrit formellement comme l’accumulation des déviations quadratiques des scores individuels par rapport à la moyenne de leur propre condition d’appartenance : SSW = ∑ (yi1 – &ymacr;1)2 + ∑ (yi2 – &ymacr;2)2. Par définition même de la variance échantillonnale, cette sommation équivaut exactement au numérateur de la formule de la variance combinée : SSW = (n1 – 1) s12 + (n2 – 1) s22. Lorsque cette somme de carrés intra-groupe est rapportée à ses degrés de liberté résiduels dfW = (n1 + n2 – 2), le quotient obtenu n’est autre que le carré moyen de l’erreur : MSE = SSW / dfW.
Cette passerelle analytique met en évidence la continuité conceptuelle unissant les tests de comparaison bivariés et les modèles linéaires généraux. La variance combinée n’est donc point un artifice circonscrit au test t de Student à deux groupes, mais constitue la matérialisation la plus fondamentale de l’estimation de la variance d’erreur non expliquée d’un modèle statistique, préfigurant l’ensemble des décompositions factorielles avancées rencontrées en modélisation multivariée.
3. Hypothèses sous-jacentes et conditions d’application rigoureuses
3.1 L’hypothèse d’homogénéité des variances (homoscédasticité)
La validité mathématique et l’optimalité inférentielle de la variance combinée reposent sur une hypothèse de distribution primordiale : l’homoscédasticité. Ce postulat exige formellement l’égalité parfaite des variances populationnelles sous-jacentes d’où sont extraits les échantillons expérimentaux, soit σ12 = σ22 = σ2. Lorsque cette égalité est rompue, on parle d’hétéroscédasticité, un état qui altère radicalement les propriétés distributives de la statistique de test calculée à partir de la variance combinée.
Les conséquences de la violation de ce postulat sont sévères, particulièrement sur la probabilité de commettre une erreur de première espèce (α). Lorsque les variances théoriques sont divergentes mais que le statisticien applique indûment l’algorithme de la variance combinée, l’erreur type estimée est faussée. La gravité de cette distorsion dépend étroitement du degré de déséquilibre entre les tailles d’échantillons respectives. Si le groupe de grand effectif présente la plus petite variance, la variance combinée sous-estime l’erreur type réelle de la différence de moyenne, provoquant une augmentation artificielle du taux d’erreur α, parfois au-delà de 20 % pour un seuil nominal fixé à 5 %.
Inversement, si l’échantillon le plus restreint présente la variance la plus faible, l’agrégation pondérée va surévaluer l’erreur type, rendant le test excessivement conservateur et détruisant sa puissance statistique empirique. Cette interaction délétère entre l’inégalité des variances et le déséquilibre des effectifs impose une vigilance méthodologique constante, exigeant la mise en œuvre de diagnostics préalables de la dispersion avant toute décision de mutualisation des variances.
3.2 Normalité distributionnelle des résidus
Outre l’homoscédasticité, l’inférence reposant sur la variance combinée présuppose que les erreurs de mesure ou résidus intra-groupes suivent une distribution normale (gaussienne). Bien que l’estimation de la variance d’échantillon s2 demeure un estimateur sans biais de σ2 même sous des lois de probabilités non gaussiennes, la distribution d’échantillonnage de cet estimateur n’obéit fidèlement à une loi du Khi-deux redimensionnée que sous l’hypothèse stricte de normalité univariée au sein de chaque population observée.
La variance est une statistique particulièrement vulnérable aux valeurs aberrantes ou extrêmes (outliers) ainsi qu’aux distributions caractérisées par un kurtosis élevé (leptokurtiques). La présence de quelques observations situées à plusieurs écarts-types de la moyenne locale va gonfler artificiellement la somme des carrés des écarts, provoquant une distorsion majeure de la variance de l’échantillon concerné et, par voie de conséquence, de la variance combinée finale. Cette sensibilité accrue peut conduire à masquer des effets de groupe statistiquement réels en élargissant artificiellement les intervalles de confiance.
Toutefois, en vertu du théorème central limite, lorsque les tailles d’échantillons atteignent des seuils substantiels couramment rencontrés dans les protocoles de validation psychométrique (par exemple n ≥ 50 par groupe), la robustesse relative de l’inférence face à des déviations modérées de la normalité est généralement assurée. En revanche, pour des cohortes cliniques rares ou de très petits échantillons (n < 15), la non-normalité associée à l’asymétrie sévère invalide totalement l’usage sans correction de l’estimateur combiné classique.
3.3 Indépendance stricte des observations
Le troisième impératif sous-tendant le recours à la variance combinée est l’indépendance statistique absolue des unités d’observation, tant à l’intérieur de chaque échantillon qu’entre les groupes expérimentaux comparés. Mathématiquement, la covariance entre deux observations distinctes quelconques yij et ykl doit être rigoureusement nulle : Cov(yij, ykl) = 0 pour tout i ≠ k ou j ≠ l. Ce postulat garantit que chaque score apporte une information véritablement nouvelle et décorrélée au calcul de la dispersion.
Cette exigence disqualifie formellement la variance combinée inter-sujets standard dans le cas de mesures répétées, d’études longitudinales ou de protocoles à échantillons appariés. Si un même participant est évalué à plusieurs moments successifs, ou si des sujets sont regroupés par dyades sur la base de caractéristiques partagées (jumeaux, couples, fratries), une covariance positive substantielle lie les mesures. Ignorer cette structure d’autocorrélation en agrégeant les variances comme s’il s’agissait de groupes autonomes entraîne une estimation erronée de l’erreur type, compromettant l’ensemble de la chaîne inférentielle.
De surcroît, la présence de structures hiérarchiques ou d’effets de grappes (clustering) non modélisés — tels que des élèves nichés dans des classes scolaires ou des patients pris en charge par des thérapeutes spécifiques — engendre une violation pernicieuse de l’indépendance. Dans ces conditions, la variance combinée naive tend à sous-estimer la variance résiduelle réelle en ignorant la corrélation intra-classe, conduisant à des inférences indûment optimistes qui requièrent l’abandon des modèles classiques au profit d’approches multiniveaux ou à effets mixtes.
4. Configuration de l’environnement R et structure des données
4.1 Préparation de la session de travail R
Pour mener à bien le calcul et la modélisation de la variance combinée de manière reproductible et pérenne, il est impératif d’adopter une démarche de programmation rigoureuse au sein de la session de travail R. La première exigence méthodologique réside dans l’initialisation explicite du générateur de nombres pseudo-aléatoires au moyen de l’instruction set.seed(). Ce verrouillage garantit que toute génération synthétique de données ou procédure de rééchantillonnage produira des résultats strictement identiques lors de réexécutions ultérieures du script, satisfaisant ainsi aux exigences de la science ouverte.
Il est également recommandé d’opérer dans un environnement de base épuré, exempt d’objets résiduels en mémoire, et de minimiser le chargement de dépendances externes superflues lors des phases de développement initial. Le langage R dispose nativement, à travers son socle base et le package stats, de l’ensemble des primitives mathématiques et matricielles indispensables au calcul exact de la dispersion sans qu’il soit impératif de solliciter immédiatement des bibliothèques tierces.
Une bonne pratique structurante consiste à configurer des options d’affichage adaptées, notamment la gestion du nombre de décimales via la directive options(digits = 5), ainsi que la proscription des facteurs implicites non contrôlés dans les versions antérieures à la branche R 4.0. Le script analytique gagne à être articulé en sections clairement délimitées par des commentaires méthodologiques, isolant la génération des structures de données, les algorithmes de calcul manuel, et les étapes de diagnostic de validité.
4.2 Modélisation d’un jeu de données psychologiques représentatif
Afin d’ancrer les démonstrations dans une réalité clinique tangible, élaborons un jeu de données simulant une étude en psychopathologie expérimentale. Imaginons la passation d’un inventaire d’auto-évaluation de la dépression auprès de deux cohortes de participants : un groupe témoin sain (Groupe 1) et un groupe de patients présentant un trouble dépressif caractérisé modéré (Groupe 2). Les scores continus sont générés selon des lois normales théoriques dont nous fixons arbitrairement les paramètres pour les besoins de l’illustration.
Dans un premier temps, les données peuvent être représentées sous la forme de deux vecteurs numériques distincts, x1 et x2. Le premier vecteur reçoit par exemple 25 observations caractérisées par une moyenne théorique de 14 et un écart-type de 4. Le second vecteur agrège 35 observations reflétant une moyenne plus élevée de 22, tout en partageant, pour respecter notre hypothèse de travail, un écart-type similaire de 4. L’utilisation de la fonction rnorm() permet de concrétiser cette simulation numérique tout en assurant un contrôle fin des propriétés distributionnelles.
Dans un second temps, pour répondre aux standards de l’analyse computationnelle contemporaine, il convient d’organiser ces mêmes observations au format tabulaire long (tidy data). Nous structurons ainsi un objet de type data.frame réunissant une variable dépendante continue, désignée par exemple sous le terme score, et une variable indépendante catégorielle binaire codée sous forme de facteur, groupe, identifiant formellement l’appartenance de chaque unité statistique à la condition témoin ou à la condition clinique.
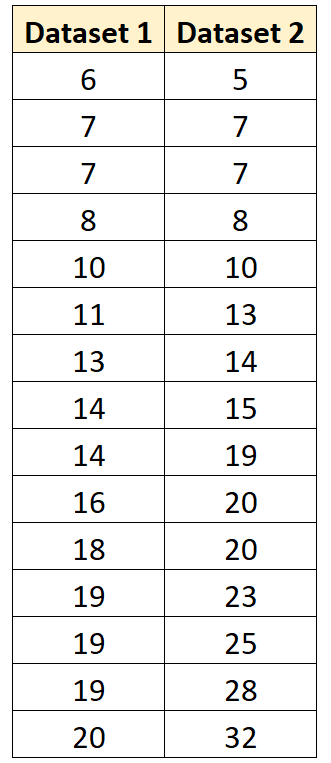
4.3 Exploration descriptive préliminaire des données
Avant d’engager toute procédure de mutualisation des variances, une inspection descriptive systématique des distributions empiriques s’impose. Cette étape liminaire permet de déceler d’éventuelles asymétries prononcées, des valeurs aberrantes ou des divergences criantes de dispersion qui mettraient en péril l’adéquation du modèle combiné. L’extraction des effectifs respectifs s’effectue simplement via les fonctions length() pour les vecteurs ou table(groupe) sur la variable catégorielle du tableau de données.
Les indicateurs de position et de dispersion locale doivent être systématiquement calculés pour chaque sous-échantillon. À l’aide des fonctions mean() et sd(), l’analyste obtient la moyenne et l’écart-type de chaque condition. Il est capital de vérifier que la variance de l’échantillon, accessible par la fonction var(), correspond bien à l’estimateur sans biais divisé par n – 1. Cette vérification prévient toute méprise ultérieure dans la recomposition des sommes de carrés intra-groupes.
Enfin, l’exploration graphique vient corroborer ces synthèses numériques. La production conjointe de diagrammes en boîte (boxplots) et de tracés de densité de probabilité superposés à l’aide des fonctions de base boxplot() et plot(density()) permet de confronter visuellement la dispersion des deux groupes. Si les boîtes présentent des largeurs d’écart interquartile drastiquement disparates ou si les queues de distribution manifestent un étalement asymétrique marqué, la prudence statistique commande d’approfondir les diagnostics formels d’homogénéité avant de valider l’usage de la variance combinée.
5. Calcul pas à pas de la variance combinée en R base
5.1 Extraction des statistiques descriptives fondamentales
L’implémentation algorithmique de la variance combinée dans le dialecte R de base repose sur l’extraction préalable et explicite des briques statistiques fondamentales constituant chaque sous-ensemble d’observation. Supposons deux vecteurs numériques x1 et x2 représentant nos deux groupes indépendants. La première opération consiste à isoler leurs effectifs respectifs par l’intermédiaire de la fonction primitive length(), assignés aux identifiants n1 et n2.
La seconde opération implique l’extraction directe des variances échantillonnales individuelles, dénotées s1_sq et s2_sq, en exploitant la fonction var(). Il est utile de rappeler ici que le moteur de calcul sous-jacent de la fonction var() dans R applique par défaut la correction de Bessel au dénominateur, divisant la somme des carrés centrés par n – 1 et non par n. Cette propriété native assure que les grandeurs obtenues correspondent rigoureusement aux estimateurs sans biais requis pour notre équation.
Ces éléments intermédiaires gagnent à être stockés dans des variables distinctes au sein de l’environnement global de travail. Cette dissociation des étapes computationnelles favorise la lisibilité du code, facilite les opérations de débogage et permet d’éviter toute redondance de calculs matriciels lourds lors de l’intégration ultérieure dans des architectures de boucles ou de simulations de Monte-Carlo.
5.2 Implémentation de l’algorithme arithmétique
Une fois les statistiques locales extraites et isolées en mémoire, l’implémentation de l’algorithme arithmétique complet suit pas à pas la dérivation analytique exposée à la section 2.1. La première étape consiste à reconstituer la somme des carrés des déviations propres à chaque groupe en multipliant leur variance respective par leur degré de liberté individuel : ss1 <- (n1 - 1) * s1_sq et ss2 <- (n2 - 1) * s2_sq.
La sommation de ces deux valeurs intermédiaires engendre la somme totale des carrés intra-groupe (la SSW de l’ANOVA) : ss_within <- ss1 + ss2. Concomitamment, le total des degrés de liberté résiduels s’obtient par la simple addition arithmétique : df_total <- (n1 - 1) + (n2 - 1), qui s’exprime de façon équivalente sous la syntaxe condensée df_total <- n1 + n2 - 2.
L’opération terminale consiste à opérer le quotient rigoureux de cette somme des carrés par ses degrés de liberté associés : sp2 <- ss_within / df_total. Le scalaire numérique résultant, stocké sous sp2, représente la variance combinée exacte. Cette démarche étape par étape permet de contrôler chaque phase du processus d’estimation, garantissant une conformité absolue avec les théorèmes fondamentaux de l’échantillonnage paramétrique.
5.3 Dérivation de l’écart-type combiné (pooled standard deviation)
Bien que la variance combinée possède des propriétés mathématiques optimales pour le calcul algébrique des tests statistiques, elle souffre d’un défaut interprétatif majeur : son unité d’expression est le carré de l’unité originale de la variable mesurée. Pour restituer la dispersion commune dans l’échelle d’évaluation originelle des participants — qu’il s’agisse de points à un questionnaire de dépression ou de millisecondes lors d’une épreuve cognitive —, il est impératif d’extraire la racine carrée de la variance combinée.
Cette grandeur, désignée sous l’appellation d’écart-type combiné (pooled standard deviation) et notée sp, s’obtient immédiatement dans R par l’application de la fonction sqrt() : sp <- sqrt(sp2). Contrairement à l’écart-type d’un groupe individuel, sp synthétise l’amplitude de l’erreur aléatoire typique qui entoure toute observation individuelle au sein du modèle global, indépendamment du groupe d’appartenance.
Une vérification empirique fondamentale permet de s’assurer de la cohérence du résultat calculé. Dans tous les cas de figure où les tailles d’échantillons sont rigoureusement identiques (n1 = n2), l’écart-type combiné sp se situe obligatoirement et strictement à une valeur intermédiaire comprise entre s1 et s2 (ou leur est égal si s1 = s2). Même en cas d’effectifs déséquilibrés, sp demeure confiné à l’intervalle délimité par le plus petit et le plus grand des écarts-types locaux, agissant comme un barycentre pondéré de la variabilité globale.
6. Développement d’une fonction R modulaire et robuste
6.1 Architecture fonctionnelle de base
Afin de s’abstraire des opérations manuelles récurrentes et d’intégrer ce traitement au sein de pipelines d’analyse reproductibles, il s’avère indispensable d’encapsuler la logique de calcul au sein d’une fonction personnalisée dédiée. Une architecture logicielle élégante repose sur la création d’une fonction recevant initialement deux vecteurs numériques en arguments principaux : pooled_var <- function(x, y).
Au sein du corps de cette fonction, le code doit automatiser l’extraction des effectifs et des variances sans tolérer de duplication syntaxique. L’évaluation directe de la formule s’opère de façon vectorisée en minimisant les variables tampons inutiles. Il convient d’adopter des conventions de nommage explicites, conformes au guide de style de programmation R usuel (par exemple, le guide de style de Hadley Wickham ou celui de Google), facilitant la maintenance et la réutilisabilité du composant par d’autres collaborateurs de l’équipe de recherche.
Le renvoi du résultat final peut se faire sous la forme d’une valeur scalaire brute ou, de manière plus sophistiquée, via une liste nommée contenant à la fois la variance combinée, l’écart-type combiné et les degrés de liberté associés. Cette modularité confère à l’outil une grande adaptabilité opérationnelle, tant pour des explorations interactives rapides que pour des intégrations au sein de systèmes d’analyse computationnelle de plus grande envergure.
6.2 Blindage et validation des entrées (defensive programming)
Un script statistique destiné à être déployé dans des recherches empiriques réelles ne saurait être qualifié de robuste s’il n’intègre pas les principes stricts de la programmation défensive. Les données comportementales brutes sont fréquemment grevées de valeurs manquantes (valeurs NA) ou de corruptions de typage consécutives à des erreurs d’encodage. Notre fonction personnalisée doit impérativement intercepter ces anomalies avant qu’elles ne propagent des erreurs silencieuses dans la chaîne de traitement.
En premier lieu, l’argument standard na.rm = TRUE doit être proposé dans la signature de la fonction afin de permettre le filtrage contrôlé des données manquantes via l’instruction na.omit(). En second lieu, des assertions logiques rigoureuses doivent être intégrées à l’aide de la fonction stopifnot() ou de blocs conditionnels explicites articulés autour de is.numeric(), vérifiant formellement que les entrées constituent d’authentiques vecteurs quantitatifs continus.
Enfin, un contrôle drastique sur la volumétrie minimale des sous-échantillons s’impose. Si un groupe comporte moins de deux observations valides (n < 2), l’estimation de sa variance d’échantillon devient indéfinie et engendre une division fatale par zéro au niveau des degrés de liberté. La fonction doit ainsi lever une exception claire et documentée via l’instruction stop("Chaque groupe doit contenir au minimum 2 observations valides.") lorsque cette contrainte n’est pas satisfaite, garantissant ainsi l’intégrité numérique du calcul.
6.3 Prise en charge de la structure formule (formula interface)
Dans l’écosystème R, la quasi-totalité des fonctions de modélisation statistique avancées (telles que lm(), t.test() ou aov()) exploitent l’interface standard par formule, adoptant la syntaxe intuitive variable_reponse ~ variable_groupe adossée à un argument explicite data = mon_dataframe. Pour conférer à notre fonction un niveau d’ergonomie équivalent, il est particulièrement judicieux d’implémenter une méthode supportant cette syntaxe symbolique.
La mise en œuvre technique de cette interface s’appuie sur la manipulation interne des fonctions de décomposition telles que model.frame() ou sur le découpage du vecteur de réponse à l’aide de la primitive split(). En fragmentant la variable dépendante continue en une liste de vecteurs indicés par les niveaux du facteur explicatif, la fonction peut ensuite router les sous-échantillons vers le cœur algorithmique de calcul de la variance combinée.
Il est par ailleurs recommandé d’attribuer une classe personnalisée (par exemple class(res) <- "pooled_var") à l’objet retourné, puis de surcharger la méthode générique print.pooled_var(). Cette approche orientée objet au format S3 permet d’afficher élégamment les résultats dans la console R, en indiquant de façon synthétique les sommes de carrés, les degrés de liberté résiduels, ainsi qu’une comparaison directe avec les variances locales des différents groupes analysés.
7. Généralisation à k groupes (calcul multi-groupes)
7.1 Formulation mathématique pour k échantillons
L’extension du principe de la variance combinée à un nombre arbitraire k d’échantillons indépendants constitue une étape théorique fondamentale qui matérialise l’universalité de cet estimateur au sein des plans factoriels complexes. Lorsque l’expérimentateur compare non plus deux, mais trois, quatre ou k conditions expérimentales distinctes, le principe de la pondération par les degrés de liberté individuels demeure rigoureusement identique.
L’équation générale de la variance combinée pour k groupes se formule ainsi :
sp2 = [ ∑i=1..k (ni – 1) si2 ] / [ ∑i=1..k (ni – 1) ]
Dans cette expression sommatoire, le numérateur correspond à la somme globale de l’intégralité des sommes de carrés intra-groupes calculées sur chacun des k sous-échantillons. Le dénominateur correspond à la somme cumulative des degrés de liberté individuels, qui se réduit algébriquement à la quantité N – k, où N représente la somme totale des observations de l’étude (N = ∑ ni) et k le nombre total de groupes ou de niveaux du facteur expérimental.
Cette variance combinée généralisée constitue l’unique estimateur non biaisé de la variance commune σ2 dans le cadre des plans d’analyse de variance unidirectionnels ou factoriels. Elle joue un rôle fondamental non seulement dans l’évaluation globale de l’effet d’un traitement via la statistique F de Fisher, mais également dans la conduite des contrastes a priori et des comparaisons multiples planifiées, où l’estimation de l’erreur type de tout contraste linéaire repose expressément sur cette variance résiduelle globalisée.
7.2 Implémentation vectorisée et programmation fonctionnelle dans R
Pour programmer cette généralisation à k groupes sans dégrader les performances computationnelles, il convient de proscrire l’usage des boucles itératives explicites au profit de la programmation vectorisée et fonctionnelle propre au moteur de R. Les fonctions d’agrégation d’ordre supérieur, telles que tapply(), aggregate() ou les outils de manipulation matricielle, se prêtent idéalement à cette tâche.
Considérons un vecteur de réponse continue y et un vecteur catégoriel groupe comportant k modalités. L’extraction simultanée des variances s’effectue en une seule ligne de code : variances <- tapply(y, groupe, var). De manière strictement analogue, la capture des effectifs de chaque modalité s’opère par l’instruction : effectifs <- tapply(y, groupe, length). L’analyste obtient ainsi deux vecteurs atomiques synchronisés, indexés par les étiquettes des différents groupes.
Le calcul de la variance combinée k-groupes s’exprime dès lors par une formulation vectorielle concise et élégante : sp2_k <- sum((effectifs - 1) * variances) / sum(effectifs - 1). En encapsulant cette séquence au sein d’une fonction générique pooled_var_k(y, groupe), le programmeur s’assure d’une vitesse d’exécution optimale, même face à des cohortes volumineuses regroupant plusieurs dizaines de strates expérimentales.
7.3 Comparaison avec les sorties de l’analyse de variance de R
Afin de valider de manière irréfutable l’exactitude de notre implémentation de la variance combinée à k groupes, il est particulièrement instructif de confronter directement notre valeur numérique à la sortie analytique générée par la fonction standard d’analyse de variance aov() de R. En ajustant le modèle linéaire modele <- aov(y ~ groupe) et en interrogeant son récapitulatif via summary(modele), R affiche la table classique de décomposition de variance de Fisher.
Dans ce tableau de résultats, la ligne identifiée sous l’intitulé Residuals présente la somme des carrés résiduelle (Sum Sq), ses degrés de liberté (Df) et, plus important encore, le carré moyen des résidus (Mean Sq). Ce carré moyen résiduel (MSE) correspond rigoureusement et au bit près à notre variance combinée calculée manuellement. L’identité mathématique MSE ≡ sp2 est ainsi numériquement vérifiée dans la console logicielle.
Pour extraire de façon programmatique cette grandeur depuis l’objet d’ANOVA sans recourir à des analyses de chaînes de caractères complexes, l’analyste peut interroger la structure interne du modèle : mse <- summary(modele)[[1]]["Residuals", "Mean Sq"]. De façon alternative, l’usage du package moderne broom et de sa fonction tidy() permet de convertir instantanément le tableau d’analyse de variance en un tibble structuré, au sein duquel la métrique de variance combinée peut être manipulée de manière totalement automatisée.
8. Intégration directe dans le test t de Student pour échantillons indépendants
8.1 Utilisation de t.test() en R base avec hypothèse d’homogénéité
L’application la plus fréquente et la plus universellement répandue de la variance combinée réside dans la conduite du classique test t de Student pour deux échantillons indépendants. Au sein de l’environnement R base, ce test est exécuté par l’intermédiaire de la commande t.test(). Toutefois, une particularité historique majeure du moteur R mérite une attention scrupuleuse : par défaut, la fonction applique la correction de Welch pour variances inégales, désactivant ainsi implicitement l’usage de la variance combinée standard.
Pour contraindre la fonction t.test() à adopter le formalisme de Student traditionnel fondé sur l’estimation d’une variance combinée commune, l’analyste doit explicitement renseigner le paramètre booléen var.equal = TRUE. Dès lors que cet argument est stipulé, R modifie son algorithme de calcul interne : le nombre de degrés de liberté de la statistique de test redevient un nombre entier exact (n1 + n2 – 2), et la statistique t empirique est calibrée en divisant la différence des moyennes d’échantillons par l’erreur type dérivée de la variance combinée.
Comprendre cette distinction est crucial pour le chercheur. Dans la version de Welch (var.equal = FALSE), l’erreur type est calculée séparément à partir des deux variances locales sans mutualisation préalable, et les degrés de liberté sont ajustés par la formule de Satterthwaite, produisant généralement une valeur fractionnaire non entière. L’activation de var.equal = TRUE constitue l’unique modalité d’exécution garantissant que l’inférence repose directement et exclusivement sur la variance combinée sp2.
8.2 Reconstruction pas à pas du calcul de t.test()
La déconstruction intégrale des calculs effectués par la fonction t.test(x1, x2, var.equal = TRUE) permet d’appréhender intimement la mécanique inférentielle de Student. Une fois la variance combinée sp2 et son écart-type combiné sp obtenus selon la méthode décrite précédemment, l’erreur type de la différence de moyennes (couramment dénotée SEdiff) se formule algébriquement comme suit :
SEdiff = sp × √( 1/n1 + 1/n2 )
Dans R, cette équation s’implémente immédiatement : se_diff <- sp * sqrt(1/n1 + 1/n2). La statistique empirique t représente alors simplement le ratio standardisé de la différence des moyennes d’échantillons observées rapportée à cette erreur type combinée : t_stat <- (mean(x1) - mean(x2)) / se_diff.
Pour convertir cette statistique t empirique en une probabilité de significativité bilatérale (la fameuse p-valeur), il suffit de convoquer la fonction de répartition cumulative de la loi de Student pt(), modulée par les degrés de liberté totaux : p_val <- 2 * (1 - pt(abs(t_stat), df = n1 + n2 - 2)). En comparant les résultats de ces trois lignes de programmation manuelle avec l’affichage officiel de t.test(x1, x2, var.equal = TRUE), on observe une stricte équivalence numérique, ce qui éclaire parfaitement le rôle moteur joué par la variance combinée dans la détermination de la significativité statistique.
8.3 Intervalles de confiance de la différence basés sur sp
L’intérêt de la variance combinée s’étend naturellement à l’estimation de l’intervalle de confiance encadrant la différence théorique entre les moyennes des deux populations (μ1 – μ2). Alors que le test d’hypothèse ponctuel se contente d’évaluer la compatibilité des données avec l’hypothèse nulle d’égalité parfaite, l’intervalle de confiance fournit une estimation continue de la précision métrique du résultat et de la magnitude plausible de l’effet clinique ou expérimental.
La formulation analytique d’un intervalle de confiance bilatéral au seuil de confiance 1 – α (habituellement fixé à 95 %, soit α = 0,05) intègre le quantile critique issu de la distribution théorique de Student. Dans R, cette valeur seuil s’extrait précisément à l’aide de la fonction des quantiles qt() : t_crit <- qt(1 - 0.05/2, df = n1 + n2 - 2).
Les bornes inférieure et supérieure de l’intervalle se calculent dès lors en retranchant et en ajoutant à la différence brute des moyennes le produit de ce quantile critique par l’erreur type combinée :
borne_inf <- (mean(x1) - mean(x2)) - t_crit * se_diff
borne_sup <- (mean(x1) - mean(x2)) + t_crit * se_diff
L’estimation conjointe de ces bornes repose entièrement sur la stabilité de sp. Si la variance combinée est adéquatement calibrée, cet intervalle offre la garantie fréquentiste exacte de capturer la différence populationnelle réelle dans 95 % des réplications potentielles de l’expérience, apportant ainsi aux psychologues et cliniciens une quantification indispensable de l’incertitude entourant leurs constats.
9. Application au calcul de la taille d’effet : Le d de Cohen
9.1 Le d de Cohen et le rôle de l’écart-type combiné
Dans le paradigme contemporain de la recherche en psychologie, la seule indication de la significativité statistique via la p-valeur est jugée notoirement insuffisante pour apprécier la pertinence théorique ou pratique d’une découverte. La puissance d’un test statistique étant étroitement assujettie à la taille de l’échantillon, un écart de moyennes trivial peut aisément franchir le seuil de rejet p < 0,05 pourvu que les cohortes analysées soient suffisamment imposantes. C’est pour remédier à cette faille que l’estimation standardisée des tailles d’effet, au premier rang desquelles trône le d de Jacob Cohen, s’est imposée comme une norme de publication universelle.
Le d de Cohen quantifie la distance séparant deux moyennes exprimée en unités d’écart-type. Or, toute la question méthodologique réside dans le choix de l’écart-type de référence servant de dénominateur à ce ratio de standardisation. Si l’on compare deux groupes indépendants issus d’un protocole randomisé régulier, l’estimation la plus puissante, stable et universellement reconnue de la variabilité sous-jacente commune n’est autre que l’écart-type combiné sp, dérivé de notre variance combinée sp2.
Il importe de distinguer avec netteté les variantes conceptuelles entourant cet indice. Tandis que le d théorique original de Cohen postulait un écart-type populationnel parfaitement connu σ, le d empirique calculé sur des échantillons repose sur sp. Lorsque les tailles d’échantillons sont particulièrement modestes, cet estimateur tend à surestimer légèrement la taille d’effet populationnelle réelle. Cette anomalie a conduit le statisticien Larry Hedges à formaliser une correction spécifique, aboutissant au g de Hedges, qui ajuste le d de Cohen basé sur sp par un facteur d’atténuation analytique non biaisé.
9.2 Calcul algorithmique du d de Cohen dans R
L’implémentation algorithmique manuelle du d de Cohen fondé sur l’écart-type combiné s’effectue dans R avec une simplicité déconcertante dès lors que sp a été programmé. La formule scalaire s’énonce ainsi : d_cohen <- (mean(x1) - mean(x2)) / sp. Cette formulation respecte strictement les préconisations du manuel méthodologique fondamental de Cohen publié en 1988.
Pour appliquer la correction non biaisée de Hedges (le fameux facteur J), particulièrement recommandée lorsque la somme totale des effectifs est inférieure à une cinquantaine d’unités (N < 50), on multiplie le d calculé par un facteur de correction polynomial exact :
df <- n1 + n2 - 2
facteur_J <- 1 - (3 / (4 * df - 1))
g_hedges <- d_cohen * facteur_J
Afin de confronter cette implémentation directe avec les outils spécialisés de l’écosystème R, l’analyste peut solliciter des bibliothèques de référence telles que effsize avec la fonction cohen.d(), ou le package plus récent effectsize développé par le consortium easystats. En exécutant effectsize::cohens_d(x1, x2, pooled_sd = TRUE), on constate une convergence algorithmique absolue avec notre démarche programmatique, attestant que la variance combinée constitue l’armature computationnelle interne des packages psychométriques majeurs.
9.3 Interprétation des seuils et implications psychométriques
L’interprétation de la taille d’effet standardisée s’appuie traditionnellement sur les seuils heuristiques formulés par Cohen : un d de 0,2 est considéré comme un effet de magnitude faible (small), 0,5 désigne un effet moyen (medium), et 0,8 correspond à un effet fort (large). Bien que Cohen ait lui-même insisté sur la relativité contextuelle de ces conventions, elles demeurent des points de repère incontournables dans la littérature en psychologie expérimentale et cognitive.
Une mauvaise estimation de la variance combinée dégrade directement la validité psychométrique de ces conclusions. Si un analyste commet l’erreur d’utiliser la variance globale non partitionnée de l’échantillon réuni au lieu de la variance combinée, la dispersion totale au dénominateur intègre mécaniquement la différence entre les moyennes de groupe. Ce gonflement artificiel du dénominateur diminue indûment la valeur du d standardisé, conduisant le chercheur à sous-estimer de manière substantielle la portée réelle de son intervention thérapeutique ou cognitive.
Enfin, dans le domaine des méta-analyses contemporaines, où des centaines d’études indépendantes sont synthétisées mathématiquement afin de dégager un consensus scientifique, le d de Cohen basé sur sp constitue l’unité d’entrée quantitative par excellence. Les algorithmes de modélisation méta-analytique (tels que ceux déployés dans le package metafor de Wolfgang Viechtbauer) pondèrent chaque étude par l’inverse de la variance d’échantillonnage de son d de Cohen, laquelle dépend directement de la variance combinée originale et des effectifs des échantillons primaires.
10. Diagnostics statistiques et tests de conformité des variances
10.1 Vérification formelle de l’homoscédasticité dans R
Avant d’entériner formellement l’usage de la variance combinée au sein d’un pipeline inférentiel, le statisticien rigoureux doit soumettre ses données à une batterie de tests diagnostiques dédiés à l’homogénéité des variances. La procédure formelle la plus largement adoptée et la plus robuste dans la recherche quantitative moderne est le test de Levene, tout particulièrement dans sa déclinaison dite de Brown-Forsythe, laquelle substitue la médiane à la moyenne pour le centrage des écarts absolus.
Dans l’environnement R, le test de Levene centré sur la médiane s’exécute commodément grâce à la fonction leveneTest() hébergée au sein de l’incontournable package car (Companion to Applied Regression) de John Fox. La syntaxe canonique s’exprime sous la forme : car::leveneTest(score ~ groupe, data = donnees, center = median). Une p-valeur supérieure au seuil usuel de 0,05 indique que l’hypothèse nulle d’égalité des variances intra-groupes ne peut être raisonnablement rejetée, accordant ainsi un feu vert théorique à l’application de la variance combinée.
Une alternative classique disponible nativement dans le socle de base de R est le test de Bartlett, sollicité via la commande bartlett.test(score ~ groupe, data = donnees). Cependant, il convient de souligner une limitation méthodologique sévère : le test de Bartlett est notoirement ultra-sensible aux déviations de la normalité univariée. En présence de résidus modérément asymétriques ou leptokurtiques, le test de Bartlett tend à rejeter massivement l’égalité des variances en raison de la forme des distributions et non d’une véritable hétéroscédasticité, ce qui pousse les méthodologistes à lui préférer systématiquement le test de Levene fondé sur la médiane.
10.2 Diagnostics graphiques des dispersions
Les tests d’hypothèses formels sur l’égalité des variances présentent le travers intrinsèque de dépendre eux-mêmes de la puissance d’échantillonnage : ils s’avèrent excessivement laxistes sur de petits effectifs (manque de puissance pour détecter une hétéroscédasticité réelle) et excessivement sévères sur de très grandes cohortes (rejetant l’homogénéité pour des déviations infimes et dénuées de pertinence pratique). Par conséquent, l’évaluation graphique de la dispersion doit obligatoirement compléter les indices numériques.
Une première approche visuelle consiste à ajuster un modèle linéaire bivarié via modele_lm <- lm(score ~ groupe, data = donnees) et à tracer le graphique classique des résidus standardisés en fonction des valeurs prédites (residuals vs fitted plot). En projetant ces grandeurs par plot(modele_lm, which = 1) ou plot(modele_lm, which = 3) (graphique de type Scale-Location), l’analyste peut examiner si l’amplitude d’étalement vertical des résidus demeure rigoureusement constante d’une condition expérimentale à l’autre.
Une seconde approche, particulièrement intuitive en psychologie différentielle, réside dans l’exploitation des graphiques d’écart-dispersion (spread-level plots), accessibles via car::spreadLevelPlot(modele_lm). Cet outil projette le logarithme des résidus absolus contre le logarithme des valeurs prédites et calcule une droite de régression dont la pente signale l’existence d’une dépendance structurelle entre l’échelle de la moyenne et l’amplitude de la dispersion. Une pente proche de zéro confirme la parfaite stabilité de la variance à travers les groupes.
10.3 Prise de décision méthodologique en cas de rejet de l’hypothèse
Que doit faire le chercheur lorsque les diagnostics empiriques révèlent sans équivoque une violation substantielle du postulat d’homoscédasticité (σ12 ≠ σ22) ? La pratique méthodologique historiquement enseignée, consistant à procéder à un pré-test de Levene pour décider conditionnellement d’utiliser soit le test t de Student à variance combinée (si p ≥ 0,05), soit le test de Welch (si p < 0,05), a été formellement invalidée par les statisticiens contemporains.
De multiples études de simulation de Monte-Carlo ont démontré que cette stratégie conditionnelle à deux étapes distord gravement le contrôle effectif du taux d’erreur α global, créant un biais d’échantillonnage insidieux. Face à ce constat, les recommandations méthodologiques actuelles préconisent d’adopter systématiquement par défaut le test t de Welch (avec var.equal = FALSE dans R), lequel n’impose pas la contrainte d’une variance commune et s’avère asymptotiquement équivalent au test de Student standard lorsque les variances sont effectivement égales.
Cependant, le maintien de la variance combinée demeure pleinement légitime et scientifiquement préférable dans des situations méthodologiques bien documentées : lorsque les effectifs d’échantillons sont rigoureusement équilibrés (n1 = n2), situation dans laquelle le test de Student standard fait preuve d’une robustesse exceptionnelle face à des hétérogénéités modérées ; lorsque des contraintes théoriques ou des données normatives antérieures massives attestent de l’invariance structurelle de l’instrument de mesure ; ou encore dans le contexte des contrastes orthogonaux a priori au sein d’une ANOVA factorielle, où la préservation de la variance combinée multi-groupes est indispensable pour maintenir l’orthogonalité algébrique des décompositions factorielles.
11. Workflow moderne et élégant avec l’écosystème Tidyverse
11.1 Calcul de la variance combinée avec dplyr
L’essor de la science des données moderne au sein de la communauté R est indissociable de l’avènement du tidyverse, un ensemble unifié de packages partageant une même philosophie de conception et une syntaxe harmonisée. Le package dplyr, en particulier, révolutionne la manipulation et l’agrégation des tableaux de données grâce à une structure d’instructions séquentielles articulée autour de l’opérateur de tuyau (le pipe traditionnel %>% ou le pipe natif de R 4.0+ |>).
Pour calculer la variance combinée de manière déclarative et lisible sur un tableau de données structuré au format long, on combine les verbes group_by() et summarise(). L’architecture du pipeline procède d’abord à l’extraction des grandeurs locales pour chaque strate factorielle :
Le flux d’instructions calcule pour chaque modalité l’effectif n = n() et la variance s2 = var(score, na.rm = TRUE). Dans un second temps, en dégroupant le tableau via ungroup() et en enchaînant sur un second bloc summarise(), les statistiques sont agrégées globalement pour appliquer la formule matricielle :
ss_total = sum((n - 1) * s2)
df_total = sum(n - 1)
pooled_var = ss_total / df_total
pooled_sd = sqrt(pooled_var)
Cette approche présente une clarté conceptuelle inégalée. Elle élimine tout risque d’inversion d’indices, s’adapte automatiquement à un nombre quelconque de groupes (2, 3 ou k) sans la moindre modification de code, et délivre en sortie un objet tibble prêt pour l’intégration dans des chaînes de production de rapports automatisés.
11.2 Création d’une fonction vectorisée compatible avec le pipe
Pour parfaire l’intégration au sein de l’écosystème tidyverse, il est particulièrement élégant de concevoir une fonction d’agrégation d’aide (helper function) compatible avec les principes de l’évaluation non standard (tidy evaluation) fournis par le package rlang. L’objectif est de permettre à un utilisateur de convoquer directement une syntaxe fluide telle que donnees %>% summarise(sp2 = pooled_variance(score, groupe)).
Dans cette architecture avancée, la fonction capture les colonnes transmises sous forme d’expressions symboliques (à l’aide des doubles accolades ou curly-curly {{ }}) et gère la résolution vectorielle en coulisses. Le code extrait les sous-vecteurs délimités par les modalités du groupe, évalue les longueurs et les variances sans biais, puis retourne un scalaire unique parfaitement compatible avec les mécaniques de réduction de summarise().
Une telle intégration simplifie considérablement les scripts de traitement au sein des plateformes d’analyse de données psychométriques. Le chercheur peut combiner en un seul pipeline l’imputation conditionnelle, le filtrage des participants n’ayant pas satisfait aux critères d’inclusion, et le calcul direct de la variance combinée pour de multiples sous-échelles d’un même inventaire psychologique, garantissant ainsi une productivité analytique optimale.
11.3 Comparaison de plusieurs conditions avec purrr et tidyr
Les protocoles de recherche contemporains en psychologie et en neurosciences comportementales mobilisent fréquemment des devis expérimentaux factoriels complexes, croisant plusieurs facteurs inter-sujets (par exemple : Type de Traitement × Sexe des Participants × Tranche d’Âge). Dans de telles configurations, l’analyste se trouve confronté à l’obligation de calculer et de comparer les variances combinées à travers une multiplicité de strates expérimentales emboîtées.
L’alliance fonctionnelle des packages tidyr et purrr offre une réponse computationnelle magistrale à ce défi grâce au concept de structures de données imbriquées (nested data frames). En utilisant la commande nest() sur les variables de stratification factorielle, le chercheur condense son tableau de données de telle sorte que chaque ligne correspond à un sous-devis expérimental contenant son propre tableau de données local logé dans une colonne de type liste (list-column).
Il devient dès lors possible d’appliquer de manière itérative notre fonction de variance combinée à chaque sous-ensemble expérimental en mobilisant la fonction fonctionnelle purrr::map() :
resultats_stratifie <- donnees_emboitees %>%
mutate(sp2 = map_dbl(data, ~ pooled_variance_k(.x$score, .x$groupe)))
En une seule expression condensée et entièrement vectorisée, des dizaines de variances combinées spécifiques sont extraites en parallèle. Le tableau résultant peut être dé-nesté ou formaté instantanément pour alimenter des tableaux récapitulatifs exhaustifs destinés aux annexes méthodologiques de publications scientifiques de rang international.
12. Rapports des résultats selon les normes de l’APA et bonnes pratiques
12.1 Restitution formelle de la variance combinée et de l’écart-type combiné
La communication des résultats statistiques au sein des revues scientifiques internationales affiliées aux sciences comportementales et biomédicales obéit à des normes typographiques et formelles particulièrement rigoureuses, dictées par le manuel de publication de l’American Psychological Association (APA, 7e édition). Une restitution conforme exige une distinction scrupuleuse dans l’écriture des indices, l’emploi de l’italique pour les symboles statistiques latins, et la mention exhaustive des paramètres critiques gouvernant l’inférence.
Dans le corps du texte narratif, l’écart-type combiné est conventionnellement identifié par le symbole sp ou SDp (en italique pour la base, avec l’indice en typographie romaine minuscule). Les résultats d’un test t indépendant reposant sur la variance combinée doivent être formulés en intégrant systématiquement les degrés de liberté, la valeur observée de la statistique t, le niveau exact de la p-valeur (en proscrivant les formulations obsolètes telles que p = 0,000 au profit de p < 0,001), et la taille d’effet standardisée assortie de son intervalle de confiance à 95 %.
Une formulation narrative standardisée respectant scrupuleusement les exigences de l’APA 7 s’énonce comme suit :
« Les scores moyens de dépression observés dans le groupe clinique (M = 22,40 ; SD = 4,12) sont significativement supérieurs à ceux enregistrés dans le groupe témoin (M = 14,15 ; SD = 3,88), t(58) = 8,12, p < 0,001, d = 2,06, IC à 95 % [1,45, 2,67], sp = 3,98. »
Sur le plan tabulaire, la présentation gagne à faire figurer dans des colonnes dédiées les effectifs (n), les moyennes (M) et les écarts-types individuels (SD) de chaque cohorte, en plaçant en note de bas de tableau la valeur globale de l’écart-type combiné mutualisé ayant alimenté les tests de contrastes.
12.2 Reproductibilité et traçabilité du code R
À l’ère de la crise de la reproductibilité qui traverse les sciences expérimentales et de l’essor incontournable du mouvement de la science ouverte (Open Science), la simple communication des valeurs synthétiques dans un article imprimé ne suffit plus. Il est désormais exigé des chercheurs qu’ils publient des scripts d’analyse complets, traçables et exécutables sans ambiguïté par des relecteurs ou des équipes indépendantes.
Pour assurer la pérennité computationnelle d’un script calculant la variance combinée, il est impératif d’intégrer en fin d’exécution la commande sessionInfo(). Cette directive compile et consigne dans le journal d’analyse la version exacte du système d’exploitation hôte, la version précise de la distribution de R exploitée, ainsi que la liste exhaustive et les numéros de version de l’ensemble des packages mobilisés. Cette traçabilité prévient les discordances potentielles résultant de modifications comportementales introduites lors de mises à jour logicielles majeures.
L’excellence méthodologique contemporaine réside dans la confection de documents computationnels dynamiques via les technologies R Markdown ou Quarto (fichiers .Rmd ou .qmd). En imbriquant au sein d’un document source unique la narration théorique, le code R d’exécution de la variance combinée et le rendu finalisé des tableaux et graphiques, le chercheur garantit une parfaite transparence méthodologique, éliminant définitivement les risques d’erreurs humaines de transcription entre la console statistique et le manuscrit finalisé.
12.3 Erreurs fréquentes à éviter absolument
La pratique empirique de l’analyse quantitative met en lumière la récurrence de plusieurs fautes méthodologiques et computationnelles majeures qu’il convient de proscrire formellement lors de la manipulation de la variance combinée dans R.
La première erreur, d’ordre arithmétique mais fréquente chez les utilisateurs peu familiers avec la théorie de l’échantillonnage, consiste à omettre la soustraction des deux unités aux degrés de liberté du dénominateur, en divisant la somme des carrés par n1 + n2 au lieu de n1 + n2 – 2. Cette omission produit un estimateur biaisé vers le bas de la variance résiduelle, affectant artificiellement l’ensemble des inférences subséquentes.
La deuxième erreur conceptuelle réside dans la confusion pernicieuse entre l’écart-type combiné sp et l’erreur type de la différence de moyennes SEdiff. Rappelons avec insistance que l’écart-type combiné sp est une mesure de dispersion individuelle décrivant la variabilité théorique entre les sujets au sein des populations parentes, tandis que l’erreur type SEdiff = sp × √(1/n1 + 1/n2) est une mesure de fluctuation d’échantillonnage de la statistique de test qui tend inexorablement vers zéro à mesure que la taille des échantillons croît vers l’infini. Remplacer l’un par l’autre au dénominateur du d de Cohen ou du test t constitue un non-sens statistique dévastateur.
Enfin, la troisième faute méthodologique critique consiste à appliquer indûment la formule de la variance combinée classique à des données issues de mesures répétées intra-sujets ou à des plans de recherche appariés. Dans ces configurations, l’existence d’une corrélation positive entre les paires d’observations invalide formellement le postulat d’indépendance. Utiliser la formule inter-sujets dans ce cadre surestime drastiquement l’erreur type résiduelle réelle, privant le protocole de l’immense gain de puissance statistique conféré par le contrôle de la variabilité interindividuelle stable propre aux plans à mesures répétées.
Références
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. https://doi.org/10.4324/9780203771587
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd. https://www.worldcat.org/title/statistical-methods-for-research-workers/oclc/514218
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage Publications. https://socialsciences.mcmaster.ca/jfox/Books/Companion/
- Hedges, L. V. (1981). Distribution theory for Glass’s estimator of effect size and related estimators. Journal of Educational Statistics, 6(2), 107–128. https://doi.org/10.3102/10769986006002107
- Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning. https://www.cengage.com
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Wickham, H., Çetinkaya-Rundel, M., & Grolemund, G. (2023). R for data science: Import, tidy, transform, visualize, and model data (2nd ed.). O’Reilly Media. https://r4ds.hadley.nz/
- Wilcox, R. R. (2017). Introduction to robust estimation and hypothesis testing (4th ed.). Academic Press. https://doi.org/10.1016/C2015-0-02298-7