
Dans le domaine de l’analyse exploratoire des données (Exploratory Data Analysis ou EDA), théorisée par le statisticien John W. Tukey à la fin des années 1970, la compréhension immédiate de la structure sous-jacente d’une distribution constitue le premier jalon incontournable de toute inférence scientifique. Avant même de recourir à des modélisations probabilistes sophistiquées ou d’éprouver des hypothèses via des tests d’hypothèse inférentiels, le chercheur et le praticien se doivent de cartographier la forme empirique de leurs observations. C’est précisément dans cette optique que s’inscrit le résumé à cinq nombres (ou five-number summary), un ensemble fondamental de statistiques d’ordre conçu pour condenser un ensemble univarié complexe sans sacrifier les nuances critiques de sa variabilité, de sa tendance centrale ou de ses anomalies potentielles.
Au sein des environnements d’analyse contemporains, Microsoft Excel demeure le logiciel de traitement matriciel et tabulaire le plus universellement déployé dans les laboratoires de recherche, les départements d’épidémiologie, les institutions financières et les unités de psychométrie. Toutefois, l’apparente simplicité du calcul d’un minimum, d’une médiane ou de quartiles sous Excel dissimule d’importantes divergences algorithmiques et méthodologiques. Le passage de la théorie statistique à son implémentation dans une feuille de calcul requiert une maîtrise rigoureuse des syntaxes, de la gestion des données aberrantes, du typage des variables et du choix fondamental entre les algorithmes exclusifs et inclusifs de percentiles.
Ce traité exhaustif a pour vocation d’exposer de manière méthodique, rigoureuse et académique la totalité des étapes requises pour concevoir, implémenter, interpréter et automatiser un résumé à cinq nombres au sein de Microsoft Excel. De l’assise mathématique des statistiques d’ordre jusqu’aux routines d’automatisation via Power Query et Visual Basic for Applications (VBA), en passant par les applications spécialisées aux distributions asymétriques en sciences humaines, ce guide constitue la référence méthodologique absolue pour transformer des séries de données brutes en indicateurs décisionnels fiables, reproductibles et conformes aux plus hauts standards de publication scientifique.
1. Fondements théoriques du résumé à cinq nombres en statistique descriptive
1.1 Définition et composantes cardinales de l’indicateur
Le résumé à cinq nombres est une synthèse statistique non paramétrique structurée autour de cinq métriques ordinales fondamentales : le minimum absolu de la série observée, le premier quartile (noté Q1 ou 25e centile), la médiane (notée Q2 ou 50e centile), le troisième quartile (noté Q3 ou 75e centile) et le maximum absolu. Mathématiquement, pour un vecteur ordonné d’observations réelles indexées de manière croissante tel que :
x(1) ≤ x(2) ≤ … ≤ x(n)
le résumé se définit par le quintuplet ordonné constitué de la première statistique d’ordre x(1), des seuils de partitionnement quartiles, et de la dernière statistique d’ordre x(n). Cette formalisation découle directement des travaux fondateurs de Tukey consignés dans son ouvrage séminal de 1977, Exploratory Data Analysis. Tukey cherchait à affranchir l’analyse descriptive préliminaire du carcan des distributions théoriques imposées (telles que la loi normale gaussienne) en privilégiant des descripteurs basés exclusivement sur les rangs relatifs des données.
L’immense valeur cognitive de cette structure réside dans sa faculté à résumer simultanément les trois dimensions cardinales d’un vecteur empirique univarié : la localisation ou tendance centrale (incarnée par la médiane), la dispersion ou variabilité locale et globale (mesurée par l’écart entre quartiles et l’étendue totale), ainsi que l’étendue géométrique du support des mesures. Contrairement aux approches condensées reposant sur un unique scalaire, le quintuplet préserve la structure topologique de la dispersion tout au long de la droite réelle.
1.2 Pertinence méthodologique dans l’analyse exploratoire des données
Dans le cadre d’une démarche d’inspection exploratoire, le résumé à cinq nombres offre un diagnostic immédiat quant à la symétrie ou l’asymétrie (communément désignée sous le terme de skewness) d’une distribution d’échantillon. En évaluant simplement la position relative de la médiane par rapport aux quartiles, l’analyste peut déduire l’allure générale de la densité de probabilité sous-jacente sans formuler le moindre postulat probabiliste a priori :
- Si la différence (Q2 – Q1) est approximativement égale à la différence (Q3 – Q2), et que la distance du minimum à la médiane reflète fidèlement la distance de la médiane au maximum, la distribution présente une symétrie empirique robuste.
- À l’inverse, si l’intervalle (Q3 – Q2) surpasse largement l’intervalle (Q2 – Q1), la distribution démontre une asymétrie positive (étalement vers la droite), phénomène quasi universel dans l’étude des temps de réaction, des revenus ou des biomarqueurs sériques.
- Réciproquement, une prédominance de la distance (Q2 – Q1) signale une asymétrie négative prononcée (queue de distribution orientée vers la gauche).
En outre, cette métrique permet d’examiner la dispersion différentielle entre la moitié inférieure (délimitée entre le minimum et la médiane) et la moitié supérieure des données (de la médiane au maximum). Lors de la phase de validation de données observationnelles ou de protocoles expérimentaux, cet outil constitue une barrière de contrôle qualité irremplaçable pour détecter d’emblée des artefacts de mesure, des effets de plancher ou des effets de plafond qui compromettraient irrémédiablement l’application ultérieure de tests statistiques paramétriques classiques.
1.3 Comparaison avec les métriques paramétriques classiques
L’inadéquation fréquente des métriques paramétriques classiques (la moyenne arithmétique et la variance empirique, ou son corollaire l’écart-type) face à des données réelles provient de leur point de rupture asymptotique extrêmement faible. En effet, le point de rupture d’une statistique mesure la proportion maximale d’observations contaminées ou arbitrairement erronées qu’un estimateur peut tolérer avant de produire une valeur infiniment fausse. La moyenne et la variance possèdent un point de rupture de 0 % (ou plus exactement 1/n), signifiant qu’une unique valeur extrême aberrante (un outlier résultant par exemple d’une erreur de virgule lors de la saisie) suffit à déplacer arbitrairement la moyenne arithmétique et à gonfler démesurément l’écart-type.
À l’opposé, le résumé à cinq nombres s’appuie sur des statistiques d’ordre non paramétriques dotées d’une résistance exceptionnelle. La médiane bénéficie du point de rupture le plus élevé concevable pour un indicateur de tendance centrale, à savoir 50 % : il faudrait corrompre plus de la moitié de l’échantillon pour fausser systématiquement la valeur médiane. Les quartiles Q1 et Q3 affichent un point de rupture de 25 %, garantissant une remarquable stabilité structurelle face aux artefacts expérimentaux.
De surcroît, le résumé à cinq nombres préserve son invariance lors des transformations monotones croissantes (telles que les échelles logarithmiques ou exponentielles courantes dans le calibrage d’instruments de mesure). Alors que la moyenne d’une série transformée par un logarithme n’équivaut absolument pas au logarithme de la moyenne originelle, la médiane et les quartiles de la série transformée correspondent exactement aux transformées des quantiles d’origine. Cette propriété mathématique justifie la primauté absolue du résumé à cinq nombres dès lors que les distributions s’écartent du paradigme gaussien ou lorsque la métrique de mesure est d’ordre ordinal.
2. Préparation et structuration rigoureuse des données dans Microsoft Excel
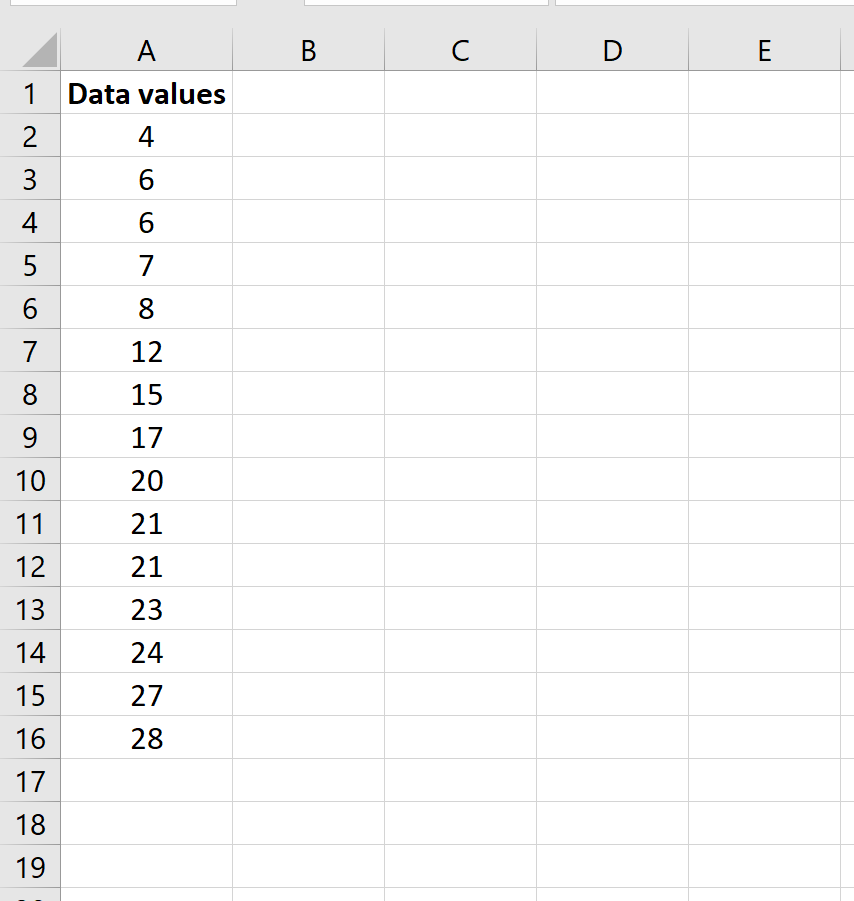
2.1 Organisation matricielle et saisie des variables univariées
La précision de tout calcul statistique sous Microsoft Excel dépend de la structuration spatiale des données sources. Une règle fondamentale en modélisation tabulaire consiste à privilégier une organisation strictement vectorielle et colonnaire (forme longue normalisée). Dans cette disposition canonique, une colonne unique et continue doit être dédiée à la variable univariée quantitative continue ou discrète soumise à l’analyse, la première ligne étant strictement réservée à un en-tête sémantique explicite dénué de caractères spéciaux (par exemple Score_Anxiete_T1 ou Temps_Reaction_ms).
L’ordonnancement physique des données, bien que théoriquement neutre pour l’évaluation des fonctions de quantiles dans les versions récentes du moteur d’Excel, revêt une importance méthodologique fondamentale. Maintenir les observations dans leur ordre chronologique de recueil ou les associer systématiquement à un identifiant d’observation unique (ID) sur la colonne adjacente gauche évite les désynchronisations accidentelles lors de tris manuels ultérieurs.
Une attention typographique rigoureuse doit être portée au formatage des décimales en fonction des paramètres régionaux de l’environnement d’exploitation. Dans les environnements francophones, la virgule (,) constitue le séparateur décimal normé, tandis que les configurations anglo-saxonnes emploient le point (.). L’insertion involontaire de nombres munis de points dans une version francophone d’Excel convertit silencieusement ces données en chaînes de texte typographiques, neutralisant purement et simplement leur intégration dans les algorithmes de calcul statistique sans nécessairement déclencher de message d’erreur explicite.
2.2 Nettoyage, typage des données et détection des anomalies de saisie
Avant de déployer les fonctions statistiques, un audit d’intégrité numérique du vecteur s’impose impérativement. Les anomalies de saisie les plus pernicieuses résident dans la présence d’espaces insécables (code ASCII 160 souvent importé d’extractions web ou de progiciels de gestion intégrée), de chaînes textuelles invisibles ou d’apostrophes d’échappement forçant le format texte. Pour attester de l’intégrité numérique d’une plage d’observations située, par exemple, dans les cellules A2:A1001, le recours combinatoire aux fonctions de diagnostic d’Excel est indispensable.
On peut implémenter dans une colonne adjacente de validation la formule suivante :
=ESTNUM(A2)
Cette assertion logique renvoie la valeur booléenne VRAI si la cellule héberge une valeur numérique exploitable et FAUX en présence d’un artefact textuel. Pour convertir de façon déterministe des représentations textuelles de nombres en valeurs réelles, l’emploi de la formule suivante est préconisé :
=CNUM(EPURAGE(SUPPRESPACE(A2)))
La fonction EPURAGE éradique les caractères non imprimables, SUPPRESPACE supprime les espacements superflus, et CNUM effectue la conversion scalaire. Concernant les données manquantes, le protocole standard d’analyse univariée requiert de laisser la cellule strictement vide (aucun espace, aucun caractère tiret - ou NA). Le moteur d’évaluation d’Excel ignore par défaut les cellules authentiquement vides lors du calcul des statistiques d’ordre, garantissant que la taille de l’échantillon effectif N soit correctement ajustée sans fausser le dénombrement des rangs.
2.3 Utilisation des tableaux structurés Excel (ListObject)
La gestion manuelle de plages absolues (comme A2:A150) représente une vulnérabilité opérationnelle majeure : toute adjonction ultérieure de nouvelles observations en aval de la plage requiert une réécriture fastidieuse de l’ensemble des formules statistiques, exposant l’analyste au risque d’omission d’observations. L’état de l’art sous Microsoft Excel consiste à encapsuler le jeu de données sous la forme d’un tableau structuré officiel (nommé objet ListObject dans le modèle d’objet Office).
La conversion s’effectue en sélectionnant le bloc de données et en utilisant le raccourci clavier Ctrl + L (ou Ctrl + T selon les versions linguistiques) ou via le ruban Insertion > Tableau. Il convient d’attribuer un nom signifiant et standardisé à cette entité via l’onglet contextuel Création de tableau, par exemple Tbl_Mesures.
L’utilisation d’un tableau structuré introduit la syntaxe de référence structurée dynamique. Si la variable d’intérêt réside dans la colonne intitulée TempsReponse, la référence formelle dans les fonctions statistiques devient :
Tbl_Mesures[TempsReponse]
Cette notation vectorielle présente des avantages décisifs :
- Elle s’auto-ajuste de façon totalement transparente lors de l’adjonction ou de la suppression de lignes au sein de la base de données.
- Elle améliore considérablement l’auditabilité et la lisibilité du modèle pour les évaluateurs tiers, en éliminant les coordonnées alphanumériques obscures au profit d’une sémantique explicite.
- Elle prévient toute corruption accidentelle de plage liée à des décalages d’adresses relatives ou absolues lors de copies inter-cellulaires.
3. Calcul du Minimum et du Maximum sous Excel
3.1 Implémentation des fonctions fondamentales MIN et MAX
Les deux bornes extrêmes du résumé à cinq nombres sont matérialisées par la plus petite et la plus grande valeur observée au sein de la distribution. Sous Microsoft Excel, les fonctions natives =MIN(plage) et =MAX(plage) évaluent respectivement les statistiques d’ordre x(1) et x(n). Leurs syntaxes canoniques s’énoncent de la manière suivante :
=MIN(A2:A500) ou, dans l’architecture structurée recommandée : =MIN(Tbl_Mesures[Valeur])
=MAX(A2:A500) ou =MAX(Tbl_Mesures[Valeur])
L’algorithme interne de ces fonctions effectue un parcours linéaire complet du vecteur à une complexité temporelle asymptotique de O(n). Il convient de souligner le comportement d’Excel face aux types de données hétérogènes : les fonctions MIN et MAX standards ignorent délibérément les cellules vides, les chaînes de texte (même celles représentant des chiffres) ainsi que les valeurs booléennes VRAI et FAUX contenues dans les plages de cellules référencées. En revanche, si ces valeurs sont directement passées sous forme d’arguments littéraux au sein de la fonction (par exemple =MIN(10; "5"; VRAI)), Excel exécutera une tentative de conversion implicite, ce qui peut fausser les évaluations. Il est donc impératif de ne référencer que des vecteurs colonnaires assainis.
3.2 Gestion des contraintes conditionnelles avec MIN.SI.CONDITIONS et MAX.SI.CONDITIONS
Dans la recherche empirique, il est fréquemment requis de décomposer le résumé à cinq nombres selon des strates d’échantillonnage spécifiques, telles que des sous-groupes démographiques, des cohortes cliniques (patients versus témoins) ou des blocs expérimentaux, sans altérer ni partitionner physiquement la table de données initiale. Depuis sa version 2019 et au sein de Microsoft 365, Excel propose les fonctions conditionnelles multivariées MIN.SI.CONDITIONS et MAX.SI.CONDITIONS.
La syntaxe de ces instructions se distingue fondamentalement de celle des fonctions traditionnelles de type SOMME.SI car la plage de calcul statistique y figure systématiquement en premier argument :
=MIN.SI.CONDITIONS(plage_min; plage_critères1; critère1; [plage_critères2; critère2]; ...)
À titre d’illustration méthodologique, supposons une structure expérimentale où la colonne A héberge le score cognitif continu, la colonne B le statut diagnostique ("Pathologique" ou "Contrôle") et la colonne C la tranche d’âge (">65"). L’extraction du minimum pour la cohorte pathologique âgée de plus de 65 ans s’effectue sans aucune formule matricielle complexe par la requête formelle :
=MIN.SI.CONDITIONS(A2:A500; B2:B500; "Pathologique"; C2:C500; ">65")
Cette approche permet de générer des tables récapitulatives conditionnelles extrêmement compactes, dynamiques et imperméables aux erreurs de manipulation humaine inhérentes aux tris et filtrages visuels successifs.
3.3 Détermination de l’étendue globale de l’échantillon
Bien que l’étendue (désignée en anglais par le terme Range) ne constitue pas formellement l’un des cinq nombres du quintuplet au sens strict de Tukey, elle en est la dérivation algébrique immédiate la plus informative quant aux frontières de l’espace métrique exploré. Elle se calcule par la soustraction scalaire directe entre le maximum absolu et le minimum absolu :
=MAX(plage) - MIN(plage)
D’un point de vue épistémologique et méthodologique, l’analyste doit impérativement garder à l’esprit la fragilité extrême de l’étendue en tant que descripteur de variabilité. Puisqu’elle repose exclusivement sur les deux statistiques d’ordre les plus périphériques de la distribution (les rangs 1 et n), son espérance mathématique croît mécaniquement avec la taille de l’échantillon n pour la plupart des lois de probabilité continues. De plus, elle présente un point de rupture statistique rigoureusement nul : une seule aberration instrumentale ou une erreur typographique démultiplie instantanément l’étendue apparente.
L’étendue conserve néanmoins un rôle capital en assurance qualité statistique : elle permet de vérifier immédiatement si l’ensemble des données recueillies demeure confiné à l’intérieur des limites théoriques ou physiologiques attendues d’une échelle psychométrique bornée (par exemple, un instrument standardisé borné entre 0 et 100).
4. Calcul de la Médiane : Le pivot central de la distribution
4.1 Fondements mathématiques et comportement de la fonction MEDIANE
La médiane (notée Q2) représente le cinquantième centile (P50) d’une série univariée. Par définition, elle constitue la valeur scalaire séparant l’échantillon ordonné en deux sous-ensembles de cardinalités rigoureusement égales, de telle sorte qu’au moins 50 % des observations lui soient inférieures ou égales et qu’au moins 50 % des observations lui soient supérieures ou égales. Soit un échantillon ordonné de taille n noté x(1) ≤ x(2) ≤ … ≤ x(n) :
- Si la taille de l’échantillon n est impaire, la médiane est formellement identifiée par l’observation unique occupant le rang central exact :
Q2 = x((n+1)/2) - Si la taille n est paire, il n’existe pas d’élément central unique ; la médiane correspond conventionnellement à la moyenne arithmétique des deux observations centrales occupant les rangs n/2 et (n/2) + 1 :
Q2 = (x(n/2) + x((n/2)+1)) / 2
L’implémentation native sous Excel s’exécute au moyen de la formule :
=MEDIANE(A2:A500) ou =MEDIANE(Tbl_Mesures[Valeur])
Le moteur algorithmique d’Excel effectue cette opération de partitionnement de manière totalement transparente sur des données brutes non préalablement triées. Il gère avec une précision numérique conforme à la norme IEEE 754 à virgule flottante le basculement automatique entre les cas de parité ou d’imparité de l’échantillon.
4.2 Robustesse statistique face aux distributions asymétriques
L’avantage cardinal de la médiane sur la moyenne arithmétique réside dans son insensibilité quasi totale aux valeurs discordantes situées dans les queues de distribution. Considérons une série de temps de latence cognitive (en millisecondes) observés chez 7 individus : {210, 215, 220, 222, 228, 235, 1850}. La dernière observation (1850 ms) résulte manifestement d’un épisode d’inattention du sujet expérimental :
- La moyenne arithmétique de cet échantillon s’établit à 454,28 ms, valeur totalement déconnectée de la réalité opératoire des six autres sujets et ne représentant en rien le comportement modal de l’échantillon.
- La médiane, calculée via
=MEDIANE(...), s’élève rigoureusement à 222 ms, reflétant avec une fidélité clinique parfaite la vitesse de traitement effective de l’échantillon.
La confrontation simultanée de la médiane et de la moyenne arithmétique (fournie par =MOYENNE(...)) constitue l’un des diagnostics exploratoires les plus élégants en statistique univariée :
- Lorsque Moyenne ≈ Médiane, la distribution peut être considérée comme symétrique autour de son centre de gravité.
- Lorsque Moyenne > Médiane, la distribution présente un étalement asymétrique vers les valeurs positives (asymétrie droite).
- Lorsque Moyenne < Médiane, la distribution est tirée vers les valeurs négatives (asymétrie gauche).
4.3 Distinction technique entre MEDIANE et les percentiles équivalents
Au sein du langage de formules de Microsoft Excel, la médiane peut être mathématiquement formulée de plusieurs manières redondantes. En particulier, elle coïncide conceptuellement avec le quantile d’ordre 0,5 ou le deuxième quartile :
=PERCENTILE.INCLURE(A2:A500; 0,5)
=PERCENTILE.EXCLURE(A2:A500; 0,5)
=QUARTILE.INCLURE(A2:A500; 2)
=QUARTILE.EXCLURE(A2:A500; 2)
Sur le plan purement mathématique, pour tout échantillon où n ≥ 2, ces quatre formulations produisent un résultat numérique strictement identique à celui délivré par =MEDIANE(A2:A500). Cependant, en termes d’architecture de feuille de calcul, de lisibilité et de conformité aux bonnes pratiques logicielles, l’emploi exclusif de la fonction MEDIANE est vivement recommandé. Non seulement sa dénomination explicite supprime toute ambiguïté intellectuelle pour le relecteur ou l’auditeur statistique du classeur, mais son empreinte d’exécution computationnelle est marginalement optimisée par rapport aux fonctions d’interpolation de percentiles plus génériques.
5. Calcul des premier et troisième quartiles : Analyse comparative des fonctions QUARTILE
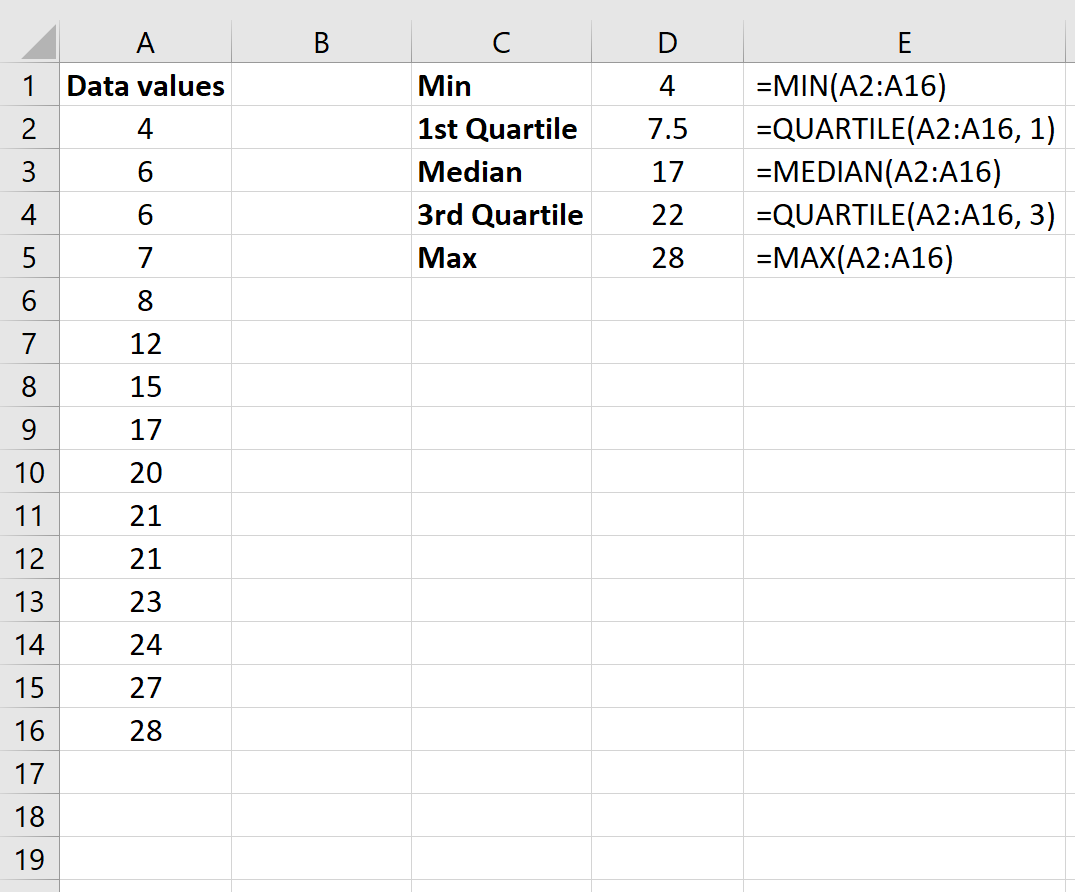
5.1 Distinction fondamentale entre QUARTILE.INCLURE et QUARTILE.EXCLURE
L’une des sources de confusion les plus chroniques dans l’utilisation de Microsoft Excel pour l’analyse de données scientifiques réside dans l’existence concomitante de deux fonctions de calcul de quartiles distinctes introduites à partir d’Excel 2010 : QUARTILE.INCLURE (disponible également sous la forme abrégée QUARTILE.INC, et correspondant à l’ancienne fonction patrimoniale QUARTILE) et QUARTILE.EXCLURE (syntaxiquement abrégée en QUARTILE.EXC).
Ces deux fonctions ne sont en aucune manière de simples variations cosmétiques ou stylistiques ; elles reposent sur des philosophies mathématiques divergentes quant à l’attribution des probabilités cumulées aux rangs extrêmes d’une distribution finie :
- La fonction
QUARTILE.INCLUREprend pour prémisse que l’intervalle des percentiles calculables s’étend de façon inclusive de 0 à 1 (soit de 0 % à 100 %). Dès lors, l’argument du quartile k accepte les entiers compris entre 0 et 4, où k=0 restitue le minimum absolu et k=4 le maximum absolu. - La fonction
QUARTILE.EXCLUREpostule au contraire que l’échantillon observé n’est qu’un sous-ensemble strict d’une population sous-jacente infinie, et qu’il est par conséquent statistiquement impossible que le minimum ou le maximum échantillonnal correspondent exactement aux centiles absolus 0 et 1 de la population parente. Par conséquent, son domaine de définition pour l’argument k est strictement restreint aux entiers 1, 2 et 3. Passer k=0 ou k=4 àQUARTILE.EXCengendre immédiatement l’erreur d’exécution#NOMBRE!.
5.2 Algorithmes d’interpolation sous-jacents (Tukey vs Weibull)
La divergence entre ces deux fonctions découle du calcul du rang théorique (souvent non entier) associé au quantile recherché au sein du vecteur ordonné d’observations réelles x(1), x(2), …, x(n) de taille n :
Pour la fonction QUARTILE.INCLURE, la détermination du rang interpolé R pour le k-ième quartile s’exécute selon la formule :
RINC = 1 + (k / 4) * (n – 1)
Cette approche correspond exactement à la méthode préconisée par l’algorithme dit C=1 (ou Type 7 dans la typologie classique établie par Hyndman et Fan en 1996). Si R n’est pas un nombre entier, Excel sépare le rang en sa partie entière tronquée i = ⌊R⌋ et sa fraction décimale f = R – i. La valeur du quartile est alors obtenue par l’interpolation linéaire classique :
Qk = x(i) + f * (x(i+1) – x(i))
Pour la fonction QUARTILE.EXCLURE, la formule du rang théorique s’aligne rigoureusement sur les travaux d’ingénierie probabiliste de Waloddi Weibull et l’algorithme Type 6 de Hyndman et Fan :
REXC = (k / 4) * (n + 1)
L’interpolation s’opère de manière analogue entre les observations encadrant le rang fractionnaire obtenu. Notons une conséquence critique : si pour une taille d’échantillon très modeste, le rang théorique REXC s’avère strictement inférieur à 1 ou strictement supérieur à n, la fonction échoue et produit l’erreur #NOMBRE!. Concrètement, QUARTILE.EXCLURE requiert un échantillon minimal de n ≥ 4 pour évaluer le premier quartile, alors que QUARTILE.INCLURE opère dès n ≥ 2.
5.3 Critères de sélection méthodologique pour la recherche
Le choix de l’algorithme de calcul des quartiles ne doit jamais résulter du hasard ou de réglages logiciels par défaut, car sur des échantillons de petite à moyenne taille (typiquement n < 30), les écarts numériques entre QUARTILE.INC et QUARTILE.EXC s’avèrent substantiels et peuvent altérer la significativité clinique ou exploratoire des résultats.
Considérons le tableau comparatif ci-dessous pour appréhender les correspondances logicielles et les propriétés statistiques fondamentales de chaque variante computationnelle :
| Caractéristique méthodologique | QUARTILE.INCLURE / QUARTILE.INC | QUARTILE.EXCLURE / QUARTILE.EXC |
|---|---|---|
| Formule de rang (Hyndman & Fan) | Type 7 : R = 1 + p*(n – 1) | Type 6 : R = p*(n + 1) |
| Alignement logiciel par défaut | R (type=7), Python (numpy.percentile linéaire), SPSS (option par défaut) |
Minitab, Python (statistics.quantiles méthode ‘exclusive’) |
| Taille d’échantillon minimale | N ≥ 2 | N ≥ 4 (pour Q1) et N ≥ 3 (pour Q2) |
| Biais de dispersion sur petit N | Tend à sous-estimer légèrement l’écart interquartile de la population parente. | Estimateur asymptotiquement non biaisé des quantiles pour des distributions continues. |
| Recommandation d’usage scientifique | Privilégié pour la standardisation avec les bibliothèques d’analyse de données dominantes (R/Python). | Privilégié en modélisation de fiabilité et d’ingénierie où les probabilités extrêmes sont modélisées via Weibull. |
Dans la grande majorité des recherches universitaires et cliniques, il est impératif d’utiliser de façon prioritaire QUARTILE.INCLURE (ou QUARTILE.INC) pour garantir une parfaite reproductibilité croisée avec les sorties standards de langages tels que R ou Python Pandas, tout en documentant systématiquement ce choix algorithmique dans la section méthodologique des manuscrits rédigés.
6. Construction étape par étape de la table du résumé à cinq nombres dans Excel
6.1 Disposition structurelle des cellules et des étiquettes descriptives
Pour garantir la clarté, l’ergonomie et la pérennité d’un tableau de bord statistique ou d’un classeur de recherche, il est vivement déconseillé d’entremêler les colonnes de données brutes et les blocs d’analyse descriptive. Une ségrégation spatiale stricte s’impose :
- Consacrez la première feuille de calcul (nommée par exemple
Donnees_Brutes) à l’hébergement exclusif des tableaux structurés de données brutes. - Déployez une seconde feuille (nommée
Resume_Statistique) pour implémenter la table d’analyse synthétique.
La disposition canonique du résumé à cinq nombres s’articule autour d’un agencement vertical rigoureux de six lignes consécutives. Les étiquettes descriptives doivent être saisies de manière standardisée et sans ambiguïté :
- Cellule
B2:Minimum (x_(1)) - Cellule
B3:Premier Quartile (Q1) - Cellule
B4:Médiane (Q2 / P50) - Cellule
B5:Troisième Quartile (Q3) - Cellule
B6:Maximum (x_(n)) - Cellule
B7: Étendue totale (Indicateur complémentaire)
Appliquez un style visuel distinct (par exemple des bordures fines, un fond grisé neutre et une typographie en gras) pour différencier ces métadonnées textuelles des cellules adjacentes (colonne C) qui contiendront les formules computationnelles dynamiques.
6.2 Rédaction des formules dynamiques avec adressage absolu
L’intégrité des calculs statistiques repose sur la maîtrise de l’adressage au sein du moteur d’évaluation d’Excel. Si l’on choisit de travailler sur des plages classiques non encapsulées dans des tables structurées (par exemple, des données situées sur la feuille Donnees_Brutes dans la plage A2:A101), il est impératif d’adopter l’adressage absolu au moyen de l’opérateur dollar ($) pour figer les coordonnées de ligne et de colonne.
Dans la colonne adjacente C de notre table récapitulative, les formules canoniques s’écrivent donc avec la plus grande rigueur syntaxique :
- En
C2(Minimum) :=MIN(Donnees_Brutes!$A$2:$A$101) - En
C3(Premier Quartile) :=QUARTILE.INC(Donnees_Brutes!$A$2:$A$101; 1) - En
C4(Médiane) :=MEDIANE(Donnees_Brutes!$A$2:$A$101) - En
C5(Troisième Quartile) :=QUARTILE.INC(Donnees_Brutes!$A$2:$A$101; 3) - En
C6(Maximum) :=MAX(Donnees_Brutes!$A$2:$A$101) - En
C7(Étendue) :=C6 - C2
Si la démarche hautement recommandée du tableau structuré a été adoptée (le tableau se nommant par exemple Tbl_Echantillon et la variable quantitative Mesure), les formules gagnent immédiatement en élégance, en lisibilité et en résilience algorithmique :
- En
C2:=MIN(Tbl_Echantillon[Mesure]) - En
C3:=QUARTILE.INC(Tbl_Echantillon[Mesure]; 1) - En
C4:=MEDIANE(Tbl_Echantillon[Mesure]) - En
C5:=QUARTILE.INC(Tbl_Echantillon[Mesure]; 3) - En
C6:=MAX(Tbl_Echantillon[Mesure])
6.3 Auditeur de formules et sécurisation contre les erreurs de calcul
L’exploitation de feuilles de calcul dans des contextes professionnels ou scientifiques exige une résilience absolue face aux exceptions algorithmiques. Les erreurs les plus susceptibles d’interrompre l’évaluation du résumé à cinq nombres incluent :
#VALEUR!: Déclenché par la présence de types incompatibles non numériques au sein d’arguments directs ou de dépendances vectorielles corrompues.#NOMBRE!: Survient typiquement lors de l’utilisation deQUARTILE.EXCsur un échantillon de taille insuffisante (n < 4) ou avec un paramètre de quartile hors limites.#DIV/0!: Peut se manifester indirectement lors de calculs dérivés de dispersion relative si l’échantillon ne contient aucune variance ou si les plages sont totalement vierges.
Pour immuniser les tableaux de restitution destinés à la direction ou aux comités de relecture, il est d’usage d’encapsuler les formules dans la fonction défensive SIERREUR :
=SIERREUR(QUARTILE.INC(Tbl_Echantillon[Mesure]; 1); "Données insuffisantes")
En outre, l’analyste doit mobiliser les outils graphiques du ruban Formules > Audit de formules. L’activation des options Repérer les antécédents et Repérer les dépendants projette des flèches directionnelles sur la grille matricielle. Cette visualisation immédiate permet de vérifier formellement qu’aucune cellule périphérique n’a été omise dans les plages absolues et qu’aucune référence circulaire n’altère la chaîne de calcul séquentielle.
7. Dérivation de l’écart interquartile et identification des valeurs aberrantes
7.1 Formulation algébrique de l’écart interquartile (EIQ)
L’écart interquartile (désigné communément par le sigle EIQ en français ou IQR pour Interquartile Range) constitue le descripteur non paramétrique fondamental de la dispersion centrale d’une distribution. Il correspond algébriquement à la largeur géométrique de l’intervalle hébergeant les 50 % centraux des observations de l’échantillon ordonné, neutralisant de fait les 25 % les plus faibles et les 25 % les plus élevés :
EIQ = Q3 – Q1
Au sein de la feuille Excel structurée précédemment, si la cellule C5 héberge la valeur du troisième quartile et la cellule C3 celle du premier quartile, la formule d’implémentation directe s’énonce simplement :
=C5 - C3
À l’instar de la médiane, l’EIQ bénéficie d’un point de rupture élevé (25 %), ce qui en fait l’alternative robuste directe à la variance et à l’écart-type. Alors que l’écart-type explose littéralement dès l’apparition d’une dérive instrumentale sur quelques observations marginales, l’écart interquartile demeure imperturbable, décrivant avec fidélité la variabilité intrinsèque du cœur de la distribution.
7.2 Implémentation des critères de clôture de Tukey
L’une des contributions méthodologiques les plus célèbres de John Tukey à l’analyse exploratoire réside dans sa méthode formalisée d’identification des observations discordantes (ou outliers), affranchie de tout prérequis de normalité. Tukey a postulé la construction de frontières imaginaires autour de la boîte centrale interquartile, baptisées « clôtures » (fences).
Les clôtures intérieures (inner fences) permettent d’identifier les valeurs aberrantes modérées (mild outliers) :
- Clôture intérieure inférieure : Borne_Inf = Q1 – (1,5 * EIQ)
- Clôture intérieure supérieure : Borne_Sup = Q3 + (1,5 * EIQ)
Les clôtures extérieures (outer fences) isolent les valeurs aberrantes extrêmes ou sévères (extreme outliers) :
- Clôture extérieure inférieure : Q1 – (3,0 * EIQ)
- Clôture extérieure supérieure : Q3 + (3,0 * EIQ)
Dans la feuille de calcul Excel, en réservant les cellules C8 et C9 aux clôtures intérieures, on saisira :
En C8 : =C3 - (1,5 * (C5 - C3))
En C9 : =C5 + (1,5 * (C5 - C3))
Toute observation se situant en dehors de l’intervalle semi-fermé [C8 ; C9] est formellement catégorisée comme une anomalie distributionnelle requérant une investigation approfondie.
7.3 Automatisation de l’étiquetage des anomalies par formules logiques
Afin d’intégrer le diagnostic de détection directement au sein de la base de données source, il est hautement pertinent d’ajouter une colonne calculée au tableau structuré originel, par exemple intitulée Diagnostic_Anomalie. Cette colonne exploitera une imbrication de fonctions logiques SI, ET et OU pour étiqueter automatiquement chaque ligne d’observation.
Considérant que la cellule Resume_Statistique!$C$8 correspond à la clôture inférieure et Resume_Statistique!$C$9 à la clôture supérieure, la formule de diagnostic conditionnel s’écrit :
=SI(OU([@Mesure] < Resume_Statistique!$C$8; [@Mesure] > Resume_Statistique!$C$9); "Aberrante"; "Normale")
Pour raffiner l’analyse et ségréger les anomalies modérées des anomalies sévères, on peut déployer une structure conditionnelle hiérarchisée :
=SI(OU([@Mesure] < (Resume_Statistique!$C$3 - 3*Resume_Statistique!$C$7); [@Mesure] > (Resume_Statistique!$C$5 + 3*Resume_Statistique!$C$7)); "Aberrante Sévère"; SI(OU([@Mesure] < Resume_Statistique!$C$8; [@Mesure] > Resume_Statistique!$C$9); "Aberrante Modérée"; "Conforme"))
Cette classification dynamique peut être couplée aux fonctionnalités de Mise en forme conditionnelle d’Excel (accessible via Accueil > Mise en forme conditionnelle > Nouvelle règle). En configurant un remplissage rouge pastel pour le texte "Aberrante", l’analyste bénéficie d’une alerte visuelle instantanée dès la saisie de données erronées ou atypiques.
8. Visualisation graphique : Création et personnalisation d’une boîte à moustaches
8.1 Insertion native du graphique Boîte à moustaches sous Excel
L’incarnation visuelle par excellence du résumé à cinq nombres est le diagramme en boîte à moustaches (communément désigné sous l’anglicisme boxplot), conceptualisé par John Tukey en complémentarité étroite avec ses travaux sur les quantiles. Historiquement fastidieux à élaborer sous les versions antérieures d’Excel (nécessitant des subterfuges à base de graphiques boursiers ou de barres d’erreur personnalisées), le tracé d’une boîte à moustaches est devenu une fonctionnalité statistique native à partir d’Excel 2016.
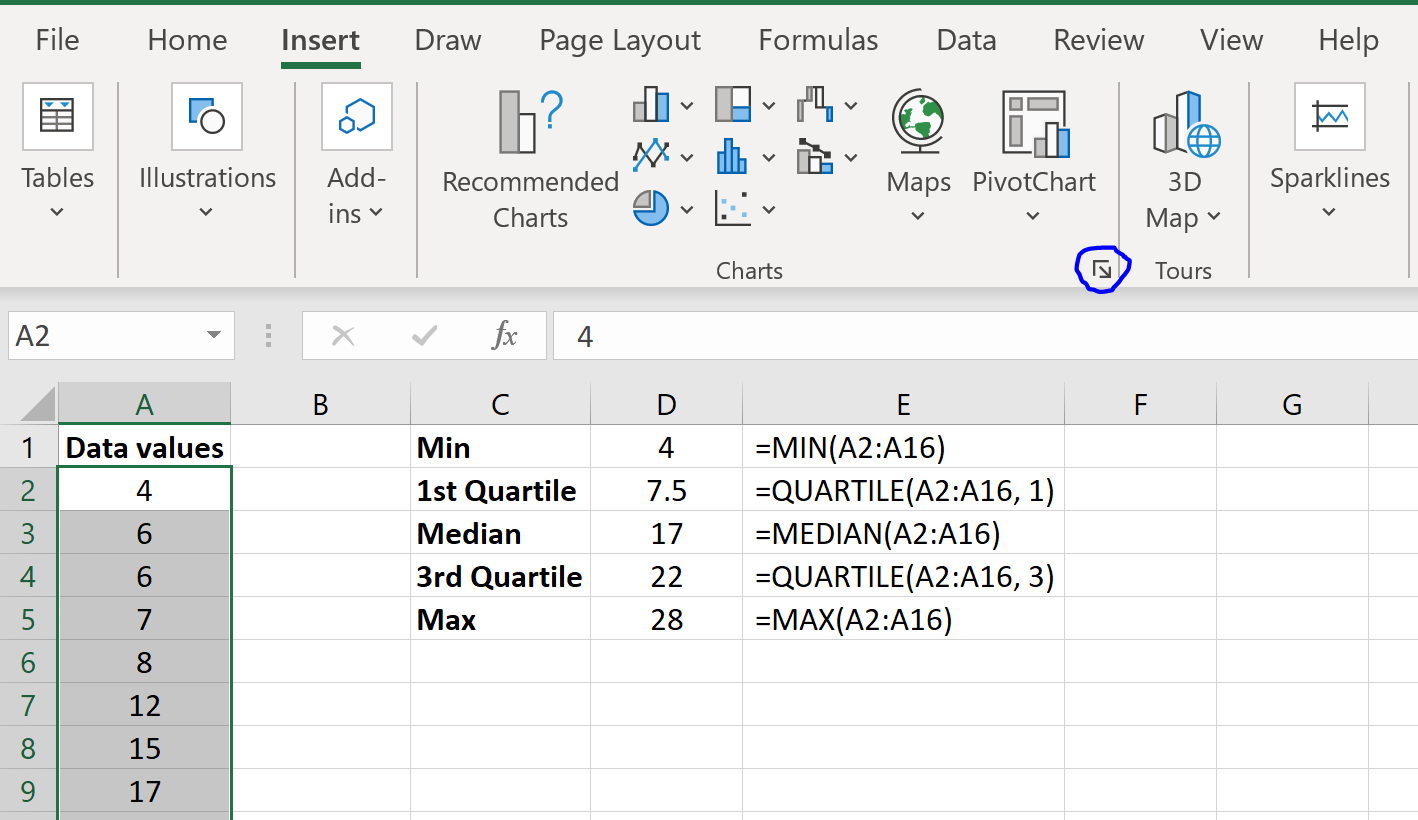
Pour insérer ce graphique de manière standardisée :
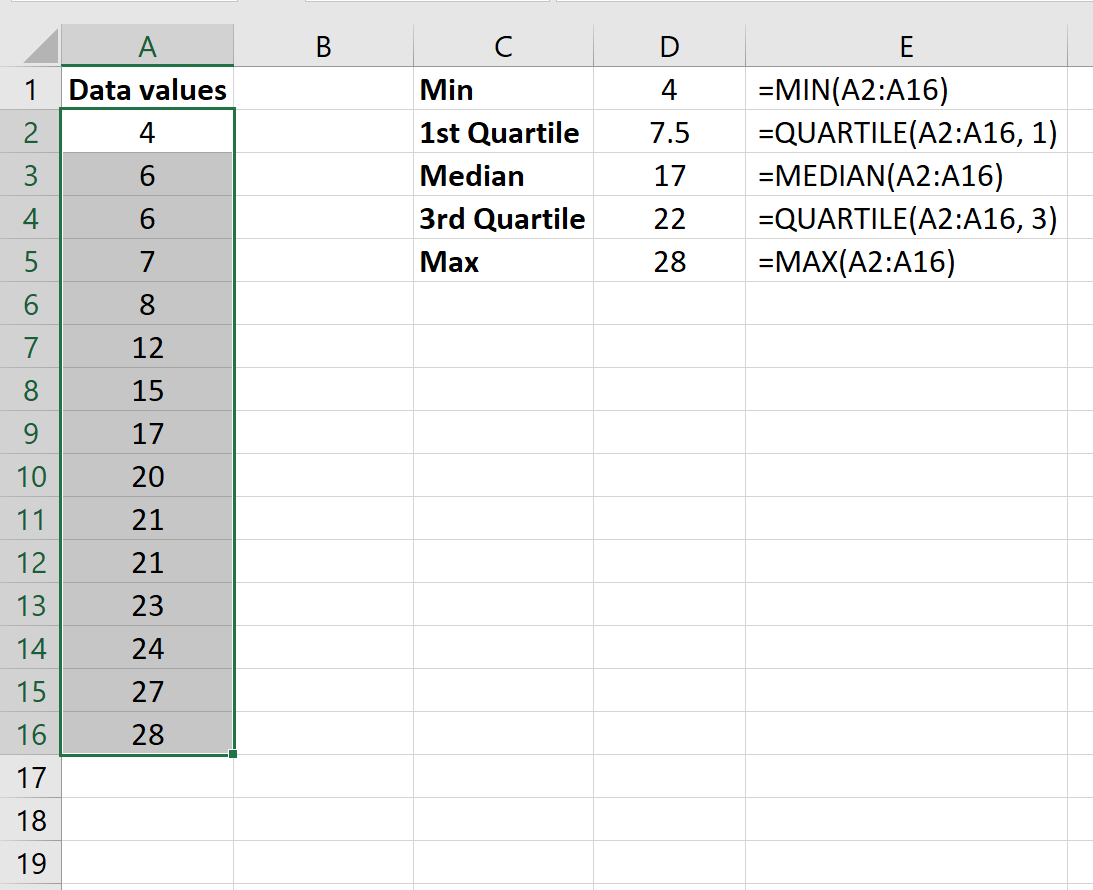
- Sélectionnez l’intégralité du vecteur de données numériques au sein de votre tableau structuré (par exemple la colonne
Tbl_Echantillon[Mesure]). Si vous désirez comparer plusieurs cohortes, sélectionnez simultanément la colonne de regroupement catégorielle et la colonne de mesures continues. - Accédez au ruban supérieur d’Excel et cliquez sur l’onglet Insertion.
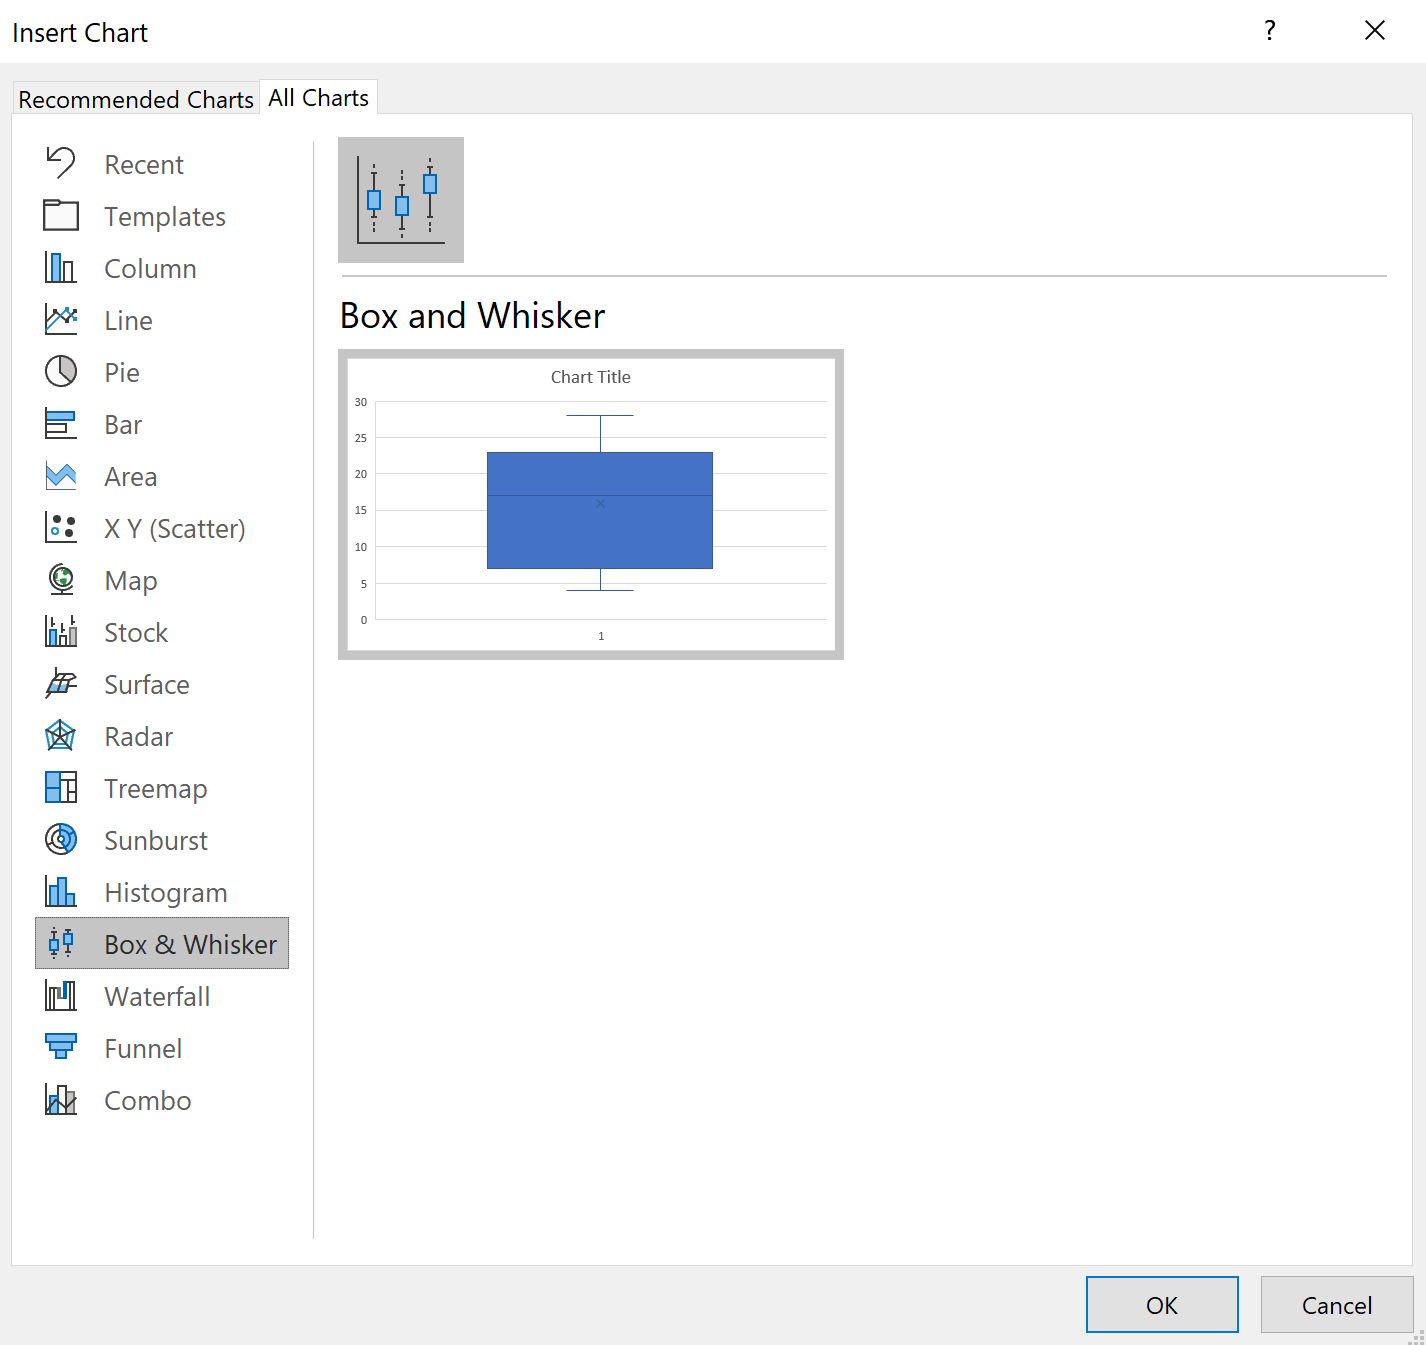
- Dans le groupe thématique Graphiques, cliquez sur le pictogramme Insérer un graphique statistique, puis sélectionnez formellement l’option Boîte et moustaches.
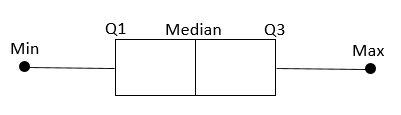
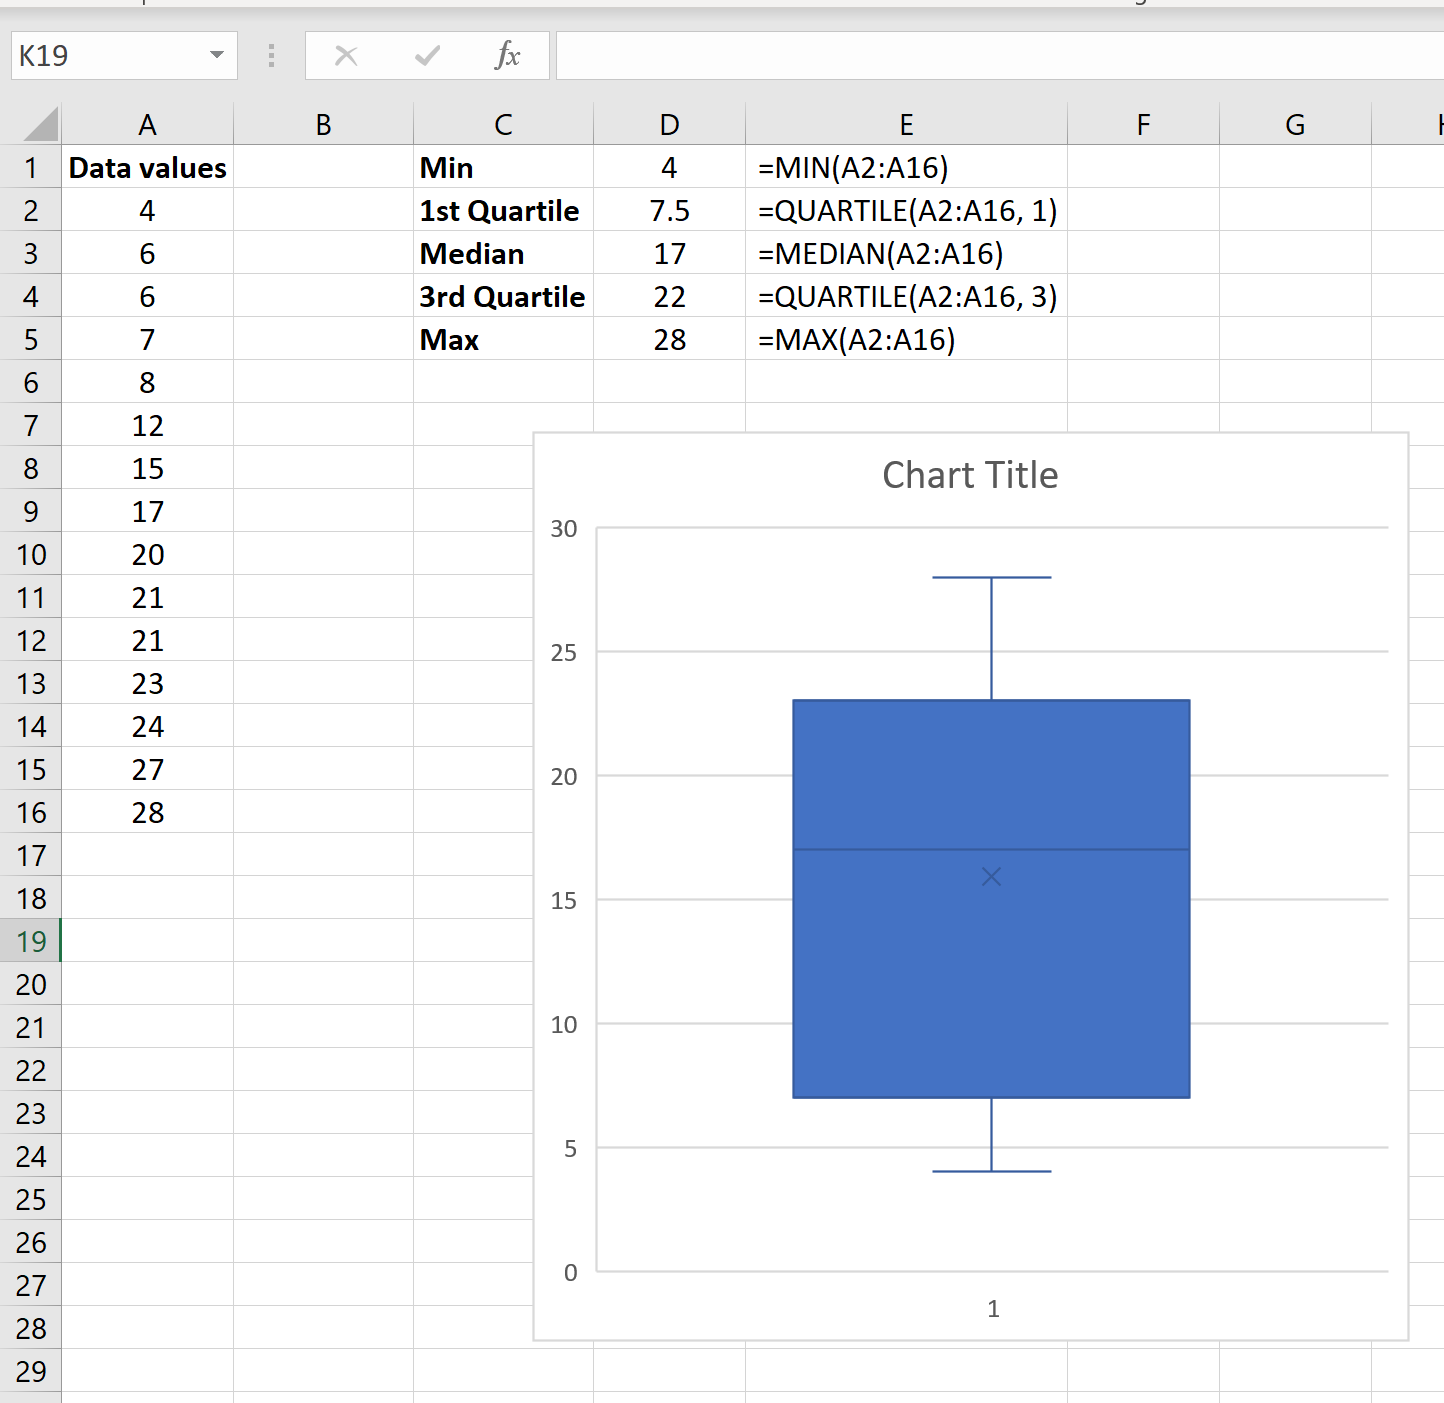
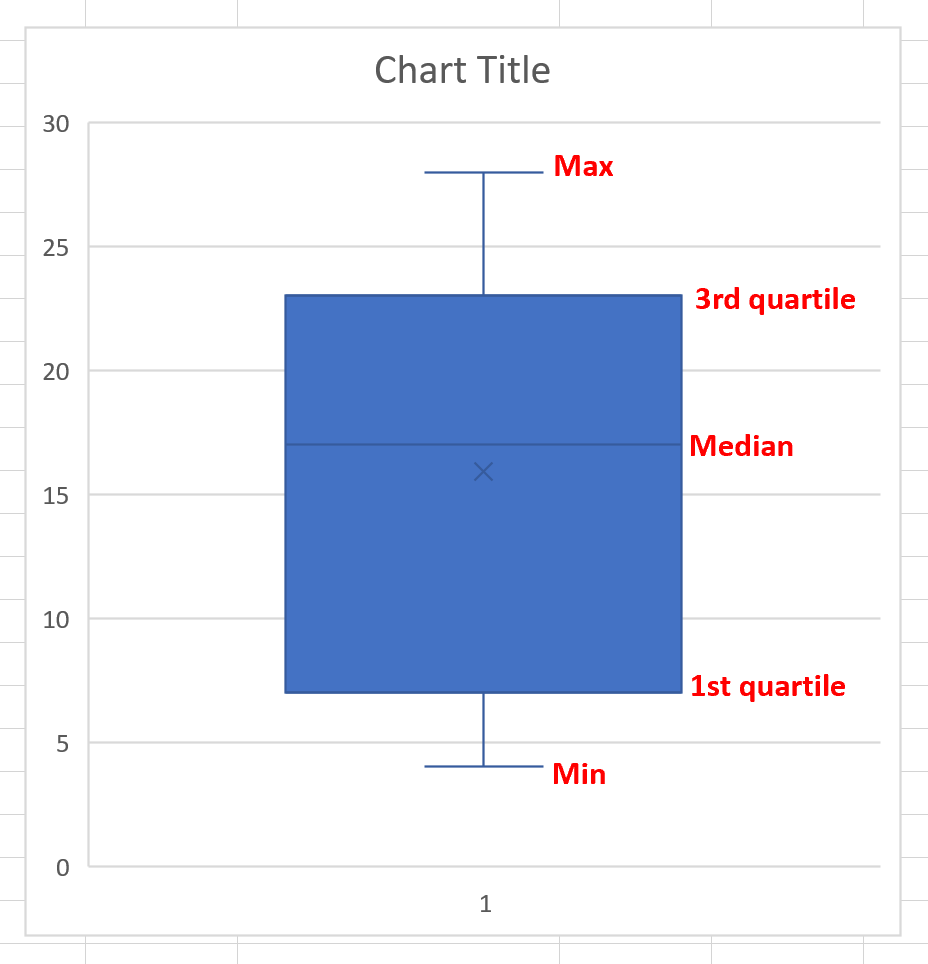
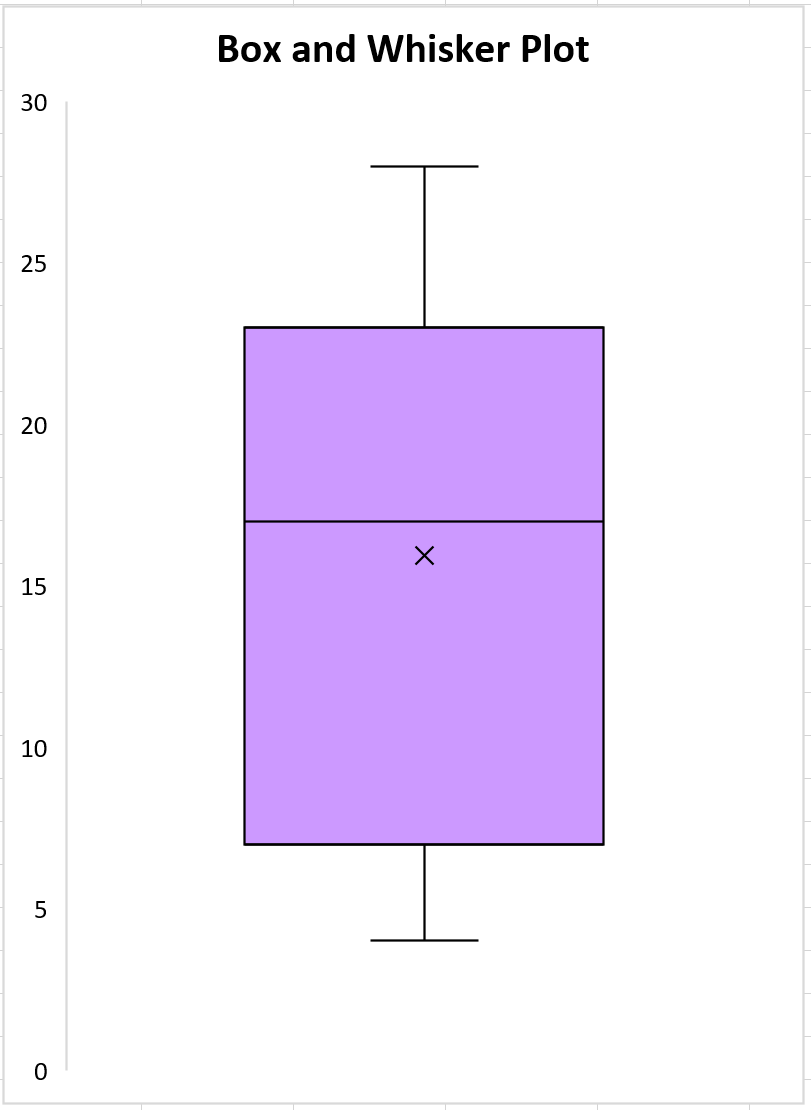
Le moteur de rendu graphique d’Excel génère instantanément la figure en calculant de manière autonome les cinq composantes numériques sous-jacentes, projetant une boîte centrale dont les arêtes horizontales correspondent aux quartiles Q1 et Q3, traversée par la ligne de la médiane Q2, et flanquée d’extensions filaires (les « moustaches ») bornées par les valeurs extrêmes non aberrantes.
8.2 Configuration fine des séries et options de traçage
Une fois l’objet graphique incorporé, l’analyste rigoureux doit en paramétrer méticuleusement les propriétés computationnelles pour garantir la conformité scientifique du rendu. Un double-clic gauche sur les boîtes tracées déploie le volet latéral contextuel intitulé Mettre en forme la série de données. Sous l’onglet symbolisé par un histogramme (Options des séries), plusieurs paramètres critiques doivent être ajustés :
- Afficher les points internes : Lorsque cette case est cochée, Excel superpose l’ensemble des observations réelles sous la forme d’un nuage de points dispersé le long de l’axe vertical de la boîte (technique apparentée au jittering). Cette option est vivement recommandée pour les cohortes à effectifs modérés (n < 50), car elle révèle des sous-structures bimodales invisibles sur une boîte standard. Pour les volumétries massives, décochez cette option pour éviter l’engorgement visuel.
- Afficher les points de valeur aberrante : Cette option doit demeurer impérativement activée. Elle ordonne à Excel d’appliquer l’algorithme des clôtures de Tukey à 1,5 × EIQ : les moustaches cessent de s’étendre jusqu’au minimum et maximum absolus dès lors que des valeurs dépassent les clôtures, ces dernières étant projetées sous forme de points individualisés au-delà des segments de moustaches.
- Afficher les marqueurs de moyenne : Excel insère par défaut une petite croix (
×) localisant la moyenne arithmétique. Si votre protocole se consacre strictement à l’analyse non paramétrique, il est méthodologiquement judicieux de désactiver cette case pour focaliser l’attention sur la seule médiane. - Ligne moyenne : Trace un trait reliant les moyennes arithmétiques des différentes séries en cas de comparaisons multigroupes.
- Calcul de quartile : Ce paramètre est le plus déterminant. Excel propose deux boutons radio : Inclusivement la médiane (qui applique l’algorithme
QUARTILE.INC) ou Exclusivement la médiane (qui mobiliseQUARTILE.EXC). Il est crucial de veiller à ce que ce réglage coïncide rigoureusement avec la fonction mathématique retenue dans vos tables analytiques formulées manuellement.
8.3 Mise en forme esthétique et conformité aux standards académiques
Pour satisfaire aux exigences typographiques et visuelles des revues scientifiques de premier plan (telles que les publications affiliées à l’American Psychological Association ou Elsevier), l’esthétique par défaut d’Excel doit être épurée de ses artifices cosmétiques superflus :
- Supprimez le quadrillage horizontal majeur et mineur en sélectionnant les lignes de grille et en appuyant sur
Suppr. Les fonds d’écran neutres blancs sans lignes parasites augmentent le contraste des éléments géométriques de la boîte. - Ajustez la couleur de remplissage des boîtes : privilégiez des nuances de gris subtiles ou des palettes adaptées aux déficiences visuelles (par exemple la palette Viridis). Appliquez une bordure de contour continue noire d’une épaisseur standard de 1 point (
1 pt) pour délimiter nettement les arêtes des quartiles. - Configurez l’axe vertical des ordonnées : effectuez un clic droit sur l’axe des valeurs, sélectionnez Format de l’axe, et ajustez manuellement les bornes Minimum et Maximum pour éviter le gaspillage d’espace vertical tout en conservant les proportions distributionnelles. Intégrez impérativement un titre d’axe explicite mentionnant la variable et son unité métrique normalisée (ex. : « Temps de réaction (ms) »).
- Pour exporter l’élément dans un manuscrit scientifique, ne procédez jamais par simple capture d’écran matricielle. Copiez l’objet graphique et effectuez un Collage spécial en tant que métafichier amélioré (EMF) ou exportez directement la feuille au format vectoriel
PDFhaute définition afin de garantir une netteté absolue à l’impression typographique.
9. Approches alternatives : Utilisation de l’Utilitaire d’analyse et fonctions matricielles
9.1 Déploiement de l’Utilitaire d’analyse statistique
Microsoft Excel intègre depuis ses premières versions professionnelles un complément statistique historique nommé Utilitaire d’analyse (ou Analysis ToolPak). Bien que largement éclipsé par les fonctions modernes, il constitue une méthode rapide pour extraire un profil univarié complet sans rédiger de formules individuelles.
L’activation de ce complément s’effectue via le menu Fichier > Options > Compléments. Dans le menu déroulant Gérer situé au bas de la fenêtre, sélectionnez Compléments Excel, cliquez sur Atteindre, cochez formellement la case Utilitaire d’analyse, puis validez par OK. Un nouveau bouton intitulé Utilitaire d’analyse apparaît alors dans l’onglet Données, groupe Analyse.
En sélectionnant l’outil Statistiques descriptives, l’utilisateur spécifie sa plage d’entrée, sélectionne le groupement par colonnes, coche impérativement Une colonne pour les étiquettes et valide la génération d’un Rapport statistique. La matrice d’extrants générée restitue instantanément la moyenne, l’erreur type, la médiane, le mode, l’écart-type, la variance, l’asymétrie, le kurtosis, l’étendue, le minimum et le maximum.
Néanmoins, cet outil présente deux limites méthodologiques rédhibitoires pour l’analyste rigoureux :
- Il omet totalement les premier et troisième quartiles au sein de son tableau standard, rendant la composition du résumé à cinq nombres incomplète sans manipulation complémentaire.
- Les résultats générés sont purement statiques. Contrairement aux formules dynamiques, aucune valeur ne s’actualise en cas de modification, de correction ou d’enrichissement de la base de données source, ce qui contrevient aux principes fondamentaux de la recherche reproductible.
9.2 Exploitation des formules matricielles dynamiques modernes (Microsoft 365)
L’introduction du moteur de calcul matriciel dynamique au sein des versions contemporaines d’Excel (Microsoft 365 et Excel 2021) a révolutionné la modélisation statistique en permettant à une formule unique saisie dans une seule cellule de se propager (« déverser » ou spill) sur plusieurs cellules contiguës sans manipulation matricielle complexe de type Ctrl + Maj + Entrée.
Il est désormais possible de générer l’intégralité du résumé à cinq nombres à l’aide d’une formule matricielle vectorielle unique combinant la fonction CHOISIR ou des fonctions d’assemblage comme VSTACK (ou ASSEMB.V en version française). Par exemple, la formule élégante suivante :
=ASSEMB.V(MIN(A2:A100); QUARTILE.INC(A2:A100; 1); MEDIANE(A2:A100); QUARTILE.INC(A2:A100; 3); MAX(A2:A100))
renvoie d’un bloc le quintuplet statistique vertical complet dans une plage déversée dynamique.
De surcroît, les nouvelles fonctionnalités d’abstraction fonctionnelle telles que LAMBDA associées à REDUCE ou BYCOL permettent de concevoir des fonctions personnalisées sans programmation VBA complexe. On peut définir dans le Gestionnaire de noms une fonction réutilisable baptisée RESUME5(vecteur) dont la définition interne s’articule comme suit :
=LAMBDA(v; ASSEMB.V(MIN(v); QUARTILE.INC(v; 1); MEDIANE(v); QUARTILE.INC(v; 3); MAX(v)))
L’appel de =RESUME5(Tbl_Echantillon[Mesure]) dans n’importe quelle cellule du classeur restitue immédiatement la totalité du quintuplet ordonné, simplifiant drastiquement l’architecture analytique des feuilles de calcul.
9.3 Arbitrage entre modèles dynamiques par formules et outils statiques
Le choix de l’infrastructure logicielle au sein d’un laboratoire ou d’une direction technique doit procéder d’une analyse d’arbitrage rigoureuse entre réactivité computationnelle, traçabilité et coûts de maintenance :
- Modèles dynamiques par formules natives : Ils garantissent une réactivité absolue face à l’enrichissement continu des données (essais cliniques en cours, recueil longitudinal). Ils assurent l’auditabilité algorithmique directe via l’explorateur de dépendances d’Excel. Cependant, appliqués à des bases massives excédant plusieurs centaines de milliers d’enregistrements, les formules volatiles ou les interpolations de quantiles réévaluées en permanence peuvent induire des latences de recalcul processeur notables.
- Rapports statiques (Utilitaire d’analyse) : Ils offrent un cliché figé à un instant t, éliminant tout risque de réévaluation involontaire des données historiques lors de l’ouverture du classeur sur des versions logicielles disparates. En revanche, ils interdisent toute automatisation industrielle et constituent un vecteur prééminent d’erreurs humaines par désynchronisation entre les données révisées et le rapport non actualisé.
En conséquence, l’ingénierie statistique moderne préconise sans réserve l’emploi des modèles dynamiques basés sur les formules natives et les tableaux structurés, réservant les instantanés statiques à l’archivage contractuel définitif sous format non modifiable (PDF ou tableurs verrouillés).
10. Automatisation du traitement par lots via Power Query et macros VBA
10.1 Agrégation du résumé à cinq nombres dans Power Query
Lorsque le volume des données outrepasse les capacités de fluidité de la feuille de calcul ou que les données proviennent d’extractions périodiques hétérogènes (fichiers CSV délimités, bases SQL distantes), le moteur d’intégration et de transformation ETL Power Query (intégré nativement à Excel) constitue la solution de traitement par excellence.
Au sein de l’éditeur Power Query, l’agrégation statistique s’effectue via l’opération Regrouper par (disponible sous l’onglet Accueil ou Transformer). Si l’interface graphique propose nativement le calcul du minimum, du maximum et de la médiane sous forme d’opérations d’agrégation colonnaires directes, elle ne propose pas de commande graphique directe pour les quartiles. Il convient dès lors d’introduire des étapes formulées dans le langage fonctionnel sous-jacent de Power Query, le langage M.
Pour calculer les quartiles dans une table tampon SourceTable regroupée par cohorte, on utilise la fonction native non documentée mais robuste List.Percentile au sein d’une colonne personnalisée :
List.Percentile(Table.Column([DonneesGroupees], "Mesure"), 0.25)
List.Percentile(Table.Column([DonneesGroupees], "Mesure"), 0.75)
Le script M consolidé exécute l’extraction des cinq nombres en un flux de traitement unique, déterministe et totalement reproductible : un simple clic sur le bouton Actualiser tout de la feuille de calcul relance l’ensemble de la séquence d’extraction, de nettoyage, de partitionnement et d’évaluation statistique sans aucune intervention humaine.
10.2 Programmation d’une fonction personnalisée (UDF) en VBA
Pour les utilisateurs évoluant sur des versions bureautiques dépourvues des fonctions matricielles déversées de Microsoft 365, le recours au langage Visual Basic for Applications (VBA) permet de concevoir une fonction personnalisée (User Defined Function ou UDF) exécutant l’extraction vectorielle du résumé à cinq nombres en une seule instruction.
Pour implémenter cette fonction, ouvrez l’environnement de développement via le raccourci Alt + F11, insérez un module standard (Insertion > Module), et saisissez le code rigoureusement typé suivant :
Function RESUME_CINQ_NOMBRES(PlageSource As Range) As Variant

    Dim Donnees As Variant

    Dim Sortie(1 To 5, 1 To 1) As Double

    Dim Wf As WorksheetFunction

    Set Wf = Application.WorksheetFunction


    On Error GoTo GestionErreurs


    Sortie(1, 1) = Wf.Min(PlageSource)

    Sortie(2, 1) = Wf.Quartile_Inc(PlageSource, 1)

    Sortie(3, 1) = Wf.Median(PlageSource)

    Sortie(4, 1) = Wf.Quartile_Inc(PlageSource, 3)

    Sortie(5, 1) = Wf.Max(PlageSource)


    RESUME_CINQ_NOMBRES = Sortie

    Exit Function
GestionErreurs:
RESUME_CINQ_NOMBRES = CVErr(xlErrNum)
End Function
Cette fonction s’exploite ensuite dans la feuille de calcul de manière intuitive. Sur les versions classiques, sélectionnez une plage verticale de 5 cellules (par exemple D2:D6), saisissez =RESUME_CINQ_NOMBRES(A2:A500) et validez via la combinaison Ctrl + Maj + Entrée. Sur Microsoft 365, la saisie dans une cellule unique déverse instantanément les cinq nombres le long de la colonne.
10.3 Traitement automatisé de répertoires entiers de données
Dans les protocoles expérimentaux d’envergure, les observations sont souvent fragmentées en centaines de fichiers individuels (un fichier CSV exporté par sujet expérimental ou par session d’enregistrement). Traiter manuellement ces classeurs est impensable et constitue une source d’erreurs majeures. L’automatisation par macro VBA permet de parcourir séquentiellement un répertoire cible sur le disque dur, d’ouvrir chaque classeur de manière silencieuse (en arrière-plan), d’extraire le résumé à cinq nombres de la variable d’intérêt, et de compiler les résultats dans un tableau de synthèse consolidé unique.
L’architecture de la routine procède selon les étapes opérationnelles suivantes :
- Désactivation de la mise à jour de l’affichage écran via
Application.ScreenUpdating = Falsepour maximiser la vitesse computationnelle. - Énumération des fichiers du répertoire via l’objet système
Scripting.FileSystemObjectou la fonction nativeDir("C:Experimentation*.csv"). - Ouverture itérative de chaque classeur dans la collection d’objets
Workbooks. - Appel des fonctions d’analyse statistique sur la colonne cible via l’objet
Application.WorksheetFunction. - Écriture de l’identifiant du sujet, du minimum, de Q1, de la médiane, de Q3 et du maximum sur la ligne incrémentée d’une feuille maîtresse.
- Fermeture immédiate du fichier source sans sauvegarde des modifications via
Workbook.Close SaveChanges:=False. - Rétablissement de l’actualisation écran et notification à l’opérateur.
Ce protocole garantit un gain de productivité inestimable, permettant de réduire des journées entières de manipulations fastidieuses à quelques secondes d’exécution computationnelle sécurisée et rigoureuse.
11. Applications méthodologiques aux données de la recherche psychologique
11.1 Analyse de données psychométriques et scores d’échelles ordinales
Les investigations psychométriques s’appuient massivement sur des instruments de mesure standardisés, tels que des inventaires de personnalité ou des questionnaires cliniques exploitant des échelles de réponse graduées de type Likert (allant couramment de 1 à 5 ou de 1 à 7). Un écueil méthodologique classique dans la littérature consiste à traiter d’emblée ces données ordinales comme des variables continues d’intervalle en leur appliquant des moyennes et des écarts-types arithmétiques.
Cette pratique viole le postulat fondamental selon lequel les distances psychologiques subjectives séparant deux échelons qualitatifs successifs (par exemple entre « Pas du tout d’accord » et « Modérément d’accord » comparativement à « Tout à fait d’accord ») ne sont pas démontrées comme étant strictement isométriques. Le résumé à cinq nombres constitue ici le seul traitement descriptif épistémologiquement licite :
- Il respecte scrupuleusement la nature ordinale de la variable en ne manipulant que des rangs et des partitions relatives.
- L’examen simultané du premier quartile, de la médiane et du troisième quartile révèle immédiatement les phénomènes d’effet de plancher (concentration massive des scores sur la valeur minimale 1, où Min = Q1 = Q2 = 1) ou d’effet de plafond, fréquemment observés dans des populations non cliniques soumises à des échelles de pathologie sévère.
- La confrontation de l’écart interquartile entre différents items permet de déceler quels aspects d’une échelle suscitent un consensus psychologique fort (faible EIQ) ou, au contraire, une polarisation marquée des attitudes au sein de la cohorte évaluée (EIQ élargi).
11.2 Traitement chronométrique des temps de réaction expérimentaux
Dans le domaine des neurosciences cognitives et de la psychologie expérimentale, les temps de réaction (exprimés en millisecondes) constituent la variable dépendante privilégiée pour sonder l’architecture mentale. Or, les distributions chronométriques violent systématiquement l’hypothèse de normalité gaussienne : elles présentent invariablement une asymétrie positive prononcée avec une queue de distribution étirée vers les latences temporelles élevées (distributions de type ex-gaussienne ou loi de Weibull).
L’utilisation de la moyenne arithmétique comme indicateur central d’un sujet expérimental induit un biais d’estimation majeur : quelques essais au cours desquels l’attention a vacillé (produisant des temps de réaction de 1500 ms face à une réponse basale moyenne de 350 ms) tirent artificiellement la moyenne vers le haut, altérant gravement les comparaisons de conditions intra-sujet.
Le recours à la médiane via =MEDIANE(...) et à l’écart interquartile via la différence des fonctions QUARTILE.INC neutralise intégralement ces artefacts comportementaux. L’EIQ sert alors d’estimateur de la variabilité cognitive intra-individuelle réelle, permettant de quantifier la stabilité attentionnelle du sujet sans que son score ne soit pollué par les anticipations motrices (valeurs excessivement basses captées par le minimum) ou les distractions environnementales (valeurs périphériques captées par le maximum et isolées au-delà des clôtures de Tukey).
11.3 Comparaison clinique inter-groupes (Contrôles vs Patients)
L’évaluation différentielle en neuropsychologie clinique exige une rigueur d’analyse extrême lorsqu’il s’agit d’opposer une population saine (groupe témoin ou contrôle) à une population souffrant d’une pathologie neurodégénérative ou psychiatrique. Très souvent, les groupes cliniques présentent des effectifs restreints (par exemple n = 15 patients rares) et une hétérogénéité symptomatique massive, se traduisant par une violation conjointe des hypothèses d’homoscédasticité (égalité des variances) et de normalité.
La construction d’un double résumé à cinq nombres présenté sous la forme de deux boîtes à moustaches parallèles permet une inspection clinique immédiate de la séparation des cohortes :
- Le non-chevauchement des boîtes centrales : Si l’intervalle interquartile
[Q1 ; Q3]du groupe clinique ne chevauche aucunement celui du groupe contrôle, l’analyste peut inférer une divergence structurelle robuste du fonctionnement cognitif entre les populations, indépendamment des valeurs extrêmes individuelles. - L’écartement des clôtures de Tukey : Un élargissement spectaculaire de l’EIQ chez les patients par rapport aux contrôles met en lumière la désorganisation ou la variabilité accrue induite par l’affection neurologique.
Ce diagnostic exploratoire rigoureux mené sous Excel constitue le préalable méthodologique indispensable avant la conduite formelle de tests inférentiels non paramétriques d’hypothèse tels que le test U de Mann-Whitney (ou Wilcoxon rank-sum test) pour deux échantillons indépendants ou le test de Kruskal-Wallis pour des comparaisons k-groupales.
12. Erreurs méthodologiques courantes, validation et normes de restitution
12.1 Pièges computationnels classiques et écueils de formulation
L’audit de feuilles de calcul appliquées à la recherche clinique révèle un ensemble d’erreurs computationnelles récurrentes qu’il convient de proscrire rigoureusement :
- L’amalgame entre le chiffre zéro et l’absence de donnée : C’est sans doute l’erreur la plus dévastatrice en analyse univariée. Dans une échelle quantitative, la valeur
0représente souvent un score réel valide. Si un chercheur remplace une cellule vide (signifiant une non-réponse ou une donnée manquante) par un0numérique, la fonctionMINretiendra ce zéro comme borne inférieure, déplaçant artificiellement le premier quartile et comprimant la médiane. Les cellules non renseignées doivent demeurer authentiquement nulles (vides) pour être ignorées par l’algorithme d’interpolation. - Le mélange incontrôlé d’algorithmes exclusifs et inclusifs : L’utilisation dans le même tableau analytique de
QUARTILE.EXCpour le calcul de Q1 et deQUARTILE.INCpour Q3 engendre une distorsion mathématique majeure de l’écart interquartile. L’analyste doit impérativement harmoniser ses choix de fonctions au sein de l’ensemble du classeur. - Les ruptures d’adresses dynamiques lors des insertions de lignes : Lorsqu’une plage classique est définie de manière absolue (ex.
$A$2:$A$100), l’insertion de nouvelles lignes au-delà de la ligne 100 n’est pas répercutée dans l’argument de la fonction, amputant silencieusement les nouvelles observations de l’échantillon d’analyse. La migration vers les références de tableaux structurés constitue l’unique parade technique pérenne.
12.2 Protocoles de vérification de la cohérence interne des extrants
Tout système d’information statistique fiable doit intégrer des protocoles de contrôle qualité automatisés fondés sur des règles d’assertion logique élémentaires. La théorie des statistiques d’ordre impose une contrainte de monotonie stricte ou large au quintuplet composant le résumé à cinq nombres :
Minimum ≤ Q1 ≤ Médiane ≤ Q3 ≤ Maximum
Si, en raison d’une corruption de formule ou d’une mauvaise manipulation d’arguments, cette inégalité séquentielle venait à être violée, le modèle doit déclencher une alerte d’invalidité immédiate. Pour matérialiser ce protocole sous Excel, on insérera sous la table de synthèse une cellule de statut qualité hébergeant le test logique suivant (considérant les cellules C2 à C6 pour les cinq métriques) :
=SI(ET(C2 <= C3; C3 <= C4; C4 <= C5; C5 <= C6); "COHÉRENCE VALIDÉE"; "ALERTE : ANOMALIE DE MONOTONIE")
Par ailleurs, dans le cas d’un vecteur de données entièrement dégénéré (constitué d’une constante unique répétée sur n lignes, par exemple la valeur 10), le système validera que :
Minimum = Q1 = Médiane = Q3 = Maximum = 10, avec un EIQ = 0.
L’implémentation de ces assertions logiques offre une sécurité opérationnelle absolue lors du déploiement de modèles de calcul automatisés destinés à des tiers non statisticiens.
12.3 Normes de présentation académique et standardisation APA
La restitution écrite ou tabulaire du résumé à cinq nombres au sein de manuscrits soumis à des comités de lecture scientifique est régie par les normes de standardisation de l’American Psychological Association (APA 7e édition). Selon ces directives stylistiques et typographiques :
- Les symboles statistiques désignés par des lettres latines doivent impérativement être mis en italique : Min, Max, Mdn (médiane), IQR (écart interquartile). Les abréviations de quartiles s’écrivent avec l’indice conventionnel en texte normal : Q1, Q3.
- L’intégration textuelle au fil d’un paragraphe descriptif obéit à une formulation canonique rigoureuse :
« L’analyse des temps de réaction révèle une distribution asymétrique positive marquée (Min = 185 ms, Q1 = 240 ms, Mdn = 295 ms, Q3 = 410 ms, Max = 1120 ms, IQR = 170 ms). » - La précision décimale doit être strictement homogène d’un bout à l’autre de la restitution : pour des données initialement mesurées à l’entier près, il est d’usage de rapporter les quantiles avec une seule décimale supplémentaire (ou sans décimale si l’ordre de grandeur de l’échelle le justifie).
- En cas de restitution sous forme tabulaire, les notes de bas de tableau doivent expliciter sans ambiguïté l’algorithme sous-jacent : « Note. Les premier et troisième quartiles (Q1 et Q3) ont été calculés selon l’algorithme d’interpolation linéaire inclusive Type 7 (QUARTILE.INC sous Microsoft Excel). »
En respectant scrupuleusement ces canons de présentation formelle, le chercheur confère à ses travaux une transparence méthodologique totale, condition sine qua non de la reproductibilité scientifique des données expérimentales et cliniques modernes.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Hyndman, R. J., & Fan, Y. (1996). Sample quantiles in statistical packages. The American Statistician, 50(4), 361-365. https://doi.org/10.1080/00031305.1996.10473566
- Microsoft Corporation. (2023). Fonction QUARTILE.INCLURE. Support technique Microsoft. https://support.microsoft.com/fr-fr/office/quartile-inclure-fonction-quartile-inc-4c070c79-e2b2-4d2a-88f5-930335025916
- Microsoft Corporation. (2023). Créer une boîte à moustaches. Support technique Microsoft. https://support.microsoft.com/fr-fr/office/cr%C3%A9er-une-bo%C3%AEte-%C3%A0-moustaches-62f4219f-db4b-4da9-a8a3-f66e08a3080e
- Tukey, J. W. (1977). Exploratory Data Analysis. Addison-Wesley Publishing Company.
- Weibull, W. (1951). A statistical distribution function of wide applicability. Journal of Applied Mechanics, 18(3), 293-297. https://doi.org/10.1115/1.4010337
- Wickham, H., & Grolemund, G. (2017). R for Data Science: Import, Tidy, Transform, Visualize, and Model Data. O’Reilly Media.