
La recherche contemporaine en sciences comportementales et en psychologie quantitative repose fondamentalement sur la modélisation statistique des différences interindividuelles et intra-individuelles. Qu’il s’agisse d’évaluer l’impact d’interventions psychothérapeutiques, de quantifier les déterminants cognitifs de l’apprentissage ou de prédire des conduites adaptatives face au stress, le chercheur se trouve confronté à une variabilité empirique omniprésente. Dans ce contexte épistémologique, l’analyse de régression linéaire et la décomposition de la variance constituent des piliers méthodologiques indispensables. Comprendre comment la dispersion totale des scores se segmente en composantes prédictibles et en composantes résiduelles constitue le point de passage obligé pour quiconque souhaite interpréter valablement la puissance explicative d’une théorie psychologique.
Au cœur de cette démarche réside la triade des sommes de carrés : la somme totale des carrés (Sum of Squares Total ou SST), la somme des carrés de la régression (Sum of Squares Regression ou SSR) et la somme des carrés des erreurs résiduelles (Sum of Squares Error ou SSE). Ces grandeurs scalaires traduisent mathématiquement la confrontation entre les observations brutes recueillies auprès des participants, les prédictions déduites d’un modèle théorique formalisé et le bruit inhérent à toute mesure du vivant. Si des environnements de programmation statistique sophistiqués tels que R, Python ou SPSS automatisent ces opérations sous des lignes de commande opaques, l’usage délibéré d’un tableur matriciel comme Microsoft Excel offre une valeur pédagogique et heuristique incomparable. En déployant les calculs pas à pas au sein des cellules, l’analyste démystifie les mécanismes calculatoires sous-jacents et consolide sa maîtrise conceptuelle des modèles linéaires généraux.
Ce guide exhaustif a pour vocation d’exposer en profondeur les fondements théoriques, les justifications mathématiques et l’implémentation pratique de la décomposition SST-SSR-SSE dans Excel. Conçu pour les chercheurs, cliniciens, statisticiens et étudiants avancés en psychométrie, ce manuel articule rigueur analytique et contextualisation empirique. À travers l’examen détaillé d’un protocole expérimental type reliant temps de préparation cognitive et performance psychométrique, nous explorerons successivement les procédures automatisées permises par l’Utilitaire d’analyse et les algorithmes de calcul manuel fondés sur les fonctions natives du tableur. Ce parcours permettra de consolider la compréhension de l’architecture d’un tableau d’analyse de variance (ANOVA), la dérivation des coefficients de détermination et l’évaluation diagnostique de la qualité des ajustements prédictifs.
1. 1. Introduction aux sommes des carrés dans la modélisation statistique en psychologie
1.1 1.1 Le rôle de la régression linéaire dans la recherche comportementale
Dans l’écosystème de la recherche comportementale, la modélisation statistique ne se résume pas à un simple ajustement de courbes ; elle incarne l’opérationnalisation formelle d’hypothèses causales et prédictives relatives au fonctionnement de l’esprit humain. Lorsque les psychologues étudient des construits complexes tels que l’intelligence fluide, la réactivité émotionnelle ou la rétention mnésique, ils cherchent à déterminer dans quelle mesure les variations observées sur un trait ou un état peuvent être imputées de manière systématique à des variables explicatives identifiées. La régression linéaire univariée ou multivariée offre un cadre paramétrique robuste permettant de tester si l’intensité d’une variable indépendante (par exemple, le nombre d’heures d’exposition à un programme de remédiation cognitive) prédit mathématiquement l’amplitude d’une variable dépendante (par exemple, le gain de performance sur une batterie de tests standardisés).
Toutefois, la psychologie se heurte à une difficulté inhérente : l’immense variabilité humaine. Deux individus soumis à des conditions expérimentales rigoureusement identiques ne présenteront jamais des réponses strictement équivalentes, en raison de différences individuelles non observées, de fluctuations attentionnelles momentanées ou d’imperfections psychométriques des outils d’évaluation. Il devient donc impératif de quantifier avec une précision chirurgicale la capacité prédictive des modèles théoriques. L’évaluation de l’adéquation globale d’un modèle ne consiste pas à exiger une prédiction parfaite, mais à isoler rigoureusement la part du comportement qui s’aligne fidèlement sur nos hypothèses de la part irréductible qui relève du bruit de mesure ou de la contingence environnementale.
Cette séparation fondamentale entre le signal théorique et le bruit stochastique constitue le cœur battant de l’inférence scientifique en psychologie. Sans une méthode formelle capable de mesurer ces composantes, le chercheur s’exposerait à deux écueils symétriques : d’une part, le risque de surinterpréter des covariations fortuites en leur attribuant une portée causale illusoire ; d’autre part, l’incapacité à reconnaître un effet robuste mais masqué par une dispersion résiduelle élevée. La régression linéaire résout cette tension en projetant les données empiriques sur un espace vectoriel où l’ajustement optimal maximise l’information expliquée tout en circonscrivant explicitement l’incertitude.
1.2 1.2 Définition conceptuelle de la partition de la variance
Le concept de partition de la variance repose sur une élégante intuition géométrique et arithmétique : la dispersion globale d’un ensemble de scores individuels autour de leur moyenne arithmétique peut être décomposée de manière exhaustive en sous-ensembles mutuellement exclusifs. Dans le cadre du modèle linéaire général, cette dispersion est saisie par les sommes de carrés d’écarts. Plutôt que de travailler directement sur les variances échantillonnales — qui intègrent une normalisation par les degrés de liberté —, les statisticiens opèrent d’abord sur les numérateurs quadratiques, appelés communément sommes des carrés (Sums of Squares). Ce principe stipule que chaque écart individuel par rapport au niveau de base non conditionnel peut être divisé en une composante attribuable au modèle prédictif et une composante laissée sans explication.
Dans l’analyse des données psychométriques et cognitives, cette partitionnement revêt une signification substantielle majeure. Lorsqu’un psychométricien administre une échelle d’anxiété sociale à une cohorte d’étudiants, les participants ne reçoivent pas tous le même score ; il existe une dispersion initiale substantielle. Si l’on introduit le niveau d’introversion comme variable prédictive, le principe de décomposition de la variance permet d’attribuer une fraction spécifique de l’hétérogénéité des scores d’anxiété aux variations systématiques d’introversion. La portion restante de dispersion est alors assignée aux facteurs non contrôlés, tels que l’histoire personnelle immédiate, la fatigue du sujet lors de la passation, ou l’erreur standard de mesure inhérente au questionnaire lui-même.
Cette transition conceptuelle de l’observation brute vers la structure factorielle sous-jacente préfigure l’ensemble des modélisations avancées en sciences humaines. De l’analyse de variance classique (ANOVA) aux équations structurelles en passant par les modèles mixtes hiérarchiques, la logique demeure invariante : quantifier la proportion de variance absorbée par les structures formelles de la théorie par rapport à la variance non structurée. La décomposition quadratique offre ainsi un pont épistémologique direct entre les postulats qualitatifs des théories psychologiques et l’exactitude numérique de l’estimation statistique.
1.3 1.3 Objectifs méthodologiques du calcul sous Microsoft Excel
À l’ère des environnements de programmation de pointe comme R, Python ou les logiciels dédiés tels que JASP et SPSS, le choix de Microsoft Excel pour mener des modélisations linéaires peut de prime abord surprendre. Pourtant, sur le plan didactique et méthodologique, le tableur matriciel offre des vertus heuristiques qu’aucun logiciel en « boîte noire » ne peut égaler. Lorsqu’un utilisateur lance une commande de régression dans un logiciel statistique automatisé, les métriques d’ajustement apparaissent instantanément dans un tableau formaté, occultant la cinématique du traitement des données. Cette abstraction précoce conduit fréquemment les praticiens et les étudiants à manipuler des concepts tels que la SST, la SSR ou la SSE sans appréhender concrètement la réalité matricielle et scalaire qu’ils recouvrent.
L’accessibilité visuelle d’Excel force au contraire l’analyste à contempler chaque ligne comme un participant singulier, chaque colonne comme une dimension psychométrique définie, et chaque cellule intermédiaire comme une étape délibérée du calcul algébrique. La comparaison méthodique entre les sorties automatisées fournies par l’Utilitaire d’analyse et la construction manuelle pas à pas des écarts quadratiques permet d’ancrer profondément l’intuition statistique. L’utilisateur constate de visu comment la moyenne de l’échantillon sert de pivot central, comment les valeurs prédites s’alignent sur la trajectoire théorique et comment les résidus se comportent individuellement le long du continuum de mesure.
En outre, dans le contexte des laboratoires de recherche en psychologie, Excel demeure un outil universel pour l’audit, le nettoyage préliminaire des données et la validation empirique rapide des modèles. Savoir implémenter manuellement les équations fondamentales au sein d’une feuille de calcul garantit une indépendance technique absolue face aux logiciels propriétaires et protège le chercheur contre les erreurs d’interprétation grossières. Cette approche analytique et transparente garantit une traçabilité intégrale du flux de données, indispensable à la reproductibilité de la recherche scientifique.
2. 2. Fondements mathématiques : Définitions et formules de la SST, SSR et SSE
2.1 2.1 La somme totale des carrés (SST : Sum of Squares Total)
La somme totale des carrés, universellement désignée par le sigle SST (Sum of Squares Total), mesure la variabilité empirique globale de la variable dépendante sans tenir compte de l’effet d’aucune variable indépendante. D’un point de vue conceptuel, la SST représente l’incertitude totale entourant le comportement des sujets de l’échantillon lorsque la seule information dont dispose le chercheur est la tendance centrale du groupe. Mathématiquement, pour un échantillon de taille n comportant les observations yi (où i varie de 1 à n) et de moyenne arithmétique globale notée ȳ (y barre), l’expression formelle s’établit comme suit :
SST = Σ (yi – ȳ)²
Cette équation illustre que la SST est la somme des écarts quadratiques entre chaque score individuel observé et la moyenne de l’échantillon. L’élévation au carré remplit une double fonction : d’une part, elle élimine les signes négatifs qui annuleraient la somme des écarts simples (puisque la somme arithmétique des écarts à la moyenne est par définition égale à zéro) ; d’autre part, elle pénalise de manière disproportionnée les écarts de grande amplitude. Cette sensibilité quadratique confère à la SST une forte vulnérabilité aux valeurs aberrantes (outliers), une caractéristique que le psychologue quantitatif doit constamment garder à l’esprit lors du dépouillement des échelles comportementales.
Sur le plan épistémologique, la SST fait office d’étalon de référence ou de « modèle nul ». Elle quantifie l’erreur globale que commettrait le chercheur s’il prédisait le score de n’importe quel sujet en lui attribuant arbitrairement la moyenne générale du groupe. C’est à l’aune de cette dispersion initiale, non conditionnelle et brute, que sera jaugée la performance de tout modèle théorique ultérieur : un modèle prédictif n’a d’utilité scientifique que s’il parvient à réduire drastiquement cette somme de déviations initiales.
2.2 2.2 La somme des carrés de la régression (SSR : Sum of Squares Regression)
La somme des carrés de la régression, couramment abrégée en SSR (ou parfois notée SSM pour Sum of Squares Model dans la littérature anglophone), quantifie la part de la variabilité totale qui est effectivement captée, structurée et expliquée par le modèle linéaire théorique. Elle représente le gain informationnel obtenu lorsque l’on substitue la prédiction uniforme de la moyenne globale par les prédictions individualisées déduites de l’équation de régression. En désignant par ŷi (y chapeau) la valeur ajustée ou prédite par le modèle pour le i-ème individu en fonction de son score sur le prédicteur xi, la formulation mathématique rigoureuse de la SSR s’écrit :
SSR = Σ (ŷi – ȳ)²
Cette expression traduit géométriquement la distance séparant chaque prédiction générée par la droite des moindres carrés de la moyenne générale de l’échantillon. Si la variable indépendante n’exerce aucune influence systématique sur la variable dépendante — ce qui se traduit graphiquement par une droite de régression parfaitement horizontale de pente nulle —, chaque valeur prédite ŷi est strictement égale à ȳ. Dans cette configuration d’inutilité prédictive absolue, la différence (ŷi – ȳ) s’annule pour chaque participant, conférant à la SSR une valeur numérique de zéro.
Inversement, plus la pente de régression s’écarte de zéro (dans le sens positif ou négatif), plus les valeurs prédites s’éloignent de la moyenne globale pour se conformer aux positions relatives des participants sur la variable explicative, et plus la SSR devient volumineuse. La SSR constitue donc l’indicateur direct de la variance expliquée par le modèle de régression. Néanmoins, il convient de souligner que la SSR est sensible aux biais de spécification : l’inclusion de variables prédictrices sans fondement théorique solide peut gonfler artificiellement la SSR au détriment de la parcimonie et de la validité externe du modèle, un écueil désigné sous le terme de surajustement (overfitting).
2.3 2.3 La somme des carrés des erreurs résiduelles (SSE : Sum of Squares Error)
La somme des carrés des erreurs résiduelles, abrégée en SSE (également désignée sous l’appellation SSRésiduelle dans certaines publications francophones), quantifie l’amplitude globale des discordances entre les observations réelles du monde empirique et les valeurs anticipées par l’équation mathématique. Pour chaque sujet étudié, le résidu ei représente la portion individuelle du comportement qui échappe à la modélisation : ei = yi – ŷi. La SSE correspond à l’agrégation quadratique de ces résidus observés sur l’ensemble de l’échantillon expérimental :
SSE = Σ (yi – ŷi)² = Σ ei²
La SSE capture la totalité du bruit expérimental, l’ensemble des erreurs de mesure non systématiques, les fluctuations d’échantillonnage aléatoires, ainsi que l’impact de toutes les variables psychologiques, biologiques ou contextuelles pertinentes qui n’ont pas été intégrées au modèle linéaire proposé. En psychométrie, une SSE non nulle n’invalide pas ipso facto la théorie sous-jacente, mais elle circonscrit la précision avec laquelle cette théorie peut prétendre décrire des cas individuels.
La méthode des moindres carrés ordinaires (MCO), conçue par Carl Friedrich Gauss et Adrien-Marie Legendre, a précisément pour dessein algorithmique de déterminer les paramètres de la droite (l’ordonnée à l’origine et la pente) qui minimisent strictement la valeur de cette SSE. Minimiser la SSE équivaut mathématiquement à rapprocher au maximum la droite d’estimation du nuage de points expérimentaux. En termes cliniques et diagnostiques, la SSE représente l’incertitude résiduelle : plus sa valeur est basse relativement à la dispersion totale, plus les inférences formulées par le psychologue à partir du modèle seront fiables et reproductibles.
2.4 2.4 L’identité fondamentale de l’analyse de variance
L’édifice de la statistique paramétrique repose sur un théorème mathématique d’une rare élégance : l’identité fondamentale de décomposition de la variance. Sous les hypothèses standard de la régression linéaire par les moindres carrés ordinaires — notamment l’inclusion d’une constante (l’ordonnée à l’origine) dans l’équation —, la somme totale des carrés est strictement égale à la somme algébrique de la somme des carrés de la régression et de la somme des carrés des erreurs :
SST = SSR + SSE
Pour comprendre la genèse de cette équation, considérons l’identité algébrique triviale relative à l’écart d’une observation quelconque à la moyenne :
(yi – ȳ) = (ŷi – ȳ) + (yi – ŷi)
En élevant les deux membres de cette égalité au carré et en sommant sur l’ensemble des n observations, le terme de gauche donne la SST, le premier terme quadratique de droite correspond à la SSR, et le second terme quadratique de droite génère la SSE. Le double produit croisé résultant de l’expansion du binôme prend la forme :
2 Σ (ŷi – ȳ)(yi – ŷi)
Dans l’espace euclidien à n dimensions, le vecteur des résidus (y – ŷ) est rigoureusement orthogonal au sous-espace engendré par les variables explicatives et la constante, ce qui implique que la corrélation empirique entre les valeurs prédites ŷ et les résidus e est strictement nulle sous les MCO. Par conséquent, ce terme croisé s’annule mathématiquement dans son intégralité (Σ (ŷi – ȳ)ei = 0). L’orthogonalité des projections garantit la parfaite additivité de ces métriques de dispersion.
Il est fondamental de noter que si un modèle est estimé sans ordonnée à l’origine (modèle forcé à passer par l’origine zéro), ou si les paramètres sont ajustés par des méthodes d’estimation non standard sans respect des hypothèses fondamentales, cette propriété d’additivité stricte (SST = SSR + SSE) s’effondre. Dans le cadre canonique des recherches psychologiques, cette identité constitue le garde-fou arithmétique absolu permettant de vérifier la rectitude des calculs déployés dans les feuilles de travail.
3. 3. Structuration et encodage des données psychométriques dans Excel
3.1 3.1 Conception du jeu de données expérimental
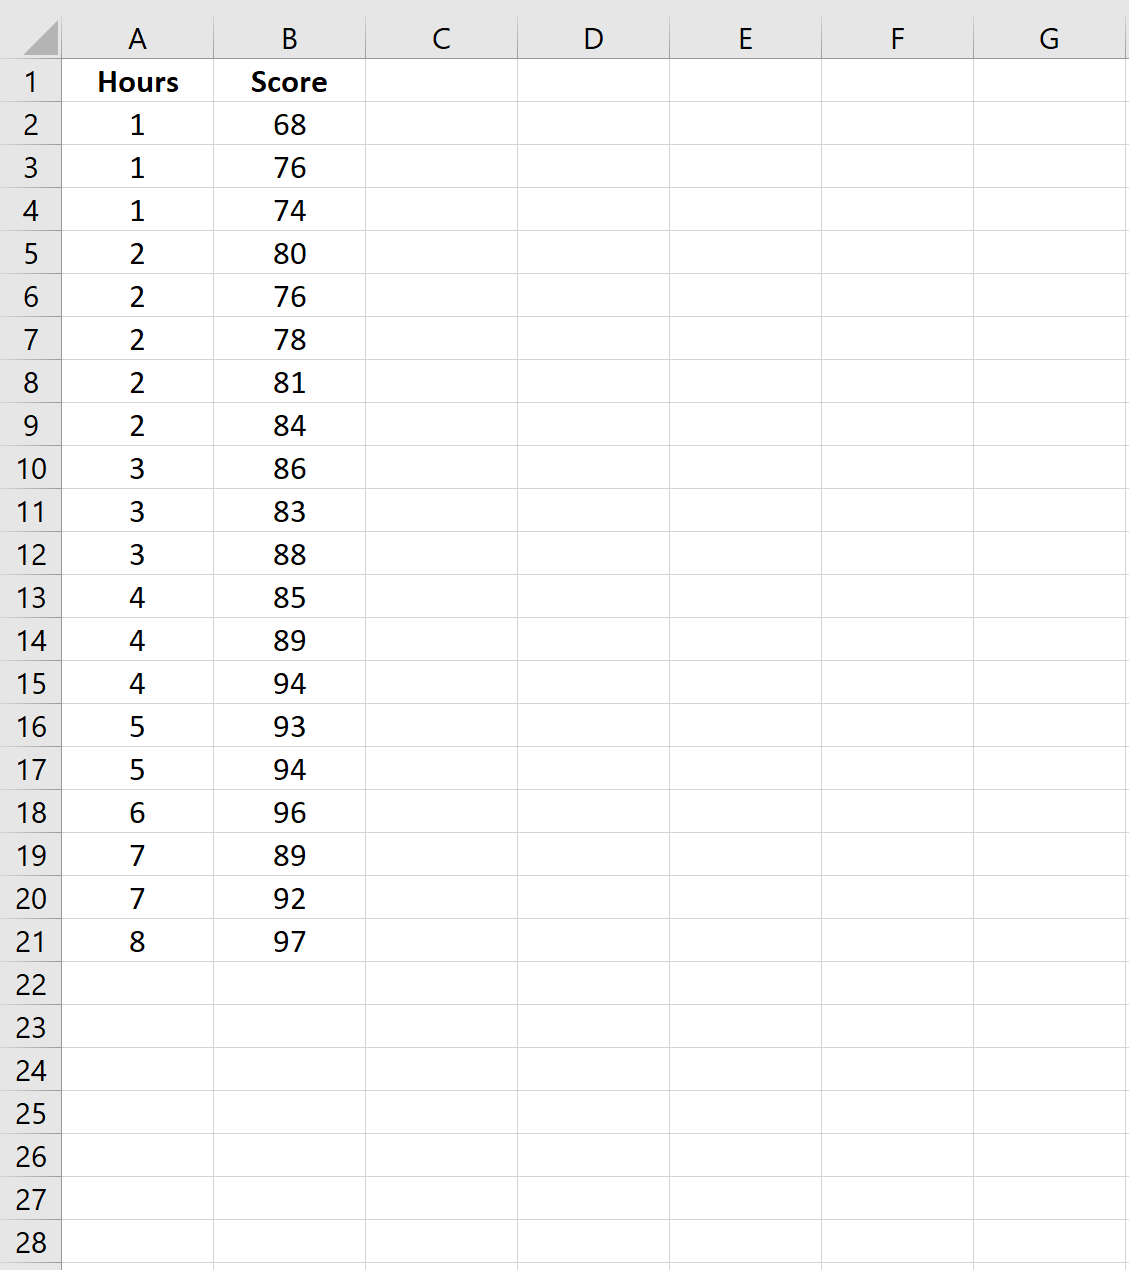
Afin d’illustrer la mise en œuvre empirique des calculs sous Microsoft Excel de façon didactique et rigoureuse, construisons un protocole de recherche réaliste en psychologie cognitive de l’éducation. Imaginons une étude examinant la relation fonctionnelle entre l’investissement temporel consenti par des étudiants pour réviser un module complexe de neurosciences comportementales et leur performance ultérieure à un examen d’évaluation standardisé. L’objectif consiste à modéliser dans quelle mesure le volume d’heures d’étude prédit formellement la note obtenue.
Définissons nos deux variables opérationnelles au sein du tableur :
- Variable indépendante (X) : Le temps d’étude hebdomadaire, exprimé en heures continues, auto-rapporté par les sujets via un journal de bord rigoureusement validé sur une période de 4 semaines consécutives.
- Variable dépendante (Y) : Le score standardisé obtenu lors de l’évaluation finale, calibré sur une échelle psychométrique continue allant de 0 à 100 points, où la moyenne normative a été fixée théoriquement à 50 avec un écart-type standardisé de 15.
Pour cette démonstration en laboratoire virtuel, nous structurons un échantillon calibré composé de 30 participants (n = 30). Cette taille d’échantillon permet de préserver la lisibilité visuelle d’une feuille de calcul tout en offrant des propriétés asymptotiques suffisantes pour satisfaire le théorème central limite et garantir la robustesse des tests inférentiels linéaires. Les données doivent être agencées de façon contiguë dans les deux premières colonnes d’une feuille de travail vierge intitulée « Donnees_Brutes ».
Dans la colonne A, nous plaçons l’identifiant des participants (du sujet S01 au sujet S30). Dans la colonne B (cellules B2 à B31), nous inscrivons les valeurs de notre variable prédictrice X (heures de révision). Dans la colonne C (cellules C2 à C31), nous encodons les scores standardisés Y correspondants. À titre illustratif, le sujet S01 a révisé 8,5 heures et a obtenu un score de 52 ; le sujet S02 a révisé 14,0 heures et a décroché un score de 71 ; tandis que le sujet S03, n’ayant consacré que 3,0 heures, a obtenu un score de 34. Cette cohérence empirique reflète une tendance linéaire sous-jacente positive, perturbée par la variabilité individuelle naturelle.
3.2 3.2 Nettoyage et vérification des hypothèses de distribution
Avant d’engager toute procédure de régression linéaire ou de sommation quadratique, l’hygiène des données requiert un contrôle scrupuleux de l’intégrité de la matrice empirique. L’une des faiblesses récurrentes observées dans l’analyse de données sous Excel réside dans la présence insidieuse d’erreurs de frappe, de formats textuels déguisés en valeurs numériques, ou de cellules vides qui biaisent silencieusement les dénominateurs des formules de variance.
La première démarche opérationnelle consiste à s’assurer de la continuité et de la conformité du typage numérique :
- Sélectionner l’ensemble de la plage de données (B2:C31) et s’assurer, via le menu d’accueil, que le format de cellule est explicitement configuré en « Nombre » avec deux décimales, proscrivant les formats généraux susceptibles de masquer des espaces typographiques indésirables.
- Vérifier l’absence d’aberrations extrêmes à l’aide des fonctions natives
=MIN(B2:B31)et=MAX(B2:B31), ainsi que=MIN(C2:C31)et=MAX(C2:C31). Des scores négatifs ou dépassant 100 sur l’échelle psychométrique signaleraient instantanément une anomalie de saisie à rectifier avant toute opération analytique.
Dans un second temps, le chercheur doit explorer brièvement les paramètres de distribution marginale. Bien que l’hypothèse de normalité porte formellement sur les résidus et non sur les variables brutes, l’existence d’une asymétrie démesurée ou d’un aplatissement excessif sur X ou Y peut sévèrement menacer la linéarité du modèle. Excel permet de calculer instantanément le coefficient d’asymétrie de Fisher-Pearson à l’aide de la formule =COEFFICIENT.ASYMETRIE(C2:C31) et l’aplatissement (kurtosis) via la fonction =KURTOSIS(C2:C31).
Des coefficients compris dans l’intervalle [-1,0 ; +1,0] attestent d’une relative préservation de la symétrie gaussienne. Une fois cette conformité attestée et toute cellule manquante éliminée (par suppression de ligne ou imputation raisonnée), la disposition tabulaire est prête à être exploitée par les algorithmes matriciels de la feuille de calcul.
4. 4. Configuration préalable d’Excel : L’Utilitaire d’analyse
4.1 4.1 Procédure d’activation du complément sous Windows
L’Utilitaire d’analyse (désigné sous l’appellation anglophone Analysis ToolPak) est une macro-complémentaire développée par Microsoft qui intègre directement dans le ruban standard du tableur un ensemble de procédures statistiques avancées, notamment l’analyse de variance factorielle, l’échantillonnage aléatoire, l’analyse spectrale de Fourier et, tout particulièrement, la régression linéaire multivariée. Par défaut, lors d’une installation conventionnelle de Microsoft Office sur le système d’exploitation Windows, ce module demeure en veille et ne figure pas dans l’interface active ; il incombe à l’opérateur de procéder à son activation initiale.
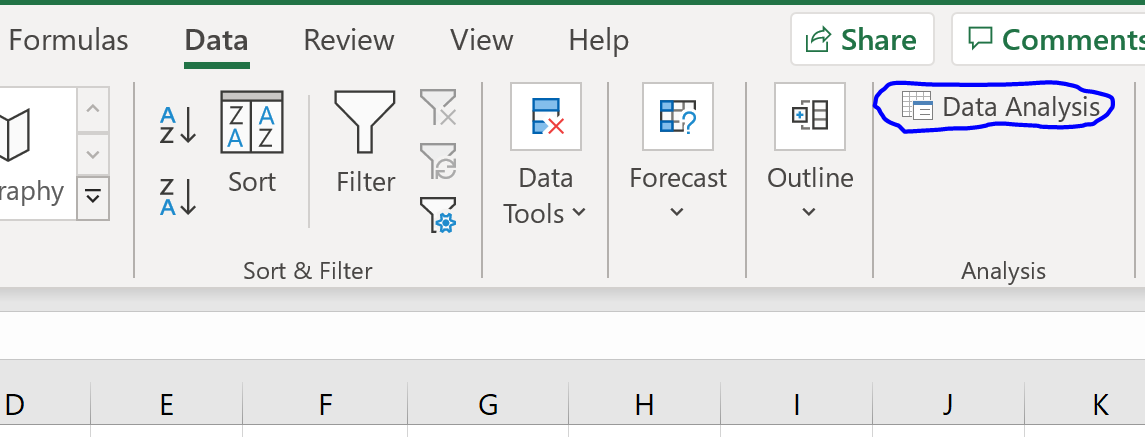
La trajectoire procédurale sous l’environnement Windows 10 et 11 s’effectue selon la séquence suivante :
- Cliquer sur l’onglet Fichier situé dans le coin supérieur gauche du ruban de navigation, puis sélectionner le menu Options logé tout en bas de la barre latérale gauche.
- Dans la boîte de dialogue contextuelle « Options Excel », diriger le curseur vers le panneau de navigation gauche et cliquer sur la catégorie Compléments.
- Au bas de la fenêtre d’affichage centrale, repérer la liste déroulante étiquetée Gérer :, s’assurer que l’option « Compléments Excel » est explicitement sélectionnée, puis cliquer sur le bouton d’exécution Atteindre….
- Une boîte de dialogue secondaire compacte se superpose à l’écran. Cocher impérativement la case intitulée Utilitaire d’analyse. Il n’est pas nécessaire à ce stade de cocher l’Utilitaire d’analyse VBA, sauf si l’analyste envisage d’automatiser ultérieurement ses partitions de variance par le biais de scripts macro Visual Basic for Applications.
- Valider la sélection en cliquant sur OK.
Dès la clôture de la boîte de dialogue, le moteur de calcul d’Excel compile le complément. L’utilisateur peut immédiatement valider la réussite de l’opération en naviguant vers l’onglet Données du ruban : à l’extrême droite, au sein du groupe fonctionnel « Analyse », doit désormais trôner l’icône interactive Utilitaire d’analyse (ou Analyse de données). Si ce bouton demeure invisible, un redémarrage de l’application suffit généralement à rafraîchir les éléments graphiques du ruban.
4.2 4.2 Procédure d’activation spécifique sur macOS
Pour les chercheurs et analystes évoluant sous le système d’exploitation macOS d’Apple, l’architecture des menus d’Excel présente des divergences ergonomiques notables par rapport à la version Windows. Historiquement omis dans les premières versions d’Office pour Mac au profit de modules tiers, l’Utilitaire d’analyse est aujourd’hui parfaitement standardisé et disponible nativement dans les versions modernes d’Excel pour Mac (Office 2019, 2021 et Microsoft 365).
L’itinéraire technique d’activation sur Mac s’articule comme suit :
- Dans la barre des menus supérieure native d’Apple (tout en haut de l’écran, en dehors de la fenêtre du document), cliquer sur le menu déroulant Outils.
- Faire défiler les options et sélectionner la rubrique Compléments Excel…. Une méthode alternative consiste à cliquer sur l’onglet Insérer du ruban, puis sur la section des modules complémentaires, bien que la voie par le menu système s’avère plus directe.
- Une modale système s’ouvre, listant les extensions enregistrées. Cocher la case associée à l’option Utilitaire d’analyse (Analysis ToolPak).
- Cliquer sur le bouton de confirmation OK.
À l’instar de l’environnement Windows, le bouton d’accès Analyse de données apparaît immédiatement dans l’onglet Données de l’interface Mac. Sur le plan fonctionnel, les algorithmes de décomposition de variance et d’estimation par les moindres carrés exécutés sous macOS sont rigoureusement identiques à ceux de Windows, garantissant une parfaite portabilité des feuilles de calcul entre les deux plateformes. La boîte de dialogue de modélisation présente la même structure paramétrique, assurant une continuité d’usage optimale pour les équipes de recherche pluridisciplinaires travaillant sous des environnements informatiques hétérogènes.
5. 5. Modélisation automatisée : Exécution de la régression linéaire via l’outil dédié
5.1 5.1 Paramétrage de la boîte de dialogue Régression
Une fois le module d’analyse opérationnel et la matrice de données calibrée, l’exécution automatisée de la régression linéaire s’effectue en sollicitant le moteur d’inférence d’Excel. En cliquant sur le bouton Analyse de données de l’onglet Données, une fenêtre modale énumère les différents algorithmes disponibles. L’analyste fait défiler la liste typologique, sélectionne l’entrée Régression, puis valide par OK. Une boîte de dialogue structurée s’ouvre alors, réclamant la spécification des vecteurs empiriques et le réglage des paramètres d’estimation.
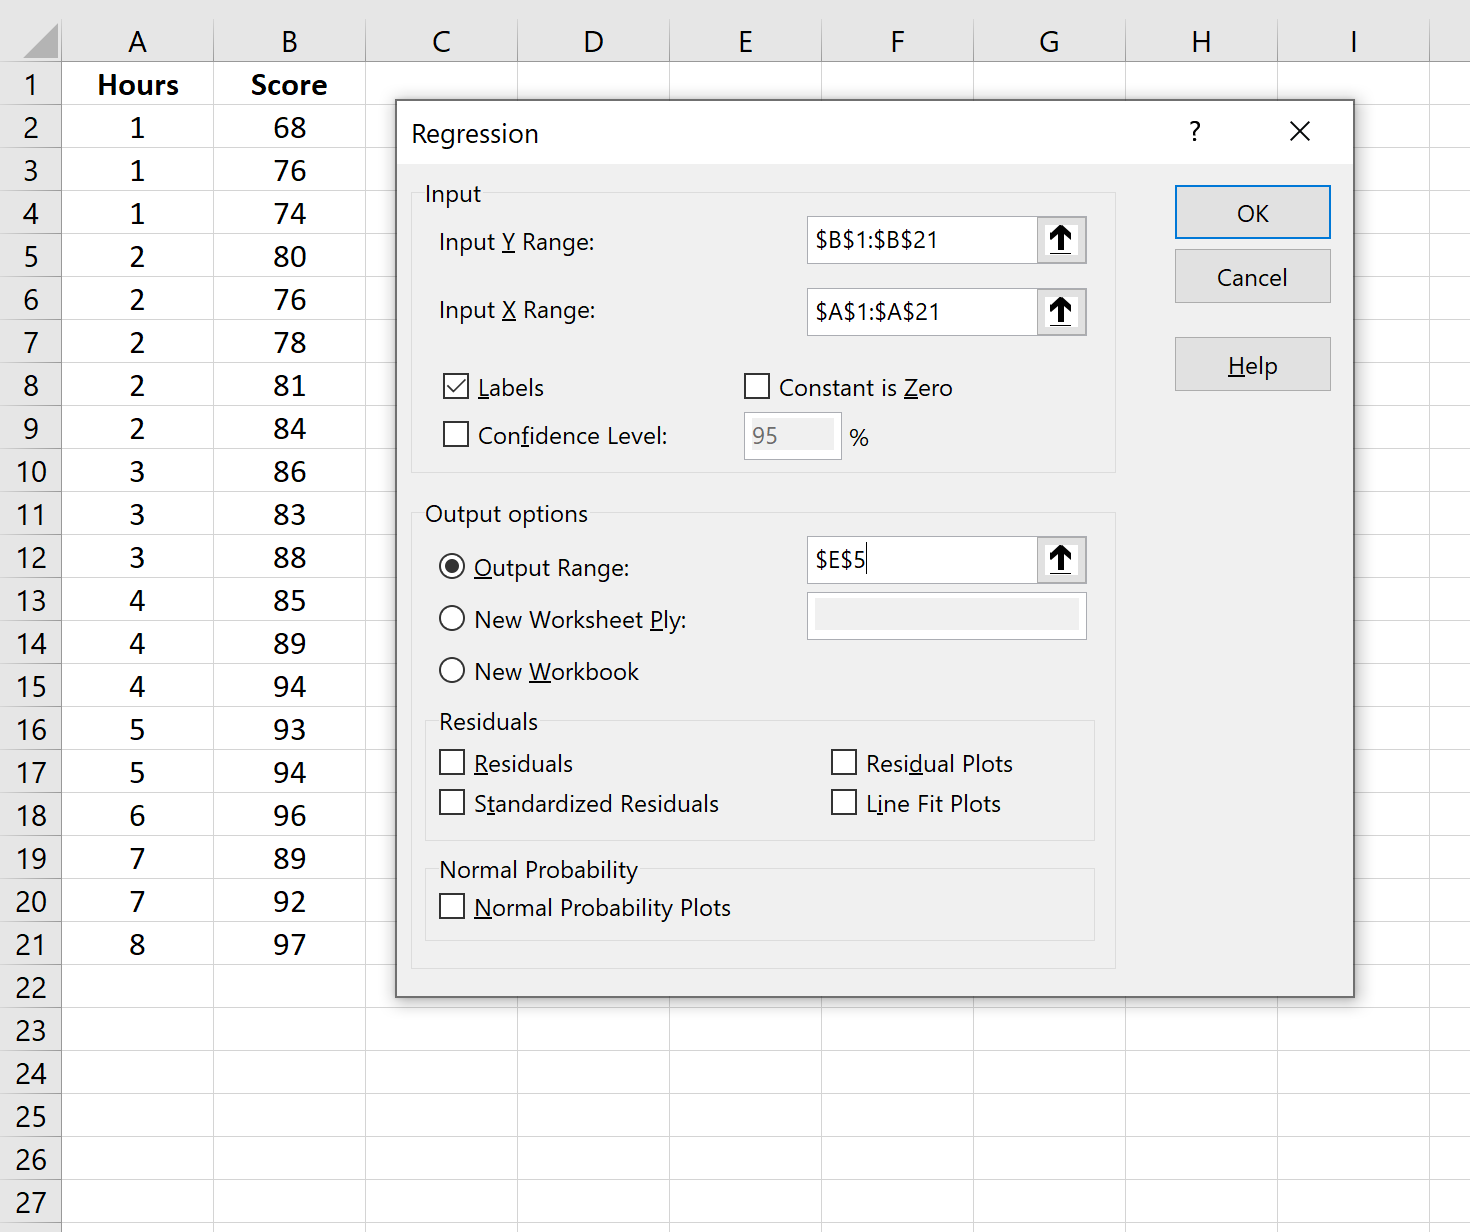
Le paramétrage des champs d’entrée exige une vigilance méthodologique sans faille :
- Plage d’entrée Y : Il s’agit du vecteur représentant la variable dépendante à prédire. Dans notre scénario de recherche comportementale, l’opérateur doit sélectionner la plage
$C$1:$C$31. Il est impératif d’inclure la cellule d’en-tête (C1) contenant le label textuel « Score_Examen ». - Plage d’entrée X : Ce champ reçoit le vecteur de la variable prédictrice indépendante. L’utilisateur sélectionne la plage
$B$1:$B$31, en intégrant scrupuleusement la cellule d’en-tête (B1) « Heures_Revision ». - Case à cocher « Intitulés » : Ayant englobé les cellules d’en-tête lors de la sélection vectorielle, il est indispensable de cocher cette case. Cette action informe le compilateur que la première ligne ne constitue pas des observations numériques mais des métadonnées lexicales, évitant ainsi le rejet d’exécution pour incompatibilité de type.
- Niveau de confiance : Par défaut, Excel applique un seuil de 95 %, correspondant au niveau alpha standard de 5 % en sciences comportementales. Cette option peut être laissée active.
- Constante égale à zéro : Il convient de laisser impérativement cette case décochée. Cocher cette option forcerait l’ordonnée à l’origine à être nulle (b₀ = 0), ce qui détruirait l’orthogonalité des résidus et violerait l’identité fondamentale d’additivité SST = SSR + SSE.
Enfin, dans la section dédiée aux options de sortie, il est fortement conseillé de sélectionner l’option Nouvelle feuille de calcul et de lui attribuer le nom explicite « Sortie_Regression ». Cette compartimentation assure une saine gouvernance des données en isolant les sorties calculatoires de la matrice brute originale.
5.2 5.2 Options de sortie des résidus et graphiques
La puissance diagnostique de l’Utilitaire d’analyse réside dans sa capacité à extraire simultanément les composantes résiduelles associées à chaque observation. Dans la portion inférieure de la boîte de dialogue de régression, un ensemble de cases à cocher permet de piloter la production de ces indicateurs d’adéquation empirique. L’analyste en psychologie doit porter une attention toute particulière à ces options afin d’étayer la validité de ses inférences statistiques.
Les fonctionnalités suivantes méritent d’être systématiquement activées lors de l’exécution du modèle :
- Résidus : Génère un tableau associant à chaque point expérimental la prédiction calculée ŷi et l’écart résiduel brut correspondant ei = yi – ŷi. Cette sortie tabulaire est indispensable pour vérifier la somme empirique des erreurs.
- Résidus standardisés : Divise chaque résidu brut par son écart-type estimé. En psychométrie, ces résidus permettent d’identifier les profils d’individus atypiques dont la réponse dévie de plus de deux ou trois écarts-types de la trajectoire attendue.
- Graphique des résidus : Insère un nuage de points projetant les résidus sur l’axe des ordonnées face aux valeurs de la variable indépendante X. Cet outil visuel constitue le test de référence pour juger de l’homoscédasticité (constance de la variance de l’erreur) et repérer d’éventuelles courbures non linéaires méconnues par le modèle.
- Tracé de probabilité normale : Génère un graphique quantile-quantile (Q-Q plot) permettant d’évaluer visuellement si la distribution empirique des résidus s’aligne rigoureusement sur la diagonale théorique d’une loi normale gaussienne, condition sine qua non de la validité des tests inférentiels paramétriques ultérieurs.
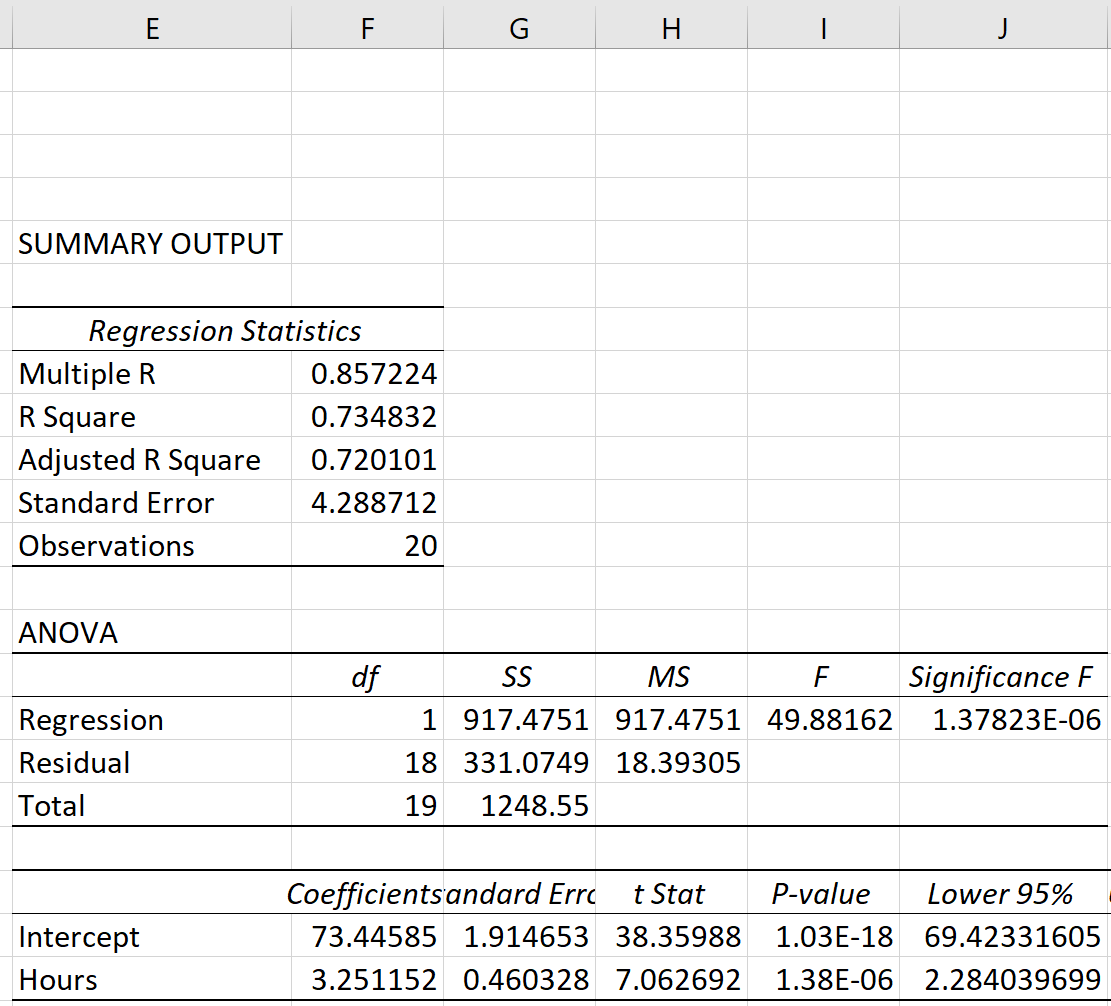
Une fois l’ensemble de ces options validé par un clic sur le bouton d’exécution final, le moteur matriciel compile instantanément la modélisation et déploie sur la nouvelle feuille de calcul un rapport d’analyse structuré comprenant les statistiques de régression, le tableau d’analyse de variance, l’estimation des coefficients de la droite et la table des observations résiduelles.
6. 6. Décodage et interprétation du tableau ANOVA produit par Excel
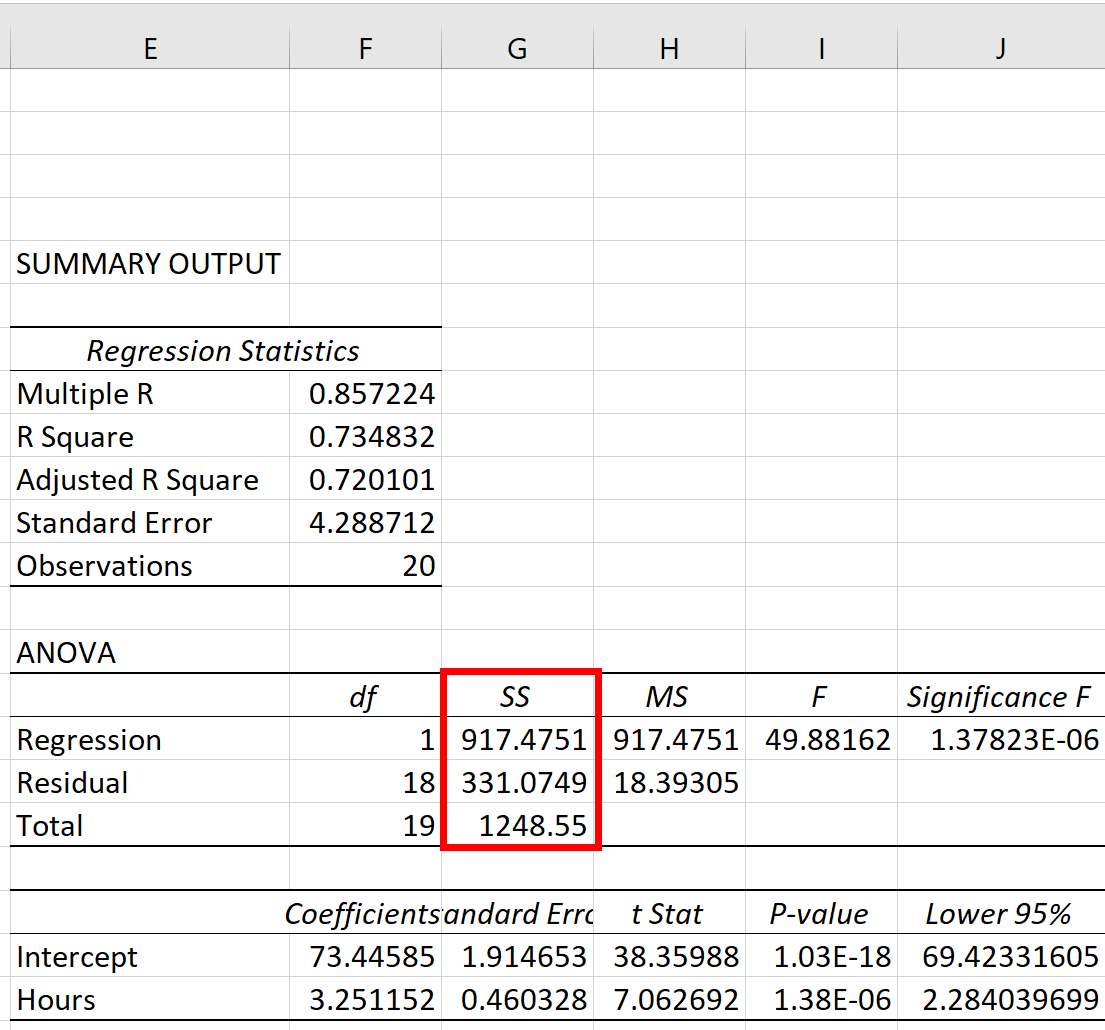
6.1 6.1 Anatomie du bloc ANOVA (Analyse de variance)
Le cœur névralgique de la sortie générée par l’Utilitaire d’analyse réside dans le bloc intitulé « ANALYSE DE VARIANCE » (communément désigné sous l’acronyme international ANOVA). Trop souvent survolé par les utilisateurs au profit des seuls coefficients de régression, ce tableau formalise précisément la partition de la somme des carrés et conditionne l’ensemble de la validité inférentielle du modèle prédictif.
Le bloc ANOVA se structure invariablement sous la forme d’une matrice bidimensionnelle rectangulaire :
- Les Lignes du tableau : Elles décrivent l’origine des composantes de variance. La première ligne, libellée Régression, synthétise l’effet imputable au modèle théorique et aux prédicteurs inclus. La deuxième ligne, libellée Résidus, regroupe l’impact du bruit, de l’erreur de mesure et des variables non contrôlées. Enfin, la troisième ligne, intitulée Total, dresse le bilan de la dispersion globale initiale non conditionnelle.
- Les Colonnes du tableau : Elles détaillent le traitement mathématique de chaque source de variance. La colonne dl indique les degrés de liberté attachés à chaque strate. La colonne SC (ou SS pour Sum of Squares) présente la somme des carrés correspondante. La colonne MS (pour Mean Squares ou Moyenne des Carrés) affiche le quotient arithmétique de la somme des carrés par ses degrés de liberté respectifs (MS = SC / dl). Enfin, les colonnes F et Signification F fournissent la statistique inférentielle de Fisher-Snedecor et le niveau de p-valeur bilatéral associé.
La correspondance univoque entre le jargon affiché par Microsoft Excel et les concepts mathématiques formels doit être parfaitement intégrée par le chercheur : la mention « SC Régression » équivaut strictement à la SSR ; la mention « SC Résidus » correspond point par point à la SSE ; et la mention « SC Total » constitue la SST intégrale de l’échantillon empirique.
6.2 6.2 Localisation et lecture critique des métriques clés
Pour exploiter avec acuité scientifique les sorties numériques d’Excel, il est nécessaire de savoir localiser immédiatement les métriques fondamentales au sein de la grille générée, habituellement située entre les rangées 10 et 14 du rapport d’analyse standard.
Considérons les cellules typiques de la colonne SC (colonne C du bloc de résultats standard) :
- Cellule C12 (SSR – Somme des carrés de la Régression) : Dans notre recherche sur le temps d’étude, cette cellule affiche la valeur chiffrée, par exemple
4285,73. Cette quantité reflète le volume absolu de variance du score d’examen qui se trouve fidèlement expliqué par la variation linéaire des heures de révision hebdomadaires. - Cellule C13 (SSE – Somme des carrés des Résidus) : Juste en dessous, cette cellule consigne la valeur résiduelle, par exemple
1842,27. Ce chiffre matérialise l’erreur d’ajustement globale : la distance quadratique totale séparant les notes réelles des étudiants des notes prédites par le modèle linéaire. - Cellule C14 (SST – Somme des carrés Totale) : À la base de la colonne, cette cellule compile la somme totale, égale ici à
6128,00. On note instantanément la vérification de l’identité fondamentale :4285,73 + 1842,27 = 6128,00.
La lecture critique ne s’arrête pas à la simple identification des scalaires : elle examine le test global du modèle. La statistique F (située en cellule E12) est obtenue en divisant la moyenne des carrés de la régression (MS Régression = SSR / dl) par la moyenne des carrés des erreurs (MS Résidus = SSE / dl). La cellule F12, intitulée Signification F, délivre la valeur de p. Si cette valeur est inférieure au seuil conventionnel de 0,05 (ou 0,01), le psychologue conclut formellement que la proportion de variance captée par la SSR est significativement supérieure à ce que le simple hasard d’échantillonnage aurait pu générer.
6.3 6.3 Les degrés de liberté associés aux composantes de variance
Les sommes de carrés ne peuvent être pleinement interprétées sans leur contrepartie dimensionnelle : les degrés de liberté (notés dl ou df pour degrees of freedom). Dans l’architecture du modèle linéaire univarié, les degrés de liberté représentent le nombre de dimensions indépendantes sur lesquelles les écarts quadratiques sont libres de fluctuer, déduction faite du nombre de contraintes paramétriques appliquées lors de l’estimation.
L’attribution des degrés de liberté s’organise selon une hiérarchie stricte :
- Degrés de liberté de la Régression (dlreg) : Ils correspondent au nombre de variables explicatives indépendantes k incluses dans la modélisation. Dans le cas d’une régression linéaire simple comportant un seul prédicteur X,
k = 1. La ligne de régression dispose donc invariablement d’un unique degré de liberté. - Degrés de liberté des Résidus (dlres) : Ils sont calculés par la formule
n - k - 1, où n représente le volume total de participants et k le nombre de régresseurs. La déduction de k + 1 paramètres s’explique par l’estimation préalable de la pente (b₁) et de la constante (b₀). Pour notre échantillon de 30 participants, nous obtenons30 - 1 - 1 = 28degrés de liberté résiduels. - Degrés de liberté Totaux (dltot) : Ils sont régis par l’expression classique
n - 1, en raison de la contrainte unique imposée par l’estimation de la moyenne générale ȳ. Dans notre démonstration, nous obtenons30 - 1 = 29degrés de liberté totaux.
À l’image de la décomposition des sommes de carrés, les degrés de liberté obéissent à une règle d’additivité stricte et immuable dans l’analyse de variance :
dltot = dlreg + dlres ⟹ (n – 1) = k + (n – k – 1)
Dans notre cas expérimental, l’égalité 29 = 1 + 28 est scrupuleusement respectée. Cette additivité est essentielle car elle permet d’obtenir des estimateurs sans biais de la variance (les carrés moyens MS) en ramenant chaque somme quadratique à son échelle dimensionnelle réelle, préalable indispensable au calcul de la statistique de Fisher.
7. 7. Calcul manuel et rigoureux de la SST dans les feuilles de calcul
7.1 7.1 Calcul de la moyenne de l’échantillon pour la variable dépendante
Bien que l’Utilitaire d’analyse produise les sommes de carrés de manière quasi instantanée, la décomposition manuelle étape par étape dans les colonnes du tableur constitue la méthode par excellence pour assimiler les fondements de la statistique descriptive et valider la structure des données. Pour entamer le calcul de la somme totale des carrés (SST), la première opération consiste à déterminer la moyenne arithmétique de la variable dépendante Y.
Revenons sur notre feuille de données initiales où les scores des participants à l’examen sont encodés dans la plage C2:C31. Pour calculer la moyenne arithmétique générale ȳ, nous choisissons une cellule de référence dédiée, par exemple la cellule C33, et nous introduisons la fonction native suivante :
=MOYENNE(C2:C31)
Supposons que cette commande renvoie une moyenne empirique de 54,60. Cette grandeur constitue le niveau de référence non conditionnel à partir duquel l’ensemble des écarts individuels sera jaugé. Il est impératif, dans les manipulations ultérieures, de verrouiller l’adresse de cette cellule à l’aide des symboles de fixation absolue du dollar ($C$33). L’omission de cette contrainte de référencement absolu engendrerait une dérive de la référence lors de l’étirement vertical de la formule, faussant irrémédiablement l’intégralité des calculs d’écarts de l’échantillon.
7.2 7.2 Détermination des écarts individuels et élévation au carré
L’étape suivante consiste à matérialiser visuellement la déviation de chaque sujet par rapport au centre de gravité de l’échantillon, puis à transformer ces déviations en valeurs quadratiques positives. Nous structurons cette opération en insérant une nouvelle colonne dans la feuille de calcul, intitulée « Ecarts_Y_Carre », occupant la plage de cellules D2:D31.
Dans la cellule D2, correspondant au premier participant de l’échantillon, nous saisissons la formulation algébrique explicite :
=(C2-$C$33)^2
Dans cette expression :
C2représente le score brut individuel observé pour le premier sujet (y₁).$C$33verrouille la référence pointant vers la moyenne générale de l’échantillon (ȳ).- Le symbole de chapeau d’accent circonflexe (
^2) ordonne au compilateur d’élever la parenthèse d’écart au carré.
Une fois la formule encodée dans la cellule D2, l’opérateur positionne son curseur sur la poignée de recopie (le petit carré noir logé dans le coin inférieur droit de la cellule active) et opère un double-clic ou un glisser-déposer vers le bas jusqu’à la cellule D31. Cette action propage la formule sur l’ensemble des 30 lignes expérimentales. Chaque cellule de cette colonne contient désormais le terme (yi – ȳ)² propre à chaque participant, reflétant sa contribution unitaire à la variabilité totale du groupe étudié.
7.3 7.3 Sommation finale et alternative par fonction native
Pour finaliser la dérivation manuelle de la somme totale des carrés, il ne reste plus qu’à agréger l’ensemble des écarts quadratiques individuels générés dans la colonne D. En se positionnant sur la cellule D33, immédiatement sous la colonne des calculs intermédiaires, l’utilisateur implémente la formule de sommation vectorielle classique :
=SOMME(D2:D31)
Le résultat obtenu constitue rigoureusement la valeur de la SST. Dans notre exemple numérique, la cellule D33 renvoie exactement la valeur 6128,00, s’alignant au centième près sur la métrique extraite de la ligne « Total » du tableau ANOVA automatisé.
Afin de consolider la vérification et d’optimiser le temps de travail lors d’analyses ultérieures, Microsoft Excel propose une fonction statistique hautement spécialisée qui dispense de la création de la colonne d’écarts intermédiaires : la fonction SOMME.CARRES.ECART (équivalent de DEVSQ dans la version anglophone). Dans une cellule libre, par exemple D34, saisissez la commande directe :
=SOMME.CARRES.ECART(C2:C31)
Cette fonction calcule de manière native et en mémoire vive la somme des carrés des déviations des points de données par rapport à leur moyenne arithmétique d’échantillon. La concordance arithmétique absolue entre le résultat renvoyé par =SOMME(D2:D31) et celui de =SOMME.CARRES.ECART(C2:C31) fournit une double validation de la rectitude du traitement statistique.
8. 8. Calcul manuel et rigoureux de la SSR dans les feuilles de calcul
8.1 8.1 Estimation des paramètres de la droite des moindres carrés
Pour déterminer manuellement la somme des carrés de la régression (SSR), nous devons d’abord formaliser l’équation de la droite d’estimation linéaire régissant la relation entre la variable explicative X (heures de révision) et la variable prédite Y (note d’examen). Cette fonction prend la forme standard de l’équation mathématique du premier degré :
ŷ = b₀ + b₁ · x
Dans cette équation, b₁ représente la pente de régression (le coefficient angulaire traduisant l’accroissement attendu sur l’échelle d’examen pour chaque heure supplémentaire d’étude) et b₀ désigne l’ordonnée à l’origine (le score prédit théorique pour un sujet dont le temps de révision serait égal à zéro). Plutôt que de résoudre à la main les fastidieuses équations normales de Gauss, nous faisons appel aux fonctions matricielles natives d’Excel :
- Calcul de la pente (b₁) : Dans une cellule dédiée, disons
F2, nous inscrivons la formule=PENTE(C2:C31; B2:B31). Notons avec la plus grande vigilance l’ordre imposé des arguments : la plage de la variable dépendante Y (C2:C31) doit obligatoirement précéder la plage de la variable indépendante X (B2:B31). Supposons que cette cellule affiche la valeur2,45. - Calcul de l’ordonnée à l’origine (b₀) : Dans la cellule contiguë
F3, nous implémentons la fonction=ORDONNEE.ORIGINE(C2:C31; B2:B31), en respectant scrupuleusement la même syntaxe d’arguments (Y puis X). Supposons que le tableur délivre le coefficient25,20.
Le modèle prédictif s’énonce désormais formellement : Score_Prédit = 25,20 + 2,45 · (Heures_Révision). Ce modèle constitue la règle d’inférence déterministe qui servira à calculer les prédictions individuelles.
8.2 8.2 Génération des valeurs prédites pour chaque observation
Muni des paramètres optimaux de la droite des moindres carrés, l’analyste peut générer la valeur ajustée ŷi correspondant au profil d’exposition de chaque participant de l’étude. Cette opération permet de concrétiser la trajectoire idéale tracée par le modèle théorique.
Nous introduisons une nouvelle colonne sur notre feuille de données, intitulée « Y_Chapeau_Predit », positionnée dans la plage E2:E31. Pour modéliser la prédiction associée au premier participant dont le temps d’étude est consigné en B2, nous inscrivons dans la cellule E2 la formule dynamique suivante :
=$F$3 + ($F$2 * B2)
Dans cette structure :
$F$3pointe vers la cellule fixe de l’ordonnée à l’origine (b₀), verrouillée par des dollars.$F$2pointe vers la cellule fixe de la pente de régression (b₁), également verrouillée.B2représente la valeur empirique X du premier participant, laissée en référence relative afin qu’elle s’adapte lors de la descente de la formule.
Il existe une alternative algorithmique élégante proposée par les versions modernes d’Excel, dispensant de l’extraction isolée préalable de la pente et de la constante : l’utilisation de la fonction =PREVISION.LINEAIRE(B2; $C$2:$C$31; $B$2:$B$31). Cette fonction évalue directement la coordonnée ajustée pour la valeur B2 en exploitant la matrice complète des données. Quelle que soit la syntaxe privilégiée, l’étirement de la formule jusqu’à la cellule E31 génère l’ensemble du vecteur des scores ajustés ŷ.
8.3 8.3 Calcul de la dispersion des prédictions autour de la moyenne
La somme des carrés de la régression (SSR) étant définie comme la somme des écarts au carré entre les valeurs prédites par le modèle et la moyenne générale de l’échantillon (Σ (ŷi – ȳ)²), l’étape suivante consiste à opérationnaliser cette distance conceptuelle. Nous créons une colonne intermédiaire intitulée « Ecarts_Reg_Carre » dans la plage F2:F31 (ou G2:G31 si F est occupée par les paramètres).
Dans la cellule G2, nous inscrivons la formule quadratique suivante :
=(E2-$C$33)^2
Cette expression soustrait la moyenne générale non conditionnelle de l’échantillon (cellule verrouillée $C$33) de la valeur prédite par le modèle pour ce sujet spécifique (cellule relative E2), puis élève la différence obtenue à la puissance 2. Cette grandeur chiffre la distance dont la prédiction du sujet s’éloigne de la prédiction naïve représentée par la moyenne générale.
Après avoir étiré cette formule sur l’intégralité des 30 lignes de la cohorte (jusqu’en G31), nous procédons à la sommation globale du vecteur dans la cellule G33 :
=SOMME(G2:G31)
La valeur retournée par le tableur affiche très exactement 4285,73. Nous constatons une adéquation numérique rigoureuse avec la métrique SC Régression délivrée par le rapport automatisé de l’Utilitaire d’analyse. Ce résultat démontre sans équivoque que la SSR correspond bel et bien à la variabilité des estimations du modèle autour du barycentre des observations.
9. 9. Calcul manuel et rigoureux de la SSE dans les feuilles de calcul
9.1 9.1 Extraction directe des résidus empiriques
La somme des carrés des erreurs résiduelles (SSE) quantifie la part de dispersion qui résiste à l’explication théorique. Elle repose sur le calcul des résidus individuels bruts, définis comme l’écart algébrique strict séparant la valeur empirique réellement manifestée par le sujet de la valeur théorique escomptée par le modèle linéaire : ei = yi – ŷi.
Pour matérialiser ces écarts au sein de la feuille de travail, nous créons une nouvelle colonne désignée sous le titre « Residus_Erreurs » dans la plage H2:H31. Dans la cellule H2, correspondant au sujet 1, nous programmons la soustraction directe :
=C2-E2
Ici, C2 héberge l’observation empirique y₁ et E2 abrite la projection linéaire ŷ₁ calculée au paragraphe précédent. En propageant cette relation élémentaire vers le bas jusqu’à la cellule H31, nous obtenons le vecteur résiduel complet de l’échantillon. Certains résidus arborent une valeur positive (le participant a surperformé par rapport aux prévisions du modèle), tandis que d’autres affichent une valeur négative (le participant a sous-performé relativement à son temps de révision).
C’est ici que l’analyste peut procéder à une vérification fondamentale de la théorie des moindres carrés ordinaires : s’il implémente dans la cellule H32 la fonction =SOMME(H2:H31), la valeur affichée sera infinitésimale, oscillant autour de zéro (par exemple 0,00000000000002 en raison des approximations de calcul à virgule flottante binaire de l’ordinateur). Cette quasi-nullité arithmétique valide la propriété fondamentale selon laquelle la droite des MCO passe rigoureusement par le centre de gravité de la distribution.
9.2 9.2 Équarrissage des résidus et agrégation finale
La somme des erreurs simples s’annulant de manière déterministe, il est nécessaire, pour capturer l’ampleur globale du désajustement, de procéder à l’élévation au carré de chaque résidu individuel. Cette opération supprime la neutralisation mutuelle des signes et accorde une importance pondérée aux fortes déviations prédictives.
Dans la colonne contiguë I2:I31, dotée de l’en-tête « Residus_Carre », nous saisissons dans la cellule I2 la formule :
=H2^2
Nous étirons ensuite cette instruction jusqu’à la cellule I31 afin d’obtenir la suite complète des erreurs quadratiques ei². Pour dériver la SSE totale consolidée, il ne reste plus qu’à agréger ce vecteur. Dans la cellule I33, nous programmons la formule de sommation :
=SOMME(I2:I31)
Le tableur renvoie avec exactitude le montant scalaire 1842,27. Ce chiffre coïncide à la décimale près avec la valeur affichée sur la ligne « SC Résidus » du tableau ANOVA compilé par l’outil d’analyse automatique.
Signalons qu’une méthode matricielle directe, particulièrement rapide et ne requérant pas la création de la colonne d’élévation au carré, consiste à appliquer la fonction native d’équarrissage vectoriel d’Excel directement sur le vecteur des résidus simples. En inscrivant dans une cellule libre la syntaxe =SOMME.CARRES(H2:H31), l’utilisateur obtient instantanément la valeur consolidée de la SSE, la fonction se chargeant d’élever chaque terme au carré avant de procéder à la sommation globale.
9.3 9.3 Évaluation de l’erreur type de l’estimation
La SSE constitue une grandeur absolue dont la métrique dépend directement de l’unité de mesure de la variable dépendante au carré, ce qui complique son interprétation clinique immédiate. Pour contourner cette limitation, les psychométriciens transforment la SSE en une mesure standardisée d’incertitude : l’erreur type de l’estimation (souvent notée se ou Standard Error of the Estimate).
L’erreur type de l’estimation correspond à l’écart-type de la distribution des résidus autour de la droite de régression, corrigé de la perte de degrés de liberté. Sa formulation mathématique s’exprime comme la racine carrée du carré moyen des résidus (MS Résidus) :
se = √(SSE / (n – 2))
Dans notre feuille Excel, nous pouvons calculer manuellement cette métrique fondamentale au sein de la cellule I35 en saisissant la formule suivante :
=RACINE(I33 / (NB(C2:C31) – 2))
Avec notre SSE de 1842,27 et 28 degrés de liberté (30 observations moins 2 paramètres estimés), le résultat calculé donne 8,11 points d’examen. Cela signifie concrètement que le modèle linéaire prédit les résultats des candidats avec une incertitude moyenne typique d’environ 8 points autour de leur note réelle.
Pour recouper la justesse de cette dérivation manuelle, Excel met à disposition une fonction dédiée : la fonction ERREUR.TYPE.REGXY. En écrivant dans une cellule de contrôle =ERREUR.TYPE.REGXY(C2:C31; B2:B31), l’analyste constate la restitution exacte de la valeur 8,11, corroborant ainsi la cohérence interne des décompositions résiduelles opérées pas à pas.
10. 10. Contrôle de cohérence, validation matricielle et calcul du coefficient R²
10.1 10.1 Vérification systématique de l’identité arithmétique
Au terme des trois cheminements manuels distincts ayant permis d’isoler la SST (cellule D33), la SSR (cellule G33) et la SSE (cellule I33), une démarche d’audit méthodologique impose de valider empiriquement l’identité fondamentale de l’analyse de variance : SST = SSR + SSE.
En théorie pure, la différence SST – (SSR + SSE) doit être rigoureusement égale à zéro. Cependant, dans les environnements informatiques numériques, les calculs portant sur des nombres décimaux étendus peuvent générer d’infimes résidus d’arrondi binaire (de l’ordre de 10-14 ou 10-15) liés à la norme de précision arithmétique à virgule flottante IEEE 754. Par conséquent, un test d’égalité logique direct tel que =D33=(G33+I33) pourrait occasionnellement renvoyer un statut FAUX fallacieux.
Pour contourner ce piège classique d’ingénierie logicielle, nous implémentons un test de tolérance epsilon dans une cellule de validation, par exemple en K2, à l’aide de la syntaxe conditionnelle suivante :
=SI(ABS(D33 – (G33 + I33)) < 0,000001; « ADDITIVITÉ VALIDÉE »; « ERREUR ARITHMÉTIQUE »)
Cette fonction utilise la valeur absolue (ABS) de la différence entre la somme totale et l’agrégat des deux composantes factorielles. Si cet écart résiduel est strictement inférieur à un millionième, le tableur certifie formellement la conformité structurelle de la feuille de calcul. L’obtention de la mention « ADDITIVITÉ VALIDÉE » assure à l’expérimentateur que ses données ne souffrent d’aucun biais de référencement, d’aucune rupture d’ancrage matriciel et qu’aucun artefact de troncature n’est venu corrompre la chaîne d’estimation.
10.2 10.2 Dérivation mathématique du coefficient de détermination (R²)
Le coefficient de détermination, universellement symbolisé par R², constitue l’indice d’effet omnibus le plus célèbre et le plus couramment rapporté dans la littérature psychologique. Il exprime la proportion relative de la variance totale de la variable dépendante qui est captée, modélisée et prévisible grâce à la variable explicative introduite.
Grâce à la décomposition préalable des sommes de carrés, le coefficient R² se calcule selon deux formulations mathématiques rigoureusement équivalentes :
- Perspective de la variance expliquée : En rapportant directement la variance expliquée par le modèle à la variance globale de référence :
R² = SSR / SST
Dans notre feuille de calcul, cette formule s’implémente en cellule
K4sous la forme :=G33/D33. - Perspective de la réduction de l’erreur : En calculant la réduction proportionnelle de l’erreur résiduelle permise par le modèle par rapport à l’erreur du modèle nul :
R² = 1 – (SSE / SST)
Dans Excel, cette dérivation s’encode en cellule
K5via l’instruction :=1-(I33/D33).
En injectant nos grandeurs empiriques (SSR = 4285,73, SSE = 1842,27, SST = 6128,00), les deux approches délivrent identiquement un résultat de 0,6994, soit 69,94 % de variance expliquée. Cela indique que près de 70 % de la dispersion des scores à l’examen de neurosciences sont systématiquement imputables au temps d’étude hebdomadaire consenti par les étudiants.
Pour recouper une nouvelle fois ces calculs manuels, Excel met à disposition la fonction directe =COEFFICIENT.DETERMINATION(C2:C31; B2:B31). De surcroît, dans le cadre univarié de la régression linéaire simple, le R² correspond très exactement au carré du coefficient de corrélation linéaire de Pearson. Si l’analyste saisit dans une cellule =COEFFICIENT.CORRELATION(B2:B31; C2:C31)^2, il obtiendra le même résultat chiffré de 0,6994, validant l’interconnexion intime unissant corrélation bivariée, analyse de variance et régression linéaire.
10.3 10.3 Ajustement du R² selon les degrés de liberté
Bien que le R² brut présente un attrait descriptif indéniable, il souffre d’un biais d’estimation mathématique systématique : il s’agit d’un estimateur optimiste de la véritable variance expliquée dans la population parente. En effet, par sa construction fondée sur les moindres carrés, le R² capitalise sur le hasard d’échantillonnage, captant accidentellement des corrélations parasites propres à l’échantillon observé. Ce phénomène s’aggrave dramatiquement à mesure que la taille d’échantillon n diminue ou que le nombre de variables prédictrices k s’accroît.
Pour corriger cette inflation artificielle, la statistique moderne recourt au coefficient de détermination ajusté (R²adj), conçu par Mordecai Ezekiel. Cet indice substitue aux sommes de carrés brutes leurs contreparties non biaisées : les carrés moyens pondérés par les degrés de liberté respectifs :
R²adj = 1 – [(SSE / dlres) / (SST / dltot)] = 1 – [(1 – R²) · (n – 1) / (n – k – 1)]
Dans notre environnement Excel, nous programmons le calcul manuel de ce coefficient corrigé au sein de la cellule K6 en écrivant :
=1 – ((I33/28) / (D33/29))
L’évaluation délivre un R²adj de 0,6886 (soit 68,86 %). L’écart entre le R² brut (69,94 %) et le R² ajusté (68,86 %) chiffre précisément la pénalité imposée pour compenser l’échantillonnage fini. Dans le rapport produit par l’Utilitaire d’analyse, cette métrique est répertoriée sous l’intitulé « R² ajusté » au sein du bloc des statistiques de régression.
En recherche psychologique, la communication systématique du R² ajusté est impérative, tout particulièrement lors de l’élaboration de protocoles impliquant de multiples traits de personnalité ou prédicteurs cognitifs concurrents, afin de ne pas induire la communauté scientifique en erreur sur la véritable généralisabilité du modèle prédictif proposé.
11. 11. Portée épistémologique et clinique des métriques en psychologie
11.1 11.1 Interprétation de la variance dans les modèles d’apprentissage et de cognition
Au-delà de la virtuosité calculatoire déployée sous Excel, l’analyste en psychologie doit investir les métriques SST, SSR et SSE d’une signification théorique et clinique tangible. Dans le domaine de l’apprentissage et des sciences cognitives, la prédominance quantitative de la SSR sur la SSE apporte la démonstration probante qu’une part prépondérante du fonctionnement intellectuel ou de la réussite pédagogique obéit à des lois d’acquisition régulières et modélisables. Lorsqu’un prédicteur comportemental tel que l’entraînement mnésique explique à lui seul près de 70 % de la dispersion des scores, le chercheur recueille un argument empirique solide en faveur de l’efficacité intrinsèque du dispositif pédagogique.
Cependant, l’examen de la SSE (la variance inexpliquée) s’avère tout aussi crucial sur le plan diagnostique. Dans l’étude des conduites humaines, les résidus ne sauraient être réduits à un simple déchet algorithmique négligeable. Une SSE substantielle renvoie à deux réalités distinctes mais intriquées :
- La variance intra-individuelle et interindividuelle non contrôlée : Elle englobe la réactivité affective différentielle face à l’épreuve d’examen, les niveaux fluctuants d’anxiété de performance, la qualité du sommeil préalable à l’évaluation ou les capacités de mémoire de travail intrinsèques des participants.
- L’imperfection métrologique : Même les échelles psychométriques les mieux calibrées intègrent une marge d’erreur standard de mesure (SEM). La fidélité imparfaite des tests contribue directement au gonflement de la SSE.
Le praticien doit donc faire preuve de modestie épistémologique : un modèle linéaire, aussi performant soit-il, ne capture qu’une projection simplifiée de la dynamique psychique. La SSE nous rappelle en permanence qu’aucun individu ne se réduit entièrement à l’étiquette mathématique issue de ses heures de préparation, et que la marge résiduelle constitue le territoire d’expression de la singularité psychologique.
11.2 11.2 Utilisation des métriques pour la sélection de modèles rivaux
Dans la démarche hypothético-déductive propre à la psychologie expérimentale, les chercheurs ne se contentent que rarement d’évaluer un modèle linéaire isolé ; ils mettent régulièrement en compétition plusieurs cadres théoriques alternatifs afin d’élucider les déterminants d’un comportement. Les sommes de carrés constituent l’arbitre numérique souverain de cette sélection de modèles, notamment à travers la comparaison de modèles emboîtés.
Imaginons que nous souhaitions tester si l’adjonction d’une seconde variable explicative — par exemple le niveau de motivation intrinsèque du sujet (mesuré par un questionnaire standardisé) — améliore significativement la prédiction de la performance à l’examen par rapport au modèle simple initial fondé sur le seul temps d’étude. Nous disposons alors d’un Modèle Réduit (Modèle 1 : temps d’étude seul) et d’un Modèle Complet (Modèle 2 : temps d’étude + motivation intrinsèque) :
- L’intégration du second prédicteur va mathématiquement accroître la somme des carrés de la régression (SSRcomplet > SSRréduit) et corrélativement amenuiser la somme des carrés des erreurs (SSEcomplet < SSEréduit).
- L’accroissement de la variance expliquée, formalisé par
ΔSSR = SSRcomplet - SSRréduit = SSEréduit - SSEcomplet, est alors soumis au test F incrémental (ou test du changement de R²) :
Fincrémental = [(ΔSSR / Δk)] / [SSEcomplet / (n – kcomplet – 1)]
Ce ratio permet de déterminer si la réduction de la SSE obtenue par l’introduction de la nouvelle variable comportementale est statistiquement significative ou si elle relève du surapprentissage opportuniste. De surcroît, la SSE sert de pierre angulaire à la dérivation de critères d’information pénalisés tels que l’Akaike Information Criterion (AIC) ou le Bayesian Information Criterion (BIC), que l’on peut facilement calculer dans une cellule Excel à partir de la formulation :
AIC = n · LN(SSE / n) + 2k
Ces métriques guident le statisticien dans sa quête d’un compromis optimal entre parcimonie théorique et pouvoir descriptif.
11.3 11.3 Communication des résultats selon les normes académiques (APA)
La restitution des analyses de modélisation statistique dans les revues internationales de psychologie et de sciences sociales est soumise aux conventions éditoriales strictes promulguées par l’American Psychological Association (normes APA, actuellement en 7e édition). Une rédaction académique rigoureuse prohibe le copier-coller brut de captures d’écran des sorties d’Excel au profit d’une synthèse narrative et tabulaire standardisée.
Sur le plan textuel, la communication de l’adéquation globale du modèle doit intégrer de façon conjointe les degrés de liberté, la valeur de la statistique de Fisher, le seuil de signification exacte et la taille d’effet mesurée par le R². Pour notre modélisation expérimentale, la formulation textuelle normalisée prendra la forme suivante :
« Une analyse de régression linéaire simple a été conduite afin de prédire la performance à l’examen standardisé à partir du temps de révision hebdomadaire. Le modèle prédictif s’avère statistiquement significatif, F(1, 28) = 65,10, p < ,001, et rend compte d’une part substantielle de la variance des scores observés, R² = ,70, R²ajusté = ,69. Le temps d’étude hebdomadaire prédit positivement et significativement le résultat psychométrique final (b = 2,45, β = ,84, t(28) = 8,07, p < ,001). »
Lorsqu’un tableau ANOVA complet est requis pour documenter les sommes de carrés, celui-ci doit respecter la mise en forme typographique APA : aucune bordure verticale, seules trois lignes horizontales majeures délimitant l’en-tête, le bloc de données et la ligne de clôture inférieure. Les colonnes doivent consigner rigoureusement les labels : Source (Régression, Résidus, Total), SS (Somme des carrés), df (Degrés de liberté), MS (Carrés moyens), F et p. Les sommes de carrés doivent être rapportées avec deux ou trois décimales de précision constante, attestant d’une parfaite transparence méthodologique.
12. 12. Diagnostic des erreurs fréquentes, dépannage et bonnes pratiques sous Excel
12.1 12.1 Erreurs de référencement et d’ancrage des cellules
L’implémentation d’algorithmes statistiques dans un tableur interactif expose l’analyste à des erreurs de logique d’adressage qui ne génèrent pas nécessairement de messages d’erreur système visibles, mais faussent silencieusement les estimations numériques. Le diagnostic régulier de ces pièges récurrents constitue un impératif pour sécuriser la validité des conclusions.
Les dysfonctionnements les plus fréquents recensés en laboratoire incluent :
- L’omission de l’ancrage absolu ($) sur la moyenne générale : Lors de l’encodage manuel de la SST (
=(C2-C33)^2au lieu de=(C2-$C$33)^2), l’absence de fixation par le symbole dollar fait glisser la référence de la moyenne vers le bas au fur et à mesure que la formule est recopiée. À partir de la rangée suivante, la formule retranche des cellules vides interprétées comme des zéros, produisant une SST aberrante et démesurée. - L’inversion des plages matricielles dans les fonctions natives : Dans les fonctions d’estimation telles que
=PENTE(plage_y; plage_x),=ORDONNEE.ORIGINE(plage_y; plage_x)ou=PREVISION.LINEAIRE(x; plage_y; plage_x), la convention logicielle d’Excel exige systématiquement la désignation de la variable dépendante Y en premier argument. L’inversion par inadvertance des plages X et Y aboutit à l’estimation de la régression inverse (X prédit par Y), faussant totalement les calculs subséquents de la SSR et de la SSE sans qu’Excel n’émette la moindre alerte d’incompatibilité. - La propagation verticale asymétrique : Lors du déploiement de formules d’écarts quadratiques sur de volumineux jeux de données, il arrive qu’une double-clique sur la poignée de recopie s’interrompe prématurément en raison d’une cellule vide isolée dans la colonne adjacente, ou au contraire se prolonge accidentellement sur des lignes de totaux ou de commentaires descriptifs, contaminant le calcul global de la somme des carrés.
12.2 12.2 Traitement des données aberrantes et violations des postulats
L’élévation au carré inhérente au calcul de la SST, de la SSR et de la SSE confère à ces métriques une hypersensibilité aux données aberrantes (outliers) et aux observations bénéficiant d’un fort bras de levier. Un score isolé manifesté par un participant déviant sévèrement de la tendance générale peut à lui seul gonfler artificiellement la SSE ou, s’il se situe à une extrémité de la variable X, déformer la pente et biaiser considérablement la répartition entre SSR et SSE.
Pour prévenir ces dérives analytiques, l’expérimentateur doit intégrer une démarche diagnostique systématique :
- Inspection graphique préalable : La construction systématique d’un diagramme de dispersion (nuage de points X-Y) permet de repérer immédiatement à l’œil nu les points s’écartant dramatiquement de la trajectoire linéaire générale avant d’exécuter la moindre formule.
- Examen des résidus studentisés : Dans les sorties de l’Utilitaire d’analyse, examiner la colonne des résidus standardisés. Toute observation dont le résidu standardisé dépasse en valeur absolue le seuil de
|3,0|(ou|2,5|pour les petits échantillons) doit faire l’objet d’une enquête approfondie : s’agit-il d’une erreur d’encodage psychométrique ou d’un profil clinique atypique ? - Limites intrinsèques d’Excel : Il convient d’avoir conscience que le moteur de base de Microsoft Excel n’intègre pas d’algorithmes de régression robuste (tels que les estimateurs de Huber, la régression de Theil-Sen ou la régression quantile) capables de neutraliser automatiquement l’influence des points de levier. Si les postulats de linéarité ou d’homoscédasticité sont sévèrement violés, l’analyste devra envisager une transformation mathématique des variables (logarithmique, racine carrée) au sein de ses colonnes Excel ou migrer temporairement vers un environnement dédié pour conduire des analyses non paramétriques.
12.3 12.3 Recommandations de gouvernance des feuilles de calcul
Afin de garantir la reproductibilité, l’auditabilité et la longévité des classeurs d’analyse dans les laboratoires de recherche et les structures de conseil, il est capital d’adopter des règles de gouvernance documentaire strictes. Une feuille de calcul désorganisée, où les données brutes côtoient pêle-mêle des résultats d’estimation intermédiaires et des synthèses graphiques, constitue un terreau propice aux erreurs de manipulation scientifique.
Il est recommandé de structurer l’environnement de calcul en adoptant une architecture modulaire à trois niveaux :
- Onglet 1 : « Matrice_Source » : Dévoué exclusivement à l’hébergement des données brutes validées. Aucune formule manuelle n’y est inscrite, hormis l’encodage des identifiants et des variables comportementales. Cet onglet est idéalement verrouillé en écriture pour sanctuariser l’intégrité du protocole d’évaluation.
- Onglet 2 : « Decomposition_Pas_a_Pas » : C’est au sein de cet espace que se déploient les calculs algorithmiques manuels décrits dans ce manuel (moyennes, colonnes des écarts quadratiques, valeurs prédites, résidus et tests de validation logique). Pour maximiser la robustesse des plages de données, il est fortement encouragé de convertir les plages brutes en Tableaux structurés Excel (via le raccourci
Ctrl + Lou l’onglet Insertion > Tableau). Cette fonctionnalité permet d’utiliser des références structurées lisibles (par exemple=[@Heures_Revision]au lieu deB2) et assure la propagation automatique des formules lors de l’adjonction ultérieure de nouveaux participants. - Onglet 3 : « Rapport_Synthese » : Cet onglet regroupe le tableau ANOVA généré par l’Utilitaire d’analyse, les indicateurs d’adéquation consolidés (R², R²adj, erreur type), les diagrammes de dispersion diagnostiques et les blocs textuels rédigés aux normes APA prêts pour l’exportation vers le manuscrit académique.
Enfin, l’insertion systématique de commentaires de cellules documentant la provenance de chaque équation mathématique et l’archivage sous format de classeur prenant en charge les métadonnées pérennisent la mémoire computationnelle du laboratoire et facilitent les démarches de révision par les pairs lors de la soumission d’articles de recherche.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Draper, N. R., & Smith, H. (1998). Applied regression analysis (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781118625590
- Fox, J. (2016). Applied regression analysis and generalized linear models (3rd ed.). SAGE Publications.
- Howell, D. C. (2013). Statistical methods for psychology (8th ed.). Wadsworth, Cengage Learning.
- Microsoft Corporation. (2024). Charger et activer l’Utilitaire d’analyse dans Excel. Support Microsoft. https://support.microsoft.com/fr-fr/office/charger-et-activer-l-utilitaire-d-analyse-dans-excel-64a391a9-7916-4382-ad91-a6effc0e2417
- Pedhazur, E. J. (1997). Multiple regression in behavioral research: Explanation and prediction (3rd ed.). Harcourt Brace College Publishers.
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.