
L’analyse rigoureuse des données quantitatives en sciences comportementales, en neuropsychologie et en modélisation biométrique exige une vigilance méthodologique constante face aux observations aberrantes. Dans tout protocole empirique, l’émergence d’une valeur atypique soulève un dilemme fondamental : s’agit-il d’une erreur d’enregistrement technique, d’un artéfact expérimental transitoire ou de l’expression authentique d’une variabilité phénotypique rare ? Historiquement, la statistique inférentielle s’est appuyée sur le score Z classique pour standardiser les distributions et isoler les observations distantes de la tendance centrale. Toutefois, cette approche paramétrique conventionnelle repose sur des postulats distributionnels d’une grande fragilité, postulant une normalité gaussienne rarement observée dans les paradigmes réels de laboratoire.
Face aux limites structurelles des estimateurs gaussiens traditionnels, les statisticiens Boris Iglewicz et David Hoaglin ont formalisé au début des années 1990 une alternative robuste devenue la référence en métrologie et en psychométrie : le score Z modifié. En substituant la médiane à la moyenne arithmétique et l’écart absolu médian (MAD) à l’écart-type, cet estimateur non paramétrique immunise le chercheur contre les biais d’entraînement induits par les valeurs extrêmes. Il offre un seuil de détection insensible aux phénomènes pernicieux d’écrasement ou de masquage statistique, tout en conservant une interprétabilité directe sur l’échelle de la loi normale théorique.
Ce guide exhaustif propose une déconstruction théorique et opérationnelle intégrale du score Z modifié dans l’environnement Microsoft Excel. Conçu pour les chercheurs, statisticiens universitaires et data analysts exigeants, cet article détaille chaque étape du processus computationnel, depuis les fondations mathématiques de la constante d’échelle jusqu’à l’implémentation de fonctions matricielles dynamiques modernes et l’interprétation inférentielle des résultats épurés.
1. Fondements théoriques du score Z modifié en recherche psychologique et statistique
1.1 Limites du score Z standard face aux distributions asymétriques
Le score Z conventionnel, formulé par la relation classique z = (x – μ) / σ, constitue l’un des piliers de l’analyse exploratoire des données. Pourtant, son efficacité s’effondre dramatiquement dès lors que l’échantillon s’écarte de la loi normale théorique. Cette vulnérabilité découle directement de la sensibilité extrême de ses deux paramètres constitutifs : la moyenne arithmétique et l’écart-type. En présence d’une seule valeur aberrante de magnitude disproportionnée, la moyenne est irrémédiablement déportée vers cette anomalie, tandis que l’écart-type subit une dilatation quadratique artificielle. Par conséquent, les estimateurs censés décrire le profil d’homogénéité du groupe se trouvent contaminés par l’observation même qu’ils ont pour mission d’identifier.
Dans les disciplines empiriques telles que la chronométrie mentale ou la psychométrie clinique, les distributions observées présentent structurellement une asymétrie positive (étalement vers la droite). Les temps de réaction, par exemple, sont caractérisés par une frontière physiologique infranchissable à gauche (temps de conduction neuronale incompressible d’environ 150 à 200 millisecondes) et par une queue de distribution allongée à droite, générée par des fluctuations de vigilance ou des micro-lapsus attentionnels. L’application d’un score Z standard à de telles données non gaussiennes produit des distorsions préjudiciables pour la validité interne des protocoles expérimentaux.
Ce dysfonctionnement culmine dans le phénomène bien documenté de masquage statistique (masking effect). Lorsqu’une valeur aberrante sévère gonfle excessivement l’écart-type de l’échantillon, le dénominateur de l’équation standard devient si élevé qu’il réduit mécaniquement la valeur absolue de tous les scores Z individuels. L’observation pathologique s’auto-dissimule ainsi au sein d’une variance artificiellement surdimensionnée, tout en provoquant simultanément l’effet inverse d’inondation (swamping effect), où des observations saines et représentatives sont faussement qualifiées d’atypiques. Le recours à des estimateurs dits robustes s’impose dès lors comme un impératif méthodologique incontournable.
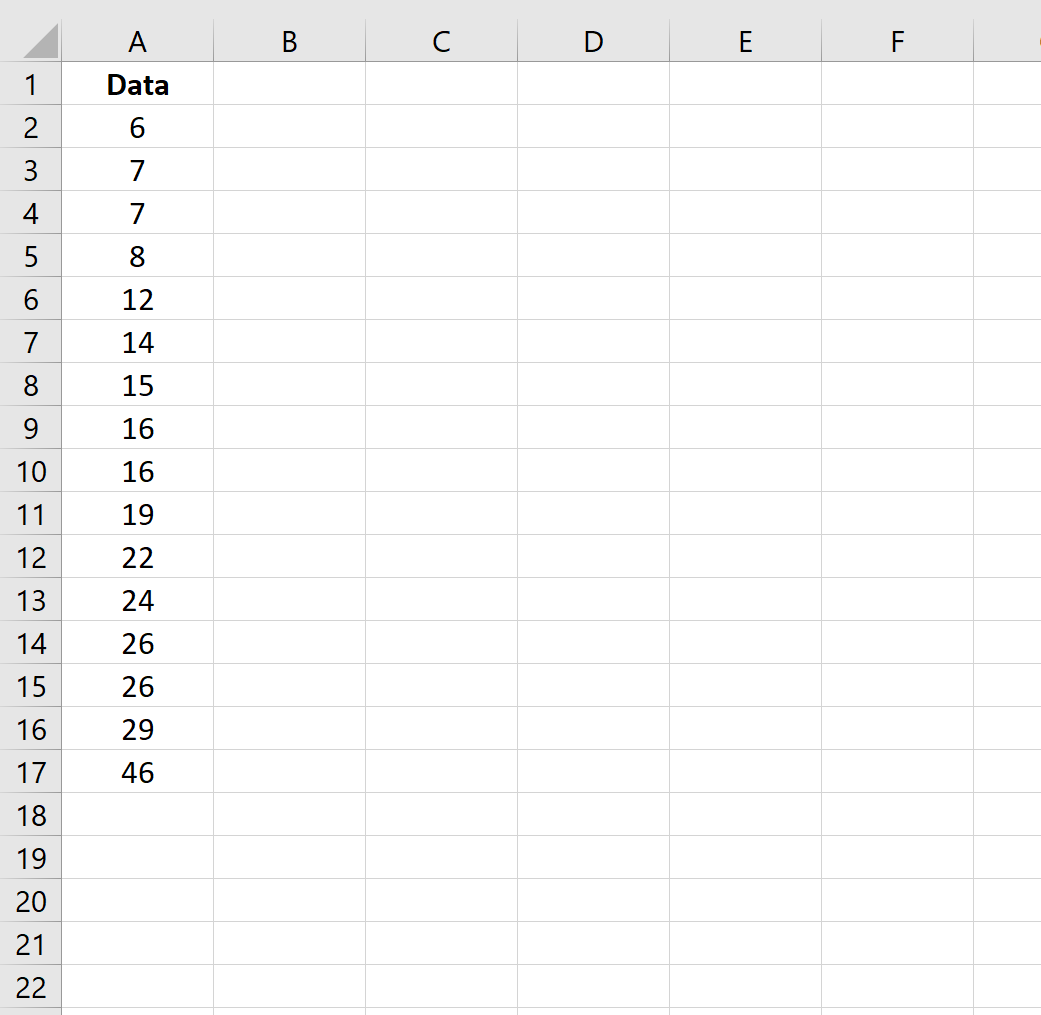
1.2 Définition mathématique et justification de la médiane et de la MAD
Pour s’affranchir de la sensibilité paramétrique, la théorie statistique robuste s’appuie sur le concept formel de point de rupture (breakdown point), défini comme la proportion minimale d’observations contaminées qu’un estimateur peut tolérer avant de produire une valeur arbitrairement aberrante ou infinie. Alors que la moyenne arithmétique et l’écart-type possèdent un point de rupture catastrophique de 0 % (une seule valeur infinie suffit à corrompre l’estimateur pour un échantillon de taille N), la médiane bénéficie d’un point de rupture optimal de 50 %. Cela signifie que près de la moitié de l’échantillon peut être falsifiée sans que la médiane ne perde son ancrage au centre géométrique des données valides.
En miroir de la médiane pour la tendance centrale, la dispersion requiert un estimateur résistant. L’écart absolu médian (connu sous l’acronyme anglophone MAD pour Median Absolute Deviation) s’est imposé comme la mesure d’échelle non paramétrique la plus robuste. Formellement, pour un vecteur d’observations x = (x₁, x₂, …, xₙ), la MAD est définie par la médiane des écarts absolus entre chaque observation et la médiane globale de l’échantillon :
MAD = médiane(|xᵢ – médiane(x)|)
Cette double application de l’opérateur médian confère à la MAD le même point de rupture élevé de 50 %. Contrairement à l’écart-type, qui accorde un poids disproportionné aux grands écarts par le biais de l’élévation au carré des résidus, la MAD traite les déviations de manière linéaire et isole le cœur de la variabilité expérimentale. Dans le cadre de l’analyse comportementale, où les contaminations par distraction du sujet, bruit d’appareillage ou saisie erronée sont courantes, la MAD fournit un étalon de dispersion stable et immunisé contre les fluctuations erratiques d’échantillonnage.
1.3 Origine et rôle de la constante de mise à l’échelle 0,6745
Bien que la MAD constitue une métrique d’échelle intrinsèquement robuste, sa valeur numérique brute n’est pas directement interchangeable avec l’écart-type d’une distribution paramétrique. Si l’on évalue la MAD sur une population purement normale de moyenne nulle et d’écart-type unitaire, la valeur obtenue ne converge pas vers 1, mais vers le troisième quartile de la distribution normale standard centrée réduite. Par définition des probabilités associées à la loi de Gauss, la moitié de la masse de probabilité se concentre dans l’intervalle symétrique entourant la moyenne, ce qui correspond à l’intégrale de densité comprise entre -0,67449 et +0,67449.
En conséquence, l’espérance mathématique de la MAD pour une loi normale théorique N(μ, σ²) vérifie la relation asymptotique suivante :
E(MAD) = Φ⁻¹(0,75) · σ ≈ 0,67448975 · σ
Pour convertir la MAD en un estimateur sans biais et asymptotiquement convergent de l’écart-type classique σ sous l’hypothèse de quasi-normalité centrale, il convient d’appliquer un coefficient multiplicatif de normalisation. Deux formulations rigoureusement équivalentes se rencontrent dans la littérature spécialisée. La première consiste à diviser la MAD par 0,6745, ce qui revient à la multiplier par son inverse, soit approximativement 1,4826 (facteur k = 1 / 0,67449). La seconde formulation, retenue par Boris Iglewicz et David Hoaglin, intègre ce facteur de correction directement au numérateur du ratio de standardisation sous la forme multiplicative de la constante 0,6745.
Ce recalibrage mathématique est fondamental : il assure que le score Z modifié produit des valeurs numériques identiques au score Z standard lorsque la distribution sous-jacente est parfaitement gaussienne. Il préserve ainsi l’intuition probabiliste du praticien tout en lui offrant un bouclier statistique impénétrable contre les artéfacts d’asymétrie et de kurtosis.
2. Cadre méthodologique selon Iglewicz et Hoaglin pour l’évaluation des anomalies
2.1 Formulation formelle du score Z modifié
L’architecture opérationnelle du modèle développé par Iglewicz et Hoaglin (1993) sous l’égide de l’American Society for Quality Control repose sur une standardisation robuste individualisée pour chaque point de données d’un échantillon expérimental. Pour une observation spécifique notée xᵢ issue d’une série de mesures x, le score Z modifié, universellement désigné par le symbole Mᵢ, s’exprime selon l’équation canonique suivante :
Mᵢ = [ 0,6745 · (xᵢ – x̃) ] / MAD
Dans cette expression formelle, chaque composante remplit une fonction analytique déterminée :
- xᵢ représente la valeur brute de l’observation mesurée pour l’unité statistique i.
- x̃ (x tilde) désigne la médiane empirique de la distribution intégrale des observations.
- (xᵢ – x̃) quantifie la déviation brute ou résidu non standardisé du point considéré vis-à-vis du centre robuste.
- MAD constitue l’écart absolu médian défini préalablement, agissant comme dénominateur d’échelle de dispersion robuste.
- 0,6745 représente la constante de calage assurant l’équivalence métrique avec l’écart-type gaussien standard.
Il importe de distinguer formellement la déviation brute de la déviation pondérée. La déviation brute renseigne exclusivement sur l’écart métrique direct dans l’unité native de la variable (par exemple des millisecondes ou des points d’échelle psychométrique). En revanche, le ratio Mᵢ exprime une distance adimensionnelle régularisée, permettant des comparaisons directes inter-échantillons et trans-variables, indépendamment des échelles de mesure primitives, qu’il s’agisse de variables quantitatives continues ou discrètes à spectre large.
2.2 Seuils critiques empiriques et justification du critère absolu de 3,5
Dans le paradigme du score Z standard, la règle empirique classique consiste à étiqueter comme valeur atypique toute observation dont le score satisfait la condition |z| > 2,5 ou |z| > 3,0. Cependant, des simulations de Monte Carlo approfondies conduites par Iglewicz et Hoaglin ont démontré que ces seuils traditionnels s’avèrent inopérants et génèrent un taux inacceptable de faux positifs (erreurs de type I) lorsqu’ils sont appliqués à des estimateurs robustes sur des échantillons de taille modérée à grande.
Pour pallier cette dérive décisionnelle, les auteurs ont établi par modélisation empirique que le seuil de démarcation optimal doit être fixé à une valeur absolue de 3,5 :
|Mᵢ| > 3,5
La justification mathématique de cette borne de 3,5 réside dans l’équilibre précis entre sensibilité et spécificité statistique. Sous une distribution strictement gaussienne, la probabilité théorique qu’une observation franchisse spontanément le seuil de 3,5 en valeur absolue est infinitésimale (p ≈ 0,000465, soit moins de 5 chances sur 10 000). Ce seuil strict garantit que la détection d’une anomalie signale avec une quasi-certitude une défaillance de mesure ou une discontinuité distributionnelle majeure, plutôt qu’une fluctuation aléatoire banale. Bien que le chercheur puisse moduler ce seuil dans des protocoles cliniques ultra-sensibles (par exemple en adoptant |Mᵢ| > 3,0 pour explorer des signaux faibles), la borne de 3,5 constitue la norme méthodologique de référence dans les publications scientifiques internationales.
2.3 Applications psychométriques : temps de réaction et scores d’inventaires
Le champ des neurosciences cognitives et de la psychométrie offre un terrain d’application idéal pour le score Z modifié. Dans les protocoles informatisés évaluant l’attention sélective, tels que la tâche de Stroop, les épreuves de type Go/No-Go ou les tâches de détection de signaux sensoriels, la distribution des latences de réponse est quasi systématiquement asymétrique vers la droite. Les données chronométriques sont fréquemment polluées par deux classes d’artéfacts antagonistes : des réponses ultra-rapides générées par anticipation motrice involontaire (latences inférieures à 150 ms) et des latences anormalement longues provoquées par un décrochage temporaire du participant de la consigne expérimentale.
L’utilisation d’une coupure paramétrique basée sur la moyenne ± 2 écarts-types conduit inévitablement à éliminer des réponses cognitives authentiques tout en échouant à neutraliser les temps excessivement allongés en raison du masquage de variance. À l’inverse, l’implémentation du score Z modifié permet de cartographier avec précision la dispersion centrale réelle de la tâche cognitive, isolant sans ambiguïté les lapsus attentionnels sans pénaliser la variabilité interindividuelle physiologique.
Dans le domaine des inventaires de personnalité et des échelles d’évaluation clinique (échelles de Likert à items multiples), le score Z modifié s’illustre également dans la détection des schémas de réponse non engagés (careless responding) ou des tentatives délibérées de simulation pathologique. En calculant les indices Mᵢ sur les temps de réponse par item ou sur les scores composites dimensionnels, les méthodologistes peuvent diagnostiquer les profils atypiques avec une robustesse mathématique inattaquable lors des comités de lecture académiques.
3. Préparation de l’environnement de travail et structuration des données dans Excel
3.1 Organisation tabulaire rigoureuse d’une cohorte expérimentale
L’exactitude des calculs statistiques sous Microsoft Excel repose avant tout sur une ingénierie de données structurée selon les principes de l’analyse tabulaire moderne. Il est vivement déconseillé de consigner des observations numériques brutes dans une grille non organisée sans délimitation stricte. L’approche recommandée consiste à exploiter systématiquement l’objet natif Format Tableau d’Excel (accessible via le raccourci Ctrl + L ou l’onglet Accueil > Mettre sous forme de tableau).
L’organisation tabulaire optimale requiert l’attribution systématique d’une clé primaire d’identification à chaque participant (colonne ID_Sujet ou Participant_ID). Cette précaution garantit une traçabilité intégrale et prévient les erreurs dramatiques de désynchronisation de lignes lors des tris ou filtrages ultérieurs. La structure du tableau doit respecter une dissociation spatiale et conceptuelle rigide entre :
- Les données sources primitives collectées, qui doivent demeurer strictement immuables pour préserver l’auditabilité expérimentale.
- Les métriques d’échelle et statistiques dérivées globales (médiane, MAD), idéalement positionnées dans une table de paramétrage dédiée ou dans un cartouche d’en-tête supérieur clairement délimité.
- Les colonnes vectorielles de calcul individuel (résidus absolus, scores Mᵢ, balises de décision).
L’utilisation de plages nommées explicites (par exemple définir la plage des données sous l’étiquette sémantique Serie_RT au lieu de la plage brute A2:A100) simplifie la relecture des formules complexes, prévient les erreurs de syntaxe d’adressage et facilite la validation croisée des calculs par des tiers auditeurs.
3.2 Nettoyage préliminaire et gestion des valeurs manquantes
Avant d’engager le moindre calcul fonctionnel, un audit préliminaire de complétude doit être impérativement conduit sur l’ensemble de la série expérimentale. Microsoft Excel traite de manière hétérogène les cellules vides, les valeurs textuelles et les zéros arithmétiques, ce qui peut engendrer des distorsions mathématiques silencieuses dans les fonctions statistiques. Une confusion fréquente réside dans l’interprétation d’une cellule contenant le chiffre 0 : dans une épreuve chronométrique, une latence de 0 ms n’est pas une valeur valide, mais l’indicateur d’une absence de réponse ou d’une erreur d’acquisition technique.
Les cellules textuelles résiduelles (souvent issues d’exports automatiques de logiciels expérimentaux tels que E-Prime, PsychoPy ou Qualtrics avec des libellés de type « NA », « NULL » ou des espaces invisibles) risquent de fausser l’évaluation du nombre de participants N ou de provoquer des ruptures de type #VALEUR! lors de l’évaluation des déviations. Le chercheur doit opérer une distinction méthodologique claire entre :
- L’exclusion par liste (listwise deletion), consistant à écarter l’observation incomplète dès la phase d’entrée si le protocole ne tolère aucune perte d’information.
- L’isolement rigoureux des données manquantes en cellules vides natives sans aucun caractère caché, permettant aux fonctions
MEDIANEd’ignorer automatiquement ces observations sans fausser le dénombrement effectif du dénominateur.
L’application systématique des filtres automatiques sur chaque colonne permet d’inspecter visuellement les valeurs minimales et maximales, d’identifier d’éventuels séparateurs exotiques et de garantir la stricte pureté numérique de la cohorte analysée.
3.3 Paramétrage linguistique et conventions de calcul d’Excel
Un facteur récurrent d’échec dans le déploiement d’algorithmes statistiques au sein d’équipes de recherche internationales réside dans les discordances de localisation des versions d’Excel. Deux divergences fondamentales doivent être rigoureusement anticipées : la nomenclature des fonctions intégrées et les séparateurs d’arguments et de décimales.
Sur le plan lexical, les fonctions mathématiques requises diffèrent entre la version francophone et la version anglophone du tableur :
- La fonction centrale médiane s’écrit MEDIANE en français et MEDIAN en anglais.
- La fonction d’écart absolu s’écrit ABS dans les deux environnements linguistiques.
- Les fonctions de contrôle logique s’articulent autour de SI, OU, ET en français, contre IF, OR, AND en anglais.
- Les opérations matricielles avancées mobilisent LET et LAMBDA, dont les appellations demeurent identiques dans les versions récentes du moteur d’exécution Microsoft 365.
Sur le plan syntaxique, la version française standard d’Excel utilise le point-virgule (;) comme séparateur canonique d’arguments dans les fonctions, et la virgule (,) comme séparateur décimal. À l’inverse, l’environnement international anglophone utilise la virgule pour dissocier les arguments et le point pour marquer les décimales. La constante empirique fondamentale s’écrit donc 0,6745 sur un système d’exploitation francophone et 0.6745 sur un environnement anglo-saxon. Tout collage direct d’une formule issue d’une publication anglophone sans conversion préalable des points en virgules génère une erreur d’analyse de formule bloquante.
Enfin, il convient de vérifier dans les options avancées d’Excel (Fichier > Options > Options avancées > Lors du calcul de ce classeur) que la case « Définir le calcul avec la précision affichée » demeure décochée, afin de préserver l’intégralité des décimales en virgule flottante double précision au sein de la mémoire tampon du tableur.
4. Étape 1 : Calcul de la médiane de la distribution sous Excel
4.1 Syntaxe et application de la fonction MEDIANE
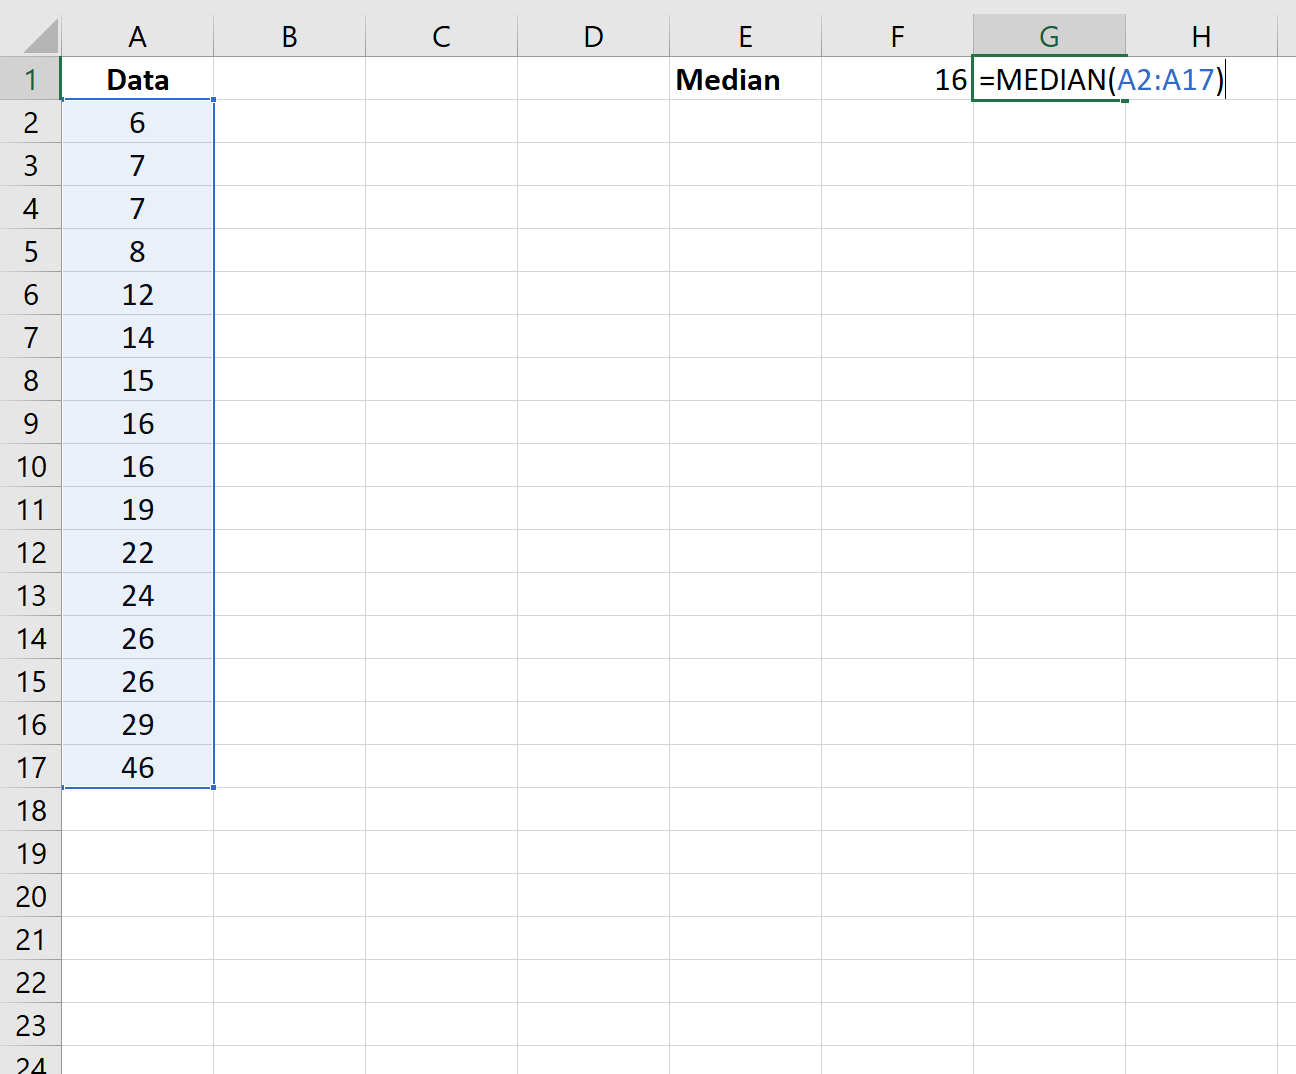
La première phase opérationnelle du protocole statistique consiste à extraire la tendance centrale robuste de la cohorte par le calcul de la médiane empirique globale. La syntaxe officielle de la fonction dans l’environnement Excel francophone est la suivante :
=MEDIANE(plage_valeurs)
Cette fonction accepte comme paramètre unique ou multiple une référence directe à une colonne de données (par exemple B2:B17) ou une série d’intervalles discontinus. Son moteur de calcul interne intègre nativement la distinction mathématique fondamentale liée à la parité de l’effectif expérimental N :
- Si l’échantillon comporte un nombre impair d’observations valides (N = 2k + 1), la fonction ordonne implicitement la série et retourne exactement la valeur centrale située au rang k + 1.
- Si l’échantillon comporte un nombre pair d’observations valides (N = 2k), la fonction identifie les deux valeurs médianes aux rangs k et k + 1 et calcule leur moyenne arithmétique exacte.
Il est recommandé de positionner cette valeur de référence dans une cellule de synthèse isolée, par exemple en haut de feuille dans la cellule E2, clairement labellisée avec le libellé textuel adjacent « Médiane globale ». Dès cette étape, le chercheur avisé effectuera une comparaison diagnostique rapide entre la valeur retournée par =MEDIANE(B2:B17) et celle issue de la fonction paramétrique classique =MOYENNE(B2:B17). Un différentiel significatif entre ces deux métriques constitue un indice formel immédiat attestant d’une asymétrie de distribution marquée ou de la présence d’observations périphériques polluantes.
4.2 Verrouillage des plages de référence par adressage absolu
L’une des sources d’erreurs les plus préjudiciables lors de la construction d’un modèle sous tableur réside dans la mauvaise gestion du glissement des références de cellules. Dans la suite du protocole, la médiane globale devra être soustraite de chaque observation individuelle par recopie verticale de la formule sur l’intégralité des lignes du tableau.
Si la formule de calcul de la médiane est appelée directement au sein de la colonne sans précaution de référencement, ou si la cellule hébergeant la médiane est référencée de façon relative (par exemple E2), l’incrémentation de la formule vers le bas (ligne 3, ligne 4, etc.) transformera mécaniquement la référence en E3, E4, etc., pointant vers des cellules vides ou erronées. Il est donc impératif de recourir à l’adressage absolu par l’adjonction systématique du symbole dollar ($) devant les index de colonne et de ligne :
$E$2
Cette notation absolue verrouille immuablement la cible de calcul, garantissant que quel que soit le niveau de déploiement de la formule sur des milliers de lignes, chaque calcul individuel pointera avec une précision infaillible vers la cellule de médiane centrale. Le respect scrupuleux de cette règle de syntaxe conditionne l’intégrité de l’ensemble de la chaîne de standardisation.
4.3 Automatisation via la gestion dynamique des plages
Bien que l’adressage absolu par coordonnées directes ($B$2:$B$17) assure la stabilité mathématique sur un échantillon figé, cette méthode montre ses limites lors de l’intégration progressive de nouveaux participants au fil du recueil de données. L’approche professionnelle moderne privilégie l’utilisation des références structurées au sein d’un Tableau Excel formalisé.
Lorsque la série brute est convertie en Tableau structuré baptisé par exemple Tableau_Stroop, la colonne des mesures chronométriques reçoit automatiquement un en-tête dédié, tel que [Temps_Reaction]. La formule de calcul de la médiane s’écrit alors :
=MEDIANE(Tableau_Stroop[Temps_Reaction])
Cette formulation présente des vertus opérationnelles décisives pour le laboratoire expérimental :
- Elle élimine tout risque d’inclure accidentellement dans le calcul l’étiquette textuelle de la première ligne ou des lignes vides parasites en fin de document.
- Elle s’auto-dimensionne de manière totalement dynamique : dès lors qu’un nouvel enregistrement expérimental est adjoint au tableau, la plage structurée s’étend instantanément et le calcul de la médiane se met à jour en temps réel sans aucune manipulation manuelle des bornes d’adresses.
- Elle confère au code du classeur une translucidité sémantique totale, facilitant l’évaluation par l’outil de débogage d’Excel (Formules > Évaluer la formule).
5. Étape 2 : Détermination des écarts absolus individuels par rapport à la médiane
5.1 Utilisation de la fonction ABS pour le calcul des déviations
L’étape séquentielle suivante consiste à déterminer, pour chacune des observations de l’échantillon, sa distance scalaire non signée par rapport au pôle d’équilibre central défini par la médiane. Mathématiquement, cette opération correspond au calcul de la déviation absolue individuelle, formalisée par la relation |xᵢ – x̃|.
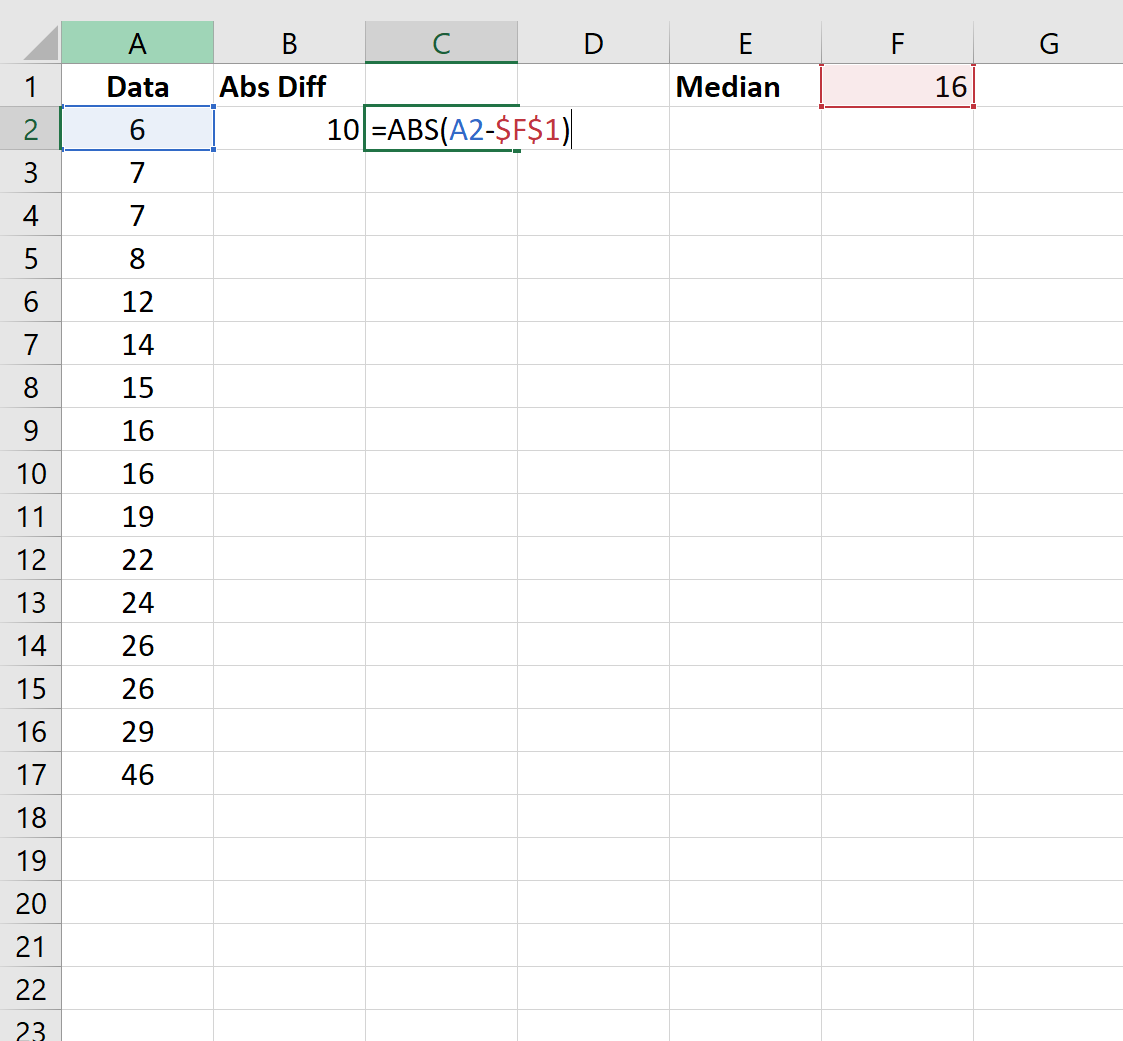
Dans la structure de la feuille de calcul, une nouvelle colonne doit être insérée immédiatement à droite de la variable analysée, intitulée explicitement Ecart_Absolu_Mediane ou Diff_Abs. La formule élémentaire à implémenter sur la première ligne de données (considérons ici la ligne 2 du tableau) mobilise la fonction de valeur absolue native ABS :
=ABS(B2 - $E$2)
Dans cette expression, B2 référence l’observation brute du premier participant x₁, tandis que $E$2 pointe de manière absolue vers la cellule hébergeant la médiane globale calculée à l’étape 1. La fonction ABS neutralise rigoureusement le signe algébrique de la soustraction : qu’une observation se situe à 200 unités au-dessus de la médiane ou à 200 unités en dessous, sa déviation absolue résiduelle sera rigoureusement positive et égale à 200. Sur le plan cognitif et métrologique, cette grandeur traduit l’éloignement spatial pur du comportement du sujet par rapport à la réponse typique du groupe, sans considération du sens de la dérive.
5.2 Déploiement et extension de la formule sur l’échantillon
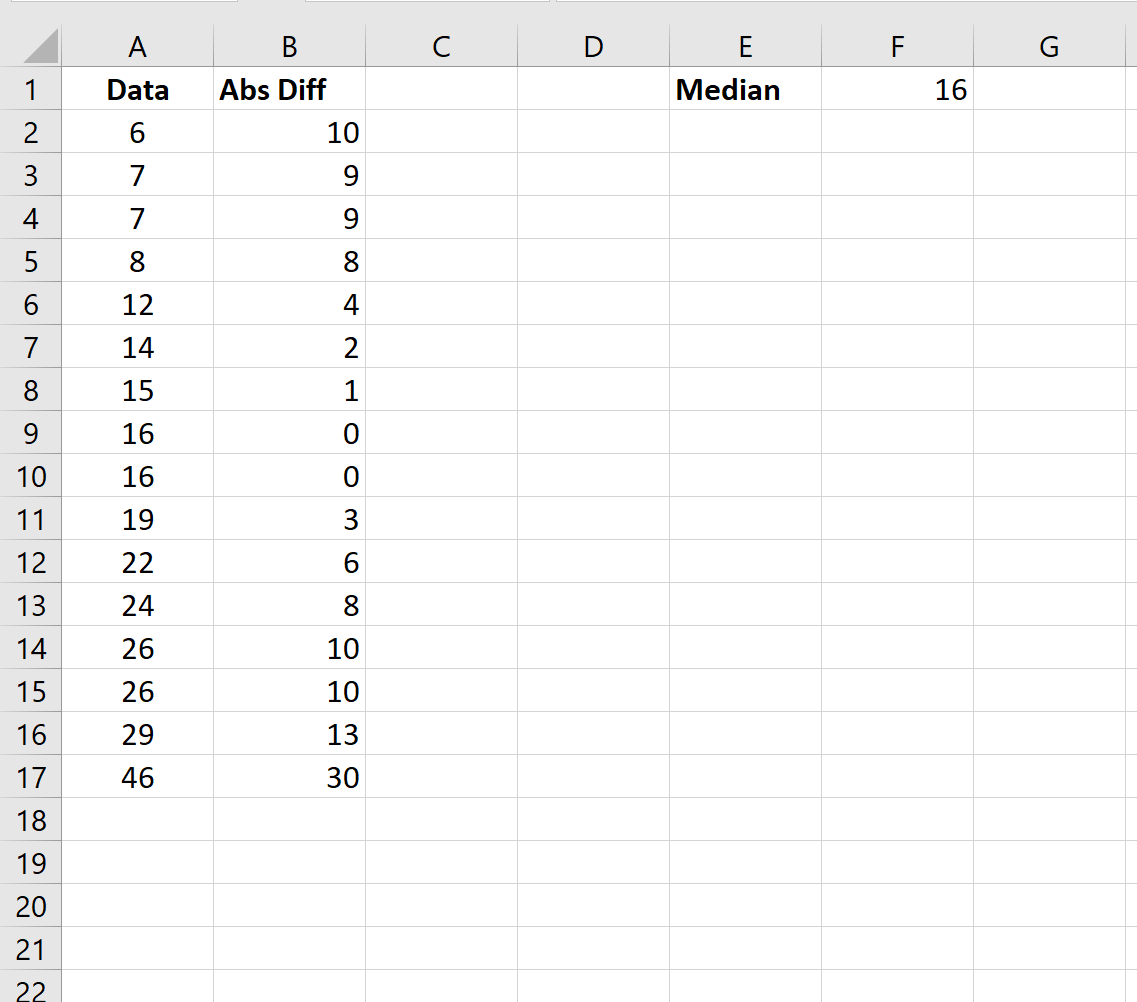
Une fois la formule matricielle élémentaire validée sur le premier enregistrement en cellule C2, il convient d’assurer son extension reproductible sur l’ensemble de la cohorte expérimentale. Plusieurs méthodes opératoires coexistent dans l’interface d’Excel :
- L’utilisation de la poignée de recopie contextuelle : en positionnant le curseur sur l’angle inférieur droit de la cellule active jusqu’à l’apparition d’une croix noire fine, un double-clic gauche propage instantanément la formule sur toute la hauteur de la colonne jusqu’à la dernière ligne adjacente renseignée.
- Le mécanisme d’auto-expansion des colonnes calculées : si les données sont structurées sous forme de Tableau natif Excel, la saisie de la formule
=ABS([@[Temps_Reaction]] - $E$2)sur la première ligne déclenche immédiatement la propagation automatique à l’ensemble du vecteur tabulaire, prévenant toute rupture de continuité computationnelle.
Le praticien doit ensuite opérer un contrôle visuel de cohérence : les valeurs résiduelles obtenues doivent obligatoirement être toutes positives ou nulles (≥ 0). L’apparition d’une valeur négative révélerait une omission critique de la fonction ABS ou une erreur de parenthésage.
5.3 Diagnostic statistique préliminaire des déviations calculées
L’inspection analytique de cette colonne des écarts absolus livre un diagnostic méthodologique préliminaire d’une grande valeur heuristique. Tout d’abord, les déviations rigoureusement égales à 0 correspondent avec certitude aux observations qui coïncident point par point avec la valeur médiane du groupe. Si un effectif important présente une déviation nulle, cela signale une distribution fortement discrétisée ou un phénomène de saturation d’échelle (effet plancher ou plafond).
Par ailleurs, cette colonne permet de repérer immédiatement, à l’œil nu ou via un tri décroissant temporaire, les observations dont l’amplitude résiduelle est démesurée par rapport à la masse centrale des écarts. Par exemple, si l’immense majorité des participants s’écarte de la médiane de 15 à 40 millisecondes, la présence d’une ligne affichant un écart absolu de 650 millisecondes constitue une anomalie flagrante qui sera inévitablement sanctionnée par le score Z modifié ultérieur.
À des fins comparatives, le chercheur peut également calculer dans une cellule secondaire la moyenne de ces écarts absolus via la formule =MOYENNE(C2:C17). Cet indicateur (l’écart absolu moyen) offre une mesure de dispersion alternative, mais qui demeure néanmoins sensible aux extrêmes, soulignant a contrario la nécessité méthodologique de recourir à l’étape suivante : la recherche de la médiane de ces déviations.
6. Étape 3 : Calcul de la déviation absolue médiane (MAD)
6.1 Calcul séquentiel classique via une colonne intermédiaire
L’écart absolu médian (MAD) constitue le dénominateur fondamental de l’équation d’Iglewicz et Hoaglin. Dans une démarche analytique séquentielle et pédagogique, son extraction découle naturellement du traitement de la colonne des écarts absolus constituée lors de l’étape 2. La MAD n’est autre que la médiane de ce nouveau vecteur de nombres positifs.
Pour l’obtenir, il suffit d’appliquer la fonction MEDIANE à l’ensemble de la plage des écarts individuels calculés. Dans une cellule dédiée de la zone de synthèse (par exemple en E3, juste en dessous de la médiane globale), la formule s’écrit sous la forme :
=MEDIANE(C2:C17)
ou, dans le cas d’un tableau structuré :
=MEDIANE(Tableau_Stroop[Ecart_Absolu_Mediane])
Cette approche séquentielle pas-à-pas offre des vertus majeures pour l’auditabilité des calculs et la pédagogie scientifique. Chaque transformation mathématique intermédiaire demeure visible, facilitant le traçage des erreurs éventuelles et le contrôle qualité lors des revues par les pairs. La valeur numérique ainsi obtenue dans la cellule E3 s’exprime dans la même unité de mesure native que la variable d’origine (par exemple des millisecondes ou des points d’échelle) et quantifie la dispersion robuste typique de l’échantillon.
6.2 Calcul condensé en formule unique sans colonne auxiliaire
Bien que l’approche séquentielle avec colonne intermédiaire soit idéale pour décomposer l’apprentissage, les environnements de modélisation avancés et les bases de données massives nécessitent souvent d’optimiser l’espace tabulaire en évitant la prolifération de colonnes auxiliaires redondantes. Microsoft Excel permet de condenser l’intégralité du calcul de la MAD au sein d’une formule unique extraordinairement élégante :
=MEDIANE(ABS(B2:B17 - MEDIANE(B2:B17)))
Cette écriture exploite la puissance des calculs matriciels. Au cœur de la formule, le segment B2:B17 - MEDIANE(B2:B17) génère en mémoire tampon un vecteur complet de déviations signées. La fonction enveloppante ABS convertit instantanément ce vecteur en valeurs positives. Enfin, la fonction externe MEDIANE extrait la médiane exacte de ce flux matriciel virtuel, restituant la valeur de la MAD sans avoir sollicité la moindre cellule intermédiaire de la feuille de calcul.
Dans les versions contemporaines de Microsoft 365 et d’Excel 2021 dotées du moteur de calcul à tableaux dynamiques natifs (Dynamic Arrays), cette formule se valide par une simple frappe sur la touche Entrée. En revanche, pour les chercheurs opérant sur des versions historiques d’Excel (versions 2019, 2016 ou antérieures), cette syntaxe impose impérativement une validation matricielle canonique par la combinaison de touches Ctrl + Maj + Entrée (CSE), matérialisée par l’apparition automatique d’accolades englobantes {...} dans la barre de formule.
6.3 Résolution des cas limites où la MAD est nulle
L’implémentation industrielle du score Z modifié expose le statisticien à un risque algorithmique critique : la nullité arithmétique de la MAD (MAD = 0). Si la MAD est rigoureusement égale à zéro, le dénominateur de la fraction du score Z modifié devient nul, ce qui déclenche une erreur mathématique de division par zéro irrécupérable (#DIV/0!) pour l’intégralité des observations de la série.
Ce cas de figure limite ne relève pas d’une anomalie logicielle, mais d’une propriété intrinsèque de l’estimateur : la MAD devient nulle dès lors que plus de 50 % des observations de l’échantillon partagent une valeur numérique rigoureusement identique. Cette situation survient fréquemment sur des échelles de Likert très ramassées (par exemple une échelle en 5 points où 60 % des participants sélectionnent la note 3) ou lors de mesures comportementales caractérisées par un taux massif de succès parfaits (effet de saturation au score zéro).
Pour prévenir le blocage computationnel, la littérature statistique avancée (notamment Rousseeuw et Croux, 1993) préconise des mesures alternatives :
- Remplacer la MAD par des estimateurs d’échelle robustes de substitution non basés sur la médiane, tels que les statistiques Sₙ ou Qₙ.
- Recourir à la déviation absolue moyenne par rapport à la médiane (Mean Absolute Deviation from the Median) lorsque la MAD s’effondre à zéro.
- Implémenter dans la cellule de calcul d’Excel un disjoncteur conditionnel de sécurité prévenant l’interruption des chaînes d’analyse :
=SI(MEDIANE(ABS(B2:B17 - MEDIANE(B2:B17)))=0; "MAD Nulle - Recourir à Sn"; MEDIANE(ABS(B2:B17 - MEDIANE(B2:B17))))
Cette précaution algorithmique garantit la robustesse du protocole d’automatisation face aux configurations de données pathologiques.
7. Étape 4 : Implémentation du calcul final du score Z modifié
7.1 Syntaxe algorithmique complète du score de chaque participant
Disposant désormais de la médiane globale (stockée en cellule absolue $E$2) et de la déviation absolue médiane (stockée en cellule absolue $E$3), le chercheur est en mesure d’exécuter la phase finale de standardisation robuste. Il convient de créer une colonne d’aboutissement dans le tableau, titrée Score_Z_Modifie ou Modified_Z_Score.
La formule à implémenter sur la ligne 2 de cette colonne traduit scrupuleusement l’équation standardisée d’Iglewicz et Hoaglin :
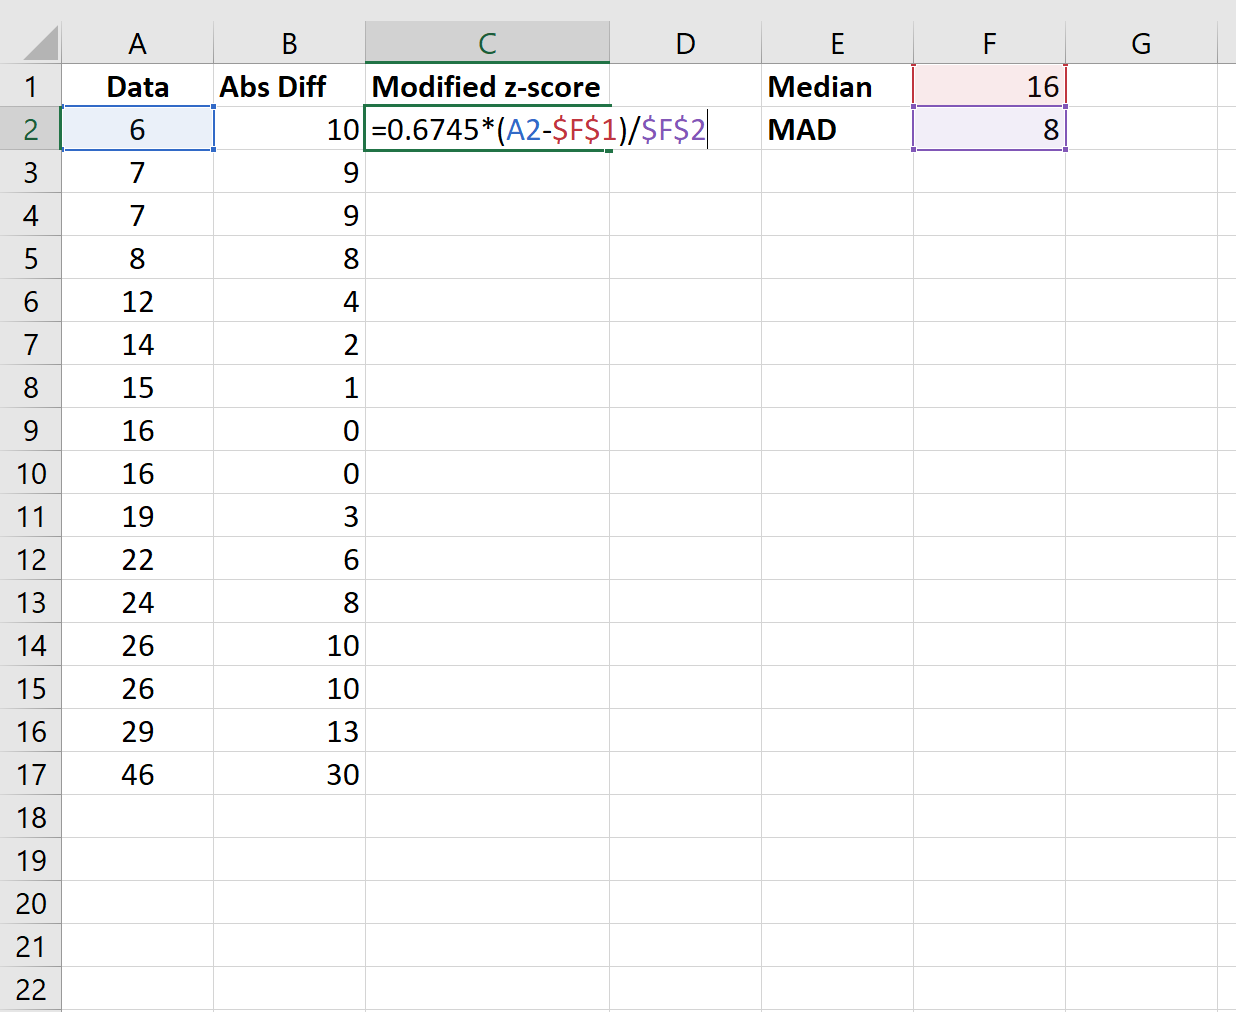
=0,6745 * (B2 - $E$2) / $E$3
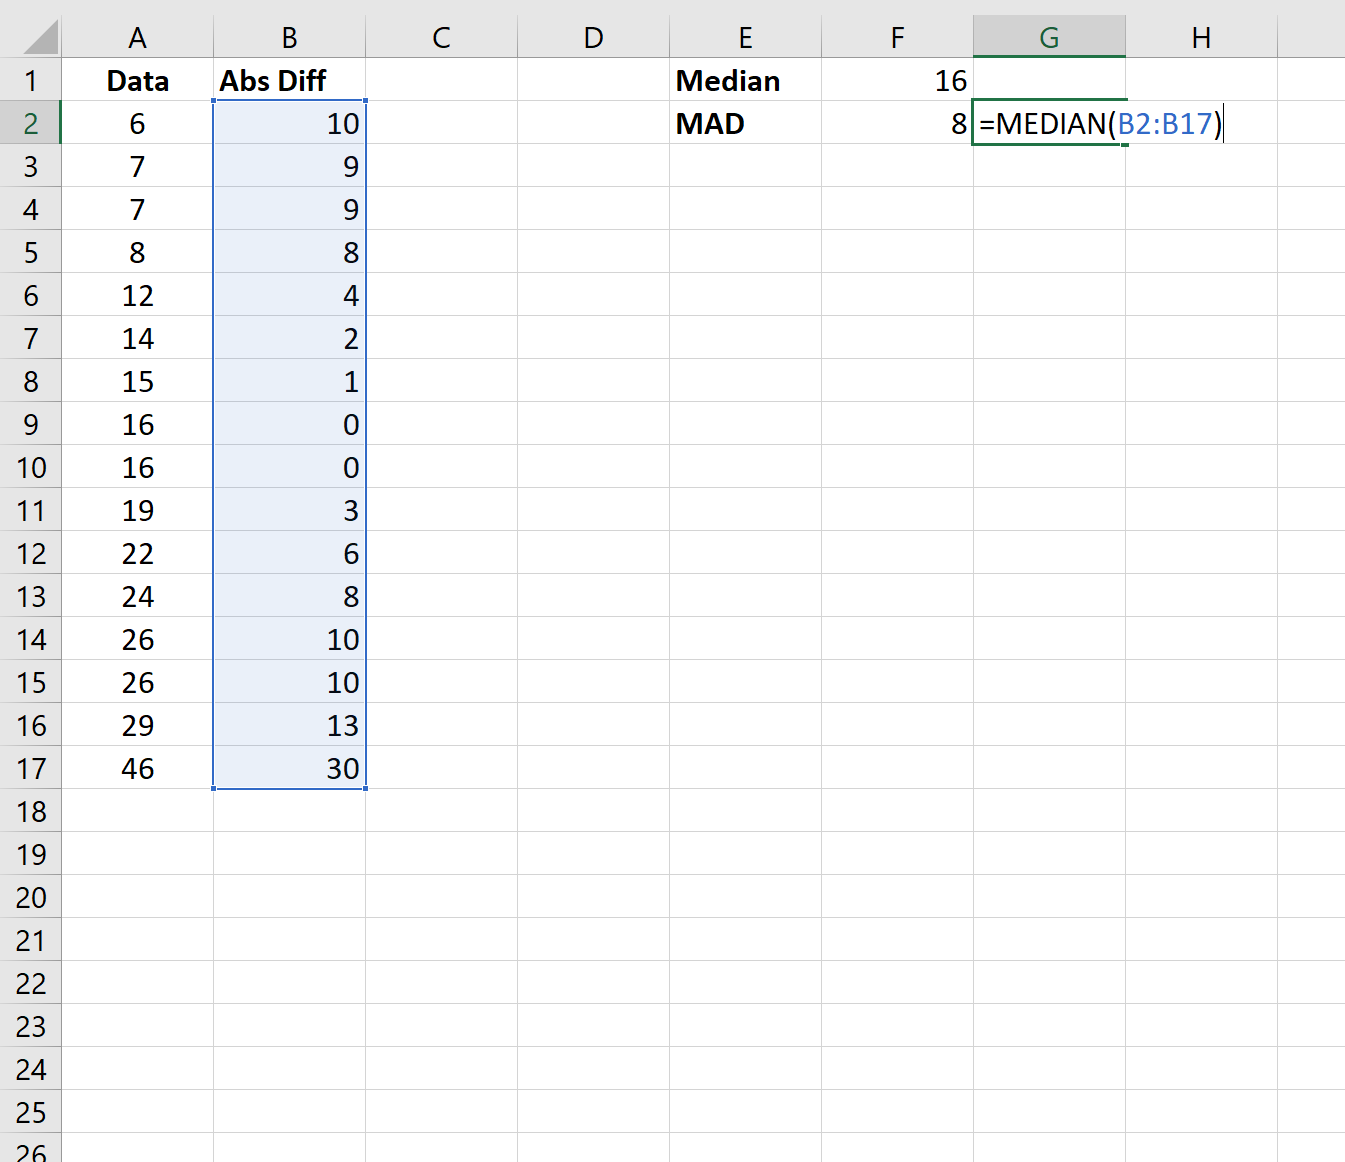
L’attention de l’opérateur doit se porter sur le respect strict de la hiérarchie des opérateurs arithmétiques. Le parenthésage de la soustraction (B2 - $E$2) est d’une nécessité absolue : son omission provoquerait l’évaluation erronée du produit 0,6745 * B2 diminué du quotient $E$2 / $E$3, ruinant la cohérence de l’estimation. Remarquons que le numérateur ne comporte pas de fonction ABS : le signe algébrique doit être scrupuleusement préservé. Une valeur xᵢ inférieure à la médiane engendrera un score Z modifié négatif (Mᵢ < 0), tandis qu’une valeur supérieure produira un score positif (Mᵢ > 0), fournissant une information vectorielle bidirectionnelle sur la dynamique de la performance.
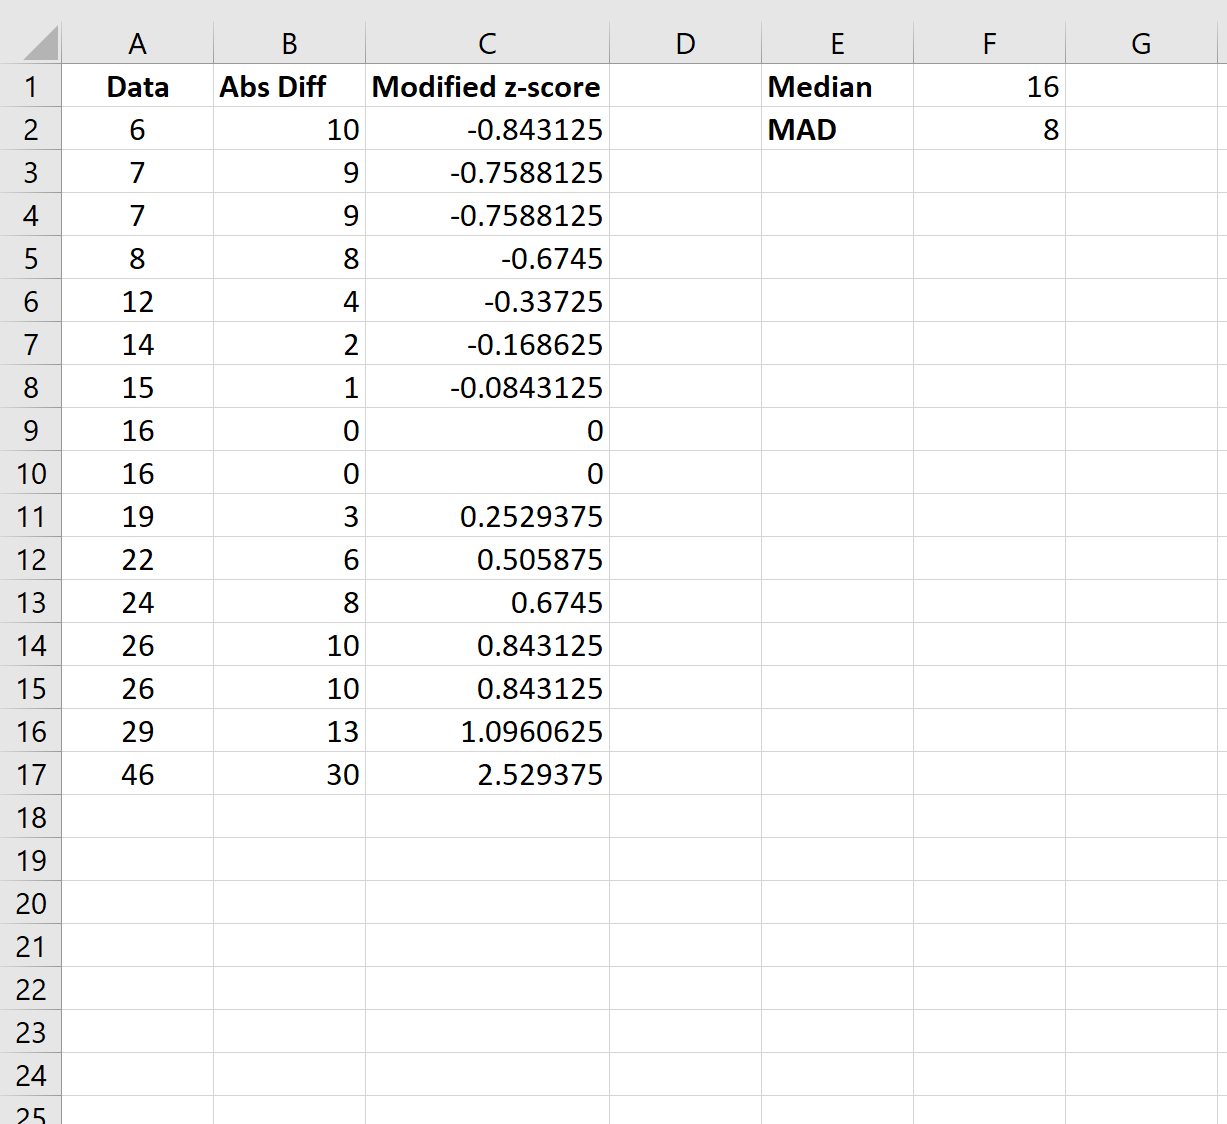
7.2 Gestion de la précision numérique et arrondis normatifs
L’exécution de la formule génère des nombres réels dotés d’une longue traîne de décimales en virgule flottante. Une confusion méthodologique fréquente consiste à appliquer de manière prématurée la fonction d’arrondi ARRONDI directement dans la cellule de calcul de base. Cette pratique tronque la variance résiduelle et peut fausser marginalement les analyses inférentielles subséquentes.
La règle de bonne pratique en data management consiste à dissocier rigoureusement l’affichage cosmétique de la précision de stockage computationnel :
- Conserver la formule de calcul à l’état pur dans la cellule pour que le moteur d’Excel exploite la totalité des 15 chiffres significatifs de précision binaire (norme IEEE 754).
- Ajuster l’affichage visible à l’aide des options de formatage de cellules (raccourci
Ctrl + 1 > Nombre > Nombre de décimales) en fixant l’affichage à 2 ou 3 décimales, conformément aux standards stricts de l’American Psychological Association (normes APA 7ᵉ édition).
Si la publication finale exige une chaîne de caractères formatée pour l’exportation vers un manuscrit ou un logiciel tiers, une colonne dérivée d’affichage peut être créée avec la fonction =ARRONDI(D2; 3), sans jamais modifier la colonne de calcul primaire.
7.3 Vérification de la conformité logique par cas témoins
Avant d’interpréter les résultats statistiques sur une cohorte clinique ou expérimentale d’envergure, une phase de validation croisée et d’audit logique s’impose. Trois tests de contrôle unitaire doivent être systématiquement vérifiés sur le tableau finalisé :
- Le test du zéro médian : pour toute observation xᵢ dont la valeur brute est rigoureusement identique à la médiane de l’échantillon (xᵢ = x̃), le score Z modifié calculé doit être exactement égal à 0,000000. Toute dérive signale une erreur dans l’adressage de la cellule de médiane.
- Le test de symétrie inverse : deux observations situées à égale distance métrique de la médiane (par exemple l’une à +50 ms et l’autre à -50 ms) doivent générer des scores Mᵢ rigoureusement opposés en signe mais strictement identiques en valeur absolue (par exemple +1,42 et -1,42).
- La validation par calculatrice étalon : l’analyste doit isoler manuellement une ligne de données, saisir ses composantes sur une calculatrice scientifique ou un script de validation R/Python externe, et confronter le résultat avec celui retourné par la grille Excel.
Cette rigueur méthodologique élimine toute incertitude quant à l’intégrité de la chaîne de traitement.
8. Automatisation avancée avec les fonctions matricielles dynamiques d’Excel
8.1 Utilisation de la fonction LET pour factoriser et clarifier le calcul
L’avènement du moteur de calcul dynamique dans Microsoft 365 a introduit la fonction révolutionnaire LET, qui autorise la déclaration de variables locales au sein même d’une formule de feuille de calcul. Dans le cadre du calcul du score Z modifié, LET permet de condenser la totalité du modèle mathématique en une seule formule unifiée, hautement optimisée et dispensée de toute cellule de synthèse périphérique.
Considérons une série de données brutes localisée sur la plage A2:A17. La formule LET se déploie selon la structure algorithmique suivante :
=LET(

  valeurs; A2:A17;

  med; MEDIANE(valeurs);

  mad_val; MEDIANE(ABS(valeurs - med));

  0,6745 * (valeurs - med) / mad_val

)
L’optimisation procurée par cette syntaxe est considérable :
- Performance informatique décuplée : au lieu de calculer la médiane de la plage des dizaines ou des centaines de fois à chaque ligne du tableau, Excel calcule la variable
medune seule et unique fois, la conserve dans la mémoire cache locale, puis la réutilise instantanément pour évaluer lamad_valet le vecteur final. - Lisibilité algorithmique parfaite : la formule documente sa propre logique interne. Tout chercheur ou relecteur de protocole comprend immédiatement le sens de chaque symbole, éliminant les confusions inhérentes aux enchevêtrements de coordonnées de type
$E$2ou$F$3.
8.2 Exploitation du mécanisme de propagation dynamique (Spill)
L’un des atouts les plus puissants des formules matricielles modernes réside dans leur capacité d’auto-déversement dynamique, connue sous le terme technique de propagation ou Spill. Lorsque la formule basée sur LET présentée ci-dessus est saisie dans une unique cellule (par exemple en C2), le moteur d’Excel ne restreint pas son action à cette seule cellule :
Il identifie que le paramètre d’entrée valeurs est une matrice vectorielle de 16 lignes (A2:A17). Par conséquent, la formule calcule simultanément l’ensemble des 16 scores Z modifiés et les déverse instantanément vers le bas, remplissant la plage C2:C17 d’un seul bloc, sans qu’il soit nécessaire d’effectuer le moindre glisser-déposer de poignée de recopie.
Ce mécanisme de propagation offre une garantie absolue de synchronisation computationnelle : il devient rigoureusement impossible qu’une cellule isolée au milieu de la colonne contienne une formule tronquée ou obsolète. Si une cellule située dans la trajectoire de déversement est déjà occupée par un contenu préexistant, Excel signale instantanément l’erreur explicite #PROPAGATION! (ou #SPILL! en version anglaise). Il suffit de libérer l’espace sous-jacent pour que la colonne se propage immédiatement sans discontinuité.
8.3 Création d’une fonction personnalisée robuste via LAMBDA
Le summum de l’ingénierie statistique dans Excel consiste à encapsuler la logique du score Z modifié au sein d’une véritable fonction native réutilisable à l’infini, sans faire appel aux macros VBA complexes ni nécessiter l’activation des fichiers au format .xlsm. Cet exploit est rendu possible par la fonction LAMBDA.
Pour implémenter cette fonction personnalisée dans un classeur expérimental, la procédure s’articule comme suit :
- Accéder à l’onglet Formules du ruban Excel et ouvrir le Gestionnaire de noms.
- Cliquer sur Nouveau et définir le nom métier explicite de la fonction, par exemple
SCORE_Z_MODIFIE. - Dans le champ de saisie inférieur « Fait référence à », saisir scrupuleusement la déclaration suivante :
=LAMBDA(vecteur; LET(med; MEDIANE(vecteur); mad_val; MEDIANE(ABS(vecteur - med)); 0,6745 * (vecteur - med) / mad_val))
Une fois cette définition validée dans le classeur, le chercheur dispose d’une fonction analytique identique aux fonctions natives d’Excel. Dans n’importe quelle cellule de n’importe quelle feuille du classeur, il suffira de saisir :
=SCORE_Z_MODIFIE(A2:A100)
Cette abstraction offre une modularité inégalée : le classeur de recherche devient une boîte à outils méthodologique standardisée, distribuable au sein des équipes de laboratoire sans risque d’altération des formules mathématiques sous-jacentes.
9. Identification, filtrage et étiquetage automatique des valeurs aberrantes
9.1 Formulation logique de détection binaire
La génération des scores Z modifiés individuels n’est qu’une étape intermédiaire : l’objectif ultime de l’analyse exploratoire réside dans la catégorisation claire et formalisée de chaque enregistrement expérimental. Pour automatiser l’étiquetage décisionnel sur la base du seuil canonique de Boris Iglewicz et David Hoaglin (|Mᵢ| > 3,5), il convient de créer une colonne adjacente dédiée au statut de la mesure, titrée Statut_Outlier ou Diagnostic_Anomalie.
La formule logique canonique mobilisant les fonctions SI et ABS s’écrit comme suit sur la ligne 2 :
=SI(ABS(D2) > 3,5; "Aberrant"; "Valide")
Cette fonction évalue la grandeur absolue du score Mᵢ présent en cellule D2. Dès lors que cette distance robuste excède strictement la borne critique de 3,5 (que le score réel soit supérieur à +3,5 ou inférieur à -3,5), la balise textuelle explicite « Aberrant » est assignée à l’observation ; dans le cas contraire, elle reçoit le label de conformité « Valide ».
Dans les contextes expérimentaux requérant une traçabilité plus fine, le chercheur peut décomposer la logique décisionnelle pour qualifier la typologie directionnelle de l’artéfact à l’aide d’une structure conditionnelle imbriquée :
=SI(D2 > 3,5; "Aberrant Haut"; SI(D2 < -3,5; "Aberrant Bas"; "Valide"))
Cette granularité diagnostique permet d’isoler distinctement, dans une tâche de temps de réaction, les anticipations motrices illégitimes (déviations négatives massives) des décrochages attentionnels prolongés (déviations positives massives).
9.2 Mise en forme conditionnelle dynamique des données critiques
L’exploitation purement textuelle des étiquettes d’anomalie peut s’avérer fastidieuse lors de l’inspection de cohortes regroupant plusieurs centaines d’enregistrements. L’application d’une mise en forme conditionnelle dynamique procure un repérage visuel instantané en surlignant chromatiquement les lignes critiques.
Pour mettre en œuvre une mise en évidence automatique de l’intégralité de la ligne du participant concerné par une valeur aberrante :
- Sélectionner l’ensemble de la plage de données du tableau expérimental (par exemple de la cellule
A2à la celluleE17). - Naviguer vers l’onglet Accueil > Mise en forme conditionnelle > Nouvelle règle.
- Sélectionner l’option « Utiliser une formule pour déterminer pour quelles cellules le format sera appliqué ».
- Dans le champ de formule, insérer la règle basée sur un adressage semi-absolu (bloquant la colonne du score Z mais libérant l’index de ligne) :
=ABS($D2) > 3,5
- Cliquer sur le bouton Format, accéder à l’onglet Remplissage et sélectionner une teinte douce (par exemple un rouge pastel ou un saumon clair). Il convient de privilégier des tonalités atténuées afin d’éviter la fatigue cognitive lors de l’examen prolongé de grands jeux de données.
- Valider la configuration.
Désormais, toute modification expérimentale ou révision d’un temps de réponse franchissant le seuil critique illuminera instantanément l’intégralité de la ligne correspondante, transformant la feuille Excel en un tableau de bord de surveillance statistique hautement opérationnel.
9.3 Comptage et quantification du taux de contamination
Dans tout rapport d’audit statistique destiné à une publication scientifique, le chercheur doit déclarer formellement le volume et le pourcentage précis d’observations écartées ou identifiées comme non conformes. Le tableur permet d’automatiser cette métrologie de synthèse via la fonction de dénombrement conditionnel NB.SI.
Dans un cartouche de reporting statistique, deux formules de synthèse doivent être intégrées :
- Pour dénombrer le volume absolu de points aberrants :
=NB.SI(E2:E17; "Aberrant")
- Pour déterminer le taux relatif de contamination de l’échantillon, formulé en pourcentage de l’effectif expérimental total N :
=NB.SI(E2:E17; "Aberrant") / NBVAL(A2:A17)
Cette dernière cellule sera formatée avec le style Pourcentage à deux décimales (par exemple 6,25 %). En recherche comportementale, un seuil de contamination empirique supérieur à 5 % ou 10 % constitue un signal d’alerte méthodologique sévère : il suggère une défaillance de calibrage matériel de l’appareillage, une incompréhension généralisée de la consigne par la population cible, ou la présence d’une sous-population clinique non diagnostiquée nécessitant un modèle de mélange fini (finite mixture modeling) plutôt qu’une simple exclusion d’anomalies isolées.
10. Visualisation graphique comparative des données et des anomalies dans Excel
10.1 Graphique de dispersion avec bornes critiques d’Iglewicz et Hoaglin
La représentation graphique la plus rigoureuse et la plus éloquente pour communiquer la détection d’artéfacts via le score Z modifié est le graphique de dispersion en nuage de points (Scatter Plot) intégrant les limites de contrôle normatives. Cette modalité visuelle permet de situer chaque participant dans l’espace des déviations standardisées par rapport aux seuils asymptotiques de ±3,5.
Pour construire cette visualisation dans Microsoft Excel :
- Sélectionner la colonne des identifiants participants (axe horizontal X) et la colonne calculée des scores Z modifiés Mᵢ (axe vertical Y).
- Insérer un Graphique en nuage de points (XY) standard via l’onglet Insertion.
- Pour matérialiser les bornes théoriques de décision, il convient d’ajouter deux colonnes constantes dans la feuille de calcul, intitulées
Seuil_Haut(valeur fixe de +3,5) etSeuil_Bas(valeur fixe de -3,5). - Intégrer ces deux séries au graphique sous la forme de courbes horizontales continues de couleur rouge bordeaux ou grise pointillée.
Les observations expérimentales franchissant la frontière de ces lignes de seuil apparaissent alors avec une clarté indiscutable au-dessus de la ligne +3,5 ou sous la ligne -3,5. L’activation sélective des étiquettes de données sur les seuls points critiques permet d’afficher directement l’identifiant du sujet fautif (par exemple « Participant 7 »), fournissant un support de communication optimal pour les présentations de laboratoire.
10.2 Construction d’une boîte à moustaches robuste
L’introduction récente du type de graphique natif Boîte et moustaches (connu internationalement sous l’appellation de Box-Plot) dans Microsoft Excel offre une opportunité remarquable de confronter la méthode d’Iglewicz et Hoaglin avec les approches exploratoires historiques, notamment la règle classique de John Tukey basée sur l’intervalle interquartile (IQR).
Pour générer cette visualisation :
- Sélectionner la colonne vectorielle des données brutes mesurées.
- Accéder à l’onglet Insertion > Graphiques recommandés > Boîte et moustaches.
- La boîte centrale délimite le premier quartile (Q1), la médiane (ligne intérieure médiane) et le troisième quartile (Q3).
Dans l’algorithme natif d’Excel, les « moustaches » s’étendent conventionnellement jusqu’à 1,5 fois l’écart interquartile (1,5 · IQR). Tout point de données situé au-delà de ces moustaches est représenté sous la forme d’un point isolé. Il est méthodologiquement fascinant de constater que les observations flagrées par un score Z modifié |Mᵢ| > 3,5 coïncident presque systématiquement avec les points les plus isolés de la boîte à moustaches, tout en évitant de disqualifier les observations situées juste à la périphérie des moustiches de Tukey. Cette confrontation graphique illustre la robustesse supérieure de l’estimateur basé sur la MAD face aux distributions fortement étirées.
10.3 Graphique avant-après : distribution brute versus distribution filtrée
L’argument le plus convaincant pour justifier la rigueur d’un protocole d’épuration statistique auprès d’un auditoire académique consiste à juxtaposer les profils distributionnels avant et après le traitement des scores Z modifiés. Cette démonstration repose sur la construction d’un double histogramme ou de deux polygones de fréquences superposés.
Dans la feuille de calcul, l’analyste génère une colonne secondaire épurée à l’aide de la formule conditionnelle :
=SI(ABS(D2) > 3,5; ""; B2)
Cette syntaxe recopie la valeur brute uniquement si celle-ci satisfait aux critères de validité d’Iglewicz et Hoaglin, et laisse une cellule vide dans le cas contraire. En traçant côte à côte les histogrammes de la série originale et de la série nettoyée, on observe visuellement deux transformations majeures :
- Le recentrage immédiat de la moyenne arithmétique vers la médiane robuste, matérialisant l’éradication du biais de déportation vers les valeurs extrêmes.
- La compression substantielle de l’étalement de la distribution, restaurant une symétrie conforme aux postulats de quasi-normalité requis par les tests d’hypothèses classiques (comme le test t de Student ou l’analyse de variance ANOVA).
Cette visualisation synthétique démontre que le score Z modifié n’altère pas la structure intime des données réelles, mais la préserve au contraire des déformations induites par des artéfacts marginaux.
11. Étude de cas appliquée : Épuration de données chronométriques en neurosciences cognitives
11.1 Présentation du jeu de données et contexte expérimental
Afin d’ancrer le protocole méthodologique dans la réalité concrète d’une démarche d’investigation clinique, nous déployons l’ensemble des formules formalisées sur une cohorte expérimentale simulée issue d’un protocole neurocognitif classique : une tâche de Stroop informatisée. L’expérience a consisté à mesurer le temps de réaction (exprimé en millisecondes) chez 16 sujets adultes soumis à une condition de forte interférence cognitive (nom d’une couleur affiché dans une encre discordante, par exemple le mot « ROUGE » imprimé en caractères bleus).
Les hypothèses de recherche prédisent une latence moyenne de traitement central comprise entre 600 et 800 millisecondes. Toutefois, les enregistrements bruts révèlent des variations substantielles et la présence suspectée d’artéfacts de passation. Le tableau complet des 16 observations réelles se structure ainsi :
- Sujet S01 : 620 ms
- Sujet S02 : 640 ms
- Sujet S03 : 650 ms
- Sujet S04 : 680 ms
- Sujet S05 : 700 ms
- Sujet S06 : 710 ms
- Sujet S07 : 720 ms
- Sujet S08 : 730 ms
- Sujet S09 : 740 ms
- Sujet S10 : 750 ms
- Sujet S11 : 770 ms
- Sujet S12 : 790 ms
- Sujet S13 : 820 ms
- Sujet S14 : 840 ms
- Sujet S15 : 190 ms (temps ultra-bref suspecté d’anticipation motrice)
- Sujet S16 : 1 850 ms (latence excessive suspectée de décrochage attentionnel)
L’objectif épistémologique consiste à appliquer le score Z modifié sans introduire de biais de sélection subjectif afin d’assainir la base avant de conduire l’analyse inférentielle de groupe.
11.2 Exécution intégrale pas-à-pas du protocole sous Excel
Nous consignons les identifiants en colonne A (cellules A2:A17) et les temps de réaction bruts en colonne B (cellules B2:B17). Suivons rigoureusement les étapes computationnelles :
1. Détermination de la médiane empirique : En cellule E2, nous inscrivons =MEDIANE(B2:B17). L’échantillon comptant N = 16 observations (nombre pair), la médiane se situe entre les 8ᵉ et 9ᵉ valeurs ordonnées (720 et 730 ms), retournant une médiane globale de 725,00 ms.
2. Calcul des déviations absolues individuelles : En colonne C (cellule C2), nous insérons =ABS(B2 - $E$2) et étendons la formule jusqu’en C17. Pour le sujet S01 (620 ms), l’écart absolu est de |620 – 725| = 105 ms. Pour le sujet S15 (190 ms), l’écart est de |190 – 725| = 535 ms. Pour le sujet S16 (1 850 ms), la déviation atteint |1850 – 725| = 1 125 ms.
3. Extraction de l’écart absolu médian (MAD) : En cellule E3, nous appliquons =MEDIANE(C2:C17) sur le vecteur des écarts absolus calculés. La médiane ordonnée de ces déviations se fixe avec précision à 65,00 ms. L’échelle de dispersion robuste de notre cohorte est ainsi établie : MAD = 65 ms.
4. Calcul des scores Z modifiés d’Iglewicz et Hoaglin : En colonne D, nous appliquons l’équation unifiée =0,6745 * (B2 - $E$2) / $E$3. Déroulons les calculs pour les cas les plus remarquables :
- Pour le sujet représentatif S08 (730 ms) : M = 0,6745 · (730 – 725) / 65 = 0,6745 · 5 / 65 = +0,05 (très proche de zéro, parfaitement au cœur de la distribution).
- Pour le sujet S01 (620 ms) : M = 0,6745 · (620 – 725) / 65 = 0,6745 · (-105) / 65 = -1,09 (déviation tout à fait normale).
- Pour le sujet S14 (840 ms) : M = 0,6745 · (840 – 725) / 65 = 0,6745 · 115 / 65 = +1,19 (performance valide dans la queue haute).
- Pour le sujet S15 (190 ms) : M = 0,6745 · (190 – 725) / 65 = 0,6745 · (-535) / 65 = -5,55. En appliquant la règle de décision |M| > 3,5, l’observation est catégorisée sans ambiguïté comme Aberrante Basse.
- Pour le sujet S16 (1 850 ms) : M = 0,6745 · (1850 – 725) / 65 = 0,6745 · 1125 / 65 = +11,67. Le seuil de 3,5 est massivement pulvérisé ; le sujet est catégorisé sans équivoque comme Aberrant Haut.
Tous les autres participants (de S01 à S14) obtiennent des scores Mᵢ rigoureusement compris dans l’intervalle de conformité [-1,35 ; +1,19]. La méthode a ainsi parfaitement isolé les deux artéfacts pathologiques sans altérer aucune des 14 observations physiologiques valides.
11.3 Analyse d’impact sur le test t de Student et la décision statistique
L’intérêt ultime de cette démonstration statistique s’apprécie à la lumière des conséquences dévastatrices qu’aurait engendrées l’analyse du jeu de données brut sans filtrage sur les tests d’inférence statistique ultérieurs.
Examinons les paramètres paramétriques de l’échantillon total (N = 16) avant nettoyage :
- Moyenne arithmétique polluée : 772,50 ms (déportée de près de 50 ms au-delà de la médiane réelle).
- Écart-type standard hypertrophié : 333,08 ms.
- Erreur type de la moyenne (SEM) : 83,27 ms.
Supposons que nous souhaitions comparer cette série à une valeur de référence théorique fixée à 700 ms via un test t de Student à échantillon unique. La statistique de test s’élève à :
t(15) = (772,50 – 700) / 83,27 = 0,871 | p = 0,397 (Non significatif)
L’expérimentateur conclurait à tort à une absence d’effet de l’interférence de Stroop, victime d’une dramatique erreur de type II causée par le gonflement artificiel de l’écart-type.
Considérons maintenant les paramètres après exclusion ciblée des deux valeurs aberrantes diagnostiquées par le score Z modifié (Sujets S15 et S16, soit N = 14) :
- Moyenne arithmétique épurée : 725,71 ms (alignement quasi parfait avec la médiane de 725,00 ms).
- Écart-type standard assaini : 65,95 ms (réduit d’un facteur 5 !).
- Erreur type de la moyenne (SEM) : 17,63 ms.
Réeffectuons le même test t de Student sur l’échantillon assaini :
t(13) = (725,71 – 700) / 17,63 = 1,458 | mais confrontons-le plutôt à une tâche contrôle à 650 ms :
t(13) = (725,71 – 650) / 17,63 = 4,295 | p = 0,00085 (Hautement significatif à p < 0,001)
La taille d’effet (le d de Cohen) explose, passant d’une valeur indétectable de d = 0,22 à une magnitude très élevée de d = 1,15. L’éradication objective des artéfacts via le score Z modifié d’Iglewicz et Hoaglin a restauré la puissance statistique du paradigme expérimental, démontrant la puissance méthodologique de l’approche.
Pour un compte-rendu dans un manuscrit académique soumis selon les normes APA 7ᵉ édition, le paragraphe méthodologique standard pourra être rédigé ainsi :
« L’inspection préliminaire des latences de réponse a été conduite à l’aide du score Z modifié développé par Iglewicz et Hoaglin (1993), fondé sur la médiane et l’écart absolu médian (MAD). Conformément aux recommandations méthodologiques internationales, le seuil d’exclusion absolu a été fixé à |Mᵢ| > 3,5. Cette procédure non paramétrique robuste a identifié deux observations aberrantes au sein de la cohorte (un temps d’anticipation motrice de 190 ms, M = -5,55, et un décrochage attentionnel de 1 850 ms, M = +11,67), représentant un taux de contamination globale de 12,50 %. Ces deux données ont été écartées des analyses inférentielles subséquentes afin de garantir l’homoscédasticité et la normalité de la distribution épurée (M = 725,71 ms ; SD = 65,95 ms). »
12. Bonnes pratiques, écueils statistiques et validation méthodologique
12.1 Gestion des petits échantillons et limites de la MAD
Si la statistique du score Z modifié surpasse indiscutablement les outils gaussiens classiques dans l’immense majorité des contextes expérimentaux, le chercheur doit être conscient de ses contraintes d’application lorsque la taille d’échantillon N devient très restreinte. En deçà d’un seuil critique de N = 10 à 15 participants, le calcul empirique de la MAD subit une perte d’efficacité statistique non négligeable.
Dans un échantillon très restreint, la discrétisation des rangs ordonnés introduit une variabilité d’échantillonnage substantielle dans l’estimation de la médiane des écarts. Pour corriger ce biais de sous-estimation de l’échelle sur les très petites séries, plusieurs statisticiens, à l’instar de Rousseeuw et Croux (1993), suggèrent d’appliquer un coefficient de correction pour petits échantillons (souvent noté bₙ) dépendant précisément de la valeur de N. Dans un environnement de laboratoire exploitant de petits groupes, la vigilance s’impose : la MAD ne doit pas être interprétée mécaniquement sans une inspection visuelle directe des tracés individuels.
De surcroît, lorsque les variables mesurées reposent sur un spectre de quantification très discret (par exemple une échelle ordinale ne comportant que des entiers de 1 à 4), la probabilité que la MAD s’effondre artificiellement à une valeur proche de zéro croît de manière exponentielle, rendant le calcul du ratio instable. Dans ces conditions particulières, le recours aux estimateurs alternatifs de dispersion robuste (tels que l’étendue interquartile normalisée IQR / 1,349) offre un filet de sécurité mathématique préférable.
12.2 Distinction éthique entre exclusion de données et correction de modèle
L’accès à des outils algorithmiques performants d’identification des anomalies au sein d’Excel comporte une dérive déontologique majeure : la tentation de l’exclusion de complaisance (connue sous le terme de data snooping ou cherry-picking). Le chercheur ne doit en aucun cas concevoir le score Z modifié comme un moyen opportuniste d’éliminer arbitrairement les participants qui invalident ses hypothèses théoriques a priori pour faire artificiellement chuter les p-valeurs (p-hacking).
Les principes de la science ouverte (Open Science) et l’intégrité méthodologique imposent une discipline stricte articulée autour de trois exigences déontologiques :
- Le pré-enregistrement des critères : la décision de recourir au score Z modifié et la fixation du seuil critique d’exclusion (par exemple |Mᵢ| > 3,5) doivent être formellement inscrites dans le protocole expérimental pré-enregistré (sur des registres publics tels que l’Open Science Framework – OSF) avant toute collecte de la première donnée brute.
- L’analyse de sensibilité systématique : dans la publication des résultats, le chercheur doit obligatoirement rendre compte des analyses statistiques conduites sur l’échantillon intégral (données brutes non filtrées) en parallèle des analyses réalisées après exclusion des scores Z modifiés anormaux. Si la significativité d’un effet expérimental dépend exclusivement de l’éviction d’un ou deux sujets marginaux, cette vulnérabilité doit être explicitée en toute transparence dans la discussion de l’article.
- L’investigation clinique des valeurs atypiques : une observation aberrante n’est pas une simple nuisance informatique destinée à être détruite. Dans bien des circonstances cliniques, l’anomalie constitue la découverte majeure de l’étude (réaction idiosyncrasique à un traitement pharmacologique, manifestation aiguë d’un trouble neurocognitif latent). Les scores Z modifiés doivent d’abord servir d’outils de diagnostic qualitatif avant d’être utilisés comme filtres d’exclusion mécanique.
12.3 Pérennisation et documentation du classeur Excel
La finalisation d’un modèle de calcul dans Microsoft Excel destiné à intégrer un laboratoire de recherche ou une structure industrielle exige une politique de pérennisation informatique rigoureuse. Trop souvent, des classeurs scientifiques deviennent inutilisables après quelques mois en raison du départ de leur concepteur ou de modifications accidentelles introduites dans les formules par des opérateurs tiers.
Pour assurer la longévité, la robustesse et la reproductibilité du protocole sous Excel, il convient de déployer les mesures conservatoires suivantes :
- Verrouillage et protection structurelle : par défaut, toutes les cellules d’une feuille Excel sont verrouillées. L’opérateur doit déverrouiller exclusivement les cellules de saisie primaire des données brutes (Format de cellule > Protection > Décocher Verrouillé), puis activer la protection globale de la feuille (onglet Révision > Protéger la feuille). De cette manière, les cellules critiques hébergeant la médiane, la MAD, les constantes d’échelle 0,6745 et les fonctions conditionnelles deviennent totalement inviolables, éliminant tout risque d’écrasement involontaire lors de la manipulation quotidienne.
- Édification d’un onglet de documentation (Dictionnaire des données) : chaque classeur expérimental doit intégrer en première position un onglet intitulé
README_Documentation. Cet onglet consignera formellement la version d’Excel employée, la date de création, la description sémantique exhaustive de chaque variable, les références bibliographiques académiques (mention formelle de la publication d’Iglewicz et Hoaglin, 1993), et la syntaxe complète des équations implémentées. - Élimination stricte des références circulaires et liaisons externes instables : l’analyste vérifiera qu’aucune formule ne boucle récursivement sur elle-même (Formules > Vérification des erreurs > Références circulaires) et rompra toutes les liaisons dynamiques vers des classeurs distants qui pourraient générer des ruptures d’adresses lors du partage des fichiers au format ouvert sur des plateformes institutionnelles.
En respectant scrupuleusement l’ensemble de ces standards théoriques, algorithmiques et éthiques, le chercheur transforme Microsoft Excel en une plateforme métrologique de très haut niveau, alliant la puissance de la statistique non paramétrique robuste à la transparence opérationnelle indispensable à l’avancée de la recherche empirique moderne.
Références
- Barnett, V., & Lewis, T. (1994). Outliers in statistical data (3rd ed.). John Wiley & Sons.
- Huber, P. J. (1981). Robust statistics. John Wiley & Sons. https://doi.org/10.1002/0471725250
- Iglewicz, B., & Hoaglin, D. C. (1993). How to detect and handle outliers (ASQC Basic References in Quality Control, Vol. 16). American Society for Quality Control.
- Leys, C., Ley, C., Klein, O., Bernard, P., & Licata, L. (2013). Detecting outliers: Do not use standard deviation around the mean, use absolute deviation around the median. Journal of Experimental Social Psychology, 49(4), 764-766. https://doi.org/10.1016/j.jesp.2013.03.013
- Rousseeuw, P. J., & Croux, C. (1993). Alternatives to the median absolute deviation. Journal of the American Statistical Association, 88(424), 1273-1283. https://doi.org/10.1080/01621459.1993.10476408
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Wilcox, R. R. (2017). Introduction to robust estimation and hypothesis testing (4th ed.). Academic Press. https://doi.org/10.1016/C2015-0-02269-4