
Dans le champ des sciences quantitatives contemporaines, de la psychométrie à la bio-informatique en passant par l’économétrie et l’évaluation clinique, la comparabilité des données empiriques constitue l’un des défis méthodologiques les plus cruciaux. Les chercheurs et les praticiens sont constamment confrontés à des métriques dissemblables : des scores bruts à des épreuves de mémoire de travail plafonnés à 30 points, des temps de réaction chronométrés en fractions de millisecondes, des échelles d’anxiété de type Likert en 5 points ou encore des taux d’hémoglobine exprimés en grammes par décilitre. Sans un cadre de normalisation mathématique rigoureux, confronter directement ces grandeurs revient à commettre un sophisme de mesure, rendant caduque toute tentative d’évaluation globale du profil d’un sujet ou d’une cohorte.
Le score standardisé, universellement désigné sous le vocable de score Z (ou z-score dans la littérature anglo-saxonne), représente la réponse formelle apportée par la théorie statistique classique à cette problématique d’hétérogénéité métrique. En traduisant l’écart d’une observation par rapport à la moyenne de son groupe de référence en unités de dispersion standardisée, le score Z opère une translation et une homothétie qui dépouillent la valeur brute de ses contingences dimensionnelles. Cette transformation affine permet d’inscrire n’importe quel score individuel au sein d’une distribution théorique de référence universelle, la loi normale centrée réduite, offrant ainsi un socle d’interprétation probabiliste direct, universellement partagé par la communauté scientifique mondiale.
Si des environnements logiciels spécialisés tels que R, SAS, SPSS ou Python permettent d’exécuter de telles normalisations en quelques lignes de commande, le tableur Microsoft Excel demeure, dans les faits, l’outil le plus ubiquitaire et le plus accessible déployé tant dans les laboratoires de recherche translationnelle que dans les cabinets cliniques, les services hospitaliers et les départements d’évaluation des ressources humaines. Sa transparence structurelle, qui matérialise physiquement les matrices de données au sein d’un maillage bidimensionnel de cellules interactives, offre un terrain pédagogique et analytique sans équivalent. Ce manuel exhaustif se propose d’explorer en profondeur les fondements mathématiques, les procédures algorithmiques, les pièges d’implémentation et les applications clinico-métriques du calcul des scores Z au sein de Microsoft Excel, en passant au crible tant les formulations arithmétiques fondamentales que les fonctions natives vectorisées de dernière génération.
1. Introduction conceptuelle : Le rôle du score Z dans l’analyse statistique et psychométrique
1.1 Définition théorique de la note standardisée (Score Z)
D’un point de vue axiomatique, le score Z correspond à l’expression de l’éloignement d’une observation brute individuelle par rapport à la tendance centrale de son groupe d’appartenance, quantifié strictement en unités d’écart-type. Formellement, il s’agit d’une métrique dérivée qui transforme une variable aléatoire continue continue quelconque en une mesure relative. Lorsque nous affirmons qu’un individu obtient un score Z de +1,5 à un test d’efficience intellectuelle, nous n’indiquons aucunement le volume de réponses correctes fournies sur le protocole papier-crayon, mais nous attestons que sa performance se situe précisément à un écart-type et demi au-dessus de la moyenne arithmétique de l’échantillon normatif d’étalonnage. Inversement, une valeur négative signale systématiquement une performance positionnée en deçà du barycentre distributionnel.
Cette standardisation remplit une mission épistémologique essentielle : la neutralisation complète des unités de mesure d’origine afin d’autoriser des comparaisons rigoureuses et exemptes de distorsions métrologiques. Les grandeurs physiques, physiologiques ou psychologiques sont intrinsèquement prisonnières de leurs instruments d’évaluation respectifs. Un écart brut de 5 points sur l’inventaire de dépression de Beck n’a aucune commune mesure avec un différentiel de 5 secondes sur un test de flexibilité attentionnelle tel que le Trail Making Test, ni avec une différence de 5 millimètres de mercure dans l’évaluation de la pression artérielle systolique. En rapportant l’écart brut à la dispersion intrinsèque de la variable au sein du groupe, le score Z convertit ces métriques disparates en une échelle sans dimension (adimensionnelle), créant une passerelle analytique universelle entre des paradigmes observationnels totalement disjoints.
Le fondement mathématique sous-jacent à cette démarche repose sur l’hypothèse de la loi normale centrée réduite, conventionnellement désignée par la notation N(0, 1). Dans ce modèle canonique élaboré historiquement par Abraham de Moivre et Carl Friedrich Gauss, la distribution des probabilités prend la forme géométrique bien connue d’une courbe en cloche symétrique, dont l’espérance mathématique est fixée à 0 et la variance à 1. Lorsque les données empiriques observées se conforment approximativement à cette distribution gaussienne, le score Z acquiert une puissance explicative probabiliste considérable. Il permet immédiatement de déduire la rareté statistique relative d’un événement clinique ou expérimental en mobilisant les tables de l’intégrale de probabilité cumulée, établissant un lien déterministe entre l’écart à la moyenne et le pourcentage de la population surpassé ou sous-jacent à ce point précis.
1.2 Utilité méthodologique en psychométrie et sciences du comportement
Dans le domaine spécifique de la psychométrie et de la neuropsychologie clinique, le recours aux scores standardisés ne constitue pas un simple confort de calcul mais une exigence de validité méthodologique absolue. Lors de l’évaluation neuropsychologique d’un patient suspecté de présenter une pathologie neurodégénérative, le clinicien administre une batterie complexe d’instruments de mesure : empans mnésiques directs et inverses, dénomination orale d’images de Boston, épreuves de fluence verbale phonémique et sémantique, et tests de raisonnement perceptif. Chacune de ces épreuves possède une échelle de notation spécifique, des planchers et des plafonds dissemblables, et des variabilités intra-échantillon hautement contrastées. La conversion immédiate de l’ensemble des scores bruts en scores Z permet de dresser un profil cognitif unifié, où l’on visualise instantanément les secteurs fonctionnels préservés et les zones d’atteinte déficitaire sans être induit en erreur par les échelles de cotation natives de chaque manuel d’évaluation.
Au-delà de la comparaison intra-individuelle entre différents domaines d’aptitudes, le score Z s’avère indispensable pour situer les performances d’un sujet singulier au regard des normes représentatives d’une population de référence clairement circonscrite. Les sciences du comportement ont abondamment démontré que les performances cognitives brutes sont fortement modulées par des variables démographiques fondamentales telles que l’âge chronologique, le niveau de scolarité formelle ou le genre sociologique. Les manuels d’étalonnage psychométrique publient par conséquent des tables normatives stratifiées par tranches d’âge et niveaux d’études. L’intégration de ces paramètres dans la feuille de calcul Excel permet de confronter le score brut d’un patient non pas à une masse indifférenciée de données, mais à l’espérance mathématique et à l’écart-type propres à sa strate démographique d’appartenance, éliminant de facto les biais de confusion dans l’évaluation du statut clinique.
Enfin, le score standardisé constitue le matériau premier, la brique fondamentale requise pour la construction d’échelles composites et d’indices factoriels globaux. Dans les grandes batteries d’efficience cognitive comme l’échelle d’intelligence de Wechsler pour adultes (WAIS-IV), les indices de Compréhension Verbale, de Mémoire de Travail ou de Vitesse de Traitement ne sont rien d’autre que des combinaisons linéaires de notes standardisées issues de plusieurs sous-tests. Additionner des scores bruts hétérogènes mènerait inéluctablement à un biais de surpondération systémique en faveur des épreuves présentant les variances brutes les plus volumineuses. Le passage préalable par le score Z garantit une équipondération mathématique parfaite des différentes dimensions psychologiques au sein de l’indice composite global, conférant ainsi au modèle structural sa solidité psychométrique et sa fidélité de mesure.
1.3 Pourquoi utiliser Microsoft Excel pour l’évaluation des scores Z
La question de la pertinence de Microsoft Excel face à des environnements de programmation statistique dédiés comme R ou des logiciels propriétaires spécialisés est régulièrement soulevée par les puristes de l’analyse computationnelle. Néanmoins, l’universalité de la suite bureautique de Microsoft au sein des structures cliniques, des équipes de recherche médicale et des institutions éducatives en fait la plateforme prédominante sur le plan empirique. Le principal avantage réside dans la manipulation transparente des cohortes de taille intermédiaire (de quelques dizaines à plusieurs dizaines de milliers d’enregistrements), pour lesquelles la mise en place d’un pipeline complet de programmation logicielle s’avère disproportionnée par rapport aux objectifs de l’investigation clinique quotidienne.
Excel offre une ergonomie particulièrement féconde pour l’analyste soucieux de maîtriser chaque articulation de son calcul. Il autorise une transition harmonieuse et pédagogique entre le calcul arithmétique fondamental décomposé pas à pas (déviation brute divisée par le paramètre d’échelle) et l’usage de fonctions natives sophistiquées intégrées au moteur de calcul du tableur, telles que la fonction d’automatisation vectorielle CENTREE.REDUITE. Cette double possibilité permet au statisticien débutant de comprendre intuitivement l’algèbre sous-jacente tout en offrant aux analystes chevronnés un rendement computationnel optimal pour traiter des matrices volumineuses en un minimum de saisies syntaxiques.
De surcroît, la nature tabulaire d’Excel permet un contrôle visuel direct et un audit permanent de l’intégrité des données psychologiques brutes. À la différence des interfaces en ligne de commande où les anomalies numériques demeurent souvent dissimulées derrière des messages d’erreur abstraits ou des imputations invisibles, la feuille de calcul expose simultanément les variables sources, les métadonnées de distribution et les colonnes de calcul transformées. Cette visibilité structurelle facilite la mise en œuvre de tests d’intégrité croisés, le repérage instantané des corruptions de formats typographiques et l’inspection minutieuse des valeurs aberrantes au fur et à mesure de l’implémentation des algorithmes de normalisation.
2. Fondements mathématiques du score Z et notation formelle
2.1 La formule canonique du score Z
Sur le plan mathématique, l’opération de centrage et de réduction d’une variable s’exprime à travers une fonction de transformation linéaire directe. La formule canonique s’articule rigoureusement selon que l’on opère au niveau d’une population statistique exhaustive ou à l’échelle d’un échantillon d’observations empiriques extrait de cette même population. Lorsque l’ensemble universel des observations est accessible, le calcul théorique s’écrit formellement :
z = (X – μ) / σ
Dans cette formulation axiomatique, la variable X incarne le score brut individuel issu de la passation de l’instrument d’évaluation, la lettre grecque μ (mu) désigne l’espérance mathématique ou la moyenne arithmétique vraie de la population intégrale, et le symbole σ (sigma) matérialise l’écart-type de cette même population. Dans la quasi-totalité des investigations en sciences humaines et médicales, l’accès à la population entière demeure un idéal inaccessible pour des raisons matérielles et temporelles évidentes. Les praticiens travaillent invariablement sur des échantillons probabilistes ou de convenance. La formule s’adapte alors sous sa forme empirique :
z = (X – x̄) / s
où la notation x̄ (x-barre) se substitue à la moyenne populationnelle pour désigner la moyenne d’échantillon, et s symbolise l’estimateur de l’écart-type empirique corrigé du biais d’estimation. L’analyse structurale de cette équation révèle deux mécanismes mathématiques distincts et successifs :
- Le numérateur (X – x̄) ou (X – μ) : Il opère le centrage de la distribution. En retranchant la mesure de tendance centrale de la valeur observée, on obtient l’écart brut, souvent qualifié de score différentiel ou déviation. Cette translation le long de l’axe des abscisses réaligne le centre de gravité de la série de données sur l’origine zéro. Un résultat positif au numérateur atteste d’un score positionné au-delà de la moyenne, tandis qu’une valeur négative dénote un positionnement situé en deçà.
- Le dénominateur s ou σ : Il accomplit la réduction de la distribution. En divisant la déviation brute par la mesure de dispersion standardisée, le dénominateur agit comme un facteur d’échelle régulateur. Il comprime ou étire la distribution de telle sorte que l’unité de mesure native s’efface au profit de l’unité universelle de l’écart-type, rendant ainsi la variabilité de la série indépendante de son échelle de construction initiale.
2.2 Propriétés distributionnelles du score standardisé
La transformation d’un ensemble de scores bruts en scores Z entraîne l’émergence de propriétés distributionnelles invariantes dont la maîtrise est indispensable pour valider la correction de tout traitement statistique réalisé sous Excel. La première propriété axiomatique réside dans le fait que la moyenne arithmétique de la nouvelle série standardisée est rigoureusement égale à zéro (μz = 0). Cette démonstration se vérifie aisément par linéarité de l’opérateur d’espérance mathématique :
E(Z) = E[(X – μ) / σ] = (1 / σ) * [E(X) – μ] = (1 / σ) * (μ – μ) = 0
Parallèlement, la variance d’une série transformée en scores Z, ainsi que son écart-type, sont invariablement égaux à l’unité (σz² = 1 et σz = 1). En effet, le calcul formel de la variance d’une variable transformée par une constante multiplicative démontre que Var(aX + b) = a²Var(X). Dans l’architecture du score Z, la constante multiplicative a équivaut à 1/σ, et le terme additif b correspond à -μ/σ. Dès lors, Var(Z) = (1/σ)² * Var(X) = σ² / σ² = 1. Cette propriété de variance unitaire garantit que la dispersion de n’importe quelle variable ramenée à l’échelle Z possède exactement le même étalement mathématique standardisé.
Il est fondamental de dissiper une confusion théorique récurrente : la transformation d’une variable en scores Z ne normalise aucunement la forme intrinsèque de sa distribution si celle-ci ne suit pas originellement une loi de Gauss. Le calcul d’un score Z est une transformation affine strictement linéaire. Par conséquent, il conserve intacts les moments d’ordre supérieur de la distribution d’origine, à savoir le coefficient d’asymétrie (skewness) et le coefficient d’aplatissement (kurtosis). Si la distribution de vos scores bruts dans Excel présente une asymétrie positive marquée (par exemple, un temps de réaction avec une longue traîne vers les valeurs lentes), la distribution des scores Z présentera rigoureusement la même asymétrie. La standardisation modifie l’origine et l’échelle de mesure, mais ne redresse en aucun cas une courbe non gaussienne en cloche symétrique.
2.3 Distinction cruciale entre paramètres de population et estimations d’échantillon
Une rigueur mathématique sans faille impose de distinguer avec acuité les calculs paramétriques appliqués à une population intégrale des estimations déduites d’un échantillonnage partiel. Cette divergence théorique se cristallise autour de la notion fondamentale de degrés de liberté (degrees of freedom). Dans l’univers d’une population exhaustive comptant N individus, la variance s’établit par la division stricte de la somme des carrés des écarts à la moyenne par N :
σ² = Σ (X – μ)² / N
En revanche, lorsque l’on extrait un échantillon de taille n à partir de cette population pour inférer ses paramètres statistiques, la moyenne de l’échantillon x̄ se substitue à la moyenne réelle inconnue μ. Cette substitution contraint les données : la somme des écarts à la moyenne de l’échantillon est obligatoirement nulle, ce qui fait perdre un degré de liberté à l’estimation de la dispersion. Pour corriger le biais sous-estimatif inhérent à cette contrainte (connu sous le nom de correction de Bessel), le dénominateur de la variance empirique doit être minoré d’une unité, soit n – 1 :
s² = Σ (X – x̄)² / (n – 1)
Cette distinction conceptuelle trouve une répercussion directe et immédiate au sein des algorithmes de Microsoft Excel. Le logiciel met à la disposition de l’utilisateur des fonctions distinctes pour ces deux paradigmes : les fonctions basées sur le suffixe « .STANDARD » (telles que ECARTYPE.STANDARD) qui divisent par n – 1, et celles exploitant le suffixe « .PEARSON » (comme ECARTYPE.PEARSON) qui divisent par N. L’utilisation inappropriée de l’une pour l’autre induit une erreur systématique dans l’estimation de la variabilité, impactant de manière disproportionnée les cohortes cliniques de taille modeste, faussant consécutivement le calcul du dénominateur du score Z et biaisant les seuils de significativité clinique déduits des tables normatives.
3. Préparation structurée de la matrice de données dans Excel
3.1 Organisation tabulaire des données psychologiques
L’intégrité de toute analyse quantitative sous Microsoft Excel dépend de la propreté architecturale de la matrice de données primaire. En psychométrie et en neurosciences computationnelles, la règle d’or repose sur le paradigme des données structurées ordonnées (dites tidy data). Chaque ligne horizontale de votre feuille de calcul doit être exclusivement allouée à une unité observationnelle unique (un participant, un patient ou un sujet d’expérimentation), tandis que chaque colonne verticale doit correspondre de manière univoque à une variable mesurée (un score de test, une latence, un âge chronologique) ou à une métadonnée d’identification.
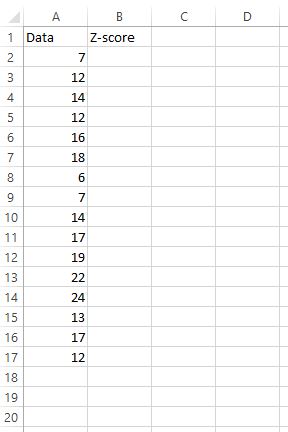
Pour des impératifs éthiques évidents et le strict respect des régulations relatives à la protection des données personnelles (telles que le RGPD en milieu européen), aucune donnée nominative directe ne doit figurer dans la matrice de travail. Il convient de dédier la première colonne (colonne A) à un identifiant alphanumérique unique et anonymisé (ex. : SUBJ_001, SUBJ_002, CLIN_2026_A). Les colonnes subséquentes accueilleront les variables psychométriques brutes, typées sans ambiguïté. L’analyste s’assurera impérativement que les cellules réservées aux variables quantitatives possèdent un format numérique natif et qu’aucun artefact textuel parasite (espaces insécables, virgules typographiques confondues avec des points décimaux, abréviations de type « sec » ou « pts ») ne soit fusionné avec la grandeur numérique, sous peine de paralyser le moteur de calcul matriciel du tableur.
3.2 Audit et nettoyage préalable des valeurs manquantes
Les protocoles d’évaluation empirique sont inévitablement confrontés à la problématique des données manquantes : un sujet refuse de répondre à une épreuve projective, une panne de chronomètre survient lors d’une évaluation motrice, ou un patient est interrompu par une décompensation clinique. Dans Excel, la gestion des cellules non renseignées requiert une vigilance absolue en raison du traitement différencié opéré par le logiciel entre une cellule vide et une cellule contenant le chiffre 0.
Une cellule laissée totalement vierge est ignorée par la quasi-totalité des fonctions statistiques descriptives natives d’Excel (notamment MOYENNE et ECARTYPE.STANDARD), ce qui préserve l’estimation des paramètres de tendance centrale et de dispersion. En revanche, si l’opérateur a saisi par mégarde un 0 pour matérialiser une absence de réponse ou une non-passation, Excel intègre cette valeur numérique dans la somme et incrémente le dénominateur de l’échantillon, ce qui effondre artificiellement la moyenne et gonfle exponentiellement l’écart-type. Il est donc recommandé d’activer les filtres automatiques sur l’ensemble de la plage de données (raccourci clavier Ctrl + Maj + L) pour auditer méthodiquement chaque variable, isoler les valeurs suspectes, identifier les cellules contenant des caractères d’échappement (tels que « NA », « N/A », « non testé » ou « . ») et convertir systématiquement les non-réponses en cellules rigoureusement vides ou en codes d’erreur contrôlés à l’aide de formules conditionnelles comme SI.NON.DISP.
3.3 Création des colonnes de travail dédiées
Une fois le jeu de données assaini, l’étape suivante consiste à configurer la topographie spatiale de la feuille de calcul afin d’accueillir les calculs intermédiaires et finaux. Il est fortement déconseillé de disséminer les paramètres globaux (moyennes et écarts-types) de manière désordonnée sur la feuille. Deux architectures spatiales sont préconisées : soit la création d’un encadré récapitulatif supérieur figé (les premières lignes au-dessus du tableau de données, protégées par le fractionnement des volets), soit le positionnement méthodique de ces descripteurs dans une ligne de totalisation située immédiatement sous la matrice d’observations.
Chaque colonne de score brut doit être doublée, sur sa droite immédiate, par une colonne de destination explicitement étiquetée pour recevoir les scores standardisés (par exemple, si la colonne C s’intitule « Score_Brut_Memoire », la colonne D sera baptisée « Z_Score_Memoire »). Pour maximiser la robustesse et la scalabilité de votre classeur, l’approche optimale consiste à convertir votre plage de données rectangulaire standard en un Tableau structuré Excel officiel (raccourci Ctrl + L ou Ctrl + T). Cette structure confère aux plages une dynamique d’expansion automatique : chaque nouvelle ligne de participant intégrée en bas de tableau hérite immédiatement des formules mathématiques de la colonne, tout en permettant l’usage des références structurées plus lisibles et moins sujettes aux erreurs de décalage d’indices de cellules.
4. Méthode pas à pas : Calcul de la moyenne arithmétique sous Excel
4.1 Implémentation de la fonction MOYENNE
La première composante requise pour l’élaboration du score Z est l’estimation de la tendance centrale de la série de données brutes, matérialisée par la moyenne arithmétique. Dans l’environnement francophone de Microsoft Excel, l’algorithme s’exécute à travers la fonction MOYENNE (strictement équivalente à la fonction AVERAGE dans les versions linguistiques anglo-saxonnes). Cette fonction effectue automatiquement l’addition arithmétique de l’ensemble des valeurs scalaires comprises dans la plage de cellules désignée et divise la somme obtenue par le décompte effectif des cellules numériques non vides :
=MOYENNE(plage_donnees)
Supposons que les scores bruts de votre cohorte pour l’épreuve de mémoire verbale s’étendent de la cellule B2 à la cellule B201. Pour enregistrer la moyenne globale dans une cellule dédiée (par exemple la cellule B203, positionnée stratégiquement au bas de la colonne d’analyse), la syntaxe formelle sera =MOYENNE(B2:B201). Il convient de souligner que cette fonction est totalement insensible aux lignes masquées manuellement par l’utilisateur : si vous masquez temporairement des sujets sans appliquer un filtre automatique formel, leurs scores continuent d’être agrégés dans l’évaluation de la moyenne. Dans le cas où l’analyse imposerait de calculer une moyenne portant exclusivement sur les lignes visibles filtrées à l’écran, il faudrait substituer à la fonction classique l’instruction =SOUS.TOTAL(101; B2:B201), garantissant l’alignement des statistiques sur l’état de filtration actif de la feuille de calcul.
4.2 Gestion des sous-groupes avec MOYENNE.SI et MOYENNE.SI.ENS
Dans la pratique psychométrique et expérimentale avancée, calculer une moyenne unique indifférenciée sur l’ensemble de la cohorte constitue fréquemment une erreur méthodologique rédhibitoire. Les performances cognitives ou comportementales varient drastiquement selon des facteurs d’hétérogénéité biologique ou socioculturelle. L’analyste doit alors être en mesure d’extraire la moyenne normative conditionnée par des critères de stratification spécifiques (par exemple, le groupe d’âge ou le sexe biologique). Excel propose pour cela des fonctions conditionnelles puissantes : MOYENNE.SI pour un critère unique et MOYENNE.SI.ENS pour des critères d’intersection multiples.
Considérons un tableau dans lequel la colonne A contient le genre des sujets (« F » ou « M »), la colonne B renseigne la tranche d’âge catégorisée (« 20-29 », « 30-39 », etc.), et la colonne C héberge les scores bruts d’un test attentionnel s’étendant des lignes 2 à 201. Si l’on souhaite dériver la moyenne normative spécifique aux femmes appartenant à la tranche d’âge de 20 à 29 ans, la formulation mobilisera MOYENNE.SI.ENS selon la structure syntaxique suivante :
=MOYENNE.SI.ENS(C2:C201; A2:A201; « F »; B2:B201; « 20-29 »)
Cette approche permet d’établir une table de normes démographiques stratifiées directement au sein de votre classeur. Les arguments de critères peuvent être codés en dur entre guillemets comme dans l’exemple susmentionné, ou pointés dynamiquement vers des cellules d’en-tête de votre table de référence. Cette dernière méthode assure une réactivité optimale du modèle : toute modification des catégories d’inclusion actualise instantanément les paramètres centraux sur lesquels s’appuiera le calcul des scores standardisés individuels.
4.3 Contrôle de validité du paramètre central
Avant de sceller la moyenne calculée comme pivot définitif de la déviation dans la formule du score Z, un contrôle de validité distributionnelle s’impose. La moyenne arithmétique présente une vulnérabilité mathématique bien documentée : son hypersensibilité aux valeurs extrêmes ou aberrantes. Dans un échantillon de 100 individus, un unique sujet obtenant un score atypique (par exemple, un participant ayant mal compris la consigne et accumulant 0 point, ou un sujet exceptionnel obtenant le plafond absolu) déplace mécaniquement la moyenne vers son pôle, déformant le repère normatif pour tous les autres membres de la cohorte.
Un test heuristique indispensable consiste à confronter immédiatement la moyenne obtenue à la médiane de la série, accessible sous Excel via la fonction =MEDIANE(B2:B201). Dans une distribution symétrique gaussienne idéale, la moyenne arithmétique et la médiane coïncident de manière quasi parfaite. Une divergence marquée entre ces deux paramètres constitue le premier signal d’alarme d’une asymétrie distributionnelle sévère (biais vers la gauche ou vers la droite). Enfin, sur le plan de la précision informatique, il importe de distinguer la valeur réelle conservée en virgule flottante dans la mémoire d’Excel du format d’affichage visuel appliqué à la cellule. Si vous formatez l’affichage pour présenter une moyenne arrondie à deux décimales, Excel continue rigoureusement d’utiliser l’ensemble des décimales internes pour les calculs subséquents de déviation, préservant ainsi l’exactitude numérique du futur score standardisé sans introduire d’erreur d’arrondi cumulatif.
5. Méthode pas à pas : Calcul de l’écart-type approprié
5.1 Sélection entre ECARTYPE.STANDARD et ECARTYPE.PEARSON
L’estimation du paramètre de dispersion qui occupera le dénominateur de la formule de transformation représente l’étape la plus critique du protocole. L’écart-type quantifie la variabilité moyenne des scores individuels autour de la moyenne arithmétique calculée précédemment. Historiquement, les versions antérieures d’Excel mettaient à disposition une fonction générique désignée sous l’appellation ECARTYPE (correspondant à STDEV en version anglaise). Bien que cette fonction soit conservée pour des raisons de compatibilité ascendante, son utilisation est désormais officiellement déconseillée en raison de son manque de précision sémantique quant au statut de la cohorte analysée.
Depuis la mise à jour majeure du moteur statistique d’Excel, deux fonctions univoques doivent être scrupuleusement discriminées selon le cadre de référence méthodologique :
- ECARTYPE.STANDARD (anglais : STDEV.S) : Cette fonction met en œuvre la correction de Bessel et divise la somme des carrés des déviations par le nombre d’observations moins une unité (n – 1). Elle doit être systématiquement sélectionnée dès lors que vos données proviennent d’un échantillon empirique représentatif ou d’une cohorte clinique issue d’un recrutement expérimental, ce qui constitue la situation standard en recherche psychologique et médicale.
- ECARTYPE.PEARSON (anglais : STDEV.P) : Cette fonction applique la formule paramétrique de la population intégrale, divisant strictement la somme des déviations quadratiques par le nombre total d’observations (N). Elle est exclusivement réservée aux cas où la base de données englobe la totalité exhaustive de la population cible (par exemple, le recensement exhaustif des résultats d’un concours national à effectif clos, sans visée d’extrapolation inférentielle vers un ensemble plus vaste).
Dans la pratique courante de l’évaluation psychométrique clinique, le recours erroné à ECARTYPE.PEARSON au lieu d’ECARTYPE.STANDARD produit une sous-estimation systématique de l’écart-type. Ce biais a pour conséquence mécanique de rétrécir artificiellement le dénominateur, ce qui gonfle indûment la magnitude des scores Z individuels et risque de faire franchir indûment à des patients les seuils diagnostiques de significativité pathologique.
5.2 Exécution pratique de la formule d’écart-type
L’implémentation opérationnelle de l’écart-type s’effectue dans une cellule dédiée de référence, positionnée idéalement au voisinage immédiat de la moyenne calculée à l’étape précédente. Si l’on poursuit notre scénario avec une série de scores bruts répartis sur la plage B2:B201, la formule sera implantée dans la cellule B204 sous la syntaxe :
=ECARTYPE.STANDARD(B2:B201)
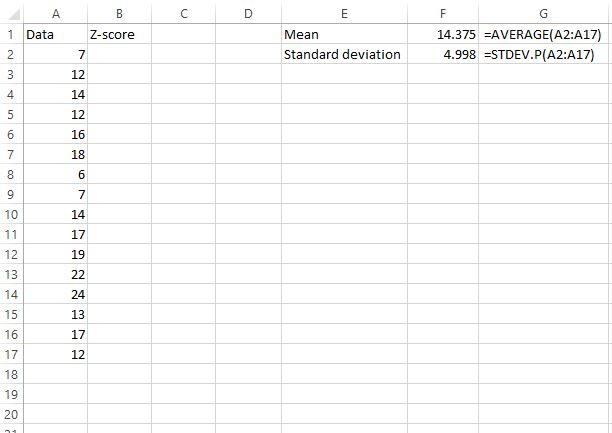
L’analyste doit vérifier rigoureusement que la sélection de la plage n’intègre pas involontairement la cellule d’en-tête textuelle de la colonne (B1) ni la cellule contenant la moyenne arithmétique (B203). Bien qu’Excel parvienne généralement à ignorer les cellules contenant du texte dans ses fonctions statistiques matricielles, l’inclusion par inadvertance de la cellule de moyenne viendrait corrompre le décompte des degrés de liberté et fausserait irrémédiablement le résultat.
Une précaution technique élémentaire consiste à s’assurer de la stricte positivité et de la non-nullité de l’écart-type obtenu. Un résultat d’écart-type égal à 0 signale que l’ensemble des individus de l’échantillon a obtenu rigoureusement le même score brut, révélant une absence totale de variance. Une telle situation se produit fréquemment lorsqu’un test psychométrique souffre d’un « effet plancher » ou d’un « effet plafond » massif, où 100 % des sujets échouent ou réussissent l’ensemble des items. Tenter de calculer un score Z dans ces conditions déclenchera inéluctablement une erreur de division par zéro dans tout le tableur, invalidant l’utilité du modèle de standardisation.
5.3 Évaluation de la variabilité des données brutes
D’un point de vue clinique et métrologique, l’obtention de la valeur de l’écart-type ne doit pas être considérée comme un simple chiffre intermédiaire destiné à alimenter une division, mais comme un puissant indicateur de la dynamique de l’instrument d’évaluation. Pour contextualiser la portée de cette dispersion indépendamment de l’ordre de grandeur de la variable, il est pertinent de calculer conjointement le coefficient de variation (CV), qui correspond au rapport mathématique entre l’écart-type et la moyenne arithmétique :
=B204 / B203
Exprimé sous forme de pourcentage (en appliquant le format Pourcentage d’Excel), le coefficient de variation renseigne immédiatement sur l’ampleur relative de l’hétérogénéité interindividuelle au sein de la cohorte. Un coefficient de variation extrêmement resserré (inférieur à 5 %) traduit une variabilité interindividuelle résiduelle très faible. Dans un tel contexte, une différence infime en termes de score brut se traduira par une déviation standardisée Z considérable, ce qui peut conduire à surinterpréter des écarts cliniquement dérisoires. À l’inverse, un coefficient de variation exceptionnellement élevé (supérieur à 40 %) indique une hétérogénéité massive des performances, suggérant fréquemment la cohabitation sous-jacente de sous-groupes cliniques non identifiés ou la présence de variables modératrices non contrôlées (telles qu’un bilinguisme non documenté dans une tâche verbale). Cette prise de recul permet d’anticiper la sensibilité réelle et la robustesse des futurs scores Z.
6. Méthode pas à pas : Calcul manuel du score Z par formule arithmétique
6.1 Construction syntaxique de la formule individuelle
Une fois les métadonnées de tendance centrale et de dispersion solidement établies dans leurs cellules respectives, l’exécution concrète de la standardisation peut débuter. La première approche méthodologique, à la fois pédagogique et universelle, repose sur la construction manuelle de la formule arithmétique élémentaire traduisant l’équation z = (X – x̄) / s. Cette méthode permet de maîtriser avec une transparence totale chaque composant de l’opération.
Plaçons-nous sur la première ligne d’enregistrement de notre tableau de données, correspondant au premier participant de la cohorte. Le score brut de ce sujet est localisé dans la cellule B2, notre moyenne d’échantillon a été calculée dans la cellule B203, et notre écart-type d’échantillon a été fixé dans la cellule B204. La formule destinée à générer le score Z dans la cellule adjacente C2 doit obligatoirement respecter les priorités opératoires de l’algèbre. En l’absence de parenthèses régulatrices, le moteur de calcul d’Excel applique la priorité conventionnelle de la division sur la soustraction, ce qui diviserait la moyenne par l’écart-type avant de soustraire le quotient du score brut. La syntaxe rigoureuse impose par conséquent l’encapsulation du numérateur au sein d’un couple de parenthèses :
=(B2 – B203) / B204
Illustrons concrètement cette mécanique par des valeurs empiriques. Supposons que le sujet n°1 présente un score brut de 75 points à une épreuve de raisonnement logique, au sein d’une cohorte caractérisée par une moyenne arithmétique x̄ de 60 points et un écart-type s de 10 points. La substitution numérique dans la formule donne =(75 – 60) / 10, ce qui produit une déviation brute de +15 points au numérateur, laquelle est ensuite divisée par le dénominateur scalaire de 10, générant un score standardisé final de +1,50. Le résultat confirme que la performance du sujet se déploie précisément à un écart-type et demi au-delà du barycentre de son échantillon normatif.
6.2 Verrouillage des paramètres par références absolues
L’erreur la plus ubiquitaire et dévastatrice commise par les analystes débutants sur Excel survient lors de la duplication de cette formule arithmétique initiale aux lignes subséquentes du tableau. Par défaut, Excel gère les adresses de cellules selon le principe des références relatives. Si la formule =(B2 – B203) / B204 saisie en C2 est copiée telle quelle vers la cellule sous-jacente C3, Excel décale tous les indices de ligne d’un incrément unitaire. La formule en C3 devient ainsi automatiquement =(B3 – B204) / B205. Dès lors, le score brut du second sujet (B3) se trouve comparé non plus à la moyenne, mais à l’écart-type (B204), et divisé par une cellule vide (B205), déclenchant immédiatement une cascade d’erreurs de division par zéro (#DIV/0!) ou produisant des résultats mathématiquement absurdes mais insidieusement silencieux.
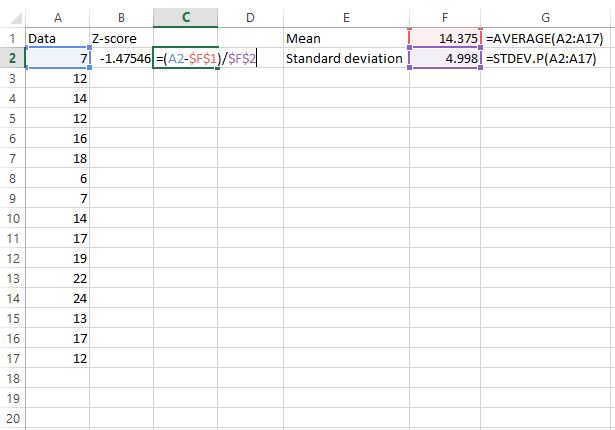
Pour immuniser la formule contre ce glissement référentiel délétère, il est impératif de verrouiller les adresses des cellules hébergeant les paramètres fixes en faisant appel aux références absolues, matérialisées dans la syntaxe Excel par le symbole du dollar ($). Le verrouillage complet d’une cellule s’opère en intercalant un dollar devant la lettre de la colonne et un dollar devant l’indice de ligne. La formule formelle en C2 doit ainsi être impérativement transcrite comme suit :
=(B2 – $B$203) / $B$204
Dans cette architecture syntaxique, la référence au score brut individuel (B2) demeure une référence relative dépourvue de dollar : elle a vocation à s’adapter librement lors de la translation verticale pour pointer successivement vers B3, B4, B5, etc. En revanche, les références désignant la moyenne ($B$203) et l’écart-type ($B$204) sont figées de manière immuable sur le plan spatial. L’appui répété sur la touche de fonction F4 lors de la saisie d’une coordonnée de cellule dans la barre de formule d’Excel permet de cycler automatiquement entre les différents états de verrouillage (relatif, absolu complet, absolu ligne, absolu colonne), garantissant une saisie rapide et sans erreur typographique.
6.3 Propagation de la formule le long de la série de données
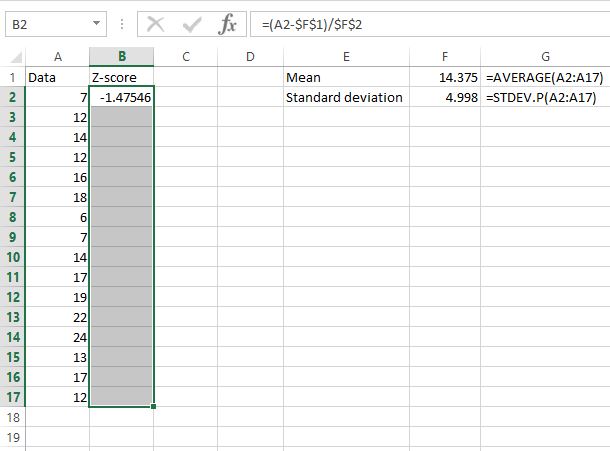
Avec une formule initiale parfaitement paramétrée en C2, l’étape suivante consiste à étendre cette opération mathématique sur l’ensemble de la série longitudinale des participants. Microsoft Excel propose plusieurs mécanismes de propagation, le plus intuitif et le plus performant pour les volumineuses séries de données étant la manœuvre du double-clic sur la poignée de recopie.
La poignée de recopie se matérialise sous la forme d’un minuscule carré noir situé dans l’angle inférieur droit de la cellule active (C2). Lorsque l’utilisateur positionne le curseur de sa souris directement sur ce carré, la forme du pointeur se métamorphose, troquant la croix blanche volumineuse habituelle contre une fine croix noire d’ajustement. Un double-clic vigoureux sur le bouton gauche de la souris déclenche alors une expansion instantanée de la formule vers le bas, le moteur d’Excel inspectant la continuité des données renseignées dans la colonne contiguë à gauche (colonne B) pour stopper automatiquement la recopie au niveau de la dernière ligne active de données (ligne 201), évitant tout débordement indésirable sur les lignes de métadonnées sous-jacentes.
Après cette exécution automatisée, il incombe à l’analyste de réaliser une série de vérifications croisées d’intégrité structurelle :
- Inspecter la formule présente dans la dernière cellule calculée (C201) en appuyant sur la touche de fonction F2, afin de vérifier visuellement que le maillage pointe toujours rigoureusement vers le score brut B201 tout en maintenant ses ancrages fixes sur les paramètres $B$203 et $B$204.
- Procéder à un sondage aléatoire sur deux ou trois lignes intermédiaires pour certifier qu’aucun décalage accidentel n’a été induit par des lignes fusionnées ou des discontinuités de cellules au sein de la matrice.
7. Méthode automatisée : Utilisation de la fonction native CENTREE.REDUITE
7.1 Syntaxe et arguments de la fonction CENTREE.REDUITE
Si la méthode arithmétique manuelle détaillée dans le chapitre précédent s’avère irremplaçable pour saisir intimement la logique de transformation des grandeurs statistiques, Microsoft Excel met à disposition une fonction dédiée native conçue expressément pour automatiser ce processus avec une pureté syntaxique maximale : la fonction CENTREE.REDUITE (strictement équivalente à la fonction STANDARDIZE dans la nomenclature anglophone du tableur). Cette fonction encapsule au sein de son propre algorithme interne l’évaluation de la déviation et la division par le facteur d’échelle.
La déclaration formelle de cette fonction s’articule autour de trois arguments positionnels rigoureusement ordonnés et tous obligatoires :
=CENTREE.REDUITE(x; moyenne; ecart_type)
Dans l’architecture de calcul francophone, les arguments sont conventionnellement délimités par des points-virgules (;). Le premier paramètre, x, représente la valeur brute individuelle soumise à normalisation. Le deuxième paramètre, moyenne, désigne l’espérance arithmétique du groupe de référence. Le troisième paramètre, ecart_type, spécifie la mesure de dispersion standardisée du groupe. Appliquée à notre première ligne d’observation (cellule B2), en liant la formule aux paramètres hébergés dans les cellules verrouillées $B$203 et $B$204, la syntaxe s’énonce comme suit :
=CENTREE.REDUITE(B2; $B$203; $B$204)
Le moteur logiciel vérifie en arrière-plan la validité du typage des données injectées dans chacun des trois paramètres. Si l’une des cellules cibles contient une valeur non numérique ou une chaîne textuelle non convertible, la fonction suspend son traitement et renvoie immédiatement le code d’erreur typologique #VALEUR!. De même, si le troisième argument pointé correspond à un écart-type nul (0) ou strictement négatif, la fonction intercepte l’impossibilité mathématique et restitue l’erreur formelle de division par zéro #DIV/0!, garantissant ainsi une étanchéité algorithmique totale.
7.2 Avantages comparatifs par rapport à la méthode arithmétique manuelle
La substitution de la formule arithmétique classique par la fonction CENTREE.REDUITE offre des bénéfices qualitatifs et opérationnels substantiels dans le cadre d’audits statistiques et d’analyses psychométriques professionnelles. Le principal écueil rencontré lors de la manipulation manuelle réside dans l’omission accidentelle des parenthèses de priorité algébrique. Dans une routine de saisie sous pression ou lors de modifications rapides de classeurs complexes, l’écriture par inadvertance de =B2 – $B$203 / $B$204 engendre une corruption silencieuse des données que rien, sur le plan formel, ne signale comme erroné à l’utilisateur : aucun code d’erreur n’apparaît, mais la valeur résultante n’a plus aucun rapport avec un score Z. La fonction CENTREE.REDUITE immunise structurellement le modèle contre ce danger en prenant intégralement en charge l’architecture opérationnelle en interne.
Par ailleurs, la lisibilité et l’auditabilité de la feuille de calcul s’en trouvent considérablement décuplées. Pour un relecteur externe, un statisticien en charge de la validation méthodologique ou un comité d’assurance qualité en recherche clinique, l’inspection d’une colonne peuplée de formules CENTREE.REDUITE dissipe instantanément toute ambiguïté quant à la nature statistique du traitement appliqué. Cette formulation explicite signale immédiatement que la variable a été convertie en note standardisée N(0, 1), là où une formule arithmétique manuelle requiert une décomposition mentale préalable pour s’assurer qu’il ne s’agit pas d’un autre type de déviation ou d’un calcul de centrage pur sans réduction d’échelle.
Enfin, sur le plan de l’optimisation des ressources informatiques, la fonction native d’Excel est compilée au plus bas niveau dans le code binaire du moteur de calcul. Lors du traitement de méga-bases de données de santé publique hébergeant des centaines de milliers de lignes et des dizaines de variables psychométriques concurrentes, l’exécution via CENTREE.REDUITE optimise l’arbre de dépendance des cellules et réduit le temps global de recalcul de la feuille de calcul par rapport à des formules arithmétiques imbriquées plus gourmandes en cycles processeur.
7.3 Intégration matricielle et formules dynamiques modernes
Avec l’avènement des versions contemporaines d’Excel (notamment issues de la souscription Microsoft 365 et des moutures Office 2021 et ultérieures), la manipulation des formules a connu une révolution conceptuelle majeure grâce à l’introduction du moteur de calcul matriciel dynamique et du mécanisme de déversement (désigné en anglais sous le terme de spill). Cette avancée technologique permet de s’affranchir totalement de la contrainte historique consistant à étendre manuellement des formules ligne par ligne à l’aide de la poignée de recopie.
Il devient désormais possible de renseigner l’ensemble d’une colonne de scores Z en injectant une formule vectorielle unique dans la toute première cellule de la colonne cible (cellule C2). Dans cette approche moderne, le premier argument de la fonction ne pointe plus vers un scalaire unique (B2), mais englobe d’emblée la totalité de la plage vectorielle des scores bruts (B2:B201). Mieux encore, les calculs de tendance centrale et de dispersion peuvent être directement imbriqués au sein de la même formule, supprimant ainsi la nécessité de dédier des cellules périphériques distinctes au stockage de la moyenne et de l’écart-type :
=CENTREE.REDUITE(B2:B201; MOYENNE(B2:B201); ECARTYPE.STANDARD(B2:B201))
Dès la validation de cette instruction par la touche Entrée, le moteur dynamique calcule instantanément l’intégralité des 200 scores standardisés et les « déverse » de façon fluide de la ligne 2 jusqu’à la ligne 201. La plage résultante est entourée d’un fin liseré bleu signalant son statut matriciel dynamique. Les cellules de C3 à C201 contiennent des formules fantômes grisées, non éditables individuellement : toute modification apportée à la cellule mère C2 répercute instantanément ses transformations sur l’ensemble du vecteur déversé. Cette méthodologie élimine définitivement les risques d’incohérence syntaxique entre le sommet et la base d’un tableau et optimise l’architecture logicielle de vos classeurs psychométriques.
8. Interprétation statistique et clinique des scores Z obtenus
8.1 Lecture des valeurs et seuils conventionnels
L’obtention des scores Z standardisés au sein de la feuille de calcul ne marque pas l’aboutissement de la démarche, mais constitue le socle quantitatif à partir duquel s’articule l’interprétation statistique et diagnostique. Le repère cardinal absolu est le zéro : un score Z rigoureusement égal à 0 indique que l’individu présente une performance qui se confond exactement avec la moyenne arithmétique de son groupe de référence normatif. La polarité du signe algébrique guide immédiatement le clinicien : les valeurs positives dénotent des performances supérieures à la tendance centrale, tandis que les grandeurs négatives traduisent une dérive infracentrique.
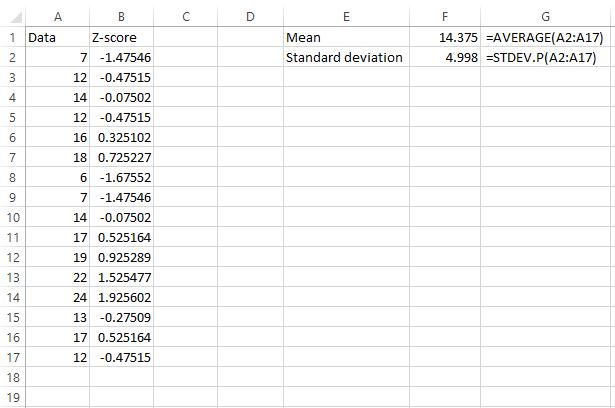
Dans l’hypothèse où la distribution de la cohorte s’ajuste de manière satisfaisante à une loi normale théorique, l’interprétation s’appuie sur la fameuse règle empirique des trois sigmas, qui découle des propriétés de l’intégrale de Gauss :
- L’intervalle [-1,00 ; +1,00] : Cet intervalle central circonscrit très précisément 68,27 % de l’ensemble de la population de référence. En psychométrie clinique, cette zone est universellement qualifiée de « zone de performance moyenne » ou de « fonctionnement préservé standard ». Un sujet dont le score oscille dans ces limites se situe dans la norme statistique stricte.
- L’intervalle [-2,00 ; +2,00] : Cet intervalle plus étendu englobe 95,45 % de la distribution globale. Les bornes -2 et +2 constituent des jalons diagnostiques majeurs. En neuropsychologie, une performance s’effondrant en deçà du seuil critique de -1,65 (équivalent au 5e percentile) ou de -2,00 écarts-types (équivalent au 2,3e percentile) déclenche l’investigation formelle d’un trouble neurocognitif caractérisé, signant une anomalie statistique indiscutable.
- L’intervalle [-3,00 ; +3,00] : Cet intervalle regroupe 99,73 % des observations. Seuls 0,27 % des individus d’une population normale se situent au-delà de ces bornes extrêmes (environ un individu sur 370). L’identification d’un score Z supérieur à +3,00 ou inférieur à -3,00 renvoie à des configurations cliniques exceptionnelles : surdouance intellectuelle et hautes compétences d’un côté, ou désintégration cognitive majeure de l’autre.
8.2 Conversion des scores Z en percentiles et rangs
Bien que le score Z représente le langage de prédilection des statisticiens et des chercheurs en raison de ses propriétés d’intervalle métrique continu, il s’avère particulièrement ardu à communiquer de manière intelligible à des tiers non initiés (patients, parents d’enfants évalués en milieu scolaire, magistrats lors d’expertises médico-légales). Pour restituer des conclusions psychologiques compréhensibles sans altérer l’exactitude des données, il est d’usage de convertir les scores standardisés en rangs percentiles, qui expriment directement le pourcentage d’individus de la population de référence qui obtiennent une performance inférieure ou égale à celle du sujet examiné.
Microsoft Excel intègre une fonction probabiliste native d’une précision remarquable permettant d’opérer cette conversion en une étape : la fonction LOI.NORMALE.STANDARD.N (ou NORM.S.DIST dans la version anglophone). Pour transformer un score Z positionné dans la cellule C2 en rang percentile, la formule s’énonce comme suit :
=LOI.NORMALE.STANDARD.N(C2; VRAI)
Le second argument booléen VRAI spécifie que l’on sollicite le calcul de la fonction de répartition cumulative (l’aire intégrée sous la courbe de Gauss depuis moins l’infini jusqu’au point Z spécifié). En appliquant un format Pourcentage à la cellule hébergeant cette formule, un score Z de 0,00 affichera instantanément 50,00 %, signifiant que le sujet dépasse précisément la moitié de la population de référence. Un score Z de +1,00 se convertira en 84,13 %, un score Z de -1,65 générera 4,95 % (le seuil pathologique conventionnel), et un score Z de +2,00 produira 97,72 %. L’analyste doit toutefois rappeler dans ses comptes rendus cliniques que les rangs percentiles ne constituent pas une échelle à intervalles constants : ils tassent visuellement les écarts aux extrémités de la distribution tout en dilatant de façon disproportionnée les variations microscopiques situées au centre de la courbe.
8.3 Transformation vers d’autres échelles psychométriques
En psychométrie appliquée, l’existence de valeurs négatives et de décimales dans l’échelle du score Z est souvent jugée peu propice aux échanges cliniques et suscite des angoisses injustifiées chez les patients confrontés à des résultats accompagnés du signe moins. De nombreux inventaires standardisés ont par conséquent élaboré des transformations affines secondaires qui convertissent le score Z canonique vers des échelles arbitraires à composantes strictement positives et entières. Excel se prête merveilleusement à cette algèbre de dérivation secondaire.
La règle générale de transformation d’un score Z vers une nouvelle échelle caractérisée par une nouvelle moyenne conventionnelle M_cible et un nouvel écart-type arbitraire ET_cible obéit à la formulation linéaire :
Score_Transformé = M_cible + (Score_Z * ET_cible)
Trois échelles majeures dominent le champ de l’évaluation internationale et s’implémentent instantanément sous Excel à partir de notre cellule C2 :
- Les Notes T (T-Scores) : Utilisées massivement dans les inventaires de personnalité comme le MMPI ou le PAI, ces notes reposent sur une moyenne fixée arbitrairement à 50 et un écart-type de 10. La formule Excel s’écrit =50 + (C2 * 10). Un score Z de -1,5 devient ainsi une note T de 35.
- L’échelle de Quotient Intellectuel Standard (QI Dérivationnel) : Canonisée par les échelles de David Wechsler, cette métrique adopte une moyenne normative de 100 et un écart-type d’échelle de 15 points. La conversion s’exécute via =100 + (C2 * 15). Un score Z de +2,00 correspond rigoureusement à un QI de 130, seuil statistique d’identification du haut potentiel intellectuel.
- Les Notes Standardisées de sous-tests (Wechsler Subtest Scaled Scores) : Les épreuves unitaires des batteries cognitives sont étalonnées sur une moyenne de 10 et un écart-type de 3. La formule s’établit par =10 + (C2 * 3). Une performance Z de -2,00 équivaut ainsi à une note d’échelle de 4, signant un déficit marqué dans le sous-test considéré.
9. Détection et traitement des valeurs aberrantes (Outliers) via les scores Z
9.1 Critères statistiques d’exclusion ou d’investigation
L’une des applications analytiques les plus valorisées du score standardisé dans l’environnement Excel concerne l’audit de qualité des données et l’identification algorithmique des valeurs aberrantes ou extrêmes (communément désignées par le terme anglo-saxon d’outliers). Dans toute campagne de recueil de données expérimentales ou cliniques, des événements atypiques sont susceptibles d’entacher la fidélité des mesures : erreurs de saisie dactylographique sur le clavier (ex. : coder 120 millisecondes au lieu de 1200), défaillance de l’appareillage chronométrique, ou passation perturbée chez un participant totalement démotivé.
Sur le plan méthodologique classique, les seuils d’identification des valeurs aberrantes reposent traditionnellement sur l’écart à la moyenne exprimé en scores Z :
- Seuil de suspicion (Outliers modérés) : Tout enregistrement générant un score Z dont la valeur absolue dépasse 2,00 ou 2,50 (|Z| > 2,5) doit être impérativement extrait pour une inspection clinique et technique circonstanciée.
- Seuil de criticité (Outliers sévères) : Les observations affichant un score Z franchissant les bornes extrêmes de ±3,00 (|Z| > 3,0) sont qualifiées d’aberrations statistiques formelles. Sous l’hypothèse de normalité, la probabilité d’occurrence spontanée d’une telle valeur est inférieure à 0,27 %.
L’investigateur doit toutefois résister à la tentation méthodologiquement coupable d’effacer machinalement toute observation signalée comme aberrante par son score Z. En recherche comportementale, un score extrêmement divergent peut constituer le signal d’un phénomène biologique authentique d’un intérêt scientifique supérieur (par exemple, la découverte d’une stratégie cognitive inédite chez un patient surperformeur, ou la signature précoce d’une amorce de défaillance neurologique). L’exclusion d’une donnée ne peut être prononcée qu’après l’authentification formelle d’un artefact technique instrumental ou d’une violation grave du protocole d’inclusion éthique de l’étude.
9.2 Mise en forme conditionnelle dynamique dans Excel
Pour automatiser le repérage visuel instantané de ces cas d’intérêt clinique ou d’aberration technique, Microsoft Excel propose un moteur de Mise en forme conditionnelle hautement paramétrable. Plutôt que de scruter passivement des centaines de lignes à l’écran, il est judicieux d’instaurer une règle de signalement chromatique dynamique qui balaye en continu la colonne des scores standardisés.
Pour mettre en place cette sentinelle visuelle sur notre colonne de scores Z (s’étendant de la cellule C2 à C201), la procédure s’articule comme suit :
- Sélectionner l’intégralité de la plage de calcul des scores Z (cellules C2 à C201).
- Déployer le menu Accueil dans le ruban supérieur d’Excel, cliquer sur Mise en forme conditionnelle, puis sélectionner l’option Nouvelle règle.
- Dans le gestionnaire de règles qui apparaît, choisir la modalité : Utiliser une formule pour déterminer pour quelles cellules le format sera appliqué.
- Dans la zone d’édition textuelle de la condition logique, saisir la formule basée sur la fonction valeur absolue : =ABS(C2)>2,5.
- Cliquer sur le bouton Format…, naviguer vers l’onglet Remplissage, et assigner une teinte d’alerte chromatique douce (par exemple, un fond rouge clair pastel avec une police de caractères rouge foncé).
L’utilisation de la coordonnée relative C2 au sein de cette règle conditionnelle est primordiale : le moteur d’Excel réévalue la condition de façon matricielle pour chaque ligne successive de la sélection. Si le score standardisé d’un sujet franchit les bornes critiques de +2,50 ou -2,50, sa cellule s’illumine instantanément de rouge. Si de nouveaux participants sont ajoutés ultérieurement ou si une correction de frappe est appliquée sur un score brut défectueux, le recalcul automatique réajuste la valeur standardisée et éteint dynamiquement l’alerte visuelle si la métrique réintègre le couloir de variabilité admis.
9.3 Scores Z robustes en présence d’asymétrie sévère
La méthodologie du score Z classique, telle que nous l’avons articulée jusqu’ici, souffre d’un paradoxe mathématique pervers connu sous le nom d’effet de contamination ou d’auto-masquage (masking effect). Dans la mesure où la moyenne arithmétique et l’écart-type constituent eux-mêmes des estimateurs hautement sensibles aux valeurs extrêmes, la présence de deux ou trois observations gigantesques dans un échantillon va simultanément décaler la moyenne vers le haut et dilater l’écart-type de manière spectaculaire. Ce gonflement artificiel du dénominateur a pour effet pernicieux de compresser les scores Z de l’ensemble de la série, masquant ainsi l’anomalie des valeurs aberrantes qui se retrouvent gratifiées d’un score standardisé faussement bénin (souvent inférieur à 2,5).
Pour pallier cette défaillance dans les distributions hautement asymétriques ou contaminées, la statistique non paramétrique a forgé le concept de Score Z Robuste (ou Modified Z-score, formalisé notamment par Boris Iglewicz et David Hoaglin). Cette méthode substitue la médiane à la moyenne arithmétique, et remplace l’écart-type standard par l’Écart Absolu à la Médiane, universellement désigné par l’acronyme MAD (Median Absolute Deviation). Dans l’environnement Excel, la mise en œuvre de ce calcul s’exécute selon l’architecture suivante :
1. Calcul de la médiane de la variable brute dans la cellule B205 :
=MEDIANE(B2:B201)
2. Création d’une colonne intermédiaire de déviations absolues (colonne D, cellule D2) mesurant l’écart à la médiane :
=ABS(B2 – $B$205)
3. Calcul de la valeur MAD dans la cellule B206, correspondant à la médiane de ces déviations absolues :
=MEDIANE(D2:D201)
4. Calcul du score Z robuste dans la colonne finale (colonne E, cellule E2). L’algèbre de normalisation applique le facteur correctif de 0,6745 (puisque pour une loi normale pure, le MAD équivaut théoriquement à 0,6745 fois l’écart-type σ) :
=0,6745 * (B2 – $B$205) / $B$206
Ce score Z robuste possède une insensibilité presque absolue face aux contaminations extrêmes de la base de données. Il permet de détecter avec une acuité mathématique irréprochable les véritables anomalies de mesure là où le score Z paramétrique standard échoue lamentablement en raison de l’inflation non contrôlée de son propre dénominateur.
10. Visualisation graphique des scores Z et analyse distributionnelle sur Excel
10.1 Construction de l’histogramme de distribution standardisée
Si la rigueur matricielle des colonnes de données garantit l’exactitude numérique des traitements statistiques, la cognition humaine appréhende bien plus efficacement les structures d’ensemble par l’intermédiaire de modélisations visuelles. L’analyse de la distribution des scores Z calculés doit impérativement faire l’objet d’une représentation graphique sous forme d’histogramme afin d’apprécier la forme empirique du nuage de données standardisées.
Pour concevoir un histogramme statistique rigoureux sous Microsoft Excel, la méthodologie classique la plus robuste repose sur le découpage préalable de l’espace standardisé en classes d’intervalles contigus réguliers (ou bins). Dans une échelle de scores Z, il est méthodologiquement recommandé d’élaborer une table de classes centrée sur zéro, s’étendant par exemple de -3,5 à +3,5 avec un incrément d’intervalle fixé à 0,5 écart-type. Ces bornes de classes sont saisies méthodiquement dans une colonne auxiliaire de votre feuille de travail (ex. : cellules F2 à F16 : -3,5; -3,0; -2,5; … ; 2,5; 3,0; 3,5).
Le dénombrement des occurrences s’effectue ensuite en exploitant la fonction matricielle d’Excel FREQUENCE. En sélectionnant la plage adjacente G2:G16, la syntaxe s’exécute selon :
=FREQUENCE(C2:C201; F2:F16)
Une fois le tableau de distribution des fréquences généré, l’utilisateur insère un graphique de type Histogramme groupé (menu Insertion > Graphiques). Pour conférer à la figure son statut d’histogramme statistique authentique, il convient de faire un clic droit sur les barres graphiques, de sélectionner Mettre en forme une série de données, et d’ajuster le paramètre Largeur du coup d’œil (ou largeur de l’intervalle) à 0 %. Cet ajustement supprime tout espace blanc entre les barres verticales, signifiant graphiquement la continuité mathématique de la variable quantitative sous-jacente.
10.2 Modélisation de la courbe de Gauss théorique
L’étape de sophistication analytique suivante consiste à superposer à cet histogramme empirique la courbe de densité de probabilité de la loi normale théorique N(0, 1). Cette juxtaposition visuelle permet d’évaluer d’un coup d’œil le degré de concordance ou d’asymétrie de votre cohorte réelle par rapport au modèle théorique universel.
Pour générer les coordonnées de cette courbe continue le long du continuum standardisé, on exploite la fonction native LOI.NORMALE.STANDARD.N, mais cette fois en désactivant le cumul d’intégration en basculant le second argument booléen sur FAUX. Cette manipulation commande à Excel de calculer la hauteur exacte de l’ordonnée (la densité de probabilité ponctuelle) correspondant à chaque abscisse Z :
=LOI.NORMALE.STANDARD.N(F2; FAUX)
Les valeurs d’ordonnées obtenues représentent des densités relatives. Pour les convertir à l’échelle d’effectif absolu de votre histogramme empirique, il convient de multiplier cette densité théorique par l’effectif total de l’échantillon (n = 200) et par le pas d’échantillonnage de vos classes d’intervalles (pas = 0,5). La formulation finale intégrée dans votre colonne de modélisation prendra la forme :
=(LOI.NORMALE.STANDARD.N(F2; FAUX) * 200 * 0,5)
En ajoutant cette nouvelle série de données au graphique précédemment constitué et en lui assignant un type de tracé Courbe avec lissage sur l’axe principal, la feuille de calcul fait émerger la fameuse courbe en cloche de Gauss qui vient draper de manière fluide les barres de votre histogramme réel. Cette comparaison permet de repérer instantanément des phénomènes de leptokurticité (pic central anormalement pointu dénotant une variance trop faible) ou une bimodalité latente signalant la présence de sous-groupes cliniques hétérogènes.
10.3 Diagrammes de dispersion et profils psychométriques individuels
Au-delà de l’analyse distributionnelle globale de la cohorte, la visualisation graphique des scores Z révèle tout son potentiel diagnostique lors de la transcription du bilan individuel d’un participant sous la forme d’un profil cognitif multidimensionnel. Supposons qu’un patient ait été soumis à une batterie d’évaluation neuropsychologique intégrant six épreuves standardisées : flexibilité mentale, empan de mémoire de travail, dénomination lexicale, vitesse visuo-motrice, mémoire épisodique immédiate et raisonnement abstrait. L’ensemble de ses scores bruts a été scrupuleusement converti en scores Z.
Pour concevoir un profil psychométrique parlant et diffusable en milieu clinique :
- Organiser les résultats individuels dans un petit tableau récapitulatif à deux colonnes : l’intitulé de la fonction neuropsychologique en colonne X, et le score Z dérivé du patient en colonne Y.
- Insérer un graphique de type Graphique en courbes avec marques ou un Graphique à barres horizontales (nuage de points reliés ou barres divergentes centrées sur l’axe vertical zéro).
- Ajouter manuellement au canevas graphique des lignes de référence horizontales ou verticales correspondant aux seuils critiques universels : une ligne pleine à Z = 0 (représentant la moyenne de la population saine), deux lignes en pointillés à Z = -1,5 et Z = +1,5 (délimitant la zone de fonctionnement moyen), et une ligne rouge à Z = -2,0 (marquant la frontière du déficit clinique caractérisé).
Ce dispositif graphique métamorphose un tableau aride de chiffres en une cartographie clinique percutante. Le médecin ou le neuropsychologue visualise instantanément la morphologie du profil : les aptitudes verbales culminant par exemple à +1,20 écarts-types (force relative préservée) contrastent violemment avec une vitesse de traitement s’effondrant à -2,30 écarts-types sous la ligne rouge critique. Cette dissociation visuelle guide directement le raisonnement diagnostique vers des hypothèses nosologiques précises (telles qu’une atteinte sous-corticale ou un ralentissement phasique spécifique).
11. Diagnostic et résolution des erreurs méthodologiques courantes dans Excel
11.1 Résolution des codes d’erreur techniques courants
Lors de la manipulation de calculs statistiques au sein d’environnements tabulaires volumineux, la survenue de messages d’erreur cryptiques générés par le moteur d’Excel est un phénomène fréquent. Comprendre l’étiologie computationnelle de ces signaux permet de rétablir rapidement l’intégrité de la feuille d’analyse.
Trois codes d’erreur majeurs surviennent régulièrement lors de la mise en œuvre des scores standardisés :
- L’erreur #DIV/0! (Division par zéro) : Dans le cadre du calcul de score standardisé, ce signal indique formellement que le dénominateur de votre formule arithmétique manuelle ou que le troisième argument de la fonction CENTREE.REDUITE pointe vers une cellule dont la valeur est égale à zéro ou vers une cellule totalement vide. Ce problème se produit soit lorsque la formule d’écart-type a englobé une plage dépourvue de toute variabilité (tous les scores bruts sont identiques), soit lorsqu’un oubli de verrouillage absolu ($) a provoqué le glissement de la formule vers une ligne inférieure non renseignée de la feuille.
- L’erreur #VALEUR! (Valeur typologique erronée) : Cette interruption de traitement signale l’injection accidentelle d’une donnée alphanumérique textuelle au sein d’une fonction réclamant exclusivement des grandeurs scalaires continues. L’investigation doit se focaliser sur l’existence d’espaces typographiques insécables, de points au lieu de virgules décimales (dans les configurations régionales françaises), ou de codes d’absence de données tels que des tirets ou la mention « absent » au sein de la plage de scores bruts analysée.
- L’erreur #NOM? (Identifiant de fonction non reconnu) : Ce code trahit systématiquement une divergence linguistique ou une coquille typographique dans l’écriture du nom de la fonction. L’analyste a par exemple saisi la commande anglophone STANDARDIZE sur une version d’Excel configurée en langue française sans passer par l’environnement VBA, ou a mal orthographié le nom de la fonction en omettant un point syntaxique obligatoire (ex. : écrire CENTREREDUITE sans le point séparateur).
11.2 Erreurs méthodologiques liées au référencement
Au-delà des pannes techniques explicites qui interrompent physiquement le calcul, les erreurs méthodologiques les plus insidieuses sont celles qui s’exécutent sans renvoyer le moindre code d’alarme, produisant des chiffres parfaitement calculés en apparence mais mathématiquement et scientifiquement aberrants.
Le piège de référencement le plus classique et dévastateur demeure l’absence de fixation rigoureuse des coordonnées des métadonnées de référence. Si la moyenne du groupe a été calculée dans la cellule D2 et l’écart-type dans la cellule D3, l’écriture fautive de =(A2 – D2) / D3 recopiée sur 500 lignes générera un calcul décalé sur chaque ligne successive. À la cinquantième ligne, le score brut du cinquantième patient sera comparé à la valeur contenue dans la cellule D51 et divisé par celle de D52. Si par extraordinaire ces cellules lointaines hébergent d’autres chiffres issus d’autres tables de calcul, Excel s’exécutera docilement et renverra un prétendu « score Z » qui ne sera en réalité qu’un artéfact numérique dépourvu de toute validité scientifique.
Une seconde aberration conceptuelle fréquente consiste à calculer un score Z en utilisant aveuglément la moyenne et l’écart-type de son propre échantillon d’expérimentation, alors même que l’objectif déclaré de l’investigation est d’évaluer le statut clinique des participants par rapport aux normes d’une population générale validée. Si un clinicien évalue un groupe de 30 patients tous atteints de la maladie d’Alzheimer à une épreuve mnésique, et qu’il standardise leurs scores à partir de la moyenne arithmétique propre à ce groupe de 30 malades, le score Z moyen de ces patients sera obligatoirement égal à 0 ! Le clinicien conclura faussement que ses patients se situent « dans la moyenne », confondant tragiquement la moyenne interne d’un groupe pathologique avec la norme d’une population saine. Pour situer adéquatement ces patients, le dénominateur et le paramètre central doivent impérativement être extraits des tables d’étalonnage publiées dans les manuels validés de l’instrument d’évaluation, et non recalculés à partir de la cohorte clinique en cours d’examen.
11.3 Protocoles de vérification et d’audit interne
Pour prémunir toute chaîne de traitement statistique contre ces défaillances invisibles, l’analyste méthodologiquement rigoureux doit systématiquement exécuter un protocole d’audit interne avant de valider et d’exploiter ses colonnes de scores standardisés. Ce protocole repose sur l’exploitation des deux invariants mathématiques canoniques démontrés au chapitre 2.
Au bas de la colonne hébergeant vos scores Z standardisés (supposons la plage C2:C201), insérez deux formules d’audit de contrôle :
1. Contrôle de tendance centrale : =MOYENNE(C2:C201)
2. Contrôle de dispersion : =ECARTYPE.PEARSON(C2:C201)
Si votre feuille de calcul a été correctement configurée selon les canons de la standardisation interne d’échantillon, la première formule doit impérativement restituer une valeur strictement égale à 0. En raison des limitations infinitésimales de l’arithmétique en virgule flottante binaire des microprocesseurs (norme IEEE 754), Excel n’affiche parfois pas exactement 0, mais une valeur infinitésimale de type 1,45E-16 (ce qui correspond à 0,000000000000000145, valeur rigoureusement indiscernable de zéro à l’échelle clinique). La seconde formule de contrôle doit obligatoirement restituer la valeur exacte de 1,0000000. Si l’une de ces deux cellules d’audit dévie de ces bornes théoriques, cela prouve sans équivoque qu’une anomalie s’est glissée dans le modèle : formule polluée, ligne oubliée, référence mal ancrée ou présence de valeurs parasites.
En complément de ces calculs de contrôle, il est fortement recommandé d’utiliser l’outil d’audit natif d’Excel logé dans le ruban Formules. Les commandes Repérer les antécédents et Repérer les dépendants tracent des flèches graphiques bleues directement à travers la feuille de calcul, matérialisant physiquement la provenance des données qui alimentent chaque cellule de score standardisé et confirmant de visu la solidité de votre maillage référentiel.
12. Étude de cas appliquée : Étalonnage complet d’une batterie psychologique
12.1 Présentation du jeu de données expérimental
Afin de concrétiser l’ensemble des notions théoriques et des procédures techniques développées au sein de ce manuel, nous allons déployer une étude de cas clinique intégrale simulant l’étalonnage psychométrique d’une batterie d’investigation des fonctions exécutives. L’échantillon expérimental collige les données de 200 participants adultes soumis à trois épreuves neuropsychologiques complémentaires évaluant des dimensions distinctes de la sphère cognitive :
- Épreuve 1 : Empan Mnésique Spatial (Variable ‘Memoire’) : Mesure de la capacité de stockage temporaire visuo-spatial. La métrique est un score brut de rappel correct, s’étendant de 0 à 30 points. Pour cette dimension, la performance est directement proportionnelle au chiffre brut : un score élevé matérialise une excellente compétence mnésique.
- Épreuve 2 : Temps de Réaction Sélectif (Variable ‘Attention’) : Évaluation de l’attention sélective informatisée. La grandeur mesurée correspond à la latence moyenne de réponse exprimée en millisecondes (ms), oscillant classiquement entre 250 et 700 ms. Dans ce paradigme chronométrique, la dynamique métrique est rigoureusement inversée : un temps court traduit une vitesse optimale, tandis qu’un chiffre élevé signale une lenteur de traitement pathologique.
- Épreuve 3 : Test d’Inhibition Motrice (Variable ‘Inhibition’) : Épreuve de type Go/No-Go quantifiant le contrôle inhibiteur. La métrique relevée est le décompte brut d’erreurs de commission (appuis intempestifs sur les leurres), allant de 0 à 25 erreurs. Ici encore, la polarité clinique est négative : l’accumulation d’erreurs dénote une faillite du contrôle exécutif frontal.
La problématique majeure à laquelle est confronté le neuropsychologue réside dans la totale impossibilité de sommer ou de confronter ces trois scores bruts hétérogènes : comment agréger des points de rappel, des millisecondes et un décompte d’erreurs sans commettre un contresens psychométrique majeur ? Seule une normalisation standardisée coordonnée via Excel permet de résoudre cette équation clinique.
12.2 Calcul pas à pas et standardisation multivariée
La structuration de notre matrice de calcul dans Excel s’organise selon une architecture rigoureuse de colonnes consécutives :
- Colonne A : Identifiant du sujet (SUBJ_001 à SUBJ_200, lignes 2 à 201)
- Colonne B : Score brut Mémoire (points)
- Colonne C : Latence brute Attention (millisecondes)
- Colonne D : Décompte brut Inhibition (erreurs)
Dans les lignes de totalisation sous le tableau, nous implantons les paramètres normatifs du groupe de référence. En ligne 203, nous calculons les moyennes arithmétiques pour chaque épreuve :
En B203 : =MOYENNE(B2:B201)
En C203 : =MOYENNE(C2:C201)
En D203 : =MOYENNE(D2:D201)
En ligne 204, nous évaluons les dispersions empiriques standardisées :
En B204 : =ECARTYPE.STANDARD(B2:B201)
En C204 : =ECARTYPE.STANDARD(C2:C201)
En D204 : =ECARTYPE.STANDARD(D2:D201)
Nous ouvrons ensuite les colonnes de standardisation individuelle. Pour la variable Mémoire (colonne E, cellule E2), la dynamique de performance étant positive (plus de points = meilleure performance), la formule CENTREE.REDUITE conventionnelle s’applique immédiatement :
=CENTREE.REDUITE(B2; $B$203; $B$204)
Pour les épreuves d’Attention (colonne F, cellule F2) et d’Inhibition (colonne G, cellule G2), une étape d’inversion algébrique de polarité est impérative. Si un sujet met 600 ms là où la moyenne est à 400 ms, son score Z standard brut sera de +2,00 écarts-types. Or, dans le langage de l’évaluation psychologique universelle, un Z de +2,00 doit obligatoirement symboliser une performance excellente et non une lenteur déficitaire. Pour harmoniser la lecture clinique de sorte qu’une valeur positive traduise systématiquement une supériorité adaptative et qu’une valeur négative signe un déficit, il convient d’inverser le signe de la standardisation en multipliant le résultat par -1 ou en inversant l’ordre de la soustraction au numérateur :
En F2 (Score Z Attention inversé) : =-CENTREE.REDUITE(C2; $C$203; $C$204)
En G2 (Score Z Inhibition inversé) : =-CENTREE.REDUITE(D2; $D$203; $D$204)
Grâce à cette inversion concertée, toutes les variables standardisées parlent désormais le même langage directionnel. Il devient alors mathématiquement légitime de dériver un Indice Exécutif Global (colonne H, cellule H2) matérialisant l’efficience cognitive générale du patient par l’intermédiaire d’une moyenne équipondérée des trois scores Z normalisés :
=MOYENNE(E2:G2)
Un patient obtenant des scores Z harmonisés de +1,20 en Mémoire, +0,80 en Attention et +1,00 en Inhibition affichera un score composite exécutif de +1,00 écart-type, synthétisant fidèlement son statut cognitif global sur une échelle universelle directement comparable à d’autres cohortes.
12.3 Génération de rapports individuels et synthèse statistique
L’aboutissement de cette architecture sous Microsoft Excel réside dans la configuration d’un module de consultation individuelle automatisé, permettant au praticien d’éditer un bilan psychométrique personnalisé à partir de l’identifiant du patient sans devoir parcourir manuellement l’immense matrice de 200 lignes.
Sur une nouvelle feuille de calcul baptisée « Rapport_Individuel », nous configurons une interface de synthèse épurée :
- En cellule B2, une liste déroulante de validation de données (menu Données > Validation des données) permet de sélectionner l’identifiant alphanumérique de n’importe quel sujet (ex. : SUBJ_042).
- Dans les cellules adjacentes de restitution clinique, nous déployons la fonction moderne RECHERCHEX (ou la combinaison classique INDEX et EQUIV) pour extraire instantanément le profil complet du patient sélectionné. Pour récupérer son score Z global :
=RECHERCHEX(B2; Data_Synthese!A2:A201; Data_Synthese!H2:H201)
Pour enrichir ce tableau de bord, on y intègre la conversion instantanée du score composite global en rang percentile clinique via la formule :
=LOI.NORMALE.STANDARD.N(RECHERCHEX(B2; Data_Synthese!A2:A201; Data_Synthese!H2:H201); VRAI)
Accompagnée d’un diagnostic textuel conditionnel généré par une formule logique imbriquée :
=SI(C5<-2; « Déficit cognitif caractérisé »; SI(C5<-1,5; « Zone de fragilité clinique »; SI(C5<=1,5; « Fonctionnement neurocognitif normal »; « Performance exceptionnelle / Haute compétence »)))
Enfin, pour garantir la pérennité institutionnelle et la reproductibilité des analyses, l’ensemble des données standardisées et des calculs d’étalonnage doit faire l’objet d’un archivage strict. Il est recommandé de verrouiller les cellules hébergeant les formules fondamentales via la protection de feuille d’Excel afin de prévenir toute manipulation accidentelle par des tiers, et d’exporter les synthèses finales au format textuel délimité par des virgules (CSV) ou au format PDF non modifiable pour l’intégration dans les dossiers médicaux ou les archives ouvertes de la recherche scientifique.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
Howell, D. C. (2013). Statistical methods for psychology (8th ed.). Wadsworth, Cengage Learning.
Iglewicz, B., & Hoaglin, D. C. (1993). How to detect and handle outliers. ASQC Basic References in Quality Control, Vol. 16, American Society for Quality Control.
Microsoft Corporation. (2024). Documentation technique de la fonction CENTREE.REDUITE (STANDARDIZE) dans Microsoft Excel. Microsoft Support. https://support.microsoft.com/fr-fr/office/centree-reduite-fonction-centree-reduite-81d66554-2e54-4982-ba9c-50e18480413a
Nunnally, J. C., & Bernstein, I. H. (1994). Psychometric theory (3rd ed.). McGraw-Hill.
Wechsler, D. (2008). Wechsler Adult Intelligence Scale–Fourth Edition (WAIS–IV). NCS Pearson.