
Dans le domaine des sciences humaines, et plus particulièrement en psychologie cognitive, clinique et expérimentale, la quantification des phénomènes psychiques se heurte de manière récurrente à l’irrégularité morphologique des distributions empiriques. Qu’il s’agisse de mesurer la latence cognitive au millième de seconde, l’intensité d’un affect dépressif à travers un inventaire clinique standardisé, ou encore le niveau d’adhésion sur une échelle de Likert multipoints, les données réelles s’écartent fréquemment de l’idéal théorique de la distribution normale de Gauss-Laplace. Face à ces asymétries prononcées, à la présence inévitable de valeurs extrêmes et aux effets d’échelle inhérents aux instruments de mesure psychométriques, l’utilisation aveugle des statistiques descriptives paramétriques traditionnelles — au premier rang desquelles trônent la moyenne arithmétique et l’écart-type — expose le chercheur à des distorsions analytiques sévères qui compromettent la validité interne des conclusions empiriques.
Afin de pallier ces vulnérabilités métrologiques, l’analyse exploratoire des données propose une approche fondée sur l’ordre et la position relative des observations, matérialisée de manière emblématique par le concept du résumé à cinq nombres (Five-Number Summary). Élaboré pour capturer l’essence structurelle d’une distribution sans postuler la moindre forme paramétrique a priori, cet ensemble synthétique condense l’information distributionnelle en cinq jalons critiques : la valeur minimale, le premier quartile (25e percentile), la médiane (50e percentile), le troisième quartile (75e percentile) et la valeur maximale. En ancrant la description quantitative sur des statistiques de rang insensibles aux contaminations marginales, le résumé à cinq nombres offre une lisibilité immédiate de la tendance centrale, de la dispersion et de l’asymétrie d’un jeu de données, constituant ainsi la colonne vertébrale numérique sur laquelle repose le diagramme en boîte de Tukey.
Le présent traité méthodologique se propose de guider de façon exhaustive les chercheurs, cliniciens et analystes de données dans la mise en œuvre pratique, l’interprétation statistique approfondie et la communication académique rigoureuse du résumé à cinq nombres au sein de l’environnement logiciel IBM SPSS Statistics. À travers l’examen détaillé des modules procéduraux intégrés, l’analyse des algorithmes d’interpolation sous-jacents, l’étude d’un protocole clinique concret et l’exposé des directives de présentation conformes à la 7e édition du manuel de publication de l’American Psychological Association (APA), cet article fournit un cadre technique complet pour exploiter pleinement la puissance descriptive des estimateurs d’ordre dans la recherche contemporaine.
1. Introduction aux statistiques descriptives et au résumé à cinq nombres en psychologie
1.1 Origines conceptuelles et vision de John Tukey
L’émergence formelle du résumé à cinq nombres s’inscrit au cœur de la révolution épistémologique initiée au début des années 1970 par le statisticien américain John Wilder Tukey. Dans son ouvrage séminal paru en 1977, intitulé Exploratory Data Analysis (EDA), Tukey s’est insurgé contre l’hégémonie quasi dictatoriale de l’inférence statistique formelle et du paradigme néo-fisherien de la confirmation d’hypothèses par le test de signification de l’hypothèse nulle (NHST). Tukey soutenait avec force que l’analyse des données devait impérativement débuter par une phase d’exploration sans œillères, une écoute attentive et visuelle de ce que les observations empiriques ont à révéler, avant toute tentative de modélisation mathématique probabiliste contraignante.
Face à la prédominance historique de la courbe de Gauss — souvent érigée en dogme indéboulonnable —, Tukey constata la vulnérabilité intrinsèque des métriques classiques lorsque les distributions réelles dévient de la symétrie théorique. Il développa la conviction que les sciences quantitatives avaient un besoin impérieux d’indicateurs de position et de variabilité fondés sur l’ordre, qui soient structurellement robustes face aux contaminations périphériques et aux asymétries morphologiques. Le résumé à cinq nombres est né de cette volonté d’opérer une réduction statistique maximale tout en préservant scrupuleusement l’intégrité de la dispersion et de la forme de l’échantillon, établissant une passerelle élégante entre la condensation numérique d’une série et la conservation de son profil volumétrique.
Dans l’histoire des sciences humaines, cette rupture paradigmatique a permis de délier l’analyse descriptive de la stricte obligation paramétrique. Alors que l’approche déductive classique contraignait le praticien à ajuster artificiellement ses données à des distributions analytiques élégantes — souvent par le biais de transformations logarithmiques ou inverses parfois dénuées de sens psychologique —, la boîte à outils exploratoire non paramétrique de Tukey a redonné toute sa légitimité à l’état brut de la mesure. Le résumé à cinq nombres est devenu le socle fondamental d’une métrologie du réel, respectueuse de la variabilité naturelle et des rugosités empiriques inhérentes à l’étude des comportements humains.
1.2 Pertinence du résumé à cinq nombres en recherche psychologique
L’investigation empirique en psychologie et en neurosciences cognitives présente des singularités méthodologiques majeures qui justifient pleinement le recours préférentiel au résumé à cinq nombres. En premier lieu, la distribution des scores psychométriques issus de populations réelles est notoire pour son caractère asymétrique. Considérons les temps de réaction recueillis dans des paradigmes d’amorçage attentionnel ou de tâche de type Stroop : ces latences présentent invariablement une distribution fortement étirée vers la droite (asymétrie positive prononcée), caractérisée par une accumulation massive d’observations rapides et une longue traîne de réponses ralenties induites par des lapsus attentionnels transitoires. Résumer de telles données par une moyenne et un écart-type aboutit à une dénaturation évidente de la réalité chronométrique.
De surcroît, le champ de la psychopathologie quantitative et de l’évaluation clinique est dominé par des échelles symptomatiques — telles que l’Inventaire de Dépression de Beck (BDI) ou l’échelle d’anxiété de Hamilton — au sein desquelles la majorité des individus issus d’échantillons non cliniques obtiennent des scores nuls ou marginaux, générant une concentration phénoménale d’observations sur la borne inférieure de l’instrument. Ce phénomène, couramment désigné sous le terme d’effet plancher, rend l’application des paramètres gaussiens totalement aberrante, dans la mesure où l’écart-type soustrait à la moyenne projette théoriquement des seuils négatifs sur des variables qui sont conceptuellement et physiquement bornées à zéro.
Enfin, la nature ordinale prépondérante des données psychologiques, particulièrement celles issues des échelles d’attitudes ou de personnalité de Likert à cinq ou sept points, impose une prudence métrologique rigoureuse. L’absence d’intervalle métrique constant et démontrable entre des modalités telles que « modérément en accord » et « tout à fait en accord » interdit sur le plan épistémologique le calcul de moyennes pondérées. En exploitant des rangs d’apparition et des fractions d’effectifs ordonnés, le résumé à cinq nombres respecte scrupuleusement l’invariance ordinale des données, tout en permettant une détection instantanée de la dispersion des symptômes au sein d’une cohorte sans que cette dernière ne soit artificiellement gonflée par quelques observations extrêmes atypiques.
1.3 Limites des statistiques paramétriques classiques
Pour mesurer pleinement la valeur scientifique du résumé à cinq nombres, il est indispensable de disséquer les faiblesses structurelles des indicateurs paramétriques que sont la moyenne arithmétique et l’écart-type. La moyenne possède une propriété de sensibilité critique extrême : son point de rupture (breakdown point) est mathématiquement égal à $1/n$. Cela signifie qu’il suffit d’une unique valeur aberrante, d’une seule erreur de saisie typographique ou du score d’un participant désengagé pour corrompre arbitrairement la moyenne et déplacer le centre de gravité de l’ensemble de l’échantillon, le rendant parfaitement non représentatif de la vaste majorité des observations sous-jacentes.
L’écart-type partage cette même vulnérabilité et l’amplifie considérablement en raison de l’élévation au carré des écarts à la moyenne dans son équation constitutive ($\sum (x_i – \bar{x})^2$). En présence d’hétéroscédasticité ou d’une queue de distribution exceptionnellement lourde — situation banale lors de l’évaluation de traits de personnalité pathologiques ou de conduites addictives —, l’écart-type se trouve exponentiellement majoré par les écarts distaux, conférant une impression trompeuse d’instabilité globale de la mesure là où il n’existe qu’une poignée de cas périphériques. L’utilisation conjointe de ces paramètres dans des distributions non gaussiennes induit ainsi le statisticien en erreur, faussant les calculs de puissance a priori et multipliant le risque d’erreurs d’inférence de type I ou de type II lors des analyses ultérieures.
À l’inverse, les estimateurs d’ordre jouissent de propriétés de robustesse locale et globale hautement désirables pour la modélisation de traits psychologiques rares ou de phénomènes hautement variables. En substituant le principe de minimisation des distances absolues à celui des moindres carrés, le résumé de Tukey préserve la fidélité de la cartographie descriptive. Il permet de discerner avec une netteté remarquable le comportement typique d’une cohorte sans l’amalgamer aux singularités comportementales isolées, garantissant une interprétation clinique et expérimentale d’une probité scientifique irréprochable.
2. Les composantes fondamentales du résumé à cinq nombres : Fondements mathématiques
2.1 La valeur minimale : Détection des seuils planchers
Sur le plan de l’analyse formelle, la première composante du résumé à cinq nombres correspond à la plus petite observation enregistrée dans une série statistique ordonnée. Si nous considérons un échantillon de taille $n$, composé d’observations indépendantes et identiquement distribuées notées $X_1, X_2, dots, X_n$, le réarrangement de ces données par ordre croissant produit la série des statistiques d’ordre notée :
$$X_{(1)} le X_{(2)} le dots le X_{(n)}$$
La valeur minimale est formellement définie comme la première statistique d’ordre, soit :
$$\text{Minimum} = X_{(1)}$$
Loin d’être une simple anecdote numérique, la statistique $X_{(1)}$ remplit des fonctions diagnostiques de premier ordre dans l’audit psychométrique. Dans les inventaires d’auto-évaluation psychologique, elle permet d’identifier l’existence d’effets planchers sévères. Lorsqu’une fraction substantielle de l’échantillon partage la valeur minimale de l’échelle théorique, cela signale immédiatement l’incapacité de l’instrument à discriminer les variations infra-cliniques ou les niveaux particulièrement bas du trait mesuré chez les sujets sains.
D’autre part, la valeur minimale constitue un filtre élémentaire mais puissant pour le diagnostic précoce des erreurs de codage de données et des anomalies matérielles. Dans un protocole évaluant des temps de réaction informatisés, l’apparition d’un minimum à 0 milliseconde ou négatif trahit sans équivoque un dysfonctionnement de l’horloge système ou une erreur de script, tandis qu’un score minimal de 15 millisecondes révèle une réponse anticipatoire réflexe biologiquement incompatible avec les délais de conduction synaptique cérébrale. Enfin, sur le plan de la géométrie distributionnelle, la valeur minimale délimite la borne inférieure absolue indispensable au calcul de l’étendue brute de l’échantillon ($E = X_{(n)} – X_{(1)}$).
2.2 Le premier quartile (Q1) : Borne du quart inférieur
Le premier quartile, universellement désigné par le symbole $Q_1$, correspond au 25e percentile de la distribution cumulative empirique. Mathématiquement, il représente la valeur sous laquelle se situent précisément 25 % des observations ordonnées de l’échantillon, et au-dessus de laquelle se trouvent les 75 % restants. Si la fonction de répartition empirique est désignée par $F_n(x)$, le premier quartile est formellement la plus petite valeur de $x$ satisfaisant l’inégalité $F_n(x) ge 0,25$.
Il importe d’établir ici une distinction conceptuelle fondamentale entre le quartile calculé selon les conventions probabilistes standard et la charnière inférieure (lower hinge) formalisée originellement par Tukey. Tandis que le quartile standard repose généralement sur des interpolations linéaires spécifiques entre deux rangs consécutifs, la charnière inférieure de Tukey est définie de manière discrète comme la médiane de la moitié inférieure de la série statistique, incluant la médiane globale lorsque l’effectif $n$ est impair selon certaines variantes algorithmiques. Bien que ces deux notions convergent vers une valeur asymptotiquement identique à mesure que l’effectif $n$ tend vers l’infini, des nuances d’arrondi peuvent apparaître sur les petits échantillons de recherche.
En pratique clinique et psychologique, le premier quartile délimite le niveau d’intensité basal d’un trait au sein d’une population ou marque le seuil de vulnérabilité inférieure. Dans les bilans de développement cognitif chez l’enfant, un score tombant sous la borne du premier quartile interpelle l’évaluateur sur un possible retard fonctionnel. Enfin, sur le plan de la modélisation statistique, $Q_1$ constitue le pivot inférieur nécessaire au calcul de l’intervalle interquartile, métrique reine de la dispersion robuste.
2.3 La médiane (Q2) : Le paramètre de position robuste
Deuxième quartile ($Q_2$) ou 50e percentile, la médiane ($\tilde{X}$ ou $\text{Mdn}$) est incontestablement le paramètre de position le plus robuste de l’analyse exploratoire. Elle divise la série ordonnée en deux sous-ensembles de cardinaux rigoureusement égaux, de sorte qu’il y a autant d’observations situées en deçà de la médiane qu’au-delà. Sur le plan du calcul direct sur la statistique d’ordre, sa formalisation classique s’énonce comme suit :
$$\text{Mdn} = \begin{\cases} X_{\left(\frac{n+1}{2}\right)} &a\mp; \text{si } n \text{ est impair} \frac{X_{\left(\frac{n}{2}\right)} + X_{\left(\frac{n}{2} + 1\right)}}{2} &a\mp; \text{si } n \text{ est pair} \end{\cases}$$
La grandeur de la médiane réside dans son point de rupture théorique maximal de 0,50 (soit 50 %). Cette propriété mathématique remarquable garantit que jusqu’à la moitié moins une des observations de l’échantillon peuvent être corrompues de manière arbitraire — déplacées vers l’infini positif ou négatif — sans que la médiane ne s’effondre ni ne s’échappe vers des valeurs aberrantes. Elle incarne ainsi le point d’ancrage le plus fidèle du participant « typique » au sein d’une cohorte psychologique.
D’un point de vue géométrique et analytique, la médiane minimise la somme des écarts absolus par rapport aux observations ($\sum |X_i – c|$), tandis que la moyenne arithmétique minimise la somme des écarts au carré. Lorsque la distribution sous-jacente est affectée d’une forte asymétrie unilatérale, la moyenne est irrésistiblement aspirée dans la direction de la longue traîne, alors que la médiane demeure fermement chevillée à la concentration de densité principale des observations, offrant ainsi une lecture métrologique non biaisée du niveau central du trait investigué.
2.4 Le troisième quartile (Q3) et le maximum : Caractérisation de la queue supérieure
Le troisième quartile ($Q_3$), ou 75e percentile de la série empirique, partitionne les données de telle sorte que trois quarts (75 %) des participants obtiennent un score égal ou inférieur à cette valeur, et qu’un quart (25 %) réalise un score supérieur. Dans les contextes de dépistage psychologique et psychiatrique, $Q_3$ assume une signification diagnostique capitale : il délimite fréquemment le seuil à partir duquel les manifestations symptomatiques cessent d’être subcliniques pour basculer dans la zone de souffrance significative, requérant une prise en charge thérapeutique personnalisée.
À l’autre extrémité de la série se dresse la valeur maximale, correspondant rigoureusement à la dernière statistique d’ordre :
$$\text{Ma\ximum} = X_{(n)}$$
À l’instar de la valeur minimale, le maximum joue un rôle de vigie méthodologique. En présence de tests d’aptitudes cognitives ou d’évaluations scolaires standardisées, un maximum saturé par un contingent massif d’individus dénonce l’existence d’un effet plafond (ceiling effect), traduisant une insuffisance de difficulté intrinsèque de l’épreuve pour discriminer les sujets hautement performants.
L’articulation dynamique entre le premier quartile, la médiane, le troisième quartile et les deux extrêmes permet de décrypter l’asymétrie distributionnelle sans nécessiter le recours au coefficient de symétrie (skewness) de Pearson. En observant simplement l’espacement relatif :
$$\Delta_1 = (Q_2 – Q_1) \quad \text{et} \quad \Delta_2 = (Q_3 – Q_2)$$
Toute discordance flagrante entre ces deux deltas révèle instantanément le sens et l’intensité de l’asymétrie de la distribution psychologique étudiée, guidant le statisticien dans ses orientations analytiques avec une élégance mathématique absolue.
3. Préparation et configuration des données psychométriques dans SPSS
3.1 Configuration rigoureuse dans la vue des variables
Préalablement à toute extraction algorithmique d’un résumé à cinq nombres au sein du logiciel SPSS, une étape fondatrice et non négociable consiste en l’audit exhaustif et la structuration méticuleuse des métadonnées dans la Vue des variables (Variable View). Une proportion substantielle des anomalies d’interprétation rencontrées dans la littérature académique trouve son origine non pas dans des défaillances de calcul du processeur de SPSS, mais dans une définition approximative des propriétés élémentaires des variables analysées.
Le premier paramètre critique à vérifier est l’attribution correcte de la mesure dans la colonne Mesure (Measure). Bien que le calcul des percentiles et des statistiques d’ordre soit techniquement toléré par SPSS sur des variables étiquetées sous forme ordinale ou métrique, il est impératif d’assigner l’attribut Échelle (Scale) aux variables quantitatives continues ou composites (telles que le score total à un inventaire d’anxiété) et l’attribut Ordinal aux items isolés de Likert. Cette différenciation conditionne la manière dont certains sous-modules graphiques et tableaux synthétiques de SPSS automatisent le rendu et préviennent les incohérences d’affichage.
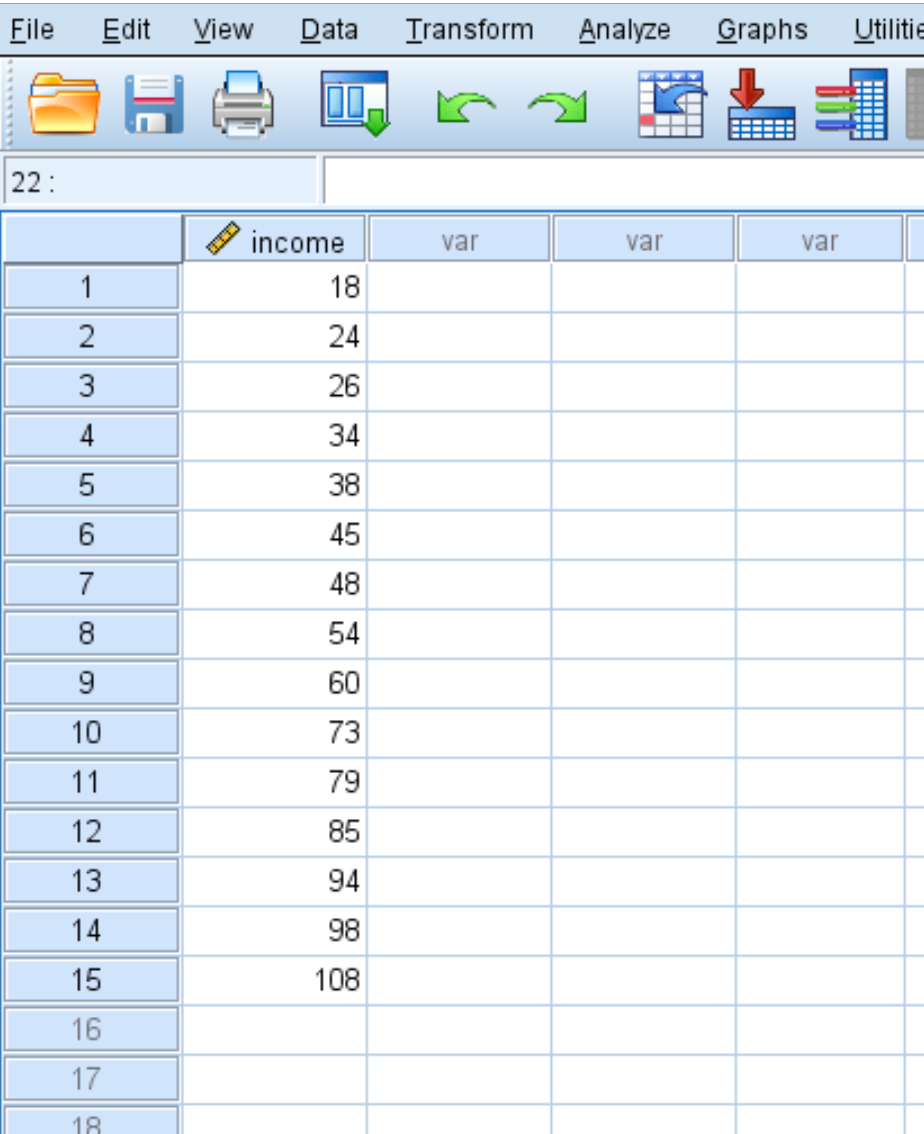
Deuxièmement, l’étiquetage sémantique précis via la colonne Libellé (Label) garantit que les sorties statistiques générées dans le visualiseur conservent une traçabilité irréprochable lors des phases ultérieures de reporting. De même, la gestion des Décimales ne doit pas être négligée : si les scores bruts sont discrets (nombres entiers), conserver au moins une à deux décimales pour les scores composites issus de moyennes partielles permet de préserver la granularité fine lors de l’interpolation des quantiles intermédiaires. L’harmonisation globale des formats évite ainsi les décalages algorithmiques silencieux lors des processus d’exportation vers d’autres environnements.
3.2 Gestion des données manquantes et valeurs sentinelles
L’un des écueils majeurs lors du traitement de questionnaires psychologiques volumineux réside dans la manipulation des non-réponses, des abandons d’épreuves ou des déclarations d’inapplicabilité. SPSS opère une distinction technique cardinale entre les valeurs manquantes système (System-Missing, matérialisées par un simple point « . » dans la grille de données) et les valeurs manquantes définies par l’utilisateur (User-Defined Missing). Les valeurs sentinelles sont des codes numériques spécifiques — tels que 999, -99 ou 9999 — conventionnellement attribués par les équipes de saisie pour différencier une absence de réponse volontaire d’une omission accidentelle ou d’une erreur d’aiguillage dans le protocole de recherche.
Si le chercheur omet d’expliciter formellement ces codes dans la colonne Manquant (Missing) de la vue des variables, SPSS les traitera comme de véritables grandeurs quantitatives. Dans une telle hypothèse, un code de valeur sentinelle fixé à 999 inséré au sein d’une échelle variant normalement de 0 à 50 viendra s’imposer immédiatement comme la valeur maximale ($X_{(n)}$), tirant de manière destructrice le troisième quartile vers le haut et faussant dramatiquement l’ensemble du résumé à cinq nombres. L’attribution rigoureuse de ces valeurs manquantes exclut automatiquement les cas corrompus du calcul des rangs ordonnés.
Par ailleurs, la manipulation préalable des non-réponses via des algorithmes d’imputation univariée (telle que l’imputation par la moyenne) doit être formellement proscrite avant le calcul d’un résumé à cinq nombres. L’imputation par la moyenne provoque une sur-densification artificielle du centre de la distribution, altérant la position géométrique réelle des quartiles $Q_1$ et $Q_3$. En présence d’un mécanisme de données manquantes complètement aléatoires (MCAR), l’analyse exclusive des cas valides (suppression par liste ou par paire) préserve fidèlement la fidélité de l’estimation des quantiles d’ordre.
3.3 Audit préliminaire et détection des incohérences de saisie
Avant d’engager le déploiement des modules d’analyse descriptive, la bonne pratique méthodologique exige la réalisation d’un audit de conformité de l’espace échantillonnal. Cet audit repose sur la confrontation systématique des bornes théoriques de l’instrument d’évaluation psychologique avec les valeurs brutes réellement inscrites dans le fichier de données. Dans un inventaire mesurant par exemple l’affirmation de soi comprenant 30 items cotés de 1 à 5, l’espace des scores théoriquement admissibles s’étend impérativement entre le minimum absolu de 30 et le maximum absolu de 150.
L’utilisation préalable de filtres conditionnels ou la génération d’un tableau d’occurrences permet d’intercepter instantanément des aberrations d’encodage (par exemple un score de 300 résultant d’une double frappe accidentelle d’une touche numérique). Dans la perspective du résumé à cinq nombres, une telle coquille de saisie corrompt instantanément la dernière statistique d’ordre $X_{(n)}$, étirant l’étendue de façon chimérique et induisant un diagnostic erroné quant à l’hétérogénéité des sujets testés.
Toute correction appliquée sur les données brutes doit faire l’objet d’une traçabilité absolue au sein du journal des commandes ou d’un fichier script SPSS (syntaxe). La documentation méticuleuse des décisions d’apurement garantit la reproductibilité intégrale de l’expérience, conformément aux standards les plus exigeants de la recherche ouverte (Open Science), avant que ne soit définitivement figé le calcul des statistiques de rang descriptives.
4. Procédure pas-à-pas : Calcul du résumé à cinq nombres via le menu Fréquences
4.1 Accès et paramétrage du module Fréquences
Dans l’architecture modulaire d’IBM SPSS Statistics, le menu Fréquences (Frequencies) représente la modalité d’accès la plus intuitive, rapide et largement plébiscitée pour dériver l’intégralité du résumé à cinq nombres au sein d’une ou de plusieurs séries statistiques. Pour initialiser le calcul, l’opérateur doit dérouler la barre de menus supérieure selon le cheminement séquentiel suivant :
Analyse > Statistiques descriptives > Fréquences… (Analyze > Descriptive Statistics > Frequencies…)
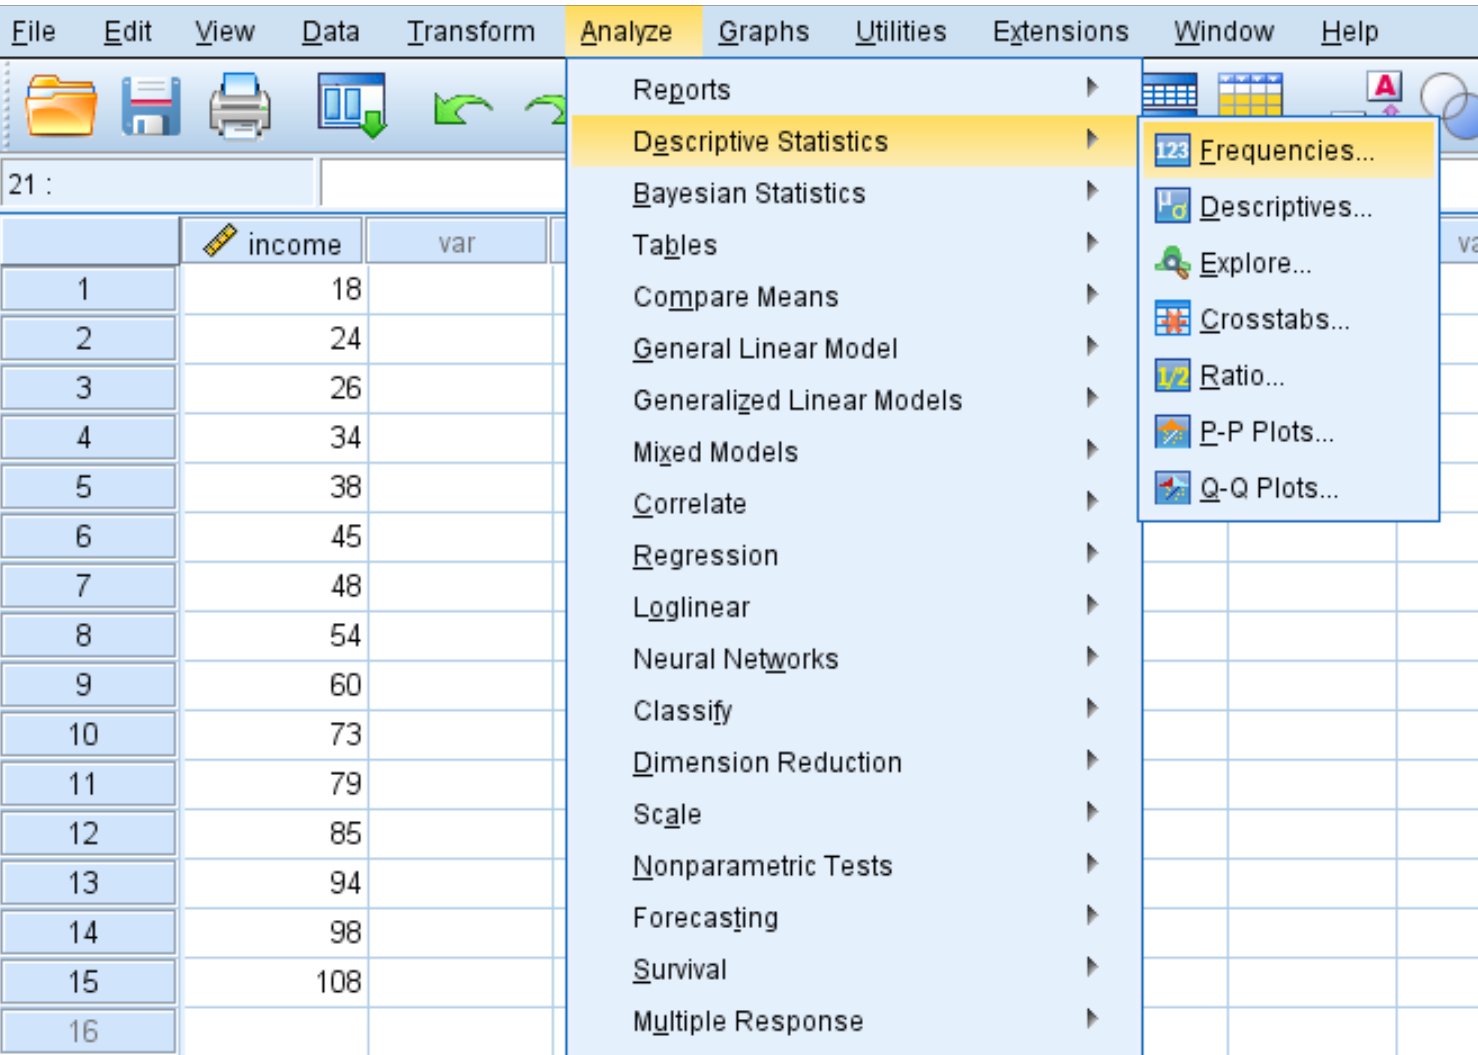
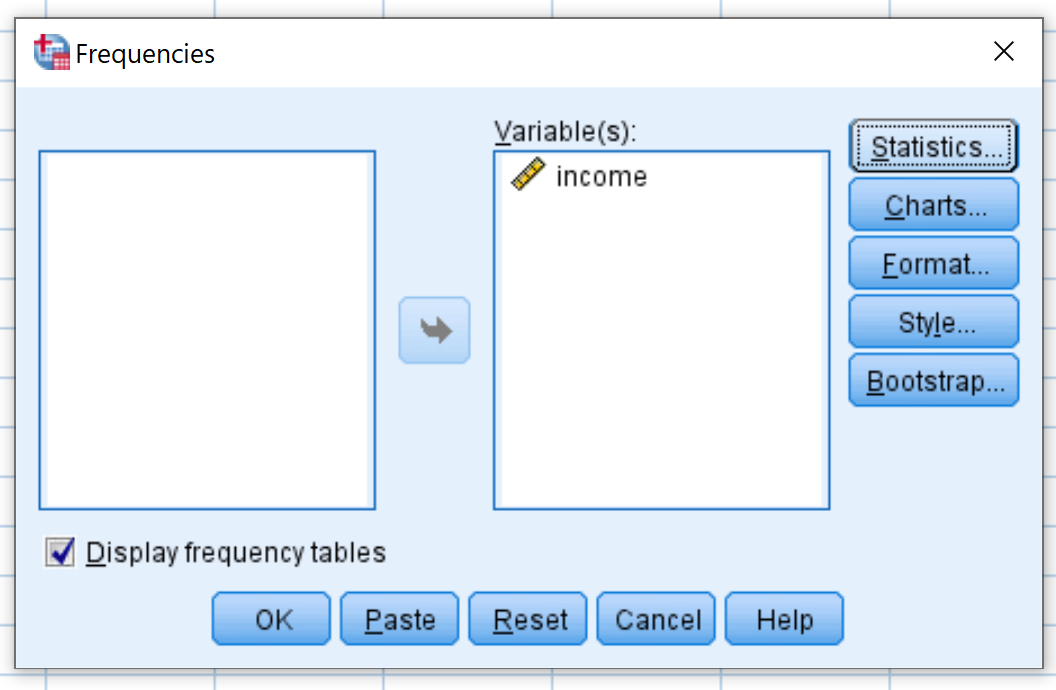
Dès l’ouverture de la boîte de dialogue principale, le panneau de gauche affiche la liste complète des variables répertoriées dans le dictionnaire actif du fichier. L’utilisateur sélectionne la ou les variables cibles d’intérêt psychométrique — par exemple, une variable de score composite continu — et les transfère dans la liste active intitulée Variable(s) : située sur le flanc droit, en utilisant la flèche directionnelle centrale ou par une manipulation intuitive de glisser-déposer.
Un paramètre opérationnel d’une importance cardinale doit être immédiatement ajusté dans cette même interface : il s’agit de la case à cocher intitulée Afficher les tableaux de fréquences (Display frequency tables). Si le maintien de cette option est pertinent pour des variables qualitatives discrètes à faible nombre de modalités, son activation sur des variables continues ou des scores composites à granularité fine s’avère totalement contre-productive. Elle génère une table d’occurrences kilométrique et illisible dans la fenêtre de sortie, surchargeant inutilement le processeur et la mémoire tampon. Il convient donc de désactiver systématiquement cette case pour concentrer la génération des résultats sur le tableau récapitulatif compact des statistiques descriptives.
4.2 Sélection rigoureuse des indicateurs statistiques
Une fois les variables cibles convenablement assignées dans la liste réceptrice, l’accès au cœur computationnel de la procédure s’effectue en cliquant sur le bouton Statistiques… (Statistics…) situé dans la partie supérieure droite de la boîte de dialogue contextuelle. Cette action convoque une nouvelle fenêtre dédiée exclusivement au paramétrage des métriques d’analyse.
L’élaboration du résumé à cinq nombres exige l’activation méthodique et exclusive des options mathématiques correspondantes :
- Dans le quadrant supérieur intitulé Valeurs de centile (Percentile Values), cochez explicitement la case Quartiles. Cette instruction algorithmique intime à SPSS l’ordre formel de dériver les 25e, 50e et 75e percentiles de la distribution empirique ordonnée.
- Dans le quadrant réservé à la Tendance centrale (Central Tendency), sélectionnez expressément la case Médiane (Median). Bien que les quartiles intègrent formellement le 50e percentile, le cochage délibéré de la médiane garantit sa visibilité sous sa désignation nominale directe dans le tableau synthétique de sortie.
- Dans le quadrant consacré à la Dispersion, cochez rigoureusement les cases Minimum et Maximum, qui matérialisent les deux bornes extrêmes $X_{(1)}$ et $X_{(n)}$ indispensables à la complétude du résumé de Tukey.
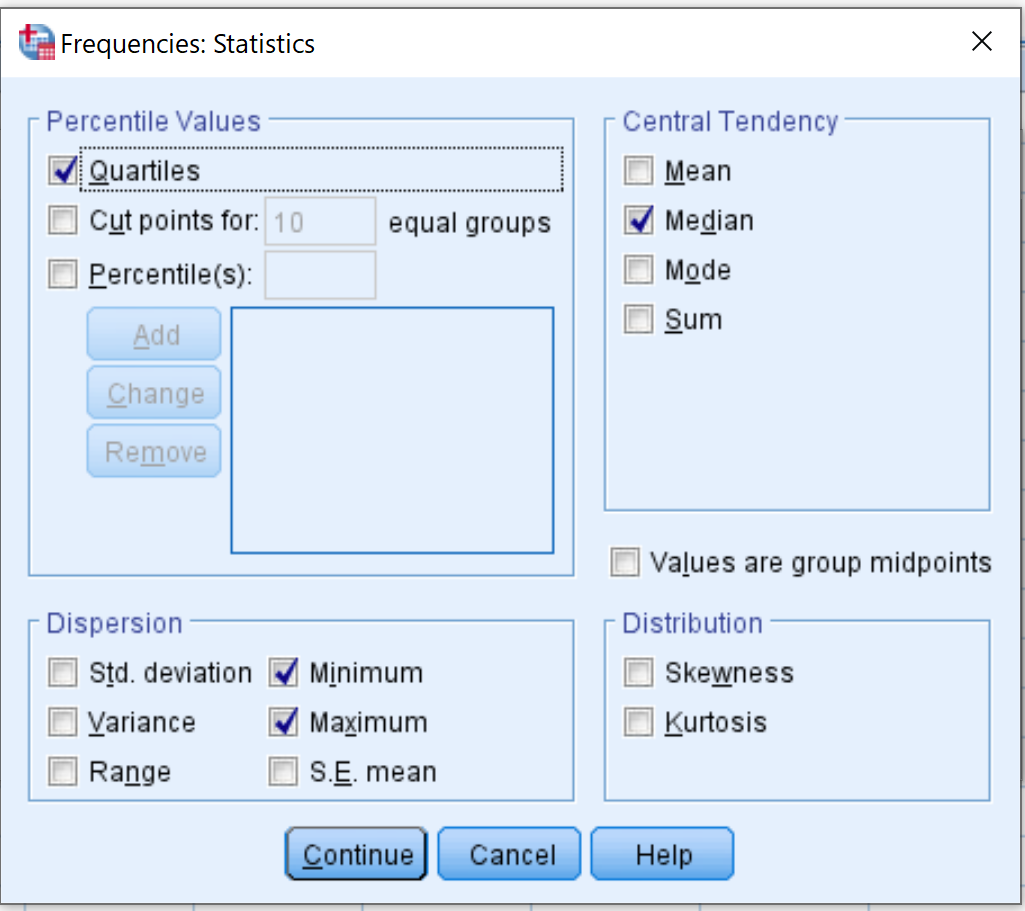
Dans un souci de rigueur méthodologique et d’hygiène analytique, l’utilisateur s’abstiendra de cocher à ce stade les métriques paramétriques classiques telles que la moyenne, l’écart-type ou la variance. L’objectif premier étant d’extraire la substantifique moelle d’un résumé exploratoire d’ordre, l’introduction concurrente d’indicateurs gaussiens au sein de la même table nuit à la lisibilité et favorise les amalgames conceptuels lors de l’étape de restitution des résultats.
4.3 Validation de l’exécution et sortie standard
Après avoir rigoureusement vérifié le paramétrage des indicateurs requis, cliquez sur le bouton Poursuivre (Continue) afin de clore la fenêtre secondaire et revenir à la boîte de dialogue maîtresse. L’exécution effective des calculs est initiée par un clic sur le bouton OK (ou alternativement sur le bouton Coller pour transférer l’instruction dans l’éditeur de syntaxe, comme détaillé plus avant dans la section 6).
Le processeur d’analyse de données sollicite alors le visualiseur de sorties de SPSS (SPSS Statistics Viewer) et y implémente instantanément le tableau intitulé Statistiques. La première étape d’inspection technique de cette table consiste à vérifier les deux premières lignes signalétiques : le nombre d’observations valides ($N$ valide) et le nombre d’observations manquantes ($N$ manquant). Cette vérification permet de s’assurer qu’aucune déperdition anormale d’effectif n’a compromis le traitement et que les filtres d’exclusion ont opéré conformément aux prévisions.
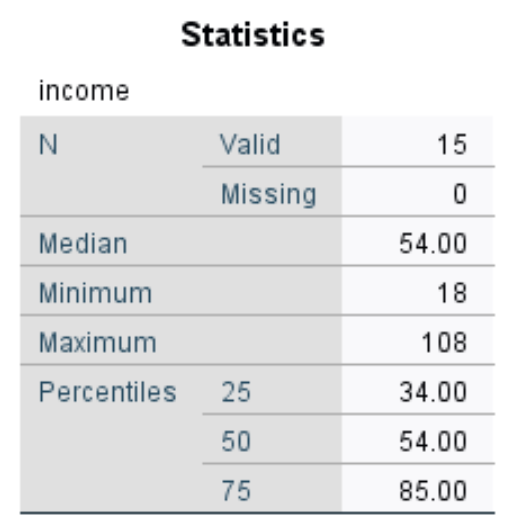
Dans le corps du tableau, les données apparaissent ordonnées selon une typologie standardisée : la ligne Médiane est rapportée en amont, suivie immédiatement des lignes Minimum et Maximum, tandis que la section inférieure regroupe sous l’intitulé Centiles les valeurs numériques assignées aux 25e, 50e et 75e rangs proportionnels. L’analyste dispose ainsi, sous un format tabulaire d’une compacité exemplaire, de l’intégralité des constituants computationnels requis pour formuler le résumé à cinq nombres de Tukey.
5. Méthode alternative : Utilisation de la procédure Explorer pour une analyse approfondie
5.1 Navigation et déploiement de la commande Explorer
Bien que le module Fréquences réponde avec une parfaite élégance au calcul élémentaire des cinq nombres, l’environnement SPSS abrite une commande native bien plus performante et spécifiquement dédiée aux préceptes de John Tukey : la procédure Explorer (procédure EXAMINE en syntaxe interne). Cet outil d’analyse distributionnelle avancée déploie des capacités diagnostiques supérieures, permettant notamment de ventiler le calcul des quantiles à travers des sous-groupes cliniques ou démographiques de manière totalement intégrée.
Pour mobiliser la puissance de la commande Explorer, accédez à la hiérarchie des menus via l’enchaînement :
Analyse > Statistiques descriptives > Explorer… (Analyze > Descriptive Statistics > Explore…)
L’interface modulaire se distingue par la présence de deux réceptacles primordiaux :
- Le champ Liste des variables dépendantes (Dependent List) : transférez-y la variable quantitative dont vous souhaitez modéliser le profil distributionnel (par exemple, un indice de détresse psychologique global).
- Le champ Liste des facteurs (Factor List) : ce champ optionnel mais hautement stratégique accueille des variables catégorielles ou de groupement (telles que le statut diagnostique : contrôle, dépression légère, dépression sévère). Son utilisation instruit SPSS de décomposer et calculer un résumé à cinq nombres distinct et autonome pour chaque strate de la population étudiée.
Cette structuration bifactorielle confère à la procédure Explorer un avantage méthodologique indéniable sur le module Fréquences lors de protocoles comparatifs transversaux.
5.2 Extraction des percentiles et des charnières de Tukey
Afin de configurer la sortie statistique de la procédure Explorer pour qu’elle produise le résumé d’ordre complet, cliquez sur le bouton Statistiques… positionné en haut à droite de l’interface graphique. Dans la boîte de dialogue secondaire qui s’affiche, deux options fondamentales méritent toute votre attention :
- Cochez la case Descriptives : elle ordonne la production du tableau descriptif exhaustif, intégrant de facto le minimum, le maximum, la médiane, ainsi que l’intervalle interquartile calculé de manière automatique.
- Cochez impérativement la case Centiles (Percentiles) : cette option débloque la génération d’un tableau spécifique hautement raffiné présentant une double décomposition mathématique des seuils de rang.
Dans la fenêtre de résultats de SPSS, la table des centiles issue de la commande Explorer offre une richesse d’analyse sans équivalent en présentant en parallèle :
- Les percentiles conventionnels calculés selon la méthode de moyenne pondérée (Weighted Average /
HAVERAGE), déclinant les 5e, 10e, 25e, 50e, 75e, 90e et 95e centiles. - Les charnières de Tukey (Tukey’s Hinges), explicitement identifiées sous les termes de charnière inférieure, médiane et charnière supérieure.
La présence simultanée de ces deux approches permet d’observer concrètement les variations marginales induites par le mode de découpage de la série ordonnée, fournissant au métrologue un niveau de transparence analytique supérieur.
5.3 Avantages comparatifs de la commande Explorer
Au-delà de la simple délivrance du quintet de Tukey, la procédure Explorer enrichit l’analyse d’une panoplie d’indicateurs de robustesse complémentaires qui sécurisent l’interprétation du psychologue. Le tableau descriptif délivre notamment des estimateurs à point de rupture élevé, tels que les M-estimateurs robustes (M-estimateur de Huber, estimateur bi-pondéré de Tukey, estimateur de Hampel et onde d’Andrews). Ces algorithmes itératifs calculent un centre de gravité distributionnel alternatif en pondérant les observations en fonction de leur distance à la médiane, offrant un compromis idéal entre la sensibilité de la moyenne et l’invariance totale des rangs médians.
D’autre part, la commande Explorer intègre automatiquement le calcul de l’écart interquartile (EIQ) et propose la génération conjointe d’indices d’asymétrie et d’aplatissement assortis de leurs erreurs types asymptotiques respectives. Enfin, elle permet d’adosser immédiatement au résumé numérique une analyse d’inférence non paramétrique de la normalité via les tests formels de Kolmogorov-Smirnov (avec correction de significativité de Lilliefors) et de Shapiro-Wilk, consolidant ainsi la légitimité du recours exclusif au résumé à cinq nombres lorsque les hypothèses de normalité univariée sont massivement rejetées par les données empiriques.
6. Automatisation et reproductibilité via la syntaxe de commande SPSS
6.1 Rédaction de la syntaxe sous FREQUENCIES
Dans un contexte de recherche professionnelle, l’utilisation exclusive des menus déroulants et des interfaces graphiques (« pointer-cliquer ») est largement découragée par les comités de lecture scientifique et les instances méthodologiques internationales. La reproductibilité computationnelle exige l’archivage rigoureux des scripts de commande ayant présidé au traitement des données brutes. Sous SPSS, le moteur d’exécution peut être intégralement piloté via le langage de commande textuel natif (syntaxe SPSS).
Pour exécuter le calcul du résumé à cinq nombres via le module des fréquences, l’instruction syntaxique se structure autour du verbe FREQUENCIES. Le code minimal et optimisé se rédige comme suit dans une fenêtre d’éditeur de syntaxe (accessible via Fichier > Nouveau > Syntaxe) :
FREQUENCIES VARIABLES=Score_Anxiete

  /FORMAT=NOTABLE

  /STATISTICS=MINIMUM MAXIMUM MEDIAN QUARTILES.

EXECUTE.
L’analyse de ce bloc d’instructions met en lumière sa rigueur fonctionnelle : la sous-commande VARIABLES= spécifie le vecteur numérique soumis à l’évaluation, tandis que la ligne /FORMAT=NOTABLE supprime radicalement l’édition chronophage et redondante du tableau de distribution des fréquences élémentaires. Le sous-ordre /STATISTICS appelle avec une concision mathématique exemplaire les cinq grandeurs cardinales constitutives du modèle de Tukey. Ce script s’exécute quasi instantanément, même sur des matrices de données massives regroupant des dizaines de milliers d’enregistrements psychométriques.
6.2 Exploitation de la syntaxe sous EXAMINE
Lorsque le protocole de recherche requiert la décomposition du résumé à cinq nombres à travers différentes conditions expérimentales ou groupes de sujets, l’instruction syntaxique EXAMINE révèle toute sa puissance programmatique. Le modèle syntaxique pour mobiliser la procédure Explorer s’articule selon l’architecture suivante :
EXAMINE VARIABLES=Score_Anxiete BY Groupe_Diagnostic

  /PLOT NONE

  /STATISTICS DESCRIPTIVES

  /PERCENTILES(25,50,75) METHOD(HAVERAGE).

EXECUTE.
Dans ce segment de code, la clause BY Groupe_Diagnostic orchestre la stratification immédiate des observations : SPSS calculera le minimum, les quartiles, la médiane et le maximum de façon totalement autonome pour chacune des catégories répertoriées dans la variable de groupement. La sous-commande /PERCENTILES(25,50,75) délimite précisément les seuils requis, tandis que l’argument METHOD(HAVERAGE) formalise le choix de l’algorithme d’interpolation mathématique sous-jacent (voir section 11.1 pour une étude approfondie de ces variantes computationnelles).
L’argument /PLOT NONE inhibe temporairement l’affichage des graphiques par défaut pour optimiser l’épuration du fichier de résultats. L’intégration d’un tel script dans un flux de travail de science ouverte garantit qu’un auditeur externe ou un réviseur de revue académique puisse exécuter à nouveau le code à l’identique et certifier la parfaite conformité des sorties numériques rapportées dans le manuscrit scientifique soumis.
6.3 Standardisation et reproductibilité méthodologique
L’adoption systématique du scriptage via la syntaxe SPSS induit des gains méthodologiques substantiels, tout particulièrement dans le cadre d’études longitudinales à vagues multiples ou de protocoles expérimentaux répliqués. En figeant les paramètres d’exécution dans un document texte immuable (.sps), l’expérimentateur élimine purement et simplement le facteur d’aléa inhérent à l’erreur humaine lors des manipulations manuelles de boîtes de dialogue complexes (oubli de désactivation d’une option, mauvaise sélection d’une variable par inadvertance).
Par ailleurs, la syntaxe confère une traçabilité intégrale à la chaîne de traitement. Elle documente avec une clarté irréfutable l’ordre chronologique dans lequel les filtres ont été appliqués, les données manquantes ont été exclues et les commandes descriptives ont été délivrées. Ce niveau d’auditabilité interne constitue désormais un prérequis formel pour prétendre à la publication au sein des revues internationales indexées affiliées à l’American Psychological Association, favorisant une transition transparente vers les idéaux contemporains de la reproductibilité scientifique universelle.
7. Interprétation statistique et métrologique des sorties SPSS
7.1 Lecture critique du tableau de statistiques généré
L’inspection analytique des résultats d’un résumé à cinq nombres dans le visualiseur de sorties de SPSS ne doit jamais être réduite à une simple transcription passive de chiffres. Elle exige une lecture critique aiguisée, guidée par la logique métrologique. Dans la table délivrée par le module FREQUENCIES, l’analyste localise immédiatement les cinq rangs cardinaux : la ligne Minimum, la ligne du Percentile 25 ($Q_1$), la ligne Médiane (ou Percentile 50), la ligne du Percentile 75 ($Q_3$), et enfin la ligne Maximum.
La première interrogation diagnostique consiste à évaluer l’espacement absolu séparant la médiane de ses deux ancrages quartiles immédiats. Dans une distribution idéalement symétrique, la distance $|Q_1 – \text{Mdn}|$ doit être rigoureusement égale à la distance $|Q_3 – \text{Mdn}|$. Tout déséquilibre volumétrique substantiel entre ces deux segments dénonce la présence d’une distorsion de forme au cœur même de l’échantillon. Simultanément, le chercheur contrôlera si les valeurs obtenues pour le minimum et le maximum coïncident avec les extrêmes empiriques attendus ou si elles signalent l’agglomération de scores excentrés.
Il conviendra également de prêter une attention soutenue au phénomène des scores liés ou ex æquo (tie values), omniprésent dans les échelles psychométriques courtes. Lorsque plusieurs dizaines de participants obtiennent des scores identiques, il arrive que le premier quartile et la médiane se confondent sur la même valeur entière discrète. Cette situation singulière doit être expressément consignée par le chercheur, car elle dénote une perte drastique de discrimination de l’instrument sur la moitié inférieure de la population évaluée.
7.2 Calcul et valorisation de l’intervalle interquartile (EIQ)
Bien que le résumé à cinq nombres soit composé stricto sensu de cinq valeurs d’ancrage ponctuelles, sa pleine exploitation clinique et inférentielle repose sur la dérivation d’un indice de dispersion fondamental : l’intervalle interquartile (EIQ ou Interquartile Range, IQR). Cet estimateur de variabilité se dérive directement par la soustraction mathématique simple du premier quartile au troisième quartile :
$$\text{EIQ} = Q_3 – Q_1$$
Sur le plan sémantique et psychométrique, l’EIQ mesure l’étendue spatiale requise pour encapsuler très exactement les 50 % centraux de la population étudiée, après élimination méthodique des 25 % d’observations les plus basses et des 25 % d’observations les plus hautes. Contrairement à l’étendue brute ($X_{(n)} – X_{(1)}$), qui est par nature hypersensible aux fluctuations marginales et aux cas excentriques isolés, l’EIQ possède un point de rupture de 25 %. Aucune perturbation violente affectant les queues de distribution (qu’il s’agisse d’un effondrement vers le zéro ou d’une projection asymptotique vers l’infini) n’est capable d’altérer l’ampleur de l’EIQ, pourvu que la contamination n’outrepasse pas le premier ou le quatrième quart de l’échantillon.
Cette propriété de résilience en fait l’indice de référence absolu pour quantifier la variabilité des traits cliniques ou des performances cognitives dans des environnements bruités. Dans les études de standardisation psychométrique, l’EIQ sert régulièrement d’étalon robuste pour normaliser des sous-groupes ou comparer l’hétérogénéité intrinsèque de deux populations cliniquement distinctes sans subir les déformations induites par les cas marginaux atypiques.
7.3 Diagnostic de l’asymétrie distributionnelle sans tests paramétriques
L’un des apports méthodologiques les plus puissants du résumé à cinq nombres réside dans sa capacité à opérer un diagnostic immédiat et sans appel de la symétrie distributionnelle, sans recourir aux coefficients formels d’asymétrie de Fisher-Pearson dont l’estimation est elle-même sujette à instabilité sur de petits échantillons. Ce diagnostic non paramétrique repose sur l’évaluation différentielle des deux demi-dispersions centrales :
- Si $(Q_3 – \text{Mdn}) \approx (\text{Mdn} – Q_1)$, la distribution manifeste une symétrie empirique remarquable. La médiane est idéalement centrée au sein de sa boîte interquartile.
- Si $(Q_3 – \text{Mdn}) > (\text{Mdn} – Q_1)$, la série est affectée d’une asymétrie positive (étalement vers la droite). La moitié supérieure des scores centraux s’étend sur une plage métrique plus vaste que la moitié inférieure. Ce profil est typique des échelles de détresse psychologique en population générale ou des latences motrices.
- Si $(Q_3 – \text{Mdn}) < (\text{Mdn} – Q_1)$, la série présente une asymétrie négative (étalement vers la gauche). Les scores tendent à s’accumuler massivement vers le haut de l’échelle, les variations s’étirant principalement vers les zones de faibles valeurs. C’est le profil caractéristique des mesures de bien-être subjectif ou des tests cognitifs de dépistage de la démence chez des adultes jeunes sains.
Cette radiographie rapide dicte en amont le choix des modèles statistiques subséquents : la constatation d’une asymétrie manifeste condamne d’office l’application de modèles linéaires généraux classiques sans ajustement préalable, orientant légitimement le chercheur vers des tests de rangs ou des régressions quantiles.
8. Visualisation graphique associée : Le diagramme en boîte (Boxplot)
8.1 Traduction graphique du résumé à cinq nombres
Il est impossible d’aborder le résumé à cinq nombres sans expliciter son incarnation graphique universelle : le diagramme en boîte ou boîte à moustaches (boxplot), conceptualisé par John Tukey conjointement à l’EDA. Le diagramme en boîte réalise une synthèse visuelle géométrique absolue des cinq grandeurs d’ordre, matérialisant instantanément l’architecture volumétrique de la série statistique.
La structure anatomique de cette représentation graphique répond à des règles de correspondance physique standardisées :
- Le corps rectangulaire central (la « boîte ») est rigoureusement délimité par le premier quartile ($Q_1$) sur sa bordure inférieure et par le troisième quartile ($Q_3$) sur sa bordure supérieure. La hauteur physique de ce rectangle équivaut par conséquent très exactement à l’intervalle interquartile (EIQ).
- À l’intérieur de ce rectangle, une ligne transversale épaisse matérialise l’emplacement exact de la médiane ($Q_2$). La position relative de cette ligne — centrée ou déportée vers l’une des bordures — traduit graphiquement l’asymétrie interne du cœur de la distribution.
- Les segments filiformes s’étirant de part et d’autre du rectangle (les « moustaches ») illustrent la dispersion des données distales jusqu’aux observations adjacentes non aberrantes. Dans la convention standard de Tukey adoptée par SPSS, la longueur des moustaches n’atteint pas aveuglément les valeurs minimale et maximale absolues si celles-ci dépassent un seuil critique d’éloignement, mais s’ancre sur les valeurs extrêmes contenues dans une frontière de sécurité.
Le diagramme en boîte permet ainsi d’embrasser d’un seul coup d’œil la position, la dispersion et l’asymétrie de multiples groupes juxtaposés sur un même repère cartésien.
8.2 Génération de diagrammes en boîte sous SPSS
L’écosystème logiciel SPSS offre deux voies distinctes pour générer des diagrammes en boîte de qualité métrologique :
La première modalité, recommandée pour les utilisateurs privilégiant les interfaces interactives riches, mobilise le Générateur de graphiques (Chart Builder), accessible via :
Graphiques > Générateur de graphiques… (Graphs > Chart Builder…)
Dans la galerie inférieure, sélectionnez la catégorie Boîte de dialogue (ou Boîte à moustaches), choisissez le modèle Boîte 1-D simple ou Boîte de dispersion juxtaposée, puis glissez la variable d’échelle sur l’axe des ordonnées ($Y$) et la variable de stratification sur l’axe des abscisses ($X$).
La seconde modalité repose sur les interfaces classiques traditionnelles :
Graphiques > Boîtes de dialogue anciennes > Boîtes à moustaches… (Graphs > Legacy Dialogs > Boxplot…)
Cette option permet de configurer en quelques clics une boîte simple ou groupée, en spécifiant si les entités visualisées représentent des résumés pour des sous-ensembles d’observations (groupes factoriels) ou des variables quantitatives distinctes.
Pour optimiser le rendu graphique en vue d’une diffusion dans une revue internationale indexée, il convient d’éditer le graphique au sein de l’éditeur de graphiques de SPSS (par double-clic sur l’objet). Il est vivement conseillé d’éliminer le quadrillage de fond grisâtre par défaut, d’assigner des bordures noires nettes et de paramétrer l’exportation au format vectoriel (Encapsulated PostScript – EPS, Enhanced Metafile – EMF, ou Portable Document Format – PDF) ou en résolution matricielle haute fidélité (TIFF à 600 DPI au minimum).
8.3 Identification et traitement des valeurs aberrantes et extrêmes
L’un des atouts diagnostiques majeurs de l’implémentation du boxplot dans SPSS réside dans son protocole algorithmique rigoureux de détection et de différenciation visuelle des observations atypiques. Contrairement aux représentations naïves où les moustaches joignent systématiquement le minimum et le maximum, SPSS applique rigoureusement la métrique des clôtures de Tukey (Tukey’s Fences) :
$$\text{Clôture intérieure inférieure} = Q_1 – 1,5 \times \text{EIQ}$$
$$\text{Clôture intérieure supérieure} = Q_3 + 1,5 \times \text{EIQ}$$
$$\text{Clôture extérieure inférieure} = Q_1 – 3,0 \times \text{EIQ}$$
$$\text{Clôture extérieure supérieure} = Q_3 + 3,0 \times \text{EIQ}$$
Sur le graphique généré par SPSS, les observations qui franchissent les clôtures intérieures sans dépasser les clôtures extérieures sont qualifiées de valeurs aberrantes modérées (outliers) et sont matérialisées sous la forme d’un petit cercle vide ($circ$). Les points qui franchissent la frontière des clôtures extérieures (au-delà de trois fois l’intervalle interquartile) sont classés comme valeurs extrêmes sévères et sont signalés sans ambiguïté par un symbole en forme d’astérisque ($ast$).
Chaque symbole est annoté dans SPSS par le numéro de ligne correspondant à l’identifiant du participant dans la grille de données active, autorisant une traçabilité et une vérification immédiates. Face à l’émergence de ces cas singuliers, le chercheur en psychologie ne doit jamais céder au réflexe réducteur d’une suppression aveugle. Une valeur extrême peut refléter une véritable souffrance psychopathologique aiguë méritant une analyse clinique qualitative distincte, ou au contraire trahir une violation manifeste du protocole de passation justifiant une exclusion documentée.
9. Étude de cas appliquée : Évaluation de la détresse psychologique
9.1 Contexte psychologique et structure des données cliniques
Afin d’ancrer les concepts développés jusqu’ici dans le réalisme de la pratique de recherche, examinons une étude de cas appliquée menée au sein d’une cohorte universitaire. Un laboratoire de psychologie de la santé évalue le niveau de détresse psychologique globale chez de jeunes adultes ($N = 80$) lors d’une période de transition académique majeure. L’instrument de mesure mobilisé est une échelle standardisée composite d’anxiété générale, générant un score total continu théoriquement borné entre 0 (absence totale de manifestations anxieuses) et 60 (anxiété clinique généralisée invalidante).
En raison du recrutement au sein d’un échantillon non institutionnalisé issu de la communauté générale, les investigateurs formulent l’hypothèse pré-analytique raisonnable que les scores manifesteront une asymétrie distributionnelle substantielle vers la droite : une forte proportion d’étudiants devrait se concentrer autour de niveaux d’anxiété bas à modérés, tandis qu’une minorité vulnérable devrait atteindre des scores particulièrement alarmants.
Le fichier de données SPSS (Anxiete_Etude2024.sav) est configuré selon les exigences méthodologiques exposées à la section 3. Il héberge la variable dépendante d’échelle Anx_Score (Score composite d’anxiété, format numérique à une décimale) ainsi qu’une variable catégorielle Niveau_Stress codant le sentiment subjectif d’épuisement. Les données sont soumises sans imputation artificielle au processeur d’analyse descriptive non paramétrique.
9.2 Exécution intégrale et obtention du résumé chiffré
La commande statistique est transmise au moteur computationnel de SPSS via l’exécution du bloc de syntaxe unifié suivant :
FREQUENCIES VARIABLES=Anx_Score

  /FORMAT=NOTABLE

  /STATISTICS=MINIMUM MAXIMUM MEDIAN QUARTILES.

EXECUTE.
À la suite du traitement par SPSS, le visualiseur de sorties génère le tableau récapitulatif standardisé des statistiques descriptives. Les résultats empiriques consolidés s’établissent rigoureusement comme suit :
| Statistique | Valeur obtenue | Signification métrologique |
|---|---|---|
| N Valide | 80 | Effectif complet sans déperdition de cas |
| N Manquant | 0 | Absence totale de données manquantes système ou utilisateur |
| Médiane | 18,50 | Point central robuste ($Q_2$) : 50 % des étudiants obtiennent $le 18,50$ |
| Minimum | 4,00 | Première statistique d’ordre $X_{(1)}$ : niveau basal d’anxiété de la cohorte |
| Maximum | 54,00 | Dernière statistique d’ordre $X_{(n)}$ : intensité de détresse maximale observée |
| Centile 25 ($Q_1$) | 12,00 | Seuil inférieur : 25 % des étudiants présentent une anxiété résiduelle $le 12,00$ |
| Centile 50 ($Q_2$) | 18,50 | Concordance parfaite avec la médiane rapportée en amont |
| Centile 75 ($Q_3$) | 28,75 | Seuil supérieur : 25 % des étudiants manifestent une anxiété élevée $ge 28,75$ |
Le résumé à cinq nombres de cette cohorte s’énonce donc officiellement sous la forme : Min = 4,00 ; Q1 = 12,00 ; Mdn = 18,50 ; Q3 = 28,75 ; Max = 54,00.
9.3 Interprétation contextuelle des seuils psychométriques
L’analyse différentielle de ce résumé à cinq nombres délivre une quantité considérable d’enseignements cliniques et statistiques. En premier lieu, la médiane empirique ($\text{Mdn} = 18,50$) se situe nettement en deçà du milieu mathématique de l’échelle théorique (qui est de 30), ce qui confirme le fait que la détresse moyenne de cet échantillon communautaire demeure globalement contenue dans des limites normatives acceptables.
Cependant, l’examen attentif de la dispersion interquartile et des écarts aux bornes met en relief une forte asymétrie positive. L’intervalle interquartile est de :
$$\text{EIQ} = 28,75 – 12,00 = 16,75$$
En décomposant cet intervalle autour de la médiane, nous constatons que :
$$\text{Mdn} – Q_1 = 18,50 – 12,00 = 6,50$$
$$\text{tandis que} \quad Q_3 – \text{Mdn} = 28,75 – 18,50 = 10,25$$
Le segment reliant la médiane au troisième quartile est près de deux fois plus étendu que celui qui la relie au premier quartile. Cette configuration géométrique traduit sans ambiguïté une dispersion considérablement plus importante des scores au sein de la frange supérieure des étudiants anxieux. Enfin, la valeur maximale de 54,00, couplée à un seuil $Q_3$ s’élevant à 28,75, démontre que si 75 % des participants conservent des niveaux de stress modérés, un quart de l’échantillon bascule vers des seuils de morbidité clinique sévère. L’utilisation d’une moyenne arithmétique aurait dilué cette dichotomie fonctionnelle cruciale, que le résumé à cinq nombres éclaire avec une netteté remarquable.
10. Comparaison approfondie : Résumé à cinq nombres versus Paramètres Gaussiens
10.1 Résistance différentielle à la contamination des scores
Pour appréhender concrètement la supériorité de la résistance du résumé à cinq nombres face aux métriques paramétriques classiques, examinons une simulation analytique simple réalisée sur notre échantillon clinique précédent ($N = 80$). Imaginons qu’un opérateur de saisie commette une erreur typographique et renseigne accidentellement un score d’anxiété de 540 au lieu de 54 pour le dernier participant. Ce type d’accident matériel survient régulièrement dans les protocoles de saisie manuelle non verrouillés.
Sous l’effet d’une seule donnée corrompue sur quatre-vingts :
- La moyenne arithmétique, initialement située autour de 21,3 points, bondit instantanément à 27,4 points. Elle subit une translation artificielle de plus de 6 points métriques entiers, déplaçant l’ensemble du profil de l’échantillon vers une sévérité factice.
- L’écart-type, primitivement estimé à environ 11,8 points, est propulsé à plus de 58,5 points, explosant sous l’effet de l’élévation au carré de l’écart extrême et ruinant toute tentative d’évaluation de la dispersion réelle.
- À l’inverse, au sein du résumé à cinq nombres, la valeur du premier quartile ($Q_1$), la médiane ($\text{Mdn}$) et le troisième quartile ($Q_3$) demeurent absolument impassibles et rigoureusement inchangés au centième près. Seul le maximum ($X_{(n)}$) absorbe la modification.
Cette invariance quasi absolue des quatre cinquièmes du résumé illustre magistralement la robustesse locale des estimateurs de Tukey. En isolant l’aberration sur l’unique statistique maximale sans contaminer le cœur battant de la distribution, la méthode d’ordre préserve l’intégrité de l’analyse contre les distorsions accidentelles d’enregistrement.
10.2 Adéquation avec les postulats des tests statistiques
Au-delà de son rôle purement descriptif, le résumé à cinq nombres assume une fonction propédeutique déterminante dans la stratégie inférentielle globale du chercheur. Il constitue un poste d’observation avancé permettant de statuer sur l’opportunité de maintenir ou d’abandonner les modèles linéaires généraux classiques (tests $t$ de Student, analyses de variance univariées ou multivariées). Ces tests reposent sur le postulat formel que les résidus du modèle sont distribués selon une loi normale et que les variances entre sous-groupes sont rigoureusement homogènes (homoscédasticité).
La comparaison juxtaposée des résumés à cinq nombres entre différents bras expérimentaux permet d’anticiper les violations graves de ces postulats. Si le ratio des intervalles interquartiles entre deux groupes excède un facteur de 2 ou 3, l’hypothèse d’homoscédasticité a de fortes probabilités d’être massivement invalidée. De même, un étirement unilatéral prononcé des quartiles périphériques signale que le test $t$ de Student verra sa puissance statistique réelle s’effondrer dramatiquement face à son équivalent non paramétrique.
Dans cette perspective, le résumé à cinq nombres offre un fondement rationnel à l’usage de méthodologies alternatives hautement légitimes :
- Le recours au test $U$ de Mann-Whitney-Wilcoxon pour la comparaison de deux échantillons indépendants, dont l’interprétation inférentielle s’articule directement autour de la confrontation des rangs médians.
- L’application du test de Kruskal-Wallis comme substitut non paramétrique à l’ANOVA unidirectionnelle en présence d’hétéroscédasticité avérée.
- Le basculement vers la régression quantile, qui modélise l’impact de prédicteurs non pas sur la moyenne conditionnelle hypothétique, mais directement sur les différents percentiles (notamment la médiane) modélisés par le résumé de Tukey.
10.3 Critères décisionnels de sélection des indicateurs à rapporter
Afin de guider les chercheurs dans l’arbitrage métrologique entre paramètres gaussiens (Moyenne, Écart-type) et paramètres d’ordre de Tukey (Cinq Nombres, EIQ), l’arbre décisionnel suivant formalise les recommandations méthodologiques contemporaines :
| Critères distributionnels et métrologiques | Indicateurs hautement prioritaires | Indicateurs secondaires ou déconseillés | Justification épistémologique |
|---|---|---|---|
| Distribution symétrique, unimodale, absence de valeurs extrêmes, échelle d’intervalle continue avérée ($N > 50$). | Moyenne arithmétique ($M$) et Écart-type ($SD$) | Résumé à cinq nombres (secondaire mais utile en exploration) | Efficacité asymptotique maximale des estimateurs des moindres carrés en condition de stricte normalité. |
| Distribution asymétrique (positive ou négative), présence d’effets de seuil (plancher/plafond), ou échelles de Likert ordinales. | Résumé à cinq nombres et Intervalle Interquartile ($IQR$) | Moyenne et Écart-type (formellement déconseillés comme uniques repères) | Invariance ordinale, immunité absolue contre les distorsions d’asymétrie et respect du niveau d’échelle. |
| Échantillons cliniques réduits ($N < 30$), grande vulnérabilité aux données aberrantes isolées. | Résumé à cinq nombres de Tukey | Statistiques paramétriques (à proscrire sans tests de robustesse préalables) | Point de rupture élevé (50 % pour la médiane) préservant l’estimation contre les artéfacts marginaux. |
L’abandon de la moyenne au profit du résumé d’ordre ne constitue nullement une perte d’information, mais un acte de lucidité analytique fondé sur le refus de plaquer une métrique inadaptée sur des phénomènes psychologiques asymétriques.
11. Divergences algorithmiques et pièges méthodologiques dans SPSS
11.1 Les différentes formules de calcul des percentiles dans SPSS
L’un des mystères les plus déconcertants pour les utilisateurs d’IBM SPSS réside dans le constat récurrent que le premier et le troisième quartile obtenus via le menu Fréquences ne coïncident pas toujours rigoureusement avec les charnières obtenues via le menu Explorer, ou avec les quantiles calculés par d’autres environnements logiciels tels que le logiciel R ou Python. Cette disparité n’est pas imputable à un dysfonctionnement computationnel, mais à l’existence d’une multiplicité de formules d’interpolation théoriques distinctes pour dériver un quantile sur une distribution discrète.
Dans la littérature spécialisée, pas moins de neuf définitions mathématiques distinctes sont recensées pour le calcul des percentiles (formalisées notamment par Hyndman et Fan en 1996). Sous SPSS, plusieurs algorithmes peuvent être invoqués via la syntaxe interne :
- HAVERAGE (Moyenne pondérée au niveau du centile $y = p(n+1)$) : c’est l’algorithme par défaut appliqué par la procédure
EXAMINE. Il interpole linéairement la valeur entre les deux statistiques d’ordre encadrant le rang théorique. - WAVERAGE (Moyenne pondérée au niveau de l’observation $y = np + (1-p)$) : méthode alternative d’interpolation pondérée continue.
- ROUND (Arrondi au rang d’observation le plus proche $y = \text{round}(np)$) : calcul discret sans interpolation fractionnaire.
- EMPIRICAL (Fonction de distribution cumulative empirique sans interpolation) : sélection brute de la statistique d’ordre $X_{(i)}$ dès que la fréquence cumulée atteint ou dépasse le seuil proportionnel.
Parallèlement, les charnières de Tukey (produites par la commande Explorer) découpent strictement l’échantillon ordonné en deux sous-groupes séparés par la médiane et calculent la médiane discrète de chaque sous-groupe. Sur des effectifs restreints comportant des valeurs impaires, les charnières de Tukey diffèrent fréquemment de quelques dixièmes par rapport aux quantiles interpolés par HAVERAGE. Le chercheur doit impérativement documenter l’algorithme retenu dans sa section méthodologique afin de garantir la réplicabilité exacte de ses résultats par d’autres équipes.
11.2 Erreurs fréquentes d’interprétation chez le chercheur
L’exploitation des sorties descriptives sous SPSS est parfois entachée de confusions conceptuelles regrettables chez les utilisateurs non statisticiens. L’erreur la plus répandue consiste à assimiler l’intervalle interquartile ($\text{EIQ} = Q_3 – Q_1$) à la demi-différence interquartile (ou écart semi-interquartile, $\text{SIQR} = (Q_3 – Q_1)/2$). Présenter un écart semi-interquartile sous l’appellation générique d’EIQ induit une réduction de moitié de la perception de la dispersion réelle de l’échantillon dans les rapports publiés.
Une seconde erreur d’interprétation réside dans la tentation erronée d’extrapoler des propriétés gaussiennes à la médiane. En distribution asymétrique, il est totalement illégitime d’affirmer que 68 % des scores se situent dans un intervalle du type $[\text{Mdn} – \text{EIQ} ; \text{Mdn} + \text{EIQ}]$. L’EIQ ne possède aucune affinité mathématique directe avec la variance ou l’écart-type ; il borne rigoureusement les observations centrales entre $Q_1$ et $Q_3$, sans préjuger de la décroissance de densité au-delà de ces seuils.
Enfin, une négligence analytique courante porte sur l’interprétation des étiquettes d’alerte des cas aberrants générées par SPSS dans les diagrammes en boîte. Déclarer qu’un participant dont la donnée est signalée par un cercle ($circ$) représente nécessairement un profil « anormal » ou « pathologique » constitue une extrapolation clinique injustifiée. Le seuil de $1,5 \times \text{EIQ}$ est une convention heuristique d’exploration géométrique, non un critère nosographique médicalement diagnostique.
11.3 Bonnes pratiques de vérification et d’audit interne
Pour immuniser ses publications contre toute faille métrologique, l’investigateur appliquera un protocole systématique de vérification en trois étapes préalablement à l’enregistrement définitif de ses synthèses :
- Recoupement croisé inter-modules : Il est vivement conseillé d’exécuter conjointement une commande
FREQUENCIESet une commandeEXAMINEsur les variables pivots. La comparaison des sorties permet de valider la stabilité des quartiles face aux variations d’interpolation et de confirmer que les cas manquants ont été traités de façon strictement cohérente par les deux processeurs. - Inspection visuelle obligatoire par diagramme en boîte : Aucun résumé à cinq nombres ne devrait être publié sans avoir généré le diagramme en boîte associé. Cette inspection visuelle directe permet de matérialiser instantanément des particularités invisibles dans le simple tableau chiffré, comme un regroupement multimodal extrême ou une densité disproportionnée d’observations sur une borne d’échelle.
- Contrôle de stabilité par rééchantillonnage (Bootstrap) : Si l’échantillon d’étude est particulièrement réduit ($N < 20$) et présente une forte asymétrie, l’activation du module de rééchantillonnage Bootstrap dans SPSS (pour les versions disposant de cette extension) permet d’estimer des intervalles de confiance à 95 % non paramétriques autour de la médiane et des percentiles, confirmant que les estimations du résumé ne sont pas tributaires des aléas d’échantillonnage d’une cohorte trop restreinte.
12. Normes de rédaction et présentation académique selon l’APA (7e édition)
12.1 Directives de rédaction textuelle des statistiques non paramétriques
La publication de résultats quantitatifs au sein des revues scientifiques adhérant aux standards de l’American Psychological Association (APA Style, 7e édition) requiert une conformité formelle rigoureuse quant à la typographie, aux abréviations et à la mise en forme textuelle des indicateurs d’ordre.
Dans le corps du texte, les symboles statistiques universels doivent impérativement être formatés en caractères italiques. La médiane s’abrège sous le sigle Mdn, tandis que l’intervalle interquartile est abrégé sous l’acronyme IQR. Les mentions du premier et du troisième quartile sont généralement typographiées en toutes lettres ou désignées par les abréviations conventionnelles Q1 et Q3 (avec le « Q » en italique selon les recommandations typographiques de base). La précision numérique des décimales doit être rigoureusement harmonisée : l’APA préconise généralement l’usage constant d’une à deux décimales au maximum pour les statistiques descriptives, en évitant d’afficher une précision illusoire non étayée par la résolution de l’outil métrologique original.
Voici un modèle rédactionnel académique exemplaire insérant de manière fluide un résumé à cinq nombres au sein d’une section Résultats :
« Le niveau de détresse psychologique générale évalué auprès des participants s’est avéré asymétrique vers les scores élevés, justifiant le recours aux statistiques descriptives d’ordre. Le score d’anxiété médian était de 18,50 (IQR = 16,75), avec un premier quartile à 12,00 et un troisième quartile à 28,75. Les scores individuels s’échelonnaient sur l’ensemble de l’étendue de l’échantillon depuis une valeur minimale de 4,00 jusqu’à une valeur maximale de 54,00. Cette dispersion confirme qu’en dépit d’une charge anxieuse modérée pour la majorité des participants, les 25 % d’étudiants les plus touchés manifestent un niveau symptomatique très prononcé. »
12.2 Conception de tableaux synthétiques conformes aux normes APA
Lorsque le protocole de recherche compare plusieurs conditions d’expérimentation, groupes diagnostiques ou vagues de recueil longitudinales, la présentation textuelle brute devient lourde et préjudiciable à la lisibilité. L’implémentation d’un tableau synthétique d’ordre conforme aux canons graphiques de l’APA 7e édition s’avère alors impérative.
Sur le plan formel, les tableaux selon l’APA excluent impérativement toute ligne verticale séparatrice et proscrivent le quadrillage complet. La structure se compose uniquement de trois lignes horizontales dominantes : une ligne fermant le sommet sous le titre, une ligne isolant l’en-tête des colonnes, et une ligne clôturant la base du tableau au-dessus des notes éventuelles. Les cinq nombres peuvent être disposés harmonieusement en colonnes pour faciliter les comparaisons transversales :
| Groupe clinique | n | Min | Q1 | Mdn | Q3 | Max | IQR |
|---|---|---|---|---|---|---|---|
| Contrôle sain | 40 | 4,00 | 9,25 | 14,00 | 19,50 | 28,00 | 10,25 |
| Vulnérabilité au stress | 40 | 11,00 | 21,50 | 29,00 | 38,25 | 54,00 | 16,75 |
Note. N = 80. Min = valeur minimale observée ; Q1 = premier quartile (25e centile) ; Mdn = médiane (50e centile) ; Q3 = troisième quartile (75e centile) ; Max = valeur maximale observée ; IQR = intervalle interquartile ($Q_3 – Q_1$). Toutes les métriques sont issues de l’algorithme d’interpolation de moyenne pondérée d’IBM SPSS Statistics.
12.3 Intégration et légendage des diagrammes en boîte
L’intégration d’un diagramme en boîte au sein d’une publication scientifique ne dispense aucunement de la fourniture d’un appareil critique et textuel exemplaire. Selon les normes de l’APA 7e édition, chaque figure doit comporter au-dessus d’elle un numéro séquentiel en gras (ex. : Figure 1), suivi sur une nouvelle ligne d’un titre bref et descriptif formaté en italique (ex. : Distribution comparée des scores d’anxiété selon le statut de vulnérabilité).
Sous la représentation iconographique, une note explicative détaillée (introduite par le mot Note en italique suivi d’un point) doit impérativement expliciter la convention de modélisation utilisée pour le tracé des moustaches et des symboles marginaux. Cette précision est capitale, car la littérature internationale compte des variantes où les moustaches délimitent les 5e et 95e percentiles ou les valeurs extrêmes absolues.
La rédaction type de la note de figure se structure ainsi :
Note. La boîte centrale délimite l’intervalle interquartile ($Q_1$ à $Q_3$), la ligne horizontale épaisse interne matérialise la médiane. Les moustaches s’étendent jusqu’aux valeurs adjacentes non aberrantes les plus distantes situées dans la limite de $1,5 \times \text{IQR}$ au-delà des quartiles. Les cercles ouverts représentent les valeurs aberrantes modérées (comprises entre 1,5 et $3 \times \text{IQR}$ au-delà de la boîte). L’alignement rigoureux entre les composantes tabulaires et la hauteur géométrique des rectangles garantit l’accessibilité visuelle universelle et la transparence méthodologique du protocole.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
- Hoaglin, D. C., Mosteller, F., & Tukey, J. W. (Eds.). (2000). Understanding robust and exploratory data analysis. John Wiley & Sons.
- Hyndman, R. J., & Fan, Y. (1996). Sample quantiles in statistical packages. The American Statistician, 50(4), 361–365. https://doi.org/10.1080/00031305.1996.10473566
- IBM Corporation. (2021). IBM SPSS Statistics 28 algorithms. IBM Documentation. https://www.ibm.com/support/pages/ibm-spss-statistics-documentation
- Micceri, T. (1989). The unicorn, the normal curve, and other improbable creatures. Psychological Bulletin, 105(1), 156–166. https://doi.org/10.1037/0033-2909.105.1.156
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Wilcox, R. R. (2017). Introduction to robust estimation and hypothesis testing (4th ed.). Academic Press. https://doi.org/10.1016/C2015-0-02206-X