
Dans le champ contemporain de l’analyse des données quantitatives, la prolifération des métriques paramétriques a longtemps occulté une exigence épistémologique fondamentale : la confrontation directe, sans intermédiaire théorique restrictif, avec la structure brute des distributions empiriques. Que l’on opère en psychologie expérimentale, en économétrie comportementale ou en épidémiologie clinique, l’analyste se trouve confronté à des séries de données fréquemment asymétriques, contaminées par le bruit expérimental ou caractérisées par une forte variance hétérogène. Réduire de tels ensembles à la simple dualité de la moyenne arithmétique et de l’écart-type constitue souvent un réductionnisme abusif, masquant des hétérogénéités sous-jacentes et exposant les conclusions inférentielles à des biais de cadrage majeurs.
Le résumé à cinq nombres (ou five-number summary), formalisé par le mathématicien et statisticien John Tukey dans le cadre de son manifeste pour l’analyse exploratoire des données, offre un contrepoids méthodologique robuste face à cette vulnérabilité. En articulant le minimum empirique, le premier quartile, la médiane, le troisième quartile et le maximum, ce dispositif synthétise la position, la dispersion et la morphologie asymétrique d’un échantillon sans poser d’hypothèse préalable quant à la normalité gaussienne de la population mère. L’architecture ordinale de ces métriques confère à l’analyste une vision panoptique de ses distributions, tout en garantissant un point de rupture élevé face aux artéfacts de mesure.
L’avènement d’outils de calcul distribués et collaboratifs sur le cloud, au premier rang desquels figure Google Sheets, a démocratisé la manipulation computationnelle de ces statistiques d’ordre. Toutefois, la transposition d’un concept théorique élégant au sein d’un tableur matriciel moderne exige une compréhension technique rigoureuse : gestion de l’interpolation quantile, distinction algorithmique entre méthodes inclusives et exclusives, automatisation via des fonctions dynamiques de dernière génération et mise en conformité avec les exigences de reproductibilité de la science ouverte. Le présent traité propose une déconstruction exhaustive, à la fois théorique, computationnelle et appliquée, du calcul du résumé à cinq nombres dans Google Sheets.
1. Fondements théoriques et épistémologiques du résumé à cinq nombres
1.1 Origine et paradigme de l’analyse exploratoire des données de John Tukey
L’émergence de l’Exploratory Data Analysis (EDA) au cours des années 1970, sous l’impulsion séminale de John Tukey, s’est constituée en véritable rupture de paradigme face à l’hégémonie de l’inférence paramétrique classique héritée de Ronald Fisher et Jerzy Neyman. Jusqu’alors, la pratique statistique dominante consistait à postuler un modèle théorique a priori, le plus souvent adossé à la loi normale, puis à évaluer la conformité des données empiriques à ce modèle via des tests de signification d’hypothèse nulle. Tukey a vigoureusement soutenu que cette posture subordonnait l’observation à des a priori dogmatiques, conduisant les chercheurs à ignorer les anomalies structurelles, les bruits systématiques et les singularités morphologiques pourtant porteurs de découvertes fondamentales.
Face à ce formalisme restrictif, Tukey a introduit la nécessité d’une description non paramétrique des données, particulièrement précieuse au sein des sciences comportementales où les échelles de mesure sont fréquemment imparfaites. L’EDA ne récuse pas l’inférence ultérieure, mais elle institue une étape préalable d’écoute attentive et visuelle des données. Au cœur de cette philosophie se trouve l’utilisation raisonnée des statistiques d’ordre. Contrairement aux moments arithmétiques qui somment l’ensemble des grandeurs et se laissent déformer par les queues de distribution, le tri et l’ordonnancement séquentiel préservent la structure empirique globale tout en restant intrinsèquement agnostiques quant à la fonction de densité sous-jacente.
Cette approche descriptive non paramétrique ne postule aucune forme paramétrique idéalisée : elle s’enracine dans la réalité tangible des observations recueillies sur le terrain. La robustesse des statistiques d’ordre face aux distributions non gaussiennes — qu’il s’agisse de distributions multimodales, fortement étalées à droite ou tronquées — permet ainsi de cartographier fidèlement l’hétérogénéité des phénomènes étudiés sans sacrifier l’intégrité de l’échantillon sur l’autel de la tractabilité mathématique.
1.2 Pertinence du résumé à cinq nombres en recherche psychologique
Dans l’écosystème de la recherche psychologique et neuropsychologique, les variables quantitatives collectées échappent presque universellement au canon de la distribution normale univariée. Le traitement des scores issus d’échelles psychométriques — qu’elles soient de nature purement ordinale ou considérées par consensus comme quasi-intervallaires (telles les échelles de Likert ou les inventaires cliniques multidimensionnels) — met immédiatement en péril les postulats de la moyenne et de la variance. Les saturations de réponses sur les bornes extrêmes, induisant des distributions en J ou en U inversé, rendent les estimateurs gaussiens hautement trompeurs quant à la trajectoire modale des participants.
Le résumé à cinq nombres démontre une résistance méthodologique remarquable face aux biais systématiques induits par les valeurs extrêmes lors d’expérimentations cognitives chronométriques. Lorsque des chercheurs analysent des temps de réaction, la distribution se caractérise systématiquement par une longue traîne asymétrique positive, causée par des défaillances attentionnelles sporadiques ou des micro-latences motrices. Dans ce contexte, l’intégration de la médiane et de l’écart interquartile offre une caractérisation synthétique du comportement sans qu’il soit nécessaire de tronquer arbitrairement les observations de manière discrétionnaire.
Il ne s’agit pas pour autant de rejeter unilatéralement les métriques traditionnelles, mais d’établir une complémentarité épistémique indispensable. Le résumé à cinq nombres fournit un socle descriptif résistant qui contextualise les estimateurs classiques de tendance centrale et de dispersion. Il permet au psychologue expérimentaliste de dissocier ce qui relève de la tendance typique du noyau central d’une population de ce qui relève de la dispersion périphérique des cas limites, ouvrant ainsi la voie à une interprétation clinique et différentielle plus fine.
1.3 Comparaison entre métriques paramétriques et non paramétriques
L’arbitrage formel entre métriques paramétriques et non paramétriques repose sur l’analyse de leur sensibilité différentielle face aux perturbations de l’échantillonnage. Considérons en premier lieu l’opposition fondamentale entre la moyenne arithmétique et la médiane. La moyenne arithmétique, définie comme le barycentre d’un ensemble de points, possède un point de rupture asymptotique égal à zéro : l’altération d’une seule observation, si elle tend vers l’infini, suffit à déplacer arbitrairement la moyenne vers des valeurs arbitrairement grandes. À l’inverse, la médiane possède un point de rupture de 50 %, ce qui signifie que la moitié des données d’un échantillon doit être corrompue avant que cet indicateur ne perde sa représentativité de la région centrale.
Cette vulnérabilité paramétrique s’accentue de façon critique lorsque l’on examine le comportement de l’écart-type et de la variance par rapport à l’écart interquartile sous une forte asymétrie. La variance reposant sur l’élévation au carré des écarts à la moyenne, toute déviation périphérique engendre une inflation exponentielle de l’indicateur de dispersion. Une telle contamination des données dégrade l’erreur quadratique moyenne de l’estimateur de l’écart-type, offrant une illusion d’hyper-variabilité là où la masse des observations demeure rigoureusement groupée. L’écart interquartile, défini par la différence stricte entre le troisième et le premier quartile, isole quant à lui la dispersion des 50 % centraux de la cohorte, garantissant une immunité fonctionnelle contre les fluctuations des queues de distribution.
Le choix de privilégier le résumé à cinq nombres découle ainsi de conditions de validité statistique précises : absence de normalité avérée après tests d’adéquation formels, présence d’asymétries structurelles inhérentes au processus générateur de données, effectifs réduits interdisant l’invocation du théorème central limite, ou volonté explicite de documenter l’anatomie distributionnelle complète d’une variable sans perte d’information géométrique.
2. Anatomie mathématique des cinq indicateurs statistiques
2.1 Le minimum et le maximum : délimitation des bornes empiriques
D’un point de vue purement analytique, les deux composantes extrêmes du résumé à cinq nombres correspondent aux statistiques d’ordre terminales au sein d’une série ordonnée de variables aléatoires indépendantes et identiquement distribuées. Si l’on note l’échantillon réordonné sous la forme standardisée ( X_{(1)} le X_{(2)} le dots le X_{(n)} ), le minimum correspond rigoureusement à la première statistique d’ordre ( X_{(1)} ), tandis que le maximum s’identifie à la dernière statistique d’ordre ( X_{(n)} ). Ces deux scalaires circonscrivent le domaine de définition empirique de l’échantillon et marquent la frontière extérieure absolue des mesures collectées.
Sur le plan métrologique, ces deux métriques présentent la caractéristique d’une sensibilité absolue aux erreurs d’échantillonnage, aux instabilités instrumentales et aux artéfacts d’encodage. Parce qu’elles occupent les confins de la distribution, une simple faute de saisie typographique ou une aberration transitoire du capteur expérimental affectera instantanément ( X_{(1)} ) ou ( X_{(n)} ). L’évaluation de l’étendue brute, formalisée par la soustraction arithmétique directe ( E = X_{(n)} – X_{(1)} ), fournit une indication préliminaire sur la portée globale des observations, mais ne saurait informer sur la répartition interne des fréquences.
En psychométrie et en évaluation cognitive, l’analyse scrupuleuse des statistiques d’ordre extrêmes permet de diagnostiquer des anomalies fondamentales de protocole, au premier rang desquelles figurent les effets de plancher (floor effects) et de plafond (ceiling effects). Lorsqu’une proportion disproportionnée de l’échantillon s’agglutine au voisinage immédiat de ( X_{(1)} ) ou de ( X_{(n)} ), cela révèle l’incapacité de l’instrument de mesure à discriminer les compétences très faibles ou exceptionnellement élevées, contraignant le statisticien à réviser la sensibilité diagnostique de ses outils avant toute modélisation ultérieure.
2.2 La médiane : point focal de la distribution
La médiane, traditionnellement notée ( tilde{X} ) ou désignée sous le terme de deuxième quartile (( Q_2 )), constitue le centre de gravité ordinal de la série statistique. Sa définition formelle stipule qu’elle scinde l’ensemble ordonné des observations en deux sous-ensembles de cardinalités rigoureusement équivalentes : au moins 50 % des observations lui sont inférieures ou égales, et au moins 50 % des observations lui sont supérieures ou égales. Elle minimise la somme des déviations absolues de la distribution, conférant à cette métrique une signification géométrique d’une remarquable pureté.
L’algorithme de détermination de la médiane dépend intrinsèquement de la parité de l’effectif total ( n ) de l’échantillon. Dans le cas d’un effectif impair, ( n = 2k + 1 ), la médiane s’identifie sans ambiguïté à la valeur de la statistique d’ordre centrale située au rang ( k + 1 ), soit mathématiquement :
[ tilde{X} = X_{(k+1)} = X_{left(frac{n+1}{2}right)} ]
À l’inverse, lorsque l’effectif global est pair, ( n = 2k ), aucune observation unique ne sépare l’ensemble en deux moitiés disjointes. Par convention arithmétique universelle, la médiane s’obtient alors par l’interpolation barycentrique des deux valeurs centrales consécutives situées aux rangs ( k ) et ( k + 1 ), se traduisant par la demi-somme :
[ tilde{X} = frac{X_{(k)} + X_{(k+1)}}{2} = frac{X_{left(frac{n}{2}right)} + X_{left(frac{n}{2} + 1right)}}{2} ]
Cette construction algorithmique confère à la médiane une propriété de stabilité exceptionnelle : son point de rupture maximal de 50 % garantit qu’aucune dérive infinitésimale ou gigantesque de la moitié moins une des observations ne peut altérer son positionnement. Sur le plan de l’interprétation clinique, la médiane s’impose ainsi comme l’estimateur de choix du niveau de base d’un trait psychologique ou comportemental, neutralisant l’effet déformant des réponses marginales hautement pathologiques ou atypiques.
2.3 Les quartiles inférieur et supérieur : délimitation du noyau central
Les quartiles inférieur (( Q_1 )) et supérieur (( Q_3 )) constituent les piliers intermédiaires du résumé à cinq nombres. Correspondant respectivement au 25e et au 75e centile de la distribution empirique, ils partitionnent la série ordonnée de manière à ce qu’un quart des observations se situe en deçà de ( Q_1 ) et trois quarts en deçà de ( Q_3 ). Ensemble, ils définissent une frontière interne fondamentale encadrant précisément le noyau médian de 50 % des participants ou des unités expérimentales.
La distance qui sépare ces deux jalons statistiques formalise l’écart interquartile (abrégé usuellement en IQR, pour Interquartile Range), exprimé par la relation :
[ text{IQR} = Q_3 – Q_1 ]
L’IQR représente l’étalon non paramétrique par excellence de la dispersion d’une variable. Contrairement à l’étendue totale qui s’étire au gré des aberrations, l’écart interquartile conserve une robustesse absolue face aux queues de distribution. Si une population présente une variabilité interne homogène tout en comportant quelques sujets présentant des comportements extravagants, l’IQR demeurera invariable, documentant avec précision le resserrement ou la dispersion effective du groupe central.
Dans l’investigation psychométrique différentielle, l’isolement de ( Q_1 ) et ( Q_3 ) joue un rôle opérationnel de premier plan pour délimiter les sous-populations cliniques intermédiaires. Les scores oscillant entre le premier et le troisième quartile caractérisent la normalité statistique fonctionnelle d’un échantillon, tandis que les régions situées au-delà de ces bornes signalent l’amorce des déviations infracliniques ou supranormales. Ce fractionnement de la variance interne offre une granularité analytique indispensable à la stratification diagnostique.
3. Préparation et structuration rigoureuse des données dans Google Sheets
3.1 Formatage et hygiène des données matricielles
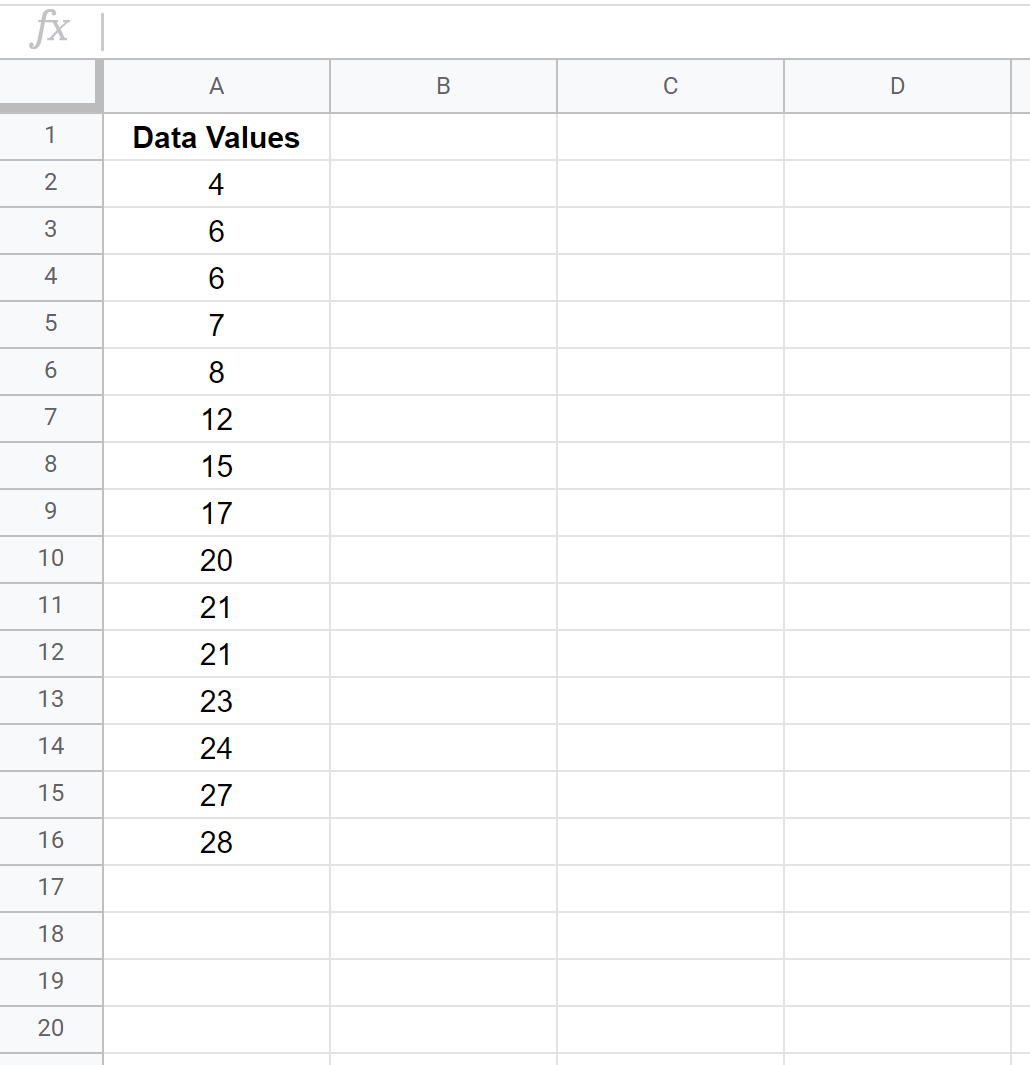
L’implémentation de calculs statistiques rigoureux au sein d’un environnement comme Google Sheets requiert une hygiène structurelle sans compromis. L’architecture du jeu de données doit impérativement adopter les principes du format tidy théorisés par Hadley Wickham : chaque variable doit occuper une colonne dédiée et exclusive, chaque observation ou unité expérimentale doit correspondre à une ligne unique, et chaque cellule individuelle doit contenir une seule valeur atomique. Toute transgression de cette norme géométrique (comme la fusion intempestive de cellules horizontales ou l’insertion de totaux partiels intercalaires) engendre des erreurs systématiques dans la résolution des plages matricielles par les moteurs de calcul.
L’uniformisation du typage numérique représente le second impératif technique. Google Sheets adapte ses conventions de parsing en fonction des paramètres régionaux de la feuille de calcul (menu Fichier > Paramètres > Paramètres régionaux). Dans les juridictions francophones, la virgule constitue le séparateur décimal officiel, tandis que le point sert de séparateur dans les juridictions anglo-saxonnes. Une importation non contrôlée de fichiers CSV peut introduire des nombres contenant des points décimaux que l’interpréteur considérera comme de simples chaînes de texte alphabétique. De telles cellules seront silencieusement ignorées par les fonctions statistiques d’ordre, faussant la valeur effective de ( n ) sans lever de message d’erreur d’interruption.
Pour assainir ces anomalies typographiques, l’utilisation systématique de fonctions textuelles préalables s’avère salutaire. La combinaison matricielle suivante garantit la conversion intégrale et la suppression des espaces résiduels :
=ARRAYFORMULA(CNUM(SUBSTITUE(SUPPRESPACE(A2:A); "."; ",")))
Ce traitement neutralise les espaces insécables issus de copier-coller depuis des interfaces web et convertit uniformément la ponctuation anglo-saxonne, assurant que chaque cellule soit traitée comme une grandeur scalaire continue légitime.
3.2 Gestion méthodologique des données manquantes et aberrantes
L’intégrité de l’analyse exploratoire dépend intimement de la qualification épistémique des données manquantes. En statistique expérimentale, la taxonomie introduite par Donald Rubin distingue rigoureusement les données manquantes complètement aléatoires (MCAR – Missing Completely at Random), les données manquantes aléatoires (MAR – Missing at Random) et les données manquantes non aléatoires (MNAR – Missing Not at Random). Si un participant interrompt un test psychométrique par épuisement ou phobie spécifique, cette cellule vide constitue un événement MNAR porteur d’une information clinique cruciale, qui ne saurait être effacée passivement.
Par défaut, les fonctions natives de Google Sheets (telles que MIN, MEDIANE ou QUARTILE) excluent silencieusement les cellules vides ainsi que les entrées textuelles lors du balayage de la plage vectorielle spécifiée. Bien que cette tolérance technique évite le blocage brutal de l’évaluation du classeur, elle induit un risque épistémique majeur : celui de sous-estimer la taille réelle de l’échantillon nominal et de modifier subreptice la distribution des rangs sans que le chercheur n’en soit formellement averti.
Pour prévenir tout biais de sélection involontaire, une règle cardinale d’hygiène numérique consiste à ségréguer formellement les données brutes des données nettoyées au sein d’onglets distincts. La feuille maîtresse hébergeant les données primaires d’acquisition doit être déclarée immuable. Les traitements d’exclusion, de redressement ou d’imputation doivent s’opérer sur une feuille dérivée, documentée par des assertions logiques explicites utilisant la fonction FILTER ou QUERY, garantissant une parfaite traçabilité méthodologique lors des réplications par des pairs.
3.3 Nommage des plages et sécurisation de l’intégrité référentielle
L’usage direct de coordonnées matricielles relatives (par exemple A2:A150) au sein de formules statistiques complexes représente un facteur de fragilisation méthodologique récurrent. Lors de la manipulation d’importantes cohortes expérimentales, les opérations de tri, de réagencement des lignes ou d’adjonction de nouvelles données provoquent fréquemment des glissements de références involontaires, rompant la parité des calculs entre les différentes conditions d’une étude.
L’attribution de plages nommées (accessible via Données > Plages nommées) permet de pallier définitivement cette vulnérabilité en instaurant un référencement absolu sémantique. Désigner le vecteur des scores d’anxiété sous l’étiquette sémantique univoque Score_STAI_Controle transforme la formulation opaque =MEDIANE(C2:C121) en une instruction computationnelle parfaitement transparente : =MEDIANE(Score_STAI_Controle). Cette pratique optimise non seulement l’intelligibilité syntaxique des modèles, mais prémunit également les formules contre tout décalage d’index lors des insertions structurelles de cellules.
Parallèlement, la protection granulaire des plages sources (via Données > Protéger les feuilles et les plages) constitue un rempart indispensable contre les altérations accidentelles au sein d’équipes de recherche collaboratives. En restreignant les autorisations d’édition sur les colonnes sources et en intégrant un dictionnaire de métadonnées directement dans une ligne d’en-tête formalisée (définissant la métrique, l’unité de mesure, les valeurs autorisées et la sémantique de la variable), l’analyste sanctuarise l’intégrité référentielle de son environnement d’investigation.
4. Calcul pas à pas des composantes élémentaires via les fonctions natives
4.1 Calcul des bornes extrêmes avec MIN et MAX
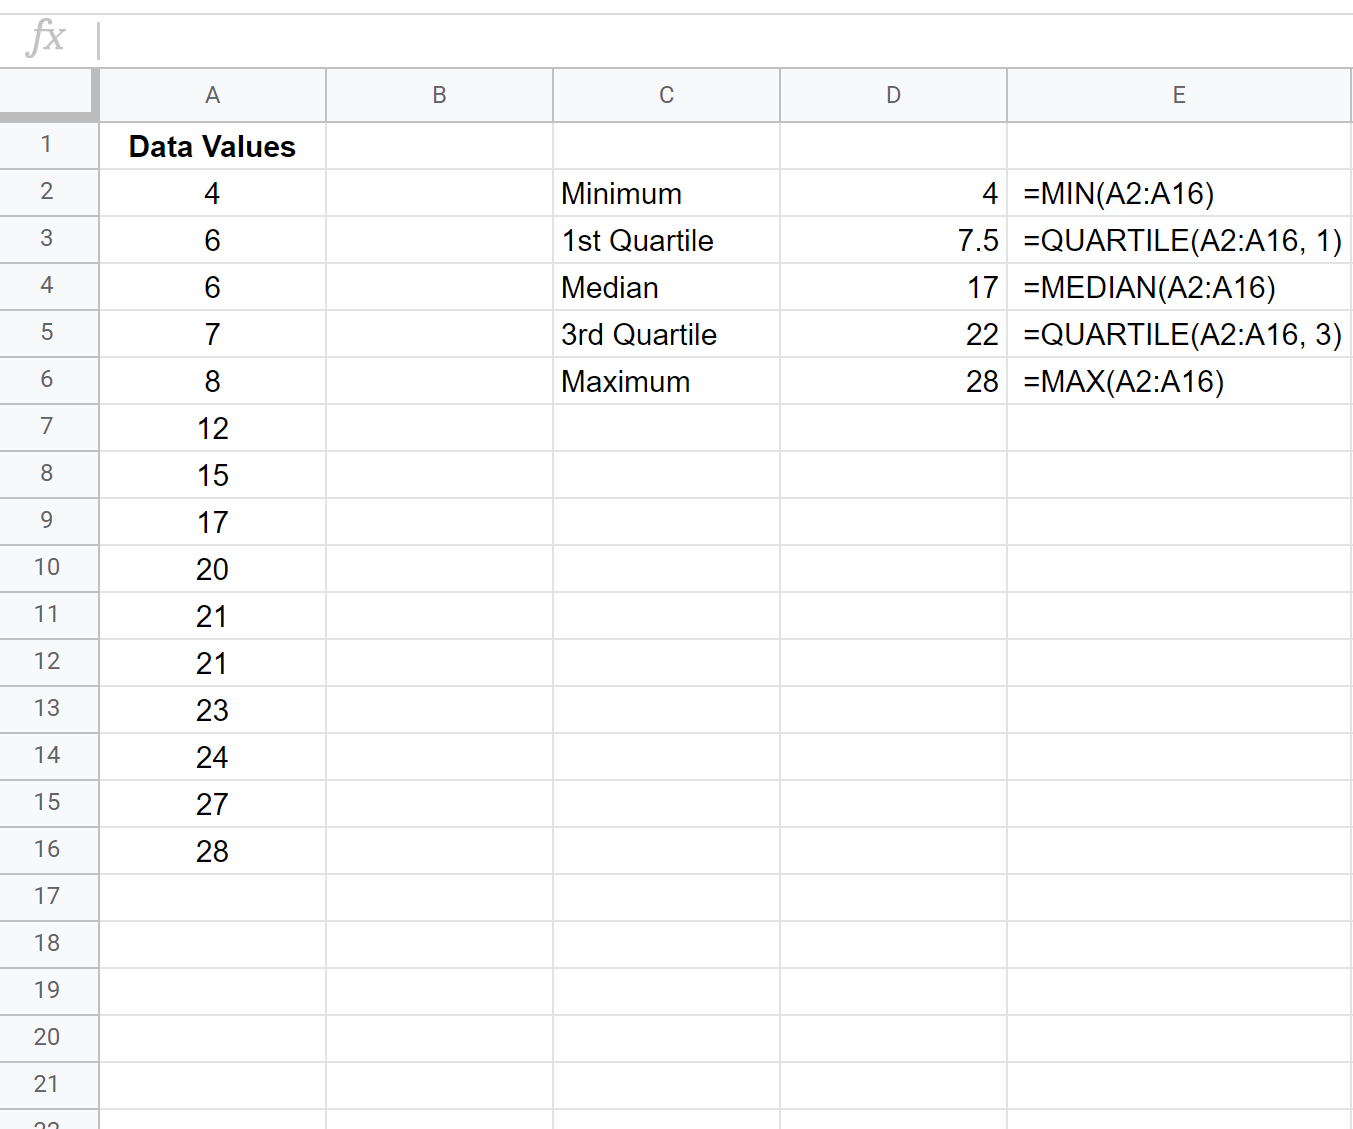
L’extraction des statistiques d’ordre terminales s’effectue dans Google Sheets au moyen des primitives mathématiques fondamentales MIN et MAX. La fonction MIN analyse l’intégralité du vecteur matriciel passé en argument et retourne le scalaire le plus faible selon la relation formelle ( X_{(1)} = min(X_1, X_2, dots, X_n) ). Sa syntaxe d’appel s’articule de manière directe :
=MIN(Donnees_Scores)
Symétriquement, la fonction MAX balaye la série empirique pour isoler le plafond supérieur de la distribution, satisfaisant l’identité mathématique ( X_{(n)} = max(X_1, X_2, dots, X_n) ), via la syntaxe homologue :
=MAX(Donnees_Scores)
La conjonction arithmétique de ces deux expressions permet de dériver immédiatement l’étendue brute de la série d’observations au sein d’une cellule récapitulative :
=MAX(Donnees_Scores) - MIN(Donnees_Scores)
Cette mesure d’amplitude globale, bien que hautement contingente, délimite l’envergure du phénomène observé. Lorsque l’analyse s’applique à des cohortes compartimentées selon des facteurs inter-sujets (par exemple en comparant un groupe témoin et un groupe expérimental), l’analyste peut mobiliser les variantes conditionnelles MIN.SI.ENS et MAX.SI.ENS. Ces fonctions avancées exécutent l’extraction des bornes tout en évaluant simultanément un ensemble de critères booléens, selon la structure syntaxique :
=MIN.SI.ENS(Scores; Groupe; "Controle")
Ce procédé isole les bornes empiriques des sous-groupes sans requérir de partitionnement manuel préalable du tableau principal.
4.2 Détermination de la tendance médiane avec MEDIANE
L’estimation de la tendance centrale robuste repose sur l’implémentation de la fonction native MEDIANE. Cette routine algorithmique intègre nativement la gestion de la parité de l’effectif ( n ). Lorsqu’elle est sollicitée sur une plage de données, la fonction procède implicitement à un tri ordonné en mémoire volatile, évalue le nombre d’éléments numériques valides, puis exécute l’extraction directe du point central (si ( n ) est impair) ou l’interpolation arithmétique moyenne des deux valeurs médianes (si ( n ) est pair) :
=MEDIANE(Donnees_Scores)
Lors de protocoles expérimentaux complexes, la détermination conditionnelle de la médiane au sein de sous-échantillons stratifiés requiert l’association de la fonction MEDIANE avec le connecteur dynamique FILTER, dans la mesure où il n’existe pas de fonction native MEDIANE.SI.ENS dans le moteur de calcul du tableur. L’expression s’articule ainsi de façon élégante :
=MEDIANE(FILTER(Donnees_Scores; Facteur_Groupe = "Experimental"))
Le filtre vectoriel isole à la volée les lignes répondant au critère théorique avant de transmettre le flux de scalaires résultant à l’opérateur de médiane.
Pour valider la robustesse de cette exécution automatisée, il est recommandé de procéder périodiquement à une validation croisée par interpolation ordinale manuelle sur des échantillons de référence. Cette contre-épreuve méthodologique assure à l’analyste que la présence inopinée de doublons numériques ou de cellules mixtes n’a pas altéré la détermination mécanique du rang médian au sein de la série ordonnée.
4.3 Génération de la structure tabulaire du résumé à cinq nombres
L’organisation typographique et architecturale du résumé au sein de la feuille de calcul doit obéir à des critères stricts de clarté cognitive et de lisibilité scientifique, facilitant son exportation ultérieure vers des logiciels de traitement de texte académique sous les directives formelles de l’American Psychological Association (APA). Le bloc de restitution gagne à être structuré verticalement sous forme d’une matrice à deux colonnes : la colonne de gauche réservée aux libellés univoques des indicateurs statistiques, la colonne de droite hébergeant les formules d’extraction dynamique associées.
Afin de garantir une pérennité absolue face à l’incrémentation continue de nouvelles cohortes de sujets, les plages de données cibles doivent être définies sous une forme vectorielle ouverte (par exemple A2:A au lieu de A2:A101). Cette convention permet aux formules de recalibrer instantanément les résultats dès qu’un nouvel enregistrement est annexé à la base principale. Les cellules d’affichage doivent être rigoureusement configurées pour restituer un nombre de décimales constant et conforme aux standards métrologiques de la discipline (habituellement deux décimales significatives pour les scores composites continus).
Enfin, une cellule de validation de la cohérence interne doit systématiquement couronner ce tableau d’affichage. L’analyste y implémente une assertion logique booléenne destinée à vérifier le postulat mathématique fondamental de monotonicité :
=SI(ET(Cell_Min <= Cell_Q1; Cell_Q1 <= Cell_Med; Cell_Med <= Cell_Q3; Cell_Q3 <= Cell_Max); "Structure Valide"; "Erreur Monotonicite")
Toute violation de cette chaîne d’inégalités signale immédiatement une corruption structurelle majeure des formules sous-jacentes ou une incohérence dans le passage des paramètres computationnels.
5. Maîtrise approfondie des fonctions de quartiles : QUARTILE.INC versus QUARTILE.EXC
5.1 Différenciation algorithmique entre inclusion et exclusion
L’une des zones d’ombre les plus tenaces dans l’enseignement de la statistique appliquée sur tableur réside dans la confusion récurrente entre les différentes méthodes d’estimation des quartiles empiriques. Dans les publications historiques, de multiples conventions d’interpolation coexistent pour déterminer la position ordinale ( k ) d’un centile, formalisées notamment dans l’article de référence de Hyndman et Fan (1996). Google Sheets propose deux implémentations distinctes, directement dérivées des standards de calcul numérique : QUARTILE.INC et QUARTILE.EXC.
La fonction QUARTILE.INC (pour *inclusive*) repose sur l’hypothèse que l’échantillon observé délimite la totalité de l’univers empirique disponible, bornant l’espace des centiles sur l’intervalle fermé ([0, 1]). Dans cette formulation, le rang relatif d’un percentile ( p ) pour un échantillon de taille ( n ) est calculé selon la relation de position :
[ text{Rang}_{text{INC}}(p) = 1 + p cdot (n – 1) ]
Sous cette convention, lorsque ( p = 0{,}25 ) (premier quartile), le rang se positionne à ( 1 + 0{,}25(n – 1) ), et la valeur s’obtient par interpolation linéaire continue entre les deux observations encadrant ce rang fractionnaire.
À l’opposé, la fonction QUARTILE.EXC (pour *exclusive*) postule que l’échantillon observé n’est qu’un sous-ensemble prélevé au sein d’une population continue sous-jacente infinie, bornant ainsi l’espace des centiles sur l’intervalle strictement ouvert (]0, 1[). La formule de positionnement s’articule alors comme suit :
[ text{Rang}_{text{EXC}}(p) = p cdot (n + 1) ]
Pour ( p = 0{,}25 ), le rang devient ( 0{,}25(n + 1) ). Sur de très grands échantillons, l’écart entre ces deux approches converge asymptotiquement vers zéro. En revanche, sur des échantillons modestes (par exemple ( n < 30 )), les divergences numériques sont notables. Les recommandations de l'American Psychological Association imposent une transparence absolue sur l'algorithme sélectionné, la variante inclusive correspondant historiquement au standard par défaut des premiers tableurs, tandis que la variante exclusive bénéficie d'une assise théorique supérieure lors des visées d'inférence vers la population générale.
5.2 Application concrète de la fonction QUARTILE.INC
La formulation syntaxique exhaustive de la fonction inclusive requiert deux arguments obligatoires : le vecteur contenant la série de données numériques et la constante entière identifiant le quartile sollicité :
=QUARTILE.INC(plage_donnees; quart)
L’argument quart n’accepte légitimement que les valeurs entières comprises entre 0 et 4, correspondant respectivement aux statistiques fondamentales suivantes :
0: Extrait la valeur minimale absolue de l’échantillon (équivalent strict à la fonctionMIN).1: Calcule le premier quartile inclusif (( Q_{1,text{INC}} ), 25e centile).2: Retourne la valeur médiane (( Q_{2} ), 50e centile, identique à la fonctionMEDIANE).3: Calcule le troisième quartile inclusif (( Q_{3,text{INC}} ), 75e centile).4: Extrait la valeur maximale absolue (équivalent strict à la fonctionMAX).
Cette modularité confère à QUARTILE.INC une remarquable compacité structurelle. Sur le plan de la stabilité statistique, cette fonction garantit que les quartiles obtenus s’inscrivent systématiquement à l’intérieur du domaine empirique défini par les observations réelles, sans risque de projeter des seuils hors de portée sur des cohortes psychométriques étendues.
5.3 Application concrète de la fonction QUARTILE.EXC
L’alternative exclusive se déploie selon une architecture syntaxique similaire dans son formalisme apparent, mais radicalement disjointe dans sa portée mathématique :
=QUARTILE.EXC(plage_donnees; quart)
Dans ce modèle computationnel, l’argument quart est strictement circonscrit aux valeurs entières 1, 2 et 3. Si l’opérateur tente d’assigner les valeurs 0 ou 4, Google Sheets génère instantanément une erreur fatale de type #NUM!, matérialisant l’impossibilité théorique pour un intervalle ouvert de coïncider avec les probabilités limites 0 et 1.
Une limitation computationnelle critique de QUARTILE.EXC réside dans sa vulnérabilité face aux échantillons d’effectif très réduit. En vertu de la formule ( text{Rang} = p(n + 1) ), si la condition ( p(n + 1) ge 1 ) et ( p(n + 1) le n ) n’est pas satisfaite pour un quartile donné, la fonction ne peut procéder à aucune interpolation et échoue avec une erreur d’invalidation numérique #NUM!. Concrètement, pour calculer un premier quartile (( p = 0{,}25 )), l’échantillon doit impérativement comporter au moins ( n = 3 ) observations réelles, et au moins ( n = 4 ) observations pour pouvoir extraire conjointement ( Q_1 ) et ( Q_3 ).
La comparaison directe des sorties numériques produites par ces deux fonctions révèle que QUARTILE.EXC tend systématiquement à repousser les quartiles vers l’extérieur de la distribution par rapport à QUARTILE.INC, résultant en un écart interquartile systématiquement plus large sur de petits effectifs. Cette dilatation reflète l’incertitude d’échantillonnage inhérente à l’inférence vers une population continue non bornée.
6. Automatisation du calcul global à l’aide de formules dynamiques et avancées
6.1 Génération instantanée via des formules matricielles verticales
L’évolution récente du moteur d’exécution de Google Sheets a introduit des capacités de vectorisation dynamique permettant d’affranchir l’analyste de la saisie fragmentée de formules cellule par cellule. Grâce à la primitive matricielle VSTACK (empilement vertical), il est désormais possible de générer l’intégralité du résumé à cinq nombres à l’aide d’une seule formule unifiée déployée dans une cellule source unique :
=VSTACK(MIN(Scores); QUARTILE.INC(Scores; 1); MEDIANE(Scores); QUARTILE.INC(Scores; 3); MAX(Scores))
Cette instruction évalue simultanément les cinq expressions et déverse verticalement un vecteur colonne de cinq scalaires dans les cellules sous-jacentes, éliminant tout risque de désynchronisation des calculs lors des manipulations de lignes.
Pour construire un tableau de synthèse autonome et auto-documenté, l’association conjointe des fonctions HSTACK (empilement horizontal) et VSTACK autorise la création instantanée d’une structure matricielle complète intégrant libellés textuels et sorties numériques :
=HSTACK({"Minimum"; "Quartile 1"; "Médiane"; "Quartile 3"; "Maximum"}; VSTACK(MIN(Scores); QUARTILE.INC(Scores; 1); MEDIANE(Scores); QUARTILE.INC(Scores; 3); MAX(Scores)))
Cette approche optimise drastiquement le temps de calcul lors de l’actualisation continue de banques de données massives, le moteur de calcul n’ayant à instancier qu’un seul graphe de dépendance matriciel pour l’ensemble du bloc de reporting.
6.2 Création d’une fonction personnalisée via LAMBDA et LET
L’introduction des fonctions d’encapsulation fonctionnelle LET et LAMBDA permet de dépasser les limites des formules statiques pour implémenter de véritables abstractions algorithmiques sans recourir à des scripts Google Apps Script externes. La fonction LET offre un avantage ergonomique et computationnel majeur : elle permet d’assigner des identifiants intermédiaires à des calculs répétés, évitant ainsi d’analyser plusieurs fois la même plage de cellules.
En encapsulant cette logique au sein d’une expression LAMBDA, l’analyste peut forger une fonction réutilisable baptisée localement RESUME_CINQ_NOMBRES. La formulation prend la structure avancée suivante :
=LET(data; Scores; inc; VRAI; q_fn; LAMBDA(d; q; SI(inc; QUARTILE.INC(d; q); QUARTILE.EXC(d; q))); VSTACK(HSTACK("Minimum"; MIN(data)); HSTACK("Quartile 1"; q_fn(data; 1)); HSTACK("Médiane"; MEDIANE(data)); HSTACK("Quartile 3"; q_fn(data; 3)); HSTACK("Maximum"; MAX(data))))
En enregistrant cette expression dans le Gestionnaire de fonctions nommées de Google Sheets (menu Données > Fonctions nommées), le laboratoire dispose d’un outil standardisé accessible par un simple appel textuel :
=RESUME_CINQ_NOMBRES(Plage_Mesures; VRAI)
Cette standardisation garantit l’application uniforme des choix algorithmiques par l’ensemble des membres d’une équipe de recherche, réduisant à néant les divergences de méthode entre collaborateurs.
6.3 Automatisation multi-groupes avec BYCOL et MAP
Dans les dispositifs expérimentaux multifactoriels, les données se présentent fréquemment sous la forme d’une matrice où chaque colonne consigne les mesures associées à une condition expérimentale spécifique. L’actualisation manuelle du résumé pour chaque condition représente une tâche fastidieuse et propice aux erreurs de copier-coller. L’emploi de la fonction matricielle d’ordre supérieur BYCOL permet d’automatiser le traitement simultané de toutes les colonnes en une seule opération élégante :
=BYCOL(Matrice_Conditions; LAMBDA(col; VSTACK(MIN(col); QUARTILE.INC(col; 1); MEDIANE(col); QUARTILE.INC(col; 3); MAX(col))))
L’itérateur BYCOL extrait séquentiellement chaque colonne de la matrice, applique la sous-fonction anonyme LAMBDA, et assemble horizontalement les vecteurs résultats pour générer une grille comparative exhaustive des différentes conditions d’étude.
Pour gérer des séries dont les longueurs diffèrent entre groupes, l’association des fonctions MAP et FILTER offre une adaptabilité totale en purgeant dynamiquement les cellules vides de chaque vecteur avant l’exécution du calcul. Cette orchestration computationnelle assure une scalabilité parfaite des feuilles de traitement, capables d’ingérer de nouvelles conditions sans aucune modification du code fonctionnel sous-jacent.
7. Visualisation graphique : transition du résumé tabulaire à la boîte à moustaches
7.1 Génération native d’un graphique en boîte à moustaches (Boxplot)
La transcription visuelle du résumé à cinq nombres trouve son incarnation canonique dans la boîte à moustaches (ou boxplot), conçue par John Tukey précisément pour matérialiser les cinq indicateurs dans un espace cartésien unifié. Pour instancier un tel graphique dans Google Sheets, l’analyste sélectionne la plage de données brutes contenant les observations numériques réparties sur une ou plusieurs colonnes étiquetées, puis active l’interface via Insertion > Graphique.
Dans l’éditeur de graphiques qui s’affiche latéralement, il convient de sélectionner le type de visualisation intitulé Graphique en boîte à moustaches (situé dans la section des graphiques spécialisés). Le moteur graphique effectue alors en tâche de fond le tri des observations, le calcul des percentiles et l’évaluation des bornes extrêmes.
Dans l’onglet de personnalisation, l’analyste doit impérativement configurer l’option d’agrégation et s’assurer que la case « Utiliser la ligne 1 comme en-tête » est convenablement cochée. Le choix du positionnement des moustaches requiert une vigilance particulière : Google Sheets propose d’étendre les moustaches soit du minimum absolu au maximum absolu (matérialisant fidèlement le résumé strict à cinq nombres), soit selon la convention de détection des valeurs aberrantes de Tukey (bloquant les moustaches à 1,5 fois l’écart interquartile et matérialisant les points isolés au-delà).
7.2 Correspondance visuelle entre les cinq nombres et l’anatomie du graphique
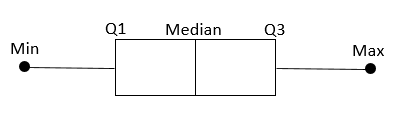
L’anatomie d’une boîte à moustaches entretient une correspondance isomorphique stricte avec les composantes scalaires du résumé à cinq nombres :
- Bord inférieur du corps de boîte : Correspond exactement à la valeur numérique du premier quartile (( Q_1 )). Il délimite le seuil en dessous duquel se situe le quart le plus faible de la distribution.
- Ligne transversale interne : Marque la position géométrique de la médiane (( Q_2 )). Elle visualise le centre de gravité ordinal de la cohorte et scinde la boîte en deux compartiments.
- Bord supérieur du corps de boîte : Représente l’emplacement du troisième quartile (( Q_3 )). Il formalise la frontière au-dessus de laquelle réside le quart supérieur des observations.
- Hauteur totale de la boîte : Matérialise graphiquement l’écart interquartile (( text{IQR} = Q_3 – Q_1 )), offrant une lecture immédiate du degré de concentration des 50 % centraux de l’échantillon.
- Terminaisons des moustaches (inférieure et supérieure) : Relient les bords de la boîte au minimum (( X_{(1)} )) et au maximum (( X_{(n)} )) dans la configuration classique du résumé à cinq nombres, cartographiant ainsi l’étendue totale des données.
Cette lecture visuelle directe permet à l’observateur d’appréhender instantanément des concepts distributionnels complexes qui demeureraient invisibles dans un tableau numérique statique.
7.3 Personnalisation avancée pour publications scientifiques
La préparation de visualisations destinées à l’édition scientifique internationale exige une mise en conformité formelle avec les chartes graphiques académiques. L’un des écueils majeurs des rendus par défaut de Google Sheets réside dans le choix de palettes chromatiques saturées et indiscernables en cas d’impression monochrome ou pour les lecteurs présentant des anomalies de la vision des couleurs (daltonisme). L’analyste doit manuellement sélectionner des teintes contrastées et ergonomiques (comme les palettes inspirées de Viridis ou ColorBrewer).
Pour enrichir la portée descriptive du graphique, il est possible d’activer l’affichage de la moyenne empirique (souvent représentée sous la forme d’un point distinct ou d’une croix au sein de la boîte). La confrontation visuelle directe entre le marqueur de la moyenne et le trait horizontal de la médiane offre un diagnostic immédiat sur le sens et la magnitude de l’asymétrie de la distribution. Les axes doivent être nettoyés de tout quadrillage superflu, dotés de graduations lisibles et munis d’intitulés dimensionnels précis accompagnés des unités de mesure appropriées.
Enfin, pour l’intégration au sein de manuscrits rédigés sous LaTeX ou dans des traitements de texte avancés, Google Sheets autorise l’exportation du graphique sous format d’image vectorielle haute résolution (via les options de menu du graphique : Télécharger > Document PDF (.pdf) ou Image vectorielle évolutive (.svg)). Cette procédure garantit une netteté typographique absolue sans aucune pixellisation lors de la mise en page finale.
8. Caractérisation de la distribution et analyse empirique de l’asymétrie
8.1 Détection informelle de l’asymétrie (Skewness) à partir des cinq nombres
Bien que le coefficient d’asymétrie paramétrique formel (le coefficient de Pearson ou le moment d’ordre 3) nécessite un calcul arithmétique complexe basé sur les écarts cubiques à la moyenne, le résumé à cinq nombres permet un diagnostic empirique immédiat de l’asymétrie distributionnelle au travers de la simple comparaison des intervalles internes. En analysant la distance qui sépare la médiane du premier quartile relativement à celle qui la sépare du troisième quartile, l’analyste infère la symétrie de la masse centrale :
- Distribution symétrique : Si ( Q_2 – Q_1 approx Q_3 – Q_2 ), la distribution présente une symétrie équilibrée autour de son centre de gravité ordinal.
- Asymétrie positive (vers la droite) : Si ( Q_3 – Q_2 > Q_2 – Q_1 ), la moitié supérieure de la boîte s’étire plus largement que la moitié inférieure. Cette configuration, universellement observée dans les mesures de temps de réaction cognitive ou les revenus économiques, signale que les valeurs s’étirent vers les scores élevés.
- Asymétrie négative (vers la gauche) : Si ( Q_2 – Q_1 > Q_3 – Q_2 ), la déviation s’accentue vers les faibles valeurs, situation typique des épreuves de compétences faciles confrontées à un net effet de plafond.
Cette heuristique d’inspection se complète par l’évaluation conjointe de la longueur des moustaches externes : un étirement disproportionné de la moustache supérieure ( X_{(n)} – Q_3 ) par rapport à la moustache inférieure ( Q_1 – X_{(1)} ) confirme sans équivoque la traction de la distribution par une queue droite prononcée.
8.2 Appréciation de l’aplatissement (Kurtosis) et de la dispersion
L’estimation de l’aplatissement ou de la concentration d’une série statistique s’opère usuellement par le moment centré d’ordre 4. Néanmoins, le résumé à cinq nombres offre un analogue non paramétrique intuitif au travers de l’examen du rapport entre l’écart interquartile et l’étendue totale. Si l’écart interquartile ( text{IQR} ) représente une fraction infime de l’étendue brute ( E = X_{(n)} – X_{(1)} ), cela témoigne d’une distribution leptocurtique caractérisée par une forte concentration des observations au cœur du noyau médian, flanquée de queues périphériques étendues et clairsemées.
À l’inverse, si l’IQR occupe une proportion substantielle de l’étendue totale (par exemple supérieure à la moitié de l’amplitude globale), la distribution relève d’un profil platycurtique ou uniforme, dans lequel les observations se répartissent de manière diffuse sans focalisation centrale prépondérante. Lors de la comparaison inter-groupes, le ratio des écarts interquartiles (( text{IQR}_{text{Groupe A}} / text{IQR}_{text{Groupe B}} )) fournit un indicateur robuste de l’homogénéité de la dispersion ordinale, totalement émancipé de la sensibilité exacerbée du test paramétrique d’homoscédasticité de Levene face aux déviations de la normalité.
Il convient toutefois de souligner une limite inhérente à cette métrique : le résumé à cinq nombres peut masquer une distribution bimodale sous-jacente. Si deux modes distincts se situent symétriquement de part et d’autre de la médiane, le tableau des cinq nombres peut simuler une distribution parfaitement symétrique et d’apparence normale. Une inspection visuelle conjointe via un histogramme de fréquences reste donc indispensable pour lever toute ambiguïté morphologique.
8.3 Implications pour le choix des tests statistiques subséquents
Le diagnostic distributionnel établi par l’examen du résumé à cinq nombres conditionne la trajectoire inférentielle de l’ensemble de la recherche. Lorsqu’une variable manifeste une asymétrie marquée (mise en évidence par une distorsion majeure entre les segments quartiles) ou une hétérogénéité patente de dispersion inter-groupes, le recours mécanique aux tests paramétriques standard — tels que le test t de Student pour échantillons indépendants ou l’analyse de variance unidirectionnelle (ANOVA) — devient méthodologiquement intenable en raison de la violation de leurs hypothèses fondatrices.
Ce renoncement guidé oriente l’analyste vers deux stratégies alternatives rigoureusement argumentées dans la section méthodologique du rapport de recherche :
- Adoption de tests de rangs non paramétriques : Remplacement du test t par le test U de Mann-Whitney (pour deux groupes indépendants) ou le test de Kruskal-Wallis (pour plus de deux groupes), dont la puissance statistique surpasse celle des tests paramétriques en présence de distributions fortement asymétriques.
- Application de transformations mathématiques stabilisatrices : Utilisation d’une transformation logarithmique, en racine carrée ou de Box-Cox, visant à symétriser la distribution des données brutes. L’évaluation de l’efficacité de la transformation s’apprécie directement en réitérant le calcul du résumé à cinq nombres sur les variables transformées pour constater la réconciliation des distances interquartiles.
La documentation transparente de ces arbitrages statistiques au sein des publications constitue une exigence fondamentale d’intégrité scientifique, prémunissant les auteurs contre les accusations d’analyses opportunistes (p-hacking).
9. Identification rigoureuse et traitement éthique des valeurs aberrantes
9.1 La règle du 1,5 x IQR de John Tukey
Au-delà de la description morphologique, le résumé à cinq nombres fournit les paramètres computationnels nécessaires à la détection formelle des observations atypiques ou aberrantes (outliers). John Tukey a formalisé une heuristique géométrique devenue universelle, fondée sur la construction de barrières ou frontières de détection intérieures et extérieures à partir de l’écart interquartile ( text{IQR} = Q_3 – Q_1 ).
Les barrières internes se définissent selon les relations arithmétiques suivantes :
[ text{Borne Inférieure} = Q_1 – 1{,}5 cdot text{IQR} ]
[ text{Borne Supérieure} = Q_3 + 1{,}5 cdot text{IQR} ]
Toute observation empirique ( X_i ) franchissant ces barrières (c’est-à-dire telle que ( X_i Q_3 + 1{,}5 cdot text{IQR} )) est formellement catégorisée comme une valeur aberrante modérée. Tukey a également introduit les barrières externes, calculées en appliquant un coefficient multiplicateur de 3 à l’écart interquartile (( Q_1 – 3 cdot text{IQR} ) et ( Q_3 + 3 cdot text{IQR} )), circonscrivant les valeurs aberrantes extrêmes.
Cette approche non paramétrique présente l’immense avantage de ne faire reposer la détection sur aucun calcul d’écart-type, évitant ainsi le piège du masquage statistique (masking effect), où la présence de points extrêmes gigantesques gonfle artificiellement l’écart-type au point de dissimuler d’autres anomalies réelles au sein du critère classique de déviation z-score.
9.2 Formules de détection conditionnelle automatisée
L’implémentation opérationnelle de la règle de Tukey dans Google Sheets s’effectue au moyen de formules logiques conditionnelles. Supposons que le premier quartile soit consigné dans la cellule E3, le troisième quartile dans la cellule E5, et que le vecteur des données individuelles s’étende sur la colonne A2:A120. On calcule dans un premier temps l’écart interquartile dans une cellule dédiée E6 par la syntaxe =E5 - E3.
Pour étiqueter automatiquement chaque observation de la série, on implémente dans une colonne adjacente une formule logique déterminant si le score se situe au-delà des barrières internes :
=SI(OU(A2 ($E$5 + 1,5 * $E$6)); "Aberrante"; "Conforme")
Cette classification binaire peut être couplée à la Mise en forme conditionnelle de Google Sheets pour colorer instantanément en rouge les cellules déviantes de la colonne source, offrant un repérage visuel immédiat.
Pour isoler sélectivement la liste des participants présentant ces déviations sans modifier le tri du tableau principal, on utilise conjointement la fonction FILTER :
=FILTER(A2:B120; (A2:A120 ($E$5 + 1,5 * $E$6)))
Cette expression extrait instantanément les identifiants et scores des individus atypiques, permettant une analyse ciblée de la sensibilité des modèles avec ou sans ces observations périphériques.
9.3 Déontologie du traitement des valeurs extrêmes en sciences humaines
La détection algorithmique d’une valeur aberrante ne confère aucune légitimité scientifique automatique à son éradication pure et simple de l’échantillon d’analyse. En sciences comportementales, l’exclusion opportuniste d’observations sous le seul prétexte qu’elles dégradent la significativité statistique d’une hypothèse constitue une dérive déontologique majeure, assimilable à un biais de confirmation manifeste. Une observation extrême peut refléter une véritable singularité neuropsychologique ou une réponse clinique hautement informative qui mérite d’être étudiée en tant que telle.
L’analyste doit d’abord déterminer la cause étiologique de l’aberration. S’il s’agit d’une erreur d’encodage avérée (par exemple une frappe de 999 sur une échelle graduée de 1 à 10) ou d’une violation objective du protocole expérimental (comme un sujet ayant appuyé sans discontinuer sur la même touche lors d’une tâche de mémoire), l’éviction de la donnée est techniquement justifiée et doit être consignée dans le journal d’audit de l’étude.
En revanche, face à une variabilité biologique ou comportementale réelle, des stratégies d’accommodation statistique doivent être privilégiées plutôt que l’élagage brutal. La méthode de winsorisation (consistant à ramener les valeurs situées au-delà des barrières de Tukey à la valeur du centile limite respectif, par exemple le 5e ou 95e centile) permet de limiter l’influence excessive de la queue de distribution sans amputer la taille d’échantillon nominale. Conformément aux directives du mouvement de l’Open Science, toute décision de rétention, de transformation ou d’élimination de données aberrantes doit être explicitée avec une totale transparence dans les sections méthodologiques des publications académiques.
10. Étude de cas appliquée : Traitement de données psychométriques sous Google Sheets
10.1 Présentation du jeu de données : Évaluation de l’anxiété préopératoire
Afin de concrétiser le déploiement opérationnel des concepts développés, considérons une étude clinique randomisée contrôlée fictive évaluant l’efficacité d’une intervention brève de thérapie cognitivo-comportementale (TCC) sur la réduction de l’anxiété préopératoire chez des patients programmés pour une intervention chirurgicale majeure. L’échantillon se compose de ( N = 120 ) participants répartis de manière équilibrée en deux conditions expérimentales : un Groupe Contrôle recevant la prise en charge standard (( n_1 = 60 )) et un Groupe TCC bénéficiant de l’intervention ciblée (( n_2 = 60 )).
La variable dépendante principale est mesurée au moyen de l’inventaire d’anxiété situationnelle STAI (State-Trait Anxiety Inventory, forme Y-A), dont les scores s’échelonnent théoriquement de 20 (absence totale d’anxiété) à 80 (anxiété paroxystique extrême). L’objectif de l’analyse exploratoire sous Google Sheets consiste à documenter rigoureusement la géométrie distributionnelle des scores post-intervention pour les deux cohortes avant de procéder aux inférences formelles.
La feuille de calcul est structurée de manière exemplaire : l’onglet principal, nommé Donnees_Brutes, héberge trois colonnes conformes au modèle tidy :
- Colonne A : Identifiant anonymisé du participant (
ID_Sujet, deSUBJ-001àSUBJ-120). - Colonne B : Condition d’assignation expérimentale (
Groupe, codé textuellement enControleouTCC). - Colonne C : Score quantitatif total au questionnaire (
Score_STAI, entier continu compris entre 20 et 80).
10.2 Exécution intégrale du pipeline analytique
Au sein d’un onglet analytique séparé intitulé Synthese_Statistique, on édifie la matrice comparative des deux groupes. Pour isoler les cinq composantes sans altérer la base source, on exploite conjointement les fonctions statistiques natives et le filtrage dynamique. Pour le Groupe Contrôle, les cellules d’extraction reçoivent les formules suivantes :
- Minimum :
=MIN(FILTER(Donnees_Brutes!C2:C121; Donnees_Brutes!B2:B121 = "Controle")) - Quartile 1 :
=QUARTILE.INC(FILTER(Donnees_Brutes!C2:C121; Donnees_Brutes!B2:B121 = "Controle"); 1) - Médiane :
=MEDIANE(FILTER(Donnees_Brutes!C2:C121; Donnees_Brutes!B2:B121 = "Controle")) - Quartile 3 :
=QUARTILE.INC(FILTER(Donnees_Brutes!C2:C121; Donnees_Brutes!B2:B121 = "Controle"); 3) - Maximum :
=MAX(FILTER(Donnees_Brutes!C2:C121; Donnees_Brutes!B2:B121 = "Controle"))
Le même bloc d’instructions est déployé en parallèle pour le Groupe TCC en substituant la chaîne de filtrage par "TCC". Supposons que l’exécution des formules produise les résultats empiriques condensés suivants :
- Groupe Contrôle : Minimum = 38, Q1 = 51, Médiane = 58, Q3 = 66, Maximum = 78. (Écart Interquartile ( text{IQR} = 15 )).
- Groupe TCC : Minimum = 22, Q1 = 30, Médiane = 36, Q3 = 43, Maximum = 61. (Écart Interquartile ( text{IQR} = 13 )).
L’évaluation des barrières d’aberrance selon la règle de Tukey révèle pour le Groupe TCC une frontière supérieure à ( Q_3 + 1{,}5 cdot text{IQR} = 43 + (1{,}5 cdot 13) = 62{,}5 ). Le score maximal de 61 s’inscrit en deçà de cette limite, confirmant l’absence d’outliers méthodologiquement invalidants.
10.3 Interprétation clinique et psychologique des résultats
L’examen comparatif des résumés à cinq nombres éclaire les dynamiques psychologiques sous-jacentes avec une précision remarquable. L’abaissement spectaculaire de la médiane, passant de 58 points dans le groupe témoin à 36 points dans le groupe TCC, matérialise une réduction clinique massive de 22 points de l’anxiété préopératoire typique sous l’effet de l’intervention. Cette contraction place la médiane du groupe traité bien en deçà du seuil clinique standard de l’anxiété modérée (fixé usuellement à 40 sur l’échelle STAI).
L’analyse de la dispersion centrale via les quartiles corrobore la robustesse de l’intervention : le troisième quartile du groupe TCC (( Q_3 = 43 )) se situe très largement en dessous du premier quartile du groupe témoin (( Q_1 = 51 )). Cette disjonction presque totale entre les deux boîtes démontre que plus de 75 % des participants ayant bénéficié de la thérapie cognitivo-comportementale présentent un niveau d’anxiété inférieur au quart le plus calme du groupe standard, témoignant d’une taille d’effet substantielle exempte d’artéfacts de chevauchement.
Enfin, la morphologie des intervalles interquartiles met en exergue une légère asymétrie positive dans le groupe TCC (( Q_2 – Q_1 = 6 ) tandis que ( Q_3 – Q_2 = 7 ), avec un maximum atteignant 61), signalant la persistance d’une minorité résiduelle de patients hyper-réactifs chez qui l’intervention brève s’est avérée insuffisante pour juguler l’anxiété anticipatoire. Ce constat oriente immédiatement les cliniciens vers l’opportunité d’une prise en charge graduée et personnalisée pour cette fraction spécifique de la cohorte.
11. Diagnostic des anomalies, erreurs de formule et écueils méthodologiques
11.1 Résolution des erreurs techniques courantes dans Google Sheets
La mise en œuvre des routines statistiques sous Google Sheets expose l’analyste à une série d’anomalies computationnelles dont la résolution requiert un diagnostic méthodique. Le tableau ci-dessous synthétise les dysfonctionnements les plus fréquents et leurs protocoles correctifs :
- Erreur
#VALEUR!: Survient typiquement lors de l’application d’opérateurs arithmétiques directs sur des plages hébergeant des chaînes de texte résiduelles ou des caractères invisibles d’espacement. Solution : assainir la colonne source par la fonctionCNUMou utiliser les fonctions natives (telles queMINouMEDIANE) qui ignorent nativement le texte au lieu d’opérations matricielles manuelles non typées. - Erreur
#NUM!avec QUARTILE.EXC : Se déclenche lorsque l’échantillon comporte un nombre d’éléments numériques insuffisant (( n < 4 )) pour assurer l'interpolation exclusive, ou lorsque le paramètre de centile est positionné sur 0 ou 4. Solution : vérifier le dimensionnement de l'effectif ou commuter vers l'algorithme inclusifQUARTILE.INC. - Erreur de référence circulaire (
#REF!) : Apparaît lorsque la formule statistique est inscrite dans une cellule appartenant elle-même à la plage vectorielle analysée. Solution : ajuster les coordonnées absolues pour exclure impérativement la cellule de destination du domaine d’agrégation. - Désynchronisation cloud et mise en cache : Lors du traitement de volumes de données massifs en mode collaboratif, des latences de recalcul peuvent afficher des résultats transitoires obsolètes. Solution : forcer l’actualisation globale du classeur via le paramétrage des calculs itératifs ou recharger la page dans le navigateur.
11.2 Pièges statistiques liés à la nature des données
Outre les écueils purement computationnels, l’application aveugle du résumé à cinq nombres peut induire des contresens statistiques majeurs découlant d’une inadéquation entre la métrique choisie et la nature de la variable observée. Le piège le plus critique consiste à appliquer des calculs de centiles à des variables nominales purement qualitatives encodées sous forme numérique (par exemple coder les diagnostics cliniques : 1 = Dépression, 2 = Phobie, 3 = Schizophrénie). Dans ce contexte, l’extraction d’une médiane ou d’un quartile produit un non-sens mathématique complet dénué de toute validité d’ordre.
Un autre écueil méthodologique subtil concerne le traitement de variables discrétisées sur des échelles courtes, telles que des échelles de Likert en 4 ou 5 points ordinaux. L’algorithme d’interpolation linéaire continue implémenté dans QUARTILE.INC et QUARTILE.EXC calcule des valeurs décimales fractionnaires (par exemple un quartile à 3,25) qui créent une illusion de continuité pour une échelle qui ne l’est pas. L’analyste doit garder à l’esprit que ces valeurs décimales ne constituent que des indices de positionnement ordinal théorique et ne reflètent pas des grandeurs mesurables tangibles.
Enfin, comme évoqué précédemment, la confiance aveugle accordée à la concision du résumé à cinq nombres peut masquer des singularités critiques telles que la multimodalité ou l’agrégation de sous-groupes latents au sein d’une cohorte appariée. La compression de données ne doit jamais dispenser le chercheur d’une inspection préalable de la densité de distribution au moyen d’un tracé en violon ou d’un histogramme fin.
11.3 Bonnes pratiques d’audit et de validation des feuilles de calcul
Afin d’élever le niveau de fiabilité des feuilles de calcul aux standards de l’audit expérimental, plusieurs garde-fous doivent être intégrés dès la phase de conception. La première règle consiste à instaurer des tests d’assertion logique disséminés stratégiquement dans le classeur. L’emploi d’assertions de conformité conditionnelle (par exemple en vérifiant par formule que la somme des effectifs partitionnés par FILTER égale rigoureusement le compte total retourné par NB) permet d’interrompre immédiatement la chaîne analytique en cas d’incohérence.
La pratique de la double saisie et de la vérification croisée par script miroir représente le standard de référence en épidémiologie et en psychométrie clinique. Une feuille de calcul validée doit voir ses résultats répliqués à l’identique par un second analyste utilisant une formulation indépendante ou un script exécuté dans un environnement externe. L’outil d’audit des formules de Google Sheets (accessible via Affichage > Afficher les formules ou le raccourci Ctrl + `) permet d’inspecter d’un coup d’œil l’ensemble des dépendances structurelles sans être distrait par les valeurs numériques calculées.
Enfin, dès que l’architecture computationnelle d’un classeur est validée et testée, l’ensemble des cellules hébergeant des formules doit être impérativement verrouillé et sanctuarisé via les outils de protection de plages. Seules les cellules strictement dédiées à la saisie des données primaires doivent demeurer accessibles en écriture, éliminant ainsi le risque d’écrasement fortuit d’une fonction statistique par un utilisateur tiers.
12. Intégration académique, communication scientifique et passerelles logicielles
12.1 Rédaction des résultats selon les normes strictes de l’APA (7e édition)
La diffusion académique des statistiques d’ordre au sein de manuscrits soumis à des comités de lecture est strictement encadrée par les conventions rédactionnelles de la 7e édition du manuel de publication de l’APA. Lorsque l’on rapporte le résumé à cinq nombres dans le corps textuel d’un rapport empirique, l’usage proscrit le déversement brut d’une suite de chiffres au profit d’une prose structurée, articulant précisément les acronymes normalisés écrits en italique.
La médiane doit être désignée par la typographie normalisée Mdn, tandis que l’écart interquartile se rapporte sous le sigle IQR. Les quartiles spécifiques peuvent être désignés sous la forme Q1 et Q3. Un modèle de restitution textuelle conforme s’articule selon la formulation standard suivante :
« L’analyse exploratoire des scores d’anxiété situationnelle a mis en évidence une réduction marquée dans le groupe d’intervention TCC (Mdn = 36,00, IQR = 13,00, Min = 22,00, Max = 61,00) par rapport au groupe contrôle standard (Mdn = 58,00, IQR = 15,00, Min = 38,00, Max = 78,00). Les premier et troisième quartiles se sont établis respectivement à 30,00 et 43,00 pour le groupe TCC, contre 51,00 et 66,00 pour les sujets témoins. »
Lors de la présentation de ces résultats sous forme de tableau de synthèse, les directives de l’APA imposent la suppression intégrale des quadrillages verticaux, l’alignement décimal des données chiffrées et la présence exclusive de trois lignes horizontales principales (au-dessus et en-dessous de l’en-tête, et au bas du corps tabulaire), assurant une sobriété typographique conforme aux critères éditoriaux internationaux.
12.2 Reproductibilité et Open Data : partage du classeur Google Sheets
À l’ère de la crise de la reproductibilité scientifique, la mise à disposition des données et des pipelines de calcul est devenue un impératif déontologique incontournable. Google Sheets se prête idéalement aux exigences du partage scientifique ouvert grâce à sa gestion native de l’accès cloud distribué. Néanmoins, le partage d’un classeur d’analyse ne doit jamais s’effectuer au détriment de la sécurité ou de l’anonymisation des données personnelles des participants (en stricte conformité avec le Règlement Général sur la Protection des Données – RGPD).
Avant toute ouverture publique, l’analyste doit purger le classeur de tout identifiant direct (noms, prénoms, adresses IP ou dates précises de naissance) et sanctuariser les droits d’accès. Le fichier doit être partagé sous le statut d’accès « Lecteur seul » (via le menu Partager > Accès général > Tous les utilisateurs disposant du lien : Lecteur) afin de prémunir les formules d’analyse contre toute altération extérieure.
Pour conférer à la recherche une validité archivistique pérenne, il est vivement recommandé d’exporter une copie figée du classeur sous format ouvert (.ods ou .xlsx) et de la déposer au sein d’un entrepôt de données scientifiques certifié, tel que l’Open Science Framework (OSF) ou Zenodo. L’attribution d’un DOI (Digital Object Identifier) à ce jeu de calcul pérennise la traçabilité des analyses et permet aux évaluateurs d’exécuter et d’auditer pas à pas l’exactitude des calculs du résumé à cinq nombres lors de la révision par les pairs.
12.3 Passerelles computationnelles : exporter vers R, JASP et SPSS
Bien que Google Sheets constitue un outil agile et accessible pour la phase d’exploration préliminaire, les étapes ultérieures d’inférence avancée requièrent couramment la migration des données vers des environnements logiciels spécialisés tels que le langage R, JASP ou IBM SPSS Statistics. Cette transition exige une rigueur méthodologique sans faille lors de l’exportation. Les données de l’onglet source doivent être extraites sous la forme d’un fichier CSV encodé universellement en UTF-8 (via Fichier > Télécharger > Valeurs séparées par des virgules).
Une divergence computationnelle fondamentale doit être anticipée lors de la réplication des quartiles sous d’autres logiciels : le logiciel R propose pas moins de neuf algorithmes distincts d’évaluation des quantiles au sein de sa fonction native quantile(). Par défaut, R implémente le Type 7, qui correspond précisément à la formulation mathématique adoptée par QUARTILE.INC dans Google Sheets :
# Validation croisée sous langage R
scores <- c(38, 51, 58, 66, 78)
summary(scores)
quantile(scores, probs = c(0, 0.25, 0.5, 0.75, 1), type = 7)
À l’opposé, le logiciel SPSS utilise par défaut le Type 6 (équivalent à QUARTILE.EXC), ce qui engendre des écarts numériques mineurs susceptibles de dérouter l’expérimentateur non averti. Documenter explicitement ces nuances algorithmiques dans le cahier de laboratoire garantit une interopérabilité computationnelle parfaite et assoit la crédibilité des analyses menées initialement sur tableur collaboratif.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Google. (2024). Liste des fonctions de Google Sheets : Fonctions statistiques. Centre d’aide Google Docs. https://support.google.com/docs/answer/6000292
- Hoaglin, D. C., Mosteller, F., & Tukey, J. W. (Eds.). (2000). Understanding robust and exploratory data analysis. John Wiley & Sons.
- Hyndman, R. J., & Fan, Y. (1996). Sample quantiles in statistical packages. The American Statistician, 50(4), 361-365. https://doi.org/10.1080/00031305.1996.10473566
- Rubin, D. B. (1976). Inference and missing data. Biometrika, 63(3), 581-592. https://doi.org/10.1093/biomet/63.3.581
- Spielberger, C. D., Gorsuch, R. L., Lushene, R., Vagg, P. R., & Jacobs, G. A. (1983). Manual for the State-Trait Anxiety Inventory. Consulting Psychologists Press.
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1-23. https://doi.org/10.18637/jss.v059.i10
- Wilcox, R. R. (2017). Introduction to robust estimation and hypothesis testing (4th ed.). Academic Press.