
L’analyse des distributions expérimentales constitue le socle méthodologique fondamental sur lequel reposent l’inférence statistique et la modélisation psychométrique contemporaine. Dans la pratique scientifique quotidienne, les chercheurs en psychologie quantitative, en neurosciences cognitives et en biomédecine sont confrontés à des corpus de données caractérisés par une forte hétérogénéité, des asymétries prononcées et la présence inévitable de valeurs extrêmes. Face à ces distorsions systématiques, l’usage exclusif des estimateurs gaussiens traditionnels, au premier rang desquels figurent la moyenne arithmétique et la variance d’échantillonnage, expose l’analyste à des biais d’interprétation substantiels. L’évaluation de la tendance centrale et de la dispersion exige dès lors le recours à des métriques robustes, insensibles aux écarts de normalité et capables de résumer fidèlement la morphologie sous-jacente des observations.
C’est précisément pour répondre à cet impératif de parcimonie et de résilience distributionnelle que John W. Tukey a conceptualisé, dans le cadre de ses travaux fondateurs sur l’analyse exploratoire des données, le résumé à cinq nombres. Ce dispositif synthétique condense la structure d’une variable quantitative continue ou ordinale à travers cinq jalons ordonnés stratégiques : la valeur minimale observée, la charnière inférieure correspondant approximativement au premier quartile, la médiane empirique, la charnière supérieure assimilable au troisième quartile, et la valeur maximale observée. En conjuguant des propriétés de résistance statistique remarquables à une lisibilité immédiate, ce quinté d’indicateurs offre une vue panoramique sur l’étalement, la symétrie et les limites absolues d’un ensemble de mesures, servant notamment de matrice algorithmique à la construction des diagrammes en boîte à moustaches.
Dans l’écosystème du langage de programmation statistique R, le calcul de ce résumé repose sur des implémentations algorithmiques précises qui méritent une clarification théorique et technique approfondie. Bien que la fonction native fivenum() constitue l’opérateur historique dédié à cette tâche, ses divergences structurelles avec d’autres fonctions omniprésentes telles que summary() et quantile() soulèvent des interrogations méthodologiques critiques quant au traitement des rangs, à l’interpolation des centiles et à la gestion des données manquantes. Ce guide propose une exploration exhaustive de la mise en œuvre du résumé à cinq nombres dans R, articulant fondements mathématiques, subtilités algorithmiques, manipulations de jeux de données psychométriques multivariés et intégration rigoureuse dans les protocoles de recherche reproductible.
1. Introduction théorique au résumé à cinq nombres en psychométrie et statistiques
1.1 Définition conceptuelle et pertinence scientifique
L’origine historique du résumé à cinq nombres s’enracine directement dans l’ouvrage fondateur de John Wilder Tukey publié en 1977, intitulé Exploratory Data Analysis. Tukey cherchait à émanciper la statistique pratique de la dépendance exclusive envers le paradigme inférentiel néo-fisherien, lequel postulait quasi systématiquement la normalité asymptotique des populations sous-jacentes. En introduisant le concept d’analyse exploratoire des données (couramment abrégée EDA pour Exploratory Data Analysis), Tukey a mis en lumière la nécessité d’examiner minutieusement les données brutes avant toute modélisation probabiliste rigide. Le résumé à cinq nombres s’inscrit au cœur de cette philosophie en tant que condensé numérique non paramétrique, composé séquentiellement du minimum, de la charnière inférieure (ou premier quartile), de la médiane empirique, de la charnière supérieure (ou troisième quartile) et du maximum.
D’un point de vue structurel, la décomposition de ces cinq métriques fondamentales permet de cartographier instantanément la répartition de la masse empirique sans faire d’hypothèse sur la fonction de densité génératrice. Contrairement aux moments d’ordre un et deux que sont la moyenne et la variance classique, le résumé à cinq nombres présente une résistance statistique exceptionnelle face à l’asymétrie distributionnelle positive ou négative. La moyenne est notoirement sensible au moindre déplacement d’une seule observation vers les extrémités du support empirique, un phénomène qui corrompt simultanément l’écart-type. À l’inverse, les estimateurs fondés sur les statistiques d’ordre possèdent des points de rupture élevés, garantissant que des anomalies de mesure ou des scores physiologiques idiosyncrasiques ne dénaturent pas la caractérisation globale de la population étudiée.
Dans le champ de la psychométrie appliquée et de la neuropsychologie clinique, cette résistance prend une importance fondamentale. L’évaluation standardisée des fonctions cognitives ou des dimensions affectives fait quasi exclusivement appel à des échelles de Likert cumulées, à des inventaires de personnalité ou à des chronométries de temps de réaction. Les distributions de ces variables manifestent structurellement de forts écarts à la loi normale, matérialisés par des planchers d’incompétence, des plafonds d’apprentissage ou des allongements unilatéraux de la queue de distribution liés à la fatigue attentionnelle. Dans de telles configurations, résumer les performances d’un groupe clinique par une moyenne et un écart-type relève du contresens méthodologique, tandis que le recours au résumé à cinq nombres préserve la vérité topologique du signal expérimental collecté.
1.2 Rôle dans la caractérisation des distributions expérimentales
L’exploitation conjointe des cinq statistiques d’ordre permet une caractérisation rapide et rigoureuse de la tendance centrale via la médiane empirique. Cette dernière sépare formellement l’échantillon ordonné en deux sous-ensembles équipotents de cinquante pour cent chacun. En s’affranchissant du barycentre arithmétique, le chercheur dispose d’une estimation non biaisée du comportement typique du participant médian, ce qui s’avère particulièrement informatif lorsque la variable mesurée présente une dynamique non linéaire. La comparaison spatiale entre la position de cette médiane et le milieu géométrique calculé entre le premier et le troisième quartile constitue d’ailleurs un premier indice diagnostique quant à la présence d’une asymétrie interne du nuage de points.
L’évaluation de la dispersion interne s’opère quant à elle par la différentiation entre la charnière supérieure et la charnière inférieure, circonscrivant ce que la littérature statistique formalise sous le nom d’écart interquartile (noté conventionnellement IQR pour Interquartile Range). Cet intervalle central englobe exactement la moitié des observations centrales de la série statistique. En ignorant délibérément les vingt-cinq pour cent inférieurs et les vingt-cinq pour cent supérieurs, l’écart interquartile capture la variabilité intrinsèque du phénomène étudié tout en demeurant parfaitement étanche aux fluctuations erratiques des valeurs périphériques. Il s’agit d’une métrique d’homogénéité incomparablement plus robuste que l’étendue totale ou l’écart-type d’échantillon.
Enfin, la délimitation absolue de l’amplitude empirique par le minimum et le maximum observés renseigne directement sur la portée globale du spectre des réponses enregistrées au sein du protocole expérimental. Cette double borne permet d’identifier l’existence éventuelle d’effets de troncature artificielle imposés par les caractéristiques de l’instrument d’évaluation lui-même. Dans les protocoles comparant des groupes cliniques (par exemple des patients souffrant d’un déficit cognitif léger ou d’un trouble anxieux caractérisé) à des cohortes témoins saines, le profilage conjoint de ces cinq nombres offre un instrument d’analyse préliminaire puissant. Il permet d’objectiver en un regard des divergences de dispersion ou des translations de médiane avant toute phase d’inférence non paramétrique de type test de Wilcoxon-Mann-Whitney.
2. Fondements mathématiques des cinq indicateurs de position et de dispersion
2.1 Le minimum et le maximum empiriques
Sur le plan strictement formel, la détermination du minimum et du maximum empiriques découle de la théorie des statistiques d’ordre. Soit un échantillon de variables aléatoires indépendantes et identiquement distribuées, noté sous la forme d’un vecteur fini x comportant n observations réelles. La réorganisation de ce vecteur selon une relation d’ordre totale croissante génère la suite des statistiques d’ordre, traditionnellement indicée entre parenthèses : x(1) inférieur ou égal à x(2), qui lui-même est inférieur ou égal aux termes subséquents jusqu’à x(n). Dès lors, le minimum empirique correspond sans ambiguïté à la première statistique d’ordre x(1), tandis que le maximum empirique s’identifie formellement à la n-ième statistique d’ordre x(n).
En dépit de leur simplicité conceptuelle apparente, ces deux métriques partagent une vulnérabilité mathématique extrême face aux erreurs de saisie numérique, aux défaillances de capteurs instrumentaux et aux artéfacts comportementaux. La statistique d’ordre x(1) et son homologue x(n) possèdent un point de rupture théorique nul, équivalent à un sur n. Cela implique mathématiquement qu’une unique perturbation erronée de magnitude infinie, survenant sur une seule ligne de la matrice de données, suffit à déplacer arbitrairement ces deux indicateurs sans aucune limite supérieure ou inférieure. Cette instabilité structurelle impose une grande vigilance lors de l’interprétation des bornes extrêmes issues d’un recueil expérimental automatisé.
En contexte clinique et psychométrique, l’analyse différentielle de x(1) et x(n) éclaire la structure des outils d’évaluation en révélant la présence de scores planchers et d’effets de plafond. Si le minimum observé coïncide parfaitement avec le score théorique le plus bas permis par l’instrument sur une fraction substantielle de l’échantillon, le test souffre d’un défaut de sensibilité inférieure, masquant les variations pathologiques profondes. Inversement, la convergence massive des participants vers la valeur maximale théorique signale un effet de plafond délétère, indiquant que la tâche cognitive s’avère insuffisamment discriminante pour différencier les capacités optimales au sein de la cohorte évaluée.
2.2 La médiane empirique comme estimateur central non paramétrique
La médiane empirique, couramment symbolisée par la lettre M ou la notation tilde x, représente la valeur d’ordre médian partitionnant la distribution échantillonnale en deux segments cardinaux rigoureusement égaux. Son calcul formel dépend directement de la parité de l’effectif total d’échantillon n. Dans l’éventualité où l’entier n s’avère impair, la médiane correspond précisément à la statistique d’ordre dont le rang central est déterminé par l’expression algébrique (n + 1) divisé par deux. La médiane s’exprime alors simplement sous la forme x((n + 1)/2). Lorsque l’effectif n est pair, il n’existe pas d’élément médian unique issu de la série discrète ; la médiane conventionnelle est alors définie par la demi-somme des deux statistiques d’ordre centrales, c’est-à-dire la moyenne arithmétique des observations occupant respectivement les rangs n divisé par deux et n divisé par deux plus un.
L’avantage cardinal de la médiane empirique réside dans sa propriété de point de rupture de cinquante pour cent. Cela signifie d’un point de vue asymptotique que la médiane demeure bornée et stable tant que moins de la moitié des observations d’un jeu de données n’est pas corrompue par des valeurs extrêmes tendant vers l’infini positif ou négatif. Cette résilience remarquable en fait l’estimateur de localisation privilégié pour caractériser le centre d’une distribution expérimentale asymétrique, là où la moyenne arithmétique glisse mécaniquement vers la queue étirée de la distribution sous l’effet du poids disproportionné des valeurs distales.
La mise en relation de la médiane empirique avec la moyenne arithmétique d’un échantillon constitue par ailleurs un test diagnostique non paramétrique de premier ordre pour évaluer l’asymétrie distributionnelle. Selon la seconde règle empirique de Pearson, dans une distribution strictement symétrique et unimodale, la moyenne arithmétique et la médiane coïncident approximativement. En présence d’une asymétrie positive étalée vers la droite (ce qui est typique des temps de réaction moteurs), la moyenne est significativement supérieure à la médiane. À l’inverse, dans une distribution asymétrique négative étalée vers la gauche (fréquente lors d’évaluations cliniques faciles où prédominent des scores élevés), la moyenne s’avère systématiquement inférieure à la médiane.
2.3 Les quartiles inférieur et supérieur (Q1 et Q3)
Les quartiles inférieur et supérieur, désignés conventionnellement par Q1 et Q3, procèdent d’une logique de partition continue de l’espace ordonné en quatre segments équiprobables, chacun contenant exactement vingt-cinq pour cent de la masse d’échantillonnage totale. Le premier quartile Q1 correspond à la valeur pour laquelle au moins un quart des observations lui sont inférieures ou égales, et au moins trois quarts lui sont supérieures ou égales. Symétriquement, le troisième quartile Q3 désigne la valeur pour laquelle au moins soixante-quinze pour cent de la distribution observée se situe en deçà, tandis que le quart restant présente des grandeurs scalaires supérieures.
Sur le plan de l’interprétation cognitive et neuropsychologique, ces seuils correspondent directement au vingt-cinquième centile et au soixante-quinzième centile de l’étalonnage psychométrique. Dans les épreuves évaluant par exemple l’empan mnésique, la flexibilité mentale ou l’attention sélective, un patient dont le score individuel s’effondre en deçà du premier quartile se situe immédiatement dans la zone de vigilance clinique, matérialisant une performance inférieure aux trois quarts de sa cohorte de référence appariée pour l’âge et le niveau d’éducation. À l’inverse, l’atteinte d’un score excédant Q3 caractérise un fonctionnement préservé ou supérieur, attestant d’une réserve cognitive substantielle face aux effets du vieillissement ou de la neurodégénérescence.
L’écart absolu séparant ces deux grandeurs numériques sert de fondement au calcul de l’écart interquartile, défini par l’opération algébrique soustractive Q3 moins Q1. Cette statistique de dispersion mesure la compacité du noyau central de la distribution. En évaluant l’homogénéité des comportements au sein du groupe étudié, un écart interquartile particulièrement resserré indique une stéréotypie ou une standardisation élevée des performances, tandis qu’un écart interquartile dilaté révèle une hétérogénéité substantielle des stratégies cognitives ou des phénotypes cliniques parmi les participants investigués au sein du protocole.
3. La fonction fondamentale fivenum() dans l’environnement de base R
3.1 Architecture logicielle et syntaxe formelle de fivenum()
Le langage de programmation statistique R intègre nativement, au sein de son package système nommé base, une fonction spécifiquement conçue pour extraire le résumé défini par John Tukey : la fonction fivenum(). Contrairement à de multiples fonctions d’analyses descriptives issues de bibliothèques tierces, cette commande ne nécessite l’importation d’aucune extension externe, garantissant ainsi une portabilité algorithmique absolue et une pérennité d’exécution sur n’importe quel terminal R, quelle que soit la version logicielle installée sur l’environnement de travail de l’analyste.
La signature formelle de la fonction se distingue par une sobriété exemplaire. Elle s’invoque conventionnellement sous la forme fivenum(x, na.rm = TRUE), où le paramètre fondamental x représente la structure de données à décomposer, qui doit obligatoirement être un vecteur numérique atomique, et na.rm constitue un argument logique stipulant s’il convient ou non d’exclure les données manquantes préalablement au traitement. L’absence intentionnelle d’options d’ajustement complexes dans la signature de la commande témoigne de la volonté originelle de préserver l’intégrité de l’algorithme des charnières de Tukey sans altération paramétrique contingente.
L’algorithme sous-jacent implémenté par la fonction fivenum() repose strictement sur la méthode des charnières de Tukey (désignées sous l’appellation anglophone de Tukey’s hinges). Selon ce mécanisme récursif, la médiane de l’ensemble ordonné est calculée en premier lieu. Ensuite, les charnières inférieure et supérieure sont déterminées en calculant respectivement la médiane exacte de la moitié inférieure et de la moitié supérieure de l’échantillon. La particularité déterminante de ce formalisme réside dans le fait que si l’effectif n est impair, la médiane empirique globale est expressément incluse dans les deux sous-ensembles pour procéder au calcul des charnières, induisant une déviation arithmétique subtile par rapport aux quantiles interpolés continus conventionnels.
3.2 Spécificités techniques du traitement numérique
Sur le plan du typage et de la manipulation en mémoire vive, la fonction fivenum() applique un contrôle strict sur la nature de ses arguments d’entrée. Si un chercheur lui soumet un vecteur d’entiers ou de nombres réels en double précision, la fonction s’exécute avec une vitesse computationnelle optimale grâce à des routines internes compilées en langage C. En revanche, si le vecteur contient des facteurs catégoriels ou des chaînes de caractères, la fonction rejette l’opération et génère une erreur d’exécution bloquante, rappelant que l’ordonnancement requis postule un niveau de mesure minimal d’intervalle ou d’ordre numérique continu.
Le traitement des cas d’exception numérique constitue une autre spécificité d’implémentation de fivenum(). Face à la présence de valeurs infinies générées par des divisions accidentelles par zéro dans un pipeline de transformation (telles que Inf ou -Inf), l’algorithme ne déclenche pas d’interruption anormale. Il classe rigoureusement -Inf comme étant la plus petite valeur possible occupant la première statistique d’ordre, et Inf comme occupant la n-ième position, déplaçant instantanément le minimum ou le maximum calculé vers ces limites non finies tout en préservant le calcul central de la médiane et des charnières si l’effectif fini résiduel s’avère suffisant.
Il importe en outre de souligner la différenciation structurelle opérée par le moteur de calcul entre un vecteur atomique univarié et une structure matricielle bidimensionnelle. Lorsque l’analyste transmet une matrice de données à la fonction fivenum(), R opère une coercition implicite par un aplatissement complet (vector flattening), détruisant l’organisation en lignes et en colonnes pour traiter l’intégralité des cellules comme un unique vecteur unidimensionnel amalgamé. Pour préserver la topologie matricielle et obtenir un résumé distinct par colonne ou par ligne, il devient dès lors indispensable d’intermédier l’appel via des fonctions d’ordre supérieur adaptées.
4. Calcul du résumé à cinq nombres sur un vecteur numérique simple (Exemple 1)
4.1 Création du vecteur expérimental et exécution élémentaire
Afin de rendre compte concrètement de la dynamique computationnelle de fivenum(), considérons une simulation empirique représentative de la chronométrie cognitive. Soit un protocole de temps de réaction de choix dans lequel un sujet neurologique doit discriminer des stimuli visuels complexes. Nous isolons une série brute de onze latences consécutives, exprimées en millisecondes : 245, 260, 275, 290, 310, 325, 340, 380, 420, 510 et 890 ms. Ce vecteur reflète fidèlement la réalité d’un recueil comportemental où coexistent une majorité d’exécutions motrices homogènes et un ralentissement épisodique marqué généré par une fluctuation attentionnelle.
L’instanciation de cette variable dans l’interpréteur R s’effectue par l’assignation d’un vecteur numérique canonique via l’opérateur d’assignation standard. Une fois le vecteur alloué en mémoire sous l’identifiant latence, l’appel de la commande fivenum(latence) déclenche immédiatement l’exécution algorithmique interne. Le résultat renvoyé dans la console interactive prend la forme d’un vecteur numérique continu dépourvu de noms d’attributs par défaut, exposant consécutivement cinq valeurs numériques alignées : 245, 282.5, 325, 400 et 890.
L’inspection de cette sortie vectorielle met instantanément en relief la concision de l’affichage fourni par fivenum(). La structure de l’objet résultant est un vecteur atomique de longueur 5 appartenant au type double. Bien que cette absence de métadonnées nominatives puisse dérouter l’expérimentateur habitué à des tableaux verbeux, elle confère en contrepartie une légèreté structurelle maximale, idéale pour les boucles d’itération massives et les calculs statistiques de rééchantillonnage de type bootstrap où l’allocation de surcharge textuelle dégraderait les performances computationnelles.
4.2 Décomposition analytique détaillée des résultats
Pour comprendre la genèse précise de ces cinq grandeurs numériques, une décomposition manuelle pas à pas s’impose. La série expérimentale comporte exactement n = 11 observations déjà ordonnées. Le minimum empirique s’identifie immédiatement à la première statistique d’ordre x(1), soit 245 ms, tandis que le maximum correspond sans ambiguïté à la onzième valeur observée x(11), soit 890 ms. Ces deux bornes délimitent l’amplitude absolue des temps de réponse observés chez le participant, attestant d’une étendue brute de 645 millisecondes.
L’effectif total étant un nombre impair (n = 11), la profondeur théorique de la médiane correspond formellement au rang calculé par la formule (n + 1) / 2, c’est-à-dire (11 + 1) / 2 = 6. En consultant la série ordonnée, la sixième observation est très précisément 325 ms. La médiane empirique de l’échantillon prend donc sans ambiguïté la valeur scalaire de 325. Il y a exactement cinq observations strictement inférieures à ce seuil (245, 260, 275, 290, 310) et cinq observations strictement supérieures (340, 380, 420, 510, 890).
Pour déterminer les charnières selon la formulation spécifique de John Tukey, la règle algorithmique stipule que l’élément médian (325) doit être inclus dans la moitié inférieure et dans la moitié supérieure de la distribution. Le sous-échantillon inférieur devient ainsi : 245, 260, 275, 290, 310, 325, comprenant un sous-effectif pair de 6 observations. La charnière inférieure (équivalente à Q1 dans fivenum) est donc la médiane de ce sous-ensemble, calculée par la demi-somme des 3e et 4e rangs : (275 + 290) / 2 = 282.5 ms. Symétriquement, le sous-échantillon supérieur comprend les valeurs 325, 340, 380, 420, 510, 890. Sa charnière supérieure est la moyenne des deux éléments médians (380 et 420) / 2 = 400 ms. L’écart inter-charnières est donc de 400 – 282.5 = 117.5 ms, reflétant la variabilité centrale du traitement cognitif sans distorsion causée par la latence atypique de 890 ms.
5. Différences méthodologiques critiques : fivenum() versus quantile() et summary()
5.1 La divergence algorithmique entre Tukey’s hinges et les quantiles types
L’un des écueils méthodologiques les plus fréquents dans la littérature empirique réside dans la confusion théorique entre les charnières de Tukey produites par fivenum() et les quartiles obtenus via la fonction générale quantile(). Dans leur article fondamental de 1996 publié dans The American Statistician, Rob Hyndman et Yanan Fan ont formellement classifié les neuf approches algorithmiques distinctes mobilisées dans les logiciels scientifiques pour estimer les quantiles continus sur des échantillons discrets. La fonction quantile() du langage R offre l’accès direct à l’ensemble de ces neuf méthodes via son paramètre type, dont la méthode par défaut est fixée à type = 7.
Or, les charnières de Tukey employées par fivenum() n’obéissent à aucun de ces schémas d’interpolation continue fondés sur des pondérations linéaires probabilistes. La méthode des charnières est une procédure purement discrète basée sur le rang et la partition en moitiés d’échantillon. Lorsque l’effectif n est de la forme 4k + 2 ou 4k + 3, les charnières de Tukey coïncident fréquemment avec les quartiles de certains types d’Hyndman et Fan. Cependant, dès que l’effectif global n prend d’autres configurations de parité (par exemple n = 8, n = 9 ou n = 12), des divergences numériques systématiques apparaissent entre la sortie de fivenum() et les quartiles calculés par quantile(x, type = 7).
Considérons à titre d’illustration un vecteur numérique élémentaire constitué des entiers pairs consécutifs de 1 à 8 (n = 8). L’exécution de fivenum() génère pour la charnière inférieure la médiane exacte de la première moitié {1, 2, 3, 4}, ce qui donne la valeur 2.5. En revanche, l’exécution par défaut de quantile(x, probs = 0.25, type = 7) applique une formule d’interpolation continue qui produit la valeur 2.75. Cette discordance arithmétique de 0.25 n’est pas une simple anomalie d’arrondi : elle reflète deux visions épistémologiques radicalement différentes de la nature d’un centile, l’une ancrée dans l’analyse exploratoire des données discrètes réelles, l’autre orientée vers l’estimation asymptotique de paramètres d’une loi de probabilité continue.
5.2 Comparaison fonctionnelle avec summary()
L’autre alternative d’analyse univariée omniprésente dans R est la fonction générique summary(). Lorsqu’elle est appliquée à un vecteur quantitatif, summary() retourne une synthèse descriptive en apparence très proche du résumé à cinq nombres, mais qui s’en distingue par deux dissemblances fonctionnelles et typologiques substantielles. La première divergence réside dans l’intégration explicite d’une sixième métrique fondamentale : la moyenne arithmétique (Mean), positionnée structurellement entre la médiane et le troisième quartile.
Cette adjonction de la moyenne transforme la finalité analytique de la commande. Alors que fivenum() demeure un résumé rigoureusement non paramétrique et ordinal, summary() crée un dispositif hybride confrontant directement les statistiques de position robustes (médiane, quartiles) à un paramètre dépendant des moments linéaires. Cette juxtaposition facilite l’appréciation immédiate de l’asymétrie empirique par contraste visuel entre la moyenne et la médiane, mais rompt avec la stricte parcimonie du modèle original de John Tukey.
La seconde dissemblance se situe au niveau de la structure d’objet en mémoire informatique. La fonction fivenum() renvoie un vecteur numérique anonyme de classe numeric, directement indexable par des positions d’indices numériques simples allant de 1 à 5. En revanche, summary() renvoie un vecteur nommé doté d’attributs textuels de classe summaryDefault ou table selon le contexte. Dans les pipelines de programmation automatisée et d’ingénierie statistique complexe, l’extraction de valeurs issues de summary() exige l’accès par chaînes de caractères ou des manipulations de coercition, introduisant une latence d’exécution computationnelle et des risques de rupture de reproductibilité si les paramètres régionaux ou les étiquettes linguistiques viennent à différer selon l’environnement de travail.
5.3 Directives académiques pour le choix de la méthode
Le choix délibéré entre fivenum(), quantile() et summary() doit être articulé de manière rigoureuse dans la section méthodologique des mémoires universitaires et des articles scientifiques évalués par les pairs. L’emploi strict de fivenum() se justifie pleinement lorsque le cadre théorique adopté relève explicitement de l’analyse exploratoire de Tukey ou lorsqu’il s’agit d’alimenter les algorithmes originaux de tracé des boîtes à moustaches. Sa rapidité d’exécution et sa robustesse structurelle en font également le choix optimal pour le balayage automatique d’un nombre élevé de variables comportementales ou génomiques au sein de matrices massives.
À l’inverse, l’emploi de quantile(…, type = 7) ou d’autres types d’interpolation continue s’impose impérativement lorsque l’objectif de la recherche consiste à standardiser des normes psychométriques destinées à être publiées sous forme de tables d’étalonnage cliniques. Les manuels de tests standardisés (tels que les échelles d’intelligence de Wechsler ou les inventaires neuropsychologiques de la mémoire) reposent sur l’hypothèse de populations sous-jacentes infinies et continues où l’interpolation affine des centiles garantit la cohérence des rangs percentiles attribués aux patients examinés.
Enfin, les recommandations de l’American Psychological Association (normes APA de 7e édition) imposent aux auteurs de spécifier formellement les algorithmes retenus dès lors que des quantiles ou des résumés robustes sont rapportés dans les tableaux de résultats empiriques. Mentionner simplement que le premier quartile d’une cohorte vaut telle quantité sans préciser s’il s’agit de la charnière de Tukey issue de fivenum() ou du percentile issu de quantile() constitue une approximation scientifique dommageable qui compromet la réplicabilité exacte des analyses par des équipes de recherche indépendantes.
6. Application pratique aux jeux de données psychométriques (data frames)
6.1 Importation et structure des variables comportementales
Pour illustrer l’implémentation opérationnelle du résumé à cinq nombres sur un tableau de données psychométriques complexe, considérons une recherche observationnelle simulant l’évaluation d’une cohorte de 150 participants adultes soumis à une double batterie diagnostique. La première variable enregistrée est le score total à l’inventaire d’anxiété état-trait de Spielberger (STAI-Y, mesuré sur une échelle discrète continue allant de 20 à 80 points), une échelle caractérisée par une dérive d’asymétrie fréquente en population générale. La seconde variable mesure la performance à une tâche d’attention soutenue informatisée (Continuous Performance Test), exprimée par le pourcentage d’omissions cibles commises face à des distracteurs.
Le chargement d’un tel tableau de données au format data frame constitue la première étape de tout flux de travail en sciences quantitatives du comportement. À la suite de la lecture du fichier de données brutes, l’expérimentateur utilise les commandes d’inspection structurelle fondamentales de R, principalement str() dans l’environnement de base ou glimpse() au sein de la bibliothèque moderne tibble. Cette étape préalable permet de s’assurer scrupuleusement que les variables quantitatives cibles n’ont pas été accidentellement converties en vecteurs de chaînes de caractères lors de l’importation à cause d’un délimiteur décimal inadéquat.
Une fois la structure matricielle validée, l’extraction et l’isolation des colonnes scalaires d’intérêt s’opèrent par l’opérateur d’indexation dollar ou par les méthodes d’extraction matricielle par crochets. L’accès direct à la colonne psychométrique via l’expression clinique$Score_STAI permet d’isoler le vecteur atomique cible avant de le soumettre aux fonctions de synthèse statistique, garantissant l’intégrité du traitement univarié.
6.2 Application itérative sur plusieurs variables avec les fonctions apply()
Dans la pratique psychométrique courante, les protocoles comportent rarement une variable d’intérêt isolée, mais plutôt une collection de sous-échelles interconnectées. L’application unitaire et répétitive de la commande fivenum() sur chaque colonne constituerait une démarche manuelle inefficace et propice à des erreurs de transcription. Pour automatiser l’extraction du résumé à cinq nombres à travers l’ensemble des items ou des échelles continues d’un data frame, le recours aux fonctions d’ordre supérieur de la famille apply de R s’avère indispensable.
La commande sapply() est particulièrement adaptée à cet impératif de calcul simultané. En transmettant à sapply() le sous-ensemble de données numériques sélectionné et en désignant fivenum comme fonction de rappel, l’interpréteur R itère automatiquement sur chaque colonne du tableau. La signature de cet appel se formule simplement : sapply(donnees_psychometriques[, c(« STAI_Anxiete », « Omissions_CPT », « Temps_Reaction »)], fivenum). Grâce aux mécanismes d’optimisation vectorielle de sapply(), la sortie est instantanément condensée sous la forme d’une matrice rectangulaire claire où chaque colonne correspond à une variable comportementale et chaque ligne représente séquentiellement l’un des cinq nombres de Tukey.
Pour conférer à cette matrice de sortie une lisibilité scientifique impeccable, il est d’usage d’enrichir ses métadonnées en réassignant manuellement les noms de lignes via la fonction rownames(). L’attribution explicite d’un vecteur de libellés descriptifs (« Minimum », « Charniere_Inf », « Mediane », « Charniere_Sup », « Maximum ») transforme le tableau brut en une matrice auto-documentée. Cette matrice peut être instantanément convertie en un nouveau tableau de données grâce à as.data.frame(), facilitant son injection subséquente dans des protocoles de reporting statistique automatisé ou son enregistrement sous forme de fichier tabulé externe.
7. Gestion rigoureuse des données manquantes (NA) et des anomalies expérimentales
7.1 Gestion du paramètre na.rm dans fivenum()
La manipulation des données issues de l’évaluation psychologique et médicale se heurte inévitablement à la présence d’observations incomplètes, symbolisées sous l’environnement R par la valeur réservée NA (Not Available). Les participants omettent fréquemment de répondre à certaines questions sensibles d’un auto-questionnaire, ou bien des défaillances techniques du système d’acquisition perturbent l’enregistrement de certains blocs expérimentaux. Dans ce cadre, la rigueur du traitement des cellules vides détermine directement la validité des statistiques calculées.
À cet égard, la fonction fivenum() adopte un comportement algorithmique par défaut singulier qui la distingue nettement des fonctions mathématiques standard de R telles que mean(), median() ou quantile(). Alors que ces dernières renvoient par défaut la valeur NA dès qu’une seule case vide est détectée dans le vecteur soumis (imposant à l’utilisateur de spécifier explicitement l’argument na.rm = TRUE pour obtenir un résultat numérique), la fonction fivenum() intègre de manière intrinsèque l’argument na.rm = TRUE comme paramètre par défaut. Par conséquent, fivenum() procède silencieusement à l’élagage préliminaire des données manquantes sans émettre d’avertissement formel dans la console.
Cette suppression automatique présente des bénéfices de fluidité algorithmique indéniables, mais elle comporte des risques statistiques insidieux en l’absence d’une vérification préalable. Un chercheur distrait pourrait ainsi appliquer fivenum() sur une échelle psychométrique sans réaliser qu’un tiers des participants ont abandonné le protocole en cours de passation. Il apparaît dès lors indispensable d’effectuer un audit préliminaire rigoureux de la matrice de données au moyen de fonctions dédiées telles que sum(is.na(variable)) ou colSums(is.na(dataframe)), afin de quantifier précisément le taux d’attrition expérimental avant toute exploitation synthétique.
7.2 Distinction entre données manquantes aléatoires et non aléatoires
D’un point de vue épistémologique et psychométrique, l’omission mécanique des valeurs NA orchestrée par na.rm = TRUE dans fivenum() postule implicitement que le mécanisme générateur des données manquantes relève du schéma complètement aléatoire au sens de Rubin (Missing Completely At Random, MCAR). Selon cette hypothèse restrictive, la probabilité d’absence d’une observation est totalement indépendante tant des variables observées que des valeurs non observées elles-mêmes. Ce n’est qu’à cette condition théorique stricte que le calcul du résumé à cinq nombres sur les cas complets résiduels conserve des propriétés d’estimation non biaisées pour la population parente.
Cependant, dans les investigations portant sur la santé mentale ou les troubles cognitifs sévères, les données manquantes sont quasi universellement non aléatoires (Missing Not At Random, MNAR). Les patients présentant les niveaux d’anxiété les plus intolérables ou les détériorations exécutives les plus avancées sont précisément ceux qui manifestent le taux d’abandon ou de refus de réponse le plus élevé lors des évaluations exigeantes. L’élagage automatique opéré par le résumé à cinq nombres va alors tronquer de manière asymétrique la distribution supérieure des scores de sévérité ou la distribution inférieure des capacités résiduelles.
Les conséquences d’une telle attrition sélective sur le résumé à cinq nombres s’avèrent délétères : le maximum observé x(n) se trouve artificiellement sous-estimé, et la médiane subit une translation trompeuse vers des zones de fonctionnement préservé, donnant l’illusion trompeuse d’une cohorte moins sévèrement affectée qu’elle ne l’est dans la réalité clinique. Dans ces circonstances méthodologiques complexes, le calcul direct du résumé à cinq nombres sur les données brutes incomplètes doit être impérativement précédé par des procédures d’imputation multiple robuste par équations chaînées ou par des modélisations non paramétriques de type forêts aléatoires, garantissant la représentativité des cinq indicateurs finaux.
8. Calcul conditionnel et groupé du résumé à cinq nombres (dplyr et base R)
8.1 Approche fonctionnelle en base R avec tapply() et aggregate()
L’analyse comparative entre sous-populations constitue l’un des piliers méthodologiques de l’expérimentation clinique. Les chercheurs ne se limitent presque jamais à la caractérisation globale d’un échantillon indifférencié ; ils cherchent à contraster la réponse psychométrique en fonction de sous-groupes diagnostiques prédéfinis, tels que des cohortes de patients étiquetés avec une pathologie spécifique face à des sujets contrôles appariés. Le langage de programmation R de base dispose d’outils fonctionnels performants pour segmenter et appliquer conditionnellement le résumé à cinq nombres.
La commande canonique pour accomplir cette tâche sans recourir à des dépendances logicielles extérieures est la fonction tapply(). La syntaxe s’articule formellement autour de trois arguments directeurs : le vecteur numérique de réponse continue, la variable de partitionnement catégorielle servant de facteur de groupement, et la fonction analytique cible à appliquer séquentiellement sur chaque strate. Ainsi, l’instruction tapply(clinique$Score_STAI, clinique$Groupe_Diagnostique, fivenum) partitionne instantanément la série des scores anxieux en fonction des étiquettes nosographiques et renvoie une liste nommée de vecteurs, chacun comprenant les cinq métriques de Tukey propres à son groupe clinique respectif.
Pour obtenir une mise en forme structurelle tabulaire plutôt qu’une arborescence de listes, l’analyste peut mobiliser la fonction aggregate(). Cependant, en raison du fait que fivenum() renvoie un vecteur de cinq éléments scalaires et non une valeur unitaire unique, l’exécution standard de aggregate(Score_STAI ~ Groupe_Diagnostique, data = clinique, FUN = fivenum) encapsule une sous-matrice de cinq colonnes à l’intérieur de la colonne de résultats du data frame produit. Cette disposition spécifique nécessite parfois une conversion finale pour aplatir la structure avant de pouvoir l’exporter aisément vers des formats de tableurs conventionnels.
8.2 Approche moderne avec l’écosystème tidyverse et dplyr
Dans la pratique contemporaine de la programmation en science des données, l’écosystème tidyverse et en particulier la bibliothèque dplyr offrent une syntaxe fluide, expressive et hautement standardisée, fondée sur l’enchaînement d’opérateurs de composition couramment désignés sous le terme de tuyaux (pipes). Lorsqu’il s’agit de calculer un résumé à cinq nombres stratifié par groupe clinique au moyen de dplyr, la combinaison traditionnelle des fonctions group_by() et summarise() rencontre une contrainte syntaxique : la fonction summarise() impose classiquement que l’expression interne renvoie une valeur scalaire unique par groupe.
Pour contourner élégamment cette limitation architecturale sans sacrifier l’idiome du tidyverse, les développeurs de dplyr ont introduit la fonction reframe(). Cette dernière accepte explicitement des opérations générant des vecteurs de longueurs arbitraires au sein de chaque strate d’échantillonnage. En conjuguant reframe() avec la création d’un vecteur d’étiquettes de texte explicites, il devient possible de formater un tableau rectangulaire parfaitement normalisé (tidy data). L’implémentation opérationnelle prend la forme d’un enchaînement harmonieux où les données sont d’abord groupées via group_by(Diagnostic), puis ventilées via reframe(Indicateur = c(« Min », « Q1 », « Mediane », « Q3 », « Max »), Valeur = fivenum(Score_STAI)).
Cette approche moderne génère une table d’analyse explicite où chaque ligne correspond univoquement à une statistique de position pour un sous-groupe clinique déterminé. Une telle structure tabulaire s’intègre ensuite sans la moindre friction computationnelle dans les fonctions de restructuration bidimensionnelle telles que pivot_wider() de la bibliothèque tidyr. Cette opération finale permet de basculer instantanément les cinq indicateurs en colonnes adjacentes (Min, Q1, Médiane, Q3, Max), offrant une table de synthèse comparative parfaitement alignée sur les exigences de présentation académique.
8.3 Comparaisons intergroupes en neuropsychologie expérimentale
La mise en miroir des résumés à cinq nombres calculés au sein de cohortes cliniques différenciées permet de capturer des dynamiques cognitives subtiles que les statistiques paramétriques masquent régulièrement. Considérons un protocole évaluant l’inhibition motrice chez des patients présentant un trouble du déficit de l’attention avec hyperactivité (TDAH) confrontés à un groupe contrôle neurotypique. Lorsque l’on examine le résumé à cinq nombres des latences d’inhibition, la médiane empirique peut s’avérer relativement comparable entre les deux groupes, indiquant une vitesse de traitement moyenne préservée chez les patients.
En revanche, l’analyse comparative des charnières et des extrema dévoile une réalité clinique radicalement différente. Dans le groupe TDAH, l’écart interquartile déterminé par la différence entre la charnière supérieure et la charnière inférieure se révèle souvent deux à trois fois plus étendu que celui du groupe témoin, objectivant formellement une variabilité intra-individuelle massive des mécanismes de contrôle exécutif. De surcroît, le maximum observé x(n) au sein du groupe clinique s’éloigne vertigineusement de la charnière supérieure, révélant la présence de décrochages attentionnels périodiques sévères.
De même, l’évaluation de la stabilité de la médiane et de l’asymétrie entre des conditions expérimentales de stress induit et de repos basal permet d’objectiver la vulnérabilité psychophysiologique des participants. La translation de la médiane empirique vers les valeurs pathologiques sous l’effet du stresseur, combinée à une déformation de la distance relative séparant la médiane de la charnière inférieure par rapport à la charnière supérieure, fournit une signature quantitative précise de la perte de régulation émotionnelle, confirmant l’utilité clinique du résumé à cinq nombres comme outil de diagnostic transversal.
9. Représentation graphique avancée : De la boîte à moustaches (boxplot) au résumé à cinq nombres
9.1 Correspondance bijective entre fivenum() et le diagramme de Tukey
Il existe une interdépendance théorique et algorithmique indissoluble entre le résumé à cinq nombres et le diagramme en boîte à moustaches, que John Tukey a introduit simultanément sous la désignation anglophone de box-and-whisker plot. La boîte à moustaches constitue en réalité la transposition géométrique et visuelle directe des statistiques d’ordre calculées par l’algorithme des charnières. Comprendre cette bijection spatiale permet d’interpréter avec une rigueur accrue les visualisations univariées générées sous l’environnement de programmation statistique R.
Dans la commande native boxplot() du package graphics de R, l’anatomie du diagramme matérialise directement ces repères statistiques. Le bord inférieur du rectangle central correspond précisément à la charnière inférieure (deuxième valeur du vecteur fivenum), tandis que le bord supérieur délimite la charnière supérieure (quatrième valeur du vecteur). La hauteur totale de ce rectangle central représente physiquement l’écart inter-charnières. À l’intérieur de cette boîte, un trait horizontal renforcé visualise la médiane empirique (troisième élément de fivenum), divisant l’espace central selon le degré de symétrie locale de la distribution.
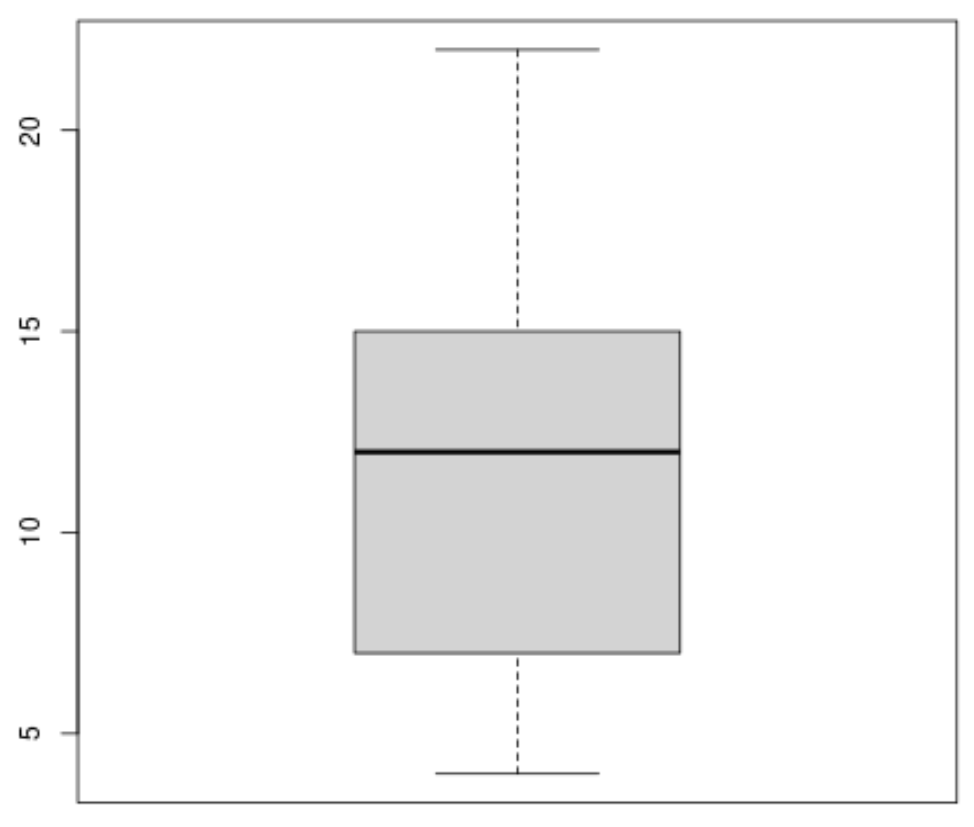
La délimitation des extrémités des moustaches et la restitution du minimum et du maximum requièrent en revanche une précision conceptuelle essentielle. Si la distribution ne présente aucune observation suspecte d’aberrance, la terminaison inférieure de la moustache coïncide rigoureusement avec le minimum observé x(1) et la terminaison supérieure rejoint le maximum observé x(n). Dès lors, la correspondance entre les cinq repères graphiques du tracé de base et les cinq métriques produites par fivenum() est absolue et bijective, matérialisant sur l’axe des ordonnées l’exacte configuration spatiale du résumé statistique de Tukey.
9.2 Visualisation hautement personnalisée avec ggplot2
Si la fonction graphique de base offre un outil de diagnostic exploratoire immédiat, la conception de figures destinées à l’édition scientifique de haut niveau s’appuie désormais quasi exclusivement sur la bibliothèque ggplot2, fondée sur la grammaire des graphiques développée par Leland Wilkinson. L’intégration du résumé à cinq nombres au sein d’un canevas ggplot2 s’articule autour de la géométrie fondamentale geom_boxplot(). Cette dernière procède de manière autonome au calcul des composantes de dispersion tout en permettant un contrôle esthétique absolu sur la présentation des éléments graphiques.
Pour superposer explicitement les coordonnées scalaires exactes du résumé à cinq nombres directement sur le rendu visuel, l’analyste peut coupler la géométrie de boîte avec la fonction stat_summary(). Cette dernière autorise l’injection de fonctions statistiques univariées personnalisées au cœur de l’espace géométrique. En configurant stat_summary() avec des fonctions de rappel pointant vers fivenum, il devient envisageable de projeter des repères ponctuels contrastés ou des étiquettes numériques au niveau exact de chaque charnière, facilitant ainsi la lecture quantitative par le lecteur sans qu’il soit nécessaire d’effectuer des allers-retours fastidieux entre la figure et le texte de l’article.
Le perfectionnement typographique de la visualisation s’achève par l’application rigoureuse des normes de publication académique, notamment celles édictées par l’American Psychological Association. Cela implique la mise en œuvre d’un thème visuel épuré, exempt d’artefacts graphiques inutiles (chartjunk), accessible via la commande theme_classic() ou theme_minimal(). L’élimination du quadrillage d’arrière-plan, la clarification des axes d’échelle, l’ajustement minutieux des polices de caractères vectorielles et l’utilisation de palettes chromatiques perceptuellement uniformes et compatibles avec les déficits de la vision des couleurs (telles que les palettes Viridis) garantissent une diffusion scientifique optimale et professionnelle des résultats empiriques.
10. Détection psychométrique des valeurs aberrantes (outliers) via l’écart interquartile
10.1 Règle des 1,5 x IQR et clôtures de Tukey
Au-delà de sa fonction descriptive de synthèse, le résumé à cinq nombres joue un rôle déterminant dans la détection objective des observations discordantes ou atypiques, communément désignées sous l’anglicisme d’outliers. John Tukey a formalisé une règle empirique devenue universelle, fondée sur l’amplitude de l’écart inter-charnières ou interquartile. Cette méthodologie établit des frontières de démarcation non paramétriques, appelées clôtures internes (inner fences) et clôtures externes (outer fences), sans postuler de normalité sous-jacente.
D’un point de vue algorithmique, la clôture interne inférieure est définie par la soustraction d’une fois et demie l’écart interquartile à la charnière inférieure, soit formellement l’expression Q1 – (1.5 multiplié par IQR). Symétriquement, la clôture interne supérieure est érigée en ajoutant cette même quantité à la charnière supérieure, soit Q3 + (1.5 multiplié par IQR). Toute observation expérimentale dont la magnitude se situe en dehors de cet intervalle fermé est qualifiée de valeur atypique modérée. Lorsque le facteur de multiplication est porté à trois fois l’écart interquartile, les bornes obtenues définissent les clôtures externes, au-delà desquelles les observations sont catégorisées comme des valeurs extrêmes sévères.
Dans l’environnement de programmation R, cette logique est celle qui régit précisément le tracé des moustaches dans boxplot() et geom_boxplot(). Dès lors qu’une ou plusieurs observations dépassent les clôtures internes de 1,5 fois l’IQR, les moustaches cessent d’atteindre le minimum et le maximum empiriques. La moustache se rétracte pour s’arrêter sur la valeur observée la plus extrême située à l’intérieur des clôtures (les valeurs adjacentes de Tukey), tandis que les points situés au-delà sont isolés graphiquement sous la forme de points discrets. Pour extraire algorithmiquement ces points aberrants dans une session de script R, l’expérimentateur utilise les opérations logiques croisées reliant les vecteurs bruts aux bornes calculées à partir de fivenum(), identifiant ainsi formellement les indices d’enregistrement des observations suspectes.
10.2 Interprétation substantive des valeurs aberrantes en psychologie
L’identification algorithmique d’une valeur extrême au moyen de la règle des clôtures de Tukey ne doit en aucun cas conduire à son élimination mécanique et irréfléchie du jeu de données expérimental. En psychologie quantitative, une observation atypique ne constitue pas nécessairement une erreur de mesure ou une défaillance instrumentale ; elle incarne souvent une manifestation authentique de la variabilité phénotypique humaine ou l’expression d’un profil cognitif rare mais valide.
L’analyse clinique approfondie de ces données requiert une discrimination phénoménologique soigneuse. D’une part, l’analyste doit traquer d’éventuelles aberrations matérielles incontestables : un temps de réponse psychomoteur de 12 millisecondes (physiologiquement incompatible avec la transmission synaptique rétino-corticale) ou un score de 999 découlant d’une convention mal encodée pour désigner une omission de réponse. Dans ces cas manifestes, la valeur doit être rectifiée ou convertie en NA sans ambiguïté. D’autre part, un temps de latence de 3 500 millisecondes chez un patient âgé confronté à une interférence de type Stroop peut refléter un décrochage temporaire du contrôle exécutif, porteur d’une signification diagnostique majeure pour la détection précoce d’une démence sous-corticale.
De même, dans l’évaluation de l’intelligence générale ou des habiletés logico-mathématiques, des scores s’isolant au-delà de la clôture supérieure matérialisent fréquemment des profils de surdouance cognitive ou de haut potentiel intellectuel. Exclure unilatéralement ces individus sous le prétexte statistique d’optimiser l’ajustement d’un modèle linéaire viole les principes fondamentaux de l’échantillonnage représentatif. Les directives éthiques et méthodologiques contemporaines imposent dès lors de documenter systématiquement toutes les valeurs aberrantes détectées par le résumé à cinq nombres et de conduire des analyses de sensibilité comparant les conclusions statistiques avec et sans l’inclusion desdites observations périphériques.
11. Automatisation, rapports statistiques et exportation des résultats
11.1 Développement d’une fonction R personnalisée pour rapports enrichis
Si la commande fivenum() remplit parfaitement son rôle d’extraction brute, son intégration dans des flux de travail professionnels requiert souvent un enrichissement métrologique. Les chercheurs éprouvent fréquemment le besoin d’adjoindre simultanément au quinté d’origine des indicateurs de dispersion complémentaires, tels que l’étendue totale absolue (Range), l’écart inter-charnières exact (IQR) et la taille de l’échantillon valide résiduel après élagage des valeurs manquantes, tout en structurant la sortie sous la forme d’un conteneur moderne de type tibble ou data frame dûment typé.
La flexibilité du langage R autorise l’encapsulation de l’algorithme fivenum() au sein d’une fonction personnalisée hautement réutilisable. Cette fonction utilisateur peut accepter un vecteur d’entrée arbitraire, vérifier son typage numérique via des assertions logiques conditionnelles, exécuter l’extraction via fivenum(x, na.rm = na.rm), puis calculer les grandeurs algébriques dérivées (différence entre le cinquième et le premier élément pour l’étendue, différence entre le quatrième et le deuxième pour l’intervalle interquartile). Les résultats sont ensuite agencés dans une structure rectangulaire unifiée où chaque statistique est associée à son libellé nominatif standardisé.
L’implémentation de cette logique modulaire confère une portabilité remarquable au pipeline d’analyse. En intégrant des mécanismes d’évaluation dynamique, la fonction personnalisée peut être cartographiée sur des dizaines de variables à l’aide de la fonction map_dfr() de la bibliothèque purrr, générant en une fraction de seconde un tableau récapitulatif global prêt pour l’inspection statistique et prêt à alimenter les moteurs de mise en page documentaire.
11.2 Exportation académique conforme aux formats standardisés
La communication des résultats de la recherche exige une mise en forme tabulaire respectant scrupuleusement les canons éditoriaux de la diffusion scientifique internationale. L’époque où les chercheurs recopiaient manuellement les chiffres de la console R vers un logiciel de traitement de texte commercial est définitivement révolue, tant cette pratique archaïque constituait une source intarissable d’erreurs de transcription numérique. L’écosystème R moderne intègre des bibliothèques de rendu documentaire de haute volée, au premier rang desquelles figurent knitr et flextable.
La fonction kable() issue du package knitr, enrichie par les extensions esthétiques de kableExtra, permet de convertir instantanément un data frame de résumés à cinq nombres en un tableau syntaxiquement irréprochable au format LaTeX pour les soumissions chez des éditeurs de référence, ou en balisage HTML pour la diffusion web interactive. Les bordures horizontales simples, l’alignement décimal rigoureux des scores psychométriques et l’insertion de légendes institutionnelles s’effectuent par le biais d’instructions déclaratives directes garantissant un rendu esthétique sobre et élégant.
Pour les chercheurs dont les revues cibles exigent exclusivement des manuscrits éditables au format Microsoft Word, la bibliothèque flextable fournit le moteur de compilation idéal. Elle autorise le paramétrage typographique micrométrique des bordures de cellules, l’application automatique d’ombrages alternés et le formatage rigoureux selon les normes de l’APA (7e édition). Ce flux programmatique s’insère de manière transparente dans les documents informatisés hybrides pilotés par R Markdown ou le système de publication scientifique de nouvelle génération Quarto, assurant une reproductibilité computationnelle totale du pipeline de recherche, depuis le traitement du signal brut jusqu’au manuscrit finalisé prêt pour l’impression.
12. Pièges statistiques courants, validité expérimentale et meilleures pratiques
12.1 Erreurs méthodologiques récurrentes lors de l’analyse
L’utilisation non critique du résumé à cinq nombres expose l’analyste à plusieurs pièges interprétatifs majeurs qu’une démarche méthodologique rigoureuse doit impérativement désamorcer. Le premier écueil réside dans l’assimilation aveugle et erronée des charnières de Tukey produites par fivenum() aux centiles continus calculés par les logiciels généralistes concurrents comme SPSS ou SAS. Ces derniers s’appuient fréquemment sur des pondérations linéaires différentes (assimilables aux types 2 ou 6 d’Hyndman et Fan), générant des valeurs de coupure légèrement divergentes pour les premier et troisième quartiles. Ne pas expliciter cette nuance computationnelle lors de la comparaison d’études cliniques croisées induit des contradictions artificielles dans la littérature.
Le second piège méthodologique critique concerne l’application du résumé à cinq nombres à des distributions expérimentales fortement bimodales ou multimodales. Par définition, le résumé de Tukey postule que l’échantillon peut être condensé le long d’une progression monotone uniaxiale articulée autour d’un centre unique. Si une population clinique contient en réalité deux sous-groupes discrets non identifiés (par exemple une population mixte composée de porteurs sains et d’individus symptomatiques à un stade prodromique), la distribution présente deux bosses distinctes. Dans cette configuration, la médiane empirique tombe exactement dans le creux séparant les deux modes, décrivant un point de densité quasi nulle qui ne représente en rien le comportement réel d’aucun participant de la cohorte.
Le troisième biais fréquent concerne l’application déraisonnable du résumé à cinq nombres sur des variables purement ordinales à très faibles modalités de réponse discrètes, telles que des échelles de Likert limitées à trois ou quatre points d’ancrage. Sur de tels supports discrets étroits, les statistiques d’ordre s’effondrent sur des paliers identiques, conduisant fréquemment à des situations où le minimum, la charnière inférieure et la médiane prennent une valeur numérique strictement égale (par exemple 1, 1, 1, 2, 3). Cette dégénérescence des quantiles prive le résumé de toute sa substance discriminante, rappelant que l’outil de Tukey nécessite une granularité de mesure continue ou quasi continue pour exprimer son plein potentiel descriptif.
12.2 Bonnes pratiques pour la reproductibilité scientifique
Afin d’élever les standards de transparence et de reproductibilité dans l’exploitation du résumé à cinq nombres, plusieurs directives fondamentales doivent être scrupuleusement observées par la communauté scientifique. La première exigence méthodologique consiste à archiver et documenter formellement l’environnement d’exécution informatique au sein duquel les calculs ont été conduits. L’appel de la commande sessionInfo() dans le script R permet de figer pour la postérité la version exacte du moteur de calcul R mobilisée ainsi que l’état précis des bibliothèques système chargées en mémoire, prévenant toute altération silencieuse des algorithmes lors des futures mises à jour logicielles.
La deuxième recommandation impérative concerne la restitution conjointe des indicateurs synthétiques et de la structure distributionnelle globale. Un résumé numérique, aussi puissant soit-il, ne doit jamais être présenté de manière déconnectée d’une inspection visuelle attentive. La publication scientifique d’un tableau récapitulatif des cinq nombres gagne à être systématiquement adossée à des graphiques de dispersion individuels enrichis, tels que des diagrammes de dispersion en bandes (strip charts), des nuages de points superposés avec gigue aléatoire (jittered points) ou des représentations en violon (violin plots). Cette multimodalité descriptive garantit qu’aucune singularité morphologique, bimodalité cachée ou concentration anormale d’observations n’échappe à la sagacité critique de la communauté scientifique.
Enfin, l’inscription pleine et entière de la recherche dans le mouvement mondial de la science ouverte (Open Science) constitue le garant ultime de la rigueur méthodologique. La mise à disposition intégrale des scripts d’analyse R, accompagnés des données brutes anonymisées sur des dépôts institutionnels publics pérennes tels que l’Open Science Framework (OSF), Zenodo ou GitHub, permet à tout examinateur ou chercheur tiers de reproduire à l’identique les calculs de fivenum(), de vérifier la pertinence de la gestion des données manquantes et d’attester de la probité des conclusions psychométriques publiées, consolidant ainsi durablement l’édifice des connaissances scientifiques.
Références
- Hyndman, R. J., & Fan, Y. (1996). Sample quantiles in statistical packages. The American Statistician, 50(4), 361–365. https://doi.org/10.1080/00031305.1996.10473566
- Little, R. J. A., & Rubin, D. B. (2019). Statistical analysis with missing data (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781119482260
- R Core Team. (2024). R: A language and environment for statistical computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
- Rubin, D. B. (1976). Inference and missing data. Biometrika, 63(3), 581–592. https://doi.org/10.1093/biomet/63.3.581
- Spielberger, C. D. (1983). State-Trait Anxiety Inventory for Adults (Form Y): Manual and scoring guide. Consulting Psychologists Press. https://doi.org/10.1037/t06496-000
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley Publishing Company.
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer Science+Business Media. https://doi.org/10.1007/0-387-28695-0