
L’analyse de régression linéaire multiple constitue depuis plus d’un siècle l’un des piliers méthodologiques les plus sollicités au sein des sciences empiriques, s’étendant de l’économétrie à la psychométrie computationnelle. En estimant les relations structurelles entre une variable réponse continue et un ensemble de covariables prédictives, la méthode des moindres carrés ordinaires s’appuie sur une élégance mathématique remarquable, formalisée par le théorème de Gauss-Markov. Néanmoins, cette apparente simplicité analytique repose sur un ensemble d’hypothèses distributionnelles particulièrement rigides concernant la structure stochastique des erreurs. Dès lors qu’un jeu de données expérimental s’éloigne de cette configuration idéale — en raison de singularités d’échantillonnage, de fautes d’enregistrement ou de perturbations latentes non contrôlées —, la validité des estimateurs pontificaux s’effondre de manière substantielle.
Au cœur de la phase diagnostique post-estimationnelle, les résidus ordinaires représentent la première ligne d’investigation offerte au statisticien pour sonder l’intégrité de son ajustement. Toutefois, l’utilisation brute de ces écarts élémentaires se heurte rapidement à des paradoxes géométriques intrinsèques : la variance des résidus n’est pas uniforme à travers l’espace multidimensionnel des régresseurs, rendant l’évaluation directe de leur magnitude profondément trompeuse. Une observation située aux confins de la distribution factorielle exercera une traction mécanique si forte sur le plan de régression que son résidu brut s’en trouvera artificiellement compressé, masquant ainsi une anomalie potentiellement destructrice pour l’inférence. C’est précisément pour remédier à ce phénomène de dissimulation que la formalisation des résidus standardisés, puis studentisés, a été développée.
Le présent article propose une exploration exhaustive, théorique et appliquée, du calcul et de l’interprétation des résidus studentisés externes dans l’écosystème Python. En nous appuyant sur des fondements d’algèbre matricielle rigoureuse, nous détaillerons comment la matrice de projection, couramment désignée sous le terme de matrice chapeau, permet de normaliser les résidus bruts selon leur levier respectif et leur impact sur la variance d’échantillonnage. Nous déploierons ensuite une mise en œuvre informatique intégrale avec les bibliothèques scientifiques de pointe telles que Statsmodels, NumPy et Pandas, tout en abordant les subtilités critiques du contrôle du taux d’erreur par famille via la correction de Bonferroni. À travers ce cheminement académique, le chercheur disposera d’un guide méthodologique complet pour auditer ses modèles statistiques et garantir la reproductibilité sans faille de ses conclusions scientifiques.
1. Fondements théoriques des résidus dans l’analyse de régression linéaire
1.1 Définition et rôle des résidus ordinaires (MCO)
Dans le cadre formel du modèle linéaire classique ajusté par la méthode des moindres carrés ordinaires, le vecteur des observations empiriques Y, de dimension n par un, est modélisé comme une combinaison linéaire de la matrice des prédicteurs X, de dimension n par p, modulée par un vecteur de paramètres inconnus β et augmentée d’un terme d’erreur stochastique non observable ε. Le résidu ordinaire, couramment désigné sous la notation ei pour la i-ième observation, se définit algébriquement comme l’écart arithmétique simple entre la valeur scalaire réellement observée yi et la valeur ajustée ou prédite par l’hyperplan de régression ŷi. Cette formulation scalaire élémentaire s’écrit ei = yi − ŷi, ou, sous forme vectorielle globale condensée, e = Y − Ŷ. Ce vecteur résiduel capture la fraction de variabilité de la variable endogène que le sous-espace vectoriel engendré par les colonnes de X échoue à expliciter.
Les propriétés statistiques fondamentales de ces résidus sont intrinsèquement tributaires des conditions de Gauss-Markov. Selon ces axiomes classiques, les erreurs théoriques εi possèdent une espérance mathématique conditionnelle nulle sachant X, présentent une variance scalaire constante et homogène notée σ2 — condition sine qua non d’homoscédasticité —, et sont mutuellement non corrélées, ce qui se traduit par une matrice de covariance des erreurs égale au produit du scalaire σ2 par la matrice identité In. Sous ces conditions idéales, le vecteur des résidus ordinaires e possède une espérance mathématique nulle. Toutefois, il est impératif de souligner que même si les erreurs théoriques εi jouissent d’une variance identique et d’une indépendance parfaite, les résidus ordinaires empiriques ei ne partagent jamais ces caractéristiques statistiques idéales dans un échantillon de taille finie.
De surcroît, la nature dimensionnelle des résidus bruts constitue une entrave méthodologique majeure à leur interprétation universelle. Étant exprimés dans la même unité de mesure physique ou psychométrique que la variable dépendante d’origine — qu’il s’agisse de millisecondes lors d’une tâche de temps de réaction, de points sur une échelle d’évaluation de la dépression ou de devises financières —, les résidus bruts sont tributaires de l’échelle d’analyse. Cette sensibilité à l’unité métrique empêche toute comparaison directe de la magnitude résiduelle d’un modèle à un autre, ou même entre deux variables critères différentes au sein d’une même expérimentation. L’absence de bornes standardisées interdit au statisticien de statuer de manière univoque sur le caractère potentiellement disproportionné d’un écart résiduel par la simple lecture de sa valeur absolue brute.
1.2 Limites des résidus bruts pour la détection d’observations atypiques
L’écueil théorique le plus redoutable propre aux résidus ordinaires découle de l’hétérogénéité structurelle de leur variance d’échantillonnage. En vertu des propriétés géométriques de la projection orthogonale opérée par l’opérateur des moindres carrés, la variance conditionnelle du résidu ordinaire ei n’est pas constante, mais s’avère fonction de la position spatiale qu’occupe le vecteur des prédicteurs de la i-ième observation relativement au centre de gravité multidimensionnel de l’échantillon. Cette variance s’exprime rigoureusement sous la forme Var(ei) = σ2 (1 − hii), où le terme scalaire hii représente le i-ième élément diagonal de la matrice de projection orthogonale, universellement qualifié d’effet de levier ou de leverage.
Puisque la quantité hii est strictement bornée par l’intervalle fermé théorique compris entre 1/n et 1, il s’ensuit mathématiquement que la variance d’un résidu ordinaire décroît de manière monotone à mesure que l’effet de levier d’une observation s’intensifie. En d’autres termes, plus une observation présente une configuration de variables explicatives atypique ou éloignée de la moyenne multivariée, plus son résidu ordinaire aura tendance à être numériquement faible. Cette dynamique contre-intuitive génère un phénomène pernicieux de masquage statistique : un point de données aberrant situé à l’extrême périphérie de l’espace des prédicteurs attire inexorablement le plan de régression vers lui-même, forçant la prédiction ŷi à se rapprocher artificiellement de la valeur observée yi. Le résidu brut ei qui en découle apparaît alors modeste, dissimulant complètement la contamination substantielle que cette observation inflige à l’ensemble des coefficients de régression estimés.
Cette carence intrinsèque rend l’utilisation exclusive des résidus ordinaires inapte à l’établissement de protocoles de détection systématique des observations discordantes. Tout diagnostic fondé sur l’inspection de distributions résiduelles brutes s’expose inévitablement à un taux dramatique de faux négatifs dans les zones à fort effet de levier, ainsi qu’à des faux positifs au centre de la distribution où la variance résiduelle est maximale. Sans une normalisation préalable incorporant explicitement la géométrie de la matrice d’expérience, toute tentative d’ordonnancement ou d’évaluation de la gravité d’un écart résiduel demeure frappée d’incohérence mathématique.
1.3 Pertinence de l’analyse résiduelle en recherche psychométrique
Dans les champs de la psychologie quantitative, des sciences du comportement et de la modélisation psychométrique, la rigueur de l’analyse diagnostique résiduelle acquiert une importance épistémologique cruciale. La majorité des construits psychologiques — qu’il s’agisse de l’évaluation de la mémoire de travail, des dimensions de la personnalité ou des indices d’intelligence fluide — sont capturés à travers des scores composites résultant de l’agrégation d’items de questionnaires ou d’indicateurs comportementaux continus. Ces instruments de mesure sont intrinsèquement vulnérables à des sources massives de bruit de mesure, parmi lesquelles figurent les comportements de réponse inattentive, les stratégies d’acquiescement systématique, la simulation délibérée ou les pannes momentanées des dispositifs d’enregistrement informatisés lors de paradigmes chronométriques.
L’incorporation involontaire de participants manifestant des trajectoires comportementales contaminées au sein d’une régression linéaire peut altérer radicalement la structure des coefficients estimés, menant à des erreurs d’inférence de type I ou de type II qui corrompent la littérature scientifique. Par exemple, lors de l’étalonnage d’une échelle psychométrique visant à prédire la réussite académique à partir de scores de régulation émotionnelle et de fluidité cognitive, une poignée de profils aberrants non identifiés peut faire basculer un coefficient de régression d’un seuil hautement significatif à une non-significativité apparente, ou réciproquement générer des corrélations illusoires. L’analyse rigoureuse des résidus permet d’isoler avec précision les participants dont le profil de réponse dévie manifestement de la dynamique théorique prédite par l’ensemble de la cohorte.
De surcroît, le diagnostic résiduel constitue le garant ultime de la validité interne des inférences causales et corrélationnelles formulées par le chercheur. Dans la mesure où les conclusions statistiques en psychométrie s’adossent très fréquemment à des tailles d’échantillons restreintes — en particulier lors de l’étude de populations cliniques spécifiques ou de protocoles d’imagerie cérébrale combinés à des batteries de tests comportementaux —, la robustesse des estimateurs se révèle extrêmement fragile face aux perturbations locales. Déceler, documenter et traiter les observations atypiques via des métriques résiduelles scientifiquement irréprochables ne relève pas d’une simple vérification technique accessoire, mais d’une exigence méthodologique centrale pour toute démarche scientifique aspirant à la réplication empirique.
2. Distinction conceptuelle : résidus bruts, standardisés et studentisés
2.1 Standardisation simple et variance estimée
Face à la défaillance des résidus ordinaires causée par la dépendance aux unités de mesure, la démarche intuitive originelle a consisté à appliquer une transformation de standardisation universelle. Cette opération arithmétique repose sur la division de chaque résidu ordinaire ei par l’écart-type résiduel global estimé du modèle, classiquement désigné par le scalaire s, qui correspond à la racine carrée de l’erreur quadratique moyenne globale (Mean Squared Error ou MSE). La formulation des résidus ainsi standardisés s’exprime donc sous la forme élémentaire zi = ei / s, où s est calculé sur la base de la somme des carrés des résidus divisée par le nombre de degrés de liberté résiduels n − p, avec p représentant le nombre total de paramètres estimés dans le modèle incluant la constante.
Quoique cette transformation confère aux résidus une dimensionnalité adimensionnelle bienvenue, elle repose sur un postulat hautement problématique : celui d’une homoscédasticité absolue de l’ensemble des résidus empiriques. En divisant chaque écart par un dénominateur commun et invariant s, cette standardisation élémentaire néglige totalement le rôle modulateur de l’effet de levier hii détaillé précédemment. Par conséquent, la variance théorique du résidu standardisé zi demeure égale à (1 − hii) et n’est donc toujours pas égale à l’unité. Les observations situées à grande distance du barycentre des variables explicatives continuent de présenter des variances systématiquement inférieures à un, ce qui perpétue le biais de sous-estimation des résidus associés aux points à fort effet de levier.
Sur le plan distributionnel, les résidus standardisés de cette nature ne suivent aucune loi de probabilité usuelle standardisée dont les quantiles critiques seraient facilement tabulés pour des seuils d’échantillons finis. L’utilisation d’une telle métrique offre certes une amélioration cosmétique par rapport aux écarts bruts en autorisant une vague lecture en termes de dispersion relative, mais elle s’avère méthodologiquement insuffisante dès lors qu’il s’agit de poser un diagnostic d’aberrance statistique fondé sur des seuils de décision probabilistes stricts et mathématiquement robustes.
2.2 Résidus studentisés internes versus externes
Pour corriger la variance non unitaire inhérente à la standardisation simple, la statistique moderne recourt au concept fondamental de studentisation, baptisé en hommage aux travaux précurseurs de William Sealy Gosset sous le pseudonyme de Student. La studentisation interne consiste à diviser le résidu ordinaire ei par son écart-type individuel théorique exact, intégrant formellement l’effet de levier. On définit ainsi le résidu studentisé interne — fréquemment qualifié dans la littérature anglophone de standardized residual ou de résidu semi-studentisé — par le rapport ri = ei / [s × √(1 − hii)]. Dans cette configuration, chaque résidu individuel est pondéré par un dénominateur personnalisé qui compense rigoureusement la baisse mécanique de variance induite par la position spatiale des prédicteurs. Chaque résidu studentisé interne possède ainsi une variance rigoureusement égale à l’unité.
Cependant, une limite mathématique majeure subsiste au sein de la studentisation interne : le terme d’erreur globale s figurant au dénominateur incorpore dans son calcul le résidu ei de l’observation même dont on cherche à tester la typicalité. Si l’observation i constitue une anomalie sévère, sa déviation va gonfler artificiellement la somme des carrés des résidus globale, entraînant une surévaluation substantielle de l’estimateur s. Ce phénomène pathologique conduit à une augmentation indue du dénominateur, ce qui compresse la magnitude du ratio ri et diminue considérablement la puissance de détection du test d’aberrance. L’anomalie s’auto-protège en contaminant l’étalon de mesure de la variance d’erreur.
Pour éradiquer définitivement cette contamination réciproque, les statisticiens ont développé la studentisation externe, également dénommée résidu supprimé studentisé (studentized deleted residual) ou résidu jackknife. Le principe directeur consiste à estimer la variance de l’erreur, notée s(i), à partir d’un modèle ajusté sur un sous-échantillon d’où l’observation i a été intégralement purgée. Le résidu studentisé externe s’exprime formellement par le ratio ti = ei / [s(i) × √(1 − hii)]. Si l’observation i s’avère être une valeur aberrante dramatique, son exclusion lors du calcul de s(i) préserve l’intégrité de l’estimation de la variance du bruit de fond, qui devient nettement plus faible. Il en résulte une explosion salutaire de la valeur absolue de ti, rendant l’aberrance immédiatement visible et statistiquement flagrante.
2.3 Comparaison synthétique des trois métriques résiduelles
L’architecture comparative de ces trois grandes familles de métriques résiduelles peut être comprise à travers le prisme de leurs propriétés distributionnelles respectives et de leur robustesse opérationnelle face à la contamination d’échantillonnage. Alors que le résidu ordinaire ne bénéficie d’aucune invariance d’échelle et dépend entièrement de la métrique originale, le résidu standardisé simple élimine cette dépendance dimensionnelle sans toutefois parvenir à égaliser les variances marginales. Seuls les résidus studentisés internes et externes parviennent à une véritable comparabilité géométrique à travers l’ensemble des points d’observation en neutralisant le biais d’attraction causé par le levier hii.
Sur le plan des distributions d’échantillonnage, la divergence est encore plus spectaculaire. Le résidu studentisé interne ri, bien que possédant une moyenne nulle et une variance unitaire, ne suit pas rigoureusement une distribution de Student théorique en raison de la dépendance stochastique qui lie son numérateur ei à son dénominateur fondé sur s. En réalité, le carré de ri, divisé par les degrés de liberté appropriés, suit une loi Bêta de première espèce. En revanche, le résidu studentisé externe ti résout parfaitement cette dépendance, car le numérateur ei et l’estimateur s(i) sont statistiquement indépendants sous l’hypothèse de normalité des erreurs. En conséquence directe, ti converge très exactement vers une distribution de Student centrale régie par n − p − 1 degrés de liberté.
Le choix méthodologique entre ces métriques ne relève donc pas d’une préférence stylistique, mais d’une rigueur analytique proportionnelle aux objectifs poursuivis. Le résidu brut demeure indispensable pour évaluer l’erreur de prédiction physique directe au sein de l’unité originale du phénomène modélisé. Le résidu studentisé interne est adapté pour des vérifications diagnostiques globales de routine relatives à l’homoscédasticité générale du système. Enfin, le résidu studentisé externe constitue le standard d’excellence absolu dès lors que la recherche vise l’isolation formelle de points aberrants isolés, l’exécution de tests d’hypothèses rigoureux régis par des seuils de rejet formels, ou l’assainissement de cohortes avant la consolidation d’un modèle prédictif définitif.
3. Formulation mathématique des résidus studentisés
3.1 Matrice de projection (Hat Matrix) et effet de levier
L’élucidation mathématique de la dynamique résiduelle requiert la manipulation algébrique de l’opérateur de projection orthogonale associé à la géométrie de la régression linéaire. Dans le formalisme matriciel, le vecteur des prédictions Ŷ est calculé par la transformation linéaire Ŷ = X βˆ = X (XT X)−1 XT Y. L’opérateur matriciel H, défini par le produit H = X (XT X)−1 XT, est désigné sous l’appellation canonique de matrice chapeau (ou hat matrix), précisément parce qu’elle convertit le vecteur des réponses observées Y en son homologue ajusté chapeauté Ŷ, tel que Ŷ = H Y.
La matrice H présente des propriétés mathématiques élégantes : elle est symétrique, de telle sorte que HT = H, et idempotente, ce qui signifie que l’application répétée de l’opérateur ne modifie pas la projection, soit H × H = H. L’opérateur résiduel correspondant, qui projette le vecteur Y directement sur l’espace orthogonal aux colonnes de X, est matérialisé par la matrice (In − H), donnant immédiatement e = (In − H) Y. En exploitant les théorèmes de variance matricielle sur les combinaisons linéaires de vecteurs aléatoires, la matrice de variance-covariance du vecteur résiduel s’établit formellement comme Var(e) = Var((In − H) Y) = (In − H) Var(Y) (In − H)T. Comme nous supposons sous les axiomes classiques que Var(Y) = σ2 In, l’idempotence et la symétrie de la matrice entraînent la simplification fondamentale : Var(e) = σ2 (In − H).
Les éléments diagonaux de cette matrice H, notés scalairement hii pour chaque individu i variant de 1 à n, concentrent l’intégralité de l’information structurelle quant à l’éloignement d’une observation par rapport au barycentre des variables explicatives. La somme de l’ensemble des éléments diagonaux d’une matrice étant égale à sa trace, et la trace d’un produit matriciel étant invariante par permutation circulaire, il s’ensuit que la somme des hii est strictement égale au rang de la matrice X, soit le nombre de prédicteurs p (en incluant le terme constant). La valeur moyenne du levier dans un échantillon s’élève donc invariablement à p/n. Dès lors qu’un point individuel présente une valeur hii qui dépasse substantiellement ce seuil moyen — couramment lorsque hii > 2p/n ou hii > 3p/n —, l’observation est catégorisée comme exerçant un levier structurel puissant.
3.2 Dérivation analytique du résidu studentisé externe (jackknife)
L’obtention conceptuelle du résidu studentisé externe semblerait à première vue exiger une débauche de ressources computationnelles rédhibitoire : l’ajustement séquentiel itératif de n régressions linéaires distinctes, chacune excluant l’observation i, afin de mesurer l’erreur d’ajustement hors échantillon et la variance d’erreur associée s(i)2. Fort heureusement, grâce aux propriétés analytiques des matrices de rang un et à l’identité algébrique de Sherman-Morrison-Woodbury, il est mathématiquement démontré qu’une telle itération exhaustive est superflue. L’ensemble des composantes du modèle sans l’observation i peut être extrait directement et analytiquement à partir des sorties du modèle ajusté sur l’échantillon global complet.
Le résidu ordinaire supprimé (ou deleted residual), qui représente l’écart entre la valeur observée yi et la prédiction extrapolée issue du modèle réestimé sans le i-ième cas, se dérive analytiquement selon la relation exacte di = yi − ŷ(i) = ei / (1 − hii). De manière parfaitement analogue, la variance résiduelle estimée hors observation i, notée s(i)2, se calcule instantanément sans réajustement par le biais de la formule algébrique close :
s(i)2 = [ (n − p) s2 − (ei2 / (1 − hii)) ] / (n − p − 1)
En substituant cette variance résiduelle externe au sein du ratio de studentisation, le résidu studentisé externe ou jackknife acquiert sa structure analytique définitive :
ti = ei / [ s(i) × √(1 − hii) ]
Une reformulation algébrique équivalente et extrêmement féconde permet d’exprimer le résidu studentisé externe directement à partir de son homologue interne ri selon l’équation de passage suivante :
ti = ri × √[ (n − p − 1) / (n − p − ri2) ]
Cette dérivation magistrale prouve que le résidu studentisé externe représente une transformation monotone non linéaire du résidu interne. Lorsque l’observation s’aligne fidèlement sur le modèle, ri est proche de zéro et ti est sensiblement équivalent à ri. Dès que ri2 croît et se rapproche de sa borne supérieure théorique (n − p), le dénominateur de la transformation tend vers zéro, propulsant le résidu externe ti vers des valeurs infiniment plus accentuées que le résidu interne. Sous l’hypothèse nulle stipulant que l’observation i est issue du même processus générateur stochastique que les autres points et ne présente aucune composante d’aberrance moyenne, la statistique ti obéit rigoureusement à une distribution de Student univariée centrale à (n − p − 1) degrés de liberté.
3.3 Conditions de validité de l’inférence distributionnelle
Pour que la statistique du résidu studentisé externe suive de manière exacte la distribution théorique de Student t(n − p − 1), l’architecture du modèle doit impérativement souscrire à l’hypothèse de normalité conditionnelle des perturbations. Cela implique formellement que le vecteur des erreurs théoriques ε soit distribué selon une loi normale multivariée de vecteur moyen nul et de matrice de covariance scalaire homoscédastique. Si la normalité des erreurs est enfreinte dans la population parente, la distribution exacte en échantillon fini de ti diverge des tables théoriques de Student, bien que la loi des grands nombres et le théorème central limite garantissent une convergence asymptotique vers une loi normale standardisée lorsque la taille de l’échantillon n tend vers l’infini.
Un autre écueil méthodologique réside dans la présence de multicolinéarité sévère au sein de la matrice des régresseurs X. Lorsque deux ou plusieurs variables prédictives présentent des corrélations mutuelles linéaires quasi-parfaites, la matrice XT X devient mal conditionnée, frôlant la singularité. Dans ce contexte d’instabilité numérique, l’inversion matricielle produit des éléments diagonaux hii qui peuvent être artificiellement gonflés ou distordus par des erreurs d’arrondi machine. L’estimation des erreurs standard devient alors excessivement volatile, introduisant des instabilités parasites dans le dénominateur des résidus studentisés et compromettant la fiabilité des diagnostics individuels.
Néanmoins, la formulation du résidu studentisé externe démontre une robustesse relative remarquable face aux écarts modérés à la normalité théorique. Dans les configurations d’échantillons de taille moyenne à large (typiquement lorsque n > 100), les déviations mineures au niveau de l’asymétrie ou de l’aplatissement (kurtosis) de la distribution d’erreur n’affectent que marginalement les taux de couverture empiriques des quantiles de rejet. Cette résilience fait du résidu supprimé studentisé l’instrument d’investigation le plus sûr pour évaluer l’adéquation d’un ajustement aux moindres carrés face aux bruits d’échantillonnage réels.
4. Configuration de l’environnement Python pour l’analyse diagnostique
4.1 Architecture logicielle et écosystème scientifique
L’implémentation algorithmique des diagnostics de régression avancés en langage Python s’adosse à un écosystème d’ingénierie statistique particulièrement mature, dont les trois piliers fondamentaux sont constitués par NumPy, Pandas et Statsmodels. La bibliothèque NumPy assure la fondation algorithmique en offrant une structure de données multidimensionnelle ultra-performante — le ndarray — alliée à des routines d’algèbre linéaire hautement optimisées via les bibliothèques bas-niveau BLAS et LAPACK. Elle permet d’effectuer les transpositions, produits matriciels et inversions requis par la décomposition de la matrice chapeau avec une efficacité temporelle de premier ordre.
La bibliothèque Pandas surmonte la couche numérique en fournissant des structures tabulaires étiquetées complexes à travers l’objet DataFrame. Dans le contexte de l’analyse des résidus, Pandas facilite l’alignement strict des métriques statistiques calculées avec les index originaux des observations, autorisant des opérations de filtrage relationnel, d’agrégation conditionnelle et de manipulation de métadonnées participant par participant. L’intégrité référentielle des données est ainsi préservée tout au long du pipeline analytique, empêchant toute permutation catastrophique d’identifiants lors de l’isolation des valeurs extrêmes.
Au sommet de cet édifice, la bibliothèque Statsmodels constitue le logiciel de référence pour l’analyse économétrique, biométrique et psychométrique en Python. Contrairement aux approches orientées vers la prédiction pure et l’apprentissage automatique incarnées par Scikit-Learn, Statsmodels a été conçu avec l’objectif prioritaire de l’inférence statistique formelle. Il implémente des classes d’ajustement détaillées qui conservent l’intégralité des tenseurs de variance, calculent automatiquement les métriques de levier, génèrent les degrés de liberté exacts et fournissent des méthodes d’extraction dédiées à la détection d’observations atypiques, telles que la méthode outlier_test().
4.2 Installation et gestion des dépendances
Pour assurer la pérennité et la reproductibilité des analyses de régression avancées, il est fondamental de structurer l’environnement informatique au moyen d’un gestionnaire d’environnements virtuels isolé, qu’il s’agisse de l’utilitaire standard venv ou de la distribution scientifique Conda. Cette précaution prévient les conflits de dépendances susceptibles d’émerger lors de mises à jour système transversales, lesquelles pourraient modifier la précision numérique des algorithmes d’inversion matricielle ou altérer la signature fonctionnelle des modules d’inspection diagnostique.
L’initialisation d’un environnement moderne s’effectue par l’exécution de directives de déploiement en ligne de commande. Il convient d’installer une suite cohérente comprenant les bibliothèques statsmodels, pandas, numpy, ainsi que les moteurs graphiques matplotlib et seaborn destinés aux représentations géométriques des résidus. Il est hautement recommandé de figer les versions majeures de ces paquetages au sein d’un fichier de configuration textuel formel de type exigences logicielles (requirements.txt ou environment.yml). Les instructions textuelles courantes reposent sur l’appel à l’installeur de paquets Python standard :
L’installation s’articule autour de la commande système : pip install numpy pandas statsmodels matplotlib seaborn. Les versions récentes de Statsmodels (versions 0.14 et supérieures) garantissent une compatibilité totale avec les distributions Python 3.9 à 3.12, tout en intégrant des correctifs de stabilité cruciaux dans les routines de calcul des décompositions d’influence statistique.
Enfin, la conception du script de diagnostic doit adopter les canons du génie logiciel académique : modularité du code, typage statique des fonctions d’analyse, contrôle rigoureux de la forme matricielle des données en amont de l’ajustement, et ségrégation propre entre la phase d’inférence brute, le calcul des métriques dérivées et la génération des représentations visuelles explicatives. Cette discipline de codage garantit que les calculs matriciels des résidus studentisés conservent leur pleine reproductibilité lors de contrôles d’audit méthodologique indépendants.
5. Préparation et structuration des données expérimentales
5.1 Importation et nettoyage des données comportementales
Pour ancrer la démonstration dans un cadre empirique représentatif des défis posés par la recherche expérimentale en sciences cognitives, envisageons un protocole psychométrique portant sur l’étude des déterminants de l’agilité mentale chez de jeunes adultes. Notre variable dépendante d’intérêt, baptisée Score_Cognitif, représente la performance standardisée à une batterie d’épreuves mesurant la flexibilité exécutive. Deux prédicteurs théoriques majeurs sont investigués : d’une part, l’Indice_Sommeil, mesurant la qualité objective du sommeil profond à l’aide d’enregistrements polysomnographiques, et d’autre part, le Niveau_Stress, capturé par des marqueurs physiologiques de cortisol salivaire.
Le chargement des données s’opère typiquement depuis des sources tabulaires CSV ou des bases de données SQL directement dans un objet Pandas sous la forme d’un DataFrame nommé usuellement df_etude. La première opération obligatoire consiste en un audit systématique de complétude. La présence de valeurs manquantes (notées NaN pour Not a Number) au sein d’une seule des variables du modèle contraint le moteur statistique de Statsmodels à procéder à une suppression par observation incomplète (listwise deletion), ce qui réduit la taille effective de l’échantillon n et modifie la valeur des degrés de liberté sans avertissement préalable explicite.
Il est donc impératif de procéder à une inspection programmatique des vecteurs à l’aide de méthodes d’interrogation logique telles que df_etude.isna().sum(). De même, les types de données attribués aux colonnes par le moteur d’inférence de Pandas doivent être vérifiés : toute variable continue encodée accidentellement sous forme de chaîne de caractères (objet générique) en raison d’une faute de saisie typographique ponctuelle (comme l’usage erroné d’une virgule décimale à la place d’un point) empêcherait la construction correcte de la matrice d’expérience numérique, générant des erreurs d’exécution lors de la factorisation matricielle.
5.2 Exploration descriptive univariée et bivariée
Préalablement à toute formulation d’un modèle d’ajustement aux moindres carrés ordinaires, la démarche diagnostique exige une caractérisation approfondie des distributions marginales et des structures d’association bivariées. L’appel aux méthodes statistiques descriptives permet d’extraire la moyenne arithmétique, l’écart-type, la médiane, ainsi que les bornes d’intervalles interquartiles pour chaque variable numérique continue.
Une attention méticuleuse doit être accordée aux coefficients d’asymétrie empirique (skewness) et d’aplatissement (kurtosis). Une asymétrie marquée au sein des prédicteurs préfigure presque systématiquement l’émergence d’observations à fort effet de levier. Si une variable prédictive présente une queue de distribution excessivement étirée vers la droite, les individus occupant cette extrémité se situeront mécaniquement à une distance considérable de la moyenne multivariée, augmentant considérablement la valeur de leur terme diagonal hii au sein de la matrice chapeau.
Parallèlement, la construction d’une matrice de corrélations de Pearson entre l’ensemble des variables prévues pour le modèle permet de repérer précocement de potentielles dérives colinéaires. Si le coefficient de corrélation linéaire bivarié entre l’Indice_Sommeil et le Niveau_Stress excédait des seuils critiques (typiquement supérieurs à 0.80 ou 0.85), le conditionnement numérique de la matrice d’expérience s’en trouverait dégradé, ce qui altérerait artificiellement le calcul ultérieur de la variance résiduelle sans observation s(i)2 lors de la studentisation externe.
5.3 Formulation du modèle de régression sous forme de formule Patsy
L’interface de modélisation de Statsmodels s’illustre par sa prise en charge du système de formalisation symbolique Patsy, qui transpose fidèlement la syntaxe d’expression des modèles statistiques popularisée par le langage R. Au lieu de manipuler manuellement des découpages matriciels complexes pour isoler la matrice des prédicteurs et le vecteur cible, l’analyste spécifie la relation structurelle sous forme de chaîne de caractères explicite, telle que :
formule = ‘Score_Cognitif ~ Indice_Sommeil + Niveau_Stress’
Cette approche déclarative présente des vertus méthodologiques remarquables. Par défaut, Patsy intercepte la formule et injecte automatiquement une colonne unitaire au sein de la matrice d’expérience pour estimer l’ordonnée à l’origine (ou terme constant d’interception β0), garantissant ainsi que la somme mathématique des résidus ordinaires ∑ ei soit strictement égale à zéro. Si le protocole expérimental requérait l’évaluation de termes d’interactions non linéaires entre prédicteurs — par exemple pour tester si l’impact du stress sur les fonctions exécutives est modéré par la dette de sommeil —, la syntaxe de Patsy autorise l’intégration immédiate d’un produit factoriel sous la formulation ‘Score_Cognitif ~ Indice_Sommeil * Niveau_Stress’.
De plus, le module formule de Statsmodels (accessible sous le sous-paquet statsmodels.formula.api via l’alias usuel smf) gère de façon complètement autonome l’encodage disjonctif complet des variables indépendantes qualitatives ou catégorielles. Les variables textuelles sont alors instantanément converties en vecteurs d’indicatrices binaires (variables muettes ou dummy variables) selon une modalité de référence définie, éliminant ainsi les risques d’erreurs humaines inhérents à l’ingénierie manuelle de variables d’expérience préalablement aux opérations d’inversion matricielle.
6. Ajustement du modèle MCO avec statsmodels
6.1 Exécution de la régression linéaire via ols()
L’ajustement effectif des paramètres du modèle linéaire sous Statsmodels repose sur l’instanciation de la classe d’optimisation ordinaire par le biais de la méthode ols() du module formula.api. Cette fonction accepte en paramètres formels la chaîne de caractères décrivant la formule structurelle ainsi que le conteneur de données tabulaire Pandas hébergeant les séries empiriques. L’objet résultant représente une spécification non encore ajustée de la modélisation.
L’estimation des coefficients de régression et des métriques de dispersion associées est déclenchée par l’appel explicite de la méthode fit() sur l’objet instancié. Au cours de cette exécution, le moteur algorithmique effectue la décomposition matricielle de (XT X)−1 XT Y, résout le système d’équations normales sous-jacent, et initialise une instance d’une classe d’une immense richesse informationnelle : l’objet OLSResults (usuellement référencé sous le nom de variable resultats ou modele_ajuste dans l’espace de travail).
Il convient de souligner que cette implémentation vérifie de manière intrinsèque la régularité mathématique de la factorisation. Si la matrice des régresseurs ne présentait pas un rang plein en raison d’une singularité linéaire parfaite, Statsmodels lèverait des exceptions ou basculerait sur l’usage de pseudo-inverses fondées sur la décomposition en valeurs singulières (SVD), signalant ainsi à l’expérimentateur l’invalidité des bases théoriques pour une inférence standard.
6.2 Analyse critique du tableau récapitulatif (summary)
L’interrogation de l’objet OLSResults via l’instruction textuelle resultats.summary() produit un bilan diagnostique complet regroupant les paramètres fondamentaux de l’ajustement global et de la significativité locale. Ce tableau récapitulatif se divise structurellement en trois sections majeures qu’il est indispensable de sonder avant de se focaliser sur l’inspection individuelle des résidus.
La partie supérieure du compte-rendu fournit les indicateurs d’adéquation omnibus, au premier rang desquels figurent le coefficient de détermination R2 et le R2 ajusté. Alors que le R2 simple mesure la proportion brute de variance de la variable réponse absorbée par le modèle, le R2 ajusté pénalise cette métrique en fonction du ratio entre le nombre de paramètres estimés p et la taille totale d’échantillon n, constituant une jauge plus réaliste de la capacité explicative théorique. La statistique du test F de Snedecor et sa p-valeur associée confirment si l’ensemble des covariables contribue de manière conjointe et non nulle à la prédiction du critère.
La section médiane dissèque les coefficients de régression vectoriels individuels. Pour chaque prédicteur, la table détaille la valeur estimée du coefficient βˆk, son erreur standard asymptotique SE(βˆk), le ratio de test de Student résultant t, la p-valeur bilatérale associée, ainsi que les bornes inférieures et supérieures de l’intervalle de confiance à 95 %. Enfin, la troisième section offre de précieux indices sur les caractéristiques distributionnelles des résidus ordinaires bruts, incluant la statistique d’autocorrélation de Durbin-Watson, ainsi que les tests d’asymétrie et d’aplatissement d’Omnibus et de Jarque-Bera. Un rejet massif de l’hypothèse de normalité à ce stade signale d’emblée la présence probable de valeurs extrêmes ou d’une mauvaise spécification fonctionnelle nécessitant impérativement le recours aux résidus studentisés.
7. Calcul effectif des résidus studentisés avec outlier_test()
7.1 Utilisation de la méthode OLSResults.outlier_test()
L’extraction programmatique directe des résidus studentisés externes est magistralement prise en charge au sein de Statsmodels par l’appel de la méthode outlier_test() directement attachée à l’instance OLSResults issue de l’ajustement. Cette méthode hautement sophistiquée encapsule l’ensemble des théorèmes de dérivation analytique de Sherman-Morrison-Woodbury présentés au chapitre précédent, éliminant tout besoin d’écrire manuellement des boucles algorithmiques fastidieuses et lourdes en temps de calcul.
La syntaxe opératoire fondamentale s’articule simplement autour de l’instruction :
df_diagnostics = resultats.outlier_test()
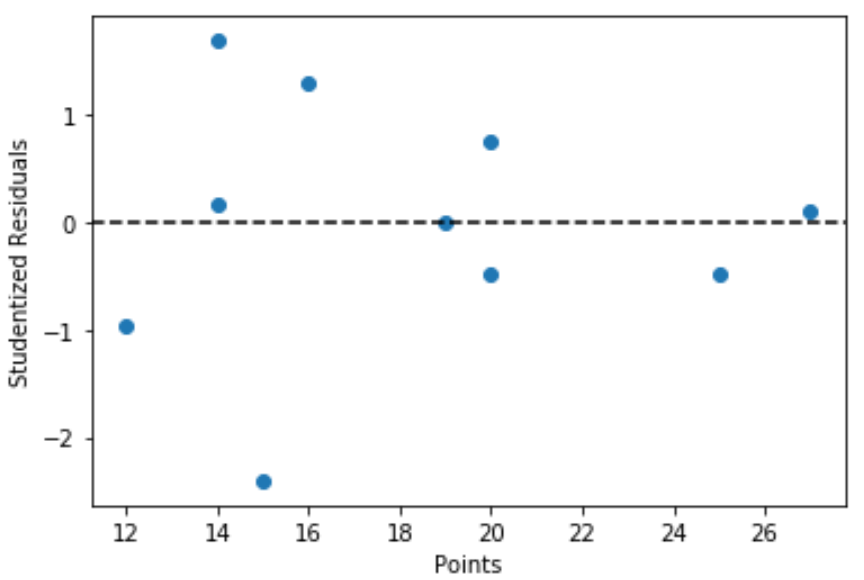
Le résultat généré par cette instruction se présente sous la forme structurée d’un nouveau DataFrame Pandas dont le nombre de lignes équivaut rigoureusement à la taille d’échantillon n du modèle ajusté, avec une indexation strictement alignée sur les identifiants d’origine. Cette table comprend trois colonnes statistiques indispensables : la première, traditionnellement étiquetée student_resid, contient la valeur scalaire du résidu studentisé externe ti ; la deuxième, nommée unadj_p, fournit la p-valeur bilatérale non ajustée dérivée de la loi de Student théorique à (n − p − 1) degrés de liberté ; enfin, la troisième colonne, désignée par bonf(p), présente la p-valeur formellement corrigée par la procédure de contrôle des tests multiples de Bonferroni.
7.2 Extraction programmatique des composantes résiduelles
Pour exploiter pleinement la richesse diagnostique générée par outlier_test(), il est méthodologiquement recommandé d’intégrer ces séries de résultats au sein de la matrice de données empirique principale. Cette consolidation relationnelle s’accomplit au moyen d’opérations de jonction ou de concaténation par colonnes sous Pandas, à l’aide de l’instruction standardisée df_analyse = pd.concat([df_etude, df_diagnostics], axis=1). Cette structuration conjointe permet au chercheur de contextualiser instantanément chaque résidu déviant avec les caractéristiques qualitatives et quantitatives du participant concerné.
Une fois la consolidation achevée, l’analyste peut procéder à l’interrogation ciblée et au filtrage indiciel des profils problématiques en appliquant des masques booléens vectorisés. Par exemple, pour isoler exhaustivement l’ensemble des participants dont le résidu studentisé externe franchit un seuil de dispersion absolue prédéfini (par exemple 3 écarts-types théoriques), la requête s’exécute de manière élégante par :
observations_anomales = df_analyse[df_analyse[‘student_resid’].abs() > 3.0]
Ce sous-ensemble d’observations suspectes peut alors être trié par magnitude décroissante de résidu studentisé absolu, exporté vers un fichier tabulaire de type tableur ou documenté directement au sein d’annexes méthodologiques d’articles de recherche. Cette transparence algorithmique garantit une traçabilité intégrale entre le calcul statistique pur et les prises de décisions relatives à la gestion des données aberrantes.
7.3 Calcul matriciel alternatif étape par étape
Afin de démystifier entièrement l’abstraction logicielle et de valider expérimentalement la formulation mathématique du jackknife sans passer par la boîte noire de la fonction outlier_test(), il est profondément formateur d’implémenter l’algorithme matriciel pas à pas en utilisant exclusivement les primitives de calcul vectoriel de NumPy.
La première phase de cette implémentation explicite consiste à extraire les éléments fondamentaux de l’objet de régression. Le vecteur des résidus ordinaires bruts s’obtient par l’attribut resultats.resid, tandis que la somme des carrés des erreurs se dérive sous la propriété resultats.ssr. L’accès aux éléments diagonaux de la matrice chapeau hii s’effectue directement en invoquant le gestionnaire d’influence via levier = resultats.get_influence().hat_matrix_diag. Les degrés de liberté résiduels correspondent au scalaire ddl = resultats.df_resid, qui est numériquement égal à n − p.
Dans un second temps, le calcul de la variance d’erreur avec exclusion d’un point s’exécute de manière vectorisée sur l’ensemble du tableau :
s2_supprime = (resultats.ssr − (resultats.resid ** 2) / (1 − levier)) / (ddl − 1)
L’estimation de l’écart-type résiduel sans l’observation s(i) s’obtient alors par l’application de la racine carrée np.sqrt(s2_supprime). Finalement, le vecteur complet des résidus studentisés externes découle de l’opération vectorielle :
residus_studentises_manuels = resultats.resid / (np.sqrt(s2_supprime) * np.sqrt(1 − levier))
En soumettant ces deux vecteurs — le résultat matriciel manuel et la colonne issue de la méthode propriétaire outlier_test() — à un test d’assertion numérique de haute précision via la directive np.allclose(residus_studentises_manuels, df_diagnostics[‘student_resid’]), la fonction renvoie immanquablement la valeur logique True. Cette congruence numérique absolue confère au chercheur une certitude totale quant à la mécanique mathématique opérant sous le capot des modules de modélisation statistique avancée.
8. Interprétation statistique et critères d’aberrance
8.1 Règles empiriques et seuil critique usuel de 3
L’usage opérationnel des résidus studentisés externes repose traditionnellement sur l’application d’heuristiques de décision empiriques largement documentées dans les traités statistiques de référence. La règle d’arbitrage la plus universellement reconnue préconise de considérer comme potentiellement aberrante — ou du moins suspecte d’anomalie sévère — toute observation dont la magnitude du résidu studentisé externe dépasse en valeur absolue le seuil scalaire conventionnel de 3 (c’est-à-dire |ti| > 3.0). D’autres auteurs plus conservateurs suggèrent l’examen attentif de tout écart franchissant la borne de 2 ou 2.5 lors de phases exploratoires préliminaires.
La justification théorique sous-jacente au seuil de 3 prend racine dans les propriétés géométriques de la distribution gaussienne standardisée et de la loi de Student. Pour une variable aléatoire suivant une loi normale centrée réduite ou une distribution de Student régie par un nombre modéré à élevé de degrés de liberté, la probabilité théorique bilatérale d’observer spontanément une déviation excédant 3 écarts-types est infinitésimale : elle s’établit très exactement à environ 0.0027, soit moins de trois chances sur mille pour un tirage purement stochastique au sein d’une population non contaminée. Lorsqu’une observation manifeste un écart d’une telle envergure, l’hypothèse de l’aléa pur devient hautement invraisemblable.
Cependant, l’adoption aveugle d’un seuil fixe et immuable de 3 sans considération de la taille volumétrique de l’échantillon n recèle un risque méthodologique pernicieux. Au sein de méga-bases de données épidémiologiques ou de cohortes psychométriques à grande échelle comportant plusieurs dizaines de milliers de participants (comme les biobanques de recherche contemporaines), la survenue d’écarts supérieurs à 3 n’est plus une anomalie mathématique, mais une certitude probabiliste absolue. Dans un échantillon de dix mille observations saines, la loi normale prédit l’apparition spontanée d’environ vingt-sept individus manifestant un |ti| > 3.0 par simple fluctuation d’échantillonnage naturelle. Qualifier automatiquement ces participants de données aberrantes contaminées relèverait d’une erreur d’interprétation grave.
8.2 Inférence statistique formelle par le test d’hypothèse
Afin de s’émanciper de la subjectivité inhérente aux règles empiriques universelles, le statisticien rigoureux formalise la détection des valeurs aberrantes sous la forme d’un test d’hypothèses statistiques emboîté. Pour chaque observation i issue de l’échantillon, on formule formellement le système d’hypothèses concurrentes suivant :
L’hypothèse nulle H0 postule que l’observation i a été générée par le même modèle de régression linéaire sous-jacent que l’ensemble des autres observations de l’échantillon, et que son espérance d’erreur est rigoureusement nulle : E(εi) = 0. À l’opposé, l’hypothèse alternative bilatérale H1 stipule que l’observation i obéit à un modèle décalé en moyenne (mean-shift outlier model), son terme d’erreur manifestant une espérance non nulle E(εi) = δi ≠ 0.
Sous l’hypothèse nulle d’absence de contamination, la statistique ti suit exactement la loi de Student à (n − p − 1) degrés de liberté. La colonne unadj_p générée par Statsmodels correspond précisément à la p-valeur bilatérale associée à cette statistique, calculée à l’aide de la fonction de répartition cumulative de la loi de Student par la formule :
pnon-ajustée = 2 × [ 1 − FStudent(|ti| ; n − p − 1) ]
Si cette probabilité s’avère inférieure au seuil de significativité conventionnel fixé a priori (typiquement α = 0.05), le chercheur est autorisé à rejeter l’hypothèse nulle pour cette observation spécifique prise isolément. Néanmoins, franchir ce cap analytique individuel ne constitue que la première étape d’une démarche inférentielle complète, car l’évaluation séquentielle de l’intégralité des n observations de l’échantillon expose inévitablement l’expérimentateur au piège statistique redoutable de la multiplicité des tests.
9. Gestion des comparaisons multiples et correction de Bonferroni
9.1 Problématique du taux d’erreur de type I global
L’application d’un test d’hypothèse univarié sur l’ensemble des résidus studentisés d’un échantillon induit un phénomène statistique critique connu sous le nom d’inflation du taux d’erreur par famille (Family-Wise Error Rate ou FWER). Si un chercheur dispose d’un jeu de données comprenant n = 100 observations et qu’il évalue l’aberrance de chaque participant au seuil nominal individuel classique de α = 0.05, il n’exécute pas un test statistique unique, mais bien une famille combinatoire de cent tests d’hypothèses conduits simultanément.
Sous l’hypothèse globale où aucune observation de l’échantillon ne serait aberrante (toutes appartenant au même modèle générateur), la probabilité de ne commettre aucune erreur de type I sur un test isolé est de (1 − α) = 0.95. Si les tests étaient totalement indépendants les uns des autres — ce qui constitue une approximation conservative, bien que les résidus soient faiblement corrélés —, la probabilité globale d’accepter simultanément l’ensemble des cent hypothèses nulles chuterait drastiquement à (1 − α)n = 0.95100 ≈ 0.0059. En corollaire direct, la probabilité d’observer au moins un faux positif (rejeter à tort l’hypothèse de non-aberrance pour un individu sain) s’élèverait à 1 − 0.0059 = 0.9941, soit plus de 99 % de risque d’erreur globale.
Il est donc mathématiquement absurde de déclarer qu’une observation est une valeur aberrante en s’appuyant uniquement sur sa p-valeur non ajustée lorsque l’analyste balaye l’intégralité d’un tableau d’échantillon à la recherche du résidu maximal. Ce comportement s’apparente à une démarche de dragage de données (p-hacking rétrospectif). Pour restaurer la validité inférentielle du modèle global et contenir le risque d’erreur de type I à un plafond global acceptable (par exemple 5 % à l’échelle de l’étude complète), un protocole rigoureux de correction pour comparaisons multiples est incontournable.
9.2 Mécanisme de correction de Bonferroni dans outlier_test()
La bibliothèque Statsmodels résout cette inflation probabiliste en intégrant par défaut dans la fonction outlier_test() la correction canonique de Carlo Emilio Bonferroni. Cette procédure s’appuie sur l’inégalité de Boole pour dériver une borne supérieure formelle sur le taux d’erreur global par famille. Le principe opérationnel consiste à ajuster le seuil critique univarié en le divisant par le nombre total de tests exécutés simultanément, soit αajusté = α / n.
De manière computationnellement symétrique et plus commode pour la lecture tabulaire, Statsmodels implémente l’ajustement directement sur les probabilités de dépassement. La p-valeur corrigée selon Bonferroni, rapportée au sein de la colonne bonf(p), est obtenue en multipliant la probabilité univariée non ajustée par la taille complète de l’échantillon n :
pBonferroni = min( 1.0, pnon-ajustée × n )
La fonction plafonne formellement le produit à la valeur scalaire maximale de 1.0, empêchant la génération aberrante de probabilités supérieures à l’unité. Bien que la correction de Bonferroni soit réputée pour sa sévérité et son caractère hautement conservateur — pouvant dans certaines configurations d’échantillons massifs majorer le taux de faux négatifs (erreur de type II) —, elle offre une garantie mathématique inexpugnable contre les déclarations prématurées d’aberrance.
Dans les contextes modernes de criblage exploratoire à très haute dimension, certains biostatisticiens lui préfèrent des ajustements fondés sur le taux de fausse découverte (False Discovery Rate ou FDR), telles que la procédure linéaire descendante de Benjamini-Hochberg. Toutefois, dans le cadre standard de la validation de modèles de régression linéaire sous Statsmodels, le critère de Bonferroni demeure le point de repère décisionnel préconisé par la communauté internationale.
9.3 Arbre de décision pour la classification finale d’une observation
La confrontation conjointe des métriques de déviation empirique absolue et des probabilités corrigées par inférence formelle permet de structurer un arbre de décision rigoureux pour statuer méthodologiquement sur le sort de chaque observation. Cette grille d’analyse distingue trois cas de figure cardinaux :
- Configuration 1 : Déviation modérée sans franchissement de seuil. Le résidu studentisé externe vérifie |ti| ≤ 3.0 et la probabilité corrigée vérifie pBonferroni > 0.05. L’observation s’intègre parfaitement dans les variations stochastiques attendues au sein du processus de Gauss-Markov. Aucune action corrective n’est requise.
- Configuration 2 : Déviation marginale avec seuil franchi mais non-significativité globale. L’observation présente |ti| > 3.0, mais sa probabilité après pénalisation multivariée reste non significative : pBonferroni ≥ 0.05. Il s’agit d’une fluctuation d’échantillonnage extrême statistiquement prévisible compte tenu du nombre n d’individus audités. Cette observation ne doit pas être supprimée du modèle, mais peut faire l’objet d’une surveillance qualitative lors des diagnostics de robustesse.
- Configuration 3 : Aberrance statistique majeure confirmée. L’observation combine un résidu studentisé externe élevé |ti| > 3.0 et une probabilité de Bonferroni formellement significative : pBonferroni < 0.05. La nullité du modèle d’erreur moyen est définitivement rejetée. L’observation ne peut pas être considérée comme issue de la même population que le reste de la cohorte.
Selon les normes méthodologiques de publication scientifique édictées par l’American Psychological Association (APA), toute observation classée sous la Configuration 3 doit faire l’objet d’une divulgation transparente intégrale au sein du rapport de recherche. L’omission silencieuse de participants basée sur un tri a posteriori non documenté viole les principes éthiques de reproductibilité empirique.
10. Visualisation graphique et diagnostics visuels en Python
10.1 Diagramme de dispersion des résidus studentisés contre valeurs ajustées
L’exploration purement tabulaire des métriques statistiques doit impérativement être corroborée par un examen sémiologique visuel. Le graphique diagnostique le plus emblématique de la modélisation linéaire consiste à projeter en diagramme de dispersion bidimensionnel les résidus studentisés externes sur l’axe vertical des ordonnées, en regard des valeurs prédites par le modèle (ŷi, accessibles via resultats.fittedvalues) sur l’axe horizontal des abscisses.
Ce graphique s’élabore avec les bibliothèques Matplotlib et Seaborn en traçant une ligne horizontale médiane de référence à l’ordonnée zéro — matérialisant l’ajustement idéal sans erreur —, complétée de deux lignes horizontales discontinues d’alerte critique positionnées aux ordonnées critiques de +3 et -3. L’instruction graphique de base s’articule autour de directives telles que plt.scatter(resultats.fittedvalues, df_diagnostics[‘student_resid’]), enrichie par plt.axhline(0, color=’grey’, linestyle=’–‘) et plt.axhline(3, color=’red’, linestyle=’:’).
L’inspection visuelle de ce nuage de points permet de valider simultanément deux axiomes de Gauss-Markov. D’une part, l’homoscédasticité se traduit par une bande de dispersion horizontale d’épaisseur constante et homogène d’un bout à l’autre de l’axe des prédictions. Si le nuage s’évase progressivement vers la droite pour former une silhouette d’entonnoir ou de pavillon de trompette, cela dénote une hétéroscédasticité sous-jacente où la variance d’erreur s’accroît avec l’ampleur de la prédiction. D’autre part, les valeurs aberrantes candidates se détachent visuellement de manière spectaculaire en s’isolant bien au-delà des corridors horizontaux matérialisés à plus ou moins trois écarts-types.
10.2 Diagramme quantile-quantile (Q-Q plot) des résidus studentisés
L’évaluation rigoureuse de la normalité des termes stochastiques s’appuie préférentiellement sur la construction d’un diagramme quantile-quantile (usuellement désigné sous l’acronyme Q-Q plot). Ce tracé géométrique projette les quantiles de la distribution empirique observée des résidus studentisés en abscisse contre les quantiles théoriques attendus d’une loi de probabilité normale standardisée (ou d’une distribution de Student correspondante) en ordonnée.
Statsmodels met à la disposition des chercheurs une fonction spécialisée hautement optimisée au sein de son sous-module graphique, accessible via statsmodels.graphics.gofplots.qqplot. En paramétrant l’option de régression line=’45’ ou line=’s’ au sein de l’instruction sm.qqplot(df_diagnostics[‘student_resid’], line=’45’), la fonction génère le nuage de points enrichi d’une droite d’accord bissectrice idéale matérialisant la parfaite concordance théorique.
Dans une configuration expérimentale saine respectant la normalité, les points s’alignent fidèlement sur cette ligne diagonale tout au long du segment médian interquartile. La présence d’observations aberrantes se manifeste instantanément par des décrochages structurels brutaux aux extrémités des queues de distribution : un point s’écartant verticalement de manière spectaculaire vers le haut dans le quadrant supérieur droit ou vers le bas dans le quadrant inférieur gauche trahit la présence d’une anomalie isolée ou d’une leptokurticité sévère (queues de distribution épaisses), remettant en cause l’inférence basée sur la loi normale.
10.3 Graphique d’index résiduel et étiquetage automatique
Pour faire la transition directe entre le repérage visuel d’une anomalie et l’action d’investigation sur le jeu de données d’origine, le graphique séquentiel par index (ou index plot) constitue un instrument de premier ordre. Cette représentation ordonne les résidus studentisés externes le long de l’axe des abscisses selon l’identifiant séquentiel d’enregistrement ou l’indice structurel du tableau Pandas, permettant d’identifier immédiatement le numéro de ligne incriminé.
Grâce à la flexibilité programmatique de Matplotlib, il est particulièrement élégant d’automatiser l’étiquetage textuel conditionnel des points problématiques au sein du script d’exécution. Au moyen d’une boucle itérative balayant le tableau filtré des anomalies (par exemple celles vérifiant pBonferroni < 0.05), le code applique la méthode d’annotation vectorielle :
plt.annotate(str(idx), (idx, residu), textcoords= »offset points », xytext=(0, 10), ha=’center’)
Cette directive positionne dynamiquement l’étiquette de l’identifiant du participant précisément au-dessus du point aberrant, rendant le graphique immédiatement interprétable sans avoir à naviguer en va-et-vient entre la console de sortie et la figure. Pour les publications académiques ou les rapports cliniques, ce graphique peut être exporté en haute résolution vectorielle (format PDF ou SVG) ou matricielle (PNG à 300 points par pouce minimum) via l’instruction plt.savefig(‘diagnostic_residus.png’, dpi=300, bbox_inches=’tight’).
11. Diagnostics d’influence complémentaires : Levier et Distance de Cook
11.1 Articulation entre levier, résidu studentisé et influence
Une rigueur scientifique absolue impose de dissiper une confusion théorique fréquente au sein des applications statistiques empiriques : l’amalgame conceptuel entre valeur atypique (outlier), observation à fort levier (high leverage point) et point influent (influential observation). Ces trois notions caractérisent des facettes géométriques profondément distinctes d’un jeu de données multidimensionnel.
Une valeur atypique, capturée par l’amplitude de son résidu studentisé externe, se définit exclusivement par son inadéquation conditionnelle par rapport à la variable réponse Y : le modèle prédit très mal son score. Un point d’expérience à fort levier, mesuré par le coefficient hii, caractérise une observation dont la position est excentrique dans l’espace factoriel des variables explicatives X, indépendamment de sa variable cible Y. Enfin, une observation n’est qualifiée d’influente que si son inclusion ou son omission modifie substantiellement la structure globale des paramètres estimés du modèle (les coefficients de régression βˆ).
L’articulation fondamentale qui gouverne ces composantes a été magistralement synthétisée par le statisticien R. Dennis Cook au travers de sa célèbre métrique, la Distance de Cook (Di). La formulation mathématique de la distance de Cook démontre qu’elle s’exprime comme le produit direct du carré du résidu studentisé interne par un facteur fonction de l’effet de levier :
Di = [ ri2 / p ] × [ hii / (1 − hii) ]
Il découle de cette formulation qu’un résidu studentisé élevé n’engendre pas automatiquement une forte influence si l’effet de levier associé hii est infinitésimal. Inversement, un point à fort levier n’exercera aucune perturbation sur les coefficients estimés s’il s’aligne exactement sur la trajectoire prédite par les autres données (résidu proche de zéro). L’influence délétère émerge de la conjonction malheureuse de ces deux dimensions : une observation manifestant à la fois un levier structurel important et un résidu studentisé conséquent attire violemment l’hyperplan vers elle, corrompant l’ensemble de l’inférence.
11.2 Extraction des métriques d’influence avec get_influence()
La bibliothèque Statsmodels concentre l’ensemble des diagnostics d’influence multidimensionnels au sein d’une classe dédiée d’une extrême polyvalence : la classe OLSInfluence, générée par l’instruction influence = resultats.get_influence(). Cet objet calcule de façon vectorisée et instantanée l’ensemble des indicateurs théoriques préconisés par la littérature statistique internationale.
Parmi les métriques capitales accessibles figurent la série des distances de Cook (obtenue via influence.cooks_distance[0]), ainsi que les mesures de changement prédictif standardisé hors observation dénommées DFFITS (via influence.dffits[0]). Pour une analyse microscopique de l’impact individuel sur chaque coefficient séparé, l’analyste peut interroger la matrice des DFBETAS (via influence.dfbetas), qui indique de combien d’écarts-types chaque coefficient βk se déplace lorsque le i-ième cas est soustrait du modèle.
De surcroît, Statsmodels propose une synthèse visuelle de haute volée méthodologique au moyen de la méthode graphique spécialisée :
from statsmodels.graphics.regressionplots import influence_plot
L’instruction influence_plot(resultats, criterion=’cooks’) génère une figure bidimensionnelle remarquable plaçant le levier hii sur l’axe horizontal et les résidus studentisés externes sur l’axe vertical, tout en modulant proportionnellement la surface géométrique (le rayon) de chaque bulle de point en fonction de l’amplitude de sa distance de Cook. Ce graphique offre au chercheur une cartographie synoptique instantanée où les observations critiques se détachent avec une lisibilité immédiate.
11.3 Stratification typologique des observations problématiques
L’intégration combinée des résidus studentisés, des leviers matriciels et des distances de Cook permet de classifier les observations déviantes au sein d’une taxonomie diagnostique rigoureuse à trois cas majeurs :
Typologie 1 : Faible levier, résidu studentisé élevé. Cette configuration correspond à une anomalie résiduelle isolée située au cœur du domaine de validité des régresseurs (faible hii, fort |ti|). En raison de sa position centrale, cette observation ne parvient pas à faire pivoter l’hyperplan de régression ; sa distance de Cook reste modérée. Ce profil dénote fréquemment une erreur ponctuelle sur la variable réponse Y (faute de codage, inattention isolée du répondant) sans déstabiliser massivement les pentes structurelles du modèle.
Typologie 2 : Fort levier, résidu studentisé faible. L’observation occupe une position extrême dans l’espace factoriel des variables explicatives X (fort hii), mais sa valeur Y s’aligne fidèlement sur le modèle estimé par le reste de la cohorte (faible |ti|). Elle agit comme un point d’ancrage conforme qui stabilise artificiellement la régression et réduit artificiellement les erreurs standard en gonflant la somme des carrés de X. Bien qu’elle ne fausse pas l’estimation des coefficients centraux, elle peut procurer une fausse sensation de précision statistique.
Typologie 3 : Fort levier, résidu studentisé élevé. Il s’agit du cas le plus pathologique pour le modélisateur. L’observation se situe à la fois aux marges géométriques des prédicteurs et refuse d’obéir à la relation prédictive générale. Sa distance de Cook explose littéralement (dépassant fréquemment les seuils critiques usuels tels que 4/n ou 1.0). Ce point d’influence critique détourne unilatéralement la pente de la régression vers lui, détruisant la validité de l’inférence pour le reste des données saines. Une telle observation exige une action méthodologique immédiate et transparente.
12. Bonnes pratiques et traitement méthodologique des données aberrantes
12.1 Investigation de la genèse des observations extrêmes
La découverte d’une observation manifestant un résidu studentisé externe statistiquement significatif après correction de Bonferroni (pBonferroni < 0.05) ne confère en aucun cas au chercheur l’autorisation aveugle de supprimer purement et simplement la ligne correspondante au sein de son tableau de données. Une telle pratique d’épuration non motivée — parfois désignée sous le terme d’élagage arbitraire post-hoc — est universellement réprouvée par les comités d’éthique et les revues scientifiques de premier rang, car elle expose la démarche scientifique à des biais de confirmation massifs et à une surévaluation artificielle de la précision apparente des modèles.
La première phase d’une conduite méthodologique responsable consiste en un audit approfondi de la genèse empirique du point aberrant. Le statisticien doit remonter la chaîne de traçabilité des données pour vérifier l’éventualité d’une bévue d’enregistrement technique, d’une erreur typographique lors de la transcription manuelle de protocoles papier, ou d’une défaillance d’instrumentation électronique lors de l’acquisition (comme une interruption de capteur ou un décalage d’échelle de saisie). Si une faute de saisie matérielle est incontestablement authentifiée, il convient soit de corriger la valeur en consultant la feuille de recueil source originale, soit d’invalider formellement la saisie erronée en consignant précisément l’incident dans le journal d’expérimentation.
Dans le domaine spécifique des sciences du comportement, l’analyse rétrospective doit également investiguer les métadonnées de passation. Un résidu studentisé massif peut matérialiser un participant ayant répondu de manière totalement aléatoire pour achever prématurément le protocole, un individu n’ayant pas compris les consignes expérimentales, ou un patient présentant une condition médicale incompatible avec les critères d’inclusion préalablement définis. Si des preuves documentées et objectives attestent que le participant n’a pas respecté le protocole opératoire standard, son exclusion se justifie sur des bases théoriques strictes et non sur le simple constat opportuniste de son écart résiduel.
12.2 Analyses de sensibilité et robustesse des modèles
Lorsque l’investigation approfondie ne révèle aucune anomalie technique manifeste et que l’observation déviante reflète une réponse comportementale authentique — bien qu’inattendue —, la stratégie d’excellence méthodologique préconisée par les normes contemporaines de réplication réside dans la réalisation d’une analyse de sensibilité exhaustive (parfois dénommée analyse par double modèle).
Cette approche impose d’ajuster le modèle de régression linéaire sous deux conditions analytiques distinctes et strictement documentées :
- L’ajustement du Modèle A, consolidé sur la totalité de l’échantillon complet sans aucune exclusion (préservant ainsi l’intégralité de la variance empirique originale).
- L’ajustement du Modèle B, réestimé sur le sous-échantillon après exclusion motivée de la ou des observations manifestant des résidus studentisés externes statistiquement aberrants combinés à une forte influence.
Le chercheur rédige ensuite un compte-rendu comparatif rigoureux — idéalement matérialisé sous la forme d’un tableau synthétique dans le manuscrit scientifique — détaillant l’évolution des coefficients de régression βˆk, des erreurs standard, des p-valeurs et des métriques d’adéquation globale R2 entre les deux modèles. Si les conclusions scientifiques majeures (la direction, la magnitude relative et le seuil de significativité des effets) demeurent inchangées entre le Modèle A et le Modèle B, le chercheur peut revendiquer en toute légitimité la robustesse de ses conclusions empiriques face aux fluctuations d’échantillonnage. Si, au contraire, la significativité s’effondre lors de l’exclusion des points aberrants, l’honnêteté intellectuelle commande d’admettre que l’effet observé était artificiellement entraîné par une minorité d’individus atypiques et ne peut prétendre à une généralisation universelle.
12.3 Alternatives analytiques : régression robuste et transformations
Face à des distributions résiduelles chroniquement contaminées par des valeurs aberrantes multiples qu’il serait méthodologiquement injustifiable d’amputer de l’échantillon, le cadre d’ajustement des moindres carrés ordinaires atteint ses limites structurelles intrinsèques. L’analyste moderne doit alors mobiliser des paradigmes d’inférence alternatifs conçus expressément pour être résilients face aux déviations distributionnelles sévères.
La bibliothèque Statsmodels propose une alternative d’une remarquable puissance à travers son module de modèles linéaires robustes (Robust Linear Models ou RLM), accessible via la classe statsmodels.api.RLM. Au lieu de minimiser la somme des carrés des résidus bruts — fonction de perte quadratique qui accorde un poids disproportionné aux écarts extrêmes —, les estimateurs robustes de type M (proposés initialement par Peter J. Huber) substituent une fonction de pénalité qui croît de manière linéaire au-delà d’un seuil de déviation standardisé. D’autres pondérations encore plus sophistiquées, telles que la fonction bi-carrée de Tukey (Tukey’s Biweight), parviennent à ramener à une pondération strictement nulle les observations dont le résidu studentisé franchit les bornes critiques, neutralisant totalement leur influence déstabilisatrice sans exiger leur suppression manuelle du tableau de données.
Parallèlement, si l’inspection des résidus studentisés révèle une asymétrie systématique ou une hétéroscédasticité fonctionnelle plutôt que des anomalies individuelles déconnectées, l’expérimentateur doit considérer l’opportunité d’appliquer des transformations non linéaires à la variable dépendante d’origine. L’usage de transformations logarithmiques, de passages à la racine carrée ou l’estimation formelle d’une transformation paramétrique optimale de type Box-Cox permet fréquemment de stabiliser la variance conditionnelle et de réaligner la distribution stochastique des perturbations sur les postulats de Gauss-Markov. Ces adaptations techniques, alliées à une communication transparente et éthique des données, garantissent que l’analyse diagnostique résiduelle remplisse pleinement son rôle fondamental : élever le niveau d’intégrité, de rigueur et de reproductibilité de la recherche scientifique contemporaine.
Références
- Belsley, D. A., Kuh, E., & Welsch, R. E. (1980). Regression diagnostics: Identifying influential data and sources of collinearity. John Wiley & Sons. https://doi.org/10.1002/0471725153
- Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.2307/1268249
- Cook, R. D., & Weisberg, S. (1982). Residuals and influence in regression. Chapman and Hall.
- Fox, J. (2016). Applied regression analysis and generalized linear models (3rd ed.). SAGE Publications.
- Kutner, M. H., Nachtsheim, C. J., Neter, J., & Li, W. (2005). Applied linear statistical models (5th ed.). McGraw-Hill Irwin.
- Rousseeuw, P. J., & Leroy, A. M. (1987). Robust regression and outlier detection. John Wiley & Sons. https://doi.org/10.1002/0471725382
- Seabold, S., & Perktold, J. (2010). Statsmodels: Econometric and statistical modeling with Python. In Proceedings of the 9th Python in Science Conference (pp. 92–96). https://doi.org/10.25080/Majora-ebaa42b7-011
- Weisberg, S. (2014). Applied linear regression (4th ed.). John Wiley & Sons. https://doi.org/10.1002/9781118594858