
Dans le champ de la recherche quantitative en psychologie et en sciences comportementales, la modélisation statistique ne constitue pas une simple formalité algorithmique destinée à produire des coefficients de corrélation ou des indices de signification. Elle représente un dispositif épistémologique rigoureux par lequel le chercheur confronte une hypothèse théorique aux fluctuations intrinsèques du comportement humain, de la cognition et des états affectifs. L’analyse de régression linéaire, qu’elle soit simple ou multiple, s’impose comme l’un des piliers méthodologiques les plus mobilisés au sein de la discipline. Néanmoins, l’application aveugle des moindres carrés ordinaires sans un examen exhaustif des postulats sous-jacents expose les investigations empiriques à des biais d’interprétation majeurs, conduisant fréquemment à des conclusions fallacieuses, à une sous-estimation dramatique des erreurs de mesure ou à une surestimation artificielle de la puissance statistique des modèles explicatifs.
Le diagnostic de régression repose de manière critique sur l’analyse des résidus, c’est-à-dire l’écart constaté entre les mesures observées auprès des participants et les estimations théoriques déduites du modèle mathématique. Alors que les résidus bruts demeurent asservis aux unités de mesure métriques ou psychométriques des instruments d’évaluation originaux, les résidus standardisés confèrent au chercheur une métrique universelle, adimensionnelle et directement interprétable à l’aune des propriétés de la loi normale. La standardisation de ces écarts ne relève pas d’une simple commodité cosmétique : elle constitue la condition indispensable pour isoler avec précision les observations atypiques, détecter les points d’influence susceptibles de déformer l’estimation des pentes de régression, et évaluer la conformité des données aux exigences incontournables d’homoscédasticité et de normalité distributionnelle.
Bien que les environnements informatiques spécialisés tels que le logiciel R, SPSS ou SAS intègrent des routines de diagnostic automatisées, le tableur Microsoft Excel demeure une plateforme omniprésente, accessible et remarquablement puissante pour la manipulation analytique des protocoles psychologiques. Toutefois, l’obtention de résidus standardisés mathématiquement rigoureux au sein d’Excel nécessite une compréhension approfondie des mécanismes matriciels et statistiques sous-jacents, l’outil natif de régression du tableur opérant des approximations qu’il convient de corriger impérativement pour répondre aux exigences méthodologiques contemporaines. Le présent traité a pour vocation de guider le chercheur, l’enseignant et l’étudiant avancé dans la mise en œuvre pas à pas, exhaustive et théoriquement fondée, du calcul des résidus standardisés sous Excel, en reliant l’architecture algébrique matricielle aux décisions pratiques de recherche dictées par les normes de publication internationales.
1. Fondements théoriques des résidus dans la modélisation statistique en psychologie
L’exploration des données psychologiques requiert une vigilance constante face aux manifestations de la variabilité interindividuelle et intra-individuelle. Avant d’aborder les manipulations logicielles, il s’avère indispensable d’asseoir le socle théorique régissant la genèse et la signification des résidus au sein de l’inférence statistique.
1.1 Définition conceptuelle du résidu statistique
Au cœur de la modélisation linéaire par les moindres carrés ordinaires réside la décomposition fondamentale de toute mesure empirique en deux composantes constitutives : la part déterministe, incarnée par la prédiction structurelle du modèle, et la part stochastique, résumée par l’erreur d’ajustement. Pour chaque observation individuelle issue d’un protocole psychologique, le résidu statistique brut se définit formellement comme la différence arithmétique simple entre la valeur réellement observée de la variable dépendante et la valeur théorique ajustée, calculée par l’équation de régression. Si une échelle psychométrique enregistre une intensité dépressive observée pour un sujet donné, le résidu quantify précisément l’écart par lequel ce sujet particulier s’éloigne de l’espérance mathématique conditionnelle prédite par le modèle à partir de ses prédicteurs cognitifs ou contextuels.
Sur le plan de la géométrie vectorielle et euclidienne, le résidu représente la distance verticale absolue séparant un point expérimental du lieu géométrique défini par la droite ou l’hyperplan de régression. Contrairement à une distance orthogonale classique qui mesurerait le plus court chemin géométrique vers la droite, la modélisation par les moindres carrés privilégie rigoureusement l’écart vertical. Ce choix axiomatique reflète le statut asymétrique des variables dans la régression linéaire classique : les prédicteurs sont postulés comme étant fixés ou mesurés sans erreur aléatoire, tandis que l’ensemble de la fluctuation d’échantillonnage non expliquée est imputé à la variable dépendante.
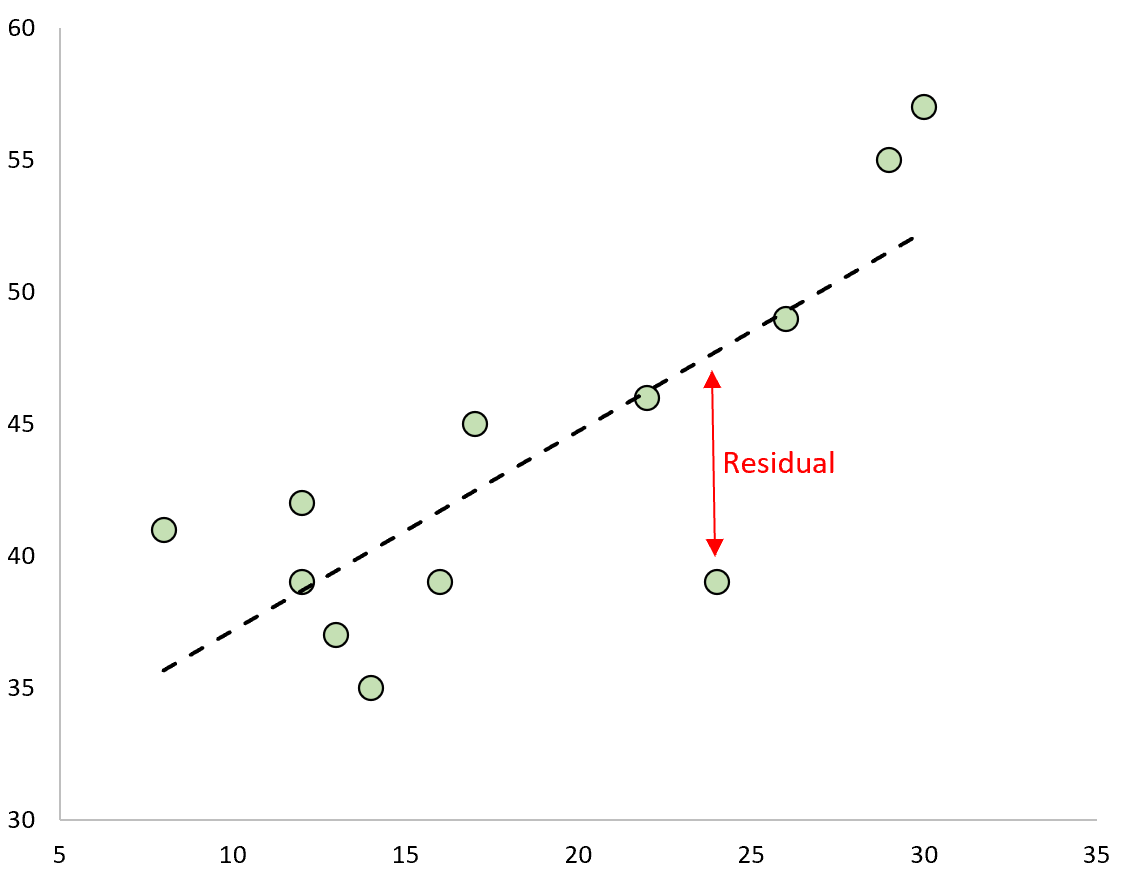
Le rôle des résidus dépasse largement le cadre du simple calcul arithmétique d’écart : ils constituent le baromètre privilégié de la validité interne des dispositifs psychométriques. L’équation canonique de l’ajustement repose sur les hypothèses classiques du théorème de Gauss-Markov, qui stipule que pour que les estimateurs des moindres carrés soient sans biais et de variance minimale, les erreurs théoriques de population doivent posséder une espérance conditionnelle nulle, présenter une variance constante à travers tous les niveaux des prédicteurs, et ne manifester aucune autocorrélation. Les résidus échantillonnaux constituent l’unique fenêtre empirique par laquelle le chercheur peut scruter ces erreurs théoriques inobservables, transformant l’examen de leur comportement en une étape diagnostique primordiale pour toute inférence causale ou prédictive robuste.
1.2 Importance du diagnostic des erreurs dans les sciences comportementales
Dans l’écosystème complexe des sciences du comportement, l’hétérogénéité des réponses individuelles, les biais de désirabilité sociale, la fatigue attentionnelle des participants ou des erreurs accidentelles d’encodage génèrent inévitablement des perturbations dans les matrices de données. L’impact de ces déviations extrêmes sur les estimations paramétriques peut s’avérer dévastateur. Le critère des moindres carrés opérant par minimisation de la somme des carrés des écarts, un seul point aberrant doté d’un résidu disproportionné exerce un moment de force considérable sur la droite de régression, déplaçant artificiellement l’ordonnée à l’origine et infléchissant la pente au point d’induire des faux positifs statistiques ou de masquer des effets psychologiques pourtant authentiques.
Au-delà de la distorsion des coefficients angulaires, l’accumulation de variance non expliquée et la présence de résidus mal caractérisés compromettent gravement la puissance statistique des tests d’hypothèse. L’erreur type des coefficients de régression dépend directement de l’amplitude de la variance résiduelle globale du modèle. Lorsque celle-ci est artificiellement gonflée par des perturbations résiduelles non identifiées, l’erreur type associée aux tests de Student s’élargit, comprimant la valeur du test statistique associé et augmentant exponentiellement le risque d’erreur de type II, à savoir le rejet erroné d’une hypothèse alternative scientifiquement valide.
L’analyse des résidus fournit enfin un cadre discriminatif indispensable pour dissocier les biais de mesure systématiques des pures fluctuations stochastiques propres aux populations humaines. Alors qu’un résidu purement aléatoire témoigne du bruit physiologique ou contextuel inhérent à toute mesure du vivant, des résidus systématiquement regroupés selon des profils non aléatoires trahissent l’omission d’une variable explicative majeure, une spécification fonctionnelle erronée du modèle (linéaire au lieu de curvilinéaire) ou des failles structurelles dans la calibration des outils d’évaluation psychologique.
1.3 Distinction entre résidus bruts, standardisés et studentisés
Bien que le résidu brut offre une mesure intuitive immédiate de l’erreur d’ajustement, son utilisation diagnostique se heurte à une limitation mathématique sévère : son échelle d’expression demeure intrinsèquement subordonnée à l’unité de mesure de la variable dépendante originale. Si un chercheur évalue le temps de réaction en millisecondes dans un paradigme d’attention sélective et l’anxiété sur une échelle de Likert de 1 à 7, un résidu brut de 45 possédera une signification statistique diamétralement opposée dans les deux contextes. Le résidu brut ne permet aucune comparaison trans-échelles, ni l’application de critères de décision standardisés quant à sa nature pathologique ou aberrante.
Pour s’affranchir de cette dépendance métrique, la standardisation statistique opère une transformation adimensionnelle en rapportant le résidu brut à une estimation de son écart-type résiduel. Le résidu standardisé qui en résulte présente une moyenne théorique égale à zéro et une variance asymptotiquement unitaire. Cette mise à l’échelle permet au méthodologue d’appliquer des seuils d’alerte universels dérivés de la loi normale, quelle que soit la nature substantive des variables analysées au sein du devis expérimental.
Il existe néanmoins une subtilité métrologique cruciale entre les résidus standardisés (fréquemment appelés résidus studentisés internes) et les résidus studentisés externes (ou résidus jackknife). Les résidus standardisés internes calculent l’erreur type résiduelle globale en incluant l’ensemble des observations du jeu de données, y compris l’observation potentiellement aberrante testée. À l’inverse, les résidus studentisés externes recalculent le modèle de régression en omettant l’observation cible pour l’estimation de la variance résiduelle, empêchant ainsi une valeur singulière de contaminer le dénominateur de son propre test diagnostique. Dans la plupart des applications psychologiques courantes où l’échantillon comprend plus d’une cinquantaine de participants, l’écart numérique entre ces deux formalismes s’atténue, conférant au résidu standardisé une efficacité analytique et une robustesse remarquables pour le tri préliminaire des observations suspectes.
2. Formalisation mathématique des résidus standardisés
Une implémentation rigoureuse d’un outil statistique dans un tableur nécessite de maîtriser l’architecture algébrique exacte de ses formules. L’estimation d’un résidu standardisé ne se résume pas à une division grossière par l’écart-type global, mais intègre des corrections fondamentales issues de la géométrie de projection linéaire.
2.1 L’équation mathématique du résidu standardisé
Sur le plan analytique formel, soit un échantillon de n participants pour lesquels une variable dépendante continue notée Y est modélisée en fonction d’un ou plusieurs prédicteurs regroupés sous la matrice X. Pour l’observation indicée i, le résidu brut s’exprime sous la forme :
ei = Yi – Ŷi
où Yi désigne la valeur empirique recueillie auprès du participant et Ŷi la prédiction correspondante fournie par la fonction de régression estimée par les moindres carrés ordinaires. L’erreur type de la régression, couramment désignée sous le symbole se ou ETR, constitue l’estimation de l’écart-type des erreurs de population et se dérive de la somme des carrés des résidus bruts divisée par le nombre de degrés de liberté résiduels :
se = √[ (∑ ei²) / (n – k – 1) ]
au sein de laquelle k représente le nombre exact de variables prédictives intégrées dans le modèle mathématique, excluant le terme constant.
L’équation complète et irréprochable du résidu standardisé interne, fréquemment noté ri ou résidu studentisé interne dans la littérature statistique spécialisée issue des travaux de Cook et Weisberg, s’écrit de la façon suivante :
ri = ei / [ se * √(1 – hii) ]
Dans cette formulation, le terme hii symbolise la valeur de levier associée à l’observation i. Lorsque les postulats de linéarité, d’homoscédasticité et de normalité des résidus théoriques sont rigoureusement respectés, le ratio ri converge distributionnellement vers une variable aléatoire suivant une loi normale standardisée centrée réduite de moyenne zéro et de variance égale à un, autorisant le chercheur à mobiliser la table de la loi normale pour évaluer la probabilité critique d’occurrence de chaque déviation individuelle.
2.2 Rôle et calcul du levier de l’observation
Le levier, désigné mathématiquement par l’élément diagonal hii de la matrice de projection orthogonale, joue un rôle fondamental et pourtant fréquemment ignoré dans la dispersion théorique des résidus d’échantillonnage. En modélisation linéaire matricielle, les prédictions du modèle s’obtiennent par l’application de la matrice chapeau (ou hat matrix) H au vecteur des observations empiriques :
Ŷ = H * Y, avec H = X * (XT * X)-1 * XT
Les éléments diagonaux hii quantifient la distance géométrique multidimensionnelle séparant le profil de prédicteurs d’un sujet individuel du barycentre ou centroïde de l’ensemble de l’échantillon expérimental. Plus un participant présente des caractéristiques atypiques ou extrêmes sur les variables explicatives indépendantes, plus sa valeur de levier se rapproche asymptotiquement de la borne supérieure théorique égale à 1.
L’intégration du terme √(1 – hii) au dénominateur du résidu standardisé corrige une anomalie statistique inhérente à l’estimation par les moindres carrés. En vertu de la structure mathématique de la projection, la variance d’échantillonnage d’un résidu brut individuel n’est pas homogène sur l’ensemble de la distribution ; elle obéit rigoureusement à la relation :
Var(ei) = σ² * (1 – hii)
Par conséquent, les observations situées aux confins de l’espace des prédicteurs (haut levier) exercent une telle traction sur la surface d’ajustement que la droite est littéralement attirée vers elles, comprimant artificiellement leur résidu brut ei. Sans la correction par le levier, le chercheur sous-estimerait gravement l’anormalité statistique des sujets périphériques. Il convient ainsi de distinguer méthodologiquement un résidu brut modeste issu d’un point à fort levier, d’un point d’influence majeur révélé par un résidu standardisé corrigé pour son éloignement centroïdal.
2.3 Seuils d’identification des valeurs aberrantes
La normalisation distributionnelle des résidus standardisés permet de définir des heuristiques décisionnelles objectives pour délimiter les frontières de l’acceptabilité statistique au sein des jeux de données comportementales. Suivant les lois de distribution d’une variable normale centrée réduite, approximativement 68,27 % des observations doivent théoriquement s’inscrire dans l’intervalle compris entre -1 et +1 écart-type, 95,45 % entre -2 et +2 écarts-types, et 99,73 % entre -3 et +3 écarts-types.
Dans la pratique académique conventionnelle, toute observation dont la valeur absolue du résidu standardisé excède le seuil critique de 3 unités (|ri| > 3,00) est formellement catégorisée comme une valeur aberrante univariée sur l’espace d’erreur. La survenue d’un tel écart présente une probabilité d’occurrence spontanée inférieure à 0,27 % sous l’hypothèse de validité du modèle, suggérant de manière quasi indiscutable la présence d’une perturbation non modélisée, qu’il s’agisse d’un artefact méthodologique, d’une incompréhension manifeste des consignes par le sujet ou d’un comportement pathologique singulier nécessitant un traitement isolé.
Néanmoins, la détermination des seuils critiques ne saurait s’abstraire de la puissance de l’échantillon psychologique investigué. Dans une cohorte clinique restreinte de 30 participants, la présence d’un résidu standardisé de 2,50 représente déjà une anomalie substantielle méritant une inspection clinique détaillée, tandis que dans une cohorte épidémiologique comprenant 10 000 sujets, observer plusieurs dizaines de résidus oscillant entre 3,0 et 3,5 constitue un phénomène statistiquement attendu en vertu de la loi des grands nombres. L’inspection visuelle naïve sans standardisation expose le statisticien à des taux prohibitifs d’erreurs de type I, l’amenant à disqualifier des observations légitimes par simple méconnaissance des lois de dispersion stochastique.
3. Configuration préalable de l’environnement de calcul dans Microsoft Excel
Microsoft Excel offre une flexibilité de calcul remarquable, mais son usage à des fins de recherche scientifique exige un paramétrage scrupuleux de son environnement analytique afin d’éviter tout artefact computationnel ou toute altération involontaire de la précision arithmétique.
3.1 Activation du complément Utilitaire d’analyse
Pour accéder aux modules avancés de modélisation statistique dans Excel, le chercheur doit préalablement vérifier la présence et le bon chargement de l’Utilitaire d’analyse (nommé Analysis ToolPak dans la version anglophone). Bien que natif dans le paquet logiciel, ce composant d’analyse spécialisé est désactivé par défaut lors de l’installation initiale du tableur afin d’alléger la mémoire vive allouée aux opérations bureautiques ordinaires.
L’activation de cette extension s’opère selon une séquence opératoire standardisée :
- Accédez au menu principal en cliquant sur l’onglet Fichier positionné dans le coin supérieur gauche du ruban applicatif, puis sélectionnez Options tout en bas de la barre latérale gauche.
- Dans la fenêtre de dialogue des options d’Excel qui s’affiche, cliquez sur la rubrique Compléments située dans le volet de navigation vertical.
- Au bas de la boîte de dialogue, vérifiez que le menu déroulant intitulé Gérer affiche précisément la mention Compléments Excel, puis activez le bouton de validation Atteindre….
- Dans la petite boîte modale contextuelle qui apparaît, cochez rigoureusement la case intitulée Utilitaire d’analyse (il n’est généralement pas nécessaire de cocher l’Utilitaire d’analyse – VBA sauf si vous prévoyez d’automatiser vos flux via des scripts procéduraux), puis confirmez votre sélection en cliquant sur OK.
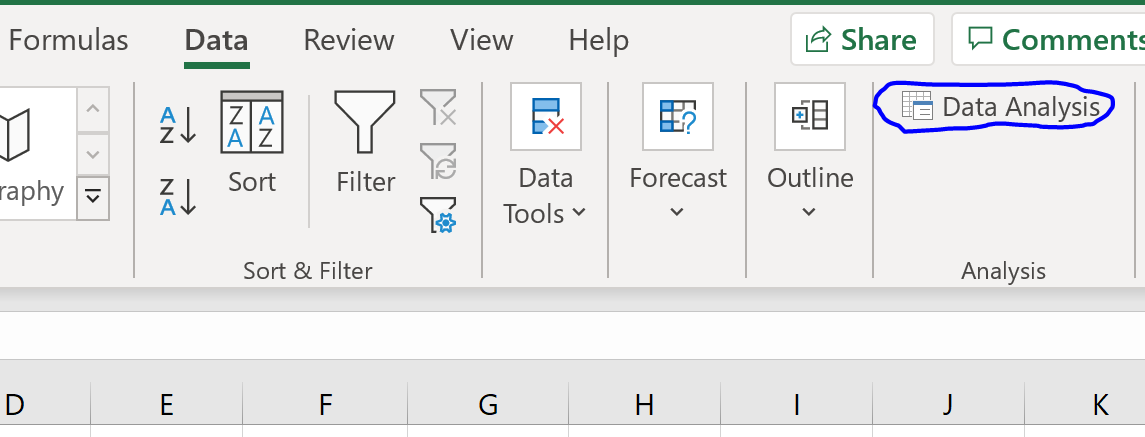
Dès la fermeture de cette boîte de dialogue, la réussite de l’installation se matérialise immédiatement par l’apparition d’un nouveau groupe fonctionnel intitulé Analyse, abritant le bouton de commande Utilitaire d’analyse, à l’extrémité droite de l’onglet Données du ruban supérieur d’Excel.
3.2 Paramétrage des options de précision et de calcul
Le calcul d’inversions matricielles, de résidus standardisés et d’erreurs quadratiques impose une fidélité numérique stricte. Le chercheur doit s’assurer que le moteur de calcul d’Excel est configuré en mode automatique. Si le mode de calcul a été accidentellement basculé en manuel lors du traitement antérieur de volumineux classeurs financiers, les formules matricielles et les soustractions algébriques des résidus cesseront de s’actualiser de manière dynamique en cas de modification ultérieure des données ou des coefficients. Cette vérification s’opère en naviguant vers l’onglet Formules, en sélectionnant le bouton Options de calcul, et en vérifiant que la coche est active sur Automatique.
Par ailleurs, la manipulation de décimales nécessite une vigilance méthodologique concernant les paramètres régionaux du système d’exploitation. Dans l’écosystème francophone, la virgule constitue le séparateur décimal conventionnel, tandis que les jeux de données internationaux issus d’outils de passation psychologique en ligne (tels que Qualtrics, Gorilla ou PsychoPy) emploient invariablement le point décimal. Pour éviter qu’Excel ne convertisse subrepticieusement des scores continus en valeurs textuelles non calculables ou en formats de dates aberrants, accédez aux Options Excel, sous la section Options avancées, puis examinez le groupe Options d’édition. Vous pouvez alors choisir de décocher Utiliser les séparateurs système pour forcer manuellement le point ou la virgule selon les nécessités de votre jeu de données.
Enfin, il est formellement recommandé de ne jamais tronquer artificiellement le nombre de décimales affichées via les fonctions d’arrondi arithmétique (telles qu’ARRONDI) au cours des étapes intermédiaires de modélisation. Les erreurs de troncature s’amplifient de manière multiplicative lors des calculs d’inversion matricielle ou de variance résiduelle. Conservez la précision interne à virgule flottante native d’Excel (qui respecte le standard IEEE 754 à double précision offrant 15 chiffres significatifs) et réservez l’ajustement esthétique des décimales à l’affichage cosmétique des cellules via la mise en forme standardisée.
4. Structuration et encodage du jeu de données psychologiques
L’intégrité de toute modélisation statistique par régression est conditionnée par la qualité de l’architecture tabulaire des données brutes. Une disposition matricielle rigoureuse prévient les erreurs de référencement de plages et facilite l’application ultérieure des calculs matriciels complexes.
4.1 Organisation tabulaire rigoureuse des variables
L’agencement des données empiriques au sein d’Excel doit respecter scrupuleusement les canons de la structure tabulaire normalisée (concept de tidy data). Chaque ligne du tableau doit correspondre de manière univoque à une et une seule unité expérimentale, c’est-à-dire un participant identifié par un code anonyme unique dans la première colonne (par exemple, de Sujet_001 à Sujet_N). L’inclusion d’identifiants textuels immuables protège l’analyste contre toute désynchronisation accidentelle des lignes lors de tris multicritères ultérieurs.
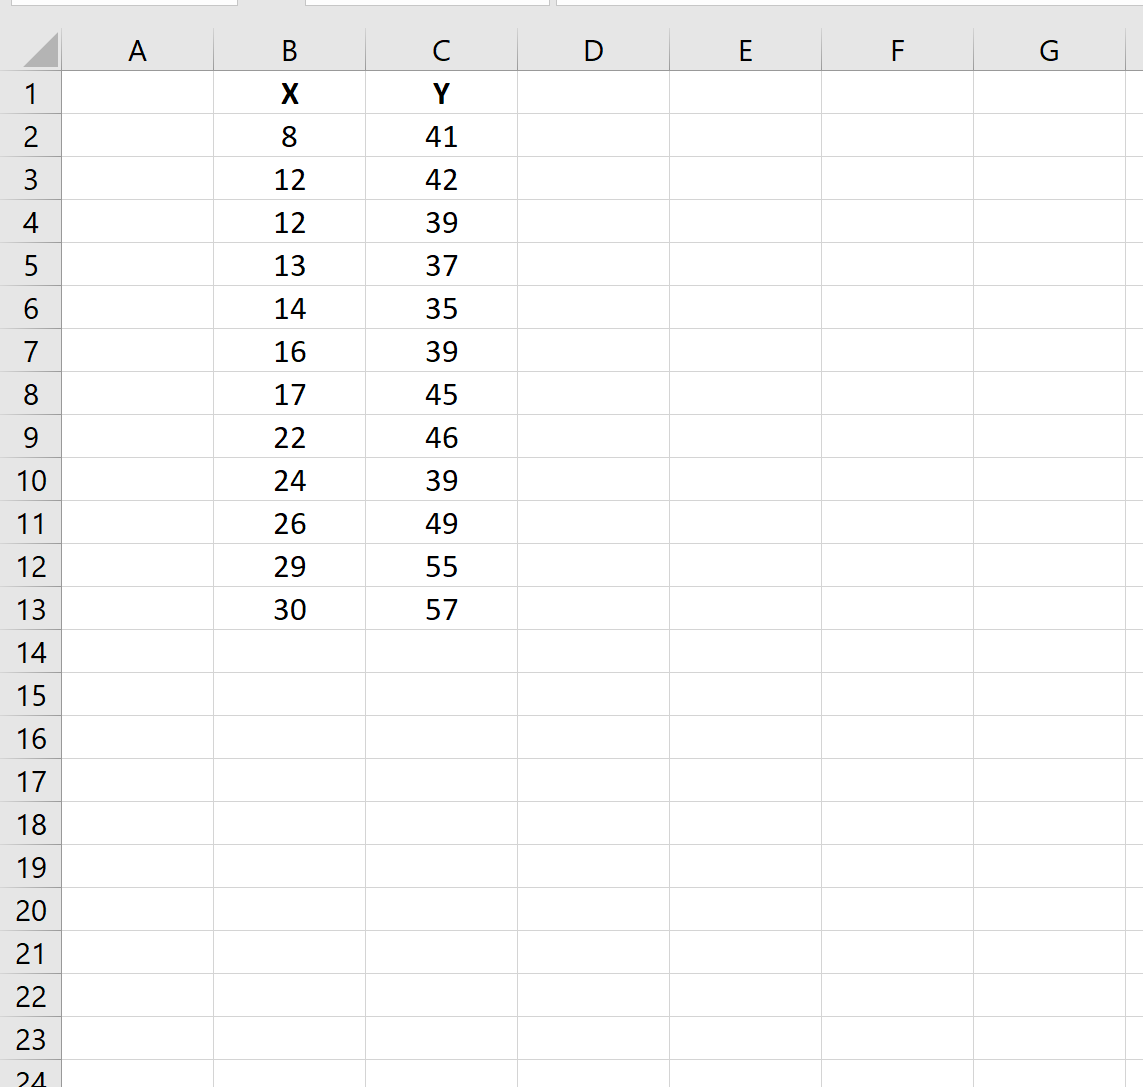
Les colonnes subséquentes doivent accueillir les variables observées en observant une compartimentation stricte : les colonnes de prédicteurs (variables indépendantes X1, X2, …, Xk) doivent de préférence être positionnées de manière contiguë. Cette contiguïté géométrique au sein de la feuille de calcul simplifie considérablement la saisie des plages matricielles dans les boîtes de dialogue et dans les fonctions de calcul matriciel avancées d’Excel. La variable dépendante (le critère psychologique Y, tel qu’un score total à une échelle validée ou un indice chronométrique) sera idéalement positionnée dans une colonne adjacente clairement étiquetée.
La première ligne du tableau doit impérativement être réservée aux étiquettes des variables (noms de variables explicites, concis, évitant les espaces superflus, les caractères diacritiques complexes ou les symboles mathématiques réservés par Excel comme le signe égal ou le tiret de soustraction). Chaque cellule de données doit être formellement encodée sous un format numérique pur. Pour vérifier l’absence d’espaces invisibles ou de formats textuels parasites souvent générés lors des exports CSV de plateformes psychométriques, appliquez la fonction logique =ESTNUM(B2) sur une colonne de contrôle temporaire : toute valeur renvoyant FAUX signale une cellule non calculable nécessitant une épuration immédiate.
4.2 Traitement préliminaire des données manquantes
Les investigations en sciences comportementales sont chroniquement confrontées à l’incomplétude des protocoles expérimentaux, qu’elle résulte de l’omission d’un item par un sujet, d’une défaillance technique du matériel d’enregistrement électrophysiologique ou d’une attrition longitudinale. Dans le paradigme mathématique de la régression par les moindres carrés ordinaires, la matrice de variance-covariance ne tolère aucun enregistrement incomplet : la présence d’une seule valeur manquante sur un prédicteur ou sur la variable réponse rend la ligne entière inopérante pour le calcul matriciel.
L’analyste doit donc procéder à une inspection d’exhaustivité avant toute tentative de génération du modèle. L’application de filtres automatiques sur l’en-tête du tableau (via le raccourci Ctrl + Maj + L) permet d’inspecter rapidement le bas des listes déroulantes de chaque colonne afin d’identifier la présence éventuelle de cellules vides ou de libellés de codes d’erreur (tels que NA, NULL ou 999). Deux approches méthodologiques se présentent alors : l’exclusion complète des cas incomplets (suppression par liste ou listwise deletion) ou la mobilisation de techniques d’imputation statistique préalables (imputation par la moyenne conditionnelle ou régression multiple d’imputation).
Si la stratégie de suppression des enregistrements incomplets est retenue pour préserver la fidélité stricte des réponses recueillies, cette décision doit faire l’objet d’une documentation méticuleuse. Il convient d’enregistrer le nombre précis de cas éliminés, de vérifier que le mécanisme de perte de données ne viole pas le postulat de manque aléatoire (Missing at Random – MAR) et de rapporter la taille de l’échantillon effectif final conformément aux standards directeurs de l’American Psychological Association (APA Style). Les lignes incomplètes devront être archivées sur une feuille séparée et définitivement purgées de la plage d’analyse active avant d’initier la régression.
5. Génération de la régression linéaire avec l’Utilitaire d’analyse
Une fois les variables nettoyées et correctement positionnées sur le classeur, la première étape d’extraction des paramètres de base repose sur l’exécution du module automatisé de régression inclus dans l’Utilitaire d’analyse d’Excel.
5.1 Paramétrage de la boîte de dialogue de régression
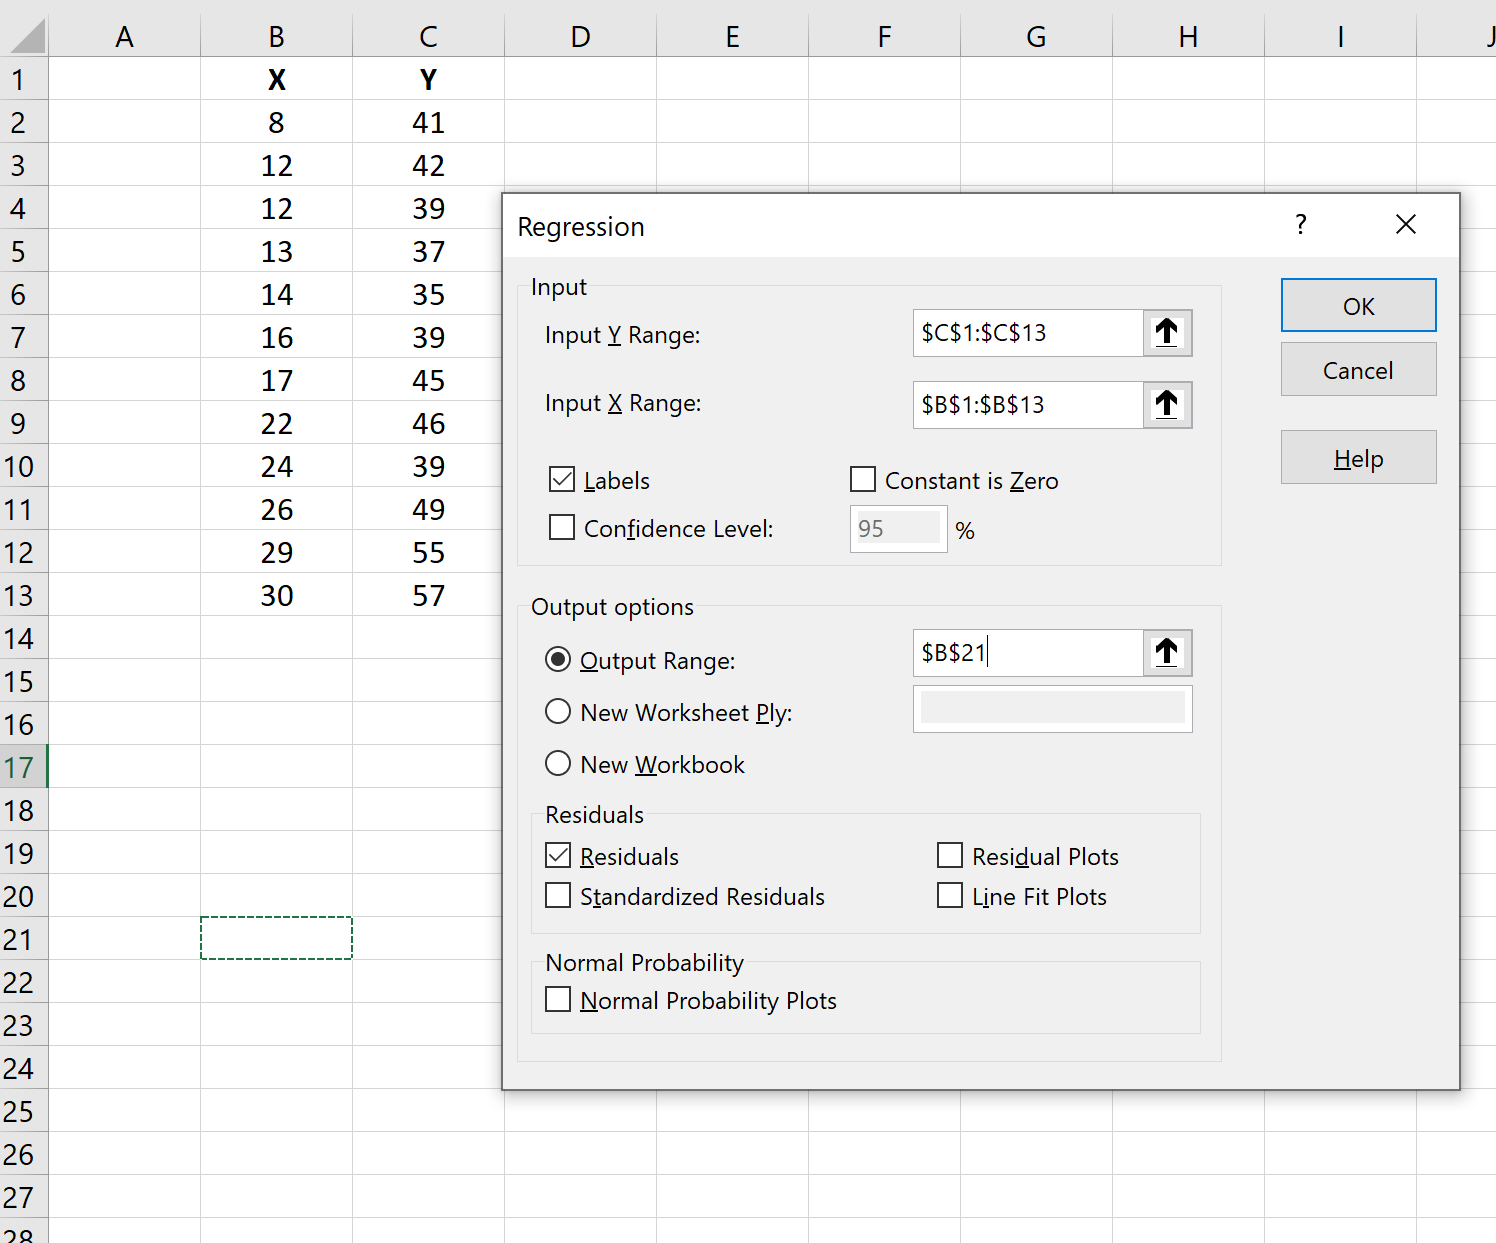
Pour lancer la procédure de régression automatisée, naviguez vers l’onglet Données et cliquez sur le bouton Utilitaire d’analyse. Dans la liste alphabétique des outils statistiques disponibles, sélectionnez la ligne intitulée Régression, puis cliquez sur OK pour afficher la boîte de paramétrage interactif. L’écran de configuration nécessite la complétion méthodique de plusieurs paramètres fondamentaux :
- Plage d’entrée Y : Cliquez sur le champ de sélection et sélectionnez la plage verticale englobant les scores de votre variable dépendante, par exemple $C$1:$C$101 pour un échantillon de cent participants, en prenant soin d’inclure la cellule d’en-tête de la première ligne.
- Plage d’entrée X : Sélectionnez la plage rectangulaire contiguë couvrant le ou les prédicteurs indépendants, par exemple $D$1:$E$101 dans le cas d’une régression multiple à deux prédicteurs, incluant également leurs étiquettes d’en-tête respectives.
- Intitulés : Cochez impérativement cette case si vous avez intégré les cellules de la première ligne contenant les désignations textuelles de vos variables. Cela ordonne à l’algorithme de ne pas interpréter ces étiquettes comme des données textuelles corrompues.
- Niveau de confiance : Par défaut, Excel applique un intervalle de confiance à 95 %, ce qui correspond au seuil alpha conventionnel de 0,05 rigoureusement appliqué en psychologie. Vous pouvez ajuster cette valeur à 99 % si votre protocole requiert une marge d’erreur plus stricte.
- Options de sortie : Cochez l’option Nouvelle feuille de calcul et attribuez-lui un nom explicite tel que Sortie_Regression afin de ne pas écraser les données sources et d’isoler les tables de résultats.
- Résidus : Dans la section inférieure de la fenêtre, cochez scrupuleusement les cases intitulées Résidus et Résidus standardisés. L’activation de ces options commande à Excel de générer deux colonnes additionnelles contenant les prédictions et les déviations pour chaque observation individuelle de la cohorte.
Après avoir validé la configuration par un clic sur OK, Excel exécute l’algorithme d’estimation et génère instantanément une feuille de calcul structurée hébergeant les statistiques d’ajustement global, le tableau d’analyse de variance (ANOVA) et le tableau des résidus d’observation.
5.2 Analyse de la table récapitulative de sortie
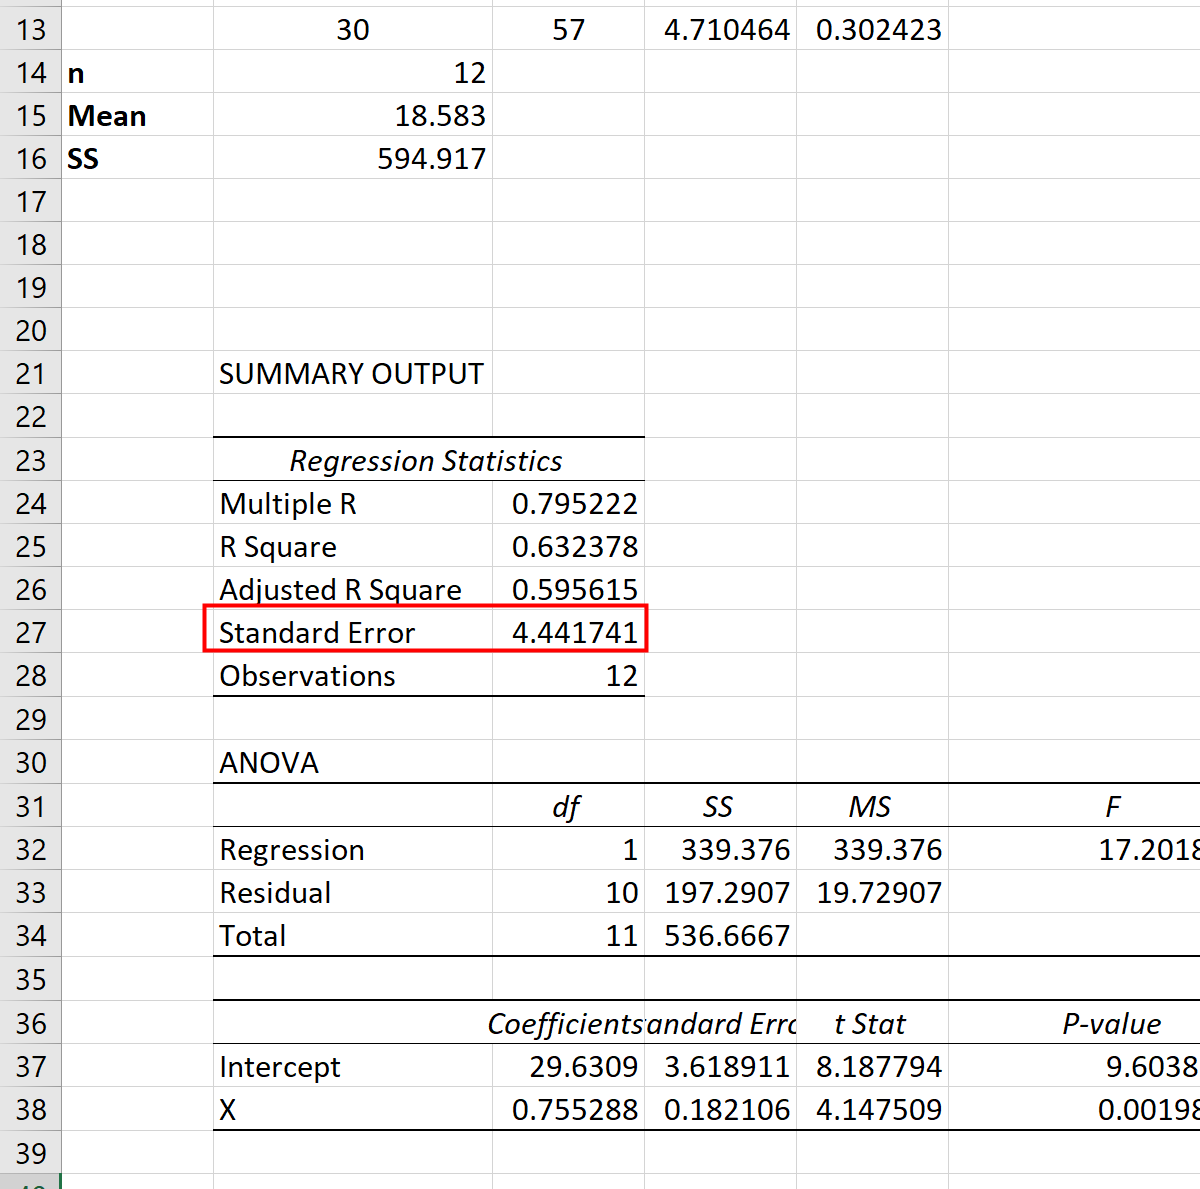
La sortie standard produite par l’Utilitaire d’analyse se segmente en trois blocs distincts dont l’examen attentif permet de vérifier la validité computationnelle globale du modèle avant d’inspecter les résidus au cas par cas. Le premier bloc, intitulé Statistiques de la régression, renseigne le coefficient de détermination multiple R², le R² ajusté (indispensable pour sanctionner l’inflation artificielle du pouvoir prédictif liée au nombre de variables dans l’échantillon), ainsi que l’Erreur-type du modèle (souvent appelée erreur type de l’estimation). Cette dernière métrique, exprimée dans l’unité de mesure de la variable dépendante, constitue le dénominateur de référence servant de base à la standardisation des erreurs résiduelles.
Le second bloc est constitué de la Table d’analyse de la variance (ANOVA). Celle-ci décompose la somme des carrés totale en deux sources de variation distinctes : la variance attribuable à la régression et la variance attribuable aux résidus. Le chercheur doit immédiatement repérer deux éléments stratégiques au sein de la ligne Résidus : les Degrés de liberté (dl) associés à l’erreur (qui correspondent rigoureusement à n – k – 1) et la Somme des carrés (SC) des résidus. La division de cette somme des carrés par ses degrés de liberté résiduels produit le Carré Moyen résiduel (MS Residual), dont la racine carrée arithmétique restitue précisément l’erreur type de la régression mentionnée dans le tableau supérieur.
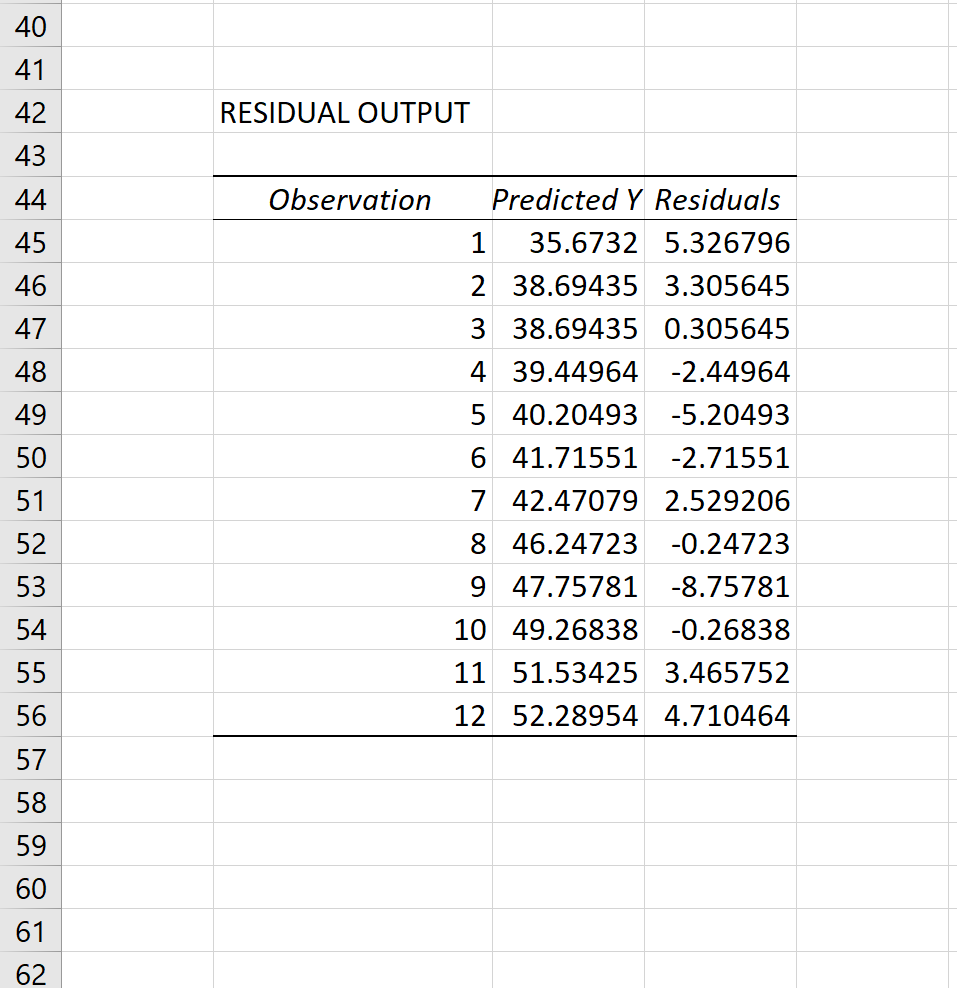
Enfin, le troisième bloc analytique positionné sous les coefficients de régression présente la Table des résidus. Pour chaque observation indicée de 1 à n, ce tableau dresse l’inventaire des Prédictions calculées pour Y, des Résidus bruts (valeur observée moins valeur prédite) et d’une colonne intitulée Résidus standardisés. L’apparente exhaustivité de cette dernière colonne invite toutefois à une prudence méthodologique extrême, en raison de raccourcis computationnels propres à l’architecture historique du tableur de Microsoft.
5.3 Limitation des résidus standardisés natifs d’Excel
Bien que la table générée par l’Utilitaire d’analyse comporte explicitement une colonne baptisée Résidus standardisés, tout chercheur soucieux d’exactitude méthodologique se doit d’être alerté sur la simplification mathématique opérée par l’algorithme sous-jacent d’Excel. En effet, l’Utilitaire d’analyse ne calcule pas un résidu standardisé au sens strict de la théorie statistique de Cook et Weisberg. Il se contente d’appliquer une standardisation grossière en divisant chaque résidu brut individuel par l’écart-type d’échantillon de l’ensemble des résidus bruts générés, sans opérer la moindre correction pour la distance de levier propre à chaque observation :
Résidu Standardisé Natif Excel = ei / se (au facteur d’échantillonnage près)
En omettant délibérément le terme multiplicateur √(1 – hii) au dénominateur, Excel postule implicitement que toutes les observations bénéficient d’une variance d’erreur strictement identique et qu’aucun point n’exerce de traction géométrique supérieure aux autres sur la droite de régression. Or, comme exposé dans le cadre théorique de ce traité, cette hypothèse est mathématiquement inexacte dès lors qu’un modèle comprend des prédicteurs continus présentant une dispersion naturelle autour de leur moyenne.
La conséquence méthodologique de cette simplification interne est directe : pour toute observation affichant des valeurs atypiques ou extrêmes sur les variables indépendantes (fort levier), la formule native d’Excel sous-estime systématiquement l’amplitude du résidu standardisé. Une observation hautement aberrante et influente peut ainsi afficher un résidu standardisé natif de 2,30 dans le rapport automatique d’Excel, échappant ainsi aux règles conventionnelles d’exclusion, alors qu’un calcul rigoureusement corrigé par la matrice chapeau révélerait un résidu réel de 3,45 justifiant sans conteste son isolement. Dès lors, pour toute recherche empirique exigeante destinée à une publication scientifique évaluée par les pairs, le calcul manuel et transparent des véritables résidus standardisés s’impose comme un impératif technique incontournable.
6. Calcul pas à pas des résidus bruts et des prédictions
Afin de s’émanciper des approximations logicielles et de garantir une traçabilité intégrale des transformations numériques, nous allons maintenant bâtir l’architecture algorithmique manuelle au sein d’une nouvelle feuille de travail dans Excel. Cette étape initiale consiste à dériver les valeurs ajustées puis à soustraire algébriquement les réponses empiriques.
6.1 Formulation des valeurs ajustées manuelles
Dans la feuille principale abritant votre jeu de données expurgé des valeurs manquantes, insérez une nouvelle colonne immédiatement à droite de votre variable dépendante et nommez son en-tête Y_Predit (cellule E1, par exemple). L’objectif est de calculer pour chaque sujet la valeur Ŷi résultant de l’application stricte des coefficients de régression extraits lors de l’exécution de l’Utilitaire d’analyse ou calculés dynamiquement par des fonctions natives.
Pour assurer une réactivité totale de votre feuille en cas d’actualisation ultérieure des données expérimentales, il est fortement conseillé de lier dynamiquement les coefficients d’ordonnée à l’origine (constante β₀) et de pente (β₁) au moyen de formules matricielles plutôt que de recopier manuellement des valeurs numériques statiques. Si votre régression est simple (un seul prédicteur), Excel met à disposition deux fonctions analytiques directes : la fonction ORDONNEE.ORIGINE(plage_Y; plage_X) et la fonction PENTE(plage_Y; plage_X). Dans le cas d’une régression multiple, nous ferons directement référence aux cellules des coefficients issues de la table de sortie générée précédemment sur la feuille Sortie_Regression.
En considérant un modèle de régression simple où la variable dépendante réside en $C$2:$C$101 et le prédicteur en $D$2:$D$101, écrivez dans la cellule E2 la formule d’équation de droite linéaire :
=ORDONNEE.ORIGINE($C$2:$C$101; $D$2:$D$101) + PENTE($C$2:$C$101; $D$2:$D$101) * D2
Notez l’usage impératif des signes dollar ($) pour figer les plages matricielles d’apprentissage de l’échantillon, tandis que l’adresse de la cellule D2 (le score du premier sujet sur le prédicteur) demeure une référence relative sans dollar, autorisant sa translation automatique vers le bas lors de la propagation de la formule sur l’ensemble de la cohorte.
6.2 Soustraction algébrique pour obtenir le résidu brut
Une fois les prédictions calculées pour chaque individu de l’échantillon, insérez une colonne subséquente que vous nommerez Residu_Brut (cellule F1). La formule de calcul du résidu brut consiste en l’implémentation arithmétique directe de la définition vue précédemment, en retranchant la prédiction linéaire de la valeur observée réelle du participant.
Dans la cellule F2, encodez la formule suivante :
=C2 – E2
Appliquez cette soustraction sur l’ensemble des lignes de participants par double-clic sur la poignée de recopie située dans le coin inférieur droit de la cellule. Pour valider l’intégrité de vos manipulations arithmétiques, il convient d’exécuter un contrôle de conformité axiomatique : en vertu des propriétés mathématiques fondamentales de la méthode des moindres carrés ordinaires, la somme de l’ensemble des résidus bruts d’un modèle linéaire doté d’une ordonnée à l’origine doit être rigoureusement égale à zéro.
Dans une cellule isolée située sous votre tableau, implémentez la fonction =SOMME(F2:F101). Le résultat obtenu doit être égal à 0 ou tendre vers un nombre infinitésimal d’ordre 10-13 à 10-15 en raison des limites de précision machine en virgule flottante. Tout écart significatif par rapport à zéro (par exemple un résultat égal à 0,45 ou -2,1) signale une anomalie grave : inversion de l’ordre des termes lors de la soustraction, omission de la constante dans le calcul prédictif, ou décalage de lignes entre la colonne observée et la colonne prédite.
7. Extraction et intégration de l’erreur type de la régression
Le dénominateur de la formule de standardisation dépend de la variance résiduelle globale de l’échantillon. Cette composante scalaire synthétise le degré moyen de dispersion des participants autour de la droite de régression multivariée.
7.1 Calcul manuel de la somme des carrés des résidus
Afin de dériver de façon transparente l’erreur type sans dépendre aveuglément des sorties statiques d’un utilitaire externe, nous allons procéder à l’agrégation de la variance d’erreur résiduelle non expliquée. Insérez une nouvelle colonne intitulée Residu_Carre (cellule G1). Dans la cellule G2, écrivez l’élévation au carré du résidu brut correspondant :
=F2^2
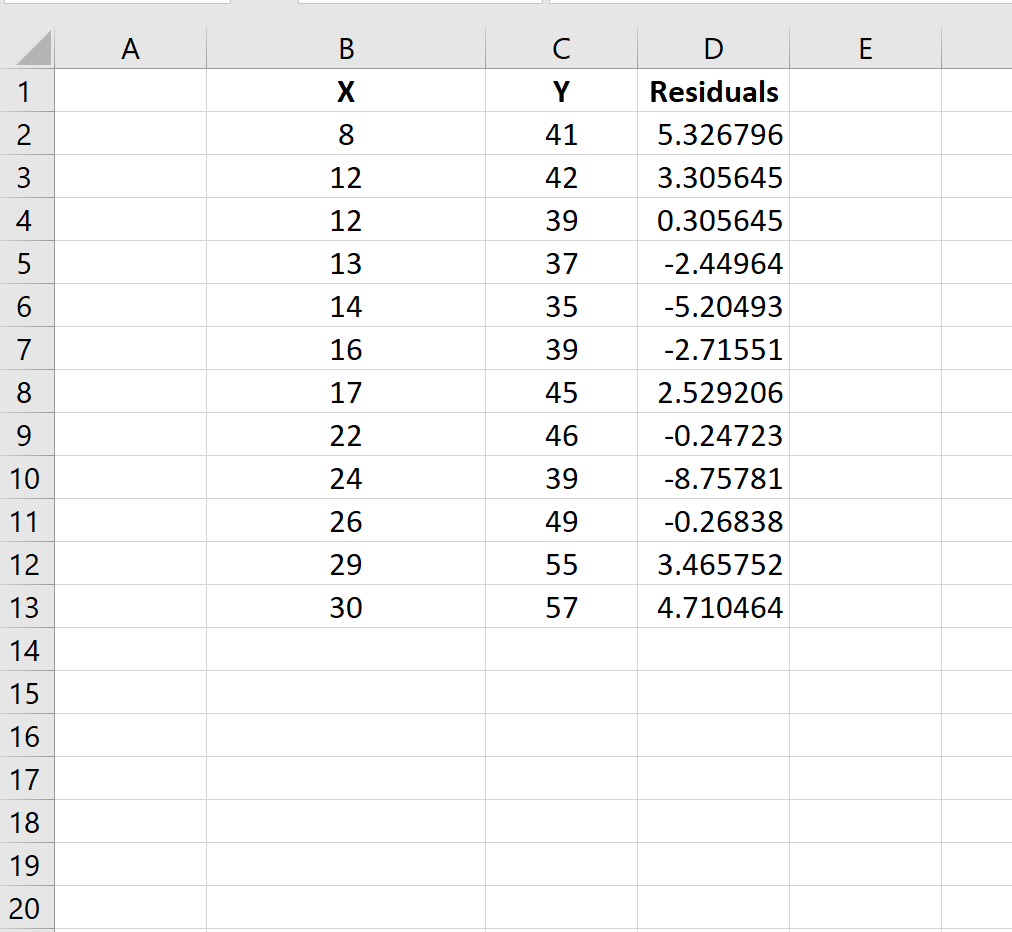
Propagez cette formule jusqu’au bas de la cohorte. Chaque cellule enregistre désormais la contribution individuelle du participant à la variabilité inexpliquée totale du modèle. Dans une cellule dédiée sous le tableau, identifiée par une étiquette textuelle explicite (par exemple en I2 nommée SCE_Residuelle), calculez la somme totale de ces écarts quadratiques à l’aide de la formule dynamique :
=SOMME(G2:G101)
À titre de contre-expertise technique, naviguez vers la feuille Sortie_Regression produite par l’Utilitaire d’analyse et comparez immédiatement la valeur calculée en I2 avec la cellule hébergeant la Somme des carrés de la ligne Résidus de la table ANOVA. Ces deux grandeurs scalaires doivent afficher une identité numérique absolue jusqu’à la dernière décimale significative, attestant que vos calculs manuels de valeurs ajustées et de résidus bruts répliquent parfaitement l’algèbre matricielle sous-jacente du moteur d’analyse statistique.
7.2 Dérivation de l’erreur type des résidus du modèle
Ayant obtenu la somme des carrés des résidus (SCE), il convient désormais d’extraire la variance d’erreur non biaisée puis l’écart-type résiduel global. Ce calcul requiert la division préalable de la SCE par ses degrés de liberté résiduels précis, définis par la taille de l’échantillon n diminuée du nombre de paramètres estimés (le nombre de prédicteurs k plus la constante).
Dans une cellule configurée sous votre somme des carrés (par exemple en I3 nommée Erreur_Type_se), implémentez la dérivation mathématique complète en utilisant les fonctions de comptage d’Excel pour préserver l’adaptabilité de la feuille aux variations d’effectifs :
=RACINE( I2 / ( NB(C2:C101) – 1 – 1 ) )
Dans cette syntaxe, la fonction NB(C2:C101) calcule dynamiquement la taille de l’échantillon n. Le premier chiffre 1 soustrait correspond au nombre de prédicteurs (dans l’hypothèse d’une régression linéaire univariée), tandis que le second chiffre 1 correspond à l’ordonnée à l’origine. Si votre modélisation intègre trois prédicteurs, l’argument deviendrait NB(…) – 3 – 1.
Pour confirmer l’exactitude de cette dérivation sans recourir à l’Utilitaire d’analyse, sachez qu’Excel intègre une fonction native calculant directement l’erreur type de la régression d’un modèle simple. Dans une cellule adjacente, tapez :
=ERREUR.TYPE.REG(C2:C101; D2:D101)
Notez bien que l’ordre des arguments de cette fonction native place impérativement la plage dépendante Y en premier argument et la plage indépendante X en second argument. La concordance absolue entre la valeur produite par votre calcul décomposé en I3 et le résultat retourné par ERREUR.TYPE.REG valide définitivement la solidité de votre dénominateur de standardisation de base.
8. Calcul de la matrice de projection et du levier dans Excel
Nous abordons à présent l’étape maîtresse qui fait défaut à l’immense majorité des tutoriels simplifiés : le calcul formel du levier individuel hii pour chaque participant de l’échantillon psychologique.
8.1 Approche simplifiée du levier pour régression simple
Dans la situation fréquente où la modélisation psychologique consiste en une régression linéaire univariée (un seul prédicteur continu X prédisant le critère Y), le recours à l’algèbre matricielle complexe n’est pas strictement obligatoire. L’élément diagonal de la matrice chapeau hii admet une simplification analytique élégante basée exclusivement sur la moyenne empirique et la somme des carrés des écarts du prédicteur :
hii = (1 / n) + [ (Xi – X̄)² / ∑ (Xj – X̄)² ]
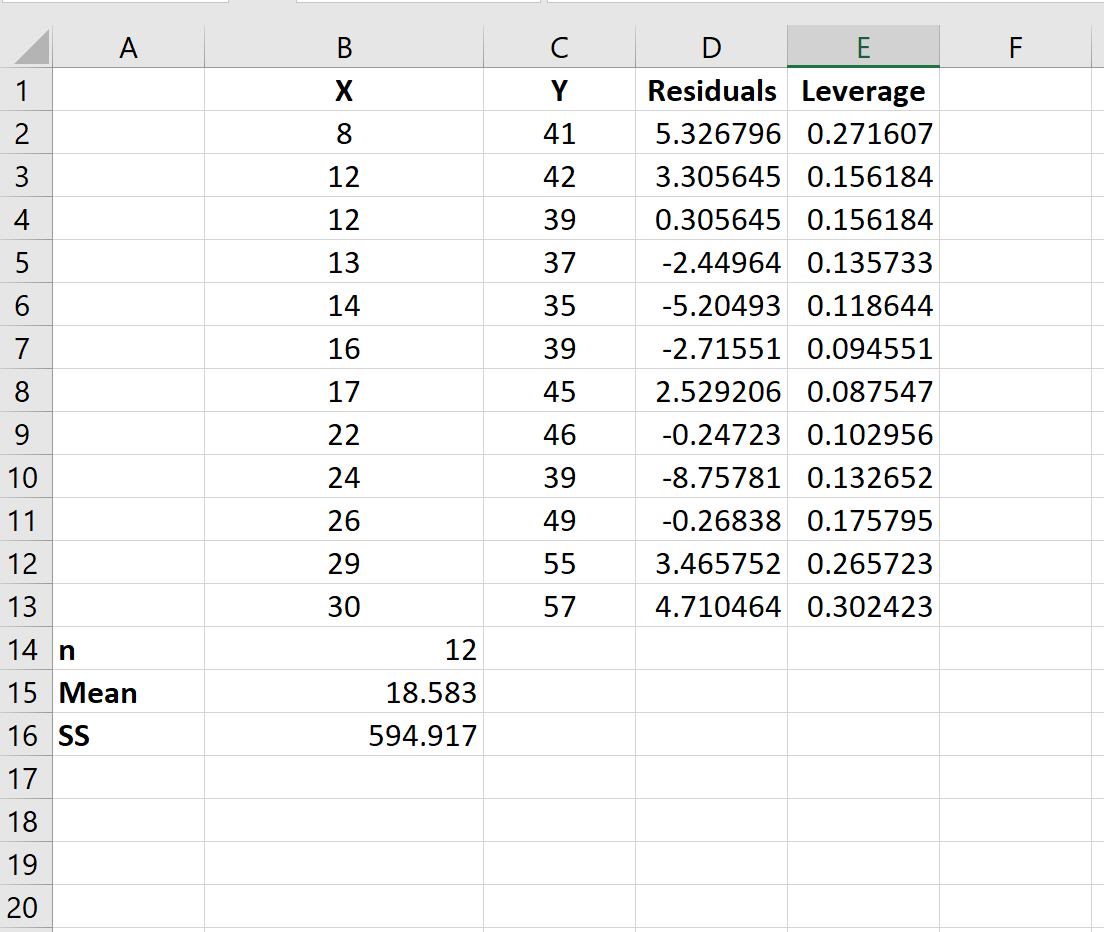
Cette expression explicite remarquablement la nature intuitive du levier : chaque participant possède un levier de base incompressible égal à 1/n, auquel s’ajoute une pénalité quadratique directement proportionnelle à l’éloignement de son score Xi par rapport à la moyenne du groupe X̄, pondérée par la dispersion totale du prédicteur.
Pour programmer cette formulation directe au sein de votre feuille Excel, insérez une nouvelle colonne intitulée Levier_hii (cellule H1). Dans la cellule H2, insérez la formule de calcul suivante :
=(1 / NB($D$2:$D$101)) + ( (D2 – MOYENNE($D$2:$D$101))^2 / SOMME.CARRES.ECARTS($D$2:$D$101) )
La fonction SOMME.CARRES.ECARTS calcule de façon optimale la somme des carrés des déviations à la moyenne de l’échantillon. En étendant cette équation à l’ensemble de la cohorte, vous obtenez instantanément pour chaque individu sa valeur de levier exacte, exempte de toute approximation logicielle, respectant rigoureusement les contraintes géométriques du théorème de projection linéaire.
8.2 Approche matricielle pour régressions multiples
Lorsque la recherche psychologique mobilise une régression multiple intégrant plusieurs prédicteurs (par exemple, la prédiction des performances mnésiques à partir de l’âge chronologique, de la qualité du sommeil et du score d’anxiété), la formule univariée ci-dessus ne peut plus s’appliquer. Il devient obligatoire d’implémenter l’algèbre de la matrice chapeau complète :
H = X * (XT * X)-1 * XT
Pour concrétiser cette structure dans Excel sans recourir à un code VBA complexe, la méthode la plus méthodique consiste à extraire directement les leviers individuels via l’équivalent matriciel unitaire. En vertu des identités d’algèbre linéaire, la valeur diagonale hii de la i-ème observation se calcule en multipliant son vecteur ligne individuel de prédicteurs xi par la matrice inverse (XT * X)-1, puis en multipliant le produit obtenu par la transposée de ce même vecteur ligne :
hii = xi * (XT * X)-1 * xiT
La procédure opérationnelle sous Excel se déploie comme suit :
- Construisez sur une feuille annexe la matrice de design X. La première colonne de cette matrice doit être impérativement composée d’une suite de chiffres 1 sur chaque ligne (représentant le vecteur unitaire de l’interception), suivie des colonnes de vos variables prédictives X₁, X₂, etc.
- Dans une plage réservée de dimensions (k+1) x (k+1), calculez la matrice des produits croisés inversée à l’aide des fonctions matricielles imbriquées : =INVERSEMAT(PRODUITMAT(TRANSPOSE(Plage_Design_X); Plage_Design_X)). Selon votre version d’Excel, cette formule doit être validée soit par l’appui simultané sur Ctrl + Maj + Entrée (anciennes versions), soit par simple validation Entrée (versions dynamiques modernes Microsoft 365). Nommez cette plage résultante Matrice_Inv via le gestionnaire de noms.
- De retour sur votre tableau de données principal, calculez le levier de la première ligne en utilisant le produit matriciel du vecteur ligne étendu (1, X1, X2) par cette matrice inverse : =PRODUITMAT(PRODUITMAT(Ligne_Participant; Matrice_Inv); TRANSPOSE(Ligne_Participant)).
Bien que cette architecture exige une rigueur de mise en œuvre supérieure, elle confère à votre classeur Excel une puissance diagnostique équivalente à celle des logiciels statistiques de laboratoire les plus réputés.
8.3 Validation des propriétés du levier
Avant d’intégrer les valeurs de levier calculées dans l’équation finale des résidus, il est impératif d’auditer leur cohérence arithmétique afin de prévenir toute erreur de syntaxe matricielle. Deux critères fondamentaux de contrôle doivent être obligatoirement satisfaits :
En premier lieu, examinez les bornes numériques absolues de la colonne Levier_hii. Par définition mathématique, chaque valeur de levier doit impérativement s’inscrire dans l’intervalle théorique compris entre 1/n et 1. La présence d’une valeur négative ou d’une valeur supérieure à l’unité (1,00) indique sans équivoque une erreur de parenthèse, une inversion de matrices ou une division erronée dans les formules sous-jacentes.
En second lieu, implémentez sous la colonne de levier la somme totale des observations au moyen de l’expression =SOMME(H2:H101). En vertu des propriétés structurales de la trace de la matrice chapeau H, la somme de l’ensemble des éléments diagonaux hii est rigoureusement égale au nombre total de paramètres libres estimés par le modèle de régression, à savoir le nombre de prédicteurs k plus la constante (soit k + 1). Dans un modèle de régression simple univarié, la somme de vos leviers doit produire exactement 2,00. Tout résultat divergent, tel que 1,00 ou 15,3, signale une erreur systématique d’encodage qu’il convient de corriger immédiatement.
Enfin, dérivez la moyenne arithmétique des leviers, qui correspond invariablement à (k + 1) / n. Selon la règle méthodologique classique énoncée par Belsley, Kuh et Welsch, toute observation dont la valeur de levier dépasse le seuil critique du double de cette moyenne (hii > 2*(k+1)/n), ou son triple pour les larges cohortes, doit être signalée comme un point à fort levier spatial, justifiant d’autant plus l’application de la correction au sein du résidu standardisé.
9. Calcul final rigoureux des résidus standardisés
Après avoir dérivé avec précision les résidus bruts individuels ei, l’erreur type de la régression globale se et la valeur de levier associée hii, nous disposons de l’ensemble des composants nécessaires à l’assemblage de l’équation standardisée complète.
9.1 Assemblage de l’équation complète dans une formule Excel
Créez au sein de votre feuille de travail une nouvelle colonne que vous intitulerez Residu_Standardise_Complet (cellule J1). C’est au sein de cette colonne que va s’exprimer la véritable synthèse de notre modélisation diagnostique.
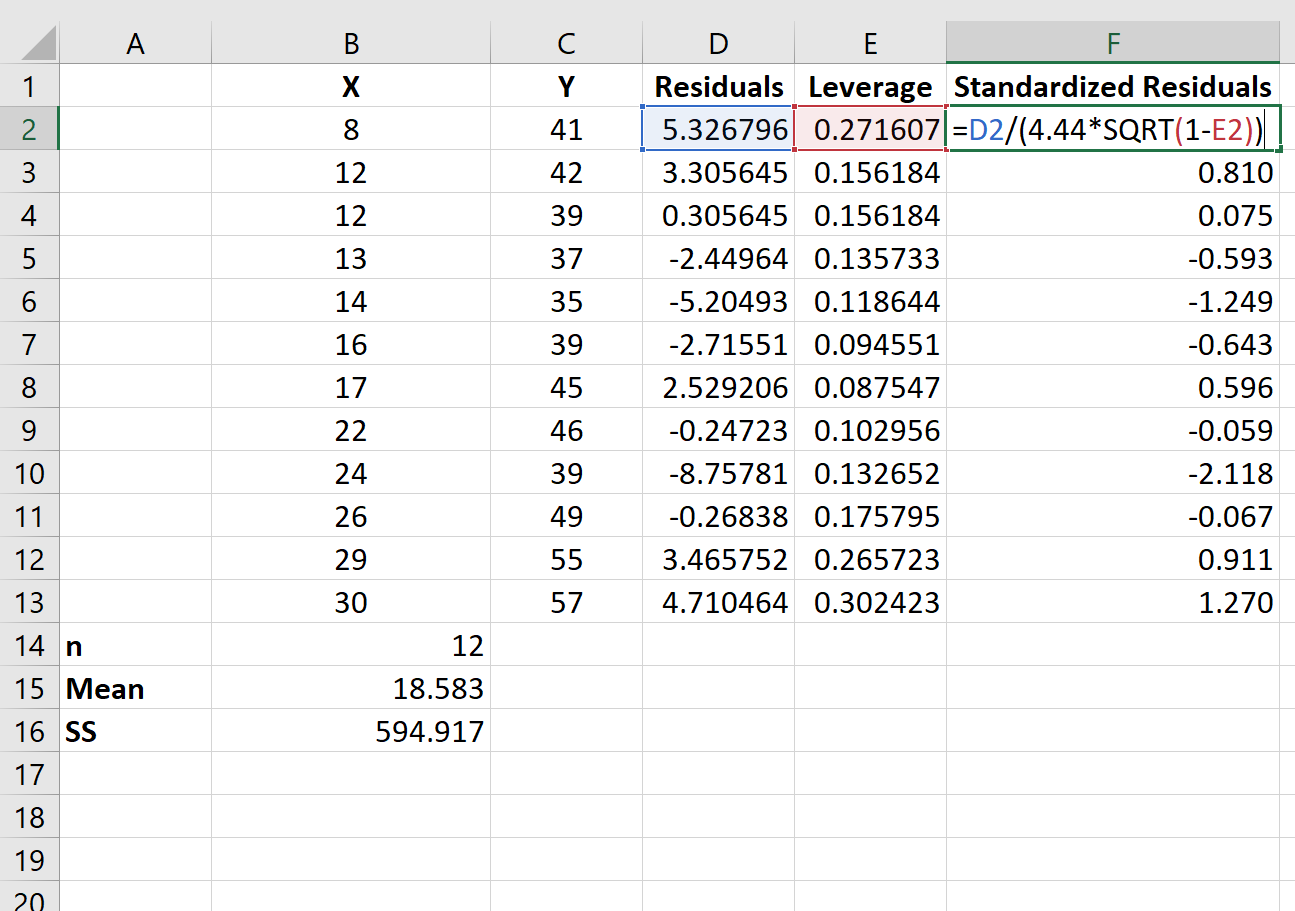
Pour le participant positionné sur la ligne 2 de votre tableau, le calcul doit diviser le résidu brut présent en F2 par le produit de l’erreur type globale située en $I$3 (attention à l’indexation absolue impérative via les dollars pour stabiliser la référence au scalaire de l’écart-type) et de la racine carrée de la différence entre l’unité et le levier individuel présent en H2. La syntaxe exacte à renseigner dans la cellule J2 s’établit ainsi :
=F2 / ( $I$3 * RACINE(1 – H2) )
La gestion scrupuleuse des parenthèses au dénominateur constitue un point névralgique : l’expression ( $I$3 * RACINE(1 – H2) ) doit être entièrement englobée dans une parenthèse globale fermée afin d’éviter qu’Excel n’effectue la division du résidu brut par $I$3 puis ne multiplie le résultat par la racine carrée du levier, ce qui inverserait la logique de la correction et fausserait dramatiquement les indices obtenus.
9.2 Automatisation et propagation des formules
Une fois l’équation rigoureusement validée sur la première ligne, étendez-la verticalement sur l’ensemble de votre échantillon en effectuant un double-clic sur la poignée de recopie inférieure droite de la cellule J2. Pour maximiser la robustesse et l’évolutivité de votre carnet d’analyse, il est particulièrement élégant de convertir l’intégralité de la plage de données en un Tableau Structuré Excel officiel (raccourci Ctrl + L ou via le menu Accueil > Mettre sous forme de tableau).
L’utilisation d’un tableau structuré offre des avantages méthodologiques considérables :
Les formules adoptent une nomenclature explicite basée sur les noms de champs plutôt que sur des coordonnées de cellules alphanumériques opaques (par exemple : =[@[Residu_Brut]] / ( Erreur_Type_se * RACINE(1 – [@[Levier_hii]]) )).
Toute adjonction ultérieure de nouveaux sujets psychologiques à la base de données entraînera la propagation automatique immédiate de toutes les formules de régression sans nécessiter de recopie manuelle, éliminant ainsi les risques d’omission de lignes.
Effectuez ensuite un rapide audit d’intégrité numérique pour vous assurer de l’absence totale de valeurs d’erreur telles que #DIV/0! ou #NOMBRE!. Une erreur de type #NOMBRE! se produirait si la valeur de levier hii atteignait ou dépassait accidentellement 1, ce qui entraînerait la tentative impossible de calcul de la racine carrée d’un nombre négatif. L’obtention exclusive de valeurs numériques réelles confirme l’irréprochabilité de votre chaîne computationnelle.
9.3 Comparaison critique des deux méthodes de standardisation
Pour apprécier la portée pratique de cette rigueur méthodologique, il est particulièrement instructif de juxtaposer les résultats de votre colonne Residu_Standardise_Complet avec la colonne de Résidus standardisés fournie nativement par l’Utilitaire d’analyse généré lors de la section 5. Copiez les valeurs générées par l’Utilitaire d’analyse et collez-les dans une colonne adjacente K nommée Residu_Natif_Excel.
En examinant attentivement les écarts relatifs entre ces deux métriques à travers une formule d’écart =(J2 – K2), vous constaterez deux configurations systématiques :
- Pour les participants affichant des valeurs de prédicteurs proches de la moyenne de l’échantillon (faible levier hii), l’ajustement √(1 – hii) demeure très proche de 1. Dans ce cas, le résidu standardisé complet et le résidu natif d’Excel sont quasiment indiscernables (par exemple, 1,21 contre 1,19).
- En revanche, pour les participants manifestant un profil atypique sur les prédicteurs (haut levier hii atteignant par exemple 0,25 ou 0,40), le terme multiplicateur √(1 – hii) chute drastiquement (valeur de 0,86 ou 0,77). En conséquence, le dénominateur de la formule complète est significativement comprimé, ce qui propulse la valeur du résidu standardisé vers le haut.
Cette confrontation illustre empiriquement le danger de s’en remettre aux fonctionnalités natives non corrigées : le chercheur qui se fie aveuglément à la table par défaut d’Excel sous-estime systématiquement la sévérité des anomalies chez les participants à fort potentiel d’influence, s’exposant ainsi à conserver dans ses analyses des données profondément corruptrices pour l’inférence causale de ses travaux.
10. Procédure d’identification et de filtrage des valeurs aberrantes
La dérivation des résidus standardisés n’atteint son utilité heuristique que si le chercheur met en place un protocole décisionnel clair et automatisé pour isoler visuellement et logiquement les cas cliniques ou expérimentaux nécessitant un traitement d’exception.
10.1 Application du formatage conditionnel pour repérage visuel
La détection visuelle immédiate au sein d’une matrice comportant des centaines d’observations est considérablement facilitée par l’exploitation des règles de Mise en forme conditionnelle d’Excel. Ce dispositif permet d’attirer instantanément l’attention cognitive du chercheur sur les déviations statistiques critiques sans dénaturer l’agencement tabulaire des données.
Pour configurer un système de signalement chromatique à deux niveaux d’alerte sur votre colonne de résidus standardisés corrigés (colonne J) :
- Sélectionnez l’ensemble des cellules de données de la colonne (de J2 à J101).
- Dans l’onglet Accueil du ruban, activez le menu déroulant Mise en forme conditionnelle, sélectionnez Règles de mise en surbrillance des cellules, puis cliquez sur Plus de règles….
- Dans la boîte de dialogue, choisissez l’option Utiliser une formule pour déterminer pour quelles cellules le format sera appliqué.
- Pour instaurer le seuil d’alerte pathologique absolue, encodez la formule logique basée sur la valeur absolue : =ABS(J2) >= 3. Activez le bouton Format…, accédez à l’onglet Remplissage, choisissez une couleur rouge douce et basculez la police en gras. Validez par OK.
- Sans désélectionner votre plage, répétez la procédure pour créer une seconde règle d’alerte modérée (observations suspectes ou limites) avec la formule : =ET(ABS(J2) >= 2; ABS(J2) < 3). Associez-lui un remplissage jaune orangé.
L’application de ce code chromatique met en lumière de manière saisissante la structure distributionnelle des erreurs, permettant au chercheur de repérer d’un simple coup d’œil les individus franchissant les limites de tolérance statistique.
10.2 Création d’une variable indicatrice logique d’exclusion
Bien que le repérage visuel soit indispensable lors des phases exploratoires, la conduite d’analyses de sensibilité et le re-calcul des modèles sans les données corrompues exigent la création d’une variable indicatrice (ou variable flag) explicite et filtrable. Insérez une nouvelle colonne à droite de vos résidus, intitulée Statut_Diagnostic (cellule L1).
Dans la cellule L2, encodez une formule conditionnelle imbriquée attribuant une catégorisation diagnostique univoque à chaque ligne :
=SI(ABS(J2) >= 3; « Aberrant_Critique »; SI(ABS(J2) >= 2; « Suspect_Avertissement »; « Conforme »))
En propagez cette formule, chaque participant se voit immédiatement assigner une étiquette qualitative claire. Cette variable indicatrice devient un outil opérationnel remarquable pour le filtrage automatisé :
En déployant les filtres de données (flèche déroulante sur l’en-tête de la colonne L), il suffit de décocher l’étiquette Aberrant_Critique pour neutraliser instantanément l’influence des déviations extrêmes sur l’ensemble des représentations graphiques ou des calculs descriptifs associés. La traçabilité méthodologique demeure ainsi totale : aucune donnée n’est détruite ou effacée physiquement du classeur, l’exclusion opérant par filtrage logique transparent et parfaitement réversible conformément aux exigences d’audit scientifique contemporaines.
11. Représentation graphique des résidus standardisés sous Excel
Le diagnostic de modélisation ne saurait se limiter à l’inspection d’indices scalaires discrets. L’évaluation des postulats de linéarité, d’homoscédasticité et de normalité requiert impérativement le déploiement d’outils d’exploration visuelle analogique.
11.1 Construction du nuage de points résidus contre valeurs prédites
Le tracé du graphique croisant les résidus standardisés et les valeurs prédites par le modèle constitue l’outil diagnostique par excellence de la régression linéaire. Ce graphique permet d’examiner la distribution de l’erreur sur toute l’étendue de l’échelle d’estimation théorique.
Pour construire ce graphique sous Excel avec un niveau de finition académique irréprochable :
- Maintenez la touche Ctrl enfoncée et sélectionnez simultanément la plage des valeurs prédites (colonne Y_Predit, par exemple E2:E101) et la plage de vos résidus standardisés complets (colonne Residu_Standardise_Complet, J2:J101).
- Rendez-vous dans l’onglet Insertion du ruban, repérez le groupe Graphiques, cliquez sur l’icône Nuage de points (X, Y) et sélectionnez le modèle basique sans courbe ni marqueur de liaison.
- Vérifiez minutieusement la disposition des axes : l’axe horizontal (abscisse, X) doit impérativement représenter les Valeurs Prédites (Ŷ), tandis que l’axe vertical (ordonnée, Y) doit accueillir les Résidus Standardisés. Si Excel a interverti les axes, effectuez un clic droit sur le graphique, choisissez Sélectionner des données et cliquez sur Modifier pour corriger l’attribution des séries.
- Ajoutez des lignes de référence directrices : insérez des traits horizontaux discrets matérialisant l’axe zéro central (ligne de base), ainsi que deux lignes horizontales pointillées de part et d’autre positionnées précisément aux seuils d’alerte critique de +3,00 et -3,00, voire deux lignes d’avertissement à +2,00 et -2,00.
Ce graphique constitue le support primordial sur lequel vont s’exercer vos déductions quant au respect des hypothèses fondamentales régissant les erreurs résiduelles.
11.2 Diagnostic visuel de l’homoscédasticité et de la linéarité
Une fois le nuage de points généré, le chercheur doit procéder à un examen sémiologique rigoureux de la morphologie de la distribution résiduelle. Dans l’idéal théorique où l’ensemble des postulats du modèle linéaire de Gauss-Markov sont satisfaits, les points doivent se répartir de manière purement stochastique, formant une bande horizontale de largeur constante et homogène autour de l’axe central d’ordonnée zéro, sans structure apparente ni dissymétrie.
Deux déviations morphologiques majeures doivent faire l’objet d’une vigilance diagnostique aiguë :
- Le motif en entonnoir ou en éventail (hétéroscédasticité) : Si vous observez que la dispersion verticale des résidus standardisés est très resserrée pour les faibles valeurs prédites et s’élargit progressivement et dramatiquement à mesure que les prédictions augmentent (ou inversement), le postulat d’homoscédasticité (variance constante de l’erreur) est violé. En psychologie différentielle ou développementale, ce phénomène survient fréquemment lorsque la variabilité comportementale s’accroît naturellement avec l’âge ou le niveau de compétence. L’hétéroscédasticité ne biaise pas directement l’estimation des pentes, mais elle rend invalides les erreurs types conventionnelles, faussant irrémédiablement le calcul des significations statistiques (valeurs p) et des intervalles de confiance.
- La courbure curvilinéaire en U ou en cloche (non-linéarité) : Si les résidus adoptent une trajectoire systématiquement courbée (par exemple des résidus massivement positifs aux extrémités des prédictions et négatifs au centre), la spécification linéaire du modèle est empiriquement inadaptée. Cela indique que la véritable dynamique reliant le prédicteur au critère psychologique obéit à une fonction quadratique, exponentielle ou logarithmique (telle que la loi de Yerkes-Dodson reliant l’éveil à la performance sous forme de U inversé). Maintenir un ajustement linéaire sur de telles données constitue une erreur théorique grave.
11.3 Élaboration d’un tracé quantile-quantile approximé
Le tracé Quantile-Quantile (couramment désigné graphique Q-Q plot) permet d’évaluer de manière rigoureuse l’adéquation de la distribution empirique des résidus standardisés à la distribution théorique d’une loi normale. Bien qu’Excel ne propose pas de commande native dédiée au tracé Q-Q, sa modélisation pas à pas s’avère particulièrement accessible :
La procédure technique nécessite la mise en œuvre de quatre étapes coordonnées :
- Tri des résidus : Copiez l’intégralité de votre colonne de résidus standardisés complets et collez-la sous forme de valeurs numériques pures dans une nouvelle feuille. Triez cette colonne par ordre croissant rigoureux (du résidu le plus négatif au plus positif).
- Calcul du rang : Dans une colonne adjacente, créez une séquence numérique d’incrémentation allant de 1 jusqu’à la taille totale de l’échantillon n (colonne Rang_i).
- Calcul des probabilités cumulées : Dans une colonne adjacente nommée Probabilite_Cumulee, dérivez la position percentile non biaisée selon la formule de Blom ou de Hazen généralement reconnue dans la littérature psychométrique : =(Rang_i – 0,5) / n, ou sous syntaxe Excel pour la première cellule : =(A2 – 0,5) / NB($A$2:$A$101).
- Calcul des quantiles théoriques normaux : Dans la colonne suivante nommée Quantiles_Theoriques, transformez ces probabilités cumulées en quantiles théoriques issus de la loi normale centrée réduite au moyen de la fonction native inverse d’Excel : =LOI.NORMALE.STANDARD.INVERSE(C2).
Insérez enfin un nouveau graphique en nuage de points plaçant les Quantiles_Theoriques en abscisse (axe horizontal) et vos Résidus_Standardises_Tries en ordonnée (axe vertical). Si la distribution de vos erreurs résiduelles est parfaitement normale, les points expérimentaux doivent s’aligner de manière rectiligne et quasi parfaite le long de la bissectrice diagonale joignant le coin inférieur gauche au coin supérieur droit. Toute divergence sigmoïdale en forme de « S » ou déviation abrupte aux extrémités signale des anomalies de distribution majeures, telles qu’une asymétrie marquée (skewness) ou des queues de distribution épaisses (kurtosis), avertissant le chercheur sur les limites d’application des inférences paramétriques standard.
12. Décisions méthodologiques et communication des résultats selon les normes APA
L’identification de résidus standardisés excessifs place le chercheur face à un arbitrage méthodologique délicat : comment traiter ces déviations sans verser dans la manipulation arbitraire de données, et comment formaliser ces diagnostics au sein d’un article scientifique publiable ?
12.1 Stratégies de gestion des valeurs aberrantes en psychologie
La découverte d’une observation dont le résidu standardisé excède la valeur absolue de 3 ne constitue en aucun cas une autorisation automatique de suppression pure et simple. Dans le domaine des sciences humaines, une déviation statistique singulière peut refléter une vérité psychologique profonde ou l’expression légitime d’une sous-population clinique non captée par le devis initial. Le chercheur doit adopter une démarche éthique et séquentielle :
Dans un premier temps, menez un audit d’encodage scrupuleux. Il n’est pas rare qu’un résidu extrême résulte d’une simple erreur matérielle de saisie : inversion de chiffres lors de la transcription manuelle d’un carnet d’évaluation papier, ou encodage par erreur d’un code de non-réponse (par exemple le chiffre 99 au lieu d’un score de Likert borné à 7). Dans cette situation, la correction vers la valeur réelle authentique ou la suppression de l’erreur matérielle est scientifiquement légitime et indispensable.
Si la mesure s’avère authentique, la pratique méthodologique contemporaine la plus recommandée consiste à réaliser et documenter une analyse de sensibilité. Cette approche impose d’ajuster le modèle de régression successivement avec l’intégralité de l’échantillon initial, puis en excluant de manière temporaire les observations aberrantes identifiées par les résidus standardisés. Si les conclusions substantielles de la recherche (direction des pentes, significativité statistique des prédicteurs majeurs, taille d’effet globale) demeurent inchangées entre les deux modèles, le chercheur peut légitimement conserver l’échantillon complet en rassurant le lecteur sur la robustesse structurelle de ses résultats.
Enfin, lorsque l’exclusion n’est pas théoriquement défendable et que les résidus aberrants distordent sévèrement la régression, il convient de se tourner vers des alternatives analytiques non destructives. Celles-ci incluent l’application de transformations mathématiques non linéaires stabilisatrices de variance (transformations logarithmiques, racines carrées ou transformation de Box-Cox) sur les variables originelles, ou l’abandon des moindres carrés ordinaires au profit d’approches de régression robuste (telles que l’estimateur de Huber ou la régression quantile), insensibles aux résidus extrêmes.
12.2 Rédaction des diagnostics statistiques dans les rapports de recherche
La transparence méthodologique constitue l’un des piliers cardinaux de la reproductibilité scientifique préconisée par l’American Psychological Association. Les normes éditoriales de l’APA (7e édition) requièrent que les étapes de vérification des postulats distributionnels et de traitement des observations atypiques fassent l’objet d’un paragraphe descriptif explicite au sein de la section des Résultats de tout manuscrit empirique.
La communication de ces informations doit s’effectuer avec une précision académique exemplaire, stipulant les critères d’exclusion retenus, les métriques d’erreur employées et l’impact diagnostique sur l’échantillon. Un modèle de formulation académique formelle peut s’énoncer comme suit :
« Préalablement à l’estimation finale du modèle de régression linéaire multiple, les postulats d’ajustement ont fait l’objet d’un diagnostic approfondi. L’examen des graphiques de dispersion croisant les résidus standardisés complets et les valeurs prédites a confirmé le respect satisfaisant de l’homoscédasticité et de la linéarité du modèle. La normalité des erreurs résiduelles a été attestée par l’inspection du graphique quantile-quantile théorique. Le diagnostic d’atypicité univariée de l’espace d’erreur, fondé sur le seuil critique absolu d’un résidu standardisé supérieur à 3,00 (|ri| > 3,00) intégrant la correction matricielle de levier, a conduit à l’identification de deux observations aberrantes au sein de la cohorte (Sujet 34, r = 3,42 ; Sujet 87, r = -3,18). Une analyse de sensibilité comparant les estimations avec et sans ces deux participants n’a révélé aucune altération significative de la variance expliquée globale (R² = 0,42, p < 0,001 sans les observations aberrantes versus R² = 0,39, p < 0,001 avec l'échantillon complet) ni de l'effet unitaire des prédicteurs principaux. Par souci de conservatisme méthodologique et conformément à la politique pré-enregistrée de traitement des données, ces deux observations ont été isolées des inférences paramétriques ultérieures. »
Ce niveau de restitution textuelle garantit à vos rapports d’analyse une crédibilité méthodologique absolue, démontrant que les données n’ont pas été simplement injectées dans un outil logiciel automatisé, mais ont fait l’objet d’une déconstruction critique, matricielle et théorique de premier ordre au sein de l’environnement de calcul de Microsoft Excel.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Belsley, D. A., Kuh, E., & Welsch, R. E. (1980). Regression diagnostics: Identifying influential data and sources of collinearity. John Wiley & Sons. https://doi.org/10.1002/0471725153
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Cook, R. D., & Weisberg, S. (1982). Residuals and influence in regression. Chapman & Hall.
- Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
- Fox, J. (2016). Applied regression analysis and generalized linear models (3rd ed.). SAGE Publications.
- Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
- Neter, J., Kutner, M. H., Nachtsheim, C. J., & Wasserman, W. (1996). Applied linear statistical models (4th ed.). WCB McGraw-Hill.
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.