
L’analyse de régression linéaire constitue l’un des piliers méthodologiques les plus largement sollicités au sein des sciences contemporaines, tout particulièrement en psychologie, en psychométrie et dans les sciences du comportement. Qu’il s’agisse d’évaluer l’impact du stress perçu sur la mémoire de travail, de modéliser l’efficacité d’un protocole d’intervention cognitive ou d’estimer les trajectoires de développement émotionnel chez l’enfant, le chercheur s’appuie continuellement sur des modèles linéaires pour formaliser des relations complexes entre des variables prédictives et des variables d’intérêt. Néanmoins, l’estimation des paramètres par la méthode des moindres carrés ordinaires ne représente que la première étape d’un processus itératif rigoureux. Un modèle mathématiquement convergent ne garantit en rien la validité théorique ou l’exactitude inférentielle des conclusions qui en découlent.
La force probante d’une modélisation statistique repose fondamentalement sur le respect scrupuleux d’un ensemble de postulats théoriques désignés sous le terme d’hypothèses de Gauss-Markov. Dès lors qu’une ou plusieurs de ces conditions sont violées, les estimateurs peuvent perdre leur propriété d’efficacité, voire présenter des biais systématiques dévastateurs, altérant la validité des tests de significativité et gonflant artificiellement le taux d’erreur de première espèce. Face à ce défi méthodologique, l’examen minutieux des écarts entre les observations empiriques et les prédictions du modèle — c’est-à-dire l’analyse des résidus — s’impose comme une nécessité absolue. Loin d’être un simple sous-produit arithmétique de l’estimation, le résidu condense l’ensemble des informations que le modèle a échoué à capturer, agissant comme un révélateur des imperfections de l’ajustement, des anomalies de mesure ou des biais d’échantillonnage.
Cependant, le recours exclusif aux résidus bruts présente des limites structurelles majeures qui entravent la comparaison interindividuelle et l’identification standardisée des déviances statistiques. C’est précisément pour surmonter ces contraintes qu’intervient la notion de résidu standardisé. En rééchelonnant chaque écart par une estimation rigoureuse de son erreur-type conditionnelle, qui intègre le positionnement spatial de l’observation dans l’espace des variables indépendantes, la standardisation transforme des résidus hétérogènes en métriques directement interprétables et comparables à une loi normale centrée réduite. L’environnement logiciel R offre une palette d’outils statistiques remarquablement sophistiqués pour orchestrer cette transition conceptuelle et calculatoire. Ce guide exhaustif a pour vocation d’exposer en détail les fondements théoriques, la formulation mathématique et l’implémentation pratique des résidus standardisés sous R, en fournissant aux chercheurs et analystes de données un protocole rigoureux de diagnostic pour consolider la robustesse de leurs conclusions empiriques.
1. Fondements théoriques des résidus dans les modèles de régression linéaire
1.1 Définition mathématique du résidu brut
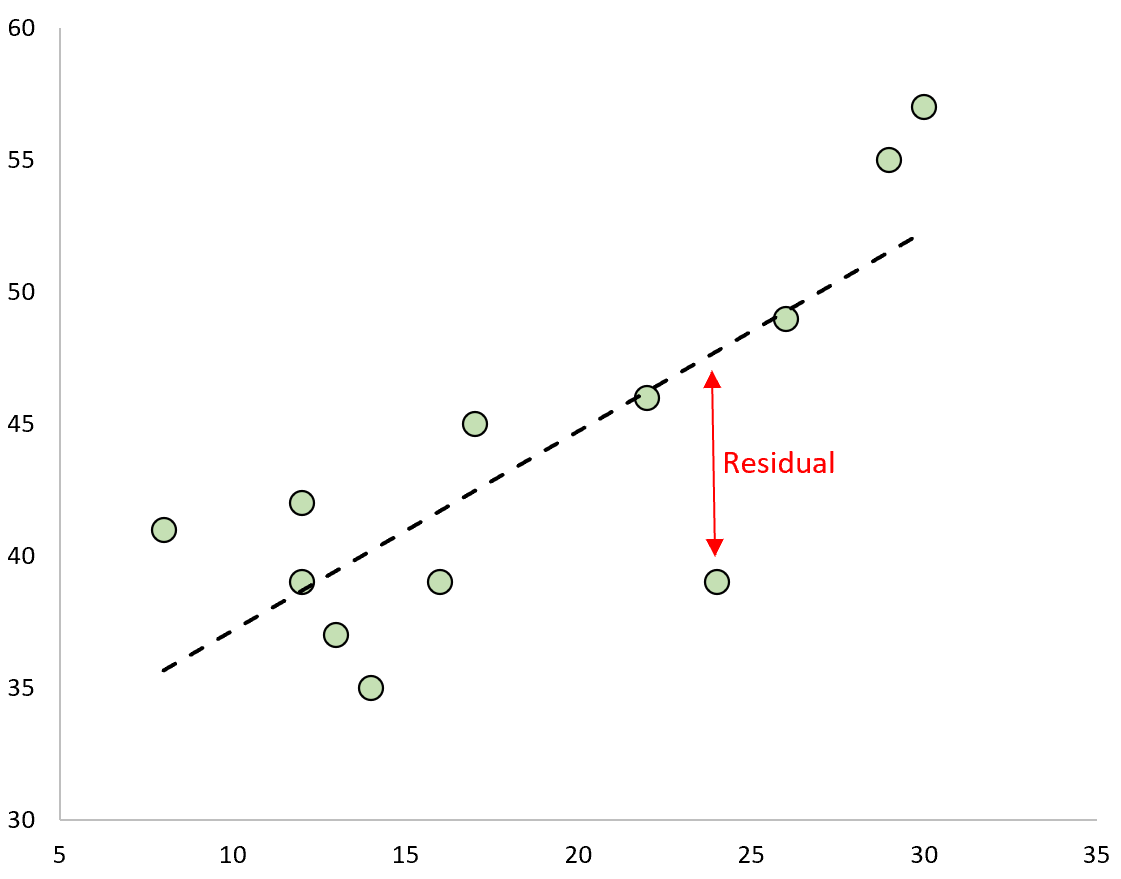
Dans le cadre formel d’un modèle de régression linéaire classique, le résidu brut, couramment désigné par la notation algébrique ei pour la i-ième observation, se définit rigoureusement comme la différence arithmétique entre la valeur empiriquement observée de la variable réponse, notée yi, et la valeur prédite par le modèle ajusté, notée ŷi. Cette relation s’exprime par l’équation fondamentale ei = yi – ŷi. Il est d’une importance capitale de ne pas confondre ce résidu d’échantillonnage avec la perturbation théorique ou l’erreur stochastique sous-jacente de la population, usuellement notée εi. Alors que la perturbation stochastique est une entité latente et inobservable issue du processus générateur de données théorique, le résidu brut constitue sa contrepartie empirique directement calculable à partir de l’échantillon prélevé et des paramètres estimés par la méthode des moindres carrés ordinaires.
D’un point de vue purement géométrique au sein d’un repère cartésien, le résidu brut représente la distance euclidienne verticale dirigée reliant le point d’observation empirique à la droite, au plan ou à l’hyperplan d’ajustement structurel. Un résidu positif signale sans ambiguïté que la performance, le comportement ou la mesure observée chez un sujet dépasse le pronostic formulé par le modèle statistique, traduisant une sous-estimation locale par l’équation prédictive. Inversement, un résidu négatif indique une surestimation, le sujet obtenant un score inférieur à ce que son profil sur les covariables laissait escompter. Lorsque l’observation coïncide rigoureusement avec la trajectoire prédictive, le résidu s’annule, signifiant une adéquation locale absolue du modèle aux données observées.
L’inconvénient premier et irréductible de ce résidu brut réside dans sa dépendance intrinsèque et absolue à l’unité de mesure initiale de la variable dépendante. Si un chercheur modélise le temps de réponse d’un participant mesuré en secondes, l’amplitude de son résidu brut s’exprimera en secondes. Si cette même variable est convertie en millisecondes, la magnitude du résidu se trouvera instantanément multipliée par un facteur mille, sans que la nature de l’ajustement statistique ou la conformité de l’observation n’aient subi la moindre altération substantielle. Cette sensibilité d’échelle empêche toute comparaison directe entre des modèles explorant des construits distincts ou employant des étalonnages variés, limitant drastiquement la portée sémiotique du résidu brut lorsqu’il s’agit de porter un jugement diagnostique universel.
1.2 Propriétés fondamentales sous les hypothèses de Gauss-Markov
L’interprétation statistique des résidus dans un cadre inférentiel repose sur le théorème de Gauss-Markov, qui formalise les conditions optimales sous lesquelles les estimateurs des moindres carrés ordinaires sont déclarés BLUE (Best Linear Unbiased Estimators). La première de ces conditions postule que l’espérance mathématique conditionnelle des perturbations stochastiques sachant la matrice des prédicteurs X est rigoureusement nulle, ce qui se traduit par l’écriture E(ε | X) = 0. Cette assertion implique que la structure fonctionnelle du modèle est correctement spécifiée : aucune variable explicative majeure n’a été indûment omise et la forme mathématique choisie — qu’elle soit linéaire, polynomiale ou interactive — reflète fidèlement la véritable dynamique sous-jacente du phénomène psychologique étudié.
La deuxième condition primordiale concerne l’homoscédasticité, qui requiert que la variance de l’aléa statistique demeure strictement constante quelle que soit la valeur prise par les prédicteurs au sein de l’espace factoriel. Formellement, cela s’exprime par Var(εi | X) = σ2 pour tout indice i. Lorsque cette constance fait défaut, le phénomène d’hétéroscédasticité émerge : la dispersion des erreurs fluctue le long du gradient prédictif. En recherche comportementale, cette situation se manifeste régulièrement lorsqu’une tâche cognitive complexe génère une variabilité interindividuelle bien plus marquée chez les sujets stressés que chez les sujets détendus, introduisant une hétérogénéité structurelle de la variance qui invalide le calcul conventionnel des erreurs-types des coefficients de régression.
Enfin, les hypothèses de Gauss-Markov stipulent l’absence totale d’autocorrélation entre les perturbations stochastiques associées à des observations distinctes, se formalisant par Cov(εi, εj | X) = 0 pour tout couple d’indices où i ≠ j. Dans le contexte de plans expérimentaux factoriels ou d’études psychométriques transversales, cette indépendance sérielle garantit que la mesure recueillie auprès d’un participant n’est aucunement contaminée par la réponse apportée par un autre individu, ni par l’ordre chronologique d’administration des épreuves. La violation de cette indépendance, fréquemment observée dans les recueils longitudinaux ou les données de passation groupée, entraîne une sous-estimation systématique des variances des estimateurs et conduit inévitablement à des conclusions abusives quant à la significativité statistique des prédicteurs testés.
1.3 Pertinence de l’analyse résiduelle en recherche psychologique
Dans le domaine spécifique de la psychologie empirique, de la psychométrie et de la recherche comportementale, l’analyse des résidus transcende le simple contrôle technique pour devenir un instrument fondamental de validation de construit. Lors de la modélisation de construits psychologiques latents — tels que l’intelligence fluide, la résilience émotionnelle ou les biais d’attribution causale —, le chercheur fait l’hypothèse que la majeure partie de la variance observée s’articule logiquement autour de dimensions théoriques explicatives. Les résidus représentent précisément la portion de comportement que notre théorie échoue à rationaliser. Une concentration systématique de résidus de forte amplitude au sein d’un sous-groupe particulier de sujets peut révéler l’existence d’une variable modératrice ignorée, comme un trait de personnalité spécifique ou un antécédent clinique pertinent.
De surcroît, l’examen résiduel offre une fenêtre privilégiée sur la détection des biais de réponse systématiques qui polluent chroniquement les protocoles d’auto-évaluation. Des phénomènes tels que la désirabilité sociale, l’acquiescement compulsif ou les réponses aléatoires motivées par l’inattention introduisent dans les données des profils de divergence majeurs. Un individu cherchant à projeter une image irréaliste de perfection morale obtiendra, sur des échelles cliniques ou occupationnelles, des scores réels s’écartant radicalement des valeurs attendues sur la base de ses autres déterminants psychologiques. L’identification de résidus exceptionnellement élevés permet ainsi aux psychométriciens de repérer ces profils non conformes, dont le comportement de passation fausse la calibration globale des instruments d’évaluation.
Enfin, dans le développement et l’optimisation des épreuves psychométriques standardisées, l’analyse résiduelle joue un rôle clé dans la vérification de l’invariance de mesure. Si un modèle de régression reliant le score à un test de raisonnement spatial au rendement académique produit des résidus dont la distribution diffère systématiquement selon le genre ou l’origine socioculturelle des participants, cela signale un fonctionnement différentiel des items ou un biais de prédiction intrinsèque à l’outil. Les résidus cessent alors d’être considérés comme un bruit blanc inévitable pour devenir un signal informationnel dense, guidant le perfectionnement des paradigmes d’expérimentation et garantissant l’équité des conclusions cliniques ou éducatives qui en seront tirées.
2. Du résidu brut au résidu standardisé : concepts et motivations
2.1 Limites interprétatives des résidus bruts en psychométrie
L’utilisation des résidus bruts en psychométrie se heurte immédiatement au problème de l’incommensurabilité des échelles psychologiques. Dans la pratique expérimentale, un chercheur peut employer une échelle de Likert en 5 points pour quantifier l’anxiété situationnelle, un chronomètre mesurant les temps de réaction en millisecondes pour évaluer l’attention sélective, et un inventaire de personnalité gradué de 0 à 100 pour sonder l’extraversion. Face à cette dispersion métrologique, observer un résidu brut de 4,5 unités possède une signification radicalement dissemblable selon qu’il s’applique à l’anxiété — où il représente un écart massif traversant la quasi-totalité de l’échelle — ou au temps de réaction, où une divergence de quatre millisecondes constitue une imprécision négligeable face à la variabilité physiologique naturelle de l’organisme humain.
La seconde limitation théorique, bien plus pernicieuse car d’ordre mathématique, concerne la variance des résidus bruts eux-mêmes. Contrairement à une intuition largement répandue chez les praticiens non spécialistes, même sous l’hypothèse d’une homoscédasticité parfaite des erreurs stochastiques de population (Var(εi) = σ2), la variance des résidus bruts d’échantillonnage ei n’est pas constante d’une observation à l’autre. Il est mathématiquement démontré que la variance théorique du i-ième résidu brut dépend de la configuration spatiale des covariables et s’exprime par la formule rigoureuse Var(ei) = σ2(1 – hii), où le terme hii représente le levier statistique de l’observation. Plus une observation se situe loin du centre de gravité des prédicteurs, plus sa valeur de levier s’élève, et plus la variance de son résidu brut s’effondre.
Cette hétérogénéité intrinsèque des variances des résidus bruts crée un paradoxe méthodologique majeur : deux observations présentant exactement la même distance structurelle par rapport au phénomène théorique sous-jacent afficheront des résidus bruts d’amplitudes divergentes en raison de leur seule localisation sur les axes des variables indépendantes. Les points disposant d’un fort effet de levier tirent la droite d’ajustement vers eux, comprimant mécaniquement leur propre résidu brut. Pour remédier à cette distorsion et rétablir une équité d’évaluation entre tous les individus de l’échantillon, la standardisation sans unité d’échelle s’impose comme un impératif méthodologique incontournable, autorisant une comparaison objective affranchie des artéfacts de levier.
2.2 Définition formelle et formule du résidu standardisé
Le résidu standardisé — que la littérature statistique anglo-saxonne désigne également sous l’appellation de résidu studentisé interne (internally studentized residual) — apporte une correction mathématique directe et élégante à l’hétérogénéité de la variance des résidus bruts. Il est défini formellement comme le quotient du résidu brut observé ei par l’estimation sans biais de son écart-type individuel. Sa formulation mathématique explicite s’établit selon l’expression suivante :
ri = ei / [ s × √(1 – hii) ]
Au sein de cette formule canonique, la quantité s symbolise l’erreur-type résiduelle globale de la régression, couramment dénommée Residual Standard Error (RSE) dans les sorties logicielles, qui estime l’écart-type de population σ à partir de la somme des carrés des résidus bruts divisée par les degrés de liberté résiduels. Le terme hii correspond à l’élément diagonal de rang i extrait de la matrice de projection orthogonale, dite matrice chapeau (Hat Matrix). Ce terme quantifie précisément le levier de l’observation au sein de l’espace multidimensionnel défini par les prédicteurs.
L’intégration explicite de l’expression √(1 – hii) au dénominateur constitue le cœur conceptuel de la standardisation. Puisque la variance du résidu brut se contracte à mesure que le levier augmente, la division par cette racine carrée compense exactement l’amenuisement artificiel du résidu. Par cette opération de rééchelonnement, chaque résidu standardisé possède désormais une variance théorique unitaire approximativement égale à 1. Sur le plan de l’interprétation, le résidu standardisé se lit et se manipule exactement comme une cote z ou un score standardisé classique : il indique avec précision le nombre d’écarts-types dont l’observation empirique dévie par rapport à la trajectoire modélisée, autorisant une appréciation universelle et standardisée de la fidélité de l’ajustement individuel.
2.3 Distinction essentielle entre résidus standardisés et résidus studentisés
Une ambiguïté terminologique substantielle persiste souvent dans la littérature appliquée quant à la démarcation entre résidus standardisés et résidus studentisés. Dans la nomenclature statistique rigoureuse, la désignation « résidu standardisé » renvoie spécifiquement à la formule présentée précédemment, où l’estimateur de la dispersion globale s est calculé en incluant la totalité des observations composant l’échantillon, sans exception. Cette métrique est ainsi qualifiée de studentisée interne car l’observation i dont on cherche à tester la typicalité participe elle-même au calcul de la variance globale qui sert à diviser son propre résidu brut. Si cette observation s’avère être une anomalie colossale, elle gonfle artificiellement la valeur de s, ce qui a pour effet pervers de réduire la magnitude apparente de son propre résidu standardisé.
Pour déjouer cet effet de masque statistique, les statisticiens ont développé le concept de résidu studentisé externe, fréquemment appelé résidu de Jackknife ou résidu supprimé (deleted residual), usuellement noté ti. Dans ce schéma computationnel, la variance résiduelle n’est plus estimée sur l’échantillon complet, mais sur un sous-échantillon d’où l’observation i a été délibérément exclue. L’estimateur de dispersion correspondant, noté s(i), devient totalement insensible à la déviance potentielle du sujet évalué. La formule du résidu studentisé externe s’écrit alors :
ti = ei / [ s(i) × √(1 – hii) ]
Le choix entre ces deux métriques dépend étroitement des objectifs diagnostiques du chercheur. Les résidus standardisés internes constituent l’outil par excellence pour l’inspection globale de l’homoscédasticité, de la linéarité fonctionnelle et de la normalité distributionnelle sur l’ensemble du continuum de prédiction. En revanche, lorsqu’il s’agit de mener une traque impitoyable des valeurs aberrantes isolées susceptibles d’avoir faussé le modèle à elles seules, les résidus studentisés externes s’avèrent théoriquement supérieurs. Ces derniers suivent rigoureusement une distribution théorique de Student à (n – p – 2) degrés de liberté, ce qui permet l’application formelle de tests d’hypothèses d’atypicité intégrant la correction de Bonferroni pour tests multiples.
3. Le levier statistique (leverage) et la matrice de projection
3.1 Rôle mathématique de la matrice chapeau (Hat Matrix)
Pour saisir en profondeur la mécanique de standardisation des résidus, il est indispensable de disséquer la structure de la matrice de projection orthogonale, universellement désignée dans le formalisme matriciel sous le nom de matrice chapeau ou Hat Matrix, notée H. En algèbre linéaire appliquée aux modèles d’estimation linéaire, le vecteur des valeurs ajustées ou prédites Ŷ s’obtient par la multiplication de la matrice des données explicatives X par le vecteur des estimateurs des moindres carrés β̂. Sachant que β̂ = (XTX)-1XTY, il s’ensuit par substitution directe que Ŷ = X(XTX)-1XTY. La matrice chapeau est précisément cet opérateur algébrique défini par l’égalité H = X(XTX)-1XT, qui « coiffe » le vecteur des observations Y pour le transformer directement en vecteur des valeurs prédites Ŷ = HY.
Cette matrice H présente des propriétés géométriques fondamentales : elle est symétrique (HT = H) et idempotente (H × H = H), matérialisant une projection orthogonale du vecteur observé sur l’espace vectoriel engendré par les colonnes de la matrice de régresseurs X. Les éléments situés sur sa diagonale principale, notés hii pour chaque individu i, sont bornés théoriquement dans l’intervalle fermé allant de 1/n (dans un modèle incluant une constante d’ordonnée à l’origine) jusqu’à 1. De surcroît, la trace de cette matrice — c’est-à-dire la somme arithmétique de tous ses éléments diagonaux — est rigoureusement égale au nombre total de paramètres estimés dans le modèle, noté p’ = p + 1, où p représente le nombre de prédicteurs distincts et le terme unitaire renvoie à l’intercepte.
L’impact d’une valeur hii élevée sur la variance du résidu d’échantillonnage est immédiat et déterminant. Puisque le résidu brut s’exprime vectoriellement par e = (I – H)Y, la matrice de variance-covariance des résidus bruts prend la forme Cov(e) = σ2(I – H). En observant les composantes diagonales de cette matrice produit, il apparaît avec une limpidité mathématique incontestable que la variance individuelle du résidu s’écrit Var(ei) = σ2(1 – hii). Plus une unité statistique s’attribue une valeur de levier proche de l’unité supérieure, plus l’expression (1 – hii) tend vers zéro, compressant dramatiquement la variance de son résidu brut. En l’absence de standardisation, ce phénomène conduirait l’analyste à ignorer des observations qui, bien qu’extrêmement distantes de la réalité théorique, présentent un résidu brut artificiellement minuscule par suite de leur emprise gravitationnelle sur l’hyperplan d’ajustement.
3.2 Impact des scores extrêmes sur les variables prédictives
Une distinction conceptuelle absolue doit être dressée entre une anomalie observée sur la variable réponse (valeur aberrante ou outlier en Y) et une position extrême occupée au sein de l’espace des covariables (point à fort levier en X). Une observation peut se révéler tout à fait atypique sur le plan de sa variable dépendante sans posséder le moindre pouvoir géométrique pour déformer l’orientation de la droite de régression, simplement parce que ses valeurs sur les variables prédictives se situent au voisinage immédiat du barycentre ou de la moyenne de l’échantillon. Dans ce scénario, son levier hii reste très bas, et le résidu brut reflète fidèlement l’amplitude de l’écart sans altérer substantiellement l’inclinaison des pentes paramétriques.
À l’inverse, un participant présentant une combinaison de scores hautement atypique ou marginale sur les prédicteurs X acquiert ipso facto une valeur de levier substantielle. Si ce sujet présente par ailleurs une performance en Y qui concorde approximativement avec la trajectoire générale établie par le reste de la cohorte, il agira comme une ancre consolidant artificiellement le modèle, réduisant la variance perçue des estimations sans dévier la pente. En revanche, si ce point à fort levier se couple avec une déviance en Y, il bascule instantanément dans la catégorie des points d’influence critiques, exerçant un couple de torsion mécanique capable de faire basculer l’orientation des pentes de régression à l’opposé de la tendance véritable portée par la majorité des sujets.
Dans la pratique de la recherche psychologique, ce cas de figure se concrétise avec une fréquence alarmante lors de l’administration de tests cognitifs chronométrés. Imaginons une étude modélisant la précision décisionnelle d’un opérateur en fonction de son temps d’exposition au stimulus visuel. Un participant qui, en raison d’une défaillance motrice ou d’une incompréhension flagrante des consignes de passation, met dix secondes de plus que tous les autres sujets à déclencher son action se positionnera à une distance extrême sur l’axe des abscisses. Ce sujet capturera à lui seul une part colossale de la somme des leviers de l’échantillon. Si ses performances décisionnelles sont par ailleurs chaotiques, sa seule présence dans la matrice de données risque de fausser l’intégralité de l’équation linéaire, masquant des relations réelles ou inventant des associations purement fallacieuses.
3.3 Calcul et extraction des valeurs de levier dans R
L’environnement statistique R fournit une implémentation logicielle directe et hautement optimisée pour extraire et analyser les valeurs de la diagonale de la matrice de projection. Pour ce faire, la fonction native de référence est hatvalues(), qui prend pour argument principal un objet résultant de l’ajustement d’un modèle linéaire standard via la fonction lm(). Lorsqu’elle est sollicitée, hatvalues(modele) retourne un vecteur numérique unidimensionnel de longueur exactement équivalente au nombre d’observations exploitées pour ajuster la régression, où chaque valeur élémentaire représente la grandeur hii du sujet correspondant.
Afin de déterminer objectivement à partir de quel seuil une valeur de levier doit éveiller la suspicion du chercheur et commander une vérification minutieuse, la communauté des statisticiens a établi des repères empiriques fondés sur la distribution moyenne du levier. Comme établi précédemment, la valeur moyenne d’un levier individuel s’élève mécaniquement à h̄ = p’/n = (p + 1)/n. Dans les protocoles méthodologiques rigoureux, une observation est déclarée comme possédant un levier substantiel ou préoccupant dès lors que sa valeur dépasse le double de cette moyenne, soit la frontière fixée à 2(p + 1)/n. Pour les échantillons de grande envergure où ce seuil peut s’avérer excessivement conservateur, un seuil plus permissif fixé au triple de la valeur moyenne, soit 3(p + 1)/n, est préconisé par de nombreux auteurs faisant autorité.
L’exploitation pratique de ces métriques sous R ne doit jamais se cantonner à une simple lecture tabulaire brute, souvent rébarbative et propice à l’oubli de points marginaux au sein de vastes bases de données. L’analyste averti articulera l’extraction logicielle avec des représentations graphiques dédiées, traçant le profil séquentiel des valeurs de levier au moyen de diagrammes en bâtonnets ou de diagrammes de dispersion confrontant les valeurs d’indice aux seuils d’alerte théoriques préalablement calculés. Cette démarche d’inspection visuelle immédiate permet d’isoler en un clin d’œil les profils comportementaux atypiques occupant les frontières de l’espace d’inférence, préalable indispensable avant d’aborder le calcul définitif des résidus standardisés.
4. Préparation de l’environnement de travail et structuration des données sous R
4.1 Configuration de la session de travail R
Toute analyse quantitative aspirant à la validité scientifique doit s’inscrire au sein d’un cadre de travail garantissant la reproductibilité intégrale des calculs et des inférences. Dans l’écosystème R, cette exigence fondamentale débute par une configuration méticuleuse de la session logicielle avant l’exécution du moindre traitement analytique. L’une des premières initiatives consiste à réinitialiser ou assainir l’environnement de travail pour prévenir toute interférence pernicieuse avec des objets ou fonctions résiduels logés dans la mémoire vive de sessions antérieures. Cette précaution est couplée à la vérification systématique de la version du moteur R afin de prévenir toute rupture de compatibilité syntaxique, particulièrement lors de l’exploitation de fonctionnalités introduites dans les versions récentes du logiciel.
Un autre jalon indispensable à la reproductibilité des protocoles statistiques impliquant la génération de nombres pseudo-aléatoires ou des procédures de rééchantillonnage réside dans la fixation explicite de la graine aléatoire à l’aide de la commande set.seed(). L’affectation d’un entier constant à ce générateur — par exemple au travers de l’instruction set.seed(12345) — garantit que toute séquence de simulation, tout bruit stochastique ajouté aux variables et toute répartition aléatoire de sujets produiront des résultats strictement identiques d’une exécution à l’autre, que ce soit sur la machine locale du chercheur ou lors de l’évaluation du script par des pairs indépendants.
Enfin, la structuration modulaire du script d’analyse constitue un garant méthodologique de premier ordre. Une architecture de script rigoureuse s’organise en blocs séquentiels distincts et documentés : initialisation des paramètres généraux et fixation de la graine d’aléa, chargement des bibliothèques de fonctions requises, importation et assainissement structurel des matrices de données brutes, modélisation statistique formelle, extraction et calcul des grandeurs diagnostiques, et enfin conception des visualisations synthétiques. Cette séparation hermétique des tâches prévient les erreurs de syntaxe croisées et assure une traçabilité exemplaire de chaque décision analytique.
4.2 Création et importation d’un jeu de données psychologiques
Afin d’illustrer la mécanique algorithmique des résidus standardisés au sein d’un contexte de recherche représentatif des sciences humaines et sociales, nous formalisons un scénario empirique axé sur l’étude de l’impact de l’anxiété cognitive sur la rapidité du traitement de l’information. Imaginons un protocole psychologique administré à un groupe de 60 participants. Pour chaque sujet, nous disposons d’un indice d’anxiété situationnelle évalué à l’aide d’une échelle psychométrique validée dont les scores s’échelonnent de 20 à 80 points, ainsi que d’une mesure chronométrique du temps de réaction moyen recueilli lors d’une tâche de discrimination visuo-spatiale exigeante, quantifié en millisecondes.
La génération programmatique de ce jeu de données sous R s’appuie sur la création d’un objet de classe data.frame structuré de manière explicite. Pour ancrer la démonstration dans la réalité expérimentale où des artefacts polluent inévitablement les recueils, nous introduisons délibérément une observation déviante au sein de cette cohorte. Ce point artificiellement injecté combinera une valeur de prédicteur particulièrement élevée avec un temps de réaction spectaculairement divergent de la tendance générale, simulant par exemple un sujet ayant décroché de la tâche cognitive pour répondre à une sollicitation extérieure pendant l’acquisition des mesures chronométriques.
Sur le plan pratique de la programmation sous R, ce tableau de données est généré par l’assemblage vectoriel de nos variables synthétisées. Le vecteur des scores d’anxiété peut être conçu à l’aide d’une distribution gaussienne réaliste centrée sur une moyenne de 50 avec un écart-type de 10 unités, tandis que le temps de réaction est formulé par une équation linéaire déterministe reliant la hausse de l’anxiété à un ralentissement cognitif, auquel s’ajoute un terme d’erreur stochastique homoscédastique d’écart-type calibré à 40 millisecondes. L’observation déviante est ensuite substituée à une position matricielle prédéterminée, offrant ainsi un laboratoire empirique parfait pour observer la sensibilité des résidus standardisés face à des perturbations localisées.
4.3 Inspection préliminaire et vérification de la cohérence des types
Avant d’engager le moindre ajustement de régression, la règle cardinale de l’analyse quantitative stipule de soumettre la matrice de données à un audit de conformité structurelle rigoureux. Sous R, cette exploration liminaire s’orchestre par la mobilisation combinée de fonctions d’inspection natives hautement informatives. La fonction str() déploie une radiographie synthétique de la structure interne de l’objet, permettant d’authentifier la nature exacte des variables hébergées dans chaque colonne : des vecteurs numériques réels ou entiers doivent impérativement être identifiés pour l’anxiété et le temps de réaction, écartant toute conversion involontaire de colonnes en facteurs ou en chaînes de caractères lors de la phase d’importation.
Dans le même prolongement diagnostique, la fonction summary() fournit un bilan statistique paramétrique et non paramétrique de premier niveau en décomposant les métriques de tendance centrale et de dispersion pour chaque variable du jeu de données : minimums, premiers quartiles, médianes, moyennes arithmétiques, troisièmes quartiles et maximums absolus. Cette synthèse permet de détecter instantanément d’éventuelles anomalies grossières de saisie, comme un score d’anxiété négatif ou une latence motrice biologiquement impossible excédant plusieurs secondes, qui trahiraient une corruption des données en amont de la modélisation.
Enfin, l’interrogation visuelle des premiers et derniers enregistrements via les fonctions head() et tail(), couplée à un décompte strict des données manquantes par l’application conjointe des fonctions is.na() et colSums(), parachève cette phase de contrôle préalable. La vérification dimensionnelle assurée par dim() confirme que l’effectif total n et le nombre de descripteurs correspondent scrupuleusement au plan expérimental décrété. Une fois cette cohérence intrinsèque validée, le jeu de données offre les garanties requises pour procéder à l’estimation mathématique du modèle de régression linéaire sous-jacent.
5. Ajustement du modèle de régression linéaire avec lm()
5.1 Syntaxe et spécification du modèle linéaire sous R
L’estimation des modèles de régression linéaire sous R s’articule autour de la fonction emblématique lm(), acronyme direct de linear models. Cette routine logicielle repose sur une syntaxe hautement déclarative articulée autour du formalisme de Wilkinson et Rogers, dans lequel l’opérateur tilde sépare la variable réponse à prédire, positionnée à sa gauche, de l’ensemble des variables explicatives ou covariables disposées sur son flanc droit. Dans le cadre de notre investigation psychométrique, la commande s’exprime sous la forme lm(temps_reaction ~ score_anxiete, data = donnees_psy), instruisant explicitement le logiciel de modéliser le temps de réaction comme une fonction linéaire directe du score d’anxiété en puisant les données dans le conteneur spécifié.
L’invocation de cette fonction déclenche l’exécution des algorithmes d’estimation matricielle s’appuyant sur la décomposition QR de la matrice des régresseurs, une méthode computationnelle remarquablement plus stable face aux problèmes d’arrondi numérique que l’inversion directe de la matrice (XTX). L’évaluation de l’instruction instancie en mémoire un objet complexe de classe lm. Loin de se limiter à un simple tableau de coefficients numériques, cet objet prend la structure d’une liste hiérarchisée encapsulant une quantité considérable d’informations sous-jacentes : le vecteur des coefficients estimés, le vecteur des valeurs ajustées fitted.values, le vecteur des résidus bruts d’estimation residuals, la matrice décomposée qr, les termes de la formule et le rappel contextuel de l’appel logiciel.
La compréhension de cette structure interne est primordiale pour l’analyste désireux d’automatiser des chaînes de traitement diagnostique. Au lieu de considérer l’objet retourné par lm() comme une boîte noire opaque, l’utilisateur averti peut en extraire sélectivement n’importe quel attribut computationnel par le truchement de l’opérateur dollar ou, de manière infiniment plus élégante et robuste sur le plan programmatique, par l’utilisation de méthodes d’accès spécialisées conçues pour préserver l’encapsulation logicielle, préparant ainsi le terrain pour la manipulation méthodique des résidus.
5.2 Extraction des paramètres et interprétation des coefficients
L’interprétation approfondie du modèle estimé débute conventionnellement par la soumission de l’objet de régression à la méthode générique summary(). Cette commande condense l’évaluation empirique au sein d’une restitution structurée en plusieurs zones diagnostiques, dont le tableau central des coefficients fournit les estimations ponctuelles, les erreurs-types associées, les valeurs du test t de Student et les probabilités critiques (p-values) correspondantes. L’intercepte indique la valeur espérée de la variable dépendante lorsque tous les prédicteurs s’annulent simultanément, tandis que la pente linéaire capture le taux de variation marginal attendu sur la réponse pour chaque accroissement d’une unité sur le régresseur.
Dans un paradigme psychologique, ces coefficients revêtent une signification conceptuelle majeure. Si la pente associée au score d’anxiété s’établit à une valeur positive statistiquement significative (par exemple une hausse estimée de 2,8 millisecondes par point d’anxiété supplémentaire, p < 0,001), cela corrobore empiriquement l’hypothèse d’une interférence cognitive de l’anxiété sur l’efficience du traitement moteur ou perceptif. Néanmoins, l’interprétation ne saurait se cantonner à la seule significativité des coefficients : l’analyste doit impérativement examiner la magnitude globale du pouvoir explicatif résumée par le coefficient de détermination R2 et son homologue ajusté, qui stipulent la proportion de la variance totale de la réponse formellement imputable aux prédicteurs intégrés.
La statistique globale F de Fisher-Snedecor, positionnée au bas de la restitution de summary(), vient quant à elle tester l’hypothèse nulle conjointe d’inutilité totale du modèle : elle évalue si le jeu de variables explicatives apporte collectivement une réduction de la dispersion résiduelle supérieure à ce qu’un pur processus aléatoire d’échantillonnage produirait. Bien qu’une valeur de F fortement significative permette de rejeter formellement l’hypothèse nulle, elle ne garantit nullement l’absence d’aberrations locales au sein de l’échantillon, réitérant avec force la nécessité absolue de ne jamais s’arrêter aux métriques d’ajustement macroscopiques pour plonger résolument dans l’examen microscopique des écarts résiduels.
5.3 Récupération de l’erreur type résiduelle (RSE)
Parmi l’ensemble des grandeurs synthétiques retournées par la commande summary(), l’erreur-type résiduelle, universellement désignée par le sigle RSE pour Residual Standard Error, occupe une place d’une importance capitale dans la théorie des modèles linéaires et le calcul de la standardisation. Sur le plan formel, le RSE constitue l’estimateur sans biais de la dispersion théorique σ des perturbations de population. Il s’obtient mathématiquement en extrayant la racine carrée du quotient de la somme des carrés des résidus bruts (Sum of Squared Residuals, SSR) par les degrés de liberté résiduels de l’ajustement, ces derniers étant rigoureusement égaux à df = n – p – 1 :
s = √[ (∑ ei2) / (n – p – 1) ]
Cette quantité mesure en réalité l’amplitude moyenne typique des écarts séparant les observations individuelles de la droite d’estimation. Dans un script R, l’extraction automatisée de cette métrique s’opère sans difficulté par le biais de l’opérateur d’indexation appliqué à l’objet sommaire, au travers de la syntaxe directe summary(modele)$sigma. L’exécution de cette commande isole la valeur scalaire précise du RSE sans exiger le moindre recalcul manuel des sommes de carrés par l’utilisateur, éliminant ainsi toute source potentielle d’imprécision arithmétique.
Le rôle de cette grandeur scalaire est central : elle forme l’assise du dénominateur dans l’équation de standardisation des résidus. Sans une estimation rigoureuse et non biaisée de σ, toute tentative de conversion des résidus bruts en une métrique d’écart-type universelle est vouée à l’échec. L’obtention programmatique de cette valeur de dispersion constitue donc le premier jalon technique indispensable pour décomposer pas à pas l’anatomie mathématique des résidus standardisés avant d’embrasser les procédures logicielles entièrement automatisées.
6. Calcul pas à pas des résidus standardisés selon la formule mathématique
6.1 Extraction manuelle des composantes élémentaires
Pour s’approprier intimement la logique computationnelle qui gouverne la standardisation, il est hautement formateur d’implémenter l’algorithme pas à pas sous R en décomposant chaque terme de l’expression mathématique formelle. La première manœuvre consiste à extraire le vecteur des résidus bruts d’estimation e. Bien qu’il soit techniquement possible de calculer ces résidus en soustrayant manuellement le vecteur des prédictions du vecteur des réponses observées via l’opération donnees_psy$temps_reaction – predict(modele), les bonnes pratiques de programmation sous R recommandent l’usage des méthodes spécialisées residuals(modele) ou resid(modele). Ces fonctions natives gèrent automatiquement d’éventuelles exclusions d’observations pour cause de données manquantes et retournent un vecteur numérique pur de longueur n.
Dans un même temps, le vecteur des valeurs prédites ŷ s’obtient par la fonction fitted(modele). Un réflexe analytique indispensable à ce stade consiste à exécuter un contrôle de cohérence élémentaire sur le vecteur des résidus bruts en calculant leur somme arithmétique à l’aide de l’instruction sum(residuals(modele)). Dans tout modèle linéaire estimé par les moindres carrés ordinaires et comportant une constante d’ordonnée à l’origine, les équations normales imposent que cette somme soit rigoureusement nulle. Sur le plan informatique, en raison des limites inhérentes à la représentation binaire des nombres en virgule flottante, le résultat affiché ne sera pas exactement 0 mais un nombre infinitésimal de l’ordre de 10-14 ou 10-15, confirmant l’exactitude mathématique de l’ajustement global.
Cette étape d’extraction élémentaire permet d’isoler l’écart individuel de chaque participant sous sa forme brute, encore exprimée en millisecondes dans notre scénario. Toutefois, comme nous l’avons théoriquement explicité, ces résidus bruts souffrent d’une variance inégale causée par la géométrie multidimensionnelle des données. L’étape computationnelle subséquente requiert dès lors l’extraction de la seconde composante clé de la formule : la diagonale de la matrice de projection orthogonale.
6.2 Extraction de la diagonale de la matrice chapeau
La deuxième composante fondamentale requise pour opérationnaliser la formule du résidu standardisé réside dans le levier individuel de chaque sujet, matérialisé par les éléments diagonaux hii de la matrice chapeau. Au sein de R, l’obtention directe de ce vecteur s’effectue sans aucune manipulation matricielle lourde grâce à l’appel de la fonction dédiée hatvalues(modele). Cette commande exécute sous le capot les projections algébriques requises et restitue instantanément un vecteur de réels positifs dont chaque élément quantifie l’éloignement spatial de l’observation correspondante par rapport au centre de gravité de l’ensemble des régresseurs.
Dès l’extraction de ce vecteur de leviers, deux contrôles de cohérence dimensionnelle et mathématique doivent être scrupuleusement opérés par l’analyste. Le premier consiste à vérifier que la longueur du vecteur retourné correspond strictement à la taille de l’échantillon via la commande length(hatvalues(modele)) == nrow(donnees_psy), certifiant l’absence de désynchronisation indexicale entre les données initiales et les métriques de levier. Le second contrôle porte sur l’intégrité des bornes théoriques : chaque valeur individuelle hii doit obligatoirement être supérieure ou égale à 1/n et strictement inférieure à 1. Dans les contextes expérimentaux non dégénérés, la condition all(hatvalues(modele) < 1) doit être rigoureusement vérifiée.
Ce point conditionne la validité même de la standardisation : si une observation venait à posséder un levier hii = 1, elle saturerait intégralement un degré de liberté à elle seule, forçant son résidu brut à zéro et annulant l’expression (1 – hii). Le calcul de la racine carrée conduirait alors à une division par zéro non définie sur le plan mathématique, se traduisant sous R par la génération d’une valeur indéfinie NaN. S’assurer que le vecteur 1 – hatvalues(modele) ne contient que des nombres réels strictement positifs est donc le prérequis technique incontournable avant de déclencher l’assemblage vectoriel final.
6.3 Application vectorielle de l’équation complète
Ayant réuni les trois composantes élémentaires du problème — le vecteur des résidus bruts e, l’estimateur scalaire de la dispersion résiduelle s, et le vecteur des leviers h —, le chercheur dispose de tous les éléments nécessaires pour appliquer vectoriellement l’équation intégrale du résidu standardisé. La programmation vectorisée native de R excelle précisément dans ce type d’opération terme à terme, dispensant totalement l’utilisateur de recourir à des boucles itératives fastidieuses et inefficaces sur le plan computationnel.
L’opération s’orchestre en calculant dans un premier temps le dénominateur spécifique à chaque observation, représentant l’écart-type estimé du résidu brut. Ce terme s’écrit de façon vectorielle sous R par l’instruction : denominateur <- summary(modele)$sigma * sqrt(1 – hatvalues(modele)). Dans cette syntaxe, R applique automatiquement la règle de recyclage scalaire-vecteur : le scalaire représentant le RSE vient multiplier chaque élément du vecteur résultant de l’extraction de la racine carrée, générant un vecteur de dénominateurs rigoureusement individualisés dont la magnitude varie inversement au levier du sujet.
La finalisation du calcul s’accomplit en réalisant la division vectorielle terme à terme du résidu brut par ce dénominateur conditionnel, selon l’instruction explicite : residus_std_manuel <- residuals(modele) / denominateur. Le résultat de cette instruction est stocké dans un nouveau vecteur numérique indépendant. Chaque observation de notre échantillon psychologique se voit dès lors attribuer un score d’écart standardisé, purgé de son unité métrique d’origine en millisecondes et corrigé pour l’emprise gravitationnelle de son positionnement sur l’axe de l’anxiété. Cette implémentation manuelle explicite éclaire parfaitement la mécanique interne du calcul statistique, posant les jalons pour une adoption éclairée des fonctions natives plus automatisées de l’environnement R.
7. Méthode directe sous R : utilisation de la fonction rstandard()
7.1 Fonctionnement et syntaxe de la fonction native rstandard()
Bien que la décomposition algorithmique manuelle soit irremplaçable sur le plan pédagogique pour appréhender la dynamique des grandeurs statistiques, la pratique quotidienne de la recherche exige des solutions computationnelles alliant rapidité d’exécution, optimisation mémoire et minimisation absolue des erreurs de saisie scripturale. À cet effet, l’architecture native du logiciel R intègre une fonction d’une efficacité redoutable, spécifiquement conçue pour court-circuiter ces manipulations intermédiaires : la fonction rstandard(). Faisant partie intégrante du package de base stats, cette fonction est universellement disponible dès l’initialisation de n’importe quelle session de travail sous R, ne requérant le chargement d’aucun module externe additionnel.
La syntaxe d’appel de cette fonction brille par sa sobriété et son élégance conceptuelle. Il suffit d’invoquer la commande en lui passant pour paramètre principal l’objet résultant de l’estimation de la régression linéaire : residus_std_auto <- rstandard(modele). En une ligne d’instruction unique, R exécute en arrière-plan, au niveau du code C compilé sous-jacent, l’extraction simultanée des résidus bruts d’ajustement, l’estimation sans biais de la dispersion résiduelle globale et la résolution matricielle de la diagonale chapeau pour délivrer un vecteur de résidus standardisés internes parfaitement formaté.
Cette approche directe offre une robustesse logicielle infiniment supérieure à l’écriture manuelle de formules arithmétiques. D’une part, rstandard() interagit de façon transparente avec les éventuels mécanismes de pondération statistique lorsque l’on ajuste des modèles par les moindres carrés pondérés (Weighted Least Squares), situation où le calcul manuel classique du dénominateur devient extraordinairement complexe. D’autre part, la fonction applique une gestion scrupuleuse des valeurs manquantes selon les règles édictées dans l’argument na.action lors de l’appel initial de lm(), garantissant que les vecteurs d’indices demeurent parfaitement synchronisés avec les lignes du jeu de données source.
7.2 Validation croisée entre calcul manuel et rstandard()
Dans toute démarche de validation logicielle, le chercheur rigoureux ne saurait accepter aveuglément les sorties automatisées sans procéder à une validation croisée minutieuse confrontant les résultats de l’implémentation algorithmique manuelle à ceux produits par la routine native intégrée. Sous R, la méthode par excellence pour attester de l’équivalence numérique de deux vecteurs ne repose pas sur l’opérateur d’égalité double ==, ce dernier étant susceptible de retourner faussement des divergences en raison de micro-variations de troncature dans les derniers bits de précision en virgule flottante, mais sur la fonction dédiée all.equal().
En soumettant nos deux vecteurs diagnostiques à l’épreuve de l’instruction all.equal(residus_std_manuel, residus_std_auto), l’environnement R réalise une comparaison différentielle exhaustive qui tient compte de la tolérance machine standard (de l’ordre de 1,5 × 10⁻⁸). Le retour explicite de la valeur booléenne TRUE atteste sans l’ombre d’un doute de la stricte identité mathématique et computationnelle des deux vecteurs calculés. Cette convergence absolue apporte au chercheur l’assurance formelle que la mécanique interne de la fonction rstandard() exécute scrupuleusement l’équation de studentisation interne théorisée au préalable.
L’examen des premières valeurs extraites à l’aide de head(residus_std_auto) permet d’observer la distribution concrète de ces métriques standardisées : la majorité des participants présentent des valeurs fluctuant de manière symétrique entre -1,5 et +1,5 écarts-types, témoignant d’une distribution harmonieuse des déviances individuelles autour de la droite d’ajustement modélisée. Cette phase de validation croisée clôt définitivement le volet computationnel pur et autorise le transfert de ces indicateurs au cœur du tableau de données de recherche pour l’amorce des diagnostics approfondis.
7.3 Intégration structurée au sein du data frame de recherche
Une fois les résidus standardisés calculés et dûment validés, la bonne pratique méthodologique en science des données commande de ne pas laisser ces grandeurs isolées sous forme de vecteurs volatils au sein de l’environnement de travail. Il convient de les incorporer immédiatement et de manière permanente comme de nouvelles colonnes structurées au sein du conteneur de données initial. Cette consolidation s’opère par une assignation directe : donnees_psy$residus_std <- rstandard(modele). Par la même occasion, il est judicieux d’adjoindre également les valeurs prédites correspondantes via donnees_psy$valeurs_predites <- fitted(modele), créant ainsi un jeu de données enrichi prêt pour l’analyse multidimensionnelle.
Cette structuration tabulaire permet de déployer instantanément des opérations de tri conditionnel pour repérer les individus dont les modèles comportementaux s’écartent le plus violemment des postulats théoriques. À titre d’illustration, l’exécution d’une commande de tri décroissant sur la base de la valeur absolue des résidus standardisés — telle que donnees_psy[order(abs(donnees_psy$residus_std), decreasing = TRUE), ] — projette immédiatement au sommet du tableau les observations affichant les tensions résiduelles les plus aiguës au sein du système statistique.
L’adjonction systématique de ces indicateurs au sein de la matrice de données offre en outre des facilités déterminantes pour la phase ultérieure de reporting scientifique. Lors de l’exportation des résultats vers des tableurs ou des formats ouverts de publication (tels que le format CSV ou des tables de données enrichies), l’ensemble du profil individuel — associant les scores expérimentaux bruts, les prédictions calculées par le modèle linéaire et les métriques de déviance standardisée — demeure accessible dans un format unifié, garantissant une traçabilité intégrale exigée par les standards méthodologiques contemporains.
8. Seuils de décision et identification empirique des valeurs aberrantes
8.1 Fondements des seuils critiques (|ri| > 2 et |ri| > 3)
La puissance diagnostique des résidus standardisés découle directement de leur propriété d’invariance d’échelle et de leur convergence distributionnelle vers une loi normale centrée réduite sous l’hypothèse de validité du modèle linéaire. Si le modèle est correctement spécifié et que les perturbations stochastiques sous-jacentes sont distribuées selon une loi gaussienne homoscédastique, les résidus standardisés ri présentent approximativement une moyenne nulle et un écart-type unitaire, ce qui autorise l’emprunt direct des seuils critiques de dispersion régissant la loi normale standardisée pour la prise de décision statistique.
Dans ce cadre théorique, les propriétés mathématiques fondamentales de la loi normale stipulent qu’environ 68,27 % des observations doivent présenter un résidu standardisé borné dans l’intervalle [-1 ; +1], tandis que 95,45 % de la cohorte doit logiquement s’inscrire à l’intérieur de l’intervalle délimité par [-2 ; +2]. Il en découle qu’une observation affichant une valeur absolue supérieure à 2 (soit |ri| > 2) correspond à un événement statistique dont la probabilité d’occurrence spontanée par simple fluctuation d’échantillonnage ne s’élève qu’à environ 4,55 %. Bien qu’un résidu franchissant cette frontière doive inciter le chercheur à la vigilance, ce seuil de deux écarts-types engendre un taux non négligeable de faux positifs (erreur de type I) au sein des échantillons volumineux, où plusieurs observations s’y retrouveront reléguées par pur hasard mathématique.
Pour cette raison fondamentale, la pratique méthodologique et psychométrique rigoureuse privilégie un seuil de décision infiniment plus conservateur et robuste, établi à trois écarts-types de déviance absolue, matérialisé par la règle |ri| > 3. Sous une hypothèse distributionnelle gaussienne pure, la probabilité qu’une observation sélectionnée aléatoirement génère un résidu standardisé excédant 3 en valeur absolue ne s’élève qu’à un dérisoire 0,27 %, soit moins de trois cas pour mille observations conformes. Par conséquent, dès lors qu’un résidu standardisé franchit le rubicon critique de trois écarts-types, l’hypothèse d’une déviance fortuite devient hautement improbable : l’analyste fait face à une véritable valeur aberrante (outlier résiduel) dont la trajectoire empirique récuse ouvertement l’adéquation locale du modèle ajusté.
8.2 Filtrage et extraction algorithmique des observations extrêmes
La détection de ces anomalies ne saurait reposer sur une inspection oculaire aléatoire au fil des pages d’une console logicielle ; elle doit être orchestrée par des instructions de filtrage booléen strictes au sein de R. L’environnement R met à disposition une syntaxe d’indexation conditionnelle extrêmement performante permettant d’isoler en une ligne de code l’ensemble des individus qui violent les seuils de tolérance préétablis. L’opération s’articule autour de l’opérateur de valeur absolue abs() couplé à une condition relationnelle supérieure stricte.
Pour identifier la cohorte d’observations franchissant le premier niveau d’alerte modérée, l’analyste formulera l’expression booléenne : sujets_alertes <- donnees_psy[abs(donnees_psy$residus_std) > 2, ]. Cette commande génère un sous-ensemble matriciel extrayant exclusivement les lignes de participants dont le résidu standardisé s’écarte de plus de deux écarts-types de la trajectoire d’estimation. Pour resserrer l’étau diagnostique et ne retenir que les anomalies majeures constituant des valeurs aberrantes patentes, l’instruction se reformule instantanément avec le seuil conservateur : sujets_aberrants <- donnees_psy[abs(donnees_psy$residus_std) > 3, ].
L’interrogation de la dimension de ce sous-ensemble par la commande nrow(sujets_aberrants) informe immédiatement l’analyste de l’ampleur numérique du phénomène de contamination au sein de son étude. En appliquant cette instruction à notre jeu de données simulé, la ligne spécifique correspondant au participant artificiellement perturbé lors de la constitution de l’échantillon est immédiatement isolée au sommet de la pile diagnostique, affichant un résidu standardisé largement supérieur au seuil critique de 3. Cette extraction automatisée offre une assise empirique incontestable pour soumettre ces profils spécifiques à un examen clinique ou méthodologique individuel approfondi.
8.3 Distinction cruciale : valeur aberrante, levier et point d’influence
L’assimilation hâtive d’une valeur résiduelle aberrante à un point d’influence destructeur constitue l’une des confusions conceptuelles les plus dévastatrices de la modélisation statistique appliquée. Il est impératif d’ancrer une démarcation catégorielle limpide entre trois entités sémiotiques distinctes mais interconnectées : la valeur aberrante (outlier), le point à fort levier (high leverage point) et le point d’influence (influential observation).
Une observation est déclarée valeur aberrante au sens de la régression si son résidu standardisé est exceptionnellement volumineux en magnitude absolue (|ri| > 3), signifiant que le modèle échoue massivement à prédire sa performance en Y sur la base de ses caractéristiques en X. Toutefois, si ce participant possède des valeurs de covariables situées au centre géométrique de l’échantillon, son levier hii sera infime. Dépourvu de tout bras de levier, ce point n’aura pratiquement aucune force d’inertie pour tirer la droite vers lui : il se borne à dégrader la variance globale s et à affaiblir le R2, sans altérer significativement l’orientation ou la valeur numérique des pentes de régression estimées.
À l’autre extrémité du spectre, une observation peut afficher un levier statistique colossal (hii > 2(p+1)/n) en raison d’un profil totalement singulier sur les régresseurs, tout en s’alignant avec une perfection remarquable sur la trajectoire théorique portée par les autres données. Dans cette configuration harmonieuse, le résidu brut et le résidu standardisé seront proches de zéro. Ce point n’est en rien une valeur aberrante ; il joue au contraire le rôle d’un tuteur stabilisateur consolidant la précision des paramètres.
Le danger méthodologique mortel surgit exclusivement de la conjonction des deux phénomènes : le point d’influence majeur. Un point d’influence est une observation qui combine simultanément un résidu théorique substantiel et un levier spatial élevé. En vertu de son éloignement multidimensionnel, ce point dispose du bras mécanique nécessaire pour contraindre la droite des moindres carrés à basculer vers lui, comblant artificiellement son résidu brut apparent au détriment de l’ajustement de tout le reste de la cohorte. Ce mécanisme d’atténuation confirme l’impérieuse nécessité de dissocier les résidus standardisés purs des indices d’influence globale, dont l’articulation conjointe garantit seule un diagnostic irréprochable.
9. Visualisation avancée des résidus standardisés sous R
9.1 Graphique des résidus standardisés contre les valeurs prédites
Si les tests numériques et les filtrages booléens sont des éléments d’arbitrage indispensables, l’inspection visuelle graphique demeure la méthode souveraine et irremplaçable pour évaluer globalement le comportement distributionnel d’un modèle de régression. Le diagramme princeps de l’analyse résiduelle consiste à projeter les résidus standardisés en ordonnée contre les valeurs ajustées (ou prédites) ŷ en abscisse. Cette représentation spatiale offre une évaluation simultanée et immédiate de deux postulats cruciaux de Gauss-Markov : l’hypothèse de linéarité fonctionnelle et l’hypothèse d’homoscédasticité de la variance.
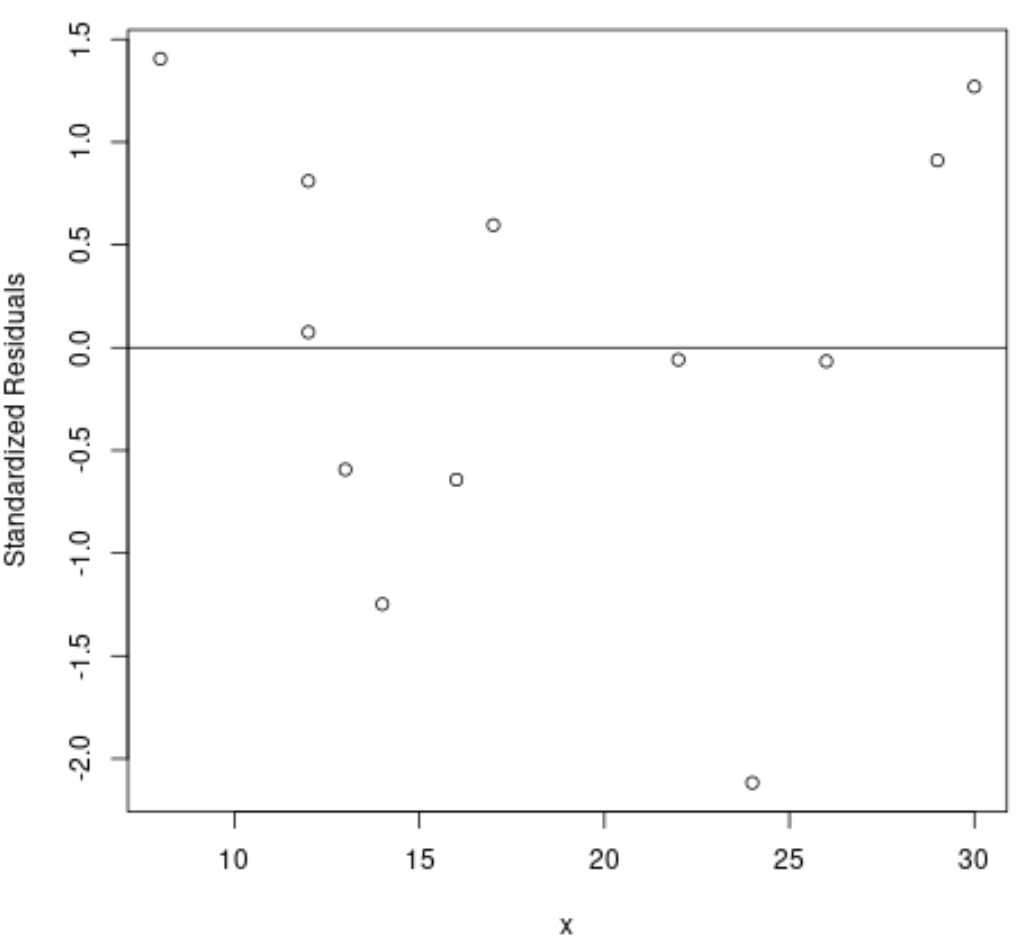
Sous l’interface graphique de base de R, la construction d’un tel canevas diagnostique s’effectue au moyen de la syntaxe fondamentale : plot(fitted(modele), rstandard(modele), xlab = « Valeurs Prédites », ylab = « Résidus Standardisés »). Pour enrichir la portée analytique de cette projection, l’utilisateur tracera impérativement des lignes de référence horizontales à l’aide de la commande abline() : une ligne pleine médiane à y = 0 pour matérialiser l’adéquation parfaite, complétée par des lignes pointillées aux seuils critiques de y = 2, y = -2, y = 3 et y = -3. Si le modèle est vertueux, le nuage de points doit adopter l’apparence d’une bande rectangulaire homogène et amorphe de dispersion constante le long de l’axe horizontal, sans aucune tendance structurelle perceptible.
Toute déformation morphologique de ce nuage trahit une pathologie sous-jacente spécifique. Si la dispersion verticale des points s’élargit progressivement à mesure que l’on progresse vers la droite de l’axe d’estimation — dessinant une forme conique évocatrice d’un mégaphone —, l’hétéroscédasticité est formellement caractérisée, signifiant que l’erreur d’ajustement grandit avec l’amplitude des prédictions. Si le nuage dessine une courbure parabolique ou une forme en U, l’hypothèse de linéarité est ouvertement violée, signalant à l’expérimentateur qu’un effet non linéaire d’ordre polynomial (quadratique) ou une interaction multiplicative négligée doit être intégré au modèle pour restituer fidèlement la réalité des processus observés.
9.2 Diagramme quantile-quantile (Q-Q Plot) des résidus standardisés
La validation formelle de l’hypothèse de normalité distributionnelle des perturbations stochastiques constitue une condition sine qua non pour asseoir la légitimité des tests d’inférence statistique (tests t sur les coefficients et tests F d’ajustement global), en particulier lorsque l’échantillon d’étude est de taille restreinte ou modérée. Pour examiner empiriquement cette conformité gaussienne, la construction d’un diagramme quantile-quantile standardisé, ou Q-Q Plot, représente l’instrument d’investigation graphique le plus sensible et le plus complet.
Dans l’environnement de base de R, ce graphique s’élabore par l’appel successif des fonctions dédiées qqnorm(rstandard(modele)) pour ordonner et projeter les quantiles empiriques observés face aux quantiles théoriques attendus d’une loi normale unitaire, suivi immédiatement de l’instruction qqline(rstandard(modele), col = « red ») qui superpose une droite de référence traversant les premier et troisième quartiles de la distribution. Sous l’hypothèse nulle d’une parfaite normalité des résidus, l’ensemble des coordonnées empiriques doit venir s’agréger avec une régularité millimétrique le long de cette droite directrice diagonale.
L’intérêt diagnostique majeur du diagramme réside dans sa capacité à révéler instantanément les pathologies d’aplatissement et d’asymétrie affectant les queues de distribution. Si les points situés aux extrémités inférieure et supérieure décrochent de la droite pour former une trajectoire sigmoïde caractéristique en esse, l’analyste identifie immédiatement le phénomène de queues lourdes ou de leptocurticité, indiquant que les observations extrêmes sont bien plus fréquentes que ne l’autoriserait une loi normale idéale. Pour aller plus loin dans la rigueur diagnostique, l’association de la commande interactive identify() ou de routines de détection d’indices permet de faire imprimer sur le graphique le numéro d’observation exact des participants déviant ostensiblement de la droite, autorisant une traçabilité individualisée des écarts distributionnels.
9.3 Graphiques de publication scientifique avec ggplot2
Bien que les commandes graphiques de base soient idéales pour les diagnostics exploratoires rapides en phase de modélisation, la communication scientifique contemporaine au sein de revues à comité de lecture exige des représentations visuelles répondant à des critères esthétiques et typographiques rigoureux, notamment ceux édictés par l’American Psychological Association (normes APA). L’écosystème graphique ggplot2 offre le cadre idéal pour générer des diagrammes résiduels d’une élégance et d’une clarté méthodologique irréprochables.
Pour construire une visualisation sous ggplot2, le jeu de données enrichi préalablement de ses métriques diagnostiques est injecté au sein de la fonction princeps ggplot(). L’agencement esthétique cartographie les valeurs prédites sur l’axe horizontal et les résidus standardisés sur l’axe vertical au moyen de la géométrie de points geom_point(). La structuration visuelle s’enrichit par l’adjonction de lignes horizontales d’avertissement tracées par geom_hline() pour baliser les frontières de ±2 et ±3 écarts-types, accompagnées d’une couche d’ajustement non paramétrique locale de type LOESS via geom_smooth(method = « loess », se = FALSE) qui permet de capturer visuellement toute micro-inflexion non linéaire résiduelle.
L’un des apports les plus déterminants de ggplot2 réside dans sa capacité d’annotation conditionnelle automatisée. En mobilisant l’extension ggrepel et sa fonction geom_text_repel(), il devient possible d’instruire le logiciel d’étiqueter exclusivement les sujets dont la valeur absolue du résidu standardisé outrepasse le seuil d’admissibilité de 3, sans risquer le chevauchement visuel des étiquettes d’identifiants. L’application finale du thème standardisé theme_classic() ou theme_minimal(), couplée à une dénomination soignée des axes métrologiques, produit une figure de niveau publication conforme aux exigences éditoriales les plus strictes de la recherche internationale.
10. Diagnostics complémentaires : Cook’s D et résidus studentisés externes
10.1 Distance de Cook et son articulation avec les résidus standardisés
Pour parachever l’arsenal diagnostique de la régression, l’examen des résidus standardisés doit être impérativement complété par une métrique synthétique d’influence multidimensionnelle. L’indicateur le plus universellement reconnu dans ce registre est la distance de Cook, conventionnellement notée Di pour l’observation i. Conçue par le statisticien R. Dennis Cook, cette métrique évalue le déplacement global simultané de l’ensemble du vecteur des prédictions qui se produirait si l’observation i était purement et simplement retranchée de la matrice de données lors de l’estimation. Sa formulation mathématique explicite révèle son imbrication symbiotique directe avec le résidu standardisé et le levier :
Di = [ ri2 / (p + 1) ] × [ hii / (1 – hii) ]
L’analyse de cette formule élégante éclaire la mécanique diagnostique sous-jacente : la distance de Cook est le produit direct de deux grandeurs structurelles distinctes. Le premier terme, proportionnel au carré du résidu standardisé ri2, mesure l’ampleur de la déviance résiduelle ou l’aberration de la réponse en Y. Le second terme, articulé sur le quotient de levier hii / (1 – hii), quantifie le potentiel géométrique d’ancrage dans l’espace des covariables X. Il s’ensuit mathématiquement qu’une observation ne peut afficher une distance de Cook colossale que si elle manifeste simultanément un écart résiduel substantiel et un levier appréciable, incarnant la définition formelle de l’observation influente.
Sous R, l’extraction de ces grandeurs s’accomplit sans détour via l’appel de la fonction native cooks.distance(modele). Quant au seuil critique de décision déclenchant l’alerte méthodologique, la littérature offre plusieurs repères. Alors qu’un seuil conservateur traditionnel fixé à Di > 1 était historiquement préconisé, la recherche moderne en psychométrie privilégie un seuil ajusté à la volumétrie de l’échantillon, formulé par la règle empirique Di > 4 / n ou 4 / (n – p – 1). Toute observation dont la distance de Cook franchit ce seuil calibré altère substantiellement les estimations paramétriques, justifiant une inspection immédiate de son profil.
10.2 Usage comparatif des résidus studentisés externes avec rstudent()
Comme explicité lors de notre analyse théorique liminaire, le résidu standardisé interne calculé par la fonction rstandard() intègre l’observation i dans le calcul de la dispersion résiduelle globale s. Si un participant s’avère être une anomalie d’une violence mathématique extrême, sa propre déviance résiduelle vient mécaniquement gonfler la variance globale du modèle, ce qui engendre un effet d’auto-atténuation en augmentant artificiellement le dénominateur de standardisation. Face à cette pathologie de masquage statistique, l’alternative souveraine réside dans le calcul des résidus studentisés externes (ou résidus de Jackknife) mis en œuvre par la fonction native rstudent().
Le fonctionnement interne de la commande rstudent(modele) repose sur un schéma itératif d’exclusion unitaire (leave-one-out). Pour chaque observation i de l’échantillon, l’algorithme recalcule mentalement l’erreur-type résiduelle de la régression en se fondant exclusivement sur les n – 1 observations restantes. En excluant ainsi le point suspect de la calibration de son propre étalon de mesure, rstudent() restitue la plénitude de sa déviance. Là où un résidu standardisé interne produira une valeur de +3,2 sous l’effet de l’écrasement de la variance gonflée, le résidu studentisé externe correspondant pourra culminer à +4,8, révélant la véritable ampleur de l’anomalie.
La confrontation programmatique des deux vecteurs sous R s’exécute avec une clarté limpide en unissant les colonnes par la commande data.frame(Standardise = rstandard(modele), Studentise = rstudent(modele)). Pour la quasi-totalité des participants vertueux présentant des déviances minimes, les deux métriques affichent une concordance numérique presque parfaite. En revanche, dès que l’analyste aborde les coordonnées du participant atypique modélisé au sein de notre cohorte, un décrochage substantiel s’opère : la métrique externe délivrée par rstudent() explose littéralement en amplitude, offrant un signal de détection d’une sensibilité incomparable pour démasquer les anomalies sévères qui tentent de dissimuler leur présence par contamination de la variance globale.
10.3 Tableau de bord diagnostique synthétique
Afin de ne pas s’égarer dans la multiplicité des indicateurs atomiques, le statisticien avisé doit synthétiser l’ensemble de ces grandeurs au sein d’une matrice d’arbitrage globale. R facilite grandement cette vision holistique dès lors que l’on invoque la méthode graphique par défaut sur un objet de régression, matérialisée par la commande plot(modele). L’exécution de cette instruction génère de manière séquentielle un tableau de bord standardisé décliné en quatre visualisations fondamentales : le diagramme des résidus bruts contre les prédictions, le graphique Q-Q de normalité, le graphique d’homoscédasticité de la racine des résidus standardisés (Scale-Location plot), et le diagramme hautement stratégique des résidus standardisés contre les leviers intégrant les courbes de niveau de la distance de Cook (Residuals vs Leverage).
Ce dernier quadrant graphique représente la quintessence de la synthèse méthodologique. En matérialisant en abscisse le levier individuel hii, en ordonnée le résidu standardisé ri, et sous forme de lignes d’isocontour en pointillés rouges les frontières critiques de la distance de Cook (généralement positionnées à 0,5 et 1,0), ce diagramme classe instantanément chaque profil dans l’une des quatre cases de la taxonomie décisionnelle :
- Sujets conformes : Faible levier et résidu standardisé contenu dans [-2 ; +2], caractérisant le cœur vertueux de l’échantillon.
- Valeurs aberrantes non influentes : Fort résidu standardisé (|ri| > 3) couplé à un levier insignifiant, signalant une anomalie locale sans répercussion majeure sur la trajectoire des paramètres globaux.
- Points de levier bénins : Faible résidu standardisé combiné à un fort levier statistique, incarnant des participants aux profils singuliers sur les régresseurs qui s’alignent fidèlement sur la tendance générale.
- Points d’influence critiques : Conjonction d’un résidu standardisé élevé et d’un fort levier débordant au-delà des courbes de distance de Cook, désignant les observations toxiques qui faussent à elles seules la modélisation globale.
11. Implications méthodologiques pour la recherche en psychologie
11.1 Diagnostics des biais de passation et comportements de réponse
Dans le domaine des sciences psychologiques, l’analyse des résidus standardisés s’émancipe de la pure mécanique des chiffres pour devenir une heuristique diagnostique fondamentale éclairant la validité des comportements de réponse. La collecte de données psychométriques — qu’elle se déroule en laboratoire sur ordinateur ou en ligne via des plateformes d’échantillonnage de foule — est chroniquement vulnérable à des artefacts humains tels que l’inattention, la fatigue cognitive ou le désengagement motivationnel. Un participant qui répond de façon erratique ou totalement aléatoire à un questionnaire d’auto-évaluation générera, au sein d’un modèle structurel reliant par exemple la conscience professionnelle à la performance au travail, des incompatibilités mathématiques flagrantes se matérialisant par un résidu standardisé franchissant allègrement les limites critiques.
Dans un registre analogue, l’apparition de résidus standardisés déviants peut trahir l’irruption d’un phénomène de saturation cognitive ou d’interférence émotionnelle transitoire lors de protocoles expérimentaux chronométrés. Un participant performant subitement à des latences motrices démesurément longues à la clôture d’une session de 45 minutes peut illustrer un effondrement de l’attention soutenue consécutif à l’épuisement des ressources cognitives. L’identification ciblée de ces résidus offre la possibilité au chercheur de repérer des dynamiques intra-individuelles indésirables, permettant de dissocier ce qui relève d’une erreur d’échantillonnage non spécifique d’une véritable hétérogénéité psychologique nécessitant un modèle plus sophistiqué.
Enfin, l’examen résiduel minutieux s’avère déterminant pour repérer les cas d’hétérogénéité clinique authentique. Dans une étude explorant l’efficacité d’une psychothérapie cognitive sur la réduction de symptômes dépressifs, un participant qui manifeste un résidu standardisé exceptionnellement discordant — par exemple une absence totale d’amélioration clinique en dépit d’une compliance irréprochable et d’un pronostic initial idéal — n’est pas nécessairement un profil polluant qu’il faut éliminer. Il peut s’agir de l’indicateur d’une forme clinique réfractaire ou de la présence d’une comorbidité sous-jacente non détectée, transformant le déchet statistique du modèle en une nouvelle piste de recherche clinique féconde.
11.2 Prise de décision éthique face aux données atypiques
L’identification formelle d’une observation affichant un résidu standardisé supérieur à 3 place inévitablement le chercheur face à un dilemme déontologique et méthodologique capital : que doit-on faire de ces données aberrantes ? La tentation la plus fréquente, mais aussi la plus pernicieuse d’un point de vue déontologique, consiste à procéder à l’élagage arbitraire et silencieux de tous les résidus dérangeants pour gonfler artificiellement le coefficient R2 et forcer la significativité statistique des tests d’hypothèses. Cette pratique d’optimisation fallacieuse, assimilable à une forme insidieuse de p-hacking, vicie gravement la reproductibilité de la science psychologique et expose l’investigateur au risque de rejeter indûment des pans entiers de la réalité empirique.
Un protocole méthodologique éthique impose une démarche d’investigation séquentielle et rigoureuse. La première mesure réside dans la vérification méticuleuse de l’intégrité de la chaîne de données : la déviance observée découle-t-elle d’une coquille matérielle de saisie manuelle (un score d’anxiété rentré à 550 au lieu de 55) ou d’un bug d’encodage du logiciel expérimental ? Dans de telles circonstances dûment documentées, la rectification de l’erreur typographique ou l’exclusion de l’enregistrement corrompu est scientifiquement légitime et impérative. En revanche, si la donnée atypique s’avère authentique et correspond à un comportement expérimental réel, l’analyste ne dispose d’aucun mandat scientifique pour la supprimer unilatéralement.
La règle d’or universellement prescrite face à des observations présentant des résidus standardisés extrêmes consiste à conduire et à documenter des analyses de sensibilité exhaustives. Le chercheur rapporte dans son mémoire ou son article les résultats du modèle ajusté sur l’intégralité de l’échantillon, puis présente conjointement l’ajustement réestimé après neutralisation de la ou des observations critiques. Si les coefficients statistiques, la significativité des tests et les inférences substantielles demeurent stables d’un modèle à l’autre, la solidité empirique des conclusions est publiquement validée. Si, en revanche, la suppression d’un seul individu inverse le signe d’une pente ou fait basculer la significativité, le chercheur a le devoir d’exposer cette instabilité fondamentale, témoignant d’une fragilité structurelle de la preuve empirique apportée.
11.3 Directives de transparence selon les normes de l’APA
L’American Psychological Association (APA), au travers de la septième édition de son manuel de publication et des recommandations du groupe de travail MARS (Methodological Reporting Standards), stipule des directives d’une rigueur inflexible concernant la divulgation des données atypiques et des métriques diagnostiques. Toute exclusion de participant au sein d’une cohorte doit impérativement être explicitée dans la sous-section consacrée aux participants au sein de la section Méthode, en spécifiant avec une clarté totale les critères statistiques formellement mobilisés (par exemple la règle explicite d’exclusion des observations affichant un résidu standardisé |ri| > 3 associé à une distance de Cook Di > 4/n).
Les recommandations éditoriales préconisent en outre de ne plus se borner à délivrer les seuls coefficients macroscopiques dans le corps du texte, mais d’annexer aux manuscrits des synthèses tabulaires diagnostiques. Ces tableaux synthétisent la distribution des résidus standardisés, le nombre exact d’observations tombant sous le coup d’une alerte méthodologique et les résultats des tests d’homoscédasticité et de normalité afférents. Une telle démarche atteste de l’honnêteté intellectuelle de l’équipe de recherche et désarme préventivement les objections des évaluateurs pairs en démontrant que le modèle linéaire a fait l’objet d’un audit de validité approfondi.
Enfin, dans le sillage irrésistible du mouvement de la science ouverte (Open Science), la transparence méthodologique contemporaine s’étend désormais au partage intégral du code computationnel. La sauvegarde et la mise à disposition publique du script R ayant orchestré le calcul des résidus standardisés, leur visualisation graphique et les analyses de sensibilité associées — via des dépôts institutionnels ouverts tels que l’Open Science Framework (OSF) — constituent la garantie ultime de reproductibilité computationnelle, permettant à n’importe quel chercheur indépendant de répliquer scrupuleusement la chaîne diagnostique déployée.
12. Bonnes pratiques de programmation et automatisation sous R
12.1 Conception d’une fonction personnalisée d’évaluation des résidus
Dans un contexte de recherche opérationnelle où l’analyste doit inspecter de façon itérative des dizaines de modèles linéaires — qu’il s’agisse de tester plusieurs covariables, d’examiner différents sous-groupes de sujets ou d’analyser des cohortes longitudinales distinctes —, répéter continuellement les mêmes séquences d’extraction et de filtrage constitue une source majeure d’inefficience et d’erreurs de syntaxe. La maturité en programmation sous R se manifeste par l’encapsulation de ces séquences d’évaluation au sein d’une fonction personnalisée modulaire et hautement réutilisable.
Une fonction diagnostique robuste prendra comme argument obligatoire l’objet retourné par l’estimation linéaire lm(), complété par un paramètre optionnel définissant le seuil critique d’admissibilité des résidus standardisés, configuré par défaut à 3. Au sein de son corps fonctionnel, l’algorithme calcule les résidus standardisés via rstandard(), extrait les leviers par hatvalues(), dérive les distances de Cook à l’aide de cooks.distance(), assemble ces éléments au sein d’un tableau d’alerte filtré sur la condition abs(rstandard) > seuil, et génère en sortie un rapport imprimé structuré signalant à l’expérimentateur le nombre exact de déviances critiques constatées ainsi que leurs identifiants de ligne.
La modularité d’une telle fonction d’audit permet son intégration fluide au sein de boucles vectorisées exploitant la famille de fonctions lapply() ou les outils itératifs du package purrr. Le traitement automatisé de larges batteries de tests psychologiques se trouve ainsi standardisé : chaque modèle passe au crible de la même grille d’évaluation sans exiger d’intervention manuelle risquée, consolidant la reproductibilité des diagnostics résiduels sur l’intégralité du pipeline d’analyse statistique.
12.2 Écosystème de packages spécialisés : car, broom et olsrr
Bien que les fonctionnalités natives de base de R suffisent amplement à conduire une analyse résiduelle approfondie, l’écosystème open-source héberge des extensions spécialisées de premier ordre qui amplifient remarquablement les capacités d’investigation diagnostique. Parmi ces modules de référence, le package car (Companion to Applied Regression), conçu par John Fox et Sanford Weisberg, fait figure d’étalon-or international au sein de la communauté académique. Il propose notamment la fonction outlierTest(), qui implémente un test d’hypothèse formel basé sur la distribution de Student des résidus studentisés externes avec application automatique de la correction de Bonferroni pour la traque rigoureuse des valeurs aberrantes isolées.
Dans la mouvance contemporaine du tidyverse, le package broom s’impose comme une bibliothèque incontournable pour les analystes soucieux de manipuler des données ordonnées (tidy data). La fonction vedette broom::augment(modele) transcende les routines traditionnelles en fusionnant en une seule instruction la matrice originelle des données avec l’intégralité des métriques diagnostiques dérivées : valeurs prédites (.fitted), erreurs-types d’estimation (.se.fit), résidus bruts (.resid), résidus standardisés (.std.resid), valeurs de levier (.hat) et distances de Cook (.cooksd), fournissant un tableau de données rectangulaire parfait directement injectable au sein des pipelines de visualisation ggplot2.
Enfin, pour les praticiens en quête de bilans automatisés exhaustifs, le package olsrr met à disposition une panoplie de routines diagnostiques de haut vol. Des commandes spécialisées comme ols_plot_resid_stand() ou ols_plot_resid_lev() construisent instantanément des graphiques d’analyse d’influence interactifs ou vectorisés pré-paramétrés avec les seuils de décision théoriques optimaux. L’intégration judicieuse de ces bibliothèques spécialisées au sein de l’environnement R démultiplie l’efficacité de l’analyste sans compromettre la rigueur mathématique sous-jacente.
12.3 Intégration dans des flux de travail reproductibles (R Markdown / Quarto)
L’aboutissement contemporain des bonnes pratiques d’analyse quantitative en sciences du comportement s’incarne dans l’utilisation des environnements de publication computationnelle reproductible, au premier rang desquels figurent R Markdown et son successeur de nouvelle génération, Quarto. Ces technologies unifient au sein d’un fichier source unique la narration académique, le code exécutable R et la génération dynamique des résultats tabulaires et graphiques, abolissant définitivement le fossé historique et dangereux qui séparait l’exécution du script statistique de la rédaction du rapport de recherche textuel.
L’intégration du code diagnostique des résidus standardisés au sein de documents Quarto permet de concevoir des alertes méthodologiques automatisées entièrement conditionnelles. À titre d’illustration, l’analyste peut implémenter des structures conditionnelles textuelles qui évaluent en temps réel la conformité des données lors de la compilation du rapport (rendering) : si le filtrage matriciel révèle la présence de participants dépassant la ligne critique de |ri| > 3, le document final insère automatiquement un paragraphe d’avertissement documentant le problème et exhibant le tableau des sujets déviants. Si aucune anomalie n’est constatée, le rapport certifie automatiquement l’intégrité distributionnelle du modèle d’ajustement.
Cette symbiose entre code computationnel et narration scientifique offre des garanties inégalables pour la pérennité et la transparence des recherches académiques. L’archivage de ces flux de travail reproductibles, combiné au gel des environnements logiciels au moyen de gestionnaires de dépendances tels que renv, protège les études contre les aléas de l’obsolescence programmatique. Le calcul et l’interprétation des résidus standardisés dans R cessent ainsi d’être une simple corvée technique pour devenir le maillon fort d’une science psychologique rigoureuse, transparente et résolument tournée vers la reproductibilité universelle.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Bollen, K. A., & Jackman, R. W. (1985). Regression diagnostics: An expository treatment of outliers and influential cases. Sociological Methods & Research, 13(4), 510–542. https://doi.org/10.1177/0049124185013004004
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE Publications.
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE Publications.
- Hoaglin, D. C., & Welsch, R. E. (1978). The hat matrix in regression and ANOVA. The American Statistician, 32(1), 17–22. https://doi.org/10.1080/00031305.1978.10479237
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Weisberg, S. (2014). Applied linear regression (4th ed.). John Wiley & Sons. https://doi.org/10.1002/9781118594858
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4