
Dans l’écosystème de l’analyse quantitative, de la biostatistique et des sciences du comportement, la distribution normale — ou distribution gaussienne — constitue sans conteste la pierre angulaire de l’inférence statistique. Depuis les bancs universitaires jusqu’aux laboratoires de recherche de pointe, des générations d’étudiants, d’ingénieurs et de chercheurs ont appris à manipuler les probabilités continues par l’intermédiaire des calculatrices graphiques emblématiques de Texas Instruments, notamment les séries TI-83 et TI-84. Au sein de cet environnement matériel, la commande emblématique normalcdf s’est imposée comme le standard intuitif universel pour évaluer l’aire sous la courbe en cloche entre deux bornes finies ou infinies. Cet opérateur élémentaire matérialise une notion mathématique fondamentale : le calcul de la probabilité cumulée qu’une variable aléatoire continue prenne une valeur comprise dans un intervalle spécifique.
Toutefois, les exigences contemporaines du traitement de données imposent une transition inévitable vers des environnements logiciels beaucoup plus flexibles, puissants et automatisables. Le traitement isolé de scores individuels sur un écran de calculatrice de quelques centimètres ne permet plus de répondre aux cadences imposées par les cohortes cliniques massives, les études épidémiologiques ou les protocoles psychométriques modernes. C’est dans ce contexte que le tableur Microsoft Excel s’affirme comme une passerelle privilégiée. Alliant une accessibilité opérationnelle universelle à une robustesse algorithmique remarquable, Excel permet d’exécuter, de vectoriser et de documenter des calculs probabilistes d’une complexité équivalente ou supérieure à celle des progiciels statistiques dédiés, pourvu que l’utilisateur en maîtrise parfaitement l’architecture fonctionnelle.
Le passage de la commande matérielle fermée normalcdf(lower, upper, μ, σ) vers le moteur computationnel d’Excel ne repose pas sur une simple transposition lexicale d’une fonction unique, mais sur une compréhension rigoureuse de la décomposition des probabilités cumulées. En exploitant la fonction native LOI.NORMALE.N (ou sa contrepartie standardisée LOI.NORMALE.STANDARD.N), le praticien doit réapprendre à manipuler le théorème fondamental de l’analyse probabiliste continue, selon lequel la probabilité d’un intervalle résulte de la soustraction algébrique de deux fonctions de répartition. Ce guide exhaustif explore de manière approfondie les fondements théoriques, la syntaxe opérationnelle, les déclinaisons pratiques unilatérales et bilatérales, ainsi que l’automatisation avancée de cette métrique capitale dans Microsoft Excel.
1. Fondements théoriques de la loi normale et concept de NormalCDF
1.1 Définition mathématique de la fonction de répartition cumulative (CDF)
La fonction de répartition cumulative, couramment désignée dans la littérature internationale sous l’acronyme CDF (pour Cumulative Distribution Function), représente la probabilité mathématique qu’une variable aléatoire réelle continue, notée X, prenne une valeur inférieure ou égale à une valeur seuil donnée, notée x. Dans le cadre théorique strict d’une distribution gaussienne caractérisée par son espérance mathématique μ et sa variance σ² (notée formellement N(μ, σ²)), la fonction de répartition ne peut être exprimée sous la forme d’une fonction élémentaire finie. Elle se définit rigoureusement par l’intégrale définie de sa fonction de densité de probabilité (PDF, ou Probability Density Function) depuis la limite asymptotique négative jusqu’à l’abscisse d’évaluation :
P(X ≤ x) = F(x) = ∫-∞x [1 / (σ √(2π))] · exp(- (t – μ)² / (2σ²)) dt
Cette intégrale possède des propriétés analytiques fondamentales qui gouvernent l’ensemble des déductions probabilistes. Premièrement, lorsque x tend vers moins l’infini, la valeur de F(x) tend asymptotiquement vers 0. Réciproquement, lorsque x croît indéfiniment vers plus l’infini, F(x) converge strictement vers 1, ce qui traduit mathématiquement la certitude absolue que la variable se réalise dans l’espace des réels. Deuxièmement, la fonction F(x) est une fonction continue, strictement monotone et non décroissante sur l’ensemble des réels.
Il est impératif d’établir une distinction conceptuelle inébranlable entre la densité ponctuelle f(x) et la probabilité cumulée F(x). Dans une loi continue, la probabilité d’observer rigoureusement une valeur scalaire isolée est strictement nulle : P(X = x) = 0. La densité de probabilité f(x) ne représente pas une probabilité en soi, mais la hauteur géométrique de la courbe à l’abscisse x, c’est-à-dire le taux de variation infinitésimal de la probabilité cumulée par unité de mesure. En revanche, la fonction de répartition F(x) mesure véritablement une surface, une masse de probabilité accumulée sous la cloche depuis l’origine infinie gauche jusqu’au point considéré.
1.2 Transition de la calculatrice graphique (TI-83/TI-84) vers les tableurs modernes
Durant des décennies, l’apprentissage pratique de l’inférence probabiliste a été structuré autour de l’environnement matériel des calculatrices programmables Texas Instruments. Au sein du sous-menu statistique de ces calculatrices (accessible via la séquence de touches 2nd [DISTR]), la fonction normalcdf a été conçue comme un outil d’ingénierie logicielle direct, intégrant nativement la borne inférieure, la borne supérieure, l’espérance et l’écart-type. Ce choix ergonomique permettait aux étudiants d’éviter l’arithmétique manuelle de la soustraction des aires cumulées en déléguant à la puce électronique l’intégration numérique directe entre deux bornes arbitraires.
Cependant, le passage aux tableurs contemporains, tels que Microsoft Excel, exige une réorganisation logique de la part de l’analyste. Les tableurs ont été historiquement architecturés pour maximiser la standardisation des fonctions de base conformément aux canons du calcul différentiel et intégral classique. Dans un tableur, une fonction de distribution cumulée est presque universellement définie comme une fonction unilatérale gauche intégrée depuis moins l’infini. Excel ne possède pas nativement une fonction qui prendrait simultanément quatre paramètres délimitant un intervalle fermé en une seule opération primitive appelée NORMALCDF.
Ce qui pourrait apparaître à première vue comme une régression ergonomique constitue en réalité une avancée computationnelle majeure. Les tableurs permettent de manipuler simultanément des centaines de milliers d’enregistrements en appliquant des formules vectorisées sur des colonnes entières de données brutes, là où la calculatrice nécessite une saisie manuelle itérative fastidieuse et vulnérable à l’erreur humaine. De plus, la décomposition explicite du calcul en soustraction d’aires renforce la rigueur méthodologique de l’analyste, garantissant une traçabilité totale des étapes de calcul dans les audits statistiques et les protocoles de recherche reproductibles.
1.3 Pertinence méthodologique en psychométrie et sciences comportementales
L’utilisation de la distribution normale cumulative revêt une importance cruciale dans les disciplines qui s’appuient sur la théorie classique des tests et la mesure standardisée des traits latents, à l’instar de la psychométrie, de la neuropsychologie clinique et des sciences de l’éducation. Dans ces domaines, les performances brutes à une épreuve cognitive ou comportementale (qu’il s’agisse du nombre d’items réussis à un subtest de mémoire, du temps de réaction à une tâche d’attention soutenue ou de l’intensité d’une symptomatologie anxieuse) ne possèdent que rarement une échelle d’évaluation signifiante par elle-même. Pour conférer une valeur clinique ou diagnostique à une observation, il est indispensable de la situer par rapport à une population de référence.
Les postulats de base de la psychométrie moderne supposent que la distribution des aptitudes cognitives fondamentales au sein de l’espèce humaine suit approximativement une loi gaussienne, sous l’effet du théorème central limite appliqué à une multiplicité de déterminants génétiques et environnementaux additifs. Ainsi, la transformation d’un score brut en probabilité cumulée via la fonction de répartition permet d’attribuer à chaque sujet un percentile normé. Ce percentile quantifie la proportion exacte d’individus de la population générale obtenant un score inférieur ou égal à celui du sujet évalué.
L’évaluation cognitive standardisée, à l’image des échelles d’intelligence de Wechsler (WAIS, WISC) ou des inventaires de personnalité multiphasiques (MMPI), repose intégralement sur cette mécanique. La maîtrise rigoureuse du calcul cumulatif dans un tableur permet aux neuropsychologues et aux chercheurs de traiter automatiquement de vastes cohortes de patients, de déterminer des probabilités d’occurrence diagnostique complexes, de délimiter avec précision des zones d’atypicité statistique et de calibrer des instruments de mesure standardisés avec une exactitude mathématique inaccessible aux méthodes d’approximation tabulaires traditionnelles.
2. Anatomie fonctionnelle de NormalCDF : De la TI-84 aux équivalents tableur
2.1 Décorticage syntaxique de la fonction TI-84 normalcdf(lower, upper, μ, σ)
Pour appréhender l’équivalence fonctionnelle dans Excel, il convient d’analyser en premier lieu la grammaire algorithmique de la fonction d’origine telle qu’elle opère sur une calculatrice TI-84. La syntaxe officielle de la commande s’articule autour de quatre arguments positionnels stricts : normalcdf(borne_inférieure, borne_supérieure, [moyenne, écart-type]). Les deux derniers paramètres sont fréquemment optionnels dans l’interpréteur de la machine ; s’ils sont omis, le système adopte par défaut les valeurs normalisées d’une loi centrée réduite, soit une moyenne μ = 0 et un écart-type σ = 1.
L’argument lower (borne inférieure) définit le point de départ spatial sur l’axe des abscisses à partir duquel l’aire sous la courbe doit être comptabilisée, tandis que l’argument upper (borne supérieure) marque l’abscisse finale où s’interrompt l’intégration. Lorsque le clinicien ou l’étudiant souhaite calculer une probabilité cumulée unilatérale s’étendant théoriquement vers les limites infinies de la courbe, la machine requiert l’injection d’approximations opérationnelles de l’infini en raison de l’impossibilité matérielle de saisir le symbole ∞. Par convention, on utilise couramment la valeur extrémale -1E99 pour représenter moins l’infini (-10⁹⁹) et 1E99 pour représenter plus l’infini (10⁹⁹).
Les paramètres μ (mu) et σ (sigma) gouvernent la morphologie intrinsèque de la cloche de Gauss. Le paramètre μ agit comme un opérateur de translation linéaire pure le long de l’axe des abscisses, centrant la distribution sur son espérance sans modifier son étalement. Inversement, l’écart-type σ, qui doit impérativement être un réel strictement positif, contrôle l’échelle de dispersion : une faible valeur de σ resserre la courbe autour du centre en augmentant son acuité sommitale (leptokurticité relative), tandis qu’une valeur élevée l’écrase et l’étale (platikurticité relative). La commande TI-84 effectue l’intégration entre les bornes spécifiées en calibrant dynamiquement les coefficients d’échelle définis par ce couple de paramètres fondamentaux.
2.2 Modélisation de l’aire sous la courbe de densité normale
La compréhension intuitive et analytique de cette opération repose sur une géométrie riemannienne sous-jacente. L’aire totale confinée entre la courbe de densité de probabilité gaussienne et l’axe horizontal des abscisses est, par définition axiomatique de la théorie des probabilités, rigoureusement égale à 1 (soit 100 % de l’espace probabilisable). Cette propriété découle directement de l’intégrale de Poisson-Gauss selon laquelle l’intégrale impropre sur l’ensemble de l’espace de la fonction exponentielle décroissante au carré vaut la racine carrée de pi, compensant exactement le facteur de normalisation présent au dénominateur de l’équation de la densité.
Lorsque l’on isole un intervalle [a, b] sur la droite réelle, la probabilité P(a ≤ X ≤ b) correspond à la surface géométrique bidimensionnelle délimitée à gauche par la droite verticale x = a, à droite par la droite x = b, en bas par l’axe des ordonnées y = 0, et en haut par la trajectoire incurvée de la fonction de densité. L’évaluation de cette aire requiert le découpage de la surface en une infinité de rectangles verticaux infinitesimaux de largeur dx et de hauteur f(x).
Un aspect structurel déterminant réside dans la symétrie axiale parfaite de la courbe par rapport à la droite verticale d’équation x = μ. En vertu de cette symétrie miroir, la probabilité d’obtenir une observation inférieure à la moyenne est précisément égale à la probabilité d’obtenir une observation supérieure à celle-ci, soit une aire exacte de 0,5 de part et d’autre. Cette invariance par réflexion implique également que l’aire comprise entre la moyenne et un point situé à +k écarts-types est parfaitement identique à l’aire confinée entre la moyenne et le point symétrique situé à -k écarts-types. Ces symétries géométriques fournissent un cadre de vérification fondamental pour l’analyste lorsqu’il s’agit de valider la plausibilité des sorties générées par les algorithmes de calcul automatique.
2.3 Limites des approximations manuelles et nécessité d’algorithmes numériques
D’un point de vue de l’analyse mathématique pure, la fonction de densité de Gauss possède la particularité redoutable de ne pas admettre de primitive exprimable sous forme close ou finie à l’aide des fonctions usuelles (polynômes, exponentielles simples, fonctions trigonométriques). La fonction dite « erreur », notée classiquement erf(z) et formalisée par :
erf(z) = (2 / √π) ∫0z exp(-t²) dt
ne peut être résolue que par le biais de méthodes d’analyse numérique approchée. Avant la démocratisation des processeurs électroniques et des suites bureautiques, les chercheurs étaient contraints de consulter de volumineuses tables numériques imprimées — couramment appelées « tables de la loi normale centrée réduite » —, compilant laborieusement les valeurs calculées à la main avec une résolution limitée à deux ou trois décimales. Cette contrainte imposait d’effectuer systématiquement des interpolations linéaires manuelles imprécises pour les valeurs intermédiaires.
Les calculateurs modernes et les moteurs d’évaluation tels que celui d’Excel ont aboli ces entraves physiques en intégrant des schémas d’approximation polynomiale de très haute précision. Les implémentations algorithmiques contemporaines mobilisent principalement des développements en séries de Taylor tronquées, des fractions continues de Laplace ou les polynômes de Chebyshev optimisés via des schémas de type Hart ou rational minimax. Ces algorithmes numériques garantissent une convergence extrêmement rapide et une précision atteignant typiquement 14 à 15 décimales significatives selon le standard IEEE 754 pour les nombres flottants en double précision. Ce degré d’exactitude numérique est devenu le prérequis indispensable pour l’intégrité des publications scientifiques soumises aux exigences des comités de lecture internationaux.
3. La fonction LOI.NORMALE.N dans Excel : Paramètres et fonctionnement
3.1 Syntaxe officielle et spécification des arguments
Au sein de la bibliothèque de fonctions statistiques natives de Microsoft Excel, l’outil pivot conçu pour modéliser la fonction de répartition cumulative gaussienne porte l’appellation française LOI.NORMALE.N. Pour les utilisateurs évoluant sur des interfaces configurées en langue anglaise, cette fonction s’intitule NORM.DIST. Sa signature formelle comprend obligatoirement quatre arguments séparés par des points-virgules (dans les configurations régionales européennes francophones) :
LOI.NORMALE.N(x; espérance; écart_type; cumulative)
Le premier argument, x, représente l’abscisse d’évaluation, c’est-à-dire la valeur quantitative brute ou standardisée dont on souhaite évaluer la position distributionnelle. Le second argument, espérance, correspond à la moyenne arithmétique μ théorique ou échantillonnale qui positionne le centre de gravité de la population. Le troisième argument, écart_type, désigne la dispersion σ mesurée dans la même unité métrique que la variable sous-jacente. Il est impératif que cette valeur soit strictement positive sous peine de générer une interruption d’exécution.
Le quatrième argument, cumulative, est une variable logique (booléenne) déterminante qui modifie radicalement le mode d’évaluation algorithmique de la fonction. Tous ces paramètres doivent impérativement être typés sous forme de scalaires numériques (ou d’expressions logiques pour le dernier). L’injection de chaînes de caractères textuelles non convertibles ou de valeurs d’erreur dans l’un de ces champs produit systématiquement l’arrêt du calcul dans la cellule concernée.
3.2 Rôle critique du paramètre booléen cumulatif
La compréhension du comportement du paramètre booléen cumulative conditionne entièrement la validité des résultats probabilistes obtenus sous Excel. Ce commutateur logique peut recevoir exclusivement deux états : VRAI (représenté numériquement par 1) ou FAUX (représenté numériquement par 0). Le choix de cet état régit l’équation mathématique interne mobilisée par le processeur d’Excel.
Lorsque le paramètre est positionné à VRAI, la fonction bascule en mode fonction de répartition cumulative (CDF). Le moteur logiciel exécute l’approximation numérique de l’intégrale impropre depuis moins l’infini jusqu’à la valeur x. Le résultat retourné constitue une mesure de probabilité absolue, nécessairement comprise dans l’intervalle réel fermé [0, 1]. C’est précisément cette modalité qui doit être continuellement sollicitée pour répliquer le comportement de l’opérateur normalcdf.
À l’inverse, si l’opérateur saisit la valeur FAUX, la fonction évalue l’équation différentielle de la densité ponctuelle de probabilité (PDF) pour le point x :
f(x) = [1 / (σ √(2π))] · exp(- (x – μ)² / (2σ²))
Dans ce cas de figure, la valeur renvoyée ne mesure en aucun cas une probabilité d’occurrence, mais l’ordonnée de la cloche (la hauteur géométrique). Il s’agit d’une source d’erreur conceptuelle extrêmement fréquente chez les néophytes et les analystes inexpérimentés, qui confondent l’altitude d’un point sur la courbe avec la masse de probabilité sous-jacente. Pour tout calcul de probabilité d’un événement réel dans une loi continue, le paramètre doit toujours être maintenu à VRAI.
3.3 Compatibilité des versions d’Excel et équivalences linguistiques
Lors de l’audit ou du développement de classeurs statistiques complexes destinés à être partagés au sein d’équipes pluridisciplinaires, il est crucial d’intégrer les impératifs de rétrocompatibilité et les disparités régionales de syntaxe logicielle. Avant la publication d’Excel 2010, la suite Microsoft employait une nomenclature plus rudimentaire, matérialisée par la fonction LOI.NORMALE (sans le suffixe « .N »). Bien que cette ancienne formulation demeure supportée par les versions modernes d’Excel au titre de la compatibilité ascendante, son utilisation est formellement déconseillée par les recommandations du support officiel de Microsoft en raison d’algorithmes d’approximation plus anciens et d’une précision numérique moindre dans les queues de distribution extrêmes.
Par ailleurs, la portabilité internationale des classeurs exige une vigilance particulière vis-à-vis des séparateurs d’arguments et de décimales. Dans les installations francophones (France, Belgique, Canada francophone, Suisse romande), le système d’exploitation applique par défaut la convention typographique continentale : la virgule est dévolue à la séparation des décimales (par exemple 3,1415), contraignant Excel à utiliser le point-virgule (;) pour distinguer les arguments successifs au sein d’une formule. Dans les environnements anglophones, le point constitue le séparateur décimal (3.1415) et la virgule standard sert de séparateur d’arguments. Si un utilisateur français saisit =LOI.NORMALE.N(10, 100, 15, VRAI) avec des virgules, Excel interprétera les arguments de manière erronée et générera une notification de syntaxe invalide.
Il est rassurant de noter que Microsoft Excel possède un compilateur interne qui traduit automatiquement les noms des fonctions et les séparateurs structurels lors de l’ouverture d’un fichier sur une machine configurée dans une autre langue. Ainsi, une formule rédigée en français sous la forme =LOI.NORMALE.N(A1; B1; C1; VRAI) sera automatiquement traduite en anglais par =NORM.DIST(A1, B1, C1, TRUE) sans altération fonctionnelle de la chaîne de calcul probabiliste.
4. Calcul d’une probabilité unilatérale inférieure : P(X ≤ b)
4.1 Formulation théorique de la queue gauche de distribution
L’opération probabiliste la plus directe dans un modèle continu consiste à évaluer l’occurrence d’un événement où la variable aléatoire ne dépasse pas un seuil plafond prédéterminé, ce que l’on qualifie formellement de probabilité de queue unilatérale gauche. Dans le formalisme stochastique, cet événement s’énonce simplement sous la forme P(X ≤ b). Cette probabilité correspond à l’intégrale continue définie sur le demi-axe réel négatif :
P(X ≤ b) = ∫-∞b f(t) dt
Dans la syntaxe propre aux calculatrices Texas Instruments, cette intégration s’exécutait en écrivant normalcdf(-1E99, b, μ, σ), l’utilisateur étant obligé de simuler la limite asymptotique gauche par une quantité numérique arbitrairement grande en valeur absolue, négative et non accessible dans le cadre physique standard de la distribution.
La beauté mathématique et algorithmique de la fonction de répartition réside dans le fait que sa conception primitive est rigoureusement synchronisée avec cette formulation unilatérale gauche. Il n’est nul besoin de spécifier un plancher numérique artificiel ou une borne fictive pour émuler moins l’infini. La fonction est analytiquement programmée pour dériver son résultat à partir de la limite asymptotique zéro à l’extrême gauche du domaine de définition. L’intégration de la queue inférieure s’effectue donc de manière directe et sans perte d’information numérique par troncature artificielle.
4.2 Mise en œuvre pratique dans une cellule Excel
Pour matérialiser ce calcul dans l’interface d’un classeur Excel, la procédure logicielle requiert l’insertion d’une formule unique faisant appel aux références d’adresses cellulaires appropriées. Supposons qu’une feuille de travail accueille les données suivantes : la cellule A1 héberge la borne supérieure d’évaluation b, la cellule B1 contient l’espérance μ de la loi, et la cellule C1 contient son écart-type σ. La syntaxe opérationnelle s’inscrit rigoureusement comme suit :
=LOI.NORMALE.N(A1; B1; C1; VRAI)
Il est de la plus haute importance méthodologique de privilégier l’usage systématique de références de cellules (adressage dynamique) plutôt que de saisir des valeurs scalaires codées en dur (hardcoded) au sein de la formule (comme par exemple =LOI.NORMALE.N(85; 100; 15; VRAI)). L’emploi de références cellulaires autorise la modularité des simulations, prévient les erreurs de transcription répétitives et permet d’étendre la formule à des milliers de lignes via le mécanisme de recopie incrémentale.
Une fois le calcul exécuté, le résultat renvoyé par le processeur d’Excel s’affiche sous la forme d’un nombre à virgule flottante compris entre 0 et 1 (par exemple 0,15865526). Pour conférer à cette donnée une lisibilité optimale conforme aux standards analytiques, il convient d’ajuster le formatage d’affichage de la cellule. L’analyste pourra opter pour le format de cellule « Pourcentage » assorti de deux décimales significatives (affichant alors 15,87 %), ou préserver le format « Nombre » calibré sur quatre décimales (0,1587), format conventionnellement préconisé dans les manuels de méthodologie quantitative et les rapports de recherche empirique.
4.3 Étude de cas psychométrique : Identification d’un déficit clinique
Pour ancrer cette procédure dans une réalité pratique rigoureuse, considérons le cadre clinique de la neuropsychologie du développement où l’on cherche à évaluer l’efficience cognitive générale d’un patient à l’aide de l’échelle d’intelligence de Wechsler pour enfants (WISC-V). Les scores composites de cette échelle sont calibrés selon une loi normale standardisée d’espérance μ = 100 et d’écart-type σ = 15.
Les critères nosographiques internationaux, notamment ceux décrits dans le DSM-5 (Manuel diagnostique et statistique des troubles mentaux) et la CIM-11 de l’Organisation Mondiale de la Santé, stipulent qu’un déficit intellectuel significatif est suspecté lorsque le rendement cognitif global d’un individu se situe à deux écarts-types au moins sous la moyenne générale de son groupe de référence chronologique. Dans notre paramétrage, cette frontière diagnostique critique s’établit à :
Seuil critique = μ – 2σ = 100 – (2 · 15) = 70
L’équipe médicale sollicite l’analyste pour quantifier avec exactitude la prévalence théorique d’un tel déficit, c’est-à-dire la probabilité qu’un sujet prélevé de manière aléatoire au sein de la population générale présente un quotient intellectuel (QI) égal ou inférieur à 70. Dans une feuille Excel, après avoir renseigné la valeur 70 en A1, 100 en B1 et 15 en C1, l’analyste applique la formule :
=LOI.NORMALE.N(70; 100; 15; VRAI)
Le tableur retourne la valeur numérique 0,02275013, soit approximativement 2,28 %. Cette valeur probabiliste fournit un ancrage diagnostique fondamental : elle atteste qu’environ 22,8 enfants sur mille se situent spontanément sous ce seuil critique du fait de la seule variabilité distributionnelle gaussienne. Toute observation empirique substantiellement supérieure à ce ratio au sein d’une cohorte spécifique signalera la présence de facteurs étiologiques ou environnementaux requérant une investigation approfondie.
5. Calcul d’une probabilité unilatérale supérieure : P(X ≥ a)
5.1 Principe mathématique de l’événement complémentaire
Dans de nombreuses applications d’ingénierie statistique, de détection de signaux ou d’identification de profils d’exception, la question scientifique porte sur la probabilité d’excéder un certain seuil de performance. Cette situation définit la queue unilatérale droite de la distribution, formellement notée P(X ≥ a). Sur une calculatrice Texas Instruments, l’utilisateur traduisait cette requête en renseignant la borne supérieure d’intégration avec l’approximation de l’infini positif : normalcdf(a, 1E99, μ, σ).
Cependant, nous avons établi qu’Excel intègre exclusivement depuis moins l’infini. Il est donc impossible de renseigner directement une valeur supérieure isolée sans ajuster la logique du calcul. La solution à cette apparente contrainte opérationnelle repose sur le deuxième axiome fondamental de Kolmogorov régissant la théorie des probabilités : l’axiome de l’événement complémentaire. La somme des probabilités de l’ensemble de l’espace échantillonnal étant égale à 1, la probabilité d’un événement et celle de son contraire sont strictement complémentaires :
P(X ≥ a) = 1 – P(X < a)
En vertu de la nature continue de la loi normale, la probabilité ponctuelle en un point singulier est infinitésimale (nulle). Par conséquent, il n’existe aucune disparité analytique entre une inégalité stricte et une inégalité large : P(X < a) = P(X ≤ a). La formule se réduit donc à l’expression élémentaire mais capitale :
P(X ≥ a) = 1 – F(a)
Ce principe mathématique garantit que l’évaluation de la queue droite s’obtient simplement en soustrayant la fonction de répartition cumulative standard à l’abscisse a de la totalité unitaire de l’aire sous la courbe.
5.2 Implémentation algorithmique de la formule du complément
Dans l’environnement de calcul d’une cellule Excel, l’algorithme du complément s’implémente par une soustraction arithmétique directe débutant par la constante 1. En supposant que le seuil plancher a se situe dans la cellule A2, la moyenne μ dans la cellule B2, et l’écart-type σ dans la cellule C2, l’expression formelle s’écrit :
=1 – LOI.NORMALE.N(A2; B2; C2; VRAI)
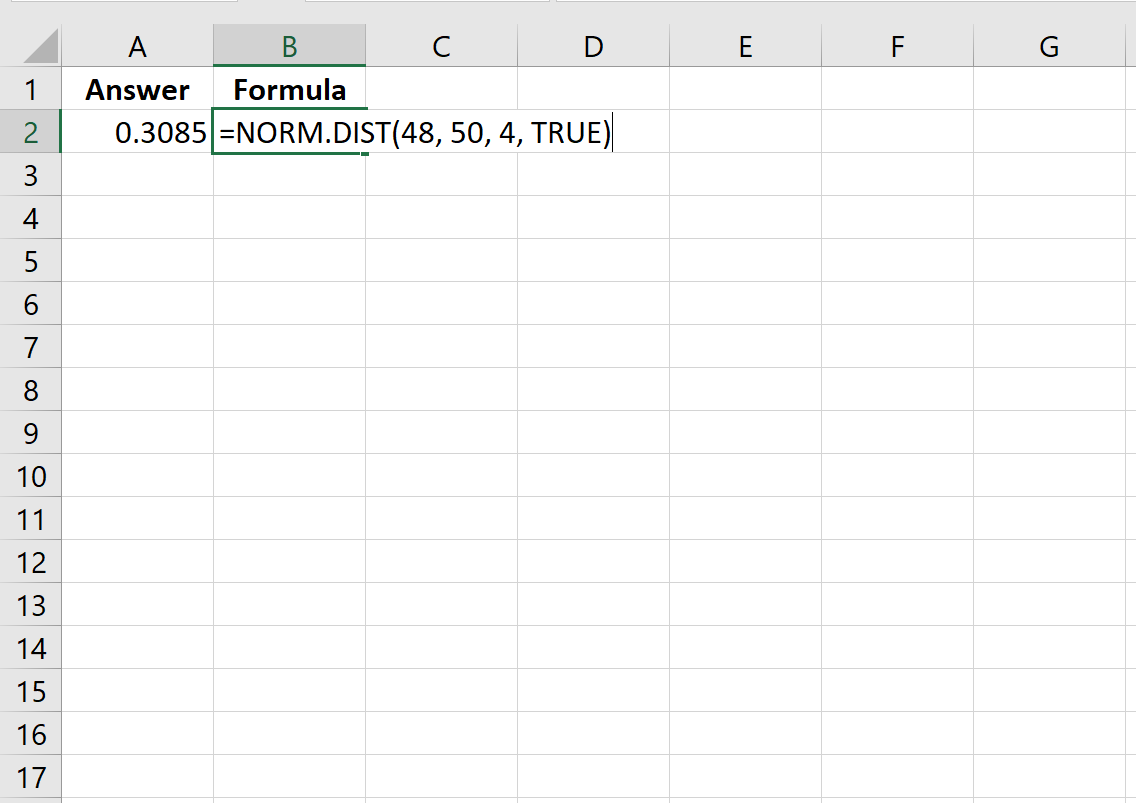
L’agencement des opérations au sein du moteur de calcul d’Excel respecte les priorités opératoires standard des mathématiques : l’évaluation de la fonction LOI.NORMALE.N est exécutée de manière prioritaire, puis son résultat scalaire est soustrait de la constante 1. Il est superflu d’englober la fonction de distribution entre parenthèses redondantes (telles que =1 – (LOI.NORMALE.N(…))), bien que cette pratique ne vicie pas le calcul.
Un enjeu technique subtil concerne la stabilité numérique de cette soustraction lorsque l’on explore des seuils situés dans les queues de distribution excessivement lointaines (par exemple au-delà de 7 ou 8 écarts-types de la moyenne). Lorsque la valeur de F(a) devient indiscernable de 1 dans la limite de précision à 15 chiffres significatifs du processeur, le résultat calculé par 1 – 1 bascule vers un zéro absolu artificiel par extinction numérique (phénomène de soustraction catastrophique). Pour les applications empiriques courantes, néanmoins, cette formulation demeure parfaitement stable et rigoureusement encadrée dans l’espace probabiliste [0, 1].
5.3 Exemple concret : Sélection de candidats à haut potentiel intellectuel
Considérons l’application de cette modélisation à un programme de dépistage et de recrutement au sein d’une organisation scientifique d’élite cherchant à sélectionner des profils présentant un « haut potentiel intellectuel » (HPI). En psychométrie différentielle, le seuil d’admissibilité conventionnel est usuellement fixé à deux écarts-types au-dessus de la moyenne de la population générale sur une échelle standard d’efficience cognitive (μ = 100, σ = 15). Ce seuil de score s’établit donc mathématiquement à :
Score HPI = μ + 2σ = 100 + (2 · 15) = 130
La direction des ressources humaines souhaite estimer précisément quelle proportion de la population candidate franchira ce filtre de sélection standardisé sans qu’aucune distorsion d’échantillonnage ne soit introduite. En configurant la borne d’exclusion 130 dans la cellule de seuil d’Excel, la cellule dédiée au résultat intègre la formule :
=1 – LOI.NORMALE.N(130; 100; 15; VRAI)
L’évaluation de cette expression engendre les étapes séquentielles suivantes au sein du processeur :
- Évaluation de la distribution cumulative inférieure : LOI.NORMALE.N(130; 100; 15; VRAI) = 0,97724987
- Soustraction complémentaire de l’unité : 1 – 0,97724987 = 0,02275013
Le système délivre un verdict numérique exact de 2,28 %. On note une symétrie mathématique absolue avec le résultat obtenu précédemment lors de l’évaluation du déficit clinique à 70 points de QI. Ce constat illustre empiriquement la symétrie parfaite de la distribution gaussienne : l’aire située à droite de μ + 2σ est rigoureusement identique à l’aire confinée à gauche de μ – 2σ. Cette information renseigne le commanditaire de l’étude sur le niveau élevé de sélectivité de son critère d’entrée, qui écartera mécaniquement plus de 97,7 % des postulants.
6. Calcul de la probabilité d’un intervalle délimité : P(a ≤ X ≤ b)
6.1 Démonstration du principe de soustraction d’aires cumulées
L’application la plus universelle, et qui constitue le cœur fonctionnel direct de l’opérateur normalcdf(a, b, μ, σ) des calculatrices graphiques, réside dans l’estimation de la probabilité qu’une observation s’insère au sein d’un intervalle bidirectionnel borné [a, b], où la contrainte d’ordre a < b est strictement respectée. La probabilité associée s’énonce mathématiquement sous la forme P(a ≤ X ≤ b).
Pour dériver cette probabilité à l’aide des fonctions de répartition unilatérales fournies par les tableurs, nous devons mobiliser le théorème fondamental de l’analyse relatif à l’additivité des aires d’intégration. L’aire sous la courbe s’étendant de moins l’infini jusqu’à la borne supérieure b (qui représente la probabilité F(b)) peut être géométriquement décomposée en deux zones contiguës disjointes : l’aire accumulée de moins l’infini jusqu’à la borne inférieure a (qui représente F(a)), et l’aire restante confinée strictement entre a et b. Dès lors, l’énoncé algébrique s’établit sans équivoque :
F(b) = F(a) + P(a ≤ X ≤ b)
En isolant la probabilité de l’intervalle cible par transposition algébrique, nous obtenons l’équation fondamentale gouvernant l’émulation de NormalCDF sous tableur :
P(a ≤ X ≤ b) = F(b) – F(a)
P(a ≤ X ≤ b) = ∫-∞b f(t) dt – ∫-∞a f(t) dt = ∫ab f(t) dt
Ce résultat démontre avec une parfaite élégance théorique que la probabilité d’un intervalle fermé quelconque équivaut à la soustraction de l’aire cumulative de la queue gauche inférieure F(a) de l’aire cumulative supérieure F(b). Tout le contenu géométrique indésirable situé à gauche de l’abscisse a est ainsi neutralisé par soustraction.
6.2 Construction de la formule combinée dans Excel
La transcription de ce principe dans la feuille de calcul s’effectue en concaténant deux appels successifs à la fonction LOI.NORMALE.N, reliés par l’opérateur arithmétique de soustraction. Supposons une architecture de feuille où la borne inférieure a réside en A1, la borne supérieure b réside en B1, l’espérance μ réside en C1, et l’écart-type σ réside en D1. La syntaxe canonique à déployer s’exprime ainsi :
=LOI.NORMALE.N(B1; C1; D1; VRAI) – LOI.NORMALE.N(A1; C1; D1; VRAI)
Il convient de porter une attention scrupuleuse à l’ordre d’agencement des paramètres : l’argument correspondant à la borne supérieure (ici B1) doit impérativement précéder le terme soustracteur faisant référence à la borne inférieure (ici A1). Une inversion de cet ordre d’évaluation aboutirait à une soustraction illégitime où une aire plus grande est déduite d’une aire plus petite, produisant un résultat probabiliste négatif dénué de toute validité physique.
Pour auditer et vérifier pas à pas l’exactitude computationnelle de cette formule complexe, l’utilisateur peut avantageusement mobiliser l’outil natif d’Évaluation de formule disponible au sein du ruban Formules d’Excel. Cet outil segmente le calcul en résolvant séquentiellement le premier terme F(b), puis le second terme F(a), avant d’afficher la soustraction résiduelle finale. Cette traçabilité interne constitue une garantie substantielle lors de la validation d’algorithmes destinés à des applications médicales ou industrielles certifiées.
6.3 Reproduction détaillée de l’exemple de référence
Afin de concrétiser la démonstration et de prouver l’équivalence arithmétique absolue entre Excel et une calculatrice graphique TI-84, reproduisons méticuleusement un cas d’école fréquemment documenté dans les cursus académiques d’introduction aux probabilités appliquées.
Soit une variable aléatoire continue X distribuée normalement selon les paramètres fondamentaux suivants :
- Espérance mathématique de la population : μ = 50
- Écart-type de la population : σ = 4
La requête computationnelle consiste à déterminer avec la plus haute fidélité numérique la probabilité que la variable X se matérialise au sein de l’intervalle symétrique fermé s’étendant de 48 à 52, ce qui se formule : P(48 ≤ X ≤ 52).
Sur une calculatrice TI-84 Plus, la séquence saisie s’exécute sous la forme :
normalcdf(48, 52, 50, 4)
Le microprocesseur de la calculatrice affiche instantanément la valeur approchée : 0,3829249225.
Configurons à présent ce problème dans une feuille de calcul Excel en insérant les données correspondantes dans les cellules dédiées :
- Cellule A1 (Borne inférieure a) : 48
- Cellule B1 (Borne supérieure b) : 52
- Cellule C1 (Espérance μ) : 50
- Cellule D1 (Écart-type σ) : 4
Nous inscrivons en cellule E1 la formule maîtresse :
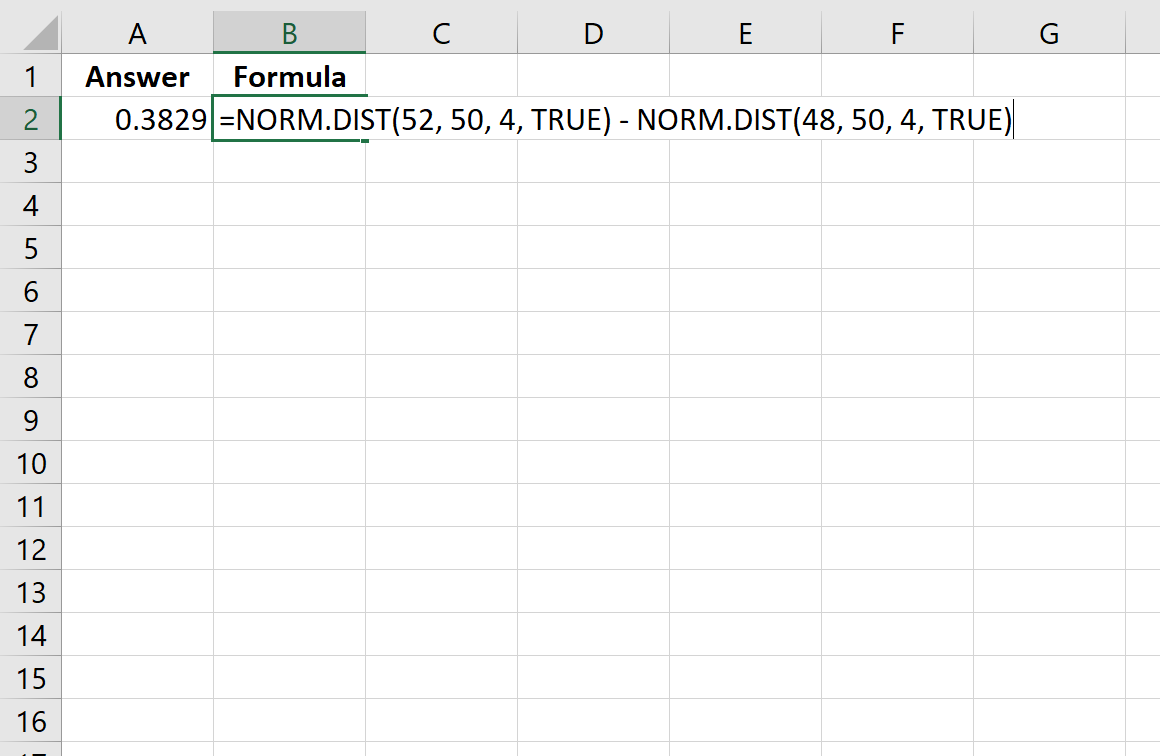
=LOI.NORMALE.N(B1; C1; D1; VRAI) – LOI.NORMALE.N(A1; C1; D1; VRAI)
L’exécution interne se déploie selon le développement numérique suivant :
- Évaluation de F(52) : LOI.NORMALE.N(52; 50; 4; VRAI) = 0,691462461274013
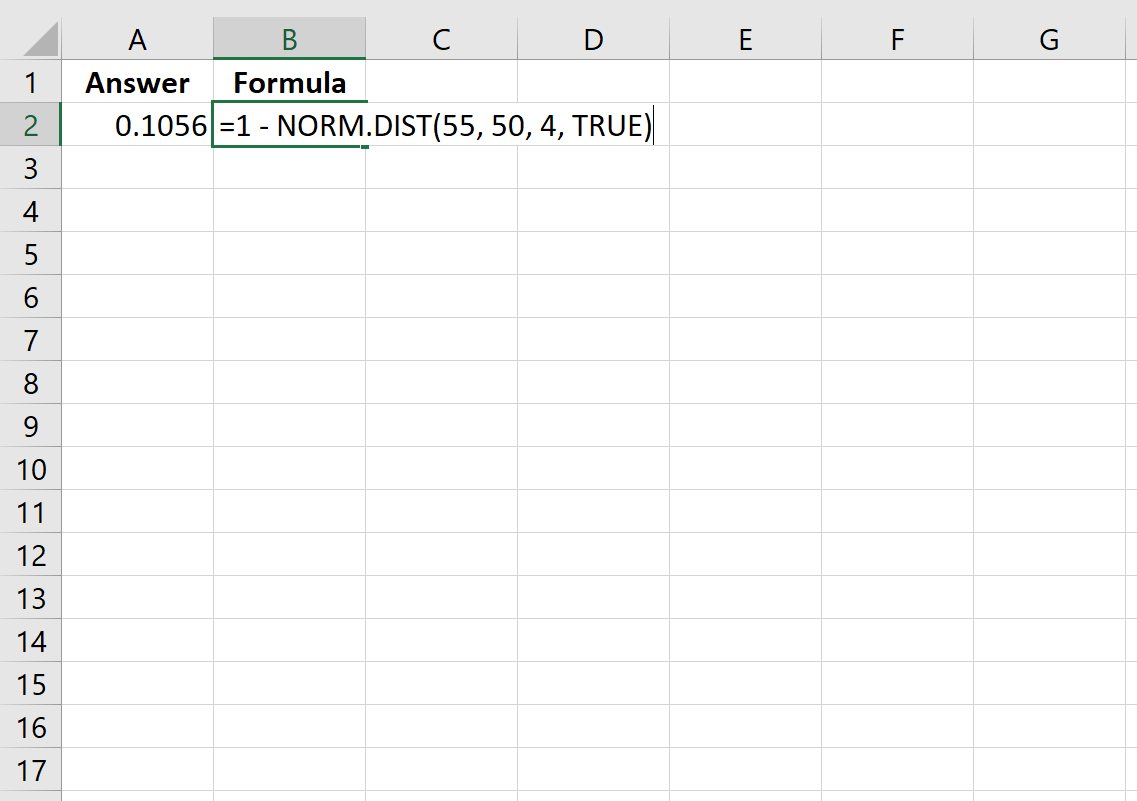
- Évaluation de F(48) : LOI.NORMALE.N(48; 50; 4; VRAI) = 0,308537538725987
- Différenciation algébrique : 0,691462461274013 – 0,308537538725987 = 0,382924922548026
Si l’on arrondit le résultat d’Excel aux quatre décimales requises par les conventions de publication scientifique, nous obtenons rigoureusement 0,3829 (soit 38,29 %). La concordance entre la calculatrice Texas Instruments et le tableur Microsoft Excel est totale et absolue jusqu’à la dixième décimale. Cet exemple prouve formellement la parfaite superposition algorithmique des deux environnements d’analyse quantitative.
6.4 Gestion des conditions d’inversion des bornes
L’un des défis majeurs dans le déploiement d’outils d’analyse partagés auprès d’équipes de saisie non mathématiciennes réside dans la vulnérabilité aux erreurs d’encodage des bornes limites. Si un opérateur inverse par inadvertance les champs et renseigne une borne inférieure a supérieure à la borne supérieure b (par exemple en saisissant 52 dans le champ minimal et 48 dans le champ maximal), la formule standard F(b) – F(a) génère implacablement un résultat négatif : -0,3829. Une telle sortie enfreint le premier axiome de probabilité qui exige que toute probabilité appartienne impérativement à l’intervalle réel positif fermé [0, 1].
Pour prémunir le modèle contre cette anomalie opérationnelle, il est recommandé d’encapsuler la formule au sein d’une structure logique conditionnelle exploitant la fonction SI d’Excel. Plusieurs stratégies de sécurisation algorithmique s’offrent au concepteur du classeur.
La première stratégie repose sur un blocage explicite avec message d’alerte, incitant l’utilisateur à rectifier sa saisie :
=SI(A1 > B1; « ERREUR : Borne Inf > Borne Sup »; LOI.NORMALE.N(B1; C1; D1; VRAI) – LOI.NORMALE.N(A1; C1; D1; VRAI))
La seconde stratégie, plus résiliente et totalement automatisée, consiste à contraindre le moteur de calcul à identifier dynamiquement la plus petite et la plus grande valeur, indépendamment de la disposition physique des cellules d’entrée, en intégrant les fonctions primitives MIN et MAX :
=LOI.NORMALE.N(MAX(A1; B1); C1; D1; VRAI) – LOI.NORMALE.N(MIN(A1; B1); C1; D1; VRAI)
Grâce à cette formulation perfectionnée, même si l’utilisateur saisit par inadvertance 52 en A1 et 48 en B1, la fonction MAX orientera le terme 52 dans le premier argument cumulatif positif, tandis que MIN affectera 48 au terme soustracteur négatif. L’intégrité numérique du résultat probabiliste est ainsi préservée contre toute anomalie de manipulation humaine.
7. Loi normale centrée réduite : Exploitation de LOI.NORMALE.STANDARD.N
7.1 Théorie de la standardisation et calcul des scores Z
En statistique descriptive et inférentielle, la notion de standardisation constitue un outil d’une puissance analytique exceptionnelle. La loi normale centrée réduite, universellement désignée comme la distribution standard N(0, 1), représente une forme canonique universelle caractérisée par une espérance mathématique nulle (μ = 0) et un écart-type unitaire (σ = 1). Toute distribution normale générale X ~ N(μ, σ²) peut être convertie en une distribution normale standard Z ~ N(0, 1) par l’application d’une transformation affine élémentaire :
z = (x – μ) / σ
La variable résultante z, communément qualifiée de score Z (ou cote standard Z), exprime l’écart relatif d’une observation brute par rapport à la moyenne arithmétique de son groupe, quantifié en unités d’écart-type. Un score Z de +1,5 indique rigoureusement que l’observation se situe à un écart-type et demi au-dessus de la moyenne de la population, tandis qu’un score Z de -2,0 désigne une valeur située à exactement deux écarts-types sous la moyenne.
L’intérêt méthodologique de cette transformation réside dans l’unification immédiate d’échelles de mesure totalement disparates. En transformant des grandeurs physiques incomparables (telles que le poids en kilogrammes, la taille en centimètres, un temps d’évaluation en millisecondes ou un score à un test psychologique) en scores Z sans dimension, l’analyste homogénéise ses données sous une métrique commune. Cette unification permet d’agréger, de comparer et d’analyser conjointement des batteries multidimensionnelles d’indicateurs hétérogènes au sein de modèles prédictifs normalisés.
7.2 Mise en œuvre de LOI.NORMALE.STANDARD.N
Reconnaissant la centralité du score Z dans l’analyse de données, Microsoft Excel intègre une fonction spécifique optimisée, dédiée exclusivement à l’évaluation cumulative de la loi normale centrée réduite : LOI.NORMALE.STANDARD.N (dont l’homologue en anglais s’intitule NORM.S.DIST). L’anatomie de cette fonction se distingue par son haut degré d’épuration paramétrique :
=LOI.NORMALE.STANDARD.N(z; cumulative)
Puisque la moyenne et l’écart-type sont implicitement et invariablement calibrés à 0 et 1 par conception algorithmique, la fonction ne réclame que deux paramètres : le score standardisé z et le paramètre booléen cumulative (qui doit, pour les mêmes impératifs méthodologiques que ceux évoqués précédemment, demeurer fixé à VRAI pour calculer une probabilité cumulée).
Cette fonction constitue l’équivalent direct de la consultation des tables Z papier historiques que l’on trouve en annexe de tous les manuels de référence en statistique inférentielle. À titre d’illustration méthodologique, le calcul de la probabilité cumulée associée au seuil critique bilatéral conventionnel de l’intervalle de confiance à 95 %, correspondant au score canonique z = 1,959964 (fréquemment arrondi à 1,96), s’exécute simplement par la syntaxe :
=LOI.NORMALE.STANDARD.N(1,959964; VRAI)
Le tableur retourne précisément la valeur 0,975000 (soit 97,5 %). La queue supérieure résiduelle au-delà de cette frontière vaut 1 – 0,975 = 0,025 (2,5 %). Par symétrie axiale, la probabilité d’observer un score inférieur à -1,96 est également de 2,5 %, scellant ainsi l’intervalle central de dispersion bilatérale à 97,5 % – 2,5 % = 95 %.
7.3 Comparaison de performance entre variables brutes et standardisées
D’un point de vue strict de l’architecture logicielle et de l’optimisation des temps de calcul, l’arbitrage entre l’emploi de LOI.NORMALE.N (opérant directement sur des variables brutes) et de LOI.NORMALE.STANDARD.N (opérant sur des scores Z préalablement normalisés) mérite une analyse rigoureuse. Sur le plan de la validité mathématique, les deux approches sont rigoureusement équivalentes, puisque l’expression :
=LOI.NORMALE.N(x; μ; σ; VRAI)
délivre un résultat strictement identique à l’imbrication :
=LOI.NORMALE.STANDARD.N((x – μ) / σ; VRAI)
Toutefois, dans le cadre de modèles de données volumineux impliquant des centaines de milliers de lignes calculées dynamiquement, le recours direct à LOI.NORMALE.N offre l’avantage substantiel d’éviter la génération d’une colonne de données auxiliaire dédiée au stockage physique des scores Z intermédiaires. La réduction du nombre de calculs dépendants allège l’empreinte mémoire vive allouée au classeur et accélère les cycles de recalcul automatique lors de la saisie en continu.
Inversement, le calcul explicite et préalable des scores Z présente un atout méthodologique indéniable en matière de diagnostic d’intégrité des données. L’inspection visuelle directe des colonnes de scores standardisés Z permet à l’analyste de repérer immédiatement la présence de valeurs aberrantes (outliers extrêmes situés typiquement au-delà de ±3 ou ±4 écarts-types) avant même d’entamer l’étape d’évaluation probabiliste. De plus, la standardisation préalable évite les distorsions computationnelles d’arrondi lors du traitement d’échelles de mesures brutes présentant des ordres de grandeur démesurés (par exemple des variables financières chiffrées en milliards ou des grandeurs de physique nucléaire infinitésimales).
8. L’opération réciproque : Retrouver les seuils avec LOI.NORMALE.INVERSE.N
8.1 Principe de la fonction quantile et équivalence avec InvNorm
Dans de nombreuses démarches scientifiques, le chercheur ou le modélisateur fait face à un problème rigoureusement inverse de celui résolu par la fonction de répartition cumulative. Plutôt que de rechercher la probabilité cumulée p correspondant à une abscisse x donnée, il dispose d’une probabilité théorique cible (par exemple un risque d’erreur consenti ou un pourcentage normatif de population) et doit identifier la valeur critique x qui délimite cette portion sous la courbe. Cette opération duale correspond à la fonction quantile, formalisée mathématiquement comme la réciproque de la fonction de répartition :
x = F-1(p)
Dans l’écosystème matériel des calculatrices Texas Instruments TI-83/TI-84, cette fonction réciproque s’intitule invNorm. La syntaxe canonique de la calculatrice s’exprime sous la forme invNorm(probabilité, [μ, σ]). Si un utilisateur cherchait la note marquant le seuil des 10 % d’élèves les plus faibles dans une classe dont la moyenne est de 50 et l’écart-type de 10, il programmait simplement invNorm(0.10, 50, 10) pour obtenir l’abscisse correspondante.
La fonction quantile constitue le socle indispensable des tests d’hypothèses statistiques. Elle permet de matérialiser physiquement les zones de rejet de l’hypothèse nulle (H0) et de définir les valeurs critiques associées aux seuils d’erreur alpha conventionnels de 5 % ou 1 %. Elle est également omniprésente en économétrie financière pour le calcul de la Valeur sous Risque (Value at Risk, ou VaR), où l’on cherche à isoler le niveau de perte financière qui ne sera dépassé qu’avec une probabilité infinitésimale de 1 % ou 5 % sur un horizon temporel donné.
8.2 Syntaxe et application de LOI.NORMALE.INVERSE.N
Pour exécuter cette opération inverse au sein d’une feuille de calcul, Microsoft Excel met à disposition la fonction native LOI.NORMALE.INVERSE.N (dont l’équivalent dans la version anglaise est NORM.INV). La structure syntaxique formelle de cet opérateur statistique s’articule comme suit :
=LOI.NORMALE.INVERSE.N(probabilité; espérance; écart_type)
Le premier argument, probabilité, est un nombre réel qui doit obligatoirement respecter l’inégalité stricte :
0 < probabilité < 1
L’injection d’une valeur extérieure à cet intervalle ouvert (y compris la saisie des bornes exactes 0 ou 1, qui correspondraient à une abscisse théorique infinie) provoquera instantanément une erreur de calcul #NOMBRE! générée par le tableur. Les arguments espérance et écart_type remplissent le même rôle dimensionnel que dans la fonction directe.
Considérons à titre d’illustration la détermination des quartiles théoriques d’une distribution normale d’un test standardisé de recrutement (μ = 1000, σ = 200). Les quartiles séparent la cohorte en quatre fractions d’effectifs rigoureusement identiques (25 %, 50 %, 75 %). Pour calculer le premier quartile (Q1), qui sépare les 25 % de candidats ayant obtenu les performances les plus faibles, l’analyste applique dans la cellule de destination la formule suivante :
=LOI.NORMALE.INVERSE.N(0,25; 1000; 200)
L’algorithme de calcul délivre le seuil critique exact : 865,10. Ce résultat indique sans ambiguïté que tout candidat dont la performance se situe en deçà de 865,10 points est assigné au premier quartile inférieur de la population évaluée. De la même façon, la médiane théorique s’obtient via =LOI.NORMALE.INVERSE.N(0,50; 1000; 200), retournant précisément la valeur centrale de 1000,00.
8.3 Calcul de bornes symétriques bilatérales
Une configuration récurrente en calibration psychométrique et en modélisation industrielle consiste à définir les deux bornes d’un intervalle central encadrant une portion symétrique fixe de la distribution, par exemple la zone médiane englobant précisément 95 % des observations normotypiques d’une population clinique.
Pour identifier ces frontières symétriques sans commettre de biais d’asymétrie, l’analyste doit partitionner le risque résiduel extérieur (communément noté α) en deux queues équiprobables de part et d’autre de la zone centrale. Dans notre cas d’école centré sur 95 % de la masse probabiliste, le reliquat extérieur s’élève à 1 – 0,95 = 0,05 (5 %). Chaque queue latérale doit donc absorber la moitié exacte de cette dispersion résiduelle :
Risque de queue = α / 2 = 0,05 / 2 = 0,025 (2,5 %)
La délimitation des deux seuils critiques régissant l’intervalle s’organise alors selon deux calculs réciproques distincts dans le tableur :
- Borne inférieure (laissant 2,5 % de surface à sa gauche) :
=LOI.NORMALE.INVERSE.N(0,025; μ; σ) - Borne supérieure (laissant 97,5 % de surface totale cumulée à sa gauche, soit 2,5 % à sa droite) :
=LOI.NORMALE.INVERSE.N(0,975; μ; σ)
Si nous reprenons nos paramètres psychométriques usuels (μ = 100, σ = 15), la borne inférieure se résout à :
=LOI.NORMALE.INVERSE.N(0,025; 100; 15) = 70,60
Tandis que la borne supérieure se résout rigoureusement à :
=LOI.NORMALE.INVERSE.N(0,975; 100; 15) = 129,40
L’analyste dispose ainsi d’un intervalle de référence certifié [70,60 ; 129,40] au sein duquel se réalise précisément 95 % de la variabilité naturelle de la cohorte. Tout individu dont le score franchit ces limites bilatérales sera qualifié d’atypique sur le plan statistique avec un niveau de confiance bilatéral de 95 %.
9. Modélisation et automatisation dynamique dans les feuilles de calcul
9.1 Architecture d’un calculateur NormalCDF réutilisable
Pour dépasser le stade des calculs ponctuels et bâtir un environnement logiciel professionnel pérenne au sein d’un laboratoire ou d’un département hospitalier, il est indispensable de structurer un module dédié et réutilisable qui émule fidèlement l’interface de la commande normalcdf. Ce type de classeur doit séparer distinctement la couche d’interface de saisie utilisateur de la couche logique d’exécution des formules sous-jacentes.
Une configuration ergonomique optimale repose sur l’aménagement visuel d’un bloc de paramètres d’entrée situé dans une plage cellulaire identifiée :
- Cellule B2 : Borne inférieure de l’intervalle (Lower)
- Cellule B3 : Borne supérieure de l’intervalle (Upper)
- Cellule B4 : Moyenne de référence de la distribution (μ)
- Cellule B5 : Écart-type de référence de la distribution (σ)
Dans la cellule de restitution des résultats (par exemple la cellule B7), l’analyste imbrique une formule universelle capable de traiter dynamiquement aussi bien les intervalles fermés bilatéraux que les queues unilatérales infinies. Si l’utilisateur laisse le champ de la borne inférieure vide ou y inscrit un texte spécifique tel que « -INF », la formule doit se comporter comme une queue gauche pure. De même, si la borne supérieure est non renseignée ou marquée « +INF », le système doit basculer automatiquement sur la formule de la queue droite complémentaire :
=SI(ET(ESTNUM(B2); ESTNUM(B3)); LOI.NORMALE.N(B3; B4; B5; VRAI) – LOI.NORMALE.N(B2; B4; B5; VRAI); SI(ET(NON(ESTNUM(B2)); ESTNUM(B3)); LOI.NORMALE.N(B3; B4; B5; VRAI); SI(ET(ESTNUM(B2); NON(ESTNUM(B3))); 1 – LOI.NORMALE.N(B2; B4; B5; VRAI); « Saisie incomplète »)))
Une fois ce dispositif déployé, la feuille de calcul gagne à être verrouillée (via l’onglet Révision > Protéger la feuille), en ne laissant déverrouillées que les cellules de saisie (B2:B5). Cette précaution de sécurité logicielle prévient toute altération accidentelle de la syntaxe des formules par les opérateurs de saisie, garantissant l’intégrité opérationnelle du calculateur à long terme.
9.2 Utilisation des références absolues et relatives pour simulations de masse
L’un des avantages les plus décisifs d’Excel par rapport aux calculatrices matérielles fermées réside dans son aptitude à appliquer un calcul probabiliste à des cohortes massives de participants par le biais de la manipulation experte des références de cellules. La distinction entre références relatives (ex. A2) et références absolues ancrées par le préfixe dollar (ex. $E$2) conditionne la réussite de cette vectorisation.
Imaginons un registre clinique répertoriant une cohorte de dix mille patients. Les scores bruts obtenus par chaque participant à une épreuve neuropsychologique sont compilés dans la colonne A, s’étendant de la cellule A2 jusqu’à A10001. Dans un cadre séparé, les paramètres de calibration de l’échantillon normatif sont figés dans les cellules E2 pour la moyenne (μ) et F2 pour l’écart-type (σ).
Pour calculer le rang centile théorique (la probabilité cumulée unilatérale inférieure) de chaque patient sans devoir ressaisir les paramètres sur chaque ligne, l’analyste positionne la formule suivante dans la première cellule active B2 :
=LOI.NORMALE.N(A2; $E$2; $F$2; VRAI)
Lors de la propagation de la formule vers le bas (soit par double-clic sur la poignée de recopie incrémentale, soit par extension verticale), le système adapte dynamiquement la référence relative A2 (qui deviendra successivement A3, A4, …, A10001), tout en maintenant un ancrage invariable sur les cellules normatives figées $E$2 et $F$2. En une fraction de seconde, dix mille probabilités cumulées sont calculées et vectorisées avec une rigueur absolue, une performance inconcevable sur une calculatrice programmable classique.
9.3 Émulation de la fonction TI-84 via une fonction personnalisée VBA
Pour les environnements de travail où les utilisateurs souhaitent retrouver rigoureusement la syntaxe d’origine de leur calculatrice Texas Instruments sans composer manuellement la soustraction des deux fonctions natives dans chaque cellule, Excel autorise la création de fonctions personnalisées (UDF, pour User-Defined Functions) via son environnement de développement Visual Basic pour Applications (VBA).
En accédant à l’éditeur VBA (via le raccourci clavier Alt + F11), puis en insérant un module de code standard dans le projet, le programmeur peut implémenter le script suivant :
Function NormalCDF(Lower As Double, Upper As Double, Optional Mean As Double = 0, Optional SD As Double = 1) As Variant
On Error GoTo ErrorHandler
If SD <= 0 Then
NormalCDF = CVErr(xlErrNum)
Exit Function
End If
Dim WorksheetFunc As Object
Set WorksheetFunc = Application.WorksheetFunction
Dim CDF_Upper As Double
Dim CDF_Lower As Double
CDF_Upper = WorksheetFunc.Norm_Dist(Upper, Mean, SD, True)
CDF_Lower = WorksheetFunc.Norm_Dist(Lower, Mean, SD, True)
NormalCDF = CDF_Upper – CDF_Lower
Exit Function
ErrorHandler:
NormalCDF = CVErr(xlErrValue)
End Function
Une fois ce module validé et le classeur enregistré sous le format prenant en charge les macros (extension .xlsm), une nouvelle fonction native nommée NormalCDF devient accessible directement dans l’ensemble des cellules du classeur. L’utilisateur peut ainsi inscrire directement :
=NormalCDF(48; 52; 50; 4)
Cette approche hybride associe l’ergonomie mnémonique historique de la TI-84 à la puissance de traitement parallèle du moteur de calcul tabulaire de Microsoft Excel. Il importe toutefois de noter que l’intégration de macros VBA peut soulever des contraintes de sécurité institutionnelles lors du partage de classeurs en réseau, nécessitant la configuration préalable des autorisations d’exécution des macros dans le centre de gestion de la confidentialité d’Office.
10. Représentation graphique de l’aire sous la courbe dans Excel
10.1 Construction de la table de données de la courbe en cloche
La formalisation abstraite d’une probabilité cumulée gagne immensément en force pédagogique et en impact clinique lorsqu’elle s’accompagne d’une représentation visuelle fidèle de la cloche de Gauss et de l’ombrage de la zone d’intégration. La construction de ce type de graphique dans Excel nécessite en premier lieu l’élaboration d’une matrice discrétisée de points de coordonnées (x, y) simulant la continuité de la fonction de densité.
Pour assurer une résolution graphique fluide sans aspérités polygonales, il est recommandé de modéliser la courbe sur un intervalle d’abscisses couvrant une amplitude totale de quatre écarts-types de part et d’autre de la moyenne, soit l’intervalle [μ – 4σ ; μ + 4σ]. Cette plage encadre plus de 99,99 % de l’aire théorique de la distribution, garantissant que les retombées asymptotiques de la courbe rejoignent visuellement le niveau zéro de l’axe horizontal.
Le tableau de coordonnées s’articule autour de trois colonnes fondamentales :
- Colonne A (Abscisses x) : Génération d’une séquence linéaire de 200 à 400 points équidistants. Le pas d’incrémentation peut être paramétré à (8σ) / 300. Par exemple, pour μ = 50 et σ = 4, l’intervalle s’étend de 34 à 66 par incréments constants de 0,1.
- Colonne B (Densité globale f(x)) : Calcul de la hauteur de la cloche en utilisant la fonction native en mode non-cumulatif :
=LOI.NORMALE.N(A2; $E$1; $F$1; FAUX).
À partir de ces deux séries, l’insertion d’un graphique de type Nuage de points avec lignes lissées permet de projeter sur la feuille l’enveloppe extérieure parfaite de la distribution gaussienne.
10.2 Coloration dynamique de la zone d’intervalle sélectionnée
L’enjeu graphique déterminant consiste à teinter ou hachurer automatiquement la portion spécifique de l’aire sous la courbe délimitée par les bornes [a, b] définies dans le calculateur, de telle sorte que la zone ombrée réagisse dynamiquement aux modifications apportées aux cellules de paramètres.
Pour matérialiser cette fonctionnalité sans recourir à des modules externes, l’analyste crée une colonne auxiliaire conditionnelle, conventionnellement positionnée en Colonne C, dédiée à l’aire de remplissage. Cette colonne interroge l’abscisse de la ligne courante au moyen d’un test logique faisant appel à la fonction SI conjuguée à la condition ET :
=SI(ET(A2 >= $H$1; A2 <= $H$2); B2; 0)
Dans cette formulation, $H$1 héberge la borne inférieure a et $H$2 la borne supérieure b. Si l’abscisse x de la ligne courante se situe à l’intérieur de l’intervalle spécifié, la formule réplique l’ordonnée de densité exacte calculée en Colonne B. Si l’abscisse est extérieure à l’intervalle, la formule assigne une valeur nulle (0).
En intégrant cette série de données au graphique sous la forme d’un graphique combiné utilisant le type Graphique en aires, Excel applique une teinte continue sous la courbe, cantonnée strictement entre les bornes désignées. Lorsque le clinicien ou l’analyste ajuste les bornes d’évaluation en H1 ou H2, la surface colorée se contracte ou se dilate en temps réel, fournissant une validation visuelle instantanée de la zone probabiliste mesurée par la formule de calcul.
10.3 Communication visuelle des résultats dans les rapports de recherche
La valorisation des résultats statistiques dans les publications académiques ou les comptes-rendus d’évaluation clinique impose de respecter des chartes graphiques rigoureuses, telles que celles prescrites par le manuel de style de l’American Psychological Association (APA). Une restitution visuelle approximative ou surchargée d’artéfacts logiciels nuit à la crédibilité scientifique du propos.
Pour conformer la figure aux exigences académiques, il convient de supprimer les éléments d’habillage superflus fréquemment ajoutés par défaut dans les graphiques bureautiques :
- Suppression intégrale du quadrillage d’arrière-plan (lignes de grille majeures et mineures) afin d’épurer l’espace de lecture.
- Calibrage de la couleur de l’aire ombrée sous un gris neutre ou une teinte pastel douce dotée d’une légère transparence visuelle (environ 30 %), permettant de percevoir distinctement la ligne de base.
- Formatage strict des axes typographiques avec libellés explicites indiquant le nom de la variable mesurée et son unité sur l’axe des abscisses, et la mention formelle Densité de probabilité sur l’axe vertical.
- Intégration d’une zone de texte dynamique directement liée à la cellule de calcul du classeur, affichant une étiquette formalisée telle que : P(48 ≤ X ≤ 52) = 0,3829.
Lorsque le graphique est finalisé, l’exportation vers le manuscrit scientifique ne doit jamais être effectuée par une capture d’écran pixelisée. Excel permet de copier l’objet vectoriel directement dans le presse-papier pour le coller en tant que « Métafichier amélioré » ou objet vectoriel scalable dans les logiciels de traitement de texte académiques, garantissant une netteté de tracé absolue quelle que soit la résolution d’impression finale.
11. Diagnostics des erreurs, précision numérique et pièges statistiques
11.1 Résolution des codes d’erreur fréquents dans Excel
Lors de la manipulation des fonctions de distribution statistique, l’analyste peut être confronté à plusieurs codes d’erreur caractéristiques émis par le moteur d’Excel. L’identification rapide de l’étiologie logicielle de ces dysfonctionnements conditionne l’efficacité du débogage.
L’erreur la plus emblématique associée aux fonctions de la loi normale est l’erreur #NOMBRE! (ou #NUM!). Ce code se manifeste quasi systématiquement lorsqu’un argument numérique viole les contraintes axiomatiques du modèle mathématique. Le cas de figure le plus récurrent concerne l’argument de dispersion : si l’analyste affecte une valeur négative ou strictement égale à zéro au paramètre écart_type (par exemple LOI.NORMALE.N(50; 50; 0; VRAI)), le dénominateur de l’équation s’annule, rendant le calcul impossible. De même, au sein de la fonction réciproque LOI.NORMALE.INVERSE.N, la spécification d’une probabilité en dehors de l’intervalle ouvert ]0, 1[ déclenchera immédiatement cette même erreur #NOMBRE!.
Une seconde anomalie récurrente est matérialisée par le code #VALEUR! (ou #VALUE!). Ce message signale une inadéquation de typage de données au sein d’un ou plusieurs arguments de la fonction. Cela se produit notamment lorsqu’une cellule de référence héberge un espace invisible, un caractère typographique indésirable ou un séparateur décimal non reconnu par les paramètres régionaux de l’ordinateur (comme l’insertion d’un point dans une suite logicielle exigeant la virgule continentale).
Pour neutraliser en amont la survenue de ces anomalies, il est fortement préconisé de configurer une Validation des données (accessible sous l’onglet Données d’Excel) sur les cellules d’entrée. En contraignant par exemple la cellule dévolue à l’écart-type à n’accepter que des « Décimaux » strictement supérieurs à zéro, le concepteur du classeur érige une barrière logicielle infranchissable qui prévient la saisie de paramètres erronés à la source.
11.2 Limites de précision en virgule flottante dans les queues extrêmes
Bien que Microsoft Excel déploie des algorithmes d’une grande rigueur pour l’évaluation des distributions classiques, l’analyste doit garder à l’esprit les limitations matérielles inhérentes à l’architecture arithmétique en virgule flottante double précision, normalisée par le standard international IEEE 754. Dans ce standard matériel, la précision numérique des nombres réels est physiquement bornée à environ 15 à 17 chiffres décimaux significatifs.
Cette contrainte technologique produit des effets notables lorsque l’on cherche à évaluer des événements de rareté exceptionnelle situés dans les queues de distribution extrêmes, généralement au-delà de 6 à 8 écarts-types de la moyenne arithmétique (phénomènes dits de « cygne noir » ou détection de particules en physique des hautes énergies). Lorsque l’abscisse x s’éloigne excessivement vers la droite, la fonction de répartition F(x) devient tellement proche de l’unité que le processeur ne parvient plus à représenter la différence binaire infinitésimale avec 1.
Conséquemment, lors de l’application de la formule complémentaire =1 – LOI.NORMALE.N(x; μ; σ; VRAI) pour une valeur de score standardisé z > 8,2, le tableur procède à un arrondi d’extinction numérique (underflow) et renvoie brutalement la valeur 0. Dans ces régions hyper-extrêmes, si le protocole expérimental requiert d’estimer des probabilités infinitésimales de l’ordre de 10⁻²⁰ ou 10⁻⁵⁰, Excel n’est plus l’outil adéquat. Le chercheur devra impérativement se tourner vers des environnements de calcul symbolique ou d’analyse en précision arbitraire (tels que R, Python avec la bibliothèque mpmath, ou Mathematica), capables de gérer des représentations mantisse-exposant étendues sans arrondi prématuré.
11.3 Différenciation stricte entre distributions discrètes et continues
Un écueil statistique classique lors de la manipulation de la distribution normale dans un tableur découle de l’oubli de la nature fondamentalement continue de cette loi lors de l’approximation de phénomènes empiriques fondamentalement discrets. Dans une distribution continue, l’intégrale sur un point singulier est rigoureusement nulle :
P(X = x) = ∫xx f(t) dt = 0
Par conséquent, si un analyste interroge Excel sur la probabilité qu’un sujet obtienne « exactement » un score de 50 à un test, la réponse théorique rigoureuse est nulle. Dans la pratique, toutefois, une mesure physique ou un score à un test est toujours discrétisé par l’instrument de mesure (les scores augmentent par pas entiers de 1 point). Pour modéliser la probabilité d’obtenir une observation discrète de 50 sous une approximation normale, il est impératif de faire appel au principe de la correction de continuité.
La correction de continuité (historiquement formulée par Frank Yates) consiste à étendre l’entier discret k en un intervalle de continuité réel d’amplitude unitaire centré sur cet entier, c’est-à-dire l’intervalle [k – 0,5 ; k + 0,5]. Ainsi, pour évaluer la probabilité empirique d’observer précisément un score de 50, l’analyste ne doit pas tenter d’évaluer la densité en 50 avec FAUX, mais doit programmer la soustraction d’intervalle suivante dans Excel :
=LOI.NORMALE.N(50,5; μ; σ; VRAI) – LOI.NORMALE.N(49,5; μ; σ; VRAI)
L’omission de cette correction d’un demi-point d’amplitude lors de l’approximation normale de lois discrètes (comme la loi binomiale ou la loi de Poisson décrivant des comptages de populations) introduit un biais systématique substantiel dans les inférences probabilistes, tout particulièrement lorsque la taille de l’échantillon analysé est restreinte.
12. Applications avancées en analyse de données psychologiques et épidémiologiques
12.1 Calcul des seuils de puissance statistique et d’erreurs de décision
Dans l’ingénierie des protocoles expérimentaux en psychologie cognitive et en épidémiologie clinique, la maîtrise de la distribution cumulative normale permet d’opérationnaliser les calculs relatifs à la puissance des tests d’inférence statistique et de contrôler rigoureusement les risques d’erreur décisionnelle formalisés par le paradigme de Neyman-Pearson.
Lorsqu’un chercheur teste l’efficacité d’une nouvelle thérapeutique par rapport à un placébo, il modélise simultanément deux distributions normales concurrentes : la distribution sous l’hypothèse nulle (H0, absence d’effet, centrée sur μ₀ = 0) et la distribution sous l’hypothèse alternative (H1, présence d’un effet réel standardisé, centrée sur μ₁ = d, où d représente l’amplitude de la taille d’effet théorique attendue).
Le chercheur commence par fixer son risque d’erreur de première espèce α (communément 0,05), qui représente la probabilité de rejeter H0 alors qu’elle est pourtant vraie. La valeur critique de décision z_critique sur la distribution H0 s’obtient via la fonction quantile :
z_critique = LOI.NORMALE.INVERSE.N(1 – α; 0; 1)
Dès lors, la probabilité de commettre une erreur de type II (notée β), consistant à échouer à détecter l’effet thérapeutique alors qu’il est authentiquement présent sous H1, s’évalue directement dans Excel en calculant la probabilité que la distribution H1 se réalise sous ce seuil critique de rejet :
β = LOI.NORMALE.STANDARD.N(z_critique – d; VRAI)
La puissance statistique du protocole expérimental, définie comme la probabilité d’identifier avec succès un effet thérapeutique avéré, se dérive par le simple complément à l’unité :
Puissance = 1 – β = 1 – LOI.NORMALE.STANDARD.N(z_critique – d; VRAI)
Grâce à cette chaîne algorithmique, le chercheur peut bâtir dans sa feuille Excel un simulateur dynamique de puissance statistique permettant d’optimiser le calibrage de la taille de son échantillon expérimental avant le début des inclusions cliniques, garantissant un protocole conforme aux plus hautes exigences des agences d’évaluation de la recherche.
12.2 Étalonnage d’instruments psychométriques et création d’échelles dérivées
L’étalonnage normatif d’un instrument psychométrique représente un cas d’application emblématique où la manipulation conjointe des fonctions LOI.NORMALE.N et LOI.NORMALE.INVERSE.N joue un rôle central. Lors de la publication d’un test standardisé, les concepteurs transforment rarement les scores bruts en simples percentiles ; ils préfèrent les projeter sur des échelles numériques dérivées normalisées, facilitant la lecture clinique.
Parmi les échelles les plus universellement reconnues, on dénombre :
- Les notes T (largement employées dans le MMPI et les tests de personnalité), caractérisées par une moyenne μ = 50 et un écart-type σ = 10.
- Les notes standardisées des subtests de Wechsler, d’espérance μ = 10 et de dispersion σ = 3.
- L’échelle des stanines (pour standard nines), qui discrétise la distribution gaussienne en neuf tranches ordinales normalisées de moyenne μ = 5 et d’écart-type σ = 2.
Lorsqu’une variable empirique brute ne suit pas initialement une loi normale parfaite mais présente une asymétrie modérée, les psychométriciens déploient la méthode de normalisation d’aire de McCall. Cette procédure repose sur une projection quantile non linéaire en deux phases au sein du tableur :
- Phase 1 : Conversion des rangs centiles empiriques P calculés sur les données brutes à l’aide des fonctions de tri et de comptage d’Excel.
- Phase 2 : Rétro-projection de ces centiles empiriques dans l’échelle cible normalisée au moyen de la fonction quantile paramétrée selon l’échelle désirée :
=LOI.NORMALE.INVERSE.N(P; 50; 10) pour dériver des notes T normalisées.
Ce procédé permet d’éliminer mathématiquement les distorsions d’asymétrie de l’épreuve d’origine et garantit l’équivalence métrique stricte entre différentes formes parallèles d’un même instrument diagnostique.
12.3 Vérification de l’adéquation distributionnelle empirique
L’ensemble des développements méthodologiques présentés dans cet ouvrage repose sur un postulat axiomatique fondamental : les données observées suivent effectivement une loi normale dans la population parente. L’application mécanique des fonctions de probabilité cumulative à des jeux de données caractérisés par une asymétrie prononcée (skewness) ou un aplatissement anomal (kurtosis) conduirait inéluctablement à des conclusions statistiques fallacieuses.
Pour s’assurer de la légitimité de ce modèle, l’analyste peut mobiliser la fonction LOI.NORMALE.N pour poser les fondations du célèbre test d’adéquation de Kolmogorov-Smirnov directement au sein de sa feuille de calcul. Ce test non paramétrique repose sur la mesure de l’écart vertical absolu maximal, désigné par la statistique D, entre la fonction de répartition cumulative théorique postulée F(x) et la fonction de répartition empirique observée sur l’échantillon S(x).
La démarche algorithmique se déploie dans le tableur selon les phases successives suivantes :
- Tri strict des données empiriques de l’échantillon par ordre croissant dans une colonne d’abscisses x(i), où i représente le rang de l’observation allant de 1 jusqu’à la taille d’échantillon totale n.
- Calcul de la fonction de répartition empirique par échelons pour chaque observation, matérialisée par la proportion cumulée S(x(i)) = i / n.
- Calcul de la fonction de répartition cumulative théorique pour chaque point à l’aide de la moyenne et de l’écart-type observés de l’échantillon :
F(x(i)) = LOI.NORMALE.N(x(i); MOYENNE; ECARTYPE; VRAI). - Évaluation des écarts différentiels absolus entre théorie et observation pour chaque rang :
=ABS(F(x(i)) – S(x(i))). - Extraction de l’écart suprémum maximal sur l’ensemble de la série via la fonction de synthèse :
=MAX(plage_des_écarts).
Si cet écart maximal D mesuré par le tableur demeure inférieur à la valeur critique tabulée pour le niveau de risque sélectionné, l’hypothèse de normalité ne peut être rejetée. L’analyste détient alors la confirmation empirique et méthodologique que ses calculs de probabilités cumulées via les fonctions équivalentes à NormalCDF reposent sur un modèle distributionnel scientifiquement irréprochable.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
American Psychiatric Association. (2013). Diagnostic and statistical manual of mental disorders (5th ed.). American Psychiatric Publishing. https://doi.org/10.1176/appi.books.9780890425596
Hart, J. F., Cheney, E. W., Lawson, C. L., Maehly, H. J., Mesztenyi, C. K., Rice, J. R., Thacher, H. C., & Witzgall, C. (1968). Computer approximations. John Wiley & Sons.
IEEE. (2019). IEEE standard for floating-point arithmetic (IEEE Std 754-2019). IEEE. https://doi.org/10.1109/IEEESTD.2019.8766229
Microsoft Corporation. (2023). Documentation de la fonction LOI.NORMALE.N. Support technique Microsoft. https://support.microsoft.com/fr-fr/office/loi-normale-n
National Institute of Standards and Technology. (2022). Digital library of mathematical functions (Release 1.1.5). U.S. Department of Commerce. https://dlmf.nist.gov
Texas Instruments. (2020). Guide de référence des calculatrices graphiques TI-83 Plus / TI-84 Plus. Texas Instruments Incorporated. https://education.ti.com
Wechsler, D. (2014). Wechsler intelligence scale for children—Fifth edition: Administration and scoring manual. Pearson.