
L’analyse stochastique et la modélisation probabiliste constituent le socle fondamental sur lequel reposent la prise de décision contemporaine, l’inférence scientifique et l’évaluation rigoureuse du risque. Qu’il s’agisse de mesurer la volatilité d’un actif financier, d’anticiper la demande au sein d’une chaîne logistique complexe, ou de quantifier les traits latents au sein d’une cohorte en psychométrie, la quantification formelle du hasard s’impose comme un impératif méthodologique incontournable. Dans cet écosystème analytique, le tableur Microsoft Excel demeure l’un des environnements computationnels les plus universellement déployés, offrant un pont opérationnel remarquable entre les théories mathématiques abstraites et la pratique quotidienne des analystes de données.
Trop souvent restreint à des opérations arithmétiques élémentaires ou à la simple tenue de registres comptables, Excel intègre en réalité une bibliothèque sophistiquée de fonctions statistiques et matricielles capables de traiter des lois de probabilité discrètes et continues avec une précision remarquable. La manipulation experte de ces outils permet non seulement de s’affranchir d’architectures de programmation plus lourdes lorsque l’agilité exploratoire est requise, mais elle confère également une transparence analytique immédiate, où chaque étape du raisonnement probabiliste peut être isolée, vérifiée et auditée visuellement au sein de la grille de calcul.
Ce guide exhaustif a pour vocation de déconstruire méthodologiquement les principes, les syntaxes et les applications du calcul des probabilités sous Excel. En articulant les axiomes formels de la théorie des probabilités avec les spécificités algorithmiques du tableur, nous examinerons la fonction native PROBABILITE, les distributions théoriques continues et discrètes, ainsi que les protocoles de validation et de simulation avancée. Chaque concept est étayé par des exemples détaillés, des formulations mathématiques rigoureuses et des contextes d’application issus du monde de l’entreprise et des sciences comportementales, garantissant ainsi une maîtrise tant théorique qu’opérationnelle.
1. Introduction aux fondements du calcul des probabilités dans Excel
1.1 Définition conceptuelle de la probabilité en sciences quantitatives
Dans le cadre épistémologique des sciences quantitatives, la probabilité se définit comme une mesure formelle de l’incertitude assignée à la réalisation d’un événement au sein d’un univers d’éventualités possibles, conventionnellement désigné par la lettre grecque oméga (Ω). Formalisée de manière moderne par les travaux axiomatiques du mathématicien Andreï Kolmogorov en 1933, cette mesure est bornée sur l’intervalle réel fermé [0, 1]. Une probabilité nulle traduit l’impossibilité ontologique de l’événement dans le cadre axiomatique défini, tandis qu’une valeur unitaire exprime sa certitude absolue. Entre ces deux extrêmes se déploie l’ensemble des gradations stochastiques que les chercheurs et analystes cherchent à quantifier pour rationaliser la prise de décision en présence d’information incomplète.
Il convient de distinguer trois approches fondamentales de la probabilité : théorique (ou a priori), empirique (ou fréquentiste) et subjective (ou bayésienne). La probabilité théorique repose sur des déductions logiques et des considérations de symétrie physique, telles que l’équiprobabilité des faces d’un dé parfait. À l’inverse, l’approche fréquentiste conçoit la probabilité comme la limite de la fréquence relative d’apparition d’un événement au cours d’une série d’expériences identiques répétées un nombre infini de fois, en vertu de la loi des grands nombres. Enfin, la perspective bayésienne interprète la probabilité comme un degré de croyance rationnel révisable à la lumière de nouvelles données empiriques.
La modélisation stochastique se révèle indispensable dès lors que l’on aborde l’étude des systèmes dynamiques et des comportements humains. Contrairement aux modèles déterministes, les approches probabilistes acceptent l’aléa résiduel comme une composante intrinsèque des phénomènes observés. En sciences humaines, en économie ou en recherche clinique, l’analyse probabiliste permet de formaliser des lois comportementales tout en intégrant la variabilité interindividuelle, transformant ainsi le chaos apparent des observations isolées en structures statistiques prédictibles et opérationnelles.
1.2 Rôle et pertinence du tableur Excel dans l’analyse stochastique
Le logiciel Microsoft Excel s’est imposé comme une interface computationnelle omniprésente, comblant le fossé entre les approches théoriques sur papier et les environnements de programmation de bas niveau. Sa force réside principalement dans sa structure matricielle native, qui permet une visualisation bidimensionnelle immédiate des vecteurs d’états et de leurs distributions probabilistes associées. Pour l’analyste, la possibilité de confronter instantanément une colonne de valeurs aléatoires à son vecteur de pondération confère une flexibilité d’exploration que les scripts de code dissimulent parfois derrière des couches d’abstraction logicielle.
Cette accessibilité démocratise l’analyse quantitative sans exiger la maîtrise préalable de langages spécialisés tels que R, Python ou SAS. Des calculs de probabilités conditionnelles, des ajustements de distributions ou des scénarios prédictifs peuvent être élaborés de manière interactive au moyen de formules intégrées et de liaisons dynamiques. L’affichage direct des résultats intermédiaires favorise une démarche pédagogique et exploratoire essentielle lors de la phase de prototypage méthodologique d’un projet de recherche ou d’audit décisionnel en entreprise.
Néanmoins, l’analyste rigoureux doit demeurer conscient des limites intrinsèques du tableur. Excel opère selon la norme de calcul à virgule flottante IEEE 754 en double précision, ce qui limite la précision numérique à approximativement 15 chiffres significatifs. Bien que largement suffisante pour la majorité des applications empiriques, cette contrainte technique peut générer des erreurs d’arrondi infinitésimales susceptibles d’altérer la sommation exacte des probabilités élémentaires ou d’engendrer des instabilités dans le calcul des queues de distribution hautement asymétriques. L’intégration d’un seuil de tolérance aux erreurs de troncature demeure donc une exigence méthodologique préalable.
1.3 Aperçu des fonctions statistiques intégrées dans l’écosystème Office
L’arsenal statistique de Microsoft Excel a connu une refonte structurelle majeure depuis la publication de sa version 2010, répondant aux critiques récurrentes de la communauté scientifique concernant la précision des algorithmes sous-jacents. Les versions contemporaines, consolidées sous l’environnement Microsoft 365, séparent nettement les estimateurs d’échantillon des paramètres de population et fournissent des algorithmes optimisés pour l’évaluation des fonctions de répartition et de densité, garantissant une conformité accrue avec les standards computationnels internationaux.
Il est impératif de distinguer fonctionnellement le traitement des distributions discrètes de celui des variables aléatoires continues. Pour les univers discrets, où les valeurs prises par la variable sont dénombrables, la fonction générique PROBABILITE permet d’effectuer des sommations ciblées sur des tables d’événements. Parallèlement, des fonctions dédiées modélisent des lois fondamentales telles que la distribution binomiale (via LOI.BINOMIALE.N) ou la loi de Poisson (via LOI.POISSON.N). Pour les phénomènes continus, la fonction de référence demeure LOI.NORMALE.N, complétée par ses variantes standardisées et inverses destinées à l’évaluation des surfaces de densité intégrées.
La localisation linguistique du logiciel introduit par ailleurs une dualité de nomenclature dont l’analyste doit être averti. Les formules anglo-saxonnes historiques, telles que PROB, ont été traduites dans la déclinaison française par PROBABILITE, tandis que les fonctions de distribution se sont vues adjoindre le suffixe standardisé .N (ou .DIST en anglais) pour signaler l’implémentation des algorithmes fiabilisés post-2010. La maîtrise de ces équivalences est indispensable pour assurer l’interopérabilité des modèles au sein d’équipes pluridisciplinaires et internationales.
2. Syntaxe mathématique et fonctionnement de la fonction PROBABILITE
2.1 Décomposition des arguments requis et optionnels
La fonction PROBABILITE est expressément conçue pour évaluer la probabilité qu’une variable aléatoire discrète prenne une valeur spécifique ou s’inscrive à l’intérieur d’un intervalle défini par deux bornes. La signature standard de la fonction s’articule autour de quatre arguments structurés : PROBABILITE(x_plage; prob_plage; seuil_inf; [seuil_sup]). Chacun de ces paramètres répond à des contraintes structurelles et logiques strictes qui conditionnent la validité du traitement algorithmique.
Le paramètre x_plage correspond à la plage de cellules hébergeant l’ensemble des valeurs numériques discrètes distinctes que peut prendre la variable aléatoire sous observation. En vis-à-vis direct, l’argument prob_plage représente le vecteur contigu contenant les probabilités élémentaires associées à chacune de ces valeurs numériques. Il existe une stricte obligation de parité dimensionnelle entre ces deux plages : si le nombre d’éléments de x_plage diffère de celui de prob_plage, le moteur de calcul interrompt l’évaluation.
L’argument seuil_inf fixe la borne inférieure à partir de laquelle la sommation probabiliste est engagée, désignant la valeur minimale d’intérêt pour l’événement considéré. Enfin, l’argument facultatif seuil_sup définit la borne supérieure de sommation. S’il est explicité, la fonction calcule la probabilité cumulative fermée comprise entre ces deux seuils inclus. En cas d’omission de cette borne supérieure, le modèle applique une logique d’égalité ponctuelle stricte, réduisant l’opération au calcul de la probabilité exacte d’observer une réalisation rigoureusement égale à la valeur fixée par seuil_inf.
2.2 Mécanisme de calcul sous-jacent et équations de sommation
D’un point de vue analytique, la fonction PROBABILITE transpose dans la feuille de calcul l’opérateur mathématique de sommation conditionnelle appliqué à une loi de distribution discrète. Considérons une variable aléatoire discrète X pouvant prendre n valeurs distinctes xi (pour i allant de 1 à n), chaque modalité étant dotée d’une probabilité théorique ou empirique p(xi). Lorsque l’analyste renseigne à la fois une limite basse a et une limite haute b, le tableur résout l’équation suivante :
P(a ≤ X ≤ b) = ∑ p(xi) pour tout xi vérifiant l’inégalité conditionnelle conjointe a ≤ xi ≤ b.
Cette formulation computationnelle est fonctionnellement équivalente à une combinaison matricielle faisant appel à la fonction SOMMEPROD. En effet, l’écriture =SOMMEPROD((x_plage>=a)*(x_plage<=b)*(prob_plage)) produit un résultat mathématiquement identique en générant un vecteur booléen qui filtre et somme les composantes scalaires pertinentes. L’intérêt majeur de la fonction dédiée réside dans son élégance syntaxique, sa robustesse face aux erreurs de typage logique et l’optimisation de son exécution en mémoire vive lors du traitement de jeux de données massifs.
Lorsque le paramètre seuil_sup est ignoré, le moteur d’évaluation modifie son prédicat de filtrage pour n’appliquer qu’une condition d’égalité scalaire stricte : a = xi. L’algorithme parcourt alors la plage x_plage, identifie l’occurrence numérique correspondant rigoureusement au seuil_inf et renvoie la probabilité correspondante extraite de prob_plage. Si la valeur stipulée dans seuil_inf n’existe pas dans la grille des modalités déclarées, la formule renvoie rigoureusement zéro, traduisant l’inexistence de masse de probabilité sur ce point discret.
2.3 Contraintes d’intégrité axiomatique et conditions de validité
L’utilisation valide de la fonction PROBABILITE impose une conformité rigoureuse avec les axiomes probabilistes élémentaires. La première exigence, directement issue du second axiome de Kolmogorov relatif à la certitude de l’univers des événements, stipule que la somme intégrale des probabilités élémentaires doit valoir exactement 1. Dans la pratique computationnelle d’Excel, une légère tolérance est admise pour absorber les arrondis de conversion binaire, mais toute déviation significative engendre un modèle stochastiquement corrompu menant à des inférences erronées.
La seconde condition fondamentale concerne l’intervalle d’appartenance des coefficients de pondération probabiliste. Pour tout indice i, la valeur p(xi) consignée dans prob_plage doit satisfaire la double inégalité élémentaire : 0 ≤ p(xi) ≤ 1. L’insertion par inadvertance d’une valeur négative ou d’une valeur supérieure à l’unité entraîne le rejet immédiat du calcul par le tableur, lequel génère systématiquement le code d’erreur d’incompatibilité numérique #NOMBRE!.
Enfin, l’intégrité des dimensions structurelles constitue un préalable technique incontournable. Les plages matricielles x_plage et prob_plage doivent présenter une cardinalité strictement superposable. Qu’elles soient organisées sous la forme de vecteurs colonnes unidimensionnels (par exemple, de dimension n × 1) ou de vecteurs lignes (1 × n), toute dissymétrie de taille entraîne la génération immédiate du code d’erreur #N/A. De surcroît, le seuil inférieur ne doit sous aucun prétexte excéder la valeur du seuil supérieur lorsque ce dernier est spécifié, sous peine d’aboutir à un ensemble de sommation vide renvoyant une probabilité nulle.
3. Structuration et préparation rigoureuse des données dans la feuille de calcul
3.1 Organisation tabulaire conforme aux normes méthodologiques
L’implémentation pérenne de modèles probabilistes dans Excel requiert une hygiène structurelle stricte dès la phase d’agencement des données brutes. Une modélisation propre repose sur la séparation distincte des variables aléatoires et de leurs mesures d’occurrence respectives. La norme méthodologique préconise une disposition en colonnes adjacentes : la première colonne héberge le spectre discret des réalisations possibles (les valeurs xi), tandis que la colonne contiguë accueille les probabilités élémentaires ou les fréquences relatives associées.
Bien que les algorithmes d’évaluation d’Excel soient capables de parcourir des vecteurs non ordonnés, il est vivement recommandé de trier systématiquement les valeurs de la variable aléatoire par ordre strictement croissant. Ce préconditionnement ordonné prévient les erreurs de diagnostic visuel lors de l’inspection manuelle des distributions cumulées et facilite grandement les calculs d’intervalles fermés. Il garantit également une cohérence parfaite lors de la transition vers des représentations graphiques sous forme de courbes cumulatives d’escalier ou de diagrammes en bâtons.
Une attention particulière doit être portée au formatage des cellules. Les valeurs de la variable aléatoire doivent être configurées en format Nombre standard ou Entier, en évitant toute contamination par des espaces insécables ou des formats monétaires complexes qui pourraient altérer l’évaluation matricielle. Pour les colonnes de probabilités, il est recommandé d’adopter un format Pourcentage à deux ou quatre décimales, ou un format numérique fixe à haute précision (six décimales par exemple), ce qui neutralise visuellement les disparités sans altérer la valeur sous-jacente stockée en virgule flottante.
3.2 Vérification automatisée de la conformité de la distribution
Pour prémunir le classeur contre les dérives analytiques consécutives à des erreurs de saisie manuelle, la mise en place de balises de validation automatisées s’avère indispensable. La première d’entre elles consiste en une cellule de contrôle unitaire positionnée au pied de la colonne des probabilités. En utilisant la formule =SOMME(prob_plage), l’analyste peut vérifier instantanément l’axiome fondamental de normalisation. Une formule logique associée, telle que =SI(ABS(SOMME(prob_plage)-1)<0,000001; "Distribution Validée"; "ERREUR: Somme différente de 1"), permet de tolérer les imprécisions binaires résiduelles tout en signalant vigoureusement toute distorsion structurelle.
Il est tout aussi pertinent de verrouiller l’intégrité de la saisie au moyen de l’outil natif de Validation des données (accessible via l’onglet Données du ruban Office). En appliquant une règle de restriction sur la plage destinée aux probabilités, on configure les critères d’acceptation sur le type Décimal, avec une borne minimale fixée à 0 et une borne maximale fixée à 1. Tout opérateur tentant d’enregistrer une valeur aberrante — telle qu’un pourcentage négatif ou une valeur de fréquence excédant l’unité — se verra immédiatement opposer un message d’interruption bloquant.
Enfin, l’adjonction de règles de Mise en forme conditionnelle enrichit considérablement le monitoring visuel du modèle. Il est recommandé de paramétrer des échelles de nuances de couleurs (par exemple, un dégradé du blanc vers le bleu roi) proportionnelles à la magnitude de chaque probabilité individuelle. Cette approche graphique met instantanément en exergue le mode de la distribution (la valeur la plus probable) tout en isolant visuellement les queues de distribution ou les cellules dont le contenu dévierait du cadre d’analyse prédéfini.
3.3 Gestion des valeurs manquantes et des valeurs non numériques
La présence d’anomalies typologiques au sein des données constitue l’une des causes majeures de dysfonctionnement des fonctions probabilistes. Si une seule cellule de la plage x_plage ou prob_plage contient une chaîne de caractères alphabétiques non interprétable, un espace invisible ou une marque de tabulation, Excel renvoie inévitablement l’erreur bloquante #VALEUR!. De même, les cellules entièrement vides au sein du vecteur peuvent provoquer un désalignement logique dans la correspondance un à un des éléments matriciels.
Pour assainir les tableaux de bord et garantir la résilience des calculs distribués à des tiers, l’encapsulation de la formule principale au sein de la fonction d’interception SIERREUR est une pratique hautement recommandée. La syntaxe =SIERREUR(PROBABILITE(x_plage; prob_plage; seuil_inf; seuil_sup); "Données Incomplètes") permet de neutraliser l’interruption des processus analytiques aval en substituant à l’erreur technique un message diagnostique explicite ou une valeur par défaut prédéterminée.
Concernant les événements théoriques dont la probabilité d’occurrence observée est rigoureusement nulle, deux approches méthodologiques s’opposent : leur maintien explicite avec un coefficient 0, ou leur exclusion pure et simple de la matrice de calcul. Si le phénomène étudié s’inscrit dans un univers discret restreint dont l’exhaustivité doit être attestée visuellement, la conservation de la modalité associée à une probabilité de zéro est préférable. En revanche, si la table compile des fréquences empiriques tirées d’échantillons massifs, l’élimination préalable des modalités à occurrence nulle optimise l’occupation mémoire sans dénaturer le comportement mathématique de la fonction PROBABILITE.
4. Exemple pratique 1 : Modélisation des probabilités discrètes équiprobables (Le jet de dé)
4.1 Configuration du modèle théorique à six états équiprobables
L’archétype par excellence de la distribution de probabilité discrète uniforme est incarné par le lancer d’un dé cubique parfait à six faces, équilibré et non pipé. Dans cette configuration probabiliste classique, l’espace échantillonnal fondamental se formalise selon l’ensemble fini Ω = {1, 2, 3, 4, 5, 6}. La condition d’équiprobabilité implique qu’aucune force mécanique ou asymétrie géométrique ne favorise une face au détriment d’une autre, assignant ainsi à chaque événement élémentaire une densité de probabilité identique et constante égale à un sixième, soit p(xi) = 1/6 ≈ 0,166667 pour tout i ∈ Ω.
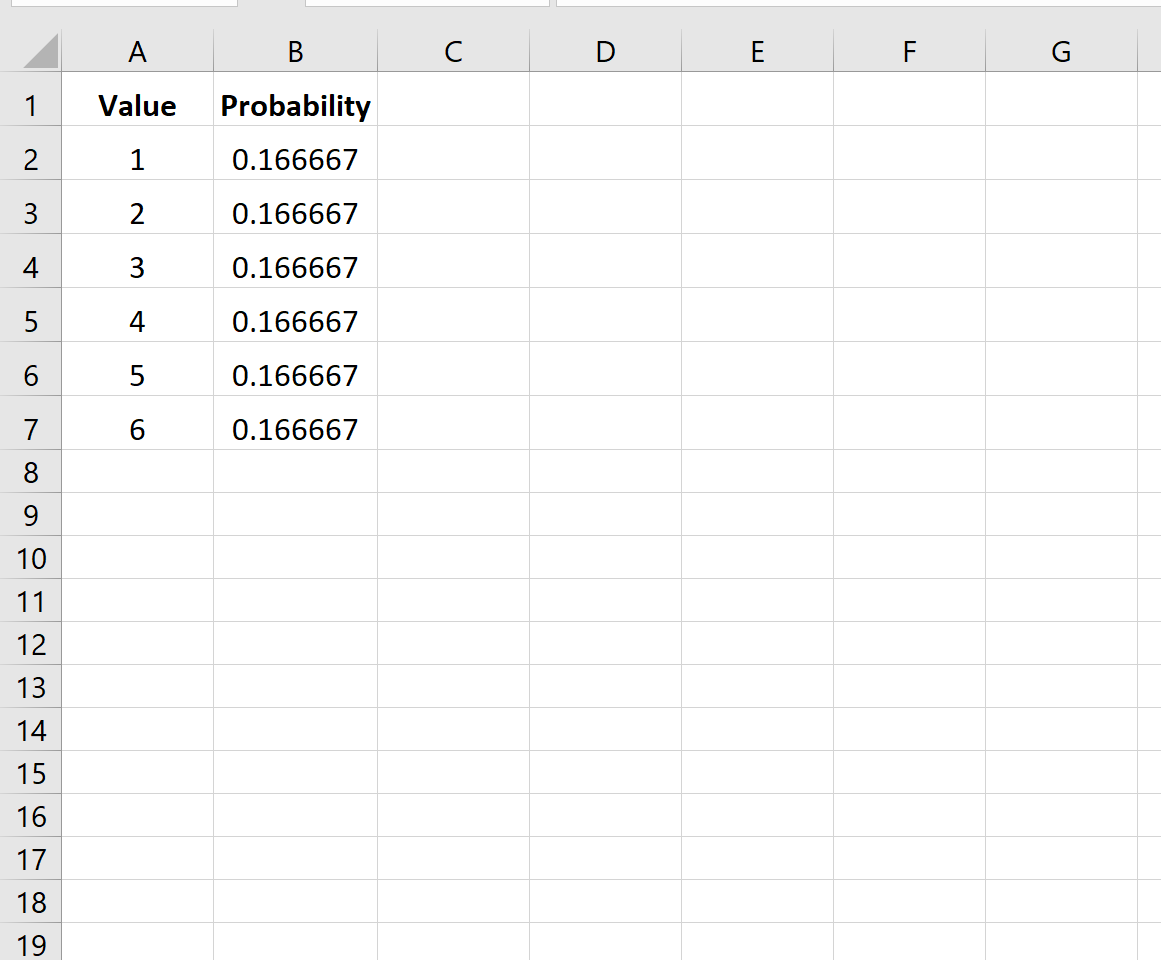
Pour transposer cette expérience classique dans l’environnement Excel, nous configurons une matrice de référence au sein d’une feuille de travail vierge. Dans la colonne A, sur la plage allant de A2 à A7, nous renseignons séquentiellement les six réalisations entières de l’espace fondamental, représentant les valeurs de la variable aléatoire discrète X. Dans la colonne contiguë B, sur la plage B2:B7, nous implémentons les probabilités théoriques correspondantes en saisissant la formule arithmétique =1/6 dans chaque cellule, plutôt qu’une constante décimale tronquée manuellement, préservant ainsi la plénitude de la précision interne du processeur.
Une fois cette architecture tabulaire mise en place, nous validons immédiatement la cohérence globale en plaçant dans la cellule B8 la formule de contrôle =SOMME(B2:B7). L’obtention de la valeur rigoureusement égale à 1 confirme l’intégrité de la distribution unitaire. Les plages de travail sont ainsi formellement délimitées : la variable aléatoire correspond à A2:A7 (qui jouera le rôle de x_plage) et le vecteur de pondération probabiliste correspond à B2:B7 (qui constituera notre prob_plage).
4.2 Calcul de la probabilité exacte d’un événement ponctuel
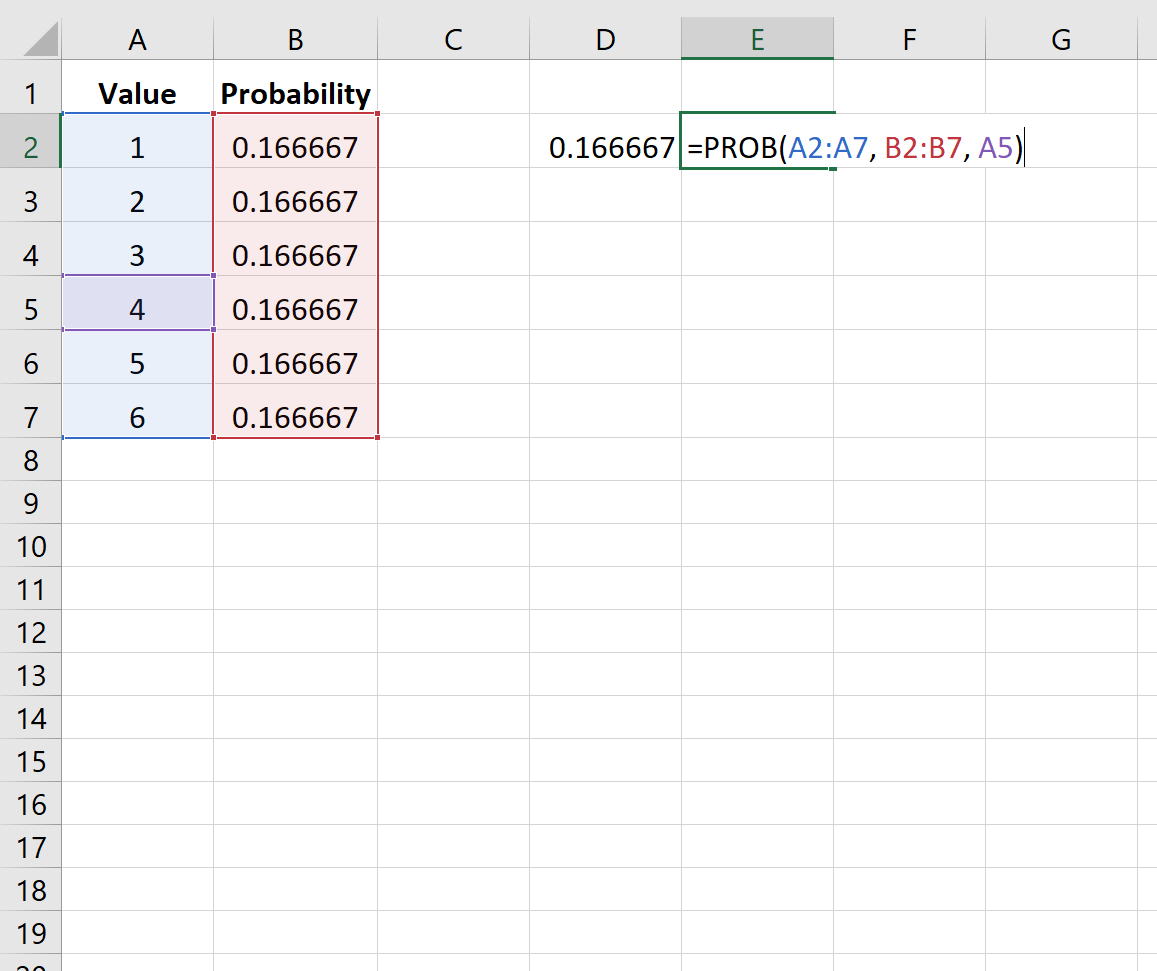
Supposons que nous souhaitions quantifier formellement la probabilité d’obtenir un résultat précis lors d’un lancer unique, par exemple la réalisation stricte du chiffre 4. Dans le cadre théorique, cet événement singulier est noté P(X = 4). En exploitant la fonction dédiée sous Excel, nous omettons volontairement le quatrième argument optionnel pour contraindre l’algorithme à une recherche d’égalité exacte. La formule s’écrit alors de la manière suivante au sein de la cellule de destination :
=PROBABILITE(A2:A7; B2:B7; 4)
Dès sa validation, la fonction balaie la plage A2:A7, localise la concordance univoque avec l’argument de seuil fixé à 4, et extrait la valeur située sur la même ligne dans la plage B2:B7, renvoyant un résultat numérique de 0,166667 (ou 16,67 % si la cellule est formatée en pourcentage). Ce résultat numérique confirme la convergence parfaite entre la prédiction mathématique théorique élémentaire et l’exécution computationnelle du tableur.
Sur le plan de l’analyse comportementale et psychologique, cet exercice élémentaire met en lumière le phénomène d’illusion de contrôle et l’incapacité intuitive de l’esprit humain à appréhender l’indépendance stochastique. Nombreux sont les sujets qui estiment intuitivement qu’après une série ininterrompue de tirages n’ayant pas produit le chiffre 4, la probabilité d’apparition de ce dernier lors du jet consécutif se trouverait majorée. Le modèle Excel démontre la nature strictement statique et invariante de cette distribution : chaque itération réinitialise intégralement le système stochastique sans conservation de mémoire historique.
4.3 Calcul de la probabilité d’un intervalle d’événements
L’avantage opérationnel de la fonction PROBABILITE réside principalement dans sa capacité à traiter sans manipulation algébrique complexe des événements composés définis par des unions de sous-ensembles continus d’entiers. Considérons l’évaluation de la probabilité d’obtenir un score au moins égal à 3 mais ne dépassant pas 6, ce qui revient à formaliser l’événement sous la forme de l’intervalle fermé P(3 ≤ X ≤ 6). Cet événement agrège les réalisations élémentaires {3, 4, 5, 6}.
Pour exécuter cette sommation dans Excel, nous mobilisons l’argument seuil_sup en saisissant la syntaxe complète :
=PROBABILITE(A2:A7; B2:B7; 3; 6)
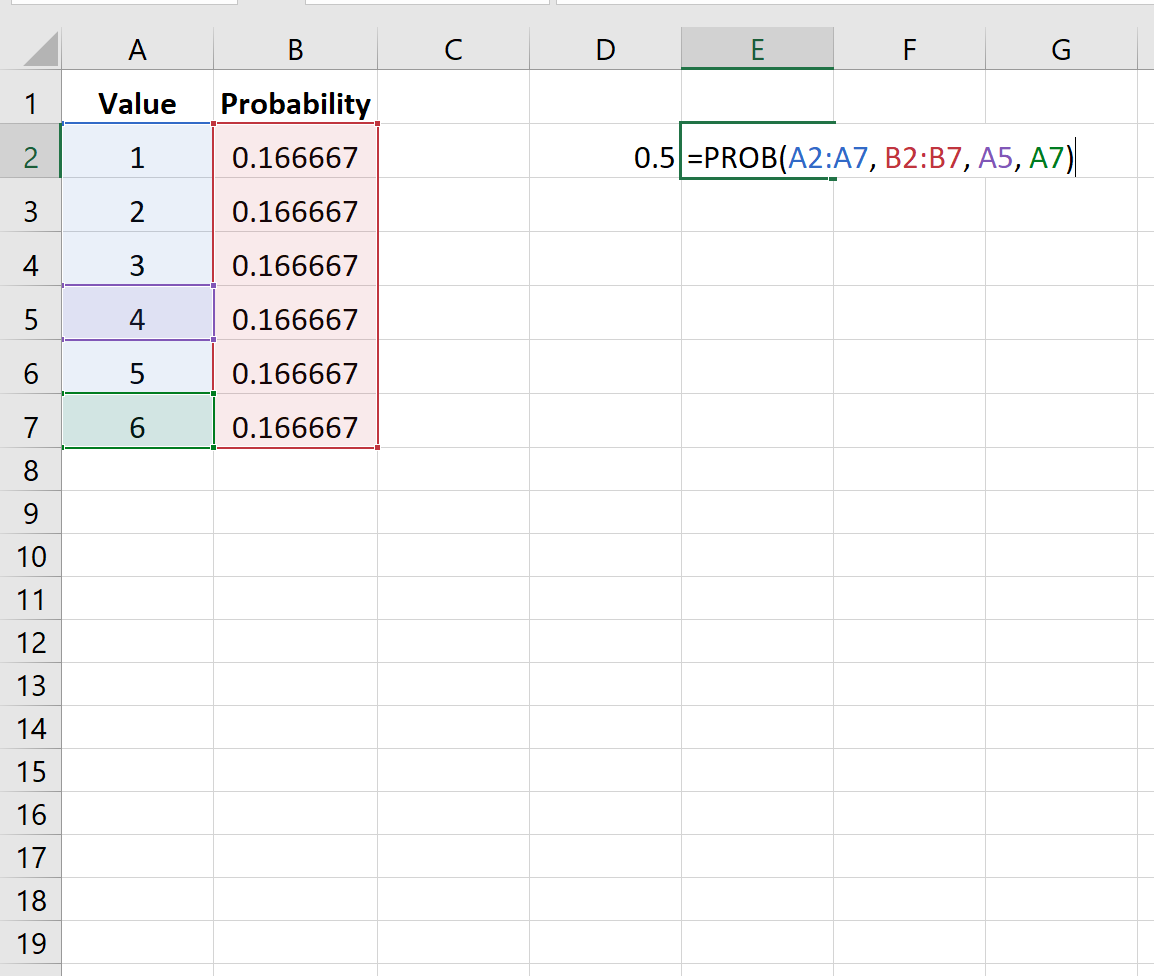
Le moteur d’Excel identifie l’ensemble des valeurs de x_plage comprises inclusivement entre la borne inférieure 3 et la borne supérieure 6, extrait les probabilités relatives à ces quatre états (1/6 + 1/6 + 1/6 + 1/6) et effectue la sommation matricielle interne. Le résultat affiché est rigoureusement égal à 0,666667, soit une probabilité cumulée de 66,67 % ou deux tiers. Si nous avions resserré l’intervalle pour calculer P(1 ≤ X ≤ 3), la formule =PROBABILITE(A2:A7; B2:B7; 1; 3) aurait instantanément généré la valeur 0,5 (50 %).
Cette approche permet de mener des analyses de sensibilité particulièrement éclairantes en faisant varier dynamiquement les bornes de sommation au moyen de références de cellules plutôt que de constantes numériques figées. En assignant la cellule C1 comme réceptacle de la limite basse et la cellule D1 comme limite haute, la formule devient =PROBABILITE(A2:A7; B2:B7; C1; D1). L’analyste peut alors tester instantanément la robustesse de différents scénarios de bornage par simple réévaluation contextuelle, visualisant l’impact de chaque élargissement d’intervalle sur la masse de probabilité accumulée.
5. Exemple pratique 2 : Analyse prévisionnelle et probabilités de ventes en entreprise
5.1 Élaboration d’une loi de probabilité empirique des volumes de ventes
Dans la gestion commerciale et logistique d’entreprise, les distributions théoriques parfaitement symétriques constituent une exception rare. Les volumes d’écoulement de marchandises se caractérisent très fréquemment par des lois empiriques asymétriques, présentant un étirement prononcé vers les valeurs élevées (asymétrie positive ou skewness droit). La construction d’une loi de probabilité opérationnelle nécessite la conversion préalable d’un historique d’observations factuelles en fréquences statistiques relatives normalisées.
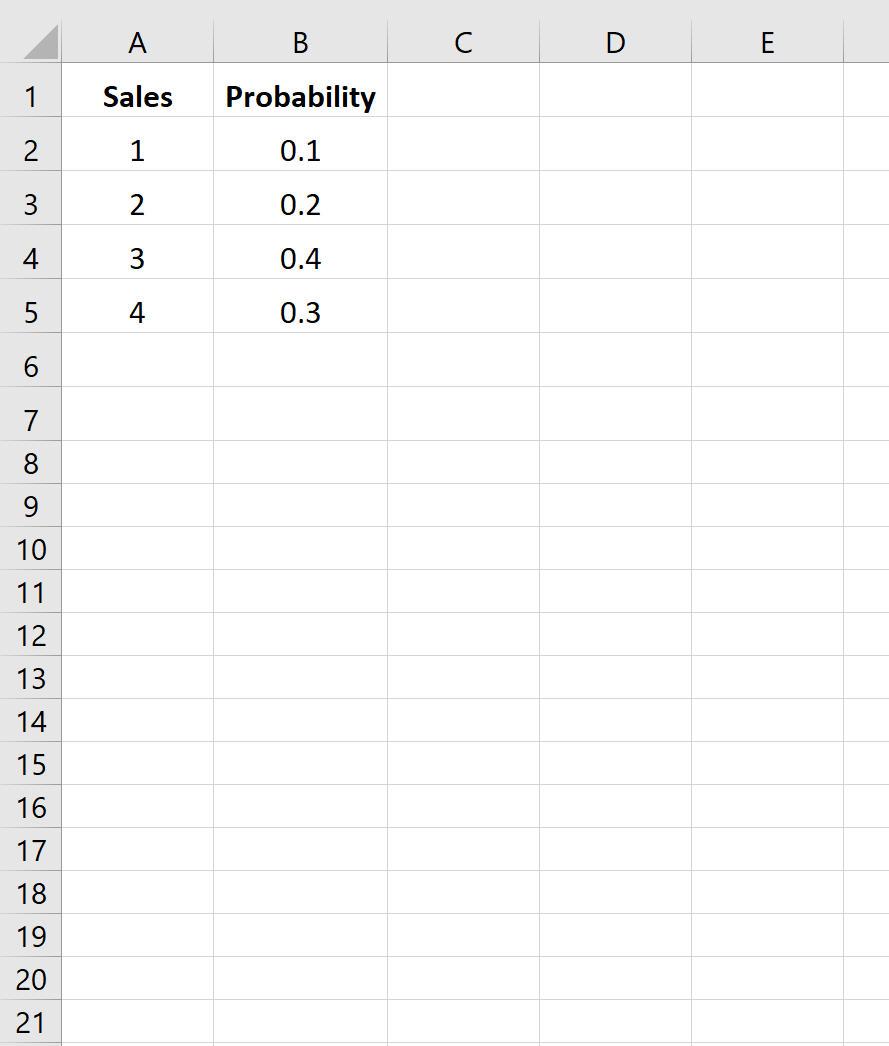
Supposons qu’une entreprise spécialisée dans les équipements industriels ait consigné sur une période de 200 jours ouvrés le nombre d’unités vendues quotidiennement d’un matériel lourd haut de gamme. Les volumes journaliers observés s’échelonnent entre 0 et 5 machines. La distribution des effectifs observés se structure ainsi : 30 jours sans aucune vente (0 unité), 60 jours à 1 unité, 50 jours à 2 unités, 35 jours à 3 unités, 15 jours à 4 unités, et seulement 10 jours exceptionnels enregistrant un écoulement de 5 unités.
Pour implémenter ce modèle dans Excel, nous organisons les données au sein d’une feuille structurée de la manière suivante :
- Dans les cellules
A2:A7, nous saisissons le spectre des volumes discrets : 0, 1, 2, 3, 4, 5. - Dans les cellules
B2:B7, nous enregistrons les effectifs bruts observés : 30, 60, 50, 35, 15, 10. La celluleB8intègre la formule=SOMME(B2:B7), affichant le total d’échantillon de 200 jours. - Dans la colonne C (plage
C2:C7), nous convertissons les effectifs en probabilités empiriques au moyen de la formule relative=B2/$B$8, étirée vers le bas. Les valeurs obtenues représentent notre vecteur prob_plage : 0,15 ; 0,30 ; 0,25 ; 0,175 ; 0,075 ; 0,05.
5.2 Évaluation du risque de sous-performance commerciale
Le contrôle de gestion et la planification financière exigent une évaluation rigoureuse des seuils de rentabilité. Supposons que le modèle économique de notre entreprise impose l’écoulement d’au moins 2 machines par jour pour couvrir intégralement les coûts fixes opérationnels d’entreposage, de masse salariale et de logistique. Dès lors, toute journée clôturée avec un volume de vente strictement inférieur à 2 unités (c’est-à-dire 0 ou 1 unité) représente une situation d’exploitation à perte nette.
La question managériale centrale s’énonce ainsi : quelle est la probabilité empirique que l’entreprise traverse une journée de sous-performance critique, notée mathématiquement P(X ≤ 1) ou de manière équivalente P(0 ≤ X ≤ 1) ? L’application directe de la fonction PROBABILITE permet d’y répondre sans ambiguïté :
=PROBABILITE(A2:A7; C2:C7; 0; 1)
Le calcul cumule la probabilité de vendre 0 unité (0,15) et celle d’en vendre 1 seule (0,30), renvoyant un résultat de 0,45, soit une probabilité de 45 %. Cette métrique démontre que dans près d’un cas sur deux, l’activité quotidienne s’avère incapable d’équilibrer ses charges fixes sans le concours des journées plus fastes. L’intégration de cet indicateur probabiliste au sein du tableau de bord exécutif permet aux directeurs financiers de calibrer précisément le fonds de roulement nécessaire pour absorber ces phases régulières de sous-activité sans risquer la rupture de liquidité.
5.3 Estimation probabiliste des scénarios de surperformance
À l’autre extrémité du spectre décisionnel, l’anticipation des pics de demande est cruciale pour éviter les ruptures de stocks préjudiciables à la relation client. Supposons que la capacité d’expédition maximale de la plateforme logistique soit plafonnée à 4 machines par jour. Toute demande journalière atteignant ou dépassant le seuil critique de 4 unités (c’est-à-dire les événements X = 4 ou X = 5) plonge le système logistique dans une situation de tension opérationnelle extrême, nécessitant le recours à des heures supplémentaires ou à des transporteurs d’urgence coûteux.
Pour mesurer l’exposition stochastique de l’entreprise à ce risque d’engorgement logistique, nous paramétrons la formule sur la queue supérieure de la distribution, calculant la probabilité P(4 ≤ X ≤ 5) :
=PROBABILITE(A2:A7; C2:C7; 4; 5)
Le tableur agrège les probabilités élémentaires associées à ces deux états : 0,075 (pour 4 unités) et 0,05 (pour 5 unités), renvoyant une probabilité d’occurrence de 0,125, soit 12,5 %. Cela signifie qu’environ un jour sur huit, l’entreprise se trouve confrontée à une situation de surchauffe logistique. L’arbitrage économique s’effectue alors en comparant le coût marginal de sécurisation d’un stock tampon additionnel avec l’espérance mathématique des pénalités financières générées par les goulets d’étranglement, concrétisant ainsi l’utilité directe de la modélisation probabiliste dans l’optimisation des opérations.
6. Exemple pratique 3 : Application aux sciences comportementales et psychologiques
6.1 Modélisation des distributions de scores psychométriques discrets
Les sciences psychologiques et les études quantitatives du comportement recourent abondamment à des instruments d’évaluation standardisés, tels que les échelles de sommation de type Likert à points discrets. Dans ce cadre méthodologique, les variables mesurées correspondent à des construits psychologiques latents (l’extraversion, la résilience, le niveau de détresse psychologique) traduits en scores discrets globaux après passation d’un questionnaire validé. Contrairement aux grandeurs physiques continues, ces indicateurs psychométriques se modélisent sous forme d’univers de variables aléatoires discrètes ordonnées.
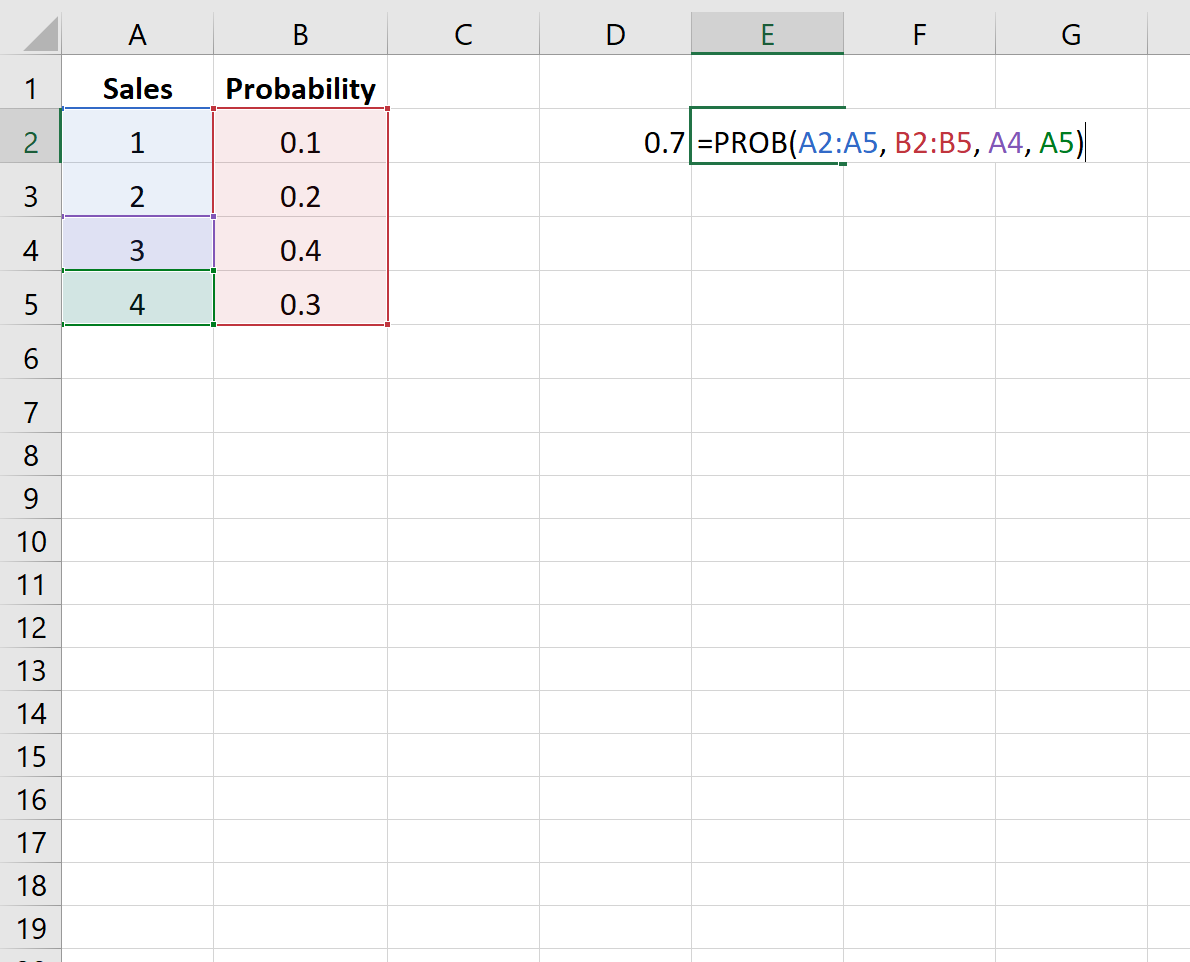
Considérons une recherche évaluant l’épuisement professionnel (burnout) auprès d’une population de 500 soignants hospitaliers au moyen d’une version abrégée d’un inventaire clinique. Le score agrégé d’épuisement émotionnel est discrétisé sur une échelle ordinale allant de 1 (absence totale d’épuisement) à 5 (épuisement critique généralisé). Les données empiriques colligées auprès de la cohorte révèlent la structure de distribution suivante : 40 soignants au niveau 1 (8 %), 110 au niveau 2 (22 %), 175 au niveau 3 (35 %), 125 au niveau 4 (25 %), et 50 soignants au niveau 5 (10 %).
L’implémentation dans la feuille Excel s’organise rigoureusement : les modalités ordinales de 1 à 5 sont consignées dans la plage A2:A6, tandis que les probabilités de réponse observées au sein de la cohorte sont calculées dans la plage B2:B6. Ce cadre permet notamment d’évaluer l’asymétrie induite par des biais de réponse psychologiques bien documentés, tels que la désirabilité sociale (tendance à minimiser ses faiblesses) ou le biais de sévérité, et d’en mesurer l’impact direct sur la dispersion de la masse de probabilité empirique.
6.2 Calcul de la probabilité d’apparition de symptômes cliniques
Dans le diagnostic psychométrique moderne, l’intérêt clinique ne se porte que rarement sur un score isolé, mais plutôt sur le franchissement de seuils nosographiques prédéfinis justifiant une prise en charge thérapeutique ciblée. Supposons que les critères du manuel diagnostique établissent qu’un individu présentant un score supérieur ou égal à 4 sur notre échelle se situe dans une zone clinique pathologique avérée, nécessitant un protocole d’intervention individualisé immédiat.
Pour le médecin du travail ou le psychologue clinicien supervisant l’établissement, il est fondamental de déterminer la proportion probabiliste de l’effectif susceptible de développer ou d’exprimer cette symptomatologie pathologique. L’événement clinique d’intérêt se modélise par l’inégalité P(4 ≤ X ≤ 5). Dans la feuille de calcul, la syntaxe s’exécute immédiatement :
=PROBABILITE(A2:A6; B2:B6; 4; 5)
Le résultat généré est de 0,35 (soit 35 %). Ce chiffre révèle qu’au sein de cette population soignante, plus d’un tiers des professionnels se situe au-delà du seuil de décompensation clinique. Une telle mesure fournit aux décideurs en santé publique un argument épidémiologique quantifié indispensable pour justifier le déploiement de ressources préventives adaptées.
6.3 Analyse de la fidélité et stabilité des patrons comportementaux
L’évaluation psychologique des interventions thérapeutiques repose fréquemment sur la mesure de la fidélité temporelle des changements de comportement. Considérons une étude comportementale s’intéressant à la récurrence hebdomadaire de conduites d’évitement anxieux chez des patients engagés dans une thérapie cognitivo-comportementale (TCC). Le nombre d’épisodes d’évitement observés par patient et par semaine est une variable de comptage discrète s’échelonnant de 0 (extinction complète du comportement dysfonctionnel) à 4 épisodes ou plus.
En structurant les données hebdomadaires au sein d’une table probabiliste dynamique sous Excel, le thérapeute-chercheur peut modéliser l’évolution temporelle de la probabilité qu’un sujet récidive au-delà d’un seuil critique entre le début et la fin de l’intervention. L’utilisation de la fonction PROBABILITE sur des intervalles mobiles permet d’isoler des fenêtres diagnostiques précises, par exemple la probabilité qu’un patient stabilise ses rechutes dans une zone sub-clinique modérée P(1 ≤ X ≤ 2) versus la probabilité de basculement vers une rechute sévère P(X ≥ 3).
L’avantage opérationnel d’Excel dans ce domaine réside dans sa capacité à lier des tables de probabilités individuelles à un tableau récapitulatif de cohorte. En calibrant les seuils probabilistes au moyen de formules matricielles, l’équipe de recherche peut identifier statistiquement les sous-groupes de patients qui s’écartent significativement des trajectoires d’amélioration attendues, ouvrant la voie à une personnalisation guidée par les données des protocoles d’exposition psychothérapeutique.
7. Calculs de probabilités conditionnelles et théorèmes combinés dans Excel
7.1 Traduction du théorème de Bayes avec les formules natives
L’inférence statistique et le raisonnement sous incertitude trouvent leur aboutissement dans le théorème formulé par le révérend Thomas Bayes. Ce théorème fondamental stipule que la probabilité a posteriori d’une hypothèse A, sachant qu’un événement observable B s’est produit, s’exprime par le produit de la probabilité a priori de l’hypothèse P(A) et de la vraisemblance de l’observation sachant l’hypothèse P(B|A), divisé par la probabilité marginale de l’observation P(B) :
P(A|B) = [P(B|A) × P(A)] / P(B) = [P(B|A) × P(A)] / [P(B|A) × P(A) + P(B|non-A) × P(non-A)].
Dans une feuille Excel, cette logique d’actualisation bayésienne se traduit avec une remarquable clarté par une structure tabulaire à double entrée. Considérons un protocole de dépistage psychologique d’un trouble neuropsychologique rare affectant 2 % de la population générale (P(A) = 0,02, consigné en cellule B1). Le test présente une sensibilité de 95 % (P(B|A) = 0,95 en B2) et une spécificité de 90 %, ce qui implique un taux de faux positifs de 10 % (P(B|non-A) = 0,10 en B3). La probabilité du complément P(non-A) est formulée en B4 par =1-B1 (soit 0,98).
Pour calculer la probabilité qu’un patient ayant obtenu un résultat positif au test soit réellement atteint du trouble, nous implémentons en cellule B5 la formule bayésienne complète :
=(B2*B1)/((B2*B1)+(B3*B4))
Le calcul renvoie approximativement 0,1624, soit une probabilité réelle de seulement 16,24 %. Ce résultat, hautement contre-intuitif pour l’esprit non formé qui s’attendrait à une fiabilité proche de 95 %, démontre la prédominance mathématique du taux de base (la faible prévalence a priori). L’environnement interactif d’Excel permet de modifier instantanément la prévalence en cellule B1 pour observer la vitesse de redressement de la valeur prédictive positive du test face à des populations cliniques plus exposées.
7.2 Utilisation conjointe de SOMMEPROD pour les conditions multidimensionnelles
Si la fonction native PROBABILITE est idéale pour les distributions univariées, elle révèle ses limites structurelles dès lors qu’il s’agit d’évaluer des lois conjointes sur des espaces multidimensionnels ou des tables de contingence croisées. Dans ce contexte, la fonction matricielle SOMMEPROD s’impose comme l’outil d’ingénierie statistique le plus puissant de la suite Office, opérant des multiplications scalaires sur des vecteurs booléens sans exiger de validation matricielle complexe.
Considérons une base de données observationnelle répertoriant deux variables catégorielles mesurées sur un échantillon d’individus : le statut tabagique (colonne A, prenant les valeurs « Fumeur » ou « Non-Fumeur ») et la présence d’une affection cardio-respiratoire (colonne B, codée « Positif » ou « Négatif »). L’échantillon brut comprend 1 000 lignes s’étalant de la ligne 2 à la ligne 1001. Pour déterminer la probabilité conjointe empirique qu’un individu tiré au sort soit simultanément fumeur et porteur de l’affection, notée P(Fumeur ∩ Positif), nous formulons l’instruction matricielle suivante :
=SOMMEPROD((A2:A1001="Fumeur")*(B2:B1001="Positif"))/LIGNES(A2:A1001)
Cette syntaxe génère deux vecteurs de zéros et de uns qui sont multipliés terme à terme ; le produit résultant ne vaut 1 que si les deux prédicats logiques sont concomitamment satisfaits. La somme de ces produits, divisée par le cardinal total de l’échantillon fourni dynamiquement par LIGNES(A2:A1001), restitue rigoureusement la probabilité conjointe.
De surcroît, SOMMEPROD constitue un moyen direct pour tester formellement l’indépendance stochastique de deux variables aléatoires. Rappelons que deux événements A et B sont indépendants si et seulement si P(A ∩ B) = P(A) × P(B). En comparant au moyen d’un test logique le résultat de la formule conjointe avec le produit des probabilités marginales univariées, l’analyste peut diagnostiquer instantanément l’existence d’une dépendance statistique significative entre les facteurs étudiés.
7.3 Exploitation des fonctions NB.SI et NB.SI.ENS pour les probabilités conditionnelles
Lorsque le modèle probabiliste doit être extrait directement d’un registre de données transactionnelles volumineux sans passer par l’étape intermédiaire d’agrégation d’une table de contingence statique, les fonctions de dénombrement conditionnel NB.SI et NB.SI.ENS offrent une alternative algorithmique remarquablement efficiente. Elles permettent de calculer des probabilités conditionnelles a posteriori selon la stricte définition fréquentiste : P(A|B) = Effectif(A ∩ B) / Effectif(B).
Reprenons l’exemple de notre cohorte médicale de 1 000 sujets (plage A2:B1001) et cherchons à évaluer la probabilité conditionnelle qu’un individu présente une affection pathologique sachant qu’il est préalablement identifié comme fumeur, notée P(Positif | Fumeur). Le dénominateur de notre ratio doit représenter le sous-groupe conditionnant complet des fumeurs, tandis que le numérateur doit isoler la co-occurrence des deux critères. La formulation s’écrit avec une remarquable limpidité :
=NB.SI.ENS(B2:B1001; "Positif"; A2:A1001; "Fumeur") / NB.SI(A2:A1001; "Fumeur")
La fonction NB.SI.ENS balaie la table pour dénombrer les lignes satisfaisant l’ensemble des critères conjoints, agissant comme l’intersection stochastique, tandis que la fonction NB.SI calcule le cardinal marginal du groupe conditionnant. Le quotient des deux valeurs livre directement l’estimation empirique sans distorsion d’arrondi.
Cette approche présente un avantage opérationnel majeur sur les tables de distribution statiques : elle est intrinsèquement dynamique. Dès lors que de nouvelles données cliniques ou expérimentales sont consignées au bas de la liste de données, ou si les plages sont converties en tableaux structurés automatiques, les probabilités conditionnelles se recalculent instantanément, assurant une veille analytique en temps réel sans intervention manuelle de restructuration tabulaire.
8. Modélisation des distributions continues : LOI.NORMALE.N et applications psychométriques
8.1 Passage des lois empiriques discrètes aux densités continues
Bien que la fonction PROBABILITE soit indispensable pour les espaces d’états dénombrables, l’analyse quantitative des grandeurs continues (le temps de réaction, la pression artérielle, le quotient intellectuel, ou le taux de rendement financier) requiert un changement de paradigme mathématique. Les variables aléatoires continues peuvent théoriquement prendre une infinité non dénombrable de valeurs réelles sur un continuum. En conséquence directe, la probabilité ponctuelle qu’une variable continue prenne une valeur scalaire strictement exacte est rigoureusement nulle : P(X = x) = 0.
Le calcul probabiliste sur les espaces continus ne s’exprime donc pas en termes de masse de probabilité discrète, mais sous forme de densité de probabilité, notée f(x). La probabilité d’un événement se formalise par l’intégrale définie de cette fonction de densité sur un intervalle d’intérêt fermé [a, b], ce qui correspond géométriquement à la surface sous la courbe comprise entre les droites verticales d’abscisses x = a et x = b :
P(a ≤ X ≤ b) = ∫ab f(x) dx.
Parmi les densités théoriques, la distribution normale (ou courbe de Carl Friedrich Gauss) occupe une position prééminente dans la méthode scientifique, en vertu du théorème central limite. Ce théorème établit que la somme ou la moyenne d’un grand nombre de variables aléatoires indépendantes et de même loi converge asymptotiquement vers une loi normale, quelle que soit la forme de la distribution sous-jacente d’origine. Cette loi se caractérise entièrement par deux paramètres fondamentaux : son espérance mathématique μ (qui détermine le centre de gravité et le sommet de la courbe symétrique en cloche) et son écart-type σ (qui gouverne l’étalement ou le degré de dispersion des observations autour de la moyenne).
8.2 Mise en œuvre technique de LOI.NORMALE.N dans Excel
L’exploitation de la distribution gaussienne au sein d’Excel s’opère par le biais de la fonction standardisée LOI.NORMALE.N, dont la syntaxe s’articule autour de quatre paramètres : LOI.NORMALE.N(x; moyenne; ecart_type; cumulative). Les paramètres moyenne (μ) et ecart_type (σ) définissent les paramètres d’échelle de la loi spécifique considérée, tandis que x désigne le seuil d’évaluation.
Le quatrième argument, cumulative, est un paramètre booléen dont le rôle conceptuel est déterminant. Si l’analyste renseigne la valeur logique FAUX (ou 0), Excel calcule la valeur scalaire de la fonction de densité f(x) au point x, ce qui est utile pour tracer graphiquement le tracé en cloche de la distribution, mais n’a pas de signification probabiliste directe. Pour obtenir une probabilité exploitable, il est impératif de déclarer l’argument VRAI (ou 1). La fonction renvoie alors la fonction de répartition cumulative, c’est-à-dire l’intégrale de -∞ jusqu’à x, notée F(x) = P(X ≤ x).
Pour évaluer la probabilité qu’une observation s’inscrive au sein d’un intervalle délimité par deux bornes réelles [a, b], il convient d’appliquer le théorème fondamental de l’analyse stochastique, en soustrayant la fonction de répartition du seuil inférieur de celle du seuil supérieur. Dans Excel, cette opération s’exécute selon la construction syntaxique suivante :
=LOI.NORMALE.N(b; moyenne; ecart_type; VRAI) - LOI.NORMALE.N(a; moyenne; ecart_type; VRAI)
Cette différence algébrique isole rigoureusement l’aire géométrique sous la courbe circonscrite entre les abscisses a et b, fournissant une probabilité continue exacte exempte de tout biais de discrétisation.
8.3 Calcul des scores Z et centiles en psychologie différentielle
En psychométrie et en psychologie différentielle, la standardisation des instruments d’évaluation (tests de quotient intellectuel, inventaires de personnalité NEO-PI) repose presque universellement sur la loi normale centrée réduite, caractérisée par une moyenne μ = 0 et un écart-type σ = 1. Cette transformation standardisée, dénommée score Z, s’obtient par la formule Z = (X – μ) / σ et peut être directement calculée dans Excel au moyen de la fonction CENTREE.REDUITE(x; moyenne; ecart_type).
Considérons l’étalonnage standard des échelles d’intelligence de David Wechsler (WAIS-IV), dont la distribution au sein de la population générale est calibrée pour afficher une moyenne théorique μ = 100 et un écart-type σ = 15. Supposons que nous souhaitions déterminer la proportion d’individus présentant un score de QI égal ou supérieur au seuil classique de haut potentiel intellectuel (HPI), conventionnellement fixé à un score de 130 (soit exactement deux écarts-types au-dessus de la moyenne populationnelle).
La probabilité cherchée correspond à la queue supérieure de la distribution : P(X ≥ 130) = 1 – P(X ≤ 130). Dans la feuille de calcul, la formule se structure de la manière suivante :
=1 - LOI.NORMALE.N(130; 100; 15; VRAI)
Le calcul renvoie la valeur stochastique 0,02275, attestant que rigoureusement 2,28 % de la population s’inscrit au-delà de cette démarcation clinique. Le rang percentile correspondant à ce score est obtenu en multipliant par 100 la fonction de répartition cumulative : =LOI.NORMALE.N(130; 100; 15; VRAI)*100, affichant le 97,72e percentile.
Réciproquement, si le praticien cherche à identifier le score seuil brut isolant une fraction spécifique de la population (par exemple, identifier le niveau de QI démarquant les 5 % des individus les plus efficients), il mobilisera la distribution inverse via la fonction LOI.NORMALE.INVERSE.N. L’instruction =LOI.NORMALE.INVERSE.N(0,95; 100; 15) résout l’équation intégrale inverse et renvoie le score seuil exact de 124,67 points.
9. Modélisation des événements discrets alternatifs : Lois binomiale et de Poisson
9.1 Application de la loi binomiale avec LOI.BINOMIALE.N
La loi binomiale modélise le nombre de succès observés lors de la répétition d’un nombre déterminé n d’épreuves de Bernoulli identiques et stochastiquement indépendantes. Chaque épreuve élémentaire ne tolère que deux issues mutuellement exclusives et exhaustives : le succès (doté d’une probabilité invariante p) et l’échec (doté de la probabilité complémentaire q = 1 – p). Cette loi est fondamentale pour modéliser des contrôles de conformité industrielle, des taux de réussite à des concours ou des réponses dichotomiques dans des expérimentations comportementales.
Excel encapsule la résolution de cette loi combinatoire au sein de la fonction LOI.BINOMIALE.N, régie par la signature suivante : LOI.BINOMIALE.N(nombre_s; tirages; probabilite_s; cumulative). Les paramètres représentent respectivement le nombre de succès ciblés (k), le volume total d’épreuves indépendantes menées (n), la probabilité unitaire de succès de l’épreuve élémentaire (p), et le drapeau logique d’accumulation.
Considérons une cohorte de 20 étudiants soumis à une épreuve d’aptitude cognitive sous forme de questionnaire à choix multiples (QCM). Chaque question comporte quatre options de réponse distinctes dont une seule est correcte. Un candidat répondant au hasard total dispose donc d’une probabilité élémentaire de succès de p = 0,25 (soit 1/4). Si l’épreuve comporte 20 questions indépendantes, nous souhaitons déterminer la probabilité qu’un candidat obtienne au moins 10 réponses correctes par simple chance statistique, ce qui équivaut à calculer P(X ≥ 10) = 1 – P(X ≤ 9).
La formule s’implémente dans la feuille de travail en faisant appel à la fonction cumulative :
=1 - LOI.BINOMIALE.N(9; 20; 0,25; VRAI)
Le tableur calcule la sommation combinatoire des probabilités d’obtenir de 0 à 9 succès et la retranche de l’unité, délivrant une valeur de 0,01386, soit une probabilité résiduelle de 1,39 %. Cela démontre qu’il est hautement improbable de valider un examen à la moitié par simple dérive aléatoire dans de telles conditions, confirmant ainsi la robustesse métrologique du format d’évaluation.
9.2 Modélisation des événements rares avec LOI.POISSON.N
La distribution de Poisson (souvent qualifiée de loi des événements rares) modélise le dénombrement k d’occurrences d’un événement au sein d’un continuum temporel ou spatial fixe et homogène. Son application présuppose que les événements surviennent de manière totalement indépendante les uns des autres et à un taux moyen constant par unité de référence, conventionnellement désigné par le paramètre grec lambda (λ). Dès lors que l’espérance mathématique des arrivées est proportionnelle à la taille du créneau d’observation, la loi de Poisson constitue le modèle descriptif par excellence des phénomènes de files d’attente, de trafic réseau ou d’incidents logistiques.
Dans l’écosystème Office, cette modélisation est assurée par la fonction LOI.POISSON.N(x; moyenne; cumulative), où x représente le nombre d’occurrences d’intérêt et moyenne correspond au paramètre d’intensité λ.
Illustrons cette application dans le cadre de la gestion hospitalière. Supposons qu’un service d’urgences psychiatriques enregistre sur les dix dernières années un taux moyen d’admissions en phase de crise aiguë de λ = 3,2 patients par nuit de garde (créneau fixe de minuit à six heures du matin). Le médecin coordonnateur souhaite dimensionner l’équipe soignante de garde pour prévenir le risque de saturation, et cherche à quantifier la probabilité que le service soit confronté à une nuit de crise extrême accueillant 7 admissions ou plus, soit P(X ≥ 7) = 1 – P(X ≤ 6).
L’implémentation de cette probabilité de débordement s’exécute selon l’instruction :
=1 - LOI.POISSON.N(6; 3,2; VRAI)
Le tableur résout l’accumulation exponentielle des masses discrètes de 0 à 6 admissions et génère un résultat probabiliste de 0,04637, soit une fréquence prévisionnelle de 4,64 % des nuits. Cette quantification stochastique précise (environ une garde tous les 21 jours) fournit à l’administration médicale une justification actuarielle rigoureuse pour provisionner un protocole d’astreinte médicale d’urgence déclenchable sur alerte.
9.3 Critères méthodologiques de sélection du modèle probabiliste adéquat
Face à un problème d’analyse quantitative, l’erreur méthodologique la plus préjudiciable consiste à appliquer un modèle de distribution théorique inadapté à la nature ontologique des données observées. Cette erreur d’ajustement (ou misspecification bias) invalide intégralement les probabilités générées, conduisant à des sous-estimations massives des risques opérationnels ou cliniques, particulièrement au niveau des queues de distribution.
Pour sélectionner rationnellement le modèle computationnel adéquat au sein d’Excel, l’analyste doit appliquer un arbre de décision rigoureux structuré autour de trois questions fondamentales :
- La variable sous-jacente est-elle discrète ou continue ? Si l’espace est discret (valeurs dénombrables, entiers, comptages d’individus ou d’événements), orientez l’analyse vers PROBABILITE, LOI.BINOMIALE.N ou LOI.POISSON.N. Si la mesure est continue (durée, dimensions physiques, flux monétaires continus), appliquez les densités telles que LOI.NORMALE.N ou LOI.EXPONENTIELLE.N.
- S’il s’agit d’un processus discret, le nombre total d’essais est-il structurellement borné ? Si l’expérience dénombre des succès sur un nombre d’épreuves strictement fixé à l’avance (n), la loi binomiale s’impose. Si le continuum temporel ou spatial n’impose aucun plafond théorique au nombre d’événements observables, la loi de Poisson est méthodologiquement requise.
- La taille d’échantillon autorise-t-elle une approximation normale ? Lorsque les paramètres d’une loi binomiale vérifient les conditions de convergence de De Moivre-Laplace (n ≥ 30, n × p ≥ 5, et n × (1 – p) ≥ 5), ou lorsqu’une variable empirique résulte de l’agrégation de nombreux facteurs indépendants, le recours à la distribution normale devient mathématiquement légitime.
L’utilisation de la fonction générique PROBABILITE demeure privilégiée lorsque l’analyste fait face à des distributions empiriques hautement spécifiques, multimodales ou non conformes aux lois paramétriques canoniques, garantissant une fidélité d’ajustement aux données observées sans imposer de contraintes théoriques a priori arbitraires.
10. Simulations probabilistes et méthode de Monte-Carlo dans Excel
10.1 Génération de nombres pseudo-aléatoires pour simuler l’incertitude
Lorsque la complexité analytique d’un système stochastique excède les capacités des formules probabilistes directes fermées, la simulation numérique s’impose comme la méthodologie de substitution par excellence. Dans l’environnement Excel, cette approche repose sur le générateur de nombres pseudo-aléatoires intégré, accessible principalement au travers de deux fonctions natives : ALEA() et ALEA.ENTRE.BORNES(bas; haut).
La fonction ALEA() génère des valeurs numériques distribuées uniformément sur l’intervalle réel semi-ouvert [0, 1[. Chaque tirage possède une probabilité équivalente de se situer dans n’importe quel sous-intervalle de taille égale. Ce mécanisme fournit la matière première computationnelle requise pour la méthode de la transformée inverse. En vertu du théorème de probabilité intégrale, si l’on applique la fonction de répartition inverse théorique d’une loi à un nombre aléatoire uniformément distribué, le résultat obtenu suivra rigoureusement la loi de distribution ciblée.
Pour générer par exemple une variable aléatoire suivant une loi normale de moyenne 50 et d’écart-type 10, il suffit de composer les fonctions au sein de la cellule : =LOI.NORMALE.INVERSE.N(ALEA(); 50; 10). Le moteur d’Excel calcule à chaque itération la valeur d’abscisse correspondant à la fraction cumulative tirée au sort.
Il est crucial de noter qu’Excel applique un protocole de recalcul automatique volatil : toute modification d’une cellule quelconque du classeur ou l’appui sur la touche de fonction F9 déclenche une régénération globale instantanée de l’ensemble des formules ALEA(). Lorsque l’analyste parvient à stabiliser un jeu de données simulé pour des fins d’audit ou de validation formelle, il est indispensable de figer temporairement les tirages par une opération de Copier / Collage spécial en valeurs pour prévenir la modification inopinée des distributions simulées.
10.2 Construction d’un modèle itératif sans programmation VBA
La méthode de simulation de Monte-Carlo consiste à simuler des milliers d’occurrences d’un processus aléatoire afin de construire empiriquement la distribution de probabilité d’une variable de sortie complexe. S’il est d’usage courant de développer des scripts de bouclage en Visual Basic for Applications (VBA) pour exécuter ces tirages, il est parfaitement envisageable — et souvent computationnellement plus efficient — de structurer un moteur de Monte-Carlo natif au moyen de la fonctionnalité des Tables de données à une ou deux entrées.
Le protocole technique se déroule en trois étapes :
- Élaboration du modèle déterministe unitaire : En cellules
A1etA2, nous définissons des générateurs stochastiques d’entrée (par exemple, des coûts de production tirés selon=LOI.NORMALE.INVERSE.N(ALEA(); 100; 15)et un volume de vente généré selon=ALEA.ENTRE.BORNES(500; 1200)). La celluleA3formalise l’équation économique de rentabilité en combinant ces deux entrées aléatoires. - Configuration de la grille de simulation : Dans une autre plage (par exemple
D2:D1001), nous insérons une colonne d’index itératif numérotée de 1 à 1 000. Dans la cellule située juste au-dessus de la première valeur simulée (soit enE1), nous faisons référence à la formule de calcul de rentabilité :=A3. - Exécution de la Table de données : En sélectionnant la matrice complète
D1:E1001, nous ouvrons la boîte de dialogue Table de données (via l’onglet Données > Analyse de scénarios). Nous laissons le champ Cellule d’entrée en ligne vide, et nous sélectionnons une cellule vierge quelconque de la feuille dans le champ Cellule d’entrée en colonne.
Dès validation, Excel force la recalculation du modèle unitaire pour chacune des 1 000 lignes de la table, consignant instantanément dans la colonne E un millier de résultats indépendants. Cette compilation itérative permet d’approcher la loi de probabilité de sortie avec une variance d’échantillonnage réduite, en vertu de la loi forte des grands nombres, contournant l’obligation d’écrire la moindre ligne de code de programmation procédurale.
10.3 Application de Monte-Carlo à l’analyse de risque comportemental
L’application de la méthode de Monte-Carlo dans les sciences de la décision et l’économie comportementale permet d’évaluer la résilience d’individus ou d’organisations soumis à des environnements hautement incertains et stressants. Considérons la modélisation de la prise de décision financière sous stress chez des ménages en situation de précarité. Les flux de trésorerie mensuels sont modélisés non par des constantes fixes, mais par des densités probabilistes croisées intégrant la survenue aléatoire d’événements de choc (dépenses médicales d’urgence, pannes de véhicules, variations des prix de l’énergie).
En agrégeant 5 000 itérations de Monte-Carlo au sein d’une table Excel, les chercheurs peuvent quantifier formellement la probabilité de défaillance budgétaire ou d’insolvabilité, formalisée par l’occurrence P(Trésorerie < 0). En appliquant la fonction de comptage =NB.SI(Plage_Simulee; "<0")/5000, on obtient une estimation directe de l’exposition au risque de détresse financière.
De même, dans la recherche clinique sur les trajectoires de rétablissement psychiatrique, la simulation de Monte-Carlo permet de projeter la probabilité cumulative de rémission complète à horizon de 12 mois en combinant des distributions de probabilité empiriques d’observance médicamenteuse, de soutien socio-émotionnel et de récurrence des stresseurs environnementaux. La restitution graphique de ces milliers de trajectoires au moyen d’un graphique en nuage de points ou d’intervalles de confiance percentiles (obtenus via les fonctions CENTILE.EXCLURE) offre aux cliniciens une cartographie probabiliste personnalisée des risques de rechute, transformant la spéculation clinique en une stratégie d’intervention probabiliste étayée par les données empiriques.
11. Diagnostic des erreurs courantes et validation empirique des modèles
11.1 Identification et correction des codes d’erreur d’Excel
L’exécution de formules probabilistes avancées dans Excel expose régulièrement l’analyste à des codes d’erreur d’interruption. L’identification rapide de l’étiologie logicielle sous-jacente est une compétence indispensable pour maintenir la fiabilité des systèmes décisionnels. Le tableau ci-après synthétise les anomalies d’évaluation les plus fréquentes rencontrées lors de l’usage des fonctions PROBABILITE et LOI.NORMALE.N :
- L’erreur
#NOMBRE!: Ce code signale systématiquement une violation des contraintes axiomatiques du domaine de définition mathématique. Dans la fonction PROBABILITE, il se déclenche dès lors qu’un des coefficients de prob_plage est strictement inférieur à 0 ou supérieur à 1, ou si l’un des paramètres est non conforme. Dans les fonctions continues, il apparaît si le paramètre d’écart-type est spécifié comme négatif ou nul (σ ≤ 0), ce qui constitue une impossibilité géométrique et statistique. - L’erreur
#N/A: Typique de la fonction PROBABILITE, cette interruption intervient dès qu’il y a dissymétrie dimensionnelle entre x_plage et prob_plage. Si la première plage couvre 10 cellules alors que la seconde n’en contient que 9, le calcul matriciel est interrompu pour défaut de bijection un à un des éléments scalaires. - L’erreur
#VALEUR!: Elle dénote la présence inopinée d’un type de données non conforme, principalement des chaînes de caractères textuels ou des espaces insécables dissimulés au sein des plages de cellules numériques. Une vigilance particulière est requise lors de l’importation de fichiers CSV où les séparateurs décimaux (point anglo-saxon versus virgule francophone) peuvent transformer des nombres en chaînes textuelles invisibles au diagnostic superficiel.
11.2 Biais statistiques et illusions d’optique dans les feuilles de calcul
Au-delà des erreurs informatiques franches qui interrompent le calcul, les biais méthodologiques sournois représentent un péril analytique bien plus insidieux, dans la mesure où Excel génère un résultat numérique apparemment valide mais intrinsèquement biaisé. Le premier d’entre eux est le biais du survivant, qui survient lorsque l’analyste construit une table de probabilités à partir d’observations historiques en omettant les événements critiques ayant conduit à l’élimination précoce de certaines entités du jeu d’échantillonnage.
Un deuxième piège cognitif fréquent au sein des environnements tabulaires réside dans la confusion entre corrélation observée et dépendance probabiliste causale. Deux colonnes de données peuvent afficher une probabilité conjointe empirique anormalement élevée sous l’effet d’une variable confondante non intégrée au modèle, induisant l’analyste en erreur lors du calcul de probabilités conditionnelles via NB.SI.ENS. Il est impératif de confronter systématiquement les inférences stochastiques à des fondements théoriques robustes avant d’entériner une conclusion causale.
Enfin, l’illusion d’hyper-précision numérique générée par le formatage par défaut d’Excel constitue une source majeure de dérive décisionnelle. L’affichage de huit décimales sur une cellule calculant une probabilité empirique ne confère aucune exactitude scientifique additionnelle si les données sources ne reposent que sur un échantillon de 50 observations. Les gestionnaires formés doivent impérativement aligner le format d’affichage sur la marge d’erreur stochastique réelle de l’échantillon, prévenant ainsi les prises de décision managériales fondées sur du bruit statistique non représentatif.
11.3 Validation de l’ajustement par le test du Chi-carré
Pour attester scientifiquement de la validité d’une distribution discrète paramétrique modélisée dans Excel, il est indispensable de confronter les fréquences empiriques observées sur le terrain aux effectifs théoriques prédits par le modèle stochastique. L’instrument statistique standard pour cette évaluation est le test d’adéquation du Khi-deux (ou Chi-carré) d’homogénéité de Karl Pearson.
Le test compare la somme normalisée des écarts quadratiques entre effectifs observés (Oi) et effectifs théoriques attendus (Ei) selon l’équation fondamentale :
χ2 = ∑ [ (Oi – Ei)2 / Ei ].
Dans Excel, cette vérification s’exécute directement grâce à la fonction native TEST.CHI2(plage_reelle; plage_attendue). La plage_reelle héberge les effectifs de comptage bruts issus du recueil de données, tandis que la plage_attendue contient les effectifs prévus par le modèle probabiliste (obtenus en multipliant le vecteur des probabilités théoriques par la taille globale d’échantillon N).
La fonction TEST.CHI2 calcule en interne la statistique de test et renvoie directement la valeur critique p (ou p-value). L’analyste interprète ce résultat selon le standard épistémologique classique : si la valeur p renvoyée est supérieure au seuil de significativité α conventionnel (typiquement 0,05 ou 5 %), l’hypothèse nulle d’adéquation ne peut être rejetée. Le modèle probabiliste paramétré sous Excel est alors déclaré formellement représentatif de la réalité empirique observée, autorisant son déploiement pour des prévisions opérationnelles fiabilisées.
12. Bonnes pratiques méthodologiques et automatisation avancée des calculs probabilistes
12.1 Dynamisation des plages de calcul avec les tableaux structurés
L’une des vulnérabilités critiques des classeurs Excel traditionnels réside dans l’utilisation de plages de cellules statiques rigides (du type A2:A50). Dès lors que de nouvelles données sont intégrées ou que la taille de l’espace échantillonnal s’étend, ces formules statiques cessent de couvrir l’intégralité du domaine probabiliste sans avertissement explicite, corrompant la normalisation de la distribution. Pour pallier cette faiblesse, l’adoption systématique des Tableaux structurés (générés via le raccourci Ctrl + L ou l’option Mettre sous forme de tableau) constitue la meilleure pratique de modélisation contemporaine.
Lorsqu’une matrice probabiliste est convertie en tableau structuré officiel (nommé par exemple Table_Probabilites), la syntaxe de la formule s’affranchit des coordonnées absolues pour adopter des références structurées lisibles et dynamiques :
=PROBABILITE(Table_Probabilites[Valeur_X]; Table_Probabilites[Probabilite]; Seuil_Inf; Seuil_Sup)
Cette architecture confère une adaptabilité automatique au modèle probabiliste. L’insertion de nouvelles modalités d’événements à la fin de la table entraîne l’extension instantanée et transparente des plages matricielles référencées dans la formule. Le modèle met automatiquement à jour ses bornes et ses sommations sans exiger la moindre modification éditoriale manuelle du code des formules, garantissant ainsi l’évolutivité et la pérennité du système décisionnel.
12.2 Visualisation graphique rigoureuse des distributions probabilistes
L’inférence statistique gagne considérablement en efficacité lorsque les distributions calculées sont soutenues par des représentations visuelles rigoureuses respectant la sémiologie graphique quantitative. Pour les distributions discrètes traitées avec la fonction PROBABILITE, le diagramme en bâtons verticaux (ou graphique à colonnes non contiguës) est la convention sémiologique impérative. L’espacement visuel entre les colonnes matérialise graphiquement l’absence de continuité entre les valeurs discrètes de l’espace échantillonnal.
À l’inverse, pour les distributions continues modélisées au moyen de la fonction LOI.NORMALE.N, l’histogramme de fréquences à colonnes contiguës (largeur d’intervalle nulle) s’impose pour illustrer la densité de surface. Une technique avancée de visualisation consiste à superposer, au sein d’un graphique combiné, l’histogramme des fréquences empiriques observées avec une courbe continue lissée représentant la densité théorique gaussienne calculée avec l’argument FAUX. Cette juxtaposition permet un contrôle visuel immédiat de la normalité des résidus et de la symétrie de la distribution.
Enfin, pour dynamiser les tableaux de bord interactifs, il est fortement recommandé d’implémenter des zones d’ombrage colorées dynamiques matérialisant précisément l’aire sous la courbe couverte par les bornes seuil_inf et seuil_sup. Cette mise en forme peut être réalisée en configurant une série de données conditionnelle dans le graphique, qui n’affiche les valeurs de densité que pour les points d’abscisse compris dans l’intervalle sélectionné, offrant aux décideurs une compréhension géométrique instantanée de la probabilité agrégée calculée.
12.3 Documentation académique et auditabilité des classeurs Excel
La crédibilité scientifique et la conformité aux normes d’audit des modèles probabilistes élaborés sous Excel exigent une traçabilité intégrale de l’ensemble des hypothèses stochastiques sous-jacentes. Un modèle probabiliste dépourvu de documentation explicite présente un risque opérationnel majeur d’invalidation lors des revues de pairs ou des audits de gouvernance d’entreprise. Chaque feuille de calcul devrait intégrer un onglet méthodologique liminaire explicitant la source d’échantillonnage, la période de recueil des données et les choix de paramétrage statistique appliqués.
L’utilisation systématique des Commentaires de cellules et des Notes permet d’annoter directement les formules critiques en justifiant le choix des lois de distribution ou la sélection des seuils de troncature. Parallèlement, l’attribution de noms explicites aux cellules contenant des paramètres stratégiques (par exemple renommer la cellule de moyenne Param_Mu au lieu de F12) renforce considérablement la lisibilité et l’auto-documentation du modèle stochastique.
Pour assurer la vérification interne de l’intégrité computationnelle, l’analyste doit exploiter régulièrement les outils natifs d’audit de formules regroupés dans le ruban Office. Les fonctionnalités Repérer les antécédents et Repérer les dépendants génèrent des traceurs graphiques vectoriels qui permettent de cartographier instantanément les flux de dépendance reliant les vecteurs de probabilités brutes aux indicateurs d’inférence finaux. Cette discipline documentaire garantit la reproductibilité des résultats quantitatifs, assurant une conformité rigoureuse avec les exigences méthodologiques les plus strictes de la recherche contemporaine.
Références
- Bayes, T. (1763). An essay towards solving a problem in the doctrine of chances. Philosophical Transactions of the Royal Society of London, 53, 370–418. https://doi.org/10.1098/rstl.1763.0053
- De Moivre, A. (1738). The Doctrine of Chances: Or, a Method of Calculating the Probabilities of Events in Play (2nd ed.). H. Woodfall.
- Gauss, C. F. (1809). Theoria motus corporum coelestium in sectionibus conicis solem ambientium. F. Perthes et I. H. Besser.
- Kolmogorov, A. N. (1933). Grundbegriffe der Wahrscheinlichkeitsrechnung. Springer-Verlag. https://doi.org/10.1007/978-3-642-49888-6
- Microsoft Corporation. (2024). Fonction PROBABILITE – Support Microsoft. Support technique Microsoft 365. https://support.microsoft.com/fr-fr/office/probabilite-fonction-probabilite-9ac30de3-8242-441a-8226-64c929e44078
- Microsoft Corporation. (2024). Fonction LOI.NORMALE.N – Support Microsoft. Support technique Microsoft 365. https://support.microsoft.com/fr-fr/office/loi-normale-n-loi-normale-n-fonction-4ba42f08-0132-4081-8848-64946d3208c6
- Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. Philosophical Magazine Series 5, 50(302), 157–175. https://doi.org/10.1080/14786440009463897
- Poisson, S. D. (1837). Recherches sur la probabilité des jugements en matière criminelle et en matière civile, précédées des règles générales du calcul des probabilités. Bachelier.
- Wechsler, D. (2008). Wechsler Adult Intelligence Scale–Fourth Edition (WAIS-IV). NCS Pearson.