
L’analyse décisionnelle moderne, la modélisation économétrique et la fouille de données reposent fondamentalement sur la capacité des analystes à quantifier l’incertitude dans des contextes d’information partielle. Dans le vaste corpus du calcul stochastique, la probabilité conditionnelle s’érige en pierre angulaire de l’inférence statistique. Elle permet de recalculer la plausibilité d’un événement à l’aune de la survenue avérée d’un événement antérieur ou connexe. Qu’il s’agisse d’évaluer le risque de défaut de crédit en fonction des antécédents bancaires, d’estimer l’efficacité d’un protocole clinique à partir de biomarqueurs spécifiques, ou de prédire l’attrition d’une cohorte de consommateurs selon leur canal d’acquisition, la mise en œuvre empirique de ce concept mathématique demeure un impératif méthodologique incontournable pour les praticiens des sciences des données.
Bien que les environnements de programmation statistique spécialisés tels que le langage R ou Python offrent des bibliothèques dédiées à l’algèbre matricielle et à la modélisation bayésienne, le tableur Microsoft Excel demeure l’écosystème le plus universellement déployé au sein des organisations pour l’exploration, l’audit et la communication des données quantitatives. La flexibilité de son modèle tabulaire, combinée à l’expressivité de ses fonctions natives et à la puissance de son moteur de calcul matriciel dynamique révisé, confère à Excel une polyvalence singulière pour structurer, décomposer et calculer les probabilités conditionnelles avec une granularité rigoureuse. Toutefois, la transposition d’abstractions probabilistes formelles dans une grille de calcul bidimensionnelle expose fréquemment l’utilisateur à des erreurs de spécification, d’inversion logique ou de division par zéro.
Ce guide exhaustif a pour vocation d’articuler la théorie mathématique de la probabilité conditionnelle avec son implémentation opérationnelle de haut niveau dans Excel. En parcourant les fondements axiomatiques de Kolmogorov, la structuration des tables de contingence bivariées, l’automatisation via les tableaux croisés dynamiques, l’usage des formules d’agrégation conditionnelle et l’inversion bayésienne avancée, ce traité fournit une méthodologie systématique et reproductible. Chaque section dissèque les mécanismes d’évaluation sous-jacents, enrichis de protocoles d’audit et de validation inférentielle, afin de transformer des données empiriques brutes en mesures prédictives parfaitement sécurisées.
1. Fondements théoriques de la probabilité conditionnelle et formalisme mathématique
1.1 Définition axiomatique et formule fondamentale
La formalisation contemporaine du calcul des probabilités repose sur l’édifice axiomatique formulé par le mathématicien soviétique Andreï Kolmogorov en 1933. Dans un espace probabilisé défini par un triplet canonique constitué d’un univers des événements possibles, d’une tribu d’événements et d’une mesure de probabilité associée, la survenue d’un événement particulier modifie de manière intrinsèque l’espace de référence. Lorsque l’on postule l’existence de deux événements dépendants notés arbitrairement A et B, la probabilité que l’événement A se réalise, sachant de manière certaine que l’événement B est advenu, est formalisée par la notation P(A|B).
L’expression analytique de ce rapport s’établit rigoureusement selon l’égalité fondamentale : P(A|B) = P(A ∩ B) / P(B). Cette relation n’est mathématiquement définie et valide que sous la contrainte stricte selon laquelle la probabilité marginale de l’événement conditionnant est strictement positive, soit P(B) > 0. Dans l’éventualité où P(B) = 0, l’événement conditionnant constitue un ensemble quasi-impossible, rendant l’opération de division arithmétiquement indéterminée et dépourvue de sens physique ou statistique dans le cadre de la théorie classique de la mesure.
D’un point de vue conceptuel et empirique, il convient d’opérer une distinction scrupuleuse entre trois notions cardinales : la probabilité conjointe, la probabilité marginale et la probabilité conditionnelle. La probabilité conjointe, notée P(A ∩ B), quantifie la fréquence relative de l’occurrence simultanée des caractéristiques A et B au sein de la population totale observée. La probabilité marginale, à l’instar de P(B) ou P(A), évalue la probabilité globale d’un événement sans tenir compte d’aucune autre variable discriminante. En revanche, la probabilité conditionnelle P(A|B) opère une altération épistémique : elle traduit une réduction délibérée de l’univers des possibles à l’unique sous-ensemble circonscrit par l’événement B. L’événement conditionnant devient ainsi le nouvel univers de référence local, renormalisant l’espace probabiliste à l’unité.
1.2 Propriétés statistiques et implications logiques
De la définition fondamentale du rapport conditionnel découle immédiatement la règle générale de multiplication stochastique : P(A ∩ B) = P(A|B) × P(B) = P(B|A) × P(A). Cette égalité symétrique démontre que l’intersection de deux événements peut s’interpréter comme le produit séquentiel de la réalisation d’une première condition et de la réalisation de la seconde sous l’hypothèse de la première. Par ailleurs, la probabilité conditionnelle obéit à l’ensemble des axiomes régissant les probabilités conventionnelles, notamment la propriété de complémentarité. Ainsi, pour tout événement A et son complémentaire non-A, la relation s’énonce comme suit : P(non-A|B) = 1 – P(A|B). Il est impératif de souligner que ce principe de complémentarité s’applique exclusivement à l’événement conditionné et non à l’événement conditionnant : P(A|non-B) ne saurait en aucun cas être déduit directement de 1 – P(A|B) sans données empiriques additionnelles.
Une propriété analytique majeure réside dans la non-équivalence structurelle entre P(A|B) et P(B|A). Cette asymétrie fondamentale constitue l’un des écueils les plus récurrents de la modélisation prédictive, couramment désigné sous le terme de sophisme du procureur ou erreur d’inversion conditionnelle. La propension d’un individu présentant une pathologie rare M à afficher un résultat de test positif T, formalisée par la sensibilité P(T|M), est conceptuellement disjointe de la valeur prédictive positive P(M|T), qui mesure la probabilité effective d’être atteint de la pathologie une fois le résultat positif établi.
En sciences empiriques et en analyse d’affaires, négliger cette distinction asymétrique engendre le paradoxe du faux positif. Lorsque l’incidence globale d’un phénomène au sein de la population générale est très faible, même un test possédant une sensibilité et une spécificité exceptionnellement élevées générera un nombre de faux positifs supérieur au volume des vrais positifs répertoriés. Il devient dès lors fondamental d’ancrer tout modèle décisionnel sur une manipulation rigoureuse de la directionnalité du conditionnement lors de l’intégration sous Excel.
1.3 Indépendance statistique versus dépendance stochastique
L’évaluation de la probabilité conditionnelle offre le critère formel le plus direct pour attester de l’indépendance statistique entre deux variables aléatoires ou événements discrets. Par définition, deux événements A et B sont dits statistiquement indépendants si et seulement si l’occurrence de l’événement conditionnant B n’apporte aucune modification informationnelle à la probabilité de survenue de A. Formellement, cette indépendance se traduit par l’identité mathématique : P(A|B) = P(A), ce qui implique par dérivation bilatérale que P(B|A) = P(B) et P(A ∩ B) = P(A) × P(B).
À l’inverse, dès lors que la mesure calculée de P(A|B) diverge de la probabilité marginale P(A), une relation de dépendance stochastique est formellement constatée. L’écart quantitatif observé entre P(A|B) et P(A) illustre le gain ou la perte d’incertitude induite par la connaissance du signal informationnel véhiculé par B. Dans le champ de la théorie de l’information, cette divergence est étroitement corrélée à l’information mutuelle partagée entre les deux variables catégorielles.
Il importe toutefois de tracer une frontière méthodologique infranchissable entre la corrélation stochastique mise en évidence par une dépendance probabiliste et une relation de causalité déterministe. La mise en lumière sous Excel d’une valeur de P(A|B) nettement supérieure à P(A) indique une association statistique significative au sein de l’échantillon, mais ne préjuge nullement de la direction causale sous-jacente. Ce couplage peut être le fruit d’une causalité bidirectionnelle, d’une causalité inverse ou de l’influence dissimulée d’un facteur confondant exogène, un phénomène connu sous le nom de régression fallacieuse ou paradoxe de corrélation.
2. Structure et organisation des données tabulaires sous Excel
2.1 Conception d’une table de contingence bivariée
Pour operationaliser le calcul probabiliste au sein de la grille de calcul d’Excel, la structuration géométrique de l’information empirique constitue la première phase critique. L’architecture optimale pour appréhender simultanément deux dimensions qualitatives réside dans la table de contingence bivariée, fréquemment dénommée tableau à double entrée ou matrice de contingence. Cette disposition tabulaire organise de façon orthogonale les modalités exhaustives d’une première variable catégorielle le long des lignes horizontales, tandis que les modalités de la seconde variable sont déployées le long des colonnes verticales.
La robustesse mathématique d’une telle matrice repose sur le respect scrupuleux de deux axiomes fondamentaux : l’exhaustivité des modalités répertoriées et l’exclusion mutuelle des classes observées. Chaque unité statistique élémentaire issue de l’échantillon collecté doit pouvoir être assignée sans ambiguïté à une cellule d’intersection unique et non recoupable. Toute collision typologique ou imprécision syntaxique dans la codification des libellés engendre une distorsion immédiate de la partition spatiale de l’univers probabiliste.
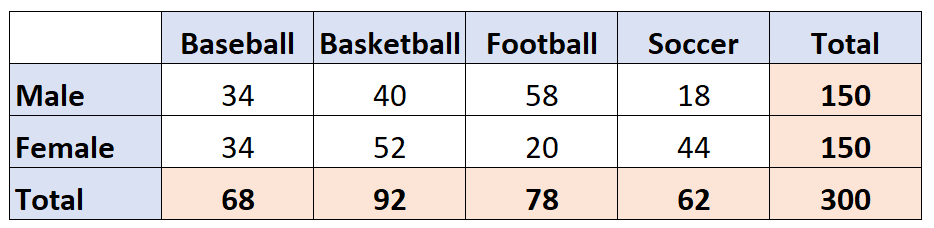
En périphérie de la zone matricielle centrale abritant les effectifs conjoints observés, il est impératif d’intégrer des marges de sommation systématiques. Une colonne terminale réservée au total horizontal agrège les effectifs pour chaque ligne individuelle, tandis qu’une ligne inférieure réservée au total vertical récapitule la sommation des colonnes respectives. L’intersection ultime de ces marges périphériques consacre l’effectif global de l’échantillon analysé, conventionnellement désigné par la variable N. Cette matrice constitue le support primaire de toute dérivation probabiliste ultérieure.
2.2 Nettoyage et validation préalable des données brutes
L’intégrité des calculs conditionnels dépend viscéralement de la propreté intrinsèque des séries de données brutes importées dans le classeur. Les microdonnées d’enquêtes ou les extractions transactionnelles issues d’entrepôts de données recèlent fréquemment des anomalies typographiques susceptibles de fausser les fonctions de dénombrement d’Excel. Des espaces résiduels invisibles en début ou en fin de chaîne de caractères induisent le logiciel à scinder artificiellement une même modalité catégorielle en deux entités disjointes lors des regroupements.
Afin de prémunir le modèle contre ces distorsions dévastatrices, l’application d’un pipeline de nettoyage standardisé est recommandée. L’emploi de la fonction SUPPRESPACE permet d’éradiquer systématiquement les espaces superflus, tandis que l’encapsulation de cette dernière au sein de la fonction MAJUSCULE homogénéise la casse des descripteurs textuels. Pour une variable brute localisée dans la cellule A2, l’instruction assainissante s’articule ainsi : =MAJUSCULE(SUPPRESPACE(A2)). Cette opération garantit une équivalence binaire absolue lors des comparaisons logiques.
Au-delà de la normalisation syntaxique, il est méthodologiquement recommandé de convertir la plage de microdonnées tabulaire statique en un véritable Tableau Structuré natif Excel, accessible via le raccourci clavier standard Ctrl + L ou par l’entremise du menu contextuel Insérer > Tableau. Cette structure confère une désignation d’en-tête dynamique et autorise l’adressage de formules reposant sur des références structurées. L’adjonction ultérieure d’enregistrements s’effectue alors de manière fluide, le tableau s’étendant automatiquement et recalculant les périmètres matriciels sans nécessiter une révision manuelle des plages de cellules.
2.3 Calcul automatique des sommes marginales
Dès lors que la matrice de contingence présente une géométrie assainie, l’implémentation des totaux marginaux doit être exécutée à l’aide de formules arithmétiques explicites et dynamiques. L’incorporation de la fonction SOMME constitue la méthode canonique pour agréger les observations transversales. Pour une table dont les cellules de données conjointes s’étendent de la colonne B à la colonne D pour la ligne indicée 4, le calcul de la marge s’effectue dans la cellule E4 via l’instruction : =SOMME(B4:D4). Cette formule est ensuite propagée le long de la marge verticale.
De façon strictement analogue, le calcul des totaux marginaux de colonnes s’opère sur la ligne inférieure délimitant la matrice. Pour la colonne B couvrant les rangées 4 à 6, la cellule sommative B7 accueillera la formule : =SOMME(B4:B6). Ces agrégations marginales mesurent le nombre total d’occurrences associées à chaque état de la variable conditionnante ou dépendante, indépendamment des variations de l’autre variable.
Le contrôle de conformité global s’établit au niveau de la cellule de grand total, située à l’angle inférieur droit de la table de contingence (par exemple en E7). L’analyste doit y vérifier que la double sommation des marges de lignes et des marges de colonnes converge vers une valeur rigoureusement identique : =SOMME(E4:E6) doit renvoyer un résultat indiscernable de =SOMME(B7:D7). Cette convergence arithmétique valide la complétude distributionnelle de l’échantillon N, prévenant toute omission d’enregistrement lors des phases ultérieures d’estimation du quotient conditionnel.
3. Construction de tables de contingence via les Tableaux Croisés Dynamiques
3.1 Génération de la matrice de distribution conjointe
L’environnement des Tableaux Croisés Dynamiques (TCD) de Microsoft Excel représente l’outil d’ingénierie le plus performant pour agréger de volumineuses bases de microdonnées individuelles sans recourir à l’écriture fastidieuse de formules intermédiaires. Lorsqu’un jeu de données comprend plusieurs dizaines ou centaines de milliers d’enregistrements transactionnels, l’extraction manuelle des fréquences observées se révèle hautement chronophage et vulnérable aux erreurs humaines. L’insertion d’un TCD permet d’opérer cette réduction matricielle de façon instantanée et algorithmiquement vérifiée.
La génération de la matrice bivariée débute par la sélection de la table structurée source, suivie de l’activation de la commande Insertion > Tableau croisé dynamique. L’agencement structurel requiert ensuite le positionnement réfléchi des variables étudiées au sein du panneau de configuration. Selon l’architecture analytique retenue, la variable explicative ou conditionnante est assignée à la zone des Colonnes (respectivement des Lignes), tandis que la variable cible ou dépendante est glissée vers la zone des Lignes (respectivement des Colonnes).
L’élément technique déterminant réside dans la configuration de la zone des Valeurs. Par défaut, Excel applique fréquemment une opération de sommation lorsque le champ sélectionné contient des données quantitatives, ou de dénombrement pour des données alphanumériques. L’analyste doit formellement accéder aux Paramètres des champs de valeurs et sélectionner l’option Nombre (dénombrement). Cette disposition garantit que la matrice affichera précisément les fréquences observées de façon conjointe, fournissant la base empirique pour le traitement probabiliste.
3.2 Configuration des affichages en pourcentages conditionnels
La force opératoire du Tableau Croisé Dynamique culmine dans son aptitude à convertir instantanément les dénombrements bruts en distributions probabilistes conditionnelles normalisées, sans requérir aucune saisie algébrique. Cette conversion repose sur l’onglet Afficher les valeurs accessible dans les paramètres avancés du champ calculé.
Lorsque la question probabiliste soumise à l’évaluation s’exprime sous la forme P(Ligne | Colonne), c’est-à-dire la probabilité d’observer une modalité spécifique en ligne sachant que la condition de colonne est remplie, l’analyste doit impérativement configurer l’affichage sur % du total de la colonne. Dans ce mode de visualisation, la somme des pourcentages le long de chaque colonne individuelle est rigoureusement égale à 100%, chaque cellule intérieure traduisant directement la probabilité conditionnelle correspondante. La marge inférieure affiche ainsi l’unité (100%), actant la réduction de l’univers probabiliste aux effectifs spécifiques de chaque colonne.
Réciproquement, si l’objet de la recherche est d’analyser la probabilité conditionnelle inverse, formalisée par P(Colonne | Ligne), le paramétrage doit être basculé sans équivoque sur % du total de la ligne. Dès lors, chaque ligne horizontale totalise 100%, et les cellules intérieures quantifient la probabilité d’occurrence des attributs de colonnes conditionnés par l’appartenance à la strate de ligne considérée. L’inversion erronée entre ces deux modes d’affichage constitue la cause première d’interprétation fallacieuse dans les rapports d’analyse de données.
3.3 Actualisation dynamique et flexibilité analytique
L’exploitation des Tableaux Croisés Dynamiques offre une réactivité décisionnelle appréciable face aux flux continus d’informations. Lorsque le jeu de données sous-jacent est enrichi par l’adjonction incrémentale de nouvelles lignes de transactions, la table de probabilités conditionnelles n’exige aucune reconstruction. Une simple commande d’actualisation, accessible via le ruban d’outils ou par l’exécution de la combinaison de touches Alt + F5, recalcule instantanément l’intégralité des marges et des ratios stochastiques.
Cette réactivité est magnifiée par l’adjonction de Segments (ou Slicers). Ces filtres visuels interactifs permettent d’isoler en temps réel des sous-populations spécifiques en appliquant des contraintes d’échantillonnage supplémentaires sans corrompre la structure sous-jacente de la table de contingence. L’analyste peut ainsi évaluer l’évolution des distributions conditionnelles à travers différentes strates temporelles, géographiques ou démographiques par une simple interaction tactile ou sélective.
Dans les contextes d’ingénierie logicielle où les valeurs issues de la table de contingence dynamique doivent alimenter un tableau de bord prévisionnel tiers, l’emploi de la fonction LIREDONNEESTABCROISDYNAMIQUE s’avère précieux. Cette fonction native d’Excel extrait de manière programmatique et sécurisée une probabilité conditionnelle spécifique logée au cœur d’un TCD en désignant textuellement les coordonnées de lignes et de colonnes, évitant ainsi les écueils liés aux décalages physiques de cellules lors des recalculs.
4. Calcul direct des probabilités conjointes et marginales par formules
4.1 Évaluation de la probabilité conjointe P(A∩B)
En marge des mécanismes d’automatisation offerts par les Tableaux Croisés Dynamiques, l’écriture explicite de formules au sein de la grille matricielle confère une traçabilité mathématique supérieure, propice aux audits et à l’intégration dans des chaînes de modélisation stochastique complexes. L’évaluation de la probabilité conjointe P(A ∩ B) constitue la première phase de cette approche granulaire.
La probabilité conjointe s’obtient en établissant le ratio mathématique entre l’effectif observé à l’intersection exacte des modalités A et B, noté nAB, et l’effectif global de l’échantillon répertorié au grand total, noté N. Si l’intersection empirique est hébergée dans la cellule B4 et que l’effectif global N est consolidé dans la cellule E7, la formule de probabilité conjointe s’écrit formellement sous la syntaxe : =B4/$E$7.
L’utilisation rigoureuse de l’opérateur de verrouillage absolu matérialisé par le dollar ($E$7) est ici impérative. Ce figeage référentiel permet de propager librement la formule par étirement dynamique à travers l’ensemble des dimensions de la grille de contingence sans induire de dérive d’indexation du dénominateur universel. L’analyste doit impérativement s’assurer que le résultat produit par cette division s’inscrit rigoureusement dans l’intervalle fermé standard [0, 1], un résultat en dehors de ces bornes signalant une erreur matérielle d’adressage ou de sommation.
4.2 Évaluation de la probabilité marginale conditionnante P(B)
L’étape subséquente réside dans la quantification de la probabilité marginale associée à l’événement érigé en condition, généralement noté B. Dans le schéma matriciel standard, cette grandeur est extraite à partir de la marge correspondante, qu’il s’agisse de la sommation d’une colonne donnée ou d’une ligne d’agrégation. L’opération repose sur la division de la valeur marginale par la taille totale de la population.
Si la condition B correspond à la colonne B, dont la sommation des effectifs marginaux se situe dans la cellule B7, la probabilité marginale P(B) s’exécute par la formule : =B7/$E$7. Cette valeur synthétise la prévalence absolue de l’état B au sein de la cohorte étudiée, sans préjuger de la ventilation de la variable dépendante A. Afin de garantir une lisibilité analytique irréprochable, cette cellule de calcul marginal doit faire l’objet d’un formatage d’affichage en pourcentage normé, calibré préférentiellement sur deux décimales de précision.
Il importe d’accorder une vigilance statistique accrue à l’amplitude de cette probabilité marginale conditionnante. Lorsque P(B) affiche une magnitude infinitésimale (par exemple P(B) < 0,01), la cellule marginale représente un événement rare. Cette situation d’asymétrie extrême augmente considérablement la sensibilité de l’estimation finale aux fluctuations d’échantillonnage et aux incertitudes résiduelles, nécessitant une documentation explicite de cette vulnérabilité au sein des métadonnées du modèle Excel.
4.3 Synthèse de la matrice de probabilités élémentaires
Pour parachever l’architecture probabiliste fondamentale, il est recommandé de dupliquer la géométrie de la table de contingence brute pour ériger une matrice unitaire de probabilités élémentaires. Cette seconde table reproduit scrupuleusement les en-têtes catégoriels initiaux, mais remplace l’ensemble des effectifs entiers par leurs équivalents probabilistes normalisés.
Chaque cellule centrale de cette nouvelle matrice reçoit la probabilité conjointe correspondante P(Ai ∩ Bj), calculée selon la syntaxe d’ancrage absolu explicitée précédemment. De façon synchronisée, les marges latérales et inférieures accueillent les probabilités marginales respectives P(Ai) et P(Bj) issues de la sommation des lignes et des colonnes élémentaires.
La validité mathématique de cette matrice de probabilités repose sur un contrôle de cohérence stochastique strict : la cellule terminale située à l’intersection des marges probabilistes (l’équivalent de l’ancien effectif N) doit afficher exactement la valeur 1,00 (soit 100,00%). L’insertion d’une formule de validation logique, telle que =SI(ARRONDI(SOMME(plage_conjointe);6)=1; « CONFORME »; « ERREUR STOCHASTIQUE »), garantit que la discrétisation probabiliste de l’univers analytique ne souffre d’aucune fuite de masse de probabilité due à des imprécisions de calcul.
5. Application explicite du ratio conditionnel P(A|B) dans la grille Excel
5.1 Calcul par le quotient des probabilités calculées
L’implémentation directe de la définition théorique de Kolmogorov s’effectue en reliant algébriquement les cellules préalablement calculées dans la matrice des probabilités élémentaires. Ce processus transpose sans altération la formule académique P(A|B) = P(A ∩ B) / P(B).
En pratique, si la probabilité conjointe P(A ∩ B) a été évaluée et consignée dans la cellule G4, et que la probabilité marginale conditionnante P(B) est localisée dans la cellule G7, l’analyste saisit dans une nouvelle cellule dédiée au ratio conditionnel la formule directe suivante : =G4/G7. Cette méthode présente l’avantage pédagogique de rendre visible chaque terme de l’équation axiomatique.
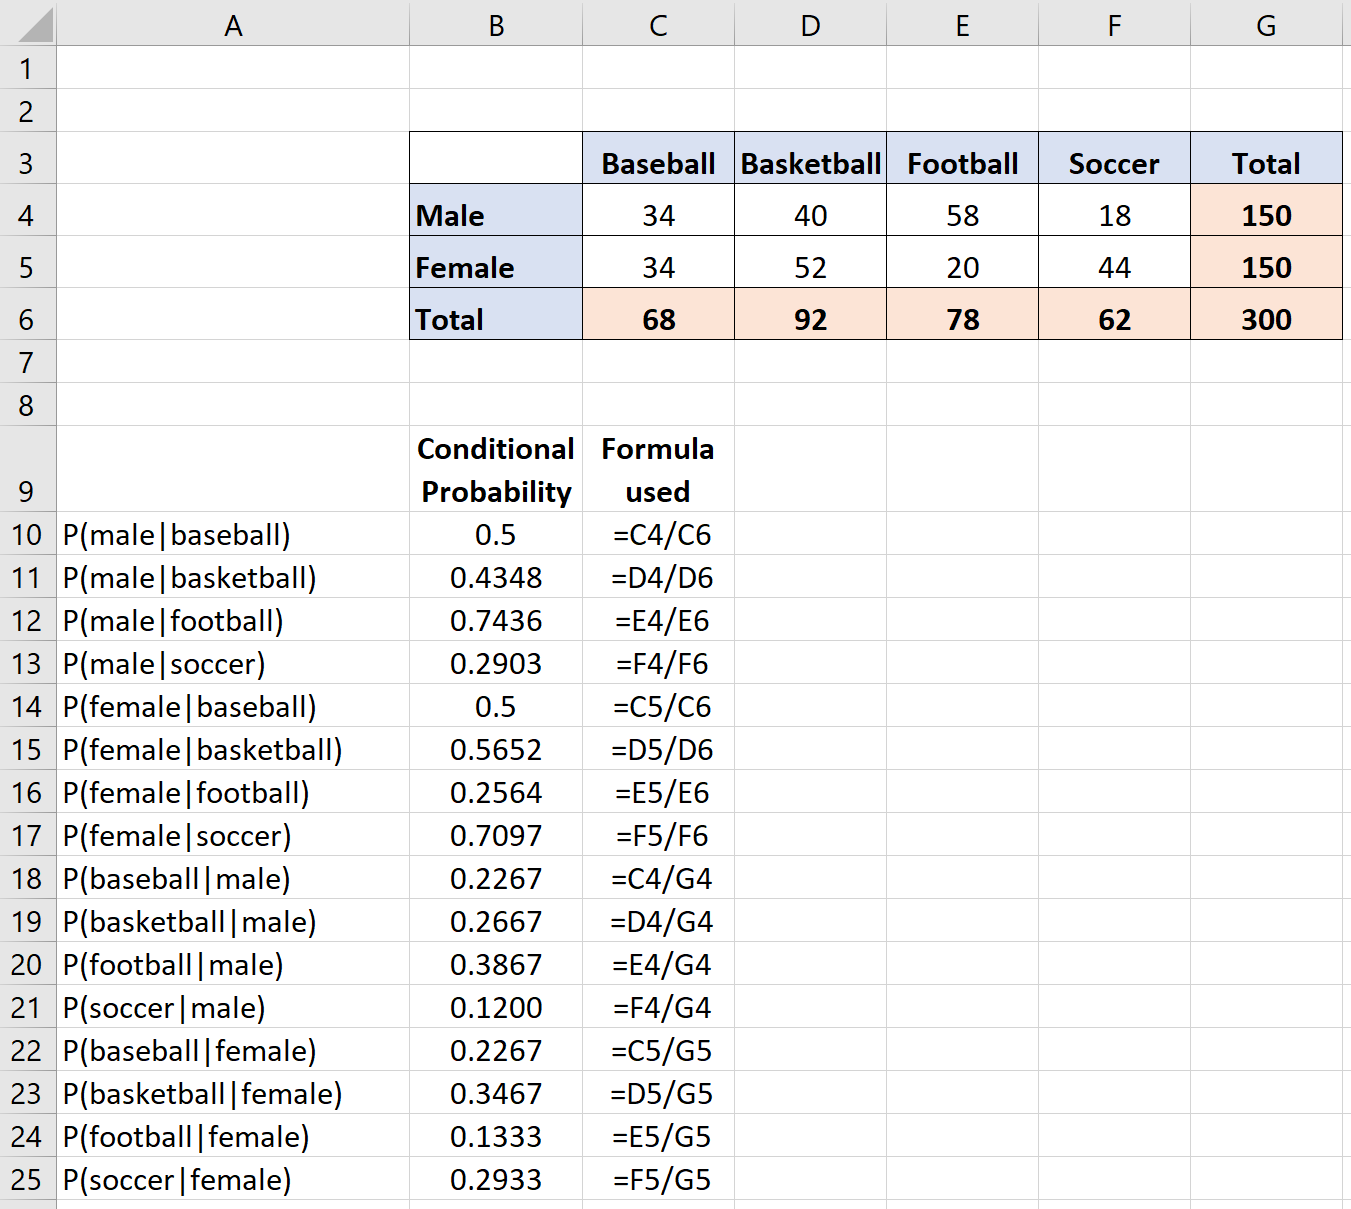
Néanmoins, la manipulation de ratios successifs dérivés de grandeurs flottantes peut, dans certaines configurations limites impliquant des probabilités minuscules, générer des micro-erreurs d’arrondi binaire propres à la norme arithmétique standard IEEE 754 exploitée par le processeur d’Excel. Bien que ces écarts se manifestent généralement au-delà de la douzième décimale, ils recommandent l’emploi de fonctions de contrôle d’arrondi si les résultats doivent ultérieurement être réinjectés dans des boucles de tests conditionnels logiques stricts.
5.2 Calcul simplifié direct par le quotient des effectifs absolus
D’un point de vue analytique et opérationnel, il existe une voie d’implémentation nettement plus élégante et efficiente, dispensant l’analyste du calcul préalable des probabilités conjointes et marginales intermédiaires. En effet, la simplification arithmétique de la fraction de Kolmogorov démontre formellement une équivalence absolue entre le rapport des probabilités et le rapport direct des effectifs observés.
Cette démonstration s’établit par une factorisation élémentaire : P(A|B) = (nAB / N) / (nB / N) = nAB / nB. Les facteurs d’échelle universels N figurant au numérateur et au dénominateur s’annulent algébriquement de façon exacte. En conséquence, la probabilité conditionnelle P(A|B) s’obtient simplement en divisant l’effectif conjoint nAB par l’effectif marginal conditionnant nB.
Sous Excel, si l’intersection de dénombrement est logée dans la cellule B4 et le total marginal de la condition se situe dans la cellule B7, la formule opérationnelle se réduit à : =B4/B7. Cette approche simplifiée procure un double avantage : elle élimine la redondance de calcul, allégeant la charge de traitement des classeurs complexes, et renforce la lisibilité intuitive de la feuille en reliant directement l’analyse à la réalité empirique des dénombrements d’échantillons.
5.3 Sécurisation de la formule contre les divisions par zéro
L’un des défis majeurs dans la conception de modèles de calcul stochastique sous Excel réside dans la gestion des événements nuls. Si, au gré d’une segmentation dynamique des données ou d’un filtrage spécifique, une modalité conditionnante B ne présente aucune occurrence observée dans l’échantillon, la cellule sommative nB contiendra la valeur zéro. L’exécution native de la division déclenchera alors inévitablement l’erreur système abrupte #DIV/0!, corrompant visuellement et structurellement la chaîne de calcul.
Pour prévenir cette défaillance, il est impératif d’encapsuler le ratio au sein de fonctions de gestion d’exception. La méthode la plus robuste et concise consiste à mobiliser la fonction SIERREUR. La syntaxe préventive s’articule ainsi : =SIERREUR(B4/B7; 0). Dans ce cas, si la division s’avère impossible du fait d’une marge nulle, la fonction intercepte l’anomalie et retourne immédiatement la valeur numérique neutre 0, ou le cas échéant une chaîne explicite telle que « Indéterminé ».
Une alternative encore plus rigoureuse sur le plan statistique fait appel à une validation conditionnelle explicite via la fonction SI, évaluant la stricte positivité du dénominateur conformément aux axiomes de Kolmogorov : =SI(B7>0; B4/B7; « Condition non observée »). Ce paradigme sécurise non seulement le classeur contre les ruptures de calcul matriciel, mais informe également de manière transparente l’utilisateur sur la vacuité empirique de la strate conditionnante sélectionnée.
6. Calcul des probabilités conditionnelles à partir de microdonnées brutes
6.1 Dénombrement conjointe avec la fonction NB.SI.ENS
Dans de multiples architectures de traitement décisionnel, les contraintes opérationnelles dictent d’évaluer des probabilités conditionnelles à la volée directement à partir de tables transactionnelles linéaires brutes, sans ériger préalablement une table de contingence physique intermédiaire. Cette approche par flux requiert la mobilisation de fonctions d’agrégation conditionnelle multicritères hautement optimisées, au premier rang desquelles trône la fonction NB.SI.ENS.
La fonction NB.SI.ENS permet de quantifier le nombre de lignes répondant simultanément à une série de critères logiques appliqués sur différentes colonnes. Sa syntaxe générale s’organise en couples réguliers de plages et de conditions : NB.SI.ENS(plage_critères1; critères1; [plage_critères2; critères2]; …). Pour extraire l’effectif conjoint nAB correspondant à l’événement A ∩ B, deux plages vectorielles distinctes doivent être scannées en parallèle.
Considérons un tableau structuré désigné sous le nom technique de TableauVentes, comportant une colonne StatutClient et une colonne SegmentProduit. Pour calculer le dénombrement conjoint de clients dont le statut est « Actif » (critère A) et ayant souscrit au segment « Premium » (critère B), l’instruction analytique s’exécute ainsi : =NB.SI.ENS(TableauVentes[SegmentProduit]; « Premium »; TableauVentes[StatutClient]; « Actif »). Le moteur de calcul parcourt les vecteurs en une seule passe optimisée pour extraire le cardinal de l’ensemble d’intersection.
6.2 Dénombrement marginal avec la fonction NB.SI
En miroir du dénombrement conjoint, l’évaluation du dénominateur conditionnant au sein d’une table brute nécessite l’isolement statistique de la modalité unique servant de condition. Cette opération repose de façon optimale sur la fonction canonique NB.SI, qui cible un périmètre unidimensionnel.
Reprenant l’architecture transactionnelle précédente, l’évaluation de l’effectif marginal des clients appartenant au segment conditionnant « Premium » (l’événement B) s’effectue par la syntaxe univariée : =NB.SI(TableauVentes[SegmentProduit]; « Premium »). Cette formule comptabilise le volume d’enregistrements vérifiant la condition cible, sans opérer la moindre discrimination sur le statut client ou toute autre variable collatérale.
Il convient de souligner que, pour maintenir une parfaite équivalence algébrique, les dimensions spatiales de la plage scannée par NB.SI doivent correspondre rigoureusement à la hauteur vectorielle exploitée dans la fonction conjointe NB.SI.ENS. Tout décalage d’indexation lié à des sélections manuelles asymétriques (par exemple comparer la plage B2:B500 avec une plage C2:C600) introduirait une rupture dimensionnelle sanctionnée par le renvoi de l’erreur #VALEUR!.
6.3 Assemblage unifié de la formule sans tableau intermédiaire
L’agrégation unifiée de la probabilité conditionnelle s’accomplit en fusionnant organiquement le numérateur conjoint et le dénominateur marginal au sein d’une formule matricielle composite unique. Ce modèle évite toute dispersion d’informations intermédiaires au sein du classeur.
L’équation de calcul direct de P(Actif | Premium) prend ainsi la forme synthétique suivante :
=NB.SI.ENS(TableauVentes[SegmentProduit]; « Premium »; TableauVentes[StatutClient]; « Actif ») / NB.SI(TableauVentes[SegmentProduit]; « Premium »)
Afin de maximiser la maintenabilité, l’adaptabilité et la lisibilité du modèle, il est vivement conseillé de remplacer les chaînes de caractères codées en dur (les littéraux comme « Premium » et « Actif ») par des références dynamiques pointant vers des cellules d’arbitrage externes, par exemple les cellules H1 et H2. La formule se transforme alors en :
=NB.SI.ENS(TableauVentes[SegmentProduit]; H1; TableauVentes[StatutClient]; H2) / NB.SI(TableauVentes[SegmentProduit]; H1)
Cette approche unifiée offre une performance de calcul remarquable lors de l’intégration incrémentale de nouvelles observations au tableau maître. Dès qu’un nouvel enregistrement est imputé au registre de base, le ratio de probabilité conditionnelle se recalcule instantanément en mémoire vive, procurant un indicateur stochastique en temps réel sans nécessiter de maintenance structurelle.
7. Application du théorème de Bayes pour l’inversion conditionnelle
7.1 Dérivation théorique et décomposition bayésienne
Le théorème de Bayes, formulé initialement par le révérend Thomas Bayes et perfectionné par Pierre-Simon de Laplace, constitue le cadre formel permettant d’inverser rationnellement le conditionnement stochastique. Dans la vaste majorité des problématiques d’inférence scientifique, il est aisé d’estimer expérimentalement la probabilité d’observer un symptôme ou un signal A sachant qu’un état pathologique ou sous-jacent B est avéré, formalisée par la vraisemblance P(A|B). En revanche, la question critique réside dans l’estimation de la probabilité a posteriori P(B|A), à savoir la plausibilité que l’état sous-jacent B soit présent une fois le signal A détecté.
La dérivation bayésienne s’énonce selon l’équation canonique :
P(B|A) = [P(A|B) × P(B)] / P(A)
Lorsque la probabilité marginale P(A) n’est pas directement accessible, le dénominateur est développé à l’aide du théorème des probabilités totales appliqué sur une partition binaire de l’espace échantillonnal, scindant l’univers en l’état B et son état complémentaire non-B :
P(A) = P(A|B) × P(B) + P(A|non-B) × P(non-B)
L’équation d’inférence bayésienne complète s’exprime dès lors comme suit :
P(B|A) = [P(A|B) × P(B)] / [P(A|B) × P(B) + P(A|non-B) × P(non-B)]
7.2 Architecture d’un modèle bayésien sous Excel
La modélisation d’une structure bayésienne sous Excel requiert la configuration ordonnée d’un panneau de paramètres probabilistes isolant distinctement les distributions a priori et les fonctions de vraisemblance empiriques. Ce bloc de données doit impérativement précéder l’étape de calcul a posteriori.
Une configuration tabulaire standardisée s’organise selon la nomenclature de cellules suivante :
- Cellule B1 : Probabilité a priori de l’état d’intérêt, P(B), désignée comme la prévalence ou taux de base.
- Cellule B2 : Probabilité a priori de l’état complémentaire, P(non-B), calculée dynamiquement par la formule de complémentarité : =1 – B1.
- Cellule B3 : Sensibilité de la détection ou taux de vraisemblance positive, P(A|B), quantifiant la probabilité d’émettre le signal lorsque la condition est présente.
- Cellule B4 : Taux de faux positifs, P(A|non-B), mesurant la probabilité d’émettre indûment le signal en l’absence de la condition cible (équivalant formellement à 1 – Spécificité).
Dans la cellule B6, l’analyste implémente le dénominateur d’évidence globale P(A) conformément à la loi des probabilités totales en agrégeant les produits pondérés :
=(B3*B1) + (B4*B2)
Cette segmentation modulaire garantit une traçabilité intégrale des composantes stochastiques et facilite l’audit algorithmique du modèle décisionnel.
7.3 Calcul de la probabilité a posteriori P(B|A)
L’évaluation définitive de la probabilité conditionnelle a posteriori P(B|A) s’exécute dans la cellule B8 en établissant le ratio final prescrit par Laplace :
=(B3*B1)/B6
Ce calcul illustre avec acuité la vulnérabilité de l’esprit humain au biais cognitif de l’oubli de la fréquence de base (ou base rate fallacy). À titre d’illustration empirique, si une maladie affecte 0,1% de la population générale (B1 = 0,001), que le test présente une sensibilité remarquable de 99% (B3 = 0,99) et un taux de faux positifs remarquablement bas de 5% (B4 = 0,05), la formule bayésienne révèle que la probabilité réelle pour un individu testé positif d’être effectivement atteint n’est que de :
P(Maladie | Positif) = (0,99 × 0,001) / [(0,99 × 0,001) + (0,05 × 0,999)] ≈ 0,00099 / 0,05094 ≈ 1,94%
Pour approfondir cette analyse au sein d’Excel, il est vivement recommandé de greffer sur ce modèle une Table de données à une variable (accessible via le menu Données > Analyse de scénarios > Table de données). En faisant varier la prévalence P(B) le long d’un vecteur de sensibilité allant de 0,01% à 10%, l’analyste peut simuler et cartographier instantanément la dérive de la probabilité a posteriori, dotant les décideurs d’une compréhension visuelle limpide de la non-linéarité des dynamiques probabilistes.
8. Modélisation avancée avec les fonctions matricielles dynamiques
8.1 Génération de matrices conditionnelles avec la fonction FILTRE
L’introduction du moteur de calcul matriciel dynamique au sein des versions modernes de Microsoft Excel (Microsoft 365 et Excel 2021+) a transformé le paradigme de calcul statistique. Les fonctions matricielles éliminent le recours aux formules de tableaux rétrocompatibles complexes combinant INDEX, EQUIV et SOMMEPROD, autorisant un traitement fluide des sous-ensembles probabilistes.
La fonction FILTRE s’avère particulièrement puissante pour isoler dynamiquement les cohortes répondant à une condition stochastique. Sa syntaxe s’établit selon le schéma : FILTRE(tableau; critère_d_inclusion; [si_vide]). Si l’on souhaite extraire l’ensemble des enregistrements vectoriels d’une variable cible A uniquement pour les observations où la variable de condition B correspond à une valeur définie, la fonction génère en mémoire vive une matrice redimensionnée sans polluer l’espace de la feuille.
Pour dénombrer la population conditionnée et calculer la probabilité conditionnelle sans générer d’agrégation statique intermédiaire, la fonction FILTRE peut être directement combinée avec la fonction LIGNES. La formulation suivante évalue le dénominateur marginal dynamique :
=LIGNES(FILTRE(TableauVentes[ID_Client]; TableauVentes[SegmentProduit]= »Premium »))
En encapsulant un critère d’inclusion booléen croisé au sein du prédicat (à l’aide de l’opérateur de multiplication logique * servant de connecteur ET), l’analyste peut extraire l’effectif conjoint et en dériver immédiatement le quotient probabiliste unifié.
8.2 Optimisation des flux de calcul avec la fonction LET
L’exécution de formules de calcul probabiliste complexes impliquant de multiples balayages de plages de données volumineuses peut dégrader substantiellement les performances de calcul du processeur. La fonction LET résout ce goulet d’étranglement en permettant de déclarer des variables locales temporaires au cœur d’une formule unitaire.
Grâce à LET, un résultat de dénombrement intermédiaire ou un sous-ensemble filtré n’est évalué qu’une seule et unique fois par le moteur d’Excel, puis réutilisé à volonté dans l’expression arithmétique finale sans réévaluer les plages sources. L’optimisation du calcul de P(A|B) s’écrit formellement ainsi :
=LET(
pop_B; NB.SI(TableauVentes[SegmentProduit]; « Premium »);
pop_AB; NB.SI.ENS(TableauVentes[SegmentProduit]; « Premium »; TableauVentes[StatutClient]; « Actif »);
SI(pop_B > 0; pop_AB / pop_B; 0)
)
L’emploi de cette structure architecturale apporte un double bénéfice : elle accélère drastiquement la vitesse de calcul en divisant les requêtes redondantes par deux, tout en rendant le code interne de la formule intelligible, documenté et immédiatement auditable pour les réviseurs de modèles financiers et statistiques.
8.3 Automatisation itérative avec LAMBDA et MAP
Le palier ultime de sophistication algorithmique dans l’écosystème contemporain d’Excel réside dans l’exploitation conjointe des fonctions LAMBDA et MAP. La fonction LAMBDA offre la possibilité inédite d’encapsuler une logique de calcul probabiliste au sein d’une fonction réutilisable entièrement personnalisée, sans recourir à la programmation en Visual Basic for Applications (VBA).
L’analyste peut ainsi définir dans le Gestionnaire de noms d’Excel une fonction sur mesure baptisée PROB_COND, structurée selon les paramètres d’arguments suivants :
=LAMBDA(plage_cible; val_cible; plage_cond; val_cond; LET(den; NB.SI(plage_cond; val_cond); num; NB.SI.ENS(plage_cond; val_cond; plage_cible; val_cible); SI(den>0; num/den; 0)))
Une fois cette fonction enregistrée dans le classeur, l’évaluation de toute probabilité conditionnelle se résume à une saisie fonctionnelle directe et épurée : =PROB_COND(TableauVentes[StatutClient]; « Actif »; TableauVentes[SegmentProduit]; « Premium »).
En combinant cette abstraction personnalisée avec la fonction d’itération vectorielle MAP, il devient possible de projeter cette évaluation sur des grilles entières de paramètres en une seule instruction dynamique :
=MAP(VecteurSegments; LAMBDA(s; PROB_COND(TableauVentes[StatutClient]; « Actif »; TableauVentes[SegmentProduit]; s)))
Cette formule engendre un déversement dynamique (spill) de l’ensemble des probabilités conditionnelles pour chaque segment répertorié. Il convient toutefois de rappeler que la portabilité de ces constructions matricielles exige que l’ensemble des utilisateurs finaux disposent d’une version d’Excel supportant le moteur de calcul dynamique moderne.
9. Étude de cas approfondie : Analyse comportementale et catégorielle
9.1 Présentation du jeu de données expérimental
Afin de consolider les développements théoriques et techniques exposés, cette section déploie un cas d’étude complet fondé sur un échantillon standardisé de N = 300 participants sélectionnés dans le cadre d’une recherche sur les préférences comportementales en matière d’activités sportives. L’expérimentation croise deux variables catégorielles distinctes : la variable démographique Genre (comportant deux modalités mutuellement exclusives : Homme et Femme) et la variable comportementale Discipline Favorite (décomposée en trois modalités : Baseball, Basketball et Football).
Les microdonnées collectées sur le terrain ont été agrégées au sein d’une table de contingence bivariée dont la distribution d’effectifs absolus se présente comme suit au sein de la grille Excel :
| Genre / Discipline | Baseball | Basketball | Football | Total Marginal (Genre) |
|---|---|---|---|---|
| Homme | 34 | 56 | 40 | 130 |
| Femme | 34 | 76 | 60 | 170 |
| Total Marginal (Discipline) | 68 | 132 | 100 | N = 300 |
Dans cette architecture, la cellule d’intersection Homme ∩ Baseball affiche un effectif n = 34, la marge conditionnante totale des amateurs de Baseball totalise 68 individus, et l’effectif global répertorié au grand total converge parfaitement vers 300 unités statistiques.
9.2 Résolution détaillée : P(Homme | Baseball)
Considérons la question stochastique suivante : quelle est la probabilité conditionnelle qu’un participant sélectionné aléatoirement soit un Homme, sachant que sa discipline favorite déclarée est le Baseball ? Formellement, l’analyste cherche à évaluer P(Homme | Baseball).
La résolution analytique débute par l’isolement formel des composantes requises selon la formule de Kolmogorov :
- Évaluation de la probabilité conjointe : P(Homme ∩ Baseball) = n(Homme ∩ Baseball) / N = 34 / 300 ≈ 0,1133 (soit 11,33%).
- Évaluation de la probabilité marginale de conditionnement : P(Baseball) = n(Baseball) / N = 68 / 300 ≈ 0,2267 (soit 22,67%).
- Calcul du quotient conditionnel théorique : P(Homme | Baseball) = P(Homme ∩ Baseball) / P(Baseball) = (34/300) / (68/300).
En opérant la simplification arithmétique directe démontrée au chapitre 5, le ratio se transpose dans la grille Excel par la mise en rapport direct des cellules de dénombrement :
P(Homme | Baseball) = n(Homme ∩ Baseball) / n(Baseball) = 34 / 68 = 0,50 (soit exactement 50,00%).
L’interprétation sémantique de ce résultat révèle que, parmi la sous-population spécifique des amateurs de baseball, il existe une parité géométrique parfaite entre les genres. Bien que les femmes représentent la majorité globale de l’échantillon d’étude (170/300, soit 56,67%), le conditionnement par le baseball opère une correction locale ramenant la distribution de genre à un équilibre strict de 50%.
9.3 Comparaisons croisées et calculs directionnels inverses
Pour illustrer empiriquement la dissymétrie inhérente au conditionnement stochastique, évaluons à présent la probabilité conditionnelle inverse : quelle est la probabilité qu’un individu préfère le Baseball, sachant qu’il s’agit d’un Homme ? Formellement, nous cherchons P(Baseball | Homme).
Dans ce scénario, le numérateur conjoint demeure invariant (n = 34), mais le dénominateur de référence est désormais transféré vers la marge horizontale masculine (n = 130) :
P(Baseball | Homme) = 34 / 130 ≈ 0,2615 (soit 26,15%).
La confrontation numérique met en exergue un écart substantiel : P(Homme | Baseball) = 50,00% alors que P(Baseball | Homme) = 26,15%. Confondre ces deux indicateurs dans le cadre d’une étude de ciblage marketing conduirait à des décisions opérationnelles erronées.
En étendant ce calcul systématique à l’ensemble des disciplines pour les deux sous-populations, nous générons sous Excel la table intégrale des probabilités conditionnelles conditionnées par le genre, P(Discipline | Genre) :
- Pour la population masculine :
- P(Baseball | Homme) = 34 / 130 ≈ 26,15%
- P(Basketball | Homme) = 56 / 130 ≈ 43,08%
- P(Football | Homme) = 40 / 130 ≈ 30,77%
- Somme de contrôle = 26,15% + 43,08% + 30,77% = 100,00%
- Pour la population féminine :
- P(Baseball | Femme) = 34 / 170 ≈ 20,00%
- P(Basketball | Femme) = 76 / 170 ≈ 44,71%
- P(Football | Femme) = 60 / 170 ≈ 35,29%
- Somme de contrôle = 20,00% + 44,71% + 35,29% = 100,00%
Cette ventilation permet de quantifier les écarts d’appétence sportive relative entre les deux sous-groupes avec une rigueur statistique indiscutable.
10. Validation de l’indépendance statistique et tests d’inférence sous Excel
10.1 Calcul des effectifs théoriques sous hypothèse d’indépendance
La simple constatation d’écarts entre les probabilités conditionnelles observées et les probabilités marginales globales ne suffit pas à conclure formellement à une dépendance stochastique réelle au sein de la population parente. Ces variations peuvent être la manifestation de simples fluctuations d’échantillonnage aléatoires. Pour statuer scientifiquement sur cette indépendance, il est indispensable de confronter la matrice empirique observée à une matrice théorique d’indépendance.
Sous l’hypothèse nulle d’indépendance stochastique (notée H0), la fréquence conjointe théorique attendue pour chaque cellule à l’intersection de la ligne i et de la colonne j, désignée par eij, est rigoureusement proportionnelle au produit de leurs marges respectives :
eij = (Total_Lignei × Total_Colonnej) / Grand_Total
Dans la feuille Excel hébergeant notre cas d’étude, l’analyste crée une matrice miroir dédiée aux effectifs théoriques. Si la marge masculine (130) réside en E4, la marge du baseball (68) en B7 et le grand total (300) en E7, l’effectif théorique attendu pour la cellule Homme ∩ Baseball s’évalue dans la cellule correspondante via la formule d’ancrage semi-absolu :
=($E4*B$7)/$E$7
L’étirement de cette formule à travers l’ensemble des cellules produit les effectifs théoriques attendus sous l’hypothèse d’absence totale d’association entre le genre et le choix de la discipline sportive.
Avant de procéder à tout test inférentiel, il convient d’effectuer le contrôle de Cochran : la totalité des effectifs théoriques eij ainsi calculés doivent impérativement être supérieurs ou égaux à 5. Si cette condition de régularité asymptotique n’était pas remplie, le test paramétrique du Chi-deux perdrait de sa validité statistique, requérant une fusion préalable des modalités contiguës ou le recours au test exact de Fisher.
10.2 Mise en œuvre du test du Chi-deux d’indépendance
La quantification de la divergence globale entre les fréquences empiriques observées (notées Oij) et les fréquences théoriques attendues (notées Eij) s’effectue par l’entremise de la statistique de test du Chi-deux de Pearson (χ²). La métrique d’écart quadratique réduit se formalise selon la sommation double :
χ² = ∑ [ (Oij – Eij)² / Eij ]
Au sein d’Excel, cette procédure d’inférence est automatisée par la fonction native TEST.KHIDEUX. Cette fonction court-circuite le calcul manuel des écarts quadratiques intermédiaires en prenant directement pour arguments la plage des valeurs observées et la plage des valeurs théoriques :
=TEST.KHIDEUX(B4:D5; B11:D12)
Pour auditer de manière transparente chaque étape de la statistique de test, l’analyste peut générer une troisième matrice matricielle calculant les contributions individuelles au Chi-deux par la formule : =(B4-B11)^2/B11, puis sommer l’ensemble des résidus via la fonction SOMME. Le degré de liberté (ddl) associé à la table de contingence bivariée se calcule par la règle combinatoire :
ddl = (Nombre_de_Lignes – 1) × (Nombre_de_Colonnes – 1) = (2 – 1) × (3 – 1) = 2
10.3 Interprétation de la p-value et impact sur les probabilités conditionnelles
La valeur retournée par la fonction TEST.KHIDEUX correspond à la probabilité asymptotique de signification, universellement désignée sous le terme de p-value. Cette grandeur probabiliste quantifie la plausibilité d’observer des divergences de contingence au moins aussi extrêmes que celles mesurées empiriquement, sous l’hypothèse théorique où les deux variables qualitatives seraient parfaitement indépendantes dans la population parente.
Cette p-value doit être rigoureusement confrontée au seuil de risque d’erreur de première espèce préétabli, désigné par la lettre grecque alpha (α), fixé conventionnellement dans la littérature académique à 0,05 (soit 5%) :
- Si la p-value > 0,05 : l’hypothèse nulle d’indépendance stochastique ne peut être rejetée. Les écarts mesurés entre P(Discipline | Genre) et les probabilités marginales P(Discipline) doivent être considérés comme des artéfacts d’échantillonnage aléatoires dépourvus de signification statistique.
- Si la p-value ≤ 0,05 : l’hypothèse nulle d’indépendance est formellement rejetée au profit de l’hypothèse alternative de dépendance stochastique. L’effet de conditionnement est statistiquement validé.
Dans l’éventualité d’une dépendance avérée, l’analyste complète le diagnostic inférentiel en calculant la force de l’association via le coefficient du V de Cramér. Ce coefficient normalisé s’évalue dans la feuille Excel à l’aide de l’expression :
=RACINE(Valeur_Chi2 / (N * (MIN(Lignes; Colonnes) – 1)))
Cette mesure d’intensité, comprise strictement entre 0 (indépendance absolue) et 1 (dépendance fonctionnelle déterministe), atteste de la magnitude réelle de la relation conditionnelle modélisée.
11. Visualisation graphique des probabilités conditionnelles
11.1 Création d’histogrammes empilés à 100%
La communication visuelle de distributions probabilistes conditionnelles exige des représentations graphiques capables de refléter la normalisation unitaire de l’univers conditionné. Les diagrammes en barres conventionnels ou les histogrammes groupés s’avèrent fréquemment trompeurs, car ils juxtaposent des effectifs absolus sans révéler la distorsion proportionnelle inhérente au conditionnement.
Le vecteur graphique le plus rigoureux pour matérialiser les distributions conditionnelles univariées sous Excel réside dans l’Histogramme empilé 100% (accessible via le ruban Insertion > Graphiques de colonnes ou de barres > Histogramme empilé 100%). Cette typologie de rendu étire uniformément chaque barre verticale jusqu’à un plafond géométrique identique de 100%, segmentant ensuite la hauteur totale en bandes colorées proportionnelles aux probabilités conditionnelles respectives de chaque modalité dépendante.
L’exactitude sémiologique de ce graphique repose sur l’orientation choisie lors de la sélection des données (fonction Intervertir les lignes et les colonnes). Si la condition étudiée est le Genre, l’axe horizontal des abscisses doit afficher distinctement les modalités « Homme » et « Femme ». Dès lors, la segmentation interne de chaque barre représente graphiquement la probabilité conditionnelle P(Discipline | Genre). L’adjonction systématique d’étiquettes de données formatées en pourcentage au centre des segments parachève le graphique en assurant une lecture analytique immédiate.
11.2 Diagrammes de surfaces et graphiques de Mosaïque (Marimekko)
Bien que l’histogramme empilé à 100% visualise avec exactitude les probabilités conditionnelles locales, il occulte délibérément une dimension statistique critique : l’importance relative de la probabilité marginale conditionnante P(B). Une probabilité conditionnelle de 80% calculée sur une sous-population marginale ne pesant que 1% de l’échantillon global présente une portée décisionnelle radicalement disjointe d’un ratio équivalent appliqué à un sous-groupe représentant 60% des observations.
Pour surmonter cette lacune dimensionnelle, le graphique de mosaïque (couramment appelé graphique Marimekko) s’érige en instrument de visualisation probabiliste par excellence. Dans cette représentation bidimensionnelle avancée, la largeur de chaque colonne est strictement proportionnelle à la probabilité marginale conditionnante P(Bj), tandis que la hauteur des subdivisions internes au sein de chaque colonne reflète la probabilité conditionnelle P(Ai | Bj).
La surface d’un rectangle élémentaire donné correspond au produit direct de sa largeur par sa hauteur, matérialisant visuellement la probabilité conjointe : Surface = P(B) × P(A|B) = P(A ∩ B). Bien qu’Excel ne propose pas nativement de modèle Marimekko en un clic dans ses versions historiques, il est aisé d’en concevoir une émulation rigoureuse en exploitant les graphiques de Surfaces empilées ou en détournant des diagrammes d’aires à coordonnées proportionnelles basés sur une table de cumul marginal échelonnée.
11.3 Mise en forme conditionnelle des matrices de probabilité
Pour faciliter l’exploration exploratoire rapide de tables de contingence denses comportant de multiples modalités croisées, l’application de règles de mise en forme conditionnelle dynamiques procure un gain d’intelligibilité majeur. Cette approche permet de transformer une grille numérique austère en une matrice thermique stochastique intuitive.
La méthode analytique préconisée repose sur l’application d’une échelle de nuances tricolores (accessible via Accueil > Mise en forme conditionnelle > Nuances de couleurs). Les teintes doivent être calibrées sur les percentiles ou sur des valeurs de déviation standard calculées par rapport à la moyenne marginale attendue sous hypothèse d’indépendance. Les cellules affichant une sur-représentation conditionnelle par rapport à la moyenne sont mises en exergue par des tonalités chaudes (chromatisme vert ou ambré), tandis que les sous-représentations sont signalées par des teintes froides.
Il est impératif d’observer une discipline ergonomique stricte dans la configuration de ces règles pour respecter les standards de publication scientifique :
- Éviter les saturations chromatiques excessives susceptibles de saturer l’attention cognitive de l’utilisateur ou d’altérer la lisibilité des chiffres.
- Appliquer la mise en forme de manière directionnelle : si l’analyse porte sur P(Ligne | Colonne), le gradient de couleur doit être appliqué colonne par colonne indépendamment, et non de façon globale sur l’ensemble de la matrice, afin de préserver la signification stochastique locale du conditionnement.
12. Diagnostic des anomalies, pièges courants et bonnes pratiques d’audit
12.1 Évitement des confusions d’inversion et de conditionnement
L’erreur la plus prévalente et dommageable observée dans les classeurs décisionnels réside dans la confusion intellectuelle et algorithmique entre l’événement cible et l’événement conditionnant. Cette inversion, fréquemment commise lors de l’écriture des quotients sous Excel, inverse le numérateur et le dénominateur de référence, attribuant à la condition les propriétés de la variable dépendante.
Pour prévenir cette bévue lors de la phase de conception, l’analyste doit instaurer un protocole d’ancrage sémantique systématique : identifier sans ambiguïté quelle variable constitue le signal contextuel avéré (l’ancrage servant de diviseur). Tout calcul de probabilité conditionnelle doit être validé par un test d’intégrité marginale : la sommation des probabilités conditionnelles calculées pour l’ensemble des modalités exhaustives d’un événement cible A sous une condition fixe B doit être rigoureusement égale à l’unité :
∑i P(Ai | B) = 1,00
Si la sommation transversale le long de l’axe conditionnant renvoie un résultat divergent de 100%, l’analyste est formellement en présence d’une erreur d’inversion directionnelle. La mise en place de cellules de contrôle périphérique intégrant des formules de test logique du type =SI(ARRONDI(SOMME(plage_conditionnelle);4)=1; « OK »; « ANOMALIE D’INVERSION ») s’impose comme une bonne pratique de gouvernance de données.
12.2 Gestion des échantillons réduits et du paradoxe de Simpson
L’évaluation aveugle de probabilités conditionnelles sur des jeux de données agrégés expose le modélisateur au redoutable paradoxe de Simpson. Ce phénomène statistique contre-intuitif se manifeste lorsqu’une tendance observée de manière constante au sein de plusieurs sous-groupes indépendants s’inverse totalement lorsque les données sont fusionnées et analysées de manière globale.
Sous Excel, ce paradoxe émerge typiquement lorsqu’une variable confondante non observée (ou variable latente) est corrélée à la fois avec la variable conditionnante et avec la variable dépendante. Par exemple, une politique de traitement médical peut afficher une probabilité conditionnelle de guérison supérieure pour le traitement X par rapport au traitement Y chez les hommes d’une part, et chez les femmes d’autre part, mais faire apparaître une supériorité trompeuse du traitement Y lorsque l’ensemble des patients est amalgamé sans stratification.
Pour diagnostiquer et circonscrire ce risque d’aberration inférentielle, l’analyste doit :
- Déployer des analyses de contingence stratifiées à trois voies en intégrant une dimension de regroupement supplémentaire dans les Tableaux Croisés Dynamiques (en insérant la variable confondante suspecte dans la zone des Filtres ou des Colonnes secondaires).
- Refuser systématiquement l’extrapolation de probabilités conditionnelles dérivées d’échantillons marginaux restreints (n < 30), car l’extrême volatilité stochastique inhérente aux lois de petits nombres génère des distorsions statistiques majeures.
12.3 Protocoles d’audit et robustesse des modèles de calcul
L’industrialisation d’un modèle stochastique sous Microsoft Excel exige l’adoption d’une méthodologie d’assurance qualité rigoureuse visant à prémunir le système contre les altérations accidentelles et les régressions algorithmiques. La première composante de ce protocole réside dans l’exploitation intensive des outils d’audit natifs intégrés au ruban Formules.
L’activation des commandes Repérer les antécédents et Repérer les dépendants trace graphiquement des flèches directionnelles sur la feuille de calcul, matérialisant avec une clarté optique absolue les liaisons de dépendance cellulaire. Cet audit visuel permet de vérifier instantanément si le dénominateur d’une formule conditionnelle pointe bien vers la marge appropriée et non vers une cellule de contingence interne ou vers le grand total général. En complément, l’utilitaire Évaluer la formule autorise une exécution pas-à-pas des sous-expressions imbriquées, révélant d’éventuels décalages d’indices ou des calculs de puissances parasites.
Enfin, la résilience opérationnelle du classeur nécessite le verrouillage physique des composants mathématiques essentiels. Les cellules hébergeant les formules de probabilités élémentaires, les matrices de contingence théoriques et les ratios bayésiens doivent être explicitement verrouillées (via l’onglet Format de cellule > Protection), puis la feuille de calcul doit être protégée par mot de passe via l’outil Révision > Protéger la feuille. Ce confinement fonctionnel interdit aux utilisateurs non accrédités de modifier, déplacer ou écraser par inadvertance les structures d’adressage matricielles, pérennisant ainsi la rigueur, l’intégrité et la reproductibilité des analyses stochastiques déployées au sein de l’organisation.
Références
- Bayes, T. (1763). An essay towards solving a problem in the doctrine of chances. Philosophical Transactions of the Royal Society of London, 53, 370–418. https://doi.org/10.1098/rstl.1763.0053
- Cochran, W. G. (1954). Some methods for strengthening the common χ² tests. Biometrics, 10(4), 417–451. https://doi.org/10.2307/3001616
- Cramér, H. (1946). Mathematical methods of statistics. Princeton University Press.
- Kolmogorov, A. N. (1956). Foundations of the theory of probability (N. Morrison, Trad.; 2e éd.). Chelsea Publishing Company. (Ouvrage original publié en allemand en 1933 sous le titre Grundbegriffe der Wahrscheinlichkeitsrechnung).
- Microsoft Corporation. (2024). Fonctions Excel (par catégorie). Support Microsoft. https://support.microsoft.com/fr-fr/office/fonctions-excel-par-cat%C3%A9gorie-5f91f4e9-7b42-46d2-9bd1-63f26a86c0eb
- National Institute of Standards and Technology. (2012). NIST/SEMATECH e-handbook of statistical methods: Chi-square goodness-of-fit test. U.S. Department of Commerce. https://www.itl.nist.gov/div898/handbook/eda/section3/eda35f.htm
- Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, 50(302), 157–175. https://doi.org/10.1080/14786440009463897
- Simpson, E. H. (1951). The interpretation of interaction in contingency tables. Journal of the Royal Statistical Society: Series B (Methodological), 13(2), 238–241. https://doi.org/10.1111/j.2517-6161.1951.tb00088.x
- Stanford Encyclopedia of Philosophy. (2021). Interpretations of probability. Metaphysics Research Lab, Stanford University. https://plato.stanford.edu/entries/probability-interpret/