
Dans le champ contemporain de la psychologie quantitative, des neurosciences comportementales et de l’épidémiologie clinique, l’analyse des données binaires constitue l’un des piliers méthodologiques les plus critiques pour la recherche empirique. Qu’il s’agisse d’évaluer la rémission d’un trouble anxieux après une psychothérapie, d’analyser le taux de rechute dans les addictions ou de quantifier la réussite à une épreuve neuropsychologique complexe, les chercheurs se heurtent continuellement à la nécessité de modéliser des événements dichotomiques. Deux métriques fondamentales dominent cette démarche analytique : le rapport de cotes (communément désigné sous l’anglicisme Odds Ratio ou OR) et le risque relatif (RR). Bien que ces deux indicateurs partagent l’objectif commun de quantifier la force d’une association entre une exposition et une issue, leurs fondements probabilistes, leurs propriétés d’échantillonnage et leurs cadres d’interprétation diffèrent fondamentalement.
Malgré l’avènement de progiciels statistiques spécialisés tels que R, SPSS, SAS ou Stata, Microsoft Excel demeure un outil incontournable au sein des laboratoires universitaires, des équipes hospitalières et des cabinets d’études cliniques. Son ubiquité, sa transparence algorithmique totale et sa flexibilité matricielle font du tableur un environnement pédagogique et professionnel exceptionnel. Loin d’être une simple calculatrice de bureau, Excel permet, lorsqu’il est manié avec rigueur méthodologique, de construire des modèles computationnels robustes, reproductibles et immédiatement vérifiables pour l’estimation ponctuelle et inférentielle des tailles d’effet dichotomiques.
Ce guide exhaustif a pour vocation d’exposer l’intégralité des fondements théoriques, des dérivations mathématiques et des procédures d’implémentation pratique sous Excel nécessaires au calcul irréprochable de l’Odds Ratio, du Risque Relatif, de leurs intervalles de confiance asymptotiques à 95 % respectifs et des tests d’indépendance associés. Destiné aux psychologues chercheurs, aux cliniciens et aux étudiants de cycles supérieurs, ce manuel opérationnel allie exigences épistémologiques et syntaxes algorithmiques avancées pour transformer le tableur en une véritable plateforme d’analyse biostatistique conforme aux standards académiques internationaux les plus rigoureux.
1. Introduction théorique : Fondements de l’Odds Ratio et du Risque Relatif en psychologie quantitative
1.1 Définition et rôle des mesures d’association en recherche comportementale
La quantification des relations empiriques dans les sciences du comportement repose traditionnellement sur la recherche de corrélations ou de différences de moyennes. Toutefois, une part substantielle des phénomènes psychologiques et cliniques ne s’exprime pas sur une échelle continue, mais se manifeste par l’apparition ou l’absence d’un état discret : rémission clinique versus persistance symptomatique, abandon précoce d’une thérapie versus maintien dans le protocole, échec versus succès à un paradigme expérimental d’inhibition cognitive. Dans ce contexte, les chercheurs doivent employer des mesures d’association non linéaires adaptées à des variables catégorielles binaires, capables de capturer l’ampleur de la liaison statistique entre une condition d’exposition et l’avènement de l’événement cible.
L’application directe de ces métriques concerne une multiplicité de devis de recherche : devis expérimentaux randomisés contrôlés (RCT), protocoles quasi-expérimentaux évaluant des programmes médico-sociaux, et études observationnelles prospectives ou transversales. Contrairement au coefficient de corrélation de Bravais-Pearson, qui postule la normalité bivariée et une relation linéaire entre deux variables métriques continues, l’évaluation du risque binaire opère directement sur des distributions de probabilités discrètes fondées sur la loi binomiale. Cette distinction est fondamentale : elle permet d’estimer non pas une intensité de co-variation le long d’un continuum, mais la modification structurelle de la vraisemblance d’un événement induite par la présence d’un facteur prédicteur.
Dans cette perspective, le recours à un tableur accessible tel que Microsoft Excel prend tout son sens. Si les logiciels spécialisés automatisent entièrement les chaînes de traitement statistique, ils agissent souvent comme des « boîtes noires » occultant les étapes de transformation algébrique. L’élaboration pas à pas des algorithmes de calcul sous Excel favorise une compréhension conceptuelle approfondie des estimateurs, tout en garantissant la reproductibilité analytique au sein d’une structure matricielle transparente, universellement partagée et vérifiable par l’ensemble des pairs évaluateurs.
1.2 Évolution historique et fondements épidémiologiques appliqués aux sciences sociales
L’histoire de l’Odds Ratio et du Risque Relatif plonge ses racines dans les travaux fondateurs de l’épidémiologie du XXe siècle, notamment marqués par les recherches de Sir Austin Bradford Hill et Richard Doll sur l’étiologie du carcinome pulmonaire lié au tabagisme, ainsi que par les théorisations statistiques majeures de Jerome Cornfield en 1951. Cornfield a démontré une propriété mathématique cruciale : lorsque la prévalence d’une maladie est faible au sein de la population générale, le rapport des cotes observé dans une enquête rétrospective constitue une approximation analytiquement exacte du risque relatif de la population source. Cette percée a permis à l’Odds Ratio de s’imposer comme la pierre angulaire des études rétrospectives cas-témoins en médecine.
Progressivement, ces outils d’inférence probabiliste ont essaimé vers la psychopathologie, la psychologie clinique et la psychologie du travail. Les chercheurs en santé mentale ont adopté l’Odds Ratio pour quantifier l’impact de traumatismes infantiles sur l’émergence ultérieure de troubles dissociatifs ou dépressifs majeurs, tandis que la psychologie organisationnelle s’en est emparée pour modéliser le risque de burnout ou d’accident du travail selon les configurations ergonomiques et le climat managérial. Cette transition vers les sciences sociales a toutefois exigé un renforcement de la vigilance épistémologique. Les phénomènes comportementaux étant multifactoriels et caractérisés par une forte hétérogénéité contextuelle, le transfert direct des méthodes biomédicales impose de respecter scrupuleusement la distinction entre association statistique et inférence causale.
L’exigence d’une rigueur computationnelle absolue s’avère d’autant plus aiguë que les erreurs de modélisation dans les sciences humaines conduisent fréquemment à des confusions préjudiciables entre cote et probabilité. La transposition non régulée de concepts épidémiologiques au domaine psychologique a parfois nourri des surévaluations dramatiques de l’efficacité de certains traitements ou de la toxicité de facteurs de risque, soulignant la nécessité d’un ancrage formel dans la mécanique statistique des tableaux de contingence.
1.3 Critères de sélection méthodologique entre Risque Relatif et Odds Ratio
Le choix d’orienter une modélisation statistique vers le Risque Relatif ou vers l’Odds Ratio ne dépend pas des préférences subjectives de l’analyste, mais des contraintes logiques et méthodologiques intrinsèques au devis d’échantillonnage employé. Dans une étude de cohorte prospective ou un essai clinique randomisé longitudinal, le chercheur sélectionne initialement des participants sains ou contrôlés, les assigne à des conditions d’exposition ou de traitement, puis dénombre les nouveaux cas au fil du temps. Dans cette configuration, le nombre total d’individus à risque au sein de chaque strate est parfaitement maîtrisé et connu, ce qui autorise le calcul direct de l’incidence cumulative et, par voie de conséquence, l’estimation valide du Risque Relatif.
À l’inverse, dans une étude rétrospective de type cas-témoins (case-control study), les participants sont recrutés sur la base de leur statut final : le groupe des « cas » présente le trouble psychologique étudié, tandis que le groupe des « témoins » en est indemne. Le ratio entre le nombre de cas et le nombre de témoins est fixé arbitrairement par le protocole de recherche de l’investigateur (par exemple, un cas pour deux témoins appariés). En conséquence, le taux d’incidence global dans l’échantillon ne reflète en rien l’incidence réelle du trouble au sein de la population générale. Le calcul du Risque Relatif est alors formellement interdit et mathématiquement dénué de sens, car les dénominateurs des risques marginaux sont biaisés par construction. L’Odds Ratio devient alors l’unique indicateur d’association non biaisé exploitable, en vertu de son invariance par rapport à la méthode d’échantillonnage rétrograde.
Un autre déterminant méthodologique réside dans « l’hypothèse de l’événement rare » (rare event assumption). Si la proportion d’individus développant l’issue d’intérêt demeure inférieure à 10 % dans l’ensemble des groupes, les valeurs de l’Odds Ratio et du Risque Relatif convergent de manière asymptotique vers une quasi-équivalence numérique. Cependant, dès lors que l’issue devient fréquente — situation banale lors d’interventions thérapeutiques brèves où les taux de rémission peuvent dépasser 40 % ou 50 % —, l’Odds Ratio s’écarte violemment du Risque Relatif. Un mauvais choix métrique conduit alors le clinicien à surestimer massivement l’effet d’une psychothérapie, en prenant la variation d’une cote pour une modification proportionnelle directe de la probabilité de guérison.
2. La structure de la table de contingence 2×2 : Modélisation conceptuelle sous Excel
2.1 Anatomie conventionnelle d’un tableau croisé 2×2
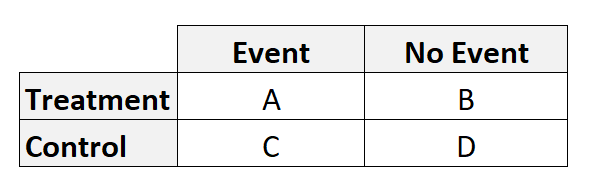
La formalisation rigoureuse d’une analyse d’association binaire commence impérativement par la construction d’une table de contingence à double entrée d’ordre 2×2. Cette table opère une réduction des données individuelles en une matrice d’effectifs croisés, croisant les deux modalités du facteur d’exposition avec les deux modalités de l’issue clinique ou comportementale. Selon les standards internationaux préconisés par l’épidémiologie moderne et la recherche clinique, la nomenclature canonique des quatre cellules s’établit universellement de la manière suivante :
- Cellule A : Effectif des sujets simultanément exposés au facteur de risque (ou engagés dans le groupe d’intervention active) et présentant l’événement d’intérêt (succès, présence du trouble, réponse thérapeutique).
- Cellule B : Effectif des sujets exposés au facteur de risque (ou engagés dans le groupe d’intervention active) ne présentant pas l’événement d’intérêt (échec, absence du trouble, non-réponse).
- Cellule C : Effectif des sujets non-exposés (ou membres du groupe témoin/placebo) présentant l’événement d’intérêt.
- Cellule D : Effectif des sujets non-exposés (ou membres du groupe témoin/placebo) ne présentant pas l’événement d’intérêt.
Cette disposition impose de situer les groupes d’exposition sur les lignes horizontales et les statuts de l’issue sur les colonnes verticales. L’architecture est complétée par le calcul systématique des totaux marginaux. La somme marginale de la première ligne correspond à l’ensemble du groupe exposé, noté n1 = A + B, tandis que la marge de la seconde ligne représente l’effectif du groupe témoin, noté n0 = C + D. Sur le plan vertical, la marge de la première colonne correspond au total des événements observés, soit m1 = A + C, et la marge de la seconde colonne quantifie l’absence globale de l’événement, soit m0 = B + D. La somme scalaire totale de l’échantillon sous observation est définie par N = A + B + C + D.
2.2 Normalisation des libellés et prévention des inversions de cellules
L’une des sources d’erreurs les plus prévalentes et dévastatrices dans l’analyse computationnelle sous tableur réside dans l’inversion par inadvertance des axes ou des catégories au sein de la table 2×2. Une interversion entre les lignes (placer le groupe témoin sur la première rangée) ou entre les colonnes (positionner l’absence d’événement avant l’apparition de l’événement) entraîne une inversion arithmétique réciproque immédiate des estimateurs : l’Odds Ratio calculé devient égal à 1 / OR_réel. Une telle interversion transforme fallacieusement un traitement thérapeutique hautement protecteur en un protocole iatrogène potentiellement létal, ou un facteur de vulnérabilité psychopathologique majeur en un facteur de résilience artificielle.
Pour immuniser les feuilles de calcul contre cette dérive opérationnelle, le statisticien doit instaurer un protocole de normalisation textuelle stricte des en-têtes dès la phase de saisie. Les catégories binaires doivent être encodées de manière univoque selon le paradigme booléen standard : la valeur numérique 1 (ou l’étiquette explicite « Événement Présent » / « Cas ») doit impérativement gouverner la première colonne de données, tandis que la valeur 0 (« Événement Absent » / « Non-Cas ») doit occuper la seconde colonne. De même, pour les lignes, l’intervention expérimentale ou l’exposition active doit être codée 1 sur la ligne supérieure, le groupe contrôle ou la situation de référence recevant la valeur 0 sur la rangée inférieure.
Il est vivement conseillé de verrouiller visuellement ces en-têtes dans Excel en inscrivant des descripteurs longs et dénués d’ambiguïté au lieu de simples notations algébriques. Des libellés tels que « Nouveau Traitement (Exposés) » et « Traitement Standard (Témoins) » pour les lignes, croisés avec « Rémission Thérapeutique (Succès) » et « Absence de Rémission (Échec) » pour les colonnes, fournissent une barrière cognitive robuste contre les erreurs de référencement croisé lors de la programmation des équations d’estimation.
2.3 Cas d’usage : Étude de l’impact d’une intervention cognitive sur la réussite d’un test
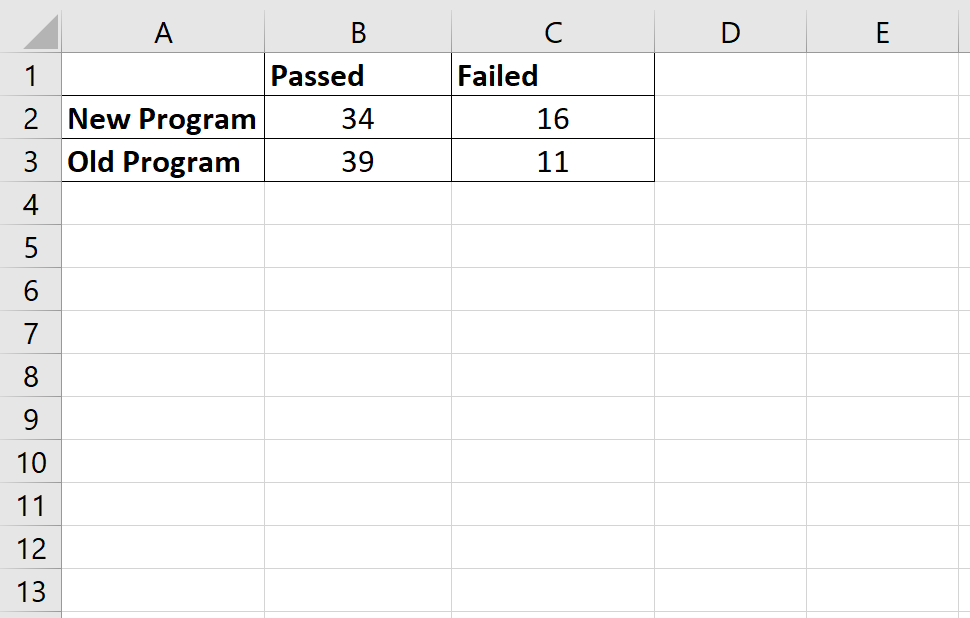
Afin d’ancrer l’ensemble des modélisations mathématiques et des formules Excel de ce guide dans une réalité empirique concrète, nous considérerons tout au long des sections suivantes un devis quasi-expérimental issu de la psychologie cognitive appliquée. Une équipe de chercheurs évalue l’efficacité d’un nouveau programme d’entraînement de la mémoire de travail destiné à améliorer le taux de réussite à un test standardisé de raisonnement logique de haut niveau.
Le protocole comporte un échantillon total de 100 étudiants de premier cycle universitaire, assignés de manière équiprobable et indépendante à deux conditions expérimentales distinctes (taille d’échantillon totale N = 100) :
- Un groupe expérimental composé de 50 participants (n1 = 50) soumis au « Nouveau programme d’entraînement cognitif ».
- Un groupe témoin composé de 50 participants (n0 = 50) soumis à l’« Ancien programme pédagogique standard ».
À l’issue de la phase d’apprentissage, l’épreuve de raisonnement logique binaire (Sanctionnée par la mention Succès ou Échec) révèle les résultats empiriques suivants : dans le groupe expérimental (Nouveau programme), 34 participants réussissent le test et 16 échouent. Dans le groupe témoin (Ancien programme), 39 participants réussissent le test et 11 échouent. La formalisation matricielle au sein de notre table 2×2 sous Excel s’établit donc avec les fréquences observées : Cellule A = 34, Cellule B = 16, Cellule C = 39, et Cellule D = 11. Ce cas d’usage servira de banc d’essai numérique direct pour le déploiement comparatif de nos calculs d’Odds Ratio, de Risque Relatif et de leurs intervalles de dispersion statistique.
3. Formulations mathématiques fondamentales : Odds Ratio contre Risque Relatif
3.1 Formalisation mathématique de l’Odds Ratio (Rapport de Cotes)
Pour conceptualiser rigoureusement l’Odds Ratio, il convient en premier lieu de définir la notion de « cote » (ou odds en anglais), concept issu de la théorie des jeux probabilistes. La cote d’un événement correspond au rapport entre la probabilité que cet événement survienne et la probabilité complémentaire qu’il ne survienne pas. Si p désigne la probabilité d’occurrence d’un phénomène, la cote w associée s’exprime formellement par la relation :
w = p / (1 – p)
Dans le cadre structurel de notre table de contingence 2×2, la probabilité d’observer l’événement dans le groupe exposé est estimée empiriquement par la proportion conditionnelle p1 = A / (A + B), et la probabilité de non-événement par 1 – p1 = B / (A + B). Dès lors, la cote de succès au sein du groupe exposé s’établit par le quotient direct :
Cote_exposés = [A / (A + B)] / [B / (A + B)] = A / B
Selon une démarche parfaitement analogue, la cote d’apparition de l’événement au sein du groupe témoin non-exposé est formalisée par :
Cote_témoins = [C / (C + D)] / [D / (C + D)] = C / D
L’Odds Ratio (OR) est défini comme le rapport entre ces deux cotes d’occurrence conditionnelles. Par une simplification algébrique immédiate des fractions superposées, nous dérivons la célèbre formule du produit croisé :
OR = (Cote_exposés) / (Cote_témoins) = (A / B) / (C / D) = (A * D) / (B * C)
L’une des propriétés fondamentales de l’Odds Ratio réside dans sa symétrie multiplicative. Lorsque l’association est parfaitement nulle (absence totale d’effet de l’exposition), la valeur de l’OR est rigoureusement égale à 1,00. Lorsque l’exposition décuple la cote de survenue de l’issue, l’OR tend vers des valeurs positives supérieures à 1, s’étendant théoriquement jusqu’à l’infini positif. En revanche, lorsque l’exposition réduit la cote de survenue (effet protecteur), l’OR se comprime dans l’intervalle fini ]0 ; 1[. Cette asymétrie d’échelle d’origine impose le recours à une transformation logarithmique népérienne, ln(OR), pour rétablir une symétrie arithmétique parfaite centrée sur zéro.
3.2 Formalisation mathématique du Risque Relatif (Rapport de Risques)
Le concept de Risque Relatif repose sur une intuition statistique distincte, adossée au concept épidémiologique de « probabilité cumulée », également dénommée « risque absolu » ou « incidence cumulative ». Le risque absolu mesure simplement la fréquence relative observée d’un événement au sein d’une population définie sur un intervalle temporel circonscrit. Contrairement à la cote, qui compare le nombre d’événements au nombre de non-événements, le risque absolu rapporte le nombre d’événements au nombre total de personnes soumises au risque d’apparition de cet événement.
En reprenant la nomenclature de notre matrice de données, le risque absolu associé au groupe exposé, désigné par R1, correspond à la proportion d’individus ayant manifesté l’événement par rapport à la taille totale de cette cohorte exposée :
R1 = A / (A + B)
De manière symétrique, le risque absolu caractéristique du groupe de référence ou témoin, désigné par R0, est formulé par le ratio :
R0 = C / (C + D)
Le Risque Relatif (RR) représente le quotient simple de ces deux probabilités conditionnelles :
RR = R1 / R0 = [A / (A + B)] / [C / (C + D)]
Le Risque Relatif exprime ainsi le facteur multiplicatif par lequel la probabilité brute de survenue de l’événement est altérée par l’appartenance au groupe exposé comparativement au groupe témoin. Tout comme l’OR, une valeur de RR égale à 1,00 signe une parfaite indépendance statistique entre l’exposition et l’issue. Un RR supérieur à 1 indique une élévation proportionnelle du risque d’apparition, alors qu’un RR inférieur à 1 quantifie une réduction relative de cette probabilité.
Toutefois, la manipulation mathématique du Risque Relatif présente des bornes structurelles strictes. Alors que la cote d’un événement peut croître sans limite à mesure que la probabilité se rapproche de 1 (lorsque p = 0,99, l’odds est égal à 99), le risque absolu est mathématiquement plafonné à l’unité (1,00). Par conséquent, la valeur maximale que peut atteindre le Risque Relatif dépend directement du risque de base du groupe témoin : RR_max = 1 / R0. Cette propriété algébrique limite grandement son comportement asymptotique lors de la modélisation statistique avancée.
3.3 Comparaison directe des comportements asymptotiques des deux indicateurs
L’analyse comparative approfondie des fonctions de calcul de l’Odds Ratio et du Risque Relatif met en lumière les conditions de divergence mathématique entre ces deux grandeurs. En examinant formellement l’expression du rapport entre les deux métriques, nous pouvons isoler le facteur de distorsion mathématique qui les relie :
OR / RR = [(A * D) / (B * C)] / [(A / (A + B)) / (C / (C + D))] = [(A + B) / B] / [(C + D) / D] = (1 + Cote_exposés) / (1 + Cote_témoins)
Une formulation algébrique alternative très éclairante exprime directement l’Odds Ratio en fonction du Risque Relatif et du taux d’incidence de base au sein du groupe témoin (R0) :
OR = RR * [(1 – R0) / (1 – R1)] = RR * [(1 – R0) / (1 – (RR * R0))]
Cette relation démontre formellement que lorsque l’événement étudié est très rare au sein de la population générale, c’est-à-dire lorsque les risques absolus R1 et R0 tendent simultanément vers zéro, les termes (1 – R0) et (1 – R1) tendent tous deux vers 1. Dans cette situation limite asymptotique :
lim_(R0, R1 -> 0) (OR / RR) = 1 => OR ≈ RR
En revanche, dès que la prévalence marginale de l’issue clinique dépasse le seuil critique conventionnel de 10 % (soit R0 > 0,10), cette approximation s’effondre. Lorsque l’effet est positif (RR > 1), l’Odds Ratio diverge vers le haut et présente une valeur systématiquement plus éloignée de l’unité que le Risque Relatif (OR > RR > 1). Inversement, lorsque l’exposition induit un effet protecteur (RR < 1), l’Odds Ratio s’éloigne également plus fortement de la valeur nulle en plongeant vers zéro (OR < RR < 1). L’Odds Ratio a donc pour propriété mathématique intrinsèque d’exagérer l’ampleur perçue de l’effet dès lors que l’événement d’intérêt cesse d’être exceptionnel, ce qui impose d’exercer un discernement absolu lors de la communication scientifique de ces résultats.
4. Préparation et structuration de la feuille de calcul Excel pour l’analyse statistique
4.1 Architecture optimale du classeur et nommage des plages de cellules
L’obtention d’une analyse statistique irréprochable sous Microsoft Excel requiert une conception architecturale méthodique de la feuille de travail. Il est hautement recommandé de proscrire l’empilement anarchique de formules disparates et d’adopter une organisation modulaire divisée en trois secteurs fonctionnels étanches : la zone d’ingestion des données brutes individuelles, la zone de consolidation matricielle (la table de contingence 2×2 standardisée), et la zone de restitution computationnelle où seront compilés les estimateurs d’effet ponctuel, les erreurs types et les intervalles de confiance.
Pour assurer une maintenabilité maximale et éliminer les risques d’erreurs de pointage lors de la rédaction de formules imbriquées complexes, l’utilisation du Gestionnaire de noms d’Excel est impérative. Au lieu de référencer des adresses relatives telles que B4 ou C5, nous attribuerons systématiquement des étiquettes sémantiques formelles aux quatre cellules névralgiques de la table de contingence :
- Attribuer le nom Cellule_A à la cellule hébergeant l’effectif des exposés avec événement.
- Attribuer le nom Cellule_B à la cellule hébergeant l’effectif des exposés sans événement.
- Attribuer le nom Cellule_C à la cellule hébergeant l’effectif des témoins avec événement.
- Attribuer le nom Cellule_D à la cellule hébergeant l’effectif des témoins sans événement.
En parallèle, l’usage des références absolues (verrouillage par le symbole dollar, par exemple $B$4) doit être rigoureusement systématisé pour les paramètres invariants de l’analyse (comme le niveau d’erreur alpha fixé à 0,05 ou la valeur critique bilatérale Z de 1,96). Enfin, pour immuniser la feuille contre des incohérences de saisie, il convient de déployer des règles de validation des données (Onglet Données > Outils de données > Validation des données) contraignant les cellules A, B, C et D à n’accepter exclusivement que des nombres entiers strictement positifs ou nuls (supérieurs ou égaux à zéro).
4.2 Agrégation dynamique des données individuelles brutes via les fonctions natives
Dans la plupart des projets de recherche réels, le statisticien ne dispose pas d’emblée d’une table 2×2 pré-agrégée, mais d’une matrice rectangulaire de microdonnées où chaque ligne représente un participant singulier (N = 100 dans notre étude de psychologie cognitive), avec une colonne identifiant le groupe d’appartenance (« Expérimental » vs « Contrôle ») et une seconde colonne codant la réussite (« Succès » vs « Échec »).
Pour convertir de manière fluide et entièrement automatisée ce tableau de données individuelles en table de contingence agrégée, il convient d’exploiter la puissance de la fonction native NB.SI.ENS. Cette fonction exécute un dénombrement conditionnel multicritère sans nécessiter de macros VBA. En supposant que la variable d’exposition soit localisée sur la plage $A$2:$A$101 et la variable d’issue sur la plage $B$2:$B$101, les équations d’alimentation de la table 2×2 s’écrivent :
Pour la Cellule A (Nouveau programme et Succès) :
=NB.SI.ENS($A$2:$A$101; « Nouveau »; $B$2:$B$101; « Succès »)
Pour la Cellule B (Nouveau programme et Échec) :
=NB.SI.ENS($A$2:$A$101; « Nouveau »; $B$2:$B$101; « Échec »)
Pour la Cellule C (Ancien programme et Succès) :
=NB.SI.ENS($A$2:$A$101; « Ancien »; $B$2:$B$101; « Succès »)
Pour la Cellule D (Ancien programme et Échec) :
=NB.SI.ENS($A$2:$A$101; « Ancien »; $B$2:$B$101; « Échec »)
Une alternative tout aussi rigoureuse consiste à insérer un Tableau Croisé Dynamique (TCD) en disposant la variable d’intervention en Lignes, la variable d’issue en Colonnes et l’identifiant du sujet en Valeurs (avec l’agrégat « Nombre »). Une fois la table peuplée, l’intégrité matricielle doit être vérifiée par des formules de sommation marginale via la fonction SOMME, s’assurant que la somme scalaire =SOMME(Cellule_A:Cellule_D) renvoie scrupuleusement la taille totale attendue de l’échantillon N.
4.3 Formatage conditionnel et lisibilité ergonomique des données quantitatives
L’ergonomie visuelle d’un classeur d’analyse quantitative conditionne directement la fiabilité de l’audit scientifique et limite l’émergence d’erreurs d’interprétation cognitive. Une feuille de calcul destinée à la recherche biomédicale ou psychologique doit respecter des règles graphiques sobres et standardisées. Les cellules de données primaires doivent être visuellement distinguées des cellules contenant des formules dérivées à l’aide d’une palette chromatique feutrée (par exemple, un arrière-plan gris très clair pour les intrants modifiables et blanc pur avec bordure fine pour les sorties calculées).
Le formatage numérique doit être ajusté avec précision selon la nature métrique des données affichées. Les effectifs de la table de contingence doivent être rigoureusement formatés sous forme d’entiers stricts, sans décimales. En revanche, les indicateurs statistiques dérivés (Odds Ratio, Risque Relatif, erreurs types logarithmiques et bornes de confiance) requièrent impérativement un format numérique personnalisé fixé à trois ou quatre décimales significatives (Format de cellule > Nombre > Décimales : 3). Une troncature visuelle excessive à une seule décimale est susceptible de masquer des divergences statistiques substantielles lors des conversions exponentielles.
Enfin, la traçabilité de la feuille doit être assurée par l’adjonction de métadonnées documentaires intégrées. L’insertion de « Commentaires » ou de « Notes » explicatives sur les en-têtes de colonnes permet d’indiquer précisément aux relecteurs les définitions opérationnelles des variables, les seuils cliniques retenus et la directionnalité méthodologique des ratios programmés.
5. Implémentation pas-à-pas du calcul de l’Odds Ratio dans Excel
5.1 Calcul de l’Odds Ratio via la méthode des produits croisés
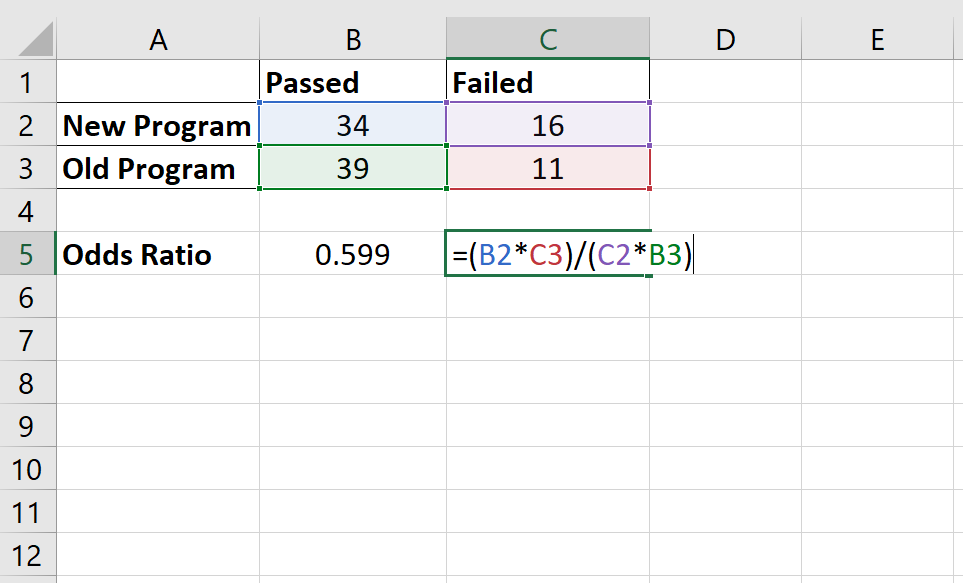
La transcription informatique de la formule des produits croisés sous Excel s’avère particulièrement simple dès lors que la table de contingence a été rigoureusement agencée. En exploitant les variables nommées définies dans notre architecture de classeur, la formule directe de calcul de l’Odds Ratio s’écrit formellement :
=(Cellule_A * Cellule_D) / (Cellule_B * Cellule_C)
En remplaçant les variables par les coordonnées concrètes de notre feuille où la Cellule A correspondrait à B4, la Cellule B à C4, la Cellule C à B5 et la Cellule D à C5, la syntaxe prend la configuration standard suivante :
=(B4 * C5) / (C4 * B5)
Si nous appliquons rigoureusement cette équation aux effectifs empiriques de notre cas pratique en psychologie cognitive (Cellule A = 34, Cellule B = 16, Cellule C = 39, Cellule D = 11), l’évaluation numérique par le moteur d’Excel produit le résultat intermédiaire suivant :
OR = (34 * 11) / (16 * 39) = 374 / 624 ≈ 0,5993589…
Soit, en appliquant un formatage professionnel à trois décimales : 0,599.
Cependant, une implémentation robuste ne saurait se limiter à cette seule opération arithmétique élémentaire. En pratique statistique, il est fréquent qu’une cellule de la table de contingence présente un effectif nul (zéro observation), notamment dans des études exploratoires à petits échantillons. Dans cette configuration, le dénominateur de l’Odds Ratio devient nul (si Cellule B ou Cellule C est égale à zéro), ce qui déclenche immédiatement l’erreur système rédhibitoire #DIV/0! sous Excel, corrompant l’ensemble de la chaîne de calculs dépendants en cascade.
Pour prévenir cette rupture logicielle, l’algorithme doit être systématiquement sécurisé au moyen de la fonction d’interception SIERREUR, couplée le cas échéant à l’application de la correction de continuité standard de Haldane-Anscombe. Cette correction biostatistique éprouvée consiste à ajouter la valeur constante 0,5 à chacune des quatre cellules de la matrice de contingence dès lors qu’un zéro structurel ou d’échantillonnage est détecté. La formulation conditionnelle avancée s’écrit ainsi sous Excel :
=SI(MIN(B4:C5)=0; ((B4+0,5)*(C5+0,5))/((C4+0,5)*(B5+0,5)); (B4*C5)/(C4*B5))
5.2 Décomposition pédagogique : Calcul intermédiaire des cotes partielles
Bien que la formulation par les produits croisés directs soit arithmétiquement la plus condensée, il est hautement profitable, tant sur le plan pédagogique que pour les audits de contrôle scientifique, de décomposer l’algorithme en calculant les cotes conditionnelles intermédiaires dans des cellules autonomes préalablement dédiées.
Dans un premier bloc de cellules, nous programmons le calcul de la cote de succès spécifique aux participants ayant suivi le nouveau programme d’entraînement cognitif (Groupe expérimental) :
=Cellule_A / Cellule_B (Soit : =B4 / C4)
L’évaluation arithmétique nous renvoie la valeur : 34 / 16 = 2,125. Cela signifie que pour un participant engagé dans le nouveau programme, la cote de réussite est de 2,125 contre 1 (il y a 2,125 réussites pour chaque échec constaté).
Dans une seconde cellule dédiée, nous établissons la formule calculant la cote de succès propre aux sujets du groupe témoin (Ancien programme standard) :
=Cellule_C / Cellule_D (Soit : =B5 / C5)
Ce calcul fournit : 39 / 11 ≈ 3,545. Dans le groupe de contrôle traditionnel, la cote de succès s’élève ainsi à 3,545 contre 1.
Enfin, dans une troisième cellule matérialisant l’étape de synthèse, l’Odds Ratio est obtenu en effectuant simplement le quotient des deux cotes partielles calculées en amont :
=Cote_Groupe_Expérimental / Cote_Groupe_Témoin
Numériquement, le calcul 2,125 / 3,54545… restitue très exactement notre valeur précédente de 0,599. Cette décomposition analytique offre une transparence méthodologique totale, permettant aux évaluateurs de vérifier immédiatement la plausibilité interne de chaque composante probabiliste avant la fusion en un ratio unique.
5.3 Traduction analytique et interprétation contextuelle du résultat obtenu
L’obtention d’une valeur numérique brute d’Odds Ratio égale à 0,599 ne prend son sens que par une exégèse sémantique rigoureuse, exempte de tout glissement conceptuel vers le risque absolu. Puisque notre estimateur ponctuel est inférieur à 1,00, nous sommes confrontés à un ratio révélant une baisse de la cote de l’événement dans le groupe expérimental par rapport au groupe témoin.
Pour convertir formellement cet Odds Ratio en une variation proportionnelle relative de la cote, la relation arithmétique standard à programmer dans une cellule connexe est la suivante :
Variation relative de la cote (%) = (OR – 1) * 100
Sous Excel, l’évaluation de =(0,5993589 – 1) * 100 produit précisément le résultat : -40,06 % (soit une diminution d’environ 40,1 %). L’énoncé scientifique exact découlant de ce résultat s’exprime comme suit : « La cote de réussite au test de logique chez les participants ayant suivi le nouveau programme d’entraînement cognitif est inférieure de 40,1 % par rapport à la cote de réussite observée chez les participants ayant suivi l’ancien programme ».
Ce résultat met en lumière une dimension critique de la recherche expérimentale : l’effet observé s’avère contre-intuitif par rapport aux attentes initiales des concepteurs du nouveau programme. Loin d’optimiser les performances intellectuelles, le nouveau protocole d’entraînement est associé à une dégradation statistiquement mesurable de la cote de réussite. Cette constatation démontre l’importance d’une métrique objective : seule une quantification non biaisée de la taille d’effet permet de réfuter scientifiquement l’utilité d’une innovation pédagogique ou clinique a priori prometteuse mais empiriquement préjudiciable.
6. Implémentation pas-à-pas du calcul du Risque Relatif dans Excel
6.1 Écriture syntaxique de l’équation du Risque Relatif
La formalisation du Risque Relatif sous Excel requiert une vigilance syntaxique renforcée quant à la gestion des parenthèses mathématiques, afin de respecter scrupuleusement la priorité des opérateurs arithmétiques. Comme établi dans la modélisation conceptuelle, le Risque Relatif confronte le rapport des probabilités cumulées observées dans chacune des deux strates de participants.
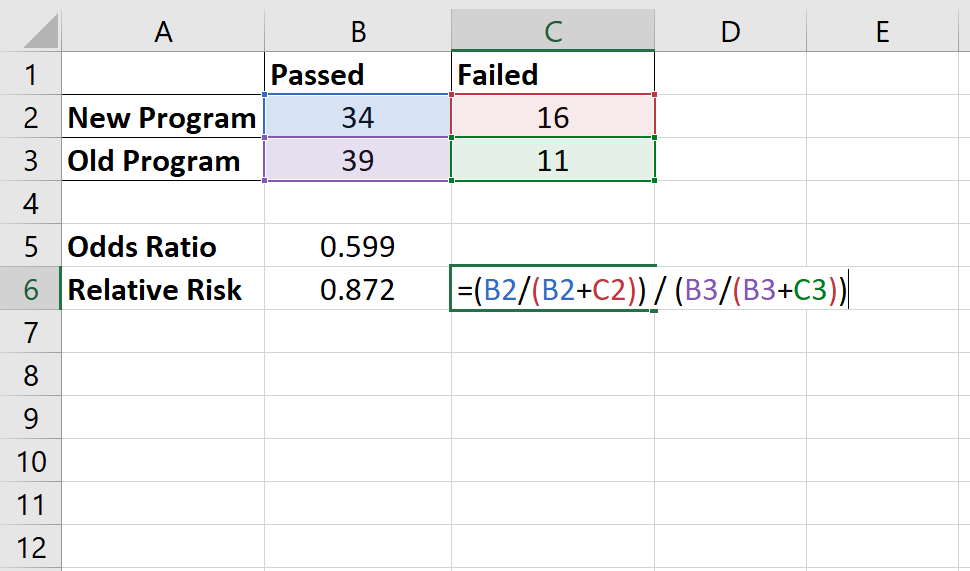
En mobilisant les références conventionnelles de notre table de contingence, où la cellule B4 héberge l’effectif A (34), la cellule C4 l’effectif B (16), la cellule B5 l’effectif C (39) et la cellule C5 l’effectif D (11), la formule condensée du Risque Relatif doit être saisie sous Excel sous la syntaxe stricte suivante :
=(B4 / (B4 + C4)) / (B5 / (B5 + C5))
Une erreur fréquente consiste à omettre les parenthèses enserrant les dénominateurs des sommes marginales, ce qui conduirait Excel à diviser B4 par B4 avant d’ajouter C4, faussant irrémédiablement l’intégralité du calcul matriciel. En décomposant arithmétiquement les termes pour notre cas pratique :
- Le risque absolu de réussite au sein du groupe expérimental s’élève à : R1 = 34 / (34 + 16) = 34 / 50 = 0,680 (soit un taux de réussite de 68,0 %).
- Le risque absolu de réussite au sein du groupe témoin s’établit à : R0 = 39 / (39 + 11) = 39 / 50 = 0,780 (soit un taux de réussite de 78,0 %).
Le Risque Relatif s’obtient alors immédiatement par l’évaluation du quotient de ces deux proportions empiriques :
RR = 0,680 / 0,780 ≈ 0,8717948…
En appliquant notre mise en forme standard à trois décimales, la valeur consolidée du Risque Relatif affichée par Excel est de 0,872.
6.2 Calcul des risques absolus et de la réduction absolue du risque
En recherche translationnelle et en psychologie clinique factuelle, le Risque Relatif ne doit jamais être interprété de manière isolée. Il doit impérativement être complété par l’estimation des métriques d’impact absolu, lesquelles renseignent directement sur l’importance quantitative réelle de l’effet à l’échelle de la cohorte observée. Pour ce faire, notre feuille Excel doit intégrer deux indicateurs complémentaires fondamentaux : la Réduction Absolue du Risque (RAR) et le Nombre de Sujets à Traiter (NNT ou Number Needed to Treat).
La Réduction Absolue du Risque quantifie la différence arithmétique simple entre les deux taux de probabilité. Dans notre scénario où l’issue positive (succès) est moindre dans le groupe d’intervention, la formule de la RAR se programme par la soustraction directe :
=Risque_Témoin – Risque_Expérimental (Soit : =(B5/(B5+C5)) – (B4/(B4+C4)))
Numériquement, nous obtenons : 0,780 – 0,680 = 0,100, soit une réduction absolue de 10,0 points de pourcentage du taux de réussite sous le nouveau programme.
À partir de cette métrique d’impact absolu, nous pouvons programmer l’estimation du Nombre de Sujets à Traiter (ou ici, du nombre de sujets pour observer un échec additionnel imputable à l’intervention). Le NNT correspond à l’inverse mathématique de la valeur absolue de la Réduction Absolue du Risque. La syntaxe sous Excel s’écrit :
=1 / ABS(Cellule_RAR)
Dans notre étude : 1 / 0,100 = 10. L’interprétation de cette valeur indique qu’il suffit de soumettre 10 étudiants au nouveau programme cognitif plutôt qu’à l’ancien programme pour observer la « perte » d’un succès supplémentaire (ou un échec additionnel qui aurait été évité avec le protocole classique). Ce calcul fournit aux décideurs institutionnels et cliniciens une appréciation pragmatique directe, d’une lisibilité infiniment supérieure à celle des ratios adimensionnels abstraits.
6.3 Interprétation sémantique et clinique de la valeur du Risque Relatif
L’explicitation du Risque Relatif obéit à des conventions sémantiques précises qui le séparent radicalement de l’Odds Ratio. Un Risque Relatif de 0,872 signifie que la probabilité brute de réussir le test de raisonnement chez les participants soumis au nouveau programme représente 87,2 % de la probabilité de réussite observée chez les participants du groupe témoin.
La formulation en termes de Réduction Relative du Risque (RRR) s’obtient par l’équation complémentaire :
RRR (%) = (1 – RR) * 100
Ce qui donne, sous notre classeur : =(1 – 0,8717948) * 100 = 12,82 %. L’énoncé académique rigoureux s’articule ainsi : « L’assignation au nouveau programme d’entraînement cognitif induit une réduction relative statistiquement estimée de 12,8 % de la probabilité de succès à l’épreuve par rapport à l’entraînement standard ».
Il est fondamental de confronter ici la valeur de la Réduction Relative du Risque (12,8 %) à celle de la diminution de la cote mesurée par l’Odds Ratio (40,1 %). L’écart entre ces deux chiffres illustre de manière saisissante le danger majeur de la confusion linguistique : affirmer dans un rapport que l’intervention entraîne une « baisse de risque de 40 % » en se fondant abusivement sur l’Odds Ratio constituerait une falsification scientifique grave, surévaluant par un facteur supérieur à trois l’impact délétère réel de l’intervention sur les probabilités de performance de nos sujets.
7. Calcul des intervalles de confiance à 95 % pour l’Odds Ratio dans Excel
7.1 Théorie de la normalité asymptotique du logarithme naturel de l’Odds Ratio
L’estimateur ponctuel de l’Odds Ratio obtenu à partir d’un échantillon fini ne constitue qu’une approximation stochastique de la véritable valeur paramétrique de la population source. Pour mesurer l’incertitude d’échantillonnage inhérente au devis, la construction d’un intervalle de confiance à 95 % (IC 95 %) est méthodologiquement indispensable. Cependant, la distribution d’échantillonnage de l’Odds Ratio brut présente une forte asymétrie positive (la valeur minimale étant bornée à 0 tandis que la valeur maximale est infinie, avec une valeur nulle fixée à 1). Cette distribution hautement dissymétrique interdit l’application directe des formules classiques de marges d’erreur linéaires fondées sur la loi normale standard.
Pour s’affranchir de cette contrainte, la statistique inférentielle recourt au « théorème central limite » appliqué à la transformation logarithmique népérienne de l’estimateur, une approche formalisée par le statisticien B. Woolf en 1955. La variable transformée ln(OR) suit de manière asymptotique une distribution normale symétrique centrée autour du logarithme de l’Odds Ratio de la population. Sous Excel, cette conversion s’opère instantanément à l’aide de la fonction native LN :
=LN(Cellule_OR)
Sur notre jeu de données : ln(0,5993589) ≈ -0,511894.
L’estimation de la variance asymptotique de cette distribution logarithmique repose sur la formule de Woolf, qui établit que la variance de ln(OR) est égale à la somme des inverses des effectifs de chacune des cellules de la table de contingence :
Var(ln(OR)) = (1 / A) + (1 / B) + (1 / C) + (1 / D)
L’erreur type asymptotique (Standard Error ou SE) s’obtient alors en extrayant la racine carrée de cette variance scalaire :
SE(ln(OR)) = RACINE((1 / A) + (1 / B) + (1 / C) + (1 / D))
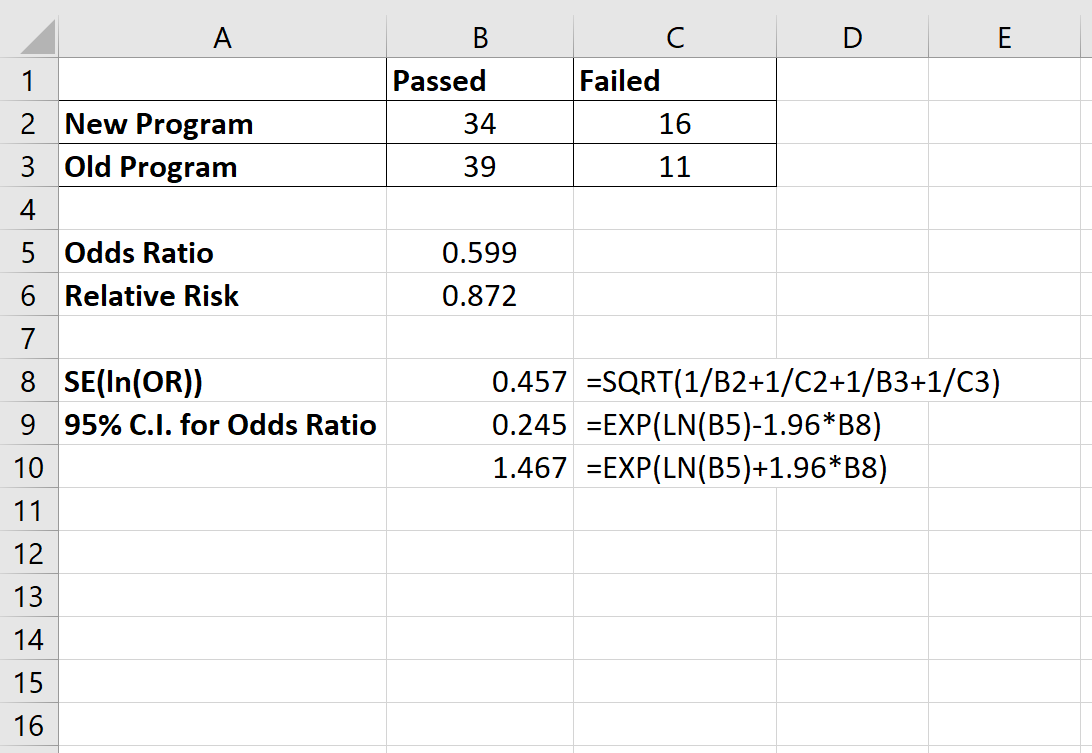
7.2 Programmation des bornes de confiance dans les cellules Excel
Le déploiement concret de cette mécanique inférentielle sous Excel s’articule en quatre cellules de calcul successives, programmées avec une rigueur absolue :
Étape 1 : Calcul de l’erreur type logarithmique (SE)
Dans une cellule dédiée nommée SE_LN_OR, nous inscrivons la transcription directe de la formule de Woolf à l’aide de la fonction racine carrée RACINE d’Excel :
=RACINE((1/Cellule_A) + (1/Cellule_B) + (1/Cellule_C) + (1/Cellule_D))
Soit avec nos adresses de cellules : =RACINE((1/B4) + (1/C4) + (1/B5) + (1/C5)).
Sur nos données : =RACINE((1/34) + (1/16) + (1/39) + (1/11)) = RACINE(0,02941 + 0,06250 + 0,02564 + 0,09091) = RACINE(0,20846) ≈ 0,456578.
Étape 2 : Détermination de la valeur critique Z
Pour un niveau de confiance bilatéral de 95 % (correspondant à un seuil d’erreur alpha de 0,05), la valeur critique de la loi normale centrée réduite s’obtient dynamiquement via la fonction :
=LOI.NORMALE.STANDARD.INVERSE(1 – (0,05 / 2)) (ou directement : =LOI.NORMALE.STANDARD.INVERSE(0,975))
Le tableur restitue la constante universelle standard : 1,95996… (usuellement arrondie à 1,96).
Étape 3 : Calcul des bornes sur l’échelle logarithmique
La marge d’erreur logarithmique correspond au produit de la valeur critique Z par l’erreur type. Les bornes inférieure et supérieure sur l’échelle ln s’écrivent :
Borne Log Inférieure : =LN(Cellule_OR) – (1,95996 * SE_LN_OR)
Ce qui donne : -0,511894 – (1,95996 * 0,456578) = -0,511894 – 0,894875 = -1,406769.
Borne Log Supérieure : =LN(Cellule_OR) + (1,95996 * SE_LN_OR)
Ce qui donne : -0,511894 + 0,894875 = +0,382981.
Étape 4 : Rétro-transformation vers l’échelle naturelle
Pour rapatrier ces limites sur l’échelle naturelle d’interprétation clinique de l’Odds Ratio, nous devons appliquer la transformation réciproque par la fonction exponentielle EXP :
Borne Inférieure de l’IC 95 % : =EXP(Borne_Log_Inférieure)
Numériquement : =EXP(-1,406769) ≈ 0,2449, soit 0,245.
Borne Supérieure de l’IC 95 % : =EXP(Borne_Log_Supérieure)
Numériquement : =EXP(0,382981) ≈ 1,4666, soit 1,467.
7.3 Interprétation inférentielle de l’intervalle de confiance de l’Odds Ratio
L’intervalle de confiance asymptotique à 95 % consolidé pour notre Odds Ratio s’établit formellement à : IC 95 % [0,245 ; 1,467]. L’exégèse statistique de cette enveloppe d’incertitude fournit un enseignement méthodologique décisif pour la validation des résultats de la recherche.
Le critère d’inférence universel stipule que pour un ratio, la valeur d’indépendance statistique (hypothèse nulle H0) est égale à 1,00. Si la valeur 1,00 se trouve incluse au sein de l’intervalle de confiance calculé, le chercheur se trouve dans l’impossibilité probabiliste de rejeter l’hypothèse nulle au seuil de significativité alpha de 5 %. Dans notre cas expérimental, bien que l’estimateur ponctuel indique une baisse de la cote de réussite (OR = 0,599), l’intervalle de confiance englobe très largement l’unité, s’étendant d’une valeur minimale de 0,245 (forte réduction de la cote) jusqu’à une valeur maximale de 1,467 (augmentation notable de 46,7 % de la cote).
Cette observation démontre que l’effet d’inhibition observé n’est pas statistiquement significatif au seuil bilatéral de 5 %. La largeur considérable de l’intervalle (amplitude de plus de 1,22 unité) trahit une imprécision d’échantillonnage marquée, directement liée à la taille modeste de l’échantillon (N = 100). En conséquence, le protocole ne permet pas d’affirmer avec certitude que le nouveau programme dégrade la performance dans la population générale des étudiants ; les données demeurent entièrement compatibles avec une simple fluctuation aléatoire d’échantillonnage.
8. Calcul des intervalles de confiance à 95 % pour le Risque Relatif dans Excel
8.1 Formulation de l’erreur type logarithmique pour le Risque Relatif
Le calcul de l’intervalle de confiance à 95 % pour le Risque Relatif procède d’une démarche conceptuellement analogue à celle mise en œuvre pour l’Odds Ratio, mais fait intervenir une formulation algébrique de l’erreur type profondément divergente. Comme le Risque Relatif opère sur des proportions marginales dépendantes de la taille totale de chaque groupe (A + B et C + D), la variance d’échantillonnage du logarithme naturel du Risque Relatif, formalisée par l’épidémiologie mathématique, s’exprime par la relation :
Var(ln(RR)) = (1 / A) – (1 / (A + B)) + (1 / C) – (1 / (C + D))
Une écriture factorisée alternative, largement adoptée dans les algorithmes biostatistiques en raison de sa stabilité numérique supérieure, prend la forme suivante :
Var(ln(RR)) = [B / (A * (A + B))] + [D / (C * (C + D))]
L’extraction de la racine carrée sous Excel fournit l’erreur type standard de ln(RR) :
SE(ln(RR)) = RACINE((1 / A) – (1 / (A + B)) + (1 / C) – (1 / (C + D)))
Il est fondamental de noter le signe négatif soustractif précédant les termes marginaux inverses 1/(A+B) et 1/(C+D). L’erreur type logarithmique du Risque Relatif est ainsi structurellement inférieure à celle de l’Odds Ratio pour un même jeu de données. La non-prise en compte de ces soustractions conduirait à appliquer fallacieusement la formule de Woolf de l’Odds Ratio au Risque Relatif, aboutissant à une surévaluation grossière de la variance d’échantillonnage.
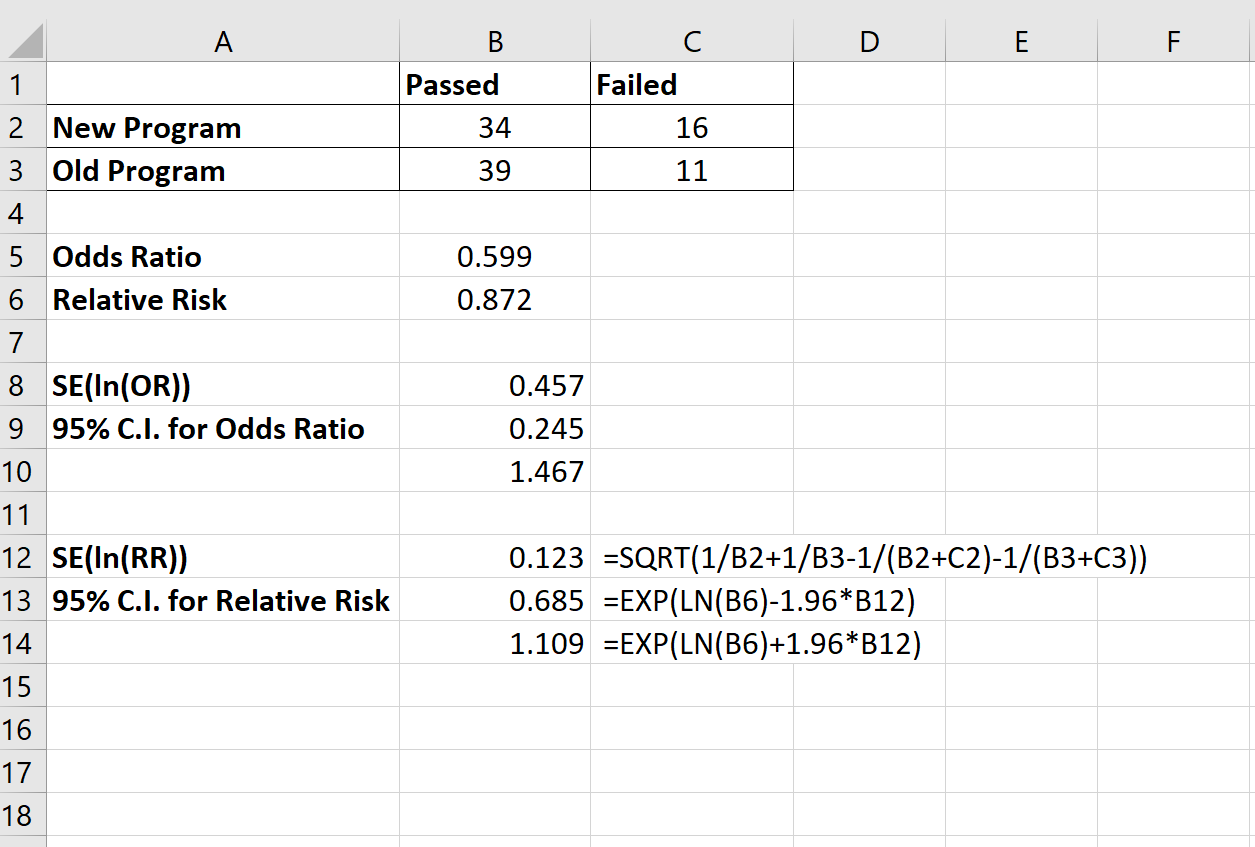
8.2 Implémentation complète des bornes inférieure et supérieure pour le Risque Relatif
L’implantation rigoureuse des bornes de confiance du Risque Relatif dans le tableur Excel s’opère selon une séquence d’instructions univoques :
Étape 1 : Calcul de l’erreur type SE(ln(RR))
Dans une cellule étiquetée SE_LN_RR, nous insérons la formule syntaxique exacte en reliant les cellules de la table de contingence :
=RACINE((1/B4) – (1/(B4+C4)) + (1/B5) – (1/(B5+C5)))
Sur nos valeurs empiriques :
=RACINE((1/34) – (1/50) + (1/39) – (1/50))
=RACINE(0,029412 – 0,020000 + 0,025641 – 0,020000)
=RACINE(0,009412 + 0,005641) = RACINE(0,015053) ≈ 0,122690.
Étape 2 : Conversion logarithmique de l’estimateur ponctuel
Dans une cellule connexe, nous évaluons le logarithme du Risque Relatif préalablement obtenu :
=LN(Cellule_RR)
Sur nos données : ln(0,8717948) ≈ -0,137201.
Étape 3 : Calcul des bornes de confiance asymptotiques
En appliquant la valeur critique bilatérale Z de 1,95996, nous programmons les bornes sur l’échelle logarithmique avant de les ré-exponentier dans les cellules de sortie terminale :
Borne Inférieure IC 95 % (RR) :
=EXP(LN(Cellule_RR) – (1,95996 * SE_LN_RR))
Numériquement : =EXP(-0,137201 – (1,95996 * 0,122690)) = EXP(-0,137201 – 0,240467) = EXP(-0,377668) ≈ 0,68546, soit 0,685.
Borne Supérieure IC 95 % (RR) :
=EXP(LN(Cellule_RR) + (1,95996 * SE_LN_RR))
Numériquement : =EXP(-0,137201 + (1,95996 * 0,122690)) = EXP(-0,137201 + 0,240467) = EXP(+0,103266) ≈ 1,10878, soit 1,109.
Pour immuniser définitivement la feuille contre des anomalies de traitement, une fonction logique de validation textuelle peut être insérée dans une cellule adjacente afin de certifier la cohérence de l’ordre géométrique :
=SI(Borne_Inf < Borne_Sup; « Validation Conforme »; « Erreur de Bornage »).
8.3 Comparaison analytique des intervalles de confiance OR versus RR
La mise en regard directe des deux intervalles de confiance obtenus pour notre devis de psychologie cognitive offre un éclairage méthodologique d’une importance capitale :
- Odds Ratio : Estimateur ponctuel = 0,599 | IC 95 % = [0,245 ; 1,467] | Amplitude de l’intervalle = 1,222
- Risque Relatif : Estimateur ponctuel = 0,872 | IC 95 % = [0,685 ; 1,109] | Amplitude de l’intervalle = 0,424
La première observation frappante concerne la disparité radicale d’amplitude entre les deux fenêtres d’incertitude. L’intervalle de confiance de l’Odds Ratio s’avère près de trois fois plus large que celui du Risque Relatif (1,222 contre 0,424). Cette divergence s’explique par la mécanique interne de la variance de Woolf, qui cumule les inverses d’effectifs purs, alors que la variance du Risque Relatif soustrait le poids d’exposition de la taille globale de chaque groupe. L’Odds Ratio présente ainsi une dispersion stochastique intrinsèque considérablement plus prononcée.
Néanmoins, sur le plan de la décision inférentielle, les deux métriques convergent vers une conclusion strictement congruente : la valeur nulle 1,00 est comprise à la fois dans l’IC de l’OR (0,245 à 1,467) et dans celui du RR (0,685 à 1,109). Dans les deux cas, le chercheur conclut à l’absence d’effet statistiquement significatif au seuil bilatéral conventionnel de 5 %. Cette convergence de décision confirme la robustesse théorique des formulations, tout en rappelant que la précision paramétrique apparente du Risque Relatif ne doit pas occulter les contraintes de conception de l’étude.
9. Tests de significativité statistique associés : Liaison avec le test du Chi-carré dans Excel
9.1 Calcul théorique des effectifs attendus sous l’hypothèse nulle d’indépendance
L’estimation des tailles d’effet que constituent l’Odds Ratio et le Risque Relatif s’adosse traditionnellement au test d’hypothèse d’indépendance du Chi-carré de Pearson (ou Chi-deux, noté χ²). Ce test évalue la divergence globale entre les fréquences empiriquement observées dans la table 2×2 et les fréquences théoriques qui seraient attendues sous l’hypothèse nulle d’absence totale d’association entre l’exposition et l’issue clinique.
Pour modéliser cette distribution théorique sous Excel, nous devons bâtir une table miroir de même dimension, dont chacune des quatre cellules calcule l’effectif attendu E_ij selon le produit des marges divisé par la taille totale de l’échantillon :
Effectif Attendu = (Total de la Ligne * Total de la Colonne) / Taille Totale N
Dans notre feuille de calcul, en désignant par D4 la marge de la ligne 1 (50), par D5 la marge de la ligne 2 (50), par B6 la marge de la colonne 1 (73) et par C6 la marge de la colonne 2 (27), la matrice théorique se programme par les formules dynamiques suivantes :
- Attendu A (Cellule B10) : =($D$4 * B$6) /$D$6 (Soit : (50 * 73) / 100 = 36,5)
- Attendu B (Cellule C10) : =($D$4 * C$6) /$D$6 (Soit : (50 * 27) / 100 = 13,5)
- Attendu C (Cellule B11) : =($D$5 * B$6) /$D$6 (Soit : (50 * 73) / 100 = 36,5)
- Attendu D (Cellule C11) : =($D$5 * C$6) /$D$6 (Soit : (50 * 27) / 100 = 13,5)
Cette étape préalable permet de contrôler rigoureusement le postulat fondamental de validité du Chi-carré formulé par William Cochran : 100 % des effectifs théoriques calculés doivent être strictement supérieurs à 1, et au moins 80 % d’entre eux doivent être supérieurs ou égaux à 5. Dans notre cas d’école, l’effectif théorique minimal observé s’établit à 13,5 (largement au-delà du seuil critique de 5), ce qui certifie la validité computationnelle pleine et entière du test du Chi-carré asymptotique sous Excel sans obligation de basculer sur un test exact de Fisher.
9.2 Exécution du test du Chi-carré d’indépendance via la fonction TEST.PEARSON
Microsoft Excel intègre une fonction native dédiée à l’évaluation probabiliste directe de l’indépendance matricielle : la fonction TEST.PEARSON (qui remplace l’ancienne nomenclature TEST.KHIDEPX dans les versions récentes du logiciel). Cette fonction haut niveau prend directement en arguments la plage des effectifs réels observés et la plage des effectifs théoriques attendus :
=TEST.PEARSON(B4:C5; B10:C11)
L’évaluation renvoie instantanément la p-valeur asymptotique exacte associée au test : p = 0,2604 (soit 26,0 %).
Pour assurer une parfaite traçabilité didactique au sein du laboratoire, il est recommandé de programmer également le calcul manuel scalaire de la statistique du Chi-carré. Dans une matrice intermédiaire, chaque cellule calcule la déviation quadratique standardisée : (Observé – Attendu)² / Attendu. La formule de synthèse s’écrit :
=SOMME(((B4:C5 – B10:C11)^2) / B10:C11) (Saisie sous forme de formule matricielle selon la version d’Excel)
Le calcul intermédiaire pas à pas fournit les déviations suivantes :
- Cellule A : (34 – 36,5)² / 36,5 = (-2,5)² / 36,5 = 6,25 / 36,5 ≈ 0,1712
- Cellule B : (16 – 13,5)² / 13,5 = (+2,5)² / 13,5 = 6,25 / 13,5 ≈ 0,4630
- Cellule C : (39 – 36,5)² / 36,5 = (+2,5)² / 36,5 = 6,25 / 36,5 ≈ 0,1712
- Cellule D : (11 – 13,5)² / 13,5 = (-2,5)² / 13,5 = 6,25 / 13,5 ≈ 0,4630
La sommation scalaire donne la valeur globale de la statistique de test : χ² = 0,1712 + 0,4630 + 0,1712 + 0,4630 = 1,2684. À partir de cette valeur, la p-valeur bilatérale pour un degré de liberté (ddl = (2 – 1) * (2 – 1) = 1) se calcule via la fonction de distribution :
=LOI.KHIDEPX(1,2684; 1)
Cette fonction confirme scrupuleusement la p-valeur de 0,260. Ce niveau de probabilité étant très largement supérieur au seuil d’inférence standard alpha = 0,05, nous échouons formellement à rejeter l’hypothèse nulle. Cette absence de significativité statistique s’accorde de façon parfaite et rigoureusement prévisible avec l’inclusion de la valeur 1,00 au sein des intervalles de confiance de l’Odds Ratio et du Risque Relatif calculés précédemment.
9.3 Complémentarité entre p-valeur, taille d’effet et indices de risque
L’articulation au sein d’une même feuille de calcul de la p-valeur du Chi-carré avec les indices d’Odds Ratio et de Risque Relatif matérialise l’un des préceptes fondamentaux de la psychologie quantitative contemporaine, tel que formalisé par les manuels de style successifs de l’American Psychological Association (APA). Une p-valeur ne constitue jamais, en elle-même, une mesure de l’intensité d’un phénomène comportemental ; elle renseigne exclusivement sur la probabilité d’obtenir des données au moins aussi extrêmes que celles observées sous la stricte hypothèse du modèle nul.
Dans notre cas expérimental, une lecture myope de la p-valeur (p = 0,260) conduirait simplement le chercheur à conclure que « l’effet n’existe pas », passant à côté d’informations cliniques cruciales. L’Odds Ratio (0,599) et le Risque Relatif (0,872) fonctionnent comme de véritables indices standardisés de la taille de l’effet. Ils indiquent la directionnalité de l’impact (une dégradation de la performance) et son ampleur empirique ponctuelle (une réduction relative de 12,8 % de probabilité brute de réussite).
Cette distinction est essentielle pour prévenir les erreurs méthodologiques induites par la taille d’échantillon. Dans une petite cohorte (comme ici N = 100), une taille d’effet substantielle peut échouer à atteindre le seuil de significativité par pur manque de puissance statistique. À l’inverse, au sein d’une méga-cohorte de 50 000 sujets, un Risque Relatif microscopique de 0,999 deviendrait hautement significatif (p < 0,001) sans présenter la moindre pertinence pratique ou clinique. Le tableur Excel doit donc être configuré pour rapporter conjointement et indissociablement ces deux dimensions de l’inférence scientifique.
10. Cas pratique complet : Étude de l’efficacité d’un protocole d’intervention psychologique
10.1 Mise en situation empirique détaillée et importation des données
Pour illustrer la mise en œuvre globale et intégrée de l’ensemble des formules développées, nous déployons à présent une étude de cas clinique complète consacrée à l’évaluation d’un protocole de psychothérapie cognitivo-comportementale (TCC) axée sur l’exposition graduée face au trouble panique avec agoraphobie.
Le protocole clinique intègre un échantillon de 120 patients (N = 120) souffrant d’un diagnostic avéré de trouble panique selon les critères du DSM-5. Les patients sont randomisés en deux groupes parallèles suivis sur une période de 16 semaines :
- Groupe TCC Active (Exposés) : 60 patients engagés dans le protocole d’exposition in vivo assistée par réalité virtuelle.
- Groupe Liste d’Attente avec Suivi Hebdomadaire (Témoins) : 60 patients bénéficiant uniquement de contacts de réassurance non directifs.
À l’issue des 16 semaines, le statut d’issue est codé sous une forme dichotomique stricte : « Rémission Complète » (absence totale d’attaques de panique sur les 30 derniers jours) ou « Persistance Symptomatique ». La consolidation des observations au sein de la table de contingence 2×2 sous Excel donne les effectifs suivants :
- Cellule A (TCC Active et Rémission) = 42 patients
- Cellule B (TCC Active et Persistance) = 18 patients
- Cellule C (Liste d’Attente et Rémission) = 15 patients
- Cellule D (Liste d’Attente et Persistance) = 45 patients
Les marges s’établissent ainsi : Groupe TCC = 60 (A + B), Groupe Contrôle = 60 (C + D), Total Rémissions = 57 (A + C), Total Persistances = 63 (B + D), et Taille globale N = 120.
10.2 Modélisation intégrée des calculs automatiques d’OR, de RR et de leurs IC
Nous agençons dans Excel une zone de restitution analytique automatisée sans aucune constante inscrite en dur, orchestrant l’intégralité des équations validées précédemment :
1. Probabilités cumulées et Cotes partielles :
Risque de rémission dans le groupe TCC (R1) : =42 / 60 = 0,7000 (70,0 % de succès).
Risque de rémission dans le groupe Contrôle (R0) : =15 / 60 = 0,2500 (25,0 % de succès).
Cote de rémission chez les exposés : =42 / 18 ≈ 2,3333.
Cote de rémission chez les témoins : =15 / 45 ≈ 0,3333.
2. Estimateurs ponctuels :
Odds Ratio : =(42 * 45) / (18 * 15) = 1890 / 270 = 7,000.
Risque Relatif : =0,7000 / 0,2500 = 2,800.
Réduction Absolue du Risque (Augmentation Absolue du Bénéfice) : =0,7000 – 0,2500 = 0,4500 (45 points de pourcentage).
Nombre de Sujets à Traiter (NNT) : =1 / 0,4500 ≈ 2,22 (soit 3 patients à traiter pour induire une rémission supplémentaire).
3. Erreurs types et Intervalles de confiance à 95 % :
Erreur type de ln(OR) : =RACINE((1/42) + (1/18) + (1/15) + (1/45)) = RACINE(0,0238 + 0,0556 + 0,0667 + 0,0222) = RACINE(0,1683) ≈ 0,4102.
Bornes IC 95 % (OR) :
Borne Inférieure = =EXP(LN(7) – (1,95996 * 0,4102)) = EXP(1,9459 – 0,8039) = EXP(1,1420) ≈ 3,133.
Borne Supérieure = =EXP(LN(7) + (1,95996 * 0,4102)) = EXP(1,9459 + 0,8039) = EXP(2,7498) ≈ 15,640.
Odds Ratio consolidé : OR = 7,00 [IC 95 % : 3,13 ; 15,64].
Erreur type de ln(RR) : =RACINE((1/42) – (1/60) + (1/15) – (1/60)) = RACINE(0,02381 – 0,01667 + 0,06667 – 0,01667) = RACINE(0,05714) ≈ 0,2390.
Bornes IC 95 % (RR) :
Borne Inférieure = =EXP(LN(2,8) – (1,95996 * 0,2390)) = EXP(1,0296 – 0,4685) = EXP(0,5611) ≈ 1,753.
Borne Supérieure = =EXP(LN(2,8) + (1,95996 * 0,2390)) = EXP(1,0296 + 0,4685) = EXP(1,4981) ≈ 4,473.
Risque Relatif consolidé : RR = 2,80 [IC 95 % : 1,75 ; 4,47].
4. Test d’indépendance statistique :
Le calcul de la statistique de Pearson renvoie : χ² = 24,38, associé via TEST.PEARSON à une valeur critique p de : p = 0,00000079 (soit p < 0,001).
10.3 Interprétation finale destinée à un rapport de publication psychologique
La transcription formelle des résultats de ce devis clinique sous un format éditorial académique prêt à être soumis à une revue médicale ou psychologique à comité de lecture s’articule selon la rédaction formalisée suivante :
« L’assignation des patients au protocole d’exposition TCC active a induit une élévation hautement significative du taux de rémission clinique complète comparativement à la condition témoin (70,0 % vs 25,0 % ; χ²(1, N=120) = 24,38 ; p < 0,001). Les patients sous TCC active présentent une probabilité brute de rémission 2,80 fois plus élevée que celle observée chez les patients en liste d’attente (Risque Relatif = 2,80 ; IC 95 % [1,75 ; 4,47]). Exprimé en termes de cotes d’occurrence, le protocole TCC multiplie par un facteur de 7 la cote de rémission par rapport au groupe témoin (Odds Ratio = 7,00 ; IC 95 % [3,13 ; 15,64]). L’impact clinique direct s’avère particulièrement prononcé, avec un gain absolu de rémission de 45,0 % (IC 95 % [28,5 % ; 61,5 %]), se traduisant par un Nombre de Sujets à Traiter (NNT) de 2,22. Ces résultats apportent une preuve empirique robuste de la supériorité thérapeutique de l’exposition par réalité virtuelle dans le traitement aigu du trouble panique. »
Cette rédaction intègre rigoureusement l’ensemble des dimensions statistiques indispensables : identification univoque des pourcentages bruts, taille d’échantillon, test inférentiel paramétrique, grandeurs d’association relatives accompagnées de leurs intervalles de confiance à 95 %, et enfin conversion en indicateur de pertinence clinique absolue (NNT). Une telle complétude garantit une transparence absolue, conforme aux recommandations du consortium CONSORT pour les essais cliniques.
11. Interprétation clinique, biais fréquents et pièges méthodologiques dans Excel
11.1 Le piège de la surestimation : L’Odds Ratio interprété à tort comme un Risque Relatif
La confusion sémantique consistant à interpréter un Odds Ratio comme un Risque Relatif constitue sans conteste l’écueil méthodologique le plus sévère de la littérature biomédicale et comportementale. Les médias généralistes, mais également une part considérable d’articles scientifiques révisés par les pairs, commettent l’erreur de déclarer qu’un Odds Ratio de 7,00 équivaut à affirmer que les sujets sous traitement ont « 7 fois plus de chances de guérir ». Cette affirmation est formellement fausse : dans notre essai clinique, les patients ont une probabilité de guérir multipliée par 2,80, et non par 7,00.
Pour immuniser les chercheurs contre cette distorsion cognitive majeure, la feuille Excel peut intégrer l’algorithme d’approximation mathématique validé par Zhang et Yu (1998). Cette formule permet de convertir analytiquement un Odds Ratio en une estimation corrigée du Risque Relatif réel lorsque l’incidence de l’événement est connue dans le groupe de référence (R0 = C / (C + D)) :
RR_corrigé = OR / [(1 – R0) + (R0 * OR)]
La syntaxe sous Excel se transcrit de la façon suivante :
=Cellule_OR / ((1 – (Cellule_C / (Cellule_C + Cellule_D))) + ((Cellule_C / (Cellule_C + Cellule_D)) * Cellule_OR))
En injectant nos paramètres (OR = 7,00 et R0 = 0,25) :
= 7 / ((1 – 0,25) + (0,25 * 7)) = 7 / (0,75 + 1,75) = 7 / 2,50 = 2,80.
La formule de Zhang et Yu restitue exactement la véritable valeur du Risque Relatif, confirmant ainsi sa précision mathématique.
La règle d’or déontologique pour les analystes de données sous tableur s’énonce ainsi : il est formellement interdit d’employer le vocabulaire de la probabilité, du « risque » ou de la « chance » pour commenter un Odds Ratio. L’Odds Ratio mesure exclusivement une variation du rapport de cotes. Dès lors que l’événement dépasse 10 % d’incidence au sein de la population étudiée, toute assimilation lexicale de l’OR au RR introduit un biais de surestimation de l’effet clinique qui fausse le consentement éclairé des patients et la prise de décision publique.
11.2 Gestion des cellules contenant des effectifs nuls (Zero-cell problem)
Le problème de la cellule vide (zero-cell problem) survient fréquemment lors d’études sur des troubles rares ou dans des protocoles hautement spécialisés à faible effectif. Si aucune observation n’est enregistrée dans l’une des cellules de la table de contingence (par exemple, 0 échec dans le groupe traité, B = 0), les équations analytiques s’effondrent : l’Odds Ratio produit une division par zéro non définie mathématiquement, tandis que l’erreur type de Woolf RACINE(1/A + 1/B + 1/C + 1/D) intègre le terme 1/0 qui tend vers l’infini.
La méthode de remédiation la plus solidement établie sur le plan asymptotique est l’ajustement empirique de Haldane-Anscombe, introduit par J.B.S. Haldane en 1955. Cet algorithme consiste à ajouter une constante fractionnaire de 0,5 à chacune des quatre cellules de la table 2×2, dès lors qu’au moins une cellule présente la valeur 0. Cette régularisation bayésienne minimale permet d’obtenir un estimateur asymptotiquement non biaisé au second ordre tout en évitant les singularités arithmétiques.
Sous Excel, l’implémentation de la correction d’Anscombe pour le calcul de l’erreur type se programme par une encapsulation logique conditionnelle de sécurité :
=SI(MIN(B4:C5)=0; RACINE((1/(B4+0,5)) + (1/(C4+0,5)) + (1/(B5+0,5)) + (1/(C5+0,5))); RACINE((1/B4) + (1/C4) + (1/B5) + (1/C5)))
Toutefois, les cliniciens doivent être conscients des limites inhérentes à cette manipulation de convenance. Lorsque la taille globale de l’échantillon est très restreinte (N < 20) ou que deux cellules sont simultanément nulles, l’adjonction de constantes artificielles de 0,5 peut induire une distorsion substantielle de la taille d’effet. Dans ce cas précis, le recours à Microsoft Excel doit être temporairement suspendu au profit de logiciels spécialisés capables d’exécuter une régression logistique exacte pénalisée selon la méthode de Firth, ou de générer des intervalles de confiance exacts basés sur la distribution hypergéométrique non centrale de Fisher.
11.3 Biais de confusion et paradoxe de Simpson dans l’analyse de tableaux 2×2
L’agrégation naïve de données au sein d’une unique table de contingence 2×2 expose le chercheur à un piège statistique redoutable : le paradoxe de Simpson. Ce phénomène contraint survient lorsqu’une association statistique observée au niveau global d’une population s’inverse totalement ou disparaît dès lors que les données sont stratifiées selon les sous-groupes d’une troisième variable modératrice (la variable de confusion).
Dans un contexte de recherche clinique en psychologie, supposons qu’une équipe évalue l’association entre une thérapie novatrice et le taux de rémission. Au niveau global de la feuille Excel (table 2×2 agrégée), le Risque Relatif calculé indique que le nouveau traitement est associé à un taux d’échec supérieur à l’ancien traitement (RR < 1,00). Cependant, si la sévérité initiale du trouble clinique a été déséquilibrée lors de l’assignation (par exemple, le groupe expérimental a reçu massivement des patients souffrant de formes chroniques et réfractaires, tandis que le groupe témoin a concentré les cas légers), la stratification par niveau de gravité (« Formes Légères » vs « Formes Sévères ») révélera que le nouveau traitement est en réalité supérieur au traitement standard au sein de chacun des deux sous-groupes (RR > 1,00 pour les deux strates).
Ce paradoxe illustre les limites structurelles d’Excel pour l’analyse épidémiologique multivariée avancée. Si le tableur permet aisément d’édifier des tables 2×2 stratifiées et de programmer manuellement l’algorithme de pondération de Cochran-Mantel-Haenszel pour calculer un Odds Ratio combiné ajusté sur les strates, il ne peut rivaliser avec la flexibilité d’environnements programmables comme R (package survival, metafor ou stats) dès lors qu’il s’agit d’ajuster simultanément sur plusieurs covariables continues via des modèles de régression logistique multivariée ou d’analyser des termes d’interaction complexes.
12. Automatisation avancée, modèles de feuilles réutilisables et fonctions dynamiques
12.1 Création d’un tableau de bord dynamique avec formules modernes Excel (LAMBDA et LET)
L’introduction récente dans Microsoft 365 des fonctions de calcul matriciel dynamique, notamment les fonctions LET et LAMBDA, transforme radicalement la programmation statistique dans Excel en hissant le tableur au rang d’un environnement de développement fonctionnel hautement modulaire et optimisé.
La fonction LET permet de déclarer des variables locales au sein même d’une formule de cellule, éliminant les recalculs arithmétiques redondants et améliorant drastiquement la lisibilité du code statistique. Par exemple, la chaîne complète de calcul de la borne inférieure de l’intervalle de confiance de l’Odds Ratio peut être condensée au sein d’une unique cellule élégante sans faire appel à des cellules tampons intermédiaires :
=LET(
A; B4;
B; C4;
C; B5;
D; C5;
OR; (A * D) / (B * C);
SE; RACINE((1/A) + (1/B) + (1/C) + (1/D));
Z; 1,95996;
EXP(LN(OR) – (Z * SE))
)
Plus puissant encore, la fonction LAMBDA permet aux chercheurs de créer leurs propres fonctions statistiques personnalisées natives sans avoir recours aux macros VBA (qui sont fréquemment bloquées par les protocoles de sécurité institutionnels des universités et hôpitaux). En accédant au Gestionnaire de noms d’Excel, nous pouvons définir une fonction réutilisable universelle baptisée CALCULER_OR paramétrée par la définition :
=LAMBDA(A; B; C; D; (A * D) / (B * C))
Une fois cette métadonnée enregistrée dans le classeur, l’analyste peut calculer l’Odds Ratio dans n’importe quelle cellule de n’importe quelle feuille de travail en tapant simplement la syntaxe épurée : =CALCULER_OR(B4; C4; B5; C5). Cette approche moderne garantit une standardisation algorithmique absolue, élimine le risque d’altération accidentelle des syntaxes de base et assure une reproductibilité computationnelle parfaite au sein des laboratoires de psychologie quantitative.
12.2 Conception d’un template automatisé à destination des chercheurs et cliniciens
Pour transformer une feuille de calcul isolée en un véritable outil méthodologique déployable auprès d’équipes de recherche multi-sites, la conception d’un template standardisé « prêt à l’emploi » s’avère hautement stratégique. L’ergonomie de ce classeur doit reposer sur un verrouillage fonctionnel rigoureux des composants structurels.
Le protocole de sécurisation architecturale s’articule selon les préconisations suivantes :
- Sélection des cellules d’intrants modifiables : Les quatre cellules destinées à recevoir les effectifs empiriques (A, B, C, D) sont sélectionnées. Dans le menu Format de cellule > onglet Protection, la case à cocher « Verrouillée » doit être explicitement décochée.
- Verrouillage de la feuille : Dans l’onglet Révision du ruban principal, l’analyste active l’option « Protéger la feuille » en assignant éventuellement un mot de passe d’administration. Toutes les cellules contenant des formules mathématiques dérivées, les en-têtes et les descripteurs textuels deviennent alors rigoureusement inviolables. Les utilisateurs ne peuvent plus modifier que les effectifs bruts, immunisant la feuille contre tout écrasement accidentel de formule lors de manipulations hâtives.
- Alertes de contrôle méthodologique automatisées : Par le biais d’instructions logiques conditionnelles imbriquées (=SI(…)), le modèle affiche des alertes méthodologiques en temps réel au-dessus de la table :
- Affichage du message « ALERTE : Effectif théorique inférieur à 5 — Validité du Chi-carré compromise » dès lors que
MIN(Table_Attendus) < 5. - Affichage de l’avertissement « ATTENTION : Issue fréquente (>10 %) — L’Odds Ratio diverge substantiellement du Risque Relatif » dès lors que le taux marginal d’événement
(A + C) / N > 0,10.
- Affichage du message « ALERTE : Effectif théorique inférieur à 5 — Validité du Chi-carré compromise » dès lors que
Cette approche d’ingénierie logicielle garantit que les praticiens de terrain et jeunes chercheurs manipulent un instrument robuste, auto-documenté et doté de garde-fous épistémologiques intégrés.
12.3 Visualisation graphique : Construction d’un Forest Plot simplifié sous Excel
La communication scientifique moderne exige une restitution graphique claire et immédiate des résultats statistiques. Dans les méta-analyses et les essais cliniques, la représentation graphique standard universelle pour visualiser les tailles d’effet dichotomiques et leurs incertitudes associées est le Forest Plot (ou graphique en forêt). Bien qu’Excel ne propose pas de type de graphique intitulé « Forest Plot » de manière native, il est tout à fait possible d’en concevoir un modèle graphique d’une rigueur professionnelle absolue en détournant astucieusement les graphiques de dispersion bivariés (Nuage de points) ou les graphiques boursiers.
La procédure d’élaboration d’un Forest Plot sous Excel s’articule selon la démarche pas à pas suivante :
1. Préparation de la table source graphique :
Dans une table technique dédiée, nous compilons sur une même ligne les coordonnées de l’estimateur ponctuel et de ses bornes. L’axe des ordonnées (Y) servira à positionner les différentes études ou sous-groupes de manière ordinale équidistante (par exemple Y = 1 pour notre étude d’intervention cognitive, Y = 2 pour l’étude clinique du trouble panique). L’axe des abscisses (X) portera l’échelle de la taille d’effet (Odds Ratio ou Risque Relatif).
2. Configuration des barres d’erreur asymétriques :
Puisque les intervalles de confiance des ratios sont asymétriques autour de l’estimateur ponctuel sur l’échelle linéaire naturelle, nous devons calculer manuellement les longueurs des segments d’erreur positifs et négatifs :
Écart d’erreur négatif (vers la gauche) : =Estimateur_Ponctuel – Borne_Inférieure
Écart d’erreur positif (vers la droite) : =Borne_Supérieure – Estimateur_Ponctuel
3. Génération du tracé graphique :
Nous insérons un graphique du type Nuage de points avec marqueurs uniquement. Dans la sélection des données, nous paramétrons les valeurs X sur la cellule de l’Odds Ratio (ou du RR) et la valeur Y sur la coordonnée ordinale fixe (1). Un point matérialisant l’estimateur ponctuel apparaît sur le canevas.
4. Intégration et paramétrage des barres d’erreur :
En sélectionnant le point graphique, nous activons l’élément de graphique « Barres d’erreur » (Options des barres d’erreur horizontales). Dans le volet de configuration :
Nous cochons « Les deux côtés » avec style « Avec empattement ».
Dans la zone « Quantité d’erreur », nous sélectionnons l’option « Personnalisée » et cliquons sur « Spécifier une valeur ».
Dans le champ « Valeur d’erreur positive », nous sélectionnons la cellule contenant l’écart positif calculé.
Dans le champ « Valeur d’erreur négative », nous sélectionnons la cellule hébergeant l’écart négatif.
Le tableur déploie instantanément l’intervalle de confiance asymétrique exact autour du point central.
5. Tracé de la ligne verticale de non-effet :
Pour finaliser le graphique selon les exigences de publication internationale, nous ajoutons une série secondaire constituée de deux points : (X = 1 ; Y = 0) et (X = 1 ; Y = 2). En reliant ces deux points par une ligne continue noire en pointillés, nous matérialisons la ligne critique de référence x = 1,00 correspondant à l’absence totale d’effet. Tout intervalle de confiance qui croise visuellement cette ligne verticale révèle immédiatement au lecteur la non-significativité statistique du résultat au seuil alpha de 5 %.
Le graphique ainsi produit peut être personnalisé (police de caractères conforme aux directives APA, suppression du quadrillage inutile, ajustement de l’axe des abscisses sur une échelle logarithmique pour rétablir la symétrie visuelle) puis exporté en haute résolution vectorielle (format PDF ou SVG) pour une insertion directe dans un manuscrit de publication ou une présentation de congrès international.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Anscombe, F. J. (1956). On estimating binomial response relations. Biometrika, 43(3/4), 461–464. https://doi.org/10.2307/2332926
Bradford Hill, A. (1965). The environment and disease: Association or causation? Proceedings of the Royal Society of Medicine, 58(5), 295–300. https://doi.org/10.1177/003591576505800503
Cochran, W. G. (1954). Some methods for strengthening the common χ² tests. Biometrics, 10(4), 417–451. https://doi.org/10.2307/3001616
Cornfield, J. (1951). A method of estimating comparative rates from clinical data; applications to cancer of the lung, breast, and cervix. Journal of the National Cancer Institute, 11(6), 1269–1275. https://doi.org/10.1093/jnci/11.6.1269
Doll, R., & Hill, A. B. (1950). Smoking and carcinoma of the lung: Preliminary report. British Medical Journal, 2(4682), 739–748. https://doi.org/10.1136/bmj.2.4682.739
Haldane, J. B. S. (1955). The estimation and significance of the logarithm of a ratio of frequencies. Annals of Human Genetics, 20(4), 309–311. https://doi.org/10.1111/j.1469-1809.1955.tb01285.x
Moher, D., Hopewell, S., Schulz, K. F., Montori, V., Gøtzsche, P. C., Devereaux, P. J., Elbourne, D., Egger, M., & Altman, D. G. (2010). CONSORT 2010 explanation and elaboration: Updated guidelines for reporting parallel group randomised trials. British Medical Journal, 340, c869. https://doi.org/10.1136/bmj.c869
Rothman, K. J., Greenland, S., & Lash, T. L. (2008). Modern epidemiology (3rd ed.). Lippincott Williams & Wilkins.
Simpson, E. H. (1951). The interpretation of interaction in contingency tables. Journal of the Royal Statistical Society: Series B (Methodological), 13(2), 238–241. https://doi.org/10.1111/j.2517-6161.1951.tb00088.x
Woolf, B. (1955). On estimating the relation between blood group and disease. Annals of Human Genetics, 19(4), 251–253. https://doi.org/10.1111/j.1469-1809.1955.tb01348.x
Zhang, J., & Yu, K. F. (1998). What’s the relative risk? A method of correcting the odds ratio in cohort studies of common outcomes. JAMA, 280(19), 1690–1691. https://doi.org/10.1001/jama.280.19.1690