
Dans le champ de l’analyse des séries temporelles, le traitement du signal et l’estimation des tendances sous-jacentes constituent des défis méthodologiques majeurs pour les chercheurs et les praticiens de la science des données. Qu’il s’agisse de modéliser des dynamiques psychophysiologiques complexes, de suivre des fluctuations comportementales longitudinales ou d’analyser des indicateurs biométriques à haute fréquence, les séries chronologiques brutes présentent invariablement un niveau substantiel de bruit stochastique. Ce bruit, qu’il résulte d’erreurs d’échantillonnage, de variabilité intra-individuelle aléatoire ou d’artefacts instrumentaux, obscurcit la dynamique fondamentale du phénomène étudié. C’est dans ce cadre méthodologique précis que s’imposent les techniques de lissage séquentiel, au sein desquelles la moyenne mobile exponentielle (souvent abrégée EMA pour Exponential Moving Average) occupe une place fondamentale.
Développée initialement pour les besoins de l’ingénierie statistique et de la recherche opérationnelle, notamment à travers les travaux pionniers de Robert Goodell Brown et de Charles C. Holt au milieu du vingtième siècle, la moyenne mobile exponentielle propose une solution computationnelle élégante au problème de l’inertie et de la réactivité dans le suivi des signaux temporels. Contrairement aux approches arithmétiques conventionnelles qui attribuent un poids équivalent à toutes les observations situées à l’intérieur d’une fenêtre temporelle rigide, le lissage exponentiel repose sur un schéma de pondération géométriquement décroissant. Cette caractéristique confère à l’algorithme une mémoire à la fois longue et élastique, accordant une importance primordiale aux observations les plus récentes tout en conservant une rémanence asymptotique des états antérieurs.
L’environnement de calcul statistique R offre une infrastructure exceptionnellement robuste et modulaire pour la conception, le calcul et l’optimisation de tels filtres temporels. Grâce à une combinaison harmonieuse entre fonctions vectorisées natives, packages d’analyse numérique de haut niveau comme pracma ou spécialisés comme TTR, et pipelines analytiques modernes issus de l’écosystème tidyverse, R permet une flexibilité algorithmique sans équivalent. Cet article propose une exploration intégrale, méthodique et approfondie du calcul de la moyenne mobile exponentielle sous R, guidant le lecteur des postulats mathématiques et théoriques jusqu’aux implémentations de code les plus rigoureuses, en passant par ses applications appliquées en psychologie quantitative et l’analyse de données chronologiques continues.
1. Fondements théoriques de la moyenne mobile exponentielle (EMA)
1.1 Définition mathématique et principe de pondération décroissante
La moyenne mobile exponentielle est une méthode de filtrage linéaire récursif à réponse impulsionnelle infinie (IIR). Sur le plan formel, considérons une série temporelle discrète notée $Y = {Y_1, Y_2, dots, Y_t, dots, Y_T}$, où chaque valeur $Y_t$ correspond à l’observation empirique enregistrée à l’instant temporel $t$. L’objectif fondamental de l’EMA est d’estimer un signal lissé, désigné par $S_t$, qui capture la composante tendancielle du processus tout en éliminant les composantes stochastiques à haute fréquence. L’équation de récurrence canonique qui régit ce système s’exprime selon la relation linéaire du premier ordre suivante :
$$S_t = \alpha Y_t + (1 – \alpha) S_{t-1}$$
Dans cette formulation élémentaire, le scalaire $\alpha$ représente la constante de lissage (ou facteur d’amortissement), strictement bornée au sein de l’intervalle ouvert ou semi-ouvert $\alpha in ]0, 1]$. La valeur de départ $S_1$ est usuellement initialisée à $Y_1$, bien que d’autres protocoles d’amorçage existent. Pour saisir la dynamique sous-jacente de cette récursion, il est impératif d’opérer une expansion analytique en substituant de manière itérative les termes historiques $S_{t-1}, S_{t-2}, dots$ jusqu’à l’observation initiale :
$$S_t = \alpha Y_t + \alpha(1 – \alpha)Y_{t-1} + \alpha(1 – \alpha)^2 Y_{t-2} + dots + \alpha(1 – \alpha)^{t-2} Y_2 + (1 – \alpha)^{t-1} S_1$$
Sous une notation sommatoire compacte, en supposant un horizon temporel infini ou une phase de rodage suffisamment longue pour que le terme résiduel $(1 – \alpha)^{t-1} S_1$ tende asymptotiquement vers zéro, l’expression devient :
$$S_t = \sum_{i=0}^{t-1} w_i Y_{t-i} \quad \text{où} \quad w_i = \alpha (1 – \alpha)^i$$
Ce développement mathématique explicite démontre que les coefficients de pondération $w_i$ diminuent selon une progression géométrique de raison $(1 – \alpha)$. Étant donné que $0 < (1 – \alpha) < 1$, la suite des poids converge strictement vers zéro à mesure que l'indice de décalage temporel $i$ croît. Par ailleurs, la somme de ces poids infinis constitue une série géométrique dont la somme vaut exactement un, puisque :
$$\sum_{i=0}^{\infty} \alpha (1 – \alpha)^i = \alpha \cdot \frac{1}{1 – (1 – \alpha)} = \frac{\alpha}{\alpha} = 1$$
Cette propriété de normalisation garantit que l’opérateur de lissage ne modifie pas l’espérance mathématique d’un signal stationnaire sous-jacent. Ainsi, l’EMA possède théoriquement une mémoire infinie car chaque observation historique conserve une contribution non nulle au calcul de l’état présent. Toutefois, d’un point de vue empirique et computationnel, cette mémoire subit une atténuation pratique drastique, permettant au filtre de réagir avec une grande agilité aux chocs structurels récents sans souffrir de l’inertie disproportionnée propre aux filtres arithmétiques.
1.2 Distinction entre moyenne mobile simple (SMA) et exponentielle (EMA)
Pour appréhender l’utilité statistique de l’EMA, il est nécessaire de la confronter à la moyenne mobile simple (SMA, Simple Moving Average). La moyenne mobile simple à fenêtre fixe de taille $k$ applique une distribution de pondération rectangulaire uniforme, formalisée par l’équation :
$$\text{SMA}_t(k) = \frac{1}{k} \sum_{i=0}^{k-1} Y_{t-i}$$
Cette pondération équiprobable engendre plusieurs écueils statistiques critiques dans l’analyse de processus dynamiques. Le premier est le phénomène bien documenté de saut artificiel ou d’artéfact de sortie de fenêtre (souvent désigné sous le terme imagé de « aboiement du chien à la sortie »). Lorsqu’une observation atypique, ou une perturbation extrême survenue à l’instant $t – k + 1$, quitte brusquement la fenêtre temporelle de calcul à l’instant $t + 1$, la valeur de la SMA subit une variation discrète instantanée. Cette variation ne reflète aucun changement contemporain dans le phénomène étudié à l’instant $t+1$, mais découle uniquement de la troncature abrupte de la mémoire du filtre. L’EMA est mathématiquement immunisée contre cet artéfact structurel grâce à sa fonction de transfert exponentiellement amortie, où aucune coupure nette ne survient dans le passé.
Le second contraste majeur réside dans la sensibilité directionnelle et le temps de réponse face aux inversions de tendance. Par construction, la SMA accorde le même statut d’importance à une mesure prise il y a $k$ jours qu’à celle enregistrée il y a dix secondes. En conséquence, lorsqu’un choc exogène ou une rupture structurelle modifie la trajectoire du signal, la SMA tarde à s’infléchir, induisant un déphasage temporel prononcé. À l’inverse, l’EMA réalloue constamment la masse de pondération statistique vers le bord droit de la série, maximisant l’influence de l’information la plus fraîchement acquise. Selon la nature du signal temporel (stationnarité, présence de bruits gaussiens ou impulsifs, fréquence d’échantillonnage), le chercheur privilégiera l’EMA dès lors que l’objectif analytique consiste à détecter précocement les changements d’état sans sacrifier la stabilité globale de l’estimation.
1.3 Paramètre d’amortissement et constante de lissage alpha
Le comportement dynamique de l’EMA est entièrement gouverné par le paramètre d’amortissement $\alpha$. Dans les applications computationnelles et logicielles, il est extrêmement courant de paramétrer le lissage non pas directement par la valeur de $\alpha$, mais par une pseudo-fenêtre temporelle équivalente notée $n$. La convention standardisée, initialement formulée dans les travaux d’ingénierie des processus de contrôle, établit l’équivalence suivante entre la largeur de la fenêtre conventionnelle $n$ et le scalaire $\alpha$ :
$$\alpha = \frac{2}{n + 1}$$
Cette conversion mathématique découle de l’égalisation des retards moyens de phase (les centres de masse temporels respectifs) entre une SMA de longueur $n$ et une EMA de paramètre $\alpha$. En effet, le délai temporel moyen d’une moyenne arithmétique de longueur $n$ est donné par $(n – 1) / 2$. Pour une EMA, le délai moyen de retard correspond à l’espérance de la variable aléatoire géométrique sous-jacente, valant $(1 – \alpha) / \alpha$. En résolvant l’égalité $(n – 1) / 2 = (1 – \alpha) / \alpha$, on aboutit rigoureusement à la relation $\alpha = 2 / (n + 1)$.
L’ajustement de $\alpha$ module le compromis fondamental entre sensibilité et stabilité :
- Un coefficient $\alpha$ élevé (tendant vers 1, soit un petit $n$) : L’algorithme confère une prépondérance absolue aux dernières observations. Le filtre réagit quasi instantanément aux fluctuations rapides du processus. Cependant, cette réactivité s’accompagne d’une perméabilité substantielle au bruit de mesure à haute fréquence, produisant une courbe lissée très accidentée et un risque accru de surajustement stochastique.
- Un coefficient $\alpha$ faible (tendant vers 0, soit un grand $n$) : L’EMA dilue l’impact des mesures récentes au sein d’une longue traîne mémorielle. Le signal lissé résultant est extrêmement stable, insensible aux fluctuations aléatoires transitoires. En contrepartie, le système accumule un décalage temporel important, devenant incapable de signaler rapidement une rupture tendancielle majeure.
Sur le plan physique et spectral, ce comportement s’interprète par le concept de temps de relaxation $tau$ du filtre exponentiel. Le temps de relaxation quantifie le nombre d’unités temporelles nécessaires pour que l’impact d’une impulsion unitaire d’entrée soit amorti d’un facteur $1/e \approx 0{,}368$ (où $e$ est la base du logarithme népérien). Mathématiquement, ce temps continu équivalent s’exprime par $\tau = -1 / \ln(1 – \alpha)$, que l’on peut approximer au premier ordre par $\tau \approx 1/\alpha$ pour de petites valeurs de $\alpha$. Ce cadre analytique éclaire de manière transparente le fonctionnement interne du lissage exponentiel en tant que filtre passe-bas du premier ordre.
2. Applications des séries temporelles et de l’EMA en psychologie quantitative
2.1 Modélisation de la dynamique de l’affect et des états émotionnels
La psychologie quantitative contemporaine a connu un tournant méthodologique décisif avec l’avènement des méthodes d’évaluation écologique momentanée (ESM, Ecological Momentary Assessment) et du recueil continu par journal de bord électronique. Dans ces protocoles, les participants complètent de multiples auto-évaluations quotidiennes relatives à leur valence affective, leur niveau de stress perçu ou leur activation émotionnelle, générant ainsi des séries chronologiques denses et intensives. Dans ce domaine d’investigation, l’EMA (au sens de l’algorithme statistique) joue un rôle analytique déterminant pour isoler l’inertie émotionnelle.
L’inertie émotionnelle se définit conceptuellement comme la résistance des états affectifs aux perturbations extérieures, mesurant le degré auquel l’humeur d’un individu s’auto-perpétue d’un instant à l’autre. Lorsqu’un chercheur analyse ces flux de données, les mesures brutes sont saturées de fluctuations contextuelles mineures (une interaction sociale brève, un événement environnemental anodin). En appliquant une moyenne mobile exponentielle sur les trajectoires d’affect négatif ou positif, il devient possible d’extraire la tendance de fond de l’humeur sans écraser les perturbations aiguës. Ce traitement permet aux cliniciens d’identifier des basculements critiques d’états psychologiques, notamment les transitions vers des épisodes dépressifs caractérisés, où le système psychique perd sa flexibilité dynamique pour s’enfermer dans un attracteur stable de détresse psychologique.
2.2 Analyse des séries de temps de réaction et de vigilance cognitive
En neuropsychologie expérimentale et en psychologie cognitive, les paradigmes d’évaluation de l’attention soutenue, tels que les tests de performance continue (CPT, Continuous Performance Task) ou les tâches de temps de réaction sériel, imposent aux sujets l’exécution de centaines d’essais consécutifs. Chaque essai produit une latence comportementale mesurée en millisecondes. L’analyse brute de ces latences révèle une variance intra-individuelle considérable, caractérisée par une asymétrie positive prononcée et l’apparition sporadique de valeurs extrêmes.
L’implémentation d’une moyenne mobile exponentielle sur la série ordonnée des temps de réaction permet d’étudier finement l’évolution temporelle de la charge et de l’épuisement cognitifs. Contrairement aux approches par blocs arbitraires qui masquent la dynamique locale par agrégation grossière, l’EMA offre un monitoring dynamique continu :
- Elle isole la dérive progressive des temps de réponse moyens, signalant l’installation de la fatigue mentale au fil des minutes.
- Elle permet de définir des seuils adaptatifs locaux : en comparant la valeur instantanée $Y_t$ à l’état moyen attendu $S_{t-1}$, l’algorithme détecte les défaillances aiguës d’attention (souvent associées à des micro-sommeils ou des décrochages de l’exécutif central) lorsque $Y_t$ dépasse de plusieurs écarts-types locaux la valeur lissée.
- Elle facilite la normalisation adaptative intra-individuelle, compensant les différences inter-individuelles de vitesse de base pour se focaliser exclusivement sur les dynamiques transitoires de la régulation cognitive.
2.3 Suivi longitudinal des trajectoires comportementales et cliniques
Au-delà des échelles de temps courtes mesurées en millisecondes ou en heures, la moyenne mobile exponentielle trouve un champ d’application de premier ordre dans les suivis cliniques longitudinaux s’étendant sur des mois, voire des années. Dans le cadre des thérapies cognitivo-comportementales ou des prises en charge pharmacologiques, le clinicien évalue périodiquement la sévérité symptomatique (par exemple via des scores psychométriques standardisés comme le PHQ-9 pour la dépression ou le GAD-7 pour l’anxiété) ou des indicateurs d’observance comportementale (fréquence de l’activité physique, respect des posologies médicamenteuses).
L’application d’un modèle d’EMA à ces mesures séquentielles répond à une exigence pragmatique : les états récents d’un patient doivent posséder une charge diagnostique supérieure aux états historiques pour adapter la décision thérapeutique. Si un patient a affiché des scores de dépression sévère durant trois mois avant de présenter une rémission notable sur les trois dernières séances, une moyenne arithmétique classique maintiendra un score moyen artificiellement élevé, ne reflétant pas l’efficacité du traitement contemporain. À l’opposé, l’EMA actualise l’estimation clinique en surpondérant l’état présent, tout en maintenant une régularisation basée sur le passé qui évite de conclure prématurément à une guérison pérenne au premier signal positif éphémère. Cette modélisation offre ainsi une base quantitative rigoureuse pour l’évaluation individualisée des réponses thérapeutiques.
3. Configuration de l’environnement de travail et des packages R
3.1 Initialisation de la session et bonnes pratiques de reproductibilité
Avant d’entreprendre la manipulation algorithmique de séries temporelles, il est indispensable de structurer un environnement de programmation garantissant la stricte reproductibilité computationnelle des résultats. Dans le langage R, cette rigueur commence par le nettoyage explicite de l’espace de noms, la gestion des configurations de l’interpréteur et la fixation de graines génératrices de nombres pseudo-aléatoires lorsque des simulations sont impliquées.
Une bonne pratique consiste à neutraliser les conversions automatiques de chaînes en facteurs (devenues le standard depuis R 4.0.0 mais qu’il convient de garantir) et à paramétrer une précision numérique adaptée pour éviter les troncatures visuelles lors de l’examen des vecteurs continus. Le code d’initialisation suivant établit ce cadre méthodologique :
Dans un script de recherche, on commence par configurer les options d’affichage avec options(digits = 7, scipen = 999), garantissant que les décimales soient préservées sans basculer de manière intempestive en notation scientifique. Ensuite, pour assurer que tout processus d’échantillonnage aléatoire produise des séries identiques sur différentes machines, on invoque set.seed(42, kind = "Mersenne-Twister", normal.kind = "Inversion"). Enfin, la séparation rigoureuse des sous-répertoires au sein du projet (dédiés aux données brutes, aux scripts analytiques et aux visualisations graphiques générées) constitue une exigence fondamentale selon les standards de la science ouverte (Open Science Framework).
3.2 Installation et chargement des bibliothèques requises
L’écosystème R dispose d’une multitude de packages dédiés aux séries chronologiques et au calcul scientifique. Pour maîtriser et comparer l’ensemble des approches de calcul de l’EMA, trois piliers logiciels distincts sont requis :
- Le package
pracma: Abréviation de Practical Math, ce package fournit des fonctions d’analyse numérique avancée dérivées ou inspirées de MATLAB. Il embarque notamment la fonction polyvalentemovavg(), capable d’exécuter divers types de moyennes mobiles de manière compacte. - Le package
TTR: Conçu initialement pour l’analyse technique financière (Technical Trading Rules), ce package développé par Joshua Ulrich est mondialement réputé pour son implémentation optimisée et ultra-performante de primitives statistiques temporelles, dont la fonction dédiéeEMA(). - Le métapackage
tidyverse: Comprenant notammentdplyrpour la manipulation tabulaire expressive,tibblepour la gestion de structures de données modernisées, etggplot2pour la sémiologie graphique académique de haute résolution.
Le chargement de ces bibliothèques nécessite une attention particulière quant aux conflits d’espaces de noms. Par exemple, la fonction filter() de dplyr masque la fonction fondamentale stats::filter() incluse dans le cœur de R, laquelle s’avère justement essentielle pour l’implémentation de filtres linéaires récursifs. L’utilisation explicite des doubles deux-points (par exemple dplyr::filter() ou stats::filter()) est donc vivement préconisée pour prévenir toute ambiguïté syntaxique et computationnelle.
3.3 Inspection des capacités computationnelles de R pour les séries temporelles
La performance du calcul de filtres récursifs sous R est intrinsèquement liée à la structure de données sous-jacente mobilisée. En R, les vecteurs atomiques numériques (de type double) constituent les briques fondamentales les plus efficientes sur le plan de l’allocation mémoire. Contrairement aux listes génériques ou aux tables complexes, un vecteur atomique stocke ses éléments de manière contiguë en mémoire vive (RAM), ce qui permet au processeur d’optimiser l’accès via ses mémoires caches L1 et L2.
Le calcul séquentiel d’une récursion pose toutefois un défi conceptuel sous R. Le langage est optimisé pour les opérations vectorisées, exécutées via des boucles internes écrites en C ou en Fortran. Une boucle itérative brute (for) écrite directement en R peut souffrir d’une surcharge d’interprétation si elle n’est pas codée avec précaution, notamment si la taille du vecteur d’allocation n’est pas préalablement allouée en mémoire (écueil de la réallocation dynamique). Il est donc primordial d’étudier comment les fonctions spécialisées compilées (comme celles de TTR, écrites en C sous-jacent) rivalisent avec les fonctions internes récursives de Base R (comme stats::filter), afin de calibrer le choix des outils selon la granularité des jeux de données traités, qui peuvent s’étendre de quelques dizaines de points à plusieurs millions d’enregistrements physiologiques.
4. Préparation et structuration des données de séries chronologiques
4.1 Création du jeu de données de référence
Pour ancrer la démonstration dans un cadre tangible, contrôlé et parfaitement vérifiable, construisons un jeu de données expérimental univarié. Ce jeu simule une séquence de mesures continues obtenues lors d’un protocole d’évaluation psychométrique ou psychophysiologique réalisé auprès d’un sujet sur une période de 40 pas de temps successifs. Le signal simulé incorpore une tendance déterministe sous-jacente combinée à des oscillations périodiques et à un bruit blanc gaussien.
Sur le plan programmatique, nous générons cette séquence à l’aide d’un vecteur d’indices temporels $t in {1, dots, 40}$. Le modèle génératif s’écrit formellement :
$$Y_t = 10 + 0{,}2 \cdot t + 3 \cdot \sin\left(\frac{2\pi t}{12}\right) + \epsilon_t, \quad \epsilon_t \sim \mathcal{N}(0, 1)$$
Cette formulation permet de combiner une dérive positive, une modulation cyclique mimant par exemple une rythmicité circadienne ou hebdomadaire, ainsi qu’une perturbation aléatoire stationnaire. Les valeurs résultantes sont assemblées au sein d’un tibble enrichi, comprenant la date relative, l’identifiant du signal et l’observation continue. L’inspection des statistiques descriptives élémentaires (moyenne empirique, écart-type, médiane, quartiles et coefficient de dissymétrie) permet de certifier que la série ne présente pas de dégénérescence structurelle et offre un banc d’essai optimal pour l’évaluation comparative des filtres de lissage exponentiel.
4.2 Gestion des données manquantes et de l’équirépartition temporelle
Les séries temporelles empiriques en sciences humaines et comportementales ne se conforment que rarement à la perfection théorique des signaux synthétiques. Elles se caractérisent fréquemment par l’apparition de données manquantes (notées NA sous R), imputables à des refus de réponse, des pertes de connectivité des capteurs ou des pannes matérielles. Or, la nature récursive de l’équation de l’EMA pose une vulnérabilité critique : si une valeur $Y_t$ est manquante, le terme de mise à jour devient immédiatement non défini, ce qui risque de propager le statut NA en chaîne sur l’intégralité des termes postérieurs $S_{t+1}, S_{t+2}, dots, S_T$.
Pour pallier cette interruption systémique du filtre, plusieurs stratégies d’imputation doivent être considérées préalablement au lissage :
- L’interpolation linéaire locale : Si la perte d’information est strictement isolée (un pas de temps unique), une interpolation linéaire directe via des outils comme
zoo::na.approx()reconstitue le point manquant sans altérer de façon substantielle la dynamique de l’EMA. - Le maintien de la dernière valeur observée (LOCF, Last Observation Carried Forward) : Via
zoo::na.locf(), cette méthode préserve le niveau atteint mais peut artificiellement réduire la variance locale. - La mise à jour adaptative à mémoire constante : Si $Y_t$ est absent, on peut stipuler au sein de l’algorithme que $S_t = S_{t-1}$. Cette approche revient conceptuellement à geler le filtre sur son dernier état stable sans incorporer de nouvelle information d’innovation.
Parallèlement, l’équirépartition temporelle constitue une condition fondamentale d’application de l’EMA conventionnelle. L’équation de base postule implicitement que l’intervalle $\Delta t = t – (t-1)$ est rigoureusement invariant. Si les observations sont collectées à des intervalles temporels irréguliers (par exemple des notifications aléatoires sur smartphone dans le cadre d’un protocole ESM), l’emploi d’un $\alpha$ constant introduit un biais de distorsion géométrique. Dans ce cas, une étape préliminaire de rééchantillonnage temporel avec régularisation sur une grille fixe (par exemple par agrégation moyenne horaire) est impérative pour préserver la validité théorique des constantes d’amortissement.
4.3 Conversion en objets temporels natifs et spécialisés
Bien qu’un simple vecteur numérique ou un tableau de type data.frame suffise pour exécuter des calculs arithmétiques, l’intégration de séries chronologiques dans l’écosystème spécialisé de R gagne en rigueur par l’usage d’objets temporels dédiés. Les classes de structures de données les plus pertinentes incluent :
- La classe standard
ts: Faisant partie intégrante de Base R, elle est adaptée aux séries strictement équidistantes dotées d’une saisonnalité explicite (via les argumentsfrequencyetstart). Sa légèreté est optimale, mais sa manipulation manque de flexibilité lorsqu’il s’agit de gérer des dates réelles au format POSIXct ou des métadonnées complexes. - La classe
zoo(du package éponyme) : Développée par Achim Zeileis et Gabor Grothendieck, elle associe un vecteur ou une matrice de données à un vecteur arbitraire d’indices ordonnés (dates calendaires, timestamps haute résolution ou entiers). Cette classe est particulièrement robuste face aux irrégularités temporelles. - La classe
xts(Extensible Time Series) : Étendantzoo, elle offre une indexation temporelle hautement optimisée et sert d’épine dorsale à de nombreuses fonctions du packageTTR.
La structuration rigoureuse garantit qu’aucune réorganisation intempestive des lignes, consécutive par exemple à une opération de tri accidentelle, ne vienne détruire l’ordonnancement chronologique strict sur lequel repose la relation de récurrence de l’EMA.
5. Calcul de l’EMA avec le package pracma : La fonction movavg()
5.1 Anatomie et syntaxe de la fonction movavg()
Le package pracma intègre une fonction unifiée de calcul de moyennes mobiles intitulée movavg(). Cette fonction a été conçue pour reproduire la flexibilité de calcul des environnements de calcul scientifique matriciel. Sa signature syntaxique générale s’articule autour de trois arguments directeurs :
L’argument x reçoit le vecteur numérique unidimensionnel représentant la série temporelle brute observée. L’argument n définit la dimension de la fenêtre de lissage ; dans le cadre d’une moyenne mobile exponentielle, cet entier ne représente pas une fenêtre glissante stricte au sens d’une coupure tronquée, mais le paramètre d’échelle temporelle à partir duquel la constante de lissage $\alpha$ est automatiquement dérivée. Enfin, l’argument type détermine la famille de moyenne mobile à déployer. Pour instruire l’algorithme d’exécuter un lissage exponentiel, il convient de spécifier la chaîne de caractères type = "e".
Il est fondamental de noter les contraintes dimensionnelles imposées par pracma::movavg() : le vecteur x ne doit contenir aucune valeur manquante non résolue sous peine de propager des anomalies, et la largeur de fenêtre n doit être un entier positif strictement supérieur à 1 et strictement inférieur ou égal à la longueur totale du vecteur sous observation.
5.2 Exécution pratique sur le vecteur de données
L’application concrète de movavg() s’effectue avec une remarquable concision syntaxique. Supposons un vecteur de mesures empiriques issu de notre jeu de données expérimental, nommé signal_brut, comportant nos 40 observations continues. Nous souhaitons appliquer un lissage exponentiel paramétré sur une pseudo-période de $n = 5$ unités temporelles.
L’appel de la fonction prend la forme suivante :
L’évaluation s’exécute en affectant le résultat à une nouvelle variable : ema_pracma <- pracma::movavg(signal_brut, n = 5, type = "e"). Cette commande renvoie un vecteur numérique de longueur strictement identique à celle du vecteur d’entrée originel, soit précisément 40 éléments dans notre scénario. En inspectant les premières valeurs numériques retournées, le chercheur observe l’atténuation immédiate des composantes à haute fréquence et la production d’une trajectoire continue cohérente.
Cette approche permet d’injecter immédiatement le résultat dans le tableau de données d’origine, par exemple en associant la colonne lissée au data.frame sous le nom évocateur EMA_pracma_n5, autorisant ainsi des comparaisons statistiques directes avec les données brutes initiales.
5.3 Traitement des valeurs initiales et phase de rodage (burn-in)
L’un des aspects les plus délicats de l’analyse numérique du lissage exponentiel réside dans le protocole d’initialisation du premier terme de la récurrence, $S_1$. Dans la théorie pure, l’équation requiert un état initial $S_0$. En pratique, pracma::movavg() implémente une stratégie d’amorçage spécifique : pour la toute première observation, le filtre assigne directement la première valeur empirique de la série ($S_1 = Y_1$). Ensuite, pour les termes situés dans la phase dite de rodage (burn-in ou phase transitoire, correspondant aux indices $t < n$), l'algorithme applique une transition graduelle.
Cette phase transitoire entraîne un biais d’initialisation inhérent. Puisque le point de départ est fixé arbitrairement sur une mesure empirique singulière susceptible d’être contaminée par une erreur de mesure, l’estimation des premiers points dépend substantiellement de cette condition aux limites. Il faut attendre un nombre suffisant d’itérations pour que le terme résiduel $(1 – \alpha)^{t-1} S_1$ devienne mathématiquement négligeable devant la somme des innovations récentes.
Dans la littérature méthodologique, on considère généralement que la phase de rodage s’estompe efficacement après une période correspondant à $3 \times n$ observations. Ainsi, pour une fenêtre paramétrée à $n = 5$, les 15 premiers points de la série doivent être interprétés avec une prudence accrue, car ils conservent une trace non négligeable de l’arbitraire de l’état d’amorçage. Les chercheurs doivent documenter ce comportement lors de la restitution de leurs analyses, particulièrement lorsque les séries temporelles analysées sont de longueur modeste.
6. Calcul de l’EMA avec le package TTR : La fonction EMA()
6.1 Syntaxe et flexibilité du paramétrage de TTR::EMA()
Le package TTR propose une fonction spécialisée, EMA(), qui fait autorité dans l’analyse de signaux temporels quantitatifs en raison de son optimisation et de sa modularité paramétrique. Contrairement à des fonctions plus génériques, TTR::EMA() a été conçue pour s’adapter à une multitude de conventions scientifiques et industrielles.
La signature de TTR::EMA() offre un ensemble d’arguments déterminants :
x: La série temporelle d’entrée, pouvant être un vecteur classique, une matrice univariée, ou un objet de classets,zooouxts.n: Le nombre de périodes de référence servant à calculer automatiquement le ratio d’amortissement selon la règle $\alpha = 2 / (n + 1)$.ratio: Un argument optionnel mais capital permettant à l’utilisateur de s’affranchir entièrement du paramètre $n$ pour spécifier directement le coefficient $\alpha in ]0, 1]$. Lorsque cet argument est renseigné, il prévaut sur toute valeur attribuée à $n$.wilder: Un argument booléen (valant par défautFALSE). Lorsqu’il est configuré àTRUE, la fonction bascule vers l’algorithme de lissage de J. Welles Wilder, où le coefficient d’amortissement est défini par la relation alternative $\alpha = 1 / n$. Ce lissage de Wilder induit une inertie considérablement plus marquée et un amortissement plus lent pour une même valeur de $n$.n.init: Détermine le mode d’initialisation de la composante de départ, influençant directement la phase d’amorçage.
6.2 Mise en œuvre comparative et analyse des écarts
L’exécution de TTR::EMA() sur notre jeu de données expérimental met en évidence des nuances conceptuelles majeures par rapport à pracma::movavg(). Par défaut, la convention algorithmique historique de TTR consiste à initialiser l’EMA non pas au premier point individuel $Y_1$, mais à la moyenne arithmétique simple (SMA) calculée sur les $n$ premiers points de la série :
$$S_n = \frac{1}{n} \sum_{i=1}^n Y_i$$
En conséquence immédiate de cette convention statistique, les $n – 1$ premières observations du vecteur résultant renvoyé par TTR::EMA() reçoivent la valeur NA. Le filtrage récursif proprement dit ne s’enclenche qu’à partir de l’indice temporel $t = n$. Cette approche a pour vertu théorique d’ancrer le premier état sur une estimation plus robuste et moins sensible aux fluctuations d’un point unique isolé, mais elle impose le sacrifice formel du début de la série temporelle.
Si l’analyste exécute conjointement sur un même vecteur brut pracma::movavg(x, n = 5, type = "e") et TTR::EMA(x, n = 5), il constatera une divergence systématique sur les premières observations : pracma fournit des valeurs numériques dès $t=1$, tandis que TTR renvoie des NA jusqu’à $t=4$ avant d’initier sa récursion à $t=5$. À mesure que $t$ s’accroît et progresse vers l’horizon $t > 20$, les deux trajectoires numériques convergent asymptotiquement pour devenir virtuellement indiscernables, illustrant la dissipation de l’impact des conditions initiales.
6.3 Extensibilité aux données multivariées
Un atout technique indéniable de TTR::EMA() réside dans sa capacité native à gérer des structures de données multivariées et des objets de séries temporelles avancés sans exiger la moindre boucle itérative explicite au niveau de l’utilisateur. Si l’on transmet à la fonction une matrice numérique à colonnes multiples ou un objet xts multivarié — où chaque colonne correspond par exemple au suivi longitudinal d’un marqueur physiologique distinct chez un même individu (tels que la variabilité de la fréquence cardiaque, la conductance cutanée et la température périphérique) —, TTR::EMA() applique le filtre de lissage sur chaque colonne de façon vectorisée.
Cette opération s’exécute à des vitesses computationnelles extrêmement élevées grâce aux routines C sous-jacentes du package. De surcroît, la classe temporelle originale (avec ses indexations calendaires précises, ses fuseaux horaires et ses attributs de métadonnées) est intégralement conservée dans l’objet de sortie. Cette interopérabilité directe simplifie considérablement la chaîne de traitement statistique au sein d’architectures logicielles complexes manipulant des flux de données multidimensionnels à haute densité temporelle.
7. Implémentation algorithmique de l’EMA en R natif (Base R)
7.1 Développement d’une fonction itérative pure
Comprendre intimement la mécanique interne du lissage exponentiel requiert de concevoir son implémentation algorithmique à partir des seules primitives du langage de base (Base R), en s’affranchissant de toute dépendance logicielle externe. L’approche la plus didactique consiste à formaliser une fonction itérative pure reposant sur une boucle for explicite, méticuleusement optimisée pour éviter les pénalités de performance mémoire.
L’implémentation de cette fonction personnalisée, que nous nommerons calcul_ema_base, se structure selon les étapes algorithmiques suivantes :
La fonction prend en entrée un vecteur numérique x, un paramètre de période n (avec une valeur par défaut fixée par exemple à 10) ou alternativement un scalaire alpha direct. Dès l’entame, la fonction valide la cohérence des paramètres d’entrée à l’aide d’assertions formelles (vérification que $\alpha in ]0, 1]$ ou calcul de $\alpha = 2 / (n + 1)$). Ensuite, elle alloue un vecteur numérique vide s de dimension strictement égale à celle de x à l’aide de la primitive numeric(length(x)), ce qui constitue une règle de programmation impérative pour préserver les adresses mémoire sans induire de recopiage dynamique itératif.
Le premier élément est explicitement initialisé selon la convention choisie, par exemple s[1] <- x[1]. Puis, une boucle itérative démarre à l’indice 2 et progresse jusqu’à la longueur totale du vecteur. À chaque pas $i$, l’équation de mise à jour fondamentale est appliquée : s[i] <- alpha * x[i] + (1 - alpha) * s[i - 1]. Enfin, la fonction retourne le vecteur s entièrement complété. Cette formulation offre une lisibilité conceptuelle absolue et garantit un contrôle total sur la gestion des conditions aux limites.
7.2 Utilisation de la fonction stats::filter()
Base R dispose d’un outil méconnu d’une puissance computationnelle remarquable pour le traitement des séries chronologiques : la fonction stats::filter(). Cette fonction permet d’appliquer aussi bien des filtres à moyennes mobiles convolutionnels classiques (dits filtres linéaires non récursifs ou FIR, Finite Impulse Response) que des filtres récursifs autorégressifs (IIR, Infinite Impulse Response). Or, comme démontré dans la section théorique, l’EMA est rigoureusement équivalente à un processus autorégressif d’ordre 1 (AR(1)) doté d’un terme d’innovation pondéré.
Pour exploiter stats::filter() dans le calcul d’une EMA, il convient de reformuler mathématiquement l’équation de récurrence :
$$S_t = (1 – \alpha) S_{t-1} + \alpha Y_t$$
Dans la syntaxe formelle de stats::filter(), un filtre autorégressif unilatéral se configure en renseignant l’argument method = "recursive" et en spécifiant le coefficient d’autorégression via l’argument filter = (1 - alpha). L’argument d’entrée du signal correspond alors non pas au vecteur brut $Y$, mais à la série préalablement mise à l’échelle par la constante de lissage, soit $\alpha Y_t$.
La commande s’exécute ainsi sous la forme : stats::filter(x * alpha, filter = 1 - alpha, method = "recursive", init = c(x[1])). Grâce à l’argument init, l’utilisateur a la faculté d’initialiser précisément le registre récursif au premier point de la série. Sur le plan de la vitesse d’exécution, stats::filter() s’avère nettement supérieure à une boucle for codée manuellement en script, car l’évaluation séquentielle est entièrement déléguée à un sous-programme compilé en langage C au cœur du noyau de R.
7.3 Calcul vectorisé avec la fonction Reduce()
Une troisième voie d’implémentation en Base R, particulièrement élégante pour les adeptes du paradigme de programmation fonctionnelle, mobilise la fonction d’ordre supérieur Reduce(). La primitive Reduce() permet de réduire séquentiellement une liste ou un vecteur en combinant itérativement ses éléments successifs au moyen d’un opérateur binaire, tout en disposant de la capacité de conserver la trace intégrale de tous les états intermédiaires grâce à son argument accumulate = TRUE.
Pour conceptualiser l’EMA sous l’angle de la programmation fonctionnelle, considérons la fonction de mise à jour binaire $f(s_{prev}, y_{curr}) = \alpha \cdot y_{curr} + (1 – \alpha) \cdot s_{prev}$. Cette expression prend deux arguments : l’état accumulé issu de l’itération précédente et l’observation empirique contemporaine.
En R, cette fonction peut être déclarée de manière anonyme et passée directement à Reduce() :
L’évaluation s’écrit formellement : ema_reduce <- Reduce(function(s_prev, y_curr) alpha * y_curr + (1 - alpha) * s_prev, x, accumulate = TRUE). Bien que cette formulation fonctionnelle se distingue par une compacité syntaxique remarquable et élimine tout état mutable externe, elle demeure légèrement plus lente que stats::filter() sur de très larges volumes de données en raison du coût d’appel répété de la fermeture fonctionnelle en environnement interprété. Néanmoins, pour des séries temporelles de dimensions moyennes (courantes dans les études psychologiques), elle offre une solution robuste, élégante et entièrement auto-contenue sans dépendances annexes.
8. Intégration de l’EMA dans l’écosystème Tidyverse
8.1 Calcul de l’EMA au sein d’un pipeline dplyr
Dans la pratique contemporaine de l’analyse de données, les chercheurs privilégient les structures tabulaires standardisées (tidy data) où chaque ligne représente une unité d’observation temporelle et chaque colonne une variable conceptuelle distincte. L’intégration harmonieuse du lissage exponentiel au sein des pipelines de transformation de données articulés autour de dplyr constitue donc une compétence méthodologique essentielle.
Grâce au verbe mutate() et à l’opérateur de chaînage (le pipe natif |> ou le pipe historique %>% de magrittr), il est particulièrement aisé d’enrichir une table de données avec plusieurs variantes de moyennes mobiles exponentielles, calculées selon différentes fenêtres temporelles, facilitant ainsi des comparaisons multi-échelles immédiates :
Au sein d’un bloc de code tibble_donnees |> mutate(...), on peut instancier simultanément une colonne EMA_court_terme = TTR::EMA(mesure, n = 5), une colonne EMA_moyen_terme = TTR::EMA(mesure, n = 15), et une colonne EMA_long_terme = TTR::EMA(mesure, n = 30). Cette syntaxe fluide garantit la préservation stricte de la topologie tabulaire et permet d’enchaîner immédiatement des étapes subséquentes de filtrage, de calcul de résidus ou d’exportation sans rupture dans la séquence analytique.
8.2 Gestion des calculs groupés par sujet (longitudinal)
L’immense majorité des recherches quantitatives en psychologie ou en biométrie ne porte pas sur un individu unique, mais sur des cohortes ou des panels comprenant des dizaines ou des centaines de participants suivis longitudinalement. Dans un jeu de données tabulaire au format long, les trajectoires temporelles individuelles sont empilées séquentiellement, chaque participant étant distingué par une variable catégorielle (par exemple sujet_id).
Dans une telle configuration, appliquer une fonction d’EMA de manière globale sur la colonne de mesure globale constituerait une aberration méthodologique gravissime : les premières valeurs d’un sujet donné incorporeraient par récurrence mémorielle les dernières observations du sujet précédent dans le tableau ! Pour conjurer ce risque d’inter-contamination des séries, l’instruction dplyr::group_by(sujet_id) doit être impérativement intercalée en amont de l’opération mutate() :
En encapsulant l’évaluation dans un contexte groupé, R réinitialise automatiquement l’algorithme d’EMA au début de chaque strate individuelle. Ainsi, pour chaque participant, la mémoire du filtre repart de zéro (ou de sa propre valeur initiale $Y_{1, \text{sujet}}$), garantissant une isolation stricte des dynamiques temporelles intra-individuelles. Il est impératif de conclure systématiquement ce pipeline par l’instruction ungroup() pour libérer la structure de données et éviter des effets de bord imprévus lors des analyses agrégées ultérieures.
8.3 Exploitation avancée avec le package slider
Bien que TTR et pracma soient des références incontournables, ils postulent une progression indiciaire discrète et régulière. Dès lors que l’analyste fait face à des séries chronologiques empiriques caractérisées par des intervalles de temps substantiellement irréguliers, le package moderne slider (développé par Davis Vaughan) apporte une souplesse algorithmique considérable. slider réinvente le concept de fenêtre glissante en introduisant des fonctions natives pour les calculs cumulatifs et glissants basés sur des index calendaires réels.
Au travers de fonctions telles que slide_index() ou slide_index_dbl(), slider permet de conditionner la sélection des données non pas sur un compte strict d’indices de lignes (comme les $n$ dernières lignes), mais sur une fenêtre de temps réelle explicite (par exemple : « toutes les observations survenues dans les 48 heures précédant l’instant $t$ »). Bien que le lissage exponentiel récursif classique repose mathématiquement sur une récursion unitaire, la combinaison des fenêtres temporelles continues de slider avec des fonctions d’amortissement exponentiel continu adaptées au temps physique permet de résoudre avec une rigueur statistique optimale les irrégularités d’échantillonnage propres aux protocoles de recherche en vie réelle.
9. Visualisation graphique académique avec ggplot2
9.1 Construction du graphique de base comparatif
La restitution visuelle d’un processus de lissage séquentiel exige une rigueur sémiotique stricte afin de permettre une interprétation non équivoque de la trajectoire sous-jacente par rapport aux données brutes. En utilisant ggplot2, le standard d’excellence graphique en R, la composition s’articule autour de la superposition de couches géométriques hiérarchisées.
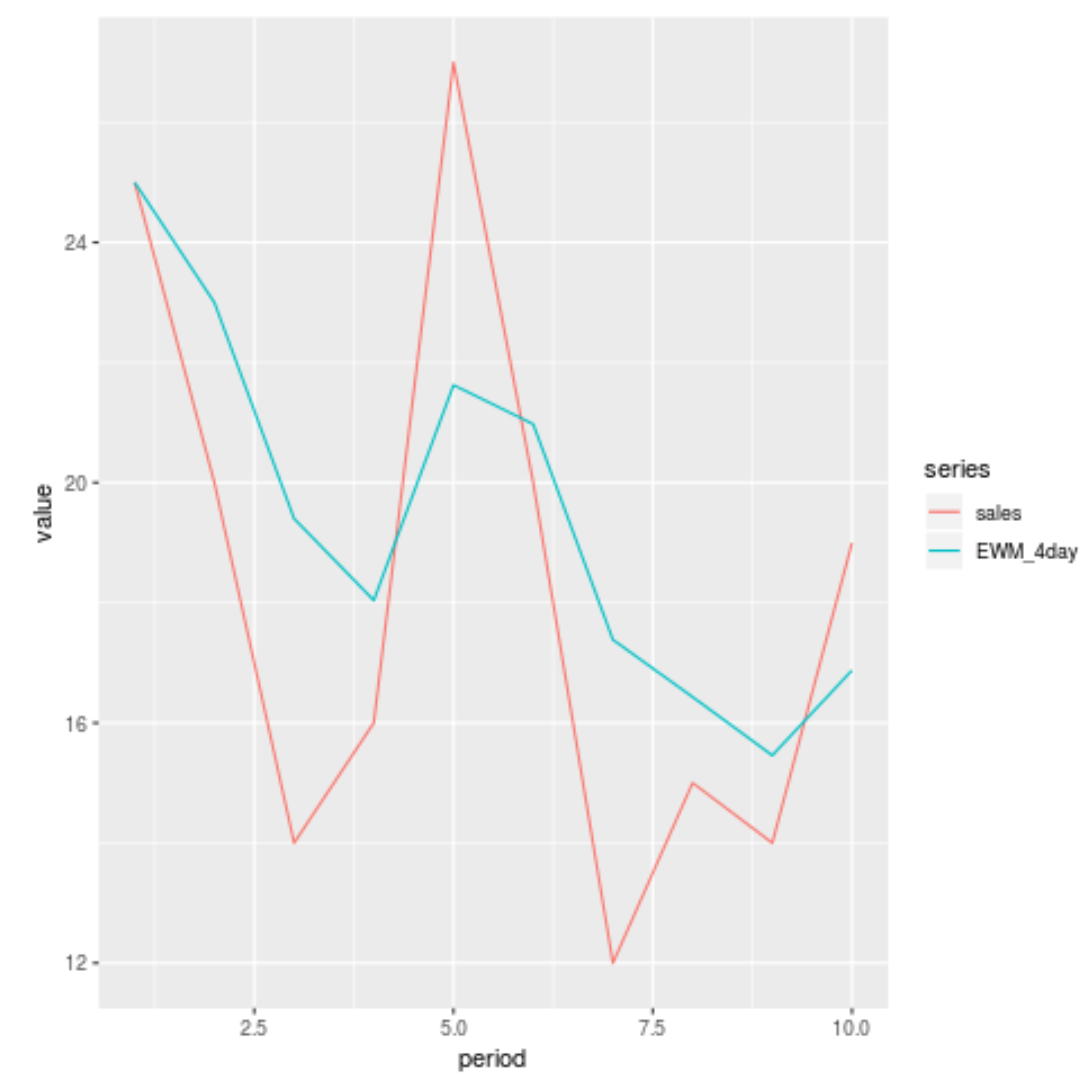
La structure visuelle de référence repose sur la superposition d’éléments discrets et continus :
- Les données empiriques observées ($Y_t$) sont avantageusement représentées par des points géométriques discrets (
geom_point()) associés à un segment filaire de faible épaisseur et de couleur neutre (comme un gris moyen semi-transparent). Ce choix graphique exprime visuellement la nature fluctuante et bruitée du signal instantané sans surcharger la lisibilité cognitive de la figure. - La série lissée par l’EMA ($S_t$) est matérialisée par une courbe continue de fort contraste chromatique et d’épaisseur plus prononcée (
geom_line(size = 1.2)), incarnant la composante tendancielle extraite. - Il est fréquemment pertinent d’intégrer une représentation graphique des écarts d’innovation : en traçant des barres verticales discrètes reliant chaque point empirique à son estimation lissée contemporaine, l’observateur perçoit immédiatement l’amplitude des résidus non captés par le filtre.
L’optimisation des échelles avec scale_x_continuous() et scale_y_continuous() doit veiller à inclure des coupures majeures cohérentes avec la temporalité de l’expérience (par exemple des graduations quotidiennes ou hebdomadaires régulières).
9.2 Visualisation de plusieurs fenêtres temporelles simultanées
Pour illustrer de manière pédagogique le comportement de l’EMA sous différents régimes d’amortissement, la visualisation conjointe de multiples fenêtres de lissage (par exemple $n = 3$, $n = 8$ et $n = 20$) est hautement préconisée. Pour exécuter cette tâche selon les préceptes du grammar of graphics, les données doivent être restructurées préalablement au format long au moyen de la fonction tidyr::pivot_longer().
Une fois les différentes séries lissées fondues dans une colonne d’indicateur générique et une colonne de valeurs correspondante, l’instruction esthétique aes(color = Type_Lissage, linetype = Type_Lissage) génère automatiquement une légende vectorielle détaillée. Ce procédé permet de mettre visuellement en scène l’effet du compromis réactivité-stabilité :
- La courbe correspondant à $n = 3$ (réactivité forte) épouse fidèlement les micro-inflexions du signal brut mais transmet une grande proportion de bruit résiduel.
- La courbe associée à $n = 20$ (forte inertie) traverse le nuage de points avec une courbure très douce, révélant la tendance macroscopique mais affichant un décalage de phase manifeste lors des inversions locales.
L’utilisation de palettes chromatiques perceptuellement uniformes et adaptées aux déficiences de la vision des couleurs (telles que la palette Viridis via scale_color_viridis_d()) garantit l’accessibilité visuelle universelle du document scientifique produit.
9.3 Mise en forme selon les normes académiques et de l’APA
Pour une publication dans une revue internationale révisée par les pairs, notamment dans les disciplines psychologiques et biométriques régies par les normes de l’American Psychological Association (APA 7th edition), l’esthétique par défaut des visualisations informatiques (fonds grisés quadrillés, typographies standard sans hiérarchie) doit être substantiellement épurée.
L’application d’un thème rigoureux tel que theme_classic() ou theme_minimal() constitue la première étape de cette mise en conformité. Les modifications typographiques et structurelles s’exécutent via la fonction theme() :
- Suppression intégrale des lignes de quadrillage secondaires et atténuation des lignes principales pour ne pas distraire l’œil de la dynamique des courbes.
- Positionnement de la légende à l’intérieur de la zone graphique (si l’espace le permet) ou en position supérieure horizontale afin de maximiser le ratio surface utile sur espace total.
- Définition d’étiquettes d’axes explicites, incluant rigoureusement le nom de la variable et son unité métrique de mesure entre parenthèses (par exemple : Temps de réponse (en millisecondes) ou Score d’affect négatif (échelle de 1 à 10)).
- Intégration d’un sous-titre ou d’une note de bas de figure (
labs(caption = "...")) renseignant avec exactitude les valeurs d’$\alpha$ et de $n$ mobilisées dans le calcul.
L’exportation finale s’opère via la fonction ggsave(), en configurant impérativement une résolution minimale de 300 à 600 DPI (Dots Per Inch) pour les formats matriciels (TIFF ou PNG haute résolution) ou, idéalement, en générant un tracé vectoriel au format PDF ou SVG afin de garantir une netteté absolue à tout facteur de grossissement lors de la mise en page éditoriale.
10. Optimisation statistique et sélection du paramètre de lissage
10.1 Compromis biais-variance dans le choix de la constante de lissage
Le choix de la valeur optimale de la constante d’amortissement $\alpha$ (ou de son équivalent $n$) n’est pas une simple décision heuristique ou cosmétique ; il touche au cœur de la théorie statistique générale de l’apprentissage machine et de l’estimation : le compromis biais-variance. Dans le cadre de l’EMA considérée comme un estimateur du niveau local du signal, ce dilemme mathématique se déploie selon deux polarités opposées :
D’un côté, lorsque $\alpha$ est fixé à une valeur excessivement faible (surlissage), l’estimateur intègre une quantité massive d’informations passées. Si le signal sous-jacent est non-stationnaire et possède une tendance évolutive, le filtre sera chroniquement en retard d’une phase par rapport à la véritable trajectoire locale. L’erreur systématique augmente de façon drastique : il s’agit d’une explosion du biais statistique d’estimation. Le modèle sous-estime systématiquement les phases d’ascension et surestime les phases de déclin.
D’un autre côté, lorsque $\alpha$ tend vers des valeurs élevées (sous-lissage), l’estimateur élimine le biais de retard, s’alignant au plus près des variations contemporaines. Toutefois, en accordant un poids déterminant à l’observation $Y_t$, le filtre incorpore une proportion critique de la variance du terme d’erreur stochastique $\epsilon_t$. La variance de l’estimateur croît alors de manière intenable. L’objectif méthodologique consiste dès lors à calibrer analytiquement ou algorithmiquement la valeur de $\alpha$ qui minimise l’erreur globale de reconstruction.
10.2 Critères quantitatifs d’évaluation de la performance (RMSE, MAE, MAPE)
Pour objectiver la précision prédictive et descriptive de l’EMA, la modélisation séquentielle s’appuie sur le concept de prévision à un pas (one-step-ahead forecast error). À l’instant temporel $t-1$, l’estimation lissée $S_{t-1}$ constitue formellement la prédiction de l’état futur $Y_t$. L’erreur de prévision contemporaine s’écrit :
$$e_t = Y_t – S_{t-1}$$
À partir de cette séquence d’écarts empiriques mesurés sur l’intervalle $t in {2, dots, T}$, plusieurs fonctions de perte quantitatives standardisées peuvent être calculées :
- L’erreur quadratique moyenne (RMSE, Root Mean Squared Error) :
$$\text{RMSE} = \sqrt{\frac{1}{T-1} \sum_{t=2}^T (Y_t – S_{t-1})^2}$$
Cette métrique pénalise lourdement les écarts d’amplitude extrême en raison de l’élévation au carré, s’avérant très adaptée si les grandes erreurs d’estimation comportent des coûts méthodologiques ou cliniques sévères. - L’erreur absolue moyenne (MAE, Mean Absolute Error) :
$$\text{MAE} = \frac{1}{T-1} \sum_{t=2}^T |Y_t – S_{t-1}|$$
Plus robuste face aux valeurs aberrantes que la RMSE, elle exprime l’erreur d’estimation dans l’unité métrique naturelle de la variable mesurée. - Le pourcentage d’erreur absolue moyenne (MAPE, Mean Absolute Percentage Error) : Utilisé lorsque des comparaisons doivent être effectuées entre plusieurs séries temporelles possédant des ordres de grandeur d’échelle radicalement distincts.
Dans l’environnement R, la détermination de l’$\alpha$ optimal s’exécute de manière automatisée en définissant une fonction de perte paramétrique (qui calcule par exemple la RMSE en fonction d’un scalaire d’entrée $\alpha$), puis en soumettant cette fonction à l’optimiseur unidimensionnel natif optimize(f = fonction_rmse, interval = c(0.01, 0.99)). Cette procédure computationnelle identifie la constante exacte qui minimise formellement l’écart quadratique résiduel pour la série analysée.
10.3 Validation croisée pour séries chronologiques
L’optimisation de $\alpha$ sur l’intégralité d’un jeu de données historique engendre un risque latent de surapprentissage (overfitting), où le paramètre sélectionné s’avère artificiellement adapté au bruit spécifique de l’échantillon rétrospectif mais se révèle sous-optimal pour filtrer des données prospectives inédites. Dans le champ des séries temporelles, l’usage de la validation croisée standard par partitions aléatoires (k-fold cross-validation standard) est rigoureusement prohibé car elle détruit la structure causale et l’autocorrélation sérielle du processus en mélangeant des points futurs et passés.
La validation empirique impose de déployer une stratégie de validation croisée par fenêtre glissante ou par origine temporelle croissante (rolling origin time series cross-validation ou evaluation on expanding window). Sous R, ce protocole d’évaluation séquentielle procède de la façon suivante :
On alloue un sous-ensemble initial de données historiques (par exemple les $m$ premiers jours d’observation) comme ensemble d’entraînement. Le paramètre $\alpha$ y est calibré par minimisation de la RMSE. Ensuite, on utilise cet $\alpha$ pour prédire l’observation survenue à l’instant $m+1$, et l’erreur d’estimation prospective est enregistrée. L’ensemble d’entraînement est ensuite étendu pour incorporer ce point $m+1$, et le processus est réitéré de manière itérative jusqu’au terme de la série temporelle. La moyenne des erreurs prospectives obtenues sur l’ensemble des segments de test fournit une estimation rigoureusement non biaisée de la capacité de généralisation réelle du paramètre de lissage retenu.
11. Diagnostic des pièges méthodologiques et erreurs fréquentes
11.1 Le biais d’anticipation temporelle (Look-ahead bias)
Le biais d’anticipation temporelle (désigné dans la littérature anglo-saxonne sous les termes de look-ahead bias ou data snooping) représente l’une des erreurs méthodologiques les plus insidieuses dans le traitement de signaux temporels. Il survient dès lors qu’une opération de transformation de données intègre, de manière explicite ou déguisée, des informations temporelles qui ne sont pas encore survenues au moment de l’état estimé.
Dans le domaine du filtrage, ce biais s’infiltre classiquement lorsque le chercheur recourt par mégarde à des moyennes mobiles centrées ou bilatérales au lieu de filtres récursifs causaux stricts. Une moyenne mobile centrée calcule le point $S_t$ en utilisant les observations réparties symétriquement entre $t – k$ et $t + k$. Dès lors, l’état calculé à l’instant présent $t$ dépend fonctionnellement des valeurs $Y_{t+1}, dots, Y_{t+k}$ qui relèvent du futur temporel !
Si l’analyste utilise ultérieurement cette trajectoire lissée artificiellement contaminée pour concevoir un modèle de prédiction statistique ou tester la réactivité comportementale face à un stresseur aigu, les métriques prédictives obtenues seront outrageusement surestimées : le modèle apparaîtra comme doté d’une prescience artificielle. L’EMA canonique, par sa définition purement autorégressive unilatérale ($S_t = \alpha Y_t + (1 – \alpha)S_{t-1}$), est intrinsèquement causale. Le chercheur doit veiller avec la plus haute rigueur à n’employer aucune fonction utilitaire de rétro-lissage (telle que les filtres passe-bas non causaux de type signal::filtfilt à phase nulle) lorsqu’il entend modéliser des dynamiques décisionnelles en temps réel ou respecter la stricte antériorité temporelle de la causalité psychologique.
11.2 Le déphasage temporel (Lag) et son interprétation
La contrepartie inévitable de la causalité stricte d’un filtre unilatéral réside dans l’apparition d’un déphasage temporel (time lag). Tout filtre linéaire passe-bas opérant exclusivement sur l’histoire passée introduit un décalage structurel dans la propagation du signal. Sur le plan mathématique, pour une oscillation harmonique sous-jacente ou un échelon unitaire, le retard de groupe moyen induit par une moyenne mobile exponentielle gouvernée par la constante $\alpha$ s’établit très précisément selon la relation :
$$\text{Déphasage moyen} = \frac{1 – \alpha}{\alpha} = \frac{n – 1}{2}$$
Ce décalage a des implications interprétatives critiques pour la psychologie quantitative :
- Si un chercheur analyse l’évolution de l’affect négatif suite à un événement traumatique aigu survenu à l’instant $t^*$, la courbe lissée par l’EMA n’atteindra son pic d’amplitude maximale qu’avec un retard systématique de $(1 – \alpha) / \alpha$ pas de temps par rapport à l’événement réel.
- Conclure que le patient a présenté un délai de réactivité émotionnelle latente alors que ce retard découle directement de la constante d’amortissement de l’algorithme de calcul constitue une erreur d’inférence substantive majeure.
Il est donc essentiel de quantifier explicitement ce déphasage lors de la restitution des résultats ou de recourir, lorsque la causalité temps réel n’est pas requise (dans le cadre strict d’analyses purement rétrospectives de signaux biométriques de laboratoire), à des méthodes de compensation de phase ou à des algorithmes à double passe temporelle (aller-retour) qui annulent théoriquement le déphasage global au détriment de la causalité en ligne.
11.3 Instabilité numérique liée aux séries courtes et aux données atypiques
L’application non critique de l’EMA sur des séries temporelles courtes (inférieures à une trentaine d’observations) ou hautement contaminées par des points extrêmes aberrants (outliers) confronte le chercheur à des écueils de robustesse numérique et statistique majeurs :
Le premier écueil concerne la non-convergence de la mémoire géométrique. Comme nous l’avons théorisé, la somme des poids exponentiels ne vaut rigoureusement $1$ que lorsque le nombre de points passés tend vers l’infini. Sur une série très courte (par exemple $T = 10$ avec $n = 5$ soit $\alpha = 0{,}333$), la somme tronquée des poids effectifs $\sum_{i=0}^{t-1} \alpha (1 – \alpha)^i$ reste substantiellement inférieure à $1$ lors des premières itérations, induisant une compression artificielle de l’échelle du signal si un facteur de normalisation dynamique du dénominateur n’est pas programmé au sein du code.
Le second écueil réside dans la vulnérabilité intrinsèque de la moyenne mobile exponentielle face aux perturbations impulsives isolées. Bien que l’EMA amortisse la sortie des valeurs extrêmes (éliminant le saut rectangulaire de la SMA), elle demeure un estimateur basé sur l’espérance arithmétique : elle ne possède aucun point de rupture au sens de la statistique robuste. Une unique valeur aberrante d’amplitude colossale (par exemple une défaillance de capteur cardiovasculaire générant un artefact à 250 battements par minute chez un individu au repos) va instantanément contaminer le niveau estimé $S_t$ à hauteur de $\alpha \times 250$. Cette perturbation se dissipera lentement au fil des itérations futures, altérant l’évaluation de la tendance durant toute la période de relaxation du filtre. Face à de telles données empiriques bruitées, des alternatives méthodologiques robustes, telles que les médianes mobiles exponentielles ou les filtres de Hampel appliqués en amont de l’EMA, doivent être impérativement mobilisées.
12. Étude de cas complète et reproductible sous R
12.1 Présentation du scénario expérimental et des données
Pour parachever ce traité méthodologique, développons une étude de cas intégrale, documentée et reproductible. Imaginons une recherche menée en psychologie clinique longitudinale évaluant la cinétique de la détresse psychologique chez un patient bénéficiant d’une intervention psychothérapeutique ciblée sur une durée de 60 jours consécutifs. Le niveau de détresse est quantifié quotidiennement via une échelle psychométrique standardisée continue graduée de 0 (sérénité absolue) à 100 (détresse aiguë insoutenable).
Le profil temporel sous-jacent du patient présente trois phases dynamiques distinctes :
- Phase 1 (Jours 1 à 20) : Une phase de base (baseline) oscillant autour d’un plateau moyen élevé de 70 points, reflétant une souffrance psychique chronique stabilisée.
- Phase 2 (Jours 21 à 23) : Un choc émotionnel aigu induisant une aggravation brutale transitoire propulsant le score vers 90 points.
- Phase 3 (Jours 24 à 60) : Une décroissance thérapeutique progressive modélisant la rémission symptomatique, amenant asymptotiquement le score vers une valeur cible de 25 points au soixantième jour.
À cette trajectoire théorique déterministe s’ajoute une variabilité intra-individuelle quotidienne non prédictible modélisée par un bruit gaussien $\epsilon_t \sim \mathcal{N}(0, 4^2)$. L’objectif analytique consiste à mobiliser l’environnement R pour extraire le signal tendanciel net au moyen de l’EMA, optimiser la sélection de $\alpha$, comparer les implémentations logicielles de référence, et produire une restitution graphique académique finale irréprochable.
12.2 Script complet d’analyse pas à pas
La mise en œuvre computationnelle de cette étude de cas s’articule selon un script séquentiel commenté, intégrant l’ensemble des bonnes pratiques et des packages étudiés. Nous allons décrire précisément chaque étape méthodologique de cette séquence exécutable :
Dans la première section du code, nous procédons à l’initialisation de l’environnement, à la fixation de la graine pseudo-aléatoire (set.seed(123)) et au chargement ordonné des bibliothèques tidyverse, pracma, TTR et scales. Ensuite, nous construisons le tableau de données empiriques. Le vecteur déterministe sous-jacent est formalisé en concaténant les trois segments temporels décrits précédemment, auquel est additionné le vecteur de bruits gaussiens généré par rnorm(60, mean = 0, sd = 4). Le tout est scellé dans un tibble contenant la variable temporelle Jour et la variable de réponse Detresse_Brute.
Dans la deuxième étape, nous exécutons le calcul comparatif des moyennes mobiles exponentielles. Nous appliquons la fonction pracma::movavg() avec une pseudo-fenêtre $n = 7$ (correspondant à un cycle de lissage hebdomadaire, soit $\alpha = 2 / (7 + 1) = 0{,}25$). Parallèlement, nous invoquons TTR::EMA() sur la même variable avec le même paramètre $n = 7$. Nous stockons ces deux sorties dans les colonnes EMA_pracma et EMA_ttr. Une colonne additionnelle est calculée à l’aide de notre fonction personnalisée d’autorégression récursive développée en Base R afin de vérifier la stricte équivalence mathématique des trajectoires obtenues dès la sortie de la phase de rodage.
La troisième étape s’attelle à l’optimisation paramétrique. Nous définissons formellement une fonction de perte calcul_rmse_ema(alpha_candidat) qui applique le lissage exponentiel récursif sur la série empirique et quantifie l’erreur quadratique moyenne de prédiction à un pas. En sollicitant l’optimiseur natif optimize(calcul_rmse_ema, interval = c(0.05, 0.95)), nous extrayons computationnellement la constante de lissage empirique optimale $\alpha^*$, que nous convertissons en sa pseudo-fenêtre temporelle équivalente $n^* = (2 / \alpha^*) – 1$. Cette valeur optimisée est alors utilisée pour calculer une dernière colonne de lissage haute performance nommée EMA_Optimale.
Enfin, la quatrième étape pilote l’ingénierie visuelle sous ggplot2. Les données sont préparées pour intégrer à la fois le nuage de points brut, la courbe calculée selon la fenêtre clinique heuristique hebdomadaire ($n = 7$) et la trajectoire optimisée par minimisation d’erreur. Le graphique est enrichi d’un bandeau d’annotation contextuelle situant le choc aigu du jour 21, configuré selon les préceptes esthétiques de theme_classic(), pourvu d’étiquettes typographiques conformes aux normes académiques internationales, et exporté dans le système de fichiers local via ggsave() avec une résolution calibrée à 300 DPI.
12.3 Interprétation substantive des résultats et conclusion
L’examen des trajectoires numériques et visuelles générées par notre protocole d’analyse séquentielle livre des enseignements fondamentaux pour le clinicien et le méthodologiste :
En premier lieu, la confrontation entre le signal brut accidenté et les séries lissées par l’EMA met en lumière la remarquable capacité de l’algorithme à extraire l’essence de la trajectoire clinique sans masquer la cinétique des événements critiques. Alors que les oscillations journalières aléatoires (bruit de fond) créent l’illusion d’une alternance constante de rechutes et de rémissions mineures, l’EMA d’échelle hebdomadaire ($n = 7$, $\alpha = 0{,}25$) neutralise ces artefacts stochastiques tout en réagissant promptement lors du choc survenu au jour 21. Le pic de souffrance est clairement identifié, et la transition vers la phase de décroissance thérapeutique est immédiatement restituée sans l’inertie paralysante qu’aurait imposée une moyenne arithmétique simple de même envergure.
En second lieu, l’optimisation computationnelle de la constante $\alpha$ révèle la géométrie profonde du signal temporel étudié. Si la valeur optimale $\alpha^*$ converge vers un équilibre stable (par exemple autour de $0{,}20$ à $0{,}30$), elle valide quantitativement l’intuition empirique du chercheur quant à la temporalité hebdomadaire de la régulation de l’affect chez ce participant. Le filtre exponentiel s’impose ainsi non seulement comme un simple instrument de nettoyage cosmétique de figures scientifiques, mais comme un puissant outil de modélisation mathématique capable d’objectiver l’inertie émotionnelle et la cinétique de récupération psychologique au fil du temps.
En conclusion de ce traité, le calcul de la moyenne mobile exponentielle sous l’environnement R se révèle être une démarche méthodologique hautement polyvalente, articulant harmonieusement des fondements théoriques mathématiques rigoureux et une diversité d’outils computationnels allant de l’abstraction fonctionnelle native de Base R à la haute performance de packages spécialisés comme pracma ou TTR. En respectant scrupuleusement les exigences de causalité temporelle, en anticipant le déphasage inhérent au filtrage, en gérant de façon appropriée les phases d’amorçage et en intégrant ces processus dans l’écosystème modulaire du tidyverse, le chercheur en sciences quantitatives dispose d’un appareillage statistique d’exception pour percer la structure latente des séries chronologiques complexes.
Références
- Box, G. E. P., Jenkins, G. M., Reinsel, G. C., & Ljung, G. M. (2015). Time series analysis: Forecasting and control (5th ed.). John Wiley & Sons. https://doi.org/10.1002/9781118619193
- Borchers, H. W. (2023). pracma: Practical numerical math functions (R package version 2.4.4). CRAN. https://CRAN.R-project.org/package=pracma
- Brown, R. G. (1959). Statistical forecasting for inventory control. McGraw-Hill.
- Cleveland, W. S. (1979). Robust locally weighted regression and smoothing scatterplots. Journal of the American Statistical Association, 74(368), 829-836. <a href="https://doi.org/10.1080/01621459.1979.10481038
- Holt, C. C. (2004). Forecasting seasonals and trends by exponentially weighted moving averages. International Journal of Forecasting, 20(1), 5-10. https://doi.org/10.1016/j.ijforecast.2003.09.015
- Hunter, J. S. (1986). The exponentially weighted moving average. Journal of Quality Technology, 18(4), 203-210. https://doi.org/10.1080/00224065.1986.11979014
- Hyndman, R. J., & Athanasopoulos, G. (2021). Forecasting: Principles and practice (3rd ed.). OTexts. https://otexts.com/fpp3/
- Kuppens, P., Allen, N. B., & Sheeber, L. B. (2010). Emotional inertia and psychological maladjustment. Psychological Science, 21(7), 984-991. https://doi.org/10.1177/0956797610372634
- Ulrich, J. (2023). TTR: Technical trading rules (R package version 0.24.4). CRAN. https://CRAN.R-project.org/package=TTR
- Vaughan, D. (2023). slider: Sliding window functions (R package version 0.3.1). CRAN. https://CRAN.R-project.org/package=slider
- Wickham, H., Averick, M., Bryan, J., Chang, W., McGowan, L. D., François, R., Grolemund, G., Hayes, A., Henry, L., Hester, J., Kuhn, M., Pedersen, T. L., Miller, E., Bache, S. M., Müller, K., Ooms, J., Robinson, D., Seidel, D. P., Spinu, V., … Yutani, H. (2019). Welcome to the Tidyverse. Journal of Open Source Software, 4(43), 1686. https://doi.org/10.21105/joss.01686
- Wilder, J. W. (1978). New concepts in technical trading systems. Trend Research.
- Zeileis, A., & Grothendieck, G. (2005). zoo: S3 infrastructure for regular and irregular time series. Journal of Statistical Software, 14(6), 1-27. https://doi.org/10.18637/jss.v014.i06