
Dans le domaine de l’économétrie appliquée, de la science des données et de la modélisation statistique contemporaine, l’évaluation rigoureuse de la performance prédictive constitue une étape épistémologique déterminante. Prédire une trajectoire temporelle ou quantifier l’évolution d’un phénomène empirique ne prend tout son sens scientifique que lorsqu’on est capable de mesurer avec une précision absolue l’écart séparant les estimations théoriques des observations réelles. Parmi l’arsenal d’indicateurs quantitatifs développés au fil des décennies, l’erreur absolue moyenne en pourcentage — universellement désignée sous son acronyme anglophone Mean Absolute Percentage Error (MAPE) — s’est imposée comme l’un des standards méthodologiques les plus largement mobilisés au sein des laboratoires de recherche et des organisations décisionnelles.
La popularité pérenne du MAPE s’explique principalement par son intuitivité conceptuelle et son invariance d’échelle. Contrairement aux mesures d’erreur absolues telles que l’erreur quadratique moyenne (RMSE) ou l’erreur absolue moyenne (MAE), dont les grandeurs numériques sont directement tributaires de l’unité de mesure propre à la variable étudiée, le MAPE s’exprime sous la forme d’un pourcentage adimensionnel. Cette caractéristique fondamentale permet aux chercheurs, analystes financiers et psychométriciens de comparer directement l’exactitude de modèles prédictifs appliqués à des séries temporelles de magnitudes radicalement dissemblables. Néanmoins, sous une apparente simplicité arithmétique se dissimulent des propriétés statistiques singulières, des asymétries mathématiques notables et des écueils de calcul qui exigent une vigilance analytique de premier ordre.
Bien que les environnements de programmation scientifique tels que R ou Python soient fréquemment sollicités pour le traitement massif de données, le tableur Microsoft Excel demeure l’écosystème analytique prédominant au sein duquel transitent, s’agrègent et se valident d’innombrables modèles décisionnels. La maîtrise de l’implémentation du MAPE dans Excel — depuis les décompositions arithmétiques séquentielles jusqu’aux formulations matricielles modernes et aux fonctions personnalisées de dernière génération — constitue une compétence indispensable pour tout analyste soucieux de rigueur, de transparence et de reproductibilité. Ce traité méthodologique propose une exploration exhaustive, théorique et opérationnelle, du calcul, de l’interprétation et de l’audit critique du MAPE au moyen des outils avancés d’Excel.
1. Fondements théoriques et épistémologiques du MAPE dans la modélisation prédictive
1.1 Définition conceptuelle et genèse statistique de la métrique
L’émergence formelle du Mean Absolute Percentage Error s’inscrit historiquement au cœur des développements pionniers de la prévision opérationnelle et de l’analyse des séries temporelles au cours de la seconde moitié du vingtième siècle. Avec l’avènement des grandes compétitions empiriques de prévision, notamment orchestrées par Spyros Makridakis et ses collaborateurs à travers les célèbres compétitions M (M-Competitions), la communauté scientifique a éprouvé la nécessité impérieuse de standardiser les protocoles d’évaluation comparative. Jusqu’alors, l’estimation des performances algorithmiques se heurtait à l’incommensurabilité des séries : comment arbitrer de manière équitable entre l’efficacité d’un modèle lissant la production industrielle de plusieurs millions de tonnes d’acier et celle d’un algorithme anticipant la vente hebdomadaire de quelques dizaines d’instruments chirurgicaux de haute précision ?
Le MAPE a précisément été conceptualisé pour répondre à cette aporie méthodologique en introduisant la notion d’écart relatif proportionnel. Plutôt que de consigner l’amplitude brute du résidu prédictif, le MAPE calcule le rapport mathématique entre l’erreur commise et la valeur empirique réellement observée, avant d’en extraire la valeur absolue. Cette normalisation transforme l’écart dimensionnel en une grandeur sans dimension, facilitant ainsi l’agrégation de séries hétérogènes. Dès lors, le chercheur dispose d’un instrument permettant d’affirmer qu’un modèle commet, en moyenne arithmétique, un écart relatif de 5 % ou de 12 % par rapport à la réalité empirique, indépendamment de l’ordre de grandeur inhérent aux unités physiques d’origine.
Sur le plan épistémologique, cette métrique ancre l’évaluation dans une perspective d’efficience relative. Dans les sciences appliquées, une déviation de cent unités ne revêt pas la même signification clinique ou économique selon qu’elle affecte un phénomène dont la ligne de base se situe à mille unités ou à dix millions d’unités. En pénalisant l’erreur proportionnellement à la grandeur du point d’ancrage réel, le MAPE confère une équité d’évaluation à l’ensemble du spectre d’observation, affirmant ainsi son rôle central dans la validation empirique des théories et des modèles mathématiques appliqués au réel.
1.2 Application du MAPE dans la recherche comportementale et psychologique
Si le secteur économique et la gestion de la chaîne logistique ont massivement adopté le MAPE, la recherche comportementale, la psychologie quantitative et les neurosciences computationnelles ont progressivement intégré cette métrique dans leurs protocoles de validation écologique. L’étude longitudinale des comportements humains — qu’il s’agisse de mesurer la fluctuation quotidienne de l’affect, la dynamique de l’attention sélective, le temps de réponse cognitif ou les patrons d’observance thérapeutique chez des cohortes de patients chroniques — repose sur la construction de modèles prédictifs continus ou discrets dont la précision doit pouvoir être quantifiée avec exactitude.
Dans l’évaluation de l’observance thérapeutique, par exemple, les chercheurs modélisent le respect des posologies médicamenteuses au moyen de capteurs connectés enregistrant l’horodatage des prises. Un modèle prédictif cherchant à anticiper les décrochages comportementaux génère des prévisions probabilistes ou fréquentielles d’adhésion. L’usage du MAPE permet dans ce contexte de chiffrer l’imprécision du modèle en regard du niveau d’activité global propre à chaque participant. Cette normalisation relative préserve l’intégrité de l’analyse en évitant que les données issues de sujets hyperactifs ou polymédiqués ne dominent artificiellement la fonction de perte statistique globale au détriment des profils caractérisés par une fréquence d’événements plus restreinte.
Par ailleurs, l’interprétabilité clinique du MAPE s’avère déterminante dans le dialogue interdisciplinaire unissant statisticiens, psychiatres et cliniciens non rompus aux abstractions de l’algèbre linéaire. Annoncer à une équipe médicale qu’un modèle présente une erreur quadratique de 2,45 points sur une échelle d’anxiété non normalisée s’avère souvent moins éloquent que de démontrer que l’algorithme dévie en moyenne de 8,2 % de l’état émotionnel mesuré. Enfin, l’usage raisonné du MAPE permet de dissocier conceptuellement le bruit stochastique résiduel — inhérent à la variabilité intrinsèque de la psychologie humaine — des déviations systématiques ou biais structurels de prédiction générés par les spécifications déficientes d’un modèle algorithmique.
2. Décomposition mathématique rigoureuse de la formule du MAPE
2.1 Analyse formelle des composantes algébriques
Pour aborder l’implémentation opérationnelle du MAPE au sein d’un environnement de calcul matriciel, il est impératif d’en décortiquer l’architecture mathématique fondamentale. Formellement, pour un échantillon de taille n comportant une série temporelle d’observations réelles indexées par t, notées yt, et une série correspondante de prédictions, notées ft (pour forecast), la formulation mathématique standard du MAPE s’énonce comme suit :
MAPE = (1 / n) * ∑t=1n | (yt – ft) / yt | * 100
L’examen minutieux de cet opérateur révèle une séquence rigoureuse d’opérations algébriques élémentaires qui conditionnent son comportement analytique :
- Le calcul du résidu brut (yt – ft) : Cette différence primordiale capture la déviation arithmétique simple entre la réalisation empirique du phénomène et la projection générée par le modèle statistique. Un résidu positif dénote une sous-estimation du modèle, tandis qu’un résidu négatif signale une surestimation.
- L’application de l’opérateur de valeur absolue (|…|) : Cette étape neutralise le signe arithmétique du résidu. En l’absence de valeur absolue, la sommation d’erreurs positives et négatives conduirait à un phénomène d’annulation mutuelle (compensation stochastique), masquant une imprécision prédictive flagrante sous une moyenne nulle. La valeur absolue assure ainsi que toute divergence par rapport au réel est comptabilisée comme une pénalité positive.
- Le ratio de normalisation par la valeur réelle observée (1 / yt) : Le résidu absolu est divisé par la valeur empirique yt (ou |yt| si la série admet des grandeurs négatives, bien que la métrique suppose classiquement la stricte positivité). Cette opération pondère le résidu par son échelle propre, générant un ratio d’erreur adimensionnel propre à chaque observation.
- L’opérateur de sommation (∑) et la division par n : Ces composantes appliquent l’espérance arithmétique standard sur l’ensemble de l’échantillon, agrégeant les ratios d’erreurs individuels en une métrique synthétique centrale.
- La multiplication scalaire par 100 : Cette dernière translation scalaire convertit la fraction décimale résultante en une expression exprimée en points de pourcentage, facilitant sa lecture standardisée.
2.2 Propriétés mathématiques et symétrie du ratio
L’analyse mathématique approfondie du MAPE met en lumière des propriétés structurelles remarquables, au premier rang desquelles figure son comportement asymptotique singulier. Lorsque la variable réelle observée yt tend vers zéro, le dénominateur de la fraction tend vers une limite nulle, provoquant une divergence vers l’infini du ratio (|yt – ft| / yt). Cette singularité mathématique signifie que la métrique est intrinsèquement hypersensible aux observations de faible magnitude, conférant à des erreurs minimes en valeur absolue un impact démesuré sur la moyenne globale.
De surcroît, le ratio sous-jacent au MAPE engendre une asymétrie fondamentale souvent critiquée dans la littérature statistique contemporaine. Cette asymétrie découle de la nature du dénominateur, systématiquement ancré sur la valeur réelle yt. Considérons deux scénarios prédictifs symétriques en amplitude absolue autour d’une valeur réelle yt = 100 :
- Cas de sous-estimation : Le modèle prédit ft = 50. Le résidu absolu est de 50. Le ratio d’erreur calculé est |100 – 50| / 100 = 50 / 100 = 50 %. Même dans le cas extrême où la prédiction est nulle (ft = 0), l’erreur relative maximale ne peut dépasser 100 %.
- Cas de surestimation : Le modèle prédit ft = 150. Le résidu absolu est également de 50. Le ratio d’erreur est de |100 – 150| / 100 = 50 / 100 = 50 %. Cependant, si le modèle prédit ft = 300, l’erreur relative atteint |100 – 300| / 100 = 200 %. Il n’existe théoriquement aucune borne supérieure pour pénaliser une surestimation, l’erreur pouvant croître indéfiniment vers l’infini positif.
Cette dissymétrie structurelle induit un biais d’évaluation systématique : le MAPE pénalise structurellement de manière plus sévère les modèles qui surestiment la réalité que ceux qui la sous-estiment. Par conséquent, lors de l’entraînement ou du calage algorithmique de fonctions prédictives cherchant à minimiser explicitement le MAPE, les modèles tendent naturellement à générer des prévisions conservatrices et biaisées vers le bas, privilégiant la sous-estimation afin d’éviter les pénalités exponentielles induites par les surestimations d’échelle.
3. Préparation et structuration des données expérimentales dans Microsoft Excel
3.1 Architecture matricielle de la feuille de calcul
L’implémentation opérationnelle et pérenne de calculs statistiques au sein d’Excel nécessite la conception préalable d’une architecture tabulaire rigoureuse répondant aux principes fondamentaux de la gestion des bases de données relationnelles. Trop souvent, les erreurs de calcul ou les distorsions d’analyse ne résultent pas d’une syntaxe mathématique erronée, mais d’une structuration anarchique des feuilles de calcul, mêlant indistinctement saisie brute, paramètres intermédiaires et indicateurs de synthèse.
Une feuille de calcul destinée à évaluer le MAPE doit être construite selon une logique colonnaire stricte respectant le principe de la première forme normale :
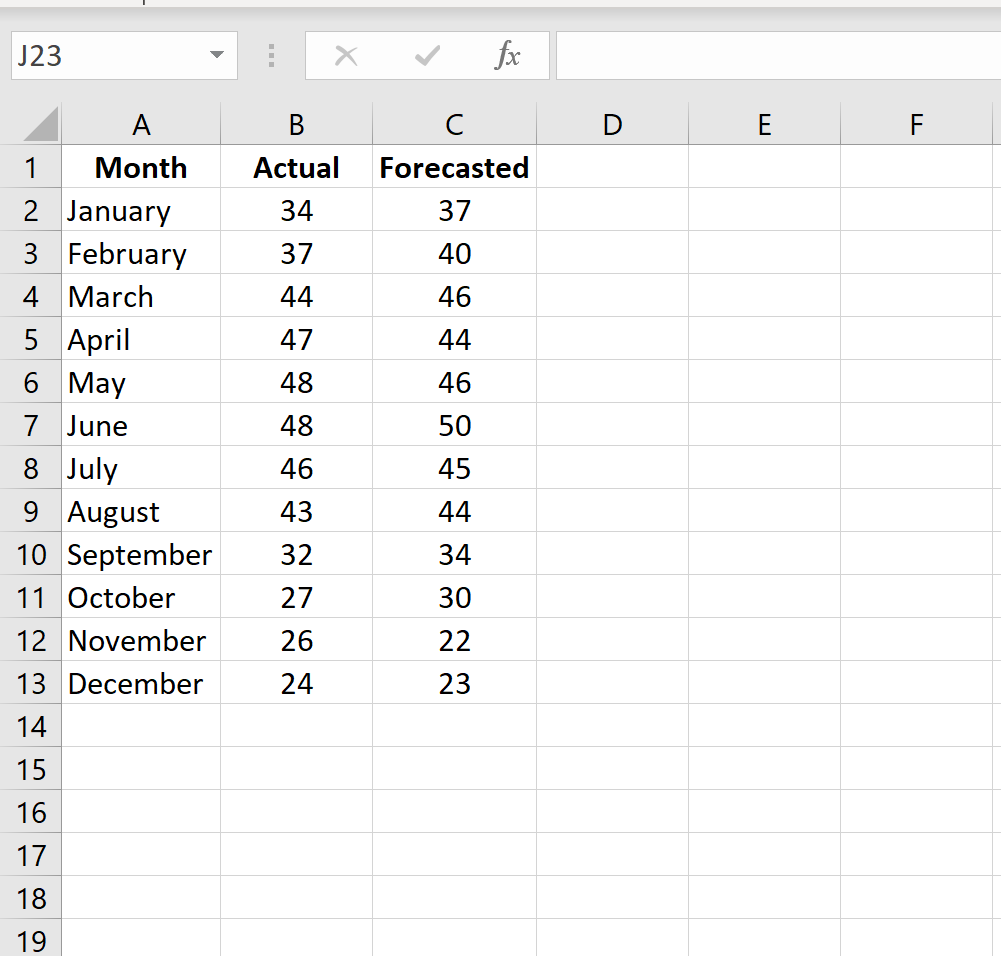
- Colonne A (Identifiant d’observation / Index temporel) : Enregistre l’horodatage précis ou l’index séquentiel (ex. Jour, Semaine, Numéro d’échantillon). Cet index garantit un alignement temporel strict et sans ambiguïté entre l’événement observé et sa prédiction correspondante.
- Colonne B (Série réelle observée – yt) : Contient exclusivement les données quantitatives empiriques mesurées expérimentalement. Le typage des cellules doit impérativement être configuré en format numérique strict, exempt de tout symbole textuel ou caractère typographique non arithmétique.
- Colonne C (Série prédite / Forecast – ft) : Consigne les valeurs numériques générées par l’algorithme ou le modèle mathématique sous évaluation.
- Colonnes D et suivantes (Calculs intermédiaires) : Dévolues aux étapes de transformation univariée (résidus bruts, valeurs absolues, ratios de normalisation).
Pour assurer la pérennité algorithmique et la lisibilité du classeur, l’emploi de plages nommées (Named Ranges) est vivement préconisé. En désignant la plage B2:B101 sous l’identifiant sémantique Valeurs_Reelles et la plage C2:C101 sous le nom Valeurs_Predites, le chercheur réduit drastiquement les risques de déréférencement spatial lors des opérations de tri ou d’insertion de lignes, tout en rendant les expressions mathématiques immédiatement intelligibles pour des auditeurs externes.
3.2 Audit préliminaire et assainissement du jeu de données
Préalablement à toute computation arithmétique, un audit exhaustif d’intégrité numérique s’impose. La présence insidieuse d’anomalies structurelles au sein du jeu de données peut non seulement fausser silencieusement les estimations du MAPE, mais également générer des erreurs d’exécution bloquantes au sein des moteurs de calcul d’Excel. Cet assainissement méthodique repose sur trois vérifications cruciales :
Premièrement, l’analyste doit identifier et traiter systématiquement les cellules orphelines ou manquantes (valeurs null). Dans Excel, si une cellule de prédiction est vide en face d’une valeur réelle, le logiciel peut l’interpréter selon le contexte comme une valeur zéro, ce qui dénature radicalement l’évaluation en simulant une erreur de sous-estimation de 100 %. Des formules de diagnostic conditionnel, telles que =NB.VIDE(Plage) ou l’utilisation de filtres automatiques, permettent de recenser instantanément les occurrences manquantes.
Deuxièmement, il est impératif de traquer les résidus textuels accidentels. L’importation de fichiers CSV ou l’exportation depuis des plateformes de psychométrie propriétaires introduisent fréquemment des espaces insécables, des séparateurs décimaux inadéquats (virgules au lieu de points selon les paramètres régionaux du système d’exploitation) ou des chaînes textuelles pour qualifier les données non renseignées (ex. « N/A », « NaN », « Absent »). L’application de la fonction =ESTNUM(B2) sur l’ensemble des colonnes numériques valide formellement la nature arithmétique des vecteurs de données.
Troisièmement, la stricte positivité des données empiriques observées (yt > 0) doit être rigoureusement contrôlée. Le MAPE interdisant formellement tout dénominateur nul, la présence d’un seul zéro au sein de la colonne des réalisations réelles invalidera irrémédiablement le calcul global. Toute exclusion d’observations non positives ou manifestement corrompues doit être formellement documentée dans un journal d’audit méthodologique adossé au protocole expérimental, garantissant ainsi la conformité de l’étude avec les standards contemporains de reproductibilité scientifique.
4. Calcul de l’erreur absolue en pourcentage par observation dans Excel
4.1 Implémentation de la fonction de valeur absolue ABS
La première phase opératoire de la décomposition pas à pas du MAPE dans Excel consiste à calculer individuellement l’écart résiduel absolu entre chaque point de mesure et son estimation prédictive. Ce calcul élimine tout risque de compensation arithmétique des déviations positives et négatives au moyen de la fonction native ABS.
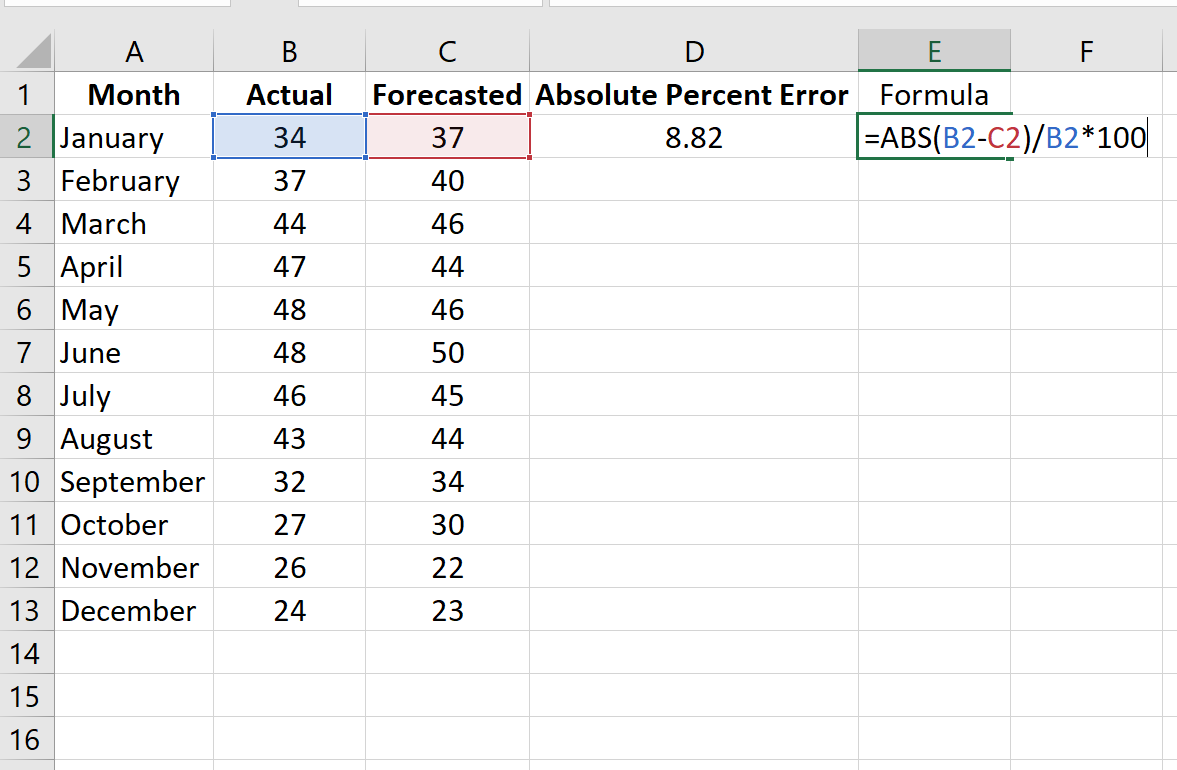
Considérons une structure tabulaire standard dans laquelle la première observation empirique est consignée dans la cellule B2 et la valeur prédite par le modèle mathématique réside dans la cellule C2. L’expression arithmétique calculant le résidu absolu s’écrit de la façon suivante :
=ABS(B2-C2)
Il importe de souligner la neutralité commutative de cette formulation interne grâce aux propriétés mathématiques de l’opérateur de module. En effet, en vertu de l’axiome fondamental selon lequel |u| = |-u|, l’écriture alternative :
=ABS(C2-B2)
produit un résultat rigoureusement identique au bit près dans la précision en virgule flottante d’Excel. L’ordre des opérandes est par conséquent sans incidence sur le résultat de cette étape élémentaire.
Sur le plan de la précision numérique, Excel traite nativement les nombres selon la norme internationale IEEE 754 relative à l’arithmétique en virgule flottante en double précision (offrant une précision d’environ 15 à 17 chiffres décimaux significatifs). Il est crucial d’éviter d’appliquer des fonctions d’arrondi explicites (telles que ARRONDI ou ARRONDI.INF) au niveau de ces calculs intermédiaires. L’affichage visuel des décimales via le panneau de mise en forme d’Excel permet de calibrer la lisibilité graphique sans corrompre la précision analytique sous-jacente des accumulateurs arithmétiques du logiciel.
4.2 Normalisation relative et conversion en pourcentage ligne par ligne
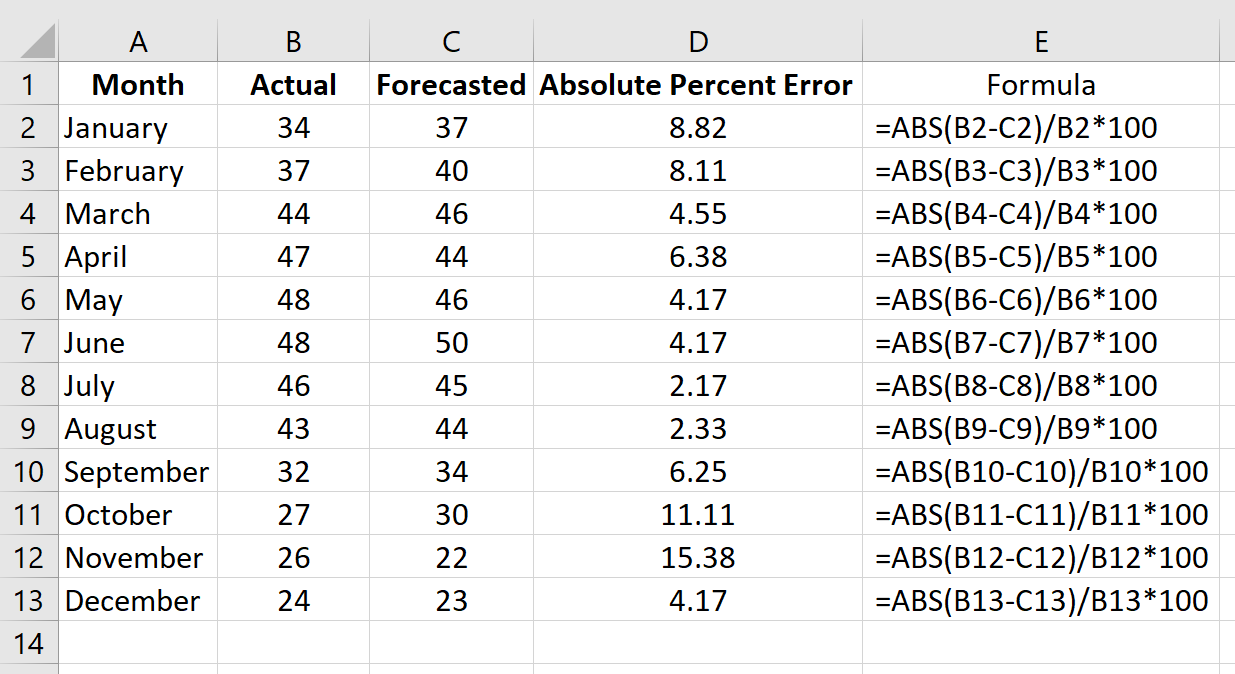
La seconde phase consiste à normaliser l’écart absolu obtenu en le rapportant à l’amplitude de l’observation réelle correspondante. Cette opération génère l’erreur absolue relative unitaire (souvent désignée sous le sigle APE, pour Absolute Percentage Error). En poursuivant sur notre ligne de données 2, l’expression complète s’articule comme suit :
=ABS(B2-C2)/ABS(B2)
L’intégration de la fonction ABS au dénominateur (ABS(B2)) constitue une précaution méthodologique indispensable, particulièrement recommandée lorsque l’environnement d’analyse manipule des données dont la polarité théorique pourrait exceptionnellement osciller, bien que l’interprétation d’un MAPE sur des séries purement négatives soulève des ambiguïtés théoriques majeures. Dans l’hypothèse canonique où la série yt est strictement positive, la formulation simplifiée =ABS(B2-C2)/B2 est couramment retenue.
Une fois cette formule matricielle individuelle validée dans la cellule D2, la conversion de la fraction décimale en un format de pourcentage intelligible s’opère selon deux approches distinctes :
- L’approche par mise en forme native (recommandée) : Le contenu de la cellule demeure une fraction décimale (par exemple
0.0452). L’analyste applique simplement le format d’affichage « Pourcentage » (raccourci clavier sous Windows :Ctrl + Maj + %), configuré avec deux décimales de précision. La cellule affiche visuellement4,52 %, tout en conservant sa valeur unitaire intrinsèque pour les éventuelles opérations d’agrégation ultérieures. - L’approche arithmétique scalaire : L’analyste multiplie manuellement le quotient par 100 via la syntaxe
=(ABS(B2-C2)/B2)*100. La cellule contient alors la valeur4.52et doit être maintenue au format standard ou nombre. Cette méthode, bien que répandue, présente l’inconvénient d’exiger une vigilance constante quant à la dimensionnalité des agrégats pour éviter des confusions d’unités lors de l’intégration dans des méta-modèles.
La propagation de cette formule sur l’ensemble de la série empirique (par exemple de la ligne 2 à la ligne 1000) s’effectue idéalement en convertissant préalablement la plage de données en un Tableau structuré Excel officiel (raccourci Ctrl + L ou Ctrl + T). Dans un tableau structuré, la formule se propage instantanément par le mécanisme des colonnes calculées sous la syntaxe explicite :
=ABS([@Reel]-[@Prevision])/[@Reel]
Cette approche garantit une robustesse opérationnelle totale face aux insertions ou suppressions dynamiques de lignes d’enregistrement.
5. Agrégation de la métrique globale et formalisation du résultat final
5.1 Utilisation de la fonction MOYENNE pour la synthèse des erreurs
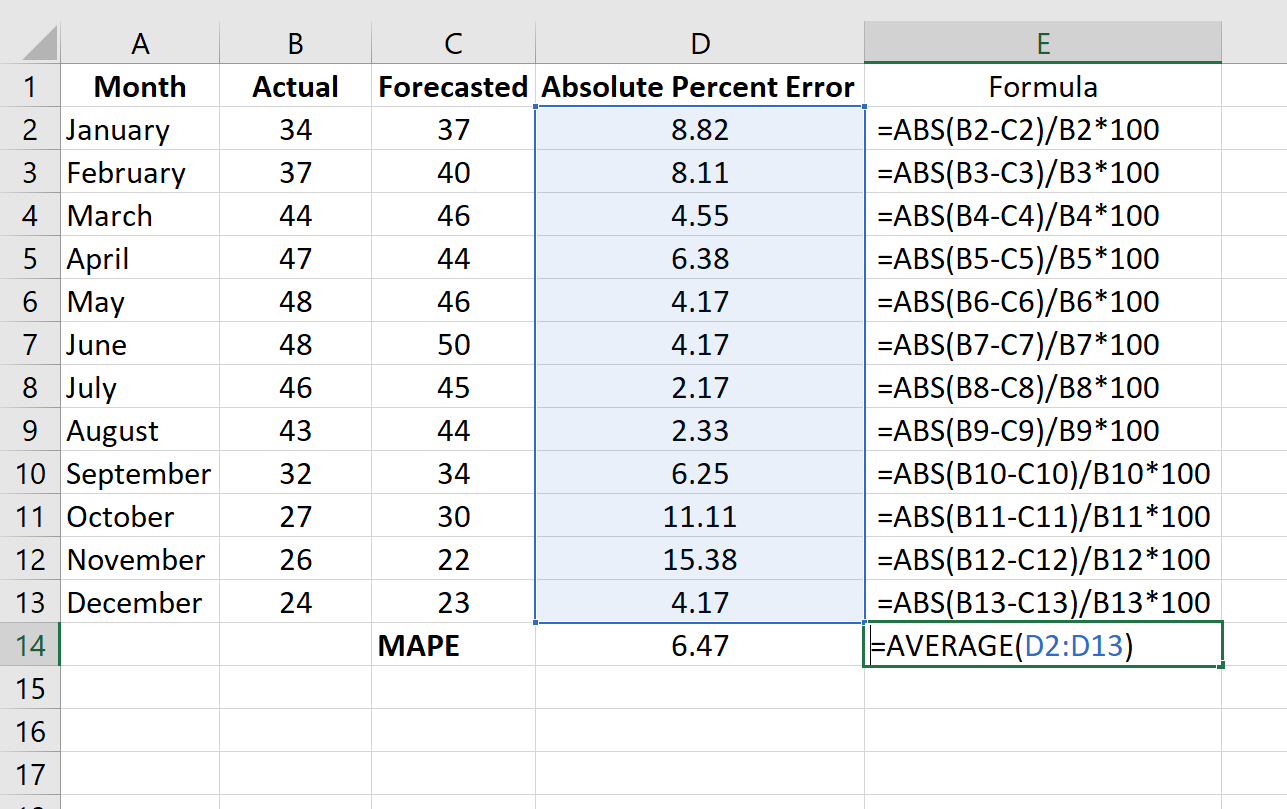
Une fois les erreurs relatives individuelles (APE) rigoureusement calculées au sein d’une colonne dédiée — supposons la colonne D, s’étendant de la ligne 2 à la ligne 101 —, la synthèse globale de la performance du modèle s’obtient par l’application de la fonction arithmétique MOYENNE. L’opérateur s’écrit de manière canonique :
=MOYENNE(D2:D101)
Cette opération réalise la sommation arithmétique de l’ensemble des déviations relatives individuelles et divise le cumul par le nombre effectif d’observations numériques valides au sein de la plage sélectionnée. Sur le plan de la logique interne d’Excel, la fonction MOYENNE possède la propriété remarquable d’ignorer automatiquement et silencieusement les cellules contenant du texte pur ou laissées intégralement vides. Cependant, si une cellule de la colonne D renvoie un message d’erreur mathématique (tel que #DIV/0! ou #VALEUR!), l’intégralité de l’agrégation MOYENNE est immédiatement corrompue et affiche le même code d’erreur, jouant ainsi un rôle salutaire de sentinelle d’intégrité.
Sur le plan épistémique, il convient de souligner la très grande sensibilité de la moyenne arithmétique aux distributions d’erreurs fortement asymétriques ou étirées vers la droite. Dans les séries chronologiques complexes, la survenue de quelques anomalies prédictives ponctuelles (outliers) peut gonfler de manière disproportionnée le MAPE global, véhiculant l’impression erronée d’un modèle structurellement défaillant alors même que la médiane des erreurs relatives demeure remarquablement basse. Pour pallier cette distorsion lors de la rédaction de rapports scientifiques, il est hautement recommandé d’adosser systématiquement à l’indicateur global MOYENNE l’indicateur robuste de position fourni par la formule =MEDIANE(D2:D101).
5.2 Calcul condensé sans colonne intermédiaire via SOMMEPROD
Bien que la décomposition séquentielle via une colonne auxiliaire soit irremplaçable pour auditer visuellement la distribution unitaire des écarts, les contraintes d’espace, d’élégance architecturale ou de vitesse de calcul dans les modèles financiers et psychométriques volumineux justifient le recours à une formulation condensée directe. Excel permet d’agréger directement le MAPE en une formule unique sans recourir à aucune colonne intermédiaire grâce à la puissance matricielle de la fonction SOMMEPROD.
En reprenant l’hypothèse de nos séries de valeurs réelles stockées en B2:B101 et de valeurs prédites en C2:C101, la syntaxe matricielle avancée s’articule ainsi :
=SOMMEPROD(ABS(B2:B101-C2:C101)/B2:B101)/NB(B2:B101)
Le décryptage algorithmique de cette expression illustre parfaitement la puissance du moteur de calcul d’Excel :
- L’argument interne
ABS(B2:B101-C2:C101)/B2:B101demande à Excel de générer en mémoire vive un vecteur unidimensionnel virtuel de 100 éléments contenant chacun le ratio d’erreur relative calculé pour chaque paire d’enregistrements. - La fonction
SOMMEPRODeffectue la sommation séquentielle de l’ensemble des éléments de ce vecteur virtuel. Contrairement aux anciennes formules matricielles traditionnelles qui exigeaient la validation lourde par la combinaison de touchesCtrl + Maj + Entrée,SOMMEPRODgère nativement le traitement matriciel sans manipulation particulière. - La fonction
NB(B2:B101)quantifie le nombre d’observations réelles numériques, assurant la division par n rigoureusement conforme à la formule algébrique.
Pour exprimer directement le résultat final sous forme de pourcentage affiché, il suffit d’appliquer le format Pourcentage à la cellule hôte, ou d’encadrer l’ensemble de la formule d’une multiplication scalaire :
=(SOMMEPROD(ABS(B2:B101-C2:C101)/B2:B101)/NB(B2:B101))*100
Les tests de performance computationnelle démontrent que sur des volumes d’enregistrements excédant plusieurs centaines de milliers de lignes, cette formulation directe via SOMMEPROD réduit l’empreinte mémoire du classeur et accélère les temps de recalcul lors des phases de simulation probabiliste (méthodes de Monte-Carlo).
6. Formulations matricielles avancées et fonctions dynamiques modernes dans Excel
6.1 Exploitation des formules matricielles dynamiques avec LET
L’introduction récente dans le moteur de calcul de Microsoft 365 des formules matricielles dynamiques et de la fonction LET a profondément métamorphosé l’ingénierie des calculs sous Excel. La fonction LET permet d’assigner des noms explicites à des plages de données ou à des résultats intermédiaires au sein même d’une formule unique, éliminant la redondance des évaluations internes et optimisant substantiellement l’efficacité algorithmique.
Dans le contexte du calcul condensé du MAPE, la fonction LET permet de déclarer formellement les vecteurs de référence une seule fois, fluidifiant considérablement la maintenance du classeur lors des phases de révision par les pairs. La syntaxe optimisée s’établit comme suit :
=LET(reels; B2:B101; prevs; C2:C101; n; NB(reels); MOYENNE(ABS(reels-prevs)/reels))
Analysons la séquence logique de cette construction d’ingénierie financière et scientifique :
reels; B2:B101: Assigne le vecteur d’observations empiriques à la variable locale reels.prevs; C2:C101: Assigne le vecteur des projections algorithmiques à la variable locale prevs.n; NB(reels): Calcule et stocke la cardinalité de l’échantillon d’analyse sous la variable n.MOYENNE(ABS(reels-prevs)/reels): Exécute l’évaluation arithmétique globale en s’appuyant directement sur le moteur de propagation dynamique matricielle (Spill Ranges), la fonctionMOYENNEréalisant directement la synthèse de la matrice résultante calculée en mémoire vive.
L’avantage cardinal de cette syntaxe réside dans sa parfaite transparence logique. Si le chercheur doit modifier la délimitation géographique ou temporelle de ses plages de données sources, il n’opère la modification que sur les deux premières déclarations de variables de la formule, sans avoir à réécrire ou vérifier les arguments des opérateurs arithmétiques situés en aval.
6.2 Création d’une fonction personnalisée réutilisable avec LAMBDA
Le déploiement de la fonction LAMBDA représente le degré ultime de sophistication algorithmique native au sein d’Excel. Grâce à LAMBDA, les analystes peuvent créer leurs propres fonctions personnalisées, exemptes de tout code VBA ou macro-instructions contraignantes en matière de sécurité informatique, et les réutiliser universellement à travers l’ensemble des feuilles de calcul d’un classeur.
Pour encapsuler la métrique du MAPE au sein d’une fonction native pérenne, la procédure d’ingénierie s’opère selon les étapes suivantes :
- Accéder au ruban supérieur d’Excel, sélectionner l’onglet Formules, puis cliquer sur l’utilitaire Gestionnaire de noms.
- Cliquer sur Nouveau pour déclarer un nouvel objet de calcul.
- Dans le champ Nom, saisir l’identifiant sémantique strict de la fonction :
CALCUL_MAPE. - Dans le champ Fait référence à :, insérer l’expression formelle
LAMBDAsuivante :
=LAMBDA(vecteur_reel; vecteur_predit; MOYENNE(ABS(vecteur_reel - vecteur_predit) / vecteur_reel)) - Valider par OK et refermer l’interface d’administration.
Dès cet instant, la fonction personnalisée CALCUL_MAPE est nativement reconnue par le moteur IntelliSense d’Excel au même titre que des fonctions historiques telles que SOMME ou RECHERCHEV. Pour calculer le MAPE global d’un protocole expérimental, l’analyste n’a plus qu’à rédiger au sein de la cellule de synthèse :
=CALCUL_MAPE(B2:B101; C2:C101)
Cette standardisation garantit une gouvernance irréprochable des processus analytiques à l’échelle d’un laboratoire de recherche ou d’un département quantitatif d’entreprise, écartant définitivement les erreurs humaines de transcription mathématique lors de la duplication de feuilles de travail.
7. Traitement rigoureux des valeurs critiques et des singularités numériques
7.1 Gestion de la division par zéro et des valeurs réelles nulles
L’obstacle méthodologique et computationnel le plus redoutable lors de la manipulation du MAPE réside indubitablement dans l’apparition d’observations empiriques réelles nulles (yt = 0). Sur le plan mathématique formel, la division d’un résidu absolu par un dénominateur nul constitue une indétermination absolue. Au sein du moteur d’exécution d’Excel, cette singularité numérique déclenche immédiatement l’interruption du calcul et le renvoi fatal de l’erreur d’exécution #DIV/0!.
Pour préserver l’intégrité globale du classeur et empêcher la contamination en cascade de toutes les formules dépendantes, l’analyste doit mettre en œuvre une stratégie de confinement conditionnel au niveau du calcul unitaire ligne par ligne. Plusieurs architectures logiques sont envisageables :
- Le filtrage conditionnel préventif via SI :
=SI(B2=0; "Non Applicable - Réel Nul"; ABS(B2-C2)/B2)
Cette formulation isole explicitement les occurrences singulières. Le fait d’injecter une chaîne textuelle au lieu d’une valeur numérique permet à la fonction d’agrégation globaleMOYENNEsituée en aval d’ignorer automatiquement ces observations sans générer d’interruption logicielle. - Le confinement a posteriori via SIERREUR :
=SIERREUR(ABS(B2-C2)/B2; "")
Cette structure capture toute anomalie de calcul issue de la division et retourne une chaîne vide, neutralisant ainsi la propagation de l’erreur.
Cependant, si le traitement informatique de l’erreur #DIV/0! se résout aisément, sa justification statistique et méthodologique exige une extrême prudence scientifique. Éliminer systématiquement les occurrences où le phénomène réel est nul revient à ignorer délibérément les périodes de calme plat, de non-consommation ou d’absence de symptômes comportementaux. Si un modèle de prévision anticipe une valeur non nulle alors que la réalité empirique est rigoureusement à zéro, l’exclusion méthodologique de ce point sous prétexte d’évitement informatique masquerait l’incapacité criante du modèle à discerner l’inactivité, induisant un biais de sélection inacceptable dans l’évaluation de la performance scientifique.
7.2 Distorsion induite par les valeurs réelles proches de zéro
Bien plus insidieuse que la valeur zéro absolue est la distorsion statistique générée par des réalisations empiriques strictement positives mais d’amplitude infinitésimale (par exemple yt = 0,001). Dans de pareils cas, la formule du MAPE s’exécute sans déclencher la moindre alerte d’erreur sous Excel, mais le ratio résultant atteint des valeurs aberrantes qui viennent déstabiliser l’ensemble de la métrique.
Considérons une série psychologique mesurant l’intensité d’un affect sur une échelle continue, où un participant enregistre une valeur réelle minime de 0,05 unité. Si le modèle algorithmique prédit une intensité de 0,95 unité — ce qui représente un écart absolu modeste de 0,90 point —, le calcul unitaire de l’APE engendre :
APE = |0,05 - 0,95| / 0,05 = 0,90 / 0,05 = 18 = 1800 %
Cette observation unique introduira une distorsion monumentale au sein de la moyenne arithmétique globale, dominant artificiellement des centaines d’autres observations dont les prédictions étaient pourtant remarquablement stables. Ce phénomène, connu sous le nom d’effet de levier des dénominateurs faibles, constitue la vulnérabilité intrinsèque la plus sévère du MAPE.
Pour neutraliser méthodologiquement cette instabilité numérique sans corrompre arbitrairement l’échantillon, deux stratégies d’assainissement doivent être rigoureusement documentées :
- L’écrêtage méthodologique (Trimming) : Définir un seuil d’éligibilité minimale de la valeur observée réelle en deçà duquel l’observation est exclue du calcul du MAPE (par exemple, retenir uniquement les observations où yt ≥ 5 % de la moyenne de la série).
- La winsorisation des pourcentages d’erreurs relatifs : Fixer un plafond statistique (par exemple 100 % ou 200 %) assigné à tout APE individuel excédant ce seuil, limitant mécaniquement l’influence des valeurs aberrantes sur l’indicateur synthétique global. Dans Excel, cette opération s’exécute élégamment via la fonction
MIN:
=MIN(2; ABS(B2-C2)/B2)
8. Grille d’interprétation empirique et benchmarks académiques du MAPE
8.1 Seuils standards d’exactitude selon la littérature scientifique
L’obtention d’un pourcentage consolidé au bas d’une feuille de calcul Excel soulève inévitablement la question de son interprétation herméneutique : à partir de quel seuil quantitatif un modèle prédictif peut-il être jugé performant, recevable ou méthodologiquement défaillant ? Dans la littérature fondatrice consacrée à l’évaluation des séries temporelles, les travaux canoniques de C. D. Lewis (1982) ont instauré une grille d’étalonnage internationale qui demeure, encore aujourd’hui, la référence empirique standard dans de multiples disciplines scientifiques :
- MAPE ≤ 10 % (Prévision hautement précise) : Ce standard d’excellence indique que le modèle statistique capture avec une remarquable fidélité la dynamique sous-jacente du phénomène. Les résidus ne constituent que des micro-fluctuations stochastiques d’amplitude négligeable par rapport à la tendance dominante.
- 10 % < MAPE ≤ 20 % (Prévision bonne et robuste) : L’architecture prédictive démontre une capacité adéquate à anticiper les oscillations temporelles. Les décisions stratégiques ou cliniques peuvent s’appuyer sur ces estimations avec un degré de confiance substantiel, bien que des perfectionnements paramétriques restent envisageables.
- 20 % < MAPE ≤ 50 % (Prévision raisonnable / Précision modérée) : Ce palier traduit une incertitude prédictive non négligeable. Bien que le modèle décèle l’orientation générale de la variable, la dispersion des erreurs impose une vigilance critique. Ce niveau de performance est fréquemment la norme empirique dans les sciences sociales et comportementales, où la stochasticité humaine limite intrinsèquement le pouvoir explicatif déterministe.
- MAPE > 50 % (Prévision inexacte et défaillante) : À ce niveau d’imprécision, le modèle est considéré comme structurellement inadéquat pour la prise de décision ou l’explication théorique. Les projections s’écartent en moyenne de plus de la moitié de la grandeur du phénomène observé, traduisant soit un surajustement pathologique (overfitting), soit une spécification erronée des covariables explicatives.
8.2 Facteurs contextuels influençant l’interprétation en psychologie quantitative
L’application mécanique et décontextualisée des seuils de Lewis peut toutefois induire de lourdes erreurs de jugement scientifique. En psychologie quantitative et dans l’étude des systèmes comportementaux, la précision intrinsèquement atteignable par un modèle est fortement contrainte par le niveau de bruit de mesure inhérent aux instruments psychométriques (faible fidélité test-retest, biais de désirabilité sociale, subjectivité des échelles de Likert).
Un facteur analytique prépondérant réside dans l’horizon et la granularité temporelle des données agrégées sous Excel :
- Séries journalières ou infra-journalières : Ces séries temporelles présentent une variance non structurée considérable. Dans ce contexte, l’obtention d’un MAPE de 25 % ou 30 % lors de la prédiction quotidienne du temps de sommeil paradoxal ou de l’impulsivité émotionnelle peut être considérée comme un triomphe de modélisation.
- Séries mensuelles ou trimestrielles agrégées : Le processus de lissage par l’agrégation temporelle gommant mécaniquement la variance résiduelle haute-fréquence, un MAPE excédant 15 % sur ces mêmes cohortes comportementales révélera une faiblesse analytique majeure.
De surcroît, tout MAPE obtenu sous Excel doit être impérativement étalonné en référence à un modèle naïf standard (principe du modèle de prévision de référence ou Benchmark model). Le modèle naïf d’ordre 1 suppose simplement que la valeur observée à l’instant t sera rigoureusement reconduite à l’instant t+1 (ft+1 = yt). Si un algorithme d’apprentissage machine hautement sophistiqué affiche un MAPE séduisant de 14 % sous Excel, mais qu’un modèle naïf basique exécuté en une seule ligne dans la cellule voisine affiche un MAPE de 12 %, l’analyste doit conclure à la totale inutilité prédictive de son architecture complexe, démontrant que l’interprétation du MAPE est fondamentalement relative au contexte empirique investigué.
9. Analyse comparative : MAPE face aux autres métriques d’erreur de prévision
9.1 Comparaison méthodologique avec la MAE et la RMSE
Le choix raisonné du MAPE au sein d’un protocole d’évaluation sous Excel ne peut se faire sans une compréhension approfondie de ses articulations différentielles avec les métriques traditionnelles d’erreur résiduelle que sont l’erreur absolue moyenne (MAE) et l’erreur quadratique moyenne (RMSE).
Le tableau analytique ci-dessous synthétise les propriétés mathématiques et les implications pratiques régissant la sélection de ces indicateurs sous Excel :
- Dépendance dimensionnelle et d’échelle : La MAE (
=MOYENNE(ABS(Reels-Prevs))) et la RMSE (=RACINE(MOYENNE((Reels-Prevs)^2))) s’expriment rigoureusement dans l’unité physique de la variable d’origine (par exemple, en milligrammes, en secondes ou en points d’inventaire clinique). Elles interdisent formellement toute comparaison croisée entre des variables d’échelles disparates. À l’inverse, le MAPE transcende les dimensions physiques grâce à sa nature de ratio en pourcentage. - Pénalisation différentielle des valeurs extrêmes : La RMSE utilise une élévation au carré des résidus, conférant une pénalité quadratique exponentielle aux grands écarts prédictifs. La MAE applique une pénalité purement linéaire et robuste. Le MAPE, quant à lui, applique une pénalité relative : un écart de 10 unités sur une base de 20 est pénalisé avec la même sévérité qu’un écart de 1 000 unités sur une base de 2 000.
- Comportement face aux distributions asymétriques : La RMSE et le MAPE sont extrêmement vulnérables aux distributions caractérisées par des queues lourdes, bien que leurs mécanismes de distorsion diffèrent : la RMSE est attirée par les grands résidus bruts, tandis que le MAPE est déstabilisé par les observations réelles proches de zéro.
Pour un reporting scientifique exhaustif conforme aux exigences de l’American Psychological Association (APA), il est hautement conseillé de présenter conjointement le MAPE (pour sa lisibilité globale et comparative) et la MAE ou la RMSE (pour quantifier l’amplitude concrète de l’erreur dans l’espace physique du phénomène étudié).
9.2 Alternatives directes pour corriger l’asymétrie : WAPE et SMAPE
Face aux tares structurelles documentées du MAPE — à savoir la division par zéro et l’asymétrie de pénalisation favorisant la sous-estimation —, la science statistique a forgé deux extensions contemporaines majeures qu’il est aisé d’implémenter sous Microsoft Excel : le Symmetric Mean Absolute Percentage Error (SMAPE) et le Weighted Absolute Percentage Error (WAPE).
Le SMAPE cherche à rééquilibrer la fonction de perte en intégrant la moyenne arithmétique de la valeur réelle et de la valeur prédite au dénominateur unitaire :
SMAPE = (1 / n) * ∑ |yt – ft| / ((|yt| + |ft|) / 2) * 100
Sous Excel, l’implémentation de la ligne 2 de calcul s’exécute ainsi :
=ABS(B2-C2)/((ABS(B2)+ABS(C2))/2)
Cette formulation possède la vertu mathématique de borner strictement l’erreur unitaire entre 0 % et 200 %, conférant une neutralité parfaite face aux sous-estimations et surestimations. Cependant, le SMAPE souffre d’une moindre intuitivité conceptuelle et demeure instable lorsque la valeur réelle et la prédiction sont toutes deux proches de zéro.
Le WAPE (souvent désigné sous l’appellation d’indicateur MAD/Mean) contourne radicalement le problème de la singularité du dénominateur en agrégeant les résidus absolus et les valeurs réelles avant d’effectuer la division :
WAPE = ∑ |yt – ft| / ∑ yt
Sous Excel, le calcul du WAPE global s’exécute sans aucune colonne intermédiaire grâce à la fonction suivante :
=SOMMEPROD(ABS(B2:B101-C2:C101))/SOMME(B2:B101)
Le WAPE présente l’avantage exceptionnel de tolérer parfaitement la présence de valeurs empiriques nulles ponctuelles (tant que la somme totale de la série empirique demeure strictement positive), tout en pondérant implicitement chaque erreur par le poids relatif de l’observation au sein de l’ensemble de l’échantillon, constituant l’alternative moderne la plus plébiscitée en modélisation quantitative.
10. Visualisation graphique des erreurs et restitution visuelle sous Excel
10.1 Conception de graphiques de concordance entre réel et prévision
L’exploration purement numérique du MAPE doit impérativement être complétée par une restitution visuelle permettant d’identifier immédiatement les régimes temporels où le modèle statistique perd son calibrage prédictif. Microsoft Excel dispose d’outils graphiques hautement paramétrables pour restituer la concordance entre observations empiriques et prévisions algorithmiques.
Le premier graphique diagnostique fondamental est la courbe chronologique superposée :
- Sélectionner simultanément les colonnes d’identifiant temporel (
A1:A101), de valeurs réelles (B1:B101) et de prévisions (C1:C101). - Insérer un Graphique en courbes avec marqueurs.
- Appliquer une stylisation rigoureuse selon les standards académiques : tracer la série des observations réelles en trait continu sombre d’épaisseur renforcée (ex. noir ou bleu marine profond), et la série prédictive en ligne discontinue ou tiretée de teinte contrastée (ex. rouge ou orange vif).
- Cette disposition permet de déceler visuellement les déphasages temporels (le modèle réagit-il systématiquement avec un temps de retard sur les inflexions réelles ?) et les écrasements de variance (le modèle lisse-t-il excessivement les pics empiriques ?).
Le second instrument visuel est le diagramme de dispersion avec droite d’identité (Scatter Plot y = x) :
- Insérer un graphique de type Nuage de points en assignant l’axe horizontal (X) aux valeurs réelles et l’axe vertical (Y) aux valeurs prédites.
- Insérer manuellement une série de données fictive représentant la diagonale parfaite d’adéquation prédictive reliant les coordonnées [0 ; 0] au point [Max(Réel) ; Max(Réel)].
- Toute observation se positionnant rigoureusement sur la droite diagonale représente une prédiction exacte (APE = 0 %). Les points situés au-dessus de la droite révèlent des zones de surestimation, tandis que les observations s’agrégeant sous la diagonale dénotent des sous-estimations chroniques.
10.2 Représentation diagnostique de la distribution des erreurs relatives
Au-delà de la confrontation entre séries brutes, l’analyse approfondie de la répartition spatiale et temporelle des erreurs relatives constitue le cœur du diagnostic statistique sous Excel. L’analyste doit contrôler que l’erreur relative ne présente pas d’hétéroscédasticité ni de clusters d’erreurs systématiques.
Pour matérialiser cette distribution, la construction d’un histogramme de fréquence des APE permet de contrôler visuellement la symétrie ou l’étalement de l’imprécision. En sélectionnant la colonne D2:D101 contenant les erreurs relatives en pourcentage et en générant un histogramme natif d’Excel (onglet Insertion > Graphique statistique > Histogramme), l’analyste visualise la proportion d’enregistrements s’inscrivant dans la zone d’excellence (≤ 10 %) par rapport aux occurrences dégradées.
De surcroît, l’application de la mise en forme conditionnelle sur la colonne des erreurs unitaires offre un diagnostic tabulaire immédiat :
- Sélectionner la plage des ratios d’erreurs relatives unilatérales
D2:D101. - Accéder au menu Mise en forme conditionnelle > Nuances de couleurs.
- Sélectionner un dégradé tricolore progressif (du vert d’eau pour les valeurs d’erreurs proches de 0 %, au jaune pour les seuils avoisinant 15 %, jusqu’au rouge profond pour les déviations excédant 40 %).
Cette visualisation tabulaire permet à l’examinateur de repérer instantanément des séries contiguës de cellules écarlates, signalant la défaillance transitoire du modèle lors de phases d’instabilité structurelle ou de ruptures temporelles dans la collecte des données expérimentales.
11. Étude de cas guidée : Modélisation prédictive d’une variable comportementale
11.1 Présentation du jeu de données expérimentales et contexte de l’étude
Afin de concrétiser l’ensemble des concepts théoriques et des syntaxes algorithmiques exposés précédemment, déployons une étude de cas empirique contrôlée. Considérons une équipe de psychologie organisationnelle et de médecine préventive cherchant à modéliser et anticiper l’affluence hebdomadaire (mesurée en nombre de consultations individuelles) au sein d’une unité d’accompagnement psychologique d’un grand centre universitaire hospitalier sur une période consécutive de dix semaines.
Deux modèles statistiques concurrents ont été calibrés par les chercheurs pour anticiper ces consultations :
- Modèle A : Une régression linéaire classique intégrant la tendance et des variables calendaires exogènes.
- Modèle B : Un algorithme de lissage exponentiel à double paramètre de Holt-Winters, supposé mieux amortir les soubresauts comportementaux de court terme.
Le jeu de données numériques brutes s’organise rigoureusement au sein de notre feuille de calcul Excel selon l’architecture suivante :
- Semaine 1 : Réel = 120 | Modèle A = 115 | Modèle B = 118
- Semaine 2 : Réel = 135 | Modèle A = 128 | Modèle B = 130
- Semaine 3 : Réel = 110 | Modèle A = 118 | Modèle B = 112
- Semaine 4 : Réel = 150 | Modèle A = 142 | Modèle B = 146
- Semaine 5 : Réel = 95 | Modèle A = 110 | Modèle B = 102
- Semaine 6 : Réel = 160 | Modèle A = 152 | Modèle B = 158
- Semaine 7 : Réel = 140 | Modèle A = 135 | Modèle B = 142
- Semaine 8 : Réel = 105 | Modèle A = 115 | Modèle B = 108
- Semaine 9 : Réel = 130 | Modèle A = 125 | Modèle B = 128
- Semaine 10 : Réel = 145 | Modèle A = 138 | Modèle B = 140
L’objectif de l’évaluation méthodologique consiste à déterminer sans équivoque, par le calcul rigoureux du MAPE sous Excel, quel modèle offre la précision relative optimale et doit être retenu pour dimensionner les plannings du personnel soignant.
11.2 Déroulement complet du calcul et interprétation comparative
Structurons notre feuille de calcul de façon modélisée : la colonne A consigne les identifiants de semaine (1 à 10), la colonne B consigne les observations réelles, la colonne C reçoit les prédictions du Modèle A, et la colonne E accueille celles du Modèle B.
Insérons pas à pas les formules d’erreur absolue unitaire :
- En colonne
D(APE Modèle A), saisissons enD2:=ABS(B2-C2)/B2, puis étirons la formule jusqu’enD11. - En colonne
F(APE Modèle B), saisissons enF2:=ABS(B2-E2)/B2, puis étirons la formule jusqu’enF11. - Configurons les plages
D2:D11etF2:F11au format natif Pourcentage avec deux décimales.
L’examen des calculs individuels révèle les résultats suivants pour le Modèle A :
- Semaine 1 : |120 – 115| / 120 = 4,17 %
- Semaine 2 : |135 – 128| / 135 = 5,19 %
- Semaine 3 : |110 – 118| / 110 = 7,27 %
- Semaine 4 : |150 – 142| / 150 = 5,33 %
- Semaine 5 : |95 – 110| / 95 = 15,79 %
- Semaine 6 : |160 – 152| / 160 = 5,00 %
- Semaine 7 : |140 – 135| / 140 = 3,57 %
- Semaine 8 : |105 – 115| / 105 = 9,52 %
- Semaine 9 : |130 – 125| / 130 = 3,85 %
- Semaine 10 : |145 – 138| / 145 = 4,83 %
Pour le Modèle B, les calculs unitaires indiquent :
- Semaine 1 : |120 – 118| / 120 = 1,67 %
- Semaine 2 : |135 – 130| / 135 = 3,70 %
- Semaine 3 : |110 – 112| / 110 = 1,82 %
- Semaine 4 : |150 – 146| / 150 = 2,67 %
- Semaine 5 : |95 – 102| / 95 = 7,37 %
- Semaine 6 : |160 – 158| / 160 = 1,25 %
- Semaine 7 : |140 – 142| / 140 = 1,43 %
- Semaine 8 : |105 – 108| / 105 = 2,86 %
- Semaine 9 : |130 – 128| / 130 = 1,54 %
- Semaine 10 : |145 – 140| / 145 = 3,45 %
Agrégation finale via la fonction MOYENNE :
- Cellule
D12(MAPE Global Modèle A) :=MOYENNE(D2:D11)renvoie 6,45 %. - Cellule
F12(MAPE Global Modèle B) :=MOYENNE(F2:F11)renvoie 2,78 %.
Interprétation scientifique : Selon la classification canonique de Lewis, les deux modèles s’inscrivent sous le seuil d’excellence des 10 % (prévisions hautement précises). Néanmoins, l’arbitrage quantitatif démontre sans ambiguïté la supériorité absolue du Modèle B (lissage exponentiel), qui réduit de plus de moitié l’erreur relative moyenne globale (2,78 % contre 6,45 %). On notera avec acuité l’observation de la Semaine 5 : lors de cette baisse soudaine de fréquentation (95 consultations), le modèle linéaire A a généré une déviation de 15,79 %, soulignant son inertie face aux ruptures de flux, tandis que le Modèle B a amorti la fluctuation avec un APE limité à 7,37 %. Le choix du modèle de lissage exponentiel est ainsi solidement étayé par les données empiriques.
12. Recommandations méthodologiques, audit de feuille et écueils à éviter
12.1 Biais d’optimisation et pièges fréquents dans Excel
L’apparente simplicité d’exécution du calcul du MAPE dans Excel ne doit pas occulter la présence d’écueils techniques et méthodologiques susceptibles de compromettre gravement la validité interne des conclusions empiriques. L’analyste averti doit exercer une vigilance constante à l’égard de quatre pièges récurrents :
Premièrement, le risque majeur de surajustement (overfitting) par minimisation artificielle du MAPE. Lorsque des chercheurs calibrent des coefficients de régression ou des hyperparamètres prédictifs directement sous Excel en utilisant le complément solveur pour minimiser le MAPE sur l’ensemble de l’échantillon connu (erreur in-sample), le modèle a tendance à se surspécifier pour s’ajuster au bruit propre à l’échantillon. Cette procédure crée une illusion rétrospective d’exactitude : le MAPE calculé sur les données d’entraînement sera remarquablement faible, mais le modèle s’effondrera littéralement lorsqu’il sera confronté à de nouvelles observations réelles non observées (erreur out-of-sample). L’évaluation doit rigoureusement dissocier l’échantillon d’apprentissage de l’échantillon de test par des protocoles de validation croisée.
Deuxièmement, les erreurs de syntaxe spatiale relatives et absolues. Lors de l’extension de formules arithmétiques par glissement de la poignée de recopie vers le bas, l’omission des ancrages absolus (le symbole $) lors de l’appel à des paramètres fixes situés dans une cellule dédiée (par exemple, un diviseur universel ou un coefficient d’échelle logé en $Z$1) génère un décalage vertical destructeur qui fausse silencieusement la logique du calcul sans nécessairement renvoyer d’erreur explicite.
Troisièmement, la confusion pernicieuse entre l’arrondi d’affichage et l’arrondi de calcul. Excel tronque visuellement l’affichage des décimales en fonction de la largeur des colonnes et des formats assignés, mais conserve en mémoire interne la totalité des décimales en virgule flottante. Si un modèle de tarification ou de posologie psychométrique réutilise un MAPE intermédiaire visualisé à 5 % alors que sa valeur non arrondie est de 5,487 %, des écarts cumulatifs significatifs peuvent vicier les calculs aval.
12.2 Protocole de contrôle qualité et reproductibilité de la recherche
Pour hisser l’ingénierie sous Excel aux exigences de transparence, d’intégrité et de reproductibilité de la science ouverte (Open Science), tout protocole quantitatif impliquant le calcul du MAPE doit intégrer un protocole d’audit et de contrôle qualité standardisé :
- La validation croisée multi-environnementale : Avant toute publication définitive de résultats au sein d’une revue à comité de lecture, il est impératif de confronter les indicateurs agrégés obtenus sous Excel aux sorties d’un script indépendant rédigé sous un langage scientifique vérifié (tel que le package
forecastsous R ou la bibliothèquescikit-learnsous Python). L’exactitude des résultats jusqu’à la sixième décimale confirme l’absence de biais algorithmique imputable au tableur. - Le verrouillage architectural des cellules maîtresses : Les cellules hébergeant les formules fondamentales de résidus relatifs et d’agrégation matricielle doivent être explicitement verrouillées et protégées par mot de passe via l’utilitaire de protection d’Excel (onglet Révision > Protéger la feuille), ne laissant accessibles à la saisie manuelle que les seules cellules réservées aux nouvelles données empiriques brutes.
- La documentation explicite de l’environnement de calcul : Les versions successives d’Excel présentant des évolutions subtiles dans leurs moteurs de calcul matriciel dynamique (comme l’introduction de la gestion native des matrices dynamiques à partir de la version 2021 et Microsoft 365), la version précise du système d’exploitation et de la suite bureautique mobilisée doit être rigoureusement consignée dans le protocole méthodologique.
- L’archivage immuable et la traçabilité des modifications : Le classeur maître contenant les données brutes, les équations analytiques et les visualisations diagnostiques doit être exporté sous un format d’archive pérenne (ex. OpenDocument Spreadsheet .ods ou XML Spreadsheet) et déposé sur un serveur de stockage institutionnel doté d’un identifiant numérique d’objet (DOI), garantissant la transparence méthodologique et la vérification pérenne par la communauté scientifique.
Références
- Armstrong, J. S. (1985). Long-range forecasting: from crystal ball to computer (2nd ed.). John Wiley & Sons.
- de Myttenaere, A., Golden, B., Le Grand, B., & Rossi, F. (2016). Mean Absolute Percentage Error for time series forecasting. Neurocomputing, 192, 38-48. https://doi.org/10.1016/j.neucom.2015.12.114
- Hyndman, R. J., & Athanasopoulos, G. (2018). Forecasting: principles and practice (2nd ed.). OTexts. https://otexts.com/fpp2/
- Hyndman, R. J., & Koehler, A. B. (2006). Another look at measures of forecast accuracy. International Journal of Forecasting, 22(4), 679-688. https://doi.org/10.1016/j.ijforecast.2006.03.001
- Lewis, C. D. (1982). Industrial and business forecasting methods: A radical guide to exponential smoothing and curve fitting. Butterworth-Heinemann.
- Makridakis, S. (1993). Accuracy measures: theoretical and practical concerns. International Journal of Forecasting, 9(4), 527-529. https://doi.org/10.1016/0169-2070(93)90079-3
- Makridakis, S., Wheelwright, S. C., & Hyndman, R. J. (1998). Forecasting: methods and applications (3rd ed.). John Wiley & Sons.
- Microsoft Corporation. (2024). Documentation officielle des fonctions Excel : ABS, MOYENNE, SOMMEPROD, LET, LAMBDA. Support Microsoft. https://support.microsoft.com/fr-fr/excel
- Willmott, C. J., & Matsuura, K. (2005). Advantages of the mean absolute error (MAE) over the root mean square error (RMSE) in assessing average model performance. Climate Research, 30(1), 79-82. https://doi.org/10.3354/cr030079