
La modélisation quantitative constitue la pierre angulaire de la recherche empirique moderne au sein des sciences psychologiques, cognitives et comportementales. Face à la complexité inhérente des processus mentaux, des dynamiques affectives et des conduites observables, le chercheur contemporain est continuellement confronté à la nécessité de formaliser des relations entre des prédicteurs empiriques et des variables d’intérêt. Au cœur de cette entreprise épistémologique, l’analyse de régression s’impose comme une méthodologie fondamentale, permettant d’extraire du signal à partir du bruit inhérent aux mesures humaines. Cependant, la quantification rigoureuse des phénomènes psychologiques exige une adéquation stricte entre la nature des construits évalués, les propriétés métriques des instruments d’évaluation et les postulats distributionnels des outils statistiques employés.
Parmi la vaste famille des approches statistiques appliquées aux sciences du comportement, deux modèles prédominent dans les publications académiques : la régression linéaire et la régression logistique. Bien que ces deux méthodologies partagent une filiation conceptuelle étroite au sein du cadre unifié des modèles linéaires généralisés, elles répondent à des logiques mathématiques distinctes, reposent sur des hypothèses distributionnelles fondamentalement divergentes et poursuivent des finalités inférentielles différentes. Confondre leurs champs d’application ou appliquer indifféremment l’une à la place de l’autre ne constitue pas une simple approximation technique, mais représente une erreur méthodologique majeure susceptible d’invalider les conclusions d’une étude clinique ou cognitive.
Le présent article propose une analyse approfondie des divergences fondamentales séparant la régression linéaire de la régression logistique dans le contexte des sciences humaines et de la santé mentale. En explorant leurs racines historiques, leurs soubassements formels, leurs algorithmes d’estimation respectifs et leurs implications psychométriques, cette contribution vise à doter les chercheurs, méthodologistes et praticiens des repères analytiques indispensables pour sélectionner l’outil statistique approprié, interpréter fidèlement les grandeurs estimées et garantir la reproductibilité de leurs inférences scientifiques.
1. Introduction aux modèles de régression en sciences psychologiques et comportementales
1.1 Définition et rôle de la modélisation statistique dans la recherche
Dans l’arsenal méthodologique des sciences du comportement, la modélisation statistique ne se réduit pas à une banale description numérique d’un échantillon empirique. Elle représente une tentative délibérée d’abstraction formelle visant à capturer la structure génératrice sous-jacente des données observées. En quantifiant les associations entre des variables explicatives indépendantes et une variable dépendante cible, le chercheur cherche à traduire des hypothèses conceptuelles abstraites en équations mathématiques testables. Cette formalisation permet d’évaluer dans quelle mesure les variations systématiques d’un construit théorique, tel que le niveau de stress perçu ou le perfectionnisme dysfonctionnel, s’articulent avec les fluctuations d’un comportement, d’une performance cognitive ou d’un statut pathologique.
Sur le plan épistémologique, il s’avère indispensable d’opérer une distinction rigoureuse entre trois finalités majeures de la modélisation statistique : l’explication théorique, la prédiction empirique et l’inférence causale. Bien que ces trois dimensions s’entrecroisent fréquemment dans la littérature, elles n’imposent pas les mêmes contraintes mathématiques. L’explication se focalise sur la significativité et la directionalité des paramètres structurels afin de valider des mécanismes postulés a priori. La prédiction s’attache à la capacité du modèle à projeter avec précision des états futurs ou non observés sur de nouvelles cohortes de sujets, indépendamment de la plausibilité interprétative des covariables. Enfin, l’inférence causale requiert des conditions méthodologiques drastiques, telles que la randomisation expérimentale ou le contrôle contrefactuel des biais de confusion, conditions que l’estimation statistique seule ne saurait suppléer sans plan de recherche adéquat.
L’importance cruciale de la modélisation réside ainsi dans son aptitude à tester des théories psychologiques complexes intégrant des facteurs multiples. Les phénomènes humains étant invariablement multidéterminés, l’analyse multivariée via la régression permet d’isoler l’effet spécifique d’un facteur tout en maintenant constants les effets parasites de variables confondantes telles que l’âge, le statut socio-économique ou les biais cognitifs préexistants. Elle constitue l’instrument privilégié permettant de passer de l’observation phénoménologique brute à une démonstration empirique reproductible et réfutable, condition sine qua non de la scientificité des disciplines comportementales.
1.2 Émergence et évolution historique des deux approches
L’histoire de la régression linéaire plonge ses racines dans les travaux pionniers de Francis Galton à la fin du XIXe siècle. Étudiant la transmission héréditaire de la taille humaine à travers les générations, Galton constata que les enfants de parents exceptionnellement grands ou petits tendaient à présenter une stature plus proche de la moyenne populationnelle que celle de leurs géniteurs. Ce phénomène, qu’il baptisa initialement « régression vers la médiocrité », devint le berceau de la régression statistique moderne. C’est ensuite son contemporain et collaborateur, Karl Pearson, qui formalisa rigoureusement les bases mathématiques du modèle linéaire classique, introduisant le coefficient de corrélation produit-moment et établissant la méthode d’ajustement par minimisation géométrique.
À l’inverse, l’émergence de la régression logistique s’est déployée plus tardivement au cours du XXe siècle, sous l’impulsion conjointe de la biométrie, de la pharmacologie et de la démographie. Face à l’impossibilité pratique de modéliser des réactions physiologiques de type « tout ou rien » (comme la survie ou le décès d’un organisme soumis à différentes doses d’un principe actif) à l’aide d’une droite linéaire classique, des chercheurs cherchèrent une fonction sigmoïde adaptée. Le biostatisticien Joseph Berkson introduisit formellement le terme et la fonction « logit » dans les années 1940, démontrant sa maniabilité calculatoire supérieure par rapport au modèle probit alors dominant. Par la suite, le statisticien britannique David Cox donna en 1958 ses lettres de noblesse à la régression logistique moderne en articulant l’estimation des cotes relatives avec la théorie asymptotique de la vraisemblance.
Cette trajectoire historique distincte a trouvé sa synthèse définitive au début des années 1970, lorsque John Nelder et Robert Wedderburn formulèrent le cadre unificateur des Modèles Linéaires Généralisés (GLM). Cette percée conceptuelle magistrale a démontré que la régression linéaire classique (fondée sur la loi normale) et la régression logistique (fondée sur la loi binomiale) ne constituaient pas des techniques disjointes ou rivales, mais plutôt deux instanciations particulières d’une même famille exponentielle de distributions statistiques. Cette convergence a permis de standardiser les procédures d’inférence, ouvrant la voie à une utilisation généralisée de ces outils dans les logiciels d’analyse psychométrique contemporains.
1.3 Problématique centrale : pourquoi distinguer impérativement les deux modèles ?
La distinction entre régression linéaire et régression logistique ne relève pas d’une simple querelle académique ou d’une subtilité réservée aux statisticiens purs. Pour le chercheur en sciences psychologiques, le recours inapproprié à un modèle statistique en violation flagrante de la nature mathématique des données engendre des conséquences scientifiques désastreuses. L’application mécanique de la régression linéaire à un critère binaire ou polytomique provoque une cascade d’invalidations formelles : violation systématique de l’homoscédasticité, non-normalité structurelle du terme d’erreur, et génération d’estimations absurdes situées en dehors des bornes réelles de probabilité, comme l’attribution d’une probabilité d’occurrence négative ou supérieure à l’unité.
Au-delà des distorsions чисто computationnelles, l’utilisation fautive de ces modèles déforme substantiellement l’interprétation théorique des comportements observés. Dans le champ de la santé mentale et des neurosciences comportementales, où les construits oscillent constamment entre dimensions continues (sévérité d’une symptomatologie, temps de latence attentionnelle) et catégorisations nosographiques discrètes (diagnostic psychiatrique formel, observance thérapeutique, récidive comportementale), choisir le mauvais outil entraîne des biais considérables dans l’estimation de la force des liens d’association. Cela peut conduire à des erreurs de type I (détection d’effets illusoires) ou de type II (incapacité à déceler des relations cliniques authentiques mais non linéaires).
Il existe une exigence épistémologique fondamentale d’adéquation entre l’architecture formelle de l’instrument mathématique et la réalité ontologique du phénomène psychologique investigué. Les processus cognitifs de sélection ou de décision binaire n’évoluent pas de manière incrémentale et illimitée ; ils obéissent à des logiques de seuils et d’asymptotes saturationnelles. Ainsi, maîtriser les lignes de démarcation méthodologiques entre régression linéaire et logistique conditionne la validité écologique, la rigueur clinique et la pérennité théorique des résultats de recherche.
2. La nature de la variable dépendante : le critère fondamental de divergence
2.1 La variable continue dans la régression linéaire
Le pilier central de la régression linéaire réside dans l’hypothèse métrique opérée sur la variable dépendante, traditionnellement notée Y. Dans ce paradigme, le critère d’intérêt doit présenter les propriétés mathématiques d’une échelle d’intervalle ou d’une échelle de rapport, selon la célèbre typologie de Stevens. Cela implique non seulement un ordre hiérarchique strict entre les valeurs recueillies, mais surtout une constance absolue de l’unité de mesure sur l’ensemble de l’échelle : la différence quantitative entre un score de 20 et un score de 25 doit avoir rigoureusement la même signification métrique que la différence séparant 70 de 75. Cette propriété d’additivité permet le calcul de moyennes arithmétiques, de variances et de covariances signifiantes.
Les exemples empiriques abondent au sein de la littérature expérimentale et neuropsychologique. Les chronométries mentales, opérationnalisées par les temps de réaction enregistrés en millisecondes lors de tâches de Stroop ou de détection de signaux, constituent l’archétype de la variable continue de rapport. De même, les concentrations physiologiques périphériques, à l’instar des taux de cortisol salivaire mesurés lors d’un protocole de stress aigu (comme le Trier Social Stress Test), ou encore les scores composites dérivés de questionnaires psychométriques validés (par exemple l’indice global du STAI pour l’anxiété état, sous réserve d’une calibration appropriée des items) relèvent conventionnellement de cette modalité continue.
Sur le plan abstrait, la régression linéaire postule que le support distributionnel théorique de la variable de réponse s’étend de façon ininterrompue sur l’axe des nombres réels, allant de moins l’infini à plus l’infini ($-\infty, +\infty$). Même si, en pratique concrète, les instruments psychométriques possèdent inévitablement des limites physiques inférieures et supérieures (effets de plancher et de plafond), le modèle suppose que la densité sous-jacente du phénomène est lisse et sans discontinuité, rendant possible l’approximation par des distributions de probabilité continues au premier rang desquelles trône la loi normale gaussienne.
2.2 La variable catégorielle dans la régression logistique
À l’opposé diamétral de l’architecture métrique continue, la régression logistique a été conçue pour modéliser des variables dépendantes intrinsèquement qualitatives, discrètes et catégorielles. Dans sa variante la plus répandue — la régression logistique binaire —, la variable de réponse ne peut prendre que deux valeurs exclusives et exhaustives, conventionnellement codées par convention binaire : $Y in {0, 1}$. Ici, le chiffre ne représente aucunement une quantité scalaire mesurable, mais fonctionne comme un marqueur qualitatif d’appartenance à une classe donnée : le chiffre 0 désigne l’absence d’un attribut ou l’échec à une tâche, tandis que le chiffre 1 symbolise la présence de l’attribut, la réussite ou la survenue de l’événement cible.
Dans le domaine de la psychopathologie clinique et de la recherche diagnostique, ce format binaire reflète la réalité de nombreuses décisions taxonomiques standardisées. Qu’il s’agisse de la présence ou de l’absence d’un épisode dépressif caractérisé selon les critères stricts du DSM-5, de l’abandon prématuré (drop-out) versus l’achèvement d’une thérapie cognitivo-comportementale, de la réussite ou de l’échec à un item d’une échelle d’aptitude intellectuelle de Wechsler, ou encore de la rechute toxicologique chez des patients dépendants à l’issue d’une cure de désintoxication, l’espace d’échantillonnage de la réponse est strictement fini, discret et borné.
Cette contrainte topologique transforme radicalement l’objectif analytique du statisticien. Il ne s’agit plus de prédire la valeur numérique exacte que prendra un individu sur un continuum infini, mais d’estimer la probabilité conditionnelle qu’un individu donné appartienne à la modalité cible ($Y = 1$), compte tenu de ses caractéristiques individuelles résumées par un ensemble de prédicteurs. L’espace de réponse cesse d’être une métrique de magnitude pour devenir un espace de probabilités strictement restreint à l’intervalle ouvert ou fermé $[0, 1]$.
2.3 Implications de l’échelle de mesure sur le choix du modèle
Tenter de forcer un modèle de régression linéaire à prédire une variable dépendante binaire engendre une aberration théorique et pratique désignée dans la littérature sous le nom de Modèle de Probabilité Linéaire (MPL). Lorsque la variable Y ne prend que les valeurs 0 ou 1, ajuster une droite par la méthode des moindres carrés conduit inévitablement l’équation à produire, pour certaines valeurs extrêmes des prédicteurs, des valeurs prédites inférieures à 0 ou supérieures à 1. Dans le contexte de la psychologie médicale, affirmer qu’un patient particulièrement exposé à des traumatismes sévères présente une probabilité de $1{,}35$ de développer un trouble de stress post-traumatique, ou qu’un individu résilient possède une probabilité de $-0{,}20$, constitue un non-sens probabiliste flagrant détruisant toute validité prédictive.
Ce paradoxe mathématique découle directement de la contradiction structurelle entre une droite linéaire, par essence infinie et monotone, et un phénomène probabiliste qui doit impérativement respecter les axiomes de Kolmogorov, bornant la probabilité entre 0 et 1. La régression logistique contourne magistralement cet écueil en appliquant une transformation non linéaire capable de contraindre les prédictions asymptotiquement à l’intérieur de cet intervalle légitime, restaurant ainsi la cohérence formelle de l’analyse.
Enfin, cette divergence impose une réflexion critique quant aux pratiques de recherche consistant à dichotomiser arbitrairement des échelles psychométriques initialement continues. Transformer un inventaire de dépression continu (comme le BDI-II) en une variable binaire (« dépressif » versus « non dépressif ») par l’application d’un score seuil clinique autorise certes l’usage de la régression logistique, mais au prix d’une amputation massive de la variance statistique, d’une chute dramatique de la puissance des tests d’hypothèses et d’une fausse homogénéisation de profils cliniques sous-jacents hétérogènes. Le choix de l’échelle de mesure et du modèle statistique associé scelle ainsi le destin informatif de l’ensemble de la démarche empirique.
3. Fondements mathématiques et formulations structurales
3.1 Équation générale de la régression linéaire
Sur le plan mathématique, le modèle de régression linéaire multiple postule que la variable dépendante continue $Y_i$ pour un individu donné $i$ s’exprime comme une combinaison linéaire directe de $p$ variables prédictives ($X_1, X_2, dots, X_p$), pondérées par des paramètres de régression inconnus, auxquels s’ajoute une composante d’erreur aléatoire. L’équation canonique s’écrit formellement sous la forme suivante :
$$Y_i = \beta_0 + \beta_1 X_{i1} + \beta_2 X_{i2} + dots + \beta_p X_{ip} + \varepsilon_i$$
Dans cette formalisation fondamentale, le terme constant $\beta_0$, désigné sous le terme d’intercepte (ou ordonnée à l’origine), spécifie la valeur attendue de la variable dépendante $Y$ lorsque l’ensemble des régresseurs du modèle prend la valeur zéro ($X_1 = X_2 = dots = X_p = 0$). Les coefficients partiels de régression $\beta_j$ (pour $j in {1, dots, p}$) quantifient la pente de la relation, c’est-à-dire le changement marginal moyen observé sur le critère $Y$ consécutif à l’augmentation d’une unité scalaire sur le prédicteur $X_j$, sous condition de stricte invariabilité (ceteris paribus) de toutes les autres covariables présentes dans l’équation.
Le paramètre $\varepsilon_i$, quant à lui, représente le résidu stochastique individuel. Loin d’être un simple artefact négligeable, ce terme d’erreur stochastique constitue le cœur probabiliste du modèle. Il agrège l’ensemble des sources de variabilité non expliquées par les prédicteurs sélectionnés : erreurs de mesure psychométriques inhérentes aux tests, variations idiosyncrasiques interindividuelles non modélisées, fluctuations temporelles imprévisibles et omissions de facteurs explicatifs pertinents. Dans le cadre théorique de la régression classique, ce résidu est supposé suivre une distribution gaussienne de moyenne nulle et de variance constante $\sigma^2$.
3.2 La fonction sigmoïde et l’équation de la régression logistique
Face à l’inadéquation de la combinaison linéaire directe pour contraindre une variable binaire dans l’espace des probabilités, la régression logistique introduit une fonction mathématique transcendantale non linéaire : la fonction logistique standard, fréquemment appelée fonction sigmoïde. Cette fonction possède la propriété remarquable de transformer n’importe quelle valeur issue de la droite des réels ($]-\infty, +\infty[$) en une valeur strictement confinée à l’intervalle ouvert $]0, 1[$.
En désignant par $\pi_i = P(Y_i = 1 mid X_i)$ la probabilité conditionnelle que l’événement clinique ou comportemental d’intérêt se produise pour un sujet $i$ caractérisé par le vecteur de prédicteurs $X_i$, l’équation de la régression logistique s’articule comme suit :
$$\pi_i = \frac{1}{1 + e^{-(\beta_0 + \beta_1 X_{i1} + dots + \beta_p X_{ip})}} = \frac{e^{\beta_0 + \beta_1 X_{i1} + dots + \beta_p X_{ip}}}{1 + e^{\beta_0 + \beta_1 X_{i1} + dots + \beta_p X_{ip}}}$$
Sur le plan géométrique, cette équation engendre une courbe caractéristique en forme de « S ». Lorsque la combinaison linéaire des prédicteurs tend vers moins l’infini, la valeur exponentielle $e^{-(\cdot)}$ tend vers l’infini, ce qui fait tendre la probabilité asymptotiquement vers 0 sans jamais l’atteindre formellement. À l’inverse, lorsque l’indice linéaire s’élève vers des valeurs positives infinies, le terme exponentiel s’annihile, conduisant la probabilité à plafonner asymptotiquement à 1. Cette formulation empêche structurellement l’apparition de prédictions aberrantes et modélise avec une élégance remarquable la saturation progressive des réponses biologiques et comportementales face à des sollicitations d’intensité croissante.
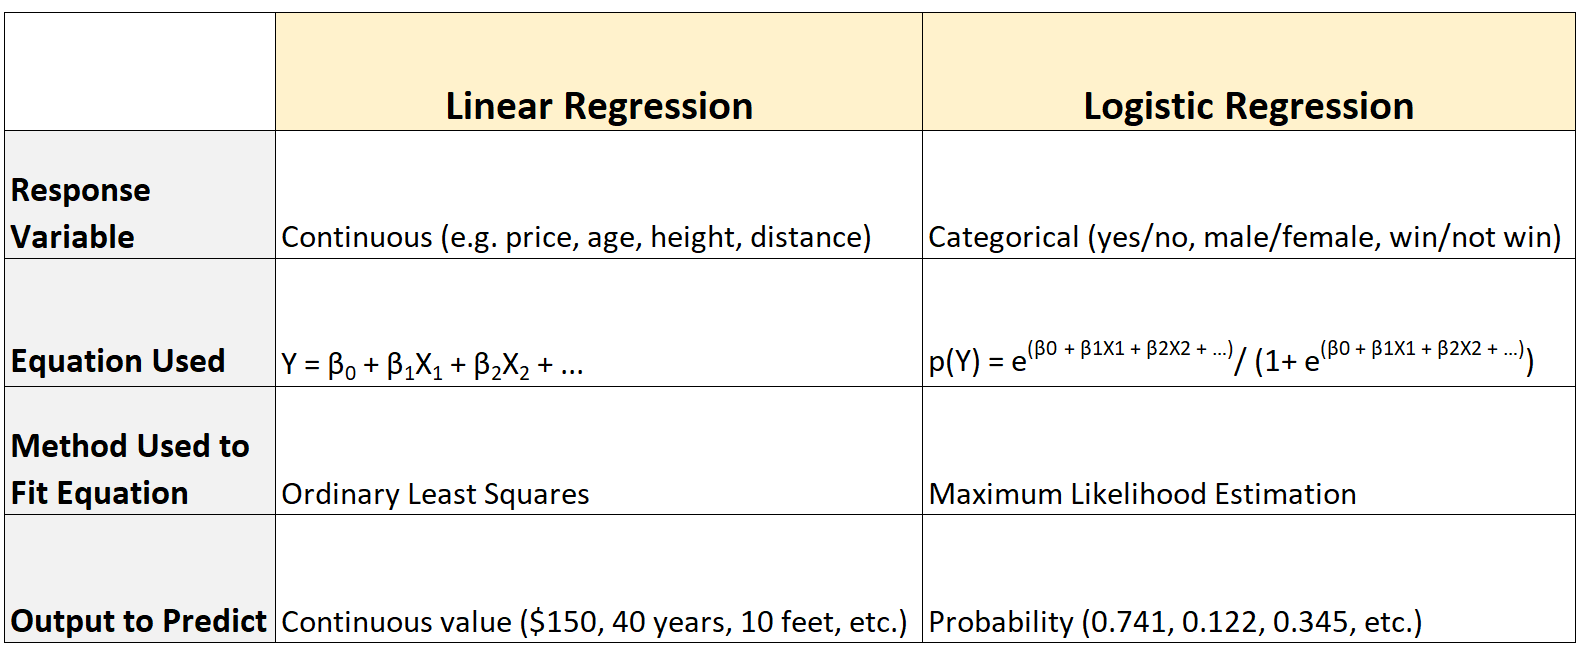
3.3 Comparaison structurelle des architectures mathématiques
L’analyse comparative des structures fonctionnelles de ces deux modèles révèle une divergence primordiale touchant à la notion même de linéarité. La régression linéaire est doublement linéaire : elle est linéaire dans ses paramètres ($\beta$) et linéaire dans ses variables de réponse ($Y$). Cela implique une propriété fondamentale : l’effet marginal d’un prédicteur est constant sur toute l’étendue de l’espace des covariables. Que le score d’anxiété d’un participant passe de 10 à 11 ou de 80 à 81, l’impact marginal attendu sur son temps de réaction cognitif sera strictement identique, matérialisé par une pente invariante.
En revanche, dans le paradigme de la régression logistique, si le modèle demeure linéaire dans ses paramètres (au niveau de l’espace abstrait sous-jacent que nous détaillerons ultérieurement), la relation unissant les prédicteurs à la probabilité observée est fondamentalement non linéaire. Le taux de variation de la probabilité en fonction de $X_j$ n’est pas constant : il correspond à la dérivée première de la fonction sigmoïde par rapport au prédicteur, laquelle s’écrit $\frac{\partial \pi}{\partial X_j} = \beta_j \pi (1 – \pi)$.
Cette dérivation formelle met en lumière un phénomène psychologique et clinique majeur : l’effet d’un prédicteur sur la probabilité de survenue d’un comportement dépend entièrement de la probabilité de base du sujet. L’impact marginal est maximal au point d’inflexion où $\pi = 0{,}5$, là où l’incertitude comportementale est à son comble. En revanche, pour des individus présentant déjà une probabilité conditionnelle extrêmement faible ($\pi \approx 0$) ou extrêmement élevée ($\pi \approx 1$), l’augmentation unitaire du prédicteur n’induit qu’une modification infinitésimale de la probabilité finale. Parallèlement, cette dynamique non linéaire confère à la régression logistique une résilience supérieure face aux valeurs extrêmes isolées sur les variables explicatives, l’asymptote absorbant les déviations qui, dans un cadre purement linéaire, auraient exercé un levier démesuré sur l’estimation de la pente.
4. La transformation des cotes et l’espace Logit
4.1 Le concept de probabilité conditionnelle et ses limites de modélisation directe
La probabilité conditionnelle, notée formellement $P(Y = 1 mid X)$, constitue l’entité que le chercheur aspire fondamentalement à quantifier lorsqu’il s’intéresse à des issues dichotomiques. Qu’il s’agisse de mesurer la probabilité qu’un adolescent scolarisé développe un comportement d’addiction aux jeux vidéo en fonction de ses scores de solitude émotionnelle, ou d’estimer les chances de rémission d’un état de stress aigu post-intervention, la probabilité est la grandeur la plus intuitive sur le plan clinique. Cependant, son intervalle fermé strict $[0, 1]$ en fait un objet mathématique particulièrement réfractaire aux opérations algébriques d’addition et de multiplication vectorielle non bornées.
Tenter de relier directement cette probabilité à une droite de régression sans intermédiaire méthodologique oblige à imposer des contraintes artificielles de troncature qui détruisent la différentiabilité de la fonction aux bornes. C’est précisément pour résoudre ce verrou conceptuel que la théorie des modèles linéaires généralisés recourt au concept révolutionnaire de fonction de lien (link function). La fonction de lien opère comme un transformateur topologique : elle mappe l’espérance conditionnelle de la variable de réponse, soumise à des restrictions de domaine, sur un espace continu non borné sur lequel les opérations linéaires classiques redeviennent parfaitement licites et cohérentes.
Dans la régression linéaire standard, la fonction de lien est dite « identité », car l’espérance mathématique de la réponse est directement équivalente au prédicteur linéaire : $g(\mu) = \mu$. Pour la régression logistique, la fonction de lien employée est la fonction logit, qui nécessite le passage intermédiaire par le concept probabiliste de « cote » ou d’odds.
4.2 Définition théorique des cotes (Odds) et du logarithme népérien des cotes (Logit)
Dans la théorie des jeux et la statistique inférentielle anglo-saxonne, la cote (odds) d’un événement se définit mathématiquement comme le ratio entre la probabilité de survenue de cet événement ($\pi$) et la probabilité de sa non-survenue ($1 – \pi$) :
$$\text{Odds} = \frac{\pi}{1 – \pi}$$
Si la probabilité d’un diagnostic clinique est de $0{,}80$, la probabilité complémentaire d’absence de pathologie est de $0{,}20$. La cote s’établit alors à $0{,}80 / 0{,}20 = 4{,}0$. Cela signifie que la survenue de l’événement est quatre fois plus probable que sa non-survenue, ou qu’il y a 4 « chances contre 1 ». Cette première transformation possède un avantage métrique majeur : alors que la probabilité $\pi$ est bornée supérieurement par 1, la cote s’étend sur un espace semi-ouvert allant de 0 à plus l’infini ($[0, +\infty[$). Toutefois, l’asymétrie persiste, les valeurs comprises entre 0 et 1 comprimant l’ensemble des situations où la non-survenue est prédominante, tandis que les valeurs supérieures à 1 s’étalent indéfiniment.
Pour parachever la linéarisation, on applique à cette cote l’opérateur logarithme népérien ($ln$). Cette transformation logarithmique engendre la variable formalisée sous le terme de Logit :
$$\text{Logit}(\pi) = \ln(\text{Odds}) = \ln\left(\frac{\pi}{1 – \pi}\right)$$
Cette fonction logit possède la propriété mathématique de projeter l’intervalle de probabilité initial $[0, 1]$ sur la droite réelle complète $]-\infty, +\infty[$. Lorsque $\pi = 0{,}5$, la cote est égale à 1, et son logarithme s’annule rigoureusement ($\text{logit} = 0$). Lorsque la probabilité s’approche de 0, le logit plonge vers $-\infty$ ; à l’inverse, lorsque la probabilité converge vers 1, le logit s’élève vers $+\infty$. En posant $\text{Logit}(\pi_i) = \beta_0 + \beta_1 X_{i1} + dots + \beta_p X_{ip}$, la régression logistique rétablit une stricte linéarité mathématique, non pas entre le prédicteur et la probabilité brute, mais entre le prédicteur et le logarithme népérien de la cote.
4.3 Interprétation psychométrique de l’espace Logit
L’introduction de l’espace logit dépasse largement l’astuce technique : elle trouve une résonance conceptuelle profonde dans les modèles contemporains de la mesure psychologique, particulièrement au sein de la théorie de réponse aux items (TRI). Le célèbre modèle logistique à un paramètre développé par le mathématicien danois Georg Rasch repose sur une formulation formellement identique à celle d’une régression logistique, où la probabilité de réussite d’un individu à un test d’aptitude cognitive s’exprime comme une fonction sigmoïde de l’écart entre le niveau de compétence latente du sujet ($\theta$) et le niveau de difficulté intrinsèque de l’item ($\delta$) : $\text{Logit}(P) = \theta – \delta$.
Dans ce cadre psychométrique, le coefficient de pente $\beta$ issu d’une régression logistique s’interprète directement comme un indice de discrimination. Plus la valeur absolue du coefficient est élevée, plus la pente de la sigmoïde est abrupte au point d’inflexion, et plus le prédicteur possède un pouvoir discriminant élevé pour différencier les individus situés de part et d’autre du seuil critique. À l’inverse, un coefficient proche de zéro génère une courbe logistique quasi plate, signalant l’inaptitude du prédicteur à modifier significativement la cote du comportement étudié.
L’espace logit permet ainsi de réconcilier la complexité des dynamiques humaines avec des structures d’analyse stables. Il modélise l’accélération et la décélération des changements psychologiques : un changement environnemental ou une intervention clinique produira des variations observables massives chez des sujets initialement en situation de balance ou d’hésitation comportementale (près du logit 0), alors que les mêmes stimuli demeureront virtuellement sans effet sur des sujets solidement ancrés dans des patterns comportementaux fixés aux extrémités de la distribution.
5. Postulats et conditions d’application des deux modèles
5.1 Les hypothèses classiques de Gauss-Markov en régression linéaire
La validité des conclusions inférentielles issues d’une régression linéaire repose sur le respect scrupuleux d’un ensemble de postulats distributionnels formalisés par le célèbre théorème de Gauss-Markov, complété par l’hypothèse de normalité stochastique. L’inobservation de ces prérequis théoriques altère directement les propriétés des estimateurs, rendant les tests de significativité statistique ($t$ de Student, $F$ de Fisher-Snedecor) invalides ou trompeurs.
Le premier postulat fondamental stipule la linéarité stricte de la relation entre l’espérance mathématique conditionnelle de la variable dépendante et les variables explicatives : $E(Y mid X) = X\beta$. Si la véritable trajectoire du phénomène psychologique sous-jacent est quadratique, exponentielle ou discontinue, le modèle linéaire sous-estimera systématiquement l’association globale.
Le second postulat concerne l’homoscédasticité, ou l’invariance de la variance des résidus. Pour l’ensemble des valeurs prises par la combinaison de prédicteurs, la dispersion de l’erreur stochastique doit demeurer strictement constante : $\text{Var}(\varepsilon_i mid X_i) = \sigma^2$. En psychométrie différentielle, l’hétéroscédasticité est pourtant monnaie courante : la variabilité des performances cognitives ou des réponses émotionnelles augmente fréquemment à mesure que l’intensité des traits mesurés croît.
Enfin, le troisième pilier postule la normalité multivariée des erreurs résiduelles : $\varepsilon \sim \mathcal{N}(0, \sigma^2 I)$. Si cette hypothèse peut être légèrement assouplie dans le cas d’échantillons volumineux grâce au théorème central limite pour ce qui touche à l’estimation asymptotique ponctuelle des coefficients, elle demeure absolument critique pour la validité empirique des intervalles de confiance à taille d’échantillon finie.
5.2 Le cadre d’hypothèses de la régression logistique
La régression logistique se caractérise par une flexibilité distributionnelle sensiblement plus vaste que celle du modèle linéaire conventionnel. Ne reposant pas sur le cadre des moindres carrés gaussiens, elle s’affranchit de plusieurs hypothèses contraignantes qui limitent régulièrement l’application de la régression linéaire dans les cohortes cliniques réelles.
Premièrement, la régression logistique n’exige en aucune manière que les variables indépendantes ($X$) suivent une distribution normale multivariée. Les prédicteurs peuvent être continus, discrètement ordinaux ou dichotomiques, et peuvent présenter des asymétries sévères sans vicier structurellement l’estimation des coefficients. De surcroît, elle élimine totalement l’hypothèse d’homoscédasticité au sens linéaire. Pour une variable de Bernoulli $Y$, la variance conditionnelle dépend mathématiquement de la probabilité elle-même : $\text{Var}(Y mid X) = \pi(1 – \pi)$. L’hétéroscédasticité n’est donc plus un artefact perturbateur à corriger, mais une propriété formellement intégrée dans la structure du modèle.
Néanmoins, la régression logistique introduit sa propre condition de validité fondamentale : l’hypothèse de linéarité dans le logit. Si la relation entre $X$ et la probabilité brute $\pi$ est intrinsèquement curvilinéaire en « S », la relation unissant $X$ au logarithme népérien des cotes ($\ln[\pi / (1 – \pi)]$) doit être rigoureusement rectiligne. La violation de ce postulat conduit à des estimations déformées de l’odds ratio, nécessitant l’emploi de transformations polynomiales des prédicteurs, de fonctions splines ou de modèles additifs généralisés (GAM) pour restaurer l’adéquation structurelle.
5.3 Hypothèses communes et vulnérabilités partagées
En dépit de leurs dissemblances fondamentales, les deux méthodologies partagent un socle de vulnérabilités communes dont l’occultation peut ruiner la reproductibilité des inférences. La première exigence transversale concerne l’indépendance conditionnelle stricte des observations. Si les données recueillies présentent une structure de dépendance spatiale, temporelle, généalogique ou organisationnelle — comme des élèves observés au sein de mêmes classes ou des mesures répétées obtenues auprès d’un même patient au fil de sessions thérapeutiques successives —, les deux modèles échouent à calibrer les erreurs standards, aboutissant à une inflation dramatique des erreurs de type I.
La seconde vulnérabilité partagée réside dans la sensibilité à la multicolinéarité sévère entre prédicteurs psychologiques. Lorsque deux ou plusieurs variables explicatives présentent de très fortes intercorrélations (par exemple l’anxiété-trait et la détresse psychologique générale), la matrice de covariance devient quasi-singulière. Cela engendre une instabilité algorithmique majeure, un gonflement disproportionné des erreurs types et une incapacité à isoler les contributions respectives de chaque construit théorique.
Enfin, la régression logistique présente une fragilité singulière absente du modèle linéaire : le phénomène pathologique de séparation complète (ou quasi-séparation), identifié formellement par Albert et Anderson (1984). Lorsque, au sein d’un échantillon psychométrique de taille modeste, une combinaison linéaire de prédicteurs permet de prédire infailliblement le critère binaire (par exemple si l’ensemble des patients ayant subi un traumatisme spécifique développent tous systématiquement la pathologie étudiée sans exception), l’algorithme d’estimation s’effondre : le coefficient logistique diverge vers $+\infty$ ou $-\infty$, et les erreurs standards explosent, rendant toute inférence conventionnelle mathématiquement impossible sans ajustement pénalisé.
6. Méthodes d’estimation des paramètres : MCO versus Maximum de Vraisemblance
6.1 L’estimation par les Moindres Carrés Ordinaires (MCO)
L’estimation des paramètres structurels dans la régression linéaire repose quasi universellement sur le paradigme séculaire des Moindres Carrés Ordinaires (MCO, ou OLS en anglais). L’objectif géométrique et algébrique de cette méthode consiste à identifier le vecteur de paramètres $\hat{\beta}$ qui minimise la somme des carrés des écarts verticaux séparant les points empiriques observés de la surface de régression prédite. Cette quantité, désignée sous le terme de somme des carrés résiduels ($SCE$), s’exprime matriciellement comme suit :
$$SCE = \sum_{i=1}^n \varepsilon_i^2 = \sum_{i=1}^n (Y_i – X_i \beta)^2 = (Y – X\beta)'(Y – X\beta)$$
L’un des avantages les plus remarquables de cette approche réside dans l’existence d’une solution analytique explicite sous forme close. En annulant le gradient vectoriel de cette fonction quadratique par rapport au vecteur $\beta$, on aboutit à la formule canonique universelle des équations normales :
$$\hat{\beta}_{MCO} = (X’X)^{-1}X’Y$$
Cette élégante formulation matricielle garantit que, dès lors que la matrice de dispersion des prédicteurs $X’X$ est de plein rang (c’est-à-dire non singulière et exempte de colinéarité parfaite), le calcul des coefficients est direct, déterministe et instantané, sans nécessiter la moindre approximation numérique. Selon le théorème de Gauss-Markov, sous réserve que les résidus soient de moyenne nulle, homoscédastiques et non autocorrélés, l’estimateur MCO possède la propriété BLUE (Best Linear Unbiased Estimator) : il constitue l’estimateur linéaire sans biais possédant la variance d’échantillonnage minimale parmi tous les estimateurs linéaires possibles.
6.2 L’estimation par le Maximum de Vraisemblance (EMV)
L’estimation par les moindres carrés s’avère totalement inopérante en régression logistique en raison de la nature discrète et bornée de la distribution de Bernoulli régissant la variable de réponse binaire. Le calcul des paramètres requiert donc le recours à une méthodologie d’optimisation plus générale et probabiliste : l’Estimation par le Maximum de Vraisemblance (EMV).
Le principe sous-jacent de l’EMV repose sur une inversion conceptuelle du raisonnement statistique classique : considérant l’échantillon de données empiriques comme fixe et immuable une fois collecté, on cherche à identifier les valeurs des paramètres $\beta$ qui rendent la survenue de cet échantillon précis la plus plausible possible. Pour une suite d’observations indépendantes issues d’une loi de Bernoulli de paramètre $\pi_i$, la fonction de vraisemblance conjointe $L(\beta)$ s’écrit sous forme de produit factoriel :
$$L(\beta) = \prod_{i=1}^n \pi_i^{Y_i} (1 – \pi_i)^{1 – Y_i}$$
Manipuler des produits infinis de probabilités soulevant d’immenses difficultés calculatoires dues au sous-débordement arithmétique (underflow), les statisticiens transforment systématiquement cette fonction en son logarithme népérien, aboutissant à la fonction de log-vraisemblance ($ell(\beta)$) :
$$ell(\beta) = \ln L(\beta) = \sum_{i=1}^n \left[ Y_i \ln(\pi_i) + (1 – Y_i) \ln(1 – \pi_i) \right]$$
En substituant dans cette expression la formulation logistique $\pi_i = \frac{1}{1 + e^{-X_i \beta}}$, la log-vraisemblance devient une fonction strictement concave des paramètres $\beta$, ce qui garantit théoriquement l’existence d’un maximum global unique en l’absence de séparation parfaite des données.
6.3 Algorithmes d’optimisation numérique et convergence
Contrairement à l’équation des moindres carrés, l’annulation des dérivées partielles de la log-vraisemblance logistique (le système d’équations de score) débouche sur un système d’équations transcendantales non linéaires qui ne possède aucune solution analytique close. Il est formellement impossible d’isoler directement le vecteur $\beta$ par une opération matricielle directe analogue à $(X’X)^{-1}X’Y$.
L’estimation nécessite impérativement l’emploi d’algorithmes d’optimisation numérique itératifs, au premier rang desquels figure la méthode de Newton-Raphson ou sa variante stochastique, l’algorithme des Moindres Carrés Répétés Itérativement (Iteratively Reweighted Least Squares, IRLS), également apparenté au Fisher Scoring. Le processus itératif actualise le vecteur de paramètres d’une étape $(t)$ à une étape $(t+1)$ selon l’opérateur matriciel :
$$\beta^{(t+1)} = \beta^{(t)} – \left[ H(\beta^{(t)}) \right]^{-1} U(\beta^{(t)})$$
où $U(\beta)$ représente le vecteur gradient (score) et $H(\beta)$ désigne la matrice hessienne des dérivées secondes, correspondant à l’opposé de la matrice d’information observée. L’algorithme débute par une estimation initiale arbitraire, calcule la pente et la courbure de la log-vraisemblance, puis ajuste progressivement les estimations jusqu’à ce que la différence entre deux itérations consécutives devienne inférieure à un critère de tolérance rigoureusement prédéfini (par exemple $10^{-6}$).
Ces mécanismes computationnels introduisent toutefois des pathologies inconnues du modèle linéaire MCO : les risques de non-convergence algorithmique. Lorsque les données cliniques sont particulièrement clairsemées, que la taille de l’échantillon est disproportionnellement modeste face au nombre de prédicteurs, ou en présence de quasi-séparation, la matrice hessienne devient instable, provoquant des boucles d’itération infinies ou des explosions d’erreurs standard que le chercheur doit savoir diagnostiquer avec lucidité.
7. Interprétation des coefficients et tailles d’effet
7.1 Interprétation quantitative dans le modèle linéaire
L’un des atouts pédagogiques et pratiques majeurs de la régression linéaire réside dans la transparence et l’intelligibilité immédiate de ses paramètres structurels. Dans une équation linéaire classique, le coefficient partiel $\beta_j$ s’interprète directement sur l’échelle de mesure originale dans laquelle la variable dépendante a été opérationnalisée. Formellement, il spécifie la variation absolue attendue de l’espérance mathématique de $Y$ pour chaque accroissement d’une unité scalaire de la variable explicative $X_j$, sous condition expresse de fixité rigoureuse de l’ensemble des autres covariables intégrées au modèle :
$$\beta_j = \frac{\Delta E(Y mid X)}{\Delta X_j}$$
À titre d’illustration, si une étude évalue la sévérité des symptômes obsessionnels-compulsifs mesurés par l’échelle Y-BOCS (allant de 0 à 40) en fonction du niveau de perfectionnisme intolérant à l’erreur, un coefficient $\beta = 0{,}85$ signifie de manière très limpide que chaque point additionnel sur l’échelle de perfectionnisme s’accompagne en moyenne d’une élévation de 0,85 point sur l’échelle de sévérité clinique du TOC, toutes choses égales par ailleurs.
Toutefois, lorsque les variables indépendantes sont mesurées sur des échelles hétérogènes dépourvues d’unités de mesure comparables (par exemple associer des milligrammes de médication, des années de scolarisation et des scores d’inventaires d’attitude), la comparaison directe de la magnitude des coefficients bruts s’avère impossible. Les méthodologistes préconisent alors l’examen des coefficients standardisés, communément désignés sous l’appellation de coefficients Bêta ($\beta^*$). Ces coefficients expriment la variation en écarts-types de la variable dépendante par déviation d’un écart-type sur le prédicteur :
$$\beta_j^* = \beta_j \left(\frac{s_{X_j}}{s_Y}\right)$$
Cette standardisation métrique offre une lecture comparative immédiate de l’importance relative des différents facteurs psychologiques au sein de l’équation prédictive.
7.2 L’Odds Ratio (OR) en régression logistique : calcul et lecture clinique
En régression logistique, la lecture des paramètres bruts se heurte d’emblée à l’abstraction de l’espace de calcul. Le coefficient estimé $\beta_j$ ne renvoie pas à une modification de probabilité observable, mais quantifie la variation du logarithme népérien de la cote pour une augmentation d’une unité sur le prédicteur. Déclarer dans un rapport psychiatrique que le risque de passage à l’acte suicidaire s’élève de « 0,693 unité logit » par échelon de désespoir n’apporte aucune signification clinique exploitable.
Pour restaurer l’intelligibilité des résultats, la pratique universelle exige d’opérer une exponentiation du coefficient logistique afin d’obtenir le célèbre Rapport de Cotes ou Odds Ratio (OR) :
$$\text{OR}_j = e^{\beta_j}$$
L’Odds Ratio représente un facteur multiplicatif appliqué directement à la cote de l’événement. Son échelle d’interprétation s’articule autour d’une valeur neutre critique fixée à 1 :
- Si $\text{OR} = 1$ ($\beta = 0$), le prédicteur n’exerce absolument aucun effet sur la cote de survenue du comportement étudié.
- Si $\text{OR} > 1$ ($\beta > 0$), chaque élévation d’une unité sur le prédicteur multiplie la cote de survenue de l’événement par la valeur de l’OR (facteur de risque ou d’accroissement comportemental).
- Si $\text{OR} < 1$ ($\beta < 0$), chaque incrément unitaire divise la cote ou la multiplie par une fraction inférieure à 1, signalant un effet protecteur ou inhibiteur.
Il est impératif d’avertir le chercheur contre la tentation pernicieuse de confondre l’Odds Ratio avec le Risque Relatif (RR). Alors que le risque relatif quantifie le ratio direct des probabilités ($P(Y=1 mid X=1) / P(Y=1 mid X=0)$), le rapport de cotes compare des ratios de probabilités complémentaires. Lorsque l’événement psychopathologique investigué est particulièrement fréquent dans la cohorte étudiée (prévalence supérieure à 10 %), l’Odds Ratio s’éloigne drastiquement du risque relatif et surestime substantiellement la magnitude de la force d’association clinique, un biais d’amplification fréquemment épinglé dans la vulgarisation des études épidémiologiques.
7.3 Difficultés courantes d’interprétation et biais de raisonnement
Au-delà de la confusion endémique entre cotes et probabilités, la régression logistique recèle un piège méthodologique sournois souvent méconnu des chercheurs appliqués : la non-invariance des coefficients face à l’omission de prédicteurs orthogonaux, un phénomène connu sous le nom de non-collapsibilité de l’Odds Ratio.
Dans le cadre linéaire classique des moindres carrés, si un chercheur omet d’inclure dans son modèle une variable explicative pourtant pertinente, mais strictement indépendante et non corrélée aux autres prédicteurs déjà modélisés, les coefficients $\beta$ des variables incluses demeurent totalement inchangés et conservent leur parfaite absence de biais. Ce principe garantit la robustesse des interprétations dans les plans factoriels randomisés.
Il en va tout autrement en régression logistique : en raison de la nature non linéaire de la fonction sigmoïde et du fait que la variance résiduelle au niveau latent est arbitrairement fixée par construction mathématique (traditionnellement à $\pi^2 / 3 \approx 3{,}29$ pour la distribution logistique standard), l’adjonction ou la suppression d’un prédicteur indépendant supplémentaire modifie mécaniquement l’échelle du terme résiduel, modifiant de facto la magnitude numérique de tous les autres coefficients logistiques et de leurs OR associés. L’Odds Ratio n’est donc pas une propriété intrinsèque de la relation entre un facteur et une réponse clinique, mais dépend structurellement de la constellation spécifique de l’ensemble des covariables intégrées à l’équation.
Pour rétablir une intelligibilité pragmatique comparable à celle du modèle linéaire, les biostatisticiens préconisent de plus en plus le calcul des effets marginaux moyens (Average Marginal Effects, AME). L’AME évalue la dérivée instantanée ou la différence finie de probabilité pour chaque individu de l’échantillon empirique avant d’en calculer la moyenne globale, permettant d’énoncer des conclusions intuitives du type : « L’élévation d’un point sur l’échelle de coping actif s’accompagne en moyenne d’une augmentation de 4,2 points de pourcentage de la probabilité de sevrage tabagique réussi ».
8. Évaluation de la qualité de l’ajustement et performances prédictives
8.1 Indicateurs d’ajustement en régression linéaire
La validation globale d’un modèle de régression linéaire repose sur l’évaluation quantitative de la quantité de variance empirique absorbée par la combinaison linéaire des régresseurs. Le coefficient de détermination, universellement noté $R^2$, formalise la proportion de la variabilité totale de la variable continue dépendante expliquée par le modèle prédictif :
$$R^2 = 1 – \frac{\sum (Y_i – \hat{Y}_i)^2}{\sum (Y_i – \bar{Y})^2} = \frac{\text{Somme des Carrés Expliquée}}{\text{Somme des Carrés Totale}}$$
Oscillant théoriquement entre 0 et 1, le $R^2$ constitue la métrique reine de l’ajustement global. Toutefois, l’adjonction purement mathématique de nouvelles variables explicatives dans une équation linéaire incrémente invariablement le $R^2$, quand bien même ces prédicteurs additionnels ne seraient que des bruits blancs stochastiques dénués de tout fondement psychologique. Pour parer à cette dérive surparamétrique, les méthodologistes scrutent prioritairement le $R^2$ ajusté ($R^2_{\text{adj}}$), lequel applique une pénalité analytique proportionnelle au rapport entre le nombre de prédicteurs ($p$) et la taille de l’échantillon empirique ($n$) :
$$R^2_{\text{adj}} = 1 – \left[ \frac{(1 – R^2)(n – 1)}{n – p – 1} \right]$$
Sur le plan de l’erreur brute de prédiction, les chercheurs examinent l’Erreur Quadratique Moyenne (Root Mean Squared Error, RMSE) ainsi que l’Erreur Absolue Moyenne (MAE), qui restituent la magnitude des déviations résiduelles dans l’unité de mesure originale de la variable étudiée. Enfin, la significativité omnibus de l’ensemble de la structure prédictive est attestée par le test $F$ global de Fisher-Snedecor, testant l’hypothèse nulle conjointe selon laquelle l’ensemble des coefficients directeurs du modèle seraient simultanément nuls ($H_0 : \beta_1 = \beta_2 = dots = \beta_p = 0$).
8.2 Indicateurs d’ajustement en régression logistique
En régression logistique, l’absence formelle d’un concept de « variance totale résiduelle » analogue à celui des moindres carrés interdit tout calcul direct d’un $R^2$ conventionnel. L’évaluation de l’ajustement global s’opère initialement via le concept de Déviance statistique, fréquemment désignée sous le vocable de $-2 \text{ Log-Likelihood}$ ($-2LL$) :
$$D = -2 \ln\left(\frac{L_{\text{modèle}}}{L_{\text{saturé}}}\right)$$
La déviance quantifie l’écart global entre les prédictions générées par le modèle spécifié et un modèle dit saturé idéal capable de reproduire à la perfection l’intégralité des données empiriques. La différence de déviance entre un modèle sans prédicteur (modèle nul ou intercepte seul) et le modèle multivarié complet suit asymptotiquement une loi du chi-deux ($\chi^2$), constituant le test de rapport de vraisemblance omnibus (l’analogue non linéaire du test $F$).
Pour répondre au besoin légitime des chercheurs en sciences humaines d’obtenir des indices standardisés normalisés entre 0 et 1, de multiples métriques de Pseudo-$R^2$ ont été élaborées :
- Le Pseudo-$R^2$ de McFadden, ancré dans la théorie de l’information, compare la log-vraisemblance du modèle ajusté ($ell_{\text{mod}}$) à celle du modèle restreint ($ell_0$) : $R^2_{\text{McF}} = 1 – (ell_{\text{mod}} / ell_0)$. Des valeurs comprises entre 0,20 et 0,40 reflètent conventionnellement un ajustement exceptionnellement robuste dans les disciplines comportementales.
- Le Pseudo-$R^2$ de Cox et Snell, fondé sur le rapport de vraisemblance géométrique, possède l’inconvénient structurel de ne jamais pouvoir atteindre la valeur maximale de 1,00, même en situation de séparation parfaite des groupes.
- Le Pseudo-$R^2$ de Nagelkerke (ou Cragg-Uhler), qui introduit une renormalisation par division géométrique, corrigeant l’indice de Cox-Snell afin de garantir que l’indice puisse couvrir formellement la totalité de l’intervalle $[0, 1]$.
Parallèlement, la calibration du modèle a longtemps été évaluée au moyen du test de qualité d’ajustement de Hosmer-Lemeshow. Ce test divise l’échantillon en déciles de risque prédit et compare les fréquences d’événements observées aux fréquences attendues via une statistique de chi-deux. Toutefois, ce test essuie aujourd’hui de sévères critiques méthodologiques en raison de sa dépendance arbitraire au découpage des sous-groupes et de sa sensibilité excessive à la taille de l’échantillon, incitant les biostatisticiens contemporains à lui préférer des courbes de calibration lissées non paramétriques.
8.3 Évaluation de la classification binaire
Contrairement au modèle linéaire dont l’issue prédictive est intrinsèquement continue, le modèle logistique permet d’opérationnaliser des protocoles de classification binaire, assignant formellement chaque participant à l’une des deux catégories diagnostiques sur la base de sa probabilité conditionnelle calculée.
Cette démarche nécessite l’établissement préalable d’un seuil de décision (cut-off), fixé par défaut à $p = 0{,}50$. Les classifications croisées entre la réalité clinique observée et la décision statistique débouchent sur la matrice de confusion, permettant l’extraction de métriques décisionnelles fondamentales :
| Métrique Décisionnelle | Formule Algébrique | Signification Psychométrique et Clinique |
|---|---|---|
| Sensibilité (Rappel) | $\frac{\text{Vrais Positifs}}{\text{Vrais Positifs} + \text{Faux Négatifs}}$ | Aptitude du modèle à détecter exhaustivement l’ensemble des individus effectivement atteints du trouble pathologique étudié. |
| Spécificité | $\frac{\text{Vrais Négatifs}}{\text{Vrais Négatifs} + \text{Faux Positifs}}$ | Capacité du modèle à exclure avec exactitude les participants sains indemnes de toute symptomatologie. |
| Précision (Valeur Prédictive Positive) | $\frac{\text{Vrais Positifs}}{\text{Vrais Positifs} + \text{Faux Positifs}}$ | Probabilité réelle qu’un patient formellement étiqueté comme à risque par le modèle présente authentiquement la condition cible. |
Le choix du seuil de décision ne relève pas d’une certitude purement mathématique, mais d’un arbitrage clinique hautement stratégique dicté par le coût asymétrique des erreurs. Dans le cadre du dépistage précoce des comportements d’auto-agression ou de crise suicidaire imminente, le coût humain d’un faux négatif (omettre de repérer un individu en détresse absolue) est infiniment supérieur à celui d’un faux positif (déclencher une prise en charge préventive de précaution pour un sujet non menacé). Le chercheur abaissera alors délibérément le cut-off (par exemple à $p = 0{,}20$) pour saturer la sensibilité au détriment calculé de la spécificité.
Pour appréhender le pouvoir intrinsèque de discrimination du modèle indépendamment du choix subjectif de tout seuil particulier, la méthodologie dominante fait appel à l’analyse de la courbe ROC (Receiver Operating Characteristic) et au calcul de l’Aire Sous la Courbe (Area Under the Curve, AUC, également appelée statistique $C$). L’AUC synthétise la performance globale du modèle sur l’ensemble des seuils de coupure envisageables. Une AUC de $0{,}50$ reflète une absence totale de discrimination (équivalente à un lancer de pièce à pile ou face), tandis qu’une AUC de 1,00 traduit une discrimination sans faille. En neuropsychologie clinique, une valeur d’AUC comprise entre $0{,}80$ et $0{,}90$ est traditionnellement considérée comme excellente, et toute valeur excédant $0{,}90$ témoigne d’une capacité prédictive exceptionnelle.
9. Gestion des prédicteurs, multicolinéarité et interactions
9.1 Traitement des prédicteurs continus et catégoriels
L’intégration des variables explicatives au sein des deux paradigmes de régression partage de larges points communs computationnels, tout en se heurtant à des exigences spécifiques de prétraitement. Les prédicteurs qualitatifs ou catégoriels à plus de deux niveaux (par exemple l’appartenance à différents groupes expérimentaux ou statuts matrimoniaux) ne peuvent être introduits tels quels dans les équations. Ils doivent obligatoirement subir une étape d’encodage formel, le plus souvent concrétisée par le codage binaire d’indicatrices (dummy coding) ou le codage d’effets (effect coding), transformant une variable nominale à $k$ catégories en un ensemble de $k – 1$ variables binaires orthogonales rapportées à une modalité de référence arbitrairement désignée.
Pour les variables indépendantes quantitatives continues, le centrage sur la moyenne (ou la standardisation complète en scores $Z$) constitue une pratique méthodologique vivement recommandée. Si le centrage ne modifie aucunement la valeur de la pente globale $\beta_j$, ni la significativité statistique du test associatif afférent, il altère de manière salutaire l’interprétation de la constante $\beta_0$. Sans centrage préalable, l’intercepte traduit l’espérance mathématique ou le logit conditionnel pour un individu dont tous les régresseurs vaudraient zéro, une situation souvent empiriquement impossible (comme un individu affichant une pression artérielle ou un QI de zéro). Le centrage attribue à $\beta_0$ la valeur attendue pour l’individu représentatif situé exactement à la moyenne de la population observée, facilitant la convergence algorithmique des approximations itératives en régression logistique.
En ce qui concerne les valeurs manquantes (missing data), particulièrement endémiques dans les protocoles d’évaluation longitudinale en psychologie, le recours réducteur à la suppression des listes de cas (listwise deletion) induit une amputation dramatique de puissance et des biais d’échantillonnage massifs dès lors que les données ne sont pas manquantes de façon strictement aléatoire (MCAR). L’emploi de l’imputation multiple par équations chaînées (MICE) s’impose désormais comme le standard académique, devant être rigoureusement harmonisé avec la forme fonctionnelle (linéaire ou logistique) du modèle analytique final envisagé.
9.2 Diagnostic et régulation de la multicolinéarité
La présence d’intercorrélations élevées au sein de la matrice des régresseurs constitue une pathologie méthodologique délétère affectant aussi bien la régression linéaire que la régression logistique. Lorsque deux construits psychométriques sont redondants, le déterminant de la matrice d’information converge vers zéro, ce qui déstabilise le calcul inverse requis pour dériver la variance des estimateurs.
Le diagnostic de cette redondance analytique s’effectue traditionnellement au moyen de l’indice de Tolérance ($T$) et de son corollaire algébrique immédiat, le Facteur d’Inflation de la Variance (Variance Inflation Factor, VIF) :
$$\text{VIF}_j = \frac{1}{\text{Tolérance}_j} = \frac{1}{1 – R_j^2}$$
où $R_j^2$ représente le coefficient de détermination obtenu en régressant artificiellement le prédicteur $X_j$ sur l’ensemble de tous les autres prédicteurs inclus dans le système. Un VIF excédant le seuil conventionnel de 5 ou 10 indique une colinéarité alarmante. Les conséquences directes se manifestent par un gonflement disproportionné des erreurs types associées aux coefficients directeurs, transformant des variables cliniquement majeures en prédicteurs statistiquement insignifiants, voire en provoquant l’inversion erratique du signe algébrique des pentes estimées.
Pour assainir la modélisation en présence de colinéarité avérée, le chercheur dispose de plusieurs alternatives rigoureuses : l’agrégation théorique des prédicteurs redondants en un score factoriel unique via une analyse en composantes principales (ACP) ou une analyse factorielle confirmatoire (AFC), l’élagage parcimonieux des construits superflus, ou l’adoption d’approches de régression pénalisée adaptées à la colinéarité structurelle.
9.3 Modélisation des termes d’interaction et modérations
L’exploration des hypothèses de modération psychologique — où l’impact d’un prédicteur focal $X$ sur le devenir clinique $Y$ varie en fonction du niveau d’un modérateur $Z$ (par exemple l’effet protecteur du soutien social sur l’anxiété face à un stress environnemental aigu) — requiert l’adjonction formelle d’un terme de produit croisé ($X \times Z$) dans l’architecture prédictive.
Dans la régression linéaire, l’intégration de ce terme de produit conserve une transparence conceptuelle remarquable. L’équation s’enrichit directement :
$$Y = \beta_0 + \beta_1 X + \beta_2 Z + \beta_3 (XZ) + \varepsilon$$
La modération est qualifiée d’additive : le coefficient $\beta_3$ reflète très simplement de combien d’unités la pente unissant $X$ à $Y$ s’altère pour chaque accroissement d’une unité scalaire sur le modérateur $Z$. L’exploration post-hoc se réalise classiquement au moyen de l’analyse des pentes simples (simple slopes) proposée par Aiken et West, consistant à recalculer l’effet focal conditionnel à des niveaux substantiels prédéfinis du modérateur (typiquement à la moyenne, à un écart-type en deçà et à un écart-type au-delà).
À l’inverse, l’analyse des modérations au sein de la régression logistique déploie une complexité mathématique déroutante. Si l’introduction du terme de produit s’écrit de façon similaire dans l’espace sous-jacent du logit :
$$\text{Logit}(\pi) = \beta_0 + \beta_1 X + \beta_2 Z + \beta_3 (XZ)$$
l’effet d’interaction sur l’échelle des probabilités réelles ne correspond en aucune façon à la dérivée croisée directe, comme l’ont magistralement démontré Ai et Norton (2003). En raison de la transformation non linéaire sigmoïde, un terme d’interaction peut être statistiquement significatif au niveau du logit tout en affichant un impact nul sur l’échelle des probabilités dans certaines tranches de l’échantillon, ou inversement, exhiber un effet d’interaction substantiel sur la probabilité sans que le coefficient $\beta_3$ n’atteigne le seuil formel de significativité statistique. L’évaluation rigoureuse de la modération logistique commande donc de procéder à des dérivations marginales croisées sur l’ensemble du continuum empirique, proscrivant toute lecture hâtive du seul ratio d’interaction.
10. Applications comparées en recherche psychologique et clinique
10.1 Cas d’usage privilégiés de la régression linéaire
La régression linéaire s’avère irremplaçable dès lors que la question de recherche fondamentale explore les modulations fines de construits psychologiques appréhendés comme des spectres dimensionnels non fragmentés. Les modèles théoriques contemporains de la personnalité, à l’exemple du modèle des Big Five, postulent que des dimensions comme le névrosisme ou l’extraversion s’expriment sur des continuums gaussiens stables au sein de la population générale. Prédire les variations incrémentales du bien-être subjectif ou de la satisfaction de vie à partir des facettes élémentaires de la personnalité trouve dans la régression linéaire son instrumentation analytique naturelle.
Un autre champ d’élection réside dans l’analyse de l’efficacité des processus psychothérapeutiques continus. Lorsqu’un protocole interventionnel évalue le gain thérapeutique au moyen de l’évolution hebdomadaire des scores totaux à des inventaires de détresse psychologique, la modélisation linéaire permet de quantifier avec une immense sensibilité métrique la part de variance du soulagement symptomatique attribuable à la qualité de l’alliance thérapeutique perçue, en neutralisant les variations individuelles initiales.
Enfin, les neurosciences cognitives et la neuropsychologie font un usage intensif de ce paradigme pour scruter le vieillissement cognitif et le déclin fonctionnel. La mesure précise de la réduction continue de la mémoire de travail, de la vitesse d’inhibition exécutive ou des volumes cérébraux hippocampiques mesurés en imagerie par résonance magnétique (IRM) s’accommode idéalement de modèles linéaires multivariés capables de préserver la sensibilité métrique des signaux physiologiques et comportementaux.
10.2 Cas d’usage privilégiés de la régression logistique
La régression logistique s’impose comme le protocole impératif dès que l’interrogation scientifique bascule d’une analyse d’intensité dimensionnelle vers une problématique de transition d’état, de classification nosographique ou de décision comportementale irréversible. L’un des théâtres cliniques les plus emblématiques concerne la suicidologie contemporaine. La transition entre l’idéation suicidaire pure (état psychologique interne passif) et le passage à l’acte suicidaire effectif (événement comportemental dichotomique dramatique) constitue une rupture fondamentale. Les études épidémiologiques et psychiatriques emploient prioritairement la régression logistique pour isoler les facteurs prédictifs spécifiques (antécédents d’impulsivité motrice, accès aux moyens létaux, ruptures affectives aiguës) modulant directement l’Odds Ratio du passage à l’acte.
Dans l’évaluation des programmes de soins et l’addictologie, la modélisation de l’observance thérapeutique et du risque de décrochage prématuré (drop-out) relève typiquement de cette architecture logistique. Savoir identifier, dès l’admission d’un patient en cure de désintoxication, les prédicteurs augmentant significativement la probabilité qu’il abandonne unilatéralement le protocole avant la fin de la troisième semaine permet aux équipes soignantes d’ajuster les stratégies préventives et d’allouer de manière efficiente des ressources institutionnelles limitées.
De façon analogue, l’aide au diagnostic différentiel automatisé en psychiatrie utilise la modélisation logistique pour discriminer, au sein de cohortes cliniques complexes, la présence ou l’absence d’une pathologie définie (par exemple distinguer un trouble bipolaire débutant d’un épisode dépressif majeur récurrent) sur la base d’une constellation d’antécédents génétiques, de profils de sommeil actigraphiques et de scores comportementaux discrets.
10.3 Étude de cas intégrative : analyse sur un même corpus de données
Pour appréhender concrètement les lignes de fracture méthodologiques entre les deux paradigmes, analysons une situation de recherche classique en psychologie du travail et de la santé : l’étude de l’épuisement professionnel (burn-out) au sein d’une cohorte hospitalière de $n = 500$ soignants. Considérons un corpus empirique comprenant des mesures de charge de travail objective, de soutien social organisationnel et de sentiment d’auto-efficacité, confrontées à deux opérationnalisations distinctes du devenir professionnel :
| Caractéristique Méthodologique | Approche Dimensionnelle Linéaire | Approche Catégorielle Logistique |
|---|---|---|
| Variable Dépendante | Score continu global au Maslach Burnout Inventory (MBI, échelle continue de 0 à 132). | Statut dichotomique de burn-out clinique avéré ($0 = \text{Non}$, $1 = \text{Oui}$ basé sur un seuil validé). |
| Modèle Statistique Appliqué | Régression linéaire multiple par Moindres Carrés Ordinaires. | Régression logistique binaire par Maximum de Vraisemblance. |
| Grandeur d’Effet Rapportée | Coefficients directeurs partiels $\beta$ et taille d’effet globale $R^2$. | Odds Ratios ($\text{OR} = e^\beta$) et Pseudo-$R^2$ de Nagelkerke. |
| Sensibilité de Détection | Maximale : capture les oscillations symptomatiques subcliniques légères à modérées. | Focalisée sur le franchissement du point de rupture pathologique. |
| Conséquence Pratique | Compréhension fine des leviers psychologiques globaux d’hygiène de vie au travail. | Identification ciblée des personnels en situation de détresse imminente requérant un arrêt médical. |
Cette étude de cas démontre sans équivoque le coût analytique majeur de la dichotomisation. En transformant le score continu du MBI en variable binaire clinique pour autoriser l’usage de la régression logistique, le chercheur sacrifie délibérément une part considérable de la variance interindividuelle. Deux soignants affichant respectivement des scores MBI de 15 et de 44 seront tous deux indistinctement amalgamés sous le code « 0 » (absence de décompensation), occultant la dégradation continue du second. Cette perte d’information statistique entraîne mécaniquement une baisse substantielle de la puissance des tests de détection, nécessitant des échantillons empiriques nettement plus vastes pour révéler des associations que le modèle linéaire mettrait au jour avec une économie de moyens substantielle.
Cependant, le modèle logistique rétablit sa légitimité au stade de l’action décisionnelle concrète. Pour le médecin du travail qui doit statuer sur une décision binaire d’inaptitude temporaire ou d’éviction du service, la prédiction d’une cote d’effondrement clinique via un modèle logistique calibré s’avère pragmatiquement plus opérante que l’estimation abstraite d’un score dimensionnel continu.
11. Limites méthodologiques, régularisation et extensions avancées
11.1 Vulnérabilité au surapprentissage (overfitting) et remèdes statistiques
La recherche psychologique contemporaine est fréquemment confrontée au fléau du surapprentissage (overfitting). Ce phénomène pernicieux survient lorsqu’un modèle statistique, doté d’une trop grande complexité paramétrique par rapport au volume effectif d’observations disponibles, commence à modéliser les fluctuations aléatoires et le bruit stochastique idiosyncrasique de l’échantillon plutôt que la véritable structure théorique sous-jacente. Si le modèle affiche alors des performances illusoirement exceptionnelles sur les données d’apprentissage (avec des $R^2$ ou des AUC artificiellement proches de la perfection), son pouvoir de généralisation sur de nouvelles cohortes de validation externe s’effondre totalement.
Pour juguler cette pathologie prédictive, l’évaluation moderne impose le recours systématique à des protocoles de validation croisée à $k$ blocs ($k$-fold cross-validation). En subdivisant aléatoirement la cohorte initiale en plusieurs sous-échantillons d’entraînement et de test tournants, le chercheur s’assure que les indices d’exactitude rapportés reflètent la solidité réelle du modèle face à des observations inédites.
Parallèlement, les avancées computationnelles ont démocratisé les techniques de régularisation mathématique par pénalisation de la fonction de perte. Les trois architectures dominantes s’intègrent aussi bien à l’estimation linéaire qu’à l’estimation logistique :
- La Régression Ridge (norme $L_2$), qui applique une pénalité quadratique proportionnelle au carré de la magnitude des coefficients ($\lambda \sum \beta_j^2$). Elle comprime harmonieusement l’ensemble des pentes vers zéro sans jamais les annuler totalement, désamorçant radicalement l’instabilité induite par la multicolinéarité sévère.
- La Régression Lasso (norme $L_1$), développée par Robert Tibshirani, qui impose une pénalité proportionnelle à la valeur absolue des coefficients ($\lambda \sum |\beta_j|$). Cette fonction possède la propriété remarquable de forcer certains coefficients structurellement marginaux à s’annuler rigoureusement, opérant ainsi une sélection automatique et parcimonieuse des prédicteurs psychologiques les plus essentiels.
- L’ElasticNet, qui combine de manière adaptative les pénalités $L_1$ et $L_2$, assurant une sélection de variables robuste face à des blocs de régresseurs hautement corrélés entre eux.
11.2 Extensions de la régression logistique au-delà du cas binaire
Si la régression logistique binaire monopolise une large part de la littérature appliquée, les sciences du comportement sont continuellement confrontées à des variables catégorielles dont l’espace d’échantillonnage excède deux modalités exclusives. Deux extensions théoriques majeures permettent de modéliser ces architectures qualitatives complexes.
La première est la régression logistique multinomiale, conçue pour traiter des variables dépendantes nominales polytomiques non ordonnées à $J$ catégories (par exemple discriminer des choix d’orientation académique ou classifier des profils d’attachement affectif : sécure, insécure-évitant, insécure-anxieux). Le modèle multinomial désigne une catégorie de référence standard et estime simultanément un ensemble de $J – 1$ équations logistiques binaires parallèles comparant chaque modalité individuelle à la modalité témoin, tout en contraignant la somme de l’ensemble des probabilités prédites à être égale à l’unité.
La seconde extension fondamentale est le modèle logit à cotes proportionnelles, couramment désigné sous le nom de régression logistique ordinale. Ce modèle est spécialement dévolu aux variables dépendantes intrinsèquement ordonnées mais dépourvues de métrique d’intervalle stricte, situation omniprésente dans l’usage des échelles de Likert en psychométrie (par exemple : « Jamais / Rarement / Souvent / Toujours »). La régression ordinale postule que la variable observée discrète reflète une variable latente continue sous-jacente divisée par une série de seuils de coupure constants (cutpoints). Le modèle suppose que l’effet de chaque prédicteur $\beta$ est invariant quel que soit le seuil de bascule envisagé (hypothèse d’équiproportionnalité des cotes), permettant une estimation hautement parcimonieuse de la progression sur l’échelle ordinale.
11.3 Intégration au sein des modèles multiniveaux et hiérarchiques
L’une des frontières méthodologiques les plus dynamiques de la modélisation en sciences humaines réside dans la prise en compte des structures de données hiérarchiques et nichées. Les postulats classiques d’indépendance stochastique des erreurs s’avèrent structurellement violés lorsque les participants partagent des environnements communs (patients suivis par différents thérapeutes au sein de multiples cliniques, élèves évalués au sein de diverses classes scolaires) ou dans le cadre de protocoles d’évaluation écologique momentanée (ESM / EMA) où une série d’enregistrements répétés s’agrège à l’intérieur de chaque participant.
Dans le domaine continu, cette complexité organisationnelle est prise en charge par les Modèles Linéaires Mixtes (LMM). Ces architectures décomposent la variance résiduelle en effets fixes (représentant les tendances universelles de la population) et en effets aléatoires (interceptes et pentes aléatoires autorisant chaque grappe ou chaque individu à exhiber sa propre trajectoire d’évolution spécifique et son propre niveau d’accrochage de base).
Lorsque la variable dépendante hiérarchisée devient binaire ou polytomique (comme la prédiction multiniveau de la rechute addictive journalière d’un sujet au fil d’un protocole ESM), l’analyse bascule dans le champ des Modèles Logistiques Mixtes Généralisés (Generalized Linear Mixed Models, GLMM). L’intégration de la fonction de lien logit au sein d’équations intégrant des termes de perturbation aléatoire multivariée empêche l’intégration analytique directe de la log-vraisemblance, exigeant le recours à des approximations par quadrature de Gauss-Hermite adaptative ou à des chaînes de Markov Monte Carlo (MCMC) dans un cadre d’inférence bayésienne avancée. Ces outils sophistiqués représentent aujourd’hui l’état de l’art pour démêler rigoureusement les dynamiques interindividuelles des processus intra-individuels dans les sciences comportementales.
12. Guide décisionnel pour le chercheur et recommandations académiques
12.1 Arbre de décision méthodologique
Afin de guider le chercheur ou le clinicien dans le choix méthodologique optimal lors de l’élaboration de son protocole d’analyse statistique, la démarche décisionnelle peut être formalisée au travers d’une séquence de jalons diagnostiques hiérarchisés :
Étape 1 : Audit de la nature ontologique et métrique du critère ($Y$)
- Si la variable dépendante est continue, mesurée sur une échelle d’intervalle ou de rapport authentique sans bornage artificiel restrictif $\rightarrow$ Orienter le diagnostic vers la Régression Linéaire.
- Si la variable dépendante est catégorielle, dichotomique, multinomiale nominale ou ordinale $\rightarrow$ Orienter impérativement vers la Régression Logistique (binaire, multinomiale ou ordinale).
Étape 2 : Vérification rigoureuse des postulats distributionnels sous-jacents
- Pour la voie linéaire : examiner la structure des résidus. Les résidus présentent-ils une homoscédasticité acceptable (test de Breusch-Pagan) et une normalité distributionnelle plausible (Q-Q plot) ? Si l’hétéroscédasticité est substantielle mais que le construit demeure continu, explorer des erreurs standards robustes (sandwich de Huber-White) ou envisager des modèles linéaires généralisés à distribution Gamma.
- Pour la voie logistique : vérifier scrupuleusement la condition de linéarité dans l’espace logit (test de Box-Tidwell) et s’assurer de l’absence formelle de séparation totale ou quasi-totale des données dans les tables de contingence croisées.
Étape 3 : Articulation avec la finalité théorique de l’investigation
- Si l’objectif est d’explorer un mécanisme psychologique fin, d’isoler des modulations dimensionnelles subcliniques ou d’optimiser la puissance statistique sur un échantillon restreint $\rightarrow$ Privilégier la mesure continue et l’architecture linéaire.
- Si la finalité est l’aide au triage décisionnel, le calcul de probabilités individualisées de survenue d’un risque ou le diagnostic nosographique formel $\rightarrow$ Consolider l’analyse logistique avec restitution des métriques de classification ROC/AUC.
12.2 Normes de rapportage selon les directives académiques et standards APA
La publication de résultats issus de modèles de régression au sein des revues académiques de référence indexées impose une conformité rigoureuse aux standards internationaux édictés par l’American Psychological Association (notamment les directives JARS : Journal Article Reporting Standards). L’opacité méthodologique et le rapportage parcellaire constituent des obstacles majeurs à la reproductibilité scientifique.
Pour une régression linéaire, le manuscrit doit obligatoirement expliciter :
- Les coefficients de régression bruts non standardisés ($B$) avec leurs erreurs standards respectives ($SE$).
- Les coefficients de régression standardisés ($\beta$).
- Les intervalles de confiance à 95 % pour chaque coefficient directeur.
- Les statistiques de test associées ($t$ de Student), accompagnées de leurs degrés de liberté exacts et des valeurs $p$ précises (éviter la formulation réductrice $p < 0{,}05$).
- Les grandeurs globales de l’ajustement : $R^2$, $R^2$ ajusté, ainsi que la valeur du test $F$ global omnibus.
- Une mention explicite des diagnostics de vérification des hypothèses d’homoscédasticité et de multicolinéarité (valeurs du VIF).
Pour une régression logistique, le chercheur se doit de documenter exhaustivement :
- La valeur des coefficients logit bruts ($\beta$) et leurs erreurs types d’échantillonnage ($SE$).
- Les statistiques de Wald associées ($z$ ou Wald $\chi^2$) et leurs degrés de liberté.
- Les Odds Ratios ($\text{OR} = e^\beta$), accompagnés de façon irrévocable de leurs intervalles de confiance à 95 %.
- La déviance résiduelle du modèle ainsi que la valeur du test de rapport de vraisemblance omnibus ($\chi^2$).
- Les indices de Pseudo-$R^2$ sélectionnés (préférablement Nagelkerke et McFadden).
- Les performances prédictives et métriques de classification discriminante : matrice de confusion, seuil de probabilité retenu, sensibilité, spécificité, et obligatoirement l’Aire Sous la Courbe ROC (AUC) avec son intervalle de confiance.
12.3 Tableau synoptique comparatif et synthèse finale
Pour clore cette analyse approfondie, le tableau ci-dessous synthétise les points de divergence névralgiques séparant la régression linéaire de la régression logistique, offrant une référence méthodologique condensée pour la pratique de recherche :
| Dimension Comparée | Régression Linéaire | Régression Logistique |
|---|---|---|
| Nature de la Variable Dépendante ($Y$) | Continue (échelle d’intervalle ou de rapport), domaine non borné théorique ($]-\infty, +\infty[$). | Catégorielle, binaire dichotomique ($Y in {0, 1}$), polytomique ou ordinale. |
| Fonction Mathématique d’Ajustement | Droite ou hyperplan linéaire : $Y = \beta_0 + \sum \beta_j X_j + \varepsilon$. | Courbe sigmoïde non linéaire : $\pi = \frac{1}{1 + e^{-X\beta}}$ (linéaire dans le logit). |
| Fonction de Lien (Cadre GLM) | Identité : $g(\mu) = \mu$. | Logit : $g(\pi) = \ln\left(\frac{\pi}{1 – \pi}\right)$. |
| Méthode Fondamentale d’Estimation | Moindres Carrés Ordinaires (MCO) : forme analytique fermée directe $(X’X)^{-1}X’Y$. | Maximum de Vraisemblance (EMV) : résolution itérative (Newton-Raphson, IRLS). |
| Hypothèse sur les Résidus | Normalité et homoscédasticité strictes ($\varepsilon \sim \mathcal{N}(0, \sigma^2)$). | Variance binomiale inhérente ($p(1-p)$), absence d’hypothèse de normalité résiduelle. |
| Grandeur d’Effet Individuelle | Coefficient directeur brut ($B$) et standardisé ($\beta^*$). | Odds Ratio ($\text{OR} = e^\beta$) et Effets Marginaux Moyens (AME). |
| Métriques d’Ajustement Global | $R^2$, $R^2$ ajusté, Erreur Quadratique Moyenne (RMSE), test $F$. | Déviance ($-2LL$), Pseudo-$R^2$ (Nagelkerke, McFadden), test de vraisemblance $\chi^2$. |
| Évaluation de la Capacité Prédictive | Minimisation des résidus scalaires et bandes de confiance. | Matrice de confusion, sensibilité, spécificité, courbe ROC et indice AUC. |
| Principaux Risques et Pathologies | Hétéroscédasticité, non-linéarité empirique, levier des points aberrants. | Séparation complète des données, non-collapsibilité des coefficients, surajustement d’AUC. |
En conclusion, la régression linéaire et la régression logistique ne doivent en aucun cas être perçues comme deux paradigmes méthodologiques antagonistes, mais comme deux formulations mathématiques profondément complémentaires dédiées à la modélisation de la psyché humaine. L’art de la méthode en psychologie empirique réside dans la lucidité avec laquelle le chercheur délimite son objet d’étude : préserver la richesse continue des processus psychologiques chaque fois que la mesure le permet au moyen de la régression linéaire, et adopter la rigueur non linéaire de la régression logistique dès lors que l’action, la clinique et le comportement imposent la réalité irréductible de choix catégoriels.
Références
Ai, C., & Norton, E. C. (2003). Interaction terms in logit and probit models. Economics Letters, 80(1), 123-129. https://doi.org/10.1016/S0165-1765(03)00032-6
Aiken, L. S., & West, S. G. (1991). Multiple regression: Testing and interpreting interactions. Sage Publications.
Albert, A., & Anderson, J. A. (1984). On the existence of maximum likelihood estimates in logistic regression models. Biometrika, 71(1), 1-10. https://doi.org/10.1093/biomet/71.1.1
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Berkson, J. (1944). Application of the logistic function to bio-assay. Journal of the American Statistical Association, 39(227), 357-365. https://doi.org/10.1080/01621459.1944.10500699
Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
Cox, D. R. (1958). The regression analysis of binary sequences. Journal of the Royal Statistical Society: Series B (Methodological), 20(2), 215-232. https://doi.org/10.1111/j.2517-6161.1958.tb00292.x
Galton, F. (1886). Regression towards mediocrity in hereditary stature. The Journal of the Anthropological Institute of Great Britain and Ireland, 15, 246-263. https://doi.org/10.2307/2841583
Hosmer, D. W., Lemeshow, S., & Sturdivant, R. X. (2013). Applied logistic regression (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781118548387
MacCallum, R. C., Zhang, S., Preacher, K. J., & Rucker, D. D. (2002). On the practice of dichotomization of quantitative variables. Psychological Methods, 7(1), 19-40. https://doi.org/10.1037/1082-989X.7.1.19
McFadden, D. (1974). Conditional logit analysis of qualitative choice behavior. In P. Zarembka (Ed.), Frontiers in Econometrics (pp. 105-142). Academic Press.
Nagelkerke, N. J. (1991). A note on a general definition of the coefficient of determination. Biometrika, 78(3), 691-692. https://doi.org/10.1093/biomet/78.3.691
Nelder, J. A., & Wedderburn, R. W. (1972). Generalized linear models. Journal of the Royal Statistical Society: Series A (General), 135(3), 370-384. https://doi.org/10.2307/2344614
Pearson, K. (1896). Mathematical contributions to the theory of evolution. III. Regression, heredity, and panmixia. Philosophical Transactions of the Royal Society of London. Series A, 187, 253-318. https://doi.org/10.1098/rsta.1896.0007
Rasch, G. (1960). Probabilistic models for some intelligence and attainment tests. Danmarks Paedagogiske Institut.
Tibshirani, R. (1996). Regression shrinkage and selection via the lasso. Journal of the Royal Statistical Society: Series B (Methodological), 58(1), 267-288. https://doi.org/10.1111/j.2517-6161.1996.tb02080.x