
Dans le champ des sciences humaines et comportementales, la modélisation statistique ne constitue pas une simple formalité calculatoire, mais un instrument épistémologique d’investigation des régularités psychologiques. Qu’il s’agisse d’évaluer l’impact du stress sur la mémoire de travail, de prédire l’adaptation sociale à partir de traits de personnalité, ou de sonder l’efficacité d’un protocole psychothérapeutique, les chercheurs recourent fréquemment aux modèles prédictifs linéaires. Toutefois, la valeur heuristique d’un modèle ne se mesure pas uniquement à l’aune de sa capacité à tracer une tendance centrale élégante à travers un nuage d’observations empiriques. Elle repose de manière tout aussi critique sur l’exploration méthodique de ce que l’équation laisse de côté, c’est-à-dire les déviations individuelles que l’on nomme formellement les résidus.
Le calcul et le diagnostic des résidus incarnent la pierre angulaire de l’inférence statistique moderne. Trop souvent reléguée au rang d’artefact secondaire par les utilisateurs novices de logiciels de traitement de données, l’analyse résiduelle offre un miroir direct de la validité interne d’une recherche. En confrontant les prédictions théoriques issues de la droite de régression aux données effectivement recueillies sur le terrain, le résidu matérialise la part d’inconnu, de bruit de mesure ou de complexité psychologique non captée par les variables explicatives sélectionnées. Loin d’être un simple déchet algorithmique, il constitue la matière première à partir de laquelle s’évalue l’adéquation d’un postulat théorique face à la réalité empirique.
Ce guide exhaustif a pour vocation d’accompagner les chercheurs, psychométriciens, étudiants de cycles supérieurs et analystes de données dans la maîtrise intégrale des résidus en analyse de régression. De la dérivation algébrique fondamentale aux procédures computationnelles avancées sous R, Python, SPSS et JASP, nous examinerons en détail les fondements mathématiques, les typologies de standardisation, les tests de conformité des postulats de Gauss-Markov et les stratégies de remédiation face aux données atypiques. À travers une démarche résolument ancrée dans la rigueur méthodologique, cet ouvrage propose une immersion complète au cœur de l’analyse des écarts, transformant l’erreur de prédiction en un puissant vecteur de découverte scientifique.
1. Introduction aux résidus dans l’analyse de régression linéaire en psychologie
1.1 Définition conceptuelle et rôle épistémologique du résidu
D’un point de vue épistémologique, la psychologie scientifique tente de formaliser des lois générales du comportement tout en composant avec l’inévitable singularité des individus observés. Lorsqu’un chercheur applique un modèle de régression linéaire, il postule qu’une variable indépendante exerce une influence structurelle, systématique et mesurable sur une variable dépendante. Néanmoins, l’observation d’un participant particulier ne coïncide que très rarement avec la trajectoire moyenne prédite par la théorie. Cet écart quantitatif précis, qui sépare la réponse empirique manifestée par le sujet de la réponse attendue selon la fonction mathématique, définit formellement le résidu.
Dans le cadre de la modélisation comportementale, l’erreur d’estimation ne doit pas être appréhendée comme une banale maladresse expérimentale ou une imperfection négligeable de l’instrumentation. Elle reflète la part intrinsèque de variance psychologique non expliquée par les déterminants intégrés au modèle. Cette variance résiduelle agrège de multiples sources : fluctuations attentionnelles passagères, antécédents biographiques idiosyncrasiques, variations neurobiologiques momentanées, erreurs aléatoires d’échantillonnage psychométrique ou omissions délibérées d’autres variables explicatives pertinentes au sein de l’architecture du protocole expérimental.
Il est impératif d’opérer une distinction sémantique et mathématique irréductible entre l’erreur théorique de population, traditionnellement notée par la lettre grecque epsilon (ε), et le résidu empirique échantillonnal, désigné par la lettre latine e. L’erreur de population représente un paramètre latent et fondamentalement inobservable ; elle renvoie à la distance exacte entre une observation individuelle et la droite de régression vraie, issue de la population globale théorique. À l’inverse, le résidu empirique est une quantité calculable, estimée directement à partir d’un échantillon fini de données via l’ajustement des paramètres d’échantillonnage. Ignorer cette divergence conceptuelle reviendrait à confondre les propriétés ontologiques de l’univers avec les approximations statistiques permises par un échantillon circonscrit.
L’analyse rigoureuse des résidus constitue ainsi le mécanisme privilégié par lequel la psychologie quantitative éprouve la robustesse de ses édifices théoriques. Si un modèle conceptuel prétend rendre compte d’un phénomène psychologique précis, les écarts à ce modèle ne doivent manifester aucune structure logique, aucune directionnalité sous-jacente ni aucune régularité non maîtrisée. L’examen des résidus offre alors un test de falsification poppérien par excellence : la présence de régularités dans l’erreur démontre sans équivoque que la théorie sous-jacente est incomplète ou fondamentalement mal spécifiée.
1.2 Le modèle de régression linéaire simple : variables prédictive et réponse
La formulation algébrique canonique de la régression linéaire simple s’énonce selon l’équation fondamentale : Y = b0 + b1X + e. Dans ce dispositif, Y représente la variable réponse, également qualifiée de critère ou d’observation dépendante, tandis que X désigne le prédicteur, communément identifié comme la variable explicative ou indépendante. Les coefficients b0 et b1 constituent respectivement l’ordonnée à l’origine (ou constante du modèle) et le coefficient de pente empirique, traduisant l’amplitude de la variation attendue de Y consécutivement à une augmentation unitaire de X.
Considérons une investigation psychométrique classique visant à modéliser le niveau d’anxiété situationnelle (Y), opérationnalisé par un score standardisé sur une échelle d’évaluation clinique, en fonction de la charge cognitive de travail (X) imposée lors d’une tâche d’attention divisée informatisée. L’équation de régression cherche à formaliser comment l’accumulation des contraintes cognitives amplifie le sentiment d’anxiété. Dès lors que le protocole recueille des données réelles, chaque participant présente un score singulier d’anxiété qui s’écarte de la valeur générale modélisée pour son niveau de charge cognitive spécifique. L’écart entre ce score clinique recueilli et le score théorique généré par la combinaison linéaire de la constante et de la pente constitue le résidu spécifique attribué à cet individu.
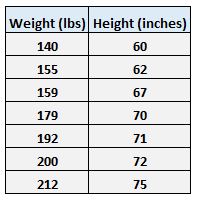
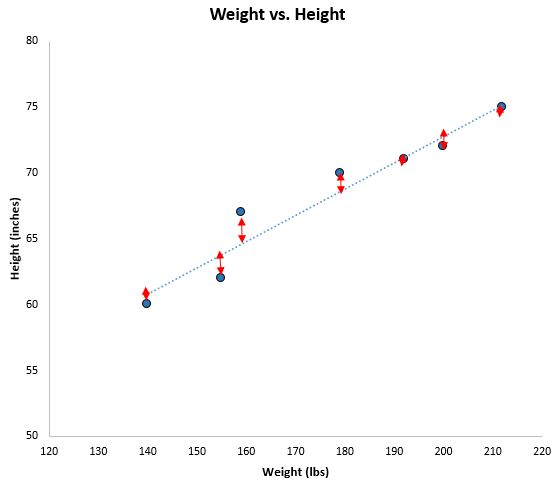
Sur le plan de l’interprétation géométrique, la régression linéaire simple par la méthode des moindres carrés ordinaires (MCO) vise à tracer une trajectoire rectiligne au sein du plan cartésien bidimensionnel défini par les axes des abscisses (X) et des ordonnées (Y). Cette droite optimale ne passe pas nécessairement par l’ensemble des points empiriques ; au contraire, elle traverse le nuage de points de telle façon que la somme des distances verticales au carré séparant chaque point de la droite soit rendue rigoureusement minimale. Le résidu s’incarne donc physiquement dans cette distance verticale mesurée parallèlement à l’axe des ordonnées, et non pas selon une projection perpendiculaire ou orthogonale directe à la droite elle-même.
1.3 Pourquoi le calcul exact des résidus est indispensable au chercheur
L’estimation numérique précise de chaque résidu individuel n’est pas un luxe computationnel : elle conditionne l’évaluation de l’adéquation globale du modèle statistique, concept désigné dans la littérature internationale sous le terme d’adéquation du modèle (goodness-of-fit). Il ne suffit pas d’obtenir un coefficient de corrélation élevé ou une valeur de significativité statistique infinitésimale (p < .001) pour conclure à la validité d’une régression. Un modèle peut afficher un coefficient de détermination séduisant tout en échouant dramatiquement à capturer la géométrie réelle du phénomène étudié en raison d’une mauvaise répartition interne des erreurs d’estimation.
Le calcul exhaustif des résidus représente la démarche incontournable pour vérifier si les postulats fondamentaux du théorème de Gauss-Markov sont respectés. Ces postulats – incluant la linéarité intrinsèque de la fonction, l’homogénéité de la variance des erreurs et l’indépendance mutuelle des observations – reposent entièrement sur les propriétés structurelles de la distribution résiduelle. Si un chercheur omet d’extraire et d’analyser ses résidus, il court le risque grave d’émettre des inférences statistiques erronées, de sous-estimer de façon trompeuse les erreurs types associées à ses coefficients de régression et, in fine, de publier des conclusions scientifiques fallacieuses basées sur des faux positifs méthodologiques.
Au-delà de la validation technique des hypothèses distributionnelles, l’exploration des grandeurs résiduelles s’avère féconde pour le diagnostic clinique et psychométrique appliqué. L’analyse des écarts met en lumière les profils comportementaux atypiques : des sujets dont les scores s’avèrent radicalement divergents de la prédiction commune. Ces individus aux résidus disproportionnés peuvent révéler des stratégies cognitives compensatoires non répertoriées, des biais de désirabilité sociale dans la passation des auto-questionnaires, ou signaler l’existence de sous-groupes cliniques méconnus dont la prise en compte nécessitera une révision théorique de grande envergure.
2. Fondements mathématiques et formulation algébrique des résidus
2.1 L’équation formelle du résidu ordinaire
Dans le formalisme de l’analyse univariée et multivariée, l’expression algébrique canonique définissant le résidu ordinaire pour la i-ième observation d’un échantillon de taille n s’écrit avec une sobriété mathématique universelle :
ei = yi − ŷi
Dans cette formulation élémentaire, yi symbolise le score empirique réel recueilli auprès du participant expérimental i. Il s’agit de la valeur brute, concrète et non modifiée, observée sur l’instrument psychométrique ou le capteur psychophysiologique. En contrepartie, ŷi (prononcé y chapeau) caractérise la valeur ajustée ou prédite par l’équation de régression linéaire pour ce participant particulier, calculée en injectant sa valeur observée sur le prédicteur xi dans le système : ŷi = b0 + b1xi.
L’analyse du signe arithmétique issu de cette soustraction revêt une importance analytique directe. Lorsque le résidu est strictement positif (ei > 0), la valeur observée yi est supérieure à la prédiction théorique ŷi : le modèle a donc commis une sous-estimation du score du sujet. Réciproquement, dès lors que le résidu affiche une valeur strictement négative (ei < 0), la valeur empirique se situe en deçà de la coordonnée projetée sur la droite : le modèle mathématique a produit une surestimation manifeste de la réponse psychologique réelle.
Un résidu d’une magnitude rigoureusement nulle (ei = 0) caractérise une coïncidence parfaite, indiquant que le point empirique représentatif du sujet repose exactement sur l’axe rectiligne de l’équation prédictive. Dans la pratique empirique des sciences du comportement, cette situation demeure rarissime en raison de l’inévitable variance d’erreur inhérente à la mesure du comportement humain.
2.2 La propriété fondamentale de la somme nulle des moindres carrés
L’une des propriétés fondamentales de l’estimation par les moindres carrés ordinaires réside dans la nullité obligatoire de la somme algébrique des résidus ordinaires, dès lors que le modèle intègre une ordonnée à l’origine (b0). Cette caractéristique découle de la dérivation analytique des conditions du premier ordre de minimisation mathématique.
Pour optimiser le modèle, l’algorithme des MCO cherche à minimiser la fonctionnelle de perte représentée par la somme des carrés des erreurs résiduelles (notée SSE pour Sum of Squared Errors) :
S(b0, b1) = ∑i=1n (yi − b0 − b1xi)2
En calculant la dérivée partielle de cette fonction d’erreur par rapport au paramètre constant b0 et en posant cette dérivée égale à zéro pour atteindre l’extremum local, nous obtenons l’égalité suivante :
∂S / ∂b0 = −2 ∑i=1n (yi − b0 − b1xi) = 0
En éliminant le facteur multiplicatif −2 et en reconnaissant que l’expression entre parenthèses équivaut rigoureusement au résidu individuel ei, la relation débouche inévitablement sur la loi fondamentale :
∑i=1n ei = 0
Cette contrainte structurelle engendre une conséquence directe : la moyenne arithmétique des résidus bruts au sein de l’échantillon d’ajustement est invariablement et exactement égale à zéro (ē = 0). Sur le plan de la géométrie vectorielle hilbertienne, cela implique que le vecteur des résidus se déploie orthogonalement à l’hyperplan sous-tendu par les prédicteurs du modèle et le vecteur unitaire associé à la constante. Le produit scalaire entre le vecteur des valeurs prédites Ŷ et le vecteur des résidus e est donc nul (ŶTe = 0), ce qui formalise l’indépendance linéaire stricte entre la prédiction et l’erreur d’ajustement globale.
2.3 Décomposition de la variance totale et rôle des résidus
L’orthogonalité mathématique entre les prédictions du modèle et les erreurs calculées constitue le pilier du principe de décomposition de la variance, central dans l’analyse de régression et l’analyse de variance (ANOVA). La dispersion totale des scores observés par rapport à leur moyenne générale s’articule autour de la Somme des Carrés Totale (SST, Total Sum of Squares) :
SST = ∑i=1n (yi − ȳ)2
Cette variabilité globale se partitionne de façon exacte en deux composantes mutuellement exclusives et exhaustives : la Somme des Carrés de la Régression (SSR, Regression Sum of Squares), qui capture la dispersion des prédictions théoriques autour de la moyenne, et la Somme des Carrés des Erreurs (SSE, Residual Sum of Squares), qui agrège l’amplitude quadratique des résidus bruts :
SST = SSR + SSE, soit : ∑ (yi − ȳ)2 = ∑ (ŷi − ȳ)2 + ∑ (yi − ŷi)2
Cette relation met en évidence la nature du coefficient de détermination R2, qui mesure la proportion de la variance de la variable critère directement attribuable aux variations de la variable explicative. Algébriquement, le R2 peut être dérivé directement de la quantité résiduelle calculée :
R2 = 1 − (SSE / SST)
Enfin, la variance résiduelle de l’échantillon, appelée également le Carré Moyen de l’Erreur (MSE pour Mean Squared Error), s’obtient en divisant la somme des carrés des résidus par les degrés de liberté résiduels associés au système, à savoir la taille de l’échantillon n amputée du nombre de prédicteurs k et de la constante unitaire :
se2 = MSE = SSE / (n − k − 1)
L’écart-type résiduel (se = √MSE), souvent dénommé erreur type de l’estimation, quantifie la dispersion moyenne des observations empiriques autour de la droite de régression finale.
3. Procédure manuelle étape par étape pour calculer les résidus
3.1 Étape 1 : Détermination des paramètres de la droite de régression
L’extraction manuelle des résidus exige en premier lieu l’estimation rigoureuse des coefficients de la fonction de régression par les MCO. Pour une régression linéaire simple reliant un prédicteur X à une variable dépendante Y, le calcul commence par la détermination de la moyenne empirique de chaque variable, notées respectivement x̄ et ȳ. L’analyste doit ensuite calculer la somme des produits des écarts à la moyenne – équivalente à la covariance non normalisée – ainsi que la somme des carrés des écarts de la variable explicative X (sa variance non normalisée).
Le coefficient de régression de la pente (b1) est dérivé en établissant le quotient suivant :
b1 = [∑i=1n (xi − x̄)(yi − ȳ)] / [∑i=1n (xi − x̄)2]
Une fois le coefficient directeur obtenu, l’ordonnée à l’origine (b0) découle immédiatement du fait obligatoire que la droite de régression des moindres carrés passe invariablement par le centre de gravité bivarié de l’échantillon, c’est-à-dire le point de coordonnées moyennes (x̄, ȳ). L’équation se résout alors de façon linéaire :
b0 = ȳ − b1x̄
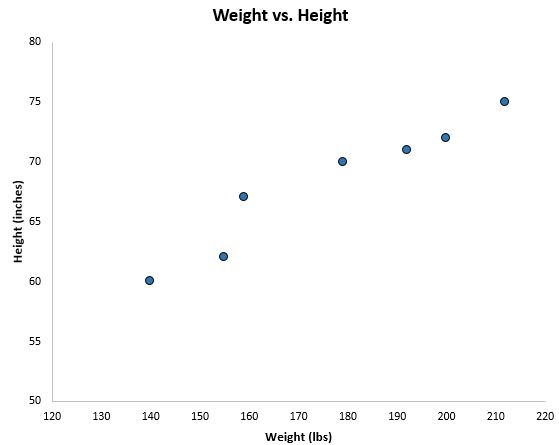
L’équation prédictive finale s’écrit dès lors sous sa forme opérationnelle : ŷ = b0 + b1x. Cette équation fixe le standard prédictif à partir duquel l’ensemble des écarts individuels va être évalué.
3.2 Étape 2 : Calcul systématique des valeurs prédites (ŷ)
La deuxième séquence opératoire consiste à calculer, pour chacun des participants composant la cohorte d’étude, la valeur spécifiquement attendue selon le modèle. Pour chaque sujet i, la valeur mesurée sur le prédicteur xi est introduite directement dans l’équation paramétrée lors de l’étape précédente.
Il est fondamental de maintenir une rigueur dimensionnelle et arithmétique totale lors de cette substitution. Si l’évaluation de la charge de travail est mesurée sur une échelle de 0 à 100, la coordonnée xi doit être traitée avec précision sans arrondis hâtifs, sous peine d’induire des erreurs d’arrondi cumulatives lors de l’estimation subséquente des composantes résiduelles.
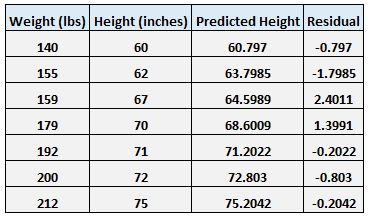
Dans le cadre d’un traitement psychométrique rigoureux, il est recommandé de compiler ces valeurs prédites dans une colonne structurée au sein d’une grille ou d’un tableau d’analyse. Chaque ligne correspond à un sujet unique, matérialisant le passage continu du niveau empirique brut au niveau théorique prédit. Cette table servira d’assise aux contrôles de cohérence ultérieurs.
3.3 Étape 3 : Soustraction pour obtenir les résidus bruts
L’étape charnière réside dans l’application rigoureuse et séquentielle de la formule de soustraction canonique ei = yi − ŷi pour chacune des lignes du jeu de données. La valeur théorique calculée ŷi est retranchée de la mesure observée yi.
Cette étape requiert une attention soutenue à la préservation rigoureuse des signes mathématiques. Une erreur fréquente chez les chercheurs en début de parcours consiste à inverser les termes de l’opérateur (en calculant ŷi − yi) ou à convertir d’autorité l’ensemble des résultats en valeurs absolues positives. Une telle inversion fausse complètement l’analyse ultérieure de la direction des biais de prédiction.
Dès l’achèvement de la colonne des résidus, une procédure de vérification interne doit être exécutée : la sommation cumulative de l’intégralité des termes ei doit converger vers zéro (aux micro-imprécisions d’arrondis machine près). Si la somme dévie substantiellement de zéro, cela signale une erreur systématique dans le calcul préalable des coefficients b0 ou b1. Enfin, chaque résidu individuel est élevé au carré (ei2) dans une colonne adjacente ; leur agrégation finale génère la SSE indispensable au diagnostic d’erreur global du protocole.
3.4 Exemple numérique guidé sur un jeu de données psychologiques
Afin d’illustrer concrètement la séquence des opérations mathématiques décrites, examinons un protocole expérimental mené sur un échantillon restreint de 10 participants adultes (n = 10). Cette étude explore l’influence du score de stress perçu (variable explicative X, mesurée de 1 à 10 sur une échelle de tension psychologique) sur le temps de réaction moyen à une tâche d’inhibition cognitive de type Stroop (variable réponse Y, mesurée en centièmes de seconde).
Les données brutes recueillies sont les suivantes :
- Sujet 1 : X = 2, Y = 35
- Sujet 2 : X = 3, Y = 42
- Sujet 3 : X = 4, Y = 40
- Sujet 4 : X = 5, Y = 55
- Sujet 5 : X = 6, Y = 50
- Sujet 6 : X = 7, Y = 68
- Sujet 7 : X = 8, Y = 62
- Sujet 8 : X = 9, Y = 75
- Sujet 9 : X = 10, Y = 82
- Sujet 10 : X = 11, Y = 81
Calculons en premier lieu les statistiques descriptives univariées de base :
x̄ = (2 + 3 + 4 + 5 + 6 + 7 + 8 + 9 + 10 + 11) / 10 = 65 / 10 = 6,5
ȳ = (35 + 42 + 40 + 55 + 50 + 68 + 62 + 75 + 82 + 81) / 10 = 590 / 10 = 59,0
Calculons ensuite la somme des carrés des écarts de X et la somme des produits croisés :
∑ (xi − x̄)2 = (-4,5)2 + (-3,5)2 + (-2,5)2 + (-1,5)2 + (-0,5)2 + (0,5)2 + (1,5)2 + (2,5)2 + (3,5)2 + (4,5)2 = 20,25 + 12,25 + 6,25 + 2,25 + 0,25 + 0,25 + 2,25 + 6,25 + 12,25 + 20,25 = 82,5
∑ (xi − x̄)(yi − ȳ) = [(-4,5)(-24)] + [(-3,5)(-17)] + [(-2,5)(-19)] + [(-1,5)(-4)] + [(-0,5)(-9)] + [(0,5)(9)] + [(1,5)(3)] + [(2,5)(16)] + [(3,5)(23)] + [(4,5)(22)] = 108 + 59,5 + 47,5 + 6 + 4,5 + 4,5 + 4,5 + 40 + 80,5 + 99 = 454,0
Déterminons désormais les coefficients de la droite de régression :
b1 = 454,0 / 82,5 ≈ 5,50303
b0 = 59,0 − (5,50303 × 6,5) = 59,0 − 35,7697 = 23,2303
L’équation prédictive ajustée s’établit par conséquent selon la formule : ŷi = 23,2303 + 5,50303 × xi. Nous pouvons désormais calculer rigoureusement pour chaque participant sa prédiction, son résidu ordinaire ainsi que le carré de ce dernier.
| Participant (i) | Stress (xi) | Temps obs. (yi) | Temps prédit (ŷi) | Résidu brut (ei) | Résidu au carré (ei2) |
|---|---|---|---|---|---|
| 1 | 2 | 35 | 34,236 | +0,764 | 0,584 |
| 2 | 3 | 42 | 39,739 | +2,261 | 5,112 |
| 3 | 4 | 40 | 45,242 | -5,242 | 27,479 |
| 4 | 5 | 55 | 50,745 | +4,255 | 18,105 |
| 5 | 6 | 50 | 56,248 | -6,248 | 39,038 |
| 6 | 7 | 68 | 61,752 | +6,248 | 39,038 |
| 7 | 8 | 62 | 67,255 | -5,255 | 27,615 |
| 8 | 9 | 75 | 72,758 | +2,242 | 5,027 |
| 9 | 10 | 82 | 78,261 | +3,739 | 13,980 |
| 10 | 11 | 81 | 83,764 | -2,764 | 7,640 |
| Total / Moyenne | x̄ = 6,5 | ȳ = 59,0 | 59,000 | ∑ ei = 0,000 | SSE = 183,818 |
Ce tableau démontre empiriquement la confirmation de la propriété théorique énoncée : la sommation algébrique précise de l’ensemble des résidus ordinaires donne exactement 0,000. Par ailleurs, la somme des carrés résiduels (SSE) s’élève à 183,818. Considérant que les degrés de liberté résiduels s’élèvent ici à n − k − 1 = 10 − 1 − 1 = 8, nous pouvons déduire la variance d’erreur résiduelle non biaisée : se2 = 183,818 / 8 = 22,977, ce qui produit un écart-type résiduel (erreur type de l’estimation) de se = √22,977 ≈ 4,793 centièmes de seconde.
4. Typologie avancée des résidus : au-delà des résidus bruts
4.1 Les résidus standardisés (ou résidus de Pearson)
Si les résidus ordinaires constituent l’expression la plus immédiate de l’erreur d’ajustement, ils présentent une limite méthodologique majeure : ils sont intrinsèquement dépendants des unités de mesure d’origine associées à la variable dépendante. Comparer l’amplitude brute d’un résidu issu d’un temps de réaction en millisecondes avec celle d’un résidu issu d’un score sur une échelle de dépression en 20 points s’avère rigoureusement impossible. Pour surmonter cette entrave métrique, la littérature statistique recourt aux résidus standardisés, souvent désignés sous l’appellation de résidus de Pearson.
La formulation algébrique d’un résidu standardisé (noté zi) consiste à diviser le résidu brut par l’estimation globale de l’écart-type résiduel de l’échantillon :
zi = ei / se = (yi − ŷi) / √MSE
Cette opération réalise une normalisation métrique de la distribution d’erreur, conférant aux résidus une échelle adimensionnelle caractérisée approximativement par une moyenne de zéro et un écart-type unitaire. Grâce à cette transformation, le statisticien peut évaluer l’écart relatif d’une observation à la droite indépendamment de l’échelle d’origine. En psychométrie computationnelle, les seuils décisionnels conventionnels appliqués aux résidus standardisés s’alignent sur les propriétés de la loi normale centrée réduite : un résidu standardisé dont la valeur absolue dépasse 2 (|zi| > 2) signale une déviation inhabituelle présente chez moins de 5 % des individus théoriques, tandis qu’une valeur absolue excédant 3 (|zi| > 3) identifie une observation suspecte méritant un audit minutieux.
4.2 Les résidus studentisés internes et externes
La standardisation simple par se souffre d’un biais théorique sous-jacent : elle postule implicitement que la variance de chaque résidu individuel est constante sur l’ensemble du domaine de prédiction. Or, les développements mathématiques démontrent que la précision prédictive d’une droite de régression des moindres carrés est maximale au niveau du centre de gravité des données (la moyenne des prédicteurs) et se dégrade au fur et à mesure que l’on s’écarte vers les extrémités de la distribution du prédicteur. En conséquence, la variance réelle d’un résidu ei dépend formellement de la position relative de son observation sur l’axe des X, grandeur formalisée par le levier (leverage, noté hii).
La variance exacte du i-ième résidu brut s’écrit de manière formelle : Var(ei) = σ2(1 − hii). Pour tenir compte de cette hétérogénéité structurelle, le résidu studentisé interne (souvent appelé internally studentized residual) ajuste chaque écart en le divisant par son erreur type locale :
ri = ei / [se √(1 − hii)]
Bien que cette métrique apporte un raffinement notable, elle demeure sensible au fait qu’une observation atypique extrême exerce une influence démesurée sur l’estimation globale de se, tendant à gonfler artificiellement ce dénominateur et à masquer le caractère divergent de ce point précis (phénomène de masquage ou masking). Pour pallier ce biais, les statisticiens ont développé le concept de résidu studentisé externe, fréquemment appelé résidu supprimé (jackknife ou externally studentized residual, noté ti). Dans cette formulation, l’erreur type résiduelle (notée s(i)) est recalculée en excluant explicitement la i-ième observation de l’échantillon d’estimation :
ti = ei / [s(i) √(1 − hii)]
Le résidu studentisé externe suit rigoureusement une loi de Student à n − k − 2 degrés de liberté. Cette propriété offre un avantage méthodologique décisif pour détecter les cas aberrants : elle autorise l’application de tests d’hypothèses formels avec ajustement pour comparaisons multiples (par exemple via la correction de Bonferroni), fournissant un critère d’exclusion statistique robuste et théoriquement fondé.
4.3 Les résidus partiels et résidus de régression partielle
Dans les configurations d’analyse impliquant plusieurs régresseurs simultanés (régression multiple), l’examen des résidus ordinaires globaux devient insuffisant pour démêler les relations spécifiques unissant la variable critère à un prédicteur unique isolé. C’est ici qu’interviennent les concepts de résidus partiels et de graphiques de régression partielle (souvent dénommés Added Variable Plots ou graphiques de variables ajoutées).
Le résidu partiel dédié au j-ième prédicteur (noté ei(j)) est construit en additionnant la composante de l’effet linéaire modélisé de ce prédicteur spécifique au résidu global du modèle complet :
ei(j) = ei + bj xij
Sur le plan géométrique, tracer le nuage de points reliant la variable xj à ces résidus partiels permet de visualiser la trajectoire non faussée du lien entre ce régresseur et le critère, une fois le signal des autres variables explicatives retiré. Cette approche graphique s’avère indispensable pour démasquer d’éventuelles relations curvilinéaires ou des seuils de rupture masqués par la colinéarité statistique dans les investigations psychologiques complexes portant sur des covariables entremêlées (par exemple, isoler l’impact net de l’anxiété sur les performances de rappel mnésique après neutralisation mathématique de l’âge et de la vitesse de traitement de base).
5. Vérification des postulats de la régression par l’examen des résidus
5.1 Postulat de linéarité de la relation
L’inférence statistique classique sous-jacente à la régression des moindres carrés postule de manière irréductible que la relation reliant les variables explicatives à l’espérance mathématique de la variable critère est de nature strictement linéaire. Une spécification erronée de cette morphologie fonctionnelle invalide d’emblée l’intégralité des estimations des pentes. Pour auditer la validité de ce postulat, le statisticien s’appuie sur le graphique fondamental des résidus en fonction des valeurs prédites (généralement désigné dans la littérature sous le vocable anglophone de diagramme Residuals vs Fitted).
Sous l’hypothèse de linéarité parfaite, le nuage de points de ce graphique doit présenter l’apparence d’une bande horizontale homogène, exempte de toute organisation spatiale prévisible. Les points doivent se distribuer de façon aléatoire et symétrique de part et d’autre de la ligne horizontale de référence située à l’ordonnée zéro.
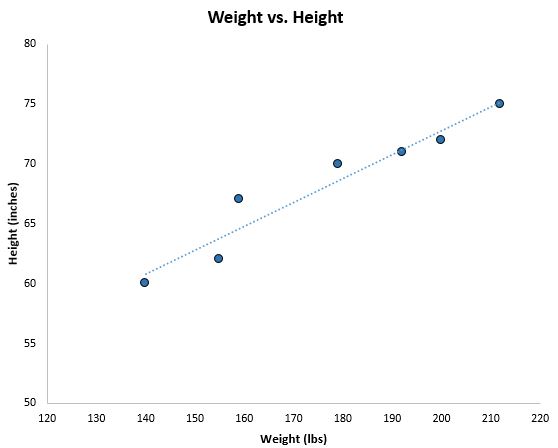
À l’inverse, l’émergence d’un motif curviligne discernable – telle qu’une parabole en forme de U, une configuration en U inversé ou une oscillation sinusoïdale – révèle que le modèle a échoué à capter une courbure intrinsèque aux données comportementales. Par exemple, la célèbre loi de Yerkes-Dodson reliant l’éveil motivationnel à la performance cognitive décrit typiquement une relation non linéaire en U inversé. Tenter de capturer ce phénomène par une équation linéaire simple engendre une concentration massive de résidus positifs aux valeurs intermédiaires et de résidus négatifs aux extrêmes. La remédiation méthodique impose alors l’introduction de termes polynomiaux (tels que X2) ou l’application de transformations non linéaires (logarithmiques, inverses) sur les prédicteurs.
5.2 Postulat d’homoscédasticité (constance de la variance de l’erreur)
Le postulat d’homoscédasticité stipule que la variance conditionnelle des termes d’erreur résiduelle demeure rigoureusement constante à travers tous les niveaux de prédiction du modèle. Formellement, cette condition s’énonce : Var(ei | X) = σ2 pour tout i. Lorsque cette hypothèse vacille, les données sont frappées d’hétéroscédasticité. Bien que les estimateurs des pentes MCO demeurent sans biais en présence de variances inégales, leurs erreurs types associées deviennent gravement inexactes, faussant les calculs de significativité des tests t et les intervalles de confiance correspondants.
L’inspection visuelle du graphique des résidus studentisés en fonction des valeurs prédites (ou du graphique dit Scale-Location, exploitant la racine carrée des résidus standardisés) fournit la première ligne diagnostique. Une manifestation emblématique de l’hétéroscédasticité réside dans l’apparition d’un patron d’évasement géométrique en cône, en mégaphone ou en entonnoir : les résidus, initialement très resserrés pour les prédictions faibles, voient leur dispersion spatiale s’amplifier considérablement à mesure que les scores prédits progressent.
Cette observation subjective doit impérativement être corroborée par des tests statistiques inférentiels rigoureux :
- Le test de Breusch-Pagan : particulièrement performant pour détecter les hétéroscédasticités de nature linéaire en modélisant les carrés des résidus en fonction des régresseurs d’origine.
- Le test de White : un test conservateur général ne nécessitant aucun a priori sur la structure de la variance et intégrant les carrés et produits croisés des prédicteurs.
- Le test de Koenker : une variante robuste du test de Breusch-Pagan, particulièrement recommandée en psychométrie lorsque le postulat sous-jacent de normalité bivariée ne peut être pleinement garanti.
5.3 Postulat de normalité de la distribution des erreurs
Pour assurer la validité de l’inférence statistique aux petits et moyens échantillons, les termes d’erreur résiduelle doivent se distribuer de manière congruente avec une distribution gaussienne théorique, condition formalisée par ei ~ N(0, σ2). Si le théorème central limite garantit une convergence asymptotique de la distribution d’échantillonnage des coefficients vers la normalité dans les cohortes volumineuses, les recherches psychologiques menées sur des échantillons restreints requièrent un examen approfondi de la normalité des résidus.
L’outil sémiologique privilégié pour cette évaluation réside dans le diagramme quantile-quantile normal (couramment baptisé Normal Q-Q Plot). Ce graphique projette les quantiles observés de la distribution des résidus standardisés contre les quantiles théoriques attendus sous une loi normale idéale. Lorsque le postulat est vérifié, les observations empiriques s’alignent étroitement sur la bissectrice diagonale à 45 degrés.
Les déviations caractéristiques à cette trajectoire idéale permettent de poser un diagnostic morphologique précis :
- Distributions à queues lourdes (leptokurtiques) : les points s’écartent vers le haut à l’extrémité droite et vers le bas à l’extrémité gauche, formant une silhouette en ‘S’ prononcée et signalant une abondance anormale de valeurs atypiques.
- Distributions asymétriques (skewness positive ou négative) : le nuage présente une convexité unilatérale continue par rapport à la diagonale de référence, révélant un plancher ou un plafond de mesure dans l’évaluation psychologique.
Ces éléments qualitatifs s’accompagnent de vérifications formelles via le test de normalité de Shapiro-Wilk (adapté aux échantillons où n < 50) ou le test de Kolmogorov-Smirnov assorti de la correction systématique de Lilliefors pour les échantillons plus amples.
5.4 Postulat d’indépendance des résidus (absence d’autocorrélation)
Le théorème de Gauss-Markov exige l’indépendance statistique mutuelle de toutes les paires d’erreurs résiduelles : la covariance entre le résidu de l’individu i et celui de l’individu j doit être strictement nulle (Cov(ei, ej) = 0 pour tout i ≠ j). Cette condition est fréquemment compromise dès lors que le protocole de recueil introduit une séquentialité temporelle (mesures répétées longitudinales, protocoles d’évaluation écologique momentanée – EMA) ou une proximité spatiale et groupale (élèves issus des mêmes classes scolaires, patients pris en charge par le même thérapeute).
La persistance d’une dépendance sérielle d’ordre un – où le résidu d’une observation au temps t prédit partiellement le résidu au temps t+1 – fausse gravement l’évaluation de la variance d’échantillonnage des estimateurs. Une autocorrélation positive comprime artificiellement les erreurs types calculées, conférant aux tests t de Student une confiance fallacieuse et conduisant à l’affirmation indue d’effets thérapeutiques ou comportementaux non significatifs dans la population cible.
L’indicateur classique d’évaluation de cette propriété est le test de Durbin-Watson. La statistique d qui en découle est calculée selon l’algorithme :
d = [∑t=2n (et − et−1)2] / [∑t=1n et2]
La métrique d oscille sur un continuum borné entre 0 et 4. Une valeur proche de 2,0 indique une indépendance sérielle satisfaisante des résidus. À l’opposé, une valeur descendant nettement en deçà de 1,5 dénonce une autocorrélation positive critique, tandis qu’une valeur excédant 2,5 traduit une autocorrélation sérielle négative. Face à de telles configurations, le cadre de la régression linéaire simple MCO doit être abandonné au profit de modèles autorégressifs intégrés (ARIMA) ou de modélisations mixtes linéaires intégrant des matrices de covariance résiduelle structurées (autorégressives d’ordre 1, toeplitz ou non structurées).
6. Détection des données aberrantes et des observations influentes
6.1 Distinction théorique entre valeur aberrante, levier et influence
Dans la littérature méthodologique consacrée au diagnostic de régression, il convient de distinguer avec rigueur trois dimensions topologiques distinctes : la valeur aberrante (outlier), le point de levier (leverage) et l’observation influente (influential observation). Confondre ces terminologies expose le chercheur à des interprétations partielles et à des décisions d’exclusion d’observations injustifiées.
Une valeur aberrante résiduelle qualifie une observation qui présente un écart vertical majeur par rapport à la trajectoire modélisée. Il s’agit d’un point dont la valeur empirique yi s’avère profondément discordante par rapport à sa prédiction ŷi, générant un résidu standardisé ou studentisé de magnitude extrême (|ti| > 3), bien que ses valeurs sur les variables prédictives X puissent se situer dans la moyenne de la population.
À l’inverse, l’effet de levier mesure l’éloignement d’une observation sur l’axe horizontal constitué par l’espace multidimensionnel des prédicteurs, indépendamment de sa coordonnée sur la variable critère Y. Formalisé par l’élément diagonal de la matrice de projection chapeau hii, le levier traduit la distance de Mahalanobis d’un individu par rapport au centroïde des variables indépendantes. Une observation peut afficher un levier considérable sans pour autant fausser le modèle si elle s’aligne fidèlement sur l’axe théorique naturel de la régression.
L’observation influente, enfin, représente l’intersection dynamique de ces deux propriétés. Un cas est qualifié d’influent dès lors que sa présence – ou son omission délibérée – modifie substantiellement les coefficients de régression estimés, la significativité statistique des tests d’hypothèses ou la qualité de prédiction globale du système. Une observation influente conjugue presque toujours un effet de levier modéré à substantiel avec un résidu de grande ampleur, agissant tel un point d’appui physique faisant pivoter artificiellement la droite de régression dans sa direction.
6.2 La distance de Cook : formulation et critères d’application
L’indicateur le plus réputé pour évaluer l’influence exercée par une observation singulière est la distance de Cook (notée Di). Conçue par le statisticien R. Dennis Cook, cette métrique synthétique quantifie le déplacement multidimensionnel global opéré sur l’ensemble du vecteur des prédictions lorsque le modèle est réestimé en soustrayant l’observation d’intérêt de l’ensemble de données.
Sur le plan computationnel, la distance de Cook se formule sans imposer le réajustement séquentiel de n régressions distinctes, grâce à une relation combinant élégamment le résidu studentisé interne ri et le coefficient de levier hii :
Di = [ei2 / ((k + 1) × MSE)] × [hii / (1 − hii)2] = [ri2 / (k + 1)] × [hii / (1 − hii)]
Cette écriture démontre que la distance de Cook est le produit direct de deux facteurs : la taille relative du résidu d’ajustement (première parenthèse) et la susceptibilité géométrique du modèle aux perturbations structurelles liée au levier (seconde parenthèse).
Quant aux seuils décisionnels régissant l’interprétation de Di, deux approches coexistent dans la communauté scientifique :
- Le seuil absolu classique : une valeur de Di > 1,0 signale une observation influente majeure, susceptible de justifier une réévaluation de l’estimation. Certains auteurs étendent cette alerte dès Di > 0,5.
- Le seuil relatif aux cohortes comportementales : dans les études où la taille de l’échantillon est plus modeste, la borne critique ajustée Di > 4 / n (ou 4 / (n − k − 1)) est préconisée. Elle permet d’identifier les individus dont l’influence est disproportionnée par rapport à la moyenne du groupe étudié.
6.3 Les indices DFFITS et DFBETAS
Pour affiner l’évaluation diagnostique au-delà de la mesure globale fournie par la distance de Cook, le psychométricien dispose d’outils analytiques individualisés : les indices DFBETAS et DFFITS. Ces indices décomposent l’impact de chaque observation cas par cas.
L’indice DFBETAS évalue la déviation spécifique imprimée par l’observation i sur un coefficient de pente bj pris isolément. Exprimé en unités d’erreur type, il s’énonce selon le rapport :
DFBETASj(i) = (bj − bj(i)) / [s(i) √(∑ (xij − x̄j)2)]
Dans cette formule, bj(i) représente la valeur réestimée du paramètre de régression après éviction complète du i-ième cas. Un seuil décisionnel conventionnel stipule qu’une valeur absolue |DFBETASj(i)| excédant l’indice 2 / √n désigne un individu modifiant de manière disproportionnée la pente de la variable explicative considérée, risquant d’en altérer la signification clinique.
De façon analogue, l’indice DFFITS mesure le nombre d’écarts-types dont la valeur prédite pour le sujet i lui-même oscille selon que ce cas particulier est intégré ou retiré de la matrice d’apprentissage :
DFFITSi = (ŷi − ŷi(i)) / [s(i) √hii] = ti √[hii / (1 − hii)]
Un seuil de coupure empirique établi à |DFFITSi| > 2 √[(k + 1) / n] signale un cas altérant sa propre prédiction. Face à ces diagnostics, la règle éthique proscrit toute suppression machinale des observations divergentes : chaque cas repéré doit d’abord faire l’objet d’une traçabilité archivistique (erreur d’encodage, non-respect avéré des consignes du test), puis être analysé dans le cadre d’analyses de sensibilité avec et sans l’observation litigieuse.
7. Calcul et diagnostic des résidus sous R pour la recherche empirique
7.1 Extraction des résidus avec les fonctions de base
Le langage et environnement statistique open-source R propose une architecture native pour l’estimation et l’extraction des composantes résiduelles. L’ajustement initial d’une régression s’effectue via la fonction générique lm() (linear model), qui configure la structure du système à partir d’une formule symbolique et d’un bloc de données désigné.
Une fois l’objet de régression instancié dans l’espace de travail (par exemple sous la dénomination modele_psy), le chercheur extrait les résidus ordinaires bruts au moyen des fonctions équivalentes residuals(modele_psy) ou resid(modele_psy). Simultanément, la commande fitted(modele_psy) fournit le vecteur exhaustif des prédictions théoriques ŷi associées à chaque ligne de la matrice expérimentale.
Pour accéder aux formes standardisées et studentisées sans recourir à des formules manuelles, R dispose des fonctions de base rstandard(modele_psy) et rstudent(modele_psy). L’appel à rstudent() applique automatiquement la formulation jackknife en calculant l’erreur type résiduelle externe par suppression itérative d’observation, fournissant des vecteurs prêts pour l’inférence.
7.2 Génération des quatre graphiques diagnostiques automatisés
L’une des fonctionnalités les plus puissantes du moteur statistique de R réside dans sa routine graphique intégrée. L’application de la fonction générique plot() sur un objet de modélisation linéaire – formulée sous la syntaxe plot(modele_psy) – engendre de manière séquentielle un tableau d’évaluation clinique composé de quatre cadrans diagnostiques fondamentaux :
Le premier panneau (Residuals vs Fitted) trace la configuration des résidus ordinaires en relation avec les niveaux de prédiction théorique, assortie d’un ajustement lissé non paramétrique local (courbe rouge de régression LOESS). Cette visualisation permet d’identifier d’éventuelles non-linéarités structurelles lorsque la courbe rouge dévie d’une rectitude horizontale.
Le deuxième panneau (Normal Q-Q) confronte les quantiles empiriques des résidus standardisés à la distribution normale idéale, mettant en relief les écarts de symétrie et l’épaisseur anormale des queues de distribution.
Le troisième panneau (Scale-Location, ou Spread-Location) projette la racine carrée des résidus standardisés absolus (√|zi|) en fonction des valeurs ajustées. Cette transformation stabilise la variance de l’indicateur graphique, facilitant le repérage de l’hétéroscédasticité par la surveillance de la pente du lissage LOESS.
Le quatrième panneau (Residuals vs Leverage), enfin, cartographie les résidus standardisés contre les coefficients de levier individuel hii. Ce graphe superpose des courbes d’isocontours en pointillés délimitant les zones critiques de la distance de Cook (typiquement pour D = 0.5 et D = 1.0), permettant d’isoler au premier regard les observations qui conjuguent un fort levier horizontal et un résidu vertical marqué.
7.3 Visualisation avancée avec ggplot2 et packages spécialisés
Pour répondre aux exigences éditoriales modernes, l’écosystème graphique ggplot2 offre une flexibilité de composition supérieure. En exploitant la fonction geom_segment(), l’analyste peut générer un diagramme de dispersion enrichi visualisant directement la projection verticale des résidus sous forme de tracés reliant chaque point empirique (xi, yi) à sa projection prédite sur la droite (xi, ŷi) :
Cette mise en scène graphique met en évidence l’écart vertical individuel et facilite l’explication visuelle des notions d’erreurs quadratiques auprès d’un public non spécialiste.
Parallèlement, la bibliothèque spécialisée car (Companion to Applied Regression), développée par Fox et Weisberg, fournit une suite d’outils analytiques d’une précision éprouvée. La fonction residualPlots(modele_psy) calcule des tests d’adéquation non linéaires pour chaque régresseur individuel, tandis que la fonction influenceIndexPlot(modele_psy) génère une matrice synoptique comprenant les graphiques d’alignement des résidus studentisés, des distances de Cook, des indices de levier et des modifications structurelles DFBETAS.
Enfin, l’extension broom transforme ces flux analytiques en données structurées exploitables via la commande augment(modele_psy). Cette fonction ajoute au jeu de données initial l’intégralité des indicateurs résiduels calculés (.fitted, .resid, .std.resid, .cooksd, .hat), facilitant les opérations d’exportation vers des tableaux de synthèse aux normes de publication de l’American Psychological Association (APA Style).
8. Calcul et analyse des résidus avec Python (Statsmodels et Scikit-Learn)
8.1 Mise en œuvre complète avec Statsmodels
Dans l’écosystème open-source Python dédié à la science des données, la bibliothèque statsmodels constitue la référence académique privilégiée pour conduire des modélisations fondées sur la rigueur inférentielle. Contrairement aux bibliothèques orientées exclusivement vers l’apprentissage automatique prédictif, statsmodels conserve l’intégralité des métriques diagnostiques chères aux biostatisticiens et psychométriciens.
La configuration d’une régression linéaire s’opère via la classe OLS (Ordinary Least Squares), typiquement alimentée par la méthode matricielle ou via le sous-module déclaratif statsmodels.formula.api. Une fois la méthode .fit() exécutée sur l’instance spécifiée, le modèle produit une structure d’attributs dédiée à l’extraction immédiate des termes résiduels. L’attribut results.resid délivre le vecteur des résidus ordinaires ei, tandis que results.fittedvalues rassemble les projections théoriques ŷi. La variance résiduelle moyenne non biaisée (MSE) est accessible via l’attribut results.mse_resid.
Pour déployer des analyses d’influence exhaustives, le module statsmodels.stats.outliers_influence offre la classe spécialisée OLSInfluence. En instanciant cet objet à partir des résultats de l’ajustement, le chercheur extrait directement une structure de données contenant les résidus studentisés externes (via resid_studentized_external), les valeurs de levier diagonal hii (via hat_matrix_diag), et les distances de Cook (via la méthode cooks_distance), simplifiant les opérations d’audit statistique.
8.2 Calcul manuel et vectorisé avec Scikit-Learn et NumPy
Lorsque les volumétries de données s’accroissent ou que l’architecture d’analyse s’intègre au sein d’un pipeline de machine learning, la bibliothèque scikit-learn s’impose par son efficience computationnelle. La classe LinearRegression issue du module sklearn.linear_model optimise l’ajustement des paramètres sur les jeux d’apprentissage.
Toutefois, scikit-learn n’encapsule pas directement les résidus sous forme d’attributs d’objets statistiques. Il incombe à l’analyste d’exécuter l’évaluation vectorielle par programmation matricielle avec numpy. Après avoir extrait le vecteur des prédictions via l’application de model.predict(X), le calcul des résidus s’opère par une soustraction vectorisée :
residus = y − model.predict(X)
À partir de ce vecteur résiduel, l’analyste dérive facilement les métriques synthétiques fondamentales via le module sklearn.metrics : l’erreur absolue moyenne (MAE, Mean Absolute Error), l’erreur quadratique moyenne (MSE, Mean Squared Error), et sa racine carrée (RMSE, Root Mean Squared Error).
L’exploration distributionnelle s’effectue ensuite par le biais des bibliothèques de rendu graphique matplotlib et seaborn. Un histogramme enrichi d’une estimation de densité par noyau (KDE) appliqué aux résidus ordinaires, combiné à un nuage de dispersion scatterplot(x=y_pred, y=residus) assorti d’une ligne de référence horizontale tracée à zéro, permet de valider rapidement l’absence de biais flagrant dans le système prédictif.
8.3 Automatisation des tests d’hypothèses sur les résidus
L’automatisation des diagnostics de résidus au sein de scripts Python robustes s’appuie sur la combinaison des fonctions analytiques de scipy.stats et de statsmodels.stats.diagnostic. Ce couplage permet d’auditer les hypothèses de Gauss-Markov sans dépendre d’inspections visuelles manuelles.
L’évaluation formelle de la normalité de la distribution des erreurs s’exécute de façon programmatique via le test de Shapiro-Wilk accessible dans la méthode scipy.stats.shapiro(residus), ou par le test d’asymétrie et d’aplatissement combiné de Jarque-Bera au moyen de statsmodels.stats.stattools.jarque_bera(residus). L’obtention d’une valeur p supérieure au seuil α conventionnel de 0,05 conclut au non-rejet de l’hypothèse de normalité.
La vérification de l’homoscédasticité s’automatise quant à elle par l’appel à la fonction het_breuschpagan(residus, X_avec_constante), laquelle retourne la statistique du multiplicateur de Lagrange ainsi que sa p-valeur associée. Enfin, le contrôle de l’indépendance mutuelle des résidus séquentiels est confié à la fonction stat_durbin_watson(residus) issue de statsmodels.stats.stattools, qui confirme l’absence d’autocorrélation linéaire d’ordre un lorsque la statistique converge autour de la valeur de référence 2,0.
9. Calcul et interprétation des résidus dans SPSS et JASP
9.1 Paramétrage de la régression linéaire sous IBM SPSS
Le logiciel commercial IBM SPSS Statistics demeure une plateforme très répandue pour le traitement des données en psychologie clinique, en sciences de l’éducation et en sociologie quantitative. L’analyse de régression s’initialise via l’arborescence des menus : Analyser > Régression > Linéaire… Après avoir positionné la variable critère et le ou les régresseurs dans leurs champs respectifs, l’accès aux composantes résiduelles requiert la configuration fine de plusieurs fenêtres de dialogue associées.
Dans le sous-menu intitulé Enregistrer… (Save), le chercheur coche les indicateurs qu’il souhaite injecter directement dans sa matrice de données active. Il est recommandé de sélectionner :
- Dans la section Résidus : les résidus non standardisés (Unstandardized), les résidus standardisés (Standardized) et les résidus studentisés supprimés (Studentized deleted).
- Dans la section Distances : les distances de Cook (Cook’s) ainsi que les valeurs de levier (Leverage values).
- Dans la section Statistiques d’influence : les indices DfBeta(s) et DfFit.
Parallèlement, la boîte de dialogue Tracés… (Plots) permet de configurer la génération automatisée des graphiques de contrôle. L’introduction de la variable *ZPRED (valeurs prédites standardisées) sur l’axe des X et de la variable *ZRESID (résidus standardisés) sur l’axe des Y produit le diagramme de dispersion indispensable à l’évaluation de l’homoscédasticité. Le cochage systématique de la case Tracé du graphique de probabilité normale (Normal probability plot) commande quant à lui la sortie du diagramme Q-Q résiduel.
9.2 Procédure d’analyse intuitive dans JASP
Proposant une alternative libre, moderne et ergonomique aux logiciels d’analyse traditionnels, la plateforme logicielle open-source JASP, développée à l’Université d’Amsterdam, simplifie l’exécution des diagnostics d’adéquation statistique. L’analyse s’amorce en sélectionnant l’onglet Regression, suivi de la commande Linear Regression.
L’affectation des variables s’effectue par glisser-déposer interactif au sein des panneaux Dependent Variable et Covariates. La singularité de JASP réside dans la mise à jour dynamique et immédiate des résultats au sein de la fenêtre de visualisation latérale dès qu’une option est cochée, favorisant un flux de travail transparent.
En déployant l’onglet déroulant intitulé Diagnostics, l’utilisateur active un éventail complet d’options d’évaluation :
- La sélection de Residuals vs. fitted génère instantanément le graphique de dispersion des résidus centré sur l’axe nul.
- L’option Q-Q plot residuals trace le graphique quantile-quantile des résidus, assorti de bandes de confiance empiriques.
- L’activation de l’option Casewise diagnostics génère un tableau identifiant automatiquement les observations présentant des résidus standardisés excédant deux ou trois écarts-types.
- L’affichage des coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis) des résidus permet d’évaluer la forme distributionnelle sans recourir à des calculs manuels.
9.3 Lecture critique des tableaux de sortie logiciels
L’interprétation des résultats générés par ces environnements logiciels exige une lecture rigoureuse des tableaux de synthèse standards, évitant de se focaliser prématurément sur les seules valeurs p des coefficients de régression.
Le premier tableau à inspecter attentivement est le Récapitulatif des modèles (Model Summary). Ce tableau fournit le R, le R-deux (coefficient de détermination), ainsi que l’Erreur standard de l’estimation. Cette dernière correspond formellement à se = √MSE ; elle quantifie la dispersion moyenne absolue des erreurs résiduelles exprimée dans l’unité de mesure de la variable réponse. Si un modèle affiche un R2 élevé mais une erreur standard disproportionnée au regard de l’échelle d’évaluation clinique, sa valeur prédictive unitaire demeure modeste.
Le tableau de l’Analyse de variance (ANOVA) explicite ensuite la décomposition formelle des sommes de carrés (Regression, Residual, Total). Le rapport entre le carré moyen de la régression (MSR = SSR / k) et le carré moyen de l’erreur (MSE = SSE / (n − k − 1)) produit la statistique du test F de Fisher. Un test F statistiquement significatif indique que le modèle linéaire extrait une variance substantiellement supérieure à celle générée par un processus résiduel aléatoire.
Enfin, le tableau du Diagnostic des cas extrêmes (Casewise Diagnostics) dresse un inventaire des observations atypiques. L’analyste doit y vérifier si certains cas isolés présentent des résidus standardisés extrêmes (|z| > 3,0). La présence conjointe de ces résidus élevés avec des distances de Cook critiques – reportées dans les colonnes ajoutées au fichier de données – impose un examen détaillé des données de ces participants avant toute conclusion définitive.
10. Les résidus dans la régression multiple et les modèles non linéaires
10.1 Calcul matriciel des résidus en régression multiple
L’extension du modèle de régression à un ensemble multidimensionnel regroupant k prédicteurs explicatifs requiert l’utilisation de l’algèbre matricielle. L’équation globale du système prend la forme condensée : Y = Xβ + e, où Y est un vecteur colonne d’observations de dimension n × 1, X représente la matrice du plan expérimental de dimension n × (k + 1) – intégrant une colonne unitaire initiale assignée à la constante –, β symbolise le vecteur des paramètres inconnus de dimension (k + 1) × 1, et e désigne le vecteur des résidus de dimension n × 1.
L’estimateur des moindres carrés ordinaires s’obtient par la résolution de l’équation matricielle classique : β̂ = (XTX)−1XTY. Le vecteur des valeurs théoriques prédites découle de l’application : Ŷ = Xβ̂ = X(XTX)−1XTY. L’opérateur matriciel central H = X(XTX)−1XT est formellement désigné sous le terme de matrice chapeau (ou Hat Matrix), précisément parce qu’il projette le vecteur des valeurs observées Y vers son approximation vectorielle ajustée Ŷ : Ŷ = HY.
Le calcul du vecteur résiduel s’exprime alors à travers une relation matricielle directe :
e = Y − Ŷ = Y − HY = (I − H)Y
Dans cette formulation, I caractérise la matrice identité de dimension n × n. La matrice (I − H) possède des propriétés géométriques fondamentales : elle est à la fois symétrique ((I − H)T = (I − H)) et idempotente ((I − H)(I − H) = (I − H)). Cela traduit le fait qu’elle opère une projection orthogonale du vecteur observé Y sur le sous-espace vectoriel résiduel d’ordre n − k − 1, mathématiquement orthogonal à l’espace vectoriel engendré par les colonnes de prédicteurs de X.
10.2 Résidus partiels et graphiques de régression résiduelle partielle
Lorsque plusieurs prédicteurs corrélés interviennent conjointement dans l’explication d’un comportement, le simple examen du lien bivarié brut entre un prédicteur Xj et la réponse Y peut véhiculer des conclusions trompeuses en raison du phénomène de confusion statistique ou de suppression. Pour appréhender l’impact net associé à une covariable particulière, la construction de résidus de régression partielle s’avère indispensable.
Cette approche implique la génération conjointe de deux vecteurs résiduels indépendants :
- On modélise en premier lieu Y par l’ensemble des prédicteurs en excluant délibérément Xj, et l’on extrait le vecteur des résidus résultant eY | X(-j). Ce vecteur représente la variance de la réponse qui ne peut pas être expliquée par les autres covariables.
- On modélise en second lieu le prédicteur Xj lui-même en fonction de l’ensemble de ces mêmes prédicteurs restants, et l’on isole le second vecteur résiduel eXj | X(-j). Ce vecteur caractérise la part de variabilité unique du prédicteur Xj, indépendante de ses relations avec les autres variables explicatives.
Le tracé du diagramme de dispersion reliant ces deux grandeurs résiduelles – eY | X(-j) en ordonnée et eXj | X(-j) en abscisse – constitue le graphique de régression partielle (ou Added-Variable Plot). La pente de la droite des moindres carrés traversant ce graphique équivaut exactement au coefficient de régression partielle bj calculé au sein du modèle multiple complet. Ce dispositif offre ainsi une fenêtre visuelle directe pour inspecter d’éventuelles non-linéarités localisées sur un prédicteur spécifique, une fois contrôlée l’influence des autres variables de contrôle.
10.3 Résidus dans les modèles linéaires généralisés (GLM) et logistiques
L’édifice des résidus ordinaires ei = yi − ŷi atteint ses limites méthodologiques dès lors que la variable réponse s’écarte du cadre des distributions continues et symétriques. En psychométrie expérimentale, les chercheurs recueillent régulièrement des variables dichotomiques (ex. : réussite ou échec à un item de test, présence ou absence d’un trouble psychopathologique) ou des données de comptage (ex. : nombre d’erreurs commises lors d’une tâche d’attention soutenue). Ces configurations relèvent des modèles linéaires généralisés (GLM).
Dans le cas d’une régression logistique où la réponse yi ∈ {0, 1} et où la prédiction correspond à une probabilité conditionnelle p̂i, le résidu brut ne peut adopter que deux valeurs possibles pour une prédiction donnée : 1 − p̂i ou 0 − p̂i. Ce caractère discret invalide les postulats traditionnels d’homoscédasticité et de normalité. Deux formulations résiduelles adaptées s’imposent alors :
Le résidu de Pearson pour GLM, qui divise l’écart brut par l’écart-type théorique découlant de la loi de distribution sous-jacente (loi binomiale dans ce contexte) :
rP, i = (yi − p̂i) / √[p̂i(1 − p̂i)]
Le résidu de déviance (Deviance residual, noté di), qui décompose la déviance totale du modèle (équivalent fonctionnel de la somme des carrés résiduels dans le paradigme de la régression logistique) en contributions individuelles signées :
di = signe(yi − p̂i) × √{2 [yi ln(yi / p̂i) + (1 − yi) ln((1 − yi) / (1 − p̂i))]}
Pour les données de comptage psychométriques (modélisées via une régression de Poisson ou binomiale négative), ces résidus de déviance jouent le même rôle que les résidus ordinaires en régression classique : leur convergence vers une distribution approximativement gaussienne autorise l’identification des profils atypiques et la détection des phénomènes de surdispersion.
11. Stratégies méthodologiques face à des anomalies de résidus
11.1 Transformations de variables pour corriger la non-linéarité et l’hétéroscédasticité
La découverte d’anomalies structurelles lors du diagnostic des résidus – telles qu’une courbure non linéaire ou un élargissement hétéroscédastique en entonnoir – ne commande pas nécessairement l’abandon immédiat du paradigme linéaire. La première ligne d’intervention méthodologique consiste à appliquer une transformation mathématique appropriée sur la variable dépendante Y, sur les prédicteurs X, ou sur les deux composantes simultanément.
L’application d’une fonction concave – telle que le logarithme népérien ln(Y) ou la racine carrée √Y – est efficace pour corriger une asymétrie résiduelle positive persistante combinée à une hétéroscédasticité où la variance augmente proportionnellement à la prédiction. Dans le contexte de l’évaluation de latences cognitives ou de seuils perceptifs, la transformation inverse (1 / Y) permet souvent de stabiliser les distributions d’erreurs.
Pour dépasser les tâtonnements empiriques informels, les statisticiens s’appuient sur la famille paramétrique des transformations de Box-Cox. Cette méthode d’optimisation par le maximum de vraisemblance estime un exposant de puissance λ adapté aux données :
y(λ) = (yλ − 1) / λ si λ ≠ 0, et y(λ) = ln(y) si λ = 0
Si la transformation de Box-Cox régularise souvent la forme des résidus et restaure l’homogénéité de leur variance, elle impose une contrepartie interprétative : les coefficients de régression estimés ne s’interprètent plus sur l’échelle métrique d’origine, nécessitant des conversions adaptées pour communiquer les conclusions cliniques aux non-statisticiens.
11.2 Régression robuste et moindres carrés pondérés (WLS)
Lorsque la structure de l’hétéroscédasticité est explicitement connue – par exemple lorsque la variance de l’erreur résiduelle est proportionnelle à la valeur d’une variable indépendante connue xi ou à la taille des groupes d’agrégation empiriques –, l’approche d’estimation par les Moindres Carrés Pondérés (Weighted Least Squares ou WLS) offre une solution performante. La méthode consiste à attribuer à chaque observation un coefficient de pondération inversement proportionnel à sa variance résiduelle propre : wi = 1 / σi2. Ce mécanisme tempère l’impact des observations très dispersées au profit de celles issues de segments stables.
Dans d’autres configurations de recherche, les résidus révèlent des violations de la normalité causées par des observations extrêmes et atypiques récurrentes, sans motif méthodologique justifiant leur exclusion unilatérale. Dans ce cadre, le recours aux régressions robustes – et singulièrement aux estimateurs de type M (dont l’archétype est l’estimateur de Huber) – s’avère particulièrement indiqué.
L’estimation de Huber modifie la fonction de minimisation des écarts : elle conserve un comportement quadratique classique (type MCO) pour les résidus de faible amplitude situés à l’intérieur d’un seuil critique (généralement fixé à |ei| ≤ 1,345 se), mais commute vers une pénalisation linéaire absolue pour les résidus plus éloignés. Cette transformation limite le pouvoir d’attraction des résidus élevés sur le calcul de la pente :
Pour des situations de contamination plus sévère, la fonction de perte bisquarrée (biweight) de Tukey neutralise complètement l’influence des points dont le résidu dépasse un seuil de dispersion fixé, garantissant une estimation robuste des coefficients structuraux.
11.3 Révision de la spécification théorique du modèle psychologique
L’observation d’une anomalie résiduelle majeure constitue souvent le symptôme direct d’une inadéquation théorique sous-jacente, soulignant la nécessité d’une révision du modèle conceptuel. L’émergence d’une structure non aléatoire dans les résidus signale fréquemment l’omission d’un prédicteur pertinent ou d’un terme d’interaction modératrice.
Si la trajectoire résiduelle prend une allure concave ou convexe selon les niveaux d’un prédicteur continu, l’introduction formelle d’un terme polynomial d’ordre supérieur (X2) dans l’équation de régression peut redresser le modèle :
Y = b0 + b1X + b2X2 + e
De même, si la variance résiduelle oscille en fonction des niveaux d’un facteur qualitatif catégoriel (comme le groupe d’appartenance ou le genre), cette hétérogénéité résiduelle traduit souvent l’omission d’un effet d’interaction multiplicatif (X × Groupe). L’intégration de ce terme d’interaction permet de modéliser une pente distincte pour chaque sous-groupe, résorbant ainsi la dispersion apparente des résidus.
Enfin, lorsque les diagnostics mettent en évidence une violation flagrante du postulat d’indépendance des erreurs due à un regroupement naturel des participants (classes, services hospitaliers, fratries), le paradigme MCO classique s’avère inadapté. Le chercheur doit alors mobiliser les modèles linéaires mixtes (Linear Mixed Models, LMM) ou la modélisation hiérarchique à effets aléatoires. Ces architectures avancées décomposent la variance résiduelle en deux niveaux : une variance résiduelle inter-groupes (entre clusters) et une variance résiduelle intra-groupe (individuelle), restaurant la rigueur de l’inférence statistique sur les données imbriquées.
12. Étude de cas intégrative en psychométrie : Épuisement professionnel et empathie
12.1 Cadre théorique, recueil des données et modélisation initiale
Afin de consolider les principes théoriques et opératoires développés tout au long de cet ouvrage, examinons une étude empirique menée auprès d’une cohorte de n = 120 personnels soignants hospitaliers en exercice dans des unités de soins critiques. L’objectif théorique de cette investigation en psychologie de la santé au travail consiste à tester l’hypothèse de l’érosion de l’empathie face à l’usure professionnelle continue. Le score d’épuisement émotionnel (évalué via la sous-échelle dédiée du Maslach Burnout Inventory, noté Burnout, variant de 0 à 54) fait office de variable prédictive (X), tandis que l’évaluation du niveau d’empathie clinique (mesurée via la Jefferson Scale of Empathy, notée Empathie, s’échelonnant sur un continuum de 20 à 140 points) constitue la variable réponse critère (Y).
Le chercheur ajuste initialement un modèle de régression linéaire simple classique par les moindres carrés ordinaires. Les résultats paramétriques initiaux se formulent selon l’équation de régression suivante :
Empathiê = 118,45 − 0,62 × Burnout
Le test de conformité globale affiche un F(1, 118) = 28,34, associé à une significativité statistique marquée (p < .001), et le coefficient de détermination s’établit à R2 = 0,194. L’interprétation hâtive de cette modélisation préliminaire suggère qu’une élévation d’une unité sur l’échelle du burnout provoque une réduction attendue moyenne de 0,62 point d’empathie clinique chez ces soignants, ce prédicteur expliquant près de 19,4 % de la variance de la réponse. Néanmoins, valider ce modèle sans conduire un audit approfondi des résidus reviendrait à ignorer de potentielles violations méthodologiques fragilisant ces conclusions.
12.2 Audit complet des résidus et identification des violations
L’investigateur engage alors l’audit méthodique des résidus d’estimation générés par le modèle initial. L’extraction systématique du vecteur résiduel ei et l’établissement des valeurs prédites ŷi permettent de construire la batterie de contrôles diagnostiques fondamentaux.
L’évaluation commence par l’examen du diagramme de dispersion des résidus standardisés en relation avec les valeurs ajustées (Residuals vs Fitted). Loin d’afficher une bande horizontale d’épaisseur homogène, le nuage de points dessine une forme en mégaphone : pour les valeurs prédites élevées d’empathie (associées à des scores d’épuisement faibles), les résidus standardisés sont fortement resserrés autour de l’axe zéro (intervalle compris entre −1,2 et +1,1). En revanche, à mesure que la valeur prédite décline (associée à un épuisement professionnel élevé), la dispersion verticale des résidus s’élargit substantiellement, oscillant entre −3,4 et +2,8. Cette configuration hétéroscédastique est confirmée par le test de Breusch-Pagan, qui affiche une significativité marquée : BP = 14,82, df = 1, p < .001.
Simultanément, l’analyse du diagramme quantile-quantile (Normal Q-Q Plot) montre un détachement manifeste des résidus dans les quantiles inférieurs de la distribution, caractérisé par un fléchissement sous la diagonale théorique à 45 degrés. Le test de Shapiro-Wilk confirme cette violation de la normalité distributionnelle (W = 0,948, p = .0002).
Enfin, le calcul des distances de Cook met en lumière deux observations influentes majeures. En appliquant le seuil critique adapté à la cohorte Dcrit = 4 / n = 4 / 120 ≈ 0,033, le sujet n° 47 (D47 = 0,112, combinant un résidu standardisé de z = −3,41 et un levier de h = 0,058) et le sujet n° 89 (D89 = 0,089, présentant un résidu de z = −2,95 et un levier de h = 0,061) pèsent de manière disproportionnée sur le calcul de la pente. Un audit des dossiers d’encodage confirme que ces deux cas correspondent à des personnels soignants soumis à des protocoles de travail de nuit atypiques, non contrôlés dans le devis d’échantillonnage initial.
12.3 Ajustement du modèle et interprétation scientifique finale
Face à cette double violation des postulats d’homoscédasticité et de normalité, assortie de la présence d’observations influentes documentées, l’ajustement du modèle devient méthodologiquement nécessaire. Le protocole d’assainissement s’articule en deux démarches complémentaires :
Dans un premier temps, une régression robuste utilisant un estimateur M de Huber est mise en œuvre afin de limiter l’influence disproportionnée des observations n° 47 et n° 89, tout en conservant l’intégralité de l’échantillon au sein de l’analyse. Dans un second temps, pour stabiliser la variance résiduelle croissante sans distordre l’échelle psychométrique, des erreurs types robustes à l’hétéroscédasticité (estimateur sandwich HC3 de MacKinnon et White) sont mobilisées lors du calcul des inférences statistiques.
Le recalcul des coefficients sous ce cadre analytique robuste produit la fonction d’estimation révisée suivante :
Empathiê = 114,20 − 0,48 × Burnout
L’évaluation des nouveaux paramètres met en évidence une modification notable de la pente : celle-ci passe de −0,62 à −0,48 point par unité d’épuisement. L’erreur type du coefficient de pente, initialement sous-estimée sous les MCO ordinaires (SE = 0,116), s’établit à SEHC3 = 0,094 après ajustement robuste, confirmant néanmoins la significativité du lien empirique (t = −5,10, p < .001, IC à 95% [−0,67 ; −0,29]).
L’audit des résidus recalculés sur le modèle robuste démontre une résorption satisfaisante des anomalies distributionnelles. Le tracé Residuals vs Fitted stabilisé ne manifeste plus d’évasement hétéroscédastique marqué. De même, les résidus studentisés externes issus du recalibrage convergent vers l’alignement sur la diagonale théorique du diagramme Q-Q plot.
La rédaction académique finale peut dès lors consigner ces résultats selon les normes éditoriales les plus strictes :
« Une analyse de régression linéaire a été conduite afin de prédire le niveau d’empathie clinique à partir du score d’épuisement professionnel chez 120 soignants en soins critiques. L’audit initial des résidus par la méthode des moindres carrés ordinaires a révélé une hétéroscédasticité significative (test de Breusch-Pagan : BP = 14,82, p < .001) ainsi qu’une influence disproportionnée exercée par deux cas singuliers identifiés par la distance de Cook (Di > 4/n). L’ajustement a été reconduit via une régression robuste utilisant l’estimateur de Huber, assortie d’une correction d’erreur type hétéroscédastique HC3. Le modèle final indique une diminution statistiquement significative de l’empathie clinique en fonction de l’épuisement émotionnel (b = −0,48, SE = 0,094, t = −5,10, p < .001, IC à 95 % [−0,67 ; −0,29]). Cette démarche garantit la validité de l’inférence théorique en neutralisant les biais d’estimation documentés lors du diagnostic des résidus. »
Cette étude de cas illustre ainsi concrètement la démarche d’analyse résiduelle : le calcul méticuleux des résidus n’a pas constitué une simple formalité technique d’ajustement, mais un filtre analytique indispensable pour préserver la recherche d’une mauvaise spécification statistique et délivrer des conclusions solides à la communauté scientifique.
Références
- Belsley, D. A., Kuh, E., & Welsch, R. E. (1980). Regression diagnostics: Identifying influential data and sources of collinearity. John Wiley & Sons. https://doi.org/10.1002/0471725153
- Breusch, T. S., & Pagan, A. R. (1979). A simple test for heteroscedasticity and random coefficient variation. Econometrica, 47(5), 1287-1294. https://doi.org/10.2307/1911963
- Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15-18. https://doi.org/10.1080/00401706.1977.10489493
- Draper, N. R., & Smith, H. (1998). Applied regression analysis (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781118625590
- Durbin, J., & Watson, G. S. (1951). Testing for serial correlation in least squares regression. II. Biometrika, 38(1/2), 159-177. https://doi.org/10.2307/2332325
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE Publications. https://socialsciences.mcmaster.ca/jfox/Books/Companion/
- Huber, P. J. (1981). Robust statistics. John Wiley & Sons. https://doi.org/10.1002/0471725250
- MacKinnon, J. G., & White, H. (1985). Some heteroskedasticity-consistent covariance matrix estimators with improved finite sample properties. Journal of Econometrics, 29(3), 305-325. https://doi.org/10.1016/0304-4076(85)90158-7
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591-611. https://doi.org/10.2307/2333709
- White, H. (1980). A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity. Econometrica, 48(4), 817-838. https://doi.org/10.2307/1912934