
Dans le champ foisonnant de la psychologie quantitative et des sciences comportementales, la modélisation statistique constitue le socle sur lequel reposent la validation d’hypothèses théoriques et la prédiction de comportements humains complexes. Qu’il s’agisse d’évaluer l’impact combiné de multiples stresseurs environnementaux sur l’émergence d’épisodes dépressifs ou d’identifier les déterminants cognitifs de la réussite académique, l’analyse par régression linéaire multiple s’impose comme une méthodologie privilégiée. Au cœur de cette démarche d’évaluation diagnostique, le coefficient de détermination ordinaire, universellement désigné par la notation R², a longtemps été considéré comme la métrique cardinale permettant d’apprécier la proportion de variance de la variable dépendante capturée par un ensemble de prédicteurs. Toutefois, cette mesure d’adéquation présente une faille structurelle majeure : sa propension systématique à croître de manière artificielle à mesure que de nouvelles variables explicatives sont incorporées au modèle, indépendamment de leur pertinence empirique réelle.
Cette vulnérabilité mathématique expose les chercheurs à un danger épistémologique redoutable : le surapprentissage (ou overfitting), caractérisé par l’illusion d’une modélisation hautement prédictive qui ne fait en réalité que capturer le bruit d’échantillonnage inhérent aux données observées. Pour remédier à cet écueil fondamental et restaurer l’exigence méthodologique de parcimonie, les statisticiens ont développé le coefficient de détermination ajusté, ou R² ajusté. En appliquant une pénalité rigoureuse proportionnelle au nombre de prédicteurs rapporté aux degrés de liberté disponibles, le R² ajusté fournit un estimateur impartial de l’efficacité prédictive d’un modèle statistique au sein de la population parente. Dans le contexte de la recherche contemporaine, maîtriser le calcul, l’interprétation et l’automatisation de cette métrique s’avère indispensable pour tout praticien soucieux de la reproductibilité de ses résultats.
Bien que des progiciels spécialisés tels que SPSS, R ou SAS soient couramment employés dans les laboratoires universitaires, Microsoft Excel demeure un environnement de calcul universellement accessible, particulièrement puissant et pédagogique pour exécuter des analyses de régression avancées. Ce guide exhaustif propose une exploration approfondie des fondements théoriques, des formulations mathématiques et des procédures opérationnelles permettant de calculer le R-carré ajusté dans Excel. À travers l’examen de trois méthodologies distinctes — l’Utilitaire d’analyse statistique, la décomposition manuelle pas à pas par formules natives et l’exploitation de la fonction matricielle dynamique DROITEREG —, cet article détaille les protocoles garantissant une analyse psychométrique rigoureuse, exempte de biais méthodologiques et strictement conforme aux standards éditoriaux de l’American Psychological Association.
1. Fondements théoriques du coefficient de détermination en recherche psychologique
1.1 Définition conceptuelle du R² ordinaire
Le coefficient de détermination ordinaire, traditionnellement symbolisé par R², représente la proportion de la variance totale observée au sein de la variable dépendante (ou variable critère) qui peut être expliquée et prédite de manière linéaire par la variation conjointe d’un ensemble de variables indépendantes (ou prédicteurs). Sur le plan psychométrique, il s’agit d’une métrique adimensionnelle standardisée, bornée par construction sur un continuum théorique s’étendant strictement entre 0 et 1. Une valeur de 0 indique une absence absolue de liaison linéaire entre les prédicteurs et le critère, signifiant que la moyenne empirique de la variable dépendante constitue une prédiction tout aussi efficiente que l’ensemble du système d’équations de régression. À l’inverse, une valeur de 1 traduit une adéquation déterministe parfaite, où chaque point d’observation coïncide rigoureusement avec l’hyperplan de régression estimé.
Dans l’évaluation des instruments psychologiques et des théories comportementales, le R² ordinaire est interprété comme un indicateur direct de la force d’association linéaire globale. Par exemple, si une batterie de tests mesurant les fonctions exécutives produit un R² de 0,35 lors de la prédiction des scores de flexibilité cognitive chez des patients cérébrolésés, le chercheur en déduit que 35 % de la variabilité interindividuelle observée sur le critère est directement attribuable aux prédicteurs retenus. Cependant, le R² ordinaire souffre d’une limite intrinsèque cardinale : il ignore délibérément le coût statistique associé à l’adjonction de nouvelles variables explicatives. En s’affranchissant du principe de parcimonie scientifique, il confère la même valeur apparente à une amélioration prédictive substantielle qu’à une fluctuation aléatoire générée par l’accumulation de prédicteurs non pertinents.
Cette carence méthodologique fragilise l’interprétation des résultats psychologiques, incitant parfois les analystes non avertis à saturer leurs modèles de covariables arbitraires dans l’unique dessein de maximiser la variance apparente. Dès lors, le R² cesse d’être une mesure neutre de validité conceptuelle pour devenir une mesure gonflée d’adéquation empirique locale, incapable d’informer sur la véritable généralisabilité des processus psychologiques sous-jacents.
1.2 La décomposition de la variance totale
La compréhension mathématique rigoureuse du coefficient de détermination repose sur le théorème fondamental de décomposition de la variabilité, structuré autour de trois composantes quadratiques distinctes : la somme des carrés totaux (SST, pour Total Sum of Squares), la somme des carrés de la régression (SSR, pour Regression Sum of Squares), et la somme des carrés des erreurs résiduelles (SSE, pour Sum of Squared Errors). La somme des carrés totaux quantifie la variabilité interindividuelle globale de la variable critère Y par rapport à sa propre moyenne arithmétique. Elle traduit l’incertitude totale initiale que le chercheur cherche à réduire par l’introduction de covariables explicatives.
La somme des carrés de la régression correspond à la portion de cette dispersion globale qui est effectivement captée par le modèle linéaire, calculée comme la différence au carré entre les valeurs prédites par l’équation et la moyenne générale de la distribution. Enfin, la somme des carrés des résidus incarne le bruit de mesure, la variance inexpliquée et l’ensemble des facteurs non contrôlés ou des fluctuations aléatoires propres à l’échantillonnage. La relation mathématique d’additivité orthogonale qui lie ces trois grandeurs s’énonce invariablement selon l’égalité fondamentale :
SST = SSR + SSE
Sur la base de cette décomposition canonique, le coefficient de détermination R² peut être formalisé soit comme le rapport de la variance expliquée sur la variance totale (SSR / SST), soit comme le complément à l’unité de la fraction de variance inexpliquée, selon la relation :
R² = 1 – (SSE / SST)
Cette seconde formulation revêt une importance conceptuelle majeure pour la psychométrie : elle met en exergue le fait que maximiser le R² équivaut strictement à minimiser la somme des carrés des résidus par la méthode des moindres carrés ordinaires. Toutefois, cette minimisation s’effectue sans aucune pondération relative au nombre de paramètres libres estimés dans l’architecture du modèle.
1.3 Le comportement asymptotique du R² lors de l’ajout de prédicteurs
D’un point de vue algébrique, l’estimation des paramètres d’une régression linéaire via les moindres carrés consiste à projeter orthogonalement le vecteur d’observations sur le sous-espace vectoriel engendré par les colonnes de la matrice des variables indépendantes. Chaque fois qu’une variable explicative additionnelle est introduite dans l’équation, la dimension de ce sous-espace augmente mécaniquement d’une unité, ou demeure inchangée si la variable est une combinaison linéaire parfaite des précédentes. En conséquence géométrique inéluctable, la distance euclidienne séparant le vecteur observé du sous-espace de projection ne peut que décroître ou, dans le pire des cas, rester constante.
Il en résulte que la somme des carrés des résidus (SSE) diminue de façon monotone ou stagne, ce qui engendre une augmentation systématique et non informative du R² ordinaire, même si la nouvelle variable injectée est un vecteur de nombres purement aléatoires généré par tirage au sort. Ce comportement asymptotique est particulièrement délétère dans les contextes de recherche en psychologie où les échantillons sont restreints, par exemple lors de l’étude de pathologies rares ou de cohortes cliniques hospitalières où le nombre d’observations n dépasse rarement quelques dizaines d’individus.
L’inflation artificielle de la métrique conduit directement à un surapprentissage empirique dévastateur : le modèle ne décrit plus une loi psychologique générale, mais s’ajuste étroitement aux singularités et aux bruits d’échantillonnage de la cohorte étudiée. Lorsque ce modèle surajusté est ultérieurement confronté à un nouvel échantillon indépendant, sa capacité de généralisation s’effondre dramatiquement, anéantissant la validité externe des conclusions scientifiques et compromettant la reproductibilité des interventions cliniques qui en découlent.
2. La nécessité statistique du R-carré ajusté face au surapprentissage
2.1 Principe de parcimonie et rasoir d’Ockham
Dans la théorie de la modélisation statistique, le principe de parcimonie — souvent assimilé au célèbre rasoir d’Ockham formulé par le philosophe médiéval Guillaume d’Ockham — stipule que face à plusieurs explications ou modèles concurrents présentant des capacités descriptives équivalentes, la structure la plus simple comportant le moins de présuppositions ou de paramètres doit systématiquement être privilégiée. Transposé à l’analyse de régression en sciences du comportement, ce principe commande de rechercher l’équilibre optimal entre la complexité structurelle du modèle (mesurée par le nombre de régresseurs inclus) et sa précision prédictive effective.
Un modèle excessivement complexe, intégrant une multitude de covariables marginales ou fortement corrélées entre elles, dissipe inutilement des degrés de liberté précieux et majore l’instabilité des estimations des coefficients. À l’opposé, un modèle excessivement dépouillé risque d’omettre des facteurs explicatifs déterminants, induisant un biais de spécification majeur. Le R² ajusté intervient précisément comme un instrument d’arbitrage mathématique rigoureux : il pénalise sévèrement l’adjonction de prédicteurs superflus dont la contribution marginale à la réduction de la variance résiduelle est inférieure au coût statistique imposé par la perte d’un degré de liberté.
Cette régulation préserve la puissance statistique des protocoles expérimentaux. Elle contraint le chercheur à faire preuve d’une rigueur épistémologique accrue dans la sélection de ses variables, décourageant les approches exploratoires aveugles au profit d’hypothèses solides ancrées dans la littérature psychologique établie.
2.2 Distinction cruciale entre R² ordinaire et R² ajusté
La divergence conceptuelle entre le R² ordinaire et le R² ajusté réside fondamentalement dans la prise en compte explicite des degrés de liberté associés respectivement à la dispersion totale et à l’erreur résiduelle. Alors que le R² ordinaire manipule des sommes brutes de déviations quadratiques, le R² ajusté substitue à ces grandeurs leurs équivalents non biaisés : les variances ou carrés moyens. Cette substitution transforme radicalement le comportement mathématique de l’indice.
Contrairement au R² classique, qui est strictement confiné à l’intervalle [0, 1], le R² ajusté possède la particularité théorique et empirique de pouvoir adopter des valeurs négatives. Cette éventualité se produit lorsque le modèle statistique proposé s’avère si médiocre que l’accroissement résiduel pénalisé dépasse la variance totale de la distribution, indiquant que la prédiction fournie par l’équation de régression est plus erratique que l’attribution simple de la moyenne générale du groupe à chaque individu.
Par ailleurs, sur le plan inférentiel, le R² ordinaire calculé sur un échantillon empirique constitue un estimateur structurellement biaisé par excès du coefficient de détermination réel présent dans la population sous-jacente. En revanche, le R² ajusté, formulé pour corriger ce biais d’échantillonnage, opère comme un estimateur quasi non biaisé de l’ampleur véritable du lien théorique. Il offre ainsi aux chercheurs une projection beaucoup plus lucide et conservatrice de la transférabilité de leurs résultats hors du laboratoire.
2.3 Applications empiriques en sciences comportementales
La pertinence de cette correction mathématique se manifeste de façon éclatante dans une multitude de paradigmes psychologiques contemporains. Considérons, à titre d’illustration, la modélisation des scores d’anxiété clinique mesurés à l’aide d’échelles standardisées telles que le STAI (State-Trait Anxiety Inventory). Un clinicien peut chercher à prédire cette symptomatologie à partir d’un ensemble de variables comprenant le cortisol salivaire, la fréquence cardiaque au repos, le nombre d’heures de sommeil paradoxal, mais également des variables sociodémographiques hétéroclites comme le revenu, le niveau d’études ou le temps d’exposition aux écrans.
Dans une telle configuration, l’utilisation exclusive du R² ordinaire masquerait le fait que plusieurs de ces variables n’apportent qu’un apport purement fortuit, gonflant le pouvoir explicatif apparent du modèle à des niveaux artificiels. L’évaluation du R² ajusté permet d’identifier immédiatement le moment exact où l’introduction d’un prédicteur supplémentaire détériore la robustesse globale du modèle au lieu de l’enrichir.
De même, dans les protocoles évaluant le rendement académique en fonction de batteries de tests neuropsychologiques (mémoire de travail, vitesse de traitement, attention sélective), la forte corrélation croisée entre les sous-tests engendre une redondance informationnelle substantielle. Le R² ajusté constitue un garde-fou méthodologique indispensable pour repérer ces inefficacités statistiques, guidant l’analyste vers des spécifications de modèles plus denses, réplicables et cliniquement interprétables.
3. Formulation mathématique rigoureuse du R² ajusté
3.1 Dérivation de l’équation standard d’Ezekiel
La formulation canonique du coefficient de détermination ajusté universellement adoptée dans les sciences sociales et intégrée dans les moteurs de calcul matriciel dérive des travaux fondateurs du statisticien et économètre Mordecai Ezekiel (1930). L’objectif d’Ezekiel était de corriger la formule classique du R² en substituant aux sommes de carrés leurs estimateurs sans biais respectifs de variance populationnelle. L’expression mathématique s’articule formellement ainsi :
R²aj = 1 – [(1 – R²) * (n – 1) / (n – k – 1)]
Dans cette architecture équationnelle rigoureuse, les termes doivent être définis avec une exactitude métrique totale :
- R² représente le coefficient de détermination ordinaire issu de la régression par moindres carrés.
- n désigne l’effectif global de l’échantillon, c’est-à-dire le nombre total d’observations individuelles valides incluses dans l’analyse.
- k incarne le nombre exact de variables prédictives indépendantes incorporées dans l’équation, en excluant explicitement le terme constant (l’ordonnée à l’origine).
- (n – 1) constitue les degrés de liberté totaux associés à la dispersion globale de la variable dépendante autour de sa moyenne.
- (n – k – 1) correspond aux degrés de liberté résiduels associés à la somme des carrés des erreurs, reflétant le nombre d’observations libres déduction faite du nombre de paramètres estimés dans le modèle complet.
Le ratio (n – 1) / (n – k – 1) joue le rôle d’un coefficient multiplicateur de pénalité. Étant donné que le dénominateur (n – k – 1) est strictement inférieur au numérateur (n – 1) dès lors que k ≥ 1, ce ratio est systématiquement supérieur à 1. Par conséquent, la fraction (1 – R²) se trouve amplifiée par ce facteur correctif, ce qui aboutit, après soustraction de l’unité, à un R² ajusté rigoureusement inférieur au R² ordinaire, sauf dans le cas trivial où R² = 1.
3.2 Dérivation basée sur les carrés moyens
Une approche mathématique alternative mais parfaitement équivalente pour dériver le R² ajusté consiste à mobiliser directement les variances non biaisées issues du tableau de l’analyse de la variance (ANOVA) associée à la régression. Dans cette perspective, la dispersion inexpliquée n’est plus représentée par la simple somme des résidus au carré, mais par le carré moyen de l’erreur (MSE, pour Mean Squared Error), défini par le quotient de la somme des carrés résiduels par ses degrés de liberté propres :
MSE = SSE / (n – k – 1)
Parallèlement, la variabilité globale de la variable dépendante est estimée par le carré moyen total (MST, pour Mean Squared Total), qui équivaut à la variance d’échantillon non biaisée de la variable Y :
MST = SST / (n – 1)
Le coefficient de détermination ajusté s’énonce alors comme le rapport entre la variance résiduelle non biaisée et la variance totale non biaisée soustrait de 1, formalisé par :
R²aj = 1 – (MSE / MST)
En développant cette égalité par substitution algébrique, nous retrouvons rigoureusement la formulation initiale d’Ezekiel :
R²aj = 1 – [(SSE / (n – k – 1)) / (SST / (n – 1))] = 1 – [(SSE / SST) * ((n – 1) / (n – k – 1))]
Puisque par définition (SSE / SST) = 1 – R², la congruence formelle entre l’approche par décomposition des variances et l’approche par pondération des degrés de liberté est totale, illustrant l’élégance et la cohérence interne de la métrique.
3.3 Impact des variations d’échantillonnage
L’intensité de la pénalisation imposée par le R² ajusté dépend étroitement de la taille de l’échantillon n et du ratio d’observations par variable prédictive (n / k). L’analyse du comportement asymptotique de l’équation démontre que lorsque la taille de l’échantillon tend vers l’infini mathématique (lim n → ∞), le terme (n – 1) / (n – k – 1) converge inévitablement vers la valeur 1. Par conséquent, dans les cohortes épidémiologiques massives composées de milliers d’individus, l’écart numérique entre le R² ordinaire et le R² ajusté devient infinitésimal, la correction perdant de son impact pratique face à la saturation informationnelle de l’échantillon.
À l’inverse, dans les protocoles de psychologie clinique, de neuro-imagerie fonctionnelle ou de psychophysiologie où les cohortes oscillent fréquemment entre 20 et 50 sujets, la pénalité s’amplifie considérablement. Par exemple, avec un échantillon de n = 25 observations et un modèle saturé de k = 6 prédicteurs affichant un R² ordinaire en apparence honorable de 0,40, le calcul révèle :
Ratio de pénalité = (25 – 1) / (25 – 6 – 1) = 24 / 18 = 1,333
R²aj = 1 – [(1 – 0,40) * 1,333] = 1 – [0,60 * 1,333] = 1 – 0,80 = 0,20
Le pouvoir explicatif effectif du modèle est ainsi réduit de moitié par rapport à son estimation naïve. C’est pourquoi la communauté méthodologique s’accorde généralement sur l’exigence d’un ratio minimal strict de 15 à 20 observations par prédicteur en psychologie afin de prévenir l’effondrement prédictif des modèles.
4. Préparation et structuration des données psychologiques dans Excel
4.1 Organisation tabulaire conforme aux standards d’analyse
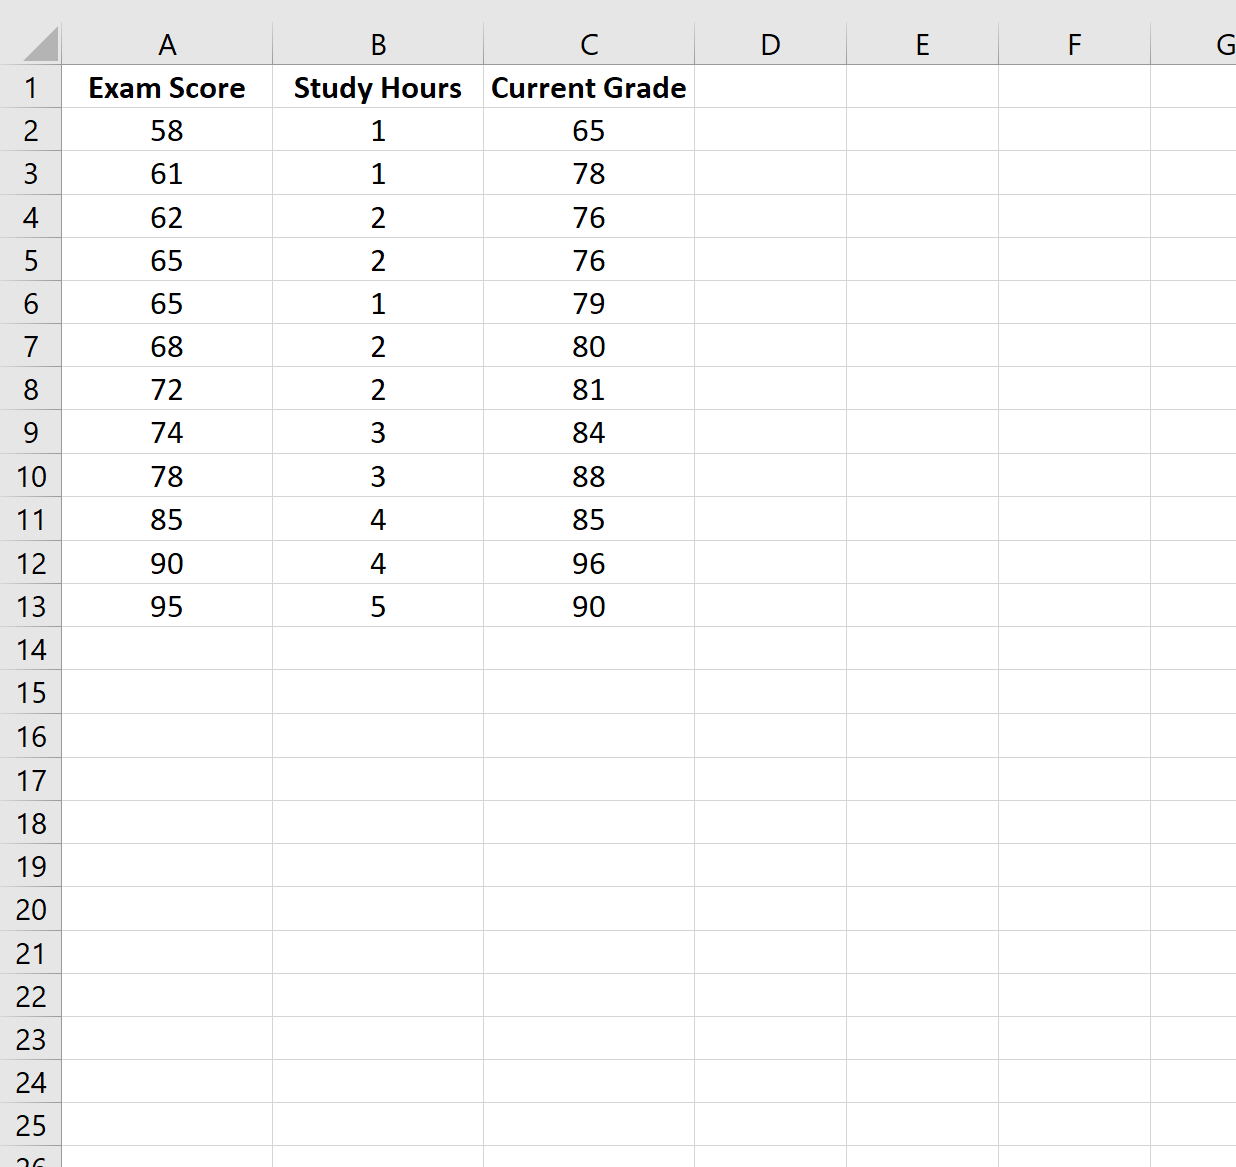
Pour exécuter sans erreur les procédures de régression dans l’environnement Microsoft Excel, l’ordonnancement de la feuille de calcul doit respecter une architecture relationnelle rigoureuse, assimilable à une structure matricielle formelle. Les principes fondamentaux de structuration requièrent que chaque ligne du tableau corresponde exclusivement à une unité d’observation individuelle unique (un sujet expérimental ou un patient clinique identifié par un code anonymisé). Les colonnes représentent les variables opérationnalisées, qu’il s’agisse de scores à des questionnaires, de mesures physiologiques ou de variables sociodémographiques codifiées.
Une règle cardinale imposée par les moteurs d’analyse d’Excel réside dans l’agencement spatial des variables :
- La variable critère (dépendante) Y doit être impérativement isolée dans une colonne vectorielle unique et continue (par exemple, la colonne B).
- L’ensemble des prédicteurs (indépendants) X doit être disposé dans un bloc de colonnes contiguës ininterrompues (par exemple, les colonnes C, D, E et F).
Tout éclatement des variables prédictives à travers des plages disjointes empêche le fonctionnement de l’Utilitaire d’analyse et complexifie considérablement la syntaxe des formules matricielles. Enfin, la première ligne du tableau doit impérativement être réservée à des étiquettes sémantiques courtes et explicites, exemptes de caractères spéciaux complexes ou de sauts de ligne, afin de faciliter la lecture des sorties générées.
4.2 Traitement préalable des valeurs manquantes et aberrantes
Les recueils de données empiriques en psychométrie sont fréquemment altérés par la présence de données manquantes, qu’elles résultent de l’omission involontaire d’une réponse à un questionnaire ou d’un incident technique lors d’un enregistrement expérimental. Les fonctions statistiques de régression sous Excel ne tolèrent pas la présence de cellules vides ou de chaînes textuelles au sein des plages numériques désignées. La détection systématique des cellules vierges doit être exécutée en combinant les fonctions ESTVIDE et SOMMEPROD, ou par le filtrage avancé des données.
En présence de données incomplètes, deux stratégies principales s’offrent au chercheur :
- L’exclusion par liste complète (listwise deletion), consistant à supprimer l’intégralité de la ligne pour tout participant présentant au moins une donnée manquante sur l’une des variables du modèle. Cette démarche est indispensable sous Excel pour garantir la stricte parité dimensionnelle des vecteurs et la cohérence des degrés de liberté.
- L’imputation statistique, bien que nécessitant des manipulations plus poussées que l’exclusion simple.
Parallèlement, la détection des valeurs aberrantes multivariées (outliers) doit être entreprise en transformant préalablement les variables brutes en scores standardisés Z via la fonction CENTRER.REDUIRE. Toute observation présentant une déviation standard supérieure à trois écarts-types (|Z| > 3) doit faire l’objet d’une inspection clinique minutieuse afin de statuer sur son exclusion ou son maintien, préservant ainsi le modèle des artefacts de levier excessif.
4.3 Vérification des postulats statistiques préalables
L’estimation non biaisée du R² ajusté repose sur la validité empirique des postulats classiques du modèle linéaire général par moindres carrés : la linéarité des relations, l’indépendance des observations, l’homoscédasticité et la normalité de la distribution des erreurs résiduelles. Avant de procéder à l’interprétation définitive des métriques d’adéquation, un travail d’exploration diagnostique préliminaire s’impose directement dans le tableur.
La linéarité de l’association entre chaque prédicteur individuel et la variable dépendante doit être inspectée visuellement par l’insertion de graphiques en nuage de points enrichis d’une courbe de tendance linéaire. Pour apprécier l’homoscédasticité (l’invariance de la variance de l’erreur à travers les différents niveaux des prédicteurs), un diagramme de dispersion confrontant les valeurs prédites aux résidus standardisés doit être généré. Une dispersion en entonnoir signale immédiatement une hétéroscédasticité problématique pouvant fausser l’estimation des erreurs-types.
Enfin, l’évaluation de la multicolinéarité — c’est-à-dire l’intercorrélation excessive entre les variables explicatives — s’avère critique. L’insertion d’une matrice de corrélations de Pearson à l’aide de l’outil Corrélations d’Excel permet de vérifier qu’aucun couple de prédicteurs ne présente un coefficient de corrélation r excédant le seuil d’alerte habituel de 0,80, garantissant ainsi l’intégrité de l’inversion matricielle sous-jacente.
5. Méthode 1 – Calcul automatique via l’Utilitaire d’analyse de données
5.1 Activation et configuration de l’Utilitaire d’analyse
Microsoft Excel intègre nativement un module d’ingénierie statistique sophistiqué intitulé l’Utilitaire d’analyse (Analysis ToolPak). Ce complément n’étant généralement pas activé lors de l’installation par défaut du logiciel, son déploiement manuel dans l’environnement de travail constitue la première étape opérationnelle. Pour procéder à son activation dans les versions modernes d’Excel, la procédure requiert de naviguer vers le menu supérieur Fichier, puis de sélectionner Options à l’extrémité inférieure de la barre latérale.
Au sein de la boîte de dialogue contextuelle des options d’Excel, l’utilisateur doit cliquer sur la catégorie Compléments située dans le volet de navigation gauche. Dans la zone inférieure intitulée Gérer, assurez-vous que l’option Compléments Excel est sélectionnée dans la liste déroulante, puis cliquez sur le bouton Atteindre…. Une nouvelle fenêtre surgissante répertorie l’ensemble des modules d’extension disponibles.
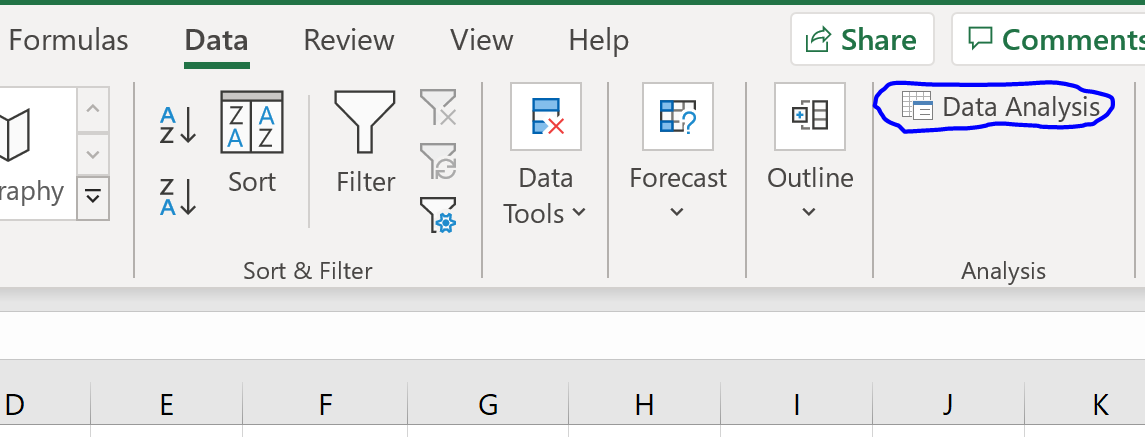
Il convient alors de cocher expressément la case intitulée Utilitaire d’analyse (veillez à ne pas confondre avec l’Utilitaire d’analyse VBA si vous n’envisagez pas de programmer en code macro pour cette étape), puis de valider l’opération en cliquant sur OK. Une fois cette manipulation finalisée, un nouveau bloc fonctionnel nommé Analyse apparaît immédiatement à l’extrémité droite du ruban sous l’onglet Données, hébergeant l’icône interactive Utilitaire d’analyse.
5.2 Paramétrage de la boîte de dialogue Régression
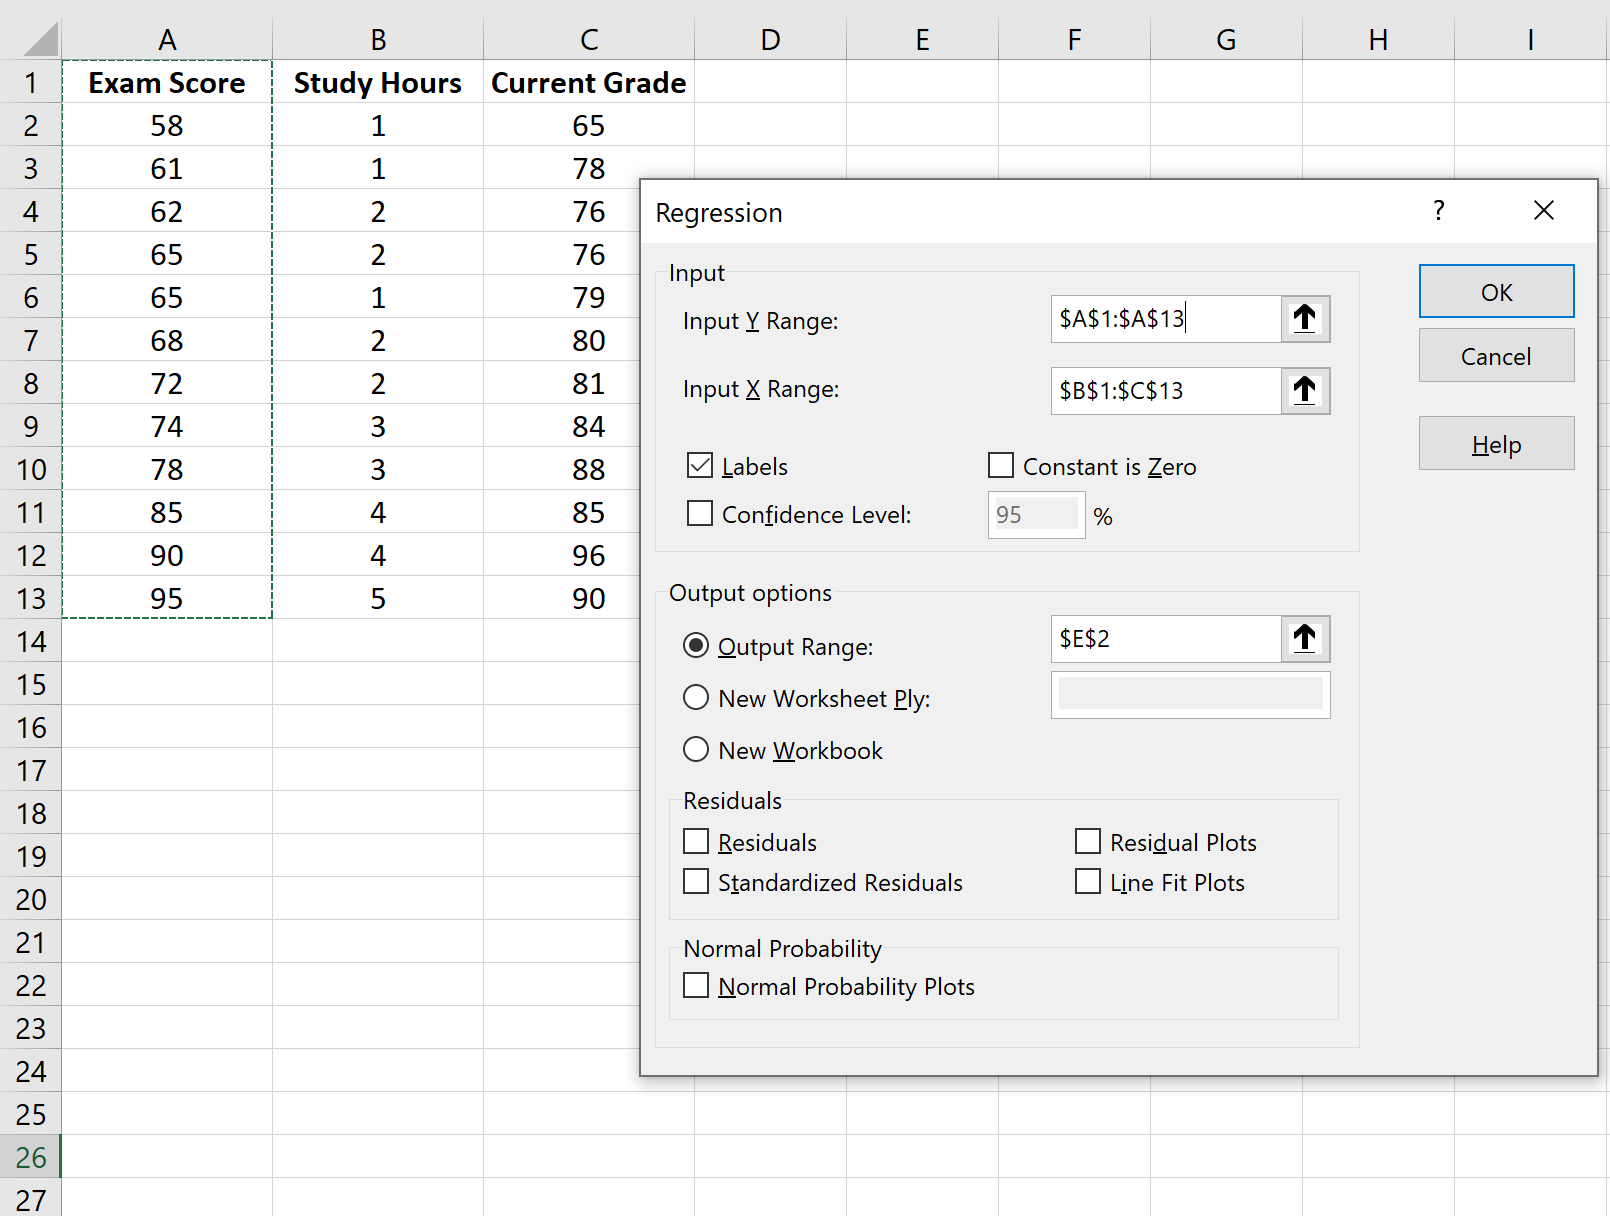
Une fois l’outil activé, l’exécution d’une régression multiple complète requiert une saisie méticuleuse des paramètres au sein de l’interface dédiée. Cliquez sur le bouton Utilitaire d’analyse dans l’onglet Données, faites défiler la liste alphabétique des outils statistiques proposés, sélectionnez la ligne Régression, puis confirmez en cliquant sur OK. L’interface de dialogue de configuration s’ouvre alors, exigeant la définition des plages de données sources :
- Plage d’entrée Y : Cliquez sur le sélecteur de cellule et surlignez le vecteur colonne continu englobant l’intégralité des observations de la variable dépendante, y compris sa cellule d’en-tête textuelle (par exemple, $B$1:$B$150).
- Plage d’entrée X : Surlignez le bloc rectangulaire contigu réunissant l’ensemble des colonnes dévolues aux variables prédictives, en intégrant impérativement la ligne d’en-têtes correspondante (par exemple, $C$1:$F$150).
- Intitulés : Cochez impérativement cette case de contrôle dès lors que la première ligne sélectionnée de vos plages comporte des étiquettes textuelles, évitant ainsi une erreur d’incompatibilité de type.
- Niveau de confiance : Par défaut calibré à 95 %, ce paramètre peut être ajusté à 99 % selon les exigences de rigueur du protocole d’investigation psychologique.
- Options de sortie : Cochez la case Nouvelle feuille de calcul et attribuez-lui un libellé évocateur tel que « Sortie_Regression » pour préserver l’intégrité de la feuille contenant les données brutes.
Pour un diagnostic approfondi des résidus, il est fortement conseillé de cocher simultanément les cases Résidus et Résidus standardisés situées dans la section inférieure de la boîte de dialogue avant de déclencher le calcul par le bouton OK.
5.3 Lecture et extraction de la valeur du R² ajusté
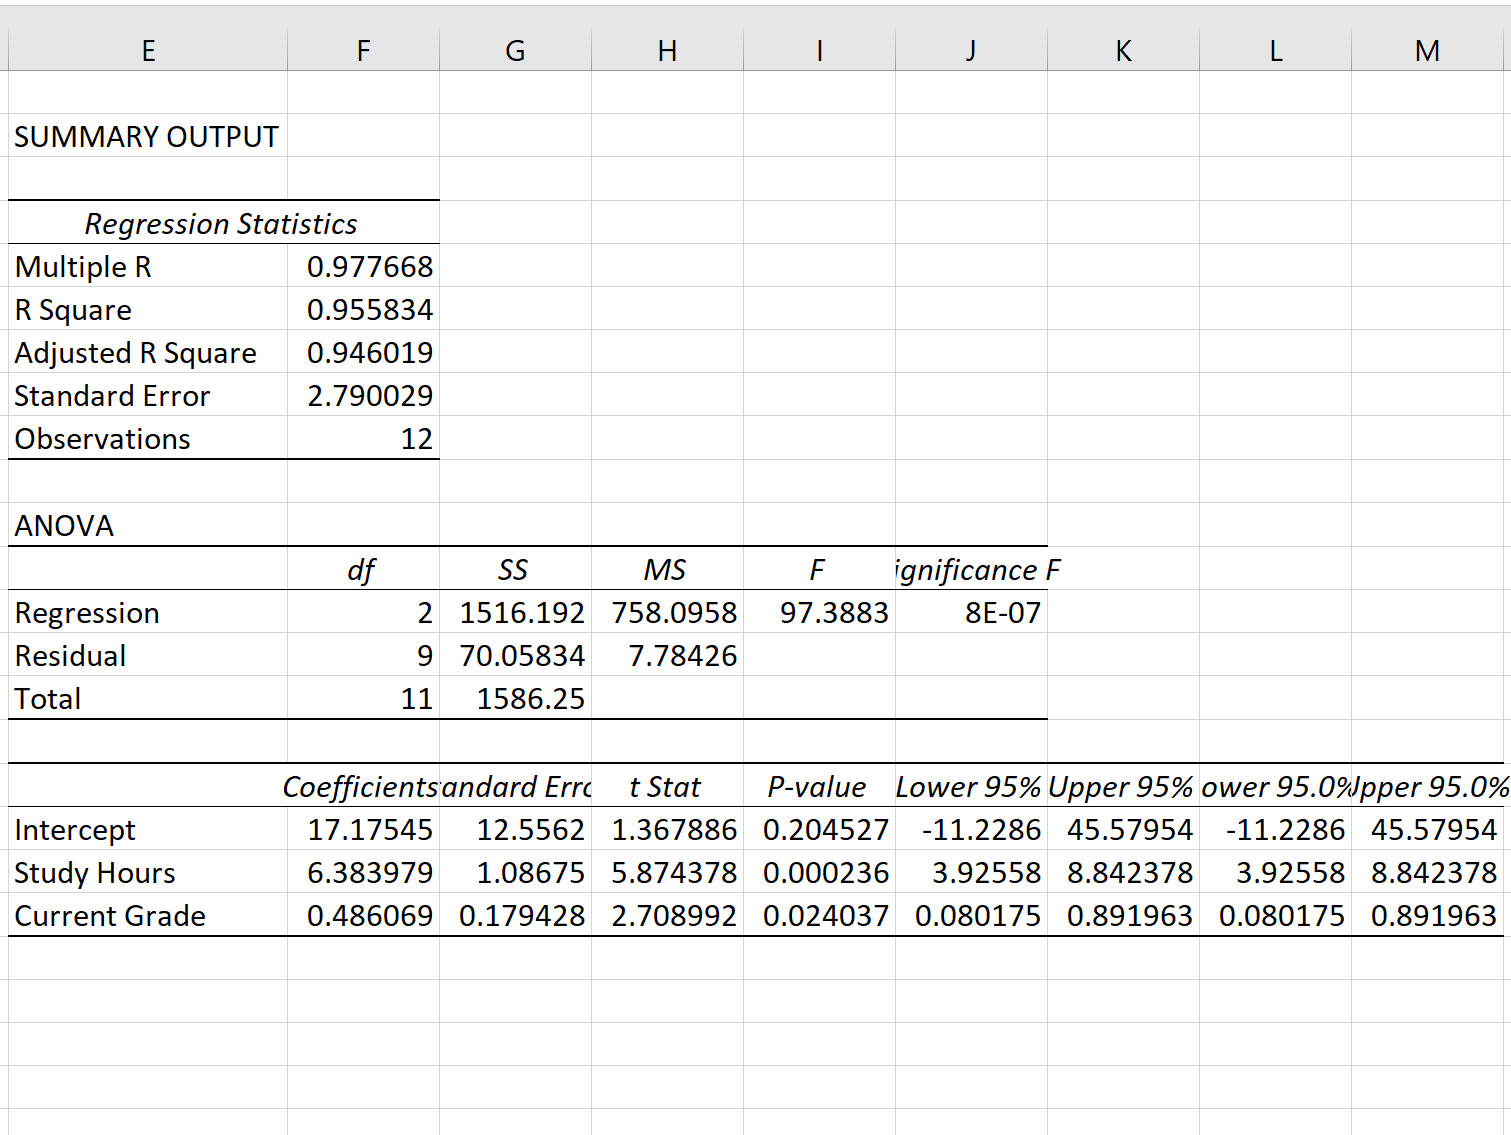
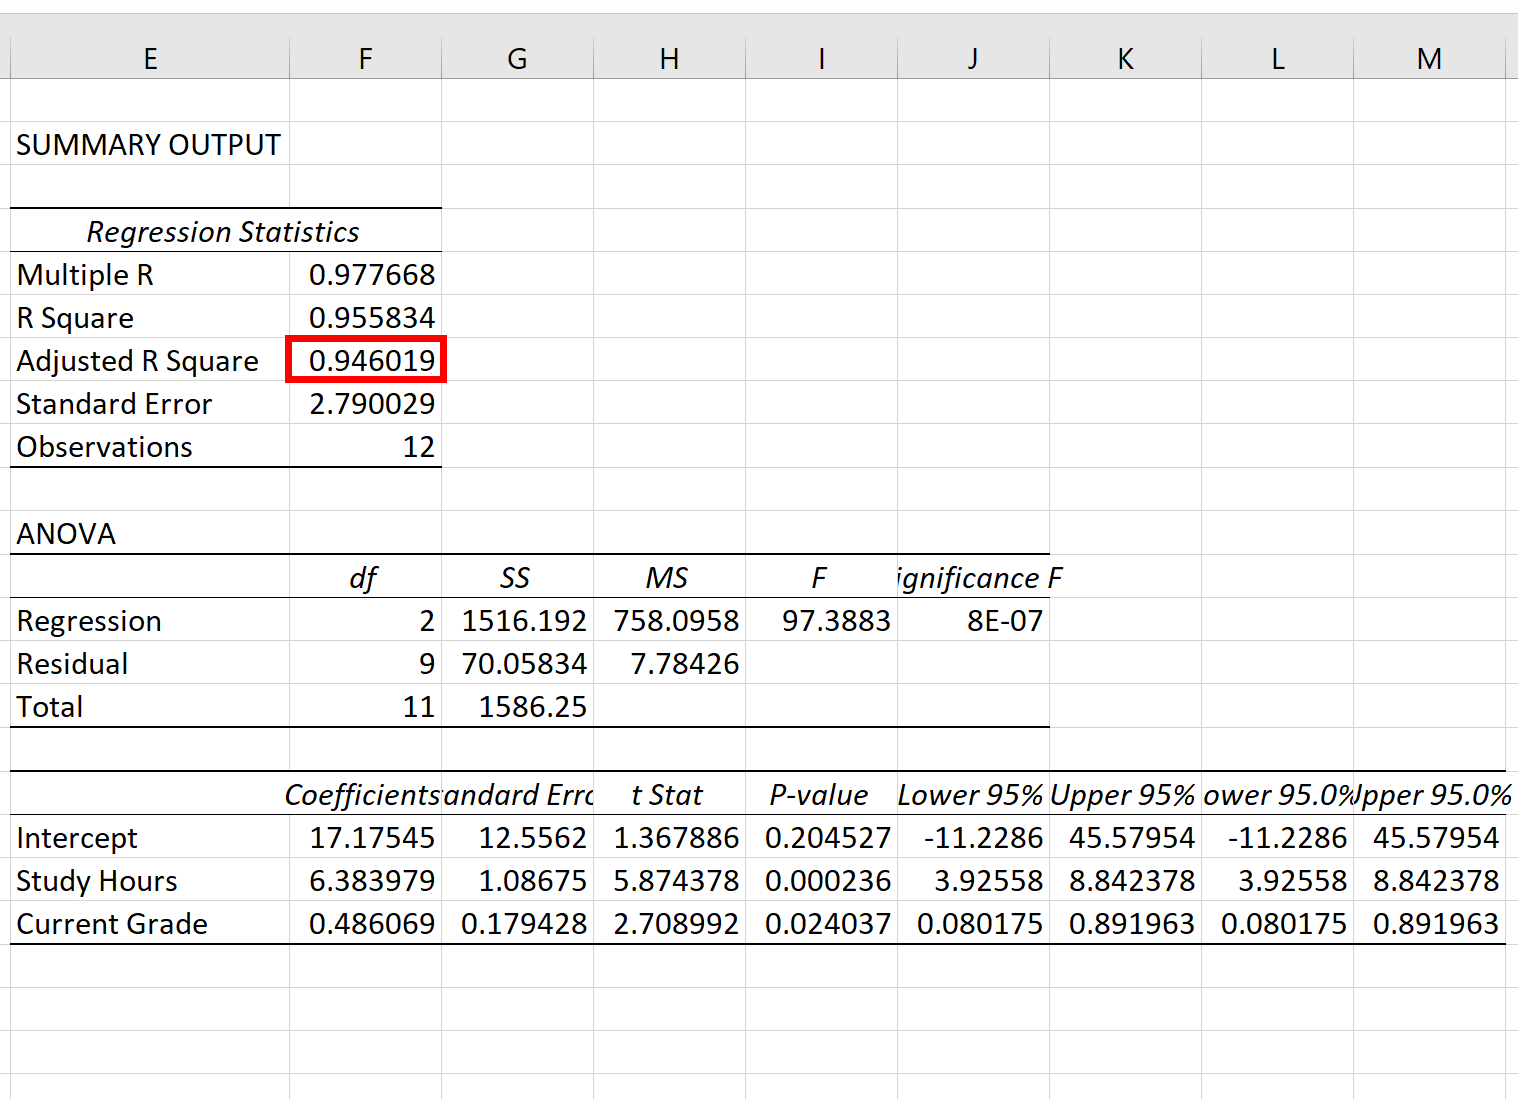
La validation du processus génère instantanément sur la nouvelle feuille de calcul un rapport statistique exhaustif scindé en trois sections hiérarchisées : les statistiques de la régression, le tableau de l’analyse de variance (ANOVA) et le tableau d’estimation des coefficients paramétriques. Pour isoler la métrique de parcimonie recherchée, l’attention de l’analyste doit se porter exclusivement sur le premier bloc supérieur intitulé Statistiques de la régression.
Ce tableau présente cinq indicateurs fondamentaux ordonnés selon une séquence immuable :
- Coefficient de détermination multiple : Correspond à la valeur absolue du coefficient de corrélation multiple R.
- R-deux : Représente le coefficient de détermination ordinaire R².
- R-deux ajusté : Constitue la valeur exacte du R² corrigé selon l’équation d’Ezekiel.
- Erreur-type : L’écart-type de la distribution d’échantillonnage des résidus (racine carrée du MSE).
- Observations : L’effectif valide total n pris en compte dans le traitement.
La ligne R-deux ajusté fournit directement le chiffre officiel à consigner dans vos rapports scientifiques. L’analyste remarquera immédiatement que cette valeur est systématiquement inférieure au R-deux classique situé sur la ligne immédiatement supérieure. L’écart entre ces deux valeurs informe visuellement sur l’ampleur de la correction infligée au modèle en raison du nombre de prédicteurs mobilisés.
6. Méthode 2 – Calcul manuel pas à pas à l’aide des formules natives d’Excel
6.1 Extraction des paramètres structurels du modèle
Bien que l’Utilitaire d’analyse offre une solution d’une grande rapidité, l’implémentation manuelle et modulaire du calcul à l’aide des fonctions mathématiques natives d’Excel présente des vertus pédagogiques et dynamiques incomparables. Contrairement aux sorties statiques de l’Utilitaire d’analyse — qui exigent une réexécution complète du processus à chaque modification des données brutes —, un modèle bâti sur des formules dynamiques s’actualise en temps réel au moindre réajustement des valeurs observées.
La première étape méthodologique consiste à extraire les paramètres structurels régissant les dimensions de l’échantillon et la complexité du modèle au sein de cellules dédiées :
- Pour calculer l’effectif total n, saisissez dans une cellule de synthèse la formule statistique basée sur le dénombrement des cellules numériques de votre variable dépendante :
=NB(B2:B151) - Pour quantifier le nombre de prédicteurs k, utilisez la fonction dénombrant les colonnes constitutives de votre matrice de variables indépendantes :
=COLONNES(C2:F151)
(Alternativement, si les variables sont agencées horizontalement ou saisies manuellement, la valeur scalaire correspondante, par exemple4, peut être directement inscrite). - Déterminez les degrés de liberté totaux (n – 1) dans une cellule voisine par l’opération élémentaire :
=Cellule_n - 1 - Déterminez les degrés de liberté résiduels (n – k – 1) via l’expression :
=Cellule_n - Cellule_k - 1
Cette décomposition explicite des grandeurs structurelles permet de prévenir toute ambiguïté lors de l’assemblage ultérieur de la formule finale et facilite le débogage arithmétique de la feuille de calcul.
6.2 Calcul du R² ordinaire via les fonctions statistiques
L’étape intermédiaire requiert la détermination du coefficient de détermination non ajusté R². Si l’analyse porte sur un modèle de régression linéaire simple comportant un unique prédicteur en colonne C, Excel dispose d’une fonction dédiée spécifique nommée COEFFICIENT.DETERMINATION. La syntaxe s’articule alors simplement ainsi :
=COEFFICIENT.DETERMINATION(B2:B151; C2:C151)
Il importe de noter que dans la syntaxe francophone d’Excel, l’argument des ordonnées connues (variable dépendante Y) précède impérativement celui des abscisses connues (prédicteur X), les deux plages étant séparées par un point-virgule.
Cependant, dans le contexte d’une régression linéaire multiple impliquant plusieurs prédicteurs (colonnes C à F), la fonction COEFFICIENT.DETERMINATION est inopérante car elle est restreinte par conception à des vecteurs unidimensionnels. Deux approches s’offrent alors à l’analyste :
- Calculer les sommes de carrés intermédiaires en générant une colonne de valeurs prédites Y_chapeau, puis calculer la somme des déviations résiduelles via SOMME.CARRES.ECARTS.
- Extraire le R² ordinaire directement à partir de la fonction matricielle DROITEREG logée au sein d’une fonction d’indexation scalaire, selon la formule :
=INDEX(DROITEREG(B2:B151; C2:F151; VRAI; VRAI); 3; 1)
Quelle que soit la méthode privilégiée, la valeur du R² obtenue dans cette cellule servira d’intrant direct pour l’ajustement structurel final.
6.3 Implémentation complète de l’équation d’Ezekiel dans une cellule
Une fois les paramètres R², n et k isolés dans leurs cellules de référence respectives (admettons que la cellule H2 contienne le R², la cellule H3 l’effectif n, et la cellule H4 le nombre de prédicteurs k), l’implémentation de la formulation mathématique rigoureuse d’Ezekiel s’exécute par la construction d’une équation combinée sécurisée.
La syntaxe de calcul formulée dans la cellule de destination s’établit formellement comme suit :
=1 - ((1 - H2) * ((H3 - 1) / (H3 - H4 - 1)))
Une vigilance particulière doit être accordée au placement des parenthèses imbriquées afin de respecter scrupuleusement l’ordre des priorités arithmétiques. La division interne ((H3 - 1) / (H3 - H4 - 1)) calcule le multiplicateur d’Ezekiel. Ce facteur est ensuite multiplié par le résidu scalaire (1 - H2), avant que le résultat global ne soit définitivement soustrait de 1.
Si vous préférez consigner l’intégralité du calcul au sein d’une unique formule autonome ne dépendant d’aucune cellule intermédiaire pour n et k, l’imbrication complète prend la forme élégante suivante :
=1 - ((1 - INDEX(DROITEREG(B2:B151; C2:F151; VRAI; VRAI); 3; 1)) * ((NB(B2:B151) - 1) / (NB(B2:B151) - COLONNES(C2:F151) - 1)))
Cette formule condensée offre l’avantage d’être totalement dynamique et inviolable : toute extension ou réduction de votre échantillon par insertion de lignes met instantanément à jour le R² ajusté sans nécessiter la moindre recalibration des plages intermédiaires.
7. Méthode 3 – Utilisation avancée de la fonction matricielle DROITEREG
7.1 Architecture et paramètres de la fonction DROITEREG
La fonction DROITEREG (acronyme de « droite de régression », équivalent de la fonction anglaise LINEST) constitue le joyau computationnel des outils statistiques natifs d’Excel. Elle utilise la décomposition matricielle QR par la méthode des moindres carrés pour calculer simultanément l’ensemble des coefficients de régression et leurs paramètres inférentiels associés. Sa signature syntaxique s’articule autour de quatre arguments obligatoires et optionnels :
DROITEREG(y_connus; [x_connus]; [constante]; [statistiques])
Pour exploiter toute la puissance du moteur d’analyse statistique, la configuration de ces arguments doit répondre aux préconisations suivantes :
- y_connus : La plage vectorielle unidimensionnelle correspondant à la variable dépendante Y (ex. B2:B151).
- x_connus : La plage matricielle bidimensionnelle englobant l’ensemble contigu des prédicteurs X (ex. C2:F151).
- constante : Une valeur logique booléenne. Définie à
VRAI(ou omise), l’ordonnée à l’origine est calculée normalement. Définie àFAUX, l’ordonnée est artificiellement forcée à zéro. Dans l’immense majorité des applications en psychologie, cet argument doit être expressément paramétré àVRAI. - statistiques : Une valeur logique booléenne cruciale. Définie impérativement à
VRAI, elle enjoint à la fonction de renvoyer une matrice d’informations statistiques supplémentaires à 5 lignes, au lieu de se limiter aux seuls coefficients de régression.
Dans les versions modernes d’Excel (Microsoft 365 et versions supportant les tableaux dynamiques), le simple fait de valider la formule avec la touche Entrée génère un déversement matriciel automatique sur une plage de 5 lignes et d’autant de colonnes qu’il y a de paramètres estimés. Dans les versions antérieures d’Excel, il est nécessaire de sélectionner préalablement la plage réceptrice (par exemple un bloc de 5 lignes par 5 colonnes), de saisir la formule, puis d’exécuter la combinaison matricielle classique Ctrl + Maj + Entrée.
7.2 Cartographie de la matrice statistique retournée
L’interprétation et l’exploitation des données déversées par DROITEREG exigent une maîtrise rigoureuse de la topographie matricielle de la sortie statistique. Le tableau généré se compose systématiquement de 5 lignes distinctes, dont la lecture s’ordonne selon un protocole strict :
- Ligne 1 : Affiche les coefficients de régression partiels estimés (pentes), ordonnés de droite à gauche en sens inverse de la sélection (du dernier prédicteur k jusqu’au premier prédicteur X₁), l’ultime cellule à droite hébergeant le terme constant (l’ordonnée à l’origine).
- Ligne 2 : Contient les erreurs-types respectives associées à chacun de ces coefficients de régression.
- Ligne 3 : Présente en première position (cellule ligne 3, colonne 1) le coefficient de détermination ordinaire R². La cellule adjacente à sa droite (colonne 2) contient l’erreur-type d’estimation de la régression.
- Ligne 4 : Renvoie en première colonne la statistique globale du test F de Fisher-Snedecor, tandis que la seconde colonne (ligne 4, colonne 2) consigne les degrés de liberté résiduels (n – k – 1).
- Ligne 5 : Expose la décomposition de la variance avec la somme des carrés de la régression (SSR) en colonne 1 et la somme des carrés des erreurs résiduelles (SSE) en colonne 2.
L’observation attentive de cette disposition spatiale met en lumière une lacune surprenante : bien que DROITEREG compile l’ensemble des statistiques inférentielles fondamentales, elle n’affiche pas explicitement le R² ajusté. Toutefois, elle fournit dans sa structure matricielle tous les composants arithmétiques nécessaires à son extraction immédiate.
7.3 Extraction directe du R² ajusté par combinaison avec INDEX
Pour s’affranchir du déploiement volumineux d’une matrice à 5 lignes sur sa feuille de travail, l’ingénierie statistique sous Excel permet de combiner la fonction matricielle DROITEREG avec la fonction de ciblage scalaire INDEX. Cette technique sophistiquée extrait sélectivement le R² et les degrés de liberté résiduels au cœur de la matrice virtuelle sans jamais imprimer le reste des sorties annexes.
Sachant que le R² ordinaire se situe invariablement à l’intersection (Ligne 3, Colonne 1) et que les degrés de liberté résiduels se situent en (Ligne 4, Colonne 2), la formulation combinée pour dériver le R² ajusté en une seule ligne de commande s’établit ainsi :
=1 - ((1 - INDEX(DROITEREG(B2:B151; C2:F151; VRAI; VRAI); 3; 1)) * ((NB(B2:B151) - 1) / INDEX(DROITEREG(B2:B151; C2:F151; VRAI; VRAI); 4; 2)))
Cette formulation est un modèle d’élégance algorithmique :
- Elle extrait le R² exact via
INDEX(...; 3; 1). - Elle extrait directement les degrés de liberté résiduels
(n - k - 1)viaINDEX(...; 4; 2)sans nécessiter le comptage manuel des colonnes de prédicteurs. - Elle calcule la taille d’échantillon globale via
NB(...)pour établir le numérateur(n - 1).
Le résultat obtenu dans la cellule unique est le R² ajusté instantané. Cette syntaxe est particulièrement recommandée lors du développement de tableaux de bord psychométriques itératifs où l’espace d’affichage doit être strictement optimisé.
8. Interprétation psychométrique des résultats obtenus dans Excel
8.1 Signification statistique versus pertinence clinique
Une erreur d’interprétation classique en sciences comportementales consiste à assimiler la significativité statistique d’un modèle de régression (sanctionnée par une valeur de p < 0,05 issue du test F de Fisher) à son utilité clinique ou pratique effective. Dans des cohortes de grande envergure (par exemple n = 1000), un modèle affichant un R² ajusté de 0,02 peut être hautement significatif sur le plan statistique (p < 0,001), signifiant formellement que l’association observée a moins d’une chance sur mille de résulter du pur hasard d’échantillonnage.
Cependant, sur le plan psychométrique, ce chiffre indique que le modèle ne parvient à expliquer que 2 % de la variabilité du phénomène étudié, laissant 98 % de la variance dans l’inconnu du bruit résiduel. Pour guider l’interprétation substantielle de l’ampleur de l’effet, les chercheurs se réfèrent conventionnellement aux seuils opérationnels définis par le statisticien et psychologue Jacob Cohen (1988) :
- Un R² de 0,01 est qualifié d’effet de petite taille (small effect).
- Un R² de 0,09 correspond à un effet de taille moyenne (medium effect).
- Un R² atteignant ou dépassant 0,25 traduit un effet de grande taille (large effect).
Néanmoins, ces repères empiriques doivent être contextualisés à la lumière de la discipline considérée. En psychologie différentielle ou en psychiatrie épidémiologique, où les conduites humaines résultent de réseaux causaux extrêmement complexes, un R² ajusté de 0,10 peut représenter une avancée théorique déterminante s’il concerne la réduction de comportements auto-agressifs ou l’amélioration du pronostic vital de patients sous traitement.
8.2 Analyse de l’écart entre R² ordinaire et R² ajusté
L’inspection comparée de la distance numérique séparant le R² ordinaire du R² ajusté constitue un outil diagnostique fondamental pour apprécier la qualité conceptuelle du modèle élaboré sous Excel. Lorsque le modèle présente une adéquation parcimonieuse optimale — c’est-à-dire que chaque variable indépendante incluse démontre une contribution unique robuste à l’explication de la variable dépendante —, l’écart entre R² et R² ajusté demeure très faible (couramment de l’ordre de 0,01 à 0,03 pour des échantillons de taille modérée).
En revanche, la constatation d’un fossé quantitatif substantiel entre les deux indices (par exemple, un R² ordinaire de 0,45 associé à un R² ajusté qui s’effondre à 0,22) constitue un signal d’alarme statistique sans équivoque. Cette divergence aiguë révèle que le chercheur a incorporé dans son équation un nombre disproportionné de prédicteurs futiles, dont le pouvoir explicatif marginal est insuffisant pour compenser le coût mathématique induit par la perte des degrés de liberté correspondants.
Face à une telle situation, la démarche recommandée impose une épuration stratégique du modèle : l’analyste doit examiner les coefficients de régression individuels et leurs tests t de Student associés (disponibles dans le rapport de l’Utilitaire d’analyse ou via DROITEREG) afin d’identifier et d’exclure séquentiellement les prédicteurs dont les seuils de significativité ne franchissent pas les critères conventionnels (p > 0,05 ou p > 0,10 selon l’orientation confirmatoire ou exploratoire de l’étude).
8.3 Cas particulier : Comprendre un R² ajusté négatif
L’une des singularités mathématiques les plus déconcertantes pour les praticiens réside dans l’apparition ponctuelle d’une valeur négative pour le R² ajusté au sein des feuilles de calcul Excel. Alors que l’esprit humain conçoit spontanément une proportion de variance comme une entité intrinsèquement positive, l’examen attentif de l’équation d’Ezekiel permet de dissiper tout mystère quant à l’origine arithmétique de cette issue :
R²aj = 1 – [(1 – R²) * ((n – 1) / (n – k – 1))]
Si le R² ordinaire est extrêmement faible (par exemple R² = 0,03) et que le ratio des degrés de liberté (n – 1) / (n – k – 1) est très élevé en raison d’un petit échantillon surchargé de covariables (par exemple n = 15 et k = 4, conduisant à un ratio de 14 / 10 = 1,4), le terme soustrait devient :
(1 – 0,03) * 1,4 = 0,97 * 1,4 = 1,358
Le calcul aboutit alors à :
R²aj = 1 – 1,358 = -0,358
Sur le plan psychométrique et épistémologique, l’interprétation d’un R² ajusté négatif est limpide : le modèle prédictif proposé s’avère pire qu’une absence totale de modèle. En d’autres termes, l’introduction de ces prédicteurs génère tellement d’erreur d’ajustement et consomme tant de degrés de liberté que la variance de l’erreur résiduelle non biaisée (MSE) dépasse désormais la variance globale originale de l’échantillon (MST).
Concernant les directives de restitution académique, les normes méthodologiques préconisent généralement de ne pas dissimuler cet échec de modélisation : le chercheur doit déclarer la valeur négative exacte dans ses tableaux de travail internes, mais rapporter formellement dans le corps du texte de son manuscrit que le modèle n’explique aucune variance populationnelle, en tronquant l’indice à zéro : R²aj = 0,00.
9. Comparaison critique de modèles prédictifs à l’aide du R² ajusté
9.1 Sélection de modèles hiérarchiques ou emboîtés
Dans la recherche comportementale expérimentale et corrélationnelle, la régression hiérarchique constitue une méthodologie standard permettant d’évaluer la contribution spécifique d’un bloc de variables théoriques après avoir neutralisé statistiquement l’impact de covariables de contrôle (telles que l’âge, le sexe ou le statut socio-économique). Dans ce cadre analytique, les modèles sont dits « emboîtés » ou hiérarchisés car les variables du premier modèle constituent un sous-ensemble strict des prédicteurs inclus dans le second modèle.
L’utilisation comparative du R² ajusté dans Excel s’avère particulièrement éclairante pour piloter cette progression hiérarchique. Si le modèle de base (Modèle 1) intégrant les variables démographiques présente un R²aj de 0,12, et que l’adjonction de variables de personnalité (Modèle 2) fait progresser cet indice à un R²aj de 0,24, le chercheur recueille une preuve mathématique directe de l’efficience empirique des nouveaux prédicteurs.
Toutefois, cette inspection descriptive du gain de R² ajusté (ΔR²aj) doit obligatoirement être corroborée par le calcul inférentiel du test F d’accroissement de variance (F-change test). La formule native d’Excel permettant de dériver ce test F de changement entre deux modèles emboîtés s’énonce selon la relation :
=((R2_complet - R2_reduit) / k_ajoutes) / ((1 - R2_complet) / (n - k_total - 1))
La valeur de probabilité associée est ensuite déterminée instantanément via la fonction LOI.F.DROITE, assurant la validation probabiliste des gains de modélisation observés.
9.2 Comparaison de modèles non emboîtés
Un défi épistémologique plus complexe surgit lorsqu’il s’agit de départager deux théories psychologiques concurrentes reposant sur des ensembles de prédicteurs totalement disjoints, appliqués à l’explication d’un même phénomène clinique. Dans ce cas de figure, les modèles sont qualifiés de non emboîtés : le modèle théorique A (par exemple, une explication neurobiologique du trouble panique) ne dérive pas du modèle théorique B (une explication cognitive et comportementale du même trouble).
Pour cette catégorie d’arbitrage comparatif, le R² ordinaire est rigoureusement inutilisable si les deux modèles concurrents n’intègrent pas exactement le même nombre de prédicteurs, car le modèle le plus saturé sera mécaniquement avantagé par l’artifice du calcul. Le R² ajusté offre ici une échelle de comparaison relative standardisée, rétablissant une équité méthodologique en neutralisant les disparités de degrés de liberté consommés.
Cependant, l’analyste doit respecter un postulat impératif : la comparaison de modèles non emboîtés via le R² ajusté n’est mathématiquement valide que si et seulement si les modèles sont évalués sur un échantillon rigoureusement identique (stricte égalité de n et des mêmes individus observés). Si l’un des modèles comporte des données manquantes entraînant l’exclusion de participants que l’autre conserve, la comparaison est méthodologiquement compromise. Dans les cas d’arbitrages hautement compétitifs, il est recommandé de compléter l’examen du R² ajusté par l’estimation manuelle des critères d’information pénalisés d’Akaike (AIC) ou bayésien (BIC), programmables dans Excel à partir de la somme des carrés des résidus.
9.3 Étude de cas appliquée : Modélisation de l’épuisement professionnel
Pour concrétiser cette méthodologie comparative, examinons une étude de cas appliquée menée auprès d’une cohorte de n = 120 soignants hospitaliers confrontés au syndrome d’épuisement professionnel (burnout), mesuré par le score continu de l’inventaire de Maslach (MBI). Deux approches de modélisation sont explorées sous Excel afin de concevoir un programme institutionnel de prévention ciblée :
- Modèle 1 (Monovarié) : La variable critère Épuisement professionnel est modélisée uniquement en fonction de la Charge de travail hebdomadaire (heures déclarées).
Résultats obtenus sous Excel :
• Nombre de prédicteurs k = 1
• Degrés de liberté résiduels = 120 – 1 – 1 = 118
• R² ordinaire = 0,220
• R² ajusté = 1 – [(1 – 0,220) * (119 / 118)] = 0,213 - Modèle 2 (Multivarié) : Le modèle intègre deux prédicteurs psychosociaux supplémentaires : le Soutien social perçu de l’équipe et le Climat de sécurité organisationnel.
Résultats obtenus sous Excel :
• Nombre de prédicteurs k = 3
• Degrés de liberté résiduels = 120 – 3 – 1 = 116
• R² ordinaire = 0,385
• R² ajusté = 1 – [(1 – 0,385) * (119 / 116)] = 0,369
L’analyse comparative des indicateurs révèle un gain d’ajustement considérable : le R² ajusté progresse de 0,213 à 0,369, soit une augmentation nette de 15,6 % de variance expliquée pénalisée. Malgré la consommation de deux degrés de liberté additionnels, la pénalisation d’Ezekiel n’absorbe qu’une fraction marginale de la variance brute capturée (l’écart entre R² et R²aj ne passant que de 0,007 à 0,016). Cette démonstration empirique valide indubitablement l’efficacité des prédicteurs psychosociaux et oriente prioritairement les interventions institutionnelles vers le renforcement du soutien social plutôt que vers la seule réduction arithmétique des horaires de service.
10. Diagnostic des anomalies statistiques et limites du R² ajusté sous Excel
10.1 Effet de la multicolinéarité sur l’ajustement du R²
L’une des limites diagnostiques majeures du R² ajusté réside dans son insensibilité aveugle à la structure de covariance interne des variables indépendantes. Un modèle de régression peut afficher un R² ajusté particulièrement flatteur (par exemple 0,65) tout en étant rongé par une multicolinéarité sévère entre ses prédicteurs psychométriques. Lorsque deux ou plusieurs variables explicatives partagent une variance commune quasi totale, l’algorithme d’inversion matricielle des moindres carrés devient instable, provoquant une inflation massive de l’erreur-type des coefficients et des inversions de signes aberrantes.
Le R² ajusté ne signale aucunement cette pathologie méthodologique : il se contente d’enregistrer la réduction globale de la somme des carrés d’erreur résiduelle. Pour pallier cette cécité d’Excel, l’analyste doit impérativement calculer un indice diagnostique dédié : le facteur d’inflation de la variance (VIF, pour Variance Inflation Factor). Ce paramètre se dérive directement sous Excel pour chaque prédicteur Xⱼ en exécutant une régression auxiliaire où ce prédicteur devient la variable dépendante expliquée par tous les autres prédicteurs :
VIF = 1 / (1 – R²auxiliaire)
Dans la cellule de calcul correspondante, appliquez la formule native basée sur le résultat du modèle auxiliaire. Si le VIF dépasse le seuil conventionnel de 5 (ou 10 selon les recommandations les plus permissives), la validité des conclusions issues du modèle global est compromise, imposant l’élimination ou la fusion par analyse en composantes principales des prédicteurs redondants.
10.2 Sensibilité aux erreurs de spécification de modèle
Le coefficient de détermination ajusté mesure strictement l’adéquation d’un modèle sous le postulat incontournable que la forme fonctionnelle modélisée est correcte. Si la relation sous-jacente unissant les concepts psychologiques est de nature non linéaire (par exemple, la célèbre loi en U inversé de Yerkes-Dodson reliant le niveau d’éveil ou de stress à la performance cognitive), un modèle de régression linéaire simple produira un R² ajusté artificiellement déprimé, suggérant à tort l’absence d’association empirique.
De même, l’omission d’une variable explicative majeure génère un biais d’omission de variable (omitted variable bias) : la variance liée à ce facteur oublié est déversée dans la somme des carrés résiduels, contractant illégitimement le R² ajusté et distordant les coefficients des variables résiduelles. Pour déceler ces vices structurels au sein d’Excel, la seule observation des indices chiffrés est insuffisante : l’analyste doit impérativement inspecter les graphiques de dispersion des résidus en fonction des valeurs prédites.
La présence d’un motif résiduel curviligne ou ondulatoire régulier indique immédiatement une violation de l’hypothèse de linéarité, signalant la nécessité d’intégrer des termes polynomiaux (X²) ou des transformations logarithmiques au sein de la feuille de calcul afin de restaurer l’adéquation structurelle du système modélisé.
10.3 Limites de généralisabilité et validation croisée
Bien que le R² ajusté corrige le biais d’optimisme inhérent à l’échantillon d’estimation et offre une meilleure approximation du coefficient de détermination de la population parente, la théorie psychométrique contemporaine a démontré qu’il demeure un prédicteur imparfait de la performance du modèle lorsqu’il est projeté sur une population totalement indépendante. Le R² ajusté quantifie l’adéquation théorique du modèle dans la population dont est extrait l’échantillon, mais il ne mesure pas la dégradation prédictive réelle — désignée sous le concept de rétrécissement ou shrinkage — observée lors de l’application des coefficients calibrés à de nouveaux sujets.
Pour mesurer ce phénomène dans les études de réplication, des formules correctives plus conservatrices ont été développées, notamment la formule de Browne ou l’équation de Stein (1960), qui pénalise encore plus lourdement la complexité des modèles en intégrant le produit croisé des degrés de liberté. La formulation de Stein s’exprime selon la structure :
R²Stein = 1 – [((n – 1) / (n – k – 1)) * ((n – 2) / (n – k – 2)) * ((n + 1) / n) * (1 – R²)]
Pour les recherches de grande envergure, l’alternative la plus robuste sous Excel consiste à mettre en place manuellement un protocole de validation croisée k-fold ou de partitionnement d’échantillon (split-half validation). En divisant la cohorte initiale en un échantillon d’apprentissage (70 % des cas) et un échantillon de test (30 % des cas), le chercheur applique les équations de régression calibrées sur le premier groupe pour générer des prédictions sur le second, corrélant ensuite les valeurs prédites aux valeurs réelles. Cette démarche fournit une estimation empirique non biaisée de la validité croisée réelle du modèle.
11. Automatisation du calcul par macros VBA pour les études à grande échelle
11.1 Structure du script VBA pour le calcul unifié
Lorsque les protocoles de recherche impliquent l’analyse répétitive de dizaines d’instruments psychométriques ou le traitement séquentiel de sous-groupes cliniques (analyses par strates d’âge, par genre ou par comorbidités), l’exécution manuelle des boîtes de dialogue ou la copie de formules complexes dans de multiples feuilles de calcul devient une source majeure d’erreurs humaines. L’environnement Visual Basic for Applications (VBA), intégré nativement au cœur d’Excel, offre un cadre programmatique robuste permettant d’automatiser instantanément l’extraction matricielle et le calcul unifié du R² ajusté.
Pour accéder à l’éditeur VBA, l’utilisateur actionne le raccourci universel Alt + F11 depuis n’importe quelle feuille Excel. La création d’un script d’automatisation commence par l’insertion d’un nouveau module standard via le menu Insertion > Module. Le code procédural doit assurer une gestion dynamique des plages variables en déclarant rigoureusement le typage des variables sous forme d’objets Range et de variables scalaires à virgule flottante (Double).
Le moteur VBA mobilise directement l’objet Application.WorksheetFunction.LinEst (l’équivalent programmatique de DROITEREG) pour générer en mémoire vive la matrice statistique sans polluer visuellement les feuilles du classeur, réalisant l’analyse en une fraction de seconde.
11.2 Création d’une fonction personnalisée (UDF)
L’une des fonctionnalités les plus valorisantes de VBA réside dans la conception d’une fonction personnalisée — désignée sous l’acronyme d’UDF (User-Defined Function) — qui peut être invoquée directement dans n’importe quelle cellule du classeur à l’instar d’une fonction native comme SOMME ou MOYENNE. Nous pouvons concevoir une fonction intitulée CALCULER_R2_AJUSTE acceptant exactement deux arguments d’entrée : la plage vectorielle de la variable dépendante Y et la plage matricielle des prédicteurs multivariés X.
La logique algorithmique intégrée au sein du module VBA s’articule selon les étapes fondamentales suivantes :
- Capture et instanciation des deux plages de données transmises par l’analyste.
- Appel à l’objet interne
WorksheetFunction.LinEst(PlageY, PlageX, True, True)stocké dans une variable de tableau dynamique en mémoire. - Extraction scalaire du R² ordinaire logé à la troisième rangée, première colonne de la matrice de régression.
- Extraction des degrés de liberté résiduels logés à la quatrième rangée, deuxième colonne de ladite matrice.
- Dénombrement de la taille globale de l’échantillon n à l’aide de la propriété
PlageY.Rows.Count. - Application de l’équation d’Ezekiel pour calculer la valeur ajustée finale et renvoi direct du résultat dans la cellule appelante.
Une fois le code compilé, le chercheur n’a plus qu’à saisir dans sa feuille de calcul l’expression élégante et limpide :
=CALCULER_R2_AJUSTE(B2:B151; C2:F151)
Cette fonction se charge d’exécuter l’intégralité du traitement statistique sans exiger la moindre cellule intermédiaire.
11.3 Gestion des erreurs et optimisation des performances
Pour déployer ce type d’outil d’automatisation dans le cadre d’études épidémiologiques de grande envergure ou de protocoles cliniques multicentriques, l’architecture logicielle du script VBA doit être blindée contre les anomalies de saisie courantes. Le risque d’incident technique majeur réside dans la survenue d’une division par zéro, inéluctable si l’opérateur sélectionne par inadvertance un nombre de prédicteurs supérieur ou égal au nombre d’observations disponibles, annulant ou rendant négatifs les degrés de liberté résiduels (n – k – 1 ≤ 0).
Le script doit obligatoirement intégrer une clause de vérification structurelle liminaire :
- Vérifier que le nombre de lignes de la plage Y coïncide rigoureusement avec le nombre de lignes de la matrice X, sous peine de renvoyer une erreur explicite du type
#DIM_INCOMPATIBLES!. - Inspecter le nombre d’observations par rapport au nombre de colonnes de X pour garantir que (n – k – 1) > 0, renvoyant le code d’erreur standardisé
#VALEUR!si les degrés de liberté sont épuisés. - Encadrer l’appel de calcul par une directive de déroutement
On Error GoTo GestionnaireErreurpour intercepter toute anomalie matricielle liée à une colinéarité parfaite (matrice singulière non inversible).
Enfin, sur le plan des performances informatiques, la désactivation temporaire du rafraîchissement d’affichage de l’écran (Application.ScreenUpdating = False) et du recalcul automatique du tableur pendant les phases d’itération intensive permet d’accélérer le traitement de cohortes massives de dizaines de milliers d’enregistrements, garantissant un flux de travail fluide et hautement professionnel.
12. Bonnes pratiques de restitution scientifique et conformité aux normes APA
12.1 Présentation formelle des statistiques de régression selon l’APA
La diffusion des résultats issus d’analyses statistiques exécutées sous Excel doit impérativement se conformer aux standards typographiques et éditoriaux édictés par l’American Psychological Association, actuellement formalisés dans la 7e édition du manuel de publication (APA 7). L’APA prescrit des règles rigoureuses quant au formatage des symboles mathématiques, imposant notamment la mise en italique systématique de toutes les lettres latines désignant des grandeurs statistiques :
- Le coefficient de détermination multiple ordinaire est formalisé par la notation R² (avec un R majuscule en italique suivi du chiffre 2 en exposant droit).
- Le coefficient de détermination ajusté s’écrit formellement R²aj (ou R²adj dans les manuscrits anglophones), la mention en indice demeurant en caractères romains non italiques.
- Les statistiques de test associées s’écrivent respectivement F, t, ainsi que le seuil de probabilité p, tous rigoureusement en italique.
Sur le plan des conventions d’arrondi numérique, les directives de l’APA stipulent que les coefficients de régression, les erreurs-types et les valeurs de R² doivent être arrondis à deux décimales (par exemple, R²aj = 0,24), bien que l’usage de trois décimales soit toléré en psychométrie lorsque la précision clinique de micro-variations l’exige. Concernant la notification textuelle dans le corps du manuscrit, la formulation standardisée adopte une structure narrative canonique du type :
« L’analyse de régression linéaire multiple indique que l’ensemble des prédicteurs psychosociaux explique une proportion significative de la variance du score d’épuisement professionnel, F(3, 116) = 23,41, p < 0,001, avec un pouvoir explicatif substantiel, R² = 0,38, R²aj = 0,37. »
12.2 Construction de tableaux synthétiques de régression dans Excel
Les recommandations de publication scientifique découragent vivement l’insertion brute de copies d’écran des sorties natives de l’Utilitaire d’analyse d’Excel au sein d’articles ou de mémoires de recherche. Les données brutes générées doivent être soigneusement synthétisées et restructurées dans un tableau propre, épuré de tout quadrillage superflu et strictement conforme à la grammaire visuelle de l’APA (qui n’admet que trois lignes de bordure horizontales principales : une en haut du tableau, une sous les en-têtes de colonnes, et une à la base inférieure du tableau fermant les totaux).
L’agencement méthodique des colonnes au sein de votre tableau Excel doit s’articuler selon la séquence normative suivante :
- Variable : Noms textuels précis des variables prédictives (en incluant le terme constant sur la première ligne de calcul).
- B : Coefficients de régression non standardisés (pentes brutes).
- SE B (ou ES B) : Erreurs-types associées aux coefficients de régression non standardisés.
- β (Bêta) : Coefficients de régression standardisés, indispensables pour apprécier le poids relatif de chaque prédicteur indépendamment de son unité de mesure métrique.
- t : Valeur de la statistique du test t de Student univarié évaluant la significativité de chaque pente.
- p : Degré de significativité bilatéral exact associé au coefficient.
Au bas de ce tableau de synthèse, une section récapitulative finale regroupe les paramètres structurels et globaux du modèle complet, disposés horizontalement : la valeur du coefficient de corrélation multiple R, le R² ordinaire, le R² ajusté, l’erreur-type globale de l’estimation, ainsi que la valeur du test F accompagnée de ses deux degrés de liberté entre parenthèses et de sa probabilité d’erreur p. Des notes de bas de tableau explicatives (notées Note. en italique) peuvent être introduites pour détailler les abréviations et préciser les niveaux de significativité usuels (*p < 0,05, **p < 0,01, ***p < 0,001).
12.3 Transparence, réplicabilité et partage des feuilles de calcul
L’avènement de la science ouverte (Open Science) et la crise contemporaine de la réplicabilité qui a profondément ébranlé la psychologie quantitative imposent désormais de nouvelles exigences éthiques de transparence méthodologique. Lorsqu’un chercheur analyse ses données empiriques sous Excel, le classeur ne constitue pas seulement un réceptacle temporaire de calculs personnels, mais un artefact scientifique à part entière devant être mis à la disposition de la communauté académique, des évaluateurs par les pairs et des revues spécialisées.
Pour assurer la pérennité et l’intégrité de ces classeurs partagés sur des plateformes d’archivage public telles que l’Open Science Framework (OSF), plusieurs bonnes pratiques professionnelles doivent être rigoureusement appliquées :
- Documentation exhaustive du modèle : Insérez un onglet d’introduction faisant office de métadonnées (« Lisez-moi » ou Codebook), détaillant précisément la signification de chaque variable, les échelles de mesure utilisées, les transformations mathématiques opérées et la version exacte d’Excel exploitée.
- Verrouillage de l’intégrité des formules : Protégez les cellules renfermant les formules d’estimation (en particulier les cellules DROITEREG et les équations d’Ezekiel) en activant la protection de la feuille de calcul après avoir laissé déverrouillées uniquement les cellules de données brutes, prévenant ainsi toute corruption accidentelle par de futurs utilisateurs.
- Anonymisation et conformité déontologique : Veillez scrupuleusement à purger les classeurs de toute donnée directement ou indirectement identifiante (noms, adresses IP, dates de naissance précises) conformément aux dispositions légales du Règlement Général sur la Protection des Données (RGPD) et aux chartes éthiques de la recherche humaine.
En respectant scrupuleusement ces impératifs de rigueur, le chercheur garantit non seulement l’exactitude mathématique de son R² ajusté, mais inscrit l’intégralité de sa démarche empirique dans une trajectoire exemplaire de probité scientifique et de reproductibilité computationnelle.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Ezekiel, M. (1930). Methods of correlation analysis. John Wiley & Sons.
- Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
- Hair, J. F., Black, W. C., Babin, B. J., & Anderson, R. E. (2019). Multivariate data analysis (8th ed.). Cengage Learning.
- Microsoft Corporation. (2024). Fonction DROITEREG – Support Microsoft. Microsoft Support. https://support.microsoft.com/fr-fr/office/droitereg-fonction-droitereg-e0dfb095-0222-4ab8-a11e-d0d4b83e1f31
- Open Science Framework. (2024). Open Science Framework: A scholarly web tool that enhances research workflow and collaboration. Center for Open Science. https://osf.io
- Stein, C. (1960). Multiple regression. In I. Olkin, S. G. Ghurye, W. Hoeffding, W. G. Madow, & H. B. Mann (Eds.), Contributions to probability and statistics: Essays in honor of Harold Hotelling (pp. 424–443). Stanford University Press.
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
- Wendorf, C. A. (2004). Primer on multiple regression in psychology: Concepts, applications, and reporting. Psychological Reports, 94(3), 1045–1058. https://doi.org/10.2466/pr0.94.3.1045-1058