
Dans le paysage foisonnant des statistiques descriptives et de l’analyse exploratoire des données, les praticiens privilégient fréquemment les mesures conventionnelles de tendance centrale que sont la moyenne arithmétique et la médiane. Pourtant, la modélisation statistique ne saurait se restreindre à ces seuls indicateurs sans occulter des dimensions critiques de la dispersion et des frontières d’un échantillon. Le milieu de l’étendue (communément désigné sous l’anglicisme midrange) constitue une métrique fondamentale, élégante et historiquement signifiante, qui synthétise le point d’équilibre géométrique parfait situé entre les deux bornes observationnelles extrêmes d’une distribution. Cette statistique d’ordre, bien que sensible aux fluctuations stochastiques périphériques, offre une fenêtre d’analyse irremplaçable sur l’amplitude et le centrage spatial des phénomènes observés, particulièrement au sein des cadres méthodologiques exigeant une évaluation instantanée des capacités limites ou des seuils d’activation.
L’essor contemporain des environnements informatiques hébergés dans le nuage, incarné de façon prééminente par Google Sheets, a démocratisé l’accès à des capacités de calcul analytique autrefois réservées aux logiciels statistiques spécialisés. Grâce à son moteur de calcul en temps réel et à son architecture collaborative, le tableur de Google s’affirme comme une plateforme de premier plan pour les chercheurs, les psychométriciens, les analystes de données et les gestionnaires de projets scientifiques. Toutefois, l’absence d’une fonction native exclusivement dévolue au calcul du milieu de l’étendue — contrairement aux fonctions omniprésentes comme MOYENNE ou MEDIANE — exige une compréhension rigoureuse des mécanismes matriciels et algorithmiques sous-jacents afin d’en dériver une implémentation robuste, exempte de biais computationnels ou d’artefacts d’échantillonnage.
Le présent traité méthodologique se propose de déconstruire de manière exhaustive les dimensions théoriques, mathématiques et informatiques du milieu de l’étendue. En articulant une réflexion approfondie sur ses fondements épistémologiques dans les sciences du comportement avec une démonstration technique pas à pas au sein de Google Sheets, ce guide procure aux analystes un protocole opératoire complet. De l’élaboration de formulations conditionnelles avancées à l’automatisation par Google Apps Script, en passant par le traitement des valeurs aberrantes et l’examen critique de sa validité métrologique, chaque étape est explicitée dans une perspective de reproductibilité scientifique intégrale et d’excellence académique.
1. Introduction théorique au concept de milieu de l’étendue en statistique
1.1 Définition épistémologique et genèse de la mesure
D’un point de vue épistémologique, le milieu de l’étendue tire son origine de la volonté d’identifier le centre géométrique d’un ensemble de mesures en se focalisant exclusivement sur ses bornes absolues. Contrairement aux mesures d’intégration globale comme la moyenne arithmétique, qui sollicite l’intégralité des points de données pour constituer un centre de gravité pondéré, le milieu de l’étendue s’établit comme un indice de tendance centrale fondé sur les extrêmes. Il postule que l’espace observationnel d’une expérience est circonscrit par deux jalons indépassables : l’infimum empirique (la plus petite valeur observée) et le supremum empirique (la plus grande valeur observée). L’équilibre de cet intervalle fermé est alors représenté par le milieu exact de ce segment linéaire, offrant une lecture spatiale de la position médiane de l’amplitude totale.
La distinction formelle entre le milieu de l’étendue, la médiane arithmétique et la moyenne pondérée réside dans la nature de l’information exploitée au sein de la série statistique. Alors que la médiane correspond au quantile d’ordre 0,5 divisant l’échantillon ordonné en deux effectifs rigoureusement égaux sans égard pour l’amplitude métrique séparant les rangs, le milieu de l’étendue est intrinsèquement métrique. Il ne tient aucun compte de la densité interne des observations ni de leur fréquence de répétition, ce qui le différencie radicalement de la moyenne pondérée où chaque valeur pèse proportionnellement à son effectif. Historiquement, cette métrique a joué un rôle déterminant dans les premières phases de l’analyse exploratoire de données, notamment à une époque où le coût computationnel manuel imposait aux expérimentateurs d’extraire rapidement un indicateur de centralité sur des cohortes réduites sans effectuer la somme fastidieuse de multiples termes.
Dans les cadres méthodologiques contemporains propres aux sciences humaines, le milieu de l’étendue conserve une pertinence descriptive majeure. Il permet de caractériser le centre d’un espace de variabilité sans présumer de la loi sous-jacente qui régit les observations intermédiaires. Dans les contextes où l’intérêt scientifique ne porte pas sur la concentration de la masse d’échantillonnage mais sur l’étendue des possibilités manifestées par les participants, cet indice permet de situer instantanément si une cohorte gravite plus près de son niveau de performance plancher ou de sa frontière d’accomplissement maximale. Cette métrique constitue ainsi un descripteur spatial de premier ordre dans les protocoles d’investigation rapide.
1.2 Le rôle du milieu de l’étendue dans les sciences du comportement
Au sein des sciences du comportement, l’expérimentateur est régulièrement confronté à l’évaluation des bornes de réactivité cognitive dans des contextes de chronométrie mentale ou de psychophysique. Le milieu de l’étendue s’avère particulièrement instructif pour mesurer la demi-somme des latences motrices minimales et maximales d’un individu soumis à des stimuli perceptifs intenses. Cette approche ne vise pas à résumer la vitesse moyenne de traitement de l’information, mais à identifier le point médian de la fenêtre temporelle dans laquelle le système nerveux du participant est capable de moduler ses réponses motrices. Ce paramètre offre une caractérisation globale des marges opérationnelles du sujet face à une contrainte environnementale standardisée.
Dans le domaine de la psychométrie, l’analyse préliminaire des échelles de réponse composite — à l’instar des inventaires standardisés fondés sur des échelles de Likert à degrés multiples — bénéficie également de cette métrique. Le calcul du milieu de l’étendue permet de situer le centre théorique et empirique des réponses fournies par un groupe clinique. Cela permet aux chercheurs de vérifier promptement l’existence d’effets de polarisation ou d’asymétrie de réponse sans devoir attendre le traitement algorithmique complet de volumineuses matrices d’invariance factorielle. Si le milieu de l’étendue d’un item dévie drastiquement du centre théorique de l’échelle de mesure, une alerte méthodologique immédiate est levée quant au calibrage des ancres verbales du test.
De surcroît, le milieu de l’étendue intervient comme un outil d’inspection privilégié pour la détection précoce des seuils planchers et plafonds au sein des cohortes cliniques. Lorsqu’une batterie de tests neuropsychologiques est administrée à des patients souffrant de déficits neurocognitifs sévères, l’observation conjointe du minimum, du maximum et de leur point médian met en lumière l’incapacité d’une échelle à discriminer les degrés d’atteinte si les scores se heurtent systématiquement à la borne inférieure. Toutefois, des limites conceptuelles strictes s’imposent : le milieu de l’étendue ne saurait être interprété comme une mesure directe d’un construit psychologique latent. Sa dépendance absolue à l’égard de deux uniques observations en fait un indicateur phénoménologique des frontières de l’échantillon, et non une estimation invariante du trait psychologique latent d’une population générale.
1.3 Propriétés distributionnelles et hypothèses sous-jacentes
L’analyse des propriétés distributionnelles du milieu de l’étendue révèle des divergences fonctionnelles majeures selon la nature de la loi de probabilité sous-jacente au phénomène analysé. Sous l’hypothèse d’une distribution continue uniforme définie sur un intervalle compact [a, b], le milieu de l’étendue se révèle être un estimateur sans biais, convergeant et remarquablement performant de la moyenne de la population. En réalité, dans ce cadre distributionnel hautement spécifique, la théorie de l’estimation démontre que le milieu de l’étendue surpasse la moyenne arithmétique en termes de vitesse de convergence asymptotique et d’efficacité statistique, car les statistiques d’ordre extrêmes contiennent l’intégralité de l’information relative aux paramètres de localisation de la frontière de la loi uniforme.
À l’inverse, dès lors que l’échantillon provient d’une distribution normale ou d’une loi à queue lourde, l’efficacité asymptotique relative du milieu de l’étendue s’effondre de manière drastique par rapport aux estimateurs robustes tels que la médiane, les moyennes tronquées ou la moyenne arithmétique. Dans une loi de Gauss, la probabilité d’observer des valeurs extrêmes très éloignées croît avec la taille de l’échantillon, ce qui induit une variance d’échantillonnage du milieu de l’étendue beaucoup plus importante que celle de la moyenne d’échantillon. L’erreur standard de cette mesure ne diminue pas à un taux favorable lorsque la taille d’échantillon N tend vers l’infini si les queues de distribution sont indéfinies, ce qui limite son usage inférentiel dans des cadres paramétriques non bornés.
L’utilisation méthodologique du milieu de l’étendue repose donc sur des hypothèses fondamentales de symétrie et de stabilité rigoureuse des frontières distributionnelles. La validité de son interprétation en tant qu’indice de centralité présuppose que les processus aléatoires générant la borne inférieure et la borne supérieure sont soumis à des contraintes structurelles identiques. Si une distribution présente une asymétrie marquée (positive ou négative), le milieu de l’étendue sera irrémédiablement attiré vers la queue allongée de la distribution, perdant toute adéquation avec la zone de densité maximale des observations et délivrant par conséquent un diagnostic déformé de la tendance centrale effective de la série.
2. Fondements mathématiques et propriétés formelles du calcul
2.1 Formulation algébrique standard
La formulation algébrique canonique du milieu de l’étendue procède d’une construction arithmétique élémentaire mais d’une grande rigueur formelle au sein de la théorie des statistiques d’ordre. Soit un échantillon aléatoire constitué de n variables aléatoires réelles indépendantes et identiquement distribuées, noté sous la forme matricielle :
X = {X₁, X₂, X₃, …, Xₙ}
Lorsque ces observations empiriques sont ordonnées de manière séquentielle croissante au sein de la série ordonnée correspondante, nous obtenons le vecteur ordonné :
X₍₁₎ ≤ X₍₂₎ ≤ X₍₃₎ ≤ … ≤ X₍ₙ₋₁₎ ≤ X₍ₙ₎
Dans ce formalisme universel, X₍₁₎ représente la première statistique d’ordre, désignant formellement la valeur minimale observée (l’infimum de l’ensemble d’échantillonnage), tandis que X₍ₙ₎ représente la n-ième statistique d’ordre, désignant le maximum empirique (le supremum de l’ensemble d’échantillonnage). L’équation canonique du milieu de l’étendue, généralement notée M ou MR (pour Midrange), s’énonce comme la moyenne arithmétique stricte de ces deux statistiques d’ordre terminales :
M = (X₍₁₎ + X₍ₙ₎) / 2
Cette expression formalise la projection orthogonale du centre de l’intervalle [X₍₁₎, X₍ₙ₎] sur l’axe des réels. Une propriété fondamentale de cette statistique réside dans sa sensibilité différentielle relative par rapport au volume global de l’échantillon N. Contrairement à la somme cumulée des termes divisée par N, où le poids mathématique d’une observation spécifique équivaut systématiquement à 1/N — tendant ainsi vers zéro lorsque la volumétrie s’accroît —, le milieu de l’étendue accorde invariablement un poids fixe de 0,5 à la valeur minimale et de 0,5 à la valeur maximale, faisant abstraction complète des (n – 2) observations intermédiaires, quel que soit le volume quantitatif des données collectées.
2.2 Comportement asymptotique et point de rupture
Dans le domaine de l’analyse statistique robuste, formalisée par Peter Rousseeuw et Frank Hampel, la résilience d’un estimateur face à la contamination d’un jeu de données est évaluée au moyen de son point de rupture (breakdown point). Le point de rupture correspond à la proportion minimale d’observations arbitrairement aberrantes ou erronées qu’un échantillon doit contenir pour que l’estimateur puisse être corrompu jusqu’à prendre une valeur infinie ou dénuée de sens. Pour le milieu de l’étendue, la démonstration mathématique conduit à un constat catégorique : son point de rupture fini est rigoureusement égal à 1/n, ce qui se traduit par un point de rupture asymptotique de zéro pour cent :
Point de rupture = 0% (quand n → ∞)
Il suffit en effet qu’une seule et unique observation de l’échantillon soit corrompue et projetée vers l’infini positif (X₍ₙ₎ → +∞) ou l’infini négatif (X₍₁₎ → -∞) pour que le milieu de l’étendue tende lui-même instantanément vers l’infini, annihilant toute signification quant à la localisation centrale de l’échantillon sous-jacent. Cette absence totale de robustesse statistique face aux variations stochastiques des bornes impose une prudence méthodologique absolue lors de son emploi.
Néanmoins, sur le plan des transformations affines, le milieu de l’étendue jouit de propriétés mathématiques particulièrement stables et désirables. Il possède la propriété formelle d’invariance par translation et d’homothétie d’échelle. Plus explicitement, si l’on applique à chaque élément Xᵢ de l’échantillon une transformation linéaire de la forme Yᵢ = a · Xᵢ + b (où a et b sont des constantes réelles avec a ≠ 0), le nouveau milieu de l’étendue M_Y obéit rigoureusement à la relation algébrique M_Y = a · M_X + b (avec permutation d’indices si a < 0). Cette propriété garantit que la métrique préserve fidèlement les changements d’unités de mesure (par exemple, la conversion de millisecondes en secondes, ou de degrés Celsius en degrés Fahrenheit).
2.3 Relations avec d’autres estimateurs d’extrêmes
L’analyse structurelle du milieu de l’étendue ne saurait être disjointe de celle de l’étendue statistique brute (notée couramment Range en littérature anglophone). L’étendue statistique constitue la mesure d’amplitude primaire définie par la différence absolue entre les deux statistiques d’ordre terminales :
Étendue = X₍ₙ₎ – X₍₁₎
Il existe une interdépendance stricte et fondamentale entre ces deux grandeurs : le milieu de l’étendue détermine la position géométrique de l’ancrage central du segment observationnel, tandis que l’étendue brute quantifie la longueur totale de ce même segment. Mathématiquement, les deux bornes originales de l’échantillon peuvent être intégralement reconstruites à partir du couple constitué par le milieu de l’étendue (M) et l’étendue (E), selon les identités suivantes :
- X₍ₙ₎ = M + (E / 2)
- X₍₁₎ = M – (E / 2)
Cette interrelation structurelle met en lumière le lien direct unissant le milieu de l’étendue aux théories des moyennes tronquées (trimmed means) et des moyennes de Winsor. Alors qu’une moyenne tronquée à 10% élimine les 10% inférieurs et supérieurs de l’échantillon avant de calculer la moyenne des termes résiduels, le milieu de l’étendue représente l’antithèse conceptuelle absolue de ce processus : il correspond à l’exclusion totale de la totalité des observations internes jusqu’à ne conserver rigoureusement que les statistiques d’ordre 1 et n. Utilisés conjointement au sein d’un tableau d’analyse spatiale, le milieu de l’étendue et l’étendue brute permettent de cartographier avec exactitude l’ancrage spatial et le gabarit de dispersion globale d’un jeu de données.
3. Environnement Google Sheets et fonctions statistiques associées
3.1 Architecture logicielle de Google Sheets pour la recherche
L’exploitation de Google Sheets en tant qu’environnement d’analyse statistique dans le cadre de la recherche expérimentale s’est accrue de manière exponentielle grâce à son modèle d’exécution infonuagique nativement collaboratif. Pour les protocoles multicentriques ou les équipes de recherche dispersées géographiquement, le tableur assure la reproductibilité des analyses en garantissant que tous les collaborateurs accèdent à une version unique et continuellement auditée des données matricielles, éliminant les biais de synchronisation inhérents aux fichiers statiques locaux.
Sur le plan de l’intégrité algorithmique, Google Sheets exécute ses calculs numériques en conformité étroite avec la norme internationale IEEE 754 régissant l’arithmétique à virgule flottante en double précision standard (64 bits). Cette caractéristique assure une précision de calcul atteignant 15 à 17 chiffres décimaux significatifs, ce qui évite les dérives cumulatives d’arrondi lors du traitement d’échantillons continus complexes. Par ailleurs, la gestion des références matricielles dynamiques au sein de son moteur de calcul permet d’appliquer des opérations vectorielles sur des plages de données expansives sans nécessiter d’itérations manuelles susceptibles d’introduire des erreurs d’encodage.
Cette architecture se distingue également par sa capacité à gérer les flux de données ouverts. En autorisant la définition de colonnes entières sous forme de vecteurs infinis (par exemple la plage A2:A), l’application recalcule instantanément les métriques statistiques au fur et à mesure que de nouveaux participants sont encodés, offrant ainsi un tableau de bord analytique évolutif pour la surveillance en temps réel de protocoles de test psychométriques ou cliniques.
3.2 Analyse fonctionnelle de la fonction MAX
L’extraction de la borne supérieure d’une distribution statistique repose nativement sur la fonction MAX. D’un point de vue algorithmique, la fonction parcourt l’ensemble des éléments référencés au sein d’une matrice donnée pour retourner la valeur algébrique la plus élevée, modélisant avec une fidélité computationnelle absolue l’identification du supremum X₍ₙ₎ de l’échantillon. La syntaxe canonique de la fonction s’articule comme suit :
=MAX(valeur1; [valeur2; ...])
Dans l’écosystème de Google Sheets, la fonction MAX fait preuve d’une robustesse spécifique dans la gestion des types de données hétérogènes. Lorsqu’elle évalue une plage de cellules continue (telle que A2:A100), le compilateur ignore automatiquement les chaînes textuelles, les cellules strictement vides ainsi que les valeurs booléennes non typées. En revanche, si une valeur logique est passée de manière explicite comme argument direct dans la fonction (par exemple MAX(VRAI; 0)), le booléen sera contraint numériquement en la valeur entière 1. Cette distinction opérationnelle est primordiale lors de la structuration de pipelines d’acquisition de données expérimentales afin de prémunir le chercheur contre les dénaturations silencieuses du supremum.
3.3 Analyse fonctionnelle de la fonction MIN
Symétrique exacte de la fonction précédente, la fonction MIN assure l’extraction programmatique de l’infimum d’un jeu de données, correspondant à la première statistique d’ordre X₍₁₎. Son implémentation algorithmique parcourt les vecteurs désignés et restitue le plus petit scalaire réel rencontré selon la syntaxe suivante :
=MIN(valeur1; [valeur2; ...])
Une distinction critique opérée par la fonction MIN au sein de Google Sheets concerne la différenciation rigoureuse entre une cellule vide et la valeur numérique zéro (0). Dans une plage matricielle référencée, toute cellule laissée vacante est totalement ignorée par l’algorithme d’optimisation de MIN. À l’inverse, si un utilisateur saisit intentionnellement ou par mégarde un zéro numérique, ce dernier est immédiatement traité comme un score empirique valide, susceptible de devenir l’infimum absolu de la distribution si l’ensemble des autres valeurs lui sont supérieures. Cette différenciation fonctionnelle constitue le pivot central sur lequel repose l’intégrité du calcul composite du milieu de l’étendue, toute confusion entre absence de réponse et score nul risquant d’altérer irréversiblement la localisation de la borne inférieure.
4. Implémentation pas à pas de la formule standard dans Google Sheets
4.1 Structuration et encodage du jeu de données
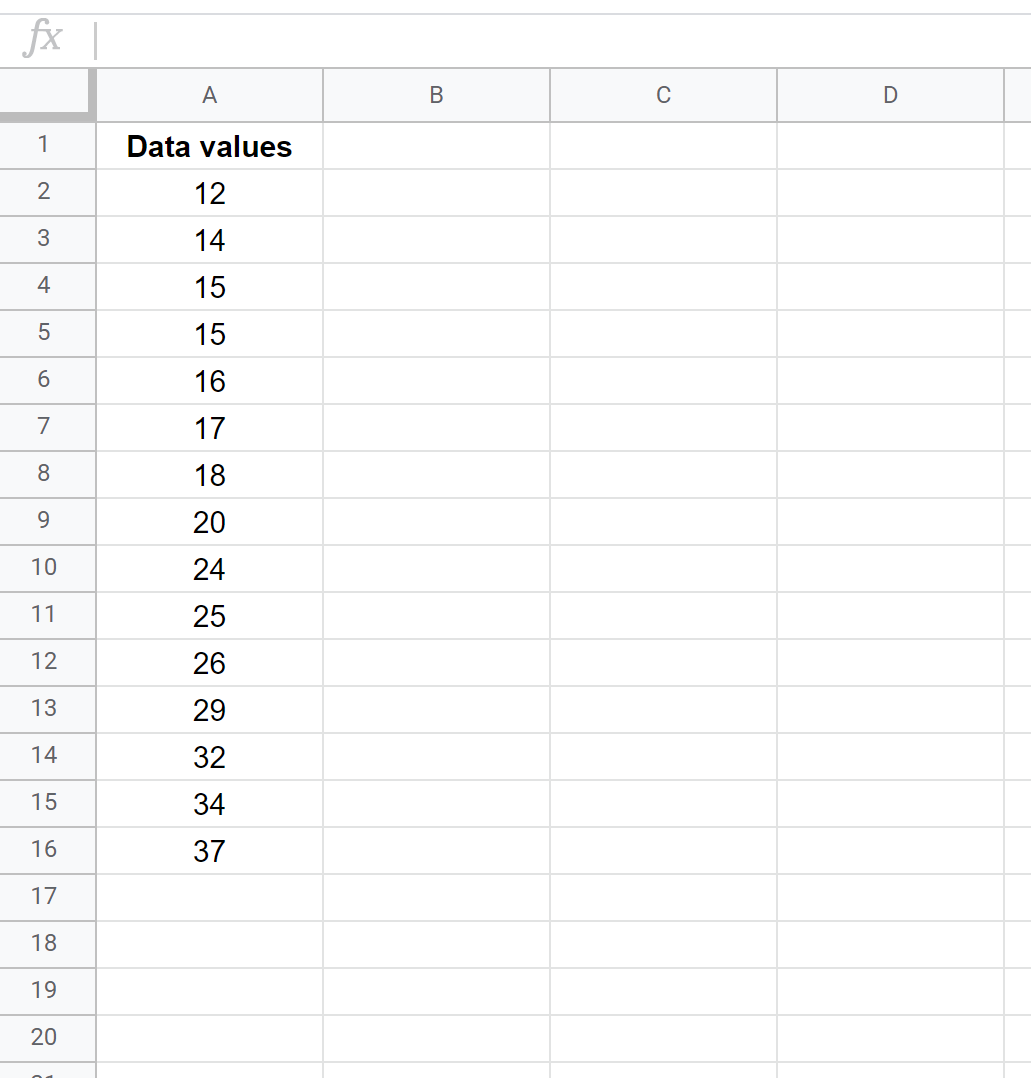
L’implémentation opérationnelle de toute analyse quantitative dans Google Sheets débute impérativement par une modélisation méthodique de la feuille de calcul selon les principes internationaux du tidy data énoncés par Hadley Wickham. Chaque variable expérimentale doit correspondre à une colonne unique, chaque participant ou unité observationnelle doit constituer une ligne distincte, et chaque intersection cellule-colonne doit renfermer une mesure atomique élémentaire, vierge de tout commentaire textuel ou symbole d’annotation parasitaire.
Afin de garantir une reproductibilité totale, les colonnes doivent être explicitement typées. La colonne hébergeant les scores de mesure continue doit être formellement configurée au format « Nombre » via le menu Format > Nombre > Nombre, ce qui prévient tout comportement ambigu du moteur arithmétique face aux séparateurs de décimales (point versus virgule selon la locale géographique du compte Google). L’analyste définira idéalement une colonne de test standardisée, par exemple la colonne A, débutant à la ligne 2 pour réserver la cellule A1 à l’étiquette de variable canonique (par exemple Temps_Reaction_ms).
Le contrôle méthodologique préalable implique de vérifier l’absence d’espaces insécables résiduels ou d’apostrophes d’échappement invisibles qui transformeraient un score quantitatif en chaîne textuelle inerte, rendant les fonctions d’extraction aveugles à l’observation concernée.
4.2 Syntaxe canonique de la formule du milieu de l’étendue
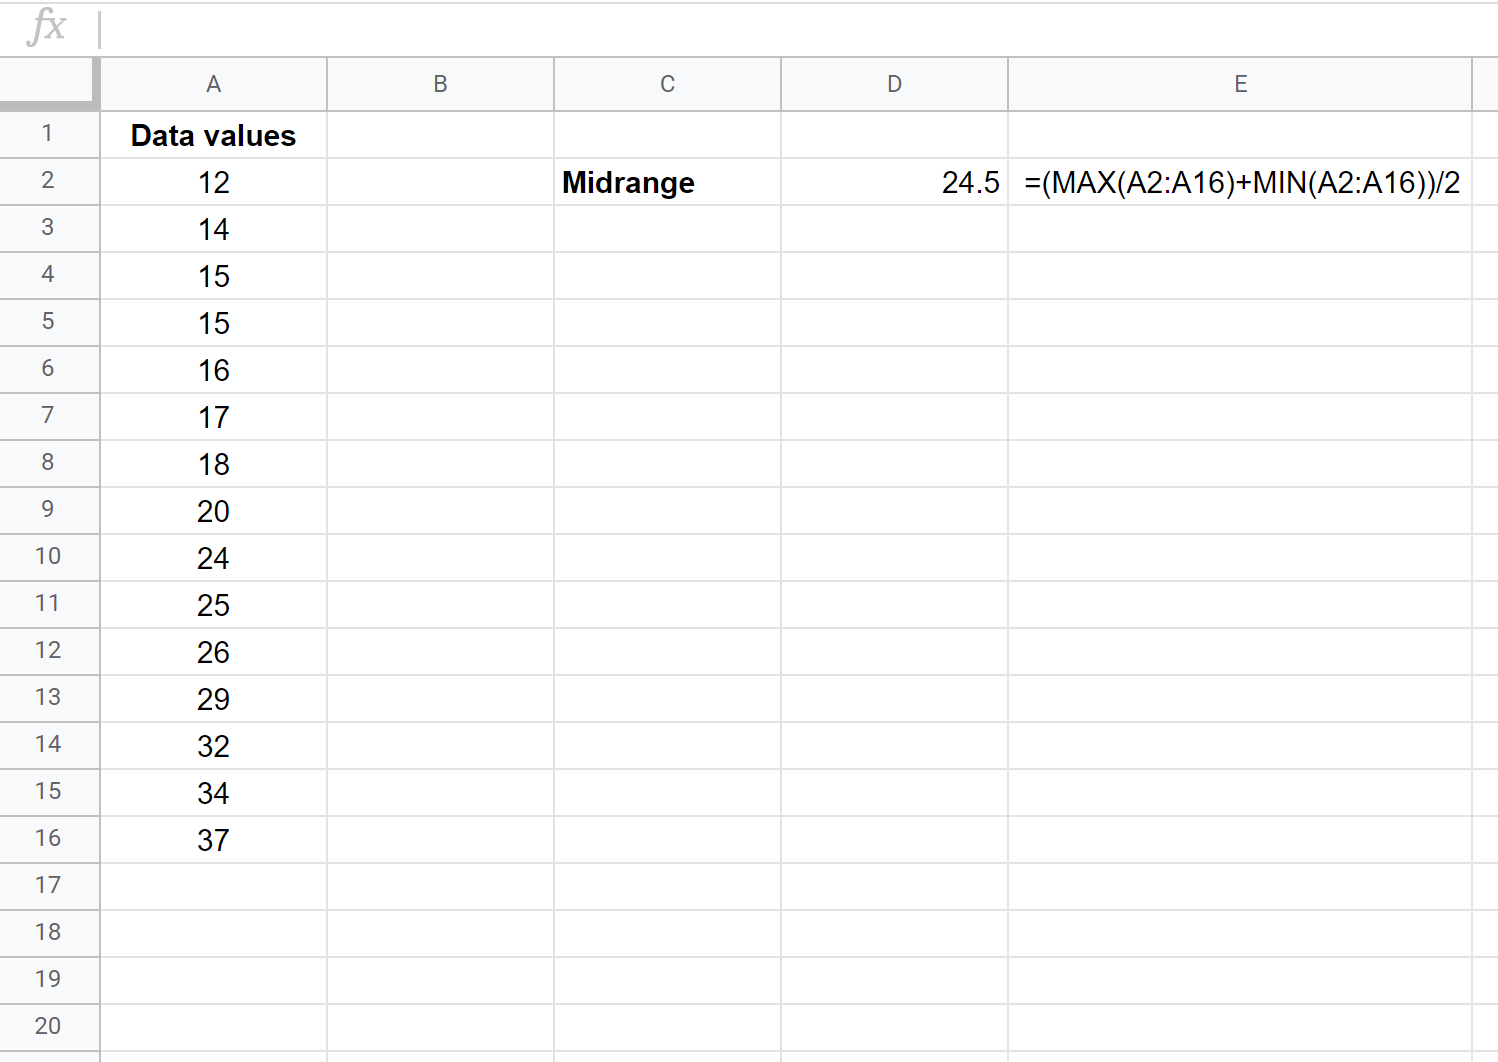
Google Sheets ne disposant pas d’une fonction atomique native MIDRANGE(), le calcul formel de cette statistique de centralité requiert la composition arithmétique de ses éléments constitutifs. L’expression canonique universelle s’implémente dans la cellule de destination (par exemple en C2) selon la formulation suivante :
=(MAX(A2:A) + MIN(A2:A)) / 2
L’architecture de cette formule met en lumière une règle incontournable d’évaluation syntaxique : la précédence absolue des opérateurs arithmétiques. En vertu des standards mathématiques internationaux, l’opérateur de division (/) possède un niveau de priorité algébrique supérieur à celui de l’opérateur d’addition (+). L’encapsulation de la somme des fonctions (MAX(A2:A) + MIN(A2:A)) au sein de parenthèses de priorité est rigoureusement impérative. L’omission accidentelle de ces parenthèses — aboutissant à la formulation incorrecte =MAX(A2:A) + MIN(A2:A)/2 — engendrerait le calcul déviant de la somme du maximum et de la moitié du minimum, corrompant la métrique de manière invisible pour un observateur non averti.
Pour un audit interne rigoureux, il est vivement conseillé de décomposer initialement cette expression modulaire dans des cellules de contrôle contiguës :
- Cellule
C2(Supremum) :=MAX(A2:A) - Cellule
C3(Infimum) :=MIN(A2:A) - Cellule
C4(Milieu de l’étendue) :=(C2 + C3) / 2 - Cellule
C5(Étendue brute) :=C2 - C3
Cette approche modulaire certifie la validité des calculs intermédiaires avant toute agrégation dans un rapport de synthèse.
4.3 Validation empirique à travers un cas chiffré
Afin de valider empiriquement l’orthodoxie méthodologique de la procédure, considérons un échantillon expérimental issu d’un protocole de psychophysique cognitive mesurant les temps de réaction (en millisecondes) de 10 participants adultes face à un stimulus auditif inattendu. Les scores bruts encodés dans la plage A2:A11 sont les suivants :
245, 188, 312, 195, 220, 480, 210, 235, 190, 265
L’application rigoureuse du protocole algorithmique se déroule comme suit au sein du moteur de Google Sheets :
- L’évaluation de la fonction
MIN(A2:A11)identifie l’infimum empirique de la distribution : 188 ms (temps de réponse le plus fulgurant). - L’évaluation de la fonction
MAX(A2:A11)identifie le supremum empirique de la distribution : 480 ms (temps de réponse le plus lent, potentiellement ralenti par une baisse attentionnelle passagère). - L’addition des deux statistiques d’ordre terminales génère la somme vectorielle : 188 + 480 = 668 ms.
- L’application du diviseur scalaire 2 fournit le résultat définitif du milieu de l’étendue : 334 ms.
À titre de comparaison diagnostique préliminaire, le calcul de la moyenne arithmétique classique via =MOYENNE(A2:A11) sur cet échantillon délivre une valeur de 254 ms, tandis que la médiane obtenue via =MEDIANE(A2:A11) se fixe à 227,5 ms. Cette divergence immédiate (334 ms contre 227,5 ms et 254 ms) illustre avec force le comportement singulier du milieu de l’étendue : l’observation maximale de 480 ms tire le milieu de l’étendue vers le haut, révélant que le centre de l’espace de réactivité globale du groupe est situé bien au-delà de la zone de concentration dense où s’exécutent la majorité des réponses motrices.
5. Méthodes alternatives de calcul au sein de Google Sheets
5.1 Utilisation de la fonction MOYENNE combinée aux fonctions extrêmes
Au-delà de la syntaxe arithmétique élémentaire utilisant l’opérateur de division, Google Sheets offre une alternative de formulation particulièrement élégante en exploitant directement sa fonction vectorielle MOYENNE (ou AVERAGE en interface anglophone). Puisque le milieu de l’étendue correspond par définition à la moyenne arithmétique de deux nombres scalaires singuliers, il est mathématiquement rigoureux et fonctionnellement valide de passer les deux statistiques d’ordre terminales comme deux arguments distincts au sein de la fonction de moyennage :
=MOYENNE(MAX(A2:A); MIN(A2:A))
Cette syntaxe présente un avantage sémantique appréciable lors de la relecture de feuilles de calcul complexes par des pairs évaluateurs ou des auditeurs de données. Elle explicite immédiatement l’intention théorique de l’opération : calculer une valeur moyenne entre deux bornes. Sur le plan de l’impact computationnel, cette formulation exige une allocation de pile d’évaluation légèrement différente au sein du moteur d’exécution JavaScript sous-jacent de Google Sheets, car elle appelle la fonction intégrée MOYENNE au lieu d’une instruction arithmétique matérielle primitive. Néanmoins, pour des jeux de données de recherche expérimentale classiques n’excédant pas plusieurs centaines de milliers d’enregistrements, la différence de latence de recalcul est rigoureusement infinitésimale (de l’ordre de la microseconde), ce qui en fait une alternative ergonomique parfaitement recommandable.
5.2 Exploitation de la fonction GRANDE.VALEUR et PETITE.VALEUR
Une seconde méthode de calcul repose sur l’utilisation des fonctions de rang statistique universelles : GRANDE.VALEUR (équivalent de LARGE) et PETITE.VALEUR (équivalent de SMALL). Ces fonctions permettent d’extraire le k-ième élément le plus grand ou le plus petit d’une matrice observationnelle. La formulation paramétrique du milieu de l’étendue s’établit alors comme suit :
=(GRANDE.VALEUR(A2:A; 1) + PETITE.VALEUR(A2:A; 1)) / 2
L’intérêt de cette méthode réside dans son extensibilité structurelle en vue de modélisations méthodologiques plus sophistiquées. En effet, cette formulation ouvre la voie au calcul immédiat de milieux d’étendues tronqués ou d’ordre secondaire. Si le chercheur suspecte la présence d’un artefact méthodologique absolu sur le premier et le dernier rang, il peut aisément paramétrer le rang k = 2 pour déterminer le milieu de l’étendue sous-jacent de deuxième ordre :
=(GRANDE.VALEUR(A2:A; 2) + PETITE.VALEUR(A2:A; 2)) / 2
Cette approche confère une flexibilité opérationnelle absente des fonctions MAX et MIN, en autorisant une gradation paramétrique continue de la robustesse de l’indice de centralité périphérique le long du continuum de tri des quantiles d’échantillonnage.
5.3 Création d’une fonction personnalisée via Google Apps Script
Pour les infrastructures de recherche nécessitant l’homogénéisation des protocoles analytiques au sein de multiples équipes, l’implémentation d’une fonction personnalisée native via l’environnement Google Apps Script représente la solution d’ingénierie logicielle la plus intégrée. En accédant au menu Extensions > Apps Script, l’analyste peut implémenter une fonction MILIEU_ETENDUE directement accessible dans la feuille de calcul :
/**
 * Calcule le milieu de l'étendue (Midrange) d'une série numérique.
 *
 * @param {A2:A} plage La plage matricielle contenant les données d'échantillonnage.
 * @return {number} Le milieu de l'étendue géométrique (Max + Min) / 2.
 * @customfunction
 */
function MILIEU_ETENDUE(plage) {
  if (!Array.isArray(plage)) {
    plage = [[plage]];
  }

  var min = Infinity;
  var max = -Infinity;
  var count = 0;

  for (var i = 0; i < plage.length; i++) {
    for (var j = 0; j < plage[i].length; j++) {
      var val = plage[i][j];
      if (typeof val === 'number' && !isNaN(val) && val !== null) {
        if (val < min) min = val;
        if (val > max) max = val;
        count++;
      }
    }
  }

  if (count === 0 || min === Infinity || max === -Infinity) {
    throw new Error("Aucune valeur numérique valide n'a été détectée.");
  }

  return (max + min) / 2;
}
L’utilisation de cette fonction personnalisée dans le tableur prend la forme intuitive =MILIEU_ETENDUE(A2:A). Sur le plan de la gouvernance des systèmes d’information, cette approche garantit que l’intégralité des règles de typage, de gestion des exceptions et d’exclusion des cellules non numériques est encapsulée de manière déterministe dans le code source du projet. Toutefois, une considération de performance s’impose : les fonctions Google Apps Script subissent une surcharge de latence d’exécution due au transfert des données entre le serveur de la feuille et le moteur d’interprétation JavaScript V8. Si le classeur contient des milliers de cellules appelant simultanément cette fonction personnalisée, un ralentissement du recalcul dynamique peut être constaté, justifiant le recours préférentiel aux formules intégrées natives de Google Sheets pour les volumes massifs.
6. Gestion des anomalies, données manquantes et pièges de saisie
6.1 Traitement rigoureux des cellules vides et des zéros implicites
L’intégrité du calcul du milieu de l’étendue est particulièrement vulnérable aux biais introduits lors de la phase de saisie des données. La confusion structurelle entre une donnée manquante (cellule laissée vide en raison de l’absence de réponse d’un sujet expérimental) et une mesure nulle (score numérique égal à zéro) constitue un piège classique dans les sciences de l’observation. Comme évoqué précédemment, la fonction native MIN(A2:A) ignore systématiquement les cellules absolument vides, préservant ainsi la recherche de l’infimum réel parmi les cellules complétées.
Cependant, si un opérateur de saisie encode un zéro par inadvertance à la place d’un code signalant une valeur manquante (par exemple dans le cas d’une épreuve psychométrique dont les scores théoriques s’échelonnent strictement de 10 à 50), ce zéro numérique devient instantanément le minimum absolu de la distribution (X₍₁₎ = 0). L’impact sur le milieu de l’étendue est direct : l’indicateur subit un effondrement artificiel d’au moins cinq unités entières. Pour prémunir les calculs contre ce phénomène sans dénaturer la matrice brute, il convient d’associer la fonction FILTRE pour circonscrire le calcul aux valeurs théoriquement admissibles :
=(MAX(FILTRE(A2:A; A2:A > 0)) + MIN(FILTRE(A2:A; A2:A > 0))) / 2
Cette formulation neutralise de manière déterministe toute valeur nulle ou négative illicite, protégeant l’infimum d’un écrasement non sollicité dans les questionnaires complexes.
6.2 Neutralisation des données non numériques et erreurs textuelles
Dans les environnements collaboratifs de collecte de données, l’insertion accidentelle de caractères textuels au sein de colonnes quantitatives représente une source fréquente de dysfonctionnements analytiques. Les fautes de frappe (telles que l’introduction accidentelle d’une lettre à la place d’un chiffre, ou l’utilisation d’un point décimal au lieu d’une virgule dans un environnement linguistique francophone) transforment immédiatement la cellule concernée en type « Chaîne de caractères » (String).
Bien que les fonctions MAX et MIN contournent passivement les valeurs textuelles sans renvoyer de code d’erreur bloquant, ce comportement tolérant peut s’avérer néfaste : si la valeur textuelle erronée masquait en réalité le véritable maximum de la série (par exemple le texte "580" saisi avec un espace initial insidieux au lieu du nombre 580), le supremum calculé sera tronqué à la valeur numérique inférieure suivante, induisant une distorsion majeure du milieu de l’étendue. Pour assainir activement les flux de données, l’analyste avisera d’employer une clause conditionnelle de validation s’appuyant sur la fonction ESTNUM afin de dénombrer et d’isoler en continu les saisies illégitimes :
=SOMMEPROD(NON(ESTNUM(A2:A100)) * NON(ESTVIDE(A2:A100)))
Si cette formule de contrôle renvoie un entier strictement supérieur à zéro, l’analyste sait immédiatement que des valeurs qualitatives polluent la colonne de référence et qu’un nettoyage structurel s’impose avant de procéder à l’interprétation du milieu de l’étendue.
6.3 Formule conditionnelle sécurisée avec SIERREUR et ESTVIDE
L’intégration du milieu de l’étendue au sein de tableaux de bord statistiques automatisés exige que les expressions matricielles démontrent une résilience intégrale face aux états d’échantillonnage nuls ou défaillants. Si une colonne de test est intégralement vide lors de l’initialisation d’un protocole d’acquisition, l’appel conjoint des fonctions MAX et MIN aboutit à la restitution de deux zéros, générant un résultat de milieu d’étendue égal à 0, ce qui constitue une information trompeuse (l’absence de données étant assimilée à un centrage sur zéro).
Afin de parer à tout résultat fallacieux au sein de pipelines de traitement automatisés, il est essentiel d’encapsuler le calcul dans une structure conditionnelle triple vérifiant d’une part la complétude minimale de l’échantillon, et prévenant d’autre part toute rupture d’exécution au moyen de SIERREUR :
=SI(NB(A2:A) < 2; "N insuffisant (<2)"; SIERREUR((MAX(A2:A) + MIN(A2:A)) / 2; "Erreur de calcul"))
Cette construction algorithmique garantit qu’aucune valeur de milieu de l’étendue ne sera publiée tant que la plage ne contient pas au moins deux observations quantitatives valides (le calcul d’une étendue et de son milieu exigeant au minimum deux points pour faire sens géométriquement). En cas de rupture inattendue de l’arbre d’exécution, la fonction SIERREUR intercepte l’exception logicielle et renvoie un message explicite, garantissant la lisibilité et l’élégance formelle des synthèses destinées aux comités de pilotage scientifique.
7. Calculs avancés et dynamiques sur des sous-groupes expérimentaux
7.1 Calcul conditionnel selon un critère d’appartenance de groupe
Dans la recherche quasi-expérimentale et clinique, l’analyse comparative inter-groupes constitue le socle des méthodologies de validation factorielle. L’analyste se trouve régulièrement dans la nécessité de calculer distinctement le milieu de l’étendue pour une cohorte expérimentale soumise à un traitement pharmacologique ou cognitif et pour un groupe témoin recevant un placebo, le tout au sein d’une feuille de données consolidée unique.
Google Sheets propose à cet effet les fonctions statistiques conditionnelles hautement optimisées MAX.SI.ENS (ou MAXIFS) et MIN.SI.ENS (ou MINIFS). Supposons que la variable de groupement soit encodée dans la colonne A (contenant par exemple les mentions verbales "Contrôle" et "Expérimental") et que les scores continus de performance résident dans la colonne B. La formulation syntaxique rigoureuse pour extraire le milieu de l’étendue du groupe expérimental s’exprime comme suit :
=(MAX.SI.ENS(B2:B; A2:A; "Expérimental") + MIN.SI.ENS(B2:B; A2:A; "Expérimental")) / 2
De manière parfaitement symétrique, le milieu de l’étendue de la cohorte témoin sera dérivé de l’expression :
=(MAX.SI.ENS(B2:B; A2:A; "Contrôle") + MIN.SI.ENS(B2:B; A2:A; "Contrôle")) / 2
Cette approche élimine tout partitionnement manuel préalable des matrices de données. Elle garantit l’actualisation instantanée des paramètres de centralité spatiale de chaque sous-population dès l’incorporation de nouveaux dossiers de sujets au sein de la base unifiée.
7.2 Formules matricielles dynamiques avec ARRAYFORMULA
L’administration de batteries de tests psychométriques complexes implique souvent le traitement simultané de multiples sous-dimensions comportementales (par exemple, les échelles d’anxiété, de dépression et d’estime de soi disposées respectivement sur les colonnes B, C et D). L’analyste peut souhaiter déployer un tableau de bord calculant de manière vectorisée le milieu de l’étendue pour chacune de ces dimensions le long d’une seule ligne d’en-tête récapitulative.
Pour des calculs dynamiques par colonne, il est possible de combiner la puissance des fonctions matricielles avec BYCOL et les expressions LAMBDA. Cette syntaxe moderne de Google Sheets s’avère nettement supérieure aux copies manuelles de formules :
=BYCOL(B2:D; LAMBDA(colonne; (MAX(colonne) + MIN(colonne)) / 2))
Dans ce paradigme fonctionnel, le moteur de calcul alloue dynamiquement une fonction anonyme à chaque vecteur de colonne compris dans l’intervalle B2:D, extrayant simultanément leurs extrema et publiant horizontalement les trois milieux de l’étendue respectifs. Si l’objectif consiste plutôt à évaluer le milieu de l’étendue ligne par ligne pour des profils individuels (par exemple, pour évaluer l’amplitude de dispersion des réponses d’un patient à travers 10 sous-échelles disposées de B2 à K2), l’analyste exploitera la fonction BYROW :
=BYROW(B2:K; LAMBDA(ligne; SI(NB(ligne)>0; (MAX(ligne) + MIN(ligne)) / 2; "")))
Cette automatisation allège la mémoire vive du navigateur client en substituant des milliers de formules redondantes par une instruction matricielle unique gérée au niveau de l’arborescence DOM de la feuille.
7.3 Filtrage dynamique via la fonction QUERY
Pour les environnements analytiques complexes nécessitant des agrégations multidimensionnelles stratifiées, l’intégration de la puissante fonction QUERY — implémentant une variante du langage déclaratif SQL au cœur de Google Sheets — offre une flexibilité de filtrage sans équivalent. Bien que la fonction QUERY ne dispose pas d’un opérateur direct midrange() dans sa grammaire interne, elle excelle à extraire dynamiquement les sous-matrices éligibles en amont du calcul canonique.
Considérons une base de données de recherche où l’on souhaite calculer le milieu de l’étendue des scores cognitifs (colonne C) uniquement pour les participants appartenant à la tranche d’âge de plus de 65 ans (colonne B) et ayant validé un critère d’inclusion d’assiduité (colonne D = "Validé"). L’imbrication s’articule comme suit :
=(MAX(QUERY(A2:D; "SELECT C WHERE B > 65 AND D = 'Validé' AND C IS NOT NULL")) + MIN(QUERY(A2:D; "SELECT C WHERE B > 65 AND D = 'Validé' AND C IS NOT NULL"))) / 2
Cette construction permet de s’affranchir de la création de colonnes intermédiaires de filtrage. Le moteur de base de données interne de Google Sheets réalise la projection et la sélection en mémoire tampon, restituant immédiatement au couple MAX/MIN les observations requises pour déduire le milieu de l’étendue de la sous-cohorte clinique ciblée.
8. Analyse critique : Vulnérabilité aux valeurs aberrantes (Outliers)
8.1 Mécanisme mathématique de la distorsion par les extrêmes
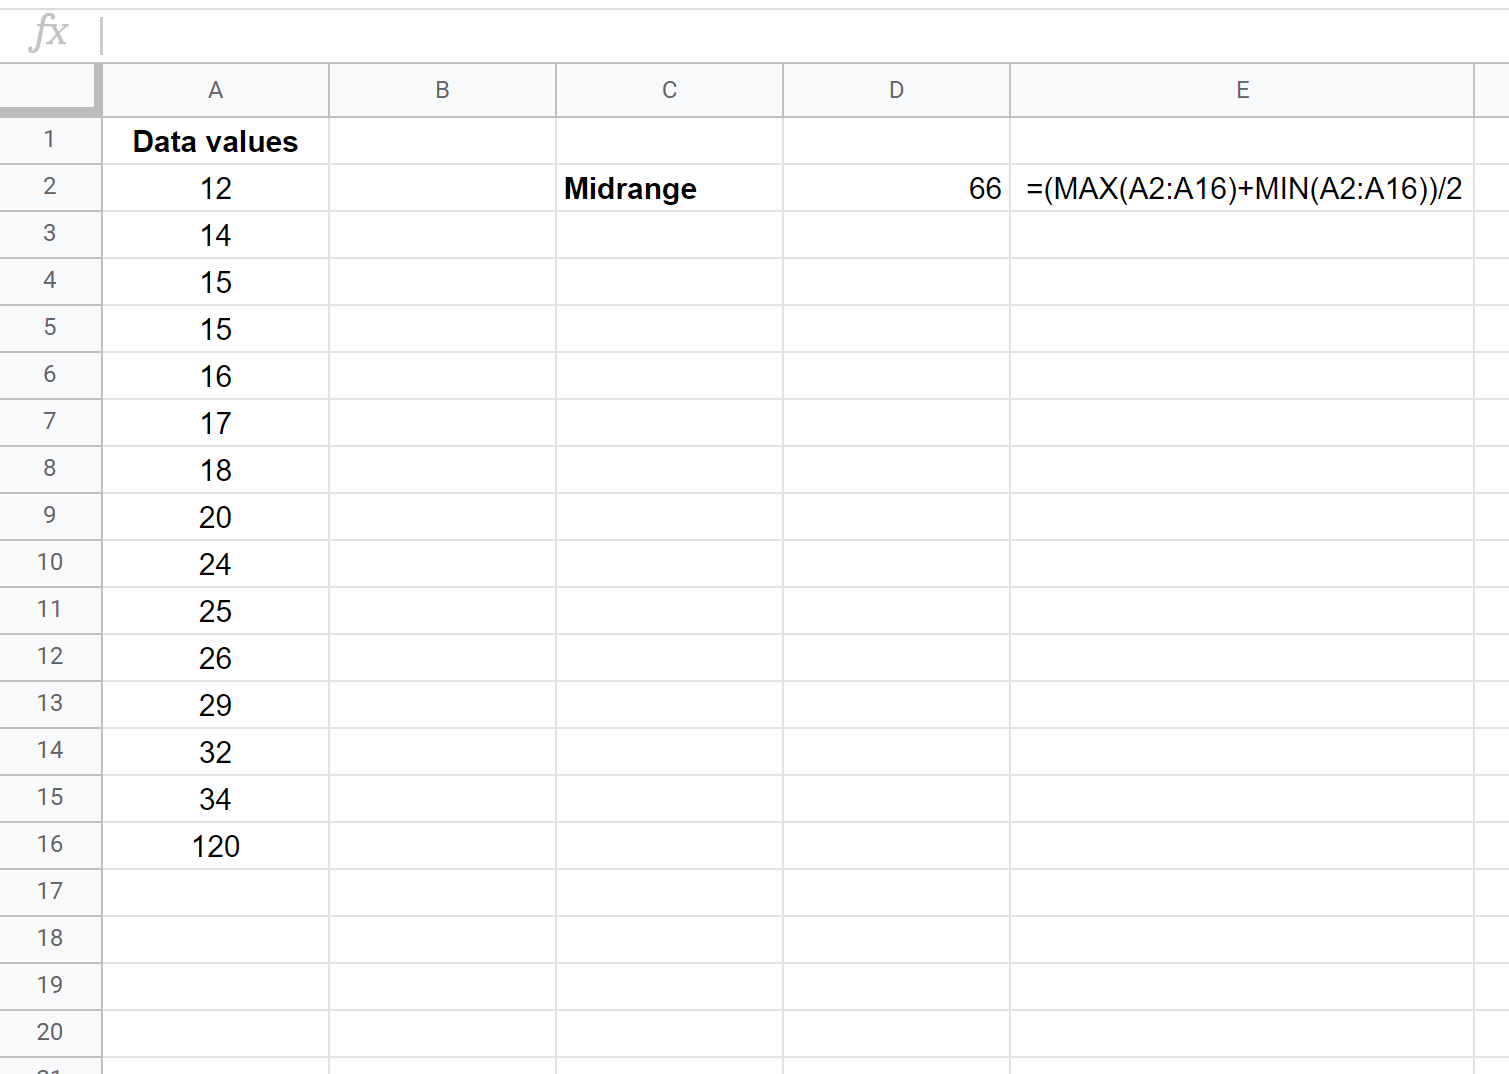
L’extrême vulnérabilité du milieu de l’étendue face aux valeurs aberrantes (outliers) constitue sa limitation méthodologique majeure. Le mécanisme mathématique sous-jacent procède directement de son équation constitutive : le milieu de l’étendue n’intègre aucune fonction de lissage ou d’amortissement fondée sur la densité d’échantillonnage. Dès lors, toute translation infinitésimale de la frontière externe de l’échantillon induit une translation mécanique du milieu de l’étendue à hauteur rigoureuse de 50% de la magnitude du déplacement de cette frontière.
Considérons un échantillon de 20 mesures de temps de réaction homogènes s’échelonnant harmonieusement entre 200 et 300 ms. L’infimum est de 200 ms, le supremum de 300 ms, ce qui fixe le milieu de l’étendue à 250 ms. Supposons qu’en raison d’un micro-parasitage de l’interface d’acquisition électronique, une unique observation aberrante soit enregistrée à 1 500 ms au lieu de 250 ms. La distribution ordonnée se voit alors contrainte par un supremum X₍₂₀₎ = 1 500 ms. Instantanément, la formule du milieu de l’étendue bascule :
M = (200 + 1 500) / 2 = 850 ms
En présence d’une seule donnée corrompue au sein d’une cohorte de 20 sujets par ailleurs irréprochables, la mesure de tendance centrale présumée se retrouve projetée à 850 ms, c’est-à-dire dans une zone spatiale où aucun sujet sain n’a jamais produit d’observation. Cet effet de levier disproportionné illustre le danger critique d’une utilisation non supervisée du milieu de l’étendue : une contamination marginale suffit à falsifier l’interprétation des marges globales de réactivité de l’ensemble d’une population.
8.2 Comparaison de l’effet d’outlier avec d’autres métriques
La vulnérabilité comparative des différentes métriques de centralité met en exergue des contrastes structurels fondamentaux résumés dans le tableau conceptuel suivant :
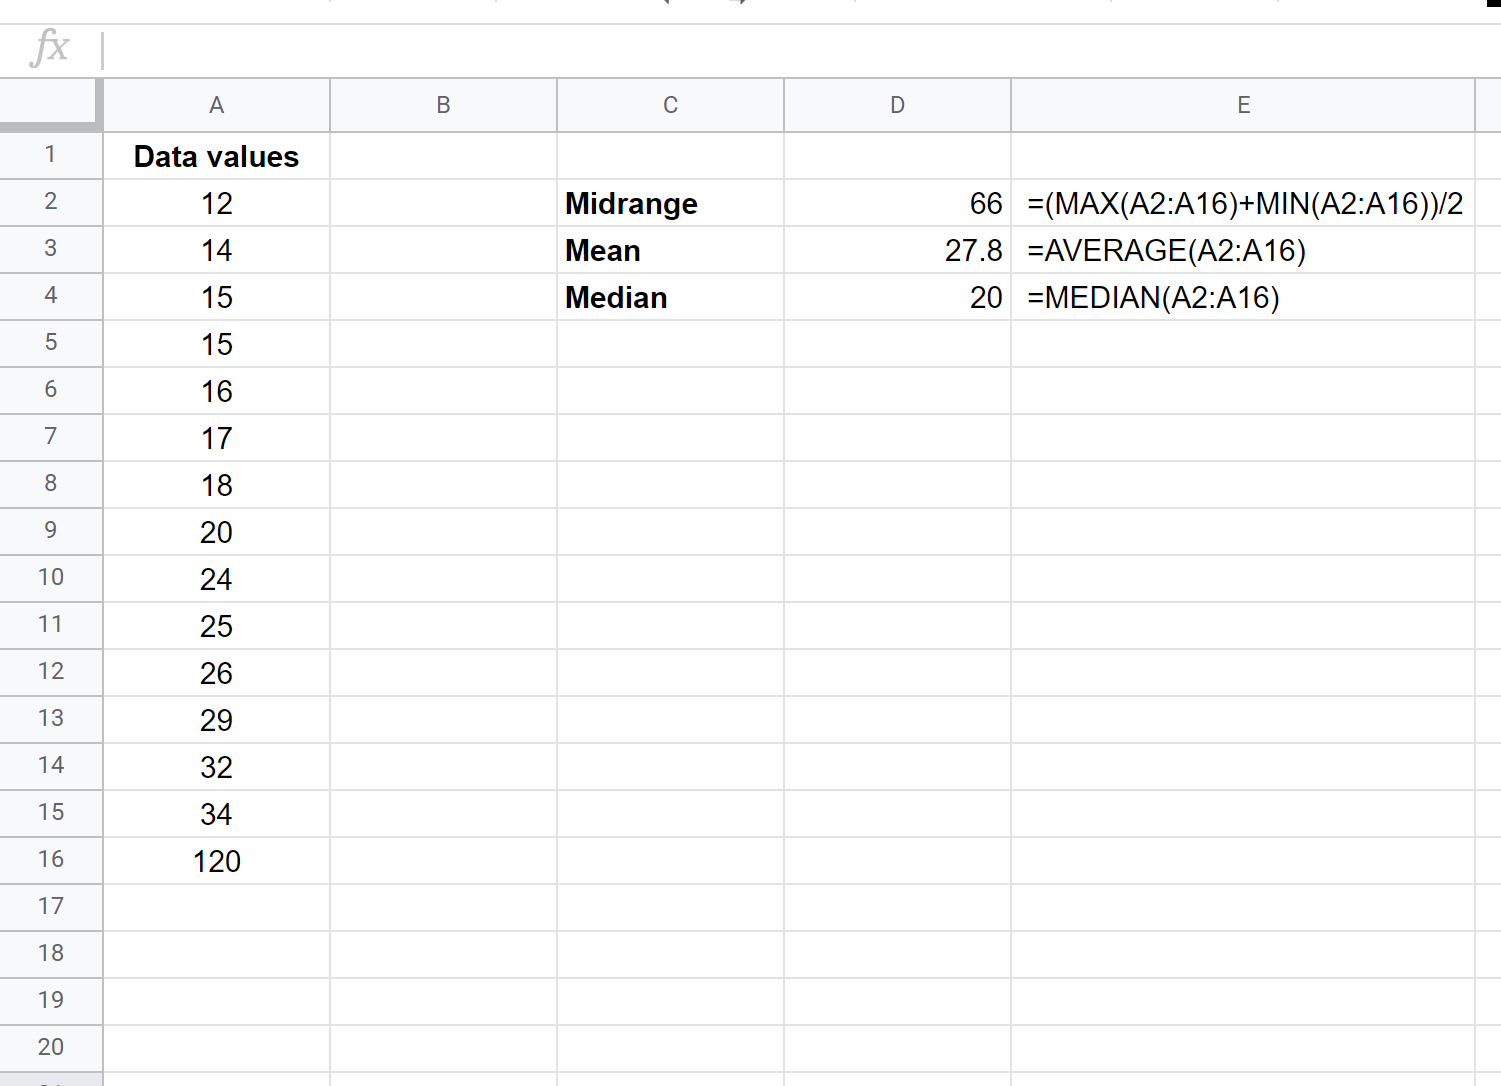
- La Médiane : Possède un point de rupture optimal de 50%. Dans l’exemple précédent de 20 participants, l’introduction de la mesure aberrante de 1 500 ms déplace la médiane d’un simple rang ordinal, induisant une variation métrique souvent indétectable ou insignifiante (par exemple, un passage de 248 ms à 251 ms). La médiane absorbe l’artefact technique avec une imperméabilité remarquable.
- La Moyenne Arithmétique : Possède un point de rupture de 0%, mais sa sensibilité est modérée par l’inertie du dénominateur N. L’artefact de 1 500 ms injecte un surplus résiduel de 1 250 ms réparti sur les 20 observations, ce qui décale la moyenne globale de seulement 1 250 / 20 = 62,5 ms. La moyenne s’établit alors à 312,5 ms, subissant une distorsion substantielle mais sans commune mesure avec celle observée sur le milieu de l’étendue.
- Le Milieu de l’Étendue : Subit un saut brutal de +600 ms (atteignant 850 ms). L’absence de terme inertiel lié à l’effectif N condamne la statistique à subir l’intégralité du choc cinétique de l’aberration.
Ce diagnostic comparatif confirme l’incapacité structurelle du milieu de l’étendue à amortir les bruits de mesure expérimentaux d’un laboratoire de psychologie ou de physiologie, exigeant impérativement des procédures de vérification en amont.
8.3 Diagnostic statistique de la contamination de l’indice
Face à cette sensibilité exacerbée, le chercheur doit obligatoirement coupler l’analyse du milieu de l’étendue à des diagnostics de dispersion robuste. Le protocole privilégié consiste à évaluer l’écart interquartile (IQR), défini par la différence entre le troisième quartile et le premier quartile (IQR = Q₃ – Q₁), calculable dans Google Sheets au moyen de la formule :
=QUARTILE(A2:A; 3) - QUARTILE(A2:A; 1)
Selon les critères classiques de John Tukey, une observation est classée comme un outlier modéré si elle excède Q₃ + 1,5 · IQR ou si elle est inférieure à Q₁ – 1,5 · IQR. Elle est qualifiée d’aberration extrême si elle franchit le seuil des 3 · IQR. La détection conjointe d’un écart majeur entre le milieu de l’étendue et la médiane, corrélée à une étendue brute excédant de manière disproportionnée l’écart interquartile, constitue une signature indiscutable de la contamination du milieu de l’étendue par des artefacts extrêmes.
Sur le plan de l’exploration visuelle, l’insertion d’un graphique en boîte à moustaches (box plot) au sein de la feuille Google Sheets permet de matérialiser instantanément ces points périphériques disjoints. Dès lors que des points apparaissent isolés au-delà des moustaches terminales du diagramme, l’analyste doit formellement récuser l’interprétation du milieu de l’étendue standard au profit d’alternatives épurées ou de métriques de localisation centrale robustes.
9. Milieu de l’étendue vs Moyenne, Médiane et Mode : Guide décisionnel
9.1 Matrice comparative des mesures de tendance centrale
Le choix d’un indice de tendance centrale dans un protocole de recherche obéit à des règles axiomatiques strictes régies par la nature de l’échelle de mesure et la morphologie de la distribution des données. Le tableau ci-après formalise cette typologie comparative afin d’éclairer le processus de sélection analytique :
- Échelle Nominale : Seul le Mode est admissible (identification de la catégorie modale la plus fréquente). La moyenne, la médiane et le milieu de l’étendue sont dénués de toute signification mathématique.
- Échelle Ordinale : La Médiane constitue l’indicateur central par excellence. Le milieu de l’étendue ne peut être calculé sur des rangs ordinaux purs, car l’opération d’addition et de division sur des intervalles d’intensités subjectives non métriques constitue une entorse épistémologique.
- Échelle d’Intervalle et de Rapport (Distribution Asymétrique) : La Médiane demeure la métrique de centralité la plus fidèle. La moyenne arithmétique est biaisée par l’étirement des queues, et le milieu de l’étendue est fortement distordu par la direction de l’asymétrie (skewness).
- Échelle d’Intervalle et de Rapport (Distribution Symétrique à queues courtes / Uniforme) : Le Milieu de l’Étendue s’avère particulièrement pertinent et peut surpasser la moyenne arithmétique en efficacité statistique si la distribution est bornée et compacte.
L’adéquation statistique du milieu de l’étendue est donc hautement conditionnée par le kurtosis (aplatissement) de la série : plus la distribution présente un profil platykurtique (aplatie, tendant vers la loi uniforme), plus le milieu de l’étendue s’affirme comme un descripteur géométrique pertinent de la scène d’observation.
9.2 Scénarios psychométriques justifiant le recours au milieu de l’étendue
Bien que son usage généralisé soit proscrit pour des distributions ouvertes ou gaussiennes contaminées, des contextes spécifiques au sein des sciences psychométriques et ergologiques légitiment le recours au milieu de l’étendue :
Le premier scénario concerne les instruments d’évaluation conçus intentionnellement selon un format uniforme borné. C’est le cas des tests psychomoteurs de balayage spatial sur écran tactile où la cible apparaît de manière équiprobable entre les coordonnées d’abscisse X_min et X_max. Dans ce dispositif, le calcul du milieu de l’étendue des coordonnées de contact permet d’estimer avec une précision maximale le véritable centre géométrique du champ attentionnel du sujet, surpassant l’instabilité de la moyenne sur des cohortes à faible volume d’essais.
Le second scénario s’articule autour de l’analyse des capacités limites globales d’un individu, désignée en psychologie du sport ou en ergonomie sous le terme de dynamique de l’écart de performance. Lorsqu’un pilote ou un athlète effectue des sessions d’entraînement sous différentes charges de stress, l’analyste cherche à déterminer le barycentre exact de son champ opérationnel. L’évaluation conjointe de sa performance minimale (en situation d’épuisement) et de sa performance maximale (en état d’hyper-vigilance) via le milieu de l’étendue offre un ancrage spatial unique de ses réserves adaptatives, que la moyenne arithmétique masquerait par effet de lissage de la masse des essais médians.
9.3 Recommandations pour une approche multivariée
L’orthodoxie méthodologique moderne condamne l’usage isolé d’une mesure de tendance centrale unique au profit d’un profilage multivarié enrichi. Il est impératif de ne jamais présenter un milieu de l’étendue dans un rapport de recherche sans l’accompagner simultanément de la médiane, de la moyenne arithmétique, de l’écart-type et de l’étendue brute de la série.
Une opportunité analytique féconde réside dans l’exploitation de la différence vectorielle entre le milieu de l’étendue (M) et la médiane (Med). L’indicateur d’écart relatif :
Δ_centre = M – Med
constitue un indice d’asymétrie des frontières d’une élégance remarquable. Si cet indice est rigoureusement nul, l’échantillon manifeste une symétrie géométrique idéale par rapport à ses bornes terminales. Si l’indice est fortement positif (M > Med), cela signale immédiatement que le supremum empirique est beaucoup plus distant du centre de gravité des données que ne l’est l’infimum, alertant le psychométricien sur l’existence d’une extension phénoménologique unilatérale vers le haut. L’intégration de ces indices composites au sein des feuilles Google Sheets permet d’enrichir considérablement l’évaluation psychologique et le diagnostic expérimental.
10. Nettoyage préalable et préparation des données dans Google Sheets
10.1 Détection et exclusion systématique des artéfacts méthodologiques
Afin de restaurer la validité empirique du milieu de l’étendue au sein de cohortes susceptibles de renfermer des artefacts techniques, un pipeline strict de prétraitement des données doit être implémenté dans Google Sheets préalablement à tout calcul. La première étape consiste à verrouiller l’encodage via les outils de validation des données. En sélectionnant la colonne de saisie et en appliquant une règle de type Données > Validation des données > Ajouter une règle > Nombre compris entre, l’analyste peut délimiter des frontières physiologiques strictes (par exemple, rejeter tout temps de réaction inférieur à 100 ms, considéré en neurophysiologie comme un seuil pré-moteur anticipatoire réflexe non intentionnel).
Pour les artefacts résiduels au sein de données déjà collectées, une colonne d’assainissement peut être générée en calculant les scores standardisés Z (Z-scores). Dans une colonne adjacente B, l’analyste standardisera les scores de la colonne A :
=STANDARDISE(A2; MOYENNE(A$2:A); ECARTYPE(A$2:A))
Les observations affichant une valeur absolue de score Z supérieure à 3 (|Z| > 3) seront systématiquement exclues par le biais d’un filtre conditionnel. La formule du milieu de l’étendue épuré sera alors formulée de la manière suivante :
=(MAX(FILTRE(A2:A; ABS(STANDARDISE(A2:A; MOYENNE(A2:A); ECARTYPE(A2:A))) <= 3)) + MIN(FILTRE(A2:A; ABS(STANDARDISE(A2:A; MOYENNE(A2:A); ECARTYPE(A2:A))) <= 3))) / 2
Cette architecture prémunit mathématiquement le milieu de l’étendue contre les déformations induites par des aberrations extrêmes à plus de trois déviations-standards de la moyenne.
10.2 Techniques de tronquage partiel (Windsorisation et Trim)
Lorsque la taille de l’échantillon N est substantielle mais que l’expérimentateur souhaite préserver la philosophie du milieu de l’étendue tout en neutralisant le risque inhérent aux rangs absolus 1 et n, il est méthodologiquement opportun de calculer un quasi-milieu de l’étendue (ou milieu de l’étendue tronqué). Cette technique emprunte aux principes de la windsorisation statistique en substituant les extrema absolus par des centiles standardisés robustes, typiquement le 5e centile (P₀,₀₅) et le 95e centile (P₀,₉₅).
Google Sheets implémente nativement des algorithmes d’interpolation centilaire au travers de la fonction CENTILE.EXCLURE (ou PERCENTILE.EXC) et de la fonction PERCENTILE (incluant les bornes). La modélisation de ce milieu d’étendue centilaire s’établit par l’équation de tableur suivante :
=(CENTILE(A2:A; 0,95) + CENTILE(A2:A; 0,05)) / 2
Cette approche hybride constitue un compromis métrologique exceptionnel : elle ignore les 5% d’observations les plus extrêmes situées à chaque périphérie de la distribution — immunisant ainsi l’estimation contre les fausses manœuvres de saisie et les artefacts instrumentaux sporadiques — tout en préservant l’esprit fondamental du milieu de l’étendue, qui consiste à évaluer le centrage spatial des frontières significatives du comportement humain.
10.3 Automatisation du pipeline de prétraitement
Pour assurer la pérennité et la transparence méthodologique des protocoles de recherche, l’organisation spatiale du classeur Google Sheets doit être rigoureusement architecturée en couches fonctionnelles découplées. L’analyste structurera son classeur en trois feuilles de travail distinctes et hiérarchisées :
- Feuille 1 :
Donnees_Brutes: Cette feuille sert de réceptacle exclusif aux saisies initiales. Aucune manipulation arithmétique directe ni altération n’y est tolérée afin de garantir la traçabilité intégrale des données sources. Cette plage fait l’objet d’une protection formelle en écriture (Données > Protéger les feuilles et les plages). - Feuille 2 :
Donnees_Normalisees: Cette feuille extrait dynamiquement les scores de la première feuille en appliquant les règles d’exclusion programmatiques développées aux sections précédentes (rejet des chaînes de caractères, exclusion des zéros non licites, filtrage des Z-scores extrêmes). - Feuille 3 :
Synthese_Analytique: Cette feuille héberge les formules canoniques et avancées du milieu de l’étendue, de l’étendue brute, de la médiane et des graphiques de contrôle associés.
Ce partitionnement fonctionnel garantit qu’aucune manipulation accidentelle ne puisse altérer les données de base tout en consignant explicitement les transformations appliquées au sein du rapport méthodologique accompagnant les publications scientifiques.
11. Études de cas appliquées à la psychologie quantitative
11.1 Cas 1 : Temps de réponse lors d’une tâche d’attention soutenue
Afin d’illustrer la mise en application clinique de ces concepts, examinons une étude de cas en neuropsychologie quantitative portant sur la réhabilitation cognitive d’un patient post-AVC soumis à une épreuve de temps de réaction continue informatisée de type SART (Sustained Attention to Response Task). L’évaluation comprend une mesure longitudinale pré-thérapie et une mesure post-thérapie de 100 essais chacune, archivées dans les colonnes A (Pré-thérapie) et B (Post-thérapie).
En phase pré-thérapie, le tableau d’évaluation met en évidence les métriques suivantes issues de Google Sheets :
=MIN(A2:A101)= 195 ms (réflexe moteur d’anticipation)=MAX(A2:A101)= 890 ms (décrochage attentionnel sévère)=MOYENNE(A2:A101)= 345 ms=MEDIANE(A2:A101)= 310 ms- Milieu de l’étendue pré-thérapie :
=(MAX(A2:A101) + MIN(A2:A101)) / 2= 542,5 ms
En phase post-thérapie (après huit semaines d’entraînement attentionnel métacognitif), les données de la colonne B restituent :
=MIN(B2:B101)= 210 ms=MAX(B2:B101)= 480 ms=MOYENNE(B2:B101)= 290 ms=MEDIANE(B2:B101)= 285 ms- Milieu de l’étendue post-thérapie :
=(MAX(B2:B101) + MIN(B2:B101)) / 2= 345 ms
L’analyse clinique met en relief la puissance diagnostique du milieu de l’étendue dans ce protocole. Si le clinicien s’était borné à scruter la moyenne arithmétique, il n’aurait constaté qu’un gain modeste de 55 ms (passage de 345 ms à 290 ms). En revanche, l’effondrement spectaculaire du milieu de l’étendue (qui passe de 542,5 ms à 345 ms, soit un gain de 197,5 ms) révèle la véritable victoire thérapeutique : la réhabilitation n’a pas seulement accéléré la vitesse nominale du patient, elle a éradiqué les décrochages attentionnels catastrophiques qui projetaient la borne supérieure à 890 ms. L’espace global de fonctionnement opérationnel du sujet s’est resserré et s’est recentré vers des valeurs physiologiques stables.
11.2 Cas 2 : Évaluation des extrêmes dans les inventaires de personnalité
Considérons une seconde étude de cas ancrée dans la psychologie de la personnalité, évaluant le trait de « Neuroticisme » via un inventaire de Likert multidimensionnel auprès d’un panel de 50 cadres dirigeants soumis à un audit organisationnel. L’échelle théorique s’étend de 10 (stabilité émotionnelle exceptionnelle) à 70 (anxiété clinique paralysante). Les scores empiriques sont ventilés le long de la plage C2:C51.
L’extraction dynamique au sein de Google Sheets délivre :
=MIN(C2:C51)= 14=MAX(C2:C51)= 66- Milieu de l’étendue du groupe :
=(MAX(C2:C51) + MIN(C2:C51)) / 2= 40 =MEDIANE(C2:C51)= 26=MOYENNE(C2:C51)= 28,4
Dans ce scénario organisationnel, la convergence remarquable entre la médiane (26) et la moyenne (28,4) situe la masse de la cohorte des dirigeants dans une zone de grande stabilité psychique. Pourtant, le milieu de l’étendue affiche une valeur de 40, coïncidant rigoureusement avec le centre théorique de l’instrument de mesure ((10+70)/2 = 40). Cette discordance majeure met en lumière la coexistence au sein du panel de cas d’extrêmes polarisés (score de 66 indiquant une détresse aiguë chez certains collaborateurs isolés). Le tableur permet au psychologue du travail d’isoler immédiatement ces profils aux bornes par le biais de formules conditionnelles, prévenant la dilution d’individus en souffrance professionnelle aiguë dans des moyennes statistiques lénifiantes.
11.3 Cas 3 : Analyse des scores de stress perçu en psychologie du travail
La troisième application pratique explore la dynamique de fluctuation du stress perçu au sein de deux départements opérationnels d’une grande entreprise de télécommunications : le service Recherche & Développement (Colonne B) et le service Support Clientèle (Colonne C), suivis de façon hebdomadaire sur une échelle continue de 0 à 100 points au cours d’une restructuration managériale.
Le traitement des séries via les fonctions MAX.SI.ENS, MIN.SI.ENS et un tableau croisé dynamique aboutit aux synthèses suivantes :
- R&D : Min = 20, Max = 60. Milieu de l’étendue = 40. Médiane = 39. Écart-type = 8,2.
- Support Clientèle : Min = 10, Max = 90. Milieu de l’étendue = 50. Médiane = 38. Écart-type = 22,4.
L’examen de ces données livre un enseignement épistémologique capital : les deux services affichent des médianes de stress perçu rigoureusement comparables (39 contre 38), suggérant faussement un ressenti similaire en situation de routine. Cependant, le milieu de l’étendue du Support Clientèle (50) combiné à son étendue brute phénoménale (80 points contre 40 pour la R&D) démasque une réalité psycho-organisationnelle radicalement différente : le Support Clientèle est soumis à une oscillation violente entre des phases d’accalmie profonde (score de 10) et des épisodes de panique professionnelle collective aiguë (score de 90). L’omission du milieu de l’étendue aurait dissimulé cette amplitude critique, conduisant la direction des ressources humaines à des choix managériaux inadaptés.
12. Visualisation, restitution académique et limites épistémologiques
12.1 Représentation graphique dans Google Sheets
Une restitution scientifique rigoureuse ne saurait faire l’économie d’une scénarisation visuelle des métriques calculées. Google Sheets propose une palette d’outils graphiques permettant de mettre en scène l’ancrage spatial du milieu de l’étendue par rapport à la dispersion empirique de l’échantillon. Le protocole préconisé repose sur la construction d’un graphique combiné intégrant un histogramme de fréquence et une ligne de repère personnalisée pour le milieu de l’étendue.
Pour matérialiser visuellement le milieu de l’étendue sur un graphique de distribution :
- Générez une colonne dédiée à l’histogramme des scores à partir de la plage
A2:A. - Dans une colonne adjacente
B, assignez à l’intégralité des cellules actives la valeur scalaire fixe issue de votre formule du milieu de l’étendue (par exemple=$C$2). - Sélectionnez les deux séries et insérez un Graphique combiné via Insertion > Graphique. Configurez la série des scores au format « Colonnes » (histogramme de distribution) et la série du milieu de l’étendue au format « Courbe » (qui tracera une droite horizontale de référence barrant la distribution).
En complément, l’analyste déploiera une mise en forme conditionnelle sur la table de données brutes : via le menu Format > Mise en forme conditionnelle, appliquez une règle de style colorimétrique mettant en surbrillance rouge la cellule correspondant à =MAX($A$2:$A) et en vert celle liée à =MIN($A$2:$A). Cette signalétique visuelle alerte immédiatement l’auditeur sur la position physique des deux ancres déterminant l’estimation du milieu de l’étendue.
12.2 Normes de rédaction et de communication selon les standards académiques
La communication des résultats statistiques au sein des revues scientifiques à comité de lecture est assujettie aux normes éditoriales de l’American Psychological Association (APA, 7e édition). Bien que l’APA n’attribue pas de symbole d’abréviation universel unique au milieu de l’étendue (contrairement au M réservé à la moyenne arithmétique et au Mdn assigné à la médiane), l’orthodoxie typographique impose d’expliciter le terme textuellement sous la forme milieu de l’étendue ou de définir son symbole en préambule (par exemple : MR pour midrange).
La restitution académique d’un milieu de l’étendue doit être formulée avec une grande précision méthodologique au sein de la section « Résultats ». Exemple de rédaction conforme :
« Les latences motrices observées lors de la tâche attentionnelle révèlent un milieu de l’étendue de 334,00 ms (borne minimale = 188,00 ms, borne maximale = 480,00 ms), indiquant un déplacement substantiel du centre spatial de l’amplitude de réponse par rapport à la médiane de l’échantillon (Mdn = 227,50 ms, IQR = 65,25 ms). Cette divergence reflète l’influence prononcée des réactions périphériques ralenties sur le calibrage des bornes de performance globales. »
Les prescriptions stylistiques proscrivent toute assertion péremptoire affirmant que le milieu de l’étendue reflète « la performance typique » des participants. Le chercheur justifiera expressément son recours à cette métrique en soulignant son statut d’indicateur des marges physiques ou perceptives extrêmes du dispositif expérimental.
12.3 Considérations épistémologiques sur la réduction de l’information
En conclusion de cette analyse métrologique approfondie, il convient de poser un regard épistémologique critique sur la nature même de la réduction de l’information statistique. L’entreprise consistant à résumer un ensemble riche, hétérogène et complexe de centaines d’observations empiriques en un nombre scalaire unique constitue invariablement une opération de simplification drastique. Le milieu de l’étendue pousse ce paradoxe de la réduction à son paroxysme : il assume le rejet conscient de (N – 2) observations pour n’ériger en modèle que la collision de deux frontières extrêmes.
Cette particularité soulève une question d’éthique de la quantification dans le diagnostic et l’évaluation psychologique. Fonder une décision clinique, une orientation pédagogique ou une sélection professionnelle sur le seul milieu de l’étendue exposerait l’évaluateur à un risque majeur d’injustice interprétative, en assujettissant le diagnostic d’un individu ou d’un groupe aux soubresauts d’un accident de mesure ou d’une performance limite isolée.
Néanmoins, loin d’être une relique obsolète des temps héroïques de la statistique manuelle, le milieu de l’étendue s’avère être un outil heuristique indispensable dès lors qu’il est réintégré dans sa juste fonction : celle d’un révélateur spatial des frontières de l’action. Intégré avec discernement dans l’architecture dynamique de Google Sheets, adossé à des contrôles de robustesse rigoureux et couplé aux métriques traditionnelles de masse et de quantile, le milieu de l’étendue enrichit significativement l’arsenal de l’analyste de données moderne, offrant un éclairage net et intransigeant sur les bornes ultimes du réel observable.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- David, H. A., & Nagaraja, H. N. (2003). Order statistics (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/0471722162
- Google Workspace Support. (2024). Google Sheets function list: MAX, MIN, and statistical calculations. Google Support. https://support.google.com/docs/table/25273
- Hampel, F. R., Ronchetti, E. M., Rousseeuw, P. J., & Stahel, W. A. (1986). Robust statistics: The approach based on influence functions. John Wiley & Sons. https://doi.org/10.1002/9781118186435
- Huber, P. J., & Ronchetti, E. M. (2009). Robust statistics (2nd ed.). John Wiley & Sons. https://doi.org/10.1002/9780470434697
- National Institute of Standards and Technology. (2012). NIST/SEMATECH e-Handbook of Statistical Methods. U.S. Department of Commerce. https://doi.org/10.18434/M32189
- Rousseeuw, P. J., & Leroy, A. M. (1987). Robust regression and outlier detection. John Wiley & Sons. https://doi.org/10.1002/0471725382
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10