
Dans le champ de l’analyse quantitative et de la modélisation statistique, la structuration des données continues sous la forme de distributions de fréquences constitue une étape analytique fondamentale. L’accumulation de scores bruts issus d’échantillonnages empiriques, qu’il s’agisse de protocoles psychométriques, d’études épidémiologiques ou de mesures comportementales, présente une entropie informationnelle élevée qui occulte les régularités distributionnelles sous-jacentes. Pour transformer cette nébuleuse de valeurs discrètes ou continues en une représentation intelligible capable de révéler l’allure de la densité de probabilité, le statisticien doit procéder à une discrétisation raisonnée de l’espace métrique. Au cœur de cette opération de réduction dimensionnelle réside le calcul de la largeur de classe, paramètre déterminant qui gouverne la résolution et la fidélité de la distribution partitionnée.
L’avènement des environnements infonuagiques de traitement de données a démocratisé les calculs statistiques tout en introduisant de nouvelles exigences de rigueur méthodologique. Parmi ces plateformes, l’application Google Sheets s’est imposée comme un instrument privilégié pour les chercheurs, analystes et praticiens en sciences humaines et sociales en raison de son interopérabilité, de ses fonctions collaboratives en temps réel et de la richesse de son moteur de calcul fonctionnel. Toutefois, l’automatisation du partitionnement de données dans un tableur distribué nécessite une maîtrise conjointe des fondements théoriques de l’estimation de densité par histogramme et des subtilités syntaxiques propres au logiciel, notamment l’évaluation matricielle et la gestion dynamique des plages d’observation.
Le présent traité méthodologique propose une exploration exhaustive des protocoles de détermination et d’automatisation de la largeur de classe au sein de l’écosystème Google Sheets. En reliant l’épistémologie de la statistique descriptive aux règles d’optimisation algorithmique contemporaines, ce guide détaille l’ensemble du continuum analytique, depuis la préparation et l’assainissement du jeu de données brut jusqu’à la visualisation graphique par histogramme calibré, en passant par l’implémentation des heuristiques de Sturges, de Scott et de Freedman-Diaconis. L’approche adoptée conjugue l’exactitude mathématique formelle avec les exigences pratiques de la recherche empirique, fournissant aux analystes les leviers nécessaires pour concevoir des feuilles de calcul robustes, reproductibles et conformes aux standards de scientificité les plus exigeants.
1. Fondements théoriques de la distribution de fréquences et de la largeur de classe
1.1 Définition épistémologique de la largeur de classe en statistique descriptive
En statistique descriptive, la largeur de classe, couramment désignée sous le terme d’intervalle de classe ou d’amplitude d’intervalle, représente la distance métrique séparant la limite inférieure de la limite supérieure d’un compartiment donné au sein d’une partition ordonnée. D’un point de vue épistémologique, cette mesure incarne l’opérateur d’agrégation élémentaire qui permet le passage d’une série univariée continue à une distribution de fréquences discrétisée. Dans ce cadre, il est impératif de distinguer rigoureusement les limites apparentes des classes de leurs frontières réelles. Les limites apparentes correspondent aux bornes effectivement affichées dans la table de fréquences, souvent conditionnées par la résolution de l’instrument de mesure, tandis que les frontières réelles tiennent compte de la continuité théorique de la variable sous-jacente et intègrent les seuils de basculement déterminés par les règles d’arrondi conventionnelles.
Le rôle de l’intervalle dans la réduction de la complexité des séries quantitatives continues répond au principe de parcimonie scientifique. En substituant un ensemble fini de compartiments contigus et mutuellement exclusifs à une infinité potentielle de valeurs ponctuelles, le chercheur synthétise l’information brute sans oblitérer les caractéristiques morphologiques de l’échantillon, telles que le mode, l’asymétrie ou l’aplatissement. Cette opération n’est cependant pas neutre sur le plan de la théorie de la mesure. Une amplitude de classe inadéquate altère la variance de l’échantillon, introduisant un biais connu sous le terme de variance d’erreur de regroupement. Lorsque l’amplitude est trop large, la variance intra-classe s’accroît artificiellement aux dépens de la variance inter-classe, créant une surestimation de l’homogénéité locale et une sous-estimation potentielle de la dispersion globale.
Les critères de représentativité lors du regroupement de données quantitatives reposent ainsi sur la recherche d’une isomorphie entre la distribution empirique des données brutes et la distribution de fréquences agrégée. Une largeur de classe optimale doit garantir que chaque intervalle contienne un effectif suffisant pour autoriser des inférences statistiques robustes, tout en préservant la fidélité aux gradients de densité locaux. La préservation de cette géométrie distributionnelle est un prérequis indispensable pour que l’histogramme qui en découle puisse prétendre au statut d’estimateur non biaisé de la fonction de densité de probabilité de la population parente.
1.2 Importance de la largeur d’intervalle en psychométrie et sciences du comportement
Dans le domaine de la psychométrie et des sciences du comportement, la détermination de la largeur d’intervalle revêt une importance critique en raison de la nature des variables investiguées. Les instruments de mesure standardisés, à l’instar des inventaires de personnalité évaluant le modèle des Big Five ou des batteries d’évaluation cognitive telles que l’échelle d’intelligence de Wechsler pour adultes (WAIS), produisent des scores composites dont l’interprétation repose sur des normes étalonnées. L’application d’une largeur de classe rigoureuse permet de transposer ces scores composites en classes d’étalonnage cohérentes, sans introduire de discontinuités arbitraires qui compromettraient la validité diagnostique ou prédictive des outils d’évaluation.
Un enjeu prépondérant dans l’analyse des distributions comportementales réside dans la minimisation du biais d’agrégation. Ce biais surgit lorsque des individus possédant des profils psychologiques ou cognitifs distincts se trouvent amalgamés au sein d’une même classe en raison d’une granularité excessivement grossière. Inversement, une granularité excessive segmente artificiellement des trajectoires de performance similaires, réduisant la puissance statistique lors des comparaisons intergroupes et augmentant le risque d’erreurs de type I dans les interprétations cliniques. La préservation de l’intégrité des données requiert donc un calibrage empirique de l’intervalle qui tienne compte de l’erreur standard de mesure inhérente à l’épreuve psychométrique utilisée.
L’équilibre optimal entre la résolution des détails et la clarté globale du profil de distribution constitue le fondement de l’utilité clinique et psychométrique des données. Une bonne segmentation permet de visualiser distinctement les phénomènes de plafonnement ou de plancher, fréquemment observés lors de l’évaluation de populations spécifiques, tout en facilitant la détection des sous-populations au sein d’échantillons hétérogènes. Par conséquent, la définition de la largeur de classe en psychométrie n’est pas un simple artifice calculatoire, mais un acte méthodologique fondamental qui conditionne la fidélité de la description psychologique des individus.
1.3 Propriétés mathématiques de la formule universelle
La formulation mathématique universelle qui sous-tend la détermination de la largeur de classe dans une série univariée s’énonce selon l’équation canonique suivante :
Largeur = (Valeur Maximale – Valeur Minimale) / n
Dans cette formulation, le numérateur représente l’étendue brute ou range de la variable observée. Cette étendue mesure l’amplitude totale de l’espace métrique occupé par les réalisations de l’échantillon. Elle condense l’écart absolu entre les deux statistiques d’ordre extrêmes, à savoir la statistique d’ordre unitaire et la statistique d’ordre de rang N. Bien que le calcul de l’étendue soit élémentaire, son inclusion au numérateur confère à la formule une vulnérabilité intrinsèque face aux valeurs atypiques, dans la mesure où un score extrême isole mécaniquement l’amplitude totale et peut gonfler artificiellement la largeur de classe si aucune procédure de contrôle robuste n’est appliquée.
Le dénominateur n symbolise le nombre de partitions, compartiments ou classes dans lesquels l’étendue totale doit être subdivisée de façon uniforme. La valeur attribuée à n exerce une sensibilité mathématique déterminante sur la partition de la variance totale de l’échantillon, régie par le théorème de décomposition de la variance (variance totale = variance intra-classe + variance inter-classe). Plus le dénominateur n est grand, plus la variance intra-classe diminue au profit de la variance inter-classe, maximisant ainsi la discrimination entre les compartiments mais réduisant l’effectif moyen par classe.
Sur le plan théorique, l’adoption d’un nombre insuffisant de partitions (un n trop faible) induit un surlissage de la distribution, dissimulant l’éventuelle multimodalité du phénomène et comprimant artificiellement l’asymétrie empirique. À l’inverse, l’affectation d’un nombre excessif de partitions génère une distribution déchiquetée, dominée par le bruit d’échantillonnage, au sein de laquelle de multiples compartiments peuvent s’avérer vides ou comporter des effectifs erratiques non représentatifs. La détermination conjointe du numérateur et du dénominateur implique donc une appréciation rigoureuse des propriétés d’échelle et de la dispersion sous-jacente des données.
2. Préparation et structuration rigoureuse du jeu de données dans Google Sheets
2.1 Organisation tabulaire et nettoyage préalable des observations
L’exécution de procédures statistiques avancées dans l’environnement Google Sheets requiert une rigueur scrupuleuse dans l’agencement structural des matrices de données. Conformément aux directives méthodologiques de l’American Psychological Association (APA) et aux standards d’intégrité des données du paradigme Tidy Data, chaque colonne de la feuille de calcul doit représenter une variable univariée exclusive, tandis que chaque ligne doit correspondre à une unité d’observation unique, telle qu’un participant ou une session expérimentale. L’en-tête de colonne, situé conventionnellement sur la première ligne, doit comporter une étiquette descriptive dénuée d’espaces superflus ou de caractères spéciaux risquant d’induire des erreurs d’interprétation dans le moteur fonctionnel du tableur.
Le nettoyage préliminaire implique impérativement l’identification et le traitement des observations aberrantes ou extrêmes qui pourraient déformer le calcul de l’étendue brute. Une valeur erronée, issue d’une faute de frappe ou d’un artefact de mesure instrumental, faussera substantiellement la fonction de valeur maximale ou minimale. L’analyste doit inspecter visuellement et algorithmiquement la série au moyen de scores standardisés (scores Z) ou d’écarts interquartiles pour isoler les anomalies métriques avant d’initialiser le calcul de la largeur des intervalles.
La gestion des cellules vides et l’implémentation de règles de validation des données constituent un rempart contre les biais de calcul. Dans Google Sheets, une cellule vide ou contenant des chaînes textuelles invisibles (telles que des espaces résiduels) peut modifier le comportement d’évaluation des fonctions statistiques scalaires. Il est recommandé de mobiliser l’outil de validation des données accessible via le menu « Données » pour restreindre les saisies à des valeurs numériques comprises dans l’intervalle théorique admissible de l’instrument. Parallèlement, l’attribution d’un nom de plage explicite, par exemple Scores_Anxiete pour désigner la plage A2:A201, optimise considérablement la lisibilité des formules statistiques complexes et prévient les erreurs de glissement de références lors de modifications structurelles ultérieures.
2.2 Vérification des propriétés d’échelle et types de variables
Avant d’opérer la moindre segmentation catégorielle, il est indispensable d’évaluer le niveau de mesure de la variable conformément à la typologie de Stevens : nominale, ordinale, d’intervalle ou de rapport. Google Sheets traite uniformément les données numériques sous forme de nombres à virgule flottante en double précision, mais la signification statistique de l’opération d’agrégation dépend étroitement de cette distinction. Les variables d’intervalle (comme les scores de température ou les échelles de quotients intellectuels) autorisent la soustraction et donc le calcul d’une étendue, tandis que les variables de rapport (telles que le temps de réaction ou la concentration salivaire en cortisol) disposent d’un zéro absolu autorisant en outre l’interprétation des ratios entre classes.
L’impact des données discrétisées par rapport aux variables continues théoriques doit faire l’objet d’une vigilance particulière. Dans le cas de variables purement discrètes issues d’échelles de Likert ou de scores de dénombrement d’items, le calcul de la largeur de classe peut produire des limites fractionnaires qui manquent de pertinence pratique si les valeurs possibles ne sont que des entiers stricts. L’analyste doit anticiper si la largeur de classe doit être contrainte à une valeur entière ou si la préservation de décimales est requise pour maintenir la continuité analytique de la mesure.
Enfin, la configuration des formats numériques au sein de l’interface Google Sheets doit être ajustée pour éradiquer les erreurs d’arrondi invisibles à l’écran. L’affichage d’un nombre tronqué à deux décimales par le formatage de la cellule ne modifie pas la valeur réelle stockée dans la mémoire vive du processeur du tableur. Des disparités entre l’amplitude affichée et l’amplitude calculée peuvent ainsi émerger, conduisant à des discordances lors du classement des observations situées exactement sur les frontières de classes. L’uniformisation du format numérique via le menu « Format > Nombre > Personnalisé » garantit une cohérence absolue entre la représentation visuelle et la manipulation arithmétique sous-jacente.
3. Analyse des fonctions fondamentales de Google Sheets nécessaires au calcul
3.1 Extraction des valeurs extrêmes avec les fonctions MAX et MIN
L’évaluation quantitative de l’étendue d’une distribution repose dans Google Sheets sur l’emploi combiné des fonctions statistiques natives MAX et MIN. La syntaxe formelle de la fonction de maximisation s’énonce sous la forme =MAX(valeur1; [valeur2; ...]) ou, plus couramment dans le contexte d’une distribution empirique, =MAX(plage). Sur le plan algorithmique, cette fonction balaie séquentiellement l’intégralité des pointeurs de données compris dans le vecteur sélectionné et retourne la plus grande valeur numérique identifiée, tout en ignorant délibérément les cellules vides et les entrées textuelles non convertibles. Dans le cadre d’un échantillon psychométrique, elle permet d’isoler avec une complexité temporelle linéaire le score d’accomplissement ou de pathologie le plus élevé de la cohorte.
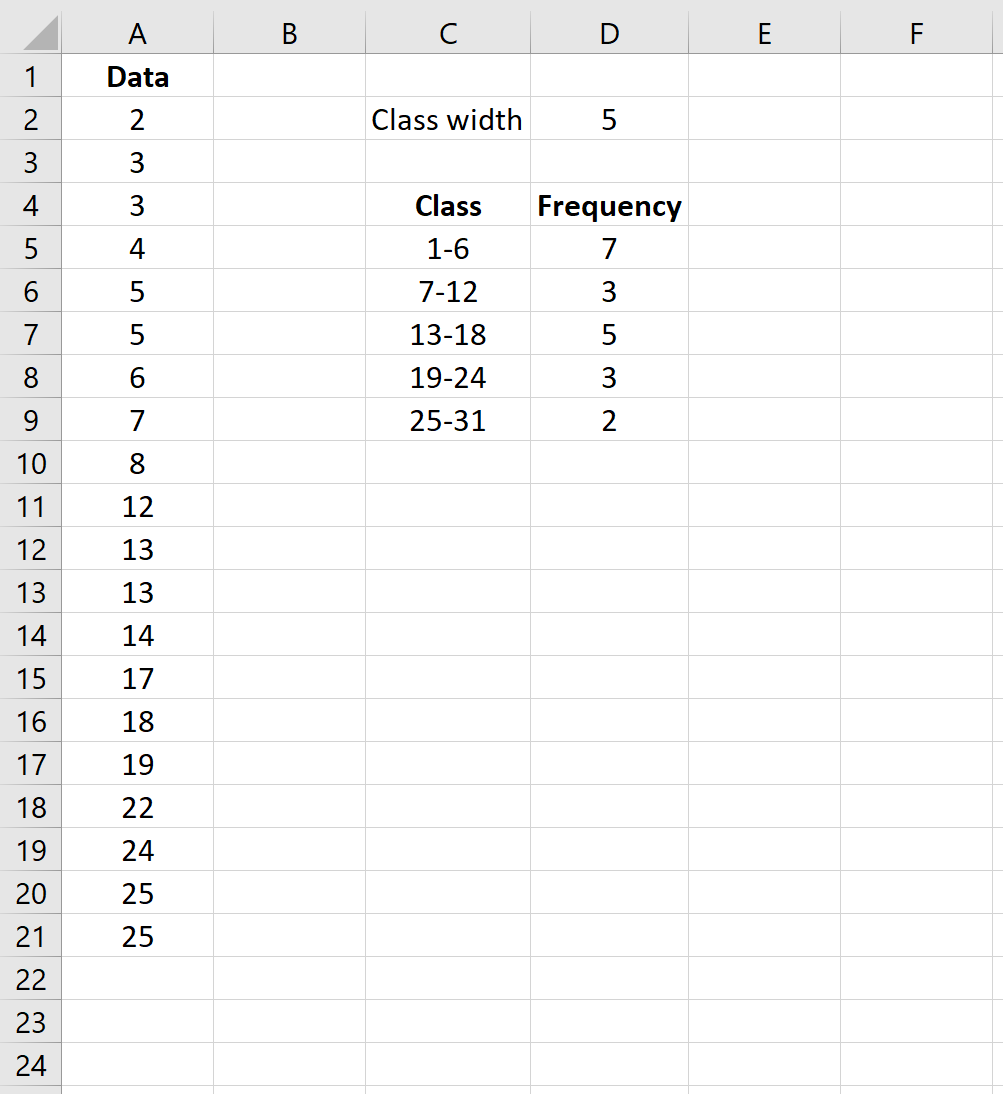
Réciproquement, la fonction =MIN(plage) procède à l’extraction de la valeur plancher de l’échantillon. Cette fonction gère avec une rigueur absolue les valeurs nulles et les grandeurs négatives, une caractéristique essentielle lors du traitement de scores différentiels ou de variables centrées-réduites où le minimum observé peut être inférieur à zéro. L’articulation de ces deux primitives fonctionnelles permet d’obtenir l’étendue brute de la distribution à l’aide de l’expression vectorielle =MAX(plage) - MIN(plage). Cette soustraction matricielle élémentaire établit la base dimensionnelle sur laquelle reposera l’ensemble de l’édifice de discrétisation.
Une précaution méthodique s’impose néanmoins quant à l’interaction entre ces fonctions et les types de données hétérogènes. Si la plage spécifiée incorpore des chaînes de texte qui imitent des valeurs numériques sans conversion explicite, le moteur de Google Sheets les éliminera de la comparaison sans notifier d’alerte contextuelle, ce qui risque de sous-estimer la valeur maximale ou de surestimer la valeur minimale. Il incombe donc à l’utilisateur de s’assurer de l’homogénéité du typage des données, notamment lors de l’importation de fichiers au format CSV ou de formulaires de collecte en ligne.
3.2 Détermination du cardinal de l’échantillon avec NB et NB.SI
La fixation rationnelle du nombre de compartiments n dépend intrinsèquement de la taille de l’échantillon, désignée formellement par le cardinal N. Google Sheets propose à cet effet la fonction =NB(valeur1; [valeur2; ...]), dont l’objet exclusif est de quantifier l’effectif des cellules renfermant des valeurs purement numériques au sein de la plage ciblée. Contrairement à la fonction NBVAL, qui dénombre indistinctement toute cellule non vide incluant les erreurs syntaxiques et les chaînes de texte, NB garantit l’exclusion systématique des métadonnées qualitatives, fournissant un dénominateur rigoureusement intègre pour le calcul des estimateurs statistiques.
Dans des contextes expérimentaux plus complexes où un filtrage des unités d’observation est indispensable avant la construction de la distribution de fréquences, la fonction conditionnelle =NB.SI(plage; critère) ou son homologue multivarié =NB.SI.ENS() s’avère incontournable. Par exemple, si l’analyste cherche à déterminer la largeur de classe pour un sous-groupe expérimental spécifique sans modifier la disposition de la table source, l’expression =NB.SI(plage_critere; "=Groupe_Controle") permet d’extraire la taille de l’échantillon conditionnel avec une précision optimale.
L’exactitude du dénombrement de N constitue un pivot méthodologique majeur. De la valeur exacte de ce cardinal dépendra le choix de l’heuristique de discrétisation. Dans les petits échantillons (N < 30), le nombre de classes optimal est restreint afin d’éviter le dépeuplement statistique des compartiments, alors que dans les grands échantillons (N > 1000), le cardinal permet de resserrer la largeur de classe sans compromettre la stabilité des fréquences relatives au sein de chaque intervalle.
4. Calcul pas à pas de la largeur de classe avec la formule standardisée
4.1 Décomposition opérationnelle de la formule dans une feuille de calcul
L’implémentation opérationnelle du calcul de la largeur de classe au sein de Google Sheets nécessite une décomposition méthodique afin d’assurer l’auditabilité et la clarté du modèle analytique. L’implantation directe de constantes statiques au sein des formules mathématiques est une pratique rigoureusement proscrite en ingénierie des données, car elle induit une rigidité structurelle et empêche l’actualisation dynamique du modèle lors de l’adjonction de nouvelles données. Il convient donc de réserver un espace paramétrique distinct au sein de la feuille de calcul pour accueillir les indicateurs intermédiaires.
La structure tabulaire recommandée consacre une zone dédiée aux paramètres de dispersion et d’échantillonnage, souvent regroupée dans un panneau latéral de synthèse. Dans cette configuration :
- La cellule désignant la valeur minimale intègre l’expression
=MIN(A2:A21); - La cellule désignant la valeur maximale reçoit
=MAX(A2:A21); - La cellule paramétrique associée au nombre de classes n est initialisée avec une valeur arbitraire ou issue d’une formule de décision (par exemple 5) ;
- La cellule finale de largeur de classe synthétise ces variables via la formule relative
=(Cellule_Max - Cellule_Min) / Cellule_n.
Cette sectorisation facilite le recours aux outils d’audit de Google Sheets, tels que le mode d’affichage des dépendances de formules, accessible via les options d’affichage du tableur. L’analyste peut tracer visuellement les flux d’informations reliant les données brutes aux paramètres de synthèse, prévenant ainsi les références circulaires ou les décalages de coordonnées relatives lors du clonage de modèles d’analyse sur différentes cohortes expérimentales.
4.2 Étude d’un cas empirique standardisé sur un échantillon de 20 observations
Pour illustrer de façon pragmatique le fonctionnement de ce protocole de calcul, considérons une étude pilote en neuropsychologie évaluant le niveau d’inhibition cognitive auprès d’une cohorte restreinte de 20 participants. Les scores composites d’interférence cognitive, mesurés sur une échelle standardisée allant théoriquement de 0 à 100 points, sont consignés dans la plage A2:A21 de la feuille de calcul. Supposons que les valeurs observées soient les suivantes : 42, 45, 48, 51, 52, 55, 57, 58, 60, 62, 63, 65, 67, 68, 71, 72, 75, 78, 82, 88.
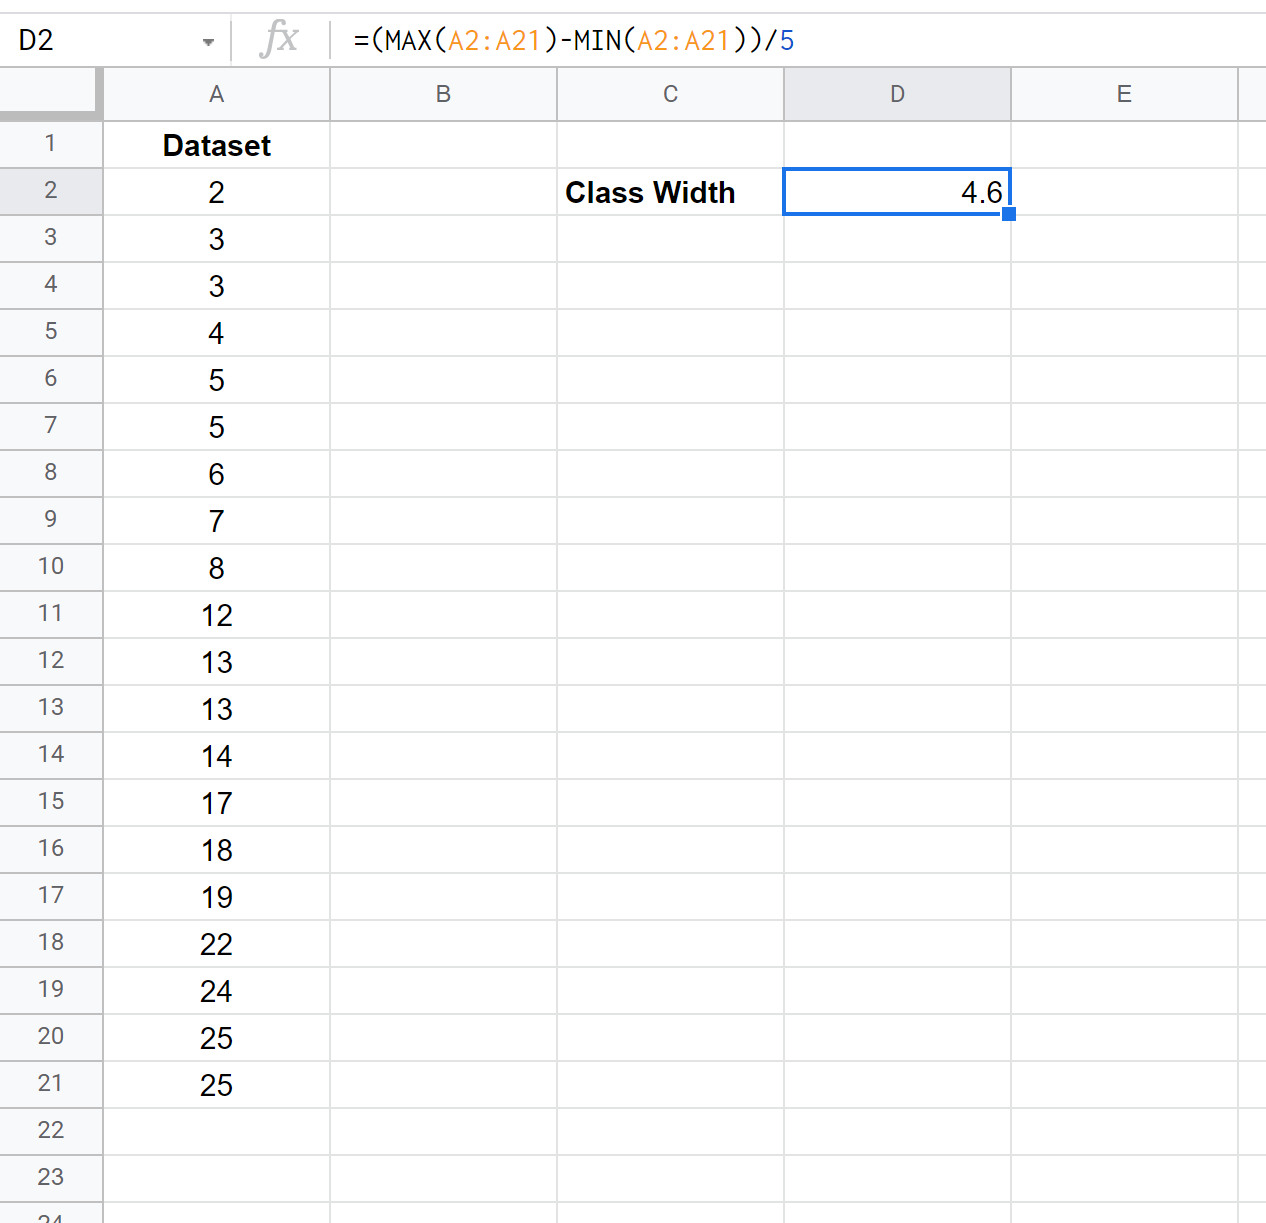
L’évaluation des primitives statistiques de base produit les résultats intermédiaires suivants : l’application de =MIN(A2:A21) renvoie la valeur 42, tandis que la formule =MAX(A2:A21) retourne 88. L’étendue brute de la distribution s’établit par conséquent à 88 - 42 = 46 points d’inhibition cognitive. En fixant a priori le nombre de classes à n = 5, afin de garantir une partition intuitive en cinq niveaux d’aptitude (très faible, faible, moyen, élevé, très élevé), la formule =(MAX(A2:A21)-MIN(A2:A21))/5 aboutit au résultat mathématique brut de 46 / 5 = 9,2.
Ce résultat brut de 9,2 illustre la dichotomie fondamentale entre la continuité théorique de l’expression mathématique et les contraintes pratiques de l’analyse tabulaire. Si l’on conservait strictement cette largeur continue de 9,2, les limites de classes deviendraient décimales (ex. [42 à 51,2[, [51,2 à 60,4[, etc.), ce qui complexifierait inutilement l’interprétation clinique pour des scores d’inventaires mesurés exclusivement en nombres entiers. Cette étape intermédiaire met en exergue la nécessité impérieuse de coupler la formule brute à des règles de décision méthodique concernant le nombre optimal de classes et les stratégies d’arrondi associées.
5. Détermination méthodique du nombre optimal de classes (n)
5.1 Application de la règle empirique de Sturges dans Google Sheets
La règle empirique formulée par le statisticien Herbert Sturges en 1926 demeure l’une des heuristiques les plus fréquemment mobilisées pour calibrer automatiquement le nombre de compartiments d’une distribution de fréquences. Établie sur l’hypothèse sous-jacente que la distribution sous observation se conforme approximativement à une distribution binomiale symétrique qui converge vers une loi normale, l’équation théorique de Sturges s’exprime sous la forme :
n = 1 + 3,322 * log10(N)
Pour implémenter cette règle au sein de Google Sheets, l’analyste transcrit l’expression en exploitant la primitive logarithmique de base 10 native. Dans une cellule dédiée au calcul dynamique de n, la syntaxe s’articule comme suit : =1 + 3,322 * LOG10(NB(A2:A21)). Dans le contexte de notre échantillon de 20 observations, le moteur de calcul évalue le logarithme décimal de 20 (environ 1,301), le multiplie par 3,322 (obtenant 4,322), puis ajoute 1 pour fournir une estimation théorique brute de n ≈ 5,32.
Bien que la règle de Sturges présente une élégance calculatoire indéniable et offre des résultats très satisfaisants pour des échantillons d’effectif modéré (compris entre 30 et 200 individus) issus de populations gaussiennes, elle révèle de sévères défaillances face à des distributions fortement asymétriques ou caractérisées par des queues de distribution épaisses. Dans ces configurations non gaussiennes, Sturges a tendance à sous-estimer substantiellement le nombre de classes nécessaire, opérant un surlissage qui occulte les structures fines de l’échantillon comportemental. De surcroît, pour de très grands échantillons (N > 10 000), cette règle surévalue l’amplitude des intervalles, masquant les variations locales de la densité empirique.
5.2 Implémentation de la règle de Freedman-Diaconis pour distributions asymétriques
Pour pallier les insuffisances structurelles de la règle de Sturges face aux distributions asymétriques ou contaminées par des valeurs atypiques, les mathématiciens David Freedman et Persi Diaconis ont conçu en 1981 une approche non paramétrique particulièrement robuste. Contrairement aux méthodes basées sur l’étendue globale ou la variance, la règle de Freedman-Diaconis détermine directement la largeur de classe idéale à partir de l’écart interquartile (IQR), une mesure de dispersion insensible aux valeurs extrêmes. La formulation théorique s’établit comme suit :
Largeur = 2 * IQR * N^(-1/3)
La transposition de cette heuristique avancée dans Google Sheets s’effectue en décomposant le calcul de l’écart interquartile via la fonction des quantiles. L’écart interquartile de la plage A2:A21 s’obtient par la soustraction vectorielle suivante : =QUARTILE(A2:A21; 3) - QUARTILE(A2:A21; 1). En synthétisant l’intégralité de l’expression mathématique au sein d’une seule formule analytique, l’utilisateur saisit dans sa feuille de calcul :
=2 * (QUARTILE(A2:A21; 3) - QUARTILE(A2:A21; 1)) * (NB(A2:A21)^(-1/3))
Cette approche démontre une supériorité statistique remarquable pour le traitement des données chronométriques en psychologie expérimentale, notamment lors de l’enregistrement de temps de réaction en millisecondes. Ces distributions présentent quasi systématiquement une asymétrie positive marquée, caractérisée par un étalement vers la droite causé par des fluctuations attentionnelles transitoires des sujets. La règle de Freedman-Diaconis isole efficacement le cœur de la distribution, évitant que quelques latences excessivement longues ne viennent dilater l’ensemble des classes et détruire la lisibilité de la tâche cognitive sous étude.
5.3 Formule de Scott basée sur l’écart-type de l’échantillon
Formulée par David Scott en 1979, la règle éponyme propose un compromis optimal fondé sur l’erreur quadratique moyenne intégrée lors de l’estimation de la densité de probabilité d’une variable aléatoire continue. Sous l’hypothèse que la population mère obéit à une distribution normale, la règle de Scott optimise mathématiquement la largeur de classe en fonction de la dispersion standardisée de l’échantillon et de son cardinal :
Largeur = 3,49 * Écart-type * N^(-1/3)
Au sein de Google Sheets, l’estimation sans biais de l’écart-type d’un échantillon s’effectue au moyen de la primitive ECARTYPE.STANDARD (ou STDEV.S dans la syntaxe anglophone unifiée). L’implémentation algorithmique directe de la formule de Scott s’écrit de la façon suivante :
=3,49 * ECARTYPE.STANDARD(A2:A21) * (NB(A2:A21)^(-1/3))
Les conditions de validité de l’heuristique de Scott reposent strictement sur le caractère gaussien des observations. Dans le champ des évaluations psychométriques standardisées, telles que les scores normalisés d’aptitudes intellectuelles ou les notes standardisées de personnalité, cette méthode s’avère particulièrement adaptée car elle capture avec fidélité l’étalement de la courbe en cloche tout en assurant une convergence asymptotique de l’histogramme vers la distribution théorique à mesure que la taille de l’échantillon progresse.
Le choix stratégique entre ces trois paradigmes (Sturges, Freedman-Diaconis, Scott) dépend donc d’un arbitrage méthodologique éclairé. Lorsque l’échantillon présente une distribution symétrique et une taille modérée, Sturges demeure commode d’accès ; lorsque la distribution est gaussienne mais de volume substantiel, Scott offre une précision supérieure ; enfin, dès lors que l’échantillon manifeste une asymétrie visible ou des aberrations métriques, Freedman-Diaconis constitue l’unique garantie d’une discrétisation robuste et dénuée de distorsion d’échelle.
6. Stratégies d’arrondi et définition des bornes réelles de classe
6.1 Nécessité de l’arrondi supérieur pour couvrir l’intégralité de l’étendue
L’une des pierres d’achoppement les plus fréquentes lors de la construction manuelle ou semi-automatisée d’une distribution de fréquences réside dans le traitement arithmétique de la largeur de classe brute obtenue par division. L’application d’un arrondi arithmétique classique (arrondi au plus proche via la fonction standard ARRONDI) génère un risque mathématique majeur : la sous-estimation de la largeur cumulée. Si la largeur de classe est arrondie à l’entier inférieur ou tronquée, la somme des largeurs des n classes ne suffira pas à recouvrir l’intégralité de l’étendue réelle des données, aboutissant à l’exclusion systématique de la valeur maximale observée, qui se retrouve rejetée hors du dernier compartiment.
Pour prévenir cet écueil préjudiciable à la complétude des données, il est méthodologiquement impératif de recourir systématiquement à la fonction ARRONDI.SUP (ou ROUNDUP). Cette primitive force l’incrémentation vers le plafond supérieur au niveau de précision décimale spécifié par l’utilisateur. Par exemple, si une formule de discrétisation produit une largeur de 9,2 points, l’évaluation de =ARRONDI.SUP(9,2; 0) convertira immédiatement cette largeur à 10 unités entières. Grâce à cette expansion contrôlée, le produit n * Largeur_Arrondie dépasse rigoureusement l’étendue brute, garantissant que chaque observation, du minimum absolu au maximum critique, sera intégrée au sein de la partition.
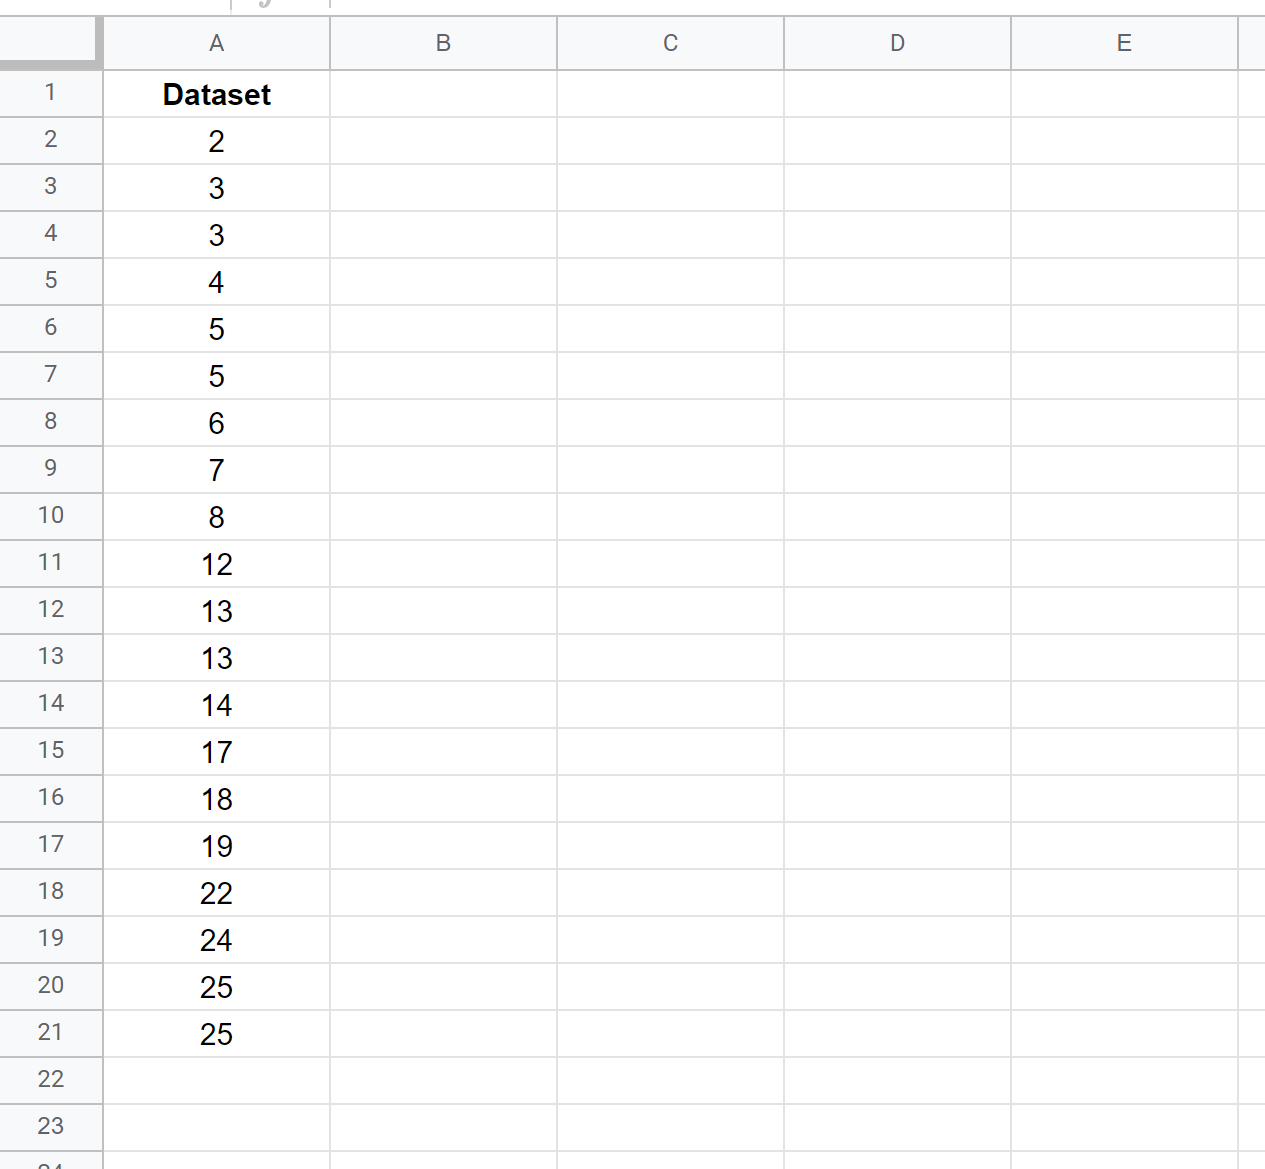
La sélection du nombre de décimales dans l’argument de précision de la fonction ARRONDI.SUP doit s’ajuster à la granularité de la métrique originale. Pour des données discrètes (scores à un questionnaire), la précision est fixée à 0 pour manipuler des entiers stricts. Pour des mesures continues de laboratoire (telles que des concentrations biochimiques ou des potentiels évoqués cognitifs enregistrés à deux décimales), la fonction doit être calibrée en conséquence : =ARRONDI.SUP(formule; 2). Cette cohérence de granularité neutralise l’apparition d’artefacts de troncature qui faussent la classification aux limites des intervalles.
6.2 Harmonisation des limites inférieures et supérieures
Une fois la largeur de classe définitivement arrêtée et majorée, la constitution opérationnelle des compartiments impose l’harmonisation de leurs frontières séquentielles. La borne inférieure de la première classe doit être établie avec discernement. Si l’approche conventionnelle consiste à fixer cette borne à la valeur minimale observée (=MIN(A2:A21)), les standards de clarté en visualisation préconisent fréquemment de caler cette limite inaugurale sur un seuil logique arrondi inférieur, facilitant la lecture cognitive des tableaux de résultats (par exemple, démarrer à 40 plutôt qu’à 42 si l’intervalle est de 10 unités).
Les bornes supérieures successives se construisent de manière itérative par incrémentation arithmétique constante. Si la cellule D2 héberge la limite inférieure inaugurale et la cellule $E$1 la largeur de classe constante et figée par des références absolues, la borne supérieure de ce premier intervalle se calcule via =D2 + $E$1. La borne inférieure du compartiment subséquent prendra alors cette même valeur de transition pour assurer une couverture continue de l’axe métrique sans discontinuité spatiale.
Cette architecture contiguë exige l’application stricte du principe de mutuelle exclusion afin d’éviter qu’une observation coïncidant exactement avec une frontière ne soit dénombrée dans deux classes simultanément. La convention la plus robuste en statistique prescriptive consiste à définir des intervalles semi-ouverts à gauche et fermés à droite, notés ]a, b], ou fermés à gauche et ouverts à droite, notés [a, b[. Dans les sciences du comportement utilisant Google Sheets, la formulation semi-ouverte à droite [a, b[ est préférentiellement adoptée pour les variables quantitatives : une valeur appartient à la classe si elle satisfait la condition Limite_Inférieure <= Score < Limite_Supérieure. Pour les échelles purement ordinales ou discrètes, un ajustement d’une unité entière entre la borne supérieure d’une classe et la borne inférieure de la suivante (ex. 40-49, 50-59) est fréquemment mobilisé pour lever toute ambiguïté de catégorisation.
7. Automatisation intégrale via des formules imbriquées complexes
7.1 Conception d’une macro-formule à cellule unique
Pour les gestionnaires de bases de données volumineuses et les concepteurs de protocoles de recherche automatisés, la démultiplication de cellules intermédiaires peut surcharger la feuille de calcul et accroître le risque de corruption accidentelle des liaisons fonctionnelles. Google Sheets autorise la condensation de l’intégralité de la chaîne décisionnelle au sein d’une unique macro-formule imbriquée. En fusionnant la recherche des extrêmes, le dénombrement de l’échantillon, la règle de Sturges et l’arrondi de sécurisation, on obtient l’architecture unifiée suivante :
=ARRONDI.SUP((MAX(A2:A1000) - MIN(A2:A1000)) / (1 + 3,322 * LOG10(NB(A2:A1000))); 0)
Bien que parfaitement fonctionnelle, cette macro-formule présente l’inconvénient d’exécuter de multiples lectures de la plage d’entrée A2:A1000, ce qui peut ralentir le moteur de rendu JavaScript du navigateur lorsque le jeu de données comporte des centaines de milliers de lignes. Pour pallier cette inefficience computationnelle tout en maximisant l’élégance syntaxique, il est vivement conseillé d’utiliser la fonction moderne LET de Google Sheets. Cette primitive permet d’assigner des variables locales temporaires aux résultats intermédiaires avant d’exécuter l’expression finale :
=LET(

  donnees; A2:A1000;

  min_val; MIN(donnees);

  max_val; MAX(donnees);

  n_obs; NB(donnees);

  k_classes; 1 + 3,322 * LOG10(n_obs);

  largeur_brute; (max_val - min_val) / k_classes;

  ARRONDI.SUP(largeur_brute; 0)

)
L’emploi de la fonction LET optimise drastiquement le temps de calcul sur les ensembles de données volumineux en limitant les requêtes vectorielles à une évaluation unitaire en mémoire vive. De surcroît, elle garantit une maintenance simplifiée du classeur scientifique : si la plage source change de topographie spatiale, l’analyste n’a besoin d’amender qu’une seule référence au sommet du bloc déclaratif.
7.2 Gestion de la dynamique d’expansion avec ARRAYFORMULA
L’automatisation contemporaine dans Google Sheets ne se limite pas au calcul scalaire de la largeur d’intervalle ; elle englobe la génération dynamique de l’ensemble de la grille de distribution à l’aide de formules matricielles expansives. Grâce à la combinaison de la fonction SEQUENCE et de l’encapsulation matricielle, il est possible de matérialiser instantanément la suite des frontières de classe à partir des paramètres dérivés, sans requérir aucun glisser-déposer manuel le long de la colonne.
Considérons une configuration où la borne initiale min_arrondi et la largeur ont été calculées via la structure précédente. La génération séquentielle des limites de compartiments peut s’orchestrer au moyen de la formule suivante saisie dans la cellule supérieure de la table de destination :
=LET(

  dep; MIN(A2:A100);

  larg; ARRONDI.SUP((MAX(A2:A100)-dep)/(1+3,322*LOG10(NB(A2:A100))); 0);

  nb_c; ARRONDI.SUP(1+3,322*LOG10(NB(A2:A100)); 0);

  SEQUENCE(nb_c + 1; 1; dep; larg)

)
Pour conférer une dimension analytique et visuelle immédiate au tableau de fréquences, il est possible de générer dynamiquement des étiquettes textuelles normalisées au format [Borne_Inf - Borne_Sup[. En employant la primitive ARRAYFORMULA couplée à des opérations de décalage vectoriel, les libellés s’auto-actualisent instantanément à chaque variation des scores bruts sous-jacents, instaurant un pipeline d’analyse de données continu, résilient et totalement immunisé contre les erreurs humaines de recopie.
8. Construction de la table de distribution de fréquences dans Google Sheets
8.1 Dénombrement des fréquences absolues avec la fonction FREQUENCE
Une fois les bornes de classes formellement délimitées, l’étape consécutive consiste à dénombrer le volume de données appartenant à chacun des intervalles constitutifs. Google Sheets intègre une primitive statistique matricielle dédiée à cette finalité spécifique : la fonction FREQUENCE (ou FREQUENCY). Sa syntaxe requiert deux arguments obligatoires : la série des données brutes univariées et le vecteur ordonné des limites supérieures de classes :
=FREQUENCE(plage_données; plage_limites)
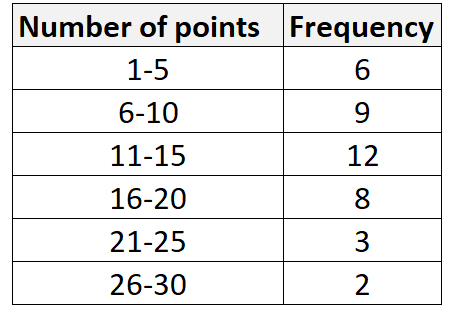
Le comportement algorithmique de FREQUENCE se distingue par sa nature matricielle auto-expansive. Contrairement aux fonctions scalaires traditionnelles, la saisie de cette formule au sein d’une seule cellule provoque un phénomène de débordement vertical automatique (array spillover), peuplant l’intégralité de la colonne adjacente sans nécessiter de recopie. Il est capital de noter que FREQUENCE fonctionne selon une logique d’intervalles semi-ouverts à gauche et fermés à droite ]a, b] : elle dénombre les valeurs strictement supérieures à la borne inférieure et inférieures ou égales à la borne supérieure du compartiment.
Un aspect structurel déterminant de FREQUENCE est sa génération systématique d’une ligne supplémentaire au bas de la colonne de résultats. Cette ligne additionnelle accueille les observations qui dépasseraient la valeur maximale stipulée dans la plage des limites de classe, garantissant ainsi qu’aucune donnée d’extrémité n’échappe à l’inventaire quantitatif. L’analyste doit impérativement auditer l’intégrité de cette distribution matricielle en confrontant la somme totale des fréquences dénombrées, calculée via =SOMME(plage_frequences), au cardinal théorique N obtenu via =NB(plage_donnees). Toute divergence entre ces deux valeurs trahit une anomalie d’inclusion géométrique ou la présence de données hors protocole.
8.2 Calcul des fréquences relatives et fréquences cumulées
L’exploitation psychométrique et descriptive d’une distribution de fréquences ne saurait se cantonner aux effectifs absolus, dont la comparabilité entre cohortes d’effectifs dissemblables s’avère restreinte. L’établissement des fréquences relatives normalise cette métrique en la convertissant en proportions de l’échantillon global. L’opération s’exécute en divisant chaque fréquence absolue par la somme totale de l’échantillon : =Frequence_Absolue / $N_Obs. L’application du formatage en pourcentage au sein de l’interface Google Sheets permet une assimilation visuelle instantanée du poids relatif de chaque segment de score au sein de la population examinée.
Le calcul séquentiel des fréquences cumulées ascendantes constitue la fondation de l’analyse quantile et de l’établissement des seuils percentiles. Dans la première rangée de la table de fréquences, la fréquence cumulée coïncide rigoureusement avec la fréquence relative inaugurale. Pour les rangées subséquentes, l’algorithme procède par incrémentation cumulative récursive :
=Frequence_Cumulee_Precedente + Frequence_Relative_Actuelle
Dans les contextes d’évaluation diagnostique en psychopathologie comportementale ou en orientation scolaire, la colonne des fréquences cumulées permet de repérer immédiatement la classe métrique abritant la médiane de la cohorte (seuil de 50 %), ainsi que les bornes de démarcation clinique conventionnelles (telles que le 5e ou le 95e percentile). La structuration rigoureuse de ces colonnes dérivées offre ainsi un pont analytique direct entre la simple distribution tabulaire et la modélisation statistique avancée des percentiles d’étalonnage.
8.3 Alternative avec les fonctions NB.SI.ENS
Bien que la fonction matricielle FREQUENCE se distingue par sa rapidité calculatoire, elle impose une rigidité structurelle inhérente à son algorithme interne, lequel fonctionne exclusivement sur des intervalles fermés à droite ]a, b]. Or, de nombreuses traditions psychométriques exigent expressément une partition fermée à gauche et ouverte à droite [a, b[. Pour conquérir une liberté totale sur la logique d’inclusion des bornes, l’analyste peut recourir à la fonction multivariée NB.SI.ENS (ou COUNTIFS).
La syntaxe opératoire de cette primitive conditionnelle permet d’encadrer les scores entre deux conditions logiques strictes et indépendantes. Pour une classe dont la limite inférieure est consignée dans la cellule D2 et la limite supérieure dans la cellule E2, la formule s’articule comme suit :
=NB.SI.ENS(Donnees; ">=" & D2; Donnees; "<" & E2)
Pour le compartiment terminal fermant l’éventail de distribution, l’opérateur d’inégalité stricte est avantageusement substitué par un opérateur large "<=" afin de réintégrer la valeur maximale absolue dans l’intervalle sans devoir décréter une classe marginale additionnelle. Bien que NB.SI.ENS requière une recopie cellulaire verticale ou une imbrication au sein d’un bloc matriciel spécifique, elle octroie une flexibilité logique sans égale pour bâtir des segmentations asymétriques ou gérer des cas limites complexes.
9. Visualisation graphique : Configuration de l’histogramme dans Google Sheets
9.1 Génération de l’histogramme natif et paramétrage des compartiments
La transcription d’une distribution de fréquences sous une forme visuelle constitue l’aboutissement naturel de la démarche descriptive. Google Sheets propose un moteur de génération d’histogrammes natif, capable de traiter directement une série univariée de scores bruts sans exiger la construction préalable d’une table de fréquences manuelle. L’analyste sélectionne la plage des données empiriques (par exemple A1:A201 incluant l’étiquette de colonne), clique sur le menu « Insertion », puis sélectionne l’option « Graphique ». Au sein du panneau de configuration de l’éditeur de graphiques, il convient de substituer le type de graphique proposé par défaut par l’icône « Histogramme ».
Par défaut, l’algorithme heuristique interne de Google Sheets calibre de manière discrétionnaire le nombre et la largeur des compartiments, générant fréquemment des découpages visuellement déroutants avec des limites d’intervalles hautement décimales. Pour assujettir l’histogramme aux exigences méthodologiques formalisées en amont, l’utilisateur doit accéder à l’onglet « Personnaliser » de l’éditeur de graphiques, puis dérouler la section intitulée « Histogramme ». Dans ce menu de calibrage :
- L’option « Taille du compartiment » (Bucket size), initialement fixée sur « Automatique », doit être commutée sur la valeur numérique exacte calculée par la règle de Sturges, de Scott ou de Freedman-Diaconis (par exemple, la valeur 10) ;
- L’option « Élément diviseur » permet d’ajuster l’échelle en sous-unités lorsque des comparaisons multi-cohortes sont engagées ;
- La configuration de l’axe horizontal (menu « Axe horizontal ») permet de stipuler formellement les bornes minimales et maximales d’affichage afin d’ancrer l’histogramme sur des repères spatiaux signifiants.
Cette standardisation garantit que l’histogramme affiché coïncide rigoureusement avec les propriétés mathématiques déduites théoriquement, assurant une parfaite fidélité géométrique entre la tabulation des données et leur restitution iconographique.
9.2 Représentation graphique via un diagramme à colonnes standardisé
Nonobstant l’accessibilité de l’histogramme natif, de nombreux contextes de publication scientifique ou académique requièrent un contrôle visuel, esthétique et typographique plus granulaire que celui permis par le module d’histogramme automatisé. La méthodologie alternative consiste à ériger un diagramme à colonnes standardisé à partir du tableau de fréquences tabulé manuellement au sein de la feuille de calcul. Dans cette approche, l’axe des abscisses est alimenté par les libellés textuels d’intervalles (ex. [40-50[, [50-60[), tandis que la série des ordonnées accueille les fréquences relatives ou absolues.
Pour transformer ce diagramme en bâtons en un histogramme conforme aux canons de la statistique descriptive, l’analyste doit impérativement intervenir sur la morphologie des barres verticales. Dans les conventions de représentation graphique, la contiguïté spatiale des rectangles symbolise la continuité théorique de la variable sous-jacente. Il convient par conséquent d’accéder aux paramètres de série de l’éditeur de graphiques et de réduire l’espacement inter-barres (la largeur de l’espace interstitiel) à zéro pour cent ou à une valeur minimale de démarcation esthétique (1 à 2 %).
Cette approche manuelle octroie une maîtrise exhaustive de l’ensemble des métadonnées graphiques. Elle autorise la superposition graphique de courbes de densité théoriques (comme une courbe normale ajustée dérivée de la moyenne et de l’écart-type de l’échantillon), l’adjonction de barres d’erreur expérimentales et l’ajustement pointilleux des conventions de police et de légendes imposées par les comités de lecture scientifique. Le tableau ci-dessous récapitule les divergences fonctionnelles entre les deux modalités de visualisation au sein de Google Sheets :
| Dimension Comparée | Histogramme Natif Automatisé | Diagramme à Colonnes Tabulé |
|---|---|---|
| Source des Données | Vecteur brut non agrégé (ex. A2:A200) |
Tableau de fréquences final (intervalles et effectifs) |
| Contrôle de la Largeur | Restreint aux choix du menu déroulant (valeurs fixes) | Totalement dynamique via les formules de la feuille |
| Régulation de l’Espacement | Automatiquement jointif (zéro espacement) | Ajustable manuellement (0 % à 100 % d’espacement) |
| Typologie des Étiquettes | Générée automatiquement par le moteur interne | Personnalisable via concaténation textuelle avancée |
| Intégration d’Éléments Mixtes | Impossible (type univarié exclusif) | Possible (courbes de fréquences cumulées combinées) |
10. Diagnostic des anomalies et résolution des erreurs de calcul courantes
10.1 Erreurs liées aux types de données et aux valeurs textuelles
L’une des défaillances computationnelles les plus pernicieuses dans les tableurs décentralisés comme Google Sheets émane de la corruption silencieuse des types de données sous-jacents. L’apparition de l’erreur générique #VALEUR! ou la production d’un résultat aberrant (tel qu’une largeur de classe égale à zéro) découle fréquemment d’un conflit de séparateur décimal induit par les paramètres régionaux du compte utilisateur ou du navigateur web. Dans les locales francophones conventionnelles, la virgule constitue le séparateur décimal officiel, tandis que les jeux de données internationaux ou exportés d’environnements de programmation comme R ou Python emploient invariablement le point typographique.
Lorsqu’un nombre décimal est injecté avec un point dans une feuille configurée en locale française, Google Sheets l’interprète instantanément comme une chaîne de caractères textuelle et l’aligne par défaut sur le bord gauche de la cellule. Conséquemment, les fonctions scalaires MIN et MAX ignorent superbement ces cellules, faussant radicalement le calcul de l’étendue brute. Pour assainir la série de données contaminée, l’analyste peut appliquer une formule de conversion coercitive au moyen de la primitive CNUM ou substituer dynamiquement les caractères via la formule matricielle suivante :
=ARRAYFORMULA(SI(ESTTEXTE(A2:A); CNUM(SUBSTITUE(A2:A; "."; ",")); A2:A))
Une vigilance égale s’impose concernant les codes réservés aux données manquantes. Dans de multiples protocoles psychométriques anciens, l’absence de réponse est codée par des valeurs extrêmes sentinelles telles que -999 ou 999. Si ces cellules ne sont pas préalablement identifiées et expurgées avant l’évaluation de la largeur de classe, la valeur minimale ou maximale capturera ce code artificiel, gonflant démesurément l’étendue totale et rendant la largeur de classe complètement caduque.
10.2 Erreurs méthodologiques d’intervalles non recouvrants
Au-delà des erreurs de syntaxe logicielle, des bévues d’ingénierie méthodologique compromettent fréquemment l’intégrité des tables de distribution. Le piège le plus insidieux réside dans le chevauchement accidentel ou l’espacement involontaire entre les bornes supérieures et inférieures de classes adjacentes. L’omission d’une règle d’exclusion claire peut induire l’attribution d’une observation à deux classes à la fois (par exemple, si les compartiments sont étiquetés [40-50] et [50-60], l’observation exacte de valeur 50 est dénombrée deux fois), violant le principe d’additivité des probabilités.
Une anomalie singulière survient lors du traitement d’échantillons pathologiques caractérisés par une variance nulle ou quasi nulle, c’est-à-dire lorsque l’ensemble des participants produit exactement le même score d’accomplissement. Dans cette conjoncture limite, la formule MAX(plage) - MIN(plage) retourne une valeur de zéro, aboutissant à une largeur de classe nulle. L’évaluation ultérieure d’une division par cette largeur nulle provoque l’effondrement algorithmique de la feuille avec une notification d’erreur #DIV/0!.
Pour immuniser les architectures complexes de traitement contre ces défaillances critiques, il est impératif d’intégrer des garde-fous logiques conditionnels en combinant les primitives SI et SIERREUR. La syntaxe résiliente suivante valide au préalable l’existence d’une dispersion métrique positive avant de libérer le processus de segmentation :
=SI(MAX(A2:A)=MIN(A2:A); "Erreur : Variance Nulle"; ARRONDI.SUP((MAX(A2:A)-MIN(A2:A))/Sturges; 0))
Ce protocole défensif garantit que le classeur ne diffusera jamais d’aberrations numériques lors de simulations de Monte Carlo automatisées ou d’analyses sélectives de sous-groupes restreints.
11. Applications pratiques en recherche psychologique et analyse de données
11.1 Standardisation d’un test psychométrique d’anxiété
Afin de concrétiser les principes énoncés au sein d’une démarche clinique appliquée, analysons le protocole de standardisation de l’Inventaire d’Anxiété État-Trait de Spielberger (STAI), administré à une cohorte transversale de 200 étudiants universitaires en situation pré-examens. Les scores globaux de détresse psychologique sont consignés dans la plage B2:B201. L’amplitude théorique du test s’échelonne de 20 à 80 points, mais la dispersion empirique observée au sein de notre échantillon d’évaluation présente un minimum mesuré de 24 et un maximum de 77 points.
L’étendue brute observée est donc évaluée à 77 - 24 = 53 unités métriques. Pour configurer l’étalonnage en vue de dégager cinq profils cliniques distincts (anxiété très basse, basse, modérée, élevée, critique), l’analyste applique l’heuristique de Sturges pour vérifier la cohérence d’un partitionnement pentamétrique : =1 + 3,322 * LOG10(200) ≈ 8,64. Bien que Sturges suggère théoriquement environ 9 partitions pour l’analyse fine de la densité, les contraintes cliniques de diagnostic standardisé préconisent une simplification à 5 classes d’interprétation pour faciliter le dépistage rapide.
Le calcul de la largeur brute s’établit à 53 / 5 = 10,6 points. L’application de la fonction de sécurisation =ARRONDI.SUP(10,6; 0) prescrit impérativement une largeur de classe de 11 points. En démarrant l’étalonnage à la borne minimale logique de 24 points, les compartiments se succèdent selon la progression rigoureuse suivante :
- Classe 1 :
[24 à 35[points (profil d’anxiété minimale) ; - Classe 2 :
[35 à 46[points (anxiété modérée ou adaptative) ; - Classe 3 :
[46 à 57[points (anxiété significative nécessitant une attention) ; - Classe 4 :
[57 à 68[points (anxiété sévère pathogène) ; - Classe 5 :
[68 à 79]points (détresse psychologique critique).
L’observation de cette distribution révèle l’asymétrie positive caractéristique des inventaires de psychopathologie en population non clinique, où la masse des observations gravite autour des classes inférieures tandis qu’une traîne étroite de scores s’étire vers les seuils cliniques supérieurs. La largeur de 11 points permet de circonscrire sans ambiguïté les 5 % d’individus situés au-delà de 68 points, conférant au tableau de fréquences une valeur opérationnelle directe pour les décisions de prise en charge thérapeutique.
11.2 Segmentation des temps de réaction dans une tâche cognitive informatisée
Un deuxième cas d’école émane des neurosciences comportementales et concerne l’évaluation de l’attention sélective au moyen d’une tâche d’inhibition de type Stroop informatisée. L’analyste recueille 500 temps de réaction enregistrés avec une précision millimétrique dans la colonne C2:C501. Les temps de latence s’étalent d’un minimum de 320 millisecondes (réponses motrices anticipatoires) jusqu’à un maximum de 1450 millisecondes (décrochages attentionnels sévères).
Face à la forte asymétrie droite inhérente aux latences chronométriques, la règle de Freedman-Diaconis est expressément mobilisée pour déjouer l’influence distorsive des temps de réaction extrêmes. L’extraction des quantiles dans Google Sheets fournit les jalons suivants : le premier quartile s’établit à 450 ms et le troisième quartile à 680 ms, déterminant un écart interquartile (IQR) de 680 - 450 = 230 millisecondes. L’application de la primitive de calcul s’exécute selon la formule formelle :
=2 * 230 * (500^(-1/3)) ≈ 460 * 0,12599 ≈ 57,95 ms
L’arrondi conservateur au multiple de dix supérieur le plus ergonomique via =ARRONDI.SUP(57,95; -1) consacre une largeur de classe de 60 millisecondes. Ce partitionnement fin permet d’isoler les temps d’anticipation motrice (< 380 ms) sans que ceux-ci ne soient agrégés avec les temps de réponse physiologiques normaux situés entre 440 et 560 ms. L’élimination contrôlée des faux positifs et la mise en évidence des asymétries de décalage cognitif sont ainsi pleinement documentées, garantissant une reproductibilité optimale du protocole expérimental conformément aux critères scientifiques contemporains.
12. Synthèse méthodologique et recommandations pour la recherche empirique
12.1 Arbre de décision pour le choix de la méthode de partitionnement
Pour guider rationnellement le statisticien ou le psychomètre dans la sélection de l’architecture de partitionnement appropriée au sein de Google Sheets, un cadre décisionnel normé s’avère indispensable. Le choix de la formule ne doit jamais découler du hasard ou de la seule commodité technique, mais doit être subordonné aux postulats distributionnels vérifiés sur l’échantillon brut.
Le processus d’arbitrage méthodologique peut se formaliser à travers la taxonomie séquentielle suivante :
- Évaluation de la taille de l’échantillon (N) :
- Si N < 30 (micro-échantillons d’exploration clinique) : Éviter les heuristiques asymptotiques. Fixer manuellement le nombre de classes à 4 ou 5 compartiments pour préserver des effectifs dénombrables par classe, et appliquer la formule standard
=(MAX - MIN) / ncouplée àARRONDI.SUP. - Si 30 <= N <= 200 : Les formules heuristiques deviennent pleinement efficientes.
- Si N < 30 (micro-échantillons d’exploration clinique) : Éviter les heuristiques asymptotiques. Fixer manuellement le nombre de classes à 4 ou 5 compartiments pour préserver des effectifs dénombrables par classe, et appliquer la formule standard
- Évaluation de la morphologie distributionnelle :
- Si la distribution est approximativement normale (symétrie vérifiée, absence d’asymétrie marquée) : Mobiliser en priorité la Règle de Scott (
3,49 * ECARTYPE.STANDARD * N^(-1/3)) ou, à défaut de dispersion calculable, la Règle de Sturges. - Si la distribution manifeste une asymétrie substantielle ou abrite des valeurs atypiques incontournables (temps de réaction, scores de psychopathologie, latences motrices) : Proscrire impérativement Sturges et implémenter rigoureusement la Règle de Freedman-Diaconis basée sur l’écart interquartile.
- Si la distribution est approximativement normale (symétrie vérifiée, absence d’asymétrie marquée) : Mobiliser en priorité la Règle de Scott (
- Objectif analytique prépondérant :
- Pour un dépistage clinique ou une standardisation réglementaire : Privilégier des seuils d’intervalles entiers et ronds en ajustant l’arrondi supérieur aux besoins décisionnels.
- Pour une modélisation théorique ou une estimation non paramétrique de densité : Préserver la largeur continue optimale sans arrondi perturbateur.
12.2 Bonnes pratiques de documentation et reproductibilité scientifique
L’intégrité de la démarche scientifique repose sur le principe cardinal de la reproductibilité universelle des calculs. Dans l’écosystème collaboratif de Google Sheets, où de multiples évaluateurs peuvent interagir concomitamment sur le même document, il est impératif d’ériger des protocoles documentaires stricts afin d’éviter la transformation de la feuille de calcul en une « boîte noire » impénétrable.
En premier lieu, la règle fondamentale de reproductibilité exige le bannissement absolu des valeurs codées « en dur » au sein des formules mathématiques. Chaque coefficient, chaque dénominateur et chaque référence de borne doit émaner soit d’une primitive dynamique, soit d’une cellule de paramétrage explicitement libellée. L’analyste doit enrichir systématiquement la feuille de calcul de métadonnées documentaires en insérant des commentaires contextuels explicatifs sur les cellules abritant des formules complexes, précisant la justification théorique de l’heuristique retenue (ex. justification du choix de Freedman-Diaconis au regard de l’asymétrie observée).
En deuxième lieu, la gouvernance des données au sein de Google Drive commande de sceller les cellules névralgiques de calcul. L’utilisation de la fonctionnalité « Protéger les feuilles et les plages », accessible via le menu « Données », prévient toute altération accidentelle des formules de largeur de classe par des collaborateurs non avertis. Seules les cellules d’entrée réservées aux données brutes doivent demeurer accessibles en écriture.
Enfin, pour permettre un audit méthodologique complet et assurer l’interopérabilité avec d’autres environnements d’analyse statistique avancée tels que SPSS, JASP ou les packages spécialisés sous R, il est vivement préconisé d’accompagner systématiquement le classeur d’un onglet de journal d’audit récapitulant les versions du modèle, les transformations de variables effectuées, et d’assurer une exportation normalisée des tables de fréquences agrégées sous un encodage universel UTF-8. En instaurant cette discipline méthodologique, le chercheur transforme un tableur en un instrument rigoureux de recherche expérimentale, garantissant l’exactitude des calculs, la transparence des analyses et la validité pérenne de ses conclusions statistiques.
Références
- Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: L2 theory. Zeitschrift für Wahrscheinlichkeitstheorie und Verwandte Gebiete, 57(4), 453-476. https://doi.org/10.1007/BF01025868
- Hyndman, R. J. (1995). The problem with Sturges’ rule for selecting the number of bins. Research Paper, Department of Econometrics, Monash University.
- Scott, D. W. (1979). On optimal and data-based histograms. Biometrika, 66(3), 605-610. https://doi.org/10.1093/biomet/66.3.605
- Spielberger, C. D., Gorsuch, R. L., Lushene, R., Vagg, P. R., & Jacobs, G. A. (1983). Manual for the State-Trait Anxiety Inventory. Consulting Psychologists Press.
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677-680. https://doi.org/10.1126/science.103.2684.677
- Sturges, H. A. (1926). The choice of a class interval. Journal of the American Statistical Association, 21(153), 65-66. https://doi.org/10.1080/01621459.1926.10502161
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1-23. https://doi.org/10.18637/jss.v059.i10