
Dans l’édifice des sciences quantitatives, la caractérisation d’un phénomène aléatoire ne saurait se restreindre à la simple identification de sa tendance centrale. Si la moyenne ou l’espérance mathématique fournit un point d’ancrage indispensable en désignant le barycentre probabiliste des réalisations possibles, elle demeure fondamentalement aveugle à la structure de leur dispersion. Deux variables aléatoires peuvent présenter une espérance rigoureusement identique tout en décrivant des réalités phénoménologiques radicalement divergentes : l’une concentrant la quasi-totalité de sa masse de probabilité dans un voisinage infinitésimal de son centre, tandis que l’autre disperse ses réalisations vers des horizons extrêmes, exposant l’observateur à une volatilité substantielle. C’est précisément pour combler cette lacune descriptive et analytique que la théorie des probabilités a forgé le concept de variance.
La variance d’une distribution de probabilité constitue la mesure fondamentale de la dispersion stochastique. Définie formellement comme le deuxième moment centré d’une variable aléatoire, elle quantifie l’écart quadratique moyen attendu entre les réalisations potentielles et leur espérance mathématique. Loin d’être un simple artefact calculatoire réservé aux théoriciens, la variance est le pivot opérationnel de la modélisation de l’incertitude dans des disciplines aussi variées que l’économétrie financière, la théorie du signal, la mécanique statistique, l’épidémiologie et la psychométrie. Sa maîtrise algorithmique et conceptuelle représente un prérequis absolu pour quiconque aspire à interpréter les données d’un monde intrinsèquement non déterministe.
Le présent traité propose une déconstruction exhaustive des principes théoriques, des formulations mathématiques et des protocoles computationnels présidant au calcul de la variance d’une distribution de probabilité. En explorant successivement les distributions discrètes et continues, la formule canonique et le théorème de Koenig-Huygens, ainsi que les implications concrètes de la dispersion dans la modélisation du risque et la standardisation des mesures, cet article offre un guide de référence rigoureux, destiné aux chercheurs, analystes, étudiants avancés et praticiens des méthodes quantitatives.
1. Introduction aux fondements de la variance d’une distribution de probabilité
1.1 Définition conceptuelle de la dispersion statistique
La modélisation probabiliste repose sur une tension dialectique fondamentale entre deux propriétés complémentaires d’un ensemble de données ou d’une loi théorique : la tendance centrale et la variabilité. Alors que les mesures de tendance centrale, à l’instar de la moyenne arithmétique, de la médiane ou du mode, cherchent à résumer l’ensemble d’une distribution en une valeur unique censée représenter le comportement typique du système, les mesures de dispersion évaluent l’hétérogénéité, l’étalement ou l’instabilité de ces réalisations autour de cette valeur centrale. Sans mesure de dispersion, une mesure de tendance centrale est non seulement incomplète, mais souvent trompeuse. Affirmer qu’un investissement présente un rendement moyen de 8 % par an ne fournit aucune information sur le risque sous-jacent : ce rendement peut résulter d’obligations d’État garanties générant invariablement 8 %, ou d’un actif spéculatif oscillant de manière erratique entre des gains de 80 % et des pertes totales de 64 %.
Dans les modèles probabilistes modernes, la nécessité de quantifier l’incertitude est devenue impérieuse. L’aléa ne peut être géré que s’il est rigoureusement mesuré. La dispersion constitue le substrat même de l’évaluation du risque, qu’il s’agisse du risque financier de marché, de la fiabilité d’un composant aérospatial ou de la variabilité interindividuelle dans les réponses à un traitement pharmacologique. D’un point de vue comportemental, la perception du risque par les agents économiques ou les décideurs publics est intimement liée à cette volatilité : une distribution compacte génère de la prévisibilité et autorise une planification stratégique robuste, tandis qu’une distribution étalée impose la constitution de marges de sécurité substantielles.
Sur le plan de l’histoire des sciences, l’émergence de la variance résulte d’un long processus d’abstraction statistique. Si les astronomes des XVIIIe et XIXe siècles, menés par Carl Friedrich Gauss et Pierre-Simon de Laplace, utilisaient déjà l’erreur quadratique moyenne pour ajuster les observations télescopiques via la méthode des moindres carrés, c’est au statisticien et biologiste britannique Ronald Aylmer Fisher que l’on doit l’introduction formelle du terme « variance » en 1918 dans son article séminal The Correlation Between Relatives on the Supposition of Mendelian Inheritance. Fisher a démontré que la décomposition de la variance totale en composantes additives permettait d’isoler les causes génétiques et environnementales de la variabilité des traits biologiques, fondant ainsi l’analyse de la variance (ANOVA) et élevant ce paramètre au rang de pierre angulaire de l’inférence statistique moderne.
1.2 Importance de la variance dans l’analyse stochastique
Au-delà de sa fonction descriptive, la variance joue un rôle fondamental dans la caractérisation morphologique des distributions aléatoires. Conjointement avec l’espérance (premier moment), le coefficient d’asymétrie ou skewness (troisième moment normalisé) et le coefficient d’aplatissement ou kurtosis (quatrième moment normalisé), la variance définit l’empreinte géométrique d’une loi de probabilité. Elle détermine l’échelle de la distribution, dictant la largeur de la cloche pour une loi de Gauss ou l’étendue du support effectif pour des lois bornées. Une modification de la variance, à espérance constante, altère profondément la répartition des masses de probabilité : une augmentation de la variance transfère mécaniquement de la probabilité depuis la zone centrale vers les queues de distribution, augmentant l’occurrence des événements extrêmes.
Le rôle de la variance devient encore plus structurant lorsqu’on examine les théorèmes limites fondamentaux qui sous-tendent l’ensemble de la statistique inférentielle. Le théorème central limite (TCL) stipule que la somme d’un grand nombre de variables aléatoires indépendantes et identiquement distribuées, pourvu qu’elles possèdent une variance finie, converge en loi vers une distribution normale dont la variance est directement proportionnelle à la variance individuelle des composantes et inversement proportionnelle à la taille de l’échantillon. L’existence d’une variance finie est la condition sine qua non de l’applicabilité de ce théorème. En son absence — comme dans le cas des distributions à queue lourde de type loi de Cauchy ou certaines lois de Pareto —, les estimateurs usuels perdent leur consistance asymptotique normale, plongeant l’analyse statistique dans le domaine des régimes de variabilité infinie.
Dans la modélisation quantitative prédictive, la variance gouverne directement la précision des prévisions. L’erreur quadratique moyenne de prédiction d’un modèle se décompose canoniquement en la somme du carré du biais de l’estimateur, de la variance de cet estimateur et de la variance irréductible inhérente au bruit stochastique du système. Ce compromis biais-variance représente le défi central de l’apprentissage automatique et de l’économétrie. Enfin, dans les sciences humaines et sociales, particulièrement en psychométrie, la variance constitue le paramètre d’étalonnage par excellence : un test psychologique ou un questionnaire psychométrique dont les items présenteraient une variance nulle serait incapable de discriminer les individus selon leurs traits latents, rendant l’instrument de mesure scientifiquement inutile.
1.3 Distinction entre variance empirique et variance d’une variable aléatoire
Une confusion épistémologique et méthodologique fréquente chez les praticiens réside dans l’assimilation hâtive de la variance empirique (ou échantillonnale) à la variance théorique d’une variable aléatoire. Il s’agit pourtant de deux objets mathématiques de nature fondamentalement différente. La variance empirique, notée usuellement s2, est une statistique calculée à partir d’un échantillon fini d’observations concrètes recueillies dans le monde réel. Elle dépend intrinsèquement des fluctuations d’échantillonnage : si l’on répète l’expérience en extrayant un nouvel échantillon de taille n, la valeur de s2 fluctuera. En revanche, la variance théorique, désignée par Var(X) ou σ2, est un paramètre déterministe fixe associé à la loi de probabilité abstraite régissant l’univers stochastique sous-jacent. Elle ne dépend d’aucun tirage particulier, mais de la structure mathématique complète de la mesure de probabilité.
Cette divergence conceptuelle se traduit immédiatement dans les formulations mathématiques employées. Lorsque l’on dispose d’un échantillon fini de n observations {x1, x2, …, xn} issu d’une population inconnue, le calcul de la variance empirique impose l’application d’un facteur correctif pour éliminer le biais statistique introduit par l’estimation simultanée de la moyenne inconnue. On utilise alors la variance échantillonnale corrigée, régie par la division par n − 1 (correction de Bessel) :
$$s^2 = \frac{1}{n – 1} \sum_{i=1}^n (x_i – \bar{x})^2$$
À l’opposé, pour une distribution de probabilité discrète théorique où l’ensemble des couples {xi, P(X = xi)} est exhaustivement et parfaitement connu, il n’existe aucun phénomène d’estimation ni de perte de degré de liberté. La variance théorique est alors définie comme une moyenne pondérée exacte par les probabilités associées :
$$\text{Var}(X) = \sum_{i} (x_i – \mu)^2 P(X = x_i)$$
Le diviseur n − 1 n’a strictement aucun sens dans le cadre d’une loi de probabilité théorique, puisque la somme des probabilités élémentaires est, par axiome, rigoureusement égale à 1. La passerelle entre ces deux mondes est garantie par la loi forte des grands nombres : à mesure que la taille de l’échantillon n tend vers l’infini, la variance empirique s2 converge presque sûrement vers la variance théorique σ2 de la distribution sous-jacente.
2. Définition formelle et notation mathématique de la distribution de probabilité
2.1 Notion de variable aléatoire discrète et loi de probabilité
Pour appréhender rigoureusement le calcul de la variance, il est nécessaire de formaliser le cadre probabiliste dans lequel évolue la variable étudiée. Selon la construction axiomatique établie par Andreï Kolmogorov en 1933, un modèle probabiliste se définit par un espace probabilisé canonique constitué d’un triplet (Ω, Σ, P), où Ω représente l’univers des événements élémentaires possibles, Σ est une tribu (ou σ-algèbre) d’événements sur Ω, et P est une mesure de probabilité associant à chaque événement de Σ un nombre réel compris dans l’intervalle [0, 1].
Dans ce cadre, une variable aléatoire discrète X est une application mesurable définie sur l’univers Ω et prenant ses valeurs dans un ensemble dénombrable de réels, noté E = {x1, x2, …, xk, …}. La loi de probabilité (ou distribution de probabilité) de X est entièrement caractérisée par sa fonction de masse de probabilité (pmf, pour probability mass function), notée p(xi) ou P(X = xi), qui assigne une mesure scalaire à chaque modalité réalisable. Pour constituer une distribution de probabilité valide sur le plan axiomatique, cette fonction de masse doit impérativement satisfaire deux conditions de normalisation incontournables :
- La positivité stricte des probabilités élémentaires : Pour toute réalisation possible xi appartenant au support de la distribution, P(X = xi) ≥ 0. Dans le cadre des événements effectivement réalisables du support, on postule généralement P(X = xi) > 0.
- La condition de clôture unitaire : La sommation exhaustive de toutes les probabilités associées aux événements élémentaires du support doit être rigoureusement égale à l’unité :
$$\sum_{i} P(X = x_i) = 1$$
Cette condition traduit la certitude ontologique que la variable X prendra nécessairement l’une des valeurs répertoriées dans son support lors de la réalisation de l’expérience aléatoire.
Sur le plan pratique, une fonction de masse se représente conventionnellement sous deux formats complémentaires : sous la forme d’un tableau de distribution mettant en correspondance biunivoque chaque réalisation xi et sa probabilité pi, ou sous la forme graphique d’un diagramme en bâtons où l’abscisse porte les valeurs de la variable et la hauteur de chaque segment vertical reflète l’amplitude exacte de la probabilité associée.
2.2 Conventions de notation mathématique standard
La littérature mathématique impose une typographie rigoureuse afin d’éviter toute ambiguïté sémiotique dans les démonstrations et les calculs stochastiques. Une variable aléatoire est invariablement désignée par une lettre majuscule latine, le plus souvent X, Y ou Z. Cette entité abstraite représente le mécanisme générateur ou la fonction avant toute observation concrète. À l’opposé, les réalisations spécifiques de cette variable aléatoire, c’est-à-dire les valeurs numériques précises qu’elle peut emprunter, sont transcrites en lettres minuscules indexées : x1, x2, …, xn. L’expression P(X = xi), souvent abrégée en pi, désigne la probabilité que la variable aléatoire X prenne précisément la valeur scalaire xi.
Pour désigner la tendance centrale théorique, deux notations sont employées de manière interchangeable : l’opérateur d’espérance mathématique, noté E[X] ou 𝔼[X], qui souligne la nature fonctionnelle de l’opération, et la lettre grecque μ (mu), parfois indicée μX, qui traite cette valeur comme un paramètre scalaire intrinsèque de la loi. Concernant la dispersion, la variance est formellement dénotée par Var(X), V(X) ou, dans le formalisme des paramètres de population, par la lettre grecque minuscule sigma élevée au carré : σ2 ou σ2X. L’usage délibéré du carré dans σ2 n’est pas une coquetterie typographique ; il rappelle de façon constante que la variance est une grandeur d’ordre quadratique, dont les unités physiques correspondent au carré des unités de la variable originale X. L’écart-type théorique, rétablissant l’homogénéité dimensionnelle avec la variable, est par conséquent désigné par σ.
3. L’étape préalable indispensable : le calcul de l’espérance mathématique
3.1 Formulation théorique de la moyenne pondérée
Le calcul de la variance d’une distribution de probabilité repose conceptuellement sur la quantification des écarts par rapport à un point focal de référence. Ce point focal est obligatoirement l’espérance mathématique. Tenter de déterminer la variance sans avoir préalablement calculé l’espérance est une impossibilité logique et computationnelle. L’espérance mathématique E[X], également désignée sous le vocable de premier moment non centré, représente la valeur moyenne théorique que l’on observerait si l’on répétait l’expérience probabiliste une infinité de fois dans des conditions strictement identiques.
D’un point de vue mécanique et physique, l’espérance mathématique s’interprète comme le barycentre ou le centre de gravité d’une distribution de masses. Si l’on imagine une tige graduée d’un poids négligeable sur laquelle sont disposées des masses ponctuelles P(X = xi) aux positions spatiales xi, le point d’équilibre parfait de cette tige correspond rigoureusement à l’abscisse μ = E[X]. Mathématiquement, pour une variable aléatoire discrète prenant un nombre fini ou dénombrable de valeurs, la formulation sommative s’écrit :
$$\mu = E[X] = \sum_{i=1}^n x_i P(X = x_i) = \sum_{i=1}^n x_i p_i$$
Chaque valeur réalisable xi participe à la constitution de l’espérance à proportion exacte de son poids probabiliste pi. Si toutes les modalités étaient équiprobables (loi uniforme discrète où pi = 1/n pour tout i), l’espérance se réduirait simplement à la moyenne arithmétique classique des valeurs. Dans le cas général, l’asymétrie des probabilités déplace le centre de gravité vers les régions concentrant les plus fortes densités de probabilité.
Dans l’éventualité où le support de la variable aléatoire comprend une infinité dénombrable de modalités (par exemple dans le cadre d’une loi géométrique ou d’une loi de Poisson où xi ∈ ℕ), l’espérance mathématique n’existe et n’est formellement définie que si la série est absolument convergente, c’est-à-dire si :
$$\sum_{i=1}^{\infty} |x_i| P(X = x_i) < \infty$$
Si cette condition de convergence absolue n’est pas remplie, la distribution ne possède pas d’espérance finie, ce qui rend caduque toute tentative ultérieure de calcul d’une variance conventionnelle.
3.2 Procédure algorithmique de calcul de mu
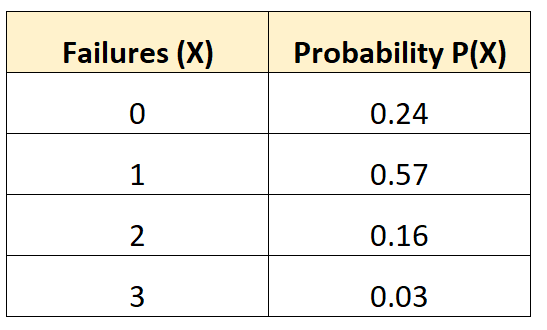
Pour calculer avec une rigueur absolue l’espérance mathématique d’une variable aléatoire discrète finie, le praticien doit suivre un protocole séquentiel strict décomposable en quatre étapes opérationnelles :
- Étape 1 : Structuration tabulaire et alignement : Disposer les données sous forme de tableau à deux colonnes principales. La première colonne répertorie exhaustivement toutes les modalités scalaires mutuellement exclusives xi. La seconde colonne consigne en regard la probabilité exacte P(X = xi) associée à chaque modalité.
- Étape 2 : Calcul des produits pondérés terme à terme : Créer une troisième colonne dédiée au produit arithmétique de chaque valeur par sa probabilité respective, soit l’opération élémentaire :
$$\pi_i = x_i \times P(X = x_i)$$
Cette étape opérationnelle pondère l’amplitude de chaque événement par sa fréquence théorique de survenue. - Étape 3 : Sommation intégrale du vecteur produit : Réaliser la sommation arithmétique de l’ensemble des valeurs calculées dans cette troisième colonne. La valeur scalaire obtenue constitue l’espérance mathématique μ :
$$\mu = \sum_{i=1}^n \pi_i$$ - Étape 4 : Contrôle de cohérence d’amplitude : Effectuer un diagnostic de vraisemblance. En vertu des propriétés fondamentales de l’opérateur d’espérance, la valeur calculée de μ doit obligatoirement être bornée par les valeurs extrêmes du support :
$$\min(x_i) le \mu le \max(x_i)$$
Si l’espérance calculée se situe en dehors de cet intervalle fermé, cela indique irrémédiablement la présence d’une erreur de calcul arithmétique ou d’une mauvaise assignation des probabilités élémentaires.
3.3 Illustration numérique pas à pas
Afin de concrétiser cette procédure avant d’aborder la variance, considérons une distribution discrète modélisant le comportement d’évaluation de la performance d’un athlète professionnel lors d’une série de compétitions majeures. Soit la variable aléatoire X représentant le nombre de pénalités techniques infligées par match. L’analyse des saisons antérieures permet d’établir la fonction de masse de probabilité suivante :
- 0 pénalité : probabilité p1 = 0,20
- 1 pénalité : probabilité p2 = 0,45
- 2 pénalités : probabilité p3 = 0,25
- 3 pénalités : probabilité p4 = 0,10
Appliquons scrupuleusement le protocole algorithmique en calculant les produits terme à terme :
$$\pi_1 = 0 \times 0{,}20 = 0{,}00$$
$$\pi_2 = 1 \times 0{,}45 = 0{,}45$$
$$\pi_3 = 2 \times 0{,}25 = 0{,}50$$
$$\pi_4 = 3 \times 0{,}10 = 0{,}30$$
La sommation intégrale de ces contributions pondérées produit la valeur de l’espérance mathématique :
$$\mu = E[X] = 0{,}00 + 0{,}45 + 0{,}50 + 0{,}30 = 1{,}25$$
Le contrôle de cohérence confirme que 1,25 s’inscrit parfaitement dans l’intervalle [0, 3]. On observera que l’espérance n’a aucune obligation d’appartenir à l’ensemble des entiers discrets : un athlète ne peut évidemment pas écoper de 1,25 pénalité lors d’un match singulier, mais sur une saison prolongée, la moyenne théorique attendue convergera précisément vers ce niveau d’occurrence.
Il importe de souligner la forte sensibilité de l’espérance mathématique aux asymétries de distribution. Si une modalité extrême, bien que rare, se voit attribuer une valeur scalaire très élevée (par exemple une modalité résiduelle de 10 pénalités dotée d’une faible probabilité de 0,02), elle déplacera substantiellement l’espérance vers la droite, modifiant de ce fait l’ensemble des écarts individuels qui serviront de base au calcul de la variance.
4. La formule canonique de la variance : déconstruction théorique
4.1 Structure mathématique de la formule standard
Une fois l’espérance mathématique μ déterminée, la question centrale de la mesure de dispersion se pose : comment quantifier rigoureusement l’éloignement global des différentes réalisations potentielles par rapport à cette valeur centrale ? Une première intuition consisterait à calculer la moyenne pondérée des écarts simples, soit la sommation des termes (xi − μ)P(X = xi). Cependant, en raison de la nature même de l’espérance qui constitue le barycentre parfait de la loi, cette somme s’annule systématiquement :
$$\sum_{i=1}^n (x_i – \mu) P(X = x_i) = \sum_{i=1}^n x_i P(X = x_i) – \mu \sum_{i=1}^n P(X = x_i) = \mu – \mu(1) = 0$$
Les déviations positives compensent exactement et intégralement les déviations négatives. Pour neutraliser cette compensation destructrice d’information, deux voies d’analyse s’offrent au mathématicien : recourir à la valeur absolue des écarts, ce qui conduit à l’écart absolu moyen, ou élever chaque écart au carré. Pour des raisons d’analyse fonctionnelle, de différentiabilité et de propriétés algébriques fécondes, la théorie mathématique a privilégié l’élévation au carré.
La structure algébrique de la formule canonique de la variance d’une variable aléatoire discrète s’établit dès lors comme la sommation pondérée des écarts quadratiques par rapport à l’espérance :
$$\text{Var}(X) = \sigma^2 = \sum_{i=1}^n (x_i – \mu)^2 P(X = x_i)$$
Cette expression réalise une synthèse élégante : le terme (xi − μ) opère le centrage de chaque modalité ; la mise au carré (xi − μ)2 garantit la stricte positivité de chaque contribution tout en supprimant le signe directionnel de la déviation ; enfin, la multiplication par P(X = xi) assure que l’impact d’un écart donné sur la dispersion globale soit strictement calibré sur sa probabilité réelle de matérialisation.
4.2 Signification intuitive du moment centré d’ordre deux
En analyse statistique avancée, la variance s’identifie formellement au deuxième moment centré d’une variable aléatoire, que l’on écrit synthétiquement sous la forme fonctionnelle :
$$\text{Var}(X) = E\left[(X – E[X])^2\right]$$
L’élévation à la puissance deux engendre une conséquence géométrique et statistique d’une portée majeure : elle introduit une pénalisation quadratique disproportionnée des valeurs fortement distantes de la moyenne. Un écart de 4 unités par rapport à μ ne contribue pas deux fois plus à la variance qu’un écart de 2 unités, mais quatre fois plus (42 = 16 contre 22 = 4). Un écart de 10 unités participe quant à lui cent fois plus qu’un écart unitaire. De ce fait, la variance est extrêmement réactive à la présence de valeurs atypiques ou d’événements à faible probabilité mais à grande amplitude situés dans les queues de distribution.
Cette formulation trouve une analogie conceptuelle directe avec le concept de moment d’inertie en mécanique classique. En physique des corps rigides, le moment d’inertie d’un système de particules matérielles par rapport à son axe de rotation passant par le centre de masse s’exprime par la somme des masses individuelles multipliées par le carré de leur distance à cet axe (∑ mi ri2). En probabilités, les masses sont remplacées par les probabilités élémentaires pi, et la distance géométrique ri par l’écart (xi − μ). Ainsi, la variance mesure l’inertie stochastique de la loi de probabilité : plus la variance est élevée, plus il est difficile de prédire la localisation exacte d’une réalisation, de même qu’un volant d’inertie doté d’une masse fortement déportée vers sa périphérie résiste davantage aux variations de mouvement angulaire.
Cette propriété structurelle influe directement sur les moments d’ordre supérieur. Une distribution possédant une variance substantielle présentera fréquemment un comportement d’aplatissement (kurtosis) spécifique, déterminant si la dispersion s’effectue de manière diffuse sur les flancs intermédiaires (loi platykurtique) ou par le biais d’un pic très aigu associé à des queues particulièrement lourdes et étendues (loi leptokurtique).
5. Protocole méthodique de calcul de la variance à partir d’un tableau
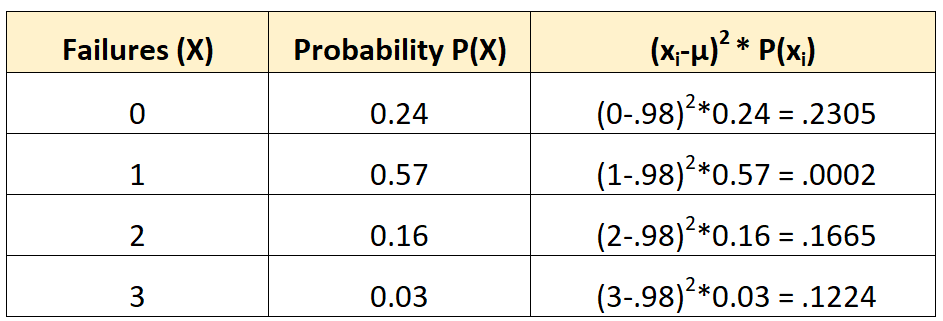
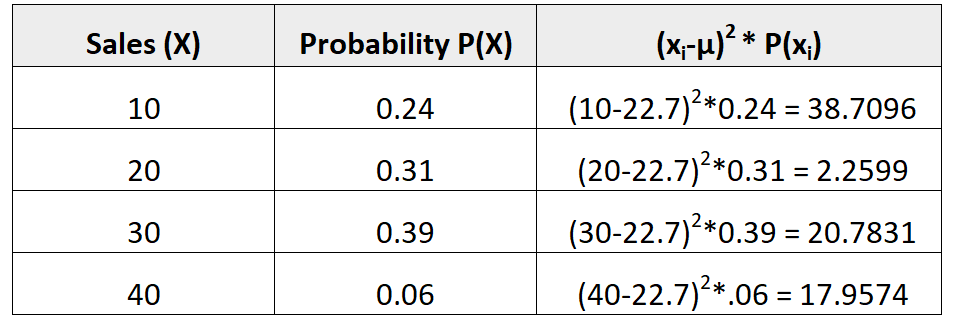
5.1 Construction d’une grille de calcul en quatre colonnes
Pour exécuter manuellement ou semi-automatiquement le calcul de la variance sans risquer d’introduire des erreurs systématiques de calcul ou d’omission, il est impératif d’adopter une méthode de disposition matricielle rigoureuse. L’approche la plus fiable repose sur la construction d’un tableau structuré en cinq colonnes séquentielles :
- Colonne 1 — Modalités ($x_i$) : Inventaire exhaustif et ordonné de toutes les réalisations scalaires admissibles de la variable aléatoire.
- Colonne 2 — Probabilités ($P(X = x_i)$) : Assignation de la probabilité ponctuelle correspondant à chaque modalité de la première colonne.
- Colonne 3 — Écarts à l’espérance ($x_i – \mu$) : Calcul de la déviation nette pour chaque modalité, obtenu en soustrayant la valeur préalablement calculée de l’espérance mathématique μ de chaque modalité xi. Ces écarts portent des signes positifs ou négatifs.
- Colonne 4 — Écarts quadratiques ($(x_i – \mu)^2$) : Élévation au carré de chaque valeur figurant dans la colonne 3. Toutes les entrées de cette quatrième colonne sont obligatoirement strictement positives ou nulles.
- Colonne 5 — Écarts quadratiques pondérés ($(x_i – \mu)^2 \times P(X = x_i)$) : Multiplication terme à terme des valeurs de la colonne 4 par les probabilités associées de la colonne 2. Cette colonne représente la contribution marginale effective de chaque modalité à la variance totale du système.
5.2 Vérification des conditions de validité
Avant d’agréger les résultats de la dernière colonne, une série de contrôles d’intégrité formels doivent être scrupuleusement appliqués à la grille de calcul :
- Contrôle de complétude de la mesure : La somme arithmétique de la colonne 2 doit impérativement être vérifiée :
$$\sum_{i=1}^n P(X = x_i) = 1{,}0000$$
Si cette somme s’écarte de 1 au-delà des micro-tolérances liées aux arrondis de troncature (par exemple 0,9999 ou 1,0001), cela indique qu’une modalité a été omise ou qu’une probabilité a été erronément retranscrite. Tout calcul poursuivi sur une distribution non unitaire est structurellement faussé. - Contrôle de conformité de Kolmogorov : Aucune valeur de la colonne 2 ne doit être strictement négative (pi ≥ 0) ni strictement supérieure à 1 (pi ≤ 1).
- Gestion de la précision et propagation d’arrondis : L’un des écueils majeurs réside dans l’arrondi prématuré de l’espérance mathématique μ. Si μ est arrondie de manière agressive à une seule décimale lors du calcul des écarts de la colonne 3, cette imprécision va être élevée au carré en colonne 4, amplifiée en colonne 5, et générera une distorsion systématique non négligeable sur la variance finale. Il est recommandé de conserver au minimum quatre à six décimales sur les calculs intermédiaires.
- Axiome de non-négativité intrinsèque : La variance étant une somme de termes quadratiques multipliés par des probabilités positives, le résultat final doit satisfaire rigoureusement la condition Var(X) ≥ 0. L’obtention d’une valeur finale négative est l’indicateur indubitable d’une faute logique ou arithmétique.
5.3 Agrégation finale et obtention du résultat
L’ultime étape calculatoire consiste à sommer l’ensemble des termes générés dans la cinquième colonne. La valeur scalaire obtenue à l’issue de cette sommation globale représente la variance théorique σ2 :
$$\sigma^2 = \text{Var}(X) = \sum_{i=1}^n \left[(x_i – \mu)^2 \times P(X = x_i)\right]$$
Il est fondamental de s’attarder sur l’unité physique de ce résultat. La variance ne s’exprime jamais dans la dimension métrique de la variable originale X, mais dans le carré de celle-ci. Si X modélise un temps d’attente exprimé en secondes, sa variance s’exprime en secondes carrées (s2). Si X quantifie une perte financière en euros, sa variance est formulée en euros carrés (€2). Cette inadéquation dimensionnelle constitue la principale limite de la variance sur le plan de l’interprétation empirique brute : il est conceptuellement difficile de concevoir ce que représente intuitivement une dispersion de 25 euros carrés.
Néanmoins, sur le plan comparatif, l’amplitude brute de σ2 fournit un diagnostic immédiat : plus sa valeur est proche de zéro, plus la distribution est hyper-concentrée autour de son espérance μ. Une variance théorique rigoureusement égale à zéro dénote une distribution dégénérée, c’est-à-dire une variable déterministe qui prend une valeur fixe constante avec une probabilité certaine de 1.
6. La formule computationnelle alternative : le théorème de Koenig-Huygens
6.1 Démonstration formelle du théorème de Koenig-Huygens
Bien que la formule canonique examinée dans les sections précédentes soit d’une limpidité conceptuelle absolue, elle s’avère fréquemment fastidieuse lors de son exécution manuelle en raison de la nécessité de soustraire la valeur de μ de chaque modalité avant d’en calculer le carré. Il existe une formulation alternative universellement employée, connue dans la tradition mathématique francophone sous le nom de théorème de Koenig-Huygens (ou théorème de König), et désignée dans la littérature anglo-saxonne sous l’appellation de computational formula for variance.
Ce théorème s’énonce formellement par l’identité remarquable :
$$\text{Var}(X) = E[X^2] – (E[X])^2$$
La démonstration de ce résultat central repose exclusivement sur les propriétés fondamentales de linéarité de l’opérateur d’espérance mathématique. Développons l’expression canonique de la variance en utilisant l’identité remarquable du carré d’un binôme :
$$\text{Var}(X) = E\left[(X – E[X])^2\right] = E\left[X^2 – 2X E[X] + (E[X])^2\right]$$
Puisque l’espérance d’une somme de variables est égale à la somme de leurs espérances respectives, et que tout terme constant ou déjà moyenné peut être factorisé en dehors de l’opérateur linéaire, nous pouvons déployer le calcul terme à terme :
$$\text{Var}(X) = E[X^2] – E[2X E[X]] + E\left[(E[X])^2\right]$$
Dans le terme central, 2 et E[X] sont des valeurs scalaires déterministes et non des variables aléatoires. Ils peuvent donc être extraits de l’espérance externe :
$$E[2X E[X]] = 2 E[X] \times E[X] = 2 (E[X])^2$$
De même, le terme (E[X])2 étant une constante scalaire absolue, son espérance mathématique est égale à lui-même :
$$E\left[(E[X])^2\right] = (E[X])^2$$
En réinjectant ces deux simplifications dans l’équation développée globale, nous obtenons :
$$\text{Var}(X) = E[X^2] – 2(E[X])^2 + (E[X])^2 = E[X^2] – (E[X])^2$$
Le terme E[X2] représente le moment non centré d’ordre deux de la variable, qui s’obtient pour une distribution discrète en sommant les carrés bruts des modalités pondérés par leurs probabilités :
$$E[X^2] = \sum_{i=1}^n x_i^2 P(X = x_i)$$
6.2 Avantages calculatoires de la formule développée
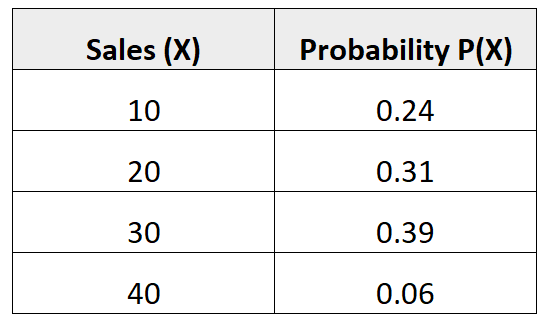
Le recours au théorème de Koenig-Huygens procure un allègement computationnel considérable, particulièrement lorsque les calculs sont conduits manuellement ou sur des calculatrices de poche non programmables. Dans la formule canonique standard, dès lors que l’espérance μ prend une valeur décimale complexe (comme 1,4782…), chaque soustraction (xi − μ) produit une quantité décimale longue dont l’élévation au carré génère des chaînes de chiffres fastidieuses à manipuler et sources probables d’erreurs d’inattention.
La formule développée dissocie entièrement le traitement des valeurs de la variable xi de la moyenne générale. Les valeurs brutes xi, qui sont très fréquemment des entiers naturels (0, 1, 2, 3…) dans le cadre des distributions de comptage, sont élevées au carré directement (0, 1, 4, 9…). Ces carrés entiers sont ensuite multipliés par leurs probabilités respectives pour fournir E[X2]. La seule et unique soustraction requise par toute la procédure algorithmique intervient à la toute dernière étape, lorsque l’on retranche le carré de l’espérance au moment d’ordre deux.
Cette dissociation chronologique minimise substantiellement les risques de propagation d’arrondis intermédiaires, accélère le flux d’exécution et simplifie l’écriture des algorithmes informatiques de base. Un seul passage séquentiel sur les données permet de cumuler simultanément la somme des xi pi et la somme des xi2 pi.
6.3 Risques numériques liés à la soustraction de termes proches
En dépit de son élégance mathématique et de son efficacité pour les calculs analytiques ou manuels, la formule de Koenig-Huygens présente une vulnérabilité numérique majeure lors de son implémentation brute sur des architectures informatiques utilisant l’arithmétique en virgule flottante standard (norme IEEE 754). Ce problème est désigné en analyse numérique sous le terme d’annulation catastrophique (catastrophic cancellation).
Ce phénomène pathologique se produit lorsque la distribution de probabilité présente une variance intrinsèquement très faible tout en étant positionnée à une distance immense de l’origine zéro. Dans une telle configuration géométrique, les deux termes de la soustraction — E[X2] et (E[X])2 — atteignent des amplitudes numériques gigantesques tout en étant extrêmement proches l’un de l’autre. Lorsque l’unité de calcul arithmétique de la machine soustrait deux grands nombres presque identiques représentés avec un nombre fini de bits de précision (mantisse), les bits de poids fort s’annulent mutuellement, ne laissant subsister dans le résultat que les bits de poids faible, qui sont précisément pollués par les erreurs de troncature machine.
Dans les cas extrêmes de mauvaise calibration, cette soustraction instable peut aboutir à un résultat numériquement inférieur à zéro, produisant une variance aberrante strictement négative, ce qui déclenche une erreur fatale lors du passage ultérieur à la racine carrée pour le calcul de l’écart-type. C’est la raison pour laquelle les bibliothèques scientifiques de référence (telles que NumPy, GNU R ou SciPy) délaissent la formule naïve de Koenig-Huygens pour le traitement de grands volumes de données empiriques au profit d’algorithmes de calcul en ligne stables, notamment l’algorithme de Welford mis au point par B. P. Welford en 1962, qui réactualise la variance pas à pas par des sommes de différences relatives centrées.
7. Application empirique détaillée : modèle de performance et d’occurrence sportive
7.1 Présentation de la distribution de buts d’une équipe
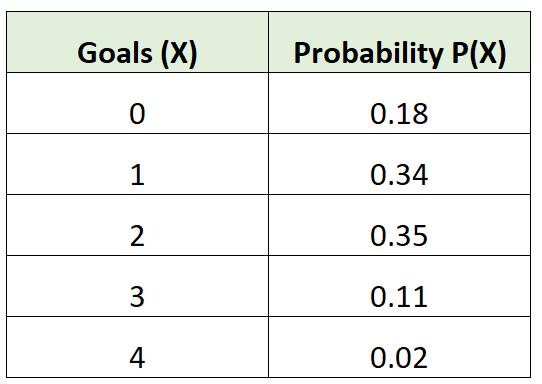
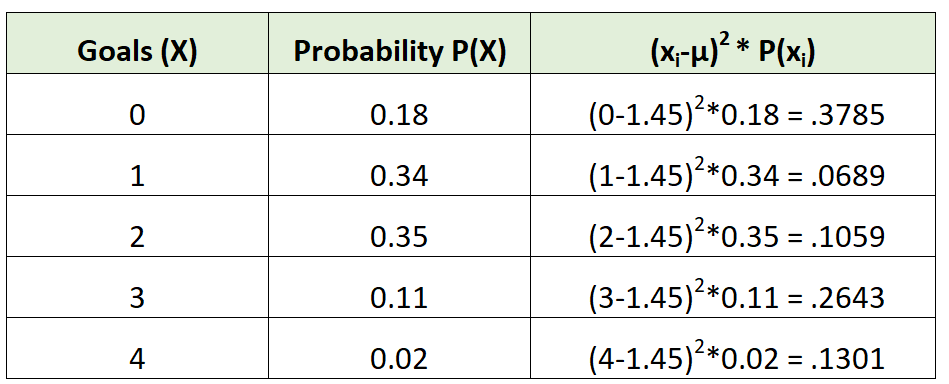
Afin d’ancrer ces développements théoriques dans une réalité tangible, examinons une application quantitative issue de l’analyse stochastique du sport de haut niveau. On s’intéresse au nombre de buts marqués par match par une équipe professionnelle de football sur un championnat de longue durée. Soit la variable aléatoire discrète X modélisant le « nombre de buts inscrits au cours d’un match officiel ».
L’analyse historique consolidée des confrontations permet d’assigner la distribution de probabilité suivante :
- Modalité $x_0 = 0$ but : $P(X = 0) = 0{,}18$
- Modalité $x_1 = 1$ but : $P(X = 1) = 0{,}34$
- Modalité $x_2 = 2$ buts : $P(X = 2) = 0{,}35$
- Modalité $x_3 = 3$ buts : $P(X = 3) = 0{,}11$
- Modalité $x_4 = 4$ buts : $P(X = 4) = 0{,}02$
Procédons immédiatement au contrôle de validité axiomatique de cette loi discrète :
$$\sum_{i=0}^4 P(X = x_i) = 0{,}18 + 0{,}34 + 0{,}35 + 0{,}11 + 0{,}02 = 1{,}00$$
La somme unitaire étant rigoureusement satisfaite et chaque probabilité élémentaire appartenant à l’intervalle semi-ouvert ]0, 1], la distribution constitue un cadre expérimental probabiliste parfaitement légitime, modélisable par une distribution de Poisson discrète tronquée à droite par les contraintes physiques du jeu.
7.2 Résolution détaillée selon la méthode canonique
Pour appliquer la méthode canonique, la première étape impose la détermination préalable de l’espérance μ de buts inscrits :
$$\mu = E[X] = (0 \times 0{,}18) + (1 \times 0{,}34) + (2 \times 0{,}35) + (3 \times 0{,}11) + (4 \times 0{,}02)$$
$$\mu = 0{,}00 + 0{,}34 + 0{,}70 + 0{,}33 + 0{,}08 = 1{,}45 \text{ buts par match}$$
Nous disposons désormais de la valeur centrale théorique : μ = 1,45. Déployons l’évaluation séquentielle des écarts quadratiques pondérés pour chacune des cinq modalités constitutives du support de la variable aléatoire :
- Pour $x_0 = 0$ :
$$\text{Écart simple} : 0 – 1{,}45 = -1{,}45$$
$$\text{Écart quadratique} : (-1{,}45)^2 = 2{,}1025$$
$$\text{Contribution pondérée} : 2{,}1025 \times 0{,}18 = 0{,}37845$$ - Pour $x_1 = 1$ :
$$\text{Écart simple} : 1 – 1{,}45 = -0{,}45$$
$$\text{Écart quadratique} : (-0{,}45)^2 = 0{,}2025$$
$$\text{Contribution pondérée} : 0{,}2025 \times 0{,}34 = 0{,}06885$$ - Pour $x_2 = 2$ :
$$\text{Écart simple} : 2 – 1{,}45 = +0{,}55$$
$$\text{Écart quadratique} : (0{,}55)^2 = 0{,}3025$$
$$\text{Contribution pondérée} : 0{,}3025 \times 0{,}35 = 0{,}105875$$ - Pour $x_3 = 3$ :
$$\text{Écart simple} : 3 – 1{,}45 = +1{,}55$$
$$\text{Écart quadratique} : (1{,}55)^2 = 2{,}4025$$
$$\text{Contribution pondérée} : 2{,}4025 \times 0{,}11 = 0{,}264275$$ - Pour $x_4 = 4$ :
$$\text{Écart simple} : 4 – 1{,}45 = +2{,}55$$
$$\text{Écart quadratique} : (2{,}55)^2 = 6{,}5025$$
$$\text{Contribution pondérée} : 6{,}5025 \times 0{,}02 = 0{,}13005$$
Il ne reste plus qu’à opérer la sommation exhaustive de ces cinq contributions pondérées pour obtenir la variance de la distribution :
$$\text{Var}(X) = 0{,}37845 + 0{,}06885 + 0{,}105875 + 0{,}264275 + 0{,}13005 = 0{,}9475$$
La variance théorique de cette distribution est ainsi précisément égale à 0,9475 but2.
7.3 Validation croisée via la méthode de Koenig-Huygens
Procédons sans délai à la vérification croisée de cette valeur en mettant en œuvre le théorème de Koenig-Huygens : σ2 = E[X2] − (E[X])2. Nous avons déjà calculé E[X] = 1,45. Élevons immédiatement cette espérance au carré :
$$(E[X])^2 = (1{,}45)^2 = 2{,}1025$$
Calculons à présent le moment non centré d’ordre deux E[X2] en multipliant le carré brut de chaque modalité par sa probabilité associée :
$$E[X^2] = (0^2 \times 0{,}18) + (1^2 \times 0{,}34) + (2^2 \times 0{,}35) + (3^2 \times 0{,}11) + (4^2 \times 0{,}02)$$
$$E[X^2] = (0 \times 0{,}18) + (1 \times 0{,}34) + (4 \times 0{,}35) + (9 \times 0{,}11) + (16 \times 0{,}02)$$
$$E[X^2] = 0{,}00 + 0{,}34 + 1{,}40 + 0{,}99 + 0{,}32 = 3{,}05$$
Appliquons l’opération finale de soustraction :
$$\text{Var}(X) = E[X^2] – (E[X])^2 = 3{,}05 – 2{,}1025 = 0{,}9475$$
La concordance entre les deux méthodes de calcul est absolue et parfaite au dix-millième près. Cette convergence arithmétique rigoureuse illustre l’invariance du résultat face à la méthode employée et valide la structure computationnelle de notre analyse.
8. Application empirique approfondie : défaillances mécaniques et fiabilité
8.1 Modélisation de pannes de batterie sur un parc de véhicules
Pour illustrer un cas d’application présentant une asymétrie marquée et des enjeux industriels de grande ampleur, nous abordons l’ingénierie de la fiabilité automobile. Une entreprise exploitant une flotte de véhicules électriques analyse la survenue des défaillances critiques des packs de batteries de traction sur une période de garantie opérationnelle de dix ans. Soit la variable aléatoire Y mesurant le « nombre de défaillances complètes subies par un véhicule donné sur la décennie ».
La table probabiliste de la loi régissant Y, dérivée de tests de vieillissement accéléré et d’historiques de télémétrie, s’établit ainsi :
- 0 défaillance : $P(Y = 0) = 0{,}60$
- 1 défaillance : $P(Y = 1) = 0{,}25$
- 2 défaillances : $P(Y = 2) = 0{,}09$
- 3 défaillances : $P(Y = 3) = 0{,}04$
- 4 défaillances : $P(Y = 4) = 0{,}015$
- 5 défaillances : $P(Y = 5) = 0{,}005$
Vérification unitaire : 0,60 + 0,25 + 0,09 + 0,04 + 0,015 + 0,005 = 1,000. Cette loi met en évidence une décroissance rapide des probabilités d’occurrence, typique des architectures matérielles fiables intégrant des mécanismes de redondance, mais présentant néanmoins une queue de distribution résiduelle non négligeable.
8.2 Exécution séquentielle du calcul de variance
Entamons la résolution séquentielle en déterminant en premier lieu l’espérance de défaillances μY sur le cycle décennal :
$$\mu_Y = E[Y] = (0 \times 0{,}60) + (1 \times 0{,}25) + (2 \times 0{,}09) + (3 \times 0{,}04) + (4 \times 0{,}015) + (5 \times 0{,}005)$$
$$\mu_Y = 0 + 0{,}25 + 0{,}18 + 0{,}12 + 0{,}06 + 0{,}025 = 0{,}635 \text{ panne par véhicule}$$
Calculons le moment non centré d’ordre deux E[Y2] :
$$E[Y^2] = (0^2 \times 0{,}60) + (1^2 \times 0{,}25) + (2^2 \times 0{,}09) + (3^2 \times 0{,}04) + (4^2 \times 0{,}015) + (5^2 \times 0{,}005)$$
$$E[Y^2] = (0 \times 0{,}60) + (1 \times 0{,}25) + (4 \times 0{,}09) + (9 \times 0{,}04) + (16 \times 0{,}015) + (25 \times 0{,}005)$$
$$E[Y^2] = 0 + 0{,}25 + 0{,}36 + 0{,}36 + 0{,}24 + 0{,}125 = 1{,}335$$
Calculons le carré de l’espérance mathématique :
$$(\mu_Y)^2 = (0{,}635)^2 = 0{,}403225$$
La variance théorique s’obtient alors immédiatement par la différence de Koenig-Huygens :
$$\text{Var}(Y) = E[Y^2] – (\mu_Y)^2 = 1{,}335 – 0{,}403225 = 0{,}931775$$
Une variance de 0,9318 panne2 révèle une dispersion relativement élevée au regard d’une espérance de seulement 0,635. L’écart-type correspondant (σ = √0,931775 ≈ 0,9653) est en réalité supérieur à la moyenne elle-même, une caractéristique typique des distributions fortement asymétriques à prédominance de zéros.
8.3 Sensibilité de la variance aux événements rares
Cet exemple met en lumière la sensibilité aiguë de la variance à la structure des événements rares situés en queue de distribution. Examinons la modalité y5 = 5 pannes. Sa probabilité de survenue est marginale : à peine 0,5 % de chance de se manifester (p = 0,005). Pourtant, sa contribution au moment d’ordre deux s’élève à 25 × 0,005 = 0,125, ce qui représente près de 10 % de la magnitude totale de E[Y2] (0,125 sur 1,335).
Supposons qu’un défaut de fabrication non détecté modifie marginalement cette probabilité, faisant passer P(Y = 5) de 0,005 à 0,020 (une augmentation brute de 1,5 point de pourcentage prélevée sur la classe zéro panne). L’espérance μ passerait de 0,635 à 0,710. En revanche, le moment E[Y2] ferait un bond spectaculaire de 1,335 à 1,710, propulsant la variance de 0,9318 à :
$$\text{Var}_{\text{nouvelle}}(Y) = 1{,}710 – (0{,}710)^2 = 1{,}710 – 0{,}5041 = 1{,}2059$$
La variance a augmenté de près de 30 % sous l’effet d’une micro-variation probabiliste confinée à l’extrémité du support. Cette hyper-réactivité mathématique montre pourquoi, dans les modèles de risque actuariel ou de régulation bancaire (accords de Bâle), les distributions empiriques de sinistres doivent faire l’objet de techniques de régularisation ou de troncature robuste afin d’éviter que des observations extrêmes et instables ne fassent dériver excessivement les estimations de variance du système.
9. Extension aux distributions de probabilité continues : le passage à l’intégrale
9.1 Transition de la fonction de masse à la densité de probabilité
Dans de nombreuses applications physiques, économiques ou biologiques, les variables étudiées ne sont plus confinées à des états discrets isolés, mais prennent leurs valeurs sur un continuum infini non dénombrable (par exemple un intervalle de réels ℝ ou un sous-ensemble [a, b]). C’est le cas de grandeurs comme la durée, la taille, le poids, la température ou la pression. Dans ce paradigme continu, la notion de fonction de masse s’effondre : la probabilité qu’une variable continue X prenne une valeur scalaire strictement exacte est rigoureusement nulle : P(X = x) = 0 pour tout x ∈ ℝ.
Le formalisme probabiliste introduit alors la notion de fonction de densité de probabilité, notée f(x). La probabilité n’est plus attribuée à un point isolé, mais à un intervalle infinitésimal [x, x + dx], tel que :
$$P(x le X le x + \mathrm{d}x) \approx f(x),\mathrm{d}x$$
La transition conceptuelle du monde discret vers le monde continu repose formellement sur le passage de la sommation discrète (∑) à l’opérateur d’intégration au sens de Riemann ou de Lebesgue (∫). L’axiome de normalisation unitaire se transcrit désormais sous la forme intégrale :
$$\int_{-\infty}^{+\infty} f(x),\mathrm{d}x = 1$$
avec la condition de stricte non-négativité f(x) ≥ 0 pour tout x appartenant au domaine de définition.
9.2 Formulation intégrale de la variance continue
En vertu du principe de substitution intégrale, l’espérance mathématique d’une variable aléatoire continue s’exprime par :
$$\mu = E[X] = \int_{-\infty}^{+\infty} x f(x),\mathrm{d}x$$
pourvu que cette intégrale converge absolument. La formule canonique de la variance d’une variable aléatoire continue devient alors la moyenne intégrale des écarts quadratiques pondérée par la fonction de densité :
$$\text{Var}(X) = \sigma^2 = \int_{-\infty}^{+\infty} (x – \mu)^2 f(x),\mathrm{d}x$$
De façon rigoureusement analogue au cas discret, le théorème de Koenig-Huygens conserve toute sa validité analytique dans le continuum :
$$\text{Var}(X) = \int_{-\infty}^{+\infty} x^2 f(x),\mathrm{d}x – \left(\int_{-\infty}^{+\infty} x f(x),\mathrm{d}x\right)^2 = E[X^2] – (E[X])^2$$
Il convient de souligner que l’existence de la variance continue est conditionnée par l’intégrabilité absolue de la fonction x2 f(x) sur l’ensemble de son support. Si cette intégrale diverge vers l’infini, la variable aléatoire ne possède pas de variance finie. Un exemple paradigmatique classique est offert par la loi de Cauchy standard, dont la densité est définie par :
$$f(x) = \frac{1}{\pi (1 + x^2)}$$
Cette loi ne possède ni espérance ni variance mathématiquement définies. De même, les distributions de Pareto caractérisées par un paramètre de forme α ≤ 2 génèrent des variances théoriques infinies, rendant inopérants les outils de modélisation gaussiens usuels.
9.3 Exemple d’application analytique : la loi uniforme continue
Pour illustrer la mécanique intégrale du calcul de variance, développons la démonstration complète de la formule de variance pour la distribution continue la plus élémentaire : la loi uniforme continue sur l’intervalle [a, b], notée U(a, b), avec a < b.
La fonction de densité d’une variable X suivant cette loi est constante sur le support [a, b] et nulle ailleurs :
$$f(x) = \frac{1}{b – a} \quad \text{pour } x in [a, b]$$
Calculons premièrement son espérance mathématique E[X] :
$$E[X] = \int_{a}^{b} x \left(\frac{1}{b – a}\right),\mathrm{d}x = \frac{1}{b – a} \left[ \frac{x^2}{2} \right]_{a}^{b} = \frac{b^2 – a^2}{2(b – a)}$$
En factorisant le numérateur sous la forme d’une différence de carrés (b2 − a2) = (b − a)(b + a), et en simplifiant par (b − a), nous retrouvons le résultat intuitif du milieu du segment :
$$E[X] = \frac{a + b}{2}$$
Calculons deuxièmement le moment non centré d’ordre deux E[X2] :
$$E[X^2] = \int_{a}^{b} x^2 \left(\frac{1}{b – a}\right),\mathrm{d}x = \frac{1}{b – a} \left[ \frac{x^3}{3} \right]_{a}^{b} = \frac{b^3 – a^3}{3(b – a)}$$
En utilisant la factorisation de la différence de cubes (b3 − a3) = (b − a)(a2 + ab + b2), il vient :
$$E[X^2] = \frac{a^2 + ab + b^2}{3}$$
Appliquons désormais le théorème de Koenig-Huygens pour déduire la variance :
$$\text{Var}(X) = E[X^2] – (E[X])^2 = \frac{a^2 + ab + b^2}{3} – \left(\frac{a + b}{2}\right)^2$$
$$\text{Var}(X) = \frac{a^2 + ab + b^2}{3} – \frac{a^2 + 2ab + b^2}{4}$$
Réduisons ces deux fractions au même dénominateur commun, à savoir 12 :
$$\text{Var}(X) = \frac{4(a^2 + ab + b^2) – 3(a^2 + 2ab + b^2)}{12}$$
$$\text{Var}(X) = \frac{4a^2 + 4ab + 4b^2 – 3a^2 – 6ab – 3b^2}{12} = \frac{a^2 – 2ab + b^2}{12}$$
En reconnaissant au numérateur l’identité remarquable (b − a)2, nous aboutissons à la formule classique et universelle de la variance d’une loi uniforme continue :
$$\text{Var}(X) = \frac{(b – a)^2}{12}$$
Ce résultat démontre avec éclat que la dispersion d’une loi uniforme ne dépend absolument pas de la localisation spatiale de l’intervalle sur l’axe des réels, mais exclusivement du carré de sa largeur (b − a).
10. Propriétés algébriques fondamentales de l’opérateur de variance
10.1 Comportement sous transformation affine
L’opérateur de variance présente un ensemble de propriétés algébriques caractéristiques qui le distinguent fondamentalement des opérateurs linéaires purs comme l’espérance mathématique. L’analyse du comportement de la variance sous une transformation affine générale Y = aX + b, où a et b sont deux constantes réelles scalaires, permet d’illustrer sa nature quadratique.
Considérons tout d’abord l’effet d’une translation pure, en posant a = 1, soit la variable Y = X + b. L’espérance de Y devient E[X + b] = E[X] + b. Déployons l’expression de la variance :
$$\text{Var}(X + b) = E\left[((X + b) – E[X + b])^2\right] = E\left[(X + b – E[X] – b)^2\right] = E\left[(X – E[X])^2\right] = \text{Var}(X)$$
Cette propriété établit l’invariance par translation de la variance : ajouter ou soustraire une constante fixe à une variable aléatoire décale l’ensemble de sa distribution sur l’axe horizontal sans modifier d’un iota son profil d’étalement. Si un enseignant ajoute uniformément 2 points à tous les étudiants d’une promotion lors d’un examen, l’espérance de la classe grimpe de 2 points, mais la variance des notes demeure strictement inchangée.
Examinons désormais l’effet d’un changement d’échelle (homothétie), en posant b = 0, soit Y = aX. L’espérance devient E[aX] = aE[X]. Déployons la formule de la variance :
$$\text{Var}(aX) = E\left[(aX – E[aX])^2\right] = E\left[(a(X – E[X]))^2\right] = E\left[a^2 (X – E[X])^2\right]$$
Par linéarité de l’espérance, le scalaire a2 s’extrait intégralement :
$$\text{Var}(aX) = a^2 \text{Var}(X)$$
La variance présente une sensibilité d’ordre quadratique au facteur d’échelle. Multiplier les réalisations d’une variable par 3 multiplie instantanément sa variance par 9. Inverser le signe d’une variable en multipliant par −1 n’altère pas sa variance : Var(−X) = (−1)2 Var(X) = Var(X).
En recombinant ces deux composantes, nous obtenons la propriété affine universelle de la variance :
$$\text{Var}(aX + b) = a^2 \text{Var}(X)$$
Cette règle structurelle constitue le fondement mathématique des protocoles de standardisation et de centration-réduction des données largement utilisés dans les analyses multivariées.
10.2 Variance d’une somme de variables aléatoires
L’évaluation de la variance de la somme de deux variables aléatoires X et Y constitue un carrefour fondamental de la théorie probabiliste et de la gestion de portefeuille d’actifs. En appliquant la définition du deuxième moment centré à la somme (X + Y), on obtient la formule de Bienaymé :
$$\text{Var}(X + Y) = \text{Var}(X) + \text{Var}(Y) + 2,\text{Cov}(X, Y)$$
où Cov(X, Y) désigne la covariance entre les variables X et Y, définie par l’espérance du produit croisé de leurs écarts respectifs : Cov(X, Y) = E[(X − E[X])(Y − E[Y])].
Dans le cas particulier fondamental où les deux variables sont stochastiquement indépendantes (ou simplement non corrélées, ce qui implique Cov(X, Y) = 0), le terme croisé s’annule rigoureusement, et la formule se réduit à l’additivité stricte des variances :
$$\text{Var}(X + Y) = \text{Var}(X) + \text{Var}(Y)$$
Cette propriété d’additivité s’étend par récurrence finie à un ensemble de n variables aléatoires mutuellement indépendantes :
$$\text{Var}\left(\sum_{j=1}^n X_j\right) = \sum_{j=1}^n \text{Var}(X_j)$$
Considérons à présent la variance d’une différence de deux variables aléatoires. En combinant la formule de Bienaymé et le comportement du signe négatif sous la mise au carré, nous obtenons :
$$\text{Var}(X – Y) = \text{Var}(X + (-Y)) = \text{Var}(X) + \text{Var}(-Y) + 2,\text{Cov}(X, -Y)$$
Comme Var(−Y) = (−1)2 Var(Y) = Var(Y) et Cov(X, −Y) = −Cov(X, Y), l’expression devient :
$$\text{Var}(X – Y) = \text{Var}(X) + \text{Var}(Y) – 2,\text{Cov}(X, Y)$$
Dans le cas de l’indépendance stochastique, nous parvenons à un résultat contre-intuitif pour les néophytes :
$$\text{Var}(X – Y) = \text{Var}(X) + \text{Var}(Y)$$
La variance d’une différence de variables indépendantes est la somme de leurs variances, et non leur soustraction. Soustraire deux processus incertains indépendants n’annule pas l’incertitude : cela superpose les sources d’aléa.
10.3 Non-linéarité stricte de l’opérateur de variance
Il ressort avec force des démonstrations précédentes que l’opérateur de variance est un opérateur strictement non linéaire. Poser de façon péremptoire Var(X + Y) = Var(X) + Var(Y) en présence de dépendance stochastique constitue une erreur méthodologique aux conséquences catastrophiques dans l’évaluation des risques industriels ou financiers.
Lorsque deux variables aléatoires présentent une covariance négative (Cov(X, Y) < 0), le terme de produit croisé 2Cov(X, Y) devient négatif, réduisant la variance globale de la somme en dessous de la somme des variances individuelles :
$$\text{Var}(X + Y) < \text{Var}(X) + \text{Var}(Y)$$
C’est précisément ce mécanisme d’amortissement de la variabilité qui forme le fondement mathématique de la théorie moderne du portefeuille développée par Harry Markowitz (1952). En associant des actifs financiers dont les fluctuations sont négativement corrélées, un investisseur peut comprimer la variance globale de son portefeuille — c’est-à-dire son niveau de risque — sans pour autant dégrader son espérance de rentabilité.
Dans une perspective plus large d’analyse conditionnelle, la non-linéarité de la variance trouve son parachèvement dans le théorème de la variance totale (souvent désigné sous l’appellation imagée de « formule d’Éve »). Pour deux variables aléatoires X et Y définies sur le même espace, ce théorème décompose la variance marginale de X en deux composantes hiérarchiques complémentaires :
$$\text{Var}(X) = E\left[\text{Var}(X mid Y)\right] + \text{Var}\left(E[X mid Y]\right)$$
Le premier terme, E[Var(X | Y)], représente la moyenne des variances résiduelles de X conditionnées à la connaissance de Y (l’aléa intra-groupe non expliqué), tandis que le second terme, Var(E[X | Y]), quantifie la variance des moyennes conditionnelles (la variabilité inter-groupes expliquée par le conditionnement). Cette équation constitue le socle mathématique formel de toute l’économétrie de la régression et de la décomposition de l’erreur dans les modèles hiérarchiques.
11. De la variance à l’écart-type : interprétation clinique et psychométrique
11.1 Le passage à l’écart-type comme nécessité d’interprétabilité
En dépit de sa supériorité algorithmique et de ses propriétés mathématiques fondamentales, la variance souffre d’une tare congénitale dès lors qu’il s’agit de communiquer des résultats analytiques : elle est dimensionnellement déconnectée des observations empiriques réelles. L’élévation systématique au carré lors du processus de calcul modifie l’échelle de mesure. Exprimer la variabilité du poids d’une population d’individus en « kilogrammes carrés », la dispersion de la pression artérielle en « millimètres de mercure carrés » ou la variabilité des revenus d’un foyer en « dollars carrés » défie toute intuition pragmatique et complique l’interprétation diagnostique.
Pour restaurer l’intelligibilité de la mesure de dispersion tout en conservant les acquis du centrage quadratique, les statisticiens ont introduit l’écart-type (souvent dénommé standard deviation dans la littérature anglo-saxonne). Défini universellement par la lettre grecque σ, l’écart-type est la racine carrée positive de la variance :
$$\sigma = \sqrt{\text{Var}(X)} = \sqrt{\sigma^2}$$
En extrayant la racine carrée, on rétablit l’homogénéité dimensionnelle de degré 1 par rapport à la variable d’origine : l’écart-type possède exactement la même dimension métrique que la variable X et que son espérance μ. Sous transformation scalaire, l’écart-type vérifie la propriété d’homogénéité stricte :
$$\sigma(aX + b) = |a|,\sigma(X)$$
L’écart-type s’interprète directement comme la magnitude géométrique « moyenne » dont s’écartent typiquement les réalisations individuelles de la variable par rapport à leur centre de gravité probabiliste.
11.2 Inégalité de Bienaymé-Tchebychev et dispersion universelle
L’une des manifestations les plus puissantes de l’utilité théorique conjointe de la variance et de l’écart-type est fournie par l’inégalité de Bienaymé-Tchebychev. Ce résultat mathématique fondamental stipule que pour toute variable aléatoire X dotée d’une espérance finie μ et d’une variance finie σ2, indépendamment de la forme géométrique de sa distribution (qu’elle soit asymétrique, bimodale ou multimodale), la probabilité que la variable s’écarte de son espérance d’au moins k écarts-types est strictement majorée par 1/k2 :
$$P(|X – mu| ge k\sigma) le \frac{1}{k^2} \quad \text{pour tout } k > 1$$
Par complémentarité événementielle, nous obtenons la borne de probabilité minimale garantissant la concentration des réalisations autour de la moyenne au sein d’une bande de confiance de largeur ±kσ :
$$P(|X – mu| < k\sigma) ge 1 – \frac{1}{k^2}$$
Cette inégalité universelle permet de formuler des déductions probabilistes sans connaître la loi sous-jacente :
- Pour $k = 2$ : $P(|X – mu| < 2\sigma) ge 1 – \frac{1}{4} = 0{,}75$. Au bas mot 75 % de toutes les réalisations possibles d'une distribution de variance finie sont rigoureusement confinées dans un rayon de deux écarts-types autour de la moyenne.
- Pour $k = 3$ : $P(|X – mu| < 3\sigma) ge 1 – \frac{1}{9} \approx 0{,}8889$. Au minimum 88,89 % de la masse de probabilité totale réside obligatoirement à l'intérieur de l'intervalle $[\mu – 3\sigma, \mu + 3\sigma]$.
À titre de comparaison, si nous disposons de la certitude que la loi est strictement gaussienne (distribution normale), ces bornes conservatrices universelles se resserrent considérablement en vertu de la célèbre règle empirique 68-95-99,7 : l’intervalle ±1σ concentre 68,27 % des cas, l’intervalle ±2σ accueille 95,45 % de la masse, et l’intervalle ±3σ englobe 99,73 % des réalisations.
11.3 Usage de la variance dans la standardisation des scores psychométriques
En psychométrie et en évaluation clinique des aptitudes cognitives, le calcul précis de la variance et de l’écart-type est au cœur du processus de standardisation normative des instruments de mesure. Les scores bruts obtenus par un individu lors d’un test psychométrique (nombre de questions réussies, temps de réaction en millisecondes) ne possèdent aucune valeur interprétative autonome s’ils ne sont pas contextualisés au regard de la distribution paramétrique de la population de référence.
Ce calibrage s’effectue par l’opération de centration-réduction menant à la construction du score standardisé élémentaire, ou Z-score :
$$Z = \frac{X – \mu}{\sigma}$$
En soustrayant l’espérance μ, on recentre la distribution sur une moyenne de 0. En divisant par l’écart-type σ (√Var(X)), on étalonne l’unité de mesure de sorte que la variance de la variable transformée Z soit rigoureusement égale à 1. Ce processus transforme un score brut arbitraire en une distance métrique relative exprimée en unités d’écart-type.
Cette standardisation est à la base des échelles d’évaluation cognitive de Wechsler (WAIS, WISC) pour le calcul du quotient intellectuel (QI). La distribution brute des scores d’aptitude est normalisée de telle sorte que la loi finale affiche délibérément une espérance théorique μ = 100 et un écart-type σ = 15 (soit une variance fixée à σ2 = 225). Dès lors, un QI de 130 ne représente pas un contingent de points bruts, mais signifie très précisément qu’un individu se positionne à exactement +2 écarts-types au-dessus de la moyenne de la population générale (100 + 2 × 15), situant son profil cognitif au-delà du 97,7e percentile sous hypothèse de normalité.
Enfin, dans la théorie classique des tests (TCT), la variance est indispensable pour estimer la fidélité de la mesure via la décomposition de la variance totale observée en variance vraie et variance d’erreur. L’erreur standard de mesure (SEM, pour Standard Error of Measurement), qui détermine l’intervalle de confiance clinique autour du score observé d’un patient, se dérive directement de la variance du test pondérée par son coefficient de cohérence interne (alpha de Cronbach) :
$$\text{SEM} = \sigma_X \sqrt{1 – r_{xx}}$$
12. Erreurs méthodologiques courantes et implémentation computationnelle
12.1 Pièges analytiques fréquents lors du calcul manuel
L’apprentissage et la mise en œuvre pratique du calcul de la variance d’une distribution de probabilité sont fréquemment jalonnés d’erreurs méthodologiques récurrentes. Un recensement typologique de ces écueils permet de sécuriser les protocoles de calcul des analystes :
- L’omission tragique des pondérations probabilistes : L’erreur la plus répandue consiste à traiter le tableau d’une distribution théorique comme s’il s’agissait d’une série statistique d’observations brutes équiprobables. L’analyste calcule alors la somme arithmétique simple des (xi − μ)2 et divise le tout par le nombre de lignes k du tableau. Cette procédure aberrante revient à assigner arbitrairement une probabilité uniforme de 1/k à chaque modalité, détruisant instantanément la fidélité du modèle à la réalité stochastique sous-jacente.
- La confusion ontologique entre $E[X^2]$ et $(E[X])^2$ : Dans la mise en œuvre de la formule de Koenig-Huygens, une inversion sémiotique courante amène à confondre le moment non centré d’ordre deux (la moyenne des carrés) et le carré de l’espérance (le carré de la moyenne). Rappelons sans ambiguïté que :
$$E[X^2] = \sum x_i^2 p_i \quad ne \quad (E[X])^2 = \left(\sum x_i p_i\right)^2$$
En vertu de l’inégalité de Jensen appliquée à la fonction convexe g(t) = t2, nous avons invariablement E[X2] ≥ (E[X])2, l’égalité stricte n’étant satisfaite que pour une distribution dégénérée de variance nulle. - L’application anachronique de la division par $n – 1$ : Des analystes familiers de la statistique descriptive tentent fréquemment d’insérer le diviseur correcteur n − 1 de Bessel au sein de la formule d’une distribution de probabilité. Une distribution théorique ne comporte aucun paramètre à débiaiser : ses probabilités somment à 1, et l’introduction d’un diviseur relève d’une profonde confusion de paradigme entre échantillonnage empirique et modélisation théorique.
- L’obtention d’une variance négative suite à une inversion de termes : Dans l’application computationnelle de la formule de Koenig-Huygens, calculer par inadvertance (E[X])2 − E[X2] produit invariablement un résultat négatif. Ce signal doit immédiatement alerter l’analyste sur une inversion dans la soustraction.
12.2 Implémentation automatisée dans les logiciels scientifiques
L’automatisation du calcul de la variance d’une distribution discrète finie dans les environnements de calcul scientifique contemporains s’appuie sur la vectorisation algorithmique. Voici comment structurer ces opérations sous les environnements les plus répandus :
Environnement R : Dans le langage R, les opérations s’effectuent sur des vecteurs synchrones. Si nous déclarons le vecteur des modalités x <- c(0, 1, 2, 3, 4) et le vecteur des masses probabilistes p <- c(0.18, 0.34, 0.35, 0.11, 0.02), le calcul de l’espérance se fait via la fonction de moyenne pondérée mu <- weighted.mean(x, p) ou par le produit scalaire vectorisé mu <- sum(x * p). Le calcul de la variance selon la formule canonique s’exécute par :
variance <- sum(p * (x - mu)^2)
Alternativement, selon le théorème de Koenig-Huygens :
variance <- sum(p * x^2) - mu^2
Environnement Python (NumPy) : Dans l’écosystème Python scientifique, l’utilisation de tableaux numpy.ndarray garantit des performances optimales et une clarté syntaxique totale :
import numpy as np

x = np.array([0, 1, 2, 3, 4])

p = np.array([0.18, 0.34, 0.35, 0.11, 0.02])

# Calcul de l'espérance théorique

mu = np.sum(x * p)

# Calcul de la variance théorique pondérée

variance = np.sum(p * (x - mu)**2)
Il convient de noter que la fonction native np.var() de NumPy calcule par défaut une variance échantillonnale empirique avec diviseur n sur un tableau de données brutes, et n’est pas conçue directement pour ingérer un vecteur de probabilités sans l’argument weights (utilisable via np.average).
Tableurs (Microsoft Excel / Google Sheets) : Dans un tableur de bureau, la disposition tabulaire exploite les fonctions de calcul matriciel. En disposant les valeurs xi dans la plage A2:A6 et les probabilités pi dans la plage B2:B6 :
- L’espérance μ s’obtient dans une cellule dédiée par la formule :
=SOMMEPROD(A2:A6; B2:B6) - Le moment non centré d’ordre deux E[X2] s’obtient par :
=SOMMEPROD(A2:A6; A2:A6; B2:B6) - La variance finale selon Koenig-Huygens se déduit par la soustraction directe :
=SOMMEPROD(A2:A6; A2:A6; B2:B6) - (SOMMEPROD(A2:A6; B2:B6))^2
12.3 Synthèse procédurale et guide de décision pour le praticien
Pour naviguer avec certitude et sélectionner la méthode la plus appropriée selon le contexte d’analyse, le praticien peut se référer au guide de décision synthétique suivant :
- Calcul manuel sur des distributions simples à valeurs entières et espérance entière : Privilégier la formule canonique $\sum (x_i – \mu)^2 p_i$. Les écarts sont des entiers aisés à élever au carré mentalement et les risques d’erreur sont minimes.
- Calcul manuel sur des distributions avec espérance fractionnaire ou décimale : Recourir impérativement au théorème de Koenig-Huygens $\sum x_i^2 p_i – \mu^2$. Cette démarche épargne la soustraction répétée de fractions sur chaque ligne du tableau.
- Calcul informatisé sur de grands jeux de données : Utiliser des implémentations basées sur des algorithmes en deux passes ou des formules récursives type Welford afin de neutraliser tout risque d’annulation catastrophique en virgule flottante.
Avant de sceller et de communiquer l’estimation d’une variance dans un rapport scientifique ou un modèle décisionnel, appliquez systématiquement la liste de vérification séquentielle suivante :
- La somme des probabilités du support de base est-elle rigoureusement égale à 1,0000 ?
- L’espérance calculée μ s’inscrit-elle strictement entre la valeur minimale et la valeur maximale de la variable ?
- La variance finale obtenue est-elle strictement positive ou nulle (σ2 ≥ 0) ?
- Les unités physiques ont-elles été correctement identifiées comme le carré de l’unité de base ?
- Pour la communication opérationnelle, un passage à l’écart-type (σ = √σ2) a-t-il été documenté pour restituer l’échelle clinique de référence ?
Enfin, tout praticien rigoureux doit garder à l’esprit les limites inhérentes à la variance. Si elle règne en maîtresse absolue sur l’univers des lois normales et symétriques, elle perd une part de sa pertinence descriptive face à des distributions fortement asymétriques ou dotées de queues lourdes sans moments finis. Dans ces contextes singuliers, des métriques alternatives de dispersion, telles que l’écart interquartile (IQR), l’écart absolu médian (MAD) ou encore l’entropie de Shannon, fournissent des prismes d’analyse complémentaires pour saisir l’incertitude dans toute sa complexité stochastique.
Références
- Bienaymé, I.-J. (1853). Considérations à l’appui de la découverte de Laplace sur la loi de probabilité dans la méthode des moindres carrés. Comptes Rendus de l’Académie des Sciences, 37, 309–324.
- Dacunha-Castelle, D., & Duflo, M. (1982). Probabilités et statistiques : Problèmes à temps fixe (Tome 1). Masson.
- Feller, W. (1968). An Introduction to Probability Theory and Its Applications (3rd ed., Vol. 1). John Wiley & Sons.
- Fisher, R. A. (1918). The Correlation Between Relatives on the Supposition of Mendelian Inheritance. Transactions of the Royal Society of Edinburgh, 52(2), 399–433. https://doi.org/10.1017/S008045680001216X
- Kolmogorov, A. N. (1933). Grundbegriffe der Wahrscheinlichkeitsrechnung. Julius Springer.
- Markowitz, H. (1952). Portfolio Selection. The Journal of Finance, 7(1), 77–91. https://doi.org/10.1111/j.1540-6261.1952.tb01525.x
- Papoulis, A., & Pillai, S. U. (2002). Probability, Random Variables, and Stochastic Processes (4th ed.). McGraw-Hill.
- Saporta, G. (2011). Probabilités, analyse des données et statistique (3e éd.). Éditions Technip.
- Tchebychev, P. L. (1867). Des valeurs moyennes. Journal de Mathématiques Pures et Appliquées, 2e série, 12, 177–184.
- Welford, B. P. (1962). Note on a method for calculating corrected sums of squares and products. Technometrics, 4(3), 419–420. https://doi.org/10.1080/00401706.1962.10484556