
L’investigation empirique dans les sciences du comportement, et singulièrement en psychologie cognitive, clinique et sociale, repose sur la collecte méticuleuse et le traitement rigoureux de corpus de données chiffrées. Qu’il s’agisse d’évaluer le temps de réaction d’un sujet face à un stimulus perceptif, de quantifier l’intensité d’un affect à travers un inventaire standardisé ou de mesurer l’évolution d’un trouble neuropsychologique post-intervention, la matière première du chercheur demeure invariablement quantitative. Cependant, des données brutes, aussi précises soient-elles, ne constituent qu’un agrégat informatif inexploitable sans l’apport fondamental de la statistique descriptive. Cette discipline mathématique appliquée a pour dessein premier de transformer le bruit numérique en signaux intelligibles, d’extraire la structure latente d’un échantillon et de synthétiser des milliers d’observations en quelques paramètres hautement représentatifs.
Au cœur de cette démarche d’extraction du sens se trouvent deux grandeurs complémentaires indissociables : la moyenne arithmétique et l’écart-type. Si la première offre un point d’ancrage en incarnant le barycentre de la distribution des scores observés, le second matérialise l’hétérogénéité des comportements individuels autour de ce centre névralgique. Prise isolément, une mesure de tendance centrale est non seulement insuffisante, mais souvent trompeuse, car elle occulte totalement la variabilité inhérente aux dynamiques humaines ; inversement, une métrique de dispersion dénuée de point focal s’avère vide de signification clinique ou théorique. La maîtrise conceptuelle et computationnelle conjointe de ces deux indices constitue donc le prérequis absolu de toute recherche scientifique valide et de toute pratique psychométrique rigoureuse.
Dans le paysage des outils contemporains d’analyse, si les environnements dédiés comme R, SPSS ou Python prévalent dans le champ des modélisations inférentielles avancées, le tableur Microsoft Excel demeure le vecteur d’initiation, de nettoyage matriciel et de manipulation statistique le plus répandu à l’échelle planétaire. Doté d’une polyvalence remarquable et d’une puissance algorithmique souvent sous-estimée, Excel permet de formaliser de manière transparente chaque étape du processus analytique. Le présent guide se propose d’explorer de manière exhaustive, systématique et ancrée dans les standards de la recherche universitaire contemporaine, le calcul, l’interprétation, la gestion des exceptions et la communication visuelle de la moyenne et de l’écart-type au sein de Microsoft Excel.
1. Introduction aux mesures de tendance centrale et de dispersion en psychologie
1.1 Importance de la statistique descriptive dans la recherche empirique
Dans l’écosystème de la recherche quantitative en sciences humaines, la statistique descriptive constitue le socle méthodologique initial sur lequel s’érige l’ensemble de l’édifice démonstratif. Toute expérimentation psychologique commence par la confrontation avec une masse informe de scores individuels : latences attentionnelles mesurées en millisecondes, cotations sur des échelles d’attitudes, scores composites issus de batteries neuropsychologiques ou fréquences de verbalisation spontanée. Face à cette profusion de données d’une grande granularité, le chercheur se trouve dans l’obligation épistémologique de réduire la dimensionnalité de son corpus sans pour autant dénaturer la richesse informative sous-jacente. Cette synthèse chiffrée ne constitue pas une simple simplification de commodité, mais une exigence de rationalité scientifique destinée à rendre comparables des observations hétérogènes et à dégager des patrons comportementaux stables.
La quantification des comportements humains impose une vigilance constante quant à la fidélité et la validité des construits analysés. L’analyse statistique descriptive permet d’opérer un diagnostic initial de la qualité des protocoles expérimentaux. C’est à ce stade précis que s’articule la complémentarité fondamentale entre tendance centrale et dispersion. Si la moyenne permet d’estimer la tendance générale d’un groupe soumis à une condition expérimentale donnée, elle demeure un indice aveugle à la dynamique interne du collectif. Deux cohortes d’individus peuvent présenter un score moyen rigoureusement identique de 50 à un test de stress perçu, tout en recouvrant des réalités psychologiques diamétralement opposées : l’une peut être caractérisée par une homogénéité remarquable où chaque sujet gravite autour de 50, tandis que l’autre peut présenter une polarisation aiguë entre des sujets indifférents oscillant autour de 10 et des individus en détresse sévère frôlant les 90 points. C’est dans l’espace mathématique délimité par l’écart-type que cette divergence structurelle se révèle pleinement.
L’omission de la mesure de dispersion hypothèque immédiatement la validité interne d’un protocole expérimental. En occultant la variabilité interindividuelle, le chercheur s’expose au risque majeur de confondre un effet expérimental systématique avec une fluctuation aléatoire ou un artefact d’échantillonnage. De surcroît, la prise en compte de la variabilité est indispensable pour statuer sur la normalité des distributions, condition sine qua non à l’application ultérieure des tests paramétriques d’inférence, tels que l’analyse de variance (ANOVA) ou le test t de Student. La statistique descriptive ne s’envisage donc pas comme un exercice préliminaire mécanique, mais comme une étape analytique souveraine qui conditionne l’ensemble des inférences scientifiques ultérieures.
1.2 Place du logiciel Excel dans le traitement des données quantitatives
Au sein des laboratoires de recherche académique et des institutions d’évaluation psychologique, Microsoft Excel occupe une place stratégique singulière. Bien que les logiciels spécialisés tels que R, IBM SPSS Statistics ou Python (via ses bibliothèques NumPy et Pandas) soient préconisés pour l’inférence multivariée complexe, Excel s’impose comme l’outil d’ingénierie des données le plus accessible, le plus transversal et le plus souple d’usage. Son interface matricielle bidimensionnelle offre une proximité visuelle immédiate avec la donnée brute, permettant aux étudiants, chercheurs et praticiens de maintenir une relation de continuité concrète avec chaque valeur enregistrée, là où des environnements programmatiques plus abstraits tendent parfois à masquer la matérialité de l’échantillon.
Cette immédiateté visuelle confère à Excel un rôle de passerelle pédagogique indispensable. La manipulation pas à pas des cellules, des plages et des fonctions statistiques élémentaires favorise l’appropriation conceptuelle des formules mathématiques. Avant d’exécuter une ligne de code scriptée dans un terminal R pour générer un écart-type, la décomposition du calcul dans une feuille de calcul — passant par les résidus individuels, leurs élévations au carré, leur sommation et enfin la division par les degrés de liberté — ancre durablement la compréhension mécanique de la métrique chez le futur chercheur. Le passage subséquent vers des logiciels d’inférence s’en trouve fluidifié, l’analyste sachant exactement quelle réalité algorithmique se cache derrière la commande invoquée.
Sur le plan de la rigueur métrologique, les versions contemporaines d’Excel bénéficient d’algorithmes statistiques révisés et consolidés par Microsoft. Historiquement critiqué pour l’imprécision relative de certains de ses modules dans les versions antérieures à 2003, le moteur de calcul statistique actuel implémente désormais des routines numériques conformes aux standards de précision de l’industrie informatique. Les fonctions statistiques dédiées au calcul de la moyenne et de la dispersion sont optimisées pour traiter sans perte de précision arithmétique des cohortes expérimentales volumineuses comprenant plusieurs dizaines de milliers d’enregistrements. Excel représente ainsi un compromis ergonomique et algorithmique de premier plan pour le nettoyage, la structuration descriptive et l’exploration initiale des métriques psychologiques fondamentales.
2. Fondements théoriques : Définitions de la moyenne et de l’écart-type
2.1 La moyenne arithmétique : Concept et formulation mathématique
La moyenne arithmétique représente, sur le plan géométrique et physique, le centre de gravité ou le point d’équilibre parfait d’une distribution de valeurs réelles. Pour appréhender ce concept intuitivement, imaginons un axe horizontal gradué le long duquel sont disposés des poids identiques à chaque coordonnée correspondant au score d’un participant : la moyenne arithmétique est précisément le point où il conviendrait de placer un pivot sous cet axe pour que l’ensemble du système demeure en équilibre stationnaire parfait, sans basculer d’un côté ou de l’autre. Cette propriété d’équilibre découle d’un théorème fondamental de la théorie statistique : la somme algébrique des écarts entre chaque valeur observée et la moyenne arithmétique de la série est rigoureusement égale à zéro.
D’un point de vue formel, la notation mathématique diffère selon que l’on considère la totalité d’une population parente ou un échantillon extrait de cette dernière. Lorsque le chercheur analyse une population exhaustive de taille $N$, la moyenne est qualifiée de paramètre populationnel et se désigne universellement par la lettre grecque mu ($\mu$). Son expression mathématique s’établit comme suit :
$$\mu = \frac{1}{N} \sum_{i=1}^{N} X_i$$
Dans la quasi-totalité des investigations en psychologie, le chercheur n’a cependant accès qu’à une fraction finie de la population, c’est-à-dire un échantillon aléatoire de taille $n$. Dans cette configuration, la moyenne devient une statistique descriptive d’échantillon, notée traditionnellement par la lettre $\bar{X}$ (X-barre) ou $M$ selon les recommandations typographiques de l’American Psychological Association (APA). Sa formalisation algébrique est équivalente dans son exécution arithmétique :
$$\bar{X} = \frac{\sum_{i=1}^{n} X_i}{n}$$
Malgré sa suprématie opérationnelle en tant qu’estimateur non biaisé du centre de la distribution, la moyenne arithmétique présente une vulnérabilité majeure : son hypersensibilité aux valeurs extrêmes, communément appelées outliers. En raison de sa construction purement additive, l’introduction d’un score exceptionnellement atypique — qu’il s’agisse d’une erreur d’encodage (par exemple, un âge de 220 ans au lieu de 22 ans) ou d’une authentique singularité psychique — déplace mécaniquement le barycentre vers l’extrémité concernée. Dès lors que la distribution d’une variable psychométrique s’écarte de la symétrie gaussienne pour adopter une forme étirée vers la droite (asymétrie positive) ou vers la gauche (asymétrie négative), la moyenne perd sa représentativité clinique au profit de la médiane, nécessitant un examen minutieux des paramètres de dispersion pour juger de sa pertinence intrinsèque.
2.2 L’écart-type : Mesure de la variabilité interindividuelle
Si la moyenne fixe l’ancrage central d’une série de mesures, l’écart-type quantifie l’ampleur moyenne des fluctuations ou de l’éloignement des observations par rapport à cette valeur de référence. Pour mesurer la variabilité, l’intuition première consisterait à faire la moyenne des écarts individuels $(X_i – \bar{X})$. Toutefois, comme nous l’avons souligné, la somme de ces résidus simples s’annule obligatoirement en raison de la compensation parfaite entre résidus positifs et résidus négatifs. Pour surmonter cette contrainte mathématique, la théorie statistique élève au carré chaque distance résiduelle avant d’en calculer la moyenne : c’est la genèse théorique de la variance.
La variance, bien qu’élégante mathématiquement, souffre d’un défaut interprétatif rédhibitoire pour le psychologue : son unité de mesure est le carré de l’unité originale. Si l’on évalue un temps de réaction en millisecondes, la variance s’exprime en millisecondes carrées ($ms^2$) ; si l’on mesure une concentration salivaire de cortisol en microgrammes par décilitre, sa variance sera en $\mu g^2/dL^2$. Pour restituer à la dispersion son échelle de mesure d’origine et la rendre immédiatement comparable à la moyenne, on extrait la racine carrée de la variance. L’écart-type, universellement symbolisé par la lettre grecque sigma ($\sigma$) au niveau de la population et par $s$ ou $SD$ au niveau échantillonnal, est ainsi formellement défini comme la racine carrée de la variance :
$$\sigma = \sqrt{\frac{\sum_{i=1}^{N} (X_i – \mu)^2}{N}}$$
Sur le plan de l’évaluation psychologique et de la pratique clinique, l’écart-type constitue l’indicateur par excellence de l’homogénéité ou de l’hétérogénéité d’un groupe. Un écart-type extrêmement restreint signale une cohésion comportementale étroite, où la performance de chaque sujet est quasi interchangeable avec celle de ses pairs. À l’inverse, un écart-type substantiel traduit une disparité interindividuelle prononcée, suggérant l’influence de variables modératrices sous-jacentes telles que le niveau socio-éducatif, la fatigue ou des profils de personnalité divergents. Par ailleurs, lorsque les données épousent les contours réguliers d’une distribution normale, l’écart-type prend une dimension prédictive grâce à la célèbre règle empirique des trois sigmas : environ 68,26 % des observations se situent dans l’intervalle $[\bar{X} – 1s ; \bar{X} + 1s]$, 95,44 % dans l’intervalle $[\bar{X} – 2s ; \bar{X} + 2s]$, et plus de 99,73 % des valeurs sont confinées entre plus ou moins trois écarts-types autour de la moyenne.
2.3 Distinction cruciale entre échantillon et population parente
La distinction conceptuelle entre une population statistique et un échantillon extrait constitue l’un des piliers les plus critiques du raisonnement inférentiel, et c’est précisément sur cette démarcation que trébuchent de nombreux utilisateurs d’Excel. En recherche clinique, la population parente représente l’ensemble hypothétique ou théorique exhaustif de tous les individus répondant à des critères définis (par exemple, la totalité des patients diagnostiqués avec un trouble dépressif majeur dans un pays donné). En pratique, il est strictement impossible sur le plan matériel, financier et logistique d’interroger l’intégralité de cette population. Le chercheur doit donc se résoudre à collecter des données auprès d’un échantillon fini de $n$ participants, avec l’ambition de généraliser les conclusions tirées de cet extrait à la population parente.
Or, lorsqu’on calcule la variabilité au sein d’un échantillon pour estimer celle de la population, un problème mathématique insidieux émerge : les scores de l’échantillon sont invariablement plus proches de leur propre moyenne échantillonnale $\bar{X}$ qu’ils ne le sont de la moyenne populationnelle théorique et inconnue $\mu$. Il en résulte que la somme des carrés des écarts calculée par rapport à $\bar{X}$ est systématiquement inférieure à celle qui aurait été calculée par rapport à $\mu$. Par conséquent, si l’on applique naïvement la formule de la population en divisant cette somme par la taille d’échantillon $n$, on aboutit à une sous-estimation systématique de la variance et de l’écart-type réels de la population. Ce biais d’échantillonnage s’avère d’autant plus sévère et préjudiciable que la taille $n$ de l’échantillon est restreinte.
Pour neutraliser rigoureusement ce biais statistique et fournir une estimation asymptotiquement exacte du paramètre de dispersion populationnel, le mathématicien allemand Friedrich Bessel a introduit une rectification arithmétique connue sous le nom de correction de Bessel. Cette correction consiste à substituer au dénominateur $n$ la quantité $n – 1$, représentant les degrés de liberté résiduels. La formule de l’écart-type échantillonnal corrigé s’énonce ainsi :
$$s = \sqrt{\frac{\sum_{i=1}^{n} (X_i – \bar{X})^2}{n – 1}}$$
En retirant une unité au dénominateur, la division produit un résultat légèrement supérieur, compensant avec une exactitude mathématique la sous-estimation intrinsèque de la variance d’échantillonnage. En psychologie empirique, où la quasi-totalité des protocoles repose sur des échantillons restreints ou modérés, le recours à la formule corrigée par $n – 1$ constitue une règle épistémologique absolue pour préserver la validité des conclusions statistiques.
3. Préparation et structuration rigoureuse des données dans Excel
3.1 Architecture matricielle optimale d’une feuille de calcul
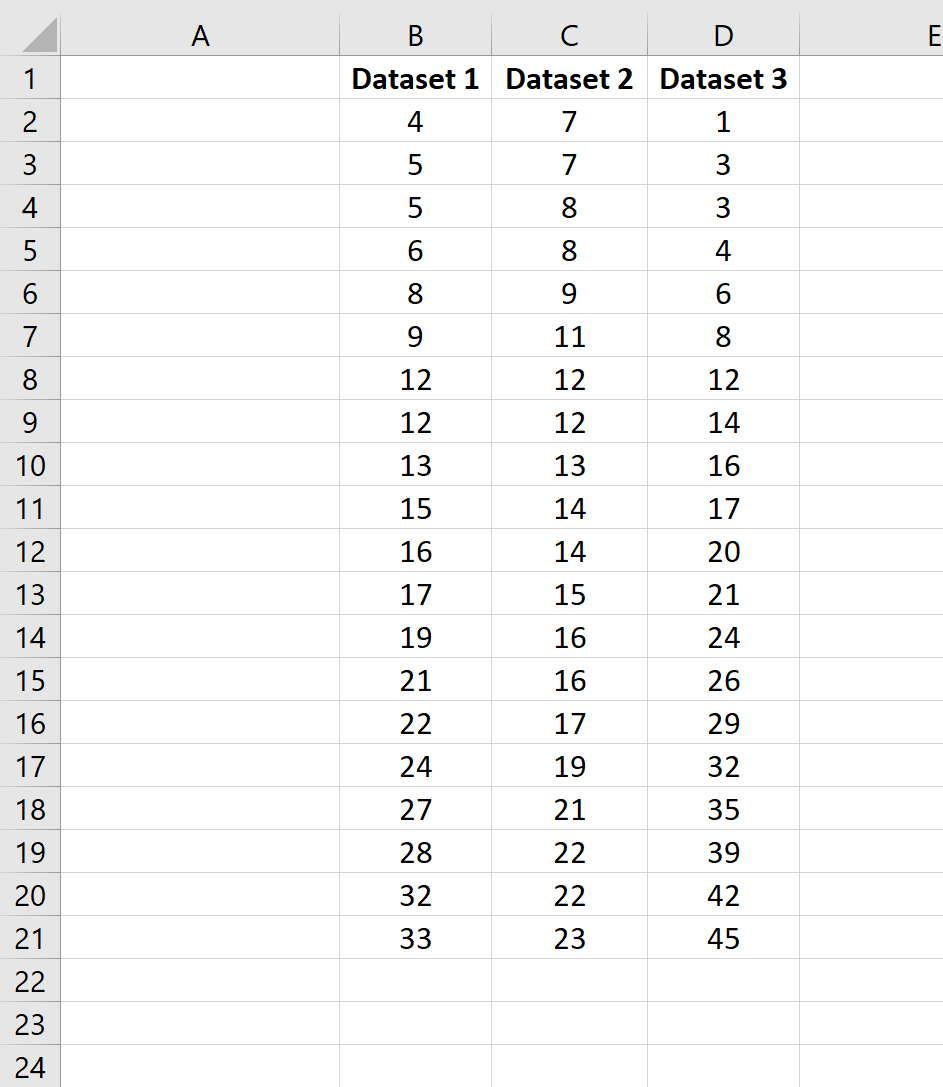
L’efficacité du traitement analytique dans Microsoft Excel dépend en amont de l’hygiène de la structure tabulaire mise en place lors de la saisie ou de l’importation des données. En psychométrie et en méthodologie expérimentale, le standard d’organisation universel repose sur le format matriciel rectangulaire strict, souvent désigné sous l’appellation de format « tidy » ou tabulaire standardisé. Selon cette convention internationale, les lignes représentent exclusivement les unités observationnelles (c’est-à-dire les participants, les sujets d’une cohorte ou les temps de mesure d’un protocole longitudinal), tandis que les colonnes sont strictement réservées aux variables (caractéristiques démographiques, conditions expérimentales, items individuels ou scores totaux).
La première ligne du classeur doit être intégralement et exclusivement dédiée aux en-têtes de colonnes. Ces identifiants doivent être univoques, concis et standardisés (par exemple, ID_Sujet, Age, Genre, TR_Congruent, TR_Incongruent, Anxiete_Pre, Anxiete_Post). Il est formellement déconseillé d’insérer des lignes d’en-têtes fusionnées, des interlignes vierges à vocation purement esthétique ou des libellés comportant des caractères typographiques spéciaux, des espaces multiples ou des accents incompatibles avec d’éventuelles exportations ultérieures vers des plateformes d’analyse statistique avancée.
Un autre écueil récurrent réside dans le typage des cellules au sein d’Excel. Une colonne destinée à recevoir des données quantitatives continues doit être rigoureusement paramétrée au format « Nombre » ou « Standard », garantissant l’alignement naturel des chiffres sur la marge droite de la cellule. Si un nombre est accidentellement importé ou saisi sous forme de texte — ce qui se manifeste visuellement par un alignement à gauche ou par la présence d’une apostrophe invisible en tête de chaîne —, les fonctions de calcul statistique d’Excel peuvent ignorer silencieusement ces entrées ou renvoyer des messages d’anomalie critique. L’assignation préalable de noms de plages standardisés (via le Gestionnaire de noms accessible dans l’onglet Formules) constitue également une excellente pratique d’ingénierie des données, facilitant la lecture des formules complexes ultérieures en remplaçant par exemple la plage cryptique C2:C150 par le descripteur sémantique Temps_Reaction.
3.2 Audit préalable et hygiène des données psychométriques
Avant d’engager le moindre calcul descriptif sur une feuille Excel, le chercheur doit procéder à un audit méthodique de l’intégrité de ses données psychométriques. Cette étape de vérification qualitative commence par la détection systématique des cellules vides résultant d’abandons de passation ou d’omissions volontaires de la part des répondants. Dans un questionnaire psychologique standardisé, une absence de réponse ne doit en aucun cas être laissée au hasard de cellules vierges ambiguës ou, pire encore, encodée par la valeur chiffrée zéro ($0$). Dans la plupart des échelles de personnalité, le zéro n’est pas une absence de valeur mais un échelon de cotation clinique valide ; confondre une non-réponse avec un score minimal fausse instantanément l’estimation de la moyenne arithmétique globale.
L’utilisation de la fonctionnalité Validation des données (située dans l’onglet Données d’Excel) s’impose comme un rempart efficace contre les erreurs matérielles de frappe. Pour une échelle de Likert mesurant l’estime de soi calibrée de 1 à 7, la règle de validation doit interdire la saisie de tout nombre décimal ou de tout entier supérieur à 7. Un audit par filtrage automatique ou par l’application de formats conditionnels permet d’isoler en un clin d’œil les aberrations métrologiques (scores négatifs impossibles, âges disproportionnés, scores totaux excédant le maximum théorique de l’instrument). Les protocoles d’investigation rigoureux adoptent généralement des codes sentinelles explicites pour les données manquantes (par exemple -999 ou la mention textuelle NA), bien qu’il faille ensuite instruire Excel pour qu’il n’incorpore pas ces valeurs fictives dans ses calculs d’agrégation.
Enfin, la question linguistique et régionale des séparateurs décimaux mérite une vigilance toute particulière. Dans l’écosystème francophone, la virgule (,) constitue le séparateur décimal officiel, tandis que le monde anglo-saxon et la majorité des instruments psychométriques informatisés utilisent le point (.). L’importation brute de fichiers au format texte délimité (CSV ou TXT) générés par des logiciels de passation expérimentale (tels qu’E-Prime, Gorilla ou Psychopy) peut conduire à une altération majeure : les nombres à virgule flottante contenant un point sont fréquemment convertis par les versions françaises d’Excel en chaînes textuelles ou même en dates calendaires arbitraires. La normalisation globale du classeur via les fonctions de remplacement de caractères (Ctrl+H pour substituer les points par des virgules) ou le paramétrage explicite des séparateurs système dans les options avancées d’Excel représente un prérequis impératif à l’obtention de métriques valides.
4. Calcul de la moyenne dans Excel : Syntaxe et méthodologie
4.1 Utilisation standard de la fonction MOYENNE (AVERAGE)
L’implémentation opérationnelle du calcul de la moyenne arithmétique au sein d’Excel s’effectue au moyen de la fonction native MOYENNE (traduite par AVERAGE dans les installations configurées en langue anglaise). L’architecture syntaxique générale de cette instruction se déploie selon le formalisme suivant :
=MOYENNE(nombre1; [nombre2]; ...)
Dans la pratique courante de l’analyse empirique, les arguments ne sont pas renseignés un à un, mais regroupés sous la forme d’une plage vectorielle de cellules continues. Par exemple, si les scores d’une batterie d’efficience mnésique administrée à un groupe de cent participants sont répertoriés de la cellule B2 à la cellule B101, la formule s’énonce simplement :
=MOYENNE(B2:B101)
Excel offre une grande flexibilité en autorisant la sélection de segments disjoints de la feuille de calcul. Dans le cadre d’un protocole expérimental factoriel où les sujets contrôles sont répartis dans différentes sections du tableau (par exemple les blocs de cellules B2:B50 et B75:B120), l’analyste peut concaténer ces segments au sein de la même formule en séparant chaque plage matricielle par un point-virgule :
=MOYENNE(B2:B50; B75:B120)
Le comportement intrinsèque de la fonction MOYENNE face aux cellules hétérogènes mérite d’être souligné avec force détails. Par conception algorithmique, la fonction MOYENNE ignore automatiquement les cellules totalement vides ainsi que celles contenant des chaînes de caractères textuels ou des valeurs logiques booléennes (VRAI ou FAUX). Cette propriété est particulièrement commode lorsqu’un participant a manqué une passation : la cellule vide n’abaisse pas artificiellement la moyenne vers le bas, contrairement à ce qui se produirait si un zéro y avait été inscrit de manière erronée. Toutefois, si l’on souhaite délibérément que les valeurs logiques ou les représentations textuelles de nombres soient prises en compte dans le traitement, il convient de recourir à la variante spécialisée MOYENNEA, bien que son utilisation en recherche psychologique demeure exceptionnelle et généralement déconseillée afin d’éviter d’introduire des biais d’interprétation.
À des fins d’assurance qualité et de validation méthodologique, tout chercheur rigoureux doit acquérir le réflexe de vérifier le comportement de la fonction sur un sous-ensemble contrôlé de données. Une méthode infaillible consiste à exécuter un recalcul manuel direct en combinant la fonction d’addition et de dénombrement :
=SOMME(B2:B101) / NB(B2:B101)
Cette formulation alternative, rigoureusement équivalente sur le plan théorique, permet de s’assurer que la fonction NB ne comptabilise que les cellules contenant effectivement des données numériques, garantissant que le dénominateur appliqué dans l’algorithme correspond précisément au nombre d’observations valides recueillies.
4.2 Traitement des scores composites et moyennes pondérées
La recherche psychométrique ne se limite que rarement à l’analyse de variables brutes isolées ; elle implique le plus souvent la construction de scores composites, issus de sous-échelles théoriques pondérées selon leur contribution relative au construit global étudié. C’est le cas par exemple d’un indice composite d’épuisement professionnel articulant des facettes d’épuisement émotionnel, de dépersonnalisation et d’accomplissement personnel, où chaque dimension se voit attribuer un coefficient d’importance spécifique défini par des analyses factorielles confirmatoires préalables.
Lorsque des poids distincts doivent être attribués à différentes variables pour refléter leur importance différentielle, la moyenne arithmétique simple s’avère caduque et doit s’effacer devant la moyenne pondérée. Formellement, la moyenne pondérée $\bar{X}_p$ d’un vecteur de valeurs $X$ affecté d’un vecteur de coefficients de pondération $W$ répond à la formule :
$$\bar{X}_p = \frac{\sum_{i=1}^{k} (w_i \cdot x_i)}{\sum_{i=1}^{k} w_i}$$
Pour exécuter cette opération matricielle sans déployer une succession laborieuse de multiplications individuelles, Excel met à disposition la puissante fonction combinée SOMMEPROD associée à SOMME. Supposons que les scores obtenus par un participant à trois épreuves cognitives soient consignés dans les cellules B2:D2 et que les coefficients de pondération théoriques respectifs de ces épreuves soient explicités dans les cellules B1:D1 (par exemple, des poids de 3, 2 et 5). Le calcul de la performance composite s’articule via l’instruction élégante suivante :
=SOMMEPROD(B2:D2; $B$1:$D$1) / SOMME($B$1:$D$1)
L’avantage cardinal de cette syntaxe réside dans l’utilisation de références absolues (matérialisées par les signes dollar $) pour figer la plage des poids. L’analyste peut ainsi étendre ou propager la formule le long de la colonne par un double-clic sur la poignée de recopie pour calculer instantanément les scores composites normalisés de plusieurs centaines de sujets d’un seul geste.
Cette méthodologie de pondération trouve une seconde application cruciale dans le méta-calcul de moyennes de groupe lors d’expérimentations comportant des blocs de passation inégaux. Si un protocole d’apprentissage teste un groupe pilote de 12 sujets présentant une vitesse moyenne de traitement de 450 ms et un groupe expérimental étendu de 48 participants affichant une moyenne de 380 ms, calculer la moyenne globale par la simple formule =(450 + 380) / 2 = 415 ms constitue une faute statistique inexcusable. L’effectif des groupes devant peser proportionnellement sur la synthèse finale, la formule de pondération via SOMMEPROD permet de restituer la juste prépondérance de l’échantillon le plus vaste, aboutissant à une valeur moyenne pondérée conforme de 394 ms.
5. Calcul de l’écart-type échantillonnal dans Excel
5.1 Mise en œuvre de la fonction ECARTYPE.STANDARD (STDEV.S)
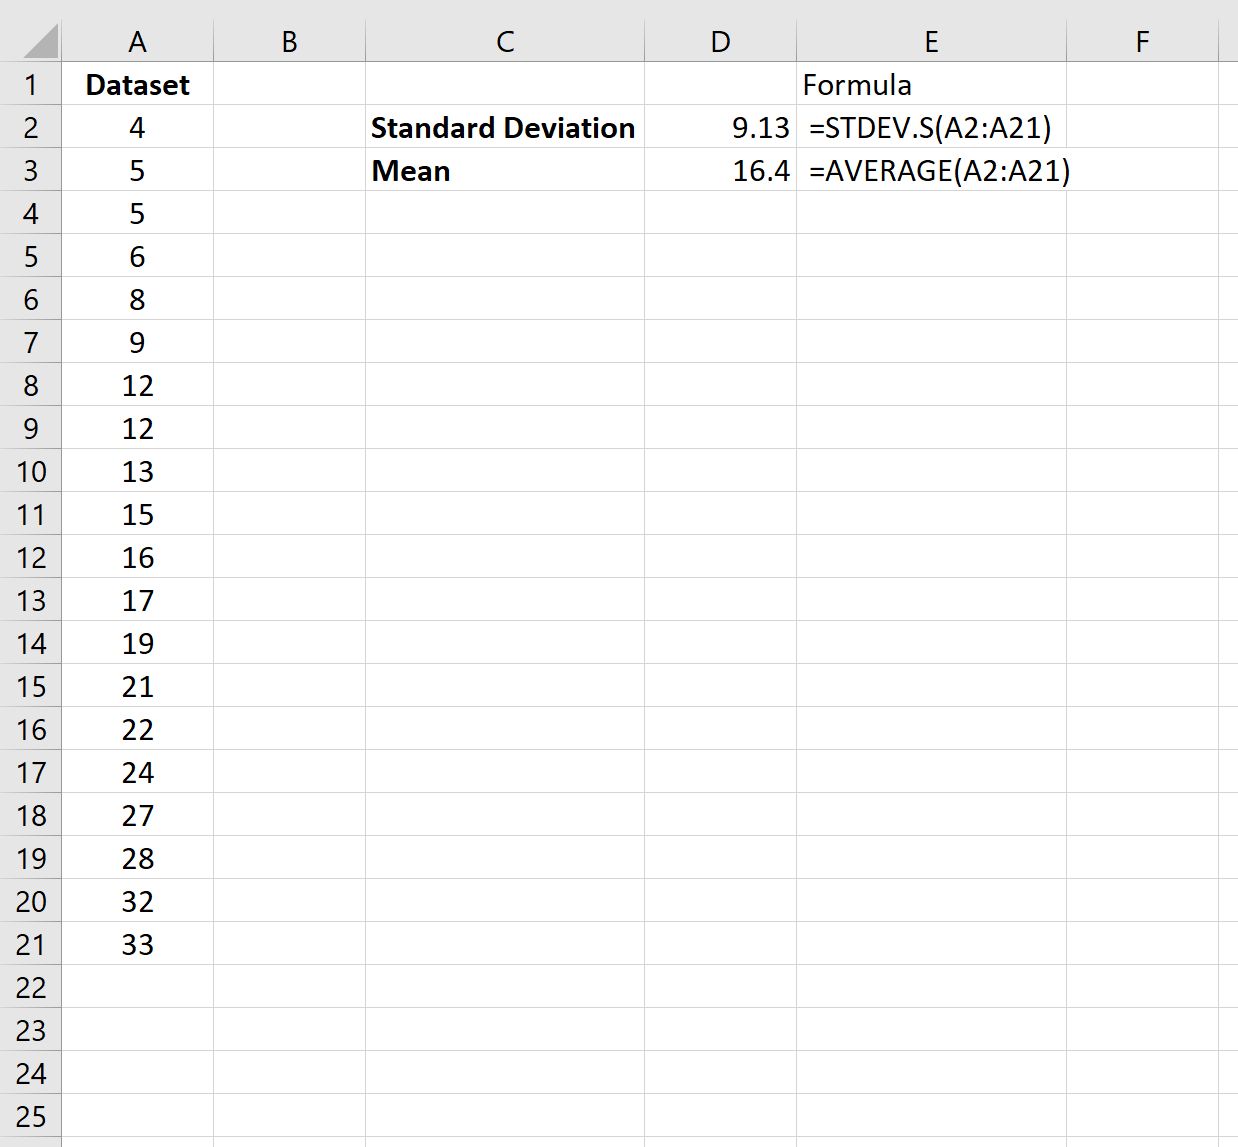
Dans l’univers opérationnel d’Excel, le calcul de l’écart-type échantillonnal — c’est-à-dire l’estimation non biaisée intégrant impérativement la correction de Bessel en divisant par les degrés de liberté $n – 1$ — s’effectue au moyen de la fonction contemporaine ECARTYPE.STANDARD. Sur les versions anglophones du logiciel, cette fonction correspond scrupuleusement à STDEV.S (où le suffixe .S renvoie explicitement au terme anglophone Sample). Sa syntaxe opératoire se décline ainsi :
=ECARTYPE.STANDARD(plage)
Pour illustrer son déploiement pratique, considérons une expérience évaluant le niveau d’inhibition cognitive auprès d’une cohorte d’étudiants dont les scores de performance sont consignés dans la plage E2:E85. L’instruction mathématique s’exécutera selon la formulation suivante :
=ECARTYPE.STANDARD(E2:E85)
Il est fondamental de noter qu’Excel calcule en arrière-plan la moyenne de la plage désignée, déduit cette valeur de chaque observation individuelle, porte chaque résidu au carré, effectue leur sommation intégrale, divise cette somme par le nombre total de cellules numériques moins une unité, et extrait enfin la racine carrée du quotient. Toute cette mécanique arithmétique complexe est condensée de manière transparente et instantanée par le moteur de calcul.
Une mise en garde historique s’impose ici quant à la nomenclature des fonctions dans Excel. Dans les éditions antérieures à Excel 2010, le logiciel utilisait la fonction indifférenciée ECARTYPE (ou STDEV en anglais). Bien que cette ancienne instruction demeure encore supportée dans les versions récentes pour garantir la rétrocompatibilité des classeurs historiques, elle est formellement classée comme obsolète par Microsoft. Le chercheur avisé évitera rigoureusement l’emploi de cette appellation ambiguë au profit de la désignation explicite ECARTYPE.STANDARD, attestant de la traçabilité et de la conformité méthodologique de ses protocoles analytiques.
5.2 Interprétation contextuelle de la dispersion observée
L’obtention d’une valeur chiffrée d’écart-type au bas d’une colonne Excel ne constitue pas une fin en soi ; elle appelle une exégèse critique en relation étroite avec la moyenne arithmétique correspondante et les spécificités de l’instrument d’évaluation utilisé. En premier lieu, l’écart-type permet d’asseoir la représentativité réelle de la moyenne : un écart-type dont la magnitude est disproportionnée par rapport à la moyenne suggère une volatilité comportementale massive au sein du groupe ou la présence d’une distribution bimodale masquée, où la moyenne ne correspond en réalité à aucun profil clinique tangible.
Cependant, l’écart-type brut souffre d’une contrainte inhérente : étant tributaire de l’unité de mesure d’origine, il ne permet pas la comparaison directe de la dispersion entre des variables calibrées sur des échelles hétérogènes. Par exemple, si une étude évalue la dispersion de l’âge des participants (mesuré en années, avec une moyenne de 20 et un écart-type de 2) et celle de leur temps de fixation oculaire (mesuré en millisecondes, avec une moyenne de 300 et un écart-type de 30), comment déterminer scientifiquement laquelle de ces deux dimensions présente la variabilité relative la plus aiguë ? Pour résoudre cette aporie métrologique, le statisticien calcule le coefficient de variation ($CV$), défini comme le ratio sans dimension de l’écart-type sur la moyenne arithmétique, couramment exprimé en pourcentage :
$$CV = \left( \frac{s}{\bar{X}} \right) \times 100$$
Dans Microsoft Excel, le calcul de cet indice d’homogénéité standardisé s’opère très facilement par la composition directe des cellules préalablement renseignées :
=(ECARTYPE.STANDARD(E2:E85) / MOYENNE(E2:E85)) * 100
En examinant le résultat de cette normalisation, si le coefficient de variation de l’âge s’établit à 10 % ($2/20 \times 100$) et celui de la fixation oculaire s’élève également à 10 % ($30/300 \times 100$), on en déduit que, malgré des écarts-types bruts incomparables dans leur magnitude brute, les deux distributions manifestent un degré de dispersion strictement identique autour de leur barycentre respectif. D’une manière générale, en sciences du comportement, un $CV$ inférieur à 15 % témoigne d’une grande homogénéité de la cohorte, tandis qu’un coefficient excédant 30 % alerte sur une instabilité expérimentale prononcée, susceptible d’altérer la puissance statistique des inférences ultérieures.
6. Écart-type de l’échantillon vs de la population : Choix des fonctions
6.1 Application de la fonction ECARTYPE.PESTIMEE (STDEV.P)
À côté de la fonction dédiée aux échantillons, Excel met à la disposition des utilisateurs une fonction alternative dont le champ d’action théorique repose sur une division stricte par la taille intégrale $N$ : la fonction ECARTYPE.PESTIMEE (ou STDEV.P dans les environnements anglophones, le .P désignant explicitement la Population). Sa syntaxe générale s’articule comme suit :
=ECARTYPE.PESTIMEE(plage)
Cette fonction exécute la formule mathématique rigoureuse de la dispersion populationnelle sans intégrer la correction de Bessel au dénominateur :
$$\sigma = \sqrt{\frac{\sum_{i=1}^{N} (X_i – \mu)^2}{N}}$$
L’utilisation de cette commande statistique ne peut se justifier que dans des contextes hautement spécifiques et relativement marginaux dans la pratique usuelle de la recherche en psychologie. Elle ne trouve sa légitimité épistémologique que lorsque l’analyste a pu recueillir la totalité exhaustive et absolue des données relatives à une population fermée sans aucune ambition d’extrapoler ses conclusions au-delà de ce groupe clos. On peut concevoir son application, par exemple, dans le cadre d’un audit psychologique mené sur l’intégralité des 24 astronautes composant un détachement spatial étatique, ou lors du recensement exhaustif des performances scolaires de tous les élèves inscrits dans une institution d’éducation spécialisée exclusive au cours d’une année donnée.
L’erreur méthodologique majeure consisterait à employer ECARTYPE.PESTIMEE sur un groupe d’individus sous prétexte que le chercheur ne s’intéresse qu’à sa cohorte du moment, tout en mobilisant ensuite ces indices pour formuler des conclusions théoriques généralisables à la nature humaine ou à une pathologie en général. Une telle méprise engendre immédiatement une sous-estimation systématique de la véritable variance sous-jacente, introduisant un biais optimiste artificiel qui fausse la signification clinique des données recueillies.
6.2 Arbre décisionnel pour le chercheur en sciences sociales
Afin de guider de façon irréfutable l’utilisateur dans les méandres de la bibliothèque statistique d’Excel, l’établissement d’un arbre décisionnel s’avère indispensable. Pour sélectionner judicieusement la syntaxe appropriée, l’expérimentateur doit soumettre sa démarche à un questionnaire méthodologique ordonné :
- Question 1 : L’ensemble des données numériques présentes dans ma plage Excel couvre-t-il la totalité absolue, exhaustive et indépassable de tous les éléments existants dans l’univers d’étude défini (population parente) ?
- Si Oui : J’utilise sans équivoque la fonction
=ECARTYPE.PESTIMEE(plage)(ouSTDEV.P). - Si Non : Je me dirige immédiatement vers la question suivante.
- Si Oui : J’utilise sans équivoque la fonction
- Question 2 : Mes observations proviennent-elles d’un échantillon (aléatoire, de convenance ou stratifié) extrait d’une population plus vaste à laquelle j’ai l’intention d’inférer mes résultats ?
- Si Oui : J’emploie impérativement la fonction
=ECARTYPE.STANDARD(plage)(ouSTDEV.S), afin de bénéficier de la correction de Bessel par $n – 1$.
- Si Oui : J’emploie impérativement la fonction
Pour mesurer concrètement l’impact arithmétique de cette distinction sur les échantillons expérimentaux usuels en psychologie, le tableau conceptuel suivant formalise les divergences numériques induites par les deux algorithmes en fonction de la taille de l’échantillon $n$, pour une somme des carrés des écarts constante égale à 100 :
Pour une petite cohorte de $n = 5$ participants, ECARTYPE.PESTIMEE renvoie une valeur de $\sqrt{100 / 5} = 4,47$, tandis que ECARTYPE.STANDARD délivre la valeur rectifiée de $\sqrt{100 / (5 – 1)} = 5,00$, soit une différence considérable de plus de 11,8 %. Si l’échantillon passe à $n = 30$, les valeurs s’établissent respectivement à 1,826 et 1,857 (un différentiel d’environ 1,7 %). Ce n’est qu’au-delà de plusieurs centaines de sujets ($n > 500$) que la divergence arithmétique entre la division par $n$ et la division par $n – 1$ devient infinitésimale et asymptotiquement négligeable.
Dans la mesure où la recherche en psychologie clinique, en ergonomie cognitive et en neurosciences fonctionne fréquemment avec des protocoles restreints mobilisant entre 15 et 50 sujets, l’impact du choix de la fonction sur les conclusions statistiques est loin d’être anodin. Les comités de lecture des revues internationales savantes alignées sur les préconisations méthodologiques de l’APA rejettent invariablement les manuscrits dont les écarts-types ont été calculés via la fonction de population ECARTYPE.PESTIMEE sur des données échantillonnales.
7. Gestion des données manquantes et valeurs aberrantes
7.1 Comportement des fonctions face aux valeurs manquantes
La confrontation à des données incomplètes constitue l’un des défis les plus ubiquitaires dans l’analyse de données comportementales. Qu’il s’agisse de questionnaires retournés avec des réponses omises, d’interruptions inopinées de capteurs physiologiques ou de participants ayant abandonné une tâche en cours de route, la feuille Excel héberge inévitablement des lacunes informationnelles. Dans ce contexte, une compréhension fine de la manière dont Excel gère les valeurs non disponibles est indispensable pour prévenir toute distorsion des métriques descriptives.
Il existe une divergence critique de traitement informatique entre une cellule rigoureusement vide, une cellule hébergeant le chiffre zéro (0) et une cellule comportant une mention textuelle (telle que "Manquant", "NA" ou "Absent"). Comme évoqué précédemment, la fonction MOYENNE et la fonction ECARTYPE.STANDARD ignorent complètement les cellules vides ainsi que les chaînes de texte alphabétique. Dès lors, si une variable a été enregistrée pour 20 sujets mais que deux cellules restent vierges dans la plage A1:A20, le logiciel calcule spontanément la moyenne sur le sous-ensemble effectif de 18 individus. Le dénominateur utilisé pour le décompte est dynamiquement ajusté à 18, sans nécessiter d’intervention manuelle.
En revanche, si l’opérateur a encodé l’absence de réponse par un chiffre 0, Excel interprète ce caractère comme une authentique mesure quantitative nulle. Dans cette configuration, les deux zéros sont ajoutés au numérateur et, surtout, le dénominateur demeure calé sur 20 sujets. Il en résulte un effondrement dramatique et totalement artificiel de la moyenne arithmétique globale, doublé d’une inflation mensongère de l’écart-type causée par l’écart abyssal séparant ces zéros factices des vrais scores du groupe. Pour repérer ces distorsions, il est vivement recommandé d’utiliser des fonctions de dénombrement conditionnel comme NB.SI(plage; 0) afin de vérifier si des valeurs nulles ne dissimulent pas un codage erroné de l’absence de réponse.
7.2 Repérage et exclusion des outliers selon les normes scientifiques
Les valeurs aberrantes, ou outliers, désignent des observations dont l’amplitude s’écarte de manière si vertigineuse du reste de la distribution qu’elles éveillent le soupçon légitime d’une erreur d’enregistrement systématique, d’une rupture du protocole expérimental ou de la présence d’un individu n’appartenant pas à la population cible. Dans les sciences de l’esprit, où la variabilité humaine est élevée, l’identification des données extrêmes doit impérativement s’adosser à des critères mathématiques objectifs et universellement documentés.
La méthode de repérage la plus prévalente en statistique paramétrique consiste à standardiser la variable sous la forme de scores z (scores réduits et centrés). Le score centré-réduit $z_i$ d’un participant indique précisément à combien d’écarts-types de la moyenne générale se situe sa propre observation :
$$z_i = \frac{X_i – \bar{X}}{s}$$
Dans Microsoft Excel, le calcul d’un score z s’exécute nativement le long d’une colonne dédiée grâce à la fonction CENTREE.REDUITE (ou STANDARDIZE dans les versions anglophones). Si la note brute du premier sujet se trouve dans la cellule B2, et que les paramètres descriptifs globaux ont été pré-calculés dans les cellules fixes $M$1 pour la moyenne et $M$2 pour l’écart-type échantillonnal, la syntaxe s’établit comme suit :
=CENTREE.REDUITE(B2; $M$1; $M$2)
Selon les conventions méthodologiques les plus rigoureuses, un score $z$ excédant le seuil absolu de $\pm 3,0$ (ou $\pm 3,29$ dans les cohortes volumineuses) signale une valeur atypique extrême se situant au-delà du 99,7e percentile de la distribution normale. L’identification peut être automatisée visuellement dans Excel grâce à une règle de Mise en forme conditionnelle configurée pour surligner en rouge toute cellule vérifiant la condition =ABS(C2)>3.
Face à des données asymétriques polluées par des extrêmes que l’on ne souhaite pas exclure manuellement sans justification formelle, le chercheur peut mobiliser une mesure de compromis hautement robuste : la moyenne tronquée ou réduite, matérialisée dans Excel par la fonction MOYENNE.REDUITE (TRIMMEAN en anglais). Cette commande statistique permet d’élaguer automatiquement un pourcentage défini des valeurs les plus basses et les plus hautes de la série avant d’en calculer la tendance centrale. Par exemple, pour évacuer les 10 % de données les plus extrêmes (5 % à chaque extrémité de la distribution) sur une cohorte enregistrée de B2 à B101, l’analyste inscrira :
=MOYENNE.REDUITE(B2:B101; 0,10)
Quelle que soit la stratégie retenue pour la neutralisation des valeurs extrêmes — qu’il s’agisse de l’élimination définitive d’une observation ou de son remplacement contrôlé (winsorisation) —, le standard de probité académique de l’APA exige une transparence totale : l’article de recherche doit obligatoirement expliciter le critère objectif de détection mobilisé, le nombre exact d’observations exclues et l’impact de cette décision sur la magnitude de la moyenne et de l’écart-type recalculés.
8. Calculs conditionnels : Moyennes et écarts-types par groupe
8.1 Segmentation par groupe avec MOYENNE.SI et MOYENNE.SI.ENS
Dans la quasi-totalité des plans expérimentaux, les participants sont affectés à des conditions distinctes (groupe contrôle, groupe placebo, groupe intervention) ou catégorisés selon des variables sociodémographiques ou diagnostiques (genre, niveau d’anxiété faible/élevé). Dès lors, le chercheur ne cherche pas à connaître la moyenne brute indifférenciée de toute sa base de données, mais à isoler et comparer les moyennes respectives de chaque sous-groupe d’intérêt. Excel répond admirablement à ce besoin par le truchement de ses fonctions de calcul conditionnel.
La fonction MOYENNE.SI permet de restreindre l’évaluation de la tendance centrale aux seules lignes répondant à un critère logique unique. Sa formalisation syntaxique se déploie comme suit :
=MOYENNE.SI(plage_critères; critère; [plage_moyenne])
Imaginons que la variable de groupe soit consignée dans la colonne A (avec les libellés catégoriels "Controle" et "Experimental") et que les scores de mémoire de travail soient situés dans la colonne B, de la ligne 2 à la ligne 120. Pour obtenir la moyenne spécifique du groupe témoin, la formule s’énonce :
=MOYENNE.SI(A2:A120; "Controle"; B2:B120)
Lorsque le protocole expérimental mobilise un devis factoriel croisé impliquant plusieurs variables indépendantes simultanées (par exemple, étudier le score de mémoire selon le groupe expérimental ET le genre du participant), la fonction MOYENNE.SI.ENS (AVERAGEIFS en anglais) s’impose avec force. Attention cependant à l’inversion d’ordonnancement des arguments : dans MOYENNE.SI.ENS, la plage contenant les valeurs numériques à moyenner est obligatoirement renseignée en premier argument, suivie par les couples successifs de plages de critères et de conditions :
=MOYENNE.SI.ENS(plage_moyenne; plage_critères1; critère1; plage_critères2; critère2; ...)
Ainsi, pour calculer la moyenne mnésique des seules participantes de genre féminin (colonne C = "Femme") assignées à la condition expérimentale (colonne A = "Experimental"), l’instruction matricielle sera :
=MOYENNE.SI.ENS(B2:B120; A2:A120; "Experimental"; C2:C120; "Femme")
Il est important de garder à l’esprit que si aucune observation dans la table ne satisfait l’ensemble des conditions logiques combinées, Excel générera l’erreur de division par zéro #DIV/0!. Pour préserver l’élégance et la robustesse du tableau de bord d’analyse, il est d’usage d’envelopper cette expression dans une fonction de capture d’anomalie : =SI.NON.DISP(MOYENNE.SI.ENS(...); "N/A") ou =SIERREUR(MOYENNE.SI.ENS(...); "").
8.2 Formules matricielles dynamiques pour l’écart-type conditionnel
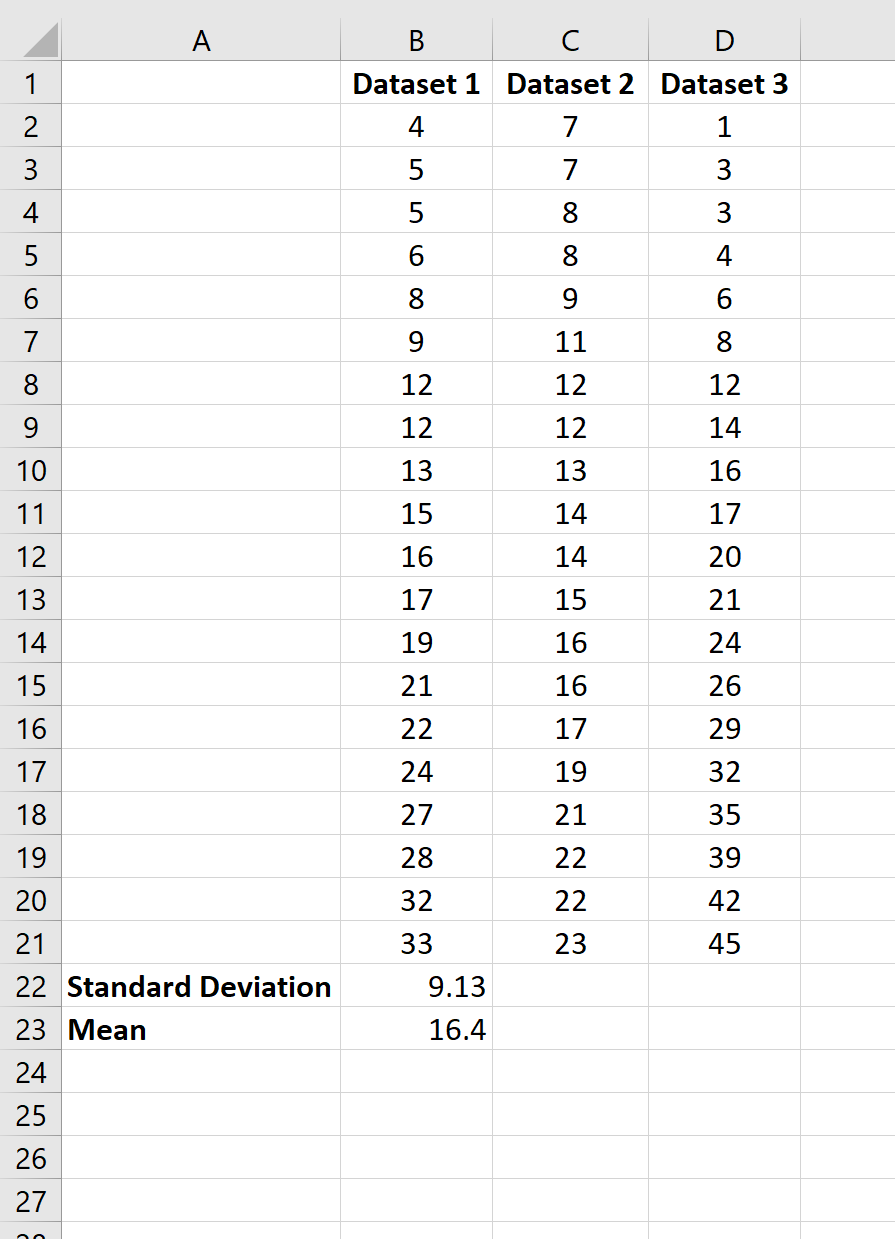
Alors que Microsoft a doté Excel de fonctions natives pour les moyennes conditionnelles (MOYENNE.SI), le logiciel ne propose étrangement, à ce jour, aucune fonction intégrée directe du type « ECARTYPE.SI » ou « STDEV.IF ». Pour calculer l’écart-type d’un sous-groupe spécifique sans avoir à scinder manuellement la table de données initiale par de fastidieux copiés-collés, le chercheur doit obligatoirement élaborer une formule matricielle en imbriquant la fonction logique SI au cœur de la fonction ECARTYPE.STANDARD.
Le principe théorique de cette construction consiste à demander à la fonction SI d’évaluer la colonne de groupe : si la condition est vérifiée pour une ligne donnée, la fonction renvoie la valeur numérique correspondante ; dans le cas contraire, elle renvoie la valeur booléenne FAUX. L’astuce opératoire repose sur le fait que la fonction ECARTYPE.STANDARD ignore structurellement les booléens FAUX. Ainsi, seul le sous-ensemble de nombres filtrés est pris en compte pour le calcul de la dispersion corrigée.
La syntaxe de cette formulation s’énonce comme suit pour isoler l’écart-type du groupe expérimental :
=ECARTYPE.STANDARD(SI(A2:A120="Experimental"; B2:B120))
L’implémentation pratique de cette formule dépend de la version d’Excel utilisée :
- Sur les versions modernes d’Excel (Microsoft 365 et Excel 2021+) : Le moteur de calcul intègre la gestion native des matrices dynamiques. Il suffit de saisir la formule normalement dans la barre de saisie et de valider par la touche classique Entrée.
- Sur les versions historiques d’Excel (2019, 2016, 2013 et antérieures) : Cette imbrication matricielle requiert impérativement une validation spéciale par la combinaison de touches simultanées Ctrl + Maj + Entrée (communément désignée sous l’acronyme CSE). Lorsque cette manipulation est exécutée avec succès, Excel encadre automatiquement la formule d’accolades décoratives (ex. :
{=ECARTYPE.STANDARD(SI(...))}). Une validation banale par la simple touche Entrée produirait un résultat erroné ou l’erreur#VALEUR!.
Si l’on doit croiser deux critères simultanés pour l’écart-type (par exemple, condition expérimentale et genre), on utilise la multiplication logique au sein du test conditionnel :
=ECARTYPE.STANDARD(SI((A2:A120="Experimental")*(C2:C120="Femme"); B2:B120))
Cette méthodologie avancée préserve l’intégrité du jeu de données brut tout en fournissant une mise à jour instantanée et dynamique des paramètres de dispersion dès lors qu’une donnée d’un participant est modifiée dans la table mère.
8.3 Exploitation des Tableaux Croisés Dynamiques (TCD)
Bien que l’élaboration de formules conditionnelles soit puissante, la manipulation de cohortes multifactorielles volumineuses peut rapidement devenir laborieuse lorsqu’il s’agit de dresser un bilan synthétique exhaustif. Les Tableaux Croisés Dynamiques (TCD) représentent sans conteste l’outil interactif le plus efficient d’Excel pour synthétiser en quelques clics les métriques descriptives transversales d’un protocole expérimental.
Pour ériger un tableau croisé dynamique performant, l’expérimentateur sélectionne l’intégralité de sa matrice rectangulaire de données, puis se rend dans le ruban supérieur et sélectionne Insertion > Tableau croisé dynamique. Dans la fenêtre de configuration du rapport :
- Faire glisser la variable indépendante principale (par exemple la variable de traitement ou de groupe) dans la zone Lignes.
- Faire glisser une éventuelle seconde variable catégorielle (par exemple le genre ou le stade clinique) dans la zone Colonnes.
- Faire glisser la variable dépendante d’intérêt (par exemple le score au test cognitif) deux fois successives dans la zone Valeurs.
Par défaut, Excel affecte aux champs insérés dans la zone Valeurs la fonction d’agrégation Nombre ou Somme. C’est ici qu’intervient la personnalisation critique : il convient d’effectuer un clic gauche sur le premier champ de valeur, de cliquer sur Paramètres des champs de valeurs, et de substituer à l’opération initiale la fonction Moyenne. L’analyste procède de même avec le second champ de valeur en sélectionnant cette fois-ci l’option EcartType (ou Écart-type standard selon les déclinaisons de la version linguistique du logiciel).
En une fraction de seconde, le tableau croisé dynamique dresse une matrice croisant tous les niveaux de facteurs expérimentaux, affichant en miroir la moyenne arithmétique et l’écart-type échantillonnal de chaque sous-groupe, assortis des totaux marginaux respectifs. Cet environnement offre de surcroît l’avantage d’intégrer des Segments visuels (Slicers), permettant de filtrer dynamiquement les observations selon des critères d’inclusion spécifiques tout en réactualisant instantanément la totalité des grandeurs descriptives sous-jacentes.
9. Visualisation graphique : Moyennes et barres d’erreur dans Excel
9.1 Construction d’histogrammes et de diagrammes en bâtons conformes
La communication scientifique des résultats empiriques exige une restitution graphique claire et sans ambiguïté des indicateurs de tendance centrale. Bien que le terme « histogramme » soit souvent utilisé de manière indistincte dans le langage courant, il importe de clarifier une distinction taxonomique essentielle : un histogramme véritable représente la distribution de fréquences d’une seule et même variable continue segmentée en classes de valeurs, tandis qu’un diagramme en bâtons ou à colonnes groupées matérialise la comparaison des moyennes d’une variable quantitative à travers plusieurs conditions expérimentales ou groupes d’individus distincts.
Pour construire un diagramme en bâtons conforme aux canons de la publication académique, il est fortement déconseillé de générer le graphique à partir de la masse informe des données individuelles brutes. La méthode appropriée consiste à construire préalablement un petit tableau récapitulatif secondaire au sein de la feuille Excel, présentant clairement les conditions expérimentales en libellés de lignes, et deux colonnes adjacentes contenant d’une part les moyennes calculées, et d’autre part les écarts-types échantillonnaux correspondants.
Une fois cette table récapitulative balisée, l’utilisateur sélectionne uniquement les libellés de conditions et la colonne des moyennes, puis active le menu Insertion > Graphiques > Histogramme 2D groupé. Le résultat initial nécessite une mise en conformité visuelle rigoureuse : il convient de bannir impérativement les représentations pseudo-tridimensionnelles (bâtons 3D), les fonds de grille bariolés, les dégradés d’ombrage et les effets de volume superflus qui encombrent l’espace perceptif sans apporter d’information pertinente. Le formatage académique commande l’utilisation de contours sobres, d’un fond blanc immaculé, d’une typographie sans empattement universelle (Arial, Calibri ou Helvetica) et d’un étiquetage sans équivoque des axes d’ordonnées, incluant toujours le nom de la variable dépendante et son unité métrique entre parenthèses.
9.2 Intégration rigoureuse des barres d’erreur d’écart-type
Un diagramme à barres affichant uniquement des moyennes constitue une représentation scientifique tronquée, voire trompeuse, car il prive le lecteur de toute visibilité sur la dispersion sous-jacente des mesures individuelles. L’adjonction de barres d’erreur constitue donc un impératif méthodologique incontournable. Toutefois, leur intégration sous Excel est truffée de pièges techniques redoutables dans lesquels tombent de nombreux analystes inattentifs.
En premier lieu, une clarification épistémologique s’impose quant à la nature de la grandeur représentée par la barre d’erreur. Il existe trois indices de variabilité radicalement distincts dans leurs fondements et leurs objectifs d’inférence :
- L’écart-type ($SD$) : Illustre la variabilité ou dispersion brute interindividuelle au sein de l’échantillon analysé.
- L’erreur standard de la moyenne ($SEM$) : Mesure la précision théorique de l’estimation de la moyenne échantillonnale ($SEM = s / \sqrt{n}$). Elle est structurellement beaucoup plus resserrée que l’écart-type.
- L’intervalle de confiance à 95 % ($IC_{95%}$) : Délimite la zone de plausibilité probabiliste où se situe la vraie moyenne de la population parente avec une probabilité de 95 %.
Lorsqu’on prend la décision explicite d’illustrer la variabilité brute au moyen de l’écart-type, il faut impérativement contourner le piège fatal d’Excel. En cliquant sur le graphique, puis sur l’icône Éléments de graphique (+) > Barres d’erreur, Excel propose des raccourcis par défaut dénommés « Écart-type » et « Erreur standard ». Il ne faut en aucun cas utiliser ces raccourcis automatiques ! Par une aberration algorithmique historique jamais corrigée, lorsqu’on coche « Écart-type » dans ce menu rapide, Excel ne lit pas les données de dispersion réelles de vos groupes : il calcule l’écart-type de la série artificielle constituée par les quelques moyennes affichées sur le graphique et applique cette valeur unique et aberrante de façon uniforme à toutes les barres du diagramme.
Pour affecter scientifiquement les véritables écarts-types calculés à chaque colonne respective, il est impératif de suivre rigoureusement le protocole technique suivant :
- Sélectionner les colonnes du graphique, cliquer sur Éléments de graphique (+) > Barres d’erreur, puis cliquer sur la petite flèche noire latérale et choisir Plus d’options…
- Dans le volet latéral d’ajustement qui s’ouvre, faire défiler les options jusqu’en bas pour repérer la section intitulée Marge d’erreur.
- Cocher impérativement la case radio Personnalisée, puis cliquer sur le bouton Spécifier une valeur.
- Une boîte de dialogue surgit, proposant deux champs de saisie : Valeur d’erreur positive et Valeur d’erreur négative.
- Effacer préalablement le contenu par défaut
={1}présent dans la case de valeur positive, puis sélectionner à l’aide de la souris la plage de cellules de la feuille Excel où sont consignés les véritables écarts-types pré-calculés des groupes correspondants. - Répéter rigoureusement la même sélection pour la case de valeur négative (afin d’obtenir des barres symétriques bidirectionnelles), puis valider par OK.
Ce n’est qu’à l’issue de cette procédure que chaque barre d’erreur reflétera fidèlement l’écart-type singulier de sa propre condition expérimentale, respectant la vérité intrinsèque des données de dispersion mesurées.
10. Automatisation via l’Utilitaire d’analyse statistique d’Excel
10.1 Activation et configuration du complément ToolPak
Pour le chercheur désireux d’obtenir en une fraction de seconde un portrait descriptif intégral d’un grand nombre de variables sans devoir écrire manuellement chaque formule de moyenne et d’écart-type, Microsoft intègre un module statistique avancé dormant : le complément Utilitaire d’analyse (ou Analysis ToolPak en anglais). Bien que présent dans toutes les installations professionnelles et éducatives d’Excel, ce module est désactivé par défaut lors de l’installation initiale du tableur.
La procédure d’activation sous l’environnement Windows s’articule à travers les étapes suivantes :
- Cliquer sur l’onglet Fichier situé à l’extrême gauche du ruban, puis sélectionner Options dans le panneau vertical inférieur.
- Dans la boîte de dialogue contextuelle des Options d’Excel, sélectionner la catégorie Compléments dans la colonne latérale.
- Au bas de la fenêtre, dans le menu déroulant Gérer, s’assurer que la mention Compléments Excel est sélectionnée, puis cliquer sur le bouton Atteindre…
- Une petite boîte modale liste les compléments disponibles. Cocher soigneusement la case intitulée Utilitaire d’analyse (inutile de cocher l’utilitaire VBA sauf pour la programmation macro), puis valider par OK.
Sur les systèmes Apple (Mac OS), la manipulation est encore plus directe : il suffit d’accéder au menu principal de l’application, de cliquer sur Outils, puis sur Compléments Excel…, de cocher Analysis ToolPak et de valider. Une fois cette opération réalisée, un nouveau bouton intitulé Utilitaire d’analyse fait son apparition permanente à l’extrême droite de l’onglet Données du ruban.
10.2 Génération du rapport complet de statistiques descriptives
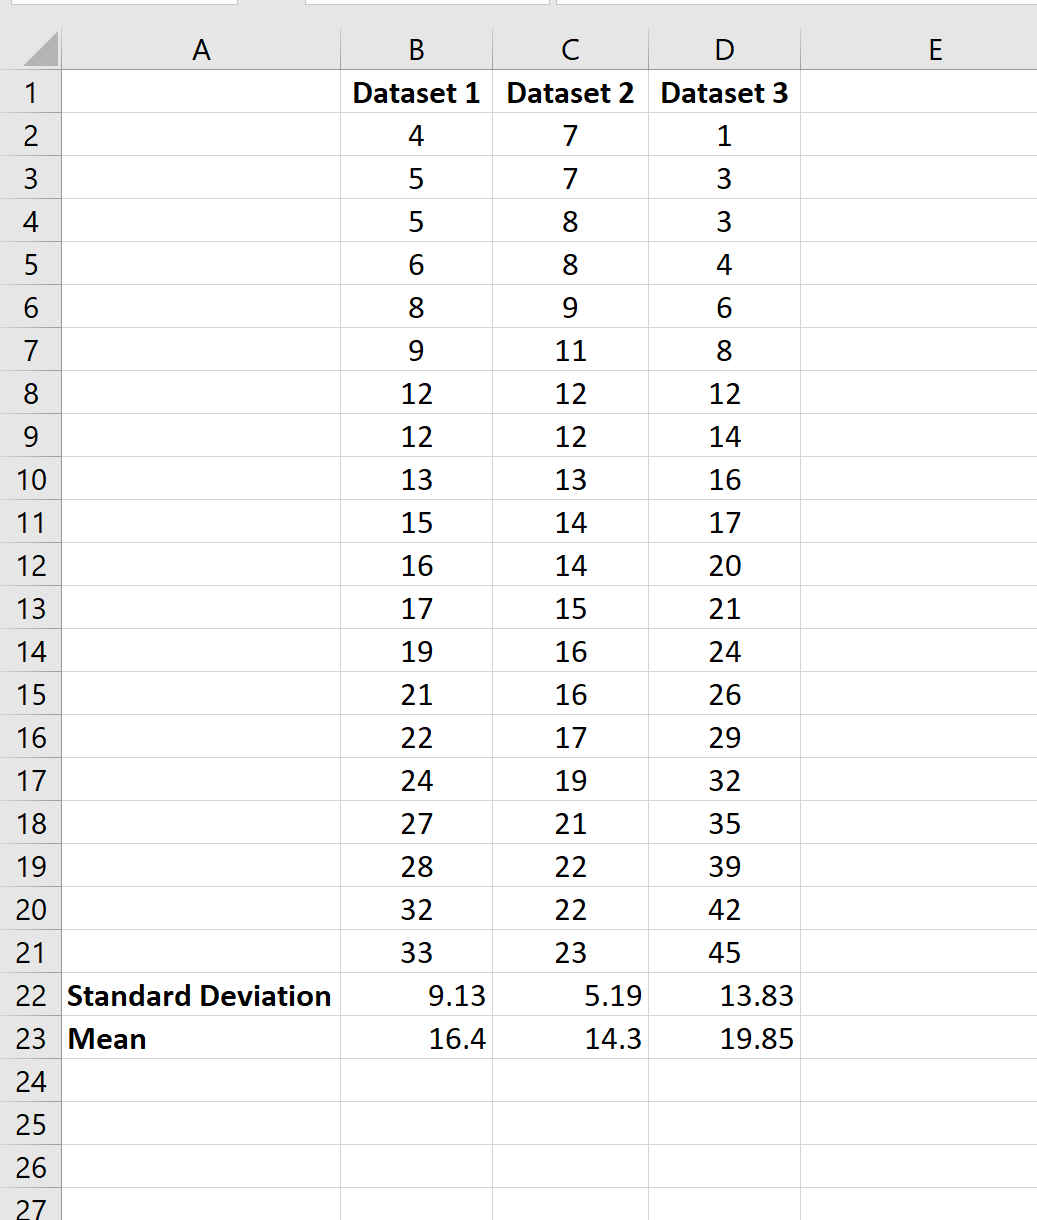
Une fois le module activé, la production d’un audit descriptif exhaustif s’opère avec une fluidité déconcertante. Supposons que nous ayons recueilli les scores de cinquante participants sur trois échelles psychométriques distinctes (Extraversion, Névrosisme, Conscienciosité), disposées dans les colonnes A, B et C, avec leurs en-têtes respectifs sur la première ligne.
Pour déclencher la compilation automatique :
- Se rendre dans l’onglet Données et cliquer sur l’icône Utilitaire d’analyse.
- Dans la liste alphabétique des outils statistiques disponibles, mettre en surbrillance l’item Statistiques descriptives, puis cliquer sur OK.
- Dans le champ Plage d’entrée, sélectionner l’ensemble du bloc matriciel incluant les en-têtes (par exemple
$A$1:$C$51). - Dans la section Groupé par, laisser la coche par défaut sur Colonnes.
- Cocher impérativement la case Intitulés en première ligne si les libellés de variables ont été inclus dans la sélection, ce qui garantira des rapports nommés avec clarté.
- Dans la section Options de sortie, choisir d’exporter les résultats vers une Nouvelle feuille de calcul.
- Dans les cases à cocher inférieures, cocher expressément la case Rapport statistique. Optionnellement, on peut cocher Niveau de confiance pour la moyenne (en laissant 95 %) pour obtenir les marges d’erreur inférentielles.
- Valider par OK.
Excel génère instantanément un tableau d’une richesse analytique incomparable. En une seule passe algorithmique, le chercheur dispose, pour chacune des variables sélectionnées, de :
- La Moyenne arithmétique.
- L’Erreur standard de la moyenne.
- La Médiane (point de partage à 50 % de la cohorte).
- Le Mode (valeur la plus fréquente).
- L’Écart-type échantillonnal (calculé strictement avec la correction de Bessel par $n-1$).
- La Variance de l’échantillon ($s^2$).
- L’Aplatissement (Kurtosis) et l’Asymétrie (Skewness), deux métriques fondamentales pour juger de la normalité de la distribution.
- L’Étendue (Intervalle Max – Min), le Minimum, le Maximum, la Somme totale et le Nombre d’observations validées ($n$).
Ce rapport condense l’ensemble des balises descriptives requises par les standards méthodologiques académiques internationaux. Il permet notamment de vérifier d’un coup d’œil si la moyenne et la médiane coïncident (signe d’une symétrie idéale) et si le ratio de l’asymétrie sur son erreur standard ne dépasse pas les seuils critiques qui invalideraient l’hypothèse de normalité gaussienne.
11. Études de cas appliquées en recherche psychologique
11.1 Cas 1 : Analyse des temps de réaction dans une tâche d’attention
Afin de concrétiser le déploiement de ces outils statistiques dans un contexte de recherche réaliste, examinons une étude en psychologie cognitive expérimentale évaluant l’effet de l’interférence attentionnelle au moyen d’un paradigme de Stroop informatisé. Dans cette tâche, vingt-quatre participants ($n = 24$) ont été confrontés à deux conditions expérimentales distinctes : une condition congruente (le mot « ROUGE » écrit à l’encre rouge) et une condition incongruente (le mot « BLEU » écrit à l’encre rouge). Les temps de réaction (TR) ont été enregistrés avec une précision à la milliseconde près.
Sur la feuille de calcul Excel, les données sont structurées de manière univoque : la colonne A contient l’identifiant anonymisé du participant (ID_01 à ID_24), la colonne B héberge les TR médians en millisecondes pour la condition congruente (TR_Congruent), et la colonne C enregistre les TR pour la condition incongruente (TR_Incongruent).
Le chercheur entreprend l’analyse descriptive comparative en implantant les formules au bas de son tableau :
- Pour la condition congruente :
- Moyenne :
=MOYENNE(B2:B25)$\rightarrow$ Le tableur affiche $542,38\text{ ms}$. - Écart-type :
=ECARTYPE.STANDARD(B2:B25)$\rightarrow$ Le tableur renvoie $45,12\text{ ms}$. - Coefficient de variation :
=(B27/B26)*100$\rightarrow$ $8,32\text{ %}$, indiquant une faible dispersion interindividuelle.
- Moyenne :
- Pour la condition incongruente :
- Moyenne :
=MOYENNE(C2:C25)$\rightarrow$ Le tableur affiche $685,71\text{ ms}$. - Écart-type :
=ECARTYPE.STANDARD(C2:C25)$\rightarrow$ Le tableur renvoie $82,64\text{ ms}$. - Coefficient de variation :
=(C27/C26)*100$\rightarrow$ $12,05\text{ %}$.
- Moyenne :
L’examen des données brutes permet également d’illustrer la détection des artefacts d’inattention ou des baisses de vigilance. En générant une colonne de différence individuelle =C2-B2 (reflétant le coût cognitif d’interférence en millisecondes) et en calculant les scores z afférents par la commande =CENTREE.REDUITE(D2; MOYENNE($D$2:$D$25); ECARTYPE.STANDARD($D$2:$D$25)), l’expérimentateur observe que le participant ID_14 affiche un score $z = +3,42$, imputable à un temps incongruent atypique de 1 120 ms consécutif à une somnolence passagère. Ce repérage chiffré permet d’exclure cette observation du traitement inférentiel en toute légitimité scientifique.
L’analyse descriptive révèle ici avec acuité le phénomène cognitif sous-jacent : non seulement la condition incongruente induit un ralentissement moyen substantiel du traitement de l’information d’environ 143 ms, mais elle s’accompagne d’un quasi-doublement de l’écart-type ($82,64\text{ ms}$ contre $45,12\text{ ms}$). Ce gonflement de la variabilité atteste que le coût cognitif du conflit perceptif ne s’exerce pas de manière uniforme chez tous les sujets, certains maintenant leur efficience d’inhibition alors que d’autres subissent une désorganisation attentionnelle massive.
11.2 Cas 2 : Évaluation psychométrique d’une échelle d’anxiété
Le second cas d’étude s’ancre dans le domaine de la psychologie clinique et de la psychométrie appliquée. Une équipe de recherche étudie les propriétés de l’Inventaire d’Anxiété Trait (STAI-Y2) administré à une cohorte de cent vingt patients admis dans un programme de gestion du stress ($n = 120$). L’instrument comprend vingt items cotés sur une échelle de Likert en quatre points (de 1 = « Presque jamais » à 4 = « Presque toujours »), générant un score total théorique borné entre 20 et 80 points. La littérature internationale établit pour une population générale saine un étalonnage normatif caractérisé par une moyenne $\mu = 41,50$ et un écart-type $\sigma = 9,80$.
Les scores bruts totaux des 120 patients sont inscrits dans la plage B2:B121 d’un classeur Excel. Le psychologue calcule les indices descriptifs fondamentaux du groupe clinique :
- Moyenne observée :
=MOYENNE(B2:B121)$\rightarrow$ Résultat : $56,40$. - Écart-type échantillonnal :
=ECARTYPE.STANDARD(B2:B121)$\rightarrow$ Résultat : $7,20$.
Pour évaluer la position relative d’un patient singulier au regard de la cohorte clinique d’une part, et de la population générale d’autre part, Excel permet de formaliser deux métriques de standardisation clinique hautement informatives :
- Le score z interne à la cohorte : Pour le patient
ID_05ayant obtenu un score brut de 63, sa formule s’énonce=(B6 - 56,40) / 7,20 = +0,92. Ce patient se situe à moins d’un écart-type au-dessus de la moyenne de ses pairs en souffrance, ce qui représente une élévation modérée au sein de ce groupe clinique spécifique. - Le score standardisé d’étalonnage général : Si l’on compare ce même patient à la norme générale saine en mobilisant les paramètres théoriques dans la formule
=(B6 - 41,50) / 9,80, son score z populationnel grimpe à $+2,19$.
En mobilisant la fonction de répartition de la loi normale centrée réduite sous Excel au moyen de l’instruction =LOI.NORMALE.STANDARD.N(2,19; VRAI), le clinicien obtient la valeur $0,9857$. Cela démontre avec une précision mathématique rigoureuse que le niveau d’anxiété de ce patient surpasse celui de 98,6 % des individus de la population générale, justifiant ainsi pleinement une prise en charge psychothérapeutique ciblée.
Ce cas concret met en lumière la puissance combinée de la moyenne et de l’écart-type dans Excel : ils ne constituent pas de simples synthèses agrégées froides, mais de véritables instruments de diagnostic et d’étalonnage permettant d’inscrire la trajectoire psychologique d’un individu dans une géographie quantitative rigoureuse.
12. Bonnes pratiques, pièges récurrents et rédaction aux normes APA
12.1 Erreurs méthodologiques fréquentes dans l’usage d’Excel
En dépit de son ergonomie séduisante, Microsoft Excel n’a pas été initialement conçu comme un progiciel de biostatistique pure, mais comme un tableur polyvalent à vocation financière et managériale. Cette genèse induit des pièges conceptuels et des routines par défaut dont l’utilisateur scientifique doit impérativement se prémunir pour garantir l’irréprochabilité de ses analyses.
L’erreur la plus préjudiciable, que nous avons déjà abondamment pointée mais dont l’occurrence demeure endémique, réside dans la confusion entre STDEV.S et STDEV.P (ou entre ECARTYPE.STANDARD et ECARTYPE.PESTIMEE). L’utilisation irréfléchie de la fonction populationnelle sur un échantillon tronque le dénominateur de ses degrés de liberté et conduit systématiquement à une surestimation de la précision des observations. Dans la même veine, la méconnaissance du rôle d’évitement des cellules vides par la fonction MOYENNE pousse parfois des utilisateurs à encoder hâtivement des zéros, corrompant irrémédiablement le jeu de données.
Un deuxième écueil classique concerne l’inclusion involontaire de cellules d’en-tête ou de lignes de totalisation au sein des plages de calcul. Lors de la saisie rapide de formules telles que =MOYENNE(B1:B102), la cellule B1 (qui contient le mot « Score ») n’arrête pas le calcul sous Excel moderne — la commande l’ignore silencieusement —, mais si la cellule B102 contient une somme globale préalablement calculée par l’opérateur, cette sommation est alors incorporée dans le calcul de la moyenne, doublant mécaniquement la valeur arithmétique obtenue ! Pour juguler définitivement ce risque, il est fortement conseillé de convertir les plages matricielles en véritables Tableaux structurés (raccourci Ctrl + L), permettant de manipuler des références textuelles explicites et inviolables du type =MOYENNE(TableauRecherche[Scores]).
Enfin, le problème des arrondis arithmétiques prématurés représente un facteur d’altération insidieux. Réduire le nombre de décimales affichées à l’écran via les boutons d’ajustement du ruban n’altère pas la précision sous-jacente du moteur d’Excel, qui conserve en mémoire jusqu’à 15 chiffres significatifs à virgule flottante. L’erreur gravissime consiste en revanche à utiliser la fonction ARRONDI(plage; 0) au milieu d’une chaîne computationnelle : tronquer prématurément les données de résidus ou les scores moyens partiels propage une erreur de troncature en cascade qui fausse le résultat final de l’écart-type et des tests d’inférence ultérieurs. Les règles de bonne pratique imposent de réaliser l’ensemble des calculs intermédiaires avec la précision machine maximale et de ne procéder à l’arrondi formel qu’au stade ultime de la rédaction textuelle du manuscrit.
12.2 Normes de présentation textuelle et tabulaire selon l’APA (7e édition)
L’aboutissement naturel d’une démarche d’analyse quantitative sous Excel réside dans la communication publique des données au sein d’un mémoire de master, d’une thèse doctorale ou d’un article scientifique soumis pour publication. Dans le champ des sciences psychologiques, l’American Psychological Association édicte des normes typographiques et structurelles extrêmement strictes à travers la 7e édition de son manuel de publication.
Sur le plan de la rédaction textuelle au fil du manuscrit :
- Les symboles statistiques latins représentant des métriques descriptives échantillonnales doivent être systématiquement composés en caractères italiques. La moyenne est symbolisée par la lettre majuscule $M$ (et non par $\bar{X}$ ou « Moyenne »), tandis que l’écart-type est désigné par le digramme majuscule $SD$ (pour Standard Deviation) : M et SD.
- Le degré de précision universellement préconisé pour les sciences du comportement est de deux décimales après la virgule (ou le point selon la langue de publication), y compris pour les zéros terminaux (ex. : $M = 45,20$ et non $45,2$). Les seules exceptions concernent les probabilités critiques (valeurs de p), qui requièrent trois décimales.
- La restitution au fil du texte doit articuler la tendance centrale et sa dispersion entre parenthèses ou virgules dans une syntaxe rigoureuse. On écrira typiquement : « Les participants assignés à la condition d’entraînement mnésique ont rapporté un score de rappel significativement supérieur (M = 18,45 ; SD = 3,12) par comparaison avec les sujets du groupe contrôle passif (M = 12,30 ; SD = 4,05). »
En matière de restitution tabulaire, les exigences de l’APA 7e édition proscrivent formellement le copier-coller brut des grilles issues d’Excel :
- Un tableau académique APA ne comporte strictement aucun quadrillage vertical.
- Il ne tolère que trois lignes horizontales majeures : une première bordant le haut du tableau au-dessus des en-têtes de colonnes, une seconde soulignant les en-têtes pour les séparer des données numériques, et une troisième fermant le bas du tableau avant les notes de bas de page.
- Les colonnes de dispersion doivent porter l’intitulé normalisé SD en italique. Les moyennes et les écarts-types peuvent être présentés dans deux colonnes disjointes contiguës ou rassemblés dans une colonne unique sous la forme synthétique conventionnelle « M (SD) », par exemple : « 54,32 (8,15) ».
- Tout tableau doit être précédé d’un numéro d’ordre en gras (ex. : Tableau 1) et d’un titre bref mais descriptif composé en italique (ex. : Statistiques descriptives des scores cognitifs selon la condition expérimentale), et complété si nécessaire par une note informative débutant par la mention Note. en italique explicitant les abréviations et les éventuelles exclusions méthodologiques de données.
En respectant avec discipline cette chaîne logique — de la structuration rigoureuse du tableur initial jusqu’à la mise en page finale conforme aux standards internationaux —, le chercheur et l’étudiant confèrent à leurs investigations quantitatives une transparence, une reproductibilité et une autorité scientifique inattaquables.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Bessel, F. W. (1815). Über den Ort des Sterns 61 Cygni. Astronomisches Jahrbuch für das Jahr 1818, 155-168.
- Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
- Howell, D. C. (2013). Statistical methods for psychology (8th ed.). Cengage Learning.
- Microsoft Corporation. (2023). Documentation des fonctions statistiques dans Excel : MOYENNE, ECARTYPE.STANDARD et Utilitaire d’analyse. Microsoft Support. https://support.microsoft.com/fr-fr/excel
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1-23. https://doi.org/10.18637/jss.v059.i10