
Dans le champ de la recherche empirique, de la biométrie et de l’analyse décisionnelle, la quantification rigoureuse de l’incertitude constitue le fondement de toute inférence scientifique valide. Mesurer un phénomène au sein d’une population exhaustive s’avérant presque systématiquement impossible pour des raisons matérielles, temporelles ou financières, les chercheurs doivent extraire des échantillons représentatifs afin d’estimer des paramètres inconnus. Cependant, une estimation ponctuelle isolée, telle qu’une moyenne ou une proportion empirique, demeure incomplète sans l’explicitation mathématique de son imprécision intrinsèque. C’est précisément à cette exigence méthodologique que répond la marge d’erreur, pierre angulaire de l’inférence fréquentiste et des intervalles de confiance.
Microsoft Excel s’est imposé, tant au sein des laboratoires universitaires que des départements de veille stratégique et d’évaluation clinique, comme un environnement de calcul universel pour le traitement de données. Bien que souvent perçu comme un simple tableur d’entreprise, Excel intègre une bibliothèque de fonctions statistiques avancées capables d’exécuter des calculs inférentiels sophistiqués, allant de la modélisation asymptotique gaussienne aux ajustements exacts de Student pour petits échantillons, en passant par les corrections pour populations finies et les approximations binomiales. Maîtriser l’implémentation de la marge d’erreur dans Excel nécessite une double compétence : une compréhension théorique approfondie des lois de probabilité sous-jacentes et une maîtrise pratique des syntaxes algorithmiques du logiciel.
Ce guide exhaustif a pour vocation de déconstruire pas à pas l’ensemble des mécanismes théoriques, mathématiques et informatiques régissant l’estimation de la marge d’erreur dans Microsoft Excel. Conçu selon les normes méthodologiques les plus strictes de la recherche quantitative, cet ouvrage détaille chaque formule, explicite les critères de choix entre modèles gaussiens et t-distributions, décortique les pièges computationnels usuels et fournit des protocoles d’automatisation avancés. Que vous pilotiez un essai clinique, une investigation psychométrique, un sondage d’opinion ou un contrôle qualité industriel, ce document constitue le manuel de référence complet pour convertir des données brutes en estimations scientifiquement irréprochables.
1. Fondements théoriques de la marge d’erreur et inférence statistique
1.1 Définition conceptuelle de la marge d’erreur en recherche empirique
Dans l’architecture de la statistique inférentielle, la marge d’erreur représente le demi-rayon de l’intervalle de confiance entourant un estimateur ponctuel issu d’un échantillon. Elle quantifie mathématiquement l’écart maximal probable entre l’estimation obtenue sur l’échantillon observé et le paramètre réel, fixe mais inconnu, de la population parente. Dès lors qu’un chercheur extrait un sous-ensemble d’individus d’une population cible, les statistiques calculées telles que la moyenne d’échantillon divergent inévitablement du paramètre populationnel en raison des fluctuations aléatoires d’échantillonnage. La marge d’erreur ne traduit pas une faute méthodologique ou une imperfection instrumentale, mais exprime la variabilité stochastique inhérente à tout processus d’observation partielle.
Le rôle premier de la marge d’erreur consiste à transformer une assertion ponctuelle fragile en un intervalle probabiliste robuste. Par exemple, affirmer que le temps de réaction moyen d’une population clinique à un stimulus cognitif est de 450 millisecondes n’offre aucune garantie de précision. En revanche, stipuler que ce temps moyen est de 450 millisecondes avec une marge d’erreur de 12 millisecondes au niveau de confiance de 95 % circonscrit l’incertitude dans une plage définie entre 438 et 462 millisecondes. La marge d’erreur dépend intrinsèquement de trois leviers : la variabilité interne du phénomène mesuré, le volume de données collectées et l’exigence de certitude probabiliste fixée par l’analyste.
Dans les sciences comportementales, l’évaluation psychologique et la recherche clinique, la quantification de cette marge conditionne la validité des conclusions. Lorsqu’un psychologue administre une batterie de tests standardisés, telle que l’échelle d’intelligence de Wechsler ou un inventaire de dépression, le score observé contient une part d’erreur de mesure et une part d’erreur d’échantillonnage de la standardisation. Ignorer la marge d’erreur conduirait à poser des diagnostics différentiels erronés en surinterprétant des variations purement fortuites. L’estimation rigoureuse de la marge d’erreur permet de distinguer les modifications cliniquement significatives des simples fluctuations aléatoires du signal de mesure.
1.2 La théorie de l’échantillonnage et le théorème central limite
La justification mathématique de la marge d’erreur repose sur le théorème central limite (TCL), l’un des piliers majeurs de la théorie des probabilités formalisé par Pierre-Simon de Laplace et Carl Friedrich Gauss. Le théorème central limite énonce que, quelle que soit la forme de la distribution d’une variable aléatoire dans la population parente — qu’elle soit asymétrique, bimodale ou uniforme —, la distribution d’échantillonnage de la moyenne arithmétique converge asymptotiquement vers une loi normale dès lors que la taille de l’échantillon augmente indéfiniment. Cette propriété assure que la moyenne d’un échantillon suit approximativement une distribution gaussienne centrée sur la véritable moyenne populationnelle.
Dans la pratique empirique, les conditions de validité du théorème central limite pour des échantillons finis exigent un seuil minimal conventionnel de 30 observations indépendantes et identiquement distribuées. Lorsque l’effectif d’échantillon est suffisant, la moyenne se comporte comme une variable normale, ce qui autorise l’utilisation directe des propriétés de la courbe en cloche de Gauss pour délimiter les intervalles d’incertitude. Si l’échantillon est inférieur à cette taille critique, la distribution d’échantillonnage demeure vulnérable aux asymétries et à l’aplatissement de la population mère, imposant le recours à des ajustements distributionnels spécifiques ou à des tests non paramétriques préalables.
Les conséquences de la non-normalité d’une population parente deviennent particulièrement critiques dans le domaine des instruments psychométriques standardisés. Lorsque les variables mesurées présentent un effet plancher ou un effet plafond marqué, la distribution des données brutes s’écarte radicalement de la symétrie gaussienne. Dans une telle configuration, l’application aveugle du théorème central limite sur des échantillons marginaux introduit un biais d’estimation de l’erreur type. Le chercheur doit alors s’assurer de la normalité de la distribution sous-jacente ou augmenter la taille de son échantillon afin de garantir la convergence asymptotique avant de procéder au calcul formel de la marge d’erreur.
1.3 Niveaux de confiance et seuils de signification statistique
Le calcul de la marge d’erreur ne peut être dissocié de la fixation d’un niveau de confiance, universellement désigné par l’expression mathématique 1 – alpha, où la lettre grecque alpha représente le seuil de risque d’erreur de première espèce. Le seuil alpha désigne la probabilité résiduelle que l’intervalle de confiance calculé échoue à contenir la véritable valeur du paramètre populationnel. En d’autres termes, si une expérience scientifique était répliquée cent fois dans des conditions strictement identiques, un niveau de confiance de 95 % (associé à un alpha de 0,05) implique que 95 des 100 intervalles construits couvriraient le paramètre réel, tandis que cinq d’entre eux l’excluraient en raison du seul hasard d’échantillonnage.
Le choix entre les seuils conventionnels de 90 %, 95 % et 99 % procède d’un arbitrage méthodologique critique entre la précision géométrique de l’intervalle et la certitude probabiliste du chercheur. Un niveau de confiance élevé de 99 % impose une réduction drastique du risque d’erreur (alpha = 0,01), mais cet accroissement de sécurité se paie par un élargissement mécanique substantiel de la marge d’erreur, rendant l’estimation moins informative. Inversement, un niveau de 90 % resserre considérablement l’intervalle d’estimation au prix d’un risque accru d’erreur d’inférence. Le seuil de 95 % demeure la norme académique consensuelle, établissant un compromis équilibré entre robustesse statistique et résolution analytique.
Dans les publications scientifiques régies par les normes de l’American Psychological Association (APA) et les comités de lecture biomédicaux, la transparence sur le seuil alpha sélectionné est une exigence absolue de reproductibilité. Les revues de neurosciences cognitives et de sciences sociales exigent systématiquement la mention explicite du niveau de confiance retenu à côté de chaque marge d’erreur rapportée. Une telle standardisation prévient les dérives d’interprétation consistant à faire varier opportunément le niveau alpha a posteriori pour masquer un manque de précision métrologique ou pour artificiellement resserrer une estimation manquant de puissance statistique.
2. Les composantes mathématiques du calcul de la marge d’erreur
2.1 Analyse de la formule mathématique fondamentale
D’un point de vue analytique, la marge d’erreur s’obtient par le produit scalaire direct entre une valeur critique issue d’une loi de probabilité théorique et l’erreur type de l’estimateur d’échantillon. L’équation canonique régissant l’estimation de la moyenne s’énonce selon la relation suivante : la marge d’erreur E est égale à la valeur critique multipliée par le quotient de l’écart-type par la racine carrée de la taille d’échantillon. Cette décomposition met en lumière la dualité intrinsèque du calcul, où la valeur critique arbitre le degré de conservatisme probabiliste tandis que le second terme modélise la précision physique du dispositif d’observation.
Il convient d’établir une différenciation formelle absolue entre l’écart-type de la population et l’écart-type de l’échantillon. L’écart-type populationnel, désigné par la lettre sigma, constitue une constante fixe mais presque universellement inaccessible. En recherche empirique courante, le praticien doit lui substituer l’écart-type d’échantillon corrigé, désigné par la lettre s, qui intègre les degrés de liberté appropriés afin d’éliminer le biais d’estimation de la variance. L’utilisation de l’un ou de l’autre de ces paramètres modifie la nature de la valeur critique à mobiliser, passant d’un cadre analytique purement gaussien à un modèle fondé sur les lois d’échantillonnage de Student.
Les propriétés algébriques de la formule révèlent la loi de décroissance de l’erreur en fonction de la taille de l’échantillon N. Puisque l’effectif N intervient sous la forme de sa racine carrée au dénominateur, la marge d’erreur décroît à un rythme sous-linéaire. Pour diviser la marge d’erreur par deux à niveau de confiance et variance constants, il est mathématiquement nécessaire de quadrupler la taille de l’échantillon. Cette contrainte volumétrique explique pourquoi les études cliniques ou les protocoles expérimentaux atteignent rapidement des seuils de rentabilité décroissante : chaque réduction incrémentale de l’incertitude exige des investissements logistiques exponentiels dans la collecte des données.
2.2 Choix de la distribution de référence : Loi normale vs Loi de Student
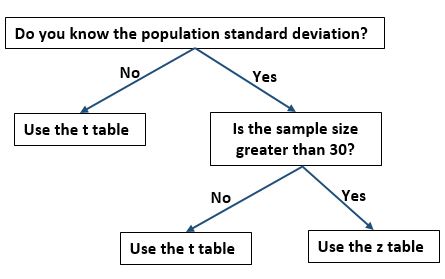
Le choix rigoureux de la distribution de référence constitue une étape décisive conditionnant l’exactitude de la marge d’erreur. Lorsque l’écart-type de la population entière est théoriquement connu, ou lorsque la taille de l’échantillon est massivement élevée, le coefficient multiplicateur correspond au quantile Z de la loi normale centrée réduite. En revanche, dès lors que l’écart-type populationnel est inconnu et doit être estimé à partir des données de l’échantillon — ce qui représente l’écrasante majorité des cas en recherche expérimentale —, la valeur critique doit impérativement être extraite de la loi t de Student, introduite par William Sealy Gosset sous le pseudonyme historique de Student.
La substitution de l’écart-type d’échantillon à l’écart-type populationnel introduit une source d’incertitude stochastique additionnelle. Parce que s varie lui-même d’un échantillon à l’autre, la distribution de la statistique pivotale présente des queues de distribution plus épaisses que celles de la loi normale. La loi de Student compense ce surplus d’incertitude en attribuant des valeurs critiques plus élevées que le score Z standard pour un niveau de confiance identique. Ces valeurs critiques sont indexées sur les degrés de liberté, calculés par l’expression N – 1, où N désigne le nombre total d’observations indépendantes composant la cohorte analysée.
Dans les cohortes cliniques restreintes fréquemment rencontrées en neuropsychologie ou dans les protocoles de pharmacologie précoce (avec des échantillons souvent inférieurs à 20 ou 30 sujets), l’utilisation erronée du score Z normal conduit à une sous-estimation systématique de la marge d’erreur. Cette imprécision produit des intervalles de confiance artificiellement étroits, augmentant dangereusement le risque de fausses conclusions statistiques. La règle méthodologique fondamentale impose donc l’utilisation exclusive de la loi de Student dès que la variance populationnelle n’est pas prédéterminée de manière externe et universelle, garantissant ainsi la couverture probabiliste nominale revendiquée par l’expérimentateur.
2.3 L’erreur type de la moyenne et sa modélisation
L’erreur type de la moyenne constitue le moteur stochastique de la marge d’erreur. Il est impératif d’établir une distinction stricte et inviolable entre la déviation standard individuelle d’une variable et l’erreur type de sa moyenne. L’écart-type individuel mesure la dispersion intrinsèque des scores des sujets autour de la moyenne au sein d’une population ou d’un échantillon donné ; il s’agit d’une métrique descriptive de l’hétérogénéité des observations qui ne diminue pas lorsque l’échantillon grandit. En revanche, l’erreur type modélise l’écart-type théorique de la distribution des moyennes d’échantillons répétés ; il s’agit d’un indice de fidélité métrologique qui tend asymptotiquement vers zéro lorsque N tend vers l’infini.
Face à des distributions asymétriques ou présentant des traînes substantielles, le comportement stochastique de l’erreur type peut être profondément altéré. L’estimateur de l’erreur type étant directement dépendant de la moyenne arithmétique et de l’écart-type d’échantillon, il hérite de leur extrême sensibilité aux valeurs aberrantes ou contaminées. L’introduction d’un seul score extrême dans une série expérimentale accroît démesurément la somme des carrés des écarts, gonflant artificiellement l’écart-type et, par voie de conséquence directe, dilatant l’erreur type et la marge d’erreur qui en découle, au point de masquer des effets expérimentaux réels.
Préalablement à toute modélisation de l’erreur type, le chercheur doit procéder à la vérification empirique de l’homoscédasticité et de la régularité de la distribution. L’homoscédasticité désigne la constance de la variance de la variable dépendante à travers les différents niveaux des facteurs expérimentaux ou des strates de l’échantillon. Lorsque l’hétéroscédasticité est prononcée, l’erreur type globale devient instable et biaisée, imposant soit des transformations de variables stabilisatrices de variance (telles que les transformations logarithmiques ou Box-Cox), soit l’usage d’estimateurs robustes de variance avant de compiler les calculs finaux dans les grilles logicielles.
3. Préparation et structuration des données dans Microsoft Excel
3.1 Organisation tabulaire et nettoyage préliminaire des variables
L’intégrité computationnelle de la marge d’erreur dans Excel dépend directement de la qualité d’organisation de la base de données source. Pour prévenir toute corruption algorithmique, les données brutes doivent être agencées selon les principes fondamentaux du modèle Tidy Data formulé par Hadley Wickham : chaque variable observée doit résider dans sa propre colonne dédiée, chaque unité expérimentale ou observation individuelle doit constituer une ligne distincte, et chaque cellule doit héberger une valeur scalaire unique. Tout mélange de formats, inclusion de sous-totaux intercalaires ou fusion de cellules au sein de la matrice d’échantillonnage doit être proscrit sous peine d’invalider le fonctionnement des plages d’analyse.
Le traitement systématique des valeurs manquantes et des non-réponses exige des procédures normalisées. Dans Excel, une cellule laissée totalement vide est ignorée par les fonctions statistiques d’agrégation, ce qui est généralement le comportement souhaité. En revanche, l’insertion d’espaces typographiques, de tirets textuels ou de codes d’erreur conventionnels (tels que « 999 » ou « NA ») altère irrémédiablement le typage de la colonne : les cellules textuelles peuvent fausser le décompte des effectifs ou provoquer le renvoi de l’erreur #VALEUR!. Il est impératif d’utiliser la fonction EST.VIDE() ou les outils de filtrage avancé pour épurer la base avant tout calcul d’inférence.
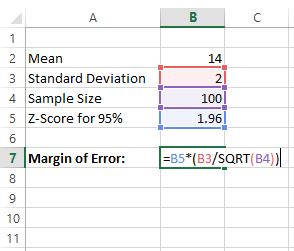
La détection statistique des observations aberrantes constitue l’étape subséquente du nettoyage méthodologique. Une approche recommandée consiste à calculer l’écart interquartile via les fonctions QUARTILE.EXCLURE() afin d’identifier les valeurs se situant au-delà de 1,5 fois l’intervalle interquartile au-dessus du troisième quartile ou en-dessous du premier quartile. Enfin, le formatage des colonnes contenant les mesures numériques doit être verrouillé en type « Nombre » avec un nombre suffisant de décimales apparentes. L’expérimentateur doit veiller à distinguer l’arrondi d’affichage visuel des valeurs réelles conservées en mémoire flottante double précision par le moteur de calcul d’Excel afin de neutraliser tout risque d’erreur d’arrondi propagée.
3.2 Utilisation des tableaux structurés et gestion des plages nommées
Pour doter les feuilles de calcul d’une robustesse professionnelle et éliminer les erreurs humaines liées aux plages de cellules statiques, l’utilisation des Tableaux Excel structurés est une pratique recommandée. Pour convertir une plage de données rectangulaire brute en tableau dynamique officiel, il suffit de sélectionner n’importe quelle cellule du jeu de données et d’appliquer le raccourci clavier universel Ctrl + L (ou Ctrl + T selon les versions régionales d’Excel). Cette action convertit la plage en une entité managée par le moteur du tableur, dotant la base de fonctionnalités natives d’extension automatique dès l’adjonction de nouveaux participants ou de nouvelles mesures expérimentales.
L’intérêt méthodologique majeur des tableaux structurés réside dans l’utilisation des références structurées dynamiques. Au lieu de référencer une variable expérimentale par des coordonnées rigides susceptibles de devenir obsolètes ou incomplètes lors de mises à jour de données (par exemple A2:A150), l’analyste formule ses équations sous la forme Tableau1[Score_Cognitif]. Cette syntaxe présente une lisibilité algorithmique immédiate et garantit que l’intégralité des observations effectives est couverte sans nécessiter d’ajustement manuel lors de l’accroissement de la taille de l’échantillon.
Parallèlement, la définition de plages nommées via le Gestionnaire de noms d’Excel (accessible via le ruban Formules) offre une excellente traçabilité pour les paramètres constants de l’analyse, tels que le niveau alpha. En affectant formellement le nom Alpha_Etude à une cellule dédiée hébergeant la valeur 0,05, l’expérimentateur sécurise ses classeurs contre les décalages accidentels lors du copier-coller de formules. L’architecture computationnelle gagne en clarté, et le risque d’erreur de pointage vers une cellule périphérique inadéquate est presque entièrement éliminé, condition indispensable pour l’auditabilité des travaux scientifiques.
3.3 Extraction des paramètres descriptifs préalables
Avant d’initier le calcul direct de la marge d’erreur, il est essentiel d’extraire de manière autonome et transparente les trois paramètres descriptifs fondamentaux de la série d’observations : la taille réelle de l’échantillon valide, sa tendance centrale et sa dispersion. La taille d’échantillon effective doit être déterminée exclusivement à l’aide de la fonction NB(), qui dénombre exclusivement les cellules hébergeant des valeurs numériques valides au sein de la plage, ignorant d’emblée les cellules textuelles ou vides. L’utilisation indiscriminée de NBVAL() doit être rigoureusement évitée si la colonne nettoyée comporte des codes d’absence de données codés sous forme de chaînes de caractères.
La tendance centrale de l’échantillon est obtenue via la fonction MOYENNE(), appliquée sur la référence de la variable d’intérêt. Ce paramètre constitue l’estimateur ponctuel autour duquel la marge d’erreur s’appliquera de manière bilatérale pour ériger l’intervalle de confiance définitif. La formule s’écrit classiquement sous la forme =MOYENNE(Tableau1[Mesure]). Il convient de s’assurer que la distribution sous-jacente ne présente pas une bimodalité sévère qui rendrait la moyenne arithmétique conceptuellement trompeuse pour caractériser le centre de masse des données.
L’évaluation de la dispersion exige une sélection précautionneuse entre les deux déclinaisons de l’écart-type intégrées dans Microsoft Excel. La fonction ECARTYPE.STANDARD() calcule l’écart-type d’échantillon corrigé, intégrant la correction de Bessel en divisant la somme des carrés par N – 1. C’est cette fonction précise qui doit être mobilisée pour l’estimation inférentielle. À l’inverse, la fonction ECARTYPE.PEARSON(), qui divise par N sans correction, modélise la variance exacte d’une population exhaustive ; l’utiliser sur un échantillon empirique introduirait un biais systématique de sous-estimation de la dispersion, faussant en cascade le calcul de la marge d’erreur.
4. Calcul de la marge d’erreur avec la fonction INTERVALLE.CONFIANCE.NORMALE
4.1 Syntaxe et paramètres de la fonction INTERVALLE.CONFIANCE.NORMALE
Microsoft Excel met à la disposition des modélisateurs la fonction native standardisée INTERVALLE.CONFIANCE.NORMALE pour le calcul direct de la marge d’erreur dans le cadre du modèle gaussien. Cette fonction a été introduite afin d’harmoniser la nomenclature logicielle avec les standards internationaux, se substituant à l’ancienne fonction dépréciée INTERVALLE.CONFIANCE qui demeure présente dans le logiciel pour préserver la rétrocompatibilité avec les classeurs conçus sous les versions antérieures à Excel 2010. L’architecture syntaxique de la fonction moderne requiert impérativement trois arguments ordonnés :
=INTERVALLE.CONFIANCE.NORMALE(alpha; ecart_type; taille)
Le premier paramètre, alpha, attend une valeur scalaire strictement comprise entre 0 et 1, correspondant au niveau de risque d’erreur consenti. Pour établir une marge d’erreur au niveau de confiance standard de 95 %, l’analyste doit injecter la valeur 0,05. Le second paramètre, ecart_type, requiert la saisie de l’écart-type de référence. Conformément aux hypothèses mathématiques du modèle normal, cet argument devrait théoriquement être l’écart-type de la population entière (sigma). Enfin, le troisième argument, taille, spécifie le nombre d’observations indépendantes constituant l’échantillon effectif.
Sur le plan computationnel interne, le moteur d’Excel évalue cette fonction en exécutant l’algorithme exact :
E = LOI.NORMALE.STANDARD.INVERSE.N(1 - alpha/2) * (ecart_type / RACINE(taille))
Le logiciel extrait le quantile bilatéral correspondant au seuil de probabilité cumulé de la loi normale centrée réduite et le multiplie par l’erreur type déduite des deux derniers paramètres fournis. Le résultat retourné par la fonction est un nombre réel positif unique, représentant l’amplitude exacte de la marge d’erreur à additionner et à soustraire de la moyenne observée.
4.2 Mise en œuvre pratique sur de grands échantillons
L’utilisation de la fonction INTERVALLE.CONFIANCE.NORMALE trouve sa justification méthodologique légitime principalement dans le traitement d’études épidémiologiques de grande envergure, d’enquêtes psychométriques nationales ou de processus industriels de haute précision où la taille d’échantillon N dépasse largement 100 observations, voire plusieurs milliers d’unités. Dans ces contextes spécifiques, l’approximation normale est pleinement légitimée par le théorème central limite, et la différence numérique entre l’écart-type d’échantillon et l’écart-type de la population devient infinitésimale.
Considérons une investigation biométrique portant sur un échantillon de standardisation de 500 individus dont les scores de capacité de mémoire de travail sont compilés dans la colonne Tableau_Normes[Memoire]. En supposant que l’écart-type théorique préalablement établi par les banques de données nationales soit de 15 unités, l’analyste implémente la formule suivante dans une cellule d’évaluation dédiée :
=INTERVALLE.CONFIANCE.NORMALE(0,05; 15; NB(Tableau_Normes[Memoire]))
Si l’écart-type théorique populationnel n’est pas prédéterminé mais que l’échantillon est volumineux (N = 500), la formule peut être écrite de manière dynamique en intégrant la déviation standard de l’échantillon :
=INTERVALLE.CONFIANCE.NORMALE(0,05; ECARTYPE.STANDARD(Tableau_Normes[Memoire]); NB(Tableau_Normes[Memoire]))
L’évaluation de cette expression génère une valeur unitaire précise, par exemple 1,314. Ce résultat s’interprète rigoureusement comme suit : au niveau de confiance de 95 %, la marge d’erreur associée à l’estimation de la moyenne populationnelle de la mémoire de travail est de plus ou moins 1,314 point. Le résultat issu de la formule représente directement la demi-largeur de l’intervalle et non l’intervalle lui-même.
4.3 Validation de cohérence statistique et gestion des erreurs de calcul
Lors de l’implémentation de la fonction INTERVALLE.CONFIANCE.NORMALE, plusieurs pathologies d’évaluation peuvent survenir en raison d’anomalies de saisie ou de non-conformités des données sources. L’erreur la plus commune est le renvoi du message #VALEUR!, qui survient invariablement lorsqu’au moins l’un des trois arguments contient du texte non convertible, des caractères invisibles ou pointe vers une cellule vide traitée de façon asynchrone. L’analyste doit inspecter les arguments pour s’assurer qu’aucun libellé textuel n’a été inséré par mégarde dans les plages numériques.
Le code d’erreur #NOMBRE! se manifeste dès lors que les valeurs fournies franchissent les frontières du domaine de définition mathématique de la fonction. C’est typiquement le cas si l’argument alpha est paramétré de façon erronée comme un pourcentage entier (par exemple 5 au lieu de 0,05 ou 5 %), conduisant à une valeur supérieure ou égale à 1, ou s’il est négatif ou nul. De même, si l’argument ecart_type est inférieur ou égal à zéro, ou si le paramètre taille est strictement inférieur à 1, Excel interrompt le calcul et renvoie ce signal d’erreur numérique.
Pour valider l’intégrité des résultats obtenus, il est recommandé d’opérer une vérification croisée en comparant la valeur critique implicitement générée par la fonction avec les tables statistiques standardisées de la loi normale centrée réduite. Au niveau de confiance de 95 % (alpha = 0,05), la valeur critique Z est égale à 1,95996 (arrondi usuellement à 1,96). Si l’on divise le résultat de la fonction par le rapport de l’écart-type sur la racine carrée de N, le ratio obtenu doit correspondre exactement à cette constante fondamentale, validant ainsi la rectitude de la chaîne de calcul.
5. Calcul de la marge d’erreur avec la fonction INTERVALLE.CONFIANCE.T
5.1 Spécificités et algèbre de la fonction INTERVALLE.CONFIANCE.T
Dans le cadre des recherches empiriques contemporaines, la variance de la population parente est presque systématiquement inconnue, imposant l’estimation concomitante de la moyenne et de la dispersion à partir des seules données d’échantillon. Pour modéliser rigoureusement cette incertitude accrue, Microsoft Excel intègre la fonction INTERVALLE.CONFIANCE.T. Cette fonction implémente le modèle stochastique de Student, calibré sur la loi t de Gosset, afin de délivrer une marge d’erreur statistiquement exacte pour les échantillons de toute taille, et tout particulièrement pour les effectifs restreints.
La syntaxe opérationnelle de la fonction se présente sous la forme suivante :
=INTERVALLE.CONFIANCE.T(alpha; ecart_type; taille)
Bien que les dénominations des arguments soient formellement identiques à celles de la fonction gaussienne examinée précédemment, le traitement algorithmique sous-jacent diffère substantiellement. L’argument ecart_type doit être impérativement fourni par l’estimation non biaisée issue de l’échantillon (obtenue par ECARTYPE.STANDARD). En coulisses, le moteur d’Excel utilise le paramètre taille pour dériver automatiquement les degrés de liberté du système, calculés par la soustraction unitaire N – 1.
L’algèbre interne exécutée par Excel pour cette fonction s’exprime par la relation :
E = LOI.STUDENT.INVERSE.BILATERALE(alpha; taille - 1) * (ecart_type / RACINE(taille))
L’adjonction de cette composante régulatrice compense l’instabilité de l’estimation de la variance en étendant mécaniquement la marge d’erreur. Plus la cohorte est réduite, plus la valeur critique t surpasse le coefficient gaussien Z, neutralisant ainsi le risque d’optimisme excessif propre au modèle normal.
5.2 Procédure d’implémentation pour études cliniques et petits échantillons
Les protocoles expérimentaux en neuro-imagerie fonctionnelle, les recherches cliniques sur des pathologies orphelines ou les études biomécaniques en laboratoire contraignent fréquemment les chercheurs à travailler sur des échantillons restreints, souvent compris entre 8 et 25 participants. Dans ce contexte, l’application de la fonction INTERVALLE.CONFIANCE.T est une exigence méthodologique stricte. Une formule imbriquée entièrement dynamique garantit l’intégrité du calcul sans recourir à des variables intermédiaires statiques :
=INTERVALLE.CONFIANCE.T(0,05; ECARTYPE.STANDARD(A2:A21); NB(A2:A21))
Dans cette expression, la plage A2:A21 héberge les 20 scores relevés chez les patients. La fonction NB extrait automatiquement l’effectif effectif (N = 20), contraignant Excel à mobiliser la loi t à 19 degrés de liberté. Pour ce niveau de liberté, la valeur critique bilatérale au seuil alpha de 0,05 s’établit à 2,093, soit une valeur nettement plus conservatrice que le facteur gaussien universel de 1,96.
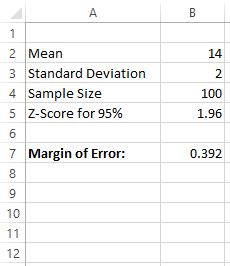
L’analyse de la robustesse de cette modélisation démontre que la fonction préserve une couverture probabiliste adéquate face à des distributions empiriques légèrement leptokurtiques ou modérément déviantes par rapport à la normalité idéale. Pour des raisons d’auditabilité scientifique et de reproductibilité académique, il est vivement conseillé de documenter explicitement la formule au sein de la feuille de calcul. L’utilisation conjointe de la fonction FORMULETEXTE() pointant vers la cellule de calcul de la marge d’erreur permet de faire apparaître en clair l’architecture syntaxique adoptée au bénéfice des évaluateurs ou auditeurs du laboratoire.
5.3 Divergences asymptotiques et transition vers les grands échantillons
L’examen comparatif des résultats issus de INTERVALLE.CONFIANCE.NORMALE et de INTERVALLE.CONFIANCE.T illustre les propriétés asymptotiques du théorème central limite au sein du tableur. Lorsque l’effectif N est faible, la divergence entre les deux fonctions est substantielle. Pour un échantillon de 10 observations et un écart-type de 5, la fonction normale produit une marge d’erreur de 3,099 unités, tandis que la fonction t de Student génère une marge de 3,577 unités, révélant un écart de plus de 15 % qui fausserait gravement l’estimation du risque si la fonction normale était utilisée de façon inappropriée.
À mesure que l’effectif d’échantillon progresse dans la matrice de calcul, les degrés de liberté augmentent et les queues de la loi de Student s’amenuisent jusqu’à se superposer parfaitement à celles de la courbe en cloche gaussienne. Dès que la taille d’échantillon atteint 60 observations, la divergence relative entre les deux estimations passe sous la barre de 1 %. À N = 120, le quantile t (1,9799) est quasiment indiscernable du quantile Z (1,95996), et à N = 1000, les sorties délivrées par les deux fonctions concordent jusqu’à la quatrième décimale.
En pratique académique, pour la rédaction de mémoires universitaires, de thèses doctorales ou d’articles soumis à des revues avec comité de lecture, la règle de standardisation méthodologique est simple : en présence d’un écart-type empirique estimé, il est systématiquement recommandé d’utiliser INTERVALLE.CONFIANCE.T, indépendamment de la taille de l’échantillon. Puisque la loi t converge de manière exacte vers la loi normale lorsque N devient grand, l’utilisation systématique de la fonction INTERVALLE.CONFIANCE.T ne pénalise en rien les grands échantillons tout en garantissant une rigueur mathématique irréprochable sur les cohortes réduites.
6. Calcul manuel étape par étape de la marge d’erreur dans Excel
6.1 Extraction de la valeur critique avec les lois inverses
Afin de maîtriser pleinement les rouages computationnels de la marge d’erreur et de concevoir des modules d’analyse personnalisés, il est formateur de décomposer le calcul sous forme d’étapes algorithmiques élémentaires en faisant appel aux fonctions inverses de distribution d’Excel. Pour isoler la valeur critique bilatérale d’une distribution normale centrée réduite, l’analyste fait appel à la fonction LOI.NORMALE.STANDARD.INVERSE.N(). Pour un niveau de risque alpha de 0,05, la probabilité cumulée à gauche correspondant à la borne supérieure bilatérale est de 1 – (alpha / 2), soit 0,975. La syntaxe s’écrit formellement :
=LOI.NORMALE.STANDARD.INVERSE.N(1 - (0,05 / 2))
Cette formule renvoie précisément la valeur 1,959964. Si l’évaluation nécessite le calibrage sur la loi de Student, la fonction moderne dédiée est LOI.STUDENT.INVERSE.BILATERALE(). Contrairement à la fonction normale qui requiert la transformation explicite de la probabilité unilatérale cumulée, cette fonction prend directement en argument la valeur de risque alpha bilatéral et les degrés de liberté du protocole expérimental :
=LOI.STUDENT.INVERSE.BILATERALE(0,05; NB(Tableau1[Donnees]) - 1)
Pour un échantillon de 16 participants, cette expression renvoie exactement la valeur critique 2,13145. La ségrégation de ces coefficients critiques dans des cellules intermédiaires individualisées offre une valeur pédagogique indéniable lors de la construction de modèles financiers ou de rapports scientifiques, car elle permet aux relecteurs de visualiser immédiatement le multiplicateur probabiliste employé avant l’étape de pondération par l’erreur type.
6.2 Calcul algorithmique de l’erreur type de la moyenne
La seconde étape de la décomposition manuelle réside dans l’implémentation algébrique de l’erreur type de la moyenne, souvent abrégée sous le sigle SEM (Standard Error of the Mean). Cette opération matérialise le ratio entre l’indicateur de dispersion de la série de données et la racine carrée de l’effectif d’échantillonnage effectif. Dans Excel, cette métrique s’obtient en combinant la fonction ECARTYPE.STANDARD() et la fonction RACINE() imbriquée avec NB() au sein d’une seule formule unitaire :
=ECARTYPE.STANDARD(Tableau1[Donnees]) / RACINE(NB(Tableau1[Donnees]))
Cette décomposition matricielle présente des avantages substantiels pour le contrôle de gestion et l’audit statistique. Elle permet de suivre isolément l’évolution de la dispersion d’échantillonnage indépendamment de l’amplitude du coefficient de confiance alpha sélectionné. De surcroît, le fait d’écrire explicitement cette formule dynamique prévient les distorsions computationnelles induites par l’enregistrement de valeurs intermédiaires tronquées. L’intégralité du calcul s’opérant dans le processeur arithmétique en mémoire vive, aucune troncature numérique ne vient dégrader la précision des décimales subséquentes.
En termes de performance computationnelle sur de très grandes bases de données comprenant plusieurs centaines de milliers d’enregistrements, cette formulation combinée native s’exécute avec une vélocité supérieure à celle de scripts ou macros VBA personnalisées. Le moteur de calcul multi-thread d’Excel optimise nativement l’évaluation séquentielle de l’écart-type et de la racine carrée, garantissant un recalcule quasi instantané des indicateurs de dispersion lors de l’actualisation dynamique des flux de données expérimentales.
6.3 Assemblage algébrique de la marge d’erreur complète
L’étape finale de cette approche décomposée consiste à opérer l’assemblage algébrique de la marge d’erreur par la multiplication directe de la cellule hébergeant la valeur critique calculée par celle contenant l’erreur type de la moyenne obtenue. Si la valeur critique réside en cellule C4 et l’erreur type en cellule C5, l’opérateur finalise le calcul par la commande arithmétique élémentaire :
=C4 * C5
Il est également possible de compiler l’intégralité de ces segments théoriques en une seule formule analytique condensée, affranchie de toute fonction dédiée de marge d’erreur, selon l’expression :
=LOI.STUDENT.INVERSE.BILATERALE(0,05; NB(A2:A50)-1) * (ECARTYPE.STANDARD(A2:A50) / RACINE(NB(A2:A50)))
Pour certifier la validité de cette construction manuelle, l’analyste doit confronter son résultat avec la sortie générée par la fonction intégrée INTERVALLE.CONFIANCE.T(0,05; ECARTYPE.STANDARD(A2:A50); NB(A2:A50)) appliquée sur les mêmes données. Une parfaite concordance des résultats jusqu’à la quinzième décimale atteste de l’exactitude de la construction.
Afin d’auditer l’architecture de cette chaîne de calcul, il est opportun de mobiliser l’outil d’évaluation pas à pas d’Excel accessible via le chemin : Ruban Formules > Groupe Audit de formules > Commande Évaluer la formule. Cette interface permet d’observer séquentiellement la résolution arithmétique de chaque sous-composante de la formule, constituant une procédure d’audit interne recommandée pour les protocoles de validation d’essais cliniques ou de contrôle qualité réglementé.
7. Calcul de la marge d’erreur pour les proportions et variables binomiales
7.1 Formulation théorique de l’erreur standard d’une proportion
L’inférence statistique ne se limite pas à l’analyse de variables continues modélisées par des moyennes arithmétiques ; elle englobe également l’estimation de variables catégorielles qualitatives exprimées sous forme de proportions ou de pourcentages. C’est le domaine propre de l’échantillonnage de Bernoulli, où chaque sujet observé manifeste ou non un attribut spécifique (succès ou échec, adhésion ou rejet, présence ou absence de symptôme). Dans ce cadre probabiliste binomial, l’espérance de la variable s’identifie à la proportion empirique p, et la variance théorique sous-jacente est modélisée par le produit p * (1 – p).
La formule mathématique de l’erreur standard d’une proportion d’échantillon dérive directement des propriétés de la loi binomiale approximée par la loi normale. L’erreur type binomiale s’écrit comme la racine carrée du quotient de p * (1 – p) par la taille de l’échantillon n. Par conséquent, la marge d’erreur E associée à une proportion observée p s’exprime par la relation formelle :
E = Z * RACINE((p * (1 - p)) / n)
Dans cette équation, Z représente le quantile d’évaluation bilatérale de la loi normale centrée réduite correspondant au niveau de confiance préalablement choisi.
Cependant, la légitimité théorique de cette approximation gaussienne repose sur la condition de Wald-Laplace. Pour que la distribution binomiale d’échantillonnage puisse être assimilée à une loi continue sans distorsion majeure, il est indispensable que l’échantillon vérifie simultanément les deux critères suivants : le produit n * p doit être supérieur ou égal à 5 (ou conventionnellement 10 dans les cadres stricts), et le produit n * (1 – p) doit également être supérieur ou égal à 5. Lorsque la proportion observée s’approche des frontières extrêmes de 0 ou de 1, ou lorsque la taille globale n est modeste, l’approximation de Wald s’effondre et produit des marges d’erreur aberrantes.
7.2 Traduction syntaxique des proportions dans les formules Excel
Pour transposer le calcul de la marge d’erreur d’une proportion dans Microsoft Excel, il convient d’abord d’extraire la proportion empirique p à partir des données brutes. Si l’on dispose d’une colonne binaire Reponses[Adhesion] où les occurrences positives sont matérialisées par le texte « Oui », la proportion s’obtient dynamiquement en divisant le nombre de succès par l’effectif global des répondants au moyen de la formule :
=NB.SI(Reponses[Adhesion]; "Oui") / NBVAL(Reponses[Adhesion])
En assignant ce résultat à une cellule nommée p_observe, et la taille d’échantillon totale à une cellule n_taille, l’analyste implémente la formule complète de la marge d’erreur au niveau de confiance de 95 % :
=LOI.NORMALE.STANDARD.INVERSE.N(1 - (0,05 / 2)) * RACINE((p_observe * (1 - p_observe)) / n_taille)
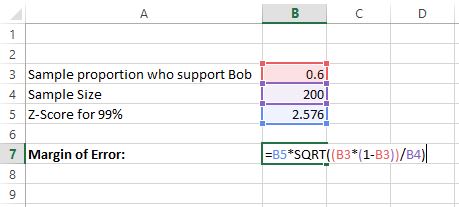
Il est également possible d’écrire cette formulation sous une syntaxe unique et entièrement consolidée, calculant la marge d’erreur sans aucune cellule intermédiaire à partir d’une série binaire encodée sous la forme de 0 et de 1 dans la plage B2:B501 :
=LOI.NORMALE.STANDARD.INVERSE.N(0,975) * RACINE((MOYENNE(B2:B501) * (1 - MOYENNE(B2:B501))) / NB(B2:B501))
Puisque la moyenne arithmétique d’une variable indicatrice binaire (codée 0 ou 1) est strictement égale à sa proportion de succès, cette syntaxe compense le manque de fonction native directe pour les proportions dans Excel en exploitant élégamment les propriétés fondamentales de l’algèbre booléenne.
7.3 Méthodes alternatives pour proportions asymétriques
Lorsque les conditions d’application de l’approximation de Wald ne sont pas satisfaites — notamment dans l’investigation de maladies rares, d’incidents techniques critiques où p est inférieur à 0,05, ou lors d’études sur des cohortes réduites —, l’intervalle classique standard génère des dérives mathématiques sévères, pouvant même produire des bornes d’intervalle biologiquement absurdes inférieures à 0 % ou supérieures à 100 %. Face à ces limites méthodologiques, la littérature biomédicale recommande l’adoption d’ajustements robustes, au premier rang desquels figurent la méthode d’Agresti-Coull et l’intervalle de score de Wilson.
L’ajustement d’Agresti-Coull (parfois désigné sous le terme empirique de méthode « plus 4 ») consiste à corriger l’estimation de base en ajoutant fictivement quatre pseudo-observations à l’échantillon : deux succès et deux échecs. La proportion ajustée p_tilde s’écrit alors formellement dans Excel sous la syntaxe :
p_tilde = (Nombre_Succes + 2) / (n_taille + 4)
La marge d’erreur robuste se dérive ensuite en substituant cette nouvelle proportion ajustée et cette taille corrigée (n + 4) dans la formule normale de l’erreur type :
=LOI.NORMALE.STANDARD.INVERSE.N(0,975) * RACINE((p_tilde * (1 - p_tilde)) / (n_taille + 4))
L’intervalle de score de Wilson, quant à lui, résout de manière analytique l’inversion du test de score sans approximer la variance au point ponctuel p. L’implémentation de Wilson dans une feuille Excel nécessite une formulation plus complexe, mais elle garantit mathématiquement que les bornes de l’intervalle d’estimation demeurent strictement circonscrites dans l’intervalle ouvert [0, 1]. Cette approche robuste évite les aberrations d’estimation tout en maintenant une couverture probabiliste réelle proche des 95 % nominaux, même face à des cohortes diagnostiques extrêmement asymétriques.
8. Construction dynamique des bornes d’intervalles de confiance
8.1 Dérivation de la borne inférieure et de la borne supérieure
La finalité concrète de l’évaluation de la marge d’erreur réside dans la dérivation opérationnelle des deux bornes délimitant l’intervalle de confiance. La borne inférieure s’obtient en retranchant la marge d’erreur calculée de l’estimateur ponctuel (la moyenne de l’échantillon ou sa proportion), tandis que la borne supérieure s’obtient par l’addition de cette même marge d’erreur à l’estimateur. Si la moyenne observée se trouve localisée en cellule D2 et la marge d’erreur générée par la fonction INTERVALLE.CONFIANCE.T en cellule E2, les formules d’extraction s’articulent selon les syntaxes respectives :
Pour la borne inférieure :
=D2 - E2
Pour la borne supérieure :
=D2 + E2
Afin de fluidifier la restitution des synthèses statistiques au sein des rapports de gestion ou des publications scientifiques, il est fréquent d’agréger ces indicateurs au sein d’une seule cellule textuelle composite au moyen des opérateurs de concaténation (l’esperluette & ou la fonction TEXTE()). La formule suivante permet d’éditer dynamiquement la chaîne descriptive normalisée :
=TEXTE(D2; "0,00") & " [IC 95 % : " & TEXTE(D2 - E2; "0,00") & " ; " & TEXTE(D2 + E2; "0,00") & "]"
Par ailleurs, le modélisateur doit instaurer des règles de validation algorithmique afin d’interdire les bornes incompatibles avec la réalité empirique du phénomène étudié. Si la mesure évalue une grandeur physique strictement non négative (comme une concentration sanguine ou un temps de latence), la borne inférieure doit être bornée à zéro via l’imbrication de la fonction MAX() :
=MAX(0; D2 - E2)
8.2 Automatisation avec tableaux de bord et scénarios de simulation
L’intégration des formules d’intervalles de confiance au sein de tableaux de bord de pilotage dynamique permet de simuler en temps réel la sensibilité de la précision d’estimation face aux fluctuations méthodologiques du protocole d’observation. L’utilisation des tables de données Excel à double entrée (disponibles via le chemin : Ruban Données > Groupe Prévision > Menu Analyse de scénarios > Commande Table de données) permet de cartographier instantanément la marge d’erreur résultante selon divers croisements d’hypothèses sur la taille d’échantillon N (en lignes) et le niveau de confiance 1 – alpha (en colonnes).
Le gestionnaire de scénarios d’Excel permet de formaliser et de comparer des cas d’évaluation contrastés. Un premier scénario modélisera une situation prudente caractérisée par un niveau de confiance de 99 % et une variance d’échantillon maximale, tandis qu’un second scénario traduira une approche exploratoire calibrée à un niveau de confiance de 90 %. La bascule dynamique entre ces scénarios actualise instantanément les marges d’erreur et les bornes associées dans l’ensemble des modules d’affichage du classeur.
Pour accroître l’ergonomie visuelle des tableaux de bord, il est vivement préconisé d’adosser ces plages de cellules à des règles de mise en forme conditionnelle dynamiques. En appliquant une règle de surlignage basée sur une formule telle que =E2>(0,1*D2), la cellule hébergeant la marge d’erreur s’illuminera automatiquement d’une alerte colorée si l’incertitude dépasse le seuil critique de 10 % de la magnitude du score moyen. Un tel dispositif procure aux analystes un indicateur visuel immédiat pour surveiller la robustesse des données collectées sans nécessiter d’inspection manuelle récurrente.
8.3 Interprétation sémantique et communication des résultats
La communication des intervalles de confiance souffre fréquemment d’un contresens conceptuel majeur que les chercheurs doivent impérativement rectifier lors de la rédaction de leurs conclusions. L’erreur la plus pernicieuse consiste à déclarer qu’« il y a 95 % de probabilité que la véritable moyenne de la population se trouve comprise entre la borne inférieure et la borne supérieure calculées ». Dans le cadre de l’inférence fréquentiste, le paramètre populationnel est une constante fixe et déterministe ; il ne constitue en aucun cas une variable aléatoire. Il se situe ou ne se situe pas dans l’intervalle calculé. L’assertion exacte stipule que « 95 % des intervalles de confiance construits selon ce protocole à partir d’échantillons aléatoires répétés contiendront la véritable valeur du paramètre populationnel ».
La rédaction académique normalisée selon les recommandations institutionnelles de l’APA (7e édition) impose un formalisme strict lors de l’intégration des marges d’erreur et intervalles de confiance dans le corps d’un texte scientifique. La formulation standardisée doit expliciter la tendance centrale, la marge d’erreur et la délimitation formelle de l’intervalle, selon le schéma rédactionnel suivant : « La performance moyenne au test d’attention s’établit à M = 104,52 points (E = 2,34, IC à 95 % [102,18, 106,86]), démontrant une précision d’échantillonnage satisfaisante ».
Cette nuance d’interprétation s’étend aux implications cliniques ou décisionnelles concrètes. Une estimation dotée d’une marge d’erreur très large — quand bien même le résultat moyen paraît prometteur — doit inciter à la réserve méthodologique, car elle indique que les données recueillies manquent de puissance statistique pour étayer une conclusion définitive. À l’inverse, une marge d’erreur étroite atteste d’une grande stabilité métrologique, autorisant des prises de décisions managériales, pharmacologiques ou thérapeutiques avec un niveau d’incertitude résiduelle parfaitement maîtrisé.
9. Représentation graphique de la marge d’erreur avec barres d’erreur dans Excel
9.1 Configuration des graphiques à barres et histogrammes avec barres d’erreur
La restitution visuelle de la marge d’erreur au sein des graphiques d’analyse permet d’appréhender d’un coup d’œil l’ampleur de l’incertitude expérimentale. Dans Microsoft Excel, les graphiques en colonnes (histogrammes de moyennes) et les diagrammes à barres constituent les supports les plus répandus pour comparer des conditions expérimentales ou des sous-groupes cliniques. Cependant, l’intégration des barres d’erreur requiert une grande vigilance technique pour éviter d’afficher des données erronées générées par les automatismes par défaut du logiciel.
Pour implémenter graphiquement les marges d’erreur, l’analyste sélectionne le graphique concerné, clique sur le bouton contextuel Éléments de graphique (symbolisé par une icône en forme de croix verte à droite de la fenêtre graphique), coche la case Barres d’erreur, puis clique sur la flèche adjacente pour sélectionner l’option critique Autres options…. Cette action ouvre le volet Office latéral de mise en forme avancée des barres d’erreur, au sein duquel se situe le panneau de paramétrage de la direction (Deux côtés, Moins ou Plus) et du style de terminaison (Avec ou Sans empattement en T).
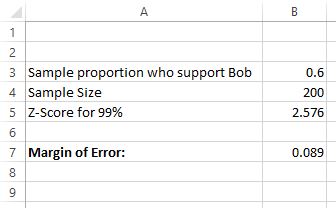
Le point névralgique de cette configuration réside dans la section inférieure intitulée Marge d’erreur. Par défaut, Excel propose des sélections prédéterminées génériques telles que « Valeur fixe », « Pourcentage » ou « Écart type ». Ces options par défaut ne doivent en aucun cas être utilisées, car elles appliquent une valeur arbitraire ou recalculent un écart-type global uniforme déconnecté des exigences de l’inférence statistique. L’utilisateur doit impérativement sélectionner l’option Personnalisée, cliquer sur le bouton Spécifier une valeur, puis pointer manuellement les champs Valeur d’erreur positive et Valeur d’erreur négative vers la plage de cellules hébergeant les marges d’erreur préalablement calculées via INTERVALLE.CONFIANCE.T.
9.2 Représentation sur nuages de points et profils longitudinaux
Dans l’analyse d’essais cliniques répétés, d’études pharmacocinétiques ou d’évaluations longitudinales en sciences cognitives, la modélisation de l’évolution temporelle des scores requiert l’emploi de graphiques en nuage de points avec lignes de raccordement ou de graphiques en courbes. Ces typologies graphiques permettent de matérialiser la trajectoire dynamique des moyennes de groupe tout en ancrant chaque point d’observation dans son fuseau d’incertitude probabiliste bilatéral.
L’un des atouts des graphiques en nuage de points (type graphique XY) réside dans leur capacité à supporter des barres d’erreur bidirectionnelles, déployables simultanément sur l’axe des ordonnées (axe Y, mesurant la variabilité de la réponse observée) et sur l’axe des abscisses (axe X, mesurant par exemple la marge d’imprécision sur le temps écoulé ou sur un dosage administré). Si l’investigateur évalue l’évolution d’un score cognitif mesuré à plusieurs reprises (par exemple à baseline, à 3 mois, à 6 mois et à 12 mois), la liaison dynamique des barres verticales personnalisées de l’axe Y aux marges d’erreur calculées pour chaque échéance permet de visualiser immédiatement si les trajectoires des groupes divergent significativement au fil du temps.
Pour parfaire la lisibilité de ces représentations en vue d’une publication imprimée en noir et blanc dans une revue académique, plusieurs ajustements stylistiques s’imposent au sein du panneau de configuration de ligne d’Excel. Il convient d’ajuster l’épaisseur du trait des barres d’erreur (idéalement entre 1 et 1,5 point), de doter les extrémités de terminaisons en T nettement visibles, et de sélectionner une teinte sombre neutre présentant un contraste suffisant par rapport aux marqueurs centraux. La suppression des quadrillages superflus et l’optimisation des espacements parachèvent la mise en page graphique selon les standards visuels professionnels de la recherche.
9.3 Erreurs courantes de mise en forme graphique dans Excel
Le piège graphique le plus prégnant dans Microsoft Excel concerne l’activation involontaire de l’option prédéfinie Écart-type au sein du menu standard des barres d’erreur. Lorsqu’un chercheur coche cette case préformatée, Excel ne calcule pas l’écart-type de chaque condition spécifique, mais applique une fraction statistique globale et uniforme calculée sur l’ensemble des points de la série graphique. Cette erreur produit des barres d’erreur d’amplitudes strictement identiques sur toutes les séries, masquant l’hétérogénéité réelle de la dispersion des groupes et invalidant l’interprétation des données.
Une seconde distorsion visuelle fréquente découle de la manipulation inadéquate des échelles des axes de mesure. En tronquant excessivement l’axe vertical des ordonnées pour amplifier artificiellement des variations mineures, l’analyste distend la perception visuelle de la marge d’erreur. Si l’échelle n’est pas proportionnelle à la métrique naturelle du phénomène, un intervalle d’incertitude pourtant très étroit peut sembler disproportionné à l’œil du lecteur. Les bonnes pratiques imposent d’ancrer l’axe des ordonnées au zéro fondamental chaque fois que l’échelle de mesure possède une origine naturelle, ou de signaler visuellement toute césure d’axe afin d’éviter toute interprétation erronée.
Enfin, une confusion persiste régulièrement dans la rédaction des légendes scientifiques associées aux graphiques : l’absence de mention explicite de la nature de la barre d’erreur. Une barre d’erreur peut en effet matérialiser un écart-type simple (SD), une erreur type de la moyenne (SEM) ou un intervalle de confiance à 95 % (CI). Dans la mesure où ces trois grandeurs possèdent des dimensions et des significations radicalement divergentes, l’omission de cette indication en note de bas de graphique compromet la reproductibilité et la validité de la communication scientifique.
10. Ajustement pour populations finies et corrections avancées
10.1 Le facteur de correction pour population finie (FCPF)
Les formulations canoniques de la marge d’erreur développées jusqu’ici reposent sur l’hypothèse sous-jacente que la population source est infinie, ou que le tirage de l’échantillon est opéré avec remise indépendante. Or, dans de nombreuses configurations empiriques de terrain — telles qu’un audit organisationnel au sein d’une entreprise fermée, une étude épidémiologique dans un isolat insulaire ou une enquête au sein d’une promotion universitaire —, la taille totale de la population cible, désignée par N_pop, est finie, restreinte et précisément quantifiée.
Lorsque le tirage des sujets d’étude s’effectue sans remise au sein d’une population finie, chaque individu consigné dans l’échantillon réduit d’autant la masse des individus non observés, augmentant progressivement l’information relative accumulée sur le collectif restant. L’incertitude d’échantillonnage s’amenuise donc plus rapidement que ne le prévoit le modèle asymptotique standard. Pour modéliser cette réduction de la variance, la théorie statistique impose l’application d’un coefficient multiplicateur modérateur désigné sous le nom de Facteur de Correction pour Population Finie (FCPF). L’expression analytique de ce facteur s’écrit formellement :
FCPF = RACINE((N_pop - n_ech) / (N_pop - 1))
Le seuil d’application empirique universellement admis prescrit d’intégrer le FCPF dès lors que la fraction de sondage (le ratio n_ech / N_pop) dépasse 5 % (0,05) de la population parente. Lorsque l’échantillon représente une part substantielle du groupe d’étude (par exemple 25 % ou 50 %), l’omission du FCPF pénalise lourdement l’estimation en gonflant artificiellement la marge d’erreur, conduisant l’expérimentateur à déclarer une imprécision d’échantillonnage déconnectée de la réalité mathématique du tirage fini.
10.2 Application pratique aux études organisationnelles et groupes fermés
Pour illustrer l’implémentation du facteur FCPF dans Excel, considérons une étude psychologique organisationnelle portant sur l’épuisement professionnel des cadres au sein d’une institution hospitalière regroupant une population exhaustive de N_pop = 400 collaborateurs. L’analyste extrait un échantillon représentatif de n_ech = 100 praticiens. La fraction de sondage s’élevant à 100 / 400 = 0,25 (soit 25 %), elle excède très largement le seuil conventionnel des 5 %, rendant impérative l’application de la correction pour population finie.
Dans la feuille de calcul Excel, assignons l’effectif de la population totale (400) à la cellule B1, l’effectif de l’échantillon (100) à la cellule B2, et l’écart-type d’échantillon observé (12) à la cellule B3. La formule complète calculant la marge d’erreur corrigée au niveau de confiance de 95 % s’écrit de manière consolidée selon la syntaxe suivante :
=INTERVALLE.CONFIANCE.T(0,05; B3; B2) * RACINE((B1 - B2) / (B1 - 1))
L’analyse comparative des sorties computationnelles met en exergue l’effet régulateur du facteur multiplicatif :
Sans l’application du FCPF, la fonction standard INTERVALLE.CONFIANCE.T(0,05; 12; 100) délivre une marge d’erreur brute de 2,381 points. Une fois pondérée par le facteur d’ajustement qui s’établit à RACINE((400 - 100) / 399) = 0,867, la marge d’erreur finale corrigée s’abaisse à 2,065 points. Cette réduction de plus de 13 % de l’amplitude de l’incertitude démontre l’impact stratégique du FCPF : il permet d’atteindre le seuil de précision clinique requis avec un effectif de participants moindre, optimisant substantiellement les coûts logistiques de collecte sur le terrain.
10.3 Gestion de l’échantillonnage stratifié et pondérations
Dans les protocoles de sondage complexes ou les enquêtes sociologiques à large spectre, la population est souvent fractionnée en plusieurs sous-ensembles homogènes désignés sous le terme de strates (par exemple des découpages par tranches d’âge, catégories socio-professionnelles ou territoires géographiques). Dans le cadre d’un échantillonnage stratifié, la marge d’erreur globale ne peut résulter d’une simple moyenne non pondérée des variances locales. La variance globale d’échantillonnage correspond à la somme des variances d’échantillon propres à chaque strate, pondérées par le carré de leurs poids démographiques respectifs dans la population globale.
Pour orchestrer ce calcul avancé dans Microsoft Excel, l’analyste structure un tableau récapitulatif présentant pour chaque strate k : le poids relatif W_k (égal à N_k / N_total), la taille de l’échantillon local n_k, et la déviation standard observée s_k. La colonne subséquente calcule la variance d’échantillonnage de chaque strate par la relation matricielle :
=(W_k ^ 2) * ((s_k ^ 2) / n_k)
L’erreur type globale de l’échantillonnage stratifié s’obtient alors en effectuant la somme de ces composantes individuelles, suivie de l’extraction de sa racine carrée globale au moyen de la formule combinée :
=RACINE(SOMME(Colonne_Variances_Strates))
La marge d’erreur stratifiée finale s’obtient en multipliant cette erreur type globale par la valeur critique adéquate (Z ou t selon les effectifs combinés). L’utilisation judicieuse des fonctions SOMMEPROD() permet d’automatiser cette agrégation sans colonnes intermédiaires, offrant aux concepteurs d’enquêtes un modèle matriciel capable d’intégrer des systèmes de pondération sociologique ou clinique sans risque de distorsion computationnelle.
11. Erreurs méthodologiques, pièges fréquents et diagnostic dans Excel
11.1 Confusions conceptuelles et erreurs de formulation
La première dérive recensée dans les audits de classeurs de recherche réside dans la confusion entre l’écart-type de l’échantillon et la marge d’erreur elle-même. Nombre d’analystes débutants reportent les résultats de la fonction ECARTYPE.STANDARD() en lieu et place de l’intervalle de confiance, commettant une faute d’inférence majeure : ils présentent la dispersion individuelle des sujets au sein du groupe au lieu de quantifier la précision métrologique de la moyenne estimée. Cette confusion produit des pseudo-marges d’erreur excessivement dilatées, sans rapport avec la réalité de la fidélité de l’estimation.
Une deuxième erreur d’implémentation concerne l’inversion d’arguments lors de la saisie manuelle des paramètres de la fonction INTERVALLE.CONFIANCE.T. En inversant par inadvertance l’argument ecart_type et l’argument taille, le moteur d’Excel peut exécuter le calcul sans renvoyer d’alerte formelle si les deux nombres sont positifs, mais le résultat produit s’avère mathématiquement erroné. De même, l’omission récurrente de la racine carrée lors de l’implémentation manuelle de l’erreur type — en écrivant par exemple =Ecart_Type / Taille au lieu de =Ecart_Type / RACINE(Taille) — génère une sous-estimation systématique de l’incertitude dès que N dépasse 1, faussant lourdement toutes les déductions subséquentes.
Enfin, il convient de souligner le piège de la confusion entre les tests d’hypothèses unilatéraux et bilatéraux. La marge d’erreur standard délimite par définition un intervalle bilatéral symétrique autour de la moyenne, exigeant la prise en compte conjointe des deux queues de la loi sous-jacente au niveau alpha/2. Introduire directement la probabilité alpha sans l’ajustement bilatéral dans les fonctions inverses normales ou de Student génère un quantile unilatéral tronqué, réduisant artificiellement l’amplitude de la marge d’erreur d’environ 20 %, ce qui altère gravement la couverture probabiliste nominale du résultat.
11.2 Diagnostic technique et audit des formules dans la feuille de calcul
L’intégrité computationnelle d’un classeur Excel hébergeant des analyses statistiques d’inférence suppose une surveillance rigoureuse des anomalies d’exécution et de structure de formules. Les références circulaires instables représentent une pathologie fréquente dans les modèles statistiques complexes, se produisant lorsqu’une cellule dépend, directement ou par chaîne indirecte, de son propre résultat d’évaluation. Ce dysfonctionnement bloque le cycle de recalcul d’Excel et fige les marges d’erreur dans un état non actualisé. L’activation du moniteur d’audit d’Excel (accessible via : Ruban Formules > Groupe Audit de formules > Flèche Vérification des erreurs > Menu Références circulaires) permet d’isoler et d’éradiquer ces dépendances problématiques.
L’utilisation des outils de traçabilité graphique intégrés au tableur s’avère indispensable pour sécuriser les chaînes de calcul. En sélectionnant la cellule contenant la formule de la marge d’erreur et en activant la commande Repérer les antécédents, Excel trace des flèches vectorielles bleues reliant le calcul à ses cellules d’alimentation. Cette inspection visuelle permet de s’assurer immédiatement qu’aucune cellule périphérique non pertinente n’a été accidentellement intégrée dans la plage d’agrégation. La commande inverse, Repérer les dépendants, permet d’identifier l’ensemble des graphiques et indicateurs décisionnels influencés par la mise à jour de la marge d’erreur.
Un autre point de contrôle concerne le typage interne des données numériques. Lorsque des données proviennent de bases externes ou de saisies manuelles en ligne, certains chiffres peuvent être importés sous forme de chaînes textuelles (signalées par un petit triangle vert en coin supérieur gauche de cellule). Ces cellules « texte forcé » sont silencieusement ignorées par les fonctions NB() et MOYENNE(), réduisant artificiellement la taille effective de l’échantillon prise en compte sans lever d’alerte explicite. L’application de la fonction CNUM() ou l’utilisation de l’outil Convertir du ruban Données permet de garantir que l’intégralité des observations est correctement convertie au format numérique flottant.
11.3 Biais d’échantillonnage et validité externe non mesurable par Excel
Il est indispensable de rappeler une vérité épistémologique fondamentale : la marge d’erreur calculée dans Microsoft Excel quantifie exclusivement l’erreur d’échantillonnage aléatoire stochastique ; elle est strictement aveugle à l’ensemble des biais méthodologiques systématiques entachant un protocole de recherche. Une marge d’erreur affichant une précision de plus ou moins 0,5 % n’offre aucune garantie de véracité scientifique si les données sources proviennent d’un échantillon vicié par un biais d’autosélection, un biais de volontariat ou un mécanisme de recrutement non aléatoire.
Dans les enquêtes d’opinion et les protocoles psychologiques, le biais de désirabilité sociale (tendance des sujets à modifier leurs réponses pour paraître conformes aux attentes supposées de l’expérimentateur) et le phénomène d’attrition différentielle (défection sélective de certains profils de patients au cours d’un suivi longitudinal) constituent des sources majeures d’erreur systématique. Le moteur de calcul d’Excel traite chaque donnée injectée comme une observation parfaite et indépendante ; il ne dispose d’aucun mécanisme pour diagnostiquer l’incomplétude sociologique ou la déformation structurelle de l’échantillon analysé.
Il incombe donc à l’expérimentateur de faire preuve de discernement critique et d’éviter de confondre une précision numérique apparente avec la validité scientifique réelle des inférences. Une marge d’erreur resserrée n’a de sens que si la représentativité de l’échantillon vis-à-vis de la population parente cible est rigoureusement validée en amont par des procédures d’échantillonnage probabiliste irréprochables. La marge d’erreur issue du tableur doit demeurer ce qu’elle est : un outil d’estimation conditionnelle de l’aléa, et non un certificat absolu de vérité méthodologique.
12. Automatisation, modèles réutilisables et fonctions personnalisées
12.1 Conception d’un classeur modèle standardisé et verrouillé
Pour pérenniser les processus de calcul et prévenir les modifications accidentelles au sein d’une équipe de recherche, la conception d’un classeur modèle standardisé constitue une excellente pratique opérationnelle. Ce classeur type s’articule autour d’une architecture compartimentée : une zone distincte dédiée à l’intégration des données brutes, un panneau de paramétrage de l’étude (permettant la saisie sécurisée du seuil de confiance) et un module de restitution affichant les indicateurs d’inférence calculés.
Le panneau de configuration méthodologique gagne à intégrer des listes déroulantes normées via le menu Validation des données d’Excel (Ruban Données > Outils de données). En contraignant la cellule de sélection du niveau de confiance à proposer uniquement les options académiques standardisées (90 %, 95 %, 99 %), l’administrateur du modèle supprime tout risque d’injection de valeurs de risque alpha invalides. De manière corollaire, le tableau de synthèse peut héberger des formules logiques utilisant des structures SI() imbriquées afin d’éditer automatiquement des paragraphes de restitution textuelle entièrement contextualisés selon les seuils retenus.
Une fois l’ingénierie des formules validée, la sécurisation du modèle s’achève par le verrouillage des cellules fonctionnelles. Par défaut, toutes les cellules d’une feuille sont verrouillées mais ce verrou reste inactif tant que la feuille n’est pas protégée. Il convient donc de déverrouiller au préalable les seules cellules réservées à la saisie des données brutes (via le format de cellule > onglet Protection > décocher Verrouillé), puis d’activer la protection globale de la feuille (Ruban Révision > Protéger la feuille). Cette configuration garantit que les utilisateurs du laboratoire peuvent intégrer leurs séries d’observations sans altérer, par maladresse ou inadvertance, l’architecture mathématique des fonctions de marge d’erreur.
12.2 Création de fonctions personnalisées avec LAMBDA et Power Query
Les versions récentes de Microsoft Excel (Microsoft 365 et Excel 2021) ont introduit une évolution majeure dans la modélisation statistique avancée grâce à la fonction LAMBDA. Cette innovation algorithmique permet de créer des fonctions personnalisées réutilisables sans écrire une seule ligne de code VBA, en encapsulant des formulations mathématiques complexes sous un identifiant fonctionnel unique. L’analyste peut ainsi concevoir une fonction native MARGE.ERREUR.STUDENT universelle en saisissant dans le Gestionnaire de noms :
=LAMBDA(donnees; alpha; INTERVALLE.CONFIANCE.T(alpha; ECARTYPE.STANDARD(donnees); NB(donnees)))
Une fois cette fonction enregistrée sous le nom MARGE.ERREUR.STUDENT au sein du classeur, l’expérimentateur n’a plus à ressaisir l’imbrication des paramètres pour chaque nouvelle variable d’étude. Il lui suffit d’appeler directement la formule simplifiée au sein de n’importe quelle cellule du tableur :
=MARGE.ERREUR.STUDENT(Tableau1[Score]; 0,05)
Pour les projets nécessitant le traitement récurrent de données massives issues de questionnaires en ligne ou d’instruments de mesure automatisés, l’association de cette approche avec Power Query offre une solution d’automatisation complète. Power Query permet d’importer, de nettoyer et de transformer les données brutes de façon systématique avant leur restitution dans la grille de calcul. Dès lors qu’un nouveau fichier de mesures est déposé dans le répertoire source, un simple clic sur le bouton Actualiser tout déclenche le pipeline complet : purge des données manquantes, typage des variables, rafraîchissement des tableaux structurés et recalcul instantané des marges d’erreur et de leurs représentations graphiques associées.
12.3 Implémentation d’une macro VBA pour le reporting automatisé
Pour les flux de travail complexes exigeant l’exportation de données d’inférence vers des formats externes ou l’exécution séquentielle de calculs sur des centaines de colonnes, le recours à une macro Visual Basic for Applications (VBA) constitue une solution robuste et pérenne. L’écriture d’un script VBA permet d’orchestrer l’extraction systématique des paramètres descriptifs et le calcul automatisé des marges d’erreur sans saturer le classeur de milliers de formules redondantes.
Le listing de programmation suivant illustre une macro professionnelle conçue pour calculer la marge d’erreur de Student à 95 % sur une série de données sélectionnée et restituer le résultat synthétique au sein d’une boîte de dialogue descriptive :
Sub CalculerMargeErreurStudent()

    Dim PlageSelection As Range

    Dim TableauValeurs() As Double

    Dim NbElements As Long

    Dim Somme As Double, Moyenne As Double

    Dim SommeCarres As Double, Variance As Double, EcartType As Double

    Dim ErreurType As Double, ValeurCritiqueT As Double, MargeErreur As Double

    Dim i As Long, Cellule As Range
If TypeName(Selection) "Range" Then Exit Sub
Set PlageSelection = Selection
NbElements = 0
Somme = 0
For Each Cellule In PlageSelection
If IsNumeric(Cellule.Value) And Not IsEmpty(Cellule.Value) Then
NbElements = NbElements + 1
ReDim Preserve TableauValeurs(1 To NbElements)
TableauValeurs(NbElements) = CDbl(Cellule.Value)
Somme = Somme + TableauValeurs(NbElements)
End If
Next Cellule
If NbElements < 2 Then
MsgBox "Effectif insuffisant pour estimer la variance.", vbExclamation, "Erreur"
Exit Sub
End If
Moyenne = Somme / NbElements
SommeCarres = 0
For i = 1 To NbElements
SommeCarres = SommeCarres + (TableauValeurs(i) - Moyenne) ^ 2
Next i
Variance = SommeCarres / (NbElements - 1)
EcartType = Sqr(Variance)
ErreurType = EcartType / Sqr(NbElements)
ValeurCritiqueT = Application.WorksheetFunction.T_Inv_2T(0.05, NbElements - 1)
MargeErreur = ValeurCritiqueT * ErreurType
MsgBox "Analyse statistique achevée (Seuil 95 %) :" & vbCrLf & _
"Effectif d'échantillon (N) : " & NbElements & vbCrLf & _
"Moyenne arithmétique : " & Round(Moyenne, 4) & vbCrLf & _
"Écart-type corrigé : " & Round(EcartType, 4) & vbCrLf & _
"Erreur type de la moyenne : " & Round(ErreurType, 4) & vbCrLf & _
"Marge d'erreur : +/- " & Round(MargeErreur, 4) & vbCrLf & _
"Intervalle : [" & Round(Moyenne - MargeErreur, 4) & " ; " & _
Round(Moyenne + MargeErreur, 4) & "]", vbInformation, "Résultats d'Inférence"
End Sub
Ce script commence par nettoyer la sélection en éliminant les entrées non numériques, extrait les degrés de liberté appropriés, applique la correction de Bessel au dénominateur de la variance, puis sollicite la fonction native T_Inv_2T de la bibliothèque Excel pour dériver la valeur critique exacte avant de compiler l’intervalle de confiance.
La pérennisation de tels modules repose sur une documentation scrupuleuse du code source, l’intégration de gestionnaires d’erreurs (permettant d’intercepter les divisions par zéro potentielles) et le respect des chartes d’ingénierie logicielle. En intégrant ces scripts d’automatisation au sein d’un ruban d’outils partagé, le laboratoire d’analyse ou l’organisme de recherche se dote d’un environnement robuste, éliminant les erreurs humaines de transcription et assurant une fiabilité absolue dans le calcul de la marge d’erreur sous Microsoft Excel.
Références
- Agresti, A., & Coull, B. A. (1998). Approximate is better than « exact » for interval estimation of binomial proportions. The American Statistician, 52(2), 119-126. https://doi.org/10.1080/00031305.1998.10480550
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cochran, W. G. (1977). Sampling techniques (3rd ed.). John Wiley & Sons.
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7-29. https://doi.org/10.1177/0956797613504966
- Microsoft Support. (2023). INTERVALLE.CONFIANCE.NORMALE (fonction). Support technique Microsoft. https://support.microsoft.com/fr-fr/office/intervalle-confiance-normale-fonction-75c64518-d0f0-4713-b5bd-bc039642d950
- Microsoft Support. (2023). INTERVALLE.CONFIANCE.T (fonction). Support technique Microsoft. https://support.microsoft.com/fr-fr/office/intervalle-confiance-t-fonction-a8aec395-9882-414d-ab47-fccd3438458b
- Student. (1908). The probable error of a mean. Biometrika, 6(1), 1-25. https://doi.org/10.1093/biomet/6.1.1
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1-23. https://doi.org/10.18637/jss.v059.i10
- Wilson, E. B. (1927). Probable inference, the law of succession, and statistical inference. Journal of the American Statistical Association, 22(158), 209-212. https://doi.org/10.1080/01621459.1927.10502953