
Dans le champ de l’analyse exploratoire des données et des statistiques descriptives, la conversion des dénombrements bruts en indicateurs proportionnels constitue une étape fondamentale de la démarche scientifique. Que ce soit en psychologie expérimentale, en sociologie quantitative ou dans les sciences du comportement, le chercheur ou l’étudiant est continuellement confronté à la nécessité de neutraliser les effets de taille d’échantillon afin d’extraire des structures comparables et signifiantes. L’examen des fréquences absolues, bien qu’indispensable au premier niveau d’observation empirique, demeure intrinsèquement tributaire du volume global des observations collectées, ce qui limite considérablement la portée des comparaisons inter-groupes et interdit toute modélisation probabiliste directe sans une opération préalable de standardisation.
Au sein de cet édifice méthodologique, la calculatrice graphique de la famille Texas Instruments TI-84 Plus (déclinée sous ses versions Standard, Silver Edition et CE) s’est imposée depuis plusieurs décennies comme l’instrument pédagogique et technique de référence. Dotée d’un moteur de calcul vectoriel reposant sur des listes dynamiques, la TI-84 combine une accessibilité matérielle immédiate avec une puissance algorithmique suffisante pour traiter des séries statistiques univariées et bivariées complexes sans nécessiter l’infrastructure lourde d’un poste de travail informatique dédié.
L’objectif de ce guide exhaustif est de décortiquer, avec une rigueur mathématique et technique absolue, l’intégralité du protocole permettant de calculer, manipuler, vérifier et représenter graphiquement les fréquences relatives sur une TI-84. En articulant les fondements de la théorie de la mesure et des probabilités avec les spécificités de l’architecture matérielle de la machine, ce manuel détaille chaque manipulation pas à pas, analyse les écueils algorithmiques classiques, explore l’automatisation par programmation interne et illustre la pertinence de ces procédures à travers des cas concrets issus des sciences comportementales et psychométriques.
1. Fondements théoriques de la fréquence relative en statistiques appliquées
1.1 Définition formelle et distinction entre fréquence absolue et relative
La statistique descriptive univariée repose sur l’observation d’un caractère ou d’une variable au sein d’une population ou d’un échantillon déterminé. Soit un ensemble fini d’observations comprenant $N$ unités statistiques, où chaque unité présente une modalité particulière parmi un ensemble discret de modalités exhaustives et mutuellement exclusives notées $k in {1, 2, dots, K}$. La fréquence absolue, communément appelée effectif de la modalité $k$ et notée $n_k$, quantifie le nombre exact d’occurrences empiriques associées à cette catégorie spécifique. Bien que cette mesure fournisse une description brute fidèle de la collecte de données, elle demeure dépendante de la taille globale de l’échantillon $N$, ce qui interdit toute confrontation rigoureuse entre deux cohortes d’étendues inégales.
Pour s’émanciper de cette contrainte dimensionnelle, l’analyste procède à une normalisation linéaire en établissant le rapport entre l’effectif catégoriel et la masse totale des observations. La fréquence relative, formellement désignée par $f_k$, est ainsi définie par l’équation canonique $f_k = \frac{n_k}{N}$, où $N = \sum_{i=1}^K n_i$. Cette opération élémentaire matérialise le passage conceptuel d’un simple dénombrement volumétrique à une mesure adimensionnelle d’occurrence, exprimée sur une échelle continue comprise entre zéro et un. La fréquence relative traduit ainsi la part contributive de chaque catégorie au phénomène global observé.
L’apport épistémologique majeur de la fréquence relative réside dans sa propriété d’invariance d’échelle. Alors que les effectifs bruts fluctuent mécaniquement selon l’effort d’échantillonnage déployé par l’expérimentateur, la distribution des fréquences relatives demeure stable sous l’hypothèse d’une représentativité de l’échantillonnage. Cette invariance permet d’opérer des comparaisons rigoureuses entre des jeux de données collectés dans des contextes temporels ou géographiques hétérogènes, établissant un socle de comparabilité indispensable à toute recherche empirique reproductible.
1.2 Rôle de la standardisation des données dans l’analyse comportementale
Dans le domaine des sciences psychologiques et des neurosciences comportementales, la variabilité interindividuelle et les contingences logistiques engendrent fréquemment des disparités notables dans le nombre d’essais réalisés par les sujets d’une étude. Par exemple, lors d’un protocole d’observation de conditionnement opérant ou d’évaluation de temps de réaction catégoriels, le nombre total de réponses enregistrées peut différer significativement d’un participant à l’autre en raison de phénomènes d’inattention, de fatigue ou de vitesses d’exécution variables. L’analyse des fréquences absolues induirait un biais systématique en surreprésentant les comportements des individus les plus actifs au détriment des profils moins productifs.
La conversion systématique des occurrences brutes en fréquences relatives permet d’éliminer ce biais d’échelle en projetant les réponses de chaque individu sur un référentiel normé. Dans l’analyse comportementale appliquée, quantifier la proportion d’actes agressifs ou d’interactions pro-sociales par rapport à l’activité motrice totale s’avère infiniment plus informatif que d’étudier le compte absolu de ces comportements. Cette standardisation garantit que chaque profil contribue avec un poids statistique équilibré à la caractérisation globale du groupe expérimental, préservant ainsi la validité interne des inférences tirées.
Au-delà de la simple description clinique ou comportementale, cette standardisation vectorielle constitue le pont analytique indispensable reliant la statistique descriptive à la statistique inférentielle. Les distributions empiriques de fréquences relatives constituent en effet les estimateurs ponctuels directs des paramètres de probabilité régissant les variables latentes. Elles servent d’entrées incontournables pour modéliser des distributions d’échantillonnage, calculer des estimateurs du maximum de vraisemblance et réaliser les tests d’ajustement nécessaires à la généralisation des résultats observés.
1.3 Propriétés mathématiques fondamentales et axiomes de probabilité
L’espace des fréquences relatives est rigoureusement contraint par des propriétés mathématiques qui reflètent directement les axiomes formels posés par Andreï Kolmogorov en 1933 pour la théorie des probabilités. La première propriété fondamentale est la condition de positivité et de bornitude : pour toute modalité $k$, la fréquence relative est strictement confinée dans le segment réel fermé $[0, 1]$, c’est-à-dire que $\forall k in {1, dots, K}, 0 \leq f_k \leq 1$. Une valeur de zéro dénote l’absence absolue de la modalité dans l’échantillon considéré, tandis qu’une valeur de un caractérise une modalité certaine, englobant l’intégralité des observations.
La seconde propriété primordiale concerne la condition de sommabilité unitaire ou de fermeture stochastique. La somme arithmétique de toutes les fréquences relatives calculées sur un ensemble de modalités exhaustives et disjointes doit être rigoureusement égale à l’unité : $\sum_{k=1}^K f_k = \sum_{k=1}^K \frac{n_k}{N} = \frac{1}{N} \sum_{k=1}^K n_k = \frac{N}{N} = 1$. Tout écart conceptuel par rapport à cette valeur unitaire indique soit une erreur dans la saisie des effectifs, soit un chevauchement illicite des catégories retenues lors de la partition de l’espace échantillonnal.
Enfin, la fréquence relative entretient une filiation asymptotique directe avec le concept de probabilité par l’entremise de la loi faible et de la loi forte des grands nombres. Lorsque la taille de l’échantillon $N$ tend vers l’infini ($N to \infty$), la fréquence relative empirique $f_k$ converge en probabilité et presque sûrement vers la probabilité théorique sous-jacente $P(k)$ de voir apparaître l’événement associé. Cette convergence constitue le fondement même de l’approche fréquentiste, légitimant l’emploi des calculatrices graphiques pour simuler des tirages aléatoires et approximer empiriquement des lois de probabilité théoriques.
2. Présentation de l’environnement matériel et logiciel de la TI-84
2.1 Architecture du gestionnaire de listes statistiques (STAT Editor)
La famille des calculatrices TI-84 Plus repose sur une architecture matérielle optimisée par un microprocesseur Zilog Z80 cadencé à 15 MHz (ou un processeur ARM sur les versions TI-84 Plus CE), associé à une mémoire vive (RAM) de 24 à 154 kilo-octets dédiée à l’exécution dynamique des calculs. Au cœur de ce système d’exploitation propriétaire, le gestionnaire de listes statistiques, couramment dénommé STAT Editor, occupe une place structurelle centrale. Contrairement à des registres scalaires simples qui ne stockent qu’une seule valeur numérique dans des variables de $A$ à $Z$, le gestionnaire de listes alloue des espaces de mémoire contigus capables d’héberger des vecteurs unidimensionnels pouvant contenir jusqu’à 999 éléments chacun.
Le système réserve nativement six listes globales désignées par les identifiants préprogrammés L1, L2, L3, L4, L5 et L6. Ces registres sont accessibles directement depuis la façade de l’appareil par la combinaison de la touche bleue 2nd suivie des touches numériques 1 à 6. L’architecture de ces listes ne se limite pas à un simple tableau passif de stockage : les en-têtes de colonnes du STAT Editor agissent comme de véritables récepteurs de formules dynamiques. L’utilisateur peut ainsi lier une liste à d’autres vecteurs par des relations fonctionnelles mathématiques réévaluées instantanément à chaque modification de la source.
La navigation au clavier s’articule autour de la touche dédiée STAT, qui donne accès à trois menus déroulants : EDIT (dédié à la saisie et à la structuration tabulaire), CALC (consacré aux moteurs d’inférence et de statistiques descriptives) et TESTS (orienté vers les tests d’hypothèses). L’ergonomie générale repose sur l’utilisation intensive des flèches multidirectionnelles du curseur pour parcourir les cellules matricielles, valider les affectations et manipuler les dimensions des vecteurs avec une fluidité adaptée aux exigences des travaux de laboratoire.
2.2 Procédure de réinitialisation et de purge préalable des données
L’un des risques méthodologiques les plus fréquents lors de l’exécution de calculs statistiques sur calculatrice réside dans la contamination des nouvelles données par des valeurs résiduelles héritées d’expérimentations antérieures. Avant d’engager toute nouvelle procédure de saisie d’effectifs, il est donc impératif de procéder à la purge intégrale des registres de travail. Le système d’exploitation de la TI-84 propose deux méthodes d’assainissement de la mémoire de travail : l’effacement direct via l’écran principal ou la purge interne dans l’éditeur statistique.
Depuis l’écran principal de calcul (accessible via la touche CLEAR ou la combinaison 2nd QUIT), la méthode la plus rapide et la plus robuste consiste à invoquer l’instruction système ClrList. Pour ce faire, l’utilisateur presse la séquence STAT, sélectionne l’option 4:ClrList, puis spécifie les listes cibles séparées par des virgules (par exemple : ClrList L1, L2, L3 via les touches 2nd 1, ,, 2nd 2, etc.). L’appui final sur la touche ENTER exécute l’instruction et renvoie le message de confirmation Done, garantissant que les vecteurs sélectionnés sont désormais vierges de tout artefact numérique.
Si l’utilisateur se trouve déjà au sein du STAT Editor, une seconde approche consiste à naviguer à l’aide de la flèche directionnelle vers le haut pour placer le curseur noir inversé directement sur le libellé d’en-tête de la colonne (par exemple sur L1). Il suffit alors d’appuyer sur la touche CLEAR, puis sur la touche ENTER. Il est crucial d’éviter formellement d’appuyer sur la touche DEL lorsque le curseur est positionné sur le libellé de la liste, car cette action ne vide pas la liste mais supprime purement et simplement la colonne de l’affichage actif de l’éditeur.
2.3 Configuration des modes d’affichage décimal et notation scientifique
La précision numérique d’une calculatrice graphique conditionne directement la validité des proportions calculées, particulièrement lorsque l’on manipule des fréquences relatives associées à des événements rares ou à des cohortes de grande taille. Le moteur interne de calcul de la TI-84 opère avec une précision native de 14 chiffres significatifs selon la norme de calcul à virgule flottante, mais le format de restitution visuelle sur l’écran LCD est régi par les paramètres configurés dans le menu MODE de l’appareil.
En pressant la touche MODE, l’analyste accède à la grille des options d’environnement de la machine. Sur la deuxième ligne de configuration apparaît l’alternative entre le mode Float (virgule flottante générale) et les réglages fixes 0 1 2 3 4 5 6 7 8 9 (désignés par le terme Fix). Par défaut, le mode Float affiche un nombre variable de décimales en adaptant dynamiquement l’arrondi à la largeur physique de l’écran, ce qui préserve l’intégrité visuelle des calculs. Toutefois, pour des besoins de standardisation académique, il peut être judicieux de fixer le nombre de décimales à 3 ou 4 en surlignant le chiffre correspondant et en validant par ENTER.
Il importe de souligner avec rigueur la distinction entre l’arrondi d’affichage et la précision interne des calculs. Lorsque le mode d’affichage est configuré sur un nombre restreint de décimales (par exemple Fix 2), la TI-84 continue d’exécuter ses opérations vectorielles internes avec ses 14 chiffres de précision. En revanche, si l’expérimentateur recopie manuellement les données tronquées affichées à l’écran pour les réinjecter dans des calculs ultérieurs, des erreurs de troncature cumulatives significatives peuvent apparaître. Le maintien du mode Float complet est donc formellement recommandé lors de toutes les phases de traitement vectoriel des fréquences relatives.
3. Saisie méthodique des données empiriques brutes dans la liste L1
3.1 Procédure d’accès et encodage séquentiel dans l’éditeur
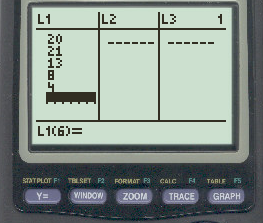
L’encodage méthodique des observations constitue le premier maillon empirique de la chaîne de traitement statistique. Sur la TI-84, cette saisie s’effectue exclusivement au sein de l’environnement matriciel du STAT Editor. Pour y accéder depuis n’importe quel écran système, il convient de presser la touche STAT, ce qui ouvre le menu principal de gestion des données statistiques, puis de sélectionner l’option 1:Edit... soit en appuyant directement sur la touche numérique 1, soit en confirmant la sélection surlignée par la touche ENTER.
L’écran affiche alors une table à colonnes multiples surmontées de leurs identifiants réservés. Le curseur clignotant se positionne spontanément sur la première ligne de la première colonne disponible, traditionnellement la liste L1. L’opérateur encode alors séquentiellement chaque effectif absolu $n_k$ observé dans l’étude. Après la saisie numérique de chaque valeur via le pavé numérique de la calculatrice, l’appui sur la commande ENTER remplit deux fonctions indispensables : il inscrit définitivement la donnée scalaire dans l’adresse mémoire correspondante et déplace automatiquement le curseur vers la cellule immédiatement inférieure ($L_1(i+1)$).
Cette saisie séquentielle doit s’effectuer avec une rigueur absolue, en veillant à ne pas insérer de valeurs nulles superflues ou de cellules vides. Si une modalité présente un effectif empirique strictement nul ($n_k = 0$), cette valeur doit néanmoins être encodée explicitement sous la forme d’un zéro numérique si l’on souhaite maintenir la structure exhaustive des catégories dans le vecteur statistique global.
3.2 Vérification systématique de l’intégrité du vecteur de données
La validité des inférences statistiques dépendant entièrement de la conformité des entrées numériques, une phase d’audit du vecteur saisi s’avère indispensable avant d’amorcer le calcul automatisé des fréquences. Le premier indicateur d’intégrité fourni par l’interface de la TI-84 se situe au bas de l’écran : lorsque le curseur met en surbrillance une cellule particulière, la ligne d’état inférieure affiche la syntaxe de positionnement sous la forme L1(m)=valeur, où $m$ représente l’index ordinal de la ligne en cours.
L’expérimentateur doit vérifier que l’indice de la dernière cellule remplie coïncide rigoureusement avec le nombre total $K$ de classes ou de modalités observées dans son protocole de recherche. Un décalage de cet indice trahit immanquablement soit l’omission d’une classe statistique, soit une double frappe involontaire. L’inspection visuelle des valeurs s’opère aisément en parcourant l’ensemble de la colonne verticale au moyen des flèches multidirectionnelles haut et bas du pavé directionnel.
En cas d’erreur de saisie avérée, la TI-84 offre plusieurs mécanismes de correction directe :
- Remplacement simple : Il suffit de positionner le curseur sur la cellule défectueuse, de taper la nouvelle valeur numérique et de presser
ENTERpour écraser la donnée erronée. - Suppression unitaire : La pression sur la touche
DELsupprime la cellule sélectionnée et opère un décalage ascendant instantané de toutes les valeurs sous-jacentes, réduisant ainsi la dimension totale du vecteur d’une unité. - Insertion omise : Si une modalité a été oubliée au sein de la séquence, l’utilisateur place son curseur sur la cellule qui doit suivre l’élément omis, presse la combinaison de touches
2ndDEL(correspondant à l’instructionINS), ce qui génère une case vierge prête à recevoir la valeur manquante sans altérer le reste de la série.
3.3 Structuration des modalités qualitatives et ordinales associées
Les calculatrices de la gamme TI-84 sont conçues pour opérer nativement sur des grandeurs scalaires réelles et ne possèdent pas d’interpréteur de chaînes de caractères au sein des cellules de leur éditeur statistique standard. Par conséquent, lors du traitement de variables qualitatives nominales (telles que le statut marital, le groupe sanguin ou la filière d’étude) ou qualitatives ordinales (comme les niveaux d’un questionnaire de type Likert ou des grades d’évaluation hiérarchique), il est impératif d’adopter une stratégie de codage numérique systématique.
La pratique méthodologique canonique consiste à associer à chaque modalité nominale un identifiant entier arbitraire ($1, 2, 3, dots, K$) ou à respecter l’ordre intrinsèque des modalités ordinales. Pour préserver la traçabilité des analyses, il est fortement conseillé d’utiliser une liste auxiliaire contiguë, traditionnellement la liste L6 ou un registre indépendant, pour stocker ces identifiants de catégories en parallèle exact des effectifs bruts encodés dans L1. Ainsi, la cellule L6(1) contiendra le code numérique de la première modalité dont l’effectif correspondant figure dans L1(1).
En parallèle de cette organisation logicielle, le chercheur doit scrupuleusement consigner sur son protocole d’expérimentation ou son cahier de laboratoire papier la table de correspondance exhaustive liant chaque code numérique à son label sémantique précis. Cette rigueur documentaire évite toute confusion ultérieure lors de l’interprétation des fréquences relatives calculées et garantit l’intégrité de la reproductibilité scientifique du traitement des données.
4. Calcul automatisé de l’effectif global de l’échantillon
4.1 Extraction de la somme vectorielle via la fonction sum(
Pour calculer les fréquences relatives $f_k = \frac{n_k}{N}$, la détermination exacte du dénominateur $N$, représentant l’effectif total de l’échantillon, constitue l’étape calculatoire centrale. Bien que ce total puisse être calculé mentalement ou saisi manuellement s’il s’agit d’une valeur ronde connue a priori, l’automatisation de son extraction via les fonctions vectorielles de la TI-84 élimine tout risque d’erreur de transcription humaine et intègre dynamiquement les éventuelles modifications apportées à la série brute.
La machine dispose d’un opérateur mathématique hautement optimisé dédié à la sommation vectorielle : l’instruction sum(. Pour mobiliser cette commande depuis l’écran principal de calcul (quitter l’éditeur au préalable par 2nd QUIT), l’analyste sollicite le catalogue des opérations sur listes en pressant la touche 2nd suivie de la touche STAT (qui correspond à la commande secondaire LIST). Il convient ensuite de se déplacer avec la flèche droite vers le troisième sous-menu intitulé MATH.
Au sein de ce menu, l’option 5:sum( est sélectionnée en pressant la touche 5 ou en appuyant sur ENTER. L’écran principal affiche alors l’invite sum(. Il ne reste plus qu’à spécifier le nom du vecteur source en tapant 2nd 1 (pour insérer le symbole de la liste L1), puis de refermer la parenthèse par ). L’expression affichée sum(L1) est validée par l’appui sur la commande ENTER. La machine exécute alors instantanément l’algorithme arithmétique suivant :
$$N = \sum_{i=1}^K L_1(i)$$
La valeur scalaire résultante qui apparaît alignée sur la droite de l’écran représente formellement l’effectif total de l’échantillon $N$. L’expérimentateur peut immédiatement vérifier que cette grandeur correspond parfaitement au cahier des charges de son échantillonnage expérimental.
4.2 Exploitation alternative de la fonction 1-Var Stats
Une procédure alternative pour déterminer l’effectif global, tout en extrayant simultanément un panorama exhaustif des métriques de statistique descriptive univariée, réside dans l’utilisation du puissant moteur de calcul statistique univarié préprogrammé de la TI-84, intitulé 1-Var Stats. Cette approche est particulièrement recommandée lors des phases exploratoires où la connaissance préalable des paramètres de tendance centrale et de dispersion est requise.
Pour engager cette commande, il convient de presser la touche STAT, de basculer vers le menu horizontal CALC à l’aide de la touche directionnelle droite, puis d’activer la toute première option 1:1-Var Stats. Selon la version du système d’exploitation embarqué (notamment sur les versions récentes TI-84 Plus CE dotées du système d’exploitation 5.x ou supérieur), un formulaire interactif (wizard) apparaît à l’écran. Dans le champ List:, l’utilisateur s’assure que la liste L1 est correctement renseignée. Le second champ, intitulé FreqList:, doit impérativement demeurer totalement vierge dans ce contexte précis, puisque la liste L1 contient déjà les effectifs bruts et non des valeurs répétées de variables pondérées.
Après avoir positionné le curseur sur l’instruction Calculate et validé par ENTER, la calculatrice génère un écran de synthèse dense. En faisant défiler les indicateurs statistiques affichés à l’aide de la flèche pointant vers le bas, l’utilisateur identifie la ligne désignée par la lettre minuscule $n$. La valeur associée à $n$ indique formellement la dimension arithmétique globale de l’échantillon, confirmant la valeur obtenue par la fonction vectorielle sum(. Cette concordance valide l’intégrité structurelle des données avant d’entreprendre l’étape suivante de vectorisation.
4.3 Stockage de l’effectif total dans une variable scalaire
Dans une perspective d’optimisation calculatoire et pour prémunir les calculs subséquents contre les fautes de frappe manuelle, la meilleure pratique de programmation sur TI-84 consiste à encapsuler la valeur scalaire de l’effectif total dans une variable mémoire dédiée. Cette technique permet de manipuler la constante $N$ sous un libellé symbolique au sein de toutes les expressions algébriques ultérieures, conférant au modèle une élégance et une flexibilité analytique remarquables.
La calculatrice offre une touche spécialisée pour l’affectation de valeurs en mémoire vive : la touche d’assignation STO> (représentée physiquement sur le clavier par une flèche orientée vers la droite, située immédiatement au-dessus de la touche ON). Pour stocker l’effectif total directement depuis l’écran principal, l’opérateur combine la sommation vectorielle et l’assignation en composant la ligne d’instruction suivante : sum(L1) -> N. La lettre $N$ s’obtient en pressant la touche verte ALPHA suivie de la touche LOG.
Dès lors que la commande est validée par ENTER, le registre mémoire N contient la valeur exacte de l’effectif global. Ce choix algorithmique présente un avantage opérationnel majeur : si l’expérimentateur modifie ultérieurement une ou plusieurs valeurs dans la liste source L1, il lui suffira de réexécuter cette unique ligne d’instruction pour mettre à jour la valeur de $N$, laquelle se propagera de manière cohérente dans l’ensemble des modules d’analyse qui en dépendent.
5. Implémentation vectorielle du calcul de fréquence relative dans L2
5.1 Programmation de la formule dans l’en-tête de liste
Le point d’orgue méthodologique du traitement sur la TI-84 réside dans l’exploitation de ses capacités de calcul matriciel pour transformer l’ensemble du vecteur des effectifs bruts en un vecteur de fréquences relatives en une seule opération. Cette manipulation s’exécute directement dans le STAT Editor en tirant parti du mécanisme d’évaluation des formules d’en-tête de colonne. Pour initier cette procédure, l’analyste retourne dans l’éditeur de données via la commande STAT suivie de 1:Edit.
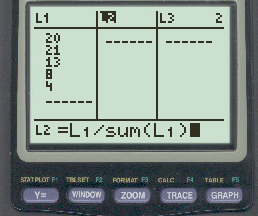
À l’aide des flèches multidirectionnelles, le curseur doit être déplacé vers le haut et vers la droite de manière à surligner très précisément le libellé textuel L2 tout en haut de la seconde colonne. Lorsque le curseur est correctement positionné sur le symbole L2, la ligne de commande tout en bas de l’écran affiche une invite d’édition explicite débutant par L2 = . Cet état de la calculatrice indique que le système n’attend pas la saisie d’un nombre isolé, mais bien la définition d’une relation mathématique vectorielle qui déterminera le contenu de l’ensemble de la colonne.
Il est fondamental de saisir la distinction opérationnelle entre une affectation statique et une formule d’en-tête dynamique. Si l’on applique la formule directement au niveau de l’en-tête, la TI-84 évalue l’expression pour chaque élément vectoriel et verrouille parfois la dépendance selon les versions d’OS. La syntaxe exacte à renseigner dans la ligne d’invite est alors : L1 / sum(L1), ou plus élégamment L1 / N si l’on a préalablement assigné la somme à la variable scalaire comme démontré à la section précédente.
5.2 Exécution de la division scalaire sur un vecteur complet
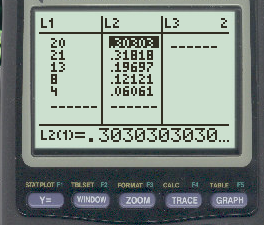
L’expression étant saisie au bas de l’écran, le déclenchement du calcul vectoriel est provoqué par l’appui sur la commande ENTER. À cet instant précis, le coprocesseur de calcul de la TI-84 exécute un traitement itératif ultra-rapide en mémoire interne. Chaque élément scalaire $L_1(i)$ hébergé dans le registre de la première liste est divisé individuellement par la constante scalaire $N$, et le quotient résultant est immédiatement injecté dans la cellule correspondante $L_2(i)$ :
$$\forall i in {1, dots, K}, \quad L_2(i) = \frac{L_1(i)}{\sum_{j=1}^K L_1(j)}$$
La colonne L2 se remplit instantanément d’une suite de valeurs numériques décimales comprises strictement entre 0 et 1. Il convient de prêter une attention rigoureuse à la syntaxe requise lors de la saisie de la référence à la liste L1 : celle-ci doit obligatoirement être insérée au moyen de la combinaison matérielle 2nd 1. La frappe manuelle des caractères alphabétiques L et 1 générerait une erreur d’interpréteur syntaxique (typiquement l’erreur ERR:SYNTAX ou ERR:UNDEFINED), car le système d’exploitation ne reconnaît pas cette concaténation comme un pointeur mémoire vers le vecteur statistique réservé.
Le vecteur L2 constitue désormais formellement la distribution empirique des fréquences relatives de la variable étudiée. L’utilisateur peut parcourir cette colonne pour apprécier la contribution proportionnelle relative de chacune des catégories observées par rapport à la masse totale des données collectées.
5.3 Contrôle de validation de la somme unitaire dans L2
En conformité absolue avec les canons de la métrologie et les axiomes de Kolmogorov formalisés au point 1.3, une phase de contrôle stochastique est requise dès l’achèvement de la division vectorielle. L’expérimentateur doit attester que la somme arithmétique des éléments constitutifs de la liste L2 vérifie scrupuleusement le critère de fermeture unitaire.
Pour mener ce contrôle, il convient de quitter le STAT Editor via la commande 2nd QUIT afin de revenir sur l’écran principal de calcul. L’utilisateur invoque à nouveau l’opérateur de sommation vectorielle en appelant l’instruction sum( via le menu 2nd STAT MATH 5:sum(, puis insère l’identifiant du second vecteur via 2nd 2 pour former l’expression sum(L2). La validation par ENTER doit renvoyer la valeur exacte : 1.
Dans certaines circonstances rarissimes, conditionnées par des tailles d’échantillons particulièrement étendues comprenant des dénominateurs fractionnaires complexes générant des développements décimaux infinis, le microprocesseur peut afficher un résultat tel que 0.99999999999999 ou 1.0000000000001. Ce micro-écart ne traduit aucunement une erreur conceptuelle ou méthodologique, mais résulte exclusivement des limites intrinsèques de la représentation binaire des nombres réels à virgule flottante sous l’architecture de calcul IEEE 754 de la calculatrice. Un tel résultat atteste d’une fermeture stochastique parfaite pour tous les usages de recherche statistique.
6. Conversion des fréquences relatives en pourcentages statistiques
6.1 Transformation linéaire vectorielle au sein de la liste L3
Bien que la fréquence relative exprimée sous forme d’une proportion décimale comprise entre 0 et 1 constitue la grandeur standard requise pour les calculs probabilistes formels, la communication des résultats au sein de rapports d’études académiques, de publications scientifiques ou de communications institutionnelles s’effectue préférentiellement sous l’échelle des pourcentages. Le pourcentage représente simplement une réexpression homothétique de la fréquence relative sur une échelle normalisée de base 100.
La TI-84 autorise une transformation linéaire vectorielle directe pour opérer ce changement d’échelle sans perte de précision. Depuis l’écran de l’éditeur statistique (STAT 1:Edit), l’analyste déplace son curseur vers le haut pour surligner l’en-tête de la troisième colonne, à savoir le label L3. Dans la ligne d’invite inférieure stipulant L3 = , il saisit la relation d’homothétie élémentaire : L2 * 100.
L’appui sur la commande ENTER déclenche l’application instantanée de l’opérateur de multiplication scalaire à chacun des éléments constituant le vecteur des fréquences relatives :
$$\forall i in {1, dots, K}, \quad L_3(i) = L_2(i) \times 100$$
La liste L3 est ainsi immédiatement peuplée des grandeurs pourcentuelles associées à chaque modalité d’observation. Cette manipulation vectorielle en chaîne (de L1 vers L2, puis de L2 vers L3) illustre la remarquable puissance du système de listes de la TI-84, capable d’exécuter un pipeline de traitement de données rigoureux et parfaitement traçable.
6.2 Différenciation conceptuelle entre proportion et pourcentage
L’utilisation interchangeable et parfois laxiste des termes « fréquence relative », « proportion » et « pourcentage » au sein des travaux d’étudiants nécessite une mise au point épistémologique stricte. Une proportion est une quantité adimensionnelle issue du rapport direct de deux grandeurs de même unité, s’inscrivant avec une rigueur absolue dans l’intervalle continu $[0, 1]$. La fréquence relative est, par essence mathématique, une proportion empirique. Son maniement est le seul formellement autorisé au sein des équations probabilistes, des fonctions de vraisemblance et des calculs d’espérance mathématique.
Le pourcentage, en revanche, est une convention typographique et notationnelle consistant à multiplier la proportion sous-jacente par un facteur scalaire de cent et à lui adjoindre le symbole spécifique « % ». Dire qu’une modalité présente une fréquence relative de 0,303 ou une prévalence de 30,3 % renvoie exactement au même état de la réalité empirique, mais la notation 30,3 % ne doit jamais être injectée brute dans une équation probabiliste sans avoir été préalablement divisée par cent.
Sur le plan rédactionnel et conformément aux exigences stylistiques des manuels académiques internationaux (notamment les normes de l’American Psychological Association), il convient de respecter des règles précises de mise en forme. Lorsque l’on rapporte des proportions pures (inférieures à 1), il est d’usage d’adopter deux à trois décimales de précision. Lors de la restitution de pourcentages, une seule décimale est généralement requise dans le corps des textes statistiques (par exemple : « 30,3 % »), sauf impératif de granularité diagnostique supérieure justifié par la taille de la cohorte.
6.3 Vérification de la somme globale à 100 pour cent
De manière parfaitement analogue au test de fermeture stochastique unitaire réalisé sur le vecteur L2, la distribution des pourcentages hébergée dans la liste L3 doit être soumise à une vérification arithmétique globale. Cette opération vise à attester que la sommation de toutes les parts catégorielles reconstitue la totalité de l’univers considéré, c’est-à-dire précisément 100 %.
L’expérimentateur regagne l’écran principal d’exécution via la combinaison de touches 2nd QUIT, puis saisit la commande : sum(L3) (obtenue toujours via 2nd STAT MATH 5:sum(, suivie de 2nd 3 pour cibler la liste L3). La validation par ENTER doit renvoyer la valeur canonique : 100.
Cependant, une mise en garde méthodologique fondamentale s’impose quant à l’interprétation des rapports rédigés après arrondi manuel : si l’opérateur procède à l’arrondi unitaire de chaque cellule de la liste L3 pour les consigner dans un tableau synthétique (par exemple en arrondissant 33,333 % à 33,3 %), la somme de ces grandeurs arrondies peut fortuitement produire un total de 99,9 % ou de 100,1 %. Les étudiants attribuent souvent à tort cette divergence à une défaillance de calcul de la machine. Il convient d’expliciter dans les notes de bas de page de tout rapport statistique que cet infime écart découle exclusivement de la sommation d’arrondis isolés et que la somme vectorielle native interne de la calculatrice, calculée à partir des valeurs réelles non tronquées, atteint invariablement le seuil de 100,0 %.
7. Calcul des fréquences relatives cumulées avec la commande cumSum(
7.1 Fondements méthodologiques de l’analyse cumulative
L’analyse cumulative constitue un prolongement analytique indispensable de la statistique descriptive univariée, applicable exclusivement aux variables quantitatives discrètes ou continues ainsi qu’aux variables qualitatives ordinales possédant un ordre sous-jacent intrinsèque. Elle est en revanche dénuée de tout fondement théorique pour des données purement qualitatives nominales, pour lesquelles la sommation séquentielle n’aurait aucune assise logique en l’absence de relation d’ordre entre les modalités.
La fréquence relative cumulée ascendante, traditionnellement notée $F_k$, exprime la proportion d’observations de l’échantillon pour lesquelles la variable mesurée prend une valeur strictement inférieure ou égale à la modalité courante $k$. Formellement, elle se définit par l’accumulation progressive des fréquences relatives simples :
$$F_k = \sum_{j=1}^k f_j = \sum_{j=1}^k \frac{n_j}{N}$$
La fonction empirique de répartition ainsi modélisée présente un intérêt méthodologique majeur en psychométrie et en évaluation comportementale : elle fournit l’outil direct de détermination des percentiles, quartiles et déciles au sein d’une population de référence, permettant d’étalonner instantanément un score individuel par rapport à la distribution globale du groupe.
7.2 Génération de la distribution cumulée dans la liste L4
La TI-84 intègre au sein de son microcode une instruction matricielle hautement performante dédiée à la sommation séquentielle cumulative de vecteurs : la fonction cumSum( (abréviation structurelle de l’expression anglaise cumulative sum). Cette fonction évite à l’opérateur d’avoir à programmer manuellement des boucles récursives de sommation.
Pour générer la séquence des fréquences relatives cumulées au sein de la colonne L4, la démarche s’opère une nouvelle fois au sein du STAT Editor (STAT 1:Edit). L’analyste déplace le curseur pour mettre en surbrillance l’en-tête de colonne L4, puis sollicite le menu des opérations sur les listes :
- Presser la touche
2ndpuis la toucheSTAT(pour afficher le menuLIST). - Utiliser la flèche multidirectionnelle droite pour atteindre le sous-menu intermédiaire intitulé
OPS(opérations sur listes). - Faire défiler vers le bas ou appuyer directement sur le chiffre
6pour sélectionner la commande6:cumSum(. - Compléter l’expression en spécifiant le vecteur source des fréquences relatives via la combinaison
2nd2(pour insérerL2), puis fermer la parenthèse par).
La ligne de commande au bas de l’écran présente alors la syntaxe achevée : L4 = cumSum(L2). L’appui final sur la touche ENTER génère instantanément dans la colonne L4 la suite des valeurs cumulées. L’opérateur peut vérifier d’un simple coup d’œil deux propriétés cardinales : la première cellule L4(1) est obligatoirement identique à la fréquence relative initiale L2(1), tandis que la dernière cellule L4(K) culmine de manière rigoureusement monotone vers la valeur exacte de 1.000, matérialisant la complétude intégrale de la distribution accumulée.
7.3 Interprétation des seuils critiques dans les distributions psychométriques
L’examen séquentiel du vecteur des fréquences cumulées L4 offre un outil diagnostique immédiat lors de l’administration de batteries de tests psychométriques ou de protocoles d’évaluation standardisés. L’application la plus directe consiste en l’identification instantanée de la médiane empirique de la série statistique. La médiane correspond précisément à la première modalité pour laquelle la fréquence relative cumulée $F_k$ franchit ou atteint le seuil critique de 0,50 (soit 50 % de l’échantillon). De même, le premier quartile ($Q_1$) et le troisième quartile ($Q_3$) sont repérés dès le dépassement respectif des seuils cumulatifs de 0,25 et de 0,75.
Dans le domaine du dépistage clinique et de la psychopathologie expérimentale, les praticiens définissent fréquemment des seuils de significativité diagnostique à l’aide des percentiles extrêmes de la distribution cumulée. Par exemple, l’identification des 5 % d’individus présentant les scores d’anxiété les plus sévères sur une échelle validée correspond directement à la recherche de la borne de score où $F_k \geq 0,95$. L’extraction tabulaire automatisée dans L4 dispense l’évaluateur de calculs d’interpolation fastidieux sur papier.
Enfin, sur le versant de la statistique inférentielle non paramétrique, le vecteur cumulé L4 constitue le matériau empirique exact mobilisé lors de la conduite du test d’adéquation de Kolmogorov-Smirnov. Ce test repose sur l’évaluation de la distance supremum absolue entre la fonction de répartition cumulée observée $F_n(x)$ — matérialisée par notre liste L4 — et une fonction de répartition cumulative théorique $F_0(x)$ (telle que la loi normale standard). La TI-84 permet ainsi de poser les bases nécessaires à ces inférences distributionnelles avancées.
8. Visualisation graphique des fréquences relatives via STAT PLOT
8.1 Paramétrage d’un histogramme de fréquences relatives
L’exploration visuelle constitue le corollaire indispensable de l’analyse tabulaire. La TI-84 embarque un moteur de rendu graphique vectoriel dénommé STAT PLOT, capable de projeter les séries statistiques sous diverses formes sémiologiques, notamment sous forme d’histogrammes ou de diagrammes en barres. Pour configurer la représentation spatiale des fréquences relatives calculées dans L2, l’utilisateur sollicite l’interface de gestion graphique en pressant la touche jaune 2nd suivie de la touche Y= (accès direct à la fonction secondaire STAT PLOT).
L’écran répertorie trois tracés indépendants (Plot1, Plot2, Plot3) complétés par des fonctions globales d’activation ou de désactivation. En appuyant sur ENTER pour pénétrer dans la configuration du Plot1, l’analyste procède à un réglage séquentiel méthodique :
- Activation : Mettre en surbrillance l’option
Onet valider parENTER. - Type de diagramme : Sur la ligne intitulée
Type:, sélectionner la troisième icône représentant un histogramme vertical en barres contiguës, puis valider parENTER. - Axe des abscisses (Xlist) : Dans le champ
Xlist, spécifier la liste contenant les modalités ou les centres de classes (par exemple la listeL6si les catégories qualitatives y ont été indexées numériquement, ou une liste spécifique de scores discrets). - Pondération des ordonnées (Freq) : Dans le champ crucial
Freq:(fréquence), remplacer la valeur par défaut1en saisissant2nd2pour insérer explicitement la listeL2. Cette opération ordonne au moteur de tracer non pas de simples dénombrements unitaires d’abscisses, mais d’assigner à la hauteur de chaque colonne la fréquence relative correspondante.
8.2 Calibrage rigoureux de la fenêtre d’affichage graphique (WINDOW)
L’une des erreurs les plus fréquentes commises par les utilisateurs de la TI-84 consiste à s’en remettre aveuglément à la fonction d’ajustement automatique de cadrage ZoomStat (accessible via la touche ZOOM puis l’option 9:ZoomStat). Si cette commande s’avère efficace pour des nuages de points simples ou des effectifs absolus entiers, elle interprète souvent imparfaitement les histogrammes pondérés par des fréquences relatives décimales inférieures à 1, générant des découpages de classes aberrants ou tronquant le sommet des rectangles.
Pour garantir un calibrage géométrique scientifiquement irréprochable, il est indispensable de définir manuellement les paramètres de projection dans le menu WINDOW, accessible par la touche physique du même nom située en haut à gauche de la calculatrice. Les paramètres doivent être ajustés selon les prescriptions suivantes :
Xmin: Fixer une valeur légèrement inférieure à la borne minimale de la première modalité (par exemple0.5si les modalités débutent à 1) afin de préserver une marge visuelle à gauche de l’origine.Xmax: Définir une borne supérieure légèrement au-delà de la dernière modalité observée (par exempleK + 0.5).Xscl: Déterminer la largeur exacte d’une barre statistique (le pas de classe). Pour des modalités unitaires entières, fixer impérativementXscl = 1.Ymin: Définir obligatoirement la borne inférieure sur la valeur0, conformément aux conventions graphiques d’honnêteté scientifique interdisant la troncature de l’axe des ordonnées.Ymax: Fixer une valeur légèrement supérieure à la fréquence relative empirique maximale observée dans la listeL2(par exemple, si $\max(f_k) = 0,42$, paramétrer judicieusementYmax = 0.50).Yscl: Définir l’échelle de graduation de l’axe des ordonnées sur une division décimale harmonieuse, typiquement0.1(10 %) ou0.05(5 %).
L’appui final sur la touche GRAPH déploie alors un tracé d’une netteté parfaite, respectant rigoureusement les proportions de la distribution empirique.
8.3 Exploration interactive et lecture empirique du tracé avec TRACE
Une fois l’histogramme des fréquences relatives matérialisé sur l’écran d’affichage, la TI-84 permet une exploration analytique interactive grâce à sa commande d’exploration TRACE. En pressant la touche physique TRACE située au sommet droit du clavier, un curseur clignotant cruciforme vient se positionner automatiquement sur le sommet de la première barre graphique de la distribution.
Au bas de l’écran LCD, la machine restitue simultanément trois indicateurs contextuels hautement informatifs :
- La borne inférieure de l’intervalle couvert par la colonne sélectionnée (
min=...). - La borne supérieure d’exclusion de cette même colonne (
max=...). - La fréquence relative empirique exacte associée à cette classe, stipulée par la variable d’ordonnée
n=...(ouy=...selon la version logicielle), correspondant exactement à la valeur calculée dans la celluleL2(i).
En sollicitant les flèches horizontales gauche et droite du pavé directionnel, l’expérimentateur parcourt séquentiellement l’ensemble des classes de la distribution. Cette inspection visuelle et numérique dynamique permet d’apprécier immédiatement les propriétés structurelles de la série statistique empirique : existence d’une asymétrie à gauche (skewness négatif) ou à droite (skewness positif), présence d’une ou plusieurs pointes trahissant un caractère unimodal ou bimodal, et étalement de la dispersion relative le long de l’axe d’évaluation.
9. Dépannage et résolution des erreurs d’exécution courantes
9.1 Résolution de l’erreur ERR:DIM MISMATCH
L’incident d’exécution le plus récurrent rencontré lors de la manipulation vectorielle des statistiques sur calculatrice graphique est le déclenchement de l’interruption logicielle ERR:DIM MISMATCH (inadéquation dimensionnelle des matrices ou listes). Cette alerte système se manifeste systématiquement lorsqu’une opération algébrique tente d’associer deux vecteurs dont la longueur respective diffère, empêchant toute correspondance terme à terme entre les éléments.
Dans le protocole de calcul des fréquences relatives, cette erreur surgit typiquement lorsque l’utilisateur tente d’associer la liste L1 (par exemple constituée de 5 catégories) avec une autre liste (comme L6 ou une ancienne liste L2 non purgée) qui contiendrait un nombre distinct de cellules (par exemple 6 ou 4). Pour diagnostiquer la dimension exacte d’un vecteur suspect, l’opérateur peut retourner sur l’écran principal de calcul et invoquer l’opérateur de dimension matricielle en pressant 2nd STAT OPS 3:dim(, suivi de l’identifiant de liste L1 :
dim(L1) renvoie immédiatement un nombre entier scalaire correspondant au compte exact d’éléments enregistrés.
Pour remédier définitivement à ce conflit de dimensions, il suffit de pénétrer dans le STAT Editor (STAT 1:Edit), de parcourir les listes impliquées jusqu’à leur terminaison, et de supprimer la ou les cellules excédentaires orphelines à l’aide de la touche DEL. Si la dimension requise est incomplète, il convient d’encoder la modalité manquante pour rétablir une parfaite symétrie dimensionnelle entre l’ensemble des listes sollicitées dans l’analyse.
9.2 Traitement de l’erreur ERR:DATA TYPE et des conflits de syntaxe
Une autre anomalie fréquemment rencontrée par les utilisateurs s’exprime par le message d’interruption logicielle ERR:DATA TYPE (erreur de typage de données) ou ERR:SYNTAX. Le processeur de la TI-84 sépare rigoureusement les espaces mémoires alloués aux scalaires réels, aux vecteurs numériques, aux matrices à deux dimensions et aux chaînes de texte alphanumériques. Tenter d’injecter une entité textuelle ou matricielle dans une formule vectorielle statistique déclenche instantanément l’exception de type de données.
L’origine la plus banale de cette défaillance réside dans l’utilisation erronée des opérateurs arithmétiques du clavier, et plus précisément dans la confusion sémiotique classique entre le signe d’opération binaire de soustraction - (situé au-dessus de la touche d’addition + sur le pavé droit) et le symbole unaire d’inversion ou de négation (-) (hébergé sur la touche inférieure entre la virgule décimale et la touche ENTER). L’insertion accidentelle de l’opérateur unaire au lieu d’un signe de division ou de soustraction invalide la chaîne syntaxique de la formule d’en-tête.
De surcroît, lors de la saisie des listes dans les formules, l’oubli de la touche 2nd conduisant à taper les caractères alphabétiques purs via le mode ALPHA (en tapant la lettre L suivie du chiffre 1) génère un pointeur indéfini provoquant l’interruption ERR:SYNTAX. La solution consiste toujours à sélectionner l’option 2:Goto proposée par l’écran d’erreur pour que le curseur se positionne exactement à l’endroit de l’anomalie typographique, permettant ainsi une rectification immédiate de l’instruction.
9.3 Gestion des effacements accidentels de colonnes de listes
Il survient fréquemment au cours des manipulations d’étudiants en laboratoire qu’une colonne entière de données statistiques — très généralement L1 ou L2 — disparaisse mystérieusement de l’affichage du STAT Editor. Cette situation anxiogène pour le néophyte résulte invariablement d’une mauvaise utilisation de la touche de suppression DEL : en plaçant le curseur tout en haut sur le label de la liste dans l’intention de la vider et en pressant DEL au lieu de CLEAR, l’utilisateur ordonne au système de masquer purement et simplement le registre d’affichage de la colonne.
Il importe de rassurer immédiatement l’expérimentateur : les données contenues dans le vecteur ne sont absolument pas détruites en mémoire vive ; seul le pointeur visuel au sein du tableau a été révoqué. La restauration complète et instantanée de l’affichage canonique d’origine s’effectue via une commande globale préprogrammée :
- Presser la touche
STATpour accéder au menu principal. - Sélectionner la cinquième option intitulée
5:SetUpEditor. - L’écran principal affiche alors l’invite textuelle
SetUpEditor. Valider immédiatement l’opération par l’appui surENTER.
La machine renvoie le message Done. En retournant dans le STAT Editor (STAT 1:Edit), l’utilisateur constate avec soulagement la réapparition immédiate des six listes système fondamentales de L1 à L6 dans leur ordre ordonné immuable, avec l’ensemble de leurs données numériques sous-jacentes intactes.
10. Automatisation du calcul par la création d’un programme TI-Basic
10.1 Architecture algorithmique du script de fréquence relative
Bien que les manipulations vectorielles séquentielles manuelles détaillées dans les chapitres antérieurs demeurent hautement formatives pour comprendre la mécanique du traitement de données, la conduite de protocoles expérimentaux itératifs implique le traitement rapide de dizaines de séries d’effectifs consécutives. Dans ce cadre de travail, la programmation d’un script algorithmique en langage embarqué TI-Basic permet de standardiser l’exécution, de diviser par dix le temps de traitement et d’immuniser l’opérateur contre tout risque d’erreur de saisie en ligne de commande.
L’architecture algorithmique d’un script de fréquence relative standardisé s’articule autour de trois modules séquentiels élémentaires :
- Le module d’initialisation et d’ingestion : Nettoyage de l’écran graphique, invite textuelle interactive guidant l’expérimentateur pour sélectionner le vecteur source ou saisir directement les données, et vérification de la présence de valeurs scalaires valides.
- Le cœur de traitement mathématique vectoriel : Extraction automatisée de la dimension $N$ par l’intermédiaire de l’opérateur vectoriel de sommation, exécution de la division matricielle élément par élément, et conversion parallèle sous forme de pourcentages et de fréquences cumulées ascendantes.
- Le module de restitution et d’assignation : Redirection ordonnée des vecteurs calculés vers les espaces mémoires dédiés (typiquement
L2pour les fréquences relatives,L3pour les pourcentages,L4pour les fréquences cumulées), et affichage textuel de contrôle à l’écran confirmant le succès de la procédure.
10.2 Écriture détaillée du code source sur la calculatrice
L’implémentation de cette routine s’effectue dans l’éditeur de programmation embarqué de la TI-84. Pour créer le programme, l’utilisateur presse la touche PRGM, bascule avec la flèche droite vers le menu NEW, valide l’option 1:Create New, puis saisit le libellé identificatoire de l’application (par exemple le nom FREQREL) avant de valider par ENTER.
L’environnement d’écriture s’ouvre, chaque ligne d’instruction débutant par le caractère deux-points (:). L’opérateur encode alors pas à pas le code source suivant, en extrayant chaque commande réservée depuis les menus dédiés du système (notamment via la touche PRGM sous le sous-menu I/O pour les commandes d’entrée/sortie, ou le catalogue des fonctions via 2nd 0) :
:ClrHome
:Disp "CALCUL FREQ REL"
:Disp "LISTE SOURCE: L1"
:sum(L1)->N
:If N=0
:Then
:Disp "ERREUR: SOMME NULLE"
:Stop
:End
:L1/N->L2
:L2*100->L3
:cumSum(L2)->L4
:Disp "EFFECTIF N=",N
:Disp "RESULTATS DANS:"
:Disp "L2: FREQ RELATIVE"
:Disp "L3: POURCENTAGES"
:Disp "L4: FREQ CUMULEES"
Une fois la saisie achevée, l’utilisateur quitte l’éditeur de programmation par la commande standard 2nd QUIT. Pour exécuter ce sous-programme lors de toute nouvelle session de mesure, il suffira d’encoder au préalable les effectifs empiriques bruts dans la liste L1, de presser la touche PRGM, de sélectionner FREQREL dans le menu EXEC et de valider par ENTER. L’intégralité des calculs vectoriels sera traitée en quelques millisecondes.
10.3 Avantages de l’automatisation pour le travail de laboratoire
L’automatisation logicielle via le langage TI-Basic confère une plus-value méthodologique considérable lors des travaux pratiques de laboratoire et des expérimentations comportementales prolongées. Premièrement, elle neutralise intégralement le risque d’altération accidentelle des formules d’en-tête du STAT Editor : une manipulation maladroite dans un tableau interactif peut aisément écraser une cellule dynamique sans que l’analyste ne s’en aperçoive, tandis qu’un script encapsule les opérations algébriques au sein d’un environnement immuable et sécurisé.
Deuxièmement, cette démarche algorithmique optimise le temps de traitement des chercheurs lors d’essais à répétition. Dans un protocole expérimental impliquant le passage successif de plusieurs dizaines de participants, la reconfiguration manuelle des formules L2 = L1 / sum(L1) à chaque passation constitue une perte d’attention et d’efficacité cognitive préjudiciable. L’exécution d’un script en une unique frappe de touche permet de focaliser toute l’attention de l’opérateur sur l’interaction avec le sujet et l’encodage précis des mesures brutes.
Enfin, sur le plan de la diffusion technique au sein d’une équipe scientifique ou d’une cohorte universitaire, les programmes stockés en mémoire interne peuvent être transférés d’une calculatrice à l’autre en quelques secondes au moyen d’un câble de liaison mini-USB direct via le menu 2nd LINK. Cette facilité de déploiement garantit que l’ensemble des collaborateurs d’un même projet emploie rigoureusement le même protocole formel de standardisation vectorielle.
11. Applications empiriques en recherche psychologique et comportementale
11.1 Analyse des profils de réponses aux échelles de Likert
L’usage des échelles de mesure ordinale d’attitude, formellement modélisées par Rensis Likert en 1932, est omniprésent en psychologie sociale, en psychométrie et dans les enquêtes d’opinion. Ces dispositifs d’évaluation sollicitent des répondants pour situer leur degré d’accord ou de désaccord vis-à-vis d’énoncés ciblés, généralement selon un gradient ordinal symétrique en 5 points (de « 1 = Pas du tout d’accord » à « 5 = Tout à fait d’accord »). Face à une cohorte de 250 sujets ayant complété un item d’évaluation du stress professionnel, l’analyse brute des dénombrements ne permet pas d’apprécier immédiatement la configuration psychologique de l’échantillon.
Supposons que les données collectées sur les 5 échelons de réponses fournissent les effectifs absolus suivants, encodés chronologiquement dans la liste L1 de la calculatrice : 22, 45, 68, 85 et 30 réponses. L’exécution du protocole de calcul vectoriel produit dans la liste L2 les fréquences relatives associées : 0,088 ; 0,180 ; 0,272 ; 0,340 et 0,120. Converties immédiatement dans L3 sous forme de pourcentages explicites (8,8 %, 18,0 %, 27,2 %, 34,0 % et 12,0 %), ces grandeurs mettent en évidence un glissement prononcé vers les valeurs supérieures de l’échelle d’évaluation.
Cette analyse proportionnelle met immédiatement en lumière l’existence éventuelle d’un « effet de plafond » (accumulation atypique de fréquences sur la modalité d’extrémité supérieure 5) ou d’un « effet de plancher » (concentration anormale sur l’extrémité 1). De telles déformations structurelles altèrent sévèrement la sensibilité métrologique de l’item étudié et signalent au psychologue la nécessité de réviser sa formulation textuelle avant son intégration définitive dans un inventaire diagnostique standardisé.
11.2 Observation standardisée du comportement chez l’humain et l’animal
Dans le domaine de l’éthologie clinique et de la psychologie comparative, les chercheurs emploient des méthodologies d’échantillonnage temporel direct pour cartographier le répertoire comportemental de sujets placés au sein d’environnements contrôlés. L’ensemble des catégories comportementales mutuellement exclusives d’une espèce est consigné dans une grille taxonomique formelle appelée éthogramme (incluant par exemple le toilettage, l’exploration motrice, l’immobilité vigilante, l’agression intraspécifique et l’alimentation).
Considérons un protocole éthologique où un observateur relève par méthode d’échantillonnage par intervalle régulier (scan sampling) les postures d’un rongeur de laboratoire sur une session standardisée de 60 minutes comprenant 120 scans d’intervalles de 30 secondes. Les effectifs absolus d’apparition des postures sont saisis dans L1 : Toilettage (18 scans), Exploration (54 scans), Immobilité (36 scans) et Alimentation (12 scans). En appliquant la routine de fréquence relative vectorielle sur la TI-84, la liste L2 révèle instantanément le budget-temps relatif de l’animal :
- Toilettage : $f_1 = \frac{18}{120} = 0,150$ (soit 15,0 % du budget-temps total).
- Exploration motrice : $f_2 = \frac{54}{120} = 0,450$ (soit 45,0 % de l’activité).
- Immobilité vigilante : $f_3 = \frac{36}{120} = 0,300$ (soit 30,0 % de l’observation).
- Comportement alimentaire : $f_4 = \frac{12}{120} = 0,100$ (soit 10,0 % de l’intervalle).
Cette conversion proportionnelle permet de comparer rigoureusement ce profil comportemental individuel avec celui d’animaux soumis à des molécules anxiolytiques ou à des paradigmes de stress aigu sans que la durée effective de l’observation ou des interruptions techniques de protocole ne viennent biaiser l’analyse comparative inter-groupes.
11.3 Préparation des données pour les tests non paramétriques du Khi-deux
Le calcul préalable des fréquences relatives constitue une étape préparatoire indispensable lors de la mise en œuvre des tests d’adéquation et d’indépendance de Karl Pearson, couramment dénommés tests du Khi-deux ($\chi^2$). Lors d’un test d’adéquation, l’analyste cherche à déterminer si la distribution des fréquences empiriques observées au sein d’un échantillon s’écarte de manière statistiquement significative d’une distribution théorique de probabilités formulée a priori sous l’hypothèse nulle ($H_0$).
Sur la TI-84, la quantification préalable des fréquences relatives observées $f_k$ permet de visualiser immédiatement l’écart proportionnel existant avec les probabilités théoriques $p_k$. En effet, la statistique de test classique s’énonce mathématiquement sous la forme :
$$\chi^2 = \sum_{k=1}^K \frac{(n_k – e_k)^2}{e_k}$$
où $e_k = N \times p_k$ symbolise l’effectif théorique attendu sous $H_0$. Or, cette expression peut se reformuler élégamment en exploitant directement le vecteur des fréquences relatives empiriques $f_k$ logé dans L2 :
$$\chi^2 = \sum_{k=1}^K \frac{(N \cdot f_k – N \cdot p_k)^2}{N \cdot p_k} = N \sum_{k=1}^K \frac{(f_k – p_k)^2}{p_k}$$
En encodant les probabilités théoriques $p_k$ dans le vecteur L5, la TI-84 permet à l’utilisateur de calculer la composante unitaire de déviation relative dans une colonne dédiée en saisissant l’expression d’en-tête vectorielle : (L2 - L5)^2 / L5. La sommation ultérieure de cette liste, multipliée par la variable scalaire scalaire globale $N$, restitue la statistique du $\chi^2$ sans avoir à recourir à des matrices de calcul lourdes, simplifiant considérablement la pédagogie des tests inférentiels.
12. Perspectives comparatives et intégration dans le flux d’analyse de données
12.1 Comparaison entre la TI-84 et les logiciels d’analyse (R, SPSS, Jamovi)
Dans l’écosystème contemporain de la science des données, il est indispensable de situer avec lucidité la place respective de la calculatrice graphique autonome face aux progiciels d’analyse statistique professionnels tels que l’environnement de programmation R, IBM SPSS Statistics ou les suites ergonomiques modernes comme Jamovi et JASP. Bien que ces dernières plateformes informatiques soient capables de traiter des millions de lignes de données massives (Big Data) et de générer des modèles d’équations structurelles complexes inaccessibles à la TI-84, la calculatrice portable conserve des atouts didactiques incomparables.
L’utilisation de logiciels à interface graphique presse-bouton induit trop souvent un comportement de « boîte noire », où l’étudiant produit des tables de sorties denses sans appréhender la mécanique computationnelle qui sous-tend la transformation de ses mesures. À l’inverse, l’implémentation manuelle des formules vectorielles d’en-tête (L2 = L1 / sum(L1)) sur la TI-84 contraint l’apprenant à conceptualiser concrètement la trajectoire mathématique de la standardisation des données. Chaque étape — de l’effectif brut à la proportion puis au pourcentage — demeure tangible, visuelle et manipulable.
En outre, la TI-84 constitue l’instrument nomade d’évaluation standard par excellence lors des examens universitaires, des concours nationaux d’admission et des collectes sur le terrain isolé, contextes où l’usage d’ordinateurs connectés est strictement proscrit pour des motifs manifestes de sécurité et d’équité académique. L’acquisition d’une dextérité parfaite sur ce matériel demeure donc un prérequis méthodologique incontournable pour tout cursus scientifique rigoureux.
12.2 Normes de présentation académique des fréquences relatives selon l’APA
L’insertion de fréquences relatives et de proportions au sein de publications de recherche évaluées par les pairs est soumise à des exigences typographiques strictes codifiées par l’American Psychological Association (manuel APA, 7e édition). La méconnaissance de ces règles stylistiques constitue l’un des motifs les plus fréquents de corrections imposées par les comités de lecture des revues scientifiques internationales.
La règle d’or stylistique régissant la restitution des nombres décimaux stipule qu’il ne faut jamais insérer de zéro initial devant le séparateur décimal (point ou virgule) lorsque le paramètre rapporté ne peut structurellement pas excéder la valeur théorique de un. Dans la mesure où une fréquence relative ou une proportion est intrinsèquement bornée dans le segment $[0, 1]$, elle doit impérativement être retranscrite sous la forme $.30$ ou $.303$ dans les manuscrits rédigés en langue anglaise (ou $,30$ et $,303$ en typographie francophone), et jamais sous la forme erronée $0.30$. En revanche, cette restriction d’omission ne s’applique pas aux pourcentages, lesquels peuvent dépasser 100 % dans d’autres contextes de mesure, et qui doivent conserver leur partie entière complète (par exemple : $30,3 %$).
De surcroît, lors de la conception de tables statistiques synthétiques dans un article conforme aux standards APA, les fréquences absolues et relatives doivent être présentées conjointement au sein de colonnes adjacentes bien distinctes, identifiées respectivement par les en-têtes standardisés en italique $n$ et $%$, comme illustré ci-dessous :
- Modalité A : $n = 45$, $30,0 %$
- Modalité B : $n = 75$, $50,0 %$
- Modalité C : $n = 30$, $20,0 contingency%$
- Total : $N = 150$, $100,0 %$
12.3 Protocole de synthèse pour les travaux dirigés et examens de statistique
Pour accompagner efficacement les étudiants et praticiens lors de situations d’épreuve sous contrainte temporelle, nous condensons l’ensemble des procédures techniques développées au sein de ce manuel sous la forme d’un protocole opérationnel synthétique en cinq phases séquentielles immuables :
- Phase d’assainissement : Exécuter
ClrList L1, L2, L3, L4depuis l’écran principal pour éradiquer tout artefact résiduel. En cas de colonne absente, rétablir la matrice viaSTAT5:SetUpEditor. - Phase d’encodage : Accéder au STAT Editor (
STAT1:Edit), saisir les effectifs catégoriels bruts dans le registreL1, puis vérifier l’indice dimensionnel de clôture au bas de l’écran. - Phase de calcul proportionnel : Positionner le curseur sur le label d’en-tête
L2, inscrire rigoureusement l’expression dynamiqueL1 / sum(L1), et valider l’exécution matricielle parENTER. - Phase de conversion et cumul : Dans l’en-tête de
L3, insérerL2 * 100pour l’échelle pourcentuelle. Dans l’en-tête deL4, sollicitercumSum(L2)(via2ndSTATOPS6) pour modéliser la fonction empirique cumulée. - Phase d’audit stochastique : Revenir sur l’écran de calcul (
2ndQUIT) et évaluer immédiatement les expressionssum(L2)etsum(L3)pour attester la fermeture rigoureuse à $1$ et $100 %$.
Ce protocole algorithmique rigoureux, adossé à une compréhension solide des concepts statistiques sous-jacents, confère à l’analyste une maîtrise absolue du calcul des fréquences relatives sur TI-84, garantissant une exécution rapide, exempte d’erreurs et pleinement conforme aux plus hauts standards académiques.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Howell, D. C. (2016). Fundamental statistics for the behavioral sciences (9th ed.). Cengage Learning.
- Kolmogorov, A. N. (1933). Grundbegriffe der Wahrscheinlichkeitsrechnung. Springer. https://doi.org/10.1007/978-3-642-49888-6
- Likert, R. (1932). A technique for the measurement of attitudes. Archives of Psychology, 22(140), 1–55.
- National Institute of Standards and Technology. (2023). NIST/SEMATECH e-Handbook of Statistical Methods. U.S. Department of Commerce. https://www.itl.nist.gov/div898/handbook/
- Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, 50(302), 157–175. https://doi.org/10.1080/14786440009463897
- Texas Instruments. (2020). TI-84 Plus CE reference guide. Texas Instruments Incorporated. https://education.ti.com/fr/produits/calculatrices/graphiques/ti-84-plus-ce-t-python
- Weisstein, E. W. (2023). Relative frequency. From MathWorld—A Wolfram Web Resource. https://mathworld.wolfram.com/RelativeFrequency.html