
L’analyse des variables catégorielles constitue un pilier fondamental de la recherche quantitative en sciences humaines, tout particulièrement en psychologie, en psychiatrie et en sciences comportementales. Lorsque les chercheurs s’affranchissent des échelles d’intervalles ou de rapports pour s’intéresser à des typologies diagnostiques, des choix comportementaux ou des profils de personnalité discrets, ils sont confrontés à la nécessité de modéliser des dénombrements d’individus au sein de catégories mutuellement exclusives. C’est dans ce cadre méthodologique rigoureux que s’inscrit le calcul de la fréquence attendue, une grandeur mathématique souvent qualifiée d’effectif théorique, qui représente la distribution des effectifs à laquelle on s’attendrait si un modèle probabiliste spécifique — le plus souvent l’absence d’effet ou l’indépendance statistique — régissait parfaitement les données observées.
Comprendre et maîtriser la détermination de ces fréquences théoriques transcende la simple exécution mécanique d’un protocole statistique. La fréquence attendue matérialise l’hypothèse nulle sous une forme directement comparable aux observations empiriques recueillies sur le terrain. Elle sert d’étalon indispensable au calcul des déviances, conditionne l’application des célèbres tests d’adéquation et d’indépendance du Khi-deux formulés par Karl Pearson, et dicte la validité même des conclusions inférentielles tirées par le chercheur. Une mauvaise estimation de ces fréquences ou une méconnaissance de leurs contraintes arithmétiques expose l’analyste à des distorsions diagnostiques sévères, à des erreurs de décision statistique de première ou seconde espèce, et à des interprétations cliniques erronées concernant les comportements humains.
Le présent traité propose une exploration exhaustive, didactique et hautement formalisée des concepts, des dérivations mathématiques et des applications concrètes régissant le calcul de la fréquence attendue. À travers l’examen détaillé des modèles d’adéquation univariés et des tables de contingence bivariées, enrichi d’études de cas cliniques et d’exemples pas-à-pas, cet article fournit aux étudiants, praticiens et chercheurs les compétences requises pour calculer, vérifier, automatiser et interpréter les fréquences théoriques avec la plus haute rigueur académique selon les standards méthodologiques contemporains.
1. Fondements théoriques de la fréquence attendue en psychologie
1.1 Définition conceptuelle et portée en méthodologie quantitative
Dans l’arsenal de l’analyse statistique inférentielle, la fréquence attendue — fréquemment désignée sous le vocable d’effectif théorique et notée traditionnellement E (pour l’anglais Expected frequency) ou fe — se définit formellement comme le produit d’une probabilité théorique postulée a priori et de la taille totale de l’échantillon observé. Contrairement à une idée reçue tenace chez les praticiens débutants, la fréquence attendue ne correspond nullement à une prévision temporelle ou à une moyenne empirique constatée historiquement dans d’autres cohortes. Elle incarne la matérialisation mathématique d’un état du monde gouverné rigoureusement par un modèle probabiliste théorique, presque systématiquement associé à l’hypothèse nulle (notée H0).
En psychologie méthodologique, l’usage de données qualitatives nominales ou ordinales impose une traduction arithmétique des concepts théoriques. Qu’il s’agisse de catégoriser des styles d’attachement, des orientations diagnostiques ou des réponses à des items de questionnaires psychométriques forcés, la distribution observée des participants ne peut être jugée atypique, asymétrique ou interdépendante que si elle est confrontée à une référence normative invariable. La fréquence théorique remplit cette fonction d’ancrage en convertissant une hypothèse abstraite — telle que l’équiprobabilité de choix d’évitement face à une menace ou l’absence totale de corrélation entre la sévérité d’un traumatisme et le type de coping mobilisé — en une quantité discrète ou continue d’individus attendus dans chaque sous-groupe d’analyse.
D’un point de vue épistémologique, la distinction entre prédiction probabiliste et régularité observée est cruciale. L’observation empirique relève du constat phénoménologique direct : elle intègre la variance d’échantillonnage, le bruit de mesure et les contingences environnementales propres au moment de l’expérimentation. À l’inverse, la fréquence attendue est un invariant logique déduit directement des axiomes du modèle probabiliste postulé. Elle relie sans ambiguïté la théorie mathématique de la mesure et l’analyse concrète des dénombrements comportementaux, offrant ainsi une grille de lecture objective sans laquelle aucune inférence catégorielle ne posséderait de valeur probante.
1.2 Origines de l’inférence non paramétrique de Karl Pearson
L’émergence formelle du concept de fréquence attendue remonte à l’aube du XXe siècle, sous l’impulsion magistrale de Karl Pearson. En publiant son article fondateur en 1900 dans le Philosophical Magazine, Pearson cherchait à résoudre un défi récurrent en biométrie et en psychophysique : comment déterminer scientifiquement si une série d’observations catégorielles s’écarte significativement d’une loi de distribution postulée ? Jusqu’alors, les chercheurs comparaient intuitivement les effectifs réels à des patrons qualitatifs, sans cadre de normalisation mathématique unifié. Pearson formalisa l’écart standardisé quadratique entre l’observation empirique et l’attente théorique, donnant naissance à la célèbre statistique du Khi-deux (notée χ²).
Pour que cette statistique quadratique possède une distribution d’échantillonnage mathématiquement connue et tabulable, Pearson comprit que le dénominateur de chaque terme devait impérativement être la fréquence attendue elle-même, agissant à la fois comme pondérateur d’échelle et comme variance approximative du comptage sous une loi de Poisson ou multinomiale. La fréquence théorique devint ainsi le socle indispensable sur lequel repose l’ensemble de la métrique d’ajustement. Sans ce pivot théorique, l’écart brut entre une observation et une hypothèse demeurait inexploitable, car un différentiel de dix individus ne revêt pas la même signification statistique selon qu’il s’applique à un groupe de vingt patients ou à une population clinique de plusieurs milliers de sujets.
Cette innovation méthodologique a profondément transformé la psychologie différentielle naissante. Des pionniers de l’évaluation intellectuelle et typologique ont rapidement adopté le cadre de Pearson pour valider la stabilité des taxinomies comportementales. En comparant les fréquences observées au sein de profils de personnalité précurseurs aux fréquences attendues dérivées du hasard ou de distributions théoriques normales discrétisées, les chercheurs disposaient pour la première fois d’une procédure objective pour valider empiriquement la pertinence de leurs modèles typologiques.
1.3 Champs d’application dans la recherche comportementale contemporaine
Dans la recherche psychologique et comportementale moderne, le calcul des fréquences attendues intervient dans une multiplicité d’architectures expérimentales et observationnelles. L’une des applications cliniques les plus courantes concerne l’évaluation de la conformité épidémiologique des diagnostics psychiatriques. Lorsqu’un centre hospitalier spécialisé souhaite vérifier si la distribution des sous-types de troubles de l’humeur au sein de sa file active est conforme aux prévalences établies par le Manuel diagnostique et statistique des troubles mentaux (DSM-5-TR) ou par la Classification internationale des maladies (CIM-11), les fréquences attendues sont calculées en pondérant l’effectif global par les taux épidémiologiques nationaux de référence.
En psychologie cognitive et en économie comportementale, la modélisation des choix décisionnels dans des contextes de risque ou d’incertitude mobilise constamment ces calculs. Dans le paradigme classique de la tâche d’Iowa (Iowa Gambling Task) ou dans les protocoles d’amorçage sémantique, le chercheur formule fréquemment l’hypothèse nulle d’un comportement non biaisé, selon lequel chaque option (favorable ou défavorable, rapide ou lente) posséderait une chance équivalente d’être sélectionnée. Le calcul d’une fréquence attendue équiprobable fournit le repère mathématique indispensable pour quantifier l’aversion au risque, le biais de cadrage ou la saillance attentionnelle d’un stimulus.
Enfin, en psychométrie et dans les enquêtes d’évaluation à grande échelle, le contrôle de la représentativité des échantillons stratifiés repose sur la comparaison systématique des effectifs observés aux effectifs théoriques déduits des données du recensement démographique. Qu’il s’agisse de valider l’adéquation d’une cohorte d’étudiants quant à la parité de genre, au niveau socio-économique ou à l’origine géographique, le calcul des fréquences attendues permet de détecter d’éventuels biais d’échantillonnage susceptibles d’invalider la portée externe et la généralisabilité des résultats psychologiques obtenus.
2. Distinction fondamentale entre fréquences observées et fréquences attendues
2.1 Nature et collecte des fréquences observées
La fréquence observée, conventionnellement notée O ou fo, représente l’effectif empirique brut dénombré directement au terme de la collecte des données sur un échantillon défini. Par nature, une fréquence observée appartient strictement à l’ensemble des entiers naturels (0, 1, 2, 3, …). On ne peut déceler de fractions d’individus lors du dénombrement d’une modalité comportementale : un participant remplit un critère clinique ou ne le remplit pas, choisit une réponse A ou une réponse B. Cette propriété de discrétion absolue et de non-négativité caractérise la matérialité concrète de l’observation de terrain.
Toutefois, la pureté apparente de ces données empiriques masque d’importantes sources de variabilité non contrôlées. En psychométrie et en clinique, les fréquences observées sont constamment parasitées par des erreurs de mesure, des biais de désirabilité sociale dans les auto-questionnaires, ou encore des fluctuations d’échantillonnage inhérentes à la sélection aléatoire des sujets. Si un chercheur observe que 34 sujets sur 100 présentent un trait d’impulsivité marqué, cette valeur 34 constitue une réalisation singulière parmi une infinité d’échantillons possibles tirés de la même population sous-jacente.
La collecte de ces fréquences requiert un protocole d’exclusion stricte. Chaque unité expérimentale doit pouvoir être classée de manière univoque dans une et une seule catégorie du système de codage retenu. Si une incertitude subsiste dans l’assignation d’un individu à un groupe — par exemple en cas de comorbidité psychiatrique non résolue par le plan de recherche —, la valeur des fréquences observées perd sa validité de construit, ce qui compromettra l’ensemble de la chaîne de calcul analytique ultérieure.
2.2 Propriétés mathématiques de la fréquence attendue
Contrairement aux données empiriques brutes, la fréquence attendue présente des propriétés formelles radicalement différentes, qui déroutent parfois les analystes novices. La caractéristique la plus frappante réside dans son statut de variable continue : une fréquence attendue peut parfaitement — et prend presque toujours en pratique — une valeur décimale non entière. Trouver un effectif théorique de 14,37 individus dans une cellule diagnostique est mathématiquement sain et rigoureusement exact, car cette valeur représente une espérance mathématique pondérée et non le dénombrement physique d’un groupe de personnes vivantes.
Une propriété régulatrice fondamentale de la fréquence attendue concerne la conservation intégrale de la masse de données. La sommation de toutes les fréquences attendues calculées sur l’ensemble des catégories d’un modèle univarié ou sur toutes les cellules d’une table de contingence bivariée doit impérativement être égale, au centième près (aux erreurs d’arrondi près), à la somme des fréquences observées, c’est-à-dire à l’effectif total N de l’échantillon :
∑ Oi = ∑ Ei = N
Cette égalité stricte montre que le calcul des effectifs théoriques ne crée ni ne détruit d’information quantitative ; il opère une redistribution idéale de l’échantillon global N selon les contraintes probabilistes édictées par l’hypothèse nulle. La fréquence attendue est par conséquent ultra-sensible à la formulation du modèle mathématique sous-jacent : la moindre altération des hypothèses probabilistes marginales ou des lois de distribution retenues réajuste instantanément l’ensemble des valeurs attendues dans le système matriciel.
2.3 Comparaison structurelle au sein du calcul du Khi-deux
La confrontation arithmétique entre fréquences observées et fréquences attendues constitue le cœur opératoire de la statistique d’ajustement. Cette interaction s’initie par l’évaluation du résidu brut, défini simplement par la différence vectorielle (O – E). Ce résidu exprime en unités naturelles d’individus le surplus ou le déficit de la modalité étudiée par rapport au pronostic théorique de l’hypothèse nulle. Néanmoins, un tel résidu brut demeure impossible à agréger directement, car la somme arithmétique de ces écarts élémentaires sur l’ensemble des cellules est systématiquement nulle en vertu du principe de conservation de la taille d’échantillon :
∑ (Oi – Ei) = ∑ Oi – ∑ Ei = N – N = 0
Pour contourner cette neutralisation algébrique et neutraliser les signes négatifs, l’écart brut est élevé au carré, générant l’écart quadratique (O – E)². Cet écart doit ensuite être normalisé en étant divisé par la fréquence attendue correspondante, ce qui génère la statistique de contribution cellulaire (O – E)² / E. Cette standardisation par l’effectif théorique reflète un principe de variance : selon la loi de Poisson, la variance d’un comptage aléatoire est égale à sa moyenne attendue. En divisant par E, Karl Pearson a donc divisé un carré d’écart par une variance, obtenant ainsi une variable centrée réduite quadratique standardisée.
Cette décomposition structurelle ouvre également la voie au calcul des résidus ajustés standardisés, souvent nommés résidus de Haberman. En divisant l’écart (O – E) non pas simplement par la racine carrée de E mais par l’erreur-type asymptotique exacte de la cellule (prenant en compte les marges globales), le chercheur obtient une statistique d’écart individuel assimilable à un score z standard de la loi normale, facilitant l’identification visuelle immédiate des catégories qui dévient de manière statistiquement significative de l’attente théorique.
3. Le rôle crucial de l’hypothèse nulle dans la dérivation des fréquences théoriques
3.1 Formulation rigoureuse de l’hypothèse nulle en psychologie
Dans la démarche hypothético-déductive propre à la psychologie expérimentale et clinique, l’hypothèse nulle H0 n’est pas simplement une posture rhétorique signifiant l’absence d’intérêt ou le vide théorique ; elle constitue une formulation axiomatique contraignante qui spécifie avec une exactitude mathématique absolue les paramètres de la distribution attendue. Affirmer l’absence de lien entre le statut socio-économique et le style d’attachement d’un individu équivaut à postuler que la probabilité conjointe d’appartenir à une modalité croisée quelconque est rigoureusement le produit de leurs probabilités marginales respectives.
Il importe de distinguer deux grandes familles d’hypothèses nulles en analyse catégorielle :
- L’hypothèse nulle d’équiprobabilité : elle postule qu’aucune force psychologique ou biologique n’oriente préférentiellement les sujets vers une option plutôt qu’une autre. Toutes les modalités possibles de la variable possèdent alors exactement la même probabilité d’occurrence théorique.
- L’hypothèse nulle de distribution théorique prédéfinie : elle postule que l’échantillon observé doit se conformer à des proportions inégales connues a priori, issues de modèles génétiques mendéliens, de normes démographiques nationales ou de prévalences épidémiologiques documentées dans la littérature internationale.
Une formulation erronée ou ambiguë de l’hypothèse nulle entraîne irrémédiablement le calcul de fréquences attendues biaisées. Si un psychologue postule une répartition égale entre quatre catégories de comportements alors que deux de ces comportements constituent des variantes cliniques sévères intrinsèquement rares, le rejet attendu de l’hypothèse nulle n’apportera aucune information scientifique utile, traduisant simplement une erreur fondamentale dans le choix du modèle probabiliste de référence.
3.2 Dérivation probabiliste sous l’hypothèse d’équiprobabilité
L’hypothèse d’équiprobabilité s’appuie philosophiquement et mathématiquement sur le célèbre principe de raison insuffisante formulé par Pierre-Simon de Laplace : en l’absence de toute raison théorique ou empirique de privilégier une éventualité par rapport à une autre au sein d’un ensemble discret fini, nous devons assigner à chacune de ces éventualités une probabilité rigoureusement identique. Dans le cadre d’une variable psychologique qualitative comportant k modalités mutuellement exclusives et exhaustives, ce principe se traduit par une loi uniforme discrète où chaque probabilité unitaire théorique pi est définie par :
p1 = p2 = … = pk = 1 / k
Lorsque ce modèle d’équiprobabilité s’applique à un échantillon global comprenant N individus, la fréquence attendue unitaire pour chacune des k catégories découle d’une logique linéaire élémentaire mais implacable :
Ei = N × pi = N × (1 / k) = N / k
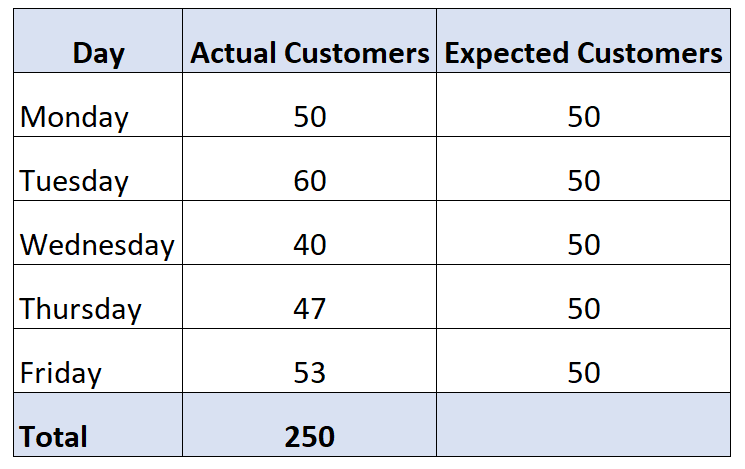
Ce calcul élémentaire confère à chaque cellule de l’espace d’échantillonnage un poids théorique identique. Par exemple, si une tâche d’attention divisée force un participant à orienter son regard vers l’un des quatre quadrants d’un écran informatique sans indice préalable, et que cette manipulation est répétée sur un total cumulé de N = 280 détections, la fréquence théorique sous l’hypothèse d’équiprobabilité sera rigoureusement de 280 / 4 = 70 occurrences par quadrant. Tout écart mesurable par rapport à cette valeur 70 constituera la matière première servant à éprouver l’existence d’un biais attentionnel spatial non aléatoire.
3.3 Implications de l’acceptation ou du rejet de la distribution attendue
L’aboutissement de la comparaison entre les fréquences observées et les fréquences attendues débouche sur une prise de décision statistique régie par la fixation d’un seuil de signification alpha (habituellement fixé à α = 0,05 ou α = 0,01 en psychologie). Le rejet de l’hypothèse nulle survient lorsque la statistique globale du test (comme le χ²) excède la valeur critique tabulée pour les degrés de liberté considérés, traduisant une probabilité d’erreur de première espèce (rejeter à tort H0) inférieure au seuil alpha prédéterminé.
Dans un contexte clinique, le rejet de l’hypothèse d’adéquation aux fréquences attendues possède une portée diagnostique majeure. Si une cohorte de patients admis pour épuisement professionnel montre une distribution des types de personnalité significativement divergente des fréquences calculées sur la base de la population générale, ce résultat démontre empiriquement l’existence d’une vulnérabilité ou d’une surreprésentation spécifique liée à certains traits. À l’inverse, l’absence de rejet de H0 ne prouve jamais que le modèle attendu est strictement vrai ; elle signifie seulement que les données recueillies ne fournissent pas d’évidence suffisante pour exclure que les écarts observés résultent du simple échantillonnage aléatoire.
Cependant, la significativité statistique brute ne renseigne aucunement sur l’amplitude clinique de cette divergence. C’est pourquoi l’analyse des fréquences attendues doit systématiquement être complétée par l’estimation de la taille d’effet. Dans les tables univariées ou bivariées, le recours au coefficient W de Cohen, au coefficient phi (φ) ou au V de Cramér s’avère indispensable :
V = √( χ² / (N × (min(r, c) – 1)) )
Cet indice normalisé, variant théoriquement entre 0 et 1, permet de quantifier si le décalage observé par rapport aux valeurs attendues relève d’une nuance anecdotique détectée artificiellement par un grand échantillon ou s’il traduit une restructuration comportementale majeure sur le plan psychologique.
4. Calcul de la fréquence attendue dans le test d’adéquation du Khi-deux
4.1 Structure générale et formule canonique
Le test d’adéquation du Khi-deux (souvent désigné par l’anglicisme Goodness-of-fit) examine la conformité d’une seule variable catégorielle distribuée sur k catégories par rapport à une distribution théorique postulée. La formule canonique universelle régissant le calcul de la fréquence attendue pour toute catégorie i s’énonce comme suit :
Ei = N × Pi
Dans cette équation fondamentale, N représente la taille globale de l’échantillon analysé (la somme de tous les individus observés), tandis que Pi désigne la proportion théorique (ou la probabilité marginale) assignée a priori à la catégorie i selon les termes de l’hypothèse nulle sous examen.
Cette relation possède des propriétés mathématiques élégantes :
- L’invariance d’échelle : si l’on multiplie l’effectif total N par une constante scalaire sans modifier les proportions Pi, chaque fréquence attendue Ei est multipliée exactement par cette même constante.
- La contrainte de clôture stochastique : l’ensemble des proportions théoriques postulées doit impérativement satisfaire l’axiome de probabilité totale selon lequel leur sommation sur l’ensemble exhaustif des catégories égale exactement 1 :
∑i=1…k Pi = P1 + P2 + … + Pk = 1,00
Si la somme de ces probabilités théoriques s’écarte ne serait-ce que marginalement de l’unité en raison d’omissions catégorielles ou de définitions imparfaites, le système de calcul devient mathématiquement caduc, et la somme des fréquences théoriques ne correspondra plus à l’effectif réel échantillonné.
4.2 Procédure d’échantillonnage univarié
L’application rigoureuse du calcul univarié des fréquences attendues exige une préparation minutieuse des données qualitatives. La variable psychologique sous examen — qu’elle soit nominale (comme le groupe d’appartenance ethnoculturelle, l’orientation diagnostique, le type de phobie) ou ordinale (stades de sévérité d’un trouble, échelons de récupération clinique) — doit faire l’objet d’un découpage rigoureux respectant deux principes cardinaux : l’exhaustivité et la mutuelle exclusivité.
Chaque sujet de l’étude doit impérativement pouvoir être classé dans une catégorie, et sous aucun prétexte un sujet ne peut appartenir simultanément à deux catégories distinctes. L’effectif total N est calculé par la sommation directe de toutes les occurrences empiriques recueillies sur l’espace d’échantillonnage :
N = ∑i=1…k Oi
Une fois la clôture de l’échantillon confirmée, le vecteur des probabilités théoriques (P1, P2, …, Pk) est appliqué à ce total N. Il est impératif de souligner que la taille de l’échantillon doit être figée avant le calcul des fréquences attendues : tout ajout ou retrait ultérieur de sujets modifie instantanément la valeur de N, imposant une réévaluation intégrale de toutes les fréquences théoriques associées au modèle.
4.3 Vérifications arithmétiques obligatoires
Avant d’introduire les fréquences attendues calculées dans l’algorithme de déviation du Khi-deux, le statisticien méthodologiste doit impérativement exécuter une série de contrôles d’intégrité arithmétique. Le premier contrôle consiste à vérifier la conservation exacte de la masse d’échantillon : la sommation formelle des fréquences théoriques obtenues doit reconstituer exactement l’effectif N de départ :
∑i=1…k Ei = E1 + E2 + … + Ek = N
Dans la pratique des calculs manuels ou semi-automatisés, la présence de fractions décimales récurrentes (par exemple 1/3 ou 1/7) engendre des valeurs décimales infinies. L’analyste doit impérativement éviter d’arrondir trop précocement les fréquences attendues à l’entier le plus proche. Arrondir prématurément un Ei de 12,333 à 12 et un autre de 15,667 à 16 génère des erreurs cumulatives qui faussent non seulement la condition de fermeture de l’échantillon, mais induisent également un biais artificiel dans le calcul des résidus quadratiques (O – E)².
La recommandation méthodologique standard consiste à conserver au minimum trois à quatre décimales significatives lors de toutes les étapes intermédiaires du calcul des fréquences théoriques, et de ne pratiquer l’arrondi (généralement à deux décimales) qu’au moment du rapportage textuel final des résultats. Un écart résiduel de fermeture supérieur à 0,01 entre ∑ Ei et N signale systématiquement une erreur de calcul intermédiaire qui doit être résolue avant toute tentative de test d’hypothèse.
5. Application pratique : Répartition uniforme des consultations psychologiques
5.1 Mise en situation clinique et données empiriques
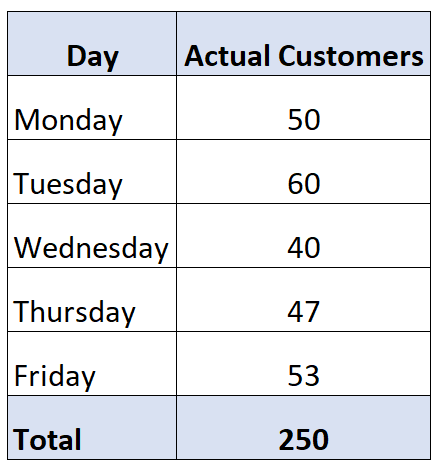
Pour illustrer de manière concrète et didactique la mise en œuvre du calcul de la fréquence attendue sous hypothèse d’équiprobabilité, considérons une recherche menée au sein d’un Centre Médico-Psychologique (CMP) urbain. L’équipe de direction souhaite déterminer si la demande d’admissions en urgence psychologique fluctue de manière significative selon les jours ouvrés de la semaine (du lundi au vendredi), ou si les variations observées ne sont que le reflet d’un bruit stochastique autour d’une demande fondamentalement stable.
Le recueil exhaustif des données sur une cohorte de patients reçus en première consultation d’urgence durant une période de référence fait apparaître la distribution empirique suivante :
- Lundi : 58 patients
- Mardi : 43 patients
- Mercredi : 52 patients
- Jeudi : 39 patients
- Vendredi : 68 patients
La sommation des observations empiriques permet d’établir l’effectif total N de l’étude :
N = 58 + 43 + 52 + 39 + 68 = 260 consultations
L’hypothèse méthodologique posée par l’institution médicale est celle d’une demande de soins constante tout au long de la semaine : il n’existerait aucun effet intrinsèque du jour ouvré sur la survenue d’un dérèglement psychologique aigu nécessitant une prise en charge immédiate.
5.2 Calcul arithmétique pas-à-pas des fréquences théoriques
Sous l’hypothèse nulle H0 d’une répartition uniforme, la semaine ouvrée étant segmentée en k = 5 jours d’ouverture mutuellement exclusifs, la probabilité théorique unitaire attribuée à chaque jour ouvré est rigoureusement identique :
Plundi = Pmardi = Pmercredi = Pjeudi = Pvendredi = 1 / 5 = 0,20 (soit 20 %)
Nous constatons immédiatement la clôture des probabilités : 0,20 + 0,20 + 0,20 + 0,20 + 0,20 = 1,00. En appliquant la formule fondamentale de la fréquence attendue, nous obtenons pour chaque journée :
Ejour = N × Pjour = 260 × 0,20 = 52,0 patients
Chaque jour de la semaine se voit ainsi attribuer une fréquence attendue théorique exactement égale à 52,0 consultations. Vérification de l’intégrité de l’échantillon : 52 + 52 + 52 + 52 + 52 = 260, ce qui correspond parfaitement à l’effectif total N observé. Nous pouvons dès lors dresser le tableau de synthèse comparatif :
| Jour ouvré | Effectif observé (O) | Proportion théorique (P) | Effectif attendu (E) | Résidu brut (O – E) | Écart quadratique (O – E)² | Contribution cellulaire (O – E)² / E |
|---|---|---|---|---|---|---|
| Lundi | 58 | 0,20 | 52,0 | +6,0 | 36,00 | 0,6923 |
| Mardi | 43 | 0,20 | 52,0 | -9,0 | 81,00 | 1,5577 |
| Mercredi | 52 | 0,20 | 52,0 | 0,0 | 0,00 | 0,0000 |
| Jeudi | 39 | 0,20 | 52,0 | -13,0 | 169,00 | 3,2500 |
| Vendredi | 68 | 0,20 | 52,0 | +16,0 | 256,00 | 4,9231 |
| Total | 260 | 1,00 | 260,0 | 0,0 | – | 10,4231 |
5.3 Calcul de la statistique du Khi-deux d’adéquation
L’observation attentive des résidus bruts révèle des divergences cliniques notables : le jeudi apparaît sous-fréquenté avec 13 consultations de moins qu’attendu par le modèle uniforme, tandis que le vendredi présente un surplus massif de 16 consultations. Pour évaluer si ces déviations dépassent ce que le simple hasard de l’échantillonnage pourrait produire, nous appliquons la formule générale du Khi-deux d’adéquation de Pearson :
χ² = ∑i=1…k [ (Oi – Ei)² / Ei ]
En reprenant la somme des contributions cellulaires calculées dans notre tableau :
χ² = 0,6923 + 1,5577 + 0,0000 + 3,2500 + 4,9231 = 10,4231
Le nombre de degrés de liberté (notés ddl ou df) pour un test d’adéquation univarié est donné par le nombre de catégories k minoré d’une unité, représentant la contrainte de fixation de la taille globale N :
ddl = k – 1 = 5 – 1 = 4
En consultant la table statistique de référence de la distribution du Khi-deux pour 4 degrés de liberté au seuil de signification conventionnel de α = 0,05, nous constatons que la valeur critique théorique requise pour rejeter l’hypothèse nulle est de 9,488. Puisque notre statistique calculée (10,42) est strictement supérieure à la valeur seuil (10,42 > 9,488), nous rejetons l’hypothèse nulle d’équiprobabilité au seuil p < 0,05 (la p-valeur exacte associée étant d’environ 0,0339).
D’un point de vue organisationnel et clinique, cette divergence statistically significative démontre que les admissions en urgence psychologique ne sont pas uniformément réparties. L’analyse des contributions cellulaires indique que le vendredi participe pour près de la moitié (4,92 sur 10,42) à la déviance totale du modèle, suggérant un mécanisme d’angoisse anticipatoire de fin de semaine ou un phénomène d’épuisement des ressources personnelles et familiales avant le week-end, justifiant un renforcement ciblé des effectifs soignants sur cette journée précise.
6. Application pratique : Proportions inégales basées sur des prévalences épidémiologiques
6.1 Établissement du modèle théorique hétérogène
Tous les modèles d’adéquation ne s’adossent pas à une hypothèse d’équiprobabilité. Dans de nombreux cas pratiques en psychopathologie, le chercheur souhaite comparer la structure diagnostique d’une cohorte locale à une distribution théorique hétérogène bien établie dans la littérature épidémiologique. Imaginons qu’une étude clinique évalue une cohorte de N = 400 adolescents orientés vers un réseau spécialisé pour la prise en charge des troubles anxieux caractérisés.
Selon les grandes enquêtes de santé publique nationales, la distribution des sous-types de troubles anxieux chez les adolescents se structure théoriquement selon les proportions relatives suivantes :
- Trouble Anxieux Généralisé (TAG) : 45 % des cas (P1 = 0,45)
- Phobie Sociale / Anxiété Sociale (AS) : 30 % des cas (P2 = 0,30)
- Trouble Panique avec ou sans Agoraphobie (TP) : 15 % des cas (P3 = 0,15)
- Trouble d’Anxiété de Séparation (TAS) : 10 % des cas (P4 = 0,10)
La somme des proportions épidémiologiques postulées vérifie parfaitement la condition de normalisation : 0,45 + 0,30 + 0,15 + 0,10 = 1,00 (100 %). L’hypothèse nulle H0 spécifie formellement que la patientèle locale de ce réseau spécialisé suit exactement la distribution de prévalence de la population générale adolescente, toute divergence observée n’étant imputable qu’aux fluctuations fortuites d’échantillonnage.
6.2 Calcul des valeurs attendues pour chaque sous-groupe psychopathologique
Pour dériver les fréquences attendues correspondantes à cette cohorte clinique de 400 adolescents, nous appliquons méthodiquement la formule Ei = N × Pi à chacune des quatre catégories diagnostiques :
- Pour le Trouble Anxieux Généralisé :
ETAG = 400 × 0,45 = 180,0 individus attendus - Pour la Phobie Sociale :
EAS = 400 × 0,30 = 120,0 individus attendus - Pour le Trouble Panique :
ETP = 400 × 0,15 = 60,0 individus attendus - Pour le Trouble d’Anxiété de Séparation :
ETAS = 400 × 0,10 = 40,0 individus attendus
Contrôle de conservation de l’effectif : 180 + 120 + 60 + 40 = 400 individus. Les fréquences théoriques reconstituent parfaitement la totalité de l’échantillon empirique. Supposons maintenant que la collecte des diagnostics posés sur le terrain révèle les effectifs empiriques suivants : OTAG = 160, OAS = 145, OTP = 45, et OTAS = 50. Nous procédons au calcul des résidus et des contributions cellulaires :
| Diagnostic | Observé (O) | Proportion théorique (P) | Attendu (E) | (O – E) | (O – E)² | (O – E)² / E |
|---|---|---|---|---|---|---|
| Trouble Anxieux Généralisé | 160 | 0,45 | 180,0 | -20,0 | 400,0 | 2,222 |
| Phobie Sociale | 145 | 0,30 | 120,0 | +25,0 | 625,0 | 5,208 |
| Trouble Panique | 45 | 0,15 | 60,0 | -15,0 | 225,0 | 3,750 |
| Anxiété de Séparation | 50 | 0,10 | 40,0 | +10,0 | 100,0 | 2,500 |
| Total | 400 | 1,00 | 400,0 | 0,0 | – | 13,680 |
6.3 Interprétation diagnostique des écarts identifiés
La statistique du Khi-deux d’adéquation résultante s’élève à χ² = 13,68. Avec k = 4 catégories diagnostiques, les degrés de liberté sont de ddl = 4 – 1 = 3. La valeur critique pour 3 degrés de liberté au seuil de signification α = 0,01 étant de 11,345, la valeur expérimentale dépasse très largement ce seuil (13,68 > 11,345, avec une p-valeur de p = 0,0034). En conséquence, le modèle de conformité épidémiologique est rejeté avec un degré de confiance supérieur à 99 %.
L’analyse qualitative des écarts met en lumière une singularité clinique majeure : le trouble d’anxiété sociale enregistre le plus fort écart positif (+25 adolescents par rapport à la prévision épidémiologique), représentant une contribution unitaire de 5,21 sur les 13,68 de la déviance totale. Parallèlement, le trouble panique et le trouble anxieux généralisé sont significativement sous-représentés au sein de cette cohorte.
Cette divergence substantielle invite à formuler des hypothèses contextuelles : ce réseau de soins est peut-être implanté dans un milieu fortement urbanisé caractérisé par une pression scolaire ou des exigences d’intégration sociale exacerbées, augmentant la propension aux phobies relationnelles chez les jeunes. Alternativement, ce profil peut refléter un biais d’adressage de la part de la médecine scolaire, particulièrement sensible au dépistage du retrait relationnel des adolescents en classe. Cet exemple prouve avec éloquence que le calcul des fréquences attendues ne se limite pas à valider une conformité statistique, mais fonctionne comme un véritable détecteur d’anomalies cliniques et sociodémographiques orientant les politiques de prévention sur le terrain.
7. Calcul de la fréquence attendue dans le test d’indépendance du Khi-deux
7.1 Fondement probabiliste de l’indépendance de deux variables
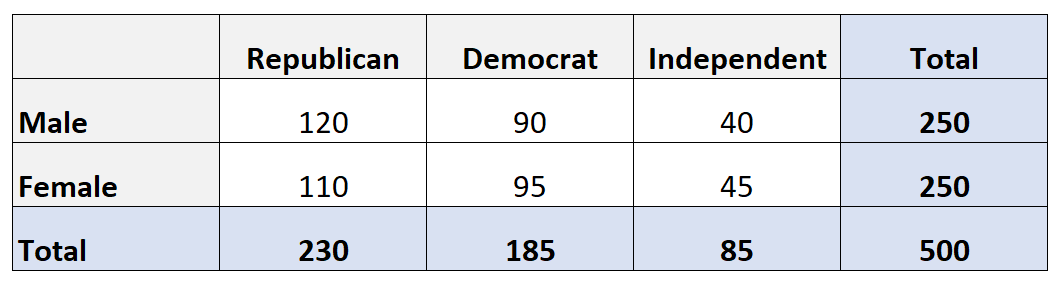
Le test d’indépendance du Khi-deux s’intéresse non plus à une distribution univariée, mais à l’interaction stochastique potentielle entre deux variables qualitatives A et B croisées au sein d’une table de contingence (ou tableau croisé) comprenant r lignes et c colonnes. Le fondement probabiliste de cette démarche repose directement sur le théorème fondamental de la multiplication des probabilités pour des événements stochastiquement indépendants.
En théorie axiomatique des probabilités, deux événements Ai et Bj sont qualifiés de rigoureusement indépendants si et seulement si la probabilité de leur intersection conjointe est égale au produit exact de leurs probabilités marginales individuelles :
P(Ai ∩ Bj) = P(Ai) × P(Bj)
Dans une démarche empirique où les probabilités théoriques réelles de la population demeurent inconnues, l’hypothèse nulle d’indépendance postule que le fait d’appartenir à la catégorie de ligne i ne modifie en rien la probabilité d’appartenir à la catégorie de colonne j. Les meilleures estimations non biaisées des probabilités marginales sous H0 sont directement fournies par les fréquences marginales observées de la table de contingence :
- Probabilité marginale de la ligne i : P(Lignei) = Total_Lignei / N
- Probabilité marginale de la colonne j : P(Colonnej) = Total_Colonnej / N
Par conséquent, sous l’hypothèse nulle d’indépendance, la probabilité théorique conjointe conjointe assignée à la cellule croisée (i, j) est modélisée par :
Pij = [ Total_Lignei / N ] × [ Total_Colonnej / N ] = (Total_Lignei × Total_Colonnej) / N²
7.2 La formule du tableau croisé (Ligne × Colonne / Total)
Pour convertir cette probabilité théorique conjointe Pij en une fréquence attendue théorique Eij pour la cellule (i, j), il suffit de multiplier cette probabilité conjointe par la taille globale de l’échantillon N, conformément à la formule canonique générale :
Eij = N × Pij = N × [ (Total_Lignei × Total_Colonnej) / N² ]
En procédant à la simplification algébrique par N au numérateur et au dénominateur, nous aboutissons à la célèbre formule standard du test d’indépendance, enseignée dans tous les manuels de méthodologie quantitative :
Eij = (Total_Lignei × Total_Colonnej) / N
Cette élégante formulation montre que le calcul de la valeur attendue d’une cellule quelconque ne dépend exclusivement que de trois valeurs : le total marginal de la ligne à laquelle elle appartient, le total marginal de la colonne correspondante, et le grand total général de l’échantillon. Cette relation bénéficie d’une propriété de symétrie parfaite : inverser le statut des variables (placer la variable de ligne en colonne et réciproquement) ne modifie en rien les fréquences attendues calculées, préservant scrupuleusement l’invariance de l’interaction statistique.
7.3 Détermination des degrés de liberté du tableau croisé
Dans un tableau croisé de dimensions r × c, le calcul des degrés de liberté (ddl) traduit le nombre exact de cellules matricielles dont les valeurs peuvent être fixées librement sans violer les totaux marginaux imposés par l’échantillon. La formule universelle régissant ces degrés de liberté s’énonce ainsi :
ddl = (r – 1) × (c – 1)
La justification mathématique de cette relation est lumineuse : dès lors que les totaux marginaux de chaque ligne et de chaque colonne sont préfixés (puisqu’ils proviennent des observations réelles), le remplissage de (r – 1) lignes et de (c – 1) colonnes contraint de manière déterministe la valeur de la dernière ligne et de la dernière colonne pour assurer la fermeture mathématique des marges. Par exemple, dans une table de contingence à 2 lignes et 2 colonnes (une table 2×2), le nombre de degrés de liberté est strictement de :
ddl = (2 – 1) × (2 – 1) = 1 × 1 = 1
Une conséquence théorique fondamentale concerne la variance de la statistique du Khi-deux d’indépendance. La distribution asymptotique du Khi-deux possède une espérance mathématique égale à ses degrés de liberté E(χ²) = ddl et une variance théorique égale au double de ses degrés de liberté Var(χ²) = 2 × ddl. Plus la table de contingence s’élargit en incluant de multiples modalités, plus le nombre de degrés de liberté croît, augmentant proportionnellement le seuil critique requis pour attester d’une association statistically significative entre les construits psychologiques étudiés.
8. Exemple pas-à-pas : Étude bivariée entre traits de personnalité et styles de coping
8.1 Construction de la table de contingence empirique
Afin d’ancrer le calcul des fréquences attendues bivariées dans la recherche clinique appliquée, considérons une étude investiguant la relation potentielle entre un profil de personnalité dominant (évalué selon le modèle du Big Five) et la stratégie préférentielle de régulation face au stress (stratégie de coping). L’échantillon est composé de N = 150 cadres d’entreprise suivis pour un accompagnement psychologique en santé au travail.
La variable de ligne (Trait de Personnalité) comprend r = 2 modalités :
- Profil à dominante Névrosisme élevé (N+)
- Profil à dominante Extraversion élevée (E+)
La variable de colonne (Style de Coping dominant) comporte c = 3 modalités :
- Coping centré sur le Problème (CP)
- Coping centré sur l’Émotion (CE)
- Coping centré sur l’Évitement (CV)
Le dénombrement empirique des 150 participants fournit la matrice de fréquences observées suivante :
| Profil de Personnalité | Coping Problème (CP) | Coping Émotion (CE) | Coping Évitement (CV) | Total Ligne |
|---|---|---|---|---|
| Névrosisme (N+) | 18 | 38 | 24 | 80 |
| Extraversion (E+) | 32 | 17 | 21 | 70 |
| Total Colonne | 50 | 55 | 45 | N = 150 |
Nous vérifions les totaux marginaux : la somme des lignes (80 + 70 = 150) et la somme des colonnes (50 + 55 + 45 = 150) coïncident parfaitement avec le grand total N = 150.
8.2 Calcul exhaustif des fréquences attendues cellule par cellule
Nous calculons désormais systématiquement la fréquence théorique attendue pour chacune des six cellules du tableau croisé, en appliquant la formule Eij = (Total_Lignei × Total_Colonnej) / N :
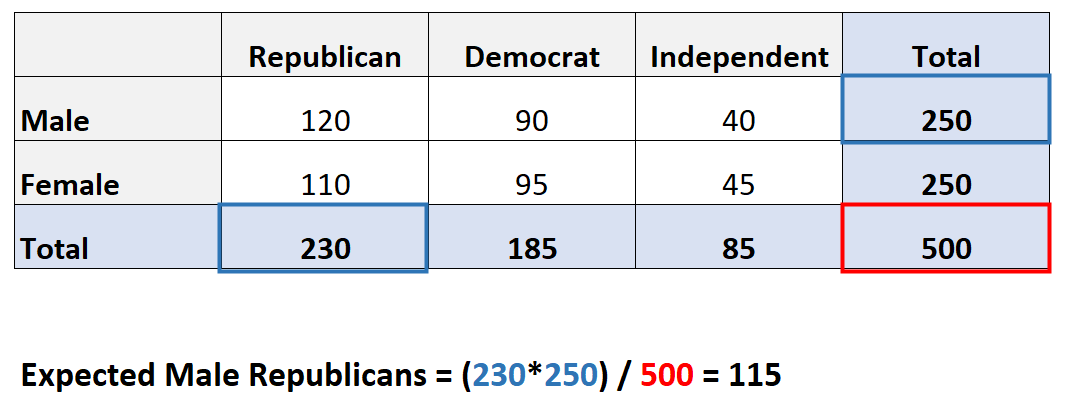
- Cellule (1,1) [Névrosisme / Coping Problème] :
E11 = (Total Ligne N+ × Total Colonne CP) / N = (80 × 50) / 150 = 4000 / 150 = 26,67 - Cellule (1,2) [Névrosisme / Coping Émotion] :
E12 = (Total Ligne N+ × Total Colonne CE) / N = (80 × 55) / 150 = 4400 / 150 = 29,33 - Cellule (1,3) [Névrosisme / Coping Évitement] :
E13 = (Total Ligne N+ × Total Colonne CV) / N = (80 × 45) / 150 = 3600 / 150 = 24,00 - Cellule (2,1) [Extraversion / Coping Problème] :
E21 = (Total Ligne E+ × Total Colonne CP) / N = (70 × 50) / 150 = 3500 / 150 = 23,33 - Cellule (2,2) [Extraversion / Coping Émotion] :
E22 = (Total Ligne E+ × Total Colonne CE) / N = (70 × 55) / 150 = 3850 / 150 = 25,67 - Cellule (2,3) [Extraversion / Coping Évitement] :
E23 = (Total Ligne E+ × Total Colonne CV) / N = (70 × 45) / 150 = 3150 / 150 = 21,00
Nous pouvons alors dresser la matrice complète des fréquences attendues :
| Profil (Attendu E) | Coping Problème | Coping Émotion | Coping Évitement | Total Ligne Théorique |
|---|---|---|---|---|
| Névrosisme (N+) | 26,67 | 29,33 | 24,00 | 80,00 |
| Extraversion (E+) | 23,33 | 25,67 | 21,00 | 70,00 |
| Total Colonne Théorique | 50,00 | 55,00 | 45,00 | 150,00 |
8.3 Contrôle d’intégrité matricielle et analyse résiduelle
Le contrôle d’intégrité matricielle confirme la rigueur mathématique de l’opération : les totaux marginaux théoriques sont strictement identiques aux totaux marginaux empiriques observés (80,00 et 70,00 en ligne ; 50,00, 55,00 et 45,00 en colonne), et la somme totale des fréquences attendues reconstitue scrupuleusement l’effectif global N = 150,00.
Calculons à présent la statistique du Khi-deux cellule par cellule :
- Cellule (1,1) : (18 – 26,67)² / 26,67 = (-8,67)² / 26,67 = 75,17 / 26,67 = 2,818
- Cellule (1,2) : (38 – 29,33)² / 29,33 = (+8,67)² / 29,33 = 75,17 / 29,33 = 2,563
- Cellule (1,3) : (24 – 24,00)² / 24,00 = (0,00)² / 24,00 = 0 / 24,00 = 0,000
- Cellule (2,1) : (32 – 23,33)² / 23,33 = (+8,67)² / 23,33 = 75,17 / 23,33 = 3,222
- Cellule (2,2) : (17 – 25,67)² / 25,67 = (-8,67)² / 25,67 = 75,17 / 25,67 = 2,928
- Cellule (2,3) : (21 – 21,00)² / 21,00 = (0,00)² / 21,00 = 0 / 21,00 = 0,000
La sommation des contributions donne la valeur globale du test :
χ² = 2,818 + 2,563 + 0,000 + 3,222 + 2,928 + 0,000 = 11,531
Le nombre de degrés de liberté est calculé par :
ddl = (r – 1) × (c – 1) = (2 – 1) × (3 – 1) = 1 × 2 = 2
Au seuil α = 0,01, la valeur critique théorique pour 2 degrés de liberté est de 9,210. Puisque notre statistique expérimentale calculée est strictement supérieure à ce seuil (11,531 > 9,210, p ≈ 0,0031), nous rejetons formellement l’hypothèse nulle d’indépendance statistique. Les profils de personnalité et les styles de coping adoptés par ces cadres sont significativement associés.
L’analyse résiduelle apporte un éclairage clinique décisif : les individus à névrosisme élevé surconsomment massivement le coping émotionnel (38 observés contre 29,33 attendus) et sous-utilisent le coping centré sur le problème (18 observés contre 26,67 attendus). À l’inverse, les sujets extravertis manifestent une tendance préférentielle marquée vers la résolution active des problèmes (32 observés contre 23,33 attendus). Fait remarquable, le coping par évitement affiche une concordance parfaite entre l’observation et la théorie (écarts strictement nuls), démontrant que la fuite face au stress est une réponse équitablement répartie quel que soit le profil de personnalité dans cet environnement professionnel.
9. Hypothèses méthodologiques et règle de Cochran sur les effectifs attendus
9.1 Les critères de validité de William G. Cochran
La statistique du Khi-deux formulée par Karl Pearson est une méthode asymptotique. Cela implique qu’elle ne suit exactement la distribution continue théorique du Khi-deux que lorsque la taille d’échantillon tend vers l’infini. Dans la réalité empirique des recherches psychologiques, où les échantillons sont nécessairement finis et parfois restreints, l’approximation discrète-continue n’est mathématiquement valide que sous certaines conditions de densité cellulaire.
C’est au statisticien William G. Cochran que l’on doit, dans ses articles fondateurs de 1952 et 1954, la formalisation des règles empiriques de robustesse universellement appliquées aujourd’hui. Les critères de validité de Cochran imposent deux contraintes strictes portant exclusivement sur les fréquences attendues E, et en aucun cas sur les fréquences observées O :
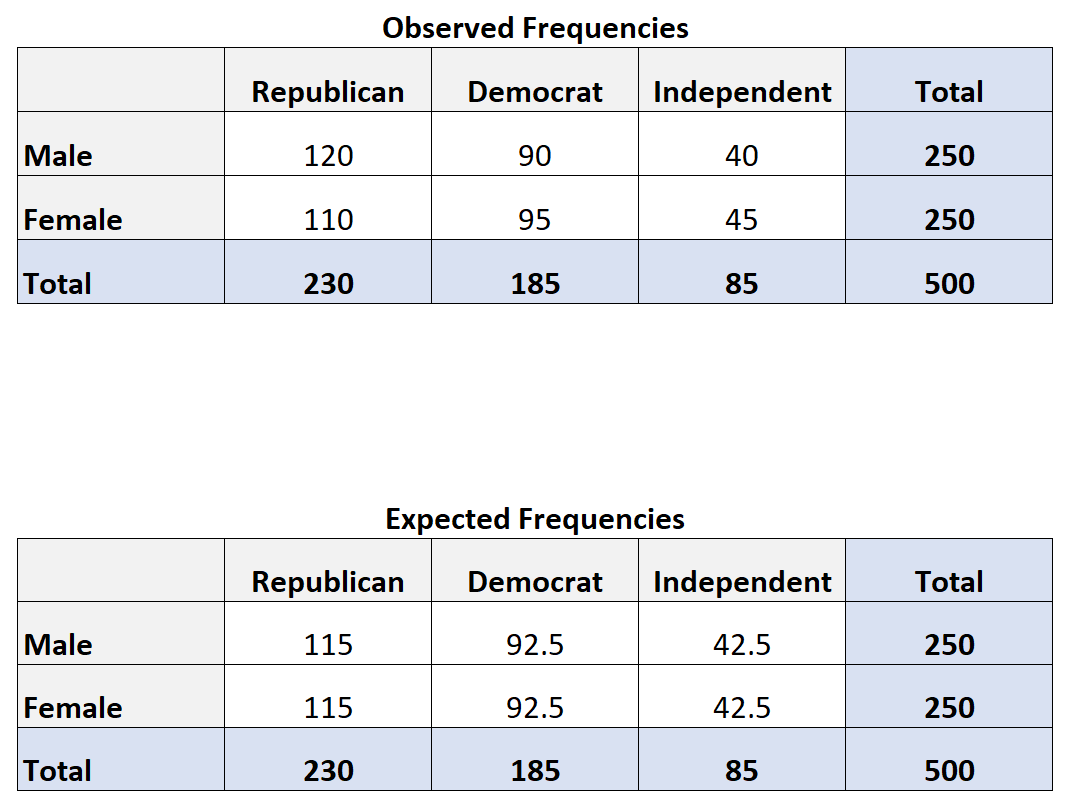
- Règle de non-vacuité absolue : aucune fréquence attendue ne doit être strictement inférieure à 1 (soit Eij ≥ 1,0 pour toute cellule de la table). Une cellule dont l’effectif attendu théorique est nul ou proche de zéro déstabilise complètement la division arithmétique (O – E)² / E, engendrant une variance quasi infinie.
- Règle des 80 % : au moins 80 % des cellules du tableau de contingence doivent présenter une fréquence attendue supérieure ou égale à 5 (soit Eij ≥ 5,0). Dans une table 2×2 ne comptant que 4 cellules au total, cette condition impose rigoureusement que 100 % des cellules (les quatre sans exception) possèdent un effectif attendu d’au moins 5.
9.2 Conséquences du non-respect des effectifs minimaux
La violation de la règle de Cochran engendre des répercussions sévères sur la validité des conclusions scientifiques tirées d’une étude comportementale. Lorsque des fréquences attendues chutent en deçà du seuil critique de 5, le dénominateur de la formule de contribution cellulaire devient artificiellement faible. Le moindre écart empirique aléatoire entre l’observation et la théorie subit alors une sur-amplification disproportionnée lors de la division arithmétique.
Cette distorsion mathématique provoque une inflation incontrôlée du risque d’erreur de première espèce (l’erreur alpha). Le chercheur observera une valeur calculée de Khi-deux artificiellement boursouflée, le conduisant à rejeter l’hypothèse nulle à tort et à affirmer triomphalement l’existence d’une association clinique ou d’un effet thérapeutique alors que la divergence observée n’était que le sous-produit d’une instabilité statistique causée par un effectif attendu rachitique.
Parallèlement, la distribution d’échantillonnage réelle de la statistique empirique cesse de se calquer sur la courbe lisse du Khi-deux théorique. Elle devient asymétrique, discontinue et fortement crénelée. La p-valeur lue dans les tables classiques ou renvoyée automatiquement par les progiciels statistiques s’avère alors inexacte, invalidant formellement le rapportage méthodologique de la recherche.
9.3 Spécificités liées aux tables de contingence deux par deux (2×2)
Les tables croisées à 4 cellules (2 lignes et 2 colonnes) représentent une configuration méthodologique extrêmement répandue en psychologie (présence/absence d’un symptôme croisée avec groupe exposé/contrôle). Elles constituent simultanément la structure la plus vulnérable aux distorsions asymptotiques, ne disposant que d’un unique degré de liberté.
Dans cette configuration spécifique, la règle de Cochran est intransigeante : dès qu’une seule des quatre fréquences théoriques attendues s’établit à une valeur inférieure à 5 (par exemple 4,85), le test asymptotique classique du Khi-deux de Pearson doit être récusé. Pour remédier à cette fragilité dans les tables 2×2, le statisticien Frank Yates a introduit en 1934 la célèbre « correction de continuité de Yates ». Cette correction consiste à soustraire systématiquement 0,5 à la valeur absolue de chaque écart brut avant de l’élever au carré :
χ²Yates = ∑ [ (|O – E| – 0,5)² / E ]
Bien que la correction de Yates ait longtemps constitué une prescription incontournable des manuels scolaires, son statut est aujourd’hui vivement débattu en biométrie et en psychométrie. De nombreuses modélisations par simulation de Monte-Carlo ont démontré que la correction de Yates s’avère souvent excessivement conservatrice, écrasant excessivement la statistique de test et gonflant indûment le risque d’erreur de seconde espèce (erreur bêta), conduisant les chercheurs à manquer d’authentiques découvertes cliniques. En conséquence, la pratique moderne préconise d’abandonner la correction de Yates au profit direct d’approches exactes d’échantillonnage.
10. Stratégies d’ajustement face aux fréquences attendues insuffisantes
10.1 Regroupement raisonné de modalités adjacentes
Lorsqu’un chercheur est confronté à des fréquences attendues déficientes violant la règle de Cochran dans une table de grandes dimensions (par exemple 3×4 ou 5×5), la stratégie curative la plus immédiate consiste à opérer un regroupement raisonné (ou effondrement catégoriel) de modalités adjacentes ou conceptuellement comparables. En fusionnant deux colonnes ou deux lignes sous-peuplées en une seule catégorie combinée plus dense, l’effectif marginal correspondant augmente mécaniquement, rehaussant immédiatement les fréquences théoriques calculées au-dessus du seuil critique des 5 unités requises.
Cependant, cette manœuvre technique n’est admissible que si elle repose sur une validité conceptuelle irréprochable. En psychopathologie, regrouper la modalité « Dépression modérée » et la modalité « Dépression sévère » au sein d’une méta-catégorie « Épisode dépressif caractérisé » est cliniquement justifiable si l’objectif de l’étude porte sur la détection du trouble thymique au sens large. En revanche, fusionner arbitrairement « Phobie simple » et « Schizophrénie paranoïde » sous l’unique prétexte d’équilibrer numériquement une cellule statistique constitue une aberration méthodologique détruisant la cohérence théorique de la recherche.
Il importe en outre de garder à l’esprit que tout regroupement de modalités réduit instantanément le nombre de degrés de liberté de la table :
ddlnouveau = (rnouveau – 1) × (cnouveau – 1) < ddlinitial
Cette perte de résolution analytique diminue le niveau de granularité des conclusions comportementales. Le chercheur doit par ailleurs veiller à ne jamais réaliser de regroupements a posteriori guidés opportunistiquement par l’inspection des données empiriques dans le seul but de franchir le cap de la significativité statistique (pratique assimilable à du p-hacking), mais documenter ces choix de codage de manière transparente et reproductible.
10.2 Recours au test exact de Fisher
Lorsque la structure expérimentale interdit tout regroupement de catégories (par exemple dans une table 2×2 irréductible) ou que les effectifs demeurent intrinsèquement modestes, l’alternative méthodologique de référence absolue est le recours au test exact de Fisher (initialement formalisé par Ronald A. Fisher). Ce test s’affranchit totalement du calcul asymptotique du Khi-deux en calculant directement la probabilité hypergéométrique exacte d’observer la table de contingence empirique conditionnellement à la fixation rigoureuse de ses marges.
Dans une table 2×2 constituée des quatre cellules a, b, c, d, la probabilité exacte d’observer cette configuration spécifique d’effectifs est régie par la combinatoire factorielle :
P = [ (a + b)! × (c + d)! × (a + c)! × (b + d)! ] / [ N! × a! × b! × c! × d! ]
Puisque le test exact de Fisher calcule la somme des probabilités de toutes les tables possibles au moins aussi extrêmes que la table observée, il ne dépend d’aucune approximation de variable continue. Il conserve une validité statistique parfaite y compris lorsque certaines fréquences attendues tombent à 1,5 ou 2,0 individus.
Pour les tables de contingence de dimensions supérieures à deux (tables r × c), l’algorithme a été étendu sous la dénomination de test exact de Fisher-Freeman-Halton. Historiquement bridé par la complexité vertigineuse des calculs factoriels combinatoires sur de grandes cohortes, ce test exact est aujourd’hui exécutable en quelques millisecondes sur n’importe quel ordinateur portable moderne grâce à l’optimisation des algorithmes de réseau matriciel.
10.3 Méthodes de rééchantillonnage et approches bayésiennes
Dans des configurations complexes où la taille de l’échantillon ou la dimension matricielle rend le test exact computationnellement prohibitif tout en violant la règle de Cochran, les approches modernes de rééchantillonnage offrent une issue statistique de premier ordre. L’estimation de la p-valeur par simulation de Monte-Carlo consiste à générer aléatoirement un nombre massif (couramment 100 000 ou 1 000 000) de tables de contingence virtuelles respectant rigoureusement les totaux marginaux de la table empirique, puis à dénombrer la proportion exacte de simulations dont la statistique calculée dépasse le Khi-deux observé.
Le bootstrapping non paramétrique (ou amorçage) permet quant à lui de rééchantillonner avec remise parmi les observations individuelles, fournissant une distribution empirique robuste des écarts aux fréquences attendues sans s’enfermer dans les présupposés théoriques contraignants des lois asymptotiques classiques.
Enfin, l’inférence bayésienne fournit une modélisation alternative raffinée à travers les distributions multinomiales de Dirichlet. Plutôt que de postuler une fréquence théorique unique rigide, le paradigme bayésien intègre des distributions a priori (informatisées par des cohortes épidémiologiques antérieures ou non-informatives de type Jeffreys) pour actualiser la probabilité d’occurrence des comptages cellulaires. Cette démarche protège l’analyste contre les aberrations des cellules à faible effectif tout en offrant une estimation probabiliste directe des paramètres comportementaux ciblés.
11. Automatisation du calcul des fréquences attendues via les logiciels statistiques
11.1 Extraction sous l’environnement R
Le langage de programmation statistique R s’est imposé comme l’environnement computationnel de référence dans les laboratoires de psychologie quantitative et de neurosciences comportementales. Le calcul des fréquences attendues pour un test d’adéquation ou d’indépendance est géré nativement et de manière particulièrement transparente via la fonction chisq.test().
Considérons l’implémentation bivariée de notre étude de cas associant la personnalité et le style de coping. Le statisticien commence par déclarer la matrice des observations empiriques :
# Construction matricielle des données brutes
donnees <- matrix(c(18, 38, 24, 32, 17, 21), nrow = 2, byrow = TRUE)
rownames(donnees) <- c("Nevrosisme", "Extraversion")
colnames(donnees) <- c("Probleme", "Emotion", "Evitement")
L’ajustement du modèle statistique s’effectue en assignant l’objet de test :
resultat_test <- chisq.test(donnees, correct = FALSE)
L’extraction spécifique de la matrice des fréquences attendues théoriques se réalise instantanément en interrogeant l’attribut dédié de l’objet résultant :
resultat_test$expected
R renvoie alors avec une précision décimale absolue le tableau des valeurs théoriques calculées (26.66667, 29.33333, etc.). Pour automatiser le diagnostic de conformité à la règle de Cochran au sein d’un pipeline d’analyse reproductible, le chercheur peut formuler un script conditionnel simple et puissant :
pourcentage_sup_5 <- mean(resultat_test$expected >= 5) * 100
minimum_attendu <- min(resultat_test$expected)
cat("Pourcentage des cellules >= 5 :", pourcentage_sup_5, "%n")
cat("Effectif attendu minimal :", minimum_attendu, "n")
Si la condition n’est pas remplie, R permet de basculer instantanément vers le test exact en sollicitant simplement la commande fisher.test(donnees) ou en activant l’estimation par simulation via l’argument chisq.test(donnees, simulate.p.value = TRUE, B = 100000).
11.2 Génération et lecture dans IBM SPSS Statistics
Dans les contextes hospitaliers et universitaires cliniques, le progiciel IBM SPSS Statistics demeure extrêmement répandu. L’extraction des fréquences attendues dans SPSS s’opère à travers une interface graphique intuitive ou via la syntaxe de commande.
Dans l’interface utilisateur, la démarche standard s’organise selon le cheminement suivant :
- Naviguer vers le menu Analyser → Statistiques descriptives → Tableaux croisés…
- Assigner la variable de groupe en Ligne et la variable d’évaluation en Colonne.
- Cliquer sur le sous-bouton Cases… (Cells).
- Dans la boîte de dialogue contextuelle, sous la rubrique « Nombres » (Counts), cocher impérativement la case Théorique (Expected) aux côtés de la case Observé (Observed).
- Pour enrichir l’analyse résiduelle, cocher sous la rubrique « Résidus » les options Standardisés et Ajustés standardisés.
- Valider les commandes et exécuter l’analyse.
Dans le visualiseur de sorties d’IBM SPSS, le tableau croisé affiche désormais, pour chaque croisement cellulaire, la valeur observée superposée à l’effectif attendu théorique. Un élément fondamental de la sortie SPSS réside dans la note de bas de page générée automatiquement sous le tableau « Tests du Khi-deux ». Le progiciel y inscrit systématiquement un avertissement diagnostique explicite formulé ainsi :
« a. 0 cellules (0,0 %) ont un effectif théorique inférieur à 5. L’effectif théorique minimal est de 21,00. »
Cette mention textuelle constitue le critère opérationnel immédiat permettant au clinicien de valider la conformité aux exigences de Cochran. Si le diagnostic automatisé indique que plus de 20 % des cellules affichent un effectif attendu inférieur à 5, SPSS invite implicitement le praticien à abandonner la lecture de la ligne de Pearson pour se reporter sur la ligne dédiée au test exact de Fisher ou à revoir le plan de partitionnement des données.
11.3 Implémentation sous Python avec SciPy et Pandas
Avec l’essor de la science des données comportementales et l’exploitation de méga-bases de données en neuro-informatique, Python est devenu un vecteur computationnel majeur. La combinaison conjointe des bibliothèques pandas et scipy.stats permet d’automatiser le traitement des fréquences attendues avec une élégance structurelle remarquable.
La structuration matricielle s’appuie d’abord sur la constitution d’un tableau croisé empirique à partir d’un DataFrame de données comportementales brutes :
import pandas as pd
import numpy as np
from scipy.stats import chi2_contingency
# Exemple de matrice de contingence
table_obs = np.array([[18, 38, 24], [32, 17, 21]])
L’exécution de la fonction chi2_contingency() traite en un seul passage l’ensemble des dérivations algébriques :
chi2, p_val, ddl, attendus = chi2_contingency(table_obs, correction=False)
L’objet retourné attendus est un tableau multidimensionnel NumPy contenant précisément la matrice des fréquences attendues théoriques. L’analyste peut convertir cette sortie en un DataFrame stylisé pour faciliter sa visualisation :
df_attendus = pd.DataFrame(attendus, index=['Nevrosisme', 'Extraversion'], columns=['Probleme', 'Emotion', 'Evitement'])
print(df_attendus.round(2))
L’intégration de cette procédure dans des scripts de modélisation comportementale permet de contrôler automatiquement la validité des hypothèses en soumettant le tableau à une condition d’assertion unitaire :
assert np.all(attendus >= 1.0), "Violation majeure : Présence d'effectif attendu < 1"
if (attendus < 5.0).mean() > 0.20:
print("Avertissement : Règle de Cochran violée (> 20% sous le seuil de 5)")
Cette approche logicielle assure un contrôle qualité rigoureux et reproductible, éliminant tout risque d’erreur manuelle dans les études à grand débit dimensionnel.
12. Interprétation clinique et psychologique des écarts aux fréquences attendues
12.1 Analyse approfondie des résidus standardisés et ajustés
Obtenir une statistique globale de Khi-deux significative indique qu’il existe une distorsion globale entre la réalité empirique et le modèle théorique attendu, mais ne permet aucunement de localiser précisément au sein de quelle catégorie ou de quelle cellule réside cette divergence. C’est ici qu’intervient l’analyse approfondie des résidus, étape interprétative essentielle pour le chercheur et le clinicien.
Le résidu de Pearson standardisé, calculé par la relation élémentaire :
rij = (Oij – Eij) / √(Eij)
fournit une première approximation normalisée de l’écart. Cependant, ce résidu n’a pas une variance strictement unitaire car il ne tient pas compte des contraintes imposées par les marges. On lui préfère donc systématiquement le résidu ajusté standardisé de Haberman (Adjusted Standardized Residual) :
zij = (Oij – Eij) / √[ Eij × (1 – Total_Lignei / N) × (1 – Total_Colonnej / N) ]
Ce score z suit rigoureusement une distribution normale centrée réduite standard N(0, 1) sous l’hypothèse nulle. Cette propriété statistique remarquable permet de lui appliquer les seuils critiques universels de la loi de Gauss :
- Un résidu ajusté dont la valeur absolue excède ±1,96 signale un écart cellulaire statistiquement significatif au seuil α = 0,05.
- Un résidu ajusté excédant ±2,58 témoigne d’une divergence hautement significative au seuil α = 0,01.
- Un résidu ajusté dépassant ±3,29 relève d’une anomalie extrême au seuil α = 0,001.
Dans notre étude sur les profils de personnalité, le calcul du résidu ajusté pour la cellule [Névrosisme / Coping Émotion] donne un score z = +3,18, attestant sans ambiguïté d’une surreprésentation hautement pathognomonique de ce comportement chez les sujets névrotiques, guidant directement la formalisation des objectifs thérapeutiques en psychologie clinique.
Pour traduire visuellement ces écarts dans les publications académiques ou les présentations scientifiques, les diagrammes en mosaïque (mosaic plots) et les diagrammes d’association fournissent une médiation graphique idéale. Dans ces représentations, la surface de chaque pavé est proportionnelle à la fréquence attendue, tandis que le gradient de couleur (généralement du bleu foncé pour les déviations positives intenses au rouge cramoisi pour les déficits marqués) reflète immédiatement l’amplitude des résidus de Haberman, rendant le paysage interactionnel instantanément intelligible.
12.2 Distinction essentielle entre significativité statistique et pertinence clinique
L’un des pièges méthodologiques les plus insidieux en psychométrie et en épidémiologie comportementale réside dans la confusion entre la significativité statistique d’une divergence et son amplitude clinique ou pratique. La statistique du Khi-deux est intrinsèquement liée à la taille d’échantillon N :
χ² = N × ∑ [ (pobs – patt)² / patt ]
Par conséquent, dès lors qu’une cohorte devient massive (par exemple N = 10 000 participants issus d’une enquête nationale sur la santé des étudiants), le calcul mathématique des fréquences attendues devient d’une sensibilité extrême. La moindre variation infinitésimale de comptage — par exemple une modalité comportementale observée à 12,3 % alors que la fréquence attendue théorique est de 11,8 % — produira une statistique de test monumentale franchissant allègrement le seuil des p < 0,001.
Le chercheur inexpérimenté risque alors de proclamer une découverte clinique majeure alors que l’écart entre le comportement réel et l’attente théorique est quantitativement négligeable sur le plan du fonctionnement psychologique individuel. Pour conjurer ce biais d’hyper-puissance statistique, la quantification de la taille d’effet normalisée par le coefficient V de Cramér ou les odds ratios (rapports de cotes) s’avère incontournable. Un V de Cramér inférieur à 0,10 traduit un effet minime à négligeable, même si la p-valeur est astronomiquement significative. C’est toujours l’ampleur de la taille d’effet, confrontée à l’analyse contextuelle du phénomène psychique, qui doit dicter l’interprétation diagnostique finale, et non l’assujettissement aveugle à la seule p-valeur du test d’adéquation.
12.3 Directives de rédaction des résultats selon les normes de publication
La dissémination des résultats de recherche au sein de la communauté scientifique internationale obéit à des normes méthodologiques strictes codifiées par l’American Psychological Association (APA, 7e édition). Lors du rapportage d’un test fondé sur le calcul des fréquences attendues, l’auteur a l’obligation formelle de présenter conjointement les effectifs observés bruts, les proportions théoriques attendues correspondantes, ainsi que l’ensemble des paramètres statistiques du test d’inférence.
La syntaxe canonique textuelle s’articule autour de la séquence normalisée suivante : la désignation du symbole statistique en italique (χ²), les degrés de liberté entre parenthèses, la taille totale de l’échantillon N, la valeur numérique calculée de la statistique arrondie à deux décimales, et le niveau exact de la p-valeur :
« L’analyse du Khi-deux d’indépendance révèle une association statistiquement significative entre le profil de personnalité dominant et le style de coping préférentiel, χ²(2, N = 150) = 11,53, p = ,003, V de Cramér = ,28. Les participants présentant un trait de névrosisme élevé ont mobilisé un coping émotionnel dans une proportion nettement supérieure aux attentes du modèle théorique d’indépendance (n = 38 observés contre 29,33 attendus, z = 3,18). Inversement, les sujets caractérisés par une extraversion dominante ont privilégié les stratégies centrées sur le problème bien au-delà de la distribution théorique neutre (n = 32 observés contre 23,33 attendus, z = 2,87). »
Lorsqu’un tableau synoptique de contingence est intégré à l’article, les bonnes pratiques de mise en page prescrivent de faire figurer, à l’intérieur de chaque cellule, la fréquence observée suivie de la fréquence théorique attendue entre parenthèses ou sur une ligne secondaire avec la mention explicite « Attendu », complétée systématiquement des pourcentages intra-lignes et intra-colonnes. L’état des hypothèses méthodologiques de Cochran (absence de cellule < 1 et pourcentage de cellules ≥ 5) doit impérativement être consigné dans une note sous le tableau, conférant à la communication scientifique une transparence et une reproductibilité académique exemplaires.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cochran, W. G. (1952). The χ² test of goodness of fit. The Annals of Mathematical Statistics, 23(3), 315–345. https://doi.org/10.1214/aoms/1177729380
- Cochran, W. G. (1954). Some methods for strengthening the common χ² tests. Biometrics, 10(4), 417–451. https://doi.org/10.2307/3001616
- Cohen, J. (1988). Statistical Power Analysis for the Behavioral Sciences (2nd ed.). Lawrence Erlbaum Associates.
- Fisher, R. A. (1922). On the interpretation of χ² from contingency tables, and the calculation of P. Journal of the Royal Statistical Society, 85(1), 87–94. https://doi.org/10.2307/2340521
- Haberman, S. J. (1973). The analysis of residuals in cross-classified tables. Biometrics, 29(1), 205–220. https://doi.org/10.2307/2529686
- Howell, D. C. (2012). Statistical Methods for Psychology (8th ed.). Cengage Learning.
- McHugh, M. L. (2013). The Chi-square test of independence. Biochemia Medica, 23(2), 143–149. https://doi.org/10.11613/BM.2013.018
- Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, 50(302), 157–175. https://doi.org/10.1080/14786440009463897
- Yates, F. (1934). Contingency tables involving small numbers and the χ² test. Supplement to the Journal of the Royal Statistical Society, 1(2), 217–235. https://doi.org/10.2307/2983604