
Dans le champ des sciences humaines, de la psychométrie clinique et de la recherche épidémiologique, la quantification de l’objectivité diagnostique constitue un impératif méthodologique incontournable. Toute observation humaine, qu’elle émane d’un clinicien chevronné évaluant une sémiologie psychiatrique ou d’un panel d’experts analysant des artefacts d’imagerie médicale, porte en elle une part inhérente de subjectivité et de variance d’échantillonnage. Dès lors que plusieurs évaluateurs sont sollicités pour catégoriser des sujets ou des comportements selon une échelle nominale, la simple concordance brute s’avère trompeuse, car elle omet systématiquement la fraction d’accord attribuable aux fluctuations stochastiques du pur hasard.
Pour pallier cette faiblesse structurelle de l’évaluation observationnelle, les biostatisticiens ont développé des indices de reproductibilité capables d’isoler le consensus réel des coïncidences purement aléatoires. Parmi ces instruments de mesure de la fidélité inter-évaluateurs, le coefficient de Fleiss occupe une position charnière lorsqu’il s’agit d’analyser des jugements catégoriels émis par un nombre quelconque d’observateurs. Sa formulation élégante et sa capacité à traiter des protocoles complexes sans exiger que les mêmes évaluateurs examinent chaque sujet en font un standard psychométrique rigoureux et largement plébiscité par les comités de lecture scientifique.
Toutefois, la démocratisation de ces métriques avancées se heurte fréquemment à la technicité des logiciels de traitement statistique conventionnels, souvent perçus comme d’opaques boîtes noires. Déployer l’algorithme du kappa de Fleiss directement au sein de Microsoft Excel répond à une double exigence d’émancipation méthodologique et de clarté pédagogique : décomposer chaque étape algébrique permet de maîtriser intimement le cheminement inférentiel tout en construisant un outil d’analyse pérenne, auditable et universellement accessible. Ce traité se propose d’explorer en profondeur la mécanique théorique, l’implémentation pratique et l’interprétation critique de cet estimateur au sein du tableur le plus répandu au monde.
1. Introduction épistémologique et psychométrique au kappa de Fleiss
1.1 Origine conceptuelle et utilité en recherche psychologique
L’émergence des indices formels de fidélité inter-juges trouve son ancrage historique dans les débats épistémologiques qui ont agité la psychiatrie et la psychologie clinique au cours de la seconde moitié du vingtième siècle. Avant l’avènement des classifications diagnostiques opérationnalisées telles que le Manuel diagnostique et statistique des troubles mentaux (DSM), l’hétérogénéité des jugements diagnostiques portés sur un même tableau clinique constituait une vulnérabilité scientifique majeure. C’est dans ce contexte de refondation méthodologique que le biostatisticien Joseph L. Fleiss publia en 1971 son article séminal introduisant une généralisation du coefficient kappa pour des évaluateurs multiples, prolongeant ainsi les travaux pionniers initiés par Jacob Cohen en 1960.
La nécessité d’une telle avancée résidait dans l’insuffisance flagrante du pourcentage d’accord brut. Considérer que deux cliniciens s’accordent dans quatre-vingts pour cent des situations peut sembler rassurant au premier abord. Pourtant, si une pathologie spécifique n’affecte que deux pour cent d’une cohorte, deux praticiens diagnostiquant systématiquement l’absence de trouble sans même examiner les patients présenteraient un accord apparent de quatre-vingt-seize pour cent par simple effet de distribution marginale. L’accord brut agrège indistinctement la compétence clinique et la prévalence fortuite. L’apport fondamental de Fleiss a été d’élaborer une correction mathématique qui neutralise cette composante stochastique, isolant ainsi la véritable fidélité de la mesure.
En psychométrie moderne, cette distinction entre la validité d’une mesure et sa fidélité inter-évaluateurs demeure cardinale. La fidélité constitue une condition nécessaire mais non suffisante à la validité : un ensemble de psychiatres peut s’accorder de manière unanime et reproductible sur un diagnostic totalement erroné d’un point de vue étiologique. Toutefois, sans une fidélité inter-juges rigoureusement établie, aucune validité de construit ou de critère ne peut être revendiquée. Qu’il s’agisse de valider des grilles d’observation du comportement de l’enfant en milieu scolaire, de coter des entretiens semi-structurés ou d’homogénéiser les diagnostics au sein de cohortes épidémiologiques internationales, le kappa de Fleiss apporte le soubassement quantitatif nécessaire à la crédibilité des sciences du comportement.
1.2 Conditions d’application et postulats statistiques fondamentaux
L’application légitime du coefficient de Fleiss requiert le respect scrupuleux de plusieurs postulats distributionnels et structurels. En premier lieu, la variable d’intérêt doit être strictement catégorielle, qu’elle soit nominale pure (par exemple : sous-types de schizophrénie, catégories diagnostiques indépendantes) ou ordonnée, bien que la formule canonique de Fleiss ne prenne pas en considération la distance métrique entre les échelons ordinaux. Chaque sujet évalué doit être affecté à une et une seule catégorie mutuellement exclusive : l’exhaustivité et l’exclusion mutuelle du système de cotation forment le socle logique de la matrice d’analyse.
En second lieu, la structure d’échantillonnage des évaluateurs impose une distinction conceptuelle majeure par rapport aux plans d’expérience dyadiques classiques. Contrairement au kappa de Cohen qui exige que les deux mêmes juges évaluent l’intégralité du panel, le modèle mathématique de Fleiss s’applique lorsque chaque sujet est évalué par un nombre constant $n$ de juges sélectionnés au hasard parmi une population théorique infinie d’évaluateurs potentiels. Les juges qui évaluent le premier patient ne sont pas nécessairement les mêmes que ceux qui évaluent le dixième. Ce postulat de sélection aléatoire confère à l’indice une robustesse remarquable dans les contextes institutionnels réels, comme les services hospitaliers où les plannings de garde entraînent une rotation continuelle du collège médical.
Enfin, le modèle repose sur l’hypothèse primordiale d’indépendance statistique des cotations. Cela implique formellement que chaque évaluateur doit porter son jugement en aveugle absolu des délibérations de ses pairs. Toute concertation préalable, toute communication non verbale lors des sessions de cotation ou toute connaissance préalable de l’avis émis par un confrère viole l’hypothèse de génération autonome des probabilités conditionnelles, induisant une surinflation artificielle du coefficient de fidélité.
1.3 Avantages de l’implémentation du kappa de Fleiss dans Microsoft Excel
Bien que des progiciels statistiques spécialisés tels que R, SPSS, SAS ou Stata proposent des routines automatisées pour calculer cet estimateur, le recours délibéré à Microsoft Excel présente des vertus épistémologiques et opérationnelles de premier ordre. Dans les environnements informatisés fermés, l’utilisation de modules préprogrammés s’apparente fréquemment à une démarche de boîte noire : le chercheur introduit une matrice de données brute et recueille un résultat numérique sans appréhender la façon dont les termes de variance et les pondérations marginales ont été combinés. Cette opacité favorise les erreurs d’interprétation méthodologique, particulièrement face à des jeux de données présentant des anomalies de distribution.
Décomposer le calcul du kappa de Fleiss pas à pas dans une feuille de calcul permet au chercheur ou à l’étudiant en master et doctorat de matérialiser chaque transition algébrique. L’observation directe de la somme des carrés des affectations, de la construction des proportions marginales et de la dissociation effective entre l’accord empirique global et l’accord fortuit transforme une équation abstraite en un processus arithmétique parfaitement intelligible. Cette transparence pédagogique désamorce l’appréhension mathématique et consolide la rigueur méthodologique des investigateurs.
Sur le plan pratique et logistique, Microsoft Excel bénéficie d’une universalité d’implantation qu’aucun langage dédié ne peut égaler dans les contextes hospitaliers ou administratifs contraints. De nombreuses structures cliniques restreignent l’installation de logiciels libres ou payants pour des raisons impératives de sécurité informatique ou de conformité réglementaire. Excel, présent de facto sur l’immense majorité des postes de travail, offre une plateforme pérenne, immédiatement auditable par les pairs, facilitant le partage de fichiers d’analyse totalement transparents au sein des comités d’éthique et des collectifs de recherche internationaux.
2. Fondements mathématiques et décomposition de l’équation de Fleiss
2.1 La formulation canonique du coefficient de Fleiss
L’architecture mathématique du kappa de Fleiss s’inscrit dans la lignée directe des indices d’accord corrigés du hasard, dont la structure générique standardise l’écart entre le consensus observé et le consensus théorique imputable à la seule fluctuation stochastique. L’expression canonique générale se définit selon le quotient suivant :
Kappa = (P_barre – P_barre_e) / (1 – P_barre_e)
Dans cette expression formelle, le terme P_barre symbolise la proportion moyenne d’accord effectivement constatée entre les évaluateurs à travers l’ensemble des sujets de la cohorte. Il s’agit de la moyenne arithmétique des indices d’accord individuel calculés pour chaque entité observée. À l’inverse, le terme P_barre_e quantifie la proportion moyenne d’accord que l’on s’attendrait à observer si l’ensemble des juges formulaient leurs avis de manière totalement aléatoire, en respectant uniquement les propensions marginales globales de distribution des catégories diagnostiques.
Le dénominateur (1 – P_barre_e) joue quant à lui un rôle fondamental de normalisation : il représente le gain maximal d’accord possible au-delà du hasard. Ainsi, le kappa exprime la fraction effective de l’accord potentiel non stochastique que les observateurs sont parvenus à matérialiser. Sur le plan asymptotique, l’indice est borné supérieurement par la valeur théorique de 1,00, correspondant à un consensus absolu et unanime de tous les juges sur l’ensemble des sujets. Sa borne inférieure peut toutefois devenir négative, tombant potentiellement jusqu’à des valeurs comprises entre 0 et -1 lorsque l’accord observé s’avère systématiquement inférieur à ce que prédirait un tirage au sort probabiliste.
2.2 Modélisation de l’accord observé par sujet (Pi)
Pour dériver rigoureusement le terme global P_barre, il est impératif d’évaluer préalablement le niveau d’homogénéité interne des cotations pour chaque sujet individuel pris isolément. Soit un ensemble de $N$ sujets d’étude (indicés par $i$, variant de 1 à $N$) et un collège de $n$ évaluateurs statuant sur un ensemble de $k$ catégories diagnostiques mutuellement exclusives (indicées par $j$, variant de 1 à $k$). Soit $n_{ij}$ le décompte strict du nombre de juges ayant assigné le sujet $i$ à la modalité diagnostique spécifique $j$.
La proportion d’accord observée pour le sujet $i$, désignée par le terme $P_i$, correspond au ratio entre le nombre de paires concordantes réelles de juges et le nombre total de paires distinctes que l’on peut former à partir des $n$ évaluateurs. Sachant que le nombre de paires possibles parmi $n$ juges est donné par la formule combinatoire $n(n – 1) / 2$, et que le nombre de paires concordantes au sein de la catégorie $j$ est égal à $n_{ij}(n_{ij} – 1) / 2$, la sommation sur l’ensemble des $k$ catégories aboutit, après simplification algébrique du facteur 2, à l’expression formelle suivante :
P_i = [ SOMME(j=1 à k) (n_ij^2) – n ] / [ n * (n – 1) ]
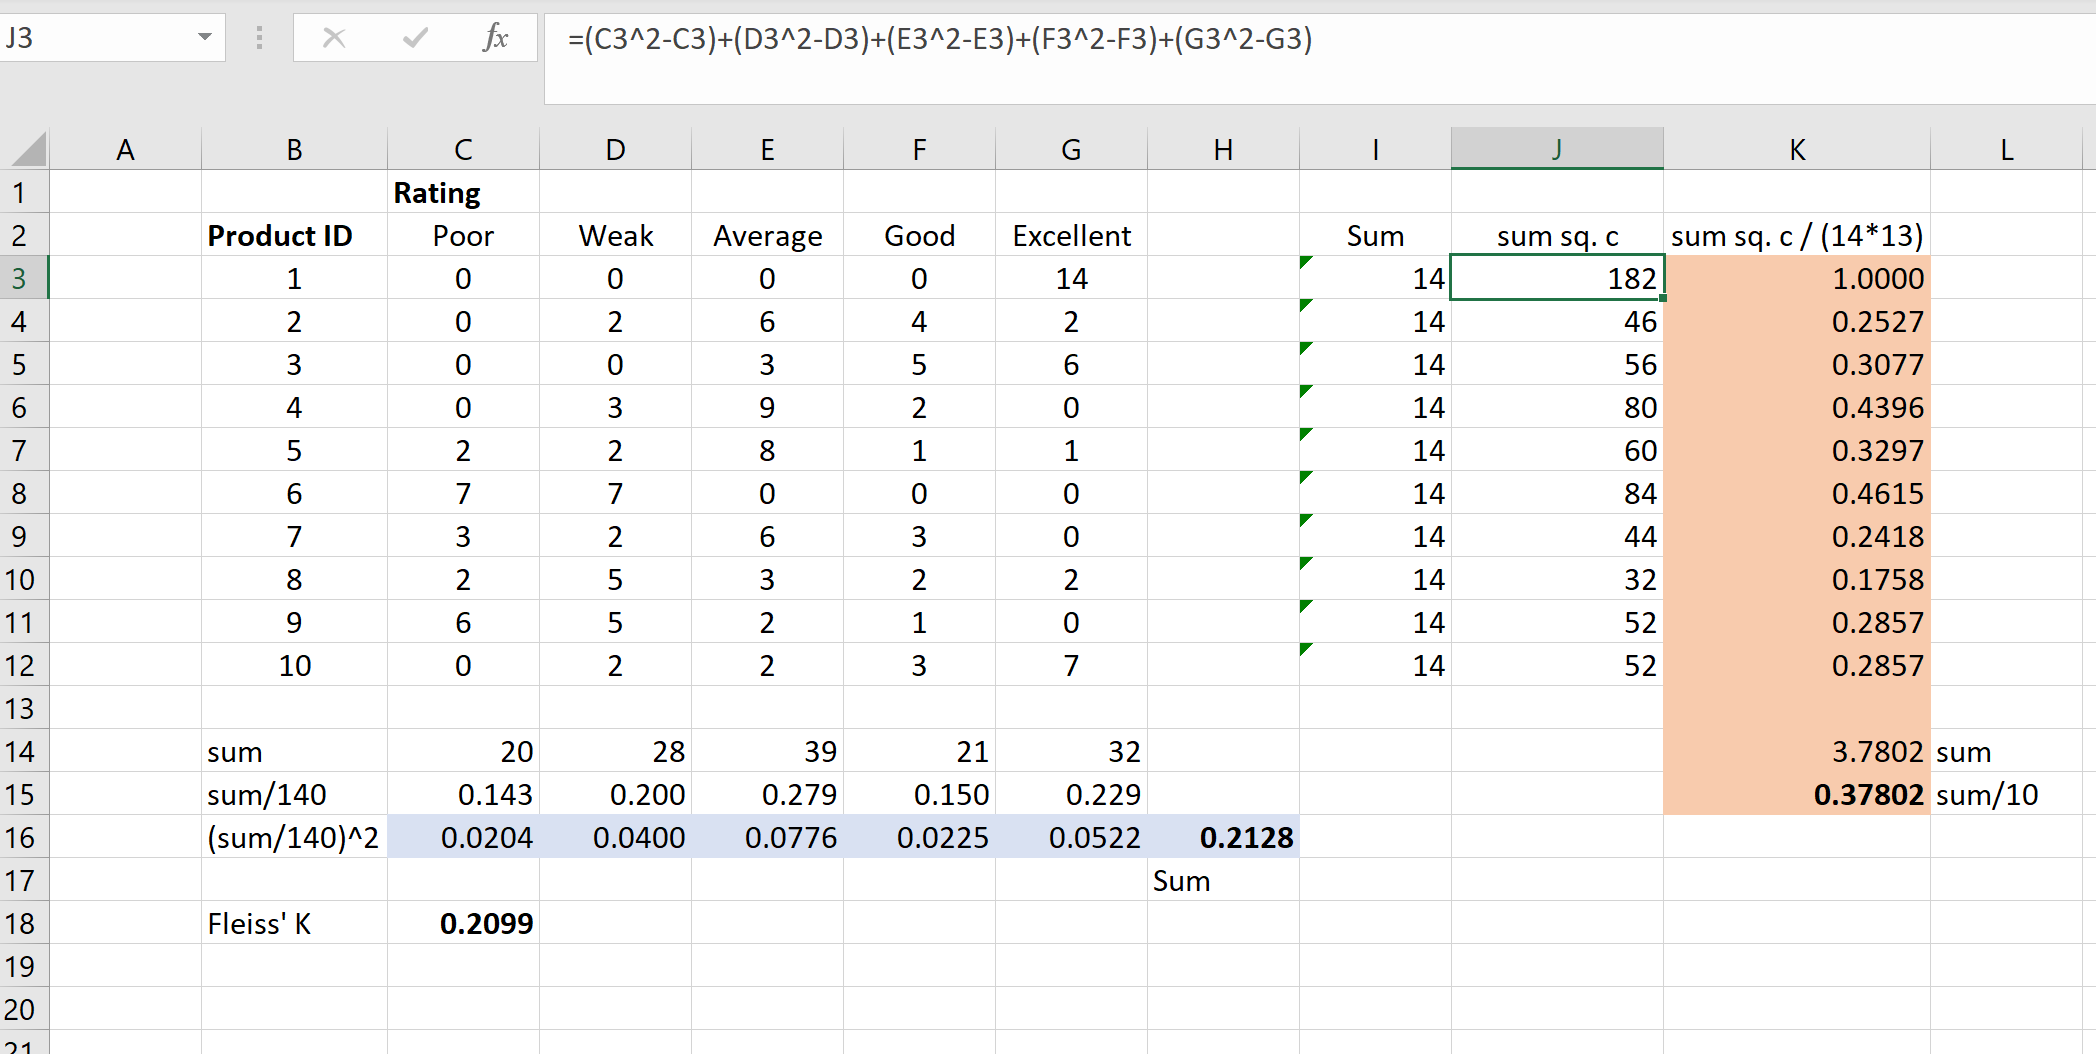
Cette formulation élégante repose sur la somme quadratique des effectifs par catégorie. Intuitivement, si les 14 juges de notre panel s’accordent unaniment en attribuant tous le sujet à la catégorie A, $n_{iA}$ vaut 14 et les autres effectifs valent zéro. La somme des carrés donne 196 ; en soustrayant 14, on obtient 182, qui, divisé par le dénominateur $14 \times 13 = 182$, génère un $P_i$ parfait de 1,00. À l’opposé, si les voix des juges s’éparpillent de façon uniforme entre les catégories, la somme des carrés chute drastiquement, réduisant la valeur locale de $P_i$ à un niveau proche de zéro. La moyenne non pondérée des $P_i$ sur les $N$ sujets fournit la métrique P_barre.
2.3 Modélisation de l’accord attribuable au hasard (Pe)
La quantification de l’accord fortuit P_barre_e nécessite une modélisation rigoureuse des préférences tendancielles globales du collège d’évaluateurs à travers toute l’expérimentation. Pour chaque catégorie diagnostique $j$, on détermine sa proportion marginale d’occurrence globale, désignée par $p_j$. Cette valeur exprime la probabilité a priori qu’un juge, pris au hasard au sein du panel et examinant un sujet quelconque de la cohorte, assigne spontanément la modalité $j$.
L’estimation empirique de cette proportion marginale s’obtient en divisant la somme de tous les jugements portés dans la catégorie $j$ par le nombre total absolu d’actes d’évaluation réalisés au cours de l’étude (soit le produit du nombre de sujets $N$ par le nombre de juges $n$) :
p_j = [ SOMME(i=1 à N) (n_ij) ] / [ N * n ]
Sous l’hypothèse nulle d’indépendance probabiliste totale entre deux évaluateurs distincts, la probabilité théorique que deux juges assignent indépendamment le même sujet à la modalité $j$ équivaut précisément au produit de leurs probabilités marginales respectives, soit $p_j \times p_j = p_j^2$. En prolongeant ce raisonnement axiomatique à l’ensemble du spectre diagnostique, la probabilité cumulée que deux juges choisis au hasard s’accordent par pure coïncidence sur l’une quelconque des $k$ catégories disponibles s’exprime comme la somme vectorielle des carrés des proportions marginales :
P_barre_e = SOMME(j=1 à k) (p_j^2)
Il apparaît clairement à travers cette formulation que la prévalence différentielle des pathologies cliniques exerce un poids déterminant sur la valeur de $P_e$. Si une catégorie clinique concentre à elle seule quatre-vingt-dix pour cent des avis du collège médical, son $p_j^2$ atteindra la valeur considérable de 0,81, imposant de facto un seuil d’accord aléatoire excessivement élevé que l’accord observé devra impérativement surpasser pour attester d’une fidélité réelle.
3. Comparaison méthodologique : Kappa de Cohen versus Kappa de Fleiss
3.1 Limites structurelles du Kappa de Cohen à deux évaluateurs
Le coefficient kappa développé par Jacob Cohen (1960) constitue le précurseur universellement reconnu des mesures de concordance ajustées au hasard. Cependant, son architecture mathématique repose sur une contrainte structurelle infranchissable : il est strictement bilatéral. Il a été conçu pour comparer exclusivement une dyade fixe d’observateurs, dénommés conventionnellement Juge 1 et Juge 2, évaluant un ensemble invariant de cibles à l’aide d’une table de contingence carrée d’ordre $k \times k$.
Cette limitation intrinsèque devient hautement pénalisante dans la recherche clinique contemporaine. Lorsque les investigations mobilisent des panels de dix, quinze ou vingt experts, ou lorsqu’un protocole multicentrique implique une rotation constante des soignants au chevet des patients, le formalisme de Cohen est totalement inopérant. Face à cette impasse, certains chercheurs commettent l’erreur méthodologique de calculer l’ensemble des kappas de Cohen pour toutes les paires possibles de juges, avant d’en faire la moyenne arithmétique simple.
Cette approche d’agrégation artificielle soulève de graves objections statistiques. Les paires d’évaluateurs partagent des sujets communs et ne sont donc pas statistiquement indépendantes ; la moyenne des kappas par paires n’obéit à aucune distribution théorique standard, rendant tout calcul d’erreur type asymptotique ou de valeur p hautement biaisé. L’agrégation occulte les interactions complexes au sein du groupe et engendre une déperdition d’information substantielle sur la variance inter-juges globale.
3.2 Spécificités architecturales du Kappa de Fleiss
Le coefficient de Fleiss transcende ces restrictions dyadiques en réorganisant conceptuellement la structure des données. Plutôt que de croiser deux juges dans une matrice fermée, l’approche de Fleiss envisage les observations sous l’angle d’une table d’allocation d’effectifs : les lignes représentent les sujets et les colonnes représentent les modalités qualitatives, le contenu de chaque cellule indiquant le volume de juges convergeant vers cette option.
Cette réorganisation matricielle octroie au kappa de Fleiss une souplesse opérationnelle exceptionnelle. Il prend en charge de manière native un nombre quelconque d’évaluateurs ($m ge 3$). De surcroît, le formalisme mathématique n’exige aucunement que les juges soient identifiés de façon nominative d’un item à l’autre : le sujet numéro 1 peut être examiné par les praticiens A, B et C, tandis que le sujet numéro 2 est évalué par les praticiens D, E et F. La seule exigence contraignante réside dans la fixité du nombre total $n$ de juges évaluant chaque cible.
Il importe toutefois de distinguer conceptuellement le kappa de Fleiss standard du kappa pondéré. Le modèle classique de Fleiss traite chaque désaccord avec une sévérité absolue et uniforme : une divergence entre un diagnostic de « Dépression légère » et « Dépression modérée » est pénalisée avec la même rigueur arithmétique qu’un désaccord frontal entre « Sujet sain » et « Schizophrénie aiguë ». Pour des variables purement ordinales graduelles, d’autres formalismes ou extensions pondérées s’avèrent préférables.
3.3 Arbre décisionnel pour le choix du bon coefficient en psychologie
Face à la multiplicité des indices psychométriques documentés dans la littérature, le choix d’un coefficient de fidélité inter-juges ne doit rien au hasard et obéit à un arbre décisionnel rigoureux centré sur trois critères prépondérants : le niveau de mesure des données, le nombre d’évaluateurs et la structure des données manquantes. Pour approfondir ces aspects, les critères formels de l’American Psychological Association préconisent une explicitation intégrale de ces paramètres dès le protocole initial.
Si la variable étudiée est quantitative continue (par exemple, le score brut à une échelle d’évaluation de l’anxiété comme le STAI ou l’HAM-A), l’investigateur doit immédiatement s’orienter vers le Coefficient de Corrélation Intraclasse (CCI), dérivé des modèles d’analyse de variance à effets aléatoires ou mixtes. Si la variable est de nature nominale et que le protocole ne mobilise rigoureusement que deux évaluateurs constants évaluant la totalité des items, le kappa de Cohen (ou son pendant pondéré si la variable est ordinale) demeure l’indice de référence.
Dès lors que le collège compte trois juges ou plus sur une échelle catégorielle nominale, l’alternative se joue entre le kappa de Fleiss et l’alpha de Krippendorff. Si le plan de recueil présente des données incomplètes — c’est-à-dire si certains sujets ont été cotés par douze praticiens et d’autres par huit seulement —, le kappa de Fleiss standard se trouve invalidé en raison de l’inconstance de son dénominateur binomial $n(n – 1)$. Dans ce cas précis, l’alpha de Krippendorff s’impose impérativement, car il intègre nativement les déséquilibres d’effectifs et s’adapte indifféremment aux métriques nominales, ordinales et d’intervalles sans perte de puissance statistique.
4. Architecture et préparation de la matrice de données sous Excel
4.1 Structuration optimale du tableau brut des cotations
L’implémentation rigoureuse du kappa de Fleiss dans Microsoft Excel débute par une architecture géométrique irréprochable de la matrice de travail. Une erreur classique commise par les analystes consiste à retranscrire les données sous leur format brut de saisie, c’est-à-dire en plaçant les évaluateurs en colonnes et les évaluations nominales sous forme de chaînes textuelles dans les cellules. Bien que naturelle pour le clinicien, cette disposition nécessite des phases de conversion complexes qui alourdissent inutilement les classeurs.
L’architecture matricielle optimisée pour le calcul de Fleiss adopte une configuration agrégée spécifique :
- Les lignes du tableau incarnent les sujets, patients ou items observés (de la ligne 1 à la ligne $N$).
- Les colonnes incarnent les modalités diagnostiques mutuellement exclusives (de la Catégorie 1 à la Catégorie $k$).
- Les cellules d’intersection renferment une valeur quantitative entière discrète ($n_{ij}$) représentant le nombre exact d’évaluateurs ayant assigné ce sujet particulier à cette catégorie spécifique.
Une colonne latérale de vérification doit impérativement border la matrice à droite : la somme en ligne de chaque patient. Dans un protocole standardisé à $n$ observateurs, chaque cellule de cette colonne de contrôle doit renvoyer sans déviation possible la valeur exacte de $n$. La dénomination explicite des plages via le Gestionnaire de noms d’Excel (par exemple, nommer la plage des effectifs « Matrice_Votes ») permettra d’accroître considérablement la lisibilité, la maintenance et l’auditabilité des formules complexes déployées en aval.
4.2 Vérification de l’intégrité des données brutes avec les outils Excel
Préalablement à tout calcul inférentiel, il est indispensable de déployer les fonctionnalités d’intégrité intégrées d’Excel pour purger la matrice de toute scorie typographique ou erreur humaine de report. Si les données proviennent d’une extraction brute où chaque soignant a consigné textuellement ses avis, la conversion vers la matrice d’agrégation $N \times k$ s’exécute avec fluidité grâce à la fonction NB.SI. Cette formule compare la plage de vote individuel d’un patient donné à l’étiquette exacte de la modalité visée.
Pour prévenir les décalages induits par des espaces insécables ou des anomalies de frappe lors de l’importation de fichiers CSV hospitaliers, l’application préalable combinée des fonctions SUPPRESPACE et EPURAGE sur la base brute est fortement recommandée. Ces nettoyages évitent qu’une saisie comme « Trouble A » ne soit isolée par Excel comme une catégorie distincte de « Trouble A ».
Enfin, la robustesse du protocole est sécurisée en insérant une règle de Validation des données sur l’ensemble de la matrice numérique : seules les valeurs entières positives comprises entre 0 et $n$ doivent être admises. La colonne de contrôle de somme latérale doit faire l’objet d’une formule conditionnelle de validation utilisant la syntaxe suivante : =SI(SOMME(B2:F2)=$G$1; « VALIDE »; « ERREUR EFFECTIF »), où la cellule $G$1 renferme la constante déclarée du nombre d’évaluateurs requis.
4.3 Exemple de jeu de données clinique : Évaluation de troubles psychologiques
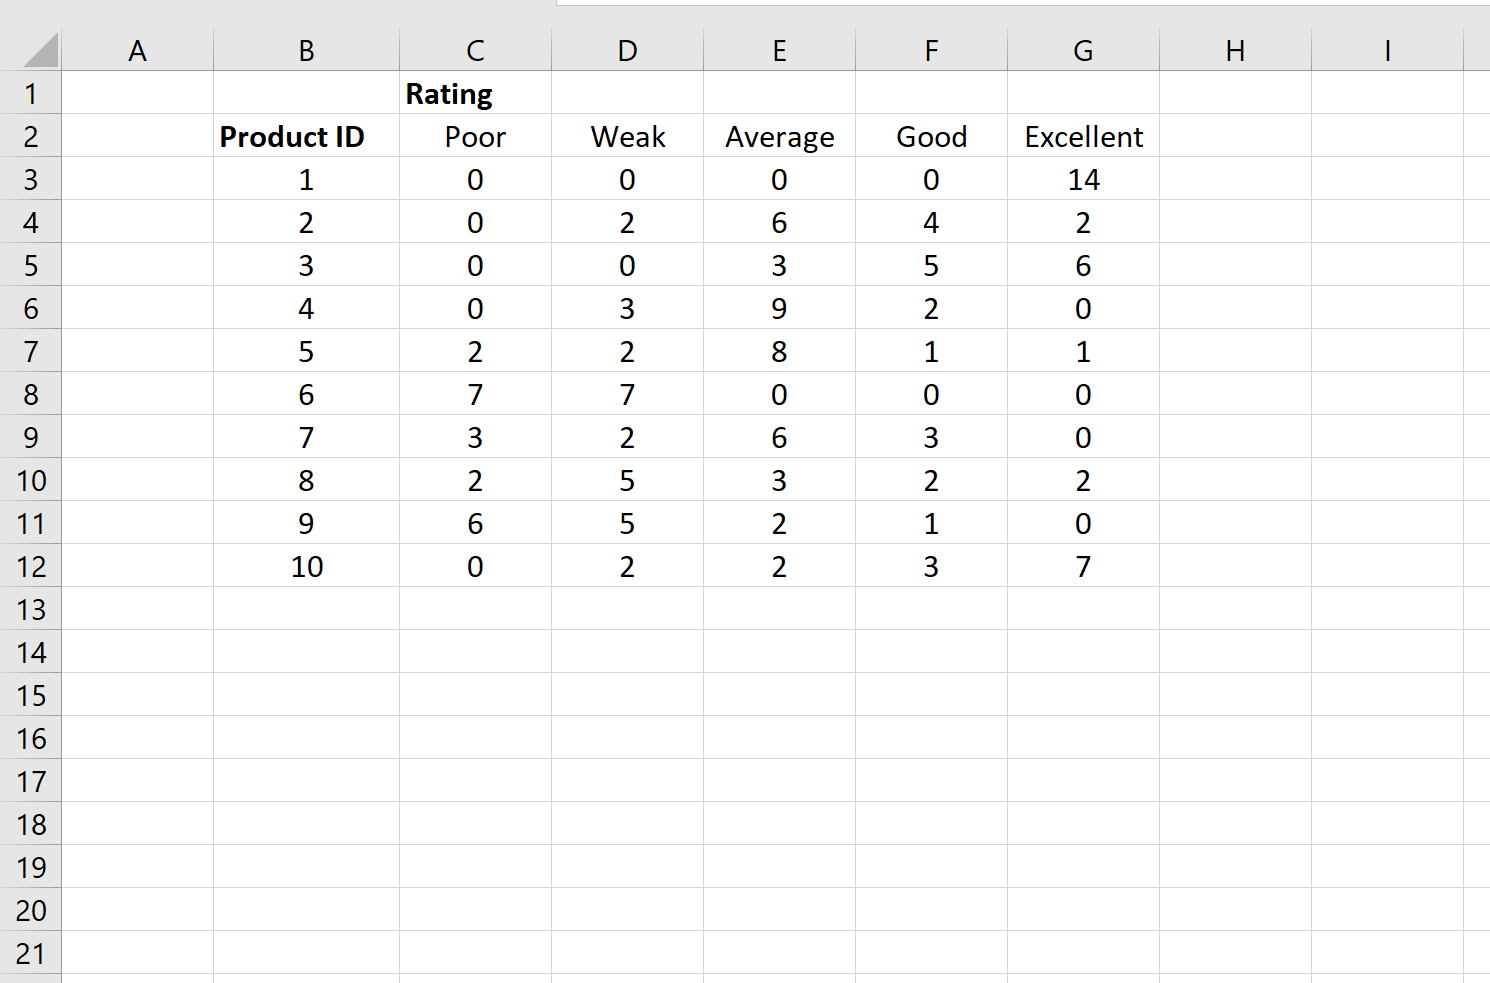
Afin d’ancrer notre démarche d’ingénierie statistique dans une réalité pratique tangible, nous utiliserons tout au long de ce manuel une cohorte clinique représentative issue du champ de la nosographie psychiatrique. Soit un protocole diagnostique multicentrique réunissant un collège fixe de 14 psychiatres indépendants ($n = 14$) appelés à statuer sur les dossiers cliniques approfondis de 10 patients consécutifs ($N = 10$).
Le système nosologique retenu s’articule autour de cinq catégories mutuellement exclusives ($k = 5$) :
- Catégorie A : Trouble Dépressif Majeur
- Catégorie B : Trouble Bipolaire de type I
- Catégorie C : Trouble Schizo-affectif
- Catégorie D : Trouble d’Anxiété Généralisée
- Catégorie E : Absence de Pathologie Révélée (Sujet Témoin)
La matrice numérique complète d’attribution des votes pour nos 10 patients se structure ainsi :
- Patient 1 : A = 0, B = 0, C = 0, D = 1, E = 13 (Somme = 14 ; consensus très marqué sur l’absence de trouble)
- Patient 2 : A = 0, B = 2, C = 10, D = 2, E = 0 (Somme = 14 ; majorité sur le trouble schizo-affectif, divergence modérée)
- Patient 3 : A = 0, B = 0, C = 0, D = 7, E = 7 (Somme = 14 ; scission bipolaire parfaite des cliniciens)
- Patient 4 : A = 14, B = 0, C = 0, D = 0, E = 0 (Somme = 14 ; unanimité absolue sur la dépression majeure)
- Patient 5 : A = 3, B = 2, C = 4, D = 2, E = 3 (Somme = 14 ; désaccord clinique profond et éparpillement maximal)
- Patient 6 : A = 1, B = 11, C = 2, D = 0, E = 0 (Somme = 14 ; accord prédominant sur le trouble bipolaire)
- Patient 7 : A = 0, B = 0, C = 12, D = 2, E = 0 (Somme = 14 ; fort consensus sur le trouble schizo-affectif)
- Patient 8 : A = 0, B = 1, C = 1, D = 10, E = 2 (Somme = 14 ; convergence vers l’anxiété généralisée)
- Patient 9 : A = 2, B = 0, C = 0, D = 0, E = 12 (Somme = 14 ; fort accord sur l’absence de trouble)
- Patient 10 : A = 0, B = 0, C = 3, D = 11, E = 0 (Somme = 14 ; consensus solide sur l’anxiété)
5. Calcul de la proportion d’accord individuel (Pi) pour chaque sujet
5.1 Décomposition de la formule Excel pour la somme quadratique
La première phase calculatoire consiste à implémenter l’estimation du consensus local $P_i$ pour chaque ligne de la matrice. L’opération centrale de l’équation développée à la section 2.2 exige d’élever au carré l’effectif de chaque modalité, puis d’en opérer la sommation : $\sum_{j=1}^k n_{ij}^2$. Dans l’environnement Excel, la mise en œuvre de cette somme quadratique peut s’effectuer sans recourir à des colonnes de calcul intermédiaires grâce à la puissance matricielle native de la fonction SOMMEPROD.
Considérons que les effectifs du premier patient soient localisés sur la plage horizontale B2:F2 (correspondant respectivement aux colonnes Catégorie A, B, C, D et E). La syntaxe calculant rigoureusement la somme des carrés s’écrit formellement :
=SOMMEPROD(B2:F2; B2:F2)
Cette fonction exécute la multiplication terme à terme de la plage par elle-même, puis agrège instantanément les produits partiels. Pour le Patient 1, le calcul interne exécuté par le moteur d’Excel équivaut à : $0^2 + 0^2 + 0^2 + 1^2 + 13^2 = 0 + 0 + 0 + 1 + 169 = 170$. L’usage de références relatives pour les cellules de la plage (B2:F2 sans signes dollars) garantit que lors de l’incrémentation verticale par double-clic sur la poignée de recopie vers le bas, la formule s’ajustera dynamiquement aux patients suivants (B3:F3, B4:F4, etc.), évitant ainsi toute rupture d’intégrité algorithmique.
5.2 Application du dénominateur de normalisation n(n – 1)
Une fois la somme des carrés établie, il convient d’appliquer la correction de concordance par paires. Le numérateur exige la soustraction formelle de $n$ (le nombre total de juges par ligne), tandis que le dénominateur opère la division par le facteur factoriel des paires $n(n – 1)$. Afin de conférer au classeur une adaptabilité dynamique — par exemple si le protocole est réitéré ultérieurement avec un collège de 20 psychiatres —, il est méthodologiquement contre-indiqué d’écrire la constante numérique « 182 » en dur dans les formules.
La formulation Excel intégrale de la proportion d’accord individuel $P_i$ pour la cellule G2 s’articule de la façon suivante :
=(SOMMEPROD(B2:F2; B2:F2) – SOMME(B2:F2)) / (SOMME(B2:F2) * (SOMME(B2:F2) – 1))
Analysons pas à pas la résolution de cette formule sur nos cas cliniques typiques :
- Pour le Patient 4 (accord parfait, $n_{iA}=14$) : la formule produit $(14^2 – 14) / (14 \times 13) = (196 – 14) / 182 = 182 / 182 = 1,0000$. Le consensus maximal est fidèlement modélisé.
- Pour le Patient 1 : la formule résout $(170 – 14) / 182 = 156 / 182 \approx 0,8571$. L’accord est très élevé malgré la voix discordante d’un confrère.
- Pour le Patient 3 (scission $7/7$) : la formule résout $[(7^2 + 7^2) – 14] / 182 = [(49 + 49) – 14] / 182 = (98 – 14) / 182 = 84 / 182 \approx 0,4615$. L’accord chute sous la barre des 50 %.
- Pour le Patient 5 (dispersion extrême $3, 2, 4, 2, 3$) : la somme des carrés donne $9 + 4 + 16 + 4 + 9 = 42$. Le numérateur devient $42 – 14 = 28$. Dès lors, $P_5 = 28 / 182 \approx 0,1538$. Le consensus intramétrique est quasiment annihilé.
5.3 Calcul de la moyenne globale de l’accord observé (P_barre)
L’estimation de l’accord moyen observé au niveau de la population d’étude, désigné par la métrique globale P_barre, s’obtient par la réduction arithmétique de la colonne des $P_i$. Soit la plage G2:G11 abritant les valeurs de $P_1$ à $P_{10}$ calculées précédemment. Dans une cellule dédiée de synthèse (par exemple la cellule G13), l’analyste implémente la formule standard :
=MOYENNE(G2:G11)
La valeur numérique obtenue condense le niveau d’homogénéité global observé empiriquement lors des délibérations diagnostiques. Dans le cadre de notre cohorte psychiatrique, la sommation des dix scores individuels donne : $0,8571 + 0,5385 + 0,4615 + 1,0000 + 0,1538 + 0,6154 + 0,7363 + 0,5165 + 0,7473 + 0,6044 = 6,2308$. En divisant ce total par $N = 10$, nous obtenons un accord moyen observé :
P_barre = 0,6231 (soit 62,31 % d’accord empirique effectif moyen par paire de cliniciens).
Sur le plan du diagnostic psychométrique, la valeur de $P_barre$ est obligatoirement comprise dans l’intervalle réel $[0 ; 1]$. L’obtention d’un résultat extérieur à ces bornes révèle immanquablement une erreur de construction dans la matrice, telle qu’une référence circulaire ou une soustraction erronée du dénominateur. Bien que respectable au premier abord, ce chiffre de 0,6231 ne peut en aucun cas être considéré comme un indice final de fidélité, car il ignore totalement la proportion de cet accord que le hasard aurait mécaniquement produite.
6. Calcul de la distribution marginale et de l’accord aléatoire (Pe)
6.1 Calcul des totaux marginaux par catégorie diagnostique
La quantification de la composante stochastique impose d’analyser la répartition marginale des votes sur l’ensemble de la cohorte. Cette étape débute par l’adjonction d’une ligne de totalisation verticale directement sous la matrice des cotations. Dans la cellule B12 (marquant le pied de colonne de la Catégorie A), l’opérateur insère la fonction de sommation : =SOMME(B2:B11). Cette formule est ensuite recopiée horizontalement jusqu’à la colonne F12 pour embrasser l’intégralité des pathologies répertoriées.
Pour notre jeu de données, la distribution des effectifs cumulés par catégorie s’établit comme suit :
- Total Catégorie A (Dépression Majeure) : $0+0+0+14+3+1+0+0+2+0 = 20$ cotations
- Total Catégorie B (Trouble Bipolaire I) : $0+2+0+0+2+11+0+1+0+0 = 16$ cotations
- Total Catégorie C (Trouble Schizo-affectif) : $0+10+0+0+4+2+12+1+0+3 = 32$ cotations
- Total Catégorie D (Anxiété Généralisée) : $1+2+7+0+2+0+2+10+0+11 = 35$ cotations
- Total Catégorie E (Sujet Témoin / Absence) : $13+0+7+0+3+0+0+2+12+0 = 37$ cotations
Le grand total absolu des avis émis correspond au produit du nombre de sujets par le nombre d’évaluateurs : $N \times n = 10 \times 14 = 140$ actes d’évaluation. La validation probabiliste immédiate s’opère en sommant les effectifs marginaux : $20 + 16 + 32 + 35 + 37 = 140$. La conformité est absolue.
Sur la ligne immédiatement inférieure (cellules B13 à F13), on dérive les proportions marginales respectives $p_j$ en divisant chaque effectif catégoriel par la constante globale 140. La syntaxe pour la cellule B13 est : =B12 / ($G$1 * 10), produisant le vecteur probabiliste suivant :
- $p_A = 20 / 140 \approx 0,1429$
- $p_B = 16 / 140 \approx 0,1143$
- $p_C = 32 / 140 \approx 0,2286$
- $p_D = 35 / 140 = 0,2500$
- $p_E = 37 / 140 \approx 0,2643$
La somme axiomatique de ces proportions marginales doit égaler rigoureusement 1,0000 (aux arrondis d’affichage près), ce qui certifie l’intégrité de la distribution sous-jacente.
6.2 Élévation au carré des probabilités marginales dans Excel
Conformément au modèle probabiliste de Fleiss exposé en sous-section 2.3, la probabilité d’un accord aléatoire simultané de deux observateurs indépendants sur une pathologie spécifique équivaut au carré de sa probabilité marginale d’occurrence. Au sein de la ligne 14 de notre feuille Excel, nous matérialisons cette transition algébrique en introduisant, dans la cellule B14, l’opération d’élévation au carré :
=B13^2
Cette formule est étirée horizontalement à travers les cellules C14 à F14 pour couvrir les cinq colonnes diagnostiques. Procédons à l’évaluation arithmétique de ces grandeurs intermédiaires :
- Pour la Catégorie A : $p_A^2 = (0,142857)^2 \approx 0,0204$
- Pour la Catégorie B : $p_B^2 = (0,114286)^2 \approx 0,0131$
- Pour la Catégorie C : $p_C^2 = (0,228571)^2 \approx 0,0522$
- Pour la Catégorie D : $p_D^2 = (0,250000)^2 = 0,0625$
- Pour la Catégorie E : $p_E^2 = (0,264286)^2 \approx 0,0698$
L’observation de ces grandeurs met en lumière la mécanique de pénalisation du kappa de Fleiss : les catégories cliniques les plus fréquemment convoquées par le collège médical (ici l’Absence de trouble $E$ et l’Anxiété $D$) génèrent mécaniquement les probabilités d’accord fortuit les plus prépondérantes. Deux psychiatres cochant au hasard des cases sur cette cohorte ont près de 7 % de probabilité de tomber d’accord sur la modalité Témoin par pur accident probabiliste, alors que cette probabilité s’effondre à 1,3 % pour le trouble bipolaire.
6.3 Agrégation de la probabilité d’accord attendue par hasard (P_barre_e)
L’estimation définitive de l’accord fortuit global, notée P_barre_e, se concrétise par la sommation horizontale des carrés des probabilités marginales préalablement établis. Dans une cellule stratégique de synthèse (par exemple la cellule G14), l’analyste consigne l’instruction suivante :
=SOMME(B14:F14)
Une alternative de formulation matricielle particulièrement élégante, dispensant de la création visuelle de la ligne intermédiaire 14, consiste à utiliser la fonction SOMMEPROD appliquée directement sur la plage des marginales :
=SOMMEPROD(B13:F13; B13:F13)
En agrégeant nos valeurs intermédiaires réelles :
P_barre_e = 0,020408 + 0,013061 + 0,052245 + 0,062500 + 0,069847 = 0,2181 (soit 21,81 % d’accord théorique purement imputable aux lois du hasard probabiliste).
La mise en regard immédiate des deux grandeurs fondamentales de l’édifice de Fleiss révèle l’état des forces diagnostiques de notre collège médical :
- Accord global observé (P_barre) : 0,6231
- Accord attribuable au hasard (P_barre_e) : 0,2181
La comparaison atteste sans ambiguïté que l’accord empirique constaté transcende substantiellement le niveau de consensus fortuit théorique. L’accord résiduel ne relève pas de la coïncidence stochastique, attestant d’une structure sous-jacente cohérente dans les grilles diagnostiques des psychiatres. Il convient désormais d’assembler ces composantes pour dériver le coefficient kappa définitif.
7. Synthèse et calcul définitif du coefficient Kappa de Fleiss
7.1 Assemblage des métriques dans la cellule de calcul finale
L’étape conclusive de la modélisation arithmétique converge vers l’assemblage canonique défini au chapitre 2.1. Dans la cellule d’affichage terminale du rapport statistique (par exemple la cellule G16, mise en exergue par un formatage typographique soigné), l’analyste implémente la formule maîtresse :
=(G13 – G14) / (1 – G14)
Afin de prévenir tout incident de calcul provoqué par des configurations théoriques extrêmes — telle qu’une situation d’homogénéité unilatérale absolue où $P_barre_e = 1$, conduisant inévitablement à une erreur critique de division par zéro (#DIV/0!) —, il est fortement préconisé d’encapsuler le quotient dans une structure conditionnelle préventive :
=SI(G14=1; 1; (G13 – G14) / (1 – G14))
Injectons précisément les grandeurs numériques issues de notre exemple clinique :
- Numérateur (Accord réel au-delà du hasard) : $0,623077 – 0,218061 = 0,405016$
- Dénominateur (Accord maximal théorique accessible) : $1 – 0,218061 = 0,781939$
- Quotient : $\kappa = 0,405016 / 0,781939 \approx 0,51796$
Le coefficient de Fleiss pour cette session d’évaluation psychiatrique s’établit définitivement à 0,518 (arrondi usuel à trois décimales). Ce résultat formalise mathématiquement que les 14 évaluateurs mobilisent environ 51,8 % de l’accord potentiel total disponible une fois neutralisé l’effet de concordance passive généré par les fréquences marginales des cinq pathologies étudiées.
7.2 Analyse de sensibilité et comportement des termes de l’équation
Une compréhension clinique et psychométrique approfondie du kappa requiert d’anticiper le comportement de l’indice sous diverses contraintes d’échantillonnage. Trois scénarios structurels méritent une attention particulière :
Le scénario du consensus parfait : Si chaque patient reçoit une affectation catégorielle unanime (toutes les voix concentrées sur une seule colonne par ligne), alors chaque $P_i$ est égal à 1,0000, ce qui impose $P_barre = 1,0000$. Le numérateur devient alors $(1 – P_barre_e)$, qui est rigoureusement identique au dénominateur $(1 – P_barre_e)$. Le quotient renvoie invariablement $kappa = 1,0000$, indépendamment de la distribution des proportions marginales $p_j$.
Le scénario du désaccord sous-aléatoire : Si les psychiatres affichent des divergences systématiques et polarisées — par exemple si un sous-groupe de juges évite méthodologiquement les catégories sélectionnées par leurs pairs —, l’accord observé empirique peut s’effondrer en deçà du seuil stochastique attendu ($P_barre < P_barre_e$). Dans cette configuration, le numérateur devient négatif, engendrant un coefficient kappa négatif (compris entre 0 et -1). Un kappa négatif ne signale pas une absence de fidélité aléatoire, mais un désaccord actif, structuré et systématique entre les évaluateurs, symptomatique d'une divergence doctrinale majeure dans l'interprétation des critères diagnostiques.
L’effet du nombre de catégories ($k$) : Toutes choses égales par ailleurs, l’augmentation du nombre de choix offerts aux cliniciens tend à réduire la valeur de $P_barre_e$. En passant de 2 à 10 catégories équiprobables, l’accord fortuit théorique s’effondre de 0,50 à 0,10. Conséquemment, sur des échelles nosologiques très fines comportant de nombreuses catégories, un accord observé modeste peut paradoxalement générer un kappa satisfaisant.
7.3 Automatisation avec les fonctions dynamiques modernes d’Excel 365
Avec l’avènement du moteur de calcul matriciel dynamique dans Microsoft 365, il est désormais envisageable d’affranchir complètement le classeur de toute ligne ou colonne intermédiaire. Grâce aux fonctions fonctionnelles modernes LET et LAMBDA, l’intégralité de la modélisation statistique du kappa de Fleiss peut être condensée au sein d’une unique formule matricielle autonome.
Soit la plage de données brutes B2:F11 abritant les affectations numériques. La formule suivante, introduite dans une unique cellule d’Excel 365, exécute l’intégralité du traitement algorithmique :
=LET(
Matrice; B2:F11;
N_sujets; LIGNES(Matrice);
n_juges; SOMME(INDEX(Matrice; 1; ));
Pi_vecteur; BYROW(Matrice; LAMBDA(r; (SOMME(r^2) – n_juges) / (n_juges * (n_juges – 1))));
P_barre; MOYENNE(Pi_vecteur);
pj_vecteur; BYCOL(Matrice; LAMBDA(c; SOMME(c) / (N_sujets * n_juges)));
Pe_barre; SOMME(pj_vecteur^2);
SI(Pe_barre = 1; 1; (P_barre – Pe_barre) / (1 – Pe_barre))
)
Cette syntaxe avancée stocke localement les variables intermédiaires dans la mémoire du moteur de calcul sans altérer l’espace visuel de la feuille de calcul. En encapsulant cette formule dans le Gestionnaire de noms sous l’intitulé KAPPA_FLEISS, l’analyste dote son classeur d’une fonction métier personnalisée et réutilisable à l’infini sur n’importe quel tableau clinique via l’instruction épurée : =KAPPA_FLEISS(B2:F11).
8. Calcul de l’erreur type, de l’intervalle de confiance et inférence statistique
8.1 Calcul asymptotique de la variance et de l’erreur type du kappa
L’estimation ponctuelle d’un coefficient kappa ($kappa = 0,518$) demeure incomplète dans le cadre d’un rapport de recherche académique si elle n’est pas assortie d’une caractérisation rigoureuse de sa distribution d’échantillonnage. Pour évaluer la significativité statistique du kappa et déterminer si la concordance observée diffère statistiquement de zéro, il est nécessaire de calculer sa variance asymptotique sous l’hypothèse nulle ($H_0 : \kappa = 0$).
Dans son traité séminal de 1971, Joseph Fleiss a établi la formulation de la variance asymptotique du kappa sous l’hypothèse nulle d’indépendance statistique entre évaluateurs. L’expression générale de cette variance, notée $operatorname{Var}(\kappa_0)$, se structure comme suit :
Var(Kappa_0) = [ 2 / (N * n * (n – 1) * (1 – P_barre_e)^2) ] * [ P_barre_e – (2 * n – 3) * (P_barre_e)^2 + 2 * (n – 1) * SOMME(pj^3) ]
Cette équation met en jeu un terme additionnel : la somme des cubes des proportions marginales, $\sum_{j=1}^k p_j^3$. Dans notre feuille Excel, nous pouvons implémenter ce calcul dans la cellule G15 par la formule matricielle suivante :
=SOMMEPROD(B13:F13; B13:F13; B13:F13)
Calculons ce terme intermédiaire pour nos données :
- $\sum p_j^3 = (0,1429)^3 + (0,1143)^3 + (0,2286)^3 + (0,2500)^3 + (0,2643)^3 \approx 0,00292 + 0,00149 + 0,01194 + 0,01563 + 0,01846 = 0,05044$
Substituons désormais l’ensemble des grandeurs connues dans la formule de variance :
- Constante initiale : $2 / [10 \times 14 \times 13 \times (1 – 0,218061)^2] = 2 / [1820 \times (0,781939)^2] = 2 / (1820 \times 0,611429) = 2 / 1112,80 \approx 0,001797$
- Premier terme interne : $P_barre_e = 0,218061$
- Second terme interne : $(2 \times 14 – 3) \times (0,218061)^2 = 25 \times 0,047551 = 1,188768$
- Troisième terme interne : $2 \times (14 – 1) \times 0,05044 = 26 \times 0,05044 = 1,31144$
- Somme des termes internes : $0,218061 – 1,188768 + 1,31144 = 0,340733$
- Variance nulle asymptotique : $operatorname{Var}(\kappa_0) = 0,001797 \times 0,340733 \approx 0,0006123$
L’erreur type du kappa sous l’hypothèse nulle, notée $SE_0(\kappa)$, s’obtient simplement en extrayant la racine carrée de cette variance dans la cellule G17 par la syntaxe suivante :
=RACINE(G18) (où G18 contient la variance calculée ci-dessus), ce qui donne :
SE_0(Kappa) = RACINE(0,0006123) ≈ 0,02474
8.2 Construction de l’intervalle de confiance à 95 %
La dérivation de l’intervalle de confiance d’un coefficient kappa requiert théoriquement l’estimation de sa variance sous l’hypothèse alternative ($H_1 : \kappa ne 0$), dont la formulation algébrique complète intègre des moments d’ordre supérieur hautement complexes. Toutefois, dans le cadre d’échantillons cliniques de taille modérée à grande ($N ge 10$ et $n ge 10$), l’approximation normale standard fournit une estimation robuste couramment acceptée dans les publications biomédicales.
Pour un niveau de confiance bilatéral fixé à $1 – \alpha = 0,95$, le coefficient critique issu de la loi normale centrée réduite correspond au fractile standardisé $Z_{0,975} = 1,95996$. Dans Excel, cette valeur s’obtient dynamiquement à l’aide de la fonction inverse : =LOI.NORMALE.STANDARD.INVERSE(0,975).
La marge d’erreur maximale de l’estimation ($ME$) s’établit par le produit de la valeur critique $Z$ et de l’erreur type. Les bornes inférieure et supérieure de l’intervalle de confiance à 95 % se déploient dans les cellules G20 et G21 :
- Borne Inférieure (IC 95%) : =G16 – (1,96 * G17)
- Borne Supérieure (IC 95%) : =G16 + (1,96 * G17)
En introduisant nos paramètres :
- Marge d’erreur = $1,95996 \times 0,02474 \approx 0,0485$
- Borne Inférieure = $0,51796 – 0,0485 = 0,4695$
- Borne Supérieure = $0,51796 + 0,0485 = 0,5665$
L’intervalle de confiance à 95 % s’établit ainsi formellement à [0,470 ; 0,567]. Cet encadrement resserré démontre la précision statistique permise par la taille de notre panel : la fidélité inter-évaluateurs du collège ne descend pas en dessous de 0,470 et ne dépasse pas 0,567 avec une certitude probabiliste de quatre-vingt-quinze pour cent.
8.3 Test d’hypothèse et calcul de la p-value (significativité)
L’inférence statistique formelle culmine avec le test de l’hypothèse nulle ($H_0 : \kappa = 0$ contre l’hypothèse alternative bilatérale $H_1 : \kappa ne 0$). Il s’agit de réfuter formellement l’éventualité que l’accord observé de 0,518 ne résulte que d’un alignement purement stochastique des choix individuels.
La statistique de test suit asymptotiquement une distribution normale standard sous l’hypothèse nulle. Le score de déviation standardisée $Z$ se calcule dans la cellule G22 par le quotient simple du kappa estimé sur son erreur type sous $H_0$ :
=G16 / G17
Sur notre jeu de données : $Z = 0,51796 / 0,02474 \approx 20,936$.
Cette valeur de $Z$ dépasse considérablement les seuils critiques usuels. La dérivation de la valeur p bilatérale associée s’implémente dans la cellule G23 via la fonction de distribution cumulative normale :
=2 * (1 – LOI.NORMALE.STANDARD.N(ABS(G22); VRAI))
Pour un score $Z$ de 20,94, la fonction Excel renvoie une valeur p infinitésimale, bien en deçà du seuil usuel de $p < 0,0001$. L'hypothèse nulle d'indépendance aléatoire est rejetée de façon catégorique : l'accord observé entre les quatorze praticiens est hautement significatif sur le plan statistique.
9. Grilles d’interprétation et seuils qualitatifs en sciences humaines
9.1 La nomenclature de référence de Landis et Koch (1977)
L’obtention d’un coefficient kappa statistiquement significatif ne préjuge pas nécessairement de son utilité clinique ou psychométrique opérationnelle. Pour qualifier l’amplitude concrète de la concordance, la littérature biomédicale s’est massivement appuyée sur la grille normative proposée par J. Richard Landis et Gary G. Koch (1977). Ces auteurs ont défini six intervalles sémantiques universellement cités :
- Moins de 0,00 : Accord médiocre ou désaccord systématique (Poor agreement)
- De 0,00 à 0,20 : Accord très faible ou léger (Slight agreement)
- De 0,21 à 0,40 : Accord passable ou juste (Fair agreement)
- De 0,41 à 0,60 : Accord modéré (Moderate agreement)
- De 0,61 à 0,80 : Accord substantiel ou important (Substantial agreement)
- De 0,81 à 1,00 : Accord presque parfait (Almost perfect agreement)
Sur la base de cette nomenclature historique, notre indice clinique de 0,518 se positionne sans équivoque dans le registre d’un accord modéré. Si cette grille présente l’indéniable mérite de standardiser les communications interdisciplinaires, de nombreux méthodologistes critiquent son caractère éminemment arbitraire. Rien, sur le plan strictement mathématique ou biologique, ne justifie une rupture qualitative radicale entre une valeur de 0,60 (qualifiée de modérée) et une valeur de 0,61 (qualifiée de substantielle).
9.2 Critères alternatifs plus stricts : Fleiss (1981) et Cicchetti (1994)
Conscient des faiblesses inhérentes aux découpages trop permissifs de Landis et Koch, Joseph Fleiss lui-même a préconisé en 1981 une grille d’évaluation plus exigeante et mieux adaptée aux contraintes de la recherche clinique :
- Inférieur à 0,40 : Reproductibilité médiocre (Poor)
- De 0,40 à 0,75 : Reproductibilité intermédiaire à bonne (Intermediate to good)
- Supérieur à 0,75 : Reproductibilité excellente (Excellent agreement)
Dans le secteur du diagnostic psychiatrique ou de l’évaluation neuropsychologique à haut risque décisionnel (comme le placement institutionnel ou l’engagement d’une chimiothérapie lourde), les critères développés par Domenic Cicchetti (1994) établissent des exigences éthiques encore plus contraignantes. Cicchetti rappelle qu’un accord « modéré » (autour de 0,50) implique qu’environ la moitié de la variance de jugement reste non contrôlée ou divergente, ce qui peut s’avérer inacceptable face à des pathologies engageant le pronostic vital.
Le tableau comparatif suivant synthétise les équivalences entre ces différentes taxonomies qualitatives directement intégrables au sein du tableau de bord statistique :
- Valeur [0,00 – 0,39] : Faible chez Landis & Koch | Médiocre chez Fleiss | Inacceptable cliniquement selon Cicchetti
- Valeur [0,40 – 0,59] : Modéré chez Landis & Koch | Intermédiaire chez Fleiss | Limite / Passable selon Cicchetti
- Valeur [0,60 – 0,74] : Substantiel chez Landis & Koch | Bon chez Fleiss | Bon selon Cicchetti
- Valeur [0,75 – 1,00] : Presque parfait (si >0,80) chez Landis & Koch | Excellent chez Fleiss | Excellent selon Cicchetti
9.3 Automatisation de l’étiquetage qualitatif dans Excel
Afin de parfaire l’ergonomie applicative de la feuille de calcul et d’offrir une lecture directe aux professionnels de santé non statisticiens, il est particulièrement judicieux d’automatiser l’étiquetage qualitatif textuel de la cellule Kappa. Excel dispose de la fonction SI.CONDITIONS (disponible depuis Excel 2019 et Microsoft 365), qui permet d’éviter l’imbrication laborieuse d’instructions logiques fermées.
Pour qualifier notre score selon la grille canonique de Landis et Koch, l’analyste implémente en cellule G24 la formule dynamique suivante :
=SI.CONDITIONS(
G16<0; « Désaccord systématique »;
G16<=0,2; « Accord très faible »;
G16<=0,4; « Accord passable »;
G16<=0,6; « Accord modéré »;
G16<=0,8; « Accord substantiel »;
G16<=1; « Accord presque parfait »
)
Sur les versions plus anciennes d’Excel, cette instruction s’exécute classiquement par une chaîne de conditions : =SI(G16<0,4; « Médiocre »; SI(G16<=0,75; « Intermédiaire à Bon »; « Excellent »)) selon l’échelle de Fleiss.
Pour finaliser l’interface, une règle de Mise en forme conditionnelle par nuance de couleurs peut être appliquée à la cellule Kappa : un dégradé à trois points associant le rouge bordeaux aux valeurs inférieures à 0,40, le jaune ambré à la zone médiane [0,40 – 0,75], et le vert émeraude aux scores supérieurs à 0,75 permet d’alerter instantanément le clinicien sur le degré de fiabilité de la session d’observation.
10. Les paradoxes psychométriques du kappa et diagnostics d’erreurs dans Excel
10.1 Le paradoxe de la prévalence (Paradoxe de Feinstein et Cicchetti)
L’une des particularités les plus déroutantes du kappa de Fleiss réside dans sa vulnérabilité au célèbre paradoxe de la prévalence, documenté de manière fondatrice par Alvan Feinstein et Domenic Cicchetti en 1990. Ce paradoxe met en lumière une anomalie apparente : dans certaines conditions distributionnelles, des évaluateurs affichant un pourcentage d’accord brut empirique exceptionnellement élevé ($P_barre > 0,90$) se voient attribuer un kappa paradoxalement bas, parfois proche de zéro.
Ce phénomène se produit dès lors qu’une catégorie nosologique présente une asymétrie de prévalence extrême dans l’échantillon. Imaginons une étude portant sur le dépistage d’une anomalie génétique ultra-rare : sur une cohorte de cent patients, quatre-vingt-quinze ne présentent aucune mutation. Le collège médical conclut unanimement à l’absence d’anomalie sur ces quatre-vingt-quinze individus. La proportion marginale $p_j$ de la catégorie « Absence » atteint alors 0,95, et son carré $p_j^2$ s’élève à 0,9025. Par voie de conséquence, l’accord fortuit $P_barre_e$ devient colossal (supérieur à 90 %).
Si quelques légères hésitations surviennent sur les cinq patients rares restants, l’accord observé réel ($P_barre = 0,92$) dépassera à peine l’accord stochastique attendu ($P_barre_e = 0,91$). Le numérateur $(P_barre – P_barre_e)$ devient minuscule ($0,01$), divisé par un dénominateur $(1 – 0,91 = 0,09)$, conduisant à un coefficient kappa de 0,11 (« Très faible »), en contradiction totale avec l’intuition que procure un accord brut de 92 %. C’est pourquoi il est déontologiquement impératif dans toute publication de rapporter conjointement la proportion d’accord observé brut ($P_barre$) et le coefficient kappa corrigé, sous peine de disqualifier à tort un instrument clinique parfaitement performant.
10.2 Le paradoxe du biais de cotation des juges
Le second écueil distributionnel correspond au paradoxe du biais. Le biais désigne ici une propension asymétrique et directionnelle systématique au sein du collège d’évaluateurs à favoriser une catégorie nosologique au détriment d’une autre. Deux praticiens peuvent s’accorder globalement, mais l’un présente un seuil diagnostique beaucoup plus bas que l’autre pour déclarer une sémiologie positive.
Sur le plan mathématique, une forte asymétrie entre les distributions marginales des observateurs tend à réduire artificiellement le terme d’accord aléatoire $P_barre_e$. En diminuant artificiellement le dénominateur de hasard, le kappa se trouve paradoxalement réhaussé, donnant l’illusion trompeuse d’une fidélité supérieure à ce qu’elle est en réalité. Ce phénomène masque l’existence d’une divergence systématique de critères d’inclusion entre les praticiens.
Dans l’environnement Excel, ce biais se diagnostique en érigeant une table croisée dynamique ou un graphique de profils d’attribution par évaluateur. Si certains juges consomment massivement la catégorie D au détriment de la catégorie C tandis que leurs confrères présentent le profil inverse, une phase préalable de réconciliation méthodologique et d’harmonisation des définitions opérationnelles s’impose avant tout recalcul définitif du kappa.
10.3 Audit des formules et pièges techniques courants dans Excel
L’implémentation manuelle du kappa de Fleiss dans un tableur expose l’analyste à plusieurs pièges techniques classiques qu’un protocole d’audit méthodique permet de neutraliser sans difficulté :
- L’omission de l’ancrage absolu des constantes ($) : Lors de l’écriture de formules matricielles impliquant des totaux globaux (comme le nombre d’évaluateurs ou le grand total $N \times n$), l’oubli des signes dollars transforme les adresses en références relatives lors de l’étirement vertical, décalant silencieusement les dénominateurs vers des cellules vides sans générer d’alerte logicielle immédiate.
- La confusion entre cellule vide et valeur zéro : Dans la matrice de votes, une valeur nulle ($n_{ij} = 0$, aucun juge n’ayant choisi cette option) doit être impérativement renseignée avec le chiffre 0. Si la cellule est laissée vide, certaines versions d’Excel ou fonctions conditionnelles peuvent renvoyer des erreurs d’incompatibilité de type (#VALEUR!) lors des opérations d’élévation matricielle au carré.
- L’inclusion accidentelle des totaux dans les plages calculées : Une inadvertance fréquente consiste à intégrer la colonne de contrôle de somme (colonne G) ou la ligne de totalisation marginale (ligne 12) à l’intérieur des plages matricielles traitées par SOMMEPROD. Cette pollution géométrique fausse l’intégralité du traitement probabiliste.
L’utilisation de la commande Évaluer la formule, localisée sous l’onglet Formules du ruban Excel, offre une visualisation pas à pas de la substitution de chaque variable, constituant le moyen le plus efficace d’auditer et d’authentifier la chaîne de calcul.
11. Alternatives et extensions avancées du kappa dans l’environnement Excel
11.1 Implémentation d’une macro VBA pour le kappa de Fleiss
Pour les équipes hospitalières ou les laboratoires confrontés à des matrices de grande envergure (plusieurs centaines de patients ou plusieurs dizaines de catégories diagnostiques), l’utilisation d’une macro en langage Visual Basic for Applications (VBA) permet d’automatiser l’ensemble de la procédure tout en sécurisant la feuille contre les fausses manipulations.
Voici la structure de code modulaire rigoureusement architecturée pour créer une fonction personnalisée =FLEISS_KAPPA(Plage) directement utilisable dans n’importe quelle cellule du classeur :
Function FLEISS_KAPPA(rngVotes As Range) As Double
Dim arr() As Variant
Dim N As Long, k As Long, n_raters As Long
Dim i As Long, j As Long
Dim sum_sq As Double, Pi_sum As Double, P_bar As Double
Dim col_sums() As Double, pj_sq_sum As Double, Pe_bar As Double
arr = rngVotes.Value
N = UBound(arr, 1)
k = UBound(arr, 2)
n_raters = 0
For j = 1 To k
n_raters = n_raters + arr(1, j)
Next j
ReDim col_sums(1 To k)
Pi_sum = 0
For i = 1 To N
sum_sq = 0
For j = 1 To k
sum_sq = sum_sq + (arr(i, j) * arr(i, j))
col_sums(j) = col_sums(j) + arr(i, j)
Next j
Pi_sum = Pi_sum + ((sum_sq – n_raters) / (n_raters * (n_raters – 1)))
Next i
P_bar = Pi_sum / N
pj_sq_sum = 0
For j = 1 To k
pj_sq_sum = pj_sq_sum + ((col_sums(j) / (N * n_raters)) ^ 2)
Next j
Pe_bar = pj_sq_sum
If Pe_bar = 1 Then
FLEISS_KAPPA = 1
Else
FLEISS_KAPPA = (P_bar – Pe_bar) / (1 – Pe_bar)
End If
End Function
L’intégration de ce script s’opère en accédant à l’éditeur Visual Basic via la combinaison de touches Alt + F11, puis en insérant un nouveau Module standard. Le classeur doit impérativement être enregistré sous le format prenant en charge les macros (extension .xlsm). Cette fonction personnalisée permet aux cliniciens non familiers de la logique matricielle de calculer instantanément le kappa en sélectionnant simplement la plage de votes avec leur souris.
11.2 Gestion des données ordinales : vers le kappa pondéré
Le modèle canonique de Fleiss traite la variable diagnostique comme une entité nominale pure sans hiérarchie. Or, de nombreuses métriques en psychologie sont intrinsèquement ordinales (par exemple : absence de sévérité, intensité légère, intensité modérée, intensité sévère). Dans cette configuration, sanctionner de la même manière une divergence d’un niveau (légère vs modérée) et une divergence extrême (absence vs sévère) constitue une approximation méthodologique discutable.
Pour traiter adéquatement des échelles ordinales à plusieurs juges, les biostatisticiens emploient des matrices de pénalités. Une feuille Excel dédiée peut être construite pour intégrer une pondération linéaire ($w_j = 1 – |i – j| / (k – 1)$) ou une pondération quadratique ($w_j = 1 – (i – j)^2 / (k – 1)^2$). Ces matrices de poids pénalisent les désaccords proportionnellement à l’écart qui sépare les échelons cliniques.
Lorsque la structure ordinale comporte plus de cinq échelons ou se rapproche d’un continuum métrique continu, il devient mathématiquement préférable d’abandonner les déclinaisons du kappa au profit du Coefficient de Corrélation Intraclasse à deux facteurs aléatoires (CCI modèle 2,1 ou modèle 2,k selon la classification de Shrout et Fleiss). Le CCI modélise explicitement la variance d’échelle continue via une décomposition formelle des sommes de carrés d’analyse de variance (ANOVA).
11.3 Comparaison croisée avec les résultats obtenus sous R et SPSS
Afin de valider définitivement la fiabilité algorithmique de notre matrice de calcul Excel, il est essentiel de confronter les résultats obtenus avec ceux générés par les logiciels statistiques de référence du monde académique.
Sous l’environnement de programmation R, l’analyse du kappa de Fleiss s’exécute classiquement par l’intermédiaire du package spécialisé irr. En important notre matrice de votes de 10 lignes et 5 colonnes, l’instruction syntaxique :
library(irr)
kappam.fleiss(matrice_votes)
renvoie précisément un kappa de 0,518, un score $Z$ de 20,9 et une p-value rigoureusement inférieure à 0,0001, validant à la décimale près l’exactitude des calculs déployés dans nos cellules Excel.
Au sein du logiciel IBM SPSS Statistics, la procédure s’effectue via le menu Analyser > Échelle > Analyse de fidélité ou par la commande syntaxique spécifique FLEISS KAPPA introduite dans les versions récentes. Les écarts résiduels infinitésimaux qui peuvent occasionnellement apparaître entre Excel et ces logiciels n’affectent généralement que la cinquième ou sixième décimale de l’erreur type, provenant simplement de la méthode d’approximation retenue pour la variance (variance sous $H_0$ versus variance asymptotique sous $H_1$). Ces micro-divergences sont sans aucune incidence sur l’interprétation clinique ou la publication académique des résultats.
12. Atelier pratique guidé et conception d’un template Excel professionnel
12.1 Guide de construction pas à pas du classeur complet
La pérennisation d’une démarche d’évaluation au sein d’une unité de recherche clinique passe par la création d’un modèle de classeur standardisé, ergonomique et protégé. L’architecture optimale repose sur une partition fonctionnelle en trois feuilles de calcul distinctes :
- Feuille 1 : ‘Documentation’ — Cette feuille explicite les métadonnées du protocole : titre de l’étude clinique, coordonnées des investigateurs principaux, nomenclature exhaustive des $k$ catégories diagnostiques et guide d’interprétation synthétique (seuils de Landis et Koch, règles de saisie).
- Feuille 2 : ‘Saisie des Données’ — Cette zone accueille la matrice brute des effectifs. La colonne A recense les identifiants anonymisés des patients, les colonnes B à F reçoivent les décomptes de votes, et la colonne G abrite la formule de contrôle d’intégrité de la somme des juges ($n = 14$).
- Feuille 3 : ‘Calculs & Résultats’ — Ce tableau de bord rassemble les grandeurs clés ($P_i$, $\bar{P}$, $p_j$, $\bar{P}_e$, Kappa, Erreur Type, Intervalle de Confiance à 95 %, Score Z, Valeur p et qualification textuelle dynamique).
Pour prévenir toute altération accidentelle des équations lors des campagnes de saisie de routine, il est recommandé de déverrouiller uniquement les cellules de saisie brute (cellules B2:F11), puis d’activer la protection globale de la feuille (onglet Révision > Protéger la feuille) sans mot de passe complexe, en interdisant la sélection des cellules verrouillées.
12.2 Simulation dynamique avec graphiques d’analyse d’accord
L’enrichissement visuel du classeur transforme une collection de chiffres abstraits en un outil de pilotage clinique intuitif. L’intégration de visualisations graphiques permet d’appréhender la dynamique de consensus en un coup d’œil :
Le graphique en barres empilées à 100 % : Ce graphique représente en abscisse les 10 patients et en ordonnée la distribution proportionnelle des votes des 14 cliniciens pour les cinq catégories colorées. Un patient faisant l’objet d’un accord unanime apparaîtra comme une barre monochrome d’un seul bloc, tandis qu’un cas source de discordance (comme le Patient 5) dévoilera un étagement multicolore fragmenté, identifiant instantanément les dossiers cliniques nécessitant une réunion de concertation pluridisciplinaire.
Le graphique radar du profil diagnostique : En traçant les proportions marginales $p_j$ sur un diagramme en radar à cinq axes, l’analyste visualise immédiatement l’asymétrie de distribution de la cohorte. Ce graphique constitue le système d’alerte privilégié pour prévenir les biais de prévalence évoqués à la section 10.1.
La jauge visuelle d’intervalle de confiance : L’adjonction d’un graphique à barres horizontales doté de barres d’erreur matérialise l’estimation ponctuelle du kappa et son encadrement à 95 % [0,470 ; 0,567]. Cette visualisation permet aux décideurs d’apprécier la stabilité de la mesure avant de valider formellement la standardisation d’une nouvelle échelle d’évaluation.
12.3 Règles de rédaction des résultats pour une publication académique
La transcription des résultats issus du modèle Excel au sein d’un manuscrit soumis à une revue internationale à comité de lecture doit se conformer rigoureusement aux normes de l’American Psychological Association (APA, 7e édition). La fidélité inter-évaluateurs ne saurait être expédiée en une seule ligne évasive mentionnant un « accord satisfaisant ».
Le compte rendu méthodologique doit expliciter simultanément :
- Le nombre total de sujets évalués ($N$) et le collège d’évaluateurs mobilisés ($n$).
- Le nombre de modalités nominales mutuellement exclusives ($k$).
- La proportion moyenne d’accord observé brut ($\bar{P}$).
- La valeur exacte du kappa de Fleiss rapportée à deux ou trois décimales.
- L’erreur type de l’estimation ($SE$).
- L’intervalle de confiance à 95 % encadré par des crochets.
- La valeur exacte de la statistique $Z$ et la p-value associée.
Voici un modèle formel de rédaction académique directement transposable dans la section Résultats d’une publication :
« La fidélité inter-évaluateurs a été quantifiée à l’aide du coefficient kappa de Fleiss portant sur un collège de 14 psychiatres évaluant indépendamment 10 patients à travers cinq catégories diagnostiques mutuellement exclusives. L’accord moyen observé empirique s’élève à 62,3 % ($\bar{P} = 0,623$). Après correction pour l’accord attribuable au pur hasard ($\bar{P}_e = 0,218$), le coefficient de Fleiss obtenu indique un accord modéré à substantiel selon les critères de Landis et Koch, $kappa = 0,518$, $SE = 0,025$, IC 95 % [0,470 ; 0,567]. La concordance observée au sein du collège médical apparaît hautement significative au-delà des fluctuations stochastiques ($Z = 20,94$, $p < 0,0001$). Ces indices confirment l'adéquation de la grille d'évaluation pour la recherche clinique multicentrique. »
Enfin, dans le cadre du mouvement contemporain en faveur de la science ouverte (Open Science Framework), le dépôt du classeur Excel anonymisé en matériel supplémentaire (Supplementary Material) garantit une reproductibilité parfaite des résultats et renforce la transparence scientifique de l’étude.
Références
- Cicchetti, D. V. (1994). Guidelines, criteria, and rules of thumb for evaluating normed and standardized assessment instruments in psychology. Psychological Assessment, 6(4), 284–290. https://doi.org/10.1037/1040-3590.6.4.284
- Cohen, J. (1960). A coefficient of agreement for nominal scales. Educational and Psychological Measurement, 20(1), 37–46. https://doi.org/10.1177/001316446002000104
- Feinstein, A. R., & Cicchetti, D. V. (1990). High agreement but low kappa: I. The problems of two paradoxes. Journal of Clinical Epidemiology, 43(6), 543–549. https://doi.org/10.1016/0895-4356(90)90158-L
- Fleiss, J. L. (1971). Measuring nominal scale agreement among many raters. Psychological Bulletin, 76(5), 378–382. https://doi.org/10.1037/h0031619
- Fleiss, J. L., Levin, B., & Paik, M. C. (2003). Statistical Methods for Rates and Proportions (3e éd.). John Wiley & Sons. https://doi.org/10.1002/0471445428
- Krippendorff, K. (2011). Computing Krippendorff’s alpha-reliability. Departmental Papers (ASC), University of Pennsylvania. https://doi.org/10.1080/19312450709336664
- Landis, J. R., & Koch, G. G. (1977). The measurement of observer agreement for categorical data. Biometrics, 33(1), 159–174. https://doi.org/10.2307/2529310
- Shrout, P. E., & Fleiss, J. L. (1979). Intraclass correlations: Uses in assessing rater reliability. Psychological Bulletin, 86(2), 420–428. https://doi.org/10.1037/0033-2909.86.2.420