
La modélisation mathématique des phénomènes de transition continue constitue l’un des piliers de l’analyse quantitative moderne. Qu’il s’agisse de mesurer la probabilité d’une prise de décision dans un protocole de psychologie cognitive, d’évaluer la réponse physiologique d’un organisme à une intensité croissante de stimulus, ou d’ajuster des modèles de régression logistique en apprentissage automatique, la fonction sigmoïde s’impose comme un outil incontournable. Sa forme caractéristique en « S », marquant le passage progressif d’un état asymptotique initial à un palier de saturation terminal, permet de traduire des grandeurs continues non bornées en proportions, probabilités ou degrés d’activation standardisés entre 0 et 1.
Bien que les progiciels statistiques spécialisés tels que R, Python, SPSS ou SAS offrent des bibliothèques dédiées à l’ajustement non linéaire de ces courbes, Microsoft Excel demeure un environnement de choix pour les chercheurs, analystes comportementaux, psychométriciens et ingénieurs de données. La transparence native de sa grille bidimensionnelle, la flexibilité de son moteur d’évaluation arithmétique et la puissance de ses outils intégrés — notamment le Solveur GRG non linéaire et les fonctions matricielles dynamiques — font du tableur une plateforme pédagogique et opérationnelle d’une robustesse remarquable.
Ce guide exhaustif a pour vocation d’analyser en profondeur les fondements formels, les déclinaisons psychométriques et les protocoles d’implémentation pratique de la fonction sigmoïde au sein de Microsoft Excel. De la théorie mathématique de base aux fonctions personnalisées de dernière génération intégrant les structures LAMBDA et LET, en passant par l’optimisation des moindres carrés et la prévention des instabilités numériques en virgule flottante, chaque étape fait l’objet d’un examen méthodique et rigoureux pour garantir l’intégrité computationnelle de vos modèles.
1. Introduction théorique à la fonction sigmoïde et ses fondements mathématiques
1.1 Définition mathématique et forme canonique
La fonction sigmoïde canonique, fréquemment qualifiée de fonction logistique de Verhulst, constitue une solution fondamentale aux équations différentielles décrivant la croissance autolimitée. Dans sa formulation mathématique standard la plus épurée, elle s’exprime sous la forme :
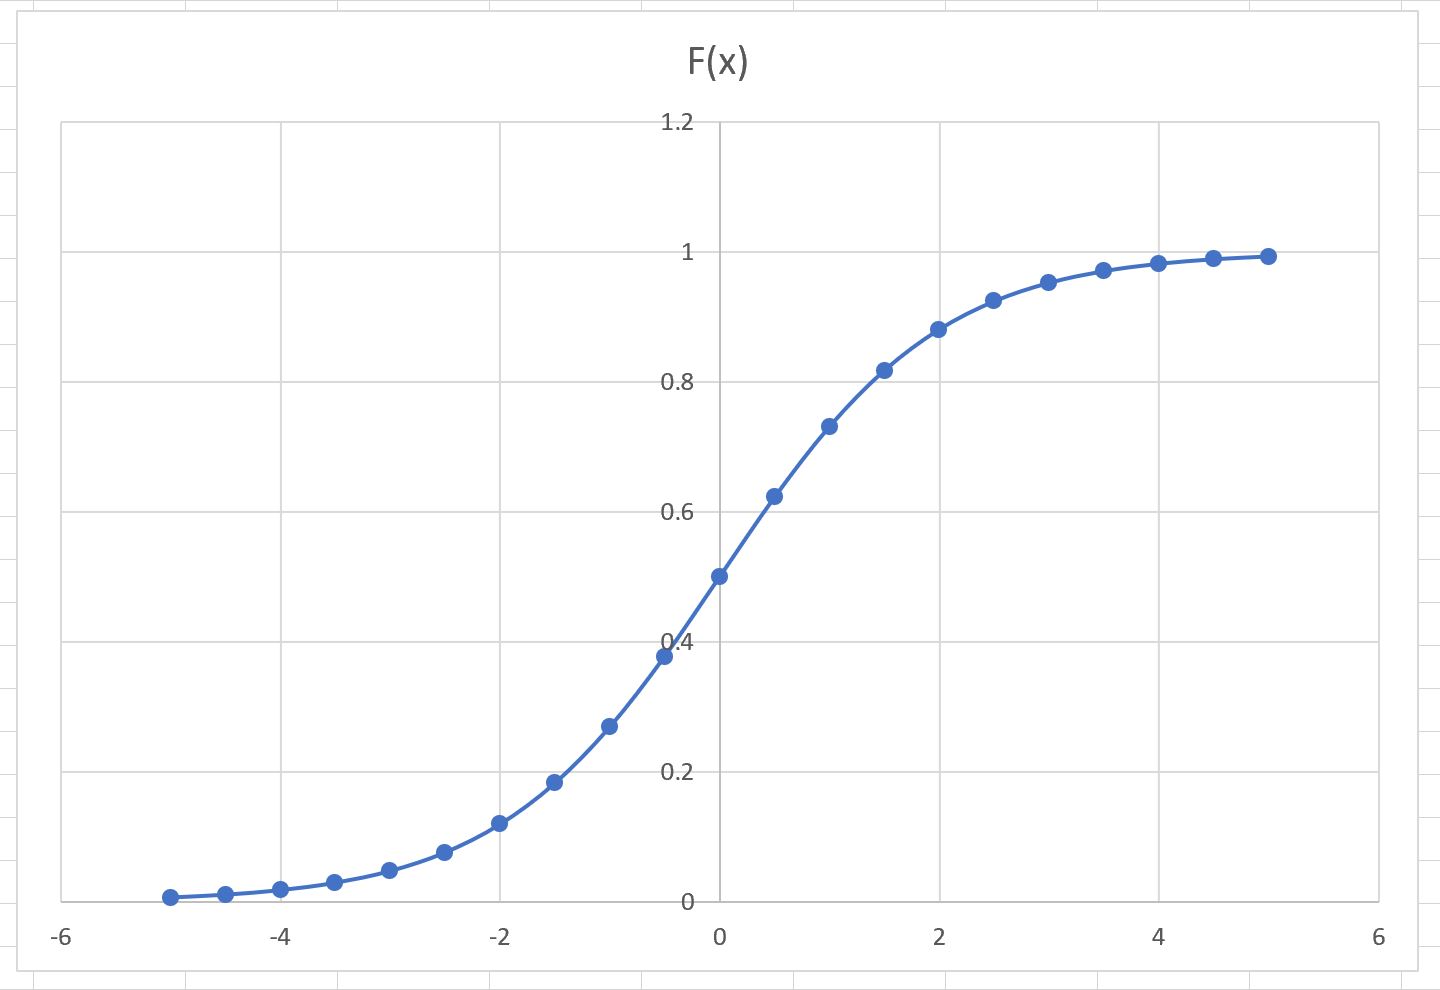
F(x) = 1 / (1 + exp(-x))
Sur le plan topologique, cette fonction continue est strictement croissante et infiniment différentiable sur l’ensemble des réels. Elle présente la particularité majeure de mapper l’espace euclidien unidimensionnel infini vers un intervalle ouvert rigoureusement borné par deux asymptotes horizontales : la limite lorsque x tend vers l’infini négatif est rigoureusement égale à 0, tandis que la limite lorsque x tend vers l’infini positif atteint 1. Cette propriété de double convergence asymptotique confère à la courbe sa capacité intrinsèque à convertir n’importe quelle échelle de mesure continue en une métrique de probabilité normalisée.
Une caractéristique géométrique essentielle de la sigmoïde réside dans sa symétrie centrale par rapport à son point d’inflexion unique, situé précisément aux coordonnées (0 ; 0,5). En ce point singulier, la concavité de la fonction bascule d’une courbure orientée vers le haut (convexe sur l’intervalle des réels négatifs) à une courbure orientée vers le bas (concave sur l’intervalle des réels positifs). Formellement, cette propriété se traduit par l’identité remarquable F(-x) = 1 – F(x), attestant que la vitesse d’approche de l’asymptote inférieure pour des valeurs négatives est rigoureusement identique à celle de l’asymptote supérieure pour des valeurs positives symétriques.
L’étude différentielle de la fonction logistique met en lumière une propriété computationnelle d’une rare élégance : sa dérivée première peut s’exprimer directement en fonction de son image par la relation F'(x) = F(x) * (1 – F(x)). Cette formulation démontre que le taux de variation instantané atteint son maximum absolu précisément au point d’inflexion x = 0, où F'(0) = 0,5 * (1 – 0,5) = 0,25. À mesure que l’on s’éloigne de cette zone médiane, le produit F(x) * (1 – F(x)) décroît rapidement vers zéro, expliquant l’atténuation graduelle du gradient et la saturation caractéristique observée aux extrêmes de la distribution.
1.2 Rôle mathématique de la constante exponentielle dans le calcul
L’utilisation de la base exponentielle népérienne, symbolisée par le nombre d’Euler e (dont la valeur approximative est de 2,718281828459045), n’est pas un artifice arbitraire, mais le moteur même de la courbure logistique. La fonction exponentielle possède la propriété singulière d’être sa propre dérivée, conférant aux systèmes qu’elle gouverne une dynamique de proportionnalité parfaite entre leur amplitude instantanée et leur vitesse de transition. Au sein du dénominateur de la sigmoïde, le terme exp(-x) module la pondération de l’asymptote.
L’insertion du signe négatif dans l’exposant inverse la dynamique d’expansion naturelle de la fonction exponentielle. Lorsque la variable indépendante x prend des valeurs positives massives, exp(-x) s’effondre de manière exponentielle vers zéro, ramenant le dénominateur (1 + exp(-x)) à une valeur infiniment proche de 1, ce qui conduit la fonction F(x) vers son asymptote supérieure unitaire. Réciproquement, lorsque x acquiert une magnitude négative substantielle, l’expression -x redevient strictement positive, provoquant une croissance vertigineuse de exp(-x). Le dénominateur devient alors colossal, écrasant la fraction vers zéro absolu.
Cette transformation exponentielle accomplit une opération primordiale : le pontage fonctionnel entre une droite réelle non bornée (les scores log-odds, ou logits) et un espace de probabilités probabilistes strictement confiné entre 0 et 1. En statistique inférentielle et en psychométrie, la quantité x représente généralement le logarithme du rapport de cotes, soit ln(p / (1 – p)). L’application de la transformation sigmoïde neutralise le logarithme et résout l’équation pour extraire directement le paramètre de probabilité sous-jacent, établissant un modèle mathématiquement stable face aux fluctuations extrêmes du trait mesuré.
2. L’importance de la fonction sigmoïde en psychologie quantitative et sciences comportementales
2.1 Modélisation psychophysique et seuils de perception
Dans le domaine de la psychophysique expérimentale, initié par les travaux pionniers de Gustav Theodor Fechner, la relation entre l’intensité physique d’un stimulus (luminance, pression acoustique, concentration chimique) et la sensation consciente qu’il génère n’est jamais linéaire. Lorsque l’on soumet un participant à des stimuli d’intensités graduées, la transition entre l’absence totale de détection (état infra-liminaire) et la détection infaillible (état supra-liminaire) ne prend pas la forme d’un saut discret ou d’une marche d’escalier, mais d’une courbe continue en S dénommée fonction psychométrique.
Cette dispersion continue des réponses résulte du bruit neuronal intrinsèque, des fluctuations attentionnelles du sujet et de l’incertitude synaptique. La sigmoïde traduit alors la probabilité cumulative qu’un signal sensoriel interne franchisse un critère décisionnel donné. Le paramètre central de cette courbe, correspondant au point d’inflexion où la probabilité de détection atteint exactement 0,5 (ou 50 %), définit le seuil absolu de perception. C’est en ce point que la sensibilité sensorielle est maximale, car une variation infinitésimale de l’intensité du stimulus physique y produit la plus forte modification de la réponse comportementale.
L’exploitation de la fonction sigmoïde dans ce contexte permet d’extraire non seulement le seuil perceptif par la localisation du centre de gravité de la transition, mais également le seuil différentiel (ou seuil de discrimination) à travers la pente de la courbe. Une pente particulièrement abrupte révèle un système sensoriel hautement résolutif, capable de discriminer de minimes nuances d’intensité, alors qu’une pente étalée traduit une variance résiduelle substantielle ou une dégradation de l’acuité sensorielle chez le sujet testé.
2.2 Théorie de réponse aux items (TRI) et évaluation cognitive
Dans l’évaluation psychométrique moderne, la Théorie de Réponse aux Items (TRI) supplante la théorie classique des tests en modélisant la probabilité de réussite d’un individu à une épreuve cognitive en fonction de son niveau de compétence latent, conventionnellement noté par la lettre grecque thêta (θ). Au cœur de cette méthodologie se trouve le modèle logistique uniparamétrique, universellement désigné sous le nom de modèle de Rasch, qui structure la probabilité de réponse correcte selon une formule strictement sigmoïdale.
Ce formalisme établit que la probabilité conditionnelle P(X = 1 | θ, b) qu’un individu doté de la compétence θ réussisse un item de difficulté b équivaut à 1 / (1 + exp(-(θ – b))). Lorsque le niveau de compétence du sujet est rigoureusement identique à la difficulté intrinsèque de l’exercice proposé (θ = b), la différence (θ – b) s’annule, aboutissant à une probabilité de succès d’exactement 0,5. Si la compétence surpasse la difficulté, la probabilité s’approche de 1 ; si elle lui est inférieure, elle décline vers zéro.
Le tracé graphique de cette équation génère la Courbe Caractéristique de l’Item (CCI). Dans le cadre de l’étalonnage psychométrique, la sigmoïde assure une propriété méthodologique inestimable : l’invariance de la mesure. Contrairement aux scores bruts sur des échelles composites, le modèle logistique permet de découpler mathématiquement les caractéristiques intrinsèques de l’instrument de mesure (la difficulté des questions) des propriétés distributionnelles de l’échantillon de participants (le niveau intellectuel ou clinique du groupe testé).
2.3 Modélisation de l’apprentissage et processus neuronaux
Au-delà de la mesure psychométrique statique, la fonction sigmoïde constitue un paradigme central pour la modélisation dynamique des courbes d’apprentissage individuel et collectif. Les études longitudinales en sciences cognitives démontrent de manière récurrente que l’acquisition d’une compétence complexe ou la mémorisation d’un corpus lexical suit une cinétique non linéaire : une phase d’amorce initiale lente caractérisée par des progrès modestes, suivie d’une accélération brutale marquant l’intégration des règles sous-jacentes, et enfin un ralentissement asymptotique correspondant au plafonnement des performances physiologiques ou mnésiques.
Cette cinétique est rigoureusement reproduite par l’architecture logistique, surpassant les approximations linéaires qui violent inévitablement les contraintes de bornage biologique en prédisant des performances infinies lors de temps d’entraînement prolongés, ou négatives aux prémices de la tâche. La sigmoïde capture l’existence d’une résistance initiale à l’apprentissage (liée à la charge cognitive) et d’un rendement décroissant de la pratique délibérée au voisinage du plafond d’expertise.
Sur le plan computationnel, cette même géométrie a motivé l’adoption de la sigmoïde comme fonction d’activation canonique dans les premières générations de réseaux de neurones artificiels mimant le fonctionnement des réseaux corticaux. En introduisant une non-linéarité douce et différentiable, la sigmoïde simule le taux de décharge moyen d’un neurone biologique, qui demeure silencieux en dessous d’un certain potentiel d’action membranaire, subit une excitation rapide dès que le seuil de dépolarisation est franchi, puis sature à une fréquence d’émission maximale contrainte par la période réfractaire absolue des canaux ioniques.
3. Architecture de la formule sigmoïde standard dans Microsoft Excel
3.1 La fonction EXP dans l’environnement Excel
Pour exécuter un calcul sigmoïde au sein de la feuille de calcul Microsoft Excel, le moteur arithmétique s’appuie sur sa fonction native d’exponentiation, formalisée par la syntaxe EXP(nombre). Cette fonction renvoie la constante mathématique e élevée à la puissance spécifiée par l’argument numérique placé entre parenthèses. Il convient de souligner que cette fonction est codée en double précision selon le standard IEEE 754, garantissant une résolution allant jusqu’à 15 chiffres significatifs.
Dans l’équation de la sigmoïde standard, l’argument transmis à la fonction exponentielle doit impérativement être inversé arithmétiquement pour représenter la valeur -x. L’écriture correcte dans Excel s’établit donc sous la forme EXP(-A1), où la cellule A1 héberge l’antécédent numérique x. L’oubli du signe négatif est une erreur fréquente qui transforme la fonction en une courbe logistique inverse (décroissante), assignant des valeurs proches de 1 aux scores fortement négatifs et tendant vers 0 pour les scores positifs, ce qui altère l’ensemble des inférences statistiques subséquentes.
Du point de vue du moteur computationnel d’Excel, l’évaluation de EXP(-x) pour des valeurs de x comprises dans l’intervalle classique de l’analyse comportementale (typiquement de -10 à +10) est quasi instantanée et bénéficie d’une précision analytique optimale. Le système résout le terme exponentiel avant toute autre interaction algébrique, préparant le dénominateur de la formule finale à l’addition de l’unité.
3.2 Syntaxe de la formule de base pour une cellule cible
L’implémentation complète de la fonction sigmoïde canonique dans une cellule réceptrice d’Excel s’articule autour d’une syntaxe mathématique élémentaire mais rigoureuse :
=1/(1+EXP(-A1))
L’analyse de l’ordre de priorité des opérateurs exécutés par Excel dans cette formule révèle une hiérarchie stricte. Le moteur arithmétique commence par appliquer l’opérateur unaire de négation sur le contenu de la cellule référencée (A1). Il procède ensuite à l’évaluation de la fonction EXP() sur ce résultat intermédiaire. Dans un troisième temps, il effectue l’addition scalaire 1 + EXP(-A1), le tout étant formellement encapsulé entre parenthèses. Enfin, l’opérateur de division unitaire divise le numérateur constant (1) par l’ensemble du bloc composant le dénominateur.
Il est impératif d’observer scrupuleusement la présence des parenthèses englobant le dénominateur. L’omission de ces délimiteurs, sous la forme erronée =1/1+EXP(-A1), conduirait le tableur à appliquer la précédence standard des opérations (division avant addition), calculant ainsi (1/1) + EXP(-A1), soit 1 + EXP(-A1), ce qui produirait une courbe exponentielle décroissante sans aucune borne supérieure, ruinant le caractère asymptotique de la modélisation.
Enfin, la distinction entre références relatives (ex. A1) et références absolues (ex. $A$1) doit être anticipée selon le contexte de déploiement. Pour une colonne de données où chaque ligne représente une observation individuelle, l’utilisation de la référence relative standard est requise afin de permettre l’incrémentation dynamique de l’indice de ligne lors de l’extension de la formule vers le bas.
4. Mise en place pas à pas d’un jeu de données pour le calcul sigmoïde
4.1 Structuration matricielle de la feuille de calcul
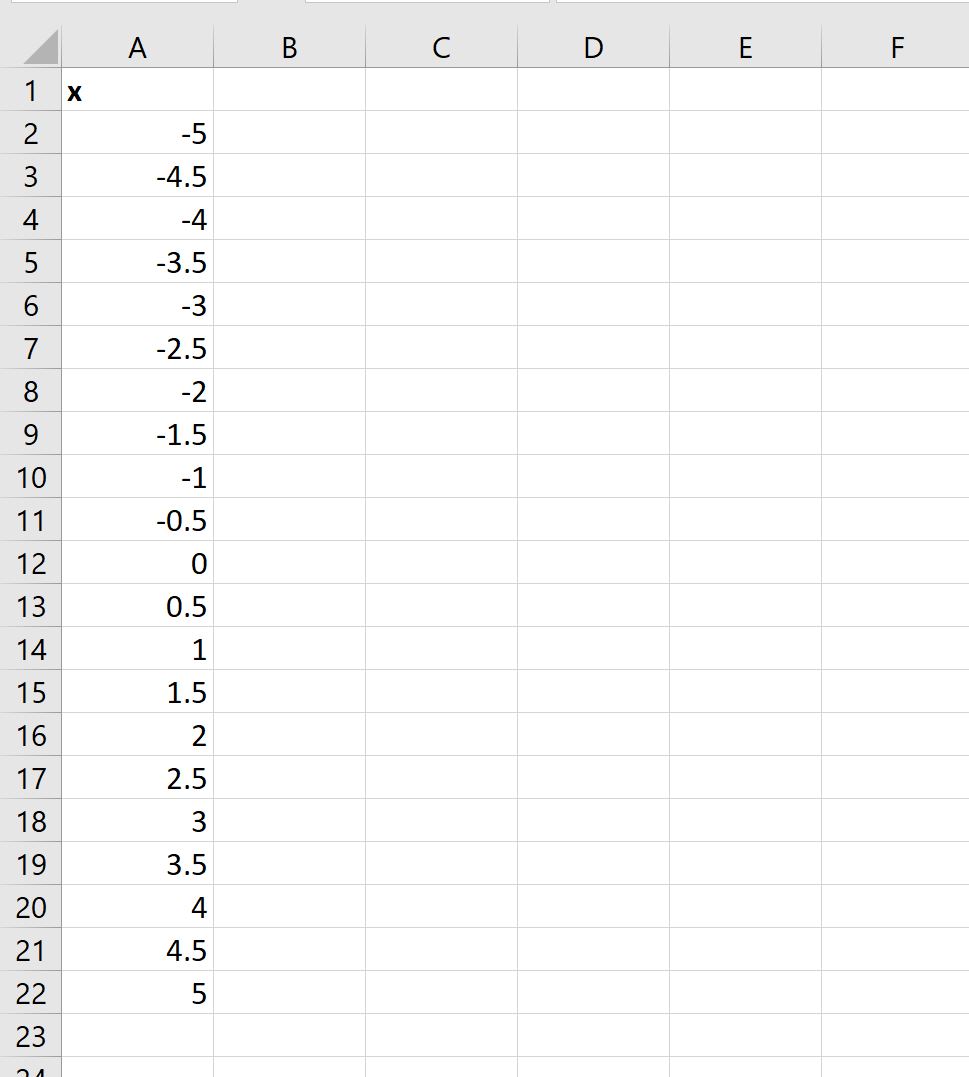
Pour concevoir un classeur méthodologiquement propre et scientifiquement exploitable, la première étape consiste à structurer les données sous une forme matricielle tabulaire. Ouvrez un classeur vierge et réservez la première ligne à l’étiquetage descriptif des variables. Dans la cellule A1, inscrivez l’en-tête Valeur_X (représentant la variable indépendante, par exemple le niveau de compétence latent θ ou l’intensité du stimulus), puis dans la cellule B1, renseignez Sigmoide_FX.
Afin de visualiser la totalité de la trajectoire sigmoïdale, depuis son asymptote inférieure jusqu’à son asymptote supérieure, il est recommandé de générer un vecteur d’abscisses s’étendant symétriquement de -6 à +6 avec un incrément fin de 0,5. Pour ce faire :
- Saisissez la valeur numérique
-6dans la cellule A2. - Dans la cellule A3, saisissez la formule d’incrémentation
=A2+0,5. - Sélectionnez la cellule A3 et étirez-la vers le bas via la poignée de recopie jusqu’à la cellule A26, qui affichera la valeur
6.
Alternativement, pour les utilisateurs disposant d’Excel 365 ou d’Excel 2021, cette séquence d’abscisses peut être générée instantanément dans la cellule A2 par la fonction de tableau dynamique moderne : =SEQUENCE(25; 1; -6; 0,5). Cette approche élimine tout risque de rupture de formule au sein de la colonne de référence.
Il convient ensuite de standardiser le formatage numérique de cette plage de données. Sélectionnez l’ensemble de la colonne A (plage A2:A26), accédez au ruban Accueil, groupe Nombre, sélectionnez le format Nombre et fixez l’affichage à deux décimales. Cette précaution garantit un alignement vertical optimal des coordonnées sans altérer la précision interne des calculs sous-jacents.
4.2 Saisie méthodique de la formule mathématique
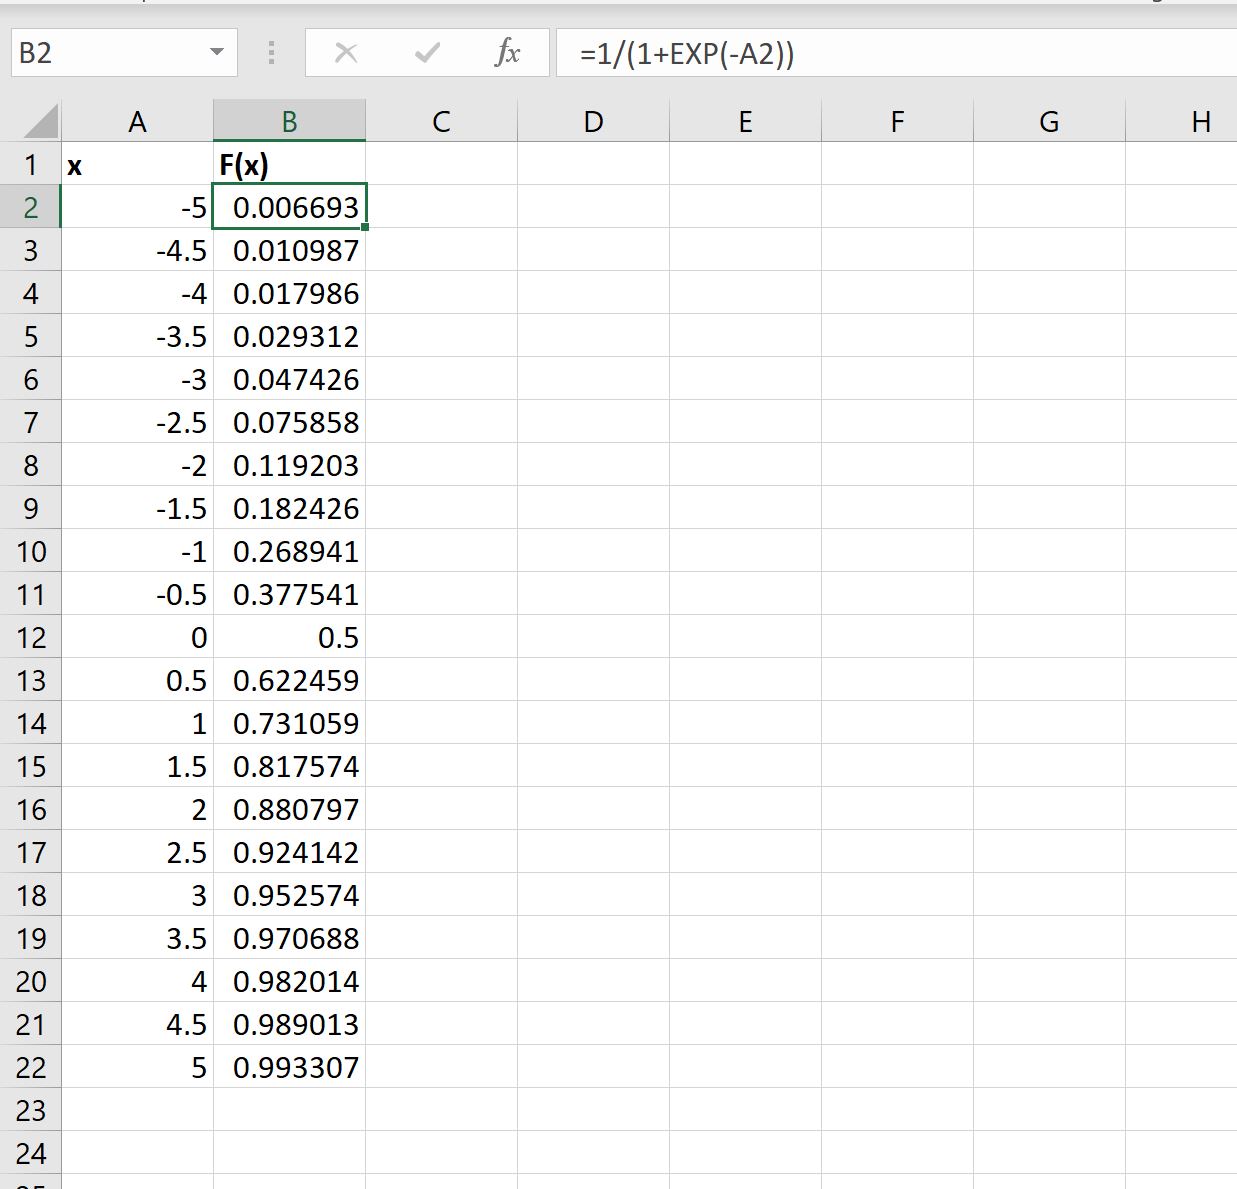
La structuration de l’espace vectoriel étant achevée, positionnez le curseur sur la cellule B2, destinée à recevoir la première évaluation de la fonction de répartition logistique. Saisissez scrupuleusement la formule suivante :
=1/(1+EXP(-A2))
Validez par la touche Entrée. Pour x = -6, Excel doit renvoyer la valeur approximative de 0,002472623, confirmant que la courbe se trouve à ce stade sur son plancher asymptotique inférieur, à moins de 0,25 % de son minimum théorique. Pour assurer un contrôle de conformité immédiat de la chaîne arithmétique, examinez les valeurs clés attendues lors de la réplication de la formule sur l’axe :
- Pour x = 0 (situé dans la cellule A14), la cellule correspondante B14 doit afficher exactement
0,500000000. Tout écart par rapport à cette valeur révèlerait un biais dans la formulation de l’exposant ou un déplacement involontaire de l’origine. - Pour x = 6 (cellule A26), le résultat affiché doit atteindre environ
0,997527377, démontrant une convergence symétrique vers l’asymptote unitaire supérieure.
Formatez la plage des résultats (B2:B26) avec une précision d’affichage minimale de quatre à six décimales. Une résolution insuffisante (par exemple fixée à un seul chiffre après la virgule) masquerait la progressivité de la courbure aux bornes en arrondissant prématurément les valeurs extrêmes à 0,0 et 1,0, ce qui empêcherait une appréciation visuelle et diagnostique adéquate de la cinétique logistique.
5. Automatisation et extension du calcul sur des séries de données étendues
5.1 Propagation dynamique de la formule
Lorsque le volume de données comprend des centaines de milliers de lignes — situation standard lors du traitement de logs comportementaux ou de signaux neurophysiologiques à haute fréquence —, l’étirement manuel de la formule via la souris devient prohibitif et source d’erreurs méthodologiques. Plusieurs techniques professionnelles permettent d’automatiser instantanément la propagation de la fonction sigmoïde le long de la colonne.
La méthode la plus rapide repose sur l’utilisation du double-clic sur la poignée de recopie. Après avoir saisi la formule initiale dans la cellule B2, positionnez le pointeur de la souris sur le coin inférieur droit de la cellule jusqu’à ce que le curseur prenne la forme d’une croix noire fine. Un double-clic instantané force Excel à projeter la formule vers le bas jusqu’à la dernière ligne consécutivement renseignée de la colonne adjacente A. Pour les utilisateurs privilégiant les raccourcis clavier, sélectionnez la plage complète à renseigner (de B2 à B26), puis exécutez la combinaison de touches Ctrl + D (ou Ctrl + B dans certaines localisations francophones historiques) pour propager la formule du haut vers le bas.
Néanmoins, la meilleure pratique de gouvernance de données consiste à convertir préalablement la plage en Tableau Excel structuré. Pour ce faire, sélectionnez n’importe quelle cellule de votre plage (A1:B26), appuyez sur Ctrl + L ou rendez-vous dans le ruban Insertion > Tableau en vous assurant que la case « Mon tableau comporte des en-têtes » est cochée. Dans cet environnement structuré, la formule saisie en B2 s’exprime sous une syntaxe explicite :
=1/(1+EXP(-[@Valeur_X]))
Le tableau génère automatiquement ce calcul sur l’intégralité des lignes existantes et l’appliquera instantanément à toute nouvelle ligne ajoutée en fin de base, éliminant de facto le risque d’omission d’actualisation de la plage calculée.
5.2 Formules de tableaux dynamiques pour calcul vectorisé
L’introduction du moteur de calcul matriciel dynamique dans les versions contemporaines de Microsoft Excel (Excel 365, Office 2021 et versions web) a fondamentalement transformé l’ingénierie des feuilles de calcul. Il n’est désormais plus nécessaire de dupliquer une formule scalaire sur des milliers de cellules réceptrices : une seule formule inscrite dans la cellule supérieure gauche d’une zone libre peut générer un vecteur complet de résultats propagés (spill range).
Pour appliquer cette approche vectorielle moderne à la fonction sigmoïde, assurez-vous que la colonne B soit intégralement dégagée, puis saisissez directement en B2 la formule référençant l’intégralité du vecteur d’entrée :
=1/(1+EXP(-A2:A26))
Dès la validation, Excel alloue une zone dynamique délimitée par un cadre bleu et remplit instantanément les cellules B2 à B26 avec les valeurs logistiques respectives. Cette vectorisation offre des garanties méthodologiques de premier ordre pour la recherche quantitative :
- Intégrité absolue des calculs : Les cellules sous-jacentes (B3:B26) ne contiennent pas de code modifiable individuellement. Il est impossible d’altérer par mégarde une cellule isolée sans invalider l’ensemble du vecteur par une erreur explicite
#PROPAGATION!(ou#SPILL!). - Optimisation de la mémoire vive : Le moteur d’évaluation traite l’opération sous forme de bloc matriciel unifié, réduisant l’empreinte mémoire et accélérant les phases de recalcul lors du traitement de jeux de données massifs.
- Réactivité dynamique : Si le vecteur d’entrée A2:A26 est remplacé par une formule de séquence ou une référence dynamique redimensionnable (ex.
A2#), le vecteur sigmoïde s’ajuste instantanément sans la moindre intervention manuelle de l’analyste.
6. Paramétrage avancé : Fonction logistique généralisée et modèle à quatre paramètres
6.1 Intégration de la pente et du point d’inflexion
Dans les applications réelles de psychologie quantitative, de bio-essai ou d’économie comportementale, les observations empiriques ne coïncident presque jamais avec la forme canonique standard centrée sur zéro et dotée d’une vitesse de transition unitaire. Il est donc indispensable d’introduire deux paramètres morphologiques fondamentaux : un paramètre d’échelle (ou de pente), désigné conventionnellement par k, et un paramètre de translation horizontale (ou point d’inflexion), désigné par x0.
L’équation généralisée à deux paramètres s’énonce comme suit :
F(x) = 1 / (1 + exp(-k * (x – x0)))
Le paramètre k gouverne l’abrupteté de la transition. Si k est strictement supérieur à 1, la courbe se redresse violemment autour de son centre, tendant vers une fonction en escalier binaire (fonction de Heaviside) lorsque k prend des valeurs très élevées. Inversement, si k est compris entre 0 et 1, la pente s’adoucit, étalant la transition sur une plage d’abscisses beaucoup plus vaste. Une valeur négative de k inverserait l’orientation de la sigmoïde, la transformant en une fonction logistique strictement décroissante.
Le paramètre x0 représente quant à lui la valeur d’abscisse exacte pour laquelle la probabilité atteint 0,5. Il décale l’intégralité de la courbe vers la droite (si x0 > 0) ou vers la gauche (si x0 < 0) le long de l’axe horizontal, sans altérer sa géométrie fondamentale.
Pour implémenter cette formulation dans Excel :
- Réservez les cellules D1 et D2 pour consigner respectivement vos paramètres, par exemple la valeur
1,5en D1 (pour le paramètre k) et la valeur2,0en D2 (pour le paramètre x0). - Dans la colonne de calcul B (cellule B2), saisissez la formule verrouillant ces paramètres par des références absolues :
=1/(1+EXP(-$D$1*(A2-$D$2))). - Propagez la formule vers le bas. Vous constaterez immédiatement que le point d’inflexion F(x) = 0,5 coïncide désormais rigoureusement avec la ligne où x = 2,0.
6.2 Le modèle logistique à 4 paramètres (4PL) pour les données biologiques et psychologiques
Dans une vaste majorité d’expérimentations réelles, les données ne démarrent pas à zéro et ne plafonnent pas à un. Par exemple, dans un questionnaire à choix multiples comportant quatre options, un participant répondant totalement au hasard obtiendra un taux de succès théorique de 25 % (asymptote basse non nulle). De même, un phénomène de fatigue cognitive, un manque d’attention ou une limite de conduction physiologique peuvent empêcher la performance d’atteindre le score parfait de 100 % (asymptote haute inférieure à 1).
Pour modéliser ces contraintes, on emploie le modèle logistique à 4 paramètres (4PL), dont la formulation s’établit selon :
F(x) = A + (B – A) / (1 + exp(-k * (x – x0)))
Dans ce cadre analytique élargi :
- A représente l’asymptote inférieure (le plancher théorique ou taux de réponse aléatoire).
- B représente l’asymptote supérieure (le plafond de performance ou niveau de saturation).
- k représente le facteur de pente (la vitesse de transition logistique).
- x0 représente le point d’inflexion médian, correspondant à l’abscisse où F(x) = (A + B) / 2.
Pour transposer le modèle 4PL dans Excel, structurez un bloc de paramètres dédiés dans votre feuille : saisissez la valeur de A en E1 (ex. 0,20), la valeur de B en E2 (ex. 0,95), la pente k en E3 (ex. 2,0) et le centre x0 en E4 (ex. 0,0). La formule matricielle ou unitaire inscrite en cellule B2 devient :
=$E$1+($E$2-$E$1)/(1+EXP(-$E$3*(A2-$E$4)))
Cette architecture confère une flexibilité totale à vos simulations : en modifiant simplement les valeurs scalaires des cellules E1 à E4, la dynamique complète de la réponse comportementale ou biologique se recalcule instantanément, garantissant le respect des bornes physiologiques imposées par votre protocole expérimental.
7. Visualisation graphique : Construire une courbe sigmoïde rigoureuse dans Excel
7.1 Sélection du type de graphique approprié
La transcription visuelle d’une fonction sigmoïde exige une rigueur méthodologique sans faille concernant le choix de l’objet graphique dans Excel. L’erreur la plus répandue parmi les analystes consiste à sélectionner un graphique standard de type « Courbe » (Line Chart). Dans ce type de rendu, Excel traite l’axe des abscisses non pas comme un continuum métrique réel, mais comme une suite ordonnée d’étiquettes textuelles discrètes équidistantes.
Si votre échantillonnage de valeurs X comporte des pas irréguliers (par exemple des mesures prises à -5, -4, -1, 0, 0,2, 0,5, 3), le graphique en Courbe espacera ces points de manière strictement identique sur l’axe horizontal, ce qui déformera dramatiquement la géométrie de la sigmoïde et faussera l’évaluation visuelle du point d’inflexion et de la pente. Pour respecter la fidélité mathématique de la distribution, le choix impératif doit se porter sur le Graphique en Nuage de points (XY).
La procédure d’insertion académique s’exécute selon les étapes suivantes :
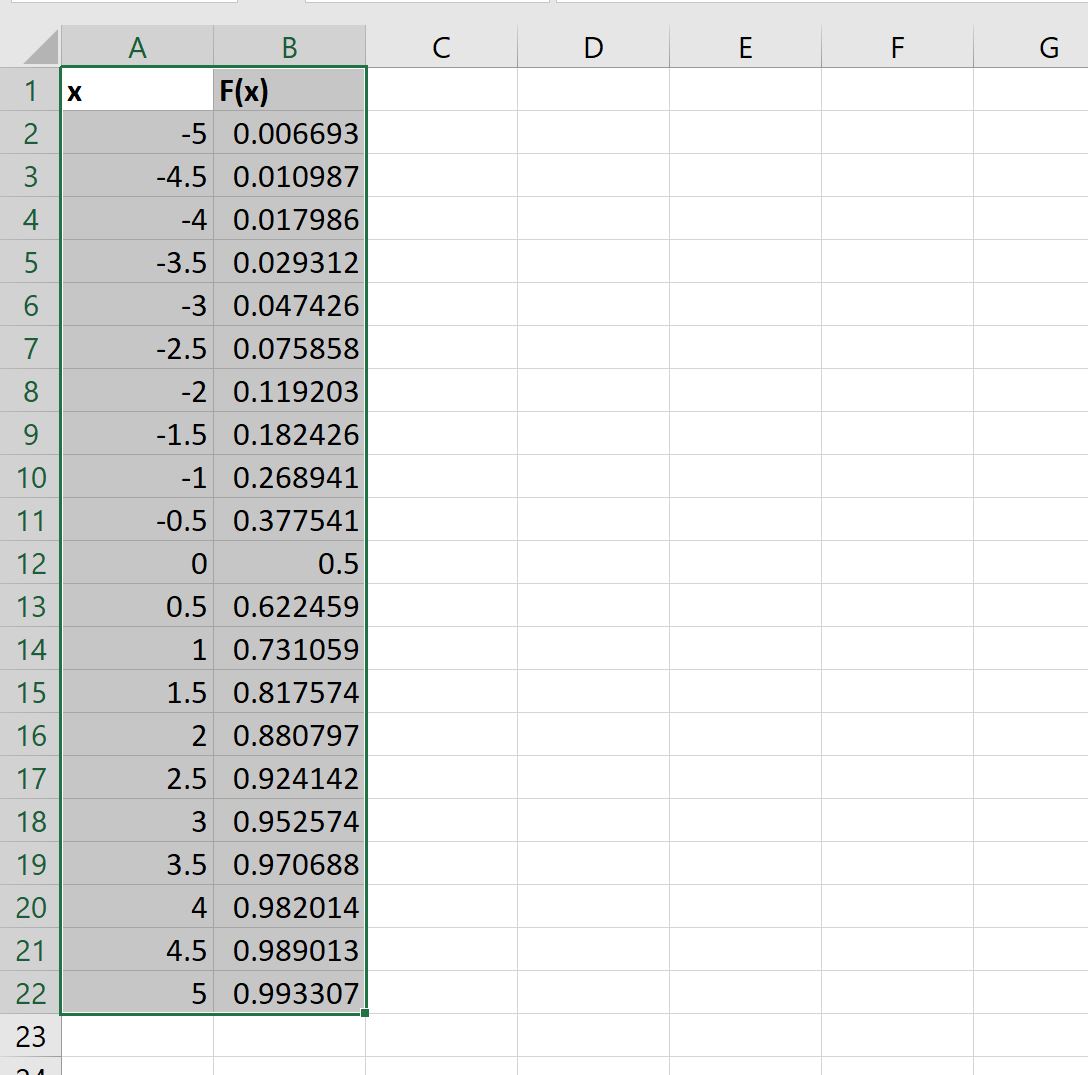
- Sélectionnez simultanément les deux colonnes de données contenant les abscisses et les ordonnées calculées (plage A1:B26).
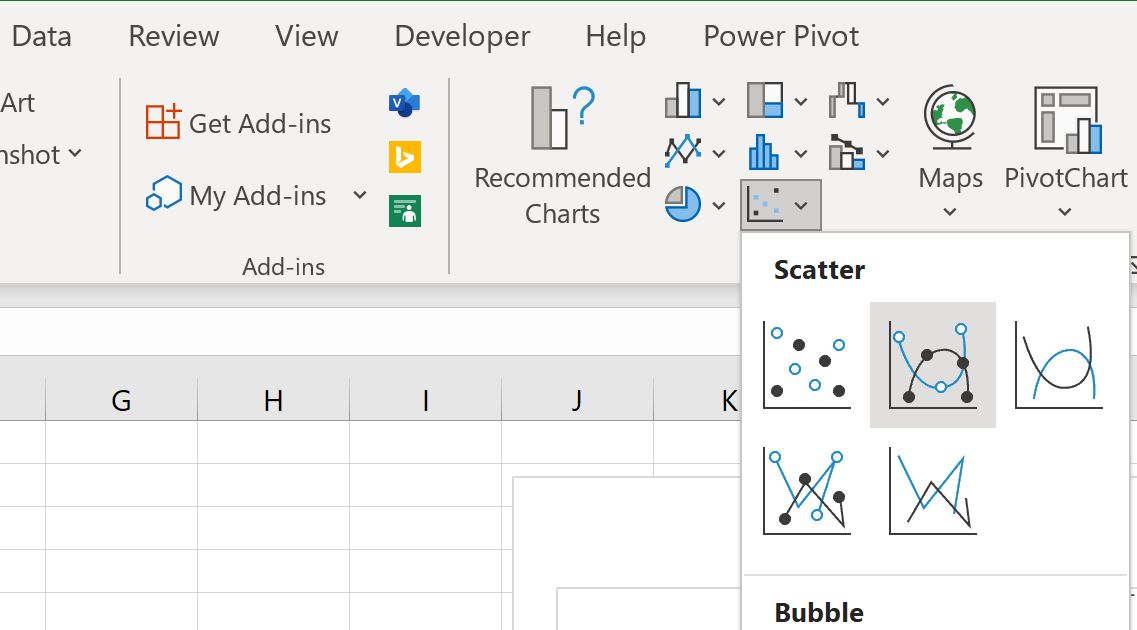
- Accédez au ruban supérieur Insertion, localisez le groupe Graphiques, puis cliquez sur l’icône Insérer un graphique en nuage de points (X, Y).
- Dans le menu contextuel déroulant, sélectionnez l’option Nuage de points avec lignes lisses (sans marqueurs si votre jeu de données comporte un grand nombre de points d’évaluation, ou avec marqueurs discrets si vous désirez mettre en évidence des observations expérimentales réelles).
Le graphique ainsi inséré projette chaque paire de données (x, y) dans un véritable repère cartésien bidimensionnel orthogonal, préservant la distance métrique exacte entre les observations.
7.2 Formatage académique et calibrage des axes
Un tracé par défaut généré par Excel présente fréquemment des réglages typographiques et scalaires inadaptés aux exigences des publications scientifiques. Un calibrage minutieux des propriétés graphiques est requis pour conférer à la figure une rigueur de publication.
En premier lieu, le calibrage de l’axe vertical (ordonnées) exige une contrainte stricte :
- Effectuez un double-clic sur l’axe vertical pour déployer le panneau latéral Format de l’axe.
- Sous l’onglet Options d’axe, forcez impérativement la borne Minimum à
0,0et la borne Maximum à1,0(ou aux valeurs correspondant aux asymptotes A et B du modèle 4PL). Laisser Excel ajuster ces bornes de manière automatique engendre souvent un étalonnage flottant (ex. de -0,1 à 1,1) qui dilue la signification probabiliste des asymptotes horizontales. - Définissez l’unité principale de graduation à
0,2ou0,1selon le degré de résolution souhaité.
En second lieu, ajustez l’axe horizontal pour centrer le tracé :
- Définissez un minimum symétrique (par exemple
-6,0) et un maximum symétrique (6,0), avec une unité principale fixée à1,0ou2,0. - Pour améliorer la lisibilité structurelle du graphique, ajoutez une ligne de référence horizontale au niveau critique y = 0,5. Pour cela, vous pouvez intégrer une série secondaire matérialisant le seuil de décision médian, ou configurer un quadrillage secondaire fin au sein de l’aire de traçage.
Enfin, appliquez un étiquetage explicite. Supprimez le titre générique automatique et activez les éléments de graphique Titres des axes via le bouton « + » situé à droite du graphique. Nommez l’axe horizontal selon la métrique sous-jacente (par exemple : Intensité acoustique (dB) ou Trait latent (θ)) et l’axe vertical de façon univoque (par exemple : Probabilité de détection P(Y=1)). Supprimez les bordures agressives et préférez une palette de couleurs monochrome sobre pour les rendus destinés aux revues à comité de lecture.
8. Ajustement non linéaire et optimisation de courbe avec le Solveur d’Excel
8.1 Formulation du critère des moindres carrés
L’utilisation de la fonction sigmoïde dans les protocoles de recherche ne se cantonne pas à la simulation théorique ; elle sert avant tout à calibrer des modèles empiriques en ajustant des paramètres inconnus sur des données expérimentales bruitées. Cet ajustement repose conventionnellement sur la méthode d’estimation non linéaire des moindres carrés ordinaires (MCO).
Considérons un scénario où la colonne A héberge les intensités de stimulus administrées, la colonne B les fréquences de réponses positives observées sur un échantillon d’individus (valeurs réelles comprises entre 0 et 1), et la colonne C les prédictions calculées par une fonction sigmoïde généralisée dépendant des paramètres k (cellule F1) et x0 (cellule F2).
Pour mesurer l’écart global entre la modélisation théorique et le corpus empirique, il est nécessaire de quantifier l’erreur d’ajustement. Dans la colonne D, calculez le résidu individuel au carré pour chaque ligne :
=(B2-C2)^2
Propagez cette formule le long de la série. Au bas de cette colonne résiduelle, ou dans une cellule d’analyse dédiée (par exemple F4), calculez la Somme des Carrés des Erreurs (SCE) — universellement désignée par l’acronyme anglais SSE (Sum of Squared Errors) — au moyen de la formule sommative :
=SOMME(D2:D26)
Alternativement, pour éviter la création d’une colonne intermédiaire de résidus, la métrique globale peut être synthétisée en une expression matricielle unique utilisant la fonction SOMMEPROD :
=SOMMEPROD((B2:B26 - C2:C26)^2)
Cette cellule cible représente la fonction objectif fondamentale du système : plus sa magnitude scalaire est faible, plus la courbe sigmoïde théorique épouse fidèlement la distribution réelle des données.
8.2 Configuration algorithmique du Solveur
Microsoft Excel intègre nativement un puissant moteur d’optimisation numérique capable de résoudre ce problème d’ajustement non linéaire : le Solveur. S’il n’apparaît pas dans l’onglet Données de votre ruban, activez-le préalablement en naviguant dans Fichier > Options > Compléments, sélectionnez Compléments Excel dans la zone de gestion, cliquez sur Atteindre, cochez Complément Solveur et validez.
Une fois l’outil déployé, la séquence de paramétrage de l’optimisation doit être configurée avec rigueur :
- Ouvrez la boîte de dialogue du Solveur depuis le ruban Données > Analyse > Solveur.
- Définir l’objectif : Pointez vers votre cellule contenant la somme des résidus au carré (cellule
$F$4). - À : Cochez impérativement la case radio Min (l’algorithme doit converger vers la variance résiduelle minimale absolue).
- En modifiant les cellules de variables : Indiquez les coordonnées des paramètres libres que l’algorithme est autorisé à modifier, en l’occurrence la plage
$F$1:$F$2(représentant la pente k et le centre x0). - Sélectionner une méthode de résolution : Choisissez impérativement le moteur GRG Non linéaire (Generalized Reduced Gradient). Le moteur Simplexe PL est formellement inapte car le modèle sigmoïdal est hautement non linéaire.
Pour prévenir les instabilités de convergence algorithmique, cliquez sur le bouton Options du solveur sous le profil GRG Non linéaire. Il est vivement conseillé d’activer l’option Multidémarrage (Multistart) si votre modèle comporte 3 ou 4 paramètres (comme dans le cas du 4PL). Cette précaution autorise l’algorithme à échantillonner aléatoirement plusieurs jeux de paramètres initiaux afin d’éviter d’être capturé par un minimum local trompeur.
Définissez également des contraintes de bon sens psychologique via le bouton Ajouter de la fenêtre principale : par exemple, forcez la pente k à demeurer strictement positive ($F$1 >= 0,01) pour interdire des inversions contre-intuitives de la fonction. Enfin, cliquez sur Résoudre. Le Solveur itère le calcul différentiel et actualise vos cellules de paramètres, produisant instantanément la sigmoïde optimale aux moindres carrés superposée à vos points empiriques.
9. Application psychométrique : Calcul des courbes caractéristiques des items (CCI)
9.1 Modélisation du paramètre de difficulté et de discrimination
Dans l’ingénierie des tests psychométriques et des évaluations standardisées du quotient intellectuel ou des compétences cognitives, le modèle de Rasch uniparamétrique s’avère fréquemment trop restrictif, car il postule que toutes les questions possèdent une capacité discriminative identique. Pour lever ce verrou théorique, Birnbaum a formalisé le modèle logistique à deux paramètres (2PL), qui étend l’équation sigmoïde en attribuant à chaque item deux coefficients métriques distincts.
L’équation de Birnbaum s’énonce :
P(θ) = 1 / (1 + exp(-a * (θ – b)))
Dans ce modèle :
- θ (thêta) représente le trait latent de l’examiné, généralement standardisé selon une loi normale centrée réduite N(0, 1), s’étendant conventionnellement sur une échelle continue de -3 (très faible compétence) à +3 (très haute compétence).
- b représente le paramètre de difficulté de l’item, positionné sur la même métrique continue que le trait latent. Un item dont la valeur b = 1,5 exigera un niveau cognitif supérieur à la moyenne pour offrir une probabilité de réussite supérieure à 0,5.
- a représente le coefficient de discrimination de l’item, mathématiquement proportionnel à la pente de la sigmoïde à son point d’inflexion. Un paramètre a élevé (par exemple a > 1,7) indique un item d’une extrême précision chirurgicale, capable de séparer sans équivoque les sujets situés de part et d’autre du seuil critique b. À l’inverse, une valeur de a proche de 0,3 révèle un item bruité, faiblement corrélé avec le construit théorique global.
Pour construire une feuille d’étalonnage psychométrique dans Excel, structurez votre tableau avec le vecteur des compétences θ dans la colonne A (de -3 à +3 avec un incrément de 0,2). Placez les coefficients d’un premier item dans des cellules dédiées, par exemple a1 = 1,8 en D1 et b1 = 0,5 en D2. Dans la cellule B2, insérez la formule de réponse logistique :
=1/(1+EXP(-$D$1*(A2-$D$2)))
En traçant cette série en regard d’un second item doté de paramètres différents (ex. a2 = 0,6 et b2 = -1,0), vous matérialisez immédiatement l’analyse différentielle des CCI, mettant en relief comment deux questions évaluent des zones radicalement dissemblables du spectre cognitif.
9.2 Intégration du paramètre de pseudo-chance (Modèle 3PL)
L’une des limites les plus critiques du modèle 2PL réside dans son incapacité à formaliser le comportement des candidats face à des questionnaires à choix multiples (QCM) où une réponse exacte peut être sélectionnée par simple chance probabiliste. Si un individu présentant un niveau de compétence latent très bas (θ = -3) est soumis à une question offrant quatre modalités de sélection, sa probabilité empirique d’approuver la bonne réponse ne s’effondre jamais vers 0, mais converge vers 0,25.
Le modèle logistique à trois paramètres (3PL) pallie cette défaillance en introduisant un paramètre de pseudo-chance (guessing parameter), noté c. La formulation mathématique s’établit selon :
P(θ) = c + (1 – c) / (1 + exp(-a * (θ – b)))
L’introduction du scalaire c opère une contraction rigoureuse de la dynamique de l’ordonnée : l’asymptote inférieure ne repose plus sur l’axe d’origine 0, mais est translatée à la cote c. Il s’ensuit que la plage des variations utiles de probabilité gouvernée par le trait latent est réduite à l’intervalle [c ; 1].
Pour transcrire le modèle 3PL dans l’environnement Excel :
- Consignez les trois paramètres d’étalonnage de l’item dans vos cellules de contrôle : le coefficient de discrimination a en E1 (ex.
1,4), le paramètre de difficulté b en E2 (ex.0,8) et la constante de pseudo-chance c en E3 (ex.0,20). - Dans la colonne de calcul de la probabilité d’occurrence, appliquez en B2 la syntaxe :
=$E$3+(1-$E$3)/(1+EXP(-$E$1*(A2-$E$2))). - Propagez cette équation sur toute la série des niveaux latents θ.
L’examen géométrique de cette nouvelle courbe révèle deux modifications capitales : l’ordonnée à l’origine basse ne descend jamais en deçà de 0,20, et l’abscisse du point d’inflexion ne coïncide plus exactement avec la valeur b sur l’échelle des probabilités absolues, mais marque le point d’inflexion d’une amplitude résiduelle compressée valant précisément (1 + c) / 2, soit 0,60 dans notre configuration.
10. Gestion des anomalies numériques et erreurs de calcul dans Excel
10.1 Dépassement de capacité arithmétique et erreurs #NOMBRE!
Bien que Microsoft Excel soit un environnement d’une puissance reconnue, son moteur mathématique interne est strictement assujetti aux limites d’encodage matériel des processeurs modernes, définies par la norme IEEE 754 pour la virgule flottante en double précision. Cette contrainte architecturale impose une limite supérieure indépassable à la valeur numérique qu’un scalaire peut atteindre, fixée à approximativement 1,7976931348623157E+308.
Cette borne matérielle a des répercussions directes sur l’évaluation de la fonction exponentielle native. Dans l’implémentation d’une fonction sigmoïde canonique =1/(1+EXP(-A2)), lorsque l’antécédent A2 prend une valeur négative extrêmement prononcée — précisément lorsque A2 < -709,78 —, l’expression interne -A2 devient supérieure à +709,78. Le calcul de EXP(-A2) tente alors de produire un scalaire surpassant la limite double précision maximale, ce qui provoque immédiatement l’interruption du calcul et le renvoi brutal d’une erreur d’exécution : #NOMBRE! (ou #NUM! en interface anglophone).
Pour neutraliser ce risque de débordement de capacité lors du traitement de flux de données massifs ou de distributions non bornées, il est méthodologiquement impératif de mettre en œuvre une stratégie de bornage numérique préventif (clamping). La solution la plus robuste consiste à intercepter conditionnellement les valeurs limites de l’argument au moyen de la fonction SI imbriquée :
=SI(A2>700; 1; SI(A2<-700; 0; 1/(1+EXP(-A2))))
Cette construction logique garantit une immunisation absolue de la feuille de calcul :
- Si x dépasse +700, le dénominateur mathématique converge si intensément vers 1 que l’écart entre la sigmoïde et 1,0 se situe bien en deçà de la granularité d’arrondi de l’ordinateur ; Excel renvoie donc immédiatement la valeur unitaire pure
1sans exécuter l’exponentielle. - Si x plonge sous -700, le système substitue instantanément la valeur limite
0, éliminant tout appel à la fonctionEXP()sur un exposant positif divergent et évitant le déclenchement du code d’erreur#NOMBRE!. - Pour toutes les valeurs contenues dans l’intervalle opérationnel [-700 ; +700], l’équation sigmoïdale standard s’exécute avec sa précision arithmétique intégrale.
10.2 Précision en virgule flottante et arrondis parasites
Une seconde anomalie algorithmique, plus insidieuse car silencieuse, découle de la gestion des arrondis binaires aux abords immédiats des paliers asymptotiques. Dans le système binaire interne d’un microprocesseur, les nombres décimaux finis ne possèdent pas tous une représentation fractionnaire exacte en base 2. Cette discordance produit d’infimes erreurs résiduelles de troncature, de l’ordre de 1E-16.
Cette idiosyncrasie computationnelle se manifeste de manière critique lorsque des instructions logiques de comparaison stricte sont appliquées aux résultats d’un calcul sigmoïdal. Par exemple, si une cellule de décision tente d’évaluer l’atteinte parfaite du plafond d’acquisition comportementale via une syntaxe conditionnelle naïve :
=SI(B2=1; "Plafond Atteint"; "En Progression")
Il est fréquent que pour une valeur de x très élevée (ex. x = 30), le résultat affiché dans la cellule B2 présente l’apparence visuelle trompeuse de 1,000000000000000 en vertu des masques d’affichage d’Excel, alors que sa valeur mémorisée sous le registre CPU demeure stockée sous la forme 0,99999999999999988.... Dans ces circonstances, le test logique d’égalité stricte B2=1 est évalué à FAUX, induisant des erreurs d’aiguillage préjudiciables dans les chaînes d’automatisation décisionnelle.
Pour circonvenir ces discordances de virgule flottante, appliquez rigoureusement les deux préceptes de programmation suivants :
- Ne testez jamais d’égalité stricte sur des asymptotes logistiques. Remplacez le test précédent par un encadrement différentiel basé sur une tolérance d’erreur (epsilon, typiquement 1E-6) :
=SI((1-B2)<0,000001; "Plafond Atteint"; "En Progression"). - Si des comparaisons strictes sont incontournables dans vos macros ou tables de recherche, encapsulez l’évaluation sigmoïde dans une fonction de troncature délibérée, telle que
ARRONDI(1/(1+EXP(-A2)); 8), afin d’aligner la représentation physique en mémoire sur le nombre de décimales méthodologiquement significatives de votre discipline expérimentale.
11. Fonctions personnalisées modernes : Utilisation de LAMBDA et LET dans Excel
11.1 Création d’une fonction sigmoïde native avec le Gestionnaire de noms
L’une des innovations structurales majeures apportées récemment à l’écosystème Microsoft Excel réside dans l’introduction de la fonction LAMBDA. Cette fonctionnalité permet de concevoir des fonctions personnalisées réutilisables à l’infini au sein du classeur sans recourir au code Visual Basic for Applications (VBA), éliminant ainsi les contraintes de sécurité liées à l’activation des macros et garantissant une compatibilité parfaite sur les versions mobiles et web du tableur.
La syntaxe de base d’une abstraction LAMBDA calculant la sigmoïde s’établit simplement par l’identification de l’argument formel suivi de l’expression mathématique :
=LAMBDA(x; 1/(1+EXP(-x)))
Pour transformer cette expression brute en une fonction véritablement native intégrée à la bibliothèque de calcul de votre document, procédez selon le protocole de déploiement suivant :
- Accédez au ruban supérieur Formules, puis cliquez sur le Gestionnaire de noms.
- Dans la fenêtre de dialogue, cliquez sur le bouton Nouveau.
- Dans le champ Nom, saisissez l’identifiant univoque que vous souhaitez invoquer dans vos cellules, par exemple :
SIGMOIDE. - Laissez le champ Étendue positionné sur Classeur afin de rendre la fonction accessible depuis n’importe quelle feuille de calcul du fichier.
- Dans le champ inférieur Fait référence à :, effacez la valeur préexistante et collez l’expression intégrale :
=LAMBDA(x; 1/(1+EXP(-x))). - Validez en cliquant sur OK, puis fermez le gestionnaire.
Dès cet instant, la fonction se comporte comme n’importe quelle fonction native d’Excel. Si vous saisissez dans n’importe quelle cellule du document :
=SIGMOIDE(A2)
Excel résout l’opération logistique avec une propreté de notation intégrale. Cette démarche élève le niveau d’abstraction de la feuille de calcul, sécurise la formule contre les fautes de frappe de parenthèses chez les utilisateurs finaux et rend le classeur infiniment plus lisible pour des relecteurs externes.
11.2 Optimisation des performances et lisibilité avec la fonction LET
Lorsque la complexité du modèle mathématique s’accroît — notamment lors de l’application de sigmoïdes généralisées dépendantes d’une cascade de transformations scalaires —, la répétition d’expressions intermédiaires au sein d’une même formule entraîne une dégradation sensible des performances de calcul ainsi qu’une opacité syntaxique indésirable. La fonction LET permet d’assigner des noms de variables à des calculs intermédiaires au sein même de la cellule.
Considérons l’implémentation d’une fonction sigmoïde paramétrique complète intégrant une mise à l’échelle de la pente k, du point d’inflexion x0, ainsi qu’une protection conditionnelle contre le dépassement arithmétique. Grâce à LET, l’architecture computationnelle se structure de manière modulaire :
=LET(

  x; A2;

  k; $D$1;

  x0; $D$2;

  z; -k * (x - x0);

  SI(z > 700; 0; SI(z < -700; 1; 1 / (1 + EXP(z))))

)
Cette organisation offre des avantages méthodologiques remarquables :
- Élimination des évaluations redondantes : L’expression normalisée
z = -k * (x - x0)n’est calculée qu’une seule et unique fois par le processeur. Elle est ensuite réutilisée instantanément par les instructions conditionnelles d’évaluation des limites et le calcul final du dénominateur, divisant le coût computationnel sur des séries de données massives. - Maintenance et lisibilité : Si l’emplacement de la variable d’entrée passe de la colonne A à la colonne C, seule la première ligne d’affectation
x; C2nécessite une modification, préservant l’intégrité de l’ensemble de la logique algorithmique sous-jacente. - Encapsulation conjointe : Il est possible de fusionner les deux technologies en enregistrant un
LAMBDAparamétrique exploitantLETdans le Gestionnaire de noms, générant ainsi des fonctions propriétaires ultra-sophistiquées de type=SIGMOIDE_4PL(x; A; B; k; x0), propulsant le tableur Excel au rang d’environnement de modélisation mathématique de haute précision.
12. Bonnes pratiques méthodologiques et reproductibilité des calculs
12.1 Documentation interne et gouvernance du classeur
L’utilisation de tableurs dans la recherche scientifique empirique et la prise de décision stratégique fait l’objet de critiques récurrentes relatives au manque de traçabilité et aux risques élevés d’erreurs humaines silencieuses. Pour garantir la robustesse académique d’un classeur modélisant des fonctions sigmoïdes, une gouvernance rigoureuse de la structure du fichier doit être instaurée dès la phase de conception.
Tout projet d’analyse quantitative sous Excel devrait systématiquement comporter une feuille dédiée exclusive, dénommée Métadonnées_Paramètres, positionnée en première place dans l’ordre des onglets. Cette feuille agit comme le dictionnaire de données du projet : elle y répertorie la définition explicite de chaque variable, les unités physiques de mesure (ex. millisecondes, logits, pourcentages), les conditions de passation expérimentale, ainsi que les valeurs globales des paramètres mathématiques (constantes k, x0, A, B).
Par ailleurs, l’usage des coordonnées alphanumériques brutes (telles que $D$1 ou $F$4) au sein des équations complexes doit être banni au profit de la nomination explicite des cellules via le Gestionnaire de noms. Assignez formellement le nom Pente_Logistique à la cellule contenant le paramètre de discrimination et Seuil_Perceptif à la cellule du point d’inflexion. Les formules deviennent alors auto-documentées, s’énonçant sous la forme limpide :
=1/(1+EXP(-Pente_Logistique*(A2-Seuil_Perceptif)))
Enfin, mettez en œuvre une politique stricte de protection en écriture. Rendez-vous dans le panneau Format de cellule > Protection, déverrouillez uniquement les cellules destinées à la saisie de nouvelles données brutes par les opérateurs, puis activez la protection de la feuille de calcul via le ruban Révision > Protéger la feuille. Cette barrière technique empêche la corruption accidentelle des formules matricielles et la suppression involontaire des constantes d’étalonnage lors des phases de manipulation courante.
12.2 Interopérabilité et validation croisée des résultats
Dans un contexte scientifique interdisciplinaire, la feuille de calcul Excel ne doit pas fonctionner en vase clos. Elle doit s’inscrire dans une chaîne de traitement reproductible et être en mesure de subir des audits de conformité croisés avec des logiciels d’analyse statistique spécialisés, tels que le langage R (notamment via le package d’optimisation non linéaire nls ou le package psychométrique mirt), Python (via la bibliothèque scipy.optimize) ou SPSS.
Pour assurer cette interopérabilité sans friction :
- Privilégiez l’exportation des données et des sorties modélisées vers des formats de stockage textuels ouverts, tels que le standard CSV (valeurs séparées par des virgules ou points-virgules) encodé en UTF-8, garantissant qu’aucun artefact propriétaire d’Excel ne viendra corrompre la réimportation des vecteurs dans un script Python ou R.
- Procédez systématiquement à une validation croisée de convergence lors des phases d’optimisation par le Solveur. Reconstituez le modèle d’ajustement non linéaire sur un sous-échantillon test sous un script R utilisant la méthode de Gauss-Newton ou de Levenberg-Marquardt, et confrontez les coefficients extraits (pente k, point d’inflexion x0, somme des résidus au carré) avec ceux délivrés par le moteur GRG Non linéaire d’Excel. Les écarts paramétriques ne doivent en aucun cas excéder la tolérance de convergence analytique fixée (typiquement 1E-5).
- Documentez intégralement l’environnement d’exécution computationnel dans un journal de bord méthodologique : version exacte d’Excel exploitée, numéro de build, système d’exploitation hôte, statut des options de calcul (itératif, précision telle qu’affichée activée ou désactivée) et valeurs d’initialisation (seeds) fournies au Solveur.
En observant ces protocoles de standardisation et de traçabilité computationnelle, le chercheur ou l’analyste confère à ses modélisations sigmoïdes élaborées sous Microsoft Excel un statut de validité méthodologique irréprochable, conjuguant l’intuitivité graphique de la grille tabulaire avec les exigences les plus rigoureuses de la science comportementale contemporaine.
Références
- Birnbaum, A. (1968). Some latent trait models and their use in inferring an examinee’s ability. In F. M. Lord & M. R. Novick (Eds.), Statistical theories of mental test scores (pp. 395-479). Addison-Wesley.
- Fechner, G. T. (1860). Elemente der Psychophysik. Breitkopf und Härtel. https://archive.org/details/elementederpsych01fech
- IEEE Computer Society. (2019). IEEE Standard for Floating-Point Arithmetic (IEEE Std 754-2019). IEEE. https://standards.ieee.org/ieee/754/6210/
- Microsoft Corporation. (2024). Fonction EXP (Support Microsoft 365). Microsoft Support. https://support.microsoft.com/fr-fr/office/exp-fonction-exp-c578f034-2c45-4c37-bc8c-329660a63abb
- Microsoft Corporation. (2024). Fonction LAMBDA (Support Microsoft 365). Microsoft Support. https://support.microsoft.com/fr-fr/office/fonction-lambda-bd212d27-1cd1-4321-a34a-ccbf254b8b67
- Rasch, G. (1960). Probabilistic models for some intelligence and attainment tests. Danmarks Paedagogiske Institut.
- Verhulst, P.-F. (1838). Notice sur la loi que la population suit dans son accroissement. Correspondance Mathématique et Physique, 10, 113-121.