
Dans l’architecture de l’analyse quantitative et de la modélisation statistique appliquée aux sciences humaines, comportementales et économiques, la régression linéaire occupe une place méthodologique centrale. Loin de se limiter à la simple détermination d’une trajectoire géométrique d’ajustement ou à l’estimation superficielle d’une proportion de variance partagée à travers le coefficient de détermination, l’analyse inférentielle exige une quantification rigoureuse de l’incertitude stochastique. L’évaluation de l’adéquation d’un modèle ne saurait en effet être complète sans une métrique capable de traduire la dispersion concrète des observations individuelles autour de la droite théorique estimée. C’est précisément cette fonction essentielle que remplit l’erreur type de la régression, couramment désignée sous le vocable d’écart-type résiduel ou d’erreur standard de l’estimation.
Le tableur Microsoft Excel demeure, en dépit de la prolifération de logiciels spécialisés tels que R, SPSS ou SAS, l’environnement de calcul matriciel et de manipulation de données le plus universellement déployé dans les laboratoires de recherche, les cabinets d’évaluation psychométrique et les départements d’analyse organisationnelle. Néanmoins, l’apparente accessibilité opérationnelle de ses interfaces tabulaires masque fréquemment une complexité conceptuelle que de nombreux praticiens peinent à appréhender de manière intégrale. L’obtention de l’erreur type de régression sous Excel ne se résume pas à l’exécution machinale d’une commande automatisée ; elle implique une maîtrise des fondements algébriques sous-jacents, une conscience aiguë des postulats distributionnels du modèle linéaire classique, ainsi qu’une capacité à discriminer entre les différentes sorties numériques offertes par le logiciel.
Le présent traité méthodologique propose une exploration exhaustive du calcul, de l’extraction et de l’interprétation académique de l’erreur type de régression au sein de l’écosystème Microsoft Excel. Depuis la décomposition théorique des sommes de carrés et la discussion épistémologique des postulats de Gauss-Markov jusqu’à l’implémentation algorithmique de formules dynamiques, de fonctions matricielles avancées telles que DROITEREG et du complément Utilitaire d’analyse, chaque étape sera disséquée avec la plus haute rigueur. En ancrant notre démonstration dans le paradigme de l’évaluation psychométrique et cognitive, nous expliciterons comment transformer une simple métrique computationnelle en un puissant outil de diagnostic prédictif et de validation empirique respectant scrupuleusement les exigences des standards de publication internationaux de l’American Psychological Association.
1. Fondements théoriques de l’erreur type de la régression en psychométrie et modélisation statistique
1.1 Définition conceptuelle de l’erreur type de régression
L’erreur type de la régression, conventionnellement notée s, Se ou sy.x dans la littérature statistique, constitue l’estimateur sans biais de l’écart-type de la composante d’erreur stochastique associée à un modèle linéaire univarié ou multivarié. Dans le cadre fondamental d’une régression linéaire définie dans une population, la relation liant la variable dépendante continue aux prédicteurs s’exprime à travers une fonction mathématique déterministe enrichie d’un terme aléatoire epsilon. Ce terme de perturbation stochastique résume l’ensemble des influences non observées, des fluctuations idiosyncrasiques, des imperfections instrumentales et de la variabilité biologique ou psychologique inhérente aux sujets évalués. L’erreur type de la régression représente l’amplitude moyenne de la divergence constatée entre les observations empiriques réelles et la droite des moindres carrés ordinaires calculée sur l’échantillon.
D’un point de vue géométrique et conceptuel, alors que la droite de régression trace le lieu des espérances conditionnelles de la variable réponse sachant les valeurs des variables explicatives, l’erreur type de régression quantifie l’épaisseur du ruban de dispersion autour de cet axe prédictif. Dans le domaine de la psychométrie appliquée et de l’évaluation cognitive, cette métrique revêt une signification épistémologique cruciale : elle permet d’évaluer avec quelle précision une échelle de mesure ou un test standardisé peut prétendre anticiper le comportement, l’efficience intellectuelle ou le niveau de détresse psychologique d’un individu singulier. L’erreur type offre ainsi une lecture directe de l’incertitude dans l’unité d’origine de la variable dépendante, conférant au clinicien ou au chercheur un ancrage pragmatique qu’un indice adimensionnel comme le coefficient de corrélation ne peut fournir.
Il convient de conceptualiser l’erreur standard d’estimation non pas comme un simple résidu calculatoire, mais comme l’expression tangible de la frontière séparant la variabilité structurelle explicable par les hypothèses théoriques du chercheur et le bruit aléatoire incompressible du système étudié. En psychologie cognitive, par exemple, lorsqu’un modèle postule une relation linéaire entre l’âge chronologique et la vitesse de traitement de l’information mesurée par un temps de réaction en millisecondes, l’erreur type de la régression isole la variance résiduelle propre aux différences individuelles non modélisées. Elle établit la borne absolue sous laquelle aucune inférence probabiliste relative à un sujet particulier ne peut descendre sans violer les limites de validité du protocole expérimental.
1.2 Rôle de l’erreur type dans l’inférence statistique et les sciences comportementales
Dans l’arsenal inférentiel des sciences comportementales, l’erreur type de régression ne constitue pas uniquement un indice descriptif de la qualité de l’ajustement global ; elle s’érige en moteur calculatoire indispensable à la détermination de toutes les erreurs types dérivées. La précision statistique avec laquelle les coefficients de régression (ordonnée à l’origine et pentes partielles) sont estimés dépend directement de la magnitude de cette erreur type résiduelle. En effet, l’erreur standard associée au coefficient bêta empirique s’obtient en divisant l’erreur type de la régression par la racine carrée de la somme des écarts quadratiques du prédicteur. Par conséquent, toute altération, mauvaise estimation ou méconnaissance de l’erreur type globale se répercute instantanément sur les intervalles de confiance encadrant les paramètres du modèle.
L’impact d’une sous-estimation de cette dispersion résiduelle est méthodologiquement dévastateur en recherche expérimentale et translationnelle. Lorsqu’un chercheur manipule des jeux de données comportementales sans s’assurer de la validité de l’estimation de l’erreur type résiduelle, le risque de gonfler artificiellement la statistique de Student t s’accroît exponentiellement. Cette défaillance conduit à une réduction factice des valeurs p, favorisant la survenue d’erreurs de type I, consistant à rejeter l’hypothèse nulle d’absence d’effet alors que la relation mise en évidence n’est qu’un artéfact stochastique. Dans des disciplines confrontées à la crise de la reproductibilité, telles que les neurosciences comportementales et la psychologie sociale, la maîtrise analytique de l’écart-type des résidus constitue un prérequis incontournable pour attester de la réplicabilité des paradigmes expérimentaux.
Au-delà de l’inférence paramétrique, l’erreur type de la régression intervient de manière décisive dans la validation psychométrique des inventaires de personnalité et des batteries d’aptitudes cognitives. Lors de l’étalonnage d’un instrument psychologique, les praticiens recourent à cette mesure pour circonscrire la dispersion des scores vrais autour des scores observés. Elle permet de quantifier la fidélité du critère prédictif et garantit que les décisions diagnostiques — qu’il s’agisse de l’identification d’un trouble du déficit de l’attention avec hyperactivité (TDAH) ou de l’évaluation d’un haut potentiel intellectuel — reposent sur une marge d’erreur statistiquement contrôlée et cliniquement transparente.
1.3 Postulats du modèle de régression des moindres carrés ordinaires (MCO)
La légitimité du calcul de l’erreur type de régression via les méthodes d’estimation classiques par les moindres carrés ordinaires (MCO) repose impérativement sur le respect scrupuleux d’un ensemble de postulats distributionnels formalisés par le théorème de Gauss-Markov. Le premier de ces axiomes stipule la linéarité intrinsèque de la relation fonctionnelle unissant la variable réponse aux variables explicatives. Si la véritable trajectoire sous-jacente aux variables comportementales adopte une allure curvilinéaire, polynomiale ou asymptotique, l’ajustement rectiligne contraindra artificiellement les résidus, surévaluant systématiquement la somme des carrés des erreurs et privant l’erreur type de toute validité interprétative.
Le second ensemble de conditions concerne la structure probabiliste des résidus stochastiques epsilon. D’une part, l’espérance mathématique conditionnelle des perturbations doit être strictement nulle pour chaque niveau des prédicteurs, ce qui garantit l’absence de biais systématique de spécification. D’autre part, ces résidus doivent présenter une indépendance mutuelle parfaite, excluant tout phénomène d’autocorrélation temporelle ou de dépendance sérielle fréquemment observé lors de mesures longitudinales répétées chez les mêmes sujets psychologiques. Enfin, l’inférence fondée sur les distributions de Student et de Fisher impose que la distribution conditionnelle des résidus suive une loi normale univariée, postulat dont la vérification empirique s’avère particulièrement sensible sur les petits échantillons cliniques.
La condition d’homoscédasticité, désignant l’homogénéité et la constance absolue de la variance des résidus sur l’ensemble du continuum de la variable indépendante, représente sans doute le réquisit le plus vulnérable dans les études comportementales. Lorsque la variance des perturbations augmente ou fluctue en fonction des valeurs croissantes de X (phénomène d’hétéroscédasticité), l’estimateur standard de l’erreur type de régression calculé par les algorithmes conventionnels perd sa propriété de variance minimale parmi les estimateurs linéaires sans biais (BLUE). Il en résulte une distorsion profonde de l’intervalle d’incertitude associé aux prédictions, compromettant irrémédiablement la robustesse des conclusions tirées sous Excel si aucun ajustement analytique n’est opéré.
2. Formulation mathématique et décomposition de l’erreur type des résidus
2.1 Équation standard de l’erreur type de régression
L’expression analytique rigoureuse de l’erreur type de la régression prend racine dans l’analyse de la discordance quadratique séparant les points de données empiriques de la surface d’ajustement multivariée ou univariée. Mathématiquement, pour un échantillon de taille n comportant k variables explicatives distinctes, l’erreur type d’estimation, notée Se, est définie comme la racine carrée du carré moyen des erreurs résiduelles (CME). La formulation algébrique générale s’énonce comme suit :
Se = √( Σ(yi – ŷi)² / (n – k – 1) )
Dans cette équation fondamentale, le terme (yi – ŷi) formalise le résidu brut ei afférent à la i-ième observation individuelle, correspondant à la soustraction arithmétique de la valeur théorique projetée par le modèle (ŷi) de la valeur empiriquement mesurée (yi). L’élévation au carré de ces écarts résiduels prévient l’annihilation mutuelle des erreurs positives et négatives, dont la somme arithmétique simple est obligatoirement nulle en vertu des propriétés de centrage orthogonal des moindres carrés ordinaires. Le numérateur de cette fraction représente ainsi la Somme des Carrés des Erreurs (SCE), couramment qualifiée de somme des carrés résiduels (SSE, pour Sum of Squared Errors).
Le dénominateur de cette relation mathématique constitue le pivot de l’ajustement inférentiel pour petits et moyens échantillons. Contrairement à un écart-type descriptif non corrigé qui diviserait par l’effectif total n, l’estimation sans biais de la variance résiduelle exige l’utilisation des degrés de liberté résiduels réels, formulés par n – k – 1. La soustraction de la constante 1 compense la fixation mathématique de l’ordonnée à l’origine (la constante du modèle), tandis que la déduction du nombre k de variables explicatives rétribue la contrainte imposée par l’estimation conjointe des différentes pentes de régression. Dans le cadre élémentaire d’une régression linéaire bivariée comportant un unique prédicteur (k = 1), le dénominateur se réduit canoniquement à n – 2, garantissant que l’estimateur de la variance résiduelle ne souffre d’aucun biais de troncation sous-estimant la variance populationnelle σ².
2.2 Décomposition de la variance totale dans l’analyse de régression
La compréhension approfondie de l’erreur type résiduelle requiert son insertion dans le paradigme global du partitionnement de la variance au sein du modèle linéaire général. La variabilité globale observée au sein de la variable dépendante Y est capturée par la Somme des Carrés Totaux (SCT), calculée comme la somme des écarts quadratiques de chaque point par rapport à la moyenne générale de l’échantillon Ȳ. En vertu du théorème fondamental de décomposition de l’analyse de variance, cette dispersion globale se scinde parfaitement en deux composantes orthogonales et additives :
SCT = SCM + SCE
La Somme des Carrés du Modèle (SCM, ou Somme des Carrés Expliquée) traduit la variabilité que la régression parvient à rendre intelligible en fonction des fluctuations des prédicteurs, tandis que la Somme des Carrés des Erreurs (SCE) absorbe la fraction de dispersion stochastique demeurant hors de portée explicative de l’équation linéaire formulée. C’est à partir de cette partition que s’articule la relation formelle unissant le coefficient de détermination R² et l’erreur type de la régression. Le R² étant défini par le ratio 1 – (SCE / SCT), il devient possible d’exprimer analytiquement l’erreur type en fonction directe de la variance totale de la variable dépendante (notée sy²) et de la proportion de variance expliquée :
Se = √( [ (n – 1) / (n – k – 1) ] × sy² × (1 – R²) )
Cette interconnexion mathématique met en exergue les divergences d’interprétation fondamentales entre le coefficient de détermination et l’erreur type. Si le R² constitue un indice adimensionnel séduisant pour communiquer une part de variance partagée comprise entre 0 et 1, il présente une sensibilité excessive à la restriction de variance dans l’échantillonnage et peut induire en erreur lors de comparaisons trans-échantillonnales. À l’inverse, l’erreur type de régression possède la propriété cardinale de préserver l’échelle de mesure originale du trait psychologique ou comportemental étudié. Elle renseigne de manière tangible sur l’amplitude physique des déviations typiques en unités concrètes (par exemple, en points de quotient intellectuel, en secondes ou en unités de concentration salivaire de cortisol), ce qui en fait une métrique d’une pertinence opérationnelle largement supérieure pour la modélisation clinique et l’ingénierie statistique.
3. Distinctions critiques entre métriques statistiques connexes
3.1 Erreur type de régression versus écart-type des observations
Une confusion méthodologique particulièrement fréquente chez les analystes de données débutants consiste à assimiler l’erreur type de régression Se à l’écart-type brut de la variable dépendante sy. L’écart-type d’échantillon sy mesure la dispersion inconditionnelle absolue de l’ensemble des observations autour de leur centre de gravité unimodal, sans faire intervenir la moindre structure explicative externe. Il quantifie l’incertitude qui prévaudrait si le chercheur devait prédire le score d’un sujet inconnu en utilisant uniquement la moyenne arithmétique globale de l’échantillon en tant qu’unique référent prédictif.
À l’opposé, l’erreur type de la régression évalue la dispersion conditionnelle des données, c’est-à-dire l’étalement des valeurs Y pour une valeur spécifiée et fixe de la variable prédictive X. Dès lors qu’une covariance significative existe entre le prédicteur et le critère, l’intégration de X au sein d’une équation linéaire opère une réduction systématique de la variance résiduelle inexpliquée. Dès lors que le coefficient de régression diffère de zéro, l’erreur type de la régression sera rigoureusement inférieure à l’écart-type univarié d’origine (sous réserve d’un ajustement mineur pour les degrés de liberté). Elle mesure donc le gain de précision informationnelle directement imputable à l’introduction du modèle prédictif.
En pratique clinique, cette distinction se traduit par une réduction de la marge d’erreur diagnostique. Si un neuropsychologue évalue le déclin mnésique d’un patient sans tenir compte de son niveau socio-éducatif ni de son âge, l’incertitude diagnostique s’étend sur l’intégralité de l’écart-type populationnel. En revanche, si ce praticien utilise un modèle de régression ajustant la performance mnésique sur ces deux prédicteurs structurants, la dispersion attendue des scores pour ce profil sociodémographique spécifique se resserre considérablement autour de l’estimation conditionnelle, cette variabilité résiduelle étant précisément délimitée par l’erreur type de la régression.
3.2 Erreur type de régression versus erreur type de la moyenne
Une seconde divergence fondamentale sépare l’erreur type de régression de l’erreur type de la moyenne (souvent désignée par SEM, pour Standard Error of the Mean). Cette dernière s’inscrit exclusivement dans la théorie de l’échantillonnage asymptotique et mesure la variabilité théorique d’un paramètre ponctuel agrégé — en l’occurrence, la moyenne arithmétique — à travers la répétition infinie d’échantillonnages aléatoires de même taille issus de la population mère. Calculée par la formule canonique SEM = s / √n, l’erreur type de la moyenne tend asymptotiquement vers zéro au fur et à mesure que la taille de l’échantillon n progresse vers l’infini.
À l’inverse, l’erreur type de la régression Se ne décrit pas la variabilité d’une statistique d’échantillon agrégée, mais quantifie la dispersion stochastique réelle des individus singuliers autour de l’hyperplan de régression. De ce fait, elle ne s’annule en aucun cas lorsque l’effectif n croît démesurément. À mesure que n augmente, l’erreur type de la régression converge de manière stable vers la variance d’erreur véritable de la population σ, capturant la variabilité intrinsèque non déterministe qui persiste même face à un échantillonnage exhaustif de la population ciblée.
La confusion entre ces deux notions entraîne des conséquences désastreuses dans l’interprétation des profils psychologiques individuels. Utiliser l’erreur type de la moyenne pour tenter d’établir l’intervalle dans lequel se situera le score futur d’un individu conduit à une sous-estimation dramatique de l’incertitude réelle, générant une surconfiance illusoire quant à la fiabilité prédictive du modèle. L’erreur type de la moyenne délimite l’emplacement de la droite théorique moyenne de la population, tandis que l’erreur type de la régression délimite le nuage de points au sein duquel gravitent les individus isolés.
3.3 Erreur type des coefficients versus erreur type de l’estimation
Il est impératif d’opérer une dissociation sans équivoque entre l’erreur type globale de régression (Se) et les erreurs types relatives aux coefficients individuels du modèle (notées SE(βj)). L’erreur type globale constitue une métrique synthétique d’ensemble qui caractérise la fidélité globale du modèle dans l’espace de la variable dépendante. Elle renseigne sur l’erreur quadratique moyenne commise lors de la tentative de modélisation de Y par l’ensemble du faisceau de variables indépendantes retenues.
En contrepartie, l’erreur type d’un coefficient particulier (par exemple, la pente b1 associée au premier prédicteur) quantifie l’incertitude échantillonnale affectant l’estimation de ce coefficient de régression spécifique. Dans un modèle bivarié simple, cette erreur type de pente se formalise par :
SE(b1) = Se / √( Σ(xi – x̄)² )
Cette dérivation démontre avec clarté la dépendance hiérarchique qui lie ces grandeurs : l’erreur type globale d’estimation Se intervient directement au numérateur de l’erreur type du paramètre de pente. Néanmoins, l’erreur type du coefficient dépend également au dénominateur de l’étalement des données sur l’axe du prédicteur X. C’est l’erreur type du coefficient qui sert de dénominateur pour ériger le test t de Wald ou le test t de Student univarié (t = bj / SE(bj)) visant à établir si un prédicteur exerce un impact statistiquement dissociable de zéro. L’erreur type de régression fournit quant à elle l’assise fondamentale de la variance globale du système à partir de laquelle ces tests différentiels peuvent être conduits.
4. Préparation et structuration rigoureuse des données sous Microsoft Excel
4.1 Configuration des variables d’une étude psychologique
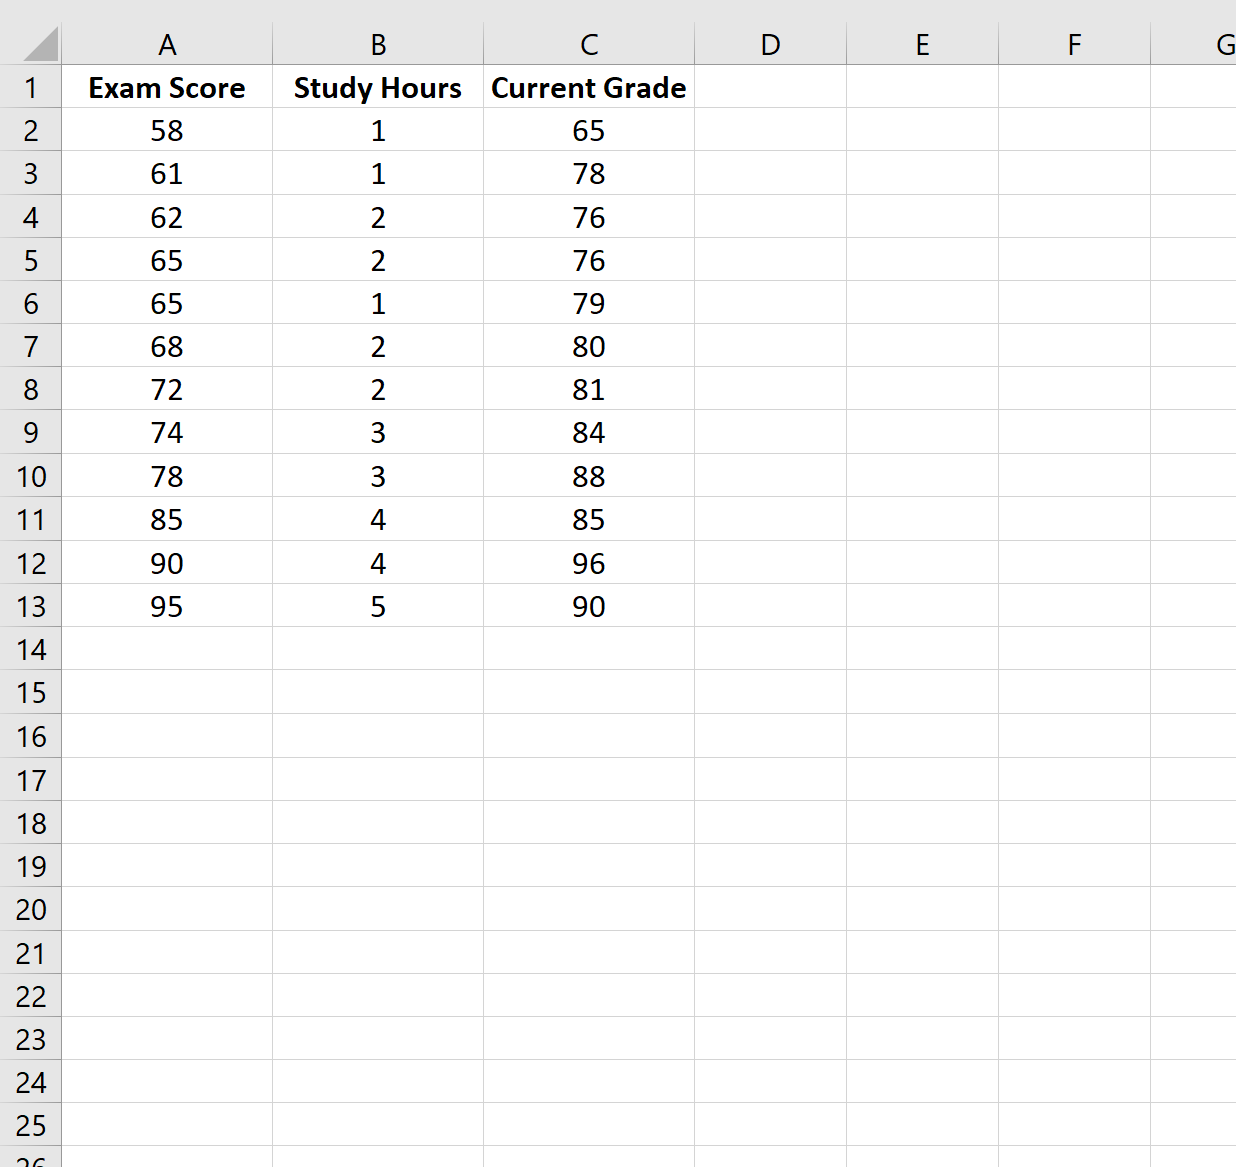
L’implémentation de modèles de régression dans l’environnement tabulaire de Microsoft Excel exige une rigueur absolue dans la mise en page matricielle des données brutes. Toute approximation structurelle lors de la phase d’encodage se répercute irrémédiablement sur la précision des calculs algorithmiques ultérieurs. Pour illustrer notre démonstration tout au long de cet article, nous prendrons appui sur une recherche empirique en neuropsychologie cognitive visant à modéliser le niveau de stress physiologique aigu (mesuré par le taux de cortisol salivaire après passation d’une tâche de stress induit, exprimé en nanomoles par litre, constituant notre variable dépendante continue Y) en fonction de deux prédicteurs théoriques majeurs : la durée préalable de privation de sommeil (mesurée en heures continues, prédicteur X1) et le score de vulnérabilité émotionnelle obtenu à un inventaire standardisé d’anxiété-trait (score continu variant de 20 à 80 sur l’échelle STAI-T, prédicteur X2).
Les données relatives à cette étude doivent impérativement être structurées selon un paradigme relationnel strict où chaque ligne représente une unité expérimentale unique (un participant identifié par un code anonymisé) et chaque colonne correspond exclusivement à une variable spécifique. Il est hautement recommandé d’attribuer la première ligne de la feuille de calcul aux libellés textuels explicites des variables (par exemple, ID_Sujet en cellule A1, Privation_Sommeil_H en B1, Score_Anxiete_Trait en C1, et Cortisol_Salivaire_nmolL en D1). Cette organisation séquentielle facilite non seulement la sélection des plages dans les boîtes de dialogue des utilitaires d’analyse, mais permet également à Excel d’intégrer formellement les intitulés dans ses rapports récapitulatifs, assurant une traçabilité irréprochable des sorties statistiques.
L’hygiène des données implique une traque rigoureuse des cellules vides, des imputations erronées et des valeurs non numériques. Dans Excel, la présence inopinée d’un espace insécable, d’un caractère textuel ou d’un séparateur décimal non conforme (par exemple, l’usage d’un point au lieu d’une virgule selon les paramètres régionaux du système d’exploitation) convertira la cellule en chaîne de caractères, induisant des erreurs d’exécution fatales telles que #VALEUR! ou faussant les calculs matriciels en omettant silencieusement des lignes. En cas d’observations incomplètes, il est impératif d’adopter une stratégie transparente d’exclusion par liste (suppression complète de la ligne pour les modèles MCO complets) ou de documenter avec exactitude la procédure d’imputation statistique préalablement appliquée.
4.2 Contrôle préliminaire de l’intégrité distributionnelle
Avant d’engager le moindre calcul de régression ou de prétendre extraire une erreur type d’estimation, une phase exploratoire approfondie s’impose afin de valider les propriétés distributionnelles des séries quantitatives encodées. Cette étape préliminaire s’articule autour du déploiement des fonctions statistiques descriptives de base au sein de la feuille Excel. Le calcul de la tendance centrale s’exécute à l’aide de la syntaxe =MOYENNE(plage), tandis que la variabilité brute s’explore conjointement par l’écart-type d’échantillon =ECARTYPE.STANDARD(plage) et la détection de l’asymétrie via =MEDIANE(plage). Une divergence substantielle entre la moyenne et la médiane constitue le premier symptôme d’un étirement asymétrique de la distribution ou de la présence de valeurs extrêmes susceptibles d’exercer un effet de levier disproportionné sur la droite de régression.
La détection des valeurs aberrantes univariées gagne à être systématisée à travers l’insertion graphique de boîtes à moustaches (ou diagrammes de Tukey), directement accessibles via le menu Insertion > Graphiques statistiques > Boîte et moustaches dans les versions modernes d’Excel. Ce formalisme visuel permet d’isoler immédiatement les observations se situant au-delà de 1,5 fois l’intervalle interquartile au-dessus du troisième quartile ou en dessous du premier quartile. Parallèlement, il convient de programmer une règle de validation logique dans une colonne adjacente afin de s’assurer que chaque score encodé s’inscrit rigoureusement dans la plage théorique des instruments psychométriques utilisés (par exemple, vérifier qu’aucun score d’anxiété n’affiche une valeur inférieure à 20 ou supérieure à 80, ce qui dénoterait une faute d’encodage typographique).
Le contrôle de l’intégrité distributionnelle doit également évaluer la dispersion relative à travers le calcul du coefficient de variation (exprimé par le rapport de l’écart-type sur la moyenne arithmétique). Cette précaution analytique permet d’anticiper d’éventuels phénomènes d’invariance d’échelle ou d’effets de plancher et de plafond qui viendraient contraindre artificiellement la variance de la variable dépendante, ce qui aurait pour effet néfaste de biaiser structurellement à la baisse l’estimation de l’erreur type de la régression.
5. Activation et configuration de l’Utilitaire d’analyse statistique dans Excel
5.1 Procédure d’activation du complément Analysis ToolPak
Bien que Microsoft Excel intègre nativement des dizaines de fonctions statistiques individuelles, le traitement standardisé et complet de la modélisation linéaire passe historiquement par l’exploitation de l’Utilitaire d’analyse statistique (désigné sous l’appellation d’origine Analysis ToolPak). Ce module complémentaire d’ingénierie mathématique et statistique est préinstallé dans l’architecture logicielle d’Excel mais requiert une activation explicite de la part de l’utilisateur, n’étant pas chargé par défaut lors du premier lancement de l’application afin d’optimiser les ressources système.
Pour activer ce composant analytique au sein de l’environnement Windows, le chercheur doit naviguer séquentiellement à travers l’arborescence des commandes logicielles :
- Cliquer sur l’onglet principal Fichier localisé dans le coin supérieur gauche du ruban, puis sélectionner la commande Options située en bas du panneau contextuel vertical.
- Dans la boîte de dialogue contextuelle Options d’Excel qui s’affiche, sélectionner la catégorie Compléments positionnée dans la colonne latérale gauche.
- Au bas de la fenêtre principale, repérer le champ déroulant intitulé Gérer, s’assurer que l’option Compléments Excel est activement sélectionnée, puis cliquer sur le bouton Atteindre… adjacent.
- Une boîte de dialogue modale répertoriant les extensions internes apparaît ; il convient alors de cocher expressément la case intitulée Utilitaire d’analyse (veiller à ne pas confondre avec l’Utilitaire d’analyse – VBA, destiné à l’automatisation par programmation macro), puis de valider l’opération en cliquant sur le bouton OK.
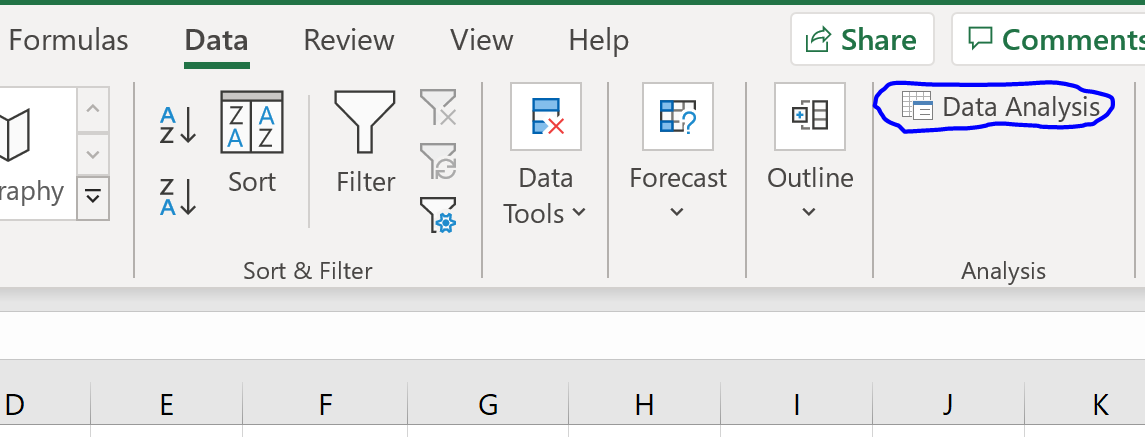
Sous macOS, le déploiement s’opère selon une cinématique simplifiée en accédant au menu déroulant Outils présent dans la barre de menus globale du système d’exploitation, puis en sélectionnant la commande Compléments Excel… afin de cocher la même option. Une fois cette séquence exécutée avec succès, un nouveau groupe fonctionnel intitulé Analyse est dynamiquement généré à l’extrémité droite de l’onglet Données du ruban principal, arborant l’icône de commande Utilitaire d’analyse. En cas d’absence persistante du bouton après redémarrage, il conviendra de vérifier l’intégrité de la version d’Office déployée et de contrôler que les stratégies de sécurité d’entreprise du système d’information n’interdisent pas l’exécution de compléments dynamiques xll.
5.2 Configuration de l’interface du module Régression
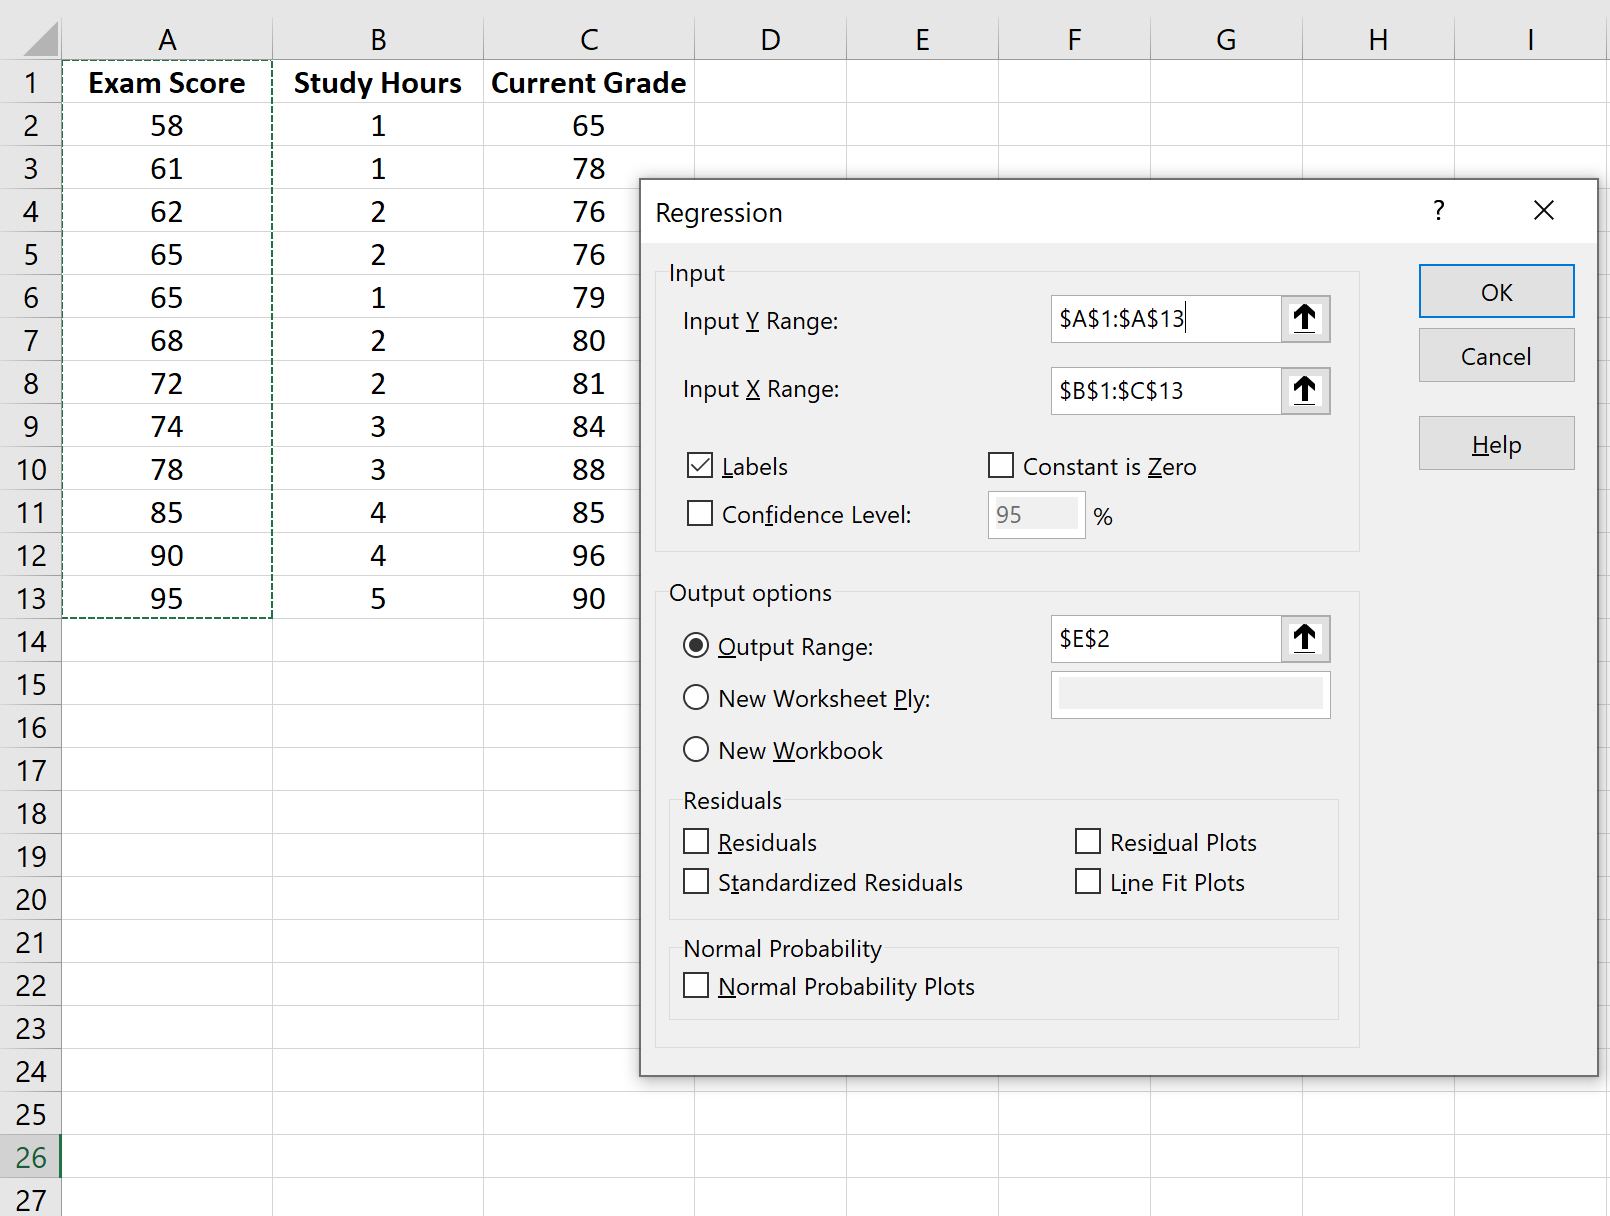
L’ouverture de l’Utilitaire d’analyse via un clic sur la commande éponyme dévoile une liste alphabétique des macro-procédures statistiques disponibles. Le chercheur doit sélectionner la commande Régression puis actionner la validation par le bouton OK, ce qui déclenche l’affichage d’une interface de paramétrage paramétrique approfondie. La configuration méticuleuse de chacune de ses rubriques conditionne directement l’exactitude des calculs matriciels qui présideront à l’extraction de l’erreur type d’estimation.
Le champ de saisie intitulé Plage d’entrée Y requiert la sélection stricte de la référence de la plage vectorielle unicolonne hébergeant la variable dépendante continue (dans notre cas d’étude, la colonne du cortisol salivaire, incluant la cellule d’en-tête, soit $D$1:$D$101 pour un échantillon de 100 participants). Symétriquement, le champ Plage d’entrée X doit recevoir les coordonnées de la matrice regroupant les prédicteurs indépendants. Pour un modèle bivarié simple, une unique colonne sera pointée (par exemple, la privation de sommeil en $B$1:$B$101) ; dans le cadre multivarié, l’utilisateur devra impérativement veiller à ce que l’ensemble des colonnes prédictives soient strictement adjacentes sur la feuille afin de sélectionner une plage bidimensionnelle continue (par exemple, $B$1:$C$101). Il s’agit là d’une contrainte technique incontournable du moteur de l’Utilitaire d’analyse qui refuse catégoriquement les sélections disjointes pour la matrice X.
Deux réglages de configuration revêtent une importance capitale pour la validité méthodologique :
- La case à cocher Intitulés doit obligatoirement être activée si les cellules d’en-tête textuelles ont été intégrées dans les plages d’entrée. Cette manipulation prévient toute tentative désastreuse de conversion textuelle en valeur zéro par l’algorithme d’estimation et assure l’annotation textuelle propre de chaque coefficient dans la feuille de résultats récapitulatifs.
- La case Niveau de confiance doit être cochée et paramétrée à sa valeur canonique de
95%(correspondant au seuil conventionnel alpha de 0,05 de l’APA), bien qu’il soit possible de la modifier pour des besoins d’inférence plus conservateurs (99%). - Dans la section inférieure dédiée aux Résidus, il est vivement préconisé de cocher l’ensemble des cases associées : Résidus, Résidus normalisés, et Courbe de régression. L’activation de ces options enrichit la sortie de données individuelles calculées point par point, indispensables au diagnostic des postulats de l’erreur type abordé ultérieurement.
6. Exécution pas à pas d’une régression linéaire simple avec l’Utilitaire d’analyse
6.1 Spécification d’un modèle bivarié en psychologie de l’apprentissage
Afin de détailler la cinématique opérationnelle de l’Utilitaire d’analyse dans une démonstration didactique univariée, modélisons une étude empirique relative à la psychologie de l’apprentissage et à l’ingénierie cognitive. Considérons une cohorte de 50 étudiants universitaires soumis à une tâche standardisée d’évaluation de la mémoire de travail (score synthétique d’empan complexe étalonné sur une échelle continue théorique de 0 à 100, constituant la variable dépendante Y, localisée dans la plage $B$1:$B$51). Le régresseur unique mobilisé (variable indépendante X, plage $A$1:$A$51) formalise le temps hebdomadaire consacré à un programme structuré d’entraînement cognitif informatisé, mesuré en heures cumulées (variant de 1 à 15 heures hebdomadaires).
Après avoir accédé à la commande Régression de l’Utilitaire d’analyse, l’utilisateur assigne méthodiquement les références des colonnes : le vecteur mémoire de travail en plage d’entrée Y et le vecteur d’entraînement cognitif en plage d’entrée X. La case Intitulés est cochée pour reconnaître les libellés de la ligne 1. Dans les options de sortie, la sélection de l’option Nouvelle feuille de calcul (baptisée pour l’occasion Sortie_Regression_Simple) est fortement privilégiée afin d’éviter tout écrasement accidentel des matrices de données brutes d’origine.
Dès l’actionnement du bouton OK, le processeur de calcul matriciel d’Excel applique les formules algébriques des projections orthogonales des moindres carrés ordinaires. En une fraction de seconde, une nouvelle feuille de calcul s’ouvre, présentant une architecture tripartite rigoureuse standardisée qui encapsule l’intégralité des indices d’adéquation globale, la table de décomposition de l’analyse de variance, ainsi que les estimations ponctuelles et inférentielles des paramètres du modèle.
6.2 Analyse structurelle des trois tableaux de résultats générés
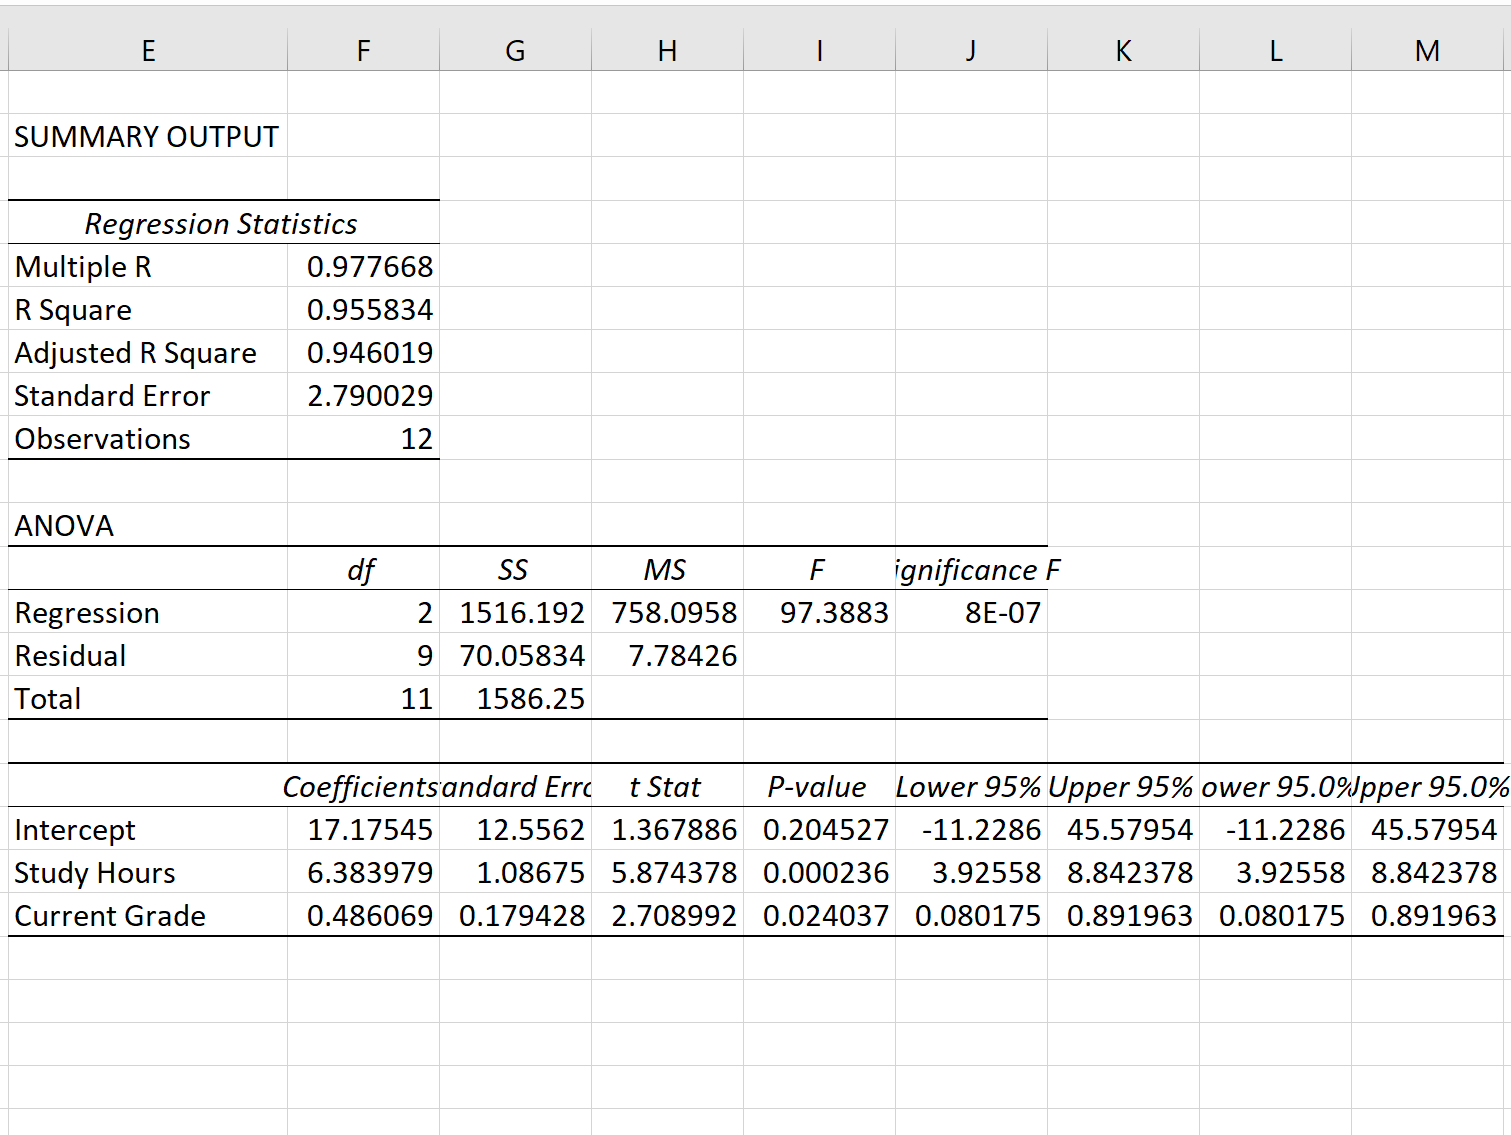
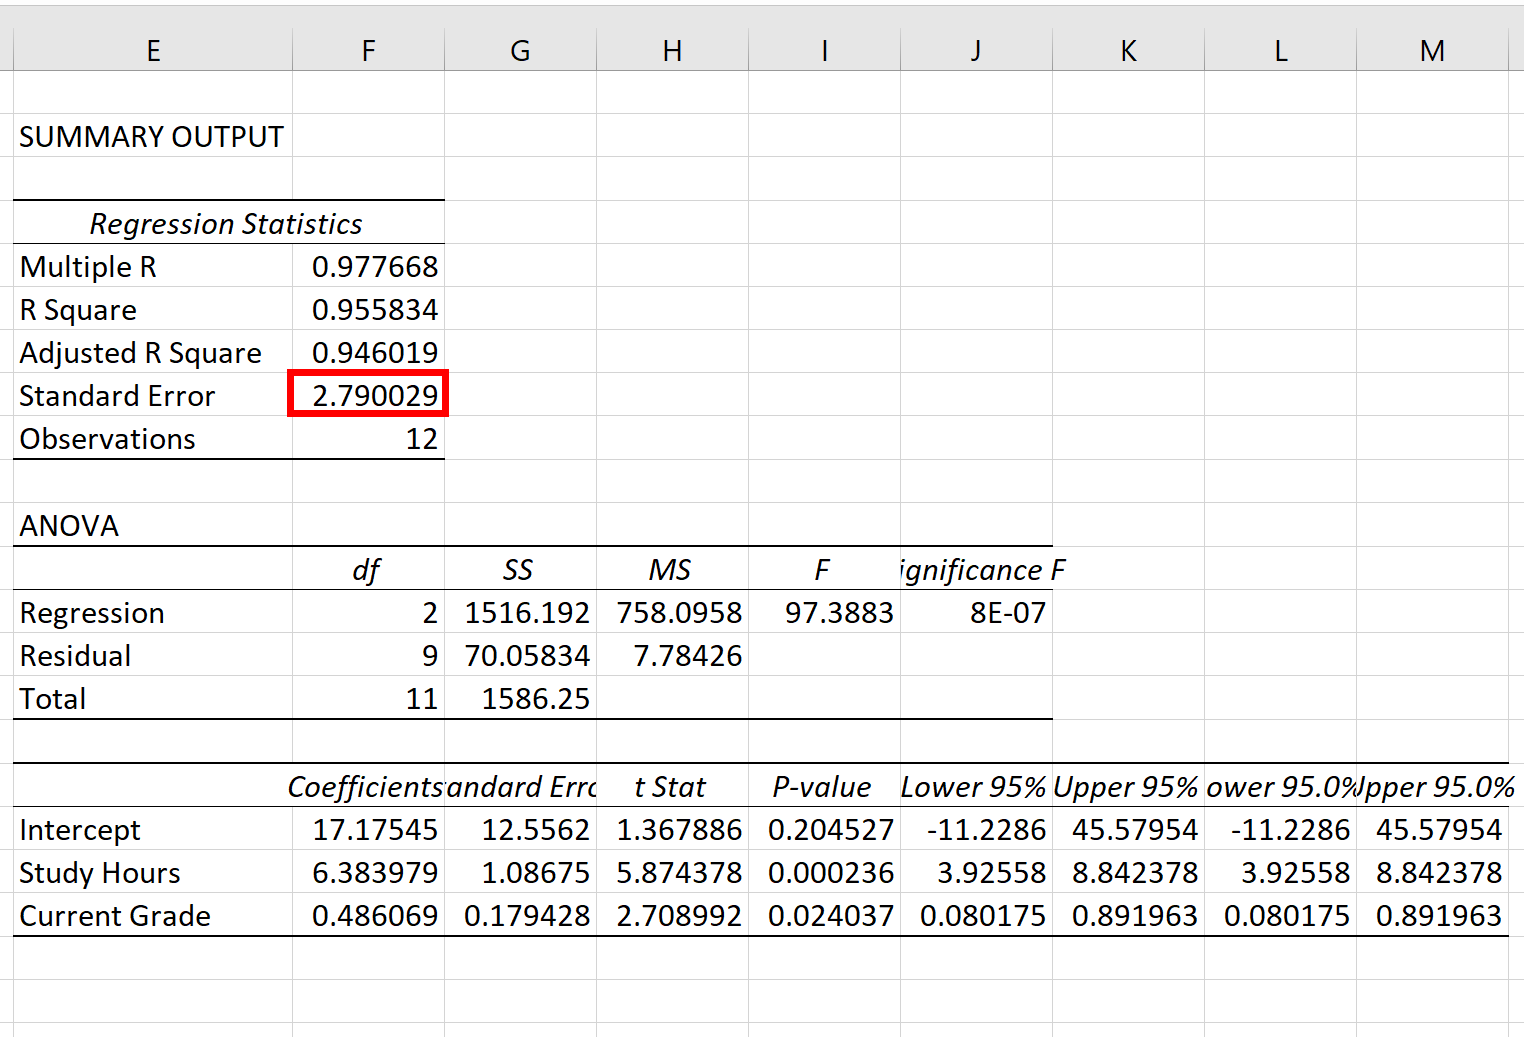
Le rapport synthétique généré par l’Utilitaire d’analyse s’articule systématiquement en trois sous-ensembles matriciels distincts, dont la lecture coordonnée est impérative pour appréhender le statut de l’erreur type :
- Le tableau des Statistiques de la régression : Positionné au sommet de la feuille, ce premier panneau synthétise les indices d’ajustement global adimensionnels et dimensionnels. On y retrouve le coefficient de corrélation multiple (Coefficient de détermination multiple), le coefficient de détermination R², le R² ajusté pour les degrés de liberté, l’incontournable Erreur-type de régression, et le décompte de l’effectif total Observations.
- Le tableau de l’Analyse de variance (ANOVA) : Ce deuxième panneau décompose la variance selon la logique d’orthogonalité décrite à la section 2.2. Il structure sur trois lignes successives la régression (le modèle explicatif), les résidus (l’erreur stochastique), et le total. Pour chaque composante, il fournit les degrés de liberté (dl), la somme des carrés (SC), la moyenne des carrés (MS ou Carré Moyen, équivalant au ratio de la somme des carrés sur ses degrés de liberté respectifs), ainsi que la statistique globale de Fisher-Snedecor (F) et sa significativité critique associée (valeur p désignée par F critique).
- Le tableau des paramètres et estimations : Le troisième registre détaille ligne par ligne la constante (ordonnée à l’origine) et chaque variable indépendante. En colonnes successives sont articulés les Coefficients non standardisés (β0 et β1), leurs Erreurs-types individuelles respectives, la statistique t de Student (quotient du coefficient par son erreur-type propre), la Probabilité critique (valeur p de bilatéralité), ainsi que les bornes inférieures et supérieures de l’intervalle de confiance à 95%.
7. Extraction et interprétation académique de l’erreur type dans le rapport Excel
7.1 Localisation précise de l’Erreur-type dans le tableau récapitulatif
Au sein de la feuille de calcul générée par l’Utilitaire d’analyse, l’erreur type de la régression ne fait l’objet d’aucune mise en valeur typographique particulière et se trouve fréquemment confondue par les utilisateurs non avertis avec les erreurs types des coefficients individuels situées dans le tableau inférieur. Pour localiser sans équivoque cette métrique cardinale, le regard doit se porter sur le premier bloc matriciel intitulé Statistiques de la régression. L’erreur type de régression y est répertoriée sous l’appellation générique et compacte Erreur-type, occupant invariablement la quatrième ligne du tableau, intercalée immédiatement entre la métrique du R-deux ajusté et celle du nombre d’Observations.
Il est fondamental de noter que la cellule numérique adjacente à cette mention affiche une valeur exprimée strictement dans la métrique et l’unité physique de la variable dépendante Y. Si notre modèle analysait la mémoire de travail étalonnée sur une échelle de 0 à 100 points, une valeur numérique affichée de 5,42 dans cette cellule signifie que l’erreur type d’estimation s’élève précisément à 5,42 points d’empan mnésique. Cette unité ne subit aucune normalisation adimensionnelle ; elle ne saurait être interprétée en pourcentage, ni assimilée à une probabilité statistique ou à une part de variance.
L’interprétation clinique et empirique directe de cette valeur se formule ainsi : lors de l’utilisation de l’équation de la droite des moindres carrés ordinaires pour estimer le score individuel de mémoire de travail d’un sujet à partir de son temps d’entraînement cognitif hebdomadaire, l’écart-type de l’erreur prédictive commise est approximativement de 5,42 points. Sous réserve de l’hypothèse de normalité distributionnelle des perturbations résiduelles, cette quantification implique qu’environ 68,2% des observations empiriques réelles fluctueront dans un couloir d’incertitude borné à ± 5,42 points autour de la trajectoire théorique prédite par l’équation, et qu’approximativement 95,4% des scores s’inscriront à l’intérieur d’un intervalle de dispersion de ± 10,84 points (soit deux erreurs types d’estimation) autour de la prédiction du modèle.
7.2 Évaluation de la qualité du modèle par l’erreur type
L’erreur type de la régression constitue le test de réalité pragmatique d’un modèle statistique, là où le coefficient de détermination R² pèche parfois par complaisance mathématique. Un modèle de régression peut tout à fait arborer un R² impressionnant de 0,85 — suggérant qu’il capture 85% de la variance observée — tout en affichant une erreur type de régression dont l’amplitude absolue demeure prohibitive pour toute application diagnostique concrète sur le terrain clinique ou neuropsychologique.
Pour évaluer rigoureusement la qualité d’ajustement du modèle à travers l’erreur type, le chercheur doit procéder à une comparaison systématique de cette dernière avec l’écart-type inconditionnel de référence de la variable dépendante (sy). Si l’écart-type brut de la mémoire de travail dans l’échantillon initial était de sy = 12,80 points, la réduction observée à un écart résiduel de Se = 5,42 points atteste d’un resserrement substantiel de plus de 57% de l’incertitude stochastique globale. Le ratio Se / sy (directement corrélé à la quantité √(1 – R²) au facteur de correction des degrés de liberté près) offre une quantification directe de l’efficience empirique du dispositif explicatif.
Une seconde métrique dérivée particulièrement éclairante consiste à calculer le coefficient d’erreur relative ou ratio d’imprécision moyenne, obtenu en divisant l’erreur type de la régression par la moyenne arithmétique de la variable critère : (Se / Ȳ) × 100. Si la moyenne générale des scores mnésiques s’établit à 65 points, un écart résiduel de 5,42 points génère une imprécision prédictive relative de 8,34%. Dans les contextes de sélection du personnel, d’orientation académique ou d’établissement de scores seuils d’inclusion dans des programmes thérapeutiques, cette analyse en unités tangibles permet aux décideurs d’arbitrer rationnellement si la résolution prédictive de l’instrument est compatible avec les impératifs éthiques et techniques de l’action psychologique envisagée.
8. Calcul manuel de l’erreur type de régression par les formules natives d’Excel
8.1 Génération des valeurs prédites et des résidus individuels
Pour s’émanciper de la rigidité des sorties automatisées de l’Utilitaire d’analyse — qui présentent le défaut majeur d’être totalement statiques et de ne jamais se réactualiser lors de la saisie ultérieure de nouvelles données —, le statisticien avisé maîtrise l’implémentation dynamique du calcul de l’erreur type via les formules élémentaires du tableur. Ce processus manuel débute par la modélisation explicite de l’équation de régression linéaire bivariée ŷ = β0 + β1X à l’aide des fonctions natives d’ajustement linéaire d’Excel.
Soit notre échantillon de travail disposé dans les colonnes A (variable explicative X, de la cellule A2 à A51) et B (variable critère Y, de B2 à B51). Dans deux cellules d’initialisation isolées (par exemple, E2 et E3), l’analyste détermine la pente et l’ordonnée à l’origine en renseignant respectivement :
Pour la pente de régression : =PENTE(B2:B51; A2:A51)
Pour l’ordonnée à l’origine : =INTERSECTION.DROITE(B2:B51; A2:A51)
Une fois ces paramètres directeurs extraits, il convient de structurer la colonne C en tant que vecteur des valeurs théoriques prédites ŷi. En saisissant en cellule C2 la formule dynamique faisant appel au verrouillage absolu des références par le caractère dollar :
=$E$3 + $E$2 * A2
puis en étirant cette expression sur l’ensemble des cinquante lignes de la cohorte, la droite d’ajustement se trouve instanciée pour chaque participant. La colonne adjacente D est ensuite dévolue au calcul du résidu stochastique brut ei = yi – ŷi. La cellule D2 reçoit simplement l’opération de soustraction arithmétique =B2 - C2, immédiatement propagée le long du tableau. À ce stade, la somme simple de cette colonne D calculée via =SOMME(D2:D51) doit afficher une valeur infinitésimale tendant vers zéro (ex. 1,42E-14), attestant de la rectitude mathématique de la projection orthogonale effectuée.
8.2 Agrégation de la somme des carrés résiduels (SCE)
Pour pallier l’annulation algébrique structurelle des écarts résiduels bruts et quantifier l’énergie résiduelle globale du modèle, l’étape suivante réside dans la sommation quadratique des résidus d’estimation. La méthodologie analytique classique consiste à dédier une colonne additionnelle E à l’élévation au carré de chaque résidu individuel. La cellule E2 est ainsi formulée par =D2^2, opération répliquée jusqu’à la cellule E51. L’agrégation finale de la Somme des Carrés des Erreurs s’obtient alors en logeant dans une cellule synthétique (par exemple, G2) la fonction de sommation :
=SOMME(E2:E51)
Cette Somme des Carrés des Erreurs (SCE) représente l’agrégat brut de la variabilité non captée par la droite d’ajustement linéaire. Néanmoins, pour les analystes souhaitant optimiser l’espace de calcul sans générer de colonnes de calcul intermédiaires, Excel met à disposition des fonctions matricielles directes capables d’exécuter cette condensation en une instruction unique. La fonction SOMME.CARRES.ECARTS ne s’applique qu’à la variance univariée globale par rapport à une moyenne arithmétique unique, mais la formule matricielle native :
=SOMMEPROD((B2:B51 - ($E$3 + $E$2 * A2:A51))^2)
réalise en mémoire vive l’estimation des prédictions, la soustraction des résidus, leur élévation à la puissance carrée et leur agrégation finale, sans nécessiter la moindre cellule tampon.
8.3 Application finale de la formule mathématique dans Excel
L’aboutissement du calcul algorithmique manuel de l’erreur type de régression réside dans l’application intégrale de la fraction définie à la section 2.1, articulant la racine carrée du quotient de la somme des carrés résiduels par leurs degrés de liberté effectifs. Les degrés de liberté du dénominateur s’évaluent dynamiquement en retranchant le nombre de paramètres estimés du nombre total d’observations valides. La fonction =NB(B2:B51) dénombrant l’effectif n de la variable dépendante, le dénominateur pour notre modèle bivarié simple (une constante et une pente, soit deux contraintes) s’écrit formellement NB(B2:B51) - 2.
La cellule finale accueillant l’erreur type de régression dynamique (par exemple G3) reçoit alors la formule canonique :
=RACINE(G2 / (NB(B2:B51) - 2))
ou, si l’on condense l’ensemble de la cinématique en une seule expression consolidée sans aucune colonne subsidiaire :
=RACINE(SOMMEPROD((B2:B51 - (INTERSECTION.DROITE(B2:B51; A2:A51) + PENTE(B2:B51; A2:A51) * A2:A51))^2) / (NB(B2:B51) - 2))
L’exécution de cette syntaxe renvoie une valeur numérique strictement identique au millième près à celle extraite du tableau des statistiques de la régression fourni par l’Utilitaire d’analyse. Toutefois, cette approche manuelle par formules confère un avantage méthodologique inestimable : l’interactivité absolue. Dès lors qu’un clinicien modifie la valeur du score d’un participant ou incorpore de nouvelles lignes à l’échantillon expérimental, l’intégralité des dépendances fonctionnelles se recalcule instantanément en arrière-plan, garantissant une actualisation en temps réel de l’écart-type des résidus.
9. Calcul direct par fonctions avancées et matricielles : ERREUR.TYPE.ESTYX et DROITEREG
9.1 Implémentation de la fonction dédiée ERREUR.TYPE.ESTYX
Conscient de la lourdeur calculatoire inhérente à la reconstruction manuelle des sommes de carrés, Microsoft a introduit au sein de la bibliothèque de fonctions statistiques d’Excel un opérateur dédié exclusivement à l’extraction directe de l’erreur type de régression dans le modèle bivarié simple : la fonction ERREUR.TYPE.ESTYX (dont l’équivalent dans les versions anglophones du logiciel est STEYX, acronyme de Standard Error of the Predicted Y for an individual X).
La syntaxe opératoire de cette fonction requiert rigoureusement deux arguments vectoriels unidimensionnels et s’articule comme suit :
=ERREUR.TYPE.ESTYX(données_Y; données_X)
Il importe de souligner avec la plus grande vigilance l’ordre d’ordonnancement des arguments : contrairement à de nombreuses fonctions mathématiques où les variables indépendantes figurent en premier lieu, ERREUR.TYPE.ESTYX exige impérativement que la plage de la variable dépendante Y (dans notre exemple, les scores d’empan de mémoire de travail B2:B51) soit renseignée en premier argument, suivie par la plage du prédicteur X (A2:A51) en second argument. Une inversion involontaire de cet ordonnancement calculera l’erreur standard de la régression inverse de X sur Y, fournissant une valeur exprimée dans l’unité de mesure de la variable indépendante qui faussera l’intégralité du diagnostic statistique.
Le recours à ERREUR.TYPE.ESTYX représente l’approche la plus efficiente pour intégrer l’erreur type résiduelle au sein de tableaux de bord dynamiques ou de routines d’évaluation psychométrique informatisées. Cette fonction gère nativement la réactivité des recalculs automatiques du moteur Excel et ignore de façon transparente les lignes où l’une des deux cellules de la paire (X, Y) est vide. Néanmoins, elle présente une limitation structurelle incontournable : elle est mathématiquement et syntaxiquement bridée au cas de la régression linéaire simple comportant un prédicteur univarié. Dès lors que la recherche comportementale engage deux prédicteurs explicatifs ou davantage, toute tentative de passer une matrice multi-colonnes dans l’argument données_X provoquera une erreur d’exécution immédiate #REF! ou #VALEUR!, contraignant l’utilisateur à se tourner vers des fonctions matricielles plus élaborées.
9.2 Déploiement de la fonction matricielle puissante DROITEREG
Pour transcender les limitations univariées d’ERREUR.TYPE.ESTYX et accéder à la plénitude des paramètres d’ajustement sans subir l’inertie figée de l’Utilitaire d’analyse, la fonction matricielle avancée DROITEREG (ou LINEST en nomenclature anglophone) s’impose comme l’outil mathématique de référence sous Excel. Cette commande applique la résolution matricielle complète des moindres carrés β = (X’X)-1X’Y et renvoie une matrice multidimensionnelle encapsulant l’ensemble des statistiques inférentielles de la régression.
La signature complète de la fonction DROITEREG requiert jusqu’à quatre paramètres d’entrée :
=DROITEREG(Y_connus; [X_connus]; [constante]; [statistiques])
Pour activer l’extraction de l’erreur type résiduelle globale, les deux derniers arguments booléens doivent obligatoirement être spécifiés à VRAI : le paramètre constante (fixé à VRAI pour autoriser le calcul standard de l’ordonnée à l’origine β0 sans forcer le passage de la droite par l’origine) et le paramètre statistiques (fixé à VRAI pour forcer l’algorithme à calculer et renvoyer la grille exhaustive des indices de variance et d’erreur).
Dans les versions contemporaines de Microsoft 365 et d’Excel intégrant le moteur de tableaux dynamiques matriciels à propagation (dynamic arrays), la saisie de l’expression :
=DROITEREG(B2:B51; A2:A51; VRAI; VRAI)
dans une seule cellule provoque la propagation automatique d’un bloc matriciel rectangulaire composé de cinq lignes et de deux colonnes (pour un prédicteur unique). Dans les versions historiques d’Excel antérieures à 2019, cette opération exigeait la sélection préalable d’une plage vide de 5 lignes par 2 colonnes, la saisie de la syntaxe dans la barre de formules, suivie de la validation matricielle solennelle par la combinaison de touches Ctrl + Maj + Entrée.
Au sein de la grille matricielle de résultats générée par DROITEREG, les indices occupent des coordonnées spatiales standardisées immuables :
- Ligne 1 : Affiche les coefficients directeurs estimés (la pente β1 en colonne 1, et l’ordonnée à l’origine β0 en colonne 2).
- Ligne 2 : Affiche les erreurs types individuelles respectives des coefficients (SE(β1) en colonne 1, et SE(β0) en colonne 2).
- Ligne 3 : Présente le coefficient de détermination R² en colonne 1, et la fameuse Erreur type de régression (Se) en colonne 2.
- Ligne 4 : Contient la statistique globale de Fisher F en colonne 1, et les degrés de liberté résiduels (n – k – 1) en colonne 2.
- Ligne 5 : Expose la Somme des Carrés du Modèle (SCM) en colonne 1, et la Somme des Carrés des Erreurs (SCE) en colonne 2.
Pour extraire isolément l’erreur type de régression sans saturer la feuille de calcul d’une matrice encombrante, l’analyste conjuguera judicieusement DROITEREG avec la fonction d’indexation dynamique INDEX :
=INDEX(DROITEREG(B2:B51; A2:A51; VRAI; VRAI); 3; 2)
Cette formule élégante cible précisément la cellule positionnée à l’intersection de la troisième ligne et de la deuxième colonne de la matrice calculée, isolant instantanément l’erreur type de régression au sein d’une unique cellule dynamique autonome.
10. Extension à la régression multiple : modélisation de covariables psychologiques
10.1 Spécification d’un modèle multivarié dans Excel
L’exploration des phénomènes psychologiques et comportementaux requiert rarement la mobilisation d’un prédicteur isolé, la complexité de l’esprit humain réclamant l’intégration conjointe de multiples déterminants cognitifs, environnementaux et biologiques. Reprenons notre protocole expérimental initial visant à modéliser le niveau de cortisol salivaire aigu (Y, localisé dans la plage $D$2:$D$101 pour 100 participants) à l’aide conjointe des heures de privation de sommeil (X1, colonne B) et du score d’anxiété-trait (X2, colonne C). Ce cadre multivarié enrichit substantiellement l’analyse en contrôlant statistiquement la part de variance unique dévolue à chaque dimension explicative.
L’exécution de cette régression multiple sous l’Utilitaire d’analyse statistique exige le strict respect de la contrainte de contiguïté spatiale des données indépendantes. Dans la boîte de dialogue du module Régression, le champ Plage d’entrée X doit embrasser simultanément les deux colonnes explicatives sous la forme d’une référence matricielle bidimensionnelle unique : $B$1:$C$101. Si les colonnes des prédicteurs se trouvaient disjointes sur la feuille de calcul, Excel refuserait catégoriquement d’exécuter la procédure, contraignant l’utilisateur à réagencer préalablement ses colonnes.
L’adjonction de multiples prédicteurs modifie l’arithmétique sous-jacente aux degrés de liberté du système stochastique. Pour un échantillon de n = 100 sujets évalués sur k = 2 variables indépendantes, le dénominateur de la variance résiduelle s’établit désormais à n – k – 1 = 100 – 2 – 1 = 97 degrés de liberté. L’algorithme des moindres carrés ordinaires projette les observations dans un espace vectoriel à trois dimensions, déterminant le plan d’ajustement qui minimise la somme des carrés des distances verticales séparant les points réels de ce plan géométrique.
10.2 Calcul de l’erreur type résiduelle multivariée par DROITEREG
Le calcul dynamique de l’erreur type de régression multivariée trouve dans la fonction matricielle DROITEREG son vecteur d’exécution le plus performant. Contrairement à ERREUR.TYPE.ESTYX devenue obsolète en dimension multiple, DROITEREG absorbe sans aucune difficulté une matrice d’entrée multi-colonnes pour son second argument. La syntaxe opérationnelle pour notre modèle neuropsychologique à deux prédicteurs s’énonce :
=DROITEREG(D2:D101; B2:C101; VRAI; VRAI)
Dans ce contexte multivarié à k = 2 régresseurs, l’architecture matricielle renvoyée par DROITEREG s’élargit horizontalement pour comporter 5 lignes et 3 colonnes (soit k + 1 colonnes). Les coefficients de pente sont disposés sur la première ligne dans l’ordre inverse de leur encodage tabulaire : la colonne 1 héberge la pente β2 associée au prédicteur le plus à droite (l’anxiété-trait), la colonne 2 accueille la pente β1 du premier prédicteur (la privation de sommeil), et la colonne 3 affiche l’ordonnée à l’origine β0.
Néanmoins, la localisation structurelle de l’erreur type résiduelle globale demeure immuablement ancrée à la même coordonnée verticale : elle se situe toujours sur la troisième ligne de la matrice générée, et occupe invariablement la deuxième colonne du bloc. Par conséquent, la formule d’extraction vectorielle combinée demeure rigoureusement identique à la spécification univariée :
=INDEX(DROITEREG(D2:D101; B2:C101; VRAI; VRAI); 3; 2)
Cette stabilité positionnelle facilite l’automatisation de scripts d’audit statistique. En observant l’évolution de cette cellule lors de l’intégration incrémentale de nouveaux prédicteurs (par exemple, en comparant un modèle univarié incluant uniquement le sommeil avec le modèle bivarié incorporant l’anxiété), le chercheur quantifie directement le gain de précision résiduelle. Si l’erreur type passe de 4,18 nmol/L dans le modèle simple à 2,85 nmol/L dans le modèle multivarié, cette rétraction de l’écart-type résiduel atteste que l’intégration conjointe de la dimension émotionnelle resserre significativement la marge d’incertitude pesant sur l’estimation biologique du cortisol.
10.3 Problématique de la multicolinéarité et son impact sur les erreurs types
L’extension au modèle multivarié introduit une vulnérabilité méthodologique majeure propre aux sciences comportementales : la multicolinéarité. Cette anomalie statistique survient lorsque deux ou plusieurs variables explicatives partagent des corrélations bivariées substantielles, signifiant qu’elles redondent sur le plan de l’information prédictive apportée au système (par exemple, si la privation de sommeil et le niveau d’anxiété-trait étaient corrélés à r = 0,85).
Il est impératif de dissocier avec la plus grande netteté l’impact de la colinéarité sur l’erreur type globale de la régression (Se) et son effet destructeur sur les erreurs types individuelles des coefficients (SE(βj)). L’erreur type globale de régression Se demeure en effet remarquablement stable face à la colinéarité : elle reflète la capacité prédictive globale conjointe de l’hyperplan et continue de mesurer fidèlement la proximité moyenne des données par rapport à cet hyperplan d’ajustement.
En revanche, la présence d’une forte multicolinéarité provoque un gonflement artificiel massif des erreurs types propres aux coefficients partiels SE(βj) (phénomène d’inflation de la variance mesuré par le VIF, ou Variance Inflation Factor). Les axes géométriques des prédicteurs devenant quasi-parallèles, l’algorithme des moindres carrés peine à délimiter la contribution unique de chaque régresseur, ce qui se traduit par une instabilité extrême des pentes estimées et un effondrement des statistiques t associées. Pour diagnostiquer ce piège sous Excel, l’analyste doit préalablement activer l’outil Corrélation de l’Utilitaire d’analyse sur l’ensemble des colonnes de régresseurs afin de s’assurer qu’aucun coefficient d’intercorrélation bivariée ne dépasse le seuil critique conventionnel de 0,70.
11. Diagnostic des postulats statistiques conditionnant l’erreur type
11.1 Inspection visuelle de l’homoscédasticité par nuages de points
L’erreur type de la régression calculée par les fonctions standard d’Excel est une métrique construite sous le postulat strict d’homoscédasticité, stipulant que la dispersion des résidus demeure rigoureusement invariable quelle que soit la valeur prédite par le modèle. Si cette condition fondamentale d’homogénéité de la variance stochastique est violée, l’erreur type unique calculée devient un artefact mathématique trompeur : elle sous-estimera l’incertitude dans certaines zones de l’échelle tout en la surestimant dramatiquement dans d’autres secteurs.
Pour diagnostiquer visuellement l’homoscédasticité au sein de l’environnement Excel, le chercheur exploite les séries individuelles de résidus et de valeurs prédites préalablement générées lors de l’exécution de la régression via l’Utilitaire d’analyse. La procédure consiste à concevoir un graphique de dispersion bidimensionnel standard :
- Sélectionner simultanément la colonne des Valeurs prédites (qui servira d’axe horizontal des abscisses X) et la colonne des Résidus bruts (assignée à l’axe vertical des ordonnées Y).
- Naviguer vers l’onglet Insertion, cliquer sur le menu Graphiques, puis sélectionner Nuage de points (X, Y) sans relier les marqueurs.
- Insérer une ligne de référence horizontale au niveau de l’ordonnée zéro afin de matérialiser visuellement la trajectoire d’équilibre des résidus.
L’inspection analytique du nuage de points ainsi formé permet de statuer sur la validité du postulat :
- Configuration homoscédastique saine : Les points résiduels se distribuent de façon parfaitement homogène et aléatoire sous la forme d’une bande ou d’un rectangle horizontal continu d’épaisseur constante, sans structure identifiable ni resserrement directionnel.
- Configuration hétéroscédastique pathologique : Les points adoptent une géométrie en entonnoir (la variance résiduelle s’accroît à mesure que la prédiction augmente) ou en fuseau. En psychologie du travail, par exemple, la variance de l’épuisement professionnel augmente souvent chez les sujets soumis à de très fortes charges de stress. En présence d’un tel pattern, l’erreur type affichée par Excel perd toute validité diagnostique ponctuelle, imposant un recours à la régression pondérée (WLS) ou à une transformation mathématique préalable des données brutes.
11.2 Évaluation de la normalité des résidus d’estimation
L’inférence statistique autorisée par l’erreur type de régression — notamment la transposition d’un intervalle de ± 1,96 Se en un seuil probabiliste exact de recouvrement à 95% — repose théoriquement sur l’hypothèse de distribution normale gaussienne des perturbations stochastiques dans la population. Si les résidus d’estimation affichent une forte asymétrie ou un aplatissement leptocurtique substantiel, les pourcentages de couverture associés aux marges d’incertitude calculées sous Excel deviennent erronés.
Pour évaluer la normalité des résidus sans quitter le tableur, la méthode graphique de référence consiste à bâtir un tracé de probabilité normale (couramment désigné sous le terme de diagramme quantile-quantile ou tracé Q-Q Plot). Cette construction requiert la standardisation préalable des résidus sous forme de cotes Z en appliquant la fonction dynamique suivante sur chaque résidu ei divisé par l’erreur type de régression globale :
=D2 / $G$3
Les résidus standardisés sont ensuite ordonnés par ordre croissant à l’aide de la commande de tri d’Excel. En regard de cette série ordonnée, le statisticien calcule le rang centile empirique théorique pour chaque observation de rang i via la formule de Hazen ou de Blom : =(i - 0,5) / n. La valeur théorique gaussienne attendue sous l’hypothèse nulle de normalité est alors extraite à l’aide de la fonction d’inversion normale centrée réduite :
=LOI.NORMALE.STANDARD.INVERSE((LIGNE() - 1 - 0,5) / NB(residus))
En traçant le nuage de points opposant les résidus standardisés observés aux quantiles théoriques normaux, la conformité distributionnelle se traduit par un alignement rectiligne rigoureux le long de la diagonale identitaire à 45 degrés. Tout décrochage structurel aux extrémités (déviations sigmoïdales ou courbures paraboliques) traduit la présence de queues de distribution épaisses ou d’une asymétrie marquée. Face à de telles anomalies distributionnelles sous Excel, la démarche académique consiste à appliquer une transformation mathématique stabilisatrice sur la variable dépendante d’origine — telle que la transformation logarithmique =LN(Y) ou la racine carrée =RACINE(Y) — avant de réexécuter l’algorithme de régression linéaire sur les données reconfigurées.
12. Application méthodologique : intervalles de prédiction et communication académique selon les normes APA
12.1 Calcul des intervalles de prédiction individuels versus intervalles de confiance
Une application opérationnelle majeure de l’erreur type de la régression réside dans l’établissement d’intervalles de prédiction destinés à encadrer la performance attendue d’un sujet unique. Il convient de distinguer avec une rigueur absolue l’intervalle de confiance de l’intervalle de prédiction. L’intervalle de confiance évalue la précision avec laquelle la moyenne conditionnelle de la population E(Y|X0) est localisée pour une valeur fixée X0. Cet intervalle converge vers une largeur quasi-nulle à mesure que l’échantillon n croît, son calcul n’intégrant que l’incertitude liée à l’échantillonnage des coefficients de régression.
À l’opposé, l’intervalle de prédiction ambitionne d’anticiper le score empirique futur d’un individu singulier Ynouveau pour un niveau donné de prédicteur X0. Cet intervalle incorpore inéluctablement deux sources distinctes et additives d’incertitude : d’une part, l’imprécision inhérente à l’estimation de la droite moyenne elle-même (l’erreur d’échantillonnage), et d’autre part, la variabilité stochastique individuelle incompressible caractérisant tout sujet comportemental autour de cette trajectoire moyenne, variabilité dont l’amplitude est directement capturée par l’erreur type de régression Se.
L’erreur standard de prédiction individuelle (notée SE(Prédiction)) pour une valeur de régresseur X0 se formalise mathématiquement par l’expression :
SE(Prédiction) = Se × √( 1 + (1 / n) + [ (X0 – X̄)² / Σ(xi – X̄)² ] )
Au sein d’Excel, la programmation de cette formule s’effectue dynamiquement en articulant les fonctions de dispersion précédemment décrites. Soit une valeur cible X0 saisie en cellule J2, l’erreur standard de prédiction individuelle s’implémente en cellule J3 par :
=G3 * RACINE(1 + (1 / NB(A2:A51)) + ((J2 - MOYENNE(A2:A51))^2 / SOMME.CARRES.ECARTS(A2:A51)))
où G3 contient l’erreur type de régression Se.
Pour ériger un intervalle de prédiction individuel au seuil bilatéral de 95%, l’analyste multiplie cette erreur standard composée par le quantile critique approprié de la distribution de Student à n – 2 degrés de liberté, calculé via :
=LOI.STUDENT.INVERSE.N(0,05; NB(A2:A51) - 2)
Les bornes inférieure et supérieure de la prédiction individuelle s’obtiennent alors en soustrayant et en additionnant cette marge d’erreur à la valeur théorique projetée ŷ0. L’examen attentif de cette formulation démontre le rôle prépondérant joué par la constante 1 sous le radical : même si la taille de l’échantillon n devenait infiniment grande (annulant le terme 1/n ainsi que le terme d’écart à la moyenne), la largeur de l’intervalle de prédiction individuelle ne s’effondrera jamais et demeurera fondamentalement bornée par la valeur intrinsèque de l’erreur type de régression (± tcritique × Se).
12.2 Rédaction standardisée des résultats statistiques au format APA (7e édition)
La restitution éditoriale des résultats d’une analyse de régression linéaire au sein d’un article scientifique soumis à une revue académique à comité de lecture affiliée à l’American Psychological Association (normes APA 7e édition) requiert une intégration rigoureuse de l’erreur type résiduelle aux côtés des statistiques d’ajustement globales et des coefficients spécifiques.
Dans le corps du texte narratif, l’incorporation de l’erreur type de régression permet de contextualiser physiquement la performance du modèle au-delà de la significativité probabiliste brute. Une formulation textuelle exemplaire selon les canons de l’APA s’énonce comme suit :
« Une analyse de régression linéaire simple a été conduite afin de déterminer dans quelle mesure la privation de sommeil hebdomadaire (en heures) prédit le taux de cortisol salivaire aigu (en nmol/L). Le modèle de régression linéaire s’est avéré statistiquement significatif, F(1, 48) = 45,67, p < ,001, attestant que le manque de sommeil explique 48,8% de la variance observée dans les concentrations de cortisol (R² = ,488, R² ajusté = ,477). L’erreur type de la régression s’élève à Se = 3,42 nmol/L, indiquant que la marge moyenne de dispersion stochastique des observations individuelles autour de la trajectoire d’ajustement est d’environ trois nanomoles et demie par litre. La privation de sommeil constitue un prédicteur positif significatif, b = 1,18, SE = 0,17, t(48) = 6,76, p < ,001, IC à 95% [0,83, 1,53]. »
Sur le plan tabulaire, les exigences de l’APA stipulent que l’erreur type globale de la régression ne doit pas être disséminée confusément dans le corps des colonnes de coefficients, mais doit figurer explicitement dans les notes infrapaginales ou dans la section des statistiques récapitulatives clôturant le tableau de régression. Le format standard impose de présenter pour chaque variable : le coefficient non standardisé (B), son erreur type propre entre parenthèses ou en colonne dédiée (SE B), le coefficient standardisé (β), la statistique de Student (t), la significativité (p), et l’intervalle de confiance à 95%. Sous le tableau, une ligne de synthèse structure les métriques globales : R², R² ajusté, statistique F, et la mention explicite de l’écart-type résiduel sous le libellé formel : « Se = valeur [unité] ».
Cette rigueur de communication permet à la communauté des pairs de ne pas se focaliser exclusivement sur des valeurs p hautement dépendantes de la puissance de l’échantillon, mais de porter un jugement critique et éclairé sur la pertinence translationnelle du modèle en confrontant directement la magnitude de l’erreur type aux variations physiologiques ou comportementales minimales cliniquement significatives (MCID, pour Minimal Clinically Important Difference).
12.3 Synthèse procédurale et bonnes pratiques d’audit statistique sous Excel
Pour clore notre traité méthodologique, il est pertinent d’ordonnancer les différentes approches opérationnelles étudiées au sein d’un cadre décisionnel clair, destiné à guider le chercheur ou l’analyste de données dans ses arbitrages informatiques quotidiens sous Microsoft Excel.
Le choix de la méthode de calcul de l’erreur type de la régression doit être gouverné par les impératifs de dynamisme, de complexité et d’auditabilité du protocole :
- L’Utilitaire d’analyse statistique : À privilégier impérativement lors des phases initiales d’exploration scientifique ou pour la génération en un clic d’un rapport académique complet comportant la table de décomposition d’ANOVA, les statistiques de Student et les séries complètes de résidus. Son inertie face à l’adjonction de nouvelles données en fait toutefois un outil inadapté aux bases de données vivantes ou incrémentales.
- La fonction dédiée ERREUR.TYPE.ESTYX : Représente la solution d’ingénierie optimale pour les modèles univariés simples intégrés au sein de tableaux de bord interactifs ou de matrices de surveillance épidémiologique nécessitant une actualisation automatique continue en temps réel.
- La fonction matricielle DROITEREG (LINEST) : Constitue sans conteste le standard méthodologique absolu pour les modélisations multivariées complexes sous Excel 365. Associée à la fonction
INDEX, elle combine la réactivité dynamique totale des formules natives à la puissance de calcul matriciel multivarié, tout en garantissant une empreinte spatiale minimale sur la feuille de calcul. - Le calcul manuel par décomposition des carrés : Doit être réservé aux démarches pédagogiques d’apprentissage statistique ou aux contextes d’audit et de validation logicielle, où la traçabilité absolue de chaque somme de carrés élémentaire est exigée par des protocoles de conformité réglementaire (normes ISO, qualification d’algorithmes cliniques).
Dans une perspective de science ouverte et de reproductibilité de la recherche, il est vivement conseillé de documenter exhaustivement les classeurs Excel en créant une feuille dédiée au dictionnaire des variables, en verrouillant les cellules de formules critiques pour éviter les écrasements accidentels, et en insérant des commentaires textuels explicitant les unités de mesure associées à l’erreur type de régression. Enfin, pour les modélisations comportementales à fort enjeu décisionnel, la pratique vertueuse de l’audit statistique impose d’exporter périodiquement les matrices de données brutes vers un environnement d’analyse statistique programmable (tel que R ou Python) afin de réaliser une vérification croisée de la convergence numérique exacte de l’erreur type extraite sous Microsoft Excel.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Fox, J. (2016). Applied regression analysis and generalized linear models (3rd ed.). SAGE Publications.
- Howell, D. C. (2013). Statistical methods for psychology (8th ed.). Wadsworth, Cengage Learning.
- Kutner, M. H., Nachtsheim, C. J., Neter, J., & Li, W. (2005). Applied linear statistical models (5th ed.). McGraw-Hill Irwin.
- Microsoft Corporation. (2024). Fonction DROITEREG dans Microsoft Excel. Support Microsoft Office. https://support.microsoft.com/fr-fr/office/droitereg-droitereg-fonction-9080c92d-9441-4770-9854-526227ab89b4
- Microsoft Corporation. (2024). Fonction ERREUR.TYPE.ESTYX dans Microsoft Excel. Support Microsoft Office. https://support.microsoft.com/fr-fr/office/erreur-type-estyx-fonction-erreur-type-estyx-81d7a0ba-d572-430d-bc65-45d661f88765
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
- Wilcox, R. R. (2017). Introduction to robust estimation and hypothesis testing (4th ed.). Academic Press. https://doi.org/10.1016/C2015-0-02206-8
- Wooldridge, J. M. (2020). Introductory econometrics: A modern approach (7th ed.). Cengage Learning.