
Dans l’arsenal méthodologique des sciences comportementales et de la psychologie quantitative, l’évaluation rigoureuse de la dispersion constitue un pilier fondamental de l’inférence statistique. Trop souvent éclipsée par l’analyse exclusive des mesures de tendance centrale, l’estimation précise de la variabilité intra-groupe conditionne pourtant directement la validité des conclusions issues des plans expérimentaux ou quasi-expérimentaux. Lorsqu’un chercheur est confronté à la nécessité de comparer deux ou plusieurs groupes indépendants, la question statistique immédiate porte non seulement sur le différentiel moyen observé entre les conditions, mais surtout sur le bruit de fond, c’est-à-dire l’amplitude des fluctuations individuelles au sein de la population étudiée. Dans ce cadre épistémologique, l’écart-type combiné (désigné en anglais sous le vocable de pooled standard deviation) s’impose comme un estimateur d’une élégance et d’une efficacité mathématique remarquables.
L’estimation conjointe de la dispersion ne relève pas d’une simple convention arithmétique ou d’une commodité de calcul. Elle repose sur le postulat théorique selon lequel les différents sous-échantillons d’une même étude, bien que soumis à des manipulations expérimentales distinctes ou issus de strates démographiques spécifiques, partagent une structure de variance commune au sein de la population parente. Dès lors que cette hypothèse d’homoscédasticité est plausible, agréger les estimations locales de variance permet d’obtenir un estimateur plus robuste, bénéficiant d’un nombre accru de degrés de liberté et réduisant considérablement l’erreur d’échantillonnage inhérente aux effectifs restreints. Qu’il s’agisse de calibrer la statistique t de Student pour échantillons indépendants, de dériver la taille d’effet standardisée conceptualisée par Jacob Cohen, ou encore de paramétrer les modèles d’analyse de variance, la maîtrise théorique et calculatoire de l’écart-type combiné demeure une compétence incontournable pour quiconque aspire à produire ou à évaluer des travaux de recherche rigoureux.
Le présent article propose une analyse approfondie et didactique de l’écart-type combiné. Depuis ses fondations conceptuelles issues des travaux pionniers de William Sealy Gosset et de Ronald Aylmer Fisher jusqu’à ses applications contemporaines dans les environnements de calcul automatisé tels que R, SPSS et Python, ce guide détaille l’ensemble des étapes mathématiques, des postulats distributionnels préalables et des choix méthodologiques critiques. À travers un exemple empirique minutieusement décomposé issu de la recherche clinique en psychologie, ce document met en lumière les propriétés formelles de cet estimateur, examine les conséquences de ses violations et fournit les repères nécessaires pour éviter les écueils d’interprétation qui persistent trop fréquemment dans la littérature scientifique.
1. Introduction fondamentale à l’écart-type combiné en recherche psychologique
1.1 Définition conceptuelle de la variance et de l’écart-type combinés
L’écart-type combiné, symbolisé universellement par la notation sp (l’indice « p » renvoyant au terme anglo-saxon pooled), représente une synthèse pondérée des dispersions observées au sein de plusieurs échantillons indépendants. D’un point de vue conceptuel, cet indice ne se contente pas de juxtaposer des mesures de dispersion ; il postule l’existence d’un paramètre populationnel unique, généralement noté σ (sigma), décrivant l’ampleur des variations individuelles autour de la moyenne respective de chaque groupe. La variance combinée, sp2, est définie formellement comme la moyenne pondérée des variances intra-groupes calculées sur chaque condition expérimentale. L’extraction de la racine carrée de cette variance combinée permet ensuite de rétablir l’indicateur dans l’unité de mesure originale de la variable dépendante, conférant à l’écart-type combiné une interprétabilité clinique et psychométrique directe.
Dans la modélisation statistique classique, il est indispensable d’établir une distinction théorique nette entre la variabilité intra-groupe (ou résiduelle) et la variabilité inter-groupes (ou systématique). La variabilité inter-groupes quantifie les divergences constatées entre les moyennes des différents groupes, reflétant potentiellement l’effet causal de l’intervention psychologique, pharmacologique ou éducative mise à l’épreuve. À l’inverse, la variabilité intra-groupe traduit les différences interindividuelles spontanées, l’hétérogénéité des traits de personnalité, les variations motivationnelles temporaires ainsi que l’erreur de mesure aléatoire propre aux instruments psychométriques utilisés. L’écart-type combiné se focalise exclusivement sur cette composante intra-groupe en faisant abstraction des écarts entre les moyennes d’échantillons, fournissant ainsi une évaluation non contaminée du bruit expérimental résiduel.
Sur le plan historique, le développement de cette approche est intimement lié aux contributions de William Sealy Gosset, qui écrivait sous le pseudonyme de « Student » au début du XXe siècle, et aux formalisations ultérieures de Ronald Aylmer Fisher dans le cadre du développement de l’analyse de la variance (ANOVA). Confronté à l’analyse de très petits échantillons dans l’industrie brassicole de Guinness, Gosset réalisa que l’estimation isolée de la variance à partir d’un échantillon minuscule introduisait une instabilité dramatique dans les tests d’hypothèses. En combinant les informations de dispersion issues de sous-groupes homogènes, Fisher et Gosset ont démontré qu’il était possible de stabiliser l’estimation du paramètre d’échelle, ouvrant ainsi la voie à l’inférence statistique moderne en sciences humaines et biologiques.
1.2 Utilité méthodologique dans les protocoles de recherche en psychologie
L’intégration de l’écart-type combiné dans les protocoles de recherche en psychologie répond à un impératif méthodologique de premier ordre : la standardisation des mesures. Dans de nombreux domaines des sciences du comportement, les échelles d’évaluation (qu’il s’agisse de questionnaires mesurant l’intensité dépressive, l’anxiété état-trait, l’estime de soi ou le sentiment d’auto-efficacité) ne reposent pas sur des unités physiques absolues telles que le mètre ou le kilogramme. L’écart-type combiné fournit précisément l’étalon de mesure requis pour convertir des différences brutes de moyennes en une métrique universelle, indépendante de l’instrument spécifique administré. Cette standardisation est au cœur de l’estimation de la taille d’effet, permettant aux cliniciens et aux chercheurs de quantifier concrètement la portée pratique d’un protocole expérimental comparativement à un groupe témoin.
Par ailleurs, l’écart-type combiné joue un rôle régulateur déterminant dans l’évaluation de l’homogénéité des réponses comportementales ou cognitives. Lorsque des sujets sont répartis entre une condition expérimentale (par exemple, l’apprentissage d’une technique de régulation émotionnelle) et une condition de contrôle (comme une tâche placebo ou une liste d’attente), la mise en commun des variances repose sur l’hypothèse que la manipulation modifie l’espérance mathématique de la réponse (la moyenne), mais n’altère pas fondamentalement la dispersion sous-jacente des scores individuels. L’analyse conjointe de cette dispersion permet aux chercheurs d’évaluer si l’intervention clinique produit un impact uniforme sur l’ensemble des participants ou si elle génère une polarisation anormale de la variabilité.
Enfin, l’utilisation de sp optimise de façon significative la puissance statistique des tests d’hypothèses. En agrégeant les données indépendantes de plusieurs cohortes pour estimer un paramètre unique de variance, le statisticien réduit l’erreur d’échantillonnage associée à l’estimation de l’erreur type. Cette démarche permet d’accroître le nombre de degrés de liberté affectés au dénominateur des tests statistiques, ce qui a pour conséquence directe de resserrer la distribution d’échantillonnage théorique, d’abaisser les valeurs critiques requises pour rejeter l’hypothèse nulle et d’augmenter la probabilité de détecter un effet réel lorsqu’il existe effectivement dans la population cible.
1.3 Principe de pondération par les tailles d’échantillons
Dans la quasi-totalité des dispositifs expérimentaux réels, les tailles des groupes ne sont pas strictement identiques. Des phénomènes tels que l’attrition expérimentale, les abandons en cours d’intervention thérapeutique, le non-remplissage complet des questionnaires ou les contraintes de recrutement créent fréquemment des déséquilibres numériques entre les conditions. Face à cette asymétrie, calculer une moyenne arithmétique ordinaire des écarts-types ou des variances observées constituerait une faute méthodologique majeure. L’estimation combinée résout ce problème en introduisant un principe de pondération rigoureux, où chaque groupe contribue à l’estimation globale au prorata exact de son volume d’information statistique.
Ce volume d’information est formellement quantifié par les degrés de liberté propres à chaque sous-échantillon, soit ni − 1. Un groupe constitué d’un effectif important apporte une estimation de la variance beaucoup plus stable et moins sensible aux fluctuations d’échantillonnage aléatoires qu’un groupe de faible effectif. Par conséquent, la formule de l’écart-type combiné accorde mathématiquement une importance prépondérante aux variances issues des échantillons les plus fournis. Ce mécanisme de pondération protège l’analyse contre les distorsions extrêmes qui pourraient être induites par un groupe restreint affichant, par pur hasard d’échantillonnage, une variabilité anormalement comprimée ou dilatée.
D’un point de vue de la théorie asymptotique, l’estimateur combiné possède des propriétés mathématiques optimales. Lorsque la taille totale de l’échantillon N tend vers l’infini, la variance d’échantillonnage de sp converge vers zéro de manière plus rapide que celle de n’importe quelle estimation isolée. Sous réserve du respect des postulats d’homoscédasticité et de normalité, sp2 constitue le meilleur estimateur linéaire non biaisé (généralement désigné par l’acronyme BLUE pour Best Linear Unbiased Estimator) de la variance commune de la population. Cette convergence assure que les inférences statistiques dérivées conservent leur robustesse même face à des configurations d’échantillonnage complexes.
2. Fondements mathématiques et dérivation de la formule
2.1 Présentation formelle de l’équation standard pour deux groupes
L’expression mathématique consacrée pour le calcul de l’écart-type combiné issu de deux groupes indépendants repose sur le ratio entre la somme cumulée des carrés des écarts et la somme des degrés de liberté résiduels. L’équation formelle se présente ainsi :
sp = √ [ ( (n1 − 1)s12 + (n2 − 1)s22 ) / (n1 + n2 − 2) ]
Dans cette formalisation algébrique, chaque terme remplit une fonction statistique précise. Les grandeurs n1 et n2 désignent les effectifs respectifs des premier et second groupes expérimentaux. Les grandeurs s1 et s2 représentent les écarts-types corrigés (estimations non biaisées sur l’échantillon) observés dans chacun de ces deux groupes, tandis que leurs carrés respectifs, s12 et s22, correspondent aux variances empiriques d’échantillons calculées avec la correction de Bessel au dénominateur.
Les termes multiplicateurs (n1 − 1) et (n2 − 1) constituent les facteurs de pondération directe des variances respectives. L’opération consistant à multiplier la variance non biaisée d’un échantillon par ses degrés de liberté permet de restaurer la somme brute des carrés des écarts à la moyenne intra-groupe. Enfin, le dénominateur commun (n1 + n2 − 2) représente le nombre total de degrés de liberté indépendants disponibles pour l’ensemble des deux distributions, le chiffre 2 retranché reflétant la fixation préalable de deux paramètres distributionnels indispensables, à savoir les deux moyennes empiriques de groupe.
2.2 Démonstration théorique à partir de la somme des carrés des écarts
Pour appréhender la légitimité structurelle de cette formulation, il est nécessaire de remonter à la définition fondamentale de la somme des carrés des écarts (désignée communément par l’abréviation SS pour Sum of Squares). Pour un échantillon donné i, la somme des carrés intra-groupe s’écrit formellement :
SSi = Σ (Xij − X̄i)2
Puisque la variance non biaisée d’un groupe individuel est universellement définie par le ratio de cette somme des carrés sur ses degrés de liberté, soit si2 = SSi / (ni − 1), nous pouvons, par simple inversion algébrique, exprimer la somme des carrés sous la forme :
SSi = (ni − 1)si2
En vertu de la propriété fondamentale d’additivité des sommes de carrés dans les modèles linéaires orthogonaux, la somme des carrés totale résiduelle intra-groupes (SSrésiduelle ou SSintra) pour deux échantillons indépendants s’obtient simplement en additionnant les variations internes propres à chaque groupe :
SSrésiduelle = SS1 + SS2 = (n1 − 1)s12 + (n2 − 1)s22
Afin d’obtenir une estimation sans biais de la variance commune de la population (σ2), le principe statistique impose de diviser cette somme globale des carrés par la somme des degrés de liberté associés aux deux estimations indépendantes. Sachant que dftotal = df1 + df2 = (n1 − 1) + (n2 − 1) = n1 + n2 − 2, nous obtenons directement l’expression de la variance combinée non biaisée :
sp2 = (SS1 + SS2) / (df1 + df2) = [ (n1 − 1)s12 + (n2 − 1)s22 ] / (n1 + n2 − 2)
L’extraction de la racine carrée de ce ratio vient clore la démonstration, restituant la métrique originale sous la forme de l’écart-type combiné sp. Cette dérivation explicite met en lumière le fait que la variance combinée n’est rien d’autre que le carré moyen résiduel de l’erreur intra-groupe.
2.3 Cas particulier : Échantillons de tailles rigoureusement identiques
Une simplification algébrique notable émerge dans le cas spécifique où le plan expérimental est parfaitement équilibré, c’est-à-dire lorsque l’effectif du premier groupe est strictement identique à l’effectif du second groupe (n1 = n2 = n). Dans cette configuration symétrique, les facteurs de pondération (n − 1) deviennent identiques pour les deux variances au numérateur, tandis que le dénominateur prend la forme n + n − 2 = 2n − 2 = 2(n − 1).
En factorisant par (n − 1) au sein du numérateur, l’équation subit une réduction remarquable :
sp = √ [ ( (n − 1)(s12 + s22) ) / ( 2(n − 1) ) ] = √ [ (s12 + s22) / 2 ]
Dans cette situation de stricte égalité des effectifs, la variance combinée équivaut rigoureusement à la moyenne arithmétique simple des deux variances d’échantillons. Toutefois, il convient d’insister fermement sur une erreur conceptuelle récurrente chez les apprentis chercheurs : même dans ce cas de figure équilibré, l’écart-type combiné sp n’est jamais égal à la moyenne arithmétique des écarts-types (s1 + s2) / 2.
L’origine mathématique de cette divergence irréductible provient de la stricte concavité de la fonction racine carrée sur l’ensemble des réels positifs. En vertu de l’inégalité de Jensen, pour toute fonction concave non linéaire telle que f(x) = √x, la valeur moyenne de la fonction appliquée à des variables distinctes est strictement supérieure à la fonction de la moyenne de ces variables dès lors que les valeurs initiales ne sont pas identiques. Par conséquent, la moyenne arithmétique simple de deux écarts-types distincts sous-estime invariablement la véritable dispersion combinée quadratique. Cette démonstration réaffirme l’impératif absolu de passer obligatoirement par l’espace des variances avant d’extraire la racine carrée finale.
3. Conditions d’application et postulats statistiques préalables
3.1 Le postulat fondamental d’homogénéité des variances (homoscédasticité)
L’utilisation de l’écart-type combiné repose sur une condition distributionnelle fondamentale : l’homogénéité des variances populationnelles, classiquement désignée sous le terme d’homoscédasticité. Ce postulat stipule que les données recueillies dans le groupe 1 proviennent d’une distribution normale ayant pour variance σ12, que les données du groupe 2 proviennent d’une distribution normale ayant pour variance σ22, et que ces deux grandeurs théoriques sont strictement équivalentes : σ12 = σ22 = σ2. L’écart-type combiné n’a de sens sur le plan conceptuel que si cette variance commune σ2 existe réellement au niveau de la population parente.
Lorsque cette condition d’homoscédasticité est substantiellement violée (phénomène d’hétéroscédasticité), agréger artificiellement deux variances hétérogènes dans une formule combinée induit de sévères distorsions inférentielles. Les conséquences les plus graves surviennent lorsque l’hétérogénéité des variances se conjugue avec des effectifs de groupes inégaux. Si le groupe de plus petite taille présente la variance la plus élevée, l’estimateur combiné sp sous-estimera l’erreur type de la différence des moyennes, entraînant une inflation exponentielle du taux d’erreur de première espèce (le risque α nominal, traditionnellement fixé à 0,05, pouvant parfois dépasser 0,15 ou 0,20). Inversement, si le groupe le plus volumineux affiche la variance la plus forte, sp surestimera l’erreur type, causant une perte drastique de puissance statistique et une augmentation inadmissible de l’erreur de seconde espèce (β).
Face à ces risques, la communauté méthodologique s’accorde sur des critères quantitatifs d’alerte. Bien qu’une tolérance minime soit accordée lorsque les tailles d’échantillons sont identiques, un écart où le ratio des variances maximales sur minimales dépasse une valeur seuil (souvent fixée arbitrairement entre 1,5 et 2,0 en cas de déséquilibre d’effectifs) interdit formellement le recours standard à la variance combinée classique sans ajustement spécifique.
3.2 Méthodes empiriques de vérification de l’homoscédasticité
Avant d’engager le calcul de l’écart-type combiné, le statisticien doit impérativement déployer des outils de diagnostic rigoureux afin de statuer sur l’état d’homogénéité des dispersions. Deux grandes familles d’approches se complètent dans cette optique : les tests statistiques formels et l’inspection visuelle des résidus de modélisation.
Parmi les procédures inférentielles, le test de Levene représente le standard le plus largement plébiscité dans les logiciels statistiques grand public. Sa robustesse découle de son principe opérationnel : plutôt que de comparer les variances directement sur les valeurs brutes, il analyse la variance des écarts absolus par rapport à la médiane de chaque groupe (dans sa version modifiée de Brown-Forsythe). Cette caractéristique lui confère une remarquable insensibilité relative aux entorses à la normalité. À l’inverse, le test de Bartlett, bien que mathématiquement plus puissant sous des conditions idéales de distribution gaussienne pure, s’avère excessivement sensible aux queues de distribution épaisses et à l’asymétrie, produisant fréquemment des alertes de rejet de l’homoscédasticité imputables en réalité à une simple déviation de la normalité.
L’approche visuelle constitue un complément indispensable aux tests de significativité, qui souffrent d’une dépendance mécanique à la taille de l’échantillon (ils s’avèrent incapables de détecter une hétérogénéité modérée sur de très petits groupes et sur-détectent des déviations négligeables sur de très grands échantillons). L’examen de diagrammes en boîte à moustaches (boxplots) superposés aux distributions de points individuels permet de comparer directement l’amplitude de l’écart interquartile de chaque groupe. De même, les graphiques de dispersion des résidus centrés en fonction des valeurs ajustées offrent une lecture immédiate : une divergence visible de l’étalement vertical entre les niveaux de la variable prédictive signale sans équivoque la rupture du postulat d’homoscédasticité.
3.3 Postulats de normalité et d’indépendance des observations
Outre l’homoscédasticité, la légitimité du calcul et de l’utilisation inférentielle de l’écart-type combiné requiert la conformité à deux autres axiomes de la statistique paramétrique : la distribution normale des erreurs et l’indépendance stricte des observations recueillies.
Le postulat de normalité exige que les valeurs de la variable continue étudiée se distribuent selon une courbe de Gauss au sein de chaque sous-population. Cette propriété garantit que la variance d’échantillon s2 suive une distribution du khi-deux (χ2) à n − 1 degrés de liberté, condition sans laquelle l’addition linéaire des sommes des carrés et leur division par les degrés de liberté totaux ne peuvent engendrer une statistique suivant fidèlement la loi t de Student. La normalité s’évalue empiriquement à travers le test de Shapiro-Wilk (particulièrement adapté aux échantillons de recherche clinique où n < 50) ainsi que par l’évaluation des coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis). Des valeurs standardisées comprises entre −1,0 et +1,0 sont couramment jugées acceptables pour valider l’approximation paramétrique.
Le postulat d’indépendance mutuelle entre les sujets représente sans conteste l’exigence la plus fondamentale et la moins négociable de l’édifice mathématique. Chaque mesure recueillie chez un participant ne doit entretenir aucune corrélation systémique avec les mesures obtenues chez les autres membres de son groupe ou du groupe opposé. La violation de l’indépendance (qui survient par exemple lors de passations collectives en classe, de mesures répétées sur les mêmes sujets, ou de données collectées au sein de fratries sans contrôle multiniveau) fausse entièrement la comptabilité des degrés de liberté. Dès lors qu’une covariance positive parasite lie les sujets, le dénominateur (n1 + n2 − 2) surestime grossièrement la véritable quantité d’information indépendante, provoquant un rétrécissement artificiel des intervalles de confiance et invalidant l’usage de la formule classique de l’écart-type combiné.
4. Guide étape par étape pour calculer l’écart-type combiné
4.1 Étape 1 : Collecte et organisation des données statistiques descriptives
L’exécution rigoureuse du calcul de l’écart-type combiné impose en premier lieu une extraction méthodique des données descriptives relatives à chaque sous-échantillon. L’analyste doit impérativement disposer de trois grandeurs distinctes pour chacun des deux groupes :
- La taille de l’échantillon pour chaque groupe, notée respectivement n1 et n2.
- La moyenne arithmétique de chaque condition, bien que celle-ci n’intervienne pas directement dans l’équation de sp, afin de valider ultérieurement le positionnement des calculs.
- L’écart-type de chaque condition, noté respectivement s1 et s2.
Un point de vigilance absolu concerne la définition exacte de l’écart-type fourni par les logiciels ou les tables récapitulatives. Il est capital de vérifier que les valeurs s1 et s2 correspondent bien à l’écart-type d’échantillon corrigé (calculé en divisant la somme des carrés par n − 1) et non à l’écart-type de population (calculé en divisant par N). La grande majorité des fonctions statistiques standard (comme sd() sous R ou l’écart-type rapporté par SPSS) intègrent par défaut la correction de Bessel. L’établissement préalable d’un tableau récapitulatif formel constitue la meilleure parade contre les erreurs de frappe ou d’inversion d’indices lors des phases arithmétiques ultérieures.
4.2 Étape 2 : Élévation au carré et calcul des sommes des carrés individuelles
Une fois les grandeurs descriptives isolées, la seconde opération consiste à élever chaque écart-type d’échantillon au carré afin d’extraire la variance empirique de chaque groupe. Cette transition est indispensable, car la dispersion ne possède de propriétés d’additivité statistique que dans l’espace quadratique des variances :
Variance du groupe 1 : s12 = s1 × s1
Variance du groupe 2 : s22 = s2 × s2
Dès que les valeurs s12 et s22 sont obtenues, il convient de calculer les degrés de liberté propres à chaque bras de l’étude. Pour le groupe 1, ces degrés de liberté valent df1 = n1 − 1 ; pour le groupe 2, ils s’établissent à df2 = n2 − 1.
L’étape charnière consiste ensuite à multiplier chaque variance par son degré de liberté respectif. Cette multiplication reconstitue mathématiquement la somme des carrés des écarts internes (la variabilité brute non divisée) de chaque distribution :
SS1 = (n1 − 1) × s12
SS2 = (n2 − 1) × s22
Ce procédé de pondération garantit que chaque unité de déviation quadratique est réintégrée à hauteur de son volume réel de données au sein de l’architecture d’analyse globale.
4.3 Étape 3 : Sommation pondérée et division par les degrés de liberté totaux
La troisième étape opère la fusion globale de l’information statistique issue des deux groupes indépendants. Elle commence par la sommation directe des deux sommes de carrés obtenues précédemment, formalisant ainsi la variabilité résiduelle cumulée sur l’ensemble de l’expérimentation :
SStotale_intra = SS1 + SS2
Concomitamment, le statisticien agrège les degrés de liberté disponibles en additionnant les marges de liberté propres à chaque sous-échantillon :
dfrésiduel = df1 + df2 = (n1 − 1) + (n2 − 1) = n1 + n2 − 2
La variance combinée de l’échantillon, sp2, découle ensuite de la division directe du numérateur cumulé par le dénominateur agrégé :
sp2 = SStotale_intra / dfrésiduel = [ (n1 − 1)s12 + (n2 − 1)s22 ] / (n1 + n2 − 2)
Cette valeur scalaire intermédiaire représente la meilleure estimation disponible de la variance commune σ2 de la population parente, incorporant toute l’information empirique collectée lors du protocole expérimental.
4.4 Étape 4 : Extraction de la racine carrée et vérification de plausibilité
L’étape ultime consiste à soumettre la variance combinée sp2 à l’opération de racine carrée unilatérale positive afin d’obtenir l’écart-type combiné formel sp :
sp = √(sp2)
Une fois le calcul finalisé, le chercheur doit obligatoirement procéder à des vérifications de cohérence interne afin d’exclure toute faute d’exécution arithmétique. Le principe de bornage constitue la règle de plausibilité la plus directe : la valeur finale de l’écart-type combiné doit strictement se situer entre l’écart-type le plus faible et l’écart-type le plus élevé des deux groupes analysés (min(s1, s2) ≤ sp ≤ max(s1, s2)). Si sp s’avère inférieur au minimum ou supérieur au maximum observé, une anomalie calculatoire s’est indubitablement produite.
De plus, l’analyste doit contrôler le sens logique de la pondération : la valeur de sp doit systématiquement se trouver plus proche de l’écart-type du groupe qui possède le plus grand effectif n. Enfin, conformément aux normes de diffusion académique, le résultat sera arrondi avec rigueur, généralement à deux ou trois décimales après la virgule selon les directives éditoriales applicables.
5. Exemple pratique détaillé : Étude psychologique expérimentale
5.1 Contexte de recherche : Évaluation d’une thérapie comportementale sur l’anxiété
Afin de concrétiser l’ensemble de ces propositions formelles, considérons une étude expérimentale randomisée menée en milieu clinique hospitalier visant à tester l’efficacité d’une nouvelle approche de Thérapie Cognitive et Comportementale (TCC) ciblant le trouble d’anxiété généralisée. Deux cohortes de patients diagnostiqués selon les critères du DSM-5 ont été constituées après consentement éclairé :
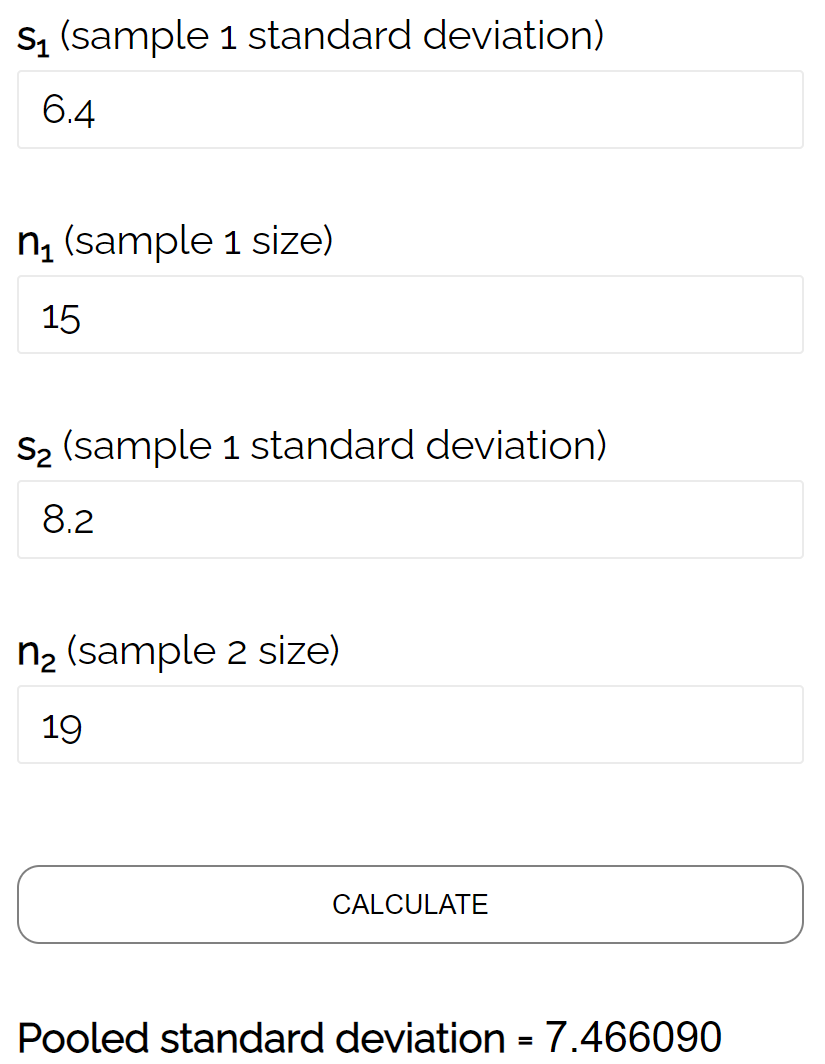
- Groupe 1 (Condition Expérimentale – TCC brève) : Ce groupe a suivi un protocole d’intervention psychothérapeutique intensive d’une durée de 8 semaines. À l’issue du protocole, un score global d’anxiété a été recueilli à l’aide de l’échelle validée d’Hamilton (HAM-A), dont les scores peuvent s’échelonner théoriquement de 0 à 56. Ce groupe se compose de n1 = 15 participants, et affiche un écart-type empirique corrigé de s1 = 6,40 points (la moyenne du groupe s’établissant à M1 = 14,20 points).
- Groupe 2 (Condition Contrôle – Liste d’attente avec suivi standard) : Les patients affectés à ce bras n’ont bénéficié d’aucune TCC ciblée durant l’intervalle expérimental mais ont conservé leurs consultations de soutien habituelles. Ce groupe comprend un effectif de n2 = 19 participants, et présente un écart-type empirique corrigé de s2 = 8,20 points (pour une moyenne observée de M2 = 22,80 points).
L’asymétrie modérée des effectifs (15 contre 19) résulte des aléas inhérents au recrutement clinique sans toutefois menacer l’équilibre fondamental du plan d’échantillonnage. Par ailleurs, l’inspection préalable des scores a confirmé l’allure approximativement gaussienne des distributions, et le test de Levene n’a révélé aucune violation significative de l’homoscédasticité (F(1, 32) = 1,42, p = 0,242). L’estimation conjointe de la variance via la formule combinée est donc scientifiquement et statistiquement autorisée.
5.2 Application pas à pas de l’équation mathématique
Procédons à présent au déroulement séquentiel des calculs arithmétiques sur la base des données numériques recueillies :
Sous-étape A : Calcul des variances individuelles d’échantillon.
Nous élevons les écarts-types individuels au carré afin d’accéder aux variances d’échantillon :
s12 = (6,40)2 = 40,9600
s22 = (8,20)2 = 67,2400
Sous-étape B : Calcul des degrés de liberté propres à chaque groupe.
df1 = n1 − 1 = 15 − 1 = 14
df2 = n2 − 1 = 19 − 1 = 18
Sous-étape C : Reconstitution des sommes des carrés intra-groupes.
En multipliant la variance par son degré de liberté, nous obtenons la somme des déviations quadratiques :
SS1 = df1 × s12 = 14 × 40,9600 = 573,4400
SS2 = df2 × s22 = 18 × 67,2400 = 1210,3200
Sous-étape D : Agrégation des sommes des carrés et des degrés de liberté totaux.
SStotale_intra = SS1 + SS2 = 573,4400 + 1210,3200 = 1783,7600
dftotal = n1 + n2 − 2 = 15 + 19 − 2 = 32
Sous-étape E : Calcul de la variance combinée.
Nous divisons la somme cumulée des carrés par les degrés de liberté résiduels totaux :
sp2 = 1783,7600 / 32 = 55,7425
Sous-étape F : Extraction de l’écart-type combiné.
En appliquant la fonction racine carrée à la variance combinée :
sp = √(55,7425) ≈ 7,466089…
En arrondissant selon les normes académiques en vigueur à trois décimales, nous retenons la valeur de 7,466 points (ou 7,47 points à deux décimales).
5.3 Analyse critique du résultat obtenu
L’observation du chiffre final confirme immédiatement la validité des propriétés attendues de l’estimateur combiné. En premier lieu, la condition de bornage est parfaitement honorée : la valeur 7,466 s’inscrit rigoureusement dans l’intervalle défini par les deux écarts-types empiriques initiaux, à savoir [6,40 ; 8,20].
En second lieu, l’influence de la pondération par les effectifs se manifeste avec une netteté remarquable. Si le chercheur avait commis la faute méthodologique grossière de calculer la moyenne arithmétique ordinaire non pondérée des deux écarts-types, il aurait obtenu :
Moyenne simpliste erronée = (6,40 + 8,20) / 2 = 14,60 / 2 = 7,300 points
La valeur correcte de sp (7,466) est sensiblement supérieure à cette moyenne non quadratique. Cette déviation s’explique par deux mécanismes statistiques convergents : d’une part, la nature quadratique de l’estimateur qui intègre la concavité de la racine carrée (inégalité de Jensen), et d’autre part, le fait que le Groupe 2, dont l’écart-type est le plus dispersé (8,20), regroupe un effectif plus volumineux (n2 = 19 contre n1 = 15). De ce fait, le Groupe 2 exerce une traction plus forte sur l’estimation globale, « tirant » l’écart-type combiné vers le haut pour refléter fidèlement le poids supérieur de son information empirique.
Sur le plan de l’interprétation clinique, ce résultat indique que la variabilité commune résiduelle des scores de détresse psychologique au sein de cette population d’anxiété clinique est désormais estimée à 7,47 points de l’échelle d’Hamilton. C’est précisément cette valeur calibrée qui servira d’étalon dans les étapes inférentielles subséquentes de l’analyse, garantissant que les tests de significativité reposeront sur un dénominateur mathématiquement non biaisé.
6. Rôle central de l’écart-type combiné dans le test t de Student
6.1 Calcul de l’erreur type de la différence entre deux moyennes
L’une des fonctions les plus universelles de l’écart-type combiné réside dans son rôle de composante pivot pour le calcul du test t de Student pour échantillons indépendants. Lorsqu’un chercheur souhaite évaluer la probabilité que la divergence observée entre deux moyennes d’échantillons (X̄1 − X̄2) soit le fruit des fluctuations aléatoires d’échantillonnage, il doit comparer cette différence brute à l’erreur type de la différence des moyennes (notée SEdiff pour Standard Error of the Difference).
Sous le postulat d’homogénéité des variances, l’expression formelle de cette erreur type intègre directement l’écart-type combiné selon l’équation :
SEdiff = sp × √ [ (1 / n1) + (1 / n2) ]
Cette formulation démontre comment sp agit en tant que facteur multiplicatif d’échelle unique. En substituant cette expression dans la définition de la statistique de test, nous obtenons le ratio t classique :
t = (X̄1 − X̄2) / ( sp × √ [ (1 / n1) + (1 / n2) ] )
L’impact d’une mauvaise estimation de sp se répercute de manière immédiate sur la valeur calculée de t. Toute sous-estimation accidentelle de l’écart-type combiné comprime artificiellement le dénominateur de l’équation, engendrant une valeur t artificiellement gonflée qui conduira le chercheur à rejeter l’hypothèse nulle à tort (faux positif). Réciproquement, une surestimation de sp dilate l’erreur type, réduisant drastiquement le ratio t et masquant des effets thérapeutiques potentiellement majeurs sous un résultat abusivement qualifié de non statistiquement significatif.
6.2 Construction des intervalles de confiance pour la différence de moyennes
Au-delà du simple rejet binaire d’une hypothèse nulle, la métrologie contemporaine en sciences psychologiques valorise prioritairement l’estimation par intervalle de confiance. Un intervalle de confiance à 95% pour la différence de deux moyennes indépendantes circonscrit la plage de valeurs au sein de laquelle se situe plausiblement la véritable différence populationnelle avec un taux de certitude théorique spécifié.
La borne inférieure et la borne supérieure de cet intervalle se construisent directement autour du différentiel observé des moyennes empiriques en lui ajoutant et en lui soustrayant une marge d’erreur calculée à partir de sp :
IC95% = (X̄1 − X̄2) ± [ tcritique(0,05 ; df) × sp × √ ( (1 / n1) + (1 / n2) ) ]
Dans cette formulation, le coefficient multiplicateur tcritique est extrait de la table de distribution de Student pour un niveau bilatéral α = 0,05 et pour un nombre de degrés de liberté strictement égal à n1 + n2 − 2. L’avantage direct de mobiliser sp dans cette construction réside dans la stabilité accrue de la marge d’erreur. En s’appuyant sur l’ensemble combiné des participants des deux groupes pour estimer la variabilité commune, l’intervalle de confiance bénéficie d’une précision supérieure à celle d’une estimation fragmentée.
Dans les publications scientifiques rédigées selon les standards académiques internationaux, la relation mathématique entre l’intervalle de confiance et le test d’hypothèse s’avère totale : si la valeur zéro n’est pas incluse dans les limites de l’intervalle de confiance à 95%, le chercheur peut formellement déclarer que la différence de moyennes est statistiquement significative au seuil p < 0,05. L’exactitude des bornes rapportées repose ainsi intégralement sur la rectitude du calcul initial de sp.
6.3 Impact direct sur la puissance statistique du plan expérimental
La puissance statistique d’un plan d’échantillonnage correspond à la probabilité (idéalement ciblée à 1 − β ≥ 0,80) de rejeter correctement l’hypothèse nulle d’absence de différence lorsque l’hypothèse alternative d’un effet réel est vraie. La mise en commun des variances exerce un effet favorable direct sur cette puissance statistique à travers deux canaux complémentaires.
Le premier canal relève de l’allocation des degrés de liberté. En consolidant l’estimation de la variance résiduelle sur la totalité de l’échantillon combiné (df = n1 + n2 − 2), la distribution théorique du test t converge plus rapidement vers la loi normale centrée réduite qu’en l’absence de mise en commun. Cela se traduit mécaniquement par une valeur critique de seuil (tcritique) plus basse, facilitant l’accès à la significativité statistique pour une différence de moyennes donnée.
Le second canal concerne la sensibilité aux fluctuations d’échantillonnage. Dans les protocoles de recherche en psychologie clinique ou en neurosciences où les tailles d’échantillons demeurent souvent modestes pour des raisons éthiques ou financières, l’estimation conjointe sp présente une variance d’échantillonnage substantiellement plus faible que n’importe quel écart-type de groupe isolé. Cette stabilisation permet de réduire le bruit dans le calcul prédictif de la puissance a priori. Lorsqu’un investigateur planifie une nouvelle étude et utilise l’écart-type combiné issu d’une étude pilote pour déterminer la taille d’échantillon requise via des analyses de puissance, il obtient des estimations de recrutement beaucoup plus précises, limitant les risques d’études sous-dimensionnées vouées à l’échec méthodologique.
7. Calcul de la taille d’effet : L’écart-type combiné et le d de Cohen
7.1 Formulation théorique du d de Cohen dans les protocoles indépendants
Alors que la valeur de significativité statistique (p) informe sur l’existence d’un effet indépendant du hasard, elle ne renseigne en rien sur son ampleur ou sa pertinence pratique, restant tributaire de la taille de l’échantillon. Pour répondre à cette lacune, le statisticien et psychologue Jacob Cohen a formalisé un indice d’une portée majeure : le d de Cohen. Cet indicateur de taille d’effet standardisée pour groupes indépendants quantifie la distance séparant deux moyennes en fractions d’écart-type :
d = (X̄1 − X̄2) / sp
L’écart-type combiné sp constitue le dénominateur standard indispensable de cette formule. Pourquoi avoir retenu sp plutôt que l’écart-type du groupe témoin ou la dispersion totale ? Parce que, sous le postulat d’homoscédasticité, sp incarne la meilleure estimation de la variabilité naturelle commune au sein de la population. Il fournit ainsi l’unité de référence métrique idéale pour apprécier le déplacement induit par l’intervention expérimentale.
Sur le plan conceptuel, un d de Cohen égal à 1,00 signifie que la moyenne du groupe expérimental se situe précisément à un écart-type combiné au-dessus de la moyenne du groupe témoin. Cette métrique affranchit totalement l’analyse de l’échelle d’évaluation sous-jacente, permettant de comparer directement l’impact d’une psychothérapie mesurée via le test d’Hamilton, l’inventaire de dépression de Beck ou une mesure d’activité électrodermale autonome.
7.2 Distinction cruciale : d de Cohen, g de Hedges et Delta de Glass
Bien que le d de Cohen basé sur sp demeure extrêmement populaire, la littérature méthodologique moderne exige de le distinguer avec clarté d’indicateurs alternatifs adaptés à des configurations spécifiques :
- Le Delta de Glass (Δ) : Formulé par Gene Glass, cet indice refuse de recourir à l’écart-type combiné et divise la différence des moyennes exclusivement par l’écart-type du groupe de contrôle pur : Δ = (X̄1 − X̄contrôle) / scontrôle. Cette alternative s’impose impérativement lorsque l’intervention expérimentale est soupçonnée de modifier profondément la variabilité intra-groupe (situation d’hétéroscédasticité induite par le traitement), rendant le concept même de variance commune caduc.
- Le g de Hedges : Développé par Larry Hedges, cet indice corrige un biais d’estimation systématique présent dans le d de Cohen traditionnel. En effet, sur des échantillons de petite taille (typiquement N total < 30), le calcul standard du d fondé sur sp tend à surestimer légèrement la véritable taille d’effet populationnelle. Le g de Hedges applique un facteur correctif d’invariance (noté J) qui dégonfle ce biais positif :
g = d × J ≈ d × [ 1 − ( 3 / (4(n1 + n2) − 9) ) ]
La formule exacte du facteur J mobilise la fonction gamma (Γ), mais l’approximation algébrique ci-dessus offre une précision supérieure à trois décimales. Dans le cadre de méta-analyses contemporaines en psychologie, le recours systématique au g de Hedges incorporant la correction sur sp est désormais expressément exigé par la majorité des comités de lecture internationaux.
7.3 Interprétation des magnitudes de taille d’effet en sciences comportementales
Pour guider l’évaluation de ces tailles d’effet standardisées calculées à partir de sp, Jacob Cohen a initialement proposé des conventions heuristiques universellement citées dans la littérature psychologique :
- d = 0,20 : Taille d’effet faible (subtile, difficilement décelable à l’œil nu sans instruments de mesure standardisés).
- d = 0,50 : Taille d’effet modérée (visible pour un observateur averti, correspondant à un différentiel cliniquement perceptible).
- d = 0,80 : Taille d’effet forte (différence marquée, traduisant un impact majeur de la manipulation expérimentale).
Toutefois, les méthodologistes actuels mettent en garde contre une lecture rigide et dogmatique de ces seuils abstraits. Une taille d’effet qualifiée de « faible » (par exemple d = 0,25) peut revêtir une portée sociétale ou clinique monumentale lorsqu’elle s’applique à des interventions préventives en santé publique touchant des millions de citoyens (comme la réduction du suicide ou le sevrage tabagique). À l’inverse, un effet « fort » (d = 0,85) peut résulter d’un artifice de laboratoire non transférable dans la complexité de la vie réelle.
De surcroît, l’écart-type combiné permet de déduire des indices complémentaires d’interprétation visuelle, tels que le pourcentage de non-chevauchement des distributions (Non-Overlap Proportion). Ainsi, pour un d de Cohen de 0,80 calculé via sp, environ 47,4% des surfaces sous la courbe gaussienne des deux populations ne se chevauchent plus, et un individu moyen du groupe expérimental obtient un résultat supérieur à environ 79% des individus appartenant au groupe témoin. Cette transposition quantitative confère à l’écart-type combiné un rôle central dans la communication transparente des résultats scientifiques.
8. Généralisation mathématique : Extension à k groupes indépendants
8.1 Formule généralisée pour trois groupes expérimentaux ou plus
Les investigations en psychologie et en neurosciences cognitives ne se limitent que rarement à la confrontation de deux conditions isolées. La mise à l’épreuve de plusieurs modalités de traitement (par exemple : TCC classique, TCC en ligne, pharmacothérapie et placebo) implique l’intégration de k groupes indépendants (où k ≥ 3). Le formalisme de l’écart-type combiné s’étend harmonieusement à ces architectures multigroupes.
La formule généralisée s’obtient en étendant le principe d’additivité des sommes des carrés intra-groupes pondérées à l’ensemble des k conditions, et en divisant cette grandeur par le total des degrés de liberté résiduels combinés :
sp = √ [ ( Σi=1..k (ni − 1)si2 ) / ( Σi=1..k (ni − 1) ) ]
En formulant explicitement le dénominateur à partir de la taille totale de l’échantillon agrégé N = Σ ni, l’expression générale se simplifie sous la forme conventionnelle :
sp = √ [ ( (n1 − 1)s12 + (n2 − 1)s22 + … + (nk − 1)sk2 ) / ( N − k ) ]
Dans cette structure mathématique universelle, le terme (N − k) reflète le fait que k moyennes d’échantillons distinctes ont été fixées préalablement pour estimer les variances locales, consommant ainsi k degrés de liberté sur l’ensemble du système de données. L’estimateur sp ainsi obtenu conserve sa propriété d’estimation sans biais de la variance résiduelle commune σ2.
8.2 Lien direct avec le carré moyen résiduel (MS_error) de l’ANOVA
Il existe une passerelle théorique directe entre l’écart-type combiné multigroupes et l’analyse de la variance (ANOVA) à un facteur. Dans le cadre du modèle linéaire général, la variabilité totale d’une expérience est partitionnée entre la somme des carrés du modèle (inter-groupes) et la somme des carrés résiduelle (intra-groupes ou d’erreur) :
SSTotal = SSInter + SSIntra
Lorsque le tableau d’ANOVA extrait le Carré Moyen de l’Erreur (noté MSError ou MSWithin), il effectue très exactement l’opération vue précédemment :
MSWithin = SSIntra / (N − k) = [ Σ (ni − 1)si2 ] / (N − k)
Il en découle une identité fondamentale : la variance combinée à k groupes est strictement identique au carré moyen de l’erreur intra-groupe de l’ANOVA (sp2 = MSWithin). Dès lors, l’écart-type combiné sp n’est autre que la racine carrée du carré moyen de l’erreur :
sp = √(MSWithin)
Cette unification conceptuelle démontre la cohérence interne des statistiques paramétriques. C’est précisément cet écart-type combiné extrait de l’ANOVA qui est mobilisé au dénominateur des tests de comparaison multiple post-hoc (tels que le test HSD de Tukey ou le test de Scheffé) pour évaluer la significativité des contrastes par paires, garantissant une protection optimale contre la prolifération de l’erreur de type I.
8.3 Exemple numérique comparatif à trois groupes
Afin d’illustrer la mécanique du calcul à trois groupes indépendants, considérons une recherche portant sur la réduction des symptômes dépressifs (mesurés sur une échelle standardisée) comparant trois modalités thérapeutiques chez des patients ambulatoires :
- Groupe A (Intervention en Pleine Conscience) : n1 = 12, s1 = 4,20
- Groupe B (Thérapie d’Acceptation et d’Engagement) : n2 = 16, s2 = 5,10
- Groupe C (Groupe Contrôle Actif) : n3 = 14, s3 = 4,80
L’effectif total agrégé est de N = 12 + 16 + 14 = 42 participants, et le nombre de groupes est de k = 3. Déroulons les calculs étape par étape :
1. Calcul des variances de groupe :
s12 = (4,20)2 = 17,6400
s22 = (5,10)2 = 26,0100
s32 = (4,80)2 = 23,0400
2. Calcul des degrés de liberté individuels :
df1 = 12 − 1 = 11 ; df2 = 16 − 1 = 15 ; df3 = 14 − 1 = 13
3. Calcul des sommes des carrés individuelles :
SS1 = 11 × 17,6400 = 194,0400
SS2 = 15 × 26,0100 = 390,1500
SS3 = 13 × 23,0400 = 299,5200
4. Sommation globale :
SSIntra = 194,0400 + 390,1500 + 299,5200 = 883,7100
dfrésiduel = N − k = 42 − 3 = 39 (ou 11 + 15 + 13 = 39)
5. Variance combinée et écart-type combiné :
sp2 = MSWithin = 883,7100 / 39 = 22,6592
sp = √(22,6592) ≈ 4,760 points
Nous constatons que sp = 4,760 se positionne harmonieusement au cœur de l’intervalle [4,20 ; 5,10], démontrant la continuité computationnelle parfaite entre les cas k = 2 et k ≥ 3.
9. Erreurs fréquentes et pièges conceptuels lors du calcul
9.1 L’erreur classique de la moyenne arithmétique des écarts-types
L’erreur méthodologique la plus fréquemment répertoriée dans les travaux d’étudiants et les publications non relues par des pairs consiste à remplacer l’écart-type combiné par la moyenne arithmétique simple des écarts-types individuels : (s1 + s2) / 2. Cette dérive intuitive repose sur une méconnaissance profonde de la géométrie des espaces statistiques.
La dispersion d’une somme de variables aléatoires indépendantes n’est pas la somme de leurs dispersions, mais la somme de leurs variances. En effectuant une moyenne directe sur les écarts-types, l’analyste méconnaît la non-linéarité de la transformation racine carrée. Comme l’établit l’inégalité de Jensen, cette opération engendre une sous-estimation systématique et mathématiquement inévitable de la dispersion réelle dès lors que les écarts-types initiaux ne sont pas parfaitement identiques.
Cette sous-évaluation artificielle de la dispersion résiduelle se transmet en cascade dans l’ensemble de l’appareil inférentiel : l’erreur type SEdiff s’en trouve amoindrie, provoquant un gonflement fallacieux de la statistique t, un abaissement artificiel de la valeur p, et une surestimation illusoire du d de Cohen. Cette erreur élémentaire altère la reproductibilité de la science psychologique et doit être détectée avec intransigeance lors des processus d’évaluation par les pairs.
9.2 Oubli de la pondération par les degrés de liberté (n – 1)
Un autre écueil courant réside dans la confusion entre l’effectif brut d’un groupe (n) et ses degrés de liberté résiduels réels (n − 1). Certains calculs amateurs procèdent à une moyenne des variances pondérée par n au lieu de (n − 1), en divisant le résultat cumulé par N = (n1 + n2) au lieu de (N − 2) :
Formule biaisée : serroné2 = (n1s12 + n2s22) / (n1 + n2)
Cette confusion annule de fait la correction de Bessel introduite pour éliminer le biais systématique d’échantillonnage de la variance. Lorsque les échantillons étudiés regroupent des centaines d’individus, l’impact de ce biais de dénominateur devient asymptotiquement négligeable (le ratio (N − 2) / N tendant vers 1). En revanche, dans les protocoles de psychologie expérimentale où les effectifs sont typiquement réduits (par exemple n1 = 8 et n2 = 8), substituer 14 à 16 au dénominateur entraîne une sous-estimation de plus de 12% de la variance d’erreur, biaisant gravement les conclusions des tests d’hypothèses.
9.3 Confusion entre écart-type combiné et écart-type de l’échantillon agrégé
Une confusion théorique fréquente oppose l’écart-type combiné (pooled SD) à l’écart-type global de l’échantillon fusionné (total sample SD). Plusieurs analystes commettent la maladresse de fusionner l’intégralité des données des deux groupes en une seule série brute de taille N, pour en calculer ensuite l’écart-type descriptif global en référence à la moyenne générale globale X̄global.
Cette approche confond deux sources orthogonales de variabilité. La variance globale d’un échantillon agrégé dérive du théorème de décomposition de la variance (formule de Huygens-Steiner) :
SSTotal = SSWithin + SSBetween
Si la manipulation expérimentale a produit un effet puissant, la distance séparant les moyennes de groupe (X̄1 − X̄2) sera très importante, ce qui aura pour conséquence de gonfler massivement la somme des carrés inter-groupes (SSBetween). L’écart-type calculé sur les données fusionnées englobera cette dispersion inter-groupes artificielle et affichera une valeur bien supérieure à la variabilité réelle des individus au sein de leur propre condition. L’écart-type combiné sp, lui, ne mesure strictement que la variabilité intra-groupe (SSWithin), isolée de toute contamination par l’écart entre les moyennes de traitement.
9.4 Calcul de variances à partir d’échantillons dépendants ou appariés
L’écart-type combiné standard sp tel que développé dans cet article est exclusivement réservé aux échantillons indépendants. Son application directe à des protocoles de mesures répétées intra-sujets (par exemple : évaluation d’un même patient avant et après intervention thérapeutique) constitue une violation méthodologique invalidante.
Dans un plan apparié, les observations pré-test et post-test recueillies chez un même sujet sont intrinsèquement corrélées par un coefficient de corrélation r positif reflétant les caractéristiques stables de l’individu. L’erreur type de la différence dépendante ne repose pas sur les variances séparées des deux temps de mesure, mais sur la variance de la variable des différences individuelles directes (D = Xpost − Xpré) :
sdiff = √ [ s12 + s22 − 2rs1s2 ]
Si un chercheur recourt aveuglément à sp pour calculer le test t apparié, il omet complètement le terme de covariance positive −2rs1s2, ce qui gonfle considérablement l’erreur type et détruit la puissance statistique exceptionnelle accordée par les plans intra-sujets. Pour les mesures répétées, l’écart-type des scores de différence (sdiff) ou des formulations spécialisées du d de Cohen apparié (dz ou drm) doivent impérativement se substituer à l’écart-type combiné classique.
10. Calcul automatisé : Implémentation dans les logiciels statistiques
10.1 Exécution et extraction de l’écart-type combiné sous R
L’environnement open-source R offre une polyvalence absolue pour extraire l’écart-type combiné, que ce soit à partir de données descriptives synthétiques ou directement depuis des vecteurs de données brutes. Lorsque seules les métriques récapitulatives sont connues, une fonction personnalisée peut être rédigée avec une transparence algorithmique totale :
Il suffit de coder une routine calculant la racine carrée du ratio pondéré :
- Calculer
df1 <- n1 - 1etdf2 <- n2 - 1 - Définir la somme des carrés :
ss <- df1 * s1^2 + df2 * s2^2 - Diviser par les degrés de liberté totaux :
sp <- sqrt(ss / (df1 + df2))
Dans le cadre de l’analyse d’un jeu de données brutes contenant une variable dépendante continue (notée score) et un facteur de groupement dichotomique (noté groupe), l’écosystème de paquets spécialisés en psychométrie simplifie la démarche. Le paquet réputé effectsize propose la fonction dédiée sd_pooled(score ~ groupe, data = mon_dataframe), qui extrait directement la valeur non biaisée de sp.
Alternativement, le chercheur peut interroger l’objet de modélisation linéaire standard issu de la fonction de base lm(). L’exécution de modele <- lm(score ~ groupe, data = mon_dataframe) permet de récupérer instantanément l’écart-type combiné via la commande sigma(modele), ce paramètre d’échelle correspondant rigoureusement à l’erreur type résiduelle intra-groupe de la régression.
10.2 Procédure sous IBM SPSS Statistics
Dans le logiciel IBM SPSS Statistics, largement implanté dans les laboratoires de recherche universitaire en psychologie, l’écart-type combiné n’est pas affiché sous une rubrique isolée portant son nom dans les tableaux descriptifs élémentaires, ce qui déroute fréquemment les utilisateurs. Il est néanmoins accessible via plusieurs sorties standardisées.
La méthode la plus directe consiste à exécuter la procédure du Test T pour échantillons indépendants via le menu Analyser > Comparer les moyennes > Test T pour échantillons indépendants. Dans le tableau des résultats, à la ligne intitulée « Hypothèse de variances égales », SPSS affiche l’erreur type de la différence (SEdiff). Sachant que cette erreur type est égale à sp × √(1/n1 + 1/n2), l’utilisateur peut déduire sp en divisant l’erreur type par la racine de la somme des inverses des effectifs.
Une extraction directe et sans recalcul manuel s’opère via la procédure du Modèle Linéaire Général : Analyser > Modèle linéaire général > Univarié. Dans le tableau d’ANOVA résultant, il suffit de localiser la ligne de la source d’erreur (« Erreur » ou « Within groups ») et de repérer la colonne « Carré moyen » (qui correspond fidèlement à MSWithin). L’extraction de la racine carrée de ce carré moyen fournit directement l’écart-type combiné. Concomitamment, la commande syntaxique GLM score BY groupe /PRINT=HOMOGENEITY. génère simultanément le test d’homogénéité de Levene indispensable à la validation préalable de la démarche.
10.3 Implémentation en Python pour la recherche expérimentale
Avec l’essor de la science des données et l’adoption croissante de Python dans les protocoles de neurosciences computationnelles et de psychophysique expérimentale, le calcul de l’écart-type combiné s’automatise avec élégance grâce aux bibliothèques scientifiques NumPy, SciPy et au paquet psychométrique Pingouin.
Sous NumPy, une fonction modulaire peut être formalisée pour accepter indifféremment des tableaux de scores individuels (array) :
- Calculer les effectifs via la méthode de taille vectorielle :
n1, n2 = len(g1), len(g2) - Extraire les variances avec l’argument d’invariance d’échantillon :
var1 = np.var(g1, ddof=1)etvar2 = np.var(g2, ddof=1) - Appliquer l’équation matricielle :
sp = np.sqrt(((n1 - 1) * var1 + (n2 - 1) * var2) / (n1 + n2 - 2))
Pour une approche orientée recherche appliquée, la bibliothèque open-source Pingouin (conçue spécifiquement pour reproduire les flux d’analyse de SPSS et R en syntaxe Pythonique) intègre le calcul automatisé de la taille d’effet et de l’écart-type combiné. La fonction pingouin.compute_effsize(x, y, eftype='cohen') dérive directement sp sous le capot pour retourner le d de Cohen avec une optimisation numérique native, tout en offrant la possibilité de basculer d’un simple paramètre vers le g de Hedges ou le Delta de Glass.
11. Alternatives méthodologiques en cas de violation des postulats
11.1 Le test t de Welch-Satterthwaite pour variances inégales
Lorsque le test de Levene rejette sans équivoque l’hypothèse d’homoscédasticité, ou lorsque les ratios de variances empiriques divergent nettement en présence d’échantillons asymétriques, l’utilisation de l’écart-type combiné unique doit être formellement abandonnée. L’alternative méthodologique universelle est le test de Welch (ou test de Welch-Satterthwaite).
Le test de Welch renonce au concept d’une variance combinée pondérée. Au lieu de cela, il préserve l’individualité des variances empiriques de chaque groupe pour composer une erreur type disjointe :
SEWelch = √ [ (s12 / n1) + (s22 / n2) ]
Le génie de la correction de Welch réside dans l’ajustement mathématique qu’elle applique aux degrés de liberté. Plutôt que de retenir n1 + n2 − 2, le test dérive des degrés de liberté corrigés (souvent non entiers) calculés à partir de l’équation de Satterthwaite, qui pénalise la statistique de test en réduisant les degrés de liberté en fonction directe de l’asymétrie conjointe des variances et des effectifs.
Dans la communauté méthodologique contemporaine, de nombreux statisticiens recommandent désormais d’adopter le test t de Welch par défaut dans toutes les analyses comparatives de deux groupes indépendants, sans même s’astreindre à un test préalable de Levene. Des simulations de Monte-Carlo massives ont démontré que le test de Welch contrôle parfaitement le taux d’erreur de première espèce au seuil nominal de 0,05 sous hétérogénéité sévère des variances, tout en ne concédant qu’une perte de puissance infime et négligeable lorsque les variances sont en réalité parfaitement égales.
11.2 Méthodes statistiques robustes et estimation par rééchantillonnage (Bootstrapping)
Face à des distributions comportementales fortement asymétriques, contaminées par des valeurs aberrantes (outliers) ou caractérisées par des queues lourdes rendant caduque la variance classique, le recours aux statistiques robustes constitue une stratégie de premier plan. L’approche conceptualisée par le statisticien Rand Wilcox préconise l’usage des moyennes tronquées (trimmed means) associées aux variances winsorisées.
Dans cette perspective, un pourcentage fixe (typiquement 20%) des valeurs extrêmes situées aux deux extrémités de la distribution de chaque groupe est neutralisé (winsorisation). Le calcul de l’écart-type combiné winsorisé s’opère ensuite sur ces données épurées, conférant à l’indicateur une résistance remarquable face aux perturbations aléatoires qui faussent habituellement la moyenne et l’écart-type de Pearson conventionnels.
Parallèlement, les méthodes de rééchantillonnage par bootstrap non paramétrique s’affranchissent totalement des postulats distributionnels. Le principe repose sur le tirage aléatoire avec remise de milliers de sous-échantillons virtuels issus des données expérimentales brutes. Pour chaque tirage, la différence des moyennes est évaluée sans imposer de modèle de variance commune rigide. La distribution empirique de ces milliers de répliques permet d’extraire des intervalles de confiance dits « ajustés et corrigés pour le biais » (BCa) d’une fiabilité remarquable, offrant une alternative d’une grande rigueur à l’écart-type combiné classique lorsque la structure des données défie les cadres d’analyse paramétriques traditionnels.
11.3 Modélisation bayésienne des variances hétérogènes
L’inférence bayésienne fournit une alternative théorique particulièrement séduisante à la dichotomie rigide imposée par l’approche fréquentiste (mise en commun intégrale via sp versus séparation absolue via Welch). Dans le cadre d’un modèle hiérarchique bayésien, le chercheur n’est plus contraint de choisir arbitrairement entre imposer une égalité absolue des variances (σ1 = σ2) ou traiter les deux groupes comme totalement indépendants.
Un modèle bayésien complet permet de spécifier deux paramètres de variance distincts, σ1 et σ2, tout en leur assignant une distribution a priori commune (hierarchical prior) qui capture leur parenté distributionnelle. L’échantillonnage par chaîne de Markov Monte-Carlo (MCMC) dérive ensuite les distributions postérieures marginales pour la moyenne de chaque condition et pour chaque écart-type individuel, quantifiant avec précision l’incertitude sur la dispersion de chaque groupe clinique.
Cette méthodologie permet d’estimer directement la distribution postérieure de la taille d’effet (le d bayésien) en intégrant formellement le fait que les variances de groupe puissent diverger sans que cette divergence n’invalide la structure du modèle. Pour les recherches cliniques portant sur des populations rares ou des échantillons restreints de patients cérébrolésés, l’approche bayésienne dépasse les apories de l’homoscédasticité fréquentiste tout en restituant une vue d’ensemble plus riche et nuancée que le recours aveugle à un estimateur combiné ponctuel.
12. Recommandations de rédaction et normes de présentation académique (APA 7)
12.1 Formatage des statistiques descriptives et inférentielles dans le texte
L’American Psychological Association, dans sa 7e édition du Publication Manual (APA 7), prescrit des règles typographiques et structurelles précises pour rapporter les résultats statistiques dans les revues académiques. La clarté, la reproductibilité et l’absence d’ambiguïté doivent guider la rédaction.
Sur le plan typographique, l’ensemble des symboles statistiques désignant des métriques empiriques d’échantillons doivent impérativement être composés en caractères italiques (par exemple : M pour la moyenne, SD pour l’écart-type individuel, sp pour l’écart-type combiné, t pour la statistique de Student, et d pour la taille d’effet de Cohen). Les lettres grecques (telles que σ, α ou β) et les indices non statistiques demeurent en revanche en romain droit. Les valeurs numériques sont conventionnellement arrondies à deux décimales, à l’exception des degrés de liberté non entiers du test de Welch et des valeurs exactes de probabilité (p-values), qui doivent être rapportées à trois décimales (par exemple : p = 0,028) sans omettre d’écrire p < 0,001 si la valeur s’avère inférieure au millième.
Voici un exemple canonique de rédaction textuelle intégrant rigoureusement l’écart-type combiné et ses dérivés inférentiels au sein d’un article de recherche :
« Une analyse par test t de Student pour échantillons indépendants a été conduite afin de comparer le niveau d’anxiété final entre le groupe soumis à la TCC (M = 14,20, SD = 6,40, n = 15) et le groupe contrôle sur liste d’attente (M = 22,80, SD = 8,20, n = 19). L’écart-type combiné sur l’ensemble des conditions s’établit à sp = 7,47 points. La diminution du score d’anxiété observée au sein du groupe TCC s’avère statistiquement significative, t(32) = 3,33, p = 0,002, révélant une taille d’effet standardisée majeure, d de Cohen = 1,15, IC à 95% [0,41 ; 1,87], g de Hedges ajusté = 1,12. »
12.2 Conception de tableaux et graphiques scientifiques transparents
La présentation des résultats statistiques sous forme tabulaire ou graphique doit répondre aux principes de la science ouverte (Open Science), garantissant que le lecteur puisse reconstituer l’ensemble des calculs sans zone d’ombre. Un tableau de statistiques descriptives élaboré selon les normes APA ne comporte jamais de lignes verticales et structure les en-têtes avec sobriété :
| Condition | n | M | SD | IC à 95% pour la moyenne |
|---|---|---|---|---|
| Thérapie Cognitive (TCC) | 15 | 14,20 | 6,40 | [10,66 ; 17,74] |
| Contrôle (Liste d’attente) | 19 | 22,80 | 8,20 | [18,85 ; 26,75] |
| Note. Écart-type combiné de l’erreur résiduelle (sp) = 7,47 points. IC = Intervalle de confiance. | ||||
Sur le plan des représentations visuelles, les recommandations méthodologiques contemporaines condamnent formellement les traditionnels diagrammes en bâtons (bar charts), qui masquent la distribution sous-jacente des données et occultent l’hétérogénéité des variances. Il est instamment préconisé d’utiliser des graphiques en violon (violin plots) combinés à la superposition intégrale des points de données individuels (stripcharts ou nuages de points jitterés).
Lorsque des barres d’erreur sont intégrées à une figure scientifique, la légende du graphique doit impérativement expliciter la nature statistique exacte de l’intervalle représenté. Le chercheur doit déclarer sans équivoque si les barres représentent un écart-type brut (SD), un écart-type combiné (sp), une erreur type de la moyenne (SE) ou un intervalle de confiance à 95%. La confusion entre ces grandeurs constitue une source majeure de mauvaise interprétation dans la littérature biomédicale.
12.3 Synthèse conclusive et arbre de décision pour le chercheur
L’estimation rigoureuse de la dispersion par l’écart-type combiné illustre avec force la nécessité d’un alignement méthodologique total entre l’architecture conceptuelle d’une recherche et son traitement statistique. Synthétiser l’information de dispersion de plusieurs échantillons indépendants en une métrique unique constitue une approche optimale pour maximiser la puissance de nos outils d’inférence, standardiser l’estimation des tailles d’effet cliniques et stabiliser l’évaluation des erreurs types d’échantillonnage.
Afin de guider le praticien et le chercheur dans le déploiement opérationnel de ces concepts, nous pouvons formaliser un arbre de décision méthodologique structuré en quatre étapes critiques :
- Étape 1 : Diagnostic de la nature des échantillons. Les données proviennent-elles de groupes strictement indépendants ?
- Si Non (mesures répétées ou paires appariées) : Rejeter formellement sp. Utiliser impérativement l’écart-type des différences appariées sdiff.
- Si Oui : Poursuivre vers l’étape 2.
- Étape 2 : Vérification de la normalité et des valeurs extrêmes. Les résidus intra-groupes suivent-ils une distribution approximativement gaussienne ?
- Si Non : S’orienter vers des méthodes d’estimation robuste (variances winsorisées combinées de Wilcox) ou des procédures de bootstrapping non paramétrique.
- Si Oui : Poursuivre vers l’étape 3.
- Étape 3 : Évaluation de l’homogénéité des variances (homoscédasticité). Le test de Levene est-il non significatif et les variances empiriques sont-elles d’un ordre de grandeur comparable (ratio < 1,5 à 2) ?
- Si Non (hétéroscédasticité caractérisée, particulièrement avec effectifs inégaux) : Abandonner l’écart-type combiné unique. Appliquer sans réserve le test t de Welch avec degrés de liberté ajustés, et privilégier le Delta de Glass pour la taille d’effet.
- Si Oui : Poursuivre vers l’étape 4.
- Étape 4 : Déploiement du calcul combiné et de ses dérivés. Appliquer l’équation générale de pondération par les degrés de liberté résiduels (ni − 1) pour dériver la variance combinée sp2, extraire la racine carrée pour obtenir sp, et calculer le test t de Student standard ainsi que le d de Cohen (ou le g de Hedges corrigé pour les petits échantillons).
En respectant scrupuleusement ces balises théoriques et opérationnelles, le chercheur en psychologie et en sciences humaines garantit que ses conclusions reposeront sur un socle quantitatif inattaquable, préservant ainsi l’intégrité, la robustesse et la reproductibilité des savoirs scientifiques partagés avec la communauté.
Références
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. https://www.utstat.toronto.edu/~brunner/oldclass/378f16/readings/CohenPower.pdf
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd. https://digital.library.adelaide.edu.au/dspace/handle/2440/15227
- Glass, G. V., McGaw, B., & Smith, M. L. (1981). Meta-analysis in social research. SAGE Publications.
- Hedges, L. V. (1981). Distribution theory for Glass’s estimator of effect size and related estimators. Journal of Educational Statistics, 6(2), 107–128. https://doi.org/10.3102/10769986006002107
- Levene, H. (1960). Robust tests for equality of variances. In I. Olkin, S. G. Ghurye, W. Hoeffding, W. G. Madow, & H. B. Mann (Eds.), Contributions to probability and statistics: Essays in honor of Harold Hotelling (pp. 278–292). Stanford University Press.
- Student [Gosset, W. S.]. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://archive.org/details/biometrika06pearrich
- Welch, B. L. (1947). The generalization of ‘Student’s’ problem when several different population variances are involved. Biometrika, 34(1/2), 28–35. https://doi.org/10.2307/2332510
- Wilcox, R. R. (2017). Introduction to robust estimation and hypothesis testing (4th ed.). Academic Press. https://dornsife.usc.edu/labs/rwilcox/