
Dans le champ de l’évaluation psychométrique et de l’analyse quantitative des comportements, la caractérisation rigoureuse de la dispersion des données constitue un impératif méthodologique tout aussi fondamental que l’estimation de la tendance centrale. Trop souvent, les chercheurs et praticiens se focalisent exclusivement sur la moyenne arithmétique ou la médiane, reléguant l’analyse de la variabilité à une simple formalité descriptive. Or, deux distributions empiriques peuvent présenter des moyennes rigoureusement identiques tout en reflétant des dynamiques psychologiques radicalement divergentes : l’une traduisant une homogénéité stricte des réponses au sein d’une cohorte clinique, l’autre dissimulant une polarisation marquée ou une instabilité cognitive notable. C’est précisément pour appréhender cette structure sous-jacente des données que les indices de dispersion prennent toute leur signification.
Parmi ces indicateurs, l’écart absolu moyen (souvent désigné sous l’acronyme EAM, ou MAD pour Mean Absolute Deviation dans la littérature anglo-saxonne) offre une perspective d’une remarquable élégance mathématique et conceptuelle. Contrairement à la variance et à l’écart-type, dont le formalisme repose sur l’élévation au carré des déviations individuelles — accordant de facto un poids disproportionné aux observations marginales —, l’écart absolu moyen quantifie la distance arithmétique linéaire séparant chaque observation de la valeur centrale. Cette métrique préserve l’échelle de mesure originale sans distorsion quadratique, conférant aux résultats une interprétabilité directe, intuitive et robuste, particulièrement bienvenue lors de l’administration de protocoles expérimentaux sensibles ou d’inventaires de personnalité.
Le déploiement de ces analyses au sein d’environnements collaboratifs modernes tels que Google Sheets démocratise l’accès à une modélisation statistique rigoureuse, sans exiger l’acquisition de suites logicielles propriétaires onéreuses ou la maîtrise immédiate d’environnements de programmation statistique complexes. Ce guide exhaustif explore de manière approfondie les fondements théoriques, les justifications mathématiques et l’implémentation opérationnelle de l’écart absolu moyen dans Google Sheets. De la décomposition pas à pas des formules canoniques à l’optimisation matricielle condensée, chaque étape est explicitée afin d’outiller les étudiants, cliniciens et chercheurs pour leurs analyses quantitatives quotidiennes.
1. Introduction conceptuelle à l’écart absolu moyen dans l’analyse de données psychologiques
1.1 Définition théorique et importance de la dispersion en psychométrie
L’étude quantitative des phénomènes psychologiques repose sur l’appréhension de construits latents — tels que l’anxiété, la mémoire de travail, l’extraversion ou l’efficience exécutive — à travers des indicateurs comportementaux manifestes. Dans cette perspective, la variabilité comportementale ne représente pas un simple bruit de mesure ou une scorie expérimentale indésirable ; elle constitue l’expression même des différences interindividuelles et intra-individuelles. Réduire un ensemble de réponses psychométriques à sa seule valeur centrale revient à occulter la géométrie profonde du phénomène observé. L’évaluation de l’homogénéité des réponses, permise par les indices de dispersion, s’avère indispensable pour statuer sur la consistance d’un trait ou sur l’uniformité de l’impact d’une intervention thérapeutique.
L’écart absolu moyen intervient précisément comme un descripteur d’homogénéité particulièrement fidèle. Dans les protocoles expérimentaux en sciences cognitives, comme lors de la mesure des temps de réaction sous paradigme de double tâche, les chercheurs sont confrontés à des distributions souvent asymétriques où quelques latences excessivement longues peuvent fausser les estimations. Dans un tel contexte, les limites inhérentes à la seule utilisation de la moyenne arithmétique deviennent critiques : une moyenne élevée peut résulter soit d’un ralentissement cognitif généralisé chez l’ensemble des participants, soit de la présence d’un nombre restreint de défaillances attentionnelles transitoires. En quantifiant la déviation moyenne des observations sous une forme linéaire, l’écart absolu moyen offre une lecture non déformée de la fidélité des conduites motrices ou verbales.
1.2 Pertinence de Google Sheets pour la modélisation statistique académique
Longtemps perçus comme de simples outils bureautiques réservés à la gestion comptable, les tableurs en ligne, et au premier rang desquels figure Google Sheets, se sont imposés comme des plateformes remarquablement puissantes pour le traitement statistique préliminaire et intermédiaire en sciences sociales. L’accessibilité universelle de la solution, garantie par son architecture infonuagique, répond parfaitement aux exigences contemporaines de la science ouverte et de la reproductibilité de la recherche. Les équipes de recherche dispersées géographiquement peuvent désormais auditer, annoter et recalculer des métriques psychométriques sur des bases de données unifiées sans craindre de disparités de versions logicielles.
Au-delà de la gratuité et de l’interopérabilité, la sécurité de l’intégrité des données psychométriques se trouve renforcée par des mécanismes robustes d’historique de versions et de gestion fine des droits d’accès. La collaboration inter-laboratoires en temps réel s’en trouve fluidifiée, autorisant la validation croisée immédiate des chaînes de calcul. En outre, Google Sheets permet d’automatiser des flux de travail statistiques complexes sans contraindre les jeunes chercheurs à l’apprentissage préalable d’environnements dédiés comme R ou Python, tout en maintenant une compatibilité ascendante stricte avec les formats d’échange ouverts tels que le CSV ou les formats tabulaires normalisés.
1.3 Objectifs pédagogiques et méthodologiques du tutoriel
L’ambition de ce document est d’accompagner pas à pas le lecteur dans l’assimilation méthodologique et technique du calcul de l’écart absolu moyen. Plutôt que de fournir une simple recette de cuisine logicielle, notre démarche adopte une posture d’ingénierie statistique : nous commencerons par décomposer manuellement chaque segment de la formule afin d’ancrer profondément la compréhension des opérations arithmétiques sous-jacentes. Cette approche analytique garantit que l’utilisateur comprenne la signification intrinsèque de chaque cellule et de chaque référence manipulée dans son classeur.
Dans un second temps, le tutoriel abordera l’optimisation algorithmique via des formules matricielles condensées, démontrant comment compacter des colonnes entières de calculs intermédiaires en une formule unitaire, élégante et dynamique. Enfin, une attention soutenue sera accordée à l’interprétation clinique et expérimentale des indices obtenus, ainsi qu’à la sensibilisation aux bonnes pratiques de gouvernance des métadonnées, garantissant la pérennité et la transparence des analyses conduites au sein des laboratoires de psychologie expérimentale et clinique.
2. Fondements mathématiques et formalisation de l’écart absolu moyen
2.1 Décomposition analytique de la formule de l’écart absolu moyen
Sur le plan formel, l’écart absolu moyen par rapport à la moyenne d’un échantillon fini de taille n est défini par une expression mathématique linéaire d’une grande limpidité. L’opérateur de sommation Sigma intervient pour agréger l’ensemble des écarts individuels mesurés entre chaque observation empirique notée xi et la moyenne arithmétique de l’échantillon, traditionnellement désignée par la notation x̄. L’expression générale s’écrit formellement comme la somme, pour l’indice i allant de 1 jusqu’à n, de la valeur absolue de la différence (xi – x̄), le tout divisé par l’effectif total n.
La présence de l’opérateur de valeur absolue, représenté par les deux barres verticales encadrant la différence algébrique, remplit une fonction structurelle incontournable. Si l’on omettait cette transformation non linéaire par morceaux, la somme algébrique des résidus par rapport à la moyenne arithmétique serait strictement et universellement égale à zéro, en vertu des propriétés géométriques fondamentales du barycentre. La valeur absolue neutralise le signe de la déviation, convertissant la distance orientée (algébrique) en une distance purement scalaire. Cette modélisation s’apparente à la distance de Manhattan en géométrie multidimensionnelle, contrastant frontalement avec la distance euclidienne canonique qui sous-tend les constructions géométriques quadratiques.
2.2 Comparaison structurelle avec la variance et l’écart-type
La distinction épistémologique et mathématique majeure entre l’écart absolu moyen et l’écart-type réside dans le traitement infligé à la magnitude des écarts. Pour éliminer les signes négatifs des déviations, la variance opère une élévation au carré : (xi – x̄)2. Ce choix mathématique, historiquement privilégié pour faciliter la dérivation différentielle et satisfaire le théorème de Gauss-Markov, induit un effet secondaire majeur : il applique une pondération non linéaire et quadratique aux résidus. Ainsi, un écart individuel de 4 unités se voit pénalisé non pas deux fois plus, mais seize fois plus qu’un écart de 1 unité, accordant un poids démesuré aux fluctuations extrêmes.
À l’inverse, l’écart absolu moyen maintient une pondération strictement linéaire : un écart de 4 unités pèse exactement quatre fois plus qu’un écart unitaire. Cette propriété confère à l’EAM une robustesse nettement supérieure face aux observations atypiques ou aberrantes, fréquentes lors de l’enregistrement de réponses psychométriques (erreurs de saisie, moments d’inattention du sujet ou réponses aléatoires). De surcroît, parce qu’il n’implique ni élévation au carré ni extraction consécutive de racine carrée, l’écart absolu moyen préserve rigoureusement l’échelle de mesure d’origine, permettant aux cliniciens de relier directement la dispersion aux unités d’évaluation clinique standardisées de leurs tests.
2.3 Propriétés statistiques de l’estimateur dans les échantillons finis
D’un point de vue inférentiel, le comportement de l’écart absolu moyen en tant qu’estimateur de la dispersion de la population présente des caractéristiques d’un grand intérêt théorique. Sous l’hypothèse stricte de normalité d’une distribution gaussienne continue d’espérance μ et d’écart-type σ, l’espérance mathématique de l’écart absolu moyen converge asymptotiquement vers la valeur σ√(2/π), soit approximativement 0,7979 fois l’écart-type de la population parente. Cela signifie que l’EAM est intrinsèquement plus petit que l’écart-type en contexte gaussien, une relation déterministe qu’il convient de garder à l’esprit lors des synthèses de résultats.
Cependant, dès que la distribution empirique s’écarte de la normalité — situation quasi universelle lors de l’administration d’échelles de sévérité clinique, de mesures de symptômes psychopathologiques ou de distributions à queues lourdes —, l’efficacité relative de l’écart-type se dégrade rapidement en présence de contaminations marginales. L’écart absolu moyen offre alors une convergence plus stable dans les échantillons de taille modérée. Sur le plan géométrique, l’EAM peut être formellement interprété comme le centre de gravité des distances absolues résiduelles, fournissant une estimation non distordue de la dispersion globale de la masse de données autour de son centre.
3. Configuration préalable de la feuille de calcul Google Sheets
3.1 Normalisation de l’environnement de calcul et paramètres régionaux
Avant d’entreprendre la moindre saisie ou d’implémenter des formules statistiques, une standardisation rigoureuse de l’environnement de travail Google Sheets s’impose. La plateforme adapte automatiquement la syntaxe de ses fonctions et le traitement des séparateurs arithmétiques en fonction des paramètres régionaux attribués au classeur. Dans l’espace francophone européen ou canadien, le séparateur décimal conventionnel est la virgule, et l’opérateur de séparation des arguments au sein des fonctions est le point-virgule. À l’inverse, sous les conventions anglophones, le séparateur décimal est le point et les arguments sont séparés par une virgule simple.
Pour auditer ou modifier ces réglages, l’utilisateur doit accéder au menu supérieur, sélectionner l’onglet Fichier, puis cliquer sur Paramètres du classeur. Dans la boîte de dialogue qui s’affiche, il convient de vérifier le fuseau horaire ainsi que le pays de référence. Si vous travaillez sur des jeux de données internationaux émanant de consortiums de recherche en psychologie cognitive, il est fréquemment judicieux d’harmoniser les conventions régionales afin d’éviter toute conversion involontaire de nombres en chaînes textuelles inopérantes. Il est également recommandé de s’assurer que le mode de recalcul automatique est configuré sur « Lors de chaque modification », garantissant la réactualisation dynamique continue de l’ensemble des métriques de dispersion.
3.2 Architecture logique des colonnes pour une traçabilité expérimentale
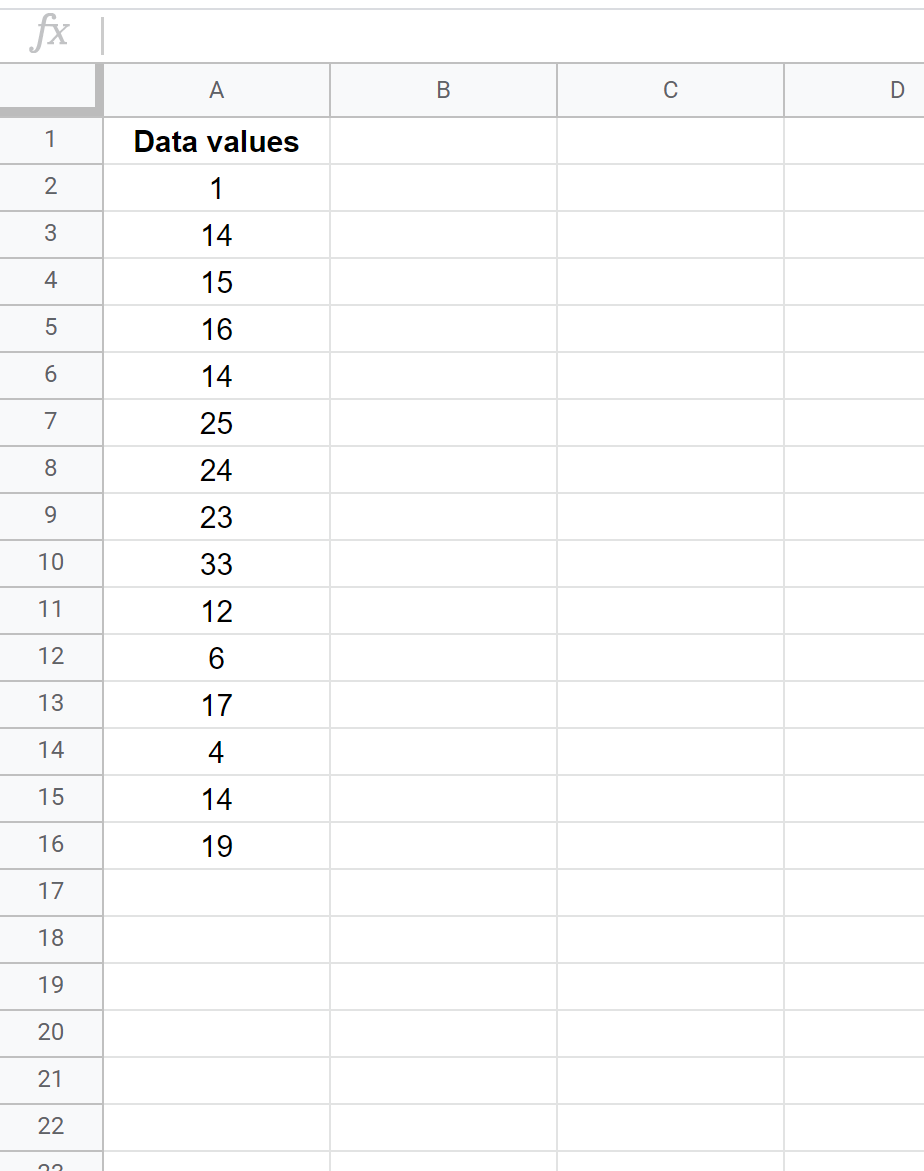
L’élaboration d’une feuille de calcul scientifique requiert une séparation étanche entre les couches de données brutes, les couches de transformations intermédiaires et les zones réservées aux synthèses agrégées. Une erreur conceptuelle fréquente consiste à juxtaposer de façon désordonnée des notes cliniques, des scores de passation et des formules statistiques dans un même espace visuel. Pour instaurer une traçabilité optimale conforme aux standards actuels de la recherche expérimentale, il convient d’adopter une structure matricielle tabulaire rigoureuse.
La première colonne d’une feuille de travail psychologique doit être impérativement dédiée à l’attribution d’identifiants uniques et strictement anonymisés pour chaque participant (par exemple, des chaînes alphanumériques du type SUJ_001, SUJ_002), préservant ainsi la confidentialité exigée par la bioéthique et le Règlement Général sur la Protection des Données (RGPD). Les colonnes subséquentes doivent accueillir, de manière univoque, les variables dépendantes quantitatives continues. Chaque ligne d’en-tête doit comporter le libellé explicite de la variable accompagné systématiquement de son unité de mesure ou des bornes de l’échelle d’évaluation utilisée (par exemple : Temps de réaction (ms), ou Score total anxiété (STAI-Y, 20-80)).
3.3 Contrôle de la qualité et typage des variables psychologiques
Une étape critique, trop souvent négligée avant l’exécution de calculs de dispersion, concerne le contrôle qualité et la vérification du typage des variables saisies. Dans un tableur, une cellule contenant par inadvertance une espace insécable avant un chiffre ou un caractère typographique incorrect sera silencieusement interprétée par le moteur logiciel comme une chaîne de caractères (texte). Dès lors, les fonctions arithmétiques standard telles que l’agrégation de moyenne ignoreront purement et simplement ces entrées sans nécessairement lever de message d’erreur bloquant, introduisant un biais systématique par sous-évaluation de l’effectif effectif.
Pour prévenir ces écueils méthodologiques, il est fortement conseillé de déployer les fonctionnalités natives de validation des données. En sélectionnant la plage destinée à recevoir les scores psychométriques et en accédant au menu Données > Validation des règles de validation des données, le chercheur peut contraindre la saisie à des valeurs exclusivement numériques comprises dans un intervalle empirique valide correspondant rigoureusement aux limites psychométriques de l’épreuve administrée. De surcroît, le verrouillage structurel des colonnes de données sources, via la commande de protection des plages, empêche les écrasements de données involontaires lors des manipulations itératives du classeur.
4. Étape 1 : Saisie et organisation méthodique du jeu de données
4.1 Importation et saisie des scores d’évaluations psychologiques
La première phase opérationnelle consiste à intégrer l’ensemble des données quantitatives dans la structure préalablement normalisée. Les observations doivent être consignées de manière strictement verticale, chaque ligne représentant une unité d’observation autonome (un sujet expérimental unique ou une session de test individualisée). L’alignement vertical facilite l’écriture ultérieure des références de plages, l’application de filtres et l’extension continue de la base sans perturbation des formules maîtresses de la feuille de calcul.
Une fois les scores numériques saisis dans la colonne dédiée — supposons la plage B2:B31 pour un groupe de 30 participants évalués dans une tâche d’inhibition motrice —, il convient de procéder à une rapide inspection visuelle de cohérence. Cette étape permet d’évaluer la distribution empirique préliminaire à l’aide d’un tri temporaire par ordre croissant, ou en s’assurant que les valeurs minimales et maximales observées demeurent physiologiquement ou cliniquement plausibles. Afin d’optimiser la clarté et la maintenance du modèle statistique, il est particulièrement recommandé d’attribuer un nom explicite à cette plage de cellules (par exemple Scores_Inhibition) via le gestionnaire de plages nommées accessible dans le menu Données > Plages nommées.
4.2 Structuration matricielle pour études multi-groupes
Les protocoles de recherche en psychologie comparent très fréquemment des conditions multiples, qu’il s’agisse de contrastes inter-sujets (groupe témoin versus groupe expérimental recevant un protocole de remédiation cognitive) ou de protocoles intra-sujets (évaluations longitudinales pré-test, post-test immédiat et suivi à moyen terme). La structuration matricielle dans Google Sheets doit s’adapter fidèlement à l’architecture du protocole afin de préserver l’indépendance ou la dépendance des mesures.
Pour un plan expérimental factoriel inter-groupes, deux stratégies organisationnelles sont envisageables. La première consiste à réserver des colonnes parallèles contiguës pour chaque modalité (colonne B pour le Groupe Contrôle, colonne C pour le Groupe Traité). La seconde stratégie, hautement recommandée pour une transition fluide vers des analyses d’inférence ultérieures, consiste à utiliser une colonne d’annotation catégorielle factorielle indiquant l’appartenance au groupe (Contrôle / Expérimental) en vis-à-vis d’une colonne unique hébergeant les scores dépendants. L’emploi des filtres natifs de Google Sheets permet alors d’isoler instantanément des sous-ensembles de données sans jamais altérer l’alignement horizontal des variables d’appariement psychologique.
4.3 Validation de l’exhaustivité de l’échantillon expérimental
Avant d’exécuter la moindre synthèse statistique, il est impératif d’auditer l’exhaustivité de l’échantillon effectif. En psychologie empirique, des interruptions de protocole, des fatigues intempestives ou des dysfonctionnements matériels lors de l’enregistrement de réponses chronométriques peuvent aboutir à des données manquantes. Pour connaître avec certitude l’effectif réel n sur lequel porteront les calculs, l’utilisateur insère une cellule de vérification instrumentée par la fonction NB (ou COUNT en version anglophone), qui quantifie rigoureusement le nombre de cellules contenant des valeurs numériques valides au sein de la plage spécifiée :
=NB(B2:B31)
Parallèlement, la détection précoce d’éventuels doublons d’enregistrement dans la cohorte s’avère indispensable pour prémunir le chercheur contre les biais de redondance. L’insertion d’une formule conditionnelle de comptage sur la colonne des identifiants (faisant appel à la fonction NB.SI) permet de mettre instantanément en exergue toute duplication involontaire de participant. Si des exclusions méthodologiques de données sont rendues nécessaires à ce stade (par exemple, pour non-respect manifeste des consignes de passation), elles doivent impérativement faire l’objet d’une documentation textuelle claire dans une colonne d’annotation dédiée, conformément aux exigences de rigueur méthodologique.
5. Étape 2 : Calcul de la tendance centrale via la fonction AVERAGE
5.1 Syntaxe formelle et exécution de la fonction MOYENNE
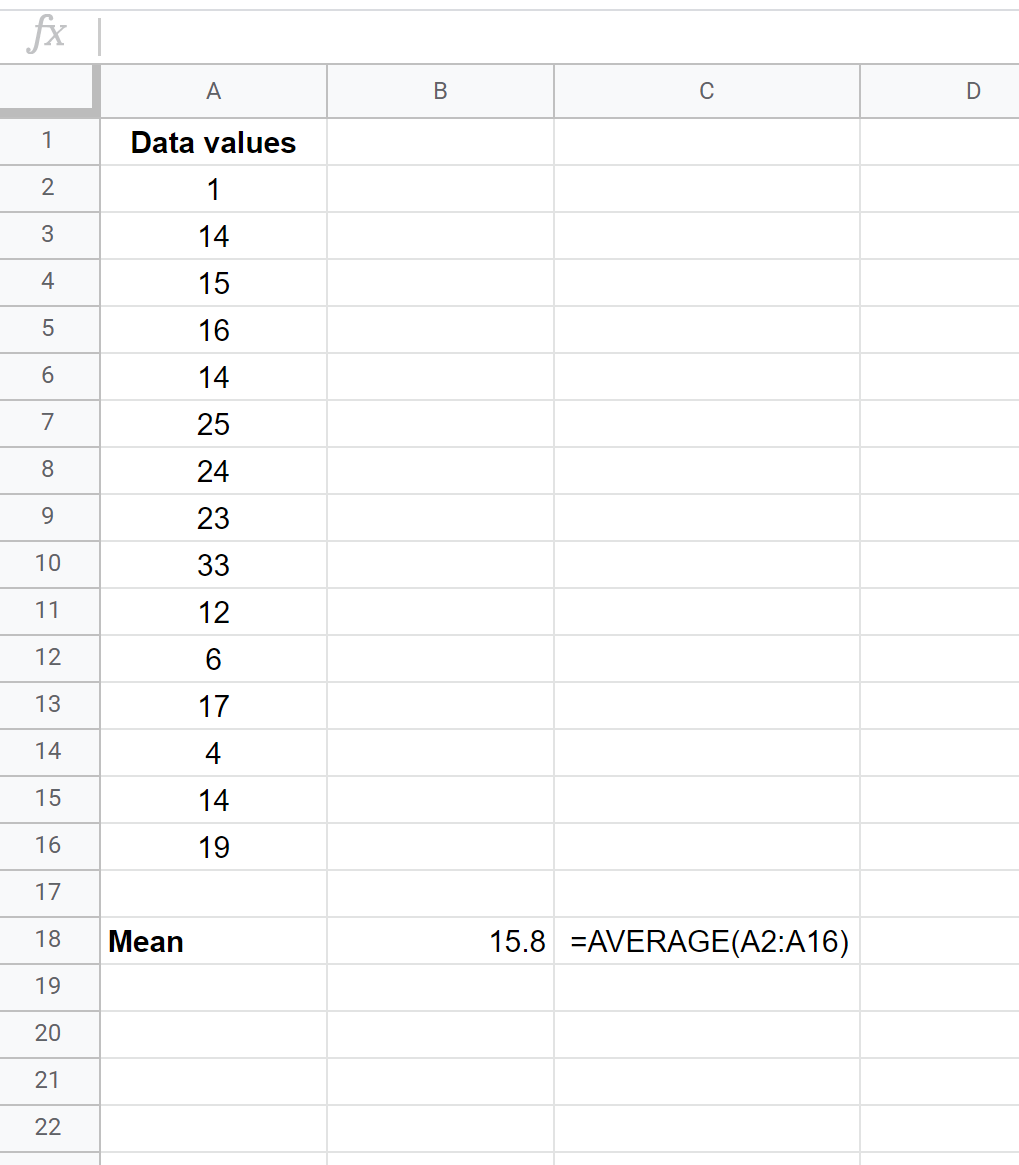
L’estimation de l’écart absolu moyen requiert, comme point d’ancrage fondamental, la détermination préalable de la tendance centrale de la série de données. Dans la formulation classique de l’EAM, c’est la moyenne arithmétique x̄ qui sert de valeur de référence. Google Sheets met à disposition de l’analyste une fonction native dédiée à cette agrégation, dont l’écriture respecte une syntaxe standardisée simple :
=MOYENNE(B2:B31)
Dans les environnements configurés en langue anglaise, la fonction correspondante est AVERAGE(B2:B31). Il importe de souligner le positionnement stratégique de cette cellule calculée : il est fortement recommandé de consigner la moyenne de l’échantillon dans un encart de synthèse distinct ou dans une ligne d’en-tête figée (par exemple en cellule E2), clairement séparée du tableau de données brutes, afin d’éviter tout chevauchement conceptuel. Le moteur de calcul de Google Sheets parcourt l’ensemble des cellules de la plage spécifiée, effectue la sommation séquentielle des grandeurs scalaires et divise automatiquement ce cumul par le nombre de cellules numériques détectées, en éliminant les entrées purement textuelles d’éventuels en-têtes sans générer d’anomalie arithmétique.
5.2 Fixation des références cellulaires pour les opérations subséquentes
La mise en œuvre des opérations différentielles étape par étape va nécessiter de soustraire cette moyenne centrale à chaque observation individuelle le long de la colonne. Cette manœuvre implique une compréhension chirurgicale du mécanisme de référencement cellulaire au sein des tableurs. Par défaut, toute référence écrite sous la forme standard E2 constitue une référence relative : lorsque la formule est copiée vers le bas ou vers la droite, l’index de ligne et de colonne s’incrémente automatiquement et proportionnellement au déplacement.
Pour neutraliser ce déplacement et forcer la formule différentielle à pointer immuablement vers la cellule unique hébergeant la moyenne arithmétique, l’analyste doit impérativement recourir à l’opérateur de verrouillage représenté par le symbole dollar $. La notation devient alors rigoureusement absolue :
$E$2
Le premier dollar fige la colonne E contre toute déviation horizontale, tandis que le second dollar fige la ligne 2 contre tout glissement vertical. L’omission de cet ancrage absolu constitue l’une des erreurs méthodologiques les plus banales chez les praticiens non rompus à l’algèbre tabulaire : dès la deuxième ligne de calcul, la formule pointerait vers la cellule vide E3, corrompant instantanément la validité mathématique de toute la chaîne de traitement.
5.3 Analyse critique de la moyenne obtenue dans le contexte psychologique
L’obtention d’une moyenne arithmétique brute ne doit jamais être accueillie de manière passive ; elle exige un audit clinique et psychométrique immédiat. Le résultat produit correspond-il aux attentes théoriques et aux normes psychométriques publiées pour le test administré dans la population de référence ? Par exemple, lors de l’administration de l’inventaire de dépression de Beck (BDI-II), un score moyen se situant aux alentours de 38 au sein d’un groupe d’étudiants non cliniques doit immédiatement éveiller l’esprit critique de l’évaluateur quant à la validité écologique de la passation ou à la présence d’erreurs de codage de variables inversées.
Par ailleurs, il convient d’évaluer brièvement la sensibilité de cette moyenne aux observations périphériques. En observant conjointement les valeurs minimales et maximales du vecteur de données, le chercheur s’assure que la moyenne n’est pas le reflet artificiel d’un artefact d’échantillonnage. Si la distribution empirique présente une asymétrie manifestement sévère (un coefficient d’asymétrie de Pearson ou skewness substantiellement éloigné de zéro), l’observateur doit d’ores et déjà envisager avec précaution l’interprétation future de l’écart absolu moyen, car l’ancrage central autour de la moyenne arithmétique devient lui-même vulnérable aux tiraillements unilatéraux de la queue de distribution.
6. Étape 3 : Calcul des écarts individuels absolus avec la fonction ABS
6.1 Rôle mathématique et programmatique de la fonction ABS
L’étape différentielle est le cœur battant du calcul de la dispersion. Pour chaque participant i, il est nécessaire d’évaluer l’ampleur de son décalage par rapport au barycentre de l’échantillon. Toutefois, la simple soustraction (B2 - $E$2) engendre inévitablement des valeurs négatives pour l’ensemble des sujets dont la performance se situe en deçà de la moyenne du groupe. Comme établi précédemment, agréger directement ces résidus bruts conduirait à une somme rigoureusement nulle, les scores inférieurs annulant arithmétiquement les scores supérieurs.
La fonction ABS de Google Sheets remplit précisément la fonction de neutralisation du vecteur directionnel. Sur le plan algorithmique, cette fonction évalue l’argument numérique qui lui est soumis : si la valeur est positive ou nulle, elle la restitue inchangée ; si la valeur est strictement négative, elle applique une multiplication scalaire par -1. La distance scalaire pure ainsi dégagée préserve fidèlement la magnitude de l’écart comportemental sans se préoccuper de son orientation positive ou négative sur l’axe des réels :
=ABS(B2 - $E$2)
6.2 Implémentation pas à pas de la colonne des déviations absolues
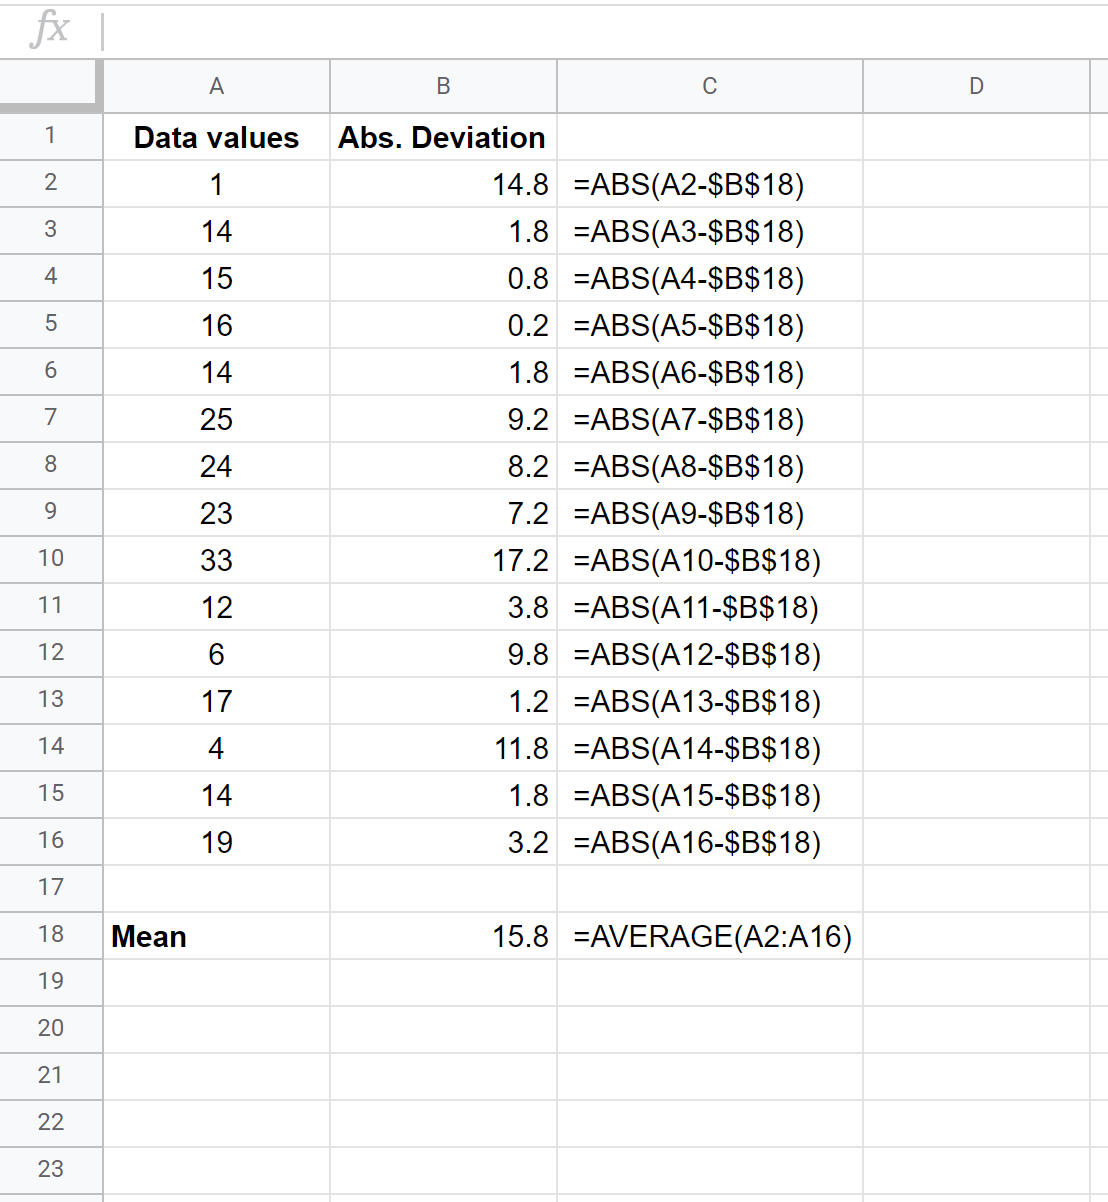
Pour mettre en place concrètement cette colonne auxiliaire, l’utilisateur se positionne sur la cellule C2, contiguë au premier score brut de la cohorte. L’en-tête de la colonne C aura été préalablement renseigné sous un libellé clair tel que Écart absolu |x – Moyenne|. Dans la cellule C2, la formule différentielle combinée est introduite selon la syntaxe rigoureuse validée précédemment :
=ABS(B2 - $E$2)
Une fois la touche Entrée validée, la cellule affiche la magnitude absolue de la déviation pour le sujet SUJ_001. L’opérateur peut alors propager cette opération arithmétique sur l’ensemble des lignes de l’échantillon. Deux méthodes ergonomiques s’offrent à lui : soit cliquer sur le coin inférieur droit de la cellule C2 (la poignée de recopie carrée) et l’étirer verticalement jusqu’à la cellule C31, soit opérer un double-clic rapide directement sur cette poignée, déclenchant l’extension automatique de la formule jusqu’au dernier enregistrement contigu de la colonne B. Une inspection de contrôle sur les cellules C3 et C31 confirmera la permanence du ciblage absolu $E$2 en vis-à-vis de l’incrémentation dynamique du premier terme (B3, B31).
6.3 Interprétation psychologique des écarts individuels maximaux
L’observation attentive des valeurs peuplant cette colonne de déviations absolues offre un aperçu qualitatif d’une remarquable richesse clinique. Les participants arborant les écarts absolus les plus élevés constituent les profils les plus distants de la norme centrale de l’échantillon. En psychologie différentielle et cognitive, cette identification immédiate des scores marginaux permet d’isoler des cas méritant un examen clinique approfondi : s’agit-il d’un individu doté de capacités cognitives exceptionnelles (haut potentiel intellectuel sur un test d’efficience), ou a-t-on affaire à un sujet ayant manifesté un état dissociatif ou anxieux aigu perturbant la réalisation de la tâche ?
Cette étape matérialise la frontière théorique entre la variabilité inhérente au construit psychologique mesuré et l’éventuelle erreur de mesure liée à l’instrumentation. Si un écart absolu s’avère manifestement disproportionné au regard de la dynamique globale de l’échantillon, le chercheur doit examiner si cet écart ne reflète pas une incompréhension des consignes expérimentales. La documentation de ces cas critiques s’avère fondamentale, car bien que l’écart absolu moyen soit moins vulnérable que l’écart-type aux valeurs aberrantes, la présence de profils divergents de magnitude extrême exercera toujours une traction sur la valeur de l’indice final.
7. Étape 4 : Agrégation finale et déduction de l’écart absolu moyen
7.1 Application de la seconde étape d’agrégation statistique
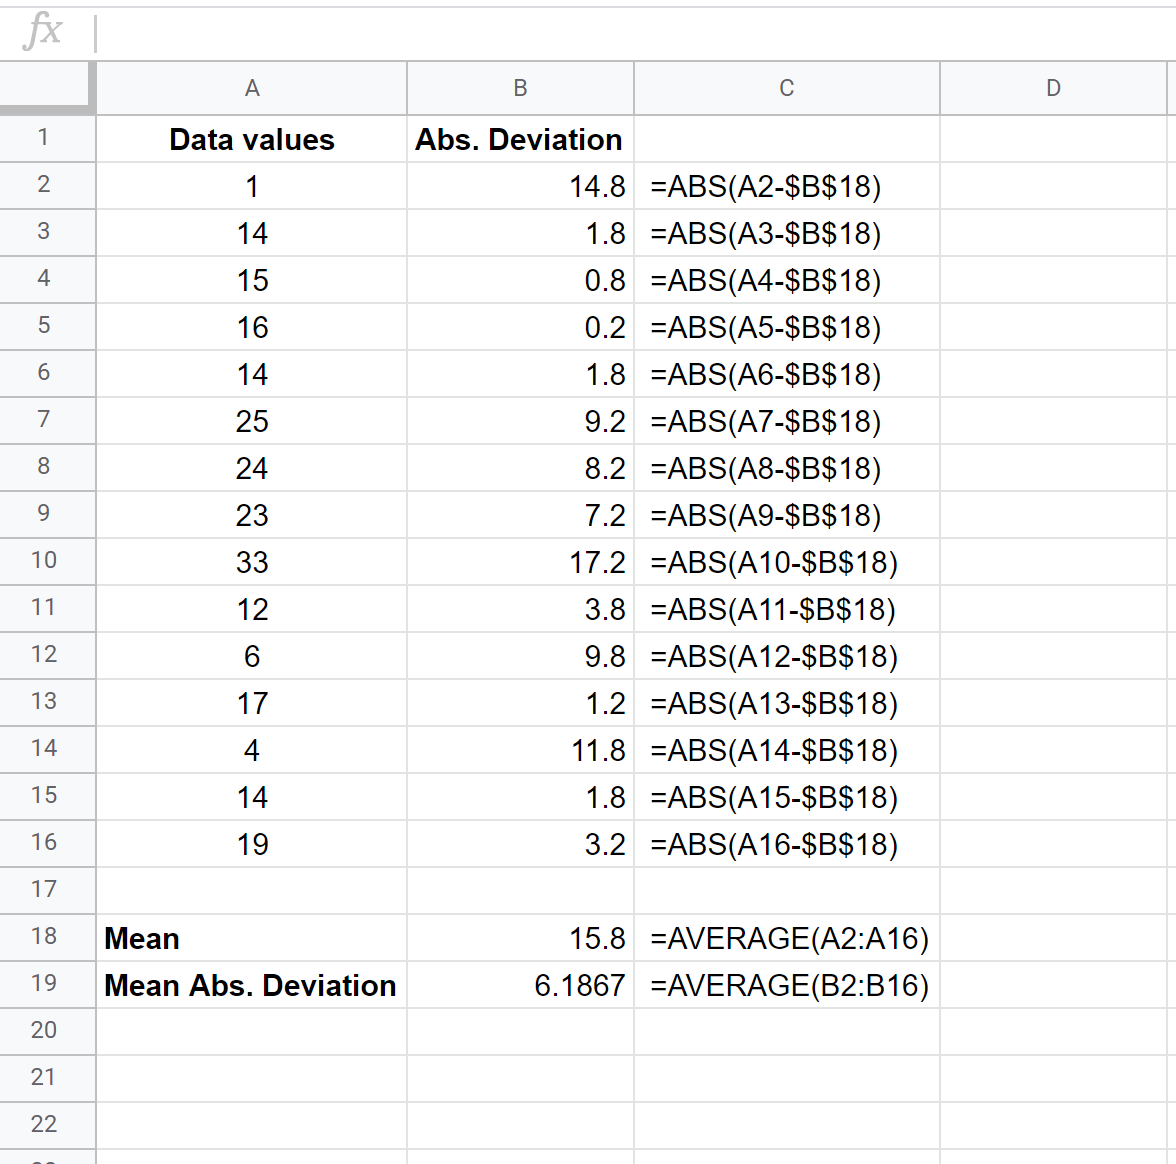
À ce stade du processus méthodologique, l’analyste dispose d’un vecteur complet de déviations scalaires pures consigné dans la colonne C2:C31. Pour parvenir à la détermination définitive de l’écart absolu moyen de l’échantillon, il ne reste plus qu’à opérer une seconde synthèse d’agrégation : le calcul de la moyenne arithmétique de ces écarts absolus individuels. Deux architectures syntaxiques équivalentes s’offrent au choix de l’opérateur au sein de la cellule de résultat final (par exemple en cellule E3) :
=MOYENNE(C2:C31)
À titre d’alternative pédagogique ou de double vérification arithmétique, l’utilisateur peut également décomposer explicitement la formule canonique en procédant à la sommation globale des déviations pondérée par le cardinal effectif calculé via la fonction NB :
=SOMME(C2:C31) / NB(C2:C31)
Ces deux formulations renvoient un résultat strictement identique au bit près dans l’arithmétique en virgule flottante du moteur de calcul. L’affichage de cet indice dans le tableau de bord synthétique de la recherche finalise la chaîne de décomposition de l’EAM, apportant une mesure globale, stable et intuitive de la dispersion de la variable psychologique considérée.
7.2 Contrôle d’intégrité et validation mathématique du résultat
L’obtention de la valeur finale impose la conduite immédiate d’un audit de cohérence interne. Une propriété mathématique absolue de l’écart absolu moyen est sa stricte positivité : EAM ≥ 0. L’obtention d’une valeur négative ou d’une erreur d’exécution logicielle (telle que #VALEUR! ou #DIV/0!) trahirait instantanément une défaillance dans la composition des chaînes de formules, comme l’inclusion accidentelle d’une cellule textuelle dans une sommation ou une division par un effectif nul.
De surcroît, la grandeur scalaire de l’écart absolu moyen doit s’inscrire dans un ordre de grandeur parfaitement cohérent avec l’étendue globale des données (valeur maximale moins valeur minimale). Dans toute distribution unimodale raisonnablement équilibrée, l’écart absolu moyen n’excède jamais la moitié de l’étendue globale, et se situe typiquement entre un sixième et un quart de celle-ci. Afin d’éliminer toute incertitude liée aux micro-arrondis logiciels ou à une éventuelle corruption de cellules masquées, il est fortement conseillé de procéder à un calcul manuel témoin sur les trois ou quatre premières observations afin de valider sans équivoque la parfaite exactitude de l’implémentation algorithmique.
7.3 Arrondis scientifiques et présentation des résultats numériques
Dans l’écosystème de Google Sheets, la précision interne du moteur de calcul stocke les valeurs décimales sous forme de nombres à double précision en virgule flottante selon la norme IEEE 754, autorisant une quinzaine de chiffres significatifs. Cependant, afficher un écart absolu moyen avec une douzaine de décimales n’a aucun sens scientifique dans le domaine de la recherche clinique et psychologique, cela conférant une illusion fallacieuse de précision ultra-fine non étayée par la sensibilité réelle des instruments de mesure psychométriques.
Il importe de formater l’affichage de la cellule via les boutons d’ajustement de décimales de la barre d’outils, en respectant scrupuleusement les directives de publication académique, telles que les normes standardisées de l’American Psychological Association (APA Style, 7e édition). Celles-ci préconisent généralement la restitution des indices de tendance centrale et de dispersion avec deux chiffres après la virgule décimale (par exemple, EAM = 4,28 ms). L’adjonction explicite de l’unité de mesure originale dans le libellé de restitution garantit que le lecteur puisse immédiatement contextualiser la dispersion sans ambiguïté interprétative.
8. Méthode condensée avancée : Utilisation de formules matricielles (ARRAYFORMULA)
8.1 Principes des formules matricielles dans Google Sheets
Bien que la méthode décomposée pas à pas décrite précédemment présente des vertus pédagogiques évidentes pour assimiler la structure du calcul, elle présente un inconvénient opérationnel majeur dans le cadre d’études complexes : elle exige l’allocation d’une colonne auxiliaire complète pour consigner les déviations absolues individuelles. Dans un protocole expérimental à large échelle comportant des dizaines de variables dépendantes ou des centaines d’items psychométriques, la multiplication de ces colonnes intermédiaires alourdit considérablement l’architecture de la feuille de calcul et accroît les risques de corruption accidentelle de formules.
C’est ici que réside la formidable puissance du moteur d’exécution matriciel de Google Sheets, matérialisé par la fonction ARRAYFORMULA. Cette commande permet d’appliquer un opérateur vectoriel ou une série d’itérations différentielles simultanément à l’ensemble des lignes d’un tableau sans nécessiter l’instanciation de cellules intermédiaires visibles. Le calcul s’exécute directement dans la mémoire vive allouée au classeur, réduisant drastiquement l’encombrement graphique et garantissant une mise à jour instantanée et dynamique de l’indice agrégé dès l’introduction de nouvelles données empiriques.
8.2 Construction de la formule matricielle autonome pour l’EAM
L’élaboration d’une formule matricielle compacte capable de calculer l’écart absolu moyen en une seule et unique cellule repose sur l’imbrication concertée des fonctions MOYENNE (ou AVERAGE), ABS et ARRAYFORMULA. Pour traiter directement le vecteur brut logé dans la plage B2:B31 sans aucune colonne auxiliaire, la syntaxe formalisée se configure de la manière suivante :
=MOYENNE(ARRAYFORMULA(ABS(B2:B31 - MOYENNE(B2:B31))))
Analysons l’évaluation algorithmique séquentielle de cette formule : le moteur calcule d’abord le terme scalaire MOYENNE(B2:B31) situé au cœur de l’imbrication. Ensuite, grâce à l’enveloppe ARRAYFORMULA, il soustrait simultanément cette valeur scalaire constante à chacun des éléments du vecteur B2:B31, générant en mémoire tampon un tableau virtuel de résidus. La fonction ABS convertit instantanément chaque résidu virtuel en sa valeur absolue scalaire. Enfin, la fonction MOYENNE externe calcule la moyenne arithmétique globale de ce tableau virtuel sans qu’aucune donnée intermédiaire n’ait eu besoin d’être imprimée sur la grille du tableur. Le gain en élégance et en compacité algorithmique est absolu.
8.3 Gestion des plages dynamiques et exclusion des cellules vides
Dans un contexte de recueil longitudinal de données, la cohorte est amenée à s’étoffer continuellement au fil des passations expérimentales. Figer la formule à une borne fixe (comme B31) contraindrait le chercheur à actualiser manuellement les coordonnées de la plage à chaque arrivée de participant. L’utilisation d’une plage ouverte, telle que B2:B, permet d’ingérer automatiquement toute nouvelle entrée. Cependant, une telle référence englobe par défaut toutes les cellules vides jusqu’au bas de la feuille, que le moteur traduirait par des zéros, corrompant dramatiquement la moyenne et faussant l’écart absolu moyen.
Pour immuniser la formule matricielle contre cet écueil, il est impératif de combiner l’architecture avec la fonction de filtrage dynamique FILTER. La syntaxe sécurisée universelle s’écrit alors :
=MOYENNE(ARRAYFORMULA(ABS(FILTER(B2:B; B2:B"") - MOYENNE(FILTER(B2:B; B2:B"")))))
Le sous-programme FILTER(B2:B; B2:B"") extrait dynamiquement et exclusivement les lignes non vides, éliminant totalement le risque de division par zéro ou de contamination par des cellules blanches. Le classeur acquiert ainsi une résilience parfaite, offrant une infrastructure automatisée pérenne pour le suivi de protocoles de recherche ouverts.
9. Analyse comparative : Écart absolu moyen versus écart-type en psychologie
9.1 Sensibilité comparée aux valeurs aberrantes de réponse
Pour mesurer la supériorité structurelle de l’écart absolu moyen dans des configurations empiriques bruitées, il est particulièrement instructif de comparer sa réactivité à celle de l’écart-type canonique face à une contamination unilatérale de l’échantillon. Considérons une série de dix participants à un test de vigilance psychomotrice dont les temps de réponse normaux oscillent harmonieusement entre 200 et 250 millisecondes. Supposons qu’au dixième essai, un sujet subisse une défaillance attentionnelle sévère ou un décrochage temporaire du capteur optique, générant un enregistrement aberrant de 1800 millisecondes.
L’écart-type de l’échantillon, du fait de l’élévation au carré de cet écart monumental par rapport à la moyenne, va subir une inflation spectaculaire, passant d’environ 16 ms à plus de 480 ms. L’indicateur est littéralement pris en otage par cette unique observation extrême, induisant le chercheur en erreur en suggérant une dispersion phénoménale de l’ensemble de la cohorte. En revanche, l’écart absolu moyen n’intègre cette déviation que sous sa forme linéaire unitaire : son accroissement demeure extrêmement modéré et borné, reflétant avec une fidélité nettement supérieure la dispersion réelle de 90 % de l’échantillon. Cette insensibilité relative aux fluctuations marginales confère à l’EAM un statut d’indicateur semi-robuste indispensable en psychométrie appliquée.
9.2 Intelligibilité conceptuelle pour les praticiens et cliniciens
L’un des défis majeurs de l’évaluation psychologique contemporaine réside dans la transmission des conclusions chiffrées à des interlocuteurs non spécialistes de l’analyse multivariée, qu’il s’agisse de patients recevant une restitution de bilan neuropsychologique, de parents d’enfants en cours d’évaluation diagnostique, ou de médecins coordinateurs d’équipes pluridisciplinaires. Dans ce contexte de vulgarisation et de clarté éthique, l’écart-type et la variance souffrent d’un lourd déficit d’intelligibilité intuitive.
Que signifie concrètement, sur le plan de la vie quotidienne, une variance de 256 « points carrés » sur une échelle d’humeur ? Même l’écart-type, ramené à l’unité d’origine (16 points), demeure conceptuellement abstrait en raison de son ancrage dans la racine carrée d’une moyenne quadratique. En revanche, l’affirmation clinique selon laquelle « l’écart absolu moyen des réponses du patient est de 8 points par rapport à la moyenne du groupe de référence » bénéficie d’une transparence sémantique totale : elle signifie sans artifice mathématique que, lors d’une passation typique, l’individu dévie en moyenne d’environ 8 unités concrètes de l’échelle d’évaluation. Ce gain en clarté s’avère précieux pour la communication clinique bienveillante et transparente.
9.3 Critères de sélection de l’indicateur selon le design expérimental
La décision méthodologique d’opter pour l’écart absolu moyen ou l’écart-type conventionnel ne doit pas être guidée par une simple préférence stylistique, mais par une analyse épistémologique stricte de la finalité de la recherche et de la morphologie des distributions. Si l’objectif principal de l’étude est de nourrir une modélisation inférentielle paramétrique classique — par exemple, soumettre les données à une analyse de variance (ANOVA), à une régression linéaire multiple ou à des équations structurelles —, l’écart-type demeure impératif, car il constitue l’estimateur canonique alimentant la somme des carrés et la théorie des modèles linéaires généraux.
En revanche, lorsque l’investigation s’inscrit dans une perspective purement descriptive, dans une analyse de cas unique (méthodologie single-case en neuropsychologie), ou lorsque l’instrument de mesure produit des échelles ordinales assimilées à du quasi-intervalle (échelles d’attitudes de type Likert fortement asymétriques), l’écart absolu moyen s’impose comme le choix le plus pertinent et le plus honnête sur le plan scientifique. Dans un souci d’exhaustivité et de transparence méthodologique, de plus en plus de revues savantes à comité de lecture encouragent d’ailleurs le rapport conjoint des deux indices au sein des tables de statistiques descriptives préliminaires.
10. Gestion des anomalies, données manquantes et valeurs aberrantes
10.1 Diagnostic des données manquantes dans les questionnaires psychologiques
Dans l’administration concrète d’inventaires d’auto-évaluation psychologique (comme le NEO-PI-3 ou le MMPI), il est récurrent que certains participants omettent involontairement de cocher certains items ou refusent d’aborder des questions jugées trop intrusives. Sur le plan statistique, la taxonomie de Rubin distingue les données manquantes survenant de manière totalement aléatoire (MCAR, Missing Completely at Random), de celles dépendant de variables observées (MAR, Missing at Random) ou de la variable sous-jacente elle-même (MNAR, Missing Not at Random).
Le comportement par défaut des fonctions d’agrégation arithmétique de Google Sheets (telles que MOYENNE ou ABS) consiste à écarter silencieusement les cellules blanches sans lever d’alerte. Si cette tolérance évite l’interruption des calculs, elle peut dénaturer gravement l’estimation de l’EAM si l’omission d’un item clinique est systématiquement liée à une sévérité symptomatique majeure. Dans le cadre d’un protocole d’analyse rigoureux, le chercheur doit préalablement quantifier le taux d’exhaustivité des réponses par participant et formaliser des règles strictes de décision : suppression par liste (exclusion du participant si le taux d’omission dépasse 10 %) ou recours à des techniques d’imputation multiple, préalablement à l’évaluation de la dispersion.
10.2 Détection visuelle et statistique des valeurs aberrantes expérimentales
L’exploitation conjointe des capacités de calcul de dispersion et des fonctionnalités de mise en forme dynamique de Google Sheets permet d’instaurer des mécanismes d’alerte visuelle automatisés pour le repérage précoce des scores suspects. L’une des heuristiques les plus efficaces consiste à identifier les observations dont la déviation absolue individuelle excède un certain multiple de l’écart absolu moyen global de l’échantillon (par exemple, |xi – x̄| > 2,5 × EAM).
Pour matérialiser visuellement ces anomalies sans altérer les données, l’utilisateur peut configurer une règle de mise en forme conditionnelle en sélectionnant la colonne des données brutes (B2:B31), en accédant au menu Format > Mise en forme conditionnelle, et en définissant une formule personnalisée. Si l’EAM global est consigné en cellule $E$3 et la moyenne en $E$2, la formule de conditionnement s’écrira :
=ABS(B2 - $E$2) > (2,5 * $E$3)
Toute cellule s’écartant dramatiquement de la tendance centrale sera instantanément mise en surbrillance chromatique, alertant le chercheur sur un éventuel biais d’acquiescement, un clic compulsif lors de passations informatisées en ligne, ou une erreur matérielle d’encodage décimal.
10.3 Formules sécurisées intégrant des filtres logiques conditionnels
Pour prémunir les algorithmes d’analyse contre les distorsions induites par des entrées aberrantes avérées ou des sous-groupes expérimentaux non pertinents, il est possible d’édifier des formules de calcul de l’écart absolu moyen encapsulant des filtres logiques conditionnels stricts. Google Sheets propose à cet égard des fonctions hautement spécialisées telles que MOYENNE.SI, MOYENNE.SI.ENS, ainsi que le puissant interpréteur de langage de requête QUERY.
Imaginons un protocole de recherche portant sur les temps de latence où les règles méthodologiques a priori prescrivent l’exclusion formelle de toute réponse chronométrique inférieure à 150 ms (considérée physiologiquement comme une anticipation anticipatoire motrice réflexe) et supérieure à 1500 ms (révélant une inattention manifeste). Une formule matricielle sécurisée intégrant ce double bornage d’exclusion peut être formulée de la manière suivante :
=MOYENNE(ARRAYFORMULA(ABS(FILTER(B2:B; B2:B>=150; B2:B=150; B2:B<=1500)))))
Cette approche algorithmique garantit que l’estimation de l’écart absolu moyen repose exclusivement sur le sous-ensemble empirique valide défini par le protocole scientifique, prévenant toute corruption de l’indice par des artéfacts comportementaux tout en éliminant les erreurs d’exécution arithmétique de type division par zéro.
11. Automatisation et dynamisation des calculs pour cohortes longitudinales
11.1 Création de modèles réutilisables pour le suivi temporel des patients
Dans la pratique clinique neuropsychologique et le suivi psychothérapeutique longitudinal, l’analyste évalue de façon répétée l’état d’un même patient au fil des semaines ou des cycles d’intervention. Dans une telle configuration de suivi temporel, la reconstruction manuelle de feuilles de calcul pour chaque nouvelle séance s’avère particulièrement fastidieuse et propice aux erreurs de copie. Il devient alors indispensable de concevoir une matrice de calcul standardisée, verrouillée et pérenne, capable d’ingérer dynamiquement de nouvelles sessions d’évaluation.
Pour bâtir un tel modèle, il est opportun de coupler l’architecture de calcul avec des plages nommées dynamiques élaborées à partir de la combinaison des fonctions DECALER et NBVAL. Cette méthodologie permet à la plage d’analyse de se redimensionner d’elle-même au fur et à mesure que le clinicien renseigne de nouveaux scores dans les cellules inférieures de la feuille, recalculant instantanément la moyenne mobile et l’écart absolu moyen glissant de la trajectoire clinique du patient. Les cellules contenant les formules maîtresses d’agrégation doivent impérativement faire l’objet d’un verrouillage d’édition via les fonctions de protection de feuilles, garantissant que les cliniciens utilisateurs ne puissent écraser involontairement les formules de synthèse lors de la saisie quotidienne.
11.2 Visualisation graphique de la dispersion dans Google Sheets
L’appréhension cognitive de la dispersion des scores est considérablement optimisée par la médiation de représentations visuelles explicites. Si l’écart-type est traditionnellement représenté sous la forme de barres d’erreur symétriques encadrant un diagramme à bâtons, l’écart absolu moyen peut être traduit visuellement de façon tout à fait remarquable au sein de Google Sheets à travers des graphiques de distribution enrichis d’intervalles de dispersion linéaires.
L’analyste peut générer un histogramme de fréquences des scores comportementaux, en surimposant une zone délimitée par les frontières [x̄ – EAM ; x̄ + EAM]. Cette surface visuelle met en lumière la proportion de participants dont les réponses s’inscrivent au sein de la « bande de dispersion normale » autour de la moyenne. Pour des suivis longitudinaux individuels, la construction d’un graphique linéaire chronologique comportant une double ligne pointillée matérialisant les bornes de déviation moyenne absolue permet au praticien d’évaluer d’un coup d’œil si le comportement du sujet lors d’une séance spécifique traduit une stabilisation ou une exacerbation de sa variabilité symptomatique.
11.3 Introduction à l’automatisation via Google Apps Script pour études complexes
Lorsque le volume des données de recherche excède les capacités de gestion fluide des formules tabulaires classiques — par exemple, lors du traitement automatisé de centaines de classeurs individuels émanant d’une cohorte multicentrique —, l’environnement de programmation Google Apps Script (fondé sur JavaScript) offre une solution d’automatisation de premier ordre. Il est en effet possible de concevoir une fonction personnalisée (User Defined Function) dédiée à l’écart absolu moyen, accessible dans l’interface de calcul exactement comme une fonction native :
En accédant au menu Extensions > Apps Script, le chercheur peut intégrer une routine scriptée compilant le traitement de l’EAM de manière étanche. Les avantages d’une telle approche sont multiples : standardisation du code source au sein d’un laboratoire de recherche, élimination définitive des risques d’altération accidentelle des formules complexes imbriquées dans les cellules visibles, traçabilité des algorithmes d’analyse via des systèmes de contrôle de versions de code (comme Git), et possibilité d’exécuter des traitements par lots en arrière-plan sur d’immenses répertoires de données de passation.
12. Études de cas concrètes et interprétation des résultats en recherche psychologique
12.1 Cas 1 : Mesure des temps de réaction dans une tâche d’attention soutenue
Examinons une application empirique concrète au sein d’un laboratoire de neuropsychologie cognitive. L’investigation porte sur l’évaluation de la variabilité exécutive chez un échantillon de 25 jeunes adultes soumis à une tâche d’attention soutenue de type psychomotor vigilance task (PVT) d’une durée de dix minutes. La variable dépendante continue est le temps de réaction motrice enregistré en millisecondes. Les données brutes recueillies dans la colonne B2:B26 révèlent une moyenne d’échantillon de x̄ = 245,30 ms.
L’application de notre formule matricielle autonome d’écart absolu moyen =MOYENNE(ARRAYFORMULA(ABS(B2:B26 - MOYENNE(B2:B26)))) retourne un indice final de EAM = 28,45 ms. Sur le plan de l’interprétation clinique et cognitive, ce résultat indique que les fluctuations individuelles de performance s’écartent en moyenne de moins de 29 millisecondes de la tendance centrale, témoignant d’une remarquable consistance exécutive et d’une allocation attentionnelle particulièrement stable tout au long de l’épreuve. Si nous introduisions dans ce même jeu de données les enregistrements d’une cohorte de patients souffrant de trouble du déficit de l’attention avec hyperactivité (TDAH), nous observerions typiquement un EAM substantiellement supérieur (par exemple aux alentours de 65 ms), attestant d’une instabilité attentionnelle intra-individuelle majeure, quand bien même leurs moyennes arithmétiques globales ne différeraient que modérément.
12.2 Cas 2 : Évaluation de la consistance interne des réponses à une échelle de dépression
Considérons à présent un second cas pratique issu du champ de la psychométrie clinique. Une cohorte de 40 patients présentant un diagnostic d’épisode dépressif caractérisé complète l’inventaire d’évaluation de la dépression de Hamilton (HAM-D), composé d’items cotés sur des échelles de Likert allant de 0 à 4 points. L’analyste s’intéresse ici à la dispersion des réponses individuelles à travers l’ensemble des items afin d’évaluer l’homogénéité sémiologique du profil symptomatique de chaque patient.
Pour un patient spécifique dont les scores sont consignés le long d’une ligne d’évaluation horizontale de B2:U2 (20 items distincts), le calcul matriciel de l’écart absolu moyen intra-individuel permet d’évaluer le degré d’ambivalence ou de spécialisation de son tableau clinique. Un patient affichant un score moyen de 2,10 avec un EAM extrêmement faible (EAM = 0,25) présente une symptomatologie diffuse et parfaitement homogène, affectant uniformément l’ensemble des dimensions de sa vie affective et somatique. À l’inverse, un second patient partageant exactement le même score moyen global de 2,10 mais présentant un EAM = 1,45 révèle un profil hétérogène et contrasté, combinant des scores maximaux sur les items d’insomnie et de ralentissement moteur avec une absence totale d’idéations suicidaires. Dans cette situation, l’écart absolu moyen apporte une valeur incrémentielle diagnostique inestimable que le seul score total cumulé était totalement incapable de mettre en relief.
12.3 Rédaction des sections méthodologiques et statistiques selon les normes académiques
La valorisation scientifique d’une recherche exige une rigueur scrupuleuse lors de la rédaction des sections « Méthode » et « Résultats » destinées à des revues savantes à comité de lecture affiliées à l’APA ou à d’autres sociétés savantes internationales. L’utilisation de l’écart absolu moyen doit être expressément explicitée et justifiée sur le plan méthodologique afin de permettre aux réviseurs d’en apprécier la pertinence analytique.
Sur le plan textuel, la formulation doit documenter sans ambiguïté le choix de cet indice de dispersion : « En raison de l’asymétrie modérée des distributions des temps de latence et de la volonté de préserver une pondération linéaire des déviations individuelles face aux fluctuations marginales, la dispersion des réponses a été quantifiée à l’aide de l’écart absolu moyen (EAM) plutôt que de l’écart-type canonique. » Dans les tableaux de statistiques descriptives synthétiques, l’EAM doit figurer dans une colonne explicitement libellée, aux côtés de la moyenne arithmétique ou de la médiane, accompagné de la notation standardisée des intervalles de confiance associés. Enfin, conformément aux préceptes du mouvement de la science ouverte (Open Science Framework), il est vivement préconisé d’adjoindre en matériel supplémentaire le lien vers le classeur Google Sheets dument anonymisé et documenté, garantissant une auditabilité et une reproductibilité parfaites des calculs réalisés.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Gorard, S. (2005). Revisiting a 90-year-old debate: The advantages of the mean deviation over the standard deviation. British Journal of Educational Studies, 53(4), 417–430. https://doi.org/10.1111/j.1467-8527.2005.00304.x
Huber, P. J. (2004). Robust statistics. John Wiley & Sons.
Leys, C., Ley, C., Klein, O., Bernard, P., & Licata, L. (2013). Detecting outliers: Do not use standard deviation around the mean, use absolute deviation around the median. Journal of Experimental Social Psychology, 49(4), 764–766. https://doi.org/10.1016/j.jesp.2013.03.013
Nunnally, J. C., & Bernstein, I. H. (1994). Psychometric theory (3rd ed.). McGraw-Hill.
Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.