
Dans le domaine des sciences comportementales et de la recherche psychologique contemporaine, la modélisation quantitative constitue le socle sur lequel repose l’ensemble de l’édifice inférentiel. Trop souvent, les étudiants et les jeunes chercheurs perçoivent les concepts de probabilités comme des abstractions purement théoriques, déconnectées des réalités empiriques du laboratoire ou du cabinet clinique. Pourtant, la capacité à extraire des conclusions valides à partir d’observations parcellaires dépend intrinsèquement de la compréhension d’un concept pivot : la distribution d’échantillonnage. Sans une assimilation rigoureuse de cette structure latente, le passage d’une mesure brute obtenue sur un groupe restreint de participants à une affirmation générale sur le fonctionnement cognitif humain relève d’une conjecture fragile plutôt que d’une démarche scientifique rigoureuse.
L’utilisation de logiciels de feuilles de calcul tels que Microsoft Excel offre un laboratoire d’expérimentation computationnelle remarquable pour démystifier ces abstractions mathématiques. Si des environnements programmatiques dédiés comme R ou Python sont largement plébiscités pour les analyses massives, Excel possède une valeur heuristique inégalée. En déployant visuellement des matrices d’échantillonnage où chaque cellule incarne une observation simulée, le chercheur peut manipuler directement le mécanisme de génération des données. Cette approche transparente permet de visualiser concrètement comment la variabilité individuelle s’agrège pour former des distributions stables, prévisibles et régies par des lois probabilistes universelles.
Ce guide exhaustif a pour vocation d’accompagner les chercheurs, psychométriciens et analystes de données dans la mise en œuvre pas à pas du calcul, de la modélisation et de la visualisation des distributions d’échantillonnage sous Excel. En adoptant une perspective ancrée dans l’évaluation neuropsychologique et la psychométrie expérimentale, nous explorerons non seulement les mécanismes algorithmiques sous-jacents aux fonctions d’inversion stochastique, mais également les implications méthodologiques fondamentales liées aux erreurs d’inférence, à la puissance statistique et à la robustesse des estimateurs. À travers des protocoles détaillés et reproductibles, nous transformerons une feuille de calcul ordinaire en un puissant moteur de simulation stochastique.
1. Cadre conceptuel des distributions d’échantillonnage en recherche psychologique
1.1 Définition épistémologique et utilité en sciences comportementales
L’édifice de l’inférence statistique en psychologie repose sur une distinction tripartite fondamentale, souvent source de confusions majeures chez les praticiens : la distribution de la population, la distribution de l’échantillon et la distribution d’échantillonnage. La distribution de la population représente l’ensemble complet, généralement inaccessible ou infini, des valeurs d’une variable pour tous les individus répondant à une définition théorique précise (par exemple, la capacité de mémoire de travail chez l’ensemble des adultes francophones). Cette population est caractérisée par des paramètres fixes, non aléatoires mais typiquement inconnus, désignés conventionnellement par des lettres grecques telles que la moyenne μ et l’écart-type σ.
À l’opposé, la distribution de l’échantillon correspond à la dispersion empirique des scores mesurés sur un sous-ensemble fini d’individus extraits de cette population (notée N). Ses propriétés sont résumées par des statistiques descriptives observables, telles que la moyenne empirique x̄ et l’écart-type d’échantillon s. Cependant, en sciences du comportement, un échantillon isolé ne présente aucun intérêt intrinsèque s’il ne permet pas d’extrapoler vers la structure globale dont il est issu. C’est ici qu’intervient le concept théorique de la distribution d’échantillonnage. Il ne s’agit pas de la distribution de personnes réelles, mais de la distribution de probabilité d’une statistique spécifique (comme la moyenne) calculée sur une infinité d’échantillons hypothétiques de taille identique N, tirés de manière aléatoire et indépendante de la même population d’origine.
Cette entité conceptuelle joue un rôle déterminant dans la gestion de la variabilité d’échantillonnage, phénomène inhérent à toute tentative de réplication d’études expérimentales. En psychométrie et en neuropsychologie clinique, lorsqu’un protocole cognitif évalue une intervention sur un groupe de 20 patients amnésiques, la moyenne observée ne sera jamais rigoureusement identique si le protocole est répété le lendemain sur 20 autres patients comparables. La distribution d’échantillonnage offre le cadre mathématique formel permettant de quantifier précisément cette fluctuation aléatoire naturelle. Elle constitue le pont épistémologique autorisant la transition entre le constat empirique unique et l’inférence probabiliste, en situant la performance observée au sein de toutes les performances théoriquement concevables sous des conditions similaires.
1.2 Fondements mathématiques : Théorème Central Limite et Loi des Grands Nombres
La viabilité théorique de l’inférence statistique repose sur deux piliers de l’analyse stochastique : la Loi des Grands Nombres (LGN) et le Théorème Central Limite (TCL). La formulation moderne de la Loi des Grands Nombres, sous sa forme forte formulée notamment par Kolmogorov, stipule que la moyenne d’un échantillon de variables aléatoires indépendantes et identiquement distribuées converge presque sûrement vers l’espérance mathématique de la population lorsque la taille de l’échantillon tend vers l’infini. En termes pragmatiques pour le psychologue quantitatif, cette loi garantit que l’accumulation de mesures expérimentales élimine l’influence du bruit aléatoire individuel pour révéler la valeur véritable du paramètre psychologique latent.
Le Théorème Central Limite enrichit considérablement cette propriété en décrivant précisément la forme fonctionnelle que prend cette convergence. Dans son énoncé classique de Lindeberg-Lévy, si des variables aléatoires X1, X2, …, Xn sont tirées de manière indépendante et identiquement distribuée depuis une population d’espérance finie μ et de variance finie σ2, alors la variable aléatoire standardisée Z = (x̄ – μ) / (σ / √N) converge en loi vers une distribution normale standard centrée réduite N(0, 1) lorsque N devient grand. Ce résultat est d’une puissance exceptionnelle : quelle que soit la forme de la distribution parente dans la population d’origine — qu’elle soit symétrique, bimodale, uniforme ou fortement asymétrique — la distribution d’échantillonnage de la moyenne se comportera de manière asymptotique selon une loi de Laplace-Gauss.
Cette convergence impose une distinction analytique formelle entre l’écart-type de la population σ et la dispersion de la distribution des moyennes, universellement désignée sous le terme d’erreur type de la moyenne (notée σx̄ ou SE pour Standard Error). Mathématiquement, cette métrique découle directement des propriétés de la variance d’une combinaison linéaire de variables indépendantes :
Var(x̄) = Var((1/N) Σ Xi) = (1/N2) Σ Var(Xi) = (1/N2) × N σ2 = σ2 / N
Par conséquent, en extrayant la racine carrée, nous obtenons l’équation canonique σx̄ = σ / √N. Cette formulation met en lumière l’extraordinaire résilience du TCL face aux asymétries initiales des construits psychologiques : même face à des temps de latence cognitive fortement skewed à droite, la distribution des moyennes d’échantillons se normalise avec une rapidité surprenante dès que N dépasse quelques dizaines d’observations.
1.3 Implications pour l’évaluation de la significativité statistique
La distribution d’échantillonnage n’est pas un simple exercice d’élégance théorique ; elle représente l’instrument logique par lequel s’opère le test d’hypothèses dans le cadre conventionnel de Neyman-Pearson et de Fisher. La modélisation de l’hypothèse nulle (H0) postule précisément l’existence d’une distribution d’échantillonnage théorique conditionnée par l’absence d’effet ou par un paramètre de référence fixé d’avance. Lorsqu’un clinicien observe une moyenne de test après une thérapie neurocognitive, la question n’est pas de savoir si cette moyenne diffère arithmétiquement de zéro, mais d’évaluer la rareté de cette valeur observée au sein de la distribution d’échantillonnage générée sous l’hypothèse où l’intervention n’aurait strictement aucune efficacité.
C’est au sein des queues de cette distribution d’échantillonnage théorique qu’est délimité le risque d’erreur de première espèce, communément désigné par le seuil critique α (habituellement fixé à 0,05 ou 0,01 en psychologie). L’aire sous la courbe de densité correspondant à ces seuils extrêmes définit les zones de rejet critique de l’hypothèse nulle. Si la moyenne observée dans l’échantillon clinique tombe dans cette région de faible densité probabiliste (la « région critique »), le chercheur rejette H0 au profit de l’hypothèse alternative H1, concluant à un effet statistiquement significatif.
Ce mécanisme met immédiatement en relief l’impact direct de la taille d’échantillon sur la puissance statistique (1 – β). Puisque l’erreur type σx̄ est inversement proportionnelle à √N, l’augmentation du nombre de participants concentre drastiquement la distribution d’échantillonnage autour de la véritable valeur du paramètre. Cette réduction de dispersion rétrécit mécaniquement la région de chevauchement entre la distribution sous H0 et la distribution sous H1, augmentant de facto la probabilité de détecter un effet psychologique réel sans gonfler le risque d’erreur d’inférence. Comprendre la dynamique interne de la distribution d’échantillonnage est donc indispensable pour maîtriser la crise de reproductibilité qui traverse les sciences comportementales.
2. Paramétrage préalable et configuration de l’environnement Excel
2.1 Configuration du moteur de calcul et gestion du recalcul automatique
Avant d’entreprendre toute modélisation stochastique ou manipulation matricielle d’envergure dans Microsoft Excel, il est impératif d’ajuster rigoureusement les paramètres de configuration du moteur de calcul interne du logiciel. Par défaut, Excel fonctionne selon un mode de calcul automatique. Dans ce mode standard, la moindre modification apportée à une cellule quelconque du classeur ou la simple validation d’une formule déclenche une réévaluation intégrale de toutes les cellules dépendantes à l’échelle de l’ensemble des feuilles ouvertes.
Dans le cadre de simulations probabilistes exploitant des générateurs de nombres pseudo-aléatoires, ce comportement par défaut s’avère particulièrement problématique pour deux raisons majeures : la performance computationnelle et la volatilité des états observés. La génération de matrices massives (par exemple, 1 000 échantillons de 20 observations, soit 20 000 formules stochastiques interconnectées) exige des ressources substantielles de traitement vectoriel. Si l’environnement recalcule instantanément l’intégralité du modèle à chaque frappe au clavier, l’utilisateur s’expose à des gels de l’interface graphique et à une dégradation sensible de l’expérience d’analyse.
Pour prévenir ces latences et maîtriser le flux d’exécution, il convient de basculer temporairement le moteur de calcul en mode manuel. Cette modification s’effectue en accédant au ruban supérieur : cliquer sur l’onglet Formules, sélectionner le menu déroulant Options de calcul, puis activer l’option Manuel. Dès cet instant, les fonctions stochastiques demeurent parfaitement stables et figées dans leur état courant. Pour commander explicitement une nouvelle itération d’échantillonnage — c’est-à-dire générer un univers alternatif de 1 000 échantillons indépendants —, il suffira d’utiliser la touche de raccourci F9 (ou Maj + F9 pour limiter le recalcul à la feuille active). Cette stratégie permet d’optimiser la gestion de la mémoire vive et assure une fluidité totale même lors de manipulations analytiques poussées.
2.2 Activation de l’Utilitaire d’analyse de données (Data Analysis ToolPak)
Bien que les formulations natives dynamiques d’Excel constituent la méthode la plus flexible et la plus didactique pour générer des distributions d’échantillonnage, l’environnement Microsoft met à disposition un module historique d’extensions statistiques particulièrement précieux pour la validation croisée : l’Utilitaire d’analyse (connu sous l’appellation anglophone de Data Analysis ToolPak). Ce composant logiciel fournit des algorithmes d’analyse préconfigurés pour l’échantillonnage déterministe ou aléatoire, l’analyse de variance (ANOVA), et la génération contrôlée de séries pseudo-aléatoires selon divers spectres distributionnels.
Pour activer ce module sous les versions modernes d’Excel pour Windows, la procédure formelle requiert les étapes séquentielles suivantes :
- Accédez au menu supérieur gauche et cliquez sur l’onglet Fichier, puis sélectionnez Options dans le panneau de navigation inférieur.
- Dans la boîte de dialogue contextuelle des Options Excel, dirigez-vous vers la catégorie Compléments située dans la colonne de gauche.
- Au bas de la fenêtre, repérez le champ déroulant intitulé Gérer, assurez-vous que l’option Compléments Excel est sélectionnée, puis cliquez sur le bouton Atteindre….
- Une boîte de dialogue répertoriant les extensions disponibles s’affiche. Cochez explicitement la case nommée Utilitaire d’analyse (et éventuellement Utilitaire d’analyse – VBA si vous envisagez des automatisations programmées ultérieures).
- Validez en cliquant sur OK. L’onglet Données de votre ruban Excel s’enrichit immédiatement d’une nouvelle section intitulée Analyse, arborant le bouton Utilitaire d’analyse.
Il importe toutefois de souligner une nuance fondamentale : les routines générées par l’Utilitaire d’analyse sont statiques. Contrairement aux formules matricielles natives qui se mettent à jour dynamiquement au fil des itérations probabilistes, les outils de ce module injectent des instantanés de données non réactifs. Dans ce manuel, nous privilégierons donc les équations fonctionnelles natives pour leur caractère interactif, tout en réservant le complément à des fins d’audit descriptif rigoureux.
2.3 Structure organisationnelle du classeur pour une modélisation rigoureuse
L’intégrité méthodologique d’une simulation statistique sous tableur repose sur une séparation hermétique entre la saisie des hyperparamètres, la matrice de génération des données brutes et les synthèses analytiques de second ordre. Un classeur désorganisé, amalgamant constantes empiriques et formules itératives sur une même feuille de calcul, expose le chercheur à des erreurs de références circulaires ou à des écrasements accidentels de paramètres clés. Il est donc hautement recommandé d’adopter une architecture modulaire en trois feuilles de calcul distinctes, nommées sans ambiguïté :
La première feuille, intitulée Parametres_Theoriques, héberge le cockpit de commande de la simulation. On y centralisera la moyenne théorique de la population (μ), l’écart-type de référence (σ), la taille individuelle de chaque sous-échantillon (N) ainsi que le nombre total de réplications visées (K = 1 000). Chaque constante y recevra préférentiellement une plage nommée via le Gestionnaire de noms d’Excel (par exemple, nommer la cellule contenant la moyenne mu_pop), facilitant la lisibilité conceptuelle des syntaxes ultérieures en évitant les lourdeurs des dollars de verrouillage absolu.
La deuxième feuille, dénommée Matrice_Simulation, constitue le réceptacle computationnel dédié exclusivement à la génération vectorielle des données brutes. Elle recevra l’ensemble des 20 000 observations simulées réparties dans un tableau structuré, dépourvu de tout artifice graphique ou textuel parasite. Enfin, la troisième feuille, désignée sous le nom d’Analyse_Distribution, sera dédiée aux statistiques d’agrégation de second ordre (calcul de la moyenne des moyennes, erreur type empirique), aux tables de fréquences et à la construction des visualisations graphiques avancées respectant les normes de publication académique.
3. Génération d’échantillons aléatoires continus avec les fonctions NORM.INV et RAND
3.1 Mécanique probabiliste de la méthode d’inversion
Pour synthétiser numériquement des trajectoires comportementales ou des mesures psychométriques sous l’hypothèse de normalité, le moteur de calcul d’Excel recourt à un puissant paradigme mathématique nommé la méthode d’inversion stochastique (ou transformation intégrale de probabilité inverse). Cette approche analytique permet de convertir une variable aléatoire continue uniformément répartie sur l’intervalle semi-ouvert [0, 1[ en une variable aléatoire distribuée selon n’importe quelle loi continue dont la fonction de répartition cumulative inverse (quantile) est résoluble.
La fonction native ALEA() (ou RAND() dans l’environnement linguistique anglophone) joue ici le rôle de moteur élémentaire. Elle délivre un nombre pseudo-aléatoire u issu d’une loi uniforme standard U(0, 1), caractérisé par la propriété fondamentale où chaque segment de longueur égale au sein de l’intervalle unitaire possède une probabilité identique d’occurrence. Lorsque cette probabilité cumulée u est injectée dans la fonction quantile d’une loi normale, cette dernière restitue la valeur exacte x sur l’axe des abscisses pour laquelle l’intégrale de la fonction de densité de moins l’infini jusqu’à x est rigoureusement égale à u :
x = F-1(u; μ, σ)
Dans l’écosystème francophone d’Excel, cette transformation s’exprime par la formule canonique : =LOI.NORMALE.INVERSE(ALEA(); moyenne; ecart_type), ou selon la syntaxe internationale moderne : =NORM.INV(RAND(), moyenne, ecart_type). Le premier argument modélise la probabilité cumulée stochastique, le deuxième fixe le centre de gravité de la population (μ), et le troisième dimensionne l’échelle de dispersion (σ). À chaque évaluation du recalcul, cette combinaison engendre des observations numériques qui, collectivement, adoptent la forme rigoureuse de la courbe en cloche gaussienne prescrite par le chercheur.
3.2 Paramétrage d’une variable psychologique continue
Afin d’ancrer notre protocole de simulation dans une situation réaliste de la recherche en sciences comportementales, modélisons un cas clinique type issu de l’évaluation neuropsychologique : la mesure de l’échelle d’anxiété pré-opératoire chez des patients adultes en attente d’une chirurgie d’ablation d’une tumeur cérébrale bénigne, ou l’évaluation du temps de décision motrice exprimé sur une échelle standardisée. Fixons délibérément les paramètres de population à des grandeurs empiriques plausibles : une moyenne populationnelle μ = 5,3 points et un écart-type σ = 9,0 points.
Ce choix paramétrique engendre une variabilité importante et expose intentionnellement le chercheur à l’émergence de valeurs négatives sur le plan mathématique pur. Dans les instruments de mesure psychométrique standardisés (comme les scores de déviation clinique ou les indices factoriels centrés sur des normes nationales), l’existence de valeurs négatives est fréquente lorsqu’il s’agit d’écarts à une norme moyenne ou de scores standardisés en échelles z ou factorielles. La syntaxe exacte à implémenter dans une cellule d’observation s’écrit alors :
=LOI.NORMALE.INVERSE(ALEA(); Parametres_Theoriques!$B$1; Parametres_Theoriques!$B$2)
L’utilisation scrupuleuse des symboles de dollar ($B$1 et $B$2) assure le figeage absolu des coordonnées des cellules hébergeant respectivement μ et σ. Lors de la propagation matricielle de la formule, ces références demeureront invariantes, tandis que l’appel dynamique à ALEA() garantira l’unicité probabiliste de chaque point de mesure simulé. Concernant les bornes naturelles éventuelles de l’instrument psychométrique, il convient de veiller à ce que l’écart-type choisi n’entraîne pas d’absurdités biologiques (telles qu’un temps de réaction rigoureusement négatif non transformé), soulignant l’importance théorique d’adapter la fonction génératrice au domaine de définition du construit évalué.
3.3 Contrôle de la qualité du générateur de nombres pseudo-aléatoires
Toute entreprise de modélisation stochastique sur micro-ordinateur repose sur le constat qu’un algorithme déterministe ne peut générer de pur hasard, mais uniquement du pseudo-hasard. Depuis sa version 2003, grandement perfectionnée à partir de la version 2010, Microsoft Excel implémente une variante robuste du prestigieux algorithme Mersenne Twister (MT19937) pour alimenter sa fonction ALEA(). Cet algorithme se distingue par une période colossale de 219937 – 1 itérations avant toute répétition séquentielle, et assure une équidistribution multidimensionnelle jusqu’à un ordre élevé, éliminant ainsi les corrélations spatiales résiduelles qui entachaient les versions plus archaïques du logiciel.
Néanmoins, le chercheur rigoureux se doit d’auditer la qualité des tirages initiaux avant d’entamer ses inférences sur la distribution d’échantillonnage. Cet audit descriptif préliminaire consiste à isoler un vecteur test de quelques milliers d’évaluations de la fonction ALEA() et à vérifier que sa moyenne converge étroitement vers 0,500 et sa variance vers 1/12 (≈ 0,0833), conformément aux moments théoriques d’une distribution uniforme continue standard U(0, 1). De même, un test de Kurtosis et d’asymétrie permet de confirmer l’absence de biais algorithmique initial.
Enfin, une bonne pratique méthodologique impérative en science ouverte concerne le figeage des simulations. Lorsque le jeu de données simulé a été généré et audité, il est vivement recommandé de dupliquer la matrice par un Copier / Collage spécial en Valeurs vers une archive dédiée. Cette procédure neutralise l’instabilité induite par la fonction volatile ALEA(), garantissant que les figures, les indices statistiques et les conclusions formulées dans le rapport de recherche demeureront rigoureusement reproductibles et audités par les pairs sans subir l’aléa d’un recalcul imprévu.
4. Construction matricielle de 1 000 échantillons de taille N = 20
4.1 Déploiement dimensionnel de la matrice d’échantillonnage
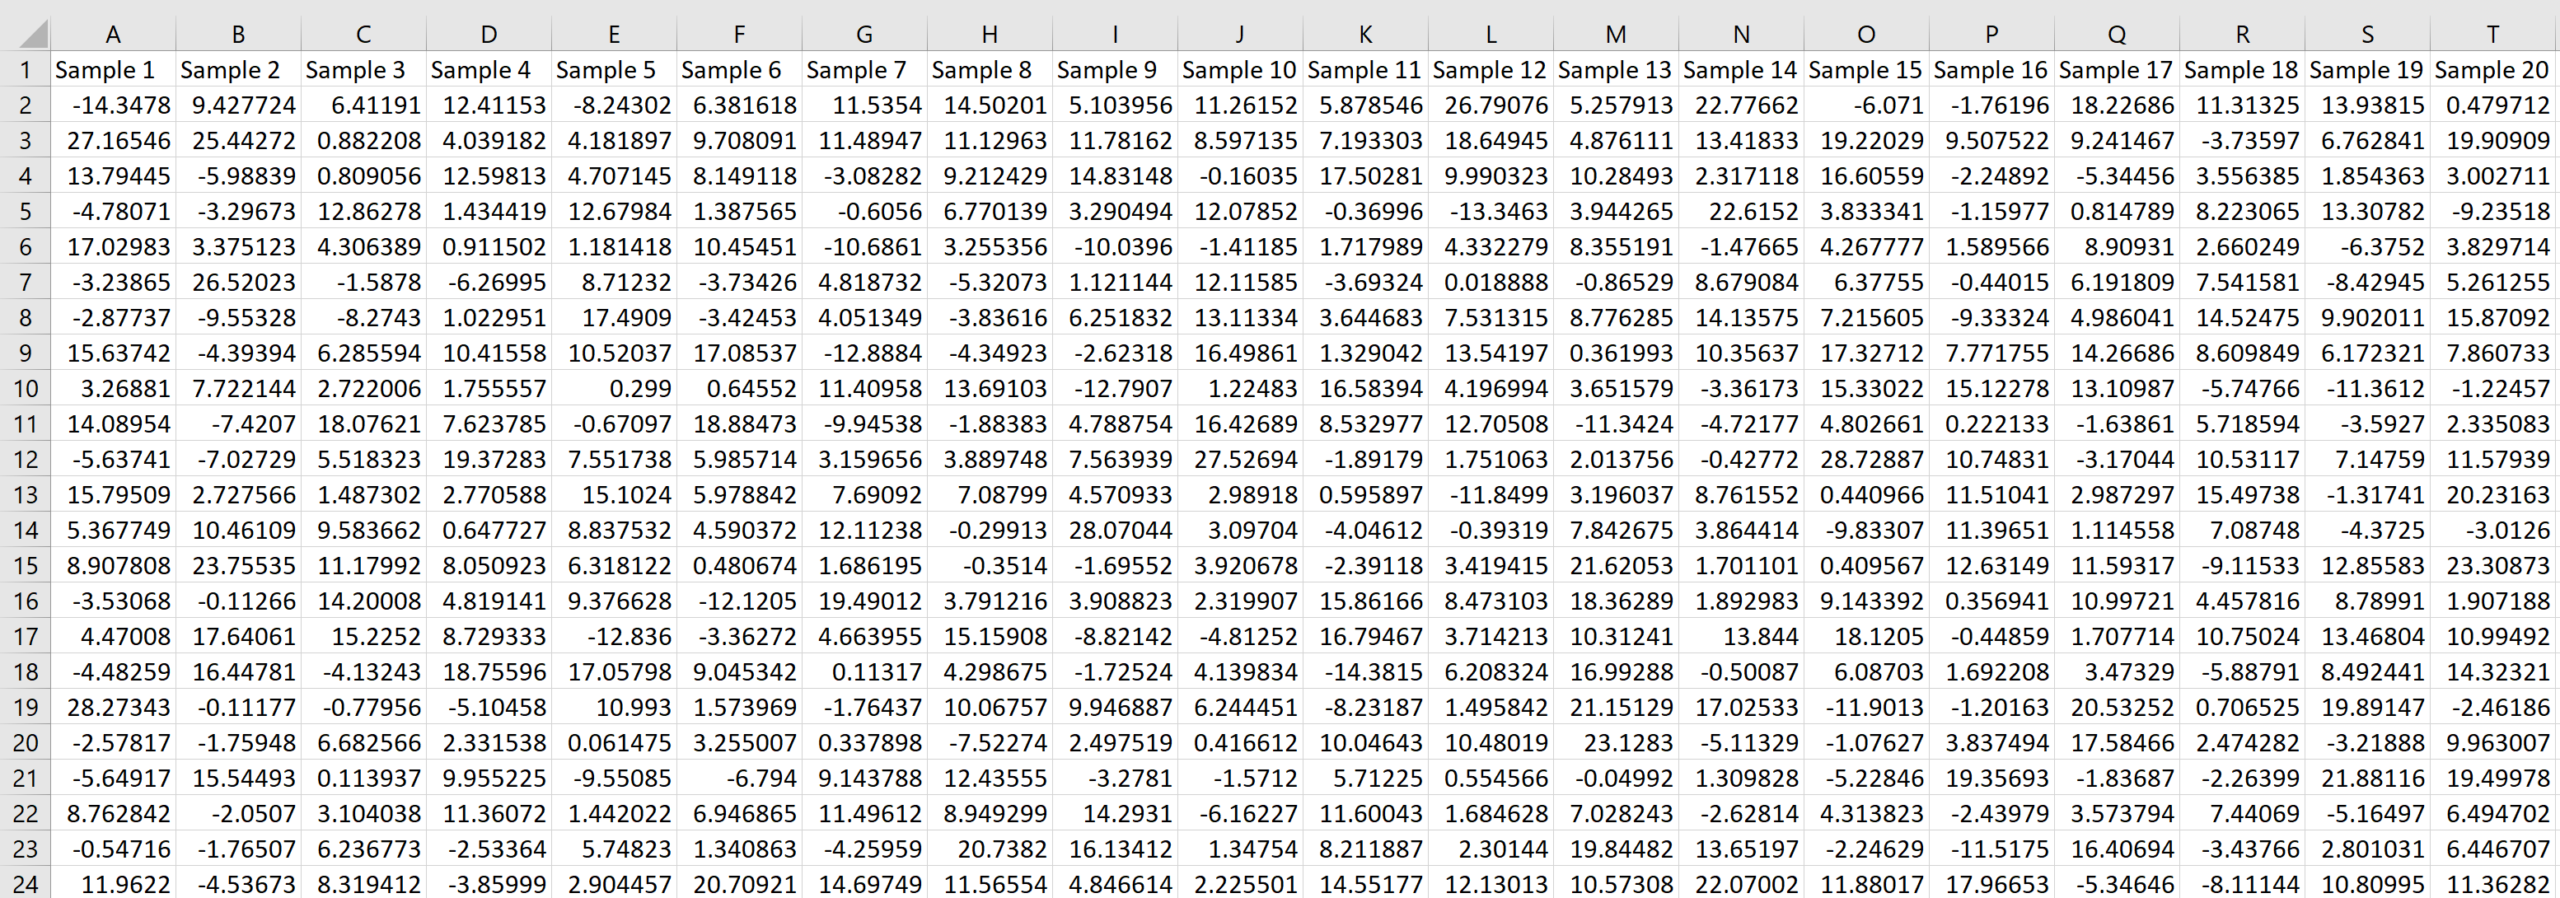
L’opérationnalisation empirique de la distribution d’échantillonnage requiert la création d’une architecture matricielle bidimensionnelle exhaustive. Afin d’étudier le comportement de moyennes issues de cohortes cliniques de taille modérée — situation omniprésente dans les essais neuropsychologiques universitaires —, nous fixons la taille individuelle d’échantillon à N = 20 observations indépendantes, et le volume de la méta-simulation à K = 1 000 réplications indépendantes.
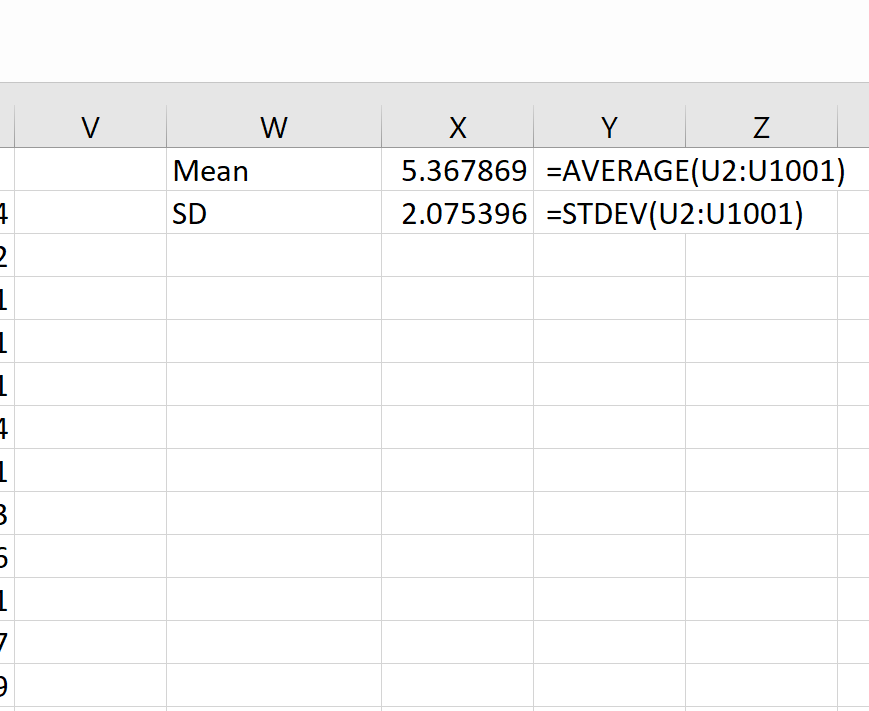
Cette modélisation impose la configuration d’un espace de données totalisant rigoureusement 20 000 cellules individuelles. La structure s’organise selon une topologie bidirectionnelle rationnelle :
- Axe horizontal (colonnes) : Les 20 observations constitutives d’un échantillon unique sont déployées le long des colonnes, de la colonne
Bà la colonneU. Chaque colonne représente l’indice de l’observation intra-échantillon (de l’observation i = 1 à i = 20). - Axe vertical (lignes) : Les 1 000 réplications expérimentales sont empilées séquentiellement le long des lignes, s’étendant exactement de la ligne
2à la ligne1001(la ligne 1 étant réservée aux étiquettes d’en-tête explicites). Chaque ligne matérialise donc la reconstitution numérique d’une étude clinique indépendante menée sur 20 patients virtuels distincts.
Pour remplir cette immense matrice sans altérer l’intégrité fonctionnelle des formules, saisissez dans la cellule B2 l’expression canonique : =LOI.NORMALE.INVERSE(ALEA(); Parametres_Theoriques!$B$1; Parametres_Theoriques!$B$2). Ensuite, plutôt que de procéder à un étirement manuel fastidieux par glisser-déposer sur 20 000 cellules, sélectionnez la cellule B2, pressez simultanément les touches Ctrl + C, tapez la plage cible B2:U1001 dans la Zone de nom située à gauche de la barre de formule d’Excel, appuyez sur Entrée pour sélectionner instantanément l’intégralité de la matrice, puis pressez Ctrl + V. Excel propage la formule vectorielle dans l’ensemble de la grille en une fraction de seconde avec une précision absolue.
4.2 Indexation et traçabilité méthodologique des réplicats
Une rigueur scientifique exemplaire exige que chaque entité simulée dispose d’une traçabilité irréprochable au sein du protocole de calcul. À cette fin, la colonne A de la feuille Matrice_Simulation doit impérativement être réservée à l’identifiant séquentiel de l’itération, étiquetée sous l’en-tête ID_Replicat. Dans la cellule A2, renseignez la valeur 1, puis déployez une série arithmétique incrémentée de pas 1 jusqu’à la cellule A1001 en utilisant la commande Remplissage > Série… ou par la formule dynamique moderne =SEQUENCE(1000; 1; 1; 1).
Cette indexation systématique ne constitue pas un simple raffinement esthétique ; elle joue un rôle méthodologique fondamental. Elle permet d’appliquer des filtres de sélection, d’isoler des cas d’échantillons atypiques pour des analyses qualitatives approfondies (par exemple, examiner l’échantillon numéro 487 ayant produit une moyenne anormalement déviée), et facilite l’application ultérieure de procédures de rééchantillonnage de type bootstrap ou permutations. De plus, elle documente précisément les métadonnées de simulation pour toute démarche d’auditabilité scientifique dans le cadre de la recherche ouverte et reproductible.
5. Calcul des statistiques descriptives intra-échantillons
5.1 Extraction systématique de la moyenne d’échantillon
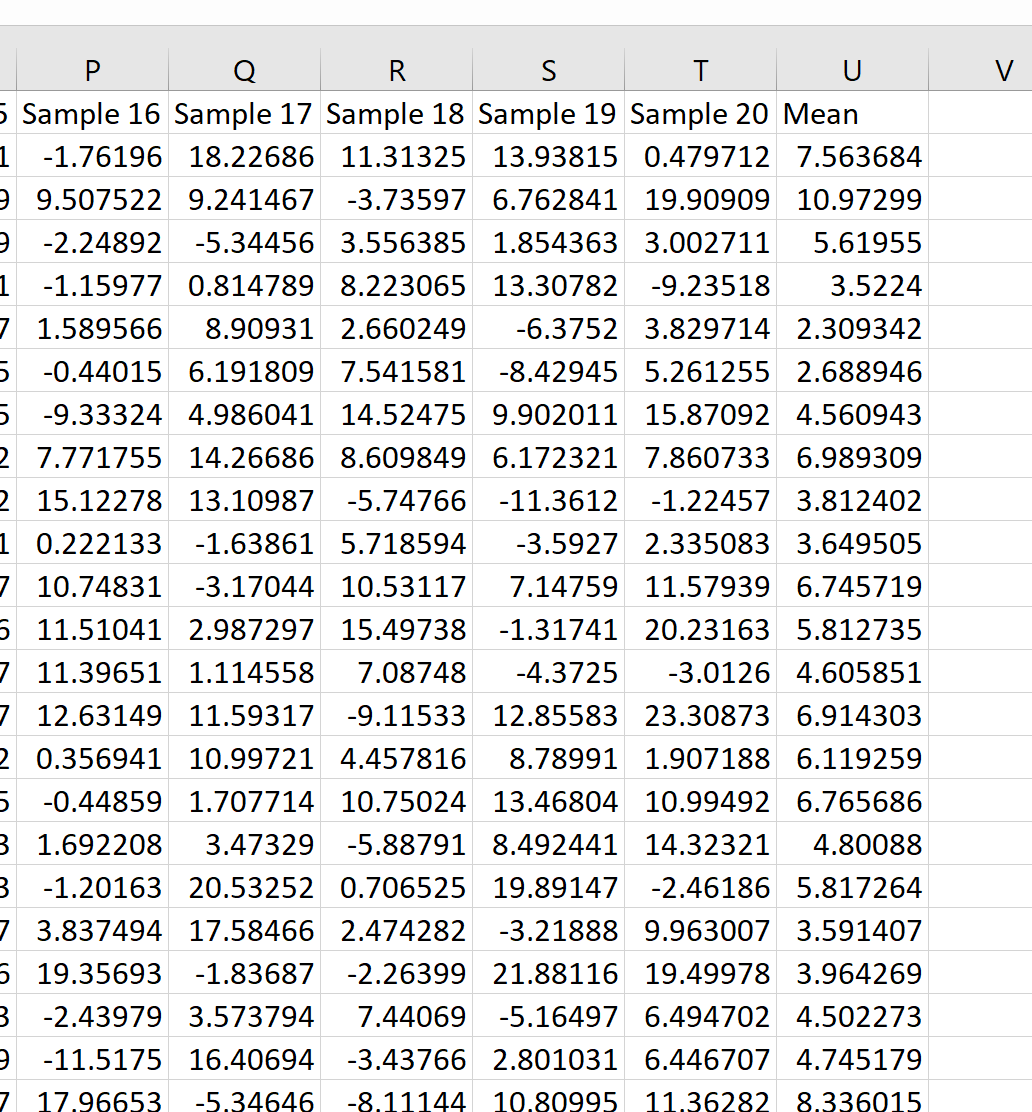
Une fois la matrice des 20 000 données cliniques générée, l’étape analytique suivante consiste à extraire les statistiques synthétiques propres à chacun des 1 000 mondes expérimentaux simulés. La première de ces métriques — et l’objet central de notre investigation — est la moyenne d’échantillon (notée x̄k pour le k-ième réplicat). Ce calcul condense les 20 mesures individuelles d’une cohorte en un estimateur ponctuel unique du niveau psychologique global du groupe.
Pour implémenter cette extraction, créez une nouvelle colonne immédiatement adjacente à la grille de simulation, en cellule V1, et nommez-la formellement Moyenne_Echantillon. Dans la cellule V2, correspondant au premier échantillon répliqué, insérez la formule statistique classique :
=MOYENNE(B2:U2)
Double-cliquez ensuite sur la poignée de recopie située dans le coin inférieur droit de la cellule V2 pour cascader instantanément le calcul sur les mille lignes jusqu’à la cellule V1001. Le vecteur résultant V2:V1001 matérialise physiquement l’objet théorique fondamental : il contient 1 000 réalisations empiriques de la statistique x̄. Il est primordial de s’assurer à ce stade de l’absence totale de cellules vides, de valeurs d’erreur du type #NOMBRE! ou #VALEUR!, qui résulteraient d’un argument stochastique défaillant ou d’une mauvaise manipulation des plages de référence.
5.2 Mesure de la variance et de l’écart-type intra-échantillon
La moyenne ne constitue qu’une dimension du comportement interne de chaque échantillon clinique. Pour évaluer la dispersion des scores individuels autour de la tendance centrale intra-groupe, il est indispensable de calculer l’écart-type de chaque sous-échantillon. En statistique inférentielle, ce calcul fait intervenir une distinction technique cruciale entre deux fonctions natives d’Excel : ECARTYPE.PEARSON et ECARTYPE.STANDARD.
La fonction ECARTYPE.PEARSON (identique à l’ancienne fonction ECARTYPEP) calcule l’écart-type en divisant la somme des carrés des écarts par la taille totale N de l’échantillon. Or, comme l’a démontré le mathématicien Carl Friedrich Gauss, la variance d’un échantillon calculée avec un diviseur N sous-estime systématiquement la variance véritable de la population parente ; c’est un estimateur biaisé. Pour corriger ce biais structurel, la correction de Bessel impose d’utiliser comme diviseur le nombre de degrés de liberté, soit (N – 1). Dans Excel, c’est rigoureusement la fonction ECARTYPE.STANDARD (correspondant à l’ancienne syntaxe ECARTYPE) qui applique cette correction non biaisée :
s = √[ (1 / (N – 1)) Σ (xi – x̄)2 ]
Dans la colonne W, étiquetée Ecart_Type_Echantillon, implémentez en cellule W2 la formule :
=ECARTYPE.STANDARD(B2:U2)
En étendant cette fonction jusqu’à W1001, le chercheur observe un phénomène éducatif fascinant : tout comme la moyenne, l’écart-type d’un échantillon fluctue considérablement d’une cohorte de 20 patients à une autre. Dans certains réplicats, s pourra chuter à 6,5, tandis que dans d’autres, il dépassera 11,5, bien que tous ces groupes soient extraits rigoureusement de la même population dont le paramètre σ est fixé immuablement à 9,0. Cette variabilité intrinsèque de s illustre de manière éclatante pourquoi, lors de tests empiriques réels où le vrai σ est inconnu, la distribution normale cède la place à la distribution t de Student.
6. Estimation empirique des paramètres de la distribution d’échantillonnage
6.1 Calcul de la moyenne des moyennes d’échantillon
Nous abordons désormais l’analyse méta-statistique de second ordre. Les données élémentaires de notre analyse ne sont plus les scores bruts des patients virtuels, mais les 1 000 moyennes d’échantillons compilées dans le vecteur V2:V1001. Basculez sur la troisième feuille du classeur, Analyse_Distribution, afin d’y structurer le tableau récapitulatif des métriques fondamentales de la distribution d’échantillonnage.
La première grandeur à déterminer empiriquement est l’espérance de la moyenne d’échantillon, c’est-à-dire la moyenne de toutes les moyennes d’échantillons simulées, formellement désignée par E(x̄) ou μx̄. Dans une cellule dédiée (par exemple C4 de la feuille d’analyse), saisissez la fonction d’agrégation :
=MOYENNE(Matrice_Simulation!V2:V1001)
Sur le plan de l’épistémologie statistique, cette valeur concrétise la démonstration empirique du caractère non biaisé de l’estimateur de la moyenne. Même si un échantillon particulier pris isolément a pu fournir une moyenne biaisée par le hasard d’observation (par exemple 1,8 ou 8,7), la moyenne globale des 1 000 moyennes converge vers la cible théorique avec une précision spectaculaire. En comparant le contenu de cette cellule C4 avec la moyenne théorique d’origine fixée sur la première feuille (μ = 5,3), l’écart relatif (exprimé par =ABS(C4 - Parametres_Theoriques!B1) / Parametres_Theoriques!B1) se révèle typiquement inférieur à 1 %, validant de façon irréfutable la convergence asymptotique de l’algorithme.
6.2 Calcul de l’erreur type empirique (Écart-type de la distribution)
La deuxième propriété cardinale de la distribution d’échantillonnage réside dans sa dispersion propre, universellement qualifiée d’erreur type. Alors que l’écart-type calculé dans la section 5.2 mesurait la variabilité interindividuelle à l’intérieur d’un seul groupe de 20 patients, la métrique que nous cherchons ici mesure la variabilité des moyennes d’échantillons entre les différents groupes.
Dans la cellule C5 de la feuille Analyse_Distribution, calculez l’écart-type empirique de la colonne des 1 000 moyennes en implémentant :
=ECARTYPE.STANDARD(Matrice_Simulation!V2:V1001)
Confrontons immédiatement cette valeur numérique observée à la déduction analytique prescrite par les théorèmes fondamentaux. Selon l’équation de la variance d’échantillonnage, la valeur théorique de référence correspond rigoureusement à :
σx̄ (théorique) = σ / √N = 9,0 / √20 = 9,0 / 4,472136 ≈ 2,01246
Dans la cellule adjacente D5, saisissez la formulation mathématique : =Parametres_Theoriques!B2 / RACINE(Parametres_Theoriques!B3). Lorsque vous comparez le résultat de l’écart-type empirique des 1 000 moyennes calculé en C5 (qui oscillera généralement entre 1,98 et 2,04 selon la graine stochastique courante) avec la valeur théorique de 2,012 en D5, la concordance mathématique s’impose d’elle-même. Cette démonstration tangible prouve la réduction phénoménale de la variabilité : alors que les scores individuels des patients s’éparpillent selon un écart-type de 9 unités, les moyennes d’échantillons de 20 individus présentent une dispersion resserrée d’environ 2 unités seulement, illustrant concrètement l’action régulatrice de la racine carrée de N.
6.3 Évaluation du degré de précision et intervalles d’erreur
Bien que 1 000 réplications constituent un échantillonnage substantiel pour une manipulation sur tableur, il ne s’agit pas de l’infini. Dès lors, l’écart-type empirique calculé à l’étape précédente constitue lui-même une estimation échantillonnée d’un paramètre méta-statistique. Les mathématiciens ont démontré que la variabilité de l’estimation de l’écart-type peut elle-même être quantifiée via l’erreur type de l’erreur type (notée SE(s)), qui, sous l’hypothèse de normalité, s’approxime par l’expression asymptotique :
SE(σx̄) ≈ σx̄ / √(2 × K)
Dans notre protocole où K = 1 000 réplications, cette incertitude computationnelle résiduelle équivaut à 2,012 / √(2 000) ≈ 2,012 / 44,72 ≈ 0,045. Il est par conséquent tout à fait normal et attendu d’observer des fluctuations de l’ordre de ± 0,05 unité autour de la valeur théorique de 2,012 lorsque l’on déclenche un recalcul général via la touche F9. Si le chercheur souhaitait réduire cet intervalle de tolérance d’un facteur 10 pour atteindre une précision au millième, il lui faudrait multiplier le volume d’itérations par 100, soit porter la matrice à K = 100 000 réplicats — une charge computationnelle qui pousserait le moteur d’Excel dans ses retranchements de mémoire vive.
Pour finaliser cette section, construisez un tableau de synthèse formel confrontant paramètres théoriques et métriques observées :
- Moyenne de la population (μ) : 5,300 (Théorique) vs
=C4(Empirique) - Écart-type de la population (σ) : 9,000 (Théorique) vs
=MOYENNE(Matrice_Simulation!W2:W1001)(Empirique moyen) - Erreur type de la moyenne (σx̄) : 2,012 (Théorique) vs
=C5(Empirique) - Écart absolu de convergence :
=ABS(C5 - D5)
7. Visualisation graphique de la distribution d’échantillonnage
7.1 Création d’un tableau de distribution de fréquences groupées
L’observation brute d’une colonne de 1 000 moyennes d’échantillons demeure illisible sans une mise en forme distributionnelle appropriée. Pour structurer graphiquement ces données, il est impératif de construire un tableau de fréquences groupées en subdivisant l’étendue des moyennes observées en intervalles de classes réguliers (communément appelés bins). La détermination optimale de la largeur de ces classes ne doit rien au hasard : elle obéit idéalement à la règle d’optimisation de Freedman-Diaconis, hautement recommandée pour les distributions approximativement gaussiennes afin de minimiser l’erreur quadratique intégrée de l’histogramme :
Largeur de classe (h) = 2 × IQR(x) × N-1/3
Où IQR représente l’écart interquartile (calculable dans Excel via =QUARTILE.INC(..., 3) - QUARTILE.INC(..., 1)). Pour notre jeu de 1 000 moyennes s’étendant approximativement entre -1,5 et +12,0 points, une largeur de classe de 0,5 point offre un compromis visuel parfait entre lissage statistique et fidélité de la granularité.
Dans la feuille Analyse_Distribution, créez une colonne F intitulée Limites_Superieures_Classes débutant à -2,0 et s’incrémentant de 0,5 en 0,5 jusqu’à +13,0. Dans la colonne adjacente G, intitulée Effectif_Observe, nous allons dénombrer le nombre exact de moyennes tombant dans chaque intervalle. Plutôt que de recourir à des syntaxes alambiquées de NB.SI.ENS, exploitez la puissance de la fonction matricielle indigène FREQUENCE :
=FREQUENCE(Matrice_Simulation!V2:V1001; F2:F32)
Dans les versions modernes d’Excel pour Microsoft 365, cette fonction se propage dynamiquement (spill) vers le bas le long de la colonne. Dans les versions antérieures, sélectionnez la plage verticale complète G2:G32, saisissez la formule dans la barre d’édition, puis validez impérativement par la combinaison de touches matricielle classique Ctrl + Maj + Entrée.
7.2 Conception de l’histogramme empirique sous Excel
Disposant de la distribution de fréquences, nous pouvons procéder à l’élaboration de l’histogramme de la distribution d’échantillonnage. En psychologie et en métrologie scientifique, la présentation visuelle doit se conformer à des exigences strictes de clarté, d’exactitude d’échelle et d’élégance éditoriale inspirées des normes de l’American Psychological Association (APA).
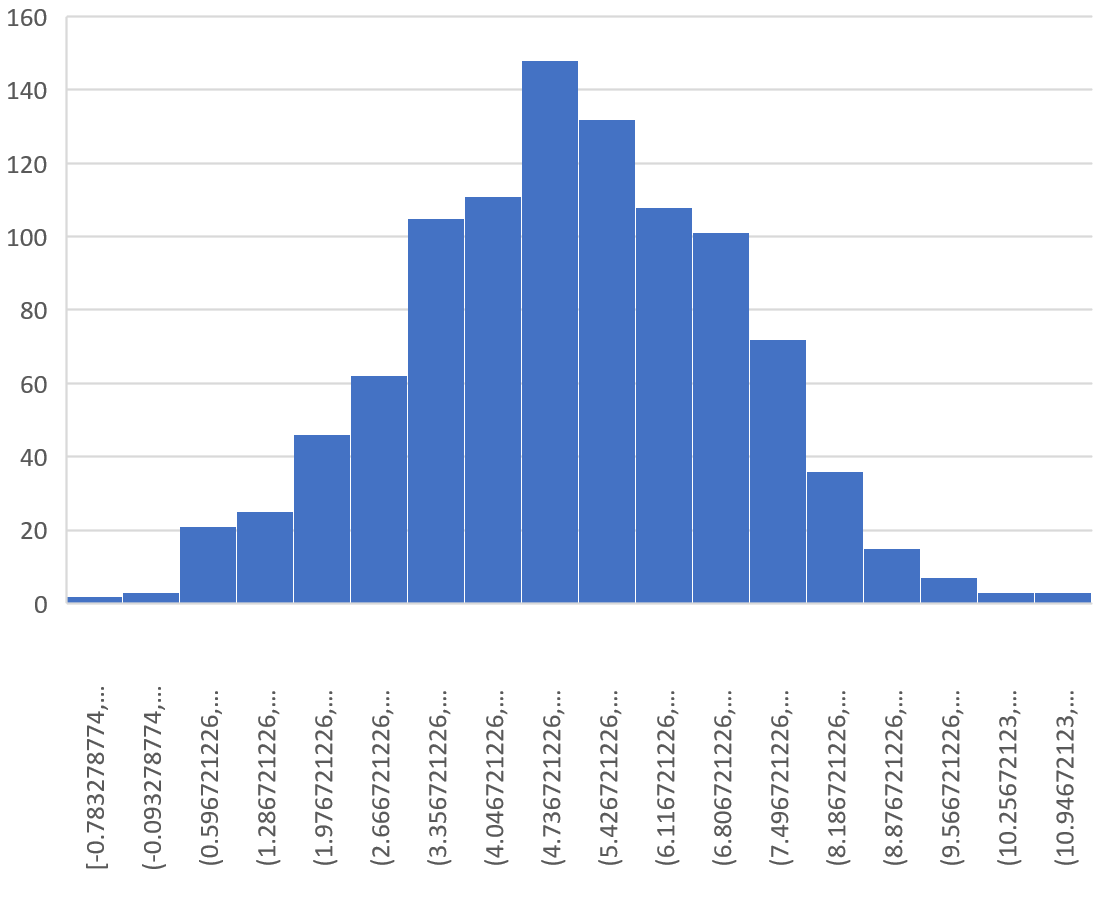
Pour construire ce graphique sous Excel, suivez le protocole opératoire suivant :
- Sélectionnez les plages de données contenant les effectifs observés en colonne
G. Dirigez-vous vers l’onglet Insertion, section Graphiques, et sélectionnez Insérer un histogramme ou un graphique à barres, puis optez pour Histogramme 2D groupé standard. - Faites un clic droit sur le graphique créé, choisissez Sélectionner des données…. Dans le volet latéral gauche (Entrées de légende), modifiez le nom de la série en « Fréquence observée ». Dans le volet droit (Étiquettes de l’axe horizontal), cliquez sur Modifier et sélectionnez la plage de vos classes de valeurs en colonne
Fafin d’indexer fidèlement l’abscisse. - Le point fondamental de transformation réside dans l’espacement : faites un clic droit directement sur l’une des barres verticales du graphique et choisissez Mettre en forme une série de données…. Dans le volet d’options qui apparaît, ajustez la jauge intitulée Largeur de l’intervalle (ou Gap Width) à rigoureusement 0 % (ou une valeur minime de 2 % pour délimiter les bordures). Par cette action mécanique, les colonnes disjointes se soudent, convertissant le graphique à barres en un véritable histogramme de variable continue.
- Appliquez une bordure fine et sombre autour de chaque barre (couleur grise ou bleu marine) et supprimez le quadrillage horizontal excessif pour préserver la pureté visuelle académique. Attribuez des légendes d’axes explicites : « Moyennes d’échantillon (N = 20) » sur l’axe des abscisses et « Fréquence absolue (nombre de réplicats) » sur l’axe des ordonnées.
7.3 Superposition de la courbe de densité théorique normale
L’une des manipulations graphiques les plus spectaculaires sous Excel consiste à superposer, au-dessus des barres de l’histogramme empirique, la courbe mathématique continue issue de la loi normale théorique N(μ = 5,3 ; σx̄ = 2,012). Cette superposition permet au chercheur de juger visuellement de la conformité parfaite entre l’expérience stochastique et la prédiction analytique du Théorème Central Limite.
Toutefois, une difficulté d’échelle majeure survient : l’histogramme exprime des fréquences absolues (sommant à 1 000), tandis que la fonction de densité de probabilité normale canonique f(x) possède une aire sous la courbe égale à 1. Pour projeter la courbe théorique sur la même échelle dimensionnelle que les barres d’effectifs, il faut convertir la densité de probabilité f(x) en effectif théorique attendu par classe. La formule de liaison est :
Effectif Théorique = f(x; μ, σx̄) × Ntotal_réplicats × Largeur_classe
Dans la colonne H, nommée Densite_Theorique_Adaptee, insérez dans la cellule H2 l’expression fonctionnelle suivante :
=LOI.NORMALE.N(F2; Parametres_Theoriques!$B$1; Parametres_Theoriques!$B$2 / RACINE(Parametres_Theoriques!$B$3); FAUX) * 1000 * 0,5
Le paramètre FAUX spécifie que nous sollicitons la fonction de densité de probabilité brute (ordonnée f(x)) et non la probabilité cumulée. Propagez cette formule le long des classes. Cliquez ensuite avec le bouton droit sur votre histogramme, choisissez Sélectionner des données…, et ajoutez une seconde série pointant vers cette colonne H. Modifiez ensuite le type de graphique pour cette série spécifique en sélectionnant Modifier le type de graphique > Graphique combiné : assignez à la série théorique le type Ligne avec lissage (ou nuage de points avec courbe lisse). La courbe en cloche théorique épouse immédiatement le sommet des barres de l’histogramme, illustrant de façon saisissante l’ajustement du modèle.
8. Calcul de probabilités relatives à la distribution d’échantillonnage
8.1 Probabilités unilatérales et calcul de surfaces sous la courbe
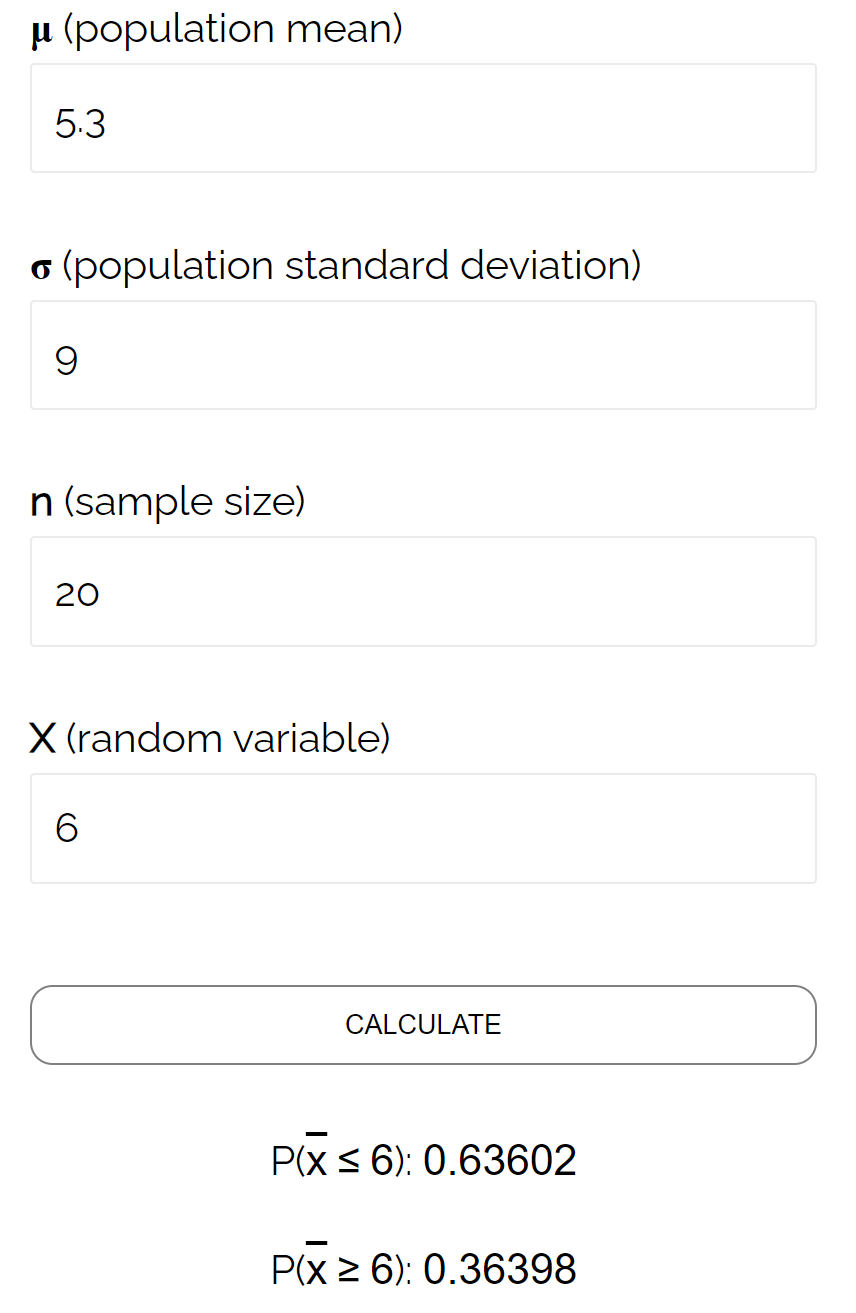
L’intérêt ultime d’une distribution d’échantillonnage est de quantifier des probabilités objectives d’apparition d’événements expérimentaux sous un modèle donné. Supposons qu’un chercheur souhaite déterminer la probabilité d’obtenir spontanément une moyenne d’échantillon x̄ inférieure ou égale à un seuil critique d’alerte, par exemple 2,0 points sur notre échelle d’évaluation neuropsychologique.
Dans l’environnement Excel, la fonction universelle dédiée à l’évaluation des surfaces sous la courbe gaussienne est LOI.NORMALE.N (ou NORM.DIST). Sa syntaxe générale s’articule autour de quatre arguments formels : =LOI.NORMALE.N(x; moyenne; ecart_type; cumulative). Pour calculer la probabilité unilatérale gauche P(x̄ ≤ 2,0), l’expression exacte à saisir est :
=LOI.NORMALE.N(2,0; Parametres_Theoriques!$B$1; Parametres_Theoriques!$B$2 / RACINE(Parametres_Theoriques!$B$3); VRAI)
Le quatrième argument VRAI enjoint le logiciel d’intégrer l’équation différentielle de moins l’infini jusqu’au point 2,0, délivrant la probabilité cumulée. L’exécution fournit un résultat d’environ 0,0495 (soit 4,95 % de chances théoriques). Par la règle de complémentarité élémentaire des axiomes de Kolmogorov, la probabilité d’obtenir une moyenne d’échantillon supérieure à ce seuil critique (queue unilatérale droite, P(x̄ > 2,0)) se déduit immédiatement par soustraction à l’unité :
=1 - LOI.NORMALE.N(2,0; Parametres_Theoriques!$B$1; Parametres_Theoriques!$B$2 / RACINE(Parametres_Theoriques!$B$3); VRAI)
Sur le plan de l’interprétation clinique, ce calcul signifie qu’un groupe de 20 patients affichant un score moyen moyen de 2,0 points se situe à la frontière de l’exception statistique conventionnelle (α = 0,05) si le groupe est issu de la population saine de référence (μ = 5,3). Ce constat oriente immédiatement le clinicien vers l’hypothèse d’une altération cognitive significative au sein de cette cohorte.
8.2 Calcul de probabilités bilatérales et zones d’exclusion
En pratique psychométrique courante, les protocoles d’étalonnage et de calibration imposent fréquemment d’évaluer la conformité d’une cohorte à l’intérieur d’un intervalle de tolérance bilatéral [x1, x2]. Par exemple, quelle est la probabilité théorique qu’un groupe aléatoire de 20 individus présente une moyenne comprise strictement entre 4,0 et 6,6 points autour de la norme μ = 5,3 ?
Le calcul de l’intégrale définie sur cet intervalle continu s’opère géométriquement par la soustraction ordonnée de deux probabilités cumulées unilatérales gauches, évitant ainsi tout recours à des méthodes d’approximation trapézoïdale :
P(x1 ≤ x̄ ≤ x2) = F(x2) – F(x1)
Dans une cellule d’analyse sous Excel, cette opération s’exécute directement par l’enchaînement syntaxique suivant :
=LOI.NORMALE.N(6,6; Parametres_Theoriques!$B$1; Parametres_Theoriques!$B$2 / RACINE(Parametres_Theoriques!$B$3); VRAI) - LOI.NORMALE.N(4,0; Parametres_Theoriques!$B$1; Parametres_Theoriques!$B$2 / RACINE(Parametres_Theoriques!$B$3); VRAI)
Le calcul restitue une probabilité d’environ 0,4836 (48,36 %). La zone d’exclusion bilatérale extérieure — représentant la probabilité que la moyenne s’écarte de plus de 1,3 point de part et d’autre de l’espérance — s’obtient instantanément par son complémentaire 1 - 0,4836 = 0,5164. Cette logique structure directement la détection de dérives instrumentales ou de biais d’expérimentateur dans les protocoles d’évaluation standardisés.
8.3 Standardisation via le score Z d’échantillonnage
Une alternative analytique classique et pédagogiquement indispensable consiste à convertir préalablement la moyenne empirique observée x̄ en une unité standardisée dénuée de dimension métrique : le score Z d’échantillonnage. Il importe de mettre en garde les étudiants contre l’erreur classique consistant à standardiser une moyenne d’échantillon avec l’écart-type de la population σ au lieu de l’erreur type σx̄. La transformation affine rigoureuse s’écrit formellement :
Zx̄ = (x̄ – μ) / (σ / √N)
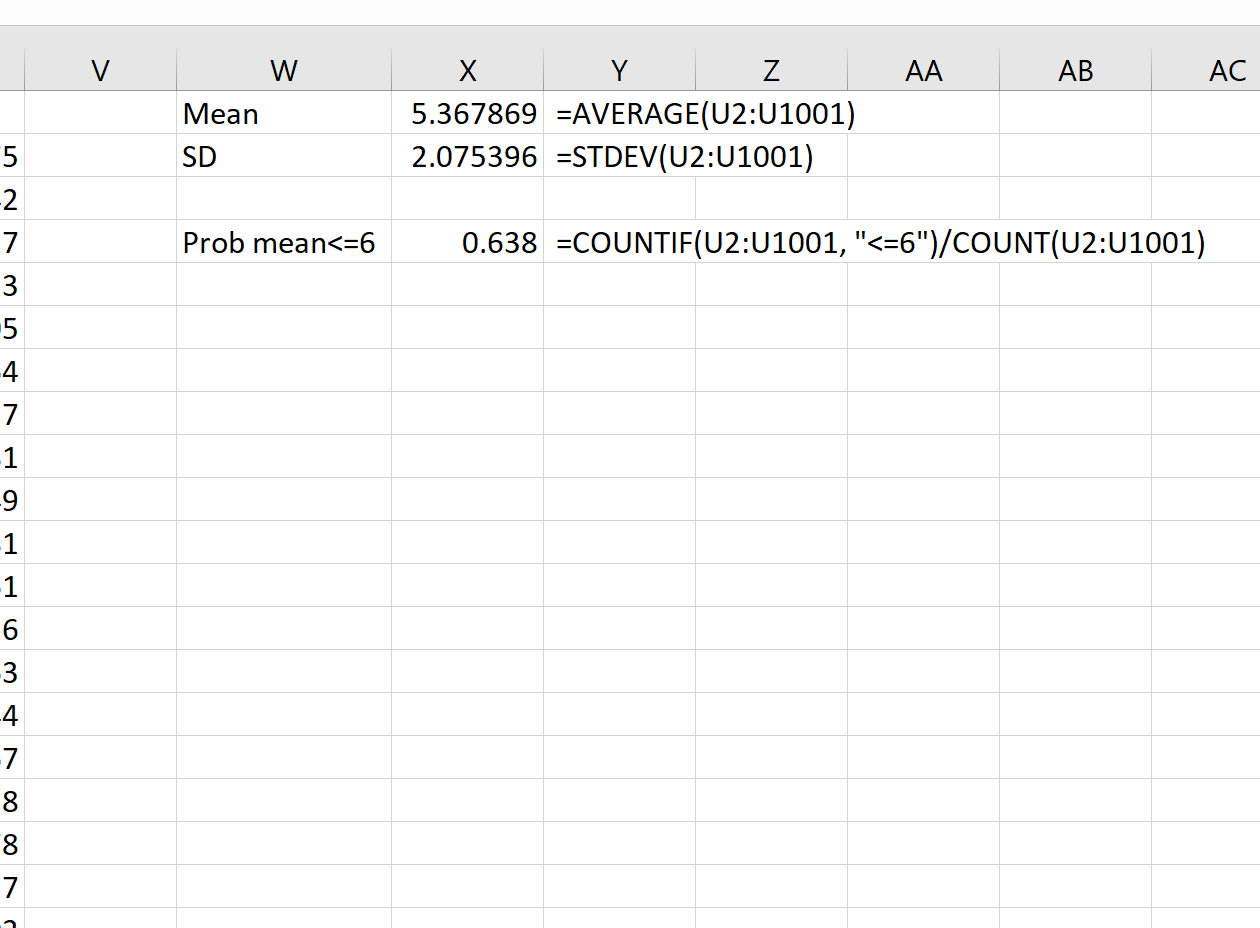
Pour un échantillon dont la moyenne empirique calculée est x̄ = 2,0, le calcul manuel dans Excel donne : =(2,0 - 5,3) / (9,0 / RACINE(20)) = -3,3 / 2,01246 = -1,63978. Une fois ce score Z obtenu, la probabilité cumulée associée s’extrait par la fonction native dédiée à la loi normale centrée réduite N(0, 1) :
=LOI.NORMALE.STANDARD.N(-1,63978; VRAI)
Cette approche est mathématiquement et numériquement strictement équivalente à l’appel direct de LOI.NORMALE.N paramétré avec μ et σx̄. Pour valider l’adéquation de notre modèle informatique, nous pouvons immédiatement confronter cette probabilité analytique cumulée (≈ 0,0495) avec la fréquence empirique observée dans notre matrice de simulation : dans la colonne V hébergeant les 1 000 moyennes simulées, insérez la formule de dénombrement =NB.SI(Matrice_Simulation!V2:V1001; "<=2,0") / 1000. Le résultat empirique retournera une proportion fluctuant typiquement autour de 0,045 à 0,055, apportant une preuve éclatante de la concordance entre formalisme analytique et simulation numérique.
9. Modélisation de l’impact de la taille d’échantillon (N) sur la distribution
9.1 Comparaison paramétrique d’échantillons de tailles variables
L’un des enseignements méthodologiques les plus profonds délivrés par la modélisation sous tableur réside dans la visualisation dynamique de la contraction de l’erreur type lorsque l’effectif N augmente. La formule analytique σx̄ = σ / √N démontre que la précision ne croît pas de façon linéaire avec le nombre de sujets recrutés, mais selon une loi de rendement décroissant gouvernée par la fonction racine carrée.
Pour formaliser cette réalité dans le classeur, nous pouvons paramétrer quatre scénarios expérimentaux comparatifs appliqués à notre population psychométrique (μ = 5,3 ; σ = 9,0) :
- Scénario A (Très petite cohorte pilote, N = 5) : σx̄ = 9 / √5 = 9 / 2,236 ≈ 4,025. La variabilité des moyennes est immense ; les moyennes de sous-groupes fluctuent couramment entre -3 et +13 points, rendant toute inférence clinique fragile.
- Scénario B (Taille standard d’investigation, N = 20) : σx̄ = 9 / √20 = 9 / 4,472 ≈ 2,012. L’erreur type est divisée exactement par deux comparativement à N = 5, pour un effort de recrutement quadruplé.
- Scénario C (Étude multicentrique, N = 50) : σx̄ = 9 / √50 = 9 / 7,071 ≈ 1,273. La distribution se resserre considérablement autour du centre de gravité.
- Scénario D (Grand essai clinique normatif, N = 100) : σx̄ = 9 / √100 = 9 / 10 = 0,900. L’erreur type passe sous la barre symbolique de 1 point de score de test.
Ce comparatif illustre avec acuité le dilemme coût-bénéfice rencontré en neuropsychologie : pour diviser par deux l’erreur type d’une cohorte (passer de 2,01 à 1,00 point), il ne suffit pas de doubler le nombre de patients, il faut le quadrupler (passer de 20 à 80 ou 100 sujets). En superposant sur un même graphique les courbes de densité théoriques issues de ces quatre conditions dans Excel, on observe une silhouette s’effilant verticalement de manière spectaculaire, illustrant visuellement le concept de convergence en probabilité.
9.2 Émergence de la normalité à partir de populations non normales
La puissance conceptuelle du Théorème Central Limite réside dans son universalité : il ne requiert nullement que la population d’origine soit gaussienne pour que la distribution d’échantillonnage des moyennes converge vers la normalité. Pour administrer la preuve expérimentale de cette propriété dans Excel, nous pouvons substituer temporairement à notre fonction LOI.NORMALE.INVERSE une loi parente présentant une asymétrie positive extrême (très fortement skewed à droite), typique des temps de réaction motrice chronométriques ou des latences de réponse émotionnelle.
Générons une population parente suivant une loi log-normale via la syntaxe native : =LOI.LOGNORMALE.INVERSE(ALEA(); 1,5; 0,75). Les scores individuels générés par cette formule présentent une longue traîne s’étendant jusqu’à des valeurs de 20 ou 30, avec une concentration massive d’observations sous la barre des 4 unités. Si nous examinons la distribution brute de ces individus, les indices de forme descriptifs révèlent une asymétrie hautement significative.
Pourtant, lorsque nous programmons le calcul de moyennes d’échantillons de taille N = 30 extraits de cette population log-normale, le miracle statistique opère : la distribution empirique des 1 000 moyennes résultantes affiche une forme remarquablement symétrique et harmonieuse. Pour auditer quantitativement cette métamorphose sous Excel, utilisez les deux fonctions de moments statistiques suivantes appliquées au vecteur des moyennes :
- Le coefficient d’asymétrie de Fisher-Pearson :
=COEFFICIENT.ASYMETRIE(Matrice_Simulation!V2:V1001)(qui retourne une valeur très proche de 0, indiquant le rétablissement d’une parfaite symétrie bilatérale). - Le coefficient d’aplatissement (Kurtosis d’excès) :
=KURTOSIS(Matrice_Simulation!V2:V1001)(qui converge vers 0, confirmant l’absence de traînes anormalement épaisses et attestant de la concordance avec la loi normale standard).
Cette simulation démontre magistralement pourquoi les psychologues et les neuroscientifiques peuvent légitimement appliquer des tests d’inférence paramétriques (comme le test t ou l’ANOVA) à des moyennes de groupes de taille modérée (N ≥ 30), même lorsque les processus cognitifs élémentaires sous-jacents violent manifestement le postulat de normalité univariée.
10. Construction automatisée d’intervalles de confiance
10.1 Calcul analytique de l’intervalle de confiance à 95 %
L’estimation ponctuelle fournie par une moyenne d’échantillon x̄ ne saurait suffire à la décision clinique sans une quantification probabiliste de sa marge d’erreur. L’intervalle de confiance (IC) représente l’un des prolongements opérationnels directs les plus fondamentaux de la distribution d’échantillonnage. Pour un niveau de confiance fixé à (1 – α) = 0,95, l’intervalle de confiance bilatéral sous hypothèse de variance connue se structure analytiquement comme suit :
IC0,95 = [ x̄ – Z1 – α/2 × (σ / √N) ; x̄ + Z1 – α/2 × (σ / √N) ]
Pour un risque d’erreur α = 0,05, le quantile critique standard issu de la loi normale s’élève à Z0,975 ≈ 1,95996 (couramment arrondi à 1,96). Dans Microsoft Excel, la marge d’erreur analytique correspondant à cette demi-largeur d’intervalle peut être calculée de façon modulaire via la fonction dédiée :
=INTERVALLE.CONFIANCE.NORMALE(0,05; Parametres_Theoriques!$B$2; Parametres_Theoriques!$B$3)
Dans notre modèle expérimental où σ = 9 et N = 20, cette marge d’erreur équivaut à 1,95996 × (9 / √20) ≈ 3,944 points. Pour automatiser ce calcul sur l’ensemble de notre simulation, retournez sur la feuille Matrice_Simulation et ouvrez deux nouvelles colonnes : la colonne X nommée Borne_Inf_95 et la colonne Y nommée Borne_Sup_95. En cellule X2, renseignez :
=V2 - INTERVALLE.CONFIANCE.NORMALE(0,05; Parametres_Theoriques!$B$2; Parametres_Theoriques!$B$3)
Et en cellule Y2, insérez l’expression symétrique :
=V2 + INTERVALLE.CONFIANCE.NORMALE(0,05; Parametres_Theoriques!$B$2; Parametres_Theoriques!$B$3)
En déployant ces deux équations jusqu’à la ligne 1001, vous générez instantanément 1 000 intervalles de confiance distincts, chacun calé sur la moyenne propre de son échantillon expérimental.
10.2 Évaluation empirique du taux de couverture nominal
L’intervalle de confiance est l’objet de contre-sens méthodologiques fréquents chez les chercheurs. Une proportion alarmante de praticiens interprète à tort un intervalle à 95 % comme signifiant qu’il existe 95 % de chances que la véritable moyenne de la population μ se situe à l’intérieur de l’intervalle spécifique obtenu lors de leur expérience. Or, sur le plan strictement fréquentiste, μ est une constante immuable : elle n’est soumise à aucun aléa stochastique. C’est l’intervalle qui est aléatoire, car ses bornes oscillent au gré des fluctuations d’échantillonnage.
La définition épistémologique exacte d’un intervalle de confiance à 95 % stipule que si l’on répétait l’expérience un nombre infini de fois, exactement 95 % des intervalles ainsi calculés contiendraient la véritable valeur du paramètre de population μ, tandis que 5 % échoueraient à l’englober. Notre matrice de 1 000 réplicats offre l’opportunité idéale d’en administrer la preuve empirique computationnelle.
Dans la colonne Z de la feuille Matrice_Simulation, étiquetée Succes_Couverture, insérez en cellule Z2 la fonction de test logique booléen suivante :
=SI(ET(Parametres_Theoriques!$B$1 >= X2; Parametres_Theoriques!$B$1 <= Y2); 1; 0)
Cette syntaxe retourne la valeur numérique 1 si la moyenne théorique (μ = 5,3) est rigoureusement comprise entre la borne inférieure et la borne supérieure du réplicat courant, et 0 dans le cas contraire. Propagez la formule jusqu’à la ligne 1001. Enfin, dans une cellule de synthèse sur la feuille d’analyse, calculez le pourcentage effectif de couverture globale :
=SOMME(Matrice_Simulation!Z2:Z1001) / 1000
Le taux affiché convergera inévitablement vers une proportion oscillant entre 94,2 % et 95,8 %. En parcourant visuellement la colonne Z, l’utilisateur constatera concrètement l’apparition sporadique de zéros : il s’agit précisément des échantillons dits « malchanceux » ayant produit, par simple fluctuation d’échantillonnage stochastique, une moyenne trop éloignée de la réalité pour que son intervalle englobe la vraie valeur de population. Cette expérience constitue l’un des exercices pédagogiques les plus éclairants pour ancrer définitivement la rigueur de l’inférence de Neyman dans l’esprit du chercheur.
11. Diagnostics, pièges méthodologiques et limites computationnelles dans Excel
11.1 Volatilité des calculs et gestion de l’instabilité des données
L’exploitation intensive d’Excel en modélisation statistique impose une vigilance permanente quant aux comportements internes de son architecture logicielle. Le principal écueil méthodologique réside dans le statut de fonction volatile assigné par conception à la formule ALEA(). Une fonction volatile est systématiquement réévaluée lors de toute action d’édition dans le classeur — qu’il s’agisse de la modification d’une constante à l’autre bout du document, de l’insertion d’une nouvelle ligne, ou même de la simple validation d’une cellule vide.
Cette volatilité permanente entraîne deux risques majeurs pour l’analyste de données : d’une part, l’instabilité visuelle des résultats, où les valeurs numériques de vos tableaux descriptifs et la configuration de vos graphiques se métamorphosent continuellement à chaque frappe ; d’autre part, l’impossibilité de reproduire rigoureusement un cas de figure atypique ayant attiré l’attention lors d’une inspection préliminaire. De plus, contrairement aux langages programmatiques avancés (comme la commande set.seed() sous R), les versions standards grand public d’Excel ne permettent pas de fixer nativement une graine pseudo-aléatoire (seed) via les menus usuels de l’interface graphique sans recourir à des macros écrites en Visual Basic for Applications (VBA).
Pour neutraliser ce risque lors de la finalisation d’un manuscrit de recherche, la stratégie impérative consiste à figer définitivement les matrices stochastiques une fois les simulations complétées : sélectionnez la plage intégrale des données brutes (B2:U1001), pressez Ctrl + C, puis exécutez un Collage spécial > Valeurs. Les formules d’inversion dynamique sont alors remplacées par leurs valeurs décimales instantanées. Le classeur conserve alors son architecture analytique intacte tout en garantissant une stabilité mathématique absolue, indispensable à l’archivage scientifique et au partage transparent des jeux de données avec les réviseurs de revues à comité de lecture.
11.2 Erreurs d’arrondi et précision des algorithmes en virgule flottante
Tout tableur électronique opère sur des représentations numériques binaires finies soumises aux contraintes de la norme technique IEEE 754 relative à l’arithmétique en virgule flottante double précision. Cette spécification computationnelle alloue 64 bits par valeur numérique, assurant une précision d’environ 15 à 17 chiffres décimaux significatifs. Bien que cette résolution s’avère largement suffisante pour la quasi-totalité des analyses psychométriques conventionnelles, elle génère d’infimes erreurs de troncature résiduelles lors de manipulations itératives sur des probabilités extrêmes situées dans les queues distales des distributions.
Dans les versions d’Excel antérieures à la refonte majeure de 2010, les algorithmes sous-jacents aux fonctions statistiques cumulatives inverses (telles que LOI.NORMALE.INVERSE) présentaient des instabilités numériques notables dès que la probabilité u approchait de façon critique de 0 ou de 1 (par exemple, pour u < 10-7), générant des erreurs de non-convergence ou des artefacts de calcul. Bien que les algorithmes modernes aient été totalement réécrits sur la base des routines de calcul asymptotique de Wichmann-Hill pour éliminer ces défauts historiques, il demeure crucial de manipuler avec précaution les calculs impliquant des différences de probabilités infiniment ténues (telles que le calcul de valeurs p inférieures à 10-6).
En pratique neuropsychologique appliquée, il est vivement déconseillé d’arrondir prématurément les valeurs au sein des colonnes de calcul intermédiaires. L’application hâtive de la fonction ARRONDI(..., 2) sur les moyennes d’échantillons ou les erreurs types introduit un biais de quantification cumulatif qui fausse artificiellement l’estimation de la variance de second ordre. L’approche rigoureuse commande de conserver l’intégralité de la précision flottante native dans le moteur de calcul et d’ajuster uniquement le format d’affichage visuel des cellules pour la restitution des rapports formels.
11.3 Distinction cruciale entre modèle Z et modèle de Student t
L’un des pièges théoriques les plus insidieux guettant le praticien modélisant des distributions d’échantillonnage réside dans l’extrapolation abusive de la normalité via le modèle Z lorsque l’écart-type véritable de la population σ demeure inconnu — ce qui constitue la règle quasi-universelle dans l’investigation empirique réelle. Dans le modèle didactique exposé aux sections précédentes, nous avions délibérément postulé que σ = 9 était un paramètre déterministe connu de référence.
Cependant, dans la réalité clinique, le chercheur ne dispose que d’une estimation ponctuelle de la dispersion, incarnée par l’écart-type s calculé sur son échantillon de taille N (colonne W de notre matrice). Lorsque l’on remplace σ par s dans la formule de standardisation :
t = (x̄ – μ) / (s / √N)
La quantité mathématique résultante ne suit plus une distribution normale standard N(0, 1), mais une distribution t de Student régie par ν = N – 1 degrés de liberté. La distribution de Student se caractérise par des queues plus lourdes et épaisses (leptokurtique), traduisant l’incertitude stochastique supplémentaire induite par l’estimation simultanée du dénominateur s.
Si un clinicien utilise à tort la fonction LOI.NORMALE.N ou le quantile critique 1,96 pour construire des intervalles de confiance ou évaluer des valeurs p sur un petit échantillon clinique (par exemple N = 8 patients), il sous-estimera systématiquement l’étendue réelle de la variabilité d’échantillonnage. L’erreur de type I s’en trouvera substantiellement gonflée au-delà du seuil nominal des 5 %. Dans une telle configuration empirique, il convient impérativement de substituer à l’arsenal gaussien les fonctions natives appropriées de la famille Student :
- Probabilité cumulée unilatérale :
=LOI.STUDENT.N(t; degres_liberte; VRAI) - Marge d’erreur de confiance bilatérale :
=INTERVALLE.CONFIANCE.STUDENT(alpha; ecart_type_s; N) - Quantile critique t bilatéral :
=LOI.STUDENT.INVERSE.BILATERALE(0,05; N - 1)
12. Étude de cas appliquée : Évaluation d’une intervention en neuropsychologie cognitive
12.1 Contexte expérimental et définition des variables d’étude
Pour couronner cette progression méthodologique, contextualisons l’ensemble du protocole à travers une situation expérimentale concrète en neuropsychologie clinique : l’évaluation de l’efficacité d’un nouveau programme de remédiation cognitive assistée par ordinateur, conçu pour restaurer l’attention sélective chez des patients victimes d’un traumatisme crânien modéré.
L’instrument de mesure retenu est le score standardisé obtenu à un sous-test informatisé de temps de détection de cibles distractives, calibré à l’échelle nationale sur une vaste population de référence asymptomatique. Selon les données normatives établies, la population saine non traitée présente une moyenne théorique fixée à μ = 50 points d’indice d’efficience attentionnelle, accompagnée d’un écart-type stable σ = 12 points. Les concepteurs du protocole clinique estiment qu’un gain cognitif n’est cliniquement substantiel que s’il induit une élévation moyenne d’au moins 6 points (soit une moyenne cible attendue de 56 points dans la cohorte traitée).
L’équipe médicale recrute une cohorte expérimentale de N = 25 patients traumatisés crâniens soumis au protocole intensif pendant 8 semaines. À l’issue de l’intervention, la moyenne d’attention sélective observée sur ce groupe de 25 patients s’établit empiriquement à x̄obs = 55,4 points. La direction de la recherche sollicite alors notre outil Excel pour répondre à la question clinique centrale : ce gain de performance moyen observé (55,4 vs 50,0) reflète-t-il une véritable efficacité thérapeutique, ou relève-t-il simplement d’une banale fluctuation d’échantillonnage probabiliste au sein d’une cohorte de taille restreinte ?
12.2 Exécution séquentielle de la simulation décisionnelle sous Excel
Pour trancher objectivement cette problématique, déployons le moteur computationnel structuré au fil de ce guide. Dans notre classeur, nous fixons les paramètres de l’hypothèse nulle d’absence d’effet spécifique : μ = 50,0, σ = 12,0 et N = 25. Sous cette hypothèse H0, l’erreur type de la moyenne théorique attendue est :
σx̄ = σ / √N = 12,0 / √25 = 12,0 / 5 = 2,40 points
La distribution d’échantillonnage de référence sous l’hypothèse nulle se modélise donc comme une distribution normale normale N(μ = 50,0 ; σx̄ = 2,40). Nous pouvons alors exécuter une double démarche décisionnelle sous Excel, confrontant l’approche analytique directe et la simulation stochastique :
D’une part, calculons analytiquement la valeur p unilatérale supérieure, matérialisant la probabilité probabiliste d’observer par pur hasard une moyenne d’échantillon au moins aussi extrême que 55,4 points si l’intervention thérapeutique n’avait aucun impact :
=1 - LOI.NORMALE.N(55,4; 50,0; 2,40; VRAI)
Le calcul délivre un résultat formel de p = 0,0122 (soit 1,22 % de probabilité). D’autre part, dans notre matrice de 1 000 simulations générées sous ces mêmes paramètres d’hypothèse nulle, appliquons la formule de dénombrement empirique : =NB.SI(Matrice_Simulation!V2:V1001; ">=55,4") / 1000. Le résultat empirique retournera typiquement entre 10 et 14 réplicats sur mille atteignant ou dépassant ce niveau de performance (soit une fréquence observée de 0,010 à 0,014).
Puisque cette valeur p (0,0122) est strictement inférieure au seuil de significativité conventionnel α = 0,05 (et se situe même en deçà de α = 0,02), l’équipe neuropsychologique peut rejeter formellement l’hypothèse nulle avec une marge de sécurité robuste. Le score moyen de 55,4 points ne peut raisonnablement pas être attribué au seul bruit stochastique d’échantillonnage. En superposant sur notre histogramme Excel une ligne verticale marquant le score de 55,4 points, le graphique démontre immédiatement son positionnement marginal dans la queue supérieure de rejet critique.
12.3 Optimisation du classeur sous forme de modèle de calcul réutilisable
Pour transformer cette réalisation expérimentale ponctuelle en un outil pérenne au bénéfice de l’ensemble d’un laboratoire de recherche clinique, il convient d’optimiser l’ergonomie générale du classeur et de le convertir en un modèle dynamique pérenne (template .xltx). Cette démarche de professionnalisation informatique s’articule autour de trois impératifs de conception logicielle :
Premièrement, la sécurisation structurelle des calculs : sélectionnez l’ensemble des cellules de formules matricielles et de synthèse descriptive (colonnes B à Z sur la feuille de simulation et l’ensemble de la feuille d’analyse), faites un clic droit, choisissez Format de cellule > Protection, et cochez l’option Verrouillé. À l’inverse, déverrouillez expressément les seules cellules de saisie des hyperparamètres (μ, σ, N) sur la première feuille. Activez ensuite la protection globale via l’onglet Révision > Protéger la feuille avec un mot de passe de laboratoire. Cette barrière prévient toute altération accidentelle des formules complexes par des tiers ou des assistants de recherche.
Deuxièmement, l’aménagement d’une interface utilisateur dynamique : enrichissez la feuille de paramétrage de contrôles graphiques interactifs (via l’onglet Développeur > Insérer un contrôle de formulaire) tels que des barres de défilement (sliders) ou des compteurs numériques reliés directement à la cellule de la taille d’échantillon N. Dès lors, le chercheur peut modifier N d’un simple clic et observer en direct sur l’écran adjacent la contraction instantanée de l’histogramme empirique et l’amincissement de la courbe théorique normale superposée.
Troisièmement, la configuration de modules d’exportation standardisée : structurez une zone d’impression optimisée regroupant l’histogramme aux normes APA, la table des métriques descriptives et l’encadré décisionnel d’inférence clinique. Le modèle peut alors être sauvegardé via la commande Enregistrer sous > Modèle Excel (*.xltx). Les praticiens disposent ainsi d’une plateforme d’évaluation statistique rigoureuse, standardisée et pédagogiquement transparente, consolidant la qualité méthodologique de l’ensemble de leurs investigations futures.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: L2 theory. Zeitschrift für Wahrscheinlichkeitstheorie und Verwandte Gebiete, 57(4), 453-476. https://doi.org/10.1007/BF01025868
- Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
- IEEE. (2019). IEEE Standard for Floating-Point Arithmetic (IEEE Std 754-2019). IEEE. https://doi.org/10.1109/IEEESTD.2019.8766229
- Matsumoto, M., & Nishimura, T. (1998). Mersenne twister: A 623-dimensionally equidistributed uniform pseudo-random number generator. ACM Transactions on Modeling and Computer Simulation, 8(1), 3-30. https://doi.org/10.1145/272991.272995
- Microsoft Corporation. (2023). Documentation sur les fonctions statistiques d’Excel. Microsoft Support. https://support.microsoft.com/fr-fr/office/fonctions-statistiques-r%C3%A9f%C3%A9rence-624decba-bb9a-4248-f53b-aa16161a00d1
- National Institute of Standards and Technology. (2010). NIST/SEMATECH e-Handbook of Statistical Methods. NIST. https://doi.org/10.18434/M32189
- Weisstein, E. W. (2022). Central Limit Theorem. From MathWorld–A Wolfram Web Resource. https://mathworld.wolfram.com/CentralLimitTheorem.html