
Dans le vaste panorama de la théorie des probabilités et de la modélisation statistique, aucune construction conceptuelle ne possède une autorité aussi universelle que la distribution normale, communément désignée sous le nom de courbe de Gauss ou loi de Laplace-Gauss. Découverte initialement par Abraham de Moivre au XVIIIe siècle dans le cadre de l’approximation de lois binomiales, puis formalisée et approfondie de manière indépendante par Pierre-Simon de Laplace et Carl Friedrich Gauss, cette fonction mathématique transcende le statut de simple abstraction théorique. Elle constitue la véritable clé de voûte de la statistique inférentielle moderne, apparaissant spontanément au sein d’une multitude vertigineuse de disciplines allant de l’astronomie de précision à la génomique quantitative, de la sociologie empirique à la biomécanique humaine.
La fascination qu’exerce cette courbe en cloche sur la communauté scientifique réside principalement dans son caractère omniprésent et régulateur au sein d’un univers fondamentalement stochastique. Alors que le monde physique et biologique se caractérise en apparence par un désordre imprévisible et une variabilité chaotique, l’agrégation de multiples processus microscopiques fait émerger, à l’échelle macroscopique, une régularité géométrique d’une harmonie parfaite. Cette émergence n’est pas le fruit d’une coïncidence contingente, mais la manifestation rigoureuse de lois asymptotiques profondes, régies au premier chef par le théorème central limite, qui érige la loi normale en attracteur universel des sommes de variables aléatoires indépendantes.
L’objectif de cette étude exhaustive est d’analyser en profondeur les fondements épistémologiques et mathématiques de cette distribution canonique, avant d’en explorer six incarnations empiriques emblématiques tirées du monde réel : le poids de naissance néonatal, la stature adulte humaine, le dimensionnement podologique, les scores psychométriques de quotient intellectuel, la pression artérielle systolique et les erreurs instrumentales en métrologie physique. À travers l’examen minutieux de ces manifestations, nous mettrons en lumière les mécanismes générateurs sous-jacents, confronterons la pureté du modèle théorique aux rugosités du terrain empirique, et évaluerons la portée de cet archétype probabiliste dans les sciences contemporaines.
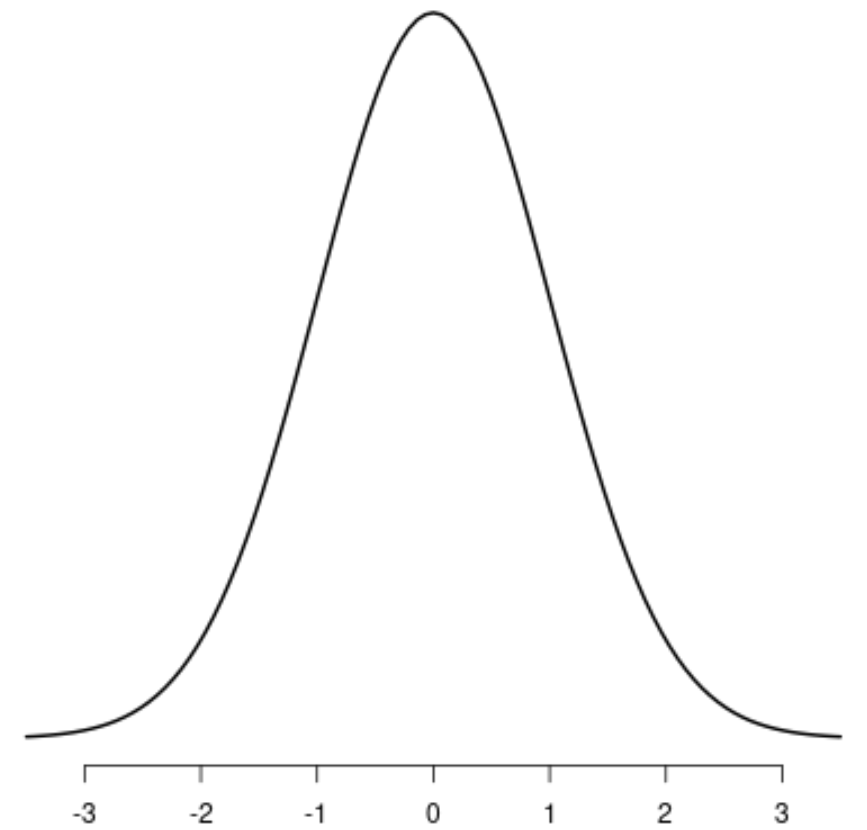
1. Fondements mathématiques et propriétés canoniques de la distribution normale
1.1 Caractérisation géométrique et symétrie axiale de la courbe de Gauss
La distribution normale univariée, notée usuellement sous la forme symbolique N(μ, σ²), est une loi de probabilité absolument continue définie sur l’ensemble des nombres réels. Sa fonction de densité de probabilité est formellement exprimée par l’équation canonique suivante :
f(x) = (1 / (σ √(2π))) * exp( – (x – μ)² / (2σ²) )
Dans cette formulation, le paramètre μ représente l’espérance mathématique, tandis que σ correspond à l’écart-type de la population, la variance étant par conséquent notée σ². L’examen géométrique de cette courbe révèle immédiatement une morphologie unimodale d’une régularité absolue, caractérisée par une forme de cloche parfaitement symétrique par rapport à l’axe vertical d’abscisse x = μ. Cette symétrie axiale stricte engendre une propriété fondamentale en analyse descriptive : la coïncidence parfaite entre les trois mesures centrales de la tendance statistique, à savoir la moyenne arithmétique, la médiane (qui sépare l’aire sous la courbe en deux proportions égales de 0,5) et le mode (qui correspond au maximum absolu de la fonction de densité de probabilité).
Au-delà de cette unicité du sommet culminant à la valeur d’ordonnée f(μ) = 1 / (σ √(2π)), la courbure du tracé géométrique présente une transition structurelle remarquable. La dérivée seconde de la fonction de densité s’annule précisément aux points d’abscisse situés à une distance d’un écart-type de la moyenne, soit en x = μ – σ et x = μ + σ. Ces deux coordonnées définissent les points d’inflexion mathématiques de la courbe, marquant la transition entre la zone de concavité orientée vers le bas (caractéristique du dôme central) et les zones de convexité orientées vers le haut qui s’étendent vers l’infini. Enfin, le comportement aux limites de la fonction démontre une décroissance exponentielle quadratique à mesure que l’on s’éloigne de l’espérance centrale. Les queues de distribution sont asymptotiques à l’axe des abscisses : elles s’en rapprochent indéfiniment sans jamais entrer en contact direct avec lui, conférant ainsi à tout événement réel non nul une probabilité théorique infinitésimale mais strictement positive sur l’intervalle ouvert ]-∞, +∞[.
1.2 La règle empirique 68-95-99,7 et la dispersion standardisée
L’une des manifestations pratiques les plus exploitées de la distribution normale découle de sa géométrie probabiliste immuable, souvent désignée dans la littérature anglo-saxonne sous le vocable de « règle empirique » ou « règle 68-95-99,7 ». Cette règle décrit la proportion d’aire sous la courbe de densité enfermée à l’intérieur d’intervalles définis par des multiples entiers de l’écart-type par rapport à la moyenne arithmétique. L’intégration de la fonction de densité montre que l’intervalle fermé délimité par [μ – σ, μ + σ] concentre rigoureusement 68,27 % de la masse de probabilité totale. Cela signifie que dans toute population idéalement gaussienne, plus des deux tiers des observations individuelles se regroupent spontanément à une distance maximale d’un écart-type de la valeur centrale moyenne.
Lorsque l’on élargit cette fenêtre d’observation à deux écarts-types, c’est-à-dire sur l’intervalle [μ – 2σ, μ + 2σ], la proportion cumulée atteint 95,45 % de la totalité des mesures. Cet intervalle constitue une référence cardinale dans les sciences appliquées, servant de fondement quasi systématique aux tests de significativité statistique conventionnels où le seuil de significativité alpha de 5 % correspond précisément à l’exclusion des 4,55 % d’observations résidant dans les queues bilatérales extrêmes. Enfin, l’intervalle étendu à trois écarts-types, noté [μ – 3σ, μ + 3σ], englobe 99,73 % de la population étudiée, ne laissant subsister hors de ses bornes qu’une fraction marginale de 0,27 % des individus, soit environ 1 observation sur 370.
Pour exploiter universellement ces propriétés géométriques sans devoir recalculer des intégrales analytiquement insolubles pour chaque couple de paramètres (μ, σ²), la méthodologie scientifique recourt à la standardisation via la variable réduite Z. La transformation linéaire opérée par la formule Z = (X – μ) / σ projette n’importe quelle variable aléatoire normale vers la distribution normale standard N(0, 1), dotée d’une moyenne nulle et d’une variance unitaire. Le calcul du score Z permet d’exprimer n’importe quelle déviation individuelle en unités universelles d’écart-type, rendant ainsi immédiatement comparables des mesures hétérogènes issues de disciplines totalement disjointes, telles que la biométrie clinique, la psychométrie ou l’économétrie.
1.3 Le théorème central limite comme genèse universelle de la normalité
La présence ubiquitaire de la distribution normale au sein des systèmes naturels ne constitue nullement une propriété arbitraire de la réalité physique, mais découle directement de l’un des résultats les plus profonds de l’analyse mathématique : le théorème central limite (TCL). Formalisé dans sa version moderne par des mathématiciens d’exception tels que Laplace, Aleksandr Lyapunov et Jarl Waldemar Lindeberg, ce théorème stipule que la somme (ou la moyenne arithmétique) d’un grand nombre de variables aléatoires indépendantes et identiquement distribuées (i.i.d.), chacune possédant une espérance et une variance finies, converge en loi vers une distribution normale standardisée lorsque le nombre de variables tend vers l’infini, quelle que soit la loi de probabilité originelle des variables sous-jacentes.
Cette convergence asymptotique est d’une robustesse exceptionnelle. Même si les distributions mères individuelles sont fortement asymétriques, uniformes, discrètes, bimodales ou exponentielles, leur sommation collective dilue progressivement leurs singularités initiales au profit de l’harmonieuse cloche gaussienne. En pratique, dès que la taille de l’échantillon dépasse un seuil modeste, classiquement fixé à n ≥ 30 dans les applications courantes, la distribution de la moyenne empirique se superpose avec une précision remarquable à la loi normale théorique. Ce comportement découle du fait que les fluctuations individuelles en sens opposé tendent stochastiquement à se compenser mutuellement, réduisant la probabilité relative des déviations cumulées conjointes et renforçant la concentration vers l’espérance globale.
Dans la nature vivante et les systèmes physiques complexes, la quasi-totalité des phénotypes macroscopiques et des grandeurs observables ne résultent pas de l’action isolée d’un déterminant unique. Au contraire, ils émergent de l’interaction cumulative d’une myriade de micro-facteurs infinitésimaux, indépendants ou faiblement corrélés, dont les contributions élémentaires s’additionnent de manière linéaire. Qu’il s’agisse de forces moléculaires, de flux métaboliques ou d’interactions cellulaires, cette cascade d’influences additives agit précisément comme le mécanisme générateur modélisé par le théorème central limite, scellant ainsi la primauté de la distribution de Gauss comme loi fondamentale de régulation des phénomènes complexes.
2. Exemple 1 : Le poids de naissance des nouveau-nés
2.1 Paramètres épidémiologiques et constance de la cloche obstétricale
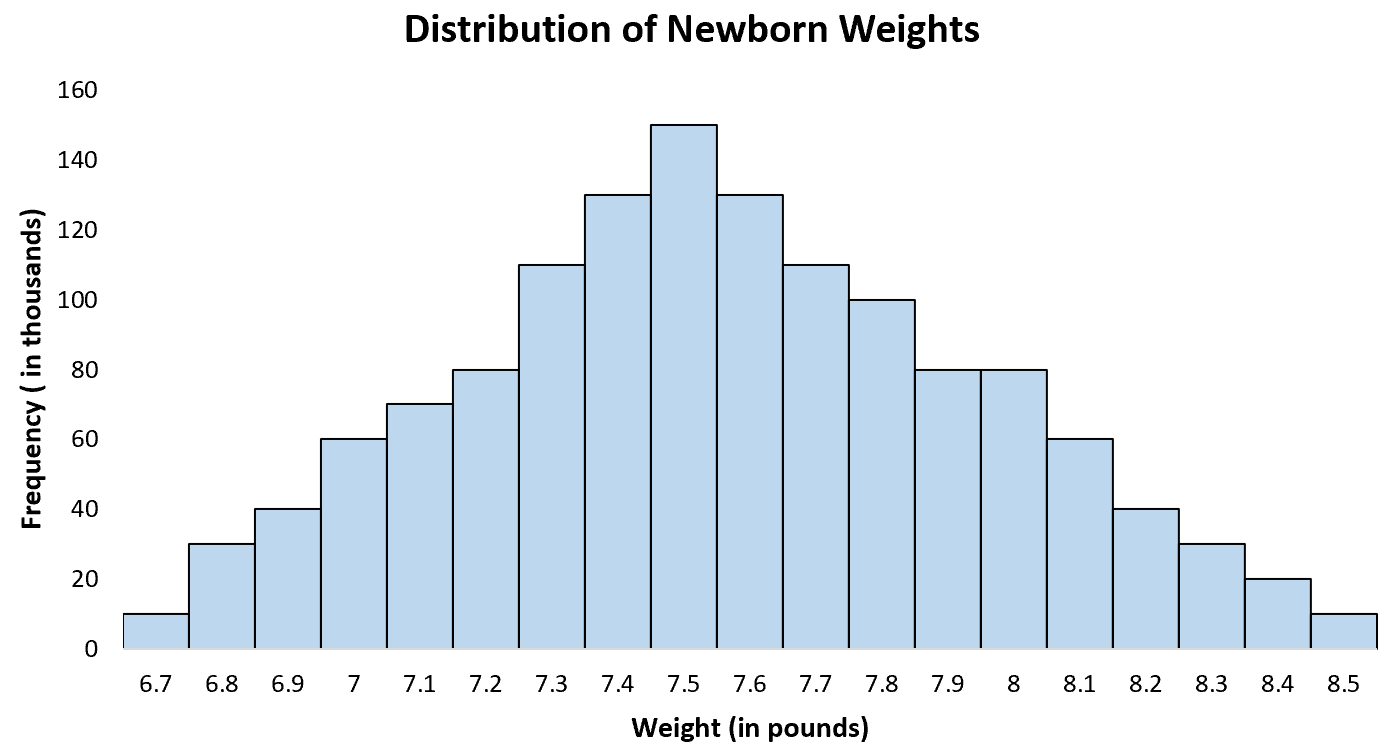
Le poids des nouveau-nés humains à terme constitue l’un des exemples biomédicaux les plus documentés et les plus parfaits d’adéquation à une distribution normale. Au sein des cohortes obstétricales modernes issues de grossesses uniques menées entre 37 et 42 semaines d’aménorrhée, l’analyse descriptive de millions de naissances révèle une régularité frappante de la fonction de densité empirique. Dans les populations d’ascendance européenne bénéficiant d’un suivi prénatal standardisé, la moyenne pondérale néonatale s’établit avec une constance remarquable autour de 3 400 grammes (approximativement 3,4 kg), avec un écart-type caractéristique oscillant de manière étroite autour de 500 grammes.
L’observation d’un histogramme de fréquences dressé à partir d’un large registre périnatal met immédiatement en évidence cette allure gaussienne typique. La densité de probabilité culmine de façon nette entre 3 300 et 3 500 grammes, zone qui concentre la fréquence modale des nouveau-nés. Conformément aux prédictions analytiques de la règle empirique, environ 68 % des nourrissons sains naissent avec un poids compris entre 2 900 grammes (μ – 1σ) et 3 900 grammes (μ + 1σ). De même, l’intervalle englobant deux écarts-types, de 2 400 grammes à 4 400 grammes, recueille plus de 95 % de la cohorte vivante.
Cette distribution se caractérise par une symétrie presque immaculée entre les deux extrémités du spectre pondéral non pathologique. La proportion de nouveau-nés présentant un poids modérément bas mais constitutionnellement normal équilibre rigoureusement celle des nourrissons présentant une macrosomie physiologique modérée. Cette balance symétrique démontre que la variabilité de la croissance fœtale dans un environnement optimal obéit à un schéma probabiliste stable, où les déviations par rapport au point d’équilibre central reflètent le jeu impartial des combinaisons génétiques et des variations physiologiques ordinaires.
2.2 Déterminants biologiques sous-jacents et multiplicité des facteurs
L’émergence d’une cloche de Gauss dans la distribution du poids de naissance s’explique directement par l’application du théorème central limite à l’architecture biologique de la gestation. Le développement somatique d’un fœtus n’est pas commandé par un commutateur biologique unique, mais représente le vecteur résultant de centaines d’influences distinctes, mutuellement indépendantes ou partiellement imbriquées, dont les effets individuels sont de faible amplitude et s’additionnent tout au long des neuf mois de la vie intra-utérine.
Sur le plan de l’architecture génomique, les études d’association pangénomique ont identifié une multitude de locus de traits quantitatifs (QTL) répartis sur l’ensemble du caryotype fœtal. Chacun de ces gènes contribue de manière infinitésimale et additive au rythme de division cellulaire, à la sécrétion d’insuline et de facteurs de croissance analogues à l’insuline (notamment IGF-1 et IGF-2), ainsi qu’à la cinétique de minéralisation osseuse. Parallèlement, le génome maternel exerce sa propre influence polygénique, régissant la capacité métabolique de la mère à mobiliser les substrats énergétiques et à moduler les résistances vasculaires utérines.
À ce substrat génétique additif se superpose une infinité de micro-perturbations environnementales et physiologiques :
- Les variations subtiles du débit sanguin utéro-placentaire et de la surface d’échange trophoblastique ;
- Le niveau nutritionnel maternel moyen durant chaque trimestre de la grossesse ;
- L’exposition à des micro-stress oxydatifs ou environnementaux quotidiens ;
- L’altitude du lieu de résidence influençant la pression partielle en oxygène tissulaire ;
- La parité et l’âge maternel agissant sur l’efficience de la vascularisation myométriale.
La sommation linéaire de cette constellation de micro-facteurs positifs et négatifs aboutit, en vertu des propriétés asymptotiques du TCL, à une distribution phénotypique macroscopique rigoureusement gaussienne.
2.3 Utilisation clinique des centiles et seuils de risque périnatal
L’assimilation du poids néonatal à une distribution normale ne relève pas d’un simple exercice de modélisation théorique ; elle constitue l’armature même de la surveillance clinique en obstétrique et en néonatologie moderne via l’usage systématique des courbes de croissance et des percentiles de Fenton ou de l’Organisation Mondiale de la Santé (OMS). En exploitant la bijection mathématique stricte existant entre le score Z d’une loi normale et les rangs centiles, les cliniciens peuvent évaluer instantanément la déviation relative d’un nouveau-né par rapport à la population générale de référence.
Dans cette perspective probabiliste, le seuil d’alerte diagnostique définissant le retard de croissance intra-utérin (RCIU) ou la petite taille pour l’âge gestationnel (PAG) est classiquement fixé au 10e centile, correspondant approximativement à un score Z inférieur à -1,28. De manière encore plus critique, le seuil de deux déviations standard sous la moyenne (μ – 2σ, soit le 2,3e centile, correspondant à un poids inférieur à 2 500 grammes pour un enfant à terme) isole la catégorie clinique du « faible poids de naissance ». À l’autre extrémité de la courbe, le franchissement du seuil de μ + 2σ (approximativement 4 400 grammes) alerte l’équipe médicale sur une macrosomie fœtale suspecte, corrélée à un risque accru de dystocie des épaules et de traumatismes obstétricaux.
Il convient de souligner que la validité de cette grille d’évaluation repose sur la stratification préalable de la population. Afin de préserver la parfaite normalité de la distribution, les courbes de croissance néonatale doivent impérativement être calibrées en fonction de l’âge gestationnel précis (exprimé en semaines révolues) et du sexe biologique du fœtus, les garçons affichant une moyenne décalée d’environ 150 grammes vers le haut par rapport aux filles. Cette normalisation conditionnelle permet d’isoler les déviances purement pathologiques de la saine variabilité stochastique naturelle.
3. Exemple 2 : La taille adulte humaine
3.1 Distribution biométrique standardisée et dimorphisme sexuel
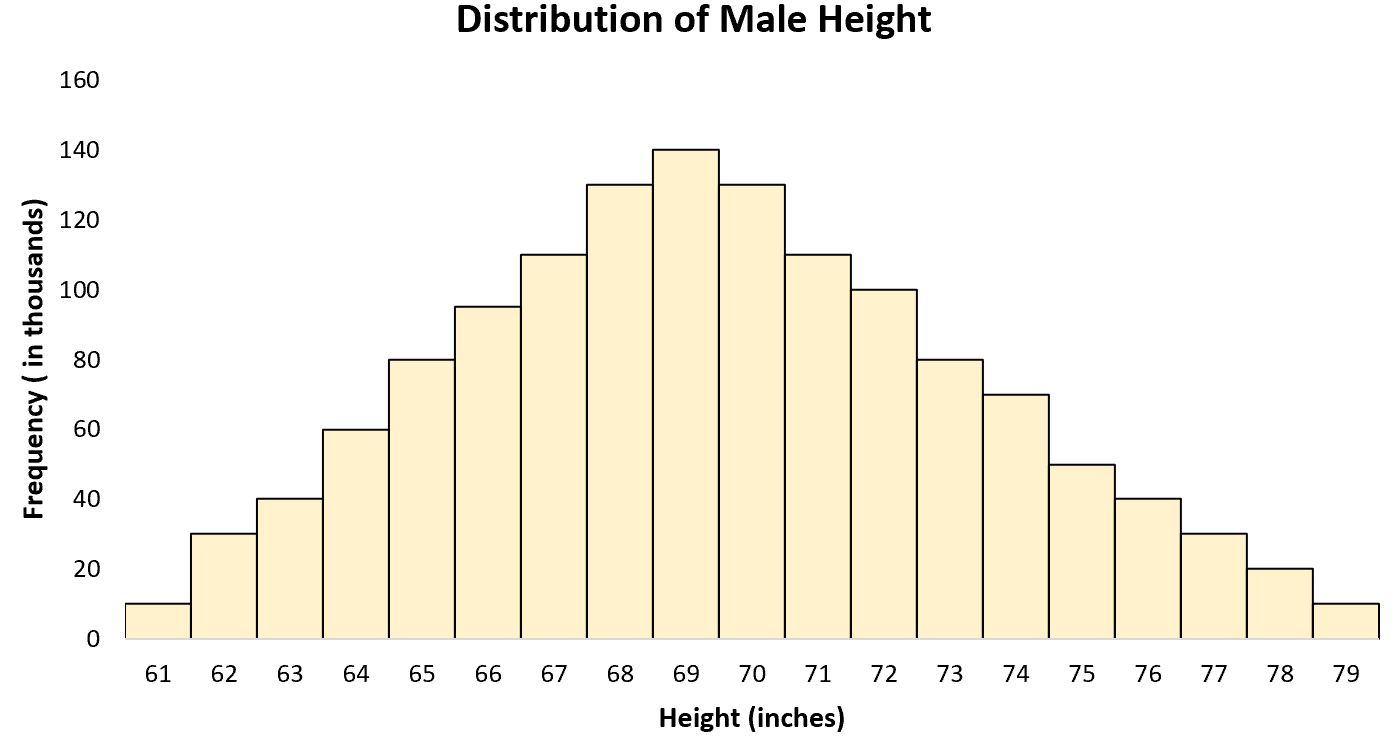
La stature humaine adulte représente historiquement l’exemple princeps ayant servi de banc d’essai aux pères fondateurs de la biométrie pour démontrer la matérialité de la distribution normale dans le règne vivant. Si l’on considère la population adulte globale sans distinction biologique, la distribution brute de la stature semble présenter un léger aplatissement ou un élargissement sommital atypique. Toutefois, cette distorsion n’est qu’un artefact d’échantillonnage masquant une réalité statistique sous-jacente : la population générale est en réalité un mélange de deux sous-populations distinctes, masculines et féminines, séparées par un dimorphisme sexuel bien établi.
Dès lors que l’on segmente l’analyse par sexe biologique au sein de populations homogènes d’un point de vue éco-géographique, la stature s’ajuste à la loi normale avec une précision quasi absolue. Dans les cohortes contemporaines occidentales, la distribution de la taille des hommes adultes affiche une moyenne μ d’environ 178 centimètres, assortie d’un écart-type σ remarquablement stable de 7,5 centimètres. Chez les femmes adultes, la morphologie de la courbe est rigoureusement identique en termes de dispersion (l’écart-type demeurant remarquablement proche de 6,5 à 7 centimètres), mais l’axe de symétrie est translaté vers la gauche d’environ 12 à 13 centimètres, fixant l’espérance mathématique féminine autour de 165 centimètres.
Au sein de chacune de ces sous-populations, la conformité aux lois de probabilité théoriques est totale. L’application des paramètres masculins indique immédiatement que 68,27 % des hommes mesurent entre 170,5 cm et 185,5 cm. De même, la proportion d’hommes mesurant plus de 193 cm (μ + 2σ) ou moins de 163 cm (μ – 2σ) n’excède pas 2,3 % à chaque extrémité. Les très grandes statures dépassant les deux mètres se situent au-delà de trois écarts-types (Z > +2,93), ce qui explique leur rareté empirique extrême dans les recensements civils standardisés.
3.2 Architecture polygénique et héritage mendélien complexe
La découverte de la normalité de la stature humaine a constitué une énigme majeure pour les généticiens du tournant du XXe siècle. Comment réconcilier les lois de l’hérédité particulaire de Gregor Mendel — qui prédisaient des traits qualitatifs discrets (comme des pois lisses ou ridés) — avec la distribution éminemment continue et fluide de la taille humaine ? La réponse définitive fut formulée en 1918 par le polymathe Ronald A. Fisher dans son article fondateur démontrant la corrélation entre parents et enfants sous l’hypothèse de l’hérédité mendélienne.
La stature humaine est un trait polygénique archétypal, gouverné par une infinité de polymorphismes mononucléotidiques (SNP) disséminés sur l’ensemble de l’ADN génomique. Les méta-analyses contemporaines d’études pangénomiques portant sur plus de cinq millions d’individus ont permis d’identifier plus de 12 000 variants génétiques indépendants influençant la taille adulte. Pris isolément, chacun de ces variants alléliques n’exerce qu’une influence minuscule, modulant la stature globale d’une fraction de millimètre. Cependant, conformément aux prédictions mathématiques les plus pures du théorème central limite, la transmission combinatoire aléatoire de ces milliers d’allèles à effet additif engendre une résultante dont la distribution macroscopique prend inévitablement la forme d’une courbe en cloche parfaite.
C’est également en étudiant la distribution normale de la taille que Francis Galton découvrit le concept universel de « régression vers la moyenne ». Galton constata que les parents exceptionnellement grands donnaient naissance à des enfants certes plus grands que la moyenne générale, mais dont la stature moyenne était statistiquement inférieure à celle de leurs géniteurs hors normes. Ce phénomène s’explique par la nature probabiliste de la distribution : posséder une taille située à +3σ requiert la confluence extrêmement improbable d’une vaste majorité d’allèles de croissance favorables additionnée à des conditions environnementales idéales. Lors de la méiose et du brassage génétique de la génération suivante, cette configuration stochastique d’exception a une probabilité écrasante de se dissoudre partiellement, ramenant la descendance vers le centre de gravité gravitationnel de la loi normale.
3.3 Applications anthropologiques et ergonomiques des données de stature
La caractérisation précise des paramètres gaussiens de la taille humaine possède des retombées directes et tangibles dans une multitude de domaines techniques, au premier rang desquels figurent l’ingénierie ergonomique, l’architecture d’intérieur et la médecine préventive. Toute société industrielle avancée est contrainte de concevoir son environnement matériel non pas en fonction d’un « homme moyen » fictif et unidimensionnel, mais en intégrant la totalité de la nappe de probabilité définie par la courbe de Gauss.
En matière d’architecture et de conception d’infrastructures de transport public, le dimensionnement des ouvertures d’urgence, des coursives ferroviaires ou de la hauteur minimale sous plafond des bâtis standardisés ne se calcule jamais sur la valeur centrale μ, ce qui pénaliserait la moitié exacte des usagers. Les ingénieurs emploient des seuils d’exclusion statistique stricts basés sur les percentiles gaussiens supérieurs, calibrant typiquement les gabarits de franchissement sur la valeur μ + 3σ (le 99,85e centile). Cette précaution assure qu’uniquement 1,5 usager sur 1 000 éprouvera une contrainte posturale lors du passage. Inversement, l’amplitude des réglages verticaux des sièges de bureaux ergonomiques ou des postes de pilotage dans l’aviation civile est impérativement conçue pour couvrir l’intervalle bilatéral [μ – 2σ, μ + 2σ], garantissant ainsi une adaptabilité biomécanique optimale à 95 % de la population utilisatrice.
Sur le versant des sciences médicales et anthropologiques, l’analyse comparative des distributions de taille à travers les époques historiques fournit un indicateur synthétique précieux de l’état sanitaire et nutritionnel global des populations. Alors que la variance (l’écart-type) tend à demeurer invariable au cours des siècles en raison de la stabilité des flux géniques, l’espérance mathématique μ fait preuve d’une grande plasticité phénotypique face aux privations systémiques, aux guerres ou aux progrès de l’hygiène publique, illustrant l’interaction constante entre déterminisme biologique gaussien et environnement extérieur.
4. Exemple 3 : Les pointures de chaussures et le dimensionnement corporel
4.1 Corrélation allométrique et normalité des mensurations podologiques
Le dimensionnement morphologique du pied humain représente une extension biomécanique directe des lois régissant la stature corporelle globale. D’un point de vue morphométrique, la longueur du pied présente une corrélation allométrique linéaire étroite avec la taille générale de l’individu, le coefficient de corrélation de Pearson (r) oscillant classiquement entre 0,75 et 0,85 selon les groupes de population étudiés. Par conséquent, en vertu des propriétés de conservation des distributions linéaires gaussiennes, la distribution spatiale de la longueur plantaire, exprimée en millimètres au sein d’une cohorte unigenrée adulte, adopte elle-même une morphologie normale univariée.
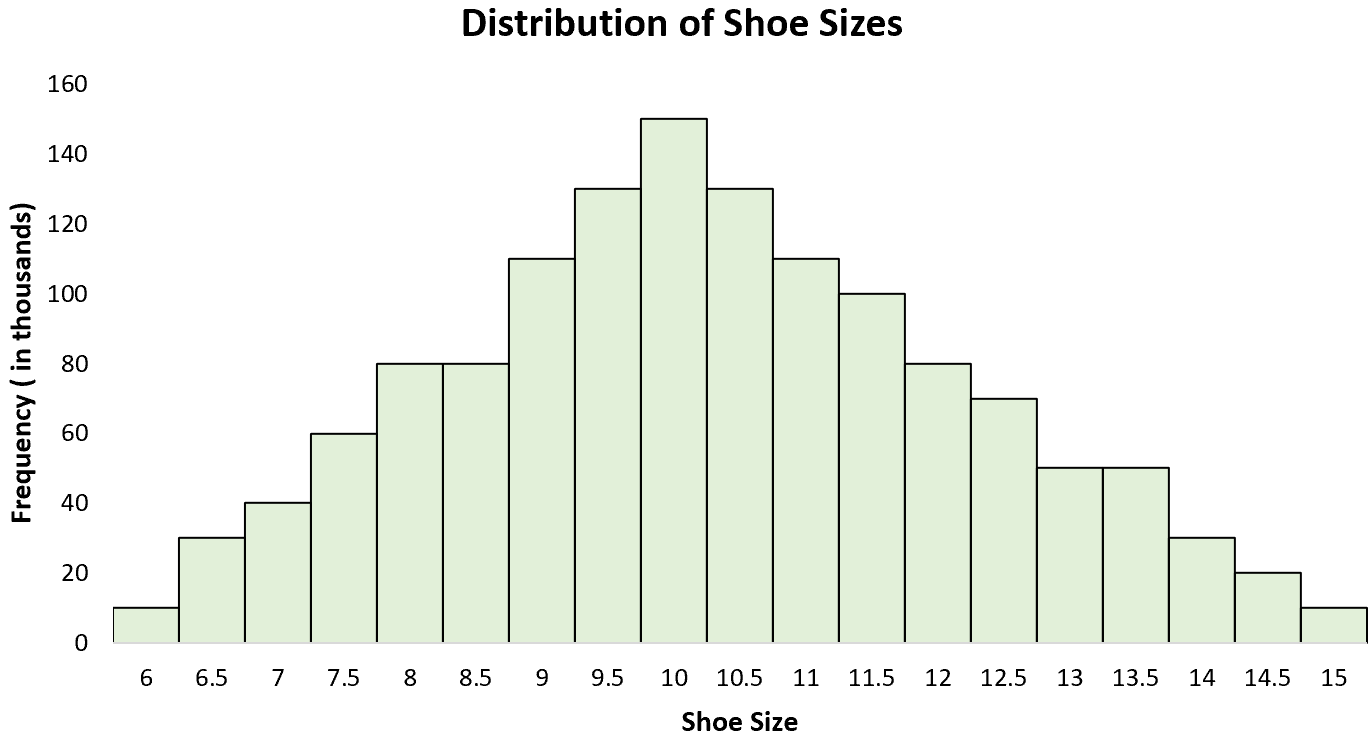
Lorsque ces mesures anatomiques continues sont transposées dans le système standardisé de l’industrie de la chaussure — qu’il s’agisse du point de Paris utilisé en Europe continentale ou des échelles anglo-saxonnes —, la variable continue se trouve discrétisée par pas de 6,67 millimètres. Malgré cette granularité imposée par les nécessités du commerce, la distribution des pointures reflète fidèlement la densité gaussienne sous-jacente. Pour les hommes adultes occidentaux, la courbe se structure autour d’une valeur centrale modale située entre les pointures 42 et 43, tandis que la distribution féminine culmine précisément autour des pointures 38 et 39.
L’observation empirique des volumes de ventes confirme le décrochement exponentiel prévisible dicté par la fonction de densité gaussienne. Les pointures situées à proximité immédiate de l’espérance mathématique représentent le cœur massif de la distribution, captant l’essentiel de la fréquence cumulée. Dès que l’on s’écarte de cette zone modale pour explorer les tailles 46 ou 47 chez l’homme, ou les tailles 35 ou 42 chez la femme, la fréquence des observations s’effondre de façon symétrique, suivant la concavité descendante puis la décroissance asymptotique propre aux queues de probabilité gaussiennes.
4.2 Implications pour l’optimisation logistique et la production industrielle
La modélisation gaussienne des pointures corporelles constitue le socle mathématique de la gestion de la chaîne d’approvisionnement (supply chain) et de l’ingénierie financière dans l’industrie manufacturière de l’habillement. Pour une marque internationale de chaussures, produire un nombre égal d’unités pour chaque pointure disponible conduirait inéluctablement à une faillite logistique rapide : les pointures centrales souffriraient d’une rupture de stock permanente, tandis que les tailles extrêmes s’accumuleraient indéfiniment dans les entrepôts sous forme de stocks dormants et dépréciés.
Les gestionnaires de production appliquent donc des lois de planification directement calquées sur les intégrales de probabilité normales. Les volumes de découpe et d’assemblage des formes industrielles sont précisément paramétrés selon l’aire sous la courbe correspondant à chaque pointure discrète. La règle générale consiste à concentrer l’effort manufacturier sur l’intervalle [μ – 1,5σ, μ + 1,5σ], ce qui permet de satisfaire de façon fluide environ 86,6 % de la demande solvable globale tout en minimisant les coûts d’immobilisation de capital dans les segments marginaux.
| Segment statistique | Intervalle de scores Z | Part de marché théorique | Stratégie industrielle associée |
|---|---|---|---|
| Noyau modal | [-0,5σ à +0,5σ] | 38,3 % | Flux tendu, approvisionnement prioritaire continu |
| Zone intermédiaire | [-1,5σ à -0,5σ] ∪ [+0,5σ à +1,5σ] | 48,3 % | Stock de sécurité standard, réassort périodique |
| Extrémités modérées | [-2,5σ à -1,5σ] ∪ [+1,5σ à +2,5σ] | 12,2 % | Production limitée sur commande, centralisation des stocks |
| Queues extrêmes | < -2,5σ ou > +2,5σ | 1,2 % | Ateliers de sur-mesure spécialisés, rejet du circuit de masse |
Cette approche probabiliste rationalise l’ensemble de la chaîne de valeur : elle permet de calculer prédictivement le coefficient d’invendus, d’ajuster les prix de liquidation en fin de saison selon la probabilité résiduelle d’achat d’un client potentiel dans une taille atypique, et d’éviter les dérives d’une production uniforme déconnectée des réalités biologiques de l’anatomie humaine.
4.3 Différenciation morphologique et limites d’ajustement du modèle
Si la longueur plantaire brute offre une excellente démonstration de comportement gaussien, une analyse morphologique plus poussée révèle que l’ajustement à une loi normale univariée présente des contraintes structurales et des asymétries secondaires. La plus marquante réside dans le fait que la géométrie du pied ne se résume pas à une dimension unidimensionnelle : la largeur métatarsienne, le périmètre du coup-de-pied et le volume de l’arche plantaire introduisent des degrés de liberté supplémentaires qui ne covarient pas de manière parfaitement homogène.
En outre, la distribution des largeurs de pied au sein d’une même catégorie de longueur a tendance à afficher une légère asymétrie positive (dévier vers la droite). Ce phénomène s’explique par des contraintes biomécaniques : il existe une limite osseuse incompressible à l’étroitesse d’un pied humain fonctionnel, tandis que des facteurs acquis — tels que l’obésité mécanique, l’affaissement de l’arche avec l’âge (perte d’élasticité ligamentaire) ou la formation d’hallux valgus — étirent la queue de distribution du côté des largeurs excessives.
Enfin, des disparités anthropologiques substantielles fragmentent l’universalité de la courbe lorsqu’on compare des populations d’origines géographiques variées. Les morphotypes asiatiques, africains et caucasiens présentent des rapports largeur/longueur significativement divergents, forçant l’industrie à adapter ses tables gaussiennes en fonction des bassins démographiques ciblés. Ces adaptations locales illustrent à quel point la distribution normale demeure un cadre de référence fondamental, dont l’application concrète nécessite d’intégrer les modulations induites par les micro-évolutions populationnelles et l’ontogénèse des individus.
5. Exemple 4 : Les scores aux tests de quotient intellectuel (QI)
5.1 Standardisation psychométrique et construction artificielle de la normalité
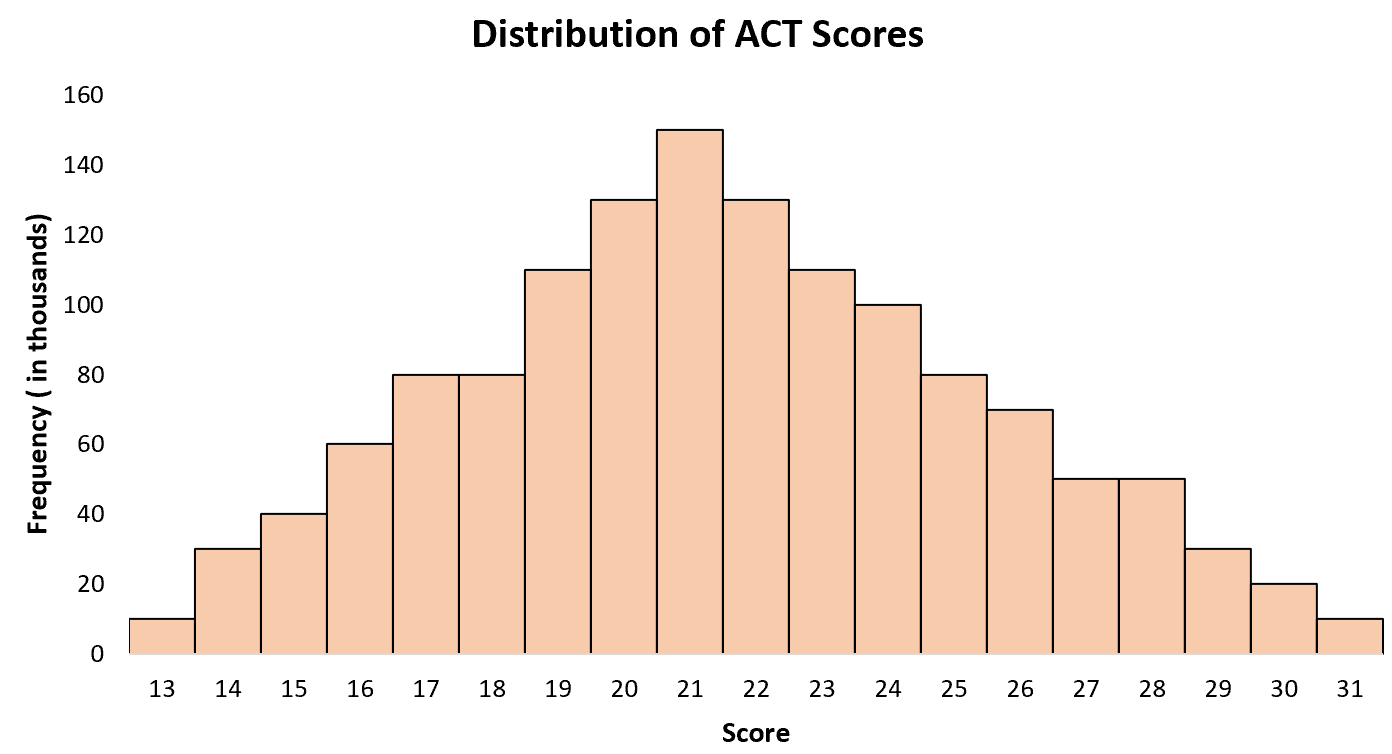
Contrairement aux grandeurs morphologiques telles que la masse ou la taille corporelle, qui constituent des propriétés physiques matérielles directement mesurables, le quotient intellectuel (QI) représente une grandeur statistique standardisée. L’apparence gaussienne des scores de QI ne découle pas d’un recensement brut de réponses correctes, mais d’une décision méthodologique délibérée et fondamentale opérée par les concepteurs des échelles psychométriques modernes, telles que les batteries de tests de David Wechsler (WAIS pour adultes, WISC pour enfants) ou l’échelle de Stanford-Binet.
Dans la construction d’un test psychométrique, le protocole expérimental recueille d’abord des « scores bruts » correspondant à la somme pondérée des épreuves cognitives résolues avec succès par l’examiné. Ces scores bruts, dont la distribution empirique initiale peut présenter des irrégularités ou des asymétries, sont ensuite systématiquement projetés et étalonnés sur une échelle normative gaussienne artificielle. Par convention mathématique universelle, cette distribution cible est rigoureusement paramétrée avec une moyenne fixée à μ = 100 et un écart-type calibré à σ = 15 (ou parfois σ = 16 dans les déclinaisons historiques de Stanford-Binet).
Cette calibration contraint impérativement la distribution des scores à épouser les proportions exactes de la cloche de Gauss théorique. Par construction arithmétique :
- 68,27 % de la population globale se situe rigoureusement dans la tranche de QI comprise entre 85 et 115 (la plage de normalité moyenne) ;
- 95,45 % des scores individuels sont obligatoirement confinés entre 70 et 130 ;
- Le seuil de 130 (μ + 2σ) isole mathématiquement les 2,28 % supérieurs de la population, définissant conventionnellement le segment du haut potentiel intellectuel (HPI) ;
- Symétriquement, le score de 70 (μ – 2σ) délimite le seuil statistique inférieur utilisé par les manuels diagnostiques comme l’un des critères de la déficience intellectuelle.
5.2 La théorie du facteur g et la sommation des facultés cognitives
Bien que la distribution normale du QI résulte d’une normalisation mathématique volontaire, ce choix épistémologique n’est pas purement arbitraire. Il s’enracine dans la théorie psychométrique de l’intelligence générale, ou facteur g, initialement formalisée par Charles Spearman au début du XXe siècle. En examinant les matrices de corrélations entre des tests mesurant des aptitudes cognitives hétérogènes (aptitudes verbales, raisonnement spatial, calcul arithmétique, mémoire séquentielle), Spearman découvrit que ces épreuves étaient toutes positivement corrélées entre elles : c’est le phénomène de la « variété positive » (positive manifold).
Ce postulat théorique avance que la performance cognitive globale observée lors de l’exécution d’une tâche complexe émerge de la sommation d’une vaste quantité de sous-processus mentaux élémentaires et semi-indépendants. Ces composantes microscopiques incluent :
- La vitesse de conduction neuronale le long des axones cérébraux ;
- La capacité tampon de stockage temporaire au sein de la mémoire de travail dorsolatérale ;
- La sensibilité des récepteurs synaptiques dopaminergiques et cholinergiques impliqués dans l’inhibition attentionnelle ;
- L’efficience métabolique de la consommation de glucose dans le cortex cérébral préfrontal.
En vertu de ce postulat additif, la cognition globale peut être interprétée comme la résultante de multiples variables physiologiques microscopiques indépendantes. De ce point de vue, le théorème central limite fournit une justification théorique solide à l’emploi de la distribution normale : si la performance mentale agrège l’efficacité opérationnelle de milliers de circuits neurobiologiques distincts agissant en parallèle, la distribution naturelle des compétences cognitives brutes devrait spontanément converger vers une géométrie gaussienne, que l’étalonnage psychométrique vient ensuite formaliser.
5.3 L’effet Flynn et les nécessités de réétalonnage psychométrique
L’un des défis empiriques majeurs posés à la pérennité de cette distribution normale standardisée réside dans la dynamique séculaire découverte par le chercheur James Flynn, désormais baptisée l’effet Flynn. En analysant les performances brutes aux tests d’intelligence standardisés à travers le monde au cours du XXe siècle, Flynn a documenté une hausse continue et substantielle des scores moyens bruts, progressant au rythme moyen d’environ 3 points de QI par décennie, en particulier sur les épreuves mesurant le raisonnement fluide abstrait (comme les matrices progressives de Raven).
Si les grilles de conversion d’un test psychométrique n’étaient pas modifiées au fil du temps, cette progression des performances brutes entraînerait un glissement systématique de la cloche vers la droite : la moyenne réelle se déplacerait vers 105 ou 110, altérant la symétrie de référence et multipliant artificiellement la proportion d’individus qualifiés de « surdoués » tout en réduisant drastiquement le nombre de personnes sous le seuil de déficience. Afin de préserver l’axiome fondamental selon lequel la moyenne de la population générale doit impérativement rester calée à 100 avec un écart-type de 15, les instituts de psychométrie sont obligés de réétalonner périodiquement leurs tests (généralement tous les 10 à 15 ans).
Ce processus de renormage continuous soulève des questions épistémologiques fascinantes sur la nature réelle de la distribution gaussienne en psychologie. Il démontre que la courbe de Gauss du QI ne reflète pas une métrique absolue immuable de l’esprit humain, mais constitue un repère de positionnement relatif et ordinal au sein d’une cohorte synchronique donnée. La normalité y est un cadre régulateur indispensable assurant l’équité diagnostique et la validité statistique des comparaisons interindividuelles dans le temps.
6. Exemple 5 : La pression artérielle systolique au sein d’une population saine
6.1 Distribution hémodynamique et constance homéostatique
La pression artérielle systolique (PAS) — correspondant à la pression maximale exercée par le flux sanguin pulsatile sur les parois des artères de gros calibre lors de la contraction ventriculaire gauche (systole) — offre un modèle remarquable d’oscillation autour d’une distribution normale au sein des cohortes d’adultes sains. Chez l’adulte jeune et normotendu, débarrassé de pathologies métaboliques sous-jacentes et mesuré au repos complet selon les protocoles de la médecine factuelle, la pression artérielle systolique se distribue de manière fluide et symétrique autour d’un point central d’équilibre hémodynamique situé approximativement à 120 millimètres de mercure (mmHg), avec un écart-type caractéristique proche de 10 mmHg.
L’architecture de cette distribution témoigne de l’existence d’une puissante homéostasie physiologique. La pression artérielle n’est pas une valeur statique fixée une fois pour toutes dans le tissu vivant, mais une variable dynamique soumise à des régulations permanentes. Les valeurs individuelles oscillent naturellement dans un couloir probabiliste étroit et délimité :
- Environ 68 % des sujets sains au repos présentent une PAS comprise dans l’intervalle [110 mmHg, 130 mmHg] ;
- Plus de 95 % des observations s’inscrivent parfaitement entre 100 mmHg (μ – 2σ) et 140 mmHg (μ + 2σ).
Cette dispersion modérée et symétrique autour de 120 mmHg traduit l’efficacité des boucles de rétroaction biologiques qui amortissent les micro-fluctuations et maintiennent en permanence l’intégrité de la perfusion des organes cibles (cerveau, reins, cœur) sans provoquer de surcharge mécanique délétère sur l’arbre vasculaire périphérique.
6.2 Mécanismes polyfactoriels de la dynamique vasculaire
Sur le plan biophysique, la genèse de cette distribution normale s’explique par la combinaison linéaire d’une multiplicité de déterminants hémodynamiques et biochimiques interagissant de façon continue selon les lois de la mécanique des fluides. L’équation biophysique fondamentale régissant la pression artérielle systolique moyenne repose sur le produit du débit cardiaque (lui-même déterminé par le volume d’éjection systolique et la fréquence cardiaque) et des résistances vasculaires périphériques totales, auxquelles s’ajoute l’influence critique de la compliance (élasticité amortissante) de l’aorte thoracique.
Chacun de ces composants macroscopiques est à son tour modulé de manière stochastique par une myriade de micro-processus indépendants ou faiblement corrélés :
- L’activité du système nerveux autonome, via la fréquence de décharge des barorécepteurs carotidiens et la libération tonique de noradrénaline ;
- La modulation endocrinienne lente exercée par l’axe rénine-angiotensine-aldostérone régissant la réabsorption tubulaire du sodium et le volume plasmatique circulant ;
- La synthèse basale de monoxyde d’azote (NO) par les cellules de l’endothélium vasculaire, induisant une vasodilatation locale continue ;
- La viscosité sanguine intrinsèque, déterminée principalement par le taux d’hématocrite et la concentration des protéines sériques.
En vertu du théorème central limite, l’addition de ces influences physiologiques indépendantes, dont aucune ne domine écraser les autres chez un sujet en bonne santé, fait converger la variabilité de la pression artérielle systolique de repos vers une densité normale univariée.
6.3 Seuils d’hypertension clinique et asymétrie acquise
Si la distribution normale décrit avec précision la dynamique vasculaire chez les cohortes sélectionnées d’adultes sains, l’observation de populations générales non filtrées révèle une rupture d’homogénéité et l’émergence d’une nette asymétrie positive (étalement de la queue de distribution vers les valeurs élevées). Ce phénomène s’explique par l’interaction entre le vieillissement tissulaire et les facteurs pathologiques environnementaux (consommation excessive de sodium, sédentarité, tabagisme, syndrome métabolique).
Avec l’avancée en âge, les fibres d’élastine constitutives de la paroi des grandes artères subissent une dégradation progressive, remplacées par des fibres de collagène rigides et des dépôts d’athérome calcifiés. Cette rigidification vasculaire détruit l’effet régulateur de Windkessel, provoquant une augmentation rapide de la pression d’onde réfléchie et déplaçant unilatéralement la PAS vers le haut. Il en résulte que dans les cohortes épidémiologiques transversales de plus de 50 ans, la queue droite de la distribution s’étire lourdement, transformant la cloche pure originelle en une distribution asymétrique (skewed) ou bimodalement contaminée.
Pour la médecine préventive, cette déviation par rapport à la distribution normale théorique a justifié l’introduction de seuils de coupure cliniques normatifs. L’Organisation Mondiale de la Santé et les sociétés savantes de cardiologie ont défini l’hypertension artérielle à partir de 140 mmHg pour la PAS en cabinet médical, ce qui correspond historiquement au franchissement de la frontière μ + 2σ d’une population jeune de référence. L’usage de modèles statistiques mixtes permet aujourd’hui d’extraire, au sein des registres de santé publique, la composante de distribution normale saine sous-jacente des sous-populations souffrant de vascularite dégénérative, affinant ainsi le ciblage thérapeutique.
7. Exemple 6 : Les erreurs de mesure en instrumentation scientifique
7.1 L’héritage historique de Gauss et la théorie des erreurs d’observation
L’association originelle de Carl Friedrich Gauss avec la distribution qui porte son nom ne s’est pas nouée autour de questions biologiques ou médicales, mais au cœur des défis posés par l’astronomie de position au début du XIXe siècle. Confronté au problème de recalculer l’orbite céleste de la planète naine Cérès, découverte par Giuseppe Piazzi en 1801 puis temporairement perdue derrière l’éblouissement du Soleil, Gauss développa la méthode d’estimation par les moindres carrés en postulant explicitement la loi de probabilité régissant les erreurs accidentelles de mesure.
Dans sa modélisation axiomatique des erreurs expérimentales, Gauss établit une distinction fondamentale entre deux catégories d’imprécisions :
- Les erreurs systématiques, introduites de façon unilatérale par un défaut constant d’étalonnage de l’appareil ou une dérive environnementale stable (qui déplacent l’espérance μ sans altérer la forme de la loi) ;
- Les erreurs aléatoires pures, qui naissent de perturbations infinitésimales et incontrôlables lors du processus de capture du signal physique.
Gauss formula l’hypothèse de symétrie selon laquelle des déviations d’amplitude égale en sens positif ou négatif possèdent rigoureusement la même probabilité d’occurrence, et que les erreurs de faible amplitude sont infiniment plus probables que les écarts d’amplitude majeure. En résolvant l’équation différentielle découlant de l’hypothèse selon laquelle la moyenne arithmétique d’une série d’observations indépendantes constitue le meilleur estimateur (l’estimateur du maximum de vraisemblance) de la valeur réelle inconnue, Gauss démontra formellement que la densité de probabilité des résidus d’observation correspondait de manière unique et exclusive à la courbe de Gauss.
7.2 Composantes des bruits instrumentaux et perturbations aléatoires
Dans l’instrumentation physique moderne de haute précision — des balances analytiques à microgrammes aux télescopes interférométriques, en passant par les spectromètres de masse et les détecteurs de particules du CERN —, la distribution normale des erreurs de mesure s’observe avec une constance remarquable. Cette adéquation physique découle du fait que tout système d’acquisition de données est immergé dans un bain thermique et électromagnétique complexe générant une multitude de micro-perturbations indépendantes.
Au niveau de l’électronique de détection la plus sophistiquée, le signal de mesure est inévitablement dégradé par le bruit de Johnson-Nyquist, généré par l’agitation thermique stochastique des porteurs de charge électrique (les électrons) à l’intérieur des résistances et semi-conducteurs. À ce bruit thermique fondamental s’ajoutent le bruit de grenaille (shot noise), associé à la nature corpusculaire discrète des photons ou des électrons franchissant une barrière de potentiel selon un processus de Poisson sous-jacent, ainsi que les micro-fluctuations acoustiques, les micro-variations de pression barométrique et les courants de convection thermique agissant sur le banc d’essai expérimental.
Chacune de ces perturbations physiques élémentaires induit un décalage infinitésimal de l’aiguille ou du convertisseur analogique-numérique. En vertu du théorème central limite, l’agrégation conjointe de ces millions de micro-variations stochastiques à l’échelle quantique et mésoscopique donne naissance à un bruit blanc additif global dont la distribution des amplitudes suit une loi normale parfaite centrée sur zéro. La moyenne d’une série de mesures répétées converge ainsi vers la valeur physique vraie avec une variance résiduelle inversement proportionnelle au nombre d’itérations expérimentales réalisées.
7.3 Applications en métrologie, étalonnage et intervalles de confiance
Cette caractérisation gaussienne des erreurs d’observation est au cœur des fondements méthodologiques de la métrologie internationale moderne, telle que codifiée par le Bureau International des Poids et Mesures (BIPM) dans son document de référence mondial : le Guide pour l’expression de l’incertitude de mesure (GUM). En métrologie de référence, aucune constante physique fondamentale ou mesure industrielle ne peut être énoncée sous la forme d’une valeur ponctuelle isolée sans lui adjoindre son incertitude type associée.
L’incertitude type d’une mesure, notée u(x), est formellement définie comme l’écart-type de la distribution normale de probabilité présumée des valeurs mesurées. L’expression normative d’un résultat physique adopte ainsi la formulation canonique :
X = x̄ ± k · u(x)
Le paramètre k représente le facteur d’élargissement probabiliste. En calibrant ce facteur d’élargissement sur k = 2 (correspondant aux deux écarts-types de la règle empirique gaussienne), la métrologie fournit un intervalle de confiance élargi à 95,45 % de probabilité de couverture. Lorsque les exigences de sécurité sont critiques, comme dans les processus de certification aérospatiale ou nucléaire, le facteur est porté à k = 3 pour garantir une probabilité de conformité de 99,73 %.
De plus, cette architecture statistique régit l’élimination objective des valeurs aberrantes au sein des laboratoires via des protocoles formels d’arbitrage comme le critère de Chauvenet ou le test de Grubbs. Ces algorithmes comparent l’écart entre une mesure suspecte et la moyenne arithmétique de l’échantillon à l’écart-type calculé ; si la probabilité d’obtenir une telle déviation sous l’hypothèse d’une loi normale est inférieure à un seuil critique prédéterminé, la donnée est rigoureusement exclue pour cause d’accident expérimental ou de défaut matériel avéré, assurant la pureté métrologique des résultats publiés.
8. Analyse comparative des mécanismes générateurs des six phénomènes
8.1 Nature génétique versus nature physique des forces en action
L’examen approfondi des six exemples analysés précédemment met en lumière une dualité fascinante : la convergence vers une même fonction mathématique de densité univariée s’opère à partir de substrats physiques et biologiques de natures fondamentalement dissemblables. Dans les quatre premiers exemples touchant aux sciences du vivant (poids fœtal, stature, morphologie plantaire et dynamique hémodynamique), les forces génératrices relèvent de la complexité organique, du polymorphisme génétique et de la régulation homéostatique. En revanche, le domaine de l’instrumentation physique mobilise des phénomènes thermodynamiques et quantiques, tandis que le quotient intellectuel fait intervenir une normalisation psychométrique formelle appliquée à un réseau de facultés neuropsychologiques.
Pourtant, un fil conducteur conceptuel indéfectible unit ces réalités disparates : l’universalité du mécanisme additif de micro-facteurs indépendants. Qu’il s’agisse de l’addition de nucléotides le long du génome, de la superposition de forces de friction dans un fluide biologique, ou de la sommation d’agitations électroniques thermiques dans un circuit en cuivre, le processus générateur obéit invariablement à une dynamique d’accumulation d’éléments microscopiques. Dans le vivant, la sélection naturelle a agi durant des millénaires comme un puissant stabilisateur, privilégiant les configurations génétiques qui maintiennent les phénotypes essentiels au sein d’un couloir optimal de viabilité, créant une attraction dynamique vers la moyenne et consolidant la symétrie gaussienne des traits vitaux.
8.2 Processus additifs contre processus multiplicatifs
Pour apprécier pleinement la genèse d’une distribution normale, il est indispensable de confronter le modèle additif au modèle multiplicatif, qui engendre quant à lui une loi log-normale. Lorsque de multiples variables microscopiques indépendantes n’agissent plus en s’additionnant (X = ε₁ + ε₂ + … + εₙ), mais en se multipliant de façon synergique (X = ε₁ · ε₂ · … · εₙ), le théorème central limite ne s’applique pas directement à la variable brute X, mais à sa transformation logarithmique :
ln(X) = ln(ε₁) + ln(ε₂) + … + ln(εₙ)
Dans ce scénario multiplicatif, la distribution de X présente une asymétrie positive marquée avec une longue queue vers la droite, comme on l’observe classiquement dans la répartition des revenus économiques, la taille des particules de sédiments ou la durée d’incubation des maladies infectieuses.
Les six exemples présentés dans cette étude se distinguent précisément par le fait que leurs forces causales opèrent selon une cinétique strictement ou préférentiellement additive. Dans le cas de la taille ou du poids de naissance, les allèles de croissance découverts dans les GWAS augmentent le phénotype par des incréments absolus de millimètres ou de grammes, sans multiplier de manière exponentielle la structure préexistante. De même, les perturbations d’un appareil de mesure s’ajoutent de manière scalaire au signal sous-jacent. L’absence d’amplification en chaîne exponentielle préserve la pureté de la symétrie axiale et prévient l’effondrement vers la log-normalité, maintenant fermement les observations dans le giron de la cloche de Gauss classique.
9. Déviations empiriques et limites de la normalité dans les données concrètes
9.1 Asymétrie (skewness) et aplatissement (kurtosis) dans les distributions réelles
Aucune grandeur du monde physique réel ne s’ajuste avec une perfection absolue et infinie aux propriétés d’une loi de probabilité mathématique idéale. Dans l’analyse de données empiriques concrètes, deux métriques d’ordre supérieur basées sur les moments centrés normalisés permettent d’évaluer la fidélité de l’ajustement : le coefficient d’asymétrie de Fisher-Pearson (skewness, noté γ₁) et le coefficient d’aplatissement (kurtosis, noté γ₂ ou excès de kurtosis).
Pour une loi normale théorique pure, l’asymétrie γ₁ est rigoureusement égale à 0 (symétrie absolue), et l’excès de kurtosis γ₂ est également nul (distribution mésocurtique). Or, dans la quasi-totalité des registres biomédicaux, des déviations apparaissent :
- Asymétrie positive (dextrogyre) : La pression artérielle et le poids de naissance présentent fréquemment un γ₁ légèrement positif (entre +0,15 et +0,40), traduisant le fait que des contraintes physiologiques minimales strictes empêchent les valeurs de descendre trop bas, tandis que des processus dégénératifs étirent la queue vers le haut ;
- Leptocurticité (queues lourdes) : Les données financières, les variations de scores psychologiques ou les mesures instrumentales complexes affichent souvent un excès de kurtosis positif (γ₂ > 0), caractérisé par un sommet central plus effilé que prévu et des queues de distribution plus fournies (fat tails) que ne l’autorise la fonction de Gauss.
Ces déviations révèlent souvent la présence d’une hétérogénéité d’échantillonnage dissimulée, où plusieurs distributions normales dotées d’espérances ou de variances subtilement différentes se trouvent fusionnées dans un même jeu de données globales.
9.2 Vulnérabilité face aux événements extrêmes et cygnes noirs
L’utilisation imprudente de l’hypothèse de distribution normale présente un danger analytique majeur : la sous-estimation dramatique de la probabilité d’occurrence des événements extrêmes. En vertu de la décroissance exponentielle quadratique de la densité gaussienne, la probabilité d’un écart situé au-delà de 4, 5 ou 6 écarts-types s’effondre vers des grandeurs infinitésimales. À titre d’illustration, la probabilité d’observer un événement distant de six déviations standard de la moyenne (Z = 6) au sein d’une loi normale univariée est d’environ 1 sur un milliard (environ 1,97 × 10⁻⁹ dans un test bilatéral).
Cette particularité mathématique a été vivement critiquée par le statisticien et épistémologue Nassim Nicholas Taleb dans son analyse des systèmes complexes et des « cygnes noirs ». Dans le monde réel, un capteur physique peut subir un choc mécanique imprévu, un gène fœtal peut être l’objet d’une mutation délétère majeure (syndrome achondroplasique entraînant un nanisme sévère), ou un vaisseau peut rompre sous l’effet d’une crise éclamptique. Ces situations ne constituent pas des déviations marginales au sein d’une distribution normale, mais des ruptures structurelles qui relèvent de lois aux queues épaisses (telles que les lois de puissance ou la loi de Cauchy).
Attribuer a priori une structure gaussienne à un jeu de données sans vérification empirique minutieuse conduit les gestionnaires de risque et les scientifiques à considérer des événements rares comme statistiquement « impossibles », alors qu’ils surviennent avec une fréquence bien supérieure dans les systèmes dynamiques instables ou soumis à des rétroactions non linéaires.
9.3 Biais de troncature et effets de bordure expérimentale
Une divergence mathématique irréconciliable entre la loi normale théorique et le monde matériel réside dans le support de la fonction. La distribution normale est formellement définie sur la droite des réels toute entière, du moins l’infini au plus l’infini (]-∞, +∞[). Par conséquent, elle attribue une probabilité théorique non nulle à des réalisations absurdes sur le plan physique, telles qu’une taille négative, un poids de naissance inférieur à zéro gramme, ou une pression artérielle systolique négative.
Dans la pratique expérimentale, ces grandeurs physiques sont bornées par le bas par le zéro absolu ou par des limites de viabilité biologique. Nous avons donc affaire en toute rigueur à des distributions tronquées. De surcroît, les instruments de collecte et les critères de sélection introduisent des effets de bordure artificiels :
- Les études en neuro-imagerie ou psychométrie excluent systématiquement les sujets non autonomes ou souffrant d’encéphalopathies profondes, provoquant un phénomène d’effet plancher ou plafond ;
- Les systèmes de mesure physique possèdent des dynamiques finies qui saturent les données hors échelle ;
- La discrétisation et l’arrondissement numérique arrondissent les valeurs continues vers les entiers les plus proches.
Pour modéliser rigoureusement ces contextes contraints, la statistique avancée recourt aux distributions normales tronquées ou aux modèles de régression censurée (comme les modèles Tobit par maximum de vraisemblance), qui redressent les estimations des paramètres de population en intégrant explicitement les frontières physiques du système analysé.
10. Méthodes statistiques de validation de la normalité
10.1 Outils visuels de diagnostic : histogrammes et diagrammes quantile-quantile
Avant d’engager des procédures d’inférence statistique reposant sur l’hypothèse de normalité, le chercheur doit soumettre ses données à une phase rigoureuse de diagnostic exploratoire. La première étape, purement intuitive, consiste à superposer la courbe théorique de Gauss calculée à partir des paramètres empiriques (x̄, s²) sur l’histogramme de fréquences des données observées. Si cette démarche permet d’apprécier la symétrie globale et l’unimodalité de la distribution, elle reste trop dépendante du choix arbitraire du nombre de classes (bins) pour offrir une validation robuste.
L’outil graphique de référence en la matière est le diagramme quantile-quantile, universellement désigné sous le terme de diagramme Q-Q (Q-Q plot). Cette technique projette les quantiles empiriques observés au sein de l’échantillon contre les quantiles théoriques exacts calculés pour une distribution normale standardisée. Si les données proviennent d’une population gaussienne, les points expérimentaux s’alignent rigoureusement le long de la première bissectrice (la droite d’identité à 45 degrés).
Le tracé du diagramme Q-Q fournit également un diagnostic précis de la nature des déviations :
- Un profil en forme de « S » inversé indique une distribution leptocurtique (queues plus lourdes que la normale, les points extrêmes s’écartant vers l’extérieur de la ligne de référence) ;
- Une courbure unilatérale ascendante ou descendante signe la présence d’une asymétrie positive ou négative marquée ;
- Des points isolés décrochant brutalement aux extrémités révèlent la présence de valeurs aberrantes nécessitant un examen clinique ou métrologique ciblé.
10.2 Tests d’hypothèse formels : Shapiro-Wilk, Kolmogorov-Smirnov et D’Agostino-Pearson
Pour dépasser l’évaluation subjective inhérente à l’inspection visuelle des tracés graphiques, la statistique inférentielle dispose de tests d’adéquation formels basés sur la formulation d’hypothèses statistiques strictes : l’hypothèse nulle (H₀) pose que l’échantillon est issu d’une population normale, contre l’hypothèse alternative (H₁) d’une distribution non gaussienne.
Parmi cet arsenal méthodologique, le test de Shapiro-Wilk, développé en 1965, est reconnu comme le plus puissant et le plus sensible pour les échantillons d’effectif restreint ou modéré (n < 50). Il calcule la corrélation entre les quantiles ordonnés de l’échantillon et les poids théoriques de Gauss. Pour les jeux de données plus volumineux, le test classique de Kolmogorov-Smirnov est utilisé, impérativement assorti de la correction de Lilliefors dès lors que les paramètres de moyenne et de variance ne sont pas connus a priori mais estimés à partir des données de l’échantillon.
Enfin, le test omnibus de D’Agostino-Pearson constitue une alternative élégante qui évalue simultanément les coefficients d’asymétrie et de kurtosis de l’échantillon via une statistique de test distribuée selon une loi du chi-carré à deux degrés de liberté. Néanmoins, l’analyste doit rester vigilant face au paradoxe bien connu des grands échantillons : lorsque n se compte en dizaines de milliers d’observations (comme dans les bases de données de taille ou de pointures), la puissance statistique des tests devient tellement élevée que le moindre écart infime et biologiquement dérisoire par rapport à la normalité conduit à un rejet statistiquement significatif de H₀ (p < 0,001). Dans ces contextes massifs, l’analyse pragmatique de la taille d’effet des déviations doit prévaloir sur le p-value brut.
11. Implications pratiques pour l’inférence statistique et les tests paramétriques
11.1 Robustesse des tests paramétriques face aux légères déviations de normalité
L’omniprésence de la loi normale dans la nature et dans la théorie probabiliste a dicté la structure de la majorité des tests statistiques paramétriques classiques, tels que le test t de Student (pour la comparaison de deux moyennes) et l’analyse de variance (ANOVA, pour l’évaluation multigroupes). Ces procédures sont dérivées sous l’hypothèse explicite que la variable dépendante mesurée suit une loi normale au sein de chaque sous-groupe expérimental considéré.
Fort heureusement pour les chercheurs de terrain, ces tests paramétriques font preuve d’une robustesse méthodologique remarquable face aux déviations modérées par rapport à la normalité idéale, à condition que la taille des échantillons soit suffisante. Cette résilience s’explique une fois encore par l’action sous-jacente du théorème central limite : la statistique de Student ne teste pas directement la normalité des valeurs brutes individuelles, mais le comportement de la différence entre leurs moyennes arithmétiques empiriques. Dès lors que les effectifs dépassent la trentaine d’individus par groupe expérimental et que la taille des groupes est équilibrée, la distribution d’échantillonnage de la moyenne se rapproche étroitement de la loi normale, préservant ainsi le taux d’erreur de première espèce (taux de faux positifs nominal alpha) à son niveau théorique de 5 %.
Toutefois, cette tolérance s’effondre lorsque la non-normalité se conjugue à une forte asymétrie bilatérale et à une hétéroscédasticité marquée (inégalité flagrante des variances entre groupes). Dans de telles configurations, les tests paramétriques peuvent perdre leur calibrage probabiliste et conduire à des conclusions scientifiques fallacieuses.
11.2 Alternatives non paramétriques et approches de rééchantillonnage
Lorsque le diagnostic formel met en évidence une distribution radicalement non normale (asymétrie sévère, bi-modalité prononcée ou contamination par des valeurs aberrantes irréductibles) au sein d’échantillons de taille réduite où le théorème central limite ne peut jouer son rôle de régulateur asymptotique, l’emploi des méthodes paramétriques classiques doit être écarté au profit d’alternatives méthodologiques robustes.
La première voie de contournement consiste à employer les tests non paramétriques basés sur les rangs :
- Le test U de Mann-Whitney (ou test de Wilcoxon-Mann-Whitney) en remplacement du test t pour échantillons indépendants ;
- Le test des rangs signés de Wilcoxon pour les séries appariées ;
- Le test de Kruskal-Wallis comme substitut à l’ANOVA à un facteur.
Ces tests s’affranchissent de toute hypothèse distributionnelle en substituant les valeurs continues par leur rang ordinal relatif. Si cette substitution garantit une robustesse sans faille, elle s’accompagne inévitablement d’une perte de puissance statistique par rapport aux tests paramétriques lorsqu’une structure normale est avérée.
La seconde approche moderne, facilitée par la montée en puissance du calcul informatique, réside dans les techniques de rééchantillonnage de type bootstrap non paramétrique. En tirant avec remise des milliers de sous-échantillons à partir des observations brutes, le bootstrap reconstruit numériquement la distribution d’échantillonnage empirique sans postuler a priori une loi de Gauss. Cette stratégie permet de générer des intervalles de confiance et d’effectuer des tests d’hypothèses sur des paramètres complexes dans des situations où les modèles analytiques canoniques atteignent leurs limites opérationnelles.
12. Applications contemporaines : Du machine learning à la génomique quantitative
12.1 Normalisation des données et algorithmes d’apprentissage automatique
Loin d’appartenir au seul passé de la statistique classique, la distribution normale occupe une place névralgique dans le développement des algorithmes contemporains d’apprentissage automatique (machine learning) et de science des données. La majorité des modèles prédictifs fondés sur la descente de gradient — tels que les réseaux de neurones profonds, la régression logistique et les machines à vecteurs de support (SVM) — voient leur vitesse de convergence et leur stabilité numérique directement conditionnées par la distribution statistique des variables d’entrée (features).
La procédure d’ingénierie des données la plus universelle, implémentée sous le nom de centrage-réduction standard (StandardScaler), consiste précisément à transformer les attributs continus d’un jeu de données pour leur conférer une moyenne nulle et une variance unitaire via la formule de standardisation du score Z :
X_scaled = (X – X̄) / s
Cette normalisation évite que des variables exprimées dans des unités aux amplitudes disproportionnées n’écrasent le processus d’optimisation mathématique. De surcroît, certains algorithmes prédictifs majeurs reposent sur l’hypothèse explicite d’une distribution normale sous-jacente des descripteurs conditionnellement aux classes : c’est le cas de l’analyse discriminante linéaire (LDA) ainsi que du classifieur Naive Bayes Gaussien.
Lorsque les données brutes s’écartent trop lourdement d’une morphologie normale, les praticiens du machine learning appliquent des transformations de stabilisation de variance, telles que les transformations paramétriques de Box-Cox ou de Yeo-Johnson. Ces fonctions mathématiques optimisent un paramètre lambda pour redresser les distributions asymétriques et les rapprocher d’une morphologie gaussienne, maximisant ainsi l’efficacité des mécanismes de régularisation (pénalités L1 Lasso et L2 Ridge) au sein des pipelines de modélisation prédictive.
12.2 Études d’association pangénomique (GWAS) et architecture des traits complexes
Le XXIe siècle a vu la consécration des modèles gaussiens au sein de la médecine génomique de pointe, à travers l’essor spectaculaire des études d’association pangénomique (GWAS). Ces vastes recherches biomédicales analysent simultanément des millions de variations génétiques réparties sur l’ensemble du génome humain au sein de cohortes comprenant des centaines de milliers de volontaires afin d’élucider l’architecture moléculaire des traits continus (comme la taille ou l’indice de masse corporelle) ou la susceptibilité aux maladies complexes polyfactorielles.
L’outil translationnel le plus prometteur issu de ces analyses est le score de risque polygénique (Polygenic Risk Score, PRS). Pour un individu donné, ce score calcule la somme pondérée du nombre d’allèles de susceptibilité portés par son génome, chaque variant étant pondéré par la taille de son effet logarithmique (log-odds ratio) estimé lors de la méta-analyse GWAS :
PRS = ∑ (βᵢ · Gᵢ)
En agrégeant ainsi les micro-effets de dizaines de milliers de locus indépendants, la distribution macroscopique du score PRS au sein de la population générale adopte une forme gaussienne d’une pureté saisissante. En positionnant le génome d’un patient sur cette courbe normale de risque génétique, les cliniciens peuvent identifier les individus situés dans les percentiles extrêmes (par exemple, au-delà de deux écarts-types, Z > +2), chez qui le risque cumulé de développer un infarctus du myocarde, un cancer du sein ou un diabète de type 2 égale ou dépasse celui induit par des mutations monogéniques rares particulièrement agressives.
Ces avancées technologiques matérialisent avec un siècle d’intervalle la vision théorique formulée par Ronald Fisher en 1918 : à l’échelle moléculaire, la somme d’une multitude d’effets génétiques élémentaires produit une résultante dont la densité continue suit rigoureusement la courbe en cloche, reliant l’infiniment petit des séquences d’ADN à l’infiniment vaste de la dynamique des populations humaines.
13. Synthèse épistémologique : Pourquoi la nature privilégie-t-elle la courbe de Gauss ?
13.1 L’entropie maximale comme principe d’indifférence informationnelle
Pour conclure cette exploration exhaustive, il convient de poser la question ultime qui interpelle physiciens, mathématiciens et philosophes depuis plus de deux siècles : pour quelle raison fondamentale la nature manifeste-t-elle une telle prédilection pour la distribution normale, érigeant la courbe de Gauss en véritable signature géométrique de la matière et du vivant ? Au-delà du théorème central limite, qui décrit le processus dynamique de convergence par addition, la réponse la plus profonde et la plus élégante est apportée par la théorie de l’information et le principe de maximisation de l’entropie, formalisés par Claude Shannon et approfondis par Edwin Jaynes.
En théorie de l’information, l’entropie différentielle mesure le degré d’incertitude ou le manque d’information contenu dans une loi de probabilité continue. Si l’on cherche à déterminer quelle distribution de probabilité continue est la plus objective, c’est-à-dire celle qui reflète le maximum d’ignorance et n’introduit aucun biais artificiel au-delà des contraintes fixées, les mathématiques démontrent un résultat d’une portée universelle :
Parmi l’ensemble infini des lois de probabilités continues définies sur l’ensemble des réels possédant une espérance μ et une variance σ² données, la distribution normale est l’unique distribution qui maximise rigoureusement l’entropie différentielle.
Ce théorème fondamental d’entropie maximale éclaire d’un jour nouveau la présence de la courbe de Gauss dans le monde réel. Lorsqu’un système physique ou biologique se structure sous l’effet d’une énergie moyenne finie et d’une dispersion stable sans qu’aucune contrainte asymétrique supplémentaire ne vienne restreindre ses degrés de liberté, il adopte naturellement la configuration statistique la plus désordonnée, la plus probable et la moins informée possible. La distribution normale n’est pas le résultat d’un dessein organisateur délibéré ou d’une mystérieuse intentionnalité cosmique ; elle est l’état d’équilibre informationnel naturel vers lequel converge inéluctablement tout système soumis à une cascade d’influences aléatoires concurrentes, incarnant ainsi le principe fondamental de l’indifférence stochastique de l’Univers.
13.2 Prudence méthodologique pour le chercheur face aux illusions de normalité
Cette puissance unificatrice et cette beauté mathématique ne doivent cependant pas faire oublier au chercheur moderne la nécessité d’une rigoureuse prudence méthodologique. Le statut de modèle de référence conféré à la courbe de Gauss a parfois induit une dérive réductionniste dans l’histoire des sciences, consistant à forcer la réalité empirique à entrer dans le moule confortable d’une équation analytique, au mépris des particularismes du terrain.
L’analyste rigoureux doit toujours distinguer le phénomène observé de sa représentation modélisée. Si la taille, le poids fœtal ou le bruit instrumental s’ajustent harmonieusement à la loi normale, cette adéquation ne constitue jamais une identité ontologique absolue, mais une approximation asymptotique hautement féconde. Dans les sciences humaines, économiques et sociales en particulier, la tentation de postuler une normalité systématique sans validation préalable a souvent conduit à ignorer les dynamiques de réseaux, les inégalités structurelles et les catastrophes de discontinuité qui régissent les sociétés humaines.
En définitive, la courbe de Gauss demeure le plus bel outil jamais forgé par l’esprit humain pour ordonner le chaos apparent du monde sensible. En appréhendant avec rigueur sa géométrie canonique, ses conditions strictes d’émergence par le théorème central limite et ses frontières de validité concrètes, l’observateur dispose d’un instrument d’une puissance inégalée pour extraire la vérité intelligible du bruit stochastique de la nature.
Références
- Bureau International des Poids et Mesures. (2008). Évaluation des données de mesure — Guide pour l’expression de l’incertitude de mesure (GUM 1995 avec corrections mineures). JCGM 100:2008. https://www.bipm.org/fr/committees/jc/jcgm/publications
- D’Agostino, R. B., & Pearson, E. S. (1973). Tests for departure from normality. Empirical results for the distributions of b2 and √b1. Biometrika, 60(3), 613-622. https://doi.org/10.1093/biomet/60.3.613
- Fisher, R. A. (1918). The correlation between relatives on the supposition of Mendelian inheritance. Transactions of the Royal Society of Edinburgh, 52(2), 399-433. https://doi.org/10.1017/S008045680001216X
- Flynn, J. R. (1987). Massive IQ gains in 14 nations: What IQ tests really measure. Psychological Bulletin, 101(2), 171-191. https://doi.org/10.1037/0033-2909.101.2.171
- Galton, F. (1886). Regression towards mediocrity in hereditary stature. The Journal of the Anthropological Institute of Great Britain and Ireland, 15, 246-263. https://doi.org/10.2307/2841583
- Gauss, C. F. (1809). Theoria motus corporum coelestium in sectionibus conicis solem ambientium. Perthes et Besser.
- Jaynes, E. T. (1957). Information theory and statistical mechanics. Physical Review, 106(4), 620-630. https://doi.org/10.1103/PhysRev.106.620
- Laplace, P.-S. (1812). Théorie analytique des probabilités. Courcier.
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591-611. https://doi.org/10.2307/2333709
- Spearman, C. (1904). « General intelligence, » objectively determined and measured. The American Journal of Psychology, 15(2), 201-292. https://doi.org/10.2307/1412107
- Taleb, N. N. (2007). The black swan: The impact of the highly improbable. Random House.
- Wechsler, D. (2008). Wechsler Adult Intelligence Scale – Fourth Edition (WAIS-IV). Pearson Assessment.
- World Health Organization. (2006). WHO Child Growth Standards: Methods and development. World Health Organization. https://www.who.int/publications/i/item/924154693X
- Yengo, L., Vedantam, S., Marouli, E., Sidorenko, J., Bartell, E., Sakaue, S., … & Hirschhorn, J. N. (2022). A saturated map of common genetic variants associated with human height. Nature, 610(7933), 704-712. https://doi.org/10.1038/s41586-022-05275-y