
L’analyse des données quantitatives en sciences sociales, en psychologie et en biométrie repose sur l’intégrité des observations collectées. Dans tout protocole de recherche empirique, la présence d’observations atypiques ou aberrantes constitue une menace systémique pour la validité interne et externe des conclusions statistiques. Si l’identification des valeurs aberrantes univariées relève d’une procédure élémentaire documentée depuis les débuts de la statistique descriptive, le traitement des données multidimensionnelles exige des instruments théoriques et algorithmiques infiniment plus sophistiqués. Lorsqu’un chercheur manipule des batteries de tests psychométriques, des échelles de Likert interconnectées ou des variables physiologiques corrélées, une observation peut présenter des valeurs parfaitement banales sur chacune de ses dimensions isolées tout en constituant une anomalie flagrante au sein de l’espace vectoriel conjoint.
Pour surmonter cette aporie méthodologique, la métrique développée en 1936 par le statisticien indien Prasanta Chandra Mahalanobis s’est imposée comme le standard analytique de référence. La distance de Mahalanobis permet de mesurer l’éloignement relatif d’un vecteur d’observations individuel par rapport au centroïde d’une distribution multidimensionnelle, tout en pondérant cet écart par la structure de covariance globale du système de variables. Contrairement aux approches géométriques naïves, cette mesure tient compte de la dispersion différentielle de chaque échelle ainsi que des intercorrélations qui unissent les indicateurs, offrant ainsi une cartographie fidèle de la rareté d’une configuration de données.
Le logiciel IBM SPSS Statistics propose des environnements algorithmiques performants pour calculer cette distance, bien que son implémentation opérationnelle nécessite une compréhension approfondie de la théorie sous-jacente et de certains stratagèmes de modélisation. Ce guide exhaustif a pour vocation d’accompagner les chercheurs, psychométriciens et analystes de données à travers les fondements mathématiques, les postulats distributionnels, les protocoles logiciels pas à pas et les décisions cliniques ou empiriques qui régissent l’identification et le traitement des valeurs aberrantes multivariées via SPSS.
1. Fondements théoriques de la distance de Mahalanobis en psychométrie et statistiques multivariées
1.1 Définition et principe mathématique de la métrique de Mahalanobis
La distance de Mahalanobis constitue une généralisation multidimensionnelle du concept d’écart réduit standardisé. Alors que le score centré-réduit univarié évalue la déviation d’une valeur brute par rapport à sa moyenne arithmétique en unités d’écart-type, la métrique de Mahalanobis quantifie l’éloignement d’un sujet ou d’une observation au sein d’un hyperespace à p dimensions par rapport au vecteur moyen de l’échantillon, couramment désigné sous le terme de centroïde multidimensionnel. Ce centroïde représente le point géométrique central d’équilibre défini par l’intersection des moyennes arithmétiques de l’ensemble des variables quantitatives continues intégrées au modèle d’analyse.
Sur le plan de l’algèbre linéaire, la formulation matricielle de la distance de Mahalanobis au carré, conventionnellement notée D², s’articule selon l’équation canonique suivante :
D² = (x – μ)ᵀ Σ⁻¹ (x – μ)
Dans cette formulation rigoureuse, le terme x représente le vecteur colonne des scores individuels observés pour une unité statistique donnée sur les p variables étudiées. L’expression μ symbolise le vecteur colonne contenant les moyennes théoriques ou empiriques de ces mêmes p variables, définissant les coordonnées spatiales du centroïde. L’opérateur (x – μ)ᵀ correspond à la transposée du vecteur d’écart, convertissant ce dernier en vecteur ligne. L’élément central Σ⁻¹ désigne la matrice inverse de la matrice de variance-covariance de population ou d’échantillon Σ. Cette inversion matricielle joue un rôle régulateur fondamental : elle applique une transformation linéaire qui standardise la variabilité intrinsèque de chaque composante vectorielle tout en neutralisant l’effet géométrique des covariances mutuelles existant entre les indicateurs psychologiques ou biologiques.
L’un des attributs les plus puissants de la métrique de Mahalanobis réside dans son caractère strictement adimensionnel et son invariance absolue face à tout changement d’échelle linéaire. En recherche psychométrique, les investigateurs compilent fréquemment des scores issus d’épreuves hétérogènes : des temps de réaction millimétrés, des scores totaux à des inventaires de personnalité variant de 20 à 100 points, ou des indices d’efficience intellectuelle calibrés sur une distribution normale de moyenne 100 et d’écart-type 15. Si l’on tentait de calculer une distance spatiale brute sans ajustement de covariance, les variables dotées des variances numériques les plus colossales écraseraient mécaniquement les dimensions à variance modérée, faussant irrémédiablement la détection de l’atypicité. La distance de Mahalanobis résout cette disparité en convertissant l’ensemble de l’espace dimensionnel en un repère orthogonal équilibré où chaque unité statistique est évaluée en termes de déviation probabiliste conjointe.
1.2 Comparaison critique entre distance euclidienne et distance de Mahalanobis
Pour appréhender la supériorité épistémologique de la métrique de Mahalanobis dans les sciences du comportement, il est impératif d’examiner les insuffisances structurelles de la distance euclidienne conventionnelle. La distance euclidienne calcule l’intervalle géométrique rectiligne séparant deux points dans un espace cartésien classique par l’application directe du théorème de Pythagore généralisé. Cette modélisation postule implicitement deux axiomes particulièrement restrictifs qui se révèlent presque systématiquement violés dans les données réelles : d’une part, l’orthogonalité parfaite des axes de mesure, signifiant une corrélation nulle entre toutes les variables, et d’autre part, une variance rigoureusement identique pour chacune des dimensions considérées.
Lorsque deux ou plusieurs variables présentent une dépendance statistique — ce qui constitue la norme en psychométrie où les facettes d’un même construit partagent une part substantielle de variance commune —, le nuage de dispersion des données ne prend pas la forme d’une sphère multidimensionnelle parfaite, mais s’étire selon une géométrie ellipsoïdale orientée le long des axes de corrélation. Dans ce contexte d’ellipticité prononcée, la distance euclidienne échoue dramatiquement à discriminer les points hautement probables des points profondément anormaux. Une observation située à l’extrémité de l’axe majeur de l’ellipsoïde partagera exactement la même distance euclidienne par rapport au centroïde qu’un point situé à la même distance physique sur l’axe mineur. Pourtant, le premier individu s’inscrit parfaitement dans la trajectoire de corrélation naturelle des variables, tandis que le second viole frontalement la relation d’interdépendance structurelle qui unit les construits.
La distance de Mahalanobis opère une correction géométrique déterminante face à cette déformation spatiale. En intégrant la matrice de variance-covariance, elle réalise une rotation des axes de dispersion le long des composantes principales de l’hyperellipsoïde, suivie d’une re-standardisation de ces axes en fonction de leurs valeurs propres respectives. Par cette opération d’homogénéisation statistique, la métrique déforme l’espace ellipsoïdal pour le transformer en un espace sphérisé. Ainsi, un individu présentant une dissociation majeure entre deux dimensions d’ordinaire étroitement associées se verra attribuer une distance de Mahalanobis extrêmement substantielle, trahissant immédiatement l’atypicité de son profil cognitif ou émotionnel, même si son éloignement métrique euclidien brut semblait parfaitement modéré au regard des valeurs extrêmes de l’échantillon global.
1.3 Rôle fondamental de la matrice de covariance
L’épicentre du formalisme de Mahalanobis réside dans l’exploitation analytique de la matrice de variance-covariance de l’échantillon, traditionnellement désignée par la lettre S. Cette matrice carrée de dimensions p × p compile sur sa diagonale principale les variances univariées estimées de chaque indicateur quantitatif, reflétant l’amplitude de dispersion des réponses individuelles, tandis que ses cellules extra-diagonales hébergent les covariances bilatérales estimant le degré de covariation partagé par chaque paire de variables. La puissance analytique de la distance découle de l’inversion pure et simple de cette matrice, notée S⁻¹.
L’inversion de la matrice de covariance accomplit deux régulations méthodologiques majeures. Premièrement, elle normalise les variances individuelles en pondérant chaque écart univarié par l’inverse de la variabilité propre de l’indicateur. Ce mécanisme neutralise mécaniquement les biais d’échelle susceptibles d’induire en erreur les observateurs. Deuxièmement, elle décompose et soustrait l’effet des redondances métriques. Si deux sous-tests d’une batterie neuropsychologique mesurent des facettes très similaires de la vitesse de traitement de l’information avec un coefficient de corrélation bivarié de r = 0,85, l’algorithme ne comptera pas deux fois cette déviation spatiale. La matrice inverse pondère à la baisse l’information partagée afin d’isoler l’apport d’information unique véhiculé par chaque dimension, protégeant ainsi l’analyste contre l’amplification artificielle de la distance provoquée par l’empilement d’épreuves redondantes.
Néanmoins, la manipulation de la matrice de variance-covariance impose une vigilance mathématique aiguë concernant son conditionnement numérique. Pour qu’une matrice soit inversible, son déterminant doit être strictement supérieur à zéro. Si une variable de l’ensemble d’indicateurs s’avère être une combinaison linéaire exacte d’autres variables, ou si les corrélations entre prédicteurs approchent la perfection absolue (atteignant par exemple des coefficients de r = 0,98 ou 0,99), la matrice devient singulière ou sévèrement mal conditionnée. Dans une telle conjoncture de quasi-singularité, l’opération matricielle échoue ou génère des instabilités computationnelles extrêmes. Les distances de Mahalanobis résultantes peuvent alors atteindre des magnitudes artificiellement infinies ou erratiques, produisant de faux diagnostics d’aberrance statistique et compromettant irrémédiablement la fiabilité de la modélisation sous-jacente.
2. Utilité méthodologique de la détection des valeurs aberrantes multivariées
2.1 Impact des observations atypiques sur la validité des modèles psychométriques
L’omission du contrôle des observations multivariées aberrantes préalablement à toute entreprise de modélisation mathématique fait peser des risques majeurs sur l’édifice de la preuve quantitative en sciences psychologiques. Au premier rang de ces distorsions figure la corruption systématique des coefficients de corrélation de Pearson, qui forment le substrat computationnel de la quasi-totalité des modélisations avancées. Une observation multivariée atypique, située en marge de la covariance naturelle des populations étudiées, possède un bras de levier disproportionné susceptible d’atténuer artificiellement une relation statistique robuste ou, inversement, de créer de toutes pièces une association fallacieuse entre des construits conceptuellement indépendants.
Dans le domaine de l’évaluation psychométrique rigoureuse, la contamination de la matrice empirique par des valeurs aberrantes altère directement les indices de consistance interne, à l’instar de l’alpha de Cronbach ou de l’oméga de McDonald, en introduisant du bruit résiduel erratique qui gonfle de manière artificielle la variance d’erreur de mesure non systématique. Les estimations de fidélité s’en trouvent substantiellement dégradées, ce qui pénalise injustement la qualité apparente des instruments de mesure standardisés. Les conséquences s’avèrent encore plus dévastatrices au sein des analyses dimensionnelles complexes, telles que la modélisation par équations structurelles (SEM). Dans ces cadres d’ajustement global, quelques profils aberrants suffisent à détériorer dramatiquement les indices de qualité d’ajustement usuels, provoquant une augmentation artificielle du Chi-deux de discordance, une baisse du Comparative Fit Index (CFI) et une inflation inadmissible du Root Mean Square Error of Approximation (RMSEA).
Sur le plan décisionnel de l’inférence statistique, la présence non régulée d’observations multivariées extrêmes perturbe profondément le contrôle des erreurs de décision méthodologique. En élargissant artificiellement les intervalles de confiance et en distordant les erreurs types d’estimation des coefficients de régression ou des saturations factorielles, ces cas aberrants diminuent la puissance statistique intrinsèque des protocoles, favorisant la survenue d’erreurs de type II (rejet injustifié d’une hypothèse réelle). Inversement, lorsque l’anomalie produit un levier unilatéral exacerbé, elle peut engendrer des erreurs de type I en validant des trajectoires prédictives non généralisables, conduisant les chercheurs à édifier des théories psychologiques fragiles sur de simples artefacts statistiques.
2.2 Distinction formelle entre anomalies univariées et multivariées
Une confusion méthodologique persistante chez les praticiens de l’analyse de données réside dans la croyance erronée selon laquelle une inspection univariée méticuleuse suffirait à garantir l’assainissement intégral d’un jeu de données quantitatives. L’examen classique des valeurs aberrantes univariées s’appuie habituellement sur la conversion des scores bruts en scores standardisés z ou sur l’analyse des boîtes à moustaches de Tukey basée sur l’écart interquartile. Or, ces méthodes sont totalement aveugles aux configurations atypiques résultant de la conjonction paradoxale de plusieurs variables qui s’avèrent, prises individuellement, parfaitement conformes aux normes attendues.
Prenons une illustration concrète issue de la neuropsychologie du vieillissement : considérons deux variables normées sur une population générale adulte, à savoir l’âge chronologique d’un participant et son score total à une batterie d’évaluation cognitive globale, tel que le Mini-Mental State Examination (MMSE). Un score de 28 au MMSE est rigoureusement normal (score univarié z proche de 0). De même, un âge de 22 ans s’inscrit sans équivoque dans les limites de l’échantillon normatif pour une étude ciblant l’ensemble du cycle de vie adulte. Si nous examinons ces deux indicateurs de manière isolée au moyen de diagrammes en boîte, aucun signal d’alarme statistique ne retentira. En revanche, si la même base de données enregistre un participant âgé de 89 ans obtenant un score parfait de 30 au MMSE avec une vitesse de traitement digne d’un adulte jeune, ou inversement un individu de 20 ans présentant un déficit cognitif sévère au MMSE sans antécédent médical particulier, la combinaison de ces deux valeurs engendre une discordance radicale vis-à-vis du patron de covariance générale de l’échantillon.
Dans l’administration de questionnaires psychométriques d’auto-évaluation en ligne, cette cécité univariée se manifeste couramment par des profils de réponse incohérents. Des participants peu consciencieux peuvent adopter des schémas d’adhésion systématique à des énoncés contradictoires (par exemple, s’attribuer simultanément un score maximal sur une sous-échelle d’extraversion sociale expansive et un score tout aussi maximal sur une échelle de phobie sociale évitante sévère). Prises une à une, ces réponses maximales entrent parfaitement dans l’éventail des possibles de l’échelle d’évaluation. C’est uniquement la violation de la covariance négative sous-jacente entre ces deux construits antagonistes qui dévoile la nature multivariée de l’anomalie, laquelle demeure insoupçonnable sans le recours explicite à un calcul vectoriel comme celui de Mahalanobis.
2.3 Applications directes en recherche quantitative et clinique
L’exploitation de la distance de Mahalanobis répond à des finalités pragmatiques décisives, tant dans l’optimisation de la qualité des données épidémiologiques que dans la finesse du diagnostic clinique individualisé. L’une de ses applications contemporaines majeures concerne l’identification et l’épuration des réponses collectées auprès d’échantillons en ligne non supervisés (tels que ceux recrutés via Amazon Mechanical Turk ou Prolific). Face aux phénomènes croissants d’inattention, d’usage de robots automatisés, de stratégies de réponses aléatoires ou de désirabilité sociale extrême, la distance de Mahalanobis calculée sur l’ensemble des items d’une batterie permet d’isoler avec une précision chirurgicale les vecteurs de réponses dont l’incohérence interne défie les probabilités statistiques de l’échantillon sincère.
En neuropsychologie et en pédopsychiatrie développementale, cette métrique se convertit en un instrument d’investigation sémiologique puissant. Elle offre l’opportunité d’isoler des profils cognitifs singuliers ou atypiques au sein de cohortes cliniques hétérogènes. Par exemple, chez des enfants évalués pour des troubles spécifiques du neurodéveloppement, la distance de Mahalanobis appliquée aux indices composites d’une échelle d’intelligence permet de repérer des dissociations inter-indices exceptionnelles (telles qu’une disparité gigantesque entre l’indice de raisonnement fluide et l’indice de mémoire de travail). Ce diagnostic ne sanctionne plus une erreur d’échantillonnage, mais met en lumière des endophénotypes cognitifs particuliers requérant des explorations cliniques qualitatives ciblées et des aménagements pédagogiques individualisés.
Enfin, en méthodologie expérimentale pure, la distance de Mahalanobis constitue le garant indispensable de la viabilité des protocoles préalablement à la conduite d’analyses multivariées de variance (MANOVA) ou de régressions logistiques multivariées. Dans la mesure où la MANOVA évalue les disparités de moyennes de groupes sur une pluralité de variables dépendantes simultanées, la moindre distorsion ellipsoïdale induite par deux ou trois observations multivariées aberrantes peut fausser dramatiquement le calcul des traces matricielles (Trace de Pillai, Lambda de Wilks), conduisant à des inférences expérimentales totalement erronées sur l’efficacité relative de protocoles thérapeutiques ou d’interventions éducatives.
3. Conditions préalables et postulats statistiques sous SPSS
3.1 Hypothèse de normalité multivariée
L’application rigoureuse de la distance de Mahalanobis et l’interprétation inférentielle de ses valeurs s’adossent à un cadre probabiliste exigeant, dont le postulat fondamental réside dans l’hypothèse de distribution normale multivariée des variables considérées. Ce postulat théorique stipule que non seulement chaque variable individuelle doit être distribuée selon une loi gaussienne univariée, mais également que chaque paire d’indicateurs doit suivre une distribution normale bivariée, et que l’ensemble des combinaisons linéaires possibles de ces variables doit former une distribution normale au sein de l’hyperespace considéré. Sous cette condition stricte, les surfaces d’égale densité de probabilité dessinent des hyperellipsoïdes concentriques parfaits autour du centroïde multidimensionnel.
Avant d’engager le calcul sous SPSS, l’analyste se doit de vérifier la normalité univariée de chaque variable explicative en inspectant scrupuleusement les coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis). Des valeurs d’asymétrie comprises entre -1 et +1, et d’aplatissement entre -2 et +2, sont généralement considérées comme tolérables dans les échantillons de taille substantielle. Néanmoins, la conformité univariée ne certifie nullement la normalité conjointe. Bien que l’interface standard de base de SPSS ne propose pas par défaut le célèbre test omnibus de normalité multivariée de Mardia (fondé sur les coefficients multivariés d’asymétrie et d’aplatissement), il demeure impératif d’évaluer la linéarité bivariée via des matrices de diagrammes de dispersion croisés pour s’assurer de l’absence de courbures polynomiales ou d’hétéroscédasticité multivariée marquée.
Il importe toutefois de souligner la robustesse relative de la métrique brute de Mahalanobis. La distance elle-même peut être calculée sur n’importe quel ensemble de données continues, quelle que soit leur distribution de base, car il s’agit d’une opération d’algèbre matricielle déterministe. La contrainte de normalité multivariée n’intervient véritablement de manière impérative que lorsque le chercheur ambitionne de convertir cette distance en une valeur de probabilité statistique en la comparant aux distributions théoriques d’échantillonnage. En cas de non-normalité multivariée sévère, le test d’hypothèse associé à la distance devient conservateur ou erratique, majorant le risque de mal classifier des unités statistiques.
3.2 Évaluation de la multicollinéarité et de la singularité
Le second verrou statistique impératif avant toute exploitation algorithmique de la distance de Mahalanobis concerne le contrôle strict de la collinéarité entre les indicateurs quantitatifs. La matrice de variance-covariance devant faire l’objet d’une inversion formelle pour obtenir la matrice de précision Σ⁻¹, toute situation de multicollinéarité extrême ou de singularité matricielle compromet la faisabilité ou la stabilité du calcul mathématique dans les processeurs de calcul de SPSS.
La multicollinéarité survient dès lors que certaines variables explicatives partagent des niveaux d’intercorrélation excessivement intenses (typiquement supérieurs à r = 0,90), signalant une redondance presque absolue dans le recueil des signaux de mesure. La singularité, pour sa part, correspond au cas extrême où une variable est une dépendance linéaire rigide d’une autre (par exemple, la saisie concomitante des scores bruts à trois sous-échelles et du score total correspondant à leur somme arithmétique exacte). Pour diagnostiquer ces pathologies d’information sous SPSS, le chercheur doit recourir aux indices de collinéarité disponibles dans le module de régression, notamment le facteur d’inflation de la variance (Variance Inflation Factor ou VIF) et son corollaire mathématique direct, la tolérance (égale à 1 / VIF). Une tolérance descendant sous le seuil critique de 0,10 ou un VIF s’envolant au-delà de 10 signale une collinéarité pathologique qui commande une remédiation urgente.
Face à une matrice mal conditionnée, l’analyste doit impérativement intervenir avant le calcul des distances sous peine de voir émerger des résultats aberrants dénués de toute signification empirique. Deux stratégies s’imposent : soit exclure purement et simplement la variable redondante de l’ensemble d’indicateurs, soit procéder à une réduction préalable de dimensionnalité via une Analyse en Composantes Principales (ACP) ou la création d’un score factoriel composite unifié. Cette réduction factorielle préliminaire assainit l’espace vectoriel tout en conservant l’exhaustivité de l’information variance partagée par les instruments psychométriques.
3.3 Taille minimale d’échantillon et ratio sujets/variables
L’estimation de la matrice de variance-covariance empirique dépend directement de la puissance et de la représentativité de l’échantillon analysé. Dans les espaces géométriques multidimensionnels, le fléau de la dimensionnalité (curse of dimensionality) induit une instabilité exponentielle des estimations paramétriques lorsque le nombre de variables s’accroît par rapport au volume global d’observations recensées.
Les recommandations méthodologiques admises stipulent l’observance d’un ratio minimal absolu entre le nombre de cas valides (N) et le nombre de variables quantitatives (p) soumises à la modélisation. Un ratio minimal de 20 observations par indicateur (N/p ≥ 20:1) constitue le consensus préconisé pour garantir une stabilité satisfaisante de la matrice d’intercorrélation. Des ratios inférieurs, bien que tolérés jusqu’à la limite plancher de 10:1 dans certaines configurations exploratoires restreintes, exposent l’investigateur à un biais d’échantillonnage sévère. Lorsque le nombre de sujets se rapproche du nombre de prédicteurs, la matrice de covariance devient fragile, les centroïdes sont artificiellement attirés vers les observations individuelles, et la capacité statistique à détecter de véritables anomalies multivariées s’effondre dramatiquement par manque de degrés de liberté résiduels.
Dans les cohortes de très petite dimension (par exemple N < 30 avec 5 ou 6 variables psychométriques complexes), l’estimation de la distance de Mahalanobis souffre d’un phénomène de sous-estimation systématique des distances réelles pour les points les plus excentrés, doublé d’une sur-influence des cas individuels sur le positionnement du centre géométrique commun. L’analyste se doit de garder à l’esprit que l’adéquation de la distance calculée à la loi théorique du Chi-deux dépend intimement des propriétés asymptotiques de l’échantillon : plus N est important, plus la convergence vers la distribution de référence s’avère fidèle et robuste.
4. Configuration du jeu de données dans l’interface SPSS
4.1 Préparation et typage des variables psychométriques
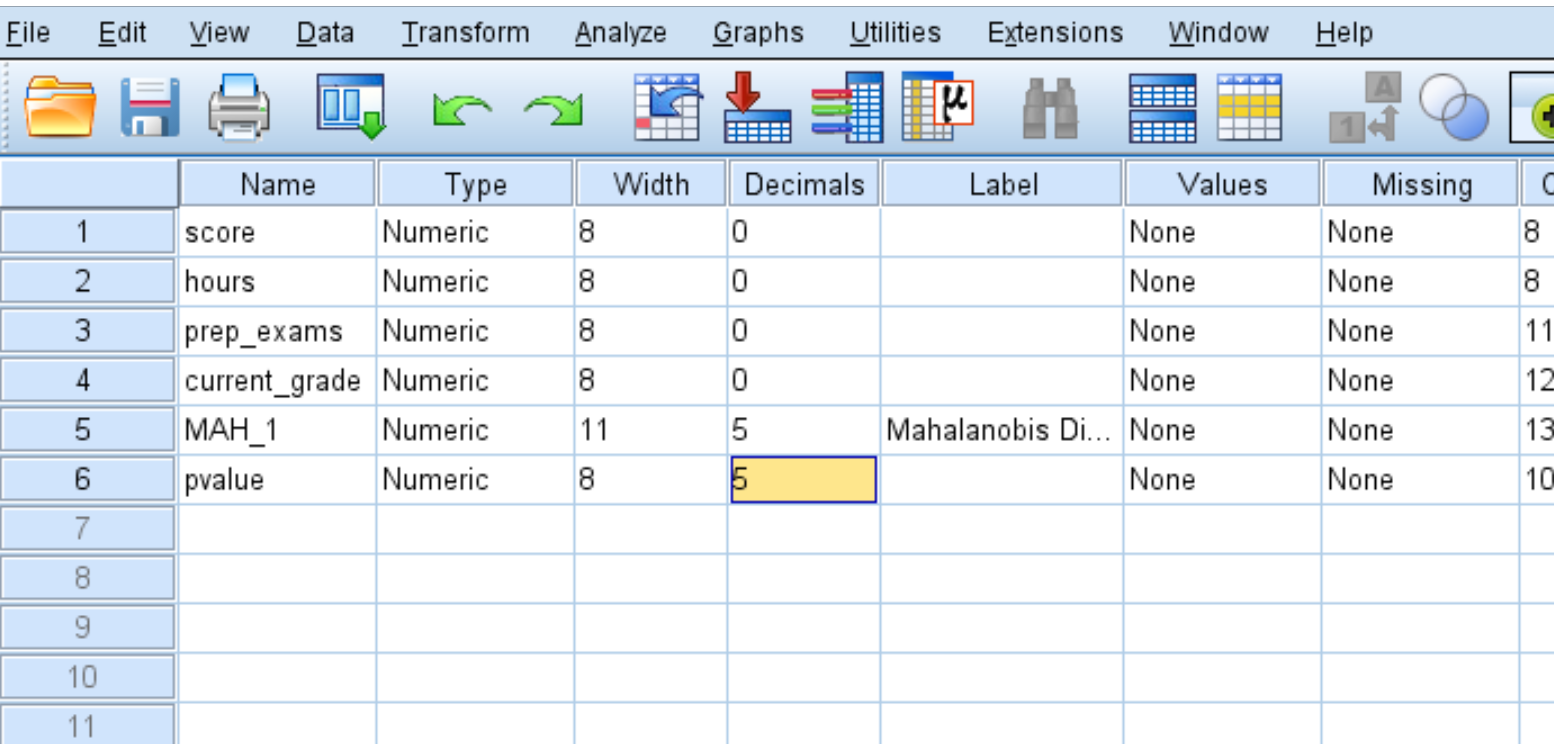
L’initialisation d’un calcul rigoureux sous SPSS commande une préparation soignée des fichiers de données au sein de la « Vue des variables ». La distance de Mahalanobis étant exclusivement conçue pour opérer sur des grandeurs géométriques continues traduisant des intervalles mesurables, il est impératif de vérifier le statut d’échelle de chaque variable psychométrique sélectionnée. Les indicateurs doivent impérativement appartenir au niveau de mesure « Échelle » (intervalle ou rapport). L’intégration de variables purement catégorielles, qu’elles soient nominales (telles que le genre ou le centre hospitalier) ou ordinales à faibles catégories sans continuité sous-jacente, est formellement proscrite dans le calcul standard, sous peine de violer la géométrie euclidienne et les propriétés de covariance de l’espace métrique.
L’analyste veillera également à une désignation sans équivoque des étiquettes de variables et au calibrage adéquat des décimales pour éviter tout tronquage numérique involontaire durant les routines algorithmiques. Une attention scrupuleuse sera portée aux échelles inversées : dans les questionnaires psychologiques intégrant des items formulés de manière antagoniste pour prévenir les biais d’acquiescement, il est fondamental de recoder préalablement l’ensemble des items dans une même polarité directionnelle si l’on s’appuie sur des variables d’items individuels, ou d’utiliser les scores composites validés reflétant la direction théorique attendue du construit.
Enfin, il est vivement conseillé de procéder à un examen préliminaire des bornes numériques acceptables. La saisie d’un score hors de l’éventail possible d’un inventaire clinique (par exemple, encoder un score de 77 sur une échelle théoriquement plafonnée à 7) engendre instantanément une valeur multivariée aberrante qui n’est que le reflet d’une erreur d’encodage humain. Le nettoyage systématique des erreurs typographiques univariées en amont conditionne l’efficacité réelle de l’exploration multidimensionnelle ultérieure.
4.2 Traitement des valeurs manquantes et incohérentes
La présence de valeurs manquantes (missing data) au sein des variables psychométriques représente une source de perturbation substantielle pour le calcul des distances matricielles dans l’environnement SPSS. Par défaut, les routines de modélisation linéaire du logiciel adoptent un comportement d’exclusion des observations observation par observation (exclusion dite « listwise » ou globale). Cela implique que si un participant a complété 9 variables sur les 10 requises, son enregistrement sera intégralement éliminé de l’analyse, réduisant mécaniquement la taille effective de l’échantillon et amputant potentiellement le calcul de sa représentativité.
Pour prévenir cette déperdition de puissance et les biais d’attrition différentielle, le chercheur doit préalablement documenter le mécanisme générateur des données manquantes en mobilisant le module « Analyse des valeurs manquantes » (Missing Value Analysis) sous SPSS. Si l’hypothèse de données manquantes de manière complètement aléatoire (Missing Completely at Random ou MCAR) est étayée par le test de Little, plusieurs alternatives s’offrent à l’analyste. Si le taux de valeurs manquantes demeure résiduel (inférieur à 2 % ou 3 % de l’ensemble de la matrice), une procédure d’imputation rigoureuse basée sur l’algorithme d’Espérance-Maximisation (EM) ou une imputation multiple par équations chaînées peut être mobilisée pour restaurer l’intégrité de la matrice sans introduire de distorsions délétères.
En revanche, lorsque les observations incomplètes comportent des omissions massives, l’élimination préalable raisonnée de ces unités statistiques s’impose comme une nécessité méthodologique. Les calculs de covariances sous-jacents ne sauraient souffrir d’imputations aléatoires hasardeuses qui viendraient densifier artificiellement le centroïde au détriment de la variance réelle des construits évalués.
4.3 Création d’un identifiant unique d’observation
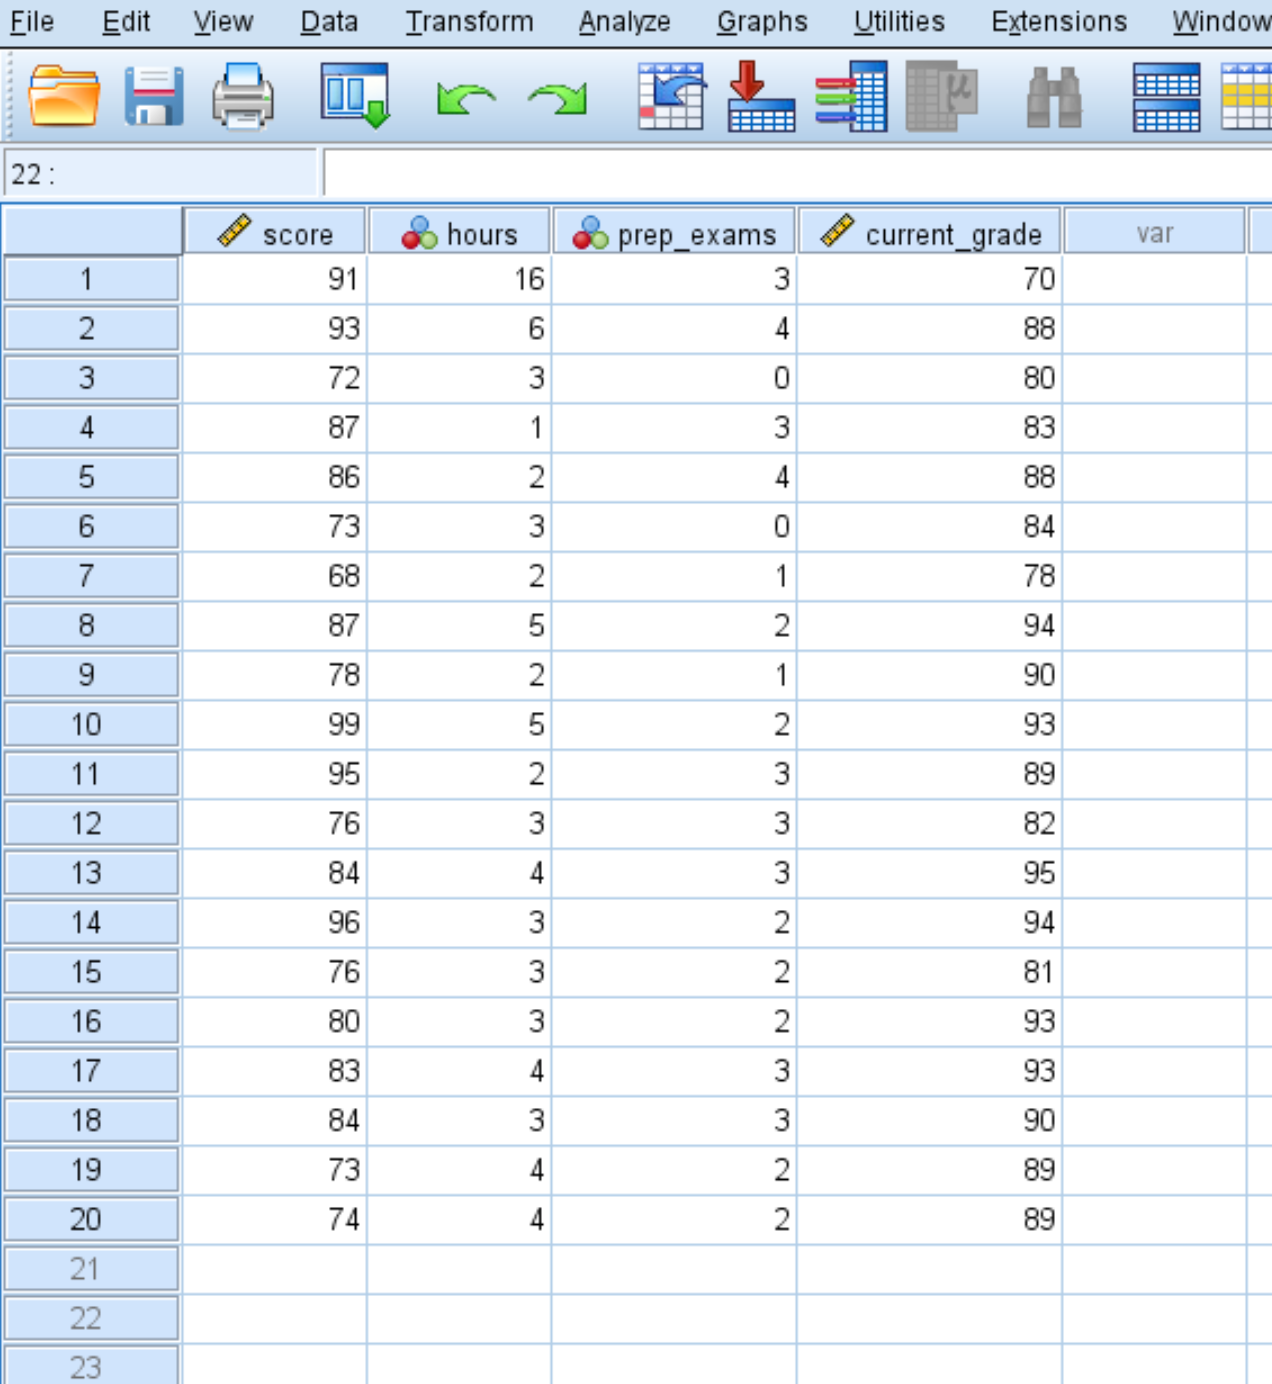
Une précaution procédurale indispensable, fréquemment négligée par les chercheurs débutants, réside dans l’adjonction formelle d’une variable identifiante primaire, unique et non ambiguë, pour chaque ligne du fichier SPSS. Dans le déroulement ordinaire de l’analyse des données aberrantes, le tableau de données subit une multitude d’opérations de manipulation : tris ascendants ou descendants des distances, filtrages sélectifs, scissions d’échantillons ou fusions de fichiers complémentaires. Si le fichier ne dispose pas d’un identifiant structurel fixe, le repérage intuitif basé sur le simple numéro de ligne de la fenêtre SPSS expose le praticien à des erreurs de traçabilité fatales, conduisant parfois à exclure par méprise des sujets parfaitement sains.
Pour générer cet identifiant séquentiel de manière automatisée et reproductible sans risque de fausse manipulation manuelle, il suffit d’exploiter la fonction interne de numérotation du logiciel. En ouvrant le menu « Transformer » puis « Calculer la variable », le chercheur peut déclarer une nouvelle cible dénommée judicieusement ID_Participant et lui assigner dans la boîte d’expression arithmétique la syntaxe suivante :
$CASENUM
Cette variable système instancie immédiatement un code numérique entier croissant (1, 2, 3, …, N) strictement associé à chaque enregistrement d’origine. Désormais, quels que soient les bouleversements ultérieurs appliqués à l’ordre d’affichage des lignes du fichier, chaque profil de réponse reste rattaché de manière inaltérable à sa clé primaire, garantissant un audit transparent et sécurisé de toutes les décisions de purification statistique ultérieures.
5. Procédure pas à pas : calcul via le module de régression linéaire
5.1 Justification méthodologique de l’utilisation de la régression linéaire
L’une des singularités opérationnelles les plus fascinantes du logiciel SPSS réside dans le fait qu’il ne comporte aucun menu direct explicitement intitulé « Calculer la distance de Mahalanobis » dans ses sous-onglets de statistique descriptive élémentaire. Pour extraire cette métrique matricielle sophistiquée, l’analyste doit faire appel à un artifice méthodologique ingénieux mais rigoureusement fondé sur le plan des mathématiques computationnelles : le recours au module de régression linéaire multiple des moindres carrés ordinaires (MCO).
Ce détour opérationnel s’explique par la nature interne des algorithmes de régression. Pour résoudre l’équation des coefficients β = (XᵀX)⁻¹XᵀY, l’algorithme d’inversion matricielle de la régression linéaire sous SPSS doit impérativement calculer la matrice de dispersion et de covariance des prédicteurs (la matrice X des variables indépendantes). Les concepteurs de SPSS ont judicieusement greffé les diagnostics de levier et de distances géométriques au cœur de cette étape d’inversion matricielle. Ainsi, la distance de Mahalanobis est disponible à titre d’option de sauvegarde au sein de ce module analytique.
Il est fondamental de rassurer le praticien sur un point d’une importance capitale : la variable dépendante (VD) assignée dans le module de régression n’exerce absolument aucune influence sur la valeur numérique de la distance de Mahalanobis calculée. En effet, par définition mathématique stricte, la métrique évalue l’éloignement d’un point uniquement au sein de l’hyperespace formé par le bloc des variables indépendantes (VI). Que l’analyste utilise comme variable dépendante une dimension psychologique continue quelconque, une variable arbitraire générée aléatoirement, ou même la variable d’identification séquentielle ID_Participant créée précédemment, le vecteur de distance résultant demeurera rigoureusement identique jusqu’à la dernière décimale. L’identifiant ID_Participant s’impose d’ailleurs en pratique comme la variable dépendante idéale pour ce protocole, évitant d’exclure arbitrairement l’un des construits psychologiques substantiels de l’espace multidimensionnel à assainir.
5.2 Paramétrage précis des menus déroulants de SPSS
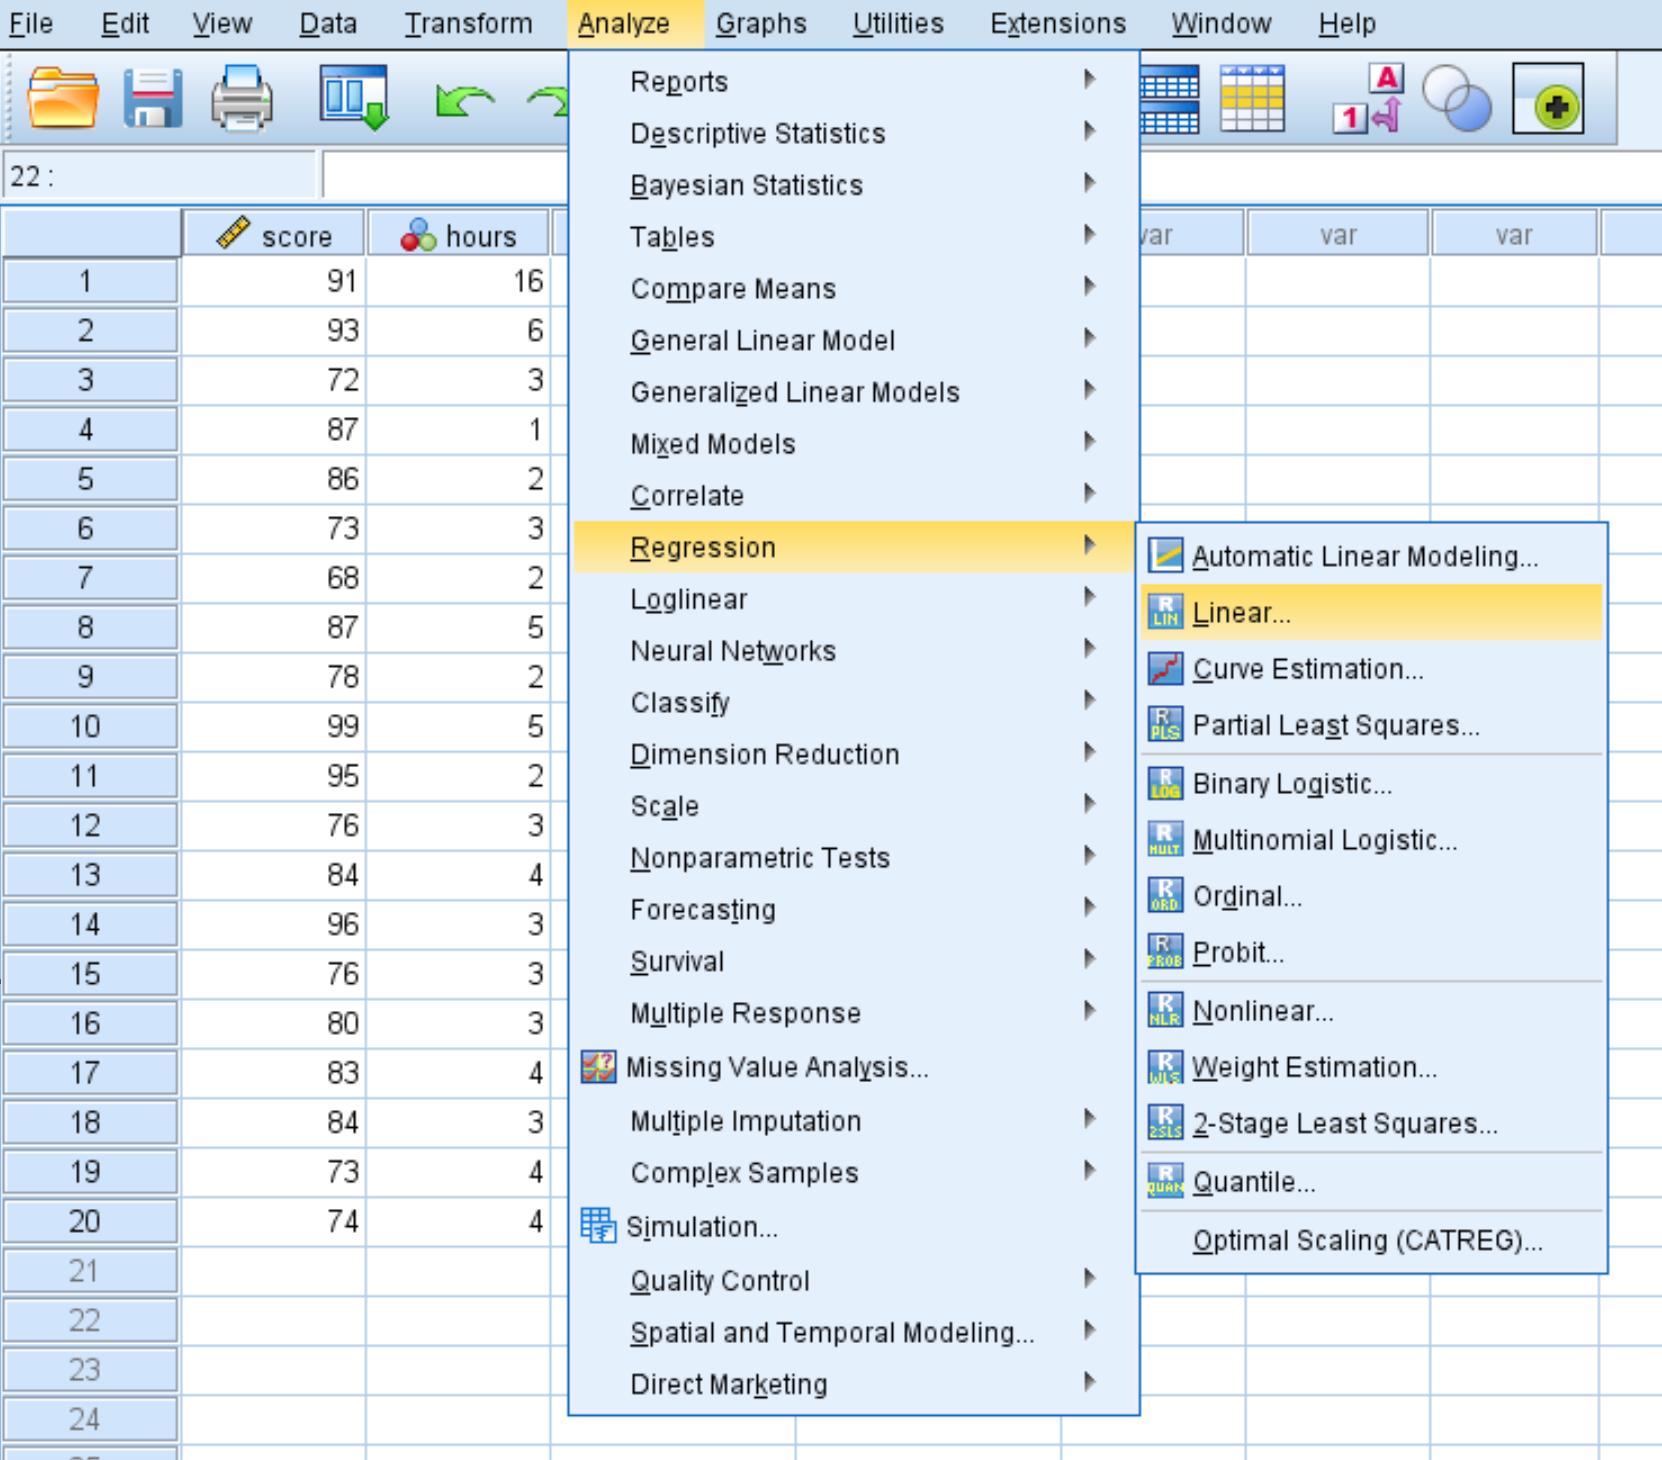
L’exécution de la procédure s’effectue au travers de la navigation ergonomique de l’interface graphique du logiciel. Le chercheur accède à la séquence suivante depuis la barre de menu principale supérieure :
Analyser > Régression > Linéaire…
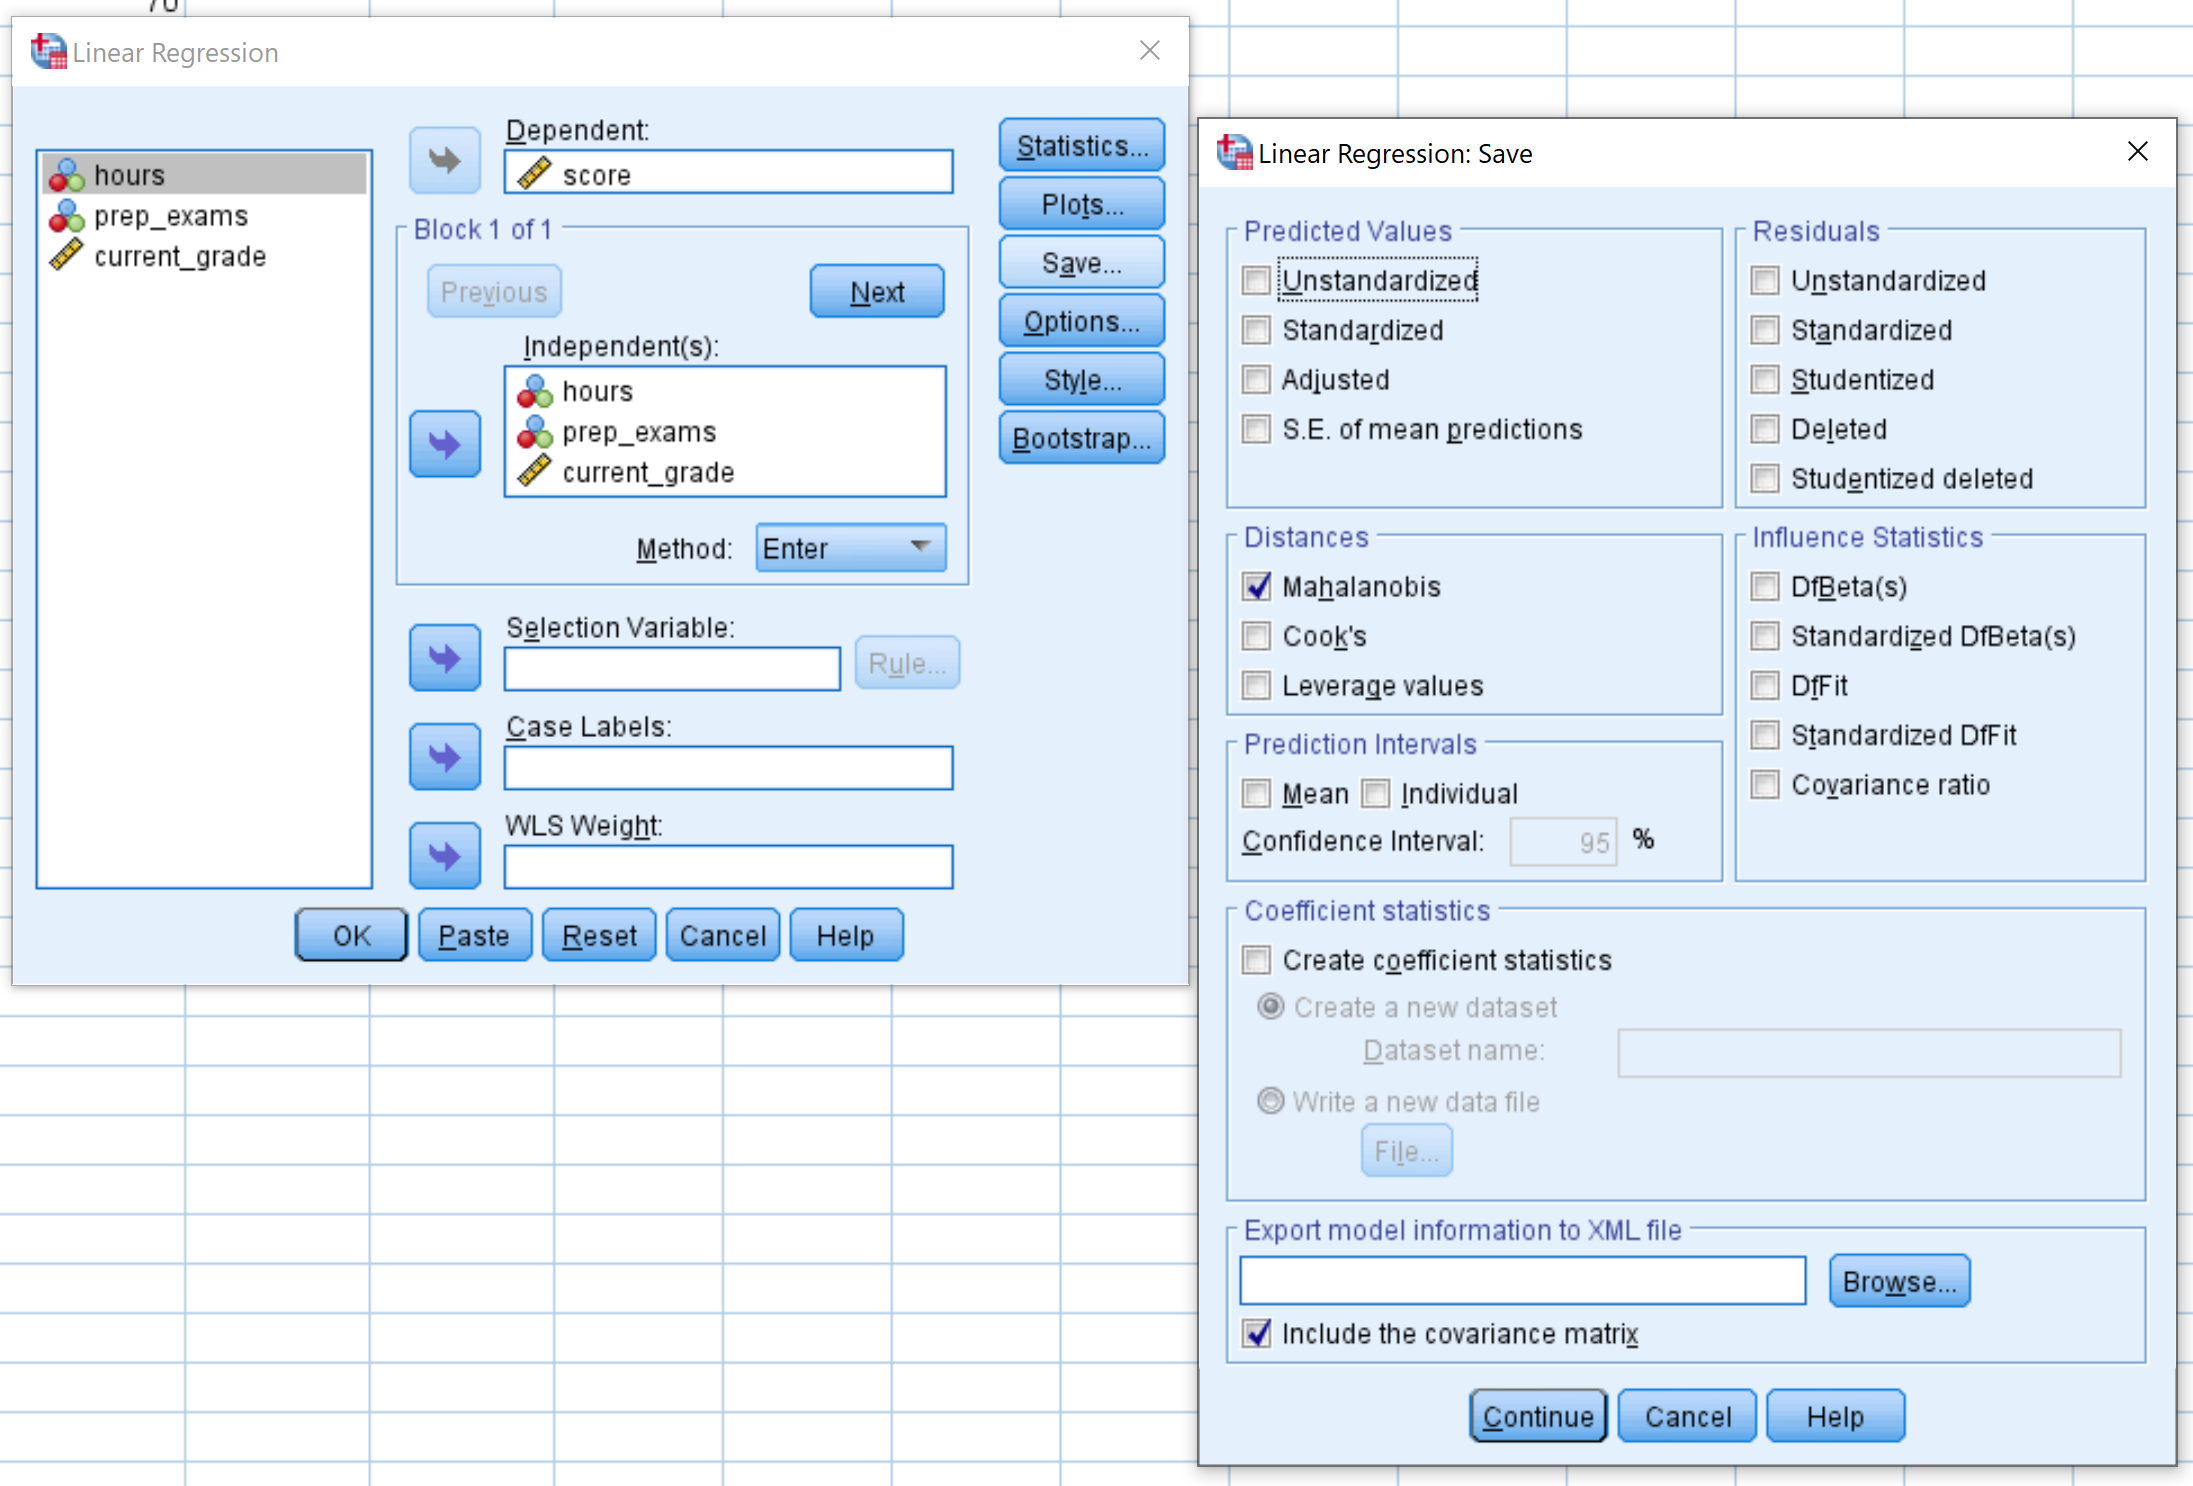
Cette commande déploie instantanément la boîte de dialogue centrale de configuration du modèle de régression linéaire. La première action consiste à transférer la variable identifiante ID_Participant depuis la liste générale des variables de gauche vers le champ récepteur intitulé « Dépendante : ». Cette manœuvre satisfait l’obligation syntaxique du logiciel d’associer une cible d’estimation sans altérer la modélisation de l’espace prédictif.
La seconde phase, au cœur même de l’architecture de détection, réside dans le transfert collectif de l’ensemble des variables psychométriques d’intérêt quantitatif dans la zone désignée sous l’étiquette « Indépendantes (bloc 1 sur 1) : ». Il convient d’y insérer rigoureusement toutes les variables continues qui délimitent l’hyperespace au sein duquel on suspecte l’existence d’observations multivariées aberrantes. La méthode de sélection par défaut « Entrée » (Enter) doit être scrupuleusement conservée, afin de forcer l’algorithme à traiter conjointement et simultanément la totalité des dimensions sélectionnées dans la même matrice de covariance globale, sans procéder à des éliminations progressives non désirées (comme le feraient les méthodes pas à pas descendantes ou ascendantes).
5.3 Sélection des options de diagnostic et sauvegarde
Une fois les variables correctement positionnées dans les champs respectifs, l’utilisateur ne doit pas valider immédiatement l’analyse, mais orienter son attention vers la série de boutons d’options annexes situés sur la bordure latérale droite de la boîte de dialogue. Il convient de cliquer précisément sur le bouton libellé « Enregistrer… » (ou Save… dans les versions anglophones de l’environnement).
Cette action ouvre une sous-fenêtre dédiée aux diagnostics d’influence et à la préservation des résidus dans la base de travail active. Cette interface est subdivisée en plusieurs sections d’analyse prédictive : « Valeurs prévues », « Résidus », « Distances », « Statistiques d’influence » et « Intervalles de prévision ». L’analyste se focalise sans équivoque sur le bloc intitulé « Distances ». Au sein de cette section spécifique, figurent trois cases à cocher : « Mahalanobis », « Cook » et « Valeurs de levier ». Il est nécessaire de cocher explicitement l’option « Mahalanobis ».
Pour parfaire la configuration, le chercheur clique sur le bouton « Poursuivre » (Continue) situé au bas de cette boîte secondaire, ce qui le ramène à la fenêtre maîtresse de régression linéaire. Dès lors, il ne reste plus qu’à cliquer sur « OK » pour exécuter le calcul. Les processeurs de SPSS procèdent alors instantanément à l’inversion de la matrice de covariance des prédicteurs, projettent chaque observation dans l’hyperespace vectoriel résultant, et créent directement une nouvelle colonne dans le tableau de données actif sans écraser les mesures préexistantes.
6. Exploration et interprétation des résultats initiaux dans la matrice SPSS
6.1 Apparition et structure de la nouvelle variable MAH_1
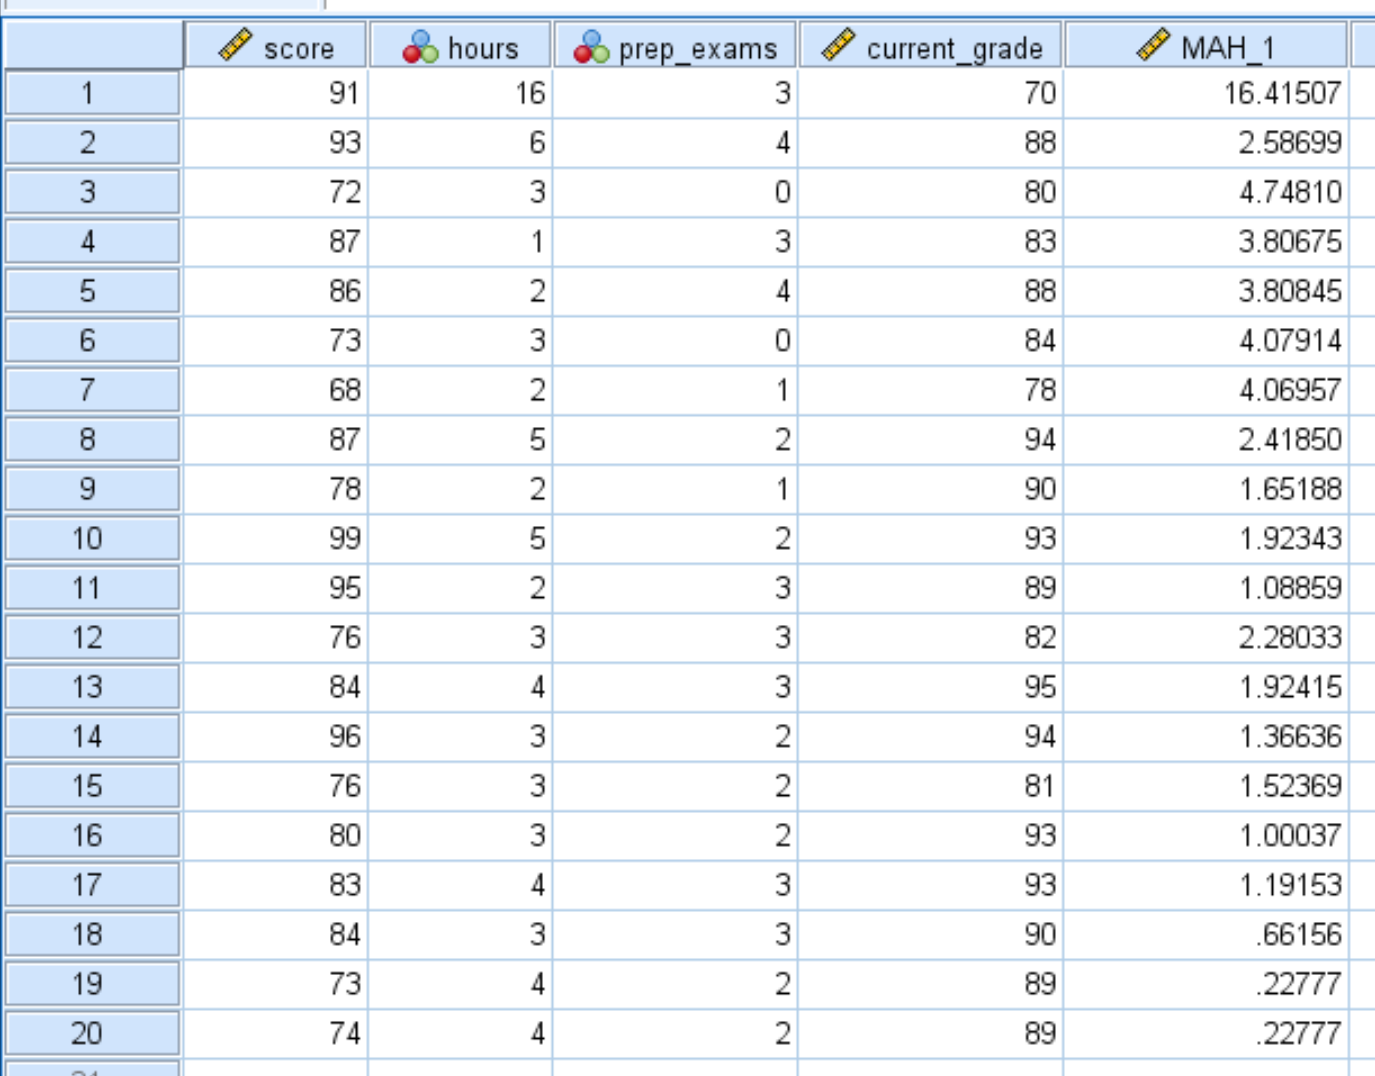
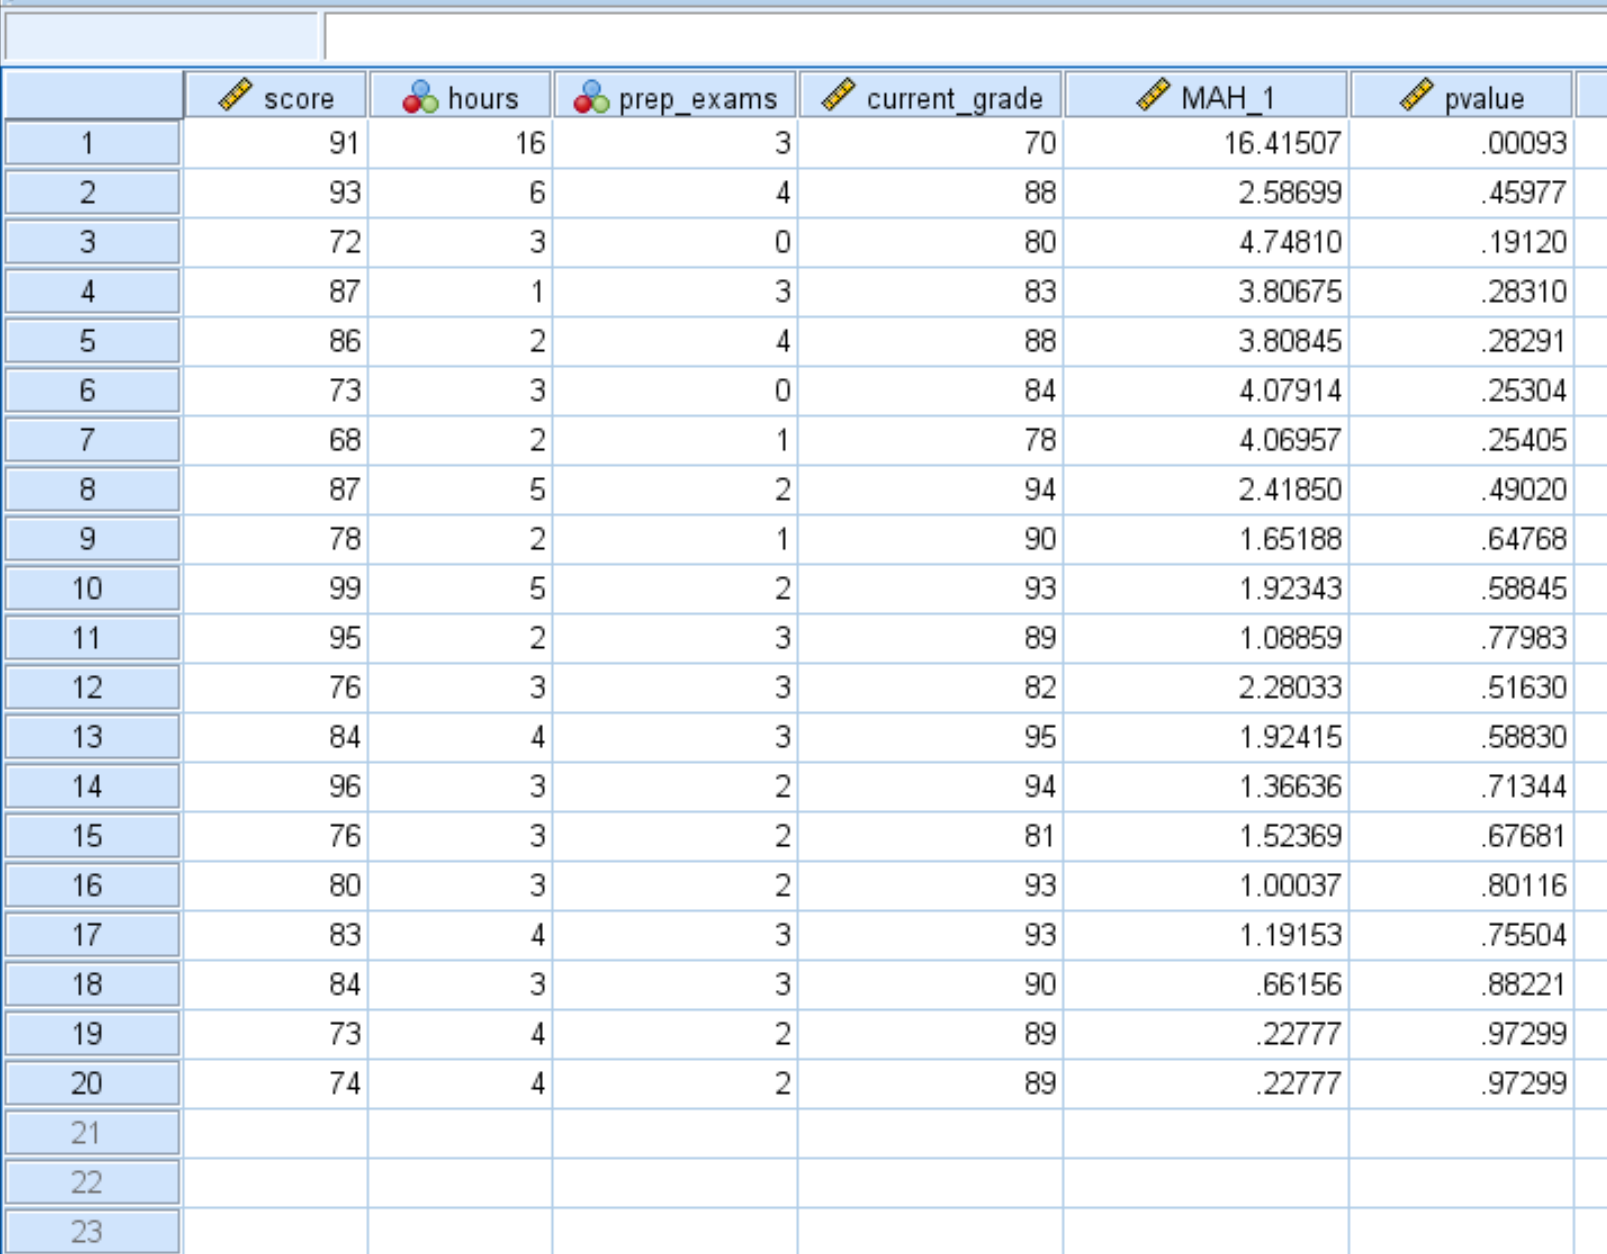
À l’issue de l’exécution de l’algorithme, la fenêtre des sorties textuelles de SPSS (Output Viewer) affiche les tableaux standard de la régression (récapitulatif des modèles, ANOVA, coefficients). Bien que ces résultats soient dénués d’intérêt substantiel compte tenu de l’utilisation instrumentale de la régression, l’événement majeur se produit directement au sein de la « Vue des données » (Data View) du fichier source. Une colonne inédite s’est automatiquement générée à l’extrémité droite du tableau matriciel, baptisée par convention logicielle interne MAH_1.
Cette variable MAH_1 consigne, pour chacune des unités statistiques de l’échantillon, la valeur numérique brute de sa distance de Mahalanobis au carré par rapport au centroïde défini par les variables explicatives sélectionnées. Chaque cellule contient ainsi un nombre réel positif non nul reflétant l’éloignement multidimensionnel spécifique du participant concerné. Une valeur modeste indique une grande proximité probabiliste avec le profil moyen conjoint de l’échantillon, tandis qu’une valeur colossale trahit un éloignement spatial prononcé.
La première manipulation exploratoire consiste à visualiser rapidement les profils les plus distants. Pour ce faire, il suffit d’effectuer un clic droit sur l’en-tête de colonne de la variable MAH_1 et de sélectionner dans le menu contextuel l’option « Tri décroissant » (Sort Descending). Le tableau réordonne instantanément l’intégralité des observations, propulsant au sommet de la matrice les participants dotés des distances de Mahalanobis les plus gigantesques. Cette manœuvre permet d’identifier visuellement les quelques identifiants singuliers qui caracolent en tête de distribution et méritent une investigation probabiliste approfondie.
6.2 Analyse descriptive de la distribution des distances
L’exploration ne saurait se borner à une inspection visuelle superficielle des cas de tête ; elle requiert une consolidation par les outils de la statistique descriptive pour valider la conformité du traitement algorithmique global. L’analyste se dirige vers le menu :
Analyser > Statistiques descriptives > Descriptives…
En transférant la variable MAH_1 dans la zone d’analyse et en cochant les paramètres d’écart-type, de variance, de minimum et de maximum, le chercheur déclenche l’édition d’un tableau récapitulatif fondamental.
Il existe une propriété mathématique théorique absolument immuable et fondamentale régissant la distance de Mahalanobis : la moyenne arithmétique exacte des distances de Mahalanobis calculées sur un échantillon est rigoureusement égale au nombre de prédicteurs (k) intégrés dans l’analyse. Par exemple, si l’espace multidimensionnel a été défini à partir de 8 sous-échelles psychométriques, la moyenne de la variable MAH_1 affichée dans la table descriptive doit converger de manière spectaculairement exacte vers 8,000 (aux arrondis décimaux près). Cette propriété constitue le contrôle de cohérence algorithmique le plus implacable : tout écart significatif de la moyenne par rapport à la valeur k signerait une erreur d’exécution logicielle ou l’omission inadmissible d’une variable dans le pipeline de traitement.
L’observation du maximum descriptif renseigne quant à elle immédiatement sur l’amplitude de l’atypicité maximale enregistrée au sein du jeu de données. La comparaison informelle de ce maximum avec la moyenne théorique k permet d’appréhender intuitivement le niveau d’asymétrie de la distribution spatiale : un maximum culminant à 45 ou 50 pour une moyenne théorique de 5 ou 6 indique d’emblée la présence quasi certaine d’anomalies multivariées majeures déviant de manière drastique de la cohorte générale.
6.3 Repérage préliminaire des écarts marqués
Pour parachever ce débroussaillage exploratoire, la représentation graphique de la distribution de MAH_1 apporte une lecture intuitive irremplaçable de la structure géométrique des données. Le recours à un histogramme à haute résolution couplé à une courbe de densité gaussienne normale, accessible via le menu « Graphes > Boîtes de dialogue anciennes > Histogramme », offre une visualisation immédiate de l’asymétrie positive caractéristique des métriques de distance multidimensionnelle.
Dans un échantillon sain et dépourvu de valeurs aberrantes cataclysmiques, la distribution des distances épouse une pente continue et dégressive régulière, dénuée de rupture spatiale majeure. En revanche, la présence de valeurs multivariées aberrantes authentiques se signale sur le graphique par l’apparition de barres disjointes et isolées, reléguées très loin sur la queue droite de la distribution, formant un « gap » ou un intervalle de vacuité absolue entre la masse principale des participants et les observations suspectes. Ces points déconnectés du continuum statistique manifestent une rupture de compacité spatiale qui transcende la simple variabilité d’échantillonnage ordinaire.
Un diagramme de dispersion simple (Scatterplot) croisant la variable séquentielle ID_Participant en abscisse et la distance MAH_1 en ordonnée permet en outre de cartographier l’ensemble de la cohorte d’un seul coup d’œil. Les observations problématiques émergent immédiatement sous la forme d’étoiles solitaires dominant l’horizon supérieur du graphique, autorisant un repérage visuel quasi instantané de leurs clés d’identification primaires.
7. Détermination du seuil critique et calcul des probabilités statistiques
7.1 Association théorique avec la distribution du Chi-deux
Bien que le repérage descriptif et graphique permette d’apprécier la magnitude relative des distances de Mahalanobis, une démarche statistique rigoureuse ne saurait s’en remettre à des jugements subjectifs d’inspection visuelle. Il est indispensable d’adosser la décision d’exclusion ou de conservation à un critère inférentiel normé. C’est ici qu’intervient l’élégance probabiliste de la métrique : sous l’hypothèse de normalité multivariée au sein de la population parente, la distance de Mahalanobis au carré (D²) d’un individu suit asymptotiquement une loi théorique de distribution du Chi-deux (χ²).
Le paramétrage des degrés de liberté (df pour degrees of freedom) de cette distribution théorique répond à une règle arithmétique simple et invariable : le nombre de degrés de liberté est strictement équivalent au nombre de prédicteurs (k) inclus dans le modèle. Ainsi, si votre analyse incorpore 6 échelles psychologiques, la distribution de référence pour tester la significativité de vos distances sera celle d’un Chi-deux à 6 degrés de liberté.
Demeure la question épineuse de la fixation du seuil de significativité statistique alpha (α). Dans les tests d’hypothèses univariés classiques, la communauté scientifique retient communément le seuil conventionnel de α = 0,05. Transposer tel quel ce critère permissif à la détection multivariée de Mahalanobis constituerait une faute méthodologique lourde. En effet, dans un échantillon de 1000 sujets sains, fixer le seuil à α = 0,05 conduirait mécaniquement à disqualifier arbitrairement 50 participants tout à fait authentiques situés simplement sur les marges naturelles de la distribution de probabilité. Pour parer à cette hécatombe statistique et prévenir les faux positifs de manière drastique, la littérature de référence en psychométrie et en modélisation multivariée (notamment les travaux canoniques de Barbara Tabachnick et Linda Fidell) impose d’adopter un seuil de significativité hautement conservateur, fixé rigoureusement à α = 0,001.
7.2 Procédure de calcul de la p-valeur via Calculer la variable
Plutôt que de reporter fastidieusement chaque observation sur une table statistique imprimée du Chi-deux, SPSS autorise le calcul computationnel instantané de la probabilité exacte d’occurrence associée à chaque distance de Mahalanobis individuelle. Pour accomplir cette standardisation inférentielle, l’analyste se rend dans le menu :
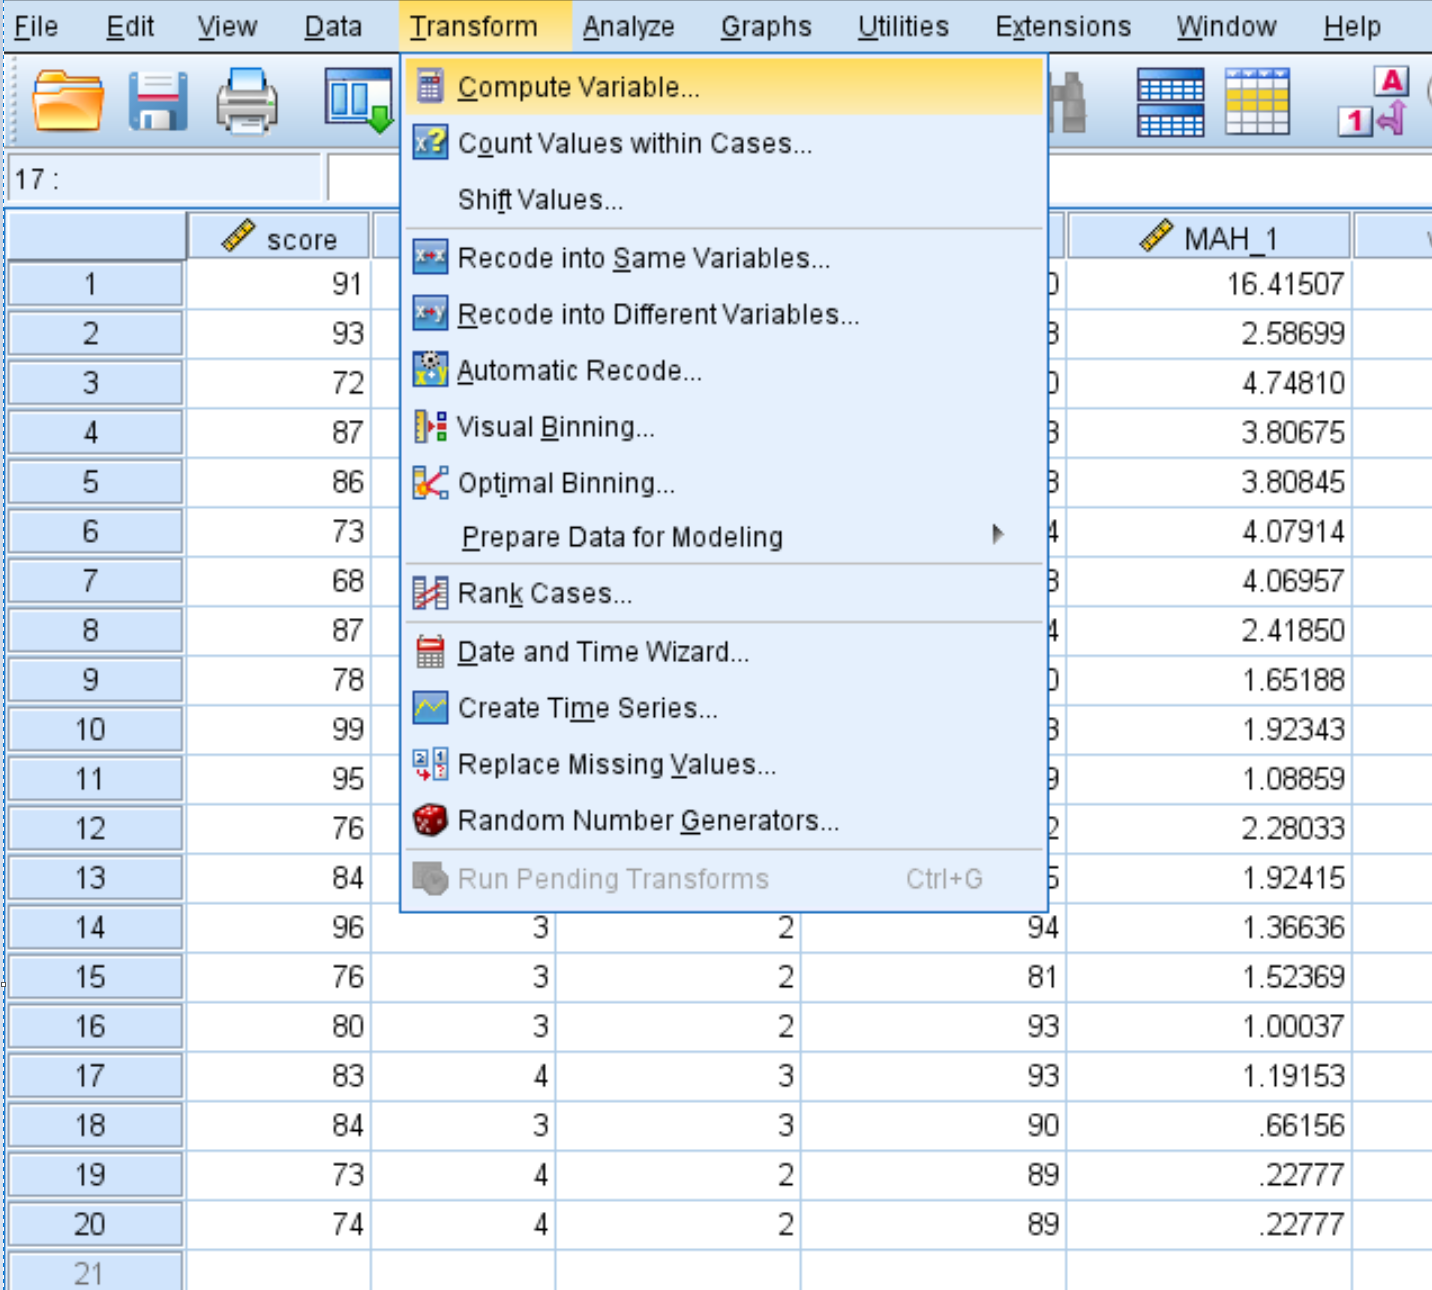
Transformer > Calculer la variable…
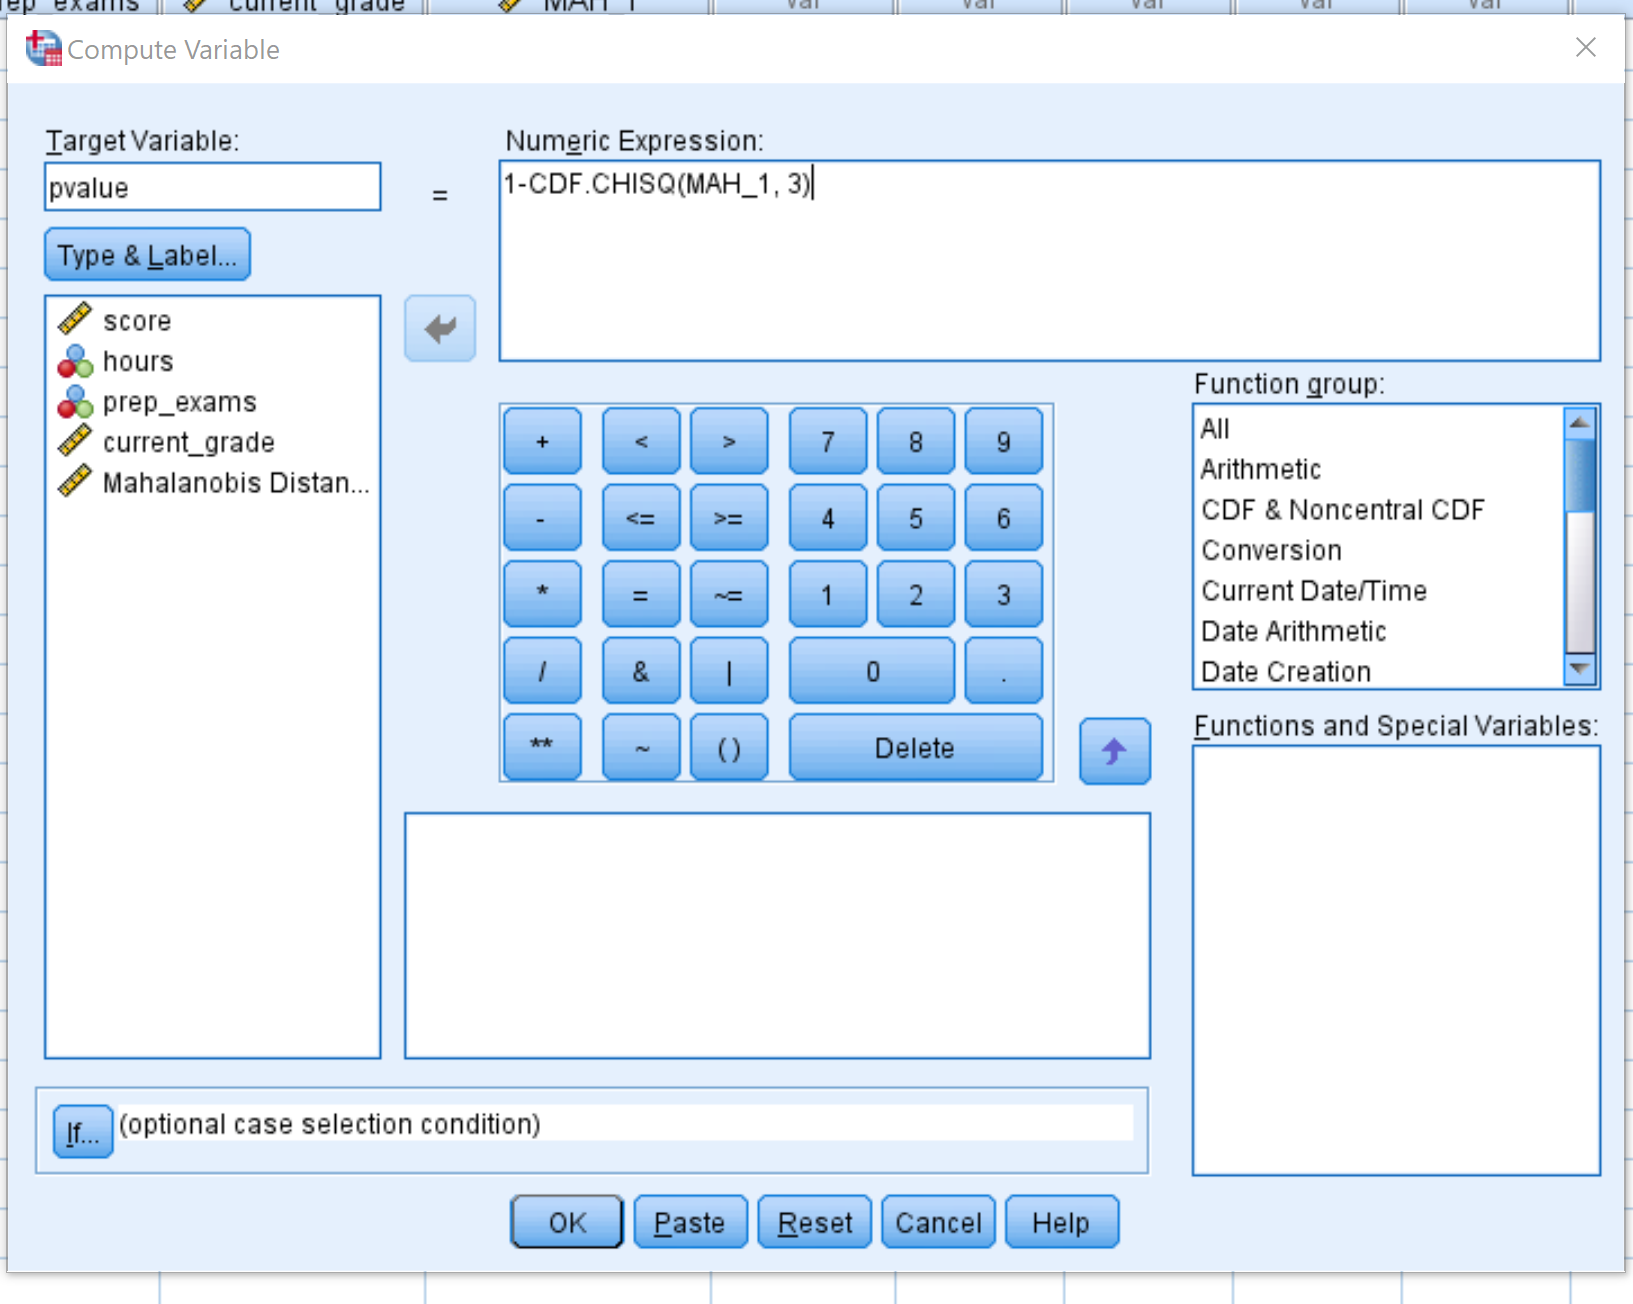
Dans la boîte de dialogue qui se déploie, le chercheur inscrit dans le champ « Variable cible : » le nom d’une variable inédite dédiée, par exemple P_Valeur_Mahal. Dans la zone « Expression numérique : », il s’agit d’injecter la fonction de répartition cumulative complémentaire de la loi du Chi-deux intégrée au moteur de calcul de SPSS. La formulation mathématique s’exprime selon la syntaxe suivante :
1 – CDF.CHISQ(MAH_1, k)
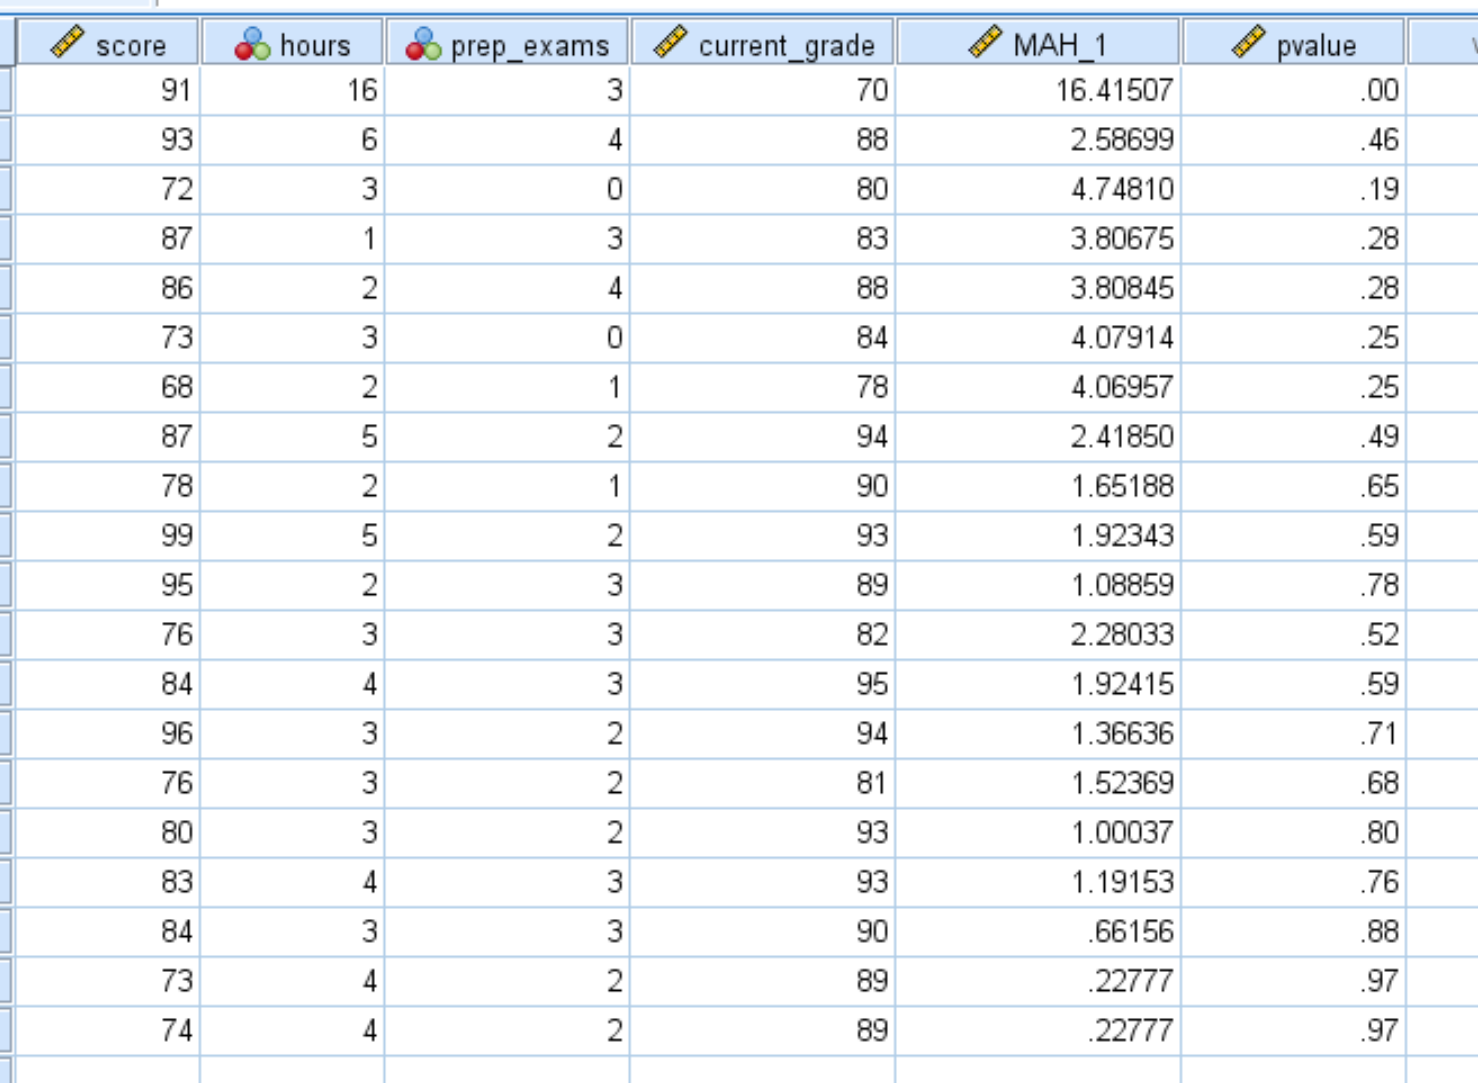
Dans cette formule, l’acronyme CDF.CHISQ désigne la fonction de distribution cumulative (Cumulative Distribution Function) du Chi-deux sous SPSS, le paramètre MAH_1 cible la colonne des distances préalablement calculées, et l’argument k doit être remplacé par le nombre entier exact de variables explicatives engagées dans l’analyse (par exemple, 1 – CDF.CHISQ(MAH_1, 5) si le modèle compile 5 dimensions continues). L’opération de soustraction 1 – CDF permet de calculer la probabilité d’excéder la valeur observée, c’est-à-dire l’aire située sur la queue supérieure droite de la loi de densité de probabilité.
Une fois le calcul validé en cliquant sur « OK », une colonne de probabilités exactes enrichit le fichier de données. Dès lors, la règle de décision inférentielle s’avère d’une limpidité absolue : toute observation présentant une valeur de P_Valeur_Mahal strictement inférieure à 0,001 (p < 0,001) est formellement déclarée comme une valeur aberrante multivariée statistiquement significative.
7.3 Consultation des tables critiques pour confirmation
Pour les analystes souhaitant corroborer le calcul algorithmique automatisé par une validation analytique externe, ou désireux de disposer d’une valeur seuil de coupure immédiate applicable directement à la variable MAH_1 sans calculer les probabilités individuelles, la consultation des tables de valeurs critiques du Chi-deux s’avère extrêmement fructueuse.
La démarche consiste à identifier la valeur critique théorique correspondant au quantile 1 – α = 0,999 pour les degrés de liberté k alloués au protocole d’investigation. Si la distance MAH_1 d’une unité statistique excède cette valeur seuil tabulée, le cas est irrémédiablement catégorisé comme aberrant. Voici un tableau synthétique compilant les seuils critiques majeurs du Chi-deux pour le seuil conservateur α = 0,001 selon une gradation de degrés de liberté couramment rencontrés en recherche :
- Pour k = 2 variables : Valeur critique seuil = 13,816
- Pour k = 3 variables : Valeur critique seuil = 16,266
- Pour k = 4 variables : Valeur critique seuil = 18,467
- Pour k = 5 variables : Valeur critique seuil = 20,515
- Pour k = 6 variables : Valeur critique seuil = 22,458
- Pour k = 7 variables : Valeur critique seuil = 24,322
- Pour k = 8 variables : Valeur critique seuil = 26,124
- Pour k = 9 variables : Valeur critique seuil = 27,877
- Pour k = 10 variables : Valeur critique seuil = 29,588
- Pour k = 15 variables : Valeur critique seuil = 37,697
- Pour k = 20 variables : Valeur critique seuil = 45,315
Le choix épistémologique de ce seuil à trois décimales (p < 0,001) trouve sa pleine justification dans la préservation du postulat de parcimonie scientifique. En psychométrie, la variabilité humaine est riche, complexe et protéiforme ; déclarer une observation « pathologique » ou méthodologiquement contaminante ne doit en aucun cas résulter d’une simple déviation marginale, mais sanctionner une discordance spatiale tellement improbable qu’elle relève, selon toute vraisemblance statistique, d’une rupture du processus de génération des données réelles.
8. Automatisation du processus via la syntaxe SPSS
8.1 Rédaction du script de régression pour l’extraction de Mahalanobis
Si la navigation par les menus déroulants et les boîtes de dialogue de SPSS offre une accessibilité pédagogique indéniable lors d’initiations méthodologiques, la pratique professionnelle de la recherche quantitative exige impérativement le recours à la ligne de commande scriptée via la syntaxe SPSS (fichiers au format .sps). La syntaxe constitue la pierre angulaire de la reproductibilité scientifique, de l’auditabilité des traitements et du gain d’efficience opérationnelle dans les laboratoires d’analyse.
Pour exécuter le calcul complet de la distance de Mahalanobis à travers le module de régression sans jamais ouvrir une seule boîte de dialogue contextuelle, il suffit de rédiger et d’exécuter le bloc de commande canonique suivant au sein d’une fenêtre de syntaxe active :
REGRESSION

    /MISSING LISTWISE

    /STATISTICS COEFF OUTS R ANOVA COLLIN TOL

    /CRITERIA=PIN(.05) POUT(.10)

    /NOORIGIN

    /DEPENDENT ID_Participant

    /METHOD=ENTER VarPsy_1 VarPsy_2 VarPsy_3 VarPsy_4 VarPsy_5

    /SAVE MAHAL.
Dans ce script condensé, la sous-commande /DEPENDENT déclare la variable identifiante ou arbitraire mobilisée à titre d’ancrage opérationnel. La ligne /METHOD=ENTER liste explicitement la séquence des prédicteurs psychométriques délimitant l’espace multivarié d’étude. La commande clé réside sans équivoque dans l’instruction /SAVE MAHAL, qui ordonne formellement au noyau d’exécution de compiler les distances de Mahalanobis individuelles et de les injecter directement dans la base sous le nom standardisé MAH_1. L’inclusion des paramètres COLLIN TOL dans l’instruction /STATISTICS permet par surcroît d’éditer simultanément les diagnostics de multicollinéarité indispensables à la validation de la qualité matricielle.
8.2 Scripting du calcul de la p-valeur et du filtrage automatisé
L’immense avantage de la syntaxe réside dans l’enchaînement fluide et séquentiel des opérations de diagnostic sans rupture d’environnement. Une fois la distance matricielle générée par la commande de régression, le script peut immédiatement enchaîner sur le calcul computationnel de la probabilité d’erreur et sur la création d’une variable binaire indicatrice (dummy variable) marquant formellement le statut de chaque cas.
Le script d’automatisation se structure selon la séquence opérationnelle suivante :
* Calcul de la p-valeur exacte adossée au Chi-deux pour k=5 variables.

COMPUTE P_Valeur_Mahal = 1 - CDF.CHISQ(MAH_1, 5).

VARIABLE LABELS P_Valeur_Mahal "Probabilité d'adéquation au Chi-deux (Mahalanobis)".

FORMATS P_Valeur_Mahal (F8.6).

EXECUTE.
* Création d'un flag binaire identifiant les valeurs aberrantes au seuil p < 0.001.
COMPUTE Outlier_Multivarie = 0.
IF (P_Valeur_Mahal < 0.001) Outlier_Multivarie = 1.
VARIABLE LABELS Outlier_Multivarie "Statut d'observation aberrante multivariée (1=Aberrant, 0=Sain)".
VALUE LABELS Outlier_Multivarie 0 "Profil Conforme" 1 "Valeur Aberrante Multivariée".
FORMATS Outlier_Multivarie (F1.0).
EXECUTE.
* Édition des fréquences et listing d'audit des cas problématiques.
FREQUENCIES VARIABLES=Outlier_Multivarie.
TEMPORARY.
SELECT IF (Outlier_Multivarie = 1).
LIST VARIABLES=ID_Participant MAH_1 P_Valeur_Mahal VarPsy_1 TO VarPsy_5.
Par ce protocole entièrement automatisé, l’analyste obtient instantanément la proportion précise d’anomalies recensées dans sa cohorte au travers de la table de fréquences, tout en générant dans la fenêtre d’affichage un listing exhaustif consignant l’ensemble des scores bruts présentés par les participants déviants, accélérant ainsi la phase ultérieure d’audit qualitatif.
8.3 Bonnes pratiques d’archivage des syntaxes dans la recherche ouverte
Dans l’écosystème contemporain de la science ouverte (Open Science), la publication d’un article empirique ne se conçoit plus sans la mise à disposition transparente des flux d’analyse ayant conduit aux résultats déclarés. Les revues à comité de lecture de premier plan exigent désormais que les démarches de nettoyage et de purification des données fassent l’objet d’un archivage pérenne accessible à la communauté scientifique.
Pour satisfaire à ces standards déontologiques, le chercheur doit annoter exhaustivement son code de syntaxe SPSS au moyen d’astérisques introductives commentant chaque étape de décision. Le script doit stipuler avec clarté la date d’exécution, la version précise du logiciel SPSS mobilisée, la justification du choix des variables introduites, les arguments théoriques présidant à l’adoption du seuil critique (α = 0,001), ainsi que la traçabilité des cas exclus. Ces fichiers de syntaxe, accompagnés des données anonymisées, sont vocationnellement hébergés au sein de répertoires institutionnels ouverts reconnus, tels que l’Open Science Framework (OSF) ou les dépôts Zenodo.
Cette rigueur de codification protège non seulement le chercheur contre les accusations d’arbitraire ou de « p-hacking » sélectif (consistant à éliminer opportunément des sujets pour forcer l’émergence d’effets significatifs), mais elle garantit également au sein d’une équipe de laboratoire que tous les doctorants et collaborateurs appliquent rigoureusement les mêmes protocoles d’assainissement statistique à travers les différentes vagues d’un projet longitudinal.
9. Prise de décision méthodologique face aux valeurs aberrantes identifiées
9.1 Diagnostic qualitatif et étiologie de l’aberrance
L’obtention d’une liste d’observations multivariées franchissant le seuil critique p < 0,001 ne constitue en aucun cas une injonction automatique à l’élimination destructive et mécanique des cas signalés. En bonne épistémologie des données, une valeur aberrante multivariée n’est pas intrinsèquement une « mauvaise » observation ; elle représente simplement une entité mathématique atypique par rapport à une modélisation théorique gaussienne présumée. L’analyste se doit d’endosser le rôle d’un médecin légiste de la donnée afin de documenter l’étiologie précise de cette atypicité spatiale.
La première piste d’audit réside dans la vérification minutieuse des erreurs d’instrumentation ou d’encodage. Bien que le nettoyage univarié préalable doive juguler les dépassements d’échelle manifestes, une permutation involontaire de deux colonnes lors d’un import de tableur Excel vers SPSS peut suffire à créer des dissociations aberrantes fictives. Le croisement des données numériques avec les formulaires originaux d’administration papier ou les fichiers journaux électroniques d’horodatage permet d’écarter cette hypothèse triviale.
La seconde piste clinique concerne les schémas d’adhésion et les comportements de passation non coopératifs. En inspectant directement la ligne de réponses brutes d’un participant marqué du flag d’aberrance, on découvre fréquemment des profils hautement suspects : réponses unilatérales invariables sur des batteries mêlant des assertions de polarités opposées, trajectoires de réponses en diagonale ou en alternance stricte (phénomène de réponse en zigzag), ou temps de complétion de questionnaire extraordinairement fulgurants (par exemple, 2 minutes pour renseigner 250 items de personnalité, attestant d’une absence totale de lecture des stimuli). Dans ces configurations incontestables, l’atypicité statistique ne fait que refléter un biais de non-validité écologique manifeste justifiant sans ambages l’éviction de l’enregistrement.
Enfin, la troisième éventualité, la plus délicate sur le plan déontologique, concerne les profils psychologiques ou cognitifs d’une véracité absolue mais structurellement rares au sein de la population générale. Un individu surdoué présentant une anxiété sociale paralysante et une dyslexie sévère constitue une singularité clinique rarissime dont la combinaison de scores viole la structure habituelle des tests psychométriques. L’exclure par commodité algorithmique prive parfois l’investigateur de l’opportunité théorique de documenter des fonctionnements cognitifs atypiques fondamentaux.
9.2 Arbitrage entre suppression, conservation et transformation
Une fois l’étiologie clarifiée, l’investigateur doit arbitrer entre plusieurs stratégies de gestion des observations multivariées discordantes. Cet arbitrage repose sur une balance méthodologique rigoureuse articulant les finalités de la recherche, les hypothèses sous-jacentes et les contraintes de robustesse matricielle.
La suppression pure et simple d’une observation ne doit intervenir que lorsque l’investigateur peut démontrer formellement que le cas n’appartient pas à la population cible postulée (erreur d’échantillonnage, non-respect des critères d’inclusion) ou que la fidélité de ses réponses est irrémédiablement compromise par une attitude d’inattention ou de falsification délibérée. Dans cette conjoncture, le filtrage sélectif sous SPSS s’opère élégamment via la commande FILTER BY appliquée à l’inverse du flag d’aberrance, conservant l’intégrité de la base brute d’origine tout en l’occultant des calculs d’estimation ultérieurs.
Si l’on soupçonne que l’émergence des distances de Mahalanobis extrêmes est induite par une asymétrie de distribution généralisée des variables explicatives brutes (par exemple, des concentrations de réponses plancher ou plafond sur des échelles cliniques mesurant des pathologies rares), une alternative élégante à l’exclusion consiste à appliquer des transformations mathématiques univariées non linéaires aux variables mères préalablement au calcul multivarié. L’application d’une transformation logarithmique, en racine carrée ou d’une transformation de type Box-Cox rétablit fréquemment la symétrie distributionnelle, comprime les écarts extrêmes sur les queues de distribution et résorbe naturellement les déviances spatiales excessives.
Une troisième approche, inspirée des statistiques robustes, réside dans la winsorisation ou la modification ciblée des scores multivariés. Au lieu de supprimer le sujet, ses valeurs sur les variables les plus discordantes sont ramenées au rang du percentile le plus proche (par exemple, le 99e percentile), maintenant la présence du sujet au sein de la cohorte tout en circonscrivant son potentiel d’influence déstabilisateur sur la matrice de covariance globale.
9.3 Analyses de sensibilité comparatives (avec et sans outliers)
Pour sanctuariser la crédibilité des publications scientifiques et répondre aux exigences éditoriales des revues les plus prestigieuses (notamment sous les standards stricts de l’American Psychological Association – APA 7e édition), la démarche la plus probante consiste à formaliser une analyse de sensibilité comparative systématique.
Ce protocole méthodique impose au chercheur d’exécuter l’intégralité de ses modèles statistiques finaux (qu’il s’agisse d’analyses factorielles, de régressions multiples ou de modélisations causales SEM) selon une double modalité parallèle : premièrement sur la base de données intégrale incluant l’ensemble des observations (échantillon contaminé), et deuxièmement sur la base épurée débarrassée des unités présentant des distances de Mahalanobis significatives (échantillon purifié).
Dans la rédaction du manuscrit scientifique, l’auteur présente un tableau de contraste documentant l’évolution précise des paramètres majeurs : stabilité des saturations factorielles, fluctuations des coefficients de régression standardisés β, altération des erreurs types et variations des indices d’ajustement global. Si les conclusions substantielles de la recherche demeurent rigoureusement inchangées en dépit de la suppression des cas aberrants, la solidité théorique du modèle est magistralement étayée, prouvant son insensibilité aux artefacts distributionnels locaux. Si, au contraire, la significativité statistique d’une trajectoire causale s’effondre consécutivement au retrait de deux ou trois profils aberrants, la déontologie scientifique commande d’admettre en toute transparence que l’effet documenté ne constitue pas une loi générale mais le produit artificiel du levier démesuré exercé par un micro-agrégat d’observations singulières.
10. Comparaison avec d’autres métriques diagnostiques dans SPSS
10.1 Distance de Cook et mesure de l’influence globale
Dans l’arsenal méthodologique du diagnostic de modélisation linéaire sous SPSS, la distance de Mahalanobis ne constitue pas un instrument isolé. Il est indispensable de la situer par rapport à d’autres mesures de diagnostic d’atypicité, au premier rang desquelles trône la célèbre distance de Cook, formulée par le statisticien américain R. Dennis Cook en 1977.
Une distinction conceptuelle cardinale doit être opérée entre la notion de « point aberrant » (outlier) et celle de « point d’influence » (influential observation). La distance de Mahalanobis évalue exclusivement la rareté géométrique d’un vecteur d’observations au sein de l’espace multidimensionnel des variables explicatives indépendantes X, sans accorder le moindre regard au comportement de ces observations sur la variable dépendante Y. La distance de Cook, en revanche, propose une mesure composite d’influence globale qui synthétise deux composantes mathématiques orthogonales : d’une part, l’effet de levier exercé par le participant dans l’espace des prédicteurs (directement proportionnel à sa distance de Mahalanobis), et d’autre part, la magnitude de son résidu d’estimation standardisé (l’erreur de prédiction commise par le modèle sur la variable dépendante Y).
Sur le plan pratique, un individu peut arborer une distance de Mahalanobis monumentale tout en présentant une distance de Cook parfaitement anecdotique. Ce cas de figure se matérialise lorsque l’observation, bien que située aux confins spatiaux de l’hyperespace des prédicteurs, s’aligne rigoureusement sur le plan de régression théorique tracé par la droite d’estimation des moindres carrés. Dans cette situation, le point ne déstabilise aucunement les paramètres du modèle : il ne fait que consolider la précision de la pente d’estimation. Inversement, une distance de Cook alarmante (traditionnellement supérieure à 1, ou excédant le seuil pragmatique de 4 / N) sanctionne une observation qui modifie substantiellement à elle seule l’orientation de l’hyperplan de régression, commandant une vigilance diagnostique prioritaire en régression explicative.
10.2 Valeur de levier centrée (Leverage)
Au sein du module de régression de SPSS, la boîte de dialogue « Enregistrer » propose, aux côtés de Mahalanobis et de Cook, une troisième grandeur métrique dénommée « Valeurs de levier » (Centered Leverage Values, conventionnellement notée h_ii). L’analyste se trouve souvent désemparé face à la coexistence de ces options. Il s’agit en réalité de deux formulations mathématiques quasi interchangeables d’un même phénomène géométrique sous-jacent.
Le levier évalue la contribution d’une observation à la formation de ses propres valeurs prédites, et dérive directement des termes diagonaux de la matrice de projection orthogonale H = X(XᵀX)⁻¹Xᵀ, communément appelée « matrice chapeau » (hat matrix). La relation mathématique exacte reliant la distance de Mahalanobis (D²) et la valeur de levier centrée (h) pour la i-ème observation s’exprime par l’équation de conversion rigide suivante :
h_i = (D_i² / (N – 1)) + (1 / N)
Cette bijection arithmétique démontre que le levier n’est rien d’autre qu’une standardisation normalisée de la distance de Mahalanobis, conçue pour contraindre les valeurs d’éloignement spatial au sein d’un intervalle borné compris obligatoirement entre 1 / N et 1. Les seuils de décision relatifs au levier s’articulent autour de critères proportionnels au ratio de dimensionnalité : on retient généralement comme seuil critique d’attention modérée la valeur 2(k + 1) / N, et comme seuil d’alarme sévère la borne 3(k + 1) / N. Tandis que le levier standardisé s’avère particulièrement prisé en économétrie pure pour calibrer le poids algorithmique des matrices chapeaux, les psychométriciens conservent une prédilection marquée pour la distance de Mahalanobis brute en raison de son adéquation directe avec la table universelle du Chi-deux, facilitant l’attribution intuitive de p-valeurs inférentielles précises.
10.3 Diagnostics des résidus : DFBETA et DFFIT
Pour affiner la traçabilité de l’impact exercé par les observations atypiques repérées par Mahalanobis, SPSS dispose d’instruments diagnostiques locaux capables de décomposer l’effet d’une observation au niveau de chaque coefficient de régression individuel. Les statistiques de la famille DFBETA et DFFIT incarnent cette microscopie paramétrique.
La statistique DFFIT (ou sa version standardisée SDFIT) mesure de combien d’écarts-types la valeur prédite globale pour un cas varie lorsque cette observation spécifique est temporairement exclue du recalcule intégral de l’algorithme de régression. Elle offre ainsi un diagnostic global d’altération de la topologie d’ajustement du modèle. Pour sa part, l’indice DFBETA standardisé évalue l’amplitude exacte de variation subie par un coefficient de régression spécifique β_j consécutivement à l’élimination de l’observation suspecte. Les conventions d’interprétation méthodologique identifient tout cas présentant un |SDFBETA| > 2 / √N comme exerçant une traction unilatérale intolérable sur le coefficient concerné.
La stratégie diagnostique d’excellence s’articule dès lors autour d’un croisement méthodologique synergique : la distance de Mahalanobis intervient en premier rideau comme un filtre de criblage spatial à haute sensibilité, chargé de détecter la rupture structurelle multivariée au sein des prédicteurs. Une fois le signalement opéré, l’inspection combinée de la distance de Cook et des DFBETA permet d’instruire le procès empirique de l’observation : si la déviance spatiale de Mahalanobis ne s’accompagne d’aucune torsion anormale des DFBETA, l’analyste peut légitimement maintenir l’observation au sein de son modèle sans craindre de pervertir la dynamique théorique de ses coefficients explicatifs.
11. Applications avancées en modélisation psychologique multivariée
11.1 Analyse factorielle exploratoire (AFE) et confirmatoire (AFC)
L’assainissement multivarié par la distance de Mahalanobis déploie son utilité stratégique la plus retentissante lors de l’étalonnage et de la validation structurale d’échelles de mesure au travers des analyses factorielles exploratoires (AFE) et confirmatoires (AFC). La découverte de la structure latente sous-jacente à un ensemble d’items psychologiques repose sur l’hypothèse que la matrice de corrélation observée reflète fidèlement l’action de construits inobservables non pollués par des artefacts de distribution.
La présence d’un contingent, même très minoritaire (par exemple moins de 1 % de l’échantillon), d’observations multivariées aberrantes est capable de fausser radicalement la configuration des valeurs propres (eigenvalues) extraites lors de la décomposition spectrale sous SPSS. Ces cas déviants peuvent générer des facteurs fallacieux entièrement construits autour de la variance d’artefact partagée par deux ou trois répondants inattentifs, ou au contraire masquer la présence d’un facteur secondaire authentique en dispersant sa variance propre. En analyse factorielle confirmatoire, ces anomalies spatiales se traduisent par une inflation dramatique des coefficients d’erreur résiduelle unilatérale et par des covariances d’erreur non modélisées substantielles, conduisant les chercheurs à rejeter à tort des modèles théoriques pourtant parfaitement congruents avec la réalité du fonctionnement psychique humain.
La purification préalable de l’échantillon au moyen du calcul de Mahalanobis garantit la stabilité et l’invariance métrique des saturations factorielles (factor loadings). En assainissant la matrice d’intercorrélations avant de soumettre les données aux algorithmes d’extraction d’axes (tels que le Maximum de Vraisemblance ou l’Axe Principal), le psychométricien s’assure que la factorialisation capture une variance psychologique authentique et généralisable, prémunissant l’instrument contre les écueils de non-réplication ultérieure lors des phases d’étalonnage croisé sur de nouvelles cohortes de sujets.
11.2 Modélisation par équations structurelles (SEM)
Dans l’écosystème de la recherche contemporaine, la modélisation par équations structurelles (Structural Equation Modeling) représente l’outil intégratif par excellence pour tester des théories causales complexes articulant variables latentes et indicateurs manifestes. La majorité des progiciels associés à l’environnement SPSS, au premier rang desquels figure le logiciel IBM SPSS Amos, mobilisent par défaut l’estimateur du Maximum de Vraisemblance (Maximum Likelihood – ML) pour déduire les paramètres structurels du réseau causal.
L’estimateur ML est célèbre dans la littérature statistique pour son hyper-sensibilité punitive à toute violation du postulat de normalité multivariée. Sous l’effet d’observations multivariées excentrées, la fonction de minimisation mathématique du ML est soumise à des tractions extrêmes qui font exploser la statistique globale du Chi-deux de discordance de l’ajustement structurel. Des indices de renommée mondiale tels que le Comparative Fit Index (CFI) et le Tucker-Lewis Index (TLI) s’effondrent brutalement, tandis que le RMSEA franchit de manière fallacieuse les plafonds de tolérance méthodologique conventionnels (dépassant 0,08 ou 0,10), contraignant l’investigateur à disqualifier à tort son architecture théorique.
La boîte à outils d’Amos incorpore d’ailleurs de manière native un tableau de diagnostic des distances de Mahalanobis au carré (d-squared) dans ses sorties d’évaluation de la normalité multivariée, attestant du rôle prépondérant de cette métrique dans le paradigme SEM. Cependant, l’exécution préliminaire du diagnostic au sein même de SPSS en amont du transfert vers le logiciel d’équations structurelles offre une plasticité bien supérieure : elle permet à l’analyste de documenter les profils d’anomalies, de filtrer dynamiquement les cas perturbateurs et de certifier que les indices de modification structurelle (Modification Indices) ne suggèrent pas des trajectoires de corrélation aberrantes dictées par une poignée d’individus atypiques.
11.3 Analyse discriminante et classification automatique
L’analyse discriminante linéaire et les méthodes de classification automatique (clustering hiérarchique ou par K-moyennes) constituent un autre sanctuaire d’application magistrale de la géométrie de Mahalanobis sous SPSS. L’analyse discriminante a pour vocation de prédire l’appartenance d’un sujet à un groupe catégoriel prédéterminé (par exemple : sous-types cliniques de dépression majeure, répondeurs versus non-répondeurs à une psychothérapie) à partir d’un ensemble de biomarqueurs ou de scores dimensionnels continus.
Au cœur de la règle de décision bayésienne de l’analyse discriminante se trouve précisément le calcul de la distance de Mahalanobis minimale séparant le profil d’un patient individuel du centroïde multidimensionnel de chacun des groupes cliniques concurrents. Le logiciel assigne l’individu au groupe pour lequel sa distance de Mahalanobis au carré, ajustée par la probabilité a priori d’appartenance, s’avère la plus faible. La présence de valeurs multivariées aberrantes lors de la phase d’apprentissage ou de calibration des fonctions discriminantes déplace artificiellement les centroïdes des groupes et gonfle la matrice de covariance intra-groupe commune, détériorant de manière dramatique le taux de classification correcte et la sensibilité diagnostique du protocole nosographique.
En outre, l’évaluation des distances de Mahalanobis calculées par rapport au centroïde du groupe d’affectation permet de dépister ce que la nosologie clinique qualifie de « profils inclassables » ou transversaux. Un patient présentant une distance de Mahalanobis statistiquement significative vis-à-vis de l’ensemble des groupes diagnostiques disponibles dans l’échantillon manifeste une constellation symptomatologique atypique qui récuse la typologie en vigueur, ouvrant la voie à des réflexions de nosographie dimensionnelle sur les comorbidités psychiatriques complexes ou les formes limites non répertoriées.
12. Limites méthodologiques, pièges fréquents et solutions robustes
12.1 Effets de masque (masking) et de submersion (swamping)
En dépit de son élégance mathématique incontestable et de son statut de référence académique, la distance de Mahalanobis classique telle qu’implémentée de base dans le module de régression de SPSS souffre d’une faille méthodologique structurelle inhérente à l’usage des estimateurs non robustes des moindres carrés : sa vulnérabilité intrinsèque face aux phénomènes géométriques dits de « masque » (masking effect) et de « submersion » (swamping effect).
L’effet de masque survient dès lors qu’un jeu de données héberge non pas une anomalie solitaire et isolée, mais un micro-agrégat ou un groupe compact de plusieurs observations multivariées aberrantes partageant une configuration similaire au sein du même cadran de l’hyperespace. Dans cette conjoncture pernicieuse, la présence conjointe de ces points aberrants exerce une force d’attraction colossale sur le calcul de la moyenne arithmétique globale, déplaçant le centroïde multidimensionnel dans leur direction tout en gonflant démesurément les termes de dispersion de la matrice de variance-covariance S. Par suite de cette distorsion matricielle de fond, la distance de Mahalanobis apparente calculée pour ces individus déviants se trouve substantiellement contractée, les maintenant artificiellement sous le seuil critique du Chi-deux. L’anomalie se masque ainsi elle-même en corrompant l’instrument même chargé de sa détection.
À l’inverse symétrique, l’effet de submersion se matérialise lorsque l’inflation de la matrice de covariance provoquée par ce foyer d’anomalies déforme les ellipsoïdes de tolérance spatiale au point d’englober de travers des zones peuplées par des observations parfaitement ordinaires. Ces points sains, situés sur les marges naturelles opposées du nuage de dispersion, se voient attribuer des distances artificiellement majorées qui franchissent indûment le seuil de significativité statistique. L’analyste se trouve alors piégé dans une double impasse : il échoue à repérer les véritables contaminateurs de sa base de données tout en stigmatisant et en éliminant à tort des participants rigoureusement représentatifs de la population normale.
12.2 Dépendance critique aux hypothèses distributionnelles
Une seconde limite méthodologique majeure réside dans l’inféodation de la règle de décision statistique au postulat d’adéquation de la distance brute à la loi théorique du Chi-deux. Si la distance mathématique de Mahalanobis peut être instanciée sans restriction sur n’importe quel tableau numérique, la conversion de cette distance en probabilité inférentielle d’aberrance (la p-valeur) repose intégralement sur l’hypothèse que les données sous-jacentes émanent d’une distribution gaussienne multivariée continue rigoureuse.
Dans la pratique concrète de la recherche en psychologie clinique, du travail ou de la santé, cette hypothèse d’hyper-sphéricité gaussienne est continuellement battue en brèche. Les inventaires psychopathologiques confrontent quasi systématiquement le statisticien à des données présentant une forte asymétrie positive (la majorité des répondants de la population générale déclarant un score nul ou minimal sur les échelles de dépression sévère ou d’idéations suicidaires, créant un pic de densité modal à l’origine). Lorsque la distance de Mahalanobis est calculée sur de telles distributions sévèrement tronquées ou asymétriques, l’adéquation au Chi-deux devient une approximation grossièrement inexacte.
L’utilisation imprudente du seuil critique p < 0,001 sur des données hautement asymétriques ou composées d’items ordinaux de Likert discrets à faible nombre de modalités engendre un taux inacceptable de faux positifs ou de fausses détections. L’analyste doit impérativement contextualiser son diagnostic et s’abstenir de disqualifier des observations dont l’éloignement vectoriel apparent n’est que la conséquence mathématique inévitable de l’asymétrie structurelle naturelle des phénomènes psychologiques investigués.
12.3 Introduction aux alternatives robustes (MCD et estimateurs S)
Pour s’émanciper des impasses méthodologiques conjuguées du masquage et de la non-normalité, la littérature statistique contemporaine a vu émerger une génération d’algorithmes de détection hautement sophistiqués, regroupés sous la bannière des méthodes d’estimation multivariée robuste. L’étalon-or incontesté de ces approches est l’estimateur du Déterminant de Covariance Minimale (Minimum Covariance Determinant ou MCD), théorisé par le statisticien belge Peter Rousseeuw.
L’algorithme FastMCD ne calcule pas la moyenne et la covariance sur la totalité brute de l’échantillon. Il opère une recherche itérative stochastique pour identifier un sous-ensemble d’observations de taille h (représentant typiquement entre 50 % et 75 % de l’échantillon total) dont la sous-matrice de variance-covariance présente le déterminant mathématique le plus faible possible (c’est-à-dire le nuage de points le plus dense et compact de tout l’hyperespace). Le centroïde robuste et la matrice de dispersion saine sont alors calculés exclusivement sur ce noyau non contaminé. Les distances de Mahalanobis robustes (notées RD pour Robust Distance) sont ensuite déduites en projetant l’intégralité des observations par rapport à cette métrique purifiée, annihilant d’un coup tout risque de masquage ou de submersion.
Bien que l’architecture propriétaire native de base d’IBM SPSS n’intègre pas encore l’estimateur MCD sous forme de bouton standard dans ses boîtes de dialogue traditionnelles, la solution logicielle réside dans la modularité contemporaine de SPSS. L’installation de l’environnement d’intégration de programmation IBM SPSS Statistics – Integration Plug-in for R ou Python permet d’exécuter directement au sein de la fenêtre de syntaxe SPSS des scripts mobilisant le célèbre package R robustbase ou MASS (via la fonction covMcd). Les distances de Mahalanobis robustes résultantes sont alors instantanément réinjectées sous forme de colonnes dans la matrice de données SPSS active, offrant aux psychométriciens et aux épidémiologistes contemporains le summum de la robustesse analytique pour l’assainissement de leurs données empiriques les plus complexes.
Références
- Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15-18. https://doi.org/10.1080/00401706.1977.10489493
- Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
- Hubert, M., & Debruyne, M. (2010). Minimum covariance determinant. WIREs Computational Statistics, 2(1), 36-43. https://doi.org/10.1002/wics.61
- IBM Corporation. (2021). IBM SPSS Statistics 28 Brief Guide. IBM Corp. https://www.ibm.com/docs/en/spss-statistics/28.0.0
- Kline, R. B. (2023). Principles and practice of structural equation modeling (5th ed.). Guilford Press.
- Mahalanobis, P. C. (1936). On the generalized distance in statistics. Proceedings of the National Institute of Sciences of India, 2(1), 49-55.
- Mardia, K. V. (1970). Measures of multivariate skewness and kurtosis with applications. Biometrika, 57(3), 519-530. https://doi.org/10.1093/biomet/57.3.519
- Rousseeuw, P. J., & Van Driessen, K. (1999). A fast algorithm for the minimum covariance determinant estimator. Technometrics, 41(3), 212-223. https://doi.org/10.1080/00401706.1999.10485670
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.