
Dans le paysage foisonnant des statistiques inférentielles et descriptives appliquées aux sciences humaines et sociales, la caractérisation précise de la dispersion d’une distribution constitue une étape analytique fondamentale. Si l’écart-type demeure l’indice de dispersion absolue prédominant au sein des publications universitaires, sa dépendance intrinsèque à l’unité de mesure et à l’ordre de grandeur de la moyenne arithmétique limite drastiquement sa pertinence lorsqu’il s’agit d’effectuer des comparaisons inter-groupes ou inter-instruments. C’est précisément à la croisée de ces exigences métrologiques que le coefficient de variation (noté CV) s’impose comme un outil d’une remarquable élégance conceptuelle, en exprimant l’ampleur des fluctuations d’une variable sous une forme adimensionnelle, directement proportionnelle à sa tendance centrale.
Le logiciel IBM SPSS Statistics, plébiscité par les chercheurs en psychologie, en neurosciences cognitives et en épidémiologie comportementale, ne propose paradoxalement pas de commande directe nommée « Coefficient de variation » dans ses menus descriptifs élémentaires usuels, tels que les modules Fréquences ou Descriptives. Cette apparente lacune ergonomique contraint fréquemment les praticiens de la recherche et les analystes de données à concevoir des contournements manuels hasardeux ou à migrer inutilement vers des tableurs tiers. Pourtant, SPSS intègre des architectures analytiques natives d’une puissance insoupçonnée, capables de calculer, de standardiser et d’automatiser l’extraction du coefficient de variation avec une rigueur algorithmique absolue.
Ce guide exhaustif a pour vocation de démythifier le calcul, l’interprétation et la modélisation du coefficient de variation au sein de l’environnement logiciel SPSS. En articulant les fondements mathématiques stricts de cet estimateur aux impératifs méthodologiques de la recherche expérimentale et clinique contemporaine, cet article propose un parcours pas-à-pas complet. De la préparation minutieuse des matrices de données jusqu’à l’implémentation de syntaxes matricielles avancées, en passant par l’analyse fine de la variabilité intra-individuelle et la restitution conforme aux standards de l’American Psychological Association (APA 7e édition), chaque chercheur trouvera ici les clés opératoires pour enrichir ses protocoles d’évaluation empirique.
1. Fondements théoriques et définition du coefficient de variation
1.1 Définition mathématique et conceptualisation statistique
Sur le plan de l’analyse mathématique formelle, le coefficient de variation est défini comme le quotient de la dispersion absolue par l’espérance mathématique de la distribution. Introduit initialement par le statisticien et biométricien britannique Karl Pearson à la fin du dix-neuvième siècle, cet indice s’énonce selon le ratio fondamental reliant l’écart-type à la moyenne arithmétique. Cette opération de normalisation confère immédiatement à l’estimateur une nature rigoureusement adimensionnelle, c’est-à-dire qu’elle annule l’unité de mesure sous-jacente de la grandeur physique ou psychologique observée, qu’il s’agisse de millisecondes, de milligrammes de cortisol salivaire ou de points bruts recueillis sur une échelle d’évaluation comportementale.
Dans la pratique scientifique, le résultat issu de cette division est très généralement multiplié par un facteur cent afin de transposer la valeur décimale sous la forme d’un pourcentage standardisé. Cette présentation fractionnaire facilite l’appréhension intuitive du phénomène en quantifiant la proportion exacte que représente l’incertitude ou la dispersion moyenne par rapport à la masse globale du signal mesuré. Un coefficient de variation s’élevant à 15 % indique formellement que l’amplitude de l’écart-type équivaut à 15 centièmes de la valeur centrale moyenne observée sur l’échantillon d’intérêt.
La distinction conceptuelle entre variabilité absolue et variabilité relative s’avère ici capitale. Tandis que la variance et l’écart-type quantifient l’étalement brut des observations autour du barycentre empirique dans l’espace métrique original, le coefficient de variation rééchelonne cette fluctuation à l’aune du niveau moyen de performance du système étudié. Deux distributions présentant des écarts-types rigoureusement identiques de dix unités n’incarnent nullement la même dynamique sous-jacente si l’une gravite autour d’une moyenne de vingt unités (CV = 50 %) et la seconde autour d’une moyenne de mille unités (CV = 1 %). Le coefficient de variation agit ainsi comme un révélateur d’échelle, garantissant une comparabilité intrinsèque indépendante de la magnitude des grandeurs physiques sous examen.
1.2 Propriétés métriques et exigences d’échelle de mesure
L’utilisation rigoureuse du coefficient de variation exige le respect scrupuleux de la typologie des échelles de mesure théorisée par Stanley Smith Stevens. La condition sine qua non à la validité métrologique du CV réside dans l’application exclusive à des variables mesurées sur une échelle de rapport, c’est-à-dire une échelle possédant une origine non arbitraire désignant un zéro absolu, synonyme d’absence totale du phénomène physique quantifié. C’est le cas typique des durées temporelles, des latences de traitement, du nombre d’erreurs commises, de la conductance cutanée ou de la force musculaire développée lors d’un effort isométrique.
À l’inverse, l’application du coefficient de variation sur des échelles d’intervalle arbitraires — dont le paradigme classique est la température mesurée en degrés Celsius ou Fahrenheit, ou encore les scores de quotient intellectuel standardisés — constitue une faute méthodologique critique. Dans une échelle d’intervalle, la position du zéro est purement conventionnelle. Par conséquent, si l’on modifie l’origine de l’échelle par une translation linéaire positive ou négative, l’écart-type demeure invariant tandis que la valeur de la moyenne arithmétique fluctue, modifiant artificiellement et de manière aléatoire la valeur numérique du coefficient de variation. Cette sensibilité à l’arbitraire du zéro dénature complètement la comparabilité inter-groupes.
De surcroît, le statisticien doit faire preuve d’une extrême circonspection face aux distributions empiriques dont la moyenne arithmétique se situe à proximité immédiate de zéro. Lorsque le dénominateur de l’équation tend vers une valeur infinitésimale, la fonction mathématique régissant le CV diverge vers l’infini, générant une instabilité asymptotique extrême. Dans de telles circonstances, une infime fluctuation de la moyenne due à l’erreur d’échantillonnage engendre des variations colossales et aberrantes du ratio, ruinant toute tentative de modélisation fiable au sein du logiciel SPSS.
1.3 Différenciation entre paramètres populationnels et estimateurs échantillonnaux
Dans le formalisme de la théorie de l’échantillonnage statistique, il est impératif de distinguer avec une rigueur absolue le paramètre théorique populationnel de son estimateur calculé à partir d’observations empiriques finies. Au niveau de la population globale, le coefficient de variation théorique, généralement désigné par la lettre grecque gamma ou la notation standardisée CV populationnel, est le ratio exact de l’écart-type populationnel (sigma) sur la moyenne populationnelle (mu). Ce ratio postule une connaissance omnisciente et asymptotique de la distribution probabiliste régissant le phénomène examiné.
Dans la réalité empirique du laboratoire ou de la recherche clinique, le chercheur n’a accès qu’à un échantillon tronqué de n observations, à partir duquel il dérive la moyenne empirique observée (notée x barre) et l’écart-type d’échantillon corrigé (noté s). Le coefficient de variation échantillonnal simple, formulé par la division s sur x barre, constitue un estimateur intuitif mais néanmoins légèrement biaisé de la réalité populationnelle. Ce biais systématique découle de la non-linéarité de l’opération d’inversion mathématique appliquée à la variable aléatoire constituant le dénominateur de l’équation.
Pour remédier à cette distorsion, particulièrement accentuée lorsque les recherches quantitatives portent sur de petites cohortes (n inférieur à 30 cas), plusieurs statisticiens renommés, à l’instar de Maurice Kendall et d’Allyn Sokal, ont formalisé un facteur de correction de biais d’ordre un. Cette correction ajuste l’estimateur par un coefficient multiplicateur lié à la taille de l’échantillon, stabilisant ainsi la variance d’échantillonnage de l’indice. Bien que SPSS calcule par défaut l’estimateur empirique standard non corrigé, la connaissance intime de ce mécanisme de biais s’avère indispensable pour le chercheur soucieux d’affiner ses inférences lors de l’étude de populations cliniques rares ou de protocoles expérimentaux hautement spécialisés.
2. Utilité et applications du coefficient de variation en recherche psychologique
2.1 Évaluation de la variabilité intra-individuelle dans les tâches cognitives
L’exploration de la dynamique cognitive contemporaine ne s’arrête plus à l’analyse exclusive de la performance moyenne d’un participant ; elle scrute avec une précision accrue les micro-fluctuations de son comportement au fil des essais répétés. Lors d’épreuves mesurant le temps de réaction continu, telles que la tâche de performance continue (CPT) ou les paradigmes d’inhibition motrice de type Go/No-Go, la mesure de la fluctuation des latences représente un indicateur cardinal de l’intégrité des fonctions exécutives. L’écart-type brut des temps de réponse souffre toutefois d’une corrélation intrinsèque positive avec la vitesse motrice moyenne : les individus les plus lents affichent mécaniquement des écarts-types plus volumineux sans que cela ne reflète une défaillance attentionnelle sous-jacente.
L’intégration du coefficient de variation intra-individuel (souvent désigné sous l’acronyme ICV dans la littérature neuropsychologique internationale) résout élégamment cette confusion métrique. En divisant l’écart-type des latences d’un individu par sa vitesse motrice moyenne sur l’ensemble du bloc expérimental, le chercheur extrait un score de dispersion relative totalement purgé du facteur d’inertie motrice générale. Cette standardisation permet d’isoler avec une clarté remarquable les épisodes de décrochage attentionnel et les instabilités transitoires de l’efficience neuronale.
Sur le plan diagnostique et nosographique, cette variabilité comportementale relative s’est progressivement érigée au rang de biomarqueur comportemental de premier ordre. Une élévation substantielle de l’ICV est systématiquement documentée chez les populations diagnostiquées avec un trouble du déficit de l’attention avec ou sans hyperactivité (TDAH), mais également chez les patients atteints de lésions cérébrales traumatiques légères ou engagés dans les phases prodromiques de pathologies neurodégénératives telles que la maladie d’Alzheimer. Le calcul précis de cet indice dans SPSS offre par conséquent une voie d’accès privilégiée à l’analyse de la robustesse computationnelle du système nerveux central.
2.2 Comparaison de protocoles expérimentaux aux métriques hétérogènes
L’un des défis méthodologiques les plus ardus en psychologie expérimentale et en neurobiologie réside dans la mise en parallèle de processus physiologiques et psychologiques mesurés via des unités de grandeurs radicalement incommensurables. Comment, par exemple, évaluer la stabilité homéostatique relative d’un participant confronté à un agent stresseur aigu en comparant simultanément la modulation de sa fréquence cardiaque (exprimée en battements par minute), la résistance galvanique de sa peau (évaluée en micro-siemens) et son taux d’anticipation subjective de la douleur (noté sur une échelle visuelle analogique continue de 0 à 100 millimètres) ?
L’utilisation de la variance brute ou de l’écart-type est totalement inopérante dans ce contexte comparatif, dans la mesure où les grandeurs numériques obtenues sont captives de leurs étalonnages physiques respectifs. En convertissant la dispersion observée de chacun de ces biomarqueurs en coefficients de variation respectifs, l’analyste neutralise l’artefact dimensionnel. Il devient dès lors parfaitement légitime de déterminer lequel de ces trois systèmes physiologiques subit la désorganisation la plus aiguë ou conserve la meilleure homéostasie régulatrice au cours de l’épreuve expérimentale.
De façon analogue, cette démarche de normalisation relative prend tout son sens lors de l’évaluation de la reproductibilité des mesures dans les devis expérimentaux longitudinaux. Lorsqu’une cohorte de participants fait l’objet de suivis psychométriques échelonnés sur plusieurs années à l’aide d’instruments d’évaluation dont les versions révisées adoptent des métriques ou des nombres d’items divergents, le coefficient de variation demeure le seul baromètre transversal fiable. Il permet d’attester si la dispersion inter-individuelle s’est resserrée ou dilatée au fil des âges de la vie, indépendamment des révisions matérielles subies par la batterie de tests.
2.3 Contrôle de la précision des instruments d’évaluation clinique
Dans l’arsenal méthodologique propre à la psychométrie clinique, l’analyse de la fidélité test-retest et de la reproductibilité instrumentale constitue le socle garantissant la validité des diagnostics. Traditionnellement, le statisticien s’en remet aux corrélations intra-classes ou aux coefficients alpha de Cronbach. Néanmoins, ces indices de consistance interne reposent lourdement sur l’hétérogénéité globale de l’échantillon recruté : un échantillon particulièrement diversifié génère artificiellement de fortes corrélations statistiques, dissimulant de potentielles imprécisions de l’outil de mesure à l’échelle fine.
Le recours au coefficient de variation vient compléter ce dispositif en offrant une quantification directe de l’erreur relative de mesure. Calculé au niveau des écarts résiduels entre sessions d’administration répétées sous des conditions identiques, un CV instrumental restreint (généralement inférieur au seuil critique de 5 % à 10 % selon les disciplines) certifie l’excellente stabilité métrologique de l’outil clinique. À l’opposé, la mise en évidence d’un coefficient de variation disproportionné signale la présence pernicieuse d’artéfacts de passation ou d’instructions expérimentales ambiguës générant un bruit de mesure inacceptable.
Cette approche par la dispersion relative permet en outre de détecter avec acuité les biais d’évaluation liés à l’émergence d’effets plancher et plafond. En confrontant le coefficient de variation au sein des différents quantiles de performance d’un panel normatif, les concepteurs de tests peuvent identifier les segments de la population pour lesquels l’instrument perd son pouvoir de discrimination fine. L’homogénéisation des panels normatifs gagne ainsi une assise quantitative indiscutable, prévenant les erreurs de classification diagnostique ultérieures en milieu hospitalier ou d’expertise médicolégale.
3. Préparation et structuration du jeu de données dans SPSS
3.1 Configuration rigoureuse de la vue des variables
L’exécution d’analyses statistiques exemptes de corruptions computationnelles dans l’écosystème SPSS débute impérativement par une configuration sans faille de l’onglet « Vue des variables ». Chaque variable quantitative candidate au calcul du coefficient de variation doit se voir attribuer sans équivoque le type métrique adéquat dans la colonne dédiée à l’Échelle de mesure. Bien que SPSS autorise formellement l’application de certaines opérations sur des données étiquetées par inadvertance comme « Nominale » ou « Ordinale », assigner explicitement la modalité « Échelle » (représentée graphiquement par une icône de règle graduée) est indispensable pour avertir le moteur logiciel de la nature continue de la variable.
Une attention méticuleuse doit également être accordée au renseignement de la colonne « Libellé » (Variable Label). SPSS ayant pour coutume d’extraire textuellement le libellé pour enrichir les en-têtes de ses tableaux de sortie, la spécification explicite des unités de mesure physiques associées (par exemple, « Temps de réaction au stimulus auditif [millisecondes] ») évite toute ambiguïté ultérieure lors de l’interprétation des rapports descriptifs. Cette traçabilité descriptive s’avère particulièrement précieuse lorsque les analyses portent sur des jeux de données denses comprenant plusieurs dizaines de métriques comportementales analogues.
Enfin, la gestion des décimales dans la matrice de données requiert une anticipation technique rigoureuse. L’analyste doit veiller à définir un affichage décimal cohérent (idéalement fixé à deux ou trois décimales) dans la colonne « Décimales » de la vue des variables. Il importe de souligner que ce paramètre ne modifie que la représentation visuelle dans la grille de données sans tronquer la précision en virgule flottante double stockée en mémoire vive par SPSS. Néanmoins, pour les variables issues de calculs automatisés préalables, maintenir une visibilité explicite sur les chiffres significatifs prévient les erreurs de retranscription empirique des fractions d’écart-type et de moyenne.
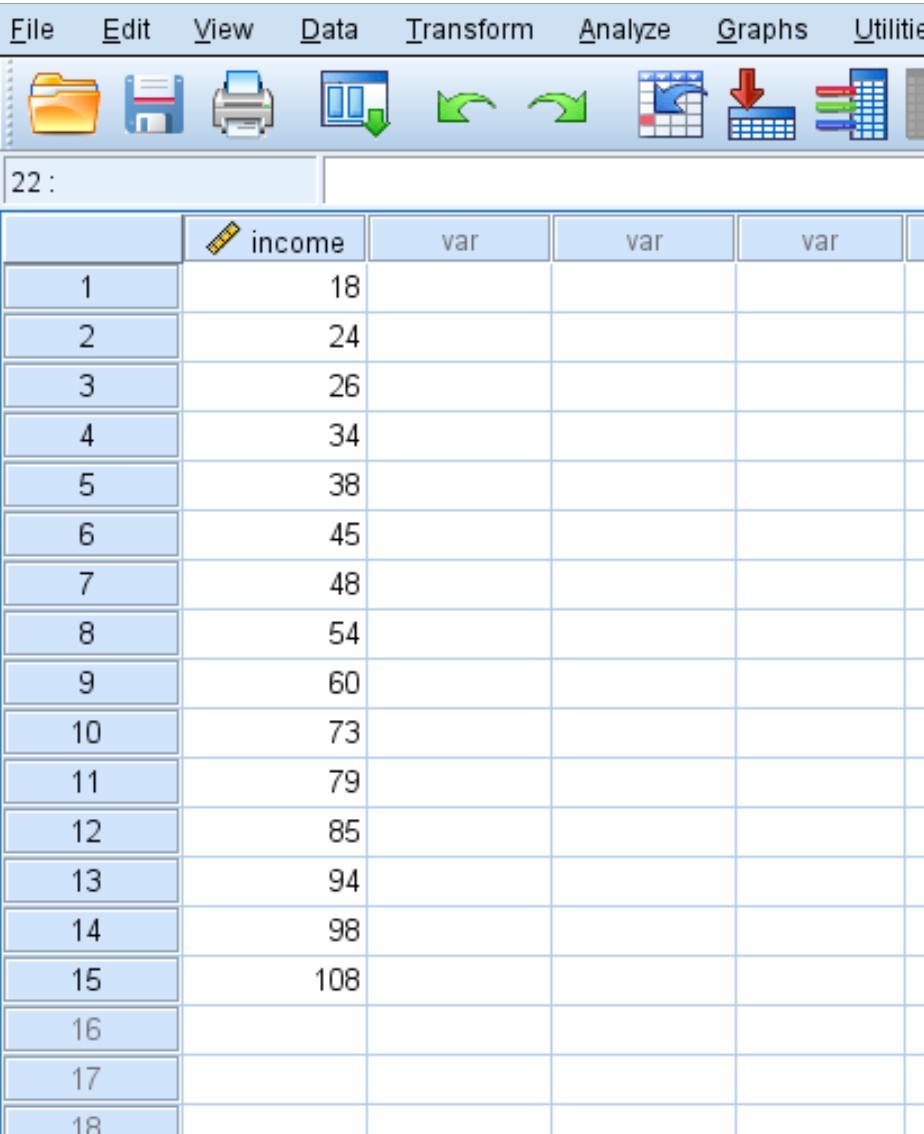
3.2 Traitement des valeurs manquantes et aberrantes
La vulnérabilité du coefficient de variation face aux déviations extrêmes impose un nettoyage préliminaire intransigeant de la distribution des données brutes. Contrairement à la médiane ou à l’écart semi-interquartile, la moyenne arithmétique et l’écart-type sont des estimateurs extrêmement sensibles qui réagissent de manière hyperbolique à la présence de valeurs aberrantes (outliers), qu’elles résultent d’erreurs de saisie cléricale, d’un décrochage technique des instruments d’enregistrement ou d’un comportement non compliant du participant.
Le chercheur doit obligatoirement explorer la forme de ses distributions univariées via la commande Explorer ou Fréquences afin d’examiner attentivement les boîtes à moustaches de Tukey, les diagrammes branche-et-feuille ainsi que les indices d’asymétrie (skewness) et d’aplatissement (kurtosis). Tout score se situant au-delà de trois écarts-types de la moyenne empirique, ou au-delà d’une distance de 1,5 fois l’espace interquartile à partir des charnières de Tukey, doit faire l’objet d’une décision méthodologique éclairée : exclusion motivée, winsorisation raisonnée ou imputation statistique robuste.
Parallèlement, la standardisation du traitement des données manquantes constitue une exigence procédurale cardinale sous SPSS. Les cellules dépourvues d’observation empirique doivent être formellement déclarées dans la colonne « Valeurs manquantes » de la vue des variables, soit sous l’étiquette des données manquantes discrètes (par exemple, le codage conventionnel de valeurs sentinelles impossibles telles que -99 ou 999), soit laissées sous la forme de points de suspension pour les valeurs manquantes système (system-missing). L’absence d’une telle déclaration conduirait le moteur de calcul à traiter ces codes sentinelles comme des données réelles, ce qui aurait pour effet de fausser complètement les grandeurs de dispersion et de ruiner l’estimation du coefficient de variation.
3.3 Création de la variable constante d’ancrage méthodologique
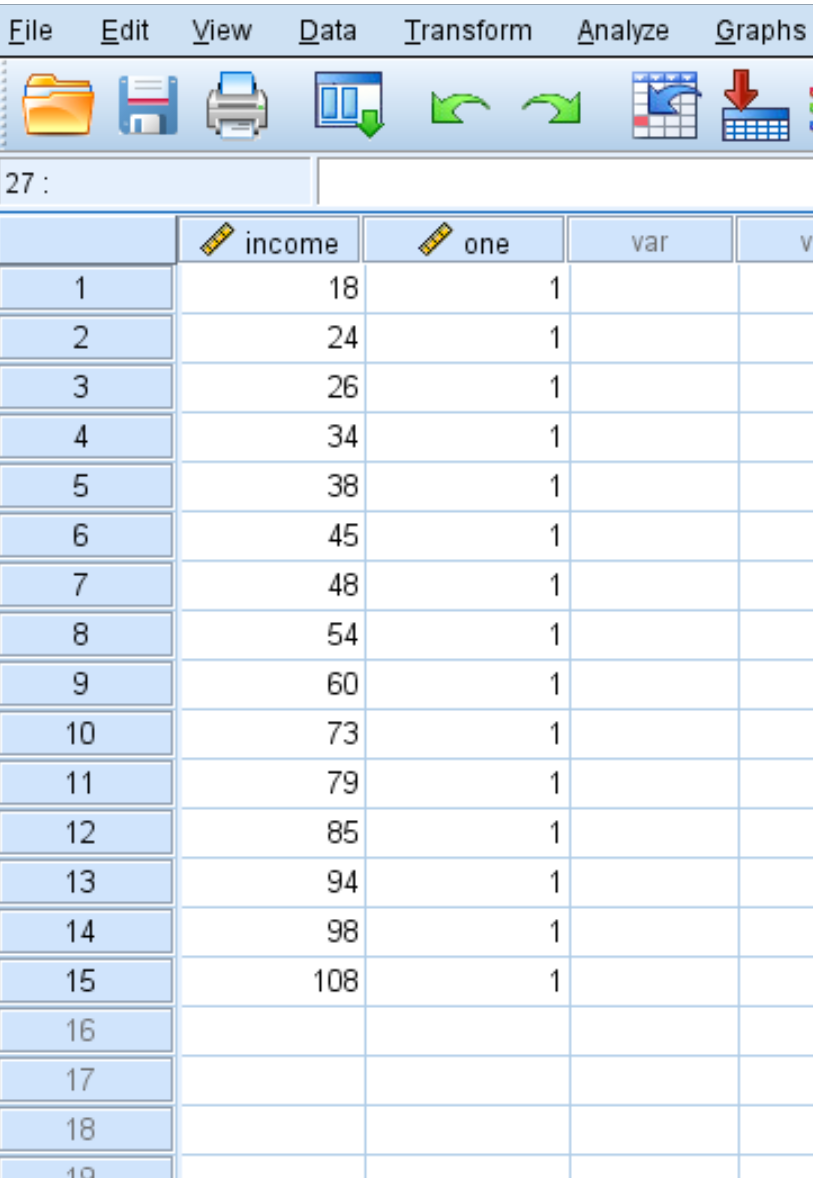
Pour débloquer l’accès direct et automatisé au calcul du coefficient de variation via l’interface des menus déroulants de SPSS sans devoir recourir à des formules artisanales, le statisticien est amené à utiliser une astuce méthodologique bien connue des utilisateurs avancés : la génération d’une variable constante unitaire. L’architecture interne de la procédure spécialisée Statistiques des ratios de SPSS impose en effet structurellement la présence conjointe d’un numérateur et d’un dénominateur dans sa boîte de dialogue principale, le module ayant été historiquement conçu pour l’analyse d’évaluation foncière et les ratios économiques.
Pour détourner élégamment cette contrainte sans dénaturer les propriétés mathématiques fondamentales de la variable quantitative d’intérêt, il suffit d’intégrer dans la matrice de données une colonne artificielle entièrement peuplée par le chiffre un. Sur le plan arithmétique élémentaire, diviser n’importe quelle valeur réelle x par le chiffre 1 renvoie strictement la valeur x elle-même. Dès lors, le ratio calculé entre la variable psychologique continue (au numérateur) et cette constante unitaire (au dénominateur) correspond rigoureusement à la distribution de base de la variable examinée, rendant le calcul du coefficient de variation de ce ratio mathématiquement identique à celui de la variable d’origine.
La génération de cette constante d’ancrage peut s’effectuer par saisie directe pour de micro-échantillons, mais s’automatise de manière bien plus propre et reproductible via l’interface logicielle en accédant au menu déroulant : Transformer > Calculer la variable. Dans la boîte de dialogue d’attribution, il suffit de nommer la « Variable cible » sous l’intitulé mnémotechnique Constante_1 et d’assigner simplement la valeur numérique 1 dans le champ « Expression numérique ». Lors de la validation, SPSS peuple instantanément l’intégralité des lignes actives de la matrice avec cette constante, préparant ainsi idéalement le terrain pour la routine analytique des ratios.
4. Procédure pas-à-pas via le menu déroulant : Statistiques des ratios
4.1 Navigation et accès à la procédure d’analyse descriptive
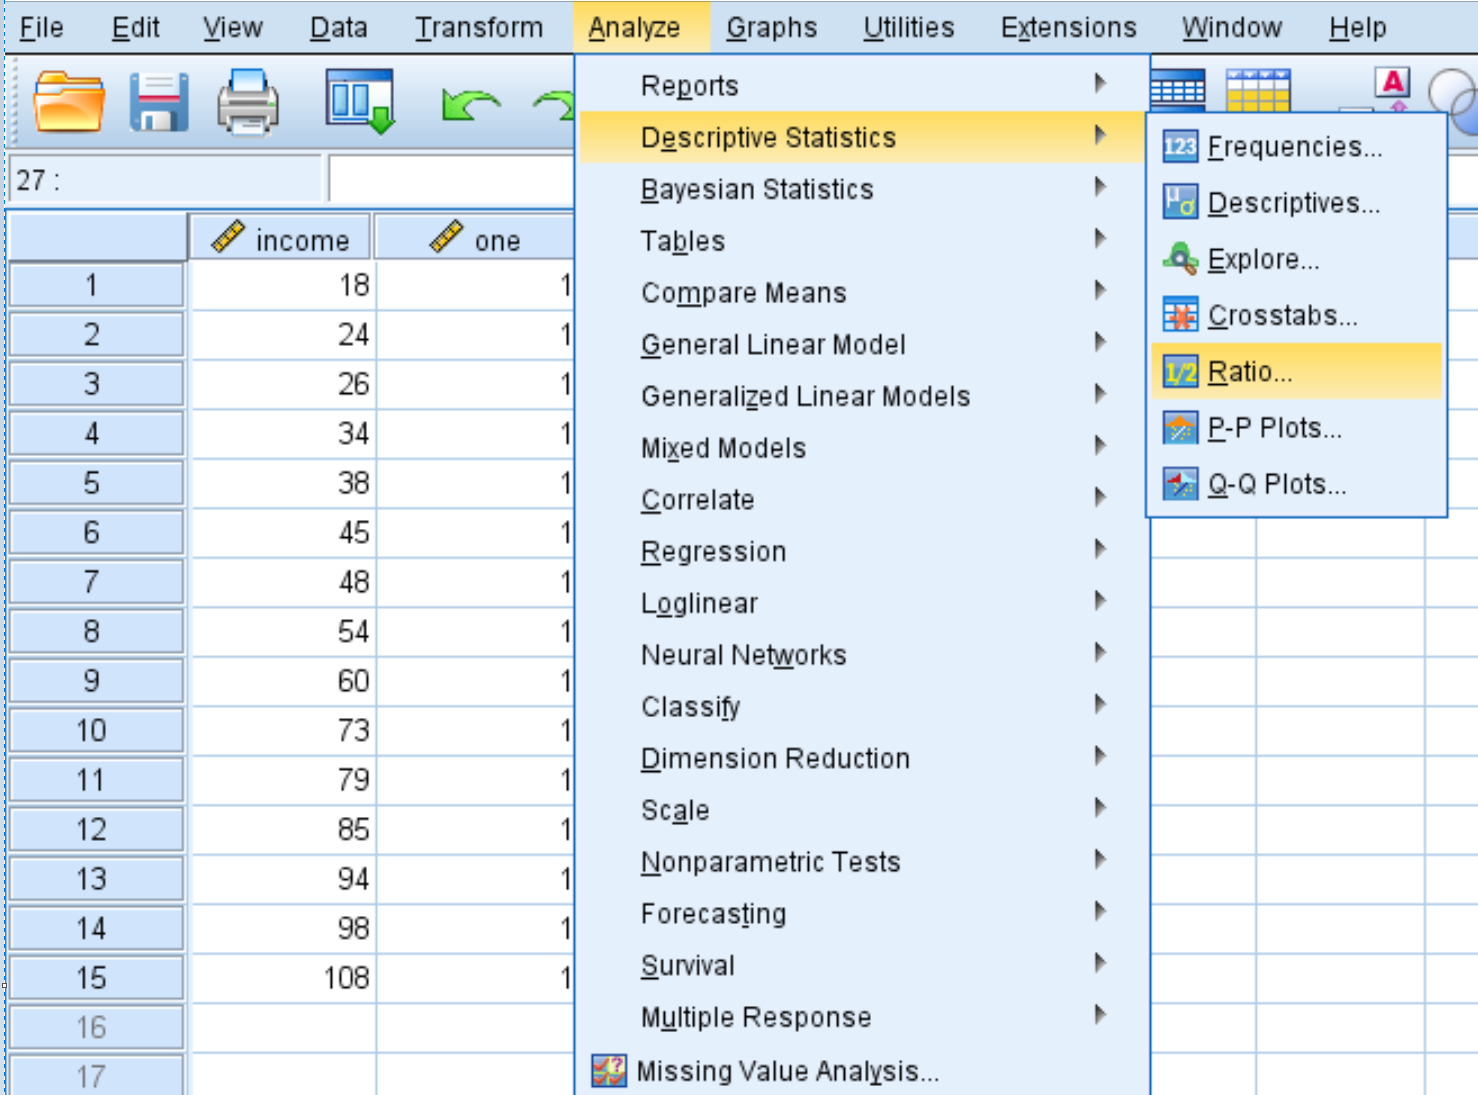
Une fois le jeu de données adéquatement assaini et pourvu de sa constante unitaire, la navigation vers le module ad hoc s’effectue avec une remarquable fluidité au travers de l’arborescence graphique de SPSS. Le chercheur doit sélectionner successivement, au sommet de l’interface graphique du logiciel, le menu principal intitulé Analyser, puis faire glisser son curseur sur le sous-menu intermédiaire Statistiques descriptives. Dans le menu contextuel étendu qui se déploie alors horizontalement, il convient de cliquer sans hésiter sur l’option spécialisée nommée Ratios….
Cette sélection déclenche l’apparition à l’écran de la boîte de dialogue modale intitulée « Statistiques des ratios ». Bien que cette procédure demeure méconnue d’une vaste frange de la communauté des psychologues et des étudiants en sciences humaines — le vocable de ratio étant plus fréquemment associé aux bilans comptables ou à la démographie géographique —, ce module renferme l’une des implémentations de modélisation univariée les plus sophistiquées et véloces de l’environnement SPSS.
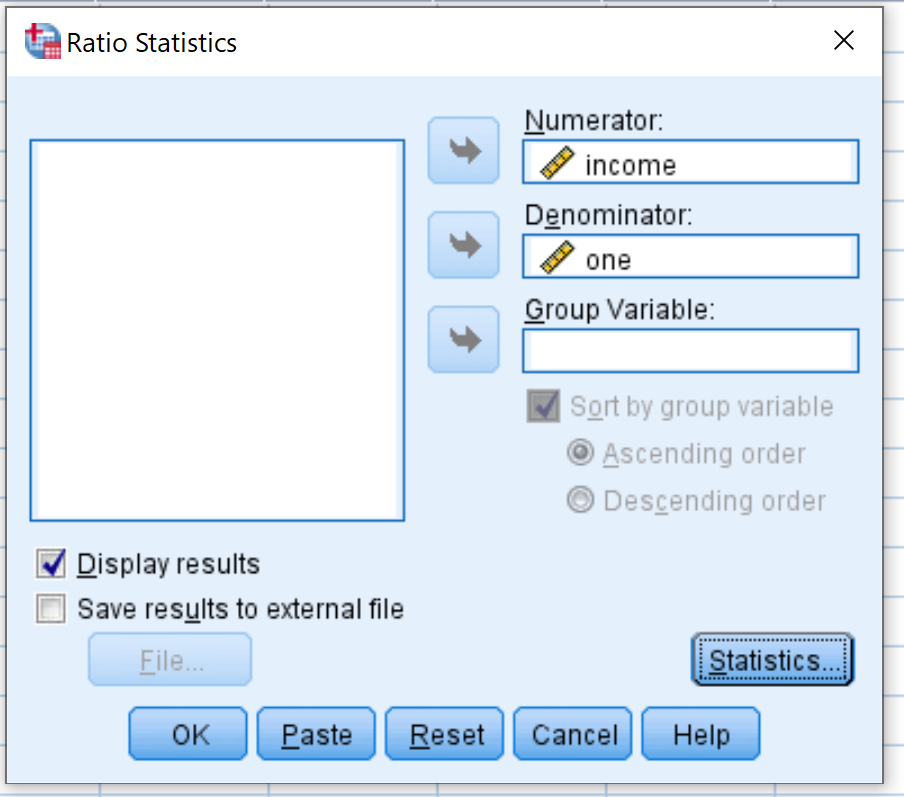
L’interface graphique de cette boîte de dialogue s’organise autour d’un panneau latéral gauche répertoriant l’intégralité des variables déclarées dans le fichier actif, et d’un panneau central comprenant plusieurs réceptacles d’assignation distincts : « Numérateur », « Dénominateur », et une section facultative nommée « Variable de regroupement ». La compréhension de la dynamique de flux entre ces différents segments conditionne le succès absolu de la démarche descriptive.
4.2 Affectation des variables cibles dans la boîte de dialogue
L’opération d’affectation spatiale des variables constitue l’étape mécanique clé de la manipulation. Depuis la liste des variables disponibles sur la gauche, le chercheur repère la variable d’intérêt psychologique ou biologique dont il entend quantifier l’amplitude de dispersion relative (par exemple, une variable continue de temps d’inspection cognitive ou de pression artérielle systolique). À l’aide de la flèche de transfert supérieure orientée vers la droite, cette variable cible est transférée au sein du champ récepteur supérieur étiqueté formellement Numérateur.
Dans un second temps, le chercheur localise dans la liste résiduelle de gauche la variable artificielle d’ancrage générée à l’étape préalable, nommée par convention Constante_1. En cliquant sur la flèche de transfert médiane, il insère impérativement cette colonne unitaire au sein du champ récepteur désigné sous le terme Dénominateur. Cette jonction mathématique impose à l’algorithme d’évaluer la distribution du quotient de la variable continue par un, préservant ainsi l’intégrité métrique originelle des données tout en activant les routines de ratios.
Le champ inférieur réservé à la « Variable de regroupement » doit demeurer vierge si l’objectif fondamental de la recherche réside dans l’obtention d’un coefficient de variation global représentatif de l’ensemble de l’échantillon univarié. En revanche, si le plan d’expérience intègre une catégorisation factorielle inter-sujets (telle que l’assignation aléatoire à un groupe clinique versus un groupe témoin, ou une stratification par tranche d’âge chronologique), il est tout à fait judicieux de placer ladite variable factorielle au sein de cet espace. SPSS générera dès lors les coefficients de variation de manière disjointe pour chacun des sous-échantillons d’intérêt.
4.3 Paramétrage des options de traitement des cas
Avant d’engager la validation des paramètres de dispersion proprement dits, l’analyste se doit de vérifier les conditions de traitement des observations au sein de l’environnement de la procédure. L’un des atouts considérables du module de statistiques des ratios de SPSS réside dans son imperméabilité native aux données incomplètes : le logiciel applique d’autorité la politique de suppression par liste (listwise deletion) sur le couple de variables impliqué dans le ratio. Toute observation présentant une donnée manquante sur la variable cible est immédiatement éludée du calcul analytique sans contaminer les autres cas.
Si la recherche empirique sous-jacente a nécessité la construction préalable d’un schéma d’échantillonnage probabiliste complexe assorti de coefficients de pondération d’enquête (par exemple, pour rectifier des déséquilibres démographiques au sein d’une enquête nationale sur la santé psychologique), il convient de vérifier la prise en compte adéquate de ces pondérations. SPSS intègre harmonieusement le statut des variables pondérées activées via la commande Pondérer les observations du menu Données dans ses calculs de ratio.
Enfin, une vérification immédiate de la compatibilité des distributions métriques avec le module s’impose : le logiciel exige impérativement que l’ensemble des valeurs contenues dans la variable dénominateur soit strictement positif. L’utilisation d’une constante fixée à un garantit une sécurité mathématique totale, prévenant l’apparition brutale d’erreurs d’exécution fatales de type « Division par zéro » susceptibles de bloquer le traitement des données au sein de la session active.
5. Configuration des options statistiques avancées dans le sous-menu Ratio
5.1 Sélection des indices de tendance centrale et de dispersion
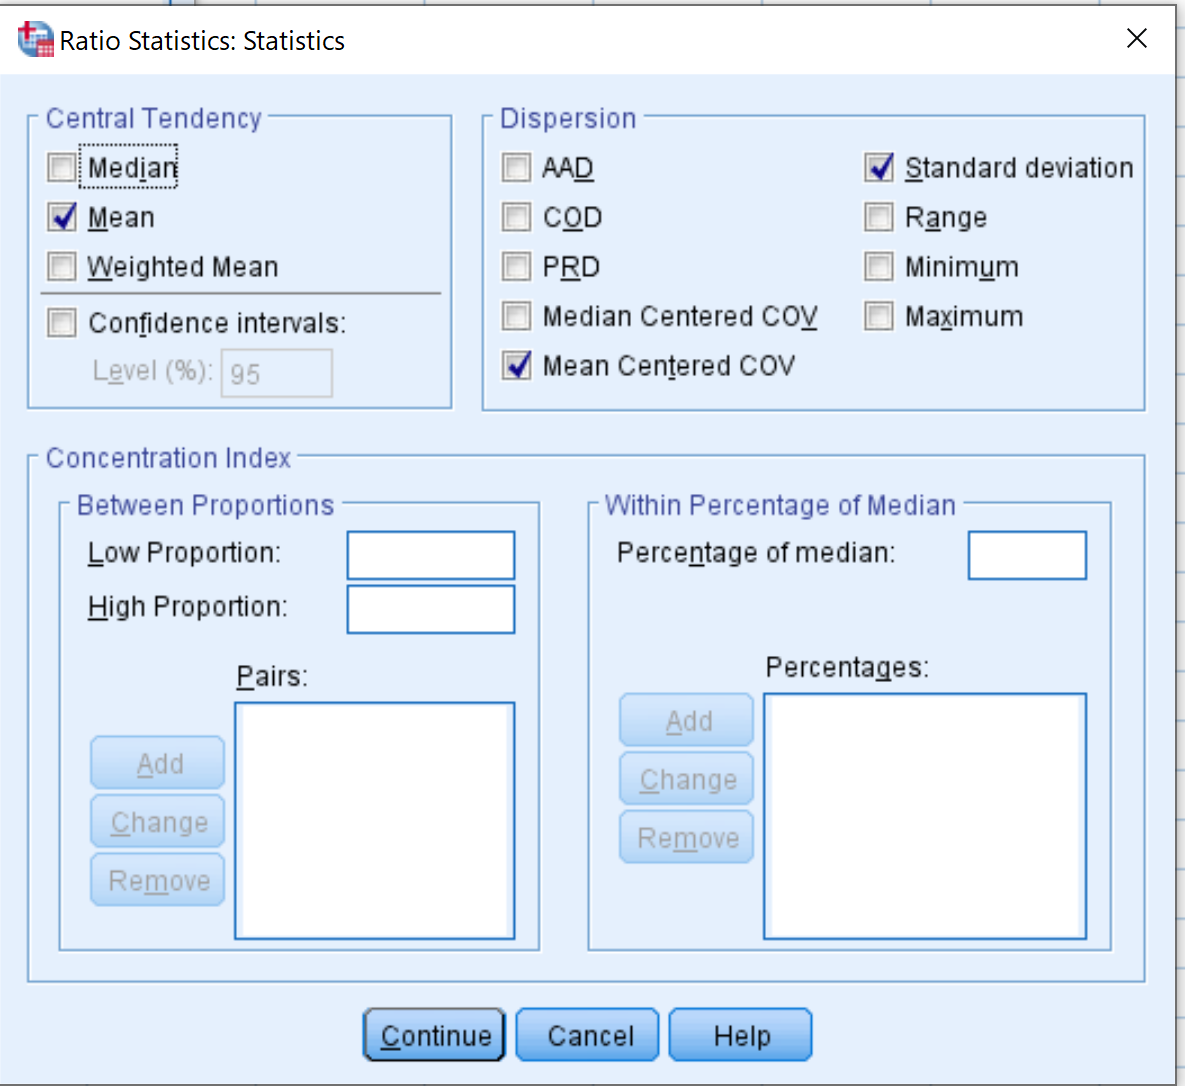
La boîte de dialogue primaire des Statistiques des ratios ne constitue qu’un portail structurel ; la véritable puissance analytique se libère lors de l’activation du bouton cliquable intitulé Statistiques…, situé dans le coin supérieur droit de l’interface. Un clic sur ce bouton déploie une fenêtre contextuelle secondaire d’une richesse exceptionnelle, condensant les principaux paramètres d’estimation de la théorie des distributions relatives.
Pour assurer une assise contextuelle irréprochable au futur coefficient de variation, l’analyste doit d’abord cocher les cases correspondant aux indicateurs de tendance centrale et de dispersion absolue classiques. Dans le bloc réservé à la tendance centrale, il convient de cocher sans hésiter la case intitulée Moyenne. Ce choix ancre le barycentre mathématique des données. Il est également recommandé d’activer l’affichage de la Médiane à des fins de comparaison robuste, particulièrement si la distribution empirique présente de légers indices d’asymétrie univariée.
Dans la section voisine dédiée à la dispersion, il est impératif de cocher la case Écart-type. L’affichage conjoint et simultané de la moyenne empirique et de l’écart-type au sein du futur tableau de sortie s’avère méthodologiquement indispensable. Ce couplage garantit en effet une totale transparence procédurale, en offrant au lecteur de la publication scientifique la possibilité de vérifier immédiatement la formule liant ces deux grandeurs primaires au ratio standardisé final calculé par la machine.
5.2 Activation spécifique du coefficient de variation centré
L’enjeu névralgique de toute la manipulation logicielle converge précisément vers la section inférieure du panneau des statistiques, intitulée explicitement « Indices de dispersion relative ». C’est au sein de cet encadré que se trouve la commande dédiée native que de nombreux chercheurs recherchent en vain dans les autres menus de SPSS. Il convient de repérer avec le plus grand soin la ligne intitulée COV centré sur la moyenne (ou Mean-Centered COV dans les versions anglophones du logiciel) et de cocher la case correspondante.
Une distinction statistique d’une importance primordiale doit être opérée à cet instant précis. L’interface logicielle propose une option immédiatement adjacente et graphiquement très similaire, désignée sous l’étiquette COV centré sur la médiane (Median-Centered COV). Cette seconde option, parfois dénommée coefficient de dispersion quartile ou ratio de dispersion robuste, substitue au calcul conventionnel le rapport de la déviation absolue moyenne par rapport à la médiane divisée par cette même médiane. Bien que hautement informative dans le cadre de l’analyse exploratoire de données fortement contaminées par des valeurs extrêmes, cette statistique ne correspond pas à la définition canonique du coefficient de variation théorisé par Pearson.
Le chercheur désireux d’obtenir le véritable coefficient de variation mathématique standardisé doit donc rigoureusement sélectionner le COV centré sur la moyenne. Cette option enjoint le processeur de SPSS à diviser l’écart-type d’échantillon par la moyenne arithmétique globale de la variable, fournissant très exactement l’estimateur de Pearson recherché. La pertinence de ce centrage garantit une conformité absolue avec les méta-analyses publiées dans les revues à comité de lecture internationales.
5.3 Finalisation et exécution de la routine descriptive
Une fois les cases Moyenne, Écart-type et COV centré sur la moyenne formellement cochées dans la boîte de dialogue secondaire, la finalisation du protocole ne requiert plus que quelques actions simples. Le chercheur clique d’abord sur le bouton Poursuivre (Continue) situé dans la partie supérieure droite de la fenêtre contextuelle. Cette action referme le panneau des options statistiques et réinjecte l’ensemble des arguments de commande au sein de la boîte de dialogue d’ancrage principale.
Depuis la fenêtre primaire des statistiques de ratios, il suffit alors de cliquer sur le bouton de commande OK pour lancer l’exécution de la routine par le compilateur interne de SPSS. Pour les chercheurs soucieux d’immédiateté reproductible ou astreints aux exigences strictes de la recherche ouverte (Open Science), il est vivement conseillé de privilégier à cet instant le bouton Coller (Paste). Cette action consigne la syntaxe textuelle exacte au sein de l’éditeur de script SPSS actif sans exécuter aveuglément l’instruction, permettant un audit ultérieur du code.
Dès l’envoi de l’instruction, SPSS active ses processus matriciels d’arrière-plan. En une fraction de seconde, le logiciel bascule vers la fenêtre de sortie statistique (IBM SPSS Statistics Viewer), consignant l’opération dans le journal d’événements (Log) et affichant de façon ordonnée les matrices récapitulatives et les tableaux descriptifs contenant les estimateurs de variabilité sollicités.
6. Interprétation et lecture analytique des tableaux de résultats SPSS
6.1 Décodage du tableau récapitulatif du traitement des observations
L’exploration des résultats générés par SPSS au sein de la fenêtre de visualisation débute obligatoirement par un contrôle qualité scrupuleux du premier tableau imprimé à l’écran, systématiquement intitulé Récapitulatif du traitement des observations (Case Processing Summary). Négliger la consultation de cette grille initiale au profit d’une lecture précipitée des indices de variabilité constitue une erreur d’analyse récurrente susceptible de biaiser lourdement les conclusions scientifiques.
Ce tableau matriciel consigne avec précision le volume effectif de cas valides (Valid Cases) ayant été effectivement intégrés dans l’algorithme computationnel, tant en valeur absolue qu’en pourcentage de la base de données totale. Il détaille parallèlement le nombre d’observations exclues (Excluded Cases) en raison de valeurs manquantes identifiées sur la variable d’intérêt ou d’incompatibilités numériques éventuelles. Le chercheur doit immédiatement vérifier si le volume effectif N affiché coïncide rigoureusement avec le nombre de participants prévus par son plan expérimental après attrition contrôlée.
Toute discordance numérique non anticipée au sein de ce récapitulatif — par exemple la perte inexpliquée de quinze participants sur une cohorte de cent sujets — signale immédiatement la présence de cellules vides non documentées ou d’erreurs d’encodage au sein de la matrice. Ce tableau introductif constitue la caution méthodologique attestant de l’adéquation parfaite entre les effectifs d’échantillonnage déclarés et la matière première empirique effectivement ingérée par la routine statistique.
6.2 Lecture de la ligne COV centré sur la moyenne
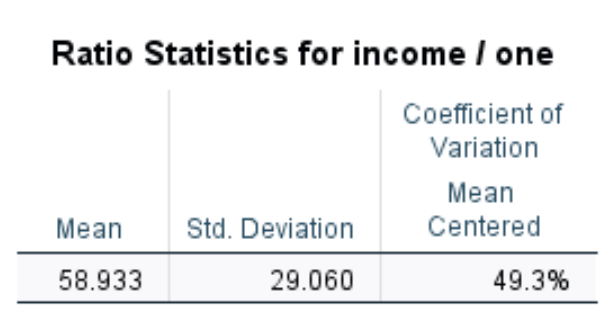
Directement en aval du récapitulatif des cas se trouve le tableau analytique central de la procédure, sobrement baptisé Statistiques des ratios (Ratio Statistics). Cette structure matricielle rassemble sur des lignes successives l’ensemble des estimateurs paramétriques cochés lors de la configuration du sous-menu : la moyenne du ratio, son écart-type associé, et enfin la ligne critique convoitée par le chercheur, désignée textuellement sous l’intitulé COV centré sur la moyenne.
La valeur numérique insérée dans la cellule correspondant à cette ligne incarne le coefficient de variation brut calculé par le processeur arithmétique de SPSS. Il importe de porter une attention métrologique maximale au format d’affichage par défaut adopté par le logiciel. SPSS livre systématiquement ce résultat sous la forme d’un nombre décimal conventionnel et non sous celle d’un pourcentage explicite. Dès lors, une valeur affichée telle que 0,248 doit obligatoirement être mentalement ou manuellement multipliée par le chiffre cent pour être traduite et restituée sous sa forme canonique de variabilité relative, soit 24,8 %.
Le chercheur avisé procédera à un contrôle manuel immédiat pour valider la robustesse du traitement en divisant la valeur figurant sur la ligne Écart-type par celle de la ligne Moyenne. La parfaite concordance numérique entre cette division élémentaire et la cellule du COV centré sur la moyenne confirme formellement que l’architecture des ratios n’a subi aucune déviation et que le paramètre affiché reflète purement le ratio s sur mu standard de Pearson.
6.3 Évaluation qualitative de l’amplitude de la variabilité relative
L’extraction numérique du coefficient de variation ne prend son véritable sens scientifique que par le truchement d’une interprétation théorique contextualisée au sein de la discipline d’ancrage. Contrairement à certains indices psychométriques encadrés par des règles rigides — tels que les critères d’acceptabilité du coefficient alpha de Cronbach —, l’appréciation du niveau de variabilité relative d’une mesure n’est pas réductible à des frontières arbitraires universelles.
Il existe néanmoins des grilles de lecture heuristiques largement partagées dans la communauté de la recherche quantitative. D’une manière générale, un coefficient de variation inférieur à 10 % est qualifié de très faible à négligeable, témoignant d’une distribution remarquablement homogène et d’une très haute stabilité du signal comportemental ou biologique mesuré. Entre 10 % et 25 %, la dispersion relative est considérée comme modérée et typique de la plasticité observée dans la plupart des conduites cognitives humaines saines. Lorsque le CV franchit le seuil des 30 % à 40 %, la variabilité est jugée substantielle à très élevée, traduisant une hétérogénéité prononcée des réponses qui appelle des investigations complémentaires quant à d’éventuels sous-profils cliniques ou des défaillances de consigne expérimentale.
Ces balises descriptives doivent impérativement être pondérées par l’objet d’étude examiné. En chronométrie mentale fine, où des temps de réaction de choix gravitent autour de 350 millisecondes, un CV intra-individuel de 18 % sera salué comme l’indice d’une excellente concentration, alors que ce même ratio de 18 % appliqué à la température corporelle centrale ou à l’osmolarité plasmatique traduirait un dysfonctionnement physiologique majeur. L’interprétation scientifique gagne toujours à situer la valeur obtenue par SPSS au regard des normes publiées dans la littérature spécialisée du domaine.
7. Calcul du coefficient de variation à l’aide de la syntaxe SPSS
7.1 Avantages de l’automatisation par la syntaxe en recherche reproductible
Bien que la navigation par le menu graphique offre un confort visuel appréciable lors de la phase exploratoire initiale, la pratique scientifique moderne impose l’archivage rigoureux de chaque acte analytique. La crise de la reproductibilité qui a profondément secoué les sciences du comportement au cours de la dernière décennie a consacré l’usage impératif de scripts programmables. Au sein de SPSS, le recours aux fichiers de commandes textuelles (les fichiers d’extension .sps) incarne le véhicule fondamental de cette traçabilité méthodologique.
L’automatisation du calcul du coefficient de variation par voie de syntaxe élimine radicalement les aléas inhérents aux clics de souris et garantit que le protocole statistique pourra être rejoué à l’identique, à plusieurs années d’intervalle ou sur des cohortes d’échantillonnage distinctes, sans la moindre dérive procédurale. De surcroît, le gain de temps s’avère considérable lorsque l’analyste se trouve confronté à des matrices longitudinales denses comprenant des centaines de variables psychologiques mesurées en continu.
Enfin, l’insertion de lignes de code transparentes et commentées dans les répertoires publics de données ouvertes — tels que l’Open Science Framework (OSF) ou Zenodo — constitue désormais un gage de probité académique requis par les plus prestigieuses revues à comité de lecture. La syntaxe SPSS atteste formellement devant la communauté des pairs des opérations algébriques exactes et des choix d’exclusion opérés sur les jeux de données brutes.
7.2 Structure et rédaction de la commande RATIO STATISTICS
La transcription scripturale de la procédure étudiée s’articule autour de la commande centrale native RATIO STATISTICS. Cette instruction SPSS obéit à une grammaire formelle stricte, conjuguant la désignation du vecteur de données dépendant, la référence au dénominateur unitaire et la liste explicite des sous-commandes de restitution désirées.
Le squelette syntaxique canonique destiné au calcul du coefficient de variation sans variable de regroupement s’agence selon la structure linéaire suivante :
RATIO STATISTICS TR_Visuel WITH Constante_1
/PRINT = MEAN STDDEV MEANCOV.
Dans cette formulation, l’identifiant TR_Visuel renvoie au nom effectif de la variable d’intérêt continue hébergée dans la base active, tandis que le mot-clé obligatoire WITH établit la frontière de division en reliant cette variable à la variable artificielle Constante_1 préalablement paramétrée à la valeur unitaire. La sous-commande /PRINT ordonne au moteur de calcul de restreindre l’affichage matriciel final aux trois indicateurs indispensables : la moyenne arithmétique (MEAN), l’écart-type d’échantillon (STDDEV), et enfin le mot-clé propriétaire régissant le coefficient de variation de Pearson, à savoir MEANCOV.
Si la démarche analytique requiert une décomposition factorielle immédiate selon les modalités d’une variable de groupe (par exemple une condition expérimentale nommée Condition_Exp prenant les modalités 1 et 2), il suffit d’insérer l’opérateur de stratification BY directement dans l’instruction de déclaration :
RATIO STATISTICS TR_Visuel WITH Constante_1 BY Condition_Exp
/PRINT = MEAN STDDEV MEANCOV.
7.3 Exécution et diagnostic du code de calcul
L’implémentation opérationnelle de ce script s’effectue au sein de l’éditeur de syntaxe SPSS, accessible depuis l’interface par le menu Fichier > Nouveau > Syntaxe. Après avoir saisi manuellement les lignes de commande ou les avoir transférées via le bouton « Coller » des menus déroulants, le chercheur sélectionne l’intégralité du texte scripté à l’aide de sa souris et déclenche l’exécution en cliquant sur le pictogramme triangulaire vert (« Exécuter la sélection ») situé dans la barre d’outils, ou en composant le raccourci clavier universel Ctrl + R (sous Windows) ou Cmd + R (sous macOS).
Une vigilance constante doit être accordée au diagnostic des éventuels avertissements générés par SPSS dans son journal de console. Si la variable constante unitaire n’a pas été préalablement générée dans la matrice, le compilateur renvoie immédiatement une erreur fatale indiquant qu’une variable non déclarée empêche la progression du calcul. De même, la présence accidentelle d’une observation nulle ou négative dans le vecteur du dénominateur déclenche l’interruption immédiate de l’instruction RATIO STATISTICS avec un message explicite d’invalidité métrique.
Lorsque le script a été vérifié et exempt de scories syntaxiques, il est vivement recommandé d’adjoindre des lignes de commentaires herméneutiques en préfaçant ces dernières par une astérisque (*) et en les clôturant par un point final (.). Cette bonne pratique documentaire permet de pérenniser la mémoire méthodologique de l’analyse, en rappelant par exemple que le mot-clé MEANCOV renvoie formellement au calcul du coefficient de variation relatif standard de Karl Pearson.
8. Approche alternative par transformation de variables et procédures descriptives
8.1 Extraction des paramètres descriptifs fondamentaux
Il existe dans l’arsenal méthodologique de SPSS une seconde voie d’accès au coefficient de variation, reposant sur une logique algorithmique totalement décorrélée du module des ratios : l’extraction analytique des paramètres primaires via la commande usuelle DESCRIPTIVES, suivie d’une réinjection arithmétique directe dans la matrice de données. Cette approche matricielle classique offre une transparence mathématique absolue qui séduit de nombreux modélisateurs.
La première phase de ce protocole alternatif consiste à exécuter une routine descriptive élémentaire sur la variable cible, en sollicitant l’affichage de la moyenne et de l’écart-type non arrondis. La formulation syntaxique standardisée s’énonce en ces termes :
DESCRIPTIVES VARIABLES=Score_Memoire
/STATISTICS=MEAN STDDEV.
Le chercheur doit impérativement récupérer les valeurs numériques brutes issues du tableau de sortie de SPSS avec le maximum de décimales disponibles. Pour ce faire, un double-clic interactif sur le tableau récapitulatif dans le visualiseur de sorties permet de faire apparaître le modèle de tableau croisé dynamique (Pivot Table) et d’inspecter les valeurs réelles non tronquées stockées en mémoire machine, éliminant ainsi les biais de troncature décimale avant l’étape de transformation subséquente.
8.2 Implémentation via la fonction Calculer la variable
Disposant de l’écart-type empirique s et de la moyenne arithmétique x barre, l’analyste peut implémenter le calcul du coefficient de variation directement sous la forme d’une nouvelle colonne de données individualisée. Cette opération s’effectue via le menu Transformer > Calculer la variable (Compute Variable).
Dans la boîte de dialogue d’édition arithmétique, le chercheur nomme sa nouvelle variable sous un libellé clair, par exemple CV_Score_Memoire. Dans le champ dévolu à la saisie de l’expression numérique, il retranscrit très simplement la formule fondamentale du CV en injectant les scalaires extraits, enrichis de la multiplication par cent pour exprimer immédiatement le résultat sous forme de pourcentage :
COMPUTE CV_Score_Memoire = (14.28547 / 65.42189) * 100.
EXECUTE.
L’exécution de cette commande via l’instruction EXECUTE. engendre la matérialisation immédiate d’une colonne vectorielle dont chaque cellule contient uniformément la valeur du coefficient de variation de la distribution globale. Bien que cette méthode puisse sembler redondante à l’échelle d’un échantillon unitaire stationnaire, elle prend une dimension algorithmique redoutable lorsqu’elle est couplée aux fonctions d’automatisation matricielle par agrégation.
8.3 Utilisation de la commande AGGREGATE pour les analyses en sous-groupes
L’une des stratégies les plus sophistiquées pour calculer de manière totalement autonome et dynamique les coefficients de variation à travers de multiples sous-populations cliniques consiste à mobiliser la puissante procédure AGGREGATE de SPSS. Cette commande permet d’effondrer ou d’agréger les informations d’un fichier volumineux selon une ou plusieurs variables de scission factorielle en créant directement des vecteurs de moyennes et d’écarts-types distincts au sein d’une nouvelle matrice ou dans le fichier actif.
Considérons un protocole évaluant l’anxiété préopératoire à travers quatre services hospitaliers distincts répertoriés sous la variable Service_ID. Le script de condensation s’élabore comme suit :
AGGREGATE
/OUTFILE=* MODE=ADDVARIABLES
/BREAK=Service_ID
/Moyenne_Anx = MEAN(Score_Anxiete)
/EcartType_Anx = SD(Score_Anxiete).
L’argument MODE=ADDVARIABLES ordonne à SPSS d’adjoindre directement deux nouvelles colonnes au fichier actif sans modifier sa structure initiale : Moyenne_Anx (qui contient la moyenne spécifique du service d’appartenance de chaque patient) et EcartType_Anx (l’écart-type correspondant à ce même service). Dès lors, le calcul dynamique du coefficient de variation pour chaque strate clinique s’opère instantanément via une ligne de calcul vectoriel simple :
COMPUTE CV_Anxiete_Groupe = (EcartType_Anx / Moyenne_Anx) * 100.
EXECUTE.
Cette méthodologie d’agrégation représente le standard d’excellence pour comparer l’homogénéité relative de multiples sous-groupes expérimentaux en une seule routine, sans jamais devoir morceler artificiellement la matrice de données par des filtres successifs.
9. Calcul du coefficient de variation intra-individuel à travers des mesures répétées
9.1 Organisation des données au format large pour les mesures répétées
Dans les champs de pointe de la psychologie cognitive, de la chronométrie mentale et des neurosciences expérimentales, le coefficient de variation change fréquemment d’échelle d’analyse : il n’est plus calculé entre les participants d’un même groupe (variabilité inter-individuelle), mais au sein des essais répétés réalisés par un unique individu (variabilité intra-individuelle). Ce basculement paradigmatique requiert une restructuration adéquate de la matrice de données au sein de l’environnement SPSS.
Pour mener à bien ce calcul intra-sujet de manière directe, la matrice doit impérativement adopter ce que les biostatisticiens nomment le « format large » (wide format). Dans cette architecture tabulaire, chaque ligne horizontale correspond exclusivement à un participant unique, identifié par son code sujet dans la première colonne, tandis que l’ensemble de ses performances successives au cours des différents essais de la tâche cognitive sont alignées horizontalement le long de colonnes distinctes (par exemple, Essai_1, Essai_2, Essai_3 jusqu’à Essai_50).
L’analyste doit s’assurer de l’équivalence métrique absolue de ces mesures répétées successives : elles doivent toutes avoir été acquises au moyen de la même unité temporelle (idéalement en millisecondes) sous des conditions expérimentales rigoureusement homogènes. De plus, une politique de filtrage rigoureuse doit être appliquée en amont pour purger les essais pollués par des anticipations motrices aberrantes (latences inférieures à 150 ms) ou des inattentions manifestes sans supprimer intégralement la ligne du participant, sous peine de biaiser son dénominateur moyen.
9.2 Application des fonctions vectorielles SD et MEAN dans SPSS
Une fois les mesures longitudinales structurées au format large, le calcul du coefficient de variation intra-individuel (ICV) s’exécute à l’aide d’une remarquable concision algorithmique grâce aux fonctions vectorielles horizontales intégrées au processeur de transformation de SPSS. Contrairement aux procédures descriptives standards qui analysent les colonnes verticales, ces fonctions calculent les estimateurs le long des lignes de la matrice pour chaque observation prise isolément.
La commande utilise conjointement les opérateurs vectoriels SD() et MEAN() au moyen de la syntaxe de sélection par étendue continue désignée par le mot-clé TO. Le script de calcul s’articule de la manière suivante :
COMPUTE ICV_TempsReponse = (SD(Essai_1 TO Essai_50) / MEAN(Essai_1 TO Essai_50)) * 100.
EXECUTE.
Dans cette instruction compacte, le compilateur évalue d’abord pour chaque participant l’écart-type de sa distribution personnelle d’essais sur la plage de variables allant d’Essai_1 à Essai_50, calcule ensuite la moyenne personnelle de cette même séquence d’essais, divise le premier résultat par le second et multiplie la fraction par cent. En une seule passe computationnelle, SPSS insère dans la grille une nouvelle variable quantitative continue baptisée ICV_TempsReponse, reflétant fidèlement l’empreinte de la dispersion relative propre à chaque sujet.
Il est important de souligner que la fonction syntaxique MEAN.n() peut être paramétrée pour tolérer un seuil prédéterminé de données manquantes (par exemple, MEAN.40(Essai_1 TO Essai_50) exigera au moins quarante essais valides sur cinquante pour produire un calcul), préservant ainsi la puissance statistique globale sans fragiliser l’estimation du barycentre individuel.
9.3 Analyse de la consistance comportementale individuelle
L’obtention de cette nouvelle variable d’instabilité relative ouvre des perspectives analytiques majeures pour le chercheur. Sur le plan de l’investigation cognitive, un coefficient de variation intra-individuel substantiellement accru constitue un témoignage univoque d’une altération de la régulation de l’éveil cortical et d’une dégradation de la stabilité du contrôle exécutif top-down au sein des circuits fronto-striataux.
Le score d’ICV ainsi généré par SPSS peut alors être immédiatement mobilisé en tant que variable indépendante, dépendante ou médiatrice au sein de modélisations inférentielles plus avancées. Le statisticien peut l’engager dans des analyses de régression linéaire multiple, des modèles linéaires mixtes ou des modèles d’équations structurelles pour prédire des phénotypes cliniques complexes, explorer des corrélations directes avec des volumes de substance blanche cérébrale mesurés par IRM morphométrique, ou évaluer l’impact direct de la charge mentale et de la privation de sommeil sur l’efficience comportementale.
Cette approche par la dispersion intra-individuelle relative s’avère infiniment plus prédictive que l’analyse des temps de réaction moyens traditionnels. Deux individus manifestant une vitesse motrice moyenne rigoureusement équivalente de 450 millisecondes peuvent déployer des dynamiques cognitives diamétralement divergentes : le premier déployant une constance robotique quasi parfaite (ICV = 8 %), tandis que le second subit des alternances chaotiques entre hyper-vigilance et effondrements attentionnels majeurs (ICV = 35 %). Le calcul de cet indice dans SPSS permet d’objectiver ces distinctions fines avec une rigueur méthodologique indiscutable.
10. Comparaison critique entre le coefficient de variation et d’autres indices de dispersion
10.1 Coefficient de variation versus écart-type standardisé
L’arbitrage méthodologique entre l’usage de l’écart-type brut (noté SD) et celui du coefficient de variation (CV) constitue un débat classique en métrologie statistique. L’écart-type présente l’avantage indéniable d’être exprimé dans l’unité originale de la mesure, ce qui confère à sa lecture une signification physique immédiate dans le cadre d’un protocole circonscrit : déclarer qu’une population clinique dévie en moyenne de 12 millimètres de mercure sur une mesure de pression systolique permet au clinicien de projeter une réalité biomédicale concrète.
Cependant, dès lors que l’objectif de la recherche implique la confrontation de plusieurs conditions expérimentales dont les moyennes empiriques divergent substantiellement, l’écart-type standardisé révèle ses limites intrinsèques. En vertu de la relation fondamentale d’hétéroscédasticité empirique (souvent modélisée par la loi empirique de Taylor), la dispersion absolue a une propension naturelle à croître proportionnellement à la magnitude moyenne du signal mesuré. Comparer les écarts-types d’un groupe d’enfants et d’un groupe d’adultes sur une tâche de mémorisation conduira presque inévitablement à conclure à une variance accrue chez le groupe adulte, simplement parce que leur empan mnésique moyen est plus élevé.
Le coefficient de variation résout de manière éclatante cette distorsion en opérant une correction d’échelle rigoureuse. En neutralisant l’effet direct de la magnitude de la moyenne, il permet de révéler si l’amplitude réelle du bruit biologique sous-jacent est véritablement disproportionnée ou si elle n’est que le reflet mécanique d’une base de mesure plus ample. Toutefois, dans les designs orthogonaux contrôlés où les moyennes de groupe demeurent strictement équivalentes, l’écart-type standardisé conserve sa suprématie descriptive en raison de sa plus grande parcimonie calculatoire.
10.2 Coefficient de variation versus intervalle interquartile relatif
Le calcul du coefficient de variation de Pearson repose sur les deux premiers moments de la distribution statistique : la moyenne arithmétique et l’écart-type fondé sur la somme des carrés des écarts. Cette filiation paramétrique confère au CV une vulnérabilité aiguë face aux violations patentes de l’hypothèse de normalité univariée, ainsi qu’une sensibilité excessive aux queues de distribution épaisses et asymétriques.
Face à des données fortement asymétriques — comme c’est typiquement le cas des données de revenus financiers, des seuils de détection olfactive ou des temps de séjour en hospitalisation psychiatrique —, l’analyste gagne à considérer une alternative non paramétrique robuste : l’intervalle interquartile relatif (ou coefficient de dispersion quartile). Cet indicateur substitue au couple moyenne/écart-type le rapport de la moitié de l’écart interquartile divisé par la médiane empirique (formalisé par le ratio : [Q3 – Q1] / [2 * Q2]).
Cet indice non paramétrique partage avec le CV son caractère adimensionnel et son indépendance d’échelle, mais jouit d’une résistance totale face à la présence de valeurs extrêmes résiduelles. Le tableau méthodologique ci-dessous synthétise les critères de décision pour orienter le statisticien entre ces deux approches métriques en fonction des caractéristiques de distribution au sein de SPSS :
| Propriété méthodologique | Coefficient de variation (CV de Pearson) | Dispersion quartile relative (IQR / Médiane) |
|---|---|---|
| Nature de l’estimateur | Paramétrique (fondé sur les moments) | Non paramétrique (fondé sur les rangs) |
| Exigence d’échelle | Échelle de rapport avec zéro absolu | Échelle ordinale ou de rapport |
| Sensibilité aux valeurs extrêmes | Très élevée (altération forte de s et x) | Nulle (résistant jusqu’à 25 % de contamination) |
| Procédure dédiée sous SPSS | RATIO STATISTICS (mot-clé MEANCOV) |
EXAMINE ou FREQUENCIES (calcul manuel) |
| Usage préférentiel | Distributions symétriques, contrôle métrologique | Distributions hautement asymétriques, données tronquées |
10.3 Coefficient de variation versus variance pour l’évaluation de la fidélité
L’évaluation de la consistance interne et de la reproductibilité d’un instrument d’évaluation psychologique oppose fréquemment les tenants de la décomposition de la variance (via le prisme de la théorie classique des tests ou de la théorie de la généralisabilité) aux partisans de la quantification de l’erreur relative par le coefficient de variation. Au sein des modèles ANOVA à effets aléatoires, la variance résiduelle inter-sessions permet de calculer le célèbre coefficient de corrélation intraclasse (ICC).
Bien que l’ICC soit indispensable pour attester de la capacité d’un test à discriminer les participants les uns des autres au sein d’une population hétérogène, il s’avère incapable d’éclairer le clinicien sur la précision métrologique absolue dont il dispose au chevet d’un patient individuel. Un test psychométrique appliqué à un échantillon extrêmement hétérogène pourra afficher un ICC mirobolant supérieur à 0,90, tout en abritant des variations de mesure inter-jours de l’ordre de 30 % chez un patient particulier, dissimulées par la variance inter-sujets globale.
Le calcul conjoint du coefficient de variation d’erreur de mesure (généralement calculé sous la forme de l’écart-type résiduel intrapersonnel intra-classe divisé par la grande moyenne globale) comble précisément cette lacune. Il fournit un indice standardisé de la marge de fluctuation attendue d’un test indépendamment de l’échantillon de validation initial. C’est pourquoi les directives contemporaines d’harmonisation de la recherche biomédicale et psychologique recommandent vivement de ne plus dissocier ces deux indices et de publier systématiquement le coefficient de variation aux côtés des indices de variance classiques lors de toute étude de validation instrumentale sous SPSS.
11. Pièges méthodologiques et limites statistiques de l’usage du CV dans SPSS
11.1 Impact déstabilisateur des données à distribution asymétrique
L’application machinale du coefficient de variation sans exploration préalable de la topologie de la distribution constitue l’un des écueils les plus pernicieux de l’analyse quantitative. Lorsque les observations s’étirent le long d’une longue traîne asymétrique positive — configuration fréquente dans l’évaluation des durées d’apprentissage ou des niveaux d’expression de cytokines pro-inflammatoires —, la moyenne arithmétique est violemment tractée vers la droite de l’axe métrique, tandis que la valeur de l’écart-type subit une dilatation exponentielle sous l’influence des carrés des résidus.
Dans ce scénario de forte déviation, le ratio théorique s sur mu cesse de refléter un comportement stable de la variance relative. Si la dilatation de l’écart-type est disproportionnée par rapport à celle de la moyenne, le coefficient de variation s’envole vers des grandeurs erratiques qui ne correspondent à aucune réalité empirique homogène. De manière tout aussi problématique, les données soumises à un phénomène d’écrêtement (effet plafond ou effet plancher matériel de l’instrument d’évaluation) induisent une troncation artificielle de la queue de distribution, provoquant une contraction factice de l’écart-type et sous-estimant dramatiquement le CV réel du système.
Une démarche méthodologique élégante pour neutraliser ce piège au sein de SPSS réside dans l’application préalable d’une transformation logarithmique népérienne sur la variable continue (via la syntaxe COMPUTE Log_Variable = LN(Variable).). Dans le cadre d’une distribution log-normale, le chercheur peut dériver un coefficient de variation géométrique corrigé hautement robuste en appliquant la formule spécialisée : CV géométrique = racine carrée de (exponentielle de [s_log au carré] moins un). Cette conversion stabilise mathématiquement l’indice face aux asymétries prononcées.
11.2 Problématique des moyennes proches de zéro et valeurs négatives
L’une des limites mathématiques les plus rédhibitoires du coefficient de variation concerne son comportement asymptotique aux abords immédiats du zéro. Lorsque le phénomène étudié présente une moyenne arithmétique globale infinitésimale (par exemple une modulation moyenne de potentiel évoqué cognitif de 0,02 microvolt), le terme du dénominateur s’effondre. Il en résulte une explosion artificielle hyperbolique du résultat final : le coefficient de variation peut atteindre des valeurs sidérantes de 1000 % ou 5000 %, traduisant uniquement la petitesse du barycentre et non une instabilité mécanique démesurée des données.
Cette instabilité mathématique s’avère particulièrement toxique lorsqu’un analyste tente d’appliquer le calcul du CV sur des variables standardisées en scores Z (moyenne zéro, écart-type un). Dans cette configuration, le dénominateur étant nul, la division algébrique est indéfinie, et toute tentative computationnelle au sein de SPSS renvoie une erreur système ou génère une valeur manquante système (system-missing). Il existe une règle méthodologique inflexible : le coefficient de variation ne doit jamais, sous aucun prétexte, être appliqué sur des données préalablement centrées-réduites ou normalisées autour d’une moyenne nulle.
Le même interdit formel frappe les échelles d’attitudes psychologiques de type Likert (par exemple graduées de -3 à +3 pour évaluer un continuum allant de « Tout à fait en désaccord » à « Tout à fait d’accord »). La présence simultanée de scores positifs et négatifs annule partiellement la moyenne globale sans altérer la variance brute, produisant un dénominateur totalement artificiel qui dénature le sens du ratio. Même lorsqu’une échelle de Likert est codée positivement (de 1 à 7), son caractère ordinal et l’absence de zéro absolu interdisent théoriquement l’usage du CV, celui-ci n’ayant aucune invariance par changement d’origine d’échelle.
11.3 Limites inhérentes à la procédure Ratio dans l’environnement SPSS
Si la procédure intégrée RATIO STATISTICS de SPSS déploie d’incontestables vertus pragmatiques, elle n’en demeure pas moins grevée de plusieurs limites fonctionnelles intrinsèques qui frustrent régulièrement les chercheurs avancés. La carence la plus flagrante réside dans l’incapacité native de cette boîte de dialogue à générer des intervalles de confiance précis pour le coefficient de variation au moyen de procédures de rééchantillonnage de type bootstrap non paramétrique.
En effet, publier une simple estimation ponctuelle du CV sans documenter son intervalle de confiance à 95 % (IC 95 %) prive la communauté scientifique d’une information cruciale concernant la précision d’échantillonnage de cet estimateur. De surcroît, le moteur interne de SPSS ne propose aucun test d’hypothèse direct — tel que le test asymptotique de Bennett, le test de Miller-Feltz ou la procédure de Wald — permettant de tester formellement la significativité statistique de la différence observée entre deux coefficients de variation indépendants ou appariés.
Pour contourner cette indigence algorithmique du logiciel de base, le statisticien est contraint de mobiliser des extensions de programmation externe. L’intégration de macros spécialisées rédigées en langage Python ou R via le module d’intégration SPSS Statistics Essentials for Python permet de pallier ces manques en orchestrant des boucles de rééchantillonnage itératives capables de dériver des intervalles de confiance par percentiles corrigés du biais (BCa) pour le coefficient de variation.
12. Restitution académique et présentation des résultats aux normes APA
12.1 Formalisation textuelle et typographie scientifique conforme
La communication des résultats statistiques au sein des revues scientifiques exige une soumission rigoureuse aux normes de rédaction de l’American Psychological Association, actuellement régies par la septième édition du manuel officiel de style (APA 7). La désignation formelle du coefficient de variation requiert une normalisation typographique précise : il convient d’employer l’abréviation latine standardisée en lettres majuscules CV, typographiée impérativement en italique lorsqu’elle fait référence à l’opérateur statistique au sein du corps du texte narratif.
Concernant la précision de restitution numérique, les préconisations de l’APA stipulent de restreindre l’affichage quantitatif à deux décimales après la virgule (ou après le point décimal en anglais académique), sauf impératif métrologique exceptionnel exigeant une précision microscopique. De plus, il est requis de spécifier systématiquement si la grandeur est restituée sous forme fractionnaire décimale ou sous sa transcription en pourcentage standardisé afin d’éviter toute méprise interprétative chez le lecteur.
Un modèle canonique d’intégration textuelle au sein de la section « Résultats » d’un manuscrit scientifique s’articule idéalement selon la formulation suivante : « L’analyse de la dispersion relative des temps de réponse a révélé une variabilité substantiellement plus contenue au sein de la cohorte d’athlètes d’élite (M = 245,32 ms, SD = 28,14 ms, CV = 11,47 %) comparativement à la cohorte des sujets sédentaires témoins (M = 312,85 ms, SD = 64,52 ms, CV = 20,62 %), suggérant une consistance attentionnelle supérieure chez les experts moteurs indépendamment de leur avantage initial de vitesse basale. »
12.2 Conception de tableaux descriptifs standardisés
L’insertion d’un tableau synthétique au format APA 7 représente le vecteur privilégié pour consigner de multiples coefficients de variation issus de diverses conditions expérimentales ou de blocs longitudinaux. Les normes APA proscrivent formellement l’utilisation de bordures verticales dans les tableaux ; seules trois lignes horizontales principales doivent structurer la matrice : une bordure fermant le sommet du tableau, une bordure séparant les en-têtes de colonnes des données, et une bordure inférieure scellant la base du tableau au-dessus des notes explicatives.
Les colonnes de tendance centrale, de dispersion absolue et de variabilité relative doivent être rigoureusement juxtaposées pour permettre une lecture comparative synoptique et fluide. Les colonnes statistiques doivent arborer les abréviations canoniques en italique : n (pour l’effectif valide du sous-groupe), M (pour la moyenne arithmétique), SD (pour l’écart-type standardisé), et CV (%) pour la dispersion relative exprimée en pourcentage. La structure typographique idéale est illustrée par le modèle standard suivant :
| Groupe expérimental | n | M (ms) | SD (ms) | CV (%) | IC 95 % du CV |
|---|---|---|---|---|---|
| Contrôle actif | 45 | 428,12 | 58,65 | 13,70 | [11,42, 16,35] |
| TDAH non traité | 42 | 485,74 | 132,41 | 27,26 | [22,81, 32,49] |
| TDAH sous pharmacothérapie | 40 | 441,09 | 73,18 | 16,59 | [13,85, 19,74] |
| Note. N = 127. Les coefficients de variation (CV) ont été dérivés de la procédure des statistiques de ratios sous IBM SPSS Statistics en assignant une constante unitaire au dénominateur métrique. Les intervalles de confiance à 95 % (IC 95 %) ont été estimés par rééchantillonnage bootstrap non paramétrique (10 000 réplications). | |||||
12.3 Visualisation graphique de la variabilité relative
L’acte final de restitution académique s’incarne fréquemment dans la modélisation graphique des données. Bien que SPSS autorise l’exportation de multiples formats vectoriels, la représentation de la dispersion relative exige une prudence conceptuelle particulière. Concevoir de simples diagrammes en bâtons (bar charts) affichant le coefficient de variation sur l’axe des ordonnées constitue une pratique tolérée mais réductrice, dans la mesure où elle masque la distribution sous-jacente des observations individuelles ayant servi à forger le ratio.
La pratique graphique privilégiée dans les revues internationales de premier rang repose sur l’élaboration de diagrammes de dispersion bivariés combinant graphiquement les moyennes de chaque participant sur l’axe des abscisses et leurs écarts-types individuels respectifs sur l’axe des ordonnées. Au sein de cet espace métrique, une série de droites linéaires rayonnant depuis l’origine (le point [0, 0]) permet de matérialiser visuellement les isoclines de coefficients de variation constants (par exemple les droites matérialisant des CV fixes de 10 %, 20 % ou 30 %).
Une alternative graphique remarquable de clarté réside dans le recours aux graphiques en nuage de pluie (raincloud plots), associant la distribution de densité de probabilité lissée (demi-violon), la boîte à moustaches de Tukey indiquant la médiane et l’intervalle interquartile, et le semis de points individuels bruts (jittered individual points) figurant les coefficients de variation intra-individuels calculés sous SPSS. Cette densité d’information visuelle certifie une transparence totale de la variabilité empirique auprès de la communauté des chercheurs.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Bedeian, A. G., & Mossholder, K. W. (2000). On the use of the coefficient of variation as a measure of diversity. Organizational Research Methods, 3(3), 285-297. https://doi.org/10.1177/109442810033005
- Castellanos, F. X., & Tannock, R. (2002). Neuroscience of attention-deficit/hyperactivity disorder: The search for endophenotypes. Nature Reviews Neuroscience, 3(8), 617-628. https://doi.org/10.1038/nrn896
- Feltz, C. J., & Miller, G. E. (1996). An asymptotic test for the equality of coefficients of variation from k populations. Statistics in Medicine, 15(6), 647-658. <a href="https://doi.org/10.1002/(SICI)1097-0258(19960330)15:63.0.CO;2-P » target= »_blank » rel= »noopener noreferrer »>https://doi.org/10.1002/(SICI)1097-0258(19960330)15:6<647::AID-SIM184>3.0.CO;2-P
- Field, A. (2018). Discovering statistics using IBM SPSS Statistics (5th ed.). SAGE Publications.
- Hopkins, W. G. (2000). Measures of reliability in sports medicine and science. Sports Medicine, 30(1), 1-15. https://doi.org/10.2165/00007256-200030010-00001
- IBM Corporation. (2021). IBM SPSS Statistics 28 algorithms. IBM Corporation. https://www.ibm.com/support/pages/ibm-spss-statistics-28-documentation
- Kendall, M. G., & Stuart, A. (1977). The advanced theory of statistics: Vol. 1. Distribution theory (4th ed.). Charles Griffin.
- MacDonald, S. W., Nyberg, L., & Bäckman, L. (2006). Intra-individual variability in behavior: Links to brain, cognition, and aging. Trends in Neurosciences, 29(8), 474-480. https://doi.org/10.1016/j.tins.2006.06.011
- Pearson, K. (1896). Mathematical contributions to the theory of evolution. III. Regression, heredity, and panmixia. Philosophical Transactions of the Royal Society of London. Series A, 187, 253-318. https://doi.org/10.1098/rsta.1896.0007
- Sokal, R. R., & Rohlf, F. J. (2012). Biometry: The principles and practice of statistics in biological research (4th ed.). W. H. Freeman.
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677-680. https://doi.org/10.1126/science.103.2684.677
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Weir, J. P. (2005). Quantifying test-retest reliability using the intraclass correlation coefficient and the SEM. The Journal of Strength & Conditioning Research, 19(1), 231-240. https://doi.org/10.1519/15184.1