
Dans le champ de l’analyse quantitative, de la biométrie et de la métrologie expérimentale, la caractérisation de la variabilité constitue une étape tout aussi fondamentale que l’estimation des tendances centrales. Si la moyenne arithmétique fournit un point d’ancrage synthétique pour résumer un ensemble d’observations, l’écart-type permet d’en quantifier la dispersion absolue autour de cette valeur centrale. Toutefois, l’interprétation brute de l’écart-type se heurte rapidement à une limitation conceptuelle majeure : étant exprimé dans la même unité physique que la variable mesurée, il ne permet aucune comparaison directe entre des distributions d’ordres de grandeur divergents ou issues d’instruments aux échelles non commutables. C’est précisément pour lever cette entrave analytique que le statisticien britannique Karl Pearson a formalisé à la fin du XIXe siècle le concept de coefficient de variation, une mesure de dispersion relative adimensionnelle qui rapporte l’écart-type à la moyenne arithmétique.
Au sein des environnements d’analyse contemporains, le tableur Microsoft Excel demeure l’outil le plus ubiquitaire pour le traitement préliminaire, la modélisation statistique et la restitution décisionnelle des données d’entreprise et de recherche. Paradoxalement, bien qu’Excel dispose de centaines de fonctions statistiques natives couvrant des calculs probabilistes hautement spécialisés, il ne propose aucune fonction préprogrammée unique portant le nom explicite de coefficient de variation. Cette omission apparente contraint le praticien, le chercheur ou l’analyste de données à construire une architecture de calcul rigoureuse en combinant les primitives d’écart-type et de moyenne, tout en naviguant à travers les subtilités d’échantillonnage, la sélection des estimateurs sans biais et la gestion des pièges algorithmiques propres aux tableurs numériques.
Le présent traité propose une exploration exhaustive, théorique et opérationnelle du calcul du coefficient de variation sous Excel. Au-delà d’une simple juxtaposition de formules mathématiques, ce guide méthodique décompose les prérequis métrologiques indispensables à sa validité, la structuration matricielle optimale des jeux de données, les mécanismes d’automatisation dynamique via les fonctions matricielles modernes et Power Query, ainsi que le diagnostic des instabilités numériques telles que les divisions par zéro ou les distorsions induites par des moyennes asymptotiquement nulles. Chaque dimension théorique est articulée à des cas pratiques approfondis, garantissant une reproductibilité sans faille des résultats dans les contextes académiques, cliniques et industriels les plus exigeants.
1. Fondements théoriques et mathématiques du coefficient de variation
1.1 Définition conceptuelle et formulation statistique
Le coefficient de variation, couramment désigné par le sigle CV ou plus formellement par la lettre grecque cv, s’énonce mathématiquement comme le rapport du moment centré d’ordre deux (l’écart-type) au moment d’ordre un (l’espérance mathématique ou la moyenne arithmétique). Cette relation fondamentale traduit la quantité de variabilité observée pour chaque unité de mesure de la valeur centrale. Sur le plan populationnel, lorsque l’intégralité des individus d’un univers statistique est recensée, le coefficient de variation s’exprime par le ratio exact des paramètres vrais :
CV = σ / μ
où σ représente l’écart-type de la population et μ en désigne la moyenne arithmétique. Dans la quasi-totalité des investigations empiriques, ces grandeurs théoriques demeurent inaccessibles et doivent être estimées à partir d’un échantillon probabiliste de taille n tiré de manière aléatoire et indépendante. Dès lors, le ratio s’appuie sur des estimateurs échantillonnaux ponctuels, substituant l’écart-type corrigé de l’échantillon, noté s, à l’écart-type populationnel, et la moyenne empirique observée, notée x̄, à la moyenne vraie :
cv̂ = s / x̄
La propriété nodale de cette métrique réside dans son adimensionnalité absolue. Alors que la moyenne et l’écart-type héritent directement des unités physiques du phénomène sous-jacent (qu’il s’agisse de millisecondes, de grammes par litre, d’euros ou de micromètres), l’opération de division scalaire neutralise intégralement ces unités au numérateur et au dénominateur. Le résultat obtenu est un nombre pur, fréquemment multiplié par cent pour être communiqué sous forme de pourcentage de variabilité relative. Cette suppression de l’échelle dimensionnelle établit une démarcation formelle entre la dispersion absolue, qui mesure l’éloignement géométrique moyen des données autour du centre dans leur espace métrique d’origine, et la dispersion relative, qui pondère cet écart par l’amplitude même du phénomène quantifié.
1.2 Exigences métrologiques et échelles de mesure
L’application rigoureuse du coefficient de variation requiert une conformité stricte avec la théorie des échelles de mesure formalisée par Stanley Smith Stevens. Le coefficient de variation n’a de validité épistémologique et mathématique que sur des données mesurées sur une échelle de rapports (ou échelle de ratios). Cette classe d’échelles se caractérise par l’existence d’un zéro absolu, non arbitraire, correspondant à l’absence totale de la quantité physique mesurée. Des variables telles que la masse, la distance, le temps d’attente ou la concentration molaire satisfont pleinement cette condition sine qua non.
À l’inverse, l’application du coefficient de variation sur des données recueillies selon une échelle d’intervalles — caractérisée par un zéro conventionnel défini arbitrairement — engendre des distorsions mathématiques critiques rendant le ratio totalement dénué de sens. L’exemple paradigmatique de cette défaillance réside dans la mesure de la température en degrés Celsius ou Fahrenheit. Une série de températures enregistrées à 2 °C, 4 °C et 6 °C produira une moyenne de 4 °C et un écart-type de 2 °C, suggérant un coefficient de variation de 50 %. Si l’on applique une simple conversion linéaire vers l’échelle Kelvin (échelle de rapports dont le zéro correspond au zéro absolu thermodynamique), les valeurs deviennent 275,15 K, 277,15 K et 279,15 K. La moyenne devient 277,15 K tandis que l’écart-type demeure rigoureusement identique à 2 K, aboutissant à un coefficient de variation réel d’environ 0,72 %. L’invariance d’échelle est donc violée dès lors que l’origine métrologique n’est pas absolue.
Par ailleurs, la représentativité du coefficient de variation est conditionnée par la morphologie distributionnelle du jeu de données. En présence de distributions asymétriques prononcées (distributions log-normales, distributions de Pareto ou séries temporelles affichant une forte skewness positive), la moyenne arithmétique perd sa légitimité en tant qu’indicateur d’emplacement représentatif de la densité centrale, tendant à surestimer le point d’équilibre sous l’influence des valeurs extrêmes. Dans de telles configurations, l’application mécanique du ratio classique produit une sous-estimation systématique de l’instabilité relative perçue. Des hypothèses paramétriques minimales, impliquant une relative symétrie de la distribution ou une transformation logarithmique préalable, sont indispensables avant toute inférence reposant sur le ratio de Pearson.
1.3 Utilité comparée dans l’analyse de données expérimentales
Dans la conduite d’investigations expérimentales et cliniques, le coefficient de variation s’érige en instrument de synthèse privilégié pour comparer la dispersion de systèmes physiques ou biologiques dont les ordres de grandeur divergent de plusieurs puissances de dix. Prenons le cas d’une étude pharmacologique comparant la stabilité métabolique d’un composé chez la souris (affichant un débit cardiaque moyen de 500 battements par minute avec un écart-type de 25 bpm) et chez l’humain adulte (moyenne de 70 battements par minute avec un écart-type de 14 bpm). L’analyse brute des écarts-types conduirait à affirmer que le rythme cardiaque de la souris présente une variabilité absolue presque double de celle de l’homme. Or, le calcul des coefficients de variation respectifs démontre sans équivoque que la variabilité relative humaine s’établit à 20 % (14/70), tandis que celle de la souris n’est que de 5 % (25/500). L’organisme du rongeur fait donc preuve d’une stabilité homéostatique relative quatre fois supérieure.
Cette métrique s’avère également incontournable pour l’évaluation fine de l’homogénéité intra-groupe par opposition à l’hétérogénéité inter-groupes. Lors de protocoles comparatifs impliquant des cohortes de rongeurs soumises à divers régimes nutritionnels, l’analyste peut quantifier si un traitement expérimental a pour conséquence d’accroître la dispersion interne des réponses métaboliques indépendamment de son impact sur le niveau d’efficacité moyen. Sans ce redimensionnement relatif, toute augmentation mécanique de la moyenne arithmétique induirait une dilatation proportionnelle apparente de l’écart-type, biaisant l’interprétation de la réponse biologique.
Enfin, en métrologie de laboratoire et en assurance qualité industrielle selon les normes ISO 5725, le coefficient de variation, souvent qualifié d’imprécision relative ou d’erreur relative résiduelle, sert d’étalon universel pour évaluer la répétabilité et la reproductibilité des équipements d’analyse spectrale ou chromatographique. Un appareil affichant un coefficient de variation systématiquement inférieur à 2 % sur des mesures répétées d’un même échantillon témoin garantit une fidélité opérationnelle suffisante pour la validation clinique, standardisant les critères d’acceptation analytique par-delà la diversité des biomarqueurs mesurés.
2. Préparation et structuration rigoureuse des données sous Excel
2.1 Architecture matricielle et disposition tabulaire
L’intégrité de toute modélisation statistique au sein du tableur repose sur une discipline rigide quant à l’agencement topologique des données brutes. L’architecture optimale respecte le paradigme dit de « données ordonnées » (tidy data), où chaque variable quantitative occupe exclusivement une colonne verticale dédiée, tandis que chaque ligne horizontale matérialise une unité observationnelle unique et indivisible. L’introduction d’espacements vides arbitraires, de sous-totaux intercalés manuellement ou d’en-têtes multidimensionnels fusionnés constitue la cause primaire de défaillance des algorithmes de calcul sous Excel.
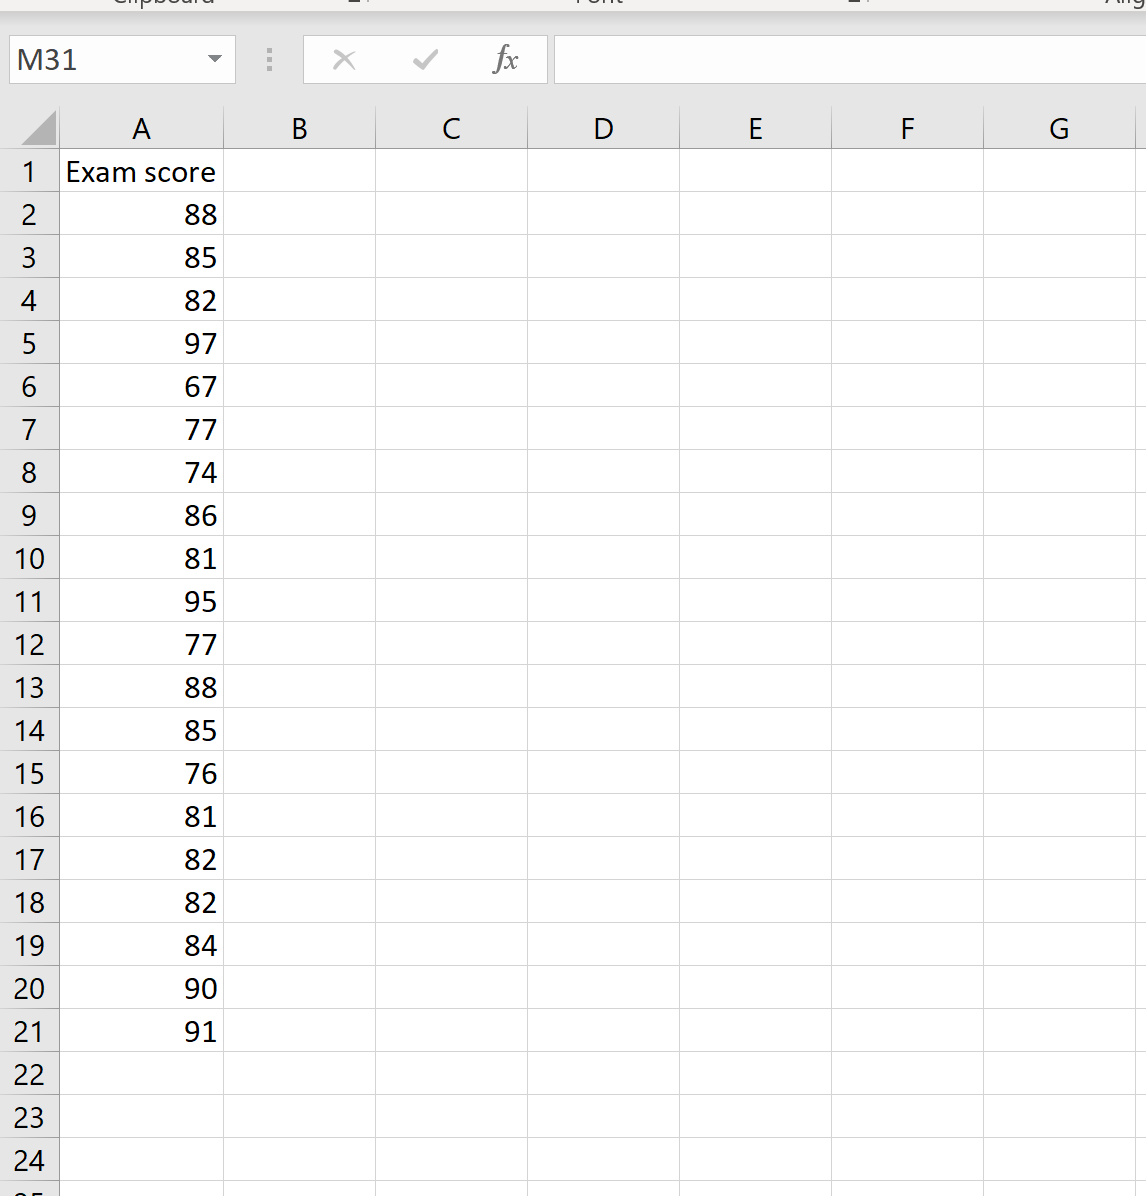
Pour assurer la traçabilité des modèles, les plages de données doivent faire l’objet d’un nommage normalisé via le Gestionnaire de noms (accessible via l’onglet Formules d’Excel). L’affectation d’un identifiant clair à une plage de cellules, tel que Serie_Biomarqueur_A pour la plage B2:B150, éradique les erreurs d’adressage statique lors du déploiement des formules. Plus fondamental encore, la conversion de la plage de cellules standard en un Tableau structuré officiel Excel (raccourci clavier Ctrl + L ou Ctrl + T) constitue la meilleure pratique professionnelle contemporaine. Ce mécanisme abstrait l’adressage alphanumérique au profit d’une notation structurée dynamique (par exemple TableauMesures[Concentration]), garantissant que toute extension verticale consécutive à l’intégration de nouvelles observations soit instantanément englobée dans les périmètres de calcul sans modification manuelle des formules.
Une rigueur méthodologique impose également de délimiter formellement la zone des données primaires de celle dévolue aux métadonnées descriptives. Les unités physiques (par exemple « mg/dL », « s » ou « μmol ») doivent être consignées exclusivement dans la ligne d’en-tête descriptive ou au sein d’une feuille de dictionnaire de variables dédiée. La saisie accidentelle de suffixes textuels directement dans les cellules numériques (écrire « 12,4 mg » au lieu de « 12,4 ») corrompt irrémédiablement le type de données sous-jacent, contraignant Excel à interpréter la valeur comme une chaîne de texte non sommable, ce qui fausse intégralement le calcul ultérieur de la moyenne et de l’écart-type.
2.2 Prétraitement, filtrage et assainissement des entrées
Préalablement à l’implémentation de la moindre équation, une série de contrôles d’assainissement doit être menée pour purger le jeu de données des scories numériques. Le premier niveau de contrôle cible l’identification systématique des cellules vides et des chaînes textuelles parasites. Bien que les fonctions d’agrégation d’Excel adoptent par défaut une politique d’omission bienveillante face aux cellules strictement vides, la présence d’espaces invisibles résiduels (caractère ASCII 32) ou d’espaces insécables (caractère ASCII 160 fréquemment importé lors d’extractions web ou de progiciels ERP) induit des erreurs silencieuses dans les algorithmes de filtrage dynamique.
Le second volet de l’assainissement réside dans le criblage des valeurs aberrantes (outliers). En raison de la sensibilité quadratique de l’écart-type, une seule valeur extrême déviante — générée par exemple par un dysfonctionnement de capteur ou une erreur de frappe typographique — entraîne une surévaluation massive de la dispersion, faussant dramatiquement le coefficient de variation. Pour neutraliser ce risque sans introduire d’arbitraire subjectif, il est recommandé de mettre en œuvre la règle de clôture de John Tukey en calculant l’écart interquartile (IQR). Dans Excel, les fonctions QUARTILE.EXCLURE(Plage; 1) et QUARTILE.EXCLURE(Plage; 3) permettent de borner l’intervalle d’acceptabilité statistique :
Limite Supérieure = Q3 + (1,5 × IQR)
Limite Inférieure = Q1 – (1,5 × IQR)
Une attention méticuleuse doit également être portée à la conformité du séparateur décimal. Dans les environnements francophones, le séparateur décimal légal est la virgule, alors que les systèmes anglo-saxons et les formats CSV bruts emploient le point. Une importation non convertie fige les valeurs chiffrées au format texte, les excluant de fait de l’évaluation numérique. L’utilisation de l’outil natif Convertir (situé dans l’onglet Données) ou de la fonction de substitution =CNUM(SUBSTITUE(A2; "."; ",")) rétablit la pureté scalaire des séries étudiées. Enfin, la sécurisation des saisies manuelles futures doit être verrouillée par des règles d’intégrité référentielle via le menu Validation des données, en interdisant expressément toute entrée non conforme à l’ensemble des réels strictement positifs.
2.3 Vérification de la positivité stricte des séries numériques
Sur le plan mathématique, le coefficient de variation perd toute pertinence lorsque la série statistique comporte des valeurs négatives ou lorsque la moyenne arithmétique converge vers zéro. Pour prévenir tout non-sens analytique, l’analyste se doit d’instituer des tests logiques préliminaires. La formulation d’une expression conditionnelle booléenne telle que :
=NB.SI(PlageDonnees; "<=0")
permet de recenser immédiatement la fréquence d’apparition de valeurs nulles ou négatives au sein de la matrice. L’existence d’une moyenne tendant vers zéro engendre une instabilité numérique asymptotique majeure : lorsque le dénominateur s’approche de zéro, le quotient tend vers l’infini indépendamment de la compacité réelle de la distribution. Deux séries distinctes présentant un écart-type minuscule de 0,001 produiront des coefficients de variation radicalement discordants si la première possède une moyenne de 0,002 (CV = 50 %) et la seconde une moyenne de 0,00005 (CV = 2000 %).
Pour assurer une surveillance visuelle immédiate au sein des feuilles de calcul volumineuses, la mise en place d’une règle de mise en forme conditionnelle constitue une excellente pratique de contrôle de gestion scientifique. En appliquant une mise en évidence automatique en rouge sur les cellules répondant à la formule =A2<=0, l’opérateur détecte instantanément les violations d’hypothèses de positivité stricte. Dans des cas expérimentaux spécifiques où des variables positives par nature ont subi un décalage d’échelle ou un centrage préalable involontaire, une translation linéaire d’échelle (ajout d’une constante arbitraire) peut être envisagée d’un point de vue informatique, bien qu’une telle manipulation altère irréversiblement la signification théorique originelle du coefficient de variation en rompant l’ancrage sur le zéro absolu.
3. Fonctions statistiques fondamentales requises sous Excel
3.1 Calcul de la tendance centrale avec la fonction MOYENNE
Le dénominateur du ratio de variation requiert une estimation rigoureuse du premier moment empirique. Dans Excel, ce calcul s’effectue via la fonction canonique MOYENNE, dont la syntaxe générale s’articule comme suit :
=MOYENNE(nombre1; [nombre2]; ...)
Sur le plan algorithmique, cette fonction cumule l’ensemble des valeurs scalaires valides fournies en arguments avant de diviser la somme obtenue par le décompte strict des cellules contenant des valeurs numériques. Il est primordial d’opérer une différenciation conceptuelle nette entre la fonction MOYENNE et la fonction MOYENNEA. Cette dernière prend en compte les valeurs logiques ainsi que les représentations textuelles : une cellule contenant du texte y est évaluée comme un zéro numérique, tandis que la valeur booléenne VRAI est convertie en 1 et FAUX en 0. L’emploi inconsidéré de MOYENNEA au sein d’une matrice comportant des libellés textuels ou des cellules codées vide avec des guillemets entraîne une dilatation artificielle du dénominateur d’effectif et l’injection indue de valeurs nulles dans la somme, tirant dramatiquement la moyenne vers le bas et gonflant artificiellement le coefficient de variation résultant.
Un autre péril méthodologique fréquent réside dans la gestion non discriminée des zéros réels versus les valeurs non renseignées. Si une cellule demeure vide, MOYENNE l’ignore purement et simplement, tant pour la somme que pour le comptage du diviseur. En revanche, si la cellule contient le chiffre zéro — qu’il provienne d’une saisie explicite ou de la désactivation de l’option d’affichage des valeurs nulles dans les paramètres généraux d’Excel —, ce zéro est pleinement intégré au calcul arithmétique. Si ce zéro résulte d’une absence d’observation plutôt que d’une mesure physique nulle, l’estimation centrale se trouve lourdement biaisée. Enfin, lors de l’évaluation de séries discontinues distribuées sur plusieurs plages géographiques disjointes au sein du classeur, la fonction admet une liste d’arguments distincts séparés par des points-virgules, optimisant l’agrégation sans exiger de consolidation préalable :
=MOYENNE(A2:A50; C2:C50; E2:E50)
3.2 Sélection rigoureuse de la fonction d’écart-type adaptée
L’estimation du numérateur représente l’étape statistique la plus délicate sous Excel en raison de la multiplicité des fonctions dédiées à l’écart-type et des risques d’imprécision méthodologique qui en découlent. L’environnement contemporain d’Excel propose deux fonctions d’écart-type majeures, introduites depuis la suite Office 2010 pour se conformer aux standards internationaux de nomenclature statistique :
ECARTYPE.STANDARD: Cette fonction calcule l’écart-type d’un échantillon probabiliste en intégrant au dénominateur la correction de Bessel, c’est-à-dire une division par (n – 1) plutôt que par n. Ce dégrèvement d’un degré de liberté compense le biais intrinsèque d’estimation qui pousse systématiquement la dispersion échantillonnale à sous-estimer la dispersion vraie de la population parente.ECARTYPE.PEARSON: Cette fonction évalue l’écart-type exhaustif d’une population complète, appliquant un dénominateur rigoureusement égal à la taille totale n de la série.
Les versions historiques d’Excel comprenaient les fonctions génériques ECARTYPE et ECARTYPEP. Bien que maintenues par Microsoft pour préserver une compatibilité descendante avec les classeurs conçus au début des années 2000, leur usage doit être proscrit dans les nouveaux développements en raison de leur dépréciation officielle. Le choix entre ECARTYPE.STANDARD et ECARTYPE.PEARSON n’a rien d’une subtilité anodine : sur un échantillon restreint de taille n = 5, l’écart mathématique entre les deux estimateurs atteint une divergence relative de plus de 11 %. Recourir par erreur à ECARTYPE.PEARSON sur un échantillon expérimental restreint produit une sous-estimation substantielle de la dispersion réelle, et donc un coefficient de variation faussement optimiste quant à la régularité du processus observé. La règle d’or heuristique impose l’usage inconditionnel de ECARTYPE.STANDARD dès lors que les données analysées ne représentent qu’une fraction extraite d’une population globale plus vaste.
3.3 Formulation algébrique standardisée du ratio
Une fois maîtrisées les fonctions élémentaires sous-jacentes, la formalisation du coefficient de variation s’effectue par la conjonction directe des deux opérateurs dans une syntaxe rationnelle :
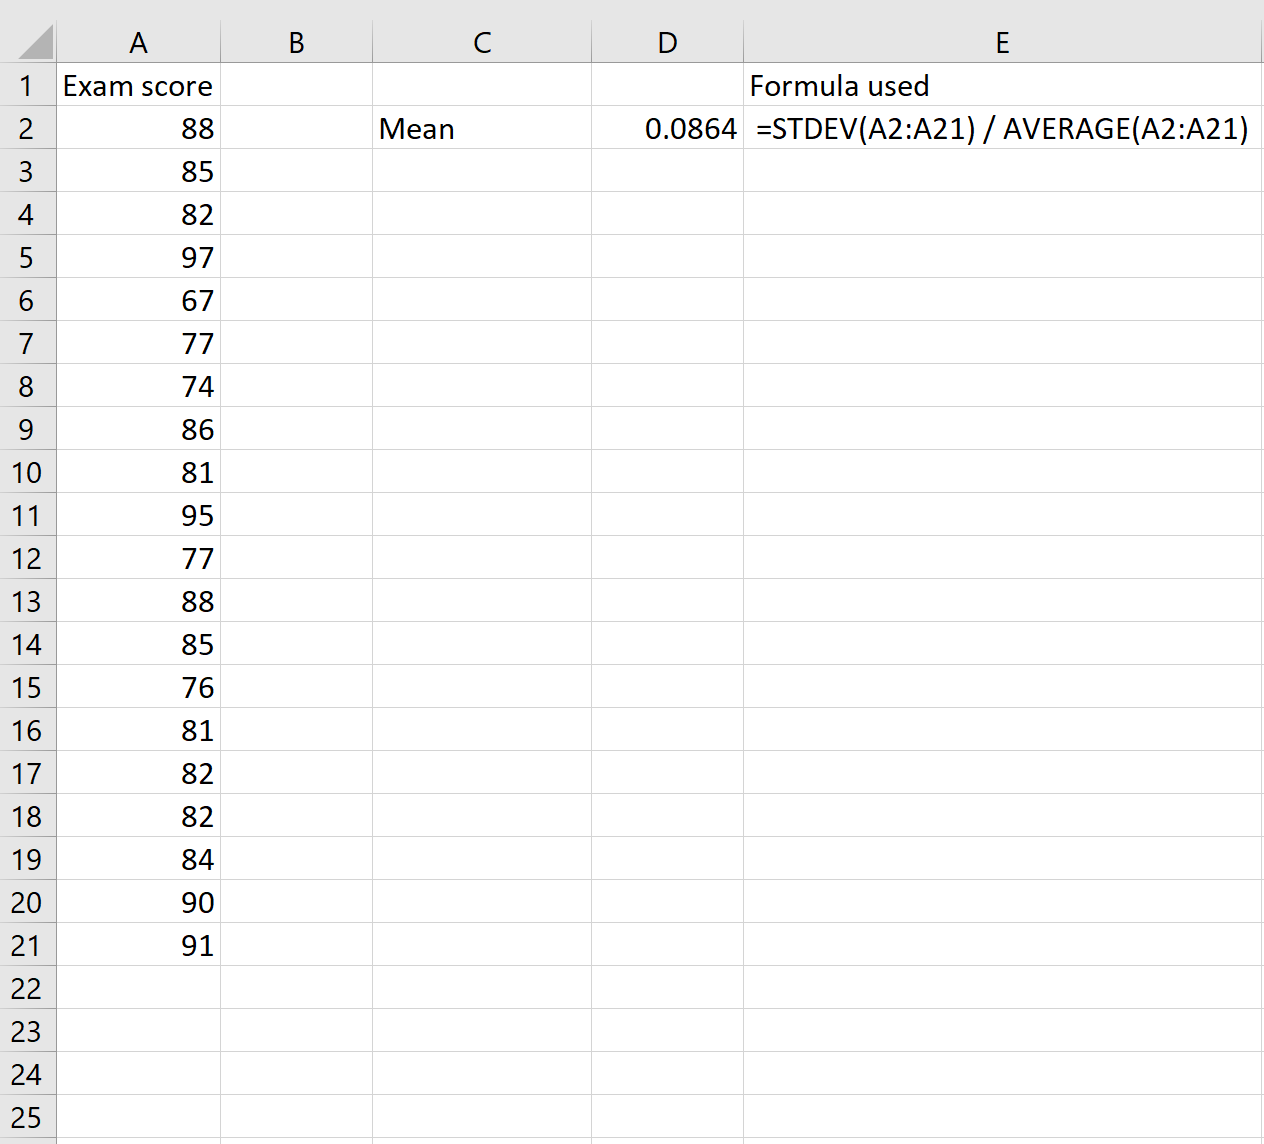
=ECARTYPE.STANDARD(A2:A100)/MOYENNE(A2:A100)
La grammaire computationnelle d’Excel applique des règles strictes de priorité opératoire (la division et la multiplication primant sur l’addition et la soustraction). Bien que dans cette formulation simple l’opérateur de division lie directement les résultats scalaires retournés par chacune des fonctions sans ambiguïté formelle, l’adjonction ultérieure de constantes ou de transformations scalaires impose un usage scrupuleux du parenthésage. Par exemple, vouloir forcer la conversion en pourcentage par une multiplication explicite sans cloisonnement syntaxique peut conduire, dans des expressions composites plus denses, à des erreurs d’arborescence de calcul.
Dans le cadre de projets d’audit de données scientifiques ou financières, la lisibilité et la maintenance des classeurs imposent de minimiser les expressions complexes imbriquées opaques. Pour vérifier dynamiquement l’intégrité de la construction syntaxique, l’utilisateur a tout intérêt à mobiliser les outils d’audit de formules intégrés à Excel, notamment la fonctionnalité Évaluer la formule accessible sous l’onglet Formules. Cet outil offre la possibilité de visualiser le calcul séquentiel étape par étape, attestant que la plage argumentaire transmise à ECARTYPE.STANDARD est rigoureusement congruente avec celle adressée à MOYENNE, évitant ainsi un décalage de plages source qui corromprait silencieusement l’exactitude du ratio statistique.
4. Procédure pas-à-pas pour calculer le coefficient de variation
4.1 Méthode décomposée en variables intermédiaires
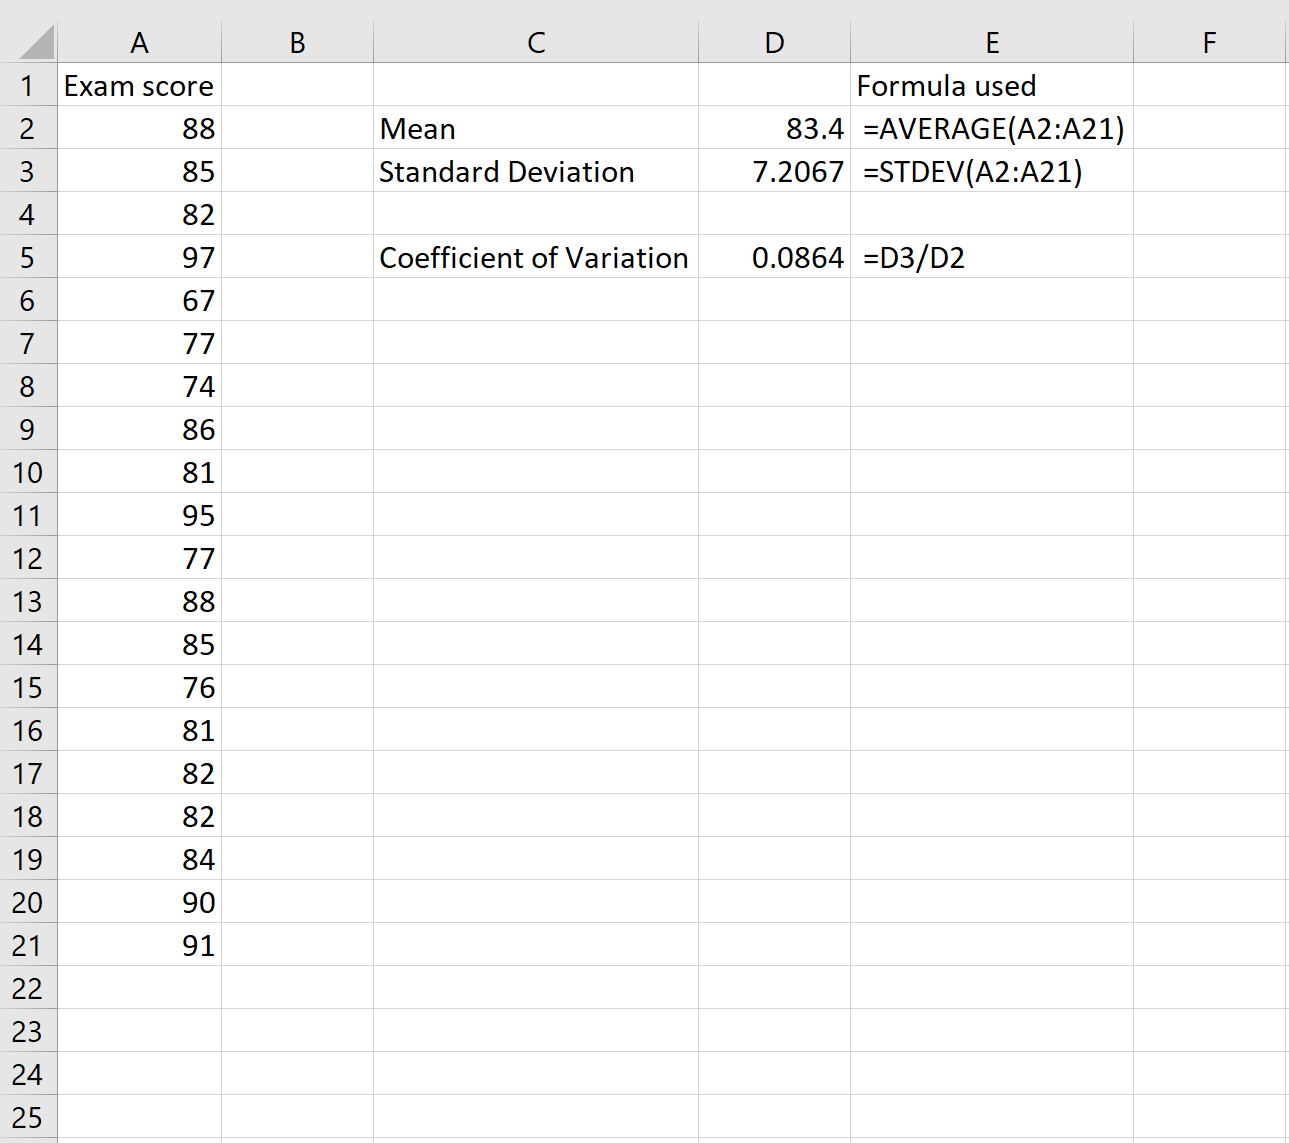
La première méthodologie opérationnelle consiste à sérier le raisonnement mathématique en affectant des cellules distinctes et dédiées à chaque étape computationnelle intermédiaire. Cette approche linéaire est particulièrement indiquée dans les environnements professionnels soumis à de strictes contraintes de conformité réglementaire (tels que les laboratoires accrédités ISO 17025 ou les départements de biostatistique pharmaceutique) en raison de sa parfaite transparence pour les auditeurs tiers.
La procédure s’articule séquentiellement comme suit :
- Étape 1 : Calcul de la tendance centrale. Sélectionner une première cellule dédiée (par exemple
B102) située sous la série d’observations (plageB2:B101), et implémenter l’instruction :=MOYENNE(B2:B101). Nommer cette cellule ou la libeller clairement « Moyenne » dans la colonne contiguë. - Étape 2 : Calcul de l’écart-type échantillonnal. Dans une seconde cellule immédiatement inférieure (par exemple
B103), renseigner la formule d’estimation de la dispersion sans biais :=ECARTYPE.STANDARD(B2:B101). Libeller cette cellule « Écart-type ». - Étape 3 : Calcul du ratio synthétique. Dans une troisième cellule terminale (par exemple
B104), exécuter la division simple référençant les deux adresses précédentes :=B103/B102.
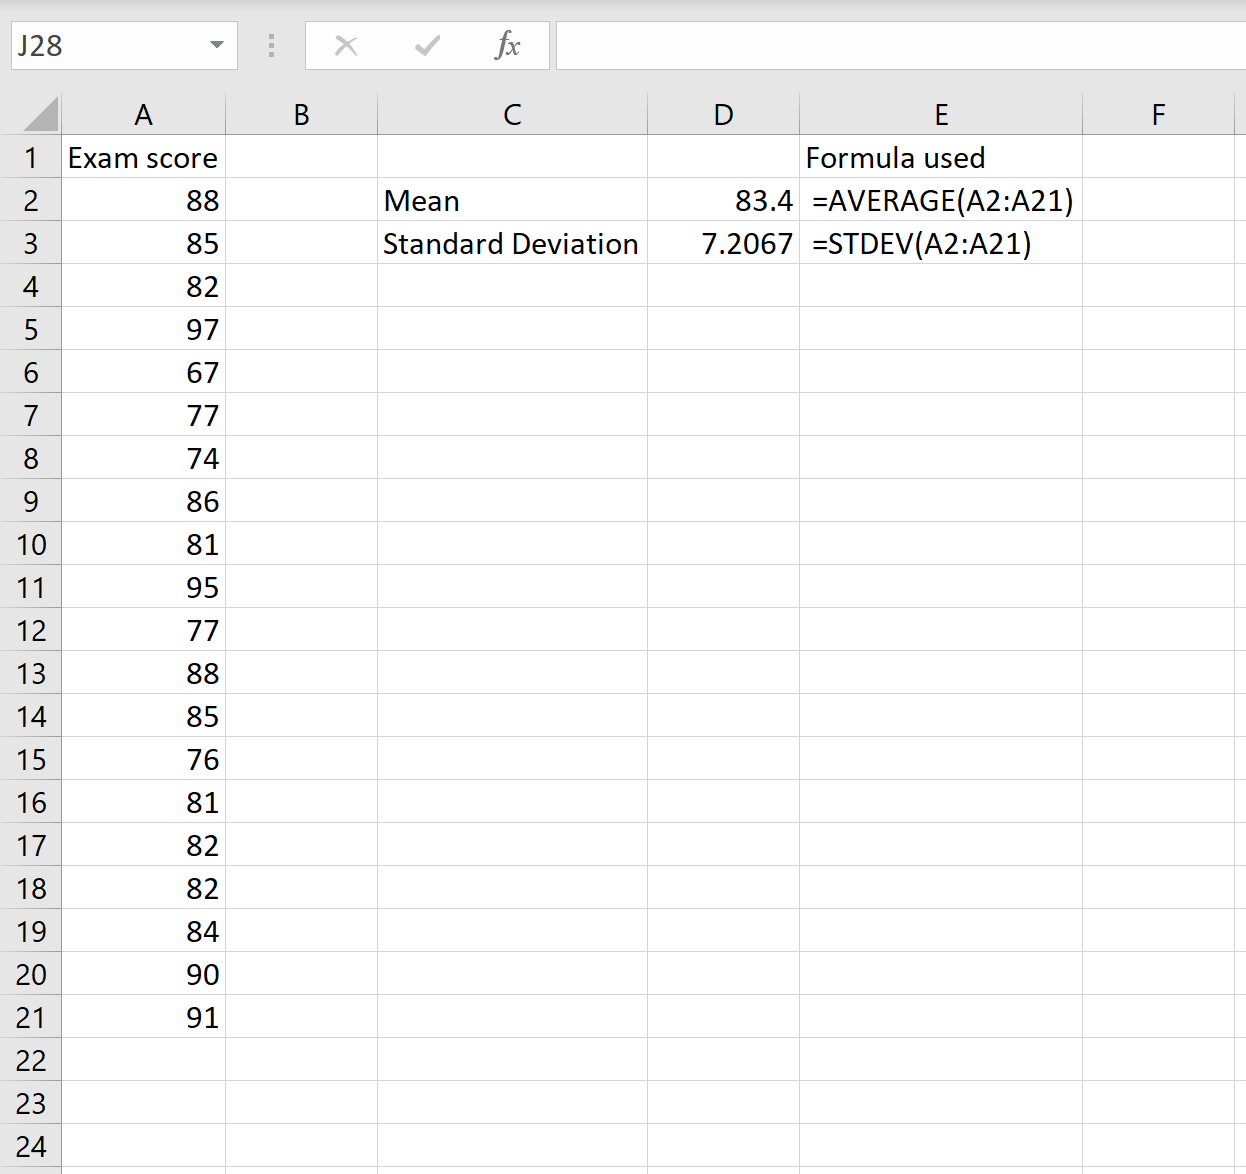
Cette décomposition pas-à-pas confère un avantage pédagogique et diagnostique incomparable : elle permet à l’analyste de dissocier visuellement l’ampleur absolue de l’erreur-type de celle de la moyenne. Si une anomalie de calcul survient — telle qu’une valeur de CV aberrante supérieure à 500 % —, le contrôle immédiat des cellules B102 et B103 permet de déterminer instantanément si le phénomène résulte d’une chute critique de la moyenne ou d’une explosion de la variance sous-jacente.
4.2 Méthode intégrée monocellulaire directe
Bien que la méthode analytique décomposée excelle par sa lisibilité pédagogique, les exigences de production industrielle et de traitement de mégadonnées tabulaires imposent fréquemment d’économiser l’espace d’affichage et de rationaliser la structure matricielle. La méthode intégrée monocellulaire résout cette contrainte en encapsulant le calcul complet au sein d’une instruction autonome et auto-suffisante, ne nécessitant qu’un seul emplacement physique sur la feuille de calcul.
La syntaxe canonique déployée directement sous la colonne d’analyse s’énonce ainsi :
=ECARTYPE.STANDARD(B2:B100)/MOYENNE(B2:B100)
Cette approche monocellulaire offre des gains significatifs en matière de consommation de ressources dans les classeurs volumineux comportant des centaines de colonnes de variables indépendantes. Elle évite la prolifération de lignes techniques intermédiaires sous les tableaux de données, qui gênent souvent les opérations de tri et d’insertion. En outre, la duplication de cette métrique sur des dizaines de colonnes parallèles s’effectue avec une fluidité remarquable par une simple extension horizontale à l’aide de la poignée de recopie incrémentale d’Excel, les références relatives des colonnes s’ajustant automatiquement d’un axe à l’autre sans intervention humaine.
4.3 Formatage typographique et conversion en pourcentage
L’obtention du ratio mathématique brut livre un résultat sous forme d’un nombre décimal pur (par exemple 0,142857). D’un point de vue conventionnel et pour en simplifier l’interprétation par les parties prenantes managériales ou scientifiques, le coefficient de variation s’exprime très largement en pourcentage (14,29 %). Deux voies s’offrent alors à l’utilisateur sous Excel, mais leur rigueur technique diffère profondément.
La première voie, vivement déconseillée, consiste à injecter une multiplication arithmétique par cent directement au sein de la formule de calcul :
=(ECARTYPE.STANDARD(B2:B100)/MOYENNE(B2:B100))*100
Cette pratique engendre un risque sévère d’erreur de propagation lors des calculs aval. En altérant la valeur scalaire intrinsèque de la cellule (en la rendant cent fois supérieure à sa réalité proportionnelle), toute formule ultérieure venant réutiliser ce coefficient de variation — par exemple pour pondérer des indices de risque financier ou des intervalles de confiance — sera faussée d’un facteur 100 si l’utilisateur oublie cette modification manuelle.
La méthode exemplaire réside dans la préservation intacte de la valeur décimale sous-jacente, combinée à l’application d’un format d’affichage natif. En activant le style de format Pourcentage (via le ruban Accueil ou le raccourci Ctrl + Maj + %), Excel se charge d’afficher le nombre multiplié visuellement par 100 assorti du symbole %, tout en conservant la grandeur réelle (0,142857…) dans son moteur d’évaluation. Il convient ensuite de paramétrer la granularité d’affichage sur deux décimales significatives. Pour des restitutions d’une élégance supérieure au sein de rapports exécutifs, l’analyste peut concevoir un format de nombre personnalisé (via la boîte de dialogue Format de cellule → Nombre → Personnalisée) en saisissant la chaîne de formatage suivante :
0,00% "CV"
Cette astuce typographique inscrit explicitement le label d’identification au sein de la cellule sans corrompre son comportement arithmétique.
5. Automatisation et calcul dynamique sur séries multidimensionnelles
5.1 Application des références relatives, absolues et mixtes
Dès lors que l’analyse statistique s’étend à des grilles multidimensionnelles comparant simultanément de multiples cohortes expérimentales ou des séries temporelles longitudinales, la maîtrise de l’adressage mémoire devient névralgique. Le verrouillage des coordonnées de cellules par l’opérateur dollar ($) conditionne la stabilité des modèles lors de leur propagation spatiale.
Considérons un scénario matriciel dans lequel des données d’essais cliniques sont agencées sur une plage s’étendant de la colonne B à la colonne M (représentant douze mois de suivi), pour des patients distribués sur les lignes 2 à 100. Si l’on désire implémenter un tableau récapitulatif synthétique sur une feuille de bord distincte, la conception d’une formule robuste impose de figer les indices de ligne pour interdire tout glissement vertical inopiné, tout en préservant la variabilité de la colonne :
=ECARTYPE.STANDARD(B$2:B$100)/MOYENNE(B$2:B$100)
L’utilisation de cette référence mixte permet d’étirer la formule horizontalement vers la droite jusqu’à la colonne M : les lettres de colonnes s’incrémentent harmonieusement sans que les bornes de début et de fin de plage de patients (2 et 100) ne soient altérées. Inversement, si le calcul du coefficient de variation s’opère individuellement pour chaque patient le long de son profil temporel horizontal (de la colonne B à la colonne M pour la ligne 2), la formule s’établira en référence mixte axée sur les colonnes :
=ECARTYPE.STANDARD($B2:$M2)/MOYENNE($B2:$M2)
Cette rigueur d’ancrage prévient les décalages d’indices sournois qui surviennent fréquemment lorsque des opérateurs non avertis procèdent à des coupés-collés ou à des insertions de lignes médianes au sein des classeurs de collecte.
5.2 Exploitation de la syntaxe des tableaux structurés
L’avènement des tableaux structurés dans Excel (objets ListObject dans l’API Microsoft) a profondément révolutionné la robustesse du traitement statistique de données complexes. En convertissant une table de données brutes en objet structuré nommé par exemple Table_Biochimie, les coordonnées cellulaires alphanumériques rigides disparaissent au profit de références sémantiques universelles.
Le calcul du coefficient de variation d’une colonne mesurant la glycémie à jeun se formalise alors comme suit :
=ECARTYPE.STANDARD(Table_Biochimie[Glycemie])/MOYENNE(Table_Biochimie[Glycemie])
Ce formalisme apporte un double bénéfice structurel décisif. D’une part, la formule devient immédiatement intelligible et auto-documentée pour n’importe quel observateur extérieur. D’autre part, et il s’agit d’une avancée capitale pour la fiabilité analytique, la plage argumentaire s’ajuste dynamiquement en temps réel : si de nouvelles cohortes de patients sont insérées au bas du tableau ou si des entrées sont purgées, les bornes d’évaluation vectorielle de Table_Biochimie[Glycemie] s’étirent ou se contractent instantanément sans nécessiter la moindre réécriture d’intervalle.
De surcroît, les tableaux structurés offrent la possibilité d’activer une ligne des totaux native. Bien que cette dernière ne propose par défaut dans son menu contextuel déroulant que des fonctions élémentaires standard (Somme, Moyenne, Écart-type…), il est tout à fait possible d’injecter manuellement une formule personnalisée de coefficient de variation directement dans cette ligne terminale, ancrant élégamment l’indice de dispersion au pied de la colonne analytique.
5.3 Utilisation des fonctions matricielles modernes et formule LET
Les versions récentes d’Excel (disponibles au sein de Microsoft 365 et Office 2021) intègrent un moteur de calcul matriciel dynamique profondément révisé, ouvrant la voie à des optimisations computationnelles majeures grâce à la fonction LET. Dans une formule classique comme =ECARTYPE.STANDARD(A2:A100000)/MOYENNE(A2:A100000), le moteur d’Excel est contraint de balayer et de parser deux fois consécutives l’intégralité de la plage de cent mille cellules : une première fois pour extraire la variance et une seconde fois pour évaluer la somme arithmétique.
La fonction LET permet d’assigner un nom de variable à une expression ou une plage de données intermédiaire, éliminant cette double évaluation redondante et améliorant substantiellement la vélocité du classeur :
=LET(plage; A2:A100000; ECARTYPE.STANDARD(plage)/MOYENNE(plage))
Dans cette architecture optimisée, la plage d’intérêt n’est allouée en mémoire de traitement qu’une unique fois sous l’alias plage, puis exploitée conjointement par les deux opérations statistiques. Il devient aisé d’enrichir cette syntaxe pour encapsuler également la vérification de conformité, par exemple en calculant les grandeurs intermédiaires :
=LET(donnees; A2:A100; ecart; ECARTYPE.STANDARD(donnees); moy; MOYENNE(donnees); SI(moy<=0; "Erreur : Moyenne non positive"; ecart/moy))
Pour aller encore plus loin dans l’abstraction fonctionnelle, les utilisateurs de Microsoft 365 peuvent concevoir leur propre fonction dédiée sans recourir au langage VBA, en exploitant la puissance conjointe des fonctions LAMBDA et du Gestionnaire de noms. En définissant une fonction nommée CALCUL_CV avec l’expression :
=LAMBDA(vecteur; ECARTYPE.STANDARD(vecteur)/MOYENNE(vecteur))
l’analyste peut désormais écrire sur n’importe quelle feuille de son classeur =CALCUL_CV(A2:A100) exactement comme s’il s’agissait d’une commande native officielle de Microsoft. Associée à la fonction de propagation dynamique MAP, cette logique permet d’appliquer le calcul en une seule ligne de commande à travers une matrice entière distribuée sur plusieurs colonnes :
=MAP(Tableau1[[Col1]:[Col5]]; LAMBDA(col; CALCUL_CV(col)))
6. Calcul conditionnel du coefficient de variation par sous-groupes
6.1 Combinaison matricielle pour conditions univariées
L’analyse de données réelles impose continuellement de segmenter les populations globales en strates homogènes — par exemple pour comparer la variabilité relative entre un groupe recevant un placebo et un groupe recevant une molécule active au sein d’une même table d’expérimentation. Dans cette perspective, la détermination du coefficient de variation conditionnel se heurte à une asymétrie fonctionnelle sous Excel : s’il existe une fonction standard dédiée au calcul de la moyenne conditionnelle (MOYENNE.SI), Microsoft n’a jamais implanté d’équivalent direct sous la forme d’un ECARTYPE.SI.
Pour surmonter cette carence, la solution réside dans l’imbrication d’un test logique conditionnel SI au sein de la fonction d’écart-type. Considérons une table où la variable qualitative de catégorisation figure dans la plage A2:A100 (avec les étiquettes « Contrôle » et « Traité ») et où la réponse quantitative est enregistrée dans la plage B2:B100. Le calcul du coefficient de variation spécifique au groupe « Contrôle » s’exécute par la construction suivante :
=ECARTYPE.STANDARD(SI(A2:A100="Contrôle"; B2:B100))/MOYENNE.SI(A2:A100; "Contrôle"; B2:B100)
Le fonctionnement de cette formule repose sur un filtrage vectoriel fin : la fonction logique SI(A2:A100="Contrôle"; B2:B100) passe en revue chaque cellule de la colonne A. Lorsque la condition est satisfaite, elle renvoie la valeur numérique correspondante de la colonne B ; dans le cas contraire, elle renvoie la valeur booléenne FAUX. L’algorithme interne de ECARTYPE.STANDARD élimine par défaut toutes les valeurs booléennes pour ne calculer l’écart-type que sur le sous-ensemble numérique filtré. Dans les versions historiques d’Excel, une telle formule matricielle exigeait une validation par la combinaison triadique de touches Ctrl + Maj + Entrée (générant des accolades d’encadrement {...}). Sous le moteur de calcul dynamique moderne de Microsoft 365, une validation simple par Entrée assure l’évaluation matricielle sans friction.
6.2 Filtrage multicritère complexe
Lorsque la segmentation expérimentale fait intervenir une conjonction de contraintes logiques multiples — par exemple isoler les observations d’un site hospitalier spécifique chez des patients d’une tranche d’âge donnée pendant une phase d’expérimentation déterminée —, l’architecture computationnelle doit monter en puissance. Si le dénominateur s’accommode parfaitement de la fonction native MOYENNE.SI.ENS, le numérateur impose d’étendre la logique matricielle vectorielle.
Considérons les colonnes suivantes : Centre hospitalier en A2:A100, Sexe en B2:B100, et Score biologique mesuré en C2:C100. Pour déterminer le CV associé au Centre « Hôpital_Nord » chez les individus de sexe « F », la formule matricielle complète s’articule ainsi :
=ECARTYPE.STANDARD(SI((A2:A100="Hôpital_Nord")*(B2:B100="F"); C2:C100))/MOYENNE.SI.ENS(C2:C100; A2:A100; "Hôpital_Nord"; B2:B100; "F")
L’opérateur de multiplication booléenne (*) joue ici le rôle fonctionnel d’un opérateur logique ET. Les tableaux de valeurs booléennes VRAI (1) et FAUX (0) générés par chaque prédicat logique sont multipliés terme à terme : l’élément résultant ne vaut 1 que si et seulement si l’ensemble des conditions est vérifié simultanément pour la ligne considérée.
Dans l’environnement Microsoft 365, une alternative infiniment plus élégante et intuitive consiste à mobiliser la fonction native FILTRE au sein d’une structure LET :
=LET(sous_echantillon; FILTRE(C2:C100; (A2:A100="Hôpital_Nord")*(B2:B100="F")); ECARTYPE.STANDARD(sous_echantillon)/MOYENNE(sous_echantillon))
Cette méthodologie moderne simplifie considérablement la maintenance des formules et réduit les risques d’incohérence entre les critères du numérateur et ceux du dénominateur. Il convient cependant de s’assurer que les critères de filtrage ne soient pas restrictifs au point d’isoler un sous-ensemble ne comportant qu’une seule observation (ce qui déclencherait une erreur sur l’écart-type échantillonnal nécessitant au moins deux observations) ou aucune observation.
6.3 Utilisation de la fonction SOUS.TOTAL et tableaux filtrés
L’exploration visuelle interactive de jeux de données tabulaires volumineux repose fréquemment sur l’usage des filtres automatiques du ruban Données d’Excel. Dans cette modalité d’investigation dynamique, les fonctions usuelles comme MOYENNE ou ECARTYPE.STANDARD continuent d’agréger aveuglément l’ensemble des lignes de données, sans tenir compte du masquage temporaire opéré par l’utilisateur via les menus déroulants de filtrage.
Pour calculer un coefficient de variation hautement dynamique capable de refléter instantanément la variabilité du jeu de données filtré à l’écran, il est indispensable de faire appel à la fonction SOUS.TOTAL. Cette commande polymorphe utilise un code numérique d’argument pour désigner l’opération statistique à appliquer, tout en excluant systématiquement les rangées occultées par un filtre automatique :
- Le code
7(ou107pour ignorer également les lignes masquées manuellement) déclenche l’estimation de l’écart-type échantillonnal équivalent àECARTYPE.STANDARD. - Le code
1(ou101) déclenche le calcul de la moyenne arithmétique équivalente àMOYENNE.
L’expression permettant de générer un coefficient de variation interactif asservi aux filtres d’une table d’observation s’énonce comme suit :
=SOUS.TOTAL(107; B2:B200)/SOUS.TOTAL(101; B2:B200)
Chaque fois que l’analyste coche ou décoche des catégories d’observations au moyen des filtres d’en-tête de colonnes, Excel recalcule instantanément le ratio de dispersion relative sur les seuls enregistrements demeurés visibles à l’écran. Il importe toutefois de noter que la fonction SOUS.TOTAL ne tolère pas l’imbrication d’autres calculs vectoriels conditionnels au sein de ses arguments directs, imposant une structure tabulaire linéaire et continue pour opérer correctement.
7. Gestion des anomalies, instabilités numériques et messages d’erreur
7.1 Traitement de l’erreur de division par zéro (#DIV/0!)
La défaillance computationnelle la plus récurrente lors de l’exécution du coefficient de variation se matérialise par l’apparition du message d’erreur natif #DIV/0!. Sur le plan opérationnel, deux mécanismes statistiques distincts sont à l’origine de ce blocage :
- La moyenne arithmétique de la série est rigoureusement égale à zéro, ce qui rend l’opération mathématiquement indéfinie.
- La série sélectionnée ne comporte aucune observation numérique valide (par exemple après un filtrage trop restrictif ayant évacué toutes les lignes) ou ne comporte qu’une seule observation pour une formule reposant sur
ECARTYPE.STANDARD, interdisant le calcul d’un écart-type échantillonnal faute d’un dénominateur (n – 1) strictement positif.
La présence brute de codes d’erreur brise la continuité des chaînes de calcul et compromet la crédibilité des tableaux de bord automatisés. Pour neutraliser ce comportement, il est impératif d’encapsuler la formule de variation au sein de la fonction protectrice SIERREUR :
=SIERREUR(ECARTYPE.STANDARD(A2:A50)/MOYENNE(A2:A50); "Indéterminé")
Une démarche encore plus méticuleuse consiste à distinguer l’absence de matière empirique d’une réelle instabilité arithmétique. Grâce à la fonction conditionnelle SI combinée au test d’effectif NB, l’analyste peut déployer une logique de détection à deux niveaux :
=SI(NB(A2:A50)<2; "Données insuffisantes (n < 2)"; SI(MOYENNE(A2:A50)=0; "Moyenne nulle"; ECARTYPE.STANDARD(A2:A50)/MOYENNE(A2:A50)))
Ce niveau de documentation contextuelle fournit aux destinataires des rapports un diagnostic analytique transparent, évitant de confondre une population parfaitement invariable avec un défaut d’échantillonnage expérimental.
7.2 Instabilité critique lorsque la moyenne est proche de zéro
L’écueil le plus pernicieux du coefficient de variation ne réside pas dans l’apparition d’un message d’erreur formel, mais dans la production d’une valeur numérique mathématiquement valide mais totalement dénuée de sens statistique. Ce phénomène survient lorsque la moyenne arithmétique d’une série tend de manière asymptotique vers une valeur infinitésimale non nulle.
Dans un tel scénario, la moindre micro-fluctuation du signal ou le simple bruit de fond de l’instrumentation métrologique produit une valeur d’écart-type infiniment plus large que la valeur moyenne elle-même. Le quotient explose alors de manière disproportionnée vers des sommets démesurés (CV de 8 000 %, 50 000 % ou plus). L’observateur non initié peut alors déduire à tort que le protocole expérimental est affecté d’une hystérésis ou d’un chaos instrumental majeur, alors que cette instabilité relève exclusivement d’un artefact arithmétique résultant du positionnement de l’indicateur d’échelle au voisinage immédiat de l’origine zéro.
Pour prévenir cette dérive dans les systèmes de pilotage automatisés, il est indispensable de formuler des conditions de garde (guard rails) fondées sur un seuil de significativité physique minimal sous lequel l’évaluation du CV est formellement débrayée. Par exemple, si la limite de quantification minimale fiable d’un équipement de laboratoire est établie à 0,05 unité, la formule de calcul intégrera un seuil de blocage algorithmique strict :
=SI(MOYENNE(A2:A100)<0,05; "Moyenne sous le seuil de significativité"; ECARTYPE.STANDARD(A2:A100)/MOYENNE(A2:A100))
Lorsque les données s’inscrivent structurellement dans une plage oscillant autour de zéro, le coefficient de variation doit être formellement révoqué au profit d’indicateurs de dispersion absolue non normalisés, tels que l’écart-type brut ou l’écart moyen absolu (Mean Absolute Deviation).
7.3 Impact des données manquantes et de l’erreur #VALEUR!
L’intégrité computationnelle d’Excel peut être mise en échec par des incohérences de typage de données, dont la conséquence la plus typique est la levée de l’erreur d’évaluation #VALEUR!. Ce message survient dès lors qu’un opérateur arithmétique standard (en l’espèce la barre oblique de division /) tente d’opérer sur une cellule qui héberge une valeur que le moteur n’arrive pas à convertir en scalaire numérique.
Cette anomalie découle fréquemment de l’utilisation inopportune de codes d’absence de réponse conventionnels au cours de la saisie des questionnaires ou des cahiers d’observation de recherche (tels que « N/A », « NA », des points d’interrogation, ou des tirets cadratins). Alors que les fonctions MOYENNE et ECARTYPE.STANDARD savent ignorer de manière transparente les cellules textuelles au sein des plages de référence déclarées, toute référence explicite à une cellule individuelle contenant du texte dans une division binaire déclenche instantanément l’erreur #VALEUR!.
Pour immuniser les flux de calcul contre cette fragilité, une fonction de vérification structurelle peut être implémentée au moyen du prédicat ESTNUM :
=SI(ET(ESTNUM(CelluleMoyenne); ESTNUM(CelluleEcartType)); CelluleEcartType/CelluleMoyenne; "Erreur de typage")
Par ailleurs, un soin scrupuleux doit être apporté à la gestion des codes numériques d’imputation d’absence de données. Dans de multiples systèmes d’information décisionnels anciens, les données manquantes sont historiquement codées par des valeurs conventionnelles sentinelles comme 999 ou -9999. Si l’analyste omet de filtrer préalablement ces entrées codées avant de transmettre la plage aux fonctions de variabilité, ces chiffres arbitraires dénaturent complètement à la fois la moyenne arithmétique et la matrice d’écart-type, aboutissant à des coefficients de variation fantaisistes sans qu’aucun message d’erreur technique ne soit généré.
8. Automatisation avancée via VBA et Power Query
8.1 Conception d’une fonction personnalisée (UDF) en VBA
Afin de pallier l’absence d’une primitive de coefficient de variation intégrée dans Excel et d’épurer l’écriture des formules au sein des classeurs complexes, le développement d’une fonction personnalisée via l’environnement Visual Basic for Applications (VBA) constitue une solution industrielle particulièrement élégante. En encapsulant l’ensemble des contrôles d’intégrité, de gestion d’erreur et de correction statistique au sein d’une procédure unifiée, l’analyste crée un outil sur-mesure déployable à l’échelle de l’organisation.
Pour insérer cette routine, ouvrir l’éditeur VBA via le raccourci Alt + F11, ajouter un nouveau Module standard (via le menu Insertion → Module), et y consigner le code source optimisé suivant :
Public Function CalculerCV(ByVal PlageDonnees As Range, Optional ByVal FormatPourcentage As Boolean = False) As Variant
Dim MoyenneVal As Double
Dim EcartTypeVal As Double
Dim Resultat As Double
Dim NbrElements As Long
On Error GoTo GestionnaireErreur
NbrElements = Application.WorksheetFunction.Count(PlageDonnees)
If NbrElements < 2 Then
CalculerCV = CVErr(xlErrDiv0)
Exit Function
End If
MoyenneVal = Application.WorksheetFunction.Average(PlageDonnees)
If Abs(MoyenneVal) < 0.00000001 Then
CalculerCV = CVErr(xlErrDiv0)
Exit Function
End If
EcartTypeVal = Application.WorksheetFunction.StDev_S(PlageDonnees)
Resultat = EcartTypeVal / MoyenneVal
If FormatPourcentage Then
CalculerCV = Resultat * 100
Else
CalculerCV = Resultat
End If
Exit Function
GestionnaireErreur:
CalculerCV = CVErr(xlErrValue)
End Function
Cette implémentation exploite les méthodes natives de l’objet WorksheetFunction (garantissant un temps d’exécution optimisé en C++ sous-jacent) et intègre un argument optionnel permettant de stipuler si le résultat doit être retourné sous forme décimale ou déjà échelonné sur base cent. Les contrôles de sécurité logicielle vérifient que le nombre d’observations numériques valides est au moins égal à deux et interceptent les dénominateurs approchant de zéro. Pour préserver cette fonction au sein du classeur, celui-ci doit impérativement être enregistré sous le format prenant en charge les macros (extension .xlsm).
8.2 Intégration du calcul du CV dans le pipeline Power Query
Pour le traitement de flux de données massifs ou hautement récurrents (tels que des extractions périodiques de bases SQL ou des consolidations de fichiers de télémétrie multi-sites), l’automatisation via le moteur d’ingestion Power Query surpasse largement les approches fondées sur les cellules de tableur. En intégrant l’évaluation du coefficient de variation directement dans le schéma de transformation en langage M, l’analyste produit des tables d’agrégation d’une stabilité totale.
Le pipeline ETL (Extract, Transform, Load) s’organise selon la séquence méthodologique suivante :
- Importation et typage : Charger le jeu de données brut dans l’éditeur Power Query et certifier la conversion de la variable quantitative analysée sous le type de données Nombre décimal strict.
- Agrégation groupée : Sous l’onglet Transformer, actionner la commande Regrouper par. Dans la boîte de dialogue modale, paramétrer le regroupement sur les colonnes dimensionnelles voulues (par exemple Catégorie, Usine ou Équipe). Configurer deux opérations simultanées : d’une part l’opération
Moyenneaffectée à une nouvelle colonne baptiséeMoyenne_Segment, et d’autre part l’opérationÉcart-typeaffectée à une colonne nomméeEcartType_Segment. - Création de la colonne de variation : Dans l’onglet Ajouter une colonne, sélectionner Colonne personnalisée et saisir l’instruction arithmétique en syntaxe M :
[EcartType_Segment] / [Moyenne_Segment], en intitulant la colonneCoefficient_Variation. - Gestion de l’exception : Remplacer les potentielles erreurs d’évaluation par la valeur nulle via un clic droit sur l’en-tête de colonne, suivi de Remplacer les erreurs par
null.
Une fois la transformation finalisée, la requête est chargée dans une nouvelle feuille de calcul Excel sous forme d’un tableau synthétique parfaitement actualisable d’un clic (via la commande Actualiser tout de l’onglet Données) dès lors que les sources d’extraction brutes sont enrichies ou modifiées.
8.3 Élaboration de macros de reporting automatisé
Dans les centres d’essais ou les départements de contrôle statistique de procédés (SPC), l’analyste se retrouve fréquemment confronté à des classeurs comprenant des centaines de colonnes de paramètres physiques distincts pour lesquels un rapport de variabilité d’ensemble doit être généré à cadence industrielle. L’écriture d’une macro VBA d’automatisation de reporting permet de parcourir l’ensemble de ces colonnes, de calculer leurs métriques de dispersion, de dresser une synthèse structurée et d’appliquer des alertes visuelles automatisées sans la moindre friction manuelle.
La macro initialise une boucle itérative inspectant chaque colonne de la feuille source, compte les cellules renseignées, injecte le calcul de la moyenne, de l’écart-type et du coefficient de variation, puis compile ces données au sein d’une nouvelle feuille nommée Synthese_Dispersion. De plus, elle intègre une instruction de mise en forme automatisant le surlignage des variables dont le coefficient de variation outrepasse des seuils de tolérance prédéfinis (par exemple une alerte orange au-delà de 15 % et une alerte rouge écarlate au-delà de 30 %). Cette génération automatisée garantit une traçabilité intégrale et standardise le contrôle de gestion de la qualité analytique à travers toute l’organisation.
9. Représentation graphique et mise en valeur visuelle dans Excel
9.1 Construction d’un graphique à barres avec barres d’erreur relatives
La transcription visuelle de l’instabilité statistique joue un rôle prépondérant dans la restitution des conclusions scientifiques auprès de décideurs non statisticiens. Un histogramme représentant uniquement des moyennes masque la dispersion sous-jacente des mesures, créant une illusion trompeuse d’équivalence entre des processus constants et des systèmes hautement erratiques. Pour enrichir la visualisation, l’adjonction de barres d’erreur personnalisées s’impose.
La démarche de paramétrage sous Excel s’exécute rigoureusement comme suit :
- Générer un graphique en colonnes groupées standard à partir des valeurs moyennes de chaque cohorte ou modalité expérimentale.
- Sélectionner la série graphique, cliquer sur le sélecteur Éléments de graphique (icône « + » verte située à la droite du tracé), cocher la case Barres d’erreur, puis accéder au sous-menu Autres options….
- Dans le volet de configuration latéral, naviguer jusqu’à la section Marge d’erreur, cocher la case Personnalisée, puis cliquer sur le bouton Spécifier une valeur.
- Dans les champs d’entrée Valeur d’erreur positive et Valeur d’erreur négative, assigner la plage de cellules hébergeant les valeurs de l’écart-type calculées préalablement (et non la valeur du CV en pourcentage directement, car les barres d’erreur du tableur doivent hériter de l’échelle métrique absolue de l’axe vertical des ordonnées).
Pour superposer le coefficient de variation au sein de cette représentation, l’analyste exploitera l’option d’étiquettes de données avancées : en activant les étiquettes de données sur les barres, puis en sélectionnant l’option Valeur à partir des cellules, il devient possible de pointer vers la plage contenant les pourcentages de coefficient de variation calculés. L’histogramme affiche ainsi la hauteur moyenne de chaque cohorte, la variabilité absolue via les moustaches d’écart-type, et le pourcentage de variabilité relative directement imprimé au sommet de chaque bâton, condensant l’intégralité de l’information statistique en un coup d’œil.
9.2 Visualisation directe par diagramme de dispersion et nuages de points
Lorsque le protocole d’étude porte sur la comparaison de plusieurs dizaines ou centaines de variables — par exemple l’analyse de l’expression différentielle de biomarqueurs transcriptomiques ou la performance de multiples unités de production industrielle —, les graphiques à bâtons s’avèrent inopérants en raison de la saturation visuelle de l’axe horizontal. Le mode de visualisation optimal repose alors sur le tracé d’un diagramme de dispersion (nuage de points X/Y) confrontant l’écart-type en fonction de la moyenne arithmétique.
Dans ce plan factoriel, chaque point matérialise une variable unique, ses coordonnées étant définies par son couple (x̄ ; s). La modélisation mathématique du coefficient de variation prend alors la forme d’un faisceau de rayons linéaires issus de l’origine (zéro) : la pente de chaque droite correspond rigoureusement à la valeur du coefficient de variation (puisque s = CV × x̄). En traçant ces lignes repères dites d’isovariation (par exemple les rayons correspondant à un CV de 10 %, 20 % et 33 %), l’analyste cartographie visuellement l’ensemble des variables.
Cette approche graphique offre un pouvoir heuristique exceptionnel : toutes les variables positionnées au-dessus d’une ligne d’isovariation donnée trahissent une instabilité relative anormale nécessitant des investigations approfondies. En outre, lorsque les séries mesurées présentent des amplitudes considérables s’étendant sur plusieurs décades, l’ajustement des axes d’abscisses et d’ordonnées sous une échelle logarithmique (base 10) garantit une répartition spatiale harmonieuse sans compression graphique des petites grandeurs physiques.
9.3 Mise en forme conditionnelle appliquée aux tableaux d’hétérogénéité
Pour les tableaux de bord matriciels et les restitutions tabulaires denses, la communication visuelle de l’instabilité peut être considérablement magnifiée sans encombrement graphique grâce à l’usage ciblé des règles de mise en forme conditionnelle sous Excel. Plutôt que de contraindre le lecteur à décrypter ligne par ligne des dizaines de valeurs chiffrées, la scénarisation colorimétrique guide immédiatement le regard sur les points chauds d’instabilité.
Deux familles de règles méritent d’être privilégiées :
- Les échelles de couleurs graduelles : L’application d’une palette thermique trichrome (par exemple du vert pour les faibles variations, au jaune pour les dispersions moyennes, et au rouge pour les instabilités élevées) fournit une cartographie thermique instantanée des données. Il convient de fixer impérativement les seuils d’inflexion en valeurs numériques absolues plutôt qu’en percentiles automatiques (par exemple fixer le vert à 0,10, le milieu jaune à 0,20 et le rouge à 0,33) afin que la tonalité des cellules réponde à des critères métrologiques universels indépendants de la distribution interne du tableau.
- Les jeux d’icônes directionnels ou de signalisation : L’insertion de disques colorés ou de drapeaux d’alerte (trois ou quatre symboles) directement adossés aux cellules offre une signalétique visuelle d’une remarquable sobriété exécutive pour repérer les dépassements de tolérance de qualité.
Pour des environnements scientifiques exigeant une sobriété typographique totale, l’usage de formules conditionnelles ciblant les centiles extrêmes — par exemple isoler les 10 % des variables affichant le coefficient de variation le plus haut via la fonction =A2>CENTILE.EXCLURE($A$2:$A$100; 0,90) associée à un encadrement gras discret — garantit une lisibilité maximale conforme aux normes de publication académiques les plus strictes.
10. Interprétation analytique et seuils de décision méthodologiques
10.1 Grille d’évaluation empirique des niveaux d’hétérogénéité
L’estimation numérique du coefficient de variation ne prend son sens analytique qu’à travers son confrontation avec des grilles de décision et des seuils d’hétérogénéité éprouvés. Dans la tradition statistique générale, une taxonomie empirique tripartite largement reconnue structure l’interprétation des séries univariées :
- CV < 10 % à 15 % (Forte homogénéité) : La distribution est réputée compacte, très resserrée et caractérisée par une fidélité de mesure élevée. Les observations individuelles oscillent très peu autour de la moyenne arithmétique, confirmant la stabilité du processus générateur et une robustesse prédictive optimale.
- 15 % ≤ CV ≤ 30 % à 33 % (Homogénéité ou dispersion modérée) : La variabilité observée est usuelle pour des systèmes biologiques ou comportementaux complexes. La distribution demeure stable, mais reflète l’expression d’influences multifactorielles modérées ou un bruit d’échantillonnage non négligeable.
- CV > 33 % (Forte hétérogénéité structurelle) : La série est considérée comme hétérogène. La moyenne arithmétique perd une part substantielle de sa représentativité en tant que descripteur unifié du jeu de données. La dispersion relative est telle que l’existence de sous-populations mixtes, de bifurcations dynamiques ou de distorsions distributionnelles doit être suspectée.
Toutefois, la rigidité de ces repères généraux doit impérativement être modulée en fonction du domaine d’investigation considéré. En chimie analytique et en pharmacométrie de haute précision, un coefficient de variation intra-essai supérieur à 3 % ou 5 % entraîne fréquemment le rejet immédiat du lot ou l’invalidation de la chaîne spectrométrique. À l’opposé, en psychologie cognitive, en sociométrie ou en écologie des populations, des coefficients de variation oscillant entre 40 % et 80 % s’avèrent monnaie courante et reflètent la diversité intrinsèque inhérente aux systèmes vivants plutôt qu’une défaillance méthodologique.
10.2 Comparaison rigoureuse de métriques issues d’échelles disparates
La vocation première du coefficient de variation réside dans sa capacité à opérer des arbitrages et des comparaisons méthodologiques entre des indicateurs recueillis selon des instruments de mesure physiquement ou psychométriquement dissemblables. Considérons une batterie d’évaluation neuropsychologique analysant chez un échantillon clinique à la fois un temps de réponse informatique (exprimé en millisecondes, oscillant autour de 850 ms avec un écart-type de 120 ms) et un score d’exactitude motrice issu d’une échelle ordinale continue (noté de 0 à 20, affichant une moyenne de 14 avec un écart-type de 3,5).
La comparaison brute des écarts-types (120 vs 3,5) induit un biais d’amplitude massif lié à l’échelle métrique. La conversion en coefficients de variation rétablit l’équilibre analytique :
- Temps de réponse :
CV = 120 / 850 ≈ 14,12 % - Exactitude motrice :
CV = 3,5 / 14 = 25,00 %
L’analyste met ainsi en lumière que la dimension comportementale la plus instable et la plus erratique chez ces sujets n’est aucunement la vitesse motrice, mais bien la précision gestuelle, qui exhibe une variabilité relative presque deux fois plus ample. Cette standardisation sans biais d’échelle autorise également la détection des variables dominantes dans l’apport d’instabilité au sein des systèmes multi-composants, guidant les ingénieurs ou les cliniciens vers les maillons faibles prioritaires de leurs modèles opérationnels.
10.3 Limites inhérentes au coefficient de variation face aux alternatives
En dépit de son élégance mathématique, le coefficient de variation présente des limitations structurelles dont l’analyste doit impérativement mesurer la portée sous peine de déductions fallacieuses. Sa première vulnérabilité fondamentale découle de sa dépendance directe envers la moyenne arithmétique et l’écart-type : ces deux paramètres constituant des estimateurs gaussiens hautement sensibles aux données aberrantes, la moindre distorsion dans les queues de distribution ou l’apparition d’une bimodalité prononcée invalide l’interprétation du ratio.
Face à des séries non gaussiennes, des distributions asymétriques ou des données ordinales continues, le statisticien avisé doit privilégier des alternatives robustes d’échelle non paramétrique. L’analogue non paramétrique le plus rigoureux du coefficient de variation est le ratio d’écart interquartile sur médiane (souvent désigné comme le coefficient de dispersion quartile ou Quartile Coefficient of Dispersion) :
QCD = (Q3 – Q1) / (Q3 + Q1) ou plus simplement IQR / Médiane
Dans Excel, cette métrique s’évalue aisément via la formule :
=(QUARTILE.EXCLURE(A2:A100; 3) - QUARTILE.EXCLURE(A2:A100; 1)) / MEDIANE(A2:A100)
Une autre alternative fondamentale dans l’analyse des inégalités économiques et de la concentration réside dans le coefficient de Gini, dont le calcul matriciel sous Excel capture la distribution globale sans subir l’asymptote d’instabilité du coefficient de variation au voisinage de zéro. Dans tout protocole d’évaluation scientifique de haut niveau, il est vivement recommandé de pratiquer une triangulation méthodologique en confrontant systématiquement le coefficient de variation classique à ses pendants non paramétriques pour vérifier l’invariance des conclusions relatives à l’hétérogénéité du phénomène sondé.
11. Applications pratiques en psychométrie, cognition et comportement
11.1 Analyse de la variabilité intra-individuelle des temps de réaction
Dans les neurosciences computationnelles et la psychologie expérimentale moderne, la fluctuation des performances comportementales au cours de tâches attentionnelles répétées constitue l’un des objets d’étude les plus fertiles. Alors que la recherche historique s’est longtemps cantonnée à mesurer la vitesse moyenne d’exécution d’un sujet (estimée par le temps de réaction moyen, MRT), les avancées contemporaines ont mis en exergue que la variabilité intra-individuelle (Intra-Individual Variability ou IIV) constitue un biomarqueur clinique fondamental de l’intégrité neuro-fonctionnelle.
Pour quantifier ce phénomène, les chercheurs calculent le coefficient de variation intra-individuel (ICV), défini comme le ratio entre l’écart-type des temps de réaction d’un sujet au cours des multiples essais d’un test et son temps de réaction moyen :
ICV = sintra / MRT
Au sein d’Excel, la matrice de collecte est typiquement structurée de manière horizontale : chaque ligne est dédiée à un participant unique, tandis que les colonnes B à CW compilent les temps de réponse recueillis sur une séquence de cent essais successifs. Dans la colonne CX, la formule suivante est déployée pour chaque individu :
=ECARTYPE.STANDARD(B2:CW2)/MOYENNE(B2:CW2)
Cette distinction métrologique est cruciale : deux patients affichant un temps de réponse moyen rigoureusement identique de 450 millisecondes peuvent manifester des architectures cognitives totalement divergentes. Le premier, présentant un ICV modeste de 8 %, témoigne d’un contrôle attentionnel soutenu exemplaire. Le second, dont l’ICV culmine à 35 % en raison de décrochages attentionnels transitoires massifs (lenteurs épisodiques caractéristiques d’un dysfonctionnement des circuits fronto-striataux), présente une instabilité cognitive critique indétectable par la simple analyse du score moyen. Cette méthode constitue un paradigme de choix dans le diagnostic précoce du TDAH ou l’évaluation du déclin exécutif dans les maladies neurodégénératives.
11.2 Fidélité test-retest et consistance interne d’épreuves psychologiques
L’édification d’outils psychométriques et de questionnaires standardisés obéit à des règles strictes de qualification métrologique définies par les normes de l’American Psychological Association. Parmi ces critères cardinaux figurent la fidélité temporelle test-retest et l’estimation de l’erreur de mesure intrinsèque. Bien que le coefficient de corrélation intraclasse (ICC) soit universellement plébiscité pour valider la reproductibilité d’une épreuve administrée à deux intervalles distincts, il présente la limitation d’être hautement dépendant de la variance inter-sujets de l’échantillon de validation.
Pour contourner ce biais, les méthodologistes intègrent le coefficient de variation de mesure (CVm). Soit une série de passations répétées pour lesquelles la différence entre deux sessions T1 et T2 est consignée. L’écart-type intra-sujet de la différence, normalisé par la moyenne d’ensemble des scores des deux sessions, permet d’établir le pourcentage moyen de dérive temporelle imputable au simple bruit de mesure :
=(ECARTYPE.STANDARD(Difference_T1_T2)/RACINE(2))/MOYENNE(Scores_Globaux)
Cette approche permet d’identifier de manière chirurgicale les items de questionnaires générant une variabilité erratique anormale entre deux sessions d’évaluation clinique. Un item affichant un coefficient de variation de mesure supérieur à 25 % auprès d’une population stable trahit une formulation équivoque ou une sensibilité excessive aux facteurs environnementaux transitoires, justifiant sa révision ou son exclusion du paradigme final.
11.3 Évaluation de la convergence inter-juges et consensus d’évaluation
De nombreux protocoles d’investigation comportementale, clinique ou ergonomique reposent sur des grilles d’observation qualitative dans lesquelles des évaluateurs humains ou des juges experts attribuent des cotes chiffrées à des performances complexes (par exemple des patterns de motricité d’enfants autistes ou des soutenances d’aptitude professionnelle). Au-delà du coefficient Kappa de Cohen — qui s’applique à des variables strictement nominales —, la dispersion des scores continus attribués par un collège d’experts quantifie le degré d’accord ou de dissension diagnostique.
En structurant sous Excel une table croisant les stimuli ou les sujets évalués en lignes et les différents juges experts en colonnes, l’analyste déploie le calcul du coefficient de variation transversal pour chaque unité observée :
=ECARTYPE.STANDARD(Cote_JugeA:Cote_JugeE)/MOYENNE(Cote_JugeA:Cote_JugeE)
Cette modélisation met immédiatement en exergue les stimuli ambigus ou hautement controversés : un comportement clinique générant un CV inter-juges de 45 % révèle un consensus méthodologique fragile et une équivocité des critères de cotation de la grille. À l’inverse, un faible coefficient de variation atteste d’une homogénéité d’appréciation rigoureuse, fournissant une métrique synthétique d’accord indispensable pour étalonner la convergence des jugements avant le déploiement opérationnel des grilles d’évaluation sur le terrain expérimental.
12. Bonnes pratiques, auditabilité et reproductibilité scientifique sous Excel
12.1 Protocole de contrôle qualité et audit des formules
L’utilisation d’Excel comme outil d’analyse scientifique et décisionnelle a fait l’objet de critiques méthodologiques récurrentes au sein de la communauté académique internationale, principalement en raison de la propension des tableurs à héberger des erreurs silencieuses de programmation cellulaire passées inaperçues. Pour hisser la pratique du tableur aux standards de rigueur des sciences ouvertes et des réglementations industrielles (telles que la directive FDA 21 CFR Part 11), un protocole d’audit et de validation s’impose.
Ce protocole s’articule autour des vérifications suivantes :
- Repérage visuel des antécédents et dépendances : Mobiliser systématiquement l’outil d’audit des formules (onglet Formules → Repérer les antécédents) pour vérifier graphiquement, au moyen de flèches indicatrices, que chaque formule de coefficient de variation référence rigoureusement les plages de données cibles, sans omettre de cellules marginales ni englober d’en-têtes inadaptés.
- Verrouillage structurel : Verrouiller et protéger les cellules accueillant les algorithmes et équations (via le format de cellule → onglet Protection → Verrouillée, puis activation de la protection de feuille). Seules les cellules dévolues à la saisie des données primaires doivent demeurer éditables, sanctuarisant le moteur de calcul contre toute maladresse de manipulation.
- Tests unitaires sur jeux témoins : Implanter dans un onglet dédié une série de données étalons synthétiques dont les propriétés mathématiques sont rigoureusement documentées par la théorie (par exemple un vecteur de valeurs générant une moyenne exacte de 100 et un écart-type connu de 15, validant que la formule retourne indiscutablement 15,00 %).
- Validation croisée avec des moteurs statistiques tiers : Comparer périodiquement les sorties générées par le classeur Excel avec les métriques issues d’environnements programmatiques de référence comme le logiciel libre R (via l’instruction
sd(x)/mean(x)) ou la bibliothèque SciPy sous Python, attestant de la totale équivalence numérique des estimateurs retenus.
12.2 Documentation interne et gouvernance des classeurs
Pour garantir la reproductibilité et la pérennité des modèles à long terme, tout classeur statistique doit être conçu comme un artefact logiciel autonome et auto-documenté. L’analyste doit proscrire l’accumulation de formules complexes sans glose explicative et concevoir une architecture d’accueil structurée.
La feuille d’accueil du classeur doit obligatoirement comporter un onglet de métadonnées regroupant la notice explicative du projet, la date de génération, l’identité des concepteurs, ainsi qu’un dictionnaire de variables rigoureux consignant la définition conceptuelle de chaque variable, son unité de mesure physique originelle, l’échelle de mesure sous-jacente et les bornes théoriques d’acceptabilité. Chaque formule composite (notamment les imbrications conditionnelles de filtrage pour l’écart-type) doit faire l’objet d’un commentaire documentaire inséré directement dans la cellule ou adossé à la ligne de commande.
De plus, une convention graphique universelle de codification colorimétrique des cellules doit être adoptée et explicitée au sein d’une légende générale sur la feuille de synthèse :
- Fond blanc ou gris très clair avec police noire pour les données brutes saisies.
- Fond bleu pastel avec police foncée pour les paramètres fixes et constantes de calcul.
- Fond vert très pâle pour les formules intermédiaires d’estimation statistique.
- Fond beige ou jaune doux pour les indicateurs de décision finaux et ratios synthétiques de variabilité.
Enfin, une gouvernance saine exige la mise en œuvre d’un versionnement rigoureux des fichiers (nommage séquentiel formalisé de type Projet_CV_Analyse_v1.3_2024.xlsx), prévenant l’écrasement malencontreux des historiques d’analyse et assurant une traçabilité totale lors des phases de révision par les pairs.
12.3 Exportation normalisée et préparation aux publications
L’aboutissement du traitement statistique sous Excel consiste en l’extraction des synthèses de dispersion pour leur incorporation dans des mémoires universitaires, des articles scientifiques ou des rapports décisionnels d’entreprise. Pour satisfaire aux exigences typographiques et méthodologiques des normes internationales (telles que le style de l’American Psychological Association – APA 7th edition), les tableaux de restitution ne doivent pas être copiés-collés de façon brute sous leur aspect visuel de tableur.
Les standards de publication académique imposent un formatage épuré : les quadrillages internes verticaux des cellules doivent être entièrement supprimés. Seules trois lignes de démarcation horizontales majeures sont admises : une bordure supérieure délimitant le haut du tableau, une bordure médiane séparant la rangée d’en-tête descriptive des observations chiffrées, et une bordure inférieure scellant la base du tableau. Les coefficients de variation doivent être clairement étiquetés sous l’abréviation normalisée en italique CV, et accompagnés de la mention explicite de l’estimateur d’écart-type mobilisé dans les notes de bas de tableau (par exemple : « Note. CV = coefficient de variation échantillonnal calculé selon la correction de Bessel (n – 1) »).
Lors de l’exportation des visualisations graphiques (diagrammes de dispersion ou histogrammes d’isovariation), il convient de privilégier des formats d’export vectoriels haute résolution (tels que le format PDF vectoriel ou des images compressées au format TIFF à un minimum de 300 DPI) afin d’interdire toute pixellisation typographique à l’impression. Enfin, dans le cadre des engagements contemporains en faveur de la science reproductible (Open Science), les tables de données nettoyées doivent être exportées et archivées en format texte universel délimité (CSV conforme UTF-8) exempt de tout formatage cosmétique propriétaire, et accompagnées du classeur Excel source dans des dépôts pérennes sécurisés (tels que Zenodo ou l’Open Science Framework), permettant à la communauté scientifique mondiale d’auditer et de répliquer fidèlement l’intégralité des calculs de dispersion relative.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Bland, J. M., & Altman, D. G. (1996). Measurement error proportional to the mean. BMJ, 313(7049), 106. https://doi.org/10.1136/bmj.313.7049.106
- International Organization for Standardization. (1994). Accuracy (trueness and precision) of measurement methods and results — Part 2: Basic method for the determination of repeatability and reproducibility of a standard measurement method (ISO Standard No. 5725-2:1994). https://www.iso.org/standard/11834.html
- Microsoft Corporation. (2024). Documentation des fonctions statistiques dans Excel. Microsoft Support. https://support.microsoft.com/fr-fr/office/fonctions-statistiques-r%C3%A9f%C3%A9rence-624decba-bb9a-4248-f536-a9e247137a95
- Pearson, K. (1896). Mathematical contributions to the theory of evolution. III. Regression, heredity, and panmixia. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 187, 253-318. https://doi.org/10.1098/rsta.1896.0007
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677-680. https://doi.org/10.1126/science.103.2684.677
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1-23. https://doi.org/10.18637/jss.v059.i10