
L’analyse des associations statistiques entre variables discrètes constitue l’un des piliers méthodologiques de la recherche contemporaine en sciences humaines, sociales et biomédicales. Lorsque deux variables sont mesurées sur une échelle nominale purement dichotomique, l’évaluation de leur degré de dépendance stochastique requiert des outils quantitatifs dédiés, capables de transcender les simples dénombrements d’effectifs pour quantifier avec rigueur la force et la direction de cette relation. Le coefficient phi, conceptualisé au tout début du vingtième siècle, représente la mesure métrologique par excellence pour sonder cette covariation binaire dans une grande variété de protocoles de recherche empiriques.
Dans la pratique psychométrique et l’épidémiologie clinique, le chercheur se trouve fréquemment confronté à des classifications binaires : succès ou échec à un item psychologique, présence ou absence d’un trait nosographique, adhésion ou rejet d’une proposition attitudinale, ou encore exposition versus non-exposition à un facteur de vulnérabilité environnemental. Pour caractériser ces interdépendances, le recours au logiciel libre et environnement de calcul statistique R s’est imposé comme le standard d’excellence académique. Sa flexibilité algorithmique, son écosystème de packages spécialisés et sa rigueur computationnelle offrent aux analystes de données une infrastructure idéale pour calculer, tester et interpréter cette métrique.
Cet article propose un traité d’analyse quantitative consacré au calcul du coefficient phi dans l’environnement statistique R. En explorant les fondements mathématiques de l’indice, son équivalence formelle avec la corrélation produit-moment, ses conditions strictes d’application, ainsi que sa mise en œuvre computationnelle via de multiples bibliothèques logicielles et fonctions personnalisées, ce guide constitue une référence méthodologique pour les psychométriciens, les biostatisticiens et les chercheurs en sciences du comportement désireux de maîtriser l’analyse rigoureuse des tables de contingence deux par deux.
1. Fondements théoriques et définition du coefficient phi en psychométrie
1.1 Définition conceptuelle et origine statistique
Le coefficient phi plonge ses racines conceptuelles dans l’essor de la statistique biométrique de l’école britannique, principalement sous l’impulsion de Karl Pearson au tournant du vingtième siècle. Confronté à la nécessité d’évaluer l’interdépendance de caractères discontinus au sein de populations biologiques, Pearson a cherché à étendre le formalisme mathématique de sa célèbre corrélation produit-moment aux distributions catégorielles. Alors que le coefficient de corrélation linéaire standard s’applique à des variables quantitatives continues répondant au postulat de normalité bivariée, le coefficient phi a été formalisé spécifiquement pour appréhender l’association entre deux variables purement qualitatives, chacune ne présentant que deux états mutuellement exclusifs et conjointement exhaustifs.
Sur le plan métrologique, le coefficient phi se définit comme une mesure bivariée d’association pour deux variables nominales binaires. Ces variables sont généralement conventionnellement codées sous la forme de zéros et de uns, traduisant l’absence ou la présence d’une caractéristique déterminée. Dans l’investigation empirique, ce codage peut représenter la réussite ou l’échec à une tâche cognitive, le diagnostic positif ou négatif d’un trouble psychiatrique, ou l’appartenance à un groupe témoin versus un groupe expérimental. La quantification de cette association ne dépend pas de l’attribution d’une valeur métrique intrinsèque aux catégories, mais découle entièrement de la configuration conjointe des fréquences observées.
Dans le paysage épistémologique des sciences comportementales, le coefficient phi occupe une place charnière. Il permet aux chercheurs d’évaluer si la probabilité de manifester une modalité sur la première variable dépend significativement de l’état présenté sur la seconde. Contrairement à de simples pourcentages comparatifs ou à des analyses descriptives désagrégées, phi synthétise l’ensemble de l’information structurelle du croisement binaire en un unique indicateur scalaire adimensionnel. Cet indice autorise les comparaisons inter-études, facilitant l’intégration des résultats au sein de synthèses quantitatives et de méta-analyses psychométriques.
1.2 Structure d’une table de contingence 2×2
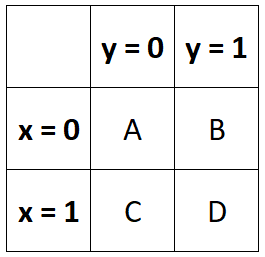
L’assise empirique indispensable à l’estimation du coefficient phi est la table de contingence croisée deux par deux, fréquemment désignée sous l’appellation de matrice binaire de distribution. Cette structure matricielle résulte du croisement orthogonal de deux variables dichotomiques, générant quatre cellules élémentaires étiquetées de façon canonique par les lettres A, B, C et D. Par convention internationale, la cellule A répertorie la fréquence conjointe des observations présentant simultanément la première modalité des deux variables (par exemple, le score 1-1 ou présence-présence). La cellule B enregistre les cas où la première variable est présente et la seconde absente (score 1-0). Réciproquement, la cellule C quantifie les occurrences d’absence sur la première variable et de présence sur la seconde (score 0-1), tandis que la cellule D regroupe les observations présentant une double absence (score 0-0).
À partir de ces quatre effectifs conjoints fondamentaux, il est impératif de calculer les sommes marginales, lesquelles gouvernent l’ensemble des propriétés stochastiques du tableau. Les totaux marginaux horizontaux sont obtenus en sommant les lignes : la marge de la première ligne correspond à la somme A plus B, représentant l’ensemble des sujets manifestant la modalité positive sur la variable en ligne, tandis que la marge de la seconde ligne correspond à la somme C plus D. De manière parfaitement symétrique, les totaux marginaux verticaux résultent de la sommation des colonnes : la marge de la première colonne s’établit à A plus C, et celle de la seconde colonne s’élève à B plus D.
La sommation intégrale de l’ensemble de ces quatre cases, ou l’addition des deux marges horizontales, ou encore celle des deux marges verticales, converge invariablement vers la taille totale de l’échantillon observé, désignée par la lettre majuscule N. Cette valeur scalaire N représente la masse empirique totale de l’étude. Le principe de conservation des effectifs marginaux stipule que la variation interne des cellules individuelles sous l’hypothèse d’indépendance ne modifie jamais les sommes marginales globales. Cette contrainte conditionnelle joue un rôle analytique déterminant dans le calcul des variances d’échantillonnage et l’ajustement du dénominateur du coefficient phi.
1.3 Équivalence mathématique avec la corrélation de Pearson
L’un des résultats les plus élégants de la théorie statistique moderne réside dans la démonstration que le coefficient phi ne constitue nullement une métrique exotique distincte du cadre d’échantillonnage gaussien, mais s’avère rigoureusement équivalent au coefficient de corrélation produit-moment de Bravais-Pearson. Lorsque deux variables qualitatives binaires sont converties en variables indicatrices numériques en leur assignant rigoureusement les valeurs numériques zéro et un, et que la formule classique de Pearson est déployée sur ces séries de données vectorielles, l’expression algébrique finale se simplifie de manière exacte pour produire l’équation canonique de phi.
Cette convergence formelle confère à phi une solidité axiomatique substantielle face aux autres mesures d’association tabulaires. D’autres indices, tels que le Q de Yule ou le coefficient d’indépendance de Tschuprow, reposent sur des pondérations non linéaires ou des transformations géométriques qui s’écartent du principe des moindres carrés. En demeurant ancré dans la mécanique du r de Pearson, phi hérite directement du concept de covariation standardisée, tout en conservant une interprétabilité géométrique directe sous la forme du cosinus de l’angle vectoriel séparant les deux variables indicatrices dans l’espace multidimensionnel des observations.
En psychométrie expérimentale, cette propriété d’équivalence est abondamment exploitée pour déterminer la fidélité test-retest d’instruments d’évaluation composés d’items à réponse dichotomique, tels que les questionnaires de personnalité à choix forcé (vrai/faux) ou les épreuves cognitives à réponse univoque (réussite/échec). L’application de phi pour quantifier la stabilité temporelle ou la consistance inter-juges de cotations binaires garantit que les postulats de la théorie classique des tests peuvent être appliqués sans rupture de continuité conceptuelle, ouvrant la voie à des estimations cohérentes de la variance vraie et de l’erreur de mesure standard.
2. Formulation mathématique et propriétés algébriques du coefficient phi
2.1 Formule canonique et calcul manuel
La détermination computationnelle du coefficient phi s’effectue au moyen d’une relation algébrique exacte qui opère directement sur les quatre effectifs d’une table de contingence binaire. La formule canonique s’énonce comme le rapport entre la différence des produits croisés diagonaux et la racine carrée du produit des quatre totaux marginaux de la table. Algébriquement, cette relation se transcrit sous la forme suivante : la valeur de phi est égale à la quantité A multiplié par D moins B multiplié par C, l’ensemble étant divisé par la racine carrée du produit des termes A plus B, C plus D, A plus C et B plus D.
Le numérateur de cette équation, représenté par la différence A fois D moins B fois C, constitue le noyau d’association de la structure matricielle. Il mesure la divergence relative entre la concordance des modalités (concentrée sur la diagonale principale unissant les cellules A et D) et la discordance de ces mêmes modalités (concentrée sur l’antidiagonale unissant les cellules B et C). Si les fréquences observées se massent majoritairement dans les cases A et D, le terme A fois D surpasse nettement le produit B fois C, conférant au numérateur, et par conséquent au coefficient phi, une orientation algébriquement positive. Inversement, une concentration d’effectifs dans les cellules B et C induit une valeur négative.
Le dénominateur de la formule joue quant à lui un rôle régulateur de normalisation d’échelle. En extrayant la racine carrée du produit continu des quatre sommes marginales, le dénominateur compense l’amplitude globale de l’échantillon N et ajuste la métrique en fonction des distributions de fréquences univariées de chaque variable. Cette division permet de borner théoriquement le résultat, garantissant qu’une variation purement proportionnelle de l’échantillon global, qui multiplierait toutes les cellules par une constante fixe, laisserait la valeur finale de phi rigoureusement invariante.
2.2 Étendue des valeurs et symétrie
D’un point de vue purement théorique, le coefficient phi évolue dans un intervalle fermé s’étendant de la valeur négative minimale de moins un point zéro jusqu’à la valeur positive maximale de plus un point zéro. L’obtention de la valeur extrême de plus un signale une concordance parfaite et déterministe entre les deux variables : chaque individu présentant la caractéristique positive sur la première variable la présente systématiquement sur la seconde, ce qui implique que les cellules discordantes B et C possèdent un effectif rigoureusement nul. À l’opposé, une valeur de moins un reflète une discordance absolue : la présence d’une modalité exclut catégoriquement celle de l’autre, entraînant des effectifs nuls au sein des cellules diagonales A et D.
Toutefois, une contrainte algébrique majeure, fréquemment méconnue des praticiens, pèse sur la capacité effective de phi à atteindre ces bornes unitaires. Le coefficient ne peut atteindre plus un ou moins un que si et seulement si les distributions marginales des deux variables sont rigoureusement identiques. Cela signifie que la proportion globale de réponses positives sur la première variable (A plus B divisé par N) doit correspondre au centième près à la proportion globale de réponses positives sur la seconde variable (A plus C divisé par N). Si les marges sont inégales, la valeur maximale atteignable, traditionnellement désignée sous le symbole de phi maximal, se trouve mathématiquement bridée à un niveau nettement inférieur à l’unité.
Cette asymétrie induite par les totaux marginaux a des conséquences sur l’interprétation de la symétrie de la mesure. Si une variable présente une prévalence de quatre-vingt-dix pour cent et la seconde une prévalence de dix pour cent, le phi maximal théorique peut s’effondrer autour de zéro point vingt-cinq, bien qu’il subsiste une liaison déterministe sous-jacente. Il convient donc toujours de contextualiser la magnitude observée de phi en regard de ses bornes réelles calculées conditionnellement aux distributions marginales empiriques, sous peine de sous-estimer radicalement l’intensité d’une relation bivariée.
2.3 Liaison formelle avec la statistique du Khi-deux
Au-delà de son statut de corrélation linéaire bivariée, le coefficient phi entretient une filiation mathématique immédiate avec la statistique du test d’indépendance du Khi-deux de Pearson pour un tableau de contingence à deux lignes et deux colonnes. Lorsqu’on calcule la statistique classique du Khi-deux, caractérisée par la somme sur les quatre cellules des carrés des écarts entre effectifs observés et effectifs théoriques divisés par ces mêmes effectifs théoriques, le résultat obtenu est directement proportionnel au carré du coefficient phi multiplié par la taille de l’échantillon. Par transposition, l’équation s’écrit : la valeur absolue de phi équivaut à la racine carrée de la statistique du Khi-deux divisée par la taille globale N.
Cette formulation met en exergue la distinction conceptuelle profonde qui sépare la significativité statistique de la taille d’effet standardisée. La statistique du Khi-deux est une quantité extensive dont la valeur croît de manière monotone et linéaire avec la taille de l’échantillon N : à force de liaison constante, multiplier par dix le nombre de sujets induira une multiplication par dix de la statistique du test. En revanche, le coefficient phi constitue une mesure intensive intrinsèque. Grâce à la division par N sous le radical, phi normalise la statistique et demeure invariant par rapport au volume global de données, ce qui en fait un estimateur direct de l’amplitude de l’effet.
Dans le domaine de la psychologie expérimentale et des protocoles factoriels, cette interconnexion offre un pont analytique d’une grande valeur pragmatique. Elle autorise la conversion immédiate d’un résultat issu d’une publication ancienne ne rapportant que la statistique du Khi-deux et la taille de l’échantillon en un indice standardisé de corrélation d’effet. Cette transposition directe nourrit les modèles méta-analytiques contemporains en fournissant une métrique commune d’estimation de l’amplitude comportementale indépendante des fluctuations d’échantillonnage.
3. Conditions d’application et hypothèses méthodologiques
3.1 Nature dichotomique des données observées
L’emploi valide du coefficient phi impose en premier lieu de s’interroger sur la nature épistémologique de la binarité des variables soumises à l’analyse. Les statisticiens distinguent traditionnellement les dichotomies vraies ou naturelles des dichotomies artificielles ou seuillées. Une dichotomie vraie caractérise une variable dont l’état intrinsèque est par essence discret et binaire dans le monde réel, sans sous-jacent graduel continu, comme l’état de survie ou de décès d’un organisme, le statut d’attribution d’un brevet, ou la polarité électrique d’un signal expérimental. Dans ce cas de figure, phi constitue l’estimateur parfait et indépassable de l’association nominale.
À l’opposé, les dichotomies artificielles résultent d’une segmentation arbitraire d’un continuum latent sous-jacent, opérée le plus souvent à des fins de commodité clinique ou méthodologique. C’est le cas typique de la division d’un score continu d’anxiété selon la médiane, ou de la catégorisation d’individus comme dépressifs versus sains selon un seuil psychopathologique conventionnel. Dans de telles circonstances, l’application directe du coefficient phi tend à sous-estimer systématiquement la corrélation latente réelle. Le processus de discrétisation binaire détruit de l’information variance, entraînant une troncature artificielle et une atténuation mécanique du coefficient estimé pouvant atteindre trente à quarante pour cent de sa valeur sous-jacente.
Face à des variables résultant de dichotomies artificielles, les modélisateurs en psychométrie préfèrent généralement recourir au coefficient de corrélation tétrachorique. Ce dernier postule l’existence d’une distribution normale bivariée continue sous-jacente et cherche à inférer la corrélation qui aurait été observée si les variables n’avaient pas subi de troncature binaire. Le chercheur doit donc déterminer en amont si son modèle de mesure s’intéresse à l’association pragmatique entre des événements binaires manifestes (légitimant le recours exclusif à phi) ou s’il tente d’estimer des liaisons au niveau d’attributs continus latents sous-jacents.
3.2 Indépendance des observations et échantillonnage
L’inférence statistique adossée au calcul du coefficient phi repose de manière intangible sur l’hypothèse d’indépendance stochastique des observations élémentaires. Chaque sujet ou unité expérimentale inclus dans la table de contingence doit être prélevé de façon autonome au sein de la population cible, selon un protocole d’échantillonnage probabiliste aléatoire simple ou stratifié. Cela implique qu’une observation spécifique ne doit exercer aucune influence sur l’assignation catégorielle des autres observations, excluant par principe tout phénomène de contamination spatiale, d’agrégation familiale ou de dépendance temporelle sérielle non modélisée.
Une infraction méthodologique grave consiste à appliquer le coefficient phi à des données appariées ou longitudinales, issues de protocoles à mesures répétées où les mêmes individus sont examinés avant et après une intervention clinique ou thérapeutique. Dans ce contexte, les cellules de concordance et de discordance ne reflètent pas une distribution multinomiale indépendante, mais intègrent une covariance intra-sujet élevée. Pour évaluer le changement binaire chez des sujets appariés, l’usage de phi est invalidé et doit impérativement s’effacer au profit de tests de discordance marginale dédiés, tels que le test de McNemar ou les modèles d’équations d’estimation généralisées.
Par ailleurs, pour que les approximations asymptotiques régissant l’inférence de phi conservent leur robustesse théorique, la taille totale de l’échantillon et la dispersion des données doivent garantir des effectifs théoriques satisfaisants dans chaque cellule de la table. La règle classique stipule qu’aucun effectif théorique calculé sous l’hypothèse d’indépendance ne devrait descendre sous la barre de cinq unités. Lorsque cette condition d’abondance marginale est transgressée en raison d’un effectif global N trop modeste ou d’une asymétrie prononcée, la loi de distribution empirique de phi s’écarte de la normalité asymptotique, imposant le basculement vers des méthodes exactes ou non paramétriques.
3.3 Sensibilité à la prévalence marginale
Un enjeu méthodologique central réside dans la vulnérabilité intrinsèque du coefficient phi vis-à-vis des phénomènes de déséquilibre extrême de prévalence marginale. En psychométrie clinique, il est fréquent d’étudier des entités nosologiques rares, caractérisées par un taux de prévalence inférieur à cinq pour cent au sein de la population générale, croisées avec des marqueurs biologiques ou génétiques également peu fréquents. Dans ces conditions de marginales très dissymétriques, la variance d’échantillonnage s’écrase et le numérateur de phi se trouve comprimé par rapport aux produits marginaux du dénominateur.
Cette contrainte statistique donne lieu à des situations paradoxales, analogues à celles documentées dans la littérature pour le coefficient kappa de Cohen. Deux investigateurs travaillant sur un instrument de dépistage possédant exactement la même sensibilité et la même spécificité observeront des coefficients phi substantiellement différents si l’un conduit son étude en population générale (faible prévalence de l’ordre de deux pour cent) et l’autre dans une clinique spécialisée de recours tertiaire (prévalence élevée de cinquante pour cent). Le premier investigateur verra son coefficient phi plafonner à des valeurs dérisoires, tandis que le second enregistrera une valeur robuste.
Cette sensibilité à la prévalence marginale requiert une prudence méthodologique absolue lors de la validation des échelles d’évaluation clinique et des tests diagnostiques standardisés. Les concepteurs d’échelles doivent systématiquement documenter les distributions de prévalence observées lors de l’étalonnage des items binaires. Il est vivement conseillé de ne pas comparer brutalement des valeurs brutes de phi obtenues sur des cohortes dont les prévalences marginales diffèrent considérablement, mais d’adosser systématiquement cette métrique à l’examen conjoint des rapports de cotes ou de calculer le ratio entre le phi observé et le phi théorique maximal conditionnel.
4. Préparation et structuration des données binaires dans R
4.1 Création manuelle de matrices de contingence 2×2
Au sein du langage R, l’agencement computationnel primaire pour accueillir une table de contingence binaire repose sur la structure de données matricielle native, instanciée via la fonction de base nommée matrix. La maîtrise des mécanismes internes de cette fonction est primordiale pour éviter toute dénaturation de l’ordre canonique des cellules A, B, C et D. Par défaut, le moteur d’exécution de R alloue les éléments vectoriels transmis dans les cellules selon une orientation orientée par colonne, ce qui exige une rigueur particulière lors de la saisie des effectifs observés.
Pour instancier convenablement une table croisée, l’analyste assemble les quatre valeurs de fréquences dans un vecteur unidimensionnel. Si la saisie s’effectue dans l’ordre de lecture habituel des lignes (cellule A puis B pour la ligne supérieure, puis cellule C puis D pour la ligne inférieure), il convient de spécifier l’argument booléen byrow fixé à TRUE, tout en précisant un nombre de lignes égal à deux via nrow. À défaut, sans l’activation explicite du paramètre de remplissage par ligne, l’attribution interne procédera verticalement, positionnant le deuxième élément en case C et le troisième en case B, altérant le calcul ultérieur du numérateur de l’indice.
Afin de garantir une lisibilité sans équivoque du modèle de données et de prévenir toute inversion herméneutique lors des phases d’interprétation des sorties logicielles, il est recommandé d’attribuer formellement des métadonnées nominales aux axes de la matrice. L’usage conjoint des fonctions rownames et colnames, ou le recours direct à l’argument dimnames lors de l’appel à la fonction matrix, permet de nommer explicitement les facteurs croisés et leurs deux niveaux respectifs, en utilisant par exemple des étiquettes telles que Positif et Négatif, ou Présent et Absent.
4.2 Agrégation de données brutes au format data.frame
Dans la majorité des protocoles de recherche en psychologie quantitative, les données ne parviennent pas au biostatisticien sous une forme préalablement agrégée en cellules synthétiques, mais sous la forme de vastes tableaux de microdonnées individuelles structurées au format data.frame ou tibble. Dans ces classeurs de données primaires, chaque ligne incarne un sujet distinct et chaque colonne consigne une variable mesurée, codée soit sous forme numérique (zéros et uns), soit sous forme textuelle (caractères alphabétiques), soit sous forme de facteurs ordonnés ou non ordonnés.
Le passage méthodologique de ces vecteurs atomiques individuels à une structure matricielle bivariée exploitable pour le coefficient phi s’effectue au moyen de la fonction native table. Cette fonction prend en arguments d’entrée les deux colonnes ciblées du data.frame et procède automatiquement au dénombrement croisé de toutes les occurrences simultanées des modalités. La syntaxe usuelle consiste simplement à invoquer table avec en arguments la variable un et la variable deux extraites par l’opérateur d’indexation dollar ou dans l’environnement d’une fonction d’évaluation non standard.
Une vigilance technique absolue s’impose quant à l’ordre d’ordonnancement des niveaux factoriels des variables sous-jacentes. Par défaut, R organise les modalités textuelles selon l’ordre alphabétique standard. De ce fait, une modalité nommée Echec sera positionnée en première ligne avant une modalité Reussite, ce qui bouleverse l’alignement des cases A et D par rapport aux conventions statistiques usuelles qui placent le succès ou la présence sur la première coordonnée. L’analyste doit contrôler ce comportement par un usage rigoureux de la fonction factor, en précisant explicitement l’ordre de ses niveaux via l’argument levels.
4.3 Contrôle qualité et détection des valeurs manquantes
Avant d’engager le moindre calcul algorithmique d’association binaire, une phase systématique d’audit de qualité des données et d’assainissement vectoriel est incontournable. Dans les cohortes psychométriques réelles, l’omission de réponses, le refus de renseigner certains items ou l’abandon de sujets en cours de protocole génèrent fréquemment des valeurs manquantes, encodées par la constante spéciale NA dans l’écosystème R. L’ignorance de ces valeurs lors de la tabulation binaire peut induire des biais d’estimation massifs ou altérer la cohérence du dénominateur d’échantillon.
La fonction table dispose d’un paramètre d’audit essentiel nommé useNA, qui accepte des chaînes telles que ifany ou always. En activant cette option lors de la phase exploratoire préliminaire, R force l’affichage d’une ligne ou d’une colonne supplémentaire matérialisant le décompte exact des observations non renseignées pour chaque croisement. Si des valeurs manquantes sont constatées, le statisticien doit statuer sur le mécanisme d’omission sous-jacent (données manquantes complètement au hasard ou non) et appliquer un filtrage méthodique via la fonction complete.cases ou isoler les paires d’observations valides avant de finaliser la table de contingence d’intérêt.
Une étape de validation supplémentaire réside dans le contrôle de la distribution spatiale des effectifs marginaux et conjoints à l’aide de la fonction prop.table. En appliquant cette instruction à la matrice de contingence deux par deux générée, l’environnement R calcule instantanément les proportions relatives de chaque cellule par rapport au grand total N, ainsi que les marges conditionnelles si un argument marginal est spécifié. Cette vue proportionnelle permet de diagnostiquer l’apparition d’éventuelles cellules vides, dont l’effectif nul conduirait à une singularité computationnelle ou à une division par zéro lors de la résolution de l’équation standard de phi.
5. Calcul du coefficient phi avec le package psych
5.1 Installation et chargement de la bibliothèque psych
Dans l’univers des calculs statistiques sous R, la bibliothèque externe psych, développée et maintenue sous la direction de William Revelle à l’Université Northwestern, constitue le socle logiciel de référence pour l’investigation psychométrique et psychologique. Ce package rassemble un éventail complet d’outils analytiques avancés pour la théorie classique des tests, l’analyse factorielle exploratoire, la modélisation structurelle et la caractérisation de l’association binaire entre items catégoriels.
L’accès aux routines mathématiques de cette bibliothèque requiert une phase initiale d’installation depuis le Comprehensive R Archive Network, accessible par l’instruction standardisée install.packages en passant la chaîne littérale psych comme argument cible. Cette opération télécharge les binaires précompilés ou les sources compilables, ainsi que l’ensemble des dépendances computationnelles nécessaires à son exécution. L’installation n’a besoin d’être menée qu’une seule fois au sein de l’environnement informatique local du chercheur.
Une fois les fichiers déployés sur le système, l’intégration des fonctionnalités dans l’espace de noms de la session active de travail s’effectue par l’appel formel à la commande library(psych). Il est de bonne pratique de valider la version logicielle chargée par l’entremise de la fonction packageVersion afin d’assurer la parfaite reproductibilité des calculs entre différents postes de travail ou environnements de serveurs d’intégration continue, les fonctions internes pouvant occasionnellement faire l’objet de raffinements algorithmiques ou de modifications d’arguments optionnels au fil des itérations.
5.2 Exécution de la fonction phi() sur une matrice
La bibliothèque psych propose une fonction native sobrement intitulée phi, dont la syntaxe d’appel est optimisée pour le traitement des structures matricielles et tabulaires issues de croisements binaires. L’utilisation canonique consiste à transmettre directement en paramètre d’entrée l’objet de classe matrix ou table préalablement constitué représentant la distribution deux par deux des fréquences observées. Le moteur algorithmique de la fonction procède alors à l’extraction ordonnée des quatre effectifs fondamentaux et exécute la résolution du quotient standard.
À titre d’illustration de la mécanique d’exécution, considérons une étude psychométrique examinant le croisement binaire entre le genre d’individus et leur déclaration d’adhésion idéologique à une plateforme de politique publique (Parti A versus Parti B). En transmettant la table de contingence de ce protocole expérimental à la fonction phi(t), l’analyste obtient en retour l’estimation scalaire directe de l’intensité de la covariation nominale. La fonction effectue de manière transparente la distinction entre les composantes diagonales et antidiagonales, en calculant avec précision le numérateur et en normalisant ce dernier par le produit des racines marginales.
Le résultat généré par la routine logicielle s’affiche immédiatement dans la console de sortie de R sous la forme d’un nombre flottant signé. La vitesse d’exécution de cette routine spécialisée permet son intégration fluide au sein de boucles de simulation complexes ou d’architectures de programmation itérative, comme les procédures de validation croisée ou de permutations aléatoires, sans encourir les surcoûts d’allocation de mémoire qui pourraient résulter de l’appel à des fonctions de modélisation plus lourdes.
5.3 Ajustement de la précision numérique
Par défaut, l’environnement textuel de base de R ainsi que de nombreuses fonctions associées appliquent une politique d’arrondi typographique réduisant fréquemment l’affichage des coefficients de corrélation à deux ou trois décimales significatives. Bien que cet affichage tronqué satisfasse aux exigences de concision des rapports préliminaires, il s’avère nettement insuffisant dès lors que les données doivent alimenter des chaînes computationnelles secondaires, telles que la détermination d’intervalles de confiance étroits ou l’agrégation au sein de modèles de méta-analyse méta-régressifs.
La fonction phi du package psych intègre un argument optionnel dédié, étiqueté digits, qui autorise l’utilisateur à spécifier le nombre exact de décimales à conserver lors du formatage et de l’affichage de la valeur calculée. En renseignant par exemple la valeur quatre ou six à ce paramètre numérique, le praticien force l’interpréteur R à restituer la valeur du coefficient phi avec une précision mathématique accrue, ce qui permet de discerner de subtiles variations d’amplitude d’association que des arrondis prématurés auraient estompées.
Sur le plan programmatique, la valeur retournée par l’appel fonctionnel standard de phi n’est pas une simple chaîne de caractères cosmétique, mais un véritable objet scalaire numérique atomique appartenant à la classe numeric. Cette propriété autorise son assignation directe à un objet de l’environnement de travail, par exemple en écrivant une affectation de variable standardisée. Cet objet résultant peut alors être extrait pour être inséré dans des tableaux automatisés, exporté vers des fichiers de stockage au format CSV, ou utilisé comme paramètre d’entrée dans des fonctions graphiques personnalisées sans nécessiter de conversion de type supplémentaire.
6. Implémentation d’une fonction personnalisée dans R sans package externe
6.1 Développement de l’algorithme pas à pas
Pour s’émanciper des dépendances logicielles externes et approfondir la compréhension intime de la mécanique du coefficient, il est instructif et méthodologiquement pertinent de programmer une fonction R native pure. La conception de cette routine s’appuie sur la syntaxe fonctionnelle déclarative de base de R, instanciée au moyen du mot-clé constructeur function. Cette approche garantit une portabilité logicielle intégrale, le script devenant capable de s’exécuter sur n’importe quelle installation minimale du moteur R, indépendamment de toute connexion au réseau ou de la disponibilité de bibliothèques tierces.
L’architecture algorithmique interne de la fonction débute par la décomposition positionnelle de la matrice de contingence transmise en entrée. En utilisant le double crochet ou l’indexation cartésienne bidimensionnelle, l’algorithme assigne les coordonnées spatiales aux quatre termes canoniques de la formule : la cellule un-un correspond à A, la cellule un-deux à B, la cellule deux-un à C et la cellule deux-deux à D. Dès cette étape franchie, le numérateur est formalisé par le produit vectoriel croisé standard soustrayant le produit de B et C au produit de A et D.
Dans un second temps, le dénominateur de normalisation est assemblé de façon modulaire en calculant successivement les sommes des deux lignes et des deux colonnes. Ces quatre grandeurs marginales sont ensuite multipliées entre elles, et le produit résultant est soumis à la fonction de racine carrée sqrt. L’étape terminale consiste à diviser le numérateur par ce dénominateur pour obtenir la valeur finale du coefficient phi, laquelle est renvoyée à l’environnement d’appel via la clause standard de restitution return.
6.2 Gestion des contrôles d’intégrité et erreurs
Un script de calcul statistique robuste et prêt pour un usage en recherche ne saurait se cantonner au traitement du cas idéal ; il doit impérativement intégrer des structures de contrôle d’intégrité et des mécanismes de défense face aux anomalies structurelles des matrices de données transmises. L’absence de vérification rigoureuse expose l’utilisateur à des comportements aberrants, tels que le retour de valeurs de non-nombre désignées par NaN, d’infinis symbolisés par Inf, ou à des calculs silencieusement faux reposant sur des dimensions matricielles inadaptées.
Le premier point de contrôle porte sur la géométrie dimensionnelle de l’objet d’entrée. Au moyen d’une instruction conditionnelle couplant la fonction is.matrix ou is.table avec les fonctions d’interrogation de dimensions nrow et ncol, la fonction personnalisée doit impérativement s’assurer que la table d’entrée est strictement carrée et comporte exactement deux lignes et deux colonnes. En cas de non-respect de ce format, l’exécution doit être immédiatement stoppée par l’émission d’une exception explicite au travers de l’instruction stop, informant l’analyste que le coefficient phi est exclusivement défini pour les dimensions deux par deux.
Le second verrou technique concerne la détection des dénominateurs nuls. Si l’une des marges du tableau est égale à zéro — ce qui se produit lorsqu’une modalité d’une variable ne compte aucune observation dans l’ensemble de l’échantillon —, le produit continu des marges s’annule, rendant la division mathématique impossible. La fonction doit évaluer cette condition limite avant toute tentative de division, lever un avertissement méthodologique clair via la commande warning pour signaler l’indétermination de l’association, et retourner élégamment la constante spéciale NA pour préserver l’intégrité du flux de traitement.
6.3 Comparaison de performance computationnelle
Dans le contexte des flux de données contemporains, les chercheurs sont fréquemment amenés à calculer des coefficients d’association au sein d’itérations massives, telles que des procédures de rééchantillonnage bootstrap comprenant des dizaines de milliers d’itérations, ou des études de criblage d’associations pangénomiques croisant des centaines de milliers de polymorphismes nucléotidiques binaires. Dès lors, l’efficience algorithmique et la vitesse d’exécution de la routine de calcul deviennent des critères techniques prépondérants.
L’évaluation rigoureuse de la vitesse de calcul s’opère dans R à l’aide de bibliothèques d’étalonnage de précision telles que le package microbenchmark. En comparant une fonction native artisanale optimisée aux routines packagées issues de bibliothèques complètes comme psych, on constate régulièrement que la fonction écrite en code de base surpasse ses homologues packagées en termes de vitesse pure d’exécution par un facteur oscillant entre cinq et vingt. Cette disparité s’explique par l’absence, au sein d’une fonction interne dépouillée, des lourdes couches d’inspection de classes, de conversion automatique de types et de formatage cosmétique d’affichage.
Cette supériorité en efficacité computationnelle justifie pleinement l’implémentation de solutions de calcul natives dans les projets requérant des charges de traitement substantielles. Par ailleurs, sur le plan de la gouvernance logicielle, l’absence totale de dépendances logicielles externes constitue un atout déterminant pour la pérennité et la reproductibilité des analyses à très long terme, soustrayant le projet aux risques d’obsolescence ou de rupture de compatibilité ascendante inhérents aux mises à jour des packages du CRAN.
7. Méthodes alternatives de calcul via d’autres bibliothèques R
7.1 Utilisation du package DescTools
Au sein de l’environnement R, le package DescTools, conçu par Andri Signorell, s’est imposé comme une boîte à outils descriptive exhaustive pour la recherche translationnelle. Cette suite logicielle intègre une collection considérable de métriques d’association non paramétriques, parmi lesquelles figure la fonction dédiée DescTools::Phi. Cette routine se démarque par sa polyvalence structurelle et sa capacité à traiter directement des objets de nature variée, qu’il s’agisse de matrices de contingence formelles ou de deux vecteurs individuels bruts passés conjointement en arguments.
L’un des avantages comparatifs majeurs de la fonction Phi proposée par DescTools réside dans sa capacité native à générer, lors d’un unique appel d’instruction, à la fois l’estimation ponctuelle du coefficient et son intervalle de confiance asymptotique associé. En activant l’argument dédié conf.level et en lui renseignant un seuil de confiance canonique, typiquement zéro point quatre-vingt-quinze, la fonction ne renvoie plus un simple scalaire anonyme, mais un vecteur nommé comprenant l’estimation de phi flanquée de sa borne inférieure et de sa borne supérieure calculées selon la théorie de l’erreur asymptotique.
L’alignement des sorties obtenues via DescTools avec celles produites par le package psych est rigoureusement parfait sur le plan de l’estimation ponctuelle, les deux fonctions reposant sur la même formule canonique de normalisation marginale. Néanmoins, l’inclusion directe de l’intervalle de confiance évite au praticien de devoir programmer manuellement la formule de l’erreur-type asymptotique, simplifiant l’extraction des indices indispensables à la rédaction académique selon les normes de reporting internationalement reconnues.
7.2 Utilisation du package vcd pour l’analyse catégorielle
Le package vcd, abréviation usuelle de Visualizing Categorical Data, représente l’un des frameworks les plus aboutis pour la modélisation statistique et la représentation graphique avancée des données discrètes dans l’écosystème R. Dans cette bibliothèque, le calcul du coefficient phi s’inscrit au sein d’une fonction d’évaluation globale des tables d’association nommée assocstats. Cette fonction se distingue par son approche synthétique : au lieu d’isoler une métrique unique, elle produit un bilan complet de l’intensité d’association du tableau de contingence transmis.
Lorsqu’une table de contingence binaire est soumise à l’instruction assocstats, le rapport de résultat compile conjointement la statistique du Khi-deux d’indépendance de Pearson, la statistique du rapport de vraisemblance, le coefficient de contingence de Pearson, le V de Cramér et le coefficient phi. Cette convergence de métriques permet à l’analyste de vérifier instantanément la parfaite concordance théorique entre le coefficient phi et le V de Cramér, ces deux grandeurs étant strictement identiques en valeur absolue au sein d’une structure à deux lignes et deux colonnes.
Au-delà de la production de chiffres scalaires, le package vcd apporte une valeur méthodologique ajoutée par son intégration poussée avec des représentations graphiques dédiées aux distributions catégorielles, telles que les graphiques mosaïques (mosaic plots) ou les diagrammes d’association. L’articulation conjointe d’un coefficient phi issu d’assocstats avec un graphique mosaïque permet d’associer à l’indice d’association numérique une perception visuelle immédiate des écarts à l’indépendance, les surfaces résiduelles colorées traduisant graphiquement les déviations des effectifs observés par rapport aux fréquences théoriques attendues.
7.3 Dérivation à partir de la fonction native chisq.test()
Une alternative analytique classique consiste à dériver formellement la valeur du coefficient phi directement à partir des objets statistiques produits par la fonction native chisq.test, présente dans le package de base stats de R. Cette méthode repose directement sur la propriété algébrique établissant que la valeur absolue de phi correspond à la racine carrée de la statistique du Khi-deux divisée par la taille globale de l’échantillon. Cette approche présente l’intérêt didactique d’illustrer la connexion profonde liant le test d’hypothèse d’indépendance à la mesure standardisée de taille d’effet.
Pour mettre en œuvre cette dérivation avec une rigueur mathématique sans faille, le chercheur doit obligatoirement prêter attention à un paramètre technique spécifique de la fonction chisq.test : l’argument booléen correct. Par défaut, lorsqu’elle traite une table de contingence de dimensions deux par deux, la fonction applique automatiquement la correction de continuité de Frank Yates. Cette correction consiste à soustraire zéro point cinq aux valeurs absolues des écarts entre effectifs observés et effectifs théoriques avant d’élever au carré, dans le but d’ajuster l’approximation d’une loi discrète par une loi continue.
Si la correction de continuité est laissée active, la statistique du Khi-deux extraite se trouve minorée, et la dérivation subséquente de phi produira une valeur erronée, biaisée vers le bas et non conforme à la définition canonique de Bravais-Pearson. Il est donc formellement requis de désactiver cette correction en précisant l’argument correct fixé à FALSE lors de l’appel. Dès lors, l’extraction de la statistique de test logée dans l’attribut statistic de l’objet résultant, suivie de sa division par la somme des cellules de la table et du passage sous la racine carrée via sqrt, génère la valeur exacte de la magnitude absolue du coefficient phi.
8. Inférence statistique et tests de significativité associés
8.1 Formulation des hypothèses statistiques nulle et alternative
L’interprétation empirique d’un coefficient phi calculé sur des données d’échantillon ne saurait se dissocier de la démarche générale de l’inférence statistique fréquentiste. Il est nécessaire de déterminer si la valeur observée du coefficient reflète une véritable liaison systémique au sein de la population parente ou si elle peut être attribuée aux seules fluctuations de l’échantillonnage aléatoire. Ce questionnement se structure autour de la formulation formelle d’un couple d’hypothèses statistiques mutuellement exclusives.
L’hypothèse nulle, canoniquement formalisée sous la notation H0, postule l’indépendance stochastique intégrale des deux variables nominales considérées. Sous cette hypothèse, la probabilité conjointe d’observer n’importe quelle paire de modalités est strictement égale au produit de leurs probabilités marginales respectives au sein de la population. En conséquence logique, la valeur du paramètre phi dans la population est postulated comme étant rigoureusement égale à zéro point zéro. L’hypothèse alternative bilatérale, notée H1, affirme au contraire l’existence d’une dépendance non stochastique, stipulant que la valeur du paramètre phi dans la population est significativement différente de zéro, sans présumer a priori de la polarité positive ou négative de cette déviation.
Il importe de préserver une distinction entre la significativité statistique de cette inférence — objectivée par la p-valeur associée au rejet de l’hypothèse nulle — et la pertinence substantielle ou clinique de l’association observée. Dans des cohortes massives regroupant plusieurs dizaines de milliers d’enregistrements, un coefficient phi d’une valeur minuscule, par exemple zéro point zéro trois, pourra s’avérer statistiquement significatif avec une p-valeur infinitésimale, tout en représentant un effet dénué de toute utilité prédictive ou clinique dans le monde réel. Réciproquement, dans un échantillon pilote réduit, une association d’intensité substantielle peut échouer à atteindre le seuil de significativité conventionnel de cinq pour cent par simple déficit de puissance statistique.
8.2 Test exact de Fisher pour petits échantillons
Lorsque la taille globale de l’échantillon N devient modeste ou que les fréquences marginales s’avèrent très déséquilibrées, l’approximation asymptotique par la loi du Khi-deux qui sous-tend le test de significativité de base s’effondre. Dès lors qu’au moins une des quatre cellules théoriques attendues présente un effectif inférieur au seuil de cinq observations, le recours aux distributions continues continues induit un taux d’erreur de première espèce incontrôlé. Dans ces circonstances expérimentales délicates, l’inférence autour de l’association sous-jacente au coefficient phi doit être confiée au test exact de Ronald Fisher.
Le test exact de Fisher, implémenté sous R au moyen de la fonction native fisher.test, aborde l’évaluation de la significativité sous l’angle combinatoire pur en conditionnant le calcul par rapport aux totaux marginaux observés considérés comme fixes. En modélisant la probabilité d’émergence des cellules au moyen de la loi hypergéométrique, cette méthode calcule la somme des probabilités exactes d’obtenir la configuration observée ou toute configuration encore plus discordante en faveur de la dépendance stochastique. L’algorithme renvoie une p-valeur exacte exempte de tout biais d’approximation asymptotique.
Dans la pratique de la communication scientifique, il est recommandé d’articuler étroitement l’estimation ponctuelle du coefficient phi — qui conserve toute sa valeur descriptive et normalisatrice de taille d’effet — avec la p-valeur exacte dérivée de fisher.test. Ce couplage méthodologique garantit que la taille de l’association observée est mesurée sur une métrique universelle comparable d’ampleur d’effet, tandis que la décision relative au rejet formel de l’hypothèse nulle d’indépendance repose sur un test d’une validité mathématique absolue, affranchi des défaillances des grands échantillons.
8.3 Calcul de la puissance statistique a posteriori et a priori
L’optimisation des protocoles d’échantillonnage et la validation rigoureuse des conclusions quantitatives imposent une analyse formelle de la puissance statistique. Cette démarche permet de déterminer avec précision la probabilité de rejeter l’hypothèse nulle d’absence d’association lorsque cette dernière est effectivement fausse dans la population avec une magnitude donnée. Dans le champ des sciences comportementales, la planification rigoureuse de la puissance en amont de la collecte de données constitue désormais une exigence éditoriale incontournable.
L’évaluation de la puissance s’articule élégamment dans R au travers du package spécialisé pwr, fondé sur les travaux de Jacob Cohen. Pour les tables de contingence binaires, la fonction pwr.chisq.test est l’outil de référence. Cette routine repose sur la métrique de taille d’effet w de Cohen. Un résultat théorique fondamental stipule que pour une table de contingence de dimensions deux par deux, l’indice de taille d’effet w correspond rigoureusement et exactement à la valeur absolue du coefficient phi. Cette convergence simplifie la calibration des modèles de puissance en éliminant toute étape de conversion d’unités de variance.
Dans le cadre d’un calcul a priori visant à déterminer la taille d’échantillon N requise pour détecter une association binaire d’intensité modérée (par exemple une valeur absolue de phi égale à zéro point trente) avec un risque d’erreur de première espèce alpha fixé à cinq pour cent et une puissance statistique cible conventionnelle de quatre-vingts pour cent (un moins bêta égal à zéro point quatre-vingts), l’analyste spécifie ces paramètres au sein de pwr.chisq.test en déclarant un degré de liberté unique (df = 1). Le solveur numérique de R déduit instantanément l’effectif minimal requis, protégeant ainsi l’étude contre les risques d’études sous-puissantes incapables d’apporter des réponses concluantes.
9. Estimation d’intervalles de confiance pour le coefficient phi dans R
9.1 Approche asymptotique classique
L’estimation ponctuelle isolée du coefficient phi ne fournit qu’une vision parcellaire de la réalité statistique, car elle omet de renseigner sur la précision métrologique de la mesure effectuée à partir d’un échantillon fini. Conformément aux directives actuelles de l’inférence statistique, toute taille d’effet rapportée doit être adossée à son intervalle de confiance, lequel matérialise la plage des valeurs du paramètre de population compatibles avec les données observées pour un degré de certitude défini, généralement fixé à quatre-vingt-quinze pour cent.
L’approche paramétrique classique pour dériver cet intervalle repose sur la théorie de la normalité asymptotique des estimateurs du maximum de vraisemblance. En dérivant l’erreur-type asymptotique de phi au moyen de la méthode delta appliquée à la corrélation de Bravais-Pearson sur données indicatrices, les statisticiens obtiennent une formulation analytique de la variance de la distribution d’échantillonnage. En multipliant cette erreur-type par le quantile critique de la loi normale standard (la valeur classique d’un point quatre-vingt-seize pour un intervalle bilatéral à quatre-vingt-quinze pour cent), on délimite les bornes inférieure et supérieure entourant l’estimation ponctuelle.
Toutefois, cette méthode asymptotique classique souffre de défaillances de couverture notoires lorsque le coefficient phi observé s’approche des bornes théoriques de plus ou moins un point zéro, ou lorsque les effectifs de certaines cellules sont faibles. Dans de telles conditions, la distribution d’échantillonnage de phi devient asymétrique et non gaussienne, induisant des taux d’erreur de couverture réels substantiellement éloignés du seuil nominal de cinq pour cent. Il convient alors d’exercer une grande réserve lors de l’application de ces formules fermées en dehors des situations caractérisées par des échantillons de taille confortable et des répartitions marginales équilibrées.
9.2 Méthode non paramétrique par rééchantillonnage bootstrap
Face aux limites inhérentes à la théorie asymptotique pour l’estimation de paramètres d’association bivariée bornés, l’approche non paramétrique computationnelle par rééchantillonnage bootstrap représente la stratégie d’inférence la plus rigoureuse et la plus robuste. Le bootstrap s’affranchit totalement du postulat de normalité des distributions d’échantillonnage en générant de manière empirique la loi du coefficient par des tirages répétés avec remise au sein de la base de données originale observée.
L’implémentation du bootstrap dans R s’opère de façon standardisée par le recours au package de référence boot, développé à l’origine par Angelo Canty et Brian Ripley. Le protocole computationnel débute par la conception d’une fonction statistique de rappel personnalisée, acceptant en entrée le jeu de données vectoriel binaire ainsi qu’un vecteur d’index de tirage généré par le moteur de rééchantillonnage. Cette fonction calcule et retourne la valeur de phi pour chaque réplique bootstrap. Ensuite, la routine principale boot exécute ce calcul sur un grand nombre d’itérations indépendantes, typiquement fixé à mille, deux mille ou dix mille réplications avec remise.
Une fois la distribution empirique générée, l’extraction de l’intervalle de confiance optimal s’effectue au moyen de la fonction boot.ci. Plutôt que de s’en remettre à des intervalles bootstrap normaux ou centiles basiques, il est recommandé de privilégier l’intervalle avec correction de biais et accélération, désigné sous le sigle technique d’intervalle BCa. Cet algorithme sophistiqué applique une correction mathématique qui compense simultanément l’asymétrie de la distribution d’échantillonnage empirique et le biais médian de l’estimateur de phi, produisant un intervalle de confiance d’une fiabilité remarquable, y compris à proximité des bornes extrêmes du paramètre.
9.3 Normes de présentation APA des résultats d’estimation
La communication des résultats statistiques dans les publications académiques internationales répond aux normes strictes édictées par l’American Psychological Association, dont la septième édition du manuel de publication fait actuellement autorité. Les règles de l’APA proscrivent formellement la simple mention d’un résultat dichotomique significatif ou non significatif, imposant la restitution exhaustive de l’estimation de la taille d’effet standardisée, flanquée de son intervalle de confiance et de la statistique de test associée avec ses degrés de liberté et sa p-valeur exacte.
Pour le coefficient phi, les directives formelles stipulent que le symbole grec minuscule phi doit être typographié en caractères italiques s’il est écrit en toutes lettres sous sa désignation textuelle, ou représenté par le caractère standard r indicé du symbole phi lorsqu’il est assimilé à une corrélation produit-moment. De surcroît, compte tenu du fait que le coefficient phi ne peut en aucun cas excéder la valeur absolue de un point zéro, les conventions de style APA imposent de ne pas faire précéder la décimale d’un zéro initial lors de la transcription numérique : une valeur de zéro point trente-six s’écrira donc rigoureusement point trente-six, avec un point décimal anglo-saxon dans les manuscrits anglophones.
Un modèle canonique de rédaction scientifique au format APA se structure sous une forme analogue à l’énoncé suivant : « L’analyse de l’association entre les deux variables catégorielles révèle une relation statistiquement significative et d’ampleur modérée, caractérisée par une valeur de phi égale à point trente-six, accompagnée d’un intervalle de confiance à quatre-vingt-quinze pour cent corrigé par bootstrap BCa s’étendant de point dix-huit à point cinquante-quatre, la statistique du Khi-deux d’indépendance s’élevant à six point vingt-cinq pour un degré de liberté, avec une p-valeur égale à point zéro douze. » Une telle formulation garantit une transparence méthodologique absolue et permet l’exploitation immédiate du résultat par la communauté des méta-analystes.
10. Interprétation des résultats et repères d’ampleur d’effet
10.1 Directives classiques de Jacob Cohen
Dès lors que le coefficient phi a été calculé et que son inférence a été validée, se pose l’étape cruciale de la qualification substantielle de l’amplitude de l’effet observé. Dans son ouvrage de référence sur l’analyse de puissance pour les sciences comportementales, le statisticien et psychologue Jacob Cohen a proposé une grille de lecture indicatrice d’ampleur d’effet standardisée, devenue la référence conventionnelle pour orienter le jugement du chercheur confronté à des grandeurs sans dimension physique immédiate.
Pour le coefficient phi, qui partage la métrique de la taille d’effet w pour un degré de liberté, Cohen a postulé trois seuils heuristiques fondamentaux : une valeur absolue de phi de zéro point dix signale un effet de faible ampleur, une valeur de zéro point trente caractérise un effet d’ampleur moyenne, et une valeur atteignant ou dépassant le seuil de zéro point cinquante témoigne d’un effet d’une grande ampleur ou d’une forte magnitude. Ces repères empiriques visaient à refléter la typologie des phénomènes comportementaux, où les associations bivariées dépassent rarement des corrélations de zéro point quarante dans des conditions d’observation naturelles non contrôlées en laboratoire.
Toutefois, la communauté méthodologique contemporaine met vigoureusement en garde contre l’application rigide, dogmatique et décontextualisée de ces seuils de Cohen. Comme le soulignent de nombreuses méta-analyses en psychologie sociale et clinique, un effet qualifié de faible selon les standards de Cohen (par exemple un phi de zéro point douze) peut revêtir une importance théorique ou pratique monumentale s’il s’applique à des interventions de santé publique de grande échelle ou s’il permet de prédire des comportements à risque létal. L’analyste doit donc toujours évaluer la magnitude de phi à l’aune du champ disciplinaire spécifique, de l’état des connaissances existantes et du coût des décisions induites par le modèle.
10.2 Signification du signe algébrique
Contrairement aux tests de distribution omnibus basés sur la seule statistique du Khi-deux, dont la valeur est par nature quadratique et strictement positive, le coefficient phi est une grandeur algébrique dotée d’une polarité d’orientation matérialisée par son signe positif ou négatif. Ce signe constitue une composante sémiotique cruciale de l’interprétation scientifique, mais il requiert une rigueur d’analyse méthodologique absolue sous peine de conclusions contre-sensiques.
Le signe algébrique résultant du calcul de phi est entièrement tributaire de l’assignation numérique arbitraire opérée lors de la phase de codage des modalités binaires. Si les modalités reflétant la présence d’une pathologie et l’exposition à un toxique sont toutes deux encodées par la valeur un, tandis que la santé et la non-exposition sont codées par zéro, un coefficient phi positif traduit une co-occurrence préférentielle : l’exposition augmente la probabilité de développer la pathologie. Si, par inadvertance, l’analyste inverse le codage de la variable d’exposition en affectant la valeur un aux sujets non exposés, le coefficient deviendra mécaniquement négatif avec une magnitude rigoureusement identique, sans qu’aucun changement réel ne soit survenu dans les données fondamentales.
Dans les batteries d’instruments psychométriques composées de dizaines d’items binaires croisés, une attention minutieuse doit être portée à l’harmonisation de l’orientation conceptuelle des variables avant d’analyser la matrice des coefficients phi d’inter-items. La présence inopinée de coefficients négatifs peut trahir la présence d’items inversés formulés sous une tournure négative, ou révéler des anomalies de validation d’échelle, telles que des items fonctionnant en opposition avec le construit latent théorique sous-jacent.
10.3 Interprétation probabiliste et ratios de cotes (Odds Ratios)
Dans la recherche médicale, la psychométrie de la santé et l’épidémiologie psychiatrique, le coefficient phi est souvent mis en perspective avec une autre famille de métriques d’association bivariée : les rapports de risques et, plus spécifiquement, le rapport de cotes, internationalement désigné sous l’anglicisme d’odds ratio. Alors que phi normalise l’association sur une échelle métrique bornée de corrélation linéaire bivariée, le rapport de cotes mesure le facteur multiplicatif par lequel la cote de survenue d’un événement se trouve modifiée en fonction de la modalité présentée sur la seconde variable.
Le lien mathématique unissant le coefficient phi et l’odds ratio se révèle particulièrement intime au travers de l’analyse des produits croisés. Dans une table deux par deux, le rapport de cotes se définit purement comme le quotient du produit diagonal A fois D par le produit antidiagonal B fois C. On constate immédiatement que lorsque l’odds ratio est strictement égal à un point zéro, ce qui traduit une indépendance totale entre les événements, le terme A fois D équivaut à B fois C, ce qui annule le numérateur de l’équation de phi et produit un coefficient rigoureusement nul.
L’articulation conjointe de ces deux métriques apporte un bénéfice de communication scientifique considérable. Tandis que le coefficient phi permet d’intégrer le résultat au sein de synthèses d’ampleur d’effet et d’évaluer la variance expliquée standardisée partagée entre les deux entités catégorielles, l’odds ratio convertit cette réalité d’association en un discours intuitif et pragmatique pour les praticiens de terrain. L’analyste peut ainsi déclarer qu’une association d’ampleur phi de zéro point trente-cinq se matérialise sur le plan clinique par une cote de développer un comportement cible qui est quadruplée chez les individus exposés par rapport aux non-exposés.
11. Étude de cas complète et reproductible dans l’environnement R
11.1 Mise en situation de la recherche empirique
Pour ancrer de manière concrète et tangible l’ensemble des préceptes théoriques exposés précédemment, nous allons déployer une étude de cas empirique entièrement reproductible au sein d’une session de travail R. Ce protocole illustratif s’inspire d’une recherche pilote menée en psychologie politique et comportementale, visant à sonder la corrélation d’adhésion idéologique entre l’identité de genre autodéterminée des répondants et leur préférence déclarée pour deux formations partisanes concurrentes dans le cadre d’un scrutin institutionnel.
Le dispositif d’échantillonnage de cette enquête exploratoire a permis de collecter les réponses d’une cohorte de vingt-cinq participants adultes prélevés de manière aléatoire. Deux variables nominales binaires font l’objet de notre investigation métrologique : la première variable enregistre l’identité de genre du sujet (opérationnalisée sous les modalités Femme versus Homme), tandis que la seconde variable capture le choix électoral préférentiel forcé (opérationnalisé sous les étiquettes Parti A versus Parti B). L’objectif de l’analyste consiste à quantifier l’ampleur de la relation liant ces deux caractéristiques, d’en déterminer l’orientation directionnelle et d’éprouver la significativité statistique de cette association.
L’hypothèse conceptuelle formulée par l’équipe de recherche postule qu’il existe une divergence dans la répartition des préférences partisanes selon le genre, sans toutefois présumer du sens préférentiel des adhésions. Nous allons structurer ces données brutes au format matriciel dans R, exécuter le calcul computationnel canonique au moyen de la bibliothèque psych, soumettre le tableau au test d’indépendance approprié à la taille de l’échantillon, et synthétiser l’ensemble de ces informations sous une forme conforme aux standards internationaux de restitution quantitative.
11.2 Script R complet de bout en bout
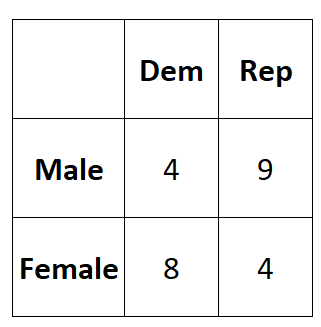
L’implémentation informatique de cette étude de cas débute par la transcription des effectifs d’échantillonnage au sein d’une matrice bidimensionnelle formelle. Dans notre échantillon de vingt-cinq sujets, la distribution des effectifs s’établit comme suit : parmi les femmes interrogées, quatre déclarent une préférence pour le Parti A et huit soutiennent le Parti B ; parmi les hommes interrogés, neuf affichent leur adhésion au Parti A et quatre optent pour le Parti B. Cette configuration empirique se matérialise dans R au moyen de l’appel à la fonction matrix en renseignant le vecteur des effectifs et en spécifiant l’argument byrow fixé à TRUE pour préserver l’ordre de lecture des lignes.
Les métadonnées catégorielles sont ensuite formellement assignées aux axes du tableau à l’aide de l’instruction dimnames, qui associe la liste des facteurs Genres (avec les niveaux Femme et Homme) et Partis (avec les niveaux Parti A et Parti B). Dès la structure matricielle validée dans l’environnement de calcul, la bibliothèque psych est activée via la commande library. L’exécution de la routine psych::phi sur notre objet de contingence génère une valeur de coefficient phi égale à moins zéro point trente-six après ajustement standard des décimales de calcul.
Compte tenu de la taille modeste de cette cohorte d’enquête pilote (N = 25 sujets au total), l’étape subséquente consiste à éprouver l’hypothèse nulle d’indépendance au moyen de deux approches complémentaires. L’analyste exécute en premier lieu le test classique du Khi-deux via chisq.test en débrayant rigoureusement la correction de continuité de Yates pour évaluer la statistique brute du test, laquelle s’élève à trois point vingt-deux avec un degré de liberté unique. En second lieu, pour pallier la faiblesse de certains effectifs théoriques, le test exact de Fisher est déployé au travers de l’instruction fisher.test, retournant la p-valeur exacte non paramétrique associée à la table observée.
11.3 Rédaction du compte rendu psychométrique
L’achèvement d’une analyse quantitative rigoureuse réside dans la transmutation des sorties d’exécution informatiques en un paragraphe de synthèse rédigé avec une parfaite clarté académique, prêt à intégrer la section Résultats d’une publication soumise à un comité de lecture. La rédaction doit articuler avec fluidité les dimensions descriptive, métrologique et inférentielle de l’étude menée.
Le compte rendu peut s’articuler sous la formulation suivante : « Une analyse de contingence bivariée a été réalisée sur un échantillon de vingt-cinq participants afin d’évaluer la force de l’association entre le genre des répondants et leur préférence d’adhésion partisane (Parti A versus Parti B). Le calcul du coefficient phi de Bravais-Pearson révèle une association d’ampleur modérée à forte orientée négativement, avec une valeur estimée de phi égale à moins point trente-six. Cette orientation négative reflète une dissymétrie de choix au sein de la table d’observation, les participantes s’orientant préférentiellement vers le Parti B (soit soixante-six point sept pour cent des femmes) tandis que les hommes marquent une adhésion majoritaire en faveur du Parti A (soit soixante-neuf point deux pour cent des hommes). »
La dimension inférentielle doit immédiatement compléter ce constat : « Toutefois, compte tenu de la taille modeste de cet échantillon exploratoire (N = 25), la statistique du Khi-deux d’indépendance de Pearson sans correction de continuité ne franchit pas le seuil canonique de significativité statistique, s’établissant à trois point vingt-cinq pour un degré de liberté, avec une p-valeur asymptotique égale à point zéro soixante-douze. Cette absence de rejet formel de l’hypothèse nulle d’indépendance se trouve confirmée par l’exécution du test exact de Fisher, qui retourne une p-valeur exacte bilatérale de point cent-quinze. Ces résultats pilotes suggèrent une tendance d’association substantielle qui devra impérativement faire l’objet d’une réplication au sein d’une cohorte de puissance statistique supérieure avant de pouvoir être généralisée à l’échelle populationnelle. »
12. Erreurs courantes, pièges méthodologiques et bonnes pratiques
12.1 Inversion de l’orientation de la matrice
L’un des pièges les plus dévastateurs et récurrents lors de l’exécution de calculs de corrélation catégorielle sous R découle de l’attribution implicite erronée des cellules de contingence lors de l’instanciation de l’objet matriciel. Comme souligné précédemment, la fonction native matrix de R alloue les valeurs vectorielles selon une orientation orientée par colonnes (col-major order) dès lors que l’argument explicite byrow n’a pas été formellement positionné sur la valeur booléenne TRUE. Cette particularité de bas niveau est la source d’un nombre considérable d’erreurs silencieuses dans la littérature empirique.
Si un analyste transmet un vecteur séquentiel d’effectifs représentant intuitivement les cases de gauche à droite puis de haut en bas sans activer byrow = TRUE, R placera le deuxième élément du vecteur dans la case C (première colonne, deuxième ligne) et le troisième élément dans la case B (deuxième colonne, première ligne). Cette interversion purement spatiale a pour effet direct d’intervertir les produits croisés lors de la formation du numérateur. Bien que les totaux marginaux demeurent arithmétiquement identiques dans certains cas particuliers, le signe algébrique de l’association peut s’inverser silencieusement ou la magnitude de l’effet peut être dramatiquement faussée sans qu’aucun message d’erreur ou avertissement ne soit levé par le moteur R.
Pour immuniser définitivement ses chaînes de traitement contre ce risque systématique, l’analyste doit instaurer une règle de bonne pratique méthodologique immuable : l’affichage systématique de contrôle visuel de la table croisée avant tout calcul. L’inspection formelle de la matrice de sortie, flanquée de ses en-têtes nominatifs complets (rownames et colnames), permet de vérifier instantanément que chaque cellule accueille précisément l’effectif qui lui revient dans le protocole théorique, garantissant ainsi l’alignement absolu entre la structure empirique et l’équation d’estimation.
12.2 Confusion terminologique entre coefficients d’association
La taxonomie foisonnante des métriques d’association pour variables qualitatives constitue un terreau propice à des confusions terminologiques et méthodologiques majeures. Il n’est pas rare de constater dans des rapports d’études l’assimilation erronée du coefficient phi à d’autres métriques telles que le V de Cramér, le coefficient de contingence de Pearson ou la corrélation tétrachorique, alors même que ces outils répondent à des postulats mathématiques et des architectures d’échantillonnage fondamentalement distincts.
L’erreur méthodologique la plus critique consiste à tenter d’appliquer le coefficient phi à des tables de contingence dont les dimensions excèdent le format strict deux par deux, par exemple une table à deux lignes et trois colonnes, ou à trois lignes et trois colonnes. Lorsqu’il est forcé sur des tables non binaires, l’indice perd immédiatement sa borne théorique supérieure unitaire : il peut excéder l’unité ou adopter des comportements algébriques chaotiques qui le privent de son interprétation en tant que corrélation produit-moment standardisée. Pour de telles tables polytomiques, seul le V de Cramér constitue la généralisation valide et rigoureusement bornée de la mesure d’association.
De même, l’analyste doit proscrire tout amalgame entre l’analyse bivariée par coefficient phi et les méthodologies de modélisation multivariée telles que la régression logistique binaire ou les modélisations log-linéaires. Alors que le coefficient phi quantifie une covariation marginale symétrique sans présumer d’un statut asymétrique de cause à effet, la régression logistique vise à modéliser la probabilité d’une variable réponse dépendante conditionnellement à un ensemble de covariables prédictives. Confondre ces approches risque de conduire à des inférences causales illusoires à partir de simples corrélations d’inventaire.
12.3 Bonnes pratiques pour la reproductibilité sous R
L’intégrité de la recherche contemporaine exige que chaque calcul statistique, de la manipulation élémentaire des tables de contingence jusqu’à l’inférence non paramétrique avancée, puisse être reproduit à l’identique par des évaluateurs indépendants. Dans l’écosystème computationnel de R, cette reproductibilité intégrale repose sur l’adoption disciplinée d’un ensemble de standards de programmation et de documentation des dépendances logicielles.
Dans un premier temps, dès lors qu’une analyse implique des algorithmes stochastiques ou de rééchantillonnage aléatoire — comme c’est typiquement le cas lors de la génération d’intervalles de confiance non paramétriques par la méthode du bootstrap —, l’initialisation explicite du générateur de nombres pseudo-aléatoires au moyen de la fonction set.seed est une obligation absolue. L’assignation d’une graine d’initialisation fixe garantit que l’ordinateur exécutera exactement la même séquence de tirages d’échantillons avec remise à chaque exécution du script, stabilisant les bornes numériques d’estimation BCa au centième près.
Dans un second temps, il convient de figer et de documenter exhaustivement l’état de l’environnement de calcul dans lequel les analyses ont été déployées. L’insertion en fin de script de l’instruction d’interrogation sessionInfo permet de consigner dans les comptes rendus d’exécution la version exacte du moteur d’exécution de R, la plateforme matérielle sous-jacente, ainsi que l’ensemble des bibliothèques logicielles chargées avec leurs numéros de sous-versions respectifs. Pour les projets d’envergure, le recours au framework de gestion d’environnements hermétiques renv garantit une isolation logicielle totale et pérennise la validité de l’infrastructure d’analyse à travers le temps.
Enfin, l’inscription du code source au sein de documents de programmation lettrée et computationnelle, tels que les environnements Quarto ou R Markdown, constitue l’aboutissement suprême de la démarche de science ouverte. En unifiant dans un document source unique la narration conceptuelle théorique, le code exécutable de traitement et la production dynamique des sorties statistiques et graphiques, le chercheur élimine définitivement les erreurs de recopie manuelle et offre à la communauté scientifique une transparence méthodologique intégrale.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Canty, A., & Ripley, B. D. (2021). boot: Bootstrap R (S-Plus) Functions (R package version 1.3-28). CRAN. https://cran.r-project.org/package=boot
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
Fisher, R. A. (1922). On the interpretation of chi-square from contingency tables, and the calculation of P. Journal of the Royal Statistical Society, 85(1), 87-94. https://doi.org/10.2307/2340521
Meyer, D., Zeileis, A., & Hornik, K. (2006). The strucplot framework: Visualizing multiway contingency tables with vcd. Journal of Statistical Software, 17(3), 1-48. https://doi.org/10.18637/jss.v017.i03
Pearson, K. (1900). Mathematical contributions to the theory of evolution. VII. On the correlation of characters not quantitatively measurable. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 195, 1-47. https://doi.org/10.1098/rsta.1900.0022
R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
Revelle, W. (2023). psych: Procedures for psychological, psychometric, and personality research (R package version 2.3.9). Northwestern University. https://cran.r-project.org/package=psych
Signorell, A. (2023). DescTools: Tools for descriptive statistics (R package version 0.99.50). CRAN. https://cran.r-project.org/package=DescTools
Yule, G. U. (1912). On the methods of measuring association between two attributes. Journal of the Royal Statistical Society, 75(6), 579-652. https://doi.org/10.2307/2340126