
Dans le champ de la psychométrie, des sciences cognitives et de la psychologie quantitative, la modélisation des relations entre les caractéristiques individuelles constitue le socle de la production scientifique. Qu’il s’agisse d’évaluer la concordance entre des traits de personnalité, de mesurer le lien entre des niveaux d’anxiété et des performances mnésiques, ou de calibrer la fidélité d’une batterie de tests standardisés, les chercheurs recourent quasi universellement à l’analyse de corrélation. Parmi les indices d’association linéaire, le coefficient de corrélation produit-moment de Pearson, couramment désigné par la lettre latine r, demeure l’étalon méthodologique par excellence. Conçu à la fin du dix-neuvième siècle, cet outil statistique a permis d’émanciper les sciences humaines et sociales des simples descriptions qualitatives en leur conférant une rigueur métrologique comparable à celle des sciences physiques.
Toutefois, l’avènement des logiciels d’analyse de données tels que SPSS, R, SAS ou Jamovi a progressivement transformé la pratique de la statistique en une série d’opérations automatisées, occultant les mécanismes mathématiques sous-jacents. Cette délégation technologique présente un danger pédagogique et épistémologique majeur : elle induit une utilisation aveugle des algorithmes, privant l’analyste d’une intuition profonde de la dispersion conjointe, des écarts à la moyenne et de la sensibilité métrique des indices calculés. L’apprentissage du calcul manuel d’un coefficient de corrélation de Pearson ne relève aucunement d’un passéisme désuet, mais constitue au contraire une démarche heuristique indispensable pour quiconque souhaite maîtriser la modélisation statistique bivariée et appréhender l’impact concret de chaque point de mesure sur l’estimation globale d’un effet.
Le présent guide a pour vocation d’exposer de manière exhaustive, systématique et didactique la procédure arithmétique intégrale permettant de calculer à la main le coefficient de corrélation de Pearson. À travers la décomposition théorique des formules, l’examen scrupuleux des postulats métrologiques, l’analyse guidée d’un jeu de données issu de la psychologie cognitive et l’exploration des prolongements inférentiels, ce document offre aux étudiants, chercheurs et praticiens les compétences nécessaires pour exécuter, vérifier et interpréter cette statistique fondamentale sans aucune dépendance logicielle.
1. Introduction aux fondements du coefficient de corrélation de Pearson en psychométrie
1.1 Définition conceptuelle et portée en sciences psychologiques
Le coefficient de corrélation produit-moment a été formalisé mathématiquement par le polymathe britannique Karl Pearson au cours des années 1890, s’appuyant sur les intuitions novatrices de son mentor Sir Francis Galton relatives aux concepts de régression vers la moyenne et d’hérédité des traits biologiques et comportementaux. Dans l’écosystème de la recherche quantitative contemporaine en psychologie, le coefficient de Pearson représente l’outil canonique pour quantifier avec une précision normalisée la force et la direction d’une relation linéaire unissant deux variables continues. Contrairement aux approches catégorielles ou qualitatives, la corrélation saisit la manière dont les variations d’une dimension psychologique s’accordent de façon ordonnée aux fluctuations d’une autre dimension au sein d’une population ou d’un échantillon spécifique.
Il est impératif d’établir une démarcation épistémologique stricte entre l’association statistique, la covariance arithmétique et la causalité psychologique. Si la covariance traduit l’orientation brute de la variabilité partagée entre deux mesures, elle demeure tributaire de leurs unités d’étalonnage respectives, ce qui interdit toute comparaison directe entre des construits disparates. Le coefficient de Pearson résout cette contrainte en standardisant la covariance. Cependant, la mise en évidence d’une valeur de r élevée n’autorise en aucun cas le chercheur à postuler un lien de cause à effet : la présence de variables tierces non contrôlées, la causalité inverse ou des phénomènes de synchronie contextuelle peuvent générer des corrélations substantielles totalement dépourvues de relation causale directe. En psychologie différentielle, les illustrations de ce principe abondent, par exemple lors de l’étude de la dynamique liant l’anxiété-trait et la performance aux tests de mémoire de travail, ou lors de l’exploration de l’interaction symétrique entre l’estime de soi globale et les scores symptomatiques de dépression sur l’échelle de Beck.
Dans la pratique psychométrique, l’indice de Pearson sert également de fondement mathématique à l’évaluation de la validité de construit convergente et divergente, ainsi qu’au calcul des coefficients de fidélité test-retest ou inter-juges. Sans une saisie formelle de cette statistique bivariée, l’évaluation psychologique moderne ne disposerait d’aucun étalon commun pour comparer l’efficacité diagnostique de ses instruments de mesure.
1.2 L’échelle de valeur de r et les postulats de base
L’espace métrique dans lequel évolue le coefficient de corrélation de Pearson est strictement délimité au continuum mathématique s’étendant de -1,00 à +1,00 inclusivement. Cette propriété de bornage découle directement de l’inégalité de Cauchy-Schwarz appliquée aux espaces vectoriels normés sous-jacents aux distributions statistiques. L’amplitude numérique du coefficient renseigne directement sur la compacité de l’association, tandis que son signe algébrique en indique la polarité directionnelle.
Sur le plan phénoménologique, une valeur de r égale à +1,00 correspond à une corrélation positive parfaite, configuration dans laquelle toutes les paires d’observations s’alignent rigoureusement le long d’une droite de régression à pente ascendante. Dans un tel scénario, toute augmentation unitaire standardisée d’une variable s’accompagne d’une progression parfaitement proportionnelle de la seconde. À l’opposé, une valeur de r égale à -1,00 désigne une corrélation négative parfaite, caractérisée par un alignement rectiligne descendant où l’accroissement d’un attribut s’accompagne de la diminution mathématiquement prévisible de l’autre. Le point médian théorique, matérialisé par r = 0, signale l’absence intégrale de relation linéaire entre les deux séries de données, ce qui implique que la connaissance de la position d’un individu sur l’axe des abscisses n’apporte aucune information prédictive quant à son positionnement sur l’axe des ordonnées par une fonction linéaire.
L’application légitime de cette mesure repose sur l’hypothèse incontournable selon laquelle les données recueillies sont mesurées au minimum sur une échelle d’intervalle, voire sur une échelle de rapport selon la taxonomie classique proposée par Stanley Smith Stevens. Les scores composites tirés de questionnaires standardisés de personnalité (comme les échelles de type Likert sommées répondant aux critères du modèle de Rasch) ou des indices chronométriques de temps de réaction satisfont couramment cette exigence fondamentale de métrique continue.

1.3 Utilité pédagogique et épistémologique du calcul manuel
À une époque dominée par la puissance de calcul informatique et la prolifération des bibliothèques de traitement automatisé, la décision d’exécuter manuellement les opérations arithmétiques du coefficient de Pearson pourrait de prime abord sembler anachronique. Pourtant, cette démarche recèle une valeur heuristique irremplaçable dans la formation des psychologues et des méthodologistes. Le calcul à la main permet de fracturer l’effet de « boîte noire » généré par les logiciels commerciaux, au sein desquels l’utilisateur se borne fréquemment à injecter des colonnes de données pour récolter des matrices d’indices dont la provenance arithmétique demeure nébuleuse.
En effectuant personnellement chaque soustraction de la moyenne, chaque élévation au carré et chaque multiplication de résidus croisés, le statisticien intègre de manière sensorielle et intellectuelle la logique de la dispersion bivariée. Il perçoit physiquement la manière dont un individu situé aux confins de la distribution influence démesurément la somme des produits d’écarts, consolidant ainsi sa sensibilité clinique et technique à l’égard de la vulnérabilité des statistiques paramétriques face aux valeurs aberrantes ou contaminées. Cette familiarisation avec les opérations fondamentales de centrage et de normalisation structure les prérequis conceptuels indispensables à l’assimilation ultérieure de modèles plus complexes, tels que l’analyse factorielle confirmatoire, la modélisation par équations structurelles ou les régressions hiérarchiques multiples.
Enfin, sur le plan épistémologique, le calcul manuel instille une discipline de rigueur analytique. Il oblige le praticien à s’interroger en amont sur la signification géométrique de ses mesures, l’incite à contrôler la validité interne de ses transcriptions numériques et le prémunit contre l’illusion de précision absolue générée par l’affichage logiciel d’une suite interminable de décimales déconnectées de la réalité métrologique du terrain expérimental.
2. Les postulats statistiques préalables au calcul de Pearson
2.1 L’hypothèse de linéarité de la relation
Le modèle de Pearson repose structurellement sur l’hypothèse selon laquelle le patron d’association qui unit les variables X et Y peut être adéquatement représenté par une droite mathématique au sein de l’espace euclidien bidimensionnel. Cette contrainte formelle impose que le taux de changement moyen de Y pour chaque variation unitaire de X demeure uniforme sur l’intégralité du domaine de définition observé. Dans l’éventualité où le phénomène psychologique sous-jacent suivrait une dynamique non linéaire, l’application aveugle du coefficient de Pearson produirait un résultat trompeur, voire totalement invalide sur le plan interprétatif.
L’illustration la plus emblématique de cet écueil méthodologique réside dans la célèbre loi de Yerkes et Dodson relative à la relation unissant le niveau d’activation physiologique (ou de stress) à l’efficacité de la performance cognitive. Cette trajectoire adopte typiquement la forme d’un U inversé : une stimulation modérée optimise les capacités de concentration, tandis qu’un état d’apathie ou un niveau d’angoisse panique dégradent conjointement la performance. Si un chercheur tentait d’ajuster un coefficient de corrélation linéaire de Pearson sur une telle distribution curvilinéaire symétrique, la statistique résultante tendrait asymptotiquement vers r = 0,00. Le praticien conclurait alors erronément à une absence totale de relation entre stress et cognition, alors même qu’il existe une dépendance fonctionnelle déterministe majeure, mais d’ordre quadratique.
Il est donc prescrit de procéder systématiquement à une inspection oculaire préalable des données brutes par l’intermédiaire d’un diagramme de dispersion (scatter plot). Cette étape exploratoire permet de certifier que l’essaim de points s’étire selon une géométrie ovoïde ou tubulaire rectiligne compatible avec les postulats du modèle additif linéaire avant d’engager toute opération algébrique.
2.2 La normalité bivariée et l’absence de valeurs extrêmes
L’inférence statistique et la validité paramétrique du coefficient de corrélation de Pearson supposent que le couple de variables $(X, Y)$ soit distribué conformément au modèle de la loi normale bivariée au sein de la population parente. Cette condition implique non seulement que la distribution univariée de X et celle de Y présentent chacune une symétrie et un aplatissement conformes à la loi de Gauss (évaluables par les coefficients de Skewness et de Kurtosis ou le test de Shapiro-Wilk), mais également que pour chaque point conditionnel le long de l’axe X, la distribution correspondante des scores Y suive une loi normale, et réciproquement.
Corrélativement à cette exigence distributionnelle, la statistique de Pearson démontre une hyper-sensibilité aux valeurs aberrantes ou atypiques, qu’elles soient univariées (scores isolés sur une seule variable) ou bivariées (combinaisons atypiques de valeurs individuellement plausibles). Une seule observation excentrique, résultant par exemple d’une erreur de saisie ou d’un sujet ayant répondu au hasard à un protocole d’évaluation psychologique, possède un pouvoir de levier démesuré capable de gonfler artificiellement une corrélation par ailleurs inexistante, ou à l’inverse d’annihiler une corrélation réelle solidement ancrée chez le reste de l’échantillon.
La détection de ces observations parasites requiert la mise en œuvre de procédures de filtrage rigoureuses, telles que le calcul des scores centrés réduits ($z$-scores supérieurs à 3 en valeur absolue), le calcul des distances de Mahalanobis pour repérer les anomalies multidimensionnelles, ou le recours à la règle graphique des boîtes à moustaches de Tukey. Lorsque des violations manifestes de la normalité bivariée sont observées et que les valeurs atypiques ne peuvent être légitimement purgées, l’analyste doit réorienter sa démarche vers des alternatives non paramétriques basées sur les rangs, à l’instar du rho de Spearman ou du tau de Kendall.
2.3 Homoscédasticité et indépendance des observations
Le troisième pilier axiomatique conditionnant l’emploi du r de Pearson réside dans le principe d’homoscédasticité, ou constance de la variance conditionnelle. Ce postulat stipule que la dispersion des résidus de Y autour de la ligne de tendance idéale doit demeurer statistiquement invariante quelle que soit la position occupée par les sujets le long du continuum de la variable prédictive X. Lorsque la variance s’accroît de manière conique au fur et à mesure que les scores progressent (hétéroscédasticité en éventail), la précision métrique de la prédiction devient asymétrique, ce qui biaise l’estimation de la force d’association et fausse les tests de significativité subséquents.
Simultanément, le protocole expérimental doit garantir l’indépendance mutuelle absolue entre chaque unité d’observation composant l’échantillon. Chaque couple de scores $(X_i, Y_i)$ doit provenir d’un sujet distinct examiné de façon totalement autonome, sans qu’aucune contamination sociale, écologique ou temporelle ne vienne coupler les résultats d’un participant à ceux d’un autre. La violation de ce postulat d’indépendance engendre le phénomène d’autocorrélation ou de regroupement (clustering), fréquemment rencontré lors de passations collectives en milieu scolaire ou hospitalier, où les élèves d’une même classe partagent l’influence d’un environnement commun.
L’omission de ces précautions méthodologiques vicie la validité interne du dispositif expérimental. Elle conduit fréquemment à des erreurs de type I (rejet intempestif de l’hypothèse nulle sous-tendu par une réduction artificielle de la variance d’erreur) ou de type II, ruinant ainsi la reproductibilité des inférences psychologiques et leur portée scientifique globale.
3. Décomposition théorique de la formule mathématique du r de Pearson
3.1 Formulation à partir de la covariance et des écarts-types
Sur le plan fondamental de la théorie statistique, le coefficient de corrélation produit-moment de Pearson est défini comme le rapport strict unissant la covariance bivariée des deux distributions au produit arithmétique de leurs écarts-types univariés respectifs. Cette structure canonique s’énonce selon l’équation :
$$r_{XY} = \frac{Cov(X, Y)}{s_X \cdot s_Y}$$
La covariance, notée $Cov(X, Y)$, mesure la moyenne des produits conjoints des déviations de chaque observation par rapport à sa moyenne arithmétique d’échantillon. Bien qu’elle permette d’identifier sans ambiguïté la directionnalité de l’association (une covariance positive signalant une variation conjointe concordante, tandis qu’une covariance négative reflète une opposition de phase), sa grandeur absolue est asservie aux échelles physiques ou psychométriques utilisées. Par exemple, si l’on mesurait un temps de traitement en millisecondes plutôt qu’en secondes, la covariance serait mécaniquement multipliée par mille, sans que le lien psychologique sous-jacent n’ait subi la moindre modification.
Le dénominateur de l’équation, constitué par la multiplication de l’écart-type de la variable X ($s_X$) par celui de la variable Y ($s_Y$), agit précisément comme un facteur universel de normalisation. En divisant la covariance brute par la dispersion géométrique intrinsèque à chaque dimension, l’indice se décharge de toute unité de mesure concrète pour devenir un nombre pur et adimensionnel. Cette standardisation confère au r de Pearson sa remarquable universalité comparative, permettant de confronter directement des liens empiriques issus d’instruments d’évaluation radicalement dissemblables.
3.2 Formulation standard par les scores centrés et réduits
Lorsque l’on développe les définitions formelles de la covariance et des écarts-types d’échantillon au sein de l’équation précédente, les termes divisionnaires liés aux degrés de liberté de l’échantillon ($n – 1$) s’annulent mutuellement. Cette simplification mène directement à l’écriture opérationnelle classique par les déviations centrées, également nommée formulation produit-moment par les écarts :
$$r = \frac{\sum_{i=1}^{n} (X_i – \bar{X})(Y_i – \bar{Y})}{\sqrt{\sum_{i=1}^{n} (X_i – \bar{X})^2 \cdot \sum_{i=1}^{n} (Y_i – \bar{Y})^2}}$$
Cette expression constitue le véritable pivot pédagogique du calcul manuel. Le numérateur, communément désigné dans la littérature francophone sous l’appellation de Somme des Produits d’écarts (noté $SP_{XY}$), quantifie la concordance nette des écarts. Chaque terme $(X_i – \bar{X})(Y_i – \bar{Y})$ exprime la contribution individuelle d’un participant à l’association globale : si un sujet se situe au-dessus de la moyenne à la fois sur X et sur Y, les deux facteurs sont positifs et leur produit est positif. S’il se situe en dessous des deux moyennes, les deux facteurs sont négatifs, et leur produit s’avère tout aussi rigoureusement positif en vertu de la règle des signes élémentaire.
Le dénominateur représente quant à lui la racine carrée du produit des deux Sommes des Carrés des écarts univariés (notées respectivement $SC_X$ et $SC_Y$). Ces quantités mesurent l’entropie ou la variabilité interne totale propre à chaque variable indépendamment de l’autre. Le dénominateur correspond mathématiquement au plafond théorique maximal que la somme des produits d’écarts pourrait atteindre dans l’éventualité où chaque point se superposerait de manière parfaite et absolue le long d’une trajectoire rectiligne univariée.
3.3 Formulation brute ou computationnelle pour calculatrice
Il existe une seconde formulation algébrique rigoureusement équivalente à la méthode par les écarts, fréquemment qualifiée de formule brute, computationnelle ou formule machine. Conçue initialement pour optimiser la vitesse de calcul des opérateurs mécaniques et des premiers ordinateurs dépourvus de registres de mémoire multiples, cette variante contourne l’obligation de calculer au préalable les moyennes arithmétiques intermédiaires :
$$r = \frac{n \sum XY – (\sum X)(\sum Y)}{\sqrt{[n \sum X^2 – (\sum X)^2][n \sum Y^2 – (\sum Y)^2]}}$$
L’avantage fonctionnel majeur de cette déclinaison computationnelle réside dans le fait qu’elle traite directement les données numériques brutes sans générer de nombres fractionnaires ou décimaux récurrents dès la première étape soustractive, ce qui limite considérablement les dérives cumulatives dues aux arrondis intermédiaires lors de calculs d’envergure. Elle ne nécessite que l’accumulation cumulative de cinq grandeurs scalaires de base : $\sum X$, $\sum Y$, $\sum X^2$, $\sum Y^2$ et $\sum XY$.
Cependant, dans un contexte académique visant l’acquisition d’une compréhension structurelle et clinique de la statistique, cette formule machine présente un inconvénient épistémique rédhibitoire : elle désintègre complètement le sens perceptif des écarts à la moyenne et de la covariance conjointe au profit d’agrégations arithmétiques abstraites. C’est la raison pour laquelle le présent traité méthodologique privilégie sans réserve l’approche analytique par déviation des moyennes, seule capable d’offrir une traçabilité conceptuelle transparente et un contrôle didactique immédiat à chaque échelon du traitement manuel.
4. Constitution du protocole et du jeu de données pour l’exercice manuel
4.1 Contexte de recherche psychologique et variables étudiées
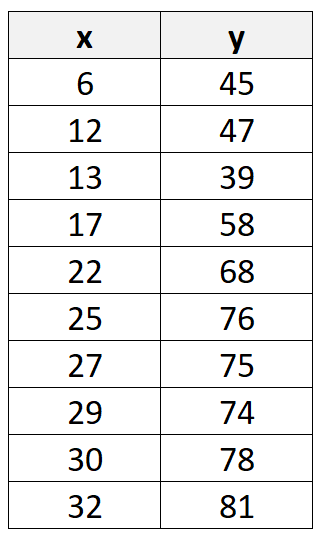
Afin d’ancrer le protocole pédagogique dans la réalité de l’investigation empirique, nous élaborons un scénario de recherche fictif mais hautement représentatif issu du domaine de la psychologie de l’éducation et des neurosciences cognitives. Un laboratoire universitaire s’intéresse à l’impact des stratégies d’autorégulation de l’apprentissage sur l’acquisition de compétences complexes chez des étudiants de premier cycle universitaire. Plus précisément, l’équipe cherche à vérifier s’il existe une corrélation linéaire significative entre la quantité de travail autonome investi sur un trimestre et la maîtrise finale des mécanismes conceptuels évaluée lors d’une épreuve standardisée.
Le dispositif expérimental opérationnalise deux variables continues mesurées auprès d’une cohorte restreinte mais calibrée de dix participants volontaires ($n = 10$) :
- Variable indépendante présumée ($X$) : Le temps hebdomadaire moyen consacré à la révision autonome et à la consolidation mnésique des cours, consigné de manière scrupuleuse par auto-enregistrement journalier et calibré en heures par semaine ($h/sem$).
- Variable dépendante présumée ($Y$) : La note finale obtenue à l’examen terminal de psychologie cognitive, cotée sur un barème d’intervalle standardisé s’étendant de 0 à 100 points, mesurant la résolution d’exercices d’application théorique.
Le jeu de données brutes recueilli auprès des dix sujets constitutifs de l’échantillon se présente comme suit dans le registre d’expérimentation initial :
- Sujet 1 : $X_1 = 4$ heures, $Y_1 = 45$ points
- Sujet 2 : $X_2 = 6$ heures, $Y_2 = 58$ points
- Sujet 3 : $X_3 = 7$ heures, $Y_3 = 52$ points
- Sujet 4 : $X_4 = 9$ heures, $Y_4 = 64$ points
- Sujet 5 : $X_5 = 10$ heures, $Y_5 = 56$ points
- Sujet 6 : $X_6 = 12$ heures, $Y_6 = 68$ points
- Sujet 7 : $X_7 = 13$ heures, $Y_7 = 61$ points
- Sujet 8 : $X_8 = 15$ heures, $Y_8 = 75$ points
- Sujet 9 : $X_9 = 16$ heures, $Y_9 = 70$ points
- Sujet 10 : $X_{10} = 18$ heures, $Y_{10} = 81$ points
4.2 Structuration optimale du tableau de calcul manuel
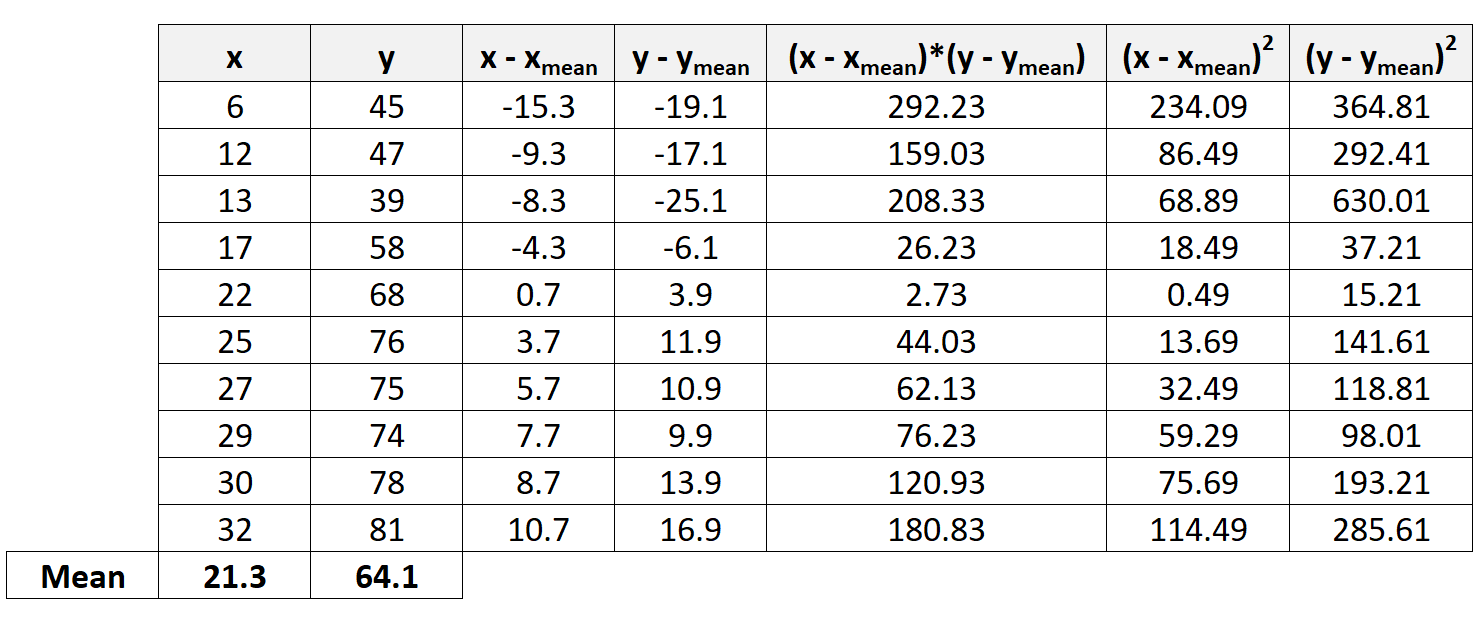
L’exécution manuelle sans faille d’une procédure statistique nécessite la mise en place d’une matrice opératoire tabulaire standardisée. La dispersion des opérations sur des feuilles volantes ou l’absence d’ordonnancement séquentiel constitue la source primaire de la quasi-totalité des erreurs arithmétiques observées chez les praticiens. Il convient d’adopter une architecture rigoureuse subdivisée en sept colonnes fonctionnelles fondamentales :
- Colonne 1 (Identifiant) : Désignation univoque du participant ($S_1$ à $S_{10}$).
- Colonne 2 ($X$) : Score brut de la première variable mesurée.
- Colonne 3 ($Y$) : Score brut de la seconde variable mesurée.
- Colonne 4 ($x = X – \bar{X}$) : Déviation univariée du score $X$ par rapport à sa moyenne arithmétique d’échantillon.
- Colonne 5 ($y = Y – \bar{Y}$) : Déviation univariée du score $Y$ par rapport à sa moyenne d’échantillon.
- Colonne 6 ($x^2$) : Carré de la déviation univariée de la variable $X$.
- Colonne 7 ($y^2$) : Carré de la déviation univariée de la variable $Y$.
- Colonne 8 ($x \cdot y$) : Produit croisé terme à terme des déviations univariées correspondantes.
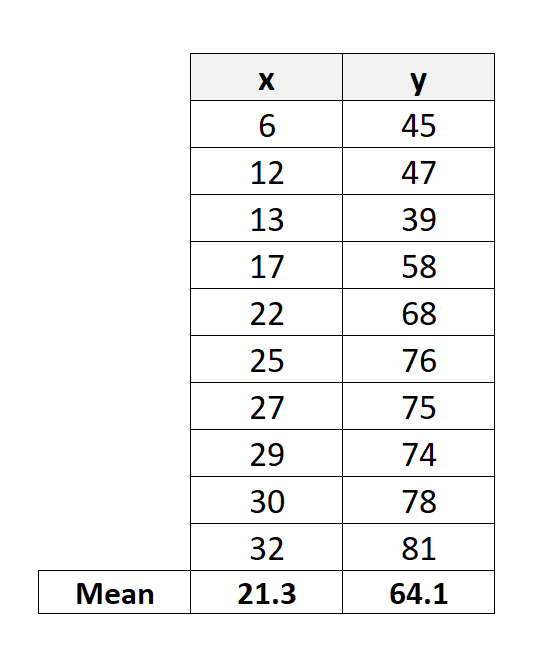
Une consigne de métrologie arithmétique doit être impérieusement respectée tout au long du protocole : afin de prévenir la propagation d’erreurs d’arrondi systématiques, aucune troncature ne doit être opérée sur les colonnes intermédiaires. Dans notre cas d’école, les données ont été calibrées pour délivrer des moyennes entières strictes, facilitant ainsi une résolution manuelle d’une pureté arithmétique absolue sans altération décimale prématurée.
5. Étape 1 : Calcul méthodique des moyennes arithmétiques (X et Y)
5.1 Sommation des valeurs brutes de chaque variable
La phase inaugurale du calcul consiste à agréger les observations brutes afin d’obtenir la somme totale des scores pour chacune des deux distributions. Cette opération d’accumulation constitue la base fondamentale sur laquelle reposent les estimations centrales de l’échantillon. Une erreur commise à ce stade initial corromprait irréversiblement l’ensemble de la chaîne de traitement ultérieure.
Pour la variable $X$ représentant le volume horaire hebdomadaire de révision, nous procédons à l’addition séquentielle des dix valeurs d’échantillonnage :
$$\sum_{i=1}^{10} X_i = 4 + 6 + 7 + 9 + 10 + 12 + 13 + 15 + 16 + 18$$
Exécutons l’addition par regroupements successifs de contrôle : $(4 + 6) = 10$ ; $(10 + 7) = 17$ ; $(17 + 9) = 26$ ; $(26 + 10) = 36$ ; $(36 + 12) = 48$ ; $(48 + 13) = 61$ ; $(61 + 15) = 76$ ; $(76 + 16) = 92$ ; $(92 + 18) = 110$. La somme totale brute pour la variable $X$ s’établit avec exactitude à $\sum X = 110$.
Nous appliquons simultanément la même rigueur sommative à la variable $Y$ traduisant les performances académiques à l’examen de cognition :
$$\sum_{i=1}^{10} Y_i = 45 + 58 + 52 + 64 + 56 + 68 + 61 + 75 + 70 + 81$$
La sommation pas à pas délivre : $(45 + 58) = 103$ ; $(103 + 52) = 155$ ; $(155 + 64) = 219$ ; $(219 + 56) = 275$ ; $(275 + 68) = 343$ ; $(343 + 61) = 404$ ; $(404 + 75) = 479$ ; $(479 + 70) = 549$ ; $(549 + 81) = 630$. La somme totale brute pour la variable $Y$ s’élève rigoureusement à $\sum Y = 630$. Pour écarter tout risque d’omission ou d’inversion typographique, il est vivement conseillé lors d’un calcul sur papier d’effectuer une seconde passe d’addition en sommant les termes de bas en haut (en ordre rétrograde).
5.2 Division par l’effectif total et obtention des moyennes
Une fois les grandeurs sommatives validées, l’étape suivante détermine les barycentres des distributions à travers l’application de la formule canonique de la moyenne arithmétique d’échantillon, où l’effectif total est défini par $n = 10$.
Pour la variable relative au temps de travail autonome ($X$) :
$$\bar{X} = \frac{\sum_{i=1}^{n} X_i}{n} = \frac{110}{10} = 11{,}0\text{ heures}$$
La moyenne du temps de révision hebdomadaire s’établit exactement à $11{,}0$ heures par semaine.
Pour la variable traduisant la note obtenue à l’épreuve cognitive ($Y$) :
$$\bar{Y} = \frac{\sum_{i=1}^{n} Y_i}{n} = \frac{630}{10} = 63{,}0\text{ points}$$
La moyenne de performance au test académique se fixe précisément à $63{,}0$ points sur 100.
Dans la pratique de la recherche psychologique réelle, les moyennes issues de passations expérimentales génèrent régulièrement des fractions décimales récurrentes ou infinies (par exemple $11{,}333…$). Dans une telle situation, la troncature précoce à une seule décimale entraîne un biais cumulatif désastreux dans les calculs de soustraction suivants. Il conviendrait alors impérativement soit de conserver les valeurs sous forme de fractions rationnelles exactes dans le tableau manuel, soit de maintenir un seuil de rigueur minimal d’au moins quatre décimales significatives tout au long des opérations intermédiaires de déviation.
6. Étape 2 : Détermination des écarts individuels aux moyennes
6.1 Calcul des écarts pour la variable X
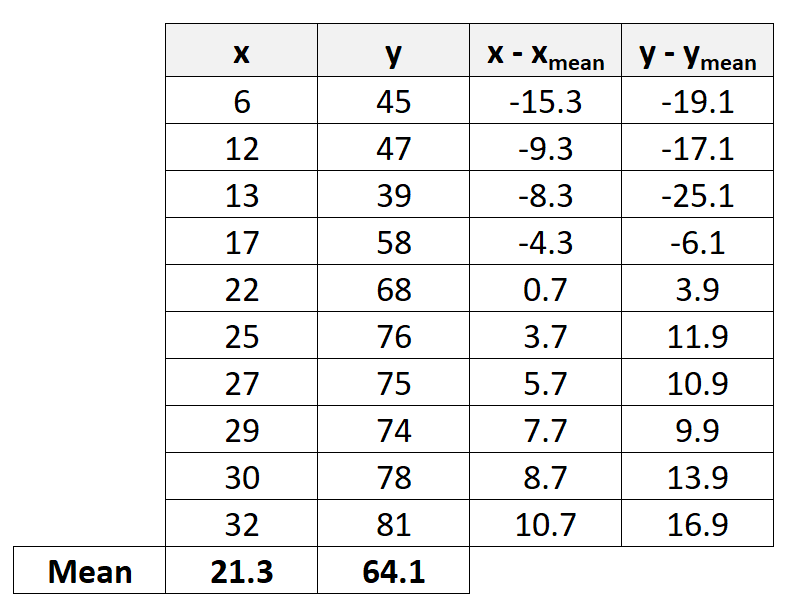
La deuxième étape opératoire engage le processus de centrage des données, mécanisme par lequel nous soustrayons la moyenne arithmétique $\bar{X} = 11{,}0$ à chaque score individuel $X_i$. Cette transformation algébrique convertit les scores absolus en grandeurs relatives indiquant la distance et la position (positive ou négative) de chaque sujet par rapport au point d’équilibre de la cohorte.
Exécutons scrupuleusement la série de soustractions individuelles pour la variable $X$ :
- Sujet 1 : $x_1 = X_1 – \bar{X} = 4 – 11 = -7$
- Sujet 2 : $x_2 = X_2 – \bar{X} = 6 – 11 = -5$
- Sujet 3 : $x_3 = X_3 – \bar{X} = 7 – 11 = -4$
- Sujet 4 : $x_4 = X_4 – \bar{X} = 9 – 11 = -2$
- Sujet 5 : $x_5 = X_5 – \bar{X} = 10 – 11 = -1$
- Sujet 6 : $x_6 = X_6 – \bar{X} = 12 – 11 = +1$
- Sujet 7 : $x_7 = X_7 – \bar{X} = 13 – 11 = +2$
- Sujet 8 : $x_8 = X_8 – \bar{X} = 15 – 11 = +4$
- Sujet 9 : $x_9 = X_9 – \bar{X} = 16 – 11 = +5$
- Sujet 10 : $x_{10} = X_{10} – \bar{X} = 18 – 11 = +7$
Contrôle arithmétique fondamental : En vertu de la propriété barycentrique universelle de la moyenne arithmétique, la somme algébrique des écarts à la moyenne doit obligatoirement être égale à zéro : $\sum (X_i – \bar{X}) = 0$. Procédons à l’addition de validation :
$$\sum x_i = (-7) + (-5) + (-4) + (-2) + (-1) + (+1) + (+2) + (+4) + (+5) + (+7)$$
Somme des résidus négatifs : $(-7) + (-5) + (-4) + (-2) + (-1) = -19$. Somme des résidus positifs : $(+1) + (+2) + (+4) + (+5) + (+7) = +19$. Total cumulé : $-19 + 19 = 0$. La validité de la colonne des déviations en $X$ est rigoureusement confirmée.
6.2 Calcul des écarts pour la variable Y
Nous reproduisons exactement la même manœuvre soustractive pour la variable d’évaluation cognitive $Y$ en retirant systématiquement la moyenne arithmétique correspondante, à savoir $\bar{Y} = 63{,}0$ points, à l’ensemble des scores observés.
Détaillons les calculs pour les dix participants :
- Sujet 1 : $y_1 = Y_1 – \bar{Y} = 45 – 63 = -18$
- Sujet 2 : $y_2 = Y_2 – \bar{Y} = 58 – 63 = -5$
- Sujet 3 : $y_3 = Y_3 – \bar{Y} = 52 – 63 = -11$
- Sujet 4 : $y_4 = Y_4 – \bar{Y} = 64 – 63 = +1$
- Sujet 5 : $y_5 = Y_5 – \bar{Y} = 56 – 63 = -7$
- Sujet 6 : $y_6 = Y_6 – \bar{Y} = 68 – 63 = +5$
- Sujet 7 : $y_7 = Y_7 – \bar{Y} = 61 – 63 = -2$
- Sujet 8 : $y_8 = Y_8 – \bar{Y} = 75 – 63 = +12$
- Sujet 9 : $y_9 = Y_9 – \bar{Y} = 70 – 63 = +7$
- Sujet 10 : $y_{10} = Y_{10} – \bar{Y} = 81 – 63 = +18$
Contrôle arithmétique fondamental : Nous appliquons derechef la règle de nullité des déviations sur cette cinquième colonne pour écarter tout risque d’inadvertance :
$$\sum y_i = (-18) + (-5) + (-11) + (+1) + (-7) + (+5) + (-2) + (+12) + (+7) + (+18)$$
Somme des écarts sous la moyenne : $(-18) + (-5) + (-11) + (-7) + (-2) = -43$. Somme des écarts au-dessus de la moyenne : $(+1) + (+5) + (+12) + (+7) + (+18) = +43$. Bilan additif global : $-43 + 43 = 0$. Le calibrage des déviations relatives à la variable $Y$ est irréprochable.
7. Étape 3 : Calcul des produits croisés et des carrés des déviations
7.1 Élévation au carré des écarts en X
L’alimentation de la sixième colonne exige d’élever au carré chacun des écarts individuels obtenus pour la variable $X$ ($x_i^2 = (X_i – \bar{X})^2$). Cette opération poursuit deux finalités statistiques majeures : d’une part, elle neutralise la polarité des signes négatifs afin de sommer des quantités strictement positives, et d’autre part, elle pondère de façon exponentielle l’éloignement d’une observation par rapport au centre de gravité de la série.
Réalisons les multiplications univariées pour chaque individu :
- Sujet 1 : $(-7)^2 = -7 \cdot (-7) = 49$
- Sujet 2 : $(-5)^2 = -5 \cdot (-5) = 25$
- Sujet 3 : $(-4)^2 = -4 \cdot (-4) = 16$
- Sujet 4 : $(-2)^2 = -2 \cdot (-2) = 4$
- Sujet 5 : $(-1)^2 = -1 \cdot (-1) = 1$
- Sujet 6 : $(+1)^2 = 1 \cdot 1 = 1$
- Sujet 7 : $(+2)^2 = 2 \cdot 2 = 4$
- Sujet 8 : $(+4)^2 = 4 \cdot 4 = 16$
- Sujet 9 : $(+5)^2 = 5 \cdot 5 = 25$
- Sujet 10 : $(+7)^2 = 7 \cdot 7 = 49$
Sur le plan géométrique, ces grandeurs scalaires représentent les surfaces des carrés euclidiens définis par les déviations, composantes directes de la dispersion univariée de la variable prédictive.
7.2 Élévation au carré des écarts en Y
La septième colonne du tableau manuel reçoit les valeurs résultant de la mise au carré méthodique de chaque déviation univariée calculée pour la variable de performance académique $Y$ ($y_i^2 = (Y_i – \bar{Y})^2$).
Procédons aux calculs pour les dix participants :
- Sujet 1 : $(-18)^2 = -18 \cdot (-18) = 324$
- Sujet 2 : $(-5)^2 = -5 \cdot (-5) = 25$
- Sujet 3 : $(-11)^2 = -11 \cdot (-11) = 121$
- Sujet 4 : $(+1)^2 = 1 \cdot 1 = 1$
- Sujet 5 : $(-7)^2 = -7 \cdot (-7) = 49$
- Sujet 6 : $(+5)^2 = 5 \cdot 5 = 25$
- Sujet 7 : $(-2)^2 = -2 \cdot (-2) = 4$
- Sujet 8 : $(+12)^2 = 12 \cdot 12 = 144$
- Sujet 9 : $(+7)^2 = 7 \cdot 7 = 49$
- Sujet 10 : $(+18)^2 = 18 \cdot 18 = 324$
Ces données reflètent fidèlement l’amplitude de l’hétérogénéité des compétences cognitives au sein de notre échantillon d’étudiants, fournissant le second élément indispensable à l’évaluation du dénominateur d’échelle.
7.3 Multiplication croisée des écarts correspondants
La huitième et dernière colonne d’opérations individuelles constitue le cœur battant du produit-moment de Pearson : elle recueille les produits croisés terme à terme des déviations respectives ($x_i \cdot y_i = (X_i – \bar{X})(Y_i – \bar{Y})$). C’est précisément cette multiplication bivariée qui détermine l’orientation dynamique du lien.
Examinons attentivement l’application des règles arithmétiques des signes pour chacun des dix sujets :
- Sujet 1 : $(-7) \cdot (-18) = +126$ (Deux déviations négatives engendrent un produit substantiellement positif).
- Sujet 2 : $(-5) \cdot (-5) = +25$ (Concordance négative délivrant une contribution positive).
- Sujet 3 : $(-4) \cdot (-11) = +44$ (Accord de signe négatif se soldant par une valeur positive).
- Sujet 4 : $(-2) \cdot (+1) = -2$ (Discordance : le sujet étudie moins que la moyenne mais réussit légèrement mieux, générant un apport négatif).
- Sujet 5 : $(-1) \cdot (-7) = +7$ (Concordance sous-moyenne positive).
- Sujet 6 : $(+1) \cdot (+5) = +5$ (Concordance positive modérée au-dessus des moyennes).
- Sujet 7 : $(+2) \cdot (-2) = -4$ (Légère discordance : davantage d’heures investies mais résultat légèrement en deçà de la moyenne).
- Sujet 8 : $(+4) \cdot (+12) = +48$ (Forte concordance positive simultanée).
- Sujet 9 : $(+5) \cdot (+7) = +35$ (Association positive solide).
- Sujet 10 : $(+7) \cdot (+18) = +126$ (Concordance maximale aux extrémités supérieures de la distribution).
Ce calcul analytique met en lumière la réalité sous-jacente à la statistique : les participants $S_4$ et $S_7$, par leurs décalages discordants, opposent une légère résistance à l’hypothèse d’une corrélation positive parfaite, tandis que les profils fortement concordants ($S_1$ et $S_{10}$) propulsent puissamment la covariance vers le haut.
8. Étape 4 : Sommation rigoureuse des colonnes de calcul
8.1 Calcul de la somme des produits d’écarts (numérateur)
Le calcul du numérateur de la formule de Pearson requiert l’addition algébrique complète de l’ensemble des dix valeurs figurant dans la colonne des produits croisés. Cette entité, désignée dans le formalisme des moindres carrés sous le terme de Somme des Produits ($SP_{XY}$), représente l’indicateur brut non standardisé de la covariation globale de l’échantillon.
Regroupons les valeurs obtenues pour dresser l’équation sommative complète :
$$SP_{XY} = \sum_{i=1}^{10} (X_i – \bar{X})(Y_i – \bar{Y}) = 126 + 25 + 44 + (-2) + 7 + 5 + (-4) + 48 + 35 + 126$$
Afin de prévenir tout égarement arithmétique lors de l’exécution manuelle sur tableur papier, ségrégons méthodiquement les composantes positives et négatives :
- Somme des apports positifs : $126 + 25 + 44 + 7 + 5 + 48 + 35 + 126 = +416$
- Somme des apports négatifs : $(-2) + (-4) = -6$
- Agrégation finale : $SP_{XY} = (+416) + (-6) = +410$
La somme des produits d’écarts s’établit irrévocablement à $SP_{XY} = +410$. Le signe résolument positif de cette valeur atteste d’emblée que la corrélation finale sera incontestablement de nature positive, actant une covariation ascendante prédominante entre le temps d’étude et le niveau de performance cognitive.
8.2 Calcul des sommes des carrés des écarts (dénominateur)
Pour parachever l’assemblage des composantes numériques de la formule de Pearson, nous devons procéder à l’addition distincte des termes peuplant les deux colonnes des déviations quadratiques univariées. Ces totaux sont formellement dénommés Somme des Carrés de $X$ ($SC_X$) et Somme des Carrés de $Y$ ($SC_Y$).
Pour la variable $X$, sommons les valeurs de la sixième colonne :
$$SC_X = \sum_{i=1}^{10} (X_i – \bar{X})^2 = 49 + 25 + 16 + 4 + 1 + 1 + 4 + 16 + 25 + 49$$
L’addition séquentielle s’opère aisément grâce à la symétrie de la distribution : $(49 + 25 + 16 + 4 + 1) \cdot 2 = 95 \cdot 2 = 190$. La somme des carrés pour la variable temporelle est donc $SC_X = 190$.
Pour la variable $Y$, réalisons la sommation méticuleuse de la septième colonne :
$$SC_Y = \sum_{i=1}^{10} (Y_i – \bar{Y})^2 = 324 + 25 + 121 + 1 + 49 + 25 + 4 + 144 + 49 + 324$$
Détaillons l’accumulation arithmétique manuelle : $(324 + 25) = 349$ ; $(349 + 121) = 470$ ; $(470 + 1) = 471$ ; $(471 + 49) = 520$ ; $(520 + 25) = 545$ ; $(545 + 4) = 549$ ; $(549 + 144) = 693$ ; $(693 + 49) = 742$ ; $(742 + 324) = 1066$. La somme des carrés pour la variable de performance cognitive est fixée sans ambiguïté à $SC_Y = 1066$.
Règle de cohérence formelle : Étant issues d’élevations au carré de nombres réels non nuls, les sommes $SC_X$ et $SC_Y$ doivent être obligatoirement et strictement positives ($SC > 0$). L’apparition d’un résultat négatif ou nul signalerait une aberration d’inattention ou l’absence totale de variance (variable invariante), ce qui interdirait l’estimation d’un coefficient de corrélation.
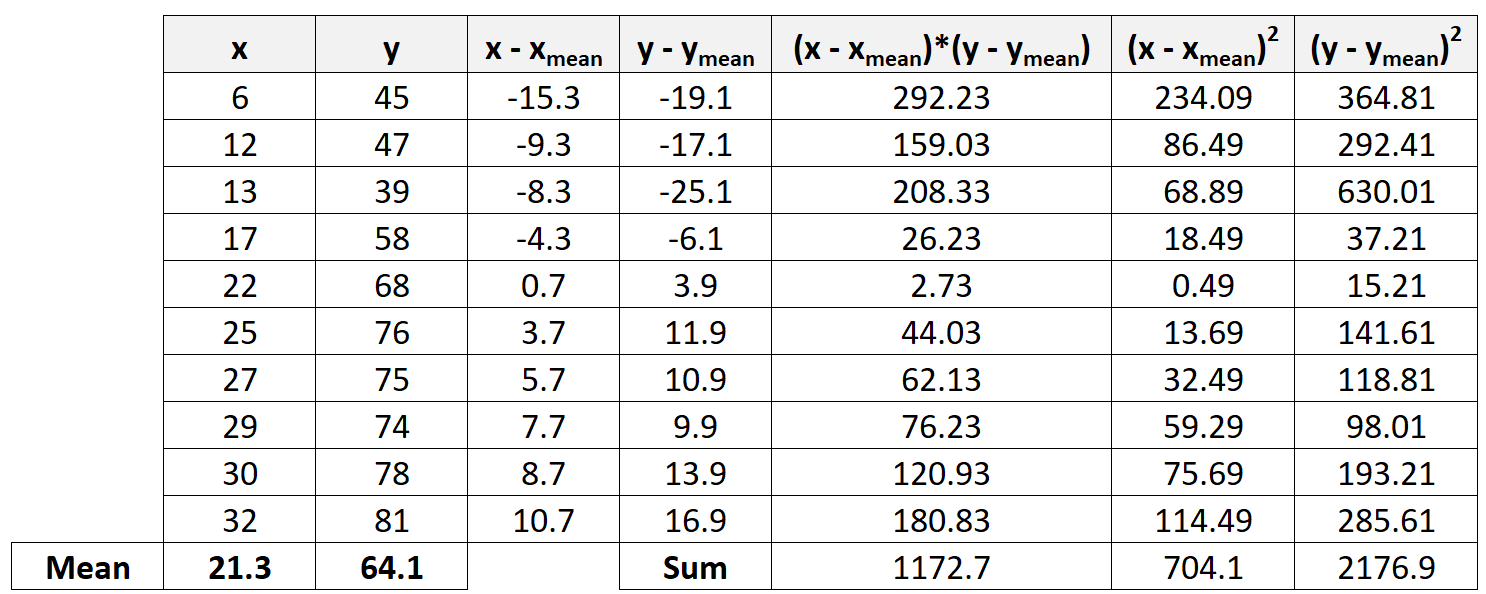
Pour consolider la clarté visuelle de l’ensemble de ces résultats intermédiaires, synthétisons notre feuille d’émulation dans un tableau récapitulatif complet :
| Sujet ($i$) | $X_i$ | $Y_i$ | $x_i = X_i – 11$ | $y_i = Y_i – 63$ | $x_i^2$ | $y_i^2$ | $x_i \cdot y_i$ |
|---|---|---|---|---|---|---|---|
| $S_1$ | 4 | 45 | -7 | -18 | 49 | 324 | 126 |
| $S_2$ | 6 | 58 | -5 | -5 | 25 | 25 | 25 |
| $S_3$ | 7 | 52 | -4 | -11 | 16 | 121 | 44 |
| $S_4$ | 9 | 64 | -2 | +1 | 4 | 1 | -2 |
| $S_5$ | 10 | 56 | -1 | -7 | 1 | 49 | 7 |
| $S_6$ | 12 | 68 | +1 | +5 | 1 | 25 | 5 |
| $S_7$ | 13 | 61 | +2 | -2 | 4 | 4 | -4 |
| $S_8$ | 15 | 75 | +4 | +12 | 16 | 144 | 48 |
| $S_9$ | 16 | 70 | +5 | +7 | 25 | 49 | 35 |
| $S_{10}$ | 18 | 81 | +7 | +18 | 49 | 324 | 126 |
| Total ($\sum$) | 110 | 630 | 0 | 0 | 190 | 1066 | 410 |
9. Étape 5 : Résolution algébrique et obtention finale du r
9.1 Calcul du dénominateur : produit et racine carrée
Disposant désormais de toutes les composantes scalaires consolidées, nous pouvons engager la résolution algébrique de la formule de Pearson. L’expression générale s’articule comme suit :
$$r = \frac{SP_{XY}}{\sqrt{SC_X \cdot SC_Y}}$$
La première phase computationnelle de cette étape finale consiste à évaluer le produit des sommes des carrés logé sous le radical du dénominateur :
$$\text{Produit des variances non réduites} = SC_X \cdot SC_Y = 190 \cdot 1066$$
Effectuons la multiplication manuelle décomposée :
$$190 \cdot 1066 = (200 – 10) \cdot 1066 = (200 \cdot 1066) – (10 \cdot 1066)$$
$$200 \cdot 1066 = 213,200$$
$$10 \cdot 1066 = 10,660$$
$$213,200 – 10,660 = 202,540$$
Le produit d’échelle sous le radical s’établit précisément à $202,540$.
Il convient à présent d’extraire la racine carrée de cette quantité : $\sqrt{202,540}$. En situation d’examen sur table dépourvu de calculatrice avancée, l’extraction peut être abordée par encadrement itératif manuel (méthode de Héron ou approximation différentielle). Observons que $400^2 = 160,000$ et $500^2 = 250,000$. En affinant, $450^2 = 202,500$. La proximité remarquable entre $202,500$ et $202,540$ démontre d’emblée que la racine carrée exacte sera infinitésimalement supérieure à 450.
En poussant la précision à quatre décimales par dérivation :
$$\sqrt{202,540} \approx 450{,}0444$$
Le dénominateur de l’équation de Pearson est donc définitivement évalué à $450{,}0444$.
9.2 Division finale et détermination de la valeur de r
L’acte terminal consiste à diviser le numérateur ($SP_{XY} = 410$) par le dénominateur standardisé que nous venons de stabiliser :
$$r = \frac{410}{450{,}0444}$$
Exécutons l’opération de division décimale :
$$410 \div 450{,}0444 = 0{,}911021…$$
Procédons immédiatement à la vérification impérative du postulat de bornage : la valeur obtenue se situe-t-elle strictement dans l’intervalle $[-1{,}00 ; +1{,}00]$ ? La réponse est affirmative, confirmant l’absence d’aberration de calcul majeure. Conformément aux préconisations typographiques internationales en vigueur dans la recherche en psychologie, notamment celles édictées par l’American Psychological Association (normes APA de la 7e édition), le coefficient de corrélation s’arrondit à deux ou trois décimales significatives sans être précédé d’un zéro devant la virgule lorsque la métrique ne peut excéder l’unité. Nous retenons ainsi la valeur définitive :
$$r = 0{,}911\quad \text{ou}\quad r = 0{,}91$$
10. Interprétation statistique et psychologique du résultat obtenu
10.1 Sens, intensité et seuils empiriques d’interprétation
Sur le strict plan de la statistique descriptive, l’indice $r = +0{,}91$ renseigne immédiatement sur deux attributs fondamentaux de la relation bivariée : son orientation et sa magnitude. Le signe positif traduit une covariation concordante univoque : les sujets qui exhibent les valeurs les plus substantielles sur l’échelle de temps de travail ($X$) ont une tendance probabiliste massive à obtenir les résultats les plus élevés à l’épreuve de psychologie cognitive ($Y$). Réciproquement, un faible investissement horaire est systématiquement associé à un rendement académique inférieur.
Pour calibrer l’intensité de cette liaison, la communauté scientifique se réfère couramment aux balises empiriques formulées par le méthodologiste Jacob Cohen dans son ouvrage séminal consacré à l’analyse de puissance statistique pour les sciences du comportement :
- Effet de faible amplitude : $|r| = 0{,}10$ (la relation est ténue mais potentiellement informative sur de très grands échantillons).
- Effet d’amplitude moyenne : $|r| = 0{,}30$ (corrélation typique observable dans les sciences sociales pour des construits complexes).
- Effet de forte amplitude : $|r| = 0{,}50$ et au-delà (relation majeure traduisant un chevauchement conceptuel substantiel).
Avec un coefficient de $r = 0{,}91$, notre jeu de données excède très largement le seuil conventionnel qualifiant une association de forte intensité. Il convient toutefois de contextualiser cette magnitude : dans la recherche psychologique réelle portant sur des traits de personnalité ou des attitudes, de tels niveaux de corrélation sont exceptionnels et peuvent même signaler un problème de redondance métrologique (deux échelles distinctes mesurant en réalité le même construit théorique). Dans le cadre spécifique de notre étude portant sur l’apprentissage délibéré, une valeur de cette envergure atteste d’une proximité quasi déterministe entre l’effort consenti et la maîtrise conceptuelle au sein de cette cohorte.
10.2 Traduction contextuelle des résultats dans l’étude psychologique
La formulation narrative des conclusions dans le rapport de recherche psychologique doit traduire ces grandeurs arithmétiques en assertions scientifiques rigoureuses, sans jamais franchir la frontière sémantique de l’imputation causale hâtive. Bien que le coefficient $r = 0{,}91$ traduise une concordance empirique exceptionnelle, l’analyste ne peut formellement certifier que l’augmentation du temps de travail constitue la cause directe unique et exclusive de l’élévation des notes d’examen.
En effet, un tel dispositif observationnel bivarié s’avère structurellement vulnérable à l’influence de variables tierces non contrôlées (phénomène de confusion). On pourrait par exemple postuler que le niveau de motivation intrinsèque initiale des apprenants, leur quotient intellectuel fluide ou des compétences métacognitives supérieures agissent comme des variables médiatrices ou modératrices communes, incitant simultanément ces étudiants à passer davantage d’heures à leur table de travail et favorisant leur réussite lors des évaluations certificatives.
Le chercheur rendra compte de ses constatations en soulignant que le volume horaire consacré à l’étude autonome représente un indicateur pronostique de premier ordre pour prédire la réussite à l’examen de psychologie cognitive au sein de la population cible, tout en appelant à la mise en place de protocoles expérimentaux contrôlés randomisés (avec assignation de volumes horaires de révision contraints) pour tester la portée strictement causale du dispositif d’apprentissage.
11. Erreurs arithmétiques classiques et techniques de contrôle de cohérence
11.1 Les écueils fréquents lors de l’exécution manuelle
La pratique pédagogique du calcul statistique manuel révèle une récurrence systématique de certains pièges arithmétiques qui compromettent la validité du résultat final. La vigilance de l’opérateur doit se focaliser prioritairement sur les points critiques suivants :
- La gestion fautive des signes négatifs lors du centrage : L’inversion involontaire du sens de la soustraction (calculer $\bar{X} – X_i$ au lieu de $X_i – \bar{X}$) inverse artificiellement le signe des déviations, faussant irrémédiablement l’orientation des produits croisés.
- La confusion entre somme des carrés et carré de la somme : Une faute conceptuelle fréquente consiste à confondre $\sum X^2$ (l’addition de chaque score préalablement élevé au carré) avec $(\sum X)^2$ (l’élévation au carré de la somme brute des scores). Cette méprise produit des valeurs numériques colossales totalement déconnectées de la variance réelle.
- L’oubli des règles de multiplication des signes relatifs : Lors du calcul de la colonne des produits croisés $x_i \cdot y_i$, il arrive fréquemment qu’un produit de deux déviations négatives (par exemple $-7 \cdot -18$) soit consigné par inadvertance sous la forme d’un nombre négatif ($-126$), détruisant le volume du numérateur.
- Les arrondis prématurés et asymétriques : Réduire la moyenne $\bar{X}$ à un nombre entier tronqué lorsque celle-ci comporte des décimales engendre un résidu sommatoire non nul ($\sum (X – \bar{X}) \neq 0$), qui se propage et se démultiplie lors de l’élévation au carré et de la multiplication croisée.
11.2 Signaux d’alerte et vérifications de plausibilité
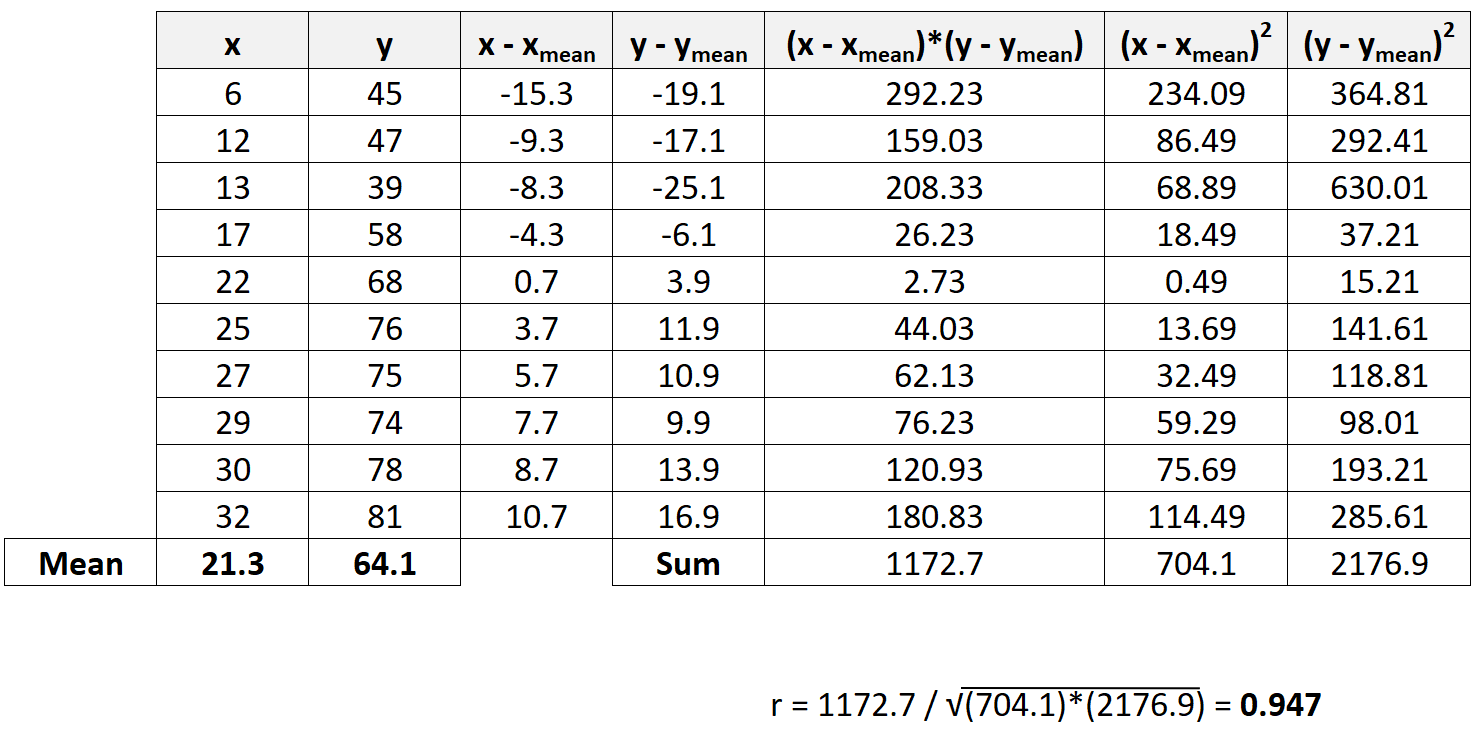
Pour s’assurer de l’exactitude d’un calcul manuel sans recourir à un ordinateur, l’analyste doit instaurer des garde-fous logiques permettant de déclencher une alerte cognitive immédiate dès qu’une anomalie métrique se profile. Le signal d’alarme le plus péremptoire réside dans l’obtention d’un coefficient de corrélation supérieur à $+1{,}00$ ou inférieur à $-1{,}00$ ($|r| > 1{,}00$). Tout résultat violant ce postulat de bornage atteste formellement d’une faute arithmétique majeure, généralement imputable à une erreur dans l’évaluation du dénominateur (par exemple, l’omission de l’extraction de la racine carrée finale).
Un second contrôle de cohérence relève de la confrontation graphique : si le tracé visuel sommaire du nuage de points dessine une tendance descendante manifeste alors que le signe du produit $SP_{XY}$ ressort positif, un examen minutieux des opérations de soustraction s’impose d’urgence. De surcroît, la vérification de la nullité stricte des sommes des colonnes de déviation ($\sum x = 0$ et $\sum y = 0$) constitue un filtre de sécurité incontournable qui doit être impérativement validé avant d’entamer la moindre mise au carré.
Enfin, en cas de doute persistant sur un résultat manuel, il est hautement recommandé d’appliquer la formule computationnelle alternative (décrite à la section 3.3) sur les deux premières observations du tableau afin de s’assurer que les trajectoires numériques convergent scrupuleusement vers les mêmes valeurs scalaires standardisées.
12. Prolongements analytiques : coefficient de détermination et inférence
12.1 Le coefficient de détermination (r²)
Au-delà de l’indice de corrélation standard $r$, la modélisation statistique enrichit son interprétation par l’estimation du coefficient de détermination, obtenu par la simple élévation au carré du coefficient de Pearson, noté $r^2$ (ou $R^2$ dans le cadre de la régression). Cette métrique dérivée présente une vertu herméneutique capitale : elle s’exprime directement sous la forme d’un pourcentage de variance partagée ou expliquée entre les deux phénomènes investigués.
Dans le cadre de notre exercice empirique :
$$r = 0{,}91102$$
$$r^2 = (0{,}91102)^2 \approx 0{,}8300$$
Exprimé sous forme de pourcentage, le coefficient de détermination atteint $83{,}00,%$. Cette grandeur atteste que $83{,}00,%$ de la variance totale observée dans les notes d’examen de psychologie cognitive des étudiants peut être directement mise en relation avec les variations de leur volume horaire hebdomadaire de travail personnel. Les $17{,}00,%$ résiduels constituent la variance non expliquée (ou résiduelle), imputable à l’ensemble des facteurs idiosyncrasiques non pris en compte dans le design expérimental, tels que le niveau de fatigue le jour du test, l’anxiété de performance spécifique à l’évaluation, ou les capacités intellectuelles préalables.
Sur le plan conceptuel, le coefficient de détermination se matérialise graphiquement par le chevauchement spatial de deux diagrammes de Venn représentant la variance propre de chaque variable. La zone de recouvrement central symbolise la part d’information commune que les deux construits partagent au sein de l’espace métrique.
12.2 Introduction au test de significativité statistique t de Student
Dans une perspective d’inférence statistique, la mise en évidence d’un coefficient $r = 0{,}91$ sur un échantillon restreint de dix participants ne permet pas spontanément de conclure que ce lien prévaut au sein de la population parente globale. Il est impératif de soumettre cette valeur d’échantillonnage à un test de significativité statistique afin de réfuter l’hypothèse nulle ($H_0$), selon laquelle la corrélation réelle au sein de la population serait rigoureusement égale à zéro ($rho = 0$), face à l’hypothèse alternative bidirectionnelle ($H_1 : \rho \neq 0$).
Lorsque les postulats de normalité bivariée sont satisfaits, la transformation de la statistique de Pearson en une variable pivotale suivant la loi de Student ($t$) s’effectue au moyen de l’équation suivante :
$$t = r \cdot \sqrt{\frac{n – 2}{1 – r^2}}$$
Le terme $(n – 2)$ symbolise les degrés de liberté ($dl$) associés au test bivarié, découlant de l’estimation préalable de deux paramètres de position indépendants ($\bar{X}$ et $\bar{Y}$). Dans le cadre de notre étude où $n = 10$, les degrés de liberté s’élèvent à :
$$dl = 10 – 2 = 8$$
Injectons nos données chiffrées au sein de la formule de conversion :
$$t = 0{,}91102 \cdot \sqrt{\frac{8}{1 – 0{,}8300}} = 0{,}91102 \cdot \sqrt{\frac{8}{0{,}1700}}$$
Évaluons le terme sous le radical :
$$\frac{8}{0{,}1700} \approx 47{,}0588$$
$$\sqrt{47{,}0588} \approx 6{,}8599$$
Calculons la valeur observée de $t$ :
$$t_{obs} = 0{,}91102 \cdot 6{,}8599 \approx 6{,}25$$
Pour déterminer si ce résultat est statistiquement significatif au seuil canonique de risque alpha $\alpha = 0{,}05$ pour un test bilatéral avec 8 degrés de liberté, nous consultons la table de distribution de la loi de Student. La valeur critique tabulée pour $t_{critique}(dl=8, alpha=0{,}05)$ s’établit à $2{,}306$. Pour un seuil d’exigence extrême à $\alpha = 0{,}001$, la valeur critique s’élève à $5{,}041$.
Puisque notre valeur observée ($t_{obs} = 6{,}25$) excède largement le seuil critique le plus conservateur ($6{,}25 > 5{,}041$), nous rejetons sans ambiguïté l’hypothèse nulle au seuil $p < 0{,}001$. Nous pouvons affirmer avec un degré de certitude statistique supérieur à $99{,}9,%$ qu'il existe une corrélation linéaire positive hautement significative entre le temps de révision hebdomadaire et la note finale obtenue à l'examen de cognition.
12.3 Rédaction académique finale selon les normes de l’APA
La communication scientifique des résultats au sein d’une revue à comité de lecture en psychologie obéit à un protocole rédactionnel standardisé. L’American Psychological Association requiert que l’énoncé textuel intègre de façon concise la statistique de corrélation, la taille d’échantillon ou les degrés de liberté afférents, ainsi que le niveau exact de probabilité critique atteint ($p$-value).
L’énoncé standardisé régissant la présentation de nos résultats s’articule comme suit :
Une analyse de corrélation produit-moment de Pearson a été menée afin d’évaluer la relation linéaire entre le volume horaire hebdomadaire consacré aux révisions autonomes et la performance académique à l’examen standardisé de psychologie cognitive. Les résultats mettent en évidence une corrélation positive statistiquement significative et de très forte amplitude entre les deux variables, r(8) = ,91, p < ,001, avec un coefficient de détermination r² = ,83, indiquant que 83 % de la variance des notes d’examen est partagée avec le temps d’étude investi.
Dans l’éventualité où le chercheur souhaiterait expliciter dans la section méthodologique la genèse manuelle préliminaire de ses indices à des fins de transparence pédagogique ou de contrôle qualité des protocoles, il est recommandé de mentionner la stricte conformité des procédures tabulaires aux formulations de déviation barycentrique standards avant l’archivage pérenne des données dans les dépôts de science ouverte.
Références
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2e éd.). Lawrence Erlbaum Associates. https://www.sciencedirect.com/book/9780121790608/statistical-power-analysis-for-the-behavioral-sciences
Galton, F. (1886). Regression towards mediocrity in hereditary stature. The Journal of the Anthropological Institute of Great Britain and Ireland, 15, 246–263. https://doi.org/10.2307/2841583
Howell, D. C. (2012). Statistical methods for psychology (8e éd.). Cengage Learning.
Pearson, K. (1895). VII. Note on regression and inheritance in the case of two parents. Proceedings of the Royal Society of London, 58(347-352), 240–242. https://doi.org/10.1098/rspl.1895.0041
Pearson, K. (1896). Mathematical contributions to the theory of evolution. III. Regression, heredity, and panmixia. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 187, 253–318. https://doi.org/10.1098/rsta.1896.0007
Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7e éd.). Pearson.
Yerkes, R. M., & Dodson, J. D. (1908). The relation of strength of stimulus to rapidity of habit-formation. Journal of Comparative Neurology and Psychology, 18(5), 459–482. https://doi.org/10.1002/cne.920180503