
La visualisation des données quantitatives contemporaine ne saurait être réduite à un simple exercice d’illustration esthétique ; elle constitue un instrument sémiotique fondamental d’investigation statistique et de communication scientifique. Dans le cadre de la recherche empirique, qu’elle relève des sciences biomédicales, de la psychologie quantitative ou de l’économétrie, la restitution graphique de distributions complexes requiert une rigueur méthodologique sans faille. L’environnement logiciel R, enrichi par son écosystème Tidyverse, a redéfini les standards de l’analyse visuelle grâce à l’implémentation de la bibliothèque ggplot2 conçue par Hadley Wickham. Ce système ne se limite pas à tracer des figures élémentaires, il structure la pensée analytique en articulant données, représentations géométriques et encodages perceptifs au sein d’une grammaire universelle et hautement modulaire.
Au cœur de cette architecture se trouve la capacité d’attribuer des attributs chromatiques à des entités catégorielles, plus formellement dénommées « facteurs » dans la terminologie du langage R. L’assignation de teintes distinctes à des modalités factorielles constitue l’un des procédés les plus puissants pour ségréguer des sous-populations au sein d’un échantillon, identifier des dynamiques de covariation multivariées ou révéler des structures latentes au sein de nuages de points denses. Cependant, la transposition non maîtrisée de variables discrètes dans l’espace chromatique expose le chercheur à des écueils majeurs : biais de saillance perceptive, distorsions cognitives induites par des variations de luminance non contrôlées ou exclusion systématique des lecteurs atteints de dyschromatopsie.
Le présent article propose une analyse approfondie des mécanismes théoriques, syntaxiques et perceptifs régissant l’attribution des couleurs par facteur dans ggplot2. À travers un parcours méthodologique exhaustif, nous examinerons comment préparer rigoureusement les structures de données, dompter les échelles de couleurs intégrées, déployer des palettes scientifiques perceptuellement uniformes et personnaliser manuellement chaque paramètre graphique afin de produire des représentations publiables dans les revues académiques internationales les plus exigeantes.
1. Fondements théoriques de l’esthétique graphique et de la couleur dans ggplot2
La compréhension approfondie des mécanismes d’encodage chromatique dans ggplot2 exige un retour préalable aux axiomes de la sémiologie graphique et de la théorie computationnelle de l’affichage statistique. Loin d’être un artifice décoratif accessoire, la couleur opère comme un canal de transmission d’information dont la validité dépend directement de la cohérence formelle entre la topologie de la variable sous-jacente et les propriétés physiologiques du système visuel humain.
1.1 La grammaire des graphiques de Leland Wilkinson appliquée à R
L’architecture interne de ggplot2 tire sa cohérence théorique de l’ouvrage fondateur de Leland Wilkinson, The Grammar of Graphics, formalisé à la fin des années 1990. Wilkinson a proposé de décomposer toute figure statistique en un ensemble formel d’éléments structurels indépendants mais combinables : les données brutes, les transformations statistiques, le système de coordonnées spatiales, les échelles de conversion métrique, les objets géométriques et les correspondances esthétiques. Dans cette perspective, la génération d’un graphique n’est plus envisagée comme le tracé d’un type de diagramme figé (tel qu’un histogramme ou un diagramme en dispersion), mais comme la projection algébrique de colonnes de données sur des attributs sensoriels perceptibles.
Dans l’implémentation conçue par Hadley Wickham pour le logiciel R, cette projection est matérialisée par la fonction de mappage esthétique aes(). Cette dernière agit comme un pont sémantique bidirectionnel. D’une part, elle inspecte la nature mathématique des vecteurs fournis dans la table de données ; d’autre part, elle informe le moteur graphique de la nature de la transformation à opérer pour relier ces valeurs aux canaux rétiniens des primitives géométriques (tels que la position spatiale selon les axes des abscisses et des ordonnées, la taille, la forme du symbole, ou la teinte chromatique). L’esthétique de la couleur constitue ainsi un canal perceptif spécifique dont le comportement doit être rigoureusement orchestré selon que la variable incidente relève d’une grandeur métrique continue ou d’une taxonomie nominale discrète.
1.2 Rôle perceptif et sémiologique de la couleur dans la visualisation scientifique
Sur le plan de la psychophysique et des sciences cognitives de la vision, la couleur se distingue par sa capacité à mobiliser le traitement pré-attentif décrit notamment par Anne Treisman. Lors de la découverte d’un canevas visuel, le cortex visuel primaire extrait quasi-instantanément — en deçà d’un seuil temporel estimé à deux cents millisecondes — des régularités chromatiques sans exiger une focalisation séquentielle de l’attention consciente. Cette ségrégation pré-attentive immédiate confère à l’encodage par la couleur une puissance de discrimination catégorielle supérieure à celle des formes géométriques ou de l’orientation spatiale.
Toutefois, cette puissance sémiologique impose une responsabilité méthodologique proportionnelle. Une utilisation inappropriée des teintes peut induire une surcharge cognitive délétère ou générer des illusions d’optique interprétatives. Si deux modalités factorielles reçoivent des couleurs dont la luminance relative diverge excessivement, le système visuel interprétera inconsciemment la modalité la plus claire ou la plus saturée comme dotée d’une magnitude quantitative supérieure ou d’une importance biologique prépondérante. Pour préserver l’intégrité sémiologique d’une recherche, les chercheurs doivent veiller à ce que les catégories nominales sans hiérarchie intrinsèque soient représentées par des teintes présentant une luminance perceptive constante, évitant ainsi d’introduire des asymétries attentionnelles artificielles au détriment de la neutralité de l’observation scientifique.
1.3 Distinction statistique entre variables continues et facteurs discrets
La distinction entre variables continues et facteurs discrets ne constitue pas une simple formalité informatique au sein de R ; elle détermine fondamentalement la structure mathématique de l’échelle graphique mobilisée. Lorsqu’un vecteur numérique continu est mappé sur l’attribut chromatique dans ggplot2, le logiciel instancie automatiquement une échelle à gradient (telle que scale_color_gradient()), interpolant les teintes de manière fluide entre des bornes extrêmes le long d’un segment chromatique unidimensionnel. Cette représentation présume que les valeurs intermédiaires sont infiniment sécables et porteuses d’une relation d’ordre métrique stricte.
À l’inverse, l’application de la couleur à un facteur exige une échelle catégorielle discrète (à l’instar de scale_color_discrete()). Dans ce contexte, l’espace chromatique ne doit pas être appréhendé comme une rampe linéaire, mais comme une collection de points distincts et équidistants prélevés dans un espace colorimétrique tridimensionnel. Si une variable numérique codant des groupes distincts (par exemple des bras d’expérimentation étiquetés conventionnellement 1, 2 et 3) n’est pas explicitement transtypée en facteur dans R avant l’exécution du code graphique, ggplot2 appliquera par défaut une rampe continue. Ce mauvais typage génère une légende graduée inadaptée et masque la nature qualitative et étanche des conditions expérimentales, compromettant immédiatement la validité du message scientifique transmis.
2. Préparation rigoureuse des données et structuration des facteurs dans R
L’application satisfaisante des attributs chromatiques dans ggplot2 dépend inextricablement de la qualité de la préparation des données en amont. En statistique computationnelle, la règle fondamentale stipule que la structure d’un graphique ne doit pas compenser le désordre d’un tableau de contingence ou d’un bloc de données mal formatté ; la cohérence factorielle doit être garantie au niveau de l’environnement de données sous-jacent.
2.1 Conversion et vérification des types de variables catégorielles
Dans l’environnement de programmation R, les vecteurs de type caractère brut (character) et les vecteurs numériques (numeric ou integer) ne possèdent pas intrinsèquement les propriétés algébriques d’un facteur au sens statistique. Un facteur dans R est un type de données complexe, stocké sous forme d’un vecteur d’entiers pointant vers une table d’attributs textuels désignée sous le terme de niveaux (levels). Pour assurer un mappage chromatique sans ambiguïté, il est indispensable de procéder à des vérifications systématiques au moyen des fonctions d’inspection de base telles que str(), class() et levels().
La conversion explicite s’opère canoniquement par l’appel à la fonction factor() ou à son dérivé as.factor(). L’utilisation de factor() doit être privilégiée dès lors que l’analyste souhaite définir avec précision l’ensemble exhaustif des modalités acceptables, y compris celles qui pourraient être temporairement absentes d’un sous-échantillon d’observations. L’omission de cette étape préparatoire contraint ggplot2 à effectuer une conversion implicite au moment du tracé, ce qui peut engendrer des instabilités lors de l’application ultérieure de palettes manuelles personnalisées ou lors de la standardisation de scripts destinés à être exécutés sur des cohortes de données volumineuses.
2.2 Gestion et réordonnancement des niveaux de facteurs
L’ordonnancement interne des niveaux d’un facteur constitue le levier exclusif par lequel R détermine la séquence temporelle et spatiale d’attribution des couleurs. Par défaut, lors de la création d’un facteur à partir d’une chaîne de caractères, R indexe les niveaux selon l’ordre alphabétique standard. Cette configuration arbitraire s’avère fréquemment inappropriée sur le plan scientifique : elle peut placer un groupe témoin (control) au centre d’une séquence de traitement ou désorganiser une échelle de Likert ordinale.
Pour maîtriser précisément cet ordonnancement, le recours aux fonctions du package spécialisé forcats s’avère d’une efficacité méthodologique remarquable. La fonction fct_relevel() permet de réassigner manuellement le niveau de référence épistémologique ou méthodologique d’une étude clinique. De même, fct_reorder() autorise le tri dynamique des niveaux factoriels en fonction des propriétés quantitatives d’une variable continue associée (telle que la médiane ou la moyenne des groupes). La maîtrise de cet ordonnancement assure que la progression chromatique attribuée par les échelles automatiques reflète fidèlement la structure logique sous-jacente du protocole expérimental.
2.3 Exploration du jeu de données canonique iris et analogues expérimentaux
Afin d’illustrer de façon reproductible les paradigmes chromatiques de ggplot2, le jeu de données historique de Ronald Fisher, iris, demeure la référence absolue en analyse multidimensionnelle. Ce jeu de données, documenté en 1936, rassemble cinquante observations pour chacune des trois espèces morphologiques d’iris : Iris setosa, Iris versicolor et Iris virginica, mesurées à travers quatre variables continues renseignant la longueur et la largeur des sépales et des pétales.
Ce jeu de données constitue un modèle idéal d’expérimentation graphique car le facteur Species présente une structure tridimensionnelle parfaitement équilibrée (effectif constant n = 50 par classe) et des frontières taxinomiques aux propriétés géométriques différenciées (setosa étant linéairement séparable des deux autres taxons, tandis que versicolor et virginica présentent un chevauchement partiel). L’exploration descriptive préalable de cette table au moyen de summary(iris) ou de table(iris$Species) confirme l’absence de valeurs aberrantes ou manquantes, offrant un cadre expérimental optimal pour tester la séparabilité perceptive des palettes graphiques avant de transposer ces protocoles à des cohortes de neuro-imagerie ou de psychologie cognitive plus hétérogènes.
3. Attribution basique des couleurs par facteur via l’argument esthétique
L’ancrage opératoire de la couleur s’effectue dans ggplot2 par l’intermédiaire de règles d’écriture syntaxique qui cristallisent la séparation formelle entre la déclaration des données et la spécification des couches géométriques.
3.1 Syntaxe fondamentale du mappage chromatique dans aes()
L’opération fondamentale par laquelle une variable qualitative pilote la différenciation visuelle s’exécute en assignant le nom de la variable catégorielle au paramètre color (ou colour) situé impérativement à l’intérieur des parenthèses de la fonction d’encodage esthétique aes(). Lorsque cette instruction est transmise au constructeur de base, sous la forme typique ggplot(data = iris, mapping = aes(x = Sepal.Length, y = Sepal.Width, color = Species)), le moteur d’évaluation non standard de R procède à plusieurs opérations combinées de haut niveau.
Premièrement, ggplot2 interroge la colonne spécifiée et extrait l’ensemble exhaustif des niveaux factoriels uniques. Deuxièmement, il calcule automatiquement une partition de l’espace colorimétrique par défaut afin d’associer un code chromatique hexadécimal distinct à chaque modalité identifiée. Troisièmement, lors de l’adjonction ultérieure d’une géométrie ponctuelle via l’opérateur d’addition unaire avec + geom_point(), le traceur assigne la couleur appropriée à chaque point d’observation en fonction de son appartenance catégorielle, tout en calculant les marges spatiales nécessaires à l’insertion dynamique d’une légende latérale décrivant cette bijection sémiotique.
3.2 Distinction cruciale entre mappage esthétique et assignation fixe
L’une des pierres d’achoppement les plus récurrentes pour les utilisateurs débutants ou intermédiaires de R réside dans la confusion fondamentale entre le « mappage esthétique dynamique » (aesthetic mapping) et « l’assignation fixe de paramètres » (aesthetic setting). Cette divergence conceptuelle dépend de la localisation syntaxique de l’argument color par rapport au bloc aes(). Si un chercheur souhaite appliquer une couleur uniforme et statique à l’intégralité des points tracés — par exemple, une teinte bleu marine constante —, cette instruction doit être placée en dehors de la fonction aes() mais à l’intérieur de la couche géométrique concernée, sous la forme geom_point(color = "navyblue").
À l’inverse, si l’instruction color = "navyblue" est malencontreusement insérée à l’intérieur de l’instruction aes(), le système ggplot2 n’interprète pas la chaîne de caractères comme un descripteur optique, mais crée artificiellement un facteur factice ne contenant qu’un seul niveau constant, dont le libellé textuel est précisément "navyblue". Le moteur attribue alors à ce niveau unique la première teinte de sa palette par défaut (généralement une nuance corail ou saumonée) et génère une légende redondante et erronée. La maîtrise rigoureuse de cette frontière syntaxique constitue un prérequis incontournable pour toute production graphique scientifique rigoureuse.
3.3 Analyse empirique du premier nuage de points avec iris
Pour matérialiser ce principe, considérons la représentation bidimensionnelle canonique croisant la longueur et la largeur des sépales du jeu de données susmentionné. En associant la variable Species à l’argument chromatique global, le graphique résultant met instantanément en exergue la ségrégation allométrique entre les trois populations végétales. Le groupe setosa, caractérisé par des sépales substantiellement plus larges et plus courts, se détache visuellement du nuage global sans qu’aucun calcul de régression ou d’analyse discriminante n’ait encore été sollicité.
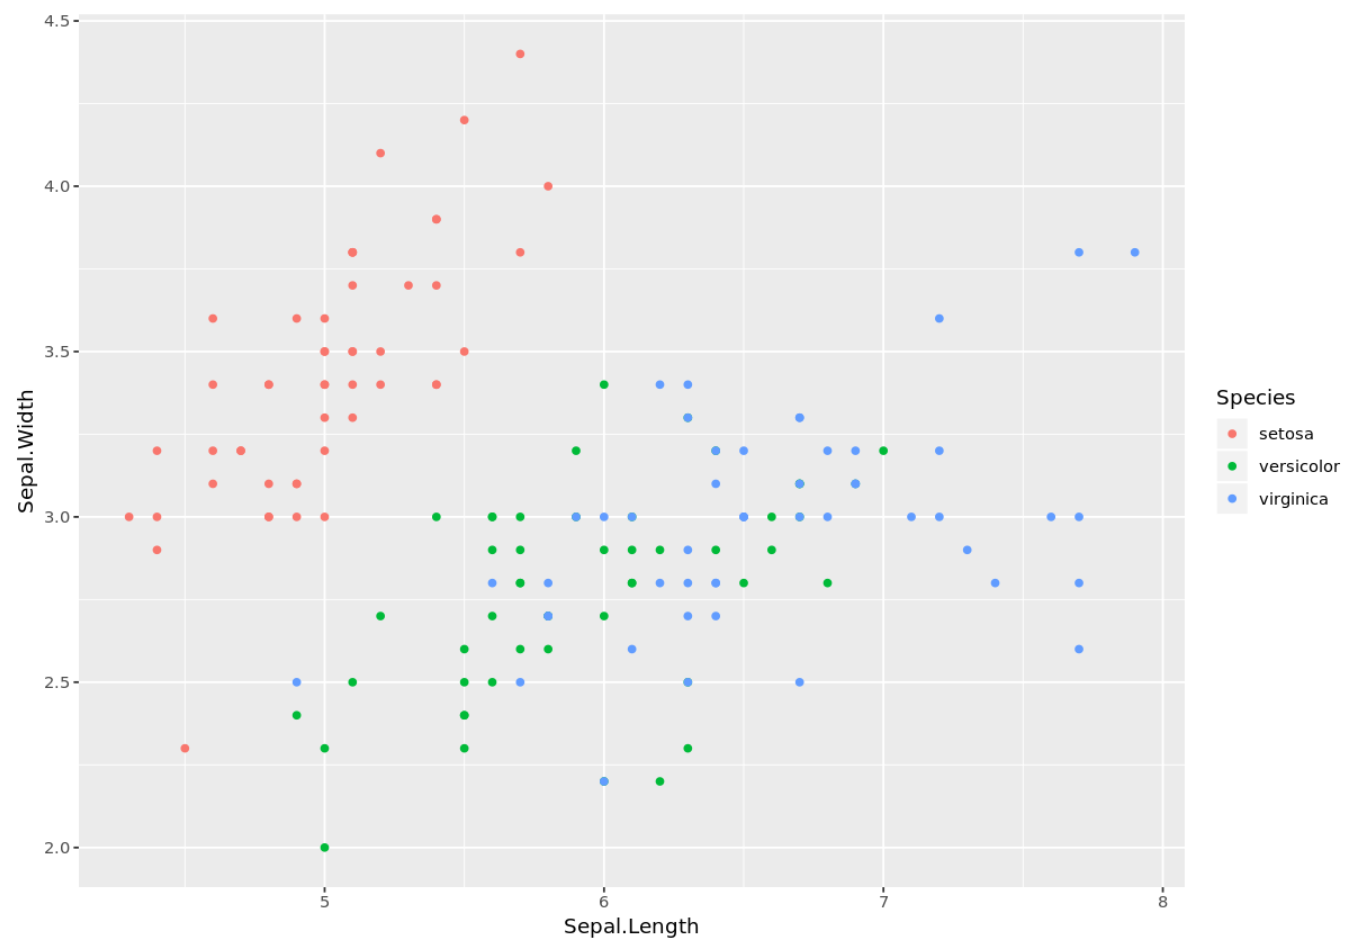
Cette visualisation immédiate démontre la supériorité cognitive de la couleur sur la simple lecture tabulaire des matrices de variances-covariances. Sans intervention manuelle sur les palettes, le système produit un artefact lisible qui permet au statisticien d’évaluer la dispersion multivariée intraclasse et d’identifier les éventuels points aberrants (outliers) au sein de chaque groupe biologique. L’étape analytique suivante requiert d’interroger la nature intrinsèque du nuancier déployé par défaut lors de cette étape de génération automatisée.
4. Fonctionnement interne de la palette discrète par défaut de ggplot2
L’automatisation du choix des couleurs au sein de ggplot2 repose sur des algorithmes colorimétriques sophistiqués, conçus pour garantir une équité perceptive maximale entre les catégories sans nécessiter une configuration manuelle laborieuse de la part du chercheur.
4.1 L’espace colorimétrique HCL et l’échantillonnage circulaire
Le moteur interne de ggplot2 utilise par défaut une échelle basée sur l’espace colorimétrique cylindrique HCL, qui formalise la couleur selon trois axes indépendants : la Teinte (Hue, mesurée sous forme d’un angle variant de 0 à 360 degrés), la Chrominance ou saturation (Chroma) et la Luminance perceptive (Lightness). Contrairement aux espaces traditionnels RVB (Rouge, Vert, Bleu) ou TLS (Teinte, Luminosité, Saturation), l’espace HCL a été calibré expérimentalement pour refléter fidèlement la réponse non-linéaire de l’appareil visuel humain.
Lorsque ggplot2 doit attribuer des teintes à un facteur comportant $k$ niveaux discrets via sa fonction sous-jacente scales::hue_pal(), il découpe le cercle chromatique HCL en $k$ segments angulaires rigoureusement égaux, tout en maintenant la luminance ($L$) et la chrominance ($C$) à des valeurs strictement constantes (généralement $L = 65$ et $C = 100$). Ce principe d’échantillonnage circulaire garantit qu’aucune modalité ne se voit dotée d’une brillance ou d’une intensité spectrale supérieure à ses voisines, éliminant théoriquement toute hiérarchisation perceptive artificielle entre les groupes expérimentaux.
4.2 Avantages et limites psychométriques de la palette standard
Cette approche algorithmique présente des bénéfices évidents pour l’analyse exploratoire rapide : elle s’adapte dynamiquement à n’importe quel nombre de catégories et fonctionne de manière générique sur l’ensemble des systèmes d’exploitation sans nécessiter de dépendances logicielles tierces. Sur le plan psychométrique, tant que le nombre de modalités demeure restreint (typiquement lorsque $k \leq 4$), la distance angulaire entre chaque teinte dans l’espace HCL reste suffisamment vaste (supérieure ou égale à 90 degrés) pour permettre une discrimination pré-attentive sans effort d’accommodation cognitive.
Cependant, ce système révèle des faiblesses critiques dès que la cardinalité du facteur s’accroît. Lorsque $k$ excède cinq ou six modalités, la proximité angulaire des points d’échantillonnage engendre des confusions visuelles majeures, notamment dans les régions spectrales comprises entre le vert, le cyan et le bleu où le pouvoir de résolution chromatique de l’œil humain décline. En outre, la palette standard s’avère hautement vulnérable aux conditions de diffusion physique défavorables : lors d’une impression en noir et blanc ou d’une rétroprojection en salle de conférence faiblement contrastée, la constance de la luminance ($L = 65$) provoque une fusion isotrope des teintes, rendant les différents groupes strictement indiscernables sous forme de nuances de gris uniformes.
4.3 Gestion native des valeurs manquantes (NA) dans les facteurs
La présence de valeurs manquantes (notées conventionnellement NA pour Not Available dans l’écosystème R) au sein d’une variable factorielle pose un dilemme sémiologique permanent. Par défaut, ggplot2 traite l’absence d’observation non pas comme une absence d’affichage, mais comme une modalité d’information à part entière. Le moteur graphique réserve ainsi une teinte grise neutre standardisée (souvent le code #7F7F7F ou un gris clair similaire) pour indexer les observations dont le statut d’assignation factorielle est non renseigné.
Ce comportement évite l’écueil critique consistant à ignorer silencieusement des données manquantes, ce qui pourrait biaiser l’interprétation épidémiologique d’un échantillon. Toutefois, l’analyste conserve la possibilité de moduler ce comportement au sein de la fonction d’échelle discrète en modifiant l’argument na.value. Il est ainsi envisageable soit d’assigner une teinte très contrastée pour faire ressortir un biais de recueil de données, soit au contraire de rendre ces observations totalement invisibles en leur assignant une valeur de transparence totale au moyen de la constante na.value = NA, excluant ainsi visuellement les données incomplètes sans altérer la cohérence du reste du graphique.
5. Personnalisation manuelle des teintes avec scale_color_manual()
Pour s’affranchir des limitations intrinsèques de la palette par défaut et se conformer aux exigences éditoriales des revues à fort facteur d’impact, le contrôle déterministe et absolu de chaque nuance chromatique s’avère indispensable. Ce niveau de précision est rendu possible par la couche scale_color_manual().
5.1 Paramétrage précis du vecteur de valeurs chromatiques
La fonction scale_color_manual() constitue l’opérateur pivot permettant de court-circuiter l’échantillonnage automatique circulaire au profit d’une liste explicite de teintes définies par le chercheur. L’argument central de cette fonction est values, qui attend un vecteur unidimensionnel de spécificateurs de couleur. Ce vecteur peut être alimenté par les noms littéraux des couleurs standardisées supportées nativement par le moteur graphique de R (obtenus via la commande colors(), qui référence plus de 650 dénominations telles que "steelblue", "firebrick", "darkgoldenrod" ou "forestgreen").
Bien que cette méthode descriptive simplifie la phase d’expérimentation initiale, elle expose le code à des variations subjectives d’appréciation de la saturation. La bonne pratique scientifique préconise l’élaboration en début de script d’un vecteur de styles dédié, regroupant les constantes chromatiques du laboratoire ou de la publication. L’injection de ce vecteur dans scale_color_manual(values = mon_vecteur) garantit une uniformité stylistique rigoureuse à travers les dizaines de figures composant un manuscrit de recherche ou un rapport d’évaluation clinique.
5.2 Sécurisation des assignations par l’usage de vecteurs nommés
L’utilisation d’un vecteur anonyme ordonné (conçu sous la forme values = c("teinte1", "teinte2", "teinte3")) recèle un danger méthodologique majeur : l’aléa de l’appariement positionnel. En l’absence de correspondances explicites, ggplot2 associe les teintes aux niveaux du facteur en se basant exclusivement sur leur index séquentiel respectif. Si les données subissent une opération de filtrage dynamique en amont (par exemple, l’exclusion temporaire d’un bras de traitement via la commande dplyr::filter()), l’ordre relatif des niveaux observés peut être modifié, entraînant une permutation silencieuse et catastrophique des couleurs entre les figures d’un même article.
Pour éliminer définitivement ce risque d’erreur scientifique, il est impératif de recourir à des vecteurs nommés. Dans cette configuration, chaque élément du vecteur chromatique porte comme nom d’attribut la chaîne exacte correspondant au niveau factoriel visé : c("setosa" = "#1B9E77", "versicolor" = "#D95F02", "virginica" = "#7570B3"). Dès lors, ggplot2 réalise une jointure déterministe entre le facteur et la couleur, assurant une parfaite reproductibilité de l’assignation chromatique, indépendamment des filtres, suppressions ou remaniements subis par la table de données durant les étapes analytiques intermédiaires.
5.3 Emploi rigoureux des codes hexadécimaux pour publications
Le standard international d’encodage de la couleur dans les environnements de publication numérique et imprimée repose sur le modèle hexadécimal à six caractères précédés d’un croisillon (#RRGGBB). Cette notation quantifie avec une précision mathématique absolue les composantes rouge, verte et bleue du signal lumineux sur une échelle variant de 00 à FF en arithmétique de base 16, offrant un répertoire de plus de 16,7 millions de nuances discernables.
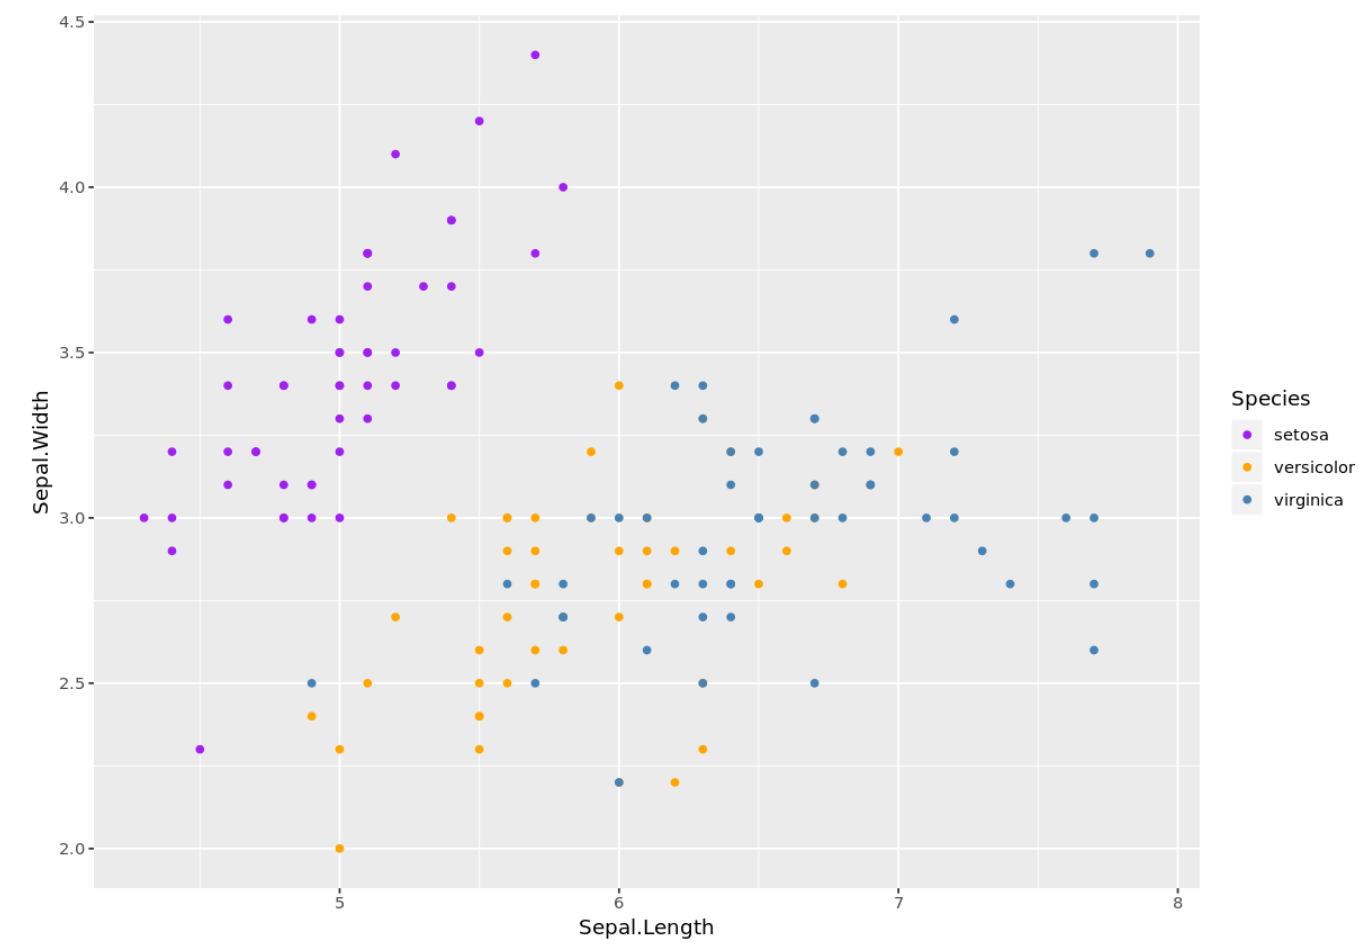
Le déploiement des codes hexadécimaux permet de calibrer les figures en respectant scrupuleusement les exigences des chartes graphiques académiques et les normes de reproduction photométrique. Par exemple, l’utilisation de triplets garantissant des contrastes de luminance suffisants par rapport aux fonds blancs purs (généralement #FFFFFF) empêche l’apparition de phénomènes d’éblouissement ou de délavage visuel lors de la restitution sur papier glacé ou sur écrans de haute densité. Le calibrage hexadécimal constitue l’interface universelle reliant les recommandations des laboratoires de colorimétrie computationnelle aux scripts d’analyse R.
6. Intégration de palettes prédéfinies scientifiques : ColorBrewer et Viridis
La conception manuelle d’une palette chromatique harmonieuse et scientifiquement irréprochable exige une expertise en psychophysique que la plupart des analystes ne possèdent pas. C’est pourquoi la communauté scientifique privilégie fréquemment l’intégration de nuanciers pré-calibrés validés empiriquement par la recherche en cartographie et en vision par ordinateur.
6.1 Application des palettes qualitatives de Cynthia Brewer
Les travaux fondamentaux de la cartographe Cynthia Brewer ont abouti au développement du système ColorBrewer, spécifiquement conçu pour optimiser la lisibilité des cartes choroplèthes et des graphiques statistiques complexes. Dans ggplot2, ce nuancier est accessible directement via la commande scale_color_brewer(). Contrairement aux échelles séquentielles ou divergentes conçues pour les gradients continus, les palettes dites « qualitatives » de Brewer sont spécifiquement dimensionnées pour les facteurs nominaux dépourvus de gradation d’ordre.
Parmi ces sélections, les nuanciers "Set1", "Set2" et "Dark2" sont largement reconnus pour leur pouvoir de séparation visuelle. La palette "Dark2", par exemple, utilise des teintes de saturation modérée mais de fort contraste mutuel, ce qui la rend particulièrement adaptée aux nuages de points fins dont la surface encrée est ténue. Il convient toutefois de noter une contrainte mathématique absolue : chaque palette qualitative de Brewer possède une capacité d’accueil limitée, plafonnée généralement entre 8 et 12 classes maximales. Tenter d’appliquer une palette Brewer qualitative à un facteur possédant 15 niveaux déclenche un avertissement explicite du système et contraint le traceur à tronquer ou recycler les couleurs, détruisant ainsi l’unicité de l’encodage.
6.2 Déploiement de scale_color_viridis_d() pour facteurs discrets
Initialement développée pour la bibliothèque Python Matplotlib et rapidement intégrée au cœur de l’écosystème R, la famille de palettes Viridis représente l’une des avancées les plus remarquables en matière de visualisation de données scientifiques. Accessible pour les variables qualitatives via l’instruction scale_color_viridis_d() (le suffixe d désignant explicitement la variante discrète), cette échelle a été optimisée algorithmiquement pour répondre à un double impératif de monotonicité de luminance et d’accessibilité perceptive universelle.
Les palettes de la suite Viridis (qui comprend également les variantes "magma", "plasma", "inferno" et "cividis") possèdent la propriété d’être perceptuellement uniformes : la distance métrique perçue entre deux nuances dans l’espace tridimensionnel HCL est strictement proportionnelle à la distance mathématique séparant les points dans la structure factorielle. Cette régularité confère aux graphiques générés une résilience absolue face aux transformations dégradantes : si une figure publiée avec la palette Viridis est photocopiée en noir et blanc ou convertie en niveaux de gris purs, le contraste structural entre les catégories demeure intégralement préservé sous forme d’échelons de luminance distincts.
6.3 Critères méthodologiques de choix de palette en psychologie quantitative
Le choix d’une palette ne doit pas s’effectuer sous le seul prisme de la commodité technique ; il doit intégrer les répercussions psychologiques de la charge affective associée aux teintes. En psychologie cognitive et sociale, de nombreuses études ont documenté l’existence de biais d’association sémantique spontanés : la couleur rouge est inconsciemment associée au danger, à l’inhibition ou à la pathologie, tandis que le vert évoque la validation, l’innocuité ou la régulation émotionnelle positive.
Si une étude comparative évalue des sous-groupes cliniques en assignant arbitrairement une teinte rouge vif au groupe contrôle et une teinte verte au groupe pathologique, le chercheur génère une dissonance cognitive chez le lecteur susceptible de biaiser le décodage rapide des conclusions scientifiques. Les recommandations de publication édictées par l’American Psychological Association (APA) encouragent l’emploi de palettes neutres, dépourvues de connotations culturelles marquées, afin de garantir une neutralité axiomatique maximale dans l’appréciation des faits expérimentaux.
7. Contrôle avancé et personnalisation de la légende du facteur
La légende d’un graphique n’est pas une simple marge textuelle passive ; elle constitue la clé de décodage formelle sans laquelle le mappage chromatique demeure une énigme sémiotique pour l’observateur extérieur. Son paramétrage minutieux participe directement à l’intelligibilité globale de l’œuvre scientifique.
7.1 Modification des intitulés de niveaux et du titre de légende
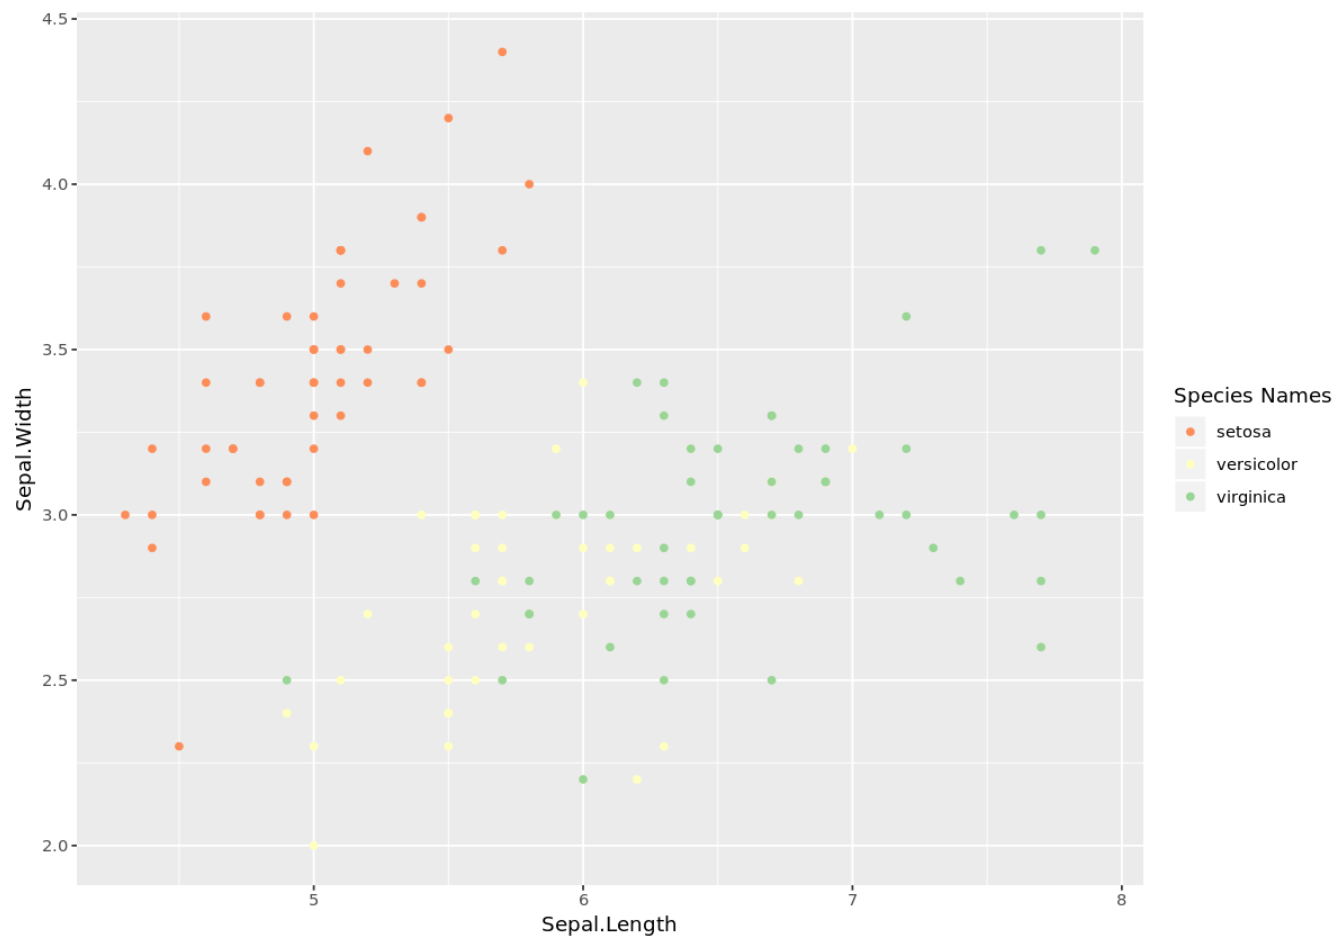
Dans sa configuration initiale, ggplot2 extrait l’intitulé du titre de la légende directement depuis le nom de la variable contenu dans le bloc de données, et copie les étiquettes des niveaux textuels de façon littérale. Cette démarche aboutit fréquemment à l’affichage d’identifiants techniques peu élégants pour une publication formelle (tels que grp_traitement_v3). La méthode la plus transparente pour renommer le titre global de la légende chromatique consiste à utiliser la fonction labs(), via l’instruction explicite labs(color = "Condition clinique").
Si l’on souhaite simultanément harmoniser les étiquettes internes des différentes catégories sans modifier irréversiblement la table de données originale, l’argument labels de l’échelle d’attribution (par exemple au sein de scale_color_manual() ou scale_color_brewer()) doit être sollicité. Il est alors possible de transmettre un vecteur textuel formatté, tel que labels = c("Témoin sain", "Trouble panique", "Épisode dépressif"). Une rigueur absolue s’impose lors de cette manipulation : le vecteur fourni à l’argument labels doit suivre très précisément l’ordre intrinsèque des niveaux sous peine d’induire des décalages d’étiquetage catastrophiques entre la table de données et sa représentation graphique.
7.2 Configuration géométrique de la légende via guides()
L’organisation spatiale des symboles au sein de la boîte de légende peut altérer significativement l’équilibre visuel du tracé, notamment lorsque le nombre de catégories est élevé ou que les libellés textuels sont longs. La fonction guides() couplée à l’opérateur guide_legend() permet de sculpter précisément cette géométrie. On peut contraindre l’agencement des éléments graphiques à se déployer sur un nombre spécifique de colonnes ou de lignes grâce aux arguments ncol et nrow, optimisant ainsi l’occupation de l’espace latéral.
Par ailleurs, une problématique récurrente concerne la visibilité des symboles de points dans la légende lorsqu’une transparence (alpha) est appliquée aux données du graphique principal pour contrer les superpositions de points. Dans cette situation, les glyphes de la légende deviennent souvent trop pâles pour être discernés. La technique avancée override.aes permet de décorréler les propriétés optiques du graphique de celles de la légende. En insérant l’instruction guides(color = guide_legend(override.aes = list(alpha = 1, size = 3))), le chercheur force les symboles de la légende à s’afficher avec une opacité maximale et un diamètre suffisant pour une identification immédiate de la teinte, préservant ainsi la lisibilité de la clé de décodage sans sacrifier la transparence nécessaire au nuage de points principal.
7.3 Positionnement spatial et intégration esthétique dans le canevas
Le positionnement par défaut de la légende sur le flanc droit du graphique consomme une largeur horizontale précieuse, particulièrement dommageable lors de la mise en page d’articles scientifiques formatés sur deux colonnes étroites. L’ajustement structurel s’opère par l’intermédiaire de la couche générale de thème theme(legend.position = ...). Les options textuelles simples permettent de relocaliser l’ensemble du bloc en haut ("top"), en bas ("bottom") ou d’en ordonner la suppression complète ("none") lorsque le propos analytique n’exige pas de redondance visuelle.
Pour un contrôle éditorial plus poussé, legend.position accepte un vecteur de coordonnées numériques à deux dimensions exprimées sur une échelle unitaire normalisée variant de 0 à 1, tel que legend.position = c(0.85, 0.20). Cette syntaxe permet d’incruster la légende directement à l’intérieur des zones topologiquement vides du plan cartésien, évitant ainsi tout gaspillage spatial. Conjointement, l’application de theme(legend.background = element_rect(...)) permet d’ajouter une bordure discrète ou un fond semi-transparent à la boîte de légende pour empêcher toute interférence textuelle avec les données graphiques sous-jacentes.
8. Différenciation technique entre couleur de contour (color) et remplissage (fill)
L’un des fondements de la syntaxe de ggplot2 repose sur la distinction anatomique entre le périmètre extérieur d’une forme géométrique et son volume surfacique intérieur. Cette séparation se traduit par l’existence de deux canaux esthétiques distincts : color et fill.
8.1 Propriétés morphologiques des géométries R et récepteurs esthétiques
En typographie computationnelle R, les objets géométriques possèdent des récepteurs esthétiques rigoureusement définis par leur identifiant de forme standard (shape). Les symboles ponctuels conventionnels indexés de 0 à 20 sont monolithiques : les formes 0 à 14 ne répondent qu’au tracé de contour (color), tandis que les formes 15 à 20 correspondent à des surfaces pleines dont la totalité du glyphe est assujettie à l’argument color.
En revanche, les glyphes de points indexés de 21 à 25 constituent des géométries bicomposantes sophistiquées. Ils possèdent à la fois une frontière extérieure pilotée par l’esthétique color et une chambre interne colorable régie par l’esthétique fill. L’épaisseur du filet périphérique peut être modulée indépendamment via le paramètre stroke. Cette distinction offre des leviers analytiques de premier ordre : il devient possible de projeter un premier facteur catégoriel sur le contour d’un point tout en remplissant son centre avec la teinte d’un second facteur, ou de cercler de noir (color = "black") des points dont le remplissage interne varie selon un facteur expérimental, maximisant ainsi le contraste des frontières visuelles lors de fortes superpositions de points (overplotting).
8.2 Application du facteur à geom_boxplot() et geom_violin()
La distinction entre color et fill s’illustre particulièrement lors du tracé de géométries surfaciques étendues, à l’image des diagrammes en boîte à moustaches (geom_boxplot()) ou des tracés en violon (geom_violin()). Si un facteur est mappé sur l’argument color dans un diagramme en boîte, seules les moustaches, les bordures extérieures des rectangles et les marqueurs de valeurs extrêmes recevront les teintes assignées, le corps central de la boîte restant invariablement d’un blanc neutre.
À l’inverse, l’assignation de la variable factorielle à l’argument fill (par exemple aes(fill = Species)) colore l’intégralité de la masse volumique de la distribution, offrant une lisibilité structurelle bien supérieure à distance d’affichage. Dans un tel contexte, les fonctions de paramétrage manuel doivent être synchronisées : la personnalisation d’un remplissage surfacique exige impérativement l’invocation de scale_fill_manual() ou scale_fill_viridis_d(), et non de leurs homologues préfixés par scale_color_. Une erreur fréquente consiste à modifier l’échelle de couleur tout en ayant mappé les données sur le remplissage, ce qui neutralise silencieusement les personnalisations chromatiques opérées par l’utilisateur.
8.3 Gestion de la transparence (alpha) combinée aux facteurs colorés
L’un des défis majeurs posés par l’emploi de surfaces colorées denses réside dans le masquage des observations individuelles et la saturation optique globale du graphique. Ce phénomène s’avère particulièrement aigu lorsque des polygones de densité de distribution se chevauchent le long d’un axe continu. L’incorporation du paramètre de transparence alpha — dont la valeur scalaire varie continûment de 0 (transparence totale) à 1 (opacité absolue) — permet de résoudre avec élégance ces conflits d’occlusion.
En paramétrant une valeur telle que geom_density(aes(fill = Facteur), alpha = 0.4), les aires spectrales superposées se mélangent selon des règles de synthèse soustractive, révélant la topologie sous-jacente des intersections distributionnelles. Toutefois, cette pratique impose une vigilance colorimétrique accrue : la transparence réduit mécaniquement la saturation et augmente la luminance effective des teintes appliquées, ce qui peut rapprocher artificiellement des nuances préalablement contrastées et tromper le lecteur sur l’amplitude réelle des variances intragroupes. Le calibrage de la valeur alpha doit donc toujours s’accompagner d’un test visuel d’équidistance des contrastes résultants.
9. Modélisation de facteurs croisés et encodages visuels multidimensionnels
La complexité inhérente aux protocoles de recherche contemporains exige fréquemment la représentation simultanée de plusieurs dimensions catégorielles croisées au sein d’une unique scène visuelle.
9.1 Création d’interactions factorielles explicites pour la couleur
Dans le cadre d’un plan factoriel complet (par exemple un plan d’expérimentation $2 \times 2$ croisant un facteur « Traitement » à deux niveaux et un facteur « Sexe » à deux modalités), l’analyste cherche souvent à visualiser les quatre cellules expérimentales au moyen de signatures chromatiques différenciées. Plutôt que de transformer préalablement la table de données par des opérations de concaténation de chaînes de caractères, ggplot2 autorise l’évaluation en ligne d’interactions factorielles complexes au sein de l’environnement esthétique grâce à la fonction primitive interaction().
L’écriture canonique aes(color = interaction(Traitement, Sexe, sep = " - ")) ordonne au système de construire dynamiquement un facteur combiné à quatre modalités distinctes, doté d’une nomenclature explicite. Dès lors, il devient possible de concevoir des familles de couleurs manuelles cohérentes au sein de scale_color_manual(), en utilisant par exemple deux nuances saturées et désaturées d’une même teinte de base pour les modalités d’un groupe, et deux nuances d’une teinte contrastante pour le second groupe. Cette structuration chromatique hiérarchisée permet au cerveau du lecteur d’appréhender instantanément les effets principaux et les dynamiques d’interaction d’ordre supérieur.
9.2 Combinaison redondante ou complémentaire de la couleur et de la forme
L’un des préceptes fondateurs de l’ergonomie visuelle appliquée aux sciences expérimentales réside dans le principe du double encodage sensoriel. Si la couleur demeure le canal d’encodage le plus rapide, son association redondante avec une seconde dimension perceptive — typiquement la forme géométrique des points (shape) — renforce considérablement la résilience du message graphique face aux contraintes d’accessibilité et aux altérations matérielles de diffusion.
En stipulant conjointement aes(color = Diagnostic, shape = Diagnostic), chaque groupe clinique se trouve caractérisé à la fois par une chromaticité propre et par une signature géométrique exclusive (par exemple un cercle plein pour les témoins, un carré pour les formes modérées et un triangle pour les formes sévères). Pour que cette double assignation conserve son élégance et son unité fonctionnelle, il est impératif d’harmoniser les titres et les libellés au sein des appels labs(color = "Diagnostic", shape = "Diagnostic"). Si ces intitulés sont rigoureusement identiques, ggplot2 fusionne automatiquement les deux clés graphiques en une seule légende unifiée et cohérente.
9.3 Arbitrage méthodologique entre couleur groupée et facettage (faceting)
Face à une structure de données hautement multidimensionnelle, l’analyste peut être tenté de surcharger le canevas en multipliant les distinctions chromatiques sur un même système d’axes cartésiens. Au-delà de cinq ou six catégories en forte superposition, la lisibilité s’effondre inévitablement en raison de l’encombrement graphique (visual clutter). La méthode de décomposition en petits multiples visuels — implémentée dans ggplot2 via les instructions facet_wrap() ou facet_grid() — offre alors une alternative méthodologique décisive.
Le choix entre un nuage de points superposé enrichi par la couleur et un ensemble de panneaux facettés dépend du type de comparaison privilégié par la question de recherche. Si l’objectif fondamental réside dans l’estimation fine du chevauchement et des intersections géométriques entre groupes, le tracé unique unifié par la couleur s’avère supérieur. En revanche, si l’étude cherche à caractériser les tendances morphologiques propres à chaque catégorie sans interférence visuelle, le partitionnement spatial en panneaux distincts, tout en conservant la coloration constante de chaque groupe à travers les facettes, combine avec brio ségrégation structurelle et identité chromatique transversale.
10. Accessibilité visuelle, daltonisme et ergonomie cognitive
L’accessibilité des productions scientifiques ne constitue pas une option stylistique secondaire ; elle relève d’une obligation éthique et déontologique de la diffusion académique. La conception de graphiques ignorant les spécificités de la vision chromatique humaine exclut de fait une proportion substantielle de la communauté des pairs de l’accès aux résultats de la recherche.
10.1 Physiopathologie des dyschromatopsies et contraintes graphiques
Les déficiences congénitales de la vision chromatique, regroupées vulgairement sous le vocable de daltonisme ou de dyschromatopsie, résultent de l’absence ou de l’anomalie fonctionnelle de l’un des trois types de photorécepteurs rétiniens coniques responsables de la photoréception spectrale. La deutéranopie (absence de cônes sensibles aux longueurs d’ondes moyennes, soit le vert) et la protanopie (déficience des cônes sensibles aux grandes longueurs d’ondes, soit le rouge) affectent jusqu’à 8 % de la population masculine d’ascendance européenne et environ 0,5 % de la population féminine. La tritanopie, touchant les récepteurs aux courtes longueurs d’ondes (bleu), présente une incidence beaucoup plus rare mais non négligeable.
Pour un chercheur atteint de deutéranopie ou de protanopie, le contraste spectral situé entre le rouge et le vert s’effondre : ces deux teintes distinctes pour un trichromate régulier sont perçues comme des nuances indiscernables de jaune-brunâtre présentant une même réflectance relative. L’emploi persistant de combinaisons rouge/vert dans les publications scientifiques internationales — notamment dans les matrices thermiques (heatmaps) et les nuages de points factoriels — engendre des contresens analytiques majeurs chez les relecteurs et les praticiens confrontés à ces représentations non inclusives.
10.2 Outils de simulation et d’audit du rendu daltonien sous R
L’écosystème logiciel de R intègre des outils d’audit prospective remarquablement puissants pour évaluer la robustesse inclusive d’une figure avant sa soumission à un comité de lecture. Le package colorblindr, qui s’appuie sur le moteur d’interpolation colorimétrique de colorspace, offre des fonctions de simulation automatisées permettant d’auditer instantanément un objet ggplot2.
L’appel de la fonction cvd_grid(mon_graphique) décompose la figure originale en une grille synoptique modélisant fidèlement sa perception visuelle sous quatre conditions rétiniennes réelles : vision trichromatique normale, deutéranopie, protanopie et tritanopie. Cet audit visuel permet au chercheur d’identifier immédiatement les paires de catégories dont la séparabilité chromatique s’effondre après projection dans l’espace réduit des dyschromates, l’incitant à reconfigurer sa sélection de codes hexadécimaux ou à opter pour des standards universels éprouvés tels que la palette Viridis.
10.3 Règles de contraste et conformité aux standards d’édition scientifique
Au-delà de l’exclusion des paires chromatiques conflictuelles, l’ergonomie visuelle scientifique impose le respect de contrastes de luminance suffisants entre les éléments d’encrage de premier plan (les données) et la couche de fond structurelle. Les standards internationaux développés pour l’accessibilité numérique, tels que les directives WCAG (Web Content Accessibility Guidelines) élaborées par le consortium W3C, définissent des ratios de contraste photométrique minimaux (typiquement un ratio de 4,5:1 pour le texte et les éléments d’information essentiels).
Dans l’univers de ggplot2, ce respect du contraste implique d’éviter formellement l’affichage de points de couleur jaune pur ou vert clair sur les fonds gris par défaut du thème standard theme_grey(), leur luminance relative étant trop proche de celle de la matrice de fond. L’adoption conjointe d’un thème à haut contraste tel que theme_bw() ou theme_classic(), associée à des teintes dont la luminance globale est abaissée, assure une restitution graphique nette et infaillible, tant pour les lecteurs souffrant d’une baisse d’acuité visuelle que lors de l’affichage sur des terminaux numériques à faible restitution lumineuse.
11. Protocoles expérimentaux et études de cas concrets sous R
La mise en pratique des règles théoriques énoncées jusqu’ici gagne à être illustrée par des scénarios de recherche appliqués, représentatifs des analyses de variance et de régression couramment conduites dans les laboratoires de sciences humaines et comportementales.
11.1 Étude 1 : Visualisation de sous-groupes diagnostiques en psychopathologie
Considérons un protocole de recherche clinique en psychopathologie computationnelle évaluant la dispersion croisée de scores psychométriques issus de deux échelles standardisées : l’Inventaire d’Anxiété de Beck (BAI) sur l’axe des abscisses et l’Échelle de Dépression de Hamilton (HAM-D) sur l’axe des ordonnées. L’échantillon expérimental réunit trois cents participants répartis en trois sous-groupes nosographiques distincts : « Contrôle Sain » ($n = 100$), « Anxiété Généralisée » ($n = 100$) et « Dépression Majeure » ($n = 100$).
Le protocole de visualisation requiert l’établissement d’une séparation visuelle contrastée, accessible aux dyschromates, respectant une hiérarchie sémantique sobre. Après avoir généré un tableau simulé cohérent et typé rigoureusement le diagnostic sous forme de facteur ordonné, le statisticien met en œuvre une couche scale_color_manual() sécurisée par un vecteur nommé aux tonalités hexadécimales soigneusement espacées : le gris acier (#6BAED6) pour les témoins, l’ambre sombre (#FD8D3C) pour l’anxiété et le violet profond (#7A0177) pour la dépression. L’adjonction de contours elliptiques de confiance statistique à 95 % au moyen de stat_ellipse(level = 0.95, linewidth = 0.8) renforce la compréhension topologique des sous-populations sans saturer le tracé de points.
11.2 Étude 2 : Temps de réaction en psychologie cognitive selon la modalité de stimulus
Notre deuxième cas d’étude aborde un paradigme d’attention sélective mesurant les temps de réaction (exprimés en millisecondes) au sein d’une tâche de détection simple. L’expérimentation manipule une variable factorielle intra-sujet à trois modalités sensorielles : « Stimulus Visuel », « Stimulus Auditif » et « Stimulus Bimodal » (combinaison audio-visuelle synchrone). L’analyste souhaite illustrer la distribution statistique complète de chaque modalité, soulignant le phénomène de facilitation multisensorielle.
La solution graphique d’excellence associe ici une géométrie de distribution semi-transparente à un tracé d’observations dispersées horizontalement pour éviter la superposition des scores identiques. On combinera donc un geom_boxplot(aes(fill = Modalite), width = 0.3, outlier.shape = NA, alpha = 0.7) avec une couche sous-jacente de points individuels geom_jitter(aes(color = Modalite), width = 0.15, alpha = 0.5). L’application coordonnée de scale_fill_viridis_d(option = "cividis") et de scale_color_viridis_d(option = "cividis") garantit une gradation perceptuelle uniforme, tout en autorisant une superposition harmonieuse des contours et des surfaces de données.
11.3 Étude 3 : Évolution longitudinale de scores psychométriques par bras thérapeutique
La troisième situation expérimentale met en scène un essai contrôlé randomisé longitudinal suivant l’évolution temporelle d’un score de bien-être psychologique mesuré à quatre étapes standardisées : pré-intervention ($T_0$), post-intervention immédiat ($T_1$), suivi à trois mois ($T_2$) et suivi à six mois ($T_3$). Les patients sont assignés soit à un bras « Prise en charge standard » (TAU, Treatment As Usual), soit à une « Thérapie Cognitive et Comportementale innovante » (TCC).
La difficulté majeure de cette restitution réside dans la coexistence de deux niveaux d’information : les trajectoires individuelles de chaque sujet au fil du temps et la trajectoire moyenne d’évolution de chaque bras de traitement. La grammaire de ggplot2 permet de structurer cette hiérarchie avec une grande élégance : les fines lignes individuelles sont tracées au moyen de geom_line(aes(group = Patient_ID, color = Bras), alpha = 0.15, linewidth = 0.4), tandis que la trajectoire macroscopique moyenne est matérialisée par une couche statistique superposée stat_summary(fun = mean, geom = "line", aes(group = Bras, color = Bras), linewidth = 1.4). L’attribution chromatique par facteur garantit que l’œil humain extrait simultanément la variabilité interindividuelle et la supériorité statistique globale d’un traitement sur l’autre.
12. Diagnostic des erreurs récurrentes et bonnes pratiques de publication
La manipulation des échelles de facteurs au sein de chaînes d’instructions ggplot2 volumineuses confronte inévitablement le chercheur à des messages d’avertissement cryptiques ou à des comportements d’affichage inattendus qu’il convient de diagnostiquer avec méthode.
12.1 Résolution des anomalies d’assignation et avertissements silencieux
L’un des messages d’erreur les plus universels rencontrés lors de l’exécution d’un code de tracé est le célèbre avertissement : « Continuous value supplied to discrete scale ». Cette notification signale que l’utilisateur a invoqué une échelle dédiée aux facteurs qualitatifs (comme scale_color_manual() ou scale_color_brewer()) alors que la variable assignée dans l’environnement aes(color = ...) est formellement stockée sous forme de vecteur numérique ou de point flottant par le moteur R. La correction exige une vérification immédiate du typage de la variable au moyen de la conversion explicite as.factor() insérée soit en amont dans la table de données, soit directement au sein de la commande graphique.
Une seconde anomalie récurrente concerne l’absence inattendue d’affichage de teintes personnalisées, remplacées par une couleur grise par défaut pour certains niveaux factoriels précis. Cette anomalie découle presque toujours d’une divergence orthographique minime (telle qu’une faute de frappe ou une différence de casse majuscule/minuscule) entre les libellés de niveaux déclarés dans les attributs d’un vecteur nommé au sein de scale_color_manual(values = c(...)) et les chaînes textuelles réelles présentes dans le tableau de données. Enfin, le phénomène des « niveaux fantômes » — des modalités factorielles historiquement définies mais ne comptant aucune observation dans un sous-échantillon filtré — peut être neutralisé en paramétrant l’argument structurel drop = FALSE ou drop = TRUE dans la définition de l’échelle d’attribution selon que l’on désire ou non préserver la catégorie vide dans la légende.
12.2 Optimisation du code pour la robustesse et la reproductibilité
Dans un contexte de science ouverte et de recherche computationnelle reproductible, l’intégration dispersée de paramètres chromatiques codés en dur (« hardcodés ») au sein de scripts graphiques volumineux constitue une mauvaise pratique technique. Il est vivement préconisé d’encapsuler ses choix esthétiques dans des fonctions de thèmes personnalisées ou de définir en en-tête d’analyse des dictionnaires de styles standardisés réutilisables par l’ensemble des collaborateurs d’un projet.
La construction de fonctions utilitaires dédiées, capables d’injecter automatiquement les palettes et les légendes canoniques du laboratoire à chaque nouvelle figure, évite les copier-coller redondants et minimise le risque d’incohérence entre les représentations visuelles d’un même protocole. De surcroît, la documentation rigoureuse des dépendances de versions de bibliothèques logicielles (à l’aide d’environnements virtualisés comme renv) garantit que les algorithmes de spatialisation chromatique continueront de produire des visualisations identiques lors de futures réanalyses des données.
12.3 Exportation vectorielle haute définition pour revues à comité de lecture
L’ultime étape méthodologique de la chaîne de visualisation réside dans le transfert du tracé informatique vers le manuscrit final sous une forme préservant intégralement l’acuité et la fidélité des nuances chromatiques. Les consignes aux auteurs des grandes revues scientifiques internationales (éditées notamment par Elsevier, Springer Nature, Wiley ou l’APA) proscrivent formellement l’exportation au format matriciel basse définition (JPEG ou PNG à 72 DPI) pour les éléments contenant des lignes fines et des symboles colorés.
La commande canonique ggsave() doit être systématiquement exploitée en ciblant des formats graphiques vectoriels normalisés tels que le PDF ou le SVG : ggsave(filename = "figure1.pdf", plot = mon_graphique, device = "pdf", width = 180, height = 120, units = "mm", dpi = 300). Le tracé vectoriel décompose chaque point et chaque contour sous forme d’instructions géométriques scalables infiniment, éliminant tout artefact de pixellisation lors de la mise sous presse. En outre, une attention rigoureuse doit être portée au modèle de restitution colorimétrique exigé par l’éditeur : si le profil RVB (RGB) s’impose pour l’affichage interactif sur écran, une conversion supervisée vers l’espace CMJN (CMYK) s’avère fréquemment requise pour l’impression finale afin de prévenir tout assombrissement imprévu des teintes saturées appliquées à vos facteurs expérimentaux.
Références
- Brewer, C. A. (2015). Designing better maps: A guide for GIS users (2nd ed.). Esri Press. https://colorbrewer2.org/
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- Fisher, R. A. (1936). The use of multiple measurements in taxonomic problems. Annals of Eugenics, 7(2), 179–188. https://doi.org/10.1111/j.1469-1809.1936.tb02137.x
- Treisman, A. M., & Gelade, G. (1980). A feature-integration theory of attention. Cognitive Psychology, 12(1), 97–136. https://doi.org/10.1016/0010-0285(80)90005-5
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://ggplot2-book.org/
- Wilke, C. O. (2019). Fundamentals of data visualization: A primer on making informative and compelling figures. O’Reilly Media. https://clauswilke.com/dataviz/
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer Science & Business Media. https://link.springer.com/book/10.1007/0-387-28695-0
- Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1), 1–49. https://doi.org/10.18637/jss.v096.i01