
L’inférence statistique moderne repose sur un ensemble de principes mathématiques dont la puissance réside dans leur capacité à extraire des certitudes probabilistes à partir de l’incertitude inhérente aux données empiriques. Au cœur de cet édifice se trouve le théorème central limite (TCL), un résultat d’une portée fondamentale qui permet d’établir des ponts méthodologiques rigoureux entre les caractéristiques méconnues d’une population parente et le comportement prévisible des échantillons qui en sont extraits. Sans cette pierre angulaire, la majeure partie des tests d’hypothèses paramétriques, de l’estimation par intervalles de confiance et de la modélisation statistique appliquée aux sciences humaines, biologiques ou comportementales serait privée de son assise théorique.
Dans les environnements pédagogiques, universitaires et professionnels, l’apprentissage de ces concepts abstraits exige un support instrumental fiable, direct et universellement accessible. La gamme des calculatrices graphiques Texas Instruments, et plus particulièrement la famille de la TI-84 (qu’il s’agisse des versions Standard, Silver Edition ou de la moderne TI-84 Plus CE), constitue la plateforme technologique privilégiée pour concrétiser ces raisonnements asymptotiques. Grâce à ses algorithmes de calcul numérique et à son microprocesseur dédié à la manipulation probabiliste, la TI-84 permet de transformer des équations d’intégration complexes en procédures opérationnelles accessibles d’un simple geste.
Toutefois, la manipulation instrumentale d’un concept aussi exigeant que le théorème central limite ne souffre d’aucune approximation. Une simple omission dans la modélisation de l’écart-type ou une confusion entre distribution individuelle et distribution d’échantillonnage peut induire des erreurs d’interprétation massives chez le chercheur ou l’étudiant. Ce guide exhaustif explore de façon méticuleuse l’ensemble des fondements théoriques, des logiques algorithmiques, des syntaxes de programmation et des applications pratiques indispensables pour maîtriser l’application du théorème central limite sur la calculatrice TI-84.
1. Fondements théoriques du théorème central limite en inférence statistique
1.1 Définition et énoncé fondamental du théorème central limite
Le théorème central limite constitue le pilier fondamental de la théorie des probabilités appliquées à l’échantillonnage statistique. Énoncé sous sa forme classique par Pierre-Simon de Laplace puis formalisé rigoureusement par des mathématiciens tels qu’Aleksandr Liapounov et Jarl Waldemar Lindeberg, ce théorème stipule que la somme — et par extension directe la moyenne arithmétique empirique — d’un nombre suffisamment grand de variables aléatoires indépendantes et identiquement distribuées (i.i.d.) converge en loi vers une loi normale, ou distribution gaussienne, indépendamment de la forme de la distribution sous-jacente des variables individuelles d’origine.
Sur le plan formel, considérons une suite de variables aléatoires réelles $X_1, X_2, dots, X_n$ définies sur un même espace de probabilité, indépendantes et suivant toutes la même loi de probabilité de moyenne théorique $\mu$ et de variance finie $\sigma^2$ (avec $\sigma > 0$). La moyenne d’échantillon, traditionnellement notée $\bar{X}_n = \frac{1}{n}\sum_{i=1}^{n} X_i$, est elle-même une variable aléatoire. Le théorème central limite affirme que la variable standardisée associée converge en distribution :
$$\lim_{n to \infty} P\left( \frac{\bar{X}_n – \mu}{\frac{\sigma}{\sqrt{n}}} le z \right) = \Phi(z) = \frac{1}{\sqrt{2\pi}} \int_{-\infty}^{z} e^{-\frac{t^2}{2}} , dt$$
Ce résultat est exceptionnel d’un point de vue épistémologique : quelle que soit la morphologie géométrique de la distribution de départ — qu’elle soit continue ou discrète, uniforme, bimodale, exponentielle, ou fortement asymétrique —, le processus d’agrégation par la moyenne opère une régularisation universelle. Les fluctuations aléatoires individuelles se compensent mutuellement au fil de l’accumulation des mesures, donnant naissance à la fameuse courbe en cloche symétrique. Dans le cadre de l’inférence statistique et des tests d’hypothèses, ce phénomène garantit aux chercheurs la possibilité d’utiliser les propriétés de la loi normale pour estimer des paramètres inconnus sans devoir postuler une normalité stricte des données brutes.
1.2 Le critère de taille d’échantillon et la règle empirique de n supérieur ou égal à 30
D’un point de vue théorique pur, la convergence décrite par le théorème central limite est un processus asymptotique, ce qui sous-entend qu’elle n’est rigoureusement exacte que lorsque la taille $n$ de l’échantillon tend vers l’infini. Cependant, pour les praticiens et les analystes de données, une question opérationnelle immédiate s’impose : à partir de quel seuil d’effectif peut-on considérer que l’approximation par la loi normale est suffisamment robuste pour autoriser des calculs de probabilités fiables sur une calculatrice graphique ?
La littérature statistique académique s’accorde quasi unanimement sur la règle empirique stipulant que lorsque la taille de l’échantillon satisfait la condition $n ge 30$, la distribution d’échantillonnage de la moyenne empirique $\bar{X}$ est raisonnablement proche d’une distribution normale pour la vaste majorité des distributions parentes rencontrées dans la pratique. Ce seuil de trente observations n’est pas une discontinuité mathématique abrupte, mais un compromis pragmatique validé par des décennies d’expérimentations par la méthode de Monte-Carlo. À partir de cette valeur, l’erreur d’approximation commise en assimilant la distribution empirique standardisée à la fonction de répartition $Phi(z)$ devient minime pour les intervalles de confiance conventionnels.
Toutefois, la vitesse de convergence dépend de la forme initiale de la population. Si la variable étudiée présente une distribution originelle déjà parfaitement gaussienne, la distribution d’échantillonnage de la moyenne sera rigoureusement normale dès $n = 1$. En revanche, si la distribution parente souffre d’une asymétrie marquée (coefficient d’asymétrie de Pearson ou skewness très éloigné de zéro) ou d’un aplatissement exceptionnel (kurtosis prononcé, présence de queues de distribution épaisses comme dans les lois de Pareto ou de Cauchy tronquées), le seuil de $n = 30$ peut se révéler insuffisant. Dans de telles circonstances, courantes par exemple en économétrie des revenus ou en psychométrie des temps de réaction extrêmes, des effectifs de $n = 50$, $n = 100$, voire davantage, deviennent indispensables pour neutraliser les déviations initiales.
1.3 Distinction formelle entre distribution de population et distribution d’échantillonnage
L’une des barrières conceptuelles les plus persistantes dans l’apprentissage des statistiques inférentielles réside dans la confusion entre la distribution d’une variable au sein d’une population et la distribution d’échantillonnage d’une statistique calculée sur cette même variable. Cette distinction doit être comprise pour programmer adéquatement la calculatrice TI-84.
La distribution de la population décrit la variabilité individuelle des éléments qui composent l’ensemble étudié. Chaque individu statistique $X_i$ possède une valeur mesurable, caractérisée par une moyenne $\mu$ et un écart-type $\sigma$. Cette dispersion reflète l’hétérogénéité naturelle du vivant ou des phénomènes mesurés : par exemple, la dispersion des tailles des adultes dans une nation, la variabilité des rendements d’un actif financier sur vingt ans, ou les scores individuels obtenus à une épreuve de mémoire de travail. La forme de cette distribution de population ne se modifie aucunement lorsque l’expérimentateur modifie la taille de ses échantillons : elle représente une réalité ontologique fixe.
En contrepartie, la distribution d’échantillonnage de la moyenne $\bar{X}$ est une entité abstraite, théorique et probabiliste. Elle représente la distribution de fréquence que l’on obtiendrait si l’on extrayait de manière répétée, indéfiniment, tous les échantillons aléatoires possibles de taille fixe $n$ au sein de cette population parente, et qu’on calculait pour chacun d’eux la moyenne arithmétique. Alors que les individus fluctuent selon l’écart-type $\sigma$, les moyennes d’échantillon fluctuent selon un écart-type drastiquement resserré, nommé erreur type. Alors que la loi faible des grands nombres stipule simplement que $\bar{X}_n$ converge en probabilité vers $\mu$ lorsque $n$ grandit (stabilisation de la valeur ponctuelle), le théorème central limite caractérise précisément la structure, l’amplitude et la forme de cette variabilité résiduelle.
2. Propriétés mathématiques de la distribution d’échantillonnage de la moyenne
2.1 L’espérance de la moyenne d’échantillon
L’étude analytique de la distribution d’échantillonnage débute par la détermination de son premier moment centré : son espérance mathématique, notée $E(\bar{X})$ ou $\mu_{\bar{X}}$. La linéarité de l’opérateur d’espérance permet d’établir une démonstration formelle directe qui ne requiert aucune condition restrictive quant à la taille d’échantillon ou à l’indépendance stricte des variables, pourvu que l’espérance de chaque variable individuelle existe et soit égale à $\mu$.
Soit un échantillon aléatoire simple $X_1, X_2, dots, X_n$. Par définition de la moyenne arithmétique :
$$E(\bar{X}) = E\left( \frac{1}{n} \sum_{i=1}^{n} X_i \right) = \frac{1}{n} \sum_{i=1}^{n} E(X_i) = \frac{1}{n} (n \cdot \mu) = \mu$$
Cette égalité formelle, $\mu_{\bar{X}} = \mu$, confère à la moyenne de l’échantillon une propriété métrologique fondamentale : celle d’être un estimateur sans biais (ou non biaisé) de la moyenne de la population. En termes concrets, cela signifie que le centre de gravité de la distribution d’échantillonnage coïncide systématiquement avec le paramètre cible de la population globale. Si un chercheur menait une infinité d’expériences identiques avec des échantillons de taille $n$, la moyenne des moyennes obtenues ne dévierait pas d’un iota de la moyenne réelle du système étudié. Cette propriété élimine toute distorsion systématique dans le calibrage des arguments de position sur la calculatrice TI-84.
2.2 L’erreur type de la moyenne et l’effet de l’accroissement de la taille d’échantillon
Si le centre de la distribution d’échantillonnage demeure invariant quelle que soit la valeur de $n$, il en va tout autrement de sa dispersion. La variance de la moyenne d’échantillon, notée $operatorname{Var}(\bar{X})$, s’obtient en exploitant les propriétés de la variance pour une combinaison linéaire de variables aléatoires indépendantes :
$$operatorname{Var}(\bar{X}) = operatorname{Var}\left( \frac{1}{n} \sum_{i=1}^{n} X_i \right) = \frac{1}{n^2} \sum_{i=1}^{n} operatorname{Var}(X_i) = \frac{1}{n^2} (n \cdot \sigma^2) = \frac{\sigma^2}{n}$$
En extrayant la racine carrée positive de cette variance d’échantillonnage, nous obtenons l’erreur type de la moyenne, notée universellement $\sigma_{\bar{X}}$ :
$$\sigma_{\bar{X}} = \frac{\sigma}{\sqrt{n}}$$
Cette formule mathématique est le cœur opérationnel de toute application du théorème central limite sur la TI-84. Elle montre que l’incertitude liée à l’estimation de la moyenne ne décroît pas linéairement avec le nombre d’observations recueillies, mais proportionnellement à la racine carrée de la taille de l’échantillon. Par conséquent, pour diviser par deux la variabilité d’une moyenne observée, il est mathématiquement impératif de quadrupler la taille de l’échantillon ($n$ multiplié par 4). Pour diviser l’erreur type par un facteur dix, il convient de multiplier le nombre d’observations par cent. Cette contraction de l’étalement de la courbe illustre la concentration de la masse probabiliste autour de $\mu$, réduisant drastiquement les risques d’obtenir une moyenne d’échantillon aberrante lors d’expérimentations d’envergure.
2.3 Transformation en cote centrée réduite (Z-score)
L’évaluation des aires sous la courbe normale à des fins probabilistes a historiquement exigé le recours à des tables numériques standardisées. Bien que la calculatrice TI-84 intègre des routines de quadrature adaptative rendant caduc l’usage papier de ces tables, la compréhension de la transformation en cote centrée réduite, ou $Z$-score, demeure indispensable pour saisir la mécanique interne du processeur.
La variable standardisée associée à une moyenne empirique donnée $\bar{x}$ se formule comme suit :
$$Z = \frac{\bar{x} – \mu_{\bar{X}}}{\sigma_{\bar{X}}} = \frac{\bar{x} – \mu}{\frac{\sigma}{\sqrt{n}}}$$
Cette transformation affine soustrait à la valeur observée la moyenne attendue, puis divise l’écart obtenu par l’erreur type. Elle convertit l’échelle d’origine de la variable (en kilogrammes, en millisecondes, en points de quotient intellectuel) en un écart standardisé adimensionnel exprimé en unités d’erreurs types. La variable résultante $Z$ suit approximativement la loi normale centrée réduite $\mathcal{N}(0, 1)$, caractérisée par une moyenne nulle et un écart-type unitaire. Sur le plan instrumental, la TI-84 effectue exactement cette mise à l’échelle en arrière-plan lorsque vous lui fournissez les paramètres $\mu$ et $\sigma / \sqrt{n}$, garantissant ainsi une précision algorithmique maximale sans exiger de conversions manuelles fastidieuses de la part de l’utilisateur.
3. Architecture et environnement statistique de la calculatrice TI-84
3.1 Présentation des versions matérielles de la famille TI-84 Plus
La gamme des calculatrices TI-84 Plus développée par Texas Instruments a connu plusieurs évolutions matérielles et logicielles majeures au fil des décennies, influençant l’ergonomie de saisie des instructions statistiques. Les modèles historiques, à l’instar de la TI-84 Plus standard et de la TI-84 Plus Silver Edition, sont équipés d’un processeur Zilog Z80 cadencé à 15 MHz et d’un écran monochrome à cristaux liquides d’une résolution de $96 \times 64$ pixels. Ces machines opèrent sous un système d’exploitation classique où l’affichage textuel est prépondérant.
Les versions contemporaines, représentées par la TI-84 Plus C Silver Edition et surtout la TI-84 Plus CE (incluant la TI-84 Plus CE-T très répandue dans l’enseignement européen), intègrent un processeur eZ80 cadencé à 48 MHz, une mémoire Flash considérablement étendue et un écran couleur rétroéclairé haute définition de $320 \times 240$ pixels. Au-delà des performances matérielles brutes, l’élément distinctif réside dans l’apparition, à partir de la version 2.53 MP du système d’exploitation TI-OS, des Stat Wizards (assistants statistiques interactifs).
Lorsque les Stat Wizards sont activés via le menu de configuration accessible par la touche [MODE], les fonctions de distributions statistiques cessent d’apparaître sous une forme de ligne de commande brute nécessitant de se souvenir de l’ordre exact des arguments. À la place, la machine déploie un formulaire interactif guidé, invitant l’utilisateur à renseigner chaque paramètre de façon explicite avant d’insérer automatiquement l’expression syntaxique adéquate sur l’écran d’accueil. La maîtrise des deux modes de saisie — guidé et classique — est néanmoins indispensable pour tout étudiant ou chercheur soucieux de sa dextérité méthodologique.
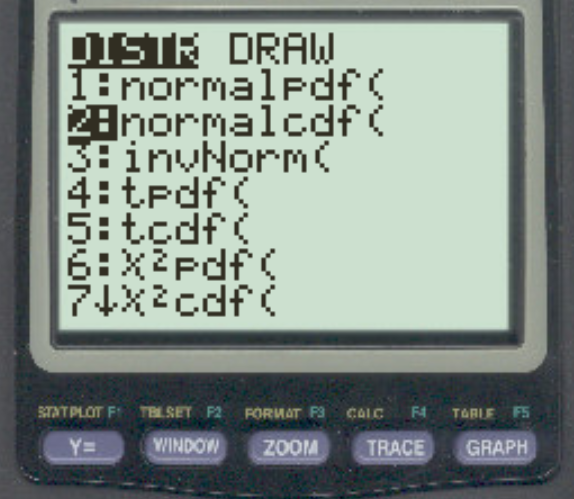
3.2 Accès au sous-menu des lois statistiques : le menu DISTR
Toutes les distributions de probabilités implémentées dans le micrologiciel de la TI-84 sont regroupées au sein d’un répertoire dédié nommé DISTR. Ce menu n’est pas accessible directement par une frappe primaire, car la commande est mutualisée sur la touche [VARS].
Pour faire apparaître le menu des distributions, la séquence opératoire universelle est la suivante :
- Appuyer sur la touche jaune ou bleue [2nd] (selon la livrée graphique de votre boîtier).
- Appuyer immédiatement sur la touche [VARS], au-dessus de laquelle figure la mention sérigraphiée DISTR.
L’écran affiche instantanément une liste numérotée de fonctions mathématiques. Le répertoire contient des fonctions continues (lois normales, lois de Student $t$, lois du Chi-carré $\chi^2$, lois de Fisher $F$) ainsi que des fonctions relatives aux lois discrètes (binomiale, géométrique, Poisson). Au sommet absolu de cette hiérarchie figurent invariablement deux commandes :
- 1: normalpdf( — Fonction de densité normale (Probability Density Function).
- 2: normalcdf( — Fonction de répartition cumulative normale (Cumulative Distribution Function).
L’utilisateur désireux de manipuler le théorème central limite doit concentrer son attention sur la seconde option, accessible soit en descendant le curseur de sélection avec la touche fléchée [$downarrow$] puis en pressant [ENTER], soit en pressant directement le chiffre [2] sur le pavé numérique de la machine.
3.3 Différenciation impérative entre normalpdf() et normalcdf()
La confusion entre les fonctions normalpdf() et normalcdf() représente l’une des anomalies opérationnelles les plus fréquentes chez les utilisateurs de la TI-84 abordant le théorème central limite. Une compréhension mathématique rigoureuse de ce qui sépare ces deux commandes est indispensable pour éviter la production de faux résultats probabilistes.
La commande normalpdf() (pour normal probability density function) calcule la valeur ponctuelle de la fonction de densité de Gauss en un point d’abscisse précis $x$. Formellement, elle évalue :
$$f(x) = \frac{1}{\sigma \sqrt{2\pi}} e^{-\frac{(x-\mu)^2}{2\sigma^2}}$$
Or, pour toute variable aléatoire continue (ce qu’est intrinsèquement une moyenne d’échantillon régie par le TCL), la probabilité qu’elle prenne une valeur numérique strictement égale à un point précis sans aucune marge d’incertitude est infinitésimale et rigoureusement nulle : $P(X = c) = 0$. La valeur renvoyée par normalpdf() n’est en aucun cas une probabilité, mais une densité géométrique, c’est-à-dire la hauteur de la courbe de Gauss à cette ordonnée. Cette fonction ne sert en réalité qu’à tracer le profil graphique de la cloche dans le menu [Y=] de la calculatrice.
À l’inverse, la commande normalcdf() (pour normal cumulative distribution function) exécute une intégration numérique définie entre deux bornes réelles délimitant un intervalle $[a, b]$ :
$$P(a le \bar{X} le b) = \int_{a}^{b} \frac{1}{\sigma_{\bar{X}} \sqrt{2\pi}} e^{-\frac{(t-\mu)^2}{2\sigma_{\bar{X}}^2}} , dt$$
Cette intégrale mesure la proportion de l’aire sous la courbe normale comprise entre ces deux jalons, fournissant la probabilité statistique recherchée. Dans toute démarche appliquant le théorème central limite pour quantifier le risque qu’une moyenne d’échantillon chute dans une région donnée, seule la fonction normalcdf() est mathématiquement appropriée.
4. Décomposition de la syntaxe de la fonction normalcdf() pour le théorème central limite
4.1 Analyse des quatre arguments fondamentaux de la fonction
Pour mobiliser pleinement la fonction normalcdf() dans le cadre du théorème central limite, il est impératif d’en décortiquer l’architecture paramétrique. L’algorithme interne de la TI-84 réclame jusqu’à quatre arguments distincts, disposés selon un ordonnancement rigoureusement invariable :
normalcdf(lower, upper, [μ], [σ])
Chacun de ces termes remplit un rôle algorithmique et théorique bien précis :
- Paramètre 1 : Borne inférieure (lower) — Il s’agit de la frontière gauche de l’intervalle d’intégration. Elle définit la valeur minimale à partir de laquelle on cherche à agréger la probabilité sous la cloche normale.
- Paramètre 2 : Borne supérieure (upper) — Il s’agit de la frontière droite de l’intervalle d’intégration. Elle fixe le point d’arrêt du calcul de la masse de probabilité.
- Paramètre 3 : Moyenne théorique de la distribution ($\mu$) — Ce paramètre correspond à l’espérance mathématique de la population parente, qui est strictement identique à l’espérance de la moyenne d’échantillon ($\mu_{\bar{X}} = \mu$) en vertu du principe de non-biais.
- Paramètre 4 : Erreur type de l’échantillonnage ($\sigma_{\bar{X}}$) — C’est ici que réside l’ajustement mathématique fondamental dicté par le théorème central limite. Ce paramètre ne doit jamais recevoir l’écart-type brut de la population $\sigma$, mais impérativement l’écart-type standardisé de la moyenne : $\frac{\sigma}{\sqrt{n}}$.
Si un utilisateur omet de renseigner les paramètres 3 et 4, la machine attribue par défaut les valeurs $\mu = 0$ et $\sigma = 1$, considérant alors que les bornes saisies correspondent déjà à des cotes $Z$-scores pré-calculées sur la loi normale centrée réduite.
4.2 Implémentation de l’erreur type dans l’argument sigma
L’un des atouts computationnels majeurs du système d’exploitation de la TI-84 réside dans la capacité de son interpréteur à évaluer des expressions arithmétiques complexes directement au sein des champs d’arguments statistiques. Il est donc totalement inutile — et même vivement déconseillé — de calculer préalablement l’erreur type à la main ou sur l’écran d’accueil pour en recopier une valeur numérique tronquée.
L’introduction d’un arrondi prématuré dans le calcul intermédiaire de $\sigma / \sqrt{n}$ constitue une source majeure de déviations lors du calcul de la probabilité finale, tout particulièrement lorsque les bornes d’intégration se situent au-delà de deux ou trois erreurs types du centre de la distribution. Pour garantir une précision maximale (jusqu’à 14 chiffres significatifs en calcul interne sur le processeur TI), il convient de saisir directement l’expression algébrique dans le quatrième argument :
- Taper la valeur numérique de l’écart-type de la population $\sigma$.
- Appuyer sur la touche de division $[div]$.
- Appeler la fonction racine carrée via la séquence [2nd] suivi de [$x^2$].
- Renseigner la taille de l’échantillon $n$.
- Fermer la parenthèse associée à la racine si vous travaillez sous un environnement TI-OS ancien (les versions récentes fermant automatiquement la portée graphique de la racine).
Par exemple, si $\sigma = 15$ et $n = 50$, la saisie dans le champ $\sigma$ prendra rigoureusement la forme 15/√(50). L’ordinateur calculera la valeur avec la précision en virgule flottante maximale de son registre avant de la transmettre aux algorithmes d’intégration de Gauss-Legendre qui alimentent normalcdf.
4.3 Représentation computationnelle de l’infini positif et négatif
Dans une multitude de problèmes d’inférence basés sur le théorème central limite, le chercheur ne cherche pas à borner sa recherche entre deux valeurs finies, mais désire calculer une probabilité unilatérale : la probabilité qu’une moyenne d’échantillon dépasse un certain seuil critique supérieur ($P(\bar{X} > k)$) ou s’avère inférieure à un seuil critique minimal ($P(\bar{X} < k)$). Sur le plan du formalisme mathématique, ces probabilités requièrent des bornes d'intégration infinies : $-\infty$ ou $+\infty$.
Une machine de calcul fini ne disposant pas d’un symbole infini absolu dans ses registres de calcul de distributions, les ingénieurs de Texas Instruments ont recours à la notation scientifique en virgule flottante pour émuler ces limites sans affecter la précision. La convention standard consiste à employer les valeurs extrêmes gérées par la calculatrice :
- Pour représenter l’infini négatif ($-\infty$), on saisit -1E99.
- Pour représenter l’infini positif ($+\infty$), on saisit 1E99.
Le symbole E représente l’opérateur de puissance de dix dans la notation scientifique intégrée de TI (équivalent à $\times 10^{99}$). Pour obtenir ce caractère, il ne faut en aucun cas taper la lettre alphabétique « E » accessible par [ALPHA] [COS], ce qui déclencherait une variable indéfinie ou une erreur de typage. Il convient d’utiliser la touche dédiée d’exponentiation scientifique, accessible en appuyant sur [2nd] puis sur la touche virgule [,] (au-dessus de laquelle figure la sérigraphie EE).
Ainsi, la saisie de l’infini négatif s’effectue précisément via : le signe moins unaire [(-)], le chiffre [1], la combinaison [2nd] puis [,], et enfin le nombre [99]. À l’échelle de distributions ayant des moyennes typiques comprises entre zéro et quelques milliers, un jalon positionné à $10^{99}$ erreurs types correspond à un point infiniment lointain dans la queue de distribution, réduisant l’erreur numérique commise par l’intégrateur sous le seuil du bruit numérique de la machine.
5. Procédure étape par étape : Navigation et paramétrage du menu normalcdf
5.1 Navigation pas à pas avec les assistants de saisie (Stat Wizards activés)
Pour les utilisateurs équipés de systèmes d’exploitation modernes disposant de l’interface guidée, la démarche de configuration de l’outil suit un cheminement logique conçu pour prévenir toute omission d’argument.
Pour activer ou vérifier l’état des assistants statistiques, accédez au menu de configuration en pressant [MODE]. Parcourez la liste des réglages jusqu’à localiser l’option STAT WIZARDS. Assurez-vous que l’option ON est en surbrillance noire. Si ce n’est pas le cas, déplacez le curseur dessus et appuyez sur [ENTER]. Quittez ensuite cet écran de configuration technique par la combinaison [2nd] [MODE] (fonction QUIT).
La séquence opérationnelle pour déployer le théorème central limite est la suivante :
- Ouvrir le menu de distribution en pressant [2nd] puis [VARS] (DISTR).
- Descendre d’un cran pour sélectionner
2:normalcdf(et valider avec [ENTER]. - Dans l’écran contextuel qui s’ouvre, renseigner la ligne
lower:en saisissant soit la borne inférieure réelle du problème, soit-1E99pour un calcul unilatéral inférieur. - Descendre sur la ligne
upper:avec la flèche [$downarrow$] et saisir la borne supérieure réelle ou1E99pour un calcul unilatéral supérieur. - Descendre sur la ligne
μ:et taper la moyenne connue de la population d’origine. - Descendre sur la ligne
σ:et insérer rigoureusement la formule d’erreur type du TCL :σ/√(n)en utilisant les touches numériques, la touche de division $[div]$ et la fonction racine [2nd] [$x^2$]. - Descendre le curseur jusqu’à la commande Paste (Coller) et appuyer sur [ENTER].
La calculatrice rapatrie instantanément la commande syntaxiquement complète sur l’écran d’accueil principal (Home Screen). Il ne reste plus qu’à presser [ENTER] une seconde fois pour déclencher l’algorithme d’évaluation numérique et afficher le résultat probabiliste.
5.2 Saisie directe en mode ligne de commande standard (Classic Mode)
Dans l’éventualité où vous utilisez une calculatrice ancienne ne disposant pas des Stat Wizards, ou si ce mode d’assistance a été volontairement désactivé par l’examinateur ou le professeur dans le menu [MODE], la sélection de normalcdf renvoie immédiatement la fonction sur l’écran d’accueil, sous la forme brute :
normalcdf(
L’opérateur doit alors renseigner manuellement chaque paramètre en respectant la grammaire syntaxique imposée par le système d’exploitation de la TI-84. La règle fondamentale réside dans l’utilisation exclusive de la touche virgule standard [,] (située physiquement juste au-dessus de la touche [7]) pour délimiter les paramètres. L’utilisation du point décimal [.] en lieu et place de la virgule de séparation conduirait inévitablement à une erreur de syntaxe système.
La ligne de commande doit être tapée selon la formulation suivante :
normalcdf(lower,upper,μ,σ/√(n))
Par exemple, pour un problème où la borne inférieure est 48, la borne supérieure 52, la moyenne 50, l’écart-type de population 8 et l’échantillon de 40 individus, la chaîne exacte de caractères à produire sur l’écran est :
normalcdf(48,52,50,8/√(40))
Bien que la fermeture finale de la parenthèse principale ne soit pas strictement requise par l’interpréteur de la machine pour exécuter le calcul, il est d’une bonne hygiène algorithmique de la refermer en appuyant sur [ ) ] avant de valider avec la touche [ENTER]. La probabilité s’affiche instantanément à l’écran, prête pour l’analyse.
5.3 Vérification des réglages système de la calculatrice
Avant d’interpréter tout résultat produit par normalcdf(), il est impératif d’auditer les paramètres globaux d’affichage de la TI-84 afin d’éviter des confusions de lecture pouvant avoir des conséquences néfastes lors d’épreuves académiques ou d’analyses statistiques professionnelles.
Le contrôle s’effectue dans le menu [MODE]. Deux éléments appellent une attention soutenue :
- Le format de notation numérique : Assurez-vous que la première ligne est positionnée sur Normal plutôt que sur Sci (scientifique) ou Eng (ingénierie), sauf si vous traitez des probabilités infimes qui requièrent un affichage en puissances de dix explicite.
- L’arrondi de décimales (Float) : Il est recommandé de conserver la sélection sur Float universel plutôt que de contraindre la machine à un nombre fixe de décimales (comme
Fix 2ouFix 3). Si le modeFix 2était activé de façon involontaire, une probabilité d’échantillonnage de $0.0034$ s’afficherait sous la forme trompeuse d’un $0.00$ absolu, masquant des éléments analytiques critiques.
De surcroît, il est conseillé de nettoyer régulièrement l’écran d’accueil avec la touche [CLEAR] avant de lancer des chaînes de calculs complexes. Cela élimine toute surcharge cognitive et permet d’associer avec clarté la commande tapée avec la sortie numérique produite immédiatement en dessous.
6. Étude de cas empirique 1 : Probabilité d’une moyenne comprise entre deux bornes
6.1 Formalisation du problème statistique
Pour appréhender le fonctionnement pratique du théorème central limite sur la TI-84, examinons une première application quantitative concrète. Considérons un processus de fabrication industriel ou une étude biométrique au sein d’une vaste population d’individus où une variable continue présente une moyenne théorique $\mu = 70$ unités et un écart-type de population $\sigma = 7$ unités. La forme distributionnelle de la population parente n’est pas spécifiée, mais elle présente des indices d’asymétrie modérée.
Un auditeur qualité extrait de manière strictement aléatoire et indépendante un échantillon de taille $n = 35$ individus au sein de cette population. La question statistique soumise à investigation s’énonce ainsi : quelle est la probabilité que la moyenne arithmétique de cet échantillon de 35 observations se trouve comprise entre 68 et 72 unités ?
Avant de toucher à la calculatrice, l’audit méthodologique est impératif :
- L’échantillon comporte $n = 35$ mesures. La condition $n ge 30$ est formellement vérifiée.
- En vertu du théorème central limite, nous pouvons affirmer que la distribution d’échantillonnage de la moyenne $\bar{X}$ suit de manière approchée une loi normale : $\bar{X} \sim \mathcal{N}(\mu_{\bar{X}}, \sigma_{\bar{X}}^2)$.
- L’espérance de la moyenne d’échantillon est $\mu_{\bar{X}} = \mu = 70$.
- L’erreur type associée est $\sigma_{\bar{X}} = \frac{\sigma}{\sqrt{n}} = \frac{7}{\sqrt{35}} \approx \frac{7}{5.91608} \approx 1.1832$.
Le problème consiste donc à évaluer l’intégrale de probabilité délimitée : $P(68 le \bar{X} le 72)$.
6.2 Exécution séquentielle sur TI-84
La transcription opérationnelle de ce problème sur la calculatrice graphique TI-84 s’exécute avec une grande simplicité en mobilisant la procédure vue précédemment :
- Pressez les touches [2nd] puis [VARS] pour entrer dans le menu DISTR.
- Sélectionnez l’élément
2:normalcdf(et validez par [ENTER]. - Si les Stat Wizards s’affichent, renseignez les paramètres tels que suit :
lower:68upper:72μ:70σ:7/√(35) — tapez [7] $[div]$ [2nd] [$x^2$] [3] [5] [ ) ]
- Positionnez le curseur sur Paste et appuyez deux fois sur [ENTER].
Si la machine opère en mode ligne de commande standard, tapez simplement sur l’écran d’accueil :
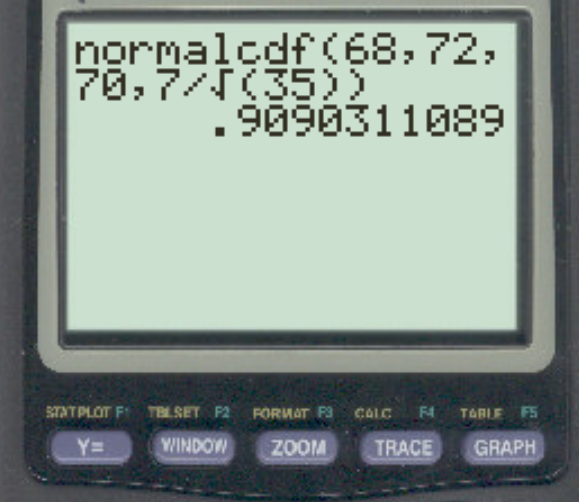
normalcdf(68,72,70,7/√(35)) puis pressez [ENTER].
Le processeur de la calculatrice résout numériquement l’intégrale et renvoie instantanément la valeur :
0.9089531518...
En arrondissant selon les conventions scientifiques habituelles à quatre décimales, nous obtenons une probabilité finale de $0.9090$, soit environ $90.90%$.
6.3 Interprétation statistique et notation académique
La restitution académique de ce résultat dans un mémoire de recherche ou un rapport d’expertise exige une rigueur de rédaction absolue, distinguant la formulation probabiliste du commentaire d’inférence :
$$P(68 le \bar{X} le 72) = P\left( \frac{68 – 70}{\frac{7}{\sqrt{35}}} le Z le \frac{72 – 70}{\frac{7}{\sqrt{35}}} \right) \approx P(-1.69 le Z le 1.69) \approx 0.9090$$
Ce chiffre indique que si l’on répétait cette opération de prélèvement de 35 individus un très grand nombre de fois dans les mêmes conditions expérimentales, environ $90.90%$ des moyennes d’échantillons obtenues se situeraient dans cette fourchette resserrée comprise entre 68 et 72 unités.
Il est extrêmement instructif de comparer ce résultat avec la probabilité qu’un individu isolé ($n = 1$) prélevé au hasard possède une valeur comprise entre 68 et 72 unités. Sur la calculatrice, cette question s’évalue en tapant normalcdf(68,72,70,7), ce qui fournit approximativement $0.2249$, soit seulement $22.5%$. Cette divergence massive entre $22.5%$ pour un individu unique et $90.9%$ pour la moyenne de 35 sujets est l’incarnation graphique et quantitative du théorème central limite : l’erreur type s’étant contractée d’un facteur $\sqrt{35} \approx 5.92$, la dispersion des moyennes est bien moindre que celle des observations individuelles.
7. Étude de cas empirique 2 : Probabilité d’une moyenne supérieure à un seuil critique
7.1 Modélisation d’une probabilité unilatérale à droite
Dans de multiples cadres décisionnels, tels que le contrôle de conformité environnementale ou l’évaluation de la performance d’un traitement en santé publique, la question porte sur le risque de dépassement d’une valeur limite supérieure acceptable. Supposons une population dont le niveau moyen de contamination d’un composé chimique dans l’eau potable est historiquement établi à $\mu = 45$ milligrammes par litre, avec un écart-type $\sigma = 12$ mg/L.
Une agence sanitaire prélève un échantillon de $n = 64$ points de captage d’eau à travers une région. Les autorités sanitaires s’inquiètent de la possibilité que la moyenne de cet échantillon excède un seuil critique fixé à 48 mg/L. L’interrogation statistique formelle se transcrit par : quelle est la probabilité d’obtenir une moyenne d’échantillon d’au moins 48 mg/L si la population sous-jacente respecte toujours sa distribution de référence ?
Sur le plan structural, nous sommes en présence d’une probabilité unilatérale à droite. Le modèle théorique s’établit comme suit :
- Taille d’échantillon : $n = 64 ge 30$, autorisant le recours immédiat au théorème central limite.
- Espérance de la moyenne : $\mu_{\bar{X}} = 45$.
- Erreur type : $\sigma_{\bar{X}} = \frac{12}{\sqrt{64}} = \frac{12}{8} = 1.5$.
- Zone d’intégration : de l’abscisse 48 jusqu’à l’infini positif ($+\infty$).
7.2 Manipulation technique et calcul sur la TI-84
L’introduction d’une borne supérieure infinie sur la calculatrice graphique implique la mise en œuvre de la convention de notation scientifique 1E99 exposée au chapitre 4.
Pour procéder à la saisie avec les Stat Wizards :
- Accédez au menu [2nd] [VARS], sélectionnez
2:normalcdf(. - Renseignez le champ
lower:avec la valeur du seuil critique, soit48. - Renseignez le champ
upper:en tapant1E99([1], puis [2nd] [,], puis [9] [9]). - Saisissez
μ:45. - Saisissez
σ:12/√(64) ou directement1.5. - Activez Paste et confirmez par [ENTER].
En ligne de commande classique, l’instruction exacte à faire figurer est :
normalcdf(48,1E99,45,12/√(64))
Après validation par la touche [ENTER], la TI-84 produit le résultat :
0.022750132...
La valeur de la probabilité unilatérale recherchée est ainsi évaluée à $0.0228$, soit $2.28%$.
7.3 Lien avec le niveau de signification et la valeur p (p-value)
Le calcul que nous venons d’exécuter sur la TI-84 dépasse le simple exercice probabiliste : il constitue la mécanique computationnelle exacte sous-jacente au calcul de la valeur p (ou p-value) d’un test $Z$ pour un échantillon unique dans le cadre des tests d’hypothèses unilatéraux supérieurs.
Si l’hypothèse nulle ($H_0$) pose que le réseau de distribution d’eau respecte la norme historique de $\mu = 45$, et que l’hypothèse alternative ($H_1$) affirme une augmentation de la pollution ($\mu > 45$), la probabilité obtenue $P(\bar{X} ge 48 mid H_0) = 0.0228$ représente la probabilité exacte d’observer un résultat d’échantillon au moins aussi extrême que 48 mg/L si l’hypothèse nulle était rigoureusement vraie.
Si le seuil de signification de l’étude (le risque d’erreur de première espèce $\alpha$) avait été fixé au standard conventionnel de $\alpha = 0.05$ ($5%$), la règle de décision s’applique sans ambiguïté : la p-value étant inférieure au seuil critique ($0.0228 < 0.05$), le chercheur ou l'inspecteur rejette l'hypothèse nulle au profit de l'hypothèse alternative. L'agence en conclut avec un fondement statistique étayé par le TCL que la contamination a très probablement augmenté. On perçoit ici l'importance vitale de la division par $\sqrt{n}$ : sans elle, le calcul aurait évalué la probabilité individuelle $P(X ge 48) = 0.4013$, menant à la conclusion erronée que la situation est parfaitement ordinaire.
8. Étude de cas empirique 3 : Probabilité d’une moyenne inférieure à une valeur seuil
8.1 Modélisation d’une probabilité unilatérale à gauche
Examinons désormais la configuration symétrique, caractérisée par une modélisation unilatérale à gauche. Considérons une épreuve d’évaluation cognitive standardisée ou un examen de compétences académiques dont les scores au sein d’une population globale affichent une moyenne de $\mu = 100$ points et un écart-type de $\sigma = 15$ points.
Une cohorte spécifique comprenant $n = 50$ étudiants suit un programme pédagogique innovant, mais les évaluateurs s’inquiètent d’un risque éventuel de décrochage ou de régression méthodologique. Ils souhaitent évaluer la probabilité que la performance moyenne de ce groupe de 50 sujets soit inférieure ou égale à 96 points sous l’hypothèse que leur niveau réel soit similaire à la moyenne générale de 100 points.
Le modèle mathématique du théorème central limite impose la structure suivante :
- Échantillon de taille $n = 50 ge 30$, garantissant la normalité de la distribution de la moyenne $\bar{X}$.
- Espérance de la moyenne empirique : $\mu_{\bar{X}} = 100$.
- Erreur type d’échantillonnage : $\sigma_{\bar{X}} = \frac{15}{\sqrt{50}} \approx \frac{15}{7.07107} \approx 2.1213$.
- Intervalle unilatéral inférieur recherché : $]-\infty, 96]$.
8.2 Exécution instrumentale sur TI-84
L’exécution instrumentale de cette probabilité cumulée à gauche exige d’ancrer la borne inférieure à $-\infty$ tout en délimitant la borne supérieure à 96.
Une vigilance technique absolue s’impose lors de la frappe du signe négatif : sur la TI-84, il existe une distinction architecturale irréductible entre la touche de soustraction binaire [$-$] (située sur la colonne de droite au-dessus de l’addition) et la touche de négation unaire [(-)] (située sur la rangée inférieure à côté de la touche point décimal). L’emploi de la soustraction pour définir -1E99 générera immédiatement un message d’erreur d’arrêt d’exécution système (ERR:SYNTAX).
La séquence rigoureuse sur la calculatrice est :
- Pressez [2nd] [VARS] et sélectionnez
2:normalcdf(. - Dans le champ
lower:, tapez le signe moins unaire [(-)], suivi de [1], puis de [2nd] [,] (pour le E) et enfin de [99]. - Dans le champ
upper:, tapez96. - Dans le champ
μ:, tapez100. - Dans le champ
σ:, tapez15/√(50). - Validez par Paste puis confirmez avec [ENTER].
En syntaxe directe, l’expression s’énonce :
normalcdf(-1E99,96,100,15/√(50))
La machine exécute le calcul et affiche l’approximation :
0.0296767...
Soit une probabilité d’environ $0.0297$ ($2.97%$).
8.3 Analyse d’impact : sensibilité aux fluctuations de n
Pour matérialiser la puissance du théorème central limite, il est d’une grande valeur pédagogique et méthodologique de soumettre ce calcul à une analyse de sensibilité en observant l’évolution de cette probabilité lorsque seule la taille d’échantillon $n$ varie, toutes les autres données du problème demeurant inchangées.
Effectuons successivement le calcul sur la TI-84 pour trois tailles d’échantillons distinctes :
- Pour $n = 15$ :
Saisie :normalcdf(-1E99,96,100,15/√(15))
L’erreur type vaut $\sigma_{\bar{X}} \approx 3.873$.
Résultat calculé : $0.1509$ (soit $15.09%$). - Pour $n = 50$ (notre cas d’étude) :
Saisie :normalcdf(-1E99,96,100,15/√(50))
L’erreur type vaut $\sigma_{\bar{X}} \approx 2.121$.
Résultat calculé : $0.0297$ (soit $2.97%$). - Pour $n = 100$ :
Saisie :normalcdf(-1E99,96,100,15/√(100))
L’erreur type vaut $\sigma_{\bar{X}} = \frac{15}{10} = 1.500$.
Résultat calculé : $0.0038$ (soit $0.38%$).
Cette comparaison chiffrée met en exergue l’effet d’entonnoir généré par l’accroissement de $n$. Alors qu’il est relativement banal d’observer une moyenne de 96 points sur un petit groupe de 15 sujets ($15%$ de chances d’apparition spontanée par simple fluctuation d’échantillonnage), ce même écart de quatre points en dessous de la norme devient exceptionnellement rare sur un groupe de 100 individus ($0.38%$). Grâce à la TI-84, la quantification de cette contraction de variance devient immédiate.
9. Visualisation graphique de la distribution d’échantillonnage avec ShadeNorm
9.1 Configuration préalable de la fenêtre graphique (Window)
L’assimilation conceptuelle du théorème central limite ne saurait être complète sans un ancrage visuel fort. La calculatrice TI-84 intègre un module de tracé de courbes probabilistes permettant non seulement de tracer la fonction de Gauss associée à la distribution d’échantillonnage, mais également de hachurer directement la surface représentant la probabilité calculée. Cependant, une erreur de configuration de la fenêtre d’affichage (WINDOW) se solde immanquablement par un écran vide ou un message d’erreur d’échelle.
Contrairement aux fonctions algébriques ordinaires, la densité d’une loi normale possède une étendue horizontale calquée sur l’erreur type et une hauteur verticale infime (puisque l’aire totale sous la cloche doit être égale à 1). Il convient donc de régler manuellement les paramètres de la fenêtre graphique en pressant la touche [WINDOW] :
- Xmin et Xmax : L’essentiel de la cloche de Gauss (plus de $99.7%$) s’étend sur un intervalle de quatre erreurs types de part et d’autre de la moyenne. Ainsi, réglez :
$$X\min = \mu – 4 \cdot \left(\frac{\sigma}{\sqrt{n}}\right)$$
$$X\max = \mu + 4 \cdot \left(\frac{\sigma}{\sqrt{n}}\right)$$ - Xscl : Fixez l’échelle des graduations de l’axe des abscisses à la valeur d’une erreur type : $\sigma / \sqrt{n}$.
- Ymin : Réglez à $-0.02$ ou $-0.05$ pour laisser un espace visuel sous l’axe des abscisses pour les inscriptions chiffrées.
- Ymax : La hauteur maximale du pic de la courbe normale au point $x = \mu$ vaut $1 / (\sigma_{\bar{X}} \sqrt{2\pi}) \approx 0.3989 / \sigma_{\bar{X}}$. Si votre erreur type vaut par exemple $1.5$, la hauteur maximale sera de $0.3989 / 1.5 \approx 0.266$. Réglez $Ymax$ à une valeur légèrement supérieure, telle que $0.3$ ou $0.4$.
- Yscl : Fixez à $0.05$ ou $0.1$.
Enfin, assurez-vous impérativement dans le menu [Y=] qu’aucune fonction mathématique résiduelle n’est cochée afin de ne pas superposer des courbes analytiques sans rapport sur votre graphique statistique.
9.2 Application de la fonction ShadeNorm via le menu DRAW
Une fois les dimensions de la fenêtre graphique scrupuleusement paramétrées, la commande de traçage et de hachurage peut être appelée. Cette commande, intitulée ShadeNorm(, ne réside pas dans le répertoire principal de calcul, mais dans le sous-menu de dessin statistique (DRAW).
Pour y accéder :
- Appuyez sur la touche [2nd] puis sur la touche [VARS] (DISTR).
- Utilisez la flèche horizontale droite [$\rightarrow$] pour basculer de l’onglet DISTR à l’onglet DRAW.
- Sélectionnez la première option :
1:ShadeNorm(et validez avec [ENTER].
La syntaxe de ShadeNorm reprend l’ordonnancement précis de celle de normalcdf :
ShadeNorm(lower, upper, μ, σ/√(n))
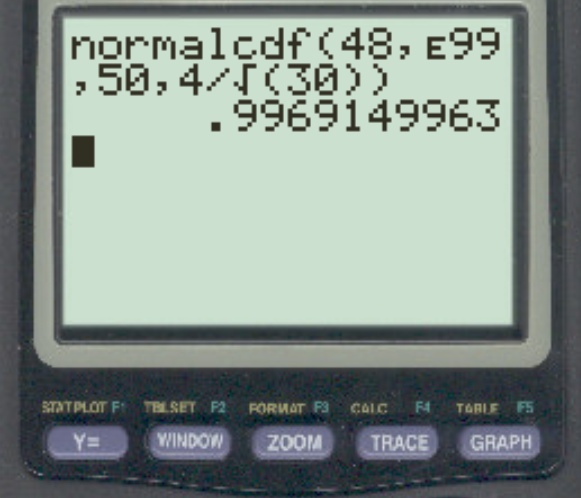
En saisissant par exemple ShadeNorm(48, 1E99, 45, 1.5) et en validant par [ENTER], la calculatrice bascule immédiatement sur l’écran graphique. Elle dessine sous les yeux de l’utilisateur la courbe de Gauss centrée en 45, dont la base s’étend de 39 à 51, et hachure en pixels noirs (ou en couleur vive sur la TI-84 Plus CE) l’aire comprise entre l’abscisse 48 et l’extrémité droite du tracé. En bas de l’écran, la calculatrice récapitule la valeur intégrée exacte (Area = .02275) ainsi que les bornes utilisées.
9.3 Gestion de l’affichage et réinitialisation de l’écran graphique
L’utilisation pédagogique de ShadeNorm() offre un ancrage cognitif fondamental pour quiconque souhaite conceptualiser la nature probabiliste du théorème central limite. La surface ombrée rend immédiatement tangible ce que représente un niveau de risque ou un rejet d’hypothèse nulle.
Néanmoins, les graphiques générés par les commandes du menu DRAW présentent une particularité technique sur la TI-84 : ils s’impriment directement sur la couche graphique de mémoire tampon (le graph buffer) sous forme de matrice de points et ne s’effacent pas automatiquement lorsque vous quittez l’écran graphique ou que vous modifiez les équations du menu [Y=]. Si vous tentez de tracer une seconde loi normale par-dessus la précédente sans réinitialisation, les deux cloches et leurs zones ombrées se superposeront dans une illisibilité complète.
Pour réinitialiser complètement l’environnement graphique après une démonstration :
- Appuyez sur la touche [2nd] puis sur la touche [PRGM] pour accéder au menu DRAW général.
- Sélectionnez la commande
1:ClrDraw(Clear Drawing) et validez par [ENTER]. - Appuyez à nouveau sur [ENTER] sur l’écran d’accueil pour exécuter l’instruction. Le message
Doneapparaît, garantissant que la mémoire graphique est vierge pour une prochaine expérimentation.
10. Diagnostics méthodologiques et prévention des erreurs sur TI-84
10.1 Erreurs de syntaxe courantes et codes d’erreur système
L’utilisation de la calculatrice TI-84 lors d’épreuves académiques peut être une source de stress, particulièrement lorsque la machine renvoie un message d’erreur brutal bloquant toute progression. Il est impératif d’identifier la racine de ces pannes techniques récurrentes pour les corriger immédiatement :
- ERR:SYNTAX (Erreur de syntaxe) : Cette interruption d’exécution survient lorsque la structure formelle de la ligne de commande a été violée. Les causes prédominantes sont l’emploi d’un point au lieu d’une virgule de séparation d’arguments, la saisie d’un double séparateur consécutif (ex.
,,), l’oubli de validation d’un argument obligatoire, ou l’utilisation du signe de soustraction [$-$] à la place du signe de négation unaire [(-)] devant la constante 1E99. Lors de l’apparition du message d’erreur, sélectionnez systématiquement l’option2:Gotoplutôt que1:Quit: la calculatrice repositionnera automatiquement le curseur clignotant sur le caractère exact ayant provoqué l’anomalie. - ERR:DATA TYPE (Type de données erroné) : Ce code indique qu’une fonction attendait une valeur numérique scalaire et qu’elle a reçu une matrice, une liste non dimensionnée, un nombre complexe, ou une chaîne de caractères alphabétiques non assignée. Vérifiez que les variables appelées dans la formule d’erreur type ne font pas référence à des listes statistiques résiduelles ($L_1, L_2$).
- ERR:ARGUMENT (Erreur d’argument) : Déclenché lorsqu’une commande reçoit un argument hors de son domaine de définition mathématique, notamment si vous tentez d’insérer un écart-type négatif ($\sigma le 0$) ou une taille d’échantillon inférieure ou égale à zéro dans le terme sous le radical.
10.2 L’erreur conceptuelle majeure : omission de la division par racine de n
Parmi toutes les failles méthodologiques répertoriées lors de l’évaluation des apprentissages statistiques, une erreur prédomine massivement par sa récurrence et sa gravité conceptuelle : l’omission de la division de l’écart-type par la racine carrée de la taille d’échantillon.
Lorsqu’un problème énonce qu’un échantillon de $n = 100$ individus est prélevé au sein d’une population caractérisée par une moyenne de 50 et un écart-type de 10, de nombreux étudiants saisissent distraitement la commande :
normalcdf(lower, upper, 50, 10)
Ce geste erroné efface intégralement l’existence de l’échantillon et détruit la nature même du théorème central limite. En omettant de diviser 10 par $\sqrt{100}$, l’utilisateur calcule la probabilité associée à une observation unique isolée tirée au sort dans la population, au lieu de modéliser la variabilité de la moyenne d’un groupe structuré de cent observations. L’erreur type réelle de cet échantillon n’est pas de 10, mais de $10 / \sqrt{100} = 1.0$.
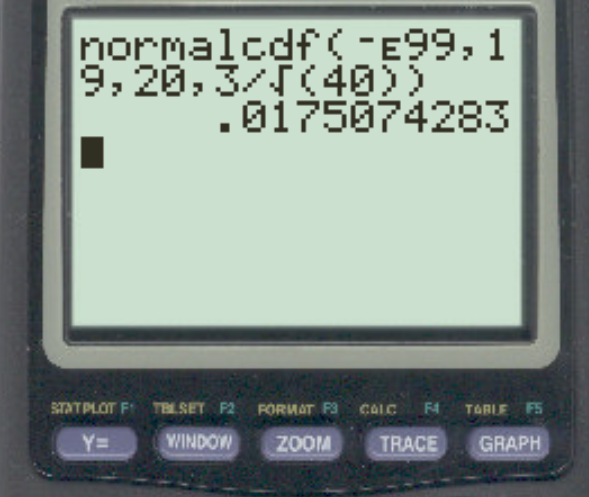
Les conséquences numériques d’une telle omission sont titanesques. Si l’on cherchait par exemple la probabilité que la moyenne d’échantillon dépasse 52, la commande correcte normalcdf(52, 1E99, 50, 1) produit une probabilité de $0.0228$ ($2.28%$). La commande omise normalcdf(52, 1E99, 50, 10) renvoie quant à elle $0.4207$ ($42.07%$). L’amplitude de l’erreur dépasse ici un facteur vingt, conduisant à des interprétations diamétralement opposées et invalidant tout travail de recherche. Pour immuniser votre pratique contre cet écueil, adoptez une règle absolue : dès que l’énoncé fait mention d’un échantillon ($n$), le quatrième argument de normalcdf doit obligatoirement arborer le symbole de division et le radical.
10.3 Gestion de la précision numérique et des notations exponentielles
Lorsque les bornes d’intégration s’éloignent considérablement de la moyenne — par exemple à plus de quatre ou cinq erreurs types dans le cadre de démarches de contrôle qualité exigeantes de type Six Sigma —, la probabilité résultante devient extrêmement restreinte. Dans ces circonstances, le microprocesseur de la TI-84 ne peut afficher le résultat sous sa forme décimale standard et bascule automatiquement en notation scientifique abrégée.
Un utilisateur novice observant un résultat affiché tel que :
3.40081E-5
pourrait, par inattention, ne lire que les premiers chiffres et consigner l’ineptie majeure selon laquelle la probabilité serait de $3.4$ (une probabilité ne pouvant mathématiquement jamais être supérieure à 1). D’autres assimilent précipitamment ce résultat à un zéro absolu sans comprendre la signification de la terminaison exponentielle.
Le suffixe E-5 signifie que la mantisse doit être multipliée par $10^{-5}$, ce qui équivaut à décaler la virgule décimale de cinq crans vers la gauche :
$$3.40081 \times 10^{-5} = 0.0000340081$$
Dans la rédaction d’un mémoire universitaire ou d’un rapport technique, consigner $p = 0.00003$ ou $p < 0.001$ traduit une compréhension métrologique rigoureuse, tandis qu'inscrire $3.4$ ou $0$ trahit une carence d'acculturation aux outils de calcul scientifique.
11. Applications en recherche psychologique et en sciences du comportement
11.1 Évaluation de batteries de tests psychométriques et scores standardisés
Le champ de la psychométrie et de l’évaluation neuropsychologique constitue l’un des territoires d’élection du théorème central limite. La plupart des échelles d’intelligence standardisées (telles que les échelles de Wechsler : WAIS pour adultes ou WISC pour enfants) sont calibrées selon une métrique standardisée de moyenne de population fixée à $\mu = 100$ et d’écart-type fixé à $\sigma = 15$.
Lorsqu’une équipe de recherche clinique examine une cohorte d’individus présentant une pathologie neurodéveloppementale spécifique ou, à l’inverse, ayant suivi un entraînement de remédiation cognitive intensive, l’investigation ne s’attache pas aux fluctuations individuelles de tel ou tel sujet pris isolément, mais au comportement de la moyenne du groupe clinique. Imaginons un échantillon clinique de $n = 45$ patients présentant un score moyen de QI de 104.5 points.
L’utilisation de la TI-84 permet d’évaluer instantanément la plausibilité d’observer une telle élévation moyenne sous l’hypothèse nulle d’absence d’effet clinique particulier. L’instruction formulée :
normalcdf(104.5, 1E99, 100, 15/√(45))
renvoie une probabilité d’environ $0.0221$. Les chercheurs en déduisent qu’il n’y a que $2.2%$ de chances d’obtenir une moyenne d’échantillon d’un tel niveau par simple fluctuation d’échantillonnage au sein d’une population non différenciée. Ce résultat appuie l’hypothèse d’une spécificité cognitive propre au groupe clinique étudié, démarche rendue possible par l’ancrage du TCL sur la moyenne de cohorte.
11.2 Analyses statistiques d’essais comportementaux randomisés
Dans le protocole standard d’un essai contrôlé randomisé en psychologie expérimentale ou en neurosciences comportementales, des sujets sont assignés aléatoirement à un groupe expérimental recevant une intervention (thérapeutique, pédagogique, stimulation cognitive) ou à un groupe témoin recevant un placebo ou une tâche contrôle. La métrique d’intérêt réside généralement dans le score différentiel moyen mesuré avant et après l’intervention.
La calculatrice TI-84 permet d’interroger la distribution des différences de moyennes grâce aux propriétés d’additivité de la variance sous-jacentes au théorème central limite. Si deux échantillons indépendants de tailles respectives $n_1$ et $n_2$ sont extraits de populations de variances $\sigma_1^2$ et $\sigma_2^2$, la distribution d’échantillonnage de la différence des moyennes $(\bar{X}_1 – \bar{X}_2)$ converge vers une loi normale d’espérance $(\mu_1 – \mu_2)$ et d’erreur type combinée :
$$\sigma_{(\bar{X}_1 – \bar{X}_2)} = \sqrt{\frac{\sigma_1^2}{n_1} + \frac{\sigma_2^2}{n_2}}$$
Cette expression s’insère directement dans le quatrième argument de la fonction normalcdf() pour calculer des seuils critiques de séparation d’efficacité sans devoir programmer de macro-instructions complexes. Conjointement, la fonction réciproque de la loi normale, invNorm( (située au point 3 du menu DISTR), permet de déterminer à rebours la valeur seuil du score moyen nécessaire pour atteindre un seuil de puissance statistique donné, offrant une complémentarité opératoire remarquable pour la conception des plans d’expérience comportementaux.
11.3 Robustesse du théorème face aux variables comportementales non gaussiennes
L’une des objections méthodologiques les plus communes en recherche comportementale tient au caractère résolument non normal des mesures brutes recueillies. Deux exemples typiques illustrent cette contrainte :
- Les temps de réaction chronométriques : Dans les tâches d’attention soutenue ou de discrimination perceptive, les distributions de temps de réaction individuels présentent systématiquement une asymétrie positive majeure (distribution ex-gaussienne ou log-normale), avec une longue traîne vers les valeurs lentes correspondant aux lapsus attentionnels.
- Les échelles de Likert et scores d’attitudes : Les données issues de questionnaires d’évaluation de la douleur, de l’anxiété ou de la satisfaction professionnelle sont mesurées sur des échelles discrètes et ordinales, souvent plafonnées (effet de plafond ou de plancher) et résolument éloignées d’un profil en cloche symétrique.
C’est précisément dans ces situations que le théorème central limite déploie toute son utilité épistémologique. Même si les distributions unitaires de temps de réaction individuels violent ouvertement la normalité, la moyenne arithmétique de ces temps de réaction calculée sur des cohortes expérimentales de $n = 40$, $60$ ou $100$ sujets suit une distribution rigoureusement normale. Les biais d’asymétrie individuelle s’annihilent sous l’effet de l’agrégation statistique. L’expérimentateur est ainsi pleinement fondé à utiliser la modélisation gaussienne standard sur sa TI-84 pour effectuer ses tests comparatifs sur les moyennes, sans enfreindre la rigueur méthodologique imposée par la théorie des probabilités.
12. Synthèse méthodologique et recommandations pour les travaux académiques
12.1 Procédure d’audit rapide pour la vérification des calculs
Afin de garantir une fiabilité totale lors de la manipulation du théorème central limite sur la calculatrice TI-84, la mise en œuvre d’une liste de vérification mentale systématique — un protocole d’audit en cinq étapes — est vivement préconisée avant d’entériner tout résultat statistique dans une publication académique ou une copie d’examen :
- Contrôle de validité du modèle : La taille de l’échantillon est-elle supérieure ou égale à 30 ($n ge 30$) ? Dans le cas inverse, l’énoncé ou la littérature certifie-t-elle sans équivoque que la population d’origine suit déjà une loi normale ? Si aucune de ces deux conditions n’est remplie, l’approximation par la loi normale via le TCL est caduque.
- Contrôle du quatrième argument : Avez-vous explicitement formulé $\sigma / \sqrt{n}$ dans le champ sigma ? Vérifiez scrupuleusement la présence du signe radical $[\sqrt{\quad}]$ et de l’effectif $n$.
- Contrôle des bornes infinies : En cas de test unilatéral, avez-vous sélectionné le signe de négation unaire [(-)] pour
-1E99? La valeur de borne est-elle positionnée dans le bon argument (inférieur pour unilatéral à droite, supérieur pour unilatéral à gauche) ? - Validation croisée par double calcul (Z-score) : En cas de doute persistant, calculez manuellement la cote centrée réduite sur l’écran d’accueil : $z = (\bar{x} – \mu) / (\sigma / \sqrt{n})$. Exécutez ensuite la commande
normalcdf(z, 1E99, 0, 1). Le résultat doit coïncider à la neuvième décimale près avec votre appel direct denormalcdf(x, 1E99, μ, σ/√(n)). - Contrôle de plausibilité universelle : Le résultat est-il impérativement borné dans l’intervalle réel $[0, 1]$ ? Une moyenne observée située au-delà de trois erreurs types de la moyenne doit générer une probabilité de queue inférieure à $0.00135$. Tout écart à ces ordres de grandeur impose une relecture immédiate de la chaîne de saisie.
12.2 Standardisation de la rédaction des résultats d’échantillonnage
La transcription d’une séquence de calcul exécutée sur calculatrice graphique au sein d’un document de recherche formel obéit à des normes académiques strictes, telles que celles édictées par l’American Psychological Association (APA). Il est proscrit d’utiliser la syntaxe propre de la calculatrice (comme normalcdf(...)) comme substitut à une argumentation mathématique en bonne et due forme.
Le compte rendu textuel rigoureux doit obligatoirement articuler trois éléments indissociables :
- L’explicitation du recours au théorème : Mentionner sans détour que la taille d’échantillon ($n = dots$) autorise l’application du théorème central limite pour modéliser la distribution d’échantillonnage de la moyenne par la loi normale.
- L’exposition des paramètres de distribution : Présenter formellement l’espérance et l’erreur type calculée sous leur notation standard : $\mu_{\bar{X}} = \mu = dots$ et $\sigma_{\bar{X}} = \frac{\sigma}{\sqrt{n}} = dots$
- L’expression formelle de la probabilité : Utiliser la notation probabiliste standardisée, en intégrant si possible la conversion en variable standardisée $Z$ avant de conclure sur la valeur p exacte arrondie à trois ou quatre décimales significatives (ex. : $P(\bar{X} ge 48) = P(Z ge 2.00) = 0.0228$).
12.3 Transition vers l’inférence avec écart-type inconnu
Pour conclure cette étude approfondie de l’application du théorème central limite sur la TI-84, il convient d’en cerner avec lucidité les limites opérationnelles en situation de recherche réelle. L’ensemble des procédures exposées dans ce guide repose sur un postulat mathématique sous-jacent : l’écart-type de la population parente $\sigma$ est supposé connu de manière certaine.
Or, dans la pratique de la recherche expérimentale et des enquêtes de terrain, il est exceptionnel de connaître l’écart-type d’une population dont on ignore précisément la moyenne générale $\mu$. Dans la quasi-totalité des cas réels, le chercheur ne dispose que d’un écart-type empirique d’échantillon, noté $s$ (ou $S_x$ sur les menus de statistiques de la TI-84), calculé à partir du même groupe d’individus que la moyenne empirique :
$$s = \sqrt{\frac{1}{n-1} \sum_{i=1}^{n} (X_i – \bar{X})^2}$$
Lorsque l’écart-type théorique $\sigma$ est substitué par cet estimateur d’échantillon $s$, la variable standardisée ne suit plus rigoureusement une loi normale, mais obéit à la loi de Student à $n – 1$ degrés de liberté :
$$T = \frac{\bar{X} – \mu}{\frac{s}{\sqrt{n}}} \sim t_{(n-1)}$$
Sur le plan instrumental, si votre taille d’échantillon est modérée ($n < 100$) et que l'écart-type de population est inconnu, la commande normalcdf() doit alors céder la place à sa contrepartie algorithmique dans le menu DISTR de la TI-84 : la fonction tcdf( (accessible à la commande 4:tcdf(). La syntaxe de tcdf exige les bornes inférieure et supérieure ainsi que les degrés de liberté : tcdf(lower, upper, df). Ce n’est que lorsque la taille $n$ franchit des seuils très élevés (plusieurs centaines d’observations) que la loi de Student s’assimile numériquement à la loi normale, restituant à normalcdf son universalité pratique sans risque d’écart d’estimation.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Casella, G., & Berger, R. L. (2002). Statistical inference (2nd ed.). Duxbury Press.
- DeGroot, M. H., & Schervish, M. J. (2012). Probability and statistics (4th ed.). Addison-Wesley.
- Feller, W. (1968). An introduction to probability theory and its applications (Vol. 1, 3rd ed.). John Wiley & Sons.
- Hogg, R. V., McKean, J., & Craig, A. T. (2019). Introduction to mathematical statistics (8th ed.). Pearson.
- Lindeberg, J. W. (1922). Eine neue Herleitung des Exponentialgesetzes in der Wahrscheinlichkeitsrechnung. Mathematische Zeitschrift, 15(1), 211–225. https://doi.org/10.1007/BF01494395
- Moore, D. S., Notz, W. I., & Fligner, M. A. (2021). The basic practice of statistics (9th ed.). W. H. Freeman.
- Texas Instruments. (2020). Guide de référence de la calculatrice graphique TI-84 Plus CE. Texas Instruments Incorporated. https://education.ti.com
- Wackerly, D. D., Mendenhall, W., & Scheaffer, R. L. (2014). Mathematical statistics with applications (7th ed.). Cengage Learning.