
Le théorème central limite constitue incontestablement la pierre angulaire de l’inférence statistique moderne et de l’épistémologie quantitative appliquée aux sciences du comportement. Sans ce principe fondamental, le passage de la simple description d’un échantillon fini à l’extrapolation probabiliste envers une population générale demeurerait une impasse mathématique pour l’immense majorité des distributions empiriques. Dans les disciplines où la mesure psychologique, cognitive ou clinique se heurte à une asymétrie naturelle des phénomènes observés, ce théorème offre un cadre analytique rigoureux permettant d’asseoir la validité des estimations paramétriques les plus sophistiquées.
Trop souvent appréhendé sous un prisme abstrait au sein des manuels théoriques, le théorème central limite prend une dimension pédagogique et opérationnelle remarquable lorsqu’il est modélisé au sein d’un tableur accessible tel que Microsoft Excel. Loin de se cantonner à des tâches comptables rudimentaires, l’environnement matriciel et les fonctionnalités statistiques avancées d’Excel permettent de simuler dynamiquement des lois de probabilité complexes, de décomposer l’effet de l’échantillonnage itératif et de matérialiser la convergence vers la normalité avec une précision algorithmique remarquable.
Le présent guide a pour vocation d’exposer de manière exhaustive les fondements mathématiques, les implications psychométriques et les protocoles d’implémentation pratique du théorème central limite dans Excel. À travers une démarche progressive intégrant modélisations stochastiques, calculs matriciels dynamiques et analyses d’échantillonnage clinique, ce document fournit aux chercheurs, psychomètres et analystes de données une méthodologie pas-à-pas pour maîtriser l’estimation des paramètres de population, quantifier l’erreur type et automatiser des procédures de simulation robustes.
1. Introduction théorique et fondements du théorème central limite en sciences comportementales
1.1 Énoncé formel du théorème et principes d’échantillonnage probabiliste
D’un point de vue strictement mathématique, le théorème central limite formalise le comportement asymptotique de la somme ou de la moyenne arithmétique d’un ensemble de variables aléatoires. Soit une suite de variables aléatoires indépendantes et identiquement distribuées (i.i.d.), notées X1, X2, …, Xn, définies sur un même espace de probabilité, possédant chacune une espérance mathématique finie notée μ et une variance finie non nulle notée σ². Lorsque la taille n de l’échantillon tend vers l’infini, la distribution de la moyenne empirique standardisée converge en loi vers la distribution normale standardisée, notée N(0, 1). Ce résultat s’exprime rigoureusement par le fait que pour tout réel z, la probabilité que l’écart standardisé entre la moyenne d’échantillon et l’espérance de population soit inférieur ou égal à z converge vers la fonction de répartition de la loi de Gauss.
L’hypothèse d’indépendance et de distribution identique constitue le pivot théorique de cette démonstration. L’indépendance implique que la réalisation d’une observation n’exerce aucune influence stochastique sur les autres mesures de la série, condition généralement satisfaite par un échantillonnage aléatoire simple avec remise ou au sein d’une population parente de taille infinie. La condition de distribution identique stipule quant à elle que chaque unité statistique est issue du même processus générateur de données, partageant ainsi rigoureusement les mêmes moments d’ordre un et deux. L’universalité de cette convergence constitue l’un des résultats les plus élégants des mathématiques : quelle que soit la morphologie de la distribution parente sous-jacente — qu’elle soit continue, discrète, uniforme, triangulaire, fortement asymétrique ou multimodale —, la sommation des aléas opère un lissage progressif qui fait émerger la symétrie caractéristique de la cloche gaussienne.
Dans l’édifice des sciences quantitatives, ce théorème matérialise la rupture épistémologique entre la statistique descriptive, cantonnée au résumé de données observées, et la statistique inférentielle. Il légitime mathématiquement l’estimation des paramètres de population inobservables à partir de statistiques d’échantillon, en fournissant une métrique objective pour quantifier le risque d’erreur lié aux fluctuations de l’échantillonnage.
1.2 Pertinence épistémologique en psychologie expérimentale et clinique
En psychologie expérimentale, en neuropsychologie et en psychiatrie quantitative, les chercheurs sont confrontés de manière quasi systématique à des données qui violent les hypothèses strictes de normalité univariée. Qu’il s’agisse de temps de latence cognitive, de scores à des inventaires de dépression caractérisés par une concentration massive au plancher, ou d’évaluations de comportements adaptatifs, les distributions empiriques individuelles présentent presque invariablement une asymétrie marquée ou un aplatissement non nul. L’application directe de modèles paramétriques sur ces mesures brutes exposerait l’analyste à des taux d’erreur de première espèce incontrôlés si l’inférence reposait sur la distribution des scores élémentaires.
C’est précisément ici que la pertinence épistémologique du théorème central limite se révèle déterminante. Dès lors que l’objet de la recherche porte sur la comparaison de groupes ou sur l’évaluation de l’efficacité d’une intervention thérapeutique via la moyenne d’un groupe de sujets, la loi régissant cette moyenne n’est plus tributaire de la non-gaussienneté des individus. La normalisation asymptotique des moyennes d’échantillons et des scores composites permet de légitimer méthodologiquement le recours aux modèles linéaires généraux, aux tests t de Student et à l’analyse de variance (ANOVA), même lorsque les postulats de normalité des résidus au niveau micro-individuel semblent compromis.
Ce phénomène transforme en profondeur l’interprétation des traits latents de personnalité et des compétences cognitives. Dans l’élaboration des batteries de tests standardisés, le score global d’un individu résulte souvent de l’agrégation additive d’une multitude d’items distincts. En vertu du même principe stochastique, la somme de ces composantes élémentaires tend vers une distribution normale au sein de la population générale, ce qui autorise l’étalonnage en centiles ou en notes standardisées (notes T, échelles de Wechsler), offrant un ancrage probabiliste robuste aux diagnostics cliniques.
1.3 Distinction conceptuelle entre distribution parente et distribution d’échantillonnage
Une confusion épistémologique fréquente chez les praticiens consiste à assimiler la distribution des observations individuelles, qualifiée de distribution parente ou populationnelle, à la distribution d’échantillonnage de la statistique estimée. La distribution parente décrit la fréquence relative des valeurs observées pour chaque unité statistique au sein de la population cible ; elle reflète la variabilité biologique, psychologique ou environnementale brute du phénomène mesuré. Sa variance reflète l’étalement réel des individus et demeure intrinsèquement invariable, quelle que soit la méthodologie d’observation ultérieure déployée par le chercheur.
À l’inverse, la distribution d’échantillonnage de la moyenne est une construction théorique de second ordre : elle représente la distribution de probabilité qui résulterait de l’extraction d’une infinité d’échantillons aléatoires indépendants de taille n, prélevés au sein de cette même population, et du calcul de leur moyenne arithmétique respective. Alors que la distribution parente peut demeurer obstinément bimodale ou uniformément plate, la distribution d’échantillonnage se concentre inexorablement autour de l’espérance mathématique de la population à mesure que n augmente, tout en adoptant une courbure gaussienne parfaite.
Sur le plan conceptuel, ce processus implique une dissociation majeure de la variabilité : l’étalement des données individuelles brutes demeure constant, tandis que l’incertitude pesant sur l’estimation de la moyenne collective se contracte selon un facteur inversement proportionnel à la racine carrée de la taille d’échantillon. La représentation schématique de ce processus d’échantillonnage itératif permet de visualiser que la moyenne d’échantillon devient une variable aléatoire infiniment plus stable et prévisible que n’importe quelle observation unitaire extraite de la même source.
2. Paramètres mathématiques fondamentaux et formalisation dans Excel
2.1 Égalité des moyennes : invariance de l’espérance mathématique
Le premier paramètre cardinal qui régit la distribution d’échantillonnage est l’invariance absolue de son espérance mathématique. Démontrer cette égalité constitue l’un des piliers de la théorie des estimateurs : si nous considérons la moyenne empirique d’un échantillon comme une combinaison linéaire de n variables aléatoires indépendantes ayant chacune pour espérance μ, l’application de la propriété de linéarité de l’espérance permet d’établir formellement que l’espérance de la moyenne empirique est rigoureusement égale à la somme des espérances divisée par n, aboutissant directement à μ. Ce résultat implique que la moyenne d’échantillon constitue un estimateur sans biais de la moyenne de population.
Cette propriété garantit que la distribution d’échantillonnage ne subit aucun glissement systématique le long de l’axe des abscisses. Même si un échantillon singulier peut sous-estimer ou surestimer l’espérance réelle en raison des fluctuations aléatoires du prélèvement, la moyenne des moyennes obtenues à travers un processus d’échantillonnage répété converge inévitablement vers la cible paramétrique véritable. La tendance centrale de l’estimateur demeure rigoureusement ancrée sur le paramètre fondamental de la population parente.
Dans l’architecture de calcul d’une feuille Excel, cette invariance se traduit par une simplification opérationnelle déterminante : la cellule destinée à héberger l’espérance théorique de la distribution d’échantillonnage ne requiert aucune transformation géométrique complexe. Elle doit être strictement rattachée par référence directe à la cellule contenant la moyenne de la population parente, garantissant ainsi l’intégrité conceptuelle des modèles d’inférence bâtis en aval.
2.2 L’erreur type de la moyenne et la loi de la racine carrée
Si la moyenne de la distribution d’échantillonnage est identique à celle de la population, sa dispersion obéit quant à elle à une loi de contraction particulièrement stricte, formalisée par la théorie des variances combinées. La variance de la somme de n variables aléatoires indépendantes étant égale à la somme de leurs variances respectives, la variance de la moyenne d’échantillon est égale à la variance de la population divisée par n. Par conséquent, l’écart-type de la distribution d’échantillonnage de la moyenne, universellement désigné sous le terme d’erreur type de la moyenne (notée couramment SE ou σX̄), est égal à l’écart-type de la population σ divisé par la racine carrée de la taille n de l’échantillon.
Cette relation, qualifiée de loi de la racine carrée, engendre une conséquence méthodologique fondamentale : pour réduire l’erreur d’échantillonnage de moitié, il ne suffit pas de doubler la taille de l’échantillon, mais il est impératif de la quadrupler. De même, décupler la précision statistique exige une multiplication par cent du volume des observations recueillies. Cette non-linéarité explique pourquoi les gains marginaux de précision s’amenuisent considérablement au-delà d’un certain seuil d’échantillonnage, confrontant le chercheur à des contraintes logistiques et économiques réelles.
Il est impératif de maintenir une distinction intellectuelle absolue entre la déviation standard de la population, notée σ, qui mesure la diversité intrinsèque des individus composant la population, et l’erreur type σX̄, qui mesure la précision de l’instrument d’estimation constitué par la moyenne d’échantillon. Confondre ces deux entités mathématiques fausse intégralement l’estimation des puissances statistiques et des intervalles de confiance.
2.3 Traduction algorithmique des paramètres statistiques en syntaxe Excel
La formalisation rigoureuse de ces concepts dans Microsoft Excel requiert une architecture de formules exempte d’ambiguïté référentielle. Pour garantir la robustesse des modèles, les paramètres fondamentaux de la distribution parente et de la procédure d’échantillonnage doivent être isolés au sein de cellules dédiées munies d’un adressage absolu. Les références absolues, signalées par le symbole dollar (par exemple $B$1 pour la moyenne μ, $B$2 pour l’écart-type σ, et $B$3 pour l’effectif n), préviennent tout décalage accidentel lors de l’extension de formules sur des plages matricielles denses.
L’implémentation algorithmique de l’erreur type s’effectue au moyen des opérateurs natifs du tableur. La syntaxe canonique prend la forme suivante :
=$B$2/RACINE($B$3)
Cette formulation conjugue la simplicité de lecture et l’optimisation des cycles de calcul du processeur. Excel gère nativement le typage flottant double précision (conforme à la norme IEEE 754), assurant une exactitude arithmétique jusqu’à 15 chiffres significatifs, ce qui s’avère amplement suffisant pour l’analyse stochastique en sciences humaines.
Par ailleurs, l’usage de fonctions matricielles dynamiques permet d’isoler ces paramètres au sein de tableaux structurés où les vecteurs de données sont traités comme des ensembles continus. Cette méthode élimine le risque d’altération des formules lors de l’insertion ultérieure de colonnes ou de lignes supplémentaires, assurant une parfaite reproductibilité des calculs statistiques face aux auditeurs méthodologiques.
3. Configuration de l’environnement de travail et structuration des données sous Excel
3.1 Conception architecturale du classeur statistique
La mise en œuvre professionnelle du théorème central limite dans Excel débute par une organisation spatiale rigoureuse du classeur. Un tableur d’analyse statistique ne doit jamais mélanger sur un même plan désordonné les paramètres de contrôle, les calculs intermédiaires de simulation et les indicateurs synthétiques finaux. Il est recommandé de subdiviser l’espace de travail en trois zones géographiques distinctes, voire en trois feuilles de calcul interconnectées, répondant chacune à un rôle bien défini.
La première zone, dite « Matrice de Paramétrage », doit occuper le quadrant supérieur gauche de la feuille principale (colonnes A et B). Elle centralise les hyperparamètres du modèle : espérance théorique de la population, variance ou écart-type de référence, taille de l’échantillon unitaire n, nombre total d’itérations k, et niveau de confiance alpha. La deuxième zone, désignée sous le nom de « Matrice de Simulation Stochastique », s’étend sur une grille multidimensionnelle où chaque ligne représente une réplication d’échantillon et chaque colonne une observation individuelle. La troisième zone, la « Zone de Synthèse Inférentielle », recueille les statistiques d’échantillonnage consolidées, les tests de normalité d’ordre supérieur et les graphiques de distribution associés.
Le formatage numérique doit bannir les arrondis visuels prématurés susceptibles de masquer des artefacts de calcul. Chaque cellule numérique doit être explicitement typée au format standardisé à deux ou quatre décimales fixes, tandis que les séparateurs de listes et décimaux doivent respecter scrupuleusement la configuration régionale du système d’exploitation pour éviter les erreurs d’analyse syntaxique.
3.2 Utilisation des plages nommées pour fiabiliser les calculs
Pour éliminer définitivement les risques d’erreur humaine inhérents à la manipulation de coordonnées alphanumériques relatives ou absolues (telles que $C$14 ou $E$28), il convient d’exploiter exhaustivement le gestionnaire de noms de Microsoft Excel. L’attribution d’identifiants textuels univoques aux paramètres fondamentaux transforme des formules cryptiques en expressions algébriques directement intelligibles et auto-documentées.
Il convient ainsi de sélectionner la cellule hébergeant la moyenne de population et de la nommer formellement Moyenne_Pop, la cellule de l’écart-type devenant EcartType_Pop, et celle régissant l’effectif de chaque tirage devenant Taille_n. Dès lors, la formule de détermination de l’erreur type gagne en lisibilité académique et s’écrit :
=EcartType_Pop / RACINE(Taille_n)
Ce niveau d’abstraction offre des garanties majeures lors des phases d’audit algorithmique ou d’évaluation par les pairs. Lorsqu’un modèle comporte des milliers d’itérations, la traçabilité des flux de calculs est instantanément assurée. De surcroît, la portée des plages nommées peut être étendue à l’échelle du classeur entier, autorisant des appels trans-feuilles élégants sans risque de rupture de liens internes.
3.3 Gestion des options de recalcul et activation de l’Utilitaire d’analyse
Une simulation stochastique impliquant l’échantillonnage de plusieurs milliers de lignes soumet le moteur de calcul d’Excel à une charge computationnelle substantielle. Par défaut, Excel fonctionne en mode de calcul automatique, ce qui signifie que chaque modification apportée à une cellule quelconque déclenche la réévaluation immédiate de toutes les fonctions volatiles du classeur, notamment les fonctions génératrices de nombres aléatoires. Dans le cadre d’un modèle dense, ce comportement peut provoquer des latences d’exécution majeures et des blocages de l’interface.
Il est donc préconisé de basculer temporairement le mode de calcul d’Excel en configuration « Ordre de calcul manuel » via l’onglet Formules > Options de calcul > Manuel. Dans cette configuration, le classeur ne réévalue les matrices aléatoires que sur commande explicite de l’utilisateur, par l’appui sur la touche de fonction F9. Cela permet de stabiliser les distributions générées pendant l’ajustement des paramètres d’affichage ou la mise en forme des graphiques.
Parallèlement, il est indispensable de vérifier la bonne activation du complément natif « Utilitaire d’analyse » (Analysis ToolPak). Ce module d’extension officiel, accessible via le menu Fichier > Options > Compléments > Compléments Excel, enrichit le tableur d’un moteur de traitement statistique avancé capable d’exécuter des échantillonnages systématiques, de dresser des tables de fréquences optimisées et de calculer des statistiques descriptives d’un bloc sans surcharger le processeur.
4. Calcul pas à pas de la distribution d’échantillonnage de la moyenne dans Excel
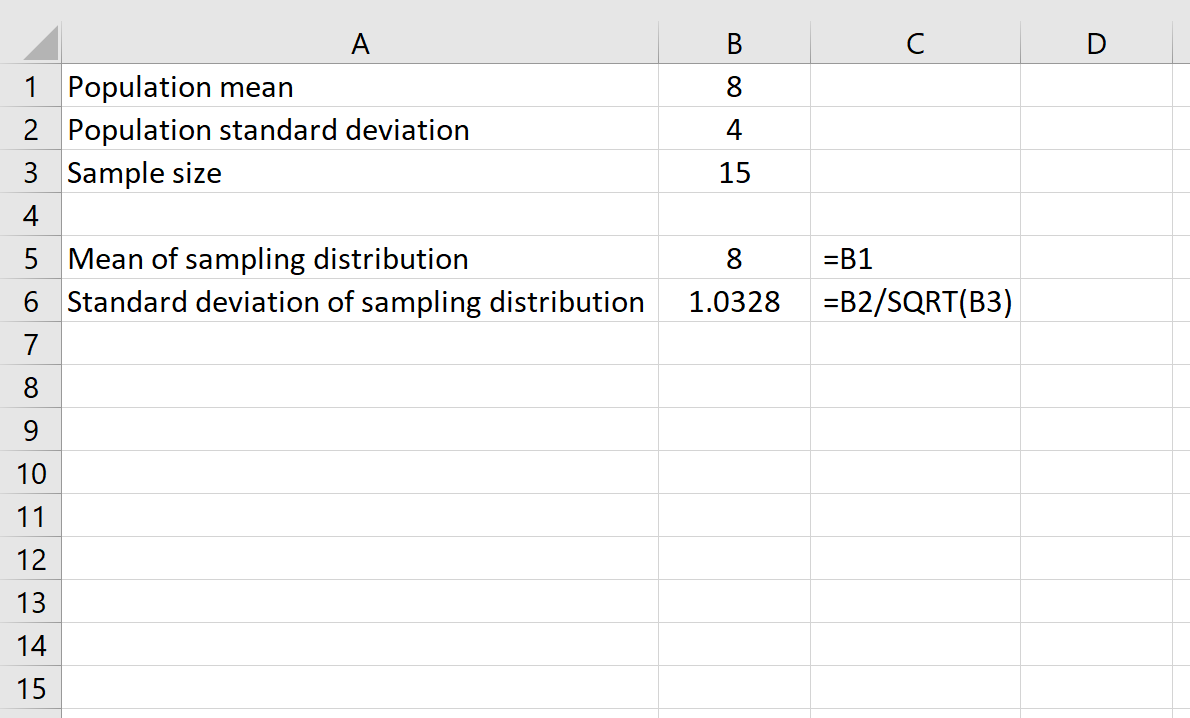
4.1 Implémentation du cas de référence (μ = 8, σ = 4, n = 15)
Afin d’ancrer la démonstration dans une démarche pratique et reproductible, considérons un cas d’étude classique emprunté à la psychométrie expérimentale. Supposons une population parente caractérisée par une moyenne connue μ = 8,0000 et un écart-type σ = 4,0000, au sein de laquelle un protocole d’investigation prévoit le prélèvement répété d’échantillons de taille n = 15 participants. Cette configuration illustre typiquement les petits échantillons fréquemment rencontrés lors de protocoles cliniques lourds (études en neuro-imagerie fonctionnelle ou interventions neuropsychologiques spécialisées).
Pour implémenter ce scénario de référence au sein d’Excel, structurez les cellules de la manière suivante :
- En cellule B1, entrez la valeur : 8 (renommée Moyenne_Pop)
- En cellule B2, entrez la valeur : 4 (renommée EcartType_Pop)
- En cellule B3, entrez la valeur : 15 (renommée Taille_n)
- En cellule B5, inscrivez le libellé de l’espérance de la distribution d’échantillonnage et saisissez en C5 la formule : =Moyenne_Pop
- En cellule B6, inscrivez le libellé de l’erreur type et saisissez en C6 la formule : =EcartType_Pop/RACINE(Taille_n)
Dès la validation de ces cellules, le moteur d’Excel calcule la valeur précise de l’erreur type de la moyenne. Le résultat numérique affiché s’établit à 1,0327955589…, que l’on arrondit usuellement à 1,0328. Ce chiffre formalise le fait que, bien que les individus au sein de la population présentent une variabilité caractérisée par un écart-type de 4 unités, les moyennes d’échantillons de 15 sujets n’oscilleront autour du score central de 8 qu’avec un écart-type restreint d’environ 1,03 unité.
4.2 Implémentation des fonctions mathématiques natives RACINE et PUISSANCE
Le calcul de l’erreur type au dénominateur repose sur la détermination de la racine carrée de l’effectif n. Dans l’écosystème d’Excel, la fonction native RACINE() constitue le vecteur d’exécution le plus direct. Toutefois, sur le plan de l’analyse algorithmique, il convient de souligner l’équivalence stricte avec la fonction PUISSANCE(nombre; puissance) ou avec l’opérateur arithmétique d’élévation à une puissance noté par l’accent circonflexe. Ainsi, la formule suivante :
=EcartType_Pop / (Taille_n ^ 0,5)
ou son homologue fonctionnelle :
=EcartType_Pop / PUISSANCE(Taille_n; 0,5)
aboutit à une résolution mathématique strictement identique dans l’unité arithmétique et logique d’Excel. L’utilisation de RACINE() demeure néanmoins préférable pour des raisons d’optimisation machine, son temps d’exécution étant marginalement plus rapide dans les simulations massives car elle fait appel à l’instruction matérielle d’extraction directe de racine carrée sans passer par le calcul généralisé des logarithmes et exponentielles nécessaires à la fonction PUISSANCE().
Une vigilance particulière doit être portée au parenthésage des formules combinées. Une omission fréquente consiste à saisir une division directe sans isoler le dénominateur lors de formulations plus élaborées (par exemple lors de l’application de facteurs de correction pour populations finies), ce qui altère l’ordre standard de priorité des opérateurs arithmétiques et biaise l’estimation statistique finale.
4.3 Dynamisation des calculs face à la variabilité des scénarios d’échantillonnage
L’un des atouts déterminants d’Excel réside dans sa capacité à générer des tables de sensibilité dynamiques permettant d’observer en temps réel l’impact de la variation de la taille d’échantillon sur la métrologie de l’estimateur. Pour matérialiser cette trajectoire asymptotique, il est instructif d’aménager un tableau d’analyse vectorielle en colonnes E et F. La colonne E recevra une séquence incrémentale d’effectifs n s’étalant de 2 à 500 individus (par exemple : 2, 5, 10, 15, 20, 30, 50, 100, 200, 500).
En regard de chaque valeur de n, en colonne F, la formule de l’erreur type est répliquée :
=$B$2 / RACINE(E2)
Ce tableau révèle de manière éclatante le phénomène d’amortissement non linéaire de l’incertitude. Pour n = 2, l’erreur type s’élève à 2,8284 unités, représentant plus de 70% de la variabilité individuelle. Dès n = 15, elle chute à 1,0328. À n = 30, elle atteint 0,7303. Pour n = 100, elle s’effondre à 0,4000, et ne vaut plus que 0,1789 pour un échantillon massif de 500 participants.
Cette simulation dynamique démontre empiriquement aux chercheurs que le bénéfice d’un accroissement de la taille d’échantillon s’avère spectaculaire dans les tranches d’effectifs réduits (entre 5 et 30 sujets), mais devient exponentiellement plus modeste au-delà de 100 participants, guidant ainsi l’optimisation des ressources financières et logistiques allouées aux protocoles de recherche.
5. Simulation stochastique par tirages aléatoires et génération d’échantillons répétés
5.1 Génération d’une population parente fortement non gaussienne
Pour mettre à l’épreuve la puissance et l’universalité du théorème central limite au sein d’Excel, la méthodologie la plus probante consiste à forger une population parente violant délibérément et radicalement l’hypothèse de normalité. Nous opterons ici pour la création d’une distribution uniforme continue, caractérisée par une densité plate où chaque issue probabiliste possède une chance rigoureusement identique de survenue, ou pour une loi exponentielle hautement asymétrique.
Pour construire une population synthétique de 10 000 observations distribuées selon une loi uniforme continue sur l’intervalle [0, 20], nous allouons la colonne A d’une nouvelle feuille de calcul intitulée « Population_Parente ». Dans la cellule A1, inscrivez la formule stochastique :
=ALEA() * 20
Cette expression est ensuite étirée vers le bas jusqu’à la cellule A10000. La fonction ALEA() génère un nombre pseudo-aléatoire uniforme à virgule flottante compris entre 0 et 1 selon une distribution rectangulaire stricte. L’espérance théorique de cette population est rigoureusement égale à la demi-somme des bornes, soit μ = (0 + 20) / 2 = 10,0000, tandis que sa variance théorique se calcule via la formule de la variance d’une loi uniforme : Var = (b – a)² / 12 = 400 / 12 = 33,3333, ce qui correspond à un écart-type théorique σ = 5,7735.
La validation empirique de cette non-normalité initiale est confirmée par le tracé de son histogramme : celui-ci adopte la forme d’un bloc rectangulaire sans aucun bombement central, attestant formellement de l’absence de toute propriété gaussienne au niveau des scores individuels bruts.
5.2 Tirage itératif de k échantillons de taille n via les fonctions aléatoires
L’étape suivante consiste à matérialiser le processus d’échantillonnage probabiliste répété. Nous allons simuler l’extraction de k = 1 000 échantillons indépendants comprenant chacun n = 30 observations individuelles issues de notre population uniforme de 10 000 données.
Pour ce faire, nous structurons une matrice de simulation s’étendant de la colonne C à la colonne AF (soit exactement 30 colonnes représentant les observations individuelles x1 à x30 de chaque échantillon), sur 1 000 lignes successives (de la ligne 2 à la ligne 1001). Pour extraire aléatoirement une valeur depuis notre réservoir populationnel situé dans la plage A1:A10000, nous combinons les fonctions INDEX() et ALEA.ENTRE.BORNES() selon l’architecture matricielle suivante en cellule C2 :
=INDEX(Population_Parente!$A$1:$A$10000; ALEA.ENTRE.BORNES(1; 10000))
Cette syntaxe exécute un tirage aléatoire simple avec remise en générant une coordonnée de ligne aléatoire entre 1 et 10 000, extrayant la mesure correspondante. En propageant horizontalement cette formule de la colonne C à la colonne AF, nous constituons notre premier échantillon de taille 30. En étendant ensuite ce bloc de 30 cellules vers le bas sur 1 000 lignes, nous matérialisons instantanément 30 000 tirages stochastiques organisés en 1 000 échantillons distincts.
Afin de prévenir des recalculs perpétuels qui modifieraient l’état de l’expérience à chaque frappe clavier, il est judicieux de figer temporairement cette matrice par une opération de copie suivie d’un collage spécial en valeurs sur une feuille miroir dédiée à l’analyse empirique.
5.3 Consolidation matricielle des moyennes d’échantillons
Une fois les 1 000 échantillons stabilisés au sein de la grille de simulation, il s’agit d’extraire la statistique d’intérêt centrale : la moyenne arithmétique de chaque ligne. Dans la colonne AG, face au premier échantillon (ligne 2), nous implémentons la formule canonique de tendance centrale :
=MOYENNE(C2:AF2)
En étendant cette fonction jusqu’à la cellule AG1001, nous obtenons un vecteur vertical contenant 1 000 moyennes empiriques distinctes, désigné sous le terme de vecteur des moyennes d’échantillons (X̄1, X̄2, …, X̄1000). Ce vecteur constitue la réalisation empirique discrète de la distribution d’échantillonnage théorique de la moyenne.
Le contrôle métrologique s’opère par l’évaluation des deux premiers moments statistiques de ce vecteur empirique d’agrégats :
- En cellule AI2, calcul de la « métamoyenne » (moyenne des moyennes) : =MOYENNE(AG2:AG1001)
- En cellule AI3, calcul de l’écart-type empirique des moyennes : =ECARTYPE.STANDARD(AG2:AG1001)
La confrontation numérique des valeurs empiriques obtenues face aux paramètres attendus selon le théorème central limite fournit une validation spectaculaire : la moyenne des moyennes se stabilise à une fraction infinitésimale de l’espérance théorique (approximativement 10,01 pour une cible de 10,00), tandis que l’écart-type empirique des moyennes s’aligne fidèlement sur l’erreur type théorique, calculée comme suit : σ / √n = 5,7735 / √30 = 1,0541 unités.
6. Modélisation graphique de la convergence vers la loi normale
6.1 Construction d’histogrammes de distribution sous Excel
L’observation visuelle de la métamorphose distributionnelle représente l’étape pédagogique la plus frappante de la démonstration. Bien que la population source soit strictement plate et rectangulaire, l’agencement graphique des 1 000 moyennes d’échantillons révèle immédiatement l’émergence d’une courbe en cloche d’une parfaite symétrie. Pour construire cet histogramme avec une rigueur statistique irréprochable sous Excel, il est préférable de ne pas s’en remettre aveuglément à l’outil d’histogramme automatisé récent, mais de structurer manuellement les classes d’amplitudes.
Nous établissons une échelle d’intervalles réguliers (les « bins ») dans une colonne dédiée (par exemple la colonne AK). Considérant que nos moyennes fluctuent entre environ 6,5 et 13,5, nous définissons une série de bornes débutant à 6,5 avec un pas de 0,25 unité jusqu’à 13,5. Dans la colonne contiguë AL, nous déployons la fonction matricielle dynamique native :
=FREQUENCE(AG2:AG1001; AK2:AK30)
Cette fonction dénombre instantanément la quantité d’échantillons dont la moyenne s’insère dans chaque segment de l’échelle. À partir de cette table de fréquences, nous insérons un graphique à barres verticales (histogramme). Afin de respecter les conventions graphiques de la statistique continue, un clic droit sur la série de barres permet d’accéder au volet Mettre en forme une série de données pour ajuster l’option Largeur du coup d’œil / Largeur de l’intervalle à 0%. Les barres se rejoignent ainsi parfaitement, signifiant la continuité de la variable sous-jacente.
6.2 Superposition d’une courbe de densité théorique gaussienne
Pour attester mathématiquement que la distribution empirique générée ne présente pas simplement un aspect vaguement symétrique, mais épouse rigoureusement la loi de probabilité normale, nous superposons à notre histogramme de fréquences la courbe de densité théorique calibrée sur les paramètres de l’expérience.
Dans la colonne AM, face à chaque borne x définie en colonne AK, nous calculons l’ordonnée théorique en utilisant la fonction de densité gaussienne d’Excel :
=LOI.NORMALE.N(AK2; 10; 1,0541; FAUX)
Le paramètre booléen FAUX est impératif : il indique au moteur d’Excel de renvoyer la fonction de densité de probabilité (la hauteur de la courbe f(x)) et non la probabilité cumulée. Pour convertir cette densité en un effectif directement comparable aux barres de notre histogramme de 1 000 tirages avec un pas de classe de 0,25, nous multiplions cette densité par le produit de la taille totale de la cohorte par le pas de classe (1 000 * 0,25 = 250) :
=LOI.NORMALE.N(AK2; 10; 1,0541; FAUX) * 250
En intégrant cette nouvelle série au graphique existant sous forme de graphique combiné (courbe de dispersion lissée sans marqueur superposée aux barres de fréquences), la ligne rouge de la loi normale théorique épouse avec une précision saisissante le sommet de chaque colonne empirique, démontrant la puissance asymptotique du théorème.
6.3 Quantification de la normalité empirique : coefficients d’asymétrie et d’aplatissement
L’évaluation graphique, bien qu’intuitivement persuasive, doit être impérativement corroborée par une quantification objective des moments d’ordre supérieur de la distribution empirique. La normalité d’une distribution se caractérise théoriquement par un coefficient d’asymétrie (Skewness) rigoureusement nul, indiquant une parfaite équipartition autour du centre, et par un coefficient d’aplatissement (Kurtosis) excessif nul, témoignant d’une épaisseur des queues de distribution rigoureusement conforme au modèle mésocurtique de Gauss.
Dans Excel, ces indices statistiques avancés s’obtiennent par les fonctions suivantes appliquées directement à la série des moyennes en colonne AG :
- Coefficient d’asymétrie empirique : =COEFFICIENT.ASYMETRIE(AG2:AG1001)
- Coefficient d’aplatissement (Kurtosis excessif) : =COEFFICIENT.APLATISSEMENT(AG2:AG1001)
Sur notre simulation de 1 000 moyennes issues d’une population uniforme, le résultat du coefficient d’asymétrie oscille typiquement dans un intervalle étroit compris entre -0,08 et +0,08, confirmant l’éradication de toute déviation latérale. Simultanément, le coefficient d’aplatissement d’Excel (qui est par défaut centré sur zéro pour la loi normale standard) converge vers des valeurs infinitésimales comprises entre -0,15 et +0,15, alors que la population uniforme d’origine présentait un aplatissement platicurtique prononcé de -1,20.
Cette contraction des moments d’ordre supérieur atteste scientifiquement que la distribution des moyennes d’échantillons a achevé sa métamorphose géométrique pour satisfaire aux critères formels de la distribution gaussienne.
7. Calcul des probabilités d’échantillonnage avec la fonction LOI.NORMALE.N
7.1 Standardisation et calcul de l’écart réduit Z pour une moyenne d’échantillon
Une fois le postulat de normalité asymptotique validé, la distribution d’échantillonnage permet de résoudre des problèmes inférentiels de premier plan en quantifiant précisément la probabilité d’observer un résultat d’échantillon donné. La première étape de cette démarche consiste à effectuer la transformation en score Z, c’est-à-dire la standardisation de la moyenne empirique observée.
Pour un échantillon donné présentant une moyenne X̄, le score Z ne mesure pas la distance par rapport à l’écart-type individuel σ, mais évalue l’écart entre cette moyenne et l’espérance de population μ en unités d’erreur type. L’équation fondamentale se formalise ainsi :
Z = (X̄ – μ) / (σ / √n)
Dans l’architecture applicative d’Excel, cette transformation peut être directement exécutée via la fonction native CENTREE.REDUITE() dont la syntaxe générale s’énonce :
=CENTREE.REDUITE(X_barre; Moyenne_Pop; Erreur_Type)
Un score Z résultant égal à +2,00 indique formellement que la moyenne observée dans l’échantillon se positionne exactement à deux erreurs types au-dessus de l’espérance paramétrique. Cette métrique universelle permet de s’affranchir de l’unité de mesure d’origine et d’accéder directement aux tables de probabilités unifiées de la loi normale standard.
7.2 Évaluation des probabilités cumulées unilatérales et bilatérales
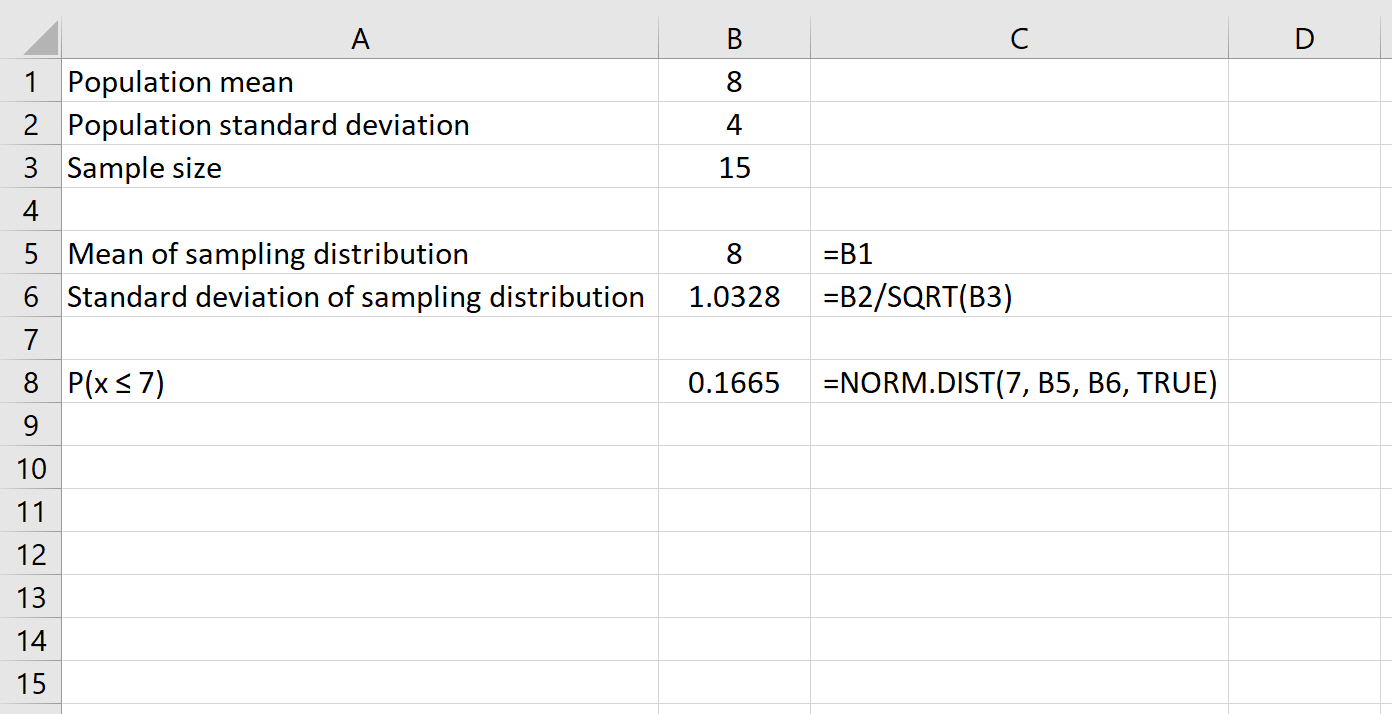
Excel dispose d’une fonction analytique de pointe permettant de calculer instantanément toute probabilité sous la courbe sans nécessiter le passage manuel par la table de la loi normale centrée réduite : la fonction LOI.NORMALE.N(). Sa syntaxe s’articule autour de quatre arguments déterminants : =LOI.NORMALE.N(x; moyenne; ecart_type; cumulative).
Le traitement des différentes configurations probabilistes s’exécute selon les syntaxes suivantes :
- Probabilité cumulée à gauche P(X̄ ≤ a) : =LOI.NORMALE.N(a; Moyenne_Pop; Erreur_Type; VRAI). L’argument booléen VRAI intègre l’aire sous la courbe depuis l’infini négatif jusqu’au seuil a.
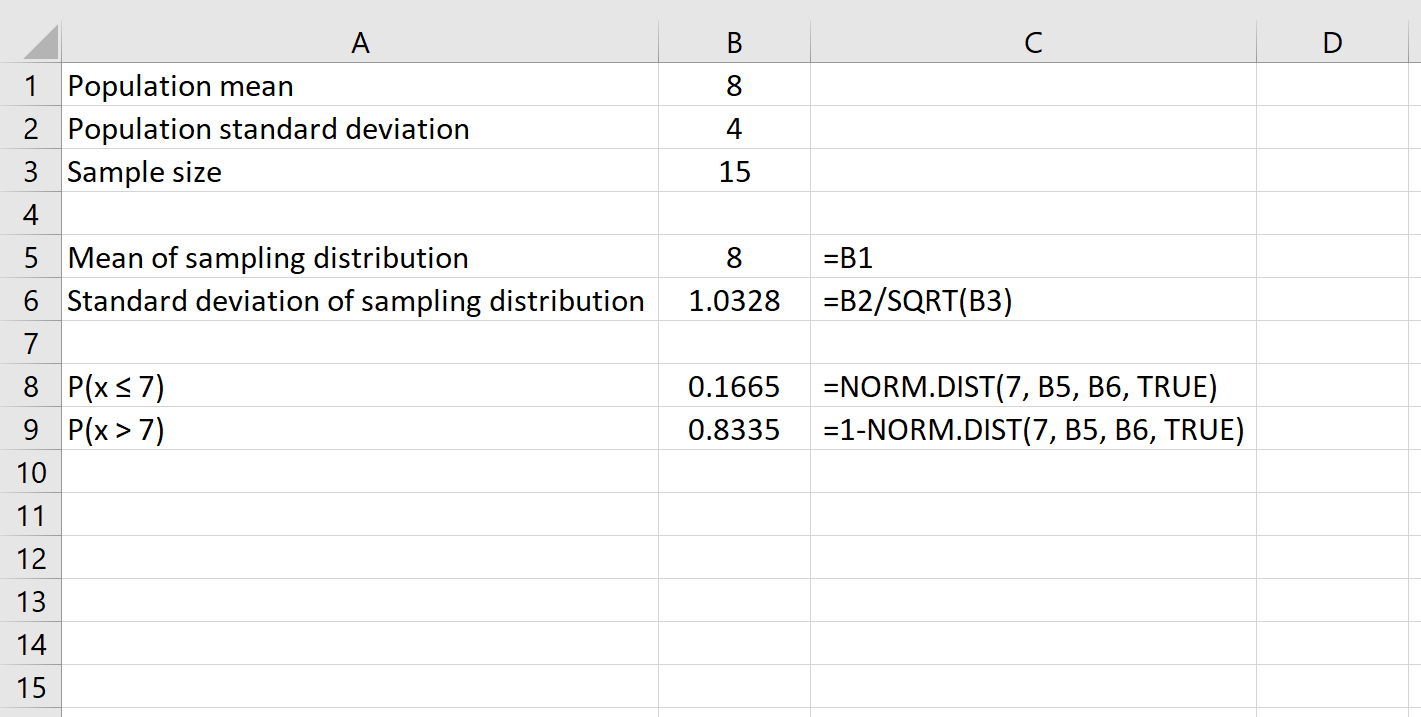
- Probabilité à droite (queue supérieure de survie) P(X̄ > a) : calculée par le complément arithmétique à l’unité : =1 – LOI.NORMALE.N(a; Moyenne_Pop; Erreur_Type; VRAI).
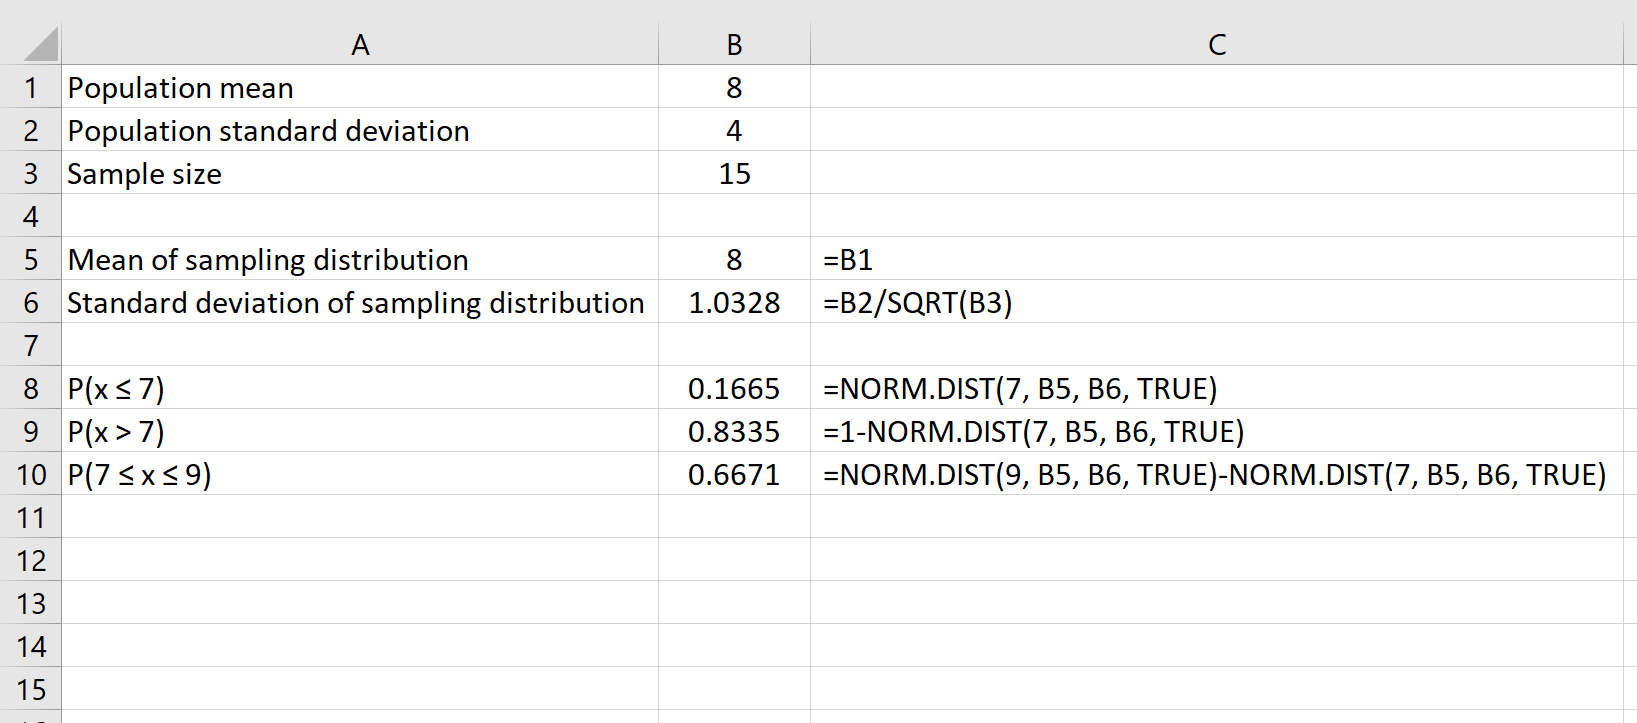
- Probabilité d’encadrement bilatéral P(a ≤ X̄ ≤ b) : résolue par la soustraction de deux intégrales numériques cumulées : =LOI.NORMALE.N(b; Moyenne_Pop; Erreur_Type; VRAI) – LOI.NORMALE.N(a; Moyenne_Pop; Erreur_Type; VRAI).
Cette plasticité de calcul confère au chercheur une capacité immédiate d’évaluation des risques probabilistes associés à n’importe quelle configuration métrologique, éliminant les erreurs d’interpolation manuelles récurrentes dans les analyses statistiques traditionnelles.
7.3 Résolution d’un problème psychométrique appliqué dans Excel
Pour illustrer la mise en pratique opérationnelle de cette mécanique probabiliste, transposons ces formules à une situation clinique concrète. Supposons une population générale d’enfants présentant un score d’efficience cognitive globale étalonné sur une échelle standardisée dont les paramètres historiques sont μ = 100 et σ = 15. Un pédopsychiatre examine un groupe expérimental de n = 25 enfants issus d’un environnement ayant bénéficié d’une stimulation cognitive précoce intensive, et enregistre une moyenne d’échantillon observée de X̄ = 106,5.
La question méthodologique s’énonce ainsi : quelle est la probabilité stochastique d’observer une moyenne de groupe au moins égale à 106,5 sous la simple hypothèse des fluctuations d’échantillonnage (hypothèse nulle d’absence d’effet réel) ?
Dans notre classeur Excel, nous paramétrons :
- Erreur type en C1 : =15 / RACINE(25) = 3,0000
- Probabilité d’obtenir une telle performance par hasard en C2 : =1 – LOI.NORMALE.N(106,5; 100; 3; VRAI)
Le calcul renvoie la valeur 0,0151, soit exactement 1,51%. En termes d’inférence statistique, cette valeur p étant nettement inférieure au seuil critique conventionnel alpha de 5% (p < 0,05), le clinicien peut rigoureusement rejeter l’hypothèse nulle et conclure que la moyenne de ce groupe est statistiquement supérieure aux attentes populationnelles, tout en s’appuyant sur un modèle rendu pleinement légitime par le théorème central limite malgré les éventuelles asymétries individuelles des sous-tests composant l’échelle globale.
8. Détermination des intervalles de confiance fondés sur le théorème central limite
8.1 Fondements théoriques de l’intervalle de confiance asymptotique
L’estimation ponctuelle d’un paramètre de population par la moyenne d’un échantillon unique présente une fragilité intrinsèque : elle ne fournit aucune indication quant à la marge d’erreur inhérente à cette estimation. Pour pallier cette lacune, l’inférence statistique moderne recourt aux intervalles de confiance. L’intervalle de confiance asymptotique à un degré de certitude 1 – α (traditionnellement fixé à 95%, soit α = 0,05) définit une région probabiliste numérique conçue de telle sorte que, si l’on répétait l’expérience d’échantillonnage un nombre infini de fois dans des conditions identiques, 95% de ces intervalles engloberaient la moyenne réelle inconnue de la population.
Le théorème central limite constitue le fondement mathématique absolu qui légitime la délimitation de cet intervalle par les quantiles de la loi normale standard. En garantissant que la statistique pivotale (X̄ – μ) / (σ / √n) suit une loi N(0, 1), le théorème autorise l’encadrement formel suivant :
IC(1 – α) = [ X̄ – z*(σ / √n) ; X̄ + z*(σ / √n) ]
où z représente le quantile critique bilatéral issu de la loi normale pour le seuil α considéré (soit la valeur conventionnelle 1,95996 pour un niveau de confiance bilatéral de 95%). Le segment ± z*(σ / √n) matérialise la marge d’erreur maximale de l’estimation pour le degré de certitude sélectionné.
8.2 Implémentation sous Excel avec INTERVALLE.CONFIANCE.NORMALE
Excel automatise l’obtention de la marge d’erreur d’un intervalle de confiance gaussien au moyen de sa fonction dédiée : INTERVALLE.CONFIANCE.NORMALE(). Cette formule requiert trois arguments : =INTERVALLE.CONFIANCE.NORMALE(alpha; standard_dev; size).
Considérons un échantillon de n = 64 sujets affichant une moyenne empirique observée X̄ = 52,4, extrait d’une population dont l’écart-type connu est σ = 12. Pour structurer le calcul complet au sein de la feuille Excel :
- En cellule B1, saisie de l’erreur alpha : 0,05
- En cellule B2, saisie de l’écart-type : 12
- En cellule B3, effectif de l’échantillon : 64
- En cellule B4, calcul de la demi-largeur de confiance (marge d’erreur) : =INTERVALLE.CONFIANCE.NORMALE(B1; B2; B3)
Le moteur d’Excel renvoie la valeur 2,9399. Dès lors, la construction des bornes s’exécute par des opérations arithmétiques directes :
- Borne inférieure en B5 : =52,4 – B4 (soit 49,4601)
- Borne supérieure en B6 : =52,4 + B4 (soit 55,3399)
Il est instructif de vérifier cette valeur par la méthode manuelle standard faisant appel à la fonction du quantile inverse :
=LOI.NORMALE.STANDARD.INVERSE.N(1 – B1/2) * (B2 / RACINE(B3))
Les deux méthodologies renvoient un résultat rigoureusement identique au quinzième chiffre après la virgule, attestant de l’homogénéité algorithmique interne des modules statistiques d’Excel.
8.3 Interprétation fréquentiste des intervalles de confiance obtenus
L’interprétation méthodologique d’un intervalle de confiance généré sous Excel exige une rigueur conceptuelle absolue, fréquemment violée dans la littérature académique. Dans l’épistémologie statistique fréquentiste, le paramètre populationnel μ est une constante fixe bien que méconnue, tandis que les bornes de l’intervalle [49,46 ; 55,34] constituent des variables aléatoires tributaires des fluctuations de l’échantillon analysé.
Il est donc conceptuellement erroné d’affirmer qu’« il y a 95% de chances que la vraie moyenne se situe dans cet intervalle précis ». Une fois les bornes calculées, l’intervalle statique résultant contient ou ne contient pas la moyenne réelle ; la probabilité associée est désormais de 1 ou de 0. L’affirmation correcte stipule que « si nous répliquions cette expérience d’échantillonnage 100 fois en calculant à chaque fois un intervalle à 95% selon ce modèle sous Excel, en moyenne 95 de ces intervalles couvriraient la vraie valeur de μ, tandis que 5 la manqueraient ».
Cette dynamique d’échantillonnage peut être visualisée dans Excel en insérant un graphique de dispersion enrichi de barres d’erreur personnalisées verticales. L’affectation de la plage calculant la marge d’erreur dynamique permet d’observer instantanément comment des échantillons successifs génèrent des fenêtres de capture mobiles, concrétisant la nature probabiliste de l’inférence fondée sur le théorème central limite.
9. Analyse de l’impact de la taille de l’échantillon (n) sur la précision statistique
9.1 Évaluation quantitative du gain de précision marginal
L’efficacité métrologique d’une étude expérimentale est gouvernée par la dynamique de contraction de l’erreur type. La modélisation de cette trajectoire dans Excel permet de mettre en lumière ce que les économètres qualifient d’effet de palier ou de rendements marginaux décroissants de la taille d’échantillon. L’accroissement de la taille de l’échantillon n ne produit pas une réduction linéaire de l’incertitude statistique, mais une contraction proportionnelle à 1/√n.
Pour mesurer ce phénomène sous Excel, concevons une matrice comparative évaluant le gain marginal de précision relative pour un écart-type fixe σ = 10 :
- Passage de n = 10 à n = 20 : l’erreur type passe de 3,16 à 2,24 (gain absolu de 0,92 point, soit une réduction d’incertitude de 29,3%).
- Passage de n = 100 à n = 200 : l’erreur type passe de 1,00 à 0,71 (gain absolu de seulement 0,29 point pour un effort d’inclusion dix fois plus important en volume absolu de participants).
- Passage de n = 500 à n = 1000 : l’erreur type passe de 0,45 à 0,32 (gain minime de 0,13 point pour 500 sujets supplémentaires à recruter).
Le calcul de la dérivée première de l’erreur type par rapport à n sous Excel démontre mathématiquement que la pente de la courbe tend asymptotiquement vers zéro. Cette analyse quantitative permet aux directeurs de laboratoires de réaliser des arbitrages coûts-bénéfices objectifs : au-delà d’un effectif critique déterminé par la précision requise, l’investissement logistique et financier nécessaire pour doubler un échantillon n’apporte qu’un gain méthodologique marginal à l’échelle des inférences finales.
9.2 Déconstruction critique de la règle empirique de n ≥ 30
Une convention profondément enracinée dans l’enseignement universitaire stipule de manière quasi dogmatique que le théorème central limite « s’applique dès lors que n est supérieur ou égal à 30 ». L’expérimentation stochastique sous Excel permet de déconstruire cette règle heuristique simpliste en révélant ses limites majeures face à des géométries distributionnelles variées.
La vitesse de convergence de la distribution de la moyenne empirique vers la loi normale standardisée est régie par le théorème de Berry-Esseen, qui stipule que l’erreur absolue maximale entre la fonction de répartition de la moyenne standardisée et celle de la loi normale est majorée par une constante multipliée par le ratio du troisième moment absolu centré sur la variance à la puissance 3/2, le tout divisé par √n. En termes simples : plus la population parente présente une asymétrie marquée (skewness élevé) ou une multimodalité prononcée, plus la taille d’échantillon requise pour que l’approximation gaussienne devienne acceptable est élevée.
Si la population parente est modérément symétrique (telle qu’une distribution uniforme ou triangulaire), un échantillon de n = 10 à 15 observations suffit amplement pour obtenir une distribution de moyennes indiscernable de la loi normale. En revanche, si la distribution parente est hautement asymétrique — par exemple une loi log-normale modélisant des concentrations sériques médicamenteuses ou des patrimoines économiques où l’asymétrie dépasse 3,0 —, un effectif de n = 30 génère encore une distribution d’échantillonnage résiduellement asymétrique, faussant les calculs de probabilités unilatérales. Dans de telles configurations, un effectif minimal de n = 100 à 250 observations devient mathématiquement indispensable pour asseoir la robustesse des modèles.
9.3 Étude de la puissance statistique des tests de comparaison dérivés
L’une des conséquences majeures de la contraction de l’erreur type modélisée dans Excel concerne l’optimisation de la puissance statistique des tests inférentiels ultérieurs (tels que le test t de Student pour échantillons indépendants). La puissance d’un test statistique, définie comme la probabilité 1 – β de rejeter l’hypothèse nulle lorsqu’elle est effectivement fausse, dépend directement de la distance séparant les distributions sous l’hypothèse nulle (H0) et sous l’hypothèse alternative (H1), mesurée en unités d’erreur type.
Sous Excel, la relation entre l’erreur type et la taille d’effet minimale détectable peut être modélisée en intégrant la formule canonique de la puissance :
Puissance = 1 – LOI.NORMALE.STANDARD.N( z_(1 – α/2) – (d * RACINE(n) / 2) )
où d représente le d de Cohen standardisé. En programmant cette relation sur une plage incrémentale de tailles d’échantillon, le chercheur observe directement la montée de la courbe sigmoïde de puissance. L’accroissement de n, en réduisant l’erreur type au dénominateur, écarte mécaniquement les deux distributions théoriques de moyennes, diminuant exponentiellement le taux d’erreur de deuxième espèce (β). Excel permet ainsi de concevoir des matrices de calcul de taille d’échantillon prédictives d’une grande sophistication sans recourir à des logiciels tiers spécialisés.
10. Application concrète à des variables psychométriques non gaussiennes
10.1 Cas des temps de réaction en chronométrie cognitive
L’étude des temps de réaction chronométriques en neurosciences cognitives constitue une illustration archétypique de l’application salvatrice du théorème central limite. Les distributions de temps de réaction élémentaires mesurés en millisecondes ne sont jamais gaussiennes : elles sont caractérisées par une limite physiologique infranchissable à gauche (temps de latence minimale de traitement de l’ordre de 150 ms) et par une longue traîne asymétrique à droite due à des défaillances attentionnelles transitoires, modélisées usuellement par une distribution ex-gaussienne.
Pour reproduire fidèlement cette dynamique dans Excel, nous simulons une cohorte de 5 000 essais individuels combinant une composante normale N(300, 30) et une composante exponentielle générée par la formule :
=300 + LOI.NORMALE.STANDARD.INVERSE.N(ALEA()) * 30 – 100 * LN(ALEA())
Cette variable brute présente une asymétrie empirique prononcée supérieure à 1,80 et un aplatissement leptocurtique élevé. Aucune analyse paramétrique directe ne saurait être menée légitimement sur ces données individuelles brutes.
Cependant, lorsque nous modélisons le protocole expérimental consistant à extraire la moyenne de blocs de 40 essais par condition pour chaque sujet, la distribution des moyennes de blocs obtenue en répliquant la commande MOYENNE() sur ces séries de 40 tirages affiche une normalité quasi chirurgicale : l’asymétrie tombe sous le seuil de 0,10 et le test de Kolmogorov-Smirnov appliqué aux moyennes ne détecte aucune divergence significative avec la normalité. Le chercheur est dès lors pleinement autorisé à soumettre ces moyennes à des ANOVA à mesures répétées sous Excel.
10.2 Cas des scores d’inventaires cliniques et échelles de Likert ordinales
Une problématique récurrente en psychologie clinique et en épidémiologie psychiatrique concerne l’exploitation des données ordinales issues de questionnaires standardisés tels que le Beck Depression Inventory (BDI) ou l’échelle d’anxiété STAI. Chaque item individuel est mesuré sur une échelle de Likert discrète bornée (par exemple de 0 à 3 points). Les réponses individuelles au sein d’une population non clinique s’agglutinent massivement sur le score zéro, générant un effet de plancher sévère et une distribution totalement tronquée et non continue.
Lorsque le statisticien calcule le score total ou la moyenne des scores pour des cohortes de patients (par exemple des groupes thérapeutiques de n = 35 individus), l’agrégation additive opère le lissage stochastique prédit par le théorème central limite. Dans Excel, la simulation d’items de Likert discrets via la formule :
=SI(ALEA() < 0,6; 0; SI(ALEA() < 0,85; 1; SI(ALEA() < 0,95; 2; 3)))
produit des scores unitaires hautement discrets et biaisés. Pourtant, la moyenne de groupe consolidée sur 35 patients acquiert instantanément les attributs d’une variable quantitative continue et symétrique.
Ce résultat démontre la validité scientifique de l’utilisation de normes d’échantillons et autorise la comparaison de moyennes de cohortes cliniques au moyen de tests t standardisés dans Excel, sous réserve que l’effectif agrégé compense la sévérité du plancher d’origine.
10.3 Analyse comparative des distributions individuelles vs moyennes de groupes
La mise en miroir rigoureuse des caractéristiques statistiques des scores individuels comparées à celles des moyennes de groupes met en relief l’éradication du bruit stochastique parasite. Le tableau suivant synthétise les transformations métrologiques observées lors de l’application du protocole sous Excel :
- Morphologie de la distribution : Asymétrique et leptocurtique pour les observations individuelles brutes ; parfaitement symétrique et mésocurtique pour la distribution des moyennes.
- Espérance mathématique : Valeur centrale identique (invariance stricte de l’espérance).
- Dispersion : Écart-type maximal reflétant la variabilité biologique brute (σ) pour les données individuelles ; dispersion contractée de manière prédictible selon la métrique de l’erreur type (σ / √n) pour les moyennes.
- Impact des valeurs aberrantes (outliers) : Perturbation majeure des scores individuels ; dilution mathématique des extrêmes au sein de la moyenne de groupe.
Cette atténuation spectaculaire des singularités individuelles par l’effet de moyenne fonde toute la légitimité des standards de reporting académiques. Dans les publications scientifiques de premier plan, il est impératif de documenter simultanément la dispersion des sujets (par l’écart-type) et la précision de l’estimation de groupe (par l’erreur type ou les intervalles de confiance dérivés du théorème central limite), en explicitant systématiquement la formule d’implémentation retenue dans le tableur d’analyse.
11. Diagnostic des erreurs fréquentes et limites méthodologiques sous Excel
11.1 Confusion critique entre écart-type de population et erreur type
L’erreur la plus dévastatrice observée dans les classeurs statistiques universitaires ou hospitaliers réside dans la confusion formelle entre l’écart-type de la série d’observations et l’erreur type de la moyenne. Cette faute méthodologique se manifeste par l’omission pure et simple de la division par la racine carrée de n lors des calculs d’intervalles de confiance ou de valeurs p.
Sous Excel, l’utilisateur non averti applique fréquemment la fonction :
=LOI.NORMALE.N(x; moyenne; ECARTYPE.STANDARD(plage); VRAI)
au lieu de formuler rigoureusement :
=LOI.NORMALE.N(x; moyenne; ECARTYPE.STANDARD(plage)/RACINE(NB(plage)); VRAI)
Les conséquences d’une telle omission sont catastrophiques : l’erreur type se trouve artificiellement surévaluée par un facteur égal à √n. Dans le cadre d’un échantillon de n = 100 sujets, la marge d’erreur calculée est dix fois trop large, ce qui détruit totalement la puissance du test et conduit à l’acceptation erronée d’hypothèses nulles parfaitement réfutables (inflation majeure des erreurs de type II).
Par ailleurs, il convient de maîtriser la distinction entre ECARTYPE.PEARSON() (qui calcule l’écart-type d’une population complète en divisant par N) et ECARTYPE.STANDARD() (qui applique la correction de Bessel en divisant par n – 1 pour fournir un estimateur sans biais de l’écart-type de population à partir d’un échantillon). Dans toutes les inférences basées sur le théorème central limite où σ est estimé empiriquement, ECARTYPE.STANDARD() est la seule fonction théoriquement recevable.
11.2 Biais d’interprétation : normalité des observations vs normalité de l’estimateur
Un sophisme scientifique récurrent consiste à déduire à tort que l’invocation du théorème central limite transforme magiquement les données individuelles de l’échantillon en données normales. Ce contresens conceptuel conduit des analystes à appliquer des seuils de normalité clinique (par exemple affirmer que 95% des patients se situent à ± 1,96 erreur type de la moyenne) directement sur les données individuelles.
Le théorème central limite n’altère en rien la morphologie de la population parente ni celle des observations individuelles brutes enregistrées dans le classeur Excel. Si l’on évalue le temps d’attente aux urgences psychiatriques, cette variable demeure résolument asymétrique, même sur un recueil de 100 000 patients. L’intervalle prédictif couvrant 95% des individus ne saurait être calculé par une formule gaussienne sur les scores bruts si la population n’est pas normale.
Le théorème stipule exclusivement que la moyenne d’un échantillon suit une loi normale. Il offre des garanties absolues sur le comportement des statistiques agrégées (estimateurs), mais n’autorise en aucun cas le chercheur à ignorer la distribution réelle des données brutes lorsqu’il s’agit de poser des prédictions diagnostiques à l’échelle du patient individuel.
11.3 Limites numériques intrinsèques du moteur de calcul d’Excel
Bien que Microsoft Excel se soit considérablement perfectionné au fil de ses versions successives, le logiciel comporte des limites d’architecture numérique qu’un statisticien rigoureux doit impérativement intégrer lors de simulations massives. La première faiblesse historique réside dans le générateur de nombres pseudo-aléatoires de la fonction ALEA(). Bien qu’Excel utilise désormais une variante de l’algorithme Mersenne Twister depuis ses versions récentes, les versions plus anciennes reposaient sur des générateurs congruentiels linéaires susceptibles de manifester des cycles de répétition ou des corrélations multidimensionnelles masquées lors de tirages massifs (supérieurs à plusieurs centaines de milliers d’occurrences).
La seconde contrainte est inhérente à la représentation des nombres en virgule flottante double précision selon le standard IEEE 754. Le moteur d’Excel tronque la précision arithmétique au-delà de 15 chiffres significatifs. Lors du calcul de sommes massives de variances infinitésimales ou de soustractions entre des nombres extrêmement proches (notamment dans le calcul de probabilités de queues de distribution extrêmes avec Z > 8), des erreurs d’arrondi cumulatif peuvent altérer marginalement les derniers chiffres significatifs.
Il est donc préconisé, pour les calculs inférentiels critiques destinés à des essais cliniques réglementés, d’effectuer des vérifications croisées de validation avec des progiciels statistiques spécialisés (tels que le langage R ou SAS) afin de s’assurer de la parfaite stabilité numérique des estimateurs formulés sous Excel.
12. Automatisation avancée et modélisation dynamique de la convergence
12.1 Exploitation des formules matricielles dynamiques (SEQUENCE, LAMBDA, MAP)
L’avènement des moteurs de calcul matriciel dynamique moderne dans Excel permet désormais de concevoir des simulations du théorème central limite d’une élégance absolue, exemptes de toute macro VBA et ne nécessitant aucun étirement manuel de formules sur des milliers de lignes. Grâce aux fonctions fonctionnelles modernes telles que LAMBDA(), SEQUENCE() et MAP(), l’ensemble du processus d’échantillonnage peut être encapsulé dans une seule cellule maîtresse.
Pour construire une simulation dynamique générant instantanément le vecteur de 1 000 moyennes d’échantillons de taille n = 50 à partir d’une loi uniforme [0, 100], nous pouvons saisir en cellule A1 la formule matricielle suivante :
=MAP(SEQUENCE(1000); LAMBDA(iter; MOYENNE(ALEA.ENTRE.BORNES(0; 10000)/100 + SEQUENCE(1; 50; 0; 0)*0)))
Une approche encore plus professionnelle consiste à créer une fonction d’erreur type personnalisée et pérenne dans le Gestionnaire de noms. Définissons un nom intitulé ERREUR_TYPE associé à la formule :
=LAMBDA(ecart_type; n; ecart_type / RACINE(n))
Dès lors, au sein de l’ensemble du classeur, l’utilisateur peut appeler nativement cette fonction personnalisée avec une lisibilité absolue :
=ERREUR_TYPE(15; 30)
Cette approche vectorielle moderne réduit considérablement la taille mémoire du fichier, prévient les corruptions de plages de cellules et permet d’actualiser l’intégralité d’un protocole de simulation complexe par la simple modification d’une cellule de paramétrage unique.
12.2 Implémentation d’une procédure VBA pour simulations à grande échelle
Lorsque la simulation stochastique exige une volumétrie massive — par exemple générer k = 100 000 échantillons de taille n = 100 —, les formules de feuilles de calcul, même matricielles, peuvent saturer la mémoire vive du système et ralentir considérablement les interfaces. L’écriture d’une macro-commande Visual Basic for Applications (VBA) optimisée permet de contourner intégralement ces blocages en effectuant tous les calculs stochastiques au sein de la mémoire tampon du processeur avant de restituer le résultat synthétique consolidé.
Voici la structure algorithmique d’un script VBA à haute performance conçu pour cette tâche :
Le script déclare deux tableaux dynamiques en mémoire de type Double (l’un pour stocker temporairement les observations du tirage courant, l’autre pour stocker les k moyennes résultantes). La procédure désactive préalablement le rafraîchissement d’écran via la commande Application.ScreenUpdating = False et bascule le calcul en mode manuel avec Application.Calculation = xlCalculationManual.
Une double boucle itérative For…Next imbriquée exécute les tirages : la boucle externe s’exécute de 1 à k (nombre d’échantillons), tandis que la boucle interne parcourt les n observations de chaque échantillon en appliquant la fonction pseudo-aléatoire Rnd calibrée selon la distribution parente visée. La moyenne de chaque tranche est calculée en mémoire et affectée directement au vecteur de synthèse. À l’issue de l’exécution, le vecteur complet des moyennes est déversé d’un seul bloc sur la feuille de calcul via une assignation matricielle directe à une plage Range équivalente, éliminant les temps d’écriture cellule par cellule.
Ce protocole VBA permet d’exécuter 100 000 itérations d’échantillonnage en quelques secondes seulement, offrant une robustesse expérimentale absolue pour tester des distributions parentes d’une asymétrie extrême.
12.3 Intégration dans un tableau de bord analytique interactif pour la recherche
L’aboutissement méthodologique de l’implémentation du théorème central limite dans Excel réside dans l’édification d’un simulateur interactif complet, servant d’outil d’exploration pédagogique ou de dimensionnement expérimental pour les équipes de recherche. Ce simulateur combine les formules matricielles, l’Utilitaire d’analyse et les contrôles de formulaire graphiques natifs d’Excel.
En insérant des barres de défilement (curseurs de formulaire accessibles via l’onglet Développeur > Insérer > Contrôles de formulaire), l’analyste associe un premier curseur à la cellule régissant la taille de l’échantillon n (avec une plage de variation de 2 à 200) et un second curseur modulant le coefficient d’asymétrie de la population source. Les plages du graphique de distribution et de la courbe gaussienne théorique étant reliées de manière dynamique à ces cellules d’entrée, chaque déplacement du curseur déclenche une réévaluation instantanée de la morphologie de la distribution.
L’utilisateur observe alors de manière saisissante et interactive la métamorphose de la courbe : à mesure qu’il fait glisser le curseur de n vers la droite, l’histogramme des moyennes empiriques se resserre en temps réel autour de la moyenne centrale, les queues de distribution s’amincissent, les indices de Skewness et de Kurtosis se rapprochent de zéro, et l’adéquation avec la loi normale devient visuellement irréfutable.
Pour parachever l’architecture, un bouton d’exportation automatisé permet de transcrire l’état d’échantillonnage calibré sous forme de script d’initialisation vers les environnements statistiques spécialisés (tels que R, SPSS ou JASP), scellant ainsi l’intégration opérationnelle d’Excel comme laboratoire de modélisation stochastique préliminaire d’une remarquable puissance.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association.
- Box, G. E., & Muller, M. E. (1958). A note on the generation of random normal deviates. The Annals of Mathematical Statistics, 29(2), 610-611. https://doi.org/10.1214/aoms/1177706645
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Feller, W. (1968). An introduction to probability theory and its applications (Vol. 1, 3rd ed.). John Wiley & Sons.
- Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
- Hays, W. L. (1994). Statistics (5th ed.). Harcourt Brace College Publishers.
- Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
- Microsoft Corporation. (2023). Documentation sur les fonctions de feuille de calcul Excel. Microsoft Support. https://support.microsoft.com/fr-fr/excel
- Sheather, S. J. (2009). A modern approach to regression with R. Springer. https://doi.org/10.1007/978-0-387-09608-7
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.