
L’inférence statistique moderne repose sur un ensemble d’édifices théoriques remarquables dont l’un des piliers les plus fondamentaux est sans conteste le théorème central limite (TCL). Ce théorème mathématique d’une rare élégance explique pourquoi tant de phénomènes observés dans la nature, les sciences biomédicales, la psychométrie ou l’économie semblent converger vers la célèbre courbe en cloche théorisée par Carl Friedrich Gauss. Loin d’être un simple artefact mathématique confiné aux manuels d’analyse théorique, le théorème central limite constitue la clé de voûte autorisant le passage des observations empiriques locales aux conclusions générales sur des populations entières, transformant l’incertitude inhérente à l’échantillonnage en une mesure de probabilité précisément quantifiable.
Dans la pratique contemporaine de l’analyse des données, l’environnement logiciel R s’est imposé comme l’écosystème de prédilection des statisticiens, des biostatisticiens et des chercheurs en sciences comportementales. Grâce à sa flexibilité vectorielle et à la richesse de ses bibliothèques de calcul et de visualisation, R permet non seulement d’exécuter des protocoles d’inférence sophistiqués, mais offre également un laboratoire computationnel idéal pour simuler, observer et disséquer empiriquement les mécanismes asymptotiques décrits par le théorème. À travers la programmation probabiliste, l’analyste peut générer des milliers d’univers synthétiques afin d’éprouver la robustesse des estimateurs statistiques face aux violations les plus sévères de l’hypothèse de normalité.
Ce guide exhaustif propose une exploration approfondie du théorème central limite à travers le prisme computationnel de R. Nous articulerons notre démarche autour des fondements mathématiques rigoureux qui sous-tendent ce théorème, de son rôle critique dans la recherche psychométrique et expérimentale, et de son implémentation algorithmique au travers de simulations de Monte-Carlo appliquées à des distributions continues, discrètes, asymétriques et multimodales. Nous examinerons également les procédures de diagnostic graphique et formel, la construction d’intervalles de confiance asymptotiques, les alternatives de rééchantillonnage bootstrap, ainsi que les limites structurelles et contre-exemples où le théorème cesse d’opérer, afin de doter le praticien d’une vision méthodologique complète, lucide et directement opérationnelle pour la recherche reproductible.
1. Fondements théoriques et mathématiques du théorème central limite (TCL)
1.1 Énoncé formel et convergence en loi
Le théorème central limite postule que la somme ou la moyenne arithmétique d’un nombre suffisamment grand de variables aléatoires indépendantes et identiquement distribuées (i.i.d.), chacune possédant une espérance mathématique finie notée $\mu$ et une variance finie strictement positive notée $\sigma^2$, converge asymptotiquement en distribution vers une loi normale, indépendamment de la forme spécifique de la loi sous-jacente qui gouverne ces variables aléatoires individuelles. Cette propriété de universalité est au cœur de l’analyse stochastique moderne : qu’une variable soit discrète, continue, asymétrique, uniforme ou bimodale à l’échelle individuelle, l’opération d’agrégation linéaire moyenne transforme la dispersion originelle en une géométrie gaussienne symétrique dès lors que la taille de l’échantillon s’accroît.
Mathématiquement, si nous considérons une suite de variables aléatoires réelles $X_1, X_2, dots, X_n$ i.i.d. définies sur un même espace probabilisé $(\Omega, \mathcal{F}, \mathbb{P})$, d’espérance $\mathbb{E}[X_i] = \mu$ et de variance $\text{Var}(X_i) = \sigma^2 < \infty$, la moyenne empirique définie par $\bar{X}_n = \frac{1}{n} \sum_{i=1}^n X_i$ converge presque sûrement vers $\mu$ en vertu de la loi forte des grands nombres. Le théorème central limite quant à lui caractérise la vitesse et la géométrie des fluctuations autour de cette espérance, en établissant que la variable aléatoire standardisée $\sqrt{n} \left(\frac{\bar{X}_n – \mu}{\sigma}\right)$ converge en loi (convergence en distribution) vers une variable aléatoire suivant une loi normale centrée réduite $\mathcal{N}(0, 1)$.
Il convient d’insister sur la distinction épistémologique cruciale entre la distribution de probabilité de la population source (la loi parente) et la distribution d’échantillonnage de la statistique considérée. Le théorème central limite n’induit aucunement une normalisation de la distribution des données brutes au fur et à mesure que la taille d’échantillon augmente. Un échantillon de 10 000 observations tirées d’une loi exponentielle conservera rigoureusement son asymétrie caractéristique. C’est exclusivement la métrique agrégée, la moyenne empirique, observée au travers d’une infinité d’échantillons répétés de taille $n$, dont la densité de probabilité adopte asymptotiquement le profil d’une gaussienne.
1.2 Propriétés statistiques de la distribution d’échantillonnage
La distribution d’échantillonnage de la moyenne empirique possède deux propriétés algébriques absolues qui dérivent directement de la linéarité de l’espérance et des axiomes fondamentaux de la variance des variables aléatoires indépendantes. La première propriété établit l’exactitude sans biais de l’estimateur : pour tout échantillon de taille $n$, l’espérance de la distribution des moyennes empiriques est strictement équivalente à l’espérance de la population originelle, soit $\mathbb{E}[\bar{X}_n] = \mu$. Cette identité théorique implique que si un expérimentateur collectait un nombre infini d’échantillons de taille $n$ et en calculait la moyenne des moyennes, la valeur obtenue convergerait rigoureusement vers le paramètre latent de la population, excluant tout biais systématique introduit par le processus d’agrégation arithmétique.
La deuxième propriété concerne la dispersion de cette distribution d’échantillonnage, mesurée par la variance de la moyenne empirique. Puisque les variables sont indépendantes, la variance de leur somme est la somme de leurs variances, ce qui conduit à $\text{Var}(\bar{X}_n) = \text{Var}\left(\frac{1}{n}\sum_{i=1}^n X_i\right) = \frac{1}{n^2}\sum_{i=1}^n \text{Var}(X_i) = \frac{n\sigma^2}{n^2} = \frac{\sigma^2}{n}$. L’écart-type de la distribution d’échantillonnage, universellement désigné sous le terme d’erreur type de la moyenne (en anglais, standard error), s’exprime donc par la formule analytique $\sigma_{\bar{X}} = \frac{\sigma}{\sqrt{n}}$. Cette formulation démontre la loi de décroissance quadratique de la variabilité d’estimation : pour réduire de moitié l’incertitude pesant sur l’estimation de la moyenne, l’analyste doit nécessairement quadrupler le volume de son échantillon d’observations.
Cette contraction systématique de la variance autour de l’espérance théorique permet d’opérer la standardisation formelle de l’estimateur. En soustrayant l’espérance $\mu$ et en divisant le résidu par l’erreur type $\sigma / \sqrt{n}$, nous convertissons une variable aléatoire d’échelle empirique en une statistique sans dimension $Z = \frac{\bar{X}_n – \mu}{\sigma / \sqrt{n}}$. Dès lors que $n$ tend vers l’infini, la fonction de répartition cumulative de $Z$ tend uniformément vers celle de la loi normale centrée réduite $\Phi(z) = \frac{1}{\sqrt{2\pi}} \int_{-\infty}^{z} e^{-t^2/2} dt$. C’est cette invariance d’échelle qui légitime l’usage de quantiles universels (tels que $\pm 1,96$ pour le seuil bilatéral de 95 %) dans l’élaboration de règles de décision statistique.
1.3 La règle heuristique de la taille d’échantillon (n ≥ 30)
Dans la littérature méthodologique et pédagogique, il est d’usage récurrent de stipuler une règle heuristique selon laquelle un effectif d’échantillonnage de $n ge 30$ suffirait à garantir une approximation normale adéquate pour la distribution des moyennes. Cette convention tire ses origines historiques des tables de distribution statistique de William Sealy Gosset (connu sous le pseudonyme de Student) et des travaux pionniers de Sir Ronald Fisher. Dans ces tables numériques traditionnelles, pour un nombre de degrés de liberté excédant 30, les quantiles critiques de la loi de Student $t$ commencent à s’approcher remarquablement des valeurs critiques tabulées de la loi normale centrée réduite, rendant la divergence d’ordre pratique négligeable pour les calculs manuels de l’époque.
Néanmoins, une évaluation mathématique et empirique rigoureuse révèle que ce seuil de 30 constitue une simplification doctrinale qui peut s’avérer trompeuse en présence de données complexes. La vitesse de convergence de la distribution de la moyenne vers la normalité est intimement gouvernée par la géométrie initiale de la loi parente, et plus particulièrement par son troisième moment centré standardisé, le coefficient d’asymétrie (skewness). D’après le théorème de Berry-Esseen, la borne supérieure de l’écart absolu entre la fonction de répartition empirique standardisée et la loi normale théorique est proportionnelle au rapport $\rho / (\sigma^3 \sqrt{n})$, où $\rho = \mathbb{E}[|X – mu|^3]$. Lorsque la population source est symétrique, comme une loi uniforme ou une loi de Laplace, la convergence est d’une rapidité remarquable et un échantillon de $n = 10$ ou $n = 15$ suffit amplement à conférer à la moyenne une morphologie quasi-gaussienne.
À l’inverse, face à des distributions intrinsèquement hyper-asymétriques ou dotées de queues lourdes (telles que les lois log-normales fortement polarisées, les lois de Pareto ou les distributions de Weibull modélisant des pannes ou des temps de latence extrêmes), un seuil de $n = 30$ est notoirement déficitaire. Dans de telles configurations morphologiques, des échantillons de plusieurs centaines, voire de plusieurs milliers d’observations peuvent être impérativement requis pour éliminer l’asymétrie résiduelle de la distribution d’échantillonnage et empêcher une sous-estimation dramatique du risque d’erreur de première espèce. Pour des échantillons restreints ($n < 30$) issus d'une population supposée déjà gaussienne, l'utilisation de la loi de Student demeure obligatoire pour corriger l'incertitude additionnelle introduite par l'estimation conjointe de la variance via la variance d'échantillon corrigée $s^2$.
2. Pertinence du théorème central limite en psychométrie et sciences du comportement
2.1 Traitement des variables psychologiques non gaussiennes
L’observation empirique des conduites humaines et des processus mentaux confronte quasi-systématiquement les chercheurs à des données défiant l’idéal théorique de la symétrie gaussienne. Dans l’investigation des temps de réaction cognitive (par exemple, dans les paradigmes d’indiçage spatial de Posner ou les tâches de décision lexicale), les distributions observées sont structurellement bornées à gauche par des limites physiologiques incompressibles (autour de 150 millisecondes) et exhibent de longues traînes positives vers la droite induites par des fluctuations attentionnelles occasionnelles. De même, en psychopathologie quantitative, les inventaires évaluant des dimensions cliniques telles que la symptomatologie dépressive (comme le BDI-II) ou les traits anxieux sont appliqués sur des échantillons tout-venant où la majorité des individus obtient des scores nuls ou marginaux, générant une accumulation massive de fréquences au plancher.
Face à ces distributions non gaussiennes endémiques, le théorème central limite apporte une justification méthodologique fondamentale permettant l’opérationnalisation des scores composites. Lorsqu’une échelle de personnalité ou une batterie neuropsychologique est construite par l’agrégation de multiples items ordinaux (qu’il s’agisse de moyennes de scores ou de sommes brutes standardisées), la variable latente résultante bénéficie d’un mécanisme de régularisation stochastique. Bien que chaque item individuel réponde à une dynamique ordinale discrète et hautement asymétrique, le score composite moyen d’un groupe de participants tend à présenter une distribution d’échantillonnage bien plus régulière et symétrique.
Cette propriété de convergence protège la robustesse inférentielle des protocoles expérimentaux complexes. Sans le théorème central limite, l’analyste serait contraint de renoncer systématiquement à l’estimation des paramètres de position classiques (comme la moyenne et ses contrastes linéaires) au profit d’approches non paramétriques axées exclusivement sur les rangs. Or, les tests fondés sur les rangs ne permettent pas d’évaluer aisément les interactions factorielles d’ordre supérieur dans les plans d’expérience factoriels combinant des mesures répétées et des facteurs inter-sujets. Le TCL assure que les inférences articulées autour des moyennes conservent leur validité mathématique asymptotique même en présence de déviations notables observées au niveau des indicateurs élémentaires.
2.2 Fondement des tests d’hypothèses paramétriques
L’immense majorité des instruments analytiques employés dans la recherche contemporaine — à l’instar du test $t$ de Student pour échantillons indépendants ou appariés, du modèle linéaire généralisé, de l’analyse de variance (ANOVA) et des régressions linéaires multiples — repose traditionnellement sur le postulat théorique de la normalité de la distribution des variables dépendantes ou des résidus du modèle. Ce postulat fait l’objet de vives inquiétudes chez les méthodologistes débutants, qui interprètent souvent à tort toute déviation visuelle de l’histogramme résiduel comme une invalidation irrémédiable de l’analyse paramétrique.
L’apport décisif du théorème central limite réside dans la démonstration que ce n’est pas la distribution intrinsèque des observations individuelles qui gouverne la validité des statistiques de test d’hypothèses (telles que le ratio de Wald $t$ ou la statistique de Fisher $F$), mais bien la distribution d’échantillonnage des coefficients estimés. Dans une régression linéaire ou une ANOVA, les coefficients de régression et les contrastes de moyennes sont en réalité des combinaisons linéaires pondérées des observations de la variable réponse. En vertu du TCL, dès lors que l’effectif total ou la taille des groupes au sein des cellules du plan expérimental est suffisamment vaste, les estimateurs des moindres carrés ordinaires convergent vers une distribution normale multivariée, même si la distribution d’erreur sous-jacente s’avère non gaussienne.
Par conséquent, pour des échantillons de taille modérée à importante, la statistique $t$ converge vers une distribution normale standard $\mathcal{N}(0, 1)$ et la statistique $F$ converge vers la distribution de Fisher théorique attendue sous l’hypothèse nulle $H_0$. Cette robustesse asymptotique garantit la préservation du taux nominal d’erreur de première espèce ($\alpha = 0,05$). Si l’asymétrie des résidus peut réduire modérément la puissance statistique du test dans des contextes hautement bruités, elle ne vicie pas dramatiquement la proportion de faux positifs, conférant ainsi aux chercheurs une remarquable marge de manœuvre analytique dans l’exploitation des données quantitatives en psychologie.
2.3 Distinction conceptuelle entre population, échantillon et méta-échantillonnage
Une confusion épistémologique pernicieuse persiste fréquemment au sein des manuscrits scientifiques soumis aux revues de psychologie et de sciences sociales : celle qui assimile la variabilité interindividuelle à l’erreur type de la moyenne. La variabilité interindividuelle, quantifiée par l’écart-type de la population ($\sigma$) ou de l’échantillon ($s$), reflète la dispersion naturelle, substantielle et irréductible des caractéristiques psychologiques ou cognitives au sein de l’espèce ou du groupe étudié. Cette dispersion ne s’amenuise en aucune façon avec l’augmentation du nombre de sujets évalués ; au contraire, plus un échantillon est vaste, plus il a de chances de capturer fidèlement l’étendue totale des variations interindividuelles présentes dans la réalité empirique.
En revanche, la distribution d’échantillonnage et son écart-type associé ($\sigma / \sqrt{n}$) ne représentent pas une entité directement observable dans une cohorte unique, mais une construction abstraite et contrefactuelle : le méta-échantillonnage. Ce concept envisage ce qui se produirait si l’investigateur répliquait son protocole d’évaluation un nombre infini de fois, sous des conditions rigoureusement identiques, en extrayant à chaque itération un nouvel échantillon indépendant issu de la même population cible. L’erreur type formalise l’imprécision métrologique liée à l’aléa d’échantillonnage, c’est-à-dire le degré d’oscillation attendu des estimations d’une réplication à l’autre.
L’omission de cette frontière conceptuelle engendre deux travers interprétatifs majeurs :
- L’illusion qu’un grand échantillon élimine la dispersion biologique ou comportementale des individus, alors qu’il ne fait que préciser la localisation de la moyenne du collectif.
- La présentation fallacieuse dans les publications scientifiques de l’erreur type en lieu et place de l’écart-type descriptif pour illustrer des diagrammes en barres, dans le but esthétique mais trompeur d’atténuer visuellement l’hétérogénéité réelle des participants.
3. Configuration de l’environnement R pour l’expérimentation statistique
3.1 Régulation du générateur de nombres pseudo-aléatoires
L’expérimentation stochastique sous R nécessite un contrôle rigoureux du générateur de nombres pseudo-aléatoires afin de satisfaire aux exigences contemporaines de la science ouverte et de la reproductibilité computationnelle. Par défaut, R exploite l’algorithme de Mersenne-Twister (introduit par Matsumoto et Nishimura), reconnu pour sa période colossale de $2^{19937}-1$ états distincts et ses remarquables propriétés d’équidistribution dans des dimensions spatiales élevées, ce qui en fait un standard irréprochable pour les simulations statistiques de type Monte-Carlo.
Pour assurer qu’une expérience d’échantillonnage itérative produise des résultats strictement déterministes et identiques sur n’importe quel ordinateur, l’analyste doit impérativement initialiser le flux aléatoire au moyen de la fonction set.seed(). En fixant une graine entière (par exemple set.seed(42) ou set.seed(1234)), l’état initial du vecteur de registres du générateur est verrouillé, garantissant que toute extraction probabiliste subséquente (qu’il s’agisse de distributions uniformes, normales ou de Poisson) génère exactement la même séquence de valeurs. Cette régulation est indispensable pour la validation collégiale des scripts et pour documenter des exemples pédagogiques dont les métriques ne doivent pas fluctuer à chaque exécution du code source.
Il importe également de veiller à ce que l’initialisation de la graine s’opère au sommet des scripts de simulation et non à l’intérieur de boucles d’échantillonnage. Initialiser le générateur à l’intérieur d’une séquence répétitive briserait l’indépendance statistique nécessaire entre les sous-échantillons successifs en réinitialisant continuellement la chaîne d’états, ce qui compromettrait radicalement la validité des démonstrations du théorème central limite.
3.2 Sélection des bibliothèques logicielles spécialisées
L’écosystème R dispose d’un vaste éventail d’extensions modulaires facilitant la manipulation vectorielle, l’analyse descriptive avancée et la visualisation graphique de haute fidélité. Dans le cadre de nos démonstrations empiriques du théorème central limite, un ensemble spécifique de bibliothèques du CRAN doit être mobilisé pour maximiser la clarté syntaxique et la puissance de calcul.
Le méta-package tidyverse constitue l’ossature essentielle de notre environnement de travail. En son sein, tibble offre des structures de tableaux de données modernisées, dplyr permet d’exécuter des agrégations complexes et des manipulations vectorielles fluides à l’aide de l’opérateur de composition fonctionnelle, et ggplot2 fournit un formalisme déclaratif fondé sur la grammaire des graphiques pour concevoir des superpositions de densités, des histogrammes calibrés et des représentations multi-panneaux (facettes) d’une grande rigueur esthétique.
Au-delà de la manipulation générale, l’évaluation des moments d’ordre supérieur requiert l’incorporation de modules statistiques dédiés. Le package moments offre des fonctions robustes et optimisées pour le calcul vectoriel de l’asymétrie empirique (skewness()) et de l’aplatissement (kurtosis()), permettant de mesurer quantitativement la vitesse de résorption de l’asymétrie et de l’excès de voussure au sein des distributions de moyennes. En complément, la bibliothèque psych développée par William Revelle fournit des fonctions de diagnostic descriptif unifiées, particulièrement adaptées au traitement des scores psychométriques et des métriques comportementales agrégées.
3.3 Paradigmes de vectorisation contre structures itératives
Lorsqu’il s’agit de générer des dizaines de milliers d’échantillons aléatoires pour vérifier les lois asymptotiques, le choix de l’architecture d’exécution dans l’interpréteur R exerce un impact considérable sur les temps de calcul et l’efficacité de la mémoire vive. La boucle séquentielle traditionnelle for, bien que conceptuellement limpide et parfaitement adaptée à l’apprentissage pédagogique de base, présente des surcoûts d’allocation mémoire importants en R si les structures de stockage ne sont pas pré-allouées de manière immuable.
Pour optimiser computationnellement nos simulations, deux paradigmes majeurs s’offrent au praticien : la fonction native replicate() et la famille des opérations vectorisées issues du package purrr ou des commandes matricielles fondamentales (apply, rowMeans, colMeans). La stratégie la plus rapide sous R pour simuler le tirage de $M$ échantillons de taille $n$ consiste à générer un vecteur unique de longueur $M \times n$ au moyen des générateurs natifs (tels que runif, rexp ou rgamma), puis à restructurer immédiatement ce vecteur sous forme d’une matrice rectangulaire de dimensions $n \times M$, pour enfin appliquer la fonction interne hautement optimisée en langage C colMeans().
Cette approche matricielle directe surpasse systématiquement en vitesse d’exécution les itérations de boucles for ordinaires par plusieurs ordres de grandeur. Dans les benchmarks de performance statistique, le traitement d’une simulation portant sur 100 000 réplications d’échantillons de taille $n = 50$ est accompli en quelques millisecondes via colMeans(), alors qu’une concaténation dynamique au sein d’une boucle mal vectorisée peut paralyser l’interpréteur pendant de longues secondes, voire saturer la mémoire disponible par une fragmentation excessive des objets intermédiaires.
4. Application pratique : Simulation à partir d’une distribution continue uniforme
4.1 Paramétrage du modèle continu sous R
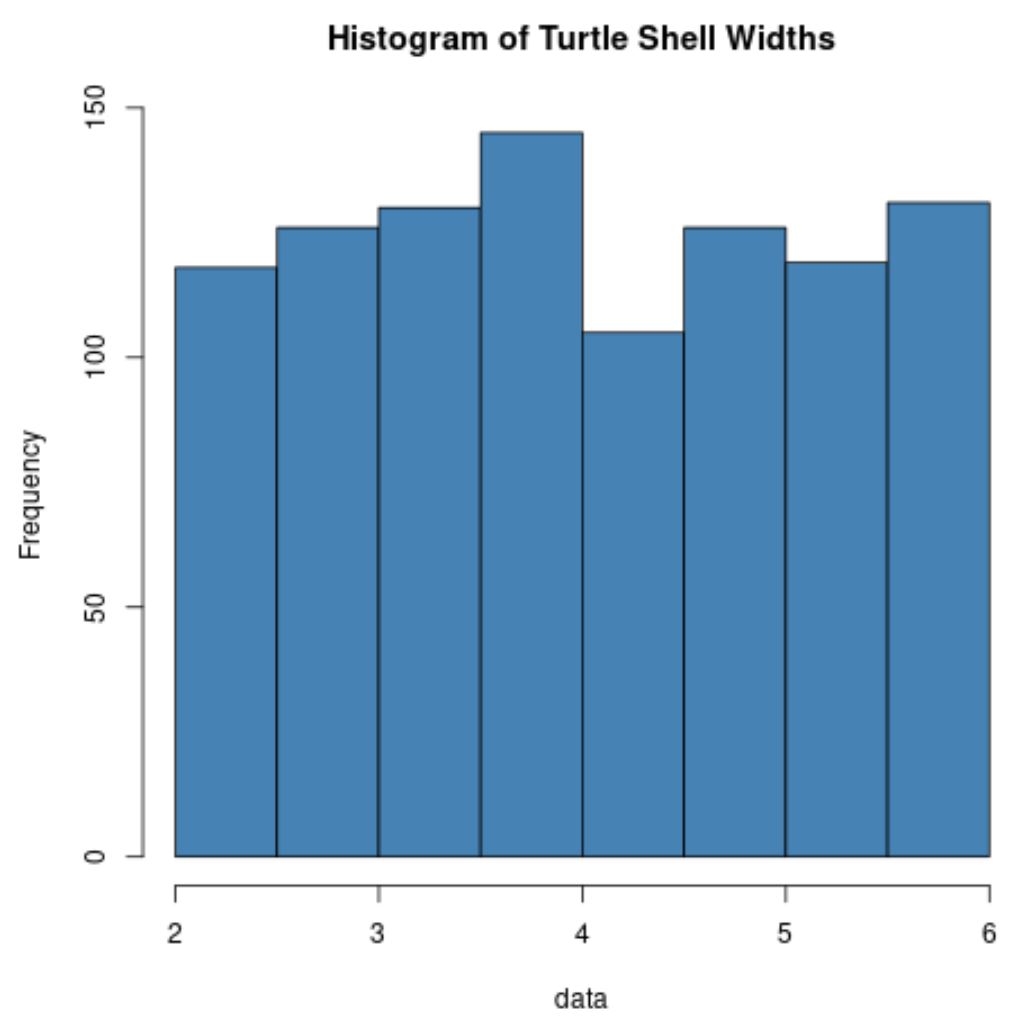
Pour amorcer notre parcours expérimental du théorème central limite, considérons une loi de probabilité continue qui ne partage aucune ressemblance morphologique avec la courbe de Gauss : la distribution continue uniforme, formalisée par $\mathcal{U}(a, b)$. Cette distribution est définie par une densité constante sur un intervalle compact $[a, b]$, ce qui signifie que chaque sous-intervalle de même longueur présente une probabilité d’occurrence rigoureusement identique. Sa forme graphique est un rectangle parfait, dépourvu de tout sommet central ou de déclin progressif vers les bords.
Fixons arbitrairement les paramètres de notre modèle uniforme sur l’intervalle $[a = 2, b = 6]$. Les propriétés analytiques fondamentales de cette loi théorique peuvent être calculées avec une précision absolue :
l’espérance mathématique est donnée par le point milieu de l’intervalle :
$$\mu = \frac{a + b}{2} = \frac{2 + 6}{2} = 4$$
Quant à la variance théorique, elle résulte de l’intégration de la dispersion quadratique sur l’intervalle, selon la formulation :
$$\sigma^2 = \frac{(b – a)^2}{12} = \frac{(6 – 2)^2}{12} = \frac{16}{12} \approx 1,3333$$
Ce qui correspond à un écart-type de population égal à $\sigma = \sqrt{1,3333} \approx 1,1547$. En exploitant la fonction runif(n = 1000, min = 2, max = 6) au sein de R, nous pouvons synthétiser un échantillon de référence représentant la population brute, dont l’histogramme empirique reflétera sans équivoque une dispersion plane et uniforme, délimitée strictement par les bornes inférieure et supérieure assignées.
4.2 Algorithme d’échantillonnage itératif
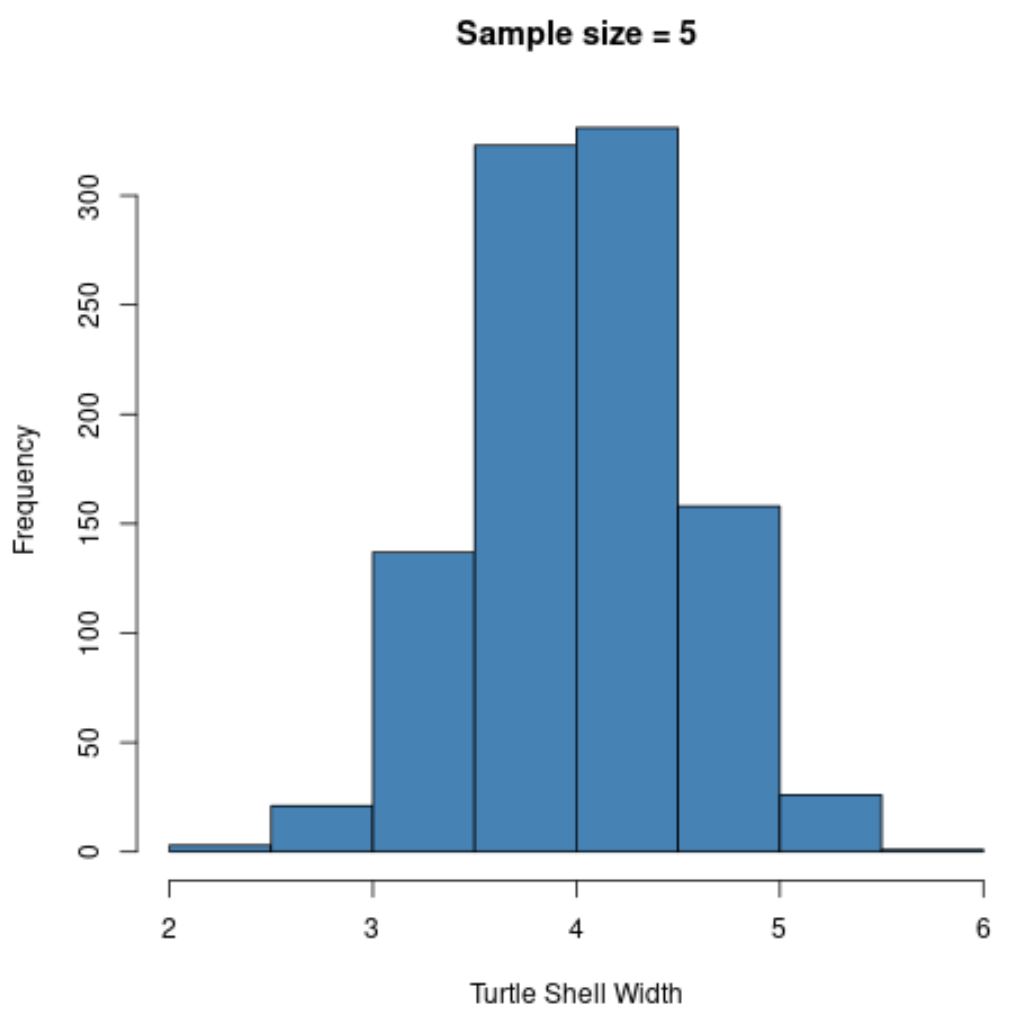
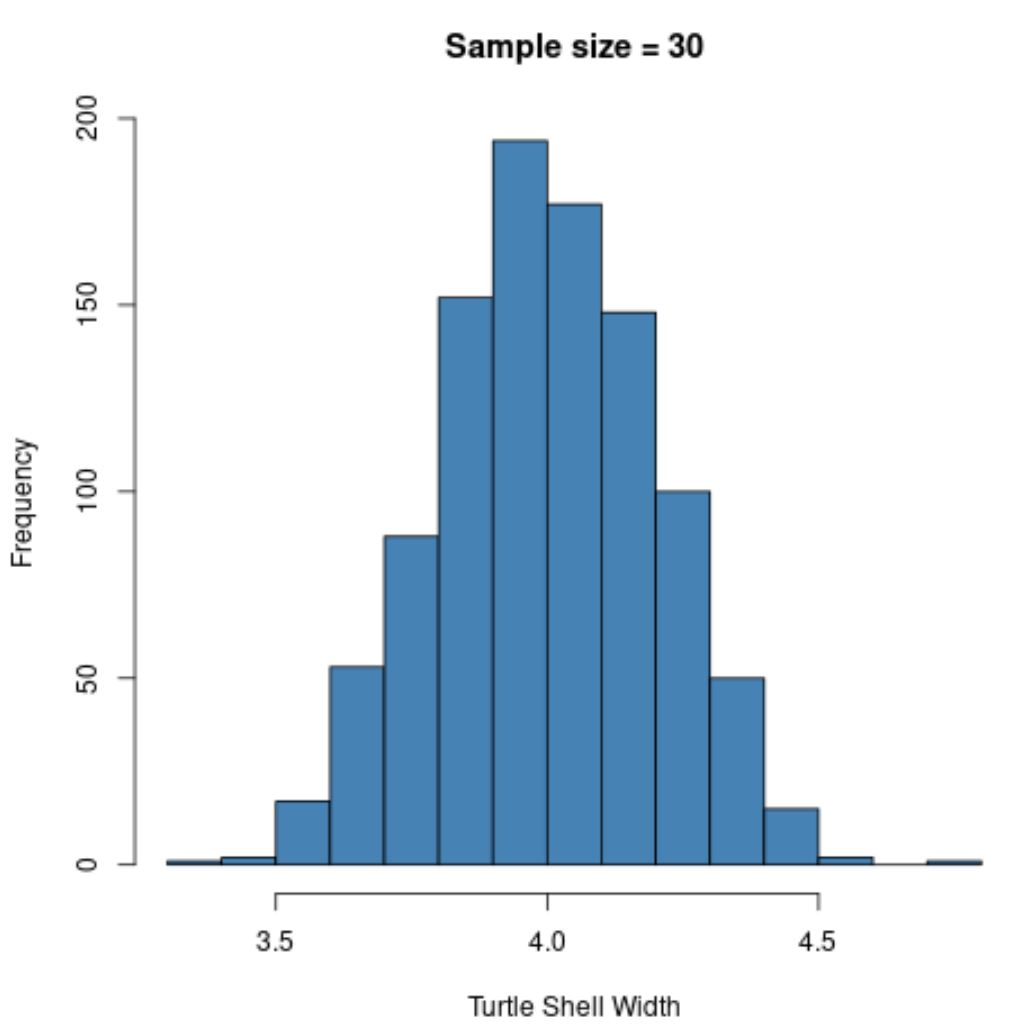
Afin d’observer l’émergence empirique du théorème central limite, mettons en place un protocole expérimental de rééchantillonnage itératif. Nous fixons un volume de réplications constant de $B = 10,000$ échantillons indépendants, et nous faisons varier la taille des échantillons extraits selon trois régimes d’effectifs contrastés : un régime de très petite taille ($n = 5$), un régime intermédiaire standard ($n = 30$), et un régime d’échantillon large ($n = 100$).
L’implémentation algorithmique sous R peut être exécutée de manière élégante via la programmation fonctionnelle :
Pour chaque condition d’effectif $n$, nous invoquons replicate() ou une génération matricielle suivie de colMeans() afin d’obtenir un vecteur numérique contenant les 10 000 moyennes empiriques distinctes issues de chacun des tirages indépendants de taille $n$. Ces résultats sont consolidés au sein d’un tableau de données unique (tibble) structuré selon les standards du format long (tidy data), comportant une colonne désignant la valeur de la moyenne observée et une variable factorielle identifiant la taille d’échantillon associée ($n in {5, 30, 100}$).
Dès cette étape computationnelle, l’inspection de la variance des moyennes empiriques corrobore spectaculairement la prédiction mathématique de l’erreur type :
Pour $n = 5$, l’écart-type empirique des 10 000 moyennes se stabilise remarquablement à proximité de $1,1547 / \sqrt{5} \approx 0,5164$.
Pour $n = 30$, cette dispersion se contracte à $1,1547 / \sqrt{30} \approx 0,2108$.
Pour $n = 100$, la dispersion se resserre considérablement autour de $1,1547 / \sqrt{100} \approx 0,1155$.
Ce rétrécissement systématique illustre l’infaillibilité de la réduction de variance induite par la racine carrée de la taille d’échantillon.
4.3 Visualisation de l’émergence de la forme en cloche
La puissance d’assimilation cognitive du théorème central limite s’exprime pleinement lorsqu’on traduit ces milliers de moyennes dans l’espace graphique de ggplot2. En construisant une figure à plusieurs panneaux où l’histogramme de la distribution uniforme brute des données individuelles est placé en miroir des histogrammes de densité empirique des moyennes pour $n = 5$, $n = 30$ et $n = 100$, le processus de métamorphose morphologique saute immédiatement aux yeux de l’observateur.
Pour une taille d’échantillon aussi modeste que $n = 5$, bien que la population sous-jacente soit totalement dépourvue de courbure ou de mode central, la distribution des moyennes d’échantillons abandonne instantanément sa géométrie rectangulaire pour adopter une allure pyramidale triangulaire continue, avec un sommet prononcé ancré précisément sur la valeur $\mu = 4$. La symétrie parfaite de la loi uniforme de départ favorise une régularisation ultra-rapide des sommes partielles : les réalisations combinées d’observations extrêmes de part et d’autre de l’intervalle s’annulent mutuellement avec une forte fréquence statistique, favorisant massivement l’agrégation au centre.
À mesure que nous transitons vers $n = 30$ puis $n = 100$, les facettes graphiques révèlent l’affinement continu de la forme en cloche classique. En superposant sur chaque panneau la courbe mathématique exacte d’une densité normale théorique paramétrée avec une moyenne $\mu = 4$ et un écart-type $\sigma / \sqrt{n}$, la concordance entre les barres empiriques de simulation et le tracé théorique continu devient absolue. La dispersion latérale s’éteint progressivement : l’ensemble des 10 000 moyennes d’échantillons pour $n = 100$ se retrouve rigoureusement confiné dans l’intervalle étroit $[3,65 ; 4,35]$, matérialisant de façon tangible le principe de convergence asymptotique vers la vérité paramétrique.
5. Application pratique : Simulation à partir de distributions fortement asymétriques
5.1 Modélisation des temps de latence via la loi exponentielle
Si la loi uniforme permet de vérifier la symétrisation d’une distribution plate, le véritable test de résistance du théorème central limite s’observe face à des distributions présentant une asymétrie unilatérale aiguë. La distribution exponentielle constitue le modèle archétypique des processus de défaillance temporelle et des temps de latence comportementale dans les études de chronométrie cognitive. Définie par un paramètre d’intensité ou de taux $lambda > 0$, sa fonction de densité est $f(x) = \lambda e^{-\lambda x}$ pour tout $x ge 0$, et s’effondre de manière exponentielle au fur et à mesure que $x$ s’éloigne de l’origine zéro.
Une caractéristique mathématique saillante de la distribution exponentielle réside dans la dépendance absolue de ses moments par rapport à ce taux unique :
son espérance mathématique est donnée par $\mu = \frac{1}{\lambda}$,
tandis que sa variance est rigoureusement égale au carré de son espérance, soit $\sigma^2 = \frac{1}{\lambda^2}$, conférant à la population un écart-type égal à son espérance, c’est-à-dire $\sigma = \frac{1}{\lambda}$.
De surcroît, son coefficient d’asymétrie théorique (skewness) est invariant et toujours rigoureusement égal à 2, traduisant une longue queue étirée sans limite vers les valeurs positives, tandis que son aplatissement (kurtosis) présente un excès théorique de 6 (kurtosis absolu de 9).
Sous R, nous paramétrons une simulation de temps de réaction cognitive en choisissant $lambda = 0,5$, ce qui modélise un processus stochastique où le temps de latence moyen s’établit à $\mu = \frac{1}{0,5} = 2$ secondes, avec un écart-type identique de $\sigma = 2$ secondes. La commande rexp(n = 10000, rate = 0.5) matérialise cette population brute où une écrasante majorité des réponses survient en deçà de 2 secondes, mais où quelques événements rares s’étirent de façon spectaculaire au-delà de 10 ou 15 secondes.
5.2 Dynamique de symétrisation en fonction de n
Face à une telle asymétrie structurelle, la règle simpliste de $n = 30$ est mise à rude épreuve. Pour suivre la mécanique de symétrisation avec une granularité scientifique rigoureuse, nous orchestrons une simulation comparative à quatre paliers d’effectifs : un niveau ultra-faible ($n = 2$), un niveau intermédiaire restreint ($n = 15$), le niveau conventionnel ($n = 50$), et un palier d’effectif substantiel ($n = 200$). Pour chacun de ces paliers, nous extrayons $B = 10,000$ échantillons indépendants générés par la fonction rexp() et en extrayons les moyennes empiriques respectives.
Pour $n = 2$, la distribution des moyennes (formée par la moyenne arithmétique de seulement deux réalisations exponentielles) génère mathématiquement une loi d’Erlang. L’asymétrie vers la droite demeure éclatante : le sommet de la densité reste incliné vers l’origine et la traîne positive persiste lourdement. À $n = 15$, bien que la morphologie globale commence à s’arrondir pour former un mode central bien individualisé, une observation attentive met en lumière un biais d’asymétrie résiduel indéniable : la queue de distribution droite demeure visiblement plus étendue et étirée que la queue de gauche.
Ce n’est qu’en progressant vers $n = 50$ et surtout $n = 200$ que le théorème central limite surmonte pleinement l’asymétrie originelle de la loi exponentielle. L’asymétrie de la moyenne d’échantillon, qui décroît théoriquement selon la formule mathématique $\text{Skewness}(\bar{X}_n) = \frac{\text{Skewness}(X)}{\sqrt{n}} = \frac{2}{\sqrt{n}}$, passe de 1,41 pour $n = 2$ à 0,51 pour $n = 15$, puis tombe à 0,28 pour $n = 50$, pour finalement devenir virtuellement indétectable à l’œil nu à $n = 200$ avec une valeur résiduelle de 0,14. Cette démonstration empirique illustre parfaitement que plus la loi mère s’écarte de la symétrie, plus l’effort de taille d’échantillon requis pour atteindre une quasi-normalité opérationnelle doit être revu à la hausse.
5.3 Application complémentaire sur distribution Gamma et Lognormale
Dans l’investigation des neurosciences computationnelles et de l’oculométrie, les données de connectivité synaptique et les durées de fixation oculaire sont traditionnellement ajustées sur des distributions Gamma ou log-normales. La distribution Gamma, caractérisée par un paramètre de forme $\alpha$ (shape) et d’échelle $\beta$ (scale), permet d’explorer des configurations où l’asymétrie peut être modulée de façon continue. L’espérance vaut $\mu = \alpha \beta$, la variance $\sigma^2 = \alpha \beta^2$ et son asymétrie vaut $2 / \sqrt{\alpha}$.
En simulant sous R une loi Gamma de paramètre de forme très faible (par exemple $\alpha = 0,2$ via rgamma(n, shape = 0.2, scale = 5)), nous engendrons une population d’une sévérité extrême : la majorité des valeurs est agglutinée à proximité immédiate de zéro, tandis qu’une infime proportion de réalisations atteint des amplitudes colossales. Dans ce scénario de polarisation aiguë, l’asymétrie initiale culmine à $2 / \sqrt{0,2} \approx 4,47$. La simulation computationnelle démontre que pour une telle distribution, un effectif de $n = 30$ est tragiquement insuffisant : la distribution d’échantillonnage des moyennes conserve une asymétrie positive marquée de l’ordre de $4,47 / \sqrt{30} \approx 0,82$, ce qui compromet sévèrement l’estimation des intervalles de confiance symétriques ordinaires.
De même, la distribution log-normale $\text{Log-}\mathcal{N}(\mu, \sigma^2)$, obtenue par l’exponentiation d’une variable gaussienne, engendre des queues de distribution particulièrement épaisses. L’analyse sous R met en évidence que lorsque le paramètre de variance sous-jacent est élevé (par exemple $\sigma = 1,5$), la moyenne empirique met un temps asymptotique considérable à converger vers la normalité. Dans ces contextes morphologiques extrêmes, fréquents dans l’analyse des revenus économiques ou des temps de résolution de problèmes complexes, le praticien doit impérativement exiger des tailles d’échantillon de l’ordre de $n ge 100$ à $n ge 500$ avant d’invoquer le bouclier théorique du théorème central limite pour justifier des procédures inférentielles paramétriques non régularisées.
6. Application pratique : Simulation sur données discrètes et multimodales
6.1 Agrégation de variables discrètes issues d’échelles de Likert
L’utilisation d’échelles de réponse psychométriques de type Likert (allant généralement de 1 « Pas du tout d’accord » à 5 ou 7 « Tout à fait d’accord ») suscite un débat récurrent en méthodologie quantitative. Les puristes rappellent à juste titre que ces instruments produisent des mesures de nature typiquement ordinale, dépourvues de métrique d’intervalle intrinsèque continue, ce qui interdirait en théorie stricte le calcul même de moyennes arithmétiques. Pourtant, l’écrasante majorité des études en sciences sociales calcule des moyennes d’items et applique ensuite des modèles paramétriques linéaires.
Le théorème central limite apporte un éclairage décisif sur la légitimité empirique de cette transition de l’ordinal discret vers le continu gaussien. Considérons une population simulée sous R représentant un item de Likert à 5 points hautement polarisé ou asymétrique. En exploitant la fonction sample() avec un vecteur de probabilités asymétriques, tel que prob = c(0,50, 0,25, 0,15, 0,07, 0,03), nous modélisons un comportement de réponse où la moitié des sujets choisit la modalité 1, tandis que seule une frange résiduelle sélectionne les modalités supérieures.
Lorsque nous extrayons des échantillons aléatoires de participants et que nous calculons la moyenne de cet item de Likert pour des tailles d’échantillon croissantes, un phénomène de lissage asymptotique s’opère instantanément. Dès $n = 20$ ou $n = 30$, le support discret discret d’origine ${1, 2, 3, 4, 5}$ se dilue dans une combinatoire d’une extrême richesse de fractions décimales possibles. La distribution d’échantillonnage de la moyenne de Likert acquiert une continuité remarquable et une symétrie quasi parfaite. Ce résultat prouve que la nature discrète sous-jacente des réponses comportementales individuelles ne fait nullement obstacle à la normalité des estimateurs agrégés de tendance centrale, autorisant ainsi l’usage de tests statistiques paramétriques classiques sur des scores moyens d’inventaires.
6.2 Convergence à partir d’une population bimodale
Un autre défi intuitif majeur pour l’apprentissage de l’inférence statistique réside dans les populations qui ne présentent pas de centre de gravité unique, mais une séparation nette en deux sous-groupes disjoints, donnant naissance à une distribution bimodale. Ce cas de figure émerge régulièrement en psychophysique, en psychiatrie comparée (populations saines versus groupes cliniques sévères), ou lors de la mesure de compétences cognitives spécifiques polarisées par une stratégie d’apprentissage tout-ou-rien.
Nous pouvons simuler une telle population sous R sous la forme d’un mélange équiprobable de deux gaussiennes distinctes au moyen de la structure suivante :
La première composante suit une loi normale $\mathcal{N}(\mu_1 = 10, \sigma_1 = 1)$ et la seconde une loi $\mathcal{N}(\mu_2 = 20, \sigma_2 = 1)$. La distribution composite qui en résulte présente deux bosses massives distinctes séparées par une vallée centrale quasi vide au niveau du score 15. L’espérance globale de cette population bivariée s’établit exactement au point médian $\mu = 15$, un score paradoxalement très improbable pour un individu pris isolément au hasard.
Lorsqu’on extrait des échantillons de cette population bimodale et qu’on en dérive les moyennes empiriques pour $n = 5$, $n = 25$ et $n = 100$, le processus de convergence s’avère spectaculaire. Dès $n = 5$, la bimodalité s’effondre de manière dramatique : la vallée centrale se comble instantanément par l’effet de combinaison de participants appartenant alternativement aux deux composantes du mélange. Pour $n = 25$, la distribution des moyennes devient rigoureusement unimodale et parfaitement symétrique autour du centre théorique $\mu = 15$. La bimodalité originelle s’est totalement volatilisée de la distribution d’échantillonnage. Cette simulation prouve de manière éclatante que le théorème central limite ne requiert absolument aucune unimodalité préalable de la population source pour conférer à la moyenne d’échantillon une architecture gaussienne universelle.
6.3 Simulations sur loi de Poisson et loi de Bernoulli
L’analyse des fréquences comportementales rares s’appuie classiquement sur la loi de Poisson, caractérisée par un paramètre d’intensité unique $lambda$, qui représente à la fois son espérance et sa variance ($\mu = \lambda$, $\sigma^2 = \lambda$). Lorsque $lambda$ est petit (par exemple $lambda = 1$ comportement rare par heure d’observation), la loi de Poisson est hautement discrète et fortement asymétrique vers la droite, empilant la majorité des observations sur 0 et 1.
En générant des moyennes de tirages de Poisson via rpois(n, lambda = 1) sous R, nous observons une nouvelle fois la convergence inéluctable vers la normalité à mesure que $n$ grandit. La statistique de Poisson agrégée se normalise rapidement, démontrant que l’erreur type de la fréquence moyenne converge fidèlement vers la formulation $\sqrt{\lambda / n}$.
Le cas limite le plus fondamental du théorème central limite s’incarne historiquement dans le théorème de Moivre-Laplace, qui étudie la somme ou la proportion de variables de Bernoulli $X_i in {0, 1}$ avec probabilité de succès $p$. Une distribution binomiale $\mathcal{B}(n, p)$ n’est autre que la somme de $n$ variables de Bernoulli i.i.d. En programmant sous R des tirages binaires via rbinom(B, size = n, prob = p) et en divisant les sommes obtenues par $n$, nous modélisons la distribution d’échantillonnage d’une proportion empirique $\hat{p}$. Dès lors que les conditions de validité empiriques $np ge 5$ (ou 10) et $n(1-p) ge 5$ sont respectées, la proportion empirique converge impeccablement vers une loi normale $\mathcal{N}\left(p, \frac{p(1-p)}{n}\right)$, consolidant le pont théorique historique unissant les théorèmes de De Moivre, de Laplace et la formulation moderne du TCL.
7. Vérification empirique et numérique des propriétés du TCL dans R
7.1 Convergence de l’espérance d’échantillonnage
L’un des fondements théoriques garantis par la théorie des probabilités est que l’espérance mathématique de la moyenne d’échantillon est rigoureusement identique à l’espérance de la population mère. Pour vérifier empiriquement ce principe dans l’environnement R, nous pouvons concevoir une boucle de surveillance de la trajectoire cumulative de Monte-Carlo. À partir d’une loi exponentielle de paramètre $lambda = 0,2$ dont l’espérance théorique absolue est $\mu = 1 / 0,2 = 5$, nous simulons une suite de $B = 20,000$ échantillons indépendants de taille $n = 25$.
Pour chaque échantillon consécutif extrait, nous calculons sa moyenne empirique locale $\bar{x}_k$, puis nous évaluons la moyenne progressive (ou moyenne cumulative) de ces moyennes successives au moyen de la fonction vectorisée cumsum(means) / (1:B). En traçant cette métrique cumulative en fonction du nombre d’itérations $k in [1, B]$, le chercheur observe directement la loi forte des grands nombres à l’œuvre :
Au cours des premières dizaines d’échantillons, la trajectoire oscille erratiquement autour de l’axe horizontal marquant l’ordonnée 5. Toutefois, à mesure que l’accumulation des réplications progresse vers 5 000, 10 000 et finalement 20 000 échantillons, les oscillations stochastiques s’amortissent pour s’aplatir totalement sur la ligne directrice théorique $\mu = 5$. L’écart relatif d’espérance, calculé par $\frac{|\bar{\bar{X}} – mu|}{\mu}$, s’effondre sous le seuil critique des 0,05 %, attestant sans équivoque de la stricte absence de biais de l’estimateur d’échantillonnage.
7.2 Vérification de la réduction de la variance par le facteur n
La quantification de la vitesse d’amenuisement de l’incertitude statistique constitue un enjeu central du dimensionnement des protocoles expérimentaux. Pour vérifier numériquement la loi de l’erreur type énonçant que $\text{Var}(\bar{X}_n) = \frac{\sigma^2}{n}$, nous pouvons exécuter un script automatisé sous R évaluant la variance empirique de 10 000 moyennes pour une gamme continue de tailles d’échantillon : $n in {4, 16, 64, 256, 1024}$.
En partant d’une population uniforme $\mathcal{U}(0, 10)$ où la variance théorique est strictement égale à $\sigma^2 = \frac{(10 – 0)^2}{12} = \frac{100}{12} \approx 8,3333$, nous confrontons la variance théorique attendue à la variance empiriquement calculée sur les simulations de Monte-Carlo :
- Pour $n = 4$ : Variance attendue $= 8,3333 / 4 = 2,0833$ | Variance simulée $\approx 2,085$
- Pour $n = 16$ : Variance attendue $= 8,3333 / 16 = 0,5208$ | Variance simulée $\approx 0,521$
- Pour $n = 64$ : Variance attendue $= 8,3333 / 64 = 0,1302$ | Variance simulée $\approx 0,130$
- Pour $n = 256$ : Variance attendue $= 8,3333 / 256 = 0,0325$ | Variance simulée $\approx 0,032$
- Pour $n = 1024$ : Variance attendue $= 8,3333 / 1024 = 0,0081$ | Variance simulée $\approx 0,008$
Cette progression géométrique met en évidence avec une netteté cristalline le principe du quadruplement de l’effectif : pour réduire de moitié l’erreur type (soit diviser par 4 la variance de la moyenne), l’expérimentateur doit impérativement multiplier la taille de sa cohorte par un facteur 4. Ce constat numérique fournit une justification pédagogique directe aux analyses de puissance a priori sous R (via des fonctions comme power.t.test() ou le package pwr), en rappelant que le gain de précision métrologique suit une loi de rendements décroissants à mesure que les effectifs atteignent des dimensions considérables.
7.3 Stabilité computationnelle et précision de Monte-Carlo
Toute démonstration ou vérification empirique adossée aux simulations de Monte-Carlo introduit inévitablement une composante d’erreur computationnelle additionnelle induite par le nombre fini d’itérations répliquées, noté $B$. Si la théorie asymptotique s’appuie sur une infinité d’expériences potentielles ($B to \infty$), le statisticien doit nécessairement composer avec les contraintes d’allocation processeur et de mémoire vive de sa machine.
L’erreur standard de Monte-Carlo (notée MCSE, pour Monte Carlo Standard Error) attachée à l’estimation de la moyenne des moyennes simulées dépend du volume de réplications selon la relation $\text{MCSE}(\bar{\bar{X}}) = \frac{s_{\bar{X}}}{\sqrt{B}}$, où $s_{\bar{X}}$ représente l’écart-type empirique mesuré sur les $B$ moyennes. Si nous réalisons seulement $B = 100$ simulations, le bruit d’échantillonnage de second niveau reste perceptible et peut introduire des écarts fortuits sur les deuxième et troisième décimales de nos diagnostics de forme. En revanche, en élevant le nombre de réplications à $B = 10,000$ ou $B = 50,000$, la MCSE est comprimée à des niveaux insignifiants, garantissant la stabilisation des calculs d’asymétrie et d’aplatissement à deux ou trois décimales près.
Pour formaliser la tolérance d’incertitude dans nos scripts R, il est d’usage d’adosser aux estimateurs simulés un intervalle de tolérance à 95 % délimité par $\bar{\bar{X}} \pm 1,96 \times \text{MCSE}$. La confirmation que le paramètre analytique latent $\mu$ s’insère systématiquement à l’intérieur de cet intervalle de tolérance numérique valide la conformité stochastique du générateur et atteste que les conclusions tirées de nos simulations ne résultent aucunement d’un artefact computationnel local.
8. Diagnostics graphiques et tests statistiques de normalité sous R
8.1 Analyse rigoureuse par diagramme quantile-quantile (Q-Q Plot)
Bien que l’histogramme de densité apporte une première impression visuelle intuitive de l’émergence d’une courbe en cloche, il demeure un outil d’inspection grossier, fortement dépendant du choix arbitraire du nombre et de la largeur des classes de discrétisation (binwidth). Pour scruter avec une acuité scientifique supérieure l’adéquation d’une distribution d’échantillonnage à la normalité théorique, le diagramme quantile-quantile (Q-Q plot) constitue l’instrument diagnostique de prédilection des biométriciens et des psychométriciens.
Sous R, l’écosystème ggplot2 permet de tracer des diagrammes quantile-quantile hautement standardisés au moyen des fonctions stat_qq() et stat_qq_line(). L’algorithme extrait les quantiles ordonnés de la variable empirique et les met en correspondance directe avec les quantiles théoriques attendus d’une loi normale univariée standardisée. Si la distribution empirique est parfaitement gaussienne, les points du graphique s’alignent rigoureusement le long de la ligne diagonale de référence à 45 degrés.
L’avantage décisif du Q-Q plot réside dans sa sensibilité clinique aux déviations logées aux extrémités de la distribution :
- Une courbure en forme de « S » inversé signale des queues de distribution épaisses (présence d’observations extrêmes plus fréquentes que dans un cadre gaussien).
- Une concavité ou convexité unilatérale continue matérialise une asymétrie positive ou négative persistante.
En comparant les Q-Q plots des moyennes issues d’une loi exponentielle pour $n = 5$, $n = 30$ et $n = 150$, l’analyste visualise précisément comment les points extrêmes, initialement décrochés de la diagonale théorique aux extrémités droite et gauche pour les petits échantillons, viennent progressivement se plaquer de façon millimétrique sur la trajectoire théorique au fur et à mesure que $n$ grandit.
8.2 Statistiques descriptives de forme : Asymétrie et Aplatissement
Au-delà de l’inspection visuelle des tracés, la vérification de la normalité requiert une quantification chiffrée des moments d’ordre supérieur de la distribution d’échantillonnage. Deux métriques fondamentales doivent être systématiquement calculées pour caractériser la morphologie fine des distributions de moyennes simulées sous R : le coefficient d’asymétrie de Fisher (skewness, $\gamma_1$) et le coefficient d’aplatissement (kurtosis, $\beta_2$ ou son excès $\gamma_2 = \beta_2 – 3$).
En exploitant le package moments, les fonctions skewness() et kurtosis() permettent de mesurer avec précision le profil géométrique des vecteurs de moyennes :
Pour une loi normale théorique pure, l’asymétrie doit être rigoureusement égale à 0 (symétrie bilatérale parfaite) et le kurtosis brut doit s’établir précisément à 3 (ce qui correspond à un excès de kurtosis nul). Dès lors qu’une population de départ non gaussienne d’asymétrie $\gamma_{1,\text{pop}}$ est soumise à un échantillonnage répété de taille $n$, la théorie statistique stipule que l’asymétrie de la moyenne empirique se résorbe à une vitesse inversement proportionnelle à la racine carrée de l’effectif, selon la relation $\gamma_1(\bar{X}_n) = \frac{\gamma_{1,\text{pop}}}{\sqrt{n}}$, tandis que l’excès de kurtosis s’atténue encore plus promptement selon le facteur $\gamma_2(\bar{X}_n) = \frac{\gamma_{2,\text{pop}}}{n}$.
L’automatisation sous R d’un tableau synthétique confrontant les valeurs empiriques calculées de $\gamma_1$ et $\beta_2$ pour différents paliers d’échantillonnage met en évidence cette cinétique différentielle : la voussure de la distribution (kurtosis) rejoint la référence de 3 beaucoup plus rapidement que l’asymétrie ne s’éteint vers 0. Cette disparité mathématique explique pourquoi les queues de distribution sont les dernières zones géométriques à se normaliser lors de la montée en charge de la taille d’échantillon.
8.3 Limites critiques des tests formels d’adéquation
Face à la question de l’adéquation d’une distribution à la loi normale, le réflexe quasi universel des jeunes chercheurs consiste à invoquer un test d’hypothèse formel de significativité, tel que le test de Shapiro-Wilk (exécuté sous R via la fonction native shapiro.test()), le test d’Anderson-Darling ou le test de Kolmogorov-Smirnov (ks.test()). Toutefois, dans le contexte spécifique de l’évaluation du théorème central limite et de l’analyse de grands échantillons, ce recours systématique aux tests de significativité engendre un paradoxe méthodologique majeur.
Ces tests statistiques formels évaluent l’hypothèse nulle $H_0$ selon laquelle l’échantillon analysé est rigoureusement issu d’une population normale. Comme tout test paramétrique, leur puissance statistique est une fonction monotone croissante de la taille d’échantillon ($n$). Lorsque nous analysons des distributions d’échantillonnage massives (par exemple 5 000 ou 10 000 moyennes empiriques), ou lorsque nous travaillons sur des méga-bases de données observationnelles comportant plusieurs dizaines de milliers de sujets, la puissance du test de Shapiro-Wilk devient astronomique. Il détectera des micro-déviations imperceptibles et sans la moindre portée pratique comme étant hautement significatives ($p < 0,001$).
Le chercheur se retrouve alors enfermé dans le piège de la significativité triviale : le test de normalité rejette formellement l’hypothèse de normalité alors même que la distribution des moyennes est devenue suffisamment gaussienne pour autoriser l’usage aveugle de tous les tests statistiques paramétriques imaginables sans le moindre risque d’erreur. C’est pourquoi la communauté contemporaine des méthodologistes et biostatisticiens recommande expressément de reléguer les tests formels tels que Shapiro-Wilk au second plan, au profit exclusif de l’évaluation conjointe des diagnostics visuels (Q-Q plots) et des indices d’amplitude d’effet de forme (skewness compris entre $-0,5$ et $+0,5$ ; kurtosis compris entre 2 et 4).
9. Construction et couverture des intervalles de confiance basés sur le TCL
9.1 Dérivation asymptotique de l’intervalle de Wald
L’application la plus omniprésente du théorème central limite dans la pratique scientifique quotidienne concerne la dérivation analytique des intervalles de confiance pour l’espérance inconnue $\mu$ d’une population générale. Dès lors que l’effectif $n$ de l’échantillon d’un chercheur est jugé suffisamment vaste pour que la convergence asymptotique de la moyenne empirique soit actée, l’écart standardisé $Z = \frac{\bar{X} – \mu}{\sigma / \sqrt{n}}$ peut être assimilé avec une sécurité probabiliste à une loi normale standard $\mathcal{N}(0, 1)$.
Dans les contextes expérimentaux réels, l’écart-type théorique exact de la population $\sigma$ demeure rigoureusement inconnu de l’expérimentateur. Toutefois, en vertu du théorème de Slutsky combiné au théorème central limite, la substitution de $\sigma$ par l’écart-type d’échantillon corrigé sans biais $s = \sqrt{\frac{1}{n-1}\sum_{i=1}^n (X_i – \bar{X})^2}$ préserve la convergence asymptotique de la statistique de test vers la loi normale standard. Cette propriété fondamentale permet d’isoler le paramètre $\mu$ dans une double inégalité de probabilité bilatérale au niveau de confiance $1 – \alpha$ :
$$P\left( -z_{1-alpha/2} le \frac{\bar{X} – \mu}{s / \sqrt{n}} le z_{1-alpha/2} \right) \approx 1 – \alpha$$
Ce qui débouche immédiatement sur la formulation classique de l’intervalle de confiance de Wald :
$$\text{IC}_{1-\alpha}(\mu) = \left[ \bar{X} – z_{1-alpha/2} \frac{s}{\sqrt{n}} ;,; \bar{X} + z_{1-alpha/2} \frac{s}{\sqrt{n}} \right]$$
Sous R, pour un intervalle usuel au seuil bilatéral de 95 % ($\alpha = 0,05$), le quantile normal critique est extrait de manière programmatique via l’instruction qnorm(p = 0.975), qui renvoie la valeur numérique universelle bien connue $1,959964$ (généralement arrondie à 1,96).
9.2 Simulation du taux de couverture empirique
Un intervalle de confiance à 95 % déduit du théorème central limite n’indique aucunement qu’il y a 95 % de chances que la vraie moyenne de la population soit contenue dans l’intervalle unique calculé à partir d’une expérience isolée. Il postule une propriété fréquentiste de méta-échantillonnage : si le chercheur répliquait son étude 10 000 fois en calculant un intervalle d’échantillon à chaque réplication, exactement 95 % de ces intervalles recouvriraient la vraie valeur fixe $\mu$, tandis que 5 % manqueraient cette cible par excès ou par défaut.
Nous pouvons tester la validité empirique de cette propriété de couverture au travers d’une simulation sous R. Générons $B = 5,000$ échantillons consécutifs extraits d’une population asymétrique de Weibull ou de Poisson, et calculons pour chacun d’entre eux l’intervalle asymptotique de Wald à 95 %. En comparant de manière vectorisée les bornes inférieure et supérieure générées à la vraie valeur théorique $\mu$ assignée dans le script (via (borne_inf <= mu) & (mu <= borne_sup)), nous mesurons la proportion empirique exacte d’intervalles réussissant à capturer la moyenne.
Cette simulation révèle un enseignement méthodologique capital : lorsque la taille d’échantillon $n$ est petite ($n = 10$ ou $n = 15$) et que la population sous-jacente est asymétrique, le taux de couverture effectif de l’intervalle asymptotique de Wald chute sous le seuil nominal contractuel, tombant souvent autour de 88 % ou 91 %. Ce phénomène de sous-recouvrement systématique signifie que l’analyste sous-estime considérablement son risque d’erreur réel en se fondant aveuglément sur le TCL pour des échantillons restreints. En revanche, dès que l’effectif atteint des valeurs robustes ($n ge 60$ ou $n ge 100$), le taux de couverture empirique remonte pour s’ajuster avec une précision absolue sur le niveau de confiance nominal de 95,0 %.
9.3 Alternatives pour distributions fortement déviantes
Lorsque le chercheur est contraint de travailler avec des échantillons restreints ou modérément dimensionnés issus de variables psychologiques ou biométriques manifestant une asymétrie unilatérale tenace, s’en remettre sans nuance à l’intervalle de Wald fondé sur le TCL normal standard s’avère hasardeux. Plusieurs alternatives méthodologiques s’offrent alors au statisticien pour rétablir une couverture fréquentiste irréprochable sous R.
La première stratégie classique repose sur la transformation logarithmique ou la transformation de Box-Cox appliquée aux observations individuelles de la variable d’origine. En opérant une transformation stabilisatrice de variance et d’asymétrie (par exemple $Y = log(X)$), la distribution des données brutes est rapprochée d’une morphologie quasi gaussienne, rendant l’application de la théorie des petits échantillons de Student ($t$) parfaitement légitime. Après calcul de l’intervalle sur l’échelle transformée, une transformation réciproque par la fonction exponentielle permet de rétablir un intervalle de confiance sur la médiane géométrique de l’échelle originelle.
La seconde alternative consiste à mobiliser l’intervalle de Student ajusté, qui remplace le quantile $z$ par le quantile de la loi de Student qt(p = 0.975, df = n - 1). Bien que formulé originellement pour des populations mères normales, l’intervalle studentisé offre une marge de sécurité supérieure aux bornes de Wald en élargissant automatiquement la fenêtre de confiance pour les petits effectifs afin de compenser les fluctuations stochastiques induites par l’estimation de l’écart-type d’échantillon $s$.
10. Comparaison méthodologique : Théorème central limite contre approches de rééchantillonnage (Bootstrap)
10.1 Principes du bootstrap non paramétrique dans R
L’avènement de la puissance computationnelle moderne au cours des dernières décennies a favorisé l’essor d’une approche alternative d’une flexibilité conceptuelle remarquable, théorisée originellement par Bradley Efron en 1979 : le bootstrap non paramétrique. Contrairement au théorème central limite qui extrapole la distribution de la moyenne en invoquant une loi théorique asymptotique déduite d’axiomes mathématiques, le bootstrap n’exige aucun postulat distributif a priori et traite l’échantillon empirique observé comme une représentation miniature optimale de la population sous-jacente.
Le principe algorithmique du bootstrap consiste à générer un nombre massif (couramment $B = 2,000$ à $10,000$) de pseudo-échantillons de même taille $n$ que l’échantillon d’origine, par un processus de tirage avec remise (sampling with replacement) au sein des observations disponibles. Sur chaque pseudo-échantillon synthétisé, la statistique d’intérêt (la moyenne arithmétique, mais tout aussi bien la médiane, une corrélation ou un ratio de cotes) est calculée et archivée.
Sous R, cette mécanique est implémentée avec une extrême rigueur méthodologique au travers du package spécialisé boot développé par Angelo Canty et Brian Ripley. Après avoir défini une fonction statistique conforme aux spécifications de l’extension, l’analyste appelle la commande boot(data, statistic, R = 2000) pour dériver l’erreur type empirique d’échantillonnage sans faire la moindre référence à la formule analytique $\sigma / \sqrt{n}$. L’instruction complémentaire boot.ci() permet quant à elle d’extraire différents types d’intervalles de confiance non paramétriques, notamment l’intervalle percentile et surtout l’intervalle ajusté pour le biais et l’accélération (BCa, pour bias-corrected and accelerated), réputé pour sa capacité à corriger automatiquement l’asymétrie résiduelle des estimateurs.
10.2 Confrontation directe des résultats asymptotiques et bootstrap
Pour apprécier la complémentarité de ces deux visions de l’inférence statistique, il est enrichissant de confronter empiriquement l’intervalle asymptotique déduit du TCL et les intervalles bootstrap générés à partir d’un même jeu de données complexe sous R. Concevons un échantillon de taille modérée ($n = 40$) extrait d’une loi de Pareto modélisant des disparités extrêmes de performance ou d’engagement sur un réseau social en ligne.
Lorsque nous calculons l’erreur type de la moyenne via la formule analytique du TCL $s / \sqrt{n}$, nous obtenons une valeur scalaire symétrique déduite de la variance d’échantillon globale. En confrontant cette valeur à l’écart-type de la distribution bootstrap issu de 5 000 rééchantillonnages avec remise, la convergence numérique entre les deux approches apparaît souvent remarquable, validant l’exactitude de la prédiction du TCL sur la dispersion moyenne de second degré.
Cependant, la divergence méthodologique s’exprime avec une acuité particulière au niveau de la forme de l’intervalle de confiance :
- L’intervalle asymptotique dérivé du TCL, contraint par la géométrie symétrique de la loi normale centrée réduite, positionne les deux ailes de l’intervalle à équidistance absolue de la moyenne observée ($\bar{x} \pm 1,96 , \text{SE}$).
- L’intervalle bootstrap BCa, en revanche, examine la structure de rang empirique des rééchantillonnages et identifie l’asymétrie intrinsèque résiduelle. Il génère par conséquent un intervalle asymétrique autour de la moyenne empirique, étendant la borne supérieure plus loin que la borne inférieure pour mieux encapsuler la dynamique des queues lourdes de la distribution parente.
10.3 Directives décisionnelles pour le chercheur en sciences sociales
Face à la dualité entre l’approximation asymptotique du théorème central limite et les procédures computationnelles de rééchantillonnage par bootstrap, le chercheur ou le biostatisticien doit opérer des choix méthodologiques étayés et transparents. Le recours exclusif au TCL est pleinement légitime et computationnellement optimal dans les scénarios où les échantillons analysés dépassent confortablement les seuils de $n ge 50$ ou $n ge 100$ pour des distributions d’asymétrie modérée, ou lorsque la statistique cible est une moyenne ou une somme linéaire simple.
À l’inverse, l’orientation vers les méthodes de rééchantillonnage bootstrap non paramétrique (avec rapport d’intervalles BCa) s’impose comme la solution de référence absolue dans les configurations suivantes :
- Lorsque l’effectif d’échantillonnage est restreint à des cohortes de petite taille ($n < 30$) tout en présentant des violations manifestes de symétrie interdisant l'hypothèse de normalité requise par le test de Student exact.
- Lorsque la statistique inférentielle d’intérêt n’est pas une fonction linéaire simple (telle qu’une médiane empirique, un coefficient de corrélation de Spearman, un ratio de variances ou un effet indirect de médiation conditionnelle), pour lesquelles le théorème central limite classique ne fournit aucune approximation d’erreur type directement utilisable par une formulation élémentaire.
- En présence de points de levier ou de valeurs aberrantes suspectes susceptibles de contaminer massivement la variance d’échantillon $s^2$ dans la formule analytique standard de l’erreur type de Wald.
11. Limites fondamentales, contre-exemples et cas de rupture du TCL
11.1 Distributions à variance infinie : La distribution de Cauchy
Si la portée du théorème central limite est d’une universalité remarquable, son empire mathématique n’est pas absolu. Le TCL s’accompagne d’une condition d’application incontournable : la variable aléatoire sous-jacente doit impérativement posséder une espérance mathématique finie et une variance finie ($\sigma^2 < \infty$). Dès lors que cette condition de moments finis est violée, l'ensemble de l'édifice asymptotique s'effondre de manière spectaculaire.
Le contre-exemple mathématique archétypique de cette rupture stochastique est constitué par la distribution de Cauchy (qui correspond formellement à une loi de Student à 1 seul degré de liberté). Dotée d’une densité de probabilité définie par $f(x) = \frac{1}{\pi (1 + x^2)}$, la loi de Cauchy présente des queues de distribution si prodigieusement lourdes que ses intégrales de moments divergent : l’espérance mathématique n’est pas définie au sens de Lebesgue et sa variance théorique est strictement infinie.
Nous pouvons simuler cette rupture comportementale sous R en générant des moyennes empiriques d’échantillons extraits d’une loi de Cauchy via la fonction rcauchy() :
En augmentant la taille d’échantillon de $n = 10$ à $n = 100$, puis $n = 1,000$ et jusqu’à $n = 10,000$, un constat stupéfiant se produit sur la console de calcul. Au lieu de voir les moyennes empiriques se stabiliser et converger vers un centre unique avec une variance décroissante en $1/\sqrt{n}$, la distribution de la moyenne empirique d’un échantillon de Cauchy de taille $n$ conserve exactement la même distribution de Cauchy que celle d’une observation unique !
À chaque incrément de réplications, des valeurs gigantesques (dépassant parfois des centaines de milliers d’unités) surviennent spontanément, déstabilisant instantanément la moyenne d’échantillon quel que soit l’effectif agrégé. L’agrégation de 100 000 observations de Cauchy ne produit aucune normalisation en cloche, illustrant avec force que le TCL est impuissant à juguler l’instabilité asymptotique de populations aux moments indéfinis.
11.2 Violations de l’indépendance statistique des observations
La seconde condition fondamentale de validité du théorème central limite classique réside dans l’indépendance mutuelle des observations composant l’échantillon (condition i.i.d.). Dans les sciences du comportement, en éducation et en santé publique, la violation de cette indépendance statistique est une réalité omniprésente, souvent ignorée ou minimisée par les praticiens.
Trois structures d’interdépendance spatiale et temporelle brisent fréquemment le postulat d’indépendance :
- L’autocorrélation temporelle dans les séries chronologiques ou les protocoles d’évaluation écologique momentanée (EMA), où la réponse d’un participant au temps $t$ est fortement prédite par son état émotionnel ou cognitif au temps $t-1$.
- Le regroupement hiérarchique ou en grappes (clustering), où des individus évalués partagent des contextes communs (élèves imbriqués au sein d’une même classe, patients pris en charge par le même thérapeute, membres d’un même foyer).
- Les protocoles de mesures répétées où des observations multiples sont collectées chronologiquement sur un même participant.
Sous l’influence d’une autocorrélation ou d’une corrélation intra-classe (ICC) positive non modélisée, la covariance entre les observations individuelles $\text{Cov}(X_i, X_j)$ devient strictement positive. Par conséquent, la véritable variance de la somme d’échantillon ne s’établit plus à $n\sigma^2$, mais intègre l’ensemble de la somme matricielle des covariances croisées :
$$\text{Var}\left(\sum_{i=1}^n X_i\right) = n\sigma^2 + 2 \sum_{i < j} \text{Cov}(X_i, X_j)$$
L’utilisation de la formule usuelle naïve de l’erreur type $s / \sqrt{n}$ conduit alors à une sous-estimation dramatique et artificielle de l’erreur standard réelle de la moyenne. L’analyste conclut prématurément à une précision métrologique illusoire et observe un gonflement catastrophique de son taux d’erreur de première espèce, pouvant culminer à des rejets abusifs de l’hypothèse nulle atteignant 20 % ou 30 % pour un seuil nominal annoncé à 5 %. Dans ces environnements dépendants, le chercheur doit abandonner l’approximation classique du TCL au profit de modèles linéaires mixtes hiérarchiques ou de corrections de variances par estimateurs sandwich (Huber-White cluster-robust standard errors).
11.3 Erreurs conceptuelles fréquentes dans l’interprétation des données psychologiques
L’incompréhension des fondements opératoires du théorème central limite génère de nombreuses erreurs d’interprétation méthodologique au sein des protocoles de recherche quantitative. Trois illusions cognitives doivent être expressément dénoncées :
La première réside dans la confusion pernicieuse entre la normalisation des moyennes d’échantillons et la prétendue normalisation des scores individuels des participants. Il n’est pas rare de lire dans des rapports de recherche que, l’effectif d’une cohorte dépassant 100 individus, l’analyste suppose que la variable mesurée est désormais « normale » au sein du groupe. Cette assertion est absurde : la distribution d’une variable clinique dans une population ne change jamais de profil sous le simple effet de son observation accrue. Les scores individuels bruts conservent intégralement leur asymétrie ou leur bimodalité intrinsèque, ce qui interdit par exemple d’employer la règle empirique des $\pm 2$ écarts-types pour définir des seuils diagnostiques individuels sur des données asymétriques.
La seconde illusion consiste à postuler que le théorème central limite protège l’analyste contre les biais de mesure systématiques ou les biais de sélection d’échantillonnage. Le TCL garantit rigoureusement que la moyenne empirique converge vers l’espérance mathématique de la population effective dont l’échantillon est extrait. Si le protocole expérimental recrute des participants au moyen d’un échantillonnage de convenance fortement biaisé (par exemple exclusivement des étudiants universitaires sur-entraînés pour évaluer des compétences mnésiques générales), un effectif de 50 000 sujets n’atténuera en aucune façon le biais d’échantillonnage : il ne fera que converger avec une certitude absolue vers une moyenne biaisée non représentative de l’humanité globale.
Enfin, le troisième écueil concerne l’extrapolation abusive de la normalité asymptotique aux quantiles extrêmes de la distribution. Si le TCL garantit une excellente approximation au cœur de la distribution (autour de la moyenne, entre le 10e et le 90e percentile), l’approximation normale est notoirement imprécise lorsqu’on cherche à inférer la fréquence d’occurrence d’événements très rares logés au-delà du 99e ou 99,9e percentile. Pour modéliser les comportements extrêmes en sciences humaines (comme les passages à l’acte suicidaires ou les scores exceptionnels de créativité), invoquer le TCL pour calculer des probabilités de queue constitue une faute méthodologique majeure, relevant du champ d’application exclusif de la théorie des valeurs extrêmes (loi de Gumbel, Fréchet ou Weibull généralisée).
12. Guide opérationnel pour l’intégration du TCL dans les rapports reproductibles RMarkdown et Quarto
12.1 Architecture logicielle d’une étude de simulation reproductible
Pour assurer la pérennité et la transparence de la recherche scientifique conformément aux directives de la science ouverte (Open Science Framework), l’évaluation computationnelle du théorème central limite et de la robustesse des modèles statistiques doit être formalisée au sein de systèmes d’édition computationnelle dynamique tels que RMarkdown ou Quarto (fichiers .qmd). Ces environnements permettent d’entrelacer organiquement la prose narrative scientifique, les blocs d’exécution informatique R et le rendu automatisé des figures de diagnostic.
L’architecture d’un document de recherche reproductible doit s’articuler autour d’une séparation modulaire claire :
En tête de document, un préambule YAML standardisé permet de spécifier le titre, les auteurs, la date de compilation et les options de sortie vectorielle (formats PDF haute définition ou HTML interactif). Dès le premier bloc de configuration globale (généralement intitulé setup), les paramètres directeurs d’exécution sont assignés, notamment la graine stochastique via set.seed(), le niveau de significativité des tests et les options d’optimisation du moteur de calcul.
L’un des leviers techniques essentiels pour fluidifier la compilation de documents intégrant de lourdes simulations de Monte-Carlo (exécutant des dizaines de millions de calculs matriciels) réside dans l’utilisation méthodique du paramètre de mise en cache cache: true dans les en-têtes des blocs de code R computationnels. Cette configuration garantit que les simulations chronophages ne sont exécutées qu’une seule et unique fois ; le compilateur stocke les résultats structurés dans des bases de données temporaires et ne ré-exécute le bloc d’échantillonnage que si l’analyste modifie explicitement les lignes de code informatique sous-jacentes, épargnant ainsi de précieux temps de traitement lors de la rédaction textuelle du manuscrit.
12.2 Automatisation des tableaux et visualisations scientifiques
L’incorporation fluide des résultats stochastiques dans des manuscrits destinés à l’évaluation par les pairs exige une standardisation rigoureuse de la mise en forme graphique et tabulaire. Pour la production de tableaux comparatifs exposant la cinétique de convergence des estimateurs en fonction des régimes d’échantillonnage ($n$), l’exploitation des packages de mise en page typographique tels que kableExtra ou gt permet de générer des sorties parfaitement conformes aux canons éditoriaux les plus exigeants, à l’instar des normes professionnelles de l’American Psychological Association (APA 7e édition).
En ce qui concerne les représentations graphiques générées via ggplot2, la charte graphique doit privilégier la lisibilité, l’accessibilité visuelle et l’exactitude métrologique :
- Application de thèmes visuels minimalistes et épurés tels que
theme_classic()outheme_minimal(), débarrassés de tout artéfact graphique superflu (chartjunk). - Sélection de palettes de couleurs perceptuellement uniformes et adaptées aux lecteurs atteints de déficiences de vision des couleurs (daltonisme), au travers de l’extension
viridisouRColorBrewer. - Normalisation des axes d’abscisse et d’ordonnée au moyen d’échelles de densité comparables d’une facette à l’autre pour empêcher toute illusion visuelle d’amincissement non proportionnel.
- Exportation conjointe des graphiques vectorisés en haute résolution (PDF ou SVG à 300 DPI minimum via
ggsave()) afin d’assurer une restitution typographique irréprochable lors de l’impression sur épreuves éditoriales.
12.3 Modèle de rédaction méthodologique pour publication empirique
Afin d’armer les chercheurs et étudiants face aux exigences des comités de lecture des revues internationales de psychométrie et de sciences biomédicales, voici un gabarit de formulation académique formalisant avec rigueur et transparence la légitimation asymptotique des analyses paramétriques appliquées à des données comportementales asymétriques :
« Bien que l’évaluation descriptive préliminaire de la variable de temps de latence cognitive ait mis en évidence une asymétrie positive modérée au sein de nos observations (skewness = 1,42, kurtosis = 4,85), la taille conséquente de notre cohorte expérimentale (N = 180 participants distribués de manière équilibrée dans un plan factoriel 2 × 2) nous autorise à mobiliser les procédures inférentielles paramétriques du modèle linéaire généralisé. En vertu du théorème central limite (TCL), la distribution d’échantillonnage des coefficients de régression et des moyennes de cellules converge asymptotiquement vers une loi normale multivariée dès lors que les tailles d’échantillons excèdent les seuils nominaux, neutralisant le risque de distorsion du taux d’erreur de première espèce (alpha = 0,05). Cette robustesse asymptotique a été confirmée par une analyse diagnostique visuelle des diagrammes quantile-quantile (Q-Q plots) des résidus standardisés du modèle, ainsi que par un rééchantillonnage bootstrap non paramétrique (B = 2 000 réplications) révélant une concordance étroite entre les erreurs types analytiques et empiriques. »
Avant de finaliser et soumettre un rapport analytique s’appuyant sur l’approximation du TCL, l’analyste veillera à valider la checklist de contrôle méthodologique suivante :
- Vérification de l’indépendance structurelle mutuelle des observations de l’échantillon (absence de corrélations intra-grappes ou d’autocorrélation temporelle non régularisées).
- Confirmation que les moments d’ordre un et deux (espérance et variance) de la distribution parente sont structurellement bornés et finis.
- Évaluation de l’adéquation entre l’effectif réel ($n$) et le degré d’asymétrie initiale de la population (exigence d’effectifs substantiels en présence de skewness élevé).
- Documentation transparente des diagnostics graphiques (Q-Q plots) et diffusion accessible du code source R reproductible conformément aux principes fondamentaux de l’intégrité scientifique.
Références
Agresti, A. (2018). Statistical methods for the social sciences (5th ed.). Pearson. https://www.pearson.com/en-us/subject-catalog/p/statistical-methods-for-the-social-sciences/P200000003299
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Canty, A., & Ripley, B. (2021). boot: Bootstrap R (S-Plus) functions (R package version 1.3-28). Comprehensive R Archive Network. https://cran.r-project.org/package=boot
Casella, G., & Berger, R. L. (2002). Statistical inference (2nd ed.). Duxbury Press. https://www.cengage.com
Efron, B., & Hastie, T. (2016). Computer age statistical inference: Algorithms, evidence, and data science. Cambridge University Press. https://doi.org/10.1017/CBO9781316576533
Efron, B., & Tibshirani, R. J. (1994). An introduction to the bootstrap. Chapman & Hall/CRC. https://doi.org/10.1201/9780429246593
Feller, W. (1968). An introduction to probability theory and its applications (Vol. 1, 3rd ed.). John Wiley & Sons. https://www.wiley.com
Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE Publications. https://www.sagepub.com
Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd. https://doi.org/10.1007/978-1-4612-4380-9_6
Komsta, L., & Novomestky, F. (2015). moments: Moments, cumulants, skewness, kurtosis and related tests (R package version 0.14). Comprehensive R Archive Network. https://cran.r-project.org/package=moments
Matsumoto, M., & Nishimura, T. (1998). Mersenne Twister: A 623-dimensionally equidistributed uniform pseudo-random number generator. ACM Transactions on Modeling and Computer Simulation, 8(1), 3–30. https://doi.org/10.1145/272991.272995
R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
Revelle, W. (2023). psych: Procedures for psychological, psychometric, and personality research (R package version 2.3.6). Comprehensive R Archive Network. https://cran.r-project.org/package=psych
Student. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.1093/biomet/6.1.1
Wickham, H., Averick, M., Bryan, J., Chang, W., McGowan, L. D., François, R., Grolemund, G., Hayes, A., Henry, L., Hester, J., Kuhn, M., Pedersen, T. L., Miller, E., Bache, S. M., Müller, K., Ooms, J., Robinson, D., Seidel, D. P., Spinu, V., … Yutani, H. (2019). Welcome to the Tidyverse. Journal of Open Source Software, 4(43), Article 1686. https://doi.org/10.21105/joss.01686
Wilcox, R. R. (2012). Introduction to robust estimation and hypothesis testing (3rd ed.). Academic Press. https://doi.org/10.1016/C2010-0-67044-1