
Dans le champ contemporain de la recherche quantitative, de l’épidémiologie clinique et des sciences computationnelles, la simulation stochastique constitue l’un des piliers méthodologiques les plus déterminants. L’aptitude à modéliser l’incertitude, à émuler des processus biologiques ou comportementaux complexes et à assigner rigoureusement des sujets d’étude au sein de protocoles expérimentaux repose fondamentalement sur la qualité des générateurs de nombres. Au cœur de cet écosystème méthodologique, le progiciel d’analyse statistique SAS (Statistical Analysis System) s’est imposé depuis plusieurs décennies comme une référence internationale incontournable, singulièrement au sein des industries pharmaceutiques, des organismes de réglementation sanitaire et des laboratoires de psychologie quantitative.
Cependant, la modélisation informatique du hasard soulève un paradoxe conceptuel fondamental : comment une machine strictement déterministe, régie par des circuits logiques et des architectures de Von Neumann, peut-elle produire une suite de valeurs imprévisibles ? La réponse réside dans le déploiement d’algorithmes sophistiqués de génération de nombres pseudo-aléatoires. Dans l’environnement SAS moderne, la maîtrise de ces techniques ne se résume pas à l’appel trivial d’une commande isolée. Elle exige une compréhension approfondie des mécanismes sous-jacents, depuis l’initialisation de l’état interne de la mémoire jusqu’au choix raisonné des distributions probabilistes théoriques régissant les données synthétiques générées.
Ce guide exhaustif a pour vocation d’analyser en profondeur les principes théoriques, algorithmiques et syntaxiques encadrant la génération de nombres aléatoires au sein de SAS. À travers l’étude minutieuse de trois exemples fondamentaux déclinés en étapes pas à pas, complétés par une exploration des distributions probabilistes avancées, des protocoles de randomisation expérimentale et des simulations de Monte-Carlo, cet article offre aux chercheurs, biostatisticiens et analystes de données un cadre de référence rigoureux. L’objectif ultime consiste à garantir une validité interne irréprochable et une parfaite reproductibilité des résultats, conformément aux exigences épistémologiques de la science ouverte.
1. Introduction à la génération de nombres pseudo-aléatoires dans SAS
1.1 Fondements théoriques de l’aléatoire en recherche quantitative
D’un point de vue épistémologique, il convient d’établir une distinction fondamentale entre l’aléa pur, souvent qualifié d’aléa ontologique, et les séquences pseudo-aléatoires générées de manière déterministe. Dans le monde physique, certains phénomènes quantiques ou bruits thermiques microscopiques sont réputés intrinsèquement non prédictibles. En revanche, le calcul numérique conventionnel ne dispose d’aucun accès direct à une telle indétermination fondamentale. Les systèmes informatiques ont donc recours à des processus déterministes hautement raffinés, capables de produire des séries numériques dont les propriétés statistiques miment fidèlement celles de variables aléatoires indépendantes et identiquement distribuées.
Dans le domaine de l’inférence statistique, la possibilité de recourir à des distributions de probabilité rigoureusement contrôlées est une exigence absolue. Sans un contrôle strict des paramètres de dispersion, de centralité et de forme des distributions sous-jacentes, toute modélisation stochastique appliquée à l’analyse de données complexes risquerait d’introduire des artefacts d’échantillonnage insidieux. La modélisation stochastique ne vise pas uniquement à introduire du désordre ; elle fournit le cadre formel au sein duquel les chercheurs peuvent évaluer la probabilité critique d’observer des configurations empiriques extrêmes sous l’hypothèse nulle, calibrant ainsi la puissance et la robustesse des tests statistiques.
1.2 Pertinence méthodologique en sciences psychologiques et comportementales
L’application rigoureuse du contrôle aléatoire revêt une importance capitale dans les disciplines expérimentales, tout particulièrement en psychologie cognitive, en neuropsychologie et dans l’étude des comportements humains. Le premier impératif méthodologique réside dans l’assignation aléatoire des participants aux conditions expérimentales. Cette procédure constitue l’unique moyen éprouvé de neutraliser à l’avance les variables parasites, qu’elles soient démographiques, génétiques ou motivationnelles, garantissant que les différences observées entre les groupes expérimentaux et témoins résultent exclusivement de la manipulation de la variable indépendante.
Parallèlement, l’échantillonnage probabiliste au sein de bases d’interrogation représentatives conditionne directement la validité externe des conclusions d’une étude de cohorte. Enfin, lors du déploiement de paradigmes expérimentaux chronométrés sur ordinateur, la génération séquentielle d’ordres de présentation contrebalancés est indispensable pour éliminer les biais d’apprentissage, d’habituation ou de fatigue cognitive chez les participants. Un protocole comportemental dont la distribution des stimuli ne satisfait pas les critères stricts d’équiprobabilité temporelle expose immanquablement le chercheur à des erreurs d’interprétation systémiques majeures.
1.3 Évolution syntaxique : transition des anciennes fonctions vers la fonction moderne rand()
L’architecture logicielle de SAS a connu une évolution majeure dans son traitement de l’aléa mathématique. Historiquement, les utilisateurs de SAS exploitaient une pléthore de fonctions disparates, telles que ranuni() pour les distributions uniformes ou rannor() pour les lois normales. Bien que ces fonctions aient rendu d’éminents services, leurs fondements reposaient sur des générateurs congruentiels linéaires aux périodes statistiques réduites, introduisant des risques avérés de corrélations sérielles lors d’exécutions à très grande échelle. De surcroît, la dispersion de ces routines compliquait la maintenance des programmes et imposait une syntaxe hétérogène selon la distribution ciblée.
Pour surmonter ces contraintes, l’éditeur a développé et standardisé la routine unifiée rand(). Cette fonction moderne concentre en une interface syntaxique unique l’accès à une multiplicité de lois de probabilité, qu’elles soient discrètes ou continues. En substituant aux anciens algorithmes un moteur mathématique de pointe, SAS garantit non seulement une précision numérique accrue dans l’évaluation des quantiles, mais homogénéise également la saisie des hyperparamètres régissant chaque distribution, alignant ainsi les standards du logiciel sur les exigences les plus avancées de la statistique computationnelle contemporaine.
2. Architecture algorithmique sous-jacente : Le générateur Mersenne Twister
2.1 Fonctionnement et période mathématique du Mersenne Twister
L’implémentation moderne de la fonction rand() dans SAS s’appuie principalement sur l’algorithme MT19937, universellement désigné sous l’appellation de Mersenne Twister, développé par Makoto Matsumoto et Takuji Nishimura. Cet algorithme repose sur une relation de récurrence matricielle définie sur un corps fini binaire, optimisée pour exploiter efficacement les opérations logiques au niveau des registres processeurs. Sa caractéristique structurelle la plus spectaculaire réside dans sa période mathématique gigantesque, établie à 2^19937 – 1, un nombre premier de Mersenne qui confère à l’algorithme sa dénomination.
Pour un expérimentateur ou un biostatisticien conduisant des simulations massives, cette période phénoménale écarte définitivement tout risque d’épuisement de la séquence pseudo-aléatoire ou de répétition prématurée des configurations de données. En outre, le Mersenne Twister présente une propriété formelle d’équirépartition multidimensionnelle jusqu’à 623 dimensions consécutives. Cela signifie que si l’on projette les n-uplets de nombres consécutifs générés au sein d’un espace vectoriel à plusieurs centaines de dimensions, la dispersion des points s’effectue sans aucune formation d’amas, attestant d’une absence absolue de corrélations géométriques spatiales indésirables.
2.2 Comparaison avec les générateurs congruentiels linéaires classiques
L’intérêt de migrer vers le Mersenne Twister s’apprécie pleinement lorsqu’on le compare aux limites intrinsèques des générateurs congruentiels linéaires (LCG) traditionnellement exploités dans les versions antérieures des langages statistiques. Ces générateurs archaïques, définis par des relations de congruence modulaire arithmétique, souffrent d’une défaillance géométrique majeure documentée dès la fin des années 1960 par George Marsaglia, souvent désignée sous le terme d’effet Marsaglia. Lorsque des suites de valeurs issues de ces générateurs sont utilisées pour former des coordonnées dans un espace euclidien, les points ont tendance à s’agglutiner sur un nombre restreint d’hyperplans parallèles.
Dans le cadre d’études de simulation statistique intensive, telles que l’évaluation empirique des erreurs de type I ou la modélisation de surfaces de réponse non linéaires, ces défauts structurels introduisent des déformations non négligeables au sein des estimations de variances résiduelles. Le Mersenne Twister neutralise intégralement ces biais de structure. En fournissant une répartition spatiale homogène, il garantit la justesse de l’estimation de la puissance statistique des tests d’hypothèses et évite la propagation de variances artificielles dans les calculs itératifs de rééchantillonnage ou d’optimisation numérique.
2.3 Conséquences pour la validité interne des protocoles expérimentaux
L’excellence mathématique du générateur algorithmique a des répercussions concrètes sur la validité interne des protocoles de recherche empirique. Lorsqu’un laboratoire configure des batteries d’épreuves cognitives ou programme l’apparition de distracteurs perceptifs lors d’une tâche de temps de réaction, toute régularité cachée au sein du flux pseudo-aléatoire est susceptible d’être implicitement détectée par le système nerveux central du participant. L’apprentissage statistique implicite chez l’être humain étant remarquablement sensible aux micro-régularités de l’environnement, un générateur déficient pourrait fausser les latences d’attention sélective.
L’utilisation de la routine rand() sous son architecture Mersenne Twister garantit une indépendance statistique irréprochable entre les observations successives. En éliminant les corrélations de court et long terme, elle préserve la neutralité méthodologique de l’administration des stimuli expérimentaux. Cette rigueur computationnelle constitue par ailleurs un gage indispensable de crédibilité scientifique lors des processus d’évaluation par les pairs, les comités de lecture des revues internationales de premier rang exigeant désormais une transparence totale sur les algorithmes régissant la randomisation expérimentale.
3. Le rôle primordial de la reproductibilité et la routine call streaminit()
3.1 Mécanisme de réinitialisation du flux stochastique
Puisque les générateurs pseudo-aléatoires fonctionnent selon des formules purement déterministes, leur trajectoire numérique est intégralement conditionnée par leur état de départ, généralement formalisé par un nombre entier désigné sous le terme de graine (ou seed en anglais). Dans SAS, le contrôle de cet état initial s’opère au moyen de l’instruction call streaminit(). Cette routine a pour fonction fondamentale de charger dans le registre mémoire du générateur une valeur d’ancrage spécifique, initialisant de manière univoque le flux des nombres qui seront ultérieurement produits par les appels subséquents à la fonction rand().
Le déterminisme algorithmique inhérent à ce processus assure qu’une même valeur positive transmise à l’instruction call streaminit() produira rigoureusement, à l’identique, la même série séquentielle de données sur n’importe quel ordinateur exécutant la même version du logiciel. Inversement, lorsque l’utilisateur fournit une graine de valeur zéro ou omet complètement d’exécuter l’instruction, SAS adopte un comportement non déterministe en exploitant l’horloge système à haute résolution comme valeur de départ. Cette distinction technique trace une ligne de partage absolue entre les travaux de recherche reproductibles et les exécutions ponctuelles non réplicables.
3.2 La reproductibilité comme pilier de la science ouverte en psychologie
Dans le contexte actuel de la crise de la reproductibilité qui traverse les sciences comportementales et biomédicales, la maîtrise de l’initialisation du flux stochastique est un impératif d’éthique scientifique. Dans les essais cliniques randomisés contrôlés évaluant l’efficacité d’une nouvelle psychothérapie ou d’une molécule pharmacologique, l’attribution d’un patient à la cohorte active ou au groupe placebo doit pouvoir être auditée rétrospectivement. L’enregistrement formel de la graine au sein du plan d’analyse statistique pré-enregistré garantit que l’assignation originale peut être recalculée avec une précision mathématique totale.
De plus, cette traçabilité intégrale prémunit l’équipe de recherche contre tout soupçon de manipulation sélective des données (le phénomène délétère de p-hacking), où un analyste peu scrupuleux multiplierait les tirages aléatoires jusqu’à obtenir incidemment une p-valeur franchissant le seuil traditionnel de 0,05. La publication ouverte du code source SAS, incluant explicitement l’appel call streaminit(), permet aux évaluateurs indépendants de reconstruire exactement les jeux de données synthétiques, d’éprouver la robustesse des modèles multivariés et d’attester de la conformité méthodologique des résultats diffusés.
3.3 Implications opérationnelles de l’omission intentionnelle de la graine
S’il est généralement requis de figer le comportement du générateur pour garantir la reproductibilité des analyses, certaines situations méthodologiques justifient au contraire l’omission délibérée d’une graine statique. C’est particulièrement le cas lors de la passation de tests adaptatifs informatisés en temps réel ou de séances d’évaluation psychométrique où des candidats passent des épreuves certificatives successives dans une même salle informatique. Si une graine fixe était intégrée dans le code du logiciel d’administration, tous les participants recevraient la même séquence d’items de contrôle, favorisant la transmission frauduleuse d’informations entre les individus.
L’utilisation de l’horloge interne de la machine, activée par une graine nulle dans l’instruction call streaminit(0), produit alors une instanciation unique lors de chaque démarrage de session. Cependant, l’analyste doit être pleinement conscient des risques inhérents à cette flexibilité lorsqu’elle est appliquée par mégarde à la phase finale de traitement statistique. Si un jeu de données est généré dynamiquement sans conservation de la graine et que les résultats doivent être modifiés suite aux remarques d’un rapporteur de revue, il sera rigoureusement impossible de recréer l’échantillon exact, contraignant les auteurs à relancer l’ensemble de leurs calculs au risque d’altérer légèrement les estimations publiées.
4. Exemple 1 : Génération d’un nombre entier aléatoire unique
4.1 Décomposition syntaxique de l’étape Data élémentaire
Pour illustrer de manière concrète la mise en œuvre de ces principes au sein de l’environnement SAS, le premier cas d’étude aborde la création élémentaire d’un enregistrement contenant un nombre entier pseudo-aléatoire unique. Cette opération s’exécute au sein d’une étape DATA standard, structure de base de la manipulation d’informations sous SAS. L’instruction primordiale repose sur l’appel de la fonction rand(), au sein de laquelle le premier argument littéral doit impérativement spécifier la chaîne de caractères désignant la distribution souhaitée, en l’occurrence ‘integer’.
Contrairement aux lois continues qui modélisent des probabilités sur des intervalles réels infinis, la distribution discrète entière exige la définition explicite de ses limites numériques. Ainsi, la fonction prend deux paramètres numériques complémentaires : la borne inférieure inclusive et la borne supérieure inclusive. Pour générer un entier compris entre 1 et 10, la syntaxe prendra la forme : valeur = rand(‘integer’, 1, 10);. L’instruction explicite output; est ensuite convoquée afin d’écrire immédiatement l’enregistrement courant constitué dans le vecteur de travail (Program Data Vector ou PDV) vers la table de sortie SAS finale.
4.2 Analyse pas à pas de l’exécution séquentielle
L’exécution de cette séquence programmatique suit une logique déterministe rigoureuse que le statisticien doit maîtriser. Dans un premier temps, l’étape DATA initialise les vecteurs internes et alloue les espaces de stockage mémoire nécessaires. L’instruction call streaminit(1); est exécutée en tout premier lieu. Elle injecte la constante numérique 1 dans le registre interne du Mersenne Twister, fixant définitivement la trajectoire stochastique qui en découlera. Ensuite, la fonction rand() est évaluée une seule et unique fois pour alimenter la variable numérique désignée.
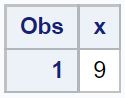
Compte tenu de la valeur d’ancrage spécifiée (la graine fixée à 1) et des bornes arithmétiques comprises entre 1 et 10, l’algorithme MT19937 transforme son état interne pour délivrer systématiquement la valeur entière 9. Ce résultat n’est en rien fortuit ni variable d’une machine à l’autre : toute installation SAS conforme, traitant cette instruction avec une graine initialisée à 1, produira invariablement ce même entier 9. Cette constance absolue confirme le respect des propriétés déterministes du générateur et atteste que la randomisation est maîtrisée de bout en bout par le programmeur.
4.3 Affichage et inspection clinique avec la procédure proc print
Une fois l’étape DATA compilée et exécutée avec succès, l’inspection de la table SAS résultante est effectuée à l’aide de la procédure universelle proc print. Cette procédure permet de visualiser directement le contenu du jeu de données dans la fenêtre de sortie ou le visualiseur de résultats. L’inspection des données permet de valider sur le plan empirique deux critères fondamentaux : d’une part, l’absence absolue de composante décimale, confirmant que le type de variable généré respecte strictement l’arithmétique discrète, et d’autre part, la stricte conformité de la valeur observée avec l’intervalle fermé défini en paramètre.
Dans la pratique des sciences psychologiques, ce tirage élémentaire d’un entier unique trouve une application directe et récurrente. Il permet, par exemple, de sélectionner aléatoirement un stimulus singulier parmi une banque fermée de matériel expérimental standardisé (par exemple, choisir une image cible parmi un répertoire d’images émotionnelles étalonnées de 1 à 10 pour amorcer une session expérimentale). La traçabilité de cette sélection permet au chercheur de justifier la neutralité du choix de l’amorce devant ses pairs lors de la restitution des observations cliniques.
5. Exemple 2 : Génération d’une variable contenant une série d’entiers aléatoires
5.1 Construction de boucles itératives do…to…end
Dans la quasi-totalité des investigations quantitatives, les besoins de simulation dépassent largement la simple génération d’une valeur isolée pour s’étendre à la constitution de séries volumineuses de données indépendantes. Pour accomplir cela sans recourir à des duplications de code redondantes, l’étape DATA de SAS mobilise la puissance de ses boucles itératives, matérialisées par la structure syntaxique do…to…end. Cette construction permet d’exécuter un bloc d’instructions de manière répétée un nombre prédéterminé de fois, contrôlé par un compteur incrémental.
Le point d’attention technique déterminant dans cette architecture réside dans le placement rigoureux de l’instruction output; à l’intérieur même du corps de la boucle itérative. À chaque itération de l’indice de boucle, la fonction rand() est invoquée pour calculer une nouvelle valeur stochastique, et l’instruction output transfère immédiatement l’état du vecteur de données vers la table cible sur disque. En fin de boucle, il est d’usage d’inclure l’option drop pour éliminer la variable d’indexation devenue inutile, évitant ainsi d’encombrer le schéma conceptuel de la table résultante avec des compteurs techniques transitoires.
5.2 Paramétrage d’un échantillon discret entre 1 et 20
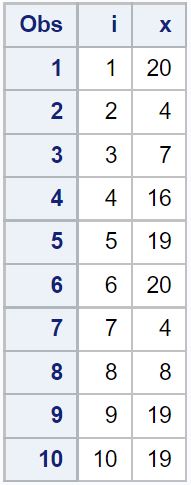
Pour illustrer ce second paradigme, considérons la génération d’une cohorte synthétique de dix observations successives, dont les valeurs doivent être des nombres entiers répartis aléatoirement entre 1 et 20. Dans le script SAS, l’instruction call streaminit(10); est appelée préalablement à l’entrée dans la boucle de traitement. Le choix de la constante 10 comme graine d’initialisation garantit que l’ensemble des dix valeurs générées séquentiellement sera immuable lors des exécutions futures du script.
Au fil des dix passages successifs dans la boucle, le générateur Mersenne Twister actualise continuellement son vecteur d’état à 624 dimensions, produisant une suite de dix nombres entiers qui oscillent harmonieusement entre les limites 1 et 20 sans jamais les franchir. L’inspection des fréquences au sein de ce sous-échantillon permet de constater une variabilité intrinsèque saine : certaines valeurs peuvent se répéter (tirage avec remise par défaut), tandis que d’autres ne sont pas observées, ce qui est strictement représentatif du comportement statistique d’un échantillon aléatoire de petite taille issu d’une population uniforme discrète.
5.3 Applications empiriques : assignation de sujets et tirages répétés
Ce mécanisme de tirage discret répété sous-tend une multitude d’applications méthodologiques dans les laboratoires de recherche comportementale. L’un des usages les plus fréquents consiste en l’assignation aléatoire de participants humains à une pluralité de conditions expérimentales distinctes. Si un protocole factoriel complexe implique la comparaison de vingt protocoles de remédiation cognitive distincts, la génération d’une suite d’entiers permet d’affecter au fil de l’eau chaque numéro d’inclusion d’un nouveau patient à son groupe de traitement respectif.
Cependant, l’analyste doit demeurer vigilant quant à la nature du tirage opéré : la fonction rand(‘integer’, min, max) modélise par essence un tirage avec remise, impliquant que la sélection d’un groupe pour un individu donné ne diminue aucunement la probabilité que les participants subséquents soient assignés au même groupe. Pour des cohortes restreintes, cela peut ponctuellement générer des déséquilibres d’effectifs entre les conditions expérimentales. Cette variabilité locale nécessite souvent le recours à des diagnostics de fréquences préliminaires afin d’évaluer l’impact potentiel d’une telle asymétrie sur la puissance des modèles d’analyse de variance ultérieurs.
6. Exemple 3 : Génération de données continues selon une distribution normale
6.1 Paramétrage de la distribution normale dans rand(‘Normal’)
Alors que les variables discrètes modélisent des dénombrements ou des identifiants catégoriels, l’immense majorité des traits psychologiques, des performances cognitives et des mesures physiologiques sont conceptualisés comme des variables continues. Dans ce registre, la distribution normale (ou loi de Gauss-Laplace) occupe une position hégémonique en raison du théorème central limite. SAS répond à cet impératif par l’intermédiaire du paramètre ‘Normal’ intégré au sein de la fonction universelle rand().
La syntaxe de base pour simuler une variable gaussienne s’énonce sous la forme : score = rand(‘Normal’, mu, sigma);, où mu représente l’espérance mathématique (la moyenne théorique de la population) et sigma l’écart-type théorique (définissant la dispersion des valeurs autour du centre de gravité). Sur le plan computationnel, SAS exécute en arrière-plan des transformations trigonométriques ou des algorithmes de rejet sophistiqués (tels que la méthode de Box-Muller ou la méthode de Ziggurat) pour convertir le flux uniforme primitif du Mersenne Twister en une distribution continue parfaitement conforme aux propriétés de la densité gaussienne.
6.2 Cas d’usage pratique : simulation de scores à une échelle psychologique
Pour ancrer cette syntaxe dans un cas concret de psychométrie empirique, envisageons la simulation d’un étalonnage normatif pour une épreuve d’évaluation du quotient intellectuel (QI) chez de jeunes adultes. Selon les standards psychométriques établis par les échelles de Wechsler, cette mesure continue est théoriquement calibrée pour présenter une moyenne générale de 100 points et un écart-type de 15 points au sein de la population générale saine. La génération d’un échantillon synthétique de 1000 participants virtuels s’obtient alors aisément en configurant la fonction rand(‘Normal’, 100, 15) dans une boucle itérative adéquate.
La création d’un tel jeu de données synthétiques s’avère particulièrement précieuse lors des phases de conception d’une recherche. Elle offre la possibilité de tester à blanc l’ensemble de la chaîne de traitement statistique, de concevoir les scripts d’analyse factorielle confirmatoire ou de modélisation par équations structurelles, et d’ajuster les fenêtres de tolérance logicielle avant même l’inclusion effective du premier patient humain. Dans certains cas, l’analyste appliquera un léger arrondi arithmétique ou une troncature aux bornes pour imiter fidèlement les contraintes des logiciels de passation clinique qui n’enregistrent que des scores entiers.
6.3 Validation de l’échantillon synthétique par proc means et proc univariate
La rigueur méthodologique impose de ne jamais utiliser des données simulées sans en vérifier au préalable l’intégrité distributionnelle empirique. Pour mener à bien cette vérification clinique sous SAS, les procédures analytiques proc means et proc univariate s’avèrent indispensables. La procédure proc means permet d’extraire rapidement les métriques descriptives fondamentales : la moyenne observée de l’échantillon simulé doit converger étroitement vers 100, et l’écart-type empirique vers 15, l’ampleur de l’écart résiduel n’étant gouvernée que par l’erreur d’échantillonnage inhérente à la taille n de la cohorte.
Pour un diagnostic plus exhaustif, la procédure proc univariate fournit l’estimation précise des moments d’ordre supérieur : le coefficient d’asymétrie (skewness), qui doit être statistiquement proche de zéro pour attester de la parfaite symétrie de la courbe, et le coefficient d’aplatissement (kurtosis), qui doit refléter l’allure mésokurtique caractéristique de la loi normale. En sollicitant l’option normal au sein de la procédure, SAS calcule automatiquement les tests de conformité formels, tels que le test de Shapiro-Wilk ou le test de Kolmogorov-Smirnov, apportant la confirmation statistique irréfutable que les données générées synthétiquement ne dévient pas de manière significative de l’idéal gaussien théorique.
7. Panorama des distributions probabilistes disponibles dans rand()
7.1 La loi uniforme : génération de probabilités et d’intervalles continus
Au-delà de la distribution normale et des entiers discrets, la fonction rand() offre un catalogue étendu de distributions théoriques. La première d’entre elles, fondamentale sur le plan théorique, est la distribution continue uniforme, invoquée par l’argument ‘Uniform’. Par défaut, cette fonction génère des valeurs réelles continues réparties de façon homogène sur l’intervalle semi-ouvert [0, 1). Elle constitue la brique élémentaire du calcul stochastique, chaque valeur pouvant être interprétée directement comme une probabilité cumulée.
Cette distribution uniforme s’avère particulièrement féconde lorsqu’on applique le théorème de la transformation intégrale de probabilité, ou méthode d’inversion. En composant l’inverse de la fonction de répartition d’une loi de probabilité arbitraire avec un tirage uniforme issu de rand(‘Uniform’), l’analyste peut générer des données selon des lois théoriques extrêmement complexes non nativement prises en charge. En outre, elle facilite l’assignation probabiliste pondérée au sein de plans expérimentaux asymétriques : il suffit de découper l’intervalle unitaire en segments proportionnels aux ratios d’allocation désirés pour distribuer les sujets selon des probabilités inégales.
7.2 La loi binomiale et multinomiale : modélisation de réponses discrètes
Dans l’évaluation clinique et la recherche psychométrique, de nombreux instruments de mesure recueillent des réponses catégorielles binaires (telles que succès versus échec à un item d’évaluation cognitive, présence ou absence d’un symptôme psychopathologique dans une grille diagnostique). Pour simuler de tels protocoles, SAS propose la distribution binomiale via le mot-clé ‘Binomial’. Cette fonction requiert la spécification de deux paramètres fondamentaux : la probabilité de succès associée à chaque essai élémentaire et le nombre total d’essais constitutifs de l’expérience de Bernoulli.
En fixant le nombre d’essais à 1, la fonction se comporte comme une distribution de Bernoulli pure, délivrant exclusivement des valeurs binaires 0 ou 1, parfaitement adaptée à la modélisation des réponses individuelles à des items dichotomiques de type vrai ou faux. Dans une perspective psychométrique avancée, ces paramètres peuvent être dynamiquement indexés sur le niveau de compétence latent du sujet simulé, selon les postulats de la théorie de réponse aux items (TRI). Pour les échelles d’attitudes de type Likert à plusieurs modalités ordonnées, des extensions combinant tirages uniformes et seuils de coupure cumulés permettent d’émuler avec fidélité des réponses multinomiales polytomiques.
7.3 Distributions asymétriques : Poisson, Exponentielle et Gamma
La réalité empirique des laboratoires de psychologie expérimentale et de neurosciences cognitives confronte fréquemment les chercheurs à des données manifestant une asymétrie positive marquée, incompatibles avec l’hypothèse de symétrie gaussienne. L’exemple paradigmatique est celui des temps de réaction motrice ou perceptuelle lors d’épreuves de détection chronométrées, où la présence d’une borne physiologique inférieure incompressible s’accompagne d’une longue traîne de réponses tardives. Pour modéliser de tels phénomènes chronométriques, SAS intègre des lois continues asymétriques majeures telles que la loi Exponentielle (‘Exponential’) et la loi Gamma (‘Gamma’).
D’autre part, lorsque l’objet d’étude concerne des variables de comptage d’événements rares survenus durant un laps de temps déterminé (par exemple, le nombre d’erreurs commises lors d’une tâche de vigilance soutenue ou le nombre d’intrusions mnésiques lors du rappel libre chez des patients amnésiques), la distribution de Poisson, paramétrée par ‘Poisson’, constitue l’outil de modélisation par excellence. En ajustant le paramètre lambda représentatif de l’intensité moyenne d’occurrence de l’événement, le chercheur synthétise des architectures de données reflétant rigoureusement la surdispersion ou la dispersion équivalente des comptages biologiques.
8. Randomisation avancée pour les protocoles expérimentaux en psychologie
8.1 Randomisation simple versus randomisation stratifiée par blocs
Dans le déploiement opérationnel d’essais comparatifs, le choix de la méthode d’assignation aléatoire conditionne la comparabilité des cohortes. Si la randomisation simple opérée par des tirages indépendants est conceptuellement élégante, elle expose le chercheur à un écueil méthodologique majeur dès lors que la taille de l’échantillon est restreinte : le risque de déséquilibre numérique marqué entre les bras expérimentaux. L’apparition d’un tel déséquilibre compromet l’équiprobabilité de l’échantillonnage et engendre une perte substantielle d’efficacité statistique lors de l’estimation des effets de traitement principaux.
Pour parer à cette vulnérabilité structurelle, les méthodologistes préconisent la randomisation stratifiée par blocs permutés. Sous SAS, cette architecture consiste à structurer le plan d’expérience en blocs homogènes de taille paire prédéfinie (par exemple, des blocs de 4, 6 ou 8 allocations) au sein desquels un équilibre parfait entre les conditions d’intervention est strictement préservé. En intégrant des covariables d’intérêt clinique (telles que les tranches d’âge, le sexe biologique ou la sévérité initiale de la pathologie mesurée par un score d’anxiété pré-test), le script génère des flux d’assignation distincts au sein de chaque strate, assurant une neutralité pronostique idéale entre les groupes.
8.2 Génération de permutations aléatoires sans répétition
Certains protocoles expérimentaux imposent l’administration d’une batterie complète d’épreuves à chaque participant selon un ordre intégralement contrebalancé, ou nécessitent l’échantillonnage sans remise d’un effectif fixe de stimuli parmi une base restreinte. Dans cette configuration, la génération élémentaire de nombres indépendants avec remise s’avère inopérante, car elle produirait inéluctablement des doublons et omettrait certaines conditions. La méthode la plus élégante et robuste sous SAS repose alors sur le paradigme du tri aléatoire.
Cette approche procédurale consiste à constituer une table contenant la liste exhaustive des éléments à permuter, puis à associer à chaque enregistrement une variable continue aléatoire issue de rand(‘Uniform’). L’exécution subséquente de la procédure proc sort ordonnant la table selon cette clé uniforme réalise une permutation pseudo-aléatoire parfaite et sans remise. Pour des architectures expérimentales encore plus complexes impliquant des plans factoriels fractionnaires ou des carrés latins équilibrés, le recours à la procédure spécialisée proc plan offre un contrôle syntaxique avancé sur l’équilibrage des séquences de passation.
8.3 Garantie du double aveugle et sécurisation des listes d’allocation
La validité interne d’une recherche thérapeutique ou comportementale dépend de l’imperméabilité des mécanismes assurant la conduite de l’expérience en double aveugle. Si les évaluateurs cliniques ou les participants eux-mêmes disposent du moindre indice leur permettant de deviner le bras d’allocation, des effets d’attente prophétique, d’effet placebo ou de biais d’évaluation risquent d’invalider irrémédiablement les conclusions de l’investigation. La phase computationnelle de génération des listes de randomisation sous SAS doit par conséquent intégrer des garde-fous de sécurisation stricts.
Dans la pratique clinique, le statisticien en charge du code de randomisation génère une table sécurisée où les modalités réelles d’intervention sont immédiatement remplacées par des codes alphanumériques cryptiques aléatoires. La correspondance formelle entre ces codes et la nature physique des traitements est séquestrée au sein d’une table d’association protégée, inaccessible aux équipes de terrain. L’exportation des bordereaux d’inclusion s’opère sous des formats non modifiables, garantissant que l’intégrité de la séquence ne sera altérée à aucun moment du processus de recrutement jusqu’au verrouillage définitif de la base de données et à la levée officielle de l’aveugle.
9. Simulations de Monte-Carlo pour l’estimation de la puissance statistique
9.1 Principes directeurs des simulations stochastiques en psychométrie
L’estimation conventionnelle de la puissance statistique a priori s’appuie fréquemment sur des formules analytiques fermées disponibles dans des progiciels spécialisés. Cependant, dès lors que l’architecture méthodologique intègre des modèles statistiques non standards, des mesures répétées non équilibrées, des structures de données hiérarchiques à plusieurs niveaux ou des violations manifestes des postulats de normalité, les formules mathématiques traditionnelles deviennent caduques. C’est dans ce contexte que les simulations de Monte-Carlo s’affirment comme l’approche analytique la plus puissante.
Le principe fondamental consiste à générer, par voie informatique, un nombre massif (couramment 10 000 ou 50 000 réplications) de jeux de données empiriques synthétiques reflétant avec exactitude la taille d’échantillon projetée et l’amplitude théorique de l’effet attendu sous l’hypothèse alternative. En ajustant le modèle statistique ciblé sur chacune de ces répliques et en observant la fréquence relative à laquelle la valeur p du test principal franchit le seuil conventionnel alpha (généralement 0,05), l’analyste obtient une estimation empirique extrêmement précise de la puissance statistique réelle associée au protocole envisagé.
9.2 Implémentation d’une boucle de simulation à grande échelle
L’implémentation opérationnelle d’un tel protocole sous SAS mobilise une architecture imbriquée au sein de l’étape DATA. Une première boucle extérieure itère sur le nombre total de simulations souhaitées, tandis qu’une seconde boucle intérieure engendre les observations individuelles composant chaque échantillon fictif. Pour maintenir des temps de calcul raisonnables lors du traitement de millions de lignes, une attention particulière doit être portée à l’optimisation des flux d’entrées/sorties : l’usage de tables temporaires logées dans la mémoire vive évite la saturation des disques durs.
L’étape computationnelle suivante réside dans l’automatisation de l’évaluation du modèle d’inférence statistique sur l’ensemble consolidé des jeux de données générés. Grâce à l’utilisation systématique de l’instruction by disponible au sein des procédures d’analyse de variance ou de régression linéaire (telles que proc glm, proc reg ou proc mixed), SAS est capable d’ajuster le modèle en série sur chacune des réplications indépendantes en une seule passe d’exécution, garantissant une efficience de traitement optimale pour les simulations d’envergure.
9.3 Extraction et agrégation des paramètres statistiques avec proc odstrace et ods output
L’exécution séquentielle d’analyses sur des dizaines de milliers de réplications générerait des volumes de rapports textuels totalement inexploitables si le logiciel tentait de les afficher visuellement. C’est ici qu’intervient le système de distribution des sorties de SAS, formalisé par l’Output Delivery System (ODS). En recourant préalablement à l’instruction ods trace on;, le programmeur identifie l’étiquette interne précise de la table de résultats générée par la procédure (par exemple, le tableau des tests d’hypothèses du modèle).
Une fois le nom de l’objet identifié, l’instruction ods output est convoquée pour intercepter directement ce tableau statistique et le rediriger vers une nouvelle table SAS de données consolidées, neutralisant l’affichage de l’ensemble des sorties graphiques ou textuelles à l’écran. Une ultime étape DATA ou un appel à proc means sur cette table d’agrégation permet de calculer la proportion exacte de réplications ayant rejeté l’hypothèse nulle, matérialisant ainsi la puissance statistique empirique du protocole, tout en traçant l’histogramme de la distribution d’échantillonnage de la taille d’effet estimée pour évaluer d’éventuels biais d’estimation asymptotiques.
10. Bonnes pratiques de programmation et pièges courants à éviter
10.1 L’erreur classique de la réinitialisation de la graine à l’intérieur d’une boucle
Parmi les anomalies conceptuelles fréquemment observées dans le code de chercheurs débutants, la mauvaise localisation de l’instruction d’initialisation de la graine constitue l’erreur la plus préjudiciable. Lorsqu’un analyste insère l’instruction call streaminit() à l’intérieur même du corps d’une boucle itérative au lieu de l’exécuter une unique fois en préambule, le générateur est brutalement forcé de réinitialiser son registre mémoire à chaque tour de boucle avec la même valeur d’ancrage initiale.
La conséquence statistique de cette maladresse est dévastatrice : la fonction rand() se retrouve contrainte de calculer systématiquement la toute première valeur de la séquence algorithmique à chaque itération. La table SAS résultante présente alors une variance purement nulle, répétant la même valeur numérique d’un bout à l’autre des observations générées. La règle d’ingénierie logicielle sous SAS est absolue et intangible : la routine call streaminit() doit toujours être appelée en amont des itérations génératrices afin de préserver la continuité du flux interne du générateur stochastique.
10.2 Optimisation des performances lors de la génération de données volumineuses
Lors de la manipulation de jeux de données massifs impliquant des millions d’enregistrements stochastiques ou lors du déploiement de rééchantillonnages par bootstrap intensif, les ressources computationnelles de la machine peuvent être rapidement saturées. L’optimisation du code SAS nécessite alors d’adopter des pratiques de programmation économes. La première mesure réside dans l’utilisation rigoureuse des instructions drop ou keep afin de purger le vecteur de données de toute variable intermédiaire inutile au calcul final, allégeant significativement l’empreinte mémoire de chaque observation.
D’autre part, la taille des tampons mémoire alloués aux transactions disque peut être ajustée via l’option système bufsize pour fluidifier l’écriture des fichiers générés. Enfin, lorsqu’un protocole nécessite la simulation simultanée de multiples variables corrélées ou d’une série chronologique d’items d’évaluation, l’utilisation de tableaux indicés en mémoire (les instructions array de SAS) permet d’effectuer les appels à la fonction rand() au sein de structures vectorielles compactes, minimisant considérablement le surcoût d’interprétation syntaxique lié à l’exécution de lignes d’assignation répétitives.
10.3 Modularité et réutilisabilité grâce aux macros SAS
Pour garantir la maintenabilité des protocoles de recherche et favoriser le partage d’outils analytiques au sein d’un laboratoire, l’encapsulation de la logique de génération stochastique au sein du langage de macro-commandes SAS représente une approche recommandée. Une macro paramétrée permet d’abstraire la complexité sous-jacente en acceptant en arguments formels le nom de la distribution désirée, les paramètres distributionnels centraux, la graine d’initialisation et l’effectif total de la cohorte d’étude à simuler.
Cette modularisation facilite grandement la reproductibilité des analyses en éliminant les risques d’erreurs de copier-coller au sein des scripts volumineux. En intégrant des tests de validation logique au sein de la macro (vérifiant par exemple que l’écart-type spécifié est strictement positif ou que les bornes discrètes sont cohérentes), le programmeur s’assure de l’intégrité des données produites. Cette documentation interne du code concourt à la pérennité des projets de recherche et assure une transférabilité immédiate des méthodologies computationnelles lors de l’intégration de nouveaux collaborateurs au sein de l’équipe scientifique.
11. Validation empirique et tests de diagnostic de l’aléa généré
11.1 Vérification statistique de la distribution avec le test du Khi-deux
La validation de la qualité d’une séquence de données pseudo-aléatoires ne doit pas reposer uniquement sur la confiance théorique accordée à l’algorithme : elle doit être attestée par des diagnostics statistiques formels appliqués sur l’échantillon effectif généré. Dans le cas de variables discrètes uniformes, telles que celles produites par l’argument ‘integer’, la démarche d’évaluation s’appuie traditionnellement sur le test d’adéquation du Khi-deux de Pearson, implémenté au travers de la procédure proc freq.
En sollicitant l’option chisq au sein de l’instruction tables, SAS compare la distribution des fréquences empiriques observées dans chaque classe discrète aux fréquences théoriques attendues sous l’hypothèse d’une équiprobabilité parfaite. L’inspection des résidus standardisés permet de localiser avec précision si certaines modalités ont fait l’objet d’une surreprésentation ou d’une sous-représentation anormale. L’obtention d’une p-valeur non significative confirme que les écarts constatés relèvent purement de la fluctuation d’échantillonnage légitime et atteste de la neutralité stochastique du tirage réalisé.
11.2 Détection d’autocorrélations résiduelles dans les séries générées
Un jeu de données aléatoires peut présenter des paramètres marginaux (moyenne, variance) impeccables tout en abritant des dépendances sérielles cachées, c’est-à-dire une corrélation entre la valeur générée à l’instant t et celle générée à l’instant t-1. L’existence d’une telle mémoire interne constituerait une altération méthodologique grave pour des protocoles expérimentaux simulant des séries chronologiques de vigilance cognitive ou d’essais comportementaux successifs, où chaque observation doit impérativement être indépendante de la précédente.
Pour s’assurer de l’absence d’autocorrélation résiduelle, l’analyste peut mobiliser la procédure proc autoreg en ajustant un modèle autorégressif d’ordre 1 sur la séquence chronologique générée. L’examen attentif de la statistique de Durbin-Watson, ainsi que des graphiques de la fonction d’autocorrélation (ACF) et d’autocorrélation partielle (PACF), offre une validation rigoureuse de l’indépendance sérielle. Une valeur de Durbin-Watson oscillant étroitement autour de 2,0 apporte la confirmation empirique formelle que la séquence produite est exempte de toute dérive inertielle ou cyclique au fil des tirages.
11.3 Diagnostic graphique à l’aide de proc sgplot
Bien que les indices numériques soient indispensables pour quantifier formellement la conformité statistique, l’inspection visuelle demeure une étape de diagnostic irremplaçable dans la boîte à outils du chercheur quantitatif. Sous SAS, la procédure graphique moderne proc sgplot offre un écosystème visuel de premier ordre pour évaluer d’un coup d’œil l’ajustement distributionnel d’une cohorte simulée. L’instruction histogram couplée à l’instruction density permet de superposer directement sur les données observées la courbe théorique de la loi ciblée.
Par ailleurs, la construction de diagrammes quantile-quantile (Q-Q plots) au travers de la procédure proc univariate permet de diagnostiquer avec acuité le comportement des valeurs extrêmes situées au niveau des queues de distribution, zones particulièrement vulnérables aux déformations algorithmiques. Enfin, la modélisation sous forme de nuages de points séquentiels permet de vérifier l’homogénéité de la dispersion spatiale à travers le temps d’exécution, garantissant l’absence de clusters de variance locaux qui pourraient biaiser l’analyse de sous-groupes séquentiels.
12. Synthèse méthodologique et recommandations pour la recherche empirique
12.1 Bilan comparatif des trois exemples fondamentaux
L’exploration détaillée des trois paradigmes de génération stochastique sous SAS met en lumière la cohérence et la modularité de la fonction universelle rand(). Le premier exemple, dédié au tirage d’un entier unique via ‘integer’, constitue la brique de base pour des décisions discrètes isolées, nécessitant une initialisation de graine mais s’affranchissant de toute structure de boucle complexe. Le deuxième exemple, étendant ce principe à une série discrète à l’aide d’une boucle do…to…end et d’instructions output itératives, incarne la matrice standard pour l’assignation de sujets expérimentaux à des groupes de traitement.
Enfin, le troisième exemple, mobilisant l’argument ‘Normal’ pour produire des trajectoires continues gaussiennes, représente le véhicule indispensable pour la création de cohortes psychométriques synthétiques et l’étalonnage d’échelles de mesure quantitatives. Le tableau conceptuel ci-dessous synthétise les propriétés opérationnelles de ces approches pour guider le chercheur dans ses arbitrages méthodologiques :
- Entier unique (‘integer’) : Structure élémentaire sans boucle, graine fixe recommandée, usage préférentiel pour la sélection d’un stimulus unique ou d’un amorçage expérimental.
- Série d’entiers discrets (‘integer’ + boucle DO) : Génération itérative de données bornées, graine fixe impérative, idéal pour la constitution de bras de randomisation simple avec remise.
- Données continues gaussiennes (‘Normal’ + boucle DO) : Modélisation de dimensions latentes d’intervalles infinis, calibrage via moyenne et écart-type théoriques, fondement des simulations de puissance et d’épreuves psychométriques.
12.2 Normes de rapportage scientifique selon les directives APA et STROBE
La communication publique des résultats issus de protocoles utilisant la randomisation ou la simulation stochastique est encadrée par des standards internationaux stricts, qu’il s’agisse des recommandations stylistiques de l’American Psychological Association (APA) ou des lignes directrices méthodologiques STROBE et CONSORT pour les études observationnelles et les essais cliniques. Les comités éditoriaux exigent désormais une transparence irréprochable quant aux conditions de génération des flux aléatoires.
Dans la section « Méthode » des manuscrits soumis à publication, les auteurs doivent explicitement documenter l’algorithme utilisé (par exemple, le générateur Mersenne Twister MT19937), la version spécifique du logiciel SAS déployée, ainsi que la valeur d’ancrage numérique (la graine) retenue pour initialiser la routine call streaminit(). Si la graine ne peut être divulguée publiquement pour des motifs de confidentialité ou de propriété industrielle, le protocole de conservation de la graine au sein d’un dépôt institutionnel sécurisé doit être mentionné. Enfin, toute restriction appliquée à la séquence aléatoire (blocs de randomisation, stratification par strates cliniques ou seuils de troncature) doit être exposée avec une clarté absolue pour permettre une réplication indépendante parfaite.
12.3 Perspectives sur les évolutions futures du calcul stochastique dans SAS
À mesure que la recherche empirique s’oriente vers l’analyse de jeux de données massifs (Big Data génomique, neuro-imagerie fonctionnelle à haute résolution spatiale, trajectoires comportementales issues d’objets connectés), les paradigmes computationnels de SAS évoluent pour répondre aux exigences de calcul haute performance. Au sein de la plateforme moderne SAS Viya, les routines de génération de nombres aléatoires ont été profondément restructurées pour opérer de manière totalement native au sein d’environnements distribués et multithreads massivement parallèles.
Cette parallélisation implique le déploiement de générateurs capables de fragmenter l’espace stochastique en sous-flux indépendants non chevauchants (streams et substreams), évitant tout goulot d’étranglement lié à la sérialisation des accès mémoire. Parallèlement, l’émergence des technologies de génération de données de synthèse destinées à la préservation de la vie privée ouvre des perspectives considérables : en combinant la simulation pseudo-aléatoire avancée et les techniques d’apprentissage profond, SAS permet désormais aux épidémiologistes de diffuser des jeux de données d’entraînement reproduisant à la perfection les covariations complexes de dossiers médicaux sensibles sans jamais révéler l’identité d’aucun patient réel. La maîtrise de l’aléa dans SAS s’affirme ainsi non seulement comme une compétence analytique fondamentale, mais comme une clé d’accès indispensable aux méthodologies d’investigation de demain.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Marsaglia, G. (1968). Random numbers fall mainly in the planes. Proceedings of the National Academy of Sciences, 61(1), 25–28. https://doi.org/10.1073/pnas.61.1.25
- Matsumoto, M., & Nishimura, T. (1998). Mersenne Twister: A 623-dimensionally equidistributed uniform pseudo-random number generator. ACM Transactions on Modeling and Computer Simulation, 8(1), 3–30. https://doi.org/10.1145/272991.272995
- SAS Institute Inc. (2021). SAS/STAT 15.2 User’s Guide. SAS Institute Inc. https://documentation.sas.com
- Schulz, K. F., Altman, D. G., & Moher, D. (2010). CONSORT 2010 Statement: Updated guidelines for reporting parallel group randomised trials. BMJ, 340, c332. https://doi.org/10.1136/bmj.c332
- Vandenbroucke, J. P., von Elm, E., Altman, D. G., Gøtzsche, P. C., Mulrow, C. D., Pocock, S. J., Poole, C., Schlesselman, J. J., & Egger, M. (2007). Strengthening the Reporting of Observational Studies in Epidemiology (STROBE): Explanation and elaboration. PLoS Medicine, 4(10), e297. https://doi.org/10.1371/journal.pmed.0040297
- Wicklin, R. (2013). Simulating Data with SAS. SAS Institute Inc.