
L’inférence statistique moderne repose sur une tension fondamentale entre deux paradigmes épistémologiques majeurs : la vision fréquentiste, qui appréhende la probabilité comme la limite asymptotique de la fréquence relative d’un événement au cours d’essais répétés à l’infini, et l’approche bayésienne, qui conçoit la probabilité comme la mesure quantitative d’un état de croyance ou d’un degré de certitude rationnel à l’égard d’une hypothèse donnée, conditionné par les données empiriques disponibles. Conceptualisé initialement par le révérend Thomas Bayes dans un mémoire posthume présenté en 1763 par Richard Price, puis formalisé indépendamment avec une rigueur mathématique éclatante par Pierre-Simon de Laplace en 1774, le théorème de Bayes constitue la pierre angulaire de l’épistémologie de l’actualisation des connaissances sous incertitude. Dans le champ contemporain des sciences cognitives, de la psychologie computationnelle, du diagnostic médical et de la science des données, ce théorème offre un cadre normatif incontournable permettant d’évaluer la rationalité des jugements humains et d’optimiser les architectures décisionnelles face à des signaux bruités ou incomplets.
Cependant, la beauté formelle du calcul des probabilités conditionnelles se heurte fréquemment à des obstacles pédagogiques et opérationnels substantiels. Les praticiens, chercheurs et cliniciens éprouvent souvent d’immenses difficultés à conceptualiser l’impact non linéaire des taux de base et des fonctions de vraisemblance sur la probabilité a posteriori finale. L’environnement logiciel de feuille de calcul Microsoft Excel, souvent relégué à tort à de simples fonctions de comptabilité d’entreprise ou d’archivage rudimentaire de données, s’avère en réalité être un outil de modélisation mathématique et matricielle d’une redoutable puissance didactique et computationnelle. Par sa transparence intrinsèque, où chaque étape intermédiaire d’un algorithme peut être rendue spatialement explicite dans un maillage de cellules interdépendantes, le tableur permet de démythifier la boîte noire algorithmique propre aux logiciels statistiques spécialisés et de concrétiser dynamiquement le moteur d’inférence bayésienne.
Ce guide méthodologique exhaustif a pour vocation de déconstruire, formaliser et implémenter le théorème de Bayes au sein de l’environnement matriciel d’Excel, depuis ses fondements théoriques les plus stricts jusqu’à ses déclinaisons psychométriques, multidimensionnelles et dynamiques les plus avancées. À travers un parcours analytique jalonné de démonstrations pas à pas, d’études de cas cliniques consacrées à l’évaluation diagnostique, de modélisations des biais cognitifs tels que la négligence du taux de base, et de simulations stochastiques par la méthode de Monte-Carlo, nous explorerons comment l’alliance de la logique bayésienne et de l’ingénierie des tableurs constitue un levier d’excellence pour l’analyse décisionnelle rigoureuse et la remédiation métacognitive.
1. Fondements épistémologiques et mathématiques du théorème de Bayes
1.1 Définition formelle des composantes bayésiennes
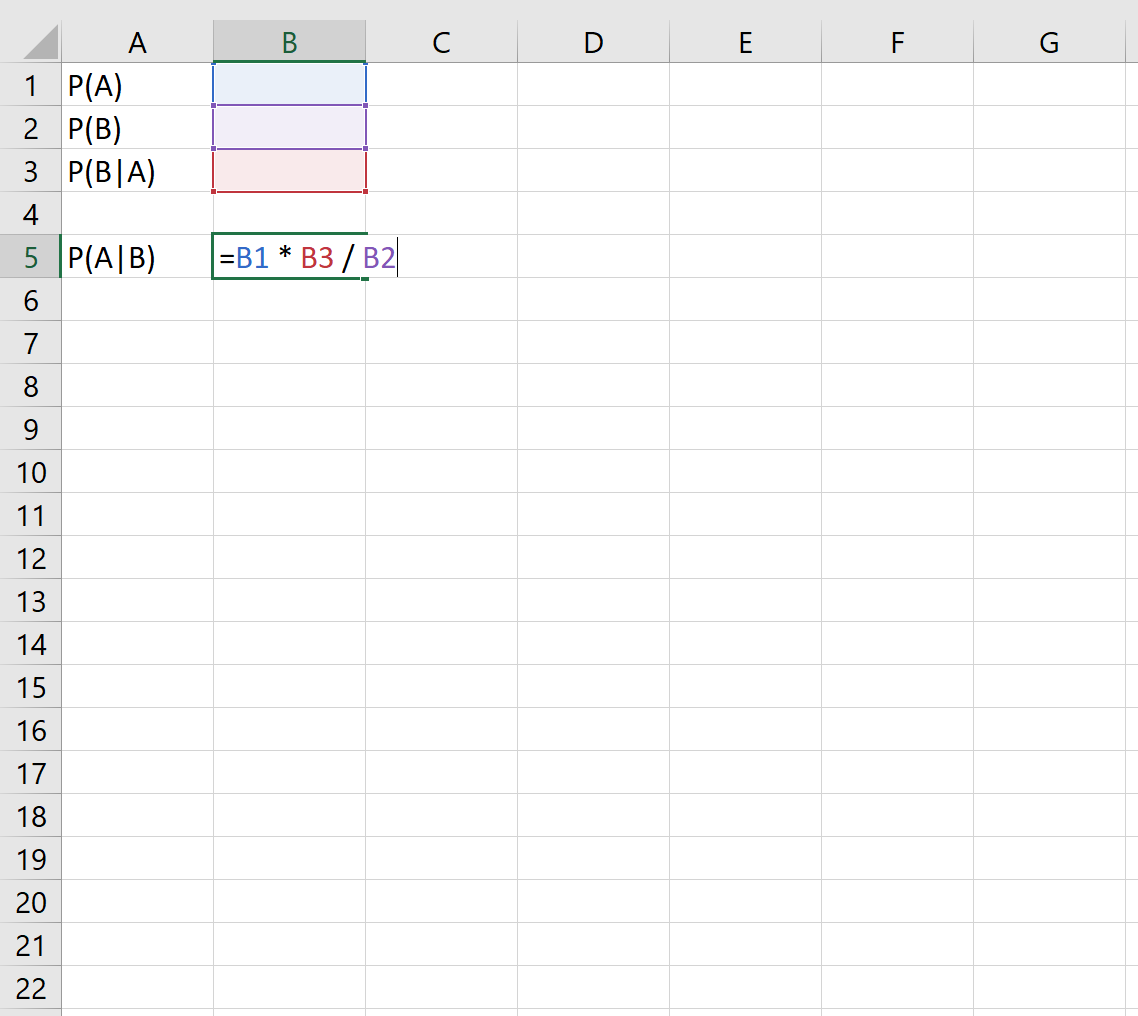
Le théorème de Bayes permet d’inverser rigoureusement les probabilités conditionnelles en liant la probabilité qu’une hypothèse théorique $A$ soit vérifiée sachant qu’un événement ou une preuve empirique $B$ a été observé. Mathématiquement, cette relation fondamentale s’énonce sous sa forme canonique :
$$P(A|B) = \frac{P(B|A) \times P(A)}{P(B)}$$
Pour appréhender la portée de cette équation, il est impératif d’élucider ses quatre constituants stochastiques distincts. En premier lieu, la probabilité a priori, désignée par $P(A)$, incarne le degré de croyance rationnel, la fréquence épidémiologique de base ou l’état d’information préalable relatif à la véracité de l’hypothèse $A$ avant toute observation empirique nouvelle. En inférence statistique, cette distribution a priori peut émaner de données historiques consolidées, de théories scientifiques préexistantes ou, dans un cadre purement subjectiviste, d’une quantification formelle de l’incertitude épistémique de l’analyste.
En second lieu, le terme $P(B|A)$ représente la vraisemblance conditionnelle (ou likelihood dans la littérature anglo-saxonne). Il quantifie la plausibilité d’observer précisément l’évidence empirique $B$ sous la condition expresse que l’hypothèse $A$ soit intrinsèquement vraie. La vraisemblance ne constitue pas une loi de probabilité sur $A$, mais plutôt une fonction qui évalue la capacité prédictive du modèle théorique à générer la donnée observée.
En troisième lieu, le dénominateur $P(B)$, fréquemment qualifié de probabilité marginale ou d’évidence globale, correspond à la probabilité inconditionnelle d’observer l’événement $B$, tous scénarios explicatifs confondus. Cette grandeur joue le rôle indispensable d’une constante normalisatrice, garantissant que la somme des probabilités de l’ensemble des hypothèses exhaustives et mutuellement exclusives demeure rigoureusement égale à l’unité.
Enfin, le résultat de cette opération, noté $P(A|B)$, est la probabilité a posteriori. Elle cristallise l’état actualisé de nos croyances concernant l’hypothèse $A$ une fois que l’évidence empirique $B$ a été intégrée au système. Le théorème de Bayes agit ainsi comme une véritable machinerie de mise à jour cybernétique de la certitude face à l’afflux d’informations nouvelles.
1.2 Pertinence du cadre bayésien en sciences cognitives et psychologie
Au-delà de son statut de théorème mathématique déduit des axiomes de Kolmogorov, le formalisme bayésien s’est imposé au cours des dernières décennies comme le paradigme théorique dominant en sciences cognitives pour modéliser le fonctionnement du système nerveux central et l’architecture de l’esprit humain. Sous l’impulsion des travaux sur le cerveau bayésien et le principe de l’énergie libre formalisé par des chercheurs tels que Karl Friston, le cerveau est désormais conceptualisé comme une machine d’inférence active. Le traitement perceptif n’est plus perçu comme une simple absorption passive de stimuli environnementaux ascendants (bottom-up), mais comme une intégration dynamique et optimale entre des prédictions descendantes formulées a priori (top-down priors) et des signaux sensoriels bruités formant la vraisemblance.
Parallèlement, la psychologie du jugement et de la décision, pionnière sous l’égide de Daniel Kahneman et Amos Tversky, a abondamment mobilisé la règle de Bayes comme étalon normatif de la rationalité délibérative. En comparant les estimations probabilistes intuitives formulées par des sujets humains aux prédictions mathématiquement rigoureuses fournies par le théorème de Bayes, les psychologues ont pu mettre en lumière des écarts systématiques et reproductibles, connus sous le nom de biais cognitifs ou heuristiques de jugement. L’évaluation expérimentale de la mise à jour des croyances individuelles permet de quantifier précisément l’amplitude de ces biais, qu’il s’agisse du conservatisme cognitif — où le décideur sous-actualise son prior face à une preuve probante — ou, à l’opposé, de la négligence spectaculaire du taux de base.
Dans les contextes d’incertitude informationnelle radicale, le cadre bayésien fournit une modélisation mathématique rigoureuse de la manière dont les représentations mentales évoluent. L’analyse bayésienne en psychologie expérimentale autorise ainsi la formalisation fine des processus d’apprentissage par renforcement, de la catégorisation conceptuelle et de la prise de décision diagnostique ou comportementale, en démontrant comment l’esprit navigue entre croyance initiale et impératif d’ajustement empirique.
1.3 Transition de l’algèbre des probabilités vers l’environnement matriciel d’Excel
Si la manipulation analytique du théorème de Bayes ne pose que peu de difficultés sur un plan théorique pour des variables aléatoires scalaires discrètes, la transposition de ces concepts dans un moteur de calcul informatique constitue une étape d’opérationnalisation déterminante. La transition depuis l’algèbre probabiliste abstraite vers l’environnement matriciel d’un tableur comme Excel s’avère particulièrement féconde. En effet, un espace de probabilités discret constitué de $k$ hypothèses s’assimile immédiatement à une structure vectorielle à une dimension, tandis que les relations de vraisemblance conditionnelle liant ces hypothèses à de multiples observations empiriques potentielles se projettent parfaitement sur une matrice à deux dimensions.
L’immense valeur didactique d’Excel réside dans l’abolition de la boîte noire algorithmique. Contrairement à un script exécuté de manière opaque dans une console de programmation fermée, le tableur oblige l’analyste à spatialiser ses concepts mathématiques : le vecteur des priors occupe une plage de cellules dédiée, la matrice de vraisemblance s’étend dans un bloc contigu, et la distribution marginale émerge d’un produit scalaire parfaitement traçable visuellement. Cette visibilité intégrale de l’arborescence calculatoire permet de désamorcer les intuitions erronées et de démystifier les mécanismes stochastiques sous-jacents.
De surcroît, l’automatisation dynamique offerte par les formules interactives d’Excel favorise l’expérimentation cognitive. En faisant varier un paramètre d’entrée au moyen d’un simple curseur ou d’une modification de valeur dans une cellule isolée, l’apprenant ou le chercheur observe en temps réel la redistribution instantanée des masses de probabilité a posteriori. Cette réactivité sensorielle immédiate transforme la formule mathématique en une expérience heuristique vivante, ancrant durablement la compréhension des lois de l’inférence rationnelle.
2. Décomposition conceptuelle des variables pour l’ingénierie dans Excel
2.1 Identification des paramètres d’entrée et formulation relationnelle
La réussite de l’implémentation du théorème de Bayes dans une feuille de calcul conditionne impérativement une rigueur méthodologique absolue dès la phase d’identification des variables. Une confusion fréquente chez les néophytes réside dans l’interversion pernicieuse entre l’hypothèse explicative sous-jacente — qui est non directement observable de manière immédiate — et la donnée empirique d’observation, qui constitue le signal mesuré. Il convient de formaliser sans ambiguïté l’ensemble des hypothèses alternatives exhaustives, généralement notées $H_1, H_2, dots, H_k$, formant une partition stricte de l’espace échantillonnal, ainsi que l’événement ou test observé $E$.
Sur le plan de la normalisation logicielle au sein d’Excel, toutes les probabilités doivent être déclarées et gérées nativement sous forme décimale comprise dans l’intervalle fermé $[0, 1]$, même si l’interface d’affichage est subséquemment configurée pour présenter ces données sous la forme visuelle de pourcentages avec deux ou plusieurs décimales de précision. L’introduction directe de fractions typographiques non calculées ou de valeurs entières arbitraires sans conversion préalable altère la validité structurelle des formules de calcul. Il est impératif d’intégrer des fonctions de vérification stochastique garantissant que l’inégalité suivante demeure scrupuleusement vérifiée pour toute cellule $C_i$ hébergeant une probabilité :
$$0 le C_i le 1$$
Toute déviation en deçà de zéro ou au-delà de un signale une distorsion structurelle du modèle stochastique sous-jacent, qui corromprait l’ensemble des ramifications algorithmiques de la feuille de calcul.
2.2 Architecture des cellules et typologie des références
L’implémentation computationnelle de la logique bayésienne requiert une architecture rigoureuse quant à la typologie des références cellulaires utilisées. La distinction fondamentale entre les références relatives, absolues et mixtes ne relève pas d’une simple convention stylistique, mais constitue la condition sine qua non de la robustesse et de la scalabilité de l’algorithme. Lors de la distribution de formules bayésiennes sur de multiples observations simultanées, les paramètres d’hypothèse fondamentaux — tels que les distributions a priori ou les taux de prévalence populationnels invariables — doivent être rigoureusement figés au moyen de références absolues (faisant intervenir le symbole dollar, par exemple $B$2).
À l’inverse, l’application de références relatives (telles que B5) est requise lorsque la formule doit parcourir itérativement les lignes d’un tableau contenant des distributions transversales de tests diagnostiques ou des jeux de données d’observations empiriques multiples. Cette stratégie permet le glissement vertical fluide des expressions mathématiques sans distorsion d’adressage.
Pour dépasser les limites inhérentes à l’opacité des coordonnées alphanumériques de type $B$4*$C$4/$D$6, il est hautement recommandé sur le plan académique et méthodologique de recourir à la définition explicite de plages nommées au sein du Gestionnaire de noms d’Excel. En assignant des identifiants sémantiques formels tels que Prior_H1, Vraisemblance_E_sachant_H1 ou Evidence_Marginale, l’expression algébrique encodée dans la cellule de restitution prend la forme élégante et transparente suivante :
=(Prior_H1 * Vraisemblance_E_sachant_H1) / Evidence_Marginale
Cette approche optimise drastiquement la lisibilité de la feuille de calcul, élimine les erreurs de ciblage lors de la maintenance du classeur et rapproche l’environnement d’Excel de la syntaxe déclarative des langages de programmation scientifique.
3. Structuration préalable et ergonomie d’une feuille de calcul bayésienne
3.1 Établissement du schéma fonctionnel du classeur
Une feuille de calcul bayésienne professionnelle ne doit en aucun cas présenter un enchevêtrement désordonné de données brutes et d’équations analytiques. Une ergonomie de modélisation optimale exige une segmentation spatiale stricte en trois blocs fonctionnels indépendants et clairement identifiés :
- Le bloc des paramètres d’entrée et hypothèses fondamentales : Cette zone regroupe exclusivement les variables exogènes du système. Elle héberge la probabilité a priori initiale de l’événement cible $P(A)$, les probabilités a priori des états alternatifs du monde $P(neg A)$ ou de la partition multinomiale complète, ainsi que les caractéristiques opérationnelles du capteur ou du test utilisé (les vraisemblances conditionnelles telles que la sensibilité $P(B|A)$ et le taux de faux positifs $P(B|neg A)$). Aucune formule computationnelle avancée ne doit résider dans ce secteur, à l’exception de calculs de complémentarité élémentaires.
- La zone dédiée aux calculs intermédiaires et d’évidence globale : Cet espace technique est voué à l’évaluation de la loi des probabilités totales. C’est ici que sont calculées les probabilités conjointes $P(A cap B)$ et $P(neg A cap B)$, qui matérialisent les intersections stochastiques entre les hypothèses et l’observation empirique. La somme de ces produits conjoints, constituant la probabilité marginale normalisatrice $P(B)$, y est établie de manière isolée et vérifiable.
- La section de restitution analytique des probabilités actualisées : Localisé idéalement dans la partie droite ou inférieure du classeur, ce bloc terminal affiche les grandeurs a posteriori finales $P(A|B)$ et $P(neg A|B)$. C’est cette zone qui accueille les indicateurs de synthèse, les visualisations graphiques synthétiques et les interprétations qualitatives destinées à orienter la prise de décision.
3.2 Application des règles de validation de données
La vulnérabilité majeure des classeurs d’aide à la décision statistique réside dans la vulnérabilité aux saisies aberrantes introduites par les utilisateurs finaux. Afin de sanctuariser l’intégrité formelle du moteur bayésien, il est impératif de configurer des restrictions strictes par l’intermédiaire de l’outil Validation des données d’Excel. Pour l’ensemble des cellules réservées à la saisie des probabilités élémentaires, la règle de validation doit imposer la saisie d’un nombre décimal restreint rigoureusement à l’intervalle compris entre un minimum de $0$ et un maximum de $1$.
De surcroît, lorsque le modèle implique une partition d’hypothèses complémentaires, une règle de validation personnalisée par formule doit être déployée sur la dernière cellule du bloc de manière à contraindre l’égalité unitaire. Par exemple, si la cellule B2 contient $P(A)$ et la cellule B3 contient $P(neg A)$, l’équation de validation personnalisée s’écrira :
=SOMME(B2:B3)=1
Pour accompagner ergonomiquement l’utilisateur et prévenir les blocages, chaque champ d’entrée doit être enrichi d’une infobulle didactique explicative (via l’onglet Message de saisie), précisant la nature de la grandeur attendue (par exemple : « Saisir la prévalence du trouble sous forme décimale entre 0 et 1 »). En cas de non-respect de ces contraintes axiomatiques, une alerte d’erreur bloquante de style « Arrêt » doit être configurée pour interdire immédiatement la poursuite de l’analyse tant que l’aberration n’a pas été corrigée.
3.3 Mise en page typographique et conventions d’étiquetage académique
La clarté cognitive d’un modèle statistique dépend étroitement de sa sémiologie graphique. Dans une démarche de rigueur académique, les en-têtes de colonnes et les libellés de lignes doivent impérativement abandonner les désignations profanes ou ambiguës au profit de la notation formelle du calcul des probabilités. Des étiquettes standardisées telles que P(H), P(E|H), P(E ∩ H) et P(H|E) doivent systématiquement structurer les grilles d’analyse.
Pour optimiser la lecture visuelle et la sécurité opérationnelle du document, il convient d’adopter un code couleur fonctionnel universel et standardisé :
- Teinte bleue pastel (Remplissage doux) : Réservée exclusivement aux cellules de saisie libre des paramètres exogènes (entrées brutes). Ce marquage signale à l’analyste les seules variables modifiables à sa convenance.
- Teinte grise neutre ou blanche : Affectée aux calculs intermédiaires structurels dont la modification manuelle est proscrite.
- Teinte verte ou jaune d’or douce : Dévolue aux résultats analytiques finaux (probabilités a posteriori et indices de décision diagnostique), concentrant l’attention décisionnelle de l’opérateur.
Enfin, la gouvernance du classeur impose une protection structurelle des cellules. Une fois les formules fondamentales de Bayes et de la loi des probabilités totales encodées, l’ensemble des cellules computationnelles doit être verrouillé (propriété Verrouillée activée dans le format de cellule), puis la feuille doit être protégée globalement, ne laissant accessibles à la sélection et à la modification que les seules cellules d’entrées brutes préalablement déverrouillées.
4. Formulation standard du théorème de Bayes dans Excel : Procédure pas à pas
4.1 Saisie des probabilités élémentaires selon le scénario météorologique
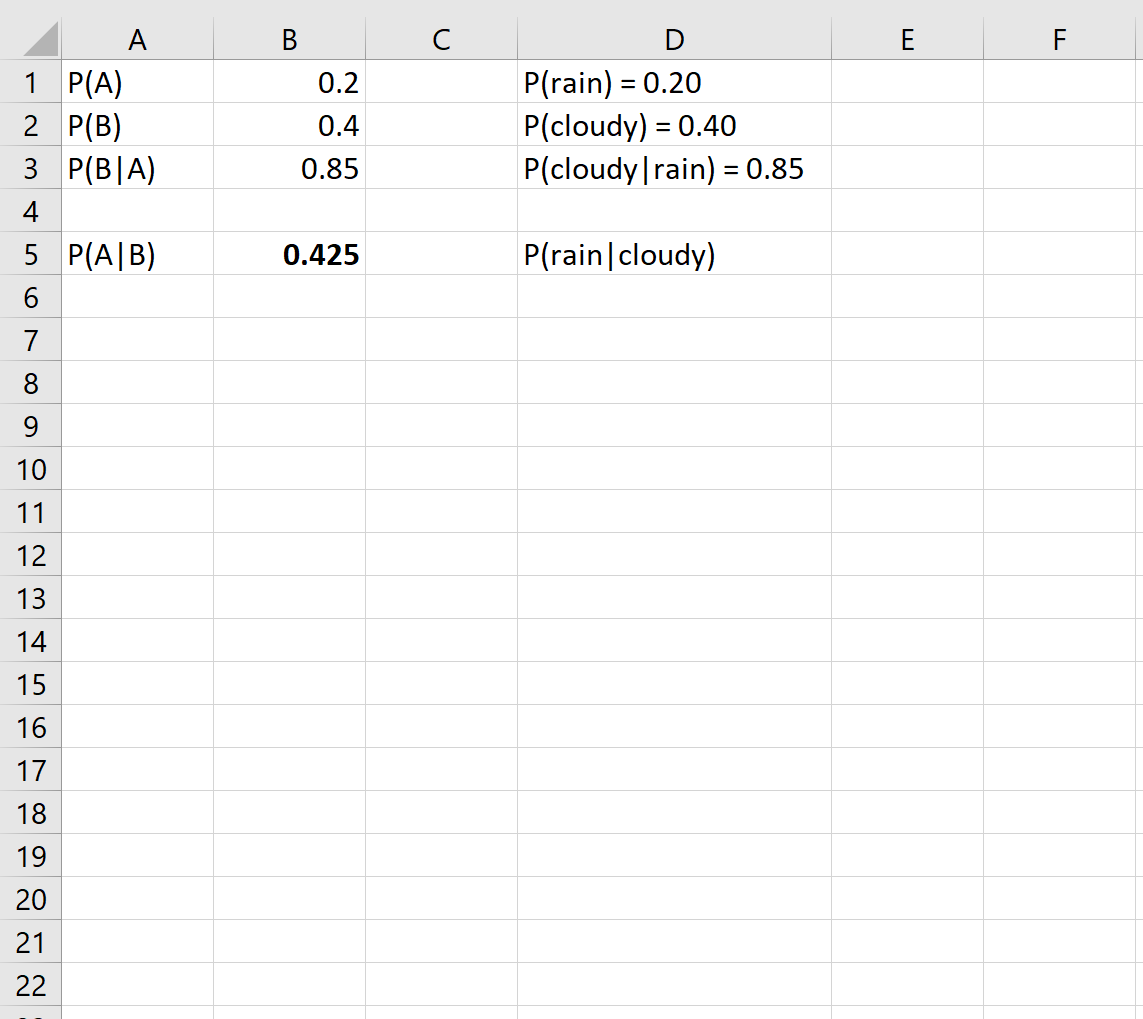
Afin de disséquer concrètement l’implémentation de la formulation standard du théorème de Bayes dans sa forme directe la plus simple, considérons le scénario d’école classique de l’analyse météorologique. Supposons que nous cherchions à déterminer la probabilité qu’il pleuve aujourd’hui (événement $A$, noté Pluie) sachant que nous observons un ciel particulièrement nuageux et couvert au réveil (événement $B$, noté Nuageux).
Dans une feuille de calcul Excel vierge, nous formalisons les cellules d’entrées élémentaires au sein de la plage B2:B4 de la façon suivante :
- En cellule
A2, inscrire le libelléProbabilité a priori de pluie : P(Pluie), puis en celluleB2, renseigner la valeur empirique décimale0,20(soit une prévalence de jours pluvieux de 20 % dans cette zone géographique). - En cellule
A3, inscrire le libelléVraisemblance empirique : P(Nuageux|Pluie), puis en celluleB3, saisir la valeur0,85(indiquant que lorsqu’il pleut effectivement, le ciel s’est avéré nuageux dans 85 % des cas répertoriés). - En cellule
A4, inscrire le libelléProbabilité marginale globale : P(Nuageux), puis en celluleB4, affecter la valeur d’évidence globale0,40(signifiant que, toutes conditions météorologiques confondues, 40 % de l’ensemble des matinées de l’année présentent un ciel nuageux).
Cette configuration isole rigoureusement l’hypothèse explicative d’intérêt ($A$ = Pluie) et le signal perceptif ou instrumental recueilli ($B$ = Nuageux).
4.2 Encodage de la formule multiplicative canonique
Une fois ces grandeurs primitives rigoureusement positionnées, l’encodage de la probabilité a posteriori conditionnelle $P(Pluie|Nuageux)$ s’opère dans une cellule de synthèse, par exemple la cellule B6, précédée en A6 du titre formel Probabilité actualisée : P(Pluie|Nuageux).
L’expression arithmétique combinant le numérateur et le dénominateur de l’équation bayésienne s’écrit scrupuleusement sous la syntaxe native d’Excel :
=(B2*B3)/B4
L’exécution computationnelle interne du tableur se déploie alors de la façon suivante :
- Calcul du numérateur représentant la probabilité conjointe $P(Pluie cap Nuageux)$ : la multiplication
B2*B3évalue le produit stochastique $0{,}20 \times 0{,}85$, générant la valeur transitoire $0{,}170$. Cela signifie que la confluence simultanée de la pluie et de la nébulosité survient dans 17 % des occurrences temporelles absolues. - Résolution de la division par l’évidence marginale : la fraction $0{,}170 / 0{,}40$ (soit la division de la valeur conjointe par le contenu de la cellule
B4) produit précisément le résultat décimal $0{,}425$.
La conformité du résultat numérique avec la valeur théorique attendue est ainsi vérifiée : la probabilité que la pluie survienne sachant la présence avérée de nuages s’élève à 42,5 %. Nous constatons matériellement l’actualisation bayésienne : la croyance initiale en la survenue de la pluie, qui n’était que de 20 % a priori, a plus que doublé sous l’effet probant de l’observation empirique de la nébulosité matinale.
4.3 Gestion de l’arrondi et présentation probabiliste rigoureuse
Un écueil méthodologique récurrent dans la pratique scientifique sous Excel réside dans la confusion pernicieuse entre l’arrondi d’affichage visuel et l’arrondi numérique de troncature. L’application directe du bouton de mise en forme de pourcentage de la barre d’outils d’Excel sur la cellule B6 ajuste la représentation graphique du nombre à l’écran (affichant par exemple 42,5% ou 43% selon le nombre de décimales spécifié), tout en préservant la précision native de calcul en virgule flottante double précision (conforme à la norme IEEE 754) dans le moteur sous-jacent du processeur.
Toutefois, dans le contexte de publications académiques ou de la conception de modèles décisionnels multi-étapes, il est parfois impératif de contrôler précisément l’impact de ces approximations numériques afin d’éviter la dérive stochastique lors des itérations en chaîne. Si un protocole expérimental requiert une troncature formelle, il convient de recourir expressément à la fonction ARRONDI :
=ARRONDI((B2*B3)/B4; 4)
Ce paramétrage garantit que la valeur numérique sous-jacente sera rigoureusement tronquée à quatre décimales (soit $0{,}4250$), interdisant toute divergence asymptotique résiduelle lors de la réinjection ultérieure de cette probabilité a posteriori comme probabilité a priori dans un cycle d’inférence séquentiel consécutif.
5. Modélisation computationnelle de la loi des probabilités totales
5.1 Décomposition du dénominateur d’évidence par partitionnement
Dans la réalité opérationnelle de l’analyse statistique et de la recherche empirique, la probabilité marginale inconditionnelle de l’évidence $P(B)$ est rarement connue d’emblée sous la forme d’une constante scalaire préexistante. Le plus souvent, elle doit être dérivée de manière endogène à partir de l’état complet du monde, par l’application rigoureuse de la loi des probabilités totales. Pour une hypothèse binaire $A$, l’espace probabilisé se partitionne de manière exhaustive entre l’hypothèse de travail $A$ et son hypothèse complémentaire (ou hypothèse nulle) notée $neg A$ (non-A).
Le dénominateur de Bayes se décompose alors selon l’expression suivante :
$$P(B) = P(B|A) \times P(A) + P(B|\neg A) \times P(\neg A)$$
Pour modéliser ce partitionnement dans Excel, supposons que nous disposions :
- En cellule
B2, de la probabilité a priori $P(A) = 0{,}05$. - En cellule
B3, du calcul automatique du complémentaire :=1-B2, qui retourne $0{,}95$ pour $P(neg A)$. - En cellule
C2, de la vraisemblance conditionnelle positive $P(B|A) = 0{,}90$. - En cellule
C3, de la vraisemblance conditionnelle sous l’hypothèse alternative ou taux de fausse alarme $P(B|\neg A) = 0{,}08$.
L’évidence marginale globale est alors formulée dans la cellule D4 par la sommation pondérée des deux branches probabilistes :
=(B2*C2)+(B3*C3)
Dans ce scénario numérique précis, le produit conjoint de la première branche s’élève à $0{,}05 \times 0{,}90 = 0{,}045$, tandis que celui de la seconde branche sous l’hypothèse complémentaire génère $0{,}95 \times 0{,}08 = 0{,}076$. La sommation totale confère à l’évidence marginale $P(B)$ la valeur exacte de $0{,}121$. On perçoit immédiatement ici comment une preuve empirique émerge majoritairement de la population saine ($0{,}076$) plutôt que de la population cible ($0{,}045$), en raison de la force asymétrique de la distribution a priori.
5.2 Exploitation de la fonction SOMMEPROD pour l’évidence agrégée
Lorsque le modèle bayésien se complexifie et que l’hypothèse centrale se ramifie en un continuum ou en une multiplicité d’états discrets, la concaténation manuelle d’opérations d’additions et de multiplications sous la forme (B2*C2)+(B3*C3)+...+(Bn*Cn) devient une source majeure d’erreurs d’encodage, de rigidité algorithmique et d’illisibilité syntaxique. La fonction la plus adaptée, la plus puissante et la plus élégante d’Excel pour synthétiser la loi des probabilités totales est sans conteste la fonction vectorielle SOMMEPROD.
En disposant la distribution des probabilités a priori de l’ensemble des états considérés dans un vecteur colonne vertical (par exemple la plage B2:B3) et l’ensemble des vraisemblances conditionnelles correspondantes dans un vecteur contigu de dimensions parfaitement identiques (la plage C2:C3), l’évidence globale $P(B)$ se calcule instantanément au moyen de l’équation vectorielle suivante :
=SOMMEPROD(B2:B3; C2:C3)
Cette formulation exécute algébriquement le produit scalaire des deux vecteurs :
$$\sum_{i=1}^{n} P(A_i) \times P(B|A_i)$$
Grâce à cette approche matricielle compacte, l’équation finale de la probabilité a posteriori hébergée dans la cellule E2 se trouve considérablement épurée :
=(B2*C2)/SOMMEPROD($B$2:$B$3; $C$2:$C$3)
La réduction drastique de la verbosité syntaxique qui en résulte permet d’étendre ultérieurement le classeur à des dizaines ou des centaines d’hypothèses alternatives par simple redimensionnement des bornes de la plage vectorielle, sans jamais altérer la structure intrinsèque de la formule de calcul.
5.3 Vérification automatisée de la cohérence stochastique
Un modèle probabiliste informatisé ne peut être considéré comme scientifiquement valide que s’il intègre ses propres garde-fous axiomatiques. Selon le premier et le deuxième axiome de Kolmogorov, toute probabilité est comprise entre zéro et un, et la somme des probabilités de l’ensemble des événements élémentaires constituant une partition de l’univers doit être rigoureusement égale à l’unité. Pour automatiser ce contrôle de cohérence stochastique au sein du tableur, il est impératif d’intégrer une cellule de balance algorithmique.
Cependant, en raison des limites inhérentes à la précision de l’arithmétique en virgule flottante des ordinateurs, une comparaison stricte de type SOMME(B2:B3)=1 peut parfois renvoyer une valeur logique FAUX erronée en raison de résidus d’arrondi infinitésimaux (de l’ordre de $10^{-16}$). Il convient par conséquent d’implémenter un test de tolérance epsilon au sein d’une fonction logique SI :
=SI(ABS(SOMME(B2:B3)-1) < 0,000001; "Distribution Cohérente"; "ERREUR : Somme stochastique ≠ 1")
Ce test vérifie formellement la complétude de la partition probabiliste. Couplée à une règle de mise en forme conditionnelle appliquant un remplissage rouge vif dès que l’alerte d’erreur est déclenchée, cette sentinelle computationnelle prévient toute tentative d’interprétation de données statistiques tronquées, lacunaires ou corrompues par une faute de frappe opérationnelle.
6. Application psychométrique : Calcul bayésien de diagnostic clinique
6.1 Formalisation des métriques cliniques : Sensibilité, spécificité et prévalence
Le diagnostic clinique, qu’il s’agisse de la détection de psychopathologies majeures en neuropsychologie (dépression clinique, troubles du spectre autistique, démence précoce de type Alzheimer) ou du dépistage virologique en santé publique, constitue le domaine d’élection de l’inférence bayésienne. L’évaluation de l’efficacité d’un outil psychométrique standardisé (inventaire de personnalité, test neuropsychologique informatisé) fait intervenir trois métriques canoniques qu’il s’agit de traduire fidèlement dans le vocabulaire probabiliste :
- La Prévalence ($P(M)$) : Elle quantifie la proportion réelle d’individus atteints de la pathologie mentale ou clinique au sein de la population de référence. En termes bayésiens, elle constitue la probabilité a priori absolue d’être malade avant toute passation de test d’évaluation.
- La Sensibilité ($Se = P(+|M)$) : Elle caractérise la capacité intrinsèque de l’instrument psychométrique à réagir positivement en présence avérée du trouble. Il s’agit de la vraisemblance empirique conditionnelle d’obtenir un résultat clinique positif (+) sachant que le patient présente effectivement la pathologie ciblée ($M$).
- La Spécificité ($Sp = P(-|neg M)$) : Elle mesure la propension de l’outil diagnostique à produire un résultat négatif (-) chez un individu rigoureusement indemne de la pathologie ($neg M$). Le taux de faux positifs, qui représente la vraisemblance conditionnelle d’obtenir un résultat positif trompeur chez un sujet sain ($P(+|neg M)$), est formellement défini par le complémentaire arithmétique de la spécificité, soit précisément : $1 – Sp$.
La structuration de ces grandeurs au sein d’une matrice Excel permet d’expliciter le comportement des tests cliniques bien au-delà des illusions d’infaillibilité fréquemment nourries par les praticiens.
6.2 Calcul de la valeur prédictive positive (VPP) dans le tableur
La question clinique fondamentale qui se pose au neuropsychologue ou au psychiatre face à un patient n’est absolument pas de savoir quelle est la sensibilité du test (propriété métrologique du réactif ou du questionnaire), mais bien : « Sachant que mon patient obtient un score positif au test, quelle est la probabilité réelle qu’il soit effectivement atteint de cette pathologie ? ». Cette grandeur correspond à la Valeur Prédictive Positive (VPP), formalisée sous la probabilité conditionnelle a posteriori $P(M|+)$.
Considérons l’agencement suivant dans une feuille de calcul dédiée :
- Cellule
B2: Prévalence de la pathologie, par exemple un trouble sévère rare touchant 1 individu sur 1000 :0,001. - Cellule
B3: Sensibilité du test psychométrique, supposée excellente à 99 % :0,99. - Cellule
B4: Spécificité du test, elle aussi remarquable à 95 % :0,95.
L’équation de la VPP selon le théorème de Bayes s’énonce formellement :
$$VPP = P(M|+) = \frac{P(+|M) \times P(M)}{P(+|M) \times P(M) + P(+|\neg M) \times P(\neg M)}$$
Dans la cellule de synthèse B6, nous implémentons l’expression Excel correspondante :
=(B3*B2) / ((B3*B2) + ((1-B4)*(1-B2)))
L’évaluation computationnelle de cette formule aboutit à un résultat stupéfiant pour l’intuition profane : la VPP générée n’est que de $0{,}0194$, soit un minuscule $1,94 %$. Bien que l’instrument psychométrique présente une sensibilité quasi-parfaite (99 %) et une spécificité très honorable (95 %), un individu testé positivement a en réalité moins de 2 chances sur 100 d’être effectivement atteint du trouble !
Ce paradoxe diagnostique découle mécaniquement de l’influence drastique du faible taux de base (la prévalence de $0{,}1 %$). Dans un échantillon théorique standardisé de 100 000 sujets, 100 individus sont réellement malades et 99 d’entre eux seront détectés positifs. En revanche, parmi les 99 900 sujets sains, le taux d’erreur de 5 % ($1 – 0{,}95$) générera pas moins de 4 995 faux positifs. L’épreuve bayésienne révèle ainsi un décalage vertigineux entre la perception intuitive de la fiabilité d’un test et sa vérité statistique effective, mettant en lumière le risque critique de surmédicalisation ou de stigmatisation psychologique découlant d’une lecture acritique des scores cliniques.
6.3 Calcul symétrique de la valeur prédictive négative (VPN)
À l’opposé de la démarche de confirmation nosologique, la pratique clinique requiert tout aussi fréquemment la capacité d’exclure formellement une pathologie lorsqu’un patient présente un score d’évaluation non significatif ou négatif (-). Cette capacité d’exclusion est quantifiée par la Valeur Prédictive Négative (VPN), qui représente la probabilité a posteriori que l’individu soit effectivement sain sachant que son résultat au test clinique est négatif : $P(neg M|-)$.
La formulation bayésienne de la VPN s’articule comme suit :
$$VPN = P(\neg M|-) = \frac{P(-|\neg M) \times P(\neg M)}{P(-|\neg M) \times P(\neg M) + P(-|M) \times P(M)}$$
Sachant que $P(-|neg M) = Sp$ et que la probabilité d’un faux négatif est le complémentaire de la sensibilité, à savoir $P(-|M) = 1 – Se$, l’encodage au sein de la cellule B7 de la feuille Excel s’exécute rigoureusement via la formule :
=(B4*(1-B2)) / ((B4*(1-B2)) + ((1-B3)*B2))
En reprenant les paramètres psychométriques de notre exemple clinique précédent, le calcul de la cellule B7 délivre la valeur de $0{,}999989$, soit un taux de certitude d’exclusion excédant $99,998 %$. L’analyse méthodologique croisée entre puissance d’affirmation et puissance d’exclusion s’avère ici particulièrement saisissante : en contexte de faible prévalence, un test diagnostique se révèle être un instrument d’exclusion d’une puissance absolue, tandis que sa puissance d’affirmation isolée demeure hautement contestable sans examens secondaires confirmatoires.
7. Généralisation à k hypothèses mutuellement exclusives et exhaustives
7.1 Construction d’une matrice multinomiale bayésienne
Le monde réel et les diagnostics différentiels complexes se limitent rarement à des alternatives dichotomiques simplistes. Un patient présentant un tableau clinique de déclin mnésique peut souffrir d’un vieillissement cognitif normal ($H_1$), d’un trouble cognitif léger d’étiologie vasculaire ($H_2$), d’une maladie d’Alzheimer débutante ($H_3$) ou d’une dépression pseudo-démentielle ($H_4$). Face à un ensemble de $k$ hypothèses constituant une partition stricte de l’espace d’états, le théorème de Bayes se généralise sous sa forme multinomiale :
$$P(H_i|E) = \frac{P(E|H_i) \times P(H_i)}{\sum_{j=1}^{k} P(E|H_j) \times P(H_j)}$$
Pour construire une matrice multinomiale bayésienne robuste et extensible au sein d’Excel, l’organisation spatiale s’opère selon une disposition tabulaire verticale ordonnée :
- Colonne A (États de la nature / Hypothèses) : Renseigner les identifiants $H_1, H_2, dots, H_k$ sur les lignes successives 2 à $k+1$.
- Colonne B (Distribution a priori) : Allouer la probabilité préalable $P(H_i)$ associée à chaque état, avec la contrainte absolue que
SOMME(B2:Bk+1)=1. - Colonne C (Vraisemblances conditionnelles) : Assigner pour chaque hypothèse la vraisemblance spécifique $P(E|H_i)$ d’observer le signal empirique $E$ (par exemple l’effondrement du score au test de rappel libre de Grober et Buschke).
Cette structure matricielle sépare distinctement les croyances préalables des caractéristiques d’observation empirique pour chaque trajectoire étiologique.
7.2 Calcul matriciel dynamique de l’actualisation bayésienne
Le moteur computationnel s’articule ensuite sur les colonnes adjacentes par le déploiement d’une chaîne de traitement arithmétique rigoureuse :
- Colonne D (Probabilités conjointes non normalisées) : En cellule
D2, inscrire l’équation du produit stochastique élémentaire :=B2*C2. Étendre cette formule par incrémentation verticale jusqu’à la ligne $k+1$. Cette colonne quantifie l’intersection probabiliste de chaque hypothèse avec la survenue du signal empirique : $P(E \cap H_i)$. - Cellule récapitulative d’évidence globale (Dénominateur normalisateur) : Dans une cellule dédiée en contrebas, par exemple
D$k+2$, sommer l’intégralité du vecteur des produits conjoints :=SOMME(D2:D$k+1$). Cette cellule matérialise l’évidence marginale globale $P(E)$ par partitionnement complet. - Colonne E (Distribution des probabilités a posteriori) : En cellule
E2, calculer la normalisation unitaire de l’hypothèse considérée en divisant son produit conjoint par l’évidence globale :=D2/$D$$k+$2. Noter l’usage indispensable d’une référence absolue sur le dénominateur normalisateur. Étendre cette formule verticalement jusqu’àE$k+1$.
Par cette séquence matricielle, le vecteur complet des probabilités a posteriori $P(H_i|E)$ se trouve généré de manière transparente, dynamique et recalculable instantanément à chaque variation des paramètres amont.
7.3 Validation de la conservation de masse de probabilité
La validation scientifique du modèle multinomial exige de vérifier que l’opération de division normalisatrice préserve scrupuleusement le principe fondamental de conservation de la masse probabiliste. Au bas de la colonne des probabilités a posteriori, en cellule E$k+2$, il convient d’encapsuler le contrôle formel :
=SOMME(E2:E$k+1$)
Le résultat doit afficher invariablement la valeur $1{,}000000$ (soit $100%$). Tout écart significatif trahit une troncature indue des états de la nature ou une discordance dimensionnelle dans les plages matricielles référencées.
Pour pousser la sophistication analytique à un niveau supérieur, il est particulièrement pertinent de monitorer la réduction d’incertitude induite par le signal $E$ au moyen de l’entropie informationnelle de Shannon. Dans une cellule dédiée, l’entropie résiduelle après observation de la preuve se calcule par la formule matricielle suivante :
=-SOMMEPROD(E2:E$k+1$; SI(E2:E$k+1$>0; LN(E2:E$k+1$); 0)) / LN(2)
Cette métrique, exprimée en bits (shannons), quantifie de manière rigoureuse le volume de doute résiduel au sein du système diagnostique. Une chute brutale de l’entropie entre la distribution a priori et la distribution a posteriori valide formellement la haute valeur informationnelle du test psychométrique administré.
8. Dynamisation du modèle bayésien via les fonctionnalités avancées d’Excel
8.1 Conversion en Tableaux Structurés dynamiques
L’utilisation de plages de cellules statiques classiques (telles que B2:D10) présente des vulnérabilités méthodologiques majeures lors de l’extension de modèles statistiques en cours d’expérimentation. Si un clinicien décide d’ajouter une cinquième ou une sixième hypothèse diagnostique différentielle à sa matrice, les formules traditionnelles doivent être manuellement réécrites ou réétendues, avec un risque critique de rupture d’adressage. La conversion immédiate de la plage de données en Tableau Structuré (via le raccourci clavier Ctrl + L ou l’onglet Insertion > Tableau) résout définitivement cet écueil.
En attribuant à la table le nom explicite Tableau_Bayes, les formules adoptent la syntaxe hautement lisible et auto-documentée des références structurées :
=[@Prior] * [@Vraisemblance]
Pour le calcul a posteriori normalisé au sein de la colonne dédiée, la formule s’énonce simplement :
=[@[Produit_Conjoint]] / SOMME([Produit_Conjoint])
L’avantage opérationnel est déterminant : toute insertion d’une nouvelle ligne d’hypothèse au sein du tableau déclenche l’héritage algorithmique automatique de l’ensemble des formules calculées, sans nécessiter la moindre intervention manuelle sur le code de calcul, éliminant de facto les erreurs de décalage de plage.
8.2 Formules matricielles dynamiques modernes et expansion automatique
Avec l’avènement des moteurs de calcul modernes d’Excel basés sur les formules matricielles dynamiques (gestion native du déversement ou spill), l’architecture des modèles bayésiens franchit un nouveau palier d’efficience et d’élégance conceptuelle. L’intégration de la fonction LET permet désormais d’encapsuler l’intégralité du calcul bayésien multinomial au sein d’une seule et unique formule maîtresse, éliminant le besoin d’allouer des colonnes physiques entières pour stocker les produits conjoints intermédiaires.
Supposons que le vecteur des priors soit stocké dans la plage B2:B5 et que le vecteur des vraisemblances conditionnelles soit localisé en C2:C5. Dans une unique cellule de destination (par exemple E2), l’analyste encode l’expression matricielle suivante :
=LET(Priors; B2:B5; Vraisemblances; C2:C5; Produits; Priors * Vraisemblances; Evidence; SOMME(Produits); Produits / Evidence)
Cette fonction assigne localement des variables internes (Priors, Vraisemblances, Produits, Evidence), procède aux multiplications vectorielles terme à terme dans la mémoire vive, effectue la sommation normalisatrice scalaire, et déverse (spills) automatiquement le vecteur résultant complet des probabilités a posteriori sur la hauteur adéquate. Cette modularisation interne garantit une vitesse computationnelle optimale, un allègement spectaculaire du poids du classeur et une immunisation absolue contre les altérations involontaires des formules intermédiaires par des utilisateurs tiers.
8.3 Intégration de listes déroulantes de scénarios diagnostiques
Pour conférer au modèle une dimension d’interface interactive professionnelle, il est hautement judicieux de découpler la matrice des données fondamentales du panneau de simulation clinique. La mise en œuvre d’un menu déroulant interactif permet au clinicien de sélectionner à la volée la nature exacte du symptôme ou du profil de biomarqueur observé, réactualisant instantanément la totalité des probabilités nosologiques.
Le protocole technique se déroule comme suit :
- Création d’une table d’observations potentielles répertoriant les différents signaux cliniques ($E_1$ = Score sous la norme, $E_2$ = Score dans la moyenne, $E_3$ = Score pathologique sévère).
- Définition d’une cellule de commande ergonomique (par exemple
G2) paramétrée via Validation des données > Liste, pointant vers les libellés de ces observations. - Couplage matriciel dynamique via la fonction
RECHERCHEXpour injecter automatiquement le bon vecteur de vraisemblances conditionnelles en fonction de la preuve sélectionnée :
=RECHERCHEX($G$2; Table_Signaux[Nom_Signal]; Table_Signaux[[Vraisemblance_H1]:[Vraisemblance_H4]])
Dès que le praticien sélectionne une modalité symptomatique différente dans la liste déroulante, le vecteur de vraisemblance est instantanément réassigné, déclenchant la réévaluation en cascade des produits conjoints et le recalibrage instantané de l’état des croyances a posteriori affichées sur le tableau de bord décisionnel.
9. Représentation visuelle des dynamiques bayésiennes dans Excel
9.1 Élaboration d’un arbre probabiliste graphique
Bien que l’arithmétique matricielle assure la précision des calculs, la transmission pédagogique des concepts bayésiens gagne immensément à être adossée à une schématisation géométrique et arborescente. L’arbre de décision probabiliste constitue l’outil visuel privilégié pour appréhender le flux de conditionnalité stochastique. Dans Excel, bien qu’il n’existe pas de graphique natif dédié exclusivement aux arbres stochastiques, une scénarisation rigoureuse sur la grille des cellules permet d’ériger des dendrogrammes d’une clarté exemplaire.
La trajectoire se ramifie méthodologiquement en trois niveaux structurels :
- Le nœud racine et les branches primaires : Partant d’un point initial commun, deux embranchements vectoriels se déploient, portant les probabilités marginales a priori $P(H)$ et $P(neg H)$.
- Les ramifications secondaires de conditionnalité : À l’extrémité de chaque branche primaire s’ouvrent deux nouvelles trajectoires, portant les vraisemblances conditionnelles relatives à la présence ou à l’absence du signal ($P(E|H)$, $P(neg E|H)$, $P(E|neg H)$ et $P(neg E|neg H)$).
- Les nœuds terminaux conjoints : À l’aboutissement de chaque chemin complet est positionnée la formule de probabilité conjointe correspondante (par exemple
=B2*C2).
En enrichissant ces embranchements d’outils de dessin vectoriel couplés aux valeurs des cellules par des formules de concaténation textuelle (du type ="P(E|H) = "&TEXTE(C2;"0,0%")), l’analyste dispose d’un modèle graphique auto-actualisé qui explicite visuellement pourquoi certains chemins marginaux supplantent numériquement les autres lors de la sommation au dénominateur.
9.2 Conception de graphiques comparatifs a priori versus a posteriori
Pour illustrer de manière percutante le saut qualitatif opéré par l’intégration de la preuve empirique, rien n’est plus efficace que la conception d’un histogramme groupé juxtaposant frontalement, pour chaque hypothèse du système, sa distribution préalable de croyance et son estimation actualisée. Cette comparaison graphique traduit matériellement la redistribution de la masse de probabilité dans le système.
Pour configurer ce graphique dans Excel :
- Sélectionner la plage contenant les libellés d’hypothèses en colonne A, la colonne des distributions a priori $P(H_i)$ et la colonne des probabilités a posteriori calculées $P(H_i|E)$.
- Insérer un Histogramme groupé 2D.
- Définir une sémiologie graphique contrastée : affecter une nuance de gris ou de bleu désaturé pour la série A priori, et une teinte bleue saturée ou ambrée pour la série A posteriori.
- Ajuster la superposition des séries à hauteur de $-20%$ et régler la largeur de l’intervalle à $80%$ afin de faciliter la lecture comparative directe.
Cette visualisation met immédiatement en relief le gain d’information conféré par l’observation empirique : l’hypothèse confortée voit sa barre s’élever verticalement au détriment des hypothèses concurrentes dont la masse s’effondre, offrant un support visuel immédiat pour argumenter un diagnostic devant une commission d’experts ou un collège de cliniciens.
9.3 Tracé des courbes d’actualisation en fonction de la force probante
L’une des manifestations les plus contre-intuitives de l’inférence bayésienne réside dans sa stricte non-linéarité. Pour l’illustrer de façon magistrale, il est possible de tracer des courbes dynamiques montrant la trajectoire de la probabilité a posteriori en fonction continue de la force probante du signal ou de la sensibilité du test. Ce tracé permet d’identifier graphiquement les zones de basculement diagnostique critique.
La démarche de modélisation sous Excel requiert la construction préalable d’une table d’échantillonnage vectorielle :
- Dans une colonne d’échelle (par exemple
X2:X102), générer une suite continue de sensibilités variant de $0{,}00$ à $1{,}00$ par incréments réguliers de $0{,}01$. - Dans la colonne adjacente
Y2:Y102, calculer la probabilité a posteriori correspondante en figeant rigoureusement la prévalence et la spécificité du modèle au moyen de références absolues :=(X2*$B$2)/((X2*$B$2)+((1-$B$4)*(1-$B$2))). - Insérer un graphique de type Nuage de points avec lignes lissées reliant la colonne X (Sensibilité) à la colonne Y (VPP résultante).
La courbe obtenue met en lumière l’inflexion sigmoidale typique du raisonnement stochastique : tant que la sensibilité ne franchit pas un seuil critique d’efficacité eu égard au bruit de fond des faux positifs, la probabilité a posteriori demeure enlisée à un niveau extrêmement bas, avant d’amorcer une ascension asymptotique abrupte vers la certitude. Ce type de graphique constitue une arme didactique majeure pour démontrer qu’une amélioration marginale d’un instrument de mesure peut, selon le positionnement sur la courbe, s’avérer soit totalement insignifiante, soit radicalement décisive pour la décision clinique.
10. Analyse de sensibilité et simulation de scénarios cognitifs
10.1 Mise en œuvre des tables de données à double entrée
Dans un contexte scientifique rigoureux, un résultat statistique ponctuel ne suffit pas : il est indispensable d’évaluer la robustesse paramétrique des inférences formulées face aux incertitudes entachant la mesure des paramètres d’entrée. Quelle serait la probabilité finale de diagnostic si la prévalence de la pathologie dans la population cible était en réalité de 2 % au lieu de 0,5 % ? Comment réagirait le modèle si la spécificité de l’examen chutait sous l’effet de variations inter-juges ? Excel propose un outil d’analyse décisionnelle exceptionnel pour répondre à ces interrogations : les Tables de données matricielles (issues du menu Données > Analyse de scénarios > Table de données).
Pour implémenter une table de sensibilité à double entrée croisant simultanément les fluctuations du taux de base (prior) et les variations de la force du test (spécificité) :
- Dans une nouvelle grille, disposer horizontalement en en-têtes de colonnes une série de taux de spécificité (par exemple de $0{,}90$ à $0{,}99$ par pas de $0{,}01$ de
F1àO1). - Disposer verticalement en en-têtes de lignes une séquence de taux de prévalence a priori (par exemple de $0{,}001$ à $0{,}050$ de
E2àE15). - À l’intersection supérieure gauche de la matrice, dans la cellule
E1, référencer l’équation centrale de la probabilité a posteriori :=B6. - Sélectionner l’ensemble de la plage matricielle
E1:O15. - Activer la fonction Table de données, assigner la cellule d’entrée de ligne à la spécificité (
$B$4) et la cellule d’entrée de colonne au prior ($B$2), puis valider.
Excel remplit instantanément l’intégralité des cellules de la matrice par substitution paramétrique itérative. En appliquant un dégradé de couleurs bicolore via la mise en forme conditionnelle, l’analyste identifie immédiatement d’un coup d’œil les zones critiques de forte volatilité stochastique, où de minuscules variations d’estimation initiale des paramètres suffisent à faire basculer le verdict clinique d’une certitude quasi-nulle à une conviction d’affirmation indiscutable.
10.2 Simulation stochastique par la méthode de Monte-Carlo
Dans les situations empiriques réelles, les paramètres d’un modèle bayésien ne sont jamais des constantes scalaires déterministes gravées dans le marbre, mais des variables aléatoires entachées d’erreurs d’échantillonnage, fréquemment distribuées selon des lois gaussiennes ou des lois Bêta. Pour quantifier la propagation stochastique de cette incertitude fondamentale vers la probabilité a posteriori finale, il est tout à fait possible d’implémenter un moteur de simulation de Monte-Carlo ultra-rapide au sein même d’Excel, sans requérir la moindre ligne de code VBA.
Le protocole algorithmique se déploie comme suit :
- Dans un tableau d’échantillonnage stochastique de 5 000 lignes, générer des distributions aléatoires du prior et de la sensibilité respectant leurs intervalles de confiance empiriques respectifs. Par exemple, pour un prior dont la moyenne expérimentale est $\mu = 0{,}10$ avec un écart-type $\sigma = 0{,}02$, générer en colonne A :
=LOI.NORMALE.INVERSE(ALEA(); 0,10; 0,02)
- Appliquer une formulation analogue en colonne B pour simuler la dispersion stochastique de la sensibilité et de la spécificité du test.
- En colonne C, calculer pour chacune des 5 000 lignes virtuelles la probabilité a posteriori résultante par l’application rigoureuse du théorème de Bayes.
Grâce à cette approche stochastique, l’estimation finale cesse d’être un point figé illusoire pour devenir une véritable distribution de crédibilité a posteriori. Dans des cellules de synthèse dédiées, l’analyste peut alors extraire la médiane empirique, mais surtout les bornes d’un intervalle de crédibilité bayésien à 95 % au moyen des fonctions statistiques d’Excel :
=CENTILE.EXCLURE(C2:C5001; 0,025) pour la borne inférieure, et :
=CENTILE.EXCLURE(C2:C5001; 0,975) pour la borne supérieure.
Cette méthodologie dote l’expérimentateur d’une métrique d’incertitude rigoureuse, indispensable à la publication de résultats scientifiques réplicables et intègres.
10.3 Utilisation du Gestionnaire de scénarios pour l’évaluation cognitive
Pour compléter l’analyse de sensibilité et calibrer des protocoles de prise de décision en situation de crise, Excel met à disposition son module de Gestionnaire de scénarios. Cet outil permet de cristalliser des ensembles cohérents de paramètres correspondant à des postulats épistémiques contrastés et de basculer instantanément d’une vision du monde à une autre.
L’expérimentateur configure typiquement trois scénarios décisionnels standardisés :
- Scénario 1 : Hypothèse pessimiste (Conservatrice) : Prévalence basse ($P(H) = 0{,}005$), sensibilité dégradée ($P(E|H) = 0{,}80$) et taux de faux positifs élevé ($P(E|\neg H) = 0{,}10$).
- Scénario 2 : Hypothèse réaliste (Médiane épidémiologique) : Prévalence nominale ($P(H) = 0{,}020$), sensibilité standard ($P(E|H) = 0{,}90$) et taux de faux positifs moyen ($P(E|\neg H) = 0{,}05$).
- Scénario 3 : Hypothèse optimiste (Haute spécificité) : Prévalence enrichie par présélection clinique ($P(H) = 0{,}100$), sensibilité optimale ($P(E|H) = 0{,}98$) et spécificité d’excellence ($P(E|\neg H) = 0{,}01$).
En générant automatiquement la Synthèse de scénarios sous la forme d’un tableau récapitulatif dynamique exporté sur une nouvelle feuille, le chercheur dispose d’une cartographie comparative limpide des issues de probabilité a posteriori. Cette vision globale met en évidence le conservatisme bayésien face aux distributions extrêmes et fournit un instrument précieux pour guider les choix stratégiques des comités de santé ou des jurys d’évaluation clinique.
11. Modélisation des distorsions cognitives et du raisonnement sous incertitude
11.1 Simulation de la négligence du taux de base
La contribution historique la plus célèbre des sciences cognitives à l’étude du raisonnement probabiliste est sans nul doute l’identification du biais de négligence du taux de base (base rate neglect), théorisé originellement par Daniel Kahneman et Amos Tversky dans leurs études séminales de 1973. Lorsqu’on leur soumet un problème d’inférence diagnostique, les sujets humains — qu’il s’agisse d’étudiants, d’officiers de justice ou de médecins chevronnés — ont une tendance cognitive systématique à focaliser quasi-exclusivement leur jugement sur la force du signal observé (la sensibilité de l’épreuve), en ignorant royalement la rareté statistique a priori de l’état considéré dans la population générale.
Excel offre un environnement exceptionnel pour modéliser mathématiquement cette distorsion de l’esprit humain et quantifier numériquement l’écart cognitif. Pour ce faire, nous construisons une cellule d’estimation intuitive naïve dans laquelle l’opérateur consigne le verdict probabiliste subjectif typiquement formulé par un praticien non formé :
Cellule H2 (Estimation intuitive) : =Sensibilite (soit souvent ~90%)
En miroir, la cellule $H_3$ calcule la probabilité rationnelle bayésienne authentique (la VPP, qui, comme nous l’avons démontré, s’établit par exemple à seulement $2%$). Dans la cellule adjacente, nous encodons un Indicateur de Distorsion Cognitive Numérique (IDCN) :
=(H2 - H3) / H3
Dans cet exemple, l’IDCN affiche un score vertigineux de $+4400%$, objectivant que l’évaluation subjective intuitive surestime la certitude rationnelle effective d’un facteur 45 ! La mise en exergue dynamique d’une telle aberration numérique au sein du tableur produit un choc cognitif salutaire chez les apprenants, détruisant instantanément l’illusion de rationalité non outillée.
11.2 Modélisation de l’heuristique de représentativité
L’origine psychologique fondamentale de la négligence du taux de base réside dans l’activation inconsciente de l’heuristique de représentativité. Face à un cas clinique ou à un profil d’observation $E$, le cerveau humain évalue la probabilité de l’hypothèse $H$ non pas sur la base des règles du calcul stochastique, mais en mesurant le degré de ressemblance typologique superficielle entre le signal $E$ et le stéréotype mental associé à $H$. Plus le signal semble représentatif de l’hypothèse, plus la vraisemblance conditionnelle $P(E|H)$ phagocyte le jugement, reléguant le prior $P(H)$ au rang de variable négligeable.
Pour modéliser l’impact délétère de cette heuristique sur l’actualisation des croyances dans Excel, nous introduisons un paramètre cognitif de pondération subjective $\omega$, compris entre 0 et 1, simulant l’ancrage mental de l’évaluateur :
- Si $\omega = 1$, le système se conforme rigoureusement à l’inférence rationnelle normative de Bayes.
- Si $\omega = 0$, le décideur sombre dans une représentativité pure et totale, ignorant intégralement le prior.
L’équation de la probabilité a posteriori pseudo-bayésienne déformée s’encode alors dans le tableur au moyen d’un prior altéré par exponentiation cognitive :
=LET(Prior_Ajuste; B2^omega; Conjoint; Prior_Ajuste * C2; Conjoint / (Conjoint + ((1-B2)^omega * (1-B4))))
En reliant le paramètre $\omega$ à une barre de défilement interactive (contrôle de formulaire Excel inséré directement sur la feuille), l’expérimentateur fait varier de façon continue le degré de rationalité du modèle. On observe alors en temps réel comment, à mesure que $\omega$ tend vers 0, le modèle subjectif dérive inexorablement vers la classification erronée et la surestimation massive des pathologies rarissimes, documentant mathématiquement la mécanique intime des erreurs de jugement médical.
11.3 Rôle d’Excel comme outil de remédiation cognitive
Loin d’être un simple instrument passif de constatation des défaillances de l’esprit humain, l’environnement logiciel Excel se révèle être un levier exceptionnel de remédiation métacognitive et de désensibilisation aux illusions décisionnelles. Les travaux pionniers menés par des psychologues de la cognition probabiliste tels que Gerd Gigerenzer ont irréfutablement démontré que l’esprit humain peine à traiter les probabilités formulées sous forme de pourcentages ou de fractions décimales normalisées (format dans lequel le cerveau n’a pas évolué au cours de la phylogenèse), mais s’avère en revanche remarquablement performant lorsqu’on lui présente les problèmes sous la forme de fréquences naturelles.
Le tableur excelle précisément dans la traduction instantanée et bidirectionnelle des données conditionnelles abstraites en représentations concrètes d’échantillons de population naturelle. En adjoignant systématiquement à la matrice bayésienne abstraite un bloc de conversion basé sur une cohorte standardisée (par exemple 1 000 ou 10 000 individus) :
- Cellule
K2: Population totale =1000. - Cellule
K3(Malades réels) :=K2*B2(ex: 10 individus). - Cellule
K4(Sains réels) :=K2*(1-B2)(ex: 990 individus). - Cellule
K5(Vrais Positifs) :=K3*B3(ex: 9 individus). - Cellule
K6(Faux Positifs) :=K4*(1-B4)(ex: 99 individus). - Cellule
K7(Formulation en fréquences naturelles) :="Sur 1 000 personnes testées positives, seuls "&TEXTE(K5;"0")&" sont malades sur un total de "&TEXTE(K5+K6;"0")&" tests positifs."
Cette transposition textuelle et fréquentielle dynamique désamorce instantanément l’illusion cognitive chez l’apprenant. En manipulant lui-même les curseurs d’Excel et en observant la redistribution tangible des individus au sein des cohortes numériques, le décideur calibre durablement son intuition statistique et acquiert une véritable résilience réflexive face aux pièges de l’incertitude.
12. Audit méthodologique, contrôle de cohérence et robustesse du classeur
12.1 Prévention et traitement des erreurs de calcul dans Excel
La conception d’un classeur bayésien destiné à un déploiement académique, clinique ou institutionnel impose une tolérance zéro vis-à-vis des défaillances algorithmiques ou des codes d’erreur informatiques natifs d’Excel. L’anomalie la plus critique et la plus fréquemment rencontrée dans les moteurs d’actualisation stochastique est le message d’erreur d’interruption #DIV/0!, qui survient inévitablement lorsque le dénominateur de l’évidence marginale $P(B)$ devient strictement nul.
Cette situation limite n’est pas qu’une simple anomalie logicielle : sur le plan épistémologique, elle signale l’observation d’un événement rigoureusement impossible sous l’ensemble des hypothèses théoriques convoquées. Pour immuniser la structure calculatoire contre ces ruptures d’exécution sans dénaturer le modèle, il est obligatoire d’encapsuler les équations de probabilité a posteriori au sein de fonctions protectrices SIERREUR :
=SIERREUR((B2*C2)/$D$4; 0)
Par ailleurs, lorsque l’évidence marginale tend asymptotiquement vers zéro (par exemple lors de l’observation d’une séquence de biomarqueurs hautement improbables flirtant avec les limites de la précision machine de $10^{-308}$), il convient de prévoir un mécanisme d’interception algorithmique évitant les instabilités d’arrondi :
=SI($D$4 < 0,0000000001; "Évidence marginale infinitésimale : Risque d'instabilité"; (B2*C2)/$D$4)
Cette approche défensive sanctuarise le classeur et garantit qu’aucune valeur indéterminée ne vienne corrompre les feuilles de calcul interdépendantes en cascade.
12.2 Outils d’audit des formules et traçabilité algorithmique
Pour assurer la stricte reproductibilité scientifique d’un modèle bayésien et faciliter son audit méthodologique par des tiers évaluateurs, il est indispensable de maîtriser les fonctionnalités d’inspection avancées logées dans l’onglet Formules d’Excel. Deux fonctionnalités natives jouent un rôle pivot dans la vérification de l’intégrité matricielle :
- Le mode Repérer les antécédents et Repérer les dépendants : Cette commande déploie des traceurs graphiques vectoriels (flèches bleues de dépendance) traversant visuellement la feuille de calcul. Elle permet de certifier immédiatement que la cellule hébergeant l’évidence globale $P(B)$ capture rigoureusement l’ensemble des branches du partitionnement sans aucune omission d’état ou, inversement, sans double comptage d’un même terme stochastique.
- La commande Évaluer la formule (Pas à pas) : Ce débogueur interne ouvre une boîte de dialogue interactive permettant de décomposer séquentiellement chaque sous-segment d’une équation complexe. L’analyste observe pas à pas l’évaluation du produit scalaire, la substitution des plages nommées par leurs valeurs scalaires temporaires et la résolution finale de la fraction, une procédure inestimable pour débusquer les éventuelles erreurs de précédence d’opérateurs arithmétiques.
De surcroît, la traçabilité documentaire impose de consigner, en regard de chaque cellule d’hypothèse source, les identifiants DOI ou les références bibliographiques précises des études épidémiologiques ayant fourni les valeurs de sensibilité et de prévalence utilisées, transformant la feuille Excel en une véritable pièce d’archive scientifique vérifiable.
12.3 Bonnes pratiques de gouvernance et de déploiement des modèles
L’étape terminale d’un projet d’ingénierie statistique dans Excel réside dans sa gouvernance opérationnelle. Un classeur non sécurisé est voué à une corruption rapide de ses équations au gré des manipulations quotidiennes non expertes. Les règles de l’art du déploiement logiciel d’un modèle bayésien exigent le respect de plusieurs jalons stricts :
- Verrouillage structurel par mot de passe : L’ensemble des cellules de formules, des matrices intermédiaires et des indicateurs de vérification doivent être verrouillées, puis la feuille entière doit faire l’objet d’une protection par mot de passe rigoureuse (via Révision > Protéger la feuille), n’autorisant la saisie que dans les seules cellules d’entrées déverrouillées en amont.
- Établissement d’une feuille d’accueil et de métadonnées (README) : Le classeur doit impérativement s’ouvrir sur un onglet inaugural détaillant le modèle conceptuel formel déployé, la version logicielle minimale requise (par exemple Microsoft 365 pour les fonctions matricielles dynamiques), l’identité des concepteurs, la date de dernière calibration et l’historique exhaustif des révisions algorithmiques.
- Standardisation des protocoles d’exportation : Pour une intégration fluide dans des dossiers de synthèse médicale ou des rapports psychométriques normalisés, le classeur doit intégrer une zone d’impression prédéfinie et optimisée, exportable en PDF non modifiable en un simple clic, garantissant que les conclusions de l’inférence bayésienne soient transmises sans ambiguïté aux professionnels de terrain et aux comités décisionnels.
En observant ces protocoles d’ingénierie logicielle et de rigueur statistique, le tableur Excel s’émancipe de son statut d’outil bureautique de base pour s’ériger en une plateforme computationnelle d’une fiabilité absolue, digne des plus hauts standards de la recherche empirique et de l’aide à la décision clinique.
Références
- Bayes, T. (1763). An essay towards solving a problem in the doctrine of chances. Philosophical Transactions of the Royal Society of London, 53, 370–418. https://doi.org/10.1098/rstl.1763.0053
- Friston, K. (2010). The free-energy principle: A unified brain theory?. Nature Reviews Neuroscience, 11(2), 127–138. https://doi.org/10.1038/nrn2787
- Gigerenzer, G., & Hoffrage, U. (1995). How to improve Bayesian reasoning without instruction: Frequency formats. Psychological Review, 102(4), 684–704. https://doi.org/10.1037/0033-295X.102.4.684
- Gigerenzer, G., Gaissmaier, W., Kurz-Milcke, E., Schwartz, L. M., & Woloshin, S. (2008). Helping doctors and patients make sense of health statistics. Psychological Science in the Public Interest, 8(2), 53–96. https://doi.org/10.1111/j.1539-6053.2008.00033.x
- Jaynes, E. T. (2003). Probability theory: The logic of science. Cambridge University Press. https://doi.org/10.1017/CBO9780511790423
- Kahneman, D., & Tversky, A. (1973). On the psychology of prediction. Psychological Review, 80(4), 237–251. https://doi.org/10.1037/h0034747
- Laplace, P.-S. (1774). Mémoire sur la probabilité des causes par les événements. Mémoires de Mathématique et de Physique Présentés à l’Académie Royale des Sciences, 6, 621–656.
- Tversky, A., & Kahneman, D. (1974). Judgment under uncertainty: Heuristics and biases. Science, 185(4157), 1124–1131. https://doi.org/10.1126/science.185.4157.1124