
Dans le domaine de l’analyse de données contemporaine et de la communication scientifique, la visualisation graphique ne constitue pas un simple artifice d’illustration, mais s’affirme comme une composante intrinsèque du raisonnement inférentiel. Au sein de l’écosystème du langage R, la bibliothèque ggplot2, conçue par Hadley Wickham sur les fondations théoriques posées par Leland Wilkinson, s’est imposée comme le standard de référence pour la production de figures analytiques de haut niveau. Toutefois, la maîtrise de cet outil exige une compréhension fine de ses mécanismes sous-jacents, particulièrement lorsqu’il s’agit de moduler des propriétés visuelles fondamentales telles que l’épaisseur des tracés. L’épaisseur d’une ligne graphique dépasse la simple décision cosmétique : elle conditionne directement l’efficacité sémiotique du message, guide l’attention pré-attentionnelle du lecteur et véhicule des hiérarchies quantitatives ou qualitatives complexes.
Pendant de nombreuses années, la manipulation de la dimension des segments linéaires reposait sur l’argument générique size. Cette approche, bien qu’intuitive, souffrait d’une ambiguïté conceptuelle majeure en traitant de manière indifférenciée les primitives ponctuelles bidimensionnelles et les éléments purement linéaires unidimensionnels. La mise à jour structurelle introduite avec la version 3.4.0 de ggplot2 a profondément redéfini ce paradigme en introduisant formellement l’argument linewidth. Cette scission technique, loin d’être une simple lubie sémantique, répond à des impératifs rigoureux de précision géométrique, de normalisation vectorielle et de fidélité lors de l’exportation des rendus graphiques dans des résolutions destinées aux publications académiques internationales.
L’objectif de cette monographie exhaustive est d’explorer l’ensemble des dimensions théoriques, syntaxiques, psychophysiques et méthodologiques liées au réglage de l’épaisseur des lignes dans ggplot2. À travers une démarche progressive et didactique, nous aborderons la transition technique vers linewidth, les principes de la perception visuelle humaine appliqués aux sciences des données, les stratégies de mappage esthétique dynamique, ainsi que la configuration avancée des composantes non liées aux données via le système de thèmes. Enfin, une étude de cas neuropsychologique approfondie viendra illustrer la mise en application concrète de ces principes pour répondre aux normes éditoriales les plus strictes, telles que celles prescrites par l’American Psychological Association.
1. Fondements théoriques et syntaxiques du tracé de lignes dans ggplot2
1.1 La grammaire des graphiques appliquée aux données longitudinales
La formalisation théorique introduite par Leland Wilkinson dans son ouvrage fondateur The Grammar of Graphics postule qu’un graphique statistique n’est pas une simple collection de points et de traits dessinés sur un canevas, mais une composition formelle constituée de couches sémantiques interconnectées. Dans cette architecture, reprise et popularisée par Hadley Wickham, la création d’un artefact visuel repose sur l’articulation méthodique d’un jeu de données, d’un système de coordonnées, d’échelles de transformation et d’objets géométriques nommés geoms. Lorsqu’il s’agit de traiter des données longitudinales, qui capturent l’évolution temporelle de variables mesurées de manière répétée chez des entités individuelles, l’objet géométrique geom_line() occupe une position centrale. Sa fonction sémiotique consiste à matérialiser la continuité temporelle ou séquentielle en reliant des coordonnées cartésiennes discrètes par des segments rectilignes continus.
Dans ce contexte, la distinction entre attributs esthétiques statiques et mappages dynamiques représente la pierre angulaire de l’ensemble de la grammaire. Un attribut statique est une constante géométrique assignée uniformément à une couche graphique pour en dicter l’apparence physique globale, sans lien direct avec les valeurs prises par une variable empirique. À l’inverse, un mappage esthétique dynamique, formalisé par la fonction aes(), établit une fonction bijective entre l’espace des données statistiques et l’espace perceptif du graphique. Comprendre cette dichotomie est impératif : décider de l’épaisseur d’une ligne peut relever soit d’une volonté d’harmonisation typographique et de lisibilité absolue, soit de l’encodage délibéré d’une dimension supplémentaire de l’information, telle que la certitude statistique, le volume d’échantillonnage ou la magnitude d’un paramètre expérimental.
1.2 Structure du jeu de données psychologiques pour geom_line
L’opérationnalisation correcte d’un tracé linéaire sous ggplot2 exige une structure de données rigoureusement alignée sur les principes du format ordonné, communément désigné sous l’anglicisme tidy data. Dans ce paradigme organisationnel, chaque variable observée doit résider dans sa propre colonne, chaque observation temporelle ou expérimentale distincte doit occuper une ligne unique, et chaque unité observationnelle doit être clairement individualisée. Dans les protocoles de recherche en psychologie cognitive ou clinique, les données sont fréquemment recueillies sous une disposition large où les sessions de test successives (par exemple, pré-test, post-test, et suivi à six mois) sont juxtaposées horizontalement. Pour permettre l’exploitation par geom_line(), ces matrices doivent impérativement faire l’objet d’un pivotement longitudinal afin de générer une variable temporelle explicite et une variable de réponse continue.
L’omission d’une déclaration structurelle adéquate du groupement constitue l’une des sources d’erreurs les plus prégnantes lors de l’usage de geom_line(). Lorsque plusieurs trajectoires individuelles sont mesurées à travers les mêmes intervalles temporels, le moteur de rendu graphique tente par défaut de relier l’ensemble des points d’une même abscisse selon l’ordre d’apparition des lignes dans la table de données, produisant un tracé erratique en dents de scie totalement dénué de cohérence scientifique. L’attribution explicite de l’argument de groupement au sein de la fonction esthétique, via la syntaxe aes(group = identifiant_sujet), permet d’isoler chaque trajectoire individuelle. Cette organisation conditionne directement la manière dont l’épaisseur de ligne sera ultérieurement perçue : si le groupement est défaillant, toute tentative de modulation du trait accentuera visuellement l’artefact au lieu de clarifier la tendance dynamique sous-jacente.
1.3 Paramètres d’initialisation par défaut et comportement graphique de base
Lorsqu’un chercheur invoque la fonction geom_line() sans renseigner d’arguments géométriques spécifiques, le moteur graphique de ggplot2 instancie une série de paramètres par défaut régis par le thème global actif. Historiquement, le tracé standard d’un segment de droite est calibré sur une valeur d’épaisseur intermédiaire, conçue pour offrir un compromis acceptable sur un écran d’ordinateur de résolution standard. Cette valeur usine, bien qu’adaptée à une phase exploratoire rapide sur un échantillon restreint, s’avère fréquemment sous-optimale dès lors que la visualisation est confrontée à des exigences éditoriales rigoureuses ou à des distributions d’observations denses.
Dans un contexte académique, le comportement par défaut de geom_line() tend à générer des lignes excessivement massives lorsque l’on souhaite représenter des faisceaux de courbes individuelles (provoquant un phénomène délétère d’occlusion visuelle), ou au contraire trop diaphanes lorsqu’une courbe de régression maîtresse doit se détacher nettement sur un fond de dispersion complexe. De surcroît, le calibrage d’origine ne prend pas en considération la réduction d’échelle physique qui s’opère inévitablement lors de l’insertion d’une figure dans une maquette de publication sur deux colonnes. L’évaluation critique de ce tracé standard démontre qu’une publication savante ne peut faire l’économie d’un calibrage millimétré de l’épaisseur, justifiant une maîtrise approfondie des syntaxes d’ajustement statique et dynamique.
2. L’évolution syntaxique : transition impérative de size à linewidth
2.1 La mise à jour ggplot2 version 3.4.0 et ses implications
L’écosystème du tidyverse a franchi un cap fondamental lors de la publication de la version 3.4.0 de ggplot2 en novembre 2022. Durant plus d’une décennie, l’argument universel size était employé pour superviser indistinctement le rayon des points dans geom_point(), la taille des étiquettes typographiques dans geom_text(), et la largeur des contours ou des segments dans geom_line(), geom_path() ou geom_segment(). Cette surcharge fonctionnelle d’un paramètre unique masquait une contradiction géométrique fondamentale : un point possède une aire bidimensionnelle dont la perception visuelle croît de façon quadratique avec son rayon, tandis qu’une ligne est un objet dont seule la largeur transversale varie, sa longueur étant dictée par l’intervalle entre les coordonnées spatiales qu’elle relie.
Pour résoudre cette incohérence technique, l’équipe de développement a scindé les fonctionnalités en introduisant linewidth, un paramètre dédié exclusivement au contrôle de l’épaisseur des éléments géométriques filiformes à une dimension. Désormais, l’utilisation de size pour paramétrer des tracés linéaires déclenche systématiquement un avertissement de dépréciation (deprecation warning). Ce message signale au développeur que l’argument historique est voué à l’obsolescence et que la fidélité géométrique de son tracé ne peut plus être garantie dans les versions futures du paquet. L’adoption de linewidth s’inscrit donc comme une obligation technique pour quiconque souhaite maintenir un environnement de production pérenne.
2.2 Rétrocompatibilité et pérennité du code en recherche reproductible
L’introduction d’une modification syntaxique majeure dans un progiciel massivement utilisé soulève d’immenses défis pour la recherche reproductible. Des milliers de dépôts de code institutionnels, de scripts d’analyse associés à des articles scientifiques évalués par les pairs et d’infrastructures de génération automatisée de rapports reposent historiquement sur la syntaxe size = x au sein de leurs couches geom_line(). Si ggplot2 maintient temporairement une couche de rétrocompatibilité traduisant dynamiquement size en linewidth pour les éléments linéaires, cette tolérance computationnelle induit une surcharge d’exécution marginale et expose les flux de travail automatisés à des ruptures brutales lors des futures montées de version majeures.
Pour les laboratoires de recherche, la transition vers linewidth impose une stratégie méthodique de refactorisation du code source. Il ne s’agit pas simplement de remplacer aveuglément des chaînes de caractères au moyen d’expressions régulières, mais d’auditer les scripts pour vérifier que les objets composites — associant par exemple des points et des lignes de contour au sein de geom_pointrange() ou geom_boxplot() — distribuent désormais adéquatement size pour les éléments ponctuels et linewidth pour les armatures linéaires. Cette discipline garantit la pérennité algorithmique des analyses et assure que les visualisations pourront être réexécutées à l’identique par de futurs pairs évaluateurs sans altération de l’équilibre visuel initial.
2.3 Différences de calcul géométrique entre linewidth et size
Sous le capot du moteur graphique de ggplot2 et du package sous-jacent grid, le passage de size à linewidth s’est accompagné d’une harmonisation cruciale des conventions d’unités physiques. Historiquement, le dimensionnement des lignes via size reposait sur un étalonnage interne singulier, où la valeur passée ne correspondait pas directement aux points typographiques standardisés utilisés dans l’industrie de l’imprimerie. Les lignes se voyaient attribuer une largeur calculée en millimètres multipliée par une constante interne, ce qui entraînait fréquemment des divergences d’échelle non intuitives lorsque les graphiques étaient exportés vers différents périphériques de sortie (graphic devices).
Avec l’implémentation formelle de linewidth, l’épaisseur d’une ligne est désormais rigoureusement calibrée en points typographiques (1 pt équivalant à 1/72 de pouce, soit environ 0,3528 mm). Ce changement assure une concordance parfaite entre l’épaisseur des traits et la typographie environnante du document d’intégration (comme les documents rédigés sous Quarto ou LaTeX). Lors d’un export vectoriel en format PDF ou SVG, une ligne spécifiée à linewidth = 1 présentera une correspondance exacte avec un filet d’un point dans le logiciel de composition finale. En revanche, lors de la génération de fichiers matriciels (tels que le PNG ou le TIFF), la largeur physique finale dépendra conjointement de la résolution déclarée en points par pouce (dots per inch ou DPI), ce qui nécessite une compréhension intime de ces relations scalaires pour éviter tout écrasement ou effilement involontaire des courbes.
3. Ajustement statique global de l’épaisseur de ligne
3.1 Définition d’une valeur numérique explicite hors esthétique
L’ajustement statique de l’épaisseur de ligne consiste à assigner une largeur uniforme, constante et déterministe à l’ensemble des segments générés par une couche géométrique donnée. D’un point de vue syntaxique, cette opération fondamentale s’effectue en déclarant explicitement le paramètre linewidth à l’intérieur de la fonction géométrique, mais impérativement en dehors de l’appel à la fonction d’association esthétique aes(). Cette convention d’écriture indique au compilateur graphique que la valeur fournie est une constante dimensionnelle absolue et non une variable issue du jeu de données nécessitant une transformation via une échelle graduée.
L’attribution de valeurs décimales permet un contrôle d’une extrême minutie sur le rendu final, supportant des fractions fines adaptées aux visualisations délicates. L’erreur classique rencontrée chez les praticiens novices consiste à positionner l’instruction sous la forme geom_line(aes(linewidth = 1.2)). Dans cette dernière configuration, ggplot2 n’interprète pas le chiffre comme une quantité géométrique, mais crée dynamiquement un facteur artificiel à niveau unique nommé « 1.2 », applique l’échelle par défaut pour ce niveau catégoriel, attribue une épaisseur arbitraire déconnectée du chiffre saisi, et pollue inutilement le graphique avec une légende superflue.
3.2 Gradation des épaisseurs : analyse comparative systématique
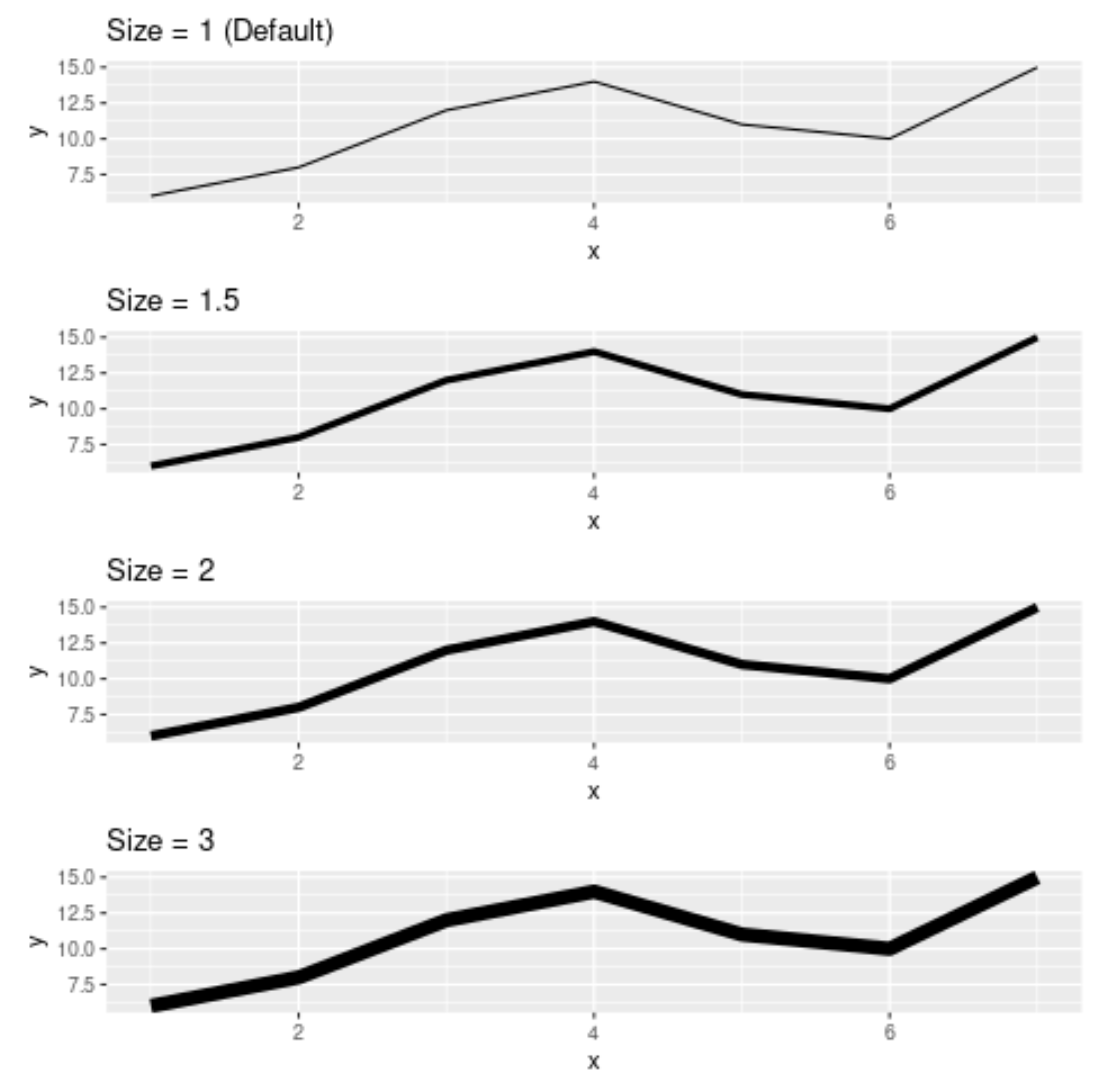
La sélection d’une épaisseur de ligne ne doit jamais résulter du hasard, mais d’une adéquation rigoureuse entre la densité des données et la surface d’affichage disponible. L’analyse systématique du comportement graphique selon une gradation numérique d’épaisseur révèle des paliers fonctionnels bien distincts :
- Épaisseur 0.25 à 0.5 : Cette finesse extrême est indispensable lors du traçage de nuages denses de trajectoires longitudinales individuelles (les tracés dits spaghetti). Elle limite les interférences destructives par chevauchement (overplotting) et préserve la détection des trajectoires marginales atypiques sans saturer l’espace visuel.
- Épaisseur 0.75 à 1.0 : Il s’agit de la plage polyvalente standard. Elle offre un équilibre optimal pour tracer deux à quatre courbes distinctes sur un graphique de dimensions conventionnelles. À ce niveau, la ligne s’imprime de façon nette sans dominer de manière disproportionnée les axes ou les textes de légende.
- Épaisseur 1.5 à 2.0 : Cette gamme confère une forte saillance visuelle. Elle est recommandée pour matérialiser des tendances centrales estimées, telles que des trajectoires moyennes issues de modèles linéaires mixtes ou des courbes de régression polynomiale superposées aux observations brutes.
- Épaisseur supérieure à 2.5 : Réservée quasi exclusivement à des fins didactiques ou à des supports de présentation orale grand format (posters scientifiques, diapositives de conférence), cette plage garantit une visibilité sans équivoque depuis le fond d’une salle, mais s’avère proscrite dans le corps de texte d’un article imprimé sous peine d’écraser la granularité des données.
3.3 Combinaison matricielle avec gridExtra pour validation visuelle
Afin de valider empiriquement le choix d’un calibrage d’épaisseur avant la soumission d’un manuscrit scientifique, il est hautement méthodique de construire une matrice comparative de figures. Cette approche systématique permet au chercheur d’évaluer côte à côte la robustesse sémiotique de différentes configurations scalaires sur le même échantillon expérimental. La bibliothèque gridExtra, combinée aux objets graphiques générés par ggplot2, offre l’infrastructure idéale pour orchestrer cette juxtaposition programmatique.
En encapsulant la création de graphiques au sein de fonctions ou de boucles itératives faisant varier le paramètre linewidth (par exemple sur des valeurs séquentielles de 0.3, 0.8, 1.5 et 2.5), le chercheur génère une série d’instances gérées de manière homogène. L’appel à la fonction grid.arrange() permet ensuite de composer un tableau synoptique sur deux colonnes et deux rangées. Cette confrontation directe simplifie grandement l’évaluation par les pairs au sein du laboratoire, permettant d’identifier immédiatement le point d’équilibre où le signal statistique se détache du bruit de fond sans engendrer d’artéfacts de saturation ou de perte d’acuité visuelle.
4. Perception visuelle et psychophysique appliquées à l’épaisseur des traits
4.1 La loi de Weber-Fechner et la sensibilité différentielle aux épaisseurs
L’efficacité d’une représentation graphique ne relève pas uniquement de la rigueur mathématique des coordonnées informatiques, mais est fondamentalement conditionnée par les mécanismes neurobiologiques du système visuel humain. La psychophysique classique, initiée par Ernst Weber et formalisée mathématiquement par Gustav Fechner, établit que la perception humaine d’un changement d’intensité physique d’un stimulus n’est pas linéaire, mais logarithmique. La loi de Weber-Fechner postule que la variation minimale perceptible (le seuil différentiel ou just noticeable difference, JND) est une fraction constante de l’intensité du stimulus d’origine :
$$\Delta I / I = k$$
Appliqué à l’épaisseur des lignes dans ggplot2, ce principe neurophysiologique démontre qu’une progression arithmétique linéaire des valeurs de linewidth engendre une distorsion perceptive. Par exemple, la différence physique entre une ligne de 0.5 pt et une ligne de 1.0 pt (+0.5 pt) représente un doublement net du stimulus visuel (+100 %), déclenchant une saillance cognitive immédiate et puissante. En revanche, l’ajout du même incrément physique de 0.5 pt entre une ligne de 3.0 pt et une ligne de 3.5 pt ne correspond qu’à une augmentation relative d’environ 16,6 %, une différence que l’œil humain peinera à discriminer sans un effort attentionnel soutenu. Dès lors, lorsque l’épaisseur sert à encoder une hiérarchie statistique discrète, le concepteur de visualisations doit privilégier des progressions géométriques ou exponentielles (par exemple : 0.5, 1.0, 2.0, 4.0) pour maintenir un contraste perceptif homogène à travers les échelons de sa représentation.
4.2 Principes gestaltistes et charge cognitive dans la lecture de graphiques
La psychologie de la forme (Gestaltpsychologie) fournit un cadre théorique indispensable pour appréhender la manière dont l’esprit humain synthétise les éléments visuels fragmentés en un tout unifié et signifiant. Dans le traçage de données relationnelles, deux lois gestaltistes prévalent : la loi de continuité et la loi de similitude. La loi de continuité dispose que l’esprit humain tend à prolonger spontanément les trajectoires linéaires régulières, même lorsque celles-ci s’entrecoupent dans l’espace bidimensionnel. Cependant, si l’épaisseur d’une ligne est calibrée de manière excessive, les zones d’intersection forment des masses volumiques amorphes qui brisent l’impression de trajectoire continue et désorientent le cortex visuel primaire.
Concomitamment, la théorie de la charge cognitive, élaborée par John Sweller, nous enseigne que la mémoire de travail humaine dispose d’une bande passante extrêmement limitée. L’épaisseur des lignes participe au traitement pré-attentionnel (preattentive visual processing) : un trait vigoureux est extrait en moins de 50 millisecondes par les aires corticales occipitales bien avant l’intervention de l’attention sélective consciente. Si un graphique attribue des épaisseurs disparates et désordonnées à de multiples courbes sans justification analytique directe, il induit un bruit visuel sévère, augmentant la charge cognitive extrinsèque au détriment de la charge essentielle consacrée à l’interprétation des données. L’épaisseur doit donc servir de filtre hiérarchique, guidant l’œil directement vers l’effet d’intérêt prioritaire.
4.3 Accessibilité visuelle et diversité physiologique des lecteurs
La dissémination universelle de la recherche scientifique impose de concevoir des représentations graphiques inclusives, capables d’être déchiffrées avec la même acuité par des lecteurs présentant des particularismes physiologiques variés. Les anomalies de la vision des couleurs (telles que le daltonisme sous ses formes deutéranope, protanope ou tritanope) affectent une part substantielle de la population masculine mondiale. Si le recours à des palettes de couleurs perceptuellement uniformes et corrigées (comme les palettes Viridis ou ColorBrewer) est devenu un standard salutaire, l’épaisseur des lignes constitue un canal visuel redondant fondamental pour garantir l’accessibilité.
En outre, la baisse naturelle de l’acuité visuelle liée à la presbytie ou aux aberrations optiques de réfraction requiert d’éviter scrupuleusement les lignes excessivement grêles. Un tracé inférieur à 0.4 pt imprimé sur papier ou projeté via un équipement audiovisuel de contraste médiocre risque purement et simplement de disparaître du champ perceptif du lecteur. De même, les personnes consultant des documents sur des terminaux mobiles de petites dimensions bénéficient grandement de tracés calibrés au-delà de 0.8 pt. L’ajustement ergonomique de l’épaisseur n’est ainsi pas une simple affaire d’esthétisme formel, mais une exigence éthique de diffusion non discriminatoire du savoir empirique.
5. Mappage dynamique de l’épaisseur sur des variables expérimentales
5.1 Liaison esthétique avec aes(linewidth = variable)
Le saut qualitatif dans l’exploitation de la grammaire des graphiques survient lorsque l’épaisseur de ligne cesse d’être une constante pour devenir un vecteur sémiotique actif encodant une dimension des données. En déclarant l’argument au sein de la fonction esthétique via aes(linewidth = variable_quantitative), le chercheur instancie un couplage dynamique dans lequel la géométrie du tracé varie continûment le long du plan cartésien. Ce procédé s’avère particulièrement puissant pour représenter graphiquement la précision d’une estimation temporelle : une ligne peut s’épaissir lorsque la variance de l’échantillon diminue ou que la puissance statistique augmente, focalisant naturellement l’attention sur les segments les plus robustes de la série.
Il importe toutefois de souligner les contraintes géométriques sous-jacentes à ce mécanisme. Dans un tracé linéaire standard géré par geom_line(), la variation de l’épaisseur le long d’une courbe continue implique la subdivision du trait en une succession de micro-segments trapézoïdaux adjacents. Si la variable prédictive associée à l’épaisseur fluctue de manière anarchique d’un point d’échantillonnage à l’autre, le tracé générera une silhouette fragmentée et disgracieuse. Pour maximiser la clarté informative, il est donc préconisé de lier l’épaisseur à des variables exhibant une autocorrélation temporelle marquée ou issues de modèles d’ajustement mathématique lissés (tels que des splines ou des polynômes locaux).
5.2 Mappage sur des variables catégorielles ou conditions expérimentales
Au-delà des dimensions continues, l’argument linewidth peut être mobilisé pour discriminer des classes d’appartenance qualitatives au sein d’un plan factoriel. Dans un essai clinique comparant l’efficacité d’un traitement expérimental face à un groupe témoin recevant un placebo, il est classique de structurer la hiérarchie visuelle en attribuant une ligne substantiellement plus épaisse à la condition novatrice. La syntaxe aes(linewidth = groupe_clinique) génère automatiquement une séparation discrète des trajectoires et adjoint au canevas une légende dédiée illustrant les différents calibres de traits attribués.
Cette approche catégorielle doit être manipulée avec parcimonie afin d’éviter l’écueil de l’illusion d’importance. En psychologie cognitive, un lecteur a naturellement tendance à associer un trait épais à une intensité supérieure, une force accrue ou une supériorité quantitative. Si l’on attribue une épaisseur lourde à un groupe témoin par simple commodité algorithmique, on court le risque d’induire un biais interprétatif inconscient chez le réviseur de l’article. La conception du mappage qualitatif doit donc toujours demeurer congruente avec la valence théorique et conceptuelle des modalités étudiées.
5.3 Interactions entre plusieurs dimensions esthétiques simultanées
La puissance d’expression de ggplot2 réside dans sa capacité à fusionner plusieurs canaux esthétiques au sein d’un même élément graphique. Une ligne peut simultanément varier en couleur spatiale via aes(color = facteur_A), en discontinuité par aes(linetype = facteur_B), et en calibre dimensionnel grâce à aes(linewidth = facteur_C). Bien que cette combinatoire offre des possibilités presque illimitées, elle pose des questions sémiologiques complexes quant à la saturation du système perceptif.
Lorsque l’on couple délibérément l’épaisseur à la même variable que celle attribuée à la couleur (par exemple aes(color = groupe, linewidth = groupe)), on pratique l’encodage redondant. Loin d’être un défaut d’optimisation, cette redondance est activement préconisée par les experts en accessibilité : elle permet à une personne incapable de distinguer la teinte chromatique de différencier infailliblement les conditions expérimentales grâce au contraste structurel de la largeur du trait. En revanche, croiser trois variables totalement orthogonales sur le même faisceau de lignes sans hiérarchie préalable mène presque inévitablement à un effondrement de la lisibilité, transformant la visualisation en un rébus cognitif indéchiffrable.
6. Contrôle programmatique avec les échelles d’épaisseur (scales)
6.1 Calibration via scale_linewidth() et scale_linewidth_continuous()
L’assignation dynamique de l’épaisseur via aes() ne représente que la moitié du travail de mise en forme ; le contrôle précis de la transformation mathématique entre les valeurs brutes de la variable et les dimensions de rendu physique incombe aux fonctions de la famille scale. La fonction scale_linewidth(), et sa variante explicite scale_linewidth_continuous(), constituent les leviers centraux pour moduler cette correspondance. L’argument le plus déterminant de ces fonctions réside dans le paramètre range, qui attend un vecteur numérique de longueur deux spécifiant les bornes inférieure et supérieure exactes de l’épaisseur en points typographiques (par exemple, range = c(0.4, 2.8)).
Par défaut, ggplot2 attribue une plage standard qui peut écraser les contrastes lorsque les données sous-jacentes présentent une dispersion asymétrique. En pilotant manuellement le paramètre range, l’expérimentateur s’assure que la valeur quantitative la plus basse de son échantillon ne produira pas une ligne imperceptiblement filiforme, et que la valeur la plus haute ne résultera pas en un bandeau écrasant. De surcroît, ces échelles acceptent des transformations analytiques directes via le paramètre trans (ou l’argument moderne transform), autorisant l’application de fonctions logarithmiques, d’inverses ou de racines carrées sur l’épaisseur du trait, une nécessité lorsque l’on cartographie des variables biologiques ou psychométriques fortement étirées vers les extrêmes.
6.2 Attribution discrète avec scale_linewidth_manual()
Pour les variables catégorielles, l’attribution aveugle de calibres par le générateur automatique de ggplot2 s’avère fréquemment insuffisante pour satisfaire aux exigences d’une identité graphique éditoriale unifiée. La fonction scale_linewidth_manual() confère au chercheur une autorité totale sur le mapping en lui permettant de déclarer un vecteur de valeurs numériques nommé. Cette spécification prend typiquement la forme syntaxique suivante :
scale_linewidth_manual(values = c("Contrôle" = 0.5, "Placebo" = 0.5, "Traitement_Faible" = 1.2, "Traitement_Fort" = 2.2))
Ce contrôle explicite résout plusieurs limitations critiques :
- Il garantit une stabilité typographique absolue à travers l’ensemble des figures successives d’une même publication : un groupe expérimental donné conservera rigoureusement la même signature géométrique d’un graphique à l’autre, évitant toute confusion cognitive lors de la lecture transversale du manuscrit.
- Il permet d’affecter une même épaisseur de base à plusieurs sous-groupes structurellement apparentés tout en réservant un trait accentué à la condition novatrice ciblée par l’hypothèse de recherche principale.
- Il offre la possibilité d’anticiper la gestion des observations incomplètes grâce à l’argument
na.value, qui fixe la largeur spécifique des segments dont les étiquettes catégorielles seraient manquantes ou corrompues.
6.3 Utilisation de scale_linewidth_binned() pour la discrétisation ordinale
Dans de nombreuses disciplines quantitatives, les chercheurs sont confrontés à des métriques continues qu’il est théoriquement pertinent de découper en intervalles ou en classes d’intensité discrètes pour en faciliter la communication. La fonction scale_linewidth_binned() répond précisément à cet impératif cognitif en segmentant une dimension continue sous-jacente en un nombre restreint de paliers d’épaisseur bien différenciés. Au lieu d’assister à une variation imperceptible et infinitésimale de la largeur du trait, le lecteur visualise des sauts discrets correspondant à des paliers normatifs ou psychométriques établis.
Cette discrétisation programmatique est configurée par le paramètre breaks, permettant d’implanter des seuils de découpage cliniquement pertinents (par exemple, des scores d’anxiété standardisés découpés en niveaux faible, modéré et sévère). L’intérêt corollaire majeur de scale_linewidth_binned() se manifeste dans la génération de sa légende : plutôt qu’une bande continue ambiguë, la clé de lecture présente une suite ordonnée d’échantillons de lignes distincts, étiquetés selon les intervalles spécifiés. Ce mode d’affichage allège considérablement la détection empirique des transitions de phase au sein des données chronologiques complexes.
7. Coordination de l’épaisseur avec les types de lignes et la transparence
7.1 Synergie entre linewidth et linetype
L’interaction entre l’épaisseur de ligne (linewidth) et sa typologie géométrique (linetype : continu, tireté, pointillé, alterné) constitue l’un des domaines les plus sensibles de la sémiologie graphique vectorielle. Une erreur fréquemment commise réside dans l’utilisation de motifs discontinus fins (tels que linetype = "dotted" ou linetype = "dashed") avec des valeurs de linewidth inférieures à 0.6 pt. À cette échelle, les points et tirets manquent de matière encrée ; ils s’effacent lors de l’impression physique ou génèrent un inconfort visuel assimilable à un scintillement (phénomène de papillotement perceptif).
Inversement, l’assignation d’une forte épaisseur à une ligne en pointillés réguliers altère fondamentalement la géométrie du motif : les points circulaires ou carrés se dilatent transversalement jusqu’à entrer en contact physique les uns avec les autres, oblitérant l’effet de discontinuité initialement recherché. Lorsque l’on recourt à des styles pointillés ou tiretés pour désigner des intervalles de prédiction, des projections contre-factuelles ou des limites théoriques de référence, il convient de compenser précisément leur porosité structurelle en rehaussant légèrement la valeur de linewidth, typiquement entre 0.8 et 1.2 pt. Cette précaution préserve le rythme spatial des vides et des pleins, empêchant tout phénomène de moirage parasite lors des croisements de trajectoires.
7.2 Modulation conjointe de la transparence (alpha)
L’introduction d’un coefficient de transparence, régulé par l’argument alpha au sein de geom_line(), ouvre des opportunités remarquables pour résoudre les problèmes d’encombrement graphique dense (overplotting). Une ligne épaisse (par exemple linewidth = 1.5) combinée à une transparence prononcée (par exemple alpha = 0.15) présente une propriété sémiotique unique : lorsque des dizaines de trajectoires individuelles s’empilent dans les mêmes régions de l’espace cartésien, la superposition additive des couches transparentes crée naturellement un gradient de densité de probabilité implicite.
Cette technique s’avère particulièrement féconde dans le cadre des démarches d’inférence bayésienne ou de modélisation non paramétrique par bootstrap. En traçant l’ensemble des trajectoires simulées par la distribution a posteriori avec un trait relativement épais mais hautement transparent, le chercheur génère un halo visuel qui reflète fidèlement l’incertitude épistémique du modèle statistique : les zones à haute certitude apparaissent saturées et opaques, tandis que les régions d’indécision s’évanouissent doucement en périphérie. Cette approche transcende la simple représentation linéaire binaire en intégrant la fonction de densité au cœur même du tracé géométrique.
7.3 Finitions géométriques : lineend et linejoin
Lorsque l’on travaille avec des valeurs de linewidth substantielles (dépassant 1.5 ou 2 points), des artéfacts géométriques majeurs se révèlent aux points de rupture angulaire et aux extrémités de courbes. Par défaut, le moteur graphique de R applique des terminaisons carrées rigides et des jonctions en onglet pointu. Au niveau des sommets d’inflexion où la pente de la courbe change brutalement de signe (fréquent lors de variations abruptes de scores chronologiques), une jonction en onglet génère une excroissance pointue extrêmement proéminente, susceptible de dépasser artificiellement les coordonnées réelles de l’observation et de fausser l’interprétation de la valeur maximale atteinte.
Pour éliminer ces anomalies géométriques, ggplot2 met à disposition deux arguments avancés au sein de geom_line() :
- linejoin : Détermine la géométrie des angles intérieurs et extérieurs reliant deux segments successifs. En substituant la valeur par défaut
"mitre"parlinejoin = "round"(arrondi) oulinejoin = "bevel"(biseauté), le chercheur élimine instantanément les pointes acérées parasites, conférant au tracé une fluidité organique respectueuse de la réalité des données. - lineend : Règle la forme géométrique assignée aux extrémités terminales du tracé complet. L’utilisation de
lineend = "round"adoucit les bordures de départ et d’arrivée, tandis quelineend = "butt"tranche la ligne perpendiculairement à son vecteur directeur sans prolongement au-delà de la coordonnée ultime, une rigueur essentielle lorsque la ligne doit s’arrêter au contact exact d’une ligne d’axe ou d’un seuil critique.
8. Applications empiriques aux paradigmes de recherche en psychologie
8.1 Tracé spaghetti et courbes de croissance individuelle en psychoclinique
Dans la recherche contemporaine sur l’efficacité des psychothérapies ou le suivi longitudinal des psychopathologies, la mise en évidence de l’hétérogénéité interindividuelle des trajectoires de rétablissement constitue une priorité clinique majeure. Le tracé dit spaghetti, qui consiste à tracer simultanément l’évolution temporelle de chaque patient d’une cohorte, est le vecteur graphique privilégié pour appréhender cette variabilité. Cependant, sans une hiérarchisation stricte des épaisseurs, cette figure sombre rapidement dans un chaos visuel impénétrable.
La méthodologie optimale consiste à superposer deux couches de geom_line() au sein du même canevas. La couche inférieure est dédiée aux trajectoires individuelles brutes : on lui attribue un linewidth = 0.35 combiné à un alpha = 0.3 et à une teinte neutre désaturée (tel qu’un gris moyen). Cette configuration permet d’embrasser d’un coup d’œil l’éventail de dispersion global et d’isoler les déviations cliniques extrêmes (outliers). Par-dessus ce fond de données brutes, on instancie une seconde couche géométrique représentant la trajectoire moyenne prédite, issue par exemple d’un modèle linéaire mixte à effets aléatoires. Cette courbe maîtresse est calibrée avec un linewidth = 1.8, une opacité totale (alpha = 1) et une couleur chromatique hautement saturée, fournissant un ancrage cognitif instantané qui transcende le bruit de fond individuel.
8.2 Courbes d’apprentissage et dynamique de temps de réaction en psychologie cognitive
Les protocoles expérimentaux de psychologie cognitive reposent massivement sur la mesure des temps de réaction et des taux d’erreur au fil de blocs d’essais répétés, visant à capturer la dynamique temporelle de l’apprentissage moteur ou exécutif. Ces séries chronologiques expérimentales présentent typiquement une composante stochastique à haute fréquence, due aux fluctuations attentionnelles momentanées des participants, masquant la cinétique globale d’acquisition de la compétence.
L’exploitation conjointe des épaisseurs permet de résoudre cette dualité échelle macroscopique / échelle microscopique. Les scores moyens observés par bloc d’essais peuvent être connectés par une ligne fine discontinue (linewidth = 0.6, linetype = "dashed"), traduisant l’instabilité empirique momentanée. Simultanément, une fonction d’ajustement non paramétrique locale (de type LOESS ou régression par splines pénalisées via geom_smooth()) est adjointe au canevas avec une épaisseur renforcée (linewidth = 1.4). Le réglage précis de l’épaisseur évite ici que l’enveloppe de l’intervalle de confiance à 95 % ne vienne éclipser visuellement la tendance asymptotique centrale, garantissant une communication fluide de la vitesse d’apprentissage.
8.3 Trajectoires développementales et seuils diagnostiques critiques
En neuropsychologie du développement et en gérontologie cognitive, l’évaluation des trajectoires cognitives longitudinales prend tout son sens lorsqu’elle est confrontée à des normes populationnelles standardisées et à des seuils diagnostiques critiques (par exemple, le seuil d’alerte indiquant une bascule d’un trouble cognitif léger vers une démence avérée). Dans ces représentations, l’épaisseur des traits devient le principal outil de différenciation ontologique entre les données observées chez les sujets et les constructions théoriques normatives.
Tandis que les courbes des participants sont dessinées avec une épaisseur dynamique dépendante de la taille de leur sous-échantillon respectif, les seuils pathologiques transversaux sont matérialisés via geom_hline() (lignes horizontales) ou geom_vline() (lignes verticales). Ces repères structurels doivent impérativement adopter une épaisseur calibrée en retrait (généralement linewidth = 0.5 à 0.7) et un style pointillé. Cette hiérarchie sémiotique rappelle visuellement au lecteur que ces limites constituent des repères de référence cardinaux fixes et stables, et non des observations empiriques fluctuantes collectées sur le terrain expérimental.
9. Ajustement de l’épaisseur des éléments structurels hors-données (thèmes)
9.1 Modification des axes de coordonnées avec theme() et element_line()
La maîtrise de l’épaisseur dans ggplot2 ne saurait être complète si elle se cantonnait exclusivement aux objets géométriques dépendants des données. L’échafaudage contextuel du graphique — son système de coordonnées cartésiennes — est constitué d’une série d’éléments linéaires régis par la fonction universelle theme() et la fonction de spécification structurelle element_line(). L’épaisseur des lignes d’axes (axis.line.x, axis.line.y ou leur parent global axis.line) conditionne l’assise typographique globale de la figure.
D’un point de vue technique contemporain, element_line() requiert désormais l’argument linewidth en lieu et place de l’ancien paramètre size, en parfaite harmonie avec la refonte syntaxique globale de la version 3.4.0. Un calibrage optimal pour une publication académique se situe classiquement entre linewidth = 0.4 et linewidth = 0.6 pour les axes cartésiens. Si ces lignes sont excessivement lourdes (par exemple 1.5 pt), elles créent un cadre asphyxiant qui attire le regard vers la périphérie vide au détriment du centre de données ; si elles sont trop diaphanes (inférieures à 0.2 pt), le graphique semble flotter sans ancrage spatial déterminé dans la page.
9.2 Calibrage de la grille d’arrière-plan majeure et mineure
Le traitement des grilles de lecture cartésienne (gridlines) est au cœur des débats sur l’ergonomie cognitive de la visualisation scientifique. Le statisticien visionnaire Edward Tufte a théorisé le concept fondamental de ratio encre-données (data-ink ratio), postulant qu’une proportion maximale de l’encre imprimée sur une page doit être consacrée exclusivement à l’affichage des informations statistiques réelles, toute encre redondante ou non informative devant être éradiquée sans pitié.
Dans cette perspective, la grille interne d’un graphique ne doit jamais rivaliser d’intensité ou d’épaisseur avec les données expérimentales. Dans le système de thématisation de ggplot2, cela implique de paramétrer panel.grid.major avec un linewidth extrêmement discret, n’excédant pas 0.25 à 0.3 pt, couplé à une teinte grise très lumineuse (telle que "grey90" ou "grey92"). Quant à la grille mineure (panel.grid.minor), qui subdivise les intervalles inter-graduations, la recommandation méthodologique prévalant dans l’édition savante consiste tout bonnement à la supprimer totalement via element_blank(), ou à la restreindre à un linewidth = 0.15, afin de délester le champ visuel de tout bruit parasite.
9.3 Lignes de contour des facettes et encadrements thématiques
La subdivision d’un jeu de données complexe en sous-graphiques juxtaposés conditionnés par des facteurs expérimentaux s’opère via les fonctions de facettage facet_wrap() et facet_grid(). Ce découpage génère de multiples panneaux spatiaux dont les contours et les bandeaux d’étiquetage (strips) reposent sur des structures linéaires d’encadrement gérées par panel.border et strip.background.
Le paramétrage de l’épaisseur de ces bordures impose une stricte cohérence systémique avec le reste du graphique. Si le contour des panneaux est spécifié avec un element_rect(linewidth = 0.5, fill = NA), ce calibre doit impérativement correspondre à l’épaisseur assignée aux marques de graduation des axes (axis.ticks). L’accumulation de micro-disparités dimensionnelles entre les encadrements de facettes et les axes produit un sentiment inconscient de négligence technique, nuisant à la perception de rigueur de la publication. La standardisation de ces paramètres géométriques au sein d’une fonction de thème institutionnelle réutilisable constitue la marque d’un flux de travail professionnel irréprochable.
10. Personnalisation des légendes d’épaisseur et conformité aux normes APA
10.1 Formatage de la boîte de légende via guides()
Lorsqu’un mappage dynamique lie l’épaisseur des lignes à une variable empirique, ggplot2 génère par défaut une légende explicative latérale destinée à guider le déchiffrement du lecteur. Toutefois, les spécifications d’affichage automatiques sont rarement prêtes pour une diffusion finale sans retouches. La boîte de légende utilise par défaut des segments de longueur restreinte qui peuvent compliquer la discrimination tactile de subtiles variations de calibre. Pour remodeler cet élément d’orientation cognitive, le chercheur doit recourir à la fonction de supervision guides() couplée à l’opérateur guide_legend().
Cette infrastructure permet d’ajuster spécifiquement la largeur physique des segments échantillonnés au moyen de l’argument keywidth = unit(1.2, "cm"), offrant un développement horizontal suffisant pour que l’œil apprécie la gradation sans hésitation. De plus, lorsque plusieurs canaux esthétiques redondants sont mobilisés conjointement (comme une variation simultanée d’épaisseur et de teinte colorée pour une même variable), ggplot2 fusionne élégamment les clés au sein d’une boîte unique à la condition expresse que les titres et les ruptures d’échelles soient formulés de manière strictement identique dans scale_linewidth_*() et scale_color_*(), évitant ainsi le dédoublement aberrant des légendes dans la marge.
10.2 Conformité rigoureuse aux standards de publication APA (7e édition)
Les normes éditoriales édictées dans la septième édition du manuel de publication de l’American Psychological Association (APA) imposent des exigences d’une extrême précision concernant la facture des illustrations statistiques. Le standard APA proscrit explicitement tout artifice visuel encombrant, privilégiant une esthétique épurée au service de la clarté conceptuelle immédiate. Sur le plan des épaisseurs linéaires, ces règles se traduisent par des prescriptions strictes :
- Les figures doivent être entièrement compréhensibles en niveaux de gris lors de l’impression papier, interdisant de reposer sur la seule couleur pour séparer deux conditions ; la modulation de
linewidth(associée judicieusement àlinetype) devient alors le vecteur obligatoire de différenciation. - La totalité du cadre périphérique extérieur et les grilles de fond colorées doivent être bannies, seules les lignes d’axes en abscisse et ordonnée devant subsister avec un trait d’une finesse contrôlée (typiquement
linewidth = 0.5). - Les notes de figures (placées sous le graphique sous la mention Note.) doivent expliciter textuellement la sémantique attachée à chaque palier de largeur de trait (par exemple : « La courbe épaisse matérialise la trajectoire moyenne de rémission, tandis que les filets fins illustrent les parcours individuels des patients »).
10.3 Export vectoriel haute définition (PDF, SVG, TIFF) sans distorsion
L’une des tragédies techniques récurrentes en production scientifique réside dans la dégradation dramatique d’une figure soigneusement calibrée lors de son exportation physique vers le disque dur. L’invocation élémentaire de ggsave("figure.png") sans paramétrage dimensionnel précis entraîne un recalcul d’échelle automatique par R, provoquant fréquemment l’écrasement ou la dilatation hypertrophique des épaisseurs de lignes. La préservation de la géométrie de linewidth dépend de la maîtrise conjointe du périphérique graphique d’exportation (device), des dimensions physiques réelles et de la résolution d’échantillonnage.
Pour des sorties destinées à des revues savantes, la génération vectorielle via cairo_pdf() ou le moteur moderne SVG constitue la méthode d’excellence : les segments y conservent leur typométrie absolue en points sans pixellisation, autorisant les imprimeurs à zoomer sur le fichier sans dégradation du rendu. Si l’éditeur exige impérativement un format matriciel (TIFF non compressé ou PNG), il est impératif d’utiliser le moteur graphique haute fidélité ragg::agg_png au sein de ggsave(), en fixant une résolution minimale de 300 DPI, voire 600 DPI, tout en spécifiant les dimensions physiques finales d’impression en centimètres ou en pouces (par exemple width = 16, height = 10, units = "cm"). Ce calcul déterministe garantit que l’épaisseur d’une ligne de 1 point mesurera rigoureusement 0,3528 mm sur la page imprimée.
11. Diagnostic des anomalies d’épaisseur et résolution des problèmes fréquents
11.1 Comprendre l’erreur commune de l’assignation dans aes()
L’aberration comportementale la plus universellement rapportée par les utilisateurs de ggplot2 réside dans l’apparition subite d’une ligne d’une épaisseur déconcertante, accompagnée sur le côté droit d’une boîte de légende mentionnant le texte laconique « 2 » ou « 1.5 ». Cette pathologie logicielle survient immanquablement lorsque le programmeur a codé geom_line(aes(linewidth = 2)) au lieu de l’instruction canonique geom_line(linewidth = 2).
Ce dysfonctionnement repose sur le principe fondamental d’évaluation paresseuse et de construction de l’espace esthétique propre à la grammaire de Wickham. En entourant la constante numérique de l’appel aes(), l’utilisateur signale au moteur R que la valeur « 2 » n’est pas une commande d’action immédiate, mais une nouvelle variable vectorielle catégorielle contenant la valeur scalaire 2 pour chaque observation de la table. En conséquence, ggplot2 génère une échelle continue ou discrète pour cartographier ce pseudo-vecteur, mappe la première modalité trouvée sur son épaisseur minimale préprogrammée usine, et génère docilement une entrée de légende pour cette variable artificielle. La résolution de ce bug nécessite simplement de déplacer la parenthèse fermante de aes() avant l’assignation du linewidth.
11.2 Problèmes de superposition (overplotting) et ordre des couches
Une autre pathologie graphique pernicieuse concerne l’occlusion d’informations critiques due à un ordre d’empilement défectueux des couches géométriques. Dans le moteur de rendu de ggplot2, l’ordre d’affichage physique des objets obéit strictement à la chronologie déclarative du script : chaque nouvel appel de couche géométrique superpose ses formes par-dessus les éléments dessinés par les fonctions précédentes. Si un chercheur déclare la trajectoire moyenne de son modèle mixte (linewidth = 2) avant de tracer les trajectoires individuelles de l’échantillon (linewidth = 0.4), les filets fins individuels viendront hacher et recouvrir la courbe principale, détruisant instantanément son autorité visuelle.
La règle d’or pour architecturer l’ordre des couches impose une stratification du discret vers le saillant :
- On initialise d’abord les zones d’arrière-plan, telles que les rubans d’intervalles de confiance transparents générés par
geom_ribbon(). - On implémente ensuite les lignes structurelles de référence fixes, telles que les lignes d’abscisse de seuil zéro tracées par
geom_hline()avec unlinewidth = 0.4. - On dessine le faisceau des séries de mesures empiriques fines individuelles via
geom_line(aes(group = subject), linewidth = 0.3, alpha = 0.4). - On appose enfin la courbe de tendance modélisée populationnelle au premier plan par un dernier appel à
geom_line(linewidth = 1.6).
Cette séquence garantit qu’aucune information d’ordre supérieur ne souffre d’un écrasement spatial par des données de niveau inférieur.
11.3 Gestion des discontinuités dues aux données manquantes (NA)
Dans les suivis expérimentaux longitudinaux, l’attrition de l’échantillon (abandon de participants en cours d’étude) ou l’omission occasionnelle d’une session de mesure produit inévitablement des valeurs manquantes formalisées par des indicateurs NA dans la matrice de données. Le comportement rigoureux par défaut de geom_line() face à un NA consiste à interrompre immédiatement le tracé : un segment ne peut exister mathématiquement dans le vide s’il lui manque l’une de ses coordonnées d’ancrage bipolaires. Cette interruption produit un graphique peruffé de brisures linéaires abruptes, particulièrement disgracieuses lorsque les lignes possèdent un fort linewidth.
Face à ce défi méthodologique, deux voies s’offrent à l’analyste. La première consiste à traiter la lacune en amont au niveau des données en recourant à des techniques d’imputation statistique validées (telles que l’imputation multiple par équations chaînées ou l’interpolation linéaire locale) avant d’injecter la table dans l’instruction graphique. La seconde stratégie, purement illustrative, consiste à substituer geom_line() par geom_point() couplé à des segments reconstitués via des modèles prédictifs continus. De surcroît, ggplot2 émet un avertissement explicite (Removed x rows containing missing values) lors de la rencontre de ces données manquantes ; il convient d’en contrôler l’origine pour s’assurer que ces brisures ne résultent pas d’une erreur de filtrage préalable sur l’axe des temps.
12. Étude de cas intégrée : modélisation mixte d’un test neuropsychologique
12.1 Préparation des données d’évaluation cognitive et modélisation statistique
Afin de synthétiser l’ensemble des connaissances théoriques, techniques et ergonomiques abordées tout au long de cette monographie, nous allons concevoir une étude de cas empirique complète. Nous nous plaçons dans le cadre d’un protocole de recherche clinique en neuropsychologie évaluant le déclin longitudinal de la fluence verbale sémantique chez une cohorte de 60 patients diagnostiqués à un stade précoce de la maladie d’Alzheimer. Ces patients ont été assignés de manière aléatoire à deux protocoles de remédiation cognitive distincts : un groupe expérimental bénéficiant d’un entraînement digitalisé intensif, et un groupe témoin recevant le protocole de suivi standard. Les performances ont été mesurées lors de cinq sessions temporelles successives (Baseline, Mois 3, Mois 6, Mois 12, et Mois 18).
L’analyse inférentielle de ces données hiérarchiques (mesures répétées nichées au sein d’individus) est menée au moyen d’un modèle linéaire à effets mixtes (LMM) implémenté sous R à l’aide de la bibliothèque lme4. Ce modèle intègre un intercept aléatoire et une pente temporelle aléatoire pour chaque sujet, tout en estimant les effets fixes du Temps, du Groupe de traitement et de leur terme d’interaction bidirectionnel. L’objectif graphique est de concevoir une figure de qualité publication irréprochable qui expose simultanément la variance interindividuelle brute, les trajectoires d’ajustement modélisées et les seuils cliniques de détérioration pathologique sévère, en mobilisant un étalonnage d’épaisseurs hautement sophistiqué.
12.2 Implémentation pas à pas de la visualisation sous ggplot2
La construction de la figure repose sur une articulation rigoureuse de couches successives, exploitant pleinement la sémantique de linewidth. En premier lieu, les trajectoires individuelles brutes des 60 participants sont tracées avec un calibrage statique minimaliste de linewidth = 0.35, associé à un coefficient de transparence modéré (alpha = 0.25). Cette configuration permet d’embrasser d’un seul regard l’hétérogénéité des profils cliniques sans qu’aucun patient singulier ne vienne saturer l’espace sémiotique. Les deux groupes expérimentaux sont différenciés par une modulation chromatique discrète mais accessible.
Dans un second temps, nous extrayons du modèle linéaire mixte les valeurs attendues au niveau populationnel (les effets fixes) pour chaque condition à travers le temps. Ces estimations marginales sont superposées au premier plan sous forme de lignes maîtresses d’un linewidth = 1.6. Afin de renforcer l’accessibilité pour les lecteurs daltoniens ou lors d’une impression en noir et blanc, cette différence de groupe est doublement encodée par l’épaisseur et par le type de trait : la condition standard hérite d’un tracé continu d’épaisseur médiane (linewidth = 1.3, linetype = "solid"), tandis que la condition expérimentale bénéficie d’un tracé accentué (linewidth = 1.9, linetype = "solid"). Enfin, un seuil d’alerte diagnostique marquant l’entrée dans une zone de dépendance cognitive sévère est injecté transversalement via geom_hline() avec un linewidth = 0.7 et un motif tireté fin (linetype = "dashed").
12.3 Finalisation esthétique, thématisation APA et script complet prêt à l’emploi
La dernière étape du pipeline consiste à draper l’ensemble du graphique dans une thématisation rigoureusement conforme aux préconisations de la 7e édition du manuel de l’APA. La grille interne est intégralement expurgée, le cadre rectangulaire du panneau est effacé pour ne conserver que les lignes orthogonales des coordonnées cartésiennes régulées à linewidth = 0.5, et la légende est positionnée stratégiquement au sommet pour maximiser l’espace horizontal alloué aux données temporelles. Les étiquettes typographiques sont harmonisées avec une police sans-empattement neutre.
Voici l’implémentation algorithmique intégrale et commentée, conçue pour une reproductibilité computationnelle immédiate dans tout environnement R contemporain :
# ==============================================================================
# TITRE : Visualisation Longitudinale Neuropsychologique sous ggplot2 (Normes APA)
# AUTEUR : Équipe d'Analyse Statistique et Méthodologie Graphique
# DESCRIPTION : Trajectoires individuelles et modélisées avec calibrage de linewidth
# ==============================================================================

# Chargement des bibliothèques requises
library(ggplot2)
library(dplyr)
library(lme4)

# 1. Simulation d'une cohorte clinique neuropsychologique (Format Long)
set.seed(1014) # Fixation du générateur pour reproductibilité absolue
n_sujets <- 60
temps_points <- c(0, 3, 6, 12, 18) # Mois de suivi

donnees_cliniques <- expand.grid(
  Sujet = factor(1:n_sujets),
  Temps = temps_points
) %>%
  mutate(
    Groupe = factor(ifelse(as.numeric(Sujet) <= 30, "Programme Standard", "Entraînement Digitalisé"))
  )

# Génération d'effets aléatoires par sujet (Intercept et Pente)
effets_aleatoires <- data.frame(
  Sujet = factor(1:n_sujets),
  Intercept_Alea = rnorm(n_sujets, mean = 0, sd = 3.5),
  Pente_Alea = rnorm(n_sujets, mean = 0, sd = 0.15)
)

donnees_cliniques <- donnees_cliniques %>%
  left_join(effets_aleatoires, by = "Sujet") %>%
  mutate(
    # Déclin cognitif simulé : effet d'interaction Temps x Groupe
    Fluence_Score = 28.5 + Intercept_Alea +
      (ifelse(Groupe == "Programme Standard", -0.45, -0.18) + Pente_Alea) * Temps +
      rnorm(n(), mean = 0, sd = 1.2)
  )

# 2. Ajustement du Modèle Linéaire Mixte (LMM)
modele_mixte <- lmer(
  Fluence_Score ~ Temps * Groupe + (1 + Temps | Sujet),
  data = donnees_cliniques
)

# Extraction des trajectoires moyennes prédites au niveau de la population
grille_prediction <- expand.grid(
  Temps = seq(0, 18, length.out = 100),
  Groupe = levels(donnees_cliniques$Groupe)
)
grille_prediction$Score_Predit <- predict(
  modele_mixte,
  newdata = grille_prediction,
  re.form = NA # Exclusion des effets aléatoires pour capturer les effets fixes
)

# 3. Assemblage du Graphique ggplot2 Haute Fidélité
figure_neuropsy <- ggplot() +

  # Ligne de référence normative (Seuil de détérioration sévère)
  geom_hline(
    yintercept = 18.0,
    linewidth = 0.65,
    linetype = "dashed",
    color = "#555555"
  ) +
  annotate(
    "text",
    x = 0.5,
    y = 17.2,
    label = "Seuil d'alerte clinique (Dépendance)",
    hjust = 0,
    size = 3.2,
    fontface = "italic",
    color = "#555555"
  ) +

  # Couche 1 : Trajectoires individuelles fines hautement transparentes
  geom_line(
    data = donnees_cliniques,
    aes(
      x = Temps,
      y = Fluence_Score,
      group = Sujet,
      color = Groupe
    ),
    linewidth = 0.35, # Épaisseur fine pour juguler l'overplotting
    alpha = 0.25      # Forte transparence pour matérialiser la densité
  ) +

  # Couche 2 : Courbes de modélisation populationnelle épaissies au premier plan
  geom_line(
    data = grille_prediction,
    aes(
      x = Temps,
      y = Score_Predit,
      color = Groupe,
      linewidth = Groupe,
      linetype = Groupe
    ),
    lineend = "round",  # Finition arrondie pour fluidité géométrique
    linejoin = "round"  # Jonctions douces prévenant les artéfacts
  ) +

  # Échelle manuelle pour linewidth garantissant la hiérarchie visuelle
  scale_linewidth_manual(
    name = "Protocole Thérapeutique :",
    values = c(
      "Programme Standard" = 1.3,
      "Entraînement Digitalisé" = 2.1
    )
  ) +

  # Échelle de types de lignes redondante pour accessibilité daltonienne
  scale_linetype_manual(
    name = "Protocole Thérapeutique :",
    values = c(
      "Programme Standard" = "solid",
      "Entraînement Digitalisé" = "solid"
    )
  ) +

  # Échelle chromatique sobre et contrastée (Palette adaptée aux publications)
  scale_color_manual(
    name = "Protocole Thérapeutique :",
    values = c(
      "Programme Standard" = "#C0392B",
      "Entraînement Digitalisé" = "#2980B9"
    )
  ) +

  # Système d'axes cartésiens et étiquetage standardisé
  scale_x_continuous(
    name = "Durée du Suivi Clinique (Mois)",
    breaks = c(0, 3, 6, 12, 18),
    limits = c(0, 18.5)
  ) +
  scale_y_continuous(
    name = "Score de Fluence Verbale Sémantique (0-40)",
    breaks = seq(10, 40, by = 5),
    limits = c(12, 38)
  ) +

  # Application rigoureuse des normes de thématisation APA 7e édition
  theme_classic(base_size = 12, base_family = "sans") +
  theme(
    # Contrôle de l'épaisseur structurelle des axes cartésiens
    axis.line = element_line(linewidth = 0.55, color = "black"),
    axis.ticks = element_line(linewidth = 0.55, color = "black"),
    axis.ticks.length = unit(0.18, "cm"),

    # Suppression totale du quadrillage d'arrière-plan (Principe de Tufte)
    panel.grid.major = element_blank(),
    panel.grid.minor = element_blank(),

    # Configuration ergonomique de la légende
    legend.position = "top",
    legend.justification = "left",
    legend.direction = "horizontal",
    legend.title = element_text(face = "bold", size = 10),
    legend.text = element_text(size = 9.5),
    legend.key.width = unit(1.4, "cm"), # Allongement pour apprécier l'épaisseur
    legend.background = element_blank(),

    # Espacement typographique
    axis.title.x = element_text(face = "bold", margin = margin(t = 8)),
    axis.title.y = element_text(face = "bold", margin = margin(r = 8)),
    plot.margin = margin(t = 12, r = 15, b = 10, l = 10)
  )

# 4. Exportation Haute Définition vectorielle et matricielle conforme aux revues
# Exportation Vectorielle cairo_pdf pour préserver la précision typométrique de linewidth
ggsave(
  filename = "trajectoires_cognitives_neuropsy.pdf",
  plot = figure_neuropsy,
  device = cairo_pdf,
  width = 18,
  height = 11,
  units = "cm"
)

# Affichage du rendu final dans l'interface de travail
print(figure_neuropsy)
Cette implémentation illustre magistralement la puissance de la grammaire de visualisation dès lors qu’elle est maniée avec une rigueur géométrique absolue. En mobilisant délibérément l’argument moderne linewidth, en distinguant scrupuleusement les constantes dimensionnelles des mappages statistiques, en calibrant les interactions avec la transparence et le type de ligne, et en respectant les lois psychophysiques de la vision humaine, l’expérimentateur transcende la production de figures rudimentaires. Le graphique qui en émane n’est plus une simple transcription brute de chiffres ; il s’affirme comme une démonstration scientifique autonome, intelligible, esthétiquement aboutie et prête à soutenir l’épreuve de l’évaluation académique internationale.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- Fechner, G. T. (1860). Elemente der Psychophysik. Breitkopf und Härtel.
- Sweller, J. (1988). Cognitive load during problem solving: Effects on learning. Cognitive Science, 12(2), 257–285. https://doi.org/10.1207/s15516709cog1202_4
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0