
L’analyse empirique des phénomènes quantitatifs repose de manière fondamentale sur la capacité des chercheurs et des praticiens à modéliser, visualiser et interpréter les relations existant entre différentes dimensions observables. Dans le vaste écosystème des outils informatiques dédiés à la manipulation des données, Microsoft Excel demeure une plateforme universellement déployée au sein des laboratoires universitaires, des départements de recherche et développement et des organisations professionnelles. Bien que des progiciels spécialisés tels que R, SPSS ou Python dominent certains segments de l’analyse computationnelle de pointe, la robustesse, l’accessibilité immédiate et l’ergonomie visuelle d’Excel en font le vecteur privilégié pour l’exploration préliminaire, l’analyse exploratoire bivariée et la communication visuelle de modèles linéaires simples.
La représentation graphique conjointe sous forme de nuage de points (ou scatterplot) enrichie d’une droite de régression linéaire représente l’archétype méthodologique par lequel une intuition théorique se confronte à la réalité métrique. Ce procédé ne se résume pas à une simple manipulation technique ou à un artifice cosmétique : il incarne la transition conceptuelle fondamentale entre une description purement géométrique d’un ensemble de mesures dispersées et l’estimation statistique rigoureuse d’une relation fonctionnelle. En reliant les points discrets par une trajectoire continue optimisée, le chercheur projette une structure théorique sur le bruit stochastique inhérent à toute collecte de données empiriques.
Ce guide exhaustif a pour vocation d’articuler avec une minutie absolue l’ensemble du processus menant de la conceptualisation mathématique de la régression linéaire ordinaire à son implémentation technique avancée dans l’environnement Microsoft Excel. Conçu pour répondre aux exigences méthodologiques les plus strictes de la recherche contemporaine, ce document examine en profondeur les fondements théoriques des moindres carrés, la préparation rigoureuse des matrices de données, le paramétrage typographique et esthétique conforme aux normes de publication scientifique (notamment le format standardisé de l’American Psychological Association), ainsi que les diagnostics critiques indispensables pour prévenir les interprétations fallacieuses et les artefacts de calcul.
1. Fondements théoriques de la régression linéaire simple dans la recherche empirique
1.1 Définition et principe de la méthode des moindres carrés ordinaires
La modélisation de la relation fonctionnelle unissant deux variables continues s’inscrit au cœur du paradigme de la régression linéaire simple. Dans ce cadre mathématique rigoureux, on postule l’existence d’une variable indépendante, explicative ou prédictive, traditionnellement désignée par la notation $X$, et d’une variable dépendante, critère ou expliquée, symbolisée par $Y$. L’objectif central consiste à déterminer une fonction linéaire théorique capable de traduire l’évolution conjointe de ces deux entités à travers une formulation de type :
$$\hat{Y}_i = aX_i + b$$
où le coefficient $a$ représente la pente de la droite (le taux de variation instantané de $Y$ par unité d’incrément de $X$), et $b$ désigne l’ordonnée à l’origine ou l’intercept (la valeur théorique attribuée à $Y$ lorsque l’abscisse $X$ prend la valeur zéro). Dans le contexte des données expérimentales ou observationnelles réelles, les mesures observées ne se superposent jamais parfaitement à cette trajectoire idéalisée en raison des erreurs de mesure et de la variabilité résiduelle inhérente aux systèmes complexes.
Pour ajuster cette droite de manière optimale, la statistique mathématique privilégie traditionnellement la méthode des moindres carrés ordinaires (MCO, ou Ordinary Least Squares en anglais). Le principe directeur de cette approche repose sur la minimisation délibérée de la somme des carrés des résidus verticaux, un résidu étant défini comme la distance algébrique séparant la valeur empiriquement observée $Y_i$ de la valeur théorique $\hat{Y}_i$ générée par le modèle d’ajustement. En élevant au carré ces écarts individuels avant de procéder à leur sommation globale, l’algorithme garantit d’une part que les écarts positifs et négatifs ne s’annulent pas mutuellement, et d’autre part qu’une pénalisation quadratique sévère soit infligée aux déviations de grande magnitude, conférant ainsi à la droite une stabilité d’ancrage optimale.
Il est impératif, sur le plan épistémologique, d’établir une ligne de démarcation conceptuelle nette entre la corrélation descriptive et la régression linéaire à visée modélisatrice. Alors que le coefficient de corrélation produit une évaluation strictement symétrique et bidirectionnelle de l’intensité de la covariation linéaire entre deux distributions standardisées sans présumer d’asymétrie structurelle, la régression impose une orientation fonctionnelle fondamentale. Elle présuppose théoriquement que l’information contenue dans le vecteur $X$ informe, contraint ou permet d’estimer statistiquement la distribution conditionnelle du vecteur $Y$, ouvrant ainsi la voie à une formalisation de la prédiction conditionnelle.
1.2 Pertinence méthodologique dans l’analyse des données psychologiques
Dans l’univers des sciences humaines, sociales et comportementales, et tout particulièrement au sein de la psychologie quantitative, la régression linéaire simple constitue un pilier méthodologique irremplaçable pour l’investigation des architectures psychométriques et des dynamiques cognitives. L’un des champs d’application les plus fréquents concerne l’analyse des liens présumés entre les dimensions structurelles de la personnalité—telles que mesurées par le modèle du Big Five—et des indicateurs de performance comportementale ou d’adaptation psychosociale. À titre d’illustration, un chercheur peut souhaiter évaluer dans quelle mesure le niveau de « méticulosité » (variable indépendante continue) permet de modéliser avec précision le rendement académique ou le respect de protocoles thérapeutiques contraignants (variable dépendante).
Au-delà de l’exploration des hypothèses substantielles, la modélisation linéaire s’avère indispensable pour les protocoles de validation métrologique d’instruments de mesure. Dans le cadre de l’évaluation de la fidélité test-retest, la droite de régression permet de cartographier la stabilité temporelle des scores attribués aux mêmes sujets à des intervalles temporels standardisés. De même, lors des processus d’établissement de la validité critériée ou convergente, la confrontation d’une nouvelle échelle d’évaluation de la dépression avec un instrument étalon préexistant valide le degré de congruence opérationnelle des mesures à travers l’inclinaison de la pente et la magnitude de la variance partagée.
Néanmoins, la rigueur académique impose de rappeler avec insistance les limites herméneutiques inhérentes à ces modèles. L’existence d’un ajustement linéaire parfait sur le plan computationnel n’autorise en aucun cas le chercheur à inférer une causalité directe, univoque et ontologique entre les variables. L’association constatée peut découler de l’influence masquée d’une troisième variable non contrôlée (effet de confusion), d’une rétroaction causale réciproque, voire d’une simple synchronie stochastique fortuite. La causalité demeure une construction théorique sanctionnée par le dispositif expérimental et le contrôle méthodologique rigoureux, et non une propriété intrinsèque émergent de l’algorithme des moindres carrés.
1.3 Hypothèses sous-jacentes à vérifier avant la modélisation
L’application légitime de la régression linéaire par les moindres carrés et la validité des inférences paramétriques qui en découlent reposent sur le respect scrupuleux d’un ensemble de postulats mathématiques préétablis (les conditions de Gauss-Markov). Le premier postulat élémentaire concerne la linéarité intrinsèque de la relation bivariée observée. Les deux variables considérées doivent être issues d’échelles de mesure quantitatives continues (d’intervalles ou de rapports), et l’inspection visuelle préliminaire de la distribution des données ne doit manifester aucune distorsion curvilinéaire systématique, sous peine de rendre l’estimation de la pente biaisée ou conceptuellement inadéquate.
Le second ensemble de conditions concerne la structure probabiliste des erreurs résiduelles du modèle. Les postulats exigent formellement :
- L’homoscédasticité des erreurs : la variance de la distribution conditionnelle des résidus doit demeurer parfaitement homogène et constante sur l’ensemble du continuum des valeurs prédites par la variable indépendante, excluant tout phénomène d’évasement ou de rétrécissement progressif du nuage d’erreurs.
- La normalité des résidus : les déviations résiduelles par rapport à la droite de régression doivent suivre une loi normale de moyenne nulle et d’écart-type constant ($\epsilon_i \sim \mathcal{N}(0, \sigma^2)$), condition particulièrement cruciale pour l’établissement ultérieur des intervalles de confiance et le calcul de la significativité statistique des tests d’hypothèses ($t$ de Student et $F$ de Fisher).
- L’indépendance mutuelle des observations : l’absence d’autocorrélation entre les résidus individuels implique que l’erreur associée à la mesure d’un sujet ne doit en aucun cas être tributaire ou prédictive de l’erreur associée à un autre sujet, un postulat souvent transgressé lors du recueil de données sérielles ou hiérarchiques.
Enfin, la méthode des moindres carrés présente une vulnérabilité mathématique notoire face aux observations extrêmes et aux valeurs atypiques bivariées. Un point unique présentant un éloignement prononcé sur l’axe des abscisses (point levier) associé à une déviation verticale substantielle peut exercer une attraction gravitationnelle disproportionnée sur l’orientation de la droite d’ajustement, altérant drastiquement les estimations paramétriques globales au détriment de la validité écologique de l’analyse.
2. Préparation et structuration des données quantitatives dans Excel
2.1 Formatage adéquat des colonnes de données
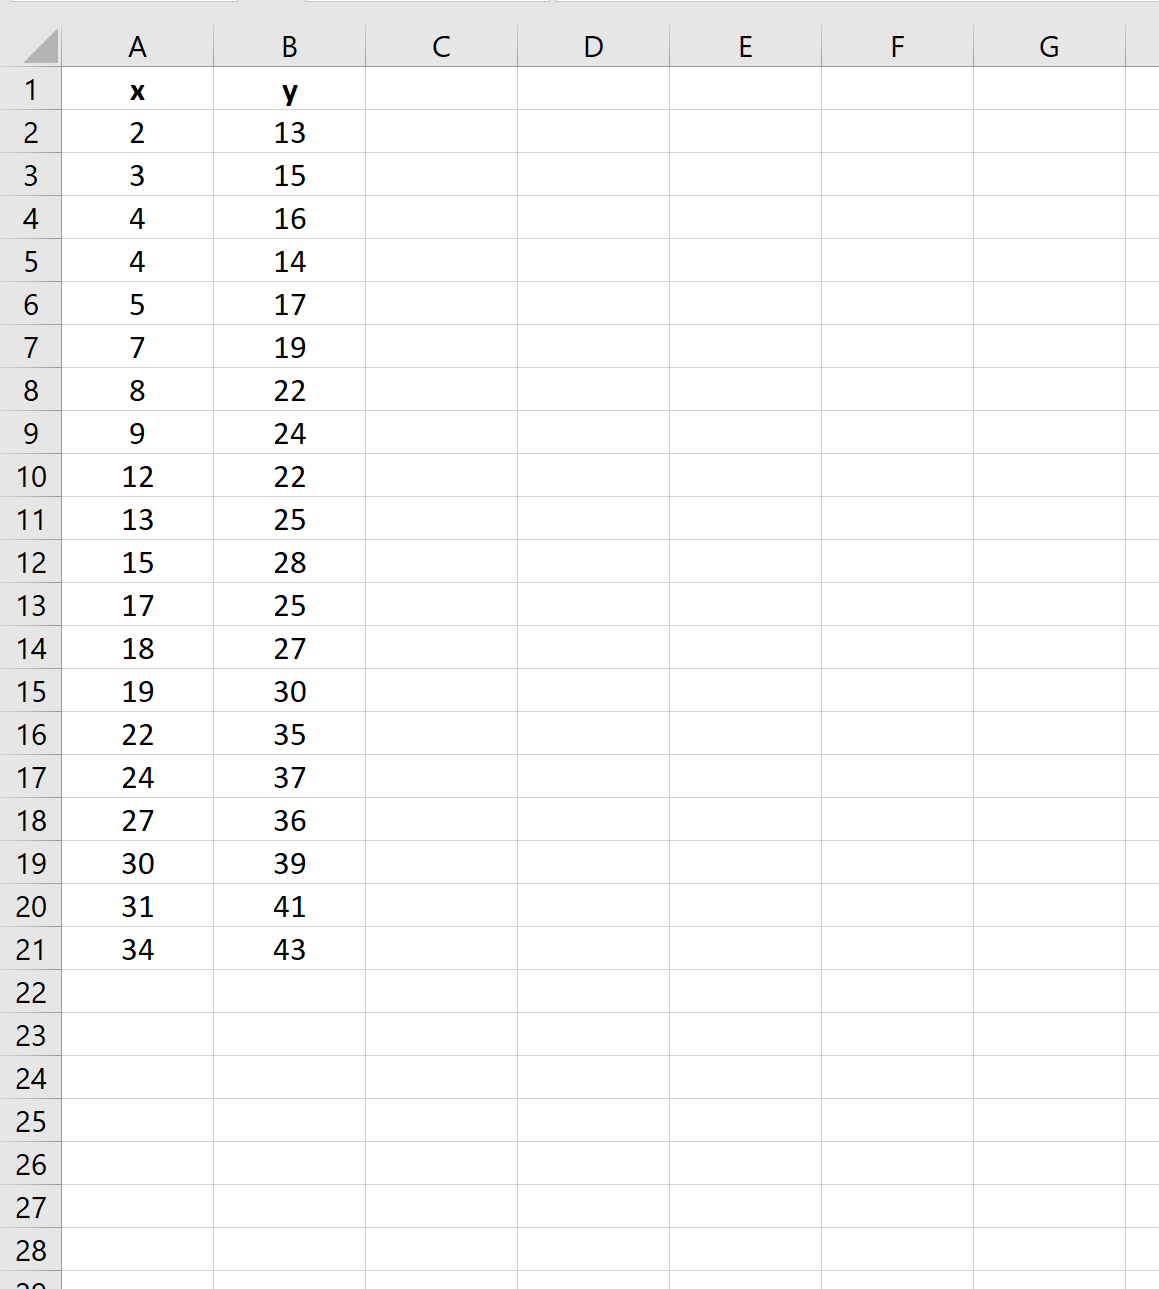
L’architecture opérationnelle de Microsoft Excel obéit à des conventions structurelles strictes pour le traitement graphique automatisé des séries de données bivariées. Afin de prévenir tout dysfonctionnement algorithmique lors de l’instanciation du nuage de points, il est impératif d’adopter une organisation normalisée des vecteurs numériques au sein de la feuille de calcul. La convention d’agencement cardinale repose sur le positionnement exclusif de la variable prédictive (la variable indépendante $X$) dans la colonne située immédiatement à gauche de celle hébergeant la variable critère (la variable dépendante $Y$).
Lorsque le moteur graphique d’Excel analyse une sélection bidimensionnelle adjacente comprenant deux colonnes de données (par exemple, la plage structurée A1:B50), il assigne par conception par défaut la première colonne rencontrée horizontalement à l’axe des abscisses (axe horizontal $X$), tandis que la seconde colonne adjacente est systématiquement dévolue à l’axe des ordonnées (axe vertical $Y$). Toute transgression de cette règle de contiguïté ordonnée contraindra l’analyste à des rectifications manuelles fastidieuses au sein de l’interface de paramétrage des séries de données.
La première rangée de la matrice de données doit être impérativement et exclusivement dédiée aux en-têtes nominatifs des variables étudiées. Ces étiquettes doivent allier concision sémantique et précision opérationnelle (par exemple, « Temps_Reaction_ms » et « Score_Precision_Pct »). L’insertion de chaînes textuelles explicites sur cette première ligne permet non seulement au logiciel d’assigner automatiquement des désignations intelligibles aux axes et aux séries lors de la configuration avancée, mais garantit également la traçabilité documentaire des métriques exploitées, prévenant toute ambiguïté lors des phases ultérieures d’interprétation des résultats.
2.2 Nettoyage préliminaire et traitement des données manquantes
Préalablement à toute démarche de visualisation géométrique, les vecteurs de données brutes doivent être soumis à une procédure de contrôle d’intégrité numérique particulièrement rigoureuse. L’une des défaillances les plus fréquentes rencontrées lors de l’importation de fichiers externes (.csv, extractions de bases relationnelles ou formulaires Web) réside dans l’hétérogénéité des formats de cellule. Des valeurs purement quantitatives peuvent se retrouver subrepticement cataloguées en tant que chaînes textuelles en raison de la présence d’espaces insécables, de caractères d’échappement invisibles ou de divergences régionales relatives au séparateur décimal (conflit structurel entre le point anglo-saxon et la virgule décimale francophone).
L’identification des cellules vides et des enregistrements corrompus constitue une étape déterminante pour la stabilité du modèle linéaire. Face à des données manquantes dans le cadre d’un échantillon restreint ou modéré, l’analyste se trouve confronté à l’arbitrage méthodologique classique :
- La suppression par liste (listwise deletion) : exclusion intégrale de l’enregistrement ou de la ligne d’observation dès lors qu’au moins l’une des deux coordonnées ($X$ ou $Y$) fait défaut. Cette approche, bien que conservatrice et réduisant la puissance statistique globale, s’impose pour préserver la symétrie bivariée de la régression.
- L’imputation de données : substitution de la valeur manquante par une estimation algorithmique (moyenne conditionnelle, modèle de régression itératif). Cette modalité requiert une justification méthodologique robuste et doit être maniée avec précaution pour ne pas atténuer artificiellement la variance résiduelle du nuage d’observations.
Dans l’environnement Excel, la vérification rapide du formatage s’effectue en s’assurant que l’alignement naturel des cellules au format numérique standard s’opère sur le bord droit de la cellule, un alignement sur le bord gauche dénonçant immanquablement une chaîne de caractères textuels inexploitable pour le calcul matriciel des moindres carrés.
2.3 Sélection efficace de la plage de travail
La délimitation manuelle d’une matrice d’observations de grande envergure au moyen du dispositif de pointage de la souris expose l’analyste à des erreurs de sélection préjudiciables, telles que l’inclusion involontaire de zones limitrophes ou le décrochage intempestif de la zone de surbrillance. Pour garantir une délimitation rigoureuse d’une plage continue de données (par exemple de la cellule A1 à la cellule B150), il est fortement recommandé de mobiliser les raccourcis clavier natifs du système d’exploitation.
Après avoir positionné le curseur actif sur la cellule supérieure gauche de l’ensemble de données (la cellule A1 intégrant l’intitulé de la première variable), la combinaison des touches Ctrl + Maj + Flèche Droite suivie immédiatement de Ctrl + Maj + Flèche Bas permet d’étendre instantanément la sélection active jusqu’aux limites extrêmes des colonnes et des lignes contiguës occupées par des valeurs non vides. Cette approche garantit l’inclusion exhaustive et immédiate du volume d’échantillonnage cible tout en excluant le risque d’omettre des fractions de données situées en dessous du champ de vision immédiat de l’écran.
Une vigilance particulière doit être observée pour proscrire impérativement l’inclusion de statistiques descriptives récapitulatives dans la plage de données dédiée à l’élaboration du graphique. Les lignes de sous-totaux, de moyennes globales ou d’écarts-types fréquemment positionnées en bas de tableau ne doivent sous aucun prétexte être intégrées dans la sélection. Leur présence altérerait dramatiquement la configuration du nuage de points en introduisant des artefacts géométriques artificiels de forte magnitude, lesquels déformeraient irrévocablement la trajectoire de la droite de régression et fausseraient l’intégralité des indicateurs de variance associés.
3. Création du nuage de points (Scatterplot) élémentaire
3.1 Accès aux outils de graphiques dans le ruban Excel
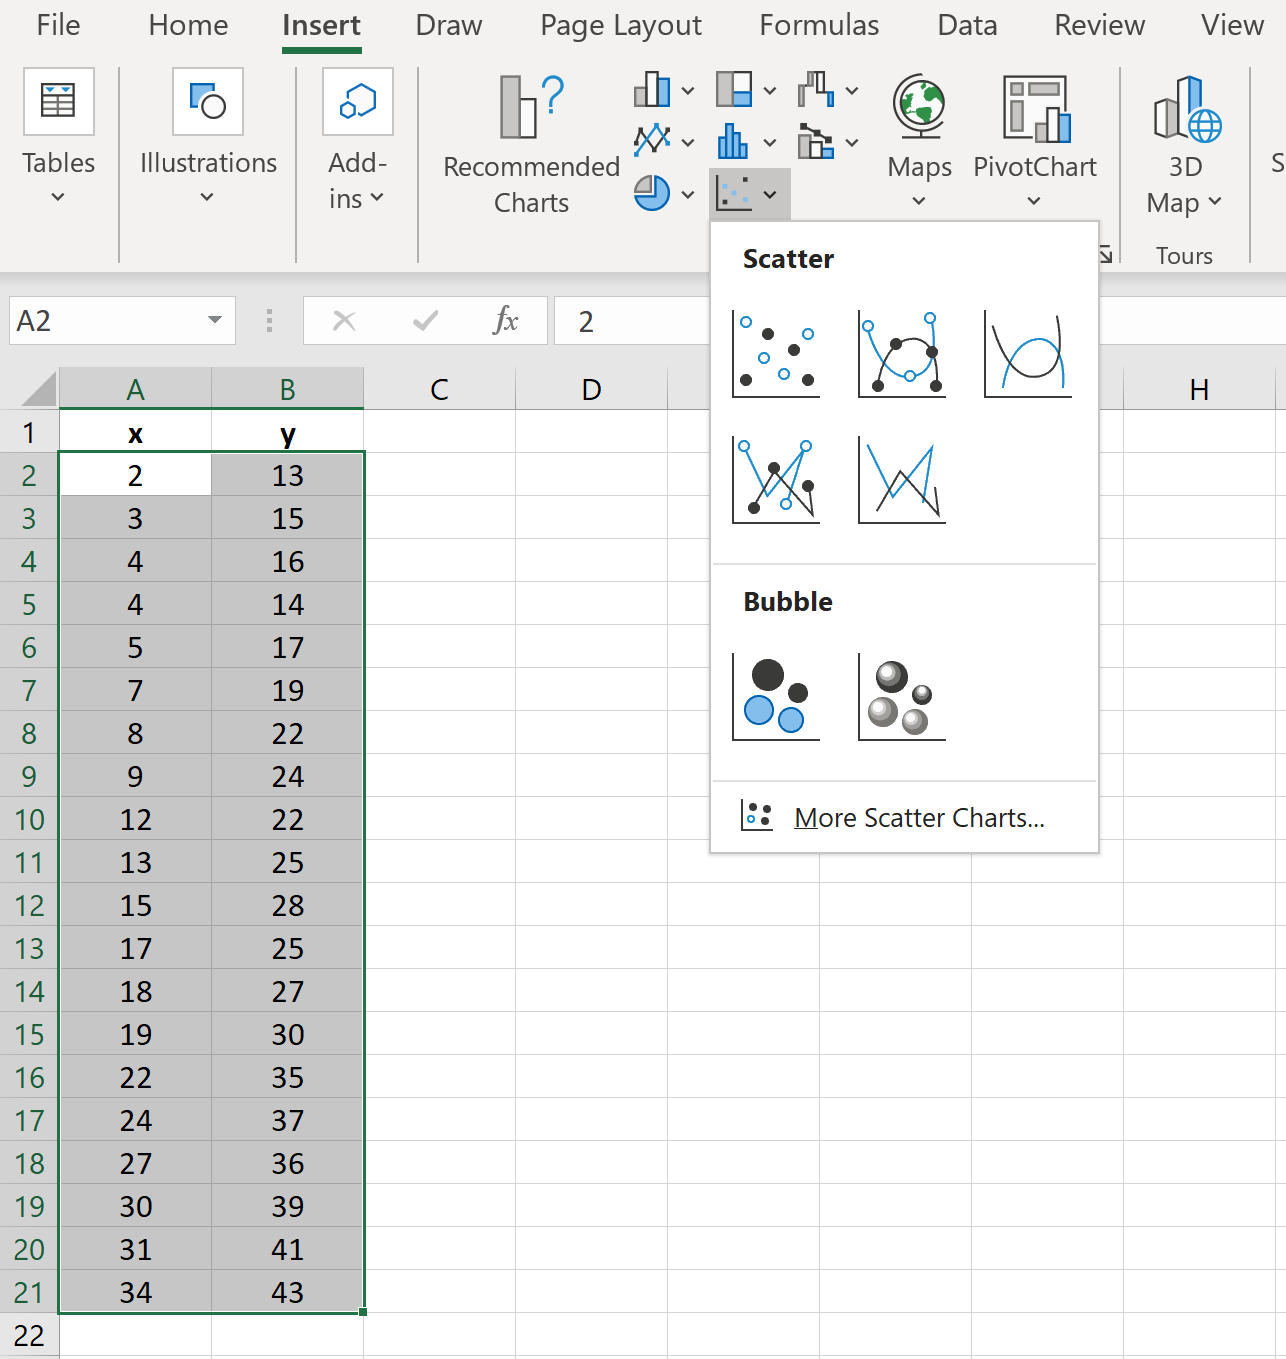
Une fois la matrice bivariée correctement délimitée et active sur la feuille de calcul, la transition vers la modélisation graphique s’opère par l’intermédiaire de la barre supérieure de commandes unifiée de Microsoft Excel. L’utilisateur doit orienter son attention vers le ruban supérieur et sélectionner l’onglet contextuel intitulé Insertion. Cette section regroupe l’intégralité des primitives logiques permettant d’implanter des composants dynamiques, des tableaux croisés, des illustrations et des dispositifs de visualisation géométrique au sein du classeur.
Au sein de l’onglet Insertion, il convient de localiser précisément le groupe fonctionnel dénommé Graphiques. Cette zone centrale rassemble une collection diversifiée d’icônes représentant les grandes familles typologiques de visualisations disponibles (diagrammes en colonnes, graphiques linéaires, aires empilées, représentations hiérarchiques et secteurs circulaires). L’élément requis pour l’analyse de régression correspond au pictogramme affichant un ensemble de coordonnées spatiales cartésiennes disjointes, formellement intitulé dans l’interface logicielle : Insérer un graphique à nuage de points (X, Y) ou à bulles.
Un clic gauche délibéré sur la flèche déroulante adossée à ce bouton déploie une galerie visuelle segmentée présentant les diverses variantes de tracés bivariés offertes par le moteur de rendu graphique. Il est capital de faire preuve d’un discernement méthodologique absolu lors de cette sélection : Excel propose des déclinaisons reliant les observations consécutives par des segments rectilignes ou des courbes lissées d’interpolation. Ces dernières doivent être catégoriquement proscrites pour toute analyse empirique standard, car elles imposent une continuité sérielle chronologique arbitraire totalement étrangère au postulat d’indépendance bivariée d’une distribution de régression.
3.2 Génération de la représentation bidimensionnelle de base
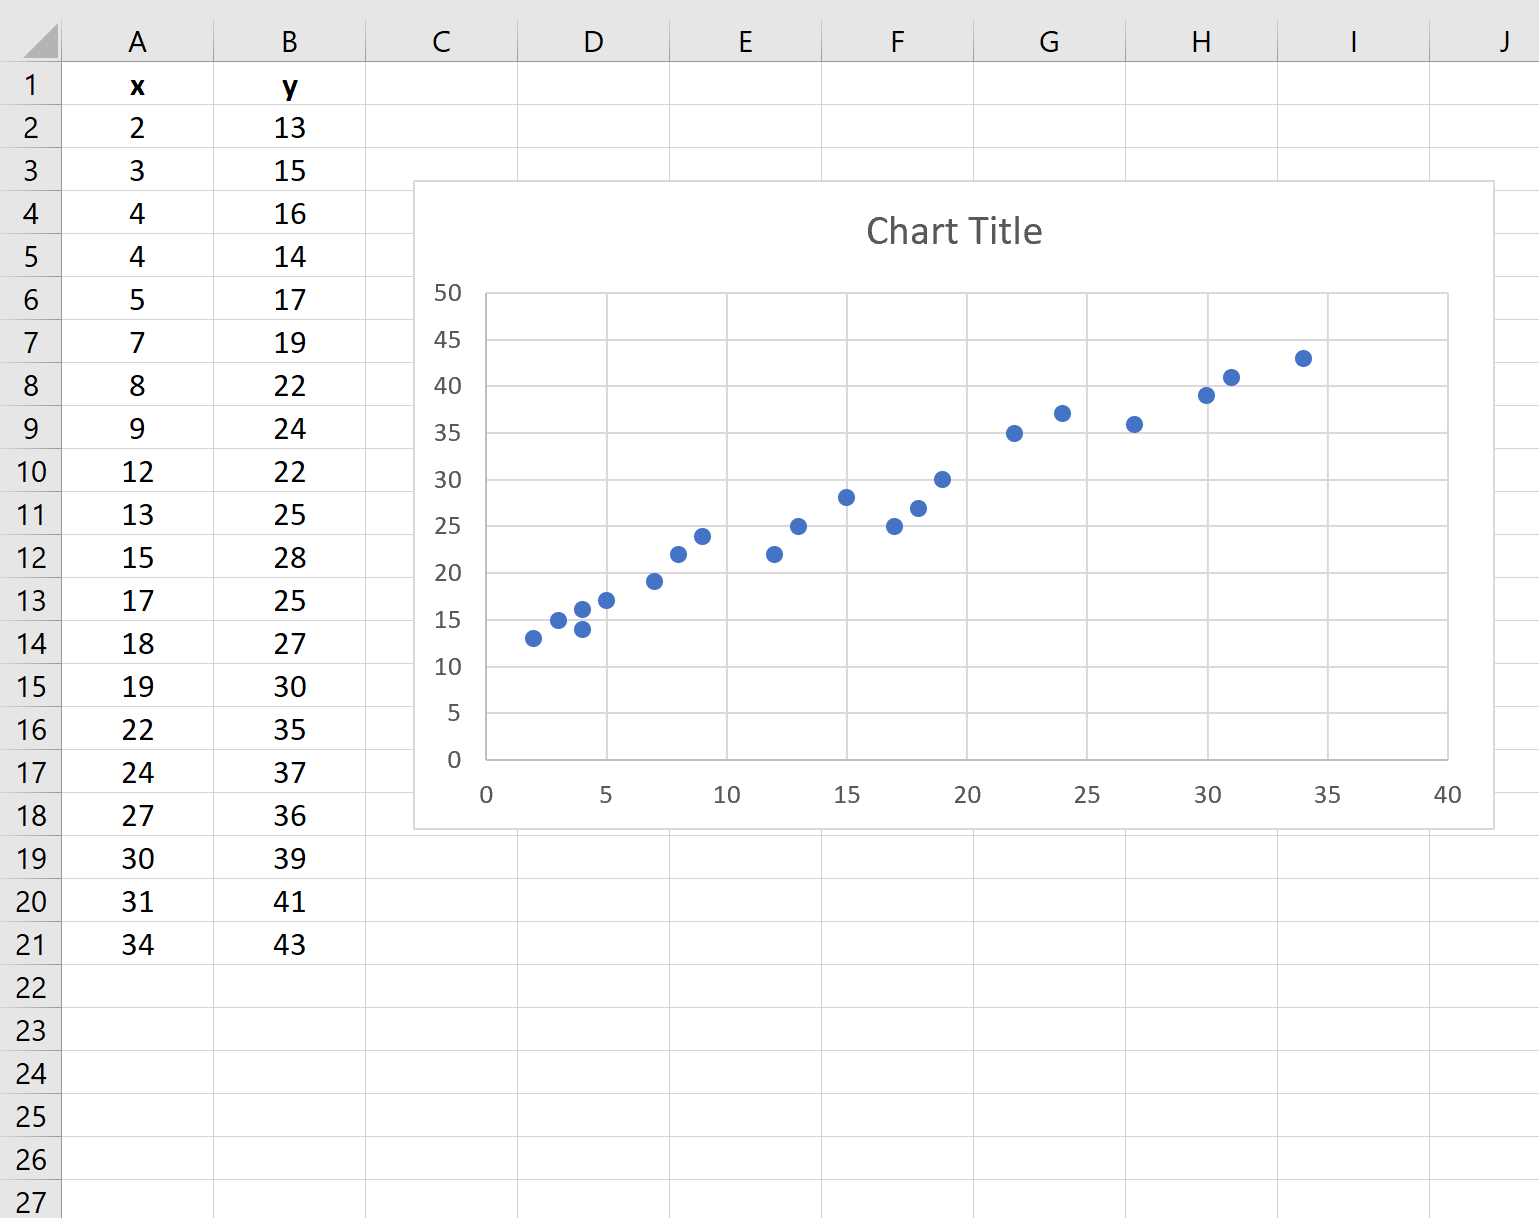
Dans la typologie des options de visualisation offertes par le sous-menu cartésien, le chercheur doit sélectionner avec une rigueur absolue la toute première vignette standardisée, identifiée explicitement sous la désignation de Nuage de points avec marqueurs uniquement. Ce choix opérationnel fondamental génère une représentation géométrique orthogonale pure, au sein de laquelle chaque paire d’observations $(X_i, Y_i)$ est traduite sur le plan spatial par un marqueur discret sans aucune liaison matérielle ou interpénétration linéaire entre les coordonnées individuelles.
Dès la génération du graphique, qui vient s’insérer en incrustation flottante sur la feuille de calcul active, une vérification métrologique impérative doit être exécutée : le contrôle d’attribution des axes géométriques. L’analyste doit immédiatement observer les bornes d’échelles numériques générées sur l’axe horizontal (abscisses) et sur l’axe vertical (ordonnées) afin de s’assurer sans ambiguïté que la variable indépendante $X$ est rigoureusement ancrée en abscisse et que la variable dépendante $Y$ se déploie le long des ordonnées. Cette confirmation garantit que l’orientation directionnelle de la modélisation ultérieure respectera scrupuleusement la posture théorique initiale de l’étude.
Sur le plan ergonomique, le conteneur graphique généré par défaut possède des dimensions relativement restreintes qui nuisent à une analyse exploratoire minutieuse. Il convient d’activer le cadre graphique par un clic sélectif, puis de saisir l’une des poignées de redimensionnement périphériques pour étendre la surface du canevas visuel. Un redimensionnement généreux combiné au positionnement du graphique dans une zone dégagée de la feuille de calcul permet d’optimiser le ratio d’aspect géométrique, évitant ainsi les distorsions perceptives susceptibles d’altérer l’appréciation visuelle de la dispersion des résidus.
3.3 Validation préliminaire de la dispersion des observations
Avant d’engager le calcul formel de la ligne de régression et l’extraction de ses paramètres mathématiques, le nuage de points élémentaire nouvellement généré doit faire l’objet d’un examen qualitatif minutieux. Cette inspection visuelle préliminaire, souvent qualifiée d’étape d’anamnèse graphique, vise à interroger la compatibilité empirique fondamentale de l’échantillon avec le modèle linéaire postulé. L’analyste observe si l’orientation générale des marqueurs suggère effectivement une trajectoire monotone continue ou si elle trahit des inflexions structurelles manifestes justifiant une modélisation non linéaire alternative.
Cette phase permet également de déceler visuellement la présence de distorsions métrologiques bien connues dans la collecte de données psychologiques ou comportementales, telles que :
- Les effets de plafond (ceiling effects) : caractérisés par une accumulation artificielle et anormale de points de données alignés de manière compacte sur la limite supérieure de l’axe vertical, indiquant que l’instrument de mesure sature précocement face à des sujets hautement performants.
- Les effets de plancher (floor effects) : matérialisés par une concentration symétrique sur les bornes minimales de l’échelle, révélant l’inaptitude de l’épreuve à discriminer les faibles niveaux de la variable mesurée.
Enfin, l’observation spatiale permet de traquer instantanément les points discordants flagrants ou les anomalies bivariées de saisie. Une observation localisée à une distance spectaculairement démesurée du centre de gravité principal du nuage signale quasi systématiquement une coquille de transcription typographique (telle qu’une erreur d’insertion décimale multipliant la coordonnée par dix). Cette anomalie doit faire l’objet d’une vérification immédiate auprès du registre de données sources avant de figer la géométrie de la droite d’ajustement.
4. Procédure d’insertion de la ligne de régression (courbe de tendance)
4.1 Méthode interactive via les éléments graphiques
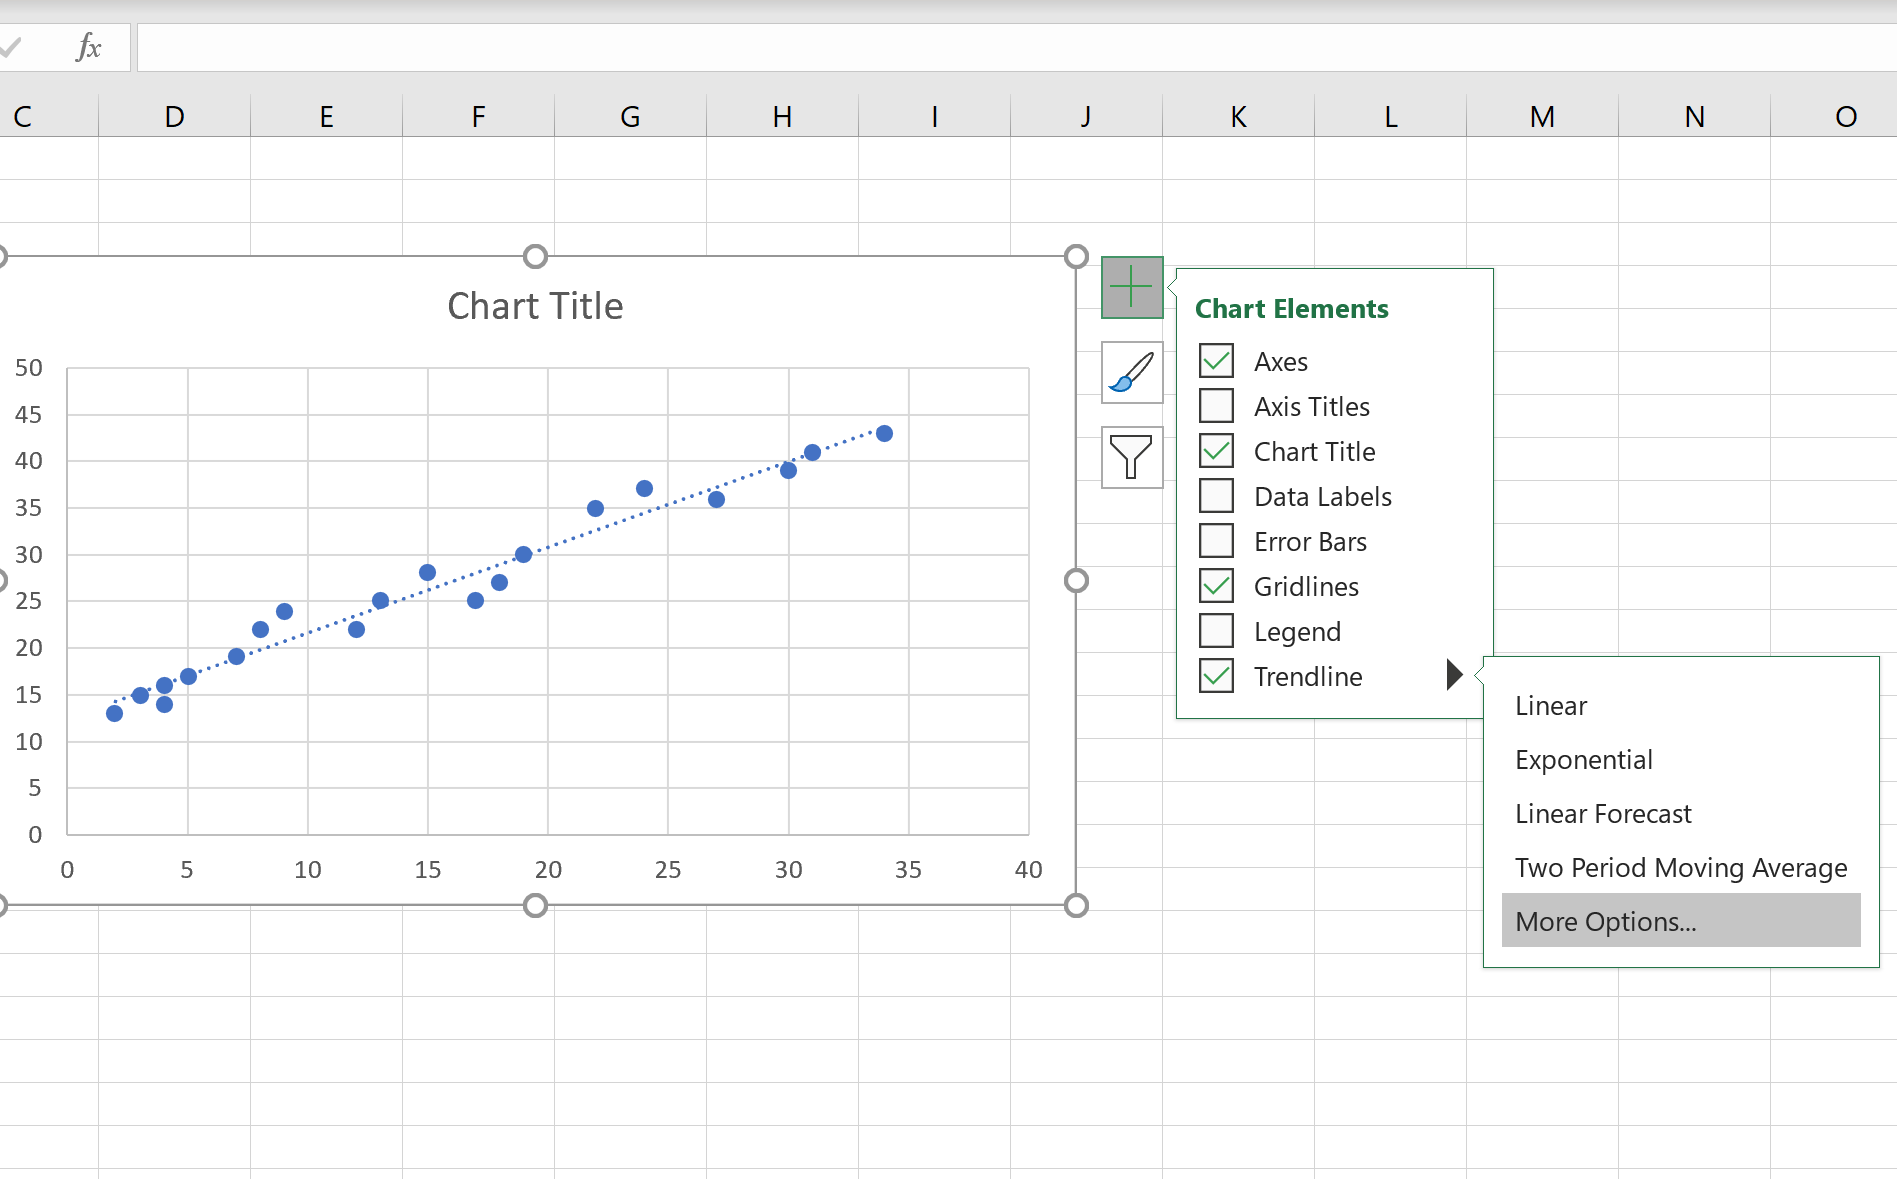
L’ergonomie des versions modernes de Microsoft Excel intègre un dispositif contextuel hautement intuitif pour l’enrichissement structurel des représentations géométriques. Dès lors que l’utilisateur sélectionne l’espace intérieur du nuage de points par un clic gauche, un ensemble de trois petits boutons contextuels apparaît en flottaison immédiate à proximité de l’angle supérieur droit de la bordure du graphique. Le premier d’entre eux, représenté universellement par le symbole typographique d’une croix d’addition verte (+), constitue le point d’entrée du gestionnaire dynamique des Éléments de graphique.
Un clic direct sur cette commande déploie instantanément une liste hiérarchique à cocher répertoriant l’ensemble des composants additionnels susceptibles d’être greffés sur le système d’axes cartésiens (axes, titres des axes, étiquettes de données, quadrillage, légende). Vers l’extrémité inférieure de ce catalogue d’outils figure l’entrée spécifiquement dédiée à la modélisation statistique, répertoriée dans le lexique d’Excel sous la terminologie de Courbe de tendance (Trendline selon la nomenclature de la version anglophone).
En cochant simplement la case d’activation associée à cette ligne, le processeur graphique d’Excel exécute instantanément l’algorithme des moindres carrés ordinaires sur la distribution des coordonnées bivariées affichées. Sans délai de latence perceptible, une droite continue vient se superposer géométriquement à la dispersion des marqueurs, matérialisant visuellement le meilleur compromis linéaire calculé pour minimiser la somme quadratique des déviations verticales.
4.2 Méthode alternative via le menu contextuel et le ruban
Pour les praticiens désireux de s’affranchir de l’interface contextuelle flottante ou opérant sur des configurations logicielles personnalisées, une méthode alternative classique repose sur la manipulation directe des composants du canevas. Cette technique consiste à diriger le pointeur de la souris directement sur l’un des marqueurs représentatifs d’une observation au sein du nuage, puis à exécuter un clic droit méthodique. Cette action déclenche l’ouverture du menu contextuel dédié à la série de données empiriques.
Au sein de ce menu contextuel exhaustif, l’utilisateur doit sélectionner sans ambiguïté l’instruction formelle désignée par l’intitulé Ajouter une courbe de tendance…. Cette manœuvre a pour effet immédiat de contraindre l’application à instancier simultanément la ligne de régression par défaut sur le plan cartésien et à faire surgir, sur le flanc droit de l’environnement de travail Excel, un volet d’administration hautement spécialisé portant le titre de Format de la courbe de tendance.
Une troisième voie d’accès procédurale équivalente s’articule directement à travers l’architecture pérenne du ruban supérieur. Lorsque le graphique est actif, le ruban se dote d’un onglet spécialisé nommé Création de graphique. À l’extrême gauche de cet onglet, le menu déroulant majeur Ajouter un élément de graphique permet d’accéder au sous-répertoire Courbe de tendance, offrant exactement les mêmes capacités de sélection et d’instanciation paramétrique que les techniques contextuelles de pointage direct.
4.3 Confirmation du type de modèle paramétrique
L’insertion initiale de la courbe de tendance ne constitue que la première phase de l’opération ; il est méthodologiquement indispensable de contrôler rigoureusement la nature fonctionnelle du modèle mathématique mobilisé en arrière-plan. Dans le volet latéral Format de la courbe de tendance, sous la rubrique symbolisée par une icône d’histogramme stylisé (intitulée Options de courbe de tendance), Excel dévoile la gamme des fonctions mathématiques disponibles pour épouser la dispersion des données.
L’utilisateur doit impérativement s’assurer que le bouton radio correspondant à l’alternative Linéaire est formellement activé par défaut. Cette option contraint l’ajustement à respecter la forme polynomiale de degré un ($Y = aX + b$). Le volet présente d’autres topologies fonctionnelles fondamentales :
- Le modèle Exponentiel ($Y = b \cdot e^{aX}$), adapté aux processus de croissance ou de décroissance auto-catalytique continue.
- Le modèle Logarithmique ($Y = a \cdot \ln(X) + b$), modélisant les phénomènes d’accélération initiale suivis d’une saturation progressive ou de rendements marginaux décroissants.
- Le modèle Polynomial d’ordre variable, capable d’épouser des fluctuations sinueuses complexes.
- Le modèle de Puissance et la Moyenne mobile.
Le maintien rigoureux du modèle linéaire ne doit pas relever d’un choix algorithmique passif ou machinal, mais d’une posture épistémologique défendable : c’est l’adéquation conceptuelle de la théorie empirique testée avec l’hypothèse d’une proportionnalité constante de l’effet marginal qui légitime impérieusement la confirmation définitive de l’option linéaire face aux tentations de surajustement par des fonctions non linéaires artificielles.
5. Affichage et interprétation de l’équation de régression
5.1 Activation de l’équation sur le graphique
La présence visuelle de la droite d’ajustement géométrique demeure incomplète pour l’évaluation scientifique tant que les paramètres fonctionnels exacts régissant son orientation ne sont pas formellement quantifiés et exposés sur le plan de travail. Pour expliciter ces coefficients, l’analyste doit se reporter aux fonctionnalités inférieures du volet latéral Format de la courbe de tendance, accessible par l’instruction Autres options de courbe de tendance… présente dans tous les menus contextuels associés.
Au bas de la section des options de modélisation mathématique, l’utilisateur doit cocher méticuleusement la case à cocher intitulée formellement Afficher l’équation sur le graphique. Dès cette validation, une zone de texte vectorielle autonome fait son apparition sur la surface du graphique, affichant en clair la formulation algébrique de la fonction ajustée aux coordonnées empiriques sous la formulation canonique :
$$y = ax + b \quad \text{ou} \quad y = mx + p$$
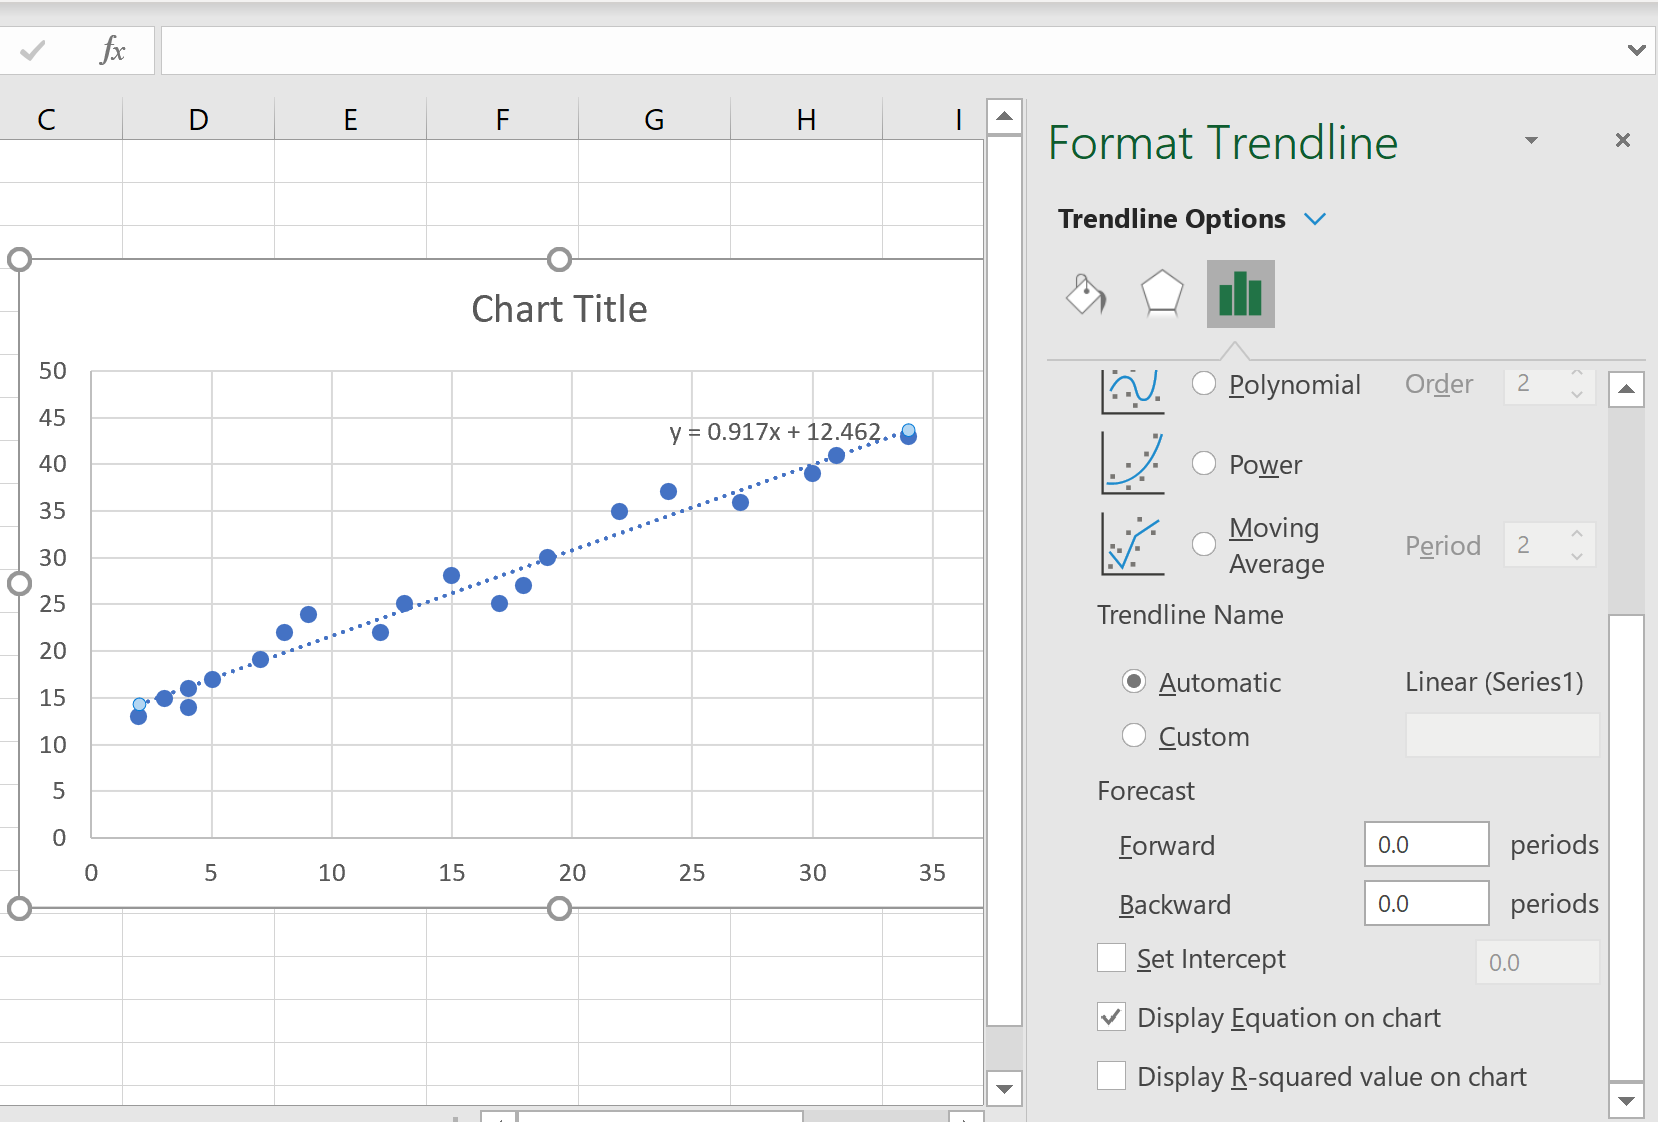
Par défaut, l’insertion automatique d’Excel dépose souvent cette étiquette de texte dans une position centrale standard qui chevauche maladroitement la droite de régression ou entre en collision visuelle avec la dispersion dense de certains marqueurs de données. Il relève des exigences fondamentales de l’ergonomie visuelle de saisir cette boîte de texte à l’aide de la souris pour la déplacer vers un quadrant vacant et contrasté du canevas cartésien (généralement dans le coin supérieur gauche ou supérieur droit), garantissant une lisibilité optique immédiate sans interférence avec les données brutes.
5.2 Décomposition structurelle de l’équation linéaire (y = ax + b)
L’explicitation de l’équation mathématique sur le graphique fournit à l’analyste les paramètres cardinaux pour décrypter la relation sous-jacente. Le coefficient $a$ (ou $m$), structurellement adossé en facteur de la variable explicative $x$, représente la pente de régression non standardisée (souvent annotée $B$ dans la littérature psychométrique et statistique internationale). Ce paramètre indique avec une rigueur absolue la magnitude et la direction du changement attendu au sein de la variable dépendante $Y$ pour chaque accroissement d’exactement une unité sur l’échelle de la variable indépendante $X$. Une valeur positive traduit une synergie ascendante, tandis qu’une valeur négative formalise une relation d’inhibition ou de décroissance inverse.
Le second paramètre, désigné par la constante $b$ (ou $p$), correspond à l’ordonnée à l’origine ou l’intercept. Sur le plan purement géométrique, il formalise le point d’impact exact où la prolongation spatiale de la droite de régression vient intercepter l’axe vertical des ordonnées au point d’abscisse $X = 0$. Il exprime ainsi la valeur attendue, ou moyenne théorique conditionnelle, de la variable dépendante lorsque la variable explicative est totalement neutralisée ou absente.
L’interprétation de cette constante $b$ exige toutefois une prudence théorique substantielle. Dans une multitude d’enquêtes comportementales, sociologiques ou psychométriques réelles, une valeur nulle de $X$ s’avère dépourvue de sens physique ou empirique (par exemple, un indice de quotient intellectuel, une pression sanguine ou une taille corporelle égale à zéro). L’ordonnée à l’origine ne possède alors qu’un rôle d’ancrage computationnel indispensable à la translation de la fonction, et ne saurait être interprétée comme un résultat empiriquement observable en dehors du domaine de validité de l’échantillonnage.
5.3 Ajustement de la précision numérique des coefficients
L’un des écueils techniques les plus insidieux générés par les paramètres par défaut de Microsoft Excel réside dans l’arrondi excessif appliqué à l’affichage des coefficients de l’équation graphique. Lorsque les unités de mesure d’origine des variables présentent des échelles numériques très resserrées ou au contraire gigantesques, Excel tronque fréquemment les paramètres de la pente ou de l’ordonnée en ne conservant que deux ou trois chiffres significatifs, affichant parfois une pente fallacieuse de $y = 0x + b$ ou masquant des variations décimales critiques.
Pour remédier à cette restriction et restituer la fidélité de l’ajustement, l’analyste doit effectuer un clic direct sur la boîte de texte contenant l’équation de régression pour la sélectionner, puis exécuter un clic droit afin d’accéder au volet contextuel spécialisé intitulé Format de l’étiquette de courbe de tendance. Au sein de cet environnement, l’onglet symbolisé par l’icône de diagramme donne accès à la section Nombre.
Dans le menu déroulant Catégorie, il est indispensable de substituer l’option Standard par la sélection de la catégorie Nombre ou Scientifique, puis d’incrémenter le champ Nombre de décimales à une valeur adéquate (usuellement comprise entre 4 et 6 décimales significatives selon le niveau de précision requis). Cette reconfiguration garantit l’affichage exhaustif de la structure fine des coefficients mathématiques, éliminant ainsi toute distorsion de prédiction consécutive aux erreurs d’arrondi lors du réinvestissement ultérieur de la formule dans des calculs prévisionnels externes.
6. Intégration et signification du coefficient de détermination R²
6.1 Activation du R² sur l’espace graphique
L’évaluation complète d’une modélisation linéaire ne peut s’arrêter à la simple spécification de la trajectoire moyenne de la droite : elle nécessite obligatoirement l’adjonction d’un indice statistique standardisé mesurant la qualité globale de l’ajustement empirique. Dans l’écosystème d’analyse d’Excel, cette métrique est incarnée par le coefficient de détermination, universellement symbolisé par la notation $R^2$ (ou R-carré). Pour intégrer ce paramètre cardinal au document graphique, l’utilisateur doit réactiver le volet Format de la courbe de tendance.
Immédiatement sous la case d’affichage de l’équation précédemment mobilisée, se trouve l’option désignée par l’énoncé Afficher le coefficient de détermination (R-carré) sur le graphique. Le cochage systématique de cette fonctionnalité enrichit instantanément le conteneur textuel de l’équation d’une seconde ligne typographique formalisée sous la syntaxe standard :
$$R^2 = \text{valeur numérique}$$
Sur le plan de l’édition scientifique et typographique, il est hautement recommandé d’harmoniser la mise en forme de cette étiquette. En cliquant à l’intérieur du texte de la zone générée, l’analyste peut sélectionner la lettre « R » et le chiffre « 2 » afin de vérifier que la casse et la mise en exposant respectent les standards éditoriaux internationaux de l’APA, lesquels prescrivent l’usage d’une typographie soignée où la lettre représentant une statistique indicielle est élégamment mise en italique : R².
6.2 Compréhension statistique de la variance expliquée
La compréhension authentique du coefficient de détermination exige de le replacer dans le cadre du partitionnement de la variance totale de la variable dépendante. La variabilité globale observée au sein du vecteur $Y$ (définie mathématiquement comme la Somme Totale des Carrés, ou Total Sum of Squares, $SST$) peut être décomposée sans résidu en deux sous-ensembles orthogonaux exclusifs :
- La variance directement imputable à l’ajustement du modèle linéaire (Somme des Carrés de Régression, ou Regression Sum of Squares, $SSR$).
- La variance d’erreur résiduelle non captée par la modélisation (Somme des Carrés des Erreurs, ou Residual Sum of Squares, $SSE$).
Dès lors, le coefficient de détermination s’établit formellement comme le ratio :
$$R^2 = \frac{SSR}{SST} = 1 – \frac{SSE}{SST}$$
Dans le périmètre exclusif de la régression linéaire simple bivariée par les moindres carrés, une propriété mathématique remarquable relie directement cet indice au coefficient de corrélation linéaire de Pearson : la valeur de $R^2$ correspond rigoureusement et sans exception au carré arithmétique de la valeur du $r$ de Bravais-Pearson mesuré entre les deux séries de variables continues ($R^2 = (r_{xy})^2$). Ainsi, une valeur de $R^2 = 0{,}64$ signifie avec une précision absolue que 64 % de la variance totale constatée dans la distribution des scores du critère $Y$ est mathématiquement expliquée, modélisée ou prédite par la connaissance des scores de la variable $X$ à travers la fonction linéaire ajustée.
Il demeure néanmoins crucial de distinguer la force d’ajustement géométrique de la validité interne d’un modèle. Un $R^2$ exceptionnellement élevé ne garantit pas per se que la structure fonctionnelle soit théoriquement saine ou exempte de biais méthodologiques profonds. Un ajustement linéaire peut présenter une proportion de variance expliquée très importante tout en ignorant une courbure sous-jacente substantielle si l’échantillon est restreint ou si la dispersion des observations comporte des points d’ancrage artificiellement distants.
6.3 Seuils d’interprétation et taille d’effet
Pour conférer une portée interprétative aux grandeurs statistiques abstraites générées par le calcul du $R^2$, la communauté scientifique mobilise fréquemment les balises heuristiques établies par le statisticien Jacob Cohen (1988) dans le cadre de l’évaluation standardisée des tailles d’effet en sciences du comportement. Selon cette typologie conventionnelle :
- Un $R^2$ avoisinant 0,02 (correspondant à un $r \approx 0{,}14$) est qualifié d’effet de petite taille ; la capacité explicative du modèle demeure marginale bien que potentiellement détectable sur de larges échantillons.
- Un $R^2$ s’élevant à 0,13 ($r \approx 0{,}36$) correspond à une taille d’effet moyenne ou modérée, reflétant une résonance empirique tangible dans la majorité des paradigmes psychologiques.
- Un $R^2$ atteignant ou dépassant le seuil de 0,26 ($r ge 0{,}51$) est qualifié de taille d’effet forte, caractérisant une convergence fonctionnelle de premier ordre entre les deux domaines métrologiques.
Cependant, l’utilisation de ces repères heuristiques universels ne doit en aucun cas exonérer l’expérimentateur d’une contextualisation aiguë inhérente à sa discipline de spécialité. Dans les protocoles de physique expérimentale ou de métrologie industrielle de précision, un coefficient de détermination inférieur à 0,99 sera fréquemment interprété comme le symptôme d’une défaillance instrumentale rédhibitoire ou d’un bruit de fond inacceptable. À l’inverse, au sein de l’épidémiologie sociale ou de l’analyse multifactorielle de traits de comportement complexes, la découverte d’un modèle linéaire simple affichant un $R^2$ de 0,10 constitue parfois une découverte fondamentale, compte tenu de l’immense diversité des variables étiologiques non mesurées influençant simultanément l’organisme humain.
7. Personnalisation esthétique du graphique selon les standards académiques
7.1 Harmonisation stylistique selon les normes APA
L’interface par défaut de Microsoft Excel produit des compositions graphiques destinées au monde corporatif qui intègrent fréquemment des artifices visuels superflus ou distrayants—souvent qualifiés de « chartjunk » dans la nomenclature théorique d’Edward Tufte (2001). La diffusion des données empiriques dans les revues académiques internationales de référence exige une mise en conformité typographique et structurelle stricte avec les prescriptions du manuel de style de l’APA (7e édition). Ce standard requiert une sobriété formelle totale et la suppression méthodique de toute fioriture cosmétique susceptible d’entraver la lisibilité cognitive immédiate des données.
La première intervention d’épuration esthétique consiste à éradiquer sans concession le quadrillage d’arrière-plan. Les lignes de grille horizontales et verticales générées par défaut dans Excel doivent être sélectionnées et supprimées en pressant la touche Suppr du clavier. De même, la bordure périphérique d’encadrement globale du graphique doit être désactivée : via le volet contextuel de Mise en forme de la zone de graphique, l’option de bordure doit être basculée sur Aucun trait pour permettre une intégration fluide et transparente du canevas dans le corps d’un manuscrit textuel.
La typographie de l’ensemble des inscriptions textuelles (titres, graduations, étiquettes de coefficients) requiert une rationalisation globale. Il convient d’exclure les polices décoratives ou à empattements fantaisistes pour instaurer une police sans empattement hautement lisible et universellement supportée, telle qu’Arial, Calibri ou une police académique classique comme Times New Roman, en veillant à maintenir une échelle hiérarchique homogène de taille de corps (généralement 10 à 11 points pour les axes et légendes, 12 points pour les titres éventuels). La palette chromatique doit prioriser les nuances monochromes en niveaux de gris profonds, le noir pur et les contrastes tranchés garantissant une parfaite reproductibilité lors de l’impression physique en noir et blanc.
7.2 Mise en forme de la droite de régression
Pour assurer une ségrégation perceptive optimale entre la trajectoire théorique continue du modèle et la myriade de points de données empiriques discrets, le tracé de la droite de régression doit faire l’objet d’un paramétrage minutieux. Dans le volet latéral Format de la courbe de tendance, la sélection de l’icône symbolisant un pot de peinture déversé (onglet Remplissage et ligne) ouvre l’accès aux commandes graphiques fondamentales régissant l’apparence du trait.
L’analyste doit ajuster avec discernement la section Épaisseur du trait (ou Largeur). Une droite excessivement épaisse (supérieure à 2,5 points) masque les marqueurs situés dans son sillage immédiat et confère une illusion de précision illusoire ; inversement, un trait excessivement gracile (inférieur à 0,75 point) devient optiquement imperceptible lors de la réduction dimensionnelle des figures dans les colonnes des revues savantes. Une épaisseur calibrée rigoureusement entre 1,25 et 1,75 point représente le compromis idéal de clarté géométrique.
En matière de texture, si le nuage d’observations est représenté par des disques pleins sombres, l’attribution à la droite de régression d’un style en Trait continu d’une teinte contrastée—un noir pur saturé ou un gris anthracite profond—permet de trancher sans équivoque avec les marqueurs. Dans les situations où plusieurs séries comparatives coexistent sur le même canevas cartésien, l’application alternative d’un motif en Tiret long permet d’assurer une discrimination visuelle immédiate, respectant les règles d’accessibilité visuelle pour les lecteurs souffrant de déficits de la perception des couleurs.
7.3 Configuration rigoureuse des marqueurs et des axes
Les marqueurs géométriques figurant les coordonnées individuelles doivent refléter une précision millimétrique. Par un clic sélectif sur les points de données, l’ouverture du volet Mise en forme des séries de données (section Remplissage et contour) permet de naviguer vers le sous-onglet Marqueur. Il convient d’y déployer les Options de marqueurs, de cocher l’alternative Intégré, et de sélectionner une primitive géométrique simple et non ambiguë, préférentiellement le cercle plein.
Le calibrage dimensionnel du diamètre du cercle doit être asservi au volume numérique total de l’échantillon analysé :
- Pour un échantillon modeste ($N < 30$), une taille de 5 à 6 points assure une présence spatiale adéquate.
- Pour des ensembles volumineux ($N > 200$), il est impératif de réduire la taille des marqueurs à 2 ou 3 points et d’appliquer une bordure fine plus claire ou un léger indice de transparence de remplissage (autour de 20 à 30 %), afin de rendre perceptibles les superpositions denses de points au cœur de la distribution (évitement du phénomène de surtraçage ou overplotting).
La structuration des axes cartésiens constitue la clef de voûte de la lisibilité de la figure. L’utilisateur doit s’assurer que les axes horizontal et vertical sont expressément dotés de leurs Titres des axes respectifs, lesquels doivent obligatoirement mentionner la nomenclature complète du construit théorique analysé, suivie scrupuleusement de l’unité de mesure métrique spécifiée entre parenthèses, par exemple : Consommation maximale d’oxygène (ml/kg/min). Enfin, les graduations des échelles doivent être paramétrées pour éliminer les zones périphériques vacantes excessives, en ajustant les limites minimale et maximale des axes au plus près du champ d’extension empirique réel de l’échantillon mesuré.
8. Exploration des modèles non linéaires alternatifs disponibles dans Excel
8.1 Modélisation logarithmique et exponentielle
L’observation du tracé géométrique du nuage de points révèle fréquemment des architectures de covariation qui violent le postulat de rectilinéarité inhérent à la régression simple des moindres carrés. Dans ces configurations complexes, l’insistance dogmatique à maintenir un modèle strictement linéaire génère des biais d’estimation critiques et une chute substantielle de la puissance explicative globale. L’architecture logicielle de Microsoft Excel permet de bifurquer avec aisance vers des fonctions alternatives au sein du volet Options de courbe de tendance.
La modélisation Logarithmique s’impose théoriquement lorsque le phénomène étudié manifeste une cinétique de variation initiale particulièrement fulgurante, laquelle est suivie progressivement d’un essoufflement continu ou d’une stabilisation asymptotique. C’est typiquement l’expression formelle des courbes d’apprentissage mnésique ou de la célèbre loi psychophysique de Weber-Fechner, stipulant que la magnitude de la sensation psychologique perçue croît de manière proportionnelle au logarithme de l’intensité de la stimulation physique sous-jacente. L’équation ajustée prend la forme :
$$y = a \cdot \ln(x) + b$$
À l’inverse, l’ajustement Exponentiel ($y = b \cdot e^{ax}$) devient impératif lorsque le taux d’accroissement de la variable dépendante s’amplifie de manière géométrique et cumulative en proportion directe de sa propre magnitude existante, une cinétique prévalente dans l’analyse de la propagation épidémiologique initiale, l’adoption virale d’innovations technologiques, ou certains processus de conditionnement pavlovien avec renforcement cumulatif accéléré.
8.2 Régression polynomiale et ajustement d’ordre supérieur
Lorsque la relation entre les deux dimensions métrologiques présente des inversions de polarité ou des trajectoires curvilinéaires complexes (formes en U ou en U inversé), la modélisation polynomiale constitue l’alternative paramétrique de référence. Dans le volet de configuration de la courbe de tendance, l’activation du bouton radio Polynomiale autorise l’analyste à moduler dynamiquement l’ordre de la fonction mathématique, le champ numérique contigu permettant de stipuler un degré oscillant conventionnellement entre 2 et 6.
L’archétype empirique par excellence de cette topologie d’ajustement quadratique (ordre 2) en sciences comportementales est incarné par la relation de Yerkes-Dodson, qui théorise de façon canonique que le niveau de performance cognitive culmine à un stade d’activation émotionnelle ou de stress intermédiaire optimal, tandis qu’un niveau de stimulation excessivement faible ou dramatiquement exacerbé induit une détérioration mesurable de l’efficience opératoire. La fonction quadratique s’articule alors selon l’expression formelle :
$$y = a_2x^2 + a_1x + b$$
L’expérimentateur doit néanmoins impérativement être mis en garde contre le danger méthodologique majeur du surajustement (communément désigné sous l’anglicisme d’overfitting). En augmentant de façon arbitraire l’ordre polynomial jusqu’aux limites maximales permises par Excel (degrés 4, 5 ou 6), l’algorithme contraindra la trajectoire de la courbe à serpenter artificiellement à travers chaque oscillation accidentelle de l’échantillon spécifique. Si cette manœuvre a pour effet mécanique inéluctable de gonfler le coefficient de détermination $R^2$ vers des niveaux proches de 1,00, elle dégrade de façon catastrophique la validité écologique du modèle et anéantit sa capacité de généralisation et de réplication prédictive sur de futures observations indépendantes.
8.3 Moyenne mobile et lissage exploratoire
L’ultime modalité de visualisation disponible au sein de la nomenclature des courbes de tendance d’Excel s’écarte radicalement du cadre formel de la modélisation paramétrique par les moindres carrés : il s’agit de l’option Moyenne mobile (Moving Average). Ce processus computationnel substitue à la recherche d’une fonction mathématique globale un algorithme de lissage local itératif, calculant pour chaque observation successive la moyenne arithmétique d’un sous-ensemble glissant d’observations contiguës délimité par le paramètre d’intervalle ou de période (défini par défaut à 2 observations consécutives).
Cette approche algorithmique est structurellement incompatible avec une démarche de régression bivariée standard portant sur des sujets ou des entités expérimentales mutuellement indépendantes, car elle présuppose un ordonnancement sériel strict. En revanche, elle acquiert une pertinence méthodologique indiscutable lors du traitement de séries temporelles longitudinales continues (recueil séquentiel de données chronologiques sur un cas unique, étude de signaux physiologiques continus comme l’électroencéphalographie ou l’évolution temporelle des variations de l’humeur au cours d’un suivi thérapeutique prolongé).
Dans ce contexte sériel restreint, la moyenne mobile n’assume aucune prétention explicative causale formelle ni de formulation prédictive unifiée. Elle agit exclusivement en tant qu’instrument descriptif de filtrage numérique, ayant pour mission d’atténuer le bruit stochastique à haute fréquence et les fluctuations aléatoires éphémères pour permettre à l’œil du chercheur de discerner visuellement les ondulations et les oscillations structurelles fondamentales de la trajectoire empirique sous-jacente.
9. Diagnostic des postulats de régression et détection des valeurs aberrantes
9.1 Identification visuelle des résidus et des points leviers
L’acceptation acritique d’une droite de régression sans déploiement préalable d’une inspection diagnostique des résidus constitue une faute méthodologique majeure dans la recherche quantitative. L’espace cartésien du nuage de points hébergeant la droite de régression permet déjà, par une lecture spatiale attentive, d’opérer un repérage préliminaire capital des déviations pathologiques les plus saillantes. Les résidus se matérialisent visuellement par les écarts verticaux séparant chaque point de données du tracé de la droite de régression.
L’attention de l’analyste doit se focaliser prioritairement sur l’isolement des points leviers (high-leverage points). Un point levier est une observation empirique caractérisée par une coordonnée d’abscisse $X_i$ dramatiquement excentrée par rapport au barycentre ou à la moyenne des valeurs $\bar{X}$ de l’échantillon. En vertu des propriétés mécaniques de la méthode des moindres carrés ordinaires, un point doté d’un fort effet levier exerce une attraction gravitationnelle substantielle sur l’orientation angulaire de la droite : si cette observation dévie verticalement ne serait-ce que modérément de la trajectoire attendue, elle inclinera artificiellement la pente entière à son avantage, créant un artefact de significativité ou masquant une absence de relation globale sur le reste des sujets.
Il importe également de distinguer rigoureusement une valeur aberrante unidimensionnelle classique d’une anomalie bivariée. Une observation peut se situer parfaitement au sein des bornes physiologiques ou acceptables pour la variable $X$ considérée isolément, et présenter un score tout à fait recevable pour la variable $Y$ prise de façon univariée, mais constituer une aberration méthodologique magistrale par la combinaison spécifique et discordante de ses deux coordonnées au regard de la relation bivariée générale de l’échantillon.
9.2 Évaluation de l’homoscédasticité par observation graphique
La conformité au postulat critique d’homoscédasticité—la constance absolue de la variance des erreurs résiduelles tout au long du continuum prédictif—peut faire l’objet d’une première expertise diagnostique visuelle hautement discriminante sur le nuage de points. Si le modèle d’ajustement est sain et respecte ce postulat fondamental, la dispersion des marqueurs de données doit se distribuer de façon symétrique, homogène et aléatoire de part et d’autre de la droite de régression, formant une bande de largeur constante sur toute l’étendue de l’axe des abscisses.
La rupture du postulat se trahit fréquemment par l’apparition d’une morphologie géométrique caractéristique en forme d’éventail ou d’entonnoir (désignée techniquement sous le terme d’hétéroscédasticité) :
- Les points se trouvent extrêmement resserrés et proches de la droite pour les faibles valeurs de la variable indépendante $X$.
- La dispersion verticale s’écarte, s’épanouit et explose de manière exponentielle à mesure que l’on progresse vers les valeurs élevées de l’échelle d’abscisse.
Les répercussions méthodologiques de l’hétéroscédasticité sont de première importance : bien que l’estimation mathématique ponctuelle de la pente demeure théoriquement sans biais à travers l’algorithme des moindres carrés, les calculs conventionnels de l’erreur-type de la pente se trouvent profondément altérés. Il en découle que les tests de significativité statistique ($t$-tests sur la nullité de la pente) ainsi que les intervalles de confiance générés pour la prédiction conditionnelle perdent toute validité inférentielle, gonflant dramatiquement le risque d’erreur de première espèce (rejet erroné d’une hypothèse nulle légitime). Lorsque l’hétéroscédasticité s’avère sévère, le recours à une transformation stabilisatrice de la variance (telle que la transformation logarithmique standard $log(Y)$ ou la méthode de Box-Cox) ou l’orientation vers des procédures de régression robuste devient impératif.
9.3 Pratiques recommandées face aux données discordantes
La confrontation inévitable avec des données empiriques discordantes ou des cas influents requiert l’application d’un protocole opérationnel normé, exempt de tout arbitraire méthodologique. La tentation naïve consistant à supprimer unilatéralement du jeu de données toute observation s’écartant du modèle sous prétexte d’optimiser mécaniquement le $R^2$ représente une faute épistémologique et déontologique grave susceptible de relever de la manipulation scientifique intentionnelle.
Le premier réflexe déontologique réside dans la traçabilité forensique des données : il est impératif de remonter scrupuleusement aux feuilles de saisie manuscrites primaires ou aux registres de log informatiques d’acquisition pour exclure une bévue typographique accidentelle lors de la saisie numérique manuelle. Si l’observation litigieuse découle d’une erreur d’encodage matérielle avérée ou d’un incident expérimental documenté (tel que la déconnexion inopinée d’une électrode au cours de l’épreuve), l’enregistrement doit être rigoureusement rectifié ou purgé du fichier source.
En revanche, si l’observation atypique représente une mesure authentique émanant d’un sujet ayant normalement accompli le protocole d’investigation sans défaillance matérielle externe, la démarche scientifique la plus vertueuse et recommandée consiste à exécuter et documenter systématiquement une analyse de sensibilité. Cette technique éprouvée consiste à calculer et à publier comparativement dans le rapport de recherche les résultats du modèle linéaire obtenus d’une part avec l’ensemble de l’échantillon complet incluant les cas limites, et d’autre part après neutralisation sélective de l’observation influente. Si la significativité substantielle des coefficients et les conclusions théoriques centrales demeurent invariantes face à cette exclusion, le modèle démontre sa robustesse intrinsèque ; dans le cas inverse, le chercheur se doit de débattre avec une transparence totale de l’extrême dépendance du phénomène identifié à l’égard de quelques observations singulières.
10. Approfondissement statistique via les fonctions et l’Utilitaire d’analyse
10.1 Extraction programmatique des paramètres par fonctions natives
Si la matérialisation visuelle de l’équation de régression sur l’espace graphique satisfait aux exigences de la communication visuelle, elle ne permet pas d’exploiter dynamiquement les coefficients statistiques au sein de calculs automatisés récurrents dans d’autres sections du classeur. Pour pallier cette contrainte, Microsoft Excel héberge un ensemble exhaustif de fonctions statistiques natives permettant d’extraire de façon purement programmatique les paramètres cardinaux de la droite des moindres carrés sans requérir l’instanciation préalable d’un graphique.
Pour calculer directement la valeur précise de la pente de régression dans une cellule indépendante, l’analyste fait appel à la fonction =PENTE() (ou SLOPE() dans la déclinaison logicielle anglophone). La syntaxe rigoureuse exige impérativement d’assigner en premier argument la plage des valeurs dépendantes, suivie en second paramètre de la plage des variables indépendantes explicatives :
=PENTE(Y_connus; X_connus)
Une inversion de l’ordre d’injection de ces matrices d’arguments générerait mathématiquement l’inverse arithmétique de la pente théorique postulée.
De façon symétrique, la détermination computationnelle de la constante d’ordonnée à l’origine s’effectue au moyen de la commande native =ORDONNEE.ORIGINE() (ou INTERCEPT()) en mobilisant une structure de syntaxe identique :
=ORDONNEE.ORIGINE(Y_connus; X_connus)
Enfin, pour extraire la force du lien de dépendance linéaire sans transiter par le tracé, la fonction =COEFFICIENT.CORRELATION(X_connus; Y_connus) (ou PEARSON()) retourne instantanément la valeur exacte du coefficient de corrélation de Pearson $r$, dont l’élévation au carré arithmétique (=COEFFICIENT.CORRELATION(...)^2) permet de restituer avec une précision décimale absolue le coefficient de détermination $R^2$.
10.2 Utilisation de la fonction matricielle DROITEREG
Pour s’émanciper des limites des formules ponctuelles individuelles et accéder d’un bloc à l’infrastructure statistique détaillée du modèle d’ajustement, Microsoft Excel met à disposition des analystes l’une de ses fonctions de calcul les plus puissantes : la fonction matricielle =DROITEREG() (ou LINEST() dans sa configuration d’origine anglophone). Cette commande permet d’extraire en un tableau matriciel compact l’intégralité des paramètres d’ajustement des moindres carrés ordinaires.
La formulation syntaxique canonique de cette instruction se déploie selon le schéma opérationnel suivant :
=DROITEREG(Y_connus; X_connus; Vrai; Vrai)
Le troisième argument booléen (Vrai) ordonne au moteur de calcul de calculer normalement la constante d’ordonnée à l’origine $b$ (au lieu de la contraindre artificiellement à valoir zéro), tandis que le quatrième paramètre (Vrai) ordonne explicitement l’extraction exhaustive des statistiques inférentielles complémentaires.
Sous les versions modernes de Microsoft 365 intégrant la gestion dynamique des tableaux matriciels élastiques, la validation d’une telle formule par simple pression de la touche Entrée provoque l’étalement automatique d’une grille de calcul s’étendant sur 5 lignes et 2 colonnes. Ce bloc d’extraction statistique offre une lecture exhaustive des métriques fondamentales du modèle :
- Ligne 1 : la pente de régression $a$ (colonne 1) et l’ordonnée à l’origine $b$ (colonne 2).
- Ligne 2 : l’erreur-type associée à la pente $s_a$ et l’erreur-type associée à l’ordonnée $s_b$, indispensables pour tester la significativité unitaire de chaque paramètre via les ratios de Student ($t = a / s_a$).
- Ligne 3 : le coefficient de détermination standard $R^2$ flanqué de l’erreur-type globale d’estimation du modèle ($\sigma_{\epsilon}$).
- Ligne 4 : la statistique globale $F$ de Fisher-Snedecor complétée par les degrés de liberté résiduels ($ddl$).
- Ligne 5 : la somme des carrés de la régression ($SSR$) et la somme des carrés des résidus d’erreur ($SSE$).
10.3 Déploiement du module ‘Utilitaire d’analyse’
Pour conférer à Microsoft Excel des capacités analytiques analogues à celles des progiciels statistiques académiques dédiés tels que SPSS ou SAS, l’analyste peut mobiliser le composant intégré officiel dénommé Utilitaire d’analyse (ou Analysis ToolPak). Si ce composant optionnel n’apparaît pas spontanément au sein de l’onglet Données du ruban, son activation s’opère par le biais du menu Fichier > Options > Compléments. Dans la liste déroulante Gérer située au bas de la boîte de dialogue, il convient de sélectionner Compléments Excel, de cliquer sur Atteindre…, puis de cocher formellement l’Utilitaire d’analyse.
Une fois cette extension greffée sur le ruban, un clic sur le bouton Utilitaire d’analyse positionné à l’extrémité droite de l’onglet Données dévoile une suite exhaustive de modules procéduraux avancés. La sélection de l’entrée Régression ouvre une boîte de configuration paramétrique complète qui permet :
- D’assigner rigoureusement les plages respectives de la variable d’entrée $Y$ et de la variable explicative $X$.
- De cocher l’option attestant de la présence d’étiquettes de variables sur la première ligne d’en-tête.
- D’ajuster le niveau d’exigence probabiliste des intervalles de confiance (généralement 95 % ou 99 %).
En validant le traitement par le bouton OK, Excel génère sur une nouvelle feuille de calcul un rapport d’évaluation économétrique et statistique d’une exhaustivité absolue. Ce livrable comporte les statistiques récapitulatives d’ajustement (incluant le $R^2$ ajusté corrigé pour les degrés de liberté), un tableau d’Analyse de Variance univariée complet (ANOVA bivariée) dégageant la significativité globale du modèle ($p$-value associée à la statistique $F$), ainsi qu’un tableau des coefficients individuels explicitant les valeurs du test $t$, les probabilités critiques de rejet bilatérales et les bornes inférieures et supérieures d’intervalle de confiance. Si l’analyste a pris soin de cocher les options dédiées aux diagnostics d’erreur, le module génère simultanément le tableau des résidus individuels ainsi que le graphique de dispersion des résidus normalisés.
11. Erreurs courantes et solutions techniques lors de l’implémentation
11.1 Inversion involontaire des variables sur les axes
L’une des défaillances techniques les plus insidieuses et récurrentes lors de l’élaboration d’un modèle linéaire dans Excel réside dans l’assignation inversée des rôles des variables sur le système de coordonnées. Cette erreur se produit quasi systématiquement lorsque la variable dépendante $Y$ a été accidentellement saisie dans la colonne située à gauche de la variable indépendante $X$ sur la feuille de calcul, et que l’utilisateur a généré son graphique sans modifier la sélection automatisée initiale.
Les conséquences d’une telle permutation sont méthodologiquement dévastatrices : si le coefficient de corrélation de Bravais-Pearson et le coefficient de détermination $R^2$ conservent des grandeurs numériques strictement identiques (la corrélation étant une métrique parfaitement symétrique entre distributions), la pente $a$ et l’ordonnée à l’origine $b$ se trouvent profondément et mathématiquement faussées. Au lieu d’estimer $\hat{Y} = aX + b$, le logiciel modélise en réalité la fonction réciproque $\hat{X} = a’Y + b’$, inversant totalement le sens de la relation explicative postulée par le chercheur.
Il n’est absolument pas nécessaire de détruire et de recommencer l’intégralité du travail de mise en forme graphique pour corriger cette dysfonction axiale. La procédure de rectification s’exécute à travers les étapes ordonnées suivantes :
- Effectuer un clic droit sur une zone vierge du graphique et sélectionner l’instruction Sélectionner des données….
- Dans la boîte de dialogue contextuelle, sélectionner la série de données défaillante dans le volet de gauche et cliquer sur le bouton Modifier.
- Deux champs de saisie matricielle distincts apparaissent : Valeurs de la série X et Valeurs de la série Y. Il suffit d’inverser manuellement ou de réassigner au curseur les plages de cellules correspondantes pour rétablir instantanément l’ancrage correct des variables.
- Valider par deux clics consécutifs sur OK : la géométrie spatiale du nuage, la trajectoire de la droite et l’équation mathématique se recalculent instantanément selon l’ordonnancement théorique authentique.
11.2 Confusion entre graphique en courbes et nuage de points
Une confusion méthodologique et ergonomique classique chez les utilisateurs néophytes consiste à concevoir un Graphique en courbes (accessible via le bouton figurant des lignes polygonales brisées) en lieu et place d’un véritable Nuage de points (Scatterplot). Bien que d’apparence superficiellement analogue au premier regard une fois les marqueurs affichés, ces deux structures reposent sur des principes de calcul spatial radicalement hétérogènes.
Le Graphique en courbes traite intrinsèquement les coordonnées positionnées sur l’axe horizontal non pas comme des grandeurs métriques continues, mais comme une suite arbitraire de catégories ordinales ou textuelles étiquetées de façon équidistante. Si la série des valeurs de la variable indépendante $X$ comporte des espacements réels inégaux (par exemple la suite de valeurs 1, 2, 5, 20, 100), le graphique en courbes placera ces données à des intervalles physiques rigoureusement identiques sur l’axe des abscisses, anéantissant toute fidélité à l’échelle continue sous-jacente.
Cette distorsion spatiale corrompt l’estimation de la régression : toute courbe de tendance greffée sur un tel support perd son assise mathématique réelle et dérive vers un ajustement ordinal fantaisiste. La règle méthodologique d’or demeure donc absolue et catégorique : pour toute modélisation statistique impliquant deux dimensions numériques continues, l’unique typologie graphique recevable au sein de la bibliothèque logicielle de Microsoft Excel est formellement et exclusivement le Nuage de points (X, Y).
11.3 Blocages techniques liés aux formats des cellules
Un nombre substantiel de blocages opérationnels ou d’affichages d’équations aberrantes (telles qu’une droite s’effondrant platement sur l’axe horizontal avec une pente affichant une valeur rigoureusement nulle) trouve sa cause originelle dans l’intégrité dégradée du formatage interne des cellules de la feuille de calcul. Lorsqu’un fichier de données est issu d’un transfert externe ou d’une manipulation textuelle, des cellules d’apparence numérique peuvent demeurer verrouillées sous un encodage textuel sous-jacent.
Dans cette configuration dégradée, le moteur computationnel de régression des moindres carrés d’Excel ignore purement et simplement ces observations lors de la sommation matricielle, ou les assimile à la valeur zéro, altérant drastiquement le tracé sans alerter explicitement l’analyste par un message d’erreur bloquant. Le conflit le plus fréquent concerne la divergence régionale du séparateur de décimales : si la configuration régionale de l’application attend une virgule et que les données intégrées comportent des points décimaux anglo-saxons (ou réciproquement), la cellule est instantanément rétrogradée au statut de chaîne de caractères textuelle inexploitable.
Pour restaurer l’intégrité du vecteur de calcul, la méthode la plus rapide consiste à mobiliser l’outil d’ingénierie de données natif Convertir :
- Mettre en surbrillance l’intégralité de la colonne incriminée sur la feuille de calcul.
- Naviguer vers l’onglet Données du ruban et cliquer sur la commande Convertir.
- Sélectionner l’option Délimité, franchir les étapes sans cocher de séparateurs, puis à la troisième étape de l’assistant, cliquer sur le bouton Avancé….
- Spécifier expressément le caractère utilisé dans les données sources pour le Séparateur décimal (par exemple le point) et valider.
Excel réécrit instantanément la totalité des valeurs sous le format numérique standard conforme aux spécifications de l’environnement de travail, ce qui rétablit sans délai la réactivité analytique de la droite de régression et l’exactitude des calculs affichés.
12. Restitution et contextualisation des résultats dans un rapport de recherche
12.1 Normes de rédaction des paramètres statistiques en texte
L’élaboration d’une restitution académique rigoureuse impose de ne jamais abandonner une représentation graphique sans lui adjoindre une contextualisation textuelle normalisée, rédigée selon les canons stricts des manuels de style scientifique contemporains (particulièrement les normes APA, 7e édition). La transcription formelle d’un modèle de régression linéaire simple au sein du corps d’un article savant obéit à des conventions de notation typographique précises qu’il convient d’honorer scrupuleusement.
Le paragraphe textuel dédié aux résultats empiriques doit obligatoirement articuler la significativité globale du test d’ajustement du modèle ($F$ de Fisher), ses degrés de liberté associés, la taille d’effet mesurée ($R^2$), ainsi que l’estimation paramétrique ponctuelle de la pente non standardisée ($B$) adossée à son erreur-type ($SE$) et à son coefficient standardisé ($\beta$). Une formulation académique canonique se structure selon le canevas exemplaire suivant :
Une analyse de régression linéaire simple a été conduite afin d’évaluer dans quelle mesure le niveau d’anxiété préopératoire mesuré par l’échelle STAI ($X$) permet de prédire l’intensité perçue de la douleur postopératoire évaluée sur une échelle visuelle analogique ($Y$). Les résultats indiquent que le modèle d’ajustement linéaire s’avère statistiquement significatif, $F(1, 48) = 28{,}42$, $p < 0{,}001$, le niveau d’anxiété rendant compte de 37{,}2 % de la variance totale des scores de douleur observée ($R^2 = 0{,}372$). L’examen de la pente non standardisée révèle qu’à chaque augmentation d’un point sur l’échelle d’anxiété correspond un accroissement statistiquement significatif de 0,45 point sur l’échelle d’évaluation de la douleur ($B = 0{,}45$, $SE = 0{,}08$, $\beta = 0{,}61$, $t(48) = 5{,}33$, $p < 0{,}001$, IC à 95 % [0,28, 0,62]).
Il importe de veiller à ce que l’ensemble des lettres symbolisant des grandeurs ou des tests statistiques ($F$, $p$, $R^2$, $B$, $SE$, $\beta$, $t$) soient systématiquement et scrupuleusement composées en typographie italique, tandis que les valeurs numériques associées demeurent composées en caractères romains droits, conformément aux prescriptions éditoriales internationales.
12.2 Conception d’une figure finale prête pour la publication
La finalisation d’un document visuel destiné à l’évaluation par les pairs ou à l’insertion dans un mémoire de thèse exige une mise en forme globale qui transcende le simple canevas généré automatiquement par le tableur. Une figure académique conforme aux standards ne doit en aucun cas comporter de grand titre interne imprimé dans la partie supérieure de son espace cartésien (les titres de graphiques intégrés par défaut dans Excel doivent être systématiquement désactivés et supprimés).
Dans l’ordonnancement éditorial conventionnel, l’identification de la représentation s’opère par l’adjonction d’un bloc textuel formel positionné immédiatement au-dessus ou en dessous de la figure au sein du traitement de texte. Ce bloc comporte impérativement le label numéroté en gras (par exemple, Figure 1), suivi sur la ligne suivante d’un titre bref et évocateur rédigé en italique décrivant la teneur métrologique du graphique (par exemple : Modélisation par régression linéaire de la douleur perçue en fonction de l’anxiété préopératoire).
Sous la figure, une légende textuelle explicative (Note en style APA, le mot « Note » étant composé en italique et suivi d’un point) doit être rédigée pour définir les abréviations utilisées, expliciter la taille exacte de l’échantillon analysé ($N = 50$) et rappeler la signification des lignes géométriques et des symboles graphiques :
Note. La ligne continue représente la droite d’ajustement calculée par la méthode des moindres carrés ordinaires ($y = 0{,}45x + 12{,}30$). Les cercles noirs désignent les observations individuelles empiriques ($N = 50$).
Enfin, l’exportation du graphique depuis Excel doit impérativement respecter les contraintes de résolution spatiale imposées par les éditeurs scientifiques (exigence standard d’un minimum de 300 DPI ou points par pouce). Pour contourner la compression matricielle destructrice lors d’un simple copier-coller d’image pixelisée, il est vivement recommandé de copier le graphique vectoriel d’Excel et de le coller dans le document final en tant qu’Image vectorielle améliorée (.emf) ou en tant qu’objet graphique incorporé natif, garantissant une netteté absolue des polices et des tracés quelle que soit l’échelle d’agrandissement finale retenue pour l’impression.
12.3 Discussion critique de la portée prédictive du modèle
L’acte d’interprétation conclusive d’un modèle de régression linéaire requiert une lucidité épistémologique et critique sans faille de la part de l’investigateur. Le piège méthodologique majeur le plus universellement dénoncé réside dans l’extrapolation abusive hors du champ d’expérience valide. La droite de régression tracée par Excel ne possède de fondement mathématique et empirique que dans les limites territoriales bornées par la valeur minimale et la valeur maximale observées de la variable indépendante ($[X_{\min}, X_{\max}]$).
Toute projection prévisionnelle prétendant anticiper le comportement de la variable dépendante $Y$ pour des grandeurs d’abscisse situées substantiellement au-delà de ces frontières empiriques relève d’une spéculation gratuite particulièrement hasardeuse. Rien ne permet en effet d’affirmer théoriquement que le phénomène étudié ne basculera pas, hors du champ d’observation actuel, vers un palier de saturation asymptotique dramatique, un seuil de rupture catastrophique ou une inflexion parabolique imprévue.
Le chercheur doit en outre intégrer dans la discussion de ses résultats les hypothèses alternatives fondées sur l’existence de mécanismes de causalité circulaire ou de variables masquées (effets de tiers facteurs). Une relation linéaire très affirmée entre deux variables comportementales peut ne traduire aucune dynamique causale directe, mais refléter fidèlement l’impact unificateur d’une variable sociodémographique, génétique ou contextuelle sous-jacente non mesurée dans le protocole. Enfin, la prudence méthodologique commande de ne jamais statuer définitivement sur l’universalité d’un modèle linéaire sans en appeler formellement à des procédures de validation croisée et à des réplications indépendantes menées sur de nouvelles cohortes empiriques afin de confirmer la reproductibilité pérenne des coefficients estimés.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. https://www.sciencedirect.com/book/9780121790608/statistical-power-analysis-for-the-behavioral-sciences
- Fox, J. (2016). Applied regression analysis and generalized linear models (3rd ed.). SAGE Publications.
- Microsoft Corporation. (2023). Ajouter une courbe de tendance ou une moyenne mobile à un graphique. Support Microsoft. https://support.microsoft.com/fr-fr/office/ajouter-une-courbe-de-tendance-ou-une-moyenne-mobile-%C3%A0-un-graphique-faee6142-d7b7-421c-8e32-ddf57210f2b4
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press. https://www.edwardtufte.com/tufte/books_vdqi
- Weisberg, S. (2014). Applied linear regression (4th ed.). John Wiley & Sons. https://doi.org/10.1002/9781118594841
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0