
Dans le champ contemporain des sciences humaines et sociales, et plus particulièrement en psychologie expérimentale et en psychométrie, la modélisation graphique des données empiriques constitue une étape charnière de l’investigation scientifique. Bien au-delà d’un simple artifice de présentation, la transcription visuelle des distributions bivariées au sein d’un repère cartésien permet d’appréhender intuitivement la morphologie des corrélations, de déceler les ruptures de linéarité et de repérer les configurations aberrantes qui échappent fréquemment aux résumés numériques univariés. Si les progiciels statistiques propriétaires ont longtemps monopolisé le traitement visuel des distributions, l’avènement d’outils collaboratifs en ligne a radicalement transformé les pratiques méthodologiques des laboratoires universitaires et des collectifs de recherche internationaux.
Parmi ces solutions technologiques, Google Sheets s’est imposé comme un environnement computationnel et visuel particulièrement robuste pour la recherche quantitative préliminaire. Toutefois, la transition d’un tracé bivarié rudimentaire vers une figure heuristique hautement informative requiert une maîtrise avancée de l’indexation spatiale des observations. L’assignation d’étiquettes nominatives ou catégorielles à chaque point d’un nuage de données — qu’il s’agisse d’identifiants de participants, de sous-types cliniques ou de conditions expérimentales — représente une exigence analytique fondamentale pour quiconque souhaite explorer les données avec une granularité fine, sans perdre de vue l’individualité des observations au profit exclusif de la masse agrégée.
Ce guide exhaustif a pour vocation de fournir aux chercheurs, statisticiens, doctorants et praticiens des sciences comportementales un protocole méthodologique complet pour concevoir, étiqueter, personnaliser et publier des nuages de points enrichis au sein de Google Sheets. En combinant considérations épistémologiques, rigueur de mise en forme tabulaire, manipulations d’interface précises et conformité aux standards de publication académique les plus exigeants, cet article détaille chaque étape nécessaire à la transformation d’un jeu de données brutes en une représentation visuelle d’une rigueur scientifique irréprochable.
1. Fondements théoriques du nuage de points dans la recherche en psychologie
1.1 Utilité épistémologique des nuages de points en analyse de données
D’un point de vue épistémologique, le nuage de points (ou scatterplot) constitue l’un des dispositifs d’exploration bivariée les plus puissants mis à la disposition des chercheurs en psychologie différentielle, clinique et cognitive. Contrairement à une croyance répandue qui subordonne la visualisation à l’inférence statistique formelle, la projection orthogonale de deux variables permet une évaluation sensible des structures sous-jacentes du phénomène observé. Lorsque l’on étudie les associations entre des variables latentes opérationnalisées par des inventaires psychométriques — telles que l’intelligence fluide et la capacité de la mémoire de travail —, le tracé géométrique met en exergue non seulement l’intensité et le sens d’une liaison linéaire, mais révèle également d’éventuelles relations curvilinéaires ou asymptotiques que le coefficient de corrélation linéaire de Pearson échoue dramatiquement à capturer.
Par ailleurs, le nuage de points s’avère indispensable pour l’inspection empirique des observations atypiques, communément désignées sous le terme d’outliers. Une valeur extrême isolée dans l’espace bivarié peut exercer un effet de levier disproportionné sur la droite de régression des moindres carrés ordinaires, induisant des erreurs de type I ou II lors des tests de significativité. De surcroît, la configuration géométrique des points met immédiatement en relief les artéfacts de mesure tels que les effets de plafond ou de plancher, indicateurs criants d’un défaut de sensibilité instrumentale sur les bornes de l’échelle d’évaluation.
L’examen graphique permet en outre d’évaluer de manière qualitative le respect des postulats statistiques nécessaires aux modélisations paramétriques subséquentes. L’homoscédasticité, définie comme la constance de la variance des erreurs résiduelles le long de l’axe prédictif, ainsi que la normalité bivariée, se manifestent visuellement par une dispersion elliptique homogène des observations. Néanmoins, l’analyste rigoureux doit impérativement maintenir une distinction conceptuelle inébranlable entre la mise en évidence visuelle ou statistique d’une corrélation bivariée et l’inférence d’un lien de causalité directionnel au sein d’un devis corrélationnel ou quasi-expérimental non randomisé.
1.2 Nécessité de l’étiquetage individuel des observations
L’agrégation anonymisée des points au sein d’un espace graphique présente un risque méthodologique majeur : celui de décontextualiser l’observation de son substrat empirique. Dans une multitude de paradigmes psychologiques, notamment les études de cas cliniques approfondies (méthodologies N-of-1), les protocoles exploratoires ou la neuropsychologie différentielle, chaque point ne représente pas une entité interchangeable, mais une singularité clinique ou un profil idiosyncrasique déterminé. L’adjonction d’un étiquetage nominal à chaque coordonnée cartésienne restaure la connexion entre la macrostructure distributionnelle et la microstructure phénoménologique du cas étudié.
Cette indexation textuelle explicite facilite l’identification nominative de participants clés, d’unités d’observation spécifiques ou de sous-catégories diagnostiques. Par exemple, au sein d’une distribution explorant la fluence verbale et les fonctions exécutives, l’étiquetage permet de repérer instantanément si les points excentrés correspondent à des patients présentant une lésion frontale ventromédiane spécifique ou s’ils relèvent d’un groupe contrôle asymptomatique. Dans les protocoles longitudinaux, cet étiquetage offre la possibilité d’effectuer le suivi traçable d’un sujet spécifique à travers plusieurs vagues d’évaluation successives projetées sur une matrice transversale.
Enfin, l’étiquetage individualisé s’avère un instrument de choix lors de la phase exploratoire de nettoyage des données. Face à un score bivarié aberrant, la présence d’une étiquette alphanumérique renvoyant directement au code d’identification du sujet permet de retourner sans délai au dossier clinique ou au journal d’expérimentation. L’analyste peut ainsi vérifier s’il s’agit d’une erreur de saisie typographique, d’un problème technique d’enregistrement du chronomètre ou d’une réelle singularité cognitive nécessitant un traitement théorique distinct.
1.3 Choix de Google Sheets comme outil d’analyse et de communication scientifique
L’utilisation de Google Sheets comme instrument de calcul et de restitution graphique s’inscrit au cœur des mutations contemporaines vers l’Open Science et la recherche collaborative. Dans un contexte où les consortia de recherche internationaux réunissent des laboratoires dispersés géographiquement, la mise en place d’environnements d’analyse unifiés et accessibles en temps réel répond à un impératif de fluidité logistique. La plateforme en nuage de Google garantit une synchronisation dynamique des modifications tabulaires et graphiques, éliminant définitivement les conflits de version inhérents aux fichiers statiques échangés par courriel.
Sur le plan de la démocratisation scientifique, Google Sheets permet de concevoir des visualisations quantitatives sans assujettir les membres de l’équipe à l’acquisition de licences logicielles onéreuses ou à la maîtrise préalable de syntaxes de programmation complexes. Cette gratuité d’accès abaisse considérablement les barrières à l’entrée pour les étudiants de premier cycle ou les chercheurs rattachés à des institutions aux ressources budgétaires limitées, tout en offrant une interface ergonomique facilitant la vérifiabilité des opérations analytiques.
De surcroît, l’interopérabilité native de Google Sheets avec les flux documentaires en ligne (notamment Google Docs et Google Slides) permet une intégration dynamique des graphiques au sein de rapports d’évaluation, de protocoles de subvention ou de manuscrits de prépublication. Toute modification apportée aux données brutes ou aux paramètres stylistiques des étiquettes au sein de la feuille de calcul matricielle peut être répercutée automatiquement dans les documents dérivés, garantissant une cohérence absolue de la chaîne de communication scientifique.
2. Structuration rigoureuse des données psychométriques dans Google Sheets
2.1 Organisation spatiale des colonnes pour un tracé optimal
L’efficacité du moteur de rendu graphique de Google Sheets repose fondamentalement sur la topologie du tableau de données source. Une architecture tabulaire inadéquate constitue la principale source de dysfonctionnement lors de la tentative d’adjonction d’étiquettes. Pour prévenir toute anomalie d’interprétation algorithmique par le logiciel, il convient d’adopter une disposition standardisée et rigoureusement contiguë des variables selon un ordre logique précis.
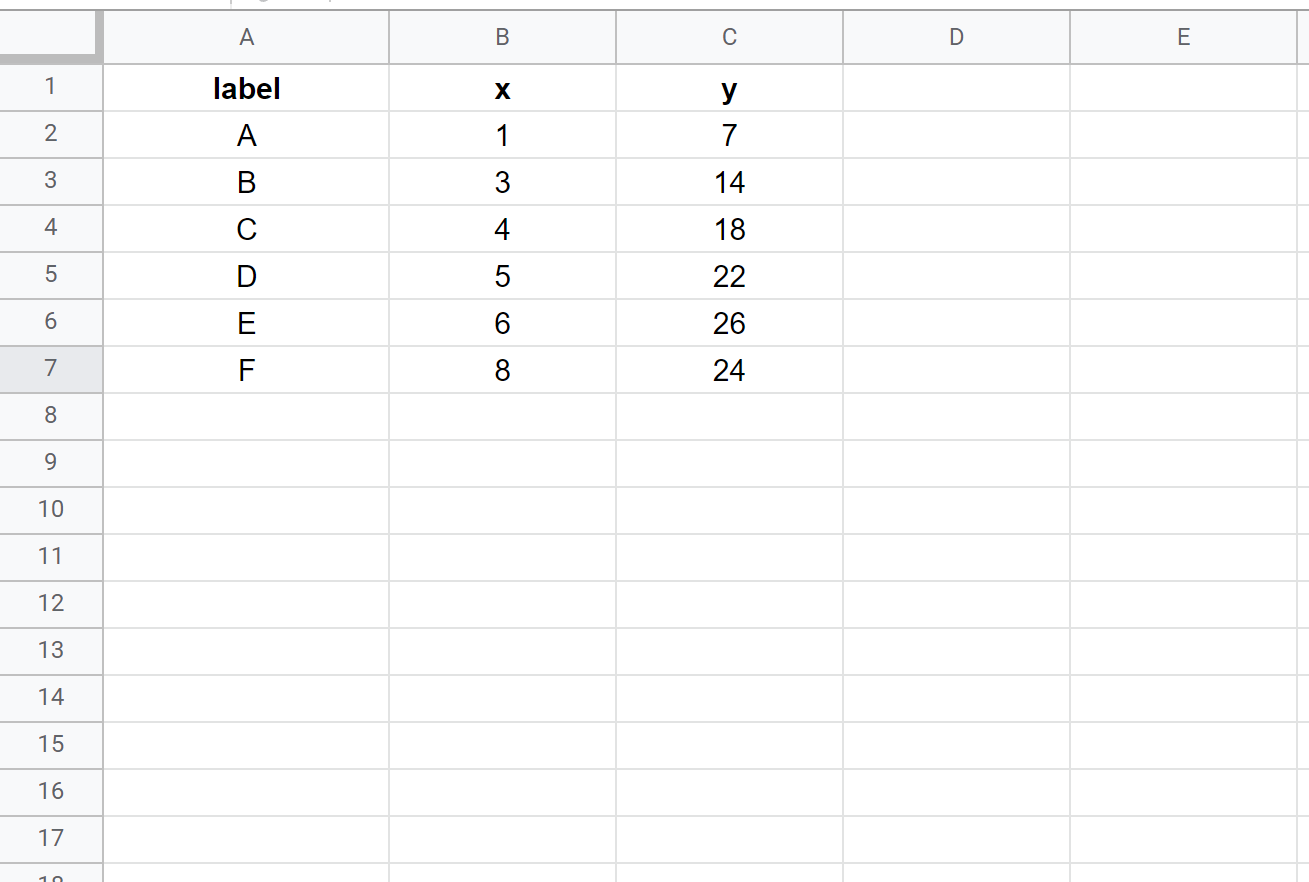
La règle empirique la plus pérenne consiste à réserver la première colonne (colonne A) aux identifiants nominatifs ou aux étiquettes textuelles. La deuxième colonne (colonne B) doit accueillir la variable continue indépendante (ou prédictive), laquelle sera assignée par convention cartésienne à l’axe horizontal des abscisses ($X$). Enfin, la troisième colonne (colonne C) reçoit la variable continue dépendante (ou critère), destinée à s’inscrire sur l’axe vertical des ordonnées ($Y$). Cette contiguïté stricte permet au moteur d’inférence de Google Sheets de pré-identifier correctement les séries numériques et les métadonnées descriptives lors de la phase de sélection automatique.
Il est formellement déconseillé d’intercaler des colonnes vides, des sous-totaux statistiques intermédiaires ou des annotations périphériques au sein de ce bloc ternaire fondamental. L’intégrité de la matrice doit être préservée : chaque ligne représente une unité expérimentale unique (le participant), et chaque colonne exprime un attribut invariant de cette unité. Cette orthogonalité structurale garantit que l’indexation matricielle ($i, j$) demeure parfaitement prévisible pour les routines graphiques internes du tableur.
2.2 Nettoyage et standardisation des variables catégorielles et continues
Préalablement à toute mise en forme visuelle, un examen minutieux de l’intégrité des types de données s’impose. Google Sheets distingue rigoureusement les chaînes textuelles (alignées à gauche par défaut) des valeurs numériques scalaires (alignées à droite par défaut). Si une valeur de l’axe $X$ ou de l’axe $Y$ est accidentellement reconnue comme du texte — fréquemment en raison d’une confusion entre le séparateur décimal point et la virgule, ou de l’insertion involontaire d’une espace insécable —, le logiciel refusera de positionner le point sur un axe continu ou déformera l’espacement métrique en traitant l’axe comme une échelle ordinale discrète.
La gestion des valeurs manquantes doit obéir à des règles méthodologiques explicites conformément aux préconisations de l’American Psychological Association. Deux stratégies prévalent : l’exclusion par liste (listwise deletion), consistant à purger l’intégralité de la ligne du sujet si une coordonnée manque, ou l’imputation statistique (par la moyenne, la médiane ou une régression multiple) préalablement documentée. La présence d’une cellule vide dans la colonne de l’axe $X$ ou $Y$ provoque la suppression du point correspondant dans le nuage, mais si la cellule d’étiquette est vide alors que les coordonnées existent, le point sera tracé de façon anonyme, introduisant une hétérogénéité visuelle indésirable.
Enfin, l’impératif éthique de confidentialité des participants impose une anonymisation irréversible des étiquettes destinées à figurer sur le graphique. Les patronymes, prénoms ou numéros de sécurité sociale doivent être systématiquement transmutés en codes alphanumériques normalisés (par exemple, P001, P002 ou Sujet_A). Ce nettoyage textuel requiert également l’élimination des espaces invisibles via la fonction =SUPPRESPACE() et l’uniformisation typographique via la fonction =MAJUSCULE() ou =NOMPROPRE() afin de prévenir toute discontinuité esthétique.
2.3 Validation des formats d’entrée avant la phase graphique
Afin de s’assurer de la validité interne des scores psychométriques avant la génération du canevas visuel, l’application de règles de validation des données via le menu natif de Google Sheets constitue une précaution méthodologique hautement recommandée. Cette mesure préventive permet de borner strictement les plages numériques acceptables en fonction des caractéristiques psychométriques des échelles administrées. Si une batterie d’évaluation repose sur une échelle de Likert bornée de 1 à 7, la saisie d’un score hors limites tel que 8 ou 77 sera immédiatement proscrite ou mise en exergue par un marqueur visuel d’avertissement.
L’utilisation concertée des filtres automatiques sur les en-têtes de colonnes permet d’effectuer une première vérification de cohérence distributionnelle. En déployant les menus déroulants de filtrage, l’analyste peut repérer instantanément la présence de valeurs non numériques égarées dans les vecteurs continus, identifier les doublons au sein des codes d’identification nominatifs des sujets, ou examiner la dispersion brute des extrêmes.
Ce protocole de vérification préliminaire épargne au chercheur des désagréments graphiques chronophages. Générer un nuage de points sur une base empirique contaminée par des incohérences syntaxiques contraint inévitablement à reconstruire le graphique a posteriori, le moteur de Google Sheets ne réactualisant pas toujours de manière optimale les échelles d’axes lorsque la typologie d’une colonne subit des mutations profondes après la création de l’objet graphique.
3. Création du nuage de points de base via l’interface de Google Sheets
3.1 Sélection des plages de données quantitatives
La première manœuvre opératoire au sein de l’interface graphique de Google Sheets consiste à délimiter avec exactitude la zone matricielle à projeter. Bien qu’il puisse sembler intuitif de sélectionner l’intégralité du tableau (incluant d’emblée les identifiants textuels de la colonne A), une telle approche conduit régulièrement l’algorithme heuristique de Google Sheets à concevoir des configurations graphiques inadaptées, telles que des graphiques combinés ou des diagrammes en bâtons catégoriels.
La pratique méthodologique la plus sûre consiste à surligner exclusivement les colonnes quantitatives destinées aux axes géométriques. Par exemple, si vos données s’étendent de la ligne 1 (en-têtes) à la ligne 50, positionnez votre curseur sur la cellule B1 (contenant le label de la variable $X$), maintenez la touche Majuscule enfoncée, et cliquez sur la cellule C50 (fin de la variable $Y$). Pour les jeux de données volumineux comprenant plusieurs centaines d’observations, l’usage combiné des raccourcis clavier s’avère hautement préconisé : sélectionnez B1:C1, puis appliquez la combinaison Ctrl + Maj + Flèche Bas (sous Windows/Linux) ou Cmd + Maj + Flèche Bas (sous macOS) pour étendre instantanément la sélection jusqu’au dernier enregistrement contigu non vide.
L’inclusion délibérée de la ligne d’en-tête (ligne 1) au cours de cette phase initiale est primordiale. Elle fournit au système d’automatisation graphique les descripteurs sémantiques indispensables pour intituler automatiquement les axes orthogonaux, évitant ainsi des interventions manuelles répétitives de titrage au sein des sous-menus de l’éditeur.
3.2 Insertion et conversion du graphique via le panneau de configuration
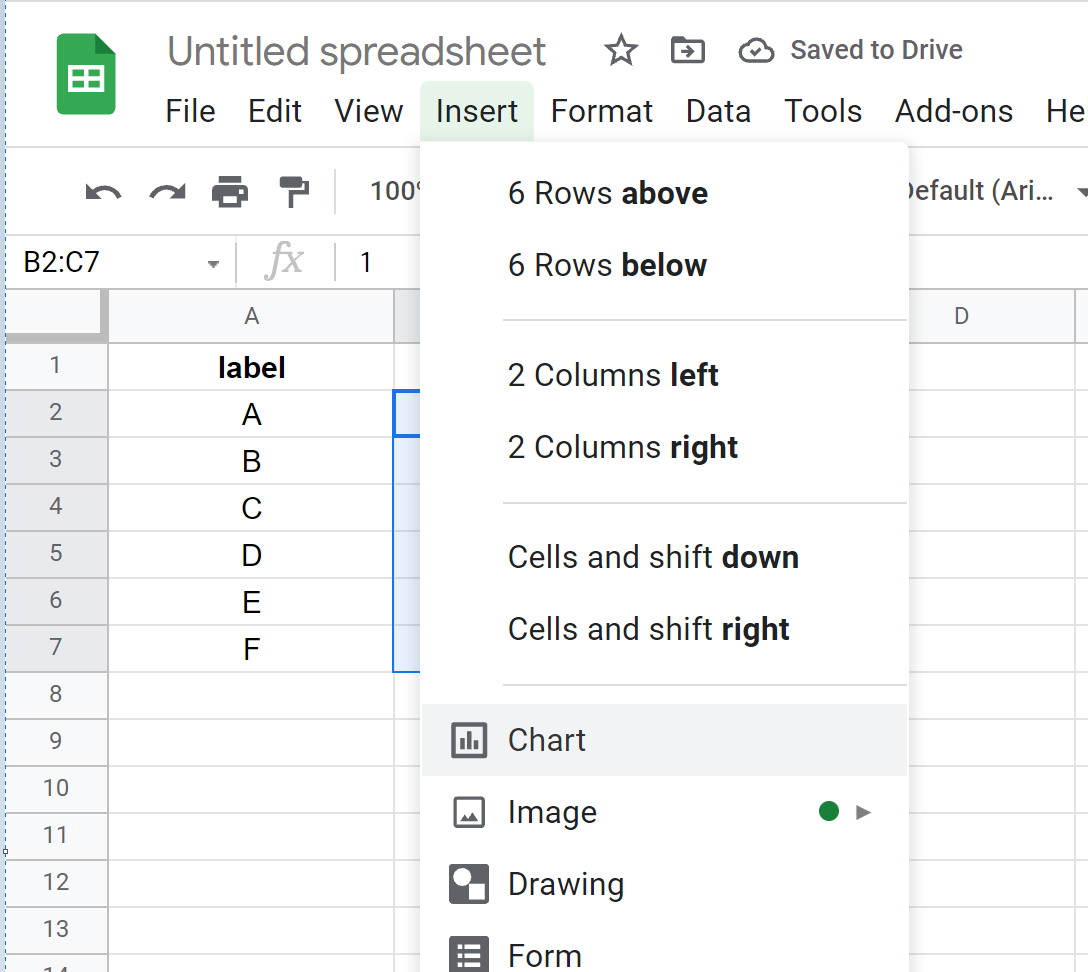
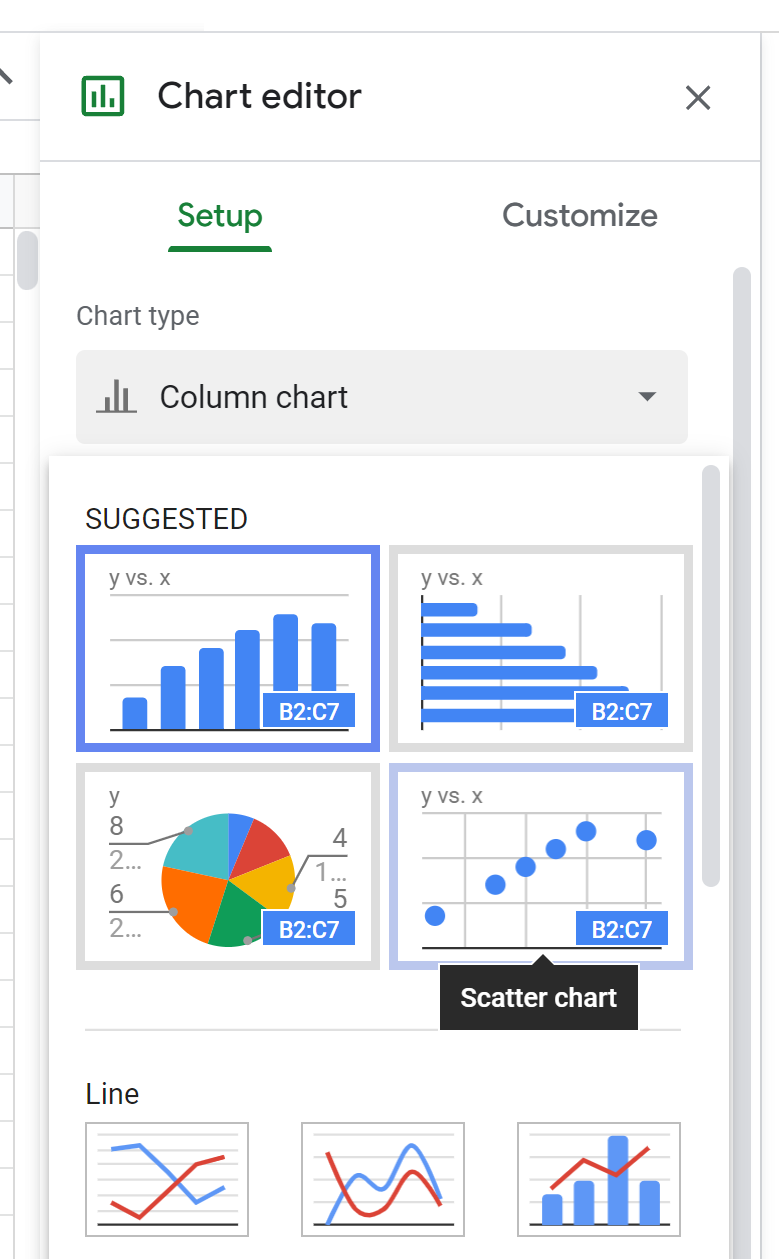
Une fois les coordonnées quantitatives dûment sélectionnées, accédez au ruban supérieur de l’interface, cliquez sur le menu Insertion, puis sélectionnez la commande Graphique. Alternativement, l’icône de raccourci représentant un mini-histogramme située dans la barre d’outils standard remplit la même fonction. Dès cette activation, Google Sheets génère une boîte graphique flottante au sein de la feuille active et déploie simultanément sur la droite de l’écran un volet contextuel intitulé Éditeur de graphiques.
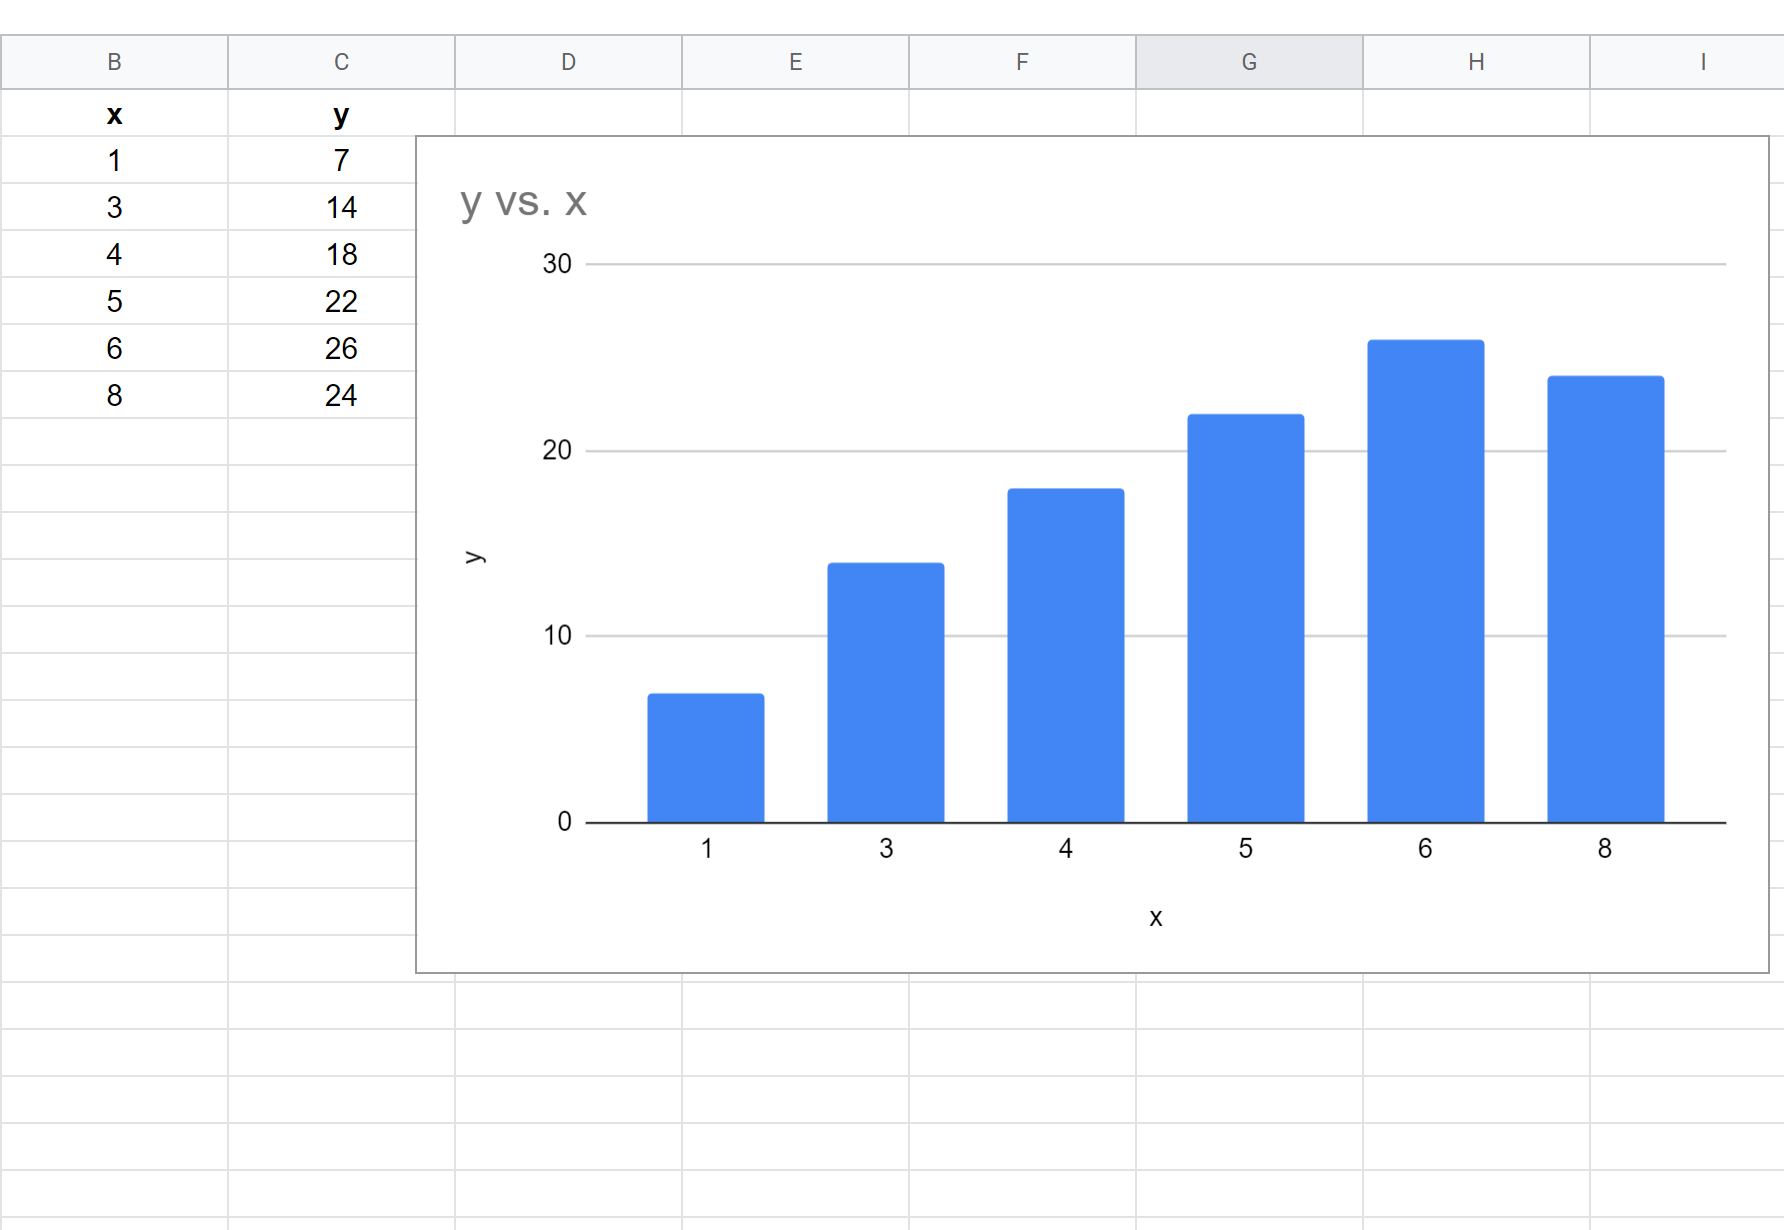
Dans la majorité des cas, le moteur de rendu tente de prédire la nature des données et génère fréquemment par défaut un graphique en colonnes ou une ligne temporelle continue non sollicitée. L’analyste doit immédiatement corriger ce comportement. Dans le volet latéral, assurez-vous que l’onglet Configuration est actif. Cliquez ensuite sur le premier menu déroulant intitulé Type de graphique. Faites défiler la typologie vers le bas jusqu’à la section dédiée aux graphiques de dispersion, et sélectionnez formellement le pictogramme désigné sous l’appellation Graphique à nuage de points (Scatter chart).
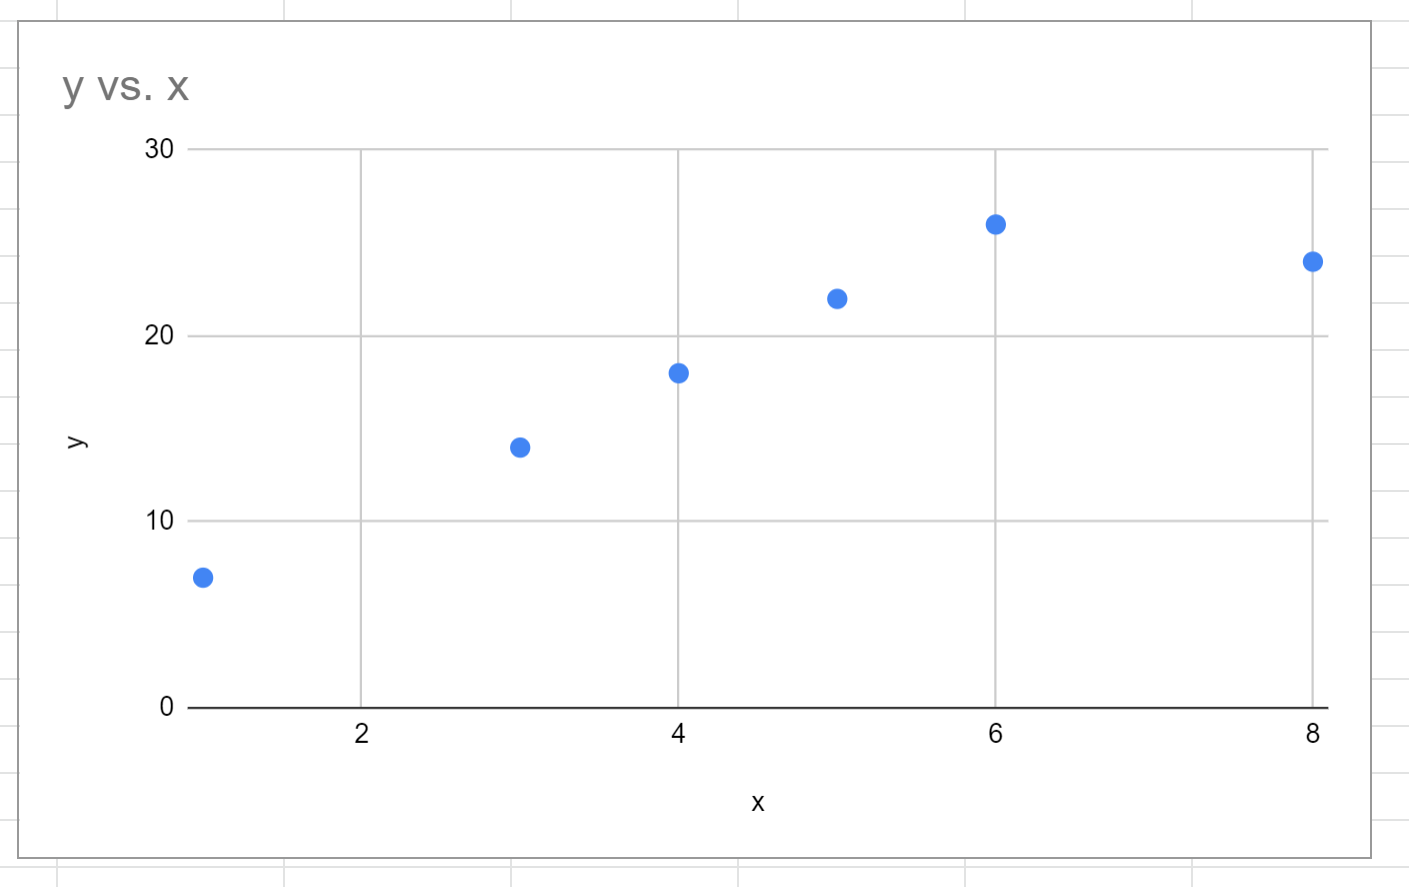
Dès cette conversion effectuée, le graphique se reconfigure sous la forme d’un espace bidimensionnel où chaque couple de données $(X_i, Y_i)$ est matérialisé par un point géométrique circulaire. Il convient alors de contrôler visuellement la disposition des axes dans l’éditeur : la case d’assignation de l’axe $X$ doit impérativement afficher la référence de votre première colonne quantitative (ex. B1:B50), tandis que la zone Séries doit répertorier le descripteur de la variable dépendante (ex. C1:C50).
3.3 Paramétrage initial des en-têtes et des axes
Avant d’engager le processus d’étiquetage nominatif, un calibrage minutieux des cases à cocher contextuelles situées au bas de l’onglet Configuration s’avère indispensable pour asseoir la cohérence sémiotique de la figure. Examinez attentivement les options suivantes : Utiliser la ligne 1 comme en-tête et Utiliser la colonne B comme libellés (cette dernière option apparaissant selon les sélections initiales).
L’activation de l’option Utiliser la ligne 1 comme en-tête garantit que les intitulés textuels ne sont pas convertis par erreur en valeurs scalaires aberrantes nulles positionnées à l’origine $(0,0)$. Cette commande extrait la valeur textuelle de la cellule B1 pour baptiser automatiquement l’axe horizontal, et celle de la cellule C1 pour nommer la série correspondante sur l’axe vertical. La légende globale hérite également de cette sémantique matricielle, instaurant d’emblée une lisibilité conforme aux canons académiques.
Enfin, assurez-vous que l’échelle d’affichage globale ne subit aucune distorsion de perspective. Si des points semblent tassés le long d’une bordure, cela signifie fréquemment que le logiciel a inclus par mégarde une valeur textuelle ou vide interprétée comme un zéro absolu. À ce stade, le chercheur dispose d’une matrice visuelle classique, rigoureusement calibrée sur le plan métrique, mais dont les points demeurent anonymes et indifférenciés.
4. Procédure pas à pas : Ajout des étiquettes aux points du graphique
4.1 Accès aux fonctionnalités avancées de la série de données
L’opération consistant à greffer une couche d’informations textuelles individualisées sur des coordonnées numériques bivariées requiert l’activation d’une fonctionnalité discrète au sein de l’architecture logicielle de Google Sheets. Cette option n’est pas accessible via le ruban de personnalisation esthétique, mais est ancrée au cœur de la définition structurelle de la série dans l’onglet de configuration.
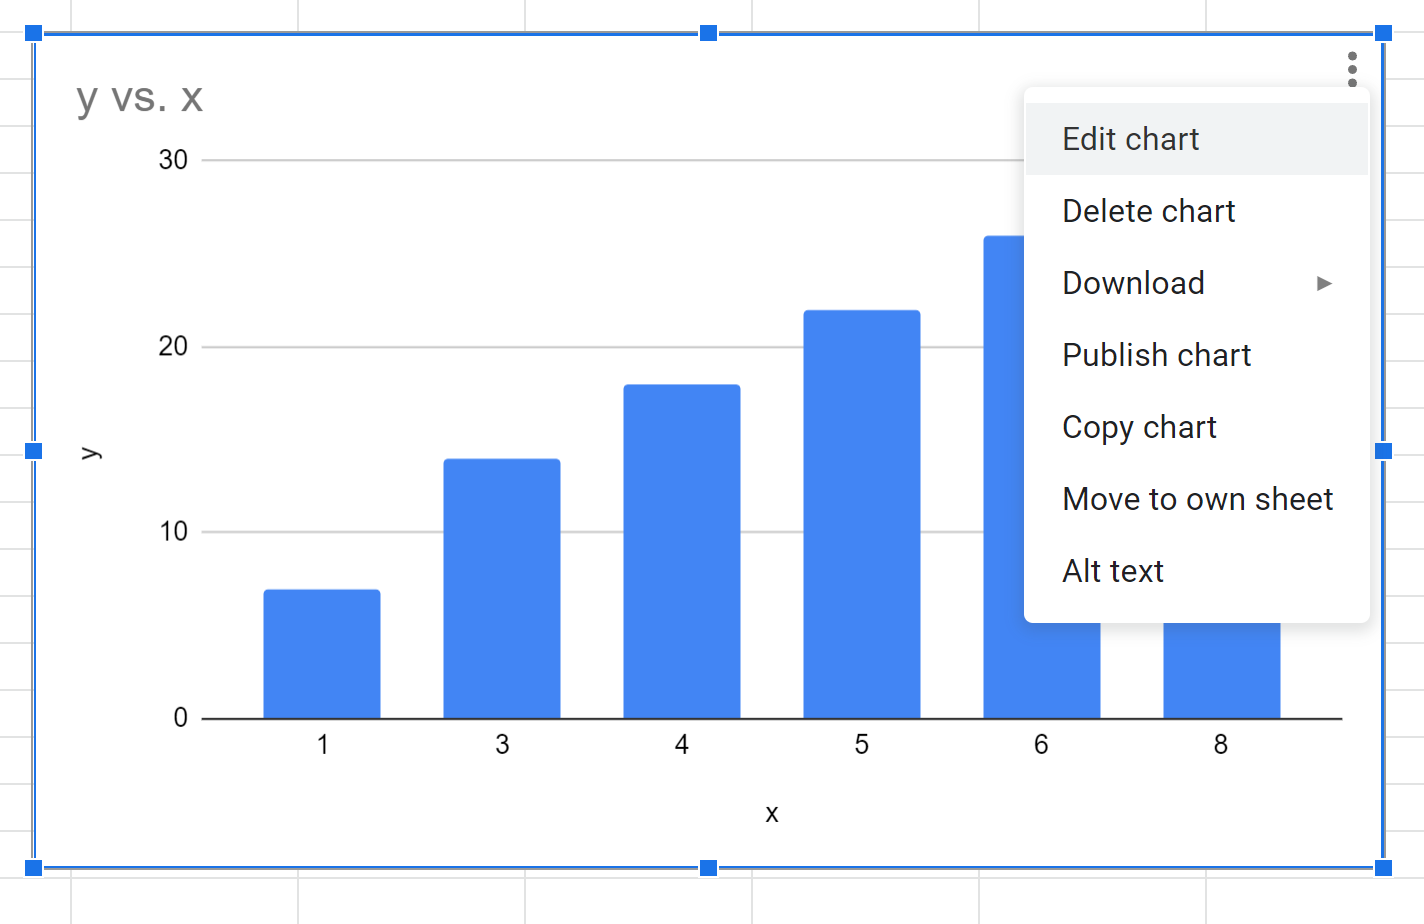
Pour engager cette procédure, activez l’Éditeur de graphiques si celui-ci s’est refermé. Pour ce faire, double-cliquez sur n’importe quel espace neutre du graphique ou cliquez sur l’icône matérialisée par trois points verticaux alignés dans le coin supérieur droit du cadre graphique, puis sélectionnez l’instruction Modifier le graphique. Une fois le volet latéral déployé, positionnez-vous impérativement sur l’onglet Configuration (et non sur l’onglet Personnaliser qui sera sollicité ultérieurement pour les ajustements de typographie).
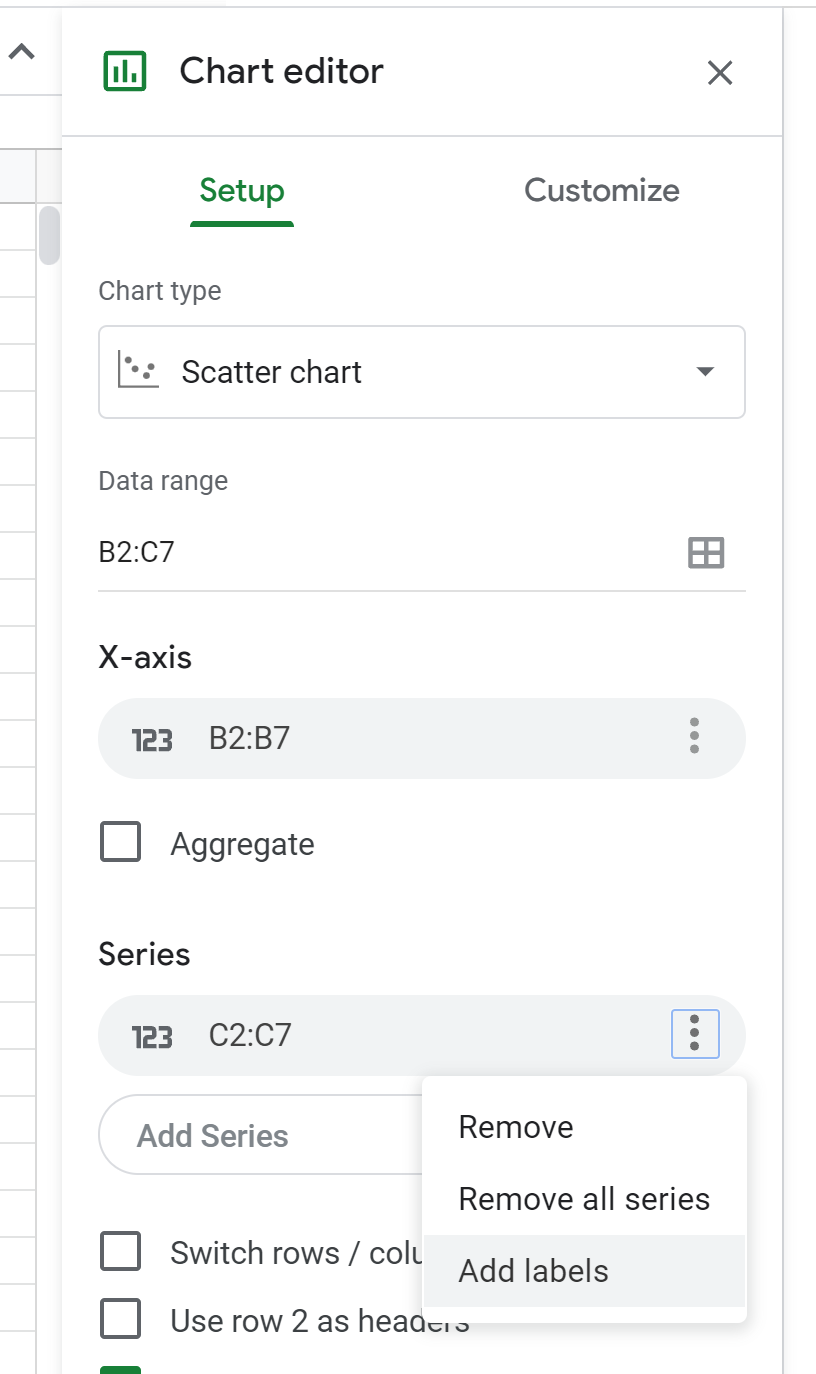
Faites défiler le volet jusqu’à la section explicitement intitulée Séries. Vous y observerez le nom de votre variable dépendante (par exemple, Performance cognitive). Survolez l’intitulé de cette série avec le pointeur de la souris pour faire apparaître un menu contextuel symbolisé par trois petits points verticaux situés immédiatement à l’extrémité droite du rectangle de la série. Cliquez sur ces trois points pour faire émerger un sous-menu contextuel déroulant.
4.2 Liaison de la plage de données d’étiquettes
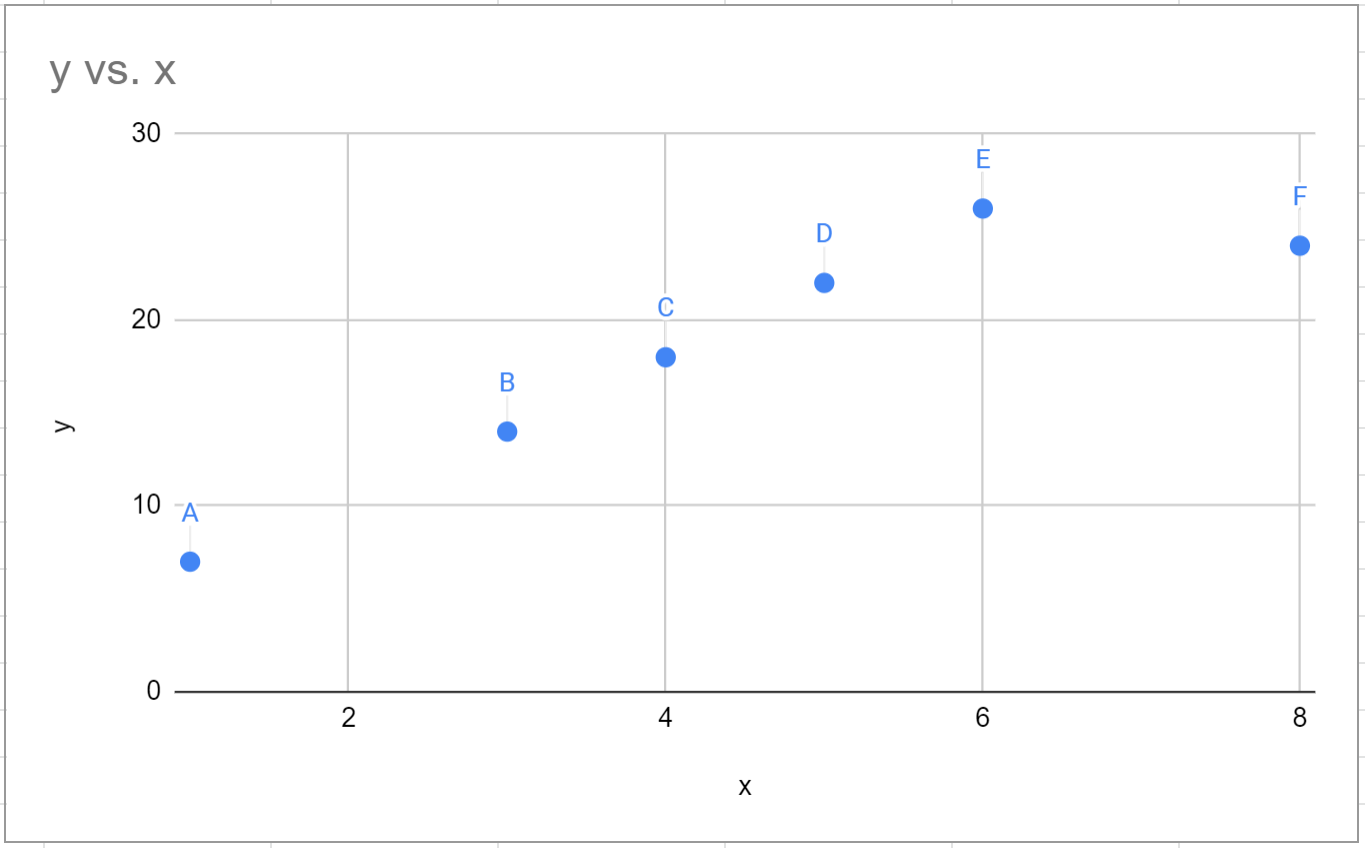
Au sein de ce menu contextuel contextuel avancé, cliquez sans hésiter sur l’option Ajouter des libellés (identifiée sous le vocable Add labels dans la version anglophone de l’outil). Dès cet instant, une nouvelle sous-section rectangulaire intitulée Libellé s’insère directement sous le bloc de définition de la série quantitative au sein du panneau de configuration.
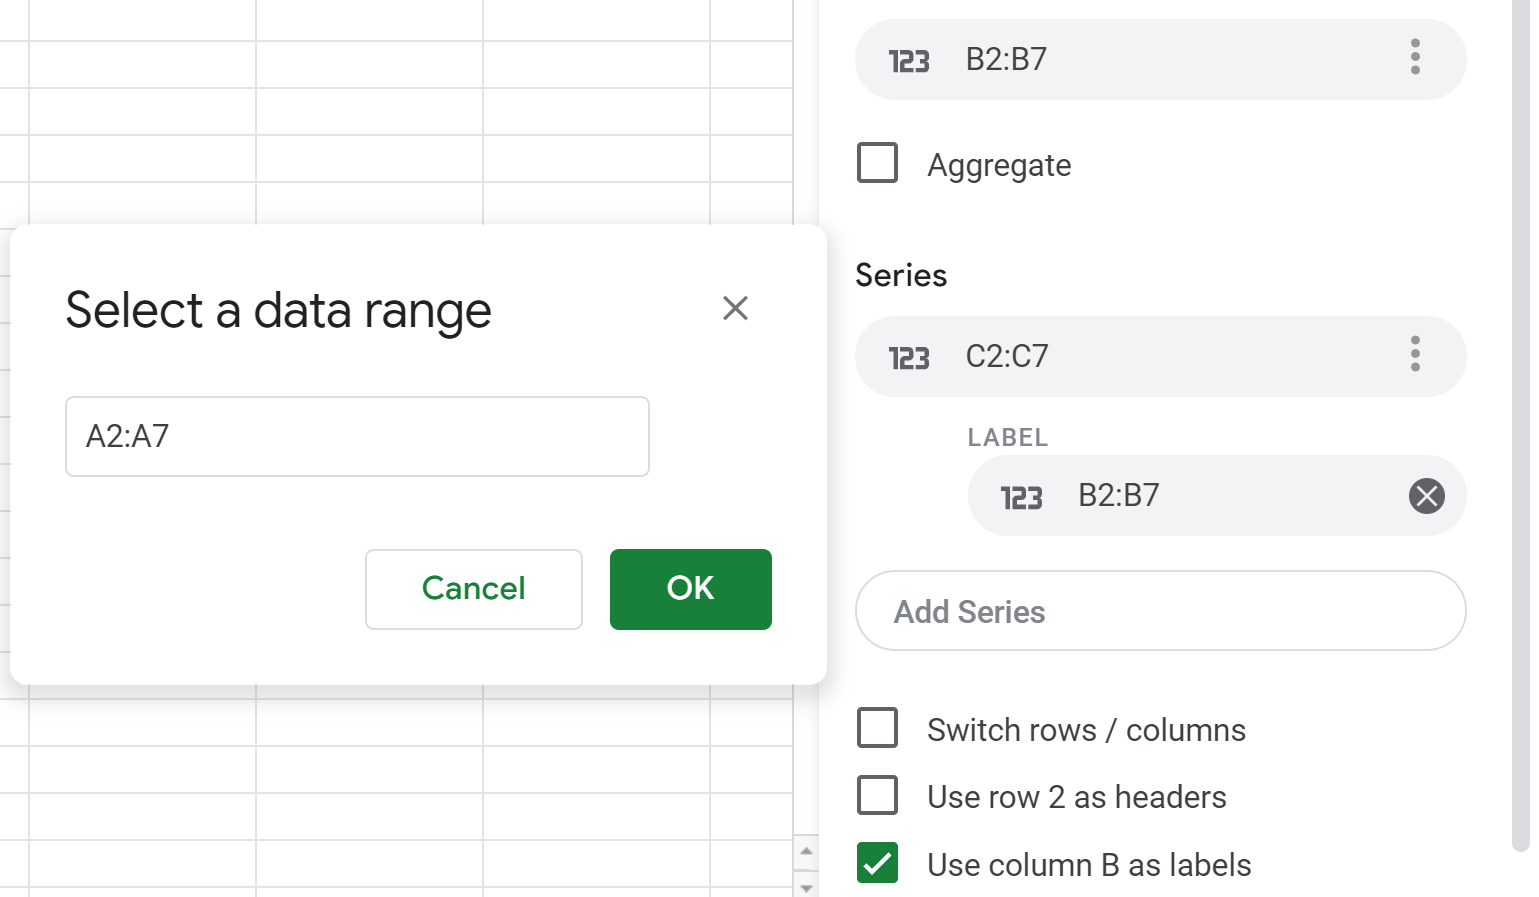
Cliquez à l’intérieur du champ de saisie vide ou appuyez sur le pictogramme en forme de grille matricielle (Sélectionner une plage de données). Une boîte de dialogue flottante s’affiche sur votre feuille de calcul, vous invitant à spécifier la référence géographique des étiquettes. Sélectionnez alors avec rigueur la plage contenant vos identifiants textuels préalablement préparés au sein de la colonne A. Si vos coordonnées numériques s’étendaient de la ligne 2 à la ligne 50, votre sélection de libellés doit impérativement cibler la plage A2:A50 (ou A1:A50 si vous avez inclus l’en-tête global).
Validez la saisie en cliquant sur le bouton bleu OK. Le moteur vectoriel de Google Sheets applique instantanément la liaison : chaque ligne de la colonne des libellés est projetée bijectivement sur la ligne correspondante des colonnes quantitatives. Le premier libellé textuel de la plage désignée vient s’ancrer avec précision sur le point géométrique défini par les coordonnées scalaires de la même rangée horizontale, matérialisant ainsi la fusion spatio-sémantique attendue.
4.3 Vérification de l’intégrité de l’affichage initial
Une inspection visuelle minutieuse de la zone de traçage s’avère indispensable dès la finalisation de cette liaison matricielle. L’analyste doit balayer des yeux l’ensemble du nuage pour s’assurer que chaque marqueur géométrique est désormais accompagné de son étiquette alphanumérique respective. Si certains points apparaissent désespérément muets, vérifiez sans attendre l’état de la feuille de calcul source : la présence d’une cellule vide ou d’un caractère d’espace insécable non visible dans la colonne A conduit inévitablement à un point dépourvu de libellé textuel.
Il importe également de s’assurer qu’aucun décalage d’indice n’a été introduit au cours de la désignation de la plage. Si la sélection des coordonnées a démarré à la ligne 2 (excluant l’en-tête) alors que la sélection des libellés a capturé l’en-tête à la ligne 1, l’ensemble des points subira une translation d’un rang vers le haut, attribuant par exemple l’étiquette du sujet 1 au sujet 2, et le label de titre au sujet 1. Ce glissement d’indice constitue une erreur méthodologique gravissime qui vicierait l’intégralité de l’interprétation clinique ultérieure.
Une fois cette validation de cohérence interne scrupuleusement opérée, il est recommandé de procéder à une sauvegarde intermédiaire de l’état de la feuille de calcul ou de dupliquer l’onglet de travail. Cette bonne pratique offre un point de restauration stable avant d’aborder les manipulations de mise en forme stylistique et de gestion de l’encombrement spatial.
5. Personnalisation stylistique et typographique des étiquettes de données
5.1 Optimisation des paramètres de police et de lisibilité
L’affichage brut des étiquettes de données généré par défaut par Google Sheets se caractérise généralement par une esthétique générique et une police de caractères neutre qui ne répondent pas spontanément aux normes rigoureuses des revues scientifiques à comité de lecture. Pour conférer à la figure une lisibilité professionnelle, il convient de migrer vers l’onglet Personnaliser au sein du panneau de l’Éditeur de graphiques, puis de déployer la section Séries.
Faites défiler les options jusqu’à atteindre les paramètres spécifiques aux Libellés de données. La première décision typographique concerne le choix de la police. Conformément aux préconisations du manuel de style de l’APA (7e édition), il est impératif de sélectionner une fonte d’une absolue clarté morphologique, dépourvue d’empattements complexes. Les polices telles que Arial, Roboto ou Helvetica sont fortement privilégiées pour leur lisibilité sur écran et sur support imprimé haute définition, bien qu’une police à empattement sobre telle que Times New Roman puisse être tolérée si l’ensemble du manuscrit adopte ce standard.
L’ajustement du corps de la police (taille en points) requiert un arbitrage rigoureux entre l’acuité perceptive du lecteur et la saturation spatiale de la figure. Une taille comprise entre 9 et 11 points constitue l’intervalle canonique pour la plupart des publications. L’application d’un style typographique spécifique — tel que l’emploi de la graisse (Gras) pour mettre en relief une cohorte clinique spécifique ou de l’Italique pour désigner des données extrapolées — permet d’introduire une hiérarchisation sémantique au premier coup d’œil.
Enfin, le contraste chromatique doit faire l’objet d’une attention scrupuleuse, non seulement pour respecter les recommandations d’accessibilité visuelle (critères WCAG pour le daltonisme et la basse vision), mais également pour anticiper les reproductions en niveaux de gris. L’usage d’un noir profond (#000000) ou d’un gris anthracite soutenu (#333333) garantit un contraste de luminance maximal sur le fond blanc immaculé de la zone de traçage, proscrivant formellement les teintes pastel ou trop claires.
5.2 Positionnement spatial des libellés par rapport aux marqueurs
L’ancrage spatial de la chaîne textuelle par rapport au centre de gravité du marqueur ponctuel obéit à des contraintes cognitives majeures dans le traitement de l’information graphique. Dans la sous-section Position des libellés de données, Google Sheets propose cinq configurations géométriques distinctes : Centre, Gauche, Droite, Au-dessus et Au-dessous.
Le positionnement centré (Centre) superpose l’étiquette au marqueur lui-même. Bien qu’il puisse être employé dans des cas très particuliers où le marqueur est un cercle large et transparent, il est rigoureusement déconseillé dans un contexte scientifique car le glyphe textuel obscurcit la localisation cartésienne exacte du point de données, altérant l’estimation visuelle de la coordonnée. Le placement Au-dessous souffre d’un défaut perceptif similaire, risquant d’entrer en collision avec les graduations numériques de l’axe des abscisses.
Par consensus en sémiologie graphique, l’alignement Au-dessus ou À droite constitue la norme préférentielle. Le placement au-dessus du marqueur exploite la direction naturelle de balayage oculaire et libère l’espace horizontal adjacent. Toutefois, si le nuage présente une densité élevée sur le plan vertical, le décalage à droite offre une meilleure dissociation visuelle. Il importe de stabiliser cet alignement de manière uniforme pour l’ensemble d’une même série afin de ne pas induire une charge cognitive superflue chez le lecteur, qui associerait involontairement un changement de position relative à une différenciation statistique inexistante.
5.3 Modification morphologique des marqueurs de points
La morphologie des marqueurs géométriques interagit directement avec l’intelligibilité des étiquettes de données. Si les points présentent un diamètre excessif, ils accaparent la surface visuelle et entrent en contact physique avec les chaînes textuelles, créant des interférences optiques désagréables. Inversement, des marqueurs microscopiques rendent impossible la localisation du centroïde exact rattaché au libellé.
Au sein de la section Séries de l’onglet Personnaliser, l’analyste peut moduler finement la taille du point. Un calibrage à 5 ou 7 pixels de diamètre offre généralement un équilibre visuel optimal pour un échantillon standard de taille modérée ($20 < N < 80$). La sélection de la géométrie du marqueur participe également à la codification scientifique : le cercle plein standard demeure le vecteur le plus neutre, mais l'usage de carrés, de losanges ou de triangles peut être mobilisé pour marquer visuellement des distinctions taxonomiques préalables.
Un paramètre capital réside dans la gestion de l’opacité du remplissage du point. En appliquant une opacité partielle (par exemple 70 % ou 80 %), l’analyste permet aux marqueurs qui se chevauchent de révéler leur superposition par une densification chromatique locale, tout en évitant que la silhouette d’un point ne masque totalement l’étiquette textuelle rattachée à un point immédiatement sous-jacent.
6. Gestion des chevauchements et optimisation de l’espace graphique
6.1 Résolution des conflits d’affichage dans les nuages denses
Le moteur d’affichage vectoriel de Google Sheets présente une limitation intrinsèque que tout chercheur quantitatif rencontre inévitablement : l’absence d’un algorithme automatisé et dynamique d’évitement des collisions textuelles (contrairement aux environnements programmés avancés). Lorsque la taille de l’échantillon croît ($N > 100$) ou que des conglomérats d’observations se forment dans des zones à forte densité distributionnelle, les étiquettes se superposent de manière chaotique, rendant la lecture parfaitement indéchiffrable et ruinant l’utilité analytique de la figure.
Face à cette congestion typographique, la première ligne d’action consiste à manipuler l’amplitude métrique des axes cartésiens pour dilater l’espace géométrique disponible. Par défaut, Google Sheets ajuste dynamiquement les bornes minimale et maximale en fonction des extrêmes des données. En naviguant dans l’onglet Personnaliser, sous les rubriques Axe horizontal et Axe vertical, l’analyste peut forcer manuellement des valeurs minimale et maximale personnalisées. En élargissant délibérément l’emprise des axes au-delà du strict champ empirique, on accroît mécaniquement la distance euclidienne séparant les observations sur le canevas d’affichage, offrant ainsi un espace de respiration salvateur pour le texte des étiquettes.
Une seconde approche repose sur le redimensionnement physique du cadre graphique global. Les dimensions par défaut de l’objet graphique incrusté dans la grille (généralement 600 × 371 pixels) s’avèrent structurellement insuffisantes pour héberger simultanément plusieurs dizaines de libellés textuels. En cliquant sur le cadre du graphique et en étirant ses poignées d’angle pour atteindre une résolution visuelle de l’ordre de 1200 × 800 pixels, on fluidifie considérablement l’affichage, réduisant spontanément les zones d’occlusion mutuelle.
6.2 Étiquetage sélectif par colonnes auxiliaires conditionnelles
Lorsque la taille de l’échantillon interdit formellement d’étiqueter exhaustivement l’ensemble des observations sans sombrer dans l’illisibilité, la démarche méthodologique la plus rigoureuse consiste à mettre en place un étiquetage sélectif orienté par des critères théoriques ou statistiques précis. Conformément au précepte minimaliste d’Edward Tufte valorisant le ratio données-encre (data-ink ratio), l’analyste doit masquer les étiquettes des scores normatifs médians pour focaliser exclusivement l’attention perceptive sur les cas présentant une déviance significative.
Pour implémenter cette stratégie élégante dans Google Sheets, il suffit de concevoir une colonne auxiliaire conditionnelle au sein de la feuille de calcul matricielle. Supposons que vos scores dépendants soient logés dans la colonne C (de C2 à C100) et que vos identifiants soient en colonne A. Créez une nouvelle colonne D intitulée Étiquettes conditionnelles. L’objectif est de ne faire apparaître l’identifiant que si le score dépasse un seuil d’intérêt clinique ou statistique, par exemple deux écarts-types au-dessus ou en dessous de la moyenne empirique.
Insérez dans la cellule D2 une formule conditionnelle de la forme suivante :
=SI(OU(C2 > (MOYENNE($C$2:$C$100) + 2*ECARTYPE($C$2:$C$100)); C2 < (MOYENNE($C$2:$C$100) - 2*ECARTYPE($C$2:$C$100))); A2; "")
Étirez cette formule jusqu’à la rangée 100. Dans cette configuration, les observations se situant dans l’enveloppe de distribution habituelle renvoient une chaîne vide (""), tandis que les cas exceptionnels (les valeurs atypiques ou profils cliniques extrêmes) conservent leur étiquette textuelle. Il suffit ensuite de reconfigurer la liaison des libellés du graphique pour pointer vers la plage D2:D100 en lieu et place de la colonne A d’origine. Le nuage de points conserve l’intégralité de ses marqueurs géométriques, mais seules les unités hautement informatives se voient assigner un libellé, allégeant instantanément le dispositif visuel sans sacrifier la rigueur heuristique.
6.3 Agrandissement dimensionnel et déportation du graphique
Une alternative fonctionnelle particulièrement efficiente pour maximiser l’aire disponible consiste à émanciper le graphique de son statut d’objet flottant au-dessus des cellules pour le métamorphoser en une feuille autonome dédiée. Pour exécuter cette déportation, cliquez sur le menu contextuel à trois points situé dans le coin supérieur droit du graphique et sélectionnez l’option Déplacer vers une feuille propre.
Cette opération génère un nouvel onglet matriciel exclusivement réservé à la visualisation, octroyant au graphique l’intégralité de la résolution surfacique offerte par la fenêtre d’affichage de votre navigateur internet. Ce gain d’espace d’environ 300 % permet de décongestionner radicalement les étiquettes préalablement resserrées, chaque point disposant d’un rayon de dégagement largement supérieur.
Dans ce mode d’affichage plein écran, l’analyste peut également affiner l’emprise des marges intérieures du canevas. En éditant les bordures de la zone de traçage proprement dite par rapport à la zone globale de la feuille, on optimise le rapport plein-vide. Cette configuration s’avère particulièrement propice à l’exportation finale de figures destinées à être imprimées sur un format pleine page (format A4 paysage) ou projetées lors de colloques scientifiques internationaux sans craindre une pixelisation dégradante.
7. Étiquetage multidimensionnel : Intégration de séries multiples
7.1 Différenciation graphique par groupes expérimentaux
Dans les devis factoriels expérimentaux ou quasi-expérimentaux classiques de psychologie, les observations n’appartiennent que rarement à une cohorte homogène indifférenciée. L’analyste est le plus souvent confronté à la nécessité de dissocier des groupes distincts (par exemple, Groupe Contrôle versus Groupe Expérimental, ou Patients Neurotypiques versus Patients avec Trouble du Spectre de l’Autisme). Si l’on applique un étiquetage uniforme à une série unique, l’appartenance catégorielle se trouve diluée visuellement.
Pour cartographier simultanément ces groupes tout en préservant l’intégrité des étiquettes individuelles, l’architecture tabulaire doit être scindée en séries parallèles. Plutôt que de stocker l’ensemble des coordonnées dépendantes dans une seule colonne, il convient de ventiler la variable $Y$ sur deux colonnes adjacentes distinctes en fonction du groupe d’appartenance : par exemple, la colonne C pour le Groupe Contrôle et la colonne D pour le Groupe Expérimental, les lignes non concernées par un groupe demeurant vierges.
En incorporant ces deux colonnes au sein du paramétrage des séries de l’Éditeur de graphiques, Google Sheets génère automatiquement deux sous-ensembles chromatiquement différenciés (par exemple, des cercles bleus pour les contrôles et des losanges rouges pour le groupe clinique). Dès lors, le chercheur a la latitude d’activer indépendamment les Libellés de données pour chaque série respective via la procédure décrite à la section 4. Cette segmentation permet d’attribuer une police, une couleur ou un positionnement spatial distinct aux étiquettes du groupe clinique par rapport à celles du groupe témoin, optimisant la lecture comparée des trajectoires individuelles.
7.2 Combinaison des libellés textuels et des valeurs numériques
L’étiquette nominale pure (ex. P042) informe sur l’identité du sujet, mais oblige le lecteur à reporter visuellement son regard vers les axes cartésiens gradués pour estimer les coordonnées quantitatives précises de l’observation. Dans certains contextes de diagnostic clinique fin ou de présentation de données complexes, il est méthodologiquement précieux de fusionner au sein du libellé textuel l’identifiant nominal et la valeur empirique exacte enregistrée.
Google Sheets ne propose pas de commande native permettant de concaténer dynamiquement dans l’éditeur le nom du point et sa coordonnée numérique sans modifier les données sources. Il revient donc à l’analyste de concevoir une colonne de métadonnées composites au sein de la grille de calcul en mobilisant l’opérateur de concaténation typographique esperluette (&) ou la fonction CONCATENER(). Par exemple, pour accoupler le code du sujet logé en A2 et son temps de réaction consigné en C2, on appliquera la syntaxe suivante :
=A2 & " (" & TEXTE(C2; "0,0") & " ms)"
Cette formulation produit une chaîne textuelle structurée du type P042 (412,5 ms). En reliant cette nouvelle colonne composite comme plage de libellés dans l’éditeur de graphique, le nuage de points affiche simultanément la référence du participant et sa valeur métrique d’un seul bloc. Il convient toutefois de manier ce procédé avec une grande parcimonie sémiologique : l’extension substantielle de la longueur de la chaîne de caractères décuple le risque d’encombrement graphique et de chevauchement spatial abordé précédemment.
7.3 Paramétrage de légendes dynamiques associées
L’enrichissement d’un graphique par des séries multiples et des étiquettes individualisées déplace l’enjeu sémiotique vers la légende générale de la figure. Une légende mal configurée surcharge l’espace utile et induit des redondances informatives préjudiciables. Dans l’onglet Personnaliser, rubrique Légende, il convient d’arbitrer rigoureusement quant à sa disposition géométrique.
Pour un graphique à nuage de points richement pourvu en étiquettes de données, le positionnement de la légende en partie supérieure (Haut) ou intégrée horizontalement au bas de l’espace de traçage (Bas) s’avère nettement supérieur à un positionnement latéral à droite. La disposition latérale compresse horizontalement la largeur utile du système cartésien, ce qui accentue mécaniquement le tassement horizontal des étiquettes de points. À l’inverse, l’alignement supérieur ou inférieur préserve l’envergure bidimensionnelle maximale de la zone de projection des coordonnées.
De surcroît, les intitulés figurant dans la légende doivent être édités avec une rigueur sémantique absolue. Les libellés d’en-tête de colonnes bruts tels que var_dep_grp1 doivent être immédiatement requalifiés en termes descriptifs conformes au vocabulaire conceptuel de l’étude (ex. Conditions avec rétroaction cognitive). Enfin, il est primordial de s’assurer que la légende globale informe exclusivement sur l’appartenance des séries, sans tenter de reproduire la taxonomie des étiquettes individuelles qui, elles, vivent au contact direct des marqueurs de points au sein du nuage.
8. Application empirique : Étude de cas sur l’anxiété et la performance cognitive
8.1 Description du paradigme de recherche et du jeu de données
Afin de cristalliser ces considérations théoriques et procédurales au sein d’une démonstration concrète, considérons un protocole expérimental classique issu de la neuropsychologie différentielle. L’étude se propose d’examiner l’impact de l’anxiété situationnelle sur l’efficience du contrôle exécutif inhibiteur. Pour ce faire, une cohorte de 20 participants a été soumise à l’inventaire d’anxiété état-trait de Spielberger (STAI-Y, scores continus s’échelonnant théoriquement de 20 à 80), constituant notre variable indépendante prédictive projetée sur l’axe $X$.
L’efficience du contrôle cognitif est quantifiée par le temps de réaction moyen (exprimé en millisecondes) lors des essais incongruents d’une tâche d’interférence de Stroop informatisée, représentant notre variable dépendante sur l’axe $Y$. Sur le plan du corpus théorique neuropsychologique, ce paradigme est classiquement adossé à la célèbre loi de Yerkes-Dodson et à la théorie de l’inhibition attentionnelle d’Eysenck : on postule une détérioration sensible des performances (allongement substantiel des temps de réaction) au-delà d’un seuil critique d’activation émotionnelle anxiogène.
Pour enrichir la portée clinique de l’expérimentation, chaque participant est codifié par un identifiant alphanumérique anonymisé, enrichi d’un index diagnostique qualitatif précisant son profil clinique (par exemple, P01_Neutre, P07_Phobie_Sociale, P14_Trouble_Panique). L’objectif explicite de la visualisation est d’individualiser immédiatement les profils dissociés au sein de la distribution générale des scores.
8.2 Exécution intégrale du protocole d’étiquetage sur le cas pratique
Pour répliquer fidèlement cet exercice empirique, implémentez dans une feuille Google Sheets vierge la matrice de données structurée suivante, s’étendant des colonnes A à C et des lignes 1 à 21 :
A1: Identifiant|B1: Score_STAI_X|C1: TR_Stroop_ms_YA2: P01_Norm|B2: 24|C2: 450A3: P02_Norm|B3: 28|C3: 440A4: P03_Norm|B4: 31|C4: 465A5: P04_Norm|B5: 35|C5: 475A6: P05_Norm|B6: 38|C6: 490A7: P06_Norm|B7: 40|C7: 510A8: P07_Clin|B8: 42|C8: 525A9: P08_Clin|B9: 45|C9: 560A10: P09_Clin|B10: 48|C10: 590A11: P10_Clin|B11: 50|C11: 615A12: P11_Clin|B12: 52|C12: 640A13: P12_Clin|B13: 55|C13: 680A14: P13_Clin|B14: 58|C14: 730A15: P14_Clin|B15: 62|C15: 790A16: P15_Clin|B16: 65|C16: 840A17: P16_Clin|B17: 68|C17: 910A18: P17_Resil|B18: 70|C18: 505A19: P18_Vuln|B19: 32|C19: 820A20: P19_Clin|B20: 72|C20: 960A21: P20_Clin|B21: 75|C21: 995
Exécutez rigoureusement le protocole opératoire : sélectionnez la plage quantitative B1:C21, insérez un graphique via le menu supérieur, convertissez le type en Graphique à nuage de points, et assurez-vous que l’option Utiliser la ligne 1 comme en-tête est cochée. Rendez-vous ensuite dans le sous-menu de la série TR_Stroop_ms_Y, activez l’instruction Ajouter des libellés, et assignez sans équivoque la plage vectorielle A2:A21. Basculez sur l’onglet Personnaliser, ajustez la police sur Roboto, taille 9 points, couleur gris foncé, et définissez l’alignement spatial sur Au-dessus.
8.3 Interprétation neuropsychologique assistée par les visualisations étiquetées
L’examen de la figure ainsi générée met immédiatement en exergue l’apport inestimable de l’étiquetage nominal par rapport à une masse anonymisée de points. Si la tendance générale illustre une détérioration marquée du temps de réaction corrélée à l’élévation du niveau d’anxiété (progression linéaire ascendante globale), l’œil de l’analyste identifie sans la moindre ambiguïté deux singularités cliniques majeures qui auraient été diluées dans un traitement agrégé.
Premièrement, le participant P17_Resil attire immédiatement l’attention : bien qu’affichant un score d’anxiété étalonnée exceptionnellement élevé (STAI = 70), son temps de réponse au test de Stroop (505 ms) le situe au même niveau d’efficience que des participants sereins de la cohorte normative. L’étiquetage permet de désigner instantanément ce cas comme illustrant un profil hautement résilient, doté d’une capacité compensatoire de focalisation attentionnelle en situation de stress intense.
À l’inverse symétrique, le point étiqueté P18_Vuln présente un score d’anxiété très modéré (STAI = 32) mais s’effondre lors de la tâche d’interférence cognitive avec un temps de réaction pathologique de 820 ms. La présence de l’étiquette nominale sur le graphique permet d’orienter immédiatement le clinicien vers le dossier d’anamnèse de ce patient pour rechercher l’existence d’un déficit sous-jacent du contrôle inhibiteur exécutif totalement indépendant de la réactivité anxiogène. La visualisation étiquetée transcende ici le simple statut d’illustration pour devenir un outil heuristique de diagnostic différentiel à part entière.
9. Lignes de tendance, métriques statistiques et interaction avec les étiquettes
9.1 Superposition de droites de régression linéaire et polynomiale
L’enrichissement d’un nuage de points par une modélisation inférentielle s’effectue couramment par la surimposition d’une ligne de tendance ajustée aux moindres carrés. Dans Google Sheets, cette opération se configure au sein de l’onglet Personnaliser, sous la section Séries, en cochant simplement la case Ligne de tendance (Trendline). Le tableur permet de sélectionner plusieurs fonctions d’ajustement mathématique : Linéaire, Exponentielle, Polynomiale, ou Logarithmique.
Cependant, l’introduction de cet objet géométrique continu soulève des défis sémiotiques sérieux lorsqu’il cohabite avec des étiquettes de données individuelles. La trajectoire rectiligne de la droite de régression traverse inévitablement l’espace occupé par les marqueurs centraux de la distribution, risquant d’obstruer ou de sectionner visuellement les chaînes textuelles des étiquettes qui lui sont superposées. Pour juguler ce conflit optique, il convient de recalibrer précisément les attributs chromatiques de la droite.
Il est vivement conseillé de réduire l’épaisseur de trait de la ligne de tendance à 1 ou 2 pixels au lieu des 4 pixels appliqués par défaut. De surcroît, assigner à la droite une opacité médiane (de l’ordre de 40 % à 60 %) ou adopter un tracé en pointillé discret permet de faire passer la modélisation mathématique au second plan visuel, laissant émerger au premier plan perceptif la typographie des étiquettes de données nominatives.
9.2 Affichage de l’équation de régression et du coefficient de détermination R²
Pour étayer la rigueur scientifique de la modélisation graphique, Google Sheets autorise la transcription directe des paramètres statistiques de la régression sur le canevas. Immédiatement sous le menu de sélection de la ligne de tendance, le menu déroulant Libellé offre l’option Utiliser l’équation. L’activation de cette commande projette l’expression formelle du modèle linéaire ($Y = \beta_1 X + \beta_0$) au sein de la zone de légende du graphique.
Concomitamment, le cochage de la case Afficher R² intègre la valeur du coefficient de détermination, quantifiant sans ambiguïté la proportion de variance de la variable dépendante directement expliquée par la variable indépendante continue. Dans l’exemple d’application clinique précédent, un ajustement polynomial d’ordre 2 révèle fréquemment un saut qualitatif de la variance expliquée par rapport au modèle linéaire univarié strict.
L’analyste veillera à ce que ce bloc statistique d’ajustement ne soit jamais confondu avec les libellés de données des observations. L’équation et le $R^2$ doivent demeurer strictement cantonnés à la légende extérieure ou aux marges périphériques de la figure, leur intrusion au sein du nuage de points saturant inutilement un espace géométrique déjà fortement mobilisé par l’indexation nominale des participants.
9.3 Affichage des barres d’erreur expérimentales
Dans de nombreuses recherches quantitatives, les coordonnées d’un point sur le scatterplot ne procèdent pas d’une mesure brute unique mais d’une moyenne empirique agrégée calculée sur plusieurs essais successifs. Dans cette conjecture, l’adjonction de barres d’erreur expérimentales constitue une exigence déontologique incontournable pour représenter la précision de la mesure ou l’hétérogénéité intraviduelle.
Dans la section Séries de l’Éditeur de graphiques, activez la case à cocher Barres d’erreur. Google Sheets propose plusieurs modes de calcul : en valeur constante, en pourcentage scalaire, ou calculées sur l’écart-type de la série. Si cette quantification métrologique élève le niveau de scientificité de la représentation, elle engendre une zone d’interférence volumétrique considérable autour du marqueur géométrique.
Les moustaches d’erreur verticales ou horizontales entrent fréquemment en collision directe avec l’étiquette textuelle du point. Si les barres d’erreur sont orientées verticalement, le positionnement de l’étiquette Au-dessus devient problématique car le texte vient recouvrir l’extrémité de la moustache supérieure. La résolution technique consiste alors à réorienter systématiquement l’ancrage des étiquettes de données vers la Droite ou le Centre décalé, préservant ainsi la visibilité intégrale de l’intervalle d’incertitude tout en maintenant la traçabilité nominative du sujet.
10. Diagnostic et résolution des anomalies techniques courantes
10.1 Dysfonctionnements liés aux sélections de plages non conformes
Lors de la manipulation de jeux de données empiriques denses, l’analyste se heurte régulièrement à des comportements erratiques du moteur graphique de Google Sheets. L’incident technique le plus récurrent réside dans l’apparition d’un message d’erreur d’inadéquation structurelle signalant que les plages de données doivent comporter le même nombre de lignes. Ce blocage surgit quasi-systématiquement lorsqu’une asymétrie dimensionnelle s’est glissée entre la série quantitative ($X, Y$) et la série descriptive des libellés.
Pour éradiquer cette discordance, ouvrez l’éditeur de graphique et vérifiez rigoureusement les coordonnées absolues des plages déclarées dans l’onglet Configuration. Si la variable $X$ est indexée de B2:B150, la série $Y$ de C2:C150, mais que le champ des libellés cible par inadvertance la plage A1:A150 (englobant la cellule textuelle d’en-tête), le moteur refusera de tracer les étiquettes ou introduira une désynchronisation fatale de l’ordre d’assignation. Les trois vecteurs matriciels doivent présenter une cardinalité strictement superposable.
Un autre écueil classique procède de la contamination des colonnes quantitatives par des cellules vides ou des descripteurs textuels (ex. la mention Absent ou Refus au lieu d’une valeur nulle). Dans ce cas de figure, Google Sheets peut subitement convertir l’intégralité de l’axe cartésien en une échelle ordinale catégorielle, espaçant arbitrairement chaque point à intervalle constant indépendamment de sa valeur métrique réelle. L’analyste doit impérativement veiller à ce que les cellules non renseignées soient gérées selon les méthodes d’imputation formelles ou laissées strictement vides sans aucune chaîne de caractères parasite.
10.2 Disparition ou troncature inattendue des étiquettes
Une anomalie visuelle déroutante concerne la troncature brutale ou la volatilisation spontanée des étiquettes de données positionnées sur les lisières extérieures du graphique. Ce phénomène s’observe avec acuité lorsque l’étiquette est ancrée sur un point proche du sommet ou du flanc droit extrême de la zone de traçage cartésienne : le texte semble coupé en biseau ou disparaît intégralement du champ visuel.
Ce dysfonctionnement n’est pas imputable à une corruption des données matricielles, mais résulte du comportement de rognage par masque vectoriel du canevas de Google Sheets. Dès lors qu’une chaîne de caractères dépasse, même de quelques pixels, la limite orthogonale maximale assignée à la zone de traçage, le moteur graphique supprime le texte pour empêcher tout débordement sur la marge extérieure. La parade technique est immédiate : il convient de se rendre dans les sections Axe horizontal et Axe vertical de l’onglet Personnaliser, et d’ajuster les bornes de graduation maximale en leur appliquant un facteur de sécurité de 5 % à 10 % au-delà du point le plus extrême.
De même, des anomalies d’affichage peuvent résulter du niveau de zoom interne du navigateur web ou de la modification dynamique de la résolution matérielle de l’écran. Un zoom paramétré à 90 % ou 110 % engendre parfois des imprécisions de calcul dans le moteur vectoriel, occasionnant des disparitions intermittentes de libellés. Le rétablissement du zoom natif à 100 % permet généralement de stabiliser l’affichage graphique de manière pérenne.
10.3 Problèmes de synchronisation dynamique et rafraîchissement
Bien que Google Sheets soit conçu pour réagir dynamiquement aux modifications des cellules sous-jacentes, il arrive fréquemment que la couche textuelle des étiquettes souffre d’un gel de mise à jour (cache stall). Si vous modifiez un code participant dans la colonne A (par exemple, mutation de P04 en P04_Retest), il arrive que le graphique flottant maintienne obstinément l’ancien libellé sans actualiser son rendu visuel.
Avant d’envisager la destruction punitive et la reconstruction intégrale du graphique, l’analyste dispose de plusieurs techniques d’actualisation douce. La plus expéditive consiste à forcer une réinitialisation de l’éditeur : ouvrez le volet latéral de modification du graphique, décochez temporairement la case Libellés de données (ou supprimez la plage de libellés dans la configuration de la série), patientez quelques secondes jusqu’à disparition des textes sur le nuage, puis réassignez la référence matricielle. Cette manœuvre purge la mémoire cache de l’objet graphique et contraint le moteur à relire l’état actuel de la grille tabulaire.
Une attention particulière doit être portée lorsque les étiquettes procèdent d’une formule matricielle dynamique telle que ARRAYFORMULA(). Si la formule matricielle recalcule des chaînes complexes en tâche de fond lors de modifications sur d’autres feuilles du classeur, la latence de traitement sur les serveurs distants de Google peut générer une désynchronisation visuelle transitoire. L’insertion d’une modification factice dans une cellule indépendante suffit généralement à forcer l’exécution de la pile de calculs en attente.
11. Conformité académique et préparation pour la publication (Normes APA 7)
11.1 Standards esthétiques et éthiques de présentation des figures scientifiques
L’intégration d’une figure au sein d’un manuscrit soumis à une revue savante affiliée à l’American Psychological Association ou à tout autre consortium académique impose une décontamination esthétique totale des artifices décoratifs par défaut. Les chartes de publication exigent une sobriété sémiotique absolue, visant à maximiser la charge utile de l’information tout en annihilant le bruit perceptif résiduel.
En premier lieu, le titre interne généré au sein de la boîte graphique de Google Sheets doit être purement et simplement éradiqué. Selon les canons de l’APA 7e édition, une figure ne supporte aucun titre enchâssé dans son canevas visuel : le titre formel est déporté à l’extérieur, en typographie standard au-dessus du bloc graphique (en caractères gras, suivi d’un sous-titre en italique). De surcroît, le quadrillage de fond (gridlines) systématiquement projeté par le tableur doit être drastiquement réduit voire supprimé. Dans la section Quadrillage et graduations, désactivez les quadrillages secondaires et n’autorisez qu’un quadrillage principal d’une absolue pâleur chromatique (gris très clair, #e0e0e0) pour ne pas concurrencer le tracé des marqueurs et la typographie des étiquettes.
Sur le versant éthique, l’analyste doit effectuer un contrôle ultime d’anonymisation avant toute diffusion publique du graphique. Aucun acronyme institutionnel, aucune date de consultation clinique ou initiale patronymique ne doit transparaître au sein des libellés de points. Les identifiants doivent être purement arbitraires et hermétiques, garantissant l’impossibilité technique et algorithmique de ré-identification des sujets d’expérience.
11.2 Exportation haute définition pour les revues à comité de lecture
L’un des écueils techniques majeurs réside dans la dégradation qualitative des figures lors de leur transfert de Google Sheets vers les traitements de texte scientifiques (tels que Microsoft Word, LibreOffice Writer ou les éditeurs d’articles scientifiques en ligne). Une capture d’écran basique via les outils du système d’exploitation capture les graphiques à la résolution d’affichage de l’écran (ordinairement 72 ou 96 DPI), générant une pixellisation floue désastreuse lors du tirage typographique professionnel qui exige un standard minimal de 300 DPI.
Google Sheets propose trois protocoles d’exportation native via le menu contextuel à trois points du graphique, sous l’instruction Télécharger : Document PDF (.pdf), Image PNG (.png), et Graphique vectoriel évolutif (.svg). Pour une publication académique de premier ordre, l’exportation au format vectoriel SVG ou PDF s’avère infiniment supérieure au format matriciel PNG.
Dans un tracé vectoriel, les marqueurs géométriques et chaque caractère typographique composant les étiquettes de données ne sont pas encodés sous la forme d’un tableau de pixels figés, mais sous forme d’instructions géométriques et d’équations de courbes de Bézier. Il est dès lors possible d’agrandir la figure à l’échelle d’un poster de conférence ou de la réduire aux dimensions d’une colonne de texte de revue sans la moindre altération de la netteté des contours typographiques. Pour les utilisateurs de flux documentaires scientifiques sous LaTeX, le format vectoriel garantit une intégration parfaite et une restitution typographique d’une pureté absolue.
11.3 Rédaction de la note de figure descriptive
Une figure scientifique ne saurait être dissociée de son appareil paratextuel explicatif. Conformément aux préconisations normatives d’APA 7, chaque figure doit être immédiatement close par une note de figure (Figure Note) positionnée sous le cadre graphique, débutant par la mention Note. en italique, suivie d’un texte descriptif exhaustif et continu.
La note de figure a pour fonction cardinale d’expliciter chaque convention sémiotique mobilisée au sein du nuage de points sans que le lecteur n’ait besoin de se reporter au corps du texte principal de l’article. Il est indispensable d’y spécifier sans omission la signification de l’ensemble des étiquettes de données apposées sur les marqueurs, la métrique exacte des échelles portées sur les axes $X$ et $Y$, ainsi que les abréviations psychométriques utilisées (ex. « STAI-Y = Inventaire d’anxiété état de Spielberger ; TR = Temps de réaction en millisecondes »).
De surcroît, si un protocole d’étiquetage sélectif a été appliqué conformément aux techniques d’optimisation spatiale exposées à la section 6.2, la note de figure doit obligatoirement énoncer le seuil statistique ayant gouverné l’attribution d’un libellé (ex. « Seuls les scores déviant de plus de deux écarts-types par rapport à la moyenne empirique de l’échantillon sont nominativement étiquetés »). Cette précision méthodologique confère à la visualisation sa pleine traçabilité épistémique et prévient toute accusation de biais de sélection subjectif dans la mise en visibilité des cas cliniques.
12. Comparaison critique et perspectives avancées de visualisation
12.1 Limites intrinsèques de Google Sheets face aux logiciels spécialisés
Si Google Sheets brille par sa flexibilité collaborative immédiate et sa gratuité d’accès, une analyse méthodologique rigoureuse se doit de souligner avec lucidité les bornes computationnelles et algorithmiques de cet instrument face aux progiciels de biostatistique spécialisés et aux environnements de programmation de données contemporains. La faiblesse la plus manifeste de Google Sheets réside incontestablement dans l’absence d’un moteur d’évitement automatique des collisions de texte comparable à la remarquable extension ggrepel développée pour l’écosystème ggplot2 sous le langage de programmation statistique R.
Dans l’environnement R ou Python (via les bibliothèques matplotlib et seaborn), des algorithmes d’optimisation spatiale et de recuit simulé calculent dynamiquement des forces de répulsion électrostatique virtuelles entre les chaînes textuelles et les points géométriques, déplaçant subtilement les étiquettes et tirant de fins segments de rappel (leader lines) pour préserver une lisibilité parfaite y compris dans les zones de saturation extrême. Sous Google Sheets, le positionnement d’une étiquette est rigoureusement statique : si deux points partagent des coordonnées contiguës, leurs libellés se chevaucheront inévitablement de façon indémêlable, exigeant des manipulations manuelles palliatives chronophages.
De surcroît, le plafond de performance computationnelle du tableur en ligne de Google se manifeste dès que la matrice empirique franchit des volumes massifs. Pour des cohortes excédant plusieurs milliers d’observations ($N > 10,000$), les temps de rendu vectoriel de l’interface web chutent de manière critique, et la tentative d’assigner des milliers d’étiquettes nominatives simultanées conduit inéluctablement à des ralentissements sévères du navigateur, situation que les moteurs graphiques compilés gèrent avec une parfaite fluidité.
12.2 Automatisation de l’étiquetage via Google Apps Script
Pour les praticiens désireux de dépasser les restrictions inhérentes à l’interface graphique standard sans abandonner l’environnement collaboratif de Google, le recours au moteur d’extension Google Apps Script ouvre des horizons fonctionnels considérables. Apps Script est un environnement de programmation basé sur JavaScript exécuté sur les serveurs de Google, permettant de manipuler programmatiquement l’ensemble des objets constitutifs d’une feuille de calcul, y compris la classe EmbeddedChart.
Grâce à la classe SpreadsheetApp et aux constructeurs graphiques avancés (ChartBuilder), un chercheur peut concevoir un script automatisant l’injection sélective des étiquettes en fonction de métriques statistiques multidimensionnelles complexes calculées à la volée (telles que la distance de Mahalanobis ou le score d’effet de levier de Cook). Le script inspecte chaque ligne de données, évalue la matrice de covariance, et injecte dynamiquement l’identifiant du sujet dans la colonne de libellé auxiliaire uniquement pour les observations identifiées comme influentes.
Il devient également envisageable d’associer ce script à un bouton interactif ancré dans la feuille de calcul, permettant aux utilisateurs finaux ou aux cliniciens de basculer d’un simple clic d’un affichage totalement anonymisé vers un affichage enrichi des profils diagnostiques spécifiques. Cette programmabilité confère à Google Sheets une dimension applicative sur mesure, comblant le fossé technique séparant la feuille de calcul grand public des progiciels d’analyse dédiés.
12.3 Synthèse des bonnes pratiques pour le chercheur en sciences humaines
Au terme de cette exploration méthodologique, il apparaît clairement que l’adjonction d’étiquettes à un nuage de points dans Google Sheets ne constitue pas une simple manipulation cosmétique, mais engage la rigueur de la chaîne de traitement et de communication de la preuve empirique. Pour guider le chercheur dans ses arbitrages visuels, l’arbre décisionnel suivant résume les postures méthodologiques à privilégier :
- Si la taille de l’échantillon est restreinte ($N < 30$), l'étiquetage individualisé exhaustif est hautement pertinent pour la traçabilité des cas ; veillez à aligner les étiquettes de manière constante au-dessus ou à droite des marqueurs.
- Si l’échantillon présente une volumétrie modérée à élevée ($30 le N le 500$), l’étiquetage exhaustif engendre une saturation rédhibitoire ; appliquez impérativement un étiquetage sélectif conditionnel (via la fonction
=SI()) ciblant les cas cliniquement déviants ou les valeurs aberrantes. - Si les observations se décomposent en sous-groupes expérimentaux distincts, scindez la variable dépendante en colonnes parallèles pour générer des séries indépendantes avec des styles d’étiquettes différenciés.
- Proscrivez systématiquement l’emploi d’identifiants directement nominatifs pour préserver l’anonymat éthique des participants d’expérience.
- Préalablement à toute exportation pour soumission éditoriale, expurgez le graphique de ses titres internes et quadrillages lourds, téléchargez l’image sous format vectoriel (SVG ou PDF), et complétez la figure par une note descriptive conforme aux critères stricts de la norme APA 7e édition.
En respectant scrupuleusement ces principes directeurs, le chercheur en psychologie et en sciences comportementales transforme un outil bureautique du quotidien en un puissant instrument d’analyse sémiotique, conciliant la convivialité du travail collaboratif contemporain avec les exigences les plus intransigeantes de la recherche scientifique internationale.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Cleveland, W. S. (1993). Visualizing data. Hobart Press.
Eysenck, M. W., Derakshan, N., Santos, R., & Calvo, M. G. (2007). Anxiety and cognitive performance: Attentional control theory. Emotion, 7(2), 336–353. https://doi.org/10.1037/1528-3542.7.2.336
Friendly, M., & Denis, D. (2005). The early origins and development of the scatterplot. Journal of the History of the Behavioral Sciences, 41(2), 103–130. https://doi.org/10.1002/jhbs.20078
Google Workspace Support. (2023). Ajouter et modifier un graphique ou un diagramme dans Google Sheets. Google Help. https://support.google.com/docs/answer/63824
Spielberger, C. D., Gorsuch, R. L., Lushene, R., Vagg, P. R., & Jacobs, G. A. (1983). Manual for the State-Trait Anxiety Inventory (Form Y). Consulting Psychologists Press.
Stroop, J. R. (1935). Studies of interference in serial verbal reactions. Journal of Experimental Psychology, 18(6), 643–662. https://doi.org/10.1037/h0054651
Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0
Yerkes, R. M., & Dodson, J. D. (1908). The relation of strength of stimulus to rapidity of habit-formation. Journal of Comparative Neurology and Psychology, 18(5), 459–482. https://doi.org/10.1002/cne.920180503