
La modélisation statistique constitue le pivot méthodologique de la démarche scientifique contemporaine, permettant de formaliser des relations complexes au sein de données empiriques. Cependant, la quantification numérique brute — qu’il s’agisse de coefficients de régression, de statistiques de test ou de valeurs p — s’avère souvent insuffisante pour transmettre intuitivement la structure d’une association. La visualisation des données joue un rôle fondamental dans la compréhension, le diagnostic et la dissémination des résultats de recherche. En superposant une équation de régression mathématique et ses métriques associées directement sur un nuage de points, le chercheur crée un pont cognitif immédiat entre l’abstraction algébrique du modèle et la réalité concrète des observations empiriques.
Dans l’écosystème du langage R, cette démarche s’inscrit au confluent de l’analyse inférentielle et de la sémiologie graphique. Si les fonctionnalités de base de R permettent d’esquisser rapidement des figures exploratoires, l’essor du paradigme de la grammaire des graphiques, incarné par le paquet ggplot2, a profondément transformé les standards de communication visuelle. L’intégration harmonieuse d’annotations statistiques textuelles — précises au plan typographique et dynamiquement liées aux estimations des modèles — représente toutefois un défi technique fréquent pour les praticiens. Les divergences de syntaxe entre les moteurs de rendu, la gestion des expressions mathématiques et le positionnement spatial des annotations exigent une maîtrise rigoureuse des concepts sous-jacents.
Le présent traité méthodologique propose une exploration exhaustive des techniques permettant d’incorporer une équation de régression sur un graphique dans R. Nous aborderons la configuration méticuleuse de l’environnement de calcul, la modélisation sous-jacente par les moindres carrés, l’automatisation des annotations par des extensions spécialisées comme ggpubr et ggpmisc, ainsi que le contrôle programmatique direct par extraction manuelle des coefficients. En adoptant les standards stricts des publications internationales (notamment les directives de l’American Psychological Association), ce guide détaille chaque étape du processus afin de garantir la reproductibilité, l’intégrité statistique et l’excellence graphique de vos présentations scientifiques.
1. Introduction méthodologique à la visualisation des modèles de régression dans R
1.1 L’importance de la communication visuelle des modèles statistiques
La restitution des résultats issus d’une analyse de régression linéaire simple ou multiple repose traditionnellement sur des tableaux récapitulatifs denses répertoriant les coefficients estimés (β), les erreurs types associées, les statistiques de Student ou de Fisher, ainsi que les niveaux de signification statistique. Bien que cette approche tabulaire réponde aux impératifs d’exhaustivité et d’archivage quantitatif, elle impose une charge cognitive substantielle au lecteur. La théorie de la charge cognitive, formalisée par John Sweller, met en lumière le fait que le traitement simultané de symboles numériques abstraits et de leurs interrelations spatiales sollicite intensément la mémoire de travail. La superposition directe de l’équation mathématique sur le diagramme de dispersion permet une intégration visuelle immédiate, réduisant l’effort d’interprétation en unifiant le modèle théorique et la distribution empirique.
En recherche expérimentale et observationnelle, cette stratégie visuelle offre une lecture instantanée de deux dimensions fondamentales du phénomène étudié : la direction de l’effet, signalée par le signe de la pente, et sa magnitude, quantifiée par la valeur absolue du coefficient directeur. L’œil humain excelle dans l’évaluation des alignements géométriques mais demeure vulnérable aux illusions d’optique générées par des échelles tronquées ou des dispersions hétérogènes. L’adjonction de l’expression mathématique formalisée, typiquement sous la forme y = β0 + β1x, complétée par la proportion de variance expliquée (R²), ancre l’interprétation perceptive dans une certitude arithmétique inaltérable. Cette double modalité d’information — analogique via la droite tracée et symbolique via l’équation — prévient les conclusions hâtives qui résulteraient d’un simple examen superficiel du nuage de points.
Par ailleurs, les exigences contemporaines de transparence méthodologique et de reproductibilité formulées par les comités de lecture des revues scientifiques de premier plan incitent à une clarté sans compromis. Présenter une droite d’ajustement sans préciser explicitement son ordonnée à l’origine, son coefficient de pente et la précision statistique de son estimation expose l’auteur à des critiques légitimes quant à l’ambiguïté de son modèle. L’annotation directe sur la figure garantit que même si l’illustration est extraite de son contexte textuel — par exemple lors de communications orales, de conférences ou de partages sur des plateformes académiques —, l’intégralité du message quantitatif demeure préservée de façon autonome et irréfutable.
1.2 L’écosystème graphique de R : de la base vers le tidyverse
Historiquement, l’environnement R proposait un système graphique standard, souvent désigné sous le terme de « base R graphics ». Des commandes fondamentales telles que plot(), abline() et text() permettaient — et permettent toujours — de superposer une droite d’ajustement issue de la fonction lm() et d’y adjoindre une chaîne textuelle arbitraire. Néanmoins, ce système procédural présente des limites méthodologiques majeures. Les annotations doivent être positionnées au moyen de coordonnées absolues calculées manuellement ou estimées empiriquement, ce qui fragilise le code face aux variations d’échelle ou à l’introduction de nouvelles données. De plus, la gestion fine des expressions mathématiques via l’interpréteur graphique natif s’avère souvent verbeuse et sujette à des distorsions typographiques lors de la modification des dimensions de la fenêtre d’affichage.
L’émergence de la grammaire des graphiques, théorisée par Leland Wilkinson et brillamment implémentée par Hadley Wickham au sein du paquet ggplot2, a instauré un changement de paradigme radical. Dans cette architecture déclarative, un graphique n’est plus envisagé comme une toile vierge sur laquelle sont dessinés séquentiellement des pixels, mais comme une composition stratifiée associant des données structurées, des correspondances esthétiques (aesthetics), des primitives géométriques (geoms) et des transformations statistiques (stats). Cette modularité conceptuelle confère une robustesse exceptionnelle à la visualisation : l’ajout d’une droite de régression s’effectue par une couche dédiée (geom_smooth) qui hérite organiquement des données sous-jacentes, garantissant une cohérence stricte entre la distribution observée et le modèle affiché.
Pour parachever cette logique sans alourdir le code utilisateur, l’écosystème s’est enrichi de bibliothèques spécialisées telles que ggpubr et ggpmisc. Conçues spécifiquement pour répondre aux attentes de la recherche biomédicale, psychologique et comportementale, ces extensions intègrent des couches statistiques automatisées capables d’ajuster le modèle linéaire, d’extraire ses paramètres, de formater la notation mathématique selon les canons de l’édition scientifique et de projeter le résultat sur le canevas sans exiger l’écriture répétitive de fonctions de formatage complexes. Ce continuum méthodologique, allant du contrôle chirurgical de la programmation manuelle à l’élégance déclarative des couches de haut niveau, constitue la force singulière de R pour l’analyste de données moderne.
2. Configuration de l’environnement de développement et gestion des paquets
2.1 Installation et chargement des bibliothèques fondamentales
La mise en œuvre d’un flux de travail rigoureux débute par la configuration d’un environnement computationnel stable et exempt de conflits. Dans le cadre de ce tutoriel, l’environnement s’articule autour de bibliothèques hébergées sur le Comprehensive R Archive Network (CRAN). L’installation s’effectue via les mécanismes conventionnels de gestion de dépendances, en veillant à vérifier l’intégrité des versions requises. L’architecture graphique de ggplot2 interagit avec des moteurs vectoriels de bas niveau ; il est donc impératif de s’assurer que la version locale de R est au moins égale ou supérieure à la version 4.0.0, garantissant ainsi la prise en charge optimale des fonctionnalités modernes de rendu typographique et des palettes colorimétriques étendues.
Lors du chargement des extensions, l’analyste doit porter une attention scrupuleuse aux éventuels conflits d’espace de noms (namespace masking). L’importation conjointe du métapaquet tidyverse et d’extensions tierces peut entraîner le masquage de fonctions fondamentales d’extraction ou de filtrage. Bien que ggplot2 et ggpubr soient conçus pour coexister harmonieusement, il demeure méthodologiquement sain de déclarer explicitement les dépendances en tête de script. L’initialisation du poste de travail doit également inclure le paramétrage des options graphiques globales, telles que le lissage des polices (antialiasing) et la résolution de prévisualisation au sein des environnements de développement intégrés comme RStudio ou VS Code.
L’installation s’effectue classiquement au moyen de la commande install.packages(c(« ggplot2 », « ggpubr », « broom », « scales »)), en veillant à ce que les dépendances système de compilation — notamment pour la gestion des polices de caractères et des formats d’image matricielle — soient correctement installées sur le système d’exploitation hôte. Une fois les paquets installés, la directive library(ggplot2) combinée à library(ggpubr) active l’accès aux grammaires graphiques et aux métriques d’inférence directe. Ce socle technique constitue le préalable indispensable à toute entreprise de restitution cartésienne de haute fidélité.
2.2 Gestion des extensions complémentaires pour l’analyse statistique
Au-delà du duo emblématique constitué par ggplot2 et ggpubr, d’autres outils s’avèrent indispensables pour couvrir l’ensemble du spectre analytique. L’extension ggpmisc se distingue particulièrement par sa polyvalence algorithmique. Contrairement à des modules strictement dédiés aux régressions linéaires simples, ggpmisc déploie des fonctions analytiques avancées capables de décomposer dynamiquement des polynômes de degré n, d’extraire des modèles non linéaires généralisés, et d’injecter des tableaux récapitulatifs directement au sein de la zone graphique. Cette bibliothèque s’appuie sur une manipulation poussée des objets d’arbres syntaxiques (abstract syntax trees), convertissant les formules statistiques en objets plotmath complexes.
Simultanément, le recours au paquet broom, développé au sein du tidyverse, s’impose dès lors que l’on privilégie une approche manuelle et programmatique de l’annotation. broom propose trois fonctions standardisées fondamentales : tidy(), glance() et augment(). La fonction tidy() décompose les coefficients du modèle sous la forme d’un tableau rectangulaire strict où chaque terme occupe une ligne, simplifiant l’extraction scriptée de la pente et de l’ordonnée à l’origine. La fonction glance(), quant à elle, extrait sur une ligne unique l’ensemble des métriques d’ajustement global (R², R² ajusté, statistique de Wald, valeur p globale, critère d’information d’Akaike). Cette décomposition ordonnée évite le recours risqué à des indexations positionnelles empiriques dans les structures complexes d’objets de classe lm.
Enfin, le paquet scales joue un rôle déterminant dans le raffinement visuel des axes et des valeurs statistiques. Il offre un ensemble cohérent de fonctions de transformation et de formatage typographique (p-values, pourcentages, notations scientifiques, virgules flottantes). L’orchestration de ces quatre bibliothèques — ggplot2, ggpubr, ggpmisc et broom — confère à l’analyste un contrôle absolu, lui permettant de basculer sans friction d’une automatisation élégante à une personnalisation micro-analytique selon les impératifs du projet éditorial.
3. Génération et structuration des données pour l’analyse
3.1 Création d’un jeu de données synthétique reproductible
Afin de garantir une reproductibilité parfaite et d’illustrer la démarche sur un cas d’école exempt d’artefacts d’échantillonnage imprévisibles, nous concevons un jeu de données synthétique contrôlé. La génération de données simulées permet de maîtriser précisément les paramètres théoriques sous-jacents (le paramètre d’interception β0, le coefficient de régression théorique β1, ainsi que la variance résiduelle σ²). La première étape méthodologique consiste à figer l’état du générateur congruentiel linéaire pseudo-aléatoire à l’aide de la fonction set.seed(), assurant ainsi que chaque exécution subséquente produira rigoureusement la même distribution numérique.
Considérons une situation d’évaluation psychométrique ou comportementale dans laquelle une variable prédictrice continue, désignée par exemple sous le terme de « Temps_Etude », mesurée en heures hebdomadaires, est supposée influencer positivement un « Score_Performance » évalué sur une échelle continue de 0 à 100. Nous générons une cohorte de 150 observations indépendantes. La variable prédictrice x est échantillonnée à partir d’une distribution uniforme ou normale tronquée, tandis que la variable dépendante y est construite conformément au postulat du modèle linéaire classique : yi = β0 + β1xi + εi, où le terme d’erreur résiduelle εi suit strictement une distribution gaussienne de moyenne nulle et d’écart-type constant.
Le tableau de données est encapsulé dans une structure rectangulaire moderne de type data.frame ou tibble. La validation de la structure empirique est opérée par les commandes canoniques str() et head(). Cette inspection confirme le typage des variables (vecteurs numériques continus à virgule flottante) et assure l’absence de valeurs manquantes (NA) susceptibles de modifier subrepticement les degrés de liberté lors de l’estimation de la régression par moindres carrés. La transparence du jeu de données constitue la pierre angulaire sur laquelle reposera l’ensemble de l’édifice visuel.
3.2 Vérification préliminaire des postulats de la régression linéaire
Avant d’apposer une équation linéaire sur une représentation visuelle, l’intégrité méthodologique exige de vérifier que les données n’enfreignent pas dramatiquement les postulats du modèle des moindres carrés ordinaires (MCO). Tracer une droite d’ajustement sur une distribution manifestement non-linéaire — telle qu’une fonction quadratique, sigmoïde ou exponentielle — relève d’une faute méthodologique qui induit le lecteur en erreur, quelle que soit l’élégance visuelle de l’annotation textuelle. L’inspection commence invariablement par l’exploration visuelle de la forme générale du nuage de points, confirmant l’existence d’une tendance monotone rectiligne.
Le contrôle univarié et bivarié comprend également l’examen de l’homoscédasticité, c’est-à-dire la constance de la variance des résidus sur l’ensemble du continuum de la variable prédictrice. Une dispersion en entonnoir (hétéroscédasticité) signale que la précision de l’estimation varie le long de l’axe des abscisses, rendant l’intervalle de confiance linéaire standard trompeur. Par ailleurs, la détection des points de levier et des valeurs aberrantes (outliers) au moyen de la distance de Cook s’avère indispensable. Un point isolé situé à l’extrémité du domaine de définition peut exercer une influence disproportionnée sur la pente estimée, modifiant artificiellement les coefficients affichés dans l’équation finale.
Enfin, la vérification de la normalité des résidus garantit la validité des inférences statistiques (tests t sur les coefficients et test F global). Si les données satisfont ces critères, la structuration en format tidy — où chaque ligne correspond à une unité expérimentale unique et chaque colonne à une variable opérationnelle — permet d’alimenter directement le moteur de ggplot2 sans nécessiter de transformations matricielles intermédiaires.
4. Construction du diagramme de dispersion fondamental avec ggplot2
4.1 Définition des correspondances esthétiques et géométries de base
L’initialisation d’un graphique sous ggplot2 repose sur l’appel à la fonction générique ggplot(), au sein de laquelle le jeu de données est formellement transmis par l’argument data. La mise en relation des dimensions empiriques et des propriétés visuelles s’opère via la fonction aes(), acronyme désignant les correspondances esthétiques (aesthetic mappings). Pour un diagramme de dispersion classique, l’abscisse cartésienne est assignée à la variable prédictrice continue (x = Temps_Etude) tandis que l’ordonnée reçoit la variable réponse (y = Score_Performance). À ce stade initial, l’objet graphique constitue un canevas abstrait dénué de toute matérialité géométrique.
L’adjonction de la couche géométrique geom_point() projette les observations sous forme de marqueurs discrets dans le plan euclidien. Afin d’optimiser la lisibilité et de prévenir le phénomène de sur-traçage (overplotting) — particulièrement fréquent lorsque la taille de l’échantillon s’accroît —, il convient de régler minutieusement les paramètres physiques des marqueurs. L’attribution d’un coefficient de transparence alpha (par exemple alpha = 0.65) permet de révéler la densité locale par superposition des nuances. Parallèlement, l’ajustement du diamètre des points (size = 2.5) et le choix d’une forme géométrique adaptée (comme shape = 21, autorisant la distinction entre la couleur de contour et la couleur de remplissage interne) confèrent à la figure une clarté typiquement observée dans les publications scientifiques professionnelles.
L’environnement graphique par défaut de ggplot2 applique un arrière-plan gris strié d’un quadrillage blanc. Bien qu’adapté à une exploration sur écran, ce rendu est largement proscrit par les normes éditoriales académiques. L’application d’un thème dénudé et épuré s’impose donc d’emblée. La substitution du thème standard par theme_classic() ou theme_bw() élimine les artéfacts visuels superflus, trace des axes cartésiens noirs nets et installe un fond blanc immaculé indispensable à une impression de haute fidélité et à une lecture fluide des annotations ultérieures.
4.2 Personnalisation des échelles et des étiquettes des axes
Un graphique destiné à la publication ne saurait tolérer des étiquettes d’axes correspondant aux noms informatiques bruts des variables (tels que « tps_etud_v1 »). La fonction labs() permet de déployer une hiérarchie textuelle complète, assignant des libellés rigoureux, exhaustifs et pourvus de leurs unités de mesure respectives (par exemple : « Temps d’étude hebdomadaire (heures) » et « Score d’évaluation cognitive (points) »). Cette explicitation des axes répond aux exigences de la norme APA 7th, qui préconise qu’une figure scientifique puisse être pleinement décodée de manière autonome sans lecture obligatoire du corps du texte.
Le contrôle de l’étendue spatiale des données relève d’une décision méthodologique critique. L’analyste doit impérativement privilégier l’ajustement des limites cartésiennes via coord_cartesian(xlim = …, ylim = …) plutôt que par l’utilisation des arguments limits dans les fonctions scale_x_continuous() ou scale_y_continuous(). En effet, modifier directement les échelles numériques via scale_* filtre et supprime les observations situées au-delà des bornes spécifiées, ce qui altère rétroactivement le calcul mathématique de la régression linéaire. La fonction coord_cartesian(), en revanche, opère un simple zoom optique sans expulser la moindre ligne du jeu de données, préservant ainsi la pureté des moindres carrés.
Enfin, la graduation personnalisée des axes à l’aide de l’argument breaks au sein de scale_x_continuous() garantit une progression arithmétique régulière et lisible. L’espacement des repères numériques doit être judicieusement calibré pour éviter l’encombrement typographique tout en autorisant une interpolation visuelle précise de la position de chaque point d’observation. Cette rigueur dans la géométrie spatiale prépare le terrain pour l’accueil de la droite de régression et de son expression algébrique.
5. Ajustement et tracé de la droite de régression par les moindres carrés
5.1 Implémentation de geom_smooth avec la méthode linéaire
Dans la grammaire de ggplot2, l’estimation et le tracé d’un modèle de tendance statistique relèvent de la primitive geom_smooth() (ou de son pendant statistique direct, stat_smooth()). Par défaut, lorsque le nombre d’observations est inférieur à 1 000, geom_smooth() applique un modèle de régression locale non paramétrique fondé sur l’algorithme LOESS (locally estimated scatterplot smoothing). Bien que le lissage LOESS constitue un outil exploratoire d’une remarquable puissance pour identifier des courbures non pressenties, il ne correspond pas à la formalisation d’une régression linéaire globale paramétrique.
Pour contraindre l’ajustement au cadre strict des moindres carrés ordinaires (OLS), il est indispensable de renseigner explicitement l’argument method = « lm ». Cette commande signale au moteur interne de ggplot2 qu’il doit exécuter en arrière-plan la fonction de modélisation linéaire univariée lm(y ~ x). Dès lors, la ligne d’ajustement tracée adopte une rectitude mathématique parfaite, reliant de façon continue les prédictions du modèle sur l’ensemble de l’étendue des valeurs observées de la variable indépendante.
L’apparence de la droite d’ajustement doit être optimisée pour assurer un contraste perceptif suffisant avec le nuage de points. L’attribution d’une couleur saturée distincte (par exemple color = « #2C3E50 » ou color = « darkblue »), d’une épaisseur calibrée (linewidth = 1.2) et éventuellement d’un type de ligne spécifique (linetype = « solid ») permet d’affirmer le statut central du modèle sans masquer les singularités des observations individuelles. La dissociation visuelle entre les données empiriques et le modèle théorique est ainsi immédiatement perceptible.
5.2 Représentation et interprétation de l’intervalle de confiance
L’estimation ponctuelle d’une droite de régression ne saurait être dissociée de son incertitude d’échantillonnage. Par défaut, geom_smooth(method = « lm ») incorpore le calcul et la représentation visuelle de l’intervalle de confiance à 95 % sous la forme d’un ruban ombragé enserrant la droite de régression. Ce ruban correspond à l’erreur type de la prédiction moyenne (standard error of the mean prediction), matérialisée par l’argument logique se = TRUE. Le niveau de couverture statistique peut être modifié selon les standards de la discipline via l’argument level (par exemple level = 0.99 pour un intervalle à 99 %).
L’épaisseur du ruban de confiance présente une morphologie hyperbolique caractéristique : il est le plus étroit au barycentre des données — c’est-à-dire au point moyen défini par les coordonnées (x̄, ȳ) — et s’élargit progressivement à mesure que l’on s’éloigne vers les bornes inférieures et supérieures du domaine observé. Cet élargissement géométrique traduit fidèlement la variance de l’estimation de la pente : plus on extrapole en périphérie des données collectées, plus l’incertitude quant à la position exacte de la population théorique s’accroît. Il importe de ne pas confondre ce ruban avec un intervalle de prédiction pour une observation individuelle future, lequel serait considérablement plus large puisqu’il intégrerait la variance résiduelle σ².
Sur le plan de la sémiologie graphique, l’intensité du ruban de confiance doit être tempérée pour ne pas saturer l’espace visuel. L’ajustement de la transparence (fill = « #2C3E50 », alpha = 0.2) permet de conserver la visibilité des points situés à l’arrière-plan tout en délimitant rigoureusement la zone d’incertitude paramétrique. Si les impératifs de la publication exigent la suppression de cette zone d’incertitude pour alléger la figure, la spécification explicite se = FALSE désactive le calcul du ruban sans altérer la trajectoire de la droite centrale.
6. Intégration de l’équation de régression via l’extension ggpubr
6.1 Syntaxe opérationnelle de la fonction stat_regline_equation
Bien que ggplot2 offre une architecture exceptionnellement riche pour la construction géométrique, il ne propose pas nativement de couche statistique dédiée au formatage direct des équations paramétriques sur le graphique. C’est précisément pour combler cette lacune opérationnelle que le paquet ggpubr a été développé par Alboukadel Kassambara. Cette extension introduit la fonction stat_regline_equation(), conçue pour s’interfacer de manière fluide au sein de la chaîne de commandes ggplot2 au moyen de l’opérateur d’addition (+).
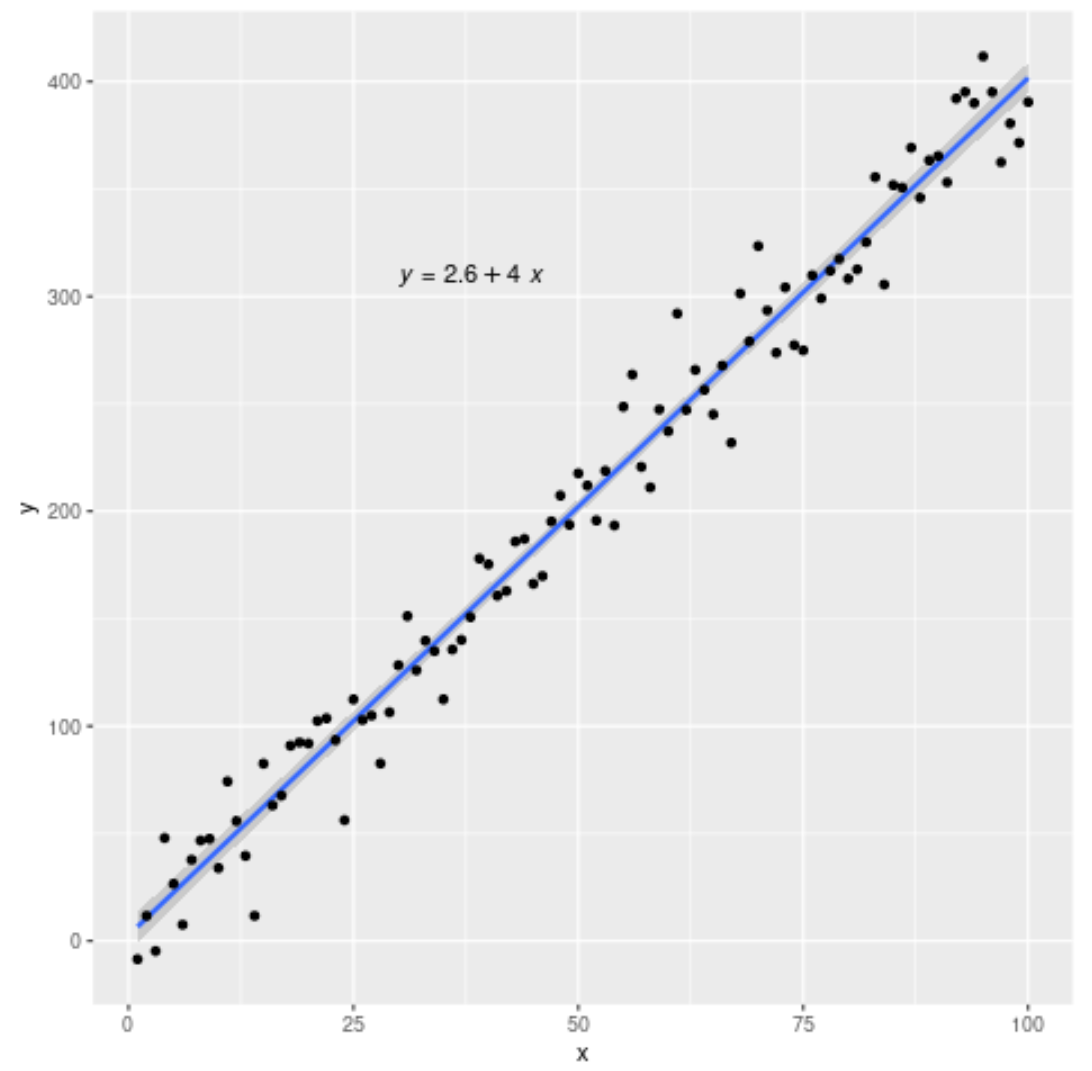
Lorsqu’elle est invoquée sans argument complexe, stat_regline_equation() effectue une série d’opérations automatisées en arrière-plan. Elle intercepte les variables cartésiennes transmises à aes(), ajuste en temps réel le modèle linéaire correspondant par moindres carrés ordinaires, extrait les coefficients β0 (ordonnée à l’origine) et β1 (pente), et compose une chaîne de caractères formatée selon la syntaxe standard y = a + b*x. Cette chaîne est ensuite automatiquement injectée dans le moteur graphique de R en tant qu’expression mathématique interprétable.
L’avantage cardinal de cette fonction réside dans son dynamisme algorithmique. Si le jeu de données d’entrée fait l’objet d’un filtrage préalable ou d’une modification structurelle, l’équation s’ajuste instantanément lors du réaffichage de la figure, éliminant tout risque d’erreur humaine lié à la saisie manuelle de chiffres dans un traitement de texte. La fonction hérite en outre des correspondances esthétiques globales, garantissant une intégration sans heurt avec l’ensemble des couches vectorielles préexistantes.
6.2 Contrôle précis des coordonnées de placement spatial
L’un des écueils majeurs lors de l’annotation textuelle sur un nuage de points réside dans le positionnement spatial de l’étiquette. Un mauvais paramétrage entraîne inexorablement le chevauchement de l’équation avec les observations empiriques ou la droite de régression elle-même, dégradant la lisibilité et l’aspect professionnel du document. La fonction stat_regline_equation() répond à cette contrainte au moyen de deux arguments dédiés : label.x et label.y, qui acceptent des coordonnées scalaires précises exprimées dans l’unité métrique des axes cartésiens respectifs.
Pour assurer un positionnement pérenne et indépendant des variations aléatoires des données, l’analyste avisé privilégiera une approche d’ancrage programmatique plutôt qu’une saisie de coordonnées fixes au doigt mouillé. En calculant les coordonnées relatives sur la base des quantiles ou des extrêmes des distributions empiriques — par exemple en fixant label.x = min(data$x) + 0.05 * diff(range(data$x)) et label.y = max(data$y) – 0.05 * diff(range(data$y)) —, l’étiquette s’installe avec une précision millimétrique dans le quadrant supérieur gauche de la figure, traditionnellement délaissé par les données dans le cas d’une corrélation positive.
De surcroît, ggpubr autorise l’utilisation de l’argument label.x.npc et label.y.npc (Natural Plot Coordinates). Ce système de coordonnées normalisées permet de spécifier des valeurs proportionnelles variant strictement entre 0 et 1 (par exemple label.x.npc = 0.05 et label.y.npc = 0.95 pour un ancrage en haut à gauche). Cette fonctionnalité supprime l’obligation de connaître les bornes numériques réelles des variables et garantit un positionnement spatial immuable, même lors de l’automatisation de graphiques en série au sein de pipelines de production industrielle de rapports.
7. Enrichissement du graphique avec le coefficient de détermination et la p-valeur
7.1 Ajout du coefficient R² pour quantifier la taille d’effet
L’équation de régression brute renseigne sur la direction et l’amplitude de la relation fonctionnelle, mais demeure muette quant à la qualité de l’ajustement du modèle aux données empiriques. En recherche quantitative, il est méthodologiquement indispensable de compléter la formulation algébrique par le coefficient de détermination (R²). Ce paramètre statistique fondamental, défini comme le ratio de la somme des carrés expliquée sur la somme des carrés totale, quantifie la proportion de variance de la variable dépendante directement imputable aux variations de la variable indépendante.
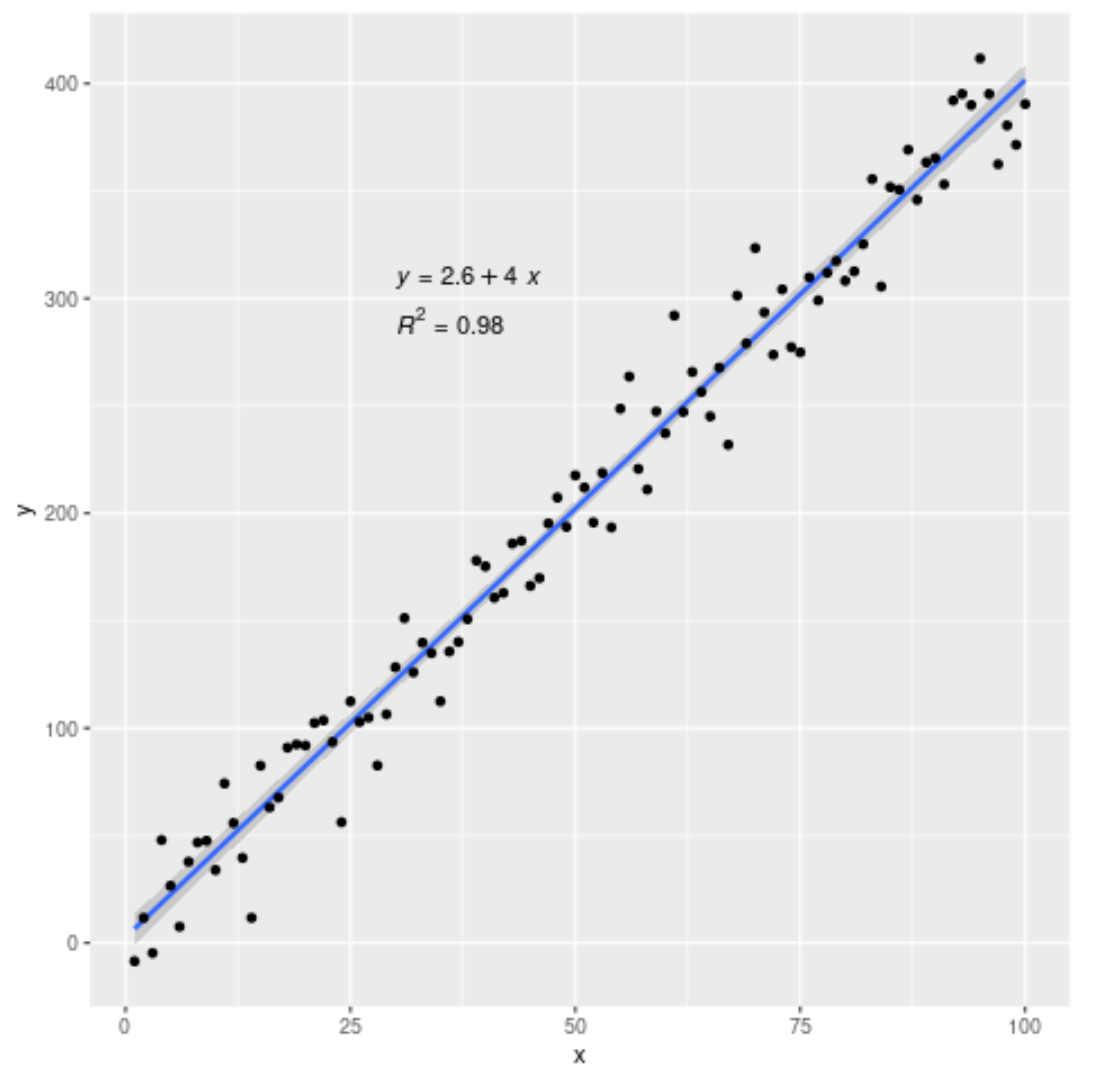
L’affichage du R² s’opère au sein de stat_regline_equation() par l’entremise de l’argument de mise en correspondance aes(label = ..rr.label..). Dans la syntaxe interne de ggplot2, la notation entourée de doubles points signale l’accès aux variables calculées en coulisses par la transformation statistique. Lorsque cette correspondance est spécifiée, la fonction substitue l’équation brute par la mention formalisée de la taille d’effet, par exemple R² = 0.68. Pour l’expérimentateur, cette valeur fournit une évaluation immédiate de la précision prédictive du modèle, distinguant une association déterministe étroite d’une tendance statistique diffuse.
Il est également possible de combiner l’équation de la droite et le coefficient de détermination au sein d’une étiquette unique et compacte. En utilisant la formulation aes(label = paste(..eq.label.., ..rr.label.., sep = « ~~~~ »)), ggpubr exploite les opérateurs de séparation de plotmath (où quatre tildes successifs symbolisent une espace cadratine) pour concaténer harmonieusement les deux dimensions statistiques sur une seule ligne continue. Cette économie spatiale préserve la surface utile du graphique tout en satisfaisant à l’exigence d’exhaustivité métrique.
7.2 Affichage combiné des métriques d’inférence avec stat_cor
L’évaluation rigoureuse d’un modèle de régression nécessite fréquemment la juxtaposition du coefficient de corrélation linéaire de Pearson (r) et de sa valeur de signification statistique associée (p-value). L’extension ggpubr propose une fonction sœur parfaitement synchronisée : stat_cor(). Cette fonction calcule les coefficients de corrélation paramétriques ou non paramétriques (Pearson, Spearman ou Kendall) et génère une annotation élégante intégrant simultanément la magnitude de la corrélation et le seuil d’inférence p.
La puissance de stat_cor() réside dans son alignement esthétique et spatial avec stat_regline_equation(). En modulant l’argument p.accuracy, l’analyste peut imposer un formatage numérique strict conforme aux recommandations de l’American Statistical Association (ASA) et de l’APA. Ainsi, la spécification p.accuracy = 0.001 formate automatiquement les valeurs extrêmement faibles sous la désignation standardisée « p < .001 », proscrivant les notations erronées telles que « p = 0.000 » qui violent les principes fondamentaux de la théorie des probabilités.
Pour orchestrer un affichage multiniveau sans chevauchement, il convient de superposer stat_regline_equation() et stat_cor() en décalant légèrement leurs coordonnées verticales d’ancrage. Par exemple, l’équation structurelle peut être positionnée à label.y.npc = 0.95, tandis que les métriques d’inférence (r, R² et p) sont reléguées à label.y.npc = 0.88. Cette stratification visuelle hiérarchisée structure l’information pour le lecteur : le premier regard perçoit le modèle théorique sous forme fonctionnelle, tandis que le second examine les critères de validité inférentielle et de significativité statistique.
8. Formatage typographique avancé et expressions mathématiques plotmath
8.1 Rendu des notations mathématiques formelles
L’affichage de formules sur un canevas graphique ne saurait se satisfaire d’une typographie télégraphique banale où les symboles d’égalité et de multiplication sont traités comme de simples caractères ASCII. Dans un rapport académique de référence, la formulation se doit d’arborer les conventions de l’écriture mathématique internationale : variables en italique, opérateurs typographiés avec des espacements réguliers, indices et exposants correctement mis en échelle supérieure ou inférieure. Le moteur graphique de base de R intègre un sous-système de composition typographique baptisé plotmath, inspiré des préceptes de Donald Knuth pour le système TeX.
L’activation de ce moteur au sein des couches d’annotation de ggplot2 ou ggpubr s’opère par l’argument parse = TRUE. Lorsque ce drapeau logique est activé, la chaîne de caractères fournie n’est plus rendue textuellement de manière littérale, mais décomposée syntaxiquement par l’interpréteur d’expressions mathématiques. Des constructions telles que beta[0] sont alors traduites par la lettre grecque β affectée d’un indice zéro, tandis que les notations d’exposant comme R^2 engendrent un véritable exposant typographique sans faire appel à des artifices de polices vectorielles externes.
Cette rigueur notationnelle revêt une importance capitale pour la distinction conceptuelle entre les variables théoriques de population et leurs estimateurs d’échantillon. Idéalement, la variable prédite devrait être coiffée d’un accent circonflexe mathématique — le fameux « y chapeau » (italic(hat(y))) — pour signaler sans ambiguïté qu’il s’agit d’une valeur ajustée issue du modèle et non d’une observation brute mesurée sur le terrain. La maîtrise des expressions plotmath confère ainsi à la visualisation une autorité scientifique et une élégance visuelle comparables aux compositions typographiques générées sous LaTeX.
8.2 Personnalisation esthétique de l’étiquette textuelle
Au-delà de la syntaxe mathématique pure, l’intégration de l’équation dans l’espace graphique requiert un ajustement fin de ses attributs formels : police de caractères, corps, graisse, couleur et arrière-plan. La lisibilité globale d’une figure dépend de la hiérarchie typographique établie entre les étiquettes des axes, les graduations numériques, la légende et les annotations internes. Les fonctions d’annotation permettent de calibrer le paramètre size (exprimé en millimètres dans l’environnement ggplot2) pour assurer une proportionnalité harmonieuse avec les autres composants textuels.
Dans les configurations denses où le nuage de points occupe une vaste superficie du panneau cartésien, une étiquette transparente risque de devenir illisible en se confondant avec les marqueurs situés en arrière-plan. Pour contourner cet obstacle, l’usage de primitives basées sur des encadrés opaques — analogues à la géométrie geom_label() — s’avère particulièrement judicieux. En adjoignant un fond blanc opacifié et un fin liseré périphérique, l’annotation s’isole du bruit de fond visuel sans obstruer l’interprétation globale de la distribution.
L’harmonisation chromatique constitue un autre levier d’optimisation sémiotique. Attribuer à l’équation textuelle exactement la même nuance colorimétrique que celle utilisée pour le tracé de la droite de régression (par exemple un bleu ardoise profond #2C3E50) tisse une association cognitive immédiate selon la loi de similarité de la psychologie de la Gestalt. Le lecteur identifie instantanément que l’énoncé algébrique explicite formellement la ligne géométrique qui traverse le nuage d’observations, renforçant l’efficacité de la transmission visuelle.
9. Stratification par sous-groupes et régressions multiples
9.1 Génération d’équations distinctes selon une variable catégorielle
L’expérimentateur est fréquemment confronté à des situations expérimentales ou observationnelles impliquant des sous-populations distinctes (telles que le sexe biologique, des cohortes de traitement versus placebo, ou différentes catégories taxonomiques). Dans ce contexte, ajuster une droite unique sur l’ensemble de l’échantillon peut masquer des phénomènes d’interaction majeurs, voire illustrer le paradoxe de Simpson. La grammaire de ggplot2 excelle dans la stratification par sous-groupes : l’affectation d’un facteur discret à l’esthétique colorimétrique globale via aes(color = Groupe) scinde immédiatement l’analyse en sous-modèles indépendants.
Lorsque stat_regline_equation() est déployée sur un graphique ainsi stratifié, la fonction hérite automatiquement du groupement structural. Elle ajuste alors autant de modèles linéaires distincts qu’il existe de niveaux dans le facteur catégoriel, et calcule les équations spécifiques à chaque strate. Toutefois, une difficulté technique émerge immédiatement : si aucune précaution n’est prise quant au positionnement spatial, l’ensemble des équations calculées sera projeté exactement aux mêmes coordonnées géométriques (label.x, label.y), engendrant un empilement illisible de textes superposés.
Pour résoudre ce conflit géométrique, il est nécessaire de spécifier un vecteur de coordonnées d’ordonnée étagées pour l’argument label.y, ou d’ajuster les positions via des fonctions de décalage vertical systématique. Dès lors, chaque sous-groupe bénéficie de sa propre équation distinctement alignée, affichée dans la teinte chromatique correspondant à sa modalité. Cette approche permet une comparaison visuelle et analytique instantanée des coefficients de pente entre conditions expérimentales, révélant au premier coup d’œil d’éventuels effets de modération ou d’interaction statistique.
9.2 Intégration d’équations au sein de graphiques partitionnés (Faceting)
Lorsque la complexité du jeu de données s’accroît ou que le chevauchement des nuages de points de différents groupes altère la lisibilité, la technique de partitionnement graphique (trellis graphics ou faceting) représente la solution de référence. Au moyen des fonctions canoniques facet_wrap() ou facet_grid(), le panneau unique est décomposé en une matrice ordonnée de sous-graphiques, chaque cellule correspondant à une modalité exclusive d’une ou plusieurs variables catégorielles de conditionnement.
L’intégration de stat_regline_equation() au sein d’une structure partitionnée démontre toute l’élégance de la programmation déclarative. La couche statistique opère de manière autonome au sein de chaque panneau : elle extrait le sous-ensemble de données spécifique à la facette, ajuste le modèle de régression MCO local, et inscrit l’équation correspondante dans l’espace délimité de la sous-figure. Aucune boucle itérative manuelle (for) ni manipulation complexe de fenêtres graphiques n’est requise de la part du programmeur.
Dans le cas où les échelles cartésiennes sont contraintes d’être uniformes sur l’ensemble des facettes (scales = « fixed »), des coordonnées relatives standardisées (telles que label.x.npc = 0.1 et label.y.npc = 0.9) garantissent que l’annotation apparaîtra rigoureusement au même emplacement relatif dans chaque sous-panneau, instaurant une harmonie symétrique reposante. Si les échelles sont libres (scales = « free »), l’utilisation des coordonnées normalisées s’avère d’autant plus cruciale qu’elle prévient tout risque de projection de l’annotation en dehors des frontières physiques visibles du sous-graphique concerné.
10. Approche alternative : Extraction manuelle depuis un modèle lm()
10.1 Modélisation explicite et extraction programmatique des coefficients
Si les extensions automatisées telles que ggpubr simplifient grandement les opérations d’annotation courantes, la maîtrise de l’approche programmatique manuelle demeure une compétence fondamentale pour l’analyste de haut niveau. Dans les architectures de production logicielle exigeantes ou lors de la rédaction de manuscrits soumis à des formats éditoriaux non standards, la dépendance envers des bibliothèques de haut niveau peut introduire des rigidités ou des ruptures de compatibilité. Le contrôle total du modèle s’obtient en ajustant explicitement l’objet de régression au moyen de la fonction de base lm().
Une fois l’objet de classe lm instancié (par exemple modele <- lm(Score ~ Temps, data = df)), l’extraction des paramètres s’opère de façon déterministe. La fonction coef(modele) renvoie un vecteur numérique contenant l’ordonnée à l’origine (indice 1) et la pente estimée (indice 2). Simultanément, la commande summary(modele) expose la structure interne complète de l’inférence, autorisant l’extraction programmatique du coefficient de détermination brut ($r.squared), du coefficient ajusté ($adj.r.squared), de l’erreur type résiduelle, ainsi que de la p-valeur issue du tableau d’analyse de variance global.
À partir de ces briques élémentaires, l’analyste assemble une chaîne textuelle sur-mesure au moyen des fonctions de formatage sprintf() ou paste(). La fonction sprintf() s’avère incomparablement supérieure pour maîtriser l’arrondi numérique : la commande sprintf(« italic(y) == %.2f + %.2f * italic(x) », coef[1], coef[2]) garantit l’affichage constant de deux décimales, y compris lorsque le chiffre terminal est un zéro muet (qui serait tronqué par les fonctions d’arrondi standard). Cette rigueur arithmétique évite toute incohérence esthétique entre les différents graphiques d’un même projet.
10.2 Injection de l’équation personnalisée avec annotate()
L’incorporation de l’expression mathématique assemblée manuellement au sein du diagramme ggplot2 s’effectue au moyen de la couche polyvalente annotate(). Contrairement aux géométries standards qui relient leurs attributs aux colonnes d’un tableau de données, la fonction annotate() est conçue pour insérer des éléments géométriques ou textuels individuels et autonomes sans hériter des correspondances esthétiques du canevas sous-jacent.
La syntaxe opérationnelle fait appel à annotate(geom = « text », x = …, y = …, label = …, parse = TRUE). L’argument x et y définit les coordonnées cartésiennes de positionnement absolu, tandis que le paramètre parse = TRUE instruit le moteur graphique d’interpréter la chaîne construite via sprintf() comme une expression plotmath valide. L’avantage architectural de cette approche réside dans son indépendance absolue : le script ne requiert aucune dépendance logicielle externe en dehors de ggplot2 lui-même, garantissant une pérennité et une portabilité optimales du code source à long terme.
De plus, cette méthode manuelle permet de gérer avec une élégance algorithmique absolue les singularités de signes. Dans le cas d’une pente négative, une concaténation naive génère fréquemment des énoncés arithmétiquement disgracieux de la forme « y = 10 + -2.5x ». Grâce à des structures conditionnelles simples au sein du script (ifelse(pente < 0, « -« , « + »)), l’analyste substitue dynamiquement l’opérateur et prend la valeur absolue du coefficient directeur, affichant une formule canonique irréprochable (y = 10 – 2.5x). Ce niveau de perfectionnement typographique témoigne du soin méthodique accordé à la production scientifique.
11. Modélisation non-linéaire et régressions polynomiales
11.1 Affichage de relations quadratiques et polynomiales
L’investigation empirique se heurte souvent à des processus biologiques, économiques ou physiques caractérisés par des rendements décroissants, des dynamiques d’accélération ou des points d’inflexion critiques. Dans ces circonstances, contraindre la relation à une droite linéaire constitue un biais de spécification majeur. ggplot2 permet d’étendre la régression par moindres carrés à des formes fonctionnelles d’ordre supérieur en modifiant l’argument formula au sein de geom_smooth(). L’assignation de formula = y ~ poly(x, 2, raw = TRUE) adapte instantanément la courbe d’ajustement à un modèle parabolique quadratique.
Toutefois, transcrire l’équation d’un polynôme de degré 2 ou 3 sur le graphique excède les capacités fonctionnelles basiques de stat_regline_equation(). C’est à ce stade que l’extension ggpmisc révèle sa supériorité opérationnelle grâce à sa fonction stat_poly_eq(). Cette couche analytique hautement sophistiquée est capable d’analyser la formule polynomiale déclarée, d’estimer les paramètres associés (β0, β1, β2, …), et de générer une chaîne d’annotation plotmath intégrant fidèlement les termes au carré (x²) et au cube (x³).
L’utilisation de stat_poly_eq(aes(label = paste(after_stat(eq.label), after_stat(rr.label), sep = « * », « * »)), formula = y ~ poly(x, 2, raw = TRUE), parse = TRUE) projette une équation mathématique exhaustive directement sur le graphique. Le lecteur visualise alors sans ambiguïté la trajectoire curviligne du modèle accompagnée de ses coefficients quadratiques précis et du gain substantiel de variance expliquée (R²) conféré par l’adjonction des degrés polynomiaux. Cette représentation explicite évite toute méprise quant à la véritable nature mathématique de l’ajustement sous-jacent.
11.2 Modèles logarithmiques et exponentiels
Outre les polynômes, les relations non linéaires prennent fréquemment la forme de fonctions exponentielles (croissance démographique, cinétique biochimique) ou logarithmiques (réponse sensorielle, saturation cognitive). Deux stratégies analytiques distinctes s’offrent alors au chercheur dans l’environnement R : la transformation préalable des données ou la modélisation directe au sein de la grammaire graphique.
La transformation d’échelles — via scale_x_log10() ou scale_y_continuous(trans = « log ») — linéarise visuellement certaines relations multiplicatives en convertissant les intervalles euclidiens en puissances d’ordre de grandeur. Toutefois, lorsqu’une équation de régression est annotée sur un axe transformé de la sorte, une ambiguïté sémiotique critique surgit : les coefficients affichés correspondent-ils aux échelles logarithmiques sous-jacentes ou aux unités physiques naturelles ? Pour prévenir toute confusion d’interprétation, l’analyste rigoureux explicitera formellement la notation fonctionnelle, écrivant par exemple ln(y) = β0 + β1x plutôt que d’utiliser la variable brute sans transformation apparente.
Lorsque la relation obéit à un modèle non linéaire intrinsèque ne pouvant être linéarisé par des transformations simples, l’ajustement par moindres carrés non linéaires via la fonction nls() devient nécessaire. Dans ce scénario, les métriques traditionnelles comme le R² perdent leur signification mathématique rigoureuse (le théorème de décomposition de la somme des carrés n’étant plus valide pour les modèles non linéaires). L’annotation devra alors privilégier le report des paramètres cinétiques estimés, de leurs erreurs types asymptotiques et des critères d’information (AIC/BIC), illustrant une fois encore que l’annotation graphique doit s’adapter scrupuleusement aux propriétés théoriques du modèle mathématique mobilisé.
12. Directives de publication, reproductibilité et exportation graphique
12.1 Alignement sur les normes de publication des revues scientifiques (APA 7th)
L’élaboration d’une figure statistique destinée à franchir avec succès le cap de l’évaluation par les pairs (peer-review) exige une conformité absolue avec les canons de l’édition scientifique internationale. Les normes de l’APA (7e édition) définissent un ensemble de directives typographiques et ergonomiques précises régissant la présentation des graphiques. Au premier rang de ces exigences figure l’usage scrupuleux de l’italique pour désigner les symboles statistiques d’échantillon : les lettres N, r, R², t, F et p doivent impérativement être composées en italique, tandis que les opérateurs arithmétiques (+, -, =, <) et les valeurs numériques demeurent strictement en caractères romains droits.
Par ailleurs, la doctrine ergonomique d’Edward Tufte sur l’intégrité graphique proscrit formellement ce qu’il nomme le « chartjunk » : l’accumulation d’ornements visuels inutiles qui n’apportent aucune information quantitative nouvelle. Les arrière-plans colorés, les ombrages superflus, les bordures épaisses et les quadrillages denses doivent être éliminés sans concession. L’accent doit être mis exclusivement sur le ratio encre-données (data-ink ratio). L’équation de régression et son nuage de points doivent s’inscrire dans une sobriété visuelle absolue, où chaque trait de plume numérique remplit une fonction sémiotique précise.
Un autre impératif fondamental réside dans l’accessibilité universelle de la figure. Le choix de la palette de couleurs ne doit jamais reposer sur de simples critères esthétiques arbitraires. L’utilisation d’échelles perceptuellement uniformes et accessibles aux personnes atteintes de déficiences de la vision des couleurs (daltonisme, deutéranopie, protanopie) — à l’instar des palettes Viridis ou ColorBrewer — s’impose systématiquement. Enfin, chaque figure doit être accompagnée d’une légende textuelle exhaustive et autonome, explicitant la signification de chaque abréviation, la taille précise de l’échantillon analysé, et la nature exacte des bandes d’incertitude représentées.
12.2 Exportation haute résolution et flux de travail reproductible
L’étape ultime du flux de production graphique réside dans la compilation et l’exportation du canevas vers des formats de fichiers physiques répondant aux spécifications techniques rigoureuses des éditeurs universitaires. Dans l’écosystème R, la fonction centrale ggsave() gouverne ce processus d’exportation. Il est méthodologiquement recommandé d’éviter l’exportation interactive par copier-coller depuis l’interface graphique de RStudio, cette pratique introduisant des distorsions imprévisibles dépendantes de la résolution spatiale momentanée de l’écran de l’opérateur.
L’analyste doit choisir de manière éclairée entre deux grands paradigmes d’exportation : le format vectoriel et le format matriciel (raster). Les formats vectoriels tels que le PDF (Portable Document Format) ou le SVG (Scalable Vector Graphics) doivent être privilégiés sans réserve pour les manuscrits soumis à l’édition. Les descriptions géométriques vectorielles conservent une netteté mathématique infinie, quelle que soit l’échelle d’agrandissement appliquée lors de la composition typographique de la revue, tout en préservant le texte des équations sous forme de chaînes de caractères sélectionnables et interrogeables.
Lorsque des contraintes éditoriales imposent la fourniture d’images matricielles (notamment pour les photographies ou les micro-données massives), le format TIFF (Tagged Image File Format) ou PNG non compressé doit être configuré avec une densité de pixels minimale de 300 à 600 DPI (dots per inch). L’appel à ggsave() doit fixer explicitement les dimensions physiques réelles de la figure (width = 16, height = 10, units = « cm », dpi = 300), assurant ainsi une maîtrise absolue du rendu final sur papier imprimé ou support numérique de haute résolution.
Enfin, la pérennité de l’ensemble de la démarche analytique repose sur l’archivage rigoureux de l’environnement logiciel au moyen de fonctions telles que sessionInfo() ou d’outils de gestion d’environnements reproductibles comme renv. En documentant précisément les versions exactes du système d’exploitation, de l’interpréteur R et de l’ensemble des dépendances logicielles mobilisées, le chercheur offre à la communauté scientifique les moyens de vérifier, de reproduire et d’étendre ses résultats graphiques en toute confiance, perpétuant ainsi les plus hauts standards d’intégrité scientifique.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Kassambara, A. (2020). ggpubr: ‘ggplot2’ Based Publication Ready Plots (R package version 0.4.0). CRAN. https://rpkgs.datanovia.com/ggpubr/
- Murrell, P. (2018). R Graphics (3rd ed.). Chapman & Hall/CRC. https://doi.org/10.1201/9780429497018
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.r-project.org/
- Robinson, D., Hayes, A., & Couch, S. (2023). broom: Convert Statistical Objects into Tidy Tibbles (R package version 1.0.5). CRAN. https://cran.r-project.org/package=broom
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0