
Dans le champ contemporain de l’analyse quantitative et de l’ingénierie des données, la transformation d’un ensemble discret d’observations empiriques en une structure intelligible constitue l’une des démarches fondamentales de la recherche appliquée. L’avènement des suites bureautiques dématérialisées, au premier rang desquelles figure Google Sheets, a profondément démocratisé l’accès à des outils d’ajustement mathématique autrefois cantonnés à des environnements logiciels spécialisés tels que SAS, SPSS ou le langage R. Au sein de cet écosystème infonuagique, l’insertion d’une courbe d’ajustement ne se résume pas à un simple artifice esthétique ; elle matérialise une opération de modélisation statistique visant à expliciter les régularités sous-jacentes à des distributions bivariées souvent bruitées.
Le recours à la régression visuelle via un tableur partagé répond à une double exigence : heuristique d’une part, en facilitant la formulation d’hypothèses sur la dynamique liant deux grandeurs physiques, psychologiques ou économiques, et communicationnelle d’autre part, en offrant une synthèse géométrique épurée d’un nuage de points complexe. Qu’il s’agisse de documenter l’évolution temporelle d’un score psychométrique, d’évaluer le rendement marginal d’un processus industriel ou de quantifier une trajectoire d’apprentissage cognitif, la courbe de tendance agit comme un filtre mathématique capable d’isoler le signal au détriment des fluctuations stochastiques résiduelles.
Toutefois, la relative simplicité ergonomique de Google Sheets dissimule des enjeux théoriques et statistiques de premier ordre. L’adjonction d’une droite ou d’une courbe non linéaire à une distribution métrique requiert une vigilance méthodologique sans faille : de la structuration rigoureuse de la matrice de données amont à l’évaluation paramétrique de la qualité d’ajustement par le coefficient de détermination, chaque étape conditionne la validité inférentielle du modèle. Ce traité exhaustif et systématique détaille l’ensemble des protocoles techniques, des prérequis mathématiques et des considérations épistémologiques nécessaires pour maîtriser l’intégration, l’interprétation et la valorisation des courbes de tendance au sein du logiciel Google Sheets.
1. Fondements théoriques et épistémologiques des courbes de tendance dans l’analyse de données
1.1 Définition et portée méthodologique de la régression visuelle
D’un point de vue épistémologique, la courbe de tendance représente l’incarnation géométrique d’un modèle fonctionnel visant à transcrire une relation sous-jacente entre une variable indépendante, conventionnellement notée $X$, et une variable dépendante, notée $Y$. L’objectif fondamental de cet ajustement consiste à réduire la complexité phénoménologique d’une multitude de mesures discontinues en une expression analytique continue $y = f(x) + epsilon$, où $epsilon$ figure le terme d’erreur ou résidu. Dans le paradigme des moindres carrés ordinaires, cette démarche méthodologique ambitionne de minimiser la somme du carré des écarts verticaux séparant chaque point de données réel de son corollaire estimé sur la courbe.
Il demeure toutefois impératif de dissocier rigoureusement la détection visuelle d’une corrélation et l’affirmation d’une causalité ontologique. Si le traçage d’une ligne d’ajustement permet de formaliser la covariance structurelle de deux grandeurs, il ne saurait en aucun cas attester que les variations de $X$ induisent mécaniquement celles de $Y$. La présence de variables confondantes, d’une causalité inversée ou de biais d’échantillonnage impose au chercheur une circonspection interprétative constante, évitant ainsi de transformer un simple alignement géométrique fortuit en un déterminisme scientifique infondé.
Dans les disciplines empiriques, notamment la psychométrie, les sciences comportementales et la biométrie, les protocoles expérimentaux se heurtent invariablement à une variance d’erreur substantielle découlant de l’imperfection des instruments de mesure ou de la variabilité biologique intra-individuelle. L’ajustement statistique opéré par la courbe de tendance remplit ici une fonction cruciale de débruitage : en agrégeant la tendance centrale des variations locales, la régression extrait l’invariance structurelle du phénomène observé, fournissant ainsi une base empirique épurée pour l’élaboration de lois fonctionnelles.
1.2 Rôle cognitif et heuristique de la visualisation des tendances
Sur le plan des neurosciences cognitives et de la psychologie de la perception visuelle, le système visuel humain est naturellement prédisposé à segmenter l’espace perceptif selon les principes de la théorie de la Gestalt, en particulier les lois de continuité, de proximité et de destin commun. Lorsqu’un observateur scrute une dispersion brute de points, la charge cognitive requise pour intégrer mentalement la trajectoire globale s’avère considérable. L’introduction d’un vecteur linéaire ou curviligne unifié soulage activement la mémoire de travail en fournissant un ancrage perceptif stable, transformant une opération analytique point par point en une saisie holistique immédiate.
Cette simplification heuristique favorise une détection rapide des régularités comportementales, des ruptures de pente et des zones d’inflexion qui échapperaient à la simple lecture tabulaire des chiffres. Le cerveau humain peut ainsi inférer quasi instantanément le sens de l’évolution (croissance, stagnation, décroissance) ainsi que sa magnitude relative. La courbe de tendance agit dès lors comme un médiateur sémiotique entre la réalité numérique brute et le schéma conceptuel de l’expérimentateur, fluidifiant la transmission de l’information scientifique lors de la diffusion des résultats de recherche.
Cependant, cette prégnance visuelle n’est pas exempte de biais perceptifs majeurs, documentés de longue date par les travaux de recherche en visualisation graphique, notamment ceux de William S. Cleveland. L’œil humain tend spontanément à évaluer la distance orthogonale la plus courte entre un point et une courbe, plutôt que la distance purement verticale qui constitue pourtant la base algorithmique de la régression par moindres carrés. De surcroît, les variations de rapport d’aspect (l’écrasement ou l’étirement des axes) induisent des distorsions massives dans l’estimation intuitive des coefficients angulaires, menant parfois les analystes à surestimer la puissance cinétique d’un phénomène dont l’ordonnée est simplement comprimée.
1.3 Pertinence pour les sciences du comportement et les ensembles de données empiriques
L’utilité pratique des modèles de régression visuelle s’illustre avec éclat dans le champ des sciences comportementales, où l’on cherche fréquemment à modéliser des cinétiques temporelles complexes. Qu’il s’agisse de quantifier la réduction progressive du temps de réaction face à un stimulus répété, de formaliser la loi de puissance de la pratique ou de cartographier la dynamique de renforcement et d’extinction d’une réponse conditionnée, la courbe d’ajustement fournit le patron mathématique indispensable à la corroboration empirique des théories psychologiques sous-jacentes.
Dans le cadre de devis longitudinaux ou d’études de cohortes, le suivi diachronique des scores psychologiques requiert une estimation rigoureuse de la stabilité temporelle des traits mesurés. L’adjonction d’une courbe de tendance transversale permet d’apprécier la persistance des performances en filtrant les oscillations circonstancielles dues à la fatigue ou aux effets d’apprentissage des instruments de test. L’ajustement visualisé constitue ainsi un étalon de référence pour jauger la variance inter-individuelle par rapport au patron développemental moyen du groupe étudié.
Enfin, au sein d’une démarche d’analyse exploratoire de données (AED) théorisée par John Tukey, la projection immédiate d’une courbe de tendance sert de catalyseur hypothétique. Avant même de déployer des batteries de tests inférentiels hautement paramétrés ou des modélisations par équations structurelles, l’examen visuel du degré d’adéquation d’une droite ou d’une courbe logarithmique guide le chercheur vers la famille fonctionnelle la plus appropriée, circonscrivant en amont les modèles mathématiques qu’il conviendra de soumettre aux procédures formelles de réfutation empirique.
2. Préparation rigoureuse et structuration des données dans Google Sheets
2.1 Organisation tabulaire optimale des variables dépendantes et indépendantes
La réussite de l’implémentation graphique d’une courbe de régression dans Google Sheets dépend en premier lieu de la conformité architecturale de la feuille de calcul. L’environnement logiciel repose sur des conventions matricielles strictes : pour qu’une projection bivariée soit interprétée sans ambiguïté par l’algorithme d’inférence visuelle, les données doivent adopter une disposition orthogonale normalisée. La variable indépendante, explicative ou prédictive (axe $X$), doit impérativement être consignée dans la première colonne de la sélection, tandis que la variable dépendante, réponse ou critère (axe $Y$), doit être allouée à la colonne contiguë à droite.
La sémantique des descripteurs joue également un rôle capital. La première ligne de chaque colonne doit être exclusivement réservée à un en-tête univoque, synthétique et exempt de symboles cryptiques, formulé par exemple sous la forme « Durée d’entraînement (semaines) » et « Précision motrice (score normalisé) ». Cette standardisation prévient les défaillances de mappage automatique du moteur graphique et facilite l’incorporation automatique des étiquettes au sein des légendes analytiques de Google Sheets.
Sur le plan métrique, il est impératif de s’assurer que les variables projetées respectent au minimum les propriétés d’une échelle d’intervalles ou de rapports. L’application d’un modèle d’ajustement linéaire ou non linéaire sur des données strictement ordinales (comme des échelles de Likert non corrigées) constitue une violation méthodologique sévère des postulats de la régression classique, aboutissant à tracer des trajectoires mathématiquement définies au sein d’espaces topologiques discontinus où la notion même de distance métrique est absente.
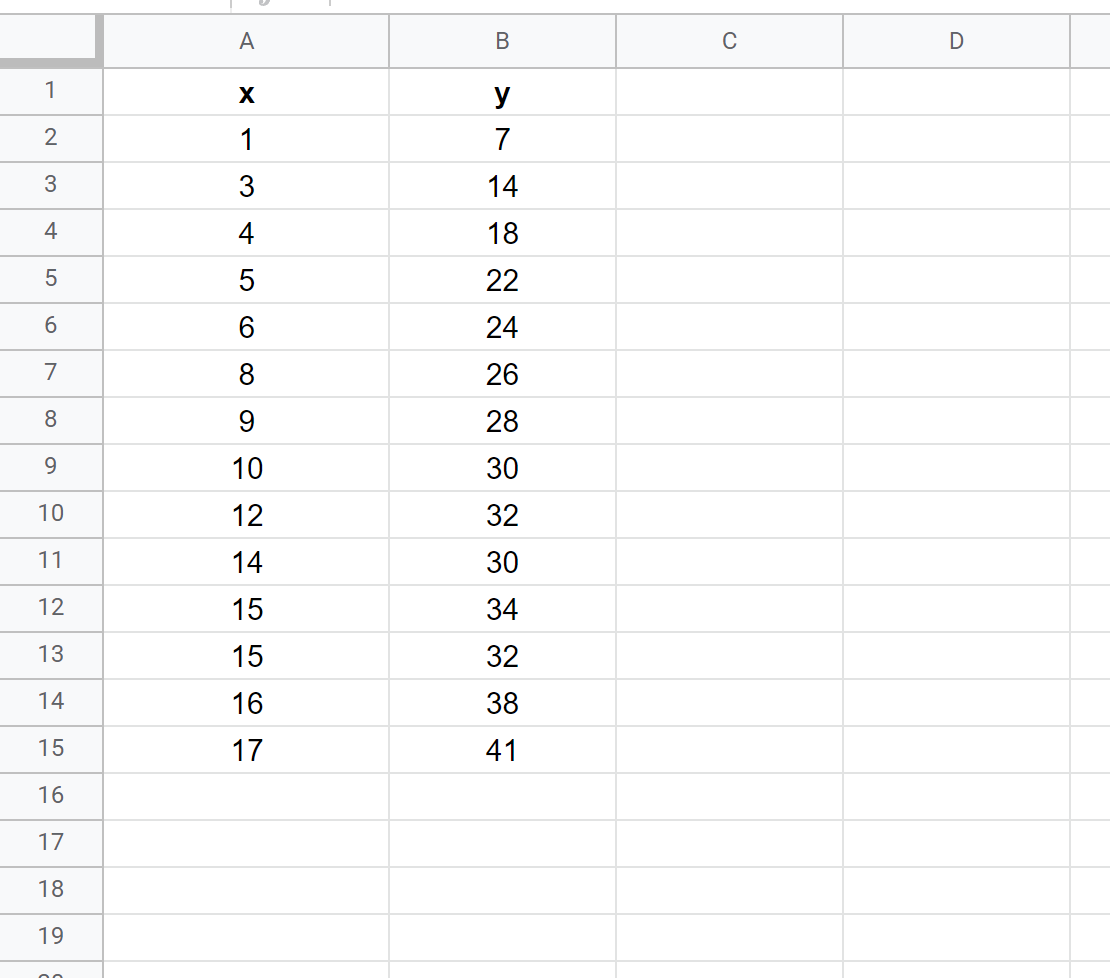
2.2 Audit et nettoyage préalable du jeu de données
Avant d’initialiser le moindre graphique, un audit méticuleux de la distribution brute s’impose afin d’identifier et de traiter les valeurs aberrantes (outliers). Qu’elles proviennent d’une erreur d’encodage typographique, d’une défaillance instrumentale ou d’un comportement participant non conforme, les valeurs extrêmes exercent un effet de levier disproportionné sur la trajectoire des moindres carrés ordinaires. L’utilisation conjointe des fonctions statistiques natives de Google Sheets, telles que MOYENNE, ECARTYPE et CENTILE, permet d’établir des filtres de vérification pour repérer les points excédant trois écarts-types de la moyenne.
La présence de cellules vides ou manquantes nécessite une décision méthodologique explicite : l’exclusion pure et simple versus l’imputation statistique. Dans le moteur de rendu de Google Sheets, une cellule vide sur l’un des axes peut conduire à une interruption de la série ou à l’omission tacite de l’observation correspondante. Si l’omission de lignes complètes (listwise deletion) demeure la stratégie la plus conservatrice face à des données manquant de manière totalement aléatoire (MCAR), elle réduit la puissance statistique de l’échantillon. L’analyste devra documenter systématiquement le choix opéré afin de garantir la reproductibilité du traitement.
Enfin, il convient d’analyser le degré d’asymétrie (skewness) et d’aplatissement (kurtosis) de la distribution. Une variable présentant une asymétrie positive massive concentre l’écrasante majorité des observations dans le coin inférieur gauche de l’espace graphique, générant un agglomérat dense dominé par une poignée de valeurs distantes. Dans de telles conditions, l’ajustement direct d’une droite de régression sans transformation préalable aboutit à un modèle factice, tracté par les quelques points distaux au détriment de la fidélité représentative du noyau central de l’échantillon.
2.3 Typage strict des formats de données numériques et chronologiques
L’une des sources les plus courantes d’anomalies lors de l’insertion de courbes de tendance dans Google Sheets réside dans le typage équivoque des formats de cellules. Pour que le moteur graphique reconnaisse une série comme métrique et autorise l’activation des options de régression, les données doivent être encodées sous forme de valeurs numériques pures ou de repères temporels sériels, et non sous forme de chaînes de texte. Un nombre malencontreusement précédé d’une apostrophe ou centré par défaut comme du texte brut empêchera le logiciel de calculer les coefficients moindres carrés correspondants.
L’harmonisation des séparateurs décimaux constitue un autre point d’achoppement fréquent, intimement lié aux paramètres régionaux du compte Google de l’utilisateur. Dans un environnement configuré en langue française, le séparateur décimal valide est la virgule, alors que le point est réservé aux conventions anglo-saxonnes. Une discordance à ce niveau engendre la transformation subreptice des valeurs numériques en étiquettes textuelles, annihilant toute possibilité d’interpolation fonctionnelle continue sur l’axe des abscisses.
Dans le cas d’analyses longitudinales basées sur des séries chronologiques, il est indispensable de structurer les dates selon le format d’horodatage natif reconnu par Google Sheets (par exemple AAAA-MM-JJ ou JJ/MM/AAAA). Cette précaution garantit que l’écart spatial entre deux points sur l’axe horizontal soit rigoureusement proportionnel au nombre réel d’unités de temps écoulées, prévenant l’écueil classique des graphiques en catégories où les intervalles temporels inégaux sont arbitrairement représentés comme équidistants.
3. Création du graphique initial sous Google Sheets : Le nuage de points
3.1 Sélection matricielle et insertion de l’objet graphique
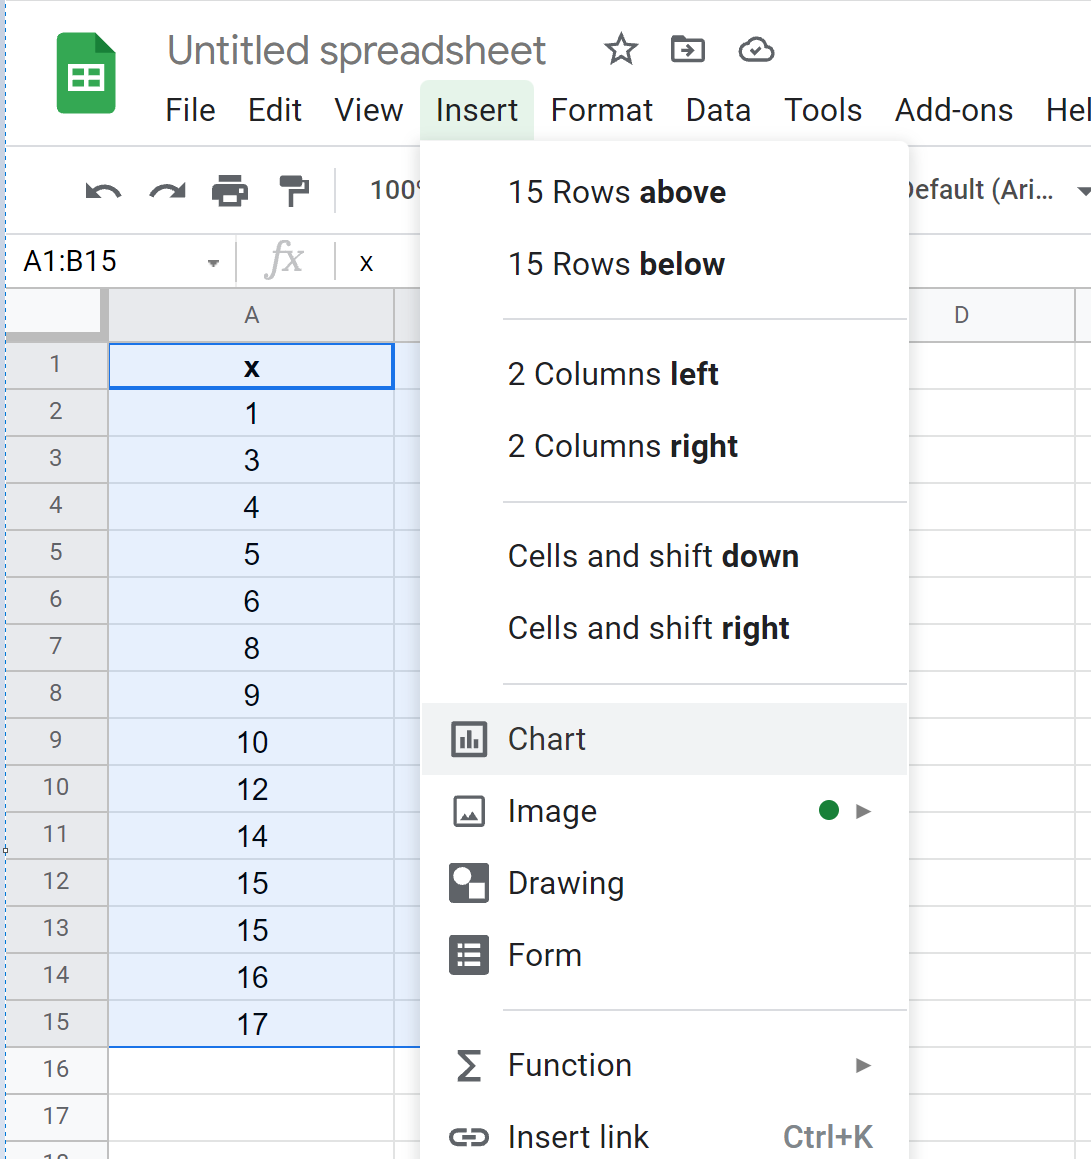
La concrétisation de l’ajustement empirique débute par la délimitation rigoureuse du champ vectoriel au sein du tableur. L’opérateur doit sélectionner, à l’aide du curseur ou des raccourcis de navigation clavière (tels que Ctrl+Maj+Flèche sur Windows ou Cmd+Shift+Flèche sur macOS), l’intégralité de la matrice contenant les données, en incluant impérativement les libellés d’en-tête situés sur la première ligne. Cette sélection englobante permet au système de contextualiser sémantiquement les axes dès l’initialisation du composant visuel.
Une fois le bloc matriciel surligné, l’insertion s’effectue via le ruban supérieur en activant le menu Insertion, puis en sélectionnant la commande Graphique. Alternativement, le recours à l’icône de raccourci figurant un petit histogramme dans la barre d’outils contextuelle déclenche la même séquence algorithmique. Cette commande a pour effet immédiat d’instancier un canevas graphique vectoriel flottant par-dessus la grille des cellules, tout en provoquant l’ouverture automatique du panneau latéral intitulé Éditeur de graphiques sur la droite de l’écran.
À cet instant précis, l’algorithme heuristique de Google Sheets tente de prédire la nature des données et génère un type de graphique par défaut, souvent sous la forme d’un diagramme en bâtons ou d’une courbe continue reliant arbitrairement chaque point chronologique. L’analyste ne doit en aucun cas se satisfaire de cette proposition préliminaire, qui ne respecte que très rarement les critères de la modélisation statistique bivariée. Il convient donc de reprendre la main sur la configuration structurelle de l’objet graphique créé.
3.2 Paramétrage du nuage de points comme standard métrique
Pour assurer la validité absolue de la régression à venir, le choix du type de visualisation est non négociable : seul le Graphique à nuage de points (Scatter chart) permet un traitement rigoureusement cartésien des coordonnées $(X, Y)$. Pour activer cette typologie, l’utilisateur doit se positionner sur l’onglet Configurer de l’Éditeur de graphiques, déployer le menu déroulant Type de graphique, et faire défiler les options jusqu’à la catégorie Point pour y sélectionner l’icône figurant une constellation de points isolés.
Le contrôle des assignations axiales s’avère ensuite fondamental. Dans la section inférieure de l’onglet Configurer, il convient de vérifier scrupuleusement que le champ Axe des X référence de façon exclusive la plage relative à la variable indépendante (par exemple A2:A100). Corrélativement, le conteneur Série doit héberger la plage dévolue à la variable dépendante (par exemple B2:B100). Toute inversion entre ces deux axes produirait un basculement de la relation fonctionnelle, inversant la pente de la régression et rendant les coefficients obtenus totalement inaptes à l’inférence théorique.
Enfin, deux cases de validation méritent une attention soutenue au sein de ce panneau : l’option Utiliser la ligne 1 comme en-tête et l’option Utiliser la colonne A comme libellés (selon la configuration). L’activation explicite de la reconnaissance des en-têtes prévient l’assimilation indue des étiquettes alphabétiques à des valeurs nulles sur les axes métriques, éliminant ainsi un artefact d’échelle classique susceptible de biaiser le calcul de la tendance globale dès l’origine.
3.3 Validation de l’intégrité visuelle préliminaire de la distribution
Avant d’enclencher la moindre procédure de calcul d’ajustement, l’examen qualitatif de la distribution représentée sur le nuage de points s’impose comme une démarche diagnostique incontournable. L’analyste doit inspecter l’ensemble de la dispersion spatiale afin de juger du respect de l’homoscédasticité, c’est-à-dire de la constance de la variance des résidus sur toute l’étendue des valeurs de la variable indépendante. La détection d’un motif conique d’évasement (hétéroscédasticité) signale immédiatement que les estimations par les moindres carrés ordinaires perdront de leur efficacité statistique.
Il importe également de surveiller la configuration des limites extrêmes des axes horizontaux et verticaux. Google Sheets opère par défaut un ajustement dynamique automatique des bornes d’échelles, ce qui peut occasionnellement tasser la dispersion observée ou, à l’inverse, isoler artificiellement des groupements de données. Si nécessaire, un recadrage manuel des minima et maxima garantit que l’œil humain perçoive l’ensemble de l’espace métrique sans distorsion d’amplitude disproportionnée.
Enfin, cette inspection visuelle préalable permet d’apprécier la géométrie fondamentale du nuage de points. Si la trajectoire générale évoque d’emblée une décélération progressive, un plateau asymptotique ou une inversion de direction, l’imposition brutale d’un modèle d’ajustement purement linéaire constituerait une faute méthodologique majeure. Cette phase d’observation renseigne directement l’analyste sur la pertinence respective des modèles linéaires, logarithmiques ou polynomiaux qu’il s’agira de tester subséquemment.
4. Procédure pas à pas : Activation de la courbe de tendance de base
4.1 Accès au volet de personnalisation des séries de données
L’initialisation de l’ajustement mathématique requiert une immersion au cœur du moteur de paramétrage de Google Sheets. Lorsque l’objet graphique est déjà présent sur le plan de travail, l’accès à ses propriétés s’effectue en opérant un double-clic consécutif avec le pointeur de la souris sur l’espace d’affichage du graphique, ou en cliquant sur l’icône matérialisée par trois points verticaux logée dans le coin supérieur droit du cadre afin de sélectionner la commande Modifier le graphique. Cette manipulation restaure le panneau de configuration latéral droit s’il avait été clos.
Une fois ce volet latéral actif, il convient d’opérer une bascule conceptuelle en quittant l’onglet initial « Configurer » pour se diriger vers l’onglet Personnaliser, identifiable par sa position contiguë au sommet de l’interface. Cet onglet regroupe l’ensemble des modificateurs de forme, d’ergonomie, de rendu typographique et de comportement analytique appliqués à la composition vectorielle.
À l’intérieur de cette interface de personnalisation, l’analyste fait défiler les rubriques jusqu’à localiser le module déroulant intitulé Séries. En cliquant sur le chevron situé à l’extrémité de cette section, on déploie une panoplie complète de sous-paramètres régissant la morphologie géométrique des marqueurs de points, la visibilité des barres d’erreur, les étiquettes de données individuelles et, singulièrement, les fonctions d’interpolation analytique globale.
4.2 Enclenchement technique de la case d’option de tendance
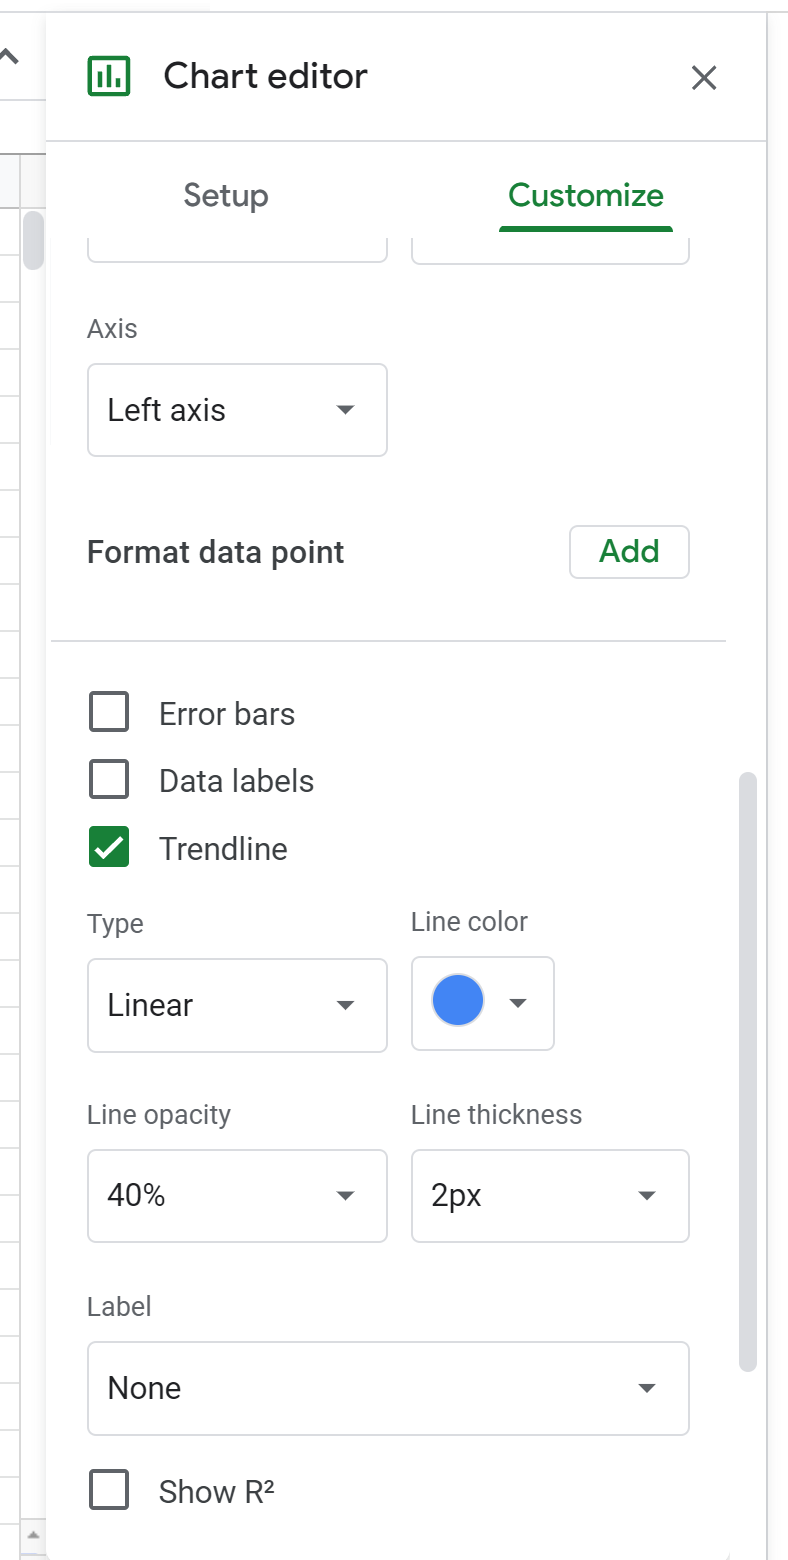
Au sein du sous-menu Séries ainsi déployé, l’opérateur observe plusieurs options de mise en forme avancée. Il convient de descendre dans l’arborescence jusqu’à repérer la case à cocher explicite intitulée Courbe de tendance (ou Trendline selon la langue de configuration du profil utilisateur). Un simple clic gauche sur cette case déclenche instantanément l’algorithme d’estimation numérique de Google Sheets en arrière-plan, modifiant la structure même du rendu graphique en temps réel.
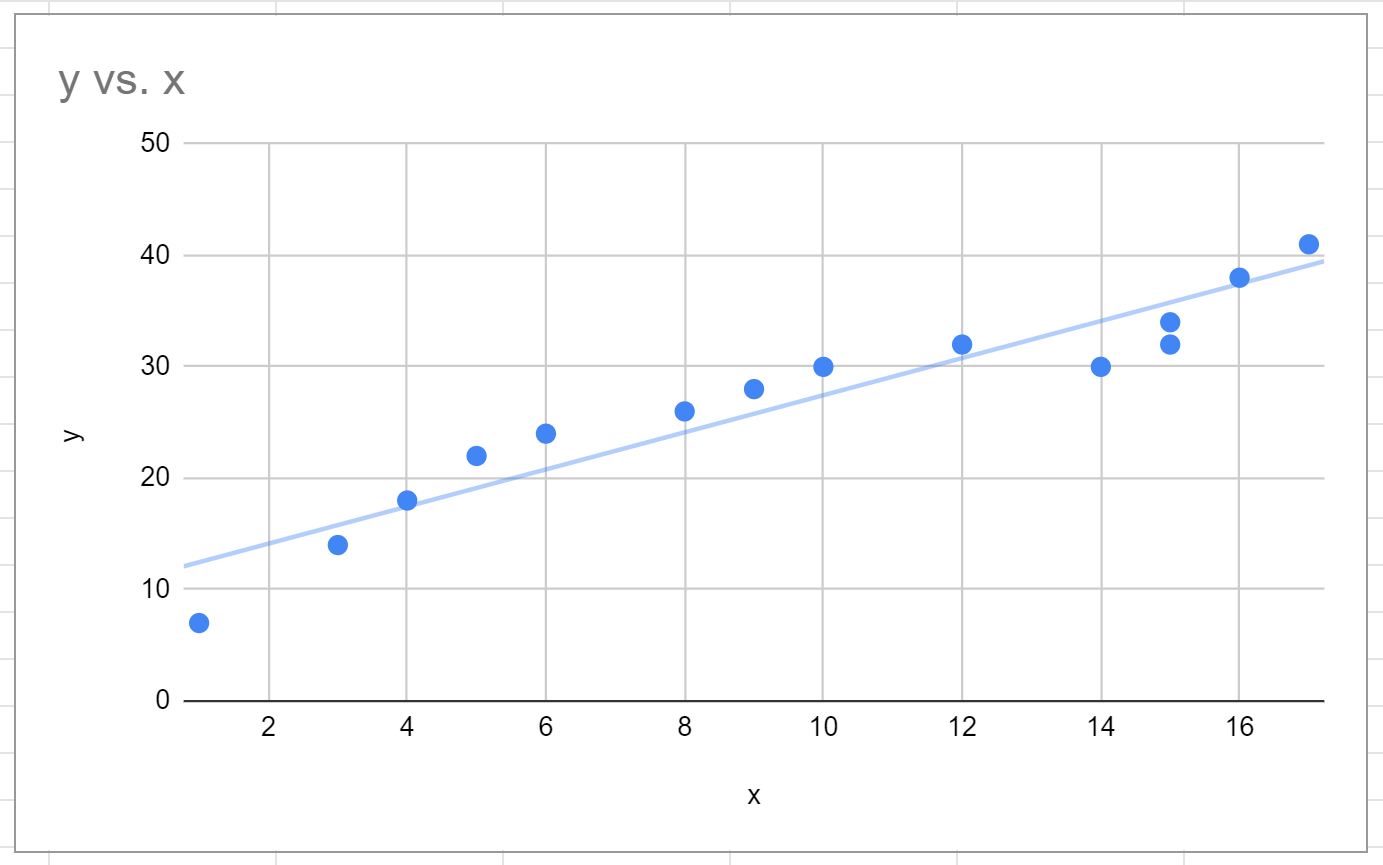
D’un point de vue informatique, cette activation n’est pas une simple commande d’habillage graphique : elle instancie un processus itératif qui parcourt l’ensemble des coordonnées stockées dans la mémoire vive, calcule le barycentre ou centroïde $(\bar{X}, \bar{Y})$ de l’échantillon bivarié, et résout le système d’équations normales pour déterminer la droite optimale minimisant les résidus verticaux. Google Sheets applique par défaut un modèle linéaire standard, projeté sous la forme d’un trait continu monochrome traversant la totalité de l’étendue des données d’abscisse.
Il convient de prêter une attention rigoureuse au sélecteur de série positionné au sommet de la section Séries. Si le graphique ne comporte qu’une unique variable réponse, les modifications s’appliquent globalement à celle-ci. En revanche, si la visualisation intègre de multiples séries de données superposées, le système offre le choix entre l’option Appliquer à toutes les séries ou la sélection individualisée d’une série spécifique dans la liste déroulante, permettant d’activer la tendance de manière sélective selon les impératifs analytiques du chercheur.
4.3 Vérification immédiate de la concordance graphique
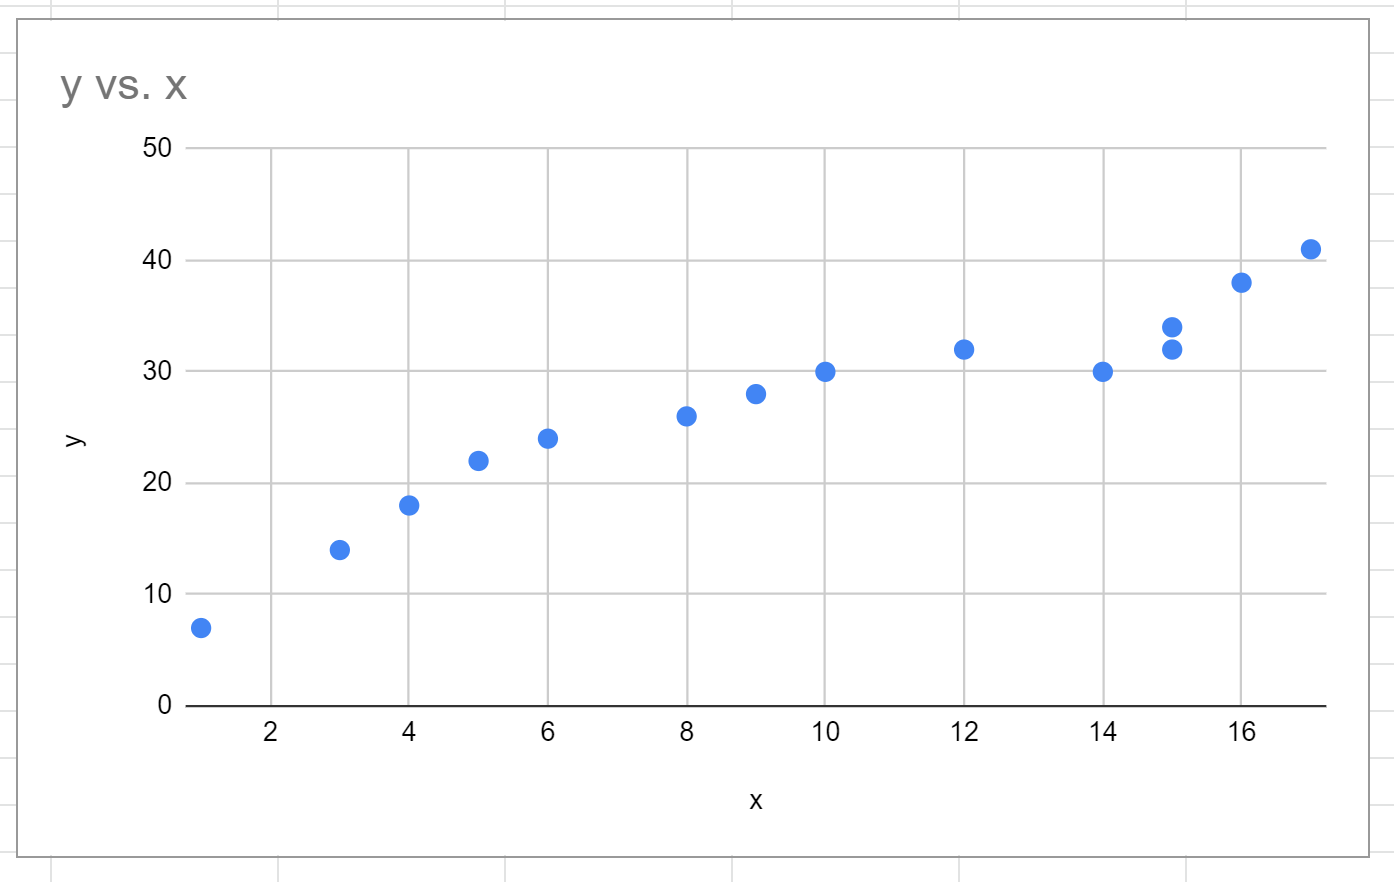
Dès l’enclenchement de la case, l’utilisateur doit procéder à une validation visuelle immédiate du résultat sur le canevas de dessin. La ligne générée doit s’étendre de manière harmonieuse à travers le nuage, sans brisure géométrique ni décrochage inattendu aux extrémités du domaine expérimental. La droite doit impérativement intercepter le centroïde de la distribution, une propriété mathématique inaliénable de la régression par moindres carrés qui garantit que la somme algébrique des résidus linéaires est strictement égale à zéro.
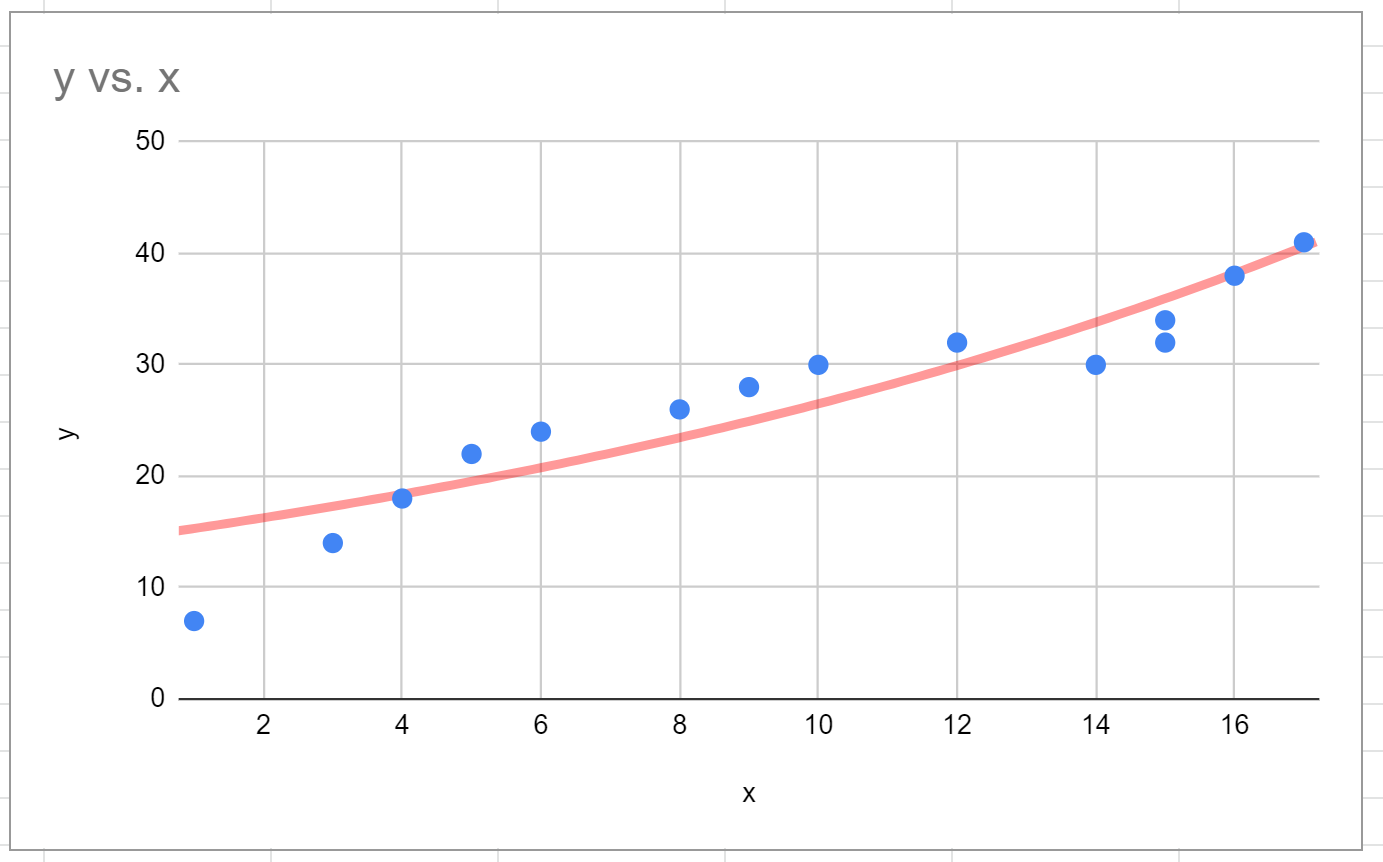
Cette observation directe offre une première approximation de l’adéquation du modèle par défaut. Si le tracé linéaire passe manifestement à côté de la masse principale des données en raison d’une cambrure prononcée de la distribution, cette discordance immédiate informe le praticien de la nécessité de modifier le type de modélisation au sein des options subsidiaires qui viennent de se débloquer sous la case à cocher active.
Enfin, l’ensemble de ces modifications est instantanément pris en charge par le protocole de synchronisation continue de l’infrastructure Google Workspace. Contrairement aux logiciels bureautiques traditionnels sur disque local, aucune commande de sauvegarde explicite n’est requise : chaque paramètre sélectionné est immédiatement sérialisé et inscrit dans l’historique des versions de la feuille de calcul, garantissant la pérennité intégrale du travail d’analyse en cours de réalisation.
5. Typologie comparative des modèles mathématiques disponibles
5.1 Le modèle linéaire : Principes, hypothèses et limites
Le modèle linéaire proposé par défaut dans Google Sheets matérialise l’archétype fondamental de la régression univariée. Mathématiquement formalisé sous l’expression algébrique classique $y = mx + b$, où $m$ désigne la pente (ou coefficient de régression empirique) et $b$ l’ordonnée à l’origine (la valeur théorique prédite de $Y$ lorsque $X$ équivaut à zéro), ce modèle repose sur l’hypothèse centrale d’un taux de variation parfaitement constant entre les deux grandeurs étudiées. Chaque incrément unitaire le long de l’axe des abscisses se traduit par une variation invariante de $m$ unités sur l’axe des ordonnées, quel que soit le niveau absolu atteint par $X$.
La validité théorique d’un tel ajustement repose sur les axiomes formalisés par le théorème de Gauss-Markov. Pour que les estimateurs des moindres carrés soient sans biais et de variance minimale (BLUE), les résidus doivent être mutuellement indépendants, présenter une variance constante (homoscédasticité) et posséder une espérance conditionnelle nulle. Dans l’exploration empirique des comportements ou des performances humaines, ce modèle convient particulièrement à la modélisation de variations incrémentales à court terme, au calcul de rendements constants ou à la quantification de relations cinétiques stables au sein de fenêtres temporelles restreintes.
Les limites intrinsèques du modèle linéaire surgissent avec acuité lorsque l’amplitude du phénomène étudié s’élargit. Dans le vivant et l’humain, les variations métriques s’accompagnent quasi systématiquement d’effets de seuil, d’épuisement des ressources ou de butées physiologiques, désignés sous les vocables d’effets de plancher et de plafond. Forcer une droite sur une distribution présentant un ralentissement progressif constitue une erreur de spécification majeure qui fausse la valeur des prédictions aux extrêmes et vicie les analyses inférentielles subséquentes.
5.2 Les modèles exponentiels et logarithmiques : Détection des cinétiques non constantes
Lorsque le taux de variation d’une grandeur n’est plus constant mais proportionnel à la magnitude même de cette grandeur, le déploiement d’un modèle non linéaire devient indispensable. Google Sheets intègre nativement le modèle Exponentiel, dont l’équation générale s’exprime sous la forme $y = a \cdot e^{bx}$. Ce modèle s’impose lors de l’étude de dynamiques de croissance cumulative sans contrainte immédiate, telles que la propagation épidémiologique d’un agent pathogène dans une population naïve, l’emballement initial d’un buzz communicationnel ou, en sens inverse, le déclin rapide de la rétention mnésique à court terme d’un individu en l’absence de consolidation.
À l’opposé architectural de la cinétique exponentielle se dresse le modèle Logarithmique, régi par l’expression mathématique $y = a \cdot \ln(x) + b$. Ce modèle formalise les phénomènes caractérisés par une progression fulgurante lors des phases initiales d’exposition à un stimulus, suivie d’une décélération continue résultant en une saturation asymptotique graduelle. En sciences psychologiques, il s’agit de la formulation mathématique canonique de la loi de Weber-Fechner, stipulant que l’intensité de la sensation perçue croît comme le logarithme de l’intensité de la stimulation physique sous-jacente.
L’utilisation de ces deux modèles impose toutefois des contraintes structurelles drastiques sur le domaine de définition numérique du jeu de données. Le calcul de la fonction logarithmique naturelle $ln(x)$ n’étant rigoureusement pas défini pour des valeurs réelles inférieures ou égales à zéro, la présence d’une seule valeur nulle ou négative sur l’axe des abscisses empêchera purement et simplement le moteur de Google Sheets d’effectuer l’ajustement logarithmique. De façon symétrique, la transformation logarithmique interne nécessaire à la régression exponentielle interdit la présence de valeurs négatives ou nulles sur l’axe des ordonnées $Y$.
5.3 Les modèles polynomiaux et de puissance : Modélisation des dynamiques complexes
Pour appréhender des distributions décrivant des trajectoires curvilignes polyphasiques, Google Sheets met à disposition le modèle Polynomial. Ce dernier formalise la trajectoire au travers d’une somme pondérée de puissances successives de la variable explicative : $y = a_n x^n + dots + a_2 x^2 + a_1 x + a_0$. Le tableur permet à l’utilisateur de sélectionner manuellement le degré du polynôme dans une plage s’étendant de 2 à 6. Un polynôme de degré 2 (fonction quadratique ou parabolique) s’avère parfait pour formaliser les lois psychophysiologiques décrivant des courbes en U ou en U inversé, à l’image de la célèbre loi de Yerkes-Dodson reliant l’éveil motivationnel à l’efficacité de la performance cognitive.
L’élévation arbitraire du degré polynomial (vers les degrés 4, 5 ou 6) constitue toutefois un piège méthodologique d’une rare dangerosité scientifique. Bien qu’un polynôme de degré élevé permette d’épouser avec une précision chirurgicale les méandres du nuage de points et d’afficher un coefficient $R^2$ flatteur, cette optimisation purement mimétique conduit irrémédiablement au phénomène délétère de surajustement (overfitting). Le modèle perd alors toute portée théorique en modélisant le bruit stochastique résiduel plutôt que la dynamique fondamentale, devenant totalement inopérant pour toute extrapolation prédictive.
Le modèle Puissance (Power series), formalisé sous la relation $y = a \cdot x^b$, occupe quant à lui une place singulière dans l’histoire de la psychologie cognitive et de l’ergonomie. Il s’agit du modèle emblématique gouvernant la loi de puissance de la pratique formulée par Newell et Rosenbloom (1981), démontrant que la vitesse d’exécution d’une tâche complexe s’accroît comme une puissance négative du nombre d’essais réalisés. Tout comme le modèle logarithmique, l’ajustement par une loi de puissance exige impérativement que les valeurs de $X$ et de $Y$ soient strictement positives sur l’ensemble de la série considérée.
5.4 La moyenne mobile : Lissage empirique des séries chronologiques bruitées
À la différence des modèles précédents qui constituent des ajustements paramétriques basés sur la résolution globale d’un système d’équations analytiques, l’option Moyenne mobile repose sur une approche non paramétrique de lissage local. Son principe opératoire consiste à remplacer la valeur observée à chaque instant $t$ par la moyenne arithmétique calculée sur une fenêtre temporelle glissante englobant un nombre fini $k$ de points consécutifs récents. Ce processus agit comme un filtre passe-bas éliminant les variations haute fréquence sans présumer de la nature fonctionnelle de la relation globale.
Google Sheets autorise la configuration explicite de la Période de la moyenne mobile (le paramètre de fenêtre glissante). L’arbitrage méthodologique réside dans le calibrage de cette période : une fenêtre excessivement étroite (par exemple 2 périodes) ne gomme pas suffisamment les fluctuations parasitaires et préserve un tracé haché, tandis qu’une fenêtre trop étendue (par exemple 15 ou 20 périodes) induit une inertie considérable, décalant temporellement les signaux réels et lissant à l’excès les véritables points d’inflexion du phénomène suivi.
Il est impératif pour l’analyste de saisir la divergence épistémologique fondamentale séparant la moyenne mobile d’une régression classique : la moyenne mobile ne possède aucune fonction prédictive analytique explicite et ne saurait être résumée sous la forme d’une équation continue utilisable pour l’extrapolation. Elle ne sert qu’à des fins descriptives et diagnostiques immédiates, aidant à discerner la trajectoire globale d’une série chronologique affectée par une forte saisonnalité ou par des variations expérimentales erratiques.
6. Personnalisation esthétique et ergonomie visuelle de la droite
6.1 Modulation chromatique et respect du contraste perceptif
L’intégration d’un composant de régression ne doit pas altérer la clarté sémiotique du document mais, au contraire, hiérarchiser les éléments informatifs en présence. Google Sheets offre une latitude substantielle pour moduler la couleur de la courbe d’ajustement au sein des paramètres de personnalisation de la série. Il est hautement recommandé d’adopter une teinte créant une dissociation chromatique franche avec la nuance allouée aux marqueurs de données empiriques. Si le nuage est représenté par des points d’un bleu profond, l’emploi d’un ton corail ou grenat pour la droite permet d’éviter toute confusion lors de la lecture rapide.
Cette réflexion chromatique doit obligatoirement intégrer les préceptes d’accessibilité visuelle, notamment les recommandations du standard WCAG (Web Content Accessibility Guidelines) ainsi que la prise en compte des troubles de la vision des couleurs (dyschromatopsies telles que la deutéranopie ou la protanopie). Les associations de couleurs fondées sur l’opposition stricte du rouge et du vert doivent être proscrites au profit de palettes reposant sur des contrastes de luminance marqués ou des combinaisons à forte lisibilité universelle telles que le bleu et l’orange.
Dans la perspective d’une publication au sein d’une revue académique imprimée ou d’une monographie soumise aux standards de l’American Psychological Association (normes APA), l’analyste aura tout intérêt à privilégier une esthétique dépouillée en niveaux de gris. Une droite d’ajustement noir pur (#000000) venant s’adosser à des marqueurs de points gris médian (#666666) garantit une lisibilité maximale et une conservation intégrale des contrastes en cas de reproduction photostatique ou d’impression monochrome.
6.2 Épaisseur du trait et hiérarchie de l’attention visuelle
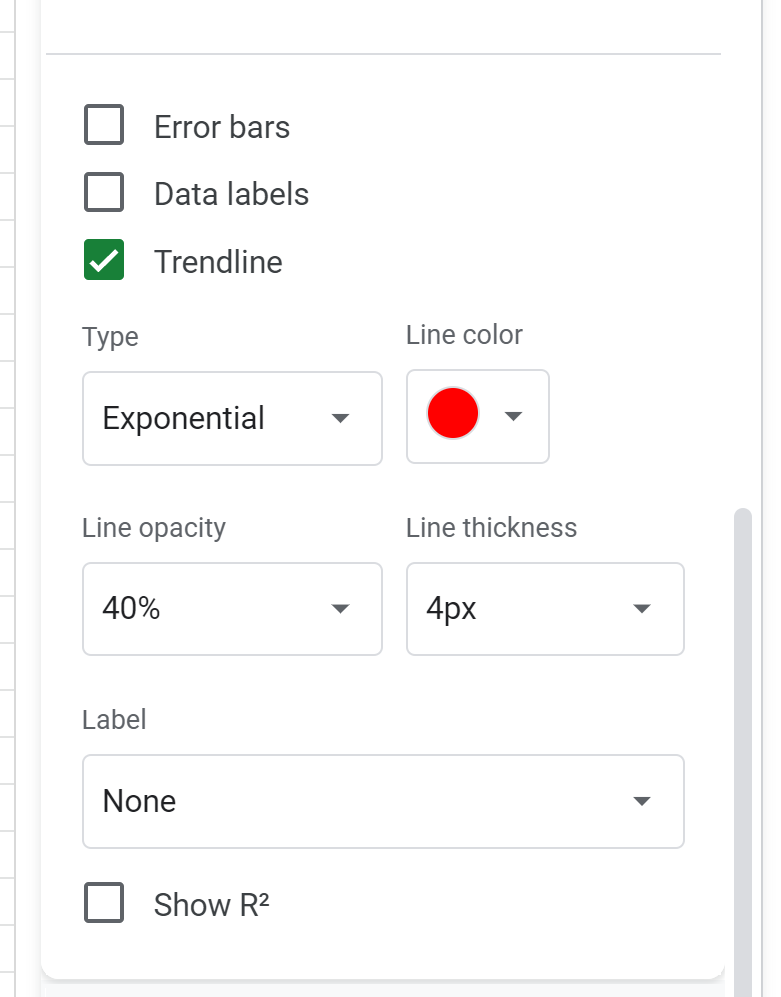
Dans l’interface de personnalisation de la courbe de tendance, le sélecteur Épaisseur de la ligne permet de calibrer le calibre du tracé vectoriel sur une échelle graduée de 1 à 8 pixels. Le choix de cette dimension n’est nullement anodin : il arbitre la répartition de l’attention perceptive du lecteur entre le modèle théorique abstrait et la réalité concrète des observations mesurées. Un trait d’une épaisseur de 8 pixels s’impose de façon hégémonique sur la scène graphique, écrasant la présence visuelle des données et créant une fausse impression de certitude déterministe quant à la trajectoire modélisée.
À l’inverse, l’application d’un calibrage trop ténu (1 pixel) peut diluer la tendance au point de la rendre imperceptible sur un écran à haute densité de pixels ou dans le cadre d’une projection en amphithéâtre. Le standard optimal d’édition académique se situe couramment entre 2 et 4 pixels : ce compromis confère à la courbe la solidité structurale requise pour guider l’œil sans occulter les points situés immédiatement sur son trajet ou à sa proximité directe.
Cette maîtrise de l’épaisseur évite également l’effet d’illusion de précision géométrique. Une droite trop fine donne l’impression infondée que la relation statistique est d’une exactitude microscopique, tandis qu’une épaisseur modérée et proportionnée au volume du canevas rappelle visuellement que la tendance constitue une synthèse synthétique globale et non une certitude punctiforme rigide exempte d’incertitude.
6.3 Gestion de la transparence et des styles de continuité du tracé
La superposition d’une ligne continue sur un nuage de points très concentré engendre fréquemment une perte d’information préjudiciable : les points situés directement derrière la ligne deviennent invisibles ou voient leur morphologie altérée. Google Sheets pallie cet inconvénient en fournissant un curseur d’Opacité de la ligne, échelonné de 0% à 100%. L’ajustement de ce paramètre à un seuil compris entre 60% et 80% confère une semi-transparence bénéfique au tracé de régression, permettant aux marqueurs empiriques de demeurer discernables par transparence même lorsqu’ils sont parfaitement sécants avec la courbe.
Un autre vecteur sémiotique fondamental repose sur le paramétrage du style de ligne. Bien que Google Sheets propose par défaut un tracé continu classique, l’utilisation de motifs discontinus (tirets ou pointillés) s’avère particulièrement pertinente sur le plan conceptuel. Dans la grammaire des représentations scientifiques, le trait plein est conventionnellement associé à l’existence de données vérifiées et tangibles, tandis que le pointillé symbolise l’extrapolation, l’estimation théorique ou l’incertitude modélisée.
Adopter une ligne en pointillés pour la courbe de tendance constitue donc une démarche méthodologiquement rigoureuse pour rappeler au lecteur que la droite ne représente pas une série de mesures physiques additionnelles, mais une construction abstraite émanant d’un algorithme mathématique. Cette distinction graphique prévient toute confusion interprétative, particulièrement dans les contextes où plusieurs séries de données réelles coexistent déjà au sein du même référentiel cartésien.
7. Quantification de la qualité d’ajustement : Affichage et interprétation du R²
7.1 Procédure d’activation du coefficient de détermination
La perception purement visuelle de l’ajustement d’une courbe de tendance ne saurait tenir lieu de validation scientifique formelle : il est impératif de quantifier numériquement l’adéquation statistique du modèle retenu aux données empiriques. Pour satisfaire à cette exigence, Google Sheets intègre un automatisme de calcul dédié au coefficient de détermination, couramment désigné sous le symbole $R^2$. L’activation de cette métrique s’opère de façon directe au sein de l’Éditeur de graphiques.
Sous la sélection du type de modèle dans le volet Séries, l’opérateur doit simplement cocher la case intitulée explicitement Afficher le R². Dès cet enclenchement technique, le logiciel calcule instantanément la valeur correspondante et l’intègre dynamiquement au sein de la légende associée au graphique, juxtaposée au libellé désignant la série ou l’équation de la droite. La réactivité du tableur permet à l’analyste de naviguer de manière interactive entre différents types de modèles (linéaire, polynomial, exponentiel) et d’observer en temps réel les fluctuations consécutives de la valeur numérique du $R^2$.
Il est important de souligner que cette valeur affichée est continuellement connectée à l’état dynamique de la grille de données. Toute modification ultérieure apportée à une cellule du tableau amont (qu’il s’agisse de la correction d’une coquille de frappe ou de l’adjonction de nouvelles mesures expérimentales) déclenche un recalcul synchrone immédiat du coefficient de détermination sur le graphique sans requérir aucune manipulation de réactualisation de la part de l’utilisateur.
7.2 Interprétation statistique rigoureuse de la métrique R²
D’un point de vue métrologique et inférentiel, le coefficient de détermination quantifie la proportion de la variance totale de la variable dépendante $Y$ qui se trouve statistiquement expliquée par la variable indépendante $X$ au travers du modèle fonctionnel déployé. Mathématiquement, il s’exprime comme le ratio de la somme des carrés de la régression ($SSR$) sur la somme des carrés totale ($SST$), soit $R^2 = 1 – (SSE / SST)$, où $SSE$ figure la somme des carrés des erreurs résiduelles. Une valeur de $R^2 = 0{,}85$ indique ainsi sans équivoque que 85 % de la dispersion des scores empiriques est prédite par la relation modélisée, les 15 % restants relevant de la variance d’erreur ou de facteurs non pris en compte.
Néanmoins, l’interprétation de cette métrique appelle des mises en garde épistémologiques capitales. Une valeur élevée de $R^2$ n’implique en aucun cas que la relation observée soit de nature causale. De surcroît, un $R^2$ apparemment respectable peut être artificiellement gonflé par un simple étirement de l’intervalle de variation de $X$, ou masquer un non-respect total des postulats fondamentaux de linéarité si l’analyste omet d’inspecter conjointement la distribution spatiale des résidus.
Dans les sciences humaines, sociales et comportementales, les standards d’évaluation du $R^2$ diffèrent radicalement de ceux des sciences physiques de laboratoire. Alors qu’en métrologie industrielle un ajustement est jugé insatisfaisant en deçà d’un seuil de $R^2 = 0{,}95$, une valeur comprise entre $0{,}20$ et $0{,}40$ en psychologie différentielle ou en sociologie empirique est fréquemment considérée comme hautement informative. En raison du bruit de mesure inhérent aux construits psychologiques et de la multiplicité des déterminants du comportement humain, expliquer un tiers de la variance totale représente déjà une avancée théorique substantielle.
7.3 Écueils méthodologiques du surajustement (overfitting)
La quête aveugle de l’optimisation maximale du coefficient $R^2$ constitue l’un des pièges les plus insidieux guettant les utilisateurs de tableurs grand public. Sur Google Sheets, il suffit de commuter le modèle linéaire vers un modèle polynomial de degré 6 pour constater une hausse mécanique, parfois spectaculaire, de la métrique affichée. Cette ascension purement mathématique provient du fait que chaque degré de liberté additionnel alloué au modèle permet à la courbe de se plier pour intercepter davantage de points précis au sein de l’échantillon d’étalonnage.
Ce phénomène, universellement désigné sous le terme de surajustement ou overfitting, détruit la représentativité scientifique du modèle. En s’efforçant d’annuler les résidus de l’échantillon présent, la courbe polynomiale de degré élevé incorpore l’aléa spécifique de cet échantillon et perd toute capacité de généralisation out-of-sample. Confronté à un nouveau jeu de données issu de la même population, ce modèle surparamétré générera des erreurs d’extrapolation massives, invalidant totalement son pouvoir prédictif.
L’arbitrage entre la complexité structurelle d’une courbe et sa fidélité explicative doit impérativement s’adosser au principe philosophique et scientifique de parcimonie, formalisé par le célèbre rasoir d’Ockham. Face à deux modèles affichant des indices d’adéquation proches (par exemple un modèle linéaire avec un $R^2 = 0{,}68$ et un polynôme quadratique avec un $R^2 = 0{,}71$), la démarche méthodologique saine commande de privilégier systématiquement le modèle le plus simple, sauf si une théorie substantive validée justifie la présence formelle d’une courbure structurelle.
8. Intégration formelle et déchiffrage de l’équation mathématique du modèle
8.1 Paramétrage du libellé pour afficher l’équation explicite
Pour dépasser le stade de l’illustration graphique muette et transformer le composant visuel en un instrument métrologique opérationnel, il est indispensable de faire figurer l’expression algébrique explicite de l’ajustement sur le graphique. Cette opération s’accomplit avec une grande fluidité ergonomique dans Google Sheets grâce aux options d’étiquetage intégrées au volet de paramétrage de la courbe.
Au sein de la section Personnaliser > Séries > Courbe de tendance de l’Éditeur de graphiques, l’utilisateur identifie le menu déroulant intitulé Libellé (Label). Par défaut, ce paramètre est positionné sur la mention Aucun. En déployant cette liste, l’opérateur doit sélectionner la commande Utiliser l’équation. Cette action force le moteur mathématique sous-jacent à instancier la formule analytique complète régissant la courbe affichée et à l’injecter au sein de l’espace graphique.
Par défaut, l’équation s’affiche au sommet ou sur le flanc droit du graphique au sein de la légende générale, sous une typographie vectorielle claire, telle que $y = 1{,}45x + 3{,}12$. Si l’option subsidiaire Afficher le R² est simultanément cochée, le logiciel génère une chaîne textuelle synthétique combinée, associant l’équation de prédiction et la métrique d’adéquation : $y = 1{,}45x + 3{,}12 \quad R^2 = 0{,}892$. L’analyste dispose alors d’une fiche signalétique statistique complète directement incorporée à sa figure.
8.2 Décomposition analytique des coefficients structurels
L’accès aux coefficients de l’équation appelle une lecture analytique méticuleuse de leurs composantes respectives, à commencer par le coefficient directeur ou pente ($m$). Ce terme chiffre l’impact marginal attendu sur la variable dépendante $Y$ pour chaque variation d’une unité positive de la variable explicative $X$. Dans un protocole mesurant le gain d’efficacité cognitive par heure de sommeil, une pente chiffrée à $+2{,}35$ indique que chaque heure supplémentaire s’accompagne en moyenne statistique d’une augmentation de $2{,}35$ points de performance sur l’échelle critère.
Le second paramètre fondamental est l’ordonnée à l’origine ($b$, constante ou intercept), qui matérialise le point de contact géométrique où la droite de régression sectionne l’axe vertical des ordonnées lorsque $x = 0$. Il convient de se montrer particulièrement vigilant quant à la plausibilité physique et empirique de cette constante : si les mesures réelles de la variable $X$ ont été collectées dans un intervalle débutant très loin de zéro (par exemple des températures humaines comprises entre 36 °C et 40 °C), la valeur projetée pour $x = 0$ n’a strictement aucun sens substantiel et représente une simple ancre géométrique sans contrepartie biologique concevable.
Dans les modèles non linéaires, la décomposition des termes requiert une gymnastique interprétative spécifique. Pour un modèle exponentiel affiché sous la forme $y = a \cdot e^{bx}$, le coefficient $b$ représente le taux de croissance instantané continu, tandis que pour un modèle logarithmique $y = a \cdot \ln(x) + b$, le coefficient $a$ gouverne l’amplitude du taux de compression marginale. L’analyste doit donc maîtriser la nature mathématique des paramètres avant d’en formuler l’exégèse dans un compte-rendu d’expérimentation.
8.3 Exploitation de l’équation pour la prédiction et l’extrapolation
L’un des apports majeurs de l’explicitation formelle de l’équation de régression réside dans la possibilité de calculer des valeurs théoriques prédites, conventionnellement notées $\hat{Y}$ (Y chapeau), pour n’importe quelle valeur assignée à la variable prédictive. L’opérateur peut ainsi reporter manuellement les coefficients extraits du graphique dans des formules de cellules de la feuille de calcul (par exemple = (1,45 * D2) + 3,12), automatisant ainsi l’estimation quantitative de scénarios prospectifs.
Cette démarche opérationnelle exige toutefois d’opérer une distinction méthodologique radicale entre l’interpolation et l’extrapolation. L’interpolation consiste à estimer une valeur de $\hat{Y}$ pour un point de données $X$ non mesuré, mais rigoureusement situé à l’intérieur de l’intervalle spatial délimité par les observations minimales et maximales collectées ($X_{\min} le X le X_{\max}$). Cette pratique présente un degré de fiabilité statistique élevé dès lors que le modèle est soutenu par un $R^2$ robuste et des résidus normalement distribués.
À l’inverse, l’extrapolation consiste à projeter l’équation bien au-delà des frontières effectives du plan expérimental exploré ($X gg X_{\max}$ ou $X ll X_{\min}$). Cette démarche recèle des risques prédictifs massifs : rien ne garantit en effet que la nature de la relation fonctionnelle observée localement persiste au-delà des bornes empiriques réelles. Dans les phénomènes comportementaux ou physiologiques, les extrapolations hors domaine se heurtent immanquablement à des effondrements de performance, des saturations de récepteurs ou des effets de fatigue qui démentent radicalement la trajectoire mathématique extrapolée.
9. Traitement des configurations multivariées et séries comparatives
9.1 Attribution individualisée de courbes de tendance par série expérimentale
Dans la recherche empirique contemporaine, les dispositifs expérimentaux reposent rarement sur une série isolée ; ils comparent le plus souvent les cinétiques différentielles de plusieurs conditions, telles qu’un groupe témoin versus un groupe expérimental, ou des cohortes exposées à des dosages thérapeutiques distincts. Google Sheets permet de gérer ces architectures comparatives en superposant plusieurs séries de points au sein du même référentiel cartésien et en allouant une modélisation analytique individualisée à chaque sous-ensemble expérimental.
Pour individualiser ces trajectoires, l’opérateur doit se rendre dans l’onglet Personnaliser > Séries et délaisser l’option globale par défaut au profit du sélecteur déroulant de série situé au sommet de la section. En choisissant successivement chacune des séries présentes dans le classeur (par exemple « Groupe Contrôle », puis « Groupe Expérimental »), le logiciel permet d’activer une courbe de tendance dédiée, d’en sélectionner le modèle fonctionnel le plus adapté et d’en personnaliser les attributs chromatiques et typographiques de manière totalement dissociée.
Cette flexibilité technique s’avère fondamentale sur le plan méthodologique : rien n’impose en effet qu’un groupe témoin et un groupe traité suivent la même loi cinétique. Il est tout à fait recevable qu’une condition de contrôle présente une stagnation linéaire ($y = mx + b$ avec une pente quasi nulle), tandis qu’un groupe soumis à une intervention active manifeste une cinétique logarithmique d’assimilation rapide suivie d’un palier asymptotique. Google Sheets permet de refléter cette hétérogénéité structurelle au sein d’une composition visuelle unifiée.
9.2 Comparaison graphique des vitesses et dynamiques d’évolution
La superposition de multiples droites de régression au sein d’un même espace graphique offre un support diagnostique de premier ordre pour évaluer visuellement l’existence d’effets d’interaction. En statistique inférentielle, une interaction signifie que l’impact de la variable indépendante $X$ sur la variable dépendante $Y$ varie qualitativement ou quantitativement selon le niveau d’une variable factorielle tierce (l’appartenance au groupe). Sur le plan graphique, cela se matérialise immédiatement par des droites de régression qui ne sont pas parallèles.
Lorsque deux droites de tendance se croisent au cœur du domaine expérimental exploré, ce point de contact géométrique (le point de croisement ou intersection) signale une inversion d’efficacité relative entre les conditions comparées. En deçà du point d’intersection, une condition surpasse l’autre ; au-delà, la hiérarchie s’inverse radicalement. Cette confrontation géométrique permet à l’expérimentateur d’apprécier la magnitude de l’écart de pente ($\Delta m = m_1 – m_2$) avant même de formaliser l’analyse de modération via une analyse de covariance (ANCOVA) ou un modèle linéaire généralisé.
Il importe toutefois de se prémunir contre les écueils de lecture induits par les graphiques à double échelle verticale (axes $Y$ secondaires gauche et droit). Bien que Google Sheets autorise l’assignation d’une série à un axe $Y$ distinct pour comparer des grandeurs d’amplitudes divergentes, cette pratique tend à manipuler visuellement l’angle relatif des pentes, créant l’illusion d’une convergence ou d’une divergence qui n’a aucune réalité dans l’espace métrique réel des données. L’analyste rigoureux s’efforcera de maintenir ses séries comparatives sur une échelle métrique commune et standardisée.
9.3 Gestion de la surcharge cognitive dans les représentations complexes
Si la juxtaposition de séries multiples est méthodologiquement séduisante, elle engendre rapidement une saturation perceptive préjudiciable dès lors que le nombre de conditions simultanées s’accroît. La présence de plus de trois ou quatre courbes de tendance entremêlées, associées à leurs nuages de points respectifs, à leurs équations de régression et à leurs indices $R^2$, engendre un phénomène d’encombrement graphique (visual clutter) qui viole le principe fondamental du ratio données-encre théorisé par Edward Tufte.
Pour prévenir cette surcharge cognitive chez le lecteur, l’analyste doit opérer des arbitrages éditoriaux réfléchis. Lorsque la superposition nuit à l’intelligibilité générale, il convient de renoncer au graphique unique au profit de la technique des petits multiples (small multiples). Cette approche consiste à scinder l’analyse en une matrice de petits graphiques juxtaposés, partageant des axes strictement identiques en abscisse et en ordonnée, chaque sous-graphique n’hébergeant qu’une seule condition expérimentale et sa courbe de tendance propre.
Si le choix du graphique combiné est malgré tout maintenu, la rigueur de la standardisation sémiotique doit être portée à son paroxysme. L’attribution des couleurs doit suivre une logique ordonnée (par exemple des variations d’intensité d’une même teinte pour des doses progressives), les équations doivent être logées dans une légende latérale parfaitement alignée, et les étiquettes de points superflues doivent être masquées afin de ne préserver que l’armature structurelle des trajectoires comparées.
10. Diagnostic des anomalies techniques et résolution des dysfonctionnements
10.1 Incompatibilités d’axes et absence de l’option de courbe de tendance
L’une des déconvenues techniques les plus fréquentes éprouvées par les utilisateurs de Google Sheets réside dans la disparition inopinée ou le grisage de la case à cocher « Courbe de tendance » au sein de l’Éditeur de graphiques. Cette anomalie n’est pas le fruit d’un bogue logiciel, mais découle presque toujours d’une incohérence dans le typage architectural du graphique initialement sélectionné lors de la phase de configuration de l’objet graphique.
Ce dysfonctionnement survient quasi systématiquement lorsque l’utilisateur a sélectionné par mégarde un Graphique en courbes (Line chart) standard ou un Histogramme à la place du véritable Nuage de points (Scatter chart). Dans un graphique en courbes standard, Google Sheets interprète par défaut l’axe horizontal $X$ comme une simple suite de libellés discrets (variables catégorielles ordinales), même si les données sous-jacentes sont composées de chiffres. L’axe n’étant pas considéré comme un continuum métrique, le moteur refuse d’appliquer un algorithme de régression mathématique qui requiert deux dimensions continues pour fonctionner.
La résolution de cette impasse technique est méthodique : il convient de revenir sur l’onglet Configurer de l’Éditeur de graphiques, de rebasculer explicitement le paramètre Type de graphique sur Graphique à nuage de points, et de vérifier que l’option « Traiter les étiquettes comme du texte » est rigoureusement désactivée. Si des chiffres étaient encodés sous forme de chaînes textuelles dans le tableau source, il sera nécessaire d’utiliser la commande Format > Nombre du tableur pour rétablir leur statut métrique authentique, débloquant instantanément l’accessibilité à la courbe de tendance.
10.2 Échecs algorithmiques des transformations non linéaires
Une autre pathologie fonctionnelle fréquente se manifeste lors du basculement d’un modèle linéaire vers une spécification logarithmique, exponentielle ou en puissance : la ligne de régression disparaît instantanément de l’affichage, ou le tableur renvoie une notification d’impossibilité de calcul. Cet incident découle directement de la transgression involontaire des contraintes de définition algébrique inhérentes à ces familles mathématiques particulières.
Comme rappelé précédemment, le calcul de l’ajustement logarithmique et de la loi de puissance implique l’évaluation interne de $ln(x)$ ou de $ln(y)$. Or, le logarithme d’un nombre négatif ou d’une valeur strictement égale à zéro n’est pas défini dans le corps des nombres réels ($\mathbb{R}$). Si la matrice de données contient ne serait-ce qu’une seule valeur nulle (par exemple un score de $0$ seconde ou une concentration basale de $0{,}0$ mg/L), l’algorithme d’optimisation numérique de Google Sheets échoue en division par zéro ou en indétermination analytique, suspendant immédiatement le tracé.
Pour contourner légitimement cet obstacle sans dénaturer la structure des données empiriques, la stratégie standard de prétraitement consiste à appliquer une translation linéaire corrective aux données. L’analyste crée une colonne dérivée dans laquelle il ajoute une constante infime mais non nulle à l’ensemble des observations (par exemple $x’ = x + 1$ ou $x’ = x + 0{,}001$). Cette translation décale l’origine géométrique hors du domaine d’indétermination mathématique sans modifier la morphologie générale de la cinétique ni l’interprétabilité des variations relatives de l’ajustement.
10.3 Problèmes de synchronisation dynamique et persistance des filtres
Dans les environnements de travail partagés et dynamiques sur Google Sheets, l’analyste est fréquemment confronté à des variations inattendues de l’allure de la courbe de tendance consécutives à la manipulation des tables sources par des collaborateurs tiers. L’activation intempestive de filtres de tri, de masquages manuels de lignes ou de vues filtrées (Filter Views) exerce une influence directe sur le comportement du moteur de rendu graphique vectoriel.
Par défaut, Google Sheets ajuste sa régression sur l’ensemble visible de la plage référencée : le masquage manuel de dix lignes de données centrales exclut tacitement ces dix points de l’estimation des moindres carrés, provoquant une modification subreptice de la pente et du $R^2$ affichés. L’utilisateur doit impérativement auditer ce comportement en accédant aux paramètres de personnalisation avancés du graphique pour s’assurer de l’état du paramètre régissant l’inclusion ou l’exclusion des cellules masquées au sein du flux de calcul.
Enfin, face à des comportements visuels aberrants ou à des gels d’affichage résultant d’une latence de rafraîchissement des serveurs distants de Google, une réinitialisation de la liaison de données s’avère efficace. Il suffit d’éditer manuellement la plage de données dans l’onglet Configurer (en retranchant puis en réintégrant la dernière cellule du champ matriciel) pour purger le cache local du navigateur web et forcer une reconstruction intégrale de la matrice de covariance et du tracé de régression associé.
11. Approches analytiques avancées via les fonctions natives de Google Sheets
11.1 Calcul programmatique des paramètres de régression par formules
Bien que la matérialisation graphique d’une courbe de tendance réponde aux impératifs de communication visuelle, une exploitation analytique automatisée exige fréquemment d’extraire les paramètres d’ajustement directement au sein de la grille de calcul, sous forme de cellules manipulables par d’autres formules. Google Sheets met à disposition un arsenal complet de fonctions statistiques permettant d’obtenir ces scalaires sans même dépendre de l’insertion d’un objet graphique flottant.
Pour isoler mathématiquement la pente ($m$) d’une régression linéaire simple, l’utilisateur sollicite la fonction native PENTE (ou SLOPE dans la syntaxe internationale), configurée sous la syntaxe stricte =PENTE(données_Y; données_X). Corrélativement, l’extraction de la constante d’ordonnée à l’origine ($b$) s’effectue via l’emploi de la formule jumelle ORDONNEE.ORIGINE (ou INTERCEPT), formulée sous la syntaxe =ORDONNEE.ORIGINE(données_Y; données_X). Il convient de prêter une attention méticuleuse à l’ordre des arguments : la variable dépendante $Y$ doit toujours être stipulée en premier argument, sous peine d’inverser involontairement la dépendance fonctionnelle du modèle calculé.
L’obtention programmatique du coefficient de détermination s’opère quant à elle au moyen de la formule COEFFICIENT.DETERMINATION (ou RSQ), renseignée par =COEFFICIENT.DETERMINATION(données_Y; données_X). Cette disposition programmatique offre un avantage méthodologique considérable : elle permet de concevoir des tableaux de bord dynamiques au sein desquels les valeurs de modélisation sont surveillées en temps réel, autorisant l’application de formats conditionnels (mise en évidence visuelle si $R^2 < 0{,}50$) impossibles à implémenter sur la légende textuelle du graphique.
11.2 Puissance matricielle de la fonction DROITEREG (LINEST)
Pour hisser l’analyse quantitative à un niveau de rigueur comparable aux progiciels d’économétrie spécialisés, l’analyste déploiera la fonction matricielle universelle DROITEREG (acronyme de Droite de régression, ou LINEST en syntaxe anglophone). Cette fonction surpasse largement les formules scalaires individuelles en générant, au sein d’une matrice cellulaire expansée, l’intégralité du tableau d’analyse de la variance (ANOVA) et des statistiques d’inférence associées aux moindres carrés ordinaires.
La syntaxe opératoire complète de cette formule matricielle s’articule ainsi : =DROITEREG(données_Y; données_X; calculer_b; statistiques_supplémentaires). En passant le quatrième argument logique à l’état VRAI, la formule génère un tableau rectangulaire compact de 5 lignes sur 2 colonnes (dans le cas d’une régression univariée simple). Cette matrice restitue non seulement les coefficients de pente et d’intercept, mais également leurs erreurs-types associées ($se_m$, $se_b$), le coefficient $R^2$, l’erreur-type de l’estimation ($se_y$), la statistique globale de test de Fisher ($F$), les degrés de liberté résiduels ($df$), ainsi que la décomposition explicite de la somme des carrés de la régression ($SSR$) et de la somme des carrés résiduelle ($SSE$).
L’accès direct aux erreurs-types des coefficients offre la possibilité de tester formellement la significativité statistique de la pente de régression au travers d’un test de Student univarié ($t = m / se_m$). L’analyste s’affranchit ainsi de la simple constatation descriptive offerte par le composant graphique de Google Sheets pour basculer dans une démarche d’inférence statistique confirmatoire, indispensable à la publication de résultats au sein de revues scientifiques à comité de lecture.
11.3 Génération de courbes personnalisées avec bandes d’intervalles de confiance
Le tracé élémentaire de courbe de tendance proposé nativement par Google Sheets souffre d’une lacune épistémologique substantielle : il matérialise une droite ponctuelle déterministe sans rendre compte de la marge d’erreur stochastique enveloppant cette trajectoire. Pour se conformer aux standards internationaux les plus rigoureux de la métrologie et des sciences biomédicales, il est éminemment souhaitable d’entourer la droite d’estimation d’une enveloppe de dispersion figurant son intervalle de confiance à 95 %.
Bien que cette fonctionnalité ne soit pas accessible via une simple case à cocher dans l’interface graphique standard, la puissance de calcul tabulaire de Google Sheets permet de la reconstruire par voie programmatique. L’opérateur commence par calculer, pour chaque point de mesure, l’écart-type de la prédiction individuelle en appliquant la formule d’erreur standard de la moyenne conditionnelle :
$$SE_{\hat{y}} = s_{e} \sqrt{\frac{1}{n} + \frac{(x – \bar{x})^2}{\sum (x_i – \bar{x})^2}}$$
À partir de cette métrique, l’analyste engendre deux colonnes de données computationnelles annexes dans sa feuille de calcul : la borne inférieure de confiance ($IC_{\inf} = \hat{y} – t_{crit} \cdot SE_{\hat{y}}$) et la borne supérieure de confiance ($IC_{\sup} = \hat{y} + t_{crit} \cdot SE_{\hat{y}}$), où $t_{crit}$ figure la valeur critique de la distribution de Student pour le seuil $\alpha = 0{,}05$ au degré de liberté $n-2$.
Une fois ces séries calculées, il suffit de les réintégrer dans le graphique sous la forme de tracés continus secondaires semi-transparents ou via l’option native des barres d’erreur personnalisées. La visualisation ainsi enrichie transcende l’outil bureautique de base pour approcher la sophistication des représentations vectorielles générées par les bibliothèques professionnelles telles que ggplot2 en langage R ou Seaborn en Python, fournissant au lecteur une perception honnête et nuancée de la précision réelle des extrapolations du modèle.
12. Normes de restitution scientifique et éthique de la visualisation graphique
12.1 Précautions éthiques contre la manipulation visuelle des tendances
L’adjonction d’une courbe de tendance à un graphique constitue un acte de communication scientifique dont la responsabilité éthique incombe pleinement à l’analyste. La plasticité des outils de mise en forme numérique de Google Sheets facilite la mise en œuvre, délibérée ou accidentelle, de procédés de rhétorique visuelle trompeurs visant à exagérer l’intensité d’une relation empirique. L’une des manipulations les plus dénoncées par la communauté statistique consiste en la troncature agressive de l’axe des ordonnées.
En fixant artificiellement l’origine de l’axe vertical au voisinage immédiat de la valeur minimale de l’échantillon plutôt qu’à zéro (lorsque l’échelle de mesure le requiert conceptuellement), l’angle apparent de la pente de régression se trouve dramatiquement amplifié. Une variation marginale insignifiante d’à peine 2 % sur le plan substantiel prend alors l’allure d’une ascension vertigineuse sur le plan graphique, induisant le lecteur non averti en erreur. Sauf justification théorique impérieuse et explicitement consignée en légende, la conservation du point zéro comme référence axiale demeure une règle de probité incontournable.
L’intégrité déontologique du chercheur implique également le rejet catégorique de la tentation du p-hacking ou du « chalutage de modèles » (model shopping). Cette dérive méthodologique consiste à tester successivement l’ensemble des typologies fonctionnelles offertes par le tableur (linéaire, logarithmique, polynomiale de degré 5) et à retenir unilatéralement celle qui délivre le coefficient $R^2$ le plus spectaculaire, en l’absence de tout fondement théorique sous-jacent. Le modèle mathématique doit refléter une hypothèse substantielle sur la nature de la réalité physique ou comportementale, et non résulter d’une opportunité statistique a posteriori.
12.2 Conformité aux exigences éditoriales académiques (normes APA)
Lorsqu’un graphique produit sous Google Sheets est destiné à intégrer un manuscrit scientifique, un rapport d’évaluation clinique ou un mémoire de recherche, il doit se conformer scrupuleusement aux conventions typographiques et structurelles formalisées par les manuels de style internationaux, au premier rang desquels figure le standard de l’American Psychological Association (APA 7e édition). Ces directives régissent l’habillage sémantique et la disposition spatiale des éléments périphériques du graphique.
Selon les préceptes APA, le graphique ne doit en aucun cas comporter de titre décoratif intégré à l’intérieur de son cadre supérieur (titre de graphique par défaut dans Google Sheets). Ce titre doit être extrait du canevas pour être rédigé au format typographique standard au-dessus de la figure, précédé de la mention du numéro de figure en gras (par exemple Figure 1), suivi à la ligne suivante d’un intitulé descriptif concis en italique (par exemple Trajectoire d’assimilation motrice en fonction de la durée de pratique quotidienne). Les axes doivent impérativement mentionner le nom de la variable mesurée et son unité métrique normalisée entre parenthèses.
Sous la figure doit obligatoirement figurer une section intitulée Note. en italique, destinée à expliciter les aspects méthodologiques de la modélisation représentée. C’est à cet emplacement normalisé qu’il convient de renseigner la formulation mathématique explicite de la courbe de tendance, le coefficient de détermination corrigé, la signification des motifs de ligne (traits pleins ou tirets) et le traitement opéré sur d’éventuelles valeurs extrêmes préalablement exclues. Enfin, pour l’intégration prépresse, l’analyste procédera à l’exportation de la figure sous forme de document vectoriel (PDF) ou d’image haute résolution, prévenant la pixellisation disgracieuse inhérente aux formats de compression matricielle standards lors de l’impression physique.
12.3 Pérennité méthodologique et réplicabilité des analyses visuelles
Dans le contexte actuel de crise de la réplicabilité qui traverse l’ensemble des disciplines scientifiques empiriques, la publication d’un graphique ne saurait être dissociée de la transparence intégrale des protocoles de calcul ayant présidé à son édification. Une courbe d’ajustement ne doit pas se présenter comme une surface vectorielle close et impénétrable ; la communauté des pairs doit pouvoir auditer précisément chaque étape computationnelle, de la matrice de données brute à la formalisation finale de la courbe de tendance.
Pour honorer ce standard de reproductibilité scientifique, l’auteur a le devoir d’adosser ses visualisations à un partage ouvert de ses feuilles de calcul Google Sheets, configurées en mode consultation ou copie publique dans des entrepôts de données ouverts tels que le serveur de l’Open Science Framework (OSF) ou Zenodo. Ce partage permet à tout chercheur tiers d’inspecter l’architecture tabulaire, d’examiner le paramétrage de l’Éditeur de graphiques, d’analyser le code des formules natives employées et de soumettre la distribution à d’autres batteries d’épreuves statistiques.
L’articulation vertueuse entre la visualisation graphique exploratoire et l’inférence statistique confirmatoire constitue l’ultime garantie d’une démarche scientifique rigoureuse. En traitant les fonctionnalités de courbe de tendance de Google Sheets non comme de simples expédients de mise en scène cosmétique, mais comme de véritables instruments d’interrogation et de modélisation mathématique du réel, l’analyste donne toute sa dimension heuristique à la statistique visuelle appliquée contemporaine.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Google Help. (2023). Ajouter et modifier une courbe de tendance dans Google Sheets. Support Google. https://support.google.com/docs/answer/91428
- Montgomery, D. C., Peck, E. A., & Vining, G. G. (2021). Introduction to linear regression analysis (6th ed.). John Wiley & Sons.
- Newell, A., & Rosenbloom, P. S. (1981). Mechanisms of skill acquisition and the law of practice. In J. R. Anderson (Ed.), Cognitive skills and their acquisition (pp. 1–55). Lawrence Erlbaum Associates.
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Wickham, H. (2010). A layered grammar of graphics. Journal of Computational and Graphical Statistics, 19(1), 3–28. https://doi.org/10.1198/jcgs.2009.07098
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer. https://doi.org/10.1007/0-387-28695-0